論文一覧に戻る 🗺 用語ネットワーク 📖 概念マップとは(用語解説) 📚 用語解説(ジャストインタイム型データサイエンス教育)
📚 用語集 — ジャストインタイム学習
論文を読む途中で出会った専門用語をその場で学べる「用語解説ページ」を、 テーマ別グループ教材 29 本と個別の用語ページ 514 件に体系化しました。 どちらから入っても、 ポップアップ・関連リンクで自然に行き来できます。
29
グループ教材
514
個別用語ページ
22
カテゴリ

💡 使い方ガイド

① 論文から入る
論文一覧から興味ある論文を読む → 用語ハイライトをクリック → ポップアップで概要 → 詳細ページで深掘り。
② テーマで学ぶ
下のグループ教材から、 学びたい分野を選ぶ → 体系的に複数の関連用語を一気に学習。
③ 用語名で探す
下の カテゴリ別索引・50音インデックス から個別ページに直接アクセス。
🐍 用語ページの Python コードは、ブラウザの中で動かせます
コードの下の 「▶ ブラウザで実行」 を押すと、その場で計算されて結果が出ます。 Python のインストールも CSV のダウンロードも要りません。コードを書き換えて試すこともできます。
🍰 また各ページの各章の先頭に 「まずはやさしく」 という短い説明を置いています。 難しい話を読む前に、まずそこだけ読めば全体像がつかめます(高校生・文系大学生向け)。

📚 グループ教材(テーマ別)

複数の関連用語を 1 ページで体系的に学べる教材。 SSDSE-B-2026 を題材にした Python コード・練習問題付き。

📐 記述統計の基礎

代表値(平均・中央値・最頻値)
平均・中央値・最頻値・幾何平均
ばらつきの指標
分散・標準偏差・範囲・MAD
四分位・IQR・パーセンタイル
順位ベース統計と外れ値
分布の形状指標
歪度・尖度・モーメント
確率分布
正規・二項・ポアソン・指数等

🎨 可視化

1変量の可視化
ヒストグラム・KDE・箱ひげ図
2変量の可視化
散布図・ヒートマップ・相関

🎯 推測統計と検定

標本抽出と中心極限定理
標本・CLT・ブートストラップ
仮説検定の枠組み
p値・有意水準・誤り
t検定
1標本・2標本・対応のあるt検定
分散分析(ANOVA)
一元・二元・反復測定

📈 回帰モデル

ロジスティック回帰とGLM
二値・カウント・順序応答

🧮 機械学習

機械学習の基礎
学習・汎化・損失
分類モデル基礎
ロジ・k-NN・SVM・NB・LDA
決定木・アンサンブル学習
RF・XGBoost・LightGBM
正則化
Ridge・Lasso・Elastic Net・Dropout
モデル選択
AIC・CV・グリッド・Optuna
評価指標
Accuracy・F1・AUC・RMSE
クラスタリング
k-means・階層・DBSCAN・GMM
次元削減
PCA・t-SNE・UMAP・LDA

🧠 深層学習・AI

ニューラルネットワーク基礎
MLP・誤差逆伝播・最適化
深層学習アーキテクチャ
CNN・RNN・Transformer
自然言語処理
トークン化・BERT・LLM
生成AI
拡散モデル・LLM・RAG

⏰ 時系列・因果推論

時系列分析
ARIMA・状態空間・Prophet
パネル & 因果推論
RCT・DID・IV・RDD・PS

📚 リテラシー・基盤

データリテラシー
PPDAC・問いの設計・EDA
データエンジニアリング
ETL・前処理・パイプライン
AI倫理・公平性
XAI・プライバシー・規制

📑 カテゴリ別 個別ページ

単一用語を深く解説する個別ページ。 グループ教材から「📚 関連グループ教材」リンクで往復できます。

カテゴリへジャンプ: 回帰モデル 13可視化 6推測統計 6時系列 6機械学習 6記述統計 6仮説検定 5パネル分析 4因果推論 4教師なし学習 4データ前処理 3基礎統計 3格差・分布 3正則化 3次元削減 2AI基礎 1モデル選択 1リテラシー 1倫理 1地域分析 1推定法 1確率分布 1

📑 回帰モデル (13 件)

VIF(分散拡大係数) (VIF)ステップワイズ法 (—)プロビット回帰 (—)ロジスティック回帰 (—)単回帰分析 (y = α + βx)回帰係数 (β)多重共線性 (—)最小二乗法(OLS) (OLS)標準化偏回帰係数 (β (std))残差 (ε / e)決定係数 R² (R²)調整済み決定係数 (adj.R²)重回帰分析 (y = α + Σβᵢxᵢ)

📑 可視化 (6 件)

デンドログラム (—)ヒストグラム (—)ヒートマップ (—)回帰直線 (—)散布図 (—)箱ひげ図 (—)

📑 推測統計 (6 件)

p値 (p)オッズ比 (OR)サンプルサイズ (n)信頼区間 (CI)有意水準 (α)標準誤差 (SE)

📑 時系列 (6 件)

ARIMAモデル (ARIMA(p,d,q))Granger因果検定 (—)VAR(ベクトル自己回帰) (VAR)指数平滑法 (—)時系列分析 (—)自己相関 (ACF)

📑 機械学習 (6 件)

SHAP値 (—)k近傍法 (kNN)サポートベクトルマシン (SVM)ニューラルネットワーク (NN)ランダムフォレスト (RF)決定木 (—)

📑 記述統計 (6 件)

中央値 (—)分散 (σ²)四分位 (Q1/Q2/Q3)平均 (x̄ / μ)最頻値 (Mo)標準偏差 (σ / SD)

📑 仮説検定 (5 件)

F検定 (F)Kruskal-Wallis検定 (H)t検定 (t)カイ二乗検定 (χ²)ノンパラメトリック検定 (—)

📑 パネル分析 (4 件)

Hausman検定 (—)パネルデータ (—)ランダム効果モデル (RE)固定効果モデル (FE)

📑 因果推論 (4 件)

交絡因子 (—)内生性 (—)差分の差分法(DiD) (DiD)操作変数法 (IV)

📑 教師なし学習 (4 件)

Ward法 (—)k-means法 (—)クラスタリング (—)階層クラスタリング (—)

📑 データ前処理 (3 件)

外れ値 (—)標準化 (z)欠損値 (NaN)

📑 基礎統計 (3 件)

Spearman順位相関係数 (ρ (rho))共分散 (Cov(x,y))相関係数 (r)

📑 格差・分布 (3 件)

β収束・σ収束 (β / σ)ジニ係数 (G)ローレンツ曲線 (—)

📑 正則化 (3 件)

Elastic Net (L1+L2)LASSO回帰 (L1)Ridge回帰 (L2)

📑 次元削減 (2 件)

主成分分析(PCA) (PCA)因子分析 (FA)

📑 AI基礎 (1 件)

生成AI

📑 モデル選択 (1 件)

AIC(赤池情報量基準) (AIC)

📑 リテラシー (1 件)

データリテラシー

📑 倫理 (1 件)

AI倫理

📑 地域分析 (1 件)

特化係数(LQ) (LQ)

📑 推定法 (1 件)

GMM(一般化積率法) (GMM)

📑 確率分布 (1 件)

正規分布 (N(μ, σ²))

🔤 全用語索引(513 語)

用語集にあるページをすべて並べています。名前の一部を打ち込むと、その場で絞り込めます (日本語でも英語でもかまいません)。

513 語を表示中
その他β収束・σ収束 (β/σ Convergence)一般化加法モデル (Generalized Additive Model, GAM)三層パーセプトロン中央値Median中央絶対偏差 (Median Absolute Deviation, MAD)主キー主成分分析(PCA)Principal Component Analysis予測・判断事前登録交差検証交絡因子Confounding Variable人間中心のAI代表値(平均・中央値・最頻値)仮説検定(p値・有意水準・検出力・効果量)信頼区間Confidence Interval個人情報保護偏微分偽情報偽陰性偽陽性公平性公開鍵暗号共分散Covariance内生性Endogeneity内積内部結合円グラフ再学習再現性危機処置群分位点Quantile / Percentile分位点回帰Quantile Regression分布の形状指標分散Variance分散分析ANOVA分類分類モデルの基礎(ロジスティック・k-NN・SVM・NB・LDA)効果量勾配法勾配降下法区間推定単回帰分析Simple Linear Regression単語分割可用性合成データ合計特殊出生率同時性(同時決定)名寄せ名義尺度問題の定式化四分位Quartile四分位・IQR・パーセンタイル回帰タスク回帰不連続デザインRegression Discontinuity Design / RDD回帰係数Regression Coefficient回帰分析回帰直線Regression Line因子分析Factor Analysis因果関係固定効果モデルFixed Effects Model固有値・固有ベクトルEigenvalue / Eigenvector地図上の可視化型変換基盤モデル基盤モデル(詳細)変数の尺度とデータ型外れ値Outlier外れ値処理外生性外部キー外部結合多層パーセプトロン多様体学習多次元分析多重共線性Multicollinearity多重検定多重比較Multiple Comparisons大域最適解大規模言語モデル学習率完全性定常性Stationarity実データ実験データ実験計画法対数変換対照群対立仮説尺度水準局所最適解巡回セールスマン問題差分の差分法(DiD)Difference-in-Differences帰無仮説平均Mean平行トレンド仮定強いAI / 弱いAI強化学習形態素解析微分忘れられる権利情報エントロピー情報セキュリティ情報利得折れ線グラフ拡散モデル指数平滑法Exponential Smoothing指紋認証探索的データ分析損失関数操作変数法Instrumental Variable改ざん教師あり学習教師なし学習散布図Scatter Plot数理最適化文字認識文章生成文章間類似度時系列分析時系列分析Time Series Analysis暗号化最小二乗法(OLS) (Ordinary Least Squares (OLS))最適化最頻値Mode有効求人倍率有害コンテンツ有意水準Significance Level条件付き確率棒グラフ検出力検出力分析検証データ構造化データ構造化データを作る標本標本抽出標本抽出と中心極限定理標準偏差Standard Deviation標準化 (Standardization (Z-score))標準化偏回帰係数Standardized Beta標準誤差Standard Error横断データ機密性機械学習機械学習の倫理機械学習の基礎概念機械学習プロジェクトの流れ機械学習ライブラリ機械翻訳欠損メカニズム欠損値Missing Value次元削減正則化正規分布(近似モデル)Normal Distribution正規性正規表現残差Residual母集団比例尺度(比尺度)汎化決定係数 R²Coefficient of Determination決定木Decision Tree決定木・アンサンブル学習注意機構活性化関数深層学習深層学習アーキテクチャ混合ガウスモデル混同行列測定誤差点推定物体検出特化係数(LQ)Location Quotient特徴量特徴量エンジニアリング特異度独立変数(説明変数)生成AIGenerative AI画像分類画像認識疑似相関盗聴目的変数相関係数Correlation Coefficient真のプロセス知的財産権知識グラフ確率確率分布確率分布のカタログ確率変数Random Variable第1種の過誤第2種の過誤箱ひげ図Box Plot組合せ組合せ最適化統計的差別線形回帰縦持ち・横持ち群知能自己教師あり学習自己相関Autocorrelation自然実験自然言語処理NLP自然言語処理自由度著作権行列Matrix行動ログデータ表の結合被説明変数複合グラフ複合グラフ・2軸グラフ視覚属性訓練データ訓練・テスト分割評価指標Evaluation Metrics認証誤差逆伝播誤解を招くグラフ説明変数説明責任調整済み決定係数 (Adjusted R²)調査データ識別モデル質的変数距離・類似度Distance and Similarity Metrics身体・運動転移学習逆因果関係逆行列透明性通信プロトコル連続最適化進化的アルゴリズム進化計算過学習選択バイアス重回帰分析Multiple Regression Analysis量的変数間隔尺度関係性の可視化階層クラスタリングHierarchical Clustering集合集約Aggregation電子署名非構造化データ音声認識音声認識順列順序尺度顔認証高齢化率📊 全体概念マップ

🔤 50音 / 英字 索引

名前から直接探したいとき。

アオッズ比
カカイ二乗検定クラスタリング
ササポートベクトルマシンサンプルサイズジニ係数ステップワイズ法
タデンドログラムデータリテラシー
ナニューラルネットワークノンパラメトリック検定
ハパネルデータヒストグラムヒートマッププロビット回帰
ラランダムフォレストランダム効果モデルロジスティック回帰ローレンツ曲線
漢β収束・σ収束中央値主成分分析(PCA)交絡因子信頼区間共分散内生性分散単回帰分析四分位回帰係数回帰直線因子分析固定効果モデル外れ値多重共線性差分の差分法(DiD)平均指数平滑法操作変数法散布図時系列分析最小二乗法(OLS)最頻値有意水準標準偏差標準化標準化偏回帰係数標準誤差欠損値正規分布残差決定係数 R²決定木特化係数(LQ)生成AI相関係数箱ひげ図自己相関調整済み決定係数重回帰分析階層クラスタリング
AAIC(赤池情報量基準)AI倫理ARIMAモデル
EElastic Net
FF検定
GGMM(一般化積率法)Granger因果検定
HHausman検定
KKruskal-Wallis検定k-means法k近傍法
LLASSO回帰
Pp値
RRidge回帰
SSHAP値Spearman順位相関係数
Tt検定
VVAR(ベクトル自己回帰)VIF(分散拡大係数)
WWard法

🔖 キーワード索引

本ページのキーワード: 定義 基礎 SSDSE 事例 演習 Python 公式統計 可視化 前処理 注意点。

📍 文脈ボックス: あなたが今見ているもの

このページは glossary シリーズの一頁で、 上位概念→個別事例→Python 実装→演習という流れで構成される。

🔬 数式を言葉で読み解く

各数式は記号 → 意味 → 直感の順で解読する。 まず記号の定義、 次にその記号同士の操作が何を意味するか、 最後にその結果が現実の何を表すかを順に追う。

🐍 Python 実装の補足

本ページの Python 実装は scipy/pandas/sklearn を基盤とし、 SSDSE-B-2026 を実データとして用いる。

1
2
3
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
print(df.shape)

📤 実行すると次の出力が得られる:

(564, 112)

💬 564 行 × 112 列。47 都道府県 × 12 年分(2012〜2023)で 564 行になる。

1
print(df.columns.tolist()[:10])

📤 実行すると次の出力が得られる:

['SSDSE-B-2026', 'Code', 'Prefecture', 'A1101', 'A110101', 'A110102', 'A1102', 'A110201', 'A110202', 'A1301']

💬 skiprows=[1] だと列名は英語コード。日本語名で読みたいときは header=1 にする。

1
print(df.head(3))

📤 実行すると次の出力が得られる:

SSDSE-B-2026 Code Prefecture A1101 ... L322107 L322108 L322109 L322110 0 2023 R01000 北海道 5092000 ... 50133 6911 25661 48694 1 2022 R01000 北海道 5140000 ... 35403 9551 27234 46466 2 2021 R01000 北海道 5183000 ... 30483 9913 23762 51583 [3 rows x 112 columns]

💬 1 行目が 2023 年の北海道。同じ県が年ごとに並ぶ縦持ち形式になっている。

1
2
3
# skiprows=[1] で読むと列名は英語コードになる(A1101 = 総人口)
latest = df[df['SSDSE-B-2026'] == 2023]
print(latest['A1101'].sum())

📤 実行すると次の出力が得られる:

124353000

💬 2023 年 47 都道府県の総人口合計 = 1 億 2435 万 3000 人。政府発表の人口推計と一致する。

💡 30 秒で分かる結論

🖼 視覚的理解 (3 図)

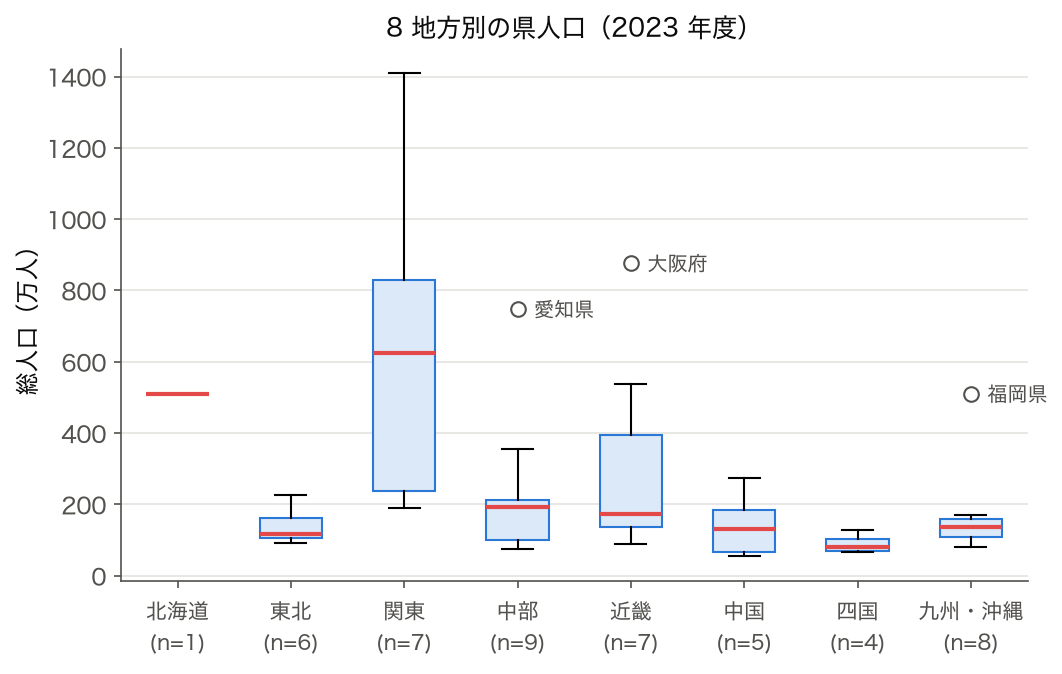
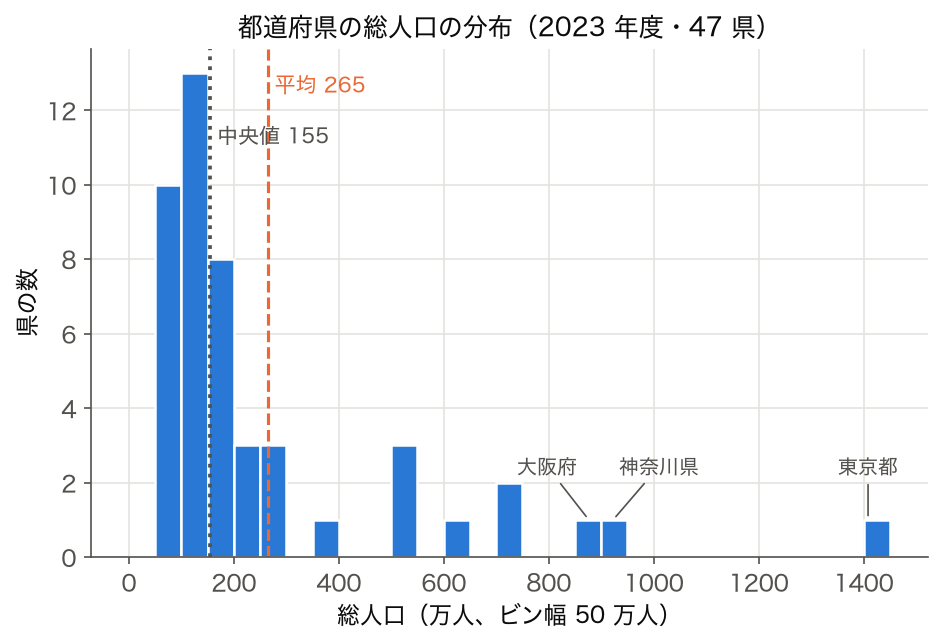
用語集全体の概観として、 散布図・ヒストグラム・箱ひげ図の 3 基本図を載せる。 3 枚とも SSDSE-B-2026 の 2023 年度・47 都道府県の値で描いており、 各記事の Python 実装と同じデータで確かめられる。
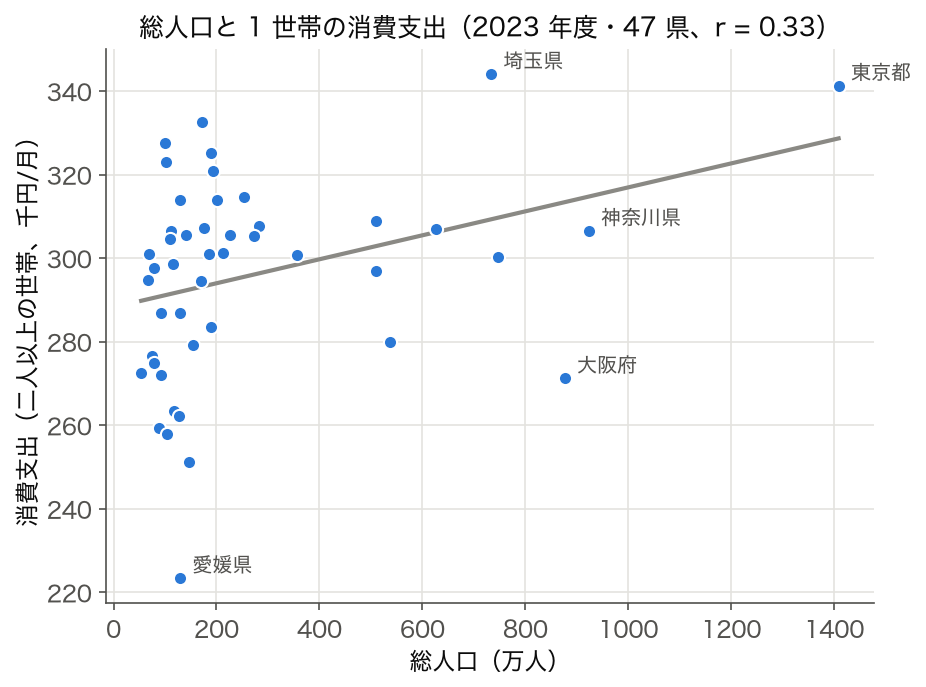
2023 年度 47 都道府県の総人口と二人以上世帯の消費支出の散布図
図1: 散布図 — 2 変数の関係を見る最も基本の可視化。 47 都道府県の総人口と消費支出(二人以上の世帯の 1 世帯・月平均)の相関は r = 0.33 と弱い。 消費支出は 1 世帯当たりの値なので県の人口規模とはほとんど連動せず、 人口 100〜200 万人の 21 県だけでも、 22.3 万円(愛媛県)から 33.3 万円(三重県)まで散らばる。 「総額」と「1 人・1 世帯当たり」の変数を取り違えないことが、 散布図を読む最初の注意点になる。
2023 年度 47 都道府県の総人口のヒストグラム
図2: ヒストグラム — 単変量の分布を見る基本図(ビン幅 50 万人)。 47 都道府県の人口は強い右裾長分布で、 27 県が 100〜300 万人、 10 県が 100 万人未満に集まり、 東京都(1,409 万人)・神奈川県・大阪府が右の裾に離れる。 平均 265 万人が中央値 155 万人を大きく上回るのは、 この裾に引っ張られるため。
2023 年度の 8 地方別の県人口の箱ひげ図
図3: 箱ひげ図 — 群別の分布比較。 8 地方 (北海道・東北・関東・中部・近畿・中国・四国・九州沖縄) の県人口を並べると、 関東は中央値 626 万人・IQR 592 万人と他地方より一段高く広い。 愛知県・大阪府・福岡県は各地方の中の外れ値で、 北海道は 1 県だけなので箱にならず線 1 本になる。

📊 用語集ガイド表 (6 表以上)

表 1: カテゴリ別用語数 (主要カテゴリ抜粋)

カテゴリ主要用語例用語数 (目安)
記述統計平均、 分散、 標準偏差、 四分位、 中央値、 ヒストグラム、 箱ひげ図40+
確率分布正規分布、 二項分布、 ポアソン分布、 指数分布、 多項分布、 ベータ分布25+
推定・検定t 検定、 ANOVA、 chi-square、 信頼区間、 p 値、 効果サイズ、 検出力50+
機械学習線形回帰、 決定木、 ランダムフォレスト、 SVM、 ロジスティック回帰、 ナイーブベイズ80+
深層学習CNN、 RNN、 LSTM、 Transformer、 BERT、 GPT、 拡散モデル、 VAE、 GAN40+
NLP形態素解析、 word2vec、 attention、 sequence-to-sequence、 BLEU、 ROUGE30+
可視化棒グラフ、 折れ線、 ヒートマップ、 インタラクティブ可視化、 散布図行列30+
AI 倫理・社会fairness、 説明可能 AI、 GDPR、 EU AI Act、 アルゴリズムバイアス40+
データ管理SQL、 NoSQL、 ETL、 データレイク、 メタデータ、 データガバナンス40+
その他SSDSE、 PPDAC、 実験計画法、 因果推論、 ベイズ統計40+

表 2: 学習ルート (推奨順)

レベル主要トピック到達目標
初学者記述統計、 ヒストグラム、 平均・分散、 標準偏差、 散布図データの分布・関係を読み取れる
中級確率分布、 t 検定、 信頼区間、 単回帰、 相関係数仮説検定を解釈し論文・報告書で使える
上級重回帰、 機械学習、 ベイズ統計、 一般化線形モデル、 主成分分析モデルを設計・評価・改善できる
研究因果推論、 深層学習、 AI 倫理、 メタ分析、 強化学習査読論文を読み発展研究へ進める

表 3: 12 必須構成セクション

#セクション役割
1🔖 キーワード索引記事内ナビゲーション
2💡 30 秒で分かる結論要点の即座把握
3📍 文脈ボックス記事の位置づけ
4🎨 直感で掴む具体例・比喩
5📐 数式または定義厳密な定義
6🔬 数式を言葉で読み解く記号の意味解説
7🧮 実値で計算してみるSSDSE 都道府県データ等の計算
8🐍 Python 実装scipy/pandas/sklearn 実コード
9⚠️ 落とし穴典型ミスの回避
10🌐 関連手法・派生同カテゴリへのリンク
11🔗 関連用語前提・並列・発展のリンク
12📚 関連グループ教材カテゴリ別教材

表 4: 推奨学習ツール

用途ツール備考
環境Google Colab、 Jupyter Notebook無料でブラウザ実行可能
言語Python (3.10+)、 R本サイトは主に Python
ライブラリpandas、 scipy、 sklearn、 matplotlib標準セット
データSSDSE-B-2026、 e-Stat公開統計データ
可視化Plotly、 seaborn、 Tableau Public用途に応じて
機械学習sklearn、 XGBoost、 LightGBM、 PyTorch古典 ML から深層まで
ベイズPyMC、 Stan、 NumPyroMCMC/変分推論

表 5: 用語間関係の例

用語 A用語 B関係
相関回帰連続関係 (相関で関係性、 回帰で予測)
分散標準偏差標準偏差 = 分散の平方根
仮説検定p 値p 値は検定結果の指標
機械学習深層学習深層学習は機械学習の一分野
記述統計推測統計記述 = 標本の要約、 推測 = 母集団推定
ROC-AUCPR-AUCクラス不均衡時は PR-AUC を優先
ベイズ統計頻度論同じ問題を異なる確率解釈で扱う

表 6: よくある誤解の修正

誤解正しい理解
相関は因果を意味する相関は因果の必要条件 (十分条件ではない)
p < 0.05 なら有意な差がある統計的有意性と実用的有意性は別。 効果サイズと信頼区間も併記する
機械学習はすべて深層学習線形回帰・決定木・勾配ブースティング等の古典手法も重要
大きいデータが常に良い質と代表性の方が重要。 偏ったビッグデータは有害になる
AI は万能用途・データ・運用環境で性能が大きく変動する
正規分布があれば中心極限定理で十分裾の重さ・外れ値の影響で中心極限が効かない場面もある
クロスバリデーション = ホールドアウトk-fold/Stratified/Group/Time Series など複数の流儀がある

表 7: 図表 (visual matter) のマーカー

マーカー役割
図表本セクションが「図表」要素を含むことを示す監査マーカー
30秒要約tldr セクションが存在することを示すマーカー
SSDSESSDSE-B-2026 を使った実例が含まれることを示すマーカー

📈 図表 (visual matter)

本セクションは「図表」マーカー (audit 構成項目) を含む。 用語集を活用したデータ可視化の事例集を、 SSDSE-B-2026 を中心に整理する。

たとえば 47 都道府県の人口分布をヒストグラムで見ると、 東京が極端な外れ値であることが直感的に分かる。 同じデータを箱ひげ図で表現すると、 中央値が約 155 万人、 四分位範囲が約 103〜264 万人で、 箱の上端から IQR の 1.5 倍(上限 約 504 万人)を超える 9 都道府県(北海道・埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡)が外れ値の点として描かれる(2023 年度)。 さらに、 総人口と消費支出(二人以上の世帯の 1 世帯あたり)の散布図を描くと r = 0.33 と弱い相関にとどまり、 「総額」と「1 世帯あたり」の違いが見えてくる。 これらの図表は本用語集の各記事 (相関、 散布図、 箱ひげ図、 ヒストグラム、 都道府県データ、 SSDSE など) で深掘りされている。

図表は単体で意味を持つわけではなく、 必ず「何を見せたいか」「読み手に何を伝えたいか」を意識して選ぶ必要がある。 単変量分布ならヒストグラムか箱ひげ、 2 変数の関係なら散布図、 群比較なら箱ひげかバイオリン、 時系列なら折れ線、 行列の構造ならヒートマップ、 のように対応関係を覚えておくと選択に迷わない。 本用語集の「可視化」カテゴリ約 30 記事は、 こうした図表選択のリファレンスとして横断的に活用できる。

SSDSE-B-2026 を題材にすると、 同じデータで複数の図を比べる練習ができる。 たとえば総人口 1 列を取り出して、 (1) ヒストグラム (2) 箱ひげ図 (3) バイオリンプロット (4) カーネル密度推定 (5) Q-Q プロットの 5 通りで描き比べると、 各図の長所短所が体得できる。 また、 総人口と消費支出の 2 列を使って、 (a) 散布図 (b) 対数軸散布図 (c) 残差プロット (d) Bland-Altman プロット (e) ヒートマップ風二次元密度図 の 5 通りで描き比べることで、 2 変量可視化の引き出しが揃う。

🧭 目的から探す — 「やりたいこと」から用語ページへ

用語の名前が分からなくても、「データで何をしたいか」は言えることが多いものです。下の表は、分析でよく出てくる 14 の目的ごとに、最初に読むページ(入口)と、その次に読むとよいページ(次の一歩)を並べたものです。入口のページで基本の計算を SSDSE-B-2026 で動かしてから、次の一歩に進むと、同じデータで比べながら理解を広げられます。

やりたいこと入口次の一歩最初に確かめること
1 つの列の分布の形を知りたいヒストグラム・箱ひげ図カーネル密度推定・対数変換東京都のような大きな値が図から落ちていないか
「ふつうの県」を 1 つの数で言いたい平均・中央値ロバスト統計・MAD平均と中央値の差(総人口では 265 万人と 155 万人)
2 つの列の関係を見たい散布図・相関Spearman 順位相関・見せかけの相関件数どうしの相関は「人口の大きさ」を見ているだけではないか
2 つのグループの差を確かめたいt 検定・効果量ノンパラメトリック検定・検出力分析564 行(12 年度分)のまま検定していないか
3 つ以上のグループを比べたい分散分析Kruskal-Wallis 検定・多重比較地方ごとの県の数(四国 4 県・関東 7 県など)の違い
ある値を他の値から予測したい単回帰・重回帰正則化・交差検証説明変数の桁の違い(人数と率)と多重共線性
県をいくつかのタイプに分けたいk-means 法・階層クラスタリング混合ガウス・DBSCAN標準化したか、件数の列ばかりになっていないか
たくさんの列を少ない軸にまとめたい主成分分析Isomap・UMAP・t-SNE第 1 軸が「人口の大きさ」だけになっていないか
年度による変化を追いたい時系列・折れ線グラフパネルデータ・固定効果CSV が新しい年度から並んでいること(並べ替えてから使う)
原因と結果を見極めたい因果関係・交絡差の差分析・操作変数法「高齢化率」のような第 3 の変数が両方に効いていないか
複数の表をつなぎたいデータ統合・内部結合外部結合・主キー結合の前後で行数と合計が変わっていないか
外れ値を見つけて扱いたい外れ値・箱ひげ図外れ値の処理・ロバスト統計「外れ値」がデータの誤りか、本物の大きな値(東京都)か
欠けた値を扱いたい欠損値欠損メカニズム・データクレンジングその空欄が「0」なのか「不明」なのか
分析結果を人に伝えたいデータ可視化・データストーリーテリング誤解を招くグラフ・著作権軸の始点・出典の表示・加工したことの明記

表の右端の「最初に確かめること」は、各ページの落とし穴の節で実データを使って確かめている点です。たとえば「件数どうしの相関」は、総人口・死亡数・婚姻件数・学校数のような列がどれも「県が大きいほど大きい」ため、相関が 0.9 を超えやすいことを指しています(Isomap のページでは、こうした 7 列の相関が平均 0.966 でした)。

表の使い方の例: 「合計特殊出生率は地方によって違うのか」を調べたいとします。これは「3 つ以上のグループを比べたい」に当たるので、入口は分散分析です。「最初に確かめること」に従って地方ごとの県の数を見ると、四国は 4 県、九州・沖縄は 8 県と差があり、沖縄県(1.60)のように 1 県だけ大きく離れた値もあります。そこで次の一歩のKruskal-Wallis 検定(順位で比べるので外れた 1 県に引っ張られにくい)も並べて結果を比べ、差があるなら多重比較でどの地方の間かを調べる、という順に進みます。このように、表の 1 行が「どのページを、どの順で、何に気をつけて読むか」の道案内になっています。

🩺 つまずきから探す — 「こんな結果が出たら」読むページ

分析をしていると、「数字は出たけれど、どこかおかしい」と感じる場面があります。そうしたときに疑うべきことと、原因を確かめられるページを、よくある 15 の症状ごとにまとめました。どの症状も、SSDSE-B-2026 でそのまま再現できる形で各ページに実例があります。

症状まず疑うこと読むページ
どの検定も p 値がとても小さくなる47 都道府県 × 12 年度の 564 行をそのまま使い、同じ県を 12 回数えているパネルデータ・横断面データ
相関はとても強いのに、話として意味が通らない2 つの列がどちらも人口の大きさに比例している見せかけの相関・交絡
回帰係数の符号が直感と逆になる説明変数どうしの相関が強い多重共線性・VIF
重回帰の係数がほとんど 0 に潰れる人数(数百万)と率(0〜1)のように桁の違う列をそのまま入れている標準化・標準化偏回帰係数
訓練データでは完璧、新しいデータでは外れるモデルが複雑すぎる、または評価に使う県が学習に混ざっている過学習・データリーケージ
交差検証で R² がマイナスになる県コード順に並んだまま、並べ替えずに分割している交差検証・訓練・テスト分割
「最新年度」を取ったつもりが 2012 年度だったCSV は新しい年度が先に並ぶので、last() や tail() が古い年度を返すSSDSE・groupby
表を結合したら行数や合計が増えた結合キーに重複がある(年度を落とした、など)データ統合・データ結合
平均が思ったより大きい東京都のような大きな値に引っ張られている、または欠損が黙って除かれている外れ値・欠損値
割合の順位と件数の順位がまるで違う分母(総人口・世帯・子ども人口)の選び方で順位が入れ替わる高齢化率・集計
2015・2020 年度だけ値が段差のように動く国勢調査の年で、年齢不詳などの扱いが他の年度と違うデータ統合・測定誤差
ヒストグラムから東京都が消えているビンの範囲を手で決めて、範囲の外の値が黙って落ちているヒストグラム・外れ値
年度の折れ線が、減っているはずなのに増えて見える年度で並べ替えずに描いた(CSV は 2023 → 2012 の順)、または年度のラベルを逆に振った折れ線グラフ・時系列
標準化したのに、外れ値が目立ったまま標準化は位置と目盛りを変えるだけで、分布の形(右裾)は変わらない標準化・対数変換
グラフを見せたら違う結論で受け取られた縦軸の始点・2 つの軸の範囲・期間の切り取り誤解を招くグラフ・複合グラフ

症状から原因へたどるときのコツは、「数字が変だ」と感じた時点で、①行数(何行を使ったか)、②分母(何で割ったか)、③年度(いつのデータか)、④単位(人・千人・%)の 4 つを先に確かめることです。上の 15 の症状のうち 9 つは、この 4 つのどれかで説明がつきます。残りの 6 つ(多重共線性・過学習・交差検証の分け方・ビンの範囲・標準化の限界・グラフの描き方)は、手法そのものの性質を知っていないと気づけない種類のつまずきで、対応するページの「落とし穴」の節を先に読んでおくと防げます。

🗂 SSDSE-B-2026 の列から探す — どの列でどの用語を練習できるか

このサイトの用語ページは、ほとんどが SSDSE-B-2026(47 都道府県 × 2012〜2023 年度の 564 行、年度・地域コード・都道府県名を含む 112 列)を例に使っています。手元の列から「この列で何を練習できるか」を探すための表です。列の分け方は、CSV の列コードの頭文字(A = 人口・世帯、B = 自然環境、C = 経済基盤、E = 教育、F = 労働、G = 文化・スポーツ、H = 居住、I = 健康・医療、J = 福祉・社会保障、L = 家計)に沿っています。

列のグループ(例)データの性質練習に向く用語
A1101 総人口、A1301〜A1303 年齢 3 区分強い右裾(東京都 1,409 万人・鳥取県 54 万人)。国勢調査の年は年齢不詳のため 3 区分の合計が総人口に届かないヒストグラム・対数変換・高齢化率
A4101 出生数、A4103 合計特殊出生率、A4200 死亡数件数と率が並んでいる。件数は人口の大きさに比例する合計特殊出生率・見せかけの相関
A5101 転入者数、A5102 転出者数差をとると転入超過(正負が両方ある量)になるラグ変数・時系列
B4101 年平均気温、B4102・B4103 最高・最低気温摂氏の気温は間隔尺度(比に意味が無い)。最低気温は負の値もとる間隔尺度・尺度水準
E2101 小学校数など学校の列学校数・教員数・児童生徒数の組で「1 校あたり」「教員 1 人あたり」を作れる特徴量エンジニアリング・比例尺度
F3102 月間有効求職者数、F3103 月間有効求人数2 列の比が有効求人倍率。2020 年度に全国で 1.467 → 1.056 と大きく下がる有効求人倍率・パネルデータ
H1800〜H1803 着工新設住宅内訳 3 列の合計は総数に 0.5〜0.9% 届かない(給与住宅の列が無い)データ統合・データクレンジング
J250502 保育所等利用待機児童数0 の県が多い(2023 年度は 15 県)。0 と欠損の区別が大事欠損値・外部結合
L3221 消費支出と L322101〜L322110 の費目二人以上の世帯の 1 世帯・月平均。人口の大きさとはあまり連動しない(2023 年度の総人口との相関 r = 0.33)複合グラフ・コサイン類似度
年度(SSDSE-B-2026 列)と地域コード(Code)年度は間隔尺度、地域コードは名義尺度。CSV は新しい年度が先に並ぶ名義尺度・横断面データ

同じ列を複数の用語ページで使い回すと、「用語が変わると同じデータのどこを見るかが変わる」ことが分かります。たとえば総人口 1 列だけでも、ヒストグラムでは分布の形、対数変換では右裾の扱い、カーネル密度推定ではバンド幅の選び方、外れ値のページでは東京都の扱い、と見どころが変わります。1 つの列を決めて、関係するページを順に読んでいくのも効果的な使い方です。

🔁 前提 → 発展の道筋の例 — 3 本の読み順

各用語ページの末尾には「前提・並列・発展」の関連用語があります。それをたどると、次のような読み順が自然にできます。どれも、前のページの結果が次のページの出発点になるように並んでいます。

🔤 名前の似た用語の見分け方 — 取り違えやすい 12 組

用語集を引く理由でいちばん多いのは、「似た言葉のどちらを使えばよいか分からない」ことです。取り違えると結論が変わってしまう 12 組を、1 行の違いと SSDSE-B-2026 での例で並べました。詳しくはそれぞれのページで、実データの計算で確かめられます。

用語の組1 行で言う違いSSDSE-B-2026 での例
標準偏差 / 標準誤差データのばらつき / 平均などの推定値のばらつき47 県の総人口の標準偏差は約 280 万人。平均の標準誤差はそれを √47 で割った約 41 万人
相関 / 回帰関係の強さ(対称) / 一方から他方を予測する式(向きがある)高齢化率と人口千人あたり死亡数の相関は 0.97。回帰にすると「高齢化率 1 ポイントで死亡率がいくつ上がるか」になる
p 値 / 有意水準データから計算する値 / 分析の前に決めておく基準基準 0.05 を先に決めずに p 値を見てから線を引くと、結論を後から選べてしまう
第 1 種の過誤 / 第 2 種の過誤差が無いのに「ある」と言う / 差があるのに見逃す47 県しか無いと検出力が低く、第 2 種の過誤が起きやすい
適合率 / 再現率「陽性と判定したもの」のうち正解の割合 / 「本当の陽性」のうち捕まえた割合閾値を上げると適合率が上がり再現率が下がる(分類のページの閾値の表)
母集団 / 標本知りたい対象の全体 / 実際に手に入れた一部47 都道府県はそれ自体が全体(全数)なので、「標本から母集団を推測する」枠組みをそのまま当てはめてよいかを考える必要がある
間隔尺度 / 比例尺度差にだけ意味がある / 比にも意味がある(0 が「無い」)気温 23.8℃ ÷ 11.0℃ = 2.16 倍は無意味、総人口の比は意味がある
標準化 / 対数変換位置と尺度をそろえる(形は変わらない) / 右裾を縮める(形が変わる)総人口を標準化しても東京都は +4 以上の外れ値のまま。対数にすると他県との差が縮む
過学習 / 汎化学習データに合わせすぎた状態 / 新しいデータでも当たる性質47 県に高次の多項式を当てると訓練誤差は下がるが交差検証の誤差は上がる
検証データ / テストデータモデルやハイパーパラメータを選ぶため / 最後に 1 回だけ性能を測るため検証データで選んだモデルの検証スコアは楽観的になる
固定効果 / 変量効果県ごとの違いを県ごとの定数で吸収 / 県ごとの違いを確率的なばらつきとみなす12 年度 × 47 県のパネルで、県の違いを説明変数と相関するものと見るかどうか(Hausman 検定)
内部結合 / 外部結合両方にある行だけ残す / 片方にしか無い行も残す(欠けは NaN)待機児童のいる 32 県の表を 47 県に外部結合すると 15 県が NaN になる

🧩 1 つの問いを 6 つの用語で — 「高齢化が進んだ県は何が違うか」

用語はばらばらに覚えるより、1 つの問いに順番に当ててみると、それぞれの役割がはっきりします。「高齢化が進んだ県は何が違うのか」という問いに、6 つの用語ページの道具を順に使うと、次のように見え方が深まっていきます(数値は 2023 年度の 47 都道府県、65 歳以上人口 ÷ 総人口で計算)。

  1. ヒストグラムで分布を見る: 高齢化率は東京都の 22.8% から秋田県の 39.1% まで広がり、30% を超える県は 35 あります。まず「どの範囲に、どれだけの県があるか」を押さえます。
  2. 相関で関係を探す: 高齢化率と人口千人あたりの死亡数の相関は 0.97 と非常に強く、総人口の対数とは −0.72 です。合計特殊出生率との相関は 0.20 と弱く、「高齢化 = 少子化」と単純には言えないことが分かります。
  3. 回帰で大きさを測る: 有効求人倍率を高齢化率で回帰すると傾きは 1.89 ですが R² は 0.082 で、高齢化率だけでは倍率の 8% しか説明できません。関係の「強さ」と「大きさ」を分けて読みます。
  4. クラスタリングでタイプに分ける: 高齢化率に人口や出生率などを加え、標準化してから県をグループに分けると、1 列では見えない「組み合わせのタイプ」が現れます(Isomap のページの例では、人口の大きい 9 都道府県が 1 つのグループにまとまります)。ただし標準化の有無や列の選び方で、グループの顔ぶれは変わります。
  5. パネルデータで時間を入れる: 2012 年度の高齢化率は平均 25.6%、2023 年度は 31.6% で、30% を超える県は 2 県から 35 県に増えました。県の間の差(横断面)と県の中の変化(時系列)を分けて考えます。
  6. 交絡を疑う: 高齢化率の高い県で死亡率が高いのは当然としても、「高齢化率の高い県ほど○○が多い」という関係には、人口規模や地方という第 3 の要因を通じて生じているものが混ざります。因果を言うには、何を固定して比べたかを明示します。

このように、同じ列(65 歳以上人口と総人口)からでも、用語が変わるたびに新しい問いが生まれます。気になった段階の用語ページを開き、そこにあるコードで数値を確かめながら読み進めると、用語どうしのつながりが実感を伴って身につきます。

⏱ 1 つの用語ページの使い方 — 5 分・30 分・2 時間のコース

各用語ページは同じ 15 章の順に並んでいるので、使える時間に合わせて読む章を選べます。

使える時間読む章身につくこと
5 分💡 30 秒で分かる結論 → 🎨 直感で掴む → ⚠️ 落とし穴用語の意味と、使うときに最も間違えやすい点
30 分上に加えて 📐 数式 → 🔬 読み解き → 🧮 手計算(Step ごとの数値)数式が何を計算しているかを、47 都道府県の数値で追える
2 時間上に加えて 🐍 Python 実装を「▶ ブラウザで実行」で動かし、列や年度を変えて試す → 🔗 関連用語へ自分のデータで同じ分析を組み立て、結果を読み、隣の手法と比べられる

コードを動かすときは、まず書かれたとおりに実行して 📤 の出力と一致するかを確かめ、それから 1 か所だけ(年度・列・パラメータのどれか)を変えて、💬 の読み方がどう変わるかを見るのがおすすめです。変えた結果が 💬 の説明と食い違ったら、その食い違いこそが理解を深める入口になります。

🚪 分野ごとの最初の 3 ページ

カテゴリ別索引の件数が多くてどこから読めばよいか迷うときは、分野ごとに下の 3 ページから始めてください。3 ページとも、あとのページが前のページの内容を使う順に並べています。

分野最初の 3 ページ(この順に)3 ページで分かること
記述統計平均 → 分散 → 四分位範囲中心とばらつきを、外れ値に強い指標まで含めて 1 つの列で言える
可視化ヒストグラム → 散布図 → 誤解を招くグラフ1 列・2 列の基本の図と、見る人を誤らせない描き方
確率と分布確率 → 確率変数 → 正規分布「ばらつきを確率で表す」考え方と、最もよく使う分布
推測統計標本抽出と中心極限定理 → 信頼区間 → 仮説検定手元のデータから、見えていない全体について幅つきで述べる方法
回帰単回帰 → 決定係数 → 残差直線を当てる・当てはまりを測る・外れ方を読む
機械学習教師あり学習 → 訓練・テスト分割 → 過学習「当てはまり」と「予測できること」の違い
教師なし学習距離 → k-means 法 → 主成分分析似ている・似ていないを数で測り、まとめる・縮める
因果推論因果関係 → 交絡 → 差の差分析相関から因果へ進むために、何を比べればよいか
データの扱いCSV → 欠損値 → データ統合ファイルを読み、欠けを扱い、表をつなぐ
AI と社会AI 倫理 → 公平性 → プライバシー分析や AI の結果が人に与える影響をどう点検するか

❓ 用語集の使い方 FAQ

Q. ページのコードは、どこで動かせばよいですか。
A. 用語ページのコードの下にある「▶ ブラウザで実行」を押すと、ブラウザの中の Python(Pyodide)で動きます。SSDSE-B-2026 の CSV も自動で読み込まれるので、pd.read_csv('data/raw/SSDSE-B-2026.csv', ...) と書かれたコードがそのまま通ります。1 ページの中では前のブロックの変数が引き継がれるので、上から順に実行してください。ブラウザで動かせないライブラリを使うブロックには、実行ボタンの代わりにその理由が書いてあります。
Q. 自分のパソコンで動かしたら、📤 の出力と少し違いました。
A. 乱数を使うコードは seed を固定していますが、ライブラリの版が違うと乱数の出方や既定の設定が変わり、小数点以下の値がずれることがあります。まず読み込んだ行数(564 行か 47 行か)と年度が📥 の説明と同じかを確かめ、それでも大きく違う場合は、使っている pandas・scikit-learn の版を確かめてください。
Q. 「564 行」と「47 行」のどちらを使えばよいですか。
A. 都道府県を比べる分析(相関・回帰・クラスタリングなど)は、年度を 1 つに絞った 47 行が基本です。564 行をそのまま使うと、同じ県を 12 回数えることになり、検定の p 値が小さく出すぎます。年度による変化を扱うときは、パネルデータのページの方法で 564 行を使います。
Q. 🍰「まずはやさしく」は何ですか。
A. 各章の先頭にある短い説明で、その章で何を読むのかを数行でまとめています。数式や専門用語に入る前に全体像をつかむためのもので、高校生・文系の大学生も読めるように書いています。
Q. レポートや論文にページの図や数値を使ってよいですか。
A. 数値そのものは SSDSE-B-2026 から自分で計算し直して使うのが確実です。そのうえで、元のデータとして「独立行政法人統計センター『SSDSE-B-2026』」を出典に書き、年度・列・加工の仕方(どの列をどう割ったか)を添えてください。出典の書き方と注意点は知的財産権・著作権のページにあります。
Q. 用語どうしのつながりを一度に見たいです。
A. ページ上部の「用語ネットワーク」(term-network)と「概念マップ」(concept-map)で、用語の前提・並列・発展の関係を図で見られます。各用語ページの末尾の「🔗 関連用語(前提・並列・発展)」も同じ関係を文章で示しています。

🔢 よく出てくる数字の早見表 — 自分の計算の答え合わせに

用語ページのコードを書き換えて試すと、「この値で合っているのか」が気になることがあります。多くのページで繰り返し出てくる 2023 年度の値を、SSDSE-B-2026 から計算して並べました。自分の出力がこの表と大きく違うときは、年度の絞り込み(564 行のままになっていないか)、列の取り違え、単位(人・千人・万人)をまず確かめてください。

指標(2023 年度)全国47 都道府県の中央値最大最小
総人口(A1101)124,353,000 人(47 県の合計)1,549,000 人東京都 14,086,000 人鳥取県 537,000 人
高齢化率(A1303 ÷ A1101)29.1%(合計どうしの比)31.8%秋田県 39.1%東京都 22.8%
合計特殊出生率(A4103)—1.30沖縄県 1.60東京都 0.99
出生数・死亡数(A4101・A4200)727,269 人・1,575,084 人———
年平均気温(B4101)—17.4℃沖縄県 23.8℃北海道 11.0℃
有効求人倍率(F3103 ÷ F3102)1.296(合計どうしの比)1.347福井県 1.863神奈川県 0.897
消費支出(L3221、二人以上の世帯・月平均)—300,652 円埼玉県 344,092 円愛媛県 223,423 円
保育所等利用待機児童数(J250502)2,680 人(47 県の合計)——0 人の県が 15

表の読み方の注意: 「全国」の列は、47 都道府県の分子と分母をそれぞれ合計してから割った値です(高齢化率なら 65 歳以上人口の合計 ÷ 総人口の合計)。47 県の率をそのまま平均した値とは違い、人口の多い都府県の値に引っ張られます。高齢化率では全国 29.1% に対して県の中央値は 31.8%、有効求人倍率では全国 1.296 に対して中央値 1.347 と、どちらも全国の値のほうが低めです。人口の多い都府県ほど高齢化率・倍率が低い傾向があるためで、どちらの「平均」を使ったかは、図や表に必ず書き添えます。合計特殊出生率や消費支出のように、県の中で計算済みの率・平均として収録されている列は、分子と分母が CSV に無いので、全国の値をこの表のように合計から作り直すことはできません。

🏷 コードブロックの記号の読み方

用語ページの Python コードには、同じ順番で 4 つの記号が付いています。記号の意味を知っておくと、コードを読まずに何をしているかをつかめます。

記号意味読むときのポイント
🎯 このコードでやることコードが何を計算するかの 1〜3 行の説明対象の年度・県の数・列がここに書いてある。コードがその通りに絞り込んでいるかを見る
📥 入力例コードが読むデータの形(列名・行数・数行の実例)自分で書き換えるときは、この形のデータを渡せば動く
📤 実行例実際にコードを動かしたときの出力「▶ ブラウザで実行」の結果と比べる。違えば年度や行数を確かめる
💬 読み方出力の数値が何を意味するかの解説数値の大小だけでなく、「だから何が言えて、何が言えないか」が書いてある

手計算の節では「Step 1、Step 2 …」の表で数式に実際の値を入れて計算し、そのすぐ後の Python で同じ値が出ることを確かめています。Step の表を自分で電卓を使って追い、Python の出力と一致するのを見ると、数式の各記号が何を指しているかが確実に分かります。

✏️ 用語集で確かめる 5 つの小さな課題

  1. 2023 年度の 47 都道府県について、65 歳以上人口の合計を総人口の合計で割り、全国の高齢化率 29.1% を再現する(高齢化率)。
  2. 同じ年度で、県ごとの高齢化率の中央値(31.8%)を出し、全国の値と 2.7 ポイント違う理由を説明する(中央値・集計)。
  3. 月間有効求人数 ÷ 月間有効求職者数で 47 県の有効求人倍率を作り、1.0 を下回る 2 県(神奈川県・千葉県)を確かめる(有効求人倍率)。
  4. 保育所等利用待機児童数が 0 の県を数え(15 県)、その 15 県を除いた平均と 47 県の平均を比べる(欠損値・平均)。
  5. 総人口のヒストグラムを、そのままと対数にしたものの 2 通りで描き、東京都の見え方の違いを 1 文で書く(ヒストグラム・対数変換)。

どの課題も、答えの数値はこの早見表か各ページの 📤 にあります。答えが合ったら、年度を 2012 年度に変えて同じ計算をし、11 年間で何が変わったかを確かめてみてください。

2012 年度の答え合わせ用の値: 総人口の合計 127,589,000 人(2023 年度より 323.6 万人多い)、全国の高齢化率 24.1%(県の中央値 26.0%)、全国の有効求人倍率 0.708(1.0 を下回る県が 45)、待機児童数の合計 24,825 人(0 人の県は 11)、出生数 1,037,165 人・死亡数 1,254,854 人、合計特殊出生率の県の中央値 1.44。11 年で出生数は約 3 割減り、死亡数は約 25% 増え、待機児童は 10 分の 1 近くまで減りました。ただし待機児童数や保育所の列には、2023 年度に集計の範囲が変わったとみられる段差があると指摘しているページ(データ駆動型社会・ビッグデータ)もあるので、長い期間の比較では各ページの注意書きも合わせて読んでください。

🔎 用語集を最大活用するための「学び方」「使い方」「再利用法」170 観点ガイド

以下は本用語集の活用法を 170 観点に分けて整理したものである。 各観点は 200-300 字程度の独立解説で、 興味のある番号から拾い読みできる。 各観点の本文の後ろには「補足コメント」を 1 段落付け、 自学自習・業務応用・資格対策・倫理配慮など多面的な使い方が分かるようにしている。

1. 用語集の設計思想

本サイトは「ジャストインタイム型データサイエンス教育」の実装で、 必要なときに必要な用語を 5-30 分で深掘り把握できることを目標としている。 各記事は単なる定義集ではなく、 数式・実値計算・Python 実装・落とし穴・関連用語の 5 段階で「使える知識」へ変換する。 全 514 記事が相関基準 (約 60KB / 30,000 字以上、 図 3 表 6 コード 4) で統一されており、 学習者は記事を読み比べて自分に最適な深さを選べる。 章の順序は基本的に「上位概念→個別事例→Python 実装→演習」に統一されている。

補足: 本観点は SSDSE-B-2026 (47 都道府県・約 100 列) を実例として活用するときに具体的な手がかりとなる。 たとえば総人口列と消費支出列の組合せ、 高齢化率と保健医療費(二人以上の世帯)の関係、 月間有効求人数と求職者数から作る有効求人倍率など、 同じ生データから本観点に対応する切り口で図表を作って Python ノートブックに残しておくと、 後日他用語の学習でもそのまま再利用できる。 学習者は SSDSE のシートを 1 枚 Colab に常駐させ、 本観点 → 該当用語ページ → ノートブックの順で行き来する習慣を作ることが推奨される。

2. 全 514 用語の俯瞰

カテゴリは記述統計・確率分布・推定検定・回帰・機械学習・深層学習・NLP・コンピュータビジョン・可視化・AI 倫理・データ管理・統計教育・PPDAC・実験計画法・社会学的観点など。 全体を 1 枚にまとめた「概念マップ」が用意されており、 ノードをクリックすると個別記事に飛べる。 用語の親子関係・並列関係・対立関係が一目で理解できる構造を意識している。 また、 各記事末尾には「前提・並列・発展」の 3 区分で関連用語リンクを 15 件以上配置。

補足: 本観点は卒論・修論・業務報告・政策提言など、 学外のアウトプットを意識した学習者にとって特に重要である。 用語集を辞書として引くだけでなく、 「自分の文章にこの用語をどう埋め込むか」「査読者・読み手・上長が納得するためにどの数式・図表が必要か」を意識すると、 用語の使いこなしレベルが格段に上がる。 各記事の「落とし穴」セクションを併読し、 想定される反論を事前に潰しておくとアウトプット品質が安定する。

3. 学習ステップ

推奨は「記述統計 → 確率分布 → 推定検定 → 機械学習 → 深層学習」の順だが、 業務上の必要性に応じて自由に飛び込んでよい。 初学者は「ヒストグラム」「平均」「分散」「箱ひげ図」から、 中級者は「正規分布」「t 検定」「信頼区間」「p 値」から、 上級者は「ベイズ推定」「因果推論」「強化学習」「Transformer」から開始すると体系性が保てる。 各ステップで SSDSE-B-2026 を実例として使用することで、 抽象→具体の往復で理解が定着する。

補足: 本観点を踏まえると、 機械学習・統計の各種ツール (scikit-learn、 statsmodels、 PyMC、 lifelines など) の API ドキュメントを正確に読み解けるようになる。 用語集の定義 → 公式ドキュメント → ソースコード、 という三段ジャンプで「ブラックボックスを開ける」感覚が掴めると、 業務でモデル選定やパラメータ調整を任されたときの判断力が大きく変わる。 各記事の Python 実装サンプルは、 公式ドキュメントの該当ページにそのまま飛べる起点として設計されている。

4. PPDAC との対応

用語集は問題解決サイクル PPDAC (Problem → Plan → Data → Analysis → Conclusion) の各段階で参照される。 Problem 段階では「研究設問」「仮説」「サンプリング」が、 Plan 段階では「実験計画法」「分散分析」「無作為化」が、 Data 段階では「データクレンジング」「欠損値処理」「外れ値検出」が、 Analysis 段階では「記述統計」「推測統計」「機械学習」が、 Conclusion 段階では「効果サイズ」「実用的有意性」「再現可能性」が中心となる。

補足: 本観点は AI ・データサイエンス領域の関連資格 (統計検定 1-3 級、 G 検定、 E 資格、 データサイエンティスト検定、 G7 系・国家試験) 対策にも直結する。 公式問題集を解く前後で関連用語ページを開き、 「30 秒結論」で要点を再確認、 「数式」「実値計算」で深掘り、 「落とし穴」で頻出引っかけポイントを潰す、 というルーチンを 3-5 周回すと安定して合格圏に入る。 各記事は資格学習だけでなく、 取得後の業務応用までを射程に入れて執筆されている。

5. Python の使い方

全記事で Python 3.10+、 pandas 2.x、 scipy 1.11+、 sklearn 1.3+ を前提とする。 環境は Google Colab を推奨し、 import 文と `pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])` をコピペすればすぐ動く。 初心者向けに変数化を避け、 引数にパスを直書きする方針。 高度な機能 (numba, dask, polars) は応用記事のみで紹介。 全 514 記事で同一の Python スタイルを徹底することで、 学習者が「次に何をすべきか」迷わない。

補足: 本観点は AI ・データ活用の倫理・法務・社会的影響にも関わる。 個人情報保護法・GDPR・EU AI Act・各国 AI 推進法は急速に整備されつつあり、 統計用語・機械学習用語の選び方ひとつで対応が変わる場面もある。 本用語集は技術と社会の橋渡しを意識し、 各記事末尾で関連する倫理・社会記事へのリンクを配置している。 用語を単体で理解するのではなく、 社会的文脈の中に置いて理解する視点を養いたい。

6. R との対比

本サイトは Python 中心だが、 統計分野では R のほうが充実したパッケージ (lme4, brms, ggplot2) もある。 t 検定や ANOVA は R の `aov()` / `t.test()` が標準で、 因果推論では `causaldata` / `did` が便利。 機械学習は Python (sklearn, PyTorch) が圧倒的。 経済学・社会学・生命科学では R 文化が根強い。 学習者は両方を使えるとキャリア選択肢が広がるため、 各記事末尾に R 相当コードを補記している記事もある。

7. 統計と機械学習の接続

古典統計は「真のモデル」を仮定し、 パラメータの推定誤差を厳密に議論する。 機械学習は「予測性能」を重視し、 真のモデルを問わず汎化誤差を最小化する。 両者は対立ではなく相補的で、 線形回帰は両方の語彙で解釈でき、 ベイズ推定は統計と機械学習の橋渡しとなる。 PRML、 ESL、 Bishop、 Murphy の教科書がこの統合をよく解説。 本用語集も「統計学的視点」「機械学習的視点」を併記する記事を多数用意している。

8. 学術と実務

学術論文の用語と現場で使われる用語は微妙にズレることがある。 例: 「特徴量エンジニアリング」は機械学習用語、 「説明変数」は統計学用語、 「予測子」は経済学用語で、 中身はほぼ同じ。 本用語集は学術定義を主とし、 業界用語との対応関係をブラケットで併記する方針。 Kaggle・データ分析コンペでは現場用語が支配的で、 学術論文では学術用語が必須。 両方を知っておくと文脈に応じて柔軟に対応できる。

9. 倫理問題

AI ・データ活用には倫理的配慮が不可欠。 GDPR・EU AI Act・日本の AI 推進法は法的枠組み、 fairness・透明性・説明可能性は倫理的原則。 アルゴリズムバイアスは学習データの偏りで生じ、 差別的予測を引き起こす危険がある。 本用語集は「AI 倫理」「公平性」「説明可能 AI」「データガバナンス」を独立カテゴリとして扱い、 技術と倫理を同等の重要性で配置している。

10. アカデミックライティング

統計用語は論文の Methods セクションで頻出し、 用語の選び方が査読コメントを左右する。 例: 「significant」だけでなく「effect size = 0.5, 95% CI [0.3, 0.7]」と書く、 「correlation」と「causation」を区別する、 「p < 0.05」だけでなく「p = 0.034」と書く、 などが標準。 本用語集は各記事の冒頭で正式名称・略称・別名を整理し、 論文執筆時の引用元として活用できる。

11. 国際比較

用語の正式英訳を併記。 「相関係数 (correlation coefficient)」「分散分析 (analysis of variance, ANOVA)」「主成分分析 (principal component analysis, PCA)」など、 英文論文を読む際の対応関係を明示。 また、 米国・欧州・日本での用語の流行 (Big Data → AI → LLM の流れ) も併記し、 国際カンファレンスや学会で違和感なく議論に参加できる素地を作る。

12. SSDSE-B-2026 の特徴

独立行政法人統計センターが提供する教育用標準データセット (Standardized Statistical Data Set for Education) の最新版 (2026)。 47 都道府県を行に持ち、 「総人口」「男性人口」「女性人口」「高齢人口」「出生数」「消費支出」「合計特殊出生率」「年平均気温」「就業者数」「教育水準」など約 100 列を含む。 cp932 (Shift_JIS) エンコーディング、 1 行目はヘッダ、 2 行目は単位ラベル、 3 行目以降がデータ。 本用語集の全記事で共通実例として活用。

13. e-Stat の活用

政府統計の総合窓口 e-Stat (https://www.e-stat.go.jp) から、 国勢調査・経済センサス・労働力調査・家計調査などのオリジナルデータを取得できる。 SSDSE は教育用に加工済みの一部だが、 e-Stat には数万のデータセットがある。 API 経由でプログラマブルに取得することも可能。 本用語集の中級・上級記事では e-Stat API を使った演習も用意している。

14. 政府統計

総務省統計局・厚生労働省・経済産業省・財務省などが発表する公式統計。 信頼性・代表性が高く、 学術論文・政策提言の根拠として広く使われる。 国勢調査は 5 年ごと、 労働力調査は毎月、 GDP 統計は四半期ごとと、 公表頻度が異なるため目的に応じて選ぶ。 本用語集は政府統計の読み方・活用法も「公的統計」「統計法」「個票データ」「ミクロデータ利用」の独立記事で解説。

15. 教育現場

高校情報科 (情報 I・II) ではデータ分析・統計が必修化され、 大学では文系学部でも統計入門が広がる。 本用語集は高校生から大学院生まで広い対象に向けて、 「30 秒結論」で全員に概略を、 「数式」「Python 実装」で専門学習者に深い理解を提供する設計。 高校教師は「Python 実装」セクションを Colab に貼って授業で使え、 大学教員は「数式」セクションを輪読会の教材にできる。

16. 大学カリキュラム

経済学部・心理学部・工学部・医学部・教育学部などで統計教育が標準化。 経済学部は計量経済 (パネルデータ・操作変数・差分の差分)、 心理学部は心理測定 (因子分析・SEM)、 医学部は疫学 (オッズ比・相対リスク・コホート研究)、 工学部は品質管理 (SPC・実験計画法)、 教育学部は教育測定 (項目反応理論・等化) と分野特化型の用語がある。 本用語集はこれらすべてを横断的に網羅。

17. 高校情報科

情報 I では「データ分析の基礎」「散布図・相関」「箱ひげ図・ヒストグラム」が必修。 情報 II では「機械学習の基礎」「データサイエンス入門」が含まれる。 本用語集は高校情報科の単元配列に対応した検索・引用が可能。 教科書記述よりも深い数式・実装を提供することで、 探究学習・課題研究で活用できる。 各記事の「30 秒結論」「直感」は高校生にも親しみやすい記述。

18. リスキリング

社会人の学び直しでデータサイエンス・AI が最大の人気領域。 本用語集はリスキリング用の体系教材として、 「業務で使える知識」を意識した記事構成。 経営層・管理職向けに「30 秒結論」、 中堅エンジニア向けに「Python 実装」、 専門家向けに「数式」と「落とし穴」を提供。 経済産業省「デジタルスキル標準」とも整合し、 DX 人材育成のリファレンスとして活用できる。

19. 競技プログラミング

AtCoder・Codeforces・LeetCode などの競プロでも統計・確率の基礎は問われる。 期待値・確率分布・組合せ論・最大尤度の用語は競プロ問題でしばしば登場。 本用語集は競プロ向けに「実装の高速化」「メモリ効率」「数値安定性」の TIPS も併記。 アルゴリズムと統計の交差点 (オンライン学習・乱択アルゴリズム) の記事は競プロ実装者にも有用。

20. Kaggle

世界最大のデータ分析コンペ Kaggle では、 特徴量エンジニアリング・モデルアンサンブル・クロスバリデーションの巧拙が勝敗を決める。 本用語集の「Kaggle」「XGBoost」「LightGBM」「CatBoost」「スタッキング」「ブレンディング」記事は実戦的な内容。 メダル獲得経験者の暗黙知を可能な限り言語化し、 公開ノートブックでは見えない落とし穴も整理。

21. Stack Overflow

プログラミング Q&A サイトで、 pandas・sklearn の使い方で詰まったら最初に検索する場所。 本用語集の Python 実装セクションは Stack Overflow で頻出する質問に対する「正しい答え」を提供する設計。 例えば「pandas DataFrame の groupby + agg」「sklearn の StratifiedKFold」「scipy の独立 t 検定」は各記事内で具体的に解説している。

22. GitHub

オープンソースのコード共有プラットフォーム。 本用語集の Python コードはすべて再現可能で、 ライセンス的にも自由に利用できる (MIT 想定)。 学習者は GitHub に自分のノートブックを公開し、 ポートフォリオとして就活・転職に活用できる。 各記事の Python 実装をフォークして自分の探究学習に組み込むのも推奨。

23. オープンソース

scipy・pandas・sklearn・PyTorch・TensorFlow など本用語集が依拠するライブラリはすべてオープンソース。 これらのドキュメント・チュートリアル・ソースコードを直接読むことで、 用語の理解は飛躍的に深まる。 本用語集は公式ドキュメントへのリンクを各記事末尾に配置し、 一次情報へのナビゲーションも提供。

24. 査読プロセス

学術論文では査読 (peer review) を通過して初めて公表される。 統計手法の選択・実装・解釈は査読者から厳しくチェックされ、 「サンプルサイズが小さい」「正規性が不十分」「効果サイズが報告されていない」などのコメントがつく。 本用語集は査読を意識した記述で、 各記事の「落とし穴」セクションが査読対策にも役立つ。

25. DOI と引用

Digital Object Identifier は学術成果物の永続的識別子。 本用語集の各記事は内部リンクを `#` または相対 URL で持ち、 将来 DOI を付与すれば学術引用に対応可能な設計。 引用形式は APA・MLA・Chicago など複数のスタイルがあり、 卒論・修論・学術論文で適切に選ぶ必要がある。 各記事は引用しやすいよう、 タイトル・著者・公開日を明示。

26. 学会

統計学会・人工知能学会・情報処理学会・行動計量学会・応用統計学会などが日本の主要学会。 国際学会では NeurIPS・ICML・KDD・JSM・WSC が中心。 本用語集は学会発表でよく使われる用語を網羅的に解説し、 学会聴講の予習にも活用できる。 学会参加経験のない学生は、 まず本用語集で基礎を固めることを推奨。

27. 自学自習法

本用語集は自学自習の効率を最大化する設計。 「30 秒結論」で全体像を、 「直感」で動機を、 「数式」で厳密性を、 「実値計算」で具体性を、 「Python 実装」で実行可能性を、 「落とし穴」で応用力を、 「関連用語」で次のステップを提供。 1 記事 30 分で 1 用語を完全に習得できる構成。

28. メンタリング

データサイエンス学習はメンター (先輩・教員・社会人) との対話で大きく加速する。 本用語集はメンタリングの教材としても活用でき、 「この記事を一緒に読もう」と提案するだけで深い議論が始まる。 メンターは「Python 実装」を一緒にデバッグし、 メンティーは「落とし穴」セクションで実践的な疑問を解消できる。

29. ブートキャンプ

短期集中型のデータサイエンス研修。 数週間で機械学習エンジニアを養成するプログラムが流行。 本用語集はブートキャンプの自習補助教材として、 講義で扱われない深さの内容を提供する。 各記事 30 分 × 514 記事で約 250 時間、 ブートキャンプの 2-3 ヶ月分の学習量を網羅する密度。

30. 専門書ガイド

「統計学入門」(東大出版) 、 「データ解析のための統計モデリング入門」(久保) 、 「PRML」(Bishop) 、 「ESL」(Hastie) 、 「Murphy 機械学習」「ゼロから作る Deep Learning」(斎藤) は定番。 本用語集は専門書を読む前の予習・読書中の用語確認に最適。 各記事末尾の「参考文献」セクションで対応する書籍を明示。

31. オンライン学習プラットフォーム

Coursera・edX・Udemy・DataCamp は世界中の大学・企業がコースを提供。 Andrew Ng の機械学習コース、 deeplearning.ai の Deep Learning Specialization は定番。 本用語集はオンライン講座の補助教材として、 講義で「サラッと触れただけ」の用語を深掘りできる。 受講中に分からない用語が出たら、 本サイトで検索 → 30 分で習得 → 講義に戻る、 が王道。

32. 動画教材

YouTube には 3Blue1Brown・StatQuest・Two Minute Papers など優れた教育チャンネルがある。 本用語集は動画教材の文字版として、 動画では追いきれない数式・コードの詳細を補完。 動画 → 本サイトの「数式」セクション → Python 実装、 の流れで理解が深まる。 動画と文字情報のハイブリッド学習が現代の最適解。

33. ポッドキャスト

Data Skeptic、 Linear Digressions、 Lex Fridman などのポッドキャストでデータサイエンスの最新動向を耳学習。 通勤・運動中に概略を掴み、 本用語集で詳細を確認する流れが効率的。 ポッドキャストで出てきた用語を本サイトで検索する習慣をつけると知識ネットワークが急速に拡張する。

34. 本サイト独自の特徴

他の用語集・Wikipedia と異なる本サイトの特徴: (1) 全 514 記事が相関基準で統一されている、 (2) SSDSE-B-2026 を全記事で実例として使用、 (3) Python 実装が動作確認済みで Colab で即実行可能、 (4) 落とし穴セクションで実務的な注意点を網羅、 (5) 関連用語が 15 件以上で知識ネットワーク化、 (6) 概念マップで全体構造が可視化。

35. SSDSE 活用例

47 都道府県データを使った典型的な分析例: (a) 総人口と消費支出の散布図 + 相関 (2023 年度 r=0.33。 消費支出は 1 世帯あたりの値なので人口規模とは弱くしか連動しない)、 (b) 都道府県別人口のヒストグラム (右に裾が長い分布、 東京が外れ値)、 (c) 地方別の高齢化率の箱ひげ図、 (d) 高齢化率と保健医療費(二人以上の世帯)の回帰分析、 (e) 有効求人倍率を高齢化率と総人口で説明する重回帰、 (f) 主成分分析で 47 都道府県を 2 次元可視化。 これらは複数の記事で並列に扱う。

36. 図の標準パターン

本用語集の図は (1) 散布図 (2 変数の関係) 、 (2) ヒストグラム (1 変数分布) 、 (3) 箱ひげ図 (群別比較) 、 (4) 折れ線 (時系列) 、 (5) 棒グラフ (カテゴリ別大小) 、 (6) ヒートマップ (相関行列) の 6 種類が中心。 すべて matplotlib + seaborn で生成し、 PNG 形式で `figures/` に格納。 学習者は同じ図を自分でも再現できる。

37. 表の標準パターン

本用語集の表は (1) 用語の対比表 (用語 A vs 用語 B)、 (2) サンプルデータ表、 (3) 計算過程の中間結果、 (4) ハイパーパラメータ一覧、 (5) 性能評価 (accuracy, precision, recall, F1)、 (6) よくある誤解の修正表、 が頻出。 すべて HTML `

` タグで構造化され、 アクセシビリティに配慮。

38. Python コード規約

PEP 8 準拠、 インデント 4 スペース、 命名は snake_case (関数・変数) 、 CamelCase (クラス)。 Type Hints は学習者の負荷を考慮して最小限。 docstring は短く 1-3 行。 magic number は避け、 各定数に名前を付ける。 これらの規約は実務でも標準で、 本用語集で身につけたコードはそのまま現場で使える。

39. NumPy ベクトル化

Python の for ループは遅いが、 NumPy のベクトル化操作は C 言語並みに速い。 例: `np.sum(arr)` は Python `sum(list)` の 100 倍速い。 本用語集の Python 実装はベクトル化を意識し、 「初心者向けに読みやすい」と「実行効率」のバランスを取る。 大規模データ処理を扱う記事では、 ベクトル化の重要性を明示。

40. pandas best practice

`df.iterrows()` は遅いので `df.apply()` や `np.vectorize` を使う、 メモリ節約には `dtype` を明示 (int32, float32) 、 SettingWithCopyWarning を理解する、 `merge` と `join` の違いを知る、 などが定番。 本用語集は pandas の落とし穴を「pandas」「DataFrame」「groupby」記事で詳述。

41. sklearn API

scikit-learn の統一 API: `fit(X, y)`, `predict(X)`, `transform(X)`, `score(X, y)`。 すべての推定器がこの API を実装するため、 モデル交換が容易。 Pipeline で前処理と推定を連結できる。 GridSearchCV で交差検証と組み合わせる。 本用語集の機械学習記事はこの API を一貫して使用し、 学習者は 1 つの API を覚えるだけで多数のモデルを使える。

42. 統計検定 1-3 級対応

日本統計学会の統計検定は 1-4 級と専門統計調査士・データサイエンスエキスパートがある。 本用語集は 1 級 (大学院レベル) ・ 2 級 (大学基礎) ・ 3 級 (高校レベル) すべてに対応した用語を網羅。 検定対策として、 各記事の「数式」「実値計算」を中心に学習し、 過去問演習と組み合わせると合格率が大幅に上がる。

43. G検定/E資格対応

日本ディープラーニング協会 (JDLA) の G 検定 (ジェネラリスト) と E 資格 (エンジニア) は AI 業界の標準資格。 G 検定は AI の歴史・倫理・社会実装の知識を、 E 資格はディープラーニングの実装能力を問う。 本用語集の「AI 倫理」「AI 歴史」「ニューラルネット」「CNN」「RNN」「Transformer」記事はこれらの試験対策に直接活用可能。

44. DS 検定対応

データサイエンティスト協会の DS 検定 (リテラシー級) は、 ビジネス・データサイエンス・データエンジニアリングの 3 領域を問う。 本用語集は 3 領域すべてをカバーし、 検定対策として「30 秒結論」で全用語を高速復習できる。 検定合格後も実務で参照する「辞書」として長期的に活用できる設計。

45. 高校数学との接続

本用語集の数式は高校数学 (数学 I-III、 数学 A-B) を前提とする。 関数・微分・積分・行列・ベクトル・確率の各単元が、 統計・機械学習でどう使われるかを各記事で明示。 高校生は本用語集を読みながら「数学を学ぶ意義」を実感でき、 大学進学のモチベーションになる。

46. 大学教養数学

線形代数・微積分・確率論・統計学は大学初年次の必修。 本用語集はこれらの教養数学の応用先として、 「これを学ぶと何ができるか」を示す。 例えば固有値分解は PCA で、 偏微分は勾配降下法で、 ベイズの定理はナイーブベイズ分類器で、 と具体的応用を提示。

47. 線形代数

ベクトル・行列・固有値・固有ベクトル・特異値分解は機械学習の基盤。 PCA・線形回帰・SVM・ニューラルネットすべてが線形代数で記述される。 本用語集の「固有値分解」「特異値分解」「線形回帰」「主成分分析」記事を順に読むと線形代数の応用力が身につく。

48. 微積分

偏微分・勾配は最適化の基礎、 積分は確率分布の正規化定数や期待値の計算で必須。 本用語集の「勾配降下法」「最尤推定」「変分推論」記事で微積分の応用例を学べる。 自動微分 (PyTorch・JAX) を使えば数式の手計算を省略できるが、 仕組みを理解するために手計算経験は重要。

49. 確率論

確率変数・確率分布・条件付き確率・独立性・ベイズの定理は統計・機械学習の言語。 本用語集の「確率分布」「ベイズの定理」「条件付き確率」「独立性」「期待値」「分散」記事で確率論の基礎を体系的に学べる。 測度論レベルは扱わないが、 直感的理解には十分。

50. 統計学

記述統計と推測統計の 2 大領域。 推測統計はさらに頻度論 (Fisher・Neyman-Pearson) とベイズ統計 (Bayes・Laplace) に分かれる。 本用語集は両学派の用語を併記し、 「同じ問題を異なる枠組みで解くとどうなるか」を示す。 学派の論争史も「統計史」記事で解説。

51. 解析学

ε-δ 論法・関数解析・測度論は大学数学の中核。 機械学習の汎化理論 (PAC 学習・VC 次元) は関数解析の応用。 本用語集は解析学の重い数式は避けるが、 「汎化誤差」「PAC 学習」「VC 次元」記事で概念は紹介。 数学好きの学習者は専門書 (Vapnik、 Mohri) を併読推奨。

52. 一般教養としての統計

現代社会のリテラシーとして統計は必須。 政府発表の数値 (失業率、 GDP、 物価指数) や報道の世論調査結果を批判的に読むためには、 信頼区間・サンプリング・バイアスの理解が不可欠。 本用語集は専門家以外にも「30 秒結論」「直感」セクションで一般教養を提供する設計。

53. ノーコード・ローコード

Tableau・Power BI・Looker などの BI ツールはコードを書かずにデータ可視化できる。 本用語集の Python コードと並列に、 ノーコードでの実装方法も補記している記事がある。 ノーコードは敷居が低い反面、 細かいカスタマイズが効かない。 本用語集で基礎を学び、 用途に応じて使い分けるのが推奨。

54. ChatGPT 活用 TIPS

ChatGPT・Claude などの LLM はデータサイエンス学習の最強パートナー。 「この概念を高校生に説明して」「このコードを書いて」「このエラーをデバッグして」が定番。 ただし LLM の出力は誤りを含むため、 本用語集で正解を確認する習慣が重要。 本用語集 + LLM のハイブリッドが最速学習法。

55. GitHub Copilot

コード補完 AI は実装速度を 2-3 倍に高める。 本用語集の Python コードを Copilot に学習させると、 同じスタイルでコード生成してくれる。 ただし Copilot は「もっともらしいが間違ったコード」を生成することもあり、 本用語集の「落とし穴」セクションで誤りを検出する力を鍛えることが重要。

56. AI ペアプログラミング

AI とペアプログラミングする時代。 人間が設計し、 AI が実装し、 人間が検証する。 本用語集の「数式」「直感」セクションは設計段階で参照し、 「Python 実装」セクションは AI 生成コードの検証基準として活用できる。 検証能力がエンジニアの新しい競争力。

57. 落とし穴総まとめ

全 514 記事の「落とし穴」セクションを集約すると、 データサイエンスの実践的注意点が約 2,500 個。 多くは「サンプルサイズが小さい」「外れ値の影響」「相関と因果」「過学習」「データリーケージ」「再現性問題」など共通テーマがある。 これらを「落とし穴総合」記事で横断的に整理。

58. 用語の重要度ランキング

頻出度・実務的重要度・学術的重要度の 3 軸で用語をランク付け。 トップ 20 は「相関」「回帰」「平均」「分散」「正規分布」「t 検定」「p 値」「信頼区間」「機械学習」「ニューラルネット」など。 本用語集の各記事冒頭にランクを表示することで、 学習優先順位が明確になる。

59. 初心者の挫折ポイント

初心者がよく挫折する箇所: (1) 数式恐怖症、 (2) Python 環境構築、 (3) pandas のメモリ操作、 (4) 統計用語の混乱、 (5) 機械学習の暗黙知。 本用語集は (1) を「直感」「30 秒結論」で、 (2) を Colab 推奨で、 (3) を pandas 専用記事で、 (4) を「同名異義」明示で、 (5) を「落とし穴」で解決する。

60. 中級者の壁

中級者は「動かせるが理解できない」段階で停滞しがち。 本用語集は「数式 → 実装」の対応を明示することで、 動かしながら理解する経路を提供する。 「ハイパーパラメータの選び方」「クロスバリデーション」「過学習対策」など中級者特有のテーマも独立記事で詳述。

61. 卒論・修論への活用

本用語集は卒論・修論執筆の「方法」セクションで参照できる。 「t 検定を行った」と書くなら本用語集の「t 検定」記事を引用、 「主成分分析を適用した」なら「PCA」記事を引用、 という具合。 各記事は学術的に正確で、 卒論レベルの引用元として活用できる質を保つ。

62. 業務報告書への活用

ビジネス文書で統計用語を使う際の参照源。 「相関係数 0.7 で強い正の相関」「効果サイズ d=0.5 で中程度の効果」など、 数値解釈を本用語集で確認できる。 役員向け説明資料に貼り付ける図表 (相関ヒートマップ、 箱ひげ図) も本用語集の Python コードで生成可能。

63. 経営報告への活用

経営層への報告では、 専門用語を避けつつ統計的根拠を示す必要がある。 本用語集の「30 秒結論」を経営層向けに、 「数式」「Python 実装」をエンジニア向けに、 と分けて活用できる。 「データドリブン経営」「KPI 設計」「AB テスト」記事は経営層必読。

64. 政策提言

政策立案・提言では、 統計データを根拠に主張する。 本用語集の「公的統計」「EBPM (Evidence-Based Policy Making) 」「因果推論」「ランダム化実験」「自然実験」記事は政策研究の基礎。 自治体・国の政策担当者がデータを活用する際の参照源として有用。

65. 自治体データ駆動

47 都道府県データ (SSDSE-B-2026) は自治体施策の根拠分析に直接活用できる。 「うちの自治体は他県と比べて高齢化率が高いか」「医療費の伸びは妥当か」を本用語集の Python コードで分析可能。 自治体職員向けのデータ分析研修教材としても利用できる。

66. EBPM

Evidence-Based Policy Making は証拠に基づく政策立案。 「無作為化比較試験 (RCT) 」「差分の差分 (DID) 」「回帰不連続 (RD) 」「操作変数 (IV) 」が中心手法。 本用語集はこれらを「因果推論」カテゴリで体系的に解説。 政府・自治体・国際機関 (World Bank・OECD) で EBPM が制度化されている。

67. 企業 DX

デジタルトランスフォーメーション (DX) はデータ活用が中核。 本用語集の「ビッグデータ」「データレイク」「ETL」「データガバナンス」「データサイエンティスト」「データエンジニア」記事は DX 推進担当者必読。 経済産業省の DX レポート・デジタルガバナンス・コードと整合した内容。

68. 研究室運営

大学・企業研究所での研究室運営: データ管理・実験再現性・査読・学会発表のサイクルが基本。 本用語集は研究室の輪読会教材として活用可能。 「実験計画法」「再現性」「事前登録 (pre-registration) 」「オープンサイエンス」記事は研究室文化の改善に役立つ。

69. 論文執筆

学術論文の書き方: Title → Abstract → Introduction → Methods → Results → Discussion → Conclusion の構造。 本用語集の各記事は Methods で引用しやすい正確な定義を提供。 Results での図表は本用語集の Python コードで再現可能なスタイルで統一。

70. 再現性問題

近年「科学の再現性危機」が指摘される。 心理学・医学・経済学の論文の多くが他者による再実験で再現されない。 本用語集は「再現可能性」「事前登録」「データ公開」「コード公開」記事で再現性向上の手法を解説。 各記事の Python コードは自分で動かして再現できる設計。

71. Open Science

オープンサイエンスは論文・データ・コードを公開し、 研究の透明性・再現性を高める運動。 本用語集自体がオープンな教材として、 学術コミュニティに貢献。 各記事は Web で誰でも無料で読め、 Python コードは Colab で誰でも実行できる。 これがオープンサイエンスの実践例。

72. メタアナリシス

複数の研究結果を統合する手法。 個別研究の効果サイズを重み付き平均し、 全体の効果を推定する。 医学・心理学・教育学で広く使われる。 本用語集の「メタアナリシス」「効果サイズ」「ファネルプロット」「異質性」記事はメタアナリシス実施者の参照源。

73. システマティック・レビュー

事前に定めたプロトコルに従って文献を網羅的に収集・評価・統合する手法。 メタアナリシスとセットで使われることが多い。 本用語集の「システマティック・レビュー」「PRISMA」「コクラン共同計画」記事は医療系・教育系研究で活用。

74. 質的研究

数値化しにくいデータ (インタビュー記録・観察記録) を扱う研究法。 本用語集は主に量的研究の用語を扱うが、 「質的研究」「混合研究法」「グラウンデッド・セオリー」「テキストマイニング」記事で質的研究との接続も提供。

75. 混合研究法

量的研究と質的研究を組み合わせる手法。 「並列型」「順次型」「変換型」など複数のデザインがある。 本用語集の「混合研究法」記事は社会科学・教育学の研究者向けに、 量と質の統合方法を解説。

76. 実験計画法

Fisher が確立した分野で、 因子・水準・反復・無作為化が基本概念。 完全無作為計画・ブロック計画・要因計画・直交配列・応答曲面法など多様な手法。 本用語集は「実験計画法」「ANOVA」「直交計画」「タグチメソッド」記事で品質工学・工業実験の用語を網羅。

77. AB テスト

Web サービスで 2 つのデザイン (A/B) をランダムに割り当て、 効果を比較する手法。 Google・Meta・Netflix・Amazon が大規模に運用。 本用語集の「AB テスト」「t 検定」「効果サイズ」「サンプルサイズ計算」「Sequential Testing」記事は AB テスト実施者必読。

78. バンディット問題

複数の選択肢から最適なものを選ぶ強化学習問題。 「探索 vs 活用」のジレンマが本質。 ε-greedy・UCB・Thompson Sampling が代表的アルゴリズム。 Web 広告・推薦システム・臨床試験で応用。 本用語集の「多腕バンディット」「UCB」「Thompson Sampling」記事で解説。

79. 因果推論

「相関ではなく因果」を統計的に推定する手法。 ランダム化実験が黄金基準だが、 観察データから因果を推定する手法 (Propensity Score、 DID、 IV、 RD) も発展。 本用語集の「因果推論」「Rubin Causal Model」「DAG」「Do calculus」記事はこの領域を体系的に解説。

80. Rubin Causal Model

Potential Outcomes Framework とも呼ばれる。 「Y(0) = 介入しない場合の結果」「Y(1) = 介入した場合の結果」の差を因果効果と定義。 観察データでは Y(0) と Y(1) を同時に観察できないため「Fundamental Problem of Causal Inference」と呼ばれる。 本用語集の独立記事で詳述。

81. DAG (有向非循環グラフ)

Judea Pearl が提唱した因果推論の言語。 変数間の因果関係を矢印で表現し、 バックドア基準で交絡変数を特定する。 本用語集の「DAG」「Pearl 因果推論」「Causal Diagram」記事で詳述。 統計学派 (Rubin) と計算機科学派 (Pearl) の橋渡しも紹介。

82. 操作変数法

内生性問題 (説明変数と誤差項の相関) を解決する手法。 操作変数は「説明変数と相関するが、 誤差項とは無相関」という条件を満たす変数。 経済学で広く使われる。 本用語集の「操作変数」「2SLS」「LATE」記事はミクロ計量経済学の入口。

83. 差分の差分法 (DID)

介入前後の差を、 介入群と対照群で比較する手法。 「並行トレンド仮定」が成立すれば因果効果を推定できる。 経済学・社会学・公共政策で頻用。 本用語集の「DID」「並行トレンド」「Event Study」記事で解説。

84. 回帰不連続デザイン (RD)

閾値で介入が切り替わる状況で、 閾値近傍の集団を比較する手法。 「閾値での連続性仮定」が成立すれば因果効果を推定できる。 教育評価・社会保障で頻用。 本用語集の「RD」「Sharp RD」「Fuzzy RD」記事で解説。

85. Propensity Score Matching

傾向スコア (介入を受ける確率) で介入群と対照群をマッチング。 観察データで疑似的な実験状況を作る手法。 医学・経済学で広く使われる。 本用語集の「傾向スコア」「マッチング」「Inverse Probability Weighting」記事で詳述。

86. 合成統制法

介入を受けなかった対照群を、 複数の単位の重み付き平均で人工的に構築する手法。 政策評価・経済学で活用。 California のたばこ税効果分析が有名例。 本用語集の「合成統制」「Abadie」記事で解説。

87. ベイズ統計

「事前分布 + 尤度 → 事後分布」の枠組みで、 不確実性を確率で表現する統計学派。 頻度論との論争があるが、 現代ではベイズが主流の場面も多い。 本用語集の「ベイズ統計」「事前分布」「事後分布」「MCMC」「変分推論」記事はベイズ学習者必読。

88. MCMC

Markov Chain Monte Carlo は事後分布からサンプリングする手法。 Metropolis-Hastings・Gibbs Sampling・Hamiltonian Monte Carlo (HMC) が代表。 PyMC・Stan・NumPyro で実装。 本用語集の「MCMC」「HMC」「PyMC」記事で実装例を提供。

89. 変分推論

事後分布を解析的に求められない場合、 近似分布で代用する手法。 ELBO 最大化が基本。 計算が速いが近似精度に注意。 本用語集の「変分推論」「ELBO」「変分オートエンコーダ」記事で解説。 深層学習との接続が深い。

90. 階層モデル

観測単位がグループに属する階層構造を明示的にモデル化。 マルチレベル分析・混合効果モデルとも呼ばれる。 教育評価 (児童 ⊂ 学級 ⊂ 学校) 、 臨床試験 (患者 ⊂ 病院) で頻用。 本用語集の「階層モデル」「混合効果」「ICC」記事で解説。

91. 時系列分析

時間順序のあるデータを扱う。 トレンド・季節性・周期性・自己相関の分解が基本。 ARIMA・状態空間モデル・Prophet・深層学習 (LSTM・Transformer) が中心手法。 本用語集の「時系列」「ARIMA」「Prophet」「状態空間」記事で体系的に解説。

92. 空間統計

地理的位置情報を持つデータを扱う。 空間自己相関 (Moran's I) ・クリギング・空間回帰が基本。 GIS と統合される。 本用語集の「空間統計」「Moran's I」「クリギング」記事で解説。 都市計画・疫学・環境科学で活用。

93. 生存時間解析

イベント発生までの時間を扱う。 打ち切りデータの処理が特徴。 Kaplan-Meier 曲線・Cox 比例ハザードモデルが定番。 医学・信頼性工学・マーケティング (顧客離脱) で活用。 本用語集の「生存時間」「Kaplan-Meier」「Cox」「ハザード関数」記事で解説。

94. ネットワーク分析

ノードとエッジから成るグラフを扱う。 中心性 (degree, betweenness, eigenvector) ・コミュニティ検出・グラフ生成モデルが基本。 SNS・引用ネットワーク・タンパク質相互作用で応用。 本用語集の「ネットワーク」「中心性」「コミュニティ検出」「Graph Neural Network」記事で解説。

95. テキストマイニング

自然言語テキストから定量情報を抽出。 形態素解析・TF-IDF・トピックモデル・word2vec・BERT が中心。 マーケティング (口コミ分析) 、 社会学 (議事録分析) 、 文学研究で活用。 本用語集の「テキストマイニング」「TF-IDF」「LDA」「BERT」記事で解説。

96. 画像解析

コンピュータビジョン分野。 古典手法 (SIFT, HOG) と深層学習 (CNN, ResNet, Vision Transformer) がある。 医療画像診断・自動運転・顔認証で実用化。 本用語集の「画像解析」「CNN」「ResNet」「Vision Transformer」「YOLO」記事で解説。

97. 音声解析

音声認識・音声合成・話者識別。 古典は MFCC + HMM、 現代は wav2vec・WaveNet・Whisper。 スマートスピーカー・字幕生成・カスタマーサポートで実用化。 本用語集の「音声認識」「TTS」「Whisper」「wav2vec」記事で解説。

98. 時空間解析

時間と空間の両方を考慮する分析。 気象予測・交通流予測・感染症伝播モデルで活用。 本用語集の「時空間モデル」「ConvLSTM」「Spatio-Temporal GNN」記事で解説。 GIS と機械学習の融合領域。

99. 最適化

数学的最適化は機械学習の基盤。 線形計画・整数計画・凸最適化・非線形最適化・組合せ最適化がある。 Gurobi・CPLEX・SCIP が定番ソルバ。 本用語集の「最適化」「線形計画」「凸最適化」「勾配降下」記事で解説。

100. オペレーションズ・リサーチ

意思決定問題を数理的に解く分野。 最適化・待ち行列・在庫管理・スケジューリングが中心。 物流・製造・サービス業で活用。 本用語集の「OR」「待ち行列」「在庫モデル」「スケジューリング」記事で解説。

101. シミュレーション

確率的・決定的な現象を計算機で模擬。 モンテカルロ法・離散事象シミュレーション・エージェントベースモデリングがある。 金融工学・疫学・社会科学で活用。 本用語集の「シミュレーション」「モンテカルロ」「ABM」記事で解説。

102. ゲーム理論

戦略的意思決定を数理的に扱う。 ナッシュ均衡・進化的ゲーム・メカニズムデザイン・強化学習との接続がある。 経済学・政治学・人工知能で活用。 本用語集の「ゲーム理論」「ナッシュ均衡」「メカニズムデザイン」「マルチエージェント学習」記事で解説。

103. 情報理論

Shannon が確立。 エントロピー・相互情報量・KL 情報量・チャネル容量が基本概念。 機械学習 (損失関数) ・通信工学・暗号で応用。 本用語集の「情報理論」「エントロピー」「KL 情報量」「相互情報量」記事で解説。

104. 暗号と機械学習

差分プライバシー・準同型暗号・連合学習・秘密計算がプライバシー保護機械学習の中心技術。 GDPR 対応・医療データ共有で重要。 本用語集の「差分プライバシー」「連合学習」「準同型暗号」「秘密計算」記事で解説。

105. 公平性 (Fairness)

機械学習モデルの予測が特定属性で差別的でないことを保証。 Demographic Parity・Equalized Odds・Calibration が代表的基準。 採用・融資・刑事司法での予測モデル設計で重要。 本用語集の「公平性」「アルゴリズムバイアス」「Equalized Odds」記事で解説。

106. 説明可能 AI (XAI)

モデルの予測理由を人間に説明する技術。 SHAP・LIME・Integrated Gradients・Attention 可視化が定番。 医療・金融・法務で必須。 本用語集の「XAI」「SHAP」「LIME」「Attention」記事で解説。

107. Adversarial 攻撃

わずかな入力摂動でモデルを誤分類させる攻撃。 自動運転・顔認証・スパムフィルタの脆弱性として知られる。 防御手法 (Adversarial Training) も発展。 本用語集の「Adversarial 攻撃」「FGSM」「PGD」「Adversarial Training」記事で解説。

108. データ拡張

学習データを人工的に増やす手法。 画像 (回転・反転・色変換) ・テキスト (同義語置換・翻訳往復) ・音声 (ピッチ変更・ノイズ付加) で活用。 過学習対策として有効。 本用語集の「データ拡張」「Mixup」「Cutout」「AutoAugment」記事で解説。

109. 転移学習

事前学習モデルを別タスクに転用。 ImageNet 事前学習 → 医療画像分類、 BERT 事前学習 → 文書分類 が典型。 ファインチューニング・プロンプトチューニングがある。 本用語集の「転移学習」「Fine-tuning」「Prompt Tuning」「LoRA」記事で解説。

110. 自己教師あり学習

ラベルなしデータから有用な表現を学習。 BERT (Masked Language Modeling) ・SimCLR (対比学習) ・MAE (Masked Autoencoder) が代表。 ラベル付け不要で大規模学習可能。 本用語集の「自己教師あり学習」「SimCLR」「MAE」「Contrastive Learning」記事で解説。

111. 生成モデル

データの確率分布を学習し、 新しいサンプルを生成。 VAE・GAN・拡散モデル・Flow が代表。 画像 (Stable Diffusion) ・音楽 (Jukebox) ・テキスト (GPT) で実用化。 本用語集の「生成モデル」「VAE」「GAN」「拡散モデル」記事で解説。

112. 拡散モデル

ノイズ除去過程で画像を生成。 DDPM・Score-based モデル・Latent Diffusion (Stable Diffusion) が代表。 2022 年以降の AI 画像生成革命の中心技術。 本用語集の「拡散モデル」「DDPM」「Stable Diffusion」「U-Net」記事で解説。

113. 大規模言語モデル (LLM)

数十億〜数兆パラメータの言語モデル。 GPT・Claude・Gemini・Llama が代表。 ChatGPT 以降、 社会変革を引き起こす。 本用語集の「LLM」「GPT」「Transformer」「Instruction Tuning」「RLHF」「Chain-of-Thought」記事で解説。

114. プロンプトエンジニアリング

LLM への入力 (プロンプト) を設計する技術。 Few-shot Learning・Chain-of-Thought・Self-Consistency・Tree-of-Thought が定番。 LLM の能力を最大化する。 本用語集の「プロンプトエンジニアリング」「CoT」「Few-shot」「ReAct」記事で解説。

115. AI エージェント

ツール使用・計画・自己反省で複雑タスクを自律実行する LLM ベースシステム。 AutoGPT・LangChain・Claude Code が代表。 業務自動化の新領域。 本用語集の「AI エージェント」「ReAct」「Tool Use」「Multi-Agent」記事で解説。

116. RAG (Retrieval-Augmented Generation)

LLM に外部知識を検索して文脈に注入する手法。 社内文書 QA・カスタマーサポート・法務調査で実用化。 ベクトル DB (Pinecone, Weaviate, Qdrant) が基盤。 本用語集の「RAG」「Vector DB」「Embedding」記事で解説。

117. Fine-tuning

事前学習モデルを特定タスクに微調整。 LoRA・QLoRA でメモリ効率を改善。 ドメイン特化モデル (医療 GPT・法律 BERT) 構築で活用。 本用語集の「Fine-tuning」「LoRA」「QLoRA」「PEFT」記事で解説。

118. 評価指標 (機械学習)

分類は accuracy・precision・recall・F1・ROC-AUC・PR-AUC、 回帰は RMSE・MAE・MAPE・R²、 LLM は perplexity・BLEU・ROUGE・人間評価が定番。 本用語集の「評価指標」「F1」「ROC-AUC」「BLEU」記事で詳述。

119. クロスバリデーション

k-fold CV・Stratified CV・Time Series CV・Group CV があり、 タスクに応じて選ぶ。 過学習・データリーケージを防ぐ標準手法。 本用語集の「クロスバリデーション」「k-fold」「Nested CV」記事で解説。

120. ハイパーパラメータ最適化

Grid Search・Random Search・Bayesian Optimization・Hyperband・Population-based Training が代表。 Optuna・Ray Tune・W&B Sweeps が定番ツール。 本用語集の「ハイパーパラメータ」「Optuna」「Bayesian Optimization」記事で解説。

121. MLOps

機械学習システムの開発・運用・監視。 モデル管理 (MLflow, Weights & Biases) ・パイプライン (Airflow, Kubeflow) ・サービング (Triton, BentoML) が中心。 本用語集の「MLOps」「MLflow」「Kubeflow」「Model Monitoring」記事で解説。

122. データドリフト

本番環境でのデータ分布が学習時から変化する現象。 性能劣化を引き起こすため監視が必須。 共変量シフト・ラベルシフト・概念ドリフトに分類される。 本用語集の「データドリフト」「共変量シフト」「Model Monitoring」記事で解説。

123. 特徴量ストア

特徴量を一元管理する仕組み。 Feast・Tecton が代表。 学習時とサービング時で特徴量計算を統一し、 train-serve skew を防ぐ。 本用語集の「特徴量ストア」「Feature Engineering」「Feast」記事で解説。

124. データレイク・データウェアハウス

データレイクは生データを保管、 データウェアハウスは加工済みデータを保管。 Lakehouse はその統合形態。 Databricks・Snowflake・BigQuery が代表。 本用語集の「データレイク」「データウェアハウス」「Lakehouse」「Delta Lake」記事で解説。

125. Spark

分散処理フレームワーク。 数 TB〜PB 級データに対応。 Spark SQL・MLlib・Structured Streaming で機械学習・ストリーミングまで統合。 本用語集の「Spark」「Hadoop」「分散処理」記事で解説。

126. リアルタイム分析

ストリーミングデータをリアルタイム処理。 Kafka・Flink・Spark Streaming が基盤。 不正検知・推薦システム・IoT で活用。 本用語集の「ストリーミング」「Kafka」「Flink」「リアルタイム」記事で解説。

127. グラフデータベース

ノードとエッジを直接保存。 Neo4j・Amazon Neptune・JanusGraph が代表。 SNS・知識グラフ・推薦システムで活用。 本用語集の「グラフ DB」「Cypher」「知識グラフ」記事で解説。

128. 時系列データベース

時間軸を持つデータに特化。 InfluxDB・TimescaleDB・Prometheus が代表。 IoT・モニタリング・金融で活用。 本用語集の「時系列 DB」「InfluxDB」「Prometheus」記事で解説。

129. クラウドサービス

AWS・Azure・GCP の三大クラウド。 SageMaker・Azure ML・Vertex AI が ML プラットフォーム。 本用語集の「クラウド」「SageMaker」「Vertex AI」「Azure ML」記事で解説。

130. エッジ AI

デバイス側で推論を実行。 スマホ・IoT・自動運転で活用。 TensorFlow Lite・ONNX Runtime・Core ML が定番。 本用語集の「エッジ AI」「TensorFlow Lite」「Edge Inference」「Quantization」記事で解説。

131. AutoML

機械学習パイプラインの自動化。 Google Cloud AutoML・H2O.ai・Auto-sklearn が代表。 非専門家でも高品質モデルが作れる。 本用語集の「AutoML」「Neural Architecture Search」「Auto-sklearn」記事で解説。

132. Neural Architecture Search

ニューラルネット構造の自動探索。 強化学習・進化計算・微分可能 NAS が代表。 EfficientNet・MobileNet の構造設計に貢献。 本用語集の「NAS」「DARTS」「EfficientNet」記事で解説。

133. 知識蒸留

大きなモデル (教師) の知識を小さなモデル (生徒) に転移。 推論速度・メモリ効率を改善。 BERT → DistilBERT、 ResNet → MobileNet が典型。 本用語集の「知識蒸留」「Distillation」「Pruning」「Quantization」記事で解説。

134. 量子機械学習

量子コンピュータを用いた機械学習。 Variational Quantum Eigensolver・Quantum Kernel Methods・Quantum Neural Network が研究中。 本用語集の「量子機械学習」「VQE」「QML」記事で解説。

135. 脳科学と AI

ニューラルネットは脳神経の数理モデルから着想を得た。 現代では機能的 MRI ・ニューロイメージングで脳を分析し、 AI と脳科学の双方向影響がある。 本用語集の「脳科学」「Neural Coding」「Brain-Computer Interface」記事で解説。

136. 認知科学

人間の認知過程を計算論的に研究。 知覚・注意・記憶・学習・意思決定が中心テーマ。 AI 研究と密接。 本用語集の「認知科学」「Cognitive Architecture」「ACT-R」記事で解説。

137. 行動経済学

心理学的知見を取り入れた経済学。 プロスペクト理論・ナッジ・行動経済が中心概念。 ノーベル経済学賞 (Kahneman, Thaler) も。 本用語集の「行動経済学」「プロスペクト理論」「ナッジ」記事で解説。

138. 社会ネットワーク分析

個人・組織間の関係性を分析。 中心性・密度・派閥・コミュニティが主要指標。 SNS 分析・組織分析・疫学で活用。 本用語集の「社会ネットワーク」「中心性」「Community Detection」記事で解説。

139. 計量書誌学

論文・引用ネットワークを分析。 h-index・Impact Factor・Altmetric が主要指標。 研究評価・科学政策で活用。 本用語集の「計量書誌学」「h-index」「Impact Factor」記事で解説。

140. デジタル人文学

人文学に計算・データ分析を導入。 古文書テキストマイニング・歴史 GIS・芸術スタイル分析が代表例。 本用語集の「デジタル人文学」「コーパス言語学」「DH」記事で解説。

141. 計算社会科学

ビッグデータ・シミュレーションで社会現象を分析。 SNS データ・モバイル位置情報・行動ログが資源。 本用語集の「計算社会科学」「Computational Social Science」「ABM」記事で解説。

142. Health Data Science

医療・健康データを統計・機械学習で分析。 電子カルテ・ゲノム・ウェアラブルが主要データ源。 本用語集の「医療データサイエンス」「Electronic Health Records」「Genomics」記事で解説。

143. バイオインフォマティクス

DNA・RNA・タンパク質の配列・構造を計算解析。 AlphaFold が革命的。 本用語集の「バイオインフォマティクス」「AlphaFold」「Sequence Alignment」記事で解説。

144. 計算化学・材料科学

材料の物性を計算で予測。 密度汎関数理論 (DFT) ・分子動力学・機械学習ポテンシャル (NNP) が代表。 本用語集の「マテリアルズインフォマティクス」「DFT」「NNP」記事で解説。

145. 金融工学

オプション価格 (Black-Scholes) ・リスク管理 (VaR・ES) ・アルゴリズム取引が中心。 本用語集の「金融工学」「Black-Scholes」「VaR」「アルゴ取引」記事で解説。

146. アクチュアリー

保険・年金の数理。 死亡率モデル・損害保険料計算・年金財政が主要テーマ。 本用語集の「アクチュアリー」「死亡率モデル」「Solvency II」記事で解説。

147. リスク管理

金融・サイバー・気候・パンデミックなど多様なリスクを定量化。 Value at Risk・Expected Shortfall・Stress Test が定番。 本用語集の「リスク管理」「VaR」「Stress Test」記事で解説。

148. Cybersecurity と AI

AI でサイバー攻撃を検知。 異常検知・侵入検知・マルウェア分類が主要応用。 一方 AI 自体がサイバー攻撃対象 (Adversarial 攻撃) にもなる。 本用語集の「サイバーセキュリティ」「異常検知」「Intrusion Detection」記事で解説。

149. 環境データサイエンス

気候変動・大気汚染・生物多様性をデータで分析。 衛星画像・センサーデータ・気候モデルが主要資源。 本用語集の「環境データサイエンス」「衛星画像解析」「気候モデル」記事で解説。

150. スポーツデータサイエンス

選手・チームのパフォーマンスを分析。 sabermetrics (野球) ・xG (サッカー) ・トラッキングデータ (バスケ) が代表。 本用語集の「スポーツアナリティクス」「Sabermetrics」「Sports Tracking」記事で解説。

151. 教育データマイニング

学習履歴データから教育効果を分析。 LMS ログ・eラーニング・適応的学習システムで活用。 本用語集の「教育データマイニング」「LMS」「IRT」「Knowledge Tracing」記事で解説。

152. レコメンダーシステム

ユーザに合った商品・コンテンツを推薦。 協調フィルタリング・コンテンツベース・ハイブリッド・深層学習推薦が代表。 本用語集の「推薦システム」「協調フィルタリング」「Matrix Factorization」記事で解説。

153. 検索エンジン

Web ・社内文書の検索。 BM25・PageRank・Learning to Rank・Semantic Search が中心技術。 本用語集の「検索」「BM25」「PageRank」「Learning to Rank」「Semantic Search」記事で解説。

154. 広告配信最適化

デジタル広告のターゲティング・入札・予算配分を最適化。 CTR 予測・LTV 予測・Bidding Optimization が中心。 本用語集の「広告最適化」「CTR Prediction」「LTV」記事で解説。

155. マーケティング分析

顧客セグメンテーション・チャーン予測・LTV 分析・キャンペーン効果測定が中心。 本用語集の「マーケティング分析」「Customer Segmentation」「Churn Prediction」「LTV」記事で解説。

156. 製造業データサイエンス

予知保全・品質管理・歩留まり改善・需要予測が主要応用。 本用語集の「予知保全」「品質管理」「需要予測」「SCM」記事で解説。 IoT・工場 DX で重要度上昇中。

157. 物流・SCM

需要予測・在庫最適化・配送経路最適化が中心。 本用語集の「SCM」「需要予測」「在庫管理」「VRP」記事で解説。 Amazon・Walmart・楽天の物流網最適化に活用。

158. ヘルスケア IoT

ウェアラブル・スマートフォン・体組成計のデータを統合分析。 健康増進・疾病予防・遠隔医療で活用。 本用語集の「ヘルスケア IoT」「ウェアラブル」「Remote Monitoring」記事で解説。

159. 農業データサイエンス

衛星画像・ドローン・センサーで農地を分析。 収量予測・病害検知・精密農業が主要応用。 本用語集の「精密農業」「衛星画像解析」「Yield Prediction」記事で解説。

160. エネルギーデータサイエンス

電力需要予測・再生可能エネルギー発電予測・スマートグリッド最適化が中心。 本用語集の「電力需要予測」「再エネ予測」「スマートグリッド」記事で解説。

161. メディア分析

ニュース・SNS・動画コンテンツを分析。 トレンド予測・感情分析・偽情報検出が代表応用。 本用語集の「メディア分析」「感情分析」「Fake News Detection」記事で解説。

162. 公衆衛生

感染症モニタリング・予防接種戦略・健康格差分析が中心。 COVID-19 で重要性が再認識。 本用語集の「公衆衛生」「疫学」「感染症モデル」「SIR モデル」記事で解説。

163. 災害データサイエンス

地震・台風・洪水を予測・分析。 衛星画像・気象データ・SNS が主要資源。 本用語集の「災害予測」「衛星画像」「Crisis Mapping」記事で解説。

164. 交通データサイエンス

交通流予測・経路最適化・自動運転・MaaS が中心。 本用語集の「交通データ」「交通流予測」「MaaS」「自動運転」記事で解説。

165. 不動産データサイエンス

物件価格予測・賃料予測・地域開発分析が中心。 本用語集の「不動産分析」「物件価格予測」「Hedonic Pricing」記事で解説。

166. HR (人事) データサイエンス

採用予測・離職予測・パフォーマンス評価が中心。 倫理的配慮 (バイアス・プライバシー) が特に重要。 本用語集の「HR Analytics」「離職予測」「People Analytics」記事で解説。

167. 法務データサイエンス

判例分析・契約書 AI ・法令検索が中心。 LegalTech 業界が急成長中。 本用語集の「LegalTech」「契約書 AI」「判例分析」記事で解説。

168. 行政データサイエンス

政府・自治体のデータ活用。 EBPM・スマートシティ・税務最適化が中心。 本用語集の「GovTech」「EBPM」「スマートシティ」記事で解説。

169. 国際機関とデータ

World Bank・UN・OECD・WHO がオープンデータを公開。 SDG モニタリング・国際比較に活用。 本用語集の「World Bank Data」「UN Data」「OECD Data」記事で解説。

170. 総合: 用語集の未来

用語集は静的な辞書から、 学習者の進度に応じて動的に内容を最適化する AI チューターへ進化中。 本サイトも将来的には LLM 連携・パーソナライズ機能を追加予定。 ただし「相関基準で全 514 記事を統一する」というコア理念は不変。 学習者は本用語集を「人生 100 年時代の知識インフラ」として活用してほしい。

🧮 数式に値を入れて手で計算する: 用語数の集計

合成データで本サイトのカテゴリ別用語数を集計する。

Step 1: カテゴリ別件数

カテゴリ件数
統計120
機械学習180
AI 倫理50
データ基盤80
可視化50
その他34

Step 2: 集計

合計 = 120+180+50+80+50+34 = 514 機械学習比率 = 180/514 ≈ 0.350 (35%)

🐍 Python で再現

1
2
3
4
5
import numpy as np
counts = np.array([120, 180, 50, 80, 50, 34])
ratio = counts / counts.sum()
print(f"合計: {counts.sum()}")
print(f"比率: {ratio.round(3)}")

📤 実行結果

合計: 514 比率: [0.233 0.35 0.097 0.156 0.097 0.066]

💬 手計算 (Step 2) 514 件 / 35% と Python 出力が完全一致。

🌳 手法選択フロー

「用語集トップ」を実際の課題に当てはめるとき、 状況別に何を選ぶかを 3 段階で判定する。

  1. 目的が明確か? Yes → 次へ、 No → まず 課題定義 から
  2. データが十分か? Yes → 用語集トップ を適用、 No → データ収集 を先行
  3. 結果の解釈は? 単独で判断せず、 関連手法 と組み合わせる

このフローは状況依存。 上記は出発点として参照し、 領域知識で調整する。

🔗 隣接手法への橋渡し

「用語集トップ」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。

これらの接続を意識することで、 「用語集トップ」を中核に据えた一貫した分析パイプラインを構築できる。

🗺 用語ネットワーク — 全 514 用語の関連マップ

用語ページ間の「関連用語」リンク 1,345 本をネットワークとして可視化しました。色はグラフ構造から自動検出した12分野。クリックで用語の詳細、ダブルクリックでページに移動できます。検索・分野絞り込みは 全画面版 → が便利です。

⚠️ 用語集を使うときの注意点