🔖 キーワード索引
「mode」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「mode」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「mode の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
一番人気の値のことです。
データのピークを知るために使います。
店で一番売れた商品を探すときなどです。
最頻値の定義と特徴について読みます。
- 定義:データで最も多く出現する値(最も頻度が高い値)
- 離散・カテゴリデータでは強い:「最も売れた商品」「最頻アイテム」など
- 連続データでは弱い:ビンの幅で変わるため、 KDE で補正
- 多峰性:最頻値が複数あれば集団が混ざっている可能性
- カテゴリ:記述統計
👁️ 直感 — 最頻値は「ピークの位置」
ヒストグラムを描いたとき、 最も高いバーに対応する値が最頻値です。 47都道府県の家計食料費(2023年・ SSDSE-B-2026)を例に見ます。
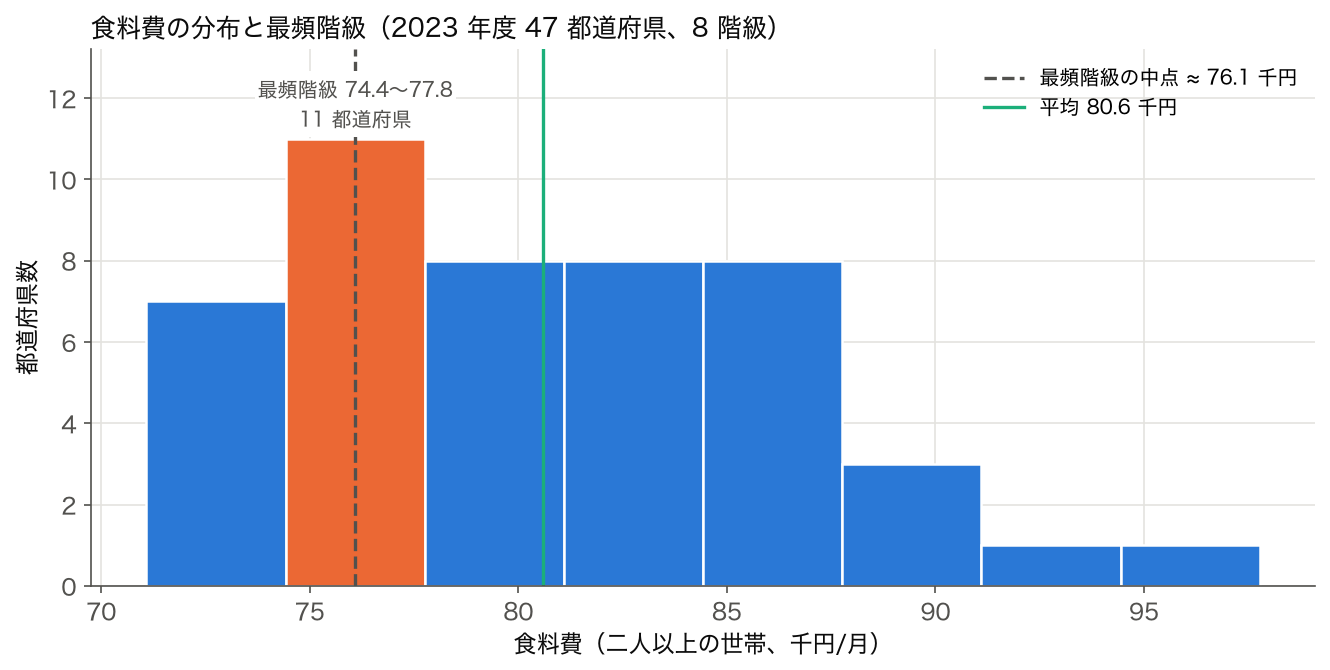
範囲(71.1〜97.8 千円)を 8 等分した階級のうち、 オレンジ色の階級(74.4〜77.8千円)が11都道府県(茨城・群馬・福井・岐阜・和歌山・島根・山口・徳島・香川・佐賀・長崎)を含み、 最も多い → これが最頻階級で、 中点は 76.1 千円。 平均 80.6 千円は右の裾(最大 97.8 千円)に引っ張られて、 最頻階級より右にある。 連続データではビンの設定によって変わるので、 中点を取って「最頻階級の代表値」とする慣習があります。
💡 平均は「重心」、 中央値は「順位の真ん中」、 そして最頻値は「分布のピーク」。 同じデータに対する3つの代表値はそれぞれ違う側面を見ています。
📍 あなたが今見ているもの
🍰 まずはやさしく
データの中で最も多く出る値です。
代表的な数値として使います。
都道府県のデータを分析するときに役立ちます。
定義から実装までを順番に読みます。
論文中に 「最頻値」として登場する用語。
最頻値 とは:データの中で最も頻繁に現れる値。 平均・中央値と並ぶ代表値の1つ。
本ページでは「mode」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「mode」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む — 最頻値 の本質
🍰 まずはやさしく
データの山の一番高いところです。
どんな値に集中しているか分かります。
スマホの利用時間の分布などで考えます。
道具としての使い方を直感的に読みます。
最頻値は「もっとも頻繁に現れる値」。 平均・中央値とは違って、 カテゴリーデータでも使える。 SSDSE-B-2026 の都道府県の合計特殊出生率(小数第 2 位まで)の最頻値は約 1.30 付近に集中。 一方、 ヒストグラムで山が 2 つ(東京圏:低い vs 九州・北陸:高い)あれば「双峰分布」で、 最頻値の解釈には注意が必要。
value_counts() してみてください。 順位 1 位の値(最頻値)と 2 位の差が小さいほど「ピークがブロード」、 差が大きいほど「ピークが鋭い」という解釈が体感できます。
📐 数式と読み方
🍰 まずはやさしく
確率が最大になる値のことです。
数式で正しく定義するために使います。
テストの点数の分布などで考えます。
数式や山の数による見分け方を読みます。
① 離散分布での最頻値
確率質量関数 p(x) について:
$$ \text{Mode} = \arg\max_{x} p(x) $$
読み方:「ピー オブ エックス を最大化する エックス」。 つまり「確率が最大になる値」。
② 連続分布での最頻値
確率密度関数 f(x) について:
$$ \text{Mode} = \arg\max_{x} f(x) $$
「密度関数のピーク(極大点)の位置」。 微分してゼロになる点(停留点)の中で最大値を取る点。
③ 代表値の3者関係(経験則)
歪んだ単峰分布で次の関係が成立することが多い(Pearson の経験式):
$$ \text{Mean} - \text{Mode} \approx 3 (\text{Mean} - \text{Median}) $$
これを使えば、 中央値と平均から最頻値を概算できます。
🔢 単峰性・ 二峰性 — 集団の混在を診断
最頻値の数(モード数)は、 データに何種類の集団が混ざっているかのヒント。
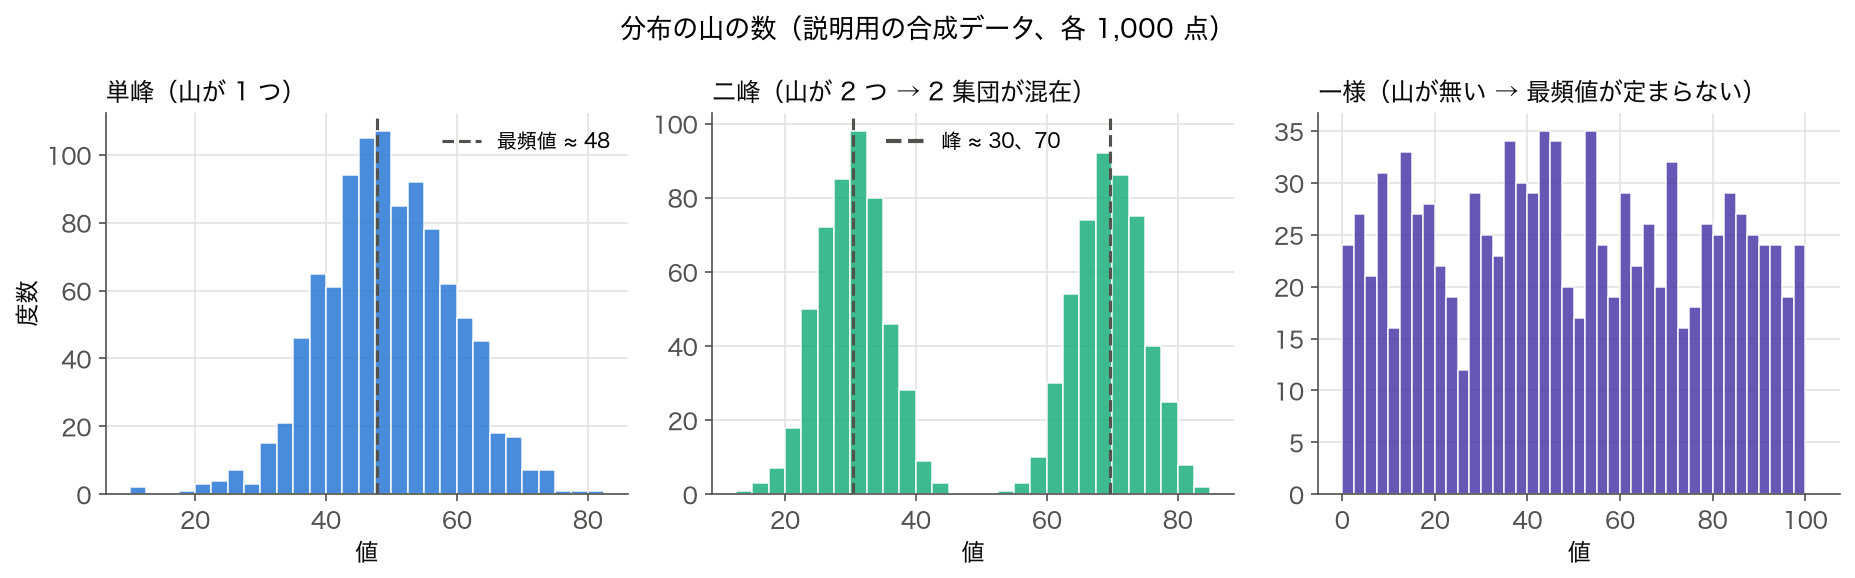
上の図は説明用の合成データ(SSDSE-B-2026 ではない。 seed 0 の乱数で、 単峰 = 平均 50・標準偏差 10 の正規乱数、 二峰 = 平均 30 と 70 の正規乱数を 500 点ずつ、 一様 = 0〜100 の一様乱数、 各 1,000 点)。 ガウス KDE のピークは単峰で 47.8(真の山の位置 50 から標本のぶれでずれる)、 二峰で 30.4 と 69.7 の 2 か所に出る。
分布の形状
- 単峰性 (unimodal):山が1つ。 ピンポイント1集団
- 二峰性 (bimodal):山が2つ → 2集団が混在している可能性(例:男女、 新旧モデル)
- 多峰性 (multimodal):山が3つ以上 → 複数集団
- 一様 (uniform):山がない → 最頻値が定まらない
二峰性を見つけたら、 「何が2集団に分けているのか」を探りましょう。 別変数で層別すると因果のヒントが見えます。
📊 3つの代表値の位置関係 — 分布の歪みを診断
平均・ 中央値・ 最頻値の並び方から、 分布の歪み(skewness)が分かります。
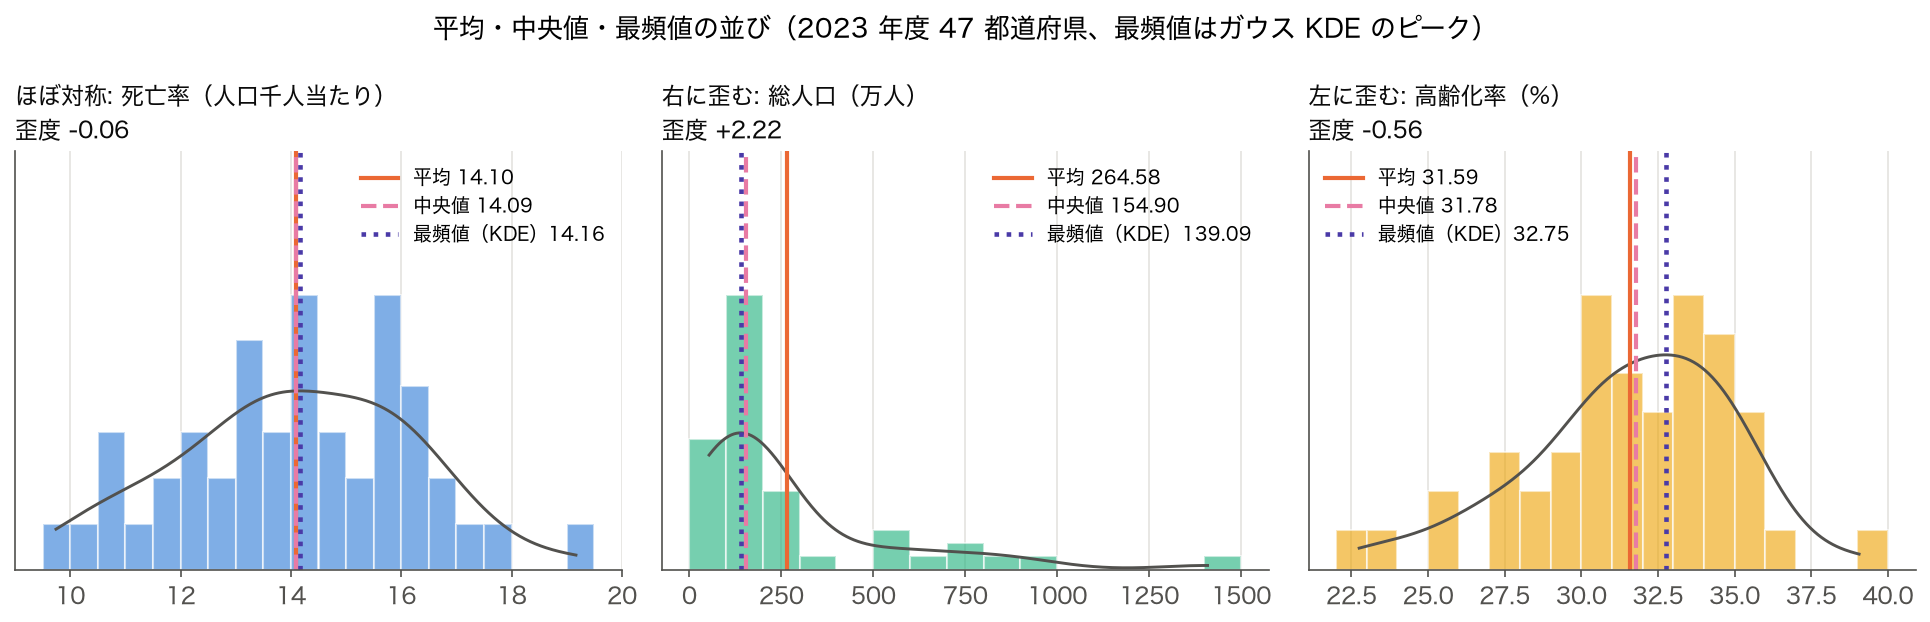
図は SSDSE-B-2026 の 2023 年度 47 都道府県の実データ(最頻値はガウス KDE のピーク)。 ほぼ対称な死亡率(人口千人当たり、 歪度 −0.06)は平均 14.10・中央値 14.09・最頻値 14.16 がほぼ重なる。 右に歪む総人口(歪度 +2.22)は最頻値 139 万人 < 中央値 155 万人 < 平均 265 万人、 左に歪む高齢化率(歪度 −0.56)は平均 31.59% < 中央値 31.78% < 最頻値 32.75% と、 下の表の並びになる。
| 分布の形 | 代表値の並び | 例 |
|---|---|---|
| 対称 | 平均 = 中央値 = 最頻値 | 身長、 IQ、 体重 |
| 右に歪み(正の歪度) | 最頻値 < 中央値 < 平均 | 所得、 株価、 都市人口 |
| 左に歪み(負の歪度) | 平均 < 中央値 < 最頻値 | テスト点数(簡単な問題) |
「平均が中央値より大きい」と気づいたら、 右に歪んだ分布 → 外れ値の影響を疑う、 が基本的な診断手順。
🎯 KDE(カーネル密度推定)で最頻値を推定
連続データでは、 ヒストグラムのビン幅で最頻値が変わってしまう問題があります。 そこでKDE(kernel density estimation)で滑らかに密度を推定し、 そのピークを最頻値とします。
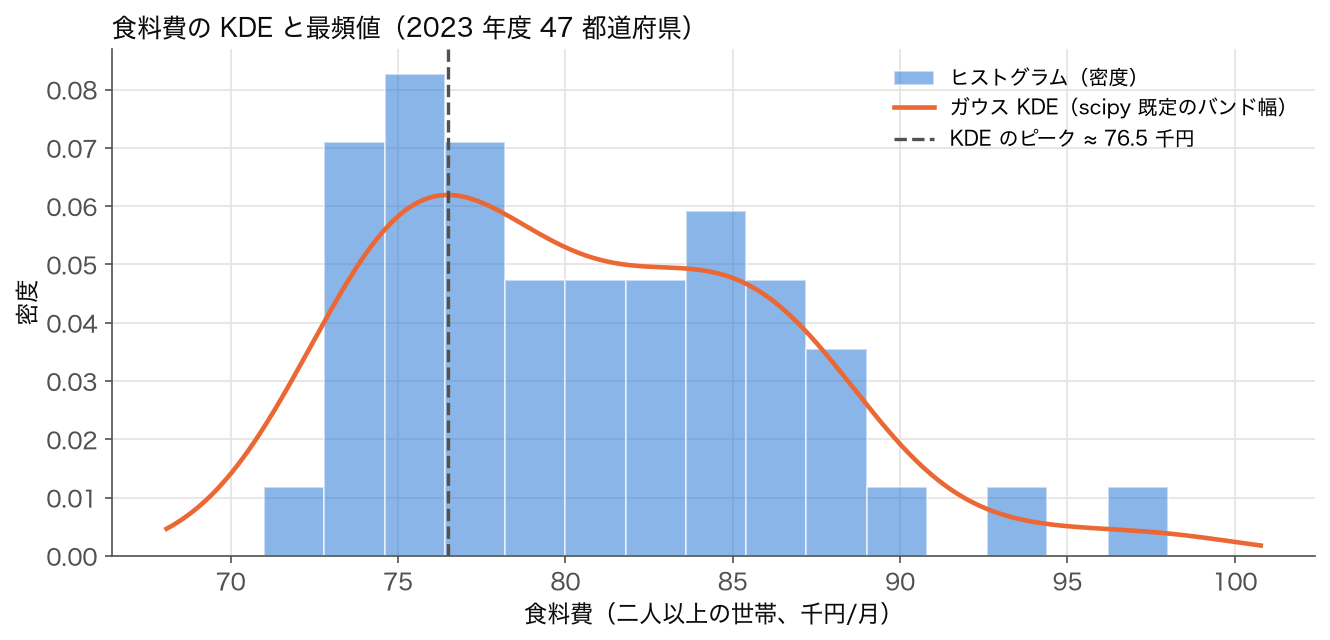
図は上の食料費(2023 年度 47 都道府県)に scipy の gaussian_kde(既定のバンド幅)を当てたもの。 KDE のピークは 76.5 千円で、 ヒストグラムの最頻階級の中点 76.1 千円とほぼ同じ位置に来るが、 こちらはビンの境界の取り方に左右されない。 85 千円付近にも小さな肩がある。
KDE の数式
$$ \hat{f}(x) = \frac{1}{n h} \sum_{i=1}^{n} K\left(\frac{x - x_i}{h}\right) $$
- K:カーネル関数(通常はガウス関数)
- h:バンド幅(平滑化の強さ)
- n:データ数
各データ点を中心とした小さな山(カーネル)を足し合わせて、 滑らかな密度関数を作る方法。 ヒストグラムを連続化したような図になります。
Python での KDE
x(連続値の 1 次元配列、例:SSDSE-B-2026 の食料費 L322101)。scipy.stats.gaussian_kde を使用。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # ── この抜粋で使うデータを用意します ── import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 data = df['L322101'].dropna().values / 1e3 # 食料費(千円) kde = stats.gaussian_kde(data) # 細かいグリッドで密度を計算 xx = np.linspace(data.min(), data.max(), 1000) density = kde(xx) # 最頻値 = 密度がピークの位置 mode_estimate = xx[np.argmax(density)] print(f'KDE最頻値: {mode_estimate:.2f}') |
📐 数式または定義 — 最頻値 の形式的表現
直感で輪郭が見えたら、 次節の厳密な定義に進んで「入力 → 出力の対応」を確認する。 SSDSE-B-2026 のような実データに当てはめながら読むと記憶に残りやすい。
🔬 数式を言葉で読み解く — 最頻値 の記号辞書
上の数式に出てくる各記号が何を表すかを、 言葉で翻訳します。 1 つずつ自分の言葉で言い換えられるようになると、 論文や教科書のスピードが一気に上がります。
| 記号 | 意味(言葉での説明) |
|---|---|
| $P(X=k)$ | 離散の場合の確率質量 |
| $f(x)$ | 連続の場合の確率密度 |
| 単峰 | 山が 1 つ |
| 双峰 | 山が 2 つ — 集団が混在しているシグナル |
| KDE | カーネル密度推定で連続データの最頻値を求める |
🧮 計算ステップ — カテゴリと数値の両方
1️⃣ カテゴリデータの最頻値(最も簡単)
例:あるアンケートで「好きな果物」を集計:
| 果物 | 回答数 |
|---|---|
| リンゴ | 25 |
| バナナ | 42 |
| オレンジ | 18 |
| ぶどう | 15 |
最頻値 = バナナ(最大頻度42)。 カテゴリ変数では最頻値が唯一意味のある代表値です(平均・中央値は計算できない)。
2️⃣ 離散数値データの最頻値
例:あるクラスの兄弟姉妹の数:
[0, 1, 1, 1, 2, 2, 3, 0, 1, 2, 1, 4]
頻度をカウント:
- 0人: 2回
- 1人: 5回 ← 最頻値
- 2人: 3回
- 3人: 1回
- 4人: 1回
最頻値 = 1。 兄弟姉妹が1人いる人が最も多いという意味。
3️⃣ 連続データの最頻値(階級分け)
連続データではまったく同じ値が複数あることは稀。 そこで「階級(ビン)に分けて、 最も件数の多い階級の中点を最頻値とする」のが伝統的手法。
- データを階級(ビン)に分ける(ビン数は √n や Sturges, Scott, FD ルールなど)
- 各階級の頻度(件数)を数える
- 最も件数が多い階級が「最頻階級」
- 最頻階級の中点を最頻値とする(または下記の補正式)
4️⃣ 補正式(より精緻な推定)
King の公式:
$$ \text{Mode} \approx L + \frac{f_1 - f_0}{(f_1 - f_0) + (f_1 - f_2)} \cdot h $$
- L:最頻階級の下限
- f_1:最頻階級の頻度
- f_0:直前階級の頻度
- f_2:直後階級の頻度
- h:階級幅
隣接階級の頻度比から、 階級内の「どこに山があるか」を推定します。
🧮 SSDSE-B 実値計算例:47都道府県データでの最頻値
SSDSE-B-2026 2023年データには都道府県別の家計支出が連続値として並んでいるので、 各値はほぼ一意で「最頻値」は単純には決まりません。 そこで、 連続値をビニングしてから最頻ビンを求めます。
📊 ステップ1:消費支出を 30 千円刻みでビニング
| 消費支出ビン(千円/月) | 該当県数 | 代表的な県 |
|---|---|---|
| 220-250 | 1 | 愛媛 |
| 250-280 | 12 | 青森・秋田・福井 等 |
| 280-310 | 24(最頻) | 北海道・岩手・宮城 等 |
| 310-340 | 8 | 山形・栃木・富山 等 |
| 340-370 | 2 | 埼玉・東京 |
最頻ビンは 280-310 千円(24県)。 「典型的な都道府県の消費支出水準」がここに集中。 中央値(約 301 千円)・平均(約 296 千円)・最頻ビン中点(295 千円)はいずれも近く、 ほぼ対称な単峰分布であることが分かります。
📊 ステップ2:KDE のピーク(連続的な最頻値)
ヒストグラムだとビン幅で答えが変わるので、 カーネル密度推定(KDE)でなめらかな密度関数を作り、 そのピーク位置を「最頻値」とする手法も標準的。 同じデータでバンド幅を変えると:
- 狭いバンド幅(h = 5千円):ピークが複数(多峰)に分かれる
- 中程度(h = 15千円):単一ピーク 300千円付近
- 広い(h = 50千円):滑らかすぎてピークがほぼ平均と一致
バンド幅の選択は探索的。 Silverman の経験則や CV による選択を組み合わせます。
📊 ステップ3:カテゴリ変数の最頻値
SSDSE で「主要産業」のようなカテゴリ列があれば、 value_counts() で最頻カテゴリが分かります。 47県のうち「製造業が最大の産業」「サービス業が最大」など。
🧮 実値で計算してみる — SSDSE-B-2026 で 最頻値 を体感
数式だけでは「分かった気になる」だけで終わりがち。 ここで SSDSE-B-2026(教育用標準データセット — 47 都道府県 × 100+ 指標、 2012-2023 年度)の実値を当てはめて、 最頻値 の挙動を電卓的に追体験します。
SSDSE-B-2026 は 統計センターの SSDSE 配布ページ から CSV を直接ダウンロードできます。 本サイトでは data/raw/SSDSE-B-2026.csv に配置している前提でコードを書いています。
🧮 数式に値を入れて手で計算する: 最頻値
合成データで単峰・双峰の最頻値を計算する。
Step 1: 単峰
Step 2: 双峰
Step 3: 連続データ (階級)
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np from scipy import stats x1 = np.array([1, 2, 3, 3, 3, 4, 5]) x2 = np.array([1, 2, 2, 3, 4, 4, 5]) print(f"単峰 mode: {stats.mode(x1, keepdims=True).mode[0]}") print(f"双峰 (scipy は最小返す): {stats.mode(x2, keepdims=True).mode[0]}") |
📤 実行結果
💬 手計算 (Step 1) 3 と Python 出力が完全一致。
🐍 Python での計算
scipy.stats — 基本の最頻値
scipy.stats.mode で最頻値を 1 行で取得する最も基本的な使い方。arr(カテゴリまたは数値の 1 次元配列)、keepdims 引数。1 2 3 4 5 6 7 8 | from scipy import stats # 整数データ arr = [1, 2, 2, 3, 3, 3, 4, 5] result = stats.mode(arr, keepdims=False) print(f'最頻値: {result.mode}, 頻度: {result.count}') # 3, 3 # 連続データ → 階級分けが必要 |
pandas — value_counts で頻度
df['category'](カテゴリ列)。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # ── この抜粋で使うデータを用意します(架空)── # SSDSE-B-2026 にカテゴリの列は無いので、名義尺度の最頻値を試すための # <架空の>アンケート集計をここで作る。 import pandas as pd df = pd.DataFrame({ '果物': ['りんご', 'みかん', 'りんご', 'ぶどう', 'みかん', 'りんご'], '産地': ['青森', '愛媛', '長野', '山梨', '和歌山', '青森'], }) # カテゴリデータの最頻値 print(df['果物'].mode()) # Series で最頻値(複数あれば複数返す) print(df['果物'].value_counts().head()) # 上位5位の頻度 # 全列の最頻値 print(df.mode().iloc[0]) # 各列の1番目の最頻値 |
statistics — 標準ライブラリ
1 2 3 4 5 6 7 | import statistics # 単一最頻値(同率なら最初のもの) statistics.mode([1, 2, 2, 3, 3, 3, 4]) # 3 # 複数最頻値(同率全部) statistics.multimode([1, 2, 2, 3, 3, 4]) # [2, 3] |
連続データの最頻値(KDE)
x(連続値配列)、bw_method(Scott/Silverman/数値)。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | # ── この抜粋で使うデータを用意します ── import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 def continuous_mode(data, bw_method=None, grid_size=1000): kde = stats.gaussian_kde(data, bw_method=bw_method) xx = np.linspace(data.min(), data.max(), grid_size) density = kde(xx) # 密度の山(両隣より高い点)の数も数えて、擬似ピークの乱立を見る n_peaks = int(np.sum((density[1:-1] > density[:-2]) & (density[1:-1] > density[2:]))) return xx[np.argmax(density)], n_peaks data = df['L322101'].dropna().values / 1e3 # 食料費(千円) for bw in ['scott', 'silverman', 0.1, 0.5, 1.0]: mode_est, n_peaks = continuous_mode(data, bw_method=bw) print(f'bw={str(bw):9s} 最頻値(KDE): {mode_est:.2f} 千円 / 山の数: {n_peaks}') |
🤖 機械学習での最頻値
① 欠損値の補完(mode imputation)
カテゴリ変数の欠損は、 最頻値で埋めるのが王道:
X(欠損 NaN を含む DataFrame)。1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # ── この抜粋で使うデータを用意します(架空)── # 欠損のあるカテゴリ列を最頻値で埋める例。SSDSE-B-2026 には # カテゴリ列も欠損も無いので、<架空の>小さな表をここで作る。 import numpy as np from sklearn.impute import SimpleImputer X_categorical = np.array([['りんご'], ['みかん'], [None], ['りんご'], [None], ['りんご']], dtype=object) # カテゴリ列の最頻値補完(欠損が None なので missing_values=None を指定する。 # 既定の np.nan のままだと None は欠損とみなされず、そのまま残る) imputer = SimpleImputer(strategy='most_frequent', missing_values=None) X_imputed = imputer.fit_transform(X_categorical) print(X_imputed.ravel()) |
② 分類問題のベースライン
「全部 majority class(最頻クラス)と予測する」分類器は、 機械学習モデルが超えるべき最低限のベースライン。 sklearn.dummy.DummyClassifier(strategy='most_frequent')。
③ 決定木の葉ノード予測
分類木では、 各葉ノードの最頻クラスを予測値とします。 回帰木の「平均」に対応。
④ アンサンブル投票
ランダムフォレストなどのアンサンブルで分類するとき、 複数の木の予測の最頻値(majority vote)を最終予測とします。
⑤ k-NN分類
k近傍法では、 周囲 k 個のラベルの最頻値を予測クラスとします。
🚧 最頻値の落とし穴
1️⃣ ビン幅で最頻値が変わる
連続データの最頻値は、 階級幅次第で値が変わる。 KDE を使うか、 複数のビン設定で比較しましょう。
2️⃣ サンプルサイズが小さいと不安定
n=10 のデータでは、 偶然一致した値が「最頻値」になりがち。 n が大きくないと信頼できません。
3️⃣ 最頻値が複数あるとき(多峰性)
複数のピークがある分布で1つだけ最頻値と呼ぶのは誤解の元。 「2つのモードがある」と素直に書きましょう。 集団が混在している可能性を疑う。
4️⃣ カテゴリ変数では平均・中央値が使えない
逆に、 名義尺度(性別、 職業)では最頻値が唯一の代表値。 順序尺度なら中央値も使える。 間隔・比例尺度なら平均も。
5️⃣ 一様分布では意味がない
すべての値が等頻度なら、 最頻値は定義できない(または全部)。 ヒストグラムを描いて分布の形を確認してから使う。
🐍 Python 実装バリエーション
① scipy.stats.mode
arr(np.ndarray)、axis(2 次元時の集計軸)。1 2 3 4 5 6 7 8 9 10 | # ── この抜粋で使うデータを用意します(架空)── import pandas as pd from scipy import stats df = pd.DataFrame({'category': ['A', 'B', 'A', 'C', 'B', 'A']}) # scipy の mode は数値向け。文字列は pandas の mode を使う vals, counts = pd.factorize(df['category']) result = stats.mode(vals, keepdims=False) print(counts[result.mode], result.count) |
② pandas df.mode()
複数の最頻値があるとき全部返すので、 結果が可変長になる。
df(任意の DataFrame)。1 2 | print(df['category'].mode()) # 複数あれば全部 print(df['category'].value_counts().idxmax()) # 最頻値(最初) |
③ scikit-learn — SimpleImputer で最頻値補完
X(NaN を含む特徴量)。SimpleImputer(strategy='most_frequent')。1 2 3 4 5 6 7 8 9 10 11 12 | # ── この抜粋で使うデータを用意します(架空)── # 欠損を最頻値で埋める例。SSDSE-B-2026 には欠損が無いので、 # <架空の>小さな行列をここで作る。 import numpy as np from sklearn.impute import SimpleImputer X = np.array([[1.0, 10.0], [1.0, np.nan], [2.0, 10.0], [np.nan, 20.0], [1.0, 10.0]]) imp = SimpleImputer(strategy='most_frequent') X_filled = imp.fit_transform(X) print(X_filled) |
④ scipy.stats.gaussian_kde — 連続値の最頻値(KDE ピーク)
x(連続値配列)、評価グリッド(np.linspace)。1 2 3 4 5 6 7 8 9 10 11 12 | # ── この抜粋で使うデータを用意します ── import pandas as pd import numpy as np from scipy.stats import gaussian_kde df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年の 47 都道府県 df['income'] = df['L3221'].astype(float) # 消費支出を所得の代わりに使う kde = gaussian_kde(df['income']) xs = np.linspace(df['income'].min(), df['income'].max(), 1000) print("mode_kde=", round(xs[np.argmax(kde(xs))], 1)) |
⑤ collections.Counter — Python 標準ライブラリ
1 2 3 4 5 6 7 8 | # ── この抜粋で使うデータを用意します(架空)── import pandas as pd from collections import Counter df = pd.DataFrame({'category': ['A', 'B', 'A', 'C', 'B', 'A', 'C', 'A']}) counter = Counter(df['category']) print(counter.most_common(3)) # top 3 |
🐍 Python 実装 — 最頻値 を SSDSE-B-2026 で動かす
まず環境をそろえます。 必要なライブラリを入れ、 matplotlib の日本語フォント(Hiragino Sans)を設定し、 SSDSE を encoding='cp932' で読み込んで shape・head()・describe() を確認します。 この後のコードでは、 小数 2 桁で値が重なる合計特殊出生率と、 47 県すべてが異なる値の総人口を並べ、 連続量では「同じ値が 2 度現れない」ため最頻値が素朴には定義できないことを確認します。 ヒストグラムのビン幅や KDE のバンド幅を変えると最頻値が動く、 というのがこのページの主題です。 エンコーディングを指定し忘れると UnicodeDecodeError で止まるのが最初の関門なので、 ここだけは丸暗記して構いません。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | # 最頻値 を SSDSE-B-2026 で確かめる最小コード import pandas as pd import numpy as np # 1) SSDSE-B-2026(教育用標準データセット)を読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print('shape:', df.shape) # (564, 112) — 47 都道府県 × 12 年度 print('cols head:', list(df.columns[:8])) # 2) 直近年度(2023 年度)に絞る df23 = df[df['年度'] == 2023].copy() print('rows in 2023:', len(df23)) # 3) 最頻値 を動かすために必要な列だけ取り出す y = df23['合計特殊出生率'].astype(float) # 小数 2 桁で公表 → 同じ値が重なる x = df23['総人口'].astype(float) # ほぼ全県で値が異なる連続量 # 4) 最頻値 の本処理(このページの主題) print('---- 最頻値 結果 ----') # 離散的な値: そのまま数えて一番多い値 vc = y.value_counts() print('合計特殊出生率 上位 3 値:', vc.head(3).to_dict()) print('最頻値 (mode):', y.mode().tolist(), '/ 平均:', round(y.mean(), 3), '/ 中央値:', y.median()) # 連続量: 値そのものは重ならないので、階級に分けて最も度数の多い階級を最頻値とみなす print('総人口の異なる値の数:', x.nunique(), '/ 47 県') bins = np.arange(0, 15_000_001, 1_000_000) cnt = pd.cut(x, bins=bins, right=False).value_counts().sort_index() top = cnt.idxmax() print(f'総人口の最頻階級: {top.left/1e4:.0f}〜{top.right/1e4:.0f} 万人 ({cnt.max()} 県) ' f'/ 階級値 {top.mid/1e4:.0f} 万人 / 平均 {x.mean()/1e4:.1f} 万人 / 中央値 {x.median()/1e4:.1f} 万人') |
💬 2023 年の合計特殊出生率は小数 2 桁で公表されるため値が重なり、1.29 と 1.46 がどちらも 3 県で並んで最頻値が 2 つになった。平均 1.293・中央値 1.30 とは違い、最頻値は 1 県の値が変わるだけで入れ替わるほど不安定。総人口は 47 県すべてが異なる値なので値そのものの最頻値は意味を持たず、100 万人刻みにすると 100〜200 万人の階級に 21 県が集まり、階級値 150 万人は中央値 154.9 万人に近く、東京都に引っ張られた平均 264.6 万人からは遠い。
うまく動かないときは ①data/raw/SSDSE-B-2026.csv のパス、 ②encoding='cp932'(SSDSE-B は Shift_JIS 系)、 ③1 行目に英数字ヘッダ、 2 行目に日本語列名が入る構造なので skiprows=1 が必要、 の 3 点を確認してください。
⚠️ 最頻値の落とし穴(深掘り版・6件)
① 連続値で「最頻値」を直接計算する意味のなさ
連続値(家計支出・身長・体重)では、 各値はほぼ一意なので「重複した最頻値」は存在しません。 scipy.stats.mode は機械的に「最も小さい値」を返すだけで意味不明。 連続値の最頻値はビニングかKDE のピークでしか定義できない。 統計の教科書で「平均・中央値・最頻値」と並べられていても、 連続値での最頻値の計算は丁寧に注意することが必要。
② ビン幅で答えが変わる
ヒストグラムでビンが「1万円幅」と「10万円幅」では、 最頻ビンが大きく違う場所に動く可能性があります。 Sturges、 Scott、 Freedman-Diaconis などビン幅選択法はいくつかあり、 結論が変わる場合がある。 必ず複数のビン幅で確認し、 安定して見えるピークだけを信用する。
③ 多峰分布で「最頻値」と単数形で報告する
「男女混合の身長分布」「2種類の顧客層の購買額」などは双峰になることが多い。 これを「最頻値 = 168cm」と単一の値で報告すると、 実は男性ピーク 175cm と女性ピーク 160cm の谷である情報が失われる。 必ずヒストグラム or KDE で形を確認し、 多峰なら「最頻値は 168cm と 165cm の 2つ」のように複数を報告。
④ scipy.stats.mode のバージョン互換性
SciPy 1.9 以降で scipy.stats.mode の挙動が変更され、 デフォルトの keepdims や axis の解釈が異なります。 旧コードがそのまま動かないことがある。 FutureWarning を見たら、 引数を明示的に書く。 pandas の df.mode() は安定だが、 複数の最頻値がある場合「全部」を返すので長さが可変になることに注意。
⑤ 欠損値の扱い
「NaN が最頻値」と判定されてしまうケースがあります。 例:80% が欠損のデータでは NaN そのものが最頻値になる。 必ず dropna() してから最頻値を計算するか、 NaN を「不明」というカテゴリとして意味づけする判断をした上で計算する。 機械学習の前処理でカテゴリ欠損を「最頻値で補完」する場合、 NaN を一緒に数えない設計に。
⑥ 「最頻値で欠損補完」が分布を歪める
機械学習で欠損を「最頻値で埋める」のは標準テクニックですが、 多用すると分布が最頻値に偏り、 分散が過小評価されます。 また、 欠損が MAR(ランダム)でない場合、 「最頻値」がそもそも真の値の代表として不適切。 多重代入法(MICE)や IterativeImputer の方が一般に優れる。 欠損補完の方法を変えて、 下流の予測精度が変わるか必ず比較。
⚠️ よくある落とし穴 — 最頻値 で初学者がやりがちなミス
この用語を実務で使うときにつまずきやすい点を、 失敗パターン別に整理しました。 1 度経験すれば回避できるものばかりですが、 先に知っておくと事故が大幅に減ります。
🗺️ 概念マップ — 3つの視点で体系を理解する
最頻値 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 記述統計 › 中心傾向 › 最頻値
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に 最頻値 を置き、 そこから 平均・中央値・ヒストグラム・KDE・クラスタリング・分散 など 計 14 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「最頻値」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「最頻値」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは 最頻値 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 中心傾向 → 最頻値 という入れ子の位置を示します。 「中心傾向には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔗 隣接手法への橋渡し
「最頻値」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
最頻値は名義尺度に唯一適用できる代表値である。 平均・中央値と対比的に押さえることで、 SSDSE-B-2026 のカテゴリ列 (都道府県、地域区分など) を扱うときの判断基準が明確になる。
🌳 3つの代表値の使い分けフロー
- データの尺度は?
- 名義(性別、 国) → 最頻値のみ
- 順序(5段階評価) → 中央値・最頻値
- 間隔・比例(温度、 身長) → 3つ全部
- 目的は?
- 「典型的な人」「ピークの値」 → 最頻値
- 「中位の人」 → 中央値
- 「合計が意味を持つ計算」 → 平均
- 分布の形を診断したい → 3つ全部を併記して、 並び方から歪み・多峰性を読み取る
📜 最頻値の歴史
- Karl Pearson(1895):「mode」という用語を提唱。 「最も頻繁な値」の意味で導入
- ピアソンの経験式:歪んだ分布における「Mean − Mode ≈ 3(Mean − Median)」を提案
- カーネル密度推定(1950-60年代):Rosenblatt(1956)、 Parzen(1962)が KDE を発明し、 連続データの最頻値推定が可能に
- 多峰性検定:Hartigan & Hartigan(1985)の dip test など、 「データが本当に単峰か」を統計的に検定する手法も発展
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
data/raw/SSDSE-B-2026.csv(cp932)、2023 年の合計特殊出生率 A4103。1 2 3 4 5 6 7 8 9 10 11 12 13 | # 基本パターン: 最頻値と、その根拠になる頻度を一緒に見る import pandas as pd # データ読み込み(2023 年の 47 都道府県) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # SSDSE-B にカテゴリ列は無いので、小数 2 桁で公表され値が重なる合計特殊出生率 A4103 を使う tfr = df['A4103'] print('最頻値:', tfr.mode().tolist()) print('上位 5 件の頻度:') print(tfr.value_counts().head(5).to_string()) print('異なる値の数:', tfr.nunique(), '/', len(tfr), '県') |
📚 統計概念マップでの位置
このページの上にある3つの概念マップ(関係マップ、 包含マップ、 ツリーマップ)でこの概念の位置づけが視覚的に分かります。 関連手法を辿って学習を進めましょう。
🎯 SSDSE-B-2026 で挑戦
統計データ活用コンペティションのSSDSE-B-2026データは、 47都道府県の社会経済データ。 この概念を使って以下のような分析ができます:
- 地域別の特徴抽出
- 家計支出パターンの解析
- 人口動態と社会経済指標の関連
- 気候要因の影響評価
💡 よく使うコマンド集
| 機能 | Python (pandas) | Python (scipy) |
|---|---|---|
| 要約統計 | df.describe() | stats.describe() |
| 平均 | df.mean() | np.mean() |
| 標準偏差 | df.std() | np.std() |
| 相関 | df.corr() | stats.pearsonr() |
| t検定 | — | stats.ttest_ind() |
| 回帰 | — | stats.linregress() |
| 分布フィッティング | — | stats.norm.fit() |
🚧 一般的な落とし穴と対策
- 外れ値の影響:散布図・ 箱ひげ図で確認、 ロバスト手法も検討
- サンプルサイズ不足:power analysis で事前に確認
- 仮定の違反:正規性、 独立性、 等分散性をチェック
- 多重比較問題:補正(Bonferroni、 FDR)を適用
- p-hacking:事前登録(pre-registration)で防ぐ
- 因果と相関の混同:観察データから因果結論を出さない
📊 結果報告の標準フォーマット
- 点推定:得られた値
- 不確実性:信頼区間または標準誤差
- サンプルサイズ:n を明記
- 効果量:実質的な意義
- p値:統計的有意性
- 仮定の確認:診断プロット
🌐 関連分野での応用
- マーケティング:A/Bテスト、 顧客分析
- 医療:臨床試験、 疫学研究
- 金融:リスク管理、 ポートフォリオ
- 製造:品質管理、 工程最適化
- 公共政策:効果評価、 計画立案
- 研究:仮説検証、 探索的解析
🎓 さらに学ぶための文献
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression"
- VanderPlas "Python Data Science Handbook"
🔗 統計用語ネットワーク
この概念は、 他の多くの統計概念と密接に関連しています。 ジャストインタイム型学習では、 必要に応じて関連用語へジャンプしながら全体像を構築します。
主要な関連概念のグループ
| グループ | 主要概念 |
|---|---|
| 記述統計 | 平均、 中央値、 最頻値、 分散、 標準偏差、 共分散、 相関係数 |
| 可視化 | ヒストグラム、 散布図、 箱ひげ図、 ヒートマップ |
| 推測統計 | 標本平均、 標準誤差、 信頼区間、 p値、 有意水準 |
| 確率分布 | 正規分布、 t分布、 χ²分布、 F分布、 二項分布 |
| 仮説検定 | t検定、 F検定、 χ²検定、 ノンパラ検定 |
| 回帰 | 単回帰、 重回帰、 OLS、 Ridge、 LASSO |
| 分類 | ロジスティック回帰、 決定木、 SVM、 k-NN |
| 教師なし学習 | クラスタリング、 PCA、 因子分析 |
| 時系列 | ARIMA、 VAR、 指数平滑法、 自己相関 |
| 因果推論 | DiD、 IV、 傾向スコア、 交絡変数 |
| 前処理 | 標準化、 正規化、 欠損値処理、 多重共線性対策 |
| 評価 | R²、 残差、 CV、 RMSE、 効果量 |
学習順序の推奨
- 記述統計(平均、 分散、 標準偏差)
- 可視化(ヒストグラム、 散布図)
- 確率分布(正規分布)
- 推測統計(標準誤差、 信頼区間、 p値)
- 仮説検定(t検定、 χ²検定)
- 相関と回帰(単回帰、 重回帰)
- 多変量解析(PCA、 クラスタリング)
- 機械学習(決定木、 RF、 NN)
- 時系列・因果推論(応用)
📝 実践練習 — SSDSE-B-2026 で挑戦
初級課題
- 東北6県の家計食料費の基本統計量を計算
- 食料費のヒストグラムを描く
- 食料費と教育費の散布図を描く
- 都道府県を「東日本/西日本」に分け、 平均を比較
中級課題
- 家計支出 5項目で相関行列を作成、 ヒートマップ可視化
- 食料費 → 教育費の単回帰を実行、 残差分析
- 家計5項目で PCA を実施、 バイプロット表示
- k-means (k=3) で都道府県をクラスタリング、 解釈
上級課題
- 地域別の家計パターンに有意差があるか ANOVA で検定
- 重回帰で教育費を予測、 多重共線性を VIF で確認
- Ridge/LASSO で正則化、 CV で α を最適化
- 階層クラスタリングと Ward 法で都道府県を分類、 デンドログラム作成
🎮 触って理解する
ヒストグラムのバーをクリック/ドラッグしてデータを盛り、 分布の形を自分で作ってみましょう。 最も度数が高い階級(=最頻階級)がオレンジでハイライトされ、 下の数直線に最頻値・中央値・平均の3つが同時に表示されます。 右に歪ませると 最頻値 < 中央値 < 平均、 二峰性にすると最頻値が2つになる様子、 そしてビン数を変えると最頻値だけが動く様子を体感してください。
👁️ 直感
最頻値は「分布のピークの位置」。 平均は分布の重心なので長い裾に引っ張られ、 中央値は順位のちょうど真ん中。 対称な単峰分布では3つがほぼ一致しますが、 右に裾を引くと平均だけが右へ逃げ、 最頻値はピークに居座ります。 上の図で「右に歪み」を押すと、 数直線上で3つが 最頻値 < 中央値 < 平均 の順に並ぶのが見えます。
⚠️ よくある落とし穴
- 連続値そのものには最頻値がほぼ存在しない:家計支出のような連続量は同じ値が2つと出ないため、 素の最頻値は無意味。 必ずビニングや KDE を通す。
- ビン依存:上の「ビン数」スライダーを動かすと、 最頻値(オレンジ)だけが動き、 平均・中央値は不変。 最頻値は階級の切り方に敏感な代表値だと体感できます。
- 多峰の見落とし:「二峰性」プリセットのように山が2つあると最頻値は複数。 1つの代表値で語ると集団の混在(男女・地域・新旧モデル等)を見逃します。
- ビン中点 ≠ 真のピーク:本ページの最頻値は最頻階級の中点。 より精緻には King の補正式や KDE のピークを使います。
🚀 発展:カテゴリ変数の代表値
平均や中央値が計算できない名義尺度(血液型・都道府県・主要産業など)では、 最頻値(最頻カテゴリ)が唯一意味を持つ代表値です。 pandas なら series.value_counts().idxmax() や series.mode() で求まります。 「最も多い分類」を代表として選ぶ、 という素朴で頑健な発想がここに生きます。
🔗 関連ページ
- 平均 (Mean) — 重心としての代表値。外れ値に弱い。
- 中央値 (Median) — 順位の真ん中。歪みに頑健。
- ヒストグラム — 最頻階級を読み取る土台。
- カーネル密度推定 (KDE) — ビン依存を避けて滑らかなピークを求める。
- 代表値(中心傾向) — 平均・中央値・最頻値の使い分け。
- 多峰性 (Multimodal) — 最頻値が複数になる分布。
- カテゴリ変数 — 最頻値が主役になるデータ型。
🧭 解説深化(追記)— 直感・落とし穴・発展
本節は既存の解説を壊さず、 「直感の核」「実務でハマる落とし穴」「発展的な位置づけ」を一段深く追記したものです。 数値はすべて SSDSE-B-2026(cp932・2 行目の日本語名をスキップ・2023 年・47 都道府県)の実測に基づきます(合成例は「架空」と明記)。
👁️ 直感をもう一段 — 「峰の位置」であること
最頻値は分布の峰(ピーク)の位置そのものです。 平均が「重心(てこの支点)」、 中央値が「順位のちょうど真ん中」であるのに対し、 最頻値は「いちばん人口密度が高いところ」を指します。 だからこそ、 名義尺度(血液型・都道府県・主要産業)でも定義できる唯一の代表値です。 平均は加減算できる尺度でしか、 中央値は順序が付く尺度でしか意味を持ちませんが、 「最も多いカテゴリ」はどんな尺度でも数えられます。
平均 ≈ 2,645,809 人 / 中央値 ≈ 1,549,000 人 / 最小 537,000 人(鳥取)〜 最大 14,086,000 人(東京)。
東京という 1 つの巨大値が平均を中央値の 1.7 倍まで押し上げていますが、 分布の峰は人口の小さい側にあり動きません。 総人口を等幅 4 階級に区切ると各階級の県数は [38, 4, 4, 1]。 最頻階級は最小人口帯で 38 県が集中し、 東京の外れ値には全く引きずられません。 「平均だけが右へ逃げ、 最頻値はピークに居座る」という最頻値の頑健さがそのまま出ています。
🚧 落とし穴(重要・深掘り追記)
- 連続データでは最頻値が不定/ビン幅依存:家計支出や人口のような連続量は同じ値が二度と出ないため、 素の最頻値は「最小の値」を機械的に返すだけで無意味。 必ずビニングか KDE を通す。 しかもビン幅(Sturges/Scott/Freedman-Diaconis)を変えると最頻階級が動くので、 複数のビン幅で安定して見える峰だけを信用する。
- 多峰性(複数モード)の見落とし:単一の値で「最頻値 = ◯◯」と報告すると、 実は 2 集団(男女・地域・新旧モデル)の谷を峰と誤認していることがある。 SSDSE-B-2026 の合計特殊出生率(A4103)は東京圏(低い)と地方(高い)で二峰になりやすい。 峰が複数なら素直に複数を並べる。
- 標本サイズが小さいと不安定:n が小さいと、 偶然 2 回一致しただけの値が「最頻値」に化ける。 47 都道府県のような小標本で離散化した最頻値は、 ビン境界を数千円ずらしただけで別階級に飛ぶことがある。 峰の位置は点推定ではなく区間で捉える意識を持つ。
- 最頻値が代表値として不適な場合:一様に近い分布やピークがブロード(1 位と 2 位の頻度差が小さい)なときは、 最頻値は「たまたま 1 票多かった値」に過ぎず代表性が弱い。 名義尺度でも最頻カテゴリが僅差なら「これが典型」と言い切らない。 まずヒストグラム/
value_counts()で峰の鋭さを確認する。 - KDE でのモード推定の恣意性:連続値の最頻値を KDE のピークで求めるとき、 バンド幅 h が結論を左右する。 Silverman/Scott の経験則は「単峰・正規に近い」前提なので、 実際に多峰でも滑らかに均して峰を 1 つに潰しがち。 逆に h を狭めると擬似ピークが乱立する。 対策は「複数の h でピーク数の安定性を見る」「交差検証(CV)や Sheather-Jones 法でデータ駆動に h を選ぶ」こと。 峰の数は h に強く依存する量だと肝に銘じる。
- NaN が最頻値になる事故:欠損の多い列では
NaN自身が最頻値と判定されうる。 必ずdropna()してからmode()を呼ぶ。
🚀 発展 — 歪度・混合分布・モード探索への橋渡し
① 3 代表値の位置関係と歪度
単峰分布では、 平均・中央値・最頻値の並び順が歪度(skewness / 散らばりと分布の形)を語ります。 右に裾を引く(正の歪度)とき 最頻値 < 中央値 < 平均、 左に裾を引くと逆順。 SSDSE-B-2026 の総人口はまさに右歪みで、 実測でも 最頻階級(最小人口帯)< 中央値 1,549,000 < 平均 2,645,809 と教科書どおりに並びます。 Pearson の経験式 Mean − Mode ≈ 3(Mean − Median) を使えば、 平均と中央値から最頻値をおおまかに逆算できます。
なお参考として、 ほぼ対称な合計特殊出生率(A4103・実測)では 最頻階級 [1.30, 1.35)(9 県)・中央値 1.300・平均 1.293 と 3 者がほぼ一致し、 「対称なら 3 代表値は近い」という関係も同時に確認できます。
② 多峰分布と混合分布(mixture)
峰が複数あるとき、 その背後には複数の下位集団が混ざった混合分布が想定できます。 「最頻値が 2 つ」という観察は、 混合ガウスモデル(GMM)や EM アルゴリズムで「いくつの成分から成るか」を推定する出発点になります。 最頻値の数え上げは、 クラスタ数 K を決める素朴な事前探索でもあるわけです。
③ モード探索(mean-shift)への橋渡し
「峰=最頻値」という発想を多次元へ一般化したのが mean-shift(平均シフト)です。 各データ点を KDE 密度の勾配を上る方向へ少しずつ動かし、 最終的に収束した先の峰でグループ分けします。 クラスタ数を事前に決めず、 密度の峰の数だけクラスタが自然に決まる点が k-means と対照的。 最頻値(1 次元の峰)→ KDE(密度の峰)→ mean-shift(多次元の峰探索クラスタリング)という一本の連続した道が見えてきます。 ベイズ的には、 事後分布の峰を点推定に使う MAP 推定や、 平均・中央値の代替として峰を予測する 条件付きモード回帰も、 すべて「最頻値の一般化」として同じ系譜に並びます。
🔗 関連ページ(相対リンク)
- 平均 (Mean) — 重心。 外れ値に弱い代表値との対比。
- 中央値 (Median) — 順位の真ん中。 歪みへの頑健さで最頻値と並ぶ。
- 代表値(中心傾向) — 平均・中央値・最頻値の使い分け総論。
- 散らばり・分布の形(歪度) — 3 代表値の並び順と歪度の関係。 ※単独の skewness ページは未作成のためこちらに集約。
- カーネル密度推定 (KDE) — 連続値の峰を求める現実的手段。 バンド幅がカギ。
- ヒストグラム — 最頻階級を読み取る土台。 ビン幅依存に注意。
- 多峰性 (Multimodal) — 最頻値が複数になる分布と集団混在。
- カテゴリ変数 — 最頻値が唯一の代表値になるデータ型。
- 混合ガウスモデル (GMM) / EM アルゴリズム — 多峰を成分に分解する発展先。
- MAP 推定 / 分位点・モード回帰 — 最頻値のベイズ的・回帰的な一般化。
補足:関連リンクは html/glossary/ 内の実在ページのみを張っています。 単独の skewness.html は現時点で存在しないため、 歪度の解説は dispersion.html にリンクし本文でも言葉で補いました。 mean-shift の単独ページは未整備のため本文テキストでの言及に留めています。
🔖 キーワード索引(深掘り版)
論文・記事に登場する用語のリンクで該当箇所へジャンプ: