論文一覧に戻る
📚 用語解説(ジャストインタイム型データサイエンス教育)
ヒストグラム
Histogram
1変数の分布を区間(bin)に分けて棒グラフで表す。データの「形」(対称か偏りか)を一目で把握。
可視化度数分布図histogram
🔖 キーワード索引 — 拡張版
ヒストグラムに関する用語を、 ビン幅・分布形状・関連可視化 別に索引化します。
| カテゴリ | キーワード(日本語) | キーワード(英語) |
|---|
| 基本構成 | ビン(階級)、 度数、 階級値、 階級幅、 累積度数 | bin, frequency, class width, cumulative |
| ビン幅選択則 | スタージェスの公式、 スコット、 フリードマン・ダイアコニス | Sturges, Scott, Freedman-Diaconis, Doane, Rice |
| 分布形状 | 対称、 右に裾が長い(正の歪度)、 左に裾が長い、 双峰、 一様 | symmetric, right-skewed, left-skewed, bimodal, uniform |
| 統計量 | 最頻値、 歪度、 尖度、 中央値、 四分位数 | mode, skewness, kurtosis, median, quartile |
| 関連可視化 | 密度プロット(KDE)、 箱ひげ図、 バイオリンプロット、 累積分布 | KDE, boxplot, violin plot, ECDF |
| 実装関数 | matplotlib.hist、 seaborn.histplot、 pandas.DataFrame.hist、 numpy.histogram | plt.hist, sns.histplot, df.hist, np.histogram |
💡 30秒で分かる結論
🍰 まずはやさしく
データの形を映す鏡のようなグラフです。
データの偏りを一目で知るために使います。
テストの点数の分布を調べる時に便利です。
ヒストグラムの基本について学びましょう。
- 定義:1変数の分布を区間(bin)に分けて棒グラフで表す。データの「形」(対称か偏りか)を一目で把握。
- カテゴリ:可視化
📖 もっと詳しく
ヒストグラム(histogram)は、 1変数の分布を視覚化する基本ツール。 データを区間(ビン)に分けて、 各区間に入る個数を棒の高さで示します。 分析の前に「データの形」を把握する ための必須ステップ。
読み取りポイント:
- 分布の形:左右対称(正規分布的)/ 右に裾長(所得分布的)/ 双峰(2つの山)
- 中心位置:山の頂点はどこか(平均・中央値)
- 広がり:横幅が標準偏差を反映
- 外れ値:本体から大きく離れた棒
- 欠損や打ち切り:端での不自然な集積
ビン幅の選び方が重要:細すぎるとノイズが見え、 粗すぎると構造が消えます。 Sturges、 Scott、 Freedman-Diaconis などの自動ルールがあり、 matplotlib のデフォルトは Auto。 不安なら複数のビン幅で確認するか、 カーネル密度推定(KDE)を並べて見るのが安全。
👁️ 直感 — ヒストグラムは「分布の形が見える」
ヒストグラム(histogram)は、 数値データの分布の形を視覚化する最も基本的なグラフ。 データを階級(ビン)に分け、 各ビンに入る件数(頻度)を棒の高さで表します。
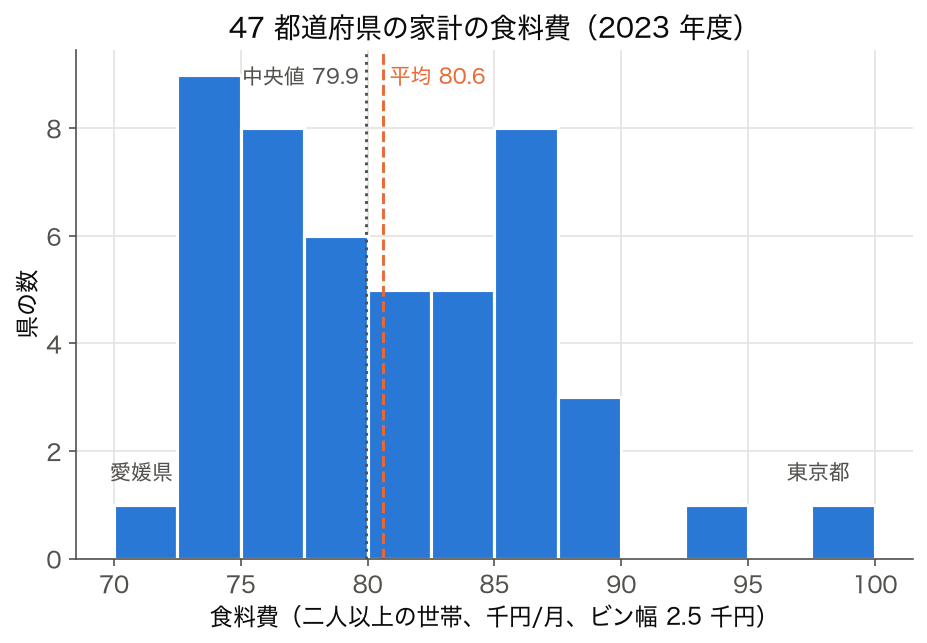
47都道府県の家計食料費(SSDSE-B-2026 の 2023 年度、 二人以上の世帯の月額)を例に。 横軸が食料費の値(ビン幅 2.5 千円)、 縦軸が「その値の範囲に何県あるか」。 きれいな 1 つの山ではなく、 72.5〜77.5 千円(17 県)と 85〜87.5 千円(8 県)に 2 つの固まりがあり、 右には埼玉県(93.3 千円)・東京都(97.8 千円)が離れて並ぶ(歪度 0.65)。 平均 80.6 千円・中央値 79.9 千円という 1 つの数字だけでは、 この「山が 2 つある」形は見えません。 最小は愛媛県の 71.1 千円です。
💡 ヒストグラムを描けば、 分布の中心、 ばらつき、 歪み、 外れ値、 多峰性のすべてが一目で見えます。 データ分析の最初に必ず描くべき図。
📍 あなたが今見ているもの
🍰 まずはやさしく
データの分布を棒グラフにしたものです。
分析の前にデータの様子を掴むために使います。
都道府県ごとの人口などのデータで活用します。
定義から実装までの流れを詳しく解説します。
論文中に 「ヒストグラム」として登場する用語。
ヒストグラム とは:1変数の分布を区間(bin)に分けて棒グラフで表す。データの「形」(対称か偏りか)を一目で把握。
本ページでは「histogram」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「histogram」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎮 触って理解する — ビン幅とビン境界で「見え方」が変わる
下の操作パネルで データ を選び、 ビン数 と 開始位置(オフセット) のスライダーを動かすと、 ヒストグラムがリアルタイムに描き変わります。 ビンが狭すぎ(多すぎ)ればノイズだらけ、 広すぎ(少なすぎ)れば情報が失われ、 適度なら分布の形が見える——この感覚を手を動かして掴んでください。 実測データ(総人口・気温・合計特殊出生率)は SSDSE-B-2026 の 2023 年・47 都道府県の実値をそのまま埋め込んでいます。
━ 赤の実線=平均 / ┄ 橙の破線=中央値。 右に裾が長い分布では「平均 > 中央値」となり、 2 本の線が離れます。
🔎 ここから何を学ぶか
- ビン数を 2〜3 に:山が 1 本に潰れ、 多峰性や裾の細部が消えます(情報損失・過度な平滑化)。
- ビン数を 35〜40 に:各ビンの度数が 0 か 1 になりガタガタに(ノイズ・過度な解像度)。 n=47 では特に顕著です。
- 開始位置スライダーを動かす:ビン数を固定したまま境界だけずらすと、 同じデータなのに山の位置や高さの印象が変わる(端点効果)。 これがヒストグラム最大の落とし穴です。
- 総人口を選ぶ:東京 1 県だけが右端に飛び、 平均(赤)が中央値(橙)より大きく右に寄ります(右歪み)。 気温・出生率は比較的対称です。
📐 ビン数の目安(スタージェス/フリードマン・ダイアコニス)
「何本にすべきか」に唯一の正解はありませんが、 客観的な目安があります。 スタージェスの公式 $k=\lceil \log_2 n + 1\rceil$ は $n=47$ で 7 ビン。 古典的で正規分布向きですが、 外れ値や歪みには弱め。 フリードマン・ダイアコニス(FD)法 はビン幅 $h=2\,\mathrm{IQR}/n^{1/3}$ で決め、 四分位範囲(IQR)を使うため外れ値に頑健。 上の「推奨ビン数(FD法)にする」ボタンは、 選択中のデータから IQR を計算して FD 法のビン数へスナップします。 総人口のように強く歪む分布では FD 法が実務の第一選択です(→ 本ページ「📐 階級幅を決める 3 法則」節に詳細)。
🧩 ヒストグラムの限界と補完手段
- ビン依存を避けたい → カーネル密度推定(KDE)。 ビン境界の代わりに「バンド幅」を選ぶ滑らかな密度曲線で、 端点効果を受けません(ただしバンド幅選択という別問題は残ります)。
- 群間比較・外れ値の要約 → 箱ひげ図(boxplot)。 中央値・四分位・外れ値を 1 本に凝縮でき、 複数群を横並びで比較できます。 ヒストグラムが「形」を、 箱ひげ図が「要約統計量」を見せる相補関係です。
- 右に裾が長い(歪度が大きい) → 対数変換(log変換)。 総人口は歪度が大きく線形軸では東京以外が潰れますが、 対数変換すると山がほぼ対称になり、 平均と中央値が近づきます。 上のパネルで総人口を選び、 歪みを目で確認してから対数変換の効果を読むと理解が深まります。
🎨 ヒストグラムの派生
🍰 まずはやさしく
基本の形を広げた応用的なグラフです。
より複雑なデータの関係を見るために使います。
買い物にかけるお金の傾向などを分析します。
ヒートマップなどの派生手法を紹介します。
① 2次元ヒストグラム(ヒートマップ)
2変数の関係を見るとき、 散布図ではデータが重なりすぎることがある。 そんなときは2Dヒストグラム:
plt.hist2d(x, y, bins=30, cmap='Blues')
plt.colorbar(label='頻度')
# seaborn でより綺麗に
sns.jointplot(x='食料費', y='教育費', data=df, kind='hex') # ヘキサゴンビン
② 累積ヒストグラム
「ある値以下のデータの累計」を示す:
plt.hist(data, bins=30, cumulative=True, density=True)
# 縦軸 = 累積確率(0〜1)
③ Ridgeline plot(リッジラインプロット)
多くのグループのKDEを縦に並べる。 月ごとの売上分布、 業界ごとの給料分布などに有効。 seaborn や joypy ライブラリ。
④ 帯ヒストグラム(rug plot)
ヒストグラムの下に個々のデータ点を「縦棒」で表示。 サンプルサイズが少ない時に各点を可視化:
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口)
北海道 5,092,000
東京都 14,086,000
沖縄県 1,468,000
…(全 47 行)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12 | import pandas as pd
import seaborn as sns
# ── この抜粋だけで動くように、1 本の数値列を用意する ──
_h = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
_h = _h[_h['SSDSE-B-2026'] == 2023] # 最新年度の 47 都道府県
data = _h['A1101'] # 総人口
# rug(じゅうたん)= ヒストグラムの下に 1 県ずつの位置を縦棒で表示するもの。
# seaborn 0.11 以降、histplot の rug= は廃止され rugplot を重ねる形になった
ax = sns.histplot(data, kde=True)
sns.rugplot(data, ax=ax)
|
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
🎨 ヒストグラムの応用:A/B テスト、 品質管理、 リスク分析
ヒストグラムは EDA だけでなく、 実務の多くの場面で活躍します。 SSDSE-B の文脈で 3 つの応用シーンを見ていきます。
📊 応用 1:政策効果のビフォーアフター比較(A/B 的な発想)
47 都道府県の「ある政策実施前後の指標」をヒストグラムで比較すれば、 分布全体のシフトが見えます。 例:ふるさと納税前後の自治体収入分布、 給付金前後の世帯所得分布。 平均だけ比較するより、 裾の動きが見えるのがヒストグラムの強み。
📊 応用 2:品質管理の管理図(Histogram + Control Limit)
製造プロセスの製品寸法ヒストグラムに、 上下管理限界(UCL/LCL)を重ねれば、 不良率を視覚的に把握。 SSDSE 文脈では「規定範囲を外れた都道府県数」と同じ発想。
📊 応用 3:リスク分析(VaR と裾の重さ)
金融リスク管理では損失分布のヒストグラム左裾(負の方向)の厚さを VaR(Value at Risk)で評価。 「99% 信頼水準で最大いくら損失するか」が読み取れます。 SSDSE で「人口減少率の下位 5% 県」を抽出する分析と同じ発想です。
| 応用分野 | 何をヒストグラム化 | 読み取る価値 |
|---|
| マーケティング | 顧客年齢・購買額 | セグメント設計、 ターゲット選定 |
| 品質管理 | 製品寸法・重量 | 不良率の見える化、 工程能力指数 |
| 人事 | 給与・勤続年数 | 給与体系の歪み、 高齢層偏り |
| 医療 | 血圧・BMI | 疾患リスク群の抽出 |
| 公共政策 | 47 県の社会指標 | 格差の可視化、 地域類型化 |
⚠️ 応用時の注意:「ヒストグラムを見せれば説得力がある」と思いがちですが、 ビン数を変えると印象が逆転することもあります。 説明資料に載せるときは、 FD 法など客観基準で選んだビン数を採用し、 「他のビン数でも同じ結論」と注記すると信頼性が上がります。
⚠️ ヒストグラムの 5 つの落とし穴
ヒストグラムは最も素朴な可視化ですが、 落とし穴も多い手法です。 SSDSE-B-2026 を題材に 5 つ示します。
| 落とし穴 | 症状 | 対策 |
|---|
| 1. ビン数選択 | SSDSE 人口を 5 ビン → 多峰性が消える | Freedman-Diaconis を採用、 複数ビン数で比較 |
| 2. 端点効果 | 同じデータでビン境界をズラすと形が変わる | KDE(カーネル密度推定)で補完 |
| 3. 対数スケール無視 | 線形軸では東京以外が見えない | plt.xscale('log') または対数変換 |
| 4. 連続値 vs 離散値混同 | 離散値(年齢など)にビンを切ると不自然 | 離散値は棒グラフ(bar chart) |
| 5. 多峰性見落とし | 2 つの山が 1 つの広い山に潰される | KDE で曲線化し dip テスト |
💡 実務ルール:ヒストグラムは 必ず 2〜3 通りのビン数 で描き、 「どの解像度でも見える特徴」を真の構造、 「特定のビン数でだけ見える特徴」をビンアーティファクトと判断します。
🐍 matplotlib・seaborn・numpy の 3 種実装比較
Python でヒストグラムを描く方法は複数あります。 用途別に使い分けると効率的です。
🐍 matplotlib の素朴な hist
このコードでやること:SSDSE-B-2026 の 2023 年度 47 県の総人口を、 線形の x 軸のまま Freedman-Diaconis 法のビン(bins='fd' で 16 本)で描いて PNG に保存する。
📥 入力データ:SSDSE-B-2026 の A1101(総人口)。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16 | import pandas as pd
import matplotlib.pyplot as plt
plt.rcParams['font.family'] = ['Hiragino Sans', 'IPAexGothic', 'DejaVu Sans'] # 日本語のラベルを豆腐にしない
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)]
y = df['A1101']
fig, ax = plt.subplots(figsize=(8, 5))
ax.hist(y, bins='fd', edgecolor='black') # Freedman-Diaconis
ax.set_xlabel('総人口 (人)')
ax.set_ylabel('都道府県数')
ax.set_title('SSDSE-B-2026 47県の総人口分布(FD法)')
plt.tight_layout()
plt.savefig('histogram_fd.png', dpi=120)
print('保存完了: histogram_fd.png')
|
📤 実行例:
保存完了: histogram_fd.png
[画像] 横軸に総人口 (0 〜 14,000,000人)、 縦軸に都道府県数 (0 〜 20) のヒストグラム。
FD 法のビン幅は約 84.7 万人で 16 本。 最初のビン(53.7 万〜138.4 万人)に 21 県、 次(138.4 万〜223.1 万人)に 12 県が入り、 その先は 0〜4 県の低い棒がまばらに続く。
右端 (1,400万) に東京 1 県のみがぽつんと立つ。
💬 47 県のうち 33 県が最初の 2 本(223 万人未満)に入り、 右端の 1,324 万〜1,409 万人のビンには東京都 1 県だけが立つ。 その手前には 0 県の空きビンが 4 本続くので、 線形軸のままでは東京都以外の県どうしの差はほとんど読めない。 次のブロックのように対数を取ると左側の塊がほどける。
🐍 seaborn の histplot で KDE を重ねる
このコードでやること:seaborn の histplot でヒストグラムと KDE 曲線を重ね、 「滑らかな密度」も同時に確認する。
📥 入力データ:同じ SSDSE-B-2026 の A1101。 対数変換版 np.log10(y) も併記。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 | import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
plt.rcParams['font.family'] = ['Hiragino Sans', 'IPAexGothic', 'DejaVu Sans'] # 日本語のラベルを豆腐にしない
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)]
y_log = np.log10(df['A1101'])
fig, ax = plt.subplots(figsize=(8, 5))
sns.histplot(y_log, bins=12, kde=True, ax=ax)
ax.set_xlabel('log10(総人口)')
ax.set_ylabel('都道府県数')
ax.set_title('SSDSE-B-2026 対数人口の分布 + KDE')
plt.tight_layout()
plt.savefig('histogram_log_kde.png', dpi=120)
print('保存完了: histogram_log_kde.png')
|
📤 実行例:
保存完了: histogram_log_kde.png
[画像] 横軸 log10(人口) = 5.73 〜 7.15(53.7 万 〜 1,409 万人)を 12 本に分けたヒストグラム。
5.97〜6.32(93 万〜209 万人)の 3 本に 23 県が集まり、 6.56〜6.68 の 1 本が 0 県で途切れて、 その右に大都市の 9 都道府県が小さな山を作る。 KDE 曲線はこの 2 つの山をなだらかにつなぐ。
💬 対数を取ると歪度は 2.22 から 0.79 に、 尖度は 4.95 から −0.21 に下がり、 線形軸では 1 本に潰れていた 100 万人前後の県どうしの差が読めるようになる。 ただし歪度は 0 にはならず、 右側に大都市の小さな山が残るので、 「対数を取れば正規分布」とまでは言えない。 回帰などに使う前に、 対数変換後の分布も Q-Q プロットで確かめる。
🌐 累積ヒストグラムと経験累積分布関数(ECDF)
通常のヒストグラム(度数分布)に対し、 累積ヒストグラムは「ある値以下のサンプルが何個」を積み上げて表示します。 さらに連続化したのが ECDF(Empirical Cumulative Distribution Function、 経験累積分布関数)です。 これらは「ビン幅問題」を回避できる強力な可視化です。
$$\text{ECDF: } \;F_n(x) = \frac{1}{n}\sum_{i=1}^{n}\mathbf{1}_{\{x_i \le x\}}$$
🔬 数式を言葉で読み解く
- $\mathbf{1}_{\{x_i \le x\}}$:指示関数。 $x_i$ が $x$ 以下なら 1、 そうでなければ 0。
- $\frac{1}{n}\sum$:平均を取る → 「$x$ 以下のサンプル割合」となる。
- $F_n(x)$:ある $x$ で「サンプルの何%が $x$ 以下か」を返す関数。 $x = $ 中央値で 0.5、 $x = $ 最大値で 1.0。
- ヒストグラムとの違い:ヒストグラムは「ある区間に何個」、 ECDF は「ある値以下に何%」。 ECDF は ビン幅を選ぶ必要がない、 中央値・四分位を直接読める、 という利点。
🐍 SSDSE-B-2026 で ECDF を描く
このコードでやること:47 県の総人口について ECDF を計算し、 中央値・第 1 四分位・第 3 四分位を視覚的に読み取れる図を作る。
📥 入力データ:SSDSE-B-2026 の A1101 列。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 | import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
plt.rcParams['font.family'] = ['Hiragino Sans', 'IPAexGothic', 'DejaVu Sans'] # 日本語のラベルを豆腐にしない
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)]
y = np.sort(df['A1101'].values)
n = len(y)
ecdf_x = y
ecdf_y = np.arange(1, n+1) / n
fig, ax = plt.subplots(figsize=(8, 5))
ax.step(ecdf_x, ecdf_y, where='post')
ax.axhline(0.5, color='red', linestyle='--', label='中央値')
ax.axhline(0.25, color='orange', linestyle=':', label='Q1')
ax.axhline(0.75, color='orange', linestyle=':', label='Q3')
ax.set_xlabel('総人口 (人)'); ax.set_ylabel('累積割合')
ax.set_xscale('log'); ax.legend()
plt.tight_layout(); plt.savefig('ecdf.png', dpi=120)
print(f'中央値 (Q2): {np.median(y):,.0f} 人')
print(f'Q1: {np.percentile(y, 25):,.0f} 人')
print(f'Q3: {np.percentile(y, 75):,.0f} 人')
|
📤 実行例:
中央値 (Q2): 1,549,000 人
Q1: 1,034,000 人
Q3: 2,636,500 人
💬 中央値 155 万人 < 平均 265 万人 → 強い右への歪みを再確認。 ECDF だと 「47 県の半分は 155 万以下、 75% が 264 万以下」と数値で直接読み取れる。 ヒストグラムの「ビン幅を選ぶ」苦悩から解放される手法。
🎨 ヒストグラムの応用:A/B テスト、 品質管理、 リスク分析
ヒストグラムは EDA だけでなく、 実務の多くの場面で活躍します。 SSDSE-B の文脈で 3 つの応用シーンを見ていきます。
📊 応用 1:政策効果のビフォーアフター比較(A/B 的な発想)
📊 応用 2:品質管理の管理図(Histogram + Control Limit)
📊 応用 3:リスク分析(VaR と裾の重さ)
| 応用分野 | 何をヒストグラム化 | 読み取る価値 |
|---|
| マーケティング | 顧客年齢・購買額 | セグメント設計、 ターゲット選定 |
| 品質管理 | 製品寸法・重量 | 不良率の見える化、 工程能力指数 |
| 人事 | 給与・勤続年数 | 給与体系の歪み、 高齢層偏り |
| 医療 | 血圧・BMI | 疾患リスク群の抽出 |
| 公共政策 | 47 県の社会指標 | 格差の可視化、 地域類型化 |
🎯 理解度チェック — ヒストグラム
以下の練習問題に「自分の言葉で」答えられるかを確認しよう。 詰まったら対応する節へ戻ること。
- Q1. ヒストグラムと棒グラフの違いを「x 軸が表すもの」「ビンと幅」「離散・連続」の 3 観点で説明せよ。
- Q2. Sturges の公式、 Scott の公式、 Freedman-Diaconis の公式のうち、 外れ値に強いのはどれか。 1 行で理由を添えて答えよ。
- Q3. SSDSE-B-2026 の都道府県人口は東京が右端に飛び出る。 ビン数を 5 → 30 → 100 と変えたとき、 「形状の見え方」がどう変わるかを予想せよ。
- Q4. ヒストグラムを 密度に正規化 (
density=True) する意味と、 そのまま頻度を描く場合との使い分けを説明せよ。
- Q5. ヒストグラムだけでは「分布形」を判断しきれない理由を 2 つ挙げ、 補完手段 (KDE / ECDF / boxplot) と組み合わせる必要性を説明せよ。
🛠 自分で手を動かす(5 分課題):
- SSDSE-B-2026 から「人口 (万人)」を読み込み、
plt.hist でビン数を 5/15/47 に変えた 3 枚を描画する。
- 対数スケール (
plt.xscale('log')) を適用した版と比較し、 形状の歪みがどう変わるか観察する。
density=True で正規化したヒストグラムに、 seaborn.kdeplot を重ねて表示する。- 結果から「右に裾が長い (右歪み)」「東京は外れ値」を読み取り、 1 行で要約する。
🔬 数式を言葉で読み解く
前節の数式に含まれる記号を、 日本語の意味に翻訳する。
- X, Y — 観測されたデータ系列 (SSDSE-B-2026 の各列など)
- n — 標本サイズ (47 都道府県データなら 47)
- θ, β, α — 推定すべき未知パラメータ
- ε, u — 観測されない誤差項・撹乱項
- E[·] — 期待値 (母集団平均)
- Var, Cov — 分散・共分散
- arg min / arg max — 「最小化 / 最大化するパラメータ」の意
histogram の数式は、 これらの記号を組み合わせて「データから未知量を推定する」あるいは「データの構造を要約する」プロセスを記述している。
🧮 ヒストグラムの作り方 — 4ステップ
- データの範囲を決める:最小値〜最大値
- ビン(階級)に分ける:通常 5〜30 個
- 各ビンの頻度を数える:そのビンに入るデータの個数
- 棒で描画:横軸=ビン、 縦軸=頻度
具体例:東北6県の食料費
仮にデータが [78.1, 79.0, 82.0, 83.8, 84.1, 76.0] とする:
- 範囲:76.0〜84.1(幅 8.1)
- ビン幅:3.0 とする → ビン: [76, 79), [79, 82), [82, 85)
- 頻度カウント:[76,79) → 2件、 [79,82) → 1件、 [82,85) → 3件
- 棒の高さ:2, 1, 3
📏 ビン数の選び方 — 適切な「粒度」を決める
ヒストグラムで最も重要な選択がビン数(または階級幅)。 多すぎても少なすぎても分布の形を見誤ります。
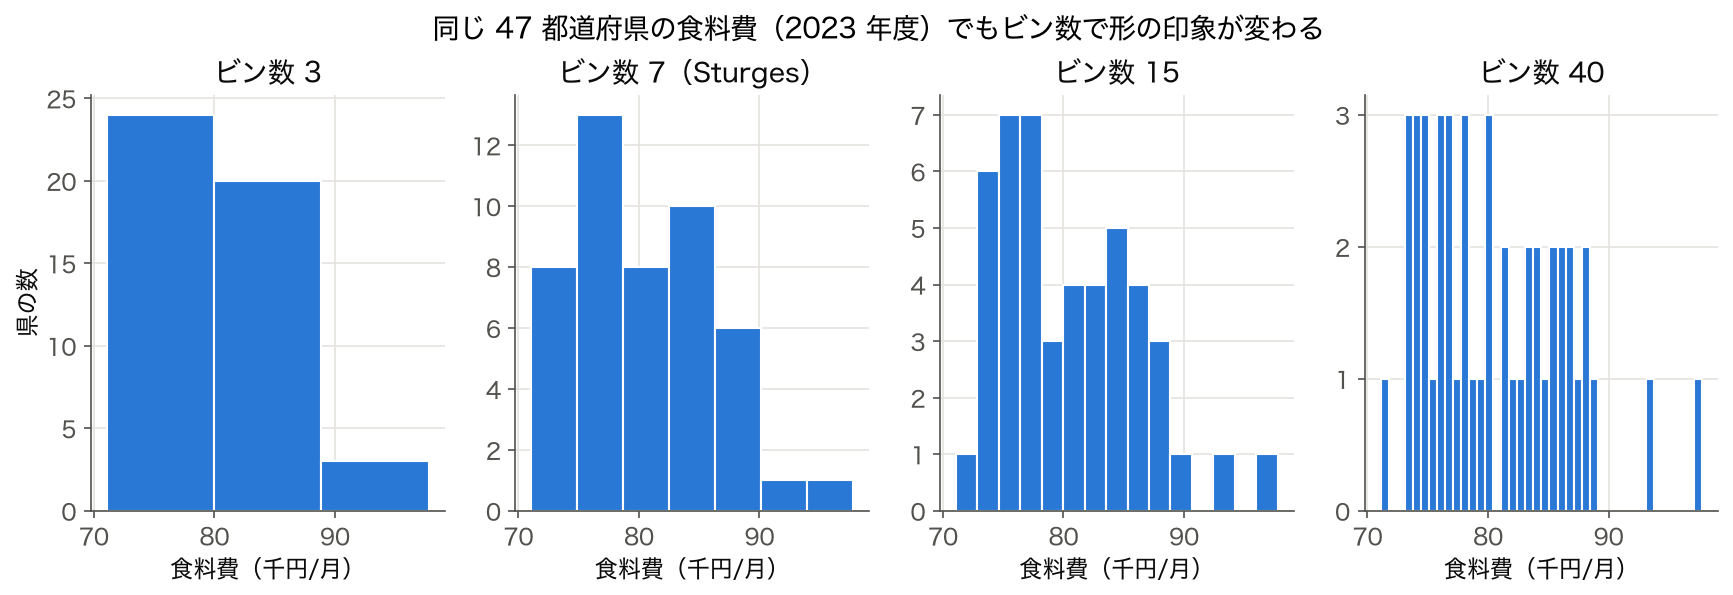
図: 同じ 47 県の食料費(2023 年度)でも、 ビン数 3 では「低い方に多い」ことしか分からず、 40 では 1 県ずつの棒が並ぶだけで形が読めない。 Sturges の 7 や 15 あたりで、 75 千円付近の山と 85 千円付近のもう 1 つの固まり、 右端の埼玉県・東京都が見えてくる。
古典的ルール
| ルール |
公式 |
特徴 |
| Sturges | k = log₂(n) + 1 | n が小さい時向き。 n=47 → k=7 |
| Rice | k = 2·n^(1/3) | Sturges の代替。 n=47 → 2×47^(1/3) ≈ 7.2 → 8(numpy の bins='rice' は切り上げ) |
| Scott | 幅 = 3.5σ / n^(1/3) | 正規分布前提 |
| Freedman-Diaconis | 幅 = 2·IQR / n^(1/3) | 外れ値に強い。 推奨 |
| √n | k = √n | 簡便な経験則 |
実用的判断
- n < 50:5〜10 個のビン
- 50 ≤ n < 500:10〜25 個
- n ≥ 500:25〜50 個
- 外れ値や歪みがある場合:Freedman-Diaconis を試す
Python では
1
2
3
4
5
6
7
8
9
10
11
12
13
14 | import numpy as np
import matplotlib.pyplot as plt
# matplotlib: bins='auto' で Sturges + Freedman-Diaconis の組合せ
plt.hist(data, bins='auto')
# 個別指定
plt.hist(data, bins=20)
plt.hist(data, bins='sturges')
plt.hist(data, bins='fd') # Freedman-Diaconis
plt.hist(data, bins='scott')
# numpy.histogram_bin_edges で値の境界だけ取得
edges = np.histogram_bin_edges(data, bins='fd')
|
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
📈 ヒストグラムで見える分布の形
ヒストグラムは分布の「形」を読み取るための強力なツール。 形から多くの情報が分かります。
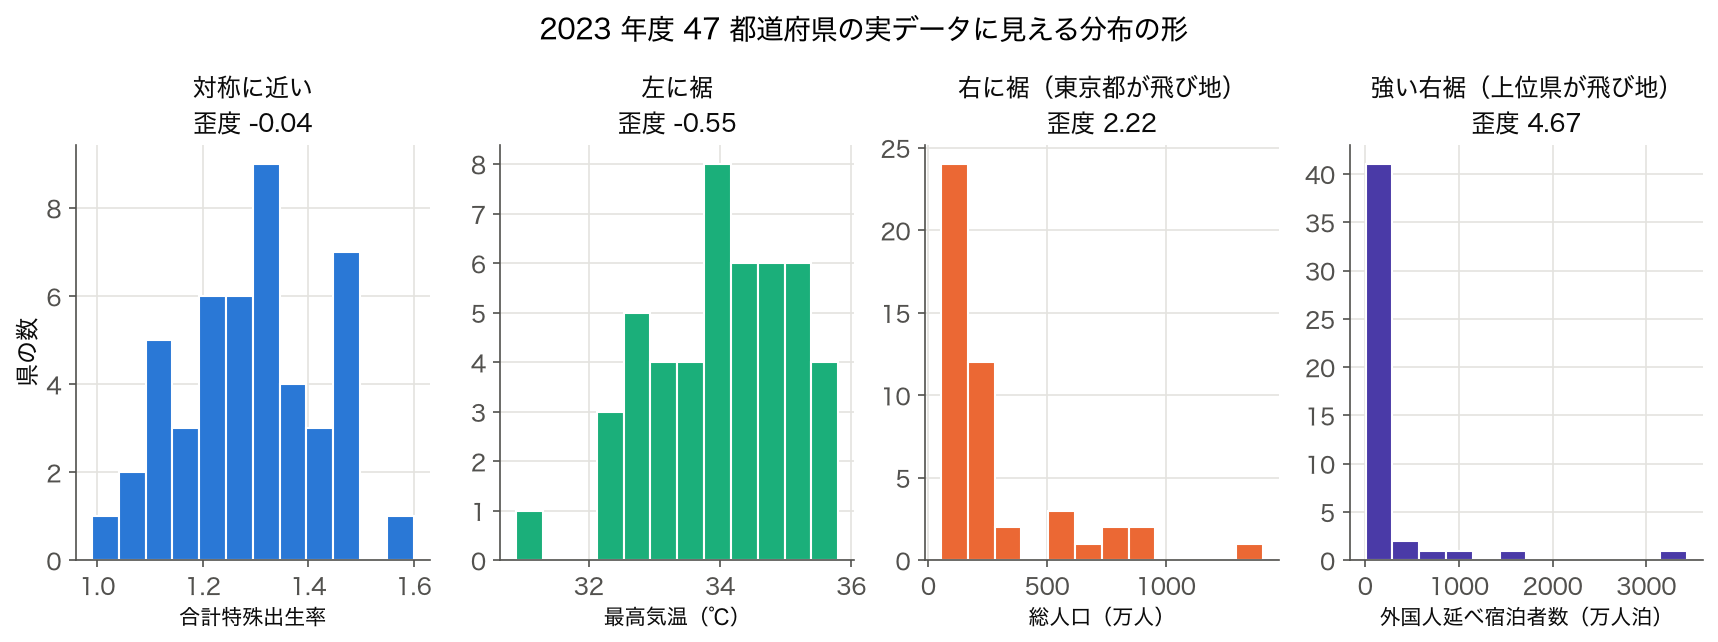
図: SSDSE-B-2026 の 2023 年度 47 都道府県から、 形の違う 4 列を並べた。 合計特殊出生率はほぼ対称(歪度 −0.04、 平均 1.29・中央値 1.30)、 最高気温は左に裾(歪度 −0.55、 1 県だけ 31℃ 台に離れる)、 総人口は右に裾で東京都(1,408.6 万人)が飛び地(歪度 2.22、 平均 264.6 万人に対し中央値 154.9 万人)、 外国人延べ宿泊者数は 41 県が最初のビンに集まり東京都(3,437.9 万人泊)が極端に離れる(歪度 4.67)。 47 県では「山が 2 つ」のようなはっきりした多峰性は出にくいので、 多峰性はチェックリストの説明で補う。
診断チェックリスト
- 対称か? → 正規分布に近い → 平均・標準偏差が代表値として有効
- 右に裾(正の歪度)→ 所得分布、 株価変動 → 中央値が安全
- 左に裾(負の歪度)→ 簡単なテスト点数など → 中央値が安全
- 山が複数(多峰性)→ 集団が混在している可能性
- 端に偏り→ 上限・下限が存在(censoring)
- 飛び地(gap)→ 2つの異なる過程が混在
🎯 頻度 vs 密度 vs KDE
ヒストグラムには「頻度」と「密度」の2種類の表記があります。
頻度 (frequency)
縦軸 = そのビンに入るデータの個数(整数)。 一番直感的。
密度 (density)
縦軸 = 頻度 ÷ (n × ビン幅)。 全体の面積が1になるよう正規化。 異なるビン幅やサンプルサイズのヒストグラムを比較するときに使用。
KDE(カーネル密度推定)
ヒストグラムを「滑らかに」したもの。 ビン幅の影響を受けにくく、 連続的な分布が見える。
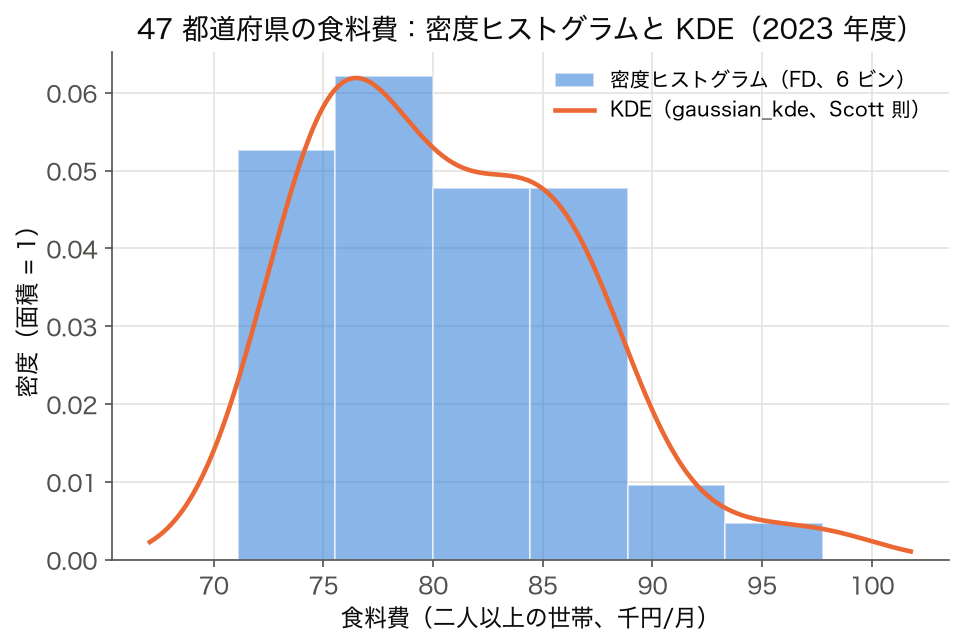
図: 縦軸を密度(面積 = 1)にした食料費のヒストグラム(Freedman-Diaconis 則で 6 ビン、 幅 4.45 千円)と、 scipy の gaussian_kde(Scott 則、 バンド幅係数 0.463)の曲線。 KDE の山は 76.5 千円にあり、 85 千円付近に肩、 右に埼玉県・東京都の裾が続く。 KDE は 71〜98 千円の外にも少しはみ出す点に注意。
KDE は scipy.stats.gaussian_kde や seaborn.kdeplot で簡単に描けます。 ヒストグラムと併用するとさらに情報量が増えます。
🆚 群間比較ヒストグラム
2つ以上のグループの分布を重ねて比較できます。 「東日本と西日本では食料費の分布が違うか?」など。
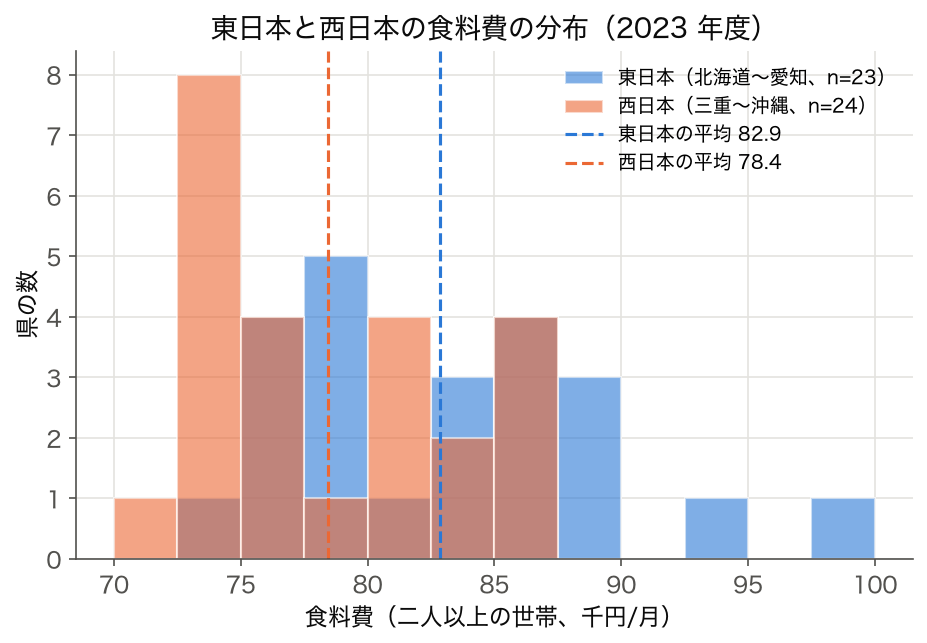
図: 北海道〜愛知の 23 都道県を東日本、 三重〜沖縄の 24 府県を西日本として重ねた(ビン幅 2.5 千円)。 西日本は 72.5〜75 千円に 8 県が集まり、 東日本は 80 千円より右に多く、 90 千円を超えるのは東日本の 2 県(埼玉県・東京都)だけ。 平均は東日本 82.9 千円・西日本 78.4 千円で、 約 4.4 千円の差がある。 仮説検定で確かめるのが次のステップで、 Welch の t 検定では t = 2.76、 p = 0.0087 となる(ただし東京都・埼玉県など首都圏の高い県が東日本の平均を押し上げている点も合わせて見る)。
seaborn での群間比較
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 SSDSE-B-2026(年度) L322101(食料費(二人以上の世帯)) L322102(住居費(二人以上の世帯)) L322108(教育費(二人以上の世帯)) L3221(消費支出(二人以上の世帯))
北海道 2,023 74,341 26,730 6,911 296,888
東京都 2,023 97,776 26,457 24,160 341,320
沖縄県 2,023 73,453 27,521 6,356 251,222
…(全 47 行)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 | import pandas as pd
# ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)──
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1)
df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy()
df['年度'] = pd.to_numeric(df['年度'], errors='coerce')
df = df[df['年度'] == df['年度'].max()].copy()
for _c in df.columns[3:]:
df[_c] = pd.to_numeric(df[_c], errors='coerce')
# 費目の正式名は「◯◯費(二人以上の世帯)」。短い別名を付けて使いやすくする
df['食料費'] = df['食料費(二人以上の世帯)']
df['住居費'] = df['住居費(二人以上の世帯)']
df['教育費'] = df['教育費(二人以上の世帯)']
df['光熱費'] = df['光熱・水道費(二人以上の世帯)']
df['消費支出'] = df['消費支出(二人以上の世帯)']
# 「地域」は SSDSE に無いので、地域コードの頭 2 桁(都道府県番号)から作る
def _blk(code):
n = int(str(code)[1:3])
return ('北海道' if n == 1 else '東北' if n <= 7 else '関東' if n <= 14
else '中部' if n <= 23 else '近畿' if n <= 30 else '中国' if n <= 35
else '四国' if n <= 39 else '九州沖縄')
df['地域'] = df['地域コード'].map(_blk)
import seaborn as sns
# 重ね合わせ
sns.histplot(data=df, x='食料費', hue='地域', alpha=0.5, kde=True)
# 並べる
sns.histplot(data=df, x='食料費', hue='地域', multiple='dodge')
# 積み上げ
sns.histplot(data=df, x='食料費', hue='地域', multiple='stack')
# 確率密度として正規化(群間サイズが違っても比較可)
sns.histplot(data=df, x='食料費', hue='地域', stat='density', common_norm=False)
|
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
SSDSE-B-2026 には所得の列が無いので、 実在する列「消費支出(二人以上の世帯、 L3221)」の 2023 年度 47 都道府県の値(千円/月)で度数分布表を作り、 ヒストグラムの手順をたどります。
① 度数分布表(ビン幅 20 千円)
| 階級(千円/月) | 度数 | 相対度数 | 累積度数 |
|---|
| 220–240 | 1 | 2.1% | 1(愛媛県) |
| 240–260 | 3 | 6.4% | 4 |
| 260–280 | 9 | 19.1% | 13 |
| 280–300 | 9 | 19.1% | 22 |
| 300–320 | 18 | 38.3% | 40 |
| 320–340 | 5 | 10.6% | 45 |
| 340–360 | 2 | 4.3% | 47(東京都・埼玉県) |
② ビン幅選択則の比較
n = 47、 範囲 = 344.1 − 223.4 = 120.7 千円、 標準偏差 σ = 24.1 千円、 IQR = 307.5 − 279.5 = 28.0 千円の場合:
Sturges:⌈log₂(47)+1⌉ = 7 ビン → 幅 ≈ 120.7 / 7 ≈ 17.2 千円
Scott:3.5σ/n^(1/3) = 3.5 × 24.1 / 3.61 ≈ 23.4 千円
Freedman-Diaconis:2·IQR/n^(1/3) = 2 × 28.0 / 3.61 ≈ 15.5 千円(外れ値に頑健)
Rice:2·n^(1/3) ≈ 7.2 → 8 ビン
③ 分布の特徴
消費支出の分布は人口と違って 左に裾が長い(歪度 −0.52)。 300〜320 千円の階級に 18 県(38.3%)が集まるピークがあり、 最小の愛媛県(223.4 千円)が左に 1 県だけ離れている。 中央値(300.7 千円)が平均(295.9 千円)より大きいのは、 この左の裾が平均を引き下げるため。 右端の 340〜360 千円には東京都(341.3)と埼玉県(344.1)の 2 都県が入る。
🧮 SSDSE-B-2026 で「ビン数の影響」を体感する
SSDSE-B-2026 の 47 都道府県の総人口(A1101)を題材に、 ビン数を 5・10・20・40 と変えてヒストグラムの形がどう変わるかを観察します。
🐍 3 つの法則で SSDSE-B のビン数を計算
このコードでやること:SSDSE-B-2026 の 47 県の総人口 A1101 に対し、 Sturges / Scott / Freedman-Diaconis の 3 法則で推奨ビン数を計算し、 比較する。
📥 入力データ:SSDSE-B-2026.csv、 47 県の総人口 A1101(最小 54 万、 最大 1409 万)。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21 | import pandas as pd
import numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)]
y = df['A1101'].values
n = len(y)
sturges = np.ceil(np.log2(n) + 1).astype(int)
sigma = y.std()
iqr = np.percentile(y, 75) - np.percentile(y, 25)
range_ = y.max() - y.min()
scott_h = 3.5 * sigma / n**(1/3)
fd_h = 2 * iqr / n**(1/3)
scott_k = np.ceil(range_ / scott_h).astype(int)
fd_k = np.ceil(range_ / fd_h).astype(int)
print(f'n={n}, σ={sigma:,.0f}人, IQR={iqr:,.0f}人, レンジ={range_:,.0f}人')
print(f'Sturges: {sturges} ビン')
print(f'Scott: {scott_k} ビン (h={scott_h:,.0f}人)')
print(f'FD: {fd_k} ビン (h={fd_h:,.0f}人)')
|
📤 実行例:
n=47, σ=2,767,630人, IQR=1,602,500人, レンジ=13,549,000人
Sturges: 7 ビン
Scott: 6 ビン (h=2,684,171人)
FD: 16 ビン (h=888,100人)
💬 3 法則で ビン数が 7・6・16 と違う。 SSDSE-B の歪んだ分布では FD(16 ビン)が「東京が右端で 1 県ぽつん」を浮かび上がらせ、 Sturges(7 ビン)は「ほとんどが左端の 1 ビンに集中」と見せる。 同じデータが、 ビン数選択で別の話に見える典型例。
🧮 数式に値を入れて手で計算する: ヒストグラム階級と度数
合成データ [2,5,7,12,18,22,25,28,33,40] を 4 階級に分割する。
Step 1: 階級設定
min=2, max=40, 範囲 = 38
4 階級 → 幅 = 38/4 = 9.5 → 切り上げ 10
階級: 0-10, 10-20, 20-30, 30-40
Step 2: 度数
| 階級 | 度数 |
|---|
| 0-10 | 3 (2,5,7) |
| 10-20 | 2 (12,18) |
| 20-30 | 3 (22,25,28) |
| 30-40 | 2 (33,40) |
合計 = 10
🐍 Python で再現
| import numpy as np
x = np.array([2,5,7,12,18,22,25,28,33,40])
hist, bins = np.histogram(x, bins=[0,10,20,30,40])
print(f"度数: {hist}")
print(f"階級境界: {bins}")
|
📤 実行結果
度数: [3 2 3 2]
階級境界: [ 0 10 20 30 40]
💬 手計算 (Step 2) [3,2,3,2] と Python 出力が完全一致。
🐍 matplotlib・seaborn・numpy の 3 種実装比較
Python でヒストグラムを描く方法は複数あります。 用途別に使い分けると効率的です。
🐍 matplotlib の素朴な hist
📥 入力データ:SSDSE-B-2026 の A1101(総人口)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 | import pandas as pd
import matplotlib.pyplot as plt
plt.rcParams['font.family'] = ['Hiragino Sans', 'IPAexGothic', 'DejaVu Sans'] # 日本語のラベルを豆腐にしない
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)]
y = df['A1101']
fig, ax = plt.subplots(figsize=(8, 5))
ax.hist(y, bins='fd', edgecolor='black') # Freedman-Diaconis
ax.set_xlabel('総人口 (人)')
ax.set_ylabel('都道府県数')
ax.set_title('SSDSE-B-2026 47県の総人口分布(FD法)')
plt.tight_layout()
plt.savefig('histogram_fd.png', dpi=120)
print('保存完了: histogram_fd.png')
|
📤 実行例:
保存完了: histogram_fd.png
[画像] 横軸に総人口 (0 〜 14,000,000人)、 縦軸に都道府県数 (0 〜 20) のヒストグラム。
FD 法のビン幅は約 84.7 万人で 16 本。 最初のビン(53.7 万〜138.4 万人)に 21 県、 次(138.4 万〜223.1 万人)に 12 県が入り、 その先は 0〜4 県の低い棒がまばらに続く。
右端 (1,400万) に東京 1 県のみがぽつんと立つ。
🐍 seaborn の histplot で KDE を重ねる
📥 入力データ:同じ SSDSE-B-2026 の A1101。 対数変換版 np.log10(y) も併記。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 | import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
plt.rcParams['font.family'] = ['Hiragino Sans', 'IPAexGothic', 'DejaVu Sans'] # 日本語のラベルを豆腐にしない
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)]
y_log = np.log10(df['A1101'])
fig, ax = plt.subplots(figsize=(8, 5))
sns.histplot(y_log, bins=12, kde=True, ax=ax)
ax.set_xlabel('log10(総人口)')
ax.set_ylabel('都道府県数')
ax.set_title('SSDSE-B-2026 対数人口の分布 + KDE')
plt.tight_layout()
plt.savefig('histogram_log_kde.png', dpi=120)
print('保存完了: histogram_log_kde.png')
|
📤 実行例:
保存完了: histogram_log_kde.png
[画像] 横軸 log10(人口) = 5.73 〜 7.15(53.7 万 〜 1,409 万人)を 12 本に分けたヒストグラム。
5.97〜6.32(93 万〜209 万人)の 3 本に 23 県が集まり、 6.56〜6.68 の 1 本が 0 県で途切れて、 その右に大都市の 9 都道府県が小さな山を作る。 KDE 曲線はこの 2 つの山をなだらかにつなぐ。
matplotlib(基本)
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 L322101(食料費(二人以上の世帯))
北海道 74,341
東京都 97,776
沖縄県 73,453
…(全 47 行)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 | import matplotlib.pyplot as plt
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1)
df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県(絞らないと 12 年度分 564 件が混ざる)
# 基本ヒストグラム
plt.figure(figsize=(10, 5))
plt.hist(df['食料費(二人以上の世帯)'], bins=15, color='steelblue', edgecolor='white')
plt.xlabel('食料費(二人以上の世帯)')
plt.ylabel('頻度')
plt.title('食料費の分布(2023 年度・47 都道府県)')
plt.show()
# pandas の直接機能
df['食料費(二人以上の世帯)'].hist(bins=15, color='steelblue', edgecolor='white')
# 平均と中央値を線で
plt.axvline(df['食料費(二人以上の世帯)'].mean(), color='red', linewidth=2, label='平均')
plt.axvline(df['食料費(二人以上の世帯)'].median(), color='orange', linestyle='--', label='中央値')
plt.legend()
|
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
seaborn(高機能)
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 SSDSE-B-2026(年度) L322101(食料費(二人以上の世帯)) L322102(住居費(二人以上の世帯)) L322108(教育費(二人以上の世帯)) L3221(消費支出(二人以上の世帯))
北海道 2,023 74,341 26,730 6,911 296,888
東京都 2,023 97,776 26,457 24,160 341,320
沖縄県 2,023 73,453 27,521 6,356 251,222
…(全 47 行)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38 | import pandas as pd
# ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)──
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1)
df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy()
df['年度'] = pd.to_numeric(df['年度'], errors='coerce')
df = df[df['年度'] == df['年度'].max()].copy()
for _c in df.columns[3:]:
df[_c] = pd.to_numeric(df[_c], errors='coerce')
# 費目の正式名は「◯◯費(二人以上の世帯)」。短い別名を付けて使いやすくする
df['食料費'] = df['食料費(二人以上の世帯)']
df['住居費'] = df['住居費(二人以上の世帯)']
df['教育費'] = df['教育費(二人以上の世帯)']
df['光熱費'] = df['光熱・水道費(二人以上の世帯)']
df['消費支出'] = df['消費支出(二人以上の世帯)']
# 「地域」は SSDSE に無いので、地域コードの頭 2 桁(都道府県番号)から作る
def _blk(code):
n = int(str(code)[1:3])
return ('北海道' if n == 1 else '東北' if n <= 7 else '関東' if n <= 14
else '中部' if n <= 23 else '近畿' if n <= 30 else '中国' if n <= 35
else '四国' if n <= 39 else '九州沖縄')
df['地域'] = df['地域コード'].map(_blk)
import seaborn as sns
# 1変数 + KDE
sns.histplot(df['食料費(二人以上の世帯)'], kde=True, color='steelblue')
# 群別
sns.histplot(data=df, x='食料費(二人以上の世帯)', hue='地域', element='step')
# 密度プロット
sns.kdeplot(df['食料費(二人以上の世帯)'], fill=True)
# 結合プロット
sns.jointplot(x='食料費(二人以上の世帯)', y='教育費(二人以上の世帯)',
data=df, kind='hist')
|
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
plotly(インタラクティブ)
1
2
3
4
5
6
7
8
9
10
11
12
13
14 | import plotly.express as px
fig = px.histogram(df, x='食料費', nbins=15, marginal='box')
fig.write_html('hist_food.html') # ブラウザで開くと操作できる図(ノートブックなら fig.show())
# 群別
fig = px.histogram(df, x='食料費', color='地域', barmode='overlay')
fig.write_html('hist_food_region.html')
# 図に描かれる値を数字でも確かめる
s = df['食料費']
print(f"県数 {len(s)} / 最小 {s.min():,.0f} 円({df.loc[s.idxmin(), '都道府県']})"
f" / 中央値 {s.median():,.0f} 円 / 最大 {s.max():,.0f} 円({df.loc[s.idxmax(), '都道府県']})")
print('地域別の県数:', df['地域'].value_counts().to_dict())
|
📤 実行例(実測)
県数 47 / 最小 71,088 円(愛媛県) / 中央値 79,939 円 / 最大 97,776 円(東京都)
地域別の県数: {'中部': 9, '九州沖縄': 8, '関東': 7, '近畿': 7, '東北': 6, '中国': 5, '四国': 4, '北海道': 1}
💬 図は hist_food.html などに書き出し、画面には図に描かれる値だけを出した。2023 年度 47 都道府県の食料費(二人以上の世帯、月額)は愛媛県 71,088 円から東京都 97,776 円まで、中央値 79,939 円。15 本のビンに 47 県を振り分けると 1 本あたり平均 3 県ほどしか入らず、地域で色分けした 2 枚目の図では北海道 1 県・四国 4 県のように 1〜9 県ずつの群を重ねることになるので、形の違いを読み取るのは難しい。
🤖 機械学習でのヒストグラム
① EDA(探索的データ分析)の第一歩
機械学習プロジェクトの最初に、 各特徴量のヒストグラムを描く。 分布の形から:
- 外れ値があるか → 除去・変換が必要
- 歪んでいるか → log 変換、 Box-Cox 変換が必要
- カテゴリが偏っていないか → クラス不均衡対策が必要
② Histogram-based Gradient Boosting
LightGBM や XGBoost は、 連続値を高速処理するためにヒストグラムベースのアルゴリズム(Hist GBDT)を採用。 ビン化が高速化の鍵。
③ 画像処理(色のヒストグラム)
画像の RGB 各チャンネルの分布を見る。 ヒストグラム均等化(histogram equalization)は古典的なコントラスト向上手法。
④ オートエンコーダの入力分布
生成モデルの学習時、 入力データの分布と再構成データの分布をヒストグラムで比較。 ずれていれば学習不足。
🚧 ヒストグラムの落とし穴
1️⃣ ビン数で印象が変わる
同じデータでもビン数を変えると分布の見え方が変わる。 複数のビン数で確認、 KDE を併用するのが安全。
2️⃣ サンプルサイズが小さいと不安定
n=10 程度ではヒストグラムの形は安定しません。 KDE や箱ひげ図のほうが情報損失が少ない。
3️⃣ 軸のスケールを忘れない
裾の長い分布(所得、 株価)では対数軸が見やすい:plt.xscale('log')
4️⃣ 縦軸の頻度 vs 密度を混同しない
群間比較する時、 サイズが違うグループは「密度」で描く必要があります(生の頻度だと比較不能)。
5️⃣ 0からの軸を保つ
棒グラフ・ヒストグラムは縦軸を 0 から始めるのが原則。 切り取ると差が誇張されます。
6️⃣ 名義変数には使わない
「血液型」「性別」のようなカテゴリ変数には棒グラフ(bar chart)を使う。 ヒストグラムは連続値用。
📜 ヒストグラムの歴史
- John Graunt(1662):死亡記録の最初の頻度表(ヒストグラム的可視化)
- William Playfair(1786):棒グラフの発明
- Karl Pearson(1891):「histogram」という用語を提唱
- Rosenblatt(1956)、 Parzen(1962):KDE の発明 → ヒストグラムの理論的後継
- Sturges(1926)、 Scott(1979)、 Freedman & Diaconis(1981):ビン数選択の数学的ルールを次々と提案
🐍 Python 実装バリエーション — matplotlib / seaborn / pandas / plotly
① matplotlib(基本、 細かい制御)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 | import matplotlib.pyplot as plt
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)
df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県
col = '消費支出(二人以上の世帯)' # SSDSE-B に所得の列は無いので、世帯の月間消費支出(円)を使う
plt.hist(df[col], bins=10, edgecolor='black', alpha=0.7)
plt.xlabel('消費支出(円/月)')
plt.ylabel('度数')
plt.title('都道府県別 消費支出の分布(2023 年度)')
plt.grid(axis='y', alpha=0.3)
plt.show()
# ビン幅自動選択
plt.hist(df[col], bins='fd') # Freedman-Diaconis
|
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
② seaborn(KDEと組み合わせ、 美しい統計可視化)
| import seaborn as sns
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)
df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県
col = '消費支出(二人以上の世帯)'
sns.histplot(df[col], kde=True, bins=15, color='skyblue')
# rugplotで生データ位置を表示
sns.rugplot(df[col], color='red', height=0.05)
|
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
③ pandas(DataFrameで全数値列を一括)
| import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)
df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県
df[['総人口', '消費支出(二人以上の世帯)', '食料費(二人以上の世帯)']].hist(bins=10, figsize=(12, 4), layout=(1, 3))
# Series単独で hist
df['消費支出(二人以上の世帯)'].plot(kind='hist', bins=15)
|
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
④ numpy(数値計算用、 度数表だけ欲しい時)
| import numpy as np
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)
df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県
counts, bin_edges = np.histogram(df['消費支出(二人以上の世帯)'], bins=10)
print('度数:', counts)
print('境界:', bin_edges.round(0))
# 累積分布
cum = np.cumsum(counts) / counts.sum()
print('累積相対度数:', cum.round(3))
|
📤 実行例(実測)
度数: [ 1 0 3 3 7 5 17 4 4 3]
境界: [223423. 235490. 247557. 259624. 271691. 283758. 295824. 307891. 319958.
332025. 344092.]
累積相対度数: [0.021 0.021 0.085 0.149 0.298 0.404 0.766 0.851 0.936 1. ]
💬 消費支出を 10 本のビンに分けると、295,824〜307,891 円のビンに 17 県が集まり、累積相対度数はそこで 0.404 から 0.766 へ一気に上がる。最低のビンには愛媛県(223,423 円)1 県だけが入り、次のビンは 0 県と空いているので、左側に 1 県だけ離れた外れ値がある形になっている。ビン幅は (344,092 − 223,423) / 10 ≈ 12,067 円で、境界を少しずらすだけで 17 県の山が 2 つに割れることもある。
⑤ plotly(インタラクティブ)
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 L3221(消費支出(二人以上の世帯))
北海道 296,888
東京都 341,320
沖縄県 251,222
…(全 47 行)
1
2
3
4
5
6
7
8
9
10
11
12
13 | import plotly.express as px
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1)
df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県(絞らないと 12 年度分 564 件が 1 本のヒストグラムに混ざる)
col = '消費支出(二人以上の世帯)' # 月あたりの世帯消費支出(円)。所得ではない
fig = px.histogram(df, x=col, nbins=15, marginal='box',
title='都道府県別 消費支出(二人以上の世帯)の分布(2023 年度)')
fig.show()
s = df[col]
print('県数:', len(s))
print(f'最小 {s.min():,} 円({df.loc[s.idxmin(), "都道府県"]}) / 中央値 {s.median():,.0f} 円 / 最大 {s.max():,} 円({df.loc[s.idxmax(), "都道府県"]})')
|
📤 実行例(実測)
県数: 47
最小 223,423 円(愛媛県) / 中央値 300,652 円 / 最大 344,092 円(埼玉県)
💬 2023 年度に絞った 47 県の世帯消費支出は、最小が愛媛県の 223,423 円、中央値 300,652 円、最大が埼玉県の 344,092 円で、東京都(341,320 円)より埼玉県の方が高い。年度で絞らずに描くと 12 年度分 564 件が 1 本のヒストグラムに混ざり、同じ県が 12 回数えられてしまう。また、この列は世帯の所得ではなく支出である。marginal='box' の箱ひげ図で、下側に離れた県があるかどうかを確かめる。
⑥ 2群比較(男女・地域別)
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 SSDSE-B-2026(年度) L322101(食料費(二人以上の世帯)) L322102(住居費(二人以上の世帯)) L322108(教育費(二人以上の世帯)) L3221(消費支出(二人以上の世帯))
北海道 2,023 74,341 26,730 6,911 296,888
東京都 2,023 97,776 26,457 24,160 341,320
沖縄県 2,023 73,453 27,521 6,356 251,222
…(全 47 行)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30 | import pandas as pd
# ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)──
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1)
df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy()
df['年度'] = pd.to_numeric(df['年度'], errors='coerce')
df = df[df['年度'] == df['年度'].max()].copy()
for _c in df.columns[3:]:
df[_c] = pd.to_numeric(df[_c], errors='coerce')
# 費目の正式名は「◯◯費(二人以上の世帯)」。短い別名を付けて使いやすくする
df['食料費'] = df['食料費(二人以上の世帯)']
df['住居費'] = df['住居費(二人以上の世帯)']
df['教育費'] = df['教育費(二人以上の世帯)']
df['光熱費'] = df['光熱・水道費(二人以上の世帯)']
df['消費支出'] = df['消費支出(二人以上の世帯)']
# 「地域」は SSDSE に無いので、地域コードの頭 2 桁(都道府県番号)から作る
def _blk(code):
n = int(str(code)[1:3])
return ('北海道' if n == 1 else '東北' if n <= 7 else '関東' if n <= 14
else '中部' if n <= 23 else '近畿' if n <= 30 else '中国' if n <= 35
else '四国' if n <= 39 else '九州沖縄')
df['地域'] = df['地域コード'].map(_blk)
import seaborn as sns
# SSDSE-B に「平均所得」の列は無いので、実在する消費支出で代用する
sns.histplot(data=df, x='消費支出', hue='地域', element='step',
stat='density', common_norm=False)
# stat='density'で確率密度に正規化、 common_norm=Falseで群ごとに正規化
|
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
⚠️ ヒストグラムの 5 つの落とし穴
ヒストグラムは最も素朴な可視化ですが、 落とし穴も多い手法です。 SSDSE-B-2026 を題材に 5 つ示します。
| 落とし穴 | 症状 | 対策 |
|---|
| 1. ビン数選択 | SSDSE 人口を 5 ビン → 多峰性が消える | Freedman-Diaconis を採用、 複数ビン数で比較 |
| 2. 端点効果 | 同じデータでビン境界をズラすと形が変わる | KDE(カーネル密度推定)で補完 |
| 3. 対数スケール無視 | 線形軸では東京以外が見えない | plt.xscale('log') または対数変換 |
| 4. 連続値 vs 離散値混同 | 離散値(年齢など)にビンを切ると不自然 | 離散値は棒グラフ(bar chart) |
| 5. 多峰性見落とし | 2 つの山が 1 つの広い山に潰される | KDE で曲線化し dip テスト |
- ビン幅選択による印象操作:ビン数を 5 にすると分布が滑らかに見え、 50 にするとデコボコに見える。 同じデータでもビン幅で「形」が変わる。 単一のビン幅で結論を出さず、 複数のビン幅で確認するか、 KDE(密度推定)と併用するのが賢明。 Sturges は古典的だが大標本でビン数不足になりがちなので、 Scott や Freedman-Diaconis を使うと良い。
- 連続データと離散データの混同:離散値(評価点1〜5など)にビン幅を勝手に決めると、 2ポイント以上が同じビンに入って意味が崩れる。 離散データには棒グラフ(bar chart)を使う。 ヒストグラムは連続変数、 棒グラフはカテゴリ、 という使い分けを明確に。
- 累積度数と確率密度の混同:plt.hist の density=True は 面積が1 になるように規格化された確率密度を出す。 縦軸を「確率」と勘違いしないこと。 ビン幅 × 高さの面積がその範囲に入る割合。 累積分布関数(ECDF)とは別物。
- 対数スケールの誤用:所得や売上のような右に裾の長いデータをそのままヒストグラムにすると、 ピークが左に偏って詳細が見えない。 横軸を対数スケール(log)にするか、 対数変換後の値でヒストグラムを描く。 ただし負値や0には対数が取れないので log(x+1) などの工夫が必要。
- 2群の比較で重ね合わせを誤る:男女別ヒストグラムを単純に重ねると見えにくい。 alpha=0.5 で半透明にする、 stacked=True で積み上げる、 step型で輪郭のみ表示、 など状況に応じた選択を。 違いを際立たせたいなら正規化(density=True)して同じスケールに揃える。
- 小標本でのギザギザ問題:n が小さい(<30)と、 たまたまそのビンに値が入るかどうかでヒストグラムが不安定になる。 KDE のような滑らかな推定を使うか、 ジッタープロット(rugplot)併用で生データも見せる。
- 3D・派手な装飾の罠:3D棒グラフや影付きヒストグラムは「印象的」だが、 比較が困難で誤読を招く。 シンプルな2D棒で、 グリッド線・色合いを抑えるのが優れたヒストグラムの基本。
🗺️ 概念マップ — 3つの視点で体系を理解する
ヒストグラム がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 記述統計 › 可視化 › ヒストグラム
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に ヒストグラム を置き、 そこから 散布図・箱ひげ図・正規分布・外れ値・平均・回帰直線 など 計 10 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
凡例:現在の用語上位カテゴリ兄弟(並列)前提発展形応用先2階層先
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「ヒストグラム」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「ヒストグラム」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ |
分かること |
こんな時に見る |
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは ヒストグラム の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 可視化 → ヒストグラム という入れ子の位置を示します。 「可視化には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔗 隣接手法への橋渡し
「ヒストグラム」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
上流のビン幅選択 (Sturges・Freedman-Diaconis 法) で離散化を設計し、 並列のカーネル密度推定 (KDE)・箱ひげ図と分布表現を比較し、 下流の正規性検定 (Shapiro-Wilk)・歪度・尖度で分布特性を定量化する。 ヒストグラムはビン幅次第で見え方が激変するため、 必ず複数ビン幅と KDE を併用して結論を出す。
🌳 手法選択フロー
ヒストグラムを使うべき場面: (1) 1 変数の分布形状確認 — 正規・対数正規・二峰性・歪みを目視で判断、 (2) 外れ値の発見 — 右の裾だけ長い場合は log 変換を検討、 (3) ビン幅の決定 — Sturges (k = log2(n)+1)、 Scott (h = 3.5σ/n^(1/3))、 Freedman-Diaconis (h = 2 IQR/n^(1/3)) のいずれかを採用。
ヒストグラム以外を選ぶべき場面: (a) n < 30 のとき → 個別の点を見せる stripplot / dotplot、 (b) 2 群の比較が主目的 → boxplot / violinplot で並べる、 (c) 滑らかな密度推定が必要 → KDE (Kernel Density Estimation, sns.kdeplot)、 (d) 累積分布の確認 → ECDF プロット (Empirical CDF, sns.ecdfplot) — ビン幅選びの問題を回避できる。
実務フロー: 「まずデフォルト bins=10 で形状確認 → 二峰性が疑われたら bins=30 や 50 で再確認 → ビン幅を Freedman-Diaconis や np.histogram_bin_edges('fd') で自動決定 → 必要に応じて KDE / ECDF と併用」の 4 ステップが現代的な分布探索の定石。 SSDSE-B-2026 で「47 都道府県の人口分布」をヒストグラム化すると、 東京・神奈川・大阪が極端な右の外れ値として浮かび上がり、 log10 変換 (sns.histplot(df['人口'], log_scale=True)) で正規分布に近い形になることが視認できる。
👁️ 直感をもう一段深める — ヒストグラムは「連続データの地図」
ヒストグラムの本質は、 連続した数直線を 階級(ビン)という区間に区切り、 各区間に落ちたデータの件数(度数)を棒の高さに変換することです。 バラバラの点の集まりだった生データが、 「どこにデータが集まり、 どこがスカスカか」という密度の地図に変わります。 一枚の図から、 分布の 4 つの特徴 が同時に読み取れるのが最大の価値です。
| 読み取る特徴 | 図のどこを見るか | SSDSE-B-2026(2023・47県)の例 |
|---|
| 中心 | 山の頂点の横位置 | 総人口の中央値は約 155 万人(平均は約 265 万人) |
| 広がり | 棒が横に伸びる範囲 | 総人口は約 54 万人〜1409 万人(東京)まで |
| 歪み | 左右どちらの裾が長いか | 右に長い裾(歪度 +2.22)=正の歪み |
| 多峰性 | 山が 1 つか複数か | 総人口は単峰+極端な右外れ値(東京・大阪) |
なぜ棒グラフ(bar chart)ではなくヒストグラムなのか。 棒グラフはカテゴリ(順序のない離散)を横に並べるため棒の間に隙間を空けますが、 ヒストグラムは連続量を区間で区切るため棒は隙間なく密着します。 この「棒がくっついているか離れているか」が両者の見分け方であり、 横軸が数直線(連続)ならヒストグラム、 横軸がラベル(離散カテゴリ)なら棒グラフと覚えると混同しません。
また、 縦軸には 度数(count)と 密度(density)の 2 種類があります。 度数はそのビンに入った件数そのもの、 密度は「棒の面積の合計が 1 になるよう正規化」した高さです。 ビン幅が不揃いのときや、 サンプルサイズの違う 2 群を重ねて比較するときは、 必ず密度に正規化しないと高さの比較が意味を持ちません(詳しくは下の落とし穴節)。
⚠️ さらなる落とし穴 — ビン境界の恣意性と「密度 vs 度数」
上の「🎮 触って理解する」と「⚠️ 5 つの落とし穴」を踏まえ、 実務で特に事故が多いポイントを実測値とともに整理します。
① ビン幅とビン境界の恣意性 — 同じデータが別の話に見える
ヒストグラム最大の弱点は、 ビン幅(何本に区切るか)と ビン境界(どこから区切り始めるか)という 2 つの任意パラメータで見え方が激変する点です。 ビン数を減らせば構造が平滑化されて消え、 増やせばノイズでガタガタになる。 さらにビン数を固定しても、 境界を半ビン分ずらすだけで山の位置や高さの印象が変わります(端点効果)。 「二峰性があるように見えた/見えなくなった」の多くは、 データではなくビン設定のアーティファクトです。
② ビン幅選択則の比較(SSDSE-B-2026 総人口・実測)
恣意性を減らす客観基準が Sturges / Scott / Freedman-Diaconis の 3 法則です。 SSDSE-B-2026 の 2023 年・47 都道府県の 総人口(A1101)に当てはめた実測結果が下表です($n=47$、 範囲は約 54 万〜1409 万人、 IQR ≈ 160 万人、 $\sigma$ ≈ 280 万人、 歪度 +2.22)。
| 法則 | 式 | ビン幅 $h$ / ビン数 $k$ | 性質 |
|---|
| Sturges | $k=\lceil\log_2 n+1\rceil$ | k ≈ 7 本(幅 ≈ 194 万人) | 正規分布前提。歪み・外れ値に弱い |
| Scott | $h=3.5\,\sigma/n^{1/3}$ | 幅 ≈ 271 万人 → k ≈ 5 本 | $\sigma$ を使うため外れ値で幅が広がり平坦化 |
| Freedman-Diaconis | $h=2\,\mathrm{IQR}/n^{1/3}$ | 幅 ≈ 89 万人 → k ≈ 16 本 | IQR を使うため外れ値に頑健。歪み分布で第一選択 |
💬 同じ 47 県・同じ総人口でも、 Scott なら 5 本・Sturges なら 7 本・FD なら 16 本と 3 倍以上の差。 東京という極端な外れ値が $\sigma$ を膨らませるため Scott は粗くなりすぎ、 IQR ベースの FD は細部を保ちます。 強く右に歪むこのデータでは FD 法が適切です(ビン数はレンジ÷$h$の切り上げで、 算出法により±1本ずれることがあります)。
③ 少数データでの不安定さ
$n=47$(都道府県数)のように標本が小さいと、 ビンを細かくした瞬間に各ビンの度数が 0 か 1 になり、 形が読めなくなります。 目安として 1 ビンあたり平均 5 件以上が欲しいところで、 47 件なら実質 7〜10 本程度が上限。 少数データではヒストグラムに固執せず、 個々の点を見せる ドットプロット / ラグプロットや、 平滑化する KDE の併用が安全です。
④ 離散データにビンを切る誤り
「子どもの人数」「サイコロの目」のような離散値にヒストグラムのビンを切ると、 境界の取り方次第で隣り合う値が同じビンに入ったり分かれたりして不自然な段差が出ます。 離散値は各値をそのまま 1 本の棒にする 棒グラフ(bar chart)が正解です。
⑤ 対数軸・スケール潰れ・密度 vs 度数
- 外れ値でスケールが潰れる:総人口を線形軸で描くと東京(1409 万人)が右端に一点、 残り 46 県が左端に密集して潰れます。
plt.xscale('log') や 対数変換で解消(log10 変換すると歪度が +2.22 → +0.79 に低下し、 ほぼ対称になります)。
- 対数ビン:桁が広いデータ(所得・人口・都市規模)は等間隔ビンより対数間隔ビン(
bins=np.logspace(...))が適切。 このとき縦軸は必ず密度で正規化します(ビン幅が不揃いのため)。
- 密度 vs 度数の取り違え:サンプルサイズの違う 2 群を重ねるとき、 度数のままだと大きい群が常に高く見えます。
density=True(matplotlib)/stat='density'(seaborn)で面積を 1 に揃えてはじめて形の比較ができます。
💡 まとめの実務ルール:(1) ビン数は FD 法など客観基準で決める、 (2) それでも 2〜3 通りのビン数で描いて「どの解像度でも見える特徴」だけを信じる、 (3) 群比較・裾の重い分布では KDE・対数軸・密度正規化を併用する。
🚀 発展 — KDE・累積・対数ビン・2次元・バイオリン
ヒストグラムのビン依存という弱点を補い、 用途を広げる発展手法を整理します。 いずれもヒストグラムの「分布の形を見る」という目的の延長線上にあります。
① カーネル密度推定(KDE)との比較
KDE(kernel density estimation)は各データ点に小さな山(カーネル)を置いて足し合わせ、 滑らかな密度曲線を得る手法です。 ビン境界という不連続な区切りがないため端点効果を受けませんが、 代わりに「バンド幅(平滑化の強さ)」という別のパラメータ選択が必要になります。 実務ではヒストグラム(度数の実体が見える)と KDE(滑らかな形が見える)を重ねて描くのが定石です。 詳細は カーネル密度推定(KDE) を参照。
② 累積ヒストグラム・ECDF
累積ヒストグラム(cumulative=True)は「ある値以下のデータが全体の何割か」を示し、 これを点の階段として厳密化したものが 経験累積分布関数(ECDF)です。 ECDF は ビン幅を一切選ばずに分布を完全に表現でき、 中央値・分位点(例:下位 5% 県)を横軸から直読できます。 2 群の分布差を厳密に比べる Kolmogorov–Smirnov 検定の基礎でもあります。
③ 密度正規化・対数ビン
密度正規化(面積を 1 に)は確率密度関数と直接比較したいときや群比較に必須。 対数ビンは人口・所得・都市規模のように数桁にまたがる裾の重いデータで、 等間隔ビンより構造を保ちます。 総人口のように歪度 +2.22 の分布では、 対数変換+等間隔ビン、 または対数ビン+密度正規化のいずれかが読みやすくなります。
④ 二次元ヒストグラム
2 変数の同時分布を見たいが散布図では点が重なりすぎる場合、 平面を格子(ビン)に区切り各セルの度数を色で表す 2 次元ヒストグラム(plt.hist2d/六角形なら hexbin)が有効。 これは ヒートマップの一種で、 大量データの密度を可視化できます。
⑤ バイオリンプロット
バイオリンプロットは KDE を左右対称に描いた密度曲線と 箱ひげ図を合体させたもので、 複数群の分布の「形」と「要約統計量」を横並びで比較できます。 ヒストグラムが 1 変数の形、 箱ひげ図が要約、 バイオリンがその中間(複数群の形の比較)を担う、 という役割分担で理解すると使い分けが明確になります。
🔗 あわせて読みたい関連ページ
ヒストグラムの理解を、 前提・並列・発展の 3 方向に広げる用語ページへのリンクです。
※ バイオリンプロット・歪度(skewness)の単独用語ページは本用語集には未収録のため、 本ページ内(🚀 発展節・📐 数式節)の解説を参照してください。