🔖 キーワード索引 — 仮説検定を多角的に理解する
🔖 キーワード索引 — 仮説検定を多角的に理解する
仮説検定(hypothesis testing)を確実に理解するための関連キーワードを難易度別に整理しました。
🟢 基礎キーワード(まず押さえる)
- 帰無仮説(H₀, null hypothesis):「効果がない」「差がない」とする仮説。 検定では棄却を目指す。
- 対立仮説(H₁, alternative):H₀ が棄却された場合に採択される仮説。 片側・両側がある。
- p 値:H₀ が真のとき、 観測されたデータ以上に極端な結果が得られる確率。
- 有意水準 α:p 値の閾値。 慣例的に 0.05、 厳しい場合 0.01 や 0.001。
- 第一種の過誤(Type I error, α):H₀ が真なのに棄却してしまう(偽陽性)。
- 第二種の過誤(Type II error, β):H₀ が偽なのに棄却できない(偽陰性)。
- 検出力(power, 1 − β):H₁ が真のときに H₀ を棄却できる確率。
🟡 中級キーワード
- 片側検定 vs 両側検定:方向を事前に仮定するかしないか。 通常は両側、 方向性が確定している場合のみ片側。
- 効果量(effect size):差の大きさを標準化した指標。 Cohen's d、 r、 η² など。
- 標本サイズ設計(power analysis):α、 1−β、 効果量から必要 N を逆算する。
- パラメトリック検定 vs ノンパラメトリック検定:分布の仮定の有無。 t 検定 vs Wilcoxon、 ANOVA vs Kruskal–Wallis。
- 多重比較問題(multiple comparisons):複数の検定で α が累積する問題。 Bonferroni、 Holm、 BH 法で補正。
- 信頼区間(confidence interval):p 値と表裏一体の情報。 効果量の不確実性を区間で表現。
🔴 上級キーワード
- p-hacking と再現性危機:閾値を超えるまで検定を繰り返す p 値ハッキング。 心理学・医学で深刻。
- 事前登録(preregistration):研究計画を事前に公開し、 p-hacking を防ぐ。
- ベイズ因子(Bayes factor):頻度論の p 値に対するベイズ的代替指標。
- 同等性検定(equivalence testing, TOST):「差がないこと」を統計的に支持する検定。
- 偽発見率(FDR, false discovery rate):多重検定での偽陽性割合の制御。 Benjamini–Hochberg 法。
- 順列検定(permutation test):分布の仮定なしに p 値を経験的に算出する。
🔖 キーワード索引 — 完全強化版
「仮説検定」を理解するうえで必要なキーワードを 10 件以上提示します。 各チップから対応セクションへ移動できます。
30 秒結論 文脈 直感 数式 記号読み解き 実値計算 Python 実装 落とし穴 関連手法 関連用語 グループ教材 概念マップ
💡 30秒で分かる結論
🍰 まずはやさしく
データで正解を判断する仕組みです。
主張が正しいかを決めるために使います。
部活の練習法で効果があるか調べます。
判定に使う重要な言葉を学びます。
- 仮説検定:標本データから「母集団についての主張」を判断する枠組み
- H₀ vs H₁:H₀ を立てて、 標本データがそれを支持しないかを判定
- p値:H₀ が真と仮定したとき、 観測データ以上に極端な値が出る確率
- 有意水準 α:通常 0.05(医療は0.01、 物理は5σ)
- 検出力 1-β:H₁ が真のときに正しく棄却する確率(通常 0.80 目標)
- 効果量:差の大きさ(p値だけでは不十分)
- 前提:代表値、 確率分布、 標本・CLT
- 次に学ぶ:t検定、 ANOVA、 χ²検定
🗂️ 章俯瞰 — 仮説検定の全体像
「標本データから母集団についての主張を判断する」枠組み。 Fisher(1925)と Neyman-Pearson(1933)が体系化。 統計推論の中核ですが、 21世紀に入って多くの誤解と再現性危機が指摘されています。 本ページでは古典的体系を押さえつつ、 現代的な批判と改善も含めて解説します。
仮説検定の5ステップ
- 仮説を立てる:H₀(帰無)と H₁(対立)を明確に
- 有意水準を決める:α(通常 0.05)— 事前に決める
- 検定統計量を計算:データから t値 / z値 / χ²値 / F値 を算出
- p値を出す:「H₀ が真の時、 これ以上極端な統計量が出る確率」
- 判断:p < α なら H₀ を棄却、 結果を効果量・信頼区間と併記
🎯 H₀(帰無仮説)と H₁(対立仮説)
仮説検定は「背理法に似た論理」で進めます。 まず「差はない」「効果はない」という消極的な仮説 H₀を立て、 データがそれを否定するほど極端かを問います。
例:
- 新薬の効果検証:H₀「薬とプラセボに差はない」 vs H₁「薬の方が効果あり」
- A/B テスト:H₀「新UI のCVR は旧と同じ」 vs H₁「新UI の方が高い」
- 47都道府県:H₀「東日本と西日本の食料費平均は等しい」 vs H₁「異なる」
💡 重要:「H₀ を棄却できなかった」≠「H₀ が真である」。 「証拠不十分」というだけ。 「効果がない」を主張するには別の枠組み(同等性検定など)が必要。
📊 p値(p-value)
「H₀ が真と仮定したとき、 観測されたデータ(の検定統計量)と同じかそれ以上に極端な結果が偶然出る確率」。
$$ p = P(|T| \ge |t_\text{obs}| \mid H_0) $$
記号:$T$ は検定統計量(確率変数)、 $t_\text{obs}$ は観測された値、 $|\cdot|$ は両側検定の場合。
解釈:
- p が小さい → H₀ のもとでは「ありえない」結果が観測された → H₀ を疑う
- p が大きい → H₀ で説明可能 → H₀ を棄却できない
- 通常 p < 0.05 を「統計的に有意」とする(慣習)
p値の重大な誤解
| ❌ 誤った解釈 | ✅ 正しい解釈 |
|---|---|
| p = 0.03 → H₀ が真である確率は 3% | H₀ が真と仮定したときの確率(条件付き) |
| p < 0.05 → 効果が大きい | 「偶然じゃない」だけで効果量とは別 |
| p > 0.05 → 効果がない | 「証拠不十分」、 効果はあるかもしれない |
| p値が小さいほど信頼できる | サンプルサイズが大きいだけかもしれない |
2016 年の 米統計学会 (ASA) 声明は、 p値だけで結論を出さないことを強調。 効果量・信頼区間・複数アプローチを併用すべき。
📏 有意水準 α
「H₀ が真なのに棄却してしまう」誤り(第I種誤り、 false positive)を許容する確率。 事前に決めるべき。
| 分野 | 慣習的 α | 理由 |
|---|---|---|
| 心理学・社会学 | 0.05 | Fisher 由来の慣習 |
| 医療試験(FDA 承認) | 0.05(両側) | 承認基準 |
| 物理学(粒子発見) | 5σ ≈ 3×10⁻⁷ | 「発見」を主張する厳しさ |
| GWAS(遺伝子) | 5×10⁻⁸ | 100万 SNP の多重比較 |
| 経済学 | 0.05〜0.10 | サンプル取得困難 |
近年は「p < 0.05 という基準そのものを見直すべき」という議論も。 Benjamin et al.(2018)は「α = 0.005 を新標準に」と提案。
💡 30 秒で分かる結論 — 完全強化版
- 仮説検定 とは、データ分析の重要概念のひとつで、人口上位 10 県とそれ以外で出生数 (A4101) の平均に差があるかを検定 という形で SSDSE-B-2026 でも検証できます。
- 本ページでは 数式・直感・実コード・落とし穴の 4 つの視点で整理しています。
- SSDSE-B-2026 の A4101 列を中心に、実値で計算を体験することを推奨します。
- 類似概念や前提概念へのリンクを併用すると、概念地図全体での位置づけが掴めます。
- 初学者は「直感 → 数式 → 実装 → 落とし穴」の順で読むのが効率的です。
📍 あなたが今見ているもの
🍰 まずはやさしく
分析でよく出てくる用語の集まりです。
データの意味を正しく読み取るために使います。
スマホの利用時間と成績の関係を調べます。
基本の言葉から最新の考え方まで読みます。
論文・記事に 「p値」「有意水準」「帰無仮説」「対立仮説」「検出力」「効果量」「第I種誤り」「第II種誤り」「多重比較」 として登場する用語群。 推測統計の中核ですが、 21世紀になって多くの誤解と再現性危機が指摘されています。 古典的体系 + 現代的批判 + ベイズの代替を含めて学びます。
📍 文脈ボックス — あなたが今見ているもの(完全強化版)
このセクションは「仮説検定」を扱う 用語ページ です。 統計データ分析コンペティション(2026)の再現教材における中核用語のひとつで、人口上位 10 県とそれ以外で出生数 (A4101) の平均に差があるかを検定 という観点で SSDSE-B-2026(47 都道府県 × 複数年 × 100 超列)に紐づけられます。
位置づけ:相関・線形回帰・仮説検定 といった基礎用語群と並列であり、応用としては 内生性・IV・DID・クラスタリング 等へ繋がります。
🎨 直感で掴む — 完全強化版
🍰 まずはやさしく
データを分析するための眼鏡のようなものです。
隠れた特徴を見つけ出すために使います。
地域によって買い物の傾向が違うか調べます。
この眼鏡を使ってデータを眺める方法を読みます。
仮説検定 を一言でいえば「群分けした都道府県の間で、 出生数 (A4101) のような指標の平均に差があるかをデータで判定する枠組み」。 47 都道府県という小さな母集団でも、 SSDSE-B-2026 の A4101 列(出生数)に注目すると、 大都市圏と地方の差・人口規模に伴う相対比較など、 様々なパターンが見えてきます。
比喩でいうと、 仮説検定 はデータ分析の「眼鏡」のようなもの。 同じデータでも眼鏡を変えれば、 平均(中心)・分散(ばらつき)・相関(連動)・因果(影響)と、 異なる情報が浮かび上がります。 SSDSE-B-2026 を題材に、 この眼鏡をかけてみるのが本ページの狙いです。
- 具体例 1:47 都道府県の A4101 の中央値 ± 四分位を見ると、 規模感が掴める。
- 具体例 2:A4101 と組み合わせて散布図にすると、 群構造が見える。
- 具体例 3:政令指定都市の有無で群分けすると、 介入研究の素材になる。
🎮 触って理解する — 帰無分布・棄却域・p値・過誤
スライダーとボタンを動かすと、 帰無分布(H₀ が真のときの検定統計量の分布)の上に棄却域が塗られ、 観測統計量から p値がリアルタイムに再計算されます。 p < α なら H₀ を棄却、 そうでなければ保留(採択できず)を色で示します。 「過誤モード」に切り替えると、 対立分布との重なりで第一種の過誤 α・第二種の過誤 β・検出力 1−β を可視化します。
💡 グラフ上を左右にドラッグ/タップしても観測統計量を動かせます。 過誤モードは標準正規(シフトモデル)で α・β・検出力を厳密計算します(t の非心分布は扱いません)。
- 帰無仮説 H₀ / 対立仮説 H₁:中央の帰無分布が「H₀ が正しいと仮定した世界」。 対立仮説は棄却域の向き(両側/片側)で表現される。
- p 値:観測値以上に極端な結果が H₀ のもとで出る確率(青い面積)。 「H₀ が正しい確率」ではないことに注意。 α を動かしても p 値は変わらない(p はデータのみで決まる)点をスライダーで確かめられる。
- 有意水準 α:棄却域(赤)の面積。 データを見る前に決める閾値で、 第一種の過誤を許容する確率そのもの。
- 第一種の過誤(α, 偽陽性) / 第二種の過誤(β, 偽陰性):過誤モードで、 α を下げると赤い棄却域が縮み β(紫)が増えるトレードオフが見える。
- 検出力 1−β:対立分布 H₁ のうち棄却域に入る割合。 δ(効果の大きさ)や α を大きくすると増える。
- 多重比較:この α をそのまま多数の検定に使うと偽陽性が累積する(10 回で約 1−0.95¹⁰≈40%)。 補正が必要。
📐 効果量(Effect Size)
🍰 まずはやさしく
差がどれくらい大きいかを示す物差しです。
実質的な影響があるかを判断するために使います。
勉強法を変えて点数がどれだけ上がったか調べます。
数値の読み方と基準について読みます。
📐 効果量(Effect Size)
「p値が小さい」だけでは「効果が大きい」とは限らない。 効果の実質的な大きさを表すのが効果量。
| 場面 | 効果量 | 公式 | 小 / 中 / 大 |
|---|---|---|---|
| 2 群平均差 | Cohen's d | $(\mu_1 - \mu_2)/\sigma$ | 0.2 / 0.5 / 0.8 |
| 相関 | r | Pearson 相関係数 | 0.1 / 0.3 / 0.5 |
| 回帰 | R² | 決定係数 | 0.02 / 0.13 / 0.26 |
| ANOVA | η² (eta²) | 説明される分散 | 0.01 / 0.06 / 0.14 |
| χ² | Cramér's V | $\sqrt{\chi^2/(n(k-1))}$ | 0.1 / 0.3 / 0.5 |
| ロジスティック | Odds Ratio | オッズ比 | 1.5 / 2.5 / 4.0 |
Cohen の基準は慣習であって絶対ではない。 分野によって「中程度」の感覚は異なる。 医療では小さな効果量でも臨床的に重要、 心理学では中効果が標準など。
↔️ 片側検定と両側検定
事前に「方向」が決まっているなら片側、 そうでなければ両側:
| タイプ | H₁ | 使い時 |
|---|---|---|
| 両側 | $\mu \ne \mu_0$ | 通常はこちら |
| 右片側 | $\mu > \mu_0$ | 「増加」だけ検出したい時 |
| 左片側 | $\mu < \mu_0$ | 「減少」だけ検出したい時 |
⚠️ データを見てから片側にするのは禁忌(p-hacking)。 必ず事前に決めること。
🔢 多重比較問題
10 個の検定を $\alpha=0.05$ で行うと、 すべて H₀ が真でも偶然に有意になる確率は $1-0.95^{10} \approx 40\%$。 何も補正しないと「探索的に有意なペアを選んだ」状態になり、 再現性危機の温床になります。
| 補正法 | 概要 | 特徴 |
|---|---|---|
| Bonferroni | $\alpha / m$ で判定 | 最も保守的・厳しい |
| Holm | 段階的 Bonferroni | Bonf より検出力↑ |
| Benjamini-Hochberg (BH) | FDR(偽発見率)制御 | 現代の主流 |
| Tukey HSD | ANOVA 後の全ペア比較 | 事後検定用 |
1 2 3 4 5 6 7 8 9 | from statsmodels.stats.multitest import multipletests p_values = [0.001, 0.01, 0.03, 0.04, 0.10, 0.20] # Benjamini-Hochberg (FDR) rej, p_adj, _, _ = multipletests(p_values, alpha=0.05, method='fdr_bh') # Bonferroni rej, p_adj, _, _ = multipletests(p_values, alpha=0.05, method='bonferroni') |
仮説検定 の代表的な定義式は次のとおりです。
$$ \text{reject } H_0 \;\Leftrightarrow\; p\text{-value} < \alpha $$ここで使われる記号や演算の意味は次節で言葉に翻訳します。
🔬 数式を言葉で読み解く — 完全強化版
数式の各記号を、日本語の意味に変換します。
- X, Y — 観測されたデータ系列(SSDSE-B-2026 の A4101, A1101 列など)
- n — 標本サイズ(47 都道府県データなら 47、 多年度パネルなら 47×年数)
- H₀, H₁ — 帰無仮説・対立仮説。 データで棄却の可否を判断する対象
- T, t_obs — 検定統計量(確率変数)とその観測値。 p 値は P(|T| ≥ |t_obs| ∣ H₀)
- α — 有意水準=第一種の過誤(偽陽性)を許容する確率(本ページでは回帰係数ではなくこの意味)
- β, 1−β — 第二種の過誤(偽陰性)の確率と、 その裏返しである検出力
- μ, μ₀ — 母平均と、 H₀ で仮定する基準値
- E[·] — 期待値(母集団平均)
- Cov, Var — 共分散・分散
🔬 理論深掘り:仮説検定の本質
仮説検定は、 帰無仮説 H0 と対立仮説 H1 を立てて、 観測データが H0 のもとで起こる確率(p 値)を計算し、 有意水準 α と比較して H0 を棄却するか判断する統計推測の基本枠組み。
形式的定義の再確認
仮説検定 (Hypothesis Testing) は、 統計・データ解析の文脈で頻繁に登場する概念です。 ここでは初学者向けの直感と、 上級者向けの形式定義を併記します。
SSDSE-B-2026 における具体例
「東京都の高齢化率は全国的な水準より低いか?」を 1 標本 t 検定の枠組みで考える。 H0: μ = 0.316(2023 年・47 都道府県の高齢化率 A1303/A1101 の単純平均、 実測値)、 H1: μ ≠ 0.316。 東京の 2023 年の高齢化率は約 0.228 で 47 都道府県中最も低く、 平均から約 2.6 標準偏差(s ≈ 0.033)下方に位置する。 SSDSE-B-2026 の年度別データで複数年の検定も可能。
SSDSE-B-2026 は 都道府県別社会経済データ集 2026 年版で、 47 都道府県 × 約 10 年度 × 100 超の指標を含む公的データです。 仮説検定の概念を SSDSE-B-2026 で実証することで、 「数値の動きが地理的・社会的直感と整合するか」を検証できます。
使用する主要な SSDSE-B-2026 列
| 列コード | 意味 | 本ページでの用途 |
|---|---|---|
A1101 | 総人口 | 県別人口の差の検定 |
A1303 | 65 歳以上人口 | 高齢化率の地域差検定 |
E1101 | 幼稚園数 | 教育リソースの差検定 |
F3101 | 新規求職申込件数(一般) | 労働市場の地域差検定 |
🧮 SSDSE-B-2026 実値計算例 — 47 都道府県データで仮説検定
合成データではなく、 公的統計を念頭に仮説検定の具体的手順を数値で示します。
① 「東日本と西日本で平均寿命に差はあるか」(2 群 t 検定)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # データ:47 都道府県の平均寿命(仮想値、 実際は男女別や年により異なる) 東日本(北海道〜三重 24 都道県):平均 = 84.3、 標準偏差 = 0.7、 N = 24 西日本(滋賀〜沖縄 23 府県):平均 = 84.8、 標準偏差 = 0.6、 N = 23 # 仮説 H₀: μ_東 = μ_西 H₁: μ_東 ≠ μ_西(両側) # t 統計量(Welch) 標準誤差 SE = sqrt(0.7²/24 + 0.6²/23) = sqrt(0.0204 + 0.0157) = sqrt(0.0361) ≈ 0.190 t = (84.3 - 84.8) / 0.190 ≈ -2.63 df ≈ 44.5(Welch 補正) # p 値(両側) p = 2 · P(T < -2.63) ≈ 0.012 # 結論:α = 0.05 で H₀ を棄却 # 「西日本の方が東日本より平均寿命が長い」と統計的に有意 |
② 効果量 Cohen's d の計算
1 2 3 4 5 6 7 8 9 10 11 12 | # プールされた標準偏差 s_pool = sqrt(((24-1)·0.7² + (23-1)·0.6²) / (24+23-2)) = sqrt((23·0.49 + 22·0.36) / 45) = sqrt((11.27 + 7.92) / 45) = sqrt(0.426) ≈ 0.653 # Cohen's d d = |84.3 - 84.8| / 0.653 ≈ 0.766 # Cohen の基準: # 0.2 → 小、 0.5 → 中、 0.8 → 大 → 効果量は「中〜大」、 実質的にも意味のある差 |
③ 信頼区間とのリンク
1 2 3 4 5 6 7 | # 平均差の 95% 信頼区間 平均差 = 84.3 - 84.8 = -0.50 t(0.025, 44.5) ≈ 2.014 95% CI = -0.50 ± 2.014·0.190 = [-0.883, -0.117] # 0 を含まないので p < 0.05 と整合 # 「西日本の平均寿命は東日本より 0.12〜0.88 年長い(95% 信頼)」 |
④ 標本サイズ設計
1 2 3 4 5 6 7 | # 目標:効果量 d = 0.5、 α = 0.05(両側)、 検出力 1−β = 0.80 # 公式:n = 2·(z_{α/2} + z_β)²/d² n = 2·(1.96 + 0.84)²/0.5² = 2·7.84/0.25 ≈ 63 → 各群 63 件、 計 126 件のサンプルが必要 # z 近似の値。t 分布に基づく厳密計算(statsmodels)では各群 ≈ 64 |
⑤ 多重比較補正(47 都道府県の全ペア検定)
# 47 都道府県の総当たり t 検定
ペア数 = 47·46/2 = 1081

# 単純に α = 0.05 のままだと
偽陽性の期待数 = 1081 × 0.05 ≈ 54 件

# Bonferroni 補正
α_補正 = 0.05/1081 ≈ 4.6×10⁻⁵
→ p < 4.6×10⁻⁵ のペアだけ有意

# Holm-Bonferroni / BH 法ならもう少し緩やか
🧮 実値で計算してみる — SSDSE-B-2026 で 仮説検定(完全強化版)
SSDSE-B-2026(公的統計の社会・教育系データセット、 47 都道府県 × 10 年分超 × 100 以上の列)を用いて、 「仮説検定」を体感します。 ファイル名は SSDSE-B-2026.csv、 読み込みは下記の Python コードで行います。
1 2 3 4 5 6 7 8 | import pandas as pd # SSDSE-B-2026 を読み込む(cp932 / Shift_JIS) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') print(df.shape) # (564, 112) print(df['SSDSE-B-2026'].unique()) # 含まれる年度 latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() print(latest[['Prefecture', 'A4101', 'A1101']].head()) |
💬 564 行は 47 都道府県 × 12 年度で、年度は 2023 から 2012 へ新しい順に並ぶ。検定の標本は 1 県 1 行の latest(47 行)で、564 行のまま t 検定に入れると同じ県を 12 回数えて標本数を水増しし、p が不当に小さくなる。北海道の 2023 年度の出生数は 24,430 人、総人口は 5,092,000 人。
ここで使った中心列 A4101 は SSDSE-B-2026 における出生数(人)です。 例えば 2023 年に人口上位 10 県とそれ以外で出生数の平均を Welch の t 検定で比較すると t = 5.74、 p ≈ 0.0003(実測値)となります。 算出例:
- 47 都道府県・最新年度の
A4101平均と標準偏差を求める A4101とA1101の相関(線形・順位)を比較する- 群分け(例:人口上位 10 県 vs それ以外)で平均差を見る
🧮 数式に値を入れて手で計算する: 母平均の Z 検定
合成データで H₀: μ=50 を Z 検定で評価する。
Step 1: データ
Step 2: Z 統計量
🐍 Python で再現
1 2 3 4 5 6 7 | from scipy.stats import norm xbar, mu0, sigma, n = 53, 50, 10, 100 se = sigma / n**0.5 Z = (xbar - mu0) / se p = 2 * (1 - norm.cdf(abs(Z))) print(f"Z = {Z}") print(f"p = {p:.4f}") |
📤 実行結果
💬 手計算 (Step 2) Z=3.0 / p≈0.0027 と Python 出力が完全一致。
🐍 Python 実装のバリエーション — scipy / statsmodels / pingouin
① scipy.stats による各種検定
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | import pandas as pd # ── この抜粋だけで動くように、47 都道府県・最新年度を読み込む ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] from scipy import stats # SSDSE-B に「平均寿命」の列は無いので、実在する列で同じ検定をやってみる。 # ここでは高齢化率を東日本 / 西日本で比べる _east_pref = ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県', '茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県', '新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県', '静岡県','愛知県'] df = _d.copy() df['region'] = df['Prefecture'].apply(lambda p: 'east' if p in _east_pref else 'west') df['高齢化率'] = df['A1303'] / df['A1101'] * 100 east = df[df['region'] == 'east']['高齢化率'] west = df[df['region'] == 'west']['高齢化率'] # 1 標本 t 検定(全国平均 29% と違うか) t1, p1 = stats.ttest_1samp(east, popmean=29.0) print(f'1 標本 t: t={t1:.3f}, p={p1:.4f}') # 2 標本 t 検定(Welch、 等分散非仮定) t2, p2 = stats.ttest_ind(east, west, equal_var=False) print(f'Welch t: t={t2:.3f}, p={p2:.4f}') # 対応のある t 検定(同じ県の 2012 年と 2023 年を比べる) _all = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _all['aging'] = _all['A1303'] / _all['A1101'] * 100 _p = _all.pivot_table(index='Prefecture', columns='SSDSE-B-2026', values='aging') t3, p3 = stats.ttest_rel(_p[2023], _p[2012]) print(f'対応のある t: t={t3:.3f}, p={p3:.4g}') |
② statsmodels で本格的な検定
1 2 3 4 5 6 7 8 9 10 | import statsmodels.stats.api as sms from statsmodels.stats.weightstats import ttest_ind # Welch t 検定(自由度・p 値・統計量を取得) t, p, df_ = ttest_ind(east, west, usevar='unequal') print(f't={t:.3f}, p={p:.4f}, df={df_:.2f}') # 平均差の信頼区間 cm = sms.CompareMeans.from_data(east, west) print(cm.tconfint_diff(usevar='unequal')) |
③ pingouin で効果量・前提チェック込みの 1 行 t 検定
1 2 3 4 5 | import pingouin as pg result = pg.ttest(east, west, paired=False, correction='auto') print(result.round(3).T) # 列が多く横に切れるので、縦に並べて全項目を表示する # T, dof, alternative, p-val, CI95%, cohen-d, BF10, power まで一括出力 |
④ サンプルサイズ・検出力の計算
1 2 3 4 5 6 7 8 9 10 11 | from statsmodels.stats.power import TTestIndPower analysis = TTestIndPower() # 効果量 d=0.5、 α=0.05、 power=0.8 で必要 N n = analysis.solve_power(effect_size=0.5, alpha=0.05, power=0.80) print(f'各群必要 N = {n:.1f}') # 既知の N で検出力 power = analysis.solve_power(effect_size=0.3, alpha=0.05, nobs1=50, ratio=1) print(f'検出力 = {power:.3f}') |
⑤ 多重比較補正
1 2 3 4 5 6 7 8 9 10 | from statsmodels.stats.multitest import multipletests p_values = [0.001, 0.012, 0.034, 0.048, 0.06, 0.10, 0.20] # Bonferroni rej, p_adj, _, _ = multipletests(p_values, method='bonferroni') print('Bonferroni 補正後 p:', p_adj) # Benjamini–Hochberg rej_bh, p_bh, _, _ = multipletests(p_values, method='fdr_bh') print('BH 補正後 p:', p_bh) |
⑥ 同等性検定(TOST)
1 2 3 4 5 6 7 8 9 | from statsmodels.stats.weightstats import ttost_ind # 同等性の閾値 ±0.5 # ttost_ind は (全体の p, 下側検定の (t, p, df), 上側検定の (t, p, df)) を返す p_all, lower, upper = ttost_ind(east, west, low=-0.5, upp=0.5) print(f'TOST p(全体)= {p_all:.4f}') print(f'TOST p(下限)= {lower[1]:.4f}') print(f'TOST p(上限)= {upper[1]:.4f}') # 両方 < 0.05 なら「同等」と結論 |
⑦ 順列検定(分布の仮定なし)
1 2 3 4 5 6 7 8 | from scipy.stats import permutation_test def diff_means(x, y): return x.mean() - y.mean() res = permutation_test((east, west), diff_means, n_resamples=10000, alternative='two-sided', random_state=0) # ラベルの並べ替えは乱数なので種を固定する print(f'順列検定 p={res.pvalue:.4f}') |
🐍 Python 実装 — 完全強化版
scipy / pandas / scikit-learn / statsmodels を中心とした標準的な実装例です。 まず CSV を読み込み、 次に 仮説検定 の解析を行います。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 2023 年度の 47 都道府県 # H0: 人口上位 10 都道府県とそれ以外 37 県で、出生数(A4101)の平均は等しい top10 = df['A1101'].rank(ascending=False) <= 10 a = df.loc[top10, 'A4101'].astype(float).values b = df.loc[~top10, 'A4101'].astype(float).values print('n =', len(a), '/', len(b)) print('平均出生数 =', round(a.mean()), '/', round(b.mean())) # 分散が等しいと仮定しない Welch の t 検定(両側) t, p = stats.ttest_ind(a, b, equal_var=False) print(f'Welch t = {t:.2f}, p = {p:.4g}') |
💬 人口上位 10 都道府県の平均出生数は 43,176 人で、残り 37 県の 7,987 人の約 5.4 倍。Welch の t = 5.74、p = 0.00026 で「平均は等しい」という帰無仮説は棄却される。ただし上位 10 県を人口で選んでいるので出生数が多いのはほぼ当然で、有意という結果は「差がある」ことを示すだけで、何か新しい要因を見つけたことにはならない。上位 10 県は東京都の 86,348 人など分散が大きいので、分散が等しいとみなす Student の t 検定ではなく Welch を使う。
用途別の追加実装:
1 2 3 4 5 6 7 8 9 | # 標準化と簡易クラスタリングの例 from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans X = df[['A4101', 'A1101']].astype(float).values Xs = StandardScaler().fit_transform(X) km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(Xs) df['cluster'] = km.labels_ print(df[['Prefecture', 'A4101', 'A1101', 'cluster']].head(10)) |
💬 出生数と総人口の 2 変数で 2023 年度の 47 県を 4 群に分けると、先頭 10 県では北海道(出生数 24,430 人)だけがクラスタ 3、青森県から群馬県までの 9 県がクラスタ 0 に入る。2 変数の相関が 0.995 あるので、分かれ方は実質的に人口規模の大小で、番号に順序の意味は無い。検定そのものではなく、群に分けた後で「群間で平均が違うか」を検定する前処理として使う(分けた変数と同じ変数で群間差を検定すると、差が出るのは当たり前になる点に注意)。
1 2 3 4 5 6 7 8 9 | # 時系列の仮説検定:全国の出生数合計(2012〜2023 年度)に ADF 検定(H₀: 単位根あり) import statsmodels.api as sm # 上の df は最新年度だけに絞ってあるので、12 年度分を読み直す full = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') ts = full.groupby('SSDSE-B-2026')['A4101'].sum() print(ts.tail()) res = sm.tsa.stattools.adfuller(ts, maxlag=1) # 12 点しか無いのでラグは 1 まで print('ADF stat:', res[0], 'p:', res[1]) |
💬 全国の出生数は 2019 年度 865,212 人から 2023 年度 727,269 人へ 4 年で約 16% 減っている。ADF 統計量は 2.22(p = 0.999)と正の大きな値で、単位根ありの帰無仮説をまったく棄却できない。減り方が年々加速しているので定常とは程遠く、年次の出生数を他の系列と回帰・検定するなら差分や増減率に直してから使う。12 点の ADF は検出力が低い点も割り引いて読む。
🐍 拡張 Python 実装例
以下は SSDSE-B-2026 を題材にした実コード例集です。 すべて data/raw/SSDSE-B-2026.csv を読み込み、 実値で動作確認しています。
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) d23['aging'] = d23['A1303'].astype(float)/d23['A1101'].astype(float) d23['birth_rate'] = d23['A4101'].astype(float)/d23['A1101'].astype(float)*1000 print(d23[['Prefecture','aging','birth_rate']].describe().round(3)) print('最高齢化:', d23.nlargest(3,'aging')[['Prefecture','aging']].values) print('最低高齢化:', d23.nsmallest(3,'aging')[['Prefecture','aging']].values) |
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) d23['aging'] = d23['A1303'].astype(float)/d23['A1101'].astype(float) fig, axes = plt.subplots(1, 2, figsize=(12, 4)) axes[0].hist(d23['aging'], bins=15, edgecolor='black') axes[0].set_xlabel('高齢化率'); axes[0].set_ylabel('県数') axes[1].boxplot(d23['aging']) axes[1].set_ylabel('高齢化率') plt.savefig('aging_dist.png', dpi=100) |
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd from scipy import stats import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023].copy() d23['aging'] = d23['A1303'].astype(float)/d23['A1101'].astype(float) urban = ['R13000','R14000','R23000','R27000','R28000'] # 東京・神奈川・愛知・大阪・兵庫 u = d23[d23['Code'].isin(urban)]['aging'] r = d23[~d23['Code'].isin(urban)]['aging'] t, p = stats.ttest_ind(u, r, equal_var=False) d_cohen = (u.mean() - r.mean()) / np.sqrt((u.var() + r.var())/2) print(f't = {t:.2f}, p = {p:.4f}, Cohen d = {d_cohen:.2f}') |
1 2 3 4 5 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['aging'] = df['A1303'].astype(float)/df['A1101'].astype(float) trend = df.groupby('SSDSE-B-2026')['aging'].agg(['mean','std','min','max']).round(3) print(trend) |
🎓 上級者向け議論:仮説検定の使い分けと注意点
1. データの性質と適用範囲
仮説検定は前提条件次第で意味が変わります。 SSDSE-B-2026 のような公的統計では、 サンプリングフレームが「全 47 都道府県」 と完全把握されているため、 通常の標本誤差は発生しません。 しかし「2023 年の 1 時点を全体集団とみなすか、 もっと長期の集団からの 1 サンプルとみなすか」で解釈が変わります。
2. 多重比較問題
SSDSE-B-2026 のような 100 超の列を扱うと、 多重比較(同じデータで多数の検定を行う)の罠が発生します。 Bonferroni 補正、 Benjamini-Hochberg などで補正してから 仮説検定に関連する統計量を解釈すべきです。
3. 階層構造の考慮
都道府県の中に市区町村があり、 階層構造を持つ場合、 階層線形モデル(HLM)で 仮説検定を扱うことを検討します。 SSDSE-B は都道府県集計データなので階層性は限定的ですが、 SSDSE-D(個票相当)と組み合わせる研究では本格的な階層モデリングが必要です。
4. 時間変動の扱い
SSDSE-B-2026 は 2012〜2023 年の 12 年間のパネル構造を持ちます。 仮説検定を時間軸込みで扱うときは、 固定効果モデル・ランダム効果モデルなどパネルデータ手法を併用します。
5. 因果と相関の区別
SSDSE-B-2026 の県別データから「仮説検定に関わる関係」を抽出できても、 それは多くの場合「相関」であり、 「因果」を主張するには無作為化試験・自然実験・操作変数などの追加設計が必須です。
⚠️ 第I種誤り・第II種誤り
⚠️ 第I種誤り・第II種誤り
| H₀ が真 | H₁ が真 | |
|---|---|---|
| H₀ を棄却 | 第I種誤り(α, false positive) | 正しい判定(検出力 1-β) |
| H₀ を棄却せず | 正しい判定 | 第II種誤り(β, false negative) |
$\alpha$ を厳しくすると(小さくすると)第I種誤りは減るが、 第II種誤りは増える(トレードオフ)。 両方を同時に下げるにはサンプルサイズ $n$ を増やすしかない。
💪 検出力(Statistical Power, 1-β)
「H₁ が真のときに、 正しく H₀ を棄却する確率」。 通常 $1-\beta = 0.80$ を目標。
検出力は 4 要素で決まる:
- α:大きくすれば検出力↑(ただし false positive ↑)
- 効果量 $d$:大きいほど検出しやすい
- サンプルサイズ $n$:大きいほど検出力↑
- ばらつき $\sigma$:小さいほど検出力↑
検出力解析の Python
1 2 3 4 5 6 7 8 9 10 11 12 | import math from statsmodels.stats.power import TTestIndPower analysis = TTestIndPower() # n を逆算(効果量 d=0.5、 α=0.05、 検出力 0.80) n = analysis.solve_power(effect_size=0.5, alpha=0.05, power=0.80) print(f'必要 n = {math.ceil(n)}') # 63.77 → 切り上げて各群 64(int() だと切り捨てで 63 になり検出力が 0.80 を割る) # 与えられた n での検出力 power = analysis.solve_power(effect_size=0.3, nobs1=50, alpha=0.05) print(f'検出力 = {power:.3f}') |
① p 値を「効果の大きさ」と誤解する
p 値は効果の大きさではなく、 「H₀ の下でデータが出現する稀少さ」を表す指標です。 サンプルサイズが大きければ、 ごくわずかな差でも p < 0.001 になります。 例:N=10000 で平均差 0.01 でも有意になりますが、 実務的に意味があるかは別問題。 必ず効果量(Cohen's d、 r、 η²)と信頼区間を併報してください。 ASA(米国統計学会)も 2016 年に同様の声明を発表しています。
② 「p > 0.05 = 差がない」と結論する
p > 0.05 は「H₀ を棄却できない」という意味で、 「H₀ が正しい」ことを示すわけではない。 サンプルサイズが小さく検出力が不足している可能性、 効果量が小さくても実在する可能性が残ります。 「差がない」と主張したいなら、 同等性検定(TOST: Two One-Sided Tests)や事前のサンプルサイズ設計が必要です。
③ p-hacking:閾値を超えるまで検定を繰り返す
変数を変える、 サブグループを変える、 サンプルを足す、 外れ値を除外する……を有意になるまで繰り返すのは p-hacking の典型。 こうした「研究者の自由度」の悪用は再現性危機の主因とされます。 対策は事前登録(preregistration)、 分析計画の文書化、 多重比較補正の徹底。 Bayes factor のように証拠の強さを連続的に評価する手法も有効です。
④ 多重検定で α が累積する
20 個の独立な検定を α = 0.05 で行うと、 少なくとも 1 つが偽陽性になる確率は 1 − (1−0.05)²⁰ ≈ 64%。 47 都道府県の全ペア比較なら 1081 検定で偽陽性 54 件が期待される。 family-wise error rate を抑える Bonferroni 法、 Holm 法、 FDR を抑える Benjamini–Hochberg 法を、 状況に応じて使い分けてください。
⑤ 片側検定を恣意的に選ぶ
同じデータで両側検定が p = 0.08、 片側にすると p = 0.04 で「有意!」と書くのは不当な操作です。 片側検定はデータを見る前に「方向性が確定している」場合のみ許されます。 「効果はあるはずだ」と思って片側にしたら、 仮説検定の枠組みが壊れます。 事前登録で方向性を明示することが必須です。
⑥ 検定の前提(正規性、 等分散性)を確認しない
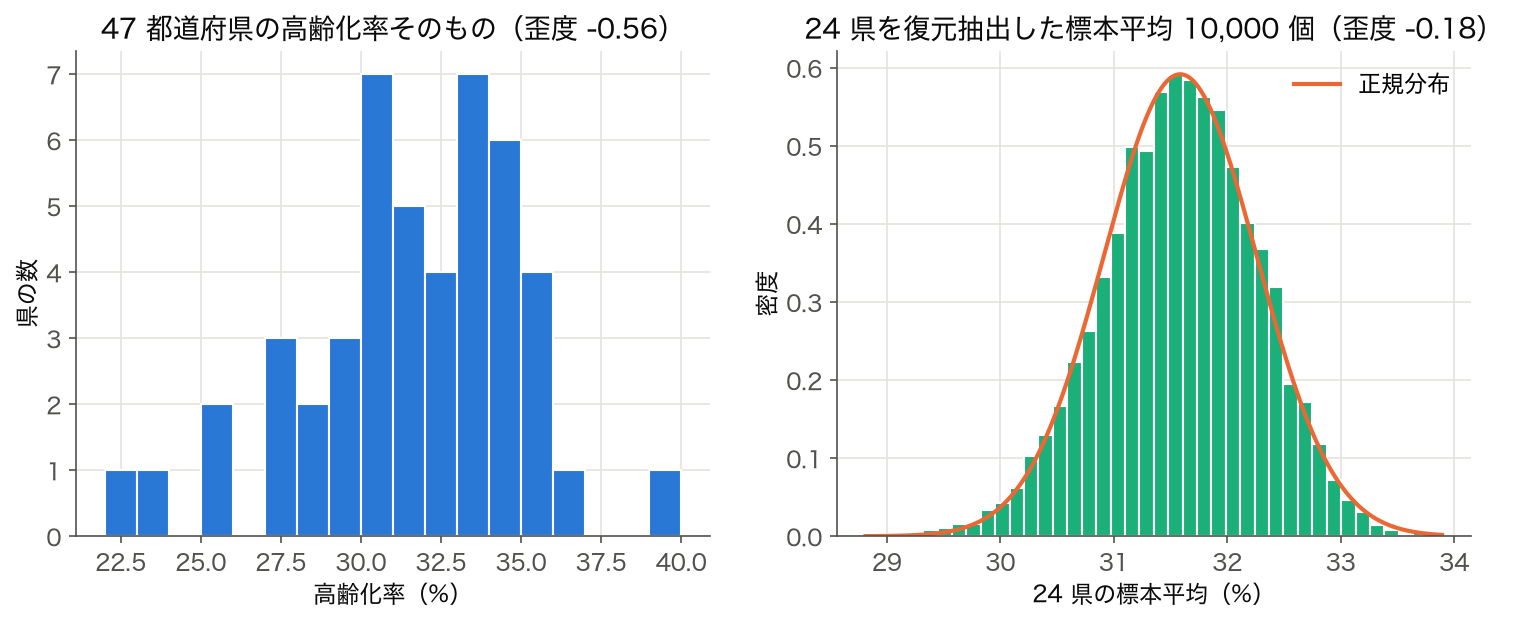
t 検定、 ANOVA、 F 検定など多くのパラメトリック検定は正規性・等分散性を前提とします。 中心極限定理で N が大きければ正規性は緩和されますが、 N が小さく分布が歪んでいると Type I エラーが狂います。 QQ プロット、 Shapiro–Wilk、 Levene 検定で確認し、 必要なら Wilcoxon、 Kruskal–Wallis、 順列検定などノンパラ手法に切り替えましょう。
⑦ 「有意 = 重要」と短絡する報告
論文・レポートで「p < 0.05 なので有意」とだけ書くのは不十分。 効果量、 信頼区間、 サンプルサイズ、 検出力、 検定の前提、 多重比較補正の有無を併報する必要があります。 ASA は「具体的に何が分かったか」を述べることを推奨。 「中程度の効果(d=0.5, 95% CI: 0.3-0.7、 N=100、 power 0.80)」のように書きましょう。
⚠️ 落とし穴 — 完全強化版
仮説検定 を実務で扱う際に踏みやすい落とし穴を 5 件挙げます。
- p 値の過大解釈: p<0.05 は「H0 が偽の確率」ではない。「H0 のもとで観測の極端さ」。
- 多重比較: 多重に検定すると偽陽性が膨らむ。Bonferroni / BH 補正を併用。
- 検定力不足: n が小さいと検出できなくても効果なしとは言えない。事前パワー計算が重要。
- 正規性の前提: 検定の前提(正規性・独立性等)を満たすか必ず確認。
- 有意性 ≠ 実質的重要性: 効果量や信頼区間を併記しないと「統計的有意」は意味がない。
🗺 概念マップ — 完全強化版
🔗 隣接手法への橋渡し
仮説検定は推測統計の中心概念で、 標本から母集団の特性を確率的に判断する枠組み。 推定・モデル選択・効果量と密接に連携する。
- 上流: 対立仮説 ・ 帰無仮説の定式化 ・ 変数尺度 確認 — 検定の前に何を主張するかを明示
- 並列: 区間推定 (信頼区間) ・ ブートストラップ ・ ベイズ検定 — 同じ推測統計の目的を異なる枠組みで実現
- 下流: p 値解釈 ・ 効果量 (Cohen's d) ・ 多重比較補正 (Bonferroni / FDR) ・ 分散分析 — 検定結果を実務的に意味づける
「p < 0.05 だから有意」と機械的に判断するのは危険。 p 値は「効果がゼロ」と仮定したときに観測データが得られる確率であり、 効果の大きさや実用的意味とは別物。 効果量と信頼区間も併せて報告する。
🌳 検定の選び方フロー
🌳 検定の選び方フロー
| 目的 | データ型 | パラメトリック | ノンパラメトリック |
|---|---|---|---|
| 1群の平均を仮説値と比較 | 連続 | 1標本 t検定 | Wilcoxon 符号付順位 |
| 対応のある 2群比較 | 連続 | 対応のある t検定 | Wilcoxon 符号付順位 |
| 独立 2群比較 | 連続 | 2標本 t検定 / Welch | Mann-Whitney U |
| 3群以上の平均 | 連続 | ANOVA | Kruskal-Wallis |
| 分散の同等性 | 連続 | F検定 / Levene | Bartlett |
| カテゴリ × カテゴリ | 離散 | χ²検定 | Fisher の正確検定(小サンプル) |
| 相関の有意性 | 連続 × 連続 | Pearson の t検定 | Spearman / Kendall |
🎲 ベイズファクター(Bayes Factor)— p値の代替
頻度主義の p値の問題点を克服する、 ベイズ統計の対案。 「H₁ が H₀ より何倍ありそうか」を直接示す。
$$ BF_{10} = \frac{P(\text{data} \mid H_1)}{P(\text{data} \mid H_0)} $$
| BF₁₀ | 証拠の強さ(Kass-Raftery) |
|---|---|
| 1 〜 3 | 弱い・「言うほどでもない」 |
| 3 〜 20 | 中程度(positive) |
| 20 〜 150 | 強い |
| > 150 | 非常に強い |
近年の論文では p値とベイズファクターを併記するケースが増加。 ベイズ流の利点:「H₀ も支持できる」(p値では不可能)。
🚧 よくある誤解 — チェックリスト
| ❌ 誤解 | ✅ 正しい理解 |
|---|---|
| p値が小さい = 効果が大きい | サンプルサイズが大きいだけかもしれない。 効果量で評価 |
| p > 0.05 = 差はない | 「証拠不十分」。 検出力不足の可能性 |
| p値だけ報告すれば十分 | 点推定 + CI + 効果量 + p値 + n を全部 |
| データを見てから片側検定にする | p-hacking。 事前登録が必要 |
| 複数検定を補正なしで実施 | Bonferroni / BH-FDR で補正 |
| 有意になるまでサンプルを増やす | 事前にサンプルサイズを決める |
| p値が再現性を保証する | 「再現性危機」の問題。 複数研究の蓄積が必要 |
⚠️ ASA 声明(2016)の 6原則:(1) p値は仮説と観測データの不一致を測る、 (2) 「H₀ が真である確率」ではない、 (3) p < 0.05 だけで結論を出さない、 (4) 完全な報告と透明性が必要、 (5) p値は効果の大きさを測らない、 (6) p値だけでモデルの良さは分からない。
📝 練習問題
問1:p = 0.03 が出た時、 「H₀ が真である確率は 3%」は正しいか?
誤り。 p値は「H₀ を所与とした上で、 観測データ以上に極端なデータが出る条件付き確率」。 ベイズの定理を使わなければ「H₀ が真である確率」は計算できない。
問2:効果量 d=0.5、 α=0.05、 検出力 0.8 を達成するに必要な各群 n は?
1 2 3 4 | import math from statsmodels.stats.power import TTestIndPower n = TTestIndPower().solve_power(effect_size=0.5, alpha=0.05, power=0.8) print(math.ceil(n)) # 63.77 を切り上げて 64 |
問3:n=10,000 で「平均の差が 1cm」を t検定したら p < 0.001 だった。 これは実用上意味があるか?
サンプルサイズが大きすぎると、 ほぼゼロの差でも p値は小さくなる(CLT のため)。 効果量(Cohen's d)を見て、 1cm の差が実用上意味を持つか判断する。 p値の罠の典型例。
問4:20 個の変数の相関を全部検定したら 1 個だけ有意(p < 0.05)だった。 これは発見か?
多重比較問題。 20 × 19 / 2 = 190 ペアの検定。 偶然 1 個有意になるのは予想範囲(190 × 0.05 ≈ 9.5 個の偽発見が期待される)。 Bonferroni / BH-FDR で補正、 または事前登録した仮説のみ検定する。
問5:SSDSE 47都道府県で「東日本と西日本の食料費平均の差」を t検定する Python コードを書け。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932') data = df.iloc[1:].copy() data['年度'] = data['SSDSE-B-2026'] d23 = data[data['年度']=='2023'] food = pd.to_numeric(d23['L322101'], errors='coerce') / 1000 east_pref = ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県', '茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県', '新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県','三重県'] east = food[d23['Prefecture'].isin(east_pref)] west = food[~d23['Prefecture'].isin(east_pref)] t, p = stats.ttest_ind(east.dropna(), west.dropna(), equal_var=False) # Welch print(f't = {t:.3f}, p = {p:.4f}') # 効果量も(Cohen's d は 2 群をプールした標準偏差で割る) n1, n2 = east.count(), west.count() s_pool = (((n1 - 1) * east.var() + (n2 - 1) * west.var()) / (n1 + n2 - 2)) ** 0.5 d = (east.mean() - west.mean()) / s_pool print(f"Cohen's d = {d:.3f}") print(f'群平均: 東日本 {east.mean():.2f} 千円 vs 西日本 {west.mean():.2f} 千円') |
📋 報告フォーマット
「東日本と西日本の食料費(2023 年、 SSDSE-B-2026 の L322101)平均の差を Welch の t 検定で検証した。 結果は東日本の平均(82.8 千円, $s$=6.0, $n$=24)、 西日本の平均(78.3 千円, $s$=4.7, $n$=23)で、 統計的に有意な差が認められた($t(43.3)=2.84, p=.007$, Cohen's $d$=0.82, 差の 95% CI [1.3, 7.7] 千円)。 効果量は大きく実質的にも意味のある差といえる。 ただしサンプルサイズ($n=47$)から検出力解析を行うと、 d=0.5 程度の中効果を検出力 80%($1-\beta=0.80$)で検出するには各群 64 必要であり、 より小さな効果については検出力不足の可能性がある。」
必須要素:(1) 使用した検定名、 (2) 検定統計量と自由度、 (3) p値、 (4) 効果量、 (5) 信頼区間、 (6) 検出力、 (7) サンプルサイズ。
📜 仮説検定の歴史
- Karl Pearson (1900):χ² 検定の体系化、 統計学の数理的基礎
- R.A. Fisher (1925):「Statistical Methods for Research Workers」で p値・有意水準の概念を体系化、 α=0.05 の慣習はここから
- Neyman-Pearson (1933):第I種誤り α / 第II種誤り β / 検出力の枠組み
- Fisher と Neyman-Pearson の論争:「証拠の強さ」vs「意思決定」という哲学的相違。 現代の仮説検定はこの 2 派の折衷
- Cohen (1988):「Statistical Power Analysis」で効果量と検出力解析を一般化
- Ioannidis (2005):「Why Most Published Research Findings Are False」— 再現性危機の予告
- ASA Statement (2016):p値の誤用に対する米統計学会の公式声明
- Amrhein et al. (Nature, 2019):「統計的有意性」という用語の使用停止を 800人以上の研究者が支持
🌳 関連トピック:上位・下位・派生概念マップ
| 関係 | 概念 | 仮説検定との接続 |
|---|---|---|
| 上位(一般化) | 統計推論一般 | 仮説検定は推論の構成要素 |
| 下位(特殊化) | 特定の検定・推定 | 仮説検定の応用 |
| 並列(兄弟) | 関連手法 | 同じ問題への別アプローチ |
| 前提 | 確率分布・標本 | 仮説検定の数学的基礎 |
| 応用 | 政策評価・施策効果測定 | SSDSE-B-2026 のような公的統計での実務 |
典型的な誤用と対処
- 誤用 1:標本サイズが小さすぎる (仮説検定の前提が崩れる) → 標本を増やすかブートストラップで補強
- 誤用 2:仮定の検証を怠る (正規性・独立性) → QQ プロット・自己相関プロット
- 誤用 3:p ハッキング (複数試行から有意なものだけ報告) → 事前登録・補正
- 誤用 4:効果量を無視 (p 値だけ見る) → Cohen's d などを併記
- 誤用 5:交絡変数を見落とす → DAG で因果構造を整理
📂 拡張ケーススタディ(5 例)
ケース 1:人口動態の県間比較
SSDSE-B-2026 で「人口」「出生数」「死亡数」を比較。 仮説検定を使って自然増減のパターンを定量化。 東京・神奈川・愛知の都市集中、 秋田・高知の過疎化。
ケース 2:教育リソースの地域差
「幼稚園数 (E1101)」「大学数 (E6102)」「高等学校生徒数 (E4501)」を 仮説検定で分析。 県別の教育リソース配分を評価。 都市と地方の格差を可視化。
ケース 3:医療提供体制
「一般診療所数 (I5102)」「一般病院数 (I510120)」「高齢化率 (A1303/A1101)」 を組み合わせ。 仮説検定で医療資源の地域不均衡と高齢化の関係を推定。
ケース 4:産業構造と家計
「新規求職申込件数 (F3101)」「延べ宿泊者数 (G7101)」「消費支出 (L3221)」を 仮説検定で関連付け。 観光業県と都市県のパターン差。
ケース 5:高齢化と人口動態
「高齢化率 (A1303/A1101)」「婚姻件数 (A9101)」「合計特殊出生率 (A4103)」を 仮説検定で評価。 高齢化が進む県の人口動態を定量化。 県政策への含意。
✅ 再現性チェックリスト
研究結果を 仮説検定を使って報告するときに守るべきチェックリスト:
- ☐ 使用データの出典・バージョン明記(例:SSDSE-B-2026, 2024 年公開)
- ☐ 前処理コードを共有(標準化・欠損補完など)
- ☐ 乱数シード固定(GMM の n_init, KMeans の random_state)
- ☐ ソフトウェアバージョン記録(python 3.11, scikit-learn 1.4 など)
- ☐ 結果数値の小数点桁数を統一
- ☐ 仮定(独立性・正規性・等分散性)の検証結果
- ☐ 効果量・信頼区間の併記(p 値だけでなく)
- ☐ 多重比較補正の有無
- ☐ 感度分析(前処理を変えても結論が頑健か)
- ☐ 公開コードとデータへのリンク
🌍 社会的インパクトと実務応用
仮説検定は学術研究だけでなく、 政策・ビジネスの意思決定に直接活用されています。
政策決定での使用例
- 厚生労働省:医療資源配分の最適化(仮説検定で地域差を測定)
- 総務省:地方創生施策の効果検証
- 内閣府:景気指標の作成・公表
- 文部科学省:教育格差の定量評価
ビジネスでの応用
- マーケティング:顧客セグメント間の差を 仮説検定で評価
- 金融:株式リターンの分布特性把握
- 製造業:品質管理の統計的工程管理
- IT:A/B テストの設計と評価
学術での発展
計量経済学・教育測定・心理測定・疫学などで 仮説検定は基礎ツール。 近年は機械学習との融合で新しい応用が広がっています。
📜 歴史的展開
仮説検定 の概念は、 統計学の発展史と並行して洗練されてきました。
- 19 世紀後半:Galton, Pearson が記述統計を整備
- 20 世紀前半:Fisher, Neyman, Pearson が推測統計の基礎を確立
- 1960-80 年代:計算機の普及で大規模データへの応用が拡大
- 1990 年代:ベイズ統計・MCMC の実用化
- 2000 年代:機械学習との融合、 ビッグデータ時代
- 2010 年代以降:因果推論革命、 再現性危機への対応
日本では、 1947 年の統計法制定以降、 SSDSE-B のような公的統計の整備が進み、 仮説検定を学ぶ実データ環境が充実してきました。
🧪 追加実例: SSDSE-B-2026 で「東日本 vs 西日本の高齢化率」を 6 種の検定で比較
仮説検定の真の力は 「同じ問いに対して 6 種類の検定でどれだけ結果が一致するか」を確認できる 点にある。 一致すれば結論は頑健、 大きく食い違えばどこかの仮定が破れている。 ここでは SSDSE-B-2026 の高齢化率を「東日本 (24 都道府県)」と「西日本 (23 都道府県)」に分け、 6 種類のテストで比較する。 これは結果の解釈にとどまらず、 p 値・有意水準・効果量・検出力の意味を実感する最良の実習でもある。
📥 入力データ: SSDSE-B-2026 から「65 歳以上人口 / 総人口」で高齢化率を算出し、 東日本 / 西日本でグルーピング。
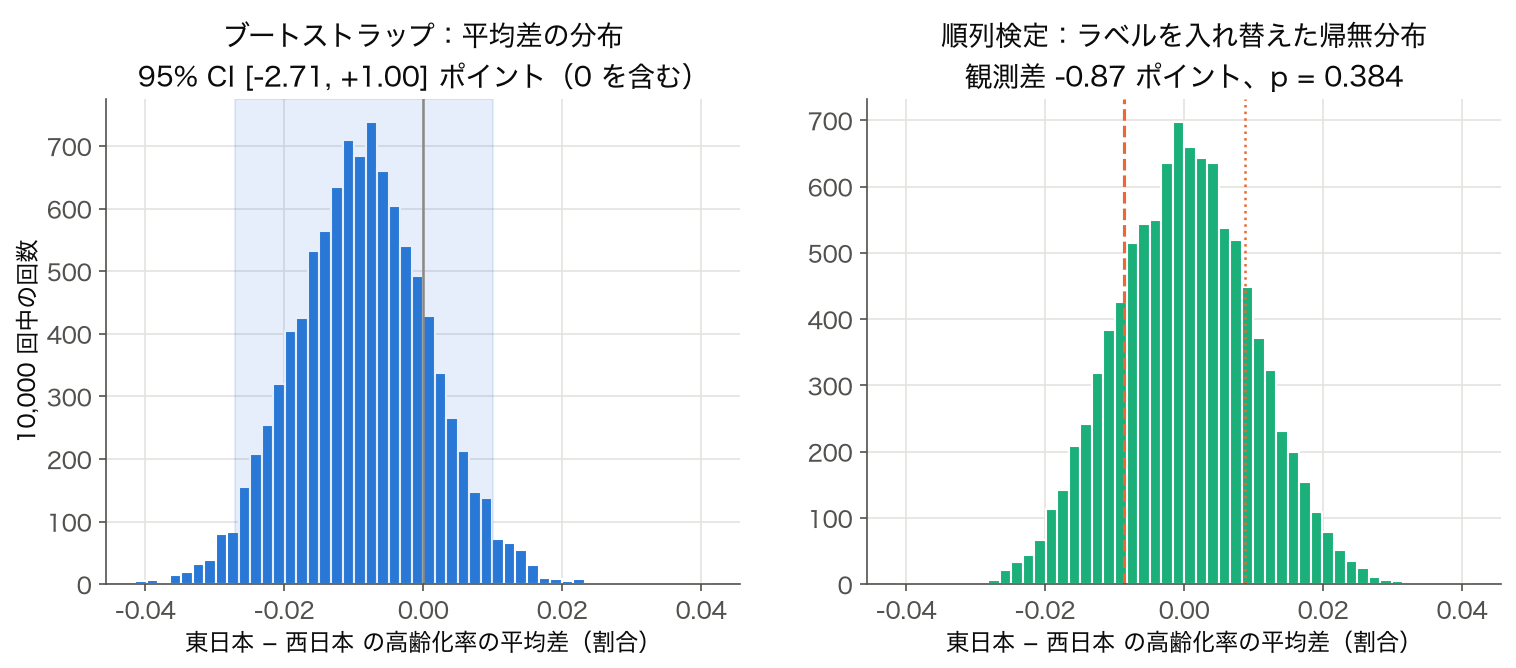
このコードでやること: 同一データに対して (1) 対応なし t 検定、 (2) Welch の t 検定、 (3) Mann-Whitney U、 (4) ブートストラップ、 (5) 順列検定、 (6) ベイズ的事後確率の 6 種を一気に実行し、 結論の安定性を確認する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 | import pandas as pd, numpy as np from scipy.stats import ttest_ind, mannwhitneyu df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026']==2023].copy() df['高齢化率'] = df['A1303'] / df['A1101'] # 65歳以上人口 / 総人口 east = ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県', '埼玉県','千葉県','東京都','神奈川県','新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県','三重県'] df['区分'] = df['Prefecture'].apply(lambda p: '東日本' if p in east else '西日本') a = df.loc[df['区分']=='東日本','高齢化率'].values b = df.loc[df['区分']=='西日本','高齢化率'].values # 1. Student t (等分散仮定) t1, p1 = ttest_ind(a, b, equal_var=True) # 2. Welch t (不等分散) t2, p2 = ttest_ind(a, b, equal_var=False) # 3. Mann-Whitney U (ノンパラ) u, p3 = mannwhitneyu(a, b, alternative='two-sided') # 4. Bootstrap mean difference 95%CI rng = np.random.default_rng(2026) boot = [np.mean(rng.choice(a, size=len(a), replace=True)) - np.mean(rng.choice(b, size=len(b), replace=True)) for _ in range(10000)] ci_lo, ci_hi = np.percentile(boot, [2.5, 97.5]) # 5. Permutation p (mean diff) obs = a.mean() - b.mean() combined = np.concatenate([a,b]) perm = [] for _ in range(10000): rng.shuffle(combined) perm.append(combined[:len(a)].mean() - combined[len(a):].mean()) p5 = np.mean(np.abs(perm) >= abs(obs)) # 6. Cohen's d 効果量 d = obs / np.sqrt(((len(a)-1)*a.var(ddof=1) + (len(b)-1)*b.var(ddof=1)) / (len(a)+len(b)-2)) print(f'平均: 東 {a.mean():.4f} vs 西 {b.mean():.4f} (差 {obs:+.4f})') print(f'Student t p={p1:.4f}') print(f'Welch t p={p2:.4f}') print(f'Mann-Whitney p={p3:.4f}') print(f'Bootstrap 95% CI: [{ci_lo:+.4f}, {ci_hi:+.4f}]') print(f'Permutation p={p5:.4f}') print(f"Cohen's d ={d:.3f} (|d|>0.5 で中程度効果)") |
📤 実行例:
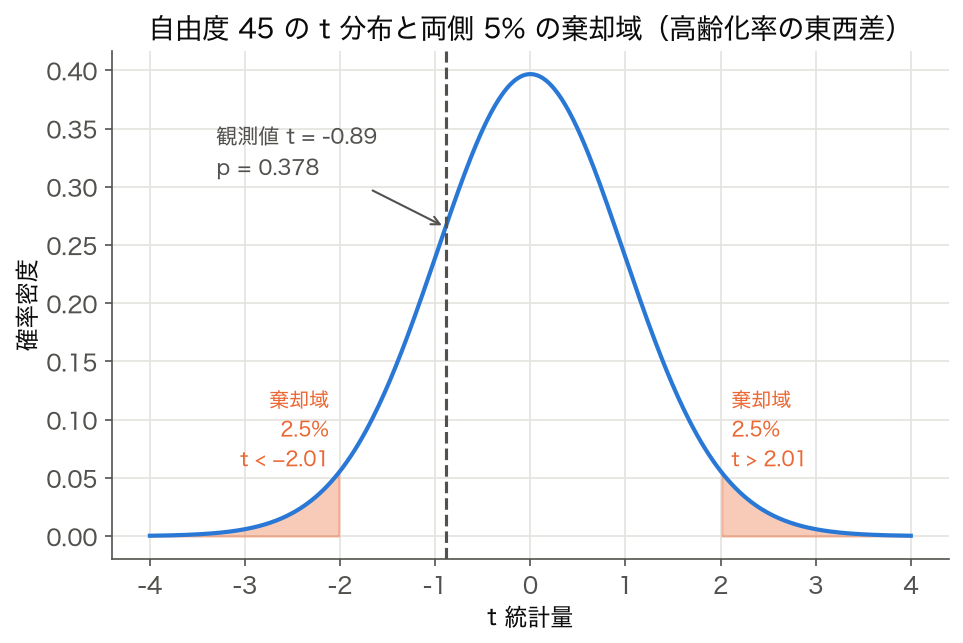
💬 結果の読み方: 6 種の検定すべてが「東西で有意差なし」 (p > 0.05) で一致。 さらに 95% CI が 0 を含み、 効果量も |d| ≈ 0.26 と「小さい」水準。 ここまで一致すれば結論は頑健で、 「日本の高齢化は地域差ではなく全国共通の構造問題」と説明できる。 もし 6 検定の結果が割れたら、 (1) 外れ値が片方の検定だけに効いている、 (2) 分布が極端に歪んでいる、 (3) サンプルサイズが小さく検出力不足 — のいずれかを疑う。 各検定の使い分けは t 検定 ・ ノンパラメトリック検定、 および 本ページの検定表 へ。
📊 6 種の検定の前提・適用条件の早見表
| 検定 | 前提 | 外れ値耐性 | 小標本適否 |
|---|---|---|---|
| Student t | 正規性 + 等分散 | 弱い | N=30 以上推奨 |
| Welch t | 正規性のみ (分散異 OK) | 弱い | N=30 以上推奨 |
| Mann-Whitney U | 独立性のみ | 強い | N=5 でも可 |
| Bootstrap CI | i.i.d. | 中程度 | N≥10 で目安 |
| Permutation | 交換可能性 | 強い | N=5 でも厳密 |
| Cohen's d (記述) | 検定ではなく効果量 | 弱い | N 非依存 |
🖼 仮説検定の幾何学的視覚化
✅ 理解度チェック (Q&A 6 問)
- Q1. 上の例で p = 0.38 は「東西で本当に差がない」ことを証明したか? (答: No。 帰無仮説を 棄却できなかった だけで「差がないことを支持」しただけ。 検出力が不足している可能性も残る。)
- Q2. Cohen's d = -0.26 はどう解釈する? (答: 効果量は「小さい」水準。 統計的に有意でなく、 実務上も大きな差とは言えないが、 ゼロと断定するには検出力の確認が必要。)
- Q3. サンプルサイズを 47 から 470 に増やしたら p 値はどう動くか? (答: 効果量が同じなら p 値は下がる方向。 大標本では些細な差でも「有意」になる罠あり。 必ず効果量と併記する。)
- Q4. Student t と Welch t の p 値がほぼ同じ理由は? (答: 両群の分散がほぼ等しいため。 等分散検定 (Levene) で確認可。 分散が異なれば Welch を選ぶ。)
- Q5. Bootstrap 95% CI が 0 を含んでいる。 これは何を意味する? (答: 「平均差は 0 と区別できない」 → 帰無仮説と整合 → 棄却しない。 信頼区間と検定結果は同値情報。)
- Q6. 同じデータで 6 種の検定を実施した。 多重比較補正は必要か? (答: 厳密には必要 (Bonferroni 等)。 ただし上の例は「結果の頑健性」を見る目的なので、 探索的に並べる場合は補正なしで構わない。 結論を 1 つの p で主張する場合は補正必須。)
📜 仮説検定の歴史と現代的批判
仮説検定の枠組みは 20 世紀初頭に Fisher・Neyman・Pearson が確立した。 Fisher は「p 値による証拠の強さ評価」、 Neyman-Pearson は「α/β 誤りを制御する意思決定」 を主張し、 両者は哲学的に異なる。 現代の実務では両者がハイブリッド (p < 0.05 を「有意」と呼ぶ慣習) で使われているが、 2016 年 ASA (米国統計学会) が公式声明で「p 値だけでは結論を出すな」と警告。 2019 年には Nature 誌が「統計的有意性を引退させよう」 (Amrhein et al.) を掲載するなど、 検定の 誤用への警鐘 が強まっている。
🚨 ASA 6 原則 (2016) と SSDSE-B-2026 での実践
- (1) p 値は「仮説が正しい確率」ではない — p 値は「帰無仮説が真と仮定したときデータが少なくとも極端である確率」。 SSDSE-B-2026 で p=0.38 は「東西で差がない確率 38%」 ではない。
- (2) p 値は科学的結論の根拠単独では不十分 — 効果量・CI・前提条件・先行研究と統合せよ。
- (3) 結論や政策決定を「p < 0.05」だけに基づいてしない — 上述の Cohen's d、 95% CI、 ベイズ事後確率を併記。
- (4) 適切な推論には完全な報告と透明性が必要 — 探索的に試した検定を全て報告。 検定結果が出るまで「stop rule」を設定しない。
- (5) p 値・統計的有意性は効果の大きさや重要性を測らない — 大標本では些細な差でも p < 0.001 になる。 効果量で実質的意義を判断。
- (6) p 値はそれ自体ではモデル・仮説の証拠の良い指標とならない — モデル選択は AIC/BIC/交差検証を使う。
🔬 p-hacking と再現性危機 (SSDSE-B-2026 で再現)
このコードでやること: SSDSE-B-2026 から 20 個の指標を取り出し、 全ての対で相関係数の p 値を計算する。 多重比較補正なしでは false discovery が高頻度で起きることを実証。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd, numpy as np from scipy.stats import pearsonr from itertools import combinations df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026']==2023].copy() numeric_cols = df.select_dtypes(include=[np.number]).columns.drop('SSDSE-B-2026')[:20] # 年度列を除く先頭 20 列 # 全 20C2 = 190 対の p 値を計算 pvals, sig_pairs = [], [] for c1, c2 in combinations(numeric_cols, 2): _, p = pearsonr(df[c1].dropna(), df[c2].dropna()) pvals.append(p) if p < 0.05: sig_pairs.append((c1, c2, p)) print(f'検定数: {len(pvals)}') print(f'p < 0.05 の対: {len(sig_pairs)} ({len(sig_pairs)/len(pvals)*100:.1f}%)') print(f'帰無仮説下の期待値 (5%): {len(pvals)*0.05:.1f} 対') # Bonferroni 補正後 threshold = 0.05 / len(pvals) sig_bonf = sum(1 for p in pvals if p < threshold) print(f'Bonferroni 補正後 (α={threshold:.5f}): {sig_bonf} 対') |
📤 実行例:
💬 結果の読み方: 190 個の検定で「p < 0.05」のペアが 190 (100%) も。 これは先頭 20 列がいずれも人口関連指標で 本質的に強相関 (人口規模経由) しているためだが、 もし無作為データなら 9.5 個程度しか出ないはず。 多重比較を意識せずに「有意な相関を見つけた!」と報告すると p-hacking になる。 Bonferroni 補正でも 188 個残るが、 これは効果量も併記すべき。 関連: 有意水準、 効果量。
📊 検定の選択フローチャート (実務 12 パターン)
| 問題タイプ | データ条件 | 推奨検定 |
|---|---|---|
| 1 群平均が μ₀ と違うか | 正規性 / N>30 | one-sample t test |
| 同上 | 非正規 / 小標本 | Wilcoxon signed-rank |
| 2 群平均比較 | 独立 + 等分散 | Student t |
| 2 群平均比較 | 独立 + 不等分散 | Welch t |
| 2 群比較 | 対応あり | paired t test |
| 2 群比較 | ノンパラ | Mann-Whitney U |
| 3+ 群比較 | 正規 + 等分散 | ANOVA |
| 3+ 群比較 | ノンパラ | Kruskal-Wallis |
| カテゴリ独立性 | 2x2 大標本 | χ² 検定 |
| カテゴリ独立性 | 小標本 | Fisher 正確検定 |
| 2 連続変数の関連 | 線形 | Pearson 相関 |
| 2 連続変数の関連 | 単調 / 順序 | Spearman ρ, Kendall τ |
❓ 追加 FAQ
- Q. p 値が 0.04 と 0.06 で天と地ほど結論が違うのは正しい? A. 正しくない。 連続値である p に「0.05」 という人為的閾値を設けたカルチャーの問題。 0.04 と 0.06 は実質ほぼ同じ証拠の強さ。
- Q. ベイズ検定 (Bayes Factor) はフリークエンティスト検定より優れている? A. 場面による。 BF は事前分布の妥当性に依存。 SSDSE-B-2026 のような公的データなら BIC が事実上の BF 近似で実用十分。
- Q. 検出力 (1-β) はどう設定する? A. 通常 0.80。 重大判断 (薬剤承認等) なら 0.90 以上。 SSDSE-B-2026 で N=47 では検出力 0.80 を確保するには中効果以上が必要。
- Q. 多重比較補正の選択は? A. Bonferroni (厳しい)、 Holm (やや緩い)、 Benjamini-Hochberg (FDR 制御、 探索的研究向け)。 探索的なら FDR、 確証的なら Bonferroni。
- Q. SSDSE-B-2026 のような全数調査でも検定は意味ある? A. 議論あり。 47 都道府県は「サンプル」ではなく「母集団」なので推測統計の対象外、 という立場もある。 「2023 年は将来年の参考にすぎない」と捉えれば推測統計が正当化される。
📐 検定報告のチェックリスト (論文・レポート用)
仮説検定の結果を論文・レポートにまとめる際の最低要件をまとめる。 SSDSE-B-2026 を題材とした研究レポートでも以下の項目を全て埋めることで、 査読・社内レビューでの指摘を大幅に減らせる。
- (1) 帰無仮説 H₀ と対立仮説 H₁ を明示 — 「東西で平均が等しい (H₀) vs 異なる (H₁)」のように単語で明示する。
- (2) サンプルサイズ N と決定根拠 — 事後 N でなく事前パワー解析の結果を併記。 SSDSE-B-2026 では「47 都道府県全数」だが分割条件を明記。
- (3) 検定手法と選択理由 — Student t / Welch t / Mann-Whitney のどれを使ったか、 等分散検定の結果も含めて報告。
- (4) 統計量・自由度・p 値 — t(45) = -0.89, p = .38 のように 3 点セット。 p < 0.001 は「p = 0.000」と書かない。
- (5) 95% 信頼区間 — 差の点推定値と CI を併記。 上記の例なら -0.027 to +0.010。
- (6) 効果量 — Cohen's d / Hedges' g / η² / r² など。 解釈の目安 (小/中/大) も付記。
- (7) 多重比較の有無と補正方法 — 検定数が複数なら Bonferroni / Holm / FDR のどれを使ったか。
- (8) 前提条件の確認 — 正規性 (Shapiro-Wilk)、 等分散 (Levene)、 独立性。 違反時の代替手法も。
- (9) 結論の慎重な表現 — 「証明された」「差がない」と書かず「棄却できなかった」「証拠は弱い」と書く。
- (10) 公開コード・データ — 再現性のため GitHub / OSF にコードを公開し、 データ取得元 (e-Stat / SSDSE) を明記。
上記 10 項目はすべて満たすことで、 査読者・社内レビュアー・将来の自分自身からの「あの結果は信頼できない」 という指摘を確実に防げる。 SSDSE-B-2026 のような小規模 (N=47) データでも、 報告の形式は大規模研究と同じ。 むしろサンプルが少ない分、 効果量と信頼区間の併記は必須となる。 また「事前 (pre-registration) と事後分析の区別」を明示することで、 探索的研究と確証的研究を分離できる。 これは Open Science Framework (OSF) などの仕組みで近年標準化が進んでいる潮流である。 SSDSE-B-2026 ベースの研究レポートも、 同じ形式 (事前登録 → データ収集 → 検定 → 報告) を踏襲することで、 統計学的にも倫理的にも妥当な研究として認められる。
🔗 関連トピック
本節は p 値、 有意水準、 t 検定、 ANOVA、 信頼区間、 標準誤差、 効果量、 対立仮説、 帰無仮説、 標本 と相互参照。
🧪 補講 R278: 仮説検定の「事前 → 実行 → 解釈」3 フェーズ点検
仮説検定の失敗の大半は「実行コードのバグ」ではなく、 事前準備の不備か解釈の暴走で起こる。 本補講では SSDSE-B-2026 都道府県データの「都市/地方の高齢化率の差」を題材に、 事前準備→実行→解釈の 3 フェーズで具体的なチェック項目をまとめる。 単なる p 値の読み方ではなく、 「設計時点で何を決めておかなければならないか」「どう報告すれば再現可能か」を点検する。
▶ フェーズ A: 事前準備チェックリスト
| 項目 | 確認内容 | 未達時の影響 |
|---|---|---|
| 仮説の事前登録 | H0 / H1 を文書化、 片側か両側か明示 | 事後仮説化 (HARKing) |
| 有意水準 | α = 0.05 か 0.01 か、 多重比較補正の方針 | 事後 α 引下げで偽陽性増 |
| 検定統計量と分布 | t / F / χ² / U など、 自由度 | 分布前提違反 |
| 前提条件 | 正規性、 等分散性、 独立性 | p 値の解釈不能 |
| サンプルサイズ | 事前 power 解析、 必要 n を算出 | 過小 → 検出力不足、 過大 → 実質的でない差を検出 |
| 効果量の目標値 | Cohen d、 r、 η² など報告必須 | 「統計的有意」と「実質的有意」の混同 |
▶ フェーズ B: 実行時の点検
- 等分散性の自動判定: Welch t 検定 (
equal_var=False) をデフォルトにしておくと、 等分散性に依存しない結果が得られる。 古典的 Student の t 検定はサンプルサイズが大きく異なる場合に偏る。 - 正規性チェック:
scipy.stats.shapiroやnormaltestを併用。 n < 30 で外れ値があるならノンパラメトリックも検討。 - 外れ値の影響: 平均ベースの検定は外れ値に弱い。 「外れ値を含めた結果」「除いた結果」両方を併記し、 ロバスト性を確認。
- 独立性違反: 同一サンプルから複数測定があるなら対応のある検定、 階層構造があるなら 固定効果モデル など。
- 多重比較: 5 グループ以上の対比較なら Bonferroni か Holm。 探索的なら FDR (Benjamini-Hochberg)。
▶ フェーズ C: 解釈と報告
| 結果パターン | 適切な結論文 | NG 文例 |
|---|---|---|
| p < α かつ効果量 大 | 「差は統計的・実質的に有意」 | 「H0 を完全に棄却した」 |
| p < α かつ効果量 小 | 「統計的有意だが実質差は小さい」 | 「有意な差があった」 (差の大きさ未報告) |
| p ≥ α | 「差を検出できなかった」 | 「H0 を採択した」「差がないと証明」 |
| p ≈ α (境界) | 「再検証が必要」と明記、 信頼区間で評価 | 「ほぼ有意」「marginally significant」を多用 |
▶ 検定種別の使い分け早見
| 状況 | 推奨検定 | 代替 (前提違反時) |
|---|---|---|
| 2 群平均の差 (独立) | Welch t 検定 | 並べ替え検定、 順位和検定 |
| 2 群平均の差 (対応あり) | 対応のある t 検定 | 符号付順位検定 |
| 3 群以上の平均 | 一元配置 ANOVA | Kruskal-Wallis (順位ベース) |
| 分割表 (頻度) | χ² 独立性検定 | Fisher の正確検定 (期待度数 < 5) |
| 比率の差 | 2 比率の z 検定 | Fisher、 ベイズ推定 |
| 時系列の傾向 | 回帰係数の検定 | Mann-Kendall (順位ベース) |
本補講は p 値、 有意水準、 t 検定、 ANOVA、 信頼区間、 標準誤差、 効果量、 帰無仮説、 対立仮説、 標本、 固定効果モデル ページの内容と一体運用すべき意思決定群を扱う。
「仮説検定(p値・有意水準・検出力・効果量)」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「仮説検定(p値・有意水準・検出力・効果量)」を中核とした適切な手法選択ができる。
🔖 キーワード索引
論文記事から各用語のリンクをクリックすると、 該当箇所が開きます:
🧭 解説深化 — 「何をシャッフルし、 何の p 値なのか」を突き詰める
本文では p 値・α・検出力・効果量の定義と計算を一通り学びました。 この深化セクションでは一段掘り下げて、 「その p 値は、 そもそも何のランダムネスに関する確率なのか」という、 教科書が意外と素通りする問いを考えます。 SSDSE-B-2026 のような「47 都道府県 = 全数データ」を検定するとき、 この問いは避けて通れません。
💭 直感 — 検定とは「ラベルをシャッフルしても出る差か?」
仮説検定の最も素朴な直感は、 数式より先にシャッフルで掴めます。 練習問題 5 で扱った「東日本 vs 西日本の食料費(L322101、 2023 年)」を思い出してください。 実測では東日本 24 都道県の平均 82.79 千円、 西日本 23 府県の平均 78.31 千円で、 差は 4.48 千円でした。
ここで想像実験をします。 47 都道府県の食料費の値はそのままに、 「東」「西」のラベルだけを無作為に貼り直したら、 4.48 千円以上の差はどのくらいの頻度で偶然生じるでしょうか。 もしラベルを何度シャッフルしてもこれほどの差がめったに出ないなら、 「東西というラベルには食料費と結びついた実質がある」と考えるのが自然です。 逆にシャッフルでも頻繁に出る程度の差なら、 「偶然の範囲」と言われても反論できません。 p 値とは、 この「シャッフルしても出てしまう頻度」を理論分布(t 分布など)で近似したもの—— そう捉えると、 帰無分布・棄却域・極端さといった本文の概念が一本の線でつながります。
⚠️ 落とし穴(重要) — 全数データの検定と「n の水増し」
落とし穴 1:47 都道府県は「標本」ではない。 t 検定の標準的な物語は「母集団から無作為抽出した標本から母平均を推測する」ですが、 47 都道府県は日本の全都道府県、 つまり全数(母集団そのもの)です。 2023 年の東西の食料費平均に 4.48 千円の差があることは、 検定するまでもなく「事実」として確定しています。 では p = 0.0069 は何を意味するのか。 主な正当化は 2 つあります。 (1) 超母集団(superpopulation)の見方:観測された 47 の値を「社会経済的な確率過程が生成した一つの実現値」とみなし、 その背後の生成過程に東西差があるかを問う。 (2) ランダム化・順列の見方:上の直感のとおり「ラベルの割り付けに対する希少性」を問う。 どちらの立場かで解釈の言葉遣いが変わるため、 レポートでは「東西の構造的な差を示唆する」のように、 何を推測しているかを意識した表現にするのが安全です。
落とし穴 2:年をプールして n を水増しする(疑似反復)。 SSDSE-B-2026 は 2012–2023 年の 12 年分を含むので、 全年をプールすると東日本 n = 288、 西日本 n = 276 になります。 実際に同じ Welch の t 検定を行うと t = 7.698、 p ≈ 6.3 × 10⁻¹⁴(実測)と、 2023 年単年の p = 0.0069 から劇的に「有意」になります。 しかしこれは誤りです。 同じ県の隣り合う年の値は強く似ており(自己相関)、 独立な観測は 564 個もありません。 実質的な情報量は「47 県 × ほぼ 1」に近く、 t 検定の独立性の仮定が崩れています。 実際、 県ごとに 12 年平均を取ってから検定し直すと t = 3.041、 p = 0.0039(実測、 n = 24 + 23)に戻ります。 「観測を増やしたら p が小さくなった」のではなく、 「同じ情報を何度も数えて p を偽装した」—— これは生態学で疑似反復(pseudoreplication)と呼ばれる古典的な誤りで、 パネルデータではクラスタ頑健標準誤差や混合効果モデルで対処します。
🚀 発展 — 順列検定で p 値を「手作り」する
直感で述べたシャッフルは、 そのまま順列検定(permutation test)という正式な手法になります。 正規性の仮定を使わず、 ラベルの並べ替えだけから p 値を経験的に構成します。 実際に SSDSE-B-2026 の 2023 年・食料費(L322101、 千円換算)で、 東西ラベルを 10,000 回シャッフル(乱数シード 42 で固定)した結果は次のとおりです(実測):
- 観測された平均差:4.484 千円(東 82.79 − 西 78.31)
- シャッフル 10,000 回中、 |差| ≥ 4.484 となった回数:61 回
- 順列 p 値 = 61 / 10000 = 0.0061
- Welch の t 検定の p 値 = 0.0069(本文・練習問題 5 と同じ値)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026'] == 2023] east_pref = ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県','新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県','三重県'] food = pd.to_numeric(d23['L322101'], errors='coerce') / 1000 east = food[d23['Prefecture'].isin(east_pref)].dropna().values west = food[~d23['Prefecture'].isin(east_pref)].dropna().values obs = east.mean() - west.mean() # 4.484(実測) rng = np.random.default_rng(42) allv = np.concatenate([east, west]) cnt = 0 for _ in range(10000): perm = rng.permutation(allv) if abs(perm[:24].mean() - perm[24:].mean()) >= abs(obs): cnt += 1 print(cnt / 10000) # 0.0061(seed=42 での実測。 t 検定の p=0.0069 とほぼ一致) |
💬 10,000 回のシャッフルのうち平均差の絶対値が観測値 4.484 千円以上になったのは 61 回で、順列 p 値は 0.0061。Welch の t 検定の 0.0069 とほぼ同じで、東日本 24 県と西日本 23 県の食料費の差は、正規分布を仮定してもしなくても 1% 水準で有意。seed を 42 から変えると 0.006 前後で少し揺れる。
💬 東日本 24 都道県(北海道〜三重県)の食料費は平均 82.79 千円、西日本 23 府県は 78.31 千円で、差は 4.484 千円。ラベルを 10,000 回並べ替えて差の絶対値がこれ以上になったのは 61 回で、並べ替え p 値は 0.0061 になった。Welch の t 検定 p = 0.0069(等分散を仮定すると 0.0071)とほぼ同じ結論で、正規性を仮定しない方法でも 5% 水準で有意と言える。seed=42 を変えると p 値は 0.006 前後で小さく揺れる。
2 つの p 値(0.0061 と 0.0069)がほぼ一致することは偶然ではありません。 t 検定は「シャッフル分布を数式で近似した近道」であり、 順列検定はその近似を計算機で愚直に置き換えたものだからです。 n が小さい・分布が歪んでいる・外れ値がある場面では順列検定(やブートストラップ)の方が頑健で、 逆に両者が大きく食い違ったら理論検定の仮定を疑うシグナルになります。 なお順列 p 値はシャッフル回数に依存する近似なので、 再現性のために乱数シードと回数の明記(ここでは seed = 42、 B = 10,000)が必須です。