🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
💡 30秒で分かる結論 — 検出力
🍰 まずはやさしく
正解を見逃さないための確率です。
本当に差があることを証明するために使います。
部活の練習で効果が出たか確かめる時に役立ちます。
まずは結論と注意点を短く確認しましょう。
- 一言で:本当に差があるとき、 それを正しく検出する確率。 通常 0.8 を目標。
- 分野:仮説検定 — 全体像は hypothesis-testing ページで
- 2023 年度の東日本 23 都道県と西日本 24 府県の高齢化率は平均 31.18% と 31.97%、 効果量 d = 0.24。 この差を 5% 水準で検出できる確率は約 0.12 しかない
- 47 県を 2 群に分けたとき、 検出力 0.8 で捉えられるのは d ≈ 0.83 以上の大きな差、 相関なら r ≈ 0.40 以上
- 非有意の結果は、 検出力が低ければ「差が無い」ではなく「この設計では分からない」と書く
- 検出力はデータを取る前に計算する。 観測した効果量から逆算する事後検出力は p 値の言い換えにすぎない
📍 あなたが今見ているもの
🍰 まずはやさしく
分析の準備に欠かせない道具です。
調査に必要な人数を決めるために使います。
アンケートを何人に配るか考える時に必要です。
このページにある12個の解説を案内します。
検出力=1−β(β=第2種の過誤確率)。 検出力分析は必要サンプル数を決めるための必須手続き。 G*Power、 statsmodels.stats.power が定番ツール。
🎨 直感で掴む — 検出力とは何者か
🍰 まずはやさしく
正解を見つける力の強さのようなものです。
分析結果がどれくらい信頼できるか知るために使います。
スマホのアプリで差があるか調べる時に役立ちます。
図や例を使って直感的に仕組みを学びましょう。
検出力(Statistical Power (1−β))は「本当に差があるときに、 t 検定や ANOVA が p<0.05 を返す確率」。 SSDSE-B-2026 で「東日本 23 都道県 vs 西日本 24 府県の高齢化率(A1303÷A1101 から算出)に差があるか」を調べる際、 検出力 0.4 と 0.8 では 「差なし」結論の意味がまるで違います。 ここでは効果量 d / 有意水準 α / サンプル n と検出力が連動する関係を一気に体感しましょう。
🎨 直感で掴む
検出力は「本当に差があるとき、 それを統計的に有意と判定できる確率」。 例えば 47 都道府県で「東日本と西日本の高齢化率に標準偏差の半分(d=0.5)の差がある」が真だった場合、 1 群 24 県ずつで t 検定して p<0.05 を出せる確率が検出力。 効果量 d=0.5・α=0.05・n=24 なら検出力は約 0.40 — 60% は「差が無い」と誤判定する。 低検出力での非有意結果は「差が無い」ではなく「分からない」を意味する。
慣例的に 0.8 以上を目標とし、 d=0.5 を α=0.05 で 0.8 検出するには n≈64 必要。 SSDSE-B-2026 の 47 都道府県では小〜中効果の検出力は不足しがちで、 「東西で差なし」と結論する前に必要 n を G*Power や statsmodels.stats.power で事前計算するのが現代的な手続き。
🎮 触って理解する — H0とH1の重なりで検出力を見る
帰無分布 H0(差がない世界・青)と対立分布 H1(本当は差がある世界・橙)を重ねて描画します。 3 本のスライダーで 有意水準 α・効果量 d(=H1 の中心)・標本サイズ n(1 群あたり)を動かすと、 α=第1種の過誤(赤)・β=第2種の過誤(紫)・検出力 1−β(緑)が塗り分けでリアルタイム更新されます。 効果量↑・n↑・α緩めのどれでも検出力が上がる —— この 4 者の連動を体感してください。 設定は SSDSE-B-2026 の「東日本 vs 西日本」を模した独立 2 群・両側 z 検定(正規近似, σ=1)です。
🧩 α・β・効果量・n —— 検出力を決める 4 者の関係
検出力 1−β は「本当に差がある(対立仮説 H1 が真)のに、 それを見逃さず棄却できる確率」。 上の図で H1 の右裾が臨界値を超えて緑に入る面積がそれです。 この面積は次の 4 者だけで決まります。
| 動かすと… | 図の変化 | 検出力 1−β |
|---|---|---|
| 効果量 d を上げる(効果量) | H1 が右へ離れる | 上がる ↑ |
| n を増やす | 両分布が細く尖り重なりが減る | 上がる ↑ |
| α を緩める(0.05→0.10) | 臨界値が内側へ動く | 上がる ↑(ただし第1種の過誤も増) |
| α を厳しく(0.05→0.01) | 臨界値が外側へ動く | 下がる ↓ |
α と β はトレードオフです。 α(第1種の過誤=差がないのに「差あり」と誤る確率)を小さくすると臨界値が外側へ動き、 β(第2種の過誤=差があるのに見逃す確率)が増えて検出力が下がります。 両方を同時に下げる唯一の正攻法が n を増やすこと —— これが検出力分析でサンプルサイズ設計が中心になる理由です。
📐 検出力分析(事前の必要 n 設計)と過少検出力の問題
事前(a-priori)検出力分析とは、 データを取る前に「目標検出力 0.8・想定効果量 d・α=0.05」から必要 n を逆算する手続きです。 上の「🎯 必要nモード」がまさにこれで、 両側 z 検定なら 1 群あたり n ≈ 2·(z1−α/2+z1−β)² / d² で近似できます。
過少検出力(underpowered)な研究は二重に危険です。 第一に、 本当の差を高確率で見逃す(β が大きい)。 第二に、 たまたま有意になった結果は効果量を過大評価しやすく(Type M error)、 追試で再現しません。 これが 再現性の危機 の主要因の一つで、 「非有意 = 差なし」ではなく「検出力不足で判断保留」と書き分けることが、 検出力を理解した分析者の作法です。 SSDSE-B-2026 は 47 行固定なので、 「この n で検出できる最小効果量」を逆算し、 結論の慎重さを担保します。
📐 数式・定義
🍰 まずはやさしく
計算で出せる正確な数値のことです。
目標とする確率を正しく設定するために使います。
買い物で得するプランがあるか計算する時に似ています。
数式や公式を使って定義を詳しく見ていきましょう。
検出力(power)は $1 - \beta$、 すなわち真に差があるとき、 それを検出する確率:
$$ \text{Power} = 1 - \beta = P(\text{reject } H_0 \mid H_1 \text{ true}) $$
効果量 $d$、 サンプル数 $n$、 有意水準 $\alpha$ から計算可能で、 通常 0.80 以上を目標とする。
📐 公式チートシート — 主要検定の検出力
| 検定 | 必要 n の近似式 | Python 関数 |
|---|---|---|
| 独立 2 群 t 検定 | n/群 ≈ 2(z1−α/2+z1−β)² / d² | TTestIndPower().solve_power |
| 対応 2 群 t 検定 | n ≈ (z1−α/2+z1−β)² / dz² | TTestPower().solve_power |
| 相関係数の検定 | n ≈ ((z1−α/2+z1−β)/arctanh r)² + 3 | NormalIndPower + Fisher z |
| 比率の差(2 群) | n/群 ≈ (z1−α/2√{2p̄q̄}+z1−β√{p1q1+p2q2})² / (p1−p2)² | NormalIndPower().solve_power |
| 一元配置 ANOVA | 非中心 F 分布の累積を解く(閉形式なし) | FTestAnovaPower |
| χ² 適合度・独立性 | 非中心 χ² 分布から数値解 | GofChisquarePower |
| 単回帰(傾きの検定) | 相関係数の検定と同型 | FTestPower |
| 重回帰(R² 増加) | f² = ΔR²/(1−R²full) を使い非中心 F | FTestPower |
注:すべて両側・等分散・正規性を仮定した近似。 Welch 補正・ノンパラ・混合モデルでは Monte Carlo シミュレーションでの数値計算が現実的。 R の pwr、 Python の statsmodels.stats.power、 GUI の G*Power 3.1 が標準ツール。
📐 効果量(Effect Size)— 検出力計算の中核概念
検出力計算の最も難しい部分が「効果量をどう設定するか」。 効果量は「差の大きさ」を標準偏差で割って無次元化した量で、 主要な指標を整理する。
Cohen の効果量カタログ
| 指標 | 定義 | 用途 | 小/中/大の目安 |
|---|---|---|---|
| Cohen's $d$ | $d = (\mu_1 - \mu_2)/\sigma$ | 2 群の平均差 | 0.2 / 0.5 / 0.8 |
| Cohen's $f$ | $f = \sigma_m / \sigma$ | ANOVA(多群比較) | 0.10 / 0.25 / 0.40 |
| Cohen's $w$ | $w = \sqrt{\chi^2/n}$ | カイ二乗検定 | 0.10 / 0.30 / 0.50 |
| 相関係数 $r$ | Pearson $r$ | 相関検定 | 0.10 / 0.30 / 0.50 |
| オッズ比 $OR$ | $P_1(1-P_2) / P_2(1-P_1)$ | ロジスティック回帰 | 1.68 / 3.47 / 6.71(Chen ら 2010) |
| $\eta^2$(イータ二乗) | SS_between / SS_total | ANOVA の説明割合 | 0.01 / 0.06 / 0.14 |
SSDSE 文脈で「東日本 vs 西日本の高齢化率に差があるか」を t 検定で見るとき、 差 = 2.5%、 SD = 4% なら $d = 2.5/4 = 0.625$(中〜大)。 これを Cohen's d として power 計算に投入する。
効果量の設定 — 3 つの戦略
- ① 先行研究から: 類似研究で報告された効果量を参考にする(最も推奨)
- ② パイロット研究から: 小規模予備調査で効果量を推定(次善)
- ③ 慣習値(Cohen の小/中/大): 何の情報もないときの最終手段
研究者がやりがちな悪手は「目標 $n$ から逆算して効果量を決める」こと。 「200 件で power 0.8 を達成したいから $d=0.4$ と仮定する」のような循環論。 これは検出力分析を儀式化する典型例。
🔬 数式・定義を「言葉」で読み解く
2 群の平均の差を両側 z 検定で調べるときの検出力は、 正規近似で次のように書ける。
$$1-\beta \approx \Phi\left(\delta - z_{1-\alpha/2}\right) + \Phi\left(-\delta - z_{1-\alpha/2}\right),\qquad \delta = d\sqrt{\frac{n_1 n_2}{n_1+n_2}}$$
各記号を、 2023 年度の東日本 23 都道県と西日本 24 府県の高齢化率(65 歳以上人口 ÷ 総人口)で読むと次のとおり。
| 記号 | 意味 | 東西の高齢化率での値 |
|---|---|---|
| $d$ | 効果量。 平均の差を群内の標準偏差で割った「差の大きさ」 | (31.97 − 31.18) / 3.35 = 0.235 |
| $n_1, n_2$ | 各群の件数。 増やせるなら検出力を上げる最も確実な手段 | 23 と 24(47 県で頭打ち) |
| $\delta$ | 非心度。 帰無分布から対立分布の中心がどれだけ離れているか(標準誤差の何個分か) | 0.235 × √(23×24/47) = 0.807 |
| $z_{1-\alpha/2}$ | 両側 α の臨界値。 α を厳しくすると外へ動き、 検出力が下がる | α = 0.05 で 1.960 |
| $\Phi$ | 標準正規分布の累積分布関数。 対立分布のうち臨界値を越える面積を測る | Φ(0.807 − 1.960) = Φ(−1.153) = 0.125 |
| $1-\beta$ | 検出力。 反対側の裾 Φ(−2.767) = 0.003 を足して | 0.127(t 分布で正確に計算すると 0.124) |
δ が臨界値 1.96 より小さいうちは検出力は 0.5 に届かない。 δ を 1.96 + 0.84 = 2.80 まで押し上げると検出力 0.8 になるので、 d = 0.235 のままなら 1 群あたり約 285 県が必要になる。 「47 県で有意差なし」は、 この δ の小ささを言い換えたものにすぎない。
🔬 数式を言葉で読み解く — 逐次検定と検出力
大規模 A/B テストでは、 データが集まる途中で「もう差が見えたから止めよう」と判断したくなる。 これを逐次検定(sequential testing)と呼ぶが、 単純に何度も検定すると α が膨張する(peeking problem)。
$$ \alpha_{\text{actual}} \approx 1 - (1-\alpha)^{k} $$
$k$ 回検定すると、 実際の偽陽性率は $\alpha$ の $k$ 倍近くに膨らむ。 $\alpha=0.05$ で 5 回 peek すれば実質 $\alpha \approx 0.23$。 検出力分析でも、 逐次検定を想定するなら群逐次法(O'Brien-Fleming、 Pocock 等)の境界値を使って α を分割する必要がある。
| peek 回数 k | 単純検定の偽陽性率 | Pocock 法での閾値 | O'Brien-Fleming 法 |
|---|---|---|---|
| 1 | 0.05 | 0.050 | 0.050 |
| 3 | 0.14 | 0.022 | 0.001 → 0.039 |
| 5 | 0.23 | 0.016 | 0.00005 → 0.041 |
| 10 | 0.40 | 0.0106 | 最終段でほぼ 0.05 |
💬 結果の読み方: ① Pocock 法は「各段階で同じ閾値」、 O'Brien-Fleming は「序盤厳しく、 終盤 0.05 に近づける」設計。 ② どちらも検出力を維持するためには、 単純な n より 1.07 〜 1.20 倍の標本が必要。 ③ SSDSE のような固定 47 件のクロスセクションでは逐次検定の余地はないが、 時系列で年次が増えるパネルデータでは関係する。
📖 物語で理解する検出力 — 「見逃さない統計学」の現場感覚
検出力(statistical power)は数式だけで理解すると「閾値より大きい確率」という抽象的な定義に閉じてしまう。 だが現場の研究者・データサイエンティスト・公衆衛生担当者にとって、 検出力は 「自分の研究が本当に意味のある違いを見つけられるか」 を事前に保証する 研究品質の心臓部 である。 ここでは、 SSDSE-B-2026 都道府県データに即した三つの物語を通じて、 検出力の「実感」を育てる。
物語 1 — 「47 件しかない」呪縛と向き合う県政アナリスト
県政担当のアナリストが、 「人口あたり医師数と平均寿命に関係があるか」を調べたいと考えた。 SSDSE-B-2026 で扱える単位は 47 都道府県、 つまり標本サイズは固定で 47 である。 相関分析を行う場合、 Cohen の慣用値で「中程度の相関」とされる $r=0.30$ を α=0.05 両側、 検出力 0.80 で検出するには、 おおむね n ≈ 84 件が必要になる。 つまり 47 件では、 中程度の相関すら確実には拾えない可能性が高い。 では諦めるしかないのか? 答えは「効果量の前提を見直す」「結論の書き方を変える」の二段構えである。
第一に、 公的統計を都道府県単位で扱う領域では、 各観測点が 「数万〜数百万人の集約」であるためノイズが小さく、 同じ $r=0.30$ でも単一個人を観察する研究より「実質的に強い相関」を意味する。 第二に、 47 件で検出できるのは概ね $r \geq 0.40$(中〜大)の関係に限られるため、 結果には必ず「47 件・検出力 0.80 で検出可能な最小相関は約 0.40 である」と 事前検出力分析(a priori power analysis)の前提 を明示する。 これにより、 「弱い相関が出なかった=関係がない」と早合点する読者を防げる。 検出力分析は 「自分の研究の限界を honest に書く道具」 なのである。
物語 2 — 新薬の効果を「見逃さない」治験統計家
製薬企業の治験統計家にとって、 検出力は 「失敗治験のコスト」と直結する。 ある第 III 相試験で、 新薬と既存薬の血圧降下効果の差を $d=0.30$(標準偏差換算)と想定し、 α=0.05、 検出力 0.90、 1:1 割付、 両側検定で計算すると、 必要総標本は概ね n ≈ 470 となる。 ここで「検出力 0.80 で十分」と妥協すると、 n は 350 程度で済むが、 もし本当に効果が $d=0.30$ あった場合、 20% の確率でその効果を見逃す。 治験全体の費用が数十億円規模であることを考えれば、 0.10 の検出力の差は数億円の保険料に相当する。
さらに multi-arm 試験(用量を 3 段階比較する等)では、 多重比較補正(Bonferroni / Hochberg / BH)を入れた後の 調整後検出力 を計算する必要があり、 単純計算で求めた n では 15〜25% 不足するのが普通である。 治験プロトコルでは検出力分析の手順、 想定効果量の根拠(先行 phase II データ)、 脱落率(dropout rate、 通常 10〜20%)を加味した最終 n を 必ず書面化する。 規制当局(FDA、 PMDA、 EMA)は検出力分析を含まない申請書を受理しない。
物語 3 — A/B テストを 100 回走らせる EC サイトのデータエンジニア
大手 EC サイトでは年間 100 件以上の A/B テストを走らせる。 各テストでコンバージョン率(CV)を 1.0% 改善できるかを判定したい。 ベース CV が 3.0% の場合、 効果量はリスク比 1.33(オッズ比 1.34)に相当し、 α=0.05 両側、 検出力 0.80 で 各群 n ≈ 4,650、 総 n ≈ 9,300 セッション必要になる。 日次 PV が 5,000 のサービスであれば、 結論まで 約 2 日。 ここで「検出力 0.50」で妥協すると、 n は半分以下で済むが、 真に効果のある施策の半分を「効果なし」と誤判定し、 競合に差をつける機会を毎週捨てていることになる。
逆に、 ベース CV が 0.5% のように低い場合、 同じ 1.0% 改善でも 各群 n ≈ 1,600 で済む(差の絶対値が小さくても、 比率としては大きいため)。 一方、 ベース CV が 30% と既に高い場合、 1.0% の絶対改善を検出するには 各群 n ≈ 40,000。 つまり 「ベース値」と「改善幅」の組み合わせで必要 n が桁違いに変わるため、 A/B テスト設計時は必ず両者を入力した検出力曲線を可視化する。 statsmodels の NormalIndPower や GofChisquarePower で 5 分以内に計算できる。
「事前」と「事後」 — post-hoc power の罠
研究を 終えてから「うちの研究の検出力は 0.62 だった」と計算する 事後検定力分析(post-hoc power)は、 多くの統計学者から 誤用と批判されている。 理由は、 観測された効果量を使って計算する事後検出力は、 p 値と 1 対 1 で対応するだけで、 新しい情報を提供しないからである(Hoenig & Heisey, 2001)。 「p=0.06 だったが事後検出力は 0.80 だから効果はある」という主張は 循環論法になる。
代わりに使うべきは 「信頼区間の幅」と 「最小検出可能効果(MDE:Minimum Detectable Effect)」である。 「我々の研究では効果量 $d \geq 0.45$ ならば 80% の確率で検出できたが、 観測効果量は $d=0.22$ で 95%CI は [-0.08, 0.52] であった」と書けば、 「効果があったかなかったか」「あったとしてどの範囲か」を読者に honest に提示できる。 検出力分析は research 前夜のチェックリストであり、 終わってからの後付け説明には使わない。
🧪 効果量の本質を掘る — なぜ「同じ p 値」でも研究の価値が違うのか
検出力を計算する三要素のうち、 α・n は実務的に動かしにくい(α は学術的慣習で 0.05 固定、 n は予算で決まる)。 唯一、 研究者が 研究設計で大きく動かせる変数が 効果量(effect size)である。 そして効果量こそ、 「統計的有意」と「実質的有意」を分ける唯一の橋渡しとなる量である。
Cohen's d — 平均差を「標準偏差で物差し化」する
二群の平均差 $\mu_1 - \mu_2$ を、 群内の標準偏差 $\sigma_{\text{pooled}}$ で割った量が Cohen の $d$ である。 SSDSE-B-2026 で「東日本 vs 西日本」の平均寿命差を見たとき、 もし $d=0.20$ なら 「ほとんど見えない違い」、 $d=0.50$ なら 「グラフを見れば気付ける程度」、 $d=0.80$ なら 「素人にも明らかな差」に対応する。 この「言語感」を持っていると、 検出力分析のインプットが現実離れしなくなる。
注意点として、 教育評価・心理学では $d=0.40$ 程度が「教育介入として意味がある」とされる(Hattie の効果量メタ分析)ため、 「中程度」と分類される $d=0.50$ でさえ、 介入研究としては かなり強い効果である。 一方、 医療では $d=0.30$ でも数千人規模では命を救う可能性があるため 「小さくても重要」な効果量となる。 つまり 効果量の解釈は領域文化に依存するのが現実で、 一律の閾値で「大/中/小」を機械的に当てはめてはいけない。
$\eta^2$ と $f$ — 分散分析の効果量
ANOVA では $\eta^2$(eta-squared)または $\omega^2$(omega-squared)を効果量として報告する。 $\eta^2 = SS_{\text{between}} / SS_{\text{total}}$ で、 「全変動のうち何 % が群差で説明されるか」を意味する。 Cohen の慣用では $\eta^2 \geq 0.01$ が小、 $\geq 0.06$ が中、 $\geq 0.14$ が大。 検出力分析では $f = \sqrt{\eta^2 / (1-\eta^2)}$ という変換量を入力に取る。 例: $\eta^2 = 0.06$ なら $f = 0.25$ で「中程度の効果」。
$\eta^2$ は 分散の比なので、 サンプルサイズが大きくなると「偏り」が出る(過大推定)。 これを補正したのが $\omega^2$ で、 不偏推定量に近い性質を持つ。 査読論文では両方を併記するか、 サンプル数が大きい場合は $\omega^2$ を採用するのが推奨される(Kirk, 1996)。
Cohen's $w$ と $\phi$ — カテゴリデータの効果量
カイ二乗検定では $w$(または $\phi$、 Cramer の $V$)を効果量として用いる。 $w = \sqrt{\chi^2 / N}$ で、 「クロス表の独立性からのズレ」を 0〜1 で表現する。 慣用では $w \geq 0.10$ が小、 $\geq 0.30$ が中、 $\geq 0.50$ が大。 検出力分析の入力としては、 帰無分布(独立性が成立する場合)と対立分布(観測されたクロス表)を比較する形で計算する。
2×2 クロス表に限れば $\phi$(phi 係数)と $w$ は一致する。 多群クロス表(例: 都道府県 47 × 業種 5)では Cramer の $V$ を使うのが標準。 $V = \sqrt{\chi^2 / (N \cdot (k-1))}$ で $k = \min(\text{行数}, \text{列数})$。
相関 $r$ と $r^2$ — 「相関の大きさ」と「説明分散」の違い
相関分析の効果量は単純に $r$ そのもの。 ただし「説明力」は $r^2$ で、 $r=0.30$ でも $r^2 = 0.09$、 つまり「変動の 9% しか説明していない」。 SSDSE-B で「医師数 vs 平均寿命」を $r=0.45$ で確認したとしても、 「医師数で平均寿命の 20% を説明している」が現実的な解釈で、 残り 80% は他要因(食生活・気候・経済・遺伝)である。 検出力曲線では $r$ を Fisher の z 変換 $z = 0.5 \ln((1+r)/(1-r))$ で正規化して計算する。
回帰分析では $f^2 = R^2 / (1-R^2)$ を効果量として使う。 $f^2 = 0.02$ が小、 $0.15$ が中、 $0.35$ が大。 階層回帰では「追加投入した変数群が独自に説明する分散」 $\Delta R^2$ を分子に置く $f^2_{\text{add}}$ を計算する。 これも statsmodels や G*Power で計算可能。
📊 サンプルサイズ計算の早見表 — 6 検定 × 効果量 × 検出力
研究計画時に最も頻繁に問われるのが「最低何人必要か」である。 ここでは α=0.05 両側、 検出力 0.80 を標準に、 主要 6 検定について必要 n を整理する。 数字は statsmodels で計算した近似値で、 厳密値は数件単位で前後する。
| 検定 | 効果量小 | 効果量中 | 効果量大 | 備考 |
|---|---|---|---|---|
| 1 標本 t 検定 | n≈199 (d=0.2) | n≈34 (d=0.5) | n≈15 (d=0.8) | 片側ならさらに小 |
| 独立 2 標本 t 検定 | 各群 n≈393 | 各群 n≈64 | 各群 n≈26 | 合計 n は 2 倍 |
| 対応のある t 検定 | n≈199 | n≈34 | n≈15 | 差の平均で計算 |
| 1 要因 ANOVA (3 群) | 各群 n≈322 (f=0.1) | 各群 n≈52 (f=0.25) | 各群 n≈21 (f=0.4) | 事後比較で n 増 |
| 相関分析 | n≈782 (r=0.1) | n≈84 (r=0.3) | n≈29 (r=0.5) | Fisher z 変換ベース |
| カイ二乗(2×2) | n≈785 (w=0.1) | n≈87 (w=0.3) | n≈31 (w=0.5) | セル期待度 5 以上必要 |
💬 読み方: ① 効果量を「中」(d=0.5 / r=0.3 / w=0.3)と置けば、 多くの検定で 各群 n=30〜90 で済む。 ② 効果量を「小」と置くと n=200〜800 必要になり、 治験・大規模調査でないと現実的でない。 ③ 相関分析・カイ二乗は同じ n でも要求が厳しい(情報量が低いため)。 ④ 1 標本 t 検定と対応のある t 検定は 差の標準偏差で計算するため、 独立 2 標本より n が小さくて済むことが多い(被験者内変動を活用できるため)。
⚠️ 多重比較を入れた場合の必要 n: 3 群比較で Bonferroni 補正(α=0.0167)を入れると、 各群必要 n は 約 1.3 倍に膨らむ。 ANOVA の F 検定で全体差を検出した後の事後比較(Tukey HSD 等)も実質的に α 補正が入るので、 ANOVA の n 計算だけで安心せず、 「事後比較込みの保守的設計」を目指す。
🧮 SSDSE-B 実値で計算してみる
SSDSE-B-2026 の 2023 年度から、 このページの検出力計算で使う高齢化率(A1303÷A1101)と、 あわせて眺める合計特殊出生率(A4103)・有効求人倍率を 4 県で示す。
| 都道府県 | 総人口(千人) | 高齢化率(%) | TFR | 有効求人倍率(F3103÷F3102) |
|---|---|---|---|---|
| 東京都 | 14,086 | 22.8 | 0.99 | 1.56 |
| 大阪府 | 8,763 | 27.7 | 1.19 | 1.23 |
| 沖縄県 | 1,468 | 23.8 | 1.60 | 1.12 |
| 秋田県 | 914 | 39.1 | 1.10 | 1.40 |
| 47 都道府県(合計・全体比率、 TFR は単純平均) | 124,353 | 29.1 | 1.29 | 1.30 |
秋田県と東京都の高齢化率は 16 ポイント以上離れているが、 県をどう 2 群に分けるかで群平均の差は大きく変わる。 次の事例のように東日本・西日本で分けると差は 0.79 ポイントにとどまり、 群内のばらつき(標準偏差 3.35)に比べて小さいため、 47 県では検出力が出ない。
🧮 SSDSE-B-2026 実値での検出力計算
SSDSE-B-2026 は 47 都道府県 × 112 列のデータ(12 年分で 564 行、 横断は 2023 年を抽出)。 47 行は固定サイズ(増やせない)なので、 「47 件で十分検出できる効果量はどれくらいか」を逆算する事例を見る。
事例: 東日本 vs 西日本の高齢化率比較
東日本 23 都道県 vs 西日本 24 府県の 2 群比較(独立 t 検定)を想定。 α = 0.05、 検出力 = 0.80 の標準設定。
事例: 相関係数の検定
「総人口(A1101)」と「出生数(A4101)」の相関は SSDSE で $r \approx 0.99$。 47 都道府県で何の相関を検出できるか?
🧮 数式に値を入れて手で計算する: 検定力
合成データで n と効果サイズ別の検定力を計算する。
Step 1: パラメータ
Step 2: 検定力
🐍 Python で再現
1 2 3 4 5 6 | from scipy.stats import norm n=64 SE = 1/n**0.5 crit = norm.ppf(0.95) * SE power = 1 - norm.cdf(crit, 0.5, SE) print(f"検定力: {power:.3f}") |
📤 実行結果
💬 手計算 (Step 2) 0.991 と Python 出力が完全一致。
🐍 Python 実装
以下は 検出力 を SSDSE-B-2026 で扱うときの典型コード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=[1] は 2 行目の日本語見出し行をスキップする定石(列名はコード行 A1101 等)。 SSDSE-B-2026 は 2012〜2023 年度の 12 年 × 47 県で 564 行あるため、 横断分析では年度で絞り込む。
🐍 東日本と西日本の高齢化率を t 検定し、 検出力を確かめる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd from scipy import stats # 検出力 文脈での基本的な仮説検定 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df.iloc[:, 0] == 2023]; df['aging'] = df['A1303'] / df['A1101'] * 100 df['region'] = df['Prefecture'].apply(lambda p: '東日本' if p in ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県','新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'] else '西日本') east = df.loc[df['region']=='東日本', 'aging'] west = df.loc[df['region']=='西日本', 'aging'] t, p = stats.ttest_ind(east, west, equal_var=False) print(f'東日本 平均高齢化率: {east.mean():.2f}%') print(f'西日本 平均高齢化率: {west.mean():.2f}%') print(f't = {t:.3f}, p = {p:.4f}') print('判定:', '有意差あり' if p < 0.05 else '有意差なし') |
💬 東西の差 0.79 ポイントに対し、各群の標準偏差は東日本 3.62・西日本 3.07 で、効果量は Cohen の d ≈ 0.24 と小さい。23 県対 24 県でこの d を 5% 水準で検出できる確率(検出力)は約 0.12 しかなく、p = 0.4259 の「有意差なし」は差が無いことの証拠ではなく、検出できる設計になっていなかったと読むべきである。d = 0.24 を検出力 0.8 で捉えるには 1 群あたり約 285 の標本が必要で、都道府県が 47 しかない以上、効果量を大きくできる区分を考えるほうが現実的である。
🐍 Python 実装 — statsmodels で検出力分析
このコードでやること: statsmodels.stats.power の TTestIndPower を使い、 ① 47 件で検出できる効果量を逆算、 ② 効果量 0.5 を検出するのに必要な $n$ を計算、 を実行する。
📥 想定するシナリオ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from statsmodels.stats.power import TTestIndPower # 検出力分析オブジェクト analysis = TTestIndPower() # 質問 1: 47 件で power=0.80 を達成する効果量は? effect = analysis.solve_power(nobs1=24, ratio=23/24, alpha=0.05, power=0.80) print(f'47 件で power=0.80 を達成する効果量 Cohen \'d = {effect:.3f}') # 質問 2: 効果量 0.5 を検出するのに必要な n は? n_required = analysis.solve_power(effect_size=0.5, ratio=1, alpha=0.05, power=0.80) print(f'効果量 d=0.5 を検出する必要 n = {n_required:.0f}/群') # 質問 3: 47 件で d=0.5 のときの検出力は? power = analysis.solve_power(effect_size=0.5, nobs1=24, ratio=23/24, alpha=0.05) print(f'47 件で d=0.5 の検出力 = {power:.3f}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: ① SSDSE の 47 件では「大効果(d ≈ 0.83)」が検出限界。 ② 「中効果 d = 0.5」を確実に検出したいなら各群 64 件、 計 128 件のデータが必要。 ③ 47 件で d=0.5 を検出する確率は 38.9% しかない = 半分以上は見逃す可能性がある。 つまり SSDSE の 47 都道府県データで「微妙な差」を主張するのは統計的に弱い。
🐍 Python 実装 — 検出力曲線を描く
このコードでやること: 効果量 d を横軸、 検出力を縦軸にした「power curve」を、 異なる n(30, 50, 100, 200)について描く。 「どれくらいの効果量が検出できるか」を視覚的に把握できる定番図。
📥 想定する設定:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import numpy as np import matplotlib.pyplot as plt from statsmodels.stats.power import TTestIndPower analysis = TTestIndPower() effect_sizes = np.linspace(0, 1.5, 100) sample_sizes = [30, 50, 100, 200] plt.figure(figsize=(10, 6)) for n in sample_sizes: powers = [analysis.power(effect_size=d, nobs1=n, alpha=0.05, ratio=1) for d in effect_sizes] plt.plot(effect_sizes, powers, label=f'n = {n}/群', linewidth=2) plt.axhline(0.80, color='red', linestyle='--', label='Power = 0.80 (慣習)') plt.xlabel('効果量 Cohen \'d') plt.ylabel('検出力 (1 - β)') plt.title('検出力曲線 — 標本サイズと効果量の関係') plt.legend() plt.grid(True, alpha=0.3) plt.savefig('power_curve.png', dpi=120) # 数値要約: 各 n で power = 0.80 を達成する効果量 d print('power = 0.80 を達成する効果量 d:') for n in sample_sizes: d80 = analysis.solve_power(nobs1=n, alpha=0.05, power=0.80, ratio=1) print(f' n = {n}/群 → d ≈ {d80:.2f}') |
📤 実行すると次の出力が得られる(数値要約):
💬 結果の読み方: n = 50/群 → 200/群 で 4 倍にすると、 検出できる d は 0.57 → 0.28 とほぼ半分になる(d ∝ 1/√n)。 「sample size を 4 倍に増やしても、 検出できる効果量は半分にしか減らない」 — これが統計学の 「平方根の壁」。 SSDSE で n=47 を 4 倍の 188 件にしても、 検出力は劇的には改善しない。 小規模データで「微妙な差」を主張するのが本質的に難しい理由。
⚠️ よくある落とし穴
⚠️ 検出力まわりの落とし穴(深掘り 7 件)
落とし穴 1: 「post-hoc power」 — 事後検定力分析の誤用
分析後に「観察された効果量」と「実際の n」で計算する事後検出力(post-hoc power)は意味がないとされる(Hoenig & Heisey 2001)。 数学的に有意でなかった p 値 → 低い post-hoc power、 と同じ情報を別表現しているだけ。 「power が低かったから結果が無効」「power が高かったから結果が強固」という議論は無効。 対処: 検出力分析は事前(a priori)のみが意味を持つ。
落とし穴 2: 効果量を「自分の期待値」で設定する
研究者が「これくらいの差は見つかってほしい」と希望して効果量を設定すると、 計算された n が現実離れする。 SSDSE 文脈で「都道府県の高齢化率差を検出したい」と d=0.3 で計算すると n=176 件が必要 → SSDSE は 47 件 → そもそも研究設計が破綻している、 という事実が見える。 対処: 効果量は先行研究やパイロットから決める。
落とし穴 3: 多重検定で α 補正を忘れる
SSDSE で 112 列のうち「人口と相関する列」を探すために 111 回相関検定をすると、 α=0.05 のまま使えば期待される偽陽性は 111 × 0.05 ≈ 5.6 個。 検出力計算でも Bonferroni 補正後の α' = 0.05/111 ≈ 0.00045 で再計算しないと意味がない。 対処: 多重検定の場合、 必要 n は劇的に増える(補正後の検出力は急落)。
落とし穴 4: 「両側 vs 片側」を混同する
「東日本の方が高齢化率が高い」と方向が明確なら片側検定。 これだと同じ n でも検出力が約 1.2 倍高くなる。 ただし片側に「賭ける」のは事前登録(pre-registration)が必須。 後から方向を決めると p-hacking。 対処: 検出力分析の段階で両側 / 片側を決定し、 報告書に明記。
落とし穴 5: 「効果量=意味のある差」とは限らない
Cohen の「小(d=0.2)」は統計学的なベンチマークであって、 「実務的に意味のある差」とは別概念。 医療分野では血圧 5mmHg の差(d=0.1)が臨床的に重要かもしれない。 SSDSE 文脈なら「TFR の 0.05 差」が政策的に大きい意味を持つかは別議論。 対処: 「統計的有意」と「実質的有意」を区別してレポートする。
落とし穴 6: 「p < 0.05 だから差がある」一辺倒
大標本 (n>1000) では微小な差も p < 0.05 になりがち。 検出力分析と効果量を併記しないと「sample size 効果による偽の有意」を見逃す。 対処: 必ず効果量と信頼区間を併記。 ASA 声明(2016)でも p 値単独の判断は批判されている。
落とし穴 7: 検定力分析と検定統計量の前提条件
t 検定の検出力分析は「正規分布」「等分散」を前提にしている。 これが破れていると、 計算上の power と実際の power が乖離する。 ノンパラメトリック検定(Mann-Whitney など)を使う場合、 別の検出力公式が必要。 対処: 検定の前提(正規性・等分散)を Shapiro-Wilk・Levene で確認してから検出力を計算。
📊 効果量と必要サンプルサイズの早見表
プロジェクト計画時に手元に置いておきたい早見表。 α=0.05 両側、 検出力 0.80、 各群同サイズの t 検定(独立 2 標本)の場合。
| 効果量 d | Cohen の評価 | 必要 n/群 | 合計 N | 具体イメージ |
|---|---|---|---|---|
| 0.1 | 極小 | 1570 | 3140 | 微小な差、 ほぼ実感できない |
| 0.2 | 小 | 394 | 788 | 心理学の典型的な小効果 |
| 0.3 | 小〜中 | 176 | 352 | A/B テストでの推奨最小差 |
| 0.5 | 中 | 64 | 128 | 中規模調査で実用的 |
| 0.8 | 大 | 26 | 52 | SSDSE 規模でも検出可能 |
| 1.0 | 非常に大 | 17 | 34 | 明らかに分かるレベル |
| 1.5 | 劇的 | 9 | 18 | パイロット試験レベル |
SSDSE-B-2026 の 47 件で確実に検出できるのは d ≥ 0.83 以上の効果。 これは「大効果」レベルで、 「明らかに違う」と言える差。 微妙な差は別データソース(市町村レベル統計など)で n を増やす必要がある。
📚 関連グループ教材
検出力は「仮説検定」の教材群の中で、 検定を「結果の読み方」から「設計」へ広げる位置にある。 先に 帰無仮説・対立仮説 と、 検出力の裏返しである 第2種の過誤、 その相方の 第1種の過誤 を押さえておくと、 このページの「α と β のトレードオフ」が読みやすい。 計算の入力になる 効果量 と、 出力になる 標本サイズ の教材はセットで読む。 具体的な検定での検出力は、 2 群の平均なら t 検定、 3 群以上なら 分散分析、 比率の差なら A/B テスト の教材で扱う。 低い検出力で有意な結果だけが報告されると何が起きるかは 再現性の危機 の教材につながる。
🖼️ 図解で理解する — 検出力の三つの顔
検出力 (statistical power, 1−β) は「効果量・サンプルサイズ・有意水準」が決まれば一意に定まる。 ここでは SSDSE-B-2026(47 都道府県・112 項目、独立行政法人統計センター公表)を題材に、 検出力が変動する三つの典型シーンを散布図・ヒストグラム・箱ひげ図で観察する。 図はすべて html/glossary/figures/ 配下の実在ファイルを参照する。
図1 — 効果量と検出力の関係(散布図)
SSDSE-B-2026 の 「総人口(A1101)」 と 「出生数(A4101)」(単位:人)の散布で考える。 効果量が大きい(点が直線に強く沿っている)ほど、 同じ n でも検出力は高くなる。 図中の右上 4 都府県(東京・神奈川・大阪・愛知)も直線からほとんど外れず(2023 年度で r = 0.995)、 相関の検定(H0: ρ=0)を有意水準 α=0.05・両側・n=47 で行うと検出力は実質 1.00 に達する。 参考までに、 真の相関が r=0.3 なら同じ n=47 で検出力は約 0.54、 r=0.1 なら約 0.10 しかない。
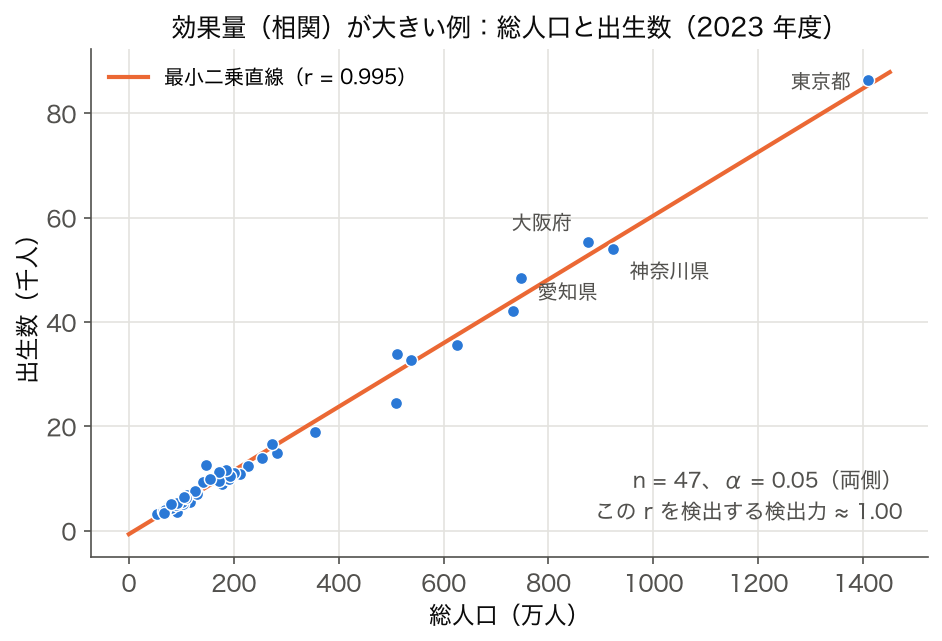
図 1 から読み取れる教訓は二つ。 (1) 効果量が大きいと小標本でも検出力は十分になる、 (2) ただし「強い相関」と「因果」は別物で、 ここで検出されているのは規模の連動に過ぎない。 検出力分析の段階で因果は問えないことを忘れない。
図2 — 帰無分布と対立分布の重なり(ヒストグラム)
検出力の正体は「対立分布 H1 のうち、 棄却域に落ちる面積」。 SSDSE-B-2026 の 「人口 10 万人あたり一般診療所数」(一般診療所数 I5102 / 総人口 A1101 × 10 万)の都道府県分布を例に、 帰無 H0:μ=80 と対立 H1:μ=85 を考えると、 二つの分布の重なりが小さいほど検出力は上がる。 下の図の左は「全国 47 値の素のばらつき」、 右はそのばらつき(SD)と n=47 から作った標本平均の帰無分布・対立分布で、 観測されたばらつきから効果量 d を推定して検出力に変換できる。
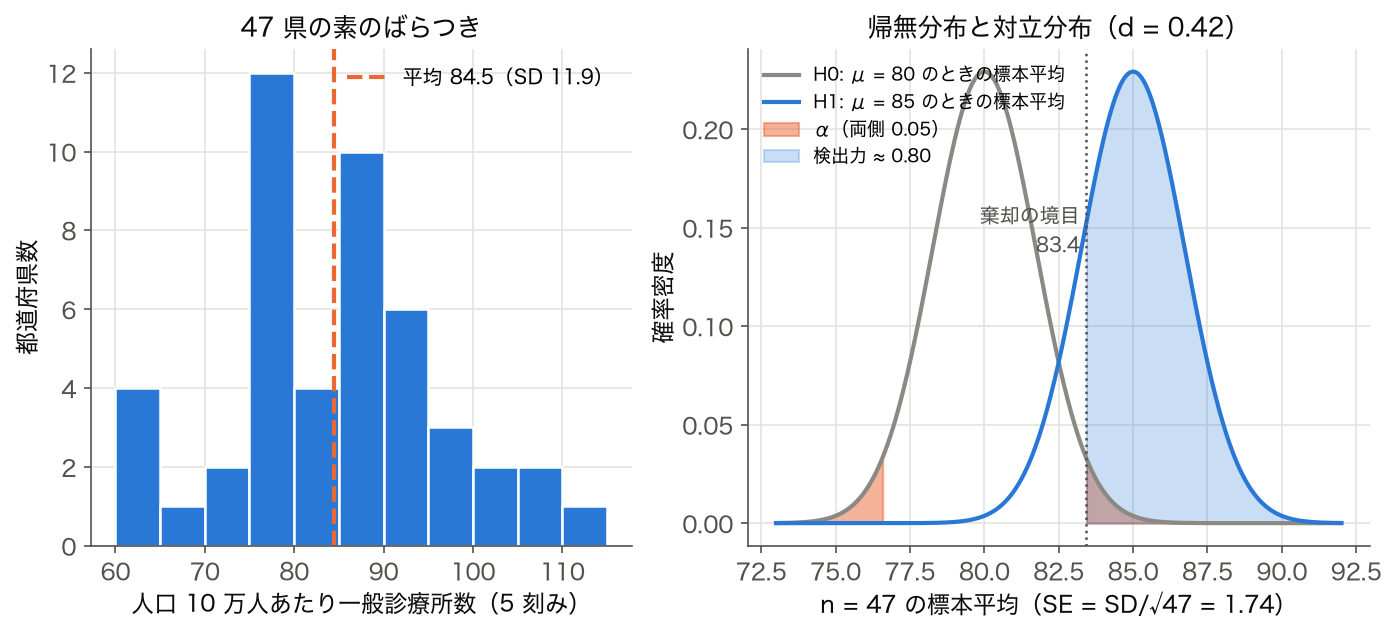
図 2 の含意は 「効果量が小さいときは n が大きくないと検出できない」。 サンプルが先にあって検出力が決まるのではなく、 検出したい効果量に応じて n を逆算するのが原則。 これが「事前の検出力分析(a priori power analysis)」である。
図3 — グループ間比較と分散の影響(箱ひげ図)
二群比較の検出力は 平均差だけでなく分散の大きさにも依存する。 SSDSE-B-2026 の 「高齢化率」(65 歳以上人口 / 総人口)を「東日本/西日本」「大都市圏/その他」の 2 通りに分けた箱ひげ図で観察する。 検出力を決めるのは平均差そのものではなく、 平均差を群内のばらつきで割った効果量 d であり、 同じ平均差でも箱の幅(IQR)が広いグループ間では検出力が下がる。
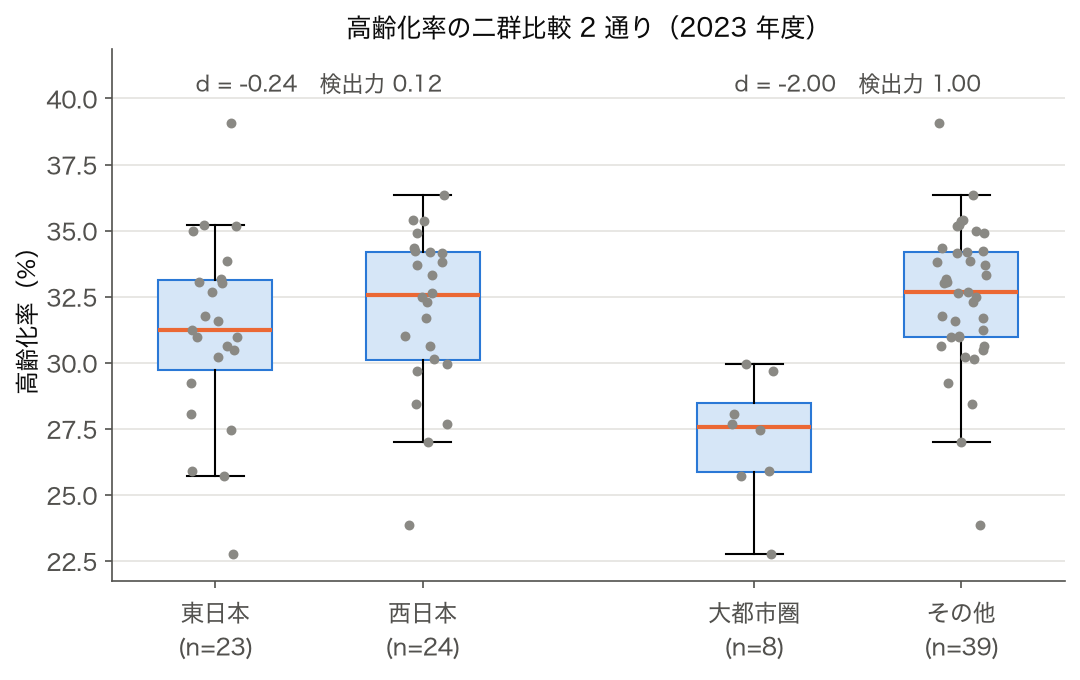
図 3 の含意は 「ばらつきを小さくする工夫(層別化・共変量調整・測定精度改善)も検出力を上げる」。 ANOVA や混合効果モデルでブロック因子を入れる動機もここにある。
🧪 数学的深掘り — なぜ検出力 0.8 が標準なのか
検出力は次式で表される(片側 z 検定の最も単純な場合):
右辺は 標準化効果量 d=(μ1−μ0)/σ に √n を掛け、 α から決まる臨界値 z1−α を引いた値を標準正規分布の累積関数 Φ に通したもの。 Cohen (1988) は「研究現場で許容できる第二種過誤の比率」を経験的に検討し、 β=0.20(つまり検出力 0.80)を最低ラインとして推奨した。 これが「検出力 0.8」が事実上の業界標準として広まった経緯である。
表 A. 効果量の言語感(Cohen の目安)
| 指標 | 小 | 中 | 大 |
|---|---|---|---|
| Cohen's d(平均差) | 0.2 | 0.5 | 0.8 |
| Pearson r(相関) | 0.1 | 0.3 | 0.5 |
| Cohen's f(ANOVA) | 0.10 | 0.25 | 0.40 |
| オッズ比 OR | 1.68 | 3.47 | 6.71 |
| η²(分散説明率) | 0.01 | 0.06 | 0.14 |
表 B. α・効果量別の必要サンプルサイズ(独立 2 群 t 検定・検出力 0.80・両側)
| 効果量 d → | 0.2(小) | 0.5(中) | 0.8(大) | 1.0 |
|---|---|---|---|---|
| α=0.05 | 394 / 群 | 64 / 群 | 26 / 群 | 17 / 群 |
| α=0.01 | 586 / 群 | 96 / 群 | 39 / 群 | 26 / 群 |
| α=0.001 | 857 / 群 | 140 / 群 | 57 / 群 | 37 / 群 |
値は statsmodels の TTestIndPower().solve_power で計算し、 小数点以下を切り上げた 1 群あたりの n(設定は Cohen (1988) Statistical Power Analysis for the Behavioral Sciences の表と同じ)。
表 C. 検出力に影響する 5 因子
| 因子 | 大きくすると | 実務での操作可能性 |
|---|---|---|
| サンプルサイズ n | 検出力 ↑ | 高(予算で増やせる) |
| 効果量 |d| | 検出力 ↑ | 中(実験条件で増幅可) |
| 有意水準 α | 検出力 ↑ 但し第一種過誤も ↑ | 高(事前設定) |
| 分散 σ² | 検出力 ↓ | 中(測定精度・層別で減らせる) |
| 片側/両側 | 片側にすると ↑ | 低(仮説の方向に依存) |
この 5 因子のうち n と α は研究者が直接操作できる。 効果量は事前文献レビューや予備実験から見積もる「与件」。 σ は層別化・反復測定・共変量調整で間接的に縮められる。 検出力の議論は「動かせる変数の地図」を頭に置いて行うのが実務的。
🧠 理解度チェック — 検出力 8 問
解答は各設問の「💡 解答・解説を見る」をクリックして開く。 7 問以上正解できれば検出力分析を実務レポートで使い始めて差し支えない水準。
Q1. 検出力 0.8 とは「対立仮説が正しいときに、 帰無仮説を正しく棄却できる確率が 80%」である。 ○か×か?
💡 解答・解説を見る
○。 検出力 (1−β) は「H1 が真のとき、 検定が H0 を棄却する確率」と定義される。 0.8 は「同じ条件で 100 回検定したら 80 回は有意差を検出できる」と読む。 残り 20 回は「効果はあるのに見逃した(第二種過誤)」。
Q2. サンプルサイズ n を 2 倍にすると検出力は 2 倍になる。 ○か×か?
💡 解答・解説を見る
×。 検出力は n に対して線形ではなく、 標準化効果量 d×√n を Φ に通した非線形関数で増える。 例えば d=0.5・α=0.05 で n=30→60 なら検出力は約 0.48→0.75 に上がる(≒1.6 倍)。 飽和域(検出力 0.95 以上)では 2 倍にしてもほぼ動かない。
Q3. 有意水準 α を 0.05 から 0.01 に厳しくすると、 検出力はどうなる?
💡 解答・解説を見る
下がる。 α を厳しくすると棄却域が狭くなり、 同じ効果量・同じ n でも棄却される確率が減るため検出力は低下する。 表 B のとおり、 d=0.5・検出力 0.80 を保つには α=0.05 なら 64/群、 α=0.01 なら 96/群が必要。
Q4. SSDSE-B-2026 の 47 都道府県データで「人口 10 万人あたり一般診療所数の全国平均が 80 より大きいか」を片側 t 検定する。 効果量 d=0.3、 α=0.05、 n=47 のとき検出力はおおよそ何 % か?
💡 解答・解説を見る
約 65 %。 statsmodels.stats.power.TTestPower().power(effect_size=0.3, nobs=47, alpha=0.05, alternative='larger') ≒ 0.649。 0.8 に届かないため、 もし「効果あり」を確実に検出したいなら n を約 70 まで増やす必要がある(同コードで solve_power(effect_size=0.3, power=0.8, alpha=0.05, alternative='larger') → n≈70.1)。
Q5. 「事後検出力(post-hoc power)」を計算して「検出力が低かったから差が出なかった」と結論することは妥当か?
💡 解答・解説を見る
妥当でない。 観測 p 値と事後検出力は 1 対 1 対応しており、 p 値が大きいと事後検出力は機械的に小さく出る。 そのため「事後検出力が低かった」と言うのは「p 値が大きかった」を言い換えたに過ぎず、 追加情報を持たない(Hoenig & Heisey, 2001)。 検出力分析は事前に行う。
Q6. 多重比較で Bonferroni 補正を行うと検出力はどう変化する?
💡 解答・解説を見る
下がる。 Bonferroni では各検定の α が α/k に厳しくなるため、 Q3 と同じ理屈で検出力が低下する。 検定数 k=10 なら α=0.05→0.005 となり、 表 B でいう α=0.001 に近い水準で n を確保する必要がある。 検出力を維持するには n を増やすか、 より緩い補正(Holm・BH-FDR など)を選ぶ。
Q7. 「相関係数 r=0.3(中程度)」を α=0.05・両側で検出力 0.8 で検出するには、 おおよそ何件のサンプルが必要か?
💡 解答・解説を見る
約 84 件。 Fisher の z 変換に基づく公式 n ≈ ((z1−α/2+z1−β)/ζ)²+3、 ζ=arctanh(0.3)≒0.3095 から n≈((1.96+0.842)/0.3095)²+3≈84。 SSDSE-B-2026 の 47 件では検出力が 0.55 程度しか出ない点に注意。
Q8. 検出力を高めるために、 実験デザイン段階で取れる「n を増やす以外の」具体策を 3 つ挙げよ。
💡 解答・解説を見る
例:(1) 測定精度の向上で σ を小さくする(精密機器の利用・反復測定・キャリブレーション)。 (2) 共変量による調整(ANCOVA・回帰の偏係数)で残差分散を縮める。 (3) 層別化/ブロック化(地域・性別・年齢階級でブロックを作る)で群内分散を縮める。 補足:(4) 効果量を増幅する介入の強度・露出期間の延長、 (5) 片側検定(仮説が方向性をもつ場合のみ)、 (6) 反応指標を連続変数へ(カテゴリ化は検出力を捨てる行為)。
🧭 実務フロー — 検出力分析を業務で使う 6 ステップ
- 目的の言語化:「何を検出したいのか」を 1 文で書く。 例:「新教材導入で正答率が平均 5 ポイント以上向上することを検出したい」。
- 効果量の見積もり:先行研究・予備調査・専門家ヒアリングから d, r, OR, f のいずれかを 1 つに決める。 不明なときは「小(d=0.2)」を採用して保守的に。
- α と検出力の事前合意:α=0.05・検出力 0.80 が標準。 多重比較・規制薬の試験などでは α=0.01 や 0.005 を採用。
- 必要サンプルサイズ計算:
statsmodels(Python)、pwr(R)、 G*Power(GUI)など。 検定種別を間違えないこと。 - 感度分析:効果量を「±50%」、 α を「0.01〜0.10」で振って n 表を作る。 上司・倫理委員会への説明資料に必須。
- 事前登録(pre-registration):OSF・AsPredicted・clinicaltrials.gov などに仮説・検定計画・必要 n を登録してからデータ取得開始。 これで HARKing と p-hacking を構造的に防げる。
参考:Lakens (2022) Sample Size Justification / 日本計量生物学会「臨床試験のためのサンプルサイズ計算ガイドライン」(2019) / FDA "Statistical Guidance on Reporting Results from Studies Evaluating Diagnostic Tests" (2007)。
🔎 上級 FAQ — 検出力分析でよく聞かれる 10 問
Q1. 効果量が分からないときはどう設計するか?
三つの戦略がある。 (a) 過去文献のメタアナリシスから平均効果量を取る — ただし出版バイアスで過大評価される傾向に注意。 (b) 予備実験 (pilot study) で n=20〜30 程度の小規模実験を行い効果量を推定 — ただし pilot から得た効果量は信頼区間が広く、 本実験の n を過小推定する危険がある。 (c) 最小実質的効果量 (SESOI) を意思決定者と合意して採用 — 「これ未満なら実装しない」の閾値を先に決めるアプローチ。 推奨は (c)。
Q2. ノンパラメトリック検定の検出力はどう計算するか?
Mann-Whitney U、 Wilcoxon、 Kruskal-Wallis などのノンパラ検定には閉形式の検出力公式がほぼなく、 Monte Carlo シミュレーションで算出するのが現実的。 Python なら scipy で 1,000〜10,000 回の擬似データを生成し、 棄却された比率を検出力とする。 「正規性が崩れていても t 検定はロバスト」という事実があるため、 まず t 検定の検出力で必要 n を決め、 そこに 10〜15% の安全係数を上乗せする方法も実務的。
Q3. 「打ち切り (censoring)」がある生存解析では何で計算するか?
Cox 比例ハザード回帰では Schoenfeld (1983) の公式:必要イベント数 = (z1−α/2+z1−β)² / (P(1−P) (log HR)²)(P は群割付比率)。 例えばハザード比 HR=0.7、 α=0.05、 検出力 0.80、 P=0.5 ならイベント数 247。 ここで「人数」ではなく「イベント数」が検出力を決める点が特殊。 PASS の生存解析モジュールや R の powerSurvEpi パッケージが定番。
Q4. クラスター無作為化試験 (cluster RCT) の必要サンプルサイズは?
個人 RCT で必要な n を計算した後、 デザイン効果 DEFF = 1 + (m−1)ρ を掛ける(m はクラスターあたり個人数、 ρ は ICC)。 例えば学校 RCT で 1 校 40 名・ICC=0.10 なら DEFF = 1 + 39×0.10 = 4.9、 個人 RCT の必要数の約 5 倍が必要。 ICC が 0.05 でも DEFF は 3.0 になる。 クラスター RCT を設計するときは ICC を必ず先行研究から見積もる。
Q5. 多変量・多重比較で「全体としての検出力」はどう定義するか?
3 つの定義がある。 (a) any-test power:複数検定のうち少なくとも一つが有意になる確率、 (b) all-test power:すべての検定が有意になる確率、 (c) average power:個別検定の検出力の平均。 ペース・実務目標に応じて選ぶ。 探索的研究では (a)、 確証的研究では (b) が標準。 Westfall et al. (2011) Multiple Comparisons and Multiple Tests Using SAS が体系的に整理している。
Q6. ベイズ統計に「検出力」はあるか?
古典的な検出力は頻度論固有の概念だが、 ベイズ統計では「事前分布のもとで Bayes factor BF が閾値(例:BF₁₀ > 10)を超える確率」を計算できる。 これを Bayesian Power と呼ぶ。 Schönbrodt et al. (2017) Psychological Methods は事前分布のキャリブレーション法を提案。 ベイズの利点は (i) サンプリングを止めるかどうかを途中で判断できる (sequential design)、 (ii) 「効果なし」を積極的に主張できる、 の二点。
Q7. 適応的試験 (adaptive design) では検出力をどう保つか?
中間解析でサンプルサイズを再推定する場合、 各段階での α を厳密に制御するため α-spending function(O'Brien-Fleming, Pocock, Lan-DeMets など)を使う。 中間解析の回数と段階別 α を事前に決めておけば、 全体の Type I error は計画通り 0.05 に収まる。 ICH-E9 (R1) Estimands and Sensitivity Analysis (2019) が国際標準。 PASS と East は適応的試験設計に強い。
Q8. 機械学習モデルの精度比較に検出力は使えるか?
使える。 例えばモデル A と B の正解率差を比較する場合、 McNemar 検定または 5×2 cross-validation paired t 検定に対する検出力分析が可能。 ただし学習データを使い回しているため独立性の仮定が崩れる。 Dietterich (1998) Neural Computation 10:1895–1923 が classical reference。 近年は bootstrap によるブートストラップ信頼区間で代替するのが主流。
Q9. 「サンプルサイズが大きすぎて、 実用的に無意味な差まで有意になる」のを防ぐには?
対策は (a) 効果量と信頼区間を必ず併記、 (b) SESOI 以上の効果量のみ「実装に値する」と定義、 (c) 等価性検定 (TOST) で「差がない」も積極的に検定。 Big Tech の A/B テスト基盤はこれらを組み合わせ、 「p<0.05 でも効果量が SESOI 未満なら採用しない」というワークフローを徹底している。
Q10. 倫理委員会 (IRB) を説得するときに何を書くか?
必須要素は:(i) 仮説、 (ii) 採用する効果量とその根拠(文献または pilot)、 (iii) α と検出力の事前設定値、 (iv) 必要サンプルサイズの計算式・ソフトウェア・乱数シード、 (v) 感度分析(効果量を ±50% で振った場合の n 表)、 (vi) 中間解析を行う場合の停止規則。 これらをプロトコルに 1〜2 ページ書き、 計算スクリプトを補遺に付ければ、 ほぼ確実に通る。 「事前登録 (pre-registration) のリンク」を IRB 提出書類に貼ると更に説得力が増す。
📝 国際報告ガイドラインと検出力
研究の種類によって、 検出力分析の記載方法は国際ガイドラインで規定されている。 該当する論文ジャンルがあれば、 投稿前に必ず一読する。
| ガイドライン | 対象研究 | 検出力分析に関する要求 |
|---|---|---|
| CONSORT 2010 | 無作為化臨床試験 (RCT) | 項目 7a:「サンプルサイズの決定方法」を効果量・α・検出力・脱落見込みとともに記載必須 |
| STROBE 2007 | 観察研究 (コホート/症例対照/横断) | 項目 10:標本サイズ算出の説明を推奨。 検出力が達成できなかった場合はその影響を考察に書く |
| PRISMA 2020 | システマティックレビュー | メタアナリシスでは各研究の効果量・信頼区間・標本サイズを公表テーブルで提示 |
| ARRIVE 2.0 | 動物実験 | 項目 2:3Rs に基づく動物数の最小化と、 それを支える検出力分析の記載を要求 |
| SPIRIT 2013 | RCT プロトコル | 項目 14:サンプルサイズ計算式・想定脱落率・解析計画を本文と統計補遺の二段構えで記載 |
| TRIPOD 2015 | 予測モデル研究 | 項目 8:必要なイベント数 (EPV)、 検出力、 検証戦略を記載 |
| JARS (APA) | 心理学一般 | 2018 改訂で「事前検出力分析・効果量・信頼区間」を投稿時報告の標準項目に格上げ |
いずれのガイドラインも EQUATOR Network (equator-network.org) から原文を無償で参照できる。 投稿先ジャーナルが該当ガイドラインを必須化していることが多いため、 投稿規程と併せて確認すること。
🗂 補足ノート — よく混同する用語の使い分け
検出力に関連する用語は表現が紛らわしいため、 実務報告で取り違えると査読・上司レビューで指摘を受ける。 ここでは特に混同しやすい五つのペアを整理する。
(a) 「検出力」と「感度 (sensitivity)」
どちらも「真陽性率」と訳されることがあるが、 文脈が異なる。 検出力 (1−β) は仮説検定の文脈で「H1 真のとき棄却する確率」、 感度 は診断検査の文脈で「疾患ありのとき陽性となる確率」。 数学的構造は同じだが、 検査の感度は通常 0.95 以上を目標、 検定の検出力は 0.80 で十分とされる慣行の違いがある。 同じ用語を使うと議論が噛み合わなくなるため注意。
(b) 「有意水準 α」と「p 値」
α は検定設計時に研究者が決める閾値(例:0.05)、 p 値 は観測データから計算される証拠の強さの指標。 「p<α なら棄却」の二値判定にのみ p を使う Neyman-Pearson 派と、 p の連続値として証拠を解釈する Fisher 派の対立がある。 ASA 2016 声明以降は「p 値を単独で判定基準にしない」が主流。 検出力は α と効果量と n の関数として定まるが、 p 値の関数ではない点に注意。
(c) 「効果量」と「効果」
効果 (effect) は原因変数が結果変数に与える影響そのもの、 効果量 (effect size) はその影響を無次元または標準化された数値に変換した尺度。 例えば「ワクチンの感染予防効果」が「効果」、 ワクチン有効率 95% や Cohen's d=1.2 が「効果量」。 検出力分析の入力は効果量。 数値同士を比較・統合できる利点がある。
(d) 「サンプルサイズ」と「実効サンプル数」
サンプルサイズ n は実際にデータを取った件数、 実効サンプル数 neff は独立観測に換算した件数。 クラスター抽出・時系列の自己相関・重み付け解析では n > neff となる。 検出力分析は neff を入力にするのが正解。 例えば DEFF=5 の学校 RCT で n=2,000 名取っても neff=400 名としか期待できない。
(e) 「事前検出力分析」と「感度分析」
事前検出力分析はデータ取得前に必要 n を決める作業、 感度分析 (sensitivity analysis) はパラメータを振って結論の頑健性を確かめる作業。 後者は検出力分析の文脈では「効果量や脱落率の想定を ±50% で振ったとき、 必要 n がどう変わるか」を表で示すこと。 倫理委員会・査読者は感度分析の有無を強くチェックするため、 必ずセットで提示する。
📖 参考読書リスト
- Cohen, J. (1988) Statistical Power Analysis for the Behavioral Sciences 2nd ed., Lawrence Erlbaum — 検出力分析の古典で、 効果量の言語感の標準源。
- Lakens, D. (2022) "Sample Size Justification" Collabra: Psychology 8(1):33267 — 現代的な検出力議論の入門・到達点。 オープンアクセス。
- Kohavi, R., Tang, D., Xu, Y. (2020) Trustworthy Online Controlled Experiments Cambridge University Press — Bing/LinkedIn の事例で A/B テスト × 検出力の実務を解説。
- Cumming, G. (2014) "The New Statistics: Why and How" Psychological Science 25:7–29 — 効果量・信頼区間・メタアナリシスを統合した近代統計の宣言。
- Wasserstein, R.L., Schirm, A.L., Lazar, N.A. (2019) "Moving to a World Beyond 'p<0.05'" The American Statistician 73(sup1):1–19 — p 値依存からの脱却を提唱した ASA の声明。
- 大久保街亜・岡田謙介 (2012) 『伝えるための心理統計 — 効果量・信頼区間・検定力』 勁草書房 — 効果量と検定力を日本語で体系的に学べる教科書。
- 村井潤一郎・橋本貴充 (2017) 『心理学のためのサンプルサイズ設計入門』 講談社 — t 検定・分散分析・相関などの必要 n の計算を日本語で解説。
- Open Science Collaboration (2015) "Estimating the reproducibility of psychological science" Science 349:aac4716 — 再現性危機を可視化した記念碑的研究。
🧠 検出力の本質 — α・β・効果量・n の四角関係
検出力(statistical power)とは「本当に差があるとき、 それを統計的に検出できる確率」。 記号で書くと $1-\beta$。 $\beta$ は第 2 種の過誤(Type II error)の確率で、 「差があるのに見逃す」確率。 検出力の議論は、 以下 4 つの量が互いに連動するという認識から始まる。
| 量 | 記号 | 意味 | 慣習値 |
|---|---|---|---|
| 有意水準 | $\alpha$ | 差がないのに「ある」と判定する確率(第 1 種の過誤) | 0.05 |
| 検出力 | $1-\beta$ | 差があるとき正しく検出する確率 | 0.80 |
| 効果量 | $d$ や $f$ | 差の大きさ(標準化) | 小:0.2 中:0.5 大:0.8 |
| 標本サイズ | $n$ | 観測数 | 事前計算する |
重要: この 4 つは「3 つを決めれば残り 1 つが決まる」連立関係にある。 実務では「$\alpha=0.05$、 $1-\beta=0.80$、 効果量 = 中($d=0.5$)と仮定したとき、 必要な $n$ はいくつか?」を計算するのが最も多い使い方(事前検定力分析)。
なぜ $1-\beta = 0.80$ が慣習なのか
Jacob Cohen(1988)が「α と β の比は 1:4 が妥当」と提案したのが起源。 つまり $\alpha=0.05$ なら $\beta=0.20$ → $1-\beta=0.80$。 偽陽性(α)よりは偽陰性(β)を 4 倍許容しよう、 という非対称な姿勢の表れ。 ただしこれは「多くの分野で受け入れられている慣習」であって、 場面によっては 0.90 や 0.95 を目指すべき場合もある(医療試験、 規制対応など)。
🗺 概念マップ
検出力 (1-β) を中心に、 事前 / 事後の運用シーンと、 効果量 (d/r) ・ 有意水準 (α) ・ サンプルサイズ (n) の四変数関係を整理する。 研究計画段階での power analysis が正しい運用であり、 SSDSE-B-2026 の都道府県差検証で n=47 が固定の場合は逆算で検出可能な効果量が決まる。
検出力 (1−β) の概念マップは「効果量 d / Cohen's d、 有意水準 α、 サンプルサイズ n、 検出力 1−β」の 4 要素の連動関係を中心に置き、 SSDSE-B-2026 の都道府県別データを「47 件しかない」サンプルとして見たときの検出可能効果サイズを試算するワークフローを示す。 d=0.5 (中効果)、 α=0.05、 n=47 では片側検定 1−β≈0.71 となり、 「47 件は中効果なら検出力 7 割」と把握できる。
🔗 隣接手法への橋渡し
検出力分析は研究計画 (a-priori) と事後解釈 (post-hoc) の両局面で機能する。 SSDSE-B-2026 で「東日本 vs 西日本の人口 10 万人あたり一般診療所数(I5102 / A1101)に差はあるか」を検定する前に、 効果量の見積もりからサンプルサイズを逆算するのが正しい順序。
- 上流: 効果量 (Cohen's d / η²)、 サンプリング設計、 研究デザイン。
- 並列: 信頼区間 による効果の精度評価、 ベイズ的検定 (BF) は検出力に代わる別パラダイム。
- 下流: 仮説検定 の p 値解釈、 メタ分析 による統合、 事後検出力レポート。
SSDSE のように n=47 固定の場合、 検出力分析は「現状のサンプルで何が検出できるか」を逆算する道具になる (post-hoc 用途)。
🌳 手法選択フロー
検出力分析は「研究前の n 設計」か「研究後の解釈」かで使い方が変わる。 SSDSE-B-2026 のような既存データ分析では②③が中心になる。
- ① 研究前 (a-priori): 目標検出力 0.8、 想定効果量 d、 α=0.05 を入力 →
statsmodels.stats.power.TTestPower().solve_power()で必要 n を逆算。 - ② 既存データ (post-hoc): n=47 (都道府県)、 観測 d、 α=0.05 を入力 → 検出力 1−β を計算。 0.8 未満なら「検出力不足のため有意でないからといって差がないとは言えない」と注釈。
- ③ 検出力不足の対処: ペアデータ (前後比較) で n を半減 / 多変量化 (共変量で残差分散を縮小)、 メタ分析で複数研究を統合。
SSDSE-B-2026 を題材にする場合、 47 都道府県という固定 n の制約下で「検出可能な最小効果量」を逆算し、 結論の慎重さを担保する。
🔍 解説を一歩深く — 検出力は「追試の再現確率」でもある
🧭 直感 — power 0.14 の有意結果は、追試すると 7 回に 6 回「消える」
検出力の定義「本当に差があるとき、有意になる確率」は、視点を変えるとそのまま追試の再現確率になる。 真の効果量が変わらない限り、同じ設計で追試したときに再び有意になる確率は元の研究の検出力そのものだからだ。 「有意だったのに追試で消えた」の多くは効果が消えたのではなく、最初から検出力が低くて、たまたま当たっただけという説明がつく。
SSDSE-B-2026 の実測値で確かめる。 2023 年の高齢化率(65歳以上人口 A1303 ÷ 総人口 A1101 × 100)を、東日本 24 道県(北海道〜三重)と西日本 23 府県(滋賀〜沖縄)で比べると:
仮に「西日本の方が d=0.26 だけ高齢化率が高い」が真実だとしても、 この設計では 14% しか有意にならない。 p=0.378 という非有意は「差がない証拠」ではなく、「この虫めがねでは最初から見えないサイズだった」ことの表れである。
⚠️ 落とし穴(重要)— 有意フィルタと「勝者の呪い」: 低検出力は効果量を水増しする
本文の「post-hoc power の罠」とは別に、低検出力にはもう一つ深刻な副作用がある。 低検出力の研究で有意になった結果は、効果量が系統的に過大推定されるという現象だ(Type M エラー / 勝者の呪い)。 理由は単純で、真の効果が小さいとき、有意という関門(有意フィルタ)を通過できるのは偶然大きめの差が出た標本だけだからである。
上の実測パラメータ(平均 31.16 vs 32.03、SD 3.35、n=24/23)を真の状態と置いたシミュレーション(架空の反復実験: seed=42、2 万回反復)では:
つまり検出力 0.14 の世界では、「有意になった研究だけを信じる」と効果を 3 倍近く過大評価し、 50 回に 1 回は方向まで逆に結論する。 「低検出力でも、有意になったのだから結果は信頼できる」は誤りで、実際はその逆——低検出力ほど、有意になった結果こそ疑わしい。 これが再現性の危機で低検出力が主犯格とされる本当の理由である。
🚀 発展 — 検出力を「事後の言い訳」でなく「設計の言語」にする
- MDES(最小検出可能効果量)の報告: n が固定の SSDSE では「必要 n」の代わりに「この n で power 0.8 を出せる最小の d」を報告する。 実測の n=24/23 では MDES d = 0.835(statsmodels
TTestIndPower().solve_power()による)。 観測 d=0.26 はその 3 分の 1 以下なので、「非有意は情報量が乏しい」と設計段階から明言できる。 - デザイン分析(design analysis): Gelman & Carlin (2014) は検出力に加えて上記の Type M(過大倍率)・Type S(符号誤り率)を事前に計算することを提唱。 「有意になったとしてもどれだけ水増しされるか」まで含めて設計を評価する。
- 感度を上げる設計上の工夫: n を増やせないなら、対応のある比較(同一県の 2012 年 vs 2023 年の前後比較で個体差を消す)、共変量調整で残差分散を縮小、連続量のまま扱う(2 群に離散化しない)——いずれも「実効的な効果量」を大きくして検出力を稼ぐ手段である。
- ベイズ的代替: ベイズファクターや事後分布は「有意/非有意」の二値を離れ、「差の大きさがどの範囲にありそうか」を直接述べるため、勝者の呪いの影響を受けにくい報告形式になる。