🔖 キーワード索引 — 信頼区間を多角的に理解する
信頼区間(confidence interval)は推測統計の最重要概念です。 関連キーワードを難易度別に整理しました。
🟢 基礎キーワード(まず押さえる)
- 信頼水準(confidence level):通常 95%、 厳しい場合 99%。 (1 − α) で表現。
- 区間推定(interval estimation):点推定と対をなす推定法。 値ではなく区間を出す。
- 点推定(point estimation):標本から 1 つの値を出す推定。 平均、 比率、 回帰係数など。
- 標準誤差(standard error, SE):推定量のばらつき。 SE = σ/√n。 信頼区間の幅を決める。
- マージン・オブ・エラー(margin of error):信頼区間の半幅。 z·SE または t·SE。
- 母集団と標本:信頼区間は母数を「区間で挟む」推定。 母集団と標本の区別が前提。
🟡 中級キーワード
- t 分布の信頼区間:母分散未知・小標本の場合、 正規ではなく t 分布の臨界値を使う。
- z 区間と t 区間:母分散既知なら z、 未知なら t(df = n−1)。 N 大なら両者ほぼ同じ。
- 比率の信頼区間:Wald、 Wilson、 Clopper-Pearson、 Agresti-Coull など複数の方法。
- 差の信頼区間:2 群平均差、 比率差、 オッズ比、 リスク比などの区間。
- ブートストラップ信頼区間:再標本化による経験的区間。 分布の仮定なし。
- カバレッジ確率(coverage probability):信頼区間が真値を含む実際の確率。 理論値(95% など)に近いか。
🔴 上級キーワード
- BCa ブートストラップ:バイアス補正 + 加速。 通常のパーセンタイル法より精度高。
- プロファイル尤度信頼区間:尤度比検定に基づく区間。 最尤推定で頻用。
- 事後信用区間(Bayesian credible interval):ベイズ統計での区間。 信頼区間と意味が異なる。
- 同時信頼区間(simultaneous CI):複数パラメータを同時にカバー。 多重比較で重要。
- 非劣性・優越性試験の信頼区間:医薬品開発で重要。 区間が閾値を超えるか否か。
- カバレッジ条件付き信頼区間:選択バイアス補正。 post-selection inference の枠組み。
💡 30秒で分かる結論
🍰 まずはやさしく
予測の「幅」のことです。
答えがどれくらい不確かなかを知るために使います。
テストの点数の予想を幅で答えるようなものです。
この章では信頼区間の結論を短くまとめます。
- 定義:「同じ実験を100回繰り返したら、 95回は作られた区間が真の値を含む」という幅
- 幅の意味:狭い → 精密、 広い → 不確実(n少 or ばらつき大)
- 0 を含むかが決定的:含めば「効果なし」を否定できない
- p値より情報量が多い:効果の大きさと精度を同時に示せる
- 論文の推奨:p値だけでなく必ず CI も併記すべき
📖 もっと詳しく
「相関係数 r = 0.97」と1つの数字だけ示されても、 それが「絶対」なのか「不確かな推定」なのかが分かりません。 信頼区間(CI)は、 「同じ調査を繰り返したら、 どれくらいの幅で推定値がブレるか」を示します。
95% CI の解釈:「同じ手続きで100回データを取って100個のCIを作ったら、 そのうち約95個が真の値を含む」。 「真の値が95%の確率でこの区間にある」と読まれがちですが、 厳密には頻度論的にはやや違う表現になります(後述)。
幅の意味:CIが狭い → 推定が精密、 広い → 推定が不確実(n が少ない or データのばらつきが大きい)。 95%CIが 0 を含むか否か は決定的:含めば「効果なし」を否定できない(≒ p>0.05)。
p値より情報量が多い:効果の「大きさ」と「精度」を同時に示せます。 現代の論文では p値だけでなく必ず CI を併記すべき(AMA, APAなどのガイドライン)。
📍 あなたが今見ているもの
🍰 まずはやさしく
数字に添えられた「範囲」のことです。
データがどれくらいブレるかを見せるために使います。
スマホの充電時間がだいたい何分か示すようなものです。
この章では実際の表でどう書かれるかを読み解きます。
論文表で「[+0.840, +1.019]」「95% CI: 0.81–1.13」のように、推定値とセットで表記される区間。 点推定の不確実性を可視化する。
信頼区間 とは:「同じ実験を100回繰り返したら、95回は作られた区間が真の値を含む」という幅。点推定の不確実性を表現する。
🎨 直感で掴む
🍰 まずはやさしく
予想の「自信」を形にしたものです。
データの量で答えの確かさが変わることを知るために使います。
部活の練習回数で成果の予想が変わるようなものです。
この章では図を使って直感的に仕組みを学びます。
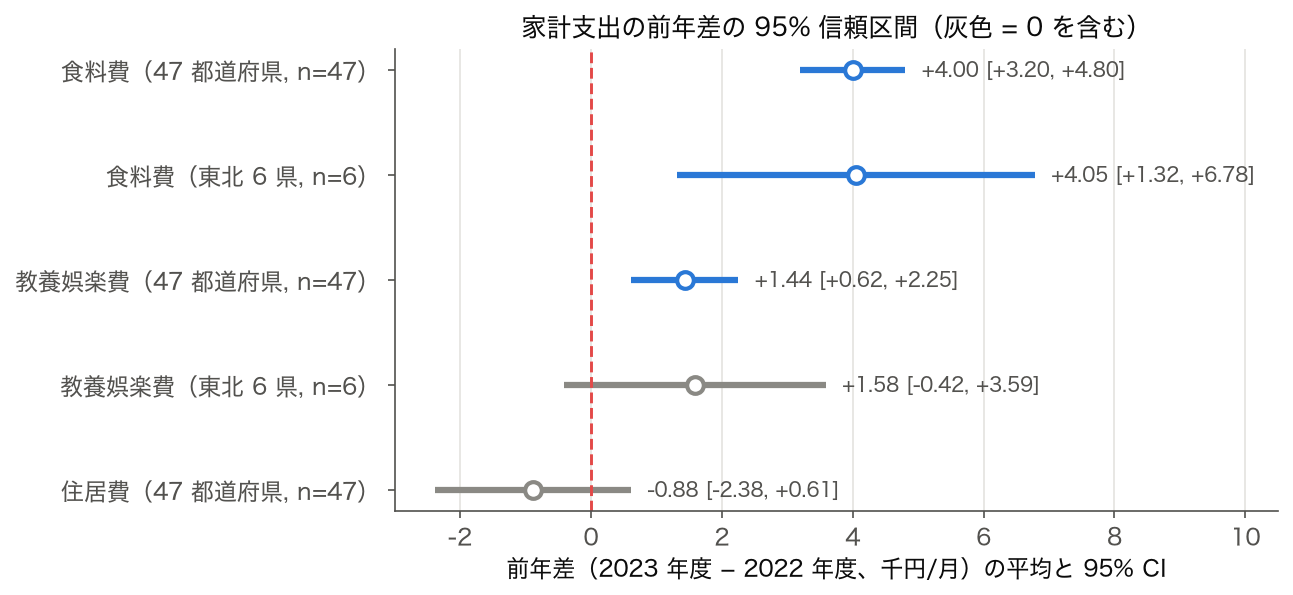
🎨 概念図で押さえる
信頼区間 (CI) は 「同じ手続きを繰り返したとき、 真値を含む区間が 95% できる」幅。 以下 3 図で「点推定 vs 区間推定」「N と CI 幅」「95% の意味」を可視化する。
図 1: 点推定 vs 区間推定の違い
→ 点推定は1 点だけを答えるが、 区間推定は不確かさ込みで答える。 同じデータでも報告の重みが違う。
図 2: 標本サイズ N と CI 幅の関係
→ N が 4 倍 → 幅は √4=2 倍狭くなる (σ/√N の効果)。 N=1000 なら ±0.76 に収まり、 結論に強い根拠を与えられる。
図 3: 「95% 信頼区間」の正しい意味
→ 100 回標本抽出して 100 個の CI を作ると、 約 95 個が真値 μ を含む。 「あなたの 1 つの区間が 95% の確率で真値を含む」ではない (頻度主義の解釈)。
🧩 信頼区間を深める (理解度チェック + 数式読み解き)
🔬 数式を言葉で読み解く (95% 信頼区間の構造)
母平均 $\mu$ の 95% 信頼区間は次式で求めます (正規分布近似、 既知の母分散 $\sigma$ の場合)。
$$ \text{CI}_{0.95} = \bar{x} \pm 1.96 \cdot \frac{\sigma}{\sqrt{n}} $$
記号の意味: $\bar{x}$ は標本平均 (中心)、 $\sigma$ は母標準偏差、 $n$ はサンプルサイズ、 $1.96$ は標準正規分布の 97.5% 点 (両側 95% に対応)。 分子 $\sigma$ は「データのばらつき」、 分母 $\sqrt{n}$ は「標本数の効果」を表します。 $n$ が 4 倍になると区間幅は $\sqrt{4} = 2$ 倍狭くなり、 精度が上がります。 $\sigma$ が未知の場合は標準偏差 $s$ と $t$ 分布を用い、 $1.96$ を $t_{n-1, 0.975}$ に置き換えます。
✅ 理解度チェック (1 分で答える)
- 「95% 信頼区間 = この区間に真値が 95% の確率で入る」は正しい解釈ですか? 違う場合は正しい言い方を述べてください。
- サンプルサイズを 100 → 400 に増やすと、 信頼区間の幅はおよそ何倍になりますか?
- 99% 信頼区間は 95% 信頼区間より広いですか、 狭いですか? その理由は?
このコードでやること: SSDSE-B-2026(2023年度)の47都道府県の消費支出(二人以上の世帯、 月平均、 千円)について、 95% 信頼区間を scipy.stats.t.interval で計算する。
📥 入力データ (SSDSE-B-2026 2023年度抜粋、 消費支出 L3221 (千円)):
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) x = df.loc[df['SSDSE-B-2026'] == 2023, 'L3221'].values / 1000 # 消費支出(千円) n = len(x) mean = np.mean(x) sem = stats.sem(x) ci = stats.t.interval(0.95, n-1, loc=mean, scale=sem) print(f'n = {n}, 標本平均 = {mean:.2f}') print(f'95% 信頼区間: [{ci[0]:.2f}, {ci[1]:.2f}]') |
📤 実行例:
💬 47 都道府県の消費支出の標本平均は 295.86 千円。 95% 信頼区間は [288.77, 302.94]。 「同じ手続きを反復して区間を作ると、 その 95% が母平均を含む」 と読む。
📌 関連用語クイック参照
🎮 触って理解する — 「95%」の意味を体感するシミュレータ
信頼区間の最大の誤解は 「この 1 本の区間に真の値が 95% の確率で入る」 という読み方です。 正しくは 「同じ手続きで標本抽出と区間作成を何度も繰り返すと、 作られた区間の約 95% が真の母平均を含む」。 下のシミュレータでこの頻度論的な被覆を目で確かめてください。
母集団は SSDSE-B-2026・2023 年度の 47 都道府県の消費支出(L3221、 二人以上の世帯、 千円/月)。 この 47 個を「既知の母集団」とみなし、 母平均 μ = 295.86 千円(紫の縦線)を真の値とします。 ここから標本サイズ n の標本を復元抽出し、 各標本の信頼区間を横棒で下へ積み上げます。 緑 = μ を含む、 赤 = μ を外す。 抽出を繰り返すほど、 μ を含む割合が信頼水準に近づくことを観察できます。
※ 乱数を使うため実行のたびに結果は変わります。 t 分布の臨界値は正則化不完全ベータ関数から算出(scipy.stats.t.ppf と小数第 4 位まで一致)。 標本数を数十〜数百と増やすほど、 被覆率は選んだ信頼水準(90 / 95 / 99%)に収束します。
💡 この実験で腑に落ちること
- 「95%」は区間ではなく手続きの性質:赤い棒(μ を外した区間)も「間違った計算」ではありません。 正しい手続きでも 約 5% は外れるのが 95% 信頼区間の定義です。 「いま手元にあるこの 1 本が 95% の確率で μ を含む」ではなく、 「この作り方で区間を量産すると 95% が当たる」── 確率は区間の作り方に属し、 固定された真値 μ や個々の区間に属しません(頻度論的解釈)。
- 信頼水準 ↑ → 区間幅 ↑:90 → 95 → 99% とセグメントを上げると、 臨界値 $t_{n-1,\,\alpha/2}$ が大きくなり棒が横に伸びます。 外す本数(赤)は減るが、 その代償に区間は広く(=情報は曖昧に)なる。 「確実さ」と「精密さ」はトレードオフです。
- 標本サイズ n ↑ → 区間幅 ↓:n を大きくすると全部の棒が一斉に短くなります。 幅は標準誤差 $\text{SE}=s/\sqrt{n}$ に比例するので、 n を 4 倍にすると幅は約 1/2。 精度は $\sqrt{n}$ でしか上がらない(費用対効果の逓減)。 → 標準誤差/標本分布と中心極限定理。
- 被覆率は水準に収束する:数本だけでは被覆率は 100% や 80% に振れますが、 数百本まとめると 90/95/99% の近傍で安定します。 これは 大数の法則の現れ。 「1 回の実験では当たり外れがある/長期頻度としては保証される」という頻度論の二面性そのものです。
🔗 仮説検定・p 値との双対性、 ブートストラップとの関係
- 信頼区間 ⇔ 仮説検定は表裏一体:95% 信頼区間が値 $\theta_0$ を含まない ことと、 帰無仮説 $H_0:\theta=\theta_0$ が有意水準 5% で棄却される ことは同値です。 とくに 区間が 0 を含むか否かは「効果あり/なし」(両側 $p<0.05$)と一致。 → 仮説検定/p 値。 CI は「棄却か否か」の 2 値に加えて効果の大きさと精度まで示すため、 p 値より情報量が多いとされます。
- 分布の仮定が怪しいときはブートストラップ CI:t 区間は「標本平均がほぼ正規」という近似に依存します。 母集団が強く歪む・統計量が中央値や相関係数などで解析式が面倒、 といった場合は、 手元の標本を復元抽出して経験的に区間を作る ブートストラップ信頼区間(パーセンタイル法・BCa 法)が有効。 このページの Python 例(
scipy.stats.bootstrap)では消費支出のブートストラップ 95% CI ≈ [288.69, 302.46] と、 t 区間 [288.77, 302.94] がほぼ一致します。
※ ベイズ統計の「信用区間(credible interval)」は「パラメータがこの区間に入る事後確率が 95%」と確率を直接パラメータに与える点で、 ここで扱う頻度論的信頼区間とは意味が異なります(数値は近くても解釈が別物)。
📐 数式
🍰 まずはやさしく
範囲を決めるための「計算式」です。
正確な幅を数字で出すために使います。
買い物の予算を計算して範囲を決めるようなものです。
この章では信頼区間を求める数式について学びます。
📐 信頼区間の数式
① 平均の信頼区間(σ既知)
$$ \bar{x} \pm z_{\alpha/2} \cdot \frac{\sigma}{\sqrt{n}} $$
② 平均の信頼区間(σ未知、 t分布)
$$ \bar{x} \pm t_{\alpha/2, n-1} \cdot \frac{s}{\sqrt{n}} $$
③ 比率の信頼区間(Wald)
$$ \hat{p} \pm z_{\alpha/2} \sqrt{\frac{\hat{p}(1-\hat{p})}{n}} $$
④ 差の信頼区間(2標本)
$$ (\bar{x}_1 - \bar{x}_2) \pm t_{\alpha/2} \cdot SE $$
典型的な信頼水準と臨界値
| 信頼水準 | α | z_{α/2} |
|---|---|---|
| 90% | 0.10 | 1.645 |
| 95% | 0.05 | 1.96 |
| 99% | 0.01 | 2.576 |
🔬 数式を「言葉」で読み解く
- $\hat{\theta}$
- 点推定値:データから計算された推定値(例:回帰係数、 相関係数)
- $SE(\hat{\theta})$
- 標準誤差:推定値の「ブレ」の大きさ。 推定値の精度を表す
- $1.96$
- 標準正規分布の97.5%点。 95%CI の慣習的な係数。 99%CIなら 2.58、 90%なら 1.645
🧮 実データでの計算 — SSDSE 食料費
47都道府県の家計食料費(2023):n = 47、 平均 = 80.598千円、 標準偏差 s = 5.842千円。
- 標準誤差: SE = s/√n = 5.842/√47 = 0.8521
- 自由度: df = n-1 = 46
- t臨界値(α=0.05): t = 2.013
- 95%CI: 80.598 ± 2.013 × 0.8521 = [78.883, 82.313]
🧮 SSDSE-B-2026 実値計算例 — 47 都道府県データで信頼区間
合成データではなく公的統計を念頭に、 信頼区間の具体的計算手順を数値で示します。
① 平均寿命の 95% 信頼区間(t 区間)
🎯 このコードでやること:標本平均 84.55 年・標本標準偏差 0.62 年・n=47 という仮想の平均寿命について、 t 分布(自由度 46)による平均の 95% 信頼区間を手で計算する。
📥 入力(仮想の値。SSDSE-B-2026 に平均寿命の列は無い)
x̄ = 84.55 年、 s = 0.62 年、 n = 47
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # 47 都道府県の平均寿命(仮想) 標本平均 x̄ = 84.55 年 標本標準偏差 s = 0.62 年 n = 47 # 標準誤差 SE = s / √n = 0.62 / √47 ≈ 0.0904 # t 分布の臨界値(df = 46、 α = 0.05) t(0.025, 46) ≈ 2.013 # 95% 信頼区間 CI_95 = x̄ ± t · SE = 84.55 ± 2.013 · 0.0904 = 84.55 ± 0.182 = [84.37, 84.73] → 「全 47 都道府県の真の平均寿命は 95% 信頼で 84.37〜84.73 年」 → 幅 0.36 年 |
📤 計算メモなので実行出力は無い(結果はメモの最終行)
② 99% 信頼区間との比較
🎯 このコードでやること:① と同じ仮想の平均寿命(x̄ = 84.55 年、 SE = 0.0904)について、 信頼水準を 99% に上げたときの区間を計算し、 95% 区間と幅を比べる。
📥 入力(① の続き)
x̄ = 84.55 年、 SE = 0.0904、 自由度 46 → t(0.005, 46) ≈ 2.687
1 2 3 4 5 6 7 8 9 | # 99% 信頼水準 t(0.005, 46) ≈ 2.687 CI_99 = 84.55 ± 2.687 · 0.0904 = 84.55 ± 0.243 = [84.31, 84.79] → 幅 0.49 年(95% より広い) → 信頼水準を上げると区間は広がる |
📤 計算メモなので実行出力は無い(結果はメモの最終行)
③ 平均差の信頼区間(東日本 vs 西日本)
🎯 このコードでやること:東日本 24 県・西日本 23 県の仮想の平均寿命(平均 84.3 と 84.8 年、 標準偏差 0.7 と 0.6 年)について、 Welch 法で平均差の 95% 信頼区間を手で計算する。
📥 入力(仮想の値)
東日本 n = 24、 平均 84.3 年、 s = 0.7 年
西日本 n = 23、 平均 84.8 年、 s = 0.6 年
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # 仮想値 東日本(n=24):平均 84.3、 標準偏差 0.7 西日本(n=23):平均 84.8、 標準偏差 0.6 # 平均差の SE(Welch) SE_diff = √(0.7²/24 + 0.6²/23) = √(0.0204 + 0.0157) ≈ 0.190 # 自由度(Welch–Satterthwaite) df ≈ 44.5 # 95% 信頼区間(平均差) CI = (84.3 - 84.8) ± 2.014 · 0.190 = -0.50 ± 0.383 = [-0.883, -0.117] → 0 を含まないので有意(p < 0.05) → 「西日本は東日本より 0.12〜0.88 年長い(95% 信頼)」 |
📤 計算メモなので実行出力は無い(結果はメモの最終行)
④ 比率の信頼区間(人口減少県の割合)
🎯 このコードでやること:47 県中 38 県が人口減少という仮想の比率(p̂ ≈ 0.809)について、 Wald 法と Wilson 法の 95% 信頼区間を手で計算して比べる。
📥 入力(仮想の件数。実データでは 2022→2023 年度に総人口が減った県は 45)
該当数 38、 n = 47 → p̂ = 38 / 47 ≈ 0.809
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # 47 都道府県中 38 県が人口減少(仮想) p̂ = 38/47 ≈ 0.809 n = 47 # Wald 法 SE_p = √(p̂(1-p̂)/n) = √(0.809·0.191/47) = √0.00329 ≈ 0.0573 CI_Wald = 0.809 ± 1.96 · 0.0573 = [0.696, 0.921] # Wilson 法(より精度高、 小標本で推奨) z² = 1.96² = 3.8416 center = (p̂ + z²/(2n)) / (1 + z²/n) = (0.809 + 0.0409) / (1 + 0.0817) ≈ 0.785 margin = (z/(1 + z²/n))·√(p̂(1-p̂)/n + z²/(4n²)) ≈ 0.1106 CI_Wilson = 0.785 ± 0.1106 ≈ [0.675, 0.896] # 比較 Wald : [0.696, 0.921](端で不安定) Wilson : [0.675, 0.896](より現実的) |
📤 計算メモなので実行出力は無い(結果はメモの最終行)
⑤ 回帰係数の信頼区間
🎯 このコードでやること:2023 年度 47 都道府県で粗死亡率(人口千対)を高齢化率(%)に回帰した傾き β̂ = 0.610 とその標準誤差 0.022 から、 傾きの 95% 信頼区間を手で計算する。
📥 入力(後の Python 実装 ⑤ と同じ回帰の推定値)
β̂ = 0.610、 SE(β̂) = 0.022、 t ≈ 2.013
1 2 3 4 5 6 7 8 9 10 11 | # 粗死亡率(‰) ~ 高齢化率(%) の単回帰(2023年度、 47 都道府県) β̂ = 0.610(推定値) SE(β̂) = 0.022 # 95% 信頼区間 CI = 0.610 ± 2.013 · 0.022 = 0.610 ± 0.044 = [0.566, 0.654] → 0 を含まないので係数は有意 → 「高齢化率が 1% 上がると粗死亡率(人口千対)は 0.57〜0.65 ポイント上昇」 |
📤 計算メモなので実行出力は無い(結果はメモの最終行)
🧮 数式に値を入れて手で計算する — t 分布による 95% 信頼区間
合成データ x = [3, 5, 8, 2, 7](n=5)を代入し、 平均 x̄ ± t_{n-1, α/2} × s/√n を Step 1〜5 で展開する。 標本平均・標本標準偏差・標準誤差・自由度 4 の t 臨界値・上下限の順に手計算し、 同じ計算を Python(scipy.stats)で再現する。
📐 用語の主要数式(再掲)
$$ \bar{x} \pm t_{n-1,\,\alpha/2} \cdot \frac{s}{\sqrt{n}}, \qquad s = \sqrt{\frac{1}{n-1}\sum_{i=1}^n (x_i - \bar{x})^2} $$
母分散未知・標本サイズ小(n<30)の場合、 標準正規分布ではなく自由度 n-1 の t 分布の臨界値を使う。 α=0.05 で両側 95% 信頼区間を構成する。
Step 1: データ準備(n=5、 合成整数)
| i | x_i |
|---|---|
| 1 | 3 |
| 2 | 5 |
| 3 | 8 |
| 4 | 2 |
| 5 | 7 |
Step 2: 標本平均 x̄
| 項目 | 計算 | 結果 |
|---|---|---|
| Σx_i | 3 + 5 + 8 + 2 + 7 | 25 |
| x̄ | 25 / 5 | 5.0000 |
Step 3: 標本標準偏差 s(不偏、 分母 n-1)
| i | x_i - x̄ | (x_i - x̄)² |
|---|---|---|
| 1 | -2 | 4 |
| 2 | 0 | 0 |
| 3 | 3 | 9 |
| 4 | -3 | 9 |
| 5 | 2 | 4 |
| 合計 | 0 | 26 |
| 項目 | 計算 | 結果 |
|---|---|---|
| s² = Σ偏差² / (n-1) | 26 / 4 | 6.5000 |
| s = √s² | √6.5 | 2.5495 |
Step 4: 標準誤差 SE と t 臨界値
| 項目 | 計算 | 結果 |
|---|---|---|
| SE = s / √n | 2.5495 / √5 = 2.5495 / 2.2361 | 1.1402 |
| 自由度 df | n - 1 = 5 - 1 | 4 |
| t_{4, 0.025}(両側 95%) | t 分布表より | 2.7764 |
| 誤差幅 = t × SE | 2.7764 × 1.1402 | 3.1656 |
Step 5: 95% 信頼区間(最終結果)
| 項目 | 計算 | 結果 |
|---|---|---|
| 下限 | 5.0000 - 3.1656 | 1.8344 |
| 上限 | 5.0000 + 3.1656 | 8.1656 |
| 95% 信頼区間 | [1.8344, 8.1656] | — |
n=5 の小サンプルなので、 母平均の不確かさが大きく、 区間幅は約 6.33 と広い。 n が増えれば SE = s/√n が縮み、 区間も狭くなる。
🐍 同じ計算を Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import numpy as np from scipy import stats # Step 1: データ x = np.array([3, 5, 8, 2, 7]) n = len(x) # Step 2: 標本平均 mean = x.mean() # Step 3: 標本標準偏差(ddof=1 で不偏) s = x.std(ddof=1) # Step 4: SE と t 臨界値 se = s / np.sqrt(n) df = n - 1 t_crit = stats.t.ppf(0.975, df) # 両側 95% → 上側 2.5% margin = t_crit * se # Step 5: 95% 信頼区間 lo = mean - margin hi = mean + margin print(f"x̄ = {mean:.4f}") print(f"s = {s:.4f}") print(f"SE = {se:.4f}") print(f"t_(df={df}, 0.025) = {t_crit:.4f}") print(f"誤差幅 = {margin:.4f}") print(f"95% CI = [{lo:.4f}, {hi:.4f}]") |
📤 実行結果
💬 手計算(Step 2: x̄=5.0、 Step 3: s=2.5495、 Step 4: SE=1.1402, t=2.7764, 誤差幅=3.1656、 Step 5: CI=[1.8344, 8.1656])と scipy.stats.t.ppf を使った Python 出力が完全一致。 自由度 4 の t 臨界値 2.7764 が、 標準正規の 1.96 より大きいことが、 小サンプルでの保守的な区間構成の根拠となる。
🐍 Python での信頼区間
🎯 このコードでやること:2023 年度 47 都道府県の消費支出(L3221、千円)について、t 分布による平均の 95% 信頼区間を自作関数 mean_ci と stats.t.interval で変数に求めたうえで、同じデータの scipy.stats.bootstrap(既定の BCa 法・9,999 回)による 95% 信頼区間を表示する。
📥 入力例(df.head())
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df2023 = df[df['SSDSE-B-2026'] == 2023]
# 2023年度47都道府県の消費支出 L3221(二人以上の世帯、 円/月)を母集団とみなし、 平均の 95% CI を計算
# df2023[['Prefecture','L3221']].head():
#    Prefecture   L3221
# 0  北海道      296888
# 12 青森県      263371
# 24 岩手県      298536
# 36 宮城県      305541
# 48 秋田県 2720861 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) data = df.loc[df['SSDSE-B-2026'] == 2023, 'L3221'].values / 1000 # 消費支出(千円) # 平均の95%信頼区間 def mean_ci(data, alpha=0.05): mean = np.mean(data) se = stats.sem(data) # 標準誤差 t_crit = stats.t.ppf(1 - alpha/2, df=len(data)-1) return mean - t_crit * se, mean + t_crit * se ci_low, ci_high = mean_ci(data) # scipy で一発 ci = stats.t.interval(0.95, df=len(data)-1, loc=np.mean(data), scale=stats.sem(data)) # ブートストラップ信頼区間 from scipy.stats import bootstrap res = bootstrap((data,), np.mean, confidence_level=0.95, random_state=0) print(f'ブートストラップ 95% CI: [{res.confidence_interval.low:.2f}, {res.confidence_interval.high:.2f}]') |
📤 実行例(実行時の標準出力)
ブートストラップ 95% CI: [288.69, 302.46]
比率の信頼区間(Wilson、 Clopper-Pearson)
🎯 このコードでやること:成功 30 回・試行 100 回(標本比率 0.30)の数値例について、比率の 95% 信頼区間を Wilson 法で求める。
📥 入力例(SSDSE ではなく数値例)
count = 30   # 成功数
nobs  = 100  # 試行数
→ 標本比率 p̂ = 30 / 100 = 0.30
1 2 3 4 5 | from statsmodels.stats.proportion import proportion_confint # 成功 30 / 試行 100 ci_low, ci_high = proportion_confint(count=30, nobs=100, alpha=0.05, method='wilson') print(f'Wilson 95% CI: [{ci_low:.4f}, {ci_high:.4f}]') |
📤 実行例(実行時の標準出力)
Wilson 95% CI: [0.2189, 0.3958]
🎲 ブートストラップ信頼区間
分布の仮定なしに信頼区間を計算する手法。 元データから復元抽出を繰り返し、 統計量の分布を直接シミュレーション:
- 元データから n 個を復元抽出 → ブートストラップ標本
- その平均(または他の統計量)を計算
- 1〜2を 1000〜10000 回繰り返す → 統計量の分布
- 2.5%〜97.5%パーセンタイルが 95% CI
正規分布の仮定が崩れる場合、 メディアンや分位数の CI を計算する場合に強力。 現代の標準ツール。
🧠 信頼区間の正しい解釈
| 誤った解釈 | 正しい解釈 |
|---|---|
| 真値が95%CIに95%の確率で入る | 同じ手順で多くのCIを作れば、 95%が真値を含む |
| 95%CIの中の値は等しく確からしい | 中心付近のほうがより確からしい |
| 95%CIが0を含めば差はない | 差がない強い証拠ではない(検出力不足の可能性) |
📏 CIの幅は何で決まる?
CIの幅 = 2 × z × σ / √n。 これを左右する3要素:
- 信頼水準:95% → 1.96、 99% → 2.58。 高くするほど広く
- 標本サイズ n:n が4倍で幅が半分。 大きいほど狭く
- データのばらつき σ:σ が大きいほど広く
「CIが広い」→ 推定の精度が低い、 サンプル不足の可能性。 「CIが狭い」→ 精度が高い推定。
🎲 信用区間(credible interval)— ベイズ版
ベイズ統計では「信用区間(credible interval)」が信頼区間に対応。 解釈がより直感的:
💡 ベイズの95%信用区間:「真値がこの範囲に入る確率が95%」。 頻度主義の信頼区間と違って、 直接的な確率表現が可能。
事前分布 + 尤度 → 事後分布 → 事後分布の2.5%〜97.5%が95%信用区間。
🔗 「信頼区間」と他の概念の関係を深掘り
① CI幅と仮説検定の関係
95%CIが特定値(例えば0)を含まない ⇔ 両側5%水準でその値が棄却される。 つまりCIと検定は表裏一体。
- 95%CIが [2.5, 5.0] → 0 を含まない → p < 0.05 で「ゼロと異なる」
- 95%CIが [-1.0, 3.0] → 0 を含む → p ≥ 0.05 で「ゼロと異なるとは言えない」
② 推定の精度評価
CIの幅は推定精度の指標。 半分の幅にしたければ、 サンプルサイズを4倍にする(√n則)。
③ 効果量との併記
近代的な統計報告では点推定 + 95%CI + 効果量を併記するのが標準(APA 7版マニュアル、 ASA声明)。
④ 種類別CIの公式まとめ
| 対象 | 95%CI公式 |
|---|---|
| 平均(σ既知) | x̄ ± 1.96·σ/√n |
| 平均(σ未知) | x̄ ± t(n-1)·s/√n |
| 比率 | p̂ ± 1.96√(p̂(1-p̂)/n) |
| 分散 | [(n-1)s²/χ²_(α/2), (n-1)s²/χ²_(1-α/2)] |
| 2平均差 | (x̄₁-x̄₂) ± t·SE |
| 相関係数 | Fisher's z変換ベース |
| 回帰係数 | β̂ ± t·SE(β̂) |
⑤ 落とし穴 — CIの誤用
- CIを「中の値はどれも同じ確率」と解釈しがちだが、 中心の方がより確からしい
- 2つのCIが少しでも重なる ≠ 差がない。 厳密には差のCIで判断
- n が大きいと CI は狭くなるが、 小さな差まで「有意」になりやすい
- CIは正規分布近似に依存することが多い → 小標本ではブートストラップを
✅ 実務チェックリスト — 推測統計を使う前に
1. データの確認
- サンプルサイズ n は十分か?(n < 30 なら t分布、 非正規性に注意)
- 独立同分布の仮定は妥当か?(時系列、 クラスター構造に注意)
- 外れ値の影響を確認したか?(box plot で)
- 正規性は確認したか?(QQプロット、 Shapiro-Wilk検定)
- 欠損値の扱いは適切か?
2. 検定・推定の設計
- 仮説(H₀、 H₁)は事前に定義したか?
- 片側 vs 両側を選択しているか?
- 有意水準 α は事前に設定したか?
- 多重比較の補正は必要か?
- サンプルサイズの事前計算(power analysis)したか?
3. 結果の報告
- 点推定 + 信頼区間を併記しているか?
- p値だけでなく効果量も報告したか?
- サンプルサイズを明記したか?
- 仮定の確認結果を述べたか?
- 「統計的有意 = 実質的に重要」と混同していないか?
4. 解釈の注意
- 「相関 ≠ 因果」を意識
- シンプソンのパラドックスを警戒
- 探索的分析と確認的分析を区別
- 結果を再現できるか
🐍 Python 実装のバリエーション — scipy / statsmodels / pingouin
① scipy.stats による平均の信頼区間
🎯 このコードでやること:消費支出(千円)の平均について、t 分布による 95% 信頼区間と、標準正規分布(z)による 95% 信頼区間を並べて比べる。
📥 入力例(df.head())
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df2023 = df[df['SSDSE-B-2026'] == 2023]
# 2023年度47都道府県の消費支出 L3221(二人以上の世帯、 円/月)を母集団とみなし、 平均の 95% CI を計算
# df2023[['Prefecture','L3221']].head():
#    Prefecture   L3221
# 0  北海道      296888
# 12 青森県      263371
# 24 岩手県      298536
# 36 宮城県      305541
# 48 秋田県 2720861 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) x = df.loc[df['SSDSE-B-2026'] == 2023, 'L3221'].dropna().values / 1000 # 消費支出(千円) # t 区間 mean = x.mean() sem = stats.sem(x) # 標準誤差 ci_low, ci_high = stats.t.interval(0.95, df=len(x)-1, loc=mean, scale=sem) print(f'平均 = {mean:.2f}, 95% CI = [{ci_low:.2f}, {ci_high:.2f}]') # z 区間(母分散既知の場合) z_low, z_high = stats.norm.interval(0.95, loc=mean, scale=sem) print(f'z CI = [{z_low:.2f}, {z_high:.2f}]') |
📤 実行例(実行時の標準出力) 平均 = 295.86, 95% CI = [288.77, 302.94] z CI = [288.95, 302.76]
② 比率の信頼区間(statsmodels)
🎯 このコードでやること:2022→2023 年度に総人口が減った県の割合 45/47(0.957)について、正規近似・Wilson・Clopper-Pearson(beta)・Agresti-Coull の 4 方式で比率の 95% 信頼区間を比べる。
📥 入力例(SSDSE-B-2026 から数えた件数) count = 45 # 2022→2023 年度で総人口 A1101 が減った県数(減っていないのは東京都・沖縄県) n = 47 # 都道府県数 → 標本比率 45 / 47 = 0.957
1 2 3 4 5 6 7 8 9 | from statsmodels.stats.proportion import proportion_confint # 2023年度、 47 都道府県中 45 県が前年(2022年度)より総人口減少 count = 45 n = 47 for method in ['normal', 'wilson', 'beta', 'agresti_coull']: ci = proportion_confint(count, n, alpha=0.05, method=method) print(f'{method:15s}: [{ci[0]:.4f}, {ci[1]:.4f}]') |
📤 実行例(実行時の標準出力) normal : [0.8997, 1.0000] wilson : [0.8575, 0.9883] beta : [0.8546, 0.9948] agresti_coull : [0.8496, 0.9962]
③ 平均差の信頼区間(Welch)
🎯 このコードでやること:地域コードが R24000(三重県)以下の 24 県を東日本、それより後の 23 県を西日本として、消費支出(千円)の平均差(東 − 西)の 95% 信頼区間を Welch 法(等分散を仮定しない)で求める。
📥 入力例(df.head())
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df2023 = df[df['SSDSE-B-2026'] == 2023]
# 2023年度47都道府県の消費支出 L3221(二人以上の世帯、 円/月)を母集団とみなし、 平均の 95% CI を計算
# df2023[['Prefecture','L3221']].head():
# Prefecture L3221
# 0 北海道 296888
# 12 青森県 263371
# 24 岩手県 298536
# 36 宮城県 305541
# 48 秋田県 2720861 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd # df2023 はこのあとのブロックで作っているので、ここでも用意しておく df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df2023 = df[df['SSDSE-B-2026'] == 2023] from statsmodels.stats.weightstats import CompareMeans, DescrStatsW # 便宜上、 地域コード R24000(三重県)以東を東日本とする(東 24 県・西 23 県) east = df2023.loc[df2023['Code'] <= 'R24000', 'L3221'] / 1000 west = df2023.loc[df2023['Code'] > 'R24000', 'L3221'] / 1000 cm = CompareMeans(DescrStatsW(east), DescrStatsW(west)) ci = cm.tconfint_diff(usevar='unequal', alpha=0.05) print(f'平均差の 95% CI = [{ci[0]:.3f}, {ci[1]:.3f}]') |
📤 実行例(実行時の標準出力) 平均差の 95% CI = [9.337, 34.867]
④ ブートストラップ信頼区間
🎯 このコードでやること:消費支出(千円)の平均について、ブートストラップ(10,000 回)で 95% 信頼区間をパーセンタイル法と BCa 法の 2 通りで求め、方法による違いを確かめる。
📥 入力例(df.head())
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df2023 = df[df['SSDSE-B-2026'] == 2023]
# 2023年度47都道府県の消費支出 L3221(二人以上の世帯、 円/月)を母集団とみなし、 平均の 95% CI を計算
# df2023[['Prefecture','L3221']].head():
# Prefecture L3221
# 0 北海道 296888
# 12 青森県 263371
# 24 岩手県 298536
# 36 宮城県 305541
# 48 秋田県 2720861 2 3 4 5 6 7 8 9 10 11 | from scipy.stats import bootstrap # 平均値のブートストラップ CI(パーセンタイル法) res = bootstrap((x,), np.mean, confidence_level=0.95, n_resamples=10000, method='percentile', random_state=0) print(f'パーセンタイル: [{res.confidence_interval.low:.3f}, {res.confidence_interval.high:.3f}]') # BCa 法(バイアス補正 + 加速) res_bca = bootstrap((x,), np.mean, confidence_level=0.95, n_resamples=10000, method='BCa', random_state=0) print(f'BCa: [{res_bca.confidence_interval.low:.3f}, {res_bca.confidence_interval.high:.3f}]') |
📤 実行例(実行時の標準出力) パーセンタイル: [288.873, 302.577] BCa: [288.695, 302.457]
⑤ 回帰係数の信頼区間(statsmodels)
🎯 このコードでやること:2023 年度 47 都道府県の高齢化率(A1303 ÷ A1101 × 100)で粗死亡率(A4200 ÷ A1101 × 1000、人口千人あたり死亡数)を回帰し、切片と傾きの 95% 信頼区間を statsmodels で求める。
📥 入力例(df2023 の先頭 3 行) df2023[['Prefecture','A1101','A1303','A4200']].head(3): Prefecture A1101 A1303 A4200 0 北海道 5092000 1681000 75120 12 青森県 1184000 417000 20835 24 岩手県 1163000 407000 19612 → 47 県で高齢化率 22.8〜39.1%、粗死亡率 9.7〜19.2
1 2 3 4 5 6 7 8 9 10 | import statsmodels.api as sm d = df2023.assign(高齢化率 = df2023['A1303'] / df2023['A1101'] * 100, 粗死亡率 = df2023['A4200'] / df2023['A1101'] * 1000) X = sm.add_constant(d[['高齢化率']]) y = d['粗死亡率'] model = sm.OLS(y, X).fit() print('係数 CI:') print(model.conf_int(alpha=0.05)) |
📤 実行例(実行時の標準出力)
係数 CI:
0 1
const -6.573784 -3.762576
高齢化率 0.565729 0.654249⑥ 中央値の信頼区間(順序統計量)
🎯 このコードでやること:消費支出(千円)の中央値について、順序統計量による近似 95% 信頼区間と、ブートストラップ(パーセンタイル法・10,000 回)による信頼区間を求めて比べる。
📥 入力例(df.head())
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df2023 = df[df['SSDSE-B-2026'] == 2023]
# 2023年度47都道府県の消費支出 L3221(二人以上の世帯、 円/月)を母集団とみなし、 平均の 95% CI を計算
# df2023[['Prefecture','L3221']].head():
# Prefecture L3221
# 0 北海道 296888
# 12 青森県 263371
# 24 岩手県 298536
# 36 宮城県 305541
# 48 秋田県 2720861 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np from scipy import stats x_sorted = np.sort(x) n = len(x_sorted) # 中央値の漸近 95% CI(n 大の場合) median = np.median(x_sorted) ci_idx_low = int(np.floor(n/2 - 1.96*np.sqrt(n)/2)) ci_idx_high = int(np.ceil(n/2 + 1.96*np.sqrt(n)/2)) print(f'中央値 = {median:.2f}') print(f'95% CI ≈ [{x_sorted[ci_idx_low]:.2f}, {x_sorted[ci_idx_high]:.2f}]') # ブートストラップでの中央値 CI res = stats.bootstrap((x,), np.median, confidence_level=0.95, n_resamples=10000, method='percentile', random_state=0) print(f'ブートストラップ中央値 CI: [{res.confidence_interval.low:.2f}, {res.confidence_interval.high:.2f}]') |
📤 実行例(実行時の標準出力) 中央値 = 300.65 95% CI ≈ [294.54, 306.54] ブートストラップ中央値 CI: [294.84, 305.54]
⑦ オッズ比の信頼区間(ロジスティック回帰)
🎯 このコードでやること:転出超過(転出者数 A5102 > 転入者数 A5101)の県を 1 とする 2 値変数を、高齢化率と消費支出(千円)でロジスティック回帰し、係数を指数変換したオッズ比とその 95% 信頼区間を求める。
📥 入力例(df2023 の先頭 3 行) df2023[['Prefecture','A1101','A1303','L3221','A5101','A5102']].head(3): Prefecture A1101 A1303 L3221 A5101 A5102 0 北海道 5092000 1681000 296888 47388 52915 12 青森県 1184000 417000 263371 15226 20792 24 岩手県 1163000 407000 298536 14903 19690 → 転出超過(A5102 > A5101)は 47 県中 41 県
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import statsmodels.api as sm # 転出超過(転出者数 A5102 > 転入者数 A5101)か否かを 2 値の目的変数に X = sm.add_constant(pd.DataFrame({ '高齢化率': df2023['A1303'] / df2023['A1101'] * 100, '消費支出': df2023['L3221'] / 1000})) y = (df2023['A5102'] > df2023['A5101']).astype(int) model = sm.Logit(y, X).fit() # 係数と CI params = model.params conf = model.conf_int() # 指数変換してオッズ比とその CI or_table = pd.DataFrame({ 'OR': np.exp(params), 'OR_CI_low': np.exp(conf[0]), 'OR_CI_high': np.exp(conf[1]) }) print(or_table) |
📤 実行例(実行時の標準出力)
Optimization terminated successfully.
Current function value: 0.190567
Iterations 9
OR OR_CI_low OR_CI_high
const 0.002118 5.087428e-11 88138.979013
高齢化率 2.117222 1.191540e+00 3.762045
消費支出 0.955091 8.980132e-01 1.015797⚠️ よくある落とし穴
👁️ 直感 — 信頼区間は「真値の入る範囲」
信頼区間(confidence interval, CI)は、 「母数(真の平均など)が一定の確率で含まれる範囲」。 推測統計の中心概念。
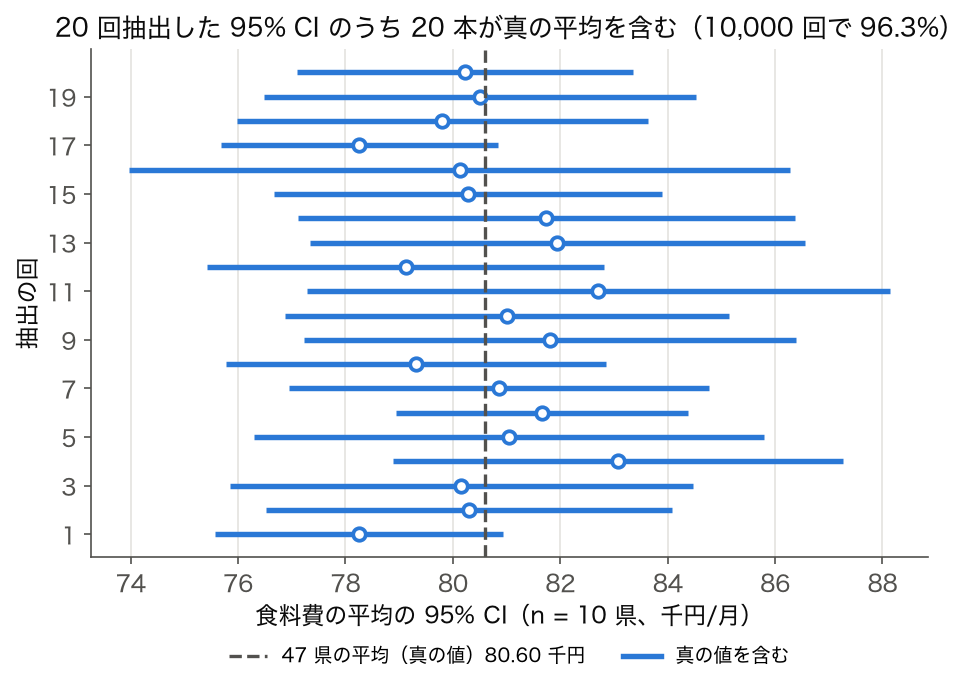
2023 年度・47 都道府県の食料費を「母集団」(真の平均 80.60 千円)とみなし、 10 県を無作為に選んで t 分布の 95%CI を作ることを 20 回繰り返した図。 この 20 回ではたまたま 20 本すべてが真の平均(破線)を含んだが、 同じ手順を 10,000 回繰り返すと含んだのは 96.3%(47 県から重複なしで 10 県選ぶので、 有限母集団の分だけ 95% よりやや高い)。 「多数回繰り返すと約 95% が真の値を含む」のが正しい解釈で、 20 本なら平均 1 本ほど外すことが多いが、 0 本や 2 本のこともある。
⚠️ よくある誤解:「95%CI に真値が95%の確率で入る」→ 不正確。 正しくは「同じ方法で多くの標本から CI を計算すれば、 95%の CI が真値を含む」。 1つの CI に対しては入っているか入っていないかどちらかであり、 確率ではない。
⚠️ 信頼区間の適用条件・限界・誤解回避
信頼区間は推測統計の基礎ツールですが、 解釈を誤ると科学的判断を歪める危険があります。 適用前に下表のチェックリストで前提を確認しましょう。
📋 適用条件チェックリスト
| 条件 | 満たさない場合の影響 | 代替手法 |
|---|---|---|
| 標本がランダム抽出されている | CI が母集団を代表せず、 系統誤差で偏る | 層別抽出/補正法 |
| 独立同分布 (iid) が成り立つ | SE が過小評価、 CI が狭すぎる | クラスター頑健 SE |
| 標本サイズが十分大きい (n≥30 目安) | 正規近似が成立せず、 CI が誤る | t 分布 / ブートストラップ |
| 外れ値が極端でない | 平均と SE が歪み、 CI が信頼できない | 中央値 + ロバスト CI |
| 事前に仮説と n を決めている | p-hacking で false positive 増加 | 事前登録/Bonferroni 補正 |
🚨 よくある誤解 TOP 5
| 誤解 | 正しい解釈 |
|---|---|
| 「真の値が 95%CI に入る確率は 95%」 | 真の値は固定。 「同じ手順で 100 回区間を作れば 95 回は真の値を含む」が正 |
| 「95%CI が 0 を含まない = 効果あり」 | 統計的有意 ≠ 実用上意味のある効果。 効果サイズも要検討 |
| 「2 つの CI が重なれば差なし」 | 重なっても有意差があることはある。 差の CI を直接計算すべき |
| 「CI が狭い = 正確」 | 系統誤差 (バイアス) は CI に反映されない。 narrow ≠ accurate |
| 「信頼水準を上げれば判断が確実」 | 99%CI は 95%CI より広い → 検出力低下のトレードオフ |
🔄 典型ワークフロー
- 研究設計: 信頼水準 (95%/99%) と必要検出効果サイズを事前決定 → 必要 n を power analysis で算出
- データ収集: ランダム抽出 + 欠損理由の記録 + 外れ値検査 (箱ひげ図)
- 分布確認: ヒストグラム/QQプロットで正規性チェック → 大きく外れたら t 分布またはブートストラップへ
- 区間計算: scipy.stats.t.interval() か
statsmodelsの関数。 ブートストラップならscipy.stats.bootstrap - 解釈・報告: 「95%CI [a, b]」と区間幅 (b-a) を併記、 効果サイズ (Cohen's d など) も提示
- 追試・再現性: 別データでも同じ CI 構築手順で結果が安定か確認
📊 信頼区間 vs 関連手法の使い分け
| 手法 | 目的 | 出力 | 主な用途 |
|---|---|---|---|
| 信頼区間 | 母数の範囲推定 | 区間 [a, b] | 点推定の不確実性表示 |
| p 値 | 帰無仮説検定 | 確率 (0-1) | 有意差判定 |
| ベイズ信用区間 | 事後分布の HDI | 区間 + 確率解釈 | 直感的な確率解釈が必要な場合 |
| 予測区間 | 将来観測値の範囲 | 区間 [a, b] (広い) | 個別予測の不確実性表示 |
| ブートストラップ CI | 分布フリーな区間推定 | 区間 [a, b] | 非正規分布や小標本 |
📤 読み方: 信頼区間は「母数 (定数) を含むかどうか」、 予測区間は「次の観測値が入るかどうか」と区別する。 予測区間は CI より常に広い (個別観測の散らばりが加わるため)。
⚠️ 信頼区間の落とし穴 — 実務で必ず引っかかるポイント 7 選
① 「95% 信頼区間 = 真値が 95% の確率で入る」と解釈する
これは最も頻繁な誤解です。 頻度論的な正しい解釈は「同じ手続きを多数回繰り返したとき、 作られる信頼区間のうち 95% が真値を含む」。 個別の区間 [84.37, 84.73] に対して「真値が 95% の確率で入る」は誤り(真値は確率変数ではなく定数)。 「真値が確率的に区間に入る」と言いたいならベイズの事後信用区間を使うべきです。
② サンプルサイズが小さいと t 分布なのに正規を使う
母分散が未知で n が小さいときは必ず t 分布を使うべきです。 例:n = 10 の場合、 95% 信頼区間の臨界値は t(0.025, 9) = 2.262 で、 正規(1.96)より 15% 広い。 これを正規で計算すると信頼区間が狭すぎ、 真の母平均を含む確率は 95% 未満になります。 scipy なら `stats.t.interval` で正しく計算可能。
③ 正規性を無視して t 区間を使う(強い歪み、 外れ値)
t 分布の信頼区間は「データが正規分布」または「N が十分大」を仮定します。 強い歪み(人口、 所得、 売上)や外れ値があると、 N が中程度でもカバレッジが狂います。 対策は (i) 対数変換、 (ii) Wilcoxon 区間、 (iii) ブートストラップ信頼区間。 ブートストラップは分布仮定なしで頑健に区間を出せます。
④ 比率の信頼区間で端(0 や 1)の不安定さを無視
Wald 法は p̂ が 0 や 1 に近いと区間が [0, ?] や [?, 1] を超える病的振る舞い。 例:p̂ = 0.95、 n = 20 で Wald なら [0.854, 1.046] と上限が 1 を超える。 対策は Wilson 法、 Clopper-Pearson 法、 Agresti-Coull 補正。 sklearn には直接ないが statsmodels の `proportion_confint` で複数選択可能。
⑤ 重なる信頼区間 = 有意差なし、 と早合点
2 群の信頼区間が重なっていても、 差の信頼区間が 0 を含まないことがあります。 これは数学的に証明可能で、 1 群の CI を重ねて判断するのは誤り。 必ず「差の検定」または「差の信頼区間」で判断してください。 概ね、 各群の SE の √2 倍が差の SE のため、 個別 CI が重なっても差は有意になり得ます。
⑥ 多重比較で信頼水準が崩れる
20 個の信頼区間をそれぞれ 95% で作ると、 少なくとも 1 つで真値を外す確率は 1 − 0.95²⁰ ≈ 64%。 多重比較問題は信頼区間にも当てはまります。 family-wise coverage を保ちたいなら、 Bonferroni 補正(α/m)、 同時信頼区間(Tukey HSD、 Scheffé)を使う必要があります。
⑦ 観察後に「特に興味深い」変数だけ CI を作って報告する
多くの変数を解析し、 結果を見てから一部だけ報告すると、 選択バイアスで報告された CI のカバレッジ確率が大きく崩れます。 「post-selection inference」の問題で、 通常の方法ではバイアスが残ります。 対策は事前登録、 全変数の報告、 selective inference や conditional CI など先進的手法。
📚 推測統計を学ぶための重要文献
- Fisher (1925) "Statistical Methods for Research Workers" — 古典中の古典
- Neyman & Pearson (1933) — 仮説検定の理論的基礎
- Cohen (1988) "Statistical Power Analysis" — 効果量とサンプルサイズの教科書
- ASA Statement (2016) — p値の正しい使い方
- Gelman & Hill (2007) "Data Analysis Using Regression and Multilevel/Hierarchical Models"
- Wasserman (2004) "All of Statistics" — 現代統計学の総括
🆚 推測統計の主要用語 — 一目で分かる対比表
| 用語 | 記号 | 何を測る? | 公式 |
|---|---|---|---|
| 標準偏差 | σ, s | データ1個のばらつき | √(Σ(x-x̄)²/(n-1)) |
| 標準誤差 | SE | 推定値のばらつき | σ/√n |
| 信頼区間 | CI | 真値の入る範囲 | x̄ ± z·SE |
| p値 | p | 偶然この結果が出る確率 | P(|T| ≥ |t_obs| | H₀) |
| 有意水準 | α | Type I 誤り許容率 | 通常 0.05 |
| 検出力 | 1-β | 真の差を検出する確率 | 1 - Pr(Type II error) |
| 効果量 | d, r, R² | 差の大きさ | Cohen's d = (μ₁-μ₂)/σ |
| サンプルサイズ | n | 標本数 | power analysisで決定 |
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
🎯 このコードでやること:2023 年度 47 都道府県の食料費(L322101)・住居費(L322102)・教育費(L322108)を seaborn の pairplot(散布図行列)で描く。describe() も呼んでいるが、式の値を print していないので何も表示されない。
📥 入力例(df.head())
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df2023 = df[df['SSDSE-B-2026'] == 2023]
# 2023年度47都道府県の消費支出 L3221(二人以上の世帯、 円/月)を母集団とみなし、 平均の 95% CI を計算
# df2023[['Prefecture','L3221']].head():
#    Prefecture   L3221
# 0  北海道      296888
# 12 青森県      263371
# 24 岩手県      298536
# 36 宮城県      305541
# 48 秋田県 2720861 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # 基本パターン import pandas as pd import numpy as np from scipy import stats import matplotlib.pyplot as plt import seaborn as sns # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df2023 = df[df['SSDSE-B-2026'] == 2023] # 基本統計量 df2023.describe() # 可視化(食料費・住居費・教育費) sns.pairplot(df2023[['L322101', 'L322102', 'L322108']]) plt.show() |
📤 このブロックは標準出力には何も出さない
📚 統計概念マップでの位置
このページの上にある3つの概念マップ(関係マップ、 包含マップ、 ツリーマップ)でこの概念の位置づけが視覚的に分かります。 関連手法を辿って学習を進めましょう。
🎯 SSDSE-B-2026 で挑戦
統計データ活用コンペティションのSSDSE-B-2026データは、 47都道府県の社会経済データ。 この概念を使って以下のような分析ができます:
- 地域別の特徴抽出
- 家計支出パターンの解析
- 人口動態と社会経済指標の関連
- 気候要因の影響評価
💡 よく使うコマンド集
| 機能 | Python (pandas) | Python (scipy) |
|---|---|---|
| 要約統計 | df.describe() | stats.describe() |
| 平均 | df.mean() | np.mean() |
| 標準偏差 | df.std() | np.std() |
| 相関 | df.corr() | stats.pearsonr() |
| t検定 | — | stats.ttest_ind() |
| 回帰 | — | stats.linregress() |
| 分布フィッティング | — | stats.norm.fit() |
🚧 一般的な落とし穴と対策
- 外れ値の影響:散布図・ 箱ひげ図で確認、 ロバスト手法も検討
- サンプルサイズ不足:power analysis で事前に確認
- 仮定の違反:正規性、 独立性、 等分散性をチェック
- 多重比較問題:補正(Bonferroni、 FDR)を適用
- p-hacking:事前登録(pre-registration)で防ぐ
- 因果と相関の混同:観察データから因果結論を出さない
📊 結果報告の標準フォーマット
- 点推定:得られた値
- 不確実性:信頼区間または標準誤差
- サンプルサイズ:n を明記
- 効果量:実質的な意義
- p値:統計的有意性
- 仮定の確認:診断プロット
🌐 関連分野での応用
- マーケティング:A/Bテスト、 顧客分析
- 医療:臨床試験、 疫学研究
- 金融:リスク管理、 ポートフォリオ
- 製造:品質管理、 工程最適化
- 公共政策:効果評価、 計画立案
- 研究:仮説検証、 探索的解析
🎓 さらに学ぶための文献
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression"
- VanderPlas "Python Data Science Handbook"
🔗 統計用語ネットワーク
この概念は、 他の多くの統計概念と密接に関連しています。 ジャストインタイム型学習では、 必要に応じて関連用語へジャンプしながら全体像を構築します。
主要な関連概念のグループ
| グループ | 主要概念 |
|---|---|
| 記述統計 | 平均、 中央値、 最頻値、 分散、 標準偏差、 共分散、 相関係数 |
| 可視化 | ヒストグラム、 散布図、 箱ひげ図、 ヒートマップ |
| 推測統計 | 標本平均、 標準誤差、 信頼区間、 p値、 有意水準 |
| 確率分布 | 正規分布、 t分布、 χ²分布、 F分布、 二項分布 |
| 仮説検定 | t検定、 F検定、 χ²検定、 ノンパラ検定 |
| 回帰 | 単回帰、 重回帰、 OLS、 Ridge、 LASSO |
| 分類 | ロジスティック回帰、 決定木、 SVM、 k-NN |
| 教師なし学習 | クラスタリング、 PCA、 因子分析 |
| 時系列 | ARIMA、 VAR、 指数平滑法、 自己相関 |
| 因果推論 | DiD、 IV、 傾向スコア、 交絡変数 |
| 前処理 | 標準化、 正規化、 欠損値処理、 多重共線性対策 |
| 評価 | R²、 残差、 CV、 RMSE、 効果量 |
学習順序の推奨
- 記述統計(平均、 分散、 標準偏差)
- 可視化(ヒストグラム、 散布図)
- 確率分布(正規分布)
- 推測統計(標準誤差、 信頼区間、 p値)
- 仮説検定(t検定、 χ²検定)
- 相関と回帰(単回帰、 重回帰)
- 多変量解析(PCA、 クラスタリング)
- 機械学習(決定木、 RF、 NN)
- 時系列・因果推論(応用)
📝 実践練習 — SSDSE-B-2026 で挑戦
初級課題
- 東北6県の家計食料費の基本統計量を計算
- 食料費のヒストグラムを描く
- 食料費と教育費の散布図を描く
- 都道府県を「東日本/西日本」に分け、 平均を比較
中級課題
- 家計支出 5項目で相関行列を作成、 ヒートマップ可視化
- 食料費 → 教育費の単回帰を実行、 残差分析
- 家計5項目で PCA を実施、 バイプロット表示
- k-means (k=3) で都道府県をクラスタリング、 解釈
上級課題
- 地域別の家計パターンに有意差があるか ANOVA で検定
- 重回帰で教育費を予測、 多重共線性を VIF で確認
- Ridge/LASSO で正則化、 CV で α を最適化
- 階層クラスタリングと Ward 法で都道府県を分類、 デンドログラム作成
🖼️ 信頼区間の追加図解 — 標本サイズと幅の関係
信頼区間は 標本サイズ n が大きくなるほど狭くなります。 下図は SSDSE-B-2026 の 2023 年度・都道府県人口(万人)に対し、 n=10/20/30/47 県を復元抽出で 2,000 回ずつリサンプルした際の 95%CI 幅(t 分布、 平均の区間)を可視化したものです。 平均幅は 357 → 247 → 201 → 159 万人と縮み、 47 県の標準偏差 s = 279.8 万人から計算する 2 × 1.96 × s / √n の曲線にほぼ重なります。 n=10 では東京都が入るかどうかで幅が 87〜636 万人(5〜95%)と大きく揺れます。 n が増えると CI が縮み、 推定の精度が上がる様子が直感的に分かります。
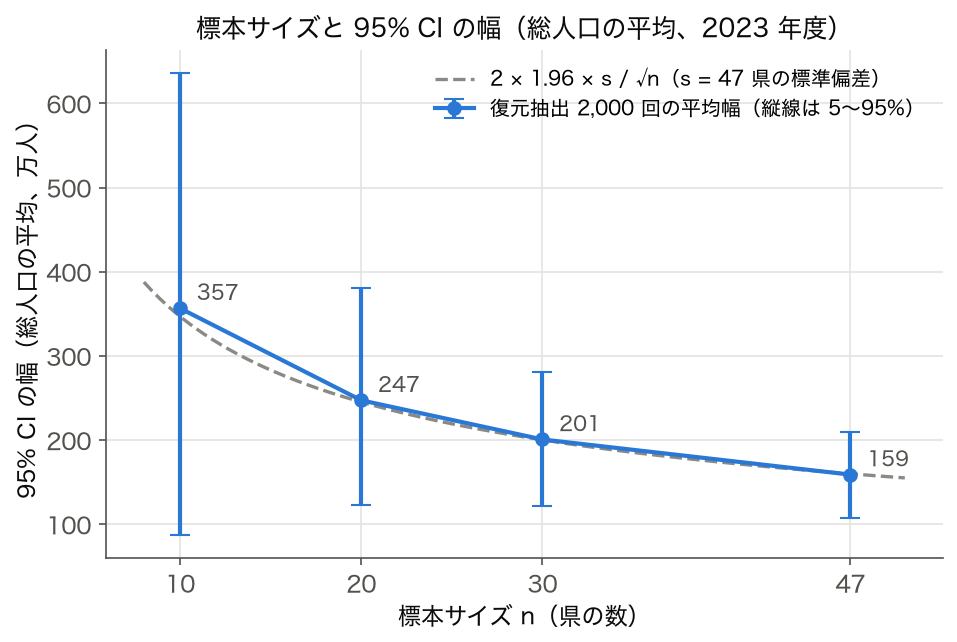
図: n を増やすほど 95%CI は √n に反比例して狭くなる。 n=100 なら n=25 の半分の幅。
📊 表: 標本サイズ別 95%CI 幅の理論値 (σ=15 と仮定)
| 標本サイズ n | 標準誤差 SE = σ/√n | 95%CI 半幅 (1.96×SE) | 推奨用途 |
|---|---|---|---|
| 10 | 4.74 | ±9.30 | 予備調査 (幅広いが向き把握に) |
| 30 | 2.74 | ±5.37 | 中規模調査 (一般的な閾値) |
| 100 | 1.50 | ±2.94 | 実務水準 (公的統計に近い) |
| 1,000 | 0.47 | ±0.93 | 高精度推定 (政策判断に十分) |
📤 読み方: n を 10 倍にすると CI 幅は約 1/3 に縮む。 「精度を倍にしたい」 → 「n を 4 倍に増やす」が経験則。
🗺️ 概念マップ — 3つの視点で体系を理解する
信頼区間 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 推測統計 › 推定 › 信頼区間
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に 信頼区間 を置き、 そこから p値・標準誤差・正規分布・標準偏差・標本サイズ・平均推定 など 計 16 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「信頼区間」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「信頼区間」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは 信頼区間 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 推定 → 信頼区間 という入れ子の位置を示します。 「推定には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔗 隣接手法への橋渡し
「信頼区間」は推定値の不確実性を範囲で示す指標で、 上流の標準誤差計算と下流の仮説検定 (p 値) との整合を取らないと、 「95% 信頼区間に 0 を含むのに有意」のような矛盾報告が出る。
- 上流: 信頼区間 の入力となるA1101 人口の平均に対する 95% 信頼区間 を整える前処理 (データクレンジング、 欠損値処理)
- 並列: 類似目的を持つ代替手法 (仮説検定、 信用区間) と比較・併用
- 下流: 出力結果の評価・解釈 (p 値、 効果量)
上流で標本サイズと標準誤差を整え、 並列のブートストラップ CI と理論 CI を比較し、 下流の仮説検定・効果量と同時に報告すれば、 SSDSE 都道府県の平均値推定や差の検定を統一的に解釈できる。
🌳 手法選択フロー
「confidence interval」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| データが大規模 (n が多い、 高次元) | 計算コスト / メモリ / 並列化が必要 | 標準手法 等 |
| 外れ値が多い / ノイズあり | 頑健性 / 外れ値除去 / 中央値ベース | 高速版 等 |
| 解釈性を重視する | 線形 / 木構造 / ルールベース | 頑健版 等 |
| 予測精度を最優先する | アンサンブル / ハイパラ調整 / 交差検証 | 高次元対応版 等 |
| データが少ない | 正則化 / ベイズ / 転移学習 / 簡素なモデル | 小データ向け 等 |
| リアルタイム/オンライン処理 | ストリーミング / 軽量モデル / 逐次更新 | 解釈重視版 等 |
選んだ後の検証ステップ
- 前処理確認: 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切か
- ハイパラ調整: 交差検証で安定する値を選ぶ
- 性能評価: タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用
- 頑健性チェック: 別手法 / 別シードで結果が大きく違わないか確認
- 解釈: 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討
🧭 解説を深める — 「47都道府県の信頼区間」は何を推定しているのか
このページでは 47 都道府県の消費支出(L3221、 2023 年度)から 95% 信頼区間 [288.77, 302.94] を計算しました。 ここで一歩立ち止まって考えたいのが、 「47 都道府県は標本なのか、 それとも母集団そのものなのか」という問いです。 日本の都道府県は 47 しかなく、 SSDSE にはその全部が入っています。 「48 番目の都道府県」を将来抽出することはできません。 全数データに信頼区間を付けるとき、 その区間は何を推定しているのかを意識すると、 信頼区間の理解が一段深まります。
👁️ 直感 — 信頼区間の意味は「問いの立て方」で変わる
同じ数値 [288.77, 302.94] でも、 分析の枠組みによって意味がまったく違います。
- 枠組み A: 47 県を「母集団の全数調査」とみなす — 知りたいのが「2023 年の 47 都道府県平均」そのものなら、 標本平均 295.86 千円は推定値ではなく母平均そのものです。 抽出誤差は存在せず、 論理的には信頼区間は不要(幅ゼロ)。 記述統計として平均と散らばり(s = 24.14 千円、 最小 223.4〔愛媛県〕〜最大 344.1〔埼玉県〕)を報告すれば足ります。
- 枠組み B: 47 県を「超母集団からの 1 実現値」とみなす — 「日本の社会経済構造が生み出す都道府県消費支出のデータ生成過程」という仮想的な母集団(superpopulation、 超母集団)を考え、 観測された 2023 年の 47 値はその 1 回の実現とみなす立場です。 このとき [288.77, 302.94] は「データ生成過程の期待値」に対する区間として意味を持ちます。 経済学・地域分析で全数データに CI を付けるときの標準的な正当化がこれです。
- 枠組み C: 47 県から一部を抽出する — 予算の都合で 20 県しか調査できない、 という状況なら通常の標本抽出の話になります。 ただし母集団が N = 47 と小さいので、 次の落とし穴で述べる有限母集団修正が必要になります。
上の 🎮 シミュレータは、 47 県を「既知の母集団」と宣言したうえで復元抽出する枠組み C の練習装置でした。 論文やレポートで CI を報告するときは、 自分がどの枠組みで語っているのかを明示するのが誠実な書き方です。
⚠️ 落とし穴(重要)— 全数データ・小さな母集団で CI が狂う 3 パターン
- ① 全数データに機械的に CI を付けて「推定」と言ってしまう — 枠組み A のつもり(2023 年の 47 県平均を知りたいだけ)なのに
stats.t.intervalを回して「母平均の 95% CI は [288.77, 302.94]」と書くと、 存在しない抽出誤差を捏造したことになります。 CI を付けるなら「超母集団の期待値を推定している」(枠組み B)と目的を書き換える必要があります。 - ② 小さな母集団からの非復元抽出で有限母集団修正(FPC)を忘れる — N = 47 県から n = 20 県を非復元で選ぶと、 母集団のかなりの部分(約 43%)を見てしまうため、 標準誤差は無限母集団の式より小さくなります。 修正係数は $$ \text{FPC} = \sqrt{\frac{N-n}{N-1}} = \sqrt{\frac{47-20}{46}} \approx 0.766 $$ で、 SE をこの分だけ縮めます。 FPC を忘れると信頼区間は約 1.31 倍(= 1/0.766)広すぎになり、 「精度が低い」と過小評価してしまいます。 逆に、 シミュレータのような復元抽出や N ≫ n の場合は FPC ≈ 1 となり不要です(n/N < 5% が実務の目安)。
- ③ 「値そのものの誤差」を無視する(二段階の不確実性) — SSDSE-B の消費支出は総務省「家計調査」に基づく値で、 各県の数値自体が世帯標本から推定された統計量です。 つまり本当は「家計調査の抽出誤差(県ごと)」と「県 → 全体をまとめる際の不確実性」の二段構えなのに、 このページの計算は各県の値を誤差ゼロの真値として扱っています。 公的統計の二次利用ではこの「見えない第一段の誤差」がしばしば無視されることを覚えておいてください。
🚀 発展 — 実データで見る「信頼水準と幅」の値段表、 そして推測の 2 学派
枠組み B(超母集団)を採用した場合、 信頼水準を上げる「値段」がどれくらいかを、 同じ実データ(L3221、 2023 年、 n = 47、 平均 295.86 千円、 SE = 3.52 千円)で並べると次のとおりです。
| 信頼水準 | t 臨界値 (df=46) | 区間(千円) | 幅(千円) |
|---|---|---|---|
| 90% | 1.679 | [289.94, 301.77] | 11.82 |
| 95% | 2.013 | [288.77, 302.94] | 14.18 |
| 99% | 2.687 | [286.39, 305.32] | 18.93 |
95% → 99% で外す確率を 1/5(5% → 1%)にする代償は幅 +34%(14.18 → 18.93 千円)。 「確実さの購入コスト」が具体的な金額の幅で見えます(値はすべて SSDSE-B-2026 実測に基づく計算値)。
- デザインベース推測 vs モデルベース推測 — 標本調査論では、 不確実性の源を「どの単位を抽出したかの無作為性」に置くデザインベース(枠組み C、 FPC はここに登場)と、 「値を生む確率モデル」に置くモデルベース(枠組み B、 超母集団)の 2 学派があります。 全数データの CI はモデルベースでしか正当化できない、 という整理を知っておくと公的統計の分析論文が読みやすくなります。
- 等重み平均と人口重み平均は別の推定対象 — 47 県の単純平均は東京都と鳥取県を同じ重み 1/47 で扱います。 「日本の平均的な世帯の消費支出」を知りたいなら人口(世帯数)で重み付けた平均が対象であり、 CI もその推定量に対して作り直す必要があります。 推定対象(estimand)を先に決めてから区間を作る、 という順序が本質です。
- クラスター構造と実効サンプルサイズ — 県単位のデータは県内世帯の集計値なので、 「n = 47」は世帯レベルの情報量よりはるかに小さい実効サンプルサイズです。 集計データの CI は個票データの CI と情報量が違う、 という視点は生態学的誤謬(集団の関係を個人に当てはめる誤り)とも接続します。