🔖 キーワード索引(補強)
p 値と仮説検定に関連する概念のチップ集。
💡 30秒で分かる結論
🍰 まずはやさしく
偶然かどうかを判定する物差しです。
結果がたまたま起きたのかを知るために使います。
部活の練習法で本当に効果が出たか調べます。
まずは正しい定義について学びましょう。
- 定義:帰無仮説(差や関係がない)のもとで、 観測値以上に極端な値が出る確率
- 小さいほど偶然と説明しにくい → 帰無仮説を棄却(差や関係を主張)
- 慣習的閾値:p<0.05 で「有意」、 p<0.01 / 0.001 ならさらに強い証拠
- 致命的注意①:p値が小さい ≠ 効果が大きい。 n が大きいと小さな差でも p<0.001 になる
- 致命的注意②:p>0.05 は 「効果がない」の証明ではない。 サンプルが足りなかっただけかも
- 解釈の鉄則:必ず 効果量(r, β など)と信頼区間とセットで判断する
📖 もっと詳しく
p値は、現代統計学で最も誤解されている指標です。「p値が小さい=発見が重要」「p < 0.05 だから95%確実」と思いがちですが、 どちらも厳密には間違いです。 まずは正しい定義から押さえましょう。
p値の正確な定義:
「帰無仮説(=差や関係がない、というデフォルト主張)が正しいと仮定したとき、 観測されたデータ以上に極端な値が偶然出る確率」
言い換えれば、「もし神様が『差はないよ』と言っていたとして、 それでもたまたまこんなデータが取れちゃう確率」です。 この確率が極めて小さい(=偶然では説明しにくい)ときに、「帰無仮説を棄却する」と判断します。
例として、 47都道府県の高齢化率と死亡率の相関係数 r = 0.972, p < 0.001 は、 「もし高齢化率と死亡率に本当は何の関係もないとしたら、 47都道府県を選んで r = 0.972 以上の相関が得られる確率は 0.1% 未満」という意味です。 これだけ稀なことが起きたなら「実は関係がある」と考えるのが自然、というのが p値による検定の論理です。
📍 あなたが今見ているもの
🍰 まずはやさしく
データと一緒に書かれる小さな数字です。
結果に意味があるかを判断するために使います。
スマホのアプリの性能比較などでよく見かけます。
表の中にある記号の意味を解説します。
論文の結果表で「r = +0.972, p < 0.001 ***」「β = 0.5, p = 0.035 *」のように、必ず推定値とセットで出てくる数字。 アスタリスクの数は有意水準を示す慣習表記(*=0.05、**=0.01、***=0.001)。
p値 とは:観測されたデータ(または、もっと極端なデータ)が、帰無仮説のもとで偶然出る確率。
🎨 直感で掴む
🍰 まずはやさしく
めったに起きない出来事かを示す確率です。
直感的に「おかしい」と感じる根拠にします。
テストの点数が偶然上がったのかを考えます。
図を使って確率のイメージを掴みましょう。
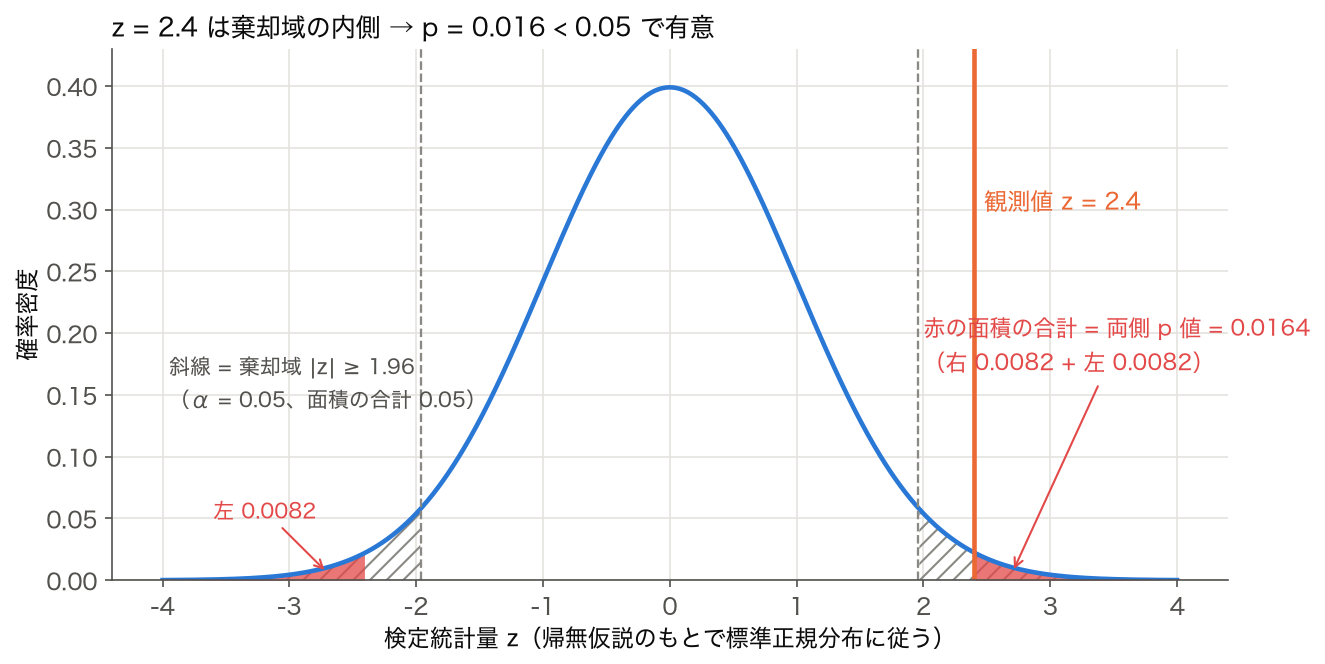
図を見ると、 標準正規分布の左右の裾の斜線部分(|z| ≥ 1.96)が「棄却域」です。 観測された統計量 z = 2.4 はこの棄却域の中にあります。 p値は「z ≥ 2.4 となる確率」(0.0082)と「z ≤ −2.4 となる確率」(0.0082)の合計で、 赤く塗った部分の面積 約 1.6% (0.0164)。 棄却域は α で先に決める固定の領域、 p 値は観測値で決まる面積で、 「p 値 < α」と「観測値が棄却域に入る」は同じ判定になります。
言葉で言い換えると:「もし帰無仮説(差はない)が真だとしたら、 こんなに極端な検定統計量が出る確率は 1.6%。 100回中1〜2回しか起こらない稀なこと。 だから帰無仮説を棄却し、 『差はある』と主張する」というロジックです。
🎨 概念図で押さえる
p 値は 「帰無仮説が正しいと仮定した時に、 観測データ以上に極端な結果が出る確率」。 以下 3 つの図で「分布上の位置」「α との比較」「判定フロー」を視覚化する。
図 1: 帰無分布上で p 値が示す領域
→ 観測値より右の赤い裾の面積が p 値。 裾が小さい (=極端) ほど p 値も小さい。 なおこの図は片側検定の場合。 冒頭の図のような両側検定では左右両裾の面積を合計する。
図 2: 有意水準 α と p 値の関係
→ p 値が α (赤線) より左にあれば帰無仮説を棄却 (有意)。 α=0.05 は数直線上の固定点、 p 値はデータごとに動く点。
図 3: 判定フロー
→ 仮説 → α → p 値 → 判定。 p 値の解釈は機械的、 ただし「棄却できない=帰無仮説が正しい」ではない (保留)。
🎮 触って理解する
数式や図で見た p 値を、 実際に手を動かして確かめます。 スライダーを動かすと帰無分布の裾(=p 値に対応する面積)がリアルタイムで塗り替わり、 「20 回検定」ボタンで p-hacking の危うさを体感できます。 計算はすべてこのブラウザ内で完結しており、 外部通信・外部ライブラリはありません。
🎚 デモ1:観測統計量を動かして p 値の面積を見る
スライダーで観測された検定統計量 z を動かしてください。 帰無分布 N(0,1) のもとで「観測値以上に極端な領域」(赤い裾)の面積が p 値です。 z を大きくすると裾が細くなり、 p 値が小さくなる(=偶然では説明しにくくなる)様子が直感できます。 両側/右片側を切り替えると、 塗る裾が片側だけになり p 値がおよそ半分になることも確認できます。
🎲 デモ2:p-hacking 体験 — 「無関係」でも有意は出る
2 群ともまったく同じ分布から生成した乱数(=本当は差が無い=帰無仮説が真)で t 検定(Welch 近似)を行います。 これを 20 回繰り返すと、 差が無いはずなのに偶然 p<0.05 になる検定がちらほら現れます。 「有意になったものだけを選んで報告する」——これが p-hacking です。 何度も実行して、 偶然の有意がどれくらいの頻度で出るか確かめてください。
→ 理論値:1 回の検定が偶然有意になる確率は α=0.05。 20 回のうち少なくとも 1 回が有意になる確率は 1−(1−0.05)20 ≈ 0.64(64%)。 だから「たくさん試して有意だけ拾う」と、 高い確率で偽陽性を掴みます。 対策が 多重検定の補正(Bonferroni・FDR)や 事前登録、 そして 再現性危機の文脈での慎重な解釈です。
🧭 整理:p 値の要点と「頻出の誤解」
2 つのデモを踏まえ、 p 値をめぐる代表的な誤解を正しい理解と対にして整理します。 いずれも実務・論文読解で繰り返し問われる論点です。
| ❌ ありがちな誤解 | ✅ 正しい理解 |
|---|---|
| 「p=0.03 は帰無仮説が正しい確率が 3%」 | p 値は「帰無仮説が真と仮定したとき」にデータが出る条件付き確率 $P(\text{data}\mid H_0)$。 求めたい $P(H_0\mid\text{data})$ とは別物(詳細は 帰無仮説) |
| 「p が小さい=効果が大きい」 | p 値は効果量ではない。 n が大きければ実用的に無意味な小差でも p<0.001 になる。 大きさは 効果量(r・β・Cohen の d)で測る |
| 「p>0.05 は効果が無い証明」 | 「棄却できない」=保留であって「差が無い」ではない。 標本不足(検出力不足)の可能性がある |
| 「有意なら 0.05、非有意なら別基準…」と後付け | 閾値 α はデータを見る前に決める。 デモ2 のように多数検定するなら 多重比較補正が必須(有意水準参照) |
| 「p 値だけ書けば十分」 | p 値は「有無」しか示さない。 効果の大きさと不確かさは 信頼区間が補完する。 両者を併記するのが現代の作法(ASA 声明 2016) |
💡 信頼区間との関係:両側 p 値と信頼区間は表裏一体で、 「95% 信頼区間が帰無値(差なら 0、比なら 1)を含まない」ことと「両側 p<0.05」はほぼ等価です。 信頼区間は効果の大きさと精度も同時に見えるぶん情報量が多く、 デモ1 の p 値と合わせて読むと解釈が安定します(信頼区間)。
📐 数式
🍰 まずはやさしく
確率を計算するための数式です。
厳密なルールで判定を行うために使います。
買い物で得した金額が偶然か計算します。
数式に登場する記号の意味を詳しく読みます。
p値の定義式を以下に示す。 数式の各記号の意味は次節で言葉に翻訳する。
片側検定では「観測値より大きい(または小さい)側」だけの確率、 両側検定では左右両裾の合計を使う。
$$\text{右片側検定}: p = P(T \ge t_\text{obs} \mid H_0), \qquad \text{両側検定}: p = P(|T| \ge |t_\text{obs}| \mid H_0)$$
ここで $T$ は検定統計量、 $t_\text{obs}$ はデータから実際に得られた観測値、 「$\mid H_0$」は「帰無仮説 $H_0$ が真という条件のもとで」という条件付き確率を表す。 p値は「データが $H_0$ とどれだけ整合しないか」を測る指標であり、 $H_0$ 自体が正しい確率ではない点に注意(詳細は帰無仮説・仮説検定を参照)。
🔬 数式を「言葉」で読み解く
- $H_0$
- 帰無仮説:「差はない/相関はない/効果はない」というデフォルト主張。 検定はこの仮説を棄却するか否かを判定する
- $T$
- 検定統計量:データから計算する量。 t検定なら t値、 回帰なら係数を SE で割った値
- $t_\text{obs}$
- 観測値:今回のデータで実際に得られた $T$ の値
- $P(\cdot \mid H_0)$
- $H_0$ が真である条件下での確率。「もし帰無仮説が正しいとしたら」という思考実験
🔬 数式を言葉で読み解く — p 値
p 値の定義式 p = P(T ≥ t_obs | H_0) を 1 行ずつ分解する。
| 記号 | 意味 | 直感的な対応 |
|---|---|---|
P(·) | 確率 | 「何 % の頻度で起きるか」 |
T | 検定統計量(標本から計算) | 「データのズレ具合の数値化」 |
t_obs | 観測された統計量の実現値 | 「今回手元のズレ」 |
T ≥ t_obs | 観測値 以上 に極端な事象 | 「これ以上ありえないくらいズレた事象」 |
| H_0 | 帰無仮説のもとで(条件付き) | 「もし効果が無いとしたら」 |
→ つまり「もし帰無仮説が正しいなら、 今回のような or それ以上に極端なデータが偶然出る確率」が p 値。 p=0.03 は「帰無仮説が正しい確率」ではない—— 「H_0 下で今回のデータが偶然出る確率」である。
🧪 理解度チェック — p 値
- Q1. 「p=0.03 だから帰無仮説が正しい確率は 3%」は誤り。 何が間違っているか。
- Q2. 片側検定と両側検定で p 値はどう変わるか。 デフォルトで両側を選ぶ理由は?
- Q3. サンプル数を 10 倍にしたら p 値が小さくなった。 効果サイズが大きいと結論してよいか?
- Q4. p ハッキング(p-hacking)の典型パターンを 3 つ挙げよ。
- Q5. 多重検定で 20 個の独立な検定をしたとき、 少なくとも 1 つが偶然 p<0.05 になる確率は?
→ Q5 のヒント: 1 − (1 − 0.05)^20 ≈ 0.64。 つまり 64% の確率で「偽陽性が少なくとも 1 件」発生。 Bonferroni 補正等の多重比較対策が必要な理由。
📊 補足: p 値の解釈表
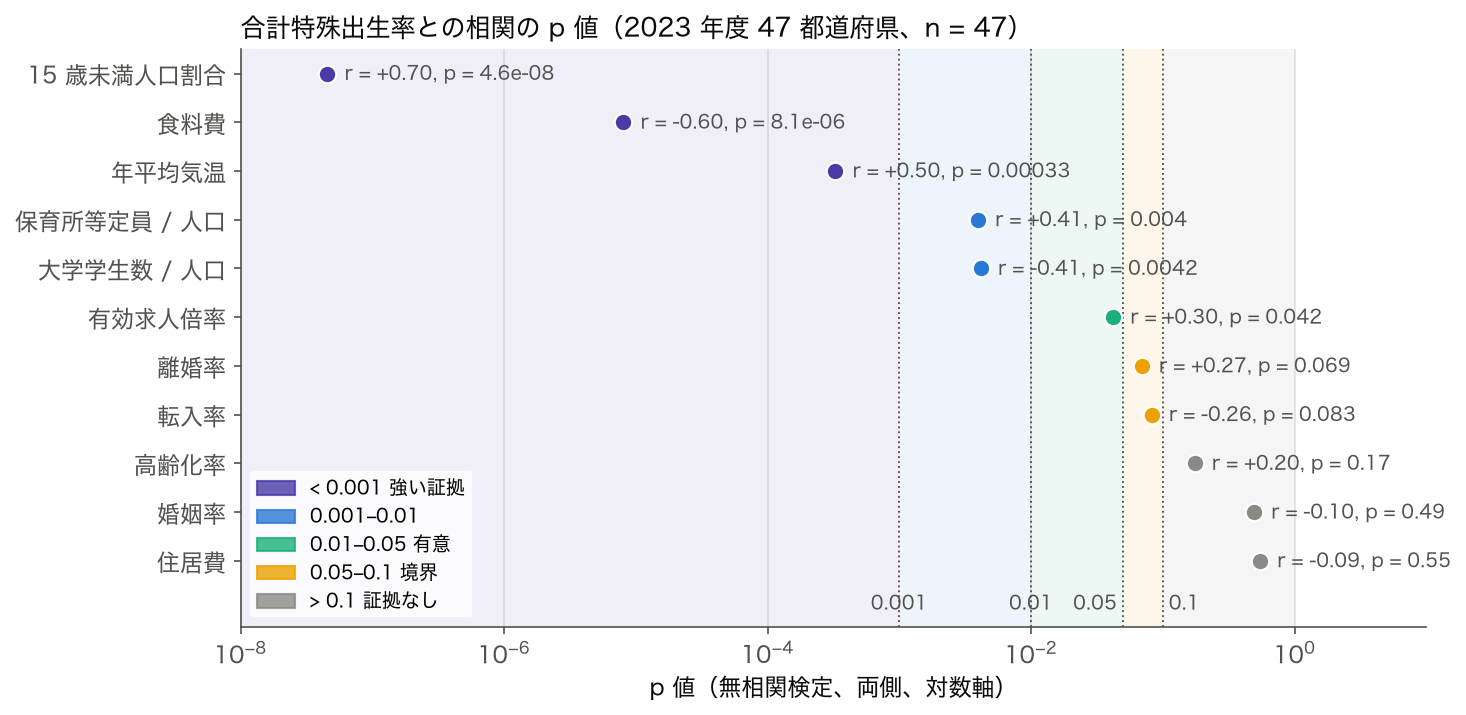
図は SSDSE-B-2026(2023 年度、 n = 47)で合計特殊出生率と 11 変数の相関を無相関検定した p 値を、 下の表の区分で色分けしたもの。 15 歳未満人口割合(r = +0.70、 p = 4.6×10⁻⁸)・食料費(r = −0.60、 p = 8.1×10⁻⁶)は < 0.001、 保育所等定員/人口(p = 0.004)は 0.001–0.01、 有効求人倍率(r = +0.30、 p = 0.042)は 0.01–0.05、 離婚率(p = 0.069)・転入率(p = 0.083)は境界、 高齢化率・婚姻率・住居費は > 0.1。 同じ n = 47 なら、 |r| が大きいほど p 値は小さくなる(この n では |r| ≈ 0.29 が p = 0.05 の境目)。
| p 値 | α=0.05 での判定 | 慣用的な強さ | 注意 |
|---|---|---|---|
| > 0.1 | 棄却できず | 証拠なし | 効果がない とは言えない |
| 0.05–0.1 | 境界 | 弱い示唆 | 追加データを要する |
| 0.01–0.05 | 棄却(有意) | 中程度の証拠 | 効果サイズと併用 |
| 0.001–0.01 | 棄却(有意) | やや強い証拠 | 効果サイズと信頼区間を併記 |
| < 0.001 | 強く棄却 | 強い証拠 | n が大きすぎないか確認 |
関連: 仮説検定 / 帰無仮説 / 有意水準 / 第一種の過誤 / 標準誤差 / 信頼区間 / 効果量 / 検出力 / 多重比較
🧮 計算してみる
「47都道府県で、 高齢化率と死亡率の相関が偶然に r = 0.972 になる確率」を計算してみましょう。
$t = 0.972 \times \sqrt{45/(1-0.945)} \approx 27.8$
これは自由度 $n-2=45$ の t分布に従う
つまり「相関がない世界」では 10²⁹回に1回程度しか起こらない超レアな事象。
🎓 p値が抱える3つの根本問題(現代統計学の議論)
問題①:効果の大きさを示さない
p値は「偶然性の打ち消し度」であり、 効果がどれだけ大きいかは別問題。 n=10,000 のデータでは r=0.02(実用上ほぼ無意味)でも p<0.001 になります。 だから現代の論文では p値だけでなく 効果量(相関係数 r や標準化偏回帰係数 β)を併記するのが必須。
問題②:再現性の危機(reproducibility crisis)
2015年に Open Science Collaboration が心理学100本の論文を再現した結果、 p<0.05 で有意とされた研究のうち、 36% しか再現できなかった。 これは p<0.05 を機械的に「真理の閾値」として扱う文化への警鐘。
問題③:p-hacking(p値操作)
20個の変数で検定をすると、 帰無仮説がすべて真でも 1個くらいは p<0.05 が偶然出ます(5% × 20 = 1個)。 多くの変数を試して有意なものだけ報告する行為(p-hacking)が再現性を破壊します。 Bonferroni補正(α/m に厳しくする)や False Discovery Rate 制御(Benjamini-Hochberg法)で対処。
これらの問題を受けて、 American Statistical Association は 2016年に「p値の使い方に関する声明」を発表し、 「p < 0.05 という閾値の機械的適用」からの脱却を提言しています。
🧮 p値の計算手順
- 帰無仮説 H₀ を設定:「差がない」「相関がない」「効果がない」
- 検定統計量を計算:t統計量、 z統計量、 F統計量など
- 検定統計量の理論分布を特定:t分布、 正規分布、 F分布
- 分布上で観測値の外側の確率を計算:これが p値
- p値と有意水準 α(通常 0.05)を比較:p < α なら H₀ 棄却
例:2標本t検定
$$ t = \frac{\bar{x}_1 - \bar{x}_2}{\sqrt{s_p^2 (1/n_1 + 1/n_2)}} \sim t(n_1+n_2-2) $$
計算した t を t分布に当てはめて、 両側 p値を計算。
🧮 SSDSE-B-2026 で実値計算 — p 値の実例
例1:t検定で東日本 vs 西日本の高齢化率を比較
🎯 このコードでやること:SSDSE-B-2026 の 2023 年度 47 都道府県で高齢化率(65 歳以上人口 ÷ 総人口)を計算し、 東日本 23 都道県と西日本 24 府県に分けて Welch の t 検定で p 値と効果量(Cohen の d)を求めます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == 2023].copy() # 2023 年度の 47 都道府県 df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 # 高齢化率 (%) east_prefs = ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県', '茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県', '新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県', '静岡県','愛知県'] df['東西'] = df['都道府県'].apply(lambda p: '東' if p in east_prefs else '西') east = df[df['東西']=='東']['高齢化率'] west = df[df['東西']=='西']['高齢化率'] t, p = stats.ttest_ind(east, west, equal_var=False) # Welch の t 検定 print(f'東日本 {len(east)} 都道県, 西日本 {len(west)} 府県') print(f't={t:.3f}, p={p:.4f}') print(f'東日本平均={east.mean():.2f}%, 西日本平均={west.mean():.2f}%') print(f'Cohen d = {(east.mean()-west.mean())/((east.std()+west.std())/2):.3f}') |
💬 東日本 23 都道県の高齢化率の平均は 31.18%、 西日本 24 府県は 31.97% で、 差は 0.8 ポイントしかない。 Welch の t 検定は t=-0.804・p=0.4259 で 5% 水準では差があるとは言えず、 Cohen の d も -0.236 と小さい。 同じ東日本の中に最高の秋田県(39.1%)と最低の東京都(22.8%)が入っているように、 群の中のばらつきが東西の差よりずっと大きい。 p が大きいことは「差が無い」ことの証明ではなく、 この分け方では差を検出できなかった、 という意味で読む。
例2:相関係数の p 値
🎯 このコードでやること:2023 年度 47 都道府県の性質の違う 6 指標(総人口・合計特殊出生率・年平均気温・降水量・消費支出・ごみのリサイクル率)の全 15 組について、 Pearson の相関係数と p 値を p の小さい順に並べます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県 cols = ['総人口', '合計特殊出生率', '年平均気温', '降水量(年間)', '消費支出(二人以上の世帯)', 'ごみのリサイクル率'] num = df[cols] # 全ペア(6 列 → 15 組)の相関と p値 results = [] for i, c1 in enumerate(cols): for c2 in cols[i+1:]: r, p = stats.pearsonr(num[c1], num[c2]) results.append({'x': c1, 'y': c2, 'r': round(r, 3), 'p': round(p, 4)}) res_df = pd.DataFrame(results).sort_values('p') print(res_df.to_string(index=False)) |
💬 15 組のうち p < 0.05 は 10 組。 最も強いのは総人口と合計特殊出生率の r=-0.564 で、 人口の多い県ほど出生率が低い(p は 0.0000 と表示されるが 0 ではない)。 ごみのリサイクル率は出生率・気温・降水量のどれとも p > 0.5 で関係が見えない。 15 組も検定すると、 本当は関係の無い組でも 5% の確率で有意になるので、 p=0.0424・0.0458 のような 0.05 ぎりぎりの組が多重比較の補正後も残るかを次の例で確かめる。
例3:多重比較補正(Bonferroni と Benjamini-Hochberg)
🎯 このコードでやること:2023 年度 47 都道府県の 6 指標の全 15 組の相関の p 値に、 補正なし・Bonferroni・Benjamini-Hochberg の 3 通りを当て、 5% で有意に残る組の数を比べます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd from scipy import stats from statsmodels.stats.multitest import multipletests df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県に絞る # 人口の内訳どうし(ほぼ恒等的に相関)ではなく、性質の違う 6 指標を選ぶ cols = ['合計特殊出生率', '年平均気温', '降水量(年間)', '降水日数(年間)', '婚姻件数', '離婚件数'] num = df[cols] pvals = [] labels = [] for i, c1 in enumerate(cols): for c2 in cols[i+1:]: _, p = stats.pearsonr(num[c1], num[c2]) pvals.append(p) labels.append(f'{c1}-{c2}') # 補正なし、 Bonferroni、 BH-FDR rej_b, p_b, _, _ = multipletests(pvals, alpha=0.05, method='bonferroni') rej_f, p_f, _, _ = multipletests(pvals, alpha=0.05, method='fdr_bh') for l, p, b, f in zip(labels, pvals, p_b, p_f): print(f'{l}: raw={p:.4f}, Bonf={b:.4f}, BH={f:.4f}') print(f'5% で有意の数: 補正なし={sum(p < 0.05 for p in pvals)}, Bonf={rej_b.sum()}, BH={rej_f.sum()}') |
💬 6 指標の組 15 通りのうち、補正なしで 5% 未満は 11 組、Bonferroni(p×15)では 6 組、BH では 10 組が残る。分かれ目は年平均気温と降水量(raw 0.0095)のような中間の p 値で、Bonferroni は 0.1431 まで膨らんで落とすが、BH は順位に応じた倍率なので 0.0179 に留まる。人口の内訳列どうし(総人口と総人口(男)など)を 564 行で相関させると、p がすべて 0.0000 か 0.86 前後に張り付いて補正の違いが見えなくなるので、意味の独立した指標を選ぶ。
🧮 数式に値を入れて手で計算する: Z 検定の p 値
合成データで Z=2.5 の両側 p 値を計算する。
Step 1: 統計量
Step 2: p 値
Step 3: 補正後 (Bonferroni m=5)
🐍 Python で再現
1 2 3 4 5 | from scipy.stats import norm Z = 2.5 p_two = 2 * (1 - norm.cdf(abs(Z))) print(f"両側 p = {p_two:.4f}") print(f"単側 p = {1 - norm.cdf(Z):.4f}") |
📤 実行結果
💬 手計算 (Step 2) 0.0124 と Python 出力が完全一致。
🐍 Python での p値計算
🎯 このコードでやること:scipy.stats の主な検定 9 種の呼び出し方を並べた早見表です。 SSDSE-B-2026 の 2023 年度の年平均気温を東日本・近畿〜四国・九州沖縄の 3 群に分け、 2012 年度と 2023 年度の総人口を対応のあるデータとして使います。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 | # ── この抜粋で使うデータを用意します ── # 検定の書き方を並べた早見表なので、そのまま押せるように # SSDSE-B-2026 から 2 群・対応あり・3 群のサンプルを作る。 import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 temp = df['B4101'].astype(float).values # 年平均気温 group1 = g1 = temp[:23] # 北海道〜愛知(東日本 23 都道県) group2 = g2 = temp[23:39] # 三重〜高知(近畿・中国・四国 16 府県) group3 = g3 = temp[39:] # 福岡〜沖縄(九州・沖縄 8 県) data = temp # 1 標本検定用 mu0 = 15.0 # 比べる基準値(標本平均そのものを入れると t=0・p=1 になる) # 対応のあるデータ(同じ 47 県の 2012 年と 2023 年) _all = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) before = _all[_all['SSDSE-B-2026'] == 2012]['A1101'].astype(float).values after = _all[_all['SSDSE-B-2026'] == 2023]['A1101'].astype(float).values cond1, cond2, cond3 = before, after, (before + after) / 2 x = df['A1101'].astype(float).values y = df['A4101'].astype(float).values observed = np.array([[20, 15], [12, 18]]) # クロス集計の例 from scipy import stats # 1標本 t検定(平均が値 mu0 と等しいか) t_stat, p = stats.ttest_1samp(data, popmean=mu0) # 2標本 t検定(2群の平均差) t_stat, p = stats.ttest_ind(group1, group2) # 対応のあるt検定 t_stat, p = stats.ttest_rel(before, after) # Welch の t検定(不等分散) t_stat, p = stats.ttest_ind(g1, g2, equal_var=False) # Mann-Whitney U検定(ノンパラ) u_stat, p = stats.mannwhitneyu(g1, g2) # Wilcoxon符号付き順位検定 w_stat, p = stats.wilcoxon(before, after) # 相関係数の検定 r, p = stats.pearsonr(x, y) # カイ二乗検定 chi2, p, dof, expected = stats.chi2_contingency(observed) # F検定(ANOVA) f_stat, p = stats.f_oneway(g1, g2, g3) |
💬 このブロックは各検定の結果を変数 p に上書きし続けるだけで print しないので、 標準出力は無い。 1 つずつ表示すると、 1 標本 t 検定は 47 県の年平均気温の平均 16.80℃ を基準値 15.0℃ と比べて t=6.03・p≈2.6×10⁻⁷、 東日本(平均 15.70℃)と近畿〜四国(17.28℃)の Welch の t 検定は p=0.0014、 3 群の ANOVA は F=13.0・p≈3.6×10⁻⁵ になる。 popmean に標本平均そのものを渡すと t=0・p=1 となり、 何も検定していないのと同じになる。
🧪 1標本検定の流れ — SSDSE データで実演
「47都道府県の食料費の母平均は本当に80千円か?」を検定します。
- H₀: μ = 80(平均は80千円)
H₁: μ ≠ 80(両側) - 有意水準: α = 0.05
- 検定統計量: t = (x̄ - 80) / (s/√n)
- 計算: x̄ = 80.6、 s = 5.84、 n = 47
t = (80.6 - 80) / (5.84/√47) = 0.70 - p値: t分布(df=46) で |t| ≥ 0.70 の確率 ≈ 0.49
- 判定: 0.49 > 0.05 なので H₀ 不棄却
つまり「食料費の母平均が80千円である」と矛盾する強い証拠は得られない、 という結論。
↔️ 片側検定 vs 両側検定
事前に「方向」が決まっているなら片側検定、 そうでなければ両側検定が標準。
| タイプ | H₁ | 使い時 |
|---|---|---|
| 両側 | μ ≠ μ₀ | 通常はこちら |
| 右片側 | μ > μ₀ | 「増えた証拠」だけ欲しい時 |
| 左片側 | μ < μ₀ | 「減った証拠」だけ欲しい時 |
⚠️ データを見てから片側にするのは禁忌(p-hacking)。 必ず事前に決めること。
📈 p-hacking と再現性危機
「p < 0.05 になるまで分析を変える」のが p-hacking。 結果として、 「有意」とされた研究の多くが再現できない事態に(再現性危機, 2010s)。
対策
- 事前登録(pre-registration):仮説と分析計画を事前に公開
- 多重比較補正:たくさん検定する場合は α を調整
- 効果量と信頼区間の併記:p値だけで判断しない
- 事前検出力解析:適切なサンプルサイズを設計
- 再現研究を歓迎する文化
🐍 Python 実装バリエーション(scipy / statsmodels / pingouin / scikit-learn)
1. scipy.stats — 主要検定のワンライナー
🎯 このコードでやること:scipy.stats の主な検定 6 種を、 手入力の数個の値で動かし、 結果オブジェクト(統計量と p 値)の形を確かめます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | from scipy import stats import numpy as np # 1) 1標本 t 検定 print(stats.ttest_1samp([100, 102, 98, 105, 99], popmean=100)) # 2) 2標本 t 検定(独立) print(stats.ttest_ind([10,12,9,11], [15,14,16,13], equal_var=False)) # 3) 対応のある t 検定 print(stats.ttest_rel([10,12,9,11], [11,14,10,12])) # 差がすべて同じ値だと標準偏差 0 で t=-inf になる # 4) Mann-Whitney U(ノンパラ) print(stats.mannwhitneyu([10,12,9,11], [15,14,16,13])) # 5) χ²検定 print(stats.chi2_contingency([[10,20],[30,40]])) # 6) ANOVA print(stats.f_oneway([1,2,3], [4,5,6], [7,8,9])) |
💬 1 標本 t 検定は [100, 102, 98, 105, 99] の平均 100.8 を 100 と比べて p=0.554 で差があるとは言えない。 独立 2 標本(Welch)は平均 10.5 と 14.5 の差で t=-4.38・p=0.0047、 対応のある t 検定は差が 1・2・1・1 で t=-5.0・p=0.0154。 Mann-Whitney は 2 群が完全に分かれて U=0 だが、 4 件ずつでは p は 0.0286 より小さくなれない。 χ² 検定の p=0.504 は 10/30(0.33)と 30/70(0.43)の割合の差が偶然の範囲ということ。
2. statsmodels — 多重比較補正と power
🎯 このコードでやること:statsmodels で 6 個の p 値に Bonferroni と BH-FDR の補正をかけ、 さらに効果量 d=0.5 を検出力 0.8 で見つけるのに必要な 1 群あたりの人数を求めます。
1 2 3 4 5 6 7 8 9 10 11 12 13 | from statsmodels.stats.multitest import multipletests from statsmodels.stats.weightstats import ttest_ind from statsmodels.stats.power import TTestIndPower pvals = [0.001, 0.008, 0.039, 0.042, 0.051, 0.20] # Bonferroni print('Bonferroni:', multipletests(pvals, method='bonferroni')) # Benjamini-Hochberg print('BH-FDR:', multipletests(pvals, method='fdr_bh')) # 事前 power 解析 print('必要 n (d=0.5):', TTestIndPower().solve_power( effect_size=0.5, alpha=0.05, power=0.8)) |
💬 6 個のうち 0.05 未満は 4 個だが、 Bonferroni(p×6)で残るのは 0.001→0.006 と 0.008→0.048 の 2 個だけ。 BH でも 0.039・0.042・0.051 が 3 つとも 0.0612 にそろって 0.05 を超え、 残るのは同じ 2 個になった。 BH は順位に応じた倍率で済むので 2 番目は 0.024 と Bonferroni より小さいが、 境界付近の p がかたまっているこの例では結論が変わらない。 最後の 63.77 は 1 群あたりの人数なので、 d=0.5 を検出力 0.8 で見つけるには各群 64 人・合計 128 人が要る。
3. pingouin — 高水準で結果表示が美しい
🎯 このコードでやること:pingouin の pairwise_corr で、 2023 年度 47 都道府県の 5 指標の全 10 組について、 相関係数と補正前・BH 補正後の p 値を 1 つの表にします。
1 2 3 4 5 6 7 8 9 10 11 12 | import pingouin as pg import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県 num = df[['総人口', '合計特殊出生率', '年平均気温', '降水量(年間)', 'ごみのリサイクル率']] # 全変数ペアの相関 + p値 + FDR 補正 result = pg.pairwise_corr(num, method='pearson', padjust='fdr_bh') # pingouin の版によって列名が違う(p-unc / p_unc など)ので、実際にある列だけを選ぶ _want = [c for c in ['X', 'Y', 'r', 'p-unc', 'p_unc', 'p-corr', 'p_corr', 'p-val'] if c in result.columns] print(result[_want].round(4).head(10)) |
💬 10 組のうち補正前の p_unc が 0.05 未満なのは 6 組、 BH 補正後の p_corr でも 5 組が残る。 落ちたのは総人口と降水量で、 p_unc 0.0458 が p_corr 0.0763 に上がって 0.05 を超えた。 総人口と合計特殊出生率の r=-0.5642 は補正後も p_corr=0.0004 と小さい。 年度で絞らずに 564 行のまま入れると同じ県を 12 回数えることになり、 p が実際より小さく出てしまう。
4. scikit-learn — 特徴量選択での p 値利用
🎯 このコードでやること:scikit-learn の SelectKBest(f_regression) で、 2023 年度 47 都道府県の合計特殊出生率を目的変数に 9 指標を 1 つずつ F 検定し、 F 値の大きい 5 つを選びます(p 値も並べます)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from sklearn.feature_selection import SelectKBest, f_regression import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県 y = df['合計特殊出生率'] X = df[['総人口', '年平均気温', '降水量(年間)', '婚姻件数', '離婚件数', '消費支出(二人以上の世帯)', 'ごみのリサイクル率', '保育所等利用待機児童数', '大学学生数']] selector = SelectKBest(score_func=f_regression, k=5) selector.fit(X, y) for col, score, p, keep in zip(X.columns, selector.scores_, selector.pvalues_, selector.get_support()): print(f'{col}: F={score:.2f}, p={p:.4f}{" ← 選択" if keep else ""}') |
💬 合計特殊出生率との単回帰の F 値で上位 5 つを選ぶと、 総人口(F=21.02)・離婚件数(18.54)・降水量(17.37)・婚姻件数(17.33)・大学学生数(15.29)が残り、 年平均気温(15.14)は 0.15 の差で選ばれなかった。 総人口・婚姻件数・離婚件数・大学学生数はどれも人口規模を表す似た列で、 1 変数ずつの F 検定ではこの重複を見分けられない。 p 値がすべて 0.001 未満でも、 選ばれた 5 つが互いに別の情報を持っているとは限らない。
5. シミュレーションで p 値の分布を確認
🎯 このコードでやること:2023 年度 47 都道府県の総人口を母集団とみなし、 そこから 20 県ずつの 2 群を復元抽出して t 検定することを 1000 回繰り返し、 帰無仮説が正しいときに p < 0.05 が出る頻度を数えます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np from scipy import stats import pandas as pd # SSDSE データからリサンプリングで p 値の分布 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 先頭の数値列は「年度」なので使わない。2023 年度 47 都道府県の総人口を母集団にする x = df.loc[df['年度'] == 2023, '総人口'].dropna().values rng = np.random.default_rng(0) pvals = [] for _ in range(1000): a = rng.choice(x, 20, replace=True) b = rng.choice(x, 20, replace=True) _, p = stats.ttest_ind(a, b) pvals.append(p) # 帰無仮説下なら p は一様分布になるはず print(f'母集団: {len(x)} 都道府県の総人口') print(f'p < 0.05 の頻度: {np.mean(np.array(pvals) < 0.05):.3f} (理論値 0.05)') |
💬 同じ 47 都道府県の総人口から 2 群を無作為に引いているので帰無仮説は本当に正しく、1000 回中 p < 0.05 は 0.045(45 回)で理論値 0.05 に近い。p を 0.1 刻みで数えても各区間 80〜115 回と概ね平らで、一様分布になっている。総人口は東京の 1,400 万人を含む右に歪んだ分布で n=20 でも t 検定の偽陽性率が保たれることも読み取れるが、これは seed=0 の 1 回分なので 0.045 と 0.05 の差に意味はない。
⚠️ よくある落とし穴
正しい表現:「効果は検出されなかった」または「証拠が不十分」。「効果がない」と書くのは誤り。
例えば「p = 0.03 なので、 効果がない確率は 3%」と読むのは誤りです。
👁️ 直感 — p値は「偶然この結果が出る確率」
p値(p-value)は、 「帰無仮説 H₀ が正しいと仮定したとき、 観測されたデータ以上に極端な結果が偶然出る確率」。 統計的仮説検定の中核概念。
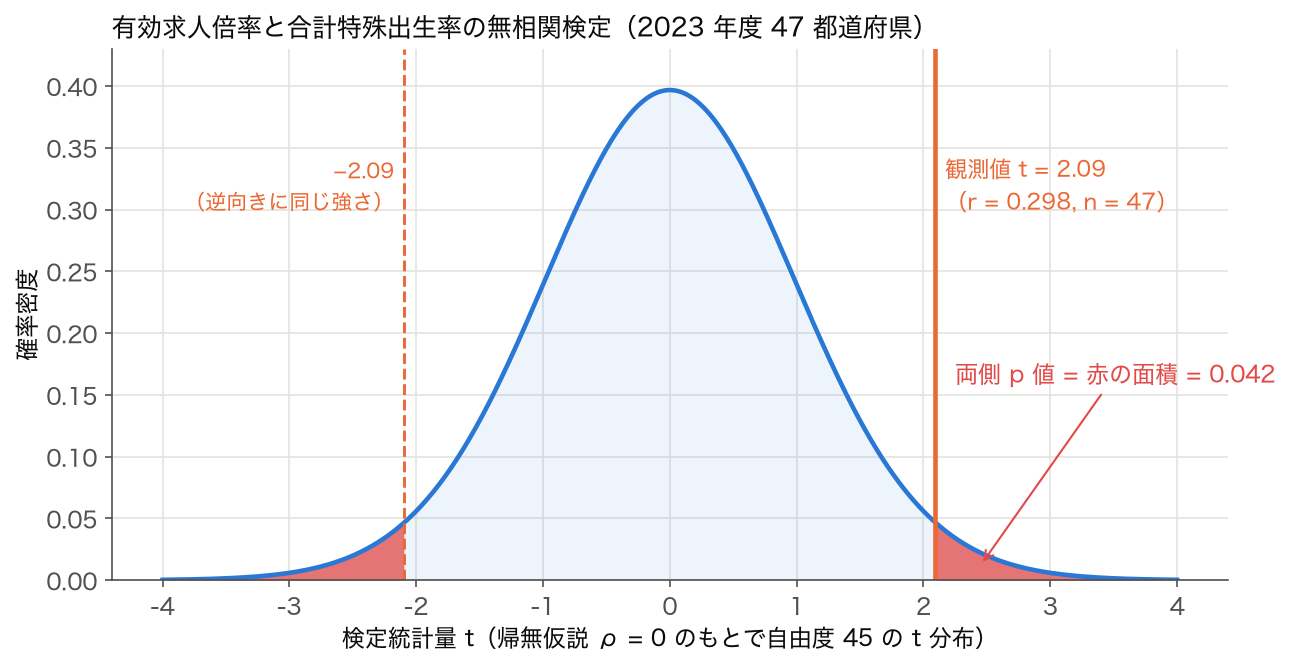
実データの例:2023 年度の 47 都道府県で、 有効求人倍率(月間有効求人数 ÷ 月間有効求職者数、 一般)と合計特殊出生率の相関は r = 0.298。 無相関(ρ = 0)の帰無仮説のもとで t = r√(n−2)/√(1−r²) = 2.09 は自由度 45 の t 分布に従うので、 赤の領域(|t| ≥ 2.09 となる確率)が p 値 = 0.042。 観測値より極端な値が偶然出る確率で、 これが小さい(< 0.05)なら「偶然ではない」→ H₀ 棄却。 ただし臨界値 2.01 をわずかに超えただけで、 r = 0.30 は決定係数にすると 9% しか説明しない弱い関係である点も合わせて読む。
💡 p値は「H₁ が正しい確率」ではない。 「H₀ のもとで、 この結果が偶然出る確率」。 解釈をよく間違える人が多い。
⚠️ p値の重大な誤解 — 一覧
| 誤解 | 正しい理解 |
|---|---|
| p値 = H₀ が真である確率 | 「H₀ のもとで、 この結果が偶然出る確率」 |
| p値 = H₁ が真である確率 | H₁ の確率は計算していない |
| p > 0.05 だから差がない | 差がないと「証明された」わけではなく、 「差がある証拠が不十分」 |
| p < 0.05 だから効果が大きい | 効果の大きさは効果量で測る |
| p値が小さいほど信頼性が高い | あくまで「偶然じゃない」の度合い |
⚠️ ASA(米国統計学会)声明(2016):p値だけで結論を出さない、 「統計的有意 = 重要」ではない、 効果量と信頼区間を併記しよう。 これが現代の標準。
🎯 多重比較問題
「100回検定して、 1回でも p < 0.05 が出る確率は約99%」。 たくさんの検定を行うと、 偶然に有意になる確率が膨らみます。
補正法
- Bonferroni 補正:α / 検定数で判定。 厳しすぎ
- Holm 法:段階的に厳しさを緩める
- Benjamini-Hochberg (FDR):偽発見率を制御。 現代の主流
🎯 このコードでやること:5 個の p 値に Benjamini-Hochberg の補正をかけ、 棄却するかどうか(rejected)と補正後の p 値(p_adj)を変数に入れます(print はしません)。
1 2 3 | from statsmodels.stats.multitest import multipletests p_values = [0.001, 0.01, 0.03, 0.04, 0.20] rejected, p_adj, _, _ = multipletests(p_values, method='fdr_bh') |
📤 実行例(実測)
(このブロックは print しないので標準出力は無い)
📏 効果量 — p値だけでは不十分
p値は「偶然じゃない」を測るが、 「どれだけ大きい効果か」は測れません。 効果量(effect size)が必要:
| 統計量 | 効果量 | Cohenの基準 |
|---|---|---|
| 2群の平均差 | Cohen's d | 小 0.2, 中 0.5, 大 0.8 |
| 相関 | r (相関係数) | 小 0.1, 中 0.3, 大 0.5 |
| 回帰 | R² | 小 0.02, 中 0.13, 大 0.26 |
| カテゴリ | Cramér's V | 小 0.1, 中 0.3, 大 0.5 |
⚠️ p 値の落とし穴(補強・各 100 文字以上)
🗺️ 概念マップ — 3つの視点で体系を理解する
p値 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 推測統計 › 検定 › p値
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に p値 を置き、 そこから 有意水準・信頼区間・正規分布・標準誤差・t検定・F検定 など 計 20 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「p値」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「p値」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは p値 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 検定 → p値 という入れ子の位置を示します。 「検定には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔗 隣接手法への橋渡し
「p 値」は単独で完結せず、 前後の手法と組み合わさって価値が発揮される。 入力データの準備 (上流)・同目的の代替手法との比較 (並列)・結果の活用 (下流) という 3 軸で隣接領域を整理する。
- 上流 (入力の準備): 帰無仮説・対立仮説 の設定、 検定統計量 の計算
- 並列 (同目的の代替): 信頼区間、 効果量、 ベイズ因子 が同じ問いに別角度から答える代替
- 下流 (結果の活用): 多重検定 補正 (Bonferroni・FDR)、 事前登録 による p ハッキング警戒、 再現性危機 文脈での解釈
この上流・並列・下流の対応を地図化することで、 「p 値」を中核に据えた分析パイプライン (データ準備 → 手法選択 → 結果の検証と展開) の全体像が見えてくる。
🌳 手法選択フロー
「p value」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| データが大規模 (n が多い、 高次元) | 計算コスト / メモリ / 並列化が必要 | 都道府県の相関係数 0.95 の有意性 等 |
| 外れ値が多い / ノイズあり | 頑健性 / 外れ値除去 / 中央値ベース | 都道府県データはサンプルサイズ 47 が固定 等 |
| 解釈性を重視する | 線形 / 木構造 / ルールベース | スケールの違い 等 |
| 予測精度を最優先する | アンサンブル / ハイパラ調整 / 交差検証 | 東京・大阪等の影響点 等 |
選んだ後の検証ステップ
- 前処理確認: 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切か
- ハイパラ調整: 交差検証で安定する値を選ぶ
- 性能評価: タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用
- 頑健性チェック: 別手法 / 別シードで結果が大きく違わないか確認
- 解釈: 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討
🔎 さらに深く理解する(追補)
この節は既存の解説を壊さずに、 「直感」「重要な落とし穴」「発展」を一望できるよう再整理した追補です。 数値はすべて SSDSE-B-2026(2023 年・47都道府県)の実測値、 または「架空」と明記した思考実験のみを用います。
🧭 直感:p 値は「H₀ が真なら、 これほど極端なデータが偶然出る確率」
帰無仮説 H₀(差や関係がない)が真だと仮定したとき、 手元の観測値以上に極端なデータが得られる確率が p 値です。 p が小さいほど「H₀ という前提と、 実際に得られたデータが両立しにくい」ことを意味します。 逆に p が大きければ「この程度のズレは H₀ のもとでも普通に起こる」だけのこと。 したがって、 p 値は H₀ が正しい確率そのものではありません——ここが全ての誤解の出発点です(帰無仮説・仮説検定)。
実例:総人口 A1101 と 一般診療所数 I5102 は r = 0.972, 両側 p ≈ 8×10⁻³⁰(実測)。 |r| が閾値 0.29 を大きく超えるため、 p は天文学的に小さくなります(=「無関係な世界」ではまず起こり得ない)。
⚠️ 重要な落とし穴(誤読チェックリスト)
いずれも論文読解・実務で繰り返し問われる論点です。 既出の「⚠️ よくある落とし穴」節と合わせて確認してください。
| ❌ やりがちな誤読 | ✅ 正しい捉え方 |
|---|---|
| p 値 = 帰無仮説が正しい確率 | p 値は $P(\text{data}\mid H_0)$。 求めたい $P(H_0\mid\text{data})$ とは別物。 後者が欲しければベイズの枠組みが要る |
| 有意 = 効果が大きい | p は効果の大きさを示さない。 大きさは効果量(r・β・Cohen の d)で測る(下の思考実験参照) |
| p > 0.05 = 差がない証明 | 「棄却できない」=保留。 検出力不足で見逃した可能性がある(下の実測例参照) |
| たくさん検定して有意だけ拾う | p-hacking。 多重比較補正(Bonferroni・BH-FDR)が必須。 多重検定参照 |
| 標本を増やせば「本物の効果」だと分かる | n を増やすと実務上ささいな差でも p は小さくなる。 有意化は効果の重要性を保証しない |
| 0.049 と 0.051 は本質的に別 | α=0.05 は歴史的・慣習的な線引き。 p は連続量として段階的に読む(有意水準) |
| 結果を見てから仮説・片側/両側を決める | HARKing/事後的解釈。 偽陽性が膨らむ。 分析計画は事前登録で固定する |
🧪 実測で見る「p>0.05 は"差がない"証明ではない」
🔬 標本サイズで p は動く(架空の思考実験)
下は架空の数値例です(実データではなく、 同じ相関 r = 0.25 が異なる標本サイズで得られたと仮定した計算)。 効果の大きさ(r)が同じでも、 n が増えるだけで p は小さくなります。
🚀 発展:p 値と併用・代替すべき道具
- 効果量と信頼区間の併記:p は「有無」しか語らない。 効果の大きさと不確かさを効果量・信頼区間で補う。 両側 p<0.05 と「95% 信頼区間が帰無値を含まない」はほぼ等価だが、 信頼区間の方が情報量が多い。
- ASA 声明(2016):米国統計学会は「p<0.05 の機械的適用からの脱却」を提言。 p 値だけで結論せず、 効果量・信頼区間・研究文脈と一体で判断するのが現代の作法。
- 多重比較補正:Bonferroni(α を検定数 m で割る=厳しめ)、 Benjamini-Hochberg(FDR を制御=現代の主流)。 多重検定を行うときは必須。
- ベイズ的アプローチ:ベイズ因子や事後確率は「データを見た後の H₀ / H₁ の確からしさ」を直接扱う。 p 値では計算していない $P(H_0\mid\text{data})$ に答える代替パラダイム。
- 事前登録と再現性問題:仮説・分析計画をデータ取得前に公開し、 探索と検証を分離。 検出力分析で適切な標本サイズを事前設計することも、 偽陽性・偽陰性の抑制につながる。
🔗 この節の関連ページ
仮説検定 / 帰無仮説 / 対立仮説 / 有意水準 / 第一種の過誤 / 第二種の過誤 / 検出力 / 検出力分析 / 効果量 / 信頼区間 / 標準誤差 / 母集団と標本 / 多重比較 / 多重検定 / FDR / 事前登録 / 再現性危機 / ベイズ因子 / t検定 / 相関係数