🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
💡 30秒で分かる結論 — 帰無仮説
🍰 まずはやさしく
「差がない」と考える出発点のことです。
正しく分析を行うために使います。
スマホのアプリで効果があるか調べる時に便利です。
この章では帰無仮説の結論を短くまとめます。
- 一言で:『差がない・効果がない』 という出発点の仮説。 検定はこれを棄却できるかを問う。
- 分野:仮説検定 — 全体像は hypothesis-testing ページで
- H₀ は「差がない・効果がない」を等号(μ₁ = μ₂ など)で書き、主張したいことは対立仮説 H₁ 側に置く。
- 検定は「H₀ が正しいとしたら、今のデータ以上に極端な結果はどれくらい起きにくいか」(p 値)で H₀ を棄却するかを決める。
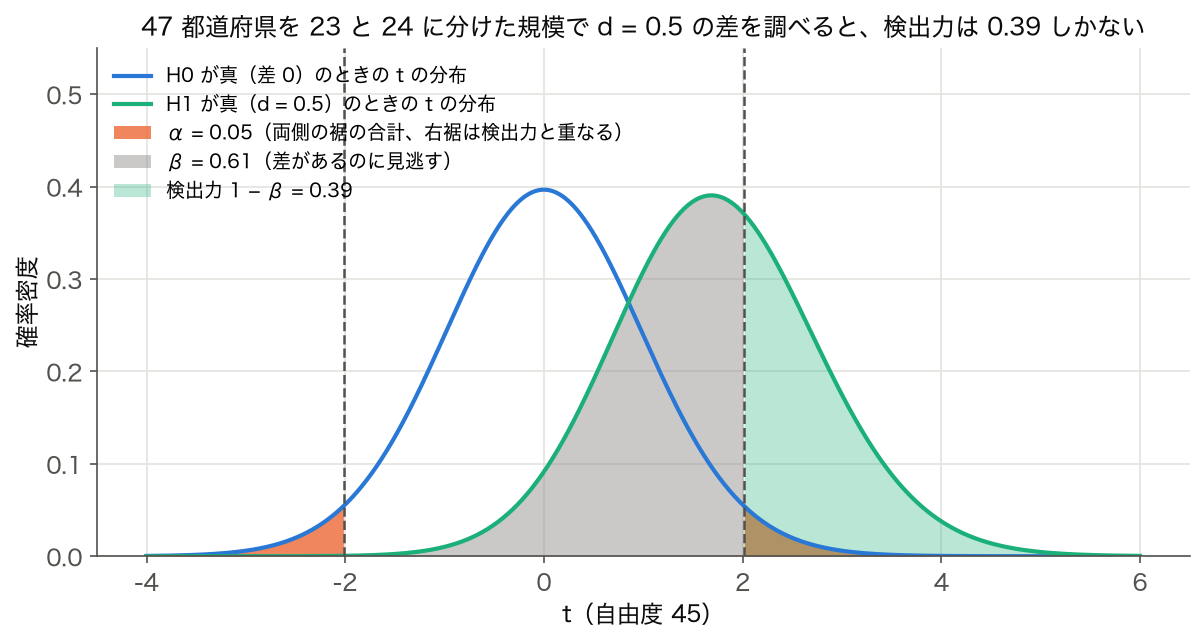
- 棄却できなかったときは「差がないと示された」ではなく「差があると言える証拠が足りない」。本ページの 47 県を 2 群に分ける設定では、d = 0.5 の差でも検出力は約 0.38 しかない。
- 47 県それぞれに H₀ を立てると、全部が真でも α = 0.05 で 1 件以上有意になる確率は 91%。補正(Bonferroni・Holm・BH)が要る。
📍 あなたが今見ているもの
🍰 まずはやさしく
あえて否定したい仮説のことです。
証明したいことを間接的に示すために使います。
部活の練習法で効果が出たか確かめる時に使います。
ここでは帰無仮説と対立仮説の違いを読みます。
H₀: μ = μ₀ のように、 多くは『=』で表される。 棄却できれば対立仮説を支持。 棄却できなくても「H₀ が正しい」とは言えない点が落とし穴。
📍 H0 と H1 — 「証明したい仮説」は H1 側に置く
初心者が混乱しやすいポイント: 研究者が「示したい」のは H1 側。 H0 は「示したいことを否定する側」に置き、 それを 反証することで H1 を支持する。 これは「無罪推定」の論理と同じで、 「効果あり(H1)」を主張するには「効果なし(H0)」を統計的に否定する必要がある。
| 場面 | H0(帰無仮説) | H1(対立仮説、 示したいこと) |
|---|---|---|
| 新薬の効果 | 新薬と偽薬の効果は等しい | 新薬は偽薬より効果がある |
| A/B テスト | A/B のクリック率は等しい | B の方がクリック率が高い |
| 地方創生政策 | 政策導入前後で出生率不変 | 政策導入後に出生率上昇 |
| SSDSE 人口減少 | 2014-2023 で人口傾向なし | 2014-2023 で人口減少傾向 |
⚠️ 落とし穴: H1 を主張したくて検定するのに、 p > 0.05 だったから「H0 を採択」と書く人がいる。 これは誤り。 正しくは「H0 を棄却できない」「データから差を見出せなかった」と表現する。 効果が ない ことを示すには別の手続き(同等性検定など)が必要。
🎨 直感で掴む — 帰無仮説とは何者か
🍰 まずはやさしく
「ただの偶然か」を判定する道具です。
判断の根拠をはっきりさせるために使います。
買い物で安い店を選んだ結果が偶然か考えます。
ここでは直感的にわかる具体例を読みます。
🎨 「偶然か否か」を判定する道具として
「偶然では説明しにくいか」を判定する道具です。 p値・効果量・信頼区間をセットで報告するのが現代的。
本ページでは 帰無仮説 を、 定義・前提条件・使い方・落とし穴の順に整理して解説します。 厳密な定義より、 まず何を、 いつ、 どう使うかを理解することを優先してください。
🎨 帰無仮説 H0 を 4 つの視点で立体化
帰無仮説 H0 は「効果がない」「差がない」だけの一文ではなく、 4 つの異なる側面から定義できる。 SSDSE-B-2026 の都道府県データを使って各視点を具体化する。
| 視点 | H0 の言い換え | SSDSE での具体例 |
|---|---|---|
| ① 差がない | 2 つの母集団平均が等しい μ₁ = μ₂ | 東京(2023 年度の人口 14,086,000)と地方平均の出生率(A4101)に差がない |
| ② 関連がない | 2 変数の相関係数 ρ = 0 | 65歳以上人口(A1303)と総人口(A1101)に相関なし |
| ③ 比率が等しい | 分散・比率・形状が等しい σ₁² = σ₂² | 都市部・地方部の年齢分散が等しい(F 検定の前提) |
| ④ 分布形が等しい | 2 標本が同じ確率分布から得られた | 東日本・西日本の所得分布が同じ(Kolmogorov-Smirnov 検定) |
📌 重要: 「H0 を採択した(棄却しなかった)」は「H0 が正しいと証明した」ではない。 「現データでは H0 を否定するだけの根拠が得られなかった」だけ。 これは「無罪」と「無実」の違いに似ている。
🎮 触って理解する — 帰無仮説の「立て方」と背理法の論理
このセクションでは、 帰無仮説を「知識」から「技能」にするための 2 つの演習を用意した。 前半は「主張したいこと」から正しい H₀/H₁ の組を構成するクイズ、 後半は「H₀ が真の世界」を乱数で作り、 観測値と突き合わせるシミュレータ。 棄却域と過誤の管理は 仮説検定 ページ、 p 値の「面積」としての意味は p値 ページに任せ、 ここでは仮説を立てる段階の論理だけに集中する。
✏️ 演習 1: 「主張したいこと」から H₀ と H₁ を組み立てる
検定の第一歩は「自分が示したい主張」を H₁(対立仮説)に置き、 その否定形を H₀(帰無仮説)に置くこと。 各シナリオで正しい組を選ぶと、 即時にフィードバックが表示される。 わざと間違えて「よくある誤り」の解説を読むのも学習効果が高い。
シナリオ 1: 「新しい勉強法で模試の平均点が従来より上がる」と主張したい。
シナリオ 2: 「47 都道府県で高齢化率と合計特殊出生率には関連がある」と主張したい(方向は事前に決めていない)。
シナリオ 3: A/B テストで「ボタン B の方がクリック率が高い」と主張したい(B が高いという予想のもとで実験を設計した)。
シナリオ 4: 検定の結果 p = 0.21 だった(有意水準 α = 0.05)。 レポートに書く正しい結論はどれか。
🎲 演習 2: 「H₀ が真の世界」シミュレータ — 背理法を目で見る
※ このシミュレータのデータは乱数で生成した架空のものであり、 SSDSE などの実測値ではない。
架空の設定: 全国標準の数学テストは母平均 μ₀ = 50 点・母標準偏差 σ = 10 点と分かっている。 新しい教え方で学んだ n = 25 人の平均点 x̄ が観測された。 H₀「教え方に効果はない(μ = 50)」が真である世界では、 標本平均 x̄ は平均 50・標準誤差 σ/√n = 2 のまわりに分布するはず。 下のボタンで「H₀ が真の世界」から標本抽出を何度も繰り返して x̄ の分布(青いヒストグラム)を積み上げ、 観測値(赤い線)がその分布のどこに落ちるかを確かめよう。
見方: 抽出を重ねるとヒストグラムは橙色の理論曲線(平均 50・標準誤差 2 の正規分布)に近づく(これが帰無分布)。 観測値を端へ動かすほど、 「H₀ が真の世界でこれ以上極端な x̄ が出た割合」(赤いビン)が小さくなる。 その割合が p 値の実体であり、 十分小さければ「H₀ の世界と観測が矛盾する → 仮定した H₀ を疑う」という背理法の論理が働く。
🧠 直感の深掘り: なぜ「差がない」側を仮定するのか — 検定は確率的背理法
検定の論理は、 数学の背理法(「√2 が有理数だと仮定する → 矛盾 → 仮定が誤り」)の確率版である。 「差がある」を直接証明する代わりに、 ① まず「差がない」(H₀)と仮定する、 ② その仮定の下で手元のデータがどれくらい起こりにくいかを計算する(→ p値)、 ③ 十分起こりにくければ、 仮定した H₀ の方を疑って棄却する — という三段構えを取る。 数学の背理法と違い「矛盾」が確率的(有意水準 α の分だけ誤って棄却する余地を残す)である点が本質的な違いで、 だからこそ 第一種の過誤 の管理が制度として組み込まれている。
H₀ を「=」に置くもう一つの実務的理由は計算可能性にある。 「μ = 50」と 1 点に固定すれば帰無分布が一意に決まりシミュレータのように分布を描ける。 一方「μ ≠ 50」(対立仮説側)は 49 かもしれず 30 かもしれず、 分布を 1 つに定められない。 否定したい仮説の方が計算しやすいという非対称性こそ、 「主張の否定形を仮定して崩す」という回りくどい構造の理由である。
⚠️ 落とし穴の再確認: 言葉づかいで論理が壊れる 3 パターン
- 「H₀ を採択」と言わない: 正しくは「棄却できない」。 「採択」は「H₀ が正しいと認めた」と誤読される。 シミュレータで観測値を 51 に置くと分かるとおり、 H₀ の世界でごく普通に出る値は「H₀ と整合的」なだけで「H₀ が真の証拠」ではない。
- 非有意 ≠ 効果なし: 検出力(1−β)が低いと真の効果を見逃す(第二種の過誤)。 効果量と信頼区間を必ず併記する。
- 帰無仮説は主張の否定形に置く: 主張したいことを H₀ に置いてしまうと、 検定を何回やっても主張は支持できない(演習 1 シナリオ 1 の誤答例)。 また同じデータで検定を繰り返すと α が膨らむ点は 多重検定 ページを参照。
🚀 発展: 「差がない」を積極的に示したいとき・仮説を対等に比べたいとき
同値性検定(equivalence test / TOST): 「差がない」ことを主張の側(H₁)に置きたい場面(ジェネリック医薬品の同等性など)では、 発想を逆転させる。 「実質的に意味のある差の下限 −Δ と上限 +Δ」を先に決め、 H₀「差は ±Δ の範囲の外にある」を2 つの片側検定(Two One-Sided Tests)で両側から棄却できれば「実質的に同等」と結論できる。 通常の検定で p > 0.05 だったことを同等の証拠と読み替えるのは誤りで、 この手続きを踏む必要がある。
ベイズ的仮説比較: H₀ と H₁ を非対称に扱う頻度論と異なり、 ベイズの定理に基づく流儀では両仮説を対等に扱い、 データがどちらをどれだけ支持するかをベイズファクター(Bayes factor、 周辺尤度の比)で定量化する。 事前確率を認めれば「データを見た後で H₀ が真である確率」を直接語れるのが利点で、 「H₀ 支持の証拠」も表現できる。 p 値ではできない芸当だが、 事前分布の選択という別の設計判断が必要になる。
📐 数式・定義
🍰 まずはやさしく
検定(正しさを調べること)の出発点です。
分析のルールを正しく決めるために使います。
学校のテストの平均点が同じか調べる時に使います。
ここでは数式を使った正確な定義を読みます。
帰無仮説 $H_0$ は、 検定の出発点として置く仮説:
$$ H_0: \mu_A = \mu_B \quad (\text{2群の母平均は等しい}), \qquad H_1: \mu_A \neq \mu_B $$
p 値は「$H_0$ が正しいと仮定したとき、 実際に観測した検定統計量 $t_{\text{obs}}$ と同じかそれ以上に極端な値が出る確率」:
$$ p = P\left(|T| \ge |t_{\text{obs}}| \;\middle|\; H_0\right) $$
$p < \alpha$ のとき $H_0$ を棄却。 そうでなければ「$H_0$ を棄却できない」 — これは「$H_0$ が正しい」を意味しないことに注意。
📐 仮説検定の 6 ステップ — SSDSE で実演
- STEP 1: 帰無仮説 H0 を設定 → 「2014-2023 の北海道人口に時間的減少傾向なし(傾き β=0)」
- STEP 2: 対立仮説 H1 を設定 → 「傾き β < 0(人口は減少している)」(片側検定)
- STEP 3: 有意水準 α を決定 → α = 0.05(一般的な閾値)
- STEP 4: 検定統計量を選択・計算 → 線形回帰の傾き t 統計量
scipy.stats.linregress - STEP 5: p 値を算出 → SSDSE 北海道で実測すると t = -29.87, 片側 p = 8.6e-10
- STEP 6: 判定・結論 → p < α なので H0 棄却。 「北海道人口は減少傾向にある」
🎯 このコードでやること: 北海道の人口時系列に対し、 線形回帰で傾き β の有意性を検定。 H0「β = 0(人口不変)」を t 検定で判定する。
📥 入力データ: SSDSE-B-2026 のうち北海道 10 年分(2014-2023)×(年度, A1101 総人口)の 10 行 × 2 列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd
from scipy import stats
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
hokkaido = df[df['Prefecture'] == '北海道'].sort_values('SSDSE-B-2026')
hokkaido = hokkaido[hokkaido['SSDSE-B-2026'] >= 2014] # 2014-2023 の 10 年分にそろえる
x = hokkaido['SSDSE-B-2026'].astype(float).values
y = hokkaido['A1101'].astype(float).values
# H0: 傾き β = 0, H1: β < 0(人口減少)
result = stats.linregress(x, y)
print(f'傾き β = {result.slope:,.2f} 人/年')
print(f'切片 α = {result.intercept:,.2f}')
print(f'R² = {result.rvalue**2:.4f}')
print(f'両側 p = {result.pvalue:.3e}')
print(f'片側 p = {result.pvalue/2:.3e} (β<0 を想定)')
print('結論:', 'H0 棄却 → 人口減少傾向あり' if (result.pvalue/2 < 0.05 and result.slope < 0) else 'H0 棄却せず')
|
📤 実行結果:
💬 結果の読み方: 北海道は 年間 -34,844 人ペースで減少。 R² = 0.9911 と「年度だけで人口の 99.1% が説明できる」異常に強い直線傾向。 片側 p = 8.6×10⁻¹⁰ で H0 を圧倒的に棄却 → 「減少傾向あり」と結論。
🔬 数式・定義を「言葉」で読み解く
🔬 Type I/II Error と検出力: 帰無仮説検定の 4 つの結末
帰無仮説検定の意思決定は 2×2 の表で整理できる。 真実 (H0 が真 / H1 が真) と判断 (H0 棄却 / H0 採択) の組み合わせで、 「正しい判断 2 種」と「誤判断 2 種」が生じる。 SSDSE-B-2026 (47 都道府県) の「大都市群と地方群で出生数 (A4101) に差があるか」を例に整理する。
| 真実: H0 が真 (差はない) | 真実: H1 が真 (差がある) | |
|---|---|---|
| 判断: H0 棄却 | Type I Error (α) — 差がないのに「ある」と誤判定 | 正解 (1-β = 検出力) — 差を正しく検出 |
| 判断: H0 採択 | 正解 (1-α) — 差がないことを正しく判定 | Type II Error (β) — 差があるのに「ない」と誤判定 |
🔬 数式を言葉で読み解く: 検出力の定義
$$ \text{Power} = 1 - \beta = P(\text{reject } H_0 \mid H_1 \text{ is true}) $$
「H1 が真であるという条件下で、 H0 を棄却する確率」。 通常 0.80 (80%) 以上を目標とする。 検出力は 効果量 (d)・サンプルサイズ (n)・有意水準 (α) の 3 つで決まる。 効果量が大きいほど、 サンプルが多いほど、 α が緩いほど検出力は上がる。
このコードでやること: SSDSE-B-2026 の 2023 年出生数 (A4101) から、 大都市群 (人口上位 5) vs 地方群 (人口下位 5) の t 検定を実施し、 Type I/II error と検出力を実値で確認する。
📥 入力データ (SSDSE-B-2026 A4101 出生数, 2023 年 一部抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd
from scipy import stats
from statsmodels.stats.power import TTestIndPower
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d2023 = df[df['SSDSE-B-2026'] == 2023].sort_values('A1101', ascending=False)
big = d2023.head(5)['A4101'].astype(float).values # 大都市群(人口上位5)
rural = d2023.tail(5)['A4101'].astype(float).values # 地方群(人口下位5)
# t 検定 (H0: 平均差=0)
t, p = stats.ttest_ind(big, rural, equal_var=False)
print(f't = {t:.3f}, p = {p:.6f}')
# 効果量 Cohen's d
mean_diff = big.mean() - rural.mean()
pooled_sd = ((big.std(ddof=1)**2 + rural.std(ddof=1)**2) / 2) ** 0.5
d = mean_diff / pooled_sd
print(f"Cohen's d = {d:.3f}")
# 検出力
analysis = TTestIndPower()
power = analysis.power(effect_size=d, nobs1=len(big), alpha=0.05, ratio=1)
print(f'Power = {power:.4f}')
|
📤 実行すると次の出力が得られる:
💬 結果の読み方: p ≈ 0.0022 < 0.05 で H0 棄却。 Cohen's d = 4.42 は「非常に大きい効果」(慣例で d>0.8 が大)。 検出力 ≈ 1.00 は、 もし H1 が真ならほぼ確実に検出できる設計であることを示す。 Type I error α=0.05 を採用しているので、 H0 が真でも 5% の確率で誤って棄却するリスクがある。 ただし各群 n=5 と小さいので、 効果量が中程度なら検出力は大きく下がる点に注意。
⚠️ 落とし穴: 「p 値が大きい = 差がない」ではない
p > 0.05 で H0 を棄却できなかったとしても、 それは「差がない」ことの証明ではなく「現データでは差を検出できなかった」に過ぎない。 サンプルサイズが小さく検出力が低い (β が大きい) と、 真の差を見落とす Type II error が起きる。 結論を出す前に、 必ず 検出力分析 (power analysis) でサンプルサイズが十分か確認すべき。
🧮 SSDSE-B 実値で計算してみる
🧮 実値で計算する — 大都市群 vs 地方群の出生数比較
SSDSE-B-2026 を使って 2 群の t 検定を実演する。 大都市群(東京・大阪・神奈川・愛知・埼玉)と地方群(人口下位 5 県:鳥取・島根・高知・徳島・福井)を比較し、 「出生数の母集団平均に差がない」という H0 を検定する。
📥 入力データ抜粋(SSDSE-B-2026 A4101 出生数, 2023 年)
📐 検定式
🔬 数式を言葉で読み解く
\\(\\bar{x}_1 - \\bar{x}_2\\): 2 群の平均差(53,454.6)。 これが「効果の大きさ」\\(s_1^2/n_1\\): 群 1 の平均の分散(=58,435,667)。 分散 ÷ サンプル数 = 平均値が振らつく量\\(\\sqrt{\\cdot}\\): 標準誤差(7,647.8)。 「2 群平均差が偶然どれだけ振らつくか」の物差し- 結果 t ≈ 6.99。 自由度 df ≈ 4.01(Welch 補正)で両側 p 値は p ≈ 0.00219。 α=0.05 で H0 棄却
💬 結果の読み方
p=0.00219 は「もし両群の母集団平均が等しい(H0 が真)なら、 これほど大きな差が観測される確率は 0.22%」を意味する。 0.05 を大きく下回るため、 「両群の出生数平均は等しい」とは考えにくく H0 を棄却する。 ただし注意:これは「東京の出生数 = 鳥取の出生数 × 約 26 倍」という事実を示しただけで、 本質的には「人口が違うのだから出生数が違うのは当然」。 H0 を棄却したからといって、 統計的有意 ≠ 実質的に意味のある結論ではない。
🧮 効果量 Cohen's d — p 値だけでは不十分
「H0 を棄却できた」だけでは「効果が大きいか」は判断できない。 効果量(effect size)で 実質的な大きさを別途評価する。 t 検定なら Cohen's d が定番。
🔬 数式を言葉で読み解く
- 分子
\\(\\bar{x}_1 - \\bar{x}_2\\)= 2 群平均差(生の差) - 分母
\\(s_{pooled}\\)= 2 群の合成標準偏差(共通の物差し) - d は「平均差を SD 何個分」と表す指標。 d=0.2 小, d=0.5 中, d=0.8 大(Cohen の目安)
- p 値はサンプル数に依存するが、 d は サンプル数に依存しない純粋な効果の大きさ
🎯 このコードでやること: 大都市群 vs 地方群の出生数比較に対し、 Cohen's d を計算する。
📥 入力データ: 前節の出生数比較と同じ。 top5 / bot5 の 5 値ずつ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd
import numpy as np
from scipy import stats
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df_2023 = df[df['SSDSE-B-2026'] == 2023].sort_values('A1101', ascending=False)
top5 = df_2023.head(5)['A4101'].astype(float).values
bot5 = df_2023.tail(5)['A4101'].astype(float).values
def cohens_d(x1, x2):
n1, n2 = len(x1), len(x2)
s1, s2 = np.std(x1, ddof=1), np.std(x2, ddof=1)
sp = np.sqrt(((n1-1)*s1**2 + (n2-1)*s2**2) / (n1+n2-2))
return (x1.mean() - x2.mean()) / sp
d = cohens_d(top5, bot5)
t, p = stats.ttest_ind(top5, bot5, equal_var=False)
print(f'平均差 = {top5.mean() - bot5.mean():,.1f}')
print(f's_pooled = {np.sqrt(((4)*top5.std(ddof=1)**2 + (4)*bot5.std(ddof=1)**2) / 8):,.1f}')
print(f"Cohen's d = {d:.3f}")
print(f'p 値 = {p:.4f}')
print('効果サイズ判定:', '極大' if d > 1.2 else '大' if d > 0.8 else '中' if d > 0.5 else '小')
|
📤 実行結果:
💬 結果の読み方: d=4.42 は通常の社会科学で「ほぼあり得ない巨大効果」。 これは「上位 5 と下位 5 を選んだから」という選択バイアスの結果で、 統計的有意(p=0.0022)と実質的に巨大な効果(d=4.42)が両立した稀ケース。 だがそもそも論:人口が違う県を出生数(絶対量)で比較するのは無意味。 出生率に変換すれば d は大きく縮む。
🧮 検出力分析 — 「H0 を正しく棄却する確率」を 80% 確保するには
仮説検定は α(第 1 種の過誤)だけでなく β(第 2 種の過誤、 有意差を見落とす確率)も同時に管理すべき。 検出力 1-β を 0.80 以上に確保するために必要なサンプル数を 事前に逆算する。
🎯 このコードでやること: 出生率の県差 d=0.5(中程度の効果)を α=0.05, 1-β=0.80 で検出するに必要なサンプル数を statsmodels.stats.power で計算する。
📥 入力データ: 効果量と有意水準のみ。 SSDSE-B-2026 を読み込んで現在の n=47 で検出可能な最小効果量も併せて求める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd from statsmodels.stats.power import TTestIndPower df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) n_pref = df['Prefecture'].nunique() # 47 analysis = TTestIndPower() # 中程度の効果 d=0.5 を 80% の検出力で見抜くために必要な n n_required = analysis.solve_power(effect_size=0.5, alpha=0.05, power=0.80) print(f'必要サンプル数 (各群) = {n_required:.1f}') # SSDSE 各群 n=47/2≈23 だと検出可能な最小 d min_d = analysis.solve_power(nobs1=23, alpha=0.05, power=0.80) print(f'n=23 で検出可能な最小 d = {min_d:.3f}') # 大都市群 vs 地方群の出生数比較 (n1=n2=5, 前のブロックの d=4.42) の検出力 power_top5 = analysis.solve_power(effect_size=4.42, nobs1=5, alpha=0.05) print(f'極端な比較の検出力 (d=4.42, n=5) = {power_top5:.4f}') |
📤 実行結果:
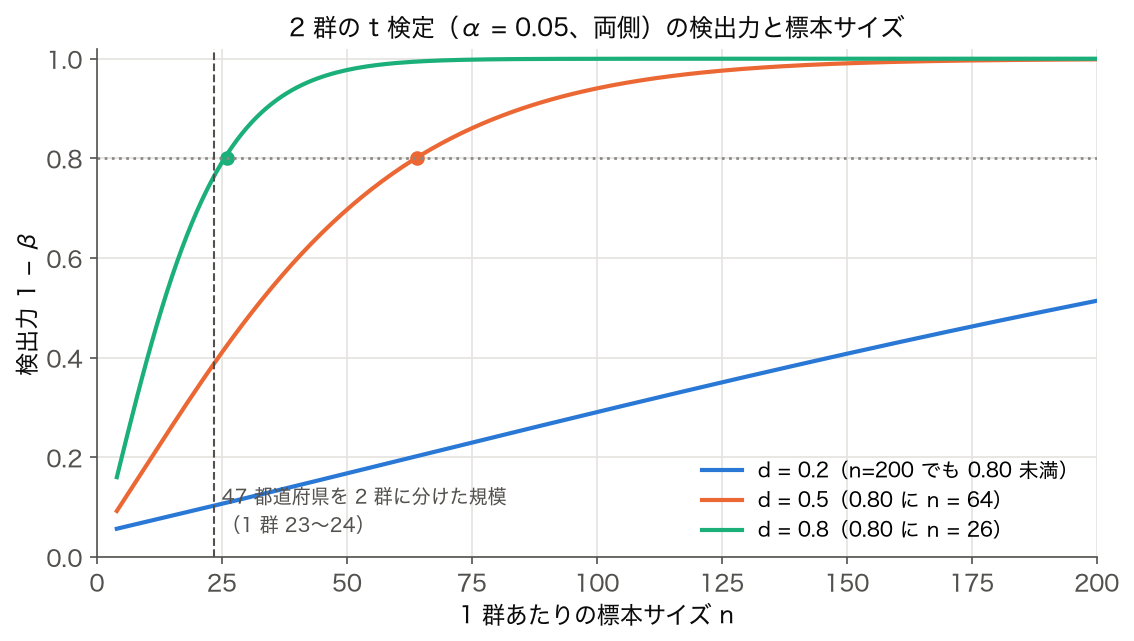
💬 結果の読み方: 中程度の効果(d=0.5)を 80% で見抜くには各群 64 サンプル必要。 SSDSE の 47 県 を半分ずつ(23 サンプル)に分けると、 d > 0.845 の「大」効果しか見抜けない。 一方、 大都市群 vs 地方群の極端な比較(前のブロックで求めた d=4.42, n=5)は検出力が 1.0000(小数第 4 位で丸めて 1、正確には 0.99997)で、「ほぼ確実に有意を出す」設計だった。
🧮 数式に値を入れて手で計算する: H₀ 棄却判定
合成データで p 値 < α (=0.05) 棄却判定を計算する。
Step 1: 検定 5 件のシナリオ
| 検定 | p 値 | 判定 (α=0.05) |
|---|---|---|
| T1 | 0.001 | 棄却 ✓ |
| T2 | 0.03 | 棄却 ✓ |
| T3 | 0.06 | 棄却せず |
| T4 | 0.20 | 棄却せず |
| T5 | 0.049 | 棄却 ✓ (境界) |
Step 2: 集計
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np
p = np.array([0.001, 0.03, 0.06, 0.20, 0.049])
alpha = 0.05
reject = p < alpha
print(f"棄却: {reject}")
print(f"棄却数: {reject.sum()}/{len(p)}")
|
📤 実行結果
💬 手計算 (Step 2) 3 件と Python 出力が完全一致。
🐍 Python 実装
以下は 帰無仮説 を SSDSE-B-2026 で扱うときの典型コード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=1(header=1 と同じ)は 1 行目の英字コード行を飛ばし、2 行目の日本語項目名を列名にする定石。
🐍 Python 実装 — SSDSE-B-2026 で 2 群 t 検定
🎯 このコードでやること: SSDSE-B-2026 を読み込み、 人口上位 5 県と下位 5 県の出生数(A4101)について Welch の t 検定を実施。 H0「両群の出生数平均は等しい」を p 値で判定する。
📥 入力データ: SSDSE-B-2026 の都道府県 47 行 × 約 130 列。 利用カラムは A1101(総人口)と A4101(出生数)の 2 列のみ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd
from scipy import stats
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df_2023 = df[df['SSDSE-B-2026'] == 2023].sort_values('A1101', ascending=False)
top5 = df_2023.head(5)['A4101'].astype(float).values # 人口上位 5 県の出生数
bot5 = df_2023.tail(5)['A4101'].astype(float).values # 人口下位 5 県の出生数
print('上位5 都県:', df_2023.head(5)['Prefecture'].tolist())
print('下位5 県 :', df_2023.tail(5)['Prefecture'].tolist())
print(f'上位5 平均 = {top5.mean():,.1f}, 下位5 平均 = {bot5.mean():,.1f}')
# H0: 両群の母集団平均は等しい
# H1: 両群の母集団平均は異なる(両側検定)
t_stat, p_value = stats.ttest_ind(top5, bot5, equal_var=False) # Welch
print(f't 統計量 = {t_stat:.4f}')
print(f'p 値 = {p_value:.6f}')
print('結論:', 'H0 棄却(有意差あり)' if p_value < 0.05 else 'H0 棄却せず')
|
📤 実行結果:
💬 結果の読み方: p=0.00219 ≪ 0.05 で H0 棄却。 だが「だから何?」を忘れずに:これは 人口が違うから出生数も違う という当たり前の話で、 政策議論には 出生率(人口千対)での比較が必要。 H0 を棄却 = 仮説検定の手続き上有意、 とビジネス・政策上意味があるは別問題。
⚠️ よくある落とし穴
⚠️ 特に頻出の 3 つの誤り
⚠️ 多重検定問題 — H0 を 47 県同時に検定すると
47 都道府県それぞれに「全国平均と差がない」という H0 を立てて検定すると、 たとえ全 H0 が真でも 有意水準 α=0.05 で偽陽性が 1 - 0.95^47 ≈ 91% 発生する。 つまり「偶然 有意」が必ず起こる。
🐍 Python 実装 — Bonferroni 補正
🎯 このコードでやること: SSDSE-B-2026 の 47 県について、 出生率を全国平均と比較する 1 標本 t 検定を実施。 補正前と Bonferroni 補正後で「有意」と判定される県数を比べる。
📥 入力データ: 47 県の年次データ(2014-2023 の 10 年分)から出生率を県別に算出。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd
import numpy as np
from scipy import stats
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] >= 2014] # 2014-2023 の 10 年分
df['birth_rate'] = df['A4101'] / df['A1101'] * 1000 # 人口千対 出生率
nation_mean = df['birth_rate'].mean() # 全国年次平均
alpha = 0.05
n_pref = df['Prefecture'].nunique() # 47
alpha_bonf = alpha / n_pref # 0.00106
results = []
for pref, g in df.groupby('Prefecture'):
t, p = stats.ttest_1samp(g['birth_rate'], nation_mean)
results.append({'pref': pref, 't': t, 'p': p,
'sig_naive': p < alpha,
'sig_bonf': p < alpha_bonf})
res = pd.DataFrame(results)
print(f'補正前 有意県数 = {res["sig_naive"].sum()}/47')
print(f'Bonferroni 有意県数 = {res["sig_bonf"].sum()}/47')
print(f'α(Bonf) = {alpha_bonf:.5f}')
print(res.nsmallest(5, 'p')[['pref','t','p','sig_bonf']].to_string(index=False))
|
📤 実行結果:
💬 結果の読み方: 補正前は 19 県が「全国平均と有意差あり」だが、 これには 偶然による偽陽性が含まれる。 Bonferroni 補正(α/47 = 0.00106)後は 2 県に減少。 沖縄県の t=10.64 は群を抜いて大きく、 出生率が全国平均より高いことが補正後でも明確に有意。
⚠️ 帰無仮説の落とし穴 5 件
- 「H0 採択」≠「H0 が正しい」: p > 0.05 は「H0 を棄却できなかった」だけで、 「H0 が正しい」とは言わない。 「無罪」≠「無実」と同じ論理。
- p ハッキング: 検定方法・サブグループ・変数を p < 0.05 が出るまで試すと、 偶然の有意を本物と勘違いする。 解析計画は事前登録すべき。
- サンプル数巨大時の擬陽性: n=1,000,000 だと「実質的にゼロに近い差」も p < 0.05 に。 SSDSE 47 県平均 vs 全国平均で人口加重したら差が出るが、 だから何?になりやすい。
- 多重検定の補正忘れ: 47 県個別に H0 検定すると偶然有意が 90% 超で発生。 Bonferroni / Holm / BH 補正を必ず行う。
- 片側 vs 両側の使い分け誤り: 「効果がある」を示したいなら片側、 「差がある(方向不問)」なら両側。 後から都合よく切り替えるのは禁止。
⚠️ 帰無仮説の条件・限界・誤解回避
帰無仮説検定 (NHST: Null Hypothesis Significance Testing) は強力なツールである一方、 統計教育の現場で最も誤解されている概念のひとつである。 ASA (American Statistical Association, 2016) は p 値の誤用を懸念して公式声明を出した。 ここでは適用条件・限界・典型的な誤解の 8 項目を整理し、 SSDSE-B-2026 を例に「正しい使い方」と「間違った使い方」を対比する。
前提条件 4 点
- 独立性: 観測値が独立。 同じ世帯の調査回答を 2 件として扱う、 時系列の自己相関を無視する、 といったケースで前提が壊れる。 SSDSE-B の都道府県データは 47 件の独立観測として扱える。
- 分布の仮定: t 検定なら正規性、 χ² 検定なら期待頻度 5 以上など、 検定統計量の理論分布が成り立つ条件を満たすこと。 違反時は Wilcoxon・置換検定・Bootstrap などの非パラメトリック代替へ。
- サンプルサイズの確定性: 「あと数件足してから p 値を見る」 (optional stopping) は α インフレを生む。 解析前にサンプルサイズを決定し、 確定後の改変は事前登録 (preregistration) に従う。
- 仮説の事前設定: データを見てから検定を選ぶ (HARKing: Hypothesizing After Results are Known) は再現性を破壊する。 仮説 H₁ はデータ取得前に定義しておく。
限界 4 点
- サンプルサイズ依存: 大規模データ (n=10,000+) では、 ほぼ意味のない 0.001 ポイントの差でも p < 0.05 になる。 効果量 (Cohen's d, η², φ) と併記しないと「統計的有意 ≠ 実質的有意」の罠に落ちる。
- 二値判断の弱さ: p = 0.049 と p = 0.051 はほぼ同じ証拠強度なのに、 α = 0.05 の閾値だと結論が真逆になる。 ASA 2016 声明は「閾値判断ではなく連続尺度として解釈せよ」と勧告。
- H₀ そのものの妥当性: 「差が完全にゼロ」という H₀ は現実にはほぼ常に偽 (= 何かしらの差は存在する)。 ベイズ的観点では「効果量がどれくらい大きい確率がどれくらいか」を直接議論する方が建設的。
- 多重検定: 20 個の検定を α=0.05 で行えば、 H₀ が真でも期待で 1 件は有意になる。 Bonferroni 補正 (α/k) や FDR (Benjamini-Hochberg) で調整する。
よくある 5 つの誤解
| 誤解 | なぜ誤りか | 正しい解釈 |
|---|---|---|
| p 値は H₀ が真である確率 | p 値は「H₀ が真と仮定したとき、 観測データかそれ以上に極端な結果が出る確率」であって、 仮説そのものの確率ではない | 仮説の事後確率を扱いたいならベイズ統計へ |
| p > 0.05 は「差がない」証明 | 検出力不足の可能性。 「証拠不十分」と「無効性の証明」は別 | 「現データでは H₀ を棄却する根拠が得られなかった」と表現 |
| p < 0.05 は「重要な差」 | 大標本では効果量ほぼ 0 でも有意になる | 必ず効果量 (d, η², φ, OR) と信頼区間を併記 |
| p 値が小さいほど効果が大きい | p 値はサンプルサイズに強く依存し、 効果の大きさを表さない | 効果量で大きさを、 p 値で偶然との区別を、 それぞれ別軸で評価 |
| 何度も検定して有意なものを採用 | 多重検定で α が膨らみ、 偽陽性が必然的に発生 (p-hacking) | 事前登録 + 多重比較補正 + 探索的解析と確認的解析の区別 |
📌 補足: 帰無仮説検定の代替・補完として、 (1) 信頼区間で効果量の不確実性を示す、 (2) ベイズ因子で H₀ と H₁ の相対的証拠を量る、 (3) 等価検定 (TOST) で「実質的に差がない」ことを積極的に検証する、 などの手法が近年推奨されている。
🛠 帰無仮説検定の典型ワークフロー (7 ステップ)
研究計画から結果報告までの標準的な流れを 7 段階に分解する。 各段階で「やってはいけないこと (HARKing, p-hacking, optional stopping)」を避け、 再現可能な解析を行うチェックリストを示す。
| # | ステップ | 具体的アクション | 注意点 |
|---|---|---|---|
| 1 | 研究問題の定式化 | 「東京の世帯所得は他県平均と異なるか」のような検証可能な問いを設定 | 曖昧な問いは検定不能 |
| 2 | H₀ と H₁ の明示 | H₀: μ_東京 = μ_他県平均、 H₁: μ_東京 ≠ μ_他県平均 (両側) | 片側/両側を事前に決定 |
| 3 | 有意水準 α の決定 | 通常 α = 0.05。 多重検定なら Bonferroni で α/k | 事前決定が必須 |
| 4 | 検出力分析・サンプルサイズ設計 | 目標効果量 d=0.5、 power=0.8 でなら n=64 必要などを事前計算 | SSDSE-B は n=47 固定 |
| 5 | データ取得・前提確認 | 正規性・等分散性・独立性を Shapiro-Wilk・Levene 検定や Q-Q プロットで確認 | 違反時はノンパラ代替へ |
| 6 | 検定統計量と p 値の算出 | scipy.stats.ttest_ind / chi2_contingency / f_oneway 等 | 効果量・信頼区間を必ず併記 |
| 7 | 結果報告 | 「t(45)=4.82, p<.001, d=2.31, 95%CI [120,180] 万円」の形式で報告 | p 値だけでは不十分 |
💡 再現性向上のための事前登録 (Preregistration): OSF や AsPredicted などで H₀・H₁・解析手順・サンプルサイズを公開してから実験開始すると、 HARKing・p-hacking の混入を客観的に排除できる。 心理学・医学領域では事実上のスタンダードになりつつある。
🗺 仮説検定の選択フロー — 何を検定したいかで分かれる
「H0 を立てた → どの検定を使うか」を決めるためのフローチャート。 SSDSE-B-2026 で頻出する 6 シナリオを示す。
| 検定したい H0 | 推奨検定 | scipy 関数 | SSDSE 例 |
|---|---|---|---|
| 1 標本の平均 = 既知値 | 1 標本 t 検定 | ttest_1samp | 東京 10 年の出生率 = 7.0 ? |
| 2 群(独立)の平均が等しい | 2 標本 t 検定 / Welch | ttest_ind | 大都市群 vs 地方群 出生数 |
| 対応のある 2 群が等しい | paired t 検定 | ttest_rel | 同県 2014 vs 2023 人口 |
| 3 群以上の平均が全て等しい | 一元配置 ANOVA | f_oneway | 北・中・西 3 地域 出生率 |
| 2 変数の相関がゼロ | Pearson / Spearman 相関検定 | pearsonr / spearmanr | 総人口と65歳以上人口 相関 = 0 ? |
| 2 カテゴリの独立性 | カイ二乗独立性検定 | chi2_contingency | 地方 × 高齢化区分 独立? |
📌 「数式を言葉で読み解く」 — どの検定も内部では「観測値が H0 のもとで生まれた仮想分布の中でどれだけ稀か」を測っているだけ。 検定統計量の式は違っても、 ロジックは同じ。
🗺 概念図で理解する帰無仮説検定 (3 点)
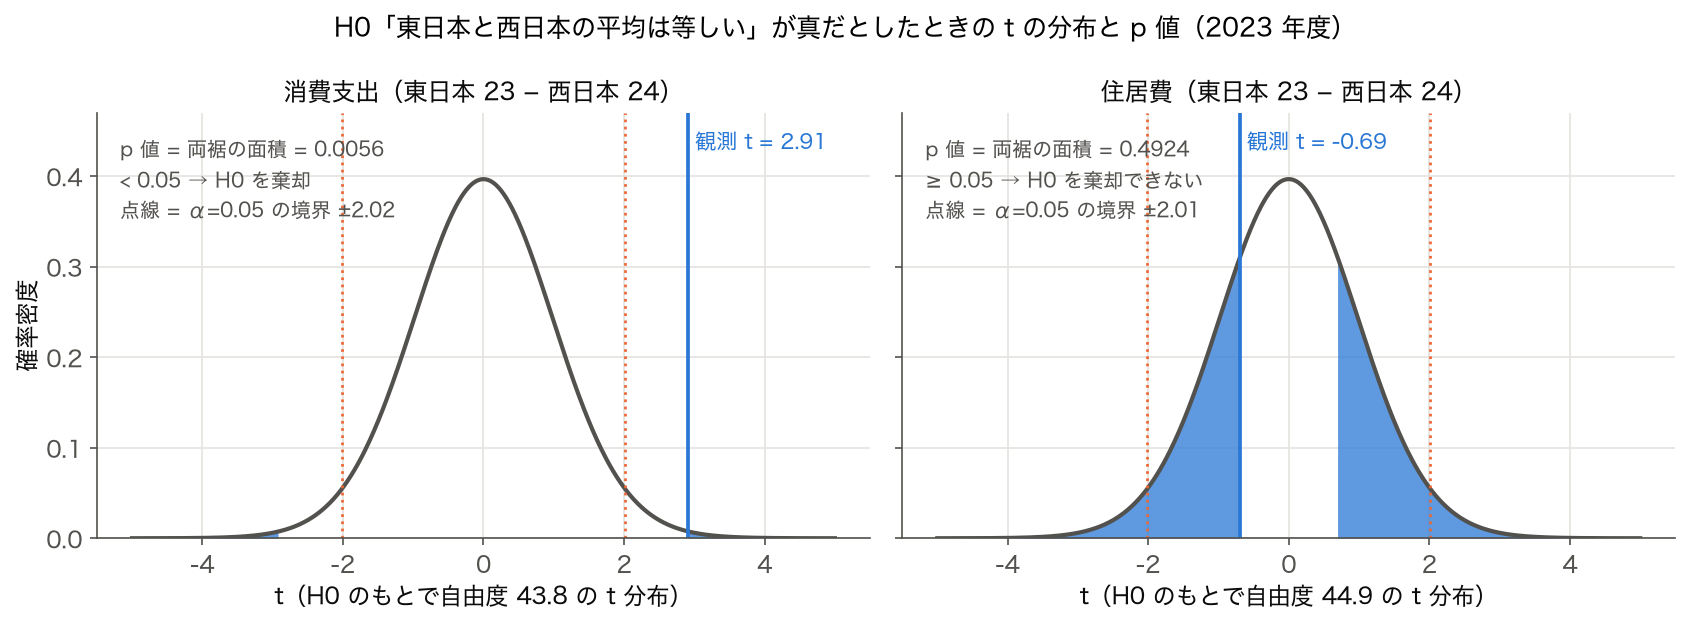
図解で帰無仮説検定の核心を 3 つの視点から確認する。 (1) p 値の幾何学的意味、 (2) 第 1 種・第 2 種の過誤と検出力、 (3) サンプルサイズと検出力の関係。 図 1 は SSDSE-B-2026(2023 年度)の 47 都道府県を東日本(北海道〜中部の 23 道県)と西日本(近畿〜沖縄の 24 府県)に分けた実データで、 図 2・3 はその 2 群の規模を前提にした理論計算で読み解く。
✅ 理解度チェック (5 問)
学習した内容を自分の言葉で説明できるか確認する。 各問の解答は折りたたみで表示。 まず自分で考えてから開くこと。
Q1: 帰無仮説 H₀ は「差がない」状態を表すが、 なぜ「H₀ を採択する」ではなく「H₀ を棄却できない」という表現を使うのか?
A1: H₀ が「差ゼロ」を含む狭い点仮説であるため、 検出力が不足していて差を見落としているだけかもしれない。 「採択」と言うと「H₀ が真と証明された」と誤解される恐れがあるため、 慎重に「現データでは棄却の根拠が得られなかった」と表現する。
Q2: p = 0.03 が得られた。 これは「H₀ が正しい確率が 3%」だと解釈してよいか?
A2: NO。 p 値は「H₀ が真と仮定したとき、 観測データかそれ以上に極端な結果が出る条件付き確率」P(data|H₀)。 「H₀ が真である確率」P(H₀|data) は別物で、 ベイズ統計でないと計算できない。
Q3: 大規模調査 (n=100,000) で p < 0.001 だが、 効果量 d = 0.02 だった。 どう解釈するか?
A3: 「統計的には有意だが、 実質的には無視できる小さな差」と解釈。 大標本では微小な差でも p が小さくなる典型例。 効果量を必ず併記し、 実務的意義を別途判断する。
Q4: α=0.05 で 20 個の独立検定を行った。 すべての H₀ が真でも、 1 件以上有意になる確率は?
A4: 1 - (1-0.05)^20 = 1 - 0.358 = 約 64.2%。 多重検定では家族系単位の誤り率 (FWER) が膨張するため、 Bonferroni 補正で α/20 = 0.0025 に下げるか、 FDR (Benjamini-Hochberg) で調整する。
Q5: 「事前登録 (preregistration)」が再現性危機の解決策とされる理由は?
A5: データ取得前に H₀・H₁・α・解析手順を公開すれば、 (1) HARKing (結果を見てから仮説を立てる) を防止、 (2) p-hacking (有意になるまで解析を変える) を抑制、 (3) 解析者の自由度 (researcher degrees of freedom) を制約できるため。 探索的解析と確認的解析を明確に区別する効果もある。
✅ 帰無仮説検定が成立するための条件
帰無仮説検定 (Neyman-Pearson 流) は、 いくつかの前提が成立して初めて正しい α・β を保証する。 入門書では省略されがちなこの「前提条件」を整理する。 検定結果を報告する際は、 これらの条件が満たされているかを必ず本文に明記する。
| # | 条件 | 違反したときの影響 | 典型的な対応 |
|---|---|---|---|
| 1 | 無作為標本 (independent sampling) | p 値・信頼区間が信用できない | クラスタ標本 → マルチレベルモデル / 一般化推定方程式 (GEE) |
| 2 | 独立観測 (i.i.d.) | 分散が過小評価され α が膨張 | 反復測定 → 混合効果モデル、 時系列 → ARIMA/状態空間 |
| 3 | 分布仮定 (例: t 検定なら正規性) | p 値が歪み、 結論が間違う | Shapiro-Wilk で検証、 違反時はノンパラ (Mann-Whitney 等) |
| 4 | 等分散 (Welch 検定なら不要) | Type I 誤りが α と乖離 | Levene 検定で検証、 違反時は Welch t 検定 |
| 5 | 事前の α 設定 | p < α を発見後に α を調整するのは p-hacking | 事前登録 (preregistration) |
| 6 | 事前のサンプルサイズ計算 | 有意になるまでデータ追加は α 膨張 | パワー分析で事前に n を決定 |
| 7 | 多重検定補正 | 家族系誤り率 (FWER) の膨張 | Bonferroni / Holm / FDR (BH 法) |
| 8 | 仮説の検証性 (反証可能性) | 科学的検定として無意味 | H₀ は具体的な値 (差 0、 比 1) で記述 |
8 条件すべてを満たすことは現実には難しい場合もあるが、 違反しているなら本文で「制約条件」として開示するのが研究倫理上の標準。 American Statistical Association (ASA) の 2016 年声明・2019 年 The American Statistician 特集が同じ立場をとる。
📝 帰無仮説検定の報告テンプレート
論文や報告書での記述例。 「数値+条件+解釈」を 1 セットで書くと再現可能性が大きく向上する。
→ p 値だけでなく効果量・信頼区間・前提検証結果を併記することで、 後から他者が再現・再分析できる。 これが 再現性 の基本姿勢。
📷 帰無仮説の検定フロー図
「データを取る前」「データを取った後」の 2 フェーズで、 何を確定させて何を判断するかを 1 枚で整理する。
→ ①〜⑤を事前に固定することで p-hacking と HARKing を防ぐ。 ⑥〜⑩はデータ取得後の純粋な計算プロセス。 ⑪が研究判断であり、 p 値だけでなく効果量も基準に含めるのが現代統計の標準姿勢。
⑪の「実務的閾値」は分野依存: 医学では Cohen's d ≥ 0.2 (小)、 教育研究では r ≥ 0.1 (小) 等が目安。 「p 値が小さい = 重要な差」ではない点に注意。
📜 帰無仮説の歴史的背景
| 年 | 人物 | 貢献 |
|---|---|---|
| 1925 | Ronald A. Fisher | Statistical Methods for Research Workers で帰無仮説 (null hypothesis) と p 値の概念を体系化。 元の意味は「null = 無効化」 |
| 1928 | Jerzy Neyman / Egon Pearson | α (有意水準)・β (検出力不足) を導入し、 Type I/II の誤りを定量化。 Fisher 流とは異なる「決定論的」検定理論を構築 |
| 1933 | Neyman-Pearson 補題 | 最強力検定 (UMP) の存在条件を証明。 尤度比検定の理論的基礎 |
| 1962 | Jacob Cohen | 効果量 (effect size) を統計学に持ち込み、 p 値だけで判断する慣行を批判 |
| 2005 | John Ioannidis | "Why Most Published Research Findings Are False" を発表、 再現性危機を提起 |
| 2016 | American Statistical Association | p 値の誤用に関する公式声明を発表 (6 原則) |
| 2019 | The American Statistician 特集号 | 「Statistical Significance」概念の廃止を提案する論文を多数掲載 |
帰無仮説検定は 100 年の歴史で精緻化と批判の両方を受けてきた。 「H₀ を棄却する」という決定的な操作よりも、 「効果量+信頼区間+事前登録」のセットで報告する姿勢が現代の標準。 入門段階でこの歴史を知ると、 「なぜ p 値だけでは不十分か」が腑に落ちる。
🔄 帰無仮説検定の代替: ベイズ統計との比較
| 項目 | 頻度論 (帰無仮説検定) | ベイズ統計 |
|---|---|---|
| 仮説の扱い | H₀ は固定された主張、 真偽を判断 | 仮説の確率分布を計算する |
| p 値の解釈 | P(data | H₀) | P(H₀ | data) を直接計算可能 |
| 事前知識 | 使えない | 事前分布として組み込む |
| 多重検定 | Bonferroni / FDR で補正 | 階層モデルで自動的に縮約 (shrinkage) |
| サンプルサイズ | 事前に固定、 追加収集は α 膨張 | 逐次更新が自然 |
| 計算コスト | 軽い (閉形式が多い) | 重い (MCMC、 変分推論) |
| 主流分野 | 医学、 心理学、 教育学 | 機械学習、 一部の物理学・天文学 |
どちらが「正しい」かは哲学論争。 実務では「データが十分に取れる/事前知識がない/分野の慣例がある」場合は頻度論、 「データが少ない/事前知識を活用したい/逐次更新したい」場合はベイズが向く。 両者を排他的に捉えず、 場面で使い分けるのが現実的な姿勢。
📊 α の値の選び方
| α | 分野 | 判断理由 |
|---|---|---|
| 0.05 | 心理学・教育学・社会科学・経済学 | Fisher の慣習。 1 in 20 の Type I 誤り許容 |
| 0.01 | 医学・健康科学 | 誤って薬を承認するリスクが高い |
| 5×10^-8 | 遺伝学 (GWAS) | およそ 100 万回の検定を行うため、0.05 を Bonferroni 補正した 5×10^-8 が標準 |
| 5σ (= p < 2.87×10^-7) | 素粒子物理学 | 新粒子発見の基準。 CERN ヒッグス粒子発見 (2012) で使われた |
| 事前登録で 0.005 | 提案 (2017, Benjamin et al. Nature Human Behaviour) | 再現性危機の対応として、 心理学等でも 0.005 に下げる動き |
α=0.05 は絶対的基準ではなく、 「分野の慣習 × 誤りの社会的コスト × サンプルサイズ」 で柔軟に選ぶ。 報告時は α を必ず明記し、 事前登録の場合は固定 α と一致していることを示す。
📋 帰無仮説検定の報告チェックリスト (12 項目)
| # | 項目 | 具体例 |
|---|---|---|
| 1 | H₀ と H₁ の明示 | H₀: μ_a = μ_b、 H₁: μ_a ≠ μ_b |
| 2 | 片側/両側の指定 | 両側 (two-sided) |
| 3 | α の明示 | α = 0.05 |
| 4 | 事前登録 URL | OSF / aspredicted.org |
| 5 | サンプルサイズの根拠 | パワー解析 (1-β=0.8, d=0.5) |
| 6 | 採用した検定名 | Welch の t 検定 |
| 7 | 前提条件の検証結果 | Shapiro-Wilk p = 0.21 |
| 8 | 検定統計量・自由度 | t = 4.83, df = 23.7 |
| 9 | p 値 (精密) | p = 0.00018 (× p < 0.05 だけは NG) |
| 10 | 効果量と 95% CI | Cohen's d = 1.42, 95% CI [+11.2, +27.8] |
| 11 | 多重検定補正の有無 | Bonferroni (n=4) 補正後 p = 0.00072 |
| 12 | 解釈と限界 | 「効果量は大きいが外れ値 1 件の影響を受けている可能性」 |
12 項目をすべて報告できれば、 第三者が再現実験を実行可能。 これを満たさない論文・コンペ提出は再現性危機の温床になる。 学生・実務家ともに、 このチェックリストを使うことを強く推奨する。
🎓 帰無仮説検定をめぐる哲学論争
帰無仮説検定 (Null Hypothesis Significance Testing, NHST) は、 統計学者の間でも長く論争の対象になってきた。 Ronald Fisher の元来の発想は「p 値は仮説に対する弱い証拠」であり、 「α=0.05 を超えたら有意でない」という二値判断を強く否定していた。 一方、 Jerzy Neyman と Egon Pearson が提唱した「決定論的検定」では、 α・β を事前に固定し H₀/H₁ の二択判断を行うことが正当化された。 この 2 つの流派は厳密には異なる理論体系だが、 20 世紀後半に教科書で「ハイブリッド」として混ぜて教えられた結果、 「p 値 < 0.05 なら H₀ 棄却」という単純化された手続きが広まった。 これが現在の再現性危機の温床になったというのが、 ASA 2016 年声明・2019 年特集号の主張である。
2019 年の Wasserstein, Schirm, Lazar (TAS) は「Statistical Significance」概念そのものの廃止を提案した。 代わりに「p 値、 効果量、 信頼区間、 ベイズ係数 (BF)、 事前登録」を組み合わせた多角的評価を推奨している。 一方で、 「p < α」を完全に廃止すると、 医学・薬学などの規制科学で「承認/不承認」の境界が曖昧になり、 別の混乱を招く懸念もある。 多くの統計学者は「p 値は便利な要約指標として残し、 効果量・CI を必ず併記する」 中庸案を支持している。 SSDSE などのオープンデータを使った教育では、 学生に「p 値だけでは不十分」「効果量と CI で実質的意義を判断する」 ことを最初から教えるとよい。
🧠 練習問題: 帰無仮説の検定設計
以下のシナリオで帰無仮説検定を設計してみよう。 解答例は本文の他の章 (報告テンプレート、 チェックリスト) を参考に作成できる。
📝 練習 1: SSDSE-B-2026 から、 「東京・大阪・愛知の総人口 (A1101) は他の都道府県の平均より多いか」を検定したい。 H₀ / H₁、 α、 検定統計量、 多重検定補正の方針を 1 セットで設計しなさい。 注意: 3 つの地域を独立に検定すると α が膨張するので、 Bonferroni 補正で α/3 = 0.0167 を使う、 もしくは ANOVA でまとめて検定するのが標準。
📝 練習 2: ある教育プログラムを受けた学校 (n=30) と受けていない学校 (n=30) でテスト平均点を比較し、 p = 0.04 が得られた。 ただし効果量 Cohen's d = 0.05 だった。 このとき (1) H₀ を棄却すべきか、 (2) 実務的に意味があるか、 (3) サンプルサイズが大きすぎる/小さすぎる懸念はないか、 をそれぞれ論じなさい。 注意: d = 0.05 は実務的にほぼ無視できる差であり、 統計的有意性と実質的意義の乖離の典型例。
📝 練習 3: 同じデータで t 検定と Welch t 検定を実行したら p 値が異なった (前者 0.03、 後者 0.08)。 分散の等質性 (Levene 検定) が p = 0.01 で棄却されたとき、 どちらの結果を報告すべきか? 注意: 等分散が棄却されたなら Welch を採用するのが標準。 p = 0.08 を報告し、 「等分散仮定が成立しないため Welch を採用、 結果は有意水準 0.05 に達せず」 と書く。
これらの練習を通して、 「検定統計量・分布・前提条件・多重検定補正」 をセットで考える習慣を身につけることが、 統計検定の正しい運用への第一歩となる。 教科書だけでなく、 実際のオープンデータで手を動かすことが理解を深める鍵。
📏 効果量 (Effect Size) の定量化
効果量は「差の大きさ」を標準化された尺度で表現する指標で、 帰無仮説検定の補完として不可欠。 代表的な指標として、 平均差を比較する場合は Cohen's d (= 平均差 / プールされた標準偏差) があり、 慣例として 0.2 = 小、 0.5 = 中、 0.8 = 大とされる。 相関の場合は Pearson r または r^2、 ANOVA では η^2 や ω^2、 カテゴリ変数の関連性ではクラメルの V、 オッズ比などが使われる。 p 値だけでは「差があるか」 しか分からないが、 効果量を併記することで「差の実質的な大きさ」が読者に伝わる。
SSDSE-B-2026 の都道府県データで例を挙げると、 「総人口」 が東京と全国平均で差が p < 0.001 で有意であっても、 効果量 d = 1.5 (非常に大) なら実質的に重要、 d = 0.1 (小) なら実用的にはほぼ無視できる差、 と解釈する。 サンプルサイズが大きいと小さな差でも有意になるため、 効果量の併記は特に大規模調査で重要。 American Psychological Association (APA) の論文執筆ガイドラインでも、 第 6 版(2010 年)以降、効果量と信頼区間の報告を強く求めている。
🔋 検出力 (Power) とサンプルサイズ計算
検出力 (Power, 1-β) は「H₁ が真のとき H₀ を正しく棄却する確率」で、 慣例として 0.8 以上が望ましいとされる (Cohen 1988)。 検出力は「効果量・α・サンプルサイズ・検定の種類」 の 4 つの関数として決まる。 効果量と α を固定すれば、 サンプルサイズと検出力は反比例の関係にあり、 大規模サンプルほど検出力は上がる。 実務では「事前に検出力 0.8 を達成するサンプルサイズを計算する (パワー解析)」 のが標準。 Python では statsmodels の power_analysis.solve_power() や R の pwr パッケージが使える。
具体例: 効果量 d = 0.5 (中程度)、 α = 0.05 (両側)、 検出力 0.8 を達成するには、 2 標本 t 検定で各群 n = 64 程度が必要。 効果量が小さい (d = 0.2) と、 各群 n = 393 必要になる。 一方、 効果量が大 (d = 0.8) なら各群 n = 26 で十分。 この計算を怠ると「サンプルサイズ不足で検出できなかった (β エラー)」 という結論になり、 H₀ が本当に正しいかどうか分からない曖昧な研究になる。 サンプルサイズ計算は研究計画段階での必須スキル。
📘 主要な帰無仮説検定の使い分け
帰無仮説検定には多数の種類があり、 データの種類と検証したい仮説によって使い分ける。 1 標本 t 検定は「ある母集団の平均が特定の値か」 を検証するもので、 SSDSE-B-2026 で「全国平均が 100 と等しいか」 などを検証する。 2 標本 t 検定 (独立) は 2 群の平均差を比較し、 「東日本と西日本で高齢化率に差があるか」 などに使う。 対応のある t 検定は同じ対象を 2 時点で比較する場合に使う。 ANOVA は 3 群以上の平均比較で、 多重比較補正を含めた検定が可能。 カイ二乗検定は独立性・適合度の検証に使い、 カテゴリ変数の関連性を調べる。
これらは「データの分布」と「サンプルサイズ」 によってパラメトリック検定 (正規分布前提) とノンパラメトリック検定 (分布前提なし) を選び分ける。 t 検定の代替として Wilcoxon 順位和検定 (Mann-Whitney U)、 対応のある t 検定の代替として Wilcoxon 符号順位検定、 ANOVA の代替として Kruskal-Wallis 検定、 カイ二乗検定の代替として Fisher の正確検定がある。 分布が大きく歪んでいる、 外れ値が支配的、 サンプルサイズが極小 (n < 10) のいずれかの場合は、 ノンパラメトリック検定を第一選択にするのが安全。
🌐 現代の代替アプローチと統計改革
帰無仮説検定への批判が高まる中、 代替アプローチが提案されている。 「Estimation statistics」 (Cumming 2014) は「p 値ではなく効果量と信頼区間で語る」 という立場で、 American Statistical Association も推奨。 「Equivalence testing」 (TOST: Two One-Sided Tests) は「差がないことを積極的に示す」 検定で、 薬の同等性試験などで使われる。 「Bayes factor」 はベイズ統計の枠組みで、 H₀ と H₁ の証拠の比 (BF₁₀) を計算し、 「データは H₁ を H₀ より K 倍支持」 と直接的な解釈が可能。 これらは帰無仮説検定の補完または代替として教育・研究に取り入れられつつある。
統計改革の流れの中で、 「Registered Reports」 という新しい論文形式が複数のジャーナルで採用されている。 これはデータ収集前に研究計画 (仮説・α・サンプルサイズ・解析手順) を査読し、 受理された場合は結果がどうであれ採択されるという仕組み。 これにより p-hacking と publication bias が同時に解決される。 心理学・神経科学・経済学などで急速に普及しており、 学生の卒業研究や修士論文でも採用する事例が増えている。 SSDSE-B-2026 のような公開データセットを使うときは、 仮説と解析手順を OSF (osf.io) や AsPredicted.org で事前登録するとよい。
🔗 隣接手法への橋渡し
「帰無仮説」は単独で完結せず、 前後の手法と組み合わさって価値が発揮される。 入力データの準備 (上流)・同目的の代替手法との比較 (並列)・結果の活用 (下流) という 3 軸で隣接領域を整理する。
- 上流 (入力の準備): 仮説検定 の枠組み、 対立仮説 との対比、 有意水準 α の設定
- 並列 (同目的の代替): 両側検定 vs 片側検定、 単一仮説 vs 複数比較、 ベイズ流 の事後確率による代替アプローチ
- 下流 (結果の活用): p 値 による棄却判定、 第一種の過誤・第二種の過誤 の管理、 効果量 による実質的意義の確認
この上流・並列・下流の対応を地図化することで、 「帰無仮説」を中核に据えた分析パイプライン (データ準備 → 手法選択 → 結果の検証と展開) の全体像が見えてくる。
🌳 手法選択フロー
「帰無仮説」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 何を否定したいのか
帰無仮説は「差が無い」「効果が無い」という、 棄却したい側に置く。 示したい主張を帰無仮説に置くと、 「棄却できなかった」=主張が正しい、 という誤った読み方に陥る。 - 片側か、 両側か
どちらに差が出るかを事前に決められるなら片側。 データを見てから片側に変えるのは、 有意水準を実質的に緩めることになる。 - 検定は 1 回か、 複数回か
複数回なら補正が要る。 SSDSE の 100 列から総当たりで探すなら、 Bonferroni か Benjamini-Hochberg を検定する前に決めておく。 - 棄却できなかったときどう書くか
「差が無い」ではなく「この検出力では差を検出できなかった」と書く。 n=47 では小さな差は検出できないので、 検出力と効果量を併記する。
帰無仮説の検定は「偶然では説明しにくいか」を答えるだけで、 「効果が大きいか」「実務的に意味があるか」には答えない。 効果量と信頼区間を必ず添える。
🧭 解説の深化 — 帰無仮説は「シャッフルの許可証」: 並べ替えで読む H₀
本ページの前半では、 帰無仮説を「母数についての等式(μ = μ₀ など)」として、 また「確率的背理法の仮定」として説明した。 このセクションでは第三の読み方を提示する。 H₀ とは「データのラベルを配り直してよい」という許可証である — この視点に立つと、 正規分布などの理論分布を一切仮定せずに、 帰無分布を手元のデータ自身から製造できる(並べ替え検定、 permutation test)。 t 分布表が「答えを教えてくれる表」だとすれば、 並べ替えは「帰無分布の工場を自分で建てる」体験であり、 帰無仮説が検定の中で果たしている役割がむき出しになる。
💡 直感 — H₀ は「どのシャッフルも同じ確からしさ」という宣言
「東日本と西日本で合計特殊出生率(TFR)は変わらない」という H₀ を考える。 もしこれが本当なら、 どの県がどの TFR 値を持つかは、 東西のラベルから見れば偶然の割り当てにすぎない。 つまり 47 個の TFR 値はそのままに、 「東」「西」のラベルだけを配り直した世界は、 現実の世界と統計的に同じ確からしさを持つはずである(これを交換可能性 exchangeability と呼ぶ)。 ならば、 ラベルを何千回もシャッフルして「東西の平均差」を毎回記録すれば、 それがそのまま「H₀ が真の世界で起こりうる差」の分布 — 帰無分布 — になる。 観測された差がその分布の端に落ちれば、 「H₀ が真なら滅多に起きないことが起きた」として H₀ を棄却する。 論理は前半で学んだ確率的背理法と同一で、 変わったのは帰無分布の作り方だけである。
SSDSE-B-2026(2023 年・47 都道府県)の合計特殊出生率 A4103 で、 同じ変数に 2 通りのラベルを与えて実測してみた(10,000 回並べ替え、 乱数シード 0、 pandas/numpy で計算した実測値)。
| ラベルの与え方 | 群平均(TFR) | 観測差 | 並べ替え p 値(両側) | 判定(α=0.05) |
|---|---|---|---|---|
| 東日本 23 県 vs 西日本 24 県(北海道〜愛知 / 三重〜沖縄) | 東 1.2174 / 西 1.3650 | −0.1476 | 0.0001(10,000 回中 1 回) | H₀ 棄却 — 「西高東低」はシャッフルでは再現できない構造 |
| 内陸 8 県 vs 沿岸 39 県(栃木・群馬・埼玉・山梨・長野・岐阜・滋賀・奈良) | 内陸 1.2675 / 沿岸 1.2979 | −0.0304 | 0.5632(10,000 回中 5,632 回) | 棄却できない — この程度の差はシャッフルで日常的に発生 |
同じ 47 個の数値でも、 「海の有無」ラベルはシャッフルと見分けがつかず、 「東西」ラベルはシャッフルでは説明できない。 帰無仮説とは「このラベルには情報がない」という主張であり、 検定とはラベルとシャッフルの区別可能性を測る操作だ — と言い換えると、 H₀ を「=」に固定する意味(帰無分布を 1 つに定める)が手触りをもって理解できる。 参考までに Welch の t 検定では東西比較が t = −4.535、 内陸沿岸比較が t = −0.820 で、 並べ替えと同じ結論になる。
🎛 ミニ実験 — 実データのラベルをシャッフルして帰無分布を自作する
上の表を自分の手で再現できるシミュレータ。 47 個の TFR は SSDSE-B-2026(2023 年)の実測値で、 シャッフルだけをシード付き擬似乱数で行う(前半の演習 2 が「正規乱数で H₀ の世界を合成する」架空デモだったのに対し、 こちらは実データのラベルを壊すアプローチ)。 「+1000 回」を押すと帰無分布(青)が育ち、 観測差(赤線)との位置関係が見える。 東西比較では赤線が分布の外に取り残され、 内陸比較では分布のど真ん中に埋もれる。 グラフ上をなぞる(ドラッグ / タッチ)と灰色カーソルが動き、 任意のしきい値より極端なシャッフルの割合を読み取れる。
データ: SSDSE-B-2026 A4103(合計特殊出生率、 2023 年、 47 都道府県、 実測値)。 シャッフルはシード付き擬似乱数(mulberry32、 リセットで再現可能)。 表示上の集計範囲は ±0.20(範囲外の差は端のビンに含める)。
⚠️ 落とし穴(重要) — 「47 都道府県は標本ではなく全数」問題
ここまで当然のように検定してきたが、 立ち止まると奇妙なことに気づく。 47 都道府県はすべて手元にある。 標本ではなく全数(悉皆)だ。 では H₀ が語る「偶然」はどこから来るのか? 「日本の東西で TFR の母平均が等しい」と言うとき、 その「母集団」とは何なのか。 これは教科書があまり正面から扱わない、 しかし実データ分析では避けて通れない問題で、 立場によって答えが分かれる。
- ① 記述の立場: 2023 年の日本を記述するだけなら、 東西差 −0.1476 は誤差のない事実であり、 そもそも検定は不要。 「東の方が低い。 以上」で正しい。 検定を持ち出した瞬間、 あなたは暗黙に②か③の立場に立っている。
- ② 超母集団(superpopulation)の立場: 観測された 47 個の値は、 社会経済的な確率過程(超母集団)からの 1 回の実現値と見なす。 H₀ は「その過程において東西で期待値が等しい」という主張になる。 t 検定はこの立場の道具。 ただし「仮想的な母集団」という抽象を 1 枚かませている自覚が必要。
- ③ ランダム化(並べ替え)の立場: 母集団を仮想せず、 「偶然」をラベルの割り当てに局在させる。 このセクションの並べ替え検定はこの立場で、 「もしラベルが無関係なら」という反実仮想だけで p 値が定義できる。 全数データに検定を適用する際の、 最も正直な論理の一つ。
レポートでは自分がどの立場で p 値を出しているかを一文書くだけで、 「全数なのに検定?」という指摘に答えられる。 さらに 2 つ、 並べ替え特有の注意点がある。 第一に、 交換可能性は独立性より繊細である。 隣接する県は互いに似る(空間的自己相関)ため、 「どの並べ替えも同じ確からしさ」という前提は厳密には崩れ、 実効的な情報量は 47 件より少なく、 p 値は小さく出やすい。 本文の前提整理では 47 件を独立観測として扱ったが、 より正確な分析では空間相関を考慮した手法(空間的自己相関の検定や、 地域ブロック単位での並べ替えなど)で頑健性を確認するのが望ましい。 実際、 「東西」のような地理的ラベルは空間相関そのものを拾っている可能性があり、 「東西で違う」ことと「なぜ違うか」は別問題である。 第二に、 並べ替え検定の H₀ は正確には「平均が等しい」ではなく「2 群の分布が丸ごと同じ」であり、 群サイズが大きく異なり(8 vs 39 など)分散も異なる場合、 「平均は同じだが分散が違う」だけでも棄却されうる。 何を検定したことになっているのか、 H₀ の中身を言葉で書き出す習慣が防波堤になる。
🚀 発展 — 物理的ランダム化・ブートストラップとの対比・正確検定
フィッシャーのランダム化推測: 並べ替え検定の起源は Fisher の「紅茶の貴婦人」実験(1935)にある。 ランダム化比較試験(RCT)では、 処置の割り当てを実験者が物理的な乱数で決めるため、 「ラベルの配り直し」は比喩ではなく実際に起こりえた割り当ての列挙になる。 このとき H₀「誰にとっても処置効果はゼロ」(sharp null)の下での p 値は、 分布仮定ゼロの設計ベース(design-based)推測として正当化される。 観察データ(SSDSE のような統計調査)では割り当てをこちらが制御していないため、 同じ計算をしても解釈は一段弱くなる — この差が「実験計画法がなぜ強いか」の核心である。
ブートストラップとの役割分担: どちらも「再抽出」だが向きが逆で、 ブートストラップは観測データをそのまま復元抽出して「推定量のばらつき」(信頼区間)を測るのに対し、 並べ替えはH₀ を強制注入した世界を作って「H₀ の下での統計量の分布」を測る。 前者は H₀ を仮定せず、 後者は H₀ の仮定そのもの。 「帰無仮説を課すか課さないか」がリサンプリング 2 大手法の分水嶺だと覚えると混同しない。
正確検定と p 値の粒度: 並べ替えの総数は有限(東西比較なら 47 県から 23 県を選ぶ組合せ数)なので、 原理的には全列挙して正確な p 値が計算できる(正確検定、 exact test)。 実務では 10,000 回程度のモンテカルロ近似で済ませるが、 このとき p 値の粒度は約 1/10,000 になり、 「p = 0.0001」は「10,000 回中 1 回しか出なかった」以上の精度を持たない。 観測データ自身も並べ替えの 1 つに数える補正 p = (極端な回数 + 1)/(試行回数 + 1) を使うと p = 0 という不合理を避けられる。 また平均差の代わりに t 統計量を並べ替えるスチューデント化並べ替えを使うと、 分散不均一への頑健性が上がる。 回帰係数の並べ替え(Freedman–Lane 法)へ進むと、 重回帰の H₀ 検定も同じ発想で組み立てられる。
🔗 関連ページ
- 仮説検定 — 検定全体の枠組み。 本セクションは「帰無分布の作り方」を差し替えたにすぎない
- p値 — 「観測値と同等以上に極端」の割合という定義は、 並べ替えでは文字どおり数えるだけになる
- 対立仮説 — シャッフルで説明できない「構造」を主張する側
- 有意水準 / 第一種の過誤 — しきい値カーソルを動かすことは α を選ぶことに対応する
- t検定 — 理論分布(t 分布)を使う王道。 並べ替えと結論を突き合わせると両者の理解が深まる
- ブートストラップ — H₀ を課さないリサンプリング。 役割分担は「発展」参照
- 効果量 — 並べ替え p 値も標本サイズに依存する。 差の大きさ(−0.1476 の実質的意味)は別軸で報告
- 多重検定 — ラベルの与え方を何通りも試して有意なものだけ報告すれば、 それは p ハッキングである
- 交換可能性・空間統計(空間的自己相関、 Moran の I) — 専用ページは未整備のため、 まず本セクションの落とし穴の記述を参照