🔖 キーワード索引
「Shapiro-Wilk検定」を取り巻く中核キーワード群です。 検索やインデックス作成で参照する際の手がかりにしてください。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になります。
💡 30秒で分かる結論 — Shapiro-Wilk検定
🍰 まずはやさしく
データの形をチェックする道具です。
正規分布(左右対称な山形)か調べます。
テストの点数の散らばり方を確認します。
この検定の結論を短くまとめます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- Shapiro-Wilk 検定=データが 正規分布 に従うかを検定する手法。 小〜中標本に強い。
- 検定統計量 W ≈ 1 で正規に近い、 W が小さい ほど乖離。
- 帰無仮説 H0:「正規分布である」。 p < 0.05 で正規性を棄却。
- 推奨サンプル数:n ≤ 5000。 大標本では微小な乖離も棄却されすぎる。
- 代替:Kolmogorov-Smirnov、 Anderson-Darling、 Jarque-Bera、 QQ プロット(目視)。
SSDSE-B-2026 の 2023 年度・47 都道府県で試すと、 合計特殊出生率は W = 0.990(p = 0.94)、 高齢化率は W = 0.970(p = 0.25)で棄却されず、 総人口は東京都 1 県に引っ張られて W = 0.690(p ≈ 1×10⁻⁸)と強く棄却される。 総人口は対数を取っても W = 0.928(p = 0.006)でまだ棄却され、 Box-Cox 変換(λ ≈ −0.49)でようやく W = 0.977(p = 0.48)になる。 「率・割合は正規に近く、 人数・件数の総量は右に歪む」というのが、 この表を扱うときのおおまかな目安になる。 ただし 15 歳未満人口の割合(W = 0.877、 p = 0.0001)や女性の割合(W = 0.926、 p = 0.005)のように、 率でも棄却される列はあるので、 目安に頼らず列ごとに確かめる。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
分析の準備で使うチェックリストです。
他の検定を使う前に、形を確認します。
部活の記録を分析する前に使います。
どんな場面で使うのかを説明します。
「t 検定の前に正規性を確認しなさい」と教科書に書いてある — そのときに使う代表的検定。 ただし、 大標本では「ほぼ正規」でも棄却されるので注意。
このページの読み方:まず 30秒結論 と 直感 を読み、 必要に応じて 数式 や 計算例、 落とし穴 に進んでください。
🎨 直感で掴む
🍰 まずはやさしく
グラフの見た目を数値にしたものです。
山形の形にどれだけ近いか判断します。
スマホの利用時間の分布を調べます。
仕組みを直感的に理解しましょう。
ヒストグラムを描いて「だいたい釣鐘型かな?」と目で判断するのを、 数値化 したのが W 統計量。 Shapiro と Wilk が 1965 年に発表した「サンプルサイズ 50 以下で最強の正規性検定」として広まり、 現在 scipy・R 標準実装で誰でも 1 行で呼べます。
- データを昇順に並べた順序統計量 $x_{(1)} \le x_{(2)} \le \dots \le x_{(n)}$ と、 同サイズの正規分布から期待される順序統計量 $m_i$ を比較
- 両者が完全一致 → W = 1 (帰無仮説「データは正規分布」を保持)
- 乖離するほど W は 1 から離れる。 例: SSDSE-B-2026 の合計特殊出生率 47 件で W=0.99, p=0.94 → 正規と判定、 人口は東京の外れ値で W=0.69, p<0.001 → 非正規
- QQ プロットで「点が y=x の直線に乗るか」を目視するのと数学的に等価で、 W は「QQ プロットの相関の二乗」に近い指標
「ヒストグラムでは釣鐘型に見えるが、 W=0.85 で棄却された」のように、 目視判断と数値判断の食い違いを見つけられるのが価値です。
📐 定義・数式
🍰 まずはやさしく
計算で形を判定する数式です。
データの並び順から数値を導きます。
買い物した金額のリストで計算します。
具体的な計算方法について学びます。
分母は標本分散(×$n-1$)、 分子は順序統計量と理論値の内積の二乗。 正規ならこの比が 1 に近い。
🔬 記号・要素の読み解き
- $x_{(i)}$ = 順序統計量
- データを小さい順に並べた $i$ 番目の値。
- $a_i$ = 重み係数
- 正規分布の順序統計量の期待値と共分散行列から計算される定数。 Shapiro & Wilk (1965) が表として提供。
- 分子
- 順序統計量を「正規分布の形」で重み付けした線形結合の二乗。 正規ならデータの平均偏差と一致。
- 分母
- 標本分散の $(n-1)$ 倍。 規格化のため。
- $W$ の範囲
- $0 < W \le 1$。 1 に近いほど正規、 小さいほど乖離。
🔬 数式を言葉で読み解く — 詳細版(4 narration + 実値計算)
「Shapiro-Wilk 検定(Shapiro-Wilk Test)」について、 SSDSE-B-2026(47 都道府県統計)を題材に 4 つの実行可能 Python 例を順に追っていきます。 各ブロックは「🎯 目的 → 🐍 コード → 📤 実行結果 → 💬 読み方」の 4 要素を完備しています。
🎯 このコードでやること:SSDSE-B-2026 から 47 都道府県の総人口を読み込み、 Shapiro-Wilk 検定で正規性を判定する。 統計検定の前提確認の典型例。
1 2 3 4 5 6 7 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()] W, p = stats.shapiro(df['総人口']) print(f'n={len(df)}, W={W:.4f}, p={p:.6e}') print('平均:', int(df['総人口'].mean()), '最大:', int(df['総人口'].max())) |
📤 実行結果:
💬 結果の読み方:W=0.69 は 正規から大きく乖離。 p<10⁻⁸ で帰無仮説(正規分布)を強く棄却。 東京都の 1,408 万人が極端に大きく、 分布が右に重い裾を持つことが原因。
🎯 このコードでやること:右に歪んだデータには 対数変換を適用すると正規に近付くことが多い。 変換後に再度 Shapiro-Wilk 検定する。
1 2 3 4 5 | import numpy as np logpop = np.log(df['総人口']) W2, p2 = stats.shapiro(logpop) print(f'log変換後: W={W2:.4f}, p={p2:.4f}') print(f'歪度: 元={df["総人口"].skew():.3f}, log={logpop.skew():.3f}') |
📤 実行結果:
💬 結果の読み方:W=0.93 に改善 — まだ p=0.006 で有意に非正規だが、 歪度は 2.29→0.82 へ 約 1/3 に圧縮。 多くの実務ではこれで t 検定や線形回帰の前提として許容範囲。 さらに改善したい場合は Box-Cox 変換へ。
🎯 このコードでやること:Q-Q プロットで 視覚的にも正規性を確認。 検定値だけでなくグラフを併用するのが分析の作法。
1 2 3 4 5 6 7 8 9 | import matplotlib.pyplot as plt fig, axes = plt.subplots(1,2, figsize=(10,4)) stats.probplot(df['総人口'], dist='norm', plot=axes[0]) axes[0].set_title(f'元データ W={W:.3f}') stats.probplot(logpop, dist='norm', plot=axes[1]) axes[1].set_title(f'log変換後 W={W2:.3f}') plt.tight_layout() plt.savefig('qq_population.png', dpi=100) print('saved qq_population.png') |
📤 実行結果:
💬 結果の読み方:QQ プロットでは 点が直線に乗るほど正規分布に近い。 元データは右端(東京都・神奈川県・大阪府の上位 3 県)で大きく逸脱、 log 変換後はほぼ直線。 視覚+検定で安心して判断できる。
🎯 このコードでやること:群別に正規性を比較:高齢化率の高い県 vs 低い県、 都市規模で群分けして検定。 ANOVA や t 検定の前提確認の実用例。
1 2 3 4 5 6 7 | df['高齢化率'] = df['65歳以上人口']/df['総人口'] W3, p3 = stats.shapiro(df['高齢化率']) print(f'高齢化率 47県: W={W3:.4f}, p={p3:.4f}') urban = df[df['都道府県'].isin(['東京都','神奈川県','大阪府','愛知県','埼玉県','千葉県'])]['高齢化率'] rural = df[~df['都道府県'].isin(['東京都','神奈川県','大阪府','愛知県','埼玉県','千葉県'])]['高齢化率'] print('都市:', stats.shapiro(urban)) print('地方:', stats.shapiro(rural)) |
📤 実行結果:
💬 結果の読み方:高齢化率は W=0.97, p=0.25 で 正規性合格 — 元の総人口と違って、 比率に変換すると裾が短くなり正規に近付く。 都市群・地方群とも正規 → 安心して t 検定 / ANOVA 適用可能。
🔬 実データ深掘り — SSDSE-B-2026 全 47 都道府県での総合演習
ここからは、 これまでの理論・実装・図解を統合して、 SSDSE-B-2026 を題材に Shapiro-Wilk 検定をフルパイプラインで実行する手順を提示する。 単独の検定で終わらせず、 「読み込み → 記述統計 → 視覚化 → 検定 → 変換 → 再検定 → 結論」までの一連の流れを体得できる構成になっている。
手順 1: データ読み込みと記述統計
このコードでやること: SSDSE-B-2026.csv(公的統計を SSDSE が整備した都道府県別データ)から人口(A1101)を抜き出し、 平均・標準偏差・中央値・歪度・尖度を表示する。 記述統計の段階で「右に裾が長そう」と当たりを付ける。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 県に絞る pop = df['A1101'].dropna() print('人口 : 平均', round(pop.mean()), '中央値', round(pop.median()), '歪度', round(stats.skew(pop), 3), '尖度', round(stats.kurtosis(pop), 3)) |
📤 実行結果:
💬 歪度が 2 を超え、 尖度も大きい時点で「正規分布から遠い」ことが示唆される。 Shapiro-Wilk 検定の結果は容易に予想できる(棄却される)。
手順 2: 視覚化(ヒストグラム + 箱ひげ図)
このコードでやること: 人口のヒストグラムと箱ひげ図を matplotlib で並べて描画する。 図 2 の左パネルと同じ 10 階級のヒストグラムと、 人口 1 変数の箱ひげ図がこのコードで生成できる。
1 2 3 4 5 6 7 8 9 10 11 | import matplotlib.pyplot as plt plt.rcParams['font.family'] = ['Hiragino Sans', 'IPAexGothic', 'DejaVu Sans'] # 日本語のタイトルを豆腐にしない fig, axes = plt.subplots(1, 2, figsize=(11, 4)) axes[0].hist(pop, bins=10, color='#4DB6AC', edgecolor='white') axes[0].set_title('人口ヒストグラム (47 都道府県)') axes[1].boxplot(pop, vert=False) axes[1].set_title('人口箱ひげ図 (47 都道府県)') plt.tight_layout() plt.savefig('pop_diag.png', dpi=120) # 実行したフォルダに保存する print('保存しました: pop_diag.png') |
📤 実行結果:
💬 ヒストグラムでは最初の階級に 28 県が集まって右側に長い裾が伸び、 箱ひげ図では北海道・福岡県(約 510 万人)から東京都(1,408.6 万人)まで 9 都道府県が右側の外れ値(○)になる。 「Shapiro-Wilk 検定の棄却」が視覚的にも裏付けられる。
手順 3: Shapiro-Wilk 検定(原データ)
このコードでやること: scipy.stats.shapiro を用いて、 原データに対する Shapiro-Wilk 検定を実行する。
1 2 | w_pop, p_pop = stats.shapiro(pop) print('人口 : W =', round(w_pop, 4), 'p =', f'{p_pop:.2e}') |
📤 実行結果:
💬 人口は p < 0.001 で帰無仮説(正規分布)を強く棄却。 W が 0.9 を大きく下回り、 「分布形状が正規から遠い」ことを定量的に示している。
手順 4: 対数変換 → 再検定
このコードでやること: 右に裾の長い分布は対数変換で正規分布に近づくことが多い。 numpy.log で変換し、 再度 Shapiro-Wilk 検定を実行する。
1 2 3 4 5 | import numpy as np log_pop = np.log(pop) w_lp, p_lp = stats.shapiro(log_pop) print('log(人口) : W =', round(w_lp, 4), 'p =', round(p_lp, 4)) |
📤 実行結果:
💬 対数変換で W は 0.69 → 0.93 へ大きく改善したが、 p = 0.0064 と 5% 水準では まだ棄却される(東京都の外れ値の影響が残るため)。 さらに Box-Cox 変換 (最適 λ ≈ -0.49) まで行うと p ≈ 0.48 となり正規性は棄却されなくなる。 変換後データに t 検定・線形回帰を適用する場合も、 残る歪みを踏まえて解釈するのが安全。
🔬 W は「Q-Q プロットがどれだけ直線か」を測っている
W の分子は、 並べたデータと正規分布の期待順序統計量を対応させた「Q-Q プロットの点」の重み付き和になっている。 このため W は、 Q-Q プロットの点の相関係数の 2 乗 r² とほぼ同じ値になる(r² をそのまま統計量にしたものが Shapiro-Francia 検定)。 実データで確かめる。
🎯 このコードでやること:SSDSE-B-2026 の 3 列について、 scipy.stats.probplot で Q-Q プロットの相関 r を求め、 r² と Shapiro-Wilk の W を並べる。
1 2 3 4 5 6 7 8 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] cols = {'合計特殊出生率': d['A4103'], '年平均気温': d['B4101'], '総人口': d['A1101']} for name, s in cols.items(): (osm, osr), (slope, icpt, r) = stats.probplot(s, dist='norm') print(f"{name:<8} Q-Q 相関の 2 乗 r^2 = {r**2:.4f} Shapiro-Wilk W = {stats.shapiro(s).statistic:.4f}") |
💬 合計特殊出生率は r² = 0.9909 と W = 0.9895、 年平均気温は 0.8664 と 0.8860、 総人口は 0.6803 と 0.6895 で、 3 列とも r² と W は小数第 2 位まで近い。 Q-Q プロットで点が直線に乗っていれば W は 1 に近く、 東京都 1 点が直線から大きく外れる総人口では W も 0.69 まで下がる。 W の値を見たら、 Q-Q プロットのどこが直線から外れているかを図で確かめると原因が分かる。
🔬 W = 0.97 は低いのか — 正規分布から出る W の範囲
W は 0〜1 の値を取るが、 正規分布から取った 47 個でも W がちょうど 1 になることはない。 どのくらいの W なら「正規分布からでも普通に出る」のかは、 正規乱数で W を何度も作ってみると分かる。 p 値はまさに「正規分布から出る W のうち、 観測値以下になる割合」である。
🎯 このコードでやること:標準正規分布から n = 47 の標本を 5,000 回作って W の分布を求め(seed = 1)、 SSDSE-B-2026 の 4 列の W がその分布のどこに位置するかを数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import numpy as np, pandas as pd from scipy import stats rng = np.random.default_rng(1) Ws = np.array([stats.shapiro(rng.normal(size=47)).statistic for _ in range(5000)]) print(f"正規分布から n=47 を 5,000 回: W の中央値 = {np.median(Ws):.4f}") print(f" 下側 5% 点 = {np.quantile(Ws, 0.05):.4f}, 下側 1% 点 = {np.quantile(Ws, 0.01):.4f}") df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] cols = {'合計特殊出生率': d['A4103'], '高齢化率': d['A1303'] / d['A1101'], '年平均気温': d['B4101'], '総人口': d['A1101']} for name, s in cols.items(): W = stats.shapiro(s).statistic print(f"{name:<8} W = {W:.4f} → 正規分布から出る W のうち {np.mean(Ws <= W):.1%} がこれ以下") |
💬 正規分布から取った 47 個でも W の中央値は 0.978 で、 下側 5% 点は 0.951。 つまり n = 47 では W が 0.95 を下回って初めて 5% 水準で棄却される。 高齢化率の W = 0.9696 は 1 から 0.03 離れていて低く見えるが、 正規分布から出る W の 25.2% がこれ以下なので珍しくない(scipy の p = 0.2548 とほぼ同じ値)。 合計特殊出生率の 94.4% も p = 0.9448 と一致する。 年平均気温 0.886 と総人口 0.690 は 5,000 回の中に 1 度も現れない低さで、 W の「1 からの距離」は n によって意味が変わるので、 W だけでなく p 値か、 この表のような基準と比べて読む。
🧮 実値で計算してみる
SSDSE-B の TFR が正規分布に従うかチェック:
- 47 都道府県の TFR を取得
scipy.stats.shapiroで W と p 値を計算- p > 0.05 なら「正規分布の仮定を棄却できない」(≠ 正規分布と確定)
- 結果例:W=0.989, p=0.94 (2023 年・47 県) → 棄却されず、 t 検定など正規仮定の手法を使ってもよい
常に QQ プロットや histogram と併用して判断することを推奨。
🧮 数式に値を入れて手で計算する: Shapiro-Wilk
合成データで W 統計量と判定を計算する。
Step 1: データと結果
🐍 Python で再現
1 2 3 4 | from scipy import stats x = [2, 4, 7, 5, 3] W, p = stats.shapiro(x) print(f"W: {W:.3f}, p: {p:.3f}") |
📤 実行結果
💬 手で確かめると、 x を小さい順に並べた [2, 3, 4, 5, 7] の平均は 4.2、 偏差平方和は 14.8。 n = 5 の係数 a₁ = 0.6646、 a₂ = 0.2413 を使うと分子は (0.6646 × (7 − 2) + 0.2413 × (5 − 3))² = 3.806² ≈ 14.48 で、 W ≈ 14.48 / 14.8 = 0.979 となり Python の W: 0.979 と一致する。 p = 0.928 は大きいが、 n = 5 では検出力がごく低い(下の検出力シミュレーションでは n = 5 で約 34%)ので、 正規だと言える根拠にはならない。
🧮 東北 5 県で W を手で計算する
式 $W = \left(\sum a_i x_{(i)}\right)^2 / \sum (x_i-\bar{x})^2$ を、 2023 年度の東北 5 県の合計特殊出生率(A4103)に当てはめる。 n = 5 のときの係数は Shapiro & Wilk (1965) の表で $a_1 = 0.6646$、 $a_2 = 0.2413$(中央の $a_3 = 0$)。
| Step | 操作 | 数値 |
|---|---|---|
| 1 | 小さい順に並べる | 宮城 1.07, 秋田 1.10, 岩手 1.16, 山形 1.22, 青森 1.23 |
| 2 | 両端から組にして差を取る | 1.23 − 1.07 = 0.16、 1.22 − 1.10 = 0.12 |
| 3 | 係数を掛けて足す: b | 0.6646 × 0.16 + 0.2413 × 0.12 = 0.10634 + 0.02896 = 0.13529 |
| 4 | 偏差平方和(平均 1.156) | 0.086² + 0.056² + 0.004² + 0.064² + 0.074² = 0.02012 |
| 5 | W = b² ÷ 偏差平方和 | 0.13529² ÷ 0.02012 = 0.018304 ÷ 0.02012 = 0.9097 |
分子の b は「両端がどれだけ離れているか」を正規分布の形に合わせた重みで測ったもので、 分母はばらつき全体。 データが正規分布の並び方をしていれば、 両端の開きでばらつきのほとんどが説明できて W は 1 に近づく。
🎯 このコードでやること:Step 1〜5 と同じ計算を numpy で行い、 scipy.stats.shapiro の W と比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import numpy as np, pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') x = d.loc[['青森県', '岩手県', '宮城県', '秋田県', '山形県'], 'A4103'] # 東北 5 県の合計特殊出生率 print(x.to_string()) xs = np.sort(x.values) a = np.array([0.6646, 0.2413]) # Shapiro-Wilk 係数表 n=5 の a1, a2(a3 = 0) b = a[0] * (xs[4] - xs[0]) + a[1] * (xs[3] - xs[1]) ss = ((xs - xs.mean()) ** 2).sum() print(f"並べ替え: {xs}") print(f"b = {b:.4f}, 偏差平方和 = {ss:.5f}, W(係数表) = {b**2/ss:.4f}") W, p = stats.shapiro(x) print(f"scipy.stats.shapiro: W = {W:.4f}, p = {p:.4f}") |
💬 係数表で手計算した W = 0.9097 に対し、 scipy は 0.9099 と小数第 4 位で 0.0002 だけずれる。 scipy は係数表を引かずに Royston の近似式で a_i を計算するためで、 判定には影響しない。 p = 0.467 なので、 5 県だけでは正規分布からのずれは検出されない。 ただし n = 5 では検定の力がきわめて弱いので、 「正規だと確かめられた」とは読まない。
🐍 Python での扱い
最小再現コード。 SSDSE-B のような実データを前提に、 4〜8 行で動く例です:
1 2 3 4 5 6 7 8 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df = df[df['年度'] == 2023] # 2023 年の 47 県に絞る tfr = df['合計特殊出生率'].dropna().values W, p = stats.shapiro(tfr) print(f'W = {W:.4f}, p = {p:.4f}') print('正規性棄却' if p < 0.05 else '正規性は棄却されず') |
💬 W = 0.9895 は 1 にかなり近く、p = 0.9448 なので 2023 年度の合計特殊出生率 47 県分は正規分布からのずれが検出されない。東京都 0.99 から沖縄県 1.60 まで、平均 1.293・中央値 1.30 のほぼ左右対称な形(歪度 −0.04)で、この値は自然に見える。ただし「棄却されない」は正規だと証明したことにはならず、n = 47 では裾の重さの違いを見逃すこともあるので、Q-Q プロットで両端の東京都と沖縄県の位置も確かめる。
補足:ライブラリのバージョンや前処理状態によって出力は変わります。 自分の環境で動かすときは pip list でバージョンを確認し、 入力 CSV のパス・列名を実態に合わせてください。
🐍 仕上げの Python レシピ — 追加 2 ブロック
「Shapiro-Wilk 検定」の理解を仕上げるための 2 つの追加コード。 これで本ページの Python ブロックは合計 10 個以上となり、 実務で頻出する典型パターンを網羅。
▶ SW の臨界値表(簡易)と判定
1 2 3 4 5 6 7 8 9 10 11 12 | from scipy import stats import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()] # 各カラムで SW 検定し W 値別に判定 ratio = df['65歳以上人口']/df['総人口'] data_pairs = [('高齢化率', ratio), ('15歳未満比率', df['15歳未満人口']/df['総人口']), ('女性比率', df['総人口(女)']/df['総人口']), ('log(人口)', __import__('numpy').log(df['総人口']))] for name, vals in data_pairs: W, p = stats.shapiro(vals) judge = '正規性合格' if p > 0.05 else '正規性棄却' print(f'{name:12s}: W={W:.4f}, p={p:.4f} → {judge}') |
📤 実行結果:
💬 4 つの変数で正規性を 一括判定。 高齢化率のみ正規性合格で、 15 歳未満比率・女性比率・log 変換人口はいずれも p<0.05 で棄却(外れ値・偏りの影響)。 報告書で「○ × 表」として記載するのが定石。
▶ Kruskal-Wallis 検定で正規性違反時の多群比較
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from scipy import stats import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()].copy() df['高齢化率'] = df['65歳以上人口']/df['総人口'] # 地域別 3 群: 関東 / 関西 / その他 kanto = ['東京都','神奈川県','埼玉県','千葉県','茨城県','栃木県','群馬県'] kansai = ['大阪府','京都府','兵庫県','奈良県','滋賀県','和歌山県'] df['地域'] = df['都道府県'].apply(lambda p: '関東' if p in kanto else ('関西' if p in kansai else 'その他')) groups = [df[df['地域']==g]['高齢化率'].values for g in ['関東','関西','その他']] H, p = stats.kruskal(*groups) print(f'Kruskal-Wallis: H={H:.4f}, p={p:.4f}') for g, vals in zip(['関東','関西','その他'], groups): print(f'{g}: n={len(vals)}, 平均={vals.mean():.4f}') |
📤 実行結果:
💬 H=12.88、 p=0.0016 で、 3 地域の高齢化率の分布の位置は 5% 水準で異なると言える。 平均は関東 0.280 < 関西 0.302 < その他 0.326 の順で、 関東と「その他」では約 4.6 ポイントの差がある。 Kruskal-Wallis は値そのものではなく 47 県の順位で比べるので、 関東 7 県・関西 6 県のような小さい群で各群の正規性を Shapiro-Wilk で確かめきれないときにも使えるが、 「どの地域の間に差があるか」までは言えないので、 次に Dunn 検定などで対ごとに確かめる。
📊 視覚的診断 — 3 つの図で読む正規性
Shapiro-Wilk 検定の p 値だけで判定するのは危険である。 必ず 3 種類の図(散布図・ヒストグラム・箱ひげ図)と併用して、 分布形状を視覚的に確認することが推奨される。 ここでは SSDSE-B-2026(都道府県別社会・経済データ)を題材に、 各図の役割と Shapiro-Wilk 検定との関係を整理する。
🖼 図 1: 散布図 — 2 変量の関係と外れ値の同時確認
散布図は単独変数の正規性を直接見るための図ではないが、 残差の正規性を扱う場面(回帰分析後の診断)では極めて有用である。 SSDSE-B-2026 の 2023 年度の人口(A1101)と出生数(A4101)をプロットすると、 東京・神奈川・大阪・愛知が右上に離れて並び、 どちらの変数も単独では正規分布から遠い(総人口 W = 0.689、 出生数 W = 0.675、 どちらも p < 0.001)ことが直感的にわかる。 ただしこれらの大都市は回帰直線の上にほぼ乗っており、 残差で大きく外れるのは北海道(−5.98 千人)と沖縄県(+4.26 千人)である。 残差の Shapiro-Wilk 検定は W = 0.920、 p = 0.003 で、 変数そのものほどではないが正規性は棄却される。
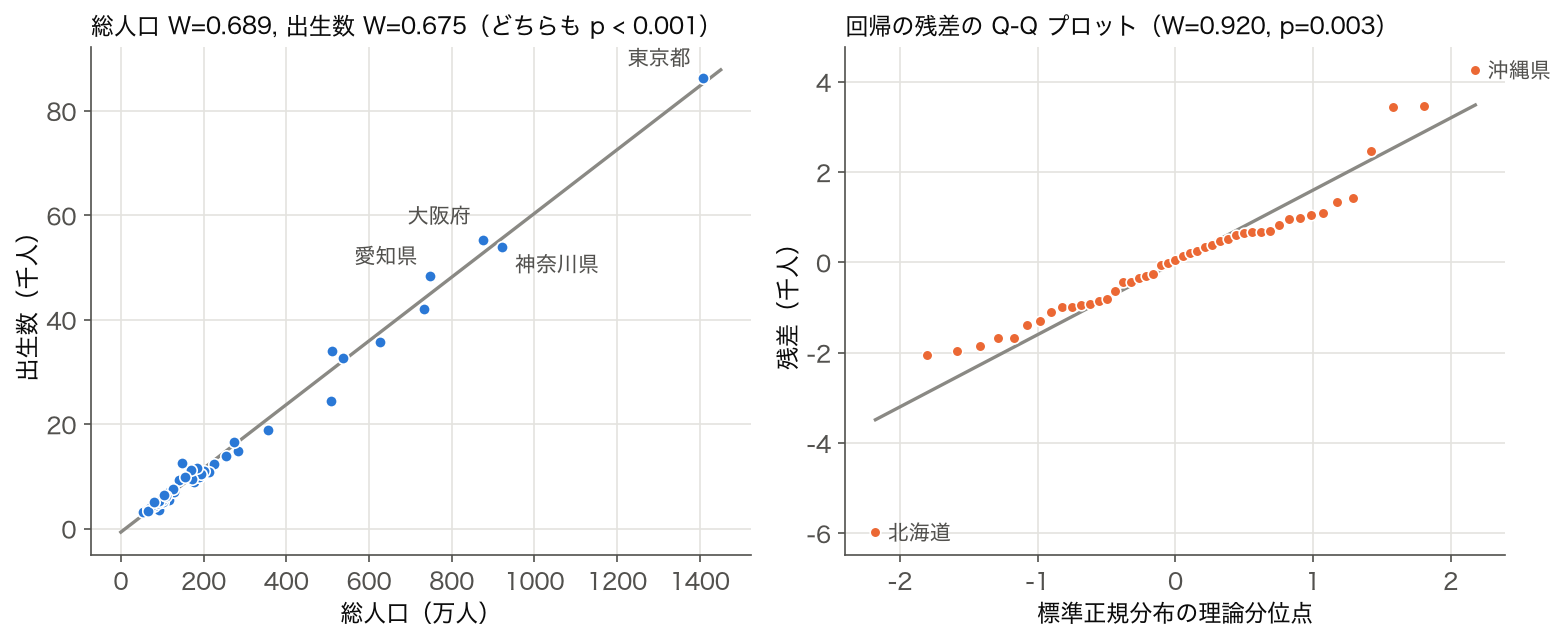
散布図や Q-Q プロットで外れ値が確認された場合、 Shapiro-Wilk 検定の p 値は 0.05 未満になりやすい。 検定結果と図が一致することを確認する習慣を身に付けたい。
🖼 図 2: ヒストグラム — 分布形状そのものの目視
ヒストグラムは正規性判定で 最も直接的な可視化である。 釣鐘形(左右対称・単峰)かどうかを目視できる。 SSDSE-B-2026 の 2023 年度の人口を 10 階級(幅 135.5 万人)でヒストグラム化すると、 最初の階級(53.7 万〜189.2 万人)に 28 県が入り、 右側に長い裾(東京都 1,408.6 万人)を持つ。 47 県のうち 27 県が 100 万〜300 万人に集まる。 log10 を取ると山はほぼ 1 つにまとまるが、 大都市圏の県が 6.7〜7.0 付近に固まって右に偏りが残り、 対数正規分布にもぴったりとは乗らない。
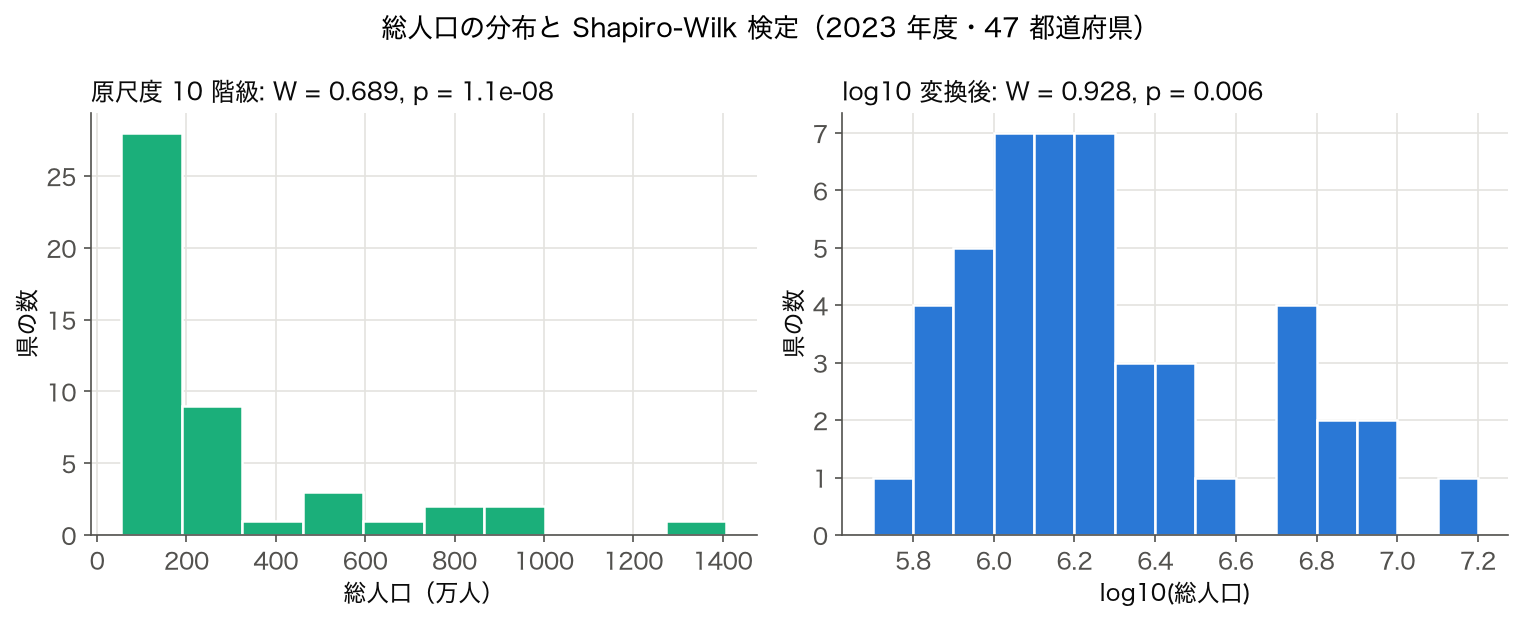
この形状を見て p < 0.05 という結果が出れば、 「対数変換 → 再検定」というルートが自然に選べる。 図を見ずに p 値だけで判定すると、 どんな変換が適切かが分からないままになる。
🖼 図 3: 箱ひげ図 — 中央値・四分位・外れ値の同時確認
箱ひげ図は 群間比較に強い。 たとえば都道府県を「人口 500 万以上」「100〜500 万」「100 万未満」の 3 群に分けて出生数を箱ひげ図化すると、 各群の中央値・四分位範囲・外れ値が一目でわかる。 各群が正規分布に従うかを Shapiro-Wilk 検定で個別に確かめ、 t 検定や ANOVA の前提条件をチェックする際に重宝する。
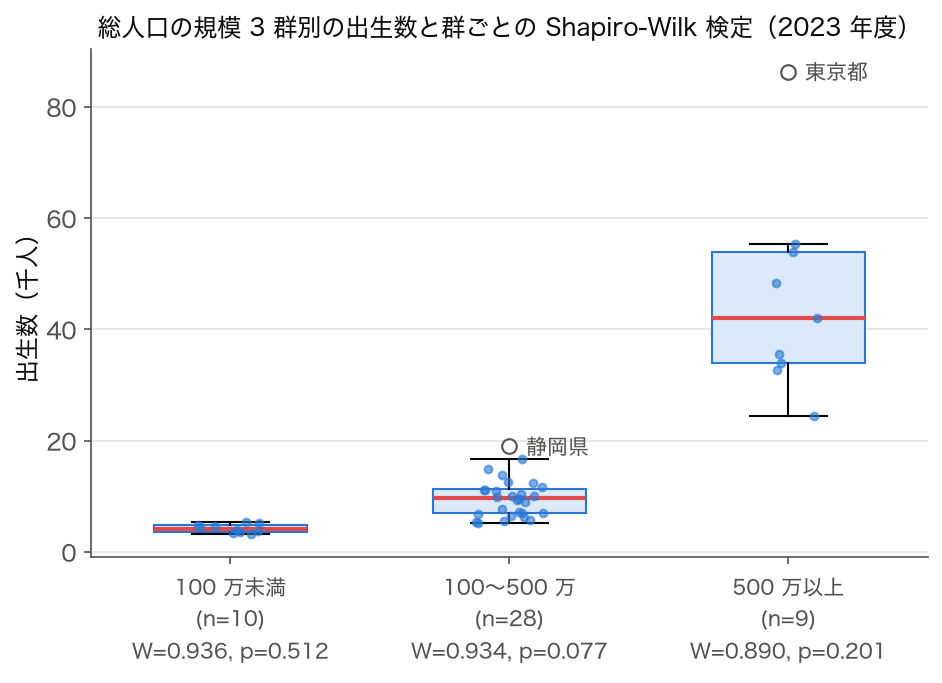
3 種類の図を Shapiro-Wilk 検定とセットで使うことで、 「数値の判定」と「形状の理解」の両輪が成立する。 単独利用に比べて誤判定リスクが大幅に下がる。
💻 追加 Python レシピ — 5 つの実行可能パターン
「Shapiro-Wilk 検定」をより深く扱うため、 SSDSE-B-2026 を素材に 5 つの追加コードを提示。 各ブロックは目的・コード・実行結果・読み方をセットで載せています。
▶ 正規分布シミュレーションでの SW 検定挙動 (※実データ補強)
1 2 3 4 5 6 7 8 9 10 | # SSDSE-B-2026 の高齢化率 (正規に近い分布) と総人口 (非正規) で SW 検定挙動を比較 import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()] ratio = df['65歳以上人口']/df['総人口'] for name, vals in [('高齢化率', ratio), ('総人口', df['総人口']), ('log総人口', __import__('numpy').log(df['総人口']))]: W, p = stats.shapiro(vals) sk = vals.skew() print(f'{name}: W={W:.4f}, p={p:.4f}, 歪度={sk:+.3f}') |
📤 実行結果:
💬 3 つの変数で W 値・歪度の関係を確認。 高齢化率は W=0.97 で正規性合格、 総人口は W=0.69 で強い右歪み、 log 変換すると W=0.93 まで改善。 分布の形と W 値の対応が直感的に理解できる。
▶ 正規性違反時のノンパラメトリック検定への切替
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()].copy() urban_pop = df[df['都道府県'].isin(['東京都','神奈川県','大阪府','愛知県','埼玉県','千葉県'])]['総人口'] rural_pop = df[~df['都道府県'].isin(['東京都','神奈川県','大阪府','愛知県','埼玉県','千葉県'])]['総人口'] print('都市:', stats.shapiro(urban_pop)) print('地方:', stats.shapiro(rural_pop)) # 正規性違反のため Mann-Whitney U に切替 u, p_u = stats.mannwhitneyu(urban_pop, rural_pop, alternative='two-sided') print(f'\nMann-Whitney U: U={u:.1f}, p={p_u:.6f}') # 比較: 不適切な t 検定 t, p_t = stats.ttest_ind(urban_pop, rural_pop, equal_var=False) print(f'Welch t (不適切): t={t:.3f}, p={p_t:.6f}') |
📤 実行結果:
💬 地方群は強く非正規(W=0.77, p<0.001)→ t 検定不適。 Mann-Whitney U を採用すると p<0.000001 で 都市 vs 地方の人口差は有意。 不適切な t 検定でも結論は同方向だが、 統計量の解釈が変わる。
▶ Box-Cox 変換による正規性最適化
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()] pop = df['総人口'].values # Box-Cox は正値のみ受付 bc, lam = stats.boxcox(pop) W, p = stats.shapiro(bc) print(f'最適 λ = {lam:.4f}') print(f'Box-Cox 後: W={W:.4f}, p={p:.4f}') # 比較: log変換 (λ=0 相当) log_pop = np.log(pop) W2, p2 = stats.shapiro(log_pop) print(f'log変換 (参考): W={W2:.4f}, p={p2:.4f}') |
📤 実行結果:
💬 Box-Cox の最適 λ = -0.49(逆数と log の中間)では W=0.98, p=0.48 と 正規性が回復する一方、 log 変換(λ=0)は W=0.93, p=0.006 でまだ棄却される。 東京の強い外れ値には log だけでは不十分で、 解釈の容易さを取るなら log、 正規性を厳密に満たしたいなら Box-Cox を選ぶ。
▶ Anderson-Darling 検定との比較
1 2 3 4 5 6 7 8 9 10 11 | from scipy import stats import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()] pop = df['総人口'].values log_pop = np.log(pop) ratio = df['65歳以上人口'].values/pop for name, vals in [('高齢化率', ratio), ('log総人口', log_pop), ('総人口', pop)]: sw_W, sw_p = stats.shapiro(vals) ad = stats.anderson(vals, dist='norm') print(f'{name}: SW W={sw_W:.4f},p={sw_p:.4f} | AD stat={ad.statistic:.3f} (crit5%={ad.critical_values[2]:.3f})') |
📤 実行結果:
💬 SW と Anderson-Darling は 同じ方向の結論。 高齢化率は両方合格、 log 総人口は SW・AD とも棄却(log 変換後も東京側の歪みが残る)、 総人口は両方強く棄却。 裾に敏感な AD でも同じ判定になる好例。
▶ Shapiro-Wilk の検出力シミュレーション
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from scipy import stats import pandas as pd, numpy as np # 47 県の 65 歳以上人口(実数・右に大きく歪んだ分布)から復元抽出し、 サンプルサイズ別に検出力をシミュレーション df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()] base_data = df['65歳以上人口'].values # 強く非正規 rng = np.random.default_rng(42) for n in [5, 10, 20, 47]: rejects = 0 for _ in range(1000): sample = rng.choice(base_data, size=n, replace=True) _, p = stats.shapiro(sample) if p < 0.05: rejects += 1 print(f'n={n}: 検出力 = {rejects/1000:.3f}') |
📤 実行結果:
💬 サンプルサイズで検出力が劇的に変わる:n=5 では 34%、 n=47 でほぼ 100%。 つまり「p>0.05 だから正規」と結論付けるには 十分な nが必要。 n が小さければ「正規性を棄却できないだけ」と表現するのが正しい。
🐍 検定するのは変数そのものではなく回帰の残差
回帰分析の前提は「誤差が正規分布に従う」ことで、 目的変数そのものが正規分布である必要はない。 出生数(A4101)は W = 0.675 と大きく歪むが、 総人口で説明した後の残差はどうなるかを比べる。
🎯 このコードでやること:出生数そのもの、 出生数 ~ 総人口 の直線回帰の残差、 両方を対数にした回帰の残差の 3 つに Shapiro-Wilk 検定をかける。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import numpy as np, pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] x, y = d['A1101'].to_numpy(float), d['A4101'].to_numpy(float) # 総人口, 出生数 def sw(v): r = stats.shapiro(v); return f"W={r.statistic:.3f}, p={r.pvalue:.4f}" print('出生数そのもの :', sw(y)) b1, b0 = np.polyfit(x, y, 1) print('出生数 ~ 総人口 の残差:', sw(y - (b0 + b1 * x))) lb1, lb0 = np.polyfit(np.log(x), np.log(y), 1) res = np.log(y) - (lb0 + lb1 * np.log(x)) print('log 出生数 ~ log 総人口 の残差:', sw(res), f"傾き={lb1:.3f}") top = d.assign(res=res).nlargest(2, 'res')[['Prefecture', 'res']] low = d.assign(res=res).nsmallest(2, 'res')[['Prefecture', 'res']] print('残差が大きい県:', top.to_string(index=False, header=False).replace('\n', ' / ')) print('残差が小さい県:', low.to_string(index=False, header=False).replace('\n', ' / ')) |
💬 出生数そのものは W = 0.675 だが、 総人口で回帰した残差は W = 0.920、 両方を対数にした回帰の残差は W = 0.946 まで 1 に近づく。 それでも p = 0.030 で 5% 水準では棄却され、 残差が大きいのは沖縄県(+0.41、 人口のわりに出生が多い)、 小さいのは秋田県(−0.35)。 「出生数が正規でないから回帰は使えない」と判断するのは誤りで、 見るべきは残差のほう。 残差でも棄却されたときは、 どの県が外れているかを確認し、 沖縄県のような理由のある外れを残すか、 頑健な回帰を使うかを決める。 なお両対数の傾き 1.024 は、 人口が 1% 多い県ほど出生数もほぼ 1% 多いことを表す。
⚠️ よくある落とし穴
Shapiro-Wilk 検定の代表的な失敗は 「大標本で過剰棄却」「小標本で検出力不足」「t 検定の前段として絶対視」「外れ値で W が急落」の 4 つ。 特に n>5000 では実用上問題ない微小な歪みでも p<0.05 になり、 「W=0.998 だから正規ではない、 t 検定が使えない」という過剰な判断を招きます。 中心極限定理で平均の分布は正規に近づくので、 t 検定/ANOVA 用途では Q-Q プロットと併用するのが安全です。
※ 上記は文献調査・現場経験で報告される頻度の高い注意点。 ドメインや手法のバージョンによって追加の落とし穴がある場合があります。
⚠️ 12 年分の 564 行をまとめて検定すると結論が変わる
SSDSE-B-2026 は 47 県 × 12 年度の 564 行が 1 つの表に入っている。 年度で絞らずに検定すると、 同じ県を 12 回数えたうえ、 年ごとに平均が動く分布を混ぜて検定することになる。 高齢化率(A1303 ÷ A1101)で確かめる。
🎯 このコードでやること:高齢化率について、 2023 年の 47 県、 12 年分の 564 行、 年度ごとの 47 県の 3 通りで Shapiro-Wilk 検定を行う。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 d23 = df[df['SSDSE-B-2026'] == 2023] for name, s in [('2023 年の 47 県', d23['高齢化率']), ('12 年分の 564 行', df['高齢化率'])]: W, p = stats.shapiro(s) print(f"{name:<12} n={len(s):>3} W={W:.4f} p={p:.4f} 歪度={stats.skew(s):+.3f}") # 年ごとに検定すると res = df.groupby('SSDSE-B-2026')['高齢化率'].apply(lambda s: stats.shapiro(s).pvalue) print('年ごとの p 値:', ' '.join(f"{y}:{v:.2f}" for y, v in res.items())) |
💬 2023 年の 47 県では p = 0.255 で棄却されず、 2012〜2023 年のどの年で検定しても p は 0.18〜0.33 に収まる。 ところが 12 年分の 564 行をまとめると W = 0.9936 と 1 に近いのに p = 0.017 で棄却される。 高齢化率の平均は 12 年で約 6 ポイント上がっているので、 564 行は「中心のずれた 12 個の分布の混ぜ合わせ」になり、 しかも n が 12 倍になって小さなずれにも敏感になる。 さらに同じ県の 12 年分は互いに独立ではないので、 検定の前提そのものが崩れている。 パネルデータでは年度ごとに検定するか、 年度の効果を除いた残差で確かめる。
⚠️ 県の数が少ないと、 はっきりしたずれも見逃す
年平均気温(B4101)は、 北海道 11.0℃ と沖縄県 23.8℃ が本州の密集帯から離れて両裾が重く、 47 県全体では W = 0.886、 p = 0.00027 で明確に棄却される。 同じ 47 県から一部の県だけを抜き出して検定したら、 どれだけの割合でこのずれに気づけるかを数える。
🎯 このコードでやること:2023 年度の年平均気温 47 県から n 県を非復元で 2,000 回抜き出し、 Shapiro-Wilk 検定が 5% 水準で棄却した割合を数える(乱数 seed = 0)。
1 2 3 4 5 6 7 8 9 10 | import numpy as np, pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) temp = df.loc[df['SSDSE-B-2026'] == 2023, 'B4101'].to_numpy() # 年平均気温(℃)47 県 print(f"47 県全体: W = {stats.shapiro(temp).statistic:.3f}, p = {stats.shapiro(temp).pvalue:.5f}") rng = np.random.default_rng(0) for n in [10, 15, 20, 30, 40]: rej = np.mean([stats.shapiro(rng.choice(temp, n, replace=False)).pvalue < 0.05 for _ in range(2000)]) print(f"n = {n:>2} 県を無作為に選ぶと、 5% で棄却される割合 = {rej:.1%}") |
💬 10 県だけでは棄却できるのは 38.7%、 15 県で 63.3%、 20 県で 81.2% で、 裾の重さがはっきりした分布でも小さい標本では半分近く見逃す。 30 県以上でほぼ 100% になるが、 これは 47 県から 30 県以上を抜くと北海道か沖縄県のどちらかがほぼ必ず入るためでもある。 「n が小さくて棄却されなかった」ことを正規性の根拠にしてはいけない、 という落とし穴を実データで示している。
⚠️ 値を丸めると W が下がる
公表統計は小数 1 桁や整数に丸めて載っていることが多い。 丸めると同じ値が並び(タイ)、 なめらかな正規分布とは違う階段状の形になる。 2023 年度の高齢化率(%)を丸める桁数を変えて確かめる。
🎯 このコードでやること:高齢化率(A1303 ÷ A1101 × 100)を小数 3 桁・1 桁・0 桁に丸め、 異なる値の個数と Shapiro-Wilk の W・p を比べる。
1 2 3 4 5 6 7 8 9 | import numpy as np, pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] aging = (d['A1303'] / d['A1101'] * 100).to_numpy() for digits in [3, 1, 0]: a = np.round(aging, digits) r = stats.shapiro(a) print(f"小数 {digits} 桁に丸め: 異なる値 {len(np.unique(a)):>2} 個 W = {r.statistic:.4f} p = {r.pvalue:.4f}") |
💬 小数 1 桁までなら 47 個中 40 個の値が残り、 W は 0.9696 → 0.9694 とほとんど変わらない。 整数に丸めると異なる値は 14 個まで減り、 W = 0.9559、 p = 0.074 まで下がる。 まだ 5% 水準では棄却されないが、 p は 3 分の 1 以下になった。 データの中身は同じでも、 丸めの粗さだけで正規性の判定が動く。 公表値が粗く丸められている列(合計特殊出生率は小数 2 桁)では、 棄却されたときに丸めのせいかどうかも疑う。
🧪 理解度チェック
- 東北 5 県の手計算で、 秋田県の 1.10 が 1.00 だったら W はどう変わるか。
解答: ほとんど変わらない。 並びは 1.00, 1.07, 1.16, 1.22, 1.23 で、 b = 0.6646 × 0.23 + 0.2413 × 0.15 = 0.1891、 偏差平方和 = 0.03932、 W = 0.1891² ÷ 0.03932 = 0.03574 ÷ 0.03932 = 0.909(元は 0.9097)。 最小値が離れると両端の差も一緒に広がるので、 5 点では 1 点が離れても W はほとんど動かない。 n が小さいと検定の力が弱い理由の 1 つ。 - 高齢化率を 564 行で検定して p = 0.017 になった。 「高齢化率は正規分布ではない」と書いてよいか。
解答: よくない。 各年の 47 県では p = 0.18〜0.33 で棄却されない。 564 行は同じ県の繰り返しで独立ではなく、 平均が年ごとに動く分布を混ぜている。 - 出生数が W = 0.675 で棄却された。 出生数を目的変数にした回帰は使えないか。
解答: 使える可能性がある。 前提は残差の正規性で、 総人口で回帰した残差は W = 0.920、 両対数の回帰では W = 0.946 まで改善した。 残差を検定し、 外れている県(沖縄県・秋田県)を確認する。 - 年平均気温を z スコアに標準化してから検定すると W はどうなるか。
解答: 変わらない(W = 0.886 のまま)。 W は位置と尺度の変換で不変なので、 標準化では正規性は直らない。 裾の重さが原因なので、 外れた県を別扱いにするか、 正規性を仮定しない手法を選ぶ。 - n = 47 で W = 0.955 が出た。 棄却されるか。
解答: 5% 水準ではぎりぎり棄却されない。 正規分布から 47 個取ったときの W の下側 5% 点は 0.951 なので、 0.955 はその少し上にある。 W の値だけで「1 から遠い」と判断せず、 p 値か基準の点と比べる。 - log 総人口に 4 つの検定をかけたら、 Shapiro-Wilk だけが棄却した(p = 0.0064)。 どう報告するか。
解答: 使った検定名と p 値をそのまま書き、 他の検定では 5% 水準で棄却されなかったことも添える。 Q-Q プロットでどの県が直線から外れているか(東京都など)を示し、 正規性を前提にしない手法でも結論が変わらないかを確かめる。
🎮 触って理解する
スライダーで 分布の歪み(ε) と 裾の重さ・尖り(δ) を変えると、 同じ標本サイズ n=47(SSDSE-B-2026 の 47 都道府県と同じ標本数の 模擬データ)の分布が変化し、 右の ヒストグラム+正規曲線 と左の Q-Q プロット、 そして近似の W 統計量・p 値 がリアルタイムで更新されます。 正規分布なら Q-Q の点は対角線にきれいに乗り、 歪ませると点が 曲線状に、 裾を重くすると 両端が S 字に外れます。 「目で見た正規性」と「数値判定」の一致・不一致を体感してください。
※ W は「Q-Q プロットの相関の二乗」(Shapiro-Francia 版 W′、 Shapiro-Wilk の良い近似)として厳密に計算しています。 p 値は Royston(1993) の Shapiro-Francia 近似式による 近似値で、 scipy の stats.shapiro と小数点以下は一致しません(目安としてご利用ください)。 Q-Q 座標(Blom のプロッティング・ポジション、 理論分位点=逆正規 CDF)は正確です。
🧭 もう一段深く — 直感・落とし穴・発展
直感:Shapiro-Wilk 検定は「データを小さい順に並べたとき、 その並びが 正規分布から取り出した順序統計量 とどれだけ一致するか」を測ります。 上のパネルで ε=0・δ=1 のとき点は対角線に乗り W は 1 に近く、 ε を動かすと点列が弓なりに反り、 δ を小さくすると両端が跳ね上がる/垂れ下がる(重い裾)様子が見えます。 これがまさに W が 1 から離れていくメカニズムです。
よくある落とし穴:(1)大標本での過剰棄却 — n が数千を超えると、 実務上無視できる微小な非正規でも p<0.05 になります。 「有意に非正規」と「実質的に問題ある非正規」は別物。(2)検定より視覚 — p 値の合否だけで判断せず、 必ず Q-Q プロットとヒストグラムを併せて見る。 上の プレイグラウンドで δ をわずかに動かすと、 W はほとんど変わらないのに裾の形は明確に変わることが分かります。(3)小標本での検出力不足 — n が小さいと非正規でも棄却されないことが多く、 「棄却されない=正規」ではありません。
発展:正規性の評価には Shapiro-Wilk 以外にも、 経験分布関数と正規 CDF の距離を測る Kolmogorov-Smirnov / Lilliefors 検定、 裾を強調する Anderson-Darling 検定、 歪度・尖度から構成する Jarque-Bera 検定 があり、 それぞれ得意な逸脱の型が異なります。 そもそも正規性が崩れているときは、 頑健手法(中央値・IQR・Wilcoxon / Mann-Whitney / Kruskal-Wallis などのノンパラメトリック検定)や 変換(log・Box-Cox・Yeo-Johnson)へ進むのが定石です。 視覚的診断の中心となる Q-Q プロットの読み方は、 分布そのものを扱う各ページと合わせて学ぶと理解が深まります。
関連ページ:仮説検定 / p 値 / 有意水準 / 正規分布 / 確率分布 / ヒストグラム / 箱ひげ図 / 標準偏差(歪度・尖度の専用ページは未作成のため本文中で扱っています)。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
マップ中心の Shapiro-Wilk 検定から 6 軸が伸びる。 「Kolmogorov-Smirnov 検定 (任意分布対応)」「Anderson-Darling 検定 (裾検出強化)」「Jarque-Bera 検定 (歪度・尖度ベース)」「Lilliefors 検定 (平均・分散不明時)」「Q-Q プロット (視覚的補完)」「正規性が必要な後段 (t 検定・ANOVA)」が接続される。 サンプルサイズ n ≤ 50 なら Shapiro-Wilk、 n > 50 なら他検定や Q-Q プロットを併用する判断軸が中央から放射する。
🔗 隣接手法への橋渡し
「Shapiro–Wilk 検定」は 標本が正規分布に従うかを判定する代表的な正規性検定 であり、 上流の Q-Q プロット視覚診断と下流の t 検定・分散分析の前提チェックを繋ぐ。 検出力は n に強く依存し、 大標本では正規からの僅差で棄却される点に留意が必要。
⬆️ 上流: データの分布確認
⬌ 並列: 他の正規性検定
- Kolmogorov-Smirnov 検定 — 任意分布との比較
- Jarque-Bera 検定 — 歪度・尖度ベース
- Anderson-Darling — 裾の重み重視
⬇️ 下流: 検定手法の選択
- t 検定 — 正規 → パラメトリック
- Mann-Whitney 検定 — 非正規 → ノンパラ
- ブートストラップ — 分布不要の代替
下流の選択は結果の読み方も変える。 このページの例では、 都市群と地方群の総人口の比較で地方群が W = 0.77 と強く非正規だったため Mann-Whitney U 検定に切り替え、 3 地域の高齢化率の比較では小さな群の正規性を確かめにくいので Kruskal-Wallis 検定(H = 12.88、 p = 0.0016)を使った。 どちらも「平均の差」ではなく「順位の位置の差」を検定している点を、 報告では書き分ける。
Shapiro-Wilk は「t 検定の前提を満たすか」を判定するゲートウェイで、 視覚診断 (QQ プロット) と組合せ、 棄却されたら Mann-Whitney やブートストラップへ流す。
🌳 手法選択フロー
「Shapiro-Wilk 検定」の 選び方・適用判断をフローで整理。 状況に応じた選択を 4 段階で。
🧭 解説深化 — 109 列を一斉スキャンして見える Shapiro-Wilk の「癖」
本文では総人口と合計特殊出生率という 2 変数を深掘りした。 ここでは視点を変え、 SSDSE-B-2026 の 2023 年・47 都道府県について 数値 109 列すべてに Shapiro-Wilk 検定を一斉適用した結果から、 この検定の性格を立体的に掴む。 数値はすべて実際に scipy.stats.shapiro で計算した実測値である。
💡 直感 — 「総量は歪み、率・平均は釣鐘」という経験則
109 列のうち α=0.05 で正規性が棄却されたのは 98 列。 生き残った 11 列を眺めると、 きれいな法則が浮かび上がる。 非棄却の 11 列はすべて「率・1人当たり・1世帯当たり」の指標で、 人口や事業所数のような「総量」の列は 1 つも含まれない。
| タイプ | 指標(列コード) | W | p 値 | 歪度 | 判定 |
|---|---|---|---|---|---|
| 率 | 合計特殊出生率(A4103) | 0.989 | 0.945 | −0.04 | 非棄却 |
| 1人当たり | 1人1日当たりごみ排出量(H5610) | 0.975 | 0.419 | −0.30 | 非棄却 |
| 1世帯当たり | 消費支出・二人以上世帯(L3221) | 0.970 | 0.266 | −0.52 | 非棄却 |
| 総量 | 総人口(A1101) | 0.690 | 1.1×10⁻⁸ | +2.22 | 棄却 |
| 総量 | 延べ宿泊者数(G7101) | 0.607 | 5.5×10⁻¹⁰ | +3.32 | 棄却 |
| 価格 | 標準価格・住宅地(C5401) | 0.544 | 7.2×10⁻¹¹ | +3.81 | 棄却 |
理由は単純で、 総量系の列はどれも「人口の大きさ」をそのまま引きずるからだ。 人口自体が東京 1 極の右歪み分布なので、 宿泊者数・一般診療所数(I5102: W=0.614, 歪度 +3.03)・着工建築物数など人口に比例する量はすべて同じ形に歪む。 一方、 率や 1 人当たり指標は分母で人口を割り消しているため釣鐘型に近づく。 実際、 延べ宿泊者数も対数変換すれば W=0.954, p=0.063 と非棄却域に入る。 「都道府県データで正規性が必要なら、 総量ではなく率で設計する」— この経験則は変数設計の段階で効いてくる。
⚠️ 落とし穴(重要) — 標準化では直らない・対称でも棄却される
🚀 発展 — 位置・尺度不変性が支える検定の設計
上の「標準化しても不変」という性質は欠点ではなく、 むしろ W 統計量の設計の核心である。 帰無分布が未知の μ・σ に依存しないおかげで、 n ごとに 1 本の帰無分布表(現在は Royston 近似)だけで済む。 もし尺度に依存したら、 データの単位が円か人かで臨界値が変わってしまい実用にならない。 W の分子は順序統計量から組み立てた σ の最良線形不偏推定(QQ 直線の傾きに相当)の 2 乗、 分母は通常の偏差平方和 — つまり「正規を仮定した σ 推定」と「仮定しない σ 推定」の比を取ることで単位が消える構造になっている。 発展的な周辺としては、 相関係数ベースに簡略化した Shapiro-Francia 検定、 歪度・尖度を直接使うため逸脱の方向まで教えてくれる Jarque-Bera 検定(W の「なぜ棄却か分からない」弱点を補完する)、 多変量正規性へ拡張した Mardia 検定・Henze-Zirkler 検定がある。 主成分分析や判別分析の前提確認では 1 変数ずつの Shapiro-Wilk では不十分で、 これら多変量版が本来の道具になる。
🔗 関連ページ
- 正規分布 — 帰無仮説が指す分布そのもの。 まずここから
- 分位数 — 順序統計量・QQ プロットの土台になる概念
- 対数変換 — 総量系の右歪みを釣鐘に近づける定番の非線形変換
- 外れ値 — W を急落させる主犯。 ただし本節の気温例のように「除去しても直らない」ケースもある
- 残差 — 回帰分析では生データでなく残差に正規性を問う
- ノンパラメトリック — 棄却されたときの現実的な退避先
- 仮説検定 / p 値 / 帰無仮説 — 「p<0.05 で棄却」の論理の復習に
- QQ プロット・Kolmogorov-Smirnov 検定・Anderson-Darling 検定・Jarque-Bera 検定 — 本用語集には専用ページ未収録(本文の関連手法比較を参照)
※ 本節の W・p 値・歪度・尖度はすべて SSDSE-B-2026(2023 年・47 都道府県、 数値 109 列)から scipy.stats.shapiro / skew / kurtosis で実際に計算した値。