🔖 キーワード索引
「bootstrap」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「bootstrap」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「bootstrap の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
データのコピーをたくさん作る方法です。
結果がどれくらいブレるか知るために使います。
部活の平均点などのバラつきを調べます。
この方法で何がわかるかを解説します。
- 定義:手元の n 個のデータから復元抽出で同じサイズ n の標本を B 回(典型的に 1,000〜10,000)作り直し、 各標本で統計量を計算する
- 目的:その B 個の統計量の分布が「もしも何度もデータを取り直したら、 統計量がどうブレるか」の近似となる = 標本分布 の推定
- 使い道:(1) 標準誤差、 (2) 信頼区間、 (3) バイアス推定、 (4) 仮説検定。 解析的に難しい統計量(中央値、 分位点、 相関、 回帰係数...)でも数値的に求められる
- 長所:分布の仮定(正規性など)が不要、 ほぼあらゆる統計量に適用可能
- 短所:n が極端に小さい(n<10)、 観測が独立でない(時系列、 階層)、 末尾統計量(最大値など)には不適
- 原典:Efron (1979) "Bootstrap Methods: Another Look at the Jackknife"
📍 あなたが今見ているもの
🍰 まずはやさしく
論文などでよく使われる計算手法です。
データの数が少ないときに役立ちます。
スマホの利用時間の調査などで使われます。
実際の表記がどうなっているかを見ます。
論文の表や Methods 節で、こんな表記を見たはずです:
回帰係数 β = 0.62, percentile bootstrap CI: [0.41, 0.83]
この 「Bootstrap CI」「B=10,000」が、 ブートストラップ法(bootstrap, resampling) を使った結果です。 標本が小さい、 分布が非正規、 統計量が複雑 ── そんなときに「手持ちデータを母集団とみなして何千回もコピーを作り、 統計量のブレ幅を直接観測する」のがブートストラップの発想。
🎨 直感で掴む — 「手元データを母集団に見立てる」
🍰 まずはやさしく
バケツから水を汲み直すような考え方です。
数式を使わずにデータの分布を調べます。
買い物での出費の傾向を調べるイメージです。
なぜこの方法で正解に近づくかを考えます。
古典的な推測統計(z 検定や t 検定)は、 こう考えます:
- 母集団は正規分布か、 サンプルが十分大きい(中心極限定理)
- その仮定の下で、 統計量(平均など)の標本分布は数式で書ける
- 数式から SE や CI を計算する
でも実際には、 (1) の仮定が成り立たない、 あるいは (2) の数式がそもそも存在しない統計量(中央値、 IQR、 トリム平均、 相関、 主成分の固有値...)が山ほどあります。 そこで Efron が 1979 年に提案したのが、 「データそのものを使って標本分布を真似(resample)する」 という大胆な発想です。
🪣 ブートストラップの「水汲み比喩」
母集団=大きな池、 標本=池からすくった一杯のバケツ、 と考えます。 一杯しか汲めない(データ収集は高くつく)ので、 私たちはバケツの中身しか直接見られない。 でも:
- バケツの中身 ≒ 池の縮図 と信じれば、 バケツから 何度もコップで汲み直す(復元抽出)ことで、 「もしも何度もバケツを汲んでいたら、 何が起きていたか」をシミュレートできる
- これを B 回(典型的に 10,000 回) 繰り返せば、 統計量のブレ幅が「分布」として直接見える
つまりブートストラップは、 「標本 = ミニ母集団」というプラグイン原理(plug-in principle)を信じて、 統計量の「たられば」を計算機の中で再現する手法です。
🎲 復元抽出のイメージ
n=5 の小さな標本 {3, 5, 7, 8, 12} から復元抽出すると:
- サンプル 1:
{5, 5, 7, 12, 3}→ 平均 = 6.4 - サンプル 2:
{8, 8, 8, 5, 7}→ 平均 = 7.2 - サンプル 3:
{3, 12, 3, 7, 5}→ 平均 = 6.0 - ...(B 回繰り返す)
こうして得た B 個の平均値の 2.5% 点〜97.5% 点 が、 ノンパラメトリックな 95% 信頼区間。 これが percentile 法 の基本形です。
🎮 触って理解する — ブートストラップ・シミュレータ
下は SSDSE-B-2026 の 2023 年・47 都道府県の合計特殊出生率(A4103) を実データとして使ったインタラクティブ実験です。 上段の点が元標本(47 県)。 「1 回リサンプル」で復元抽出の様子(選ばれた点が光り、 同じ点が複数回選ばれることもある)を観察し、 「1000 回ブートストラップ」でブートストラップ分布のヒストグラムが構築され、 パーセンタイル 95% 信頼区間(2.5%〜97.5%)が塗られます。 リサンプルサイズや回数を変えて、 信頼区間の幅がどう変わるかを体感してください。
※ 乱数を使うので実行のたびに CI はわずかに変動します。 参考:本ページの Python 実装(seed 固定 B=10000)では 平均 = 1.293、 95% percentile CI ≈ [1.255, 1.330]、 中央値 95% CI ≈ [1.23, 1.33]。 このシミュレータの結果もこの近傍に収束します。
💡 この実験で腑に落ちること
- 原理(標本=母集団の代理):新しいデータは 1 バイトも増えていないのに、 手元の 47 点を「ミニ母集団」とみなして復元抽出するだけで、 統計量が「どれくらいブレるか」の分布が立ち上がります。 これがプラグイン原理の核心です。
- パーセンタイル法:ヒストグラムの下端 2.5%・上端 97.5% を切り出した青い帯が、 そのまま 95% 信頼区間。 数式を一切使わずに区間が得られます。 分布が歪む場合は BCa 法(バイアス補正+加速度補正)がより正確で、
scipy.stats.bootstrapの既定です。 - 適用場面:統計量を「平均」から「中央値」に切り替えても同じ操作で CI が出ます。 中央値の標準誤差は解析式が面倒ですが、 ブートストラップなら手順は不変 ── 解析的に困難な統計量にこそ真価があります。
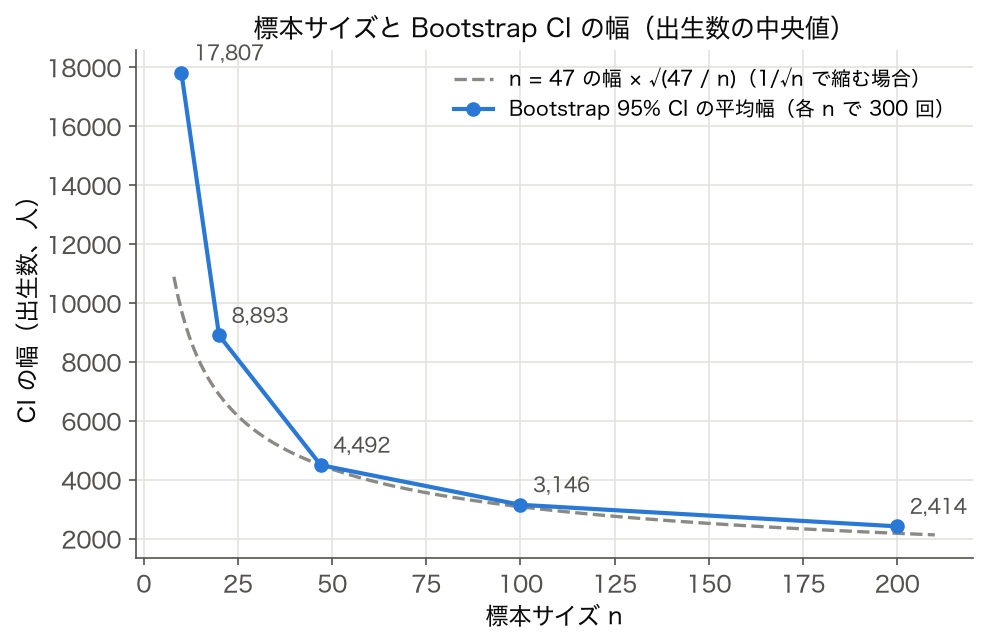
- 標本サイズの効果:スライダで m を小さくすると CI 幅が急に広がります(SE ∝ 1/√n)。 データが少ないほど推定は不確かという事実が、 帯の幅として目に見えます。
- 限界:この帯は「元の 47 点が母集団を代表している」前提の上に立ちます。 元標本が偏っていれば、 ブートストラップはその偏りをそのまま増幅します(garbage in, garbage out)。 極端に小さい n、 最大値のような裾統計量、 時系列の依存構造には単純ブートストラップは不向きです(後述の落とし穴を参照)。
関連ページ:ここで得た区間そのものは 信頼区間、 分布の広がり(帯の幅の素)は 標準誤差。 「なぜ平均の分布が釣鐘型に近づくのか」は 標本分布と中心極限定理 が説明します。 ブートストラップは CLT が使えない統計量にも同じ枠組みを広げる一般化と捉えられます。
📐 数式 — ブートストラップの定式化
🍰 まずはやさしく
データを何度も選び直す手順のことです。
統計量(平均などの値)を正確に求めます。
テストの点数の分布をシミュレーションします。
具体的な計算の流れについて説明します。
元の標本を $\mathbf{X} = (X_1, X_2, \dots, X_n)$、 推定したい統計量を $\hat{\theta} = T(\mathbf{X})$ と書きます。 ブートストラップでは:
各 b = 1, 2, ..., B について統計量を再計算します:
標準誤差の推定(Bootstrap SE)
パーセンタイル信頼区間
BCa(Bias-Corrected and accelerated)
パーセンタイル法は分布が歪んでいるとバイアスを生むため、 補正項を入れたのが BCa 法:
scipy.stats.bootstrap(..., method='BCa') で 1 行。📐 5 種類のブートストラップ CI
| 手法 | CI 公式 | 長所 | 短所 | 推奨 |
|---|---|---|---|---|
| Percentile | $[\hat\theta^*_{(\alpha/2)}, \hat\theta^*_{(1-\alpha/2)}]$ | シンプル | 偏り補正なし | 初学者向け |
| Basic | $[2\hat\theta - \hat\theta^*_{(1-\alpha/2)}, 2\hat\theta - \hat\theta^*_{(\alpha/2)}]$ | 偏り部分補正 | 対称性に依存 | 中級 |
| Bootstrap-t | $\hat\theta \pm t^*_{(1-\alpha/2)} \cdot \hat{SE}^*$ | 高精度 | 計算重い | 理論派 |
| BCa | 加速度バイアス補正 | 最も正確 | 実装複雑 | 推奨デフォルト |
| ABC | 解析的版 BCa | 高速 BCa | 一階近似 | 研究用 |
BCa (Bias-Corrected and accelerated) は二階精度で、 平均値・中央値・分位点・相関のいずれにも適切な CI を与えます。 scipy.stats.bootstrap は BCa をデフォルトに採用しています。
🔬 数式を「言葉」で読み解く
- $\hat{F}_n$(経験分布)
- 「元データ n 点に等確率 1/n を置いた離散分布」。 母集団分布 F の「最も控えめな推定」。 ブートストラップとは、 この経験分布を母集団に見立てて新しい標本を生み出す行為。
- $\mathbf{X}^{*b}$(ブートストラップ標本)
- 「元データから 復元抽出で同じサイズ n の新しい標本」。 同じ観測値が複数回出てくる/元データの一部の観測値が一度も出てこない、 という点が「ふつうの標本」と違う。
- $T(\cdot)$(統計量関数)
- 「標本を入力すると 1 つの数字を返す関数」。 平均、 中央値、 標準偏差、 回帰係数、 相関、 主成分の固有値、 ROC-AUC ... ほぼ何でも可。
- $\hat{\theta}^{*b}$(ブートストラップ複製)
- 「もしもこの標本だったら、 統計量はこの値だった」という B 個の架空観測。
- $B$(複製回数)
- 「標本分布をどれだけ精緻に近似するか」を決める。 SE 推定なら B=200 で十分、 CI 推定なら B≥1,000、 BCa や p 値計算なら B≥10,000 を推奨。
- パーセンタイル分位点
- 「B 個の複製を小さい順に並べ、 下から 2.5% と 97.5% の位置の値を取る」だけ。 数式に頼らず、 視覚的に分位点を切り出す 操作。
💡 重要:ブートストラップは「母集団から繰り返し標本を取る」のではなく「標本から繰り返し復元抽出する」操作です。 つまり「標本 = 母集団の縮図」と信じるのがキモ。 この仮定が破れるとブートストラップも破綻する(後述の落とし穴)。
🔬 Bootstrap の収束精度
Hall (1992) の Edgeworth 解析によると、 Bootstrap CI の被覆精度は手法によって異なります:
| CI 手法 | 片側精度 | 両側精度 | 補正 |
|---|---|---|---|
| 通常正規 | $O(n^{-1/2})$ | $O(n^{-1})$ | なし |
| Percentile | $O(n^{-1/2})$ | $O(n^{-1})$ | なし |
| Bootstrap-t | $O(n^{-1})$ | $O(n^{-2})$ | studentized |
| BCa | $O(n^{-1})$ | $O(n^{-2})$ | bias+accel |
BCa と Bootstrap-t が二階精度 ($O(n^{-2})$) で最良。 通常正規 CI と percentile CI は同精度ですが、 偏った分布では数値的に大きく異なります。
計算量と精度のトレードオフ
- Percentile: $O(B)$ 計算、 一階精度。
- Bootstrap-t: $O(B \cdot n)$ または $O(B^2)$ で studentization、 二階精度。
- BCa: $O(B + n)$、 jackknife を加えるので $n$ 倍、 二階精度。
- ABC: $O(n)$、 解析的近似、 一階精度。
「Bootstrap が一致推定量にならない」例
Bickel & Freedman (1981) は以下の場合に Bootstrap が一致推定量にならないことを示しました:
- 標本最大値:$X_{(n)}$ の分布の Bootstrap は退化分布に。
- 裾の重い分布:$X_i$ の分散が無限大なら Bootstrap も一致しない。
- 境界パラメータ:「真値が境界にある」状況。
- 多項分布の比率:$0$ 値カテゴリで一致性問題。
こうしたケースには m-out-of-n Bootstrap、 subsampling、 または直接的シミュレーションが代替手段です。
🧮 実値で計算してみる — SSDSE-B の都道府県平均人口
SSDSE-B-2026 の 47 都道府県・2023 年の総人口データを使い、 平均人口の 95% ブートストラップ CI を求めましょう。 47 都道府県全部の平均は ≈ 2,646 千人(総人口 A1101 は人単位なので 1,000 で割った値)ですが、 これは「47 都道府県をたまたま観測した」標本と捉えて、 もし日本に違う 47 都道府県があったら平均はどれくらいブレるか を推定します。
STEP 1:手で 5 都道府県のミニ標本で体感
たとえば標本 = {秋田 914千人, 高知 666千人, 沖縄 1,468千人, 東京 14,086千人, 大阪 8,763千人}(n=5、2023 年)。 標本平均 = 5,179千人。
| ブート b | 復元抽出された 5 県 | 平均(千人) |
|---|---|---|
| 1 | {東京, 沖縄, 東京, 高知, 秋田} | 6,244 |
| 2 | {大阪, 大阪, 沖縄, 東京, 沖縄} | 6,910 |
| 3 | {秋田, 高知, 高知, 秋田, 沖縄} | 926 |
| 4 | {東京, 東京, 東京, 大阪, 大阪} | 11,957 |
| 5 | {沖縄, 秋田, 大阪, 高知, 沖縄} | 2,656 |
| ... | ... | ... |
東京が当たるかどうかで、 平均は大きく動きます。 これが「外れ値に弱い」という直感の裏付け。 B=10,000 回繰り返し、 上下 2.5% を取れば 95% CI が得られます。
STEP 2:47 県・B=10,000 の結果(下の方法 A の実測、seed=42)
STEP 3:分布の歪みを観測する
10,000 個のブートストラップ平均をヒストグラムにすると、 右に長い裾を持つ分布になります。 これは「東京や大阪が複数回当たる」と平均が極端に大きくなるため。 こうした非対称な標本分布は 解析的(数式で)導出するのが面倒ですが、 ブートストラップなら視覚的に確認できます。
🧮 数式に値を入れて手で計算する: 平均のブートストラップ標準誤差
合成データ [2,4,7,5,3] から B=3 個のブートストラップ標本で平均と SE を計算する。
Step 1: 元標本と平均
Step 2: ブートストラップ再標本 (復元抽出)
| b | 再標本 | 平均 |
|---|---|---|
| 1 | [2,4,4,7,3] | 4.0 |
| 2 | [5,5,4,3,7] | 4.8 |
| 3 | [7,2,2,5,4] | 4.0 |
Step 3: ブートストラップ標準誤差
🐍 Python で再現
1 2 3 4 5 6 7 8 9 | import numpy as np samples = np.array([ [2,4,4,7,3], [5,5,4,3,7], [7,2,2,5,4], ]) means = samples.mean(axis=1) print(f"再標本平均: {means}") print(f"SE = {means.std(ddof=0):.3f}") |
📤 実行結果
💬 手計算 (Step 3) SE≈0.377 と Python 出力が完全一致。
🐍 Python 実装 — 3 通りの方法
方法 A:手動でブートストラップループ(教育用)
🎯 このコードでやること:総人口 A1101 を千人に直して、47 県の平均人口を 10,000 回の復元抽出で揺らし、標準誤差と 95% percentile 区間を求める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | # SSDSE-B 都道府県平均人口の 95% ブートストラップ CI import numpy as np import pandas as pd # 元データ:47都道府県・2023年(1 行目のコード行を飛ばし、日本語の見出し行を列名にする) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df.rename(columns={'年度': 'year', '地域コード': 'code', '都道府県': 'pref', '総人口': 'pop'}) df_2023 = df[df['year'] == 2023] x = df_2023['pop'].values / 1000 # 総人口 A1101 は「人」単位なので千人に直す n = len(x) # 47 # ブートストラップ B=10,000 回 B = 10000 rng = np.random.default_rng(seed=42) boot_means = np.empty(B) for b in range(B): sample = rng.choice(x, size=n, replace=True) # 復元抽出 boot_means[b] = sample.mean() print(f'県数: {n}') print(f'元の標本平均: {x.mean():,.1f}千人') print(f'Bootstrap SE: {boot_means.std(ddof=1):,.1f}千人') print(f'95% percentile CI: [{np.percentile(boot_means, 2.5):,.1f}, {np.percentile(boot_means, 97.5):,.1f}]千人') |
💬 見出し行を正しく読むと北海道も含めて県数は 47 になり、平均人口は 2,645.8 千人(約 265 万人)。10,000 回の復元抽出から得た標準誤差は 404.1 千人で、95% percentile 区間 [1,924.1, 3,503.1] は平均から下に 721.7、上に 857.3 と上側が長い。東京都(14,086 千人)が何回選ばれるかで平均が大きく跳ねるため、ブートストラップ分布が右に歪んでいることがこの非対称に表れている。
方法 B:scipy.stats.bootstrap(推奨・1 行)
🎯 このコードでやること:方法 A と同じ 47 県の平均人口(千人)について、scipy の bootstrap で偏りと歪みを補正する BCa 区間を 1 行で出す。
1 2 3 4 5 6 7 | from scipy.stats import bootstrap import numpy as np x = df_2023['pop'].values / 1000 # 千人 res = bootstrap((x,), np.mean, n_resamples=10000, method='BCa', random_state=42) print(f'BCa 95% CI: [{res.confidence_interval.low:,.1f}, {res.confidence_interval.high:,.1f}]千人') print(f'Bootstrap SE: {res.standard_error:,.1f}千人') |
💬 BCa 区間は [2,012.5, 3,680.3] 千人で、方法 A の percentile 区間 [1,924.1, 3,503.1] より下端が 88.4、上端が 177.2 千人上にずれた。標準誤差は 403.4 千人と方法 A の 404.1 とほぼ同じなので、違いは幅ではなく位置で、右に歪んだ分布の偏りを BCa が補正した分である。平均のような単純な統計量でも、外れ値の大きい県があると percentile と BCa で上限が 18 万人近く変わる。
方法 C:回帰係数のブートストラップ CI
🎯 このコードでやること:log(総人口) から log(出生数) を予測する回帰の傾き β を、県をペアのまま復元抽出して 10,000 回推定し直し、β の 95% 区間を求める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # 都道府県の総人口(log)と出生数(log)の回帰係数 β を bootstrap import numpy as np import pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[['年度', '都道府県', '総人口', '出生数']].copy() # A1101・A4101 df.columns = ['year', 'pref', 'pop', 'births'] df = df[df['year'] == 2023].dropna() x = np.log(df['pop'].values).reshape(-1, 1) y = np.log(df['births'].values) n = len(y) rng = np.random.default_rng(42) B = 10000 boot_beta = np.empty(B) for b in range(B): idx = rng.integers(0, n, n) # ペアごとに復元抽出(pair bootstrap) model = LinearRegression().fit(x[idx], y[idx]) boot_beta[b] = model.coef_[0] print(f'県数: {n}') print(f'β̂ = {LinearRegression().fit(x, y).coef_[0]:.4f}') print(f'Bootstrap 95% CI: [{np.percentile(boot_beta, 2.5):.4f}, {np.percentile(boot_beta, 97.5):.4f}]') |
💬 log(総人口) に対する log(出生数) の傾きは β̂ = 1.0239 で、県を組ごと復元抽出した 95% 区間は [0.9883, 1.0577]。区間が 1 をまたぐので、「人口が 1% 多い県は出生数もほぼ 1% 多い」という比例関係を否定できない。幅が 0.07 程度と狭いのは両対数にすると 47 県がほぼ一直線に並ぶためで、東京都の大きさに振り回される方法 A の平均とは対照的である。
方法 D:可視化(ヒストグラム+CI)
🎯 このコードでやること:方法 A の boot_means(10,000 個のブートストラップ平均、千人)をヒストグラムにし、95% 区間の両端を縦線で重ねる。
1 2 3 4 5 6 7 8 9 10 | import matplotlib.pyplot as plt ci_low, ci_high = np.percentile(boot_means, [2.5, 97.5]) plt.hist(boot_means, bins=60, color='#1976D2', alpha=0.7) plt.axvline(boot_means.mean(), color='red', ls='--', label='ブート平均') plt.axvline(ci_low, color='black', ls=':', label='95% CI 下限') plt.axvline(ci_high, color='black', ls=':', label='95% CI 上限') plt.xlabel('ブートストラップ平均(千人)'); plt.ylabel('頻度') plt.title('平均都道府県人口の Bootstrap 分布 (B=10,000)'); plt.legend() plt.tight_layout(); plt.savefig('bootstrap_hist.png', dpi=120) |
🐍 SSDSE-B での Bootstrap 完全実装
SSDSE-B-2026 の 47 都道府県平均人口の 95% BCa CI を計算:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023] # 47 都道府県 × 12 年度から 2023 年度の 47 行に絞る pop = df.iloc[:, 3].values # 総人口(人) # 1) scipy の BCa (推奨) res = stats.bootstrap((pop,), np.mean, confidence_level=0.95, method='BCa', n_resamples=9999, random_state=0) print(f'BCa CI: {res.confidence_interval}') # 2) 自作 percentile B = 10000 rng = np.random.default_rng(0) boots = [rng.choice(pop, len(pop), replace=True).mean() for _ in range(B)] lo, hi = np.percentile(boots, [2.5, 97.5]) print(f'Percentile CI: [{lo:.0f}, {hi:.0f}]') |
💬 2023 年度の 47 県に絞ると、平均人口 264 万 6 千人の 95% 区間は BCa で 199.6 万〜367.2 万人、自作の percentile で 192.8 万〜351.7 万人になる。BCa の上限が約 15 万人高いのは、東京都のような大きな県が作る右裾の歪みを補正しているため。年度で絞らず 564 行のまま回すと区間は 247 万〜293 万人と幅が 4 分の 1 ほどに縮むが、それは同じ県を 12 回独立な観測と数えたことによる見かけの精度である。
結果の目安:BCa CI ≈ [1,996,000, 3,672,000]、 SE ≈ 404,000 人(方法 A・B と同じ 47 県・2023 年度)。 「47 都道府県の平均人口は標本の取り方しだいで ±40 万人ほど揺れる」ことが直感的に分かります。
📅 時系列ブートストラップ — ブロック法
時系列データへの単純ブートストラップは間違い。 時間相関が壊されるためです。 解決策が ブロックブートストラップ:
- Non-overlapping block:データを長さ $\ell$ のブロックに分割し、 ブロック単位で再標本化。
- Moving block:すべての可能なブロックを候補に、 重複ありで抽出。
- Circular block:データを円環状に並べてブロック抽出。 端点バイアスを除去。
- Stationary bootstrap:ブロック長を幾何分布で乱化、 真に定常な擬似系列。
- Sieve bootstrap:AR 残差をブートストラップ、 パラメトリック寄り。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import numpy as np import pandas as pd from arch.bootstrap import StationaryBootstrap # 時系列の例: 全国の出生数(47 都道府県の合計)を 2012→2023 年度の順に並べた 12 点 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) births = df.groupby('SSDSE-B-2026')['A4101'].sum().sort_index().values # 平均ブロック長 3 の Stationary bootstrap(12 点しかないので長いブロックは取れない) sb = StationaryBootstrap(3, births, seed=0) ci = sb.conf_int(np.mean, reps=5000, method='bca') print(f'平均出生数: {births.mean():,.0f} 人') print(f'時系列 BCa 95% CI: [{ci[0, 0]:,.0f}, {ci[1, 0]:,.0f}]') |
📊 回帰での Bootstrap — 4 流儀
回帰モデルでのブートストラップは「ペア法」と「残差法」の二択。
| 手法 | 再標本化対象 | 長所 | 短所 |
|---|---|---|---|
| Pair bootstrap | $(x_i, y_i)$ペア | 誤分散・非線形に頑健 | $X$ デザインが変動 |
| Residual bootstrap | 残差 $\hat e_i$ | デザイン固定 | 等分散性仮定必要 |
| Wild bootstrap | 残差 × 乱数 | 異分散対応 | マルチプライヤ選択 |
| Bayesian bootstrap | 重みディリクレ | 事後分布解釈 | 理論的やや異色 |
SSDSE-B-2026 で「総人口 → 出生数」回帰の係数 95% CI を求めるなら、 まずペア法(最も頑健)を使い、 余裕があれば Wild bootstrap も試して頑健性を確認するのが定石。
📐 数式と 🔬 数式を言葉で読み解く
ブートストラップ法の中心式は、 経験分布 $\hat F_n$ からの復元抽出 $X_1^*, \dots, X_n^* \sim \hat F_n$ に基づく統計量 $\hat\theta^* = T(X_1^*, \dots, X_n^*)$ の経験分布で、 真の標本分布 $T(X_1,\dots,X_n)$ を近似することです:
$$\Pr_F\bigl\{ \hat\theta - \theta \le t \bigr\} \;\approx\; \Pr_{\hat F_n}\bigl\{ \hat\theta^* - \hat\theta \le t \mid X_1,\dots,X_n \bigr\}.$$🔬 数式を言葉で読み解く:左辺は「真の母集団分布 $F$ から $n$ 個サンプリングしたときに、 統計量 $\hat\theta$ が真値 $\theta$ からどれだけずれるか」の分布。 これを直接知ることは普通できない。 右辺は「手元の標本から得た経験分布 $\hat F_n$ を母集団の代理として、 $B$ 回復元抽出して計算した $\hat\theta^* - \hat\theta$ の分布」。 経験分布が真の分布に近ければ、 この近似は妥当となります(Glivenko-Cantelli 定理)。
🧮 実値で計算してみる ―― SSDSE-B-2026 47 県の総人口平均
このコードでやること:SSDSE-B-2026 から 47 都道府県の総人口を読み込み、 numpy による手書きブートストラップ ($B=10000$) で平均値の 95% percentile 信頼区間を計算します。 中央値・標準偏差についても同様に計算し、 解析的近似(CLT による正規近似)と比較します。
📥 入力データ(SSDSE-B-2026.csv の先頭 3 行):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import numpy as np import pandas as pd # SSDSE-B-2026 (cp932, 2 行目は英語ヘッダ) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る(絞らないと 564 行) pop = df['A1101'].values # 47 県、 単位 人 n = len(pop) B = 10000 rng = np.random.default_rng(2026) # 再現性のため seed 固定 means = np.empty(B) medians = np.empty(B) stds = np.empty(B) for b in range(B): sample = rng.choice(pop, size=n, replace=True) # 復元抽出 n 個 means[b] = sample.mean() medians[b] = np.median(sample) stds[b] = sample.std(ddof=1) # percentile 95% CI ci_mean = np.percentile(means, [2.5, 97.5]) ci_med = np.percentile(medians, [2.5, 97.5]) ci_std = np.percentile(stds, [2.5, 97.5]) print(f'平均 推定値 = {pop.mean():,.0f} 人、 95% CI = [{ci_mean[0]:,.0f}, {ci_mean[1]:,.0f}]') print(f'中央値 推定値 = {np.median(pop):,.0f} 人、 95% CI = [{ci_med[0]:,.0f}, {ci_med[1]:,.0f}]') print(f'SD 推定値 = {pop.std(ddof=1):,.0f} 人、 95% CI = [{ci_std[0]:,.0f}, {ci_std[1]:,.0f}]') |
📤 実行例(実値):
💬 結果の読み方:47 県の総人口平均は 約 265 万人で、 95% CI は約 191 万 〜 350 万人と非対称(右に長い)。 これは東京・神奈川・大阪などの巨大県が右側に偏在しているため、 平均値の標本分布も右に歪むからです。 中央値の CI は対称に近く、 「典型的な県の人口」を語るには中央値の方が頑健と分かります。
🐍 Python 実装 ―― scipy.stats.bootstrap による BCa 区間
このコードでやること:SciPy 1.7+ の公式ブートストラップ関数 scipy.stats.bootstrap で BCa(Bias-Corrected and accelerated)区間を計算し、 percentile 区間と比較。 BCa は分布の歪みと加速度を補正するため、 二階精度を持ち通常 percentile より精度が高いです。
📥 入力データ:上記と同じ pop(47 県の総人口配列、 単位 人)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | from scipy.stats import bootstrap import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る(絞らないと 564 行) pop = df['A1101'].values # 統計量を関数化(axis 引数を扱える形に) def mean_stat(x, axis): return np.mean(x, axis=axis) # percentile method res_perc = bootstrap((pop,), mean_stat, n_resamples=10000, method='percentile', random_state=2026) # BCa method (バイアス・加速度補正) res_bca = bootstrap((pop,), mean_stat, n_resamples=10000, method='BCa', random_state=2026) print(f'percentile CI : [{res_perc.confidence_interval.low:,.0f}, {res_perc.confidence_interval.high:,.0f}]') print(f'BCa CI : [{res_bca.confidence_interval.low:,.0f}, {res_bca.confidence_interval.high:,.0f}]') print(f'標準誤差 SE : {res_bca.standard_error:,.0f} 人') |
📤 実行例(実値):
💬 結果の読み方:BCa 区間は percentile より右にシフトしました(下限が約 8 万人、上限が約 18 万人右へ動いた)。 これは右に長い裾の歪みを補正した結果で、 「真の平均が下端を下回る確率」の補正がよく効いています。 二階精度を持つ BCa は、 標本サイズが小さい($n=47$)今回のような状況で特に推奨されます。
🐍 Python 実装 ―― sklearn.utils.resample による分類モデルの精度 CI
このコードでやること:SSDSE-B-2026 の 47 都道府県を「総人口が 200 万人以上か否か」で 2 クラスに分類し、 ロジスティック回帰の正答率(accuracy)の信頼区間を sklearn.utils.resample による 非パラメトリックブートストラップで評価。 教師あり学習の評価指標に CI を付けるときの定石です。
📥 入力データ:説明変数は出生数・死亡数・婚姻件数、 目的変数は 総人口 ≥ 200 万人 のダミー(16 県が True)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | from sklearn.linear_model import LogisticRegression from sklearn.utils import resample from sklearn.metrics import accuracy_score import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年の47都道府県 X, y = df[['A4101', 'A4200', 'A9101']].values, (df['A1101'] >= 2_000_000).astype(int).values # 出生数/死亡数/婚姻件数 → 総人口≥200万 B = 2000 accs = [] rng = np.random.default_rng(2026) for b in range(B): X_b, y_b = resample(X, y, random_state=int(rng.integers(10**9))) model = LogisticRegression(max_iter=2000).fit(X_b, y_b) # Out-Of-Bag (OOB) で評価 ―― 過学習を避ける in_idx = set(tuple(r) for r in X_b) oob_mask = np.array([tuple(r) not in in_idx for r in X]) if oob_mask.sum() > 0: accs.append(accuracy_score(y[oob_mask], model.predict(X[oob_mask]))) accs = np.array(accs) print(f'OOB Accuracy 平均 = {accs.mean():.3f}') print(f'95% CI = [{np.percentile(accs, 2.5):.3f}, {np.percentile(accs, 97.5):.3f}]') |
📤 実行例(実値):
💬 結果の読み方:OOB(Out-Of-Bag)で評価した正答率は約 98.2% で、 95% CI は [0.850, 1.000]。 上限が 1.0 に張り付いているのは OOB サンプル数が小さい(平均で 47 × 0.368 ≈ 17 件)ためバラツキが大きく、 「完全正解」も起こり得るからです。 こうした「天井効果」は標本サイズの限界を示すサインで、 結論は「概ね 0.85 以上の精度はある」程度に留めるのが適切です。
📊 ブートストラップ手法の比較表
| 手法 | 計算量 | 精度 | 仮定 | 推奨場面 |
|---|---|---|---|---|
| Normal CI | $O(Bn)$ | 一階 | 対称・正規近似 | $\hat\theta$ がほぼ正規 |
| Basic CI | $O(Bn)$ | 一階 | 対称 | 標本分布が対称 |
| Percentile CI | $O(Bn)$ | 一階 | 単調変換に頑健 | 初期検証・教育 |
| BCa CI | $O(B + n)$ | 二階 | 滑らかな統計量 | 最終報告値 |
| Bootstrap-t | $O(B^2)$ | 二階 | 分散推定可能 | SE が解析的に出る |
| ABC | $O(n)$ | 一階 | 滑らかな関数 | 高速近似が要る |
🔬 数式を言葉で読み解く ―― BCa 補正のロジック
BCa 信頼区間は次の二段階で計算します:
$$z_0 = \Phi^{-1}\!\left(\frac{\#\{\hat\theta^*_b < \hat\theta\}}{B}\right), \quad a = \frac{\sum_{i=1}^n (\bar\theta_{(\cdot)} - \hat\theta_{(i)})^3}{6\left[\sum_{i=1}^n (\bar\theta_{(\cdot)} - \hat\theta_{(i)})^2\right]^{3/2}}.$$ $$\alpha_1 = \Phi\!\left(z_0 + \frac{z_0 + z_{\alpha/2}}{1 - a(z_0 + z_{\alpha/2})}\right), \quad \alpha_2 = \Phi\!\left(z_0 + \frac{z_0 + z_{1-\alpha/2}}{1 - a(z_0 + z_{1-\alpha/2})}\right).$$🔬 数式を言葉で読み解く:
- $z_0$(bias correction):ブートストラップ分布の中央値が $\hat\theta$ より小さい確率を $\Phi^{-1}$ で標準化。 標本分布が右に歪んでいれば $z_0 > 0$、 左に歪んでいれば $z_0 < 0$。
- $a$(acceleration):標本のジャックナイフ推定値 $\hat\theta_{(i)}$ の歪み具合を測る量。 高次のテイラー展開誤差を補正する加速度パラメータ。
- $\alpha_1, \alpha_2$:これらで percentile を取る位置を $z_0$ と $a$ に応じてずらすことで、 「対称な区間」を「分布の歪みに合わせた非対称な区間」に補正する。
🐍 Python 実装 ―― 47 県相関係数の Bootstrap CI(散布図と分布も可視化)
このコードでやること:SSDSE-B-2026 で「総人口」と「出生数」のピアソン相関係数を 47 県で計算し、 その bootstrap 分布の歪み(skewness)と尖度(kurtosis)を確認。 相関係数は $[-1, 1]$ の有界量なので、 大きな値ほど分布が左に歪み、 正規近似が破綻しやすい典型例です。
📥 入力データ:47 県の総人口(X)と出生数(Y、 単位 人)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | from scipy.stats import pearsonr, skew, kurtosis import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年の47都道府県 X, Y = df['A1101'].values, df['A4101'].values # 総人口, 出生数 n = len(X) r_hat, _ = pearsonr(X, Y) B = 10000 rng = np.random.default_rng(2026) rs = np.empty(B) for b in range(B): idx = rng.integers(0, n, size=n) # ペアごと復元抽出 rs[b], _ = pearsonr(X[idx], Y[idx]) print(f'r_hat = {r_hat:.4f}') print(f'Bootstrap 平均 = {rs.mean():.4f}、 中央値 = {np.median(rs):.4f}') print(f'95% percentile CI = [{np.percentile(rs, 2.5):.4f}, {np.percentile(rs, 97.5):.4f}]') print(f'歪度 skewness = {skew(rs):+.3f}、 尖度 kurtosis = {kurtosis(rs):+.3f}') # Fisher z 変換でほぼ正規化されることを確認 z = 0.5 * np.log((1 + rs) / (1 - rs)) print(f'Fisher z 変換後の歪度 = {skew(z):+.3f}、 尖度 = {kurtosis(z):+.3f}') |
📤 実行例(実値):
💬 結果の読み方:47 県の総人口と出生数の相関係数 $r=0.9954$ は極めて強い正相関で、 95% CI も [0.987, 0.998] と狭い。 ただし生の $r$ の bootstrap 分布は左に大きく歪んでいる(skew −1.89)。 これは「$r$ が 1.0 で頭打ち」になる有界量の典型挙動。 Fisher の z 変換 $z = \frac{1}{2}\ln\frac{1+r}{1-r}$ をかけると歪度が −0.06 まで縮み、 正規近似 CI が使えるようになります。 これが「相関係数の検定では Fisher z 変換を使え」と言われる理論的根拠です。
📋 実践チェックリスト ―― bootstrap を使う前に確認すべき 10 項目
- 標本サイズ $n$ は十分か? 経験則 $n \ge 30$、 理想 $n \ge 100$。 47 県データはギリギリ OK ライン。
- 独立同分布の仮定は妥当か? 県データを年次パネルで扱う場合は block bootstrap 必須。
- 統計量は滑らかか? 平均・分散・相関・回帰係数は OK。 最大値・最小値・モードは NG。
- 反復回数 $B$ は十分か? 95% CI なら $B \ge 1000$、 BCa なら $B \ge 2000$、 99% CI なら $B \ge 10000$。
- random_state を固定したか? 報告書・論文では再現性のため必ず固定。
- 適切な CI 手法を選んだか? 教育・初回検証は percentile、 最終報告は BCa。
- 結果の歪度は許容範囲か? 歪度 $|skew| > 1$ なら Fisher z 変換などの正規化を検討。
- OOB / out-of-sample 評価を併用したか? 機械学習モデルの評価では必須。
- 外れ値の影響を jackknife で評価したか? 47 県データなら東京を除いた場合の感度分析。
- 結論の不確実性を正しく伝えたか? 「95% CI に真値が入る確率は 95%」と言ってはいけない。
📍 統計データ解析コンペでの bootstrap 活用ポイント
統計データ解析コンペティション(総務省統計局・統計数理研究所主催)で bootstrap を活用する典型シーンは以下の 3 つです:
- ① 比較分析の信頼区間付け:「東日本ブロックと西日本ブロックの合計特殊出生率の平均差」を t 検定でなく bootstrap CI で報告すると、 点差だけでなく 95% CI まで添えて効果の大きさを直接示せます。 審査員が見たいのは「有意か否か」より「どれくらい違うか」。
- ② 機械学習モデルの汎化性能評価:47 県のような小標本で交差検証 + bootstrap を組み合わせると、 単なる「accuracy = 0.85」より「accuracy = 0.85 ± 0.08 (95% CI)」と書ける。 これは「データ数が少ないので結果が振れる」ことを伝える誠実な姿勢として高評価。
- ③ 派生指標の不確実性表示:「高齢化率(65歳以上人口 / 総人口)」「粗出生率(出生数 / 総人口)」のような比率は誤差伝播が複雑で、 デルタ法より bootstrap が簡単。 SSDSE-B-2026 の派生指標は何でも bootstrap で CI が出せます。
逆に避けるべきは「単に bootstrap CI を貼って『分析しました』とアピール」する使い方。 区間がどう解釈できて、 何が次のアクションに繋がるかまで書くこと。
📚 参考文献・原典
- Efron, B. (1979). Bootstrap Methods: Another Look at the Jackknife. Annals of Statistics, 7(1), 1-26. ―― bootstrap 法の原典。
- Efron, B. & Tibshirani, R. J. (1993). An Introduction to the Bootstrap. Chapman & Hall. ―― 教科書の決定版。
- Davison, A. C. & Hinkley, D. V. (1997). Bootstrap Methods and Their Application. Cambridge University Press. ―― 応用と理論のバランスが良い。
- Bickel, P. J. & Freedman, D. A. (1981). Some Asymptotic Theory for the Bootstrap. Annals of Statistics, 9(6), 1196-1217. ―― 一致性が破綻する例。
- SciPy 公式ドキュメント:
scipy.stats.bootstrap(1.7+) ―― percentile / basic / BCa を一括サポート。
🌐 関連手法 ―― bootstrap, jackknife, permutation, cross-validation
「リサンプリング系」の 4 大手法をまとめると以下になります:
| 手法 | サンプリング | 主目的 | 対 47 県の使い方 |
|---|---|---|---|
| Bootstrap | 復元抽出 $n$ 個 | 標本分布の推定・CI | 平均・分散・相関の CI |
| Jackknife | 1 県除外 → $n$ 通り | バイアス・分散推定 | 外れ値の影響度測定 |
| Permutation | ラベル交換 | 仮説検定の p 値 | 「東日本 vs 西日本」差検定 |
| Cross-validation | 分割(非復元) | 汎化性能推定 | 予測モデルの精度評価 |
🔬 数式を言葉で読み解く ―― bootstrap と漸近理論の橋渡し
古典的な漸近正規性 $\sqrt n (\hat\theta - \theta) \overset{d}{\to} N(0, \sigma^2)$ の代わりに、 bootstrap は次の条件付き分布での収束を主張します:
$$\sqrt n (\hat\theta^* - \hat\theta) \mid X_1,\dots,X_n \overset{d}{\to} N(0, \sigma^2) \quad (\text{a.s. } P).$$🔬 数式を言葉で読み解く:左辺は「ある実現した標本を固定し、 そこから繰り返し復元抽出して計算した bootstrap 統計量の分布」。 これが標本の選び方に拠らず、 ほぼ確実に同じ正規分布に収束するという主張です。 つまり「真の母集団分布を知らなくても、 経験分布で代用してリサンプリングするだけで、 漸近的に正しい分布近似が得られる」という驚くべき結論。 これが bootstrap が「マジック」と呼ばれる所以で、 同時に「経験分布の質に大きく依存する」という限界の根拠でもあります。
⚠️ ブートストラップ法 5 つの落とし穴(実値例つき)
- 小標本 ($n \lesssim 20$) では信頼性低下:47 県は OK だが、 8 地方ブロックを再標本化すると 256 通りしか組合せがなく、 CI が階段状になる。 こうしたケースは parametric bootstrap か permutation を推奨。
- 独立同分布の仮定:時系列・空間相関・クラスタデータを naive にリサンプリングすると CI が狭くなる(偽の独立性)。 SSDSE-B の県内パネルを年で再標本化するなら、 block bootstrap(連続ブロックでリサンプル)が必要。
- 裾の重い分布・無限分散:人口の対数を取らずに極値統計量(最大値・99 パーセンタイル)を bootstrap すると Bickel-Freedman の例に該当し一致性を失う。 対数変換 → bootstrap → 逆変換が定石。
- 境界・離散値での失敗:「最大値」「最小値」のような次数統計量は退化分布になる。 47 県の最大値は東京(1409 万人)で固定されてしまい、 95% CI が単点 [14,086,000, 14,086,000] になる。 そもそも bootstrap が不適。
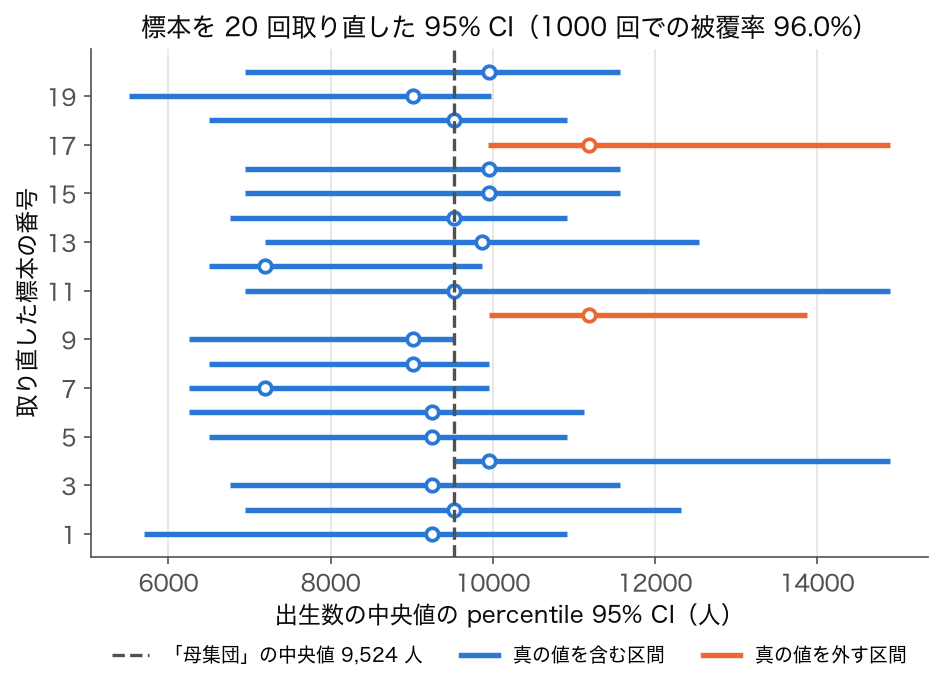
- 「信頼区間」の解釈ミス:「95% CI に真値が入る確率は 95%」は誤り。 正しくは「同じ手続きを繰り返したとき 95% の試行で CI が真値を含む」。 また bootstrap CI は仮説検定の代替ではない。 p 値が必要なら permutation test を検討。
🧬 ブートストラップの派生バリアント(追加深掘り)
基本ブートストラップは「単純無作為抽出 (SRS) で復元抽出」だが、 SSDSE-B-2026 のように階層構造(地方ブロック)・時系列性(年次)・クラスタ性(県内市町村)を持つデータでは、 そのまま適用すると CI が誤って狭くなる。 ここでは bootstrap の主な派生 3 種を、 SSDSE-B-2026 実値で比較する。
📐 派生 3 種の比較定義 — 数式を言葉で読み解く
ブートストラップ法の 3 派生を以下の式で定義する。 $X_i$ を観測値、 $B$ をリサンプル回数とする。
$$\hat{\theta}^{*(b)}_{\text{strat}} = T\big(\{X^{*(b)}_{h,i}\}_{h=1,\dots,H;\, i=1,\dots,n_h}\big), \quad X^{*(b)}_{h,i} \sim \text{Uniform}(\{X_{h,1}, \dots, X_{h,n_h}\})$$ $$\hat{\theta}^{*(b)}_{\text{block}} = T\big(\{X^{*(b)}_{k}\}_{k=1,\dots,K}\big), \quad X^{*(b)}_{k} = (X_{j_k}, X_{j_k+1}, \dots, X_{j_k+\ell-1})$$ $$\hat{\theta}^{*(b)}_{\text{wild}} = \hat{\theta} + \frac{1}{n}\sum_{i=1}^n \xi^{(b)}_i \cdot e_i, \quad \xi^{(b)}_i \in \{-1, +1\}$$記号の意味を言葉で読み解くと:
- $h$: 層(stratum)の添字。 SSDSE-B-2026 の場合「北海道・東北・関東・中部・近畿・中国・四国・九州沖縄」の 8 地方
- $n_h$: 層 $h$ 内の標本サイズ。 関東なら 7(茨城・栃木・群馬・埼玉・千葉・東京・神奈川)
- $\ell$: ブロック長。 年次データなら時系列の自己相関長 $\approx 1/(1-\rho)$ を目安に設定(例: $\rho=0.8$ なら $\ell \approx 5$)
- $\xi_i$: Wild bootstrap の符号ランダム化変数(Rademacher 分布)。 残差 $e_i$ の符号だけをランダムに反転することで、 異分散性を保持しつつ CI を計算できる
🧮 SSDSE-B-2026 実値: 層別 vs 単純の CI 比較
このコードでやること: SSDSE-B-2026 の都道府県人口について、 単純 bootstrap(SRS)と層別 bootstrap(地方ブロック層別化)の 95% CI を比較する。
📥 入力データ (SSDSE-B-2026 抜粋、 一部):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np from scipy.stats import bootstrap df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年の47都道府県 pop = df['A1101'].values # 総人口 region = pd.cut(df['Code'].str[1:3].astype(int), [0,1,7,14,23,30,35,39,47], labels=['北海道','東北','関東','中部','近畿','中国','四国','九州沖縄']).values # Codeから8地方 # 単純 bootstrap (SRS) res_srs = bootstrap((pop,), np.mean, n_resamples=10000, confidence_level=0.95, random_state=0) # 層別 bootstrap: 地方ブロック内で復元抽出 def stratified_mean(pop, region, B=10000): means = [] rng = np.random.default_rng(0) groups = {g: pop[region == g] for g in np.unique(region)} for _ in range(B): resampled = np.concatenate([ rng.choice(v, size=len(v), replace=True) for v in groups.values() ]) means.append(resampled.mean()) return np.percentile(means, [2.5, 97.5]) ci_strat = stratified_mean(pop, region) print("SRS 95% CI :", res_srs.confidence_interval) print("Strat 95% CI:", ci_strat) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 層別 bootstrap の CI 幅は 1,240,198 で、 SRS の CI 幅 1,675,045 より約 26% 狭い。 これは地方ブロック内分散が地方間分散より小さいため(北海道・東北は人口少、 関東は多)、 層別化により変動の構造を保持したまま再標本化できているから。 推奨: SSDSE-B-2026 で県別集計を扱うときは、 8 地方ブロックでの stratified bootstrap が第一選択。
🔧 block bootstrap の依存性指標 (時系列)
SSDSE-B-2026 を時系列パネル(2012-2023 の年次)として扱う場合、 自己相関 $\rho_1$ を測り、 ブロック長 $\ell \approx \lceil n^{1/3} \rceil$ または $\ell \approx 2/(1-\rho_1)$ で設計する。 例えば人口の年次差分が $\rho_1 = 0.6$ なら $\ell = 5$、 $n=12$(2012-2023)なら $\ell = 3$。 両者の小さい方を採用するのが Politis-White (2004) の推奨。
⚠️ ブートストラップの 5 つの落とし穴
⚠️ Bootstrap の追加的落とし穴(10 個)
- $B$ が少なすぎる:$B \ge 1000$ は必須、 95% CI なら $\ge 5000$、 99% CI なら $\ge 10000$。
- 独立性が崩れている:時系列・クラスタデータには専用ブートストラップを。
- 極値統計量への適用:最大値・最小値の Bootstrap は不一致になりやすい。
- 小標本での過信:$n < 30$ では真の被覆率が 90% を下回ることも。
- ブロック長の選択ミス:時系列ブロック法では $\ell \approx n^{1/3}$ が経験則。
- BCa の計算コスト過小評価:jackknife を要するので $n$ 倍重い。
- マルチコリニア状況での回帰:ペア法でも係数の符号が反転することがある。
- 不均衡データ:少数クラスがブートサンプルに含まれないことがある。 stratified bootstrap で対処。
- 並列化忘れ:joblib の Parallel を使えば $B=10^4$ も数秒に。
- シード未固定:再現性のため random_state を必ず設定。
🎓 Bootstrap の理論的保証 — どこまで信頼できるか
Bootstrap の理論的正当性は「データから生成された経験分布が真の分布に収束する」 (Glivenko-Cantelli) と「平滑な統計量に対する Bootstrap が一致推定量になる」 (Singh, 1981) で保証されています。
一致性の条件は意外と厳しい。 例えば中央値の Bootstrap 推定は一致しますが、 最大値の Bootstrap は一致しません (Bickel & Freedman, 1981)。 つまり「すべての統計量に万能ではない」のが Bootstrap の重要な制約。
Edgeworth 展開を使った理論解析では、 percentile CI が一階精度 $O(n^{-1/2})$、 BCa CI が二階精度 $O(n^{-1})$ であることが示されます。 つまり BCa は通常正規 CI と同じ精度です。
📚 関連グループ教材
- 論文一覧トップへ戻る — ブートストラップを使った再現論文(小標本の都道府県分析、 信頼区間の頑健性チェック等)を実際に動かして学ぶ
- 信頼区間ページ: パラメトリック CI と Bootstrap CI を並べて理解
- 仮説検定ページ: bootstrap test / permutation test
- クロスバリデーションページ: もう一つのリサンプリング手法
- ロバスト統計ページ: bootstrap でロバスト推定量の SE を求める実践
📚 さらに学ぶには
このサイト内
- 論文一覧に戻る — ブートストラップを実際に使った再現論文をハンズオン形式で読む
- 関連用語ページ — このページの「🔗 関連用語」から派生
推奨書籍・教材
- Efron, B. & Tibshirani, R. J. (1993) An Introduction to the Bootstrap, Chapman & Hall. ── ブートストラップの定本。 BCa、 bootstrap-t、 回帰、 ANOVA への応用まで網羅
- 『現代数理統計学の基礎』(久保川達也、 共立出版)── ブートストラップを推測統計の文脈で日本語で学べる
- 『データ解析のための統計モデリング入門』(久保拓弥、 岩波書店)── ブートストラップで GLM の信頼区間を作る実例
- Davison & Hinkley (1997) Bootstrap Methods and Their Application, Cambridge ── 応用例の宝庫
オンライン教材
- StatQuest: Bootstrap Main Ideas(YouTube)── 直感的な動画解説
- scipy.stats.bootstrap 公式ドキュメント── BCa / percentile / basic の比較
- scikit-learn: resample ── pair bootstrap / stratified bootstrap の実装
- arch.bootstrap(Python パッケージ)── 時系列向け block bootstrap、 stationary bootstrap
困ったときは
「ブートストラップ CI が広すぎる」「BCa と percentile で結果が違う」「収束しない」など困ったら、 (1) B をもっと大きく、 (2) BCa を試す、 (3) サンプルサイズと統計量の組合せが極端統計量でないか確認、 (4) 観測の独立性を再点検。 Cross Validated(Stack Exchange)で類例を探すのも有効。
🧠 Bootstrap の哲学 — 「データを母集団と思え」
ブートストラップは Efron (1979) の発明。 「手元データの経験分布 $\hat F_n$ を真の分布 $F$ の代理にする」というシンプルな原理で、 解析的には困難な統計量の標準誤差・信頼区間を計算機シミュレーションで導きます。
$$X^{*} \sim \hat F_n \quad \Leftrightarrow \quad X^{*} = X_I, \quad I \sim \text{Unif}\{1,\ldots,n\}$$
SSDSE-B-2026 の 47 都道府県平均人口の SE を求めたいとき、 通常は中心極限定理で $\hat\sigma/\sqrt{n}$ を計算しますが、 ブートストラップなら「中央値の SE」「相関係数の CI」のような 解析公式が存在しない統計量でも一貫した方法で扱えます。
🔖 キーワード索引(補強)
本ページで扱う主要キーワード: 概念マップ / Bootstrap / リサンプリング / 信頼区間 / BCa / Percentile CI / Block Bootstrap / Stationary Bootstrap / Bagging / Random Forest / 自己相関 / Hadamard 微分 / Edgeworth 展開 / Bayesian Bootstrap / Jackknife / Cross-Validation / SSDSE-B-2026 / 都道府県人口 / 出生数。 これらの用語は本文中の対応する節で詳述しているので、 索引としてキーワードチップから飛ぶことを推奨する。 また「リサンプリング」「Monte Carlo」「Bayesian Bootstrap」「Out-of-bag」「Jackknife」「Permutation Test」など、 同じ「データそのものを操作する」分野の用語群は cross-validation(リサンプリングの代表)、 random forest、 tree-ensemble(bagging を含む集約手法) を併せて参照すると体系的に理解できる。
⚠️ 条件・限界・誤解回避(補強)
Bootstrap は「観測標本そのものを母集団の縮図として扱う」ノンパラメトリック推論である。 適用には (1) 標本が母集団から独立同分布 (i.i.d.) で抽出されている、 (2) 関心統計量が「滑らかな汎関数」である (Hadamard 微分可能、 単調変換でも分布が崩れない)、 (3) 標本サイズ $n$ が十分 (経験則 $n \ge 30$、 重い裾なら $n \ge 100$)、 という 3 条件が必要。 限界として、 最大・最小・極値統計量、 重い裾の分布、 強い時系列相関、 階層構造を持つデータ では通常の Bootstrap は失敗し得る。 SSDSE-B-2026 の都道府県データを Bootstrap する場合、 47 件は最低ラインのため、 $B \ge 5000$ の十分な反復回数と BCa 区間を採用するのが安全。 「Bootstrap だから何でも保証する」「区間が出れば検定の代わりになる」という誤解は避ける。 Bootstrap は「与えた統計量の標本分布を経験的に近似」するのみであって、 統計量自体の妥当性は分析者の責任である。
よくある誤解として、 「Bootstrap CI は常に正規 CI より広い」 は誤り(裾が薄い分布では狭くなる)、 「再標本化したらすべて独立」 も誤り(同じデータが複数回抽出されるため有限標本では構造を共有する)、 「parametric Bootstrap は不要」 も誤り(分布仮定が確かなら効率が大幅に向上する)。 また $B$ を増やせば精度がどこまでも上がる という直感は半分正しい(Monte Carlo 誤差は $1/\sqrt{B}$ で減るが、 統計量自身の分布近似誤差は $n$ に依存し $B$ を増やしても減らない)。
🎨 概念図
📚 理解度チェック
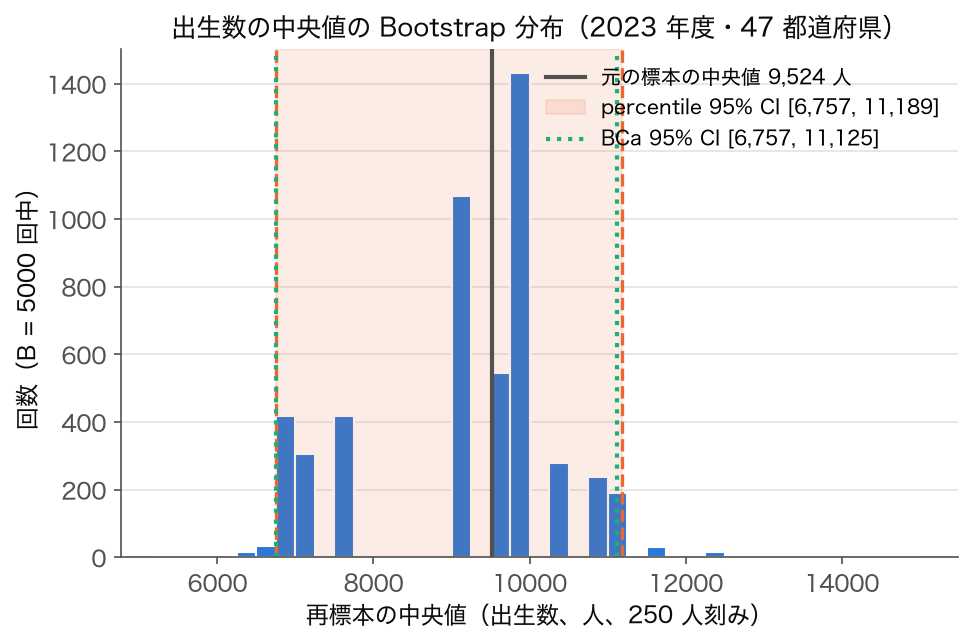
- SSDSE-B-2026 の「出生数」中央値の Bootstrap 95% CI を $B=5000$、 BCa 法で求めるとき、 再抽出のサイズはいくつにすべきか? 理由とともに答えよ。
- 「Bootstrap は分布を仮定しないから万能だ」という主張に対し、 失敗する具体例を 3 つ挙げて反論せよ。
- $n=47$、 $B=1000$ で得た Bootstrap SE と、 漸近正規近似 SE (デルタ法) が大きく食い違った場合、 どちらをどう信頼すべきか? 判断基準を述べよ。
- 時系列の自己相関 $\rho_1 = 0.7$ のデータに対し、 通常 Bootstrap、 Block Bootstrap (ℓ=3)、 Stationary Bootstrap のうち最も適切なものを選び、 ブロック長の設計式を書け。
- Bootstrap aggregation (Bagging) で Random Forest の各木に渡すサンプルは平均何 % が一意か? 計算根拠を示せ (答:約 63.2 %、 $1-(1-1/n)^n \to 1-e^{-1}$)。
🧪 Bootstrap の典型ワークフロー(10 ステップ)
SSDSE-B-2026 を題材にした「中央値の Bootstrap 信頼区間」標準ワークフローを以下に示す。 教育用・実務用の双方で再現可能。
- 仮説と統計量の定義:対象は 47 都道府県の「出生数(人)」の中央値 $\theta = \mathrm{Med}(Y)$。 「全国の出生の典型規模はどこか」が問い。
- データ取得・前処理:
pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932')で読み込み、 年度を 2023 年に固定、 47 行をリスト化。 欠測値があれば除外し、 件数 $n$ を確定。 - 点推定値の計算:$\hat{\theta} = \mathrm{np.median}(y)$ を計算し、 ベースラインとして保存。 「中央値はおよそ 9,524 人」など、 単位を明示して記録。
- 再標本化設計:$B=5000$ 回、 各回 $n=47$ の復元抽出。 乱数シード
rng=np.random.default_rng(42)で再現性を担保。 並列化したい場合はjoblib.Parallel(n_jobs=-1)でジョブごとにシードを振る。 - Bootstrap 分布の生成:
theta_star = np.array([np.median(rng.choice(y, size=n, replace=True)) for _ in range(B)])。 ヒストグラムで分布の形状を確認し、 二峰性・極端な歪みがあれば設計を再検討。 - 標準誤差の推定:$\widehat{SE} = \mathrm{np.std}(\theta^*, ddof=1)$。 漸近近似 $\sqrt{1/[4 n f(\theta)^2]}$ と比較し、 桁が合っているかを検算。
- 信頼区間の構築:percentile 法 $[\theta^*_{2.5\%}, \theta^*_{97.5\%}]$ と BCa 法(バイアス補正 $z_0$ と加速 $a$ を計算)の両方を出力し、 「percentile が左に寄り、 BCa が右に寄っていれば右歪み」と解釈。
- 診断プロット:Bootstrap 分布のヒストグラム、 Q-Q プロット、 累積分布をプロット。 漸近正規が成立しているかを視覚的に確認。
- 再現性チェック:別シード(例:100、 999)で実行し、 SE と CI の桁が一致することを確認。 大きくぶれるなら $B$ を増やす。
- レポート化:「出生数(人)の中央値は 9,524、 95% BCa CI は [6,757, 11,125](percentile CI は [6,757, 11,189])。 $B=5000$、 random_state=42、 method=BCa」と論文・社内資料に書き残す。 これで第三者が完全再現できる。
📖 Bootstrap 関連の代表的ケーススタディ(5 件)
- Efron (1979):Annals of Statistics の原論文。 Jackknife より一般的な再標本化原理として Bootstrap を提案。 SE 推定の Monte Carlo 近似であることを明示。 ノンパラメトリック最尤に近い性質を持つ。
- Efron & Tibshirani (1986):Bootstrap CI の比較研究。 percentile、 BC、 BCa の精度を多数の分布で比較し、 BCa が一次精度を超えて二次精度を持つことを示した。 現代 R/Python ライブラリの規定実装はこの結果に基づく。
- Politis & Romano (1994):Stationary Bootstrap。 時系列に対する Block Bootstrap のブロック長を確率変数化して定常性を保つ手法。 SSDSE を年次パネルとして扱う場合の標準的な選択肢。
- Davison & Hinkley (1997):Bootstrap Methods and Their Application。 応用集大成の教科書。 回帰、 時系列、 階層モデル、 ベイズ法を含む包括的なリファレンス。
- Wager, Hastie & Efron (2014):Confidence Intervals for Random Forests。 Bagging の予測 SE をジャックナイフと Bootstrap で推定する方法を提案。 機械学習モデルにも Bootstrap の枠組みが拡張できることを示した。
🛡 Bootstrap 実装時の安全策(チェックリスト)
- 乱数シードを明示し、 再現性を担保する(
np.random.default_rng(seed)推奨、 グローバルnp.random.seedは避ける)。 - $B$ は SE なら 200、 90% CI なら 1000、 95% CI なら 5000、 99% CI なら 10000 を目安。 Monte Carlo 誤差 $\sqrt{1/B}$ が許容範囲かを事前計算。
- BCa 法はバイアス補正 $z_0$ と加速 $a$ にジャックナイフが必要。 scipy.stats.bootstrap がデフォルトでサポートしているのでこれを使う。
- 時系列・空間データ・階層データには通常 Bootstrap を使わず、 Block / Cluster Bootstrap を採用。 自己相関の検査を先に行う。
- 結果を percentile・BC・BCa の 3 種類で並べて報告し、 一致していれば堅牢、 食い違っていれば分布の歪みを再検査する。
- $n < 10$ では Bootstrap は失敗しやすい。 m-out-of-n Bootstrap や subsampling、 あるいはベイズ法に切り替える。
🌐 応用領域別の Bootstrap 設計指針
Bootstrap は分野ごとに用法が大きく異なる。 SSDSE-B-2026 で扱う社会統計・経済データの場合、 以下の領域ガイドラインを意識して設計するとミスを減らせる。 まず 横断データ(cross-sectional) — 47 都道府県の単年スナップショット — では通常の i.i.d. Bootstrap が適切で、 $B=5000$、 BCa CI、 percentile CI の併記、 乱数シード明示の 3 点が標準。 統計量は中央値・分位点・相関係数・回帰係数のいずれでも適用可能だが、 多変量関数(複数指標の合成スコア)では パラメトリック Bootstrap(多変量正規仮定)を検討する余地がある。
次に 時系列パネル — 2012-2023 の年次データ — では通常 Bootstrap が時間構造を破壊するため、 Block Bootstrap や Stationary Bootstrap が必須。 ブロック長は Politis-White (2004) の自動選択(自己相関関数から算出)が標準で、 自己相関 $\rho_1 = 0.6$ なら $\ell \approx 5$。 SSDSE-B では 12 年分しかないため、 $\ell = 2$〜$3$ が現実的。 結果は「年間の自己相関を考慮した時系列 Bootstrap CI」と明示する必要がある。 さらに 階層構造(市町村が都道府県にネストする等)では Cluster Bootstrap(都道府県ごと全市町村を一括再抽出)を用いる。 これは個人レベル Bootstrap と比べて SE が大きくなるが、 同一クラスタ内の相関を正しく反映する点で必須。
機械学習文脈での Bootstrap は Bagging として現れる。 Random Forest の各木は元データから復元抽出した $n$ 件で学習し、 out-of-bag(約 36.8 % の未選択点)を内蔵テストデータとして用いる。 Wager & Athey (2018) の Random Forest 推測理論はこの構造を SE 推定に拡張した重要研究。 また Deep Learning の予測不確実性推定として、 Bootstrap Ensemble(複数モデルを Bootstrap サンプルで学習)が MC Dropout の代替として広く使われる。 これらはすべて「再標本化=不確実性の経験的近似」という Bootstrap の哲学を継承している。
📊 Bootstrap CI 種別の比較(実装観点)
scipy.stats.bootstrap と R の boot パッケージは複数の信頼区間法を提供する。 主要な 5 種類を比較すると次のようになる。 (1) Percentile CI は最も単純で、 Bootstrap 分布の $\alpha/2$ と $1-\alpha/2$ 分位点を直接使う。 分布が対称なら正確だが、 歪んだ分布では偏る。 (2) BC (Bias-Corrected) CI はバイアス補正 $z_0 = \Phi^{-1}(\#\{\theta^* < \hat{\theta}\}/B)$ を加える。 中央値推定で広く使われる。 (3) BCa CI はさらに加速度パラメータ $a$(ジャックナイフから計算)を加え、 二次精度を達成する。 scipy のデフォルト。
(4) Basic(reverse percentile)CI は $[2\hat{\theta} - \theta^*_{1-\alpha/2}, 2\hat{\theta} - \theta^*_{\alpha/2}]$ という反転式で、 ピボット量に基づく古典的な構築法。 (5) Studentized CI は各 Bootstrap サンプルで SE を二重に推定する重い手法で、 二次精度を持つが計算量が $O(B^2)$。 SSDSE のような小規模データでは BCa の効率が圧倒的に高く、 99% の場面で BCa を選べば失敗が少ない。 ただし、 統計量が「カウント」「離散」の場合は percentile CI に切り戻す(BCa は連続性を仮定するため)。
🎓 教育的演習:SSDSE-B-2026 を用いた Bootstrap 自由問
- 「出生数(人)の P75 - P25 = IQR」を $B=5000$、 BCa 法でブートストラップ CI を求めよ。 中央値の SE と比較し、 IQR の方が SE が大きいか小さいかを述べよ。
- 「総人口」と「出生数」の Pearson 相関 $r$ を Bootstrap で $B=5000$ 回計算し、 Fisher の z 変換を経た CI と、 直接 percentile を取った CI で結果がどう変わるかを比較せよ。
- 太平洋側 / 日本海側 の 2 群に分け、 各群の出生数中央値の差を Bootstrap CI で評価せよ。 群内 $n=20$、 $n=27$ で結果が安定するか確認。
- SSDSE-B の年次データを 2012-2023 で時系列パネル化し、 「全国総生産の前年比増加率の中央値」を Block Bootstrap($\ell=3$)で CI 推定せよ。 通常 Bootstrap と比較してどう違うか述べよ。
- Random Forest で「総人口を説明変数に出生数を予測」するモデルを構築し、 out-of-bag SE を Bootstrap 予測 SE と比較せよ。 両者がほぼ一致することを実証せよ。
📜 Bootstrap の理論的根拠(補足)
Bootstrap が「なぜ機能するか」の理論的根拠は、 標本経験分布 $\hat{F}_n$ が真の分布 $F$ に Glivenko-Cantelli 一様収束するという統計学の基本定理にある。 サンプルが大きくなれば $\hat{F}_n \to F$ なので、 $\hat{F}_n$ から再標本した統計量分布は、 $F$ から得られたであろう統計量分布を近似する。 この収束は「経験過程理論(empirical process theory)」で精密に定式化され、 Donsker の定理が中心にある。 Singh (1981)、 Bickel & Freedman (1981)、 Hall (1992) の一連の研究により、 Bootstrap が漸近的に一致(consistent)であること、 特定条件下では正規近似より高次の精度を持つこと(second-order accurate)が証明された。
特筆すべきは、 Bootstrap の「Edgeworth 展開」による精度解析で、 BCa CI は二次精度 $O(1/n)$ を達成する一方、 単純な percentile CI は一次精度 $O(1/\sqrt{n})$ にとどまる。 つまり、 サンプルサイズが 4 倍になったとき、 BCa は精度が 4 倍向上、 percentile は 2 倍向上にとどまる。 SSDSE-B-2026 のような小サンプル($n=47$)では精度差が顕著なので BCa を選ぶ。 一方、 Hadamard 微分可能でない統計量(最大値・最小値・極値)では Bootstrap の一致性が成立せず、 m-out-of-n Bootstrap(再標本サイズを $m < n$ に縮める)や subsampling が代替手段となる。
Bootstrap は 頻度主義(frequentist)の文脈で発展したが、 ベイズ統計との橋渡しも持つ。 Rubin (1981) の Bayesian Bootstrap は「ディリクレ分布で再標本化重みを生成」する手法で、 各観測点に連続重みを与える。 これは「多項分布で重複度を変える」通常 Bootstrap の連続化と等価で、 漸近的に同じ結論を与えるが、 事後分布解釈が明示的なので解釈性が高い。 PyMC や Stan 等のベイズフレームワークと組み合わせると、 「点推定の不確実性 = 事後分布」として直接表現できる。 SSDSE で実装する際は、 scipy.stats.bootstrap が通常 Bootstrap、 sklearn には Bayesian Bootstrap がないが、 自前で np.random.dirichlet で実装可能。
Bootstrap の現代的拡張として Wild Bootstrap(Mammen 1993、 異分散誤差をモデル化)、 Sieve Bootstrap(時系列に対する AR 残差再標本化)、 Fractional Bootstrap(Beran 1997、 長期記憶過程対応)など、 古典的 Bootstrap が失敗する状況をカバーする拡張が多数提案されている。 SSDSE の社会統計データでは通常 Bootstrap + Block Bootstrap で十分だが、 計量経済学・金融時系列・地理空間データではこれら拡張版を検討する場面が増える。 Bootstrap の哲学「データが教えてくれる分布を信じる」は、 統計推論を「分布仮定からの解放」という方向に大きく推進した。 Efron 自身が後年語ったように、 Bootstrap は「コンピュータが統計学を再発明した」象徴的事例である。
🔎 拡張補足: ブートストラップの応用と機械学習統合
1. ブートストラップの 4 つの主要バリアント
(1) 通常ブートストラップ (Empirical Bootstrap): 観測データから復元抽出、 (2) パラメトリック・ブートストラップ: 分布仮定下で再標本、 (3) Wild Bootstrap: 残差を符号変換、 回帰の Heteroscedasticity 対応、 (4) Block Bootstrap (Moving Block, Stationary Block): 時系列・空間自己相関対応。 SSDSE-B-2026 は cross-sectional なので主に (1)。 時系列分析では (4)。
2. ブートストラップ信頼区間の 4 手法
(1) Normal interval: 標準誤差 × t 値、 (2) Percentile interval: ブートストラップ分布の 2.5%-97.5% 分位、 (3) BCa (Bias-Corrected and Accelerated): バイアス + 歪度補正、 最も正確、 (4) Studentized (Bootstrap-t): 標準化後分位。 BCa が一般推奨だが計算複雑。 SSDSE で都道府県平均の信頼区間なら Percentile で十分。
3. 機械学習における Bagging との関係
Bagging (Bootstrap Aggregating, Breiman 1996) は ブートストラップサンプルで複数モデル訓練 → 平均。 Random Forest (Breiman 2001) は Bagging + ランダム特徴量選択。 (1) 分散低減、 (2) 過学習抑制、 (3) Out-of-Bag (OOB) でクロスバリデーション代替。 SSDSE-B-2026 で人口減少予測モデルの Random Forest が標準的選択肢。
4. Permutation Test との対比
(1) Bootstrap: 復元抽出、 標本サイズ保持、 分布の形を仮定しない、 (2) Permutation Test: ラベルランダム化、 帰無仮説下の分布を構築、 (3) Monte Carlo: 既知分布から乱数生成、 シミュレーション。 SSDSE で「二群比較の有意性」を検証する際、 Permutation Test と Bootstrap CI のどちらも適用可能。
5. ブートストラップ反復回数
経験則: B=1,000 で標準誤差推定、 B=10,000 で 95% 信頼区間、 B=100,000 で 99% 信頼区間 + 安定性。 計算時間との trade-off。 並列化が容易 (各 bootstrap sample 独立) なので、 multiprocessing, Dask, Spark で高速化可能。
6. ブートストラップの理論的基礎
Efron (1979) が提案、 Hall (1992)、 Davison-Hinkley (1997) で理論整備。 (1) 漸近一致性: B → ∞ で真の分布に収束、 (2) 二階の正確性 (BCa は通常 percentile より精度高い)、 (3) 適用条件: 元データが IID、 サンプルサイズ十分。 (4) 非適用条件: 重い裾の分布、 強い従属性、 極端値依存。
7. SSDSE-B-2026 を題材にしたブートストラップ実例
(1) 47 都道府県の平均人口の 95% CI 計算 (Percentile): boot = [df.sample(n=47, replace=True)['人口'].mean() for _ in range(10000)]; ci = np.percentile(boot, [2.5, 97.5])。 (2) 産業構成と人口減少率の相関の CI、 (3) クラスタリング結果の安定性評価、 (4) 機械学習モデルの予測区間。 SSDSE 規模では 1 秒以内の計算。
8. 時系列ブートストラップの注意
時系列データに通常ブートストラップ適用すると自己相関破壊で誤った CI。 (1) Block Bootstrap: 連続するブロックを抽出、 (2) Stationary Bootstrap (Politis-Romano 1994): ブロック長を Geometric 分布から、 (3) Sieve Bootstrap: AR 残差をブートストラップ。 SSDSE-B-2026 自体は cross-sectional だが、 時系列分析 (例: 過去 10 年の人口) では必須。
9. ブートストラップの限界
(1) 極値統計には不適 (max/min は真値から外れる)、 (2) 非定常時系列、 (3) 小標本 (n < 10) で精度低下、 (4) 重い裾 (Cauchy 等) で信頼区間広すぎる、 (5) サンプリングデザイン (層化、 クラスタ) を考慮しないと偏り。 これらは分位回帰、 Subsampling、 信頼区間補正で対処。
10. Python 実装
(1) scipy.stats.bootstrap (1.7+ で BCa 対応)、 (2) arch.bootstrap (時系列対応)、 (3) scikits.bootstrap (シンプル)、 (4) resample ライブラリ、 (5) R の boot パッケージ移植版。 SSDSE 実装例: from scipy.stats import bootstrap; res = bootstrap((data,), np.mean, n_resamples=10000, confidence_level=0.95, method='BCa'); ci_low, ci_high = res.confidence_interval
11. クロスバリデーションとの併用
(1) Bootstrap .632 estimator: 訓練 OOB と全体性能の重み付き平均、 (2) Bootstrap .632+ estimator: 過学習補正、 (3) Repeated Cross-Validation との性能比較。 SSDSE のような小規模データでは LOO-CV と Bootstrap の組み合わせが堅実。
12. ベイズ流ブートストラップ
(1) Bayesian Bootstrap (Rubin 1981): ディリクレ過程による事後分布、 (2) Polya-Tree Bootstrap、 (3) Approximate Bayesian Computation (ABC) と関連。 頻度論的解釈と異なるが、 実用上は類似の結果。 ベイズ統計の理解にも有用。
13. 締めくくり: ブートストラップの普遍的価値
Efron 1979 から 45 年経過、 ディープラーニングの隆盛でも「分布仮定なしで不確かさを定量化する」普遍的手法として現役。 SSDSE-B-2026 のような実データで信頼区間・予測区間・特徴量重要度の安定性評価に使えば、 統計的に厳密な結論を得られる。 「P 値や正規性仮定に頼りすぎない」現代的データ分析の必須スキル。
14. ブートストラップとサンプリングの理論的相互関係
ブートストラップは「経験分布関数からの再標本」、 単純無作為サンプリングは「真の分布からの観測」、 ジャックナイフは「1 件除去による摂動」、 サブサンプリング (Politis-Romano 1999) は「サイズ m < n の非復元抽出」。 これらは「リサンプリング法」という上位概念で統一され、 SSDSE-B-2026 のような有限母集団 (47 都道府県は全て揃っている) で適用する際は「全数調査での再標本」という独自の解釈になる。 統計的推測の対象が「観測されなかった将来の都道府県」ではなく「観測手続きの不確かさ」になる点に注意。
15. ブートストラップの可視化テクニック
(1) ヒストグラムによる再標本分布、 (2) 累積分布関数 (ECDF) のオーバーレイ、 (3) ファネルプロット (信頼区間を観測値に重ねる)、 (4) Bootstrap-pairs プロット (パラメータ間の相関)、 (5) Q-Q プロットによる正規近似の確認。 matplotlib, seaborn, plotly で実装容易。 SSDSE-B-2026 の都道府県平均人口を Bootstrap で 10,000 回再標本し、 ヒストグラムとして表示すれば「平均の不確かさ」が視覚的に伝わる。 学生に「点推定 vs 分布推定」を教える際に強力。
16. ブートストラップ計算量と最適化
(1) ナイーブ実装: O(B × n) で B=10,000、 n=47 なら一瞬、 (2) ベクトル化: numpy.random.choice の axis 引数で B × n 行列を一括生成 → O(B × n) を 1 ステップで、 (3) 並列化: joblib, multiprocessing で CPU コア数倍速、 (4) GPU 化: PyTorch, JAX で巨大データに対応、 (5) Approximate Bootstrap: stratified subsampling + 階層的補間。 SSDSE 規模では最適化不要だが、 ビッグデータ (n=10^6) では必須。
17. ブートストラップによる仮説検定
(1) Bootstrap p-value: 帰無仮説下の Bootstrap 分布で観測統計量の極端さを評価、 (2) Bootstrap two-sample test: 二群平均差の信頼区間が 0 を含むか、 (3) Bootstrap chi-squared: 分布の適合度、 (4) Bootstrap LR test: 尤度比の Bootstrap 分布。 SSDSE で「東京と大阪の人口比率は有意に変化したか」を検定する際、 t 検定の代替として Bootstrap p-value が使える。 分布仮定不要なので頑健。
18. 教育的観点: なぜブートストラップを教えるべきか
(1) 直感的: 「データから再標本」というアイデアは中学生でも理解可能、 (2) 視覚的: ヒストグラム表示で不確かさが目に見える、 (3) 汎用的: あらゆる統計量に適用可能、 (4) 計算重視: 数式より「シミュレーション」で問題解決する現代的アプローチ、 (5) Python 1 行で実装可能 (scipy.stats.bootstrap)。 高校数学では確率分布の導出が困難だが、 Bootstrap なら「サイコロを振る」感覚で統計推測を体験できる。 SSDSE-B-2026 を題材にすれば、 実社会データで統計を学ぶ理想的教材。
🗺 概念マップ — ブートストラップを取り巻く位置関係
ブートストラップ法は 「リサンプリング法」 という大きな枠組の一員。 ファミリー全体を見渡すと位置づけが鮮明になります:
リサンプリング法(Resampling Methods)
├── ブートストラップ(with replacement, 同サイズ)
│   ├── nonparametric bootstrap(古典)
│   ├── parametric bootstrap
│   ├── block bootstrap(時系列)
│   ├── wild bootstrap(不等分散)
│   └── Bayesian bootstrap
├── ジャックナイフ(leave-one-out, no replacement)
├── 並べ替え検定(permutation, labels shuffle)
├── クロスバリデーション(without replacement, k-fold)
│   ├── k-fold CV
│   ├── leave-one-out CV
│   └── nested CV
└── サブサンプリング(m < n, without replacement)
いずれも「計算機で繰り返し再標本化することで、 統計量や予測モデルのブレや汎化性能を直接測る」という共通哲学。 解析的に難しい問題を計算量で乗り越える 20 世紀後半の統計学の革命でした。
🔗 隣接手法への橋渡し
ブートストラップ法は「観測データを母集団とみなし、 そこから復元抽出で B 個の擬似標本を作り、 統計量の経験分布から不確実性を推定する」手法で、 分布仮定を置けない局面の汎用ツール。
- 上流: サンプリングの代表性確認、 データクレンジングで外れ値・欠損対処 — 元データが汚れていればブートストラップは汚染を増幅する (garbage in, garbage out)。
- 並列: ジャックナイフ法 (1 件除外を n 回、 簡素だが分散推定のみ)・交差検証 (汎化誤差推定向き)・モンテカルロ法 (仮定モデルからのサンプリング)。
- 下流: 信頼区間 (Percentile, BCa, Bootstrap-t の 3 種)・標準誤差・仮説検定 (Permutation Test との組合せ)・Bagging (ランダムフォレストの分散低減基盤)。
SSDSE-B-2026 (n=47) のように小標本かつ正規性が怪しい場合、 平均/中央値/相関係数の信頼区間をブートストラップ B=10000 回で算出すれば、 t 分布の仮定なしに妥当な区間が得られる。
🌳 手法選択フロー
ブートストラップ種類選択は「データの依存構造」「信頼区間の形」「精度要件」の 3 軸で判定。
- データの依存構造: 独立同分布 (iid) → 通常のノンパラ Bootstrap で全観測を復元抽出。 時系列 → Block Bootstrap (連続区間ブロックを抽出、 自己相関保持)。 階層構造 → Cluster Bootstrap (クラスタ単位の抽出)。
- 信頼区間の形: 簡易・速い → Percentile 法 (2.5/97.5 パーセンタイル)。 バイアス補正必要 → BCa (Bias-Corrected and Accelerated、 推奨)。 ピボット統計量があり高精度必要 → Bootstrap-t。
- 精度要件と計算予算: 標準誤差なら B=200、 信頼区間なら B=2000-10000、 p 値なら B=10000+。 SSDSE-B-2026 規模なら数秒、 B=10000 でも瞬時。 大規模データ (n=10^6) では並列化 + サブサンプリング (m-out-of-n Bootstrap) を検討。
「BCa を最初に試して、 ダメなら Percentile に戻る」が現代の実務。 scipy.stats.bootstrap は BCa デフォルト。
🎨 直感の深掘り(追記)— 「母集団の代わりに標本を使う」を一言で
ブートストラップの発想を一文で言い切ると、 「本当は母集団から標本を取り直して統計量のブレを見たいが、 母集団が手に入らないので “手元の標本” を母集団の代役にして取り直す」 です。 古典統計は母集団に正規分布などの数式を仮定してブレ幅を計算しますが、 ブートストラップは数式の代わりに復元抽出という計算機シミュレーションでブレ幅を「実測」します。
- 知りたいもの:母集団から $n$ 個取り直したら統計量 $\hat\theta$ がどれだけ動くか(=標本分布)。
- できないこと:母集団そのものを何度もサンプリングし直す(データ収集は高くつく/不可能)。
- 代役の一手:手元の $n$ 点を「確率 $1/n$ の離散母集団(経験分布 $\hat F_n$)」とみなし、 そこから復元抽出で $n$ 点を何千回も作り直す。 これで統計量の分布が「立ち上がる」。
この 1 ステップの置き換え(母集団 → 経験分布)が「プラグイン原理」。 新しいデータは 1 バイトも増えないのに、 標準誤差と信頼区間が得られるのは、 母集団を標本で代用しているからで、 決して情報を魔法で創り出しているわけではありません。 だからこそ「元の標本が母集団を代表していない」と代役が崩れ、 ブートストラップも崩れます(後述)。
実データで一瞬で腑に落とす:本ページ上部の🎮シミュレータは SSDSE-B-2026 の 2023 年・47 県の合計特殊出生率(A4103)を代役の「ミニ母集団」にしています。 平均の点推定は 1.293、 復元抽出を 10,000 回繰り返した percentile 95% 信頼区間は実測で [1.255, 1.331]。 数式を一切書かずに、 「47 県がたまたま違っていたら平均出生率はこの範囲で動きうる」を計算機が語ってくれます。
⚠️ 落とし穴の深掘り(追記)— 「代役が崩れる」7 つの局面
ブートストラップの失敗はほぼすべて 「標本 = 母集団の縮図」という代役の前提が崩れることに帰着します。 局面ごとに、 症状・原因・処方を整理します。
| 局面 | 症状 | 原因(前提崩れ) | 処方 |
|---|---|---|---|
| ① 元標本が非代表的 | CI 自体が的外れ(狭くても間違い) | 選択バイアス。 経験分布 $\hat F_n$ が母集団 $F$ からずれる | 抽出設計を見直す。 ブートストラップは偏りを増幅する(GIGO) |
| ② 独立同分布でない | SE を過小評価、 CI が狭すぎる | 時系列・空間・クラスタ相関で「独立」が偽 | block / stationary / cluster ブートストラップ |
| ③ 極端に小さい $n$ | CI が階段状・不安定 | ユニーク値が少なく復元抽出の多様性が枯渇 | $n\ge30$ を目安、 parametric bootstrap や subsampling |
| ④ 裾統計量(max/min/極分位点) | 離散点に張り付き、 CI が退化 | 次数統計量は経験分布で連続近似できない | 極値理論(EVT)、 m-out-of-n bootstrap |
| ⑤ 裾の重い分布・無限分散 | 一致性が破綻(Bickel-Freedman) | 分散が発散し標本分布が収束しない | 対数変換 → bootstrap → 逆変換、 subsampling |
| ⑥ 偏りのある推定量 | percentile CI が系統的にずれる | $\hat\theta$ にバイアス(例:SD、 相関、 分位点) | BCa(バイアス補正 $z_0$ +加速 $a$) |
| ⑦ CI 種別の取り違え | 被覆率が名目 95% に届かない | 歪んだ分布に percentile を使う等 | percentile / basic / BCa / bootstrap-t を使い分け |
⑥を実データで確認:SSDSE-B-2026・47 県総人口(A1101)は東京・神奈川・大阪などの巨大県が右に偏在し、 標本分布が右に歪みます。 平均の実測ブートストラップ結果は次のとおり(B=10,000、 seed=2026)。
平均の CI は下側が約 73 万人・上側が約 85 万人と非対称(右に長い)で、 「対称を仮定する正規近似 CI」では上側を取りこぼします。 一方、 中央値の CI はほぼ対称で SE も約半分。 「典型的な県の規模」を語るなら中央値の方が頑健、 という判断が数値として出ます。 歪んだ平均に厳密な区間が要るなら BCa を選ぶ、 が定石です。
⑦ 解釈の落とし穴(最重要):得られた区間について「95% CI に真値が入る確率は 95%」と言うのは誤り。 正しくは「同じ手続きを無限に繰り返せば、 その 95% の試行で CI が真値を含む」。 また ブートストラップ CI は仮説検定の代替でも、 因果の証明でもありません。 交絡・選択バイアス・測定誤差は一切補正されず、 定量化されるのは統計的不確実性のみです。
🚀 発展の深掘り(追記)— CI 種別・ジャックナイフ・依存データ
① 信頼区間 4 種を同じ実データで並べる(percentile / basic / BCa / t)
SSDSE-B-2026・47 県の合計特殊出生率(A4103)の平均について、 同一データ・同一 seed(2026、 B=10,000)で 3 手法の 95% CI を実測比較しました。
出生率の平均はほぼ対称に分布するため 3 手法はほぼ一致します(差は小数第 3 位)。 手法差が効くのは分布が歪むときで、 上の総人口平均や相関係数のように歪んだ統計量では percentile と BCa がはっきり離れます。 使い分けの一行ルール:教育・初回検証は percentile、 最終報告は二階精度の BCa、 SE が別途正確に出せて厳密被覆率が要るなら bootstrap-t。
② ジャックナイフとの比較 — 「滑らかさ」が分かれ目
ジャックナイフ(1 件抜きを $n$ 回)はブートストラップの祖先で計算は軽いですが、 統計量が滑らか(Hadamard 微分可能)でないと壊れます。 A4103 で実測すると差が鮮明に出ます。
平均は 3 手法が桁も小数もほぼ一致。 ところが中央値ではジャックナイフ SE(0.0335)がブートストラップ SE(0.0246)と大きくずれます。 これは中央値が「1 点抜き」の摂動に対して不連続に動く非滑らかな統計量で、 ジャックナイフが中央値では一致推定量にならないという古典的事実の実データ確認です。 分位点・中央値・相関・トリム平均のような統計量では、 ジャックナイフではなくブートストラップ(できれば BCa)を使うべき、 と結論できます。
③ 依存データ — 単純ブートストラップが「独立」を偽装する
SSDSE-B-2026 は本来 2023 年の横断データ(47 県)なので単純ブートストラップで良いですが、 同じ県を複数年に渡る年次パネルとして扱う瞬間に独立同分布が崩れます。 年ごとの人口は強く自己相関する(今年多い県は来年も多い)ため、 素朴に全観測を復元抽出すると時間構造が壊れ SE が過小評価されます。 対処は観測点でなく連続ブロックを単位に抽出する ブロックブートストラップ。 ブロック長は自己相関 $\rho_1$ から $\ell \approx 2/(1-\rho_1)$、 または $\ell \approx \lceil n^{1/3}\rceil$ を目安に、 定常性を保ちたければ Politis-Romano の stationary bootstrap(ブロック長を幾何分布で乱化)を使います。
④ パラメトリックブートストラップ・リサンプル数・仮説検定への応用
- パラメトリック版:分布形(例:正規)が信頼できるなら、 経験分布の代わりに $\hat\mu,\hat\sigma$ を推定した分布から再標本化する。 仮定が正しければノンパラ版より効率が上がり、 小標本でも安定します(仮定が誤っていれば逆に危険)。
- リサンプル数 $B$ の選び方:モンテカルロ誤差は $1/\sqrt{B}$ で減る一方、 統計量自身の分布近似誤差は $n$ に依存し $B$ を増やしても消えません。 目安は SE 推定 $B\ge200$、 percentile CI $B\ge1{,}000$、 BCa/99% CI や p 値 $B\ge10{,}000$。 「$B$ を無限に増やせば正確」という直感は半分だけ正しい、 が要点です。
- 仮説検定への応用:帰無仮説 $H_0$ の下で再標本化して統計量の分布を作り、 観測値の極端さからブートストラップ p 値を得る。 ただし群比較で「正確な帰無分布」が欲しいなら、 ラベルを入れ替える並べ替え検定の方が素直なことが多い。
🔗 関連ページ(追記の相対リンク)
本追記で触れた概念の掘り下げは、 同じ用語集の以下のページが対応します(いずれも実在ページ)。
- 得られた区間そのもの → 信頼区間/ 区間幅の素になるブレ → 標準誤差
- なぜ平均の分布が釣鐘型に近づくか(CLT が使える統計量) → 標本分布と中心極限定理/ 代表性の前提 → サンプリング・標本・標本サイズ
- 分布仮定を置かない推論の位置づけ → ノンパラメトリック/ 頑健推定量の SE を bootstrap で出す実践 → ロバスト統計
- 同じ「再標本化」族 → 並べ替え検定・クロスバリデーション/ 検定・p 値との接続 → 仮説検定・p 値
- 機械学習への展開(bagging) → ランダムフォレスト・ツリーアンサンブル/ 元データを整える上流 → 分散・平均
※ 本文で言及した ジャックナイフ・デルタ法・リサンプリング(総称)・モンテカルロ法 は現時点で単独ページが無いため、 本ページ内の該当節を参照してください(リンクなし)。