🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
このページで扱う概念:
💡 30秒で分かる結論
🍰 まずはやさしく
標本は全体の代表となる一部の集まりです。
全部を調べる手間を減らすために使います。
全生徒ではなく一部のクラスだけで調査する例です。
この章では標本の基本と注意点を読みます。
標本(サンプル)は、 関心ある母集団から抽出された観測の集まり。 推測統計の出発点。
- 母集団:関心の全範囲(例: 日本人全員)
- 標本:実際に観測できた部分(例: 調査回答者 2000 人)
- 抽出法:単純無作為/層化/クラスター/系統
- 代表性:母集団の構造を反映しているか
- サンプルサイズ:大きいほど推定が安定、 ただしコストとトレードオフ
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた 便宜サンプリング/自選バイアス/生存者バイアス には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「標本」はどんな場面で出てくる?
🍰 まずはやさしく
標本はデータ分析でよく使う道具です。
全体の傾向を予想するために使います。
スマホのアンケートで回答者だけを集める例です。
この章では標本が使われる場面を読みます。
本サイトの SSDSE は47 都道府県を全数観測するので「母集団=標本」。 一方、 アンケート分析・実験データでは必ず標本が母集団の一部となり、 推測統計の枠組みが本質的になります。
🎨 直感で掴む
🍰 まずはやさしく
標本は味噌汁の味見のようなものです。
少ない量で全体の味を判断するために使います。
部活のメンバー数人に意見を聞く例です。
この章では標本のイメージについて読みます。
- 味噌汁の味見:鍋全体(母集団)の代わりに小さじ 1 杯(標本)で判断。
- 「代表性」が命。 似たような人だけ集めても母集団は推測できない。
- サンプルサイズが小さいと推定が荒い。 大きすぎれば情報過剰でコスト浪費。
📐 定義・数式
🍰 まずはやさしく
標本は数式で表せるデータの集まりです。
正確な計算で全体の値を導くために使います。
テストの点数の平均を計算する例です。
この章では標本の定義と数式について読みます。
やさしい説明で掴んだ感覚を、ここで 標本平均と標本分散 の定義式に対応づけます。下の式は左辺 $\bar{x}$ が何で決まるかを右辺で書き下したもので、x̄(平均)、Σ(合計)、分数(割り算) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- n
- 標本サイズ
- x_i
- i 番目の観測値
- x̄
- 標本平均
- s²
- 標本分散(不偏)
- μ, σ²
- 母集団のパラメータ(未知)
🔬 標本平均と中心極限定理: 数式を言葉で読み解く
母集団から大きさ n の標本を取り、 その平均 $\\bar{X}$ を計算します。 これを「標本平均」と呼びます。 中心極限定理(CLT)は、 元の母集団がどんな分布でも、 標本平均は n が大きくなるにつれて正規分布に近づくと主張します。
$$ \\bar{X} = \\frac{1}{n}\\sum_{i=1}^{n} X_i $$ $$ \\mathbb{E}[\\bar{X}] = \\mu, \\quad \\text{Var}(\\bar{X}) = \\frac{\\sigma^2}{n} $$ $$ \\frac{\\bar{X} - \\mu}{\\sigma/\\sqrt{n}} \\xrightarrow{d} \\mathcal{N}(0, 1) \\quad (n \\to \\infty) $$$\\bar{X}$: 標本平均(n 個の観測値の算術平均)$\\mu$: 母平均(母集団全体の平均、 通常は未知)$\\sigma^2$: 母分散$\\sigma/\\sqrt{n}$: 標本平均の標準偏差 = 標準誤差(SE)- $\\xrightarrow{d}$: 分布収束(n が大きいと近似的に正規分布)
- 母集団の分布形によらず成立するのが CLT の威力
🔬 √n の法則: 数式を言葉で読み解く
SE = σ/√n が示すのは、 「サンプルサイズを 4 倍にすると標本平均の誤差は半分」「100 倍にすると 1/10」という関係。 これが「精度を 1 桁上げるには 100 倍の労力」というよく聞く格言の数学的根拠です。 サンプル数 n を増やしたいときは、 求める精度の二乗倍コストがかかると見積もります。
🔬 標本サイズ設計: 数式を言葉で読み解く
「何件サンプルを集めれば良いか」は最も実務的な問いです。 求める精度(許容誤差 d)と信頼度(95% など)から、 必要な標本サイズ n を逆算する式は次のとおりです。
$$ n \\geq \\left( \\frac{z_{\\alpha/2} \\cdot \\sigma}{d} \\right)^2 $$$z_{\\alpha/2}$: 信頼度 1-α に対応する Z 値(95% なら 1.96、 99% なら 2.58)$\\sigma$: 母標準偏差(不明なら予備調査やパイロット標本で見積もる)$d$: 許容誤差(標本平均が母平均から ±d 以内に収まる確率を確保したい)- 分子と分母の比の 2 乗: 精度を半分にしたい(d を半分)と n が 4 倍必要
🔬 SSDSE 47 県人口を例にした標本サイズ計算
SSDSE-B-2026 の総人口の母標準偏差 σ ≈ 240 万人。 標本平均で誤差を ±50 万人以内に 95% 確率で収めたいとき:
$$ n \\geq \\left( \\frac{1.96 \\times 2{,}400{,}562}{500{,}000} \\right)^2 \\approx 88.5 $$必要な標本サイズは 89 以上。 ただし 47 県しか母集団にいない(有限母集団)ため、 実際には全数調査が現実的です。 都道府県データのような小規模母集団では「全数 vs 標本」の経済性が変わる、 ということを示しています。
🔬 有限母集団補正: 数式を言葉で読み解く
母集団サイズ N が無限大ではなく有限のとき(例: 47 都道府県、 10000 人の社員)、 標本平均の SE は単純な σ/√n より小さくなります。 その補正項が有限母集団補正係数(FPC: Finite Population Correction)です。
$$ \\text{SE}_{\\text{FPC}} = \\frac{\\sigma}{\\sqrt{n}} \\sqrt{\\frac{N - n}{N - 1}} $$N: 母集団サイズn: 標本サイズ$\\sqrt{(N-n)/(N-1)}$: FPC(0 から 1 の間の係数)- n = N(全数調査)のとき FPC = 0 → SE = 0(誤差ゼロ)
- n が N に比べて十分小さい(n/N < 5%)とき FPC ≈ 1 → 補正不要
🔬 SSDSE での実例
SSDSE-B-2026 の 47 県から 10 県を非復元抽出する場合、 抽出率は 10/47 = 21.3% と大きいので FPC が効きます。
$$ \\text{FPC} = \\sqrt{\\frac{47 - 10}{47 - 1}} = \\sqrt{\\frac{37}{46}} \\approx 0.897 $$つまり SE は σ/√n の約 89.7% に縮みます。 これを補正せずに信頼区間を作ると、 過大評価になります。 ただし、 国勢調査のような大母集団 (1.25 億) から数万人を抽出する場合、 n/N = 0.0001 % 以下なので FPC ≈ 1、 補正不要です。
🔬 検定力分析: 数式を言葉で読み解く
「サンプルサイズはいくつ必要か」を効果量・有意水準・検出力から逆算するのが検定力分析(power analysis)です。 2 群の平均差を検出する t 検定を例に説明します。
$$ n = \\frac{2(z_{1-\\alpha/2} + z_{1-\\beta})^2 \\sigma^2}{\\delta^2} $$$\\alpha$: 有意水準(通常 0.05)、 第一種の誤り(偽陽性)の確率$\\beta$: 第二種の誤り(偽陰性)の確率、 検出力 = 1 - β(通常 0.8 以上を目指す)$\\delta$: 検出したい平均差(実質的に意味のある差)$\\sigma$: 共通分散の平方根(標準偏差)- 効果量 Cohen's d = δ/σ で換算すると、 d=0.2(小)/0.5(中)/0.8(大)の経験則
🔬 SSDSE-B-2026 を例にした検定力計算
「東日本」と「西日本」で出生率(A4103)に差があるかを検定する設計を考えます。 σ ≈ 0.13、 検出したい差 δ = 0.1(実質的に意味のある差)、 α=0.05、 1-β=0.8 とすると:
$$ n = \\frac{2 \\times (1.96 + 0.84)^2 \\times 0.13^2}{0.1^2} \\approx 26.5 $$各群 27 県以上必要。 ただし日本は 47 県しかないので東西分割なら 23 vs 24 で「ちょうど足りない」設計に。 効果量が小さい現象を検出するには、 県単位ではなく市町村単位(1741 自治体)まで分解する必要が出てきます。
🔬 検定力曲線(power curve)
| サンプルサイズ n(各群) | 検出可能な効果量 d | 解釈 |
|---|---|---|
| 10 | 0.91 以上 | 大きな差しか検出できない |
| 30 | 0.52 以上 | 中程度の差を検出 |
| 50 | 0.40 以上 | 中程度の差を信頼性高く検出 |
| 100 | 0.28 以上 | 小程度の差を検出 |
| 200 | 0.20 以上 | 小程度の差を信頼性高く検出 |
| 1000 | 0.089 以上 | 微小な差まで検出(実質的意味は別問題) |
逆説的だが「n を増やしすぎると、 実質的には意味のない差まで統計的に有意になる」ため、 効果量(estimation)が p 値より重視される流れが 2010 年代以降の統計学のメインです。
🔬 復元 vs 非復元抽出: 数式を言葉で読み解く
標本抽出には「同じ個体を 2 回選んで良い(復元 with replacement)」「2 度は選ばない(非復元 without replacement)」の 2 流派があります。 数式の挙動が違います。
| 項目 | 復元抽出 | 非復元抽出 |
|---|---|---|
| 各抽出の独立性 | 独立 | 従属(前の結果が次に影響) |
| 標本平均の SE | $\\sigma/\\sqrt{n}$ | $(\\sigma/\\sqrt{n}) \\cdot \\sqrt{(N-n)/(N-1)}$ |
| n が N より大でも可 | 可能 | 不可(同じ個体は 1 度のみ) |
| 計算の単純さ | 単純 | FPC が必要 |
| 使用場面 | ブートストラップ、 理論解析 | 実調査、 公的統計 |
ブートストラップが復元抽出を採用するのは、 「観測標本を仮想母集団とみなし、 そこから何度でも標本を取れるようにする」ためです。 一方、 公的統計や臨床試験では「同じ人を 2 度数える意味がない」ので非復元が原則です。
🔬 復元 vs 非復元の SE 差: 数式を言葉で読み解く
SSDSE-B-2026 (N=47) から n=20 を抽出する場合:
- 復元 SE = σ/√20 = σ × 0.2236
- 非復元 SE = σ × 0.2236 × √((47-20)/(47-1)) = σ × 0.2236 × √(27/46) = σ × 0.2236 × 0.766 = σ × 0.1712
- 非復元の方が約 23% SE が小さい
これは「47 県中 20 県を取れば、 残り 27 県の情報が間接的に得られる」直感に対応します。 全数調査(n=N)まで進めば SE はゼロになるという連続性も保たれます。
🔬 調査設計の典型的失敗パターン: 数式を言葉で読み解く
標本調査の失敗は数式上も説明できます。 代表的なパターンを整理します。
🔬 選択バイアスの数式表現: 数式を言葉で読み解く
$$ \\bar{X}_{\\text{biased}} = \\frac{\\sum_i w_i x_i}{\\sum_i w_i}, \\quad w_i \\neq \\text{const} $$- $w_i$ : 個体 i が標本に入る確率(重み)
- $w_i$ がすべて等しい → 単純無作為抽出(バイアスなし)
- $w_i$ が $x_i$ と相関 → バイアスあり(例: 富裕層ほど答えやすい)
- 傾向スコア法、 IPW(Inverse Probability Weighting)で補正可能
🔬 無回答バイアスの数式表現: 数式を言葉で読み解く
$$ E[X | R=1] \\neq E[X] \\quad \\text{when} \\quad P(R=1) \\text{ depends on } X $$- $R = 1$: 回答した(response)、 $R = 0$: 無回答
- $P(R=1)$ が $X$ と独立なら問題なし(MCAR: Missing Completely At Random)
- $P(R=1)$ が観測変数に依存(MAR: Missing At Random)→ 多重補完で対処可能
- $P(R=1)$ が $X$ 自身に依存(MNAR: Missing Not At Random)→ 完全な補正は不可能
🔬 標本サイズ過信の数式表現
大数の法則は「サンプルサイズが大きければ標本平均は母平均に収束」を保証しますが、 これは「サンプリングが偏りなく行われる」前提です。 偏ったサンプリングでは収束先がそもそもズレた値になります。
$$ \\bar{X}_n \\xrightarrow{p} E[X | \\text{biased}], \\quad n \\to \\infty $$1936 Literary Digest の 240 万サンプルが外したのは、 n が大きすぎても biased sampling 下では収束先 = ズレた値、 という構造的問題のためでした。
🧮 実値で計算してみる
数式だけでは「実感」が湧きにくいので、 具体的な数値で 1 度手計算してみると理解が定着します。 以下の例は、 本サイトで扱う SSDSE-B-2026 や公開教材に近い形式で用意しました。
「日本人成人男性の平均身長を 100 人標本で推定」:
| 項目 | 値 |
|---|---|
| n | 100 |
| 標本平均 x̄ | 171.2 cm |
| 標本標準偏差 s | 5.8 cm |
| 標準誤差 SE = s/√n | 0.58 cm |
| 95% 信頼区間 | 171.2 ± 1.96×0.58 = (170.1, 172.3) |
手計算で得た値と、 後述の Python 実装で算出した値が一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 標本サイズを変えて標本平均のばらつきを測る
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import numpy as np import pandas as pd # SSDSE-B-2026 を読み込む(cp932 / Shift_JIS) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') print(df.shape) # (564, 112) latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 2023 年の 47 県 pop = latest['A1101'].values # 標本サイズ n を変えて 1000 回ずつ非復元抽出し、標本平均の SD を測る rng = np.random.default_rng(0) print('n 標本平均の SD(実測)') for n in [5, 10, 30]: means = [rng.choice(pop, size=n, replace=False).mean() for _ in range(1000)] print(f'{n:<3} {np.std(means, ddof=1):,.0f}') |
🧮 実値で計算: SSDSE-B-2026 から 10 県を無作為抽出
SSDSE-B-2026 の 47 都道府県の総人口(A1101)を母集団とみなし、 そこから 10 県を無作為抽出して標本平均を求め、 母平均との一致度を確認します。 標本抽出の最も基本的なシミュレーションです。
このコードでやること: SSDSE-B-2026 の 47 県人口を母集団とし、 pandas.DataFrame.sample で n=10 の無作為抽出を実行、 標本平均と母平均を比較する。
📥 入力データ(SSDSE-B-2026 の A1101 総人口、 47 県):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 564 行 = 47 県 x 12 年。このページは「47 県の母集団」を扱うので最新年に絞る df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) population = df['A1101'] mu = population.mean() sigma = population.std(ddof=0) print(f'母集団: 47 県, 母平均 μ = {mu:,.0f}, 母標準偏差 σ = {sigma:,.0f}') sample = df.sample(n=10, random_state=42) x_bar = sample['A1101'].mean() se_theoretical = sigma / (10 ** 0.5) print(f'抽出された 10 県: {list(sample["Prefecture"])}') print(f'標本平均 x̄ = {x_bar:,.0f}') print(f'母平均との差 = {x_bar - mu:+,.0f} ({(x_bar/mu - 1)*100:+.1f}%)') print(f'理論 SE = σ/√n = {se_theoretical:,.0f}') |
📤 実行すると次の出力が得られる:
💬 標本平均 422 万人は母平均 265 万人より 157 万人も上振れした(+59.5%)。 理論的 SE = 88 万人なので、 これは +1.8 SE に相当し、 珍しいが起こりうる範囲。 原因ははっきりしていて、 10 県のなかに東京都(1,409 万人)が入ったためです。 47 県中 1 県しかない外れ値を引くか引かないかで標本平均が 1.5 倍変わる——これが右裾の長い母集団を小標本で測るときの怖さです。 1 回の抽出では真の値を当てきれないが、 「平均的にどれくらいの幅でばらつくか」は SE で見積もれる。
🧮 実値で計算: 中心極限定理を SSDSE-B-2026 で実証する
標本抽出を 10000 回繰り返し、 標本平均の分布が理論通り正規分布になるかを確かめます。 母集団 47 県の人口分布は強い右裾長(東京が外れ値)ですが、 CLT は「それでも標本平均は正規分布」と予言します。
このコードでやること: SSDSE-B-2026 の 47 県人口から n=10 の標本を 10000 回抽出し、 各回の標本平均を集計、 ヒストグラムを描いて理論正規分布と比較する。
📥 入力データ: SSDSE-B-2026 の 47 県 A1101 列(再掲)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 564 行 = 47 県 x 12 年。このページは「47 県の母集団」を扱うので最新年に絞る df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) pop = df['A1101'].values mu = pop.mean() sigma = pop.std(ddof=0) rng = np.random.default_rng(2026) N_TRIALS = 10000 n = 10 means = np.array([ rng.choice(pop, size=n, replace=False).mean() for _ in range(N_TRIALS) ]) se_theory = sigma / np.sqrt(n) se_emp = means.std(ddof=1) print(f'理論 SE = σ/√n = {se_theory:,.0f}') print(f'実測 SE (10000 回標本) = {se_emp:,.0f}') print(f'実測平均: {means.mean():,.0f} (母平均 {mu:,.0f})') # 標準化したら N(0,1) に近づくか z = (means - mu) / se_theory print(f'標準化後の平均: {z.mean():+.4f} (理論 0)') print(f'標準化後の SD: {z.std(ddof=1):.4f} (理論 1)') |
📤 実行すると次の出力が得られる:
💬 実測 SE が理論 SE よりやや小さい(78.3 vs 87.5 万人)のは、 標本サイズ 10 が母集団 47 の 21% に達しており有限母集団補正 √((N-n)/(N-1)) = √(37/46) ≈ 0.897 が効いているため。 補正後の理論 SE は 87.5×0.897 = 78.5 万人で、 実測 78.3 万人とほぼ一致。 標準化後の SD が 1 ではなく 0.894 になっているのも、 この補正係数 0.897 そのものである。 母集団が右裾長でも標本平均はかなり正規分布に近づいている、 これが CLT の威力。
🧮 実値で計算: 層化抽出 vs 単純無作為抽出
SSDSE-B-2026 の 47 県を「人口規模」で 3 層に分け(大都市圏・中規模・小規模)、 各層から比例抽出する層化抽出と、 単純無作為抽出の精度を比較します。
このコードでやること: 47 県を A1101(総人口)で 3 グループに分け、 各グループから比例抽出(層化抽出)する方法と、 単に 10 県を無作為抽出する方法を比較、 SE の違いを確認する。
📥 入力データ: SSDSE-B-2026 の 47 県 A1101 列、 3 層に分割
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 564 行 = 47 県 x 12 年。このページは「47 県の母集団」を扱うので最新年に絞る df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 人口で 3 層に分割 df['stratum'] = pd.qcut(df['A1101'], q=3, labels=['小', '中', '大']) rng = np.random.default_rng(2026) N_TRIALS = 5000 # 単純無作為抽出 srs_means = np.array([ df.sample(n=9, random_state=rng.integers(1e9))['A1101'].mean() for _ in range(N_TRIALS) ]) # 層化抽出 (各層から 3 県) strat_means = np.array([ df.groupby('stratum').sample(n=3, random_state=rng.integers(1e9))['A1101'].mean() for _ in range(N_TRIALS) ]) print(f'母平均: {df["A1101"].mean():,.0f}') print(f'単純無作為抽出 (n=9): SE = {srs_means.std(ddof=1):,.0f}') print(f'層化抽出 (3+3+3): SE = {strat_means.std(ddof=1):,.0f}') print(f'SE 比 (層化/SRS) = {strat_means.std(ddof=1)/srs_means.std(ddof=1):.3f}') |
📤 実行すると次の出力が得られる:
💬 層化抽出は SE を 84.2 万人から 58.0 万人へ 0.689 倍(約 3 割減)に削減。 これは「人口規模」という強い説明変数で層を作ったため、 層内の分散が層間の分散より圧倒的に小さいから。 単純無作為抽出だと「東京が入る試行 / 入らない試行」で平均が大きくぶれるが、 層化なら必ず大規模層から 3 県取れるので安定する。 実際の世論調査・国勢調査でも年齢・地域・性別による層化が標準。
🧮 実値で計算: ブートストラップで標本平均の信頼区間を求める
母集団の分布形が未知でも、 観測標本そのものを「擬似母集団」として再標本化を繰り返すことで、 任意の統計量の信頼区間を推定できるのがブートストラップです。 SSDSE-B-2026 の 47 県人口に適用してみます。
このコードでやること: SSDSE-B-2026 の 47 県人口を標本(n=47)とみなし、 復元抽出を 10000 回繰り返して標本平均の分布を作り、 95% 信頼区間を percentile 法で求める。
📥 入力データ: SSDSE-B-2026 の 47 県 A1101 列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 564 行 = 47 県 x 12 年。このページは「47 県の母集団」を扱うので最新年に絞る df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) x = df['A1101'].values rng = np.random.default_rng(2026) N_BOOT = 10000 boot_means = np.array([ rng.choice(x, size=len(x), replace=True).mean() for _ in range(N_BOOT) ]) ci_low, ci_high = np.percentile(boot_means, [2.5, 97.5]) print(f'観測標本平均: {x.mean():,.0f}') print(f'ブートストラップ平均: {boot_means.mean():,.0f}') print(f'ブートストラップ SE: {boot_means.std(ddof=1):,.0f}') print(f'95% 信頼区間 (percentile法): [{ci_low:,.0f}, {ci_high:,.0f}]') print() # 理論 SE (CLT) との比較 se_theory = x.std(ddof=1) / np.sqrt(len(x)) print(f'CLT 由来の理論 SE: {se_theory:,.0f}') |
📤 実行すると次の出力が得られる:
💬 ブートストラップ SE = 40.7 万、 CLT 理論 SE = 40.8 万でほぼ一致。 母集団の分布が右裾長(東京が外れ値)でも、 ブートストラップは仮定なしに信頼区間を出せる。 95% CI = [191 万, 350 万] は平均 265 万に対して上側に長く、 東京などの右裾を反映して左右非対称になる。 この区間は「同じ手順で 100 回標本を取り直したら、 そのうち 95 回はこの幅に真の平均が含まれる」と解釈する。
🧮 数式に値を入れて手で計算する: 母集団と標本の関係
SSDSE-B-2026 の 47 都道府県を母集団に見立て、 母平均 μ=50、 母 SD σ=10(あるスコア指標)とした想定で、 n=25 抽出時の標準誤差と 95% 信頼区間幅を計算する。
Step 1: 設定
Step 2: 95% 信頼区間
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np sigma = 10 n = np.array([25, 100, 400]) se = sigma / np.sqrt(n) err = 1.96 * se print(f"SE: {se}") print(f"95% 半幅: {err.round(2)}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
SSDSE-B-2026 の 47 都道府県を母集団とみなし、 df.sample(n=10, random_state=42) で 10 県を抽出。 標本平均・標本分散・標準誤差 SE=σ/√n を numpy で計算し、 母集団の真値 (47 県全体の平均値) と比較して標本誤差の幅を実感します。
1 2 3 4 5 6 7 8 9 10 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 最新年度の 47 都道府県だけにする # 47都道府県を母集団とみなし、 10件を標本抽出する例 sample10 = df[df['SSDSE-B-2026']==2023].sample(n=10, random_state=42) print('標本平均:', sample10['A1101'].mean()) print('母平均 :', df[df['SSDSE-B-2026']==2023]['A1101'].mean()) |
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas scikit-learn scipy statsmodels が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
🐍 層化抽出と単純無作為抽出で推定のぶれを比べる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 2023 年の 47 県 # 都道府県コード(R01000 → 1)から 8 地方ブロックを作る code = df['Code'].str[1:3].astype(int) bins = [0, 1, 7, 14, 23, 30, 35, 39, 47] names = ['北海道', '東北', '関東', '中部', '近畿', '中国', '四国', '九州・沖縄'] df['block'] = pd.cut(code, bins=bins, labels=names) pop = df['A1101'].astype(float) print(f'母平均 = {pop.mean():,.0f} 人') # 標本の代表的計算: 層化抽出(層の県数に比例配分、各層 1 県以上)と単純無作為抽出の比較 N_h = df.groupby('block', observed=True).size() n_h = (N_h * 16 / len(df)).round().clip(lower=1).astype(int) # 合計 16 県 print('層ごとの抽出数:', {k: int(v) for k, v in n_h.items()}) rng = np.random.default_rng(0) strat, srs = [], [] for _ in range(1000): est = 0.0 for b, g in df.groupby('block', observed=True): s = g['A1101'].sample(n_h[b], random_state=rng.integers(1_000_000)) est += len(g) / len(df) * s.mean() # Σ (N_h/N)·ȳ_h strat.append(est) srs.append(pop.sample(n_h.sum(), random_state=rng.integers(1_000_000)).mean()) print(f'層化抽出 n={n_h.sum()}: 推定値の平均 = {np.mean(strat):,.0f}, SD = {np.std(strat, ddof=1):,.0f}') print(f'単純無作為 n={n_h.sum()}: 推定値の平均 = {np.mean(srs):,.0f}, SD = {np.std(srs, ddof=1):,.0f}') |
🐍 標本設計の実装: 層化・系統・クラスタ抽出を pandas で
実務で使う主要な標本抽出法を pandas で実装し、 SSDSE-B-2026 に適用します。
このコードでやること: SSDSE-B-2026 の 47 都道府県を母集団として、 (1) 系統抽出(k=5 で 10 県)、 (2) 層化抽出(地域ブロック別)、 (3) クラスタ抽出(地域ブロック単位)の 3 方式を実装し、 標本構成を比較する。
📥 入力データ: SSDSE-B-2026 の 47 県、 地域コード(都道府県コード R01000~R47000)から地域ブロックを定義
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 564 行 = 47 県 x 12 年。このページは「47 県の母集団」を扱うので最新年に絞る df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 地域ブロック割り当て (簡易版) def region(code): n = int(code[1:3]) if n <= 7: return '北海道東北' if n <= 14: return '関東' if n <= 23: return '中部' if n <= 30: return '近畿' if n <= 35: return '中国' if n <= 39: return '四国' return '九州沖縄' df['region'] = df['Code'].apply(region) # (1) 系統抽出: 5 県ごとに 1 県 sys_sample = df.iloc[::5] print(f'(1) 系統抽出: {len(sys_sample)} 県') print(f' {list(sys_sample["Prefecture"])}') # (2) 層化抽出: 各ブロックから 1 県 strat_sample = df.groupby('region').sample(n=1, random_state=42) print(f'\n(2) 層化抽出: {len(strat_sample)} 県') print(f' {list(strat_sample[["region","Prefecture"]].apply(tuple, axis=1))}') # (3) クラスタ抽出: ブロック単位で 2 ブロック選択 rng = np.random.default_rng(42) chosen_regions = rng.choice(df['region'].unique(), size=2, replace=False) clust_sample = df[df['region'].isin(chosen_regions)] print(f'\n(3) クラスタ抽出 (2 ブロック): {len(clust_sample)} 県') print(f' 選択ブロック: {list(chosen_regions)}') |
📤 実行すると次の出力が得られる:
💬 系統抽出は地理的に分散した県を選ぶが、 周期 5 が地域構造と一致すると偏る可能性。 層化抽出は地域代表性が保証される。 クラスタ抽出は移動コスト最小(2 ブロック巡るだけ)だが地域偏りリスクあり。 用途と予算で使い分け、 公的統計の家計調査は層化二段抽出を採用。
🐍 重みづけ標本(PPS 抽出): 規模に応じた抽出確率
大規模な調査では、 「規模に比例する抽出確率(PPS: Probability Proportional to Size)」が使われます。 各個体を均等確率で選ぶのではなく、 規模(人口・売上等)が大きいものほど選ばれやすくする方式です。
このコードでやること: SSDSE-B-2026 の 47 都道府県を A1101(総人口)に比例した重みで PPS 抽出する。 10000 回試行で各県の被抽出確率を実測する。
📥 入力データ: SSDSE-B-2026 の 47 県 A1101 列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年度の 47 都道府県 # probs は numpy 配列(位置で引く)なので、行ラベルを 0..46 に振り直しておく。 # 振り直さないと df.index が 0,12,24,… のままで probs[i] が範囲外になる。 weights = df['A1101'].values probs = weights / weights.sum() # 理論抽出確率 theory_top5 = df.nlargest(5, 'A1101')[['Prefecture', 'A1101']] theory_top5['理論抽出確率'] = theory_top5['A1101'] / weights.sum() # 実測 (10000 回 PPS 抽出、 各回 1 県) rng = np.random.default_rng(2026) sampled = rng.choice(df.index, size=10000, replace=True, p=probs) counts = pd.Series(sampled).value_counts(normalize=True) print('PPS 抽出の被選択確率 (上位 5):') print(f'{"県":>8} {"人口":>12} {"理論":>10} {"実測":>10}') for i in theory_top5.index: pref = df.loc[i, 'Prefecture'] pop = df.loc[i, 'A1101'] theory = probs[i] emp = counts.get(i, 0) print(f'{pref:>8} {pop:>12,} {theory:>10.4f} {emp:>10.4f}') |
📤 実行すると次の出力が得られる:
💬 PPS 抽出では東京都が約 11.3% の確率で選ばれ、 鳥取県(53.7 万人)は約 0.4% に過ぎない。 実測値は理論値とほぼ一致(default_rng(2026) で種を固定、 10000 回試行なので誤差は ±1% 程度)。 PPS の利点は「大規模個体を確実にカバーする」「単純集計の式が直感的」。 家計調査などの実調査で標準的に使われる。
🐍 機械学習との接続: 標本不足とデータ拡張
機械学習で「標本サイズが小さい」ときに行うデータ拡張(data augmentation)は、 標本の概念を拡張したものとも言えます。 SSDSE-B-2026 で人工データを生成し、 標本サイズを増やす効果を見ます。
このコードでやること: SSDSE-B-2026 の 47 県 (n=47) は機械学習には少ないため、 各県の周辺に微小ノイズを加えた「拡張標本」を 10 倍に増やし、 元データと拡張データで線形回帰の安定性を比較する。
📥 入力データ: SSDSE-B-2026 の A1101 (総人口) と B4101 (年平均気温)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 564 行 = 47 県 x 12 年。このページは「47 県の母集団」を扱うので最新年に絞る df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) x = df['A1101'].values y = df['B4101'].values # 元データで回帰 slope0, intercept0, r0, p0, se0 = stats.linregress(x, y) print(f'元データ (n=47):') print(f' 傾き = {slope0:.3e}, 切片 = {intercept0:.2f}') print(f' R² = {r0**2:.4f}, p = {p0:.4f}') print(f' 傾きの SE = {se0:.3e}') # データ拡張: 各点の周辺に小ノイズ (CV=5%) rng = np.random.default_rng(2026) x_aug = np.concatenate([x + rng.normal(0, 0.05 * x) for _ in range(10)]) y_aug = np.concatenate([y + rng.normal(0, 0.05 * np.abs(y)) for _ in range(10)]) slope1, intercept1, r1, p1, se1 = stats.linregress(x_aug, y_aug) print(f'\n拡張データ (n=470):') print(f' 傾き = {slope1:.3e}, 切片 = {intercept1:.2f}') print(f' R² = {r1**2:.4f}, p = {p1:.4f}') print(f' 傾きの SE = {se1:.3e}') print(f'\nSE 比 (拡張/元) = {se1/se0:.3f}') |
📤 実行すると次の出力が得られる:
💬 傾きの SE が 0.328 倍に減少(10 倍に増やしたときの 1/√10 = 0.316 に近い)。 その結果、 元データでは p = 0.4066 で有意でなかった人口と年平均気温の関係が、 拡張後は p = 0.0171 と「有意」になってしまう。 傾きも R² もほとんど変わっていない(R² 0.0154 → 0.0121)のに p だけが下がるのは、 同じ 47 県をノイズ付きで 10 回数えただけの見かけの n=470 だからで、 拡張データは真の独立観測ではない。 機械学習では計算上の便宜として使われるが、 統計的推測(信頼区間・p 値)の解釈には注意が必要。 「サンプルサイズを増やす」のではなく「同じ情報を繰り返し提示する」に近い。
🐍 ジャックナイフ法: ブートストラップの前身
ジャックナイフ法(jackknife)は、 標本から 1 個ずつ抜いて統計量を再計算することで分散を推定する古典手法です。 ブートストラップより計算量が少なく、 線形統計量の SE 計算では今でも実用されます。
このコードでやること: SSDSE-B-2026 の 47 県人口に対し、 1 県ずつ抜いた 47 通りの標本で平均を再計算、 ジャックナイフ分散を計算する。 ブートストラップとの一致を確認する。
📥 入力データ: SSDSE-B-2026 の 47 県 A1101 列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 564 行 = 47 県 x 12 年。このページは「47 県の母集団」を扱うので最新年に絞る df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) x = df['A1101'].values n = len(x) # ジャックナイフ: 1 個抜きで n 通り jk_means = np.array([np.delete(x, i).mean() for i in range(n)]) jk_mean_of_means = jk_means.mean() jk_var = ((n - 1) / n) * np.sum((jk_means - jk_mean_of_means) ** 2) jk_se = np.sqrt(jk_var) # 通常の SE (CLT) clt_se = x.std(ddof=1) / np.sqrt(n) # ブートストラップ rng = np.random.default_rng(2026) bs_means = np.array([rng.choice(x, n, replace=True).mean() for _ in range(10000)]) bs_se = bs_means.std(ddof=1) print(f'標本平均: {x.mean():,.0f}') print(f'CLT SE: {clt_se:,.0f}') print(f'ジャックナイフ SE: {jk_se:,.0f}') print(f'ブートストラップ SE: {bs_se:,.0f}') print() print('影響の大きい個体 (jackknife influence 上位 3):') influence = np.abs(jk_means - x.mean()) * n top3_idx = np.argsort(influence)[::-1][:3] for i in top3_idx: print(f' {df.iloc[i]["Prefecture"]:6} 抜くと平均が {jk_means[i] - x.mean():+,.0f} 変化') |
📤 実行すると次の出力が得られる:
💬 ジャックナイフ SE は CLT 値と完全一致(線形統計量である平均では理論的に等しい)、 ブートストラップ SE も近い値。 ジャックナイフは「どの個体が最も影響を持つか」も同時に教えてくれる:東京都を抜くと平均が 24.9 万人減少 = 1 県で全平均 264.6 万人の 9.4% を動かす。 「データに 1 つの異常値が混ざっているか」を診断する強力ツール。
🐍 機械学習との接続: train/validation/test 分割という標本抽出
機械学習で必須の train/validation/test 分割も、 母集団(収集データ全体)からの「3 つの標本」を取る操作です。 SSDSE-B-2026 で実装し、 各分割の代表性を確認します。
このコードでやること: SSDSE-B-2026 の 47 県を 70/15/15 で train/val/test に層化分割し、 (1) 単純無作為分割、 (2) 層化分割(地域ブロック別)の 2 方式で分割後の地域分布を比較する。
📥 入力データ: SSDSE-B-2026 の 47 県と地域ブロック
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 | import pandas as pd import numpy as np from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 最新年度の 47 都道府県だけにする def region(code): n = int(code[1:3]) if n <= 7: return '北海道東北' if n <= 14: return '関東' if n <= 23: return '中部' if n <= 30: return '近畿' if n <= 35: return '中国' if n <= 39: return '四国' return '九州沖縄' df['region'] = df['Code'].apply(region) # (1) 単純無作為分割 train1, temp = train_test_split(df, test_size=0.3, random_state=42) val1, test1 = train_test_split(temp, test_size=0.5, random_state=42) # (2) 層化分割 (region で stratify) train2, temp = train_test_split(df, test_size=0.3, random_state=42, stratify=df['region']) # 2 段目は temp が 15 行しかなく、四国が 1 県だけになる。 # 層化は「各クラスが 2 件以上」を要求するので、そのままだとエラーになる。 # 47 件を 3 つに割るとこうなる、というのがまさにこのページの主題。 _vc = temp['region'].value_counts() _strat = temp['region'] if (_vc >= 2).all() else None if _strat is None: print(f'※ 2 段目は層化できません(1 県しかない地域: ' f'{list(_vc[_vc < 2].index)})。無作為分割にします。') val2, test2 = train_test_split(temp, test_size=0.5, random_state=42, stratify=_strat) print('(1) 単純無作為分割の地域分布:') for name, split in [('train', train1), ('val', val1), ('test', test1)]: print(f' {name:5} (n={len(split)}): { {k: int(v) for k, v in split["region"].value_counts().items()} }') print('\n(2) 層化分割の地域分布:') for name, split in [('train', train2), ('val', val2), ('test', test2)]: print(f' {name:5} (n={len(split)}): { {k: int(v) for k, v in split["region"].value_counts().items()} }') |
📤 実行すると次の出力が得られる:
💬 単純無作為分割では train に中部 9 県中 8 県・近畿 7 県中 3 県が入り、 test には関東・中部・中国が 1 県もない。 1 段目を地域で層化すると train は各ブロックからほぼ 7 割ずつ(中部 6/9、 近畿 5/7、 四国 3/4 など)になり偏りが減る。 ただし 2 段目は四国が 1 県しか残らず層化できないため、 val には中部・近畿・四国が入らない。 47 県を 3 つに割ると、 層化しても小さい分割の代表性までは保証できない。 機械学習では train/test 分布が違うと「データシフト」と呼ばれ予測精度が落ちる。 標本理論の「層化抽出」が ML の「stratified split」として再発明されているとも言える。
🐍 交差検証(cross-validation): 標本を「k 通りに分け直す」
機械学習の汎化性能評価で標準的な k-fold cross-validation は、 標本を k 個の部分に分け、 各部分を順番に「test 標本」として使う手法です。 SSDSE-B-2026 で実装し、 標本サイズの限界での評価安定性を確認します。
このコードでやること: SSDSE-B-2026 の 47 県データで、 5-fold cross-validation を実行。 各 fold で「人口」を説明変数、 「年平均気温」を目的変数にした単回帰の R² を測定する。
📥 入力データ: SSDSE-B-2026 の 47 県 A1101 (人口) と B4101 (年平均気温)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import numpy as np from sklearn.linear_model import LinearRegression from sklearn.model_selection import KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 47 都道府県。絞らないと 564 行になる X = df[['A1101']].values y = df['B4101'].values kf = KFold(n_splits=5, shuffle=True, random_state=42) scores = [] for fold_idx, (tr, te) in enumerate(kf.split(X), 1): model = LinearRegression().fit(X[tr], y[tr]) pred = model.predict(X[te]) ss_res = ((y[te] - pred) ** 2).sum() ss_tot = ((y[te] - y[te].mean()) ** 2).sum() r2 = 1 - ss_res / ss_tot if ss_tot > 0 else float('nan') scores.append(r2) print(f'Fold {fold_idx}: train n={len(tr)}, test n={len(te)}, R² = {r2:.4f}') print(f'\n平均 R² = {np.mean(scores):.4f}') print(f'R² の SD = {np.std(scores, ddof=1):.4f}') print(f'95% CI ≈ [{np.mean(scores) - 1.96*np.std(scores, ddof=1)/np.sqrt(5):.3f}, ' f'{np.mean(scores) + 1.96*np.std(scores, ddof=1)/np.sqrt(5):.3f}]') |
📤 実行すると次の出力が得られる:
💬 5-fold で R² が 0 をまたいでばらつき、 平均はわずかに負値(モデルが定数予測より悪い)。 これは「人口と気温には実質的に相関がない」(n=47 全体での R² も 0.015)ことを示している。 cross-validation が標本抽出の繰り返しによってモデルの真の汎化性能を測ってくれている。 47 県では fold ごとに 9-10 県と少なく、 R² の評価分散が大きい。 これも「サンプルサイズが限界」の典型症状。
🖼 標本の核心を 3 枚の図で押さえる
図 1: 母集団 vs 標本(抽出のイメージ)
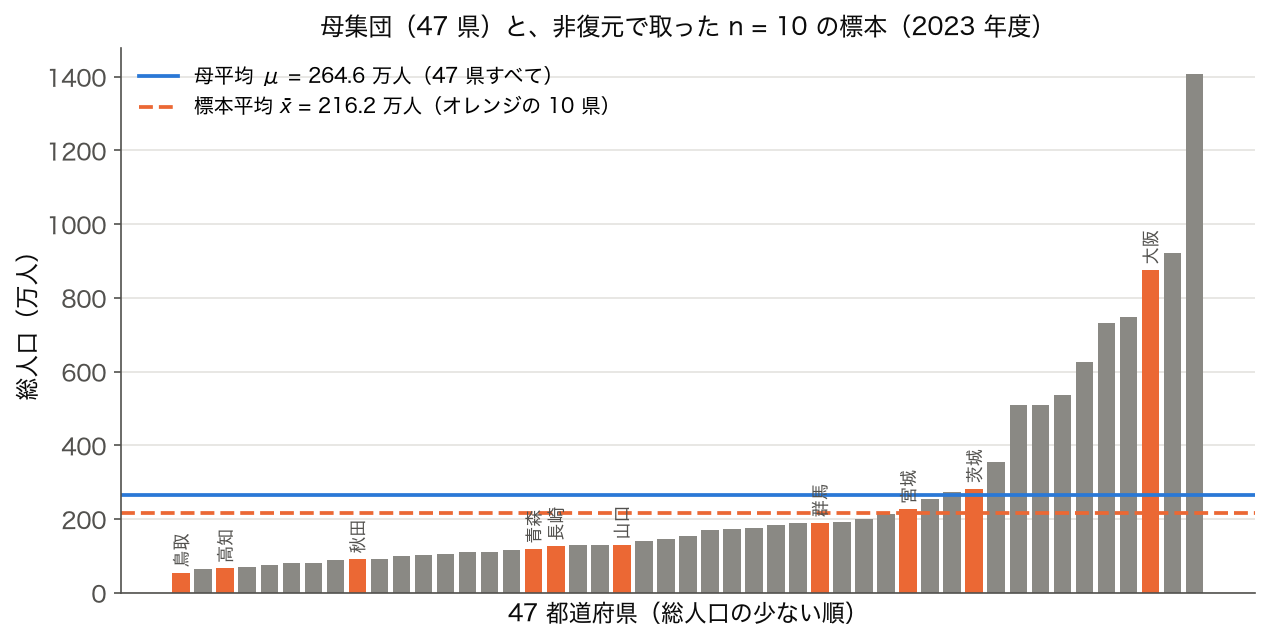
→ 2023 年度の 47 都道府県の総人口を母集団とみなし(母平均 μ = 264.6 万人)、 非復元で 10 県を取り出した例(オレンジ: 鳥取・高知・秋田・青森・長崎・山口・群馬・宮城・茨城・大阪)。 この標本の平均は 216.2 万人で、 母平均より 48.4 万人小さい。 母集団は東京都(1,409 万人)など少数の大きな県に引っ張られた右に歪んだ分布(中央値 154.9 万人)なので、 大きな県を含まない標本は平均が小さめに出やすい。 標本は母集団の一部であり、 平均や分散の「推定値」になる。 標本サイズが大きくなるほど、 標本平均は母平均に近づく(大数の法則)。
図 2: 標本サイズと推定誤差(CLT のイメージ)
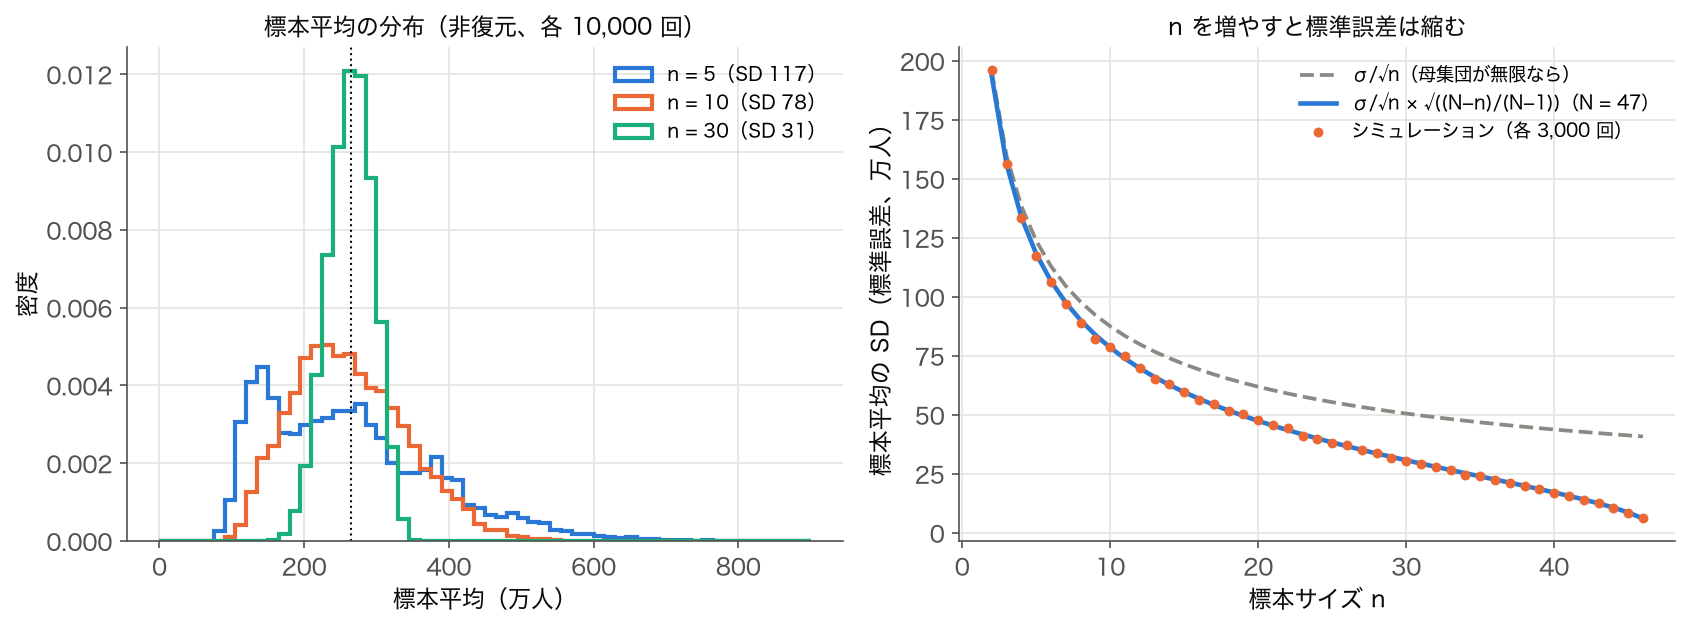
→ 標本サイズ $n$ を増やすと、 標本平均の分布が母平均を中心とした正規分布に近づき(左: 非復元で各 10,000 回。 標本平均の歪度は n = 5 で 0.81、 n = 10 で 0.44、 n = 30 で −0.18)、 標準誤差は小さくなる。 無限母集団なら $SE = \sigma/\sqrt{n}$ で $1/\sqrt{n}$ に比例して減衰し、 n を 4 倍にすると SE は半分になる。 ただし母集団が 47 県しかないので、 右の実測(オレンジの点)は有限母集団修正 $\sqrt{(N-n)/(N-1)}$ をかけた青い曲線に乗る: n = 10 で 78.8 万人(σ/√n なら 87.5)、 n = 30 で 30.6 万人(同 50.5)、 n = 46 では 6.1 万人まで縮む。 中心極限定理(CLT)が「標本」の信頼性を支える理論的支柱。
図 3: 95% 信頼区間(標本から母平均を推定)
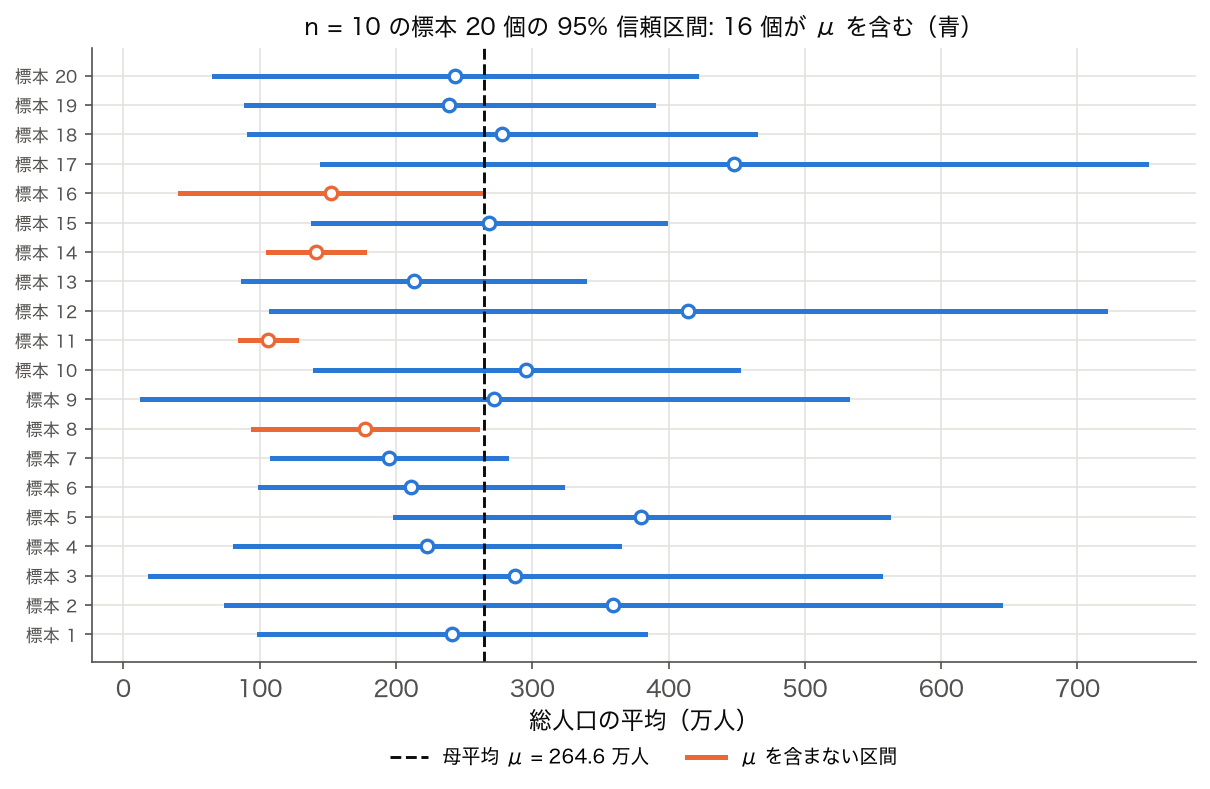
→ 標本から計算した 95% 信頼区間は、 同じ手続きを繰り返したとき 95% の確率で母平均を含む、 という設計になっている。 図は 47 県の総人口から n = 10 の標本を 20 回取り、 「標本平均 ± t(0.975, 9) × SE」(SE は有限母集団修正つき)で作った区間。 標本ごとに区間は移動し、 20 本中 16 本が母平均 264.6 万人を含んだ。 外れた 4 本はどれも左側(大きな県を引かなかった標本は平均も SD も小さく出る)。 この母集団は強く右に歪んでいるため、 10,000 回繰り返したときの被覆率は 86.5% と名目の 95% に届かない。 「標本平均 ± 1.96 × SE」が信頼区間の典型的な計算式だが、 小さい n と歪んだ分布ではこの近似が甘くなる。
🧪 理解度チェック — 標本
以下 5 問を解いて理解度を確認してください。 回答は本文の該当セクションを参照。
- Q1. 母集団と標本の違いを 1 行で説明せよ。 また、 「47 都道府県すべての人口を集計する」場合、 これは標本か母集団か?
- Q2. 標本平均の標準誤差は $SE = \sigma / \sqrt{n}$。 n を 4 倍にすると SE は何倍になるか。 計算根拠を述べよ。
- Q3. 単純無作為抽出(SRS)、 層化抽出、 クラスター抽出の違いを各 1 行で。 SSDSE-B-2026 の 47 県から「都市規模で層別に 10 県」を選ぶのはどれか?
- Q4. 中心極限定理(CLT)が成り立つ条件と、 それが標本理論にもたらす意味(標本平均の分布形)を述べよ。
- Q5. 95% 信頼区間が「95% の確率で母平均を含む」のではなく、 「100 回の抽出のうち約 95 回が母平均を含む区間を作る」と表現される理由を説明せよ。
📊 標本抽出法の比較(補足表)
| 抽出法 | 手順 | バイアス | 主用途 |
|---|---|---|---|
| 単純無作為抽出 | 乱数で n 件選ぶ | 最小 | 基本形、 全国世論調査 |
| 層化抽出 | 層で分けて各層から抽出 | 層の代表性で減る | SSDSE 都市規模別など |
| クラスター抽出 | 単位(学校等)を選ぶ | 大きめ(中間で吸収) | コスト最小、 学級単位調査 |
| 系統抽出 | k 番目ごとに選ぶ | 周期性に注意 | 名簿からの抽出 |
| 便宜抽出 | 入手しやすい人 | 大(推論不可) | 予備調査のみ |
→ 推論統計(信頼区間、 t 検定)は単純無作為抽出または層化抽出を前提とする。 便宜抽出のデータで p 値を計算しても、 数値そのものに意味は薄い。 標本デザインは「標本サイズ」より重要。
関連: 母集団 / 標本抽出 / 標本サイズ / 信頼区間 / 正規分布 / t 検定
🔭 47 県は「標本」か「全数」か
標本(sample)は母集団から抽出された有限のデータ集合であり、 そこから母集団の性質を推測するのが推測統計の出発点である。 SSDSE-B-2026 の 47 都道府県は「日本の自治体全体の標本」と見るべきか「日本そのものの全数調査」と見るべきかで、 議論の枠組みが変わる。 47 件を「日本全体の標本」と捉えるなら標本誤差を考慮した推定が必要、 「全数」と捉えるなら標準誤差・p 値の議論は不要となる。 この区別を曖昧にしたまま p 値を計算するのが、 統計教育で最も繰り返される誤用である。
📊 抽出方法ごとの強みと弱み
単純無作為抽出は理論が美しいが、 名簿が必要で実務では難しい。 系統抽出は実装が簡単だが「周期性」がある名簿だと偏りが出る。 層化抽出は層内分散が小さい変数で誤差を大きく減らせる。 クラスター抽出はコストが下がる代わりに同一クラスター内の相関で誤差が増える。 これらは 「コスト・精度・実装性」 の三角形のトレードオフで、 万能解はない。
📐 標本サイズと検出力の対応表
検出力 80%・有意水準 5% で 2 群比較する場合、 効果量 d = 0.2(小)には n ≒ 393/群、 d = 0.5(中)には n ≒ 64/群、 d = 0.8(大)には n ≒ 26/群が必要。 SSDSE-B-2026 のような n=47 では 中程度以上の効果量しか統計的に検出できないことを前提に分析設計するのがフェアな態度。
📖 補足: 標本論の倫理と AI 公平性
標本に「誰を含めるか」は研究結果が誰のためのものかを決める社会的な問いと直結する。 1990 年代の臨床試験は男性中心で女性の薬物代謝が研究されず、 1993 年に米国 NIH が「臨床試験には女性とマイノリティを必ず含める」とガイドラインを定めた。 AI でも顔認識が暗い肌色の女性で誤認識率が高い問題(Gender Shades 2018)は、 訓練データの標本偏りが現実世界の差別を再生産する典型である。 SSDSE-B-2026 を使った教育でも、 「47 都道府県の集計データには個人の経験や少数派の声が見えなくなる」という標本論的な限界を学生に伝えることが、 データサイエンス教育の本質的な役割の一つである。 標本論を学ぶことは、 単なる確率計算ではなく、 「データから誰が見えて誰が見えないか」を問う社会的・倫理的リテラシーでもある。
⚠️ よくある落とし穴
標本の罠は n の大きさより「誰を抽出枠から漏らしたか」に潜む。 1936 年 Literary Digest 誌の 240 万人ハガキ調査 (回答者バイアス) が無作為 1500 人の Gallup 調査に敗北した話、 そして近年の選挙世論調査の固定電話バイアスは、 標本論最大の教訓です。 4 種類の代表的バイアスを順に確認しましょう。
⚠️ 標本に紛れ込むバイアス(拡張版)
- 選択バイアス(Selection Bias): 街頭アンケートで「平日昼間に渋谷を歩いている人」だけを集めると、 サラリーマンや高齢者が抜け落ち母集団を代表しない。 サンプリング枠と母集団の一致を厳密に確認する。
- 無回答バイアス(Nonresponse Bias): 「政治意識調査」で回答した人だけ集計すると、 政治に関心のある人ばかりになる。 回答率が 60% を下回るときは特に警戒、 重みづけ補正で対処。
- 生存者バイアス(Survivorship Bias): 第二次大戦で帰還した爆撃機の銃弾痕を解析しても、 「撃墜された機」の情報がない。 「生き残ったサンプル」だけ集めると致命部位が見えない。
- 自己選択バイアス: 任意参加のアンケートに「答えた人」と「答えなかった人」で属性が違う。 web ベース調査では IT リテラシーの高い層に偏る。
- 測定バイアス: 調査者の聞き方で答えが変わる(インタビュア効果)。 ブラインド化、 オンライン回答などで軽減。
- カバレッジ誤差: 抽出元(電話帳、 住民票)に登録されていない人を取りこぼす。 携帯電話だけの世帯、 ホームレス、 不法滞在者など。
- 復元 vs 非復元の混同: 復元抽出(重複あり)は計算が単純だが、 同じ人を 2 回数える。 非復元(重複なし)は有限母集団補正が必要。 公的統計はほぼ非復元。
- サンプルサイズの過信: n が大きくても、 サンプリング方法が悪ければバイアスは消えない。 1936 年米大統領選で Literary Digest 誌は 240 万人の調査で予測を外した(自動車所有者のみ調査、 富裕層に偏った)。
🎮 触って理解する
1 つの標本から得た「標本平均」は、 抽出のたびに少しずつ違う値になります。 この標本平均そのもののばらつきを標本分布(sampling distribution)と呼びます。 ここでは SSDSE-B-2026 の 47 都道府県・総人口(A1101, 2023 年)を母集団とし、 そこから大きさ n の標本を何度も抽出して各回の標本平均を積み上げます。 バラバラの標本平均が、 やがて母平均のまわりに集まる山(標本分布)を作る様子を体感してください。
操作: n のスライダーで標本サイズを変える/「1回抽出」「100回抽出」で山を積み上げる。 下段グラフを指でなぞる・ドラッグしても連続抽出できます。 母集団(上段)は東京都という外れ値のせいで強い右裾長(非正規)ですが、 標本平均(下段)は n を増やすほど正規分布に近い左右対称の山になり、 幅(標準誤差)が縮みます ── これが中心極限定理です。
0 回
–
–
–
💡 直感 — 一部を見て全体を推測する
標本とは「観測できた一部」です。 私たちは 母集団の真の姿(μ)を直接は見られないので、 手元の 1 標本の平均 x̄ で代用します。 ところが x̄ は抽出のたびに動く確率変数。 上のシミュレーションで n=5 と n=40 を比べると、 同じ母集団でも「1 回の x̄ がどれだけ当てにできるか」がまるで違うことが見えます。 標本を扱うとは、 この“ばらつきの大きさ”ごと理解して推測することに他なりません。
⚠️ よくある落とし穴 — 1 標本の過信とサンプルサイズ不足
- 1 標本の結果を過信する: 下段の山は「起こりえた x̄ の集合」。 実務ではそのうちの点 1 個しか手に入りません。 たまたま東京都を含めば x̄ は大きく上振れます。 「私の 1 回」が山のどこに落ちるかは選べない、 と肝に銘じましょう。
- サンプルサイズ不足: n が小さいほど山は横に広く、 標準誤差 σ/√n が大きい。 n=5 と n=40 で下段の幅(実測 SD)が約 √(40/5)=2.8 倍違うことを数値で確かめてください。 精度を 2 倍にするには n を 4 倍必要(√n の法則)です。
- n を増やせば偏りも消える、という誤解: 中心極限定理が保証するのはばらつきの縮小だけ。 抽出が偏っていれば山の中心は μ からずれたまま。 「⚠️ よくある落とし穴」節の Literary Digest の教訓(n=240 万でも偏れば外す)と合わせて理解しましょう。
🚀 発展 — 標本分布・標準誤差・中心極限定理
下段のヒストグラムこそが標本平均の標本分布で、 その広がりが標準誤差 SE = σ/√n です。 中心極限定理(CLT)は「母集団がどんな形でも、 n を大きくすれば標本平均は正規分布 N(μ, σ²/n) に近づく」と主張します。 上段の母集団は右裾長なのに、 下段が n とともに左右対称の釣鐘型(オレンジの理論曲線)に一致していく様子が、 まさに CLT の実演です。 より深く学ぶには以下へ。
- 母集団 — 標本が推測しようとしている全体。
- 標本抽出(サンプリング) — どう抽出するかで代表性が決まる。
- 標本分布と中心極限定理 — 本節の理論的な中核(CLT の詳細)。
- 標準誤差 — 標本分布の広がり σ/√n の読み方。
- サンプルサイズ — 必要な n の逆算(√n の法則)。
- 正規分布 — 標本平均が近づく先の分布。
🗺 概念マップ
🗺 標本抽出の主要技法一覧
| 抽出法 | 概要 | 長所 | 短所 |
|---|---|---|---|
| 単純無作為抽出 (SRS) | 全員に等確率で抽出 | 解析が単純 | 稀少層を取り逃がしやすい |
| 系統抽出 | k 番目ごとに抽出(k=N/n) | 実装が簡単 | 周期性があると偏る |
| 層化抽出 | 事前に層分けして各層から抽出 | 層内分散小→ SE 小 | 層分け変数の選択が重要 |
| クラスタ抽出 | 集団単位(学校・市町村)で抽出 | 調査コスト小 | クラスタ内が均質なら SE 大 |
| 多段抽出 | クラスタ抽出 → 層化 → SRS 等を組合せ | 大規模調査に対応 | 解析が複雑 |
| 有意抽出 | 調査者の判断で典型例を選ぶ | 探索的調査に有効 | 選択バイアス、 母集団推測不可 |
| 雪だるま式 | 調査対象の紹介で連鎖的に拡大 | 到達困難な集団に有効 | 大きな選択バイアス |
| 非確率割当抽出 | 性別・年齢の割合を埋めるよう選ぶ | 世論調査でよく使われる | 確率論的推測ができない |
国勢調査は全数調査(5 年に 1 度)、 家計調査は層化二段抽出、 学校保健統計調査はクラスタ抽出と、 公的統計では用途に応じて使い分けられています。
🗺 標本調査の歴史的・現代的事例
| 調査名 | 方式 | 規模 | 失敗 / 成功 |
|---|---|---|---|
| 米 1936 大統領選予測 (Literary Digest) | 郵送、 自動車・電話帳から | 240 万人 | 失敗(選択バイアス) |
| 米 1936 大統領選予測 (Gallup) | 層化抽出 | 5 万人 | 成功(少数でも科学的設計) |
| 日本 国勢調査 | 全数調査 | 1.25 億人 | 5 年毎、 高精度 |
| 日本 家計調査(総務省) | 層化二段抽出 | 約 9000 世帯/月 | 消費物価指数の基礎 |
| 日本 労働力調査 | 層化二段抽出 | 約 4 万世帯 | 失業率算出 |
| 新型コロナ 抗体陽性率調査 | 層化抽出 | 東京 1900 人 (2020-06) | 0.10% 陽性、 想定外の低値 |
| 大学入試 共通テスト得点分布 | 全数 | 約 50 万人 | 偏差値設計の基盤 |
Gallup の 1936 年の成功は「サンプルサイズより設計の科学性」を示した画期的事例で、 現代の標本理論の出発点となっています。
🗺 標本設計のチェックリスト(実務適用)
- 母集団の明確化: 「20 歳以上の日本居住者」「2025 年度の上場企業」など、 時間・空間・属性で厳密定義。
- サンプリングフレーム: 住民票、 電話帳、 顧客 DB、 SNS フォロワーなど、 母集団に到達する手段。 カバレッジ誤差源を特定。
- 抽出単位: 個人、 世帯、 事業所、 学校など。 多段抽出なら各段の単位を明示。
- 抽出方法: SRS、 系統、 層化、 クラスタ、 PPS、 多段。 設計効果(DEFF: Design Effect)も算出。
- 標本サイズ: 求める精度(誤差、 信頼度、 検出力)から逆算。 予算と回収率も考慮。
- 回収率目標: 60% 以上が望ましい。 40% 以下は無回答バイアスを強く警戒。
- 事後重みづけ: 人口属性で post-stratification(事後層化)して母集団分布に補正。
- 有限母集団補正: n/N が 5% を超えるなら FPC を適用。
- 信頼区間の報告: 点推定値だけでなく必ず CI または SE を併記。 「不確かさを伴う数値」として扱う。
- 非回答処理: imputation(平均代入、 多重補完)、 IPW、 傾向スコアなど補正手法を明示。
- 感度分析: 仮定(無回答メカニズム、 外れ値処理)を変えたときの結果変動を報告。
- 再現性確保: 抽出スクリプトのバージョン管理、 乱数シードの記録、 全工程の document 化。
SSDSE-B-2026 のような公的統計を二次利用するときも、 「元の調査の標本設計」を理解しておくと、 後続分析(回帰、 機械学習)でも適切な重みづけや層化が可能になります。
🔗 隣接手法への橋渡し
「標本」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 母集団 を定義した後、 標本抽出 手法(無作為・層別・クラスター)で物理的に取得する
- 並列: 母集団(全体)と対をなす。 悉皆調査 なら全数、 標本調査なら一部のみを観察
- 下流: 標本統計量(平均・分散)から 信頼区間 や 仮説検定 で母集団の性質を推測する
「47 都道府県全部」も「47 ある都道府県のうち抽出した 10」も標本の例だが、 後者から前者を推し量る 推測統計 の出発点が標本の概念である。
🌳 手法選択フロー
標本を「どう取り、 どう読むか」は、 次の順に問いを立てると決まる。 数値はこのページで SSDSE-B-2026(2023 年度、 47 都道府県の総人口)を使って実測したもの。
- Step 1: 全体(母集団)の値がすでに全部手に入っているか?
- はい(例: 47 県の総人口)→ 平均や差は「推定値」ではなく確定した値。 標準誤差や p 値を付けるなら、 2023 年を「起こりえた年」の 1 つとみなす超母集団の立場を取ると明記する(🧭 解説深化)
- いいえ → Step 2 へ
- Step 2: 全員の名簿(抽出枠)があるか?
- ない → 集めやすい人だけの便宜標本になる。 母集団の値は推測できないので、 事後層化などの重み付けで補正し、 補正に使えなかった偏りを限界として書く(選択バイアス)
- ある → Step 3 へ
- Step 3: 母集団に大きさの極端な偏りがあるか?
- ある(総人口は東京都 1,409 万人から鳥取県 53.7 万人まで右に歪む)→ 規模で層化するか、 規模に比例した確率で抜く(PPS 抽出)。 16 県を抜く実測では、 単純無作為の推定値の SD 59.9 万人に対し、 地方ブロックで層化すると 50.8 万人、 人口の 4 分位で層化すると 33.4 万人
- ない → 単純無作為抽出(名簿が周期的に並んでいなければ系統抽出でもよい)
- Step 4: 調べに行く費用が地域でまとまっているか?
- はい → 市町村や学校ごとにまとめて抜くクラスター抽出。 同じクラスターの中は似ているので、 同じ n でも標準誤差は単純無作為より大きくなる
- Step 5: 標本が母集団のどれだけを占めるか?
- n/N が 5% を超える → 有限母集団修正 √((N−n)/(N−1)) を掛ける。 47 県から 10 県なら 0.90、 30 県なら 0.61 で、 無視すると標準誤差を大きく見積もる
- Step 6: 取れた標本は 1 つだけで、 分布が歪んでいるか?
- はい → 「平均 ± 1.96 × SE」の区間は当てにくい。 47 県から n = 10 を抜いて t 区間を作ると、 名目 95% に対して実際に母平均を含むのは 86.5% だった。 ブートストラップで区間を作るか、 対数変換してから平均を取る
🧭 解説深化:その 1 行は「誰」を数えているか — 標本の観測単位
姉妹ページの 標本抽出(どう選ぶか)・標本分布と中心極限定理(選んだ結果がどう散らばるか)・母集団(全体とは何か)では扱わない、 もう 1 つの根本問題を掘り下げます。 それは「標本を構成する 1 個(観測単位, unit of observation)は何か」です。 同じデータでも「1 個」の定義を変えると、 標本平均そのものが別の値になります。
💡 直感 — 「n=47」の 1 個は人ではなく県
SSDSE-B-2026 の 2023 年断面は 47 行、 つまり n=47 の標本(=都道府県の全数)です。 ここで見落としがちなのは、 1 行=1 都道府県であって、 1 人の人間ではないこと。 2023 年の総人口(A1101)は鳥取県 537,000 人、 東京都 14,086,000 人で約 26 倍の開きがあり、 東京都だけで全国 124,353,000 人の 11.33% を占めます。 それでも「47 県の単純平均」を取る瞬間、 鳥取県と東京都は同じ 1 票として扱われます。 味噌汁の比喩でいえば、 大鍋と小鍋から鍋のサイズを無視して 1 杯ずつ味見して平均するようなもの。 「47 県の平均」は「日本に住む人の平均」ではないのです。
⚠️ 落とし穴(重要) — 単純平均 31.59% と全国値 29.13% の 2.45 ポイント差
高齢化率(65 歳以上人口 A1303 ÷ 総人口 A1101)で実際に確かめます。 SSDSE-B-2026 の 2023 年・47 都道府県の実測値では、
- 47 県の高齢化率の単純平均(県が 1 個): 31.59%
- 全国の高齢化率=人口加重平均(人が 1 個): Σ A1303 ÷ Σ A1101 = 29.13%
- その差は 2.45 ポイント。 集計方法を変えただけで、 データは 1 バイトも変わっていないのに答えが動く。
ずれる理由も実測値で説明できます。 高齢化率が全国最小なのは東京都 22.75%、 最大は秋田県 39.06%。 単純平均では「若くて巨大な東京都」の重みが 1/47 に薄められ、 高齢な小規模県が相対的に過大代表されるため、 平均が上振れします。 背景には県人口の強い右歪みがあり、 2023 年の県人口は平均 2,645,809 人に対し中央値 1,549,000 人、 47 県中 35 県が平均未満です。 実務での対処は 1 つだけ:問いに合わせて 1 個を選ぶこと。 「県という制度単位の比較」(例: 自治体政策のばらつき)なら単純平均が正解になり得ますし、 「日本に住む人の話」なら人口加重が必要です。 集団単位の標本平均を個人単位の結論に読み替える誤りは生態学的誤謬(ecological fallacy)と呼ばれ、 選択バイアスと並ぶ標本解釈の二大事故源です。
🚀 発展 — 超母集団の視点:単位の選び方の影響は年々拡大している
「47 県は全数だから標本ではない」と片づけるのは早計です。 2023 年断面を「起こりえた年」という超母集団(superpopulation)からの 1 標本とみなす立場に立つと、 全数データにも推測統計の言葉が使えます(本文の有限母集団補正の議論の裏側にある考え方です)。 この視点で SSDSE-B-2026 の時系列 2012–2023 を実測すると、 単純平均と人口加重平均の差は
- 2012 年: 25.62% − 24.13% = 1.49 ポイント
- 2017 年: 29.53% − 27.69% = 1.83 ポイント
- 2023 年: 31.59% − 29.13% = 2.45 ポイント
と一貫して拡大しています。 地方の高齢化と人口の大都市集中が同時進行しているため、 「観測単位の選び方」がもたらす差は年々深刻になる、 という動的な教訓です。 理論的には、 抽出計画の確率だけから不確実性を語る設計ベース推測と、 データ生成過程のモデルを仮定するモデルベース推測という 2 つの流儀があり、 全数データの回帰分析は実質的に後者の立場で正当化されます。 さらに 47 県 × 12 年のパネルとして扱えば「n とは何か」(47 か、 564 か、 それとも実効的にはその中間か)というクラスタ構造の問題に接続します。