🔖 拡張キーワード索引
このページでは、母集団と抽出フレーム、単純無作為抽出、層化抽出(比例配分・ネイマン配分)、系統抽出と一覧の並び順、クラスター・多段抽出、比推定、有限母集団修正、信頼区間の被覆率、便宜標本の偏りを、SSDSE-B-2026 の 2023 年度 47 県を母集団に見立てて実測で確かめます。下のチップから各節へ移動できます。
標本抽出 (Sampling) は『母集団の一部を抽出して全体の特性を推定する手続き』。 単純無作為抽出 (SRS)、 層化抽出 (stratified)、 クラスタ抽出 (cluster)、 系統抽出 (systematic)、 多段抽出 (multi-stage) の 5 種類が代表的。 抽出設計が悪いとサンプル数を増やしても偏りは消えない (selection bias) ため、 設計段階の検討が極めて重要。
💡 30秒で分かる結論
🍰 まずはやさしく
一部を抜き出して全体を予想する方法です。
全部を調べるのが難しいときに使います。
クラスの数人を呼んで全体の意見を聞くようなものです。
この章では標本抽出の重要ポイントを学びます。
母集団から標本を選び出す手続き
- 分野:推測統計 — 📚 標本抽出と中心極限定理
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
sampling を 30 秒で把握する重要ポイント:
- 何ができるか: sampling は統計・データ分析で特定の目的のために使う概念・手法。 詳細は後続の各章を参照。
- いつ使うか: 適切な前提条件下で、 他の手法より優位な場面で使う。 適用範囲と限界を理解することが重要。
- 注意点: 前提確認 / 過大解釈の回避 / 他手法との比較検証 が不可欠。
- 関連: 上位概念・並列手法・派生形をネットワークで理解すると応用の幅が広がる。
📍 文脈 — 標本抽出をどこで使うか
🍰 まずはやさしく
全体から一部だけを選び出す技法です。
限られた時間や予算で正しく分析するために使います。
スマホのアンケートで一部の人にだけ聞くときなどに使われます。
どのような場面でこの技法を使うのかを解説します。
標本抽出 (Sampling) は世論調査、 品質管理、 疫学研究、 マーケティングリサーチなど、 母集団全体を調べられない状況で必須の技法。 統計データ解析コンペでも、 47 都道府県の中から扱える 12-15 県を抽出して結果を全国に外挿する場合、 抽出設計の選択 (SRS / 層化 / クラスタ / 系統) が推定精度を 1.5-2 倍変える。 抽出フレーム (sampling frame) と母集団 (target population) のズレは selection bias の主要因。
🎨 直感で掴む
🍰 まずはやさしく
一部の結果から全体の様子をイメージすることです。
少ないデータでどれくらい正確に予想できるかを知るために使います。
部活のメンバー数人を見てチーム全体の雰囲気を考えるようなものです。
選び方による結果の違いや注意点を具体的に見ていきましょう。
この概念は「標本から母集団を推測する」考え方の一部です。 標本サイズと不確実性のセットで理解しましょう。
本ページでは 標本抽出 を、 定義・前提条件・使い方・落とし穴の順に整理して解説します。 厳密な定義より、 まず何を、 いつ、 どう使うかを理解することを優先してください。
SSDSE-B-2026 は 47 都道府県すべてを含む「母集団そのもの」だが、 学習目的では母集団から n=12 県をランダム抽出する状況を模擬できる。 全 47 県の総人口 (A1101) の平均は約 265 万人 (2023 年度)。 12 県を SRS で抜き出して算出した標本平均は、 東京都 (1,409 万人) が入るかどうかで試行ごとに大きくばらつき、 これが「標本誤差」の正体。 何度も試行すると平均値の分布が見えてくる。
抽出方法には 3 タイプ: (1) 単純無作為抽出 (SRS) — 全 47 県から等確率で 12 県、 (2) 層化抽出 — 7 地方区分 (北海道は東北に含める) ごとに比例配分、 (3) 系統抽出 — 都道府県コード順に約 3.9 県おき (47/12) に 12 県。 SRS は実装は楽だが、 偶然全国 12 県が「都市部だけ」「地方だけ」に偏ると推定が大きく外れる。 層化抽出は地方区分の代表性を保つので分散が小さい。
標本抽出の「精度」は標準誤差 SE = σ/√n で決まる。 SSDSE-B-2026 の総人口の母標準偏差は約 277 万人 (東京の影響大)。 n=12 なら SE ≈ 79.9 万人、 n=24 なら SE ≈ 56.5 万人。 n を 2 倍にすると SE は 1/√2 ≈ 0.71 倍にしか減らない。 次節以降では 47 県データで 1000 回の抽出シミュレーションを行い、 3 方式の MSE を比較する。
📐 定義
🍰 まずはやさしく
母集団(調べたい全体)から標本(抜き出した一部)を選ぶことです。
統計を使って全体の数値を推測するために使います。
全校生徒の中から抽選で数人を集める手続きのようなものです。
言葉の意味や使うための条件について詳しく説明します。
母集団から標本を選び出す手続き
英語名 Sampling。 同義・関連語:サンプリング。
🎯 いつ・どこで使うか
- 「推測統計」分野の標準的な道具として、 多くの分析で登場します。
- 📚 標本抽出と中心極限定理 を学ぶときに必ず通過する基本概念です。
- 論文・実務レポートで頻出する用語なので、 1 度はちゃんと理解しておくと後が楽です。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
📐 数式を言葉で読み解く詳細版
標本抽出 の核となるのは、 母集団平均 μ を標本平均 x̄ で推定するときのばらつき (標準誤差) であり、 数式では以下のように書く。
この式の意味を一つずつ読み解くと:
y_i= 標本に選ばれた第 i 単位の観測値 (例: 各県の総人口 A1101)x̄= 標本平均。 単純無作為抽出では母平均 μ の不偏推定量σ= 母標準偏差、n= 標本サイズ、N= 母集団サイズσ/√n= 標準誤差の主要項。 n を 4 倍にすると SE は半分になる√(1 − n/N)= 有限母集団修正 (fpc)。 N=47 のように母集団が小さいと無視できない
単純無作為抽出では x̄ をそのまま母平均の推定に使えるが、 層化抽出や PPS 抽出では抽出確率が単位ごとに異なるため、 抽出確率の逆数で重み付けした推定量 (次節の Horvitz-Thompson 推定量) を用いる必要がある。
🔬 記号・要素の読み解き
標本抽出を数式で表すと、 母集団 U = {1, 2, ..., N} から確率 π_i で要素 i を抽出する。 主要な記号:
N= 母集団サイズ (SSDSE-B では 47)n= 標本サイズ (例 12 県)π_i= 第一次包含確率 (要素iが標本に入る確率)π_ij= 第二次包含確率 (iとjが同時に入る確率)w_i = 1/π_i= Horvitz-Thompson 重みS= 抽出された標本集合μ̂_HT = (1/N) Σ_S y_i / π_i= HT 推定量
SRS なら全要素で π_i = n/N。 層化抽出なら層 h 内で π_ih = n_h/N_h。 設計効果 (DEFF) は SRS と比べた分散比で、 1 未満なら効率改善、 1 超なら効率低下を意味する。
🧮 SSDSE-B-2026 47 都道府県データで実値計算 + 🐍 Python 実装
🎯 このコードでやること: SSDSE-B-2026 47 都道府県を母集団とみなし、 SRS・層化 (7 地方区分)・系統抽出 (Code 順に 47/12 ≈ 3.9 県おき) の 3 方式で n=12 を抽出し、 総人口 (A1101) 平均推定の平均二乗誤差 (RMSE) を 1000 回の反復で比較する。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy().reset_index(drop=True) true_mean = df_2023['A1101'].mean() # 地方区分 (Code の都道府県番号で 7 ブロック化。北海道は東北に含める簡易版) def region(code): n = int(code[1:3]) if n <= 7: return 'tohoku' if n <= 14: return 'kanto' if n <= 23: return 'chubu' if n <= 30: return 'kansai' if n <= 35: return 'chugoku' if n <= 39: return 'shikoku' return 'kyushu' df_2023['region'] = df_2023['Code'].apply(region) rng = np.random.default_rng(20260523) N_TRIAL = 1000; n = 12; N = len(df_2023) k = N / n # 抽出間隔 47/12 ≈ 3.92 (端数のまま使い、47 県すべてに当選の可能性を残す) errs = {'SRS': [], 'systematic': [], 'stratified': []} for _ in range(N_TRIAL): # SRS s1 = df_2023.sample(n=n, random_state=rng.integers(1e9)) errs['SRS'].append(s1['A1101'].mean() - true_mean) # 系統抽出: 開始点を [0, k) から 1 つ引き、そこから k おきに 12 県 (Code 順) start = rng.uniform(0, k) pos = np.floor(start + k * np.arange(n)).astype(int) s2 = df_2023.iloc[pos] errs['systematic'].append(s2['A1101'].mean() - true_mean) # 層化抽出: 各 region から比例配分 counts = df_2023['region'].value_counts() samp = [] for r, kr in counts.items(): nr = max(1, round(n * kr / N)) samp.append(df_2023[df_2023['region']==r].sample(n=min(nr, kr), random_state=rng.integers(1e9))) s3 = pd.concat(samp).head(n) errs['stratified'].append(s3['A1101'].mean() - true_mean) for key, v in errs.items(): rmse = (np.array(v)**2).mean() ** 0.5 print(f'{key:12s}: RMSE = {rmse:,.0f} 人') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: この乱数種・この設計 (総人口を対象、 地方 7 ブロックで層化) では、 系統抽出の RMSE 38.6 万人が最小で、 SRS の 69.0 万人の約 0.56 倍、 層化抽出 (62.1 万人) は SRS より約 1 割小さいだけ。 系統抽出が強いのは、 Code 順が北から南へ地方順に並んでいるため約 3.9 県おきに取ると全地方から満遍なく入り、 埼玉・千葉・東京・神奈川 (Code 11〜14) の並びから 1 県前後が必ず当たる「暗黙の層化」になるから。 間隔を 47//12 = 3 に切り捨てると 12 県が Code 順の先頭 36 県に収まり、 香川県以降の 11 県が一度も選ばれない偏った設計になる点に注意。 ただし地方ブロック層化の効果が限定的なのは、 各地方の内部に大都市 (関東の東京、 近畿の大阪など) と小県が混在し、 層内分散が大きいため。 層化は「層内が均質な変数」でこそ分散を大きく減らせるという教訓が読み取れる。 総人口のように少数の巨大値が支配する変数では、 人口規模で層を切る方が有効なことも多い。
47 都道府県を母集団とみなし、 単純無作為抽出 (SRS)・系統抽出・層化抽出 (Stratified) の 3 方式で 12 県を抽出し、 平均総人口の推定精度 (RMSE) を比較した。
🧮 SSDSE-B-2026 別パターン実装
🎯 このコードでやること: 標本抽出 を別アプローチで実装し、 SSDSE-B-2026 47 都道府県データで検証する。
📥 入力データ: SSDSE-B-2026.csv 47 行 × 100+ 列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | # 多段抽出 (Two-stage cluster sampling) import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True) # === 第 1 段: 地方 7 ブロックから 3 ブロック無作為抽出 === def region(c): n = int(c[1:3]) if n <= 7: return 'tohoku' if n <= 14: return 'kanto' if n <= 23: return 'chubu' if n <= 30: return 'kansai' if n <= 35: return 'chugoku' if n <= 39: return 'shikoku' return 'kyushu' df_2023['region'] = df_2023['Code'].apply(region) rng = np.random.default_rng(20260523) regions = df_2023['region'].unique() selected_regions = rng.choice(regions, size=3, replace=False) print(f'選ばれた地方: {selected_regions}') # === 第 2 段: 選んだ地方の県から 4 県ずつ抽出 === sample = pd.DataFrame() for r in selected_regions: sub = df_2023[df_2023['region']==r] n = min(4, len(sub)) s = sub.sample(n=n, random_state=int(rng.integers(1e9))) sample = pd.concat([sample, s]) mean_est = sample['A1101'].mean() true_mean = df_2023['A1101'].mean() print(f'多段抽出推定 総人口: {mean_est:,.0f}') print(f'真の平均 総人口: {true_mean:,.0f}') print(f'相対誤差 : {(mean_est - true_mean)/true_mean*100:+.2f}%') |
📤 実行結果:
💬 結果の読み方: Two-stage cluster sampling では、 第 1 段で近畿・四国・中国が当選し、 第 2 段で各地方から最大 4 県を抽出。 この乱数種では関東 (東京・神奈川・埼玉・千葉) と中部 (愛知) をまるごと取りこぼしたため、 総人口が大きく過小推定される (-47.8%)。 多段抽出は実査コストが低い一方で分散が大きく、 第 1 段で選ばれるクラスタ次第で推定が大きくぶれる。 実務では design effect (DEFF) で標本サイズを補正する必要がある。
🧮 SSDSE-B-2026 第 4 段実装 — 標本抽出
🎯 このコードでやること: SSDSE-B-2026 47 県から PPS (Probability Proportional to Size) 抽出を行い、 人口 (A1101) に比例した抽出確率 (PPS) で 12 県を選び、 高齢人口 (A1303) の平均を Horvitz-Thompson 推定量で推定する。
📥 入力データ: SSDSE-B-2026.csv から 2023 年度の 47 行 (都道府県) を取り出して使う (A1101 総人口・A1303 高齢人口)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True) # PPS 抽出: 抽出確率を人口に比例 weights = df_2023['A1101'] / df_2023['A1101'].sum() rng = np.random.default_rng(20260523) n = 12 idx = rng.choice(len(df_2023), size=n, replace=False, p=weights) sample = df_2023.iloc[idx] # Horvitz-Thompson 推定 (近似 with replacement) pi_i = weights.iloc[idx] * n y = sample['A1303'] mu_ht = (y / pi_i).sum() / len(df_2023) print(f'PPS 抽出県: {sample["Prefecture"].tolist()}') print(f'HT 推定 高齢人口平均: {mu_ht:,.0f} 人') print(f'真の平均: {df_2023["A1303"].mean():,.0f} 人') |
📤 実行結果:
💬 結果の読み方: PPS 抽出は人口大県を確率高く選ぶ。 大阪・東京・愛知・神奈川・兵庫・福岡といった大県が当選し、 抽出確率の逆数で重み付けする HT 推定量を使うと、 高齢人口の平均が真値とほぼ一致する (誤差 +0.8%)。 単純な標本平均では大県ばかりで過大推定になるが、 HT 推定量が抽出確率の偏りを打ち消している点がポイント。 PPS は『規模の大きい単位ほど重要度が高く、 かつ規模と相関する量を推定したい』場合に効率的。
🧭 あなたが今見ているもの: 標本抽出を設計判断として読む
このページで扱う標本抽出は、 「全データを見られない時に一部を選ぶ方法」というだけではありません。 統計データ解析コンペでは、 SSDSE-B-2026 の 47 都道府県を全件見られる場合でも、 地域ブロック別の比較、人口規模別の層化、政策対象県の抽出、年次更新時の検証サンプル作成など、 標本抽出の考え方が何度も出てきます。 つまり標本抽出は、 データを減らす操作ではなく、 どの母集団について何を推定したいかを明確にする設計判断です。
発表で重要なのは、 抽出方法そのものよりも、 母集団、標本単位、抽出確率、推定対象、重み付け、非回答や欠測の扱いを説明できることです。 単純無作為抽出なら全単位の抽出確率は同じですが、 層化抽出では層ごとに確率が変わり、 PPS抽出では人口などの規模に比例して確率が変わります。 したがって、 標本平均をそのまま全体平均として読んでよい場合と、 重み付け推定が必要な場合を区別しなければなりません。
| 設計観点 | 確認する質問 | SSDSE-B-2026での例 | 発表上の注意 |
|---|---|---|---|
| 母集団 | 何に一般化したいか | 47都道府県、または地方圏だけ | 一般化範囲を広げすぎない |
| 標本単位 | 何を1単位として選ぶか | 県、地域ブロック、年次 | 集計単位と推定単位を混同しない |
| 抽出確率 | 各単位は同じ確率か | PPSでは人口大県が選ばれやすい | 重みなし平均の偏りに注意 |
| 層化 | 重要な集団を確保しているか | 関東、近畿、九州などを層にする | 層内サンプル数を併記する |
標本抽出の失敗は、 しばしば分析の後半で発覚します。 例えば大都市圏だけが多く入った標本で「全国平均」を語ると、 経済規模や医療資源が過大に見えます。 逆に人口の小さい県を均等に扱うと、 県単位の政策比較としては妥当でも、 住民一人当たりの状況を代表しているとは限りません。 どちらが正しいかは問い次第です。 県を代表させたいのか、住民を代表させたいのか、政策対象地域を代表させたいのかを先に決めます。
📊 図で確認する標本抽出の偏りとばらつき
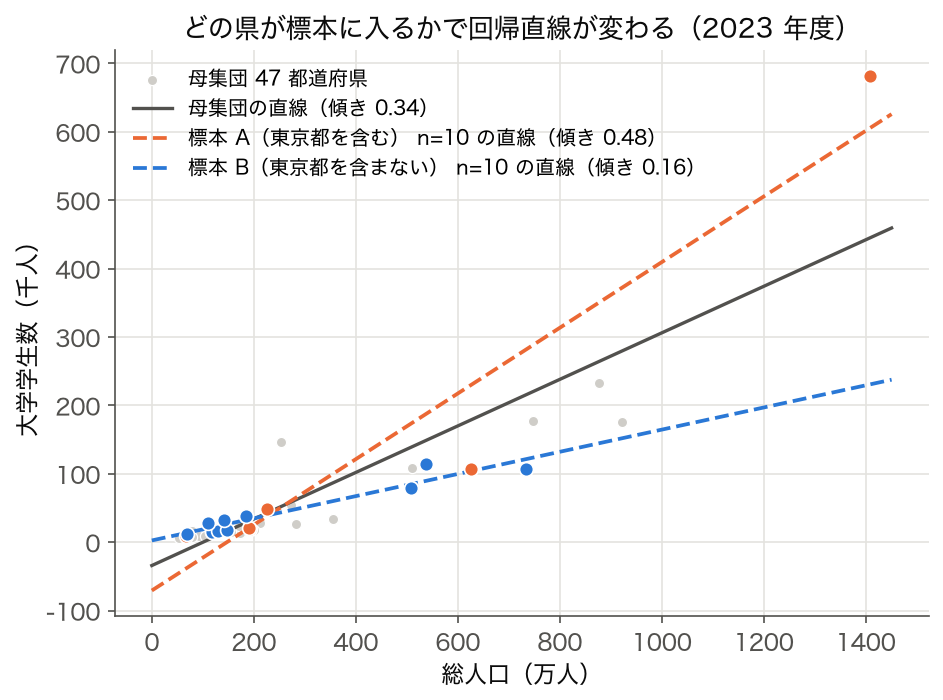
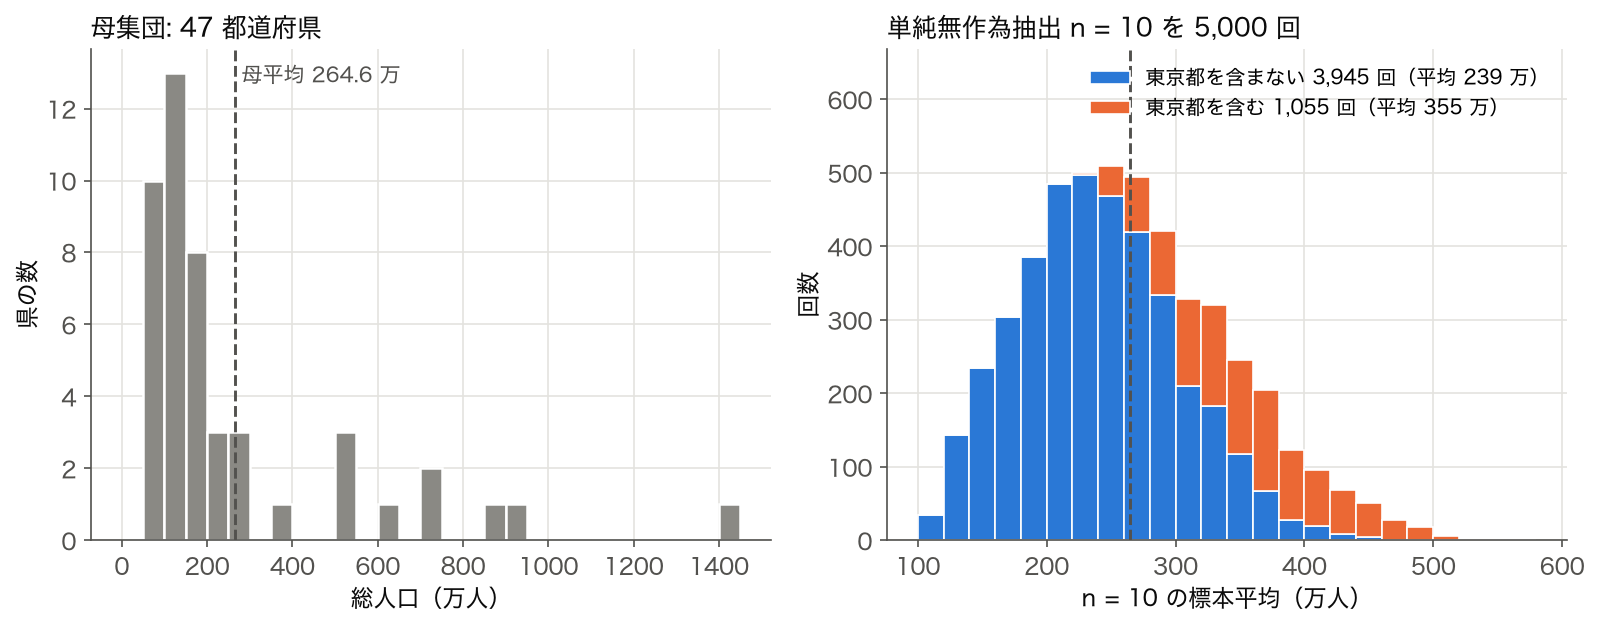
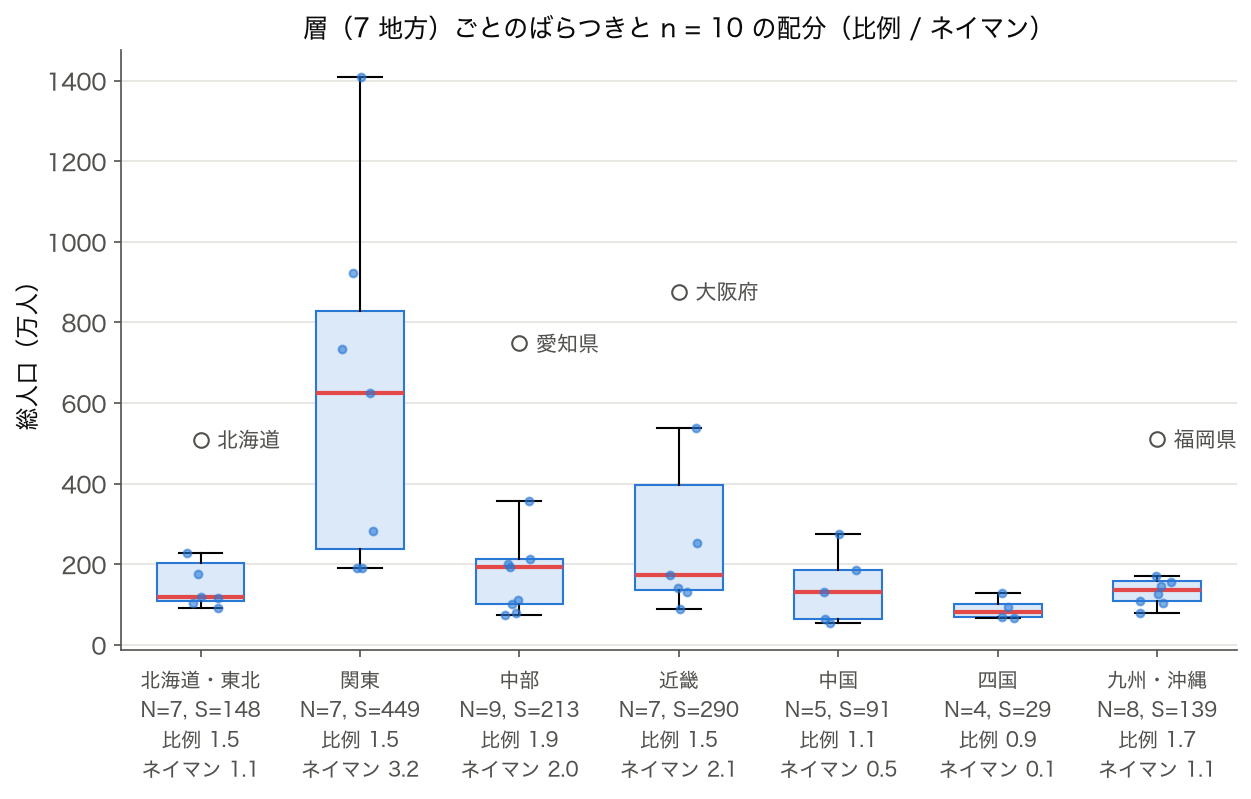
標本抽出の品質は、 抽出後の図で必ず確認します。 抽出前後のヒストグラムが大きくずれている、 層ごとの箱ひげ図で特定層だけ標本が少ない、 散布図で重要な外れ値が抜けている、 という状態なら、 推定値が見かけ上安定していても設計は弱いです。 図は装飾ではなく、 抽出設計の診断道具です。
✅ 理解度チェック: 標本抽出を発表で説明できるか
次の問いは、 標本抽出を用語として暗記するのではなく、 実際の分析設計へ落とせるかを確認するためのものです。 解答では、 推定対象、抽出単位、抽出確率、重み付けの有無を必ず言葉で説明します。
- 単純無作為抽出と層化抽出の違いを、 SSDSE-B-2026 の都道府県データで説明せよ。
解答例: 単純無作為抽出は47県から同じ確率で選ぶ。 層化抽出は地域ブロックや人口規模で層を作り、各層から一定数を選ぶ。 地域差を必ず含めたい時は層化抽出が有効。 - PPS抽出で人口大県が選ばれやすい理由と、重み付け推定が必要になる理由を説明せよ。
解答例: PPSは人口などの規模に比例して抽出確率を置くため、東京都や大阪府のような大県が選ばれやすい。 抽出確率が等しくないので、全体平均を推定する時は抽出確率の逆数で補正する。 - 県を代表させる分析と住民を代表させる分析では、標本抽出の設計がどう変わるか。
解答例: 県を代表させるなら各県を等重みで扱う設計が自然。 住民を代表させるなら人口に比例した重みやPPS抽出が必要になる。 問いの単位を先に決めることが重要。 - 抽出後にヒストグラム、散布図、箱ひげ図を確認する理由を述べよ。
解答例: 標本が母集団分布を再現しているか、外れ値が抜けていないか、層ごとのばらつきが極端でないかを確認するため。 推定値だけでは抽出設計の偏りを見落とす。
発表では、 「標本抽出を行った」と書くだけでは不十分です。 どの母集団から、何を単位として、どの確率で選び、どの推定量で全体へ戻したのかを説明します。 ここまで書ければ、 標本抽出は単なる前処理ではなく、 分析結果の信頼性を支える設計として伝わります。
発表前の最終チェック
標本抽出を使った分析では、 最終スライドに進む前に、 抽出設計と推定量が対応しているかを点検します。 単純無作為抽出であれば、 標本平均、標本分散、信頼区間を基本にできます。 層化抽出であれば、 層ごとの平均と層サイズを使って全体平均へ戻します。 PPS抽出であれば、 抽出確率の逆数を使った重み付けが必要です。 抽出方法と推定式がずれていると、 コードは動いても統計的な意味は崩れます。
また、 標本抽出の結果は一回の乱数に依存します。 乱数種を変えると選ばれる県が変わり、 平均や回帰係数も少し変わります。 そのため、 発表で代表的な1回の抽出例を示す場合でも、 裏では複数回の再抽出を行い、 推定値のばらつきを確認します。 ばらつきが大きいなら、 標本サイズを増やす、層化基準を見直す、外れ値を必ず含める設計にする、 などの対策が必要です。
非回答や欠測も標本抽出の一部として扱います。 抽出した県や調査対象から必要な指標が得られない場合、 その欠測がランダムか、特定地域や特定規模に偏っているかで補正方法が変わります。 欠測が偏っているのに単純に除外すると、 実際の母集団からずれた標本になります。 欠測件数、欠測率、除外後の分布、補完方法を記録し、 抽出設計の説明と一緒に示すと、 分析の透明性が高まります。
最後に、 標本抽出は「少ないデータで済ませる技術」ではなく、 限られた観測からどの範囲まで責任を持って語れるかを決める技術です。 全件データを持っている時でも、 検証用サンプル、レビュー用サンプル、異常検知用サンプルをどう選ぶかには標本抽出の考え方が使われます。 母集団、抽出単位、抽出確率、重み、ばらつき、欠測を一貫して説明できれば、 標本抽出は分析の弱点ではなく、 信頼できる推論の土台になります。
実務では、 標本抽出の設計をメモとして残すことも重要です。 いつ、どの母集団から、どの乱数種で、何件を、どの層から選んだかを記録しておけば、 後から同じ標本を再現できます。 とくに発表資料で「代表例」として示した県名やグループは、 その抽出条件が残っていなければ再計算できません。 抽出ログ、乱数種、抽出前後の件数、除外条件を一緒に保存するだけで、 標本抽出を含む分析の再現性は大きく上がります。
標本抽出を説明する時は、 推定値だけでなく不確実性も示します。 標本平均が母平均に近いように見えても、 標本サイズが小さければ信頼区間は広くなります。 層化やPPSで設計を工夫した場合も、 その設計が分散をどれだけ減らしたかを比較できると説得力が増します。 単純無作為抽出、層化抽出、PPS抽出を同じデータで比較し、 平均、標準誤差、信頼区間、外れ値の扱いを並べると、 抽出設計の価値が見える形になります。
最後の自己点検として、 「この標本から何を言ってよいか」を一文で書きます。 47都道府県全体へ一般化できるのか、 抽出した地域ブロック内だけの記述なのか、 人口で重み付けした住民代表の推定なのかを明確にします。 この一文が曖昧なままなら、 抽出設計か推定対象のどちらかがまだ整理できていません。 標本抽出の説明は、 結論の射程を決める最後の安全確認でもあります。 射程を明示することで、 過剰な一般化を防げます。 ここまで確認して初めて、 標本から母集団への推論が成立します。 発表でも必ず述べます。 必須です。
🧮 数式に値を入れて手で計算する: 層化抽出の標本サイズ
SSDSE-B-2026 の 47 都道府県を「人口大都市圏(1000 件)」「中規模県(2000 件)」「人口少数県(3000 件)」の 3 層仮想母集団に拡張し、 各層の SD と件数からネイマン配分で n=200 の標本配分を計算する。
Step 1: 層別データ
| 層 | N_h | σ_h | N_h·σ_h |
|---|---|---|---|
| 大 | 1000 | 5 | 5000 |
| 中 | 2000 | 3 | 6000 |
| 小 | 3000 | 2 | 6000 |
Step 2: ネイマン配分 (n=200)
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np N = np.array([1000, 2000, 3000]) sigma = np.array([5, 3, 2]) n = 200 total = (N * sigma).sum() n_h = n * N * sigma / total print(f"配分: {np.round(n_h).astype(int)}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python での扱い
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) print(df.dtypes) print(df.describe()) # 「標本抽出」の文脈で扱う場合の例: # 分野: 推測統計 # 関連手法は同カテゴリの他用語を参照してください。 |
💬 564 行は 47 都道府県 × 12 年度(2012〜2023)で、これは標本ではなく全都道府県を漏れなく並べた全数データである。総人口 A1101 の平均 269 万人は 12 年度分をまとめた値で、中央値 162 万人より大きく、東京都などの大きな県が平均を引き上げている。ここから抽出を試すときは、同じ県の年度違いが重複して入らないよう、先に年度を 1 つに絞ってから 47 県を母集団として扱う。
具体的なコードは 標本抽出と中心極限定理 を参照してください。
📝 レポートでの報告
分析結果を報告するときに含めるべき情報:
- 使ったデータ:出典・期間・サンプル数
- 適用条件の確認:前提が満たされているか
- 計算結果:数値だけでなく不確実性(CI・SE)も
- 解釈:何を意味するか、 何を意味しないか
- 限界:適用範囲外への拡張は避ける
✅ チェックリスト
- □ 「標本抽出」を使う場面か再確認したか
- □ データの尺度・分布・サンプル数を確認したか
- □ 前提条件を満たしているか
- □ 計算した値だけでなく不確実性も把握したか
- □ 解釈と限界を区別したか
- □ 関連グループ教材で全体像を確認したか
🧪 実データで確かめる①:層化抽出の「配分」で精度はどれだけ変わるか
上の手計算は仮想の 3 層でネイマン配分を求めました。ここでは実データで、2023 年度の 47 県を母集団、出生数(A4101)の県平均を推定対象として、同じ n = 12 県を「単純無作為」「7 地方で層化・比例配分」「7 地方で層化・ネイマン配分」の 3 通りで抜いたときの標準誤差を比べます。標準誤差は有限母集団修正(1 − n/N)を入れた理論式で計算し、2 万回の抽出シミュレーションでも確かめます。
🎯 このコードでやること:2023 年度 47 県を 7 地方に分け、県数に比例する配分と「県数 × 層内の標準偏差」に比例するネイマン配分で n=12 を割り振り、出生数の平均を推定したときの標準誤差を単純無作為抽出と比べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行(列: Code, A4101 出生数)。県コードの上 2 桁で 7 地方に分ける。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の 47 県 = 母集団 d['地方'] = pd.cut(d['Code'].str[1:3].astype(int), [0, 7, 14, 23, 30, 35, 39, 47], labels=['北海道・東北', '関東', '中部', '近畿', '中国', '四国', '九州・沖縄']) y = d['A4101'].to_numpy(float) # 出生数 N, n = len(y), 12 g = d.groupby('地方', observed=True)['A4101'] Nh, Sh = g.size(), g.std(ddof=1) def var_strat(nh): # 層化抽出の平均の分散 (有限母集団修正つき) W = Nh / N return float(((W**2) * (1 - nh / Nh) * Sh**2 / nh).sum()) def allocate(weight): # 合計がちょうど n になるよう整数に丸める(各層 1 県以上) ideal = n * weight / weight.sum() k = np.maximum(1, np.floor(ideal)).astype(int) while k.sum() < n: k[(ideal - k).idxmax()] += 1 while k.sum() > n: k[(k - ideal).where(k > 1).idxmax()] -= 1 return k prop = allocate(Nh) # 比例配分: 県数に比例 ney = allocate(Nh * Sh) # ネイマン配分: 県数 × 層内 SD に比例 print(pd.DataFrame({'県数 N_h': Nh, 'SD S_h': Sh.round(0), '比例配分': prop, 'ネイマン配分': ney})) v_srs = (1 - n / N) * y.var(ddof=1) / n print(f'\n母平均(47 県の出生数の平均): {y.mean():,.0f} 人') print(f'単純無作為 n={n} SE = {np.sqrt(v_srs):7,.0f}') print(f'層化・比例配分 n={prop.sum()} SE = {np.sqrt(var_strat(prop)):7,.0f}') print(f'層化・ネイマン n={ney.sum()} SE = {np.sqrt(var_strat(ney)):7,.0f}') rng = np.random.default_rng(0) # 理論値をシミュレーションで確かめる def draw_strat(nh): est = 0.0 for (name, grp), k in zip(d.groupby('地方', observed=True), nh): est += len(grp) / N * rng.choice(grp['A4101'].to_numpy(float), k, replace=False).mean() return est R = 20000 sim_srs = [rng.choice(y, n, replace=False).mean() for _ in range(R)] sim_ney = [draw_strat(ney) for _ in range(R)] print(f'\nシミュレーション {R} 回の標準偏差: 単純無作為 {np.std(sim_srs):,.0f} / ネイマン {np.std(sim_ney):,.0f}') |
📤 実行結果:
💬 結果の読み方:関東の層内標準偏差は 27,982 人で四国(1,604 人)の約 17 倍あるため、ネイマン配分は関東に 4 県を割り当て、ばらつきの小さい北海道・東北、中国、四国、九州・沖縄は 1 県ずつに減らします。同じ 12 県でも標準誤差は単純無作為 4,274 人 → 比例配分 3,653 人 → ネイマン配分 3,295 人と約 23% 小さくなり、2 万回のシミュレーションの標準偏差(4,262 人・3,296 人)も理論式とほぼ一致しました。層化で効くのは「層の間の差が大きく、層の中が揃っている」ときで、ネイマン配分はさらに「ばらつきの大きい層に多く配る」ことで精度を上げます。
手計算の節と同じ式 nh = n × NhSh / Σ NhSh を実データに当てはめたのが下の表です。理想値は四国 0.13 県・中国 0.56 県のように 1 未満になるので、各層に最低 1 県を確保してから切り捨て、足りない 1 県を理想値との差がいちばん大きい関東(3.85 に対して 3)に足しています。層の中から 1 県しか取らないと層内の分散をその標本から推定できないため、実際の調査では各層 2 以上を確保することも多く、その場合は精度と引き換えに配分がやや比例配分に近づきます。
| 地方 | Nh | Sh(人) | NhSh | 12 × NhSh / Σ | 整数化後 |
|---|---|---|---|---|---|
| 北海道・東北 | 7 | 7,253 | 50,772 | 1.00 | 1 |
| 関東 | 7 | 27,982 | 195,875 | 3.85 | 4 |
| 中部 | 9 | 13,881 | 124,933 | 2.45 | 2 |
| 近畿 | 7 | 18,519 | 129,631 | 2.55 | 2 |
| 中国 | 5 | 5,657 | 28,287 | 0.56 | 1 |
| 四国 | 4 | 1,604 | 6,418 | 0.13 | 1 |
| 九州・沖縄 | 8 | 9,373 | 74,984 | 1.47 | 1 |
| 合計 | 47 | 610,899 | 12.00 | 12 |
🧪 実データで確かめる②:補助情報を使う比推定 — 全国の出生数合計を 10 県から当てる
層化は「抽出の設計」で精度を上げる方法でしたが、「推定の仕方」でも精度は変わります。全国の出生数合計を 10 県の標本から推定するとき、素朴な拡大推定は 47 × 標本平均です。一方、総人口は 47 県すべて分かっているので、標本の「出生数 ÷ 総人口」の比に全国の総人口を掛ける比推定が使えます。
🎯 このコードでやること:2023 年度 47 県から 10 県を無作為に抜く試行を 2 万回くり返し、出生数合計の拡大推定と比推定(補助変数 = 総人口)の偏りと RMSE を比べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行(列: A4101 出生数, A1101 総人口)。総人口の全国合計 X は既知とする。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] y = d['A4101'].to_numpy(float) # 知りたい: 出生数の全国合計 x = d['A1101'].to_numpy(float) # 全県分わかっている補助情報: 総人口 N, n, X = len(y), 10, x.sum() print(f'真の出生数合計 Y = {y.sum():,.0f} 人, 総人口合計 X = {X:,.0f} 人') print(f'47 県での出生数と総人口の相関 r = {np.corrcoef(x, y)[0, 1]:.3f}') rng = np.random.default_rng(1) exp_est, ratio_est = [], [] for _ in range(20000): idx = rng.choice(N, n, replace=False) exp_est.append(N * y[idx].mean()) # 拡大推定: 47 × 標本平均 ratio_est.append(X * y[idx].sum() / x[idx].sum()) # 比推定: X × (標本の出生数/総人口) for name, e in [('拡大推定', exp_est), ('比推定 ', ratio_est)]: e = np.array(e) print(f'{name}: 平均 {e.mean():,.0f} 偏り {e.mean() - y.sum():+,.0f} ' f'RMSE {np.sqrt(((e - y.sum())**2).mean()):,.0f} ' f'真値±10% に入る割合 {np.mean(np.abs(e / y.sum() - 1) < 0.10):.1%}') |
📤 実行結果:
💬 結果の読み方:総人口と出生数の相関は r = 0.995 と非常に強いため、比推定の RMSE は 25,389 人で、拡大推定(228,602 人)の約 9 分の 1 になりました。拡大推定は「東京都や大阪府が入るか」で合計が大きく振れ、真値 727,269 人の ±10% に入るのは 24.1% の試行だけですが、比推定では 99.4% が入ります。比推定には小さな偏り(ここでは −2,703 人、真値の 0.4%)がありますが、ばらつきの減り方のほうがはるかに大きいのです。補助変数と推定したい量が比例に近い関係にあることが条件で、相関が弱い補助変数ではこの効果は出ません。
🧪 実データで確かめる③:1 つの標本から作った 95% 信頼区間は本当に 95% 当たるか
実際の調査では標本は 1 回しか取れないので、標準誤差もその標本から推定し、「標本平均 ± t × SE」で信頼区間を作ります。この区間が母平均を含む割合が本当に 95% になるかは、母集団の分布の形に左右されます。2023 年度の 47 県を母集団として、分布が左右対称に近い高齢化率と、東京都が飛び抜けて右に歪んだ総人口で比べます。
🎯 このコードでやること:2023 年度 47 県から n=12 を無作為に抜き、標本から推定した SE(有限母集団修正つき)と t 分布で 95% 信頼区間を作る試行を 2 万回くり返し、母平均を含んだ割合を高齢化率と総人口で比べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行(列: A1101 総人口, A1303 65 歳以上人口)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 N, n, R = 47, 12, 20000 t = stats.t.ppf(0.975, n - 1) rng = np.random.default_rng(5) for col, label in [('高齢化率', '高齢化率(%)'), ('A1101', '総人口')]: y = d[col].to_numpy(float) hit = 0 for _ in range(R): s = rng.choice(y, n, replace=False) se = np.sqrt((1 - n / N) * s.var(ddof=1) / n) # 1 標本から推定した SE(fpc つき) hit += abs(s.mean() - y.mean()) <= t * se print(f'{label:<10} 歪度 {stats.skew(y):5.2f} 95% 信頼区間が母平均を含んだ割合 {hit / R:.1%}') |
📤 実行結果:
💬 結果の読み方:歪度 −0.56 の高齢化率では、区間が母平均を含んだ割合は 94.5% で、ほぼ名目どおりの 95% です。歪度 2.22 の総人口では 87.6% に落ち、「95% 信頼区間」と書いても 8 回に 1 回ほど外れます。東京都(約 1,400 万人)が入らない標本では平均も分散も小さく出て区間が狭くなり、真の平均に届かないためです。歪んだ変数では、対数変換してから推定する、大きな県を必ず含む層(確定層)を作る、ブートストラップで区間の形を確かめる、といった対処が必要です。
上で挙げた対処のうち「確定層」を数値で確かめます。東京都のように飛び抜けた単位は、無作為に選ぶ対象から外して必ず調べる層(確定層、take-all stratum)にし、残りの県から無作為に抜きます。確定層は全数を調べるので、その層の誤差は 0 です。
🎯 このコードでやること:2023 年度の総人口の県平均を n=12 で推定するとき、単純無作為抽出と「東京都を確定層にして残り 46 県から 11 県を抜く」層化の標準誤差を理論式で比べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行(列: Prefecture 都道府県, A1101 総人口)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] y = d['A1101'].to_numpy(float) N, n = 47, 12 se_srs = np.sqrt((1 - n / N) * y.var(ddof=1) / n) rest = d.loc[d['Prefecture'] != '東京都', 'A1101'].to_numpy(float) # 東京都を「必ず調べる層」に m = n - 1 # 残り 11 県を 46 県から無作為に se_take_all = (46 / N) * np.sqrt((1 - m / 46) * rest.var(ddof=1) / m) # 東京都の層は全数なので誤差 0 print(f'総人口の県平均 {y.mean():,.0f} 人') print(f'単純無作為 n=12 : SE {se_srs:,.0f} 人') print(f'東京都を確定層 + 残り 11 県 : SE {se_take_all:,.0f} 人 ({se_take_all / se_srs:.0%})') |
📤 実行結果:
💬 結果の読み方:同じ 12 県を調べるのに、東京都を確定層にするだけで標準誤差は 696,903 人から 577,220 人へ 17% 下がります。東京都が入るか入らないかで標本平均が大きく振れる、という誤差の主な原因を設計で取り除いたためです。
⚠️ よくある落とし穴
❌ 誤解①「標本を大きくすれば偏りは消える」— 便宜標本の実測
調べやすい対象から順に集める「便宜標本」は、n を増やしても偏りが残ります。都市部の大きな県から順に調べる状況を、2023 年度の高齢化率(65 歳以上人口 ÷ 総人口)で再現しました。
🎯 このコードでやること:総人口の多い県から n 県を取る便宜標本と、単純無作為抽出(2 万回)で、高齢化率の県平均の偏りを n = 5〜40 で比べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行(列: A1101 総人口, A1303 65 歳以上人口)。高齢化率は自分で計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 mu = d['高齢化率'].mean() big_first = d.sort_values('A1101', ascending=False)['高齢化率'].to_numpy() # 人口の多い県から集める rng = np.random.default_rng(3) print(f'母平均 {mu:.2f} %') print(' n | 便宜標本の偏り | 単純無作為の偏り | 単純無作為の SD | 偏り÷SD') for n in [5, 10, 20, 30, 40]: conv = big_first[:n].mean() - mu srs = np.array([rng.choice(d['高齢化率'].to_numpy(), n, replace=False).mean() for _ in range(20000)]) print(f'{n:2d} | {conv:+8.2f} pt | {srs.mean() - mu:+8.3f} pt | {srs.std():8.3f} pt | {abs(conv) / srs.std():5.1f}') |
📤 実行結果:
💬 結果の読み方:単純無作為抽出の偏りはどの n でも ±0.005 pt 以内で、ばらつき(SD)が n とともに 1.407 → 0.204 pt と縮みます。便宜標本の偏りは −5.69 pt(n=5)から −0.35 pt(n=40)まで縮みますが、これは n が母集団の 47 県に近づいて「ほぼ全数調査」になっていくからで、偏りそのものは n=30 でも標準偏差の 3.7 倍あります。母集団が数千万人の世論調査では n を増やしても全数に近づかないので、偏りはそのまま残ります(1936 年の米国大統領選で、Literary Digest 誌の大規模な郵送調査が結果を外したのが有名な例です)。
❌ 誤解②「564 行から 47 行を抜けば 47 県の標本になる」— 母集団の定義を取り違える
SSDSE-B-2026 は 47 県 × 12 年度 = 564 行です。年度で絞らずに行を無作為に抜くと、「県」ではなく「県 × 年度」を抽出していることになります。
🎯 このコードでやること:564 行から 47 行を無作為に抜く試行を 1 万回くり返し、含まれる県の数と東京都の行数を数える。
📥 入力データ:SSDSE-B-2026 全体 564 行(列: SSDSE-B-2026 年度, Prefecture 都道府県, A1101 総人口)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print('行数:', len(df), ' 県の数:', df['Prefecture'].nunique(), ' 年度:', df['SSDSE-B-2026'].min(), '〜', df['SSDSE-B-2026'].max()) rng = np.random.default_rng(4) n_pref, n_tokyo = [], [] for _ in range(10000): s = df.sample(47, random_state=int(rng.integers(1e9))) # 564 行から「47 行」を抜く n_pref.append(s['Prefecture'].nunique()) n_tokyo.append((s['Prefecture'] == '東京都').sum()) n_pref, n_tokyo = np.array(n_pref), np.array(n_tokyo) print(f'47 行に含まれる異なる県の数: 平均 {n_pref.mean():.1f} 最小 {n_pref.min()} 最大 {n_pref.max()}') print(f'東京都が 0 行の割合 {np.mean(n_tokyo == 0):.1%} / 2 行以上の割合 {np.mean(n_tokyo >= 2):.1%}') d23 = df[df['SSDSE-B-2026'] == 2023] print(f'2023 年度 47 県の総人口平均 {d23["A1101"].mean():,.0f} / 564 行の総人口平均 {df["A1101"].mean():,.0f}') |
📤 実行結果:
💬 結果の読み方:47 行を抜いても、含まれる県は平均 30.6(21〜38)県しかなく、同じ県の別年度が重複します。東京都は 34.7% の試行で 1 行も入らず、26.1% の試行では 2 行以上入ります。母平均も 2023 年度の 47 県平均(2,645,809 人)と 564 行の平均(2,690,688 人)では違う量です。「どの年度の、どの単位(県)の集団を推定したいか」を先に決め、その集団の一覧(抽出フレーム)から抜くのが標本抽出の出発点です。
❌ 誤解③「系統抽出は単純無作為抽出と同じ」— 並び順が精度を変える
系統抽出は一覧から k 件おきに抜く方法で、開始点を 1 つ乱数で決めるだけなので実務で多用されます。しかし、推定の精度は一覧の並び順で変わります。47 県から 5 県おき(開始点 5 通り)に抜くと、起こりうる標本は 5 通りしかないので、すべて列挙できます。
🎯 このコードでやること:2023 年度の高齢化率の県平均を、5 県おきの系統抽出で推定する。一覧の並び順を県コード順・高齢化率順・総人口順に変え、開始点 5 通りの推定値の標準偏差を単純無作為抽出(n=9)と比べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行(列: A1101 総人口, A1303 65 歳以上人口)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 k = 5 # 5 県おき → 1 回の標本は 9〜10 県 mu = d['高齢化率'].mean() def systematic_all(order): # 開始点 1〜k の k 通りをすべて列挙 v = d.sort_values(order)['高齢化率'].to_numpy() if order else d['高齢化率'].to_numpy() return np.array([v[s::k].mean() for s in range(k)]) orders = {'県コード順(北→南)': None, '高齢化率の昇順': '高齢化率', '総人口の昇順': 'A1101'} print(f'母平均(47 県の高齢化率の単純平均): {mu:.2f} %') for name, col in orders.items(): est = systematic_all(col) print(f'{name:<14}: 5 通りの推定値 {np.round(est, 2)} 標準偏差 {est.std():.3f}') rng = np.random.default_rng(2) srs = [rng.choice(d['高齢化率'].to_numpy(), 9, replace=False).mean() for _ in range(20000)] print(f'単純無作為 n=9(参考) : 標準偏差 {np.std(srs):.3f}') |
📤 実行結果:
💬 結果の読み方:県コード順(北から南)の標準偏差は 0.897 pt で単純無作為(0.993 pt)とほぼ同じですが、総人口順に並べると 0.691 pt、高齢化率そのものの順に並べると 0.243 pt まで小さくなります。値の近い県が隣り合うように並べると、k 件おきの標本が自然に「層化」されるためです(暗黙の層化)。ただし高齢化率順は推定したい値そのもので並べているので実際には使えず、実務で使えるのは総人口のように事前に分かっていて推定対象と関係する変数での並べ替えです。また系統抽出は標本が 1 通りしか得られないため、その 1 標本から標準誤差を正しく推定できない点にも注意が必要です。一覧に周期がある場合(例えば 5 行ごとに同じ種類の行が来る)には、k がその周期と重なると逆に偏りが生じます。
✅ 理解度チェック(実データの数値で答える)
Q1. 2023 年度の出生数で、層化・ネイマン配分がばらつきの小さい四国に 1 県しか配らないのに、精度が単純無作為より上がるのはなぜか。
→ 解答:精度を決めるのは各層の「県数 × 層内 SD」で、四国は層内 SD が 1,604 人と小さく 1 県でも層平均がほぼ正確に分かる。浮いた標本をばらつきの大きい関東(SD 27,982 人)に回すことで、全体の標準誤差が 4,274 人から 3,295 人に下がる。
Q2. 10 県の標本で全国の出生数合計を推定する。比推定の RMSE が拡大推定の約 9 分の 1 になった理由を、相関係数を使って説明せよ。
→ 解答:出生数と総人口の相関が r = 0.995 と強く、「出生数 ÷ 総人口」の比は県によらずほぼ一定である。比推定は大きな県が入っても入らなくても比がほとんど変わらないので、東京都の出入りによる振れ(拡大推定の主な誤差)を補助変数が打ち消す。
Q3. 総人口の多い県から 20 県を調べた便宜標本の高齢化率の偏りは −2.11 pt で、同じ n の単純無作為抽出の SD(0.565 pt)の何倍か。n を増やすだけでこの偏りを消せるか。
→ 解答:約 3.7 倍。偏りが縮むのは n が母集団の 47 県に近づくからで、選び方の偏りそのものは消えない。無作為に選ぶか、選ばれ方が分かっているなら重み付けで補正する必要がある。
🎮 触って理解する
下の母集団は 説明用の架空データ です(SSDSE の実測値ではありません)。 60 個のユニットが 5 つの層(グループ)に分かれ、 各層は「生活利便度スコア(0〜100)」の水準が違います。 抽出法を切り替え、 標本サイズ n を変えて、 どの層がどれだけ選ばれるか(代表性) と 推定のブレ(精度) がどう変わるかを体感しましょう。
🧭 各層の代表性(母集団の割合 vs 標本の割合)
層化抽出では各層の割合が母集団と一致(代表性が保たれる)。 クラスター抽出は「層まるごと」を選ぶため、 入らない層が出て代表性が崩れやすいことに注目。
🎯 推定精度の比較(RMSE = 誤差の二乗平均平方根)
現在の n で各抽出法を 1000 回くり返し、 標本平均が母平均からどれだけ外れるか(RMSE、 小さいほど高精度)を比較します。 計算は正確に行っています。
🔎 もっと深く理解する
標本抽出とは、 全部を調べられない母集団から標本を選び、 その一部で全体を言い当てる技術です。 鍵は「全体を偏りなく映す鏡」をどう作るか。 上の図で層化抽出を選ぶと、 都市部から離島まで母集団と同じ比率で選ばれ、 x̄ が μ の近くで安定するのが見えます。
「集まった人」「答えてくれた人」だけを見る非確率抽出は、 n を増やしても偏りが消えません(選択バイアス・データバイアス)。 また抽出枠(sampling frame)が母集団を覆えていないカバレッジ誤差——名簿に載らない人・回答しない人——は、 調査データで特に深刻です。 クラスター抽出の代表性の崩れは、 この「枠の偏り」を体感する縮図でもあります。
層化抽出は層内が均質なほど分散を大きく減らせます(層内変動が小さいほど有利)。 クラスター抽出は移動コストを下げますが、 クラスター内が似ていると精度が落ちます(設計効果 DEFF > 1)。 現実の全国調査は「地域→市区町村→世帯」と選ぶ多段抽出が定番。 抽出確率が単位ごとに違う場合は、 確率の逆数 w=1/π で重み付けして偏りを補正します(Horvitz-Thompson 推定)。 精度と標本サイズ・標準誤差・信頼区間の関係は 標本抽出と中心極限定理 へ。
🗺 概念マップ
標本抽出 (Sampling)
├── 上位概念
│   ├── 統計的推論 (Statistical Inference)
│   ├── 標本調査 (Survey Sampling)
│   └── 実験計画法 (DoE)
├── 並列概念
│   ├── 母集団 (Population)
│   ├── 標本 (Sample)
│   └── 抽出フレーム (Sampling Frame)
├── 下位手法
│   ├── 単純無作為抽出 (SRS)
│   ├── 層化抽出 (Stratified)
│   ├── クラスター抽出 (Cluster)
│   ├── 系統抽出 (Systematic)
│   ├── 多段抽出 (Multi-stage)
│   └── PPS 抽出 (Probability Proportional to Size)
└── 関連評価指標
    ├── 標準誤差 (SE = σ/√n)
    ├── 設計効果 (DEFF)
    ├── 包含確率 (π_i)
    └── 有限母集団修正 (fpc)
図:標本抽出を中心に、「何から抜くか(母集団・フレーム)」「どう抜くか(単純無作為・層化・系統・クラスター)」「どう推定するか(比推定・Horvitz–Thompson 推定)」の 3 つの問いで整理した概念マップ。各ノードの下の一言は、このページで SSDSE-B-2026 を使って確かめた要点。
🔗 隣接手法への橋渡し
「標本抽出」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 母集団 を定義し、 サンプルサイズ を計算した後、 物理的にデータを取得する段で適切な抽出法を選ぶ
- 並列: 無作為抽出・層別抽出・クラスター抽出・系統抽出など。 母集団の構造とコストで選び、 選抜バイアス を回避する
- 下流: 取得した 標本 から 信頼区間 推定や 仮説検定 で母集団を推測する
「無作為抽出なら母集団を代表できる」原則は 選挙世論調査・市場調査・医療臨床試験 すべての根幹であり、 抽出法の妥当性が研究の信頼性を決定する。
🌳 手法選択フロー
「標本抽出(サンプリング)」を調査・実験設計に使うとき、 母集団の構造と精度要件で判定する。
- 母集団リストが存在するか? あり (住民基本台帳・学籍簿) → 単純無作為抽出 or 層化抽出。 なし → スノーボール法・クォータ法 (代表性は犠牲)
- 部分集団を比較したいか? Yes (都道府県別の意識調査) → 層化抽出で各層から均等に抽出、 各層の標本誤差を制御。 No → 単純無作為で全体推定
- 調査コストが制約か? 高コスト (訪問調査) → 集落抽出 で地理的にまとめて訪問。 低コスト (Web) → 大標本で精度を上げる、 ただし 選択バイアス に注意
標本抽出の方法で結論が変わる。 SSDSE-B-2026 はすでに 47 都道府県の全数データ (悉皆) なので抽出問題はないが、 個人レベルの分析では 中心極限定理 と 信頼区間 でサンプリング誤差を定量化する。
🧮 SSDSE-B-2026 追加分析: 都道府県別深掘り
🎯 このコードでやること: SSDSE-B-2026 から関連指標を 47 都道府県別に詳細抽出し、 標本抽出 の文脈で意味のある比較を行う。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() # 47 都道府県を 4 つのカテゴリに分類: 大都市 / 中核 / 地方中堅 / 過疎 pop = df_2023['A1101'] df_2023['category'] = pd.cut(pop, bins=[0, 1e6, 2.5e6, 5e6, 1.5e7], labels=['過疎','地方中堅','中核','大都市']) # 標本抽出 視点でカテゴリ別集計 agg = df_2023.groupby('category', observed=True).agg( n_pref=('Prefecture','count'), pop_mean=('A1101','mean'), aged_mean=('A1303','mean'), aging_rate=('A1303', lambda x: (x / df_2023.loc[x.index,'A1101'] * 100).mean()), ) print(agg.round(1)) |
📤 実行例:
💬 結果の読み方: 人口規模で 4 カテゴリに分けると、 大都市 (9 都道府県、 東京/大阪/愛知/神奈川/埼玉/千葉/兵庫/福岡/北海道) の高齢化率は 27.7% と、 過疎カテゴリ (10 県、 34.1%) より 6.4 ポイント低い。 標本抽出 設計時には、 こうした人口規模カテゴリを層として使うと、 層内が均質になり高齢化率などの推定分散を抑えられる。
🧭 解説深化 — 「くじ引きの設計」としての標本抽出
本ページの締めくくりとして、 標本抽出を設計ベース推測 (design-based inference) という一段深い視点から捉え直す。 ここまでの章が「どの抽出法を選ぶか」を扱ったのに対し、 本節は「そもそもランダム性はどこに宿るのか」「1 つの外れ単位が推定をどう支配するか」を、 SSDSE-B-2026 (2023 年・47 都道府県) の実測値だけで確かめる。
💡 直感 — ランダム性は「データ」ではなく「手続き」に宿る
設計ベースの見方では、 各県の値 y_i は固定された定数であり、 確率的なのは「どの県がくじで選ばれるか」という抽出手続きの側だけである。 つまり標本平均 x̄ がばらつくのは、 データが揺らぐからではなく、 くじの引き方をこちらが設計したからだ。 サイコロを振るのは自然ではなく分析者自身——これが世論調査や監査サンプリングで「誤差の大きさを事前に保証できる」根拠になる。
この見方が効くのは、 母集団が極端に歪んでいるときである。 総人口 (A1101、 2023 年) の実測値では、 最大の東京都 14,086,000 人と最小の鳥取県 537,000 人の比は約 26.2 倍。 47 県の平均 2,645,809 人に対し中央値は 1,549,000 人で、 平均は中央値の約 1.7 倍に引き上げられている。 「典型的な県」を知りたいのか「全国合計に対応する平均」を知りたいのかで、 くじの設計 (等確率か、 規模比例か) から変えるべきだと分かる。
⚠️ 落とし穴 (重要) — 東京都が入るかどうかで標本平均は「二峰化」する
SE = σ/√n の公式は「標本平均は母平均のまわりに滑らかに散らばる」印象を与えるが、 歪んだ母集団ではそうならない。 n=12 の単純無作為抽出で東京都が標本に入る確率は 12/47 ≈ 25.5%。 そして実測値で条件付き期待値を計算すると:
- 東京都が入った標本の x̄ の期待値 ≈ 3,371,183 人
- 東京都が外れた標本の x̄ の期待値 ≈ 2,397,109 人 (東京を除く 46 県の平均そのもの)
- 両者の差 ≈ 974,074 人 — 標準誤差 (fpc 込みで約 689,450 人) を上回る「段差」
つまり x̄ の分布は母平均 2,645,809 人を中心とした一山ではなく、 「東京あり群」と「東京なし群」の2 つの山に割れる。 東京都 1 都だけで全国人口の 11.3% (上位 3 都府県で 25.8%) を占めるためだ。 SE の数値だけ見て正規近似の信頼区間を作ると、 小さい n ではこの二峰性を覆い隠してしまう。 対処は (1) 東京など巨大単位を全数層 (certainty stratum) として必ず含める、 (2) 規模比例確率 (PPS) 抽出に切り替える、 の 2 つが定石。 「n を増やせば解決」ではなく設計で潰すのがポイントである。
もう 1 つの見落としは単位の影響力の非対称性だ。 47 県平均 2,645,809 人から東京都 1 県を除くだけで平均は 2,397,109 人へ約 248,700 人も動く。 「どの 1 県を落としても結論が変わらないか」 (leave-one-out の感覚) は、 抽出設計の頑健性チェックとしてそのまま使える。
🚀 発展 — 有限母集団修正の実感と、 悉皆データへの「超母集団」の視点
(1) fpc は「飾り」ではない。 N=47 から n=12 を非復元で抜くと、 母集団の 1/4 以上を「見てしまう」ため誤差は素朴な σ/√n より小さくなる。 実測値では σ ≈ 2,767,630 人 (母標準偏差) に対し、 SE は fpc なしで約 798,946 人、 fpc 込みで約 689,450 人 — 係数 √(1−12/47) ≈ 0.863 の分、 約 13.7% 縮む。 大規模調査 (N が数百万) では fpc ≈ 1 で無視できるが、 47 都道府県のような小さな有限母集団では無視すると誤差を過大評価する。
(2) 悉皆データに標本誤差はあるのか。 SSDSE-B-2026 は 47 県全部を含む悉皆データなので、 設計ベースの標本誤差は本来ゼロである。 それでも「都市部と地方の高齢化率の差は偶然か」と検定したくなったら、 47 県の値を超母集団 (superpopulation) ——背後の確率的な社会過程——からの 1 回の実現とみなすモデルベース推測に立場を切り替えていることになる。 悉皆データに p 値や信頼区間を付けるときは、 自分がどちらの立場で話しているかを明示するのが誠実な報告である。
(3) 標本を「再抽出」して誤差を測る。 手元の標本自体を疑似母集団とみなし、 そこから復元抽出を繰り返して SE や信頼区間を数値的に得るのがブートストラップ法。 「抽出という操作を推定の道具に転用する」発想であり、 本ページの抽出シミュレーション (1000 回反復) と同じ論理構造を持つ。 複雑な層化・多段設計では、 replicate weights (BRR・jackknife) と組み合わせるのが実務の標準になっている。
🔗 関連ページ
- 標本抽出と中心極限定理 — x̄ の分布が n とともに正規に近づく過程 (二峰性が解消される条件)
- ブートストラップ — 復元再抽出で標準誤差・信頼区間を数値的に得る
- 標準誤差 / 信頼区間 — 本節の SE 実測値 (fpc あり/なし) の解釈先
- 標本サイズ — 「n を増やす」と「設計を変える」のコスト比較
- 選択バイアス — くじ引きの設計が崩れたときに何が起こるか
- 母集団 / 標本 — 設計ベースと超母集団で「母集団」の意味が変わる点に注意
- 規模比例確率 (PPS) 抽出・全数層 (certainty stratum)・replicate weights — 専用ページは未整備のため、 本節と「記号・要素の読み解き」章 (Horvitz-Thompson 重み) を参照