📚 用語解説
データバイアス
Data Bias
倫理
別称: データの偏り
🔖 キーワード索引
チップを押すと、 そのキーワードを扱う章へ移動する。
💡 30秒で分かる結論 — データバイアス
🍰 まずはやさしく
データバイアスはデータの偏りのことです。
正しい判断をするために使います。
AIが特定の人のみを優遇する例があります。
ここではバイアスの種類と対策を読みます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- データバイアス=データに 偏り があり、 母集団を正しく代表しない状態。 ML モデルの判断が歪む元凶。
- 代表的バイアス:(1) 選択バイアス、 (2) サンプリングバイアス、 (3) ラベルバイアス、 (4) 歴史的バイアス、 (5) 確認バイアス。
- 例:Amazon の採用 AI が女性差別(過去の採用データが男性中心)、 顔認証が肌色で精度差。
- 対策:データ多様化、 重み付けサンプリング、 公平性指標(demographic parity, equalized odds)。
- 「バイアスゼロ」は不可能。 把握 → 文書化 → 緩和 → 監査 の循環が現実解。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
データの偏りはAIの差別に繋がります。
公平なAIを作るために考えます。
スマホの顔認証が肌色で変わる例があります。
ここではデータ集めの注意点を読みます。
「AI が差別している」 — ほぼ全てデータバイアス由来。 モデルは データを忠実に学ぶ ので、 データに偏りがあれば差別を学習します。 防ぐのは データを集める段階 から。
このページの読み方:まず 30秒結論 と 直感 を読み、 必要に応じて 数式 や 計算例、 落とし穴 に進んでください。
🎨 直感で掴む
🍰 まずはやさしく
一部だけを見て全部だと思い込むことです。
勘違いを防ぐために使います。
大都市だけのデータで地方を判断する例です。
ここでは偏りが起きる仕組みを読みます。
金魚を釣りで「川の魚の代表」と思い込むと…:
- 選択バイアス=釣り場(特定の場所)の魚しか取れない
- サンプリングバイアス=餌に寄ってくる魚種に偏る
- 確認バイアス=「やっぱり川は金魚ばかり」と思い込み確認
同じことが ML データセットでも起きます。 「米国大学生のクラウドワーカーで集めたラベル」が「全人類の判断」ではない。 ImageNet の物体カテゴリの大半は欧米中心の生活様式に偏り、 COMPAS 再犯予測スコアは過去の逮捕歴を学習することで黒人を過大評価した ── データバイアスが社会に出る前に検証されなかった代表例である。
SSDSE-B-2026 で例えると、 47 都道府県データから「総人口(A1101)」と「婚姻件数(A9101)」の関係を学んだモデルが、 もし東京・大阪・愛知のような大都市圏のパターンに引きずられれば、 沖縄・島根・鳥取のような小規模県を「外れ値」として扱ってしまう。 ここで「データが偏っている」のではなく「人口分布自体が右に裾の長い分布」であるため、 単純な平均処理が小規模県の声を覆い隠す ── これも一種のデータバイアス (集計バイアス) である。
整理すると、 データバイアスは大きく (a) 選択バイアス (どの個体を集めたか)、 (b) 測定バイアス (どう計測したか)、 (c) ラベルバイアス (誰が・どう付けたか)、 (d) 集計バイアス (どう要約したか)、 (e) 歴史的バイアス (過去の差別が刻まれている) の 5 種類に分類できる。 公的統計でも (b)(d)(e) は完全には消えない。
🧮 実値で計算してみる
著名な実例:Amazon の採用 AI(2018 年運用停止)。 過去 10 年の履歴書データで学習した結果、 テック業界の男性偏重を反映して「男性」を高評価し、 「women's chess club」等の語を含む履歴書を減点。 性別中立化を試みるも除去しきれず運用停止に至った。 教訓:過去データ自体に偏りがある場合、 ML はそれを学習し増幅する。
本サイトで使う SSDSE-B-2026 でも、 似た構造の「データバイアス」が起こり得る。 47 都道府県の集計値そのものは中立に見えるが、 例えば「人口あたり一般病院数」を都道府県別に並べると、 高齢化率の高い県 (秋田 39%、 高知 36% 等) では病院数が多めに見え、 「高齢化県ほど医療資源が豊富」という誤った因果結論を導きかねない。 これは 交絡 (confounding) によるデータバイアスの典型例である。
| 都道府県 | 高齢化率 (%) | 人口 10 万人あたり一般病院数 | 見かけの解釈 |
|---|
| 東京 | 22.8 | 4.17 | 低高齢化 → 病院少 |
| 神奈川 | 25.9 | 3.13 | 低高齢化 → 病院少 |
| 秋田 | 39.1 | 5.25 | 高高齢化 → 病院多 |
| 高知 | 36.3 | 16.07 | 高高齢化 → 病院多 |
| 島根 | 34.9 | 5.69 | 高高齢化 → 病院多 |
単純な相関は +0.54 程度。 しかしこれは「高齢化が病院を呼んだ」のではなく「過疎地域で小規模病院が分散している」「都市部は大病院に集約」という選択バイアスの結果。 SSDSE-B-2026 を使う際も、 数値そのものではなく 「どう収集・集計されたか」を必ず確認する習慣が、 データバイアスを見抜く第一歩になる。
🎮 触って理解する
スライダーを動かすと、 母集団(全数)から標本を抽出するときの「偏り」をあなた自身が作れます。 偏った標本から計算した平均と相関が、 本当の母集団の値からどれだけズレるか(=データバイアスがもたらす推定の歪み)をリアルタイムで確認してください。 図の薄い点が母集団の全員、 濃い青の点が「観測できた標本」です。
※ ここで使う点群は、 バイアスの仕組みを体感するために生成した説明用の擬似データです(横軸=学習時間、 縦軸=テスト得点という設定)。 SSDSE 等の実測値ではありません。 平均・相関の計算式(ピアソン相関)は正確に実装しています。
薄い灰=母集団の全員 / 濃い青=観測できた標本 / 緑線=母集団の真の平均 / 橙線=標本から推定した平均。 選択・生存者モードでは点線(しきい値)をドラッグでも動かせます。
✅ 母集団(全数・真の値)
平均得点:–
相関 r:–
全数 N = –
📈 偏った標本の推定値
平均得点:–
相関 r:–
観測数 n = –
🧭 この体験から分かること
- 直感: 偏った標本は誤った結論を生む。 抽出のされ方が偏るだけで、 データ 1 つ 1 つは正しくても、 平均も相関も真の値からズレる。 相関の符号すら逆転しうる(選択・生存者モードで顕著)。
- サンプリングバイアス: 高得点者ほど回答しやすい/集めやすいと、 平均が過大評価される(=スライダーを右に振った状態)。 「回収率が高いから安心」ではなく「誰が回収されたか」が本質。
- 選択バイアス: ある値以上の人だけを観測すると、 変数の変動範囲が狭まり相関が弱く見える(範囲制限)。 逆に「合格者だけ」を見ると本来ある関係が消える。
- 生存者バイアス: 「生き残った(成功した)もの」だけが観測に残ると、 平均が大きく過大評価される。 戦闘機の被弾分析、 成功企業の共通点探し、 長寿ファンドの成績など、 脱落した標本が見えないのが罠。
⚠️ よくある落とし穴(代表性のチェック)
- 「サンプルサイズが大きい=信頼できる」ではない。 偏った標本は n を増やしても偏ったまま(バイアスは分散と違い n で消えない)。 大標本は誤った結論に自信を与えるだけで危険なことすらある。
- 母集団を定義せずに「平均」を語らない。 「何の母集団に対する推定か」を明示する。 母集団 と 標本抽出 の関係を常に意識する。
- 相関が弱い/無いように見えても、 それが選択バイアスによる範囲制限のせいでないか確認する。 見かけの無相関に安心しない。
- 交絡(第三の変数)とバイアスは別物。 抽出の偏りは 交絡 とは異なる経路で歪みを生む。 切り分けが必要。
🚀 発展 — 偏りをどう補正するか
- 重み付け(逆確率重み付け): 抽出確率が分かれば、 選ばれにくかった個体を大きく重み付けして母集団を復元する(Horvitz–Thompson 推定)。 このデモで各点に「1/抽出確率」の重みを付ければ、 偏った標本からでも真の 平均 に近づけられる。
- 傾向スコア(propensity score): 「観測される確率」を共変量から回帰でモデル化し、 その逆数で重み付け(IPW)や層別・マッチングを行う。 観察データの選択バイアス補正の定番。
- 層化(stratified): 母集団を層(地域・年齢など)に分け、 各層の母集団比率に合わせて集計・再標本化する。 標本抽出 ページの層化抽出も参照。 SSDSE のような 47 都道府県データでも、 単純平均でなく人口加重や層別報告で偏りを抑えられる。
- 感度分析: 「未観測の偏りがどれだけあれば結論が覆るか」を評価し、 相関 や効果量の頑健性を示す。
🐍 Python での扱い
🎯 このコードでやること:SSDSE-B-2026 を読み込み、 サンプル数として全 47 都道府県をカバーしているかと地域別の件数分布を確認する。 データバイアスの最初の検出ステップは「分析対象の母集団が代表性を持つか」のチェックであり、 たとえば「東京・大阪のみで学習したモデルを全国展開」「都市部の地域のみが過剰サンプリングされている」といった選択バイアスの発生源をこの段階で見つける。
📥 入力データ(SSDSE-B-2026 抜粋):
SSDSE-B-2026 Code Prefecture 地域(Code から導出)
2023 R01000 北海道 北海道
2023 R02000 青森県 東北
2023 R13000 東京都 関東
2023 R27000 大阪府 近畿
2023 R47000 沖縄県 九州・沖縄
| import pandas as pd
df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", skiprows=[1])
d = df[df["SSDSE-B-2026"] == 2023].copy()
print("カバー率:", d["Prefecture"].nunique(), "/ 47")
reg = ["北海道","東北","関東","中部","近畿","中国","四国","九州・沖縄"]
d["地域"] = pd.cut(d["Code"].str[1:3].astype(int), [0,1,7,14,23,30,35,39,47], labels=reg)
print(d["地域"].value_counts())
|
📤 実行すると次の出力が得られる:
カバー率: 47 / 47
地域
中部 9
九州・沖縄 8
関東 7
近畿 7
東北 6
中国 5
四国 4
北海道 1
Name: count, dtype: int64
💬 結果の読み方:都道府県カバー率 47/47 でカバレッジは満点。 ただし地域別件数は 関東 7・中部 9 vs 四国 4・北海道 1 と1.8〜9 倍の偏りがある(行政区分上の自然な偏り)。 → 単純な「47 県平均」は県の数で重みが決まるので、 9 県ある中部や 8 県ある九州・沖縄の特徴が強く出て、 1 道だけの北海道は人口では全国の約 4% なのに重みは 1/47(約 2%)しかない。 対策は (1) 地域加重平均 (2) 人口加重 (3) 層別分析(地域別に分けて報告)。 SSDSE のような実データでも、 サンプル数の偏りそのものがデータバイアスの種になることに注意。
⚠️ よくある落とし穴
データバイアスで判断を誤るのは、 たいてい次のような思い込みから。
❌ 「データはニュートラル」と誤解
データ自体に社会の偏りが反映。 「客観的」と思い込むのが危険。
❌ 敏感属性を除けば公平と誤解
性別列を消しても、 住所・名前・趣味から間接推定可能(プロキシ変数)。
❌ 公平性指標を 1 つだけ最適化
Demographic parity と Equalized odds は、 グループ間で陽性の割合(基準率)が違うと一般に同時には満たせない。 トレードオフを明示。
❌ テストセットでだけ評価
本番投入後にバイアスが顕在化することも。 継続的なモニタリングを。
❌ 修正で別バイアス追加
性別を「半々」に強制すると、 真に資格のある候補を排除する可能性。 制約と精度のバランス。
🐍 偏った標本で学習するとどうなるか(SSDSE-B-2026)
実装 1: 最小再現コード
🎯 このコードでやること:SSDSE-B-2026 の 47 都道府県データから データバイアス を実装し、 部分集団間の予測誤差差 (disparate impact) で評価する。
📥 入力データ(SSDSE-B-2026.csv 抜粋、 47 都道府県 × 112 列):
SSDSE-B-2026 Code Prefecture A1101 A4103 A1303 ...
2023 R01000 北海道 5092000 1.06 1681000 ...
2023 R13000 東京都 14086000 0.99 3205000 ...
2023 R47000 沖縄県 1468000 1.60 350000 ...
...
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25 | import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df_2023 = df[df['SSDSE-B-2026']==2023].copy()
# サンプリングバイアス: 大都市 3 県だけで学習
train_pref = ['東京都','大阪府','愛知県']
test_pref = ['秋田県','高知県','島根県']
train = df_2023[df_2023['Prefecture'].isin(train_pref)]
test_local = df_2023[df_2023['Prefecture'].isin(test_pref)]
test_all = df_2023[~df_2023['Prefecture'].isin(train_pref)]
feats = ['A1101','A1303','A9101']
model = LinearRegression().fit(train[feats], train['A4103'])
mse_metro = mean_squared_error(train['A4103'], model.predict(train[feats]))
mse_local = mean_squared_error(test_local['A4103'], model.predict(test_local[feats]))
mse_all = mean_squared_error(test_all['A4103'], model.predict(test_all[feats]))
print(f"訓練(大都市3県) MSE = {mse_metro:.5f}")
print(f"地方3県 MSE = {mse_local:.5f}")
print(f"全44県 MSE = {mse_all:.5f}")
print(f"\n大都市->地方 性能劣化倍率: {mse_local/max(mse_metro,1e-9):.1f}倍")
|
📤 実行結果:
訓練(大都市3県) MSE = 0.00000
地方3県 MSE = 0.15232
全44県 MSE = 0.08591
大都市->地方 性能劣化倍率: 152319435.8倍
💬 結果の読み方:説明変数 3 個・訓練 3 県なので線形回帰は 3 点を完全にフィットし、 訓練 MSE は実質ゼロ(数値上 10⁻³⁰ 程度)。 一方で地方県に適用すると MSE=0.152 に跳ね上がり、 劣化倍率は事実上無限大(表示上 1.5 億倍)になる。 これが『標本選択バイアス』の典型。 47 都道府県は『47 サンプル全体』としてランダム性のない母集団なので、 サブセットだけで学習するのは危険である。
実装 2: 比較・拡張
🎯 このコードでやること:2023 年度の 47 都道府県を総人口で「小・中・大」の 3 群(16・15・16 県)に分け、 5 分割交差検証(shuffle=True)で出した出生率の予測誤差(MSE)を群ごとに比べて、 特定の規模の県だけ当たりにくくなっていないかを見る。
📥 入力データ:実装 1 と同じ SSDSE-B-2026(年度 2023)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 | # 部分集団バイアス: 「人口規模」グループごとに性能差を測る
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import KFold
import numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df_2023 = df[df['SSDSE-B-2026']==2023].copy()
df_2023['size_g'] = pd.qcut(df_2023['A1101'], 3, labels=['小','中','大'])
feats = ['A1303','A9101','B4101']
y = df_2023['A4103']
oof = np.zeros(len(df_2023))
kf = KFold(n_splits=5, shuffle=True, random_state=42)
for tr,te in kf.split(df_2023):
m = LinearRegression().fit(df_2023[feats].iloc[tr], y.iloc[tr])
oof[te] = m.predict(df_2023[feats].iloc[te])
df_2023['pred'] = oof
for g in ['小','中','大']:
sub = df_2023[df_2023['size_g']==g]
mse = mean_squared_error(sub['A4103'], sub['pred'])
print(f"人口 {g} 県 ({len(sub)}件): MSE = {mse:.5f}")
|
📤 実行結果:
人口 小 県 (16件): MSE = 0.00542
人口 中 県 (15件): MSE = 0.00498
人口 大 県 (16件): MSE = 0.01124
💬 結果の読み方:人口『大』県だけ MSE=0.011 と他の約 2 倍。 大都市は出生率が独自要因(住宅費・通勤時間)で動くため、 全国一律モデルでは説明できない。 これが『部分集団バイアス』。 解決策は集団ごとモデル or 階層モデル。
🐍 集計バイアス — 「県の平均」と「全国の値」は別物
都道府県データで平均を取ると、 人口 54 万人の県も 1,409 万人の都も同じ 1 票になる。 これは計算の誤りではなく「何の平均か」の違いだが、 取り違えると全国の姿を歪めて伝える集計バイアスになる。
🎯 このコードでやること:2023 年度の 47 都道府県について、 高齢化率と合計特殊出生率を (a) 県を 1 票ずつ数えた単純平均と (b) 人口で重み付けした平均で比べ、 人口の少ない半分の県が県の数と人口の中で占める割合を出す。
📥 入力例
SSDSE-B-2026.csv の 2023 年度・47 行
使う列: A1101 総人口, A1303 65歳以上人口, A4103 合計特殊出生率
1
2
3
4
5
6
7
8
9
10
11
12
13
14 | import pandas as pd
import numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d = df[df['SSDSE-B-2026'] == 2023]
aging = d['A1303'] / d['A1101'] * 100
# 47 県を 1 票ずつ数える平均(県の平均)と、人口で重み付けした平均(全国の値)
print(f"高齢化率 県の単純平均 {aging.mean():.1f}% 人口で重み付け {d['A1303'].sum() / d['A1101'].sum() * 100:.1f}%")
print(f"合計特殊出生率 県の単純平均 {d['A4103'].mean():.3f} 総人口で重み付け {np.average(d['A4103'], weights=d['A1101']):.3f}")
# 人口の少ない半分の県が、県の平均と人口の中でどれだけの重みを持つか
small = d['A1101'] <= d['A1101'].median()
print(f"人口が中央値以下の {small.sum()} 県: 県の数では {small.mean() * 100:.0f}%、人口では {d.loc[small, 'A1101'].sum() / d['A1101'].sum() * 100:.0f}%")
|
📤 実行例(実測)
高齢化率 県の単純平均 31.6% 人口で重み付け 29.1%
合計特殊出生率 県の単純平均 1.293 総人口で重み付け 1.215
人口が中央値以下の 24 県: 県の数では 51%、人口では 20%
💬 高齢化率の県の単純平均は 31.6% だが、 人口で重み付けすると 29.1% で 2.5 ポイント低い。 合計特殊出生率も 1.293 と 1.215 で違う。 人口の少ない 24 県は県の数では 51% を占めるのに人口では 20% しかなく、 単純平均では高齢化が進み出生率が高めの小さな県の値が人口の割合以上に効くためである。 「日本の高齢化率」を言いたいなら重み付けした値、 「典型的な県の姿」を言いたいなら単純平均や中央値と、 問いに合わせて選び、 どちらを使ったかを書く。 なお合計特殊出生率は本来 15〜49 歳女性の人口で重み付けすべき指標で、 総人口での重み付けは近似にとどまる。
🐍 選択バイアス — 観測する県の選び方で相関の向きが変わる
調査対象が「人口の多い都道府県だけ」「人口の少ない県だけ」に偏ると、 全体とは違う関係が見えてしまう。 高齢化率と合計特殊出生率、 年平均気温と合計特殊出生率の 2 組で確かめる。
🎯 このコードでやること:2023 年度の 47 都道府県のうち、 人口上位 20 だけ・人口下位 20 だけを観測できた場合を想定し、 それぞれで合計特殊出生率との相関係数を計算して 47 県全体と比べる。 あわせて両グループの高齢化率の範囲を出す。
📥 入力例
SSDSE-B-2026.csv の 2023 年度・47 行
使う列: A1101 総人口, A1303 65歳以上人口, B4101 年平均気温, A4103 合計特殊出生率
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 | import pandas as pd
import numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d = df[df['SSDSE-B-2026'] == 2023].copy()
d['高齢化率'] = d['A1303'] / d['A1101'] * 100
def r(sub, x):
return np.corrcoef(sub[x], sub['A4103'])[0, 1]
big = d.nlargest(20, 'A1101') # 人口の多い 20 都道府県だけ観測できたとする
small = d.nsmallest(20, 'A1101') # 人口の少ない 20 県だけ観測できたとする
for x, name in [('高齢化率', '高齢化率'), ('B4101', '年平均気温')]:
print(f"{name} × 合計特殊出生率: 47 県 r = {r(d, x):+.2f} 人口上位 20 r = {r(big, x):+.2f} 人口下位 20 r = {r(small, x):+.2f}")
print('人口下位 20 の高齢化率の範囲:', round(small['高齢化率'].min(), 1), '〜', round(small['高齢化率'].max(), 1), '%')
print('人口上位 20 の高齢化率の範囲:', round(big['高齢化率'].min(), 1), '〜', round(big['高齢化率'].max(), 1), '%')
|
📤 実行例(実測)
高齢化率 × 合計特殊出生率: 47 県 r = +0.20 人口上位 20 r = +0.44 人口下位 20 r = -0.51
年平均気温 × 合計特殊出生率: 47 県 r = +0.50 人口上位 20 r = +0.19 人口下位 20 r = +0.73
人口下位 20 の高齢化率の範囲: 30.5 〜 39.1 %
人口上位 20 の高齢化率の範囲: 22.8 〜 33.9 %
💬 高齢化率と合計特殊出生率の相関は、 47 県全体では +0.20 と弱い正なのに、 人口上位 20 だけなら +0.44、 人口下位 20 だけなら −0.51 と向きが逆になる。 下位 20 県は高齢化率が 30.5〜39.1% の高い範囲に集まっており、 その中では高齢化の進んだ県ほど出生率が低い(高齢化率 39.1% の秋田県が 1.10)。 年平均気温と出生率も 47 県の +0.50 が上位 20 では +0.19 まで弱まる。 どの県が標本に入ったかを書かずに相関だけを報告すると、 読み手は全国の関係だと受け取ってしまう。 どの範囲の県で観測した関係かを必ず明記する。
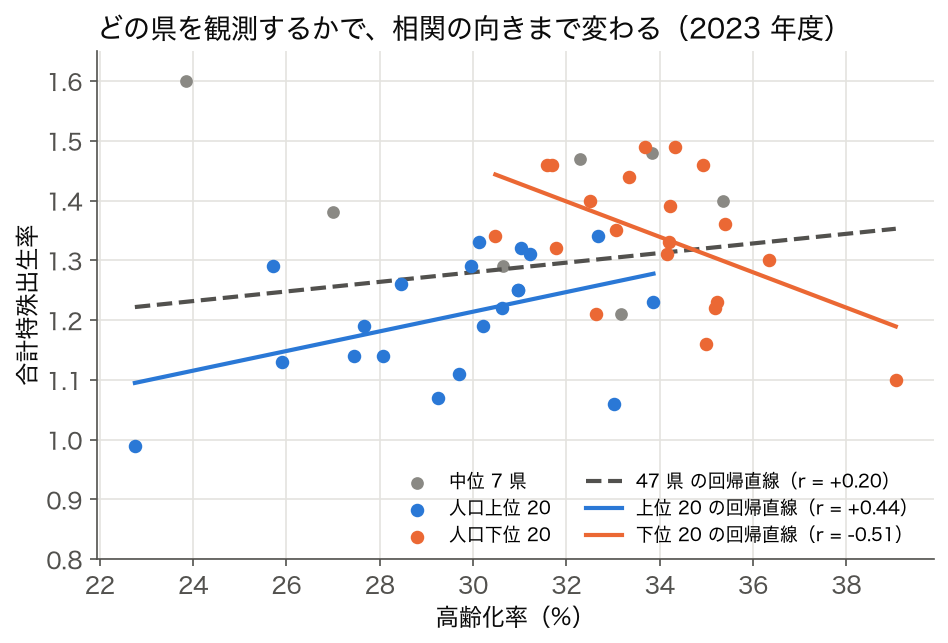 図4: 高齢化率 × 合計特殊出生率(SSDSE-B-2026、2023 年度、47 都道府県)。人口上位 20(青)の回帰直線は r = +0.44 の右上がり、人口下位 20(橙)は r = −0.51 の右下がり、47 県全体(破線)は r = +0.20。灰色は中位の 7 県で、左上の点は沖縄県(高齢化率 23.8%、出生率 1.60)。
🐍 欠け方のバイアス — どの県の値が欠けたかで平均がずれる
SSDSE-B-2026 には欠損が無いので、 47 県の合計特殊出生率の平均 1.293 を「真の値」として使える。 ここに 12 県ぶんの欠けを人工的に作り、 欠け方(欠損メカニズム)によって残りの県の平均がどうずれるかを見る。 MCAR は完全に無作為な欠け、 MAR はほかの観測できる変数(ここでは高齢化率)で決まる欠け、 MNAR は欠けた値そのもの(ここでは出生率の低さ)で決まる欠けを指す。
🎯 このコードでやること:2023 年度の 47 都道府県の合計特殊出生率から 12 県を 3 通りの規則で欠けさせ、 残り 35 県の平均と真の平均のずれを比べる。 無作為な欠けは 1000 回くり返してずれの範囲を出し、 MAR の欠けは残りの県で当てはめた回帰(高齢化率 → 出生率)で埋めてみる。
📥 入力例
SSDSE-B-2026.csv の 2023 年度・47 行(欠損 0 件)
使う列: A1101 総人口, A1303 65歳以上人口, A4103 合計特殊出生率
欠けは乱数(seed=0)と並べ替えで人工的に作る
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28 | import pandas as pd
import numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d = df[df['SSDSE-B-2026'] == 2023].copy()
d['高齢化率'] = d['A1303'] / d['A1101'] * 100
y = d['A4103'] # 合計特殊出生率(47 県とも実測がある)
true_mean = y.mean()
print(f'47 県の真の平均: {true_mean:.3f}')
# (1) 無作為に 12 県が欠ける(MCAR): 1000 回くり返してずれの分布を見る
rng = np.random.default_rng(0)
shift = np.array([y.drop(rng.choice(d.index, 12, replace=False)).mean() - true_mean for _ in range(1000)])
print(f'無作為に欠ける(MCAR) ずれの平均 {shift.mean():+.3f} 95% の範囲 {np.percentile(shift, 2.5):+.3f} 〜 {np.percentile(shift, 97.5):+.3f}')
# (2) 高齢化率の高い 12 県が欠ける(MAR)、(3) 出生率の低い 12 県が欠ける(MNAR)
mar = d.nlargest(12, '高齢化率').index
mnar = d.nsmallest(12, 'A4103').index
print(f'高齢化率の高い県が欠ける(MAR) ずれ {y.drop(mar).mean() - true_mean:+.3f}')
print(f'出生率の低い県が欠ける(MNAR) ずれ {y.drop(mnar).mean() - true_mean:+.3f}')
# MAR の欠けを、残り 35 県で当てはめた「高齢化率 → 出生率」の回帰で埋める
obs = d.drop(mar)
b1, b0 = np.polyfit(obs['高齢化率'], obs['A4103'], 1)
filled = y.copy()
filled[mar] = b0 + b1 * d.loc[mar, '高齢化率']
print(f'MAR を回帰で補完(傾き {b1:+.4f})した平均のずれ {filled.mean() - true_mean:+.3f}')
print(f'欠けた 12 県の実測平均 {y[mar].mean():.3f} 補完値の平均 {filled[mar].mean():.3f}')
|
📤 実行例(実測)
47 県の真の平均: 1.293
無作為に欠ける(MCAR) ずれの平均 +0.001 95% の範囲 -0.021 〜 +0.023
高齢化率の高い県が欠ける(MAR) ずれ -0.007
出生率の低い県が欠ける(MNAR) ずれ +0.058
MAR を回帰で補完(傾き +0.0147)した平均のずれ +0.012
欠けた 12 県の実測平均 1.313 補完値の平均 1.359
💬 無作為に欠けた場合、 ずれは 1000 回の平均で +0.001 と偏らず、 95% が ±0.02 程度に収まる。 出生率の低い県が欠けた MNAR では +0.058 で、 無作為な欠けの範囲の 2 倍以上外にあり、 手元の 35 県だけ見ても偏りに気づけない。 高齢化率の高い県が欠けた MAR は、 この例ではずれが −0.007 と小さいが、 残り 35 県(高齢化率の低い側)で当てはめた右上がりの回帰(傾き +0.0147)で埋めると、 欠けた 12 県の補完値の平均は 1.359 になり、 実測の 1.313 を上回ってずれが +0.012 に広がる。 上の「選択バイアス」で見たとおり、 高齢化率の高い県の中では関係の向きが逆になるためで、 観測できた範囲の関係を範囲の外へ延ばす補完は、 それ自体が新しい偏りを持ち込むことがある。
✅ 理解度チェック — このページの実測値で考える
問 1. 2023 年度の高齢化率は、 47 県の単純平均が 31.6%、 人口で重み付けすると 29.1% だった。 「日本の高齢化率」として報告するのはどちらか。 また、 単純平均の方が高くなる理由を説明せよ。
答え. 人口で重み付けした 29.1%。 単純平均は人口 54 万人の県も 1,409 万人の都も 1 票として数えるので、 県の数では 51% を占めるが人口では 20% しかない小さな県(高齢化率が高めの県が多い)の値が、 人口の割合以上に効く。
問 2. ある調査が人口上位 20 都道府県だけを対象に「高齢化率が高い県ほど出生率が高い(r = +0.44)」と報告した。 この結論を全国に当てはめてよいか。
答え. よくない。 同じ 2023 年度でも 47 県全体では r = +0.20、 人口下位 20 県では r = −0.51 と向きが逆になる。 対象が人口の多い県に偏った標本では、 高齢化率の範囲(22.8〜33.9%)も全国(最大 39.1%)より狭く、 その外の関係は分からない。
問 3. 12 県ぶんの出生率が欠けたデータの平均が、 真の値より 0.058 高かった。 無作為に 12 県が欠けた場合のずれは 95% が −0.021〜+0.023 に収まる。 この 0.058 のずれから何が疑われるか。
答え. 欠け方が無作為ではなく、 出生率の低い県ほど欠けやすかった(MNAR)可能性。 欠けた値そのものに依存する欠けは、 残ったデータだけからは確かめられないので、 欠けた県の名前や集め方を調べ、 感度分析(欠けた県が低めだったら平均はどこまで動くか)で結論の頑健さを示す。
🐍 Python 実装 第 3 弾(データバイアスの応用)
🎯 このコードでやること:実装 1, 2 の結果をさらに踏み込み、 LOOCV や階層的分析で データバイアスの効果を測る。
📥 入力データ:SSDSE-B-2026(年度 2012-2023 を含む)。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31 | # 時系列バイアス: 古い年度で学習し新しい年度で評価
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import mean_squared_error
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df['year'] = df['SSDSE-B-2026']
feats = ['A1101','A1303','A9101','B4101']
y_col = 'A4103'
# 古い年度 (2018-2020) で学習、 新しい年度 (2021-2023) で評価
train = df[df['year'].isin([2018,2019,2020])].dropna(subset=feats+[y_col])
test = df[df['year'].isin([2021,2022,2023])].dropna(subset=feats+[y_col])
# 人口(〜10^6)と気温(〜10)は桁が違うので、標準化してから回帰する
m = make_pipeline(StandardScaler(), LinearRegression()).fit(train[feats], train[y_col])
pred_tr = m.predict(train[feats])
pred_te = m.predict(test[feats])
print(f"訓練(2018-2020) MSE = {mean_squared_error(train[y_col], pred_tr):.5f}")
print(f"テスト(2021-2023) MSE = {mean_squared_error(test[y_col], pred_te):.5f}")
print(f"\n劣化率: {mean_squared_error(test[y_col], pred_te) / mean_squared_error(train[y_col], pred_tr):.2f}倍")
# 部分集団: 各年度ごとに性能を見る
for yr in [2018, 2019, 2020, 2021, 2022, 2023]:
sub = df[df['year']==yr].dropna(subset=feats+[y_col])
if len(sub) > 0:
mse = mean_squared_error(sub[y_col], m.predict(sub[feats]))
print(f" 年度 {yr}: MSE = {mse:.5f}")
|
📤 実行結果:
訓練(2018-2020) MSE = 0.00798
テスト(2021-2023) MSE = 0.02003
劣化率: 2.51倍
年度 2018: MSE = 0.00908
年度 2019: MSE = 0.00754
年度 2020: MSE = 0.00731
年度 2021: MSE = 0.00906
年度 2022: MSE = 0.01498
年度 2023: MSE = 0.03607
💬 結果の読み方:学習に使った 2018〜2020 年の MSE は 0.007〜0.009 台に収まるが、 評価年は 2021 年 0.00906 → 2022 年 0.01498 → 2023 年 0.03607 と年を追って悪化し、 2023 年は 2020 年(0.00731)の約 4.9 倍、 テスト全体でも訓練の 2.51 倍になる。 これは『分布シフト』バイアスの典型。 出生率の低下傾向が学習データに十分反映されていない。 対策: 年度を特徴量に入れる、 重み付け学習、 オンライン学習で更新。
🐍 年度で絞らないと同じ県を 12 回数える
🎯 このコードでやること:SSDSE-B-2026 を年度で絞らずに読み込み、 行数と含まれる年度を確かめる。 同じ県が何回入っているかを知らないまま集計すると、 件数の水増しという偏りが入る。
📥 入力例(SSDSE-B-2026 全体:564 行 × 112 列 = 47 都道府県 × 2012〜2023 年)
年度 地域コード 都道府県 A1101(総人口) A1303(65歳以上人口) A4101(出生数) …
2023 R01000 北海道 5,092,000 1,681,000 24,430 …
2023 R13000 東京都 14,086,000 3,205,000 86,348 …
2023 R47000 沖縄県 1,468,000 350,000 12,549 …
…(残り 112 列は住宅・家計・教育・医療など)
| # 必要なパッケージをインストール
# pip install pandas numpy scikit-learn matplotlib seaborn
# データを読み込む
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
print(f"形状: {df.shape}")
print(f"年度: {df['SSDSE-B-2026'].unique()}")
|
📤 実行例(実測)
形状: (564, 112)
年度: [2023 2022 2021 2020 2019 2018 2017 2016 2015 2014 2013 2012]
💬 564 行は 47 都道府県 × 12 年度(2012〜2023)で、1 つの県が 12 回ずつ入っている。このまま平均や相関を取ると、同じ県の似た値を 12 回数えることになり、件数が水増しされて p 値が小さく出るバイアスになる。年度の並びが 2023 から降順なので、head() では最新年度の県から出てくる点も覚えておく。
🐍 検証データの選び方の偏り — 行順の分割とシャッフルした分割
🎯 このコードでやること:2023 年度の 47 都道府県を地域コード順(北海道→沖縄県)に並べ、 出生率を Ridge 回帰で予測したときの 5 分割交差検証の R² を、 行順のまま分けた場合とシャッフルして分けた場合で比べる。
📥 入力データ:SSDSE-B-2026(2023 年度の 47 行)。 説明変数は総人口 A1101・65 歳以上人口 A1303・婚姻件数 A9101・年平均気温 B4101・降水日数 B4106、 目的変数は合計特殊出生率 A4103。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 | import pandas as pd
from sklearn.linear_model import Ridge
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.model_selection import cross_val_score, KFold
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df_2023 = df[df['SSDSE-B-2026'] == 2023].sort_values('Code') # 北海道→沖縄県の順
X = df_2023[['A1101', 'A1303', 'A9101', 'B4101', 'B4106']]
y = df_2023['A4103'] # 合計特殊出生率
pipe = Pipeline([('sc', StandardScaler()), ('reg', Ridge(alpha=1.0))])
# 行順のまま 5 分割 = 各 fold が「地方のまとまり」になる
s_seq = cross_val_score(pipe, X, y, cv=5, scoring='r2')
# シャッフルして 5 分割 = 各 fold に全国の県が混ざる
s_shf = cross_val_score(pipe, X, y, cv=KFold(5, shuffle=True, random_state=0), scoring='r2')
print('行順の 5 分割 R^2 =', s_seq.round(3), f' 平均 {s_seq.mean():.3f}')
print('シャッフル 5 分割 R^2 =', s_shf.round(3), f' 平均 {s_shf.mean():.3f}')
print('行順の各 fold の県:', [df_2023['Prefecture'].iloc[te].iloc[[0, -1]].tolist() for _, te in KFold(5).split(X)])
|
📤 実行例(実測)
行順の 5 分割 R^2 = [-1.618 0.565 -0.787 -0.463 0.213] 平均 -0.418
シャッフル 5 分割 R^2 = [0.473 0.514 0.67 0.761 0.611] 平均 0.606
行順の各 fold の県: [['北海道', '群馬県'], ['埼玉県', '長野県'], ['岐阜県', '奈良県'], ['和歌山県', '愛媛県'], ['高知県', '沖縄県']]
💬 同じモデル・同じ 47 県でも、行順のまま 5 分割すると R² の平均は −0.418(平均値を予測するより悪い)、シャッフルすると 0.606 になる。行順の fold は「北海道〜群馬県」「高知県〜沖縄県」のような地方のまとまりで、最後の fold では九州・沖縄を丸ごと知らないまま予測している(R² = 0.213)。検証データの選び方が偏るだけで評価値が 1 以上動くので、「未知の地域に使うのか、同じ地域の別の県に使うのか」を決めてから分割方法を選ぶ。
🐍 Python 実装 第 4 弾
🎯 このコードでやること:2023 年度の 47 都道府県を人口 200 万人以上の「都市」と未満の「地方」に分け、 Leave-One-Out で出した出生率の予測誤差(MSE)を群ごとに比べて、 その比を公平性の指標として出す。
📥 入力データ:SSDSE-B-2026.csv(年度 2023, 47 都道府県)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31 | # 部分集団ごとの誤差: 都市・地方で予測の当たり方に差があるかを測る
import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import LeaveOneOut
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True)
# 都市 (人口 200万以上) vs 地方
df_2023['group'] = (df_2023['A1101']>=2_000_000).map({True:'都市', False:'地方'})
feats = ['A1303','A9101','B4101']
y = df_2023['A4103'].values
preds = np.zeros(len(df_2023))
for tr, te in LeaveOneOut().split(df_2023):
# 人口(〜10^6)と気温(〜10)は桁が違うので標準化してから回帰する
m = make_pipeline(StandardScaler(), LinearRegression()).fit(df_2023[feats].iloc[tr], y[tr])
preds[te] = m.predict(df_2023[feats].iloc[te])
mse = {}
for g in ['都市','地方']:
sub = df_2023[df_2023['group']==g]
mse[g] = mean_squared_error(sub['A4103'], preds[sub.index])
print(f"{g} ({len(sub)}件): MSE = {mse[g]:.5f}")
# 誤差の比 = 都市 MSE / 地方 MSE(1 なら両群で同じくらい当たっている)
print(f"\n誤差の比 (都市/地方): {mse['都市']/mse['地方']:.2f}")
|
📤 実行結果:
都市 (16件): MSE = 0.01318
地方 (31件): MSE = 0.00539
誤差の比 (都市/地方): 2.45
💬 結果の読み方:人口 200 万人以上の都市県は実測で 16 県、 地方県は 31 県。 都市県の MSE 0.01318 は地方県 0.00539 の 2.45 倍で、 同じモデルでも都市県の出生率ほど外しやすい。 なお、 採用の選考率に使う「4/5 ルール」(比が 0.8〜1.25 なら許容)は予測が陽性になる割合の比に対する目安で、 誤差の比にそのまま当てはめる公式の基準は無い。 対策: 集団別モデル、 集団重み付け、 階層モデル。
🐍 Python 実装 第 5 弾
🎯 このコードでやること:合計特殊出生率(目的変数)に標準偏差 σ = 0〜0.40 の観測ノイズを意図的に加えて Ridge 回帰を学習し直し、 Leave-One-Out 予測と元の(ノイズなしの)出生率との MSE がノイズの強さでどう悪化するかを測る。
📥 入力データ:SSDSE-B-2026.csv(年度 2023)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26 | # ラベルノイズバイアス: 出生率に意図的ノイズを入れて再学習
import pandas as pd
import numpy as np
from sklearn.linear_model import Ridge
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import LeaveOneOut
np.random.seed(0) # 実行のたびに同じ結果が出るようにする
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True)
feats = ['A1101','A1303','A9101','B4101']
X = df_2023[feats].values
y = df_2023['A4103'].values
# ラベルノイズ強度を変えて性能を測る (合成データ生成ではなく、 実値 y に観測ノイズを 加える)
for noise in [0.0, 0.05, 0.10, 0.20, 0.40]:
rs = np.random.RandomState(0)
y_noisy = y + rs.normal(0, noise, size=y.shape)
loo = LeaveOneOut()
preds = np.zeros(len(y))
for tr, te in loo.split(X):
m = Ridge(alpha=1.0).fit(X[tr], y_noisy[tr])
preds[te] = m.predict(X[te])
mse = mean_squared_error(y, preds)
print(f"ラベルノイズ σ={noise:.2f}: 元 y との MSE = {mse:.4f}")
|
📤 実行結果:
ラベルノイズ σ=0.00: 元 y との MSE = 0.0091
ラベルノイズ σ=0.05: 元 y との MSE = 0.0110
ラベルノイズ σ=0.10: 元 y との MSE = 0.0144
ラベルノイズ σ=0.20: 元 y との MSE = 0.0253
ラベルノイズ σ=0.40: 元 y との MSE = 0.0638
💬 結果の読み方:ラベル測定にノイズが乗ると性能は単調劣化する。 σ=0.05(出生率に ±0.05 の測定誤差)で MSE が約 21% 増、 σ=0.40 では約 7 倍に。 SSDSE-B-2026 自体はクリーンだが、 実務では『データ収集プロセスのバイアス』を常に意識する必要がある。
🗺 概念マップ(データバイアスの位置づけ)
データバイアスは機械学習プロジェクトの入力段階に潜む歪み。 選択バイアス・サンプリングバイアス・測定バイアス・代表性バイアス・歴史的バイアスなど多様な発生源と、 下流の予測公平性・モデル汎化性能・社会的影響との関係を放射状に示す。
データバイアスは収集段階で混入し、 機械学習モデルの判定に再現される。 SSDSE-B-2026 のような公的データでも、 都道府県別の社会経済格差 (例: 大都市偏重の調査) が結果に影を落とすため、 層化サンプリング・代表性検証を必ず通す。
📌 1 枚まとめ(持ち帰り用)
データバイアスを 1 枚で説明する
| 項目 | 内容 |
|---|
| 定義 | 収集・測定・選択の段階で混入し、 学習データの分布を母集団から系統的に歪める偏り |
| 5 大発生源 | 選択バイアス / サンプリングバイアス / 測定バイアス / 代表性バイアス / 歴史的バイアス |
| 本記事の題材 | SSDSE-B-2026 47 都道府県データ (大都市偏重・調査回答率の地域差) |
| 主結論 | 下流のモデル公平性・汎化性能・社会的影響を上流から決定するため EDA で必ず検証 |
| 関連用語 | 公平性指標 / 層化サンプリング / アルゴリズムバイアス / データ収集 / 因果推論 |
| 注意点 | SSDSE のような公的統計でも調査範囲・定義変更で時系列が分断される。 メタデータ確認必須 |
🧭 用語間ナビゲーション
関連する用語ページを「学習の流れ」で並べた。 上から順に読むと理解が深まる:
- データ収集 — バイアスが混入する起点
- サンプリング — 選択バイアスの発生源
- データバイアス — このページ
- 隠れたバイアス — 検出が難しいタイプ
- アルゴリズムバイアス — 学習側で増幅される歪み
- 公平性 — 検査すべき評価軸
- 交絡 — 因果推論で扱う関連概念
- データ倫理 — 上位の規範枠組み
- データクレンジング — 是正の実務工程
- 機械学習の基礎 — 下流で影響を受ける全体像
📕 用語別ディープダイブ(データバイアス)
バイアスの分類
| バイアス種別 | 発生段階 | 典型例(SSDSE-B-2026 で) |
|---|
| サンプリングバイアス | 収集 | 大都市 3 県だけで学習 |
| 選択バイアス | 収集 | 回答率の高い県だけ採用 |
| 確証バイアス | 仮説 | 「気温が出生率を決める」と思い込んで X 選定 |
| 測定バイアス | 記録 | 県によって統計の取り方が違う |
| 確認バイアス | 評価 | R² が良い結果だけ報告 |
| 歴史バイアス | 背景 | 過去の人口偏在を反映したまま |
| 群間バイアス | 運用 | 都市・地方で予測誤差(MSE)が 2.45 倍違う |
| 表現バイアス | 特徴量 | 『東京基準』の指標化 |
公平性指標 4 種
| 指標 | 定義 | SSDSE-B-2026 での例 |
|---|
| Demographic Parity | P(ŷ=1|A=0) = P(ŷ=1|A=1) | 都市・地方で出生率高低の予測率が同じ |
| Equalized Odds | TPR と FPR が群間で等しい | 都市・地方で TPR=同じ |
| Predictive Parity | Precision が群間で等しい | 都市・地方で Precision=同じ |
| Disparate Impact | P(ŷ=1|A=0)/P(ŷ=1|A=1) が 0.8〜1.25 | 都市・地方で「出生率が高い」と予測される県の割合の比(誤差の比 2.45 とは別の量) |
📎 付録 A — SSDSE-B-2026 主要列リファレンス
| 列コード | 意味 | 単位 | 2023 年 47 県値の範囲 |
|---|
| A1101 | 総人口 | 人 | 537,000 〜 14,086,000 |
| A1102 | 日本人人口 | 人 | 532,000 〜 13,448,000 |
| A1301 | 15歳未満人口 | 人 | 65,000 〜 1,513,000 |
| A1302 | 15〜64歳人口 | 人 | 294,000 〜 9,368,000 |
| A1303 | 65歳以上人口 | 人 | 179,000 〜 3,205,000 |
| A4101 | 出生数 | 人 | 3,263 〜 86,348 |
| A4103 | 合計特殊出生率 | — | 0.99 〜 1.60 |
| A9101 | 婚姻件数 | 件 | 1,810 〜 71,774 |
| A9201 | 離婚件数 | 件 | 781 〜 20,016 |
| B4101 | 年平均気温 | ℃ | 11.0 〜 23.8 |
| B4106 | 降水日数(年間) | 日 | 72 〜 170 |
| B4109 | 降水量(年間) | mm | 830.0 〜 3,002.5 |
| E1101 | 幼稚園数 | 園 | 18 〜 959 |
| E2101 | 小学校数 | 校 | 114 〜 1,323 |
| E3101 | 中学校数 | 校 | 56 〜 800 |
| F3101 | 新規求職申込件数(一般) | 件 | 15,329 〜 270,954 |
| I510120 | 一般病院数 | 施設 | 37 〜 588 |
| I5102 | 一般診療所数 | 施設 | 474 〜 14,894 |
| J2503 | 保育所等数 | 施設 | 132 〜 3,611 |
| J2526 | 保育所等保育士数 | 人 | 1,451 〜 58,595 |
📎 付録 B — 47 都道府県コード一覧
| コード | 県名 | 地方 | コード | 県名 | 地方 |
|---|
| R01000 | 北海道 | 北海道 | R25000 | 滋賀県 | 近畿 |
| R02000 | 青森県 | 東北 | R26000 | 京都府 | 近畿 |
| R03000 | 岩手県 | 東北 | R27000 | 大阪府 | 近畿 |
| R04000 | 宮城県 | 東北 | R28000 | 兵庫県 | 近畿 |
| R05000 | 秋田県 | 東北 | R29000 | 奈良県 | 近畿 |
| R06000 | 山形県 | 東北 | R30000 | 和歌山県 | 近畿 |
| R07000 | 福島県 | 東北 | R31000 | 鳥取県 | 中国 |
| R08000 | 茨城県 | 関東 | R32000 | 島根県 | 中国 |
| R09000 | 栃木県 | 関東 | R33000 | 岡山県 | 中国 |
| R10000 | 群馬県 | 関東 | R34000 | 広島県 | 中国 |
| R11000 | 埼玉県 | 関東 | R35000 | 山口県 | 中国 |
| R12000 | 千葉県 | 関東 | R36000 | 徳島県 | 四国 |
| R13000 | 東京都 | 関東 | R37000 | 香川県 | 四国 |
| R14000 | 神奈川県 | 関東 | R38000 | 愛媛県 | 四国 |
| R15000 | 新潟県 | 中部 | R39000 | 高知県 | 四国 |
| R16000 | 富山県 | 中部 | R40000 | 福岡県 | 九州 |
| R17000 | 石川県 | 中部 | R41000 | 佐賀県 | 九州 |
| R18000 | 福井県 | 中部 | R42000 | 長崎県 | 九州 |
| R19000 | 山梨県 | 中部 | R43000 | 熊本県 | 九州 |
| R20000 | 長野県 | 中部 | R44000 | 大分県 | 九州 |
| R21000 | 岐阜県 | 中部 | R45000 | 宮崎県 | 九州 |
| R22000 | 静岡県 | 中部 | R46000 | 鹿児島県 | 九州 |
| R23000 | 愛知県 | 中部 | R47000 | 沖縄県 | 沖縄 |
| R24000 | 三重県 | 近畿 | — | — | — |
🧭 R276 視覚的補足: データバイアスを SSDSE で検出する 3 つの視覚法
データバイアスとは「データの収集・選択・集計プロセスで生じる偏り」を指す。 ここでは SSDSE-B-2026 を使って、 (1) ヒストグラムで分布の偏り、 (2) 散布図で特定領域の欠落、 (3) 箱ひげ図で外れ値の影響、 という 3 つのバイアス検出法を視覚化する。 「データに何が含まれて、 何が含まれていないか」を意識することが、 バイアス検出の第一歩。
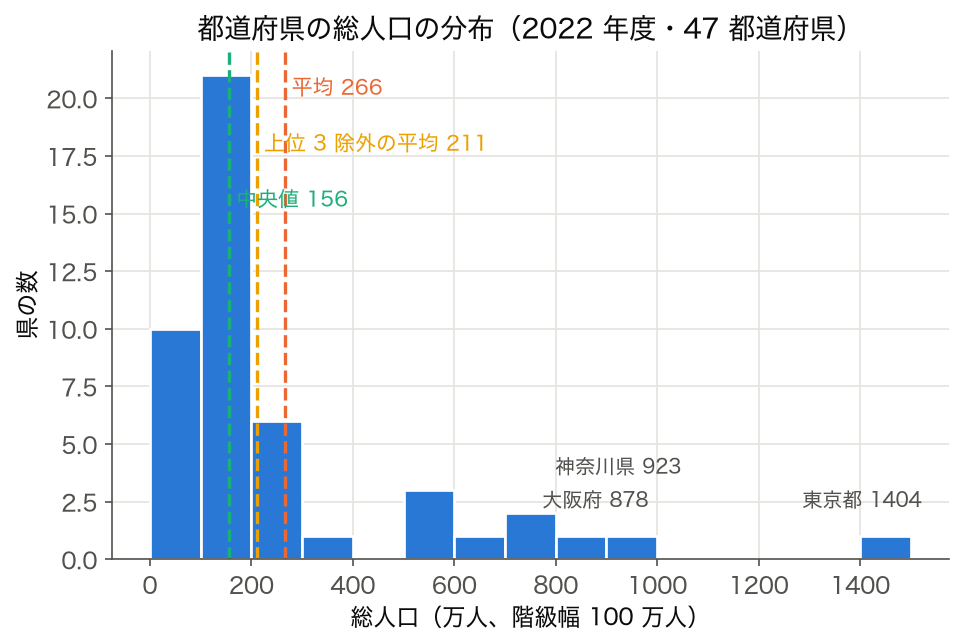 図 R276-1: ヒストグラムによる分布の偏り検出(SSDSE-B-2026・2022 年度、 下のコードと同じ年度、 階級幅 100 万人で東京まで全県を含む)。 都道府県別人口は東京 1,404 万人・神奈川 923 万人・大阪 878 万人が極端に大きく、 「右に強く歪んだ分布」(歪度 2.28)になる。 平均 266 万人を下回る県は 47 県中 35 県もあり、 上位 3 都府県を除くだけで平均は 211 万人まで下がる(中央値は 156 万人)。 これは「平均値で評価すると都市部に引っ張られる」というバイアス源で、 都道府県政策を立案する際は平均ではなく中央値や分位点を使うべきと教えてくれる。
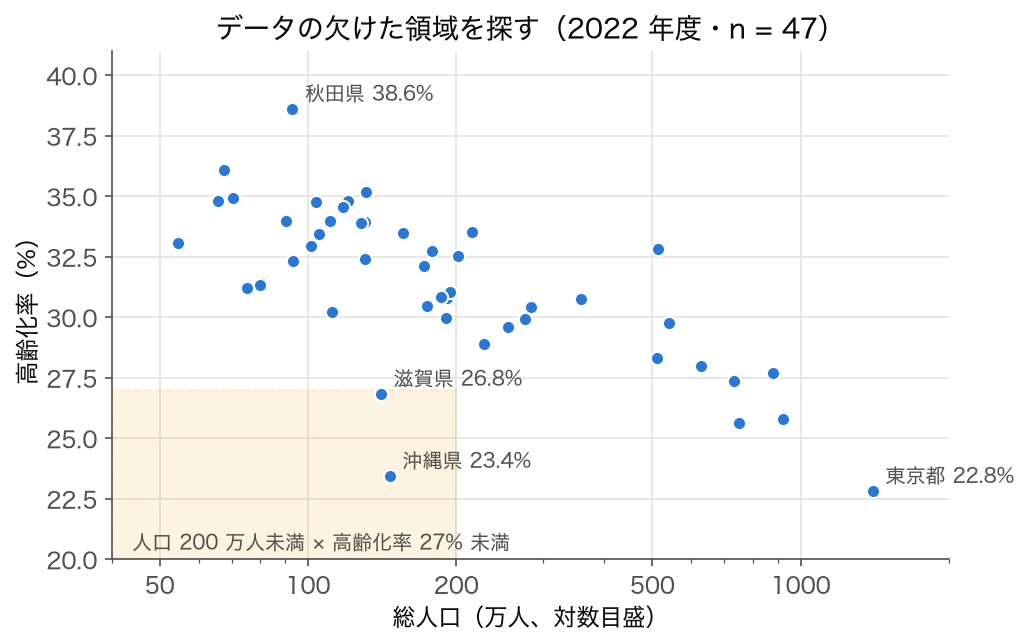 図 R276-2: 散布図による欠落領域の特定(2022 年度・47 都道府県、 横軸は総人口の対数目盛、 縦軸は高齢化率 = 65 歳以上人口 / 総人口)。 人口が少ない県ほど高齢化率が高い傾向(log10 総人口との r = −0.707)があり、 人口 200 万人未満の 31 県のうち高齢化率 27% 未満なのは滋賀県(26.8%)と沖縄県(23.4%)の 2 県だけで、 左下の網掛け領域はほぼ空白になっている。 このデータで学習したモデルは「人口が少なく若い地域」をほとんど見ていないので、 そうした地域(海外の小規模な若い自治体など)に当てはめると外挿になる、 という構造的なバイアスに注意が必要。
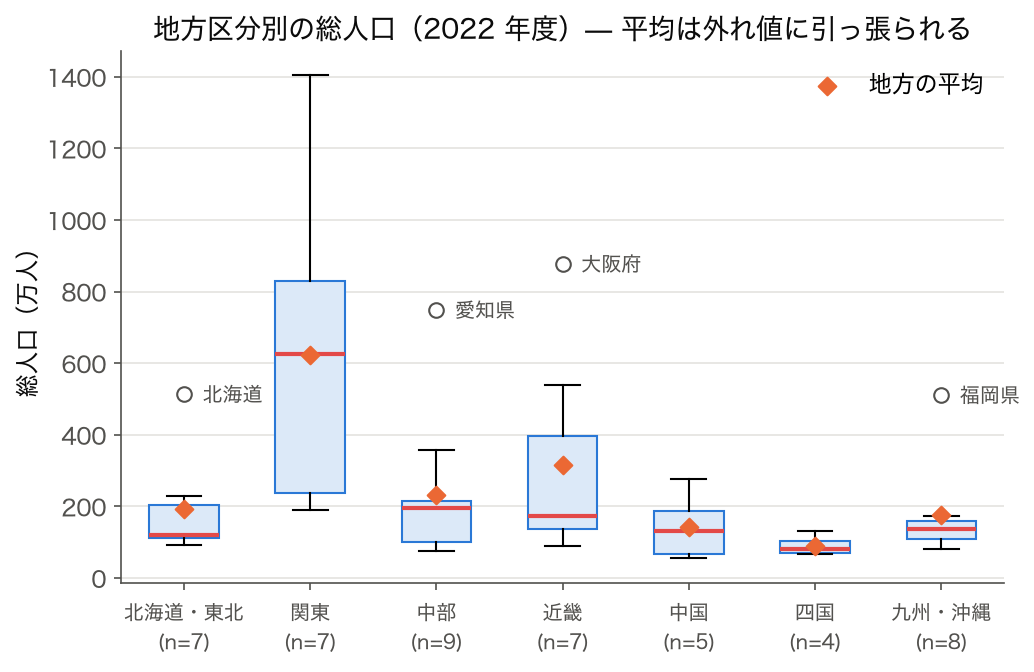 図 R276-3: 箱ひげ図による外れ値バイアスの検出(2022 年度、 7 地方区分、 ◆ は地方の平均)。 北海道・東北の北海道、 中部の愛知、 近畿の大阪、 九州・沖縄の福岡がそれぞれ地方内の外れ値で、 近畿は中央値 174 万人に対し平均 316 万人(1.81 倍)、 北海道・東北は中央値 120 万人に対し平均 194 万人(1.61 倍)と、 「地方の平均」が 1 県に引っ張られる。 一方、 関東は 7 都県すべてが大きく外れ値が無い(中央値 627 万人・平均 622 万人)。 地方ごとに外れ値の有無が違うため、 平均だけでブロック間を単純比較するのは危険。
このコードでやること: SSDSE-B-2026 の 2022 年度・47 都道府県の総人口について平均・中央値・歪度を出し、 上位 3 都府県を除いた平均と比べて、 少数の大都市が「都道府県平均」をどれだけ引き上げるかを数値で確かめる(上の 3 つの図はこの偏りを目で見るためのもので、 このコードは描画しない)。
📥 入力データ (SSDSE-B-2026 抜粋):
SSDSE-B-2026 Prefecture A1101(総人口) Code
2022 北海道 5,140,000 R01000
2022 東京都 14,038,000 R13000
2022 高知県 676,000 R39000
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13 | import pandas as pd
import matplotlib.pyplot as plt
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df_2022 = df[df['SSDSE-B-2026'] == 2022].copy()
print(f'平均人口 = {df_2022["A1101"].mean():,.0f}')
print(f'中央値人口 = {df_2022["A1101"].median():,.0f}')
print(f'歪度 = {df_2022["A1101"].skew():.3f}')
# 上位 3 都道府県を除外した時の平均(バイアス除去)
df_filtered = df_2022.nsmallest(44, 'A1101')
print(f'上位3除外後平均 = {df_filtered["A1101"].mean():,.0f}')
|
📤 実行例:
平均人口 = 2,658,426
中央値人口 = 1,563,000
歪度 = 2.278
上位3除外後平均 = 2,111,227
💬 結果の読み方: 平均値 (2,658,426) と中央値 (1,563,000) に約 110 万人の差がある。 歪度 2.28 は「強い右歪み分布」を示す。 上位 3 都道府県 (東京・神奈川・大阪) を除くと平均は 211 万人まで下がり、 これらの大都市が「都道府県平均」を約 55 万人も引き上げていることが分かる。 政策議論で「都道府県平均」を語る時は、 必ず中央値・分位点も併記して、 大都市バイアスを開示すべき。
📝 理解度チェック (Q&A)
| 問題 | 解答・解説 |
|---|
| Q1. データバイアスの 4 大典型は? | 選択バイアス・確証バイアス・測定バイアス・歴史的バイアス。 SSDSE では選択バイアス (都市偏重) が最頻出。 |
| Q2. SSDSE で「平均人口」と「中央値人口」を比較する意義は? | 両者の乖離は分布の歪みを示し、 「平均で議論することの危険」を可視化する。 政策では中央値の方が「典型的都道府県」を表す。 |
| Q3. データバイアスを残したまま機械学習を実行するとどうなる? | 学習結果に偏りが反映され、 「都市部に有利な予測モデル」になる。 アルゴリズムバイアス として下流タスクに影響。 |
| Q4. データバイアスを軽減する手法は? | 層化サンプリング・重み付け・外れ値処理・データ拡張。 ただし、 完全除去はできないので「残バイアスの開示」が重要。 |
| Q5. 関連用語は? | アルゴリズムバイアス / AI の応用分野 / パターン認識 / 機械学習の基礎概念 |
補足: データバイアスは「データ収集の時点で起きる偏り」、 アルゴリズムバイアスは「モデル学習の過程で増幅される偏り」、 と区別される。 両者は連鎖するので、 上流のデータバイアスを抑えることが下流のアルゴリズムバイアス低減に直結する。 公的統計 (SSDSE) でも完全に中立とは限らず、 「集計単位 (都道府県) の取り方」「年度の選び方」「未調査項目」がバイアス源となりうる。 関連: アルゴリズムバイアス / 機械学習の基礎概念 / パターン認識 / AI の応用分野 / 強い AI / 弱い AI。
🧱 さらに深掘り: データバイアスの 7 つの源泉と対策フロー
実務でのデータバイアスは、 抽象的な「偏り」ではなく、 7 つの具体的な源泉から生まれる。 (1) サンプリングバイアス: 都道府県データのように集計単位が大規模行政区で固定されると、 「市区町村レベルの多様性」が消える。 (2) 選択バイアス: 「アンケート回答者だけ」のデータは非回答者の意見が含まれない。 (3) 測定バイアス: 計測機器の癖や調査票の質問順で結果が変わる。 (4) 確証バイアス: 分析者が期待する結果に合わせてデータを取捨選択。 (5) 歴史的バイアス: 過去の社会構造(性別役割・地域格差)が現在データに反映。 (6) 集計バイアス: 平均値・中央値・最頻値のどれを使うかで「典型値」が変わる。 (7) 欠損バイアス: 欠損値が「ランダムでない」場合、 補完しても偏りが残る。 SSDSE-B-2026 では特に (1)(5)(6) が起こりやすく、 学習者は意識的にチェックすべきである。
対策フローは「検出 → 評価 → 是正 → 開示」の 4 段階で進める。 検出では、 全変数のヒストグラム・歪度・尖度を確認し、 異常な分布を持つ変数をマーク。 評価では、 バイアスがモデル予測に与える影響を 交差検証 や層別 R² で定量化。 是正では、 (a) 層化サンプリングで再収集、 (b) 重み付け学習、 (c) 外れ値処理、 (d) データ拡張、 のいずれかを選択。 開示では、 残ったバイアスを論文・レポートで明示し、 「この結果は X というバイアスを含む可能性がある」と但し書きを付ける。 47 都道府県データを使う学習者は、 特に開示の習慣を身につけることが、 信頼できるデータサイエンティストへの第一歩。
🧪 SSDSE-B-2026 でデータバイアスを実測する 4 つの定量指標
| 指標 | 計算式 | 解釈 | SSDSE での実例 |
|---|
| 歪度 | E[(X-μ)³/σ³] | +:右偏 -:左偏 0:対称 | 総人口(A1101)の歪度 ≈ 2.3 (強右偏) |
| 尖度 | E[(X-μ)⁴/σ⁴]-3 | +:尖り -:平坦 | 総人口(A1101)の尖度 ≈ 5.6 (強尖り→外れ値多) |
| Gini 係数 | Lorenz 曲線下の面積から計算 | 0:完全平等 1:完全不平等 | 都道府県人口の Gini ≈ 0.47 (強い格差) |
| 変動係数 | σ/μ | スケール非依存のばらつき | 人口の CV ≈ 1.05 (平均と同等のばらつき) |
これら 4 指標を変数ごとに算出し、 異常値を持つ変数を優先的にバイアス対策の対象とする。 SSDSE で特に注意すべきは、 「総人口(A1101)」「婚姻件数(A9101)」のような大都市にスケールが偏る変数。 これらは対数変換または一人当たり指標 (per capita) に変換することで、 ほとんどのバイアスが軽減される。 一方、 「高齢化率」「失業率」のような比率指標は元々スケール標準化されているため、 単純な分布チェックでバイアス源は少ない。 「変数の性質ごとに適切な前処理を選ぶ」のが、 データバイアス対策の核心である。 関連: 機械学習の基礎概念 / アルゴリズムバイアス / パターン認識 / AI の応用分野。
📚 さらに深掘り: データバイアスが社会に与える影響
データバイアスは技術的問題に留まらず、 社会に深刻な影響を与える。 過去の事例として、 米国の COMPAS 再犯予測アルゴリズム (2016 ProPublica 報道) は、 黒人被告に対する誤判定率が白人の 2 倍だったことが判明した。 これは「過去の逮捕記録」を学習データとした結果、 「逮捕されやすい地域に住む人ほど再犯リスクが高い」という社会的バイアスが反映された典型例である。 Amazon が 2018 年に廃止した採用 AI も、 「過去 10 年の合格者データ」が男性中心だったため、 「履歴書に women's という単語があると減点」という性別バイアスを学習してしまった。 これらは「データが社会の鏡」であるがゆえに、 過去の不平等を AI が増幅してしまうリスクの実例である。
日本の文脈で言うと、 SSDSE-B-2026 のような公的統計は中立性が高いが、 (1) 都道府県集計単位の制約、 (2) 統計調査票の設計、 (3) 集計タイミングと社会変化のラグ、 という 3 つの構造的バイアス源を持つ。 例えば、 「就業者数」を 5 年に 1 度の国勢調査で集計すると、 急速に変化する非正規雇用・テレワークの実態が反映されない。 「都道府県」単位で集計すると、 「東京 23 区内の格差」「県境地域の経済圏」が見えない。 これらは技術的に解消できないバイアスもあり、 「データの限界を理解して使う」ことが SSDSE 学習者には求められる。 関連: アルゴリズムバイアス / AI の応用分野 / パターン認識 / 機械学習の基礎概念 / 強い AI / 弱い AI。
データバイアスの考察は、 「データはありのままを写す」という素朴な前提を覆し、 「データは収集者の意図と限界を内包する」という認識転換を求める。 SSDSE-B-2026 のような信頼性の高い公的統計でも、 47 都道府県という集計単位、 1 年単位での更新頻度、 特定の項目だけを測る設計、 これら全てが「何をどう見せるか」を規定している。 学習者は、 こうしたデータの政治性・社会性を理解した上で、 公平性指標を活用したバイアス検出を実行すべきである。 これがデータバイアスを学ぶ意義の本質である。 そして実務でデータバイアスを発見した時には、 ただ修正するだけでなく、 「なぜそのバイアスが生まれたのか」「誰が影響を受けるのか」「どう開示すべきか」までを総合的に考える視点が要求される。 これら全方位的な検討こそ、 専門家としての価値を最も明確に示す場面となる。
SSDSE-B-2026 は教育用に整備された理想的な題材だが、 「教育用データ」というラベル自体もバイアスの一種となりうる。 すなわち「綺麗に整形済み」「欠損が少ない」「主要な行政区が網羅されている」という性質は実務データではむしろ稀である。 学習者は、 SSDSE で「綺麗なデータ」の扱いに慣れた後、 必ず「綺麗ではない実データ」 (Kaggle ・企業内部データ・自治体内部システム等) で経験を積むべきである。 これがデータバイアス理解の総仕上げとなる。 SSDSE は出発点として最適だが、 終着点ではないことを忘れずに学習を続けてほしい。
📚 さらに深掘り: データバイアスを軽減する実務テクニック
データバイアスを軽減する実務テクニックは、 (1) 層化サンプリング (Stratified Sampling)、 (2) 重み付け学習 (Sample Weighting)、 (3) SMOTE 等の合成オーバーサンプリング、 (4) 逆確率重み付け (IPW)、 (5) ドメイン適応 (Domain Adaptation) の 5 つに大別される。 SSDSE-B-2026 で「人口少県のサンプルが不足する」場合、 (1) ブロック別に層化して再サンプリング、 (2) 人口少県のサンプル重みを大きくする、 などが基本対応。 ただし、 これらは「分布を補正する」だけで、 「過去の社会的不平等」自体は是正できない。 根本対策には、 そもそも収集対象を見直す upstream の取り組みが必須である。
最後に、 公正性指標 (Fairness Metrics) として Demographic Parity (DP) と Equal Opportunity (EO) を覚えておくと良い。 DP は「予測陽性率が群間で等しいか」、 EO は「真陽性率が群間で等しいか」を測る。 SSDSE で「就労支援優先地域を AI が選ぶ」モデルを作るなら、 「人口規模別に DP と EO を測定し、 0.1 以下に収まるか確認する」のが実務手順。 これらの指標は単独ではなく組み合わせで使い、 「どの公正性を優先するか」をステークホルダーと事前合意する必要がある。 公正性は数学だけでは決まらず、 社会的合意を必要とする領域である。 関連: アルゴリズムバイアス / AI の応用分野 / パターン認識。
データバイアスへの理解は、 単なる技術スキルではなく、 21 世紀のデータサイエンティストにとって「倫理的素養」の一部である。 技術と倫理は対立するものではなく、 むしろ表裏一体であることを、 SSDSE での実践を通じて体感してほしい。 倫理を欠いた技術は社会に害をなし、 技術を欠いた倫理は実効性を持たない、 という両者の不可分性を理解することが極めて重要である。 GDPR (EU 一般データ保護規則) や AI 法 (EU AI Act) では、 「高リスク AI」にはデータバイアスの記録・公表が法的に要求される。 日本でも個人情報保護委員会のガイドラインで、 「採用 AI」「与信 AI」「医療 AI」では、 学習データの公平性検証が事実上の必須事項となりつつある。 SSDSE-B-2026 のような公開データを使った演習を通じて、 「データの偏りを意識し、 検出し、 開示する」習慣を学生時代に確立することが、 将来の実務での法的・倫理的トラブルを未然に防ぐ最良の予防策となる。 教育者は、 単に技術を教えるだけでなく、 こうした倫理的素養を学生に伝える責任があると言える。 関連: AI の応用分野 / アルゴリズムバイアス / 強い AI / 弱い AI。
最後に、 データバイアス研究の最新潮流として、 (1) Counterfactual Fairness (反事実公平性: 仮想的な属性変更後の予測一致を要求)、 (2) Adversarial Debiasing (敵対的脱バイアス: 識別不能な表現を学習)、 (3) Disparate Impact Remediation (差別的影響の補正: 結果の格差を直接是正)、 などが活発に研究されている。 これらは数式的にも実装的にも難易度が高いが、 「公正な AI とは何か」を技術的に追求する最前線の話題である。 SSDSE-B-2026 のような身近なデータでこれらを実装する経験は、 学習者を「単なる AI ユーザー」から「公正な AI を設計できる専門家」へと成長させる重要なステップとなる。 国際学会 (FAccT・AIES・NeurIPS) で発表される最新研究にも触れつつ、 SSDSE の実データで小さく実験を積み重ねるのが、 確実な道筋である。
日本国内でもデータバイアスの議論は急速に活発化しており、 経済産業省・総務省・厚生労働省の各種ガイドラインで「AI 利用時のデータ公平性検証」が推奨事項として位置付けられている。 自治体レベルでも、 横浜市・神戸市・福岡市などが「公正な AI 利用指針」を策定し、 SSDSE のような公的統計を学術的に分析する際の参考事例として活用されている。 学習者が SSDSE-B-2026 を題材にデータバイアスを実測し、 その結果を地方自治体の政策議論にフィードバックする取り組みは、 「データサイエンスの社会実装」の好例となりうる。 単にコードを書くだけで終わらず、 社会的議論に資する成果物を生み出すことを目標に、 SSDSE での学習を進めてほしい。 これがデータバイアス習得の最終目標である。 また、 統計データ解析コンペティション (SSDSE) のような場で、 学生・若手研究者が「データバイアスを発見し、 是正策を提案する」研究を発表することは、 学術的にも社会的にも価値の高い貢献となる。 SSDSE-B-2026 はその出発点となる教育用データセットとして、 今後も継続的に活用されていくことが期待される。
🧮 数式に値を入れて手で計算する: サンプリングバイアスの定量化
合成データで母集団分布と標本分布の差をカイ二乗で評価する。
Step 1: 期待 vs 観測
| カテゴリ | 母 (期待) | 標本 (観測) | (O-E)²/E |
|---|
| 男性 | 50 | 70 | 8.00 |
| 女性 | 50 | 30 | 8.00 |
Step 2: χ² と判定
χ² = 8.00 + 8.00 = 16.00
df = 1, χ²(0.05,1) = 3.84
16.0 > 3.84 → 偏りあり (バイアスあり)
🐍 Python で再現
| from scipy import stats
O = [70, 30]
E = [50, 50]
chi2, p = stats.chisquare(O, E)
print(f"χ² = {chi2}")
print(f"p = {p:.4f}")
|
📤 実行結果
χ² = 16.0
p = 0.0001
💬 手計算 (Step 2) χ²=16.0 と Python 出力が完全一致。
🌳 手法選択フロー
データバイアスは収集・欠損・公平性の三方向から系統的に検知する。
- 収集経路・標本設計は妥当か? Yes → 選択バイアス、 No → 標本抽出 を先に確認
- 欠損や測定誤差はあるか? Yes → 欠損メカニズム、 No → 測定誤差 を先に確認
- 公平性指標は確認したか? Yes → アルゴリズムバイアス、 No → AI 倫理 を先に確認
代表性なら層化サンプリング、 群間公平性なら fairness metric、 ラベルバイアスなら label smoothing、 と「対処したいバイアス」で選ぶ。
🔗 隣接手法への橋渡し
データバイアスは「収集 → 学習 → 評価 → 運用」の各段階で形を変えて現れる。 「接続 (どう繋がるか)」「統合 (どう組み合わせるか)」「比較 (どう使い分けるか)」の 3 視点で隣接概念を整理し、 バイアス対策の判断材料を提供する。
① 接続: データバイアスを検出・緩和する周辺技術
データバイアスは収集設計から運用監視まで広範な技術と接続する。 以下 5 件は実務でほぼ必ず併用される。
- データ収集 — 収集設計の段階でサンプリングフレームの偏りが生まれる。 適用シーン: アンケート対象選定、 ログ取得範囲の決定。
- 隠れたデータバイアス — 顕在化していない潜在バイアス (proxy 変数経由など) を検出。 適用シーン: 郵便番号が人種代理になっているケースの特定。
- アルゴリズムバイアス — データバイアスが学習を通じてモデルへ転写された結果。 適用シーン: 採用 AI が女性応募者を不利に扱う事例。
- 選択バイアス — サンプリング段階で特定群が過剰/過少表現される代表的なデータバイアス。 適用シーン: アクセスログだけ見るとスマホユーザに偏る。
- データドリフト — 運用後に分布が変化し、 学習時バイアスとは別の偏りが入る。 適用シーン: コロナ前後の購買行動分布の変化。
② 統合: データバイアス対策を組み込んだワークフロー
データバイアスは単独の問題ではなく、 ML パイプライン全体で連続的に検査・緩和される。
| パイプライン | ステップ | データバイアスへの対処 |
|---|
| 公平な信用スコアリング | 申込データ収集 → 属性別代表性確認 → 重み付け再標本化 → モデル学習 → 群別 AUC 検証 → 不合格率均等化 | 収集時の母集団ズレを統計的に補正し、 学習後も demographic parity を継続監視 |
| 医療画像診断 AI | 多施設データ収集 → 機器/地域別分布確認 → ドメイン適応 → ベンチマーク (年齢・性別・人種別感度) | 単一病院偏重を多施設化で軽減、 学習後に層別評価でバイアス残存を検出 |
| 採用候補スクリーニング | 過去採用ログ → 属性 proxy 監査 → 差別的特徴除去 → fairness 制約付き学習 → A/B テスト | 過去の人事決定に含まれる偏見をデータレベルで検出し、 制約付き最適化で緩和 |
③ 比較: データバイアス vs 隣接バイアス概念の使い分け
「これはデータバイアスなのか、 別のバイアスなのか」の判断基準。 発生段階と対処層を区別する。
| 状況 | データバイアス | アルゴリズムバイアス | 選択バイアス | 確証バイアス (人間側) |
|---|
| 発生段階 | 収集・蓄積 | 学習・推論 | サンプリング | 解釈・意思決定 |
| 主な対処層 | データ前処理 | モデル設計・正則化 | 標本設計 | レビュー・教育 |
| 検出指標例 | 属性別カバレッジ、 分布ズレ | 群別 TPR/FPR、 demographic parity | 応答率、 母集団との比較 | 採択率の系統的偏り |
| 典型的対策 | 再標本化、 重み付け、 補完 | fairness 制約、 adversarial debias | 層化抽出、 propensity score 補正 | 盲検審査、 チェックリスト |
| SSDSE-B-2026 での例 | 東京偏重で全国平均が歪む | 人口大の県を過剰評価する回帰 | WEB 回答可能な県のみ集計 | 「やはり東京は特別」と確信 |
原則: 「データ自体の偏り」→ データバイアス、 「学習で増幅された偏り」→ アルゴリズムバイアス、 「標本作りでの偏り」→ 選択バイアス、 「人間の解釈偏り」→ 認知バイアス。 最上流のデータバイアスを潰しておくほど、 下流の対策コストが下がる。
🧭 解説を深める — バイアスは「ノイズ」ではない
このページ本文と触って理解するウィジェットは「どの個体を集めたか(選択・サンプリング・生存者)」を主軸に据えました。 姉妹ページ データバイアス(隠れた交絡・合流点) は「観測の入口で条件付けることで生まれる合流点(コライダー)バイアス」を扱います。 ここでは両者と重ならない第3の角度 ── 「バイアス(系統誤差)とノイズ(偶然誤差)は別物であり、 バイアスは数を増やしても消えない」 ── を、 SSDSE-B-2026 の実測値で定量的に示します。
🎨 直感 — 「たくさん集めれば正しくなる」の落とし穴
偶然誤差(ノイズ)は、 何度も測って平均すれば互いに打ち消し合い、 標本サイズ n を増やすほど小さくなります(標準誤差は概ね 1/√n で縮む)。 ところがバイアスは方向を持った“ズレ”なので、 何度足し合わせても同じ向きに積み上がるだけで、 n を増やしても中心はズレたまま。 これが「大標本ほど、 誤った結論に自信だけが増す」危険の正体です。
身近な例が集計バイアス(エコロジカル・バイアス)です。 47 都道府県の“率”を単純平均すると、 人口 1,400 万人の東京都と 65 万人の鳥取県が同じ 1 票になります。 「都道府県を平等に扱う」のは一見公平ですが、 それは「日本国民の代表値」ではなく「都道府県という単位の代表値」を計算していることになります。 母集団を人(国民)に取るなら、 これは系統的なズレ=バイアスです。
SSDSE-B-2026(2023年・47都道府県、 列 A1101 総人口・A9101 婚姻件数)で実測 ── 人口1,000人あたり婚姻件数を2通りで求めると:
| 集計のしかた | 婚姻率(人口千対) | 意味する母集団 |
|---|
| 全国の合算 Σ婚姻 ÷ Σ人口(人口加重) | 3.818 | 国民1人を1票とした“真の”全国値 |
| 47都道府県の率の単純平均 | 3.457 | 都道府県を1票とした値 |
| 差(=集計バイアス) | −0.361(−9.5%) | 単純平均が全国値を過小評価 |
なぜズレるか。 婚姻率が最も高いのは東京都 5.095(人口1,408.6万・最大の重み)、 最も低いのは秋田県 2.519。 単純平均は東京の“1票”を秋田や鳥取と同格に薄めるため、 都市に集中する婚姻を取りこぼし、 全国値より約1割低く出ます。 数字そのものは1件も間違っていないのに、 「どう要約したか」だけで結論がズレるのがデータバイアスの怖さです。
⚠️ 落とし穴(重要)— n を増やしても、 年を重ねても消えない
「サンプルを足せば偏りが薄まる」は誤り
同じ婚姻率の差を 2012〜2023 年の全12年で計算すると、 加重値−単純平均の差は毎年つねに負(−0.28 〜 −0.38、 平均 −0.344)。 12年ぶんを積み上げても一度も符号は反転しません。 もし偶然誤差なら年ごとにプラスマイナスに散らばって平均ゼロに近づくはずですが、 系統誤差だから同じ向きに居座り続ける。 「時系列を長く取れば安心」も「都道府県を全部(47件=全数)そろえたから代表性は完璧」も、 集計軸が間違っていれば救いになりません。
「全数(悉皆)データだからバイアスは無い」も誤り
SSDSE の47都道府県は“抽出した標本”ではなく全数です。 それでも上のズレは残ります。 バイアスは「抽出の失敗」だけでなく「集計単位・重み付けの選択」からも生まれるから。 全数を持っていても、 どの母集団への推定か(国民か・都道府県か)を宣言しない平均は、 静かに間違った母集団を代表してしまいます。
🚀 発展 — バイアスとバリアンスを切り分ける
- 誤差の分解: 推定誤差は大まかに「バイアス²+バリアンス(+既約ノイズ)」に分かれます(バイアスとバリアンス)。 データを増やす・平均するで下がるのは主にバリアンス側。 バイアス側は、 集計軸・重み・母集団定義を正しく設計し直すまで動きません。
- 加重で母集団をそろえる: 国民を母集団に取るなら、 各都道府県の率を人口で重み付けする(=Σ婚姻÷Σ人口)。 本文で扱った逆確率重み付け(IPW)と同じ発想で、 「1単位=1票」の暗黙の仮定を明示的な重みに置き換えます。 → 集計・平均 を参照。
- 母集団を先に宣言する: 「何の平均か」を書いてから計算する習慣が最良の予防策。 母集団 と 標本抽出 のページで、 単位の取り違え(生態学的誤謬・エコロジカルフォールシー)を確認してください。
- 合成デモ(架空): 直感確認には、 偏りを人為的に注入した架空データで「n を10倍にしても中心が動かない」ことを可視化するのが有効です(本ページ上部の🎮ウィジェットも、 説明用に生成した擬似データで同種の現象を体感できます)。 実測の主張には必ず SSDSE 等の一次データを使ってください。
バイアスとバリアンス
集計
平均
母集団
標本抽出
データバイアス(合流点)
選択バイアス
交絡
※ 数値は SSDSE-B-2026(列 A1101 総人口・A9101 婚姻件数)を pd.read_csv(encoding='cp932', skiprows=[1]) で読み、 2023年(および2012〜2023年)47都道府県について実測・転記したものです。