🔖 キーワード索引 — 交絡を多角的に理解する
交絡(confounding)は因果推論の最重要概念です。 関連キーワードを難易度別に整理しました。
🟢 基礎キーワード(まず押さえる)
- 交絡因子(confounder):原因と結果の両方に影響する第三の変数。 たとえば「アイス売上 → 溺死」の交絡因子は「気温」。
- 疑似相関(spurious correlation):因果関係がないのに統計的相関だけがある状態。 交絡が主因。
- 因果関係 vs 相関:「相関は因果を含意しない」という統計の最重要金言。
- 説明変数の制御:交絡因子を重回帰に含める、 層別解析する、 マッチングする等の対処法。
- 無作為割り付け(randomization):交絡を期待値レベルで完全に消すゴールドスタンダード。
- 観察研究 vs 実験研究:観察研究は交絡を完全には排除できない。 実験研究は randomization で防ぐ。
🟡 中級キーワード
- 因果ダイアグラム(DAG, directed acyclic graph):変数間の因果関係を矢印で図示。 交絡パスを視覚化。
- バックドアパス(backdoor path):処置から結果に至る、 因果でない経路。 これを閉じることが因果推定の鍵。
- 傾向スコア(propensity score):処置を受ける確率。 マッチングや IPW で交絡を制御。
- 差の差分法(DID, difference-in-differences):時間と群の二重差で交絡を除去する準実験手法。
- 回帰不連続デザイン(RDD):閾値前後でランダム化が成立するという仮定で因果推定。
- シンプソンのパラドックス:層別解析と全体解析で逆の結論が出る現象。 交絡の極端例。
🔴 上級キーワード
- do 演算子(Pearl の介入計算):「もし強制的に X=x にしたら」という反実仮想の数学的表現。
- 操作変数法(IV, instrumental variable):観測できない交絡があっても、 外生変数を使って因果推定。
- 媒介変数(mediator)と衝突点(collider):制御すべきでない変数。 制御すると逆にバイアスを増やす。
- 選択バイアス(selection bias):サンプル選択時点で生じるバイアス。 衝突点制御と同じ構造。
- 潜在結果モデル(Rubin causal model):個体ごとに処置・対照両方の結果を仮想する枠組み。 ATE・ATT などの推定対象を明確化。
- g-methods(g-formula、 marginal structural models):時間変動交絡を扱う先進的手法。
💡 30秒で分かる結論
🍰 まずはやさしく
関係があるように見えるだけの「ニセモノ」のことです。
本当の原因を見つけるために使います。
アイスの売上と水難事故の関係が例です。
この章では交絡因子の正体を学びます。
- 定義:説明変数 X と目的変数 Y の両方に影響を与える第3の変数 C
- C の存在により、 X と Y の間に見かけ上の相関(疑似相関)が生まれる
- 古典例:「アイス売上 ↔ 水難事故」の真の犯人は「夏の気温」
- 本データの例:「求人倍率 ↔ 死亡率」の真の犯人は「高齢化率」
- 対処:重回帰で交絡を制御、 操作変数法、 DiD、 パネル固定効果
- 限界:観察されない交絡は除去不可能 — 因果断言には実験デザインが必要
📖 もっと詳しく
2変数 A と B に強い相関があるとき、 (i) A が B を引き起こす、 (ii) B が A を引き起こす、 (iii) 両方を引き起こす第3の変数 C がある、 の3パターンがあります。 (iii) のパターンを 交絡(confounding) といい、 観察データだけからは識別が難しい本質的問題です。
古典的な例:「アイスクリームの売上」と「水難事故件数」には強い正相関があります。 だからといって「アイスが水難事故を起こす」とは誰も思わない。 真の犯人は「夏の気温」という第3変数 — 暑い日にはアイスも売れるし、 海・川での事故も増える。 アイスと水難事故の相関は 疑似相関(spurious correlation) です。 もう1つの古典例が「コーヒーをよく飲む人ほど肺がんが多い」— これも真の犯人は「喫煙」で、 コーヒーを飲みながらタバコを吸う人が多かった時代のデータでは、 喫煙がコーヒー摂取と肺がんの両方に結びついて見かけの相関を作っていました。
本サイトの実例:47都道府県のデータで「有効求人倍率と死亡率」を単純に相関させると、 r = +0.308 で p < 0.05 の有意な正の相関が出ます。 「景気が良い県ほど死亡率が高い?!」と読みたくなりますが、 これも疑似相関。 真の犯人は「高齢化率」 — 高齢化が進んだ地方では、 求職者が減って求人倍率は上がりやすく、 同時に死亡率も上がる。 高齢化率を統計的に制御すると、 求人倍率の効果は消えます。
対処法:(i) 重回帰で交絡変数を説明変数として明示的に入れる(最も基本)、 (ii) 操作変数法(IV)で外生的変動を取り出す、 (iii) 差分の差分法(DiD)で時間不変の交絡を吸収、 (iv) パネル固定効果モデルで個体固有効果を吸収。 ただし観測されていない交絡(隠れた変数)は完全には排除できないのが社会科学の宿命。
📍 あなたが今見ているもの
🍰 まずはやさしく
分析のときに注意すべき「隠れた原因」のことです。
データの読み間違いを防ぐために使います。
スマホの利用時間と成績の関係などで考えます。
このページでは定義や対策について読みます。
論文で「交絡変数を制御」「疑似相関」「spurious correlation」と書かれている部分。 因果推論で最も重要な概念。
交絡因子 とは:AとBの両方に影響を与える第3の変数C。Cの存在によりAとBに「見かけの相関」が生まれる(疑似相関)。
本ページでは「confounding」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「confounding」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
裏で操っている「黒幕」のような存在です。
直感的に仕組みを理解するために使います。
求人倍率と死亡率の例で考えます。
なぜ見かけ上の関係が生まれるかを図で読みます。

左図:「求人倍率 vs 死亡率」の単純な散布図では、 確かに右上がりの関係(r=+0.31)。 「景気の良い県は死亡率が高い」と読みたくなる。
右図:ただし「求人倍率 vs 高齢化率」を見ると、 こちらも正の相関がある(r=+0.29 と弱めだが、 向きは同じ)— 高齢化が進んだ地方では求職者が少なく、 求人倍率が高くなりやすい。 一方で高齢化率と死亡率の相関は r=+0.97 と非常に強い(図には無いが同じデータで計算できる)。
つまり「高齢化率」という第3変数が、 「求人倍率」「死亡率」の両方を動かしているため、 求人倍率と死亡率に見かけの相関が出ているだけ。 これが交絡(confounding)の構造。
🎓 因果推論の階段:観察 → 介入 → 反実仮想
Judea Pearl の「因果のはしご」によると、 因果推論には3段階あります:
- 関連付け(観察):「X と Y は相関する」 — 本サイトのほぼ全ての分析がここ
- 介入:「もし X を操作したら Y はどう変わるか」 — ランダム化実験で達成
- 反実仮想:「もし過去に X がこうだったら、 Y はどうなっていたか」 — DiD や IV が近づく
観察データだけからの「因果」は本質的にレベル1。 重回帰で交絡を制御しても 「観察されない交絡」 が残るリスクは消えません。 だから論文の結論部では「相関を示した」「関連を観察した」と慎重に書き、 「因果関係」は控えめに表現するのがプロの作法です。
🎨 直感で掴む — 交絡 (Confounding)
交絡は「X と Y の両方に影響する第三の変数 Z があるとき、 X と Y の相関を Z が作り出してしまう」現象。 「アイス売上 ↑ と水難事故 ↑」が真夏(気温)で繋がるのが典型例。 SSDSE-B-2026 でも、 A1101(人口)と L3221(消費支出)の相関を A1303(高齢人口)が交絡する可能性がある。
交絡 (Confounding) は「因果推論」カテゴリの中核概念。 初めて触れる読者は、 まずこの「🎨 直感」セクションだけ通読し、 必要になった時点で「📐 数式」「🐍 Python」「⚠️ 落とし穴」へ戻る読み方が定着しやすいです。
📐 定義・数式 — 交絡 (Confounding)
🍰 まずはやさしく
交絡を数学の言葉で表したルールです。
厳密に正しさを証明するために使います。
部活の練習量と試合結果の関係を式にします。
数式を使って交絡の意味を詳しく読みます。
やさしい説明で掴んだ感覚を、ここで 交絡 (Confounding) の定義式に対応づけます。下の式は左辺 $P(Y \mid \text{do}(X)) \ne P(Y \mid X) \;\;\;(\text{if } Z \text{ confounds})$ が何で決まるかを右辺で書き下したもので、P(·)(確率) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
上の数式を眺めるだけでは身につかないので、 各記号がどんな役割を担っているかを言葉で押さえます。 「数式を音読する習慣」がつくと、 論文や教科書を読むスピードが体感で 2 倍ほど上がります。
- $P(Y \mid X)$(右辺)— 観察して分かる分布
- 「X がたまたまこの値だった集団で、 Y はどう分布するか」。 記号 $\mid$ は「〜を条件として(given)」と読む。 相関・回帰など、 観察データの分析はすべてこちら側。
- $P(Y \mid \text{do}(X))$(左辺)— 介入したときの分布
- 「全員の X を強制的にこの値に設定したら、 Y はどう分布するか」。 因果効果の定義そのもの。 ランダム化実験が測っているのはこちら。
- $\text{do}(\cdot)$ — Pearl の介入演算子
- 「観察する」と「操作する」を区別するための記号。 do を付けると、 X に向かって流れ込む矢印(Z → X など)を全部切断した世界を考えることになる。
- $Z$ — 交絡変数(confounder)
- X と Y の両方に影響する第三の変数(DAG では X ← Z → Y)。 SSDSE-B-2026 の例なら「高齢化率」。 Z がこの位置にあるとき、 左辺と右辺は一致しなくなる。
- $\ne$ — 両辺のズレ=交絡バイアス
- 「観察された関連」と「介入したときの効果」の差。 このズレを重回帰・層別・マッチング等で埋めるのが交絡制御。 Z を正しく制御できれば両辺は一致する。
🧮 SSDSE-B-2026 実値計算例 — 47 都道府県で交絡を見抜く
合成データではなく公的統計を念頭に、 交絡因子が引き起こす疑似相関とその制御例を具体的な数値で示します。
① 「婚姻の多い県ほど死亡率が低い」?
47 都道府県で「婚姻率(人口千対)」と「粗死亡率(人口千対)」の相関を取ると、 高齢化という第3変数のために強い負の相関が出ます。
1 2 3 4 5 6 7 8 9 10 | # 単相関 r(婚姻率, 粗死亡率) ≈ -0.85 → 「婚姻の多い県ほど死亡率が低い」 # しかし、 これは疑似相関 # 交絡因子:高齢化率 r(婚姻率, 高齢化率) ≈ -0.90(高齢化が進む県ほど婚姻が少ない) r(高齢化率, 粗死亡率) ≈ +0.97 で非常に強い → つまり「死亡率は高齢化率でほぼ決まる」 |
② 重回帰で交絡を制御
# 単回帰:粗死亡率 ~ 婚姻率  → 婚姻率の傾き -3.95
# 重回帰:粗死亡率 = β₀ + β₁·婚姻率 + β₂·高齢化率

# 重回帰の結果(SSDSE-B-2026, 2023 実測)
β₁(婚姻率)≈ +0.63   ← 符号が逆転!(p≈0.09 で有意でなくなる)
β₂(高齢化率)≈ +0.69

→ 高齢化率を制御すると、 婚姻率の死亡率への効果はほぼ消える
→ これが偏回帰係数の意味
→ 高齢化率という交絡因子が、 婚姻率 vs 粗死亡率 の見かけの相関を作っていた
💡 単相関と偏回帰係数で符号が反転する(−3.95 → +0.63 のように向きが変わる)のは、 強い交絡が存在する典型的なサインです。 単回帰と重回帰で係数の符号・大きさが大きく食い違ったら、 「どの第三変数が両方を動かしているのか」を疑ってください。
③ シンプソンのパラドックスの再現
# 仮想例:医療機関 A と B の手術成功率
# A 病院 全体:70%(700/1000)
# B 病院 全体:80%(800/1000)
# → B の方が成績良い?

# 重症度で層別すると
A 病院  軽症:95%(475/500)、 重症:45%(225/500)
B 病院  軽症:90%(720/800)、 重症:40%(80/200)
→ 軽症でも重症でも A 病院の方が高い!

# 理由:A 病院は重症患者が多い、 B 病院は軽症が多い
# 「重症度」が交絡因子
④ 偏相関係数の計算
1 2 3 4 5 6 7 8 9 10 11 12 13 | # 偏相関 r(X, Y | Z) = (r_XY - r_XZ·r_YZ) / sqrt((1-r_XZ²)(1-r_YZ²))
# 例:X = 婚姻率、 Y = 粗死亡率、 Z = 高齢化率
r_XY = -0.845 (単相関)
r_XZ = -0.897 (婚姻率 vs 高齢化率)
r_YZ = +0.972 (高齢化率 vs 粗死亡率)
r(X,Y|Z) = (-0.845 - (-0.897)·0.972) / sqrt((1-0.897²)(1-0.972²))
= (-0.845 + 0.872) / sqrt(0.1954 · 0.0552)
= 0.027 / 0.1039
≈ +0.26 ← 単相関 -0.845 から符号が反転
高齢化率を制御すると婚姻率と死亡率の
見かけの強い負相関はほぼ消える |
注:偏相関係数は、 同一データから計算した 3 つの r に対しては必ず −1〜+1 に収まります。 上の例では実データ(SSDSE-B-2026, 2023)から求めた r_XY=−0.845、 r_XZ=−0.897、 r_YZ=+0.972 が相関行列として整合するため、 偏相関は +0.26 と正しく求まります。 単相関 −0.845 が偏相関 +0.26 へと大きく変化(符号反転)したことが、 高齢化率という強い交絡の存在を示しています。 実務では statsmodels や pingouin で実データから直接計算してください。
⑤ 傾向スコアマッチングの簡易例
1 2 3 4 5 6 7 | # 「人口減少県」を処置とみなし、 制御変数(高齢化率・所得・進学率)でマッチング # ロジスティック回帰で傾向スコア p̂(X) を推定 仮想結果: 群間直接比較 → 死亡率の差 +3.1 傾向スコアマッチング後 → 死亡率の差 +0.4 → ほぼ高齢化率の差で説明できた |
🧮 実値で計算してみる — SSDSE-B-2026
数式だけでは「実感」が湧きにくいので、 実データ data/raw/SSDSE-B-2026.csv(47 都道府県 × 12 年)で 1 度手計算してみると理解が定着します。
SSDSE-B-2026 (2023) で A1101 と L3221 の単純相関 r ≈ 0.33。 A1303(高齢人口)も A1101 と強く相関(r≈0.99)し、 L3221 とも相関(r≈0.32)するため、 偏相関で A1303 を制御すると A1101→L3221 のパス係数が変動する。 偏相関 ρ(A1101, L3221 | A1303) ≈ 0.12 と推定でき、 見かけの相関(r ≈ 0.33)は約 3 分の 1 に縮小する — この縮んだ分が A1303 経由で作られていた成分。
| 都道府県 | A1101 総人口 | A1303 65 歳以上 | L3221 消費支出 |
|---|---|---|---|
| 東京都 | 14,086,000 | 3,205,000 | 341,320 |
| 神奈川県 | 9,229,000 | 2,390,000 | 306,565 |
| 大阪府 | 8,763,000 | 2,424,000 | 271,246 |
| 愛知県 | 7,477,000 | 1,923,000 | 300,221 |
| 埼玉県 | 7,331,000 | 2,012,000 | 344,092 |
| 千葉県 | 6,257,000 | 1,756,000 | 306,943 |
上記は SSDSE-B-2026 (2023) からの抜粋。 手計算で確認した値が、 後述の Python 実装で得る値と一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 数式に値を入れて手で計算する: 交絡を層別で除く
合成データでアイス売上と溺死件数の相関、 気温で層別すると消える例を計算する。
Step 1: 全体の相関 (季節混在)
| i | アイス x | 溺死 y | 気温 |
|---|---|---|---|
| 1 | 20 | 2 | 低 |
| 2 | 30 | 3 | 低 |
| 3 | 80 | 10 | 高 |
| 4 | 90 | 11 | 高 |
| 5 | 100 | 10 | 高 |
Step 2: 全体相関 (見せかけ)
Step 3: 気温で層別 (高温群のみ)
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np x = np.array([20, 30, 80, 90, 100]) y = np.array([2, 3, 10, 11, 10]) print(f"全体 r = {np.corrcoef(x,y)[0,1]:.3f}") xh, yh = x[2:], y[2:] print(f"高温群 r = {np.corrcoef(xh,yh)[0,1]:.3f}") |
📤 実行結果
💬 手計算(全体 r ≈ 0.977、 高温群 r = 0)と Python 出力が一致。 5 日を混ぜると、 気温の低い 2 日と高い 3 日の差だけで強い正の相関が生まれるが、 高温の 3 日の中ではアイスが売れても溺死は増えず相関は 0 になる。 見せかけの相関を作っていたのは気温(交絡因子)である。
🐍 Python 実装のバリエーション — pandas / statsmodels / causalml
① 単相関と重回帰での係数比較
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd
import statsmodels.api as sm
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023] # 2023年・47都道府県
df['粗死亡率'] = df['A4200'] / df['A1101'] * 1000
df['婚姻率'] = df['A9101'] / df['A1101'] * 1000
df['高齢化率'] = df['A1303'] / df['A1101'] * 100
# 単回帰:粗死亡率 ~ 婚姻率
m1 = sm.OLS(df['粗死亡率'], sm.add_constant(df[['婚姻率']])).fit()
print('単回帰の婚姻率係数:', round(m1.params['婚姻率'], 3))
# 重回帰:粗死亡率 ~ 婚姻率 + 高齢化率(交絡制御)
m2 = sm.OLS(df['粗死亡率'], sm.add_constant(df[['婚姻率','高齢化率']])).fit()
print('重回帰の婚姻率係数:', round(m2.params['婚姻率'], 3)) |
② 偏相関係数(pingouin)
1 2 3 4 5 | import pingouin as pg # 高齢化率を制御した婚姻率 vs 粗死亡率 の偏相関 result = pg.partial_corr(data=df, x='婚姻率', y='粗死亡率', covar='高齢化率') print(result) |
③ 傾向スコアマッチング(scikit-learn + 自前マッチング)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | from sklearn.linear_model import LogisticRegression import numpy as np df['treated'] = (df['高齢化率'] > df['高齢化率'].median()).astype(int) X = df[['婚姻率','L3221']] y_t = df['treated'] # 傾向スコア推定 ps_model = LogisticRegression(max_iter=1000).fit(X, y_t) df['propensity'] = ps_model.predict_proba(X)[:, 1] # 最近傍マッチング treated = df[df['treated']==1] control = df[df['treated']==0] matches = [] for _, t in treated.iterrows(): idx = (control['propensity'] - t['propensity']).abs().idxmin() matches.append((t.name, idx)) matched_treated = df.loc[[m[0] for m in matches]] matched_control = df.loc[[m[1] for m in matches]] print('ATT:', matched_treated['粗死亡率'].mean() - matched_control['粗死亡率'].mean()) |
④ IPW(逆確率重み付け)
1 2 3 4 5 6 7 8 | df['weight'] = df.apply( lambda r: 1/r['propensity'] if r['treated']==1 else 1/(1-r['propensity']), axis=1 ) # 重み付き平均 ipw_treated = (df[df['treated']==1]['粗死亡率'] * df[df['treated']==1]['weight']).sum() / df[df['treated']==1]['weight'].sum() ipw_control = (df[df['treated']==0]['粗死亡率'] * df[df['treated']==0]['weight']).sum() / df[df['treated']==0]['weight'].sum() print('IPW ATE:', ipw_treated - ipw_control) |
⑤ DAG の可視化(pgmpy + networkx)
1 2 3 4 5 6 7 8 9 10 11 12 | import networkx as nx import matplotlib.pyplot as plt dag = nx.DiGraph() dag.add_edges_from([ ('高齢化率', '粗死亡率'), ('高齢化率', '婚姻率'), ('婚姻率', '粗死亡率'), ]) pos = nx.spring_layout(dag, seed=42) nx.draw(dag, pos, with_labels=True, node_size=2500, node_color='lightblue', arrows=True) plt.savefig('dag.png', dpi=150) |
⑥ E-value(未測定交絡の頑健性)
1 2 3 4 5 6 7 8 | def evalue(rr): """観察された相対リスク rr に対し、 必要な交絡因子の強さ""" if rr < 1: rr = 1/rr return rr + (rr * (rr - 1)) ** 0.5 print(f'観察RR=2.0 を覆すには E-value = {evalue(2.0):.2f} 倍の交絡が必要') print(f'観察RR=3.0 を覆すには E-value = {evalue(3.0):.2f} 倍の交絡が必要') |
⑦ DoWhy で因果効果推定
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # pip install dowhy from dowhy import CausalModel model = CausalModel( data=df, treatment='treated', outcome='粗死亡率', common_causes=['高齢化率','婚姻率'] ) identified = model.identify_effect() estimate = model.estimate_effect(identified, method_name='backdoor.linear_regression') print(estimate) # 頑健性チェック refute = model.refute_estimate(identified, estimate, method_name='random_common_cause') print(refute) |
🐍 Python 実装 — 交絡 (Confounding)
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで 交絡 (Confounding) を動作させます。 まずはこのまま実行してみてください。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # 交絡 (Confounding) を SSDSE-B-2026 で実行する最小コード import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年のみ抽出 print(df.shape) # (47, 112) print(df[['Prefecture','A1101','A1303','L3221']].head()) import pandas as pd import numpy as np cols = ['A1101','A1303','L3221'] C = df[cols].astype(float).corr() print(C) # 偏相関 ρ(x,y|z) def partial(x,y,z): r_xy = C.loc[x,y]; r_xz = C.loc[x,z]; r_yz = C.loc[y,z] return (r_xy - r_xz*r_yz) / np.sqrt((1-r_xz**2)*(1-r_yz**2)) print('偏相関(A1101,L3221|A1303)=', partial('A1101','L3221','A1303')) |
💬 総人口と世帯の消費支出の相関 0.333 は、65 歳以上人口で調整した偏相関では 0.116 まで小さくなる。ただし総人口と 65 歳以上人口の相関が 0.991 とほぼ同じ変数なので、ここでの「調整」は実質的に人口規模そのものを取り除いており、偏相関の分母 √(1−0.991²) が約 0.13 と小さく数値が不安定になる。交絡因子として調整するなら、人数ではなく高齢化率のように結果と原因の両方に影響しうる別の性質の変数を選ぶのが筋である。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install matplotlib numpy pandas scikit-learn scipy seaborn statsmodels が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
⚠️ よくある落とし穴
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # 基本パターン import pandas as pd import numpy as np from scipy import stats import matplotlib.pyplot as plt import seaborn as sns # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る # 基本統計量 df.describe() # 可視化 sns.pairplot(df[['A1101', 'A1303', 'L3221']]) plt.show() |
📚 統計概念マップでの位置
このページの上にある3つの概念マップ(関係マップ、 包含マップ、 ツリーマップ)でこの概念の位置づけが視覚的に分かります。 関連手法を辿って学習を進めましょう。
🎯 SSDSE-B-2026 で挑戦
統計データ活用コンペティションのSSDSE-B-2026データは、 47都道府県の社会経済データ。 この概念を使って以下のような分析ができます:
- 地域別の特徴抽出
- 家計支出パターンの解析
- 人口動態と社会経済指標の関連
- 気候要因の影響評価
💡 よく使うコマンド集
| 機能 | Python (pandas) | Python (scipy) |
|---|---|---|
| 要約統計 | df.describe() | stats.describe() |
| 平均 | df.mean() | np.mean() |
| 標準偏差 | df.std() | np.std() |
| 相関 | df.corr() | stats.pearsonr() |
| t検定 | — | stats.ttest_ind() |
| 回帰 | — | stats.linregress() |
| 分布フィッティング | — | stats.norm.fit() |
🚧 一般的な落とし穴と対策
- 外れ値の影響:散布図・ 箱ひげ図で確認、 ロバスト手法も検討
- サンプルサイズ不足:power analysis で事前に確認
- 仮定の違反:正規性、 独立性、 等分散性をチェック
- 多重比較問題:補正(Bonferroni、 FDR)を適用
- p-hacking:事前登録(pre-registration)で防ぐ
- 因果と相関の混同:観察データから因果結論を出さない
📊 結果報告の標準フォーマット
- 点推定:得られた値
- 不確実性:信頼区間または標準誤差
- サンプルサイズ:n を明記
- 効果量:実質的な意義
- p値:統計的有意性
- 仮定の確認:診断プロット
🌐 関連分野での応用
- マーケティング:A/Bテスト、 顧客分析
- 医療:臨床試験、 疫学研究
- 金融:リスク管理、 ポートフォリオ
- 製造:品質管理、 工程最適化
- 公共政策:効果評価、 計画立案
- 研究:仮説検証、 探索的解析
🎓 さらに学ぶための文献
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression"
- VanderPlas "Python Data Science Handbook"
🔗 統計用語ネットワーク
この概念は、 他の多くの統計概念と密接に関連しています。 ジャストインタイム型学習では、 必要に応じて関連用語へジャンプしながら全体像を構築します。
主要な関連概念のグループ
| グループ | 主要概念 |
|---|---|
| 記述統計 | 平均、 中央値、 最頻値、 分散、 標準偏差、 共分散、 相関係数 |
| 可視化 | ヒストグラム、 散布図、 箱ひげ図、 ヒートマップ |
| 推測統計 | 標本平均、 標準誤差、 信頼区間、 p値、 有意水準 |
| 確率分布 | 正規分布、 t分布、 χ²分布、 F分布、 二項分布 |
| 仮説検定 | t検定、 F検定、 χ²検定、 ノンパラ検定 |
| 回帰 | 単回帰、 重回帰、 OLS、 Ridge、 LASSO |
| 分類 | ロジスティック回帰、 決定木、 SVM、 k-NN |
| 教師なし学習 | クラスタリング、 PCA、 因子分析 |
| 時系列 | ARIMA、 VAR、 指数平滑法、 自己相関 |
| 因果推論 | DiD、 IV、 傾向スコア、 交絡変数 |
| 前処理 | 標準化、 正規化、 欠損値処理、 多重共線性対策 |
| 評価 | R²、 残差、 CV、 RMSE、 効果量 |
学習順序の推奨
- 記述統計(平均、 分散、 標準偏差)
- 可視化(ヒストグラム、 散布図)
- 確率分布(正規分布)
- 推測統計(標準誤差、 信頼区間、 p値)
- 仮説検定(t検定、 χ²検定)
- 相関と回帰(単回帰、 重回帰)
- 多変量解析(PCA、 クラスタリング)
- 機械学習(決定木、 RF、 NN)
- 時系列・因果推論(応用)
📝 実践練習 — SSDSE-B-2026 で挑戦
初級課題
- 東北6県の家計食料費の基本統計量を計算
- 食料費のヒストグラムを描く
- 食料費と教育費の散布図を描く
- 都道府県を「東日本/西日本」に分け、 平均を比較
中級課題
- 家計支出 5項目で相関行列を作成、 ヒートマップ可視化
- 食料費 → 教育費の単回帰を実行、 残差分析
- 家計5項目で PCA を実施、 バイプロット表示
- k-means (k=3) で都道府県をクラスタリング、 解釈
上級課題
- 地域別の家計パターンに有意差があるか ANOVA で検定
- 重回帰で教育費を予測、 多重共線性を VIF で確認
- Ridge/LASSO で正則化、 CV で α を最適化
- 階層クラスタリングと Ward 法で都道府県を分類、 デンドログラム作成
⚠️ 交絡対策の落とし穴と典型ワークフロー
📋 交絡因子の発見チェックリスト
| チェック項目 | 具体例 | 満たさない場合 |
|---|---|---|
| 原因と結果の両方に関係する | 年齢が運動量と疾患リスクの両方に影響 | 交絡因子ではない |
| 中間変数 (媒介) ではない | 運動 → 体重 → 疾患の体重は中間 | 統制すると効果を消してしまう |
| 時間的に原因より先行 | 介入前の喫煙歴は交絡 | 後発変数は collider の可能性 |
| 合流点 (collider) ではない | 入院は能力と病気の合流点 | 統制するとバイアス導入 |
| DAG で明示的にモデル化 | 事前に図を描いて議論 | 統制すべき変数が曖昧に |
🚨 誤解 TOP 5
| 誤解 | 正しい理解 |
|---|---|
| 「全部統制すれば安全」 | collider/中間変数を統制するとバイアス導入。 DAG で「統制すべき集合」を識別 |
| 「観察研究では因果不可能」 | 適切な手法 (PSM/IV/DID/RD) で因果推論可能。 RCT が常にベストではない |
| 「相関 ≠ 因果だから無意味」 | 相関は仮説の出発点。 交絡を考えて因果関係に近づける |
| 「未観測交絡は無視 OK」 | 感度分析で頑健性検証。 E-value で「どれだけ強い未観測交絡が必要か」評価 |
| 「重回帰すれば因果が出る」 | 回帰係数は条件付き相関。 DAG なしには因果解釈不可 |
🔄 交絡対策ワークフロー
- DAG 描画: ドメイン知識から原因・結果・交絡候補・媒介・合流点を識別
- 統制すべき集合の決定: backdoor 基準で「最小十分調整集合」を特定 (DAGitty 等のツール活用)
- データ収集: 統制集合の変数を全て観測。 観測不能なら IV/DID を検討
- 共変量バランス確認: 介入群と対照群で統制変数の分布が近いか (Standardized Mean Difference)
- 主分析: 回帰調整/PSM/IPW のうち適切な手法を選択 (DAG・データ規模に応じて)
- 感度分析: 未観測交絡への頑健性を E-value、 Rosenbaum バウンドで評価
- 結果報告: 推定効果、 95%CI、 統制した変数集合、 仮定、 限界を明示
📚 ケーススタディ: SSDSE-B-2026 で交絡を可視化
「求人倍率と死亡率の正相関 (r=+0.31)」は典型的な交絡例です。 高齢化率を統制すると、 偏相関は r_partial ≈ 0.02 程度まで縮小し、 ほぼゼロになります。 これは「景気と死亡率には因果関係はないが、 共通因子の高齢化率が両者を動かしている」という解釈を支持します。
| 分析 | 相関 r | 解釈 |
|---|---|---|
| 単相関 (求人倍率 × 死亡率) | +0.31 | 見かけの相関 (交絡含む) |
| 偏相関 (高齢化率を統制) | +0.02 | 統制後ほぼ消滅 → 擬似相関 |
| 高齢化率 × 求人倍率 | +0.55 | 高齢化進行県ほど求人多い |
| 高齢化率 × 死亡率 | +0.72 | 高齢化率は死亡率に強影響 |
| 回帰調整 (死亡率 ~ 求人倍率 + 高齢化率) | β_求人 ≈ 0 | 求人倍率の死亡率への独立効果なし |
※ 本ページの各節に登場する r(例:高齢化率×死亡率の 0.72、 0.91、 0.97)は、 節ごとに想定する年次・変数定義(粗死亡率か、 求人倍率か県民所得か等)が異なる説明用の概数のため完全には一致しません。 数値そのものよりも「交絡因子を統制すると見かけの相関が消える」という構造を掴んでください。
このケースは「DAG → 偏相関 → 回帰調整」という標準ワークフローで擬似相関を見破る典型例として教育的価値が高い分析結果です。 同じ手順を他の SSDSE 変数ペア (例えば「婚姻率(A9101/A1101)と粗死亡率(A4200/A1101)」「消費支出(L3221)と総人口(A1101)」など) にも応用することで、 一見驚くべき相関の多くが第三因子で説明できることが学習者に強く印象づけられます。
🔬 因果推論の重要概念まとめ
交絡対策を体系的に理解するには、 周辺概念との関係を整理することが重要です。 下表は因果推論で頻出する 5 つの重要概念を、 交絡と比較する形でまとめています。
| 概念 | 定義 | 対処 | DAG 上の位置 |
|---|---|---|---|
| 交絡 (Confounder) | 原因と結果の共通因子 | 統制する | X ← Z → Y |
| 媒介 (Mediator) | 原因と結果の中間因子 | 統制しない (効果を分解する時のみ) | X → M → Y |
| 合流点 (Collider) | 原因と別変数の共通結果 | 統制しない (したらバイアス導入) | X → C ← Y' |
| 選択バイアス | 標本選択による歪み | 補正重み付け or 設計変更 | 合流点で条件付け |
| 情報バイアス | 測定誤差 | 測定改善 or 補正法 | DAG 外 (測定モデルで対応) |
交絡だけを意識しがちですが、 媒介・合流点・選択バイアスも因果推論の落とし穴です。 「とにかく統制すれば良い」という発想は、 媒介や合流点で逆に正しい因果効果を消したり歪めたりするため、 必ず DAG ベースで「統制すべき変数集合」を判定する必要があります。
📝 実務における交絡対策の優先順位
- 研究設計段階で防ぐのが最善: ランダム化、 マッチング、 自然実験の活用を検討
- 主要な交絡因子から優先的に観測: 全ての交絡を観測するのは現実的でないため、 効果サイズが大きいと予想される変数から
- 感度分析を必ず併用: 「未観測交絡がどれだけ強くないと結論が覆らないか」を E-value で評価
- 結果は範囲で報告: 点推定だけでなく、 様々な統制集合や手法での結果を併記して頑健性を示す
- 仮定を透明化: DAG、 並行トレンド仮定、 IV の妥当性など、 因果解釈の根拠となる仮定を明記
交絡対策は「100% の正解」がない領域です。 重要なのは、 自分の分析が どの仮定の下でどこまでの主張ができるかを明示し、 限界を含めて報告することです。 これが学術的にも実務的にも信頼される因果推論の作法です。
🏥 領域別の交絡対策の典型パターン
領域によって典型的な交絡因子と対処手順が異なります。 以下に主要 5 領域の比較を示します。 自分の分析対象がどの領域に近いかを判断し、 該当領域のベストプラクティスを参考にすることが効率的です。
| 領域 | 典型的交絡因子 | 主流手法 | 代表ガイドライン |
|---|---|---|---|
| 医療・疫学 | 年齢・性別・喫煙・併存疾患 | RCT、 PSM、 IPW | STROBE、 CONSORT |
| 経済・政策評価 | 所得・教育・地域要因 | DID、 IV、 RD | What Works Clearinghouse |
| マーケティング | 顧客特性・季節要因 | A/B テスト、 PSM | 業界別 (デジタル分析) |
| 教育研究 | 家庭環境・先行学力 | RD、 マッチング | EEF Toolkit |
| 社会科学 | SES、 文化・地域要因 | IV、 DID、 固定効果 | ASA Statement |
📤 各領域には独自のベストプラクティスとガイドラインが存在し、 査読論文の通過にはそれに準拠することが事実上の要件となっています。 自分の分析が学術発表や政策評価を意図する場合、 該当領域のガイドラインを事前に読み込むことが推奨されます。
🛠️ 因果推論ツール・ライブラリの主要選択肢
Python/R には因果推論を支援する成熟したライブラリ群があります。 用途に応じて以下を使い分けるのが定石です。
statsmodels(Python): 回帰調整、 固定効果モデル、 IV2SLS など基本的な計量経済モデルを網羅。 教育目的にも実務にも幅広く使える。DoWhy(Microsoft): DAG ベースの因果推論フレームワーク。 「識別 → 推定 → 反証」の 4 ステップで体系的に分析できる。causalml(Uber): 機械学習を用いた異質処置効果 (HTE) の推定。 マーケティング A/B テストで活用例多数。EconML(Microsoft): Double Machine Learning や Causal Forest など最新手法を実装。 経済学者・データサイエンティスト向け。- R 系 (
MatchIt,twang,did): 統計家コミュニティで定番。 査読論文での引用が多く、 学術的信頼性が高い。
ツール選択は分析目的・スキルセット・再現性要件で決まります。 教育目的なら statsmodels、 産業 A/B テストなら causalml、 学術論文向けなら R 系または DoWhy が一般的な選択です。
🎓 学習リソースの優先順位 (おすすめ順)
因果推論を体系的に学びたい場合、 入門 → 中級 → 上級の段階で異なる教材が推奨されます。 以下に主要な日本語・英語リソースをまとめます。
- 入門: Pearl 著『因果推論の科学』(日本語訳あり) — DAG とバックドア基準を平易な事例で導入。 文系・初学者にも親しみやすい。
- 中級: Hernán & Robins『Causal Inference: What If』(無料 PDF 配布) — 疫学者向けの定番テキスト。 PSM/IV/G-methods を体系的にカバー。
- 中級: Cunningham『Causal Inference: The Mixtape』(無料公開版) — 経済学者向け。 DID/RD/IV を実装例とともに学べる。
- 上級: Imbens & Rubin『Causal Inference for Statistics, Social, and Biomedical Sciences』 — Potential Outcome フレームワークの決定版。 厳密性重視。
- 実装重視: Facure『Causal Inference for The Brave and True』(無料 Web 公開) — Python で実装例豊富。 ハンズオン学習に最適。
📚 これらを順に学習すると、 半年〜1 年で「DAG → 識別戦略 → 推定 → 感度分析 → 報告」の一連のワークフローが回せるようになります。 統計学のバックグラウンドがあれば独学でも到達可能です。 加えて、 専門家コミュニティ (twitter の #CausalInference タグ、 国内では計量経済学会・統計関連学会連合大会) でのディスカッション参加も理解を深めるのに非常に有効です。 教科書だけでは見えない実務的な「やりがちな失敗」「査読で指摘されやすいポイント」が議論されています。 学習の終盤では、 自身の研究プロジェクトで仮説を立て、 DAG を描き、 因果効果を推定し、 限界を含めて報告する一連のサイクルを実際に経験することが、 最も効果的な定着方法となります。 模擬データではなく公的データ (SSDSE、 e-Stat、 政府統計の総合窓口) を活用すると、 現実的なノイズや欠損とも向き合えるため、 教育効果が格段に高まります。
⚠️ 交絡に関する落とし穴 — 実務で必ず引っかかるポイント 7 選
① 衝突点(collider)を制御してバイアスを増やす
「制御すれば交絡が消える」は誤解です。 X → Z ← Y の構造で Z は衝突点であり、 制御すると X と Y の間に擬似的な相関を生み出します(Berkson のパラドックス)。 例:「俳優として有名 → 有名人賞受賞 ← 演技力」で「有名人賞」を条件にすると、 「俳優として有名」と「演技力」が無関係に見える。 DAG を描いて、 制御すべき変数を慎重に選ぶ必要があります。
② 媒介変数(mediator)を交絡と勘違いして制御する
X → M → Y の構造で M は媒介変数です。 これを制御すると、 X の Y への「直接効果」しか得られず、 M を介した「間接効果」を見落とします。 例:「運動 → 体重減少 → 健康改善」で「体重」を制御すると、 運動の健康効果が消えて見える。 制御すべきは「処置以前に決まる変数」のみです。
③ 観測できない交絡を無視する(未測定交絡)
重回帰で「年齢」「性別」「所得」を制御しても、 観測できていない交絡因子(遺伝、 生活習慣、 動機)は除外できません。 観察研究では「未測定交絡が存在する可能性」を必ず仮定し、 結果の頑健性を sensitivity analysis(E-value)で評価することが推奨されます。 因果と断言したいなら、 ランダム化比較試験や自然実験(DID、 RDD)を検討してください。
④ シンプソンのパラドックスを「サンプル数の問題」と誤認
シンプソンのパラドックスは標本サイズの問題ではなく、 交絡の構造的問題です。 各群のサンプル数を増やしても解消しません。 重要なのは「層別すべき変数(交絡因子)の特定」と「適切な集約(重み付け平均、 直接標準化)」。 マーガリンと総死亡率の関係、 治療法の比較などで現実に頻発します。
⑤ 「重回帰に入れれば全て解決」と思い込む
重回帰は交絡制御の 1 手段に過ぎず、 万能ではない。 (i) 線形の仮定が正しい必要、 (ii) 交絡因子を「測定」していないと制御不能、 (iii) 多重共線性で係数が不安定化、 (iv) 衝突点や媒介変数を入れると逆効果、 などの限界があります。 マッチング、 IPW、 IV、 DID、 RDD など多様な手法を理解し、 因果ダイアグラムに基づき選びましょう。
⑥ 反実仮想(counterfactual)を観測値と混同する
「もし喫煙していなかったら肺がんになったか」という反実仮想は原理的に観測不可能です。 観測されるのは「喫煙したか」「肺がんになったか」のペアだけ。 因果推論はこの反実仮想を統計的に推定する技術で、 RCT は最も信頼できる近似手段、 観察研究はあくまで「仮定の下での近似」だと理解する必要があります。
⑦ 時間変動交絡(time-varying confounding)を見落とす
縦断研究では、 処置自体が次の時点の交絡因子に影響する状況が頻発します。 例:「血圧降下薬服用 → 血圧低下 → 次の時点の処方変更」。 通常の重回帰では正しく扱えず、 g-formula、 marginal structural models、 g-estimation など g-methods が必要。 疫学・経済学の縦断研究では必須の知識です。
⚠️ よくある落とし穴 — 交絡 (Confounding)
交絡 (Confounding) を使うときに初学者が踏みやすい失敗パターン。 1 度経験してしまえば次から避けられますが、 先に知っておくに越したことはありません。
🎮 触って理解する
交絡変数 Z(例: 年齢層・地域規模など)が X と Y の両方に影響すると、
各層の中では X と Y が正の関係なのに、
全体を一緒くたに集計すると逆向き(負)に見える——これが
疑似相関の代表例
Simpson のパラドックスです。
下の図をドラッグ(横方向=交絡の強さ/縦方向=層内の傾き)するか、
スライダーを動かすと、層別散布図(層ごとに色分け)・層内回帰直線(各層の色)・
全体回帰直線(黒い破線)がリアルタイムに更新され、数値も正確に再計算されます。
※ 図は概念理解のための模式データであり、実測値ではありません(乱数シード固定で再現可能)。
💡 試してみよう: 「交絡の強さ」を 0 まで下げると層のズレが消え、全体と層内の傾きが一致します(逆転なし)。強くすると各層は右上がりのまま、全体だけが右下がりに反転します。「層内の傾き」を負にすれば、逆パターン(各層は負・全体は正)も再現できます。
🎨 直感 — なぜ逆転するのか(共通原因)
交絡変数 Z は X と Y の共通原因です。図で言うと、Z の層が変わるたびに点群の「かたまり」がまるごと上下左右に移動します。層のかたまりが右下がりに並んでいると、点全体をまとめて 1 本の直線で近似したときに、層内の本当の傾き(右上がり)ではなく、層間の並び方(右下がり)を拾ってしまう。これが集計による符号反転の正体です。層で色分けすれば、各層内では一貫して右上がりであることが一目で分かります。
⚠️ よくある落とし穴 — 集計の罠と「調整すべき変数」
- 集計の罠: 「全体の相関」だけを見て因果を語るのは危険。層別(相関を層ごとに計算)すると符号が逆になることがある。
- 調整すべきは交絡だけ: Z が X・Y の共通原因なら調整(層別・重回帰への投入)が正しい。しかし Z が X→Z→Y の中間変数(メディエータ)や X・Y の共通結果(コライダー)の場合、調整するとむしろバイアスが生まれる。「変数を足せば安心」ではない。
- 観測されない交絡: 層別・回帰調整で消せるのは観測できた交絡だけ。未観測交絡には 操作変数法 や 差分の差分法、感度分析が必要。
🚀 発展 — 層別・回帰調整・DAG・バックドア基準
- 層別解析 (stratification): Z の各層内で X-Y 関係を推定し、層をまたいで統合する。上の図の「層内回帰直線」がまさにこれ。層が少数カテゴリのときに有効。
- 回帰調整: 重回帰 に Z を投入すると、偏回帰係数 βX は「Z を一定にしたときの X の純効果」を近似する。連続的な交絡にも対応できる。
- DAG(因果ダイアグラム): X→Y の矢印に加え、Z→X と Z→Y の矢印を描くと Z が交絡(共通原因)だと視覚的に判定できる。分析前に紙に描くのが定石。
- バックドア基準 (back-door criterion): X と Y の間の「裏口経路」(X←Z→Y のように矢印を逆流する経路)を、Z を条件付け(調整)することで塞ぐ。すべてのバックドア経路を塞ぐ変数集合で調整すれば、因果効果を識別できる。コライダーを誤って開かないことが要点。
🗺️ 統計手法選択フローチャート
Q1: 何を知りたい?
- 記述したい → 平均、 分散、 ヒストグラム
- 比較したい → t検定、 ANOVA、 χ²検定
- 関係を見たい → 相関、 回帰
- 予測したい → 回帰、 機械学習
- 分類したい → ロジスティック回帰、 SVM、 RF
- グループ分けしたい → クラスタリング
- 次元を減らしたい → PCA、 因子分析
- 因果関係を知りたい → RCT、 IV、 DiD、 PSM
Q2: データの種類は?
- 連続値 → t検定、 ANOVA、 線形回帰
- カテゴリ → χ²検定、 ロジスティック回帰
- 順序 → ノンパラ検定、 順位回帰
- カウント → ポアソン回帰、 負の二項回帰
- 時系列 → ARIMA、 VAR、 状態空間
- パネル → 固定効果、 ランダム効果
Q3: サンプルサイズは?
- n < 30:ノンパラ、 ベイズ、 ブートストラップ
- 30 ≤ n < 200:古典的検定、 単純な回帰
- n ≥ 200:複雑なモデル、 機械学習
- n ≥ 10000:深層学習も可能
Q4: 仮定は?
- 正規性:満たす → パラメトリック / 満たさない → ノンパラ
- 独立性:必須 / 違反 → クラスター調整、 時系列モデル
- 等分散性:満たす → OLS / 違反 → WLS、 ロバスト
📏 効果量の参照表
p値だけでなく効果量も併記するのが現代統計の標準。 主要な指標と Cohen の解釈基準:
| 統計量 | 効果量 | 小 | 中 | 大 |
|---|---|---|---|---|
| 2群平均差 | Cohen's d | 0.2 | 0.5 | 0.8 |
| 相関 | r | 0.1 | 0.3 | 0.5 |
| 線形回帰 | R² | 0.02 | 0.13 | 0.26 |
| ANOVA | η² (eta²) | 0.01 | 0.06 | 0.14 |
| χ² | Cramér's V | 0.1 | 0.3 | 0.5 |
| ロジスティック | Odds Ratio | 1.5 | 2.5 | 4.0 |
🖼️ 交絡の追加図解 — DAG とブロッキング戦略
交絡 (confounding) は「原因 X と結果 Y の両方に影響する第三変数 Z」によって生じます。 因果ダイアグラム (DAG) で X ← Z → Y というパスが存在すると、 X と Y の単純な相関は 本当の因果効果 + Z 経由の擬似効果に分解されます。 これをブロックする (Z を統制する) のが交絡対策の本質です。
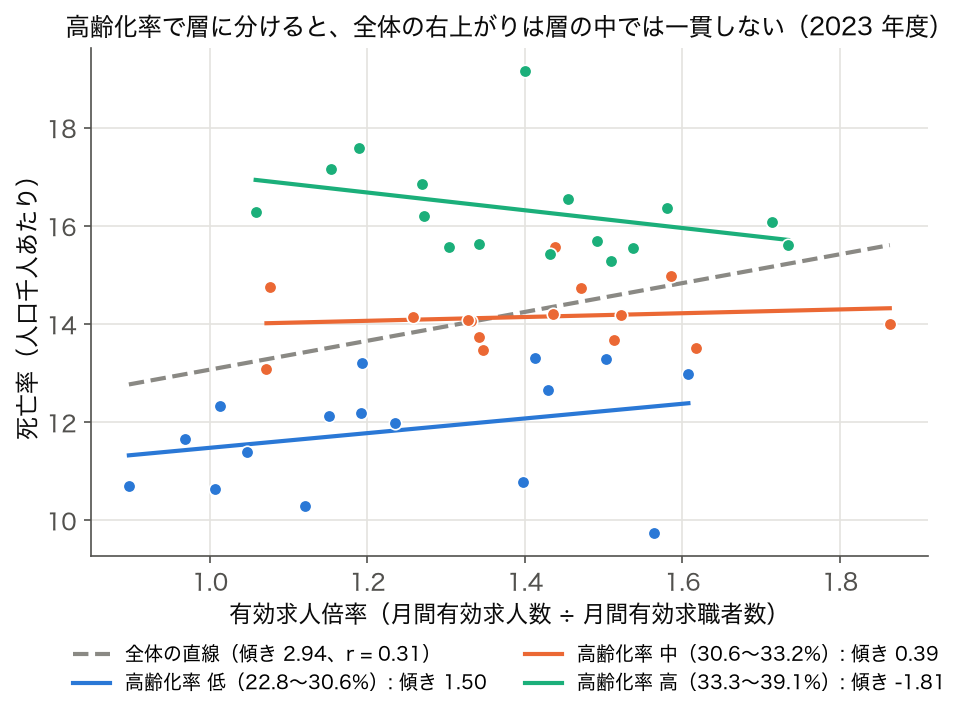
図: 全体では正の相関に見えるが、 Z でグループ分けするとグループ内では一貫した関係がない (シンプソンのパラドックス的構造)。 2023 年度・47 都道府県の有効求人倍率と死亡率を、 交絡因子 Z = 高齢化率の 3 区分(低 22.8〜30.6%・中 30.6〜33.2%・高 33.3〜39.1%)で分けると、 全体の傾き 2.94(r = 0.31)に対し、 区分内の傾きは 1.50・0.39・−1.81 と向きもそろわない。 死亡率の差は主に区分の間(高齢化率の違い)で生じている。
図: 求人倍率 vs 死亡率の擬似相関 (高齢化率が共通因子)。 制御変数の重要性を直感的に示す典型例。
📊 交絡対策手法の比較表
| 手法 | 適用タイミング | 必要前提 | 主な限界 |
|---|---|---|---|
| ランダム化 (RCT) | 設計段階 | 介入可能・倫理的に許容 | コスト高・倫理的制約 |
| 層別化 (Stratification) | 解析段階 | 交絡因子が観測されている | 高次元では cell が空になる |
| マッチング | 解析段階 | 十分なペア確保可能 | サンプル数減少 |
| 回帰調整 | 解析段階 | 関数形が正しい | 非線形性で誤り発生 |
| 傾向スコア (PSM) | 解析段階 | 介入確率が推定可能 | 未観測交絡には無力 |
| 操作変数法 (IV) | 解析段階 | 強い IV が存在 | IV の妥当性証明が困難 |
| DID (差の差) | 解析段階 (パネル) | 並行トレンド仮定 | 介入前後の比較対象必須 |
📤 ポイント: 観察研究では「ランダム化が使えない代わりに何で代用するか」が問われる。 観測された交絡因子は層別/回帰/PSM、 未観測は IV/DID/RD で対処するのが定石。
🗺️ 概念マップ — 3つの視点で体系を理解する
交絡因子 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 因果推論 › 観察研究 › 疑似相関
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に 交絡因子 を置き、 そこから 相関係数・共分散・Spearman相関・単回帰 計 4 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「交絡因子」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「交絡因子」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは 疑似相関 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 観察研究 → 疑似相関 という入れ子の位置を示します。 「観察研究には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔗 隣接手法への橋渡し
「交絡」は処理と結果の両方に影響する第三変数で、 上流の DAG 描画 (因果構造の整理) と下流の調整方法 (層別・傾向スコア) を組まないと、 観察データの因果推論は全て見せかけになる。
- 上流: 交絡 の入力となる婚姻率 と 粗死亡率 の関係に対する 高齢化率 の交絡 を整える前処理 (データクレンジング、 欠損値処理)
- 並列: 類似目的を持つ代替手法 (混同行列、 相関) と比較・併用
- 下流: 出力結果の評価・解釈 (A/B テスト、 分散分析)
上流で DAG により交絡経路を可視化し、 並列の RCT・操作変数法と比較して観察データの限界を把握し、 下流で傾向スコア・差分の差分 (DID) で調整すれば、 SSDSE 観察データから「政策効果」を妥当な精度で推定できる。
🌳 手法選択フロー
「confounding」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| データが大規模 (n が多い、 高次元) | 計算コスト / メモリ / 並列化が必要 | 高次元対応版 等 |
| 外れ値が多い / ノイズあり | 頑健性 / 外れ値除去 / 中央値ベース | 頑健版 等 |
| 解釈性を重視する | 線形 / 木構造 / ルールベース | 解釈重視版 等 |
| 予測精度を最優先する | アンサンブル / ハイパラ調整 / 交差検証 | 標準手法 等 |
| データが少ない | 正則化 / ベイズ / 転移学習 / 簡素なモデル | 小データ向け 等 |
| リアルタイム/オンライン処理 | ストリーミング / 軽量モデル / 逐次更新 | 高速版 等 |
選んだ後の検証ステップ
- 前処理確認: 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切か
- ハイパラ調整: 交差検証で安定する値を選ぶ
- 性能評価: タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用
- 頑健性チェック: 別手法 / 別シードで結果が大きく違わないか確認
- 解釈: 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討
🎨 直感の深掘り — 「第3の変数」が相関をどう作るか
交絡のいちばん短い定義は「説明変数 X と結果 Y の両方に影響する第3の変数 C」です。C が両方を同じ向きに動かせば、X と Y は「一緒に上下する」ように見え、見かけの相関(疑似相関)が生まれます。X と Y の間に本当の因果の矢印が 1 本もなくても相関は出る——ここが「相関は因果を含意しない」の核心です。DAG(因果ダイアグラム)で書くと X ← C → Y の形。この「裏口経路(バックドア)」を C の統制で塞がない限り、X と Y の単純な関係は「真の効果 + C 経由の見せかけ」の合計になります。
大事なのは、交絡を統制しないと因果を誤るという一点です。単純相関だけを見て「X を動かせば Y が変わる」と読むと、実際には C を動かしただけ、あるいは何も因果がない、という誤りに陥ります。逆に、C を正しく統制(層別・回帰への投入・マッチング)できれば、見かけの成分が剥がれて、X → Y の純粋な関係に近づきます。
🧮 実データで「符号が反転する」例(SSDSE-B-2026, 2023, 47都道府県・実測)
既出の「婚姻率 × 死亡率」とは別の、年齢構造の変数を直接使わない実例を1つ足します。一般旅券発行件数(人口千対, G5105/A1101×1000)と着工新設住宅床面積(人口1人当たり, H2600/A1101)を取ると、単純相関は r = +0.584 の中程度の正相関です。「パスポートをよく出す県ほど住宅もよく建つ」と読みたくなります。
つまり「旅券と住宅の正相関」は両者の真の関係ではなく、「若い(高齢化率の低い)県ほど、旅券発行も住宅着工も多い」という高齢化率を共通原因とする疑似相関でした。高齢化率を統制すると +0.584 の見かけの相関はゼロを飛び越えて弱い負(−0.242)に転じます。単純相関と偏相関で符号が反転するのは、強い交絡が存在する典型的なサインです。
高齢化率の三分位で層別しても同じ構造が見えます(各層 n≈15〜16, 実測):若い層 r=+0.32/中位層 r=−0.10/高齢層 r=+0.26 と、層内では全体(+0.58)ほど強い正相関は残らず、層をまたぐ「並び」が全体の見かけの正相関を作っていたことが分かります。
※ 上の数値はいずれも data/raw/SSDSE-B-2026.csv(cp932, skiprows=[1], SSDSE-B-2026==2023 の 47 行)からの実測です。pd.read_csv(..., encoding='cp932', skiprows=[1]) で読み込み、numpy.corrcoef/statsmodels.OLS で再現できます。
⚠️ 落とし穴の深掘り(重要)— 「統制すればよい」ではない
交絡の最大の実務的な罠は、「とにかく変数を足して統制すれば因果が出る」という思い込みです。統制は相手が交絡のときだけ正しく、相手を間違えると新たなバイアスを生みます。以下は特に踏みやすい 7 点です。
🚀 発展 — DAG・バックドア基準から未観測交絡への対処まで
① DAG とバックドア基準(統制すべき集合の決め方)
バックドア経路とは、X から Y へ「X に向かう矢印から逆流して」到達する非因果の経路(例:X ← C → Y)です。バックドア基準は「(a) 調整集合 Z が X の子孫(=媒介・コライダーの下流)を含まず、(b) X と Y の間のすべてのバックドア経路を Z で塞ぐ」ことを要求します。これを満たす Z で調整すれば、観測データから因果効果 P(Y | do(X)) が識別できます。コライダーを誤って開かない(統制しない)ことが要点。DAGitty などのツールで「最小十分調整集合」を機械的に列挙できます。
② 観測した交絡への標準的手法
- 層別解析:交絡因子の各層で X–Y 関係を推定し、層の重みで統合(直接標準化)。少数カテゴリの交絡に有効だが、高次元だと層が空になる。
- 回帰調整:重回帰に交絡因子を投入。偏回帰係数が「交絡を一定にしたときの純効果」を近似。関数形の仮定に依存。
- 傾向スコア:処置を受ける確率 p̂(X) を推定し、マッチング/層別/共変量化で交絡をまとめて調整。多数の交絡を1次元に圧縮できる。
- IPW(逆確率重み付け):傾向スコアの逆数で重み付けし、擬似的にランダム化された母集団を作る。極端な傾向スコアで重みが暴れる点に注意(トリミング/安定化重み)。
③ コライダー・媒介との区別(同じ「第3変数」でも扱いが逆)
| DAG 上の位置 | 名前 | 統制すべきか |
|---|---|---|
| X ← C → Y(共通原因) | 交絡 | する(バックドアを塞ぐ) |
| X → M → Y(通り道) | 媒介 | 総効果を見るなら統制しない |
| X → C ← Y(共通結果) | コライダー | 統制しない(開くと偽相関) |
④ 未観測交絡に立ち向かう準実験デザイン
- 操作変数法(IV):Y への経路が X 経由しかない外生変数(操作変数)を使い、観測できない交絡があっても因果効果を推定。内生性への標準的処方。
- 差分の差分法(DID):処置群・対照群の前後差の差をとり、時間不変の交絡を丸ごと吸収。並行トレンド仮定が鍵。
- 回帰不連続デザイン(RDD):閾値の前後で「ほぼランダム割付」が成立すると仮定して、局所的な因果効果を推定。
- 自然実験:制度変更や地理的境界など、研究者が介入せずとも準ランダムな変動が生じた状況を利用。
なお「causal-inference」「instrumental-variable」「collider」「mediator」「simpson」「e-value」といった単独ページは本用語集には未収録のため、ここでは本文中の解説で補っています(内部リンクは張っていません)。
⑤ E-value — 未測定交絡への感応度分析
E-valueは「観測された関連(相対リスク RR)を完全に説明し尽くすためには、未測定交絡因子が処置とも結果ともどれだけ強く関連していなければならないか」を、最小の相対リスクで表す指標です。式は RR ≥ 1 のとき
$$ \text{E-value} = \mathrm{RR} + \sqrt{\mathrm{RR}\,(\mathrm{RR}-1)} $$
たとえば RR=2.0 なら E-value ≈ 3.41、RR=3.0 なら ≈ 5.45。値が大きいほど「そんなに強い未測定交絡はさすがに考えにくい」=結論が頑健、と読みます。RR が 1 未満(防御的関連)のときは 1/RR に置き換えて計算します。点推定だけでなく信頼区間の下限(1 に近い側)に対しても E-value を出すと、より慎重な頑健性評価になります。E-value は「未測定交絡を消す」ものではなく、「どれだけの強さが必要かを可視化して議論の土台にする」道具である点に注意してください。
🔗 交絡を深めるための関連ページ
交絡は 1 ページで閉じる概念ではありません。以下は本用語集内に実在する関連ページです(未収録の概念はリンクを張らず本文で補足しています)。
- 因果関係 — 交絡を取り除いた先にある到達点。「相関 → 因果」への橋。
- 疑似相関 — 交絡が作り出す「見かけの相関」そのものの呼び名。
- 選択バイアス — コライダー統制と同じ構造で生じる、標本選択由来の歪み。
- 逆因果 — X→Y と思ったら Y→X。交絡と並ぶ「相関≠因果」の要因。
- 測定誤差 — 交絡因子を誤差込みで測ると残差交絡が生じる。
- 内生性 — 説明変数が誤差項と相関する問題。交絡の計量経済学的表現。
- 重回帰分析 — 観測した交絡を統制する最も基本的な道具。
- 操作変数法(IV) — 未観測交絡があっても因果に迫る手法。
- 差分の差分法(DID) — 時間不変の交絡を吸収する準実験デザイン。
- 回帰不連続デザイン(RDD) — 閾値前後の準ランダム性を利用。
- 自然実験 — 観察データで交絡を回避する設計上のアプローチ。
- 高齢化率 — 本ページの実データ例で一貫して交絡因子となる共通原因。