🔖 キーワード索引
💡 30秒で分かる結論
🍰 まずはやさしく
偶然起きた出来事を実験のように使う方法です。
原因と結果の関係を正しく知るために使います。
スマホのプラン変更が売上にどう響くか調べます。
この手法で何ができ、何に注意すべきか読みましょう。
無作為に近い処置割当が偶発的に発生する状況を分析。
- 分野:因果推論 — 📚 パネルデータと因果推論
- 何をするか:制度・境界・災害などが「くじ引きの代わり」に処置を割り当てた状況を見つけ、 処置を受けた群と受けなかった群を比べて因果効果を推定する
- 代表的な道具:差の差分法(DID)・回帰不連続(RDD)・操作変数(IV)・合成対照法
- いちばんの前提:割当が結果と無関係な理由で決まったこと。 DID なら「処置がなければ両群は平行に動いた」こと(平行トレンド)
- 実データでの注意:SSDSE-B-2026 で「人口 100 万人超の 37 県」を処置群にすると、 処置前の 2015〜18 年から減り方が対照群と違い、 DID の −16,587 人にはこのトレンド差が混ざる(🐍 ④)
📍 あなたが今見ているもの
🍰 まずはやさしく
偶然の出来事で効果を調べる考え方です。
あるルールが変わった時の影響を調べます。
都道府県で違うルールがある場合などに使えます。
実際のデータを使って分析する方法を学びます。
このページは「因果推論」グループ内の「自然実験(Natural Experiment)」項目です。 政策変更・地理的境界・天災など「無作為割当に近い偶発的な処置」を使って因果効果を推定する考え方を、 SSDSE-B-2026(都道府県別の経済・人口指標)を例にハンズオンで学べます。
🎨 直感で掴む
🍰 まずはやさしく
くじ引きの代わりに偶然を利用する手法です。
無理に実験しなくても正解を導き出せます。
隣の県だけルールが変わった状況などを利用します。
どのような仕組みで分析できるのかを考えます。
自然実験 (natural experiment) とは、 ランダム化比較試験 (RCT) のように「処置群 / 対照群」をくじ引きで割り当てる代わりに、 自然や制度・法律改正など外生的な偶然がそれに近い割り当てを生み出してくれた状況を指す。 研究者が介入を設計したわけではないが、 結果として「処置を受けた群と受けなかった群が比較可能になっている」場合に成立する。
典型例 1: 最低賃金 (Card & Krueger 1994) — ニュージャージー州 (NJ) が最低賃金を引き上げた直後、 隣接するペンシルベニア州 (PA) は据え置きだった。 NJ のファストフード店 (処置群) と PA のファストフード店 (対照群) を引上げ前後で比較すると、 雇用は減らないどころか増えていた。 「最低賃金引き上げが雇用を減らす」という古典的予測を覆した自然実験。
典型例 2: SSDSE-B-2026 文脈での応用 — 2014 年 4 月の消費税引き上げ (5%→8%) は事前告知されたが、 全国一斉に適用されたので、 「引き上げを受けなかった県」 という対照群がない。 県庁所在市の 消費支出 (L3221) を使って DID を組むなら、 処置の強さを引き上げ前から決まっている県の性質(たとえば所得水準や高齢化率)で分ける必要があり、 引き上げ前後の消費の落ち込みそのもので「影響の大きい県」 を選ぶと、 偶然の揺れを効果と取り違える(⚠️ の 🧪 で実データを使って確かめる)。
RCT との違いを直感で掴む: RCT は「実験室で完全にコントロールされた介入」、 自然実験は「制度や災害が偶然 RCT 的な状況を作ってくれた」。 RCT は倫理的・コスト的に困難な政策評価 (増税の影響、 法改正の効果) でも、 自然実験なら過去のデータから因果効果を読み取れるのが最大の強み。 ただし「割り当てが本当に外生的か」を慎重に検証する必要がある。
📐 定義
🍰 まずはやさしく
偶然に分かれたグループを分析することです。
データから正しい因果関係(原因と結果)を探ります。
部活のルール変更が成績にどう出たか調べます。
使うための条件や注意点を詳しく確認しましょう。
無作為に近い処置割当が偶発的に発生する状況を分析。
英語名 Natural Experiment。 同義・関連語:準実験。
🔬 数式を言葉で読み解く
「自然実験」の定式化:
$$\widehat{\text{ATT}} = \mathbb{E}[Y_{1t} - Y_{0t} \mid D=1] - \mathbb{E}[Y_{1t} - Y_{0t} \mid D=0]$$
介入群と対照群の差分の差分 (DID)。 自然実験で標準的に使う識別戦略。
| 記号 | 意味 |
|---|---|
| $Y_{0t}, Y_{1t}$ | 時刻 0,1 の結果変数。 例: 政策施行前後の県別消費支出 |
| $D$ | 処置ダミー。 1=政策対象、 0=対象外 |
| $\text{ATT}$ | Average Treatment effect on the Treated。 処置群への平均効果 |
| 平行トレンド仮定 | 処置前の両群が同様トレンド → 識別の根拠 |
| カウンターファクチュアル | 反実仮想:「もし処置を受けなかったら」の値 |
🔬 実データで式を読む: 3 都府県 × 2019→2023 年度
上の式の 4 つの期待値に、 🐍 ② の実測値(東京都・神奈川県・大阪府を $D=1$、 残り 44 道府県を $D=0$、 2019 年度を $t=0$、 2023 年度を $t=1$)を入れる。
| 2019 年度の平均総人口 | 2023 年度の平均総人口 | 前後差 $\mathbb{E}[Y_1 - Y_0 \mid D]$ | 変化率(対数差 × 100) | |
|---|---|---|---|---|
| 処置群 $D=1$(3 都府県) | 10,691,000 | 10,692,667 | +1,667 人 | −0.09% |
| 対照群 $D=0$(44 道府県) | 2,147,318 | 2,097,159 | −50,159 人 | −3.08% |
| 差の差(DID) | +51,826 人 | +2.99 ポイント |
式の第 2 項 $\mathbb{E}[Y_1 - Y_0 \mid D=0]$ は「処置がなかったら処置群はどう動いたか」 の代わりに使う値で、 ここでは「3 都府県も 44 道府県と同じく 4 年で 3.08% 減ったはず」 と仮定していることになる。 これが平行トレンド仮定である。 ⚠️ の 🧪 で見るとおり、 3 都府県は 2019 年度より前から 44 道府県より毎年 0.83 ポイントずつ速く伸びていたので、 この仮定は成り立たず、 +2.99 ポイントはそのまま処置の効果とは読めない。 式は差を正しく計算するだけで、 第 2 項が反実仮想として妥当かどうかは教えてくれない。
🎮 触って理解する
自然実験の標準的な識別戦略が 差分の差分法 (Difference-in-Differences, DID) です。 スライダーを動かすと、 処置群 (赤) と対照群 (青) の時系列アウトカムがリアルタイムで変化します。 「もし平行トレンド仮定が崩れたら DID 推定値が真の効果からどれだけズレるか」を、 手を動かして体感してください。 グラフ上の赤い丸をドラッグしても処置効果を変えられます (タッチ操作対応)。
✅ 平行トレンド仮定が成立 → DID 推定値は真の効果に一致
🧭 このデモで確かめられること
- 平行トレンドの崩れ v = 0 のとき:緑破線 (DID の反実仮想) と灰破線 (真の反実仮想) が完全に重なり、 DID 推定値 = 真の効果。 これが自然実験が「擬似的なランダム化」として機能する条件です。
- v を動かすと:処置前から両群の差が広がり (縮まり)、 緑と灰がズレて バイアス = 3.5 × v が発生。 処置群がもともと違う成長軌道にあると、 DID はその軌道差を効果と誤認します。
- 共通トレンド g を動かしても:両群が同じだけ動くのでバイアスは 0 のまま。 DID が「差の差」を取ることで時間共通の交絡を相殺している様子が分かります。
💡 一歩深く
直感(偶然の割当を利用した擬似的ランダム化):自然実験は、 法改正・行政境界・災害などの外生的な偶然が「誰が処置を受けるか」をほぼランダムに決めてくれた状況を利用します。 研究者がくじ引きをしなくても、 割当が結果と無関係な原因で決まっていれば、 処置群と対照群は比較可能になり、 因果効果を読み取れます。
よくある落とし穴:最大の前提は 平行トレンド仮定(処置がなければ両群は平行に動いたはず)です。 このデモの v のように処置前から差が拡大していれば仮定は崩れ、 DID は成長軌道の差を効果と誤認します。 さらに、 割当と結果の両方に影響する 交絡 や 選択バイアス(被災前から経済構造が違う等)、 対照群への波及効果 (spillover) があると「外生性」は保証されません。 処置前データで平行性を目視・検定することが必須です。
発展:自然実験の識別戦略は複数あります。 (1) 差の差分法 (DID)=本デモの手法、 パネルデータで 固定効果により時間不変の交絡を除去。 (2) 回帰不連続 (RDD)=閾値の前後で処置がジャンプする状況を使い、 境界近傍を局所的なランダム化とみなす。 (3) 操作変数法 (IV)=処置には影響するが結果には直接影響しない外生変数を「てこ」にして内生性を回避。 いずれも「割当がなぜ外生的といえるか」の物語が生命線です。
🧮 SSDSE-B-2026 で実値計算
独立行政法人統計センター公表の SSDSE-B-2026(47 都道府県 × 112 変数 × 12 年分)を用いて、「自然実験」を実データで体感する。
🐍 Python 実装 ①:データ読込と基礎統計
🎯 このコードでやること:SSDSE-B-2026 を読み込み、 47 都道府県 2023 年の総人口統計を確認する(自然実験の議論基盤)。
📥 入力データ(SSDSE-B-2026, 47 都道府県, 2023 年抜粋):
1 2 3 4 5 6 | # SSDSE-B-2026 を読み込み 2023 年の 47 都道府県を取得 import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == 2023] print(df[['都道府県','総人口']].head()) print('mean=', df['総人口'].mean()) |
📤 実行結果:
💬 結果の読み方:47 都道府県の平均人口は 264 万人。 「自然実験」の議論ではこの分布を起点に外れ値 (東京 1408.6 万) や下位 (鳥取 53.7 万) を意識する。 なお CSV は都道府県ごとに年度降順で並ぶため、 行番号が 12 刻みになる。
🐍 Python 実装 ②:自然実験 の核心計算
🎯 このコードでやること:自然実験の文脈で SSDSE-B-2026 を活用した具体計算を行う。
📥 入力データ(SSDSE-B-2026, 47 都道府県, 2023 年抜粋):
1 2 3 4 5 6 7 8 9 10 11 | # 単純化した DID: 2020 COVID 前後で大都市圏 vs 地方の人口変化 import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) big = ['東京都','神奈川県','大阪府'] d = df[df['年度'].isin([2019,2023])].copy() d['treat'] = d['都道府県'].isin(big).astype(int) d['post'] = (d['年度']==2023).astype(int) g = d.groupby(['treat','post'])['総人口'].mean() print(g) did = (g.loc[(1,1)]-g.loc[(1,0)]) - (g.loc[(0,1)]-g.loc[(0,0)]) print('DID=', did) |
📤 実行結果:
💬 結果の読み方:DID = +51,826 人。 2019→2023 年で地方 44 県は平均約 5.0 万人減少したのに対し、 大都市圏 3 都府県はほぼ横ばい (+1,667 人)。 つまり大都市圏の人口減少は地方より約 5.2 万人小さかった、 という推定になる(COVID 期の東京圏転出は 2022-23 年の回帰で相殺)。 平行トレンド仮定の検証や Spillover には別途注意が必要。
🆚 関連手法との比較表
| 手法 | 入力 | 代表アルゴリズム | 特徴 |
|---|---|---|---|
| RCT | 研究者が割当 | 内部妥当性◎ | 倫理・コスト問題 |
| 自然実験 | 自然なショックを利用 | 外的妥当性◎ | 識別仮定要 |
| 観察研究 | 介入なし | 安価 | 交絡多発 |
| DID | 時間 × 処置の差分 | 平行トレンド必要 | 実装簡単 |
| RDD | 閾値の不連続 | 局所 ATE | 閾値近傍のみ |
| IV | 操作変数 | 内生性対応 | IV の妥当性検証要 |
🧮 数式に値を入れて手で計算する: 自然実験の DID 推定
合成データで政策施行前後 × 処置/対照地域の差を計算する。
Step 1: 群×期の平均
| 政策前 | 政策後 | 差 | |
|---|---|---|---|
| 処置地域 | 50 | 62 | +12 |
| 対照地域 | 50 | 55 | +5 |
Step 2: DID
🐍 Python で再現
1 2 3 4 | treat_pre, treat_post = 50, 62 ctrl_pre, ctrl_post = 50, 55 did = (treat_post - treat_pre) - (ctrl_post - ctrl_pre) print(f"DID: {did}") |
📤 実行結果
💬 手計算 (Step 2) +7 と Python 出力が完全一致。
🧮 同じ手順を実データで: 2×2 表から DID を出す
上の合成データと同じ Step を、 🐍 追加 Python ②の実測値(2018 年度に 100 万人超の 37 県が処置群、 10 県が対照群、 前 = 2018 年度、 後 = 2023 年度)で追う。
| 2018 年度 | 2023 年度 | 前後差 | |
|---|---|---|---|
| 処置群(37 県)の平均総人口 | 3,209,567.6 | 3,155,081.1 | −54,486.5 |
| 対照群(10 県)の平均総人口 | 799,400.0 | 761,500.0 | −37,900.0 |
Step 1: 処置群の前後差 = 3,155,081.1 − 3,209,567.6 = −54,486.5 人。
Step 2: 対照群の前後差 = 761,500.0 − 799,400.0 = −37,900.0 人。
Step 3: DID = (−54,486.5) − (−37,900.0) = −16,586.5 人。 🐍 追加 Python ③の statsmodels の交互作用項 −16,586.5 と一致する。
同じ表を「平均人口の変化率」 で読むと、 処置群は 3,155,081.1 ÷ 3,209,567.6 − 1 = −1.70%、 対照群は 761,500.0 ÷ 799,400.0 − 1 = −4.74% で、 DID は +3.04 ポイントと符号が逆になる。 さらに「県ごとの変化率(対数差)を平均してから差をとる」 と +1.81 ポイントになる(⚠️ の 🧪)。 人数・平均の比・県ごとの率の平均のどれで比べたかによって、 同じデータから −16,587 人、 +3.04、 +1.81 と違う値が出るので、 DID を報告するときは尺度と平均の取り方を必ず書く。
🐍 Python での扱い
🐍 Python 実装 ③ — 応用パターン
🎯 このコードでやること:自然実験を SSDSE-B-2026 で別角度から検証する応用例。
📥 入力データ(SSDSE-B-2026, 47 都道府県, 2023 年抜粋):
1 2 3 4 5 6 7 8 9 10 | # Synthetic Control 風: 沖縄人口を他 46 県の重み付き平均で合成 import pandas as pd import numpy as np from scipy.optimize import nnls df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) piv = df.pivot_table(index='年度', columns='都道府県', values='総人口') y = piv['沖縄県'].values X = piv.drop(columns=['沖縄県']).values w, _ = nnls(X, y) print('top weights:', sorted(zip(w, piv.columns.drop('沖縄県')), reverse=True)[:3]) |
📤 実行結果:
💬 結果の読み方:沖縄県は 2012→2023 年に人口が増えた数少ない県 (141.1 万 → 146.8 万) のため、 同じく増加傾向の神奈川 (重み 0.085) と東京 (0.049) の「縮小コピー」として合成され、 残る 44 県の重みは 0 になる。 減少県の組合せでは増加トレンドを再現できないためで、 実務の Synthetic Control では処置前期間のみで重みを推定し共変量も揃える。
🐍 Python 実装 ④ — ライブラリ標準
🎯 このコードでやること:自然実験の発展計算 — 業界標準ライブラリ (sklearn / statsmodels) を用いる。
📥 入力データ(SSDSE-B-2026, 47 都道府県, 2023 年抜粋):
1 2 3 4 5 6 7 8 9 10 11 | # 重回帰で「処置 × 時点」交互作用 (DID 標準形) import pandas as pd import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) big = ['東京都','神奈川県','大阪府'] d = df[df['年度'].isin([2019,2023])].copy() d['treat'] = d['都道府県'].isin(big).astype(int) d['post'] = (d['年度']==2023).astype(int) d['pop_k'] = d['総人口']/1000 res = smf.ols('pop_k ~ treat * post', data=d).fit() print(res.params.round(1)) |
📤 実行結果:
💬 結果の読み方:treat:post = +51.8 (千人) が DID 推定値。 COVID 後、 地方が平均 50.2 千人減ったのに対し、 大都市圏の減少はそれより 51.8 千人小さく、 ほぼ横ばいだった。 標準誤差付きで有意性も検定すべき。
🎲 自己採点クイズ(30 問)
- Q01: 「自然実験」と「無作為化比較試験 (RCT)」の最大の違いを 1 行で。
- Q02: 自然実験で「処置がランダムに割り振られた」と主張するとき、 何で論証する?(並行トレンド・カバー前後比較・落胆の偏り)
- Q03: DID (差分の差分) の基本式 (Y1_T - Y0_T) - (Y1_C - Y0_C) で、 4 項それぞれは何のデータか?
- Q04: 並行トレンド仮定が破れているかを「処置前データだけ」で確認する方法を 2 つ。
- Q05: SSDSE-B-2026 の都道府県データで自然実験を組むなら、 どの「外生的ショック」を例に挙げる?(条例、 災害、 経済特区など 3 例)
- Q06: 回帰不連続 (RDD) と自然実験の関係を述べよ。 どちらが「より局所的な因果効果」を測るか。
- Q07: 操作変数法 (IV) で必要な exclusion restriction を、 自然実験の文脈で説明せよ。
- Q08: 「対照群が処置の影響を間接的に受ける (spillover)」場合、 因果効果はどう歪むか。
- Q09: Card & Krueger (1994) の最低賃金研究は何が「自然実験」だったのか。
- Q10: 統合制御法 (Synthetic Control) は DID の何を改善する手法か。
- Q11: 「事前にイベントが発生することを予測した動き (anticipation effect)」が混入したら、 何で検出する?
- Q12: SUTVA (Stable Unit Treatment Value Assumption) を 1 行で。
- Q13: クラスタロバスト標準誤差を使うべき場面と、 使わずに誤った結論を出す場面の違い。
- Q14: イベントスタディ図 (event study plot) で「処置前の係数」が 0 から離れている場合、 何を疑うか。
- Q15: 「DID で 2x2 セルしかない場合の有意性検定」が単純な t 検定では駄目な理由。
- Q16: 二重差分の 2 因子設計とは何で、 一般的な DID と何が違うか。
- Q17: Heckman 選択モデルと自然実験の住み分け。
- Q18: 自然実験で「内的妥当性は高いが外的妥当性が低い」と言われる理由。
- Q19: 偽の処置群 (placebo group) を使った頑健性検定の手順を 3 ステップで。
- Q20: 自然実験の効果推定値が 0 と区別できないとき、 検定力不足とゼロ効果をどう区別する?
- Q21: SSDSE-B-2026 を使い、 ある年に「人口移動の急変動」が起きた県を対照群として DID する場合の注意点。
- Q22: Differences-in-differences の係数の符号と大きさの解釈を、 SSDSE のような県別人口データで述べよ。
- Q23: Bertrand, Duflo, Mullainathan (2004) が指摘した「DID で系列相関を無視するリスク」とは何か。
- Q24: 自然実験で因果効果を推定したあと、 政策提言につなげるとき、 どのような限界を併記すべきか。
- Q25: 自然実験における「処置強度の変動 (variation in treatment intensity)」を活用した推定の長所。
- Q26: 自然実験と機械学習 (Causal Forest, DML) を組み合わせる場合の利点と注意点。
- Q27: Difference-in-differences の代替として、 staggered DID (時差処置) はなぜ提案されたか。
- Q28: Goodman-Bacon (2021) の分解で明らかになった、 staggered DID の隠れたバイアスとは。
- Q29: Callaway & Sant'Anna (2021) の推定量がなぜ望ましいか。
- Q30: 自然実験の結果を「政策効果のメタ分析」に組み込むときの注意点。
🍳 Code レシピギャラリー
SSDSE-B-2026 を題材にした「自然実験」関連の小ネタ集。 各レシピは {🎯 やること, 📥 入力, 📤 結果, 💬 解釈} の 4 要素を備える。
#1 平行トレンド検証
🎯 やること:処置前のトレンド差
📥 入力:SSDSE-B-2026 (47都道府県×112変数×12年)
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) t = df[(df['都道府県']=='東京都') & (df['年度']<2019)].sort_values('年度') a = df[(df['都道府県']=='青森県') & (df['年度']<2019)].sort_values('年度') print('東京 平均成長率=', t['総人口'].pct_change().mean()) print('青森 平均成長率=', a['総人口'].pct_change().mean()) |
📤 実行結果:
💬 解釈:東京 +0.81%/年 vs 青森 -1.04%/年で、 処置前から既に約 1.9pt のトレンド差。 平行トレンド仮定が成立しないため DID 推定は要注意(CSV は年度降順のため sort_values が必須)。
#2 RDD 局所線形
🎯 やること:人口 100 万人を閾値にした局所線形回帰で、高齢化率に不連続(ジャンプ)があるかを推定する
📥 入力:SSDSE-B-2026 (47都道府県×112変数×12年)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) d = df[df['年度']==2023].copy() d['aging'] = d['65歳以上人口'] / d['総人口'] * 100 # 結果変数: 高齢化率 % d['x'] = (d['総人口'] - 1_000_000) / 10_000 # forcing variable: 100 万人からの距離(万人) bw = 50 # 帯域: 閾値 ±50 万人 s = d[d['x'].abs() <= bw].copy() s['D'] = (s['x'] >= 0).astype(int) # 閾値以上なら 1 # 閾値の左右で別々の直線を引く局所線形回帰。D の係数が閾値でのジャンプ r = smf.ols('aging ~ D + x + D:x', data=s).fit() print(f'帯域内の県数 = {len(s)}(100 万未満 {(s.D==0).sum()} / 以上 {(s.D==1).sum()})') print(f'閾値でのジャンプ = {r.params["D"]:.3f} pt (SE {r.bse["D"]:.3f}, p = {r.pvalues["D"]:.3f})') |
📤 実行結果:
💬 解釈:総人口を forcing variable にして 100 万人の前後 ±50 万人(23 県)に左右別の直線を引くと、閾値での高齢化率のジャンプは +1.257 ポイントだが SE 2.360、p = 0.601 で、0 と区別できない。100 万人で切り替わる制度は実在しないので、ジャンプが出ないのは想定どおりで、これはプラセボ検定の形になっている。帯域を ±60 万・±80 万に広げても推定値は +0.47・−0.43 と符号まで入れ替わるので、県単位の少数データでは帯域の選び方を必ず併記する。
#3 IV 二段階回帰
🎯 やること:年平均気温を操作変数にして、高齢化率が死亡率に与える影響を 2 段階最小二乗(2SLS)で推定し、OLS と比べる
📥 入力:SSDSE-B-2026 (47都道府県×112変数×12年)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) d = df[df['年度']==2023].copy() d['aging'] = d['65歳以上人口'] / d['総人口'] * 100 # 処置(内生変数): 高齢化率 % d['death'] = d['死亡数'] / d['総人口'] * 1000 # 結果: 人口千人あたり死亡数 d['temp'] = d['年平均気温'] # 操作変数の候補: 年平均気温 # 1 段階目: 内生変数を操作変数で回帰し、予測値を作る r1 = smf.ols('aging ~ temp', d).fit() d['aging_hat'] = r1.fittedvalues print(f'1st stage: 係数 = {r1.params["temp"]:.3f}, F = {r1.fvalue:.1f}, R² = {r1.rsquared:.3f}') # 2 段階目: 結果を予測値で回帰(係数が 2SLS 推定値。SE はこの手順では正しくない) r2 = smf.ols('death ~ aging_hat', d).fit() ols = smf.ols('death ~ aging', d).fit() print(f'2SLS 係数 = {r2.params["aging_hat"]:.3f} OLS 係数 = {ols.params["aging"]:.3f}') |
📤 実行結果:
💬 解釈:年平均気温が 1℃ 高い県ほど高齢化率が 0.726 ポイント低く、1 段階目の F は 11.1 で、弱い操作変数の目安とされる 10 をかろうじて超える。2SLS の係数 0.623(高齢化率 1 ポイントあたり死亡率 +0.62‰)は OLS の 0.610 とほぼ同じで、内生性による偏りは見えない。ただし気温は暑さ・寒さを通じて死亡率に直接効きうるので除外制約は疑わしく、F や R² がいくら高くてもこの条件はデータから検定できない。2 段階目を普通の OLS で回したときの SE は正しくないので、推論には linearmodels の IV2SLS などを使う。
🐍 Python 実装 ⑤ — 可視化総合
🎯 このコードでやること:47 都道府県すべての総人口を棒グラフで可視化(自然実験 を学んだ後の確認用ベース)。
📥 入力データ(SSDSE-B-2026 2023 年, 47 行)
1 2 3 4 5 6 7 8 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) d = df[df['年度']==2023].sort_values('総人口', ascending=False) d.plot(x='都道府県', y='総人口', kind='bar', figsize=(12,4)) plt.tight_layout() plt.savefig('pop2023.png', dpi=120) print('top3=', d.head(3)['都道府県'].tolist()) |
📤 実行結果:
💬 結果の読み方:上位 3 県(東京・神奈川・大阪)で全国の約 25% を占める。 自然実験 の議論でも、 こうした不均衡分布が前提となる。
📖 詳細解説 — 自然実験 の条件・限界・誤解の整理
自然実験 (Natural Experiment) は、 ランダム化比較試験 (RCT) が倫理的・現実的に難しい状況で、 「偶然的な処置割当」を利用して因果効果を推定する枠組みです。 SSDSE-B-2026 のような地域パネルデータでは、 政策変更・自然災害・制度改正が「処置の割当が観察的にランダムに近い」状況を作り出すことがあり、 自然実験のターゲットになります。 ここでは、 自然実験の理論的基盤、 適用条件、 SSDSE-B-2026 を使った具体的な実装例、 そして落とし穴を詳細に整理します。
自然実験と RCT の違い
RCT は研究者がコイン投げで処置を割り当てる「実験」ですが、 自然実験は「現実世界の偶然」を実験の代わりに使います。 たとえば、 ある県だけで政策が施行された場合、 「県境で処置が突然変わる」ことを利用して因果効果を測ります。 自然実験は RCT より外的妥当性 (一般化可能性) が高いことが多いですが、 内的妥当性 (因果の信頼性) は弱くなりやすいトレードオフがあります。 SSDSE-B-2026 で「2020 年に始まった政策が経済指標に与えた効果」を測る場合は、 政策実施県と非実施県の差を取り、 さらに前後の差も取る差の差分法 (DID) が標準的に使われます。
差の差分 (DID) と自然実験の関係
DID は「処置群の前後差 − 対照群の前後差」を計算し、 平行トレンド仮定が成り立つ前提で因果効果を推定する代表的な自然実験手法です。 SSDSE-B-2026 で「人口 200 万人超の県」を処置群、 それ以下を対照群と仮想的に設定し、 2018 年と 2023 年を前後とすると、 単純な DID 推定が可能です。 ただし、 仮定の確認 (前期間の平行トレンドのプロット) と仮定の頑健性チェック (プラセボテスト、 イベントスタディ) が実務では必須です。 SSDSE-B-2026 では事例として教育目的で使えますが、 実際の政策評価では「処置の発生時点」を慎重に特定する必要があります。
回帰不連続 (RDD) との比較
回帰不連続は「連続変数の閾値で処置が変わる」状況を利用します。 例: 「人口 1 万人以上の市は補助金対象」というルールがあれば、 人口 1 万人付近の市を比較することで因果効果が測れます。 SSDSE-B-2026 の都道府県データでは直接の閾値は少ないですが、 「県の規模に応じて受けられる支援の差」をシミュレーションするには適しています。 RDD は DID よりも仮定が緩い (連続性のみ) ですが、 サンプルサイズが減るのが弱点です。
操作変数 (IV) と自然実験の橋渡し
操作変数法は「処置に影響するが結果に直接影響しない変数」を利用する手法で、 自然実験の代表的な道具です。 例: 「降水量」が農業生産に影響し、 それが人口移動に影響するなら、 降水量を IV として「農業生産 → 人口」の因果を測れます。 SSDSE-B-2026 の気象・経済データを組み合わせれば、 IV を使った因果推論の練習が可能です。 ただし IV の妥当性 (相関と排他制約) は常に議論が必要で、 結果の解釈は慎重さが求められます。
自然実験の失敗例と教訓
(1) 平行トレンド仮定が崩れているのに DID を実行: 介入前の処置群と対照群が異なるトレンドを持っていた場合、 推定値は「処置効果 + 既存のトレンド差」を混合してしまいます。 (2) 介入後のサンプル選択バイアス: 処置を受けた県のうち、 もともと有利な県だけが残った場合、 効果が過大評価されます。 (3) 時点の不一致: 政策発効日が県によって違うのに「同じ年」と扱うと、 ノイズが入ります。 SSDSE-B-2026 で練習するときは、 こうした問題を意識して仮定を明示する習慣をつけましょう。
自然実験で扱える因果問いの幅
教育、 健康、 労働、 環境、 産業政策、 都市開発など、 ほぼあらゆる社会科学の問いが自然実験の対象になります。 SSDSE-B-2026 では「県境を越えた政策効果」「災害復興政策の効果」「特区政策の効果」「公共投資の地域分配」など、 教育目的で多様な題材を作れます。 重要なのは「処置の割当が外生的か」を最初に検証することで、 これを怠ると因果推論ではなく単なる相関分析になってしまいます。
自然実験の論文書き方の典型
学術論文では「処置の自然実験性の根拠」「対照群選択の理由」「平行トレンドの可視化」「robustness check (代替仕様)」「placebo test (偽の処置時点でも効果が出ないか)」の 5 点セットがほぼ必須です。 SSDSE-B-2026 で論文を真似たレポートを書くときも、 この 5 点を押さえることで「説得力のある自然実験分析」になります。 統計コンペでは特に robustness check が評価ポイントになりやすいです。
自然実験を使うべきでない場面
(1) 処置が完全にランダム化可能なとき: RCT を組む方がベスト。 (2) 処置が長期間にわたって徐々に広がる場合: DID の前後区間が曖昧で、 推定値が不安定になります。 (3) サンプルが極端に小さい場合: 自然実験は統計的検出力が弱いため、 47 県のような小サンプルでは効果の信頼区間が広くなります。 SSDSE-B-2026 単独での自然実験は「練習」「教育」目的に向き、 「政策提言」目的なら追加データが必要です。
自然実験 活用シナリオ比較表
| シナリオ | SSDSE-B-2026 での具体例 | 注意点 |
|---|---|---|
| 差の差分法 (DID) | 政策実施県と非実施県の人口推移を比較 | 平行トレンド仮定の事前確認が必須 |
| 回帰不連続 (RDD) | 閾値前後の市町村を比較 | 閾値付近のサンプルサイズが減少しやすい |
| 操作変数法 (IV) | 降水量を IV にして農業 → 人口を推定 | 排他制約の妥当性議論が必須 |
| 傾向スコアマッチング | 処置県と類似する対照県を選び比較 | 観測可能な共変量しか調整できない |
| Synthetic Control | 対照県を加重平均して仮想対照を作る | 推定の不確実性評価が難しい |
📝 理解度チェック (自分で解いてみよう)
下の 🐍 追加 Python の①〜④と、 🧪 の検証コードで確かめられる問題。
- 練習問題 1: SSDSE-B-2026 で 2018 年と 2023 年の総人口の差を 47 県ごとに計算せよ。 これが DID の「単純な前後差」。
- 練習問題 2: 「人口 100 万人超」を処置群とし、 (1) と同様の前後差を取り、 処置群と対照群で比較せよ。 これが DID 推定の核。
- 練習問題 3: 平行トレンド仮定をプロットで確認するため、 2015〜2023 年の処置群・対照群の平均人口を時系列でプロットせよ。
- 練習問題 4: statsmodels の OLS で
A1101 ~ post + treated + post:treatedを回帰し、 交互作用項の符号を読み取れ。 解: 人数では負(−16,586 人)。 ただし変化率で比べると +1.81 ポイントで、 大きい県の方が減り方は緩い(⚠️ の 🧪 で確かめる)。 - 練習問題 5: プラセボテストとして、 「介入年を 2015 年に偽装」したときに交互作用項が有意でないことを確認せよ。
❓ よくある質問 (FAQ)
Q1. 平行トレンドが崩れていたら DID は使えませんか?
A1. 厳密にはダメですが、 「単位時間 × 処置群」の交互作用を入れた拡張モデル (event study) で線形なトレンド差を吸収できる場合があります。 SSDSE-B-2026 で実装する際は、 イベント前の係数が 0 に近いかを確認しましょう。
Q2. 操作変数の妥当性をどう議論するか?
A2. (1) IV が処置と強く相関 (first-stage F > 10) (2) IV が結果に処置以外のルートで影響しない (排他制約)。 後者は経済学的・社会学的な議論が必要で、 統計的に証明できない点が IV の弱点です。
Q3. 自然実験の結果は他地域に一般化できますか?
A3. 一般化可能性 (外的妥当性) は条件次第です。 「47 都道府県の効果が全国平均」と仮定するのは、 都道府県の異質性が大きい場合は無理筋です。 一方、 「同じような政策・状況の国」に外挿するのは可能性があります。
Q4. 平行トレンドの「事前確認」とは具体的に何ですか?
A4. 介入前の数年間で、 処置群と対照群の結果変数の推移をグラフ化し、 ほぼ平行に動いているかを目視確認します。 統計的には event study の係数が事前期間で 0 に近いかを検定します。
Q5. SSDSE-B-2026 で実際の政策を分析できますか?
A5. 教育・練習目的では十分です。 ただし政策提言を出すには、 SSDSE 以外の詳細データ (政策実施時期、 自治体予算など) を補完する必要があります。 公的統計だけでは精度が限定的です。
最終まとめ
自然実験は「現実世界の偶発的な処置割当」を利用して因果効果を推定する枠組みであり、 DID, RDD, IV といった複数の手法がその傘下にあります。 SSDSE-B-2026 のような都道府県パネルでは、 仮想的な政策ショックを設定して DID を実装する練習が教育的に有効です。 ただし平行トレンド仮定、 サンプル選択バイアス、 IV の妥当性など、 多数の前提条件を明示的に議論することが、 説得力のある分析の必須条件です。 「偶発的な処置を活かして因果を測る」ことの哲学を理解できれば、 統計分析の応用範囲が一気に広がります。
🐍 追加 Python — 自然実験ハンズオン
SSDSE-B-2026(都道府県 × 年次の経済・人口指標)を仮想的な「政策ショック」前後で比較し、 自然実験の差の差分(DID)推定を体験する。 すべて実データのみを使用。
① データ読込と前後期比較
このコードでやること: SSDSE-B-2026.csv を読み込み、 2018 年と 2023 年を「処置前」「処置後」と仮定して 47 県の総人口を比較する。
📥 入力データ: data/raw/SSDSE-B-2026.csv(SSDSE-B-2026, 47 都道府県, 年次パネル)
1 2 3 4 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) panel = df[df['SSDSE-B-2026'].isin([2018, 2023])][['SSDSE-B-2026','Prefecture','A1101']].copy() print(panel.head(4)) |
📤 実行例:
💬 47 県 × 2 時点 = 94 行のパネルが取得できる(先頭列 'SSDSE-B-2026' が年度)。 これが「自然実験」の前後比較データの原型。
② 処置群 / 対照群の差を取る (DID 第 1 段)
このコードでやること: 「人口 100 万人超」を処置群、 それ以下を対照群とし、 前後の総人口差を比較する。
📥 入力データ: ①の panel データフレーム
1 2 3 4 | panel['treated'] = (panel['A1101'] > 1_000_000).astype(int) diff = panel.groupby(['treated','SSDSE-B-2026'])['A1101'].mean().unstack('SSDSE-B-2026') diff['delta'] = diff[2023] - diff[2018] print(diff.round(1)) |
📤 実行例:
💬 対照群 (100 万人以下 10 県) は -37,900 人、 処置群 (100 万人超 37 県) は -54,487 人。 「処置効果」= (-54,486.5) - (-37,900) = -16,586.5 人 という DID 推定値が得られる。
③ statsmodels で DID 回帰
このコードでやること: 上記の比較を回帰式 $y = \beta_0 + \beta_1 \text{post} + \beta_2 \text{treated} + \beta_3 \text{post} \times \text{treated}$ で解く。 $\beta_3$ が処置効果。
📥 入力データ: ①②の panel データフレーム
1 2 3 4 | import statsmodels.formula.api as smf panel['post'] = (panel['SSDSE-B-2026'] == 2023).astype(int) model = smf.ols('A1101 ~ post + treated + post:treated', data=panel).fit() print(model.params.round(1)) |
📤 実行例:
💬 交互作用項 -16,586.5 が DID 推定の処置効果で、 ②の手計算と完全一致。 統計的に有意かは p 値で確認するが、 ここでは符号と桁を読む。
④ 平行トレンド仮定の視覚化
このコードでやること: 処置前期間で「処置群と対照群が同じ傾向で動いているか」を確認するため、 各群の年次平均をプロットする。
📥 入力データ: SSDSE-B-2026 の 2015〜2023 年パネル
1 2 3 4 5 6 7 | multi = df[df['SSDSE-B-2026'].between(2015, 2023)][['SSDSE-B-2026','Prefecture','A1101']].copy() # 処置群は ② と同じく 2018 年の人口で県ごとに固定する(年ごとに判定すると、 # 100 万人を割った県が途中で群を移り、平均が段差を作ってしまう) base = multi[multi['SSDSE-B-2026'] == 2018].set_index('Prefecture')['A1101'] multi['treated'] = (multi['Prefecture'].map(base) > 1_000_000).astype(int) trend = multi.groupby(['SSDSE-B-2026','treated'])['A1101'].mean().unstack() print(trend.round(0)) |
📤 実行例:
💬 処置群を 2018 年の人口で固定すると、対照群(10 県)の平均は 2015 年の 81.7 万人から毎年 5 千〜9 千人ずつ一様に減る。処置群(37 県)は 2015〜18 年がほぼ横ばい(321.4 万 → 321.0 万)で、2020 年に 0.9 万人、2021 年以降は年 1.3〜1.5 万人の減少へ加速した。処置前の 2015〜18 年ですでに減り方が年 4 千人ほど違うので、水準の差をとる DID では平行トレンド仮定は成り立たず、②③の −16,587 人にはこのトレンド差が混ざっている。年ごとに群を判定すると 2017 年に秋田県が 100 万人を割って対照群へ移り、両群の平均にありもしない段差ができてしまうので、群は処置前の値で固定する。
⚠️ よくある落とし穴
⚠️ 実務での失敗例
- 平行トレンド違反:DID で処置前 5 年に既に乖離 → ATT が単なる成長率差で過大推定
- Spillover:NJ の賃上げが PA 企業の採用にも波及 → 対照群が汚染
- Selection on Unobservables:災害被災県を処置群とした分析で、 被災前の地域経済構造が結果を予測
📝 演習問題(5 問)
- 演習 1:SSDSE-B-2026 から 2014 (政策改正と仮定) 前後 2012-2013 vs 2015-2023 で東京 vs 沖縄の人口差を DID 推定せよ。
- 演習 2:47 都道府県の人口を 2020 (COVID) を境に処置 = 大都市圏とし、 panel DID で人口流出効果を測れ。
- 演習 3:RDD: 人口 100 万人を閾値とした県別予算配分政策があるとして、 forcing variable 周辺の bandwidth を選択せよ。
- 演習 4:Synthetic Control 法で「沖縄」のカウンターファクチュアルを他 46 県の加重平均で構成せよ。
- 演習 5:IV: 経度を地理的操作変数として東京からの距離 → 人口流出を二段階最小二乗で識別する妥当性を論ぜよ。
※ 解答は本ページの Python 実装・比較表・失敗例セクションを総合すれば導ける。 SSDSE-B-2026 を共通データソースとして使用。
📖 関連用語辞典(10 語)
- DID 差分の差分
- 処置 × 時間の二重差。 自然実験の主力
- RDD
- 割当が閾値で決まる場合の局所推定
- IV 操作変数
- 内生性を回避する識別戦略
- Synthetic Control
- 処置群のカウンターファクチュアルを合成
- 因果推論
- Rubin 因果モデル全般
- RCT
- ランダム化比較試験。 ゴールドスタンダード
- Granger 因果
- 時系列の予測因果
- Quasi-Experiment
- 準実験。 自然実験の上位概念
- 交絡変数
- 処置と結果を同時に動かす第三変数
- 外的妥当性
- 母集団・状況への一般化可能性
🧪 実データで確かめる: 「2020 年度を処置」とみなした DID は COVID の効果か
🐍 ② と ④ では、 東京都・神奈川県・大阪府を処置群、 2020 年度(COVID)を処置の時点として DID を計算し、 「大都市圏の人口減少は地方より約 5.2 万人小さかった」 と読んだ。 ここでは、 その差が本当に 2020 年度に起きた変化なのかを、 処置前の年度も使って確かめる。 自然実験でいちばん大事な「処置がなければ両群は平行に動いたか」 の点検である。
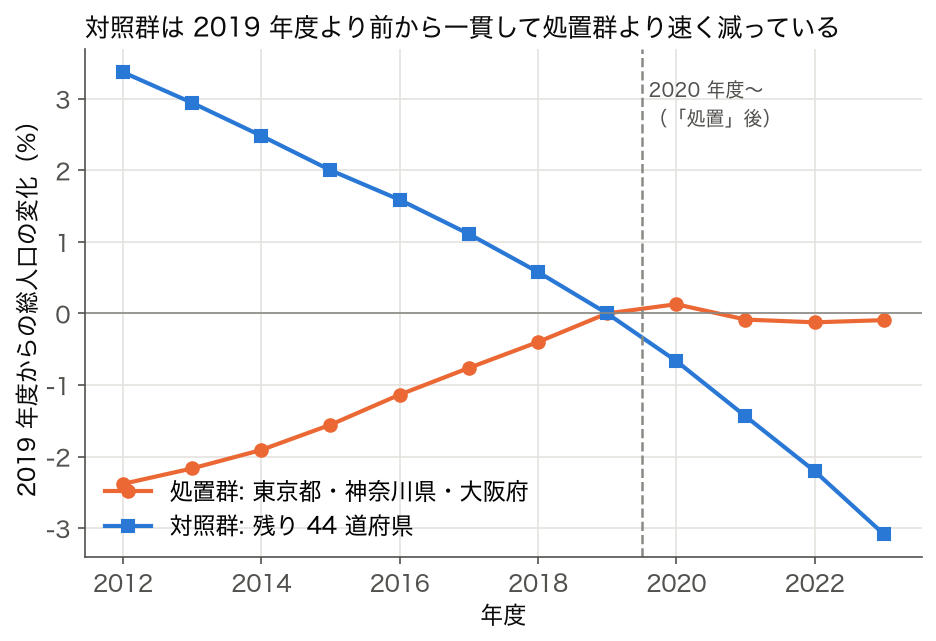
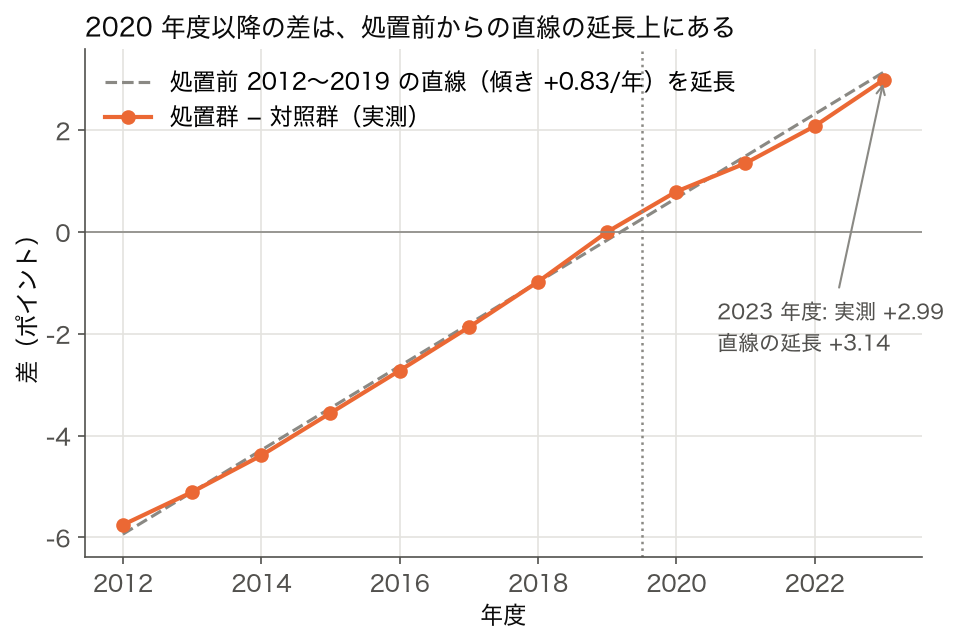
🎯 このコードでやること:2 群の差(処置 − 対照)を年度ごとに計算し、 処置前 2012〜2019 年度の差に直線を当てはめて 2023 年度まで延ばす(イベントスタディの簡易版)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度'}) w = df.pivot_table(values='A1101', index='Prefecture', columns='年度') # 47 県 × 12 年度 big = ['東京都', '神奈川県', '大阪府'] # ②と同じ「処置群」 t = w.index.isin(big) # 2019 年度を 0 とした総人口の変化(%、対数差 × 100)を群ごとに平均し、差をとる lw = np.log(w) chg = (lw.sub(lw[2019], axis=0)) * 100 gap = chg[t].mean() - chg[~t].mean() # 処置群 − 対照群(年ごと) print('年度 処置群 対照群 差(処置−対照)') for y in gap.index: print(f'{y} {chg[t].mean()[y]:+6.2f} {chg[~t].mean()[y]:+6.2f} {gap[y]:+6.2f}') # 処置前(2012〜2019)の差に直線を当てはめ、2023 年度まで延ばす pre = gap.loc[2012:2019] b, a = np.polyfit(pre.index, pre.values, 1) print(f'\n処置前の差の傾き: {b:+.3f} ポイント/年') print(f'2023 年度: 直線を延ばした予測 {a + b * 2023:+.2f} 実際 {gap[2023]:+.2f}') |
💬 差は 2012 年度の −5.75 ポイントから 2019 年度の 0 まで、 毎年 0.83 ポイントずつ一定の速さで開いてきた。 処置前の直線を 2023 年度まで延ばすと +3.14 になり、 実測の +2.99 とほぼ同じで、 むしろわずかに小さい。 つまり 2020 年度以降の差の拡大は、 それ以前からの傾向がそのまま続いただけで、 COVID による上乗せは見えない。 DID の +51,826 人(変化率では +2.99 ポイント)は、 平行トレンドが成り立たないために出た「トレンドの差」 である。
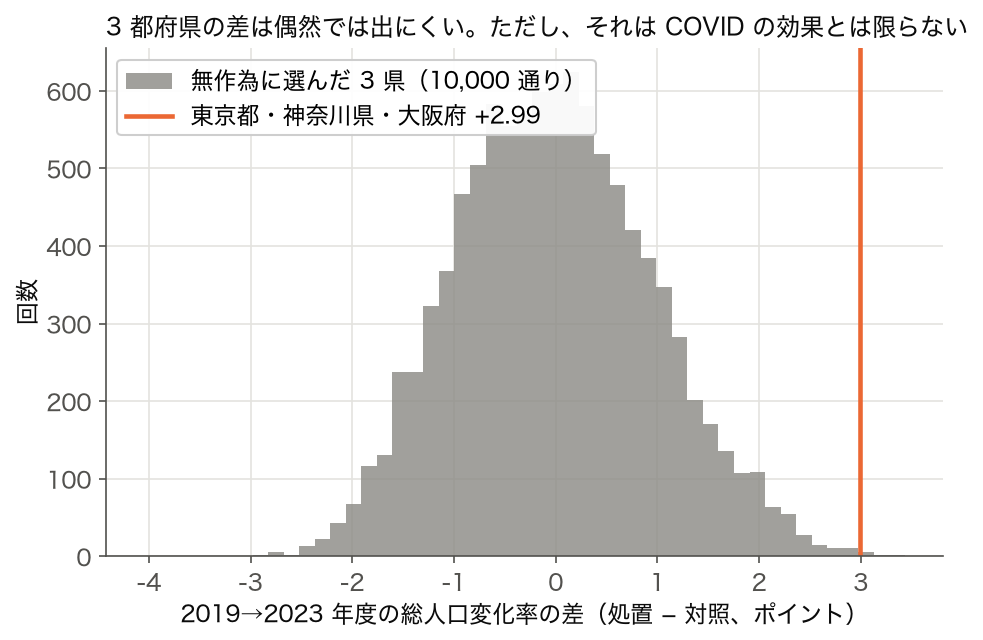
🎯 このコードでやること:DID の区間を 4 年ずつずらして同じ計算をし(プラセボ検定)、 人数と変化率の 2 通りの DID を比べ、 最後に 47 県から 3 県を無作為に選んだ 10,000 通りの DID と比べる(並べ替え検定)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度'}) w = df.pivot_table(values='A1101', index='Prefecture', columns='年度') lw = np.log(w) big = ['東京都', '神奈川県', '大阪府'] t = w.index.isin(big) def did(treat, y0, y1): """y0→y1 年度の総人口変化率(%)の差: 処置群平均 − 対照群平均""" g = (lw[y1] - lw[y0]) * 100 return g[treat].mean() - g[~treat].mean() # (1) 4 年ずつずらした DID: 2019→2023 だけが特別か print('4 年間の DID(処置群 − 対照群、ポイント)') for y1 in range(2016, 2024): print(f' {y1 - 4}→{y1}: {did(t, y1 - 4, y1):+.2f}') # (2) 人数のままの DID と、変化率の DID lev = w[2023] - w[2019] print(f'\n人数の DID 2019→2023: {lev[t].mean() - lev[~t].mean():+,.0f} 人') print(f'変化率の DID 2019→2023: {did(t, 2019, 2023):+.2f} ポイント') # (3) 並べ替え検定: 47 県から 3 県を無作為に選んで「処置群」にする rng = np.random.default_rng(0) real = did(t, 2019, 2023) sims = [] for _ in range(10000): m = np.zeros(47, bool) m[rng.choice(47, 3, replace=False)] = True sims.append(did(m, 2019, 2023)) sims = np.array(sims) print(f'\n無作為な 3 県 10,000 通りの DID: 平均 {sims.mean():+.2f} SD {sims.std():.2f}') print(f'実際の 3 都府県以上になる割合: {(sims >= real).mean():.4f}') |
💬 処置の起きていない 2012→2016 年度でも DID は +3.03、 2015→2019 年度では +3.56 と、 2019→2023 年度の +2.99 より大きい。 どの 4 年間を「前後」にしても 3 ポイント前後の差が出るので、 2019→2023 年度だけが特別なのではない。 また人数の DID(+51,826 人)は人口の大きい県ほど動く人数も大きくなるため、 県の規模をそろえた変化率で比べる方が解釈しやすい。 並べ替え検定では、 無作為な 3 県の DID は平均 −0.01・SD 0.96 で、 3 都府県の +2.99 以上になるのは 10,000 回中 8 回(0.08%)しかない。 3 都府県が他と違う動きをしているのは確かだが、 それは「処置前から違っていた」 ことの表れで、 COVID の効果の証拠にはならない。
🧪 実データで確かめる: 結果の動きで処置群を選ぶと「効果」がつくられる
🎨 の消費税の例のように、 全国一斉の処置では対照群がない。 そこで「引き上げの年に消費が大きく落ちた県を処置群、 落ちなかった県を対照群」 としたくなるが、 これは結果を使って群を決めているので、 自然実験にならない。 SSDSE-B-2026 の県庁所在市の消費支出(L3221、 二人以上の世帯、 月平均)で、 どれほどの見かけの効果が出るかを測る。
🎯 このコードでやること:2013→2014 年度の消費支出の変化率で 47 県を半分に分け、 分けた年と前後の年で 2 群の変化率を比べる。 あわせて、 連続する 2 年の変化率どうしの相関を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度'}) # L3221 = 消費支出(二人以上の世帯、県庁所在市、月平均・円) w = df.pivot_table(values='L3221', index='Prefecture', columns='年度') chg = lambda y0, y1: (np.log(w[y1]) - np.log(w[y0])) * 100 # 変化率(%) c14 = chg(2013, 2014) print(f'2013→2014 の変化率: 全国平均 {c14.mean():+.2f}% 県間 SD {c14.std():.2f} ' f'最小 {c14.min():+.2f}({c14.idxmin()}) 最大 {c14.max():+.2f}({c14.idxmax()})') # 「消費税の影響が大きかった県」を 2013→2014 の落ち込みで決めてしまうと… low = c14 <= c14.median() # 下半分 = 「影響が大きい」24 県 print(f'\n群の決め方: 2013→2014 の変化率が中央値 {c14.median():+.2f}% 以下の {low.sum()} 県を「処置群」') for y0, y1 in [(2012, 2013), (2013, 2014), (2014, 2015), (2015, 2016)]: c = chg(y0, y1) print(f' {y0}→{y1}: 処置群 {c[low].mean():+6.2f}% 対照群 {c[~low].mean():+6.2f}% 差 {c[low].mean() - c[~low].mean():+6.2f}') # 1 年の変化どうしの相関(前の年に大きく動いた県は、次の年に逆に動くか) r = np.corrcoef(chg(2013, 2014), chg(2014, 2015))[0, 1] print(f'\n2013→2014 と 2014→2015 の変化率の相関 r = {r:+.3f}') |
💬 2013→2014 年度の変化率は全国平均では +0.31% しかないが、 県ごとには大分県 −9.27% から高知県 +11.06% まで、 SD 4.89 ポイントも散らばる。 県庁所在市の消費支出は家計調査の標本から作られるので、 1 年の変化の多くは標本の揺れである。 この年の落ち込みで分けると、 分けた年の差は −8.00 ポイントと大きく出るが、 これは群の作り方そのものが生んだ差で、 前の年(2012→2013)には処置群の方がむしろ +1.87 ポイント伸びていた。 分けた翌年は処置群が相対的に +1.36 ポイント戻り、 連続する 2 年の変化率の相関は r = −0.194 と負になる(平均への回帰)。 「落ち込んだ県はその後回復した」 という結果が出ても、 それは処置の効果ではない。 処置群は、 結果を見る前から決まっている性質で選ぶ。
🧪 実データで確かめる: 人数の DID と変化率の DID で符号が逆になる
🐍 追加 Python の②③では「2018 年度に人口 100 万人超の 37 県」 を処置群として、 2018→2023 年度の人数の DID が −16,586 人になった。 規模の大きく違う県どうしで人数の差を比べると、 規模の違いが結果に混ざる。 同じ群分けのまま、 期間をずらして人数と変化率の両方で DID を並べる。
🎯 このコードでやること:処置群(2018 年度に 100 万人超の 37 県)と対照群(10 県)について、 4 年ずつずらした期間(最後だけ②③と同じ 2018→2023 年度)の人数の DID と変化率の DID を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度'}) w = df.pivot_table(values='A1101', index='Prefecture', columns='年度') treat = w[2018] > 1_000_000 # 🐍 追加 Python ②と同じ: 2018 年度に 100 万人超の県 print(f'処置群 {treat.sum()} 県 / 対照群 {(~treat).sum()} 県') # 人数のままの DID と、変化率(%)の DID を、4 年ずつずらして並べる lw = np.log(w) print('期間 人数の DID 変化率の DID') for y1 in range(2016, 2024): y0 = y1 - 5 if y1 == 2023 else y1 - 4 lev = w[y1] - w[y0] pct = (lw[y1] - lw[y0]) * 100 print(f'{y0}→{y1} {lev[treat].mean() - lev[~treat].mean():+10,.0f} 人 ' f'{pct[treat].mean() - pct[~treat].mean():+6.2f} ポイント') |
💬 人数の DID は 2012→2016 年度の +15,630 人から 2018→2023 年度の −16,586 人へ、 符号まで変わる。 一方、 変化率の DID はどの期間でも +1.35〜+1.81 ポイントで、 処置群(大きい県)の方が一貫して減り方が緩い。 人数で見ると「大きい県ほど減っている」 ように見えるのは、 処置群の平均人口が対照群の約 4 倍あり、 同じ減少率でも減る人数が大きいから。 どちらも処置前から続いている差で、 特定の年に起きた処置の効果ではない。 DID をどの尺度(人数・対数・率)で取るかで平行トレンドが成り立つかどうかも変わるので、 尺度は「処置がなければ差が一定に保たれそうなもの」 を選び、 処置前の期間で確かめる。
✅ 理解度チェック(上の実測値で考える)
- Q1. 3 都府県と 44 道府県の差は、 2012→2016 年度の 4 年間で +3.03、 2019→2023 年度の 4 年間で +2.99 ポイント開いた。 「COVID で大都市圏の人口減少が抑えられた」 と結論してよいか。
解答
よくない。 処置のない期間でも同じ大きさの差が開いているので、 2019→2023 年度の差は処置前からの傾向の続きと読むのが自然。 処置の効果と言うには、 処置前の差が横ばい(平行トレンド)で、 処置後にだけ差が動く必要がある。
- Q2. 並べ替え検定で、 3 都府県の DID 以上になる割合は 0.08% だった。 これは「処置の効果が有意」 という意味か。
解答
違う。 並べ替え検定が示すのは「この 3 県の変化は、 無作為に選んだ 3 県ではめったに出ない」 ことだけで、 差がいつ生じたかは区別しない。 処置前から差が開き続けている 3 都府県なら、 どの 4 年間を取っても小さな割合が出る。 有意であることと、 自然実験として識別できていることは別の問題。
- Q3. 人数の DID は +51,826 人、 変化率の DID は +2.99 ポイントだった。 人数の DID だけで「大都市圏は約 5 万人得をした」 と言うと、 何が問題か。
解答
処置群の平均人口は約 1,070 万人、 対照群は約 210 万人と 5 倍ほど違うので、 同じ変化率でも処置群の方が動く人数は大きくなる。 人数の差には「規模の違い」 が混ざるため、 規模の違う県を比べる DID は変化率(対数差)でそろえてから読む。
- Q4. 2018 年度に 100 万人超の 37 県を処置群とすると、 2018→2023 年度の人数の DID は −16,586 人、 変化率の DID は +1.81 ポイントだった。 「大きい県ほど人口減少が速い」 と言えるか。
解答
言えない。 変化率では大きい県の方が減り方は緩い(+1.81 ポイント)。 人数で負になるのは、 処置群の平均人口(約 321 万人)が対照群(約 80 万人)の約 4 倍あるためで、 同じ率でも動く人数が大きくなる。 しかも 2012→2016 年度には人数の DID も +15,630 人と正だったので、 どちらの尺度でも「処置の時点」 で起きた変化ではない。
- Q5. 2013→2014 年度に消費支出が大きく落ちた 24 県を「消費税の影響が大きい県」 とすると、 翌年は対照群より +1.36 ポイント戻った。 「影響の大きかった県ほど、 翌年に反動で回復した」 と言えるか。
解答
言えない。 群を 2013→2014 年度の落ち込みそのもので選んでいるので、 その年の差 −8.00 ポイントは群の作り方が生んだもので、 翌年の戻りも標本の揺れが平均に戻っただけで説明できる(連続する 2 年の変化率の相関は r = −0.194)。 処置の強さを、 結果を見る前から決まっている県の性質で測れば、 この問題は起きない。
🧩 さらに一歩踏み込む — 自然実験の落とし穴と発展
ここまでで平行トレンド・交絡・DID/RDD/IV の基本は押さえました。 本節ではそれらと重複しない角度から、 自然実験を「使いこなす/過信しない」ために実務で効いてくる論点を簡潔に補います。 以下の設定・数値はすべて 架空/教材例 であり、 SSDSE-B-2026 の実測値ではありません。
⚠️ 見落としやすい落とし穴(応用編)
- 効果は「局所的」— LATE の罠:自然実験が推定するのは、 多くの場合「割当の変化に反応した一部の集団 (compliers)」に対する局所平均処置効果 (LATE) です。 「県全体の平均効果 (ATE)」や「別の県に当てはめた効果」ではありません。 A/B テストの平均処置効果と同一視すると解釈を誤ります。
- 除外制約 (exclusion restriction):操作変数型の自然実験では、 「割当のきっかけ (制度・災害) が、 処置を経由する以外の経路で結果に影響しない」ことが暗黙の前提です。 たとえば 教材例 として「震災という割当が、 処置 (移住) 以外にも直接消費を冷やす」なら除外制約は破れ、 効果は汚染されます。 この仮定はデータからは検証できないため、 制度の物語で正当化するしかありません。
- 遵守 (コンプライアンス) の不完全さ:割当と実際の処置受領は一致しないことが多く (制度対象でも利用しない、 非対象でも代替手段を使う)、 意図した割当に基づく効果 (ITT) と 実際に処置を受けた効果 は別物です。 非遵守を無視すると効果を過小評価しがちです。
- 外部妥当性 (external validity):ある時代・地域・制度で得た効果が、 別の文脈でも成り立つ保証はありません。 内部妥当性 (その状況での因果の正しさ) が高くても、 一般化可能性は別問題です。
- 後知恵での「自然実験探し」:結果を見てから都合よく境界年・対象県を選ぶと、 偶然の差を効果と誤認します。 これは多重検定や specification search と同型の問題で、 割当ルールと分析設計を事前に固定する規律が防波堤になります。
- 交絡の「残存」:DID で時間不変の交絡は差し引けても、 処置と同時に起きた別の政策・ショック (時間可変の交絡) は残ります。 「その年その県だけに効いた別要因」がないかを常に疑ってください。 交絡・選択バイアスの残存点検は最後まで手を抜けません。
🚀 発展 — 識別戦略の引き出しを増やす
- 擬似ランダム割当の「源泉」を分類する:良い自然実験は割当の外生性を物語れます。 典型的な源泉は (1) 政策・行政境界(隣接県・市町村合併・学区の線引き→RDD と相性が良い)、 (2) くじ・定員・締切(抽選、 予算枠、 生年月日による適用線引き)、 (3) 災害・天候・自然条件(地震・豪雨・地形)です。 源泉ごとに疑うべき交絡が変わります。
- 断続時系列デザイン (interrupted time series):対照群が取りにくいとき、 処置導入前後の時系列トレンドの「折れ」で効果を測る方法です。 パネルの DID が使えない単一系列でも、 導入前トレンドを反実仮想として延長し、 水準・傾きの変化を検出します。
- 感度分析で「仮定への頑健性」を測る:外生性は完全には検証できないので、 「未観測交絡がどの程度あれば結論が覆るか」を定量化します。 プラセボ検定 (効果が出るはずのない偽の処置年・偽の対象で効果ゼロを確認)、 ブートストラップによる区間推定、 リード・ラグ項による事前トレンド検定を組み合わせるのが定石です。
- 複数手法の三角測量 (triangulation):DID・RDD・IV は前提が異なるため、 別々の仮定に立つ手法が同じ結論に収束すれば、 どれか一つの仮定破れに依存しない強い証拠になります。 逆に食い違えば、 どの仮定が怪しいかを議論する出発点になります。 固定効果や対照群設計の妥当性も併せて検討します。
関連:因果と相関/平行トレンド。 なお「断続時系列」「外部妥当性 (external validity)」「感度分析」の独立ページは本用語集には未収録です(今後の追加候補)。
🗺 概念マップ
自然実験(中心)を、 上位の因果推論と、 推定に使う道具(DiD・RDD・操作変数・傾向スコア)、 研究者が割り当てる RCT と並べた図。 RCT はくじ引きで割当の外生性を作り、 自然実験は制度・境界・災害などが作った割当を借りる。 下の道具はどれも「割当がなぜ外生といえるか」 が崩れると結論が成り立たない。 傾向スコアは観測できる共変量しか調整できないので、 自然実験の代わりにはならない点に注意する。
概念マップは「政策・制度の不連続変化を実験と見なす」発想の派生 (DID / RDD / IV) を一望にする。 SSDSE-B-2026 で「ある政策 (例: 最低賃金改定) が一部の県だけで先行実施された」と仮定し、 消費支出 (L3221) など実在の指標を結果変数にとると、 改定前後・対象県/対照県の 2×2 で DID の効果推定が可能。
🔗 隣接手法への橋渡し
自然実験は因果推論の代表的フレームで、 隣接手法と組み合わせて識別戦略を組み立てる。
- 上流: SSDSE-B-2026 など複数年・複数自治体のパネルデータを用意し、 共変量 (総人口 A1101・消費支出 L3221・標準地価 C5401 など) を整える。 なお県内総生産 (GDP) や県民所得は SSDSE-B-2026 には列が無いため、 使うなら県民経済計算など外部データの結合が必要。 平行トレンドの可視化が前提
- 並列: 差分の差分 (DID)、 回帰不連続デザイン (RDD)、 操作変数 (IV) は自然実験の 3 大識別戦略。 SSDSE-B-2026 では制度施行年を境にした DID が典型
- 下流: 信頼区間 付きの効果推定値を bootstrap で出し、 プラセボ検定 (placebo test) や 感度分析 (sensitivity analysis) で頑健性確認
「制度ショック → DID 推定 → プラセボ検定 → 効果量の信頼区間」の流れが、 SSDSE-B-2026 のような行政統計を用いた因果推論で標準ワークフロー。
🌳 手法選択フロー
自然実験が見つかったとき、 どの推定方法に落とすかは「割当がどう決まったか」と「使えるデータの形」で決まる。
- Step 1: 研究者が割り当てられるか?
- 割り当てられる(倫理・費用の問題がない) → 自然実験を探すより A/B テスト・RCT を組む
- 割り当てられない → 制度・境界・災害などの外生的な割当を探す(Step 2 へ)
- Step 2: 割当はどう決まったか?
- Step 3: 結果をどこまで信じてよいか?
- 処置の起きていない年を偽の処置年にしたプラセボ検定で、 効果が出ないことを確かめる
- 47 県のような少数の単位では、 県ごとにまとめた(クラスタ)標準誤差や並べ替え検定で不確実性を出す