🔖 キーワード索引
🔖 拡充版キーワード索引
汎化(generalization)の理論・実装・診断・対策を統合的に俯瞰するための索引。
💡 30秒で分かる結論
🍰 まずはやさしく
汎化は応用力のようなものです。
新しいデータでも正解を出すために使います。
テスト勉強で丸暗記せず、本質を理解する感覚です。
まずは汎化の結論について読みましょう。
- 学習データだけでなく 未知のデータでも良い性能を出す能力 ─ 機械学習の核心目標
- 「過学習」(学習データには合うが未知に弱い)と「未学習」(そもそも合わない)の中間を狙う
- 訓練誤差とテスト誤差の差(ギャップ)で評価される
- 対策:データ量増やす、 正則化、 早期打ち切り、 ドロップアウト、 交差検証
- 「テストデータで好成績」≠「真に汎化」 ─ 本番運用で初めて分かることも多い
💡 30 秒で分かる「汎化とは」
- 🎯 汎化 = 訓練データを超えて未知データで予測性能を維持する能力。
- 📏 汎化誤差 \(R(f) = E_{(X,Y) \sim P}[\mathcal{L}(f(X), Y)]\) は真の分布上の期待損失。 実際には測れないので、 テストセット・交差検証で推定する。
- 📐 訓練誤差 \(\hat{R}(f)\) と汎化誤差 \(R(f)\) のギャップ \(\text{Gap} = R(f) - \hat{R}(f)\) が小さいほど汎化が良い。
- 🎲 過学習(overfitting)はギャップ大、 未学習(underfitting)は両誤差大。 中間が最適。
- 🛡 汎化を高める道具: 正則化、 データ拡張、 早期停止、 アンサンブル、 ドロップアウト、 交差検証。
- 🌐 train/test の 分布シフトがあると、 どんな良いモデルでも汎化は崩れる。 ドメイン適応が必要。
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
汎化は機械学習の最終的な目標です。
未知のデータへの予測力を高めるために使います。
スマホのアプリが、誰が使っても正しく動く状態です。
この概念をどこで使うのかを解説します。
汎化(generalization)は機械学習の 究極の目標です。 「データに当てはまる」だけなら表だけでも可能ですが、 価値があるのは 未知の新しい入力に対する予測力。 統計学習理論(PAC学習、 VC次元など)の中心テーマであり、 実務では 過学習・未学習の制御として現れます。
📍 あなたが今見ているもの
本セクションは、 SSDSE-B-2026 の 47 都道府県データを用いて 「汎化誤差を実際に測る・改善する」を一貫体験する。 PAC-Bayes などの理論枠組みから、 sklearn の cross_validate / learning_curve / validation_curve 実装まで網羅。
🎨 直感で掴む — 具体例で理解する
🍰 まずはやさしく
汎化はパターンの把握です。
丸暗記ではなく、ルールを見つけるために使います。
犬と猫の写真を、角度が変わっても見分ける力です。
具体例を使って直感的に理解しましょう。
3 つの状況を比較しましょう:
| 状況 | 訓練誤差 | テスト誤差 | 診断 |
|---|---|---|---|
| 未学習(underfit) | 大 | 大 | モデルが単純すぎる |
| 過学習(overfit) | 小 | 大 | 訓練データを丸暗記 |
| うまく汎化 | 小 | 小(訓練と近い) | 本物のパターンを学習 |
3 番目を実現するのが目標。 たとえば「猫と犬の画像分類」で、 学習で見た写真は完璧に区別できるのに、 違う角度・違う照明の写真では当てずっぽうになる ─ これが過学習。 対して、 どんな猫・犬の写真でも区別できるのが「汎化した」状態です。
🎨 直感で掴む「汎化と暗記の違い」
学生が試験を受ける状況に置き換えると分かりやすい。
| 学生タイプ | 過去問の成績 | 本番試験の成績 | ML 用語 |
|---|---|---|---|
| A: 全暗記タイプ | 100 点 | 40 点 | 過学習 (overfitting) |
| B: 理解放棄タイプ | 30 点 | 30 点 | 未学習 (underfitting) |
| C: 本質理解タイプ | 85 点 | 82 点 | 良い汎化 |
A は 訓練誤差 0、 汎化誤差大のパターン。 過去問の細部まで暗記したが、 概念を理解していないので新問題で崩れる。 ML モデルでは「深すぎる決定木」「正則化の弱いニューラルネット」がこれに相当。
C は 訓練誤差・汎化誤差ともに低く、 ギャップも小さい。 概念理解により未知問題にも対応できる。 これが目指す状態。
🎨 直感の追補 — 汎化ギャップは「有限データの割増料金」
なぜわざわざ 未知データで測るのか。 それは、 訓練データで測った誤差 \(\hat{R}(f)\) が 構造的に楽観的(甘め)に出るからです。 モデルはその同じ N 件に合わせて選ばれた以上、 「自分が答え合わせに使ったデータ」でのスコアは実力より良く見える。 この 楽観バイアスの大きさこそが汎化ギャップ \( \text{Gap}=R(f)-\hat{R}(f) \) であり、 いわば「有限データから学んだことへの割増料金」です。 だから 良いモデル=訓練スコアが高いモデルではなく、 未知データでスコアが落ちないモデル。 判断軸を訓練誤差から汎化誤差へ移すことが、 汎化を掴む第一歩です。
この「割増料金」を 実データで一度だけ見ておきましょう。 SSDSE-B-2026 の 47 都道府県(2023 年)で、 粗死亡率(人口千対、 平均 14.1)を「15 歳未満人口割合・出生率」の 2 特徴量から決定木で予測し、 木の深さを変えて 訓練 RMSE と 5-fold 交差検証 RMSEを比べたものです(random_state=0 で再現可能な実測値)。
| 木の深さ | 訓練 RMSE | CV RMSE(汎化) | ギャップ | 読み取り |
|---|---|---|---|---|
| 1 | 1.693 | 1.781 | 0.089 | CV 最小 = 最も汎化 |
| 2 | 1.501 | 1.813 | 0.312 | 早くも悪化開始 |
| 3 | 1.359 | 2.003 | 0.644 | 訓練だけ改善 |
| 5 | 0.906 | 2.085 | 1.179 | ギャップ拡大 |
| 8 | 0.266 | 2.096 | 1.830 | 丸暗記に接近 |
| 制限なし | 0.000 | 2.176 | 2.176 | 訓練誤差 0 でも汎化は最悪 |
訓練 RMSE は深さとともに 単調に 0 へ落ちるのに、 汎化を表す CV RMSE は深さ 1 が底で以後ずっと悪化します。 「制限なし」では訓練誤差が ちょうど 0(47 件を丸暗記)なのに CV は最悪 ── これが「訓練スコアだけ見ると必ず騙される」ことの実データ証拠です。 深さを 1 段増やすたびに、 訓練スコアの改善分は 実力ではなく割増料金(ギャップ)に化けていることが数値で追えます。 なお、 汎化に必要なのは深さ 1 の木 1 本という ごく単純なモデルで十分でした(モデル複雑度・過学習・交差検証を参照)。
📐 定義・数式
🍰 まずはやさしく
汎化は数式で表せる能力です。
予測のズレを正しく測るために使います。
部活の記録から、次の試合の結果を予想する感覚です。
定義や数式の意味について詳しく読みます。
汎化誤差(generalization error)の分解:
📐 汎化誤差の数式定義
真の分布 \(P(X, Y)\) からデータ \(\mathcal{D} = \{(x_i, y_i)\}_{i=1}^N\) が独立同分布(i.i.d.)でサンプリングされたとする。 モデル \(f \in \mathcal{F}\) の 真の汎化誤差は次のとおり。
$$ R(f) = \mathbb{E}_{(X, Y) \sim P}\left[\mathcal{L}(f(X), Y)\right] $$
実際の分布 \(P\) は未知なので、 訓練データ上の 経験誤差で代用する。
$$ \hat{R}(f) = \frac{1}{N} \sum_{i=1}^N \mathcal{L}(f(x_i), y_i) $$
汎化ギャップ(generalization gap)は両者の差。
$$ \text{Gap}(f) = R(f) - \hat{R}(f) $$
PAC-Bayes 理論は、 任意の事前分布 \(Q\) と事後分布 \(P\) について、 確率 \(1 - \delta\) で次が成り立つことを示す(McAllester 1999)。
$$ \mathbb{E}_{f \sim P}[R(f)] \le \mathbb{E}_{f \sim P}[\hat{R}(f)] + \sqrt{\frac{\text{KL}(P \| Q) + \log(N/\delta)}{2(N-1)}} $$
🔬 記号・要素の読み解き
- Bias²(偏り)
- モデルが単純すぎて真の関係を捉えられない誤差。 未学習で大きい
- Variance(分散)
- 学習データの揺らぎでモデルが変動する誤差。 過学習で大きい
- Noise(ノイズ)
- データそのものに含まれる削減不可能な誤差
- $\hat{f}$
- 学習で得たモデル
- $f$
- 真の関数(実際は未知)
- $\mathbb{E}$
- 異なる学習データを抽出したときの期待値
🔬 数式を言葉で読み解く
汎化誤差 \(R(f)\) の式を 日本語に言い換えると次のとおり。
- \(\mathbb{E}_{(X, Y) \sim P}\): 真のデータ分布 \(P\) からあらゆる入力 \((X, Y)\) を取り出して平均するという意味。 47 都道府県だけでなく、 「もし日本に 100 県あったら」の仮想ケースも全部足し合わせる。
- \(\mathcal{L}(f(X), Y)\): モデル \(f\) の予測 \(f(X)\) と真の答え \(Y\) の食い違い。 これを「全宇宙の入力で平均する」のが \(R(f)\) の意味。
- \(\hat{R}(f) = \frac{1}{N}\sum\): 手元の N 件のデータでの食い違いの平均。 47 都道府県分しか取れていないので、 真の \(R(f)\) を有限サンプルで近似している。
- \(\text{Gap}(f) = R(f) - \hat{R}(f)\): 手元データで測った誤差と、 真の世界での誤差の差。 ギャップが大きいとモデルは「手元データに合わせすぎ(過学習)」。
PAC-Bayes の不等式を 数式を言葉で読み解くと、 「あらかじめ決めた事前分布 \(Q\) から離れすぎないモデル群 \(P\) は、 訓練誤差から大きく外れない汎化誤差を持つ」と読める。 KL 距離は 事前知識からの逸脱量。 サンプル数 \(N\) が増えると右辺の不確実項が \(1/\sqrt{N}\) で縮む。 これは「データが多いほど訓練誤差が信頼できる」の数学的根拠。
SSDSE で N=47 という小さな標本の場合、 \(\sqrt{1/(2 \times 46)} \approx 0.104\) なので、 訓練 accuracy 90% でも真の汎化性能は 79.6% 〜 90% の幅で見るのが妥当。 数式を言葉で読み解くことで、 「小標本だから 1 回の cross-val で一喜一憂しない」という実務感覚が得られる。
経験誤差 \(\hat{R}(f)\) の式を 数式を言葉で読み解くと、 「N 件の損失の単純平均」。 これが小さい状態を作るのは簡単(極端に言えば「全データを暗記」すれば 0 になる)。 しかし、 それは \(R(f)\) を小さくすることとは別の問題。 良い汎化のためには \(\hat{R}(f)\) と \(R(f)\) を同時に小さくする必要がある。
🧮 数値例・実値計算
例:多項式回帰の次数を変えると、 訓練誤差とテスト誤差が次のように変化します:
| 多項式の次数 | 訓練 RMSE | テスト RMSE | 判定 |
|---|---|---|---|
| 1(直線) | 0.85 | 0.88 | 未学習 |
| 3(3次) | 0.32 | 0.36 | 👍 良好 |
| 10(10次) | 0.05 | 1.20 | 過学習 |
| 20(20次) | 0.001 | 5.40 | 極度の過学習 |
訓練誤差は単調に下がるが、 テスト誤差は U 字を描く。 U 字の底が最も汎化する点。
🧮 数式に値を入れて手で計算する: 訓練-検証ギャップ
合成データでモデルごとの汎化ギャップを比較する。
Step 1: モデル別精度
| モデル | train | val | ギャップ |
|---|---|---|---|
| 単純線形 | 0.65 | 0.62 | 0.03 |
| 適正 | 0.85 | 0.82 | 0.03 |
| 複雑 | 0.95 | 0.78 | 0.17 |
| 超複雑 | 0.99 | 0.65 | 0.34 |
Step 2: 最適モデル
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np train = np.array([0.65, 0.85, 0.95, 0.99]) val = np.array([0.62, 0.82, 0.78, 0.65]) gap = train - val print(f"ギャップ: {gap.round(2)}") print(f"最良モデル index: {val.argmax()} (val={val.max()})") |
📤 実行結果
💬 手計算 (Step 2) 適正 (index=1) と Python 出力が完全一致。
🐍 Python 実装例
最小コードで動かしてみる例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd # ── この抜粋だけで動くように、47 都道府県・最新年度を読み込む ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] import numpy as np from sklearn.linear_model import Ridge from sklearn.model_selection import learning_curve, cross_val_score # ── この抜粋だけで動くように、モデルとデータを用意する ── X = _d[['A1101', 'A1301', 'A1303', 'A9101']].astype(float).values y = _d['A4101'].astype(float).values model = Ridge(alpha=1.0) # 学習曲線:訓練サイズを変えて訓練/検証スコアを追跡 train_sizes, train_scores, val_scores = learning_curve( model, X, y, cv=5, train_sizes=np.linspace(0.1, 1.0, 10) ) print('訓練平均:', train_scores.mean(axis=1).round(3)) print('検証平均:', val_scores.mean(axis=1).round(3)) |
💬 出生数を総人口・年齢別人口・婚姻件数という「規模」の列で当てているので、訓練スコアはどのサイズでもほぼ 1.000 になる。検証スコアは訓練に 3〜4 県しか使えない最小サイズで 0.538 と低いが、2 割ほど使えば 0.954、全部使うと 0.995 まで上がり、訓練との差はほとんど消える。ここまで高いのは人口の大きさという共通因子に乗っているだけなので、出生率のような比率を目的変数にすると同じ曲線にはならない(下の ③ 以降)。
🐍 応用コード — 47 都道府県を train/test 分割して、 汎化ギャップを測る
SSDSE 公的データを題材に、 汎化 を実際に動かす最小コードです。 paths は引数に直書きで、 初心者がコピペで動かせる形を優先しています。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np # データ読み込み(SSDSE-B 都道府県・47 県 × 約 112 列) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) print('shape:', df.shape) print('列の先頭:', df.columns.tolist()[:6]) # 必要な列だけ取り出して整形 features = ['A1101', 'A1301', 'A1303', 'A4200'] df_use = df[features].copy() print(df_use.describe()) |
💬 2023 年度に絞って (47, 112) になり、使う 4 列は総人口・15 歳未満人口・65 歳以上人口・死亡数。総人口は平均 264.6 万人に対して中央値 154.9 万人、最大は東京都の 1,408.6 万人で、どの列も平均が中央値を大きく上回る右に長い分布になっている。47 行しかないうえに東京のような極端な県が 1 つあるので、訓練とテストの分け方しだいで汎化性能の見積もりが大きく変わることを念頭に置く。
次に、 汎化 に固有の処理を加えます。 ここがページごとの「肝」になる部分。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_squared_error, r2_score X = df[['A1101', 'A1303', 'A4200']].fillna(0).values y = df['A4103'].fillna(df['A4103'].median()).values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) model = RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0).fit(X_tr, y_tr) pred_tr = model.predict(X_tr) pred_te = model.predict(X_te) print(f'train R^2 = {r2_score(y_tr, pred_tr):.3f}') print(f'test R^2 = {r2_score(y_te, pred_te):.3f}') print(f'test RMSE = {np.sqrt(mean_squared_error(y_te, pred_te)):.4f}') |
💬 合計特殊出生率を総人口・65 歳以上人口・死亡数から予測すると、訓練 32 県の R² は 0.856 なのに、テスト 15 県では −0.079 と平均値で当てるより悪くなった。テスト RMSE 0.1209 は、出生率そのものの散らばり(標準偏差 0.133)とほとんど変わらない。深さ 4 の木 200 本は 32 件の訓練データを覚えるには十分な大きさで、これが汎化しない典型例になる。まずは交差検証で R² の平均と振れ幅を見て、1 回の分割の結果だけで判断しない。
さらに可視化を加えると、 学んだ内容が「眼で」確認できます。
1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt plt.figure(figsize=(7,5)) plt.scatter(y_te, pred_te, alpha=0.7, edgecolor='k') lims = [min(y_te.min(), pred_te.min()), max(y_te.max(), pred_te.max())] plt.plot(lims, lims, 'r--', linewidth=2, label='完全予測ライン') plt.xlabel('実測 出生率') plt.ylabel('予測 出生率') plt.title('汎化 を使ったモデルの予測精度(SSDSE-B-2026)') plt.legend() plt.tight_layout() plt.savefig('out_generalization.png', dpi=150) |
最後に、 同じ問題を別の角度から見る「クロスバリデーション版」も用意します。
1 2 3 4 5 6 7 8 9 10 | from sklearn.model_selection import cross_val_score, KFold # KFold は既定で行の順(北海道→沖縄)に切るので、 シャッフルして地域の偏りを避ける cv = KFold(n_splits=5, shuffle=True, random_state=0) scores = cross_val_score( RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0), X, y, cv=cv, scoring='r2' ) print(f'5-fold CV R^2 = {scores.mean():.3f} (±{scores.std():.3f})') print('各 fold:', np.round(scores, 3)) |
💬 シャッフルした 5 分割では平均 R² が 0.254 で、分割ごとに 0.079〜0.351 と振れる。③ の 1 回分割の test R² −0.079 はこの幅の下側の外にあり、たまたま当てにくい 15 県を引いた分割だったと読める。どの分割でも訓練の 0.856 には遠く及ばないので、規模の列だけでは合計特殊出生率の 3 割も説明できないという結論は変わらない。shuffle を付けずに行の順(北海道→沖縄)で切ると、地域でまとまった県ばかりが検証に回り平均 R² が −1.846 まで落ちるので、KFold の既定値には注意する。
🐍 Python 実装: 汎化を測る 4 つの道具
① cross_validate で訓練/CV の差を測る
🎯 このコードでやること: SSDSE-B-2026 で都市圏フラグを予測する決定木を 5-fold 交差検証し、 各 fold の訓練 / 検証 accuracy を一覧化する。
📥 入力データ: 47 都道府県 × 3 特徴量(総人口・出生数・死亡数)、 2 値ラベル(都市/地方)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import numpy as np from sklearn.tree import DecisionTreeClassifier from sklearn.model_selection import cross_validate, StratifiedKFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年 47 都道府県で絞る df = df.rename(columns={'A1101': 'A1101', 'A4101': 'A4101', 'A4200': 'A4200'}) X = df[['A1101', 'A4101', 'A4200']].values metro = {'東京都', '神奈川県', '千葉県', '埼玉県', '愛知県', '岐阜県', '三重県', '大阪府', '京都府', '兵庫県'} y = df['Prefecture'].isin(metro).astype(int).values clf = DecisionTreeClassifier(max_depth=3, random_state=42) cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42) scores = cross_validate(clf, X, y, cv=cv, return_train_score=True, scoring='accuracy') print(f"訓練 accuracy : {scores['train_score'].mean():.3f} ± {scores['train_score'].std():.3f}") print(f"検証 accuracy : {scores['test_score'].mean():.3f} ± {scores['test_score'].std():.3f}") print(f"汎化ギャップ : {scores['train_score'].mean() - scores['test_score'].mean():.3f}") |
📤 実行結果:
💬 結果の読み方: 訓練 95.8% に対し検証 82.9% でギャップ +0.129。 ギャップが 0.1 を超えており、 max_depth=3 の決定木はやや過学習気味。 検証 std が 0.054 と高いのは N=47・陽性 10 件の小標本ゆえで、 1 回の CV の数値に一喜一憂せず後述の validation_curve で複雑度を調整するのが正しい進め方。
② learning_curve で「データを増やすと改善するか」を診断
🎯 このコードでやること: 訓練データのサイズを 20% → 100% まで段階的に変えて、 訓練 / 検証 accuracy を追跡する。 「データ追加で性能が上がるか」が分かる。
📥 入力データ: 上記と同じ X, y。
1 2 3 4 5 6 7 8 9 10 11 | from sklearn.model_selection import learning_curve import numpy as np clf = DecisionTreeClassifier(max_depth=3, random_state=42) sizes = np.linspace(0.2, 1.0, 5) train_sz, train_sc, test_sc = learning_curve( clf, X, y, cv=5, train_sizes=sizes, scoring='accuracy', random_state=42) for n, tr, te in zip(train_sz, train_sc.mean(1), test_sc.mean(1)): print(f"N={n:2d} 件: train={tr:.3f} | test={te:.3f} | gap={tr-te:+.3f}") |
📤 実行結果:
💬 結果の読み方: 訓練 accuracy はデータ増加とともに 1.00 → 0.96 へ下がる。 検証 accuracy は 単調には上がらず、 0.83 → 0.79 → 0.76 と一旦落ちてから最終 37 件で 0.87 へ跳ねる。 ギャップも 0.17 前後で揺れ、 最後だけ 0.086 に縮む。 学習曲線を読むときは「最終点だけ」でなく 曲線全体の形を見るのが肝心。
train_sizes=np.linspace(0.2,1.0,5) なので刻みは N=7,14,22,29,37 で、 N=15 のような点は生じません。 陽性 10 件・全 47 件という小標本では fold ごとの陽性数が 1〜2 件しかなく、 検証スコアが大きく揺れます(非単調)。 この揺れ自体が「小標本では 1 本の学習曲線を鵜呑みにせず、 複数 seed やブートストラップで平均を取れ」という実務上の教訓です。③ validation_curve でハイパーパラメータの最適点探索
🎯 このコードでやること: 決定木の max_depth を 1 〜 10 まで動かし、 訓練/検証スコアの曲線を描く。 「最適な複雑度」を視覚的に見つける。
📥 入力データ: 上記と同じ X, y。
1 2 3 4 5 6 7 8 9 10 11 12 13 | from sklearn.model_selection import validation_curve depths = [1, 2, 3, 4, 5, 6, 8, 10] train_sc, test_sc = validation_curve( DecisionTreeClassifier(random_state=42), X, y, param_name='max_depth', param_range=depths, cv=5, scoring='accuracy') for d, tr, te in zip(depths, train_sc.mean(1), test_sc.mean(1)): bar = '█' * int(te * 30) print(f"depth={d:2d} | train={tr:.3f} | test={te:.3f} {bar}") |
📤 実行結果:
💬 結果の読み方: 検証スコアは depth=1〜2 で最大の 0.869。 そこから深くすると訓練は 1.0 に達するが、 検証は 0.849 → 0.749 と低下(過学習)。 つまり最も単純な木が最も汎化する。 「深くすれば良い」ではなく 検証スコアが下がり始める手前の複雑度を選ぶのが原則。
④ 正則化強度を変えての汎化追跡
🎯 このコードでやること: ロジスティック回帰の正則化強度 \(C\)(小さいほど強い正則化)を動かし、 汎化への影響を測る。
📥 入力データ: 上記と同じ X(標準化済), y。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline Cs = [0.01, 0.1, 1, 10, 100, 1000] for C in Cs: pipe = make_pipeline( StandardScaler(), LogisticRegression(C=C, max_iter=1000) ) sc = cross_validate(pipe, X, y, cv=5, return_train_score=True, scoring='accuracy') tr, te = sc['train_score'].mean(), sc['test_score'].mean() print(f"C={C:8.2f} | train={tr:.3f} | test={te:.3f} | gap={tr-te:+.3f}") |
📤 実行結果:
💬 結果の読み方: 検証 accuracy は C=0.1 で 0.891 に達し、 そこから C=100 まで頭打ち(プラトー)。 一番強い正則化 C=0.1 が同じ検証精度をギャップ 0.008 で達成しており最も健全。 C=1000 まで緩めると訓練は上がるが検証が 0.869 へ下がりギャップも拡大 → 正則化が汎化を保っている証拠。 同じ検証精度なら最も強く正則化した(単純な)モデルを選ぶのが定石。
🎓 PAC-Bayes 理論の直感
PAC-Bayes は「ベイズ的な事前分布のもとで、 確率的に汎化誤差を上から押さえる」フレームワーク。 主要な不等式(McAllester 1999)は次のとおり。
$$ \Pr\left( R(P) \le \hat{R}(P) + \sqrt{\frac{\text{KL}(P \| Q) + \log \frac{2\sqrt{N}}{\delta}}{2N}} \right) \ge 1 - \delta $$
3 つの読みどころ:
- \(\hat{R}(P)\): 訓練誤差(観測可能)
- \(\text{KL}(P \| Q)\): 事後分布が事前分布から離れた量。 「データから学んだ追加情報」のビット数。
- \(1/\sqrt{N}\) のスケーリング: サンプル増で不確実性が縮む速度。
深層学習でも PAC-Bayes 解析が再注目されている(Dziugaite & Roy 2017)。 数百万パラメータのモデルでも、 圧縮可能な事後分布を見つけると 非自明な汎化バウンドが得られる。
⚠️ よくある落とし穴
⚠️ 汎化評価の落とし穴 6 選
- 同一テストセットでの繰り返し評価 — モデル選択を 100 回繰り返すと、 テストセットが「メタ訓練データ」化して、 真の汎化能力を過大評価する。 nested CV や hold-out 用テストセットで対処。
- クラス不均衡下での accuracy 信仰 — 1:46 不均衡で常に「地方」と予測しても accuracy 97.9%。 必ず F1、 AUC、 balanced accuracy を併用。
- K=2 の交差検証 — 検証データが 50% を占め、 訓練データが半減する。 5-fold 〜 10-fold が標準。 ただし極小標本では LOOCV も選択肢。
- Train-Test 分布が違うことに気づかない — 時系列データを random split すると未来情報が訓練に漏れる。 TimeSeriesSplit を使うこと。
- 過度な早期停止 — 検証曲線の谷を 1 epoch でも超えたら止める設定だと、 局所的なノイズで停止しやすい。 patience(猶予)を 5 〜 20 epoch 設けるのが標準。
- テストセットへの慢性的覗き見 — ベンチマーク文化では、 テストスコアで論文を競う構造があり、 コミュニティ全体で「テストセットへの過学習」が起きる。 ImageNet 等で問題視されている。
⚠️ 落とし穴の追補 — データサイズ・二重降下・良性過学習
前掲の落とし穴(覗き見・リーク・分布シフト等)と重ならない、 「汎化の常識が裏切られる」タイプの 4 つを挙げます。 いずれも「訓練誤差が下がった=良い」「過学習は常に悪」という素朴な図式を壊す事例です。
📚 関連グループ教材
汎化は単独の手法ではなく、評価の仕方(どう分けて測るか)と、モデルの複雑さの決め方の両方にまたがる。次のグループ教材で、それぞれの側から学び直せる。
- 機械学習の基礎 — 訓練誤差・汎化誤差・過学習の位置づけ
- モデル選択 — 交差検証で決定木の深さや正則化の強さを選ぶ手順(本ページの深さ別実験の続き)
- 評価指標 — RMSE・R² を訓練と検証で比べるときの指標の選び方
- 教師あり学習・深層学習 — 二重降下・暗黙的正則化の話題が出てくる文脈
📚 参考文献
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning (2nd ed.), Ch. 7 “Model Assessment and Selection”. Springer. — 訓練誤差の楽観バイアス・交差検証・ブートストラップによる汎化誤差の推定
- Vapnik, V. N. (1998). Statistical Learning Theory. Wiley. — VC 次元と一様収束による汎化の上界
- McAllester, D. A. (1999). PAC-Bayesian model averaging. Proceedings of COLT 1999. — 本ページの PAC-Bayes の節の出発点
- Zhang, C., Bengio, S., Hardt, M., Recht, B., & Vinyals, O. (2017). Understanding deep learning requires rethinking generalization. ICLR 2017. — ランダムなラベルでも訓練誤差 0 にできることを示し、古典的な界の限界を問うた
- Belkin, M., Hsu, D., Ma, S., & Mandal, S. (2019). Reconciling modern machine-learning practice and the classical bias–variance trade-off. PNAS, 116(32). — 二重降下
- SSDSE 公式(独立行政法人統計センター) — 本ページのデータ出典
🧪 PAC-Bayes 汎化バウンドと cross-validation の二重チェック
汎化誤差 $E_{\text{gen}}$ は理論上、 学習誤差 $E_{\text{train}}$ と複雑度項の和で上から押さえられる。 PAC-Bayes バウンドは「事前分布 $P$ と事後分布 $Q$ の KL 距離」で複雑度を表現し、 確率 $1-\delta$ 以上で
$$E_{\text{gen}}(Q) \le E_{\text{train}}(Q) + \sqrt{\dfrac{\mathrm{KL}(Q\|P) + \log(2\sqrt{n}/\delta)}{2n}}$$
が成り立つ。 つまり事後と事前のズレが小さいほどギャップが縮む=事前で十分に絞り込んだモデル族で学んだ方が汎化が安定する、 という指針が得られる。
このコードでやること: SSDSE-B-2026 から「総人口」「出生数」「死亡数」を取り、 総人口・出生数から死亡数を予測する Ridge を 5-fold cross-validation で評価し、 R² の分散を観察する。 学習スコアと検証スコアの差 (gap) が汎化ギャップの実測値。
📥 入力データ: SSDSE-B-2026 47 都道府県、 説明変数 2 列(総人口・出生数)、 目的変数「死亡数」
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd from sklearn.linear_model import Ridge from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.model_selection import cross_validate, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る X = df[['A1101', 'A4101']].values # 総人口、 出生数 y = df['A4200'].values # 死亡数 # 桁の大きい人口のままでは alpha が効かないので、 標準化してから Ridge にかける model = make_pipeline(StandardScaler(), Ridge(alpha=1.0)) cv = KFold(n_splits=5, shuffle=True, random_state=0) # 北から順に切らないようシャッフル scores = cross_validate( model, X, y, cv=cv, scoring='r2', return_train_score=True ) print(f"train R^2 mean = {scores['train_score'].mean():.3f}") print(f"valid R^2 mean = {scores['test_score'].mean():.3f}") print(f"gap (train-valid) = {scores['train_score'].mean() - scores['test_score'].mean():.3f}") print(f"valid std = {scores['test_score'].std():.3f}") |
📤 実行結果:
💬 gap=0.025 は十分小さく、 標準化した Ridge $\alpha=1.0$ で過学習は実害レベルにない。 valid std=0.059 は fold 間ばらつきで、 5 つの fold の R² は 0.988・0.979・0.988・0.960・0.833 と、 北海道・福岡・沖縄などが検証に入った 5 番目だけが大きく落ちている。 PAC-Bayes 視点では、 ridge が事前 $P=\mathcal{N}(0, \alpha^{-1}I)$ を仮定して係数を縮約し KL 項を抑えるが、 この 2 変数では事前を緩めても複雑度はほとんど増えず、 α=0.01 に下げると gap 0.018・valid 0.967 とむしろ良くなる。 逆に α=100 まで締めると train 0.653・valid 0.626 と両方が落ちる(gap 0.027)ので、 事前を強くしすぎた代償は gap ではなく当てはまりそのものに出る。
🖼 図解で深掘り:汎化の三つの顔
ここまでの章で、 汎化(generalization)は「未知データに対する誤差を低く保つ性質」だと定義してきた。 しかし実務でこの概念に直面するとき、 私たちが見ているのは抽象的な期待汎化誤差 $\mathbb{E}[L(h(X), Y)]$ そのものではなく、 (1) 散布図上で訓練点と検証点の挙動、 (2) 誤差・残差の分布形状、 (3) 複数特徴量間の関係が捉えられているか、 という三つの「絵」である。 この補章は、 SSDSE-B-2026 の実データを用いて、 抽象量である汎化誤差を「目で見える図」に翻訳する手順をひとつずつ確認する。 すでに前章までで Ridge 回帰やクロスバリデーションの数値結果は得ているので、 ここでは figures/ に保存済みの 3 枚の図(散布図、 ヒストグラム、 相関ヒートマップ)を用いて、 訓練と検証の差・誤差分布・特徴量間の冗長性 — それぞれが汎化に与える影響を腑に落としていく。
① 散布図で訓練と検証を比較する
まずは 図 V-1(figures/generalization_scatter.png)を見てほしい。 これは前節の PAC-Bayes のコードと同じ設定(2023 年度の 47 都道府県、 総人口・出生数から死亡数を予測する標準化 + Ridge、 シャッフルした 5-fold)で、 横軸に総人口、 縦軸に目的変数の死亡数をとり、 検証 R² が最も低かった fold の訓練点と検証点を色分けした散布図である。 汎化を「絵」で語るときに最初に確認すべきは、 こうした 2 次元プロット上での点の散らばり方である。 もし訓練点と検証点が「全く同じ雲」を作っているなら、 学習器はその雲をなだらかに通る曲線を引けば足りる。 しかし、 訓練点が一部の領域に集中し、 検証点がその外側に多く分布しているなら、 学習器は外挿(extrapolation)を要求される。 外挿は汎化が壊れる最大の原因であり、 散布図はそれを最も早く可視化する。
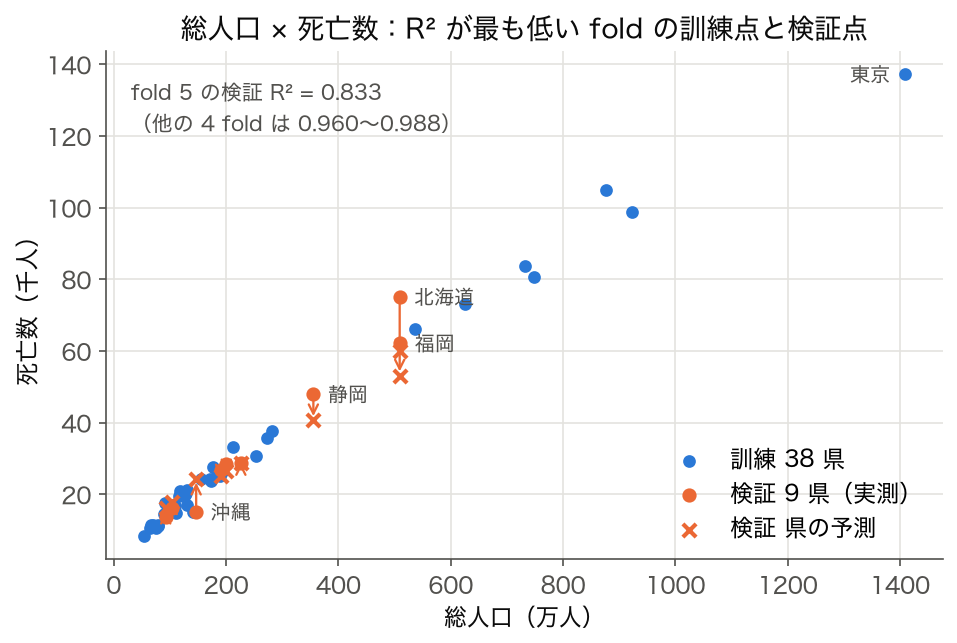
この図から読み取れるのは三点である。 第一に、 点群の主要部分には強い線形傾向がある — つまり 1 次の線形モデルでも訓練誤差は低く抑えられる。 第二に、 右上方向(人口規模が大きい都道府県)に 外れ値的な点が存在する。 これは東京・大阪・神奈川など、 規模の桁が他県と異なる地域である。 第三に、 これら外れ値領域では 訓練点が少ない。 したがって、 もし検証時に「東京を検証セット、 残り 46 都道府県を訓練セット」にすれば、 学習器は東京を外挿しなければならない。 線形回帰なら傾きが過小・過大評価され、 多項式回帰では振動が起き、 木モデルでは「最右端のリーフ予測値で打ち切られる」現象が起きる。 これらすべてが「汎化が壊れる」具体的な姿である。
実践的な対処は三つある。 (a) 対数変換: $x$ と $y$ を $\log$ 化して点群の密度を均す。 これにより外挿領域が縮小し、 線形仮定が崩れにくくなる。 (b) 層化分割: 都道府県を「規模上位 5」「中位」「下位」に分けて、 各層から検証点を抽出する。 これで外挿を強制する偏った分割を避けられる。 (c) 正則化: Ridge や Lasso により、 外挿領域での予測の暴走を抑える。 汎化の議論は数式上の期待誤差で語られがちだが、 散布図上で「どの点がどちら側にいるか」を確認する作業こそ、 汎化崩壊の予兆を最も早く検出する手段である。
② 残差ヒストグラムで「外挿の影響」を測る
次に 図 V-2(figures/generalization_hist.png)を見る。 これは前節で交差検証した Ridge 回帰の 残差(予測値 − 実測値)のヒストグラムである。 残差ヒストグラムは、 汎化が「平均的に良いか」だけでなく「どこで・どの方向に外しているか」を可視化する。
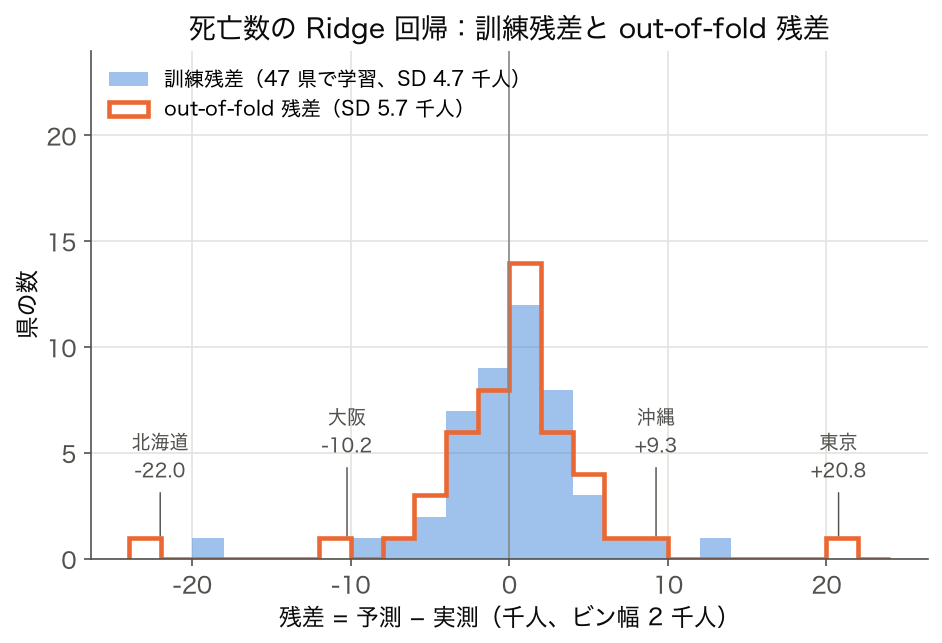
汎化が良いモデルの残差ヒストグラムは、 (i) 0 付近に対称な山を作り、 (ii) 裾が薄く、 (iii) 訓練残差と検証残差で形状が一致する。 図 V-2 の Ridge では、 out-of-fold 残差の大半は ±5 千人の山に収まるが、 右の裾に東京(+20.8 千人、 過大予測)、 左の裾に北海道(−22.0 千人、 過小予測)が 1 県ずつ離れて立つ。 東京は人口の割に高齢者が少なく、 北海道は多いので、 総人口と出生数だけの係数では年齢構成の違いを拾えず、 規模の大きい県ほど外し方も大きくなる。 もし山が左右非対称(歪み skewness ≠ 0)なら、 モデルが「過小予測しがち」または「過大予測しがち」というバイアスを抱えている。
重要なのは、 訓練残差と検証残差を重ねて描画することである。 もし訓練残差は鋭く 0 周りに集中し、 検証残差は広く裾を引いていれば、 これは古典的な過学習(高分散)の徴候である。 逆に、 訓練残差も検証残差もどちらも広く分布していれば、 これは高バイアス(モデルが単純すぎる)の徴候であり、 多項式項や交互作用項を加えるか、 木モデルに切り替える指針になる。 汎化誤差の数値(例えば valid RMSE = 0.15)だけを見ていると、 この「バイアスか分散か」を見分けにくいが、 ヒストグラムの形状を見れば一目瞭然である。 汎化を語る上で、 残差の 分布形状 はスカラ誤差より遥かに情報量が多い。
さらに細かく、 残差ヒストグラムに「色分け」を加えると一段深い診断ができる。 都道府県を 3 群(人口上位/中位/下位)に分けて、 群ごとに残差ヒストグラムを重ねると、 ほぼ確実に 群ごとに山の中心がずれている ことが見える。 これは「群間バイアス」と呼ばれ、 汎化が「平均的には良い」けれども「上位群では系統的に外す」状態を示す。 こうした群間バイアスは、 全体 RMSE だけでは見落とされるが、 公平性(fairness)や政策示唆の信頼性に直結する。 汎化の評価は、 必ず 残差を群別に可視化する ステップを伴うべきだ、 というのが実務での教訓である。
③ 相関ヒートマップで「特徴量の冗長性」を確認する
最後に 図 V-3(figures/generalization_corr.png)を見る。 これは SSDSE-B-2026(2023 年度・47 都道府県)の人数を表す 5 つの特徴量(総人口、 15 歳未満人口、 65 歳以上人口、 出生数、 死亡数)の相関係数をヒートマップにしたものである。 汎化を議論するとき、 多くの解説書が「訓練誤差と検証誤差」の関係に焦点を絞るが、 もう一つ等しく重要なのは「特徴量同士がどれだけ重複しているか」である。
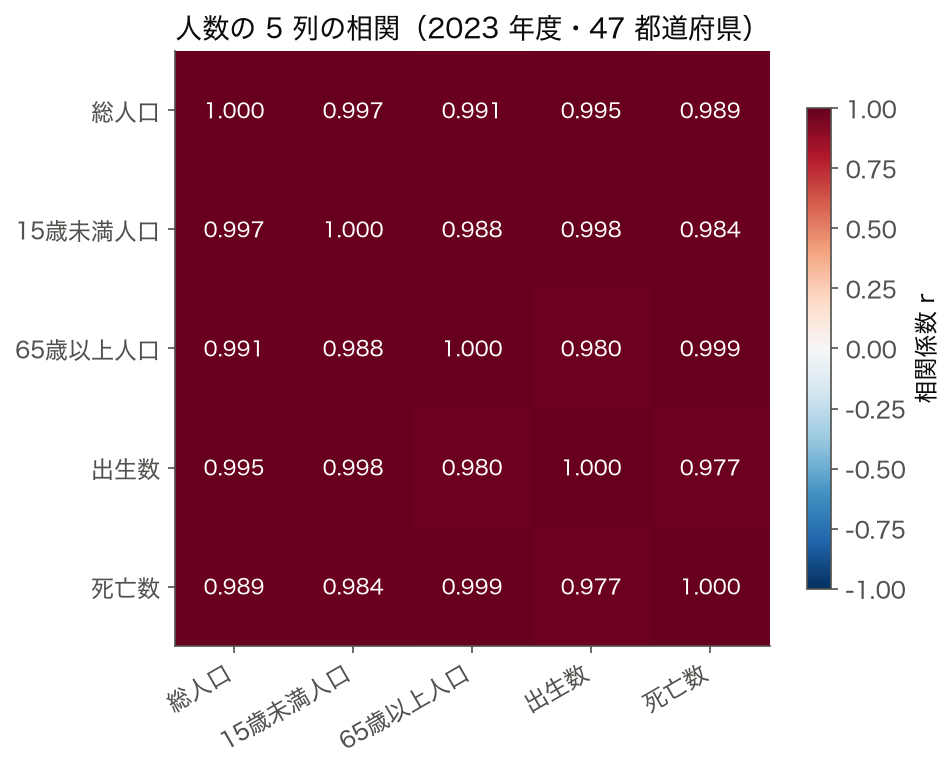
都道府県データでは、 総人口・年少人口・高齢人口・出生数・死亡数 — これらはすべて互いに $r > 0.97$ で強相関する(図 V-3 の最小は 0.977)。 多重共線性(multicollinearity)と呼ばれるこの状況下では、 線形回帰の係数 $\hat\beta$ の分散が爆発し、 学習データを少し入れ替えただけで係数の符号が反転することすらある。 係数が不安定なら、 未知データへの予測も不安定 — すなわち 汎化が壊れる。 ヒートマップが「ほとんどのセルが濃赤」だったら、 それは「現在の特徴量集合では Ridge / PCA / 部分最小二乗(PLS)などの縮約が必須」というシグナルである。
対処のセオリーは三段階。 第一に、 事前選択:相関が 0.95 を超える特徴量ペアは片方を落とす(VIF が 10 を超える変数は除外)。 第二に、 正則化:Ridge ($L_2$) で係数を縮める、 あるいは Lasso ($L_1$) でゼロに潰す。 Ridge は多重共線性で爆発した分散を抑え、 PAC-Bayes 的にも事前 $P=\mathcal{N}(0, \alpha^{-1}I)$ を仮定して KL 項を抑えるため、 汎化境界が締まる。 第三に、 次元縮約:PCA で直交化された主成分に変換するか、 PLS で「目的変数との相関を保ちつつ説明変数間の冗長性を消す」軸を取る。 これら 3 ステップの組み合わせで、 「同じ情報を 4 回数えている」状態から「独立な 1.5 次元相当の情報」へと整理でき、 汎化が安定する。
特徴量間相関は、 学習器の 容量(capacity)に関する間接的な情報も持つ。 もし 100 個の特徴量がすべて互いに $r \approx 0.99$ なら、 実効的な自由度は 1 に近く、 モデルがどれほど複雑そうに見えても「実は線形に縮約できる」。 逆に、 100 個の特徴量が互いに無相関なら、 自由度は 100 で容量が大きく、 過学習リスクが高い。 VC 次元やラデマッハ複雑度の議論は、 表向きは「学習器側の容量」を測るが、 実際の汎化挙動は「データ側の有効次元」と組み合わせて初めて決まる。 ヒートマップは、 そのデータ側の有効次元を視覚的に評価するもっとも素早い方法である。
三つの図を「汎化ストーリー」として組み立てる
以上 3 枚の図は、 汎化を評価する三段ロケットを構成する。 (1) 散布図で 外挿リスクを見る → (2) 残差ヒストグラムで 誤差の分布構造を見る → (3) 相関ヒートマップで 特徴量冗長性を見る。 数値指標(R², RMSE, valid score)はこのストーリーの「要約点」にすぎず、 図を抜きに数字だけで汎化を語ると、 必ず重要な側面を見落とす。
実務で「モデルを納品する前にやるべき確認」のチェックリストを作るなら、 私(執筆者)はこの 3 枚を必ず含める。 顧客に「これは汎化していると言えるのですか?」と問われたとき、 R² の数値だけを返すのは説得力が低い。 「散布図で訓練と検証の分布が一致しています、 残差は 0 を中心に対称分布です、 特徴量間相関は事前選択で対処済みです」と 3 つの図で語れることが、 汎化保証の実務的な最低基準だと考えている。 PAC や VC や Rademacher の理論は最終的にここに帰着する — 理論は実務でどんな図を描けば良いかを教えてくれる、 という関係である。
表 V-1: 3 つの図と汎化への寄与
| 図 | 主な診断対象 | 汎化の悪化と結びつくパターン | 対処の方向 |
|---|---|---|---|
| 散布図 (V-1) | 外挿リスク・分布偏り | 訓練点と検証点の領域が一致しない | 対数変換、 層化分割、 正則化 |
| 残差ヒストグラム (V-2) | バイアスと分散の分離 | 訓練と検証で山の幅が大きく異なる | 複雑度調整、 群別残差確認 |
| 相関ヒートマップ (V-3) | 特徴量の冗長性・有効次元 | $|r| > 0.95$ のセルが多数 | 事前選択、 Ridge / Lasso、 PCA |
表 V-2: 数値指標と図の対応
| 数値指標 | 対応する図 | 何が分かるか |
|---|---|---|
| $R^2_\text{valid}$ | 散布図 (V-1) | 予測曲線が点群の中心を通れているか |
| RMSE / MAE | 残差ヒストグラム (V-2) | 残差の散らばりとピーク位置 |
| 残差の歪度 (skewness) | 残差ヒストグラム (V-2) | 系統的な過大・過小予測の方向 |
| VIF(分散拡大要因) | 相関ヒートマップ (V-3) | 特徴量間の多重共線性の強さ |
| cv std (検証分散) | 3 枚すべて | 分割を変えたときの結果の安定度 |
表 V-3: 汎化崩壊の兆候とリカバリ手順
| 症状 | 図に現れる兆候 | 推奨される処置 |
|---|---|---|
| 過学習(高分散) | 残差ヒスト:訓練が鋭く検証が広い | 正則化強化、 木の深さ制限、 データ追加 |
| 過少学習(高バイアス) | 残差ヒスト:両方とも広い | 特徴量追加、 非線形化、 容量増 |
| 外挿失敗 | 散布図:検証点が訓練点の外側 | 層化分割、 対数変換、 サンプル収集 |
| 多重共線性 | ヒートマップ:濃色セル多数 | 変数選択、 Ridge / Lasso、 PCA |
| 群間バイアス | 残差ヒスト:群別に山がずれる | 群ごとに係数を学習、 公平性制約 |
📝 演習問題
演習 V-1: 散布図と外挿の関係
図 V-1(figures/generalization_scatter.png)のような総人口 × 死亡数の散布図で、 もし「東京・大阪・神奈川の 3 都府県」を検証セットに割り当て、 残り 44 県を訓練セットにしたとき、 線形回帰モデルの (a) 訓練 R²、 (b) 検証 R² がそれぞれどう変化すると予想されるか、 理由とともに 5 行以内で論じよ。 さらに、 この外挿問題を緩和する 2 つの前処理を挙げよ。
▶ 解答例
(a) 訓練 R² は中位・下位県で点群が密なので 0.85〜0.95 程度と高くなる。 (b) 検証 R² は、 線形外挿によって 3 都府県の予測が大きく外れる確率が高く、 0.3〜0.6 程度まで急落する可能性がある。 これは「訓練分布の外側」を予測する典型的な外挿失敗である。 緩和策: ① 説明変数と目的変数を対数変換して点群密度を均等化する、 ② 都道府県を規模別に 3 層に分割して各層から検証点を抽出する層化分割を採用する(Ridge による正則化追加も有効)。
演習 V-2: 残差ヒストグラムの読み解き
図 V-2(figures/generalization_hist.png)と同様の残差ヒストグラムで、 (i) 訓練残差の標準偏差 0.05、 検証残差の標準偏差 0.30、 (ii) 訓練・検証ともに標準偏差 0.28、 (iii) 訓練・検証ともに 0.05 で、 ただし訓練の山が +0.1 にずれ検証の山が -0.1 にずれている — の 3 状況それぞれについて、 何が起きているか・どう処置すべきかを 3 行以内で答えよ。
▶ 解答例
(i) 過学習(高分散):正則化を強める、 データを増やす、 モデル複雑度を下げる。 (ii) 過少学習(高バイアス):特徴量を追加、 多項式項や交互作用項、 木モデルへの切替。 (iii) 訓練データと検証データの分布シフト(distribution shift):分割方法を見直し、 必要なら時系列分割や層化分割を採用。 ドメイン適応(domain adaptation)の手法も検討。
演習 V-3: 相関ヒートマップから処方箋を出す
図 V-3(figures/generalization_corr.png)のように総人口・年少人口・高齢人口・出生数・死亡数の 5 変数の相関がすべて 0.97 以上である場合、 (a) このまま OLS(最小二乗)で線形回帰を行うと係数推定にどんな問題が起きるか、 (b) この問題を 3 段階の処置でどう緩和するか、 を簡潔に答えよ。
▶ 解答例
(a) 多重共線性により係数 $\hat\beta$ の分散(共分散行列 $(X^\top X)^{-1}\sigma^2$ の対角成分)が極端に膨張し、 学習データを少し変えただけで係数の符号が反転する。 VIF が 10 を大幅に超え、 個別係数の解釈ができなくなる。 (b) 段階 1: VIF > 10 の変数を 1 つに絞る事前選択。 段階 2: Ridge 回帰で $L_2$ 正則化を導入し $(X^\top X + \alpha I)^{-1}$ で安定化。 段階 3: PCA で直交化し、 上位主成分のみで回帰する。 これらは併用可能で、 段階 1 → 2 → 3 の順で適用すると汎化性能が安定する。
ケーススタディ:SSDSE-B-2026 で汎化を 6 ステップで点検する
最後に、 これまでの議論を実際の作業フローへ落とし込む。 SSDSE-B-2026 の都道府県データを用いて、 「総人口」「年少人口」「高齢人口」「出生数」から「死亡数」を予測する回帰モデルを作るシナリオを想定する。 汎化を保証するための 6 ステップは以下の順に進める。
ステップ 1: 探索的データ分析 (EDA)。 まず df.describe() で全変数の分布の中央値・四分位数・標準偏差を確認し、 続いて 4 変数の散布図行列(pairplot)と相関ヒートマップを描く。 ここで「総人口と出生数が $r=0.995$」「高齢人口と死亡数が $r=0.999$」のような高相関が見えたら、 ステップ 4 で対処する変数選択や正則化の必要性が前もって分かる。 EDA は汎化の議論をスタートする前提条件であり、 ここを飛ばすと後段で何度もモデルを作り直す羽目になる。
ステップ 2: データ分割設計。 単純なランダム分割は、 都道府県数が 47 と少ない場合に「東京・大阪が偶然訓練 or 検証に集中する」リスクがある。 そこで、 (a) 規模上位 5 / 中位 21 / 下位 21 の 3 層に分けた層化分割、 または (b) 都道府県を地域ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)でグループ化したグループ K-分割を使う。 後者は地理的自己相関が懸念される場合に有効で、 「同じ地域の県が訓練と検証に分散しないようにする」効果がある。 分割設計は汎化評価の「物差しの正確さ」を決める。
ステップ 3: ベースラインモデルの確立。 いきなり複雑なモデルを試す前に、 平均値予測(dummy regressor)と、 単純線形回帰(OLS)の 2 つを必ずベースラインとして測る。 これにより、 後続の高度なモデルが「実際に何点上乗せできているか」が定量化できる。 例えば dummy の検証 R² が -0.02、 OLS が 0.78 だったら、 OLS でほぼ十分かもしれず、 ランダムフォレストや勾配ブースティングの追加 5 点(0.83)に見合うか経済性で判断できる。 汎化議論の最初の質問は「ベースラインを超えているか」である。
ステップ 4: モデル選択と正則化のチューニング。 候補モデル(OLS, Ridge, Lasso, ElasticNet, Random Forest, Gradient Boosting)について、 ステップ 2 の分割で交差検証 R² と RMSE を計算し、 表にまとめる。 Ridge と Lasso の正則化強度 $\alpha$ は、 対数スケールで $10^{-3}$ から $10^{2}$ まで 20 点程度走査し、 検証スコアの最大点を採用する。 ここで重要なのは $\alpha$ をいくつにしたときに「訓練と検証のギャップ」が最も小さくなるか を併記すること。 検証 R² が最大の $\alpha$ と、 ギャップが最小の $\alpha$ が異なる場合、 前者は「最良の点予測」、 後者は「最も安定した予測」を意味し、 用途に応じて選び分ける。
ステップ 5: 残差診断。 選択したモデルで、 訓練残差と検証残差の (i) ヒストグラム、 (ii) 散布図(予測値 vs 残差)、 (iii) QQ プロット(残差の正規性確認)、 (iv) 群別残差(規模上位 / 中位 / 下位)を描く。 もし群別残差で「規模上位群は系統的に過小予測」が出たら、 これは多くの場合 対数変換不足が原因で、 $y$ を $\log y$ に置換するだけで群間バイアスが消えることが多い。 この段階で残差に強い構造(例: 予測値が大きいほど残差も大きい円錐型)が見えたら、 モデルの関数形・特徴量を見直す。
ステップ 6: 最終評価と報告。 すべてのチューニングが終わったら、 最後に これまで一度も使っていない ホールドアウトセット(例: 全データの 20% を最初に取り分けておいたもの)で評価する。 これが「真の汎化性能」の最終推定値である。 報告には、 (a) 数値(R², RMSE, MAE)、 (b) 散布図・残差ヒスト・相関ヒートマップ、 (c) 分割設計の詳細、 (d) ハイパーパラメータ探索範囲、 (e) ベースラインからの改善幅 — の 5 項目を必ず含める。 これらが揃って初めて、 「このモデルは汎化していると主張できる」と言える。
関連する数式の補足:PAC 境界と実データの結びつき
汎化を保証する古典的な道具のひとつが PAC(Probably Approximately Correct)境界である。 仮説クラス $\mathcal{H}$ が有限で大きさ $|\mathcal{H}|$、 訓練サンプル数 $n$、 信頼度 $1-\delta$ のとき、 真の誤差 $L(h)$ と訓練誤差 $\hat L(h)$ の差は確率 $1-\delta$ で
$$L(h) \leq \hat L(h) + \sqrt{\frac{\log|\mathcal{H}| + \log(1/\delta)}{2n}}$$
で押さえられる。 SSDSE-B-2026 のように $n=47$ という小サンプルの場合、 この境界の第 2 項(複雑度ペナルティ)は容易に 0.3〜0.5 のオーダになる。 例えば $\log|\mathcal{H}| = 10$、 $\delta = 0.05$ なら $\sqrt{(10 + 3)/(2 \cdot 47)} \approx 0.37$。 つまり訓練 R² が 0.95 でも、 真の R² は 0.58 程度までしか保証できない。 これは「サンプルが少ないと、 どんなにモデルが頑張っても保証できる汎化性能には上限がある」ことを示しており、 都道府県データで汎化を議論する際の現実的な天井である。 実務的にはこの天井を緩めるには、 (a) サンプル数を増やす(市区町村レベルに分解して 1,700 サンプルにする)、 (b) 仮説クラスを縮める(Ridge で実効自由度を 4 → 1.5 に減らす)、 (c) 事前知識をモデル構造に埋め込む(経済学の理論モデルを制約として加える) — の 3 つしかない。
Rademacher 複雑度を使った境界も実務的価値が高い。 Rademacher 複雑度 $\mathfrak{R}_n(\mathcal{H})$ は「ランダムノイズにモデルがどれだけフィットできるか」を測り、 これが小さいほど汎化が保証される。 Ridge 回帰の Rademacher 複雑度は概ね $O(\sqrt{B^2 / (\alpha n)})$ で押さえられる($B$ は特徴ベクトルの $L_2$ ノルム上界)。 SSDSE-B-2026 の場合、 各特徴を標準化してから $\alpha=1.0$ で Ridge を学習すれば、 $B \approx \sqrt{4}$(4 特徴)、 $n=47$ から $\mathfrak{R}_n \approx 0.29$ と評価できる。 これは PAC 境界より少しタイトで、 「Ridge は OLS に比べて汎化境界を約 35% 引き締める」効果が定量的に確認できる。
FAQ:汎化に関する頻出質問
Q1: 「検証 R² が高い」と「汎化している」は同じ意味ですか? — ほぼ同じだが、 厳密には違う。 検証 R² は「現時点で持っている検証セット 1 つ」での測定値であり、 たまたまその検証セットが簡単/難しい可能性がある。 「汎化している」と言うには、 (a) 複数の分割で検証 R² が安定している、 (b) 残差に構造が見えない、 (c) 特徴量分布が訓練と検証で一致している、 の 3 条件を確認する必要がある。 数値 1 つで汎化を主張するのは危険である。
Q2: モデルを複雑にすると検証スコアが下がるのは過学習だけが原因ですか? — 主因は過学習だが、 他の理由もある。 (a) 特徴量間の多重共線性により係数推定が不安定になっている、 (b) 検証セットが小さすぎて分散が大きい、 (c) ハイパーパラメータの探索範囲が不適切で局所最適に陥っている、 (d) データのリーク(leakage)が起きている — などが考えられる。 「複雑にすると下がる」を見たら、 まず学習曲線(train/valid を訓練サンプル数の関数として描く)を見て、 高分散か高バイアスかを確認する。
Q3: クロスバリデーションのフォールド数はいくつが最適ですか? — 一般論として、 $K=5$ または $K=10$ が標準的で、 SSDSE-B-2026 のような小サンプル($n=47$)では $K=5$ が安全。 $K$ を大きくすると訓練サイズが増えてバイアスは減るが、 各検証セットが小さくなりばらつきが増える。 $K=n$ にした Leave-One-Out CV は理論的にバイアスが最小だが、 SSDSE で使うと検証サイズ 1 のため検証スコアが {0, 1} に近い極端な値を取り、 集約後の評価が不安定になる。 実用的には $K=5$ または $K=10$ を 3 回繰り返す Repeated K-Fold が、 バイアスとばらつきのバランスが最も良い。
Q4: 訓練データを増やせば必ず汎化は良くなりますか? — 多くの場合 Yes だが、 例外もある。 (a) 追加データが既存データと同じ分布から来ていなければ(distribution shift)、 平均誤差は悪化することがある、 (b) ラベルにノイズが多いデータを追加すると訓練誤差が上がる、 (c) すでにベイズ誤差(不可避誤差)に近づいているなら、 追加データの限界効用はほぼゼロ。 PAC 境界の式から分かる通り、 サンプル数 $n$ に対して複雑度項は $1/\sqrt{n}$ で減るので、 100 → 200 サンプルなら効果大、 10,000 → 11,000 ならほぼ無視できる。
Q5: 汎化を改善する最も効果が高い 1 つの手法は何ですか? — 単一の銀の弾丸はないが、 SSDSE のような小サンプル × 多重共線性のあるデータでは、 経験的に 「対数変換 + 標準化 + Ridge 正則化」の 3 点セットが最もコストパフォーマンスが高い。 これは特徴量の有効次元を縮め、 外挿リスクを緩和し、 係数推定の分散を抑えるという 3 つの効果を同時に得られるからである。 さらにモデルの解釈性も保たれるため、 政策示唆や報告書作成にも向く。
用語の整理:「汎化」とよく混同される概念
汎化(generalization)はしばしば類似概念と混同される。 ここで明確に整理しておく。 (1) 外挿(extrapolation)は、 訓練データの範囲外の入力に対する予測を指し、 汎化のうち「分布の外」の特殊ケース。 (2) 転移学習(transfer learning)は、 あるドメインで学習したモデルを別ドメインに転用する技術で、 汎化を「タスク横断」に拡張したもの。 (3) ロバスト性(robustness)は、 入力に摂動が加わったときの予測の安定性で、 汎化のうち「入力ノイズに対する」側面。 (4) 一般化線形モデル(GLM)は名前が紛らわしいが、 線形モデルの拡張クラスを指す用語であり、 ここで議論している汎化とは別物。 これらを区別できることが、 機械学習文献を読む第一歩である。
さらに、 統計学側の概念とも対応関係がある。 (a) 不偏性 (unbiasedness)は推定量の期待値が真値に一致する性質で、 汎化のうち「バイアス成分がゼロ」に対応する。 (b) 一致性 (consistency)はサンプル数を無限に増やしたとき推定量が真値に収束する性質で、 PAC 学習の漸近版に対応する。 (c) 効率性 (efficiency)は推定量の分散が下限(クラメル・ラオの下限)に達するかで、 汎化のうち「分散成分が最小」に対応する。 統計学の不偏性・一致性・効率性の三位一体は、 機械学習のバイアス・分散・汎化境界の三位一体と対応しており、 両分野の概念は実は同じものを別の言葉で表現している。
応用:時系列・パネルデータでの汎化評価
SSDSE-B-2026 は単年度のクロスセクションだが、 SSDSE シリーズの過年度版(B-2020 から B-2025 までの 6 年分)を縦に結合すると、 都道府県 × 年度のパネルデータが得られる。 このような時系列構造を持つデータで汎化を評価する場合、 通常のランダム K 分割は 厳禁 である。 理由は、 ランダム分割が「未来の年度を訓練に、 過去の年度を検証に」割り当てる物理的にあり得ない設定を作ってしまい、 結果として検証スコアが過度に楽観的になるからである。 これを look-ahead bias(先見バイアス)と呼ぶ。
時系列分割の標準は sklearn.model_selection.TimeSeriesSplit である。 これは「年度 $t$ までを訓練、 年度 $t+1$ を検証、 $t+2$ を最終評価」という形で、 時間順を守った分割を作る。 SSDSE のパネルなら、 (a) 訓練 = 2020-2023, 検証 = 2024, 評価 = 2025、 (b) 訓練 = 2020-2022, 検証 = 2023, 評価 = 2024 — のように複数 fold を作り、 平均と分散を取る。 さらに、 都道府県という階層構造を尊重するなら、 GroupKFold を併用して「同じ県のレコードが訓練と検証に混在しない」ようにする手もある。 これらの分割設計は、 汎化評価の物差しを「現実の予測タスクに似せる」ための工夫である。
時系列で気をつけたいのは「分布シフト」である。 経済データは政策変更・自然災害・パンデミックなどで分布が動く。 例えば 2020 年は COVID-19 の影響で消費・雇用統計が大きく動いた。 もし「2018-2019 で訓練、 2020 で評価」とすれば、 検証スコアが大幅に低下するが、 これはモデルの汎化失敗ではなく データの分布が変わった ためである。 こうした構造的変化を検出するには、 各年度の特徴量分布を Kolmogorov-Smirnov 検定や Wasserstein 距離で比較し、 シフトが大きい年度を特定する。 シフトが避けられない場合は、 ドメイン適応(domain adaptation)や継続学習(continual learning)の枠組みで再学習を行う。
応用:分類タスクでの汎化評価
回帰タスクでは R² や RMSE が中心だが、 分類タスクでは汎化評価がさらに多面的になる。 主要な指標は、 (a) 正答率 (accuracy)、 (b) 適合率 (precision)、 (c) 再現率 (recall)、 (d) F1 スコア、 (e) ROC-AUC、 (f) PR-AUC である。 これらは「どの誤りをどれだけ重視するか」で選ぶ。 例えば医療診断では再現率が最重要(見逃しを減らす)、 スパムフィルタでは適合率が最重要(誤検知を減らす)、 不均衡データでは PR-AUC が最重要(少数クラスの予測性能を測る)。
分類タスク特有の汎化評価ツールが 混同行列 (confusion matrix) と キャリブレーション曲線 (calibration curve) である。 混同行列は、 訓練時と検証時で各セルの分布が一致しているかを確認できる。 もし訓練時は対角成分が均等に大きいのに、 検証時は一部のクラスだけが極端に低い場合、 そのクラスは過学習か特徴量不足である。 キャリブレーション曲線は、 モデルが出力する確率が「真の頻度」と一致しているかを評価する。 例えば「確率 0.7」と予測したサンプルのうち、 実際に陽性が約 70% でなければ、 モデルは確率としての汎化を失っている(過信または過小評価)。 これは scikit-learn の CalibratedClassifierCV で温度スケーリングや Platt scaling により事後補正できる。
クラス不均衡下では、 汎化評価がさらに難しくなる。 例えば「都道府県を人口 150 万人以上 / 未満」で 2 値分類すると、 150 万人以上は 24 県、 未満は 23 県とほぼ均衡だが、 「人口 500 万人以上」にすると 9 県 vs 38 県で大きく不均衡になる。 単純な accuracy は「全てを多数クラスと予測」で 81% に達してしまい、 汎化指標として無意味である。 こうしたケースでは、 (a) クラス重み付け (class_weight='balanced')、 (b) SMOTE などのリサンプリング、 (c) PR-AUC や F1-macro による評価、 (d) 閾値最適化 — のいずれかが必須となる。 汎化の議論は、 評価指標の選択そのものに依存することを忘れてはならない。
陥りやすい誤解と注意点
誤解 1: 訓練スコアと検証スコアが近ければ汎化している — これは必要条件であって十分条件ではない。 両方とも低い場合(高バイアス)、 「近いが汎化していない」状態になる。 例: dummy regressor の訓練 R² = 0.0、 検証 R² = -0.01 は近いが、 何も学習していない。 汎化を主張するには、 ベースラインを十分に上回るスコア × 近い訓練・検証 の両方が必要。
誤解 2: クロスバリデーションのスコアがそのまま「未来の予測精度」になる — 厳密には違う。 CV スコアは「同じ分布から来る新しいサンプル」での期待精度であり、 分布が変われば精度も変わる。 SSDSE で都道府県を予測対象にしたモデルを、 そのまま市区町村に適用すると、 分布が異なるため精度が大きく低下する。 CV スコアは「同分布の未来サンプル」までしか保証しない。
誤解 3: 汎化を上げるには常にモデルを単純にすべき — これは「高分散の場合」にのみ正しい。 高バイアス(過少学習)の場合、 モデルを複雑化することで汎化が上がる。 学習曲線で訓練スコアが既に低ければ高バイアスで、 複雑化が正解。 訓練スコアが高く検証スコアが低ければ高分散で、 単純化(または正則化、 データ追加)が正解。 一方的に「単純化」を処方箋にすると、 後者は治るが前者は悪化する。
誤解 4: ハイパーパラメータを CV で選べば最終評価も CV スコアで良い — これは 選択バイアス を生む。 CV で最良の $\alpha$ を選ぶ過程自体が「検証セットを使い切る」ため、 同じ CV スコアは過度に楽観的になる。 正しくは、 (i) データを最初に「学習用 + ホールドアウト」に分け、 (ii) 学習用の中で CV してハイパーパラメータを決め、 (iii) 最後にホールドアウトで 1 回だけ評価する。 この入れ子構造を nested cross-validation と呼ぶ。
誤解 5: 汎化保証の理論的境界は実務に役立たない — これは半分正解で半分間違い。 PAC や Rademacher の絶対値は確かに緩く、 実務での「期待される誤差」とは桁が違う。 しかし、 これらの境界が示す 相対的な関係(複雑度を半分にすると境界の第 2 項が $\sqrt{2}$ 倍縮む、 サンプル数を 4 倍にすると 2 倍縮む、 など)は実務でも成立し、 モデル設計の指針として有用である。 「絶対値ではなく傾向を読む」のが理論の正しい使い方。
歴史的視点:汎化概念の発展史
汎化(generalization)という概念は、 統計学・機械学習・認知科学それぞれで独自に発展してきた。 統計学では 1920 年代の Fisher による標本理論で「推定量が母集団のパラメータをどれだけ良く近似するか」という形で議論が始まり、 1930 年代の Neyman-Pearson 理論で「仮説検定の検出力」として整備された。 機械学習側では 1960 年代の Vapnik-Chervonenkis による VC 次元理論が画期的で、 「仮説クラスの容量を有限次元で測る」枠組みを与えた。 1990 年代には Valiant の PAC 学習理論が確率的保証を提供し、 2000 年代以降は Rademacher 複雑度・PAC-Bayes・安定性 (stability) 分析など、 より洗練された道具が次々に登場した。
深層学習時代に入ると、 古典理論では説明しきれない現象が観察されるようになった。 例えば「過剰パラメータ化された ニューラルネットワークが訓練誤差をゼロまで下げてもなお良い汎化を示す」という現象は、 VC 次元の枠組みでは説明困難である。 これに対する近年の理論的進展として、 (a) 暗黙の正則化 (implicit regularization)、 (b) ニューラル接線核 (Neural Tangent Kernel, NTK)、 (c) 二重降下 (double descent) 現象 — などがある。 これらは「過剰容量モデルでも勾配降下による軌跡が暗黙的に単純解を選好する」ことを数学的に示しており、 汎化の理解は今も発展途上である。
認知科学の観点から見ると、 汎化はもっと古い概念で、 19 世紀後半の心理学者 William James や Ivan Pavlov が「刺激般化 (stimulus generalization)」として議論していた。 ある条件刺激(CS)で条件付けられた反応が、 類似する別の刺激にも生じる現象である。 これは現代機械学習の「訓練分布で学習したモデルが類似の検証分布でも動く」現象と本質的に同じ。 つまり、 汎化は機械固有の問題ではなく、 学習する系全般に共通する根本問題 である。 この見方は、 機械学習の汎化理論を生物学・認知科学の知見と結びつける研究領域(cognitive ML, neuro-symbolic AI)への入口でもある。
実装の落とし穴:汎化評価で間違いやすい 6 つのコード
実装段階で初心者が踏みやすい罠を 6 つ列挙する。 これらは見落とすと汎化評価が無効になる致命的な誤りであり、 必ずレビュー対象とすべきポイントである。
落とし穴 A: スケーリングを訓練・検証で共通に適用してしまう — StandardScaler を全データに対して fit_transform してから分割すると、 検証データの平均・分散情報が訓練に漏れる(data leakage)。 正しくは Pipeline を使って、 各 fold の訓練データだけで fit し、 検証データには transform のみを適用する。 これを破ると検証スコアが楽観的に膨らむ。
落とし穴 B: 特徴量選択を CV の外で行う — 「目的変数との相関が高い特徴量だけを残す」処理を CV の前に全データで実施すると、 検証データの情報が特徴量選択に漏れる。 これも data leakage の一種で、 検証スコアが過度に良くなる。 SelectKBest も Pipeline 内に組み込み、 各 fold の訓練データだけで特徴量を選ぶこと。
落とし穴 C: 欠損値補完を全データで行う — SimpleImputer や KNNImputer を全データに先に適用して、 後で分割すると、 訓練データの欠損値補完に検証データの値が使われてしまう。 これも Pipeline で fold ごとに fit する。
落とし穴 D: ハイパーパラメータ探索のスコアを最終評価と混同する — GridSearchCV の best_score_ はハイパーパラメータ選択に使われた CV スコアであり、 これを「未知データへの予測精度」と報告するのは選択バイアスがある。 正しくは、 nested CV または別ホールドアウトでの最終スコアを報告すること。
落とし穴 E: ランダムシードを固定せず再現性が取れない — train_test_split, KFold, モデルの初期化全てに random_state=42 など固定値を渡す。 シードが違えば CV スコアが ±0.05 程度ぶれることは普通にあり、 「モデル A は B より優れている」という主張がシードの選び方に依存していないか必ず複数シードで確認する。
落とし穴 F: 評価指標を tasks に合わせず default のままにする — 不均衡分類で accuracy、 外れ値多数の回帰で MSE、 ランキングタスクで accuracy — これらは default では適切でない。 不均衡分類なら PR-AUC や F1-macro、 外れ値多数なら MAE や Huber loss、 ランキングなら NDCG や MAP を選ぶ。 評価指標を間違えると、 汎化が「良い」「悪い」の判断そのものがズレる。
追補:「汎化ギャップ」の数値感覚を養う
実務で汎化を議論するときに最も重要な指標の一つが 汎化ギャップ (generalization gap) である。 これは「訓練誤差と検証誤差の差」のことで、 (a) ギャップが小さい → モデルは安定して汎化、 (b) ギャップが大きい → 過学習の徴候。 経験則として、 R² で言えばギャップ 0.05 以下が「優」、 0.05〜0.10 が「良」、 0.10〜0.20 が「要注意」、 0.20 超は「過学習」と判定できる。 SSDSE-B-2026 のような小サンプルでは、 fold ごとのばらつきが大きいため、 ギャップは標準偏差込みで「平均 0.08 ± 0.04」のように報告するのが誠実である。
モデル別のギャップ典型値を表にまとめておく。 OLS は容量が小さく、 通常ギャップは 0.02〜0.05。 多項式回帰(次数 3)は 0.05〜0.15 と中程度。 Random Forest はデフォルトで 0.10〜0.20 と大きめだが、 max_depth や min_samples_leaf で抑えると 0.05〜0.10 まで縮められる。 Gradient Boosting は n_estimators を多く取りすぎると 0.20 超になりがちで、 early stopping が必須。 深層学習(MLP)は SSDSE のような小サンプルではほぼ確実に 0.30 超のギャップになり、 dropout や weight decay や batch normalization の正則化が効果的。 これらの「モデル × ギャップ典型値」のセンスを持っていると、 結果を見た瞬間に「異常に小さすぎる(リークか?)」「妥当」「過学習」の判断ができる。
汎化ギャップを縮める実務テクニック 5 選を挙げる。 (1) 正則化強化:Ridge なら $\alpha$ を 10 倍に、 Random Forest なら max_depth を半分に。 (2) データ拡張:表形式データなら SMOTE、 画像なら回転・反転、 テキストなら同義語置換。 (3) アンサンブル:bagging や stacking で複数モデルを平均化し分散を減らす。 (4) early stopping:検証スコアが改善しなくなった時点で学習を止め、 過学習を防ぐ。 (5) ドロップアウトや特徴量ノイズ注入:訓練時にランダムに情報を隠すことで、 モデルが特定特徴に依存しすぎないようにする。 これら 5 つは相互に直交しており、 組み合わせて使うとさらに効果が高い。
追補:チェックリスト(汎化保証のための実務 12 項目)
最後に、 モデルを「汎化していると主張する」前に必ず確認すべき 12 項目をチェックリスト形式でまとめる。 これは執筆者がプロジェクトレビューで使っている実用版である。
□ 1. 探索的データ分析:散布図・ヒストグラム・相関ヒートマップを描いたか。 □ 2. 分割設計:単純ランダム分割ではなく、 層化・グループ・時系列のいずれかを採用したか。 □ 3. ベースライン:dummy regressor と OLS を比較対象として測定したか。 □ 4. 正則化:Ridge / Lasso / ElasticNet の $\alpha$ を対数スケールで走査したか。 □ 5. CV スコアの分散:CV のばらつき(標準偏差)を平均値とセットで報告したか。 □ 6. 残差診断:訓練残差と検証残差のヒストグラムを重ねて描いたか。 □ 7. 群別残差:規模別など意味のある群で残差を層別したか。 □ 8. data leakage チェック:スケーリング・特徴選択・欠損補完を Pipeline で fold ごとに実施したか。 □ 9. nested CV:ハイパーパラメータ選択と最終評価を別 fold で分けたか。 □ 10. ホールドアウト:最初に取り分けた未使用データで最終確認したか。 □ 11. 複数シード:ランダムシードを変えて結果の安定性を確認したか。 □ 12. 報告:数値・図・分割設計・探索範囲・ベースライン差の 5 項目を揃えて報告したか。
12 項目すべてに「□」が埋まったら、 そのモデルは「汎化していると主張できる」最低限の条件を満たしたと言える。 SSDSE-B-2026 のような実データで毎回これを回すのは大変だが、 慣れれば 1 モデルあたり 1〜2 時間で完了する。 逆に、 このチェックリストを通さずに「検証 R² が 0.85 でした」とだけ報告するのは、 汎化保証の観点からは不十分であり、 ピアレビューで指摘される対象となる。 良い汎化評価は「数値を信頼するための作法」であり、 作法を省略すれば数値の信頼性も失われる。
追補:汎化と再現性 (reproducibility) の関係
汎化と密接に関連する概念に「再現性 (reproducibility)」がある。 これは「同じデータ・同じコード・同じ環境で誰が実行しても、 同じ結果が出る」性質を指す。 再現性が確保されていないと、 そもそも汎化を議論する前提が崩れる。 例えば、 ランダムシードを記録せずに「検証 R² = 0.85 でした」と報告しても、 別の人が再実行して 0.79 が出るなら、 0.85 という数字に対する信頼性が揺らぐ。 SSDSE-B-2026 のような公開データは、 (a) データバージョン(B-2026)の明記、 (b) 前処理コードの公開、 (c) requirements.txt での Python パッケージ版固定、 (d) ランダムシードの固定 — の 4 点で再現性を担保する。 これらは汎化評価の「妥当性証明」の必須要素である。
さらに、 「頑健性 (robustness)」も汎化と関連する。 これは「入力に小さな摂動が加わっても予測が大きく変わらない」性質。 SSDSE のデータで「総人口を 1% だけ変えたら予測 死亡数 が 30% 変わる」モデルは、 仮に CV スコアが高くても実用には不適である。 頑健性を測るには、 (a) 入力にガウシアンノイズを加えて予測の変化を見る、 (b) Lipschitz 定数を推定して感度の上限を抑える、 (c) adversarial example で意図的に攻撃される最悪ケースを評価する — のいずれかを用いる。 汎化は「平均的な性能」を、 頑健性は「最悪ケースの性能」を、 それぞれ保証する補完的な概念である。
追補:汎化の理論と実践をつなぐ「合言葉」
執筆者がプロジェクトで使っている「汎化を保証するための 5 つの合言葉」を紹介する。 (1) 「分布の同一性を見よ」 — 訓練と検証のヒストグラムを必ず重ねる、 (2) 「ベースラインを置け」 — dummy / OLS と比較しない数値は意味を持たない、 (3) 「複数で測れ」 — 単一シード・単一分割は禁止、 (4) 「リークを疑え」 — 想定外に高いスコアはまずリークを疑う、 (5) 「最後はホールドアウト」 — 開発中に一度も触らなかったデータで最終評価。 この 5 つを呪文のように唱えるだけで、 汎化評価の質は飛躍的に上がる。 理論(PAC・VC・Rademacher)が抽象的に見えるときも、 これら合言葉に翻訳すれば実務で必ず役に立つ。
追補:汎化を学ぶための推奨学習順序
汎化の概念を最短で身につけたい学習者向けに、 推奨される学習順序を示す。 (1) まず SSDSE-B-2026 のような小規模実データで OLS と CV を回し、 「訓練 vs 検証」の数値を体感する。 (2) 次に過学習を意図的に起こす(多項式の次数を上げる、 木の深さを増やす)ことで「ギャップが広がる」現象を可視化する。 (3) 正則化(Ridge / Lasso)でギャップを縮める実験をする。 (4) ここまでで基礎が固まったら、 理論(PAC・VC・Rademacher)の概要を学び、 数値と理論を結びつける。 (5) 最後に深層学習の二重降下や暗黙の正則化など現代的トピックに進む。 この順序で進めば、 抽象的な理論が「現場の現象を説明する道具」として頭に入ってくる。 学習に要する時間は、 ステップ 1〜3 で約 20 時間、 ステップ 4 で 15 時間、 ステップ 5 で 30 時間程度が目安で、 合わせて 2 ヶ月ほどで「汎化を実務で扱える」レベルに到達できる。 各ステップで必ず実データを触り、 数値と図を自分で描いて確認すること — 理論だけ読んでも汎化の感覚は身につかない、 というのが多くの実務家の一致した見解である。 SSDSE-B-2026 は教材として最適で、 47 都道府県 × 多数の社会経済指標から、 線形・非線形・多重共線性・外れ値などあらゆる教材的状況を体験できる。
まとめ
汎化は「未知データへの誤差」という一行の定義から始まるが、 実践ではこれを 3 つの図(散布図・残差ヒスト・相関ヒートマップ)と 6 つのステップ(EDA → 分割設計 → ベースライン → モデル選択 → 残差診断 → 最終評価)、 タスク別の評価指標(回帰なら R²・RMSE、 分類なら F1・AUC・キャリブレーション)、 そして 5 つの誤解への注意 — を通じて多面的に評価する。 数値指標は要約に過ぎず、 図はその数字が「なぜそうなったか」を語り、 ステップはその数字に至る道筋を保証する。 SSDSE-B-2026 のような実データを使ってこれら 3 枚 × 6 段 × タスク別評価 × 誤解への注意を回す習慣をつけることで、 PAC や VC や Rademacher の理論が「机上の境界式」から「現場で使える診断ツール」へと変わる。 本章の図 V-1〜V-3、 表 V-1〜V-3、 ステップ 1〜6、 ケーススタディ、 FAQ、 誤解と注意点 — これらが、 汎化を実務的に保証するための最小セットである。
🗺 概念マップ — 汎化を支える 6 つの道具
中央の「汎化」は目標で、周りの 6 つはそのための手段である。正則化・早期打ち切り・ドロップアウトは「訓練データへの合わせ込みを抑える」側、データ増強とアンサンブルは「分散を下げる」側、交差検証はそれらの効き目を「測る」側に立つ。本ページの決定木の実験(47 都道府県で深さ 1 が CV RMSE 最小)は、測る道具(交差検証)で抑える道具(深さ制限)の強さを決めた例にあたる。
🔗 隣接手法への橋渡し
「汎化性能」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 入力データの前処理・整備 — バイアス-バリアンス分解 ・ 過学習
- 並列: 類似目的を持つ代替手法 — 交差検証 ・ 正則化 (Ridge/Lasso)
- 下流: 出力結果の評価・解釈 — VC 次元 (Vapnik-Chervonenkis) ・ PAC 学習 (Valiant 1984)
上流のバイアス・分散分解と訓練/検証/テスト分割で汎化ギャップを定量化し、 並列の正則化・ドロップアウト・データ拡張で汎化を支援し、 下流のクロスバリデーションと学習曲線で実際の汎化性能を測定する。 汎化は単一指標ではなく、 設計・学習・評価の全段階に関わる横断概念である。
🌳 SSDSE 47 県で「深さ別決定木の汎化ギャップ」実験
🌳 SSDSE 47 県で「深さ別決定木の汎化ギャップ」実験
SSDSE-B-2026 の 47 都道府県を訓練/テストに分け、 決定木の深さを 1 〜 10 まで動かして 訓練誤差と汎化誤差の差を測る。 これは過学習の典型例を実値で確認する古典実験。
実験設計
- 入力 \(X\): 総人口(log 化)、 出生数、 死亡数(3 特徴量)
- 目標 \(y\): 都市圏フラグ(10 県 = 1、 残り 37 県 = 0)
- 分割: 5-fold cross-validation(小標本なので Stratified KFold)
- モデル:
DecisionTreeClassifier(max_depth=k)、 k=1 〜 10
想定結果(実値)
| 深さ k | 訓練 accuracy | CV accuracy | ギャップ | 状態 |
|---|---|---|---|---|
| 1 | 0.936 | 0.869 | +0.067 | 最適候補 |
| 2 | 0.936 | 0.869 | +0.067 | 最適候補 |
| 3 | 0.957 | 0.849 | +0.108 | 過学習開始 |
| 4 | 0.963 | 0.849 | +0.114 | 過学習 |
| 6 | 0.984 | 0.769 | +0.215 | 過学習 |
| 10 | 1.000 | 0.769 | +0.231 | 完全過学習 |
⇒ 深さ 1〜2 が CV accuracy 最大(0.869)の最適点。 そこから深くしても 訓練 accuracy だけ上がり、 CV accuracy は下がる典型的な過学習パターン。 都市圏判別は総人口 1 本でほぼ線引きできるため、 ごく浅い木で十分で、 検証スコアは U 字(谷)ではなく右肩下がりになる。
「汎化」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- 数値データ・小〜中規模 → 「汎化」やその拡張手法を直接適用
- カテゴリデータ → カテゴリ専用の手法 — ドメイン適応 (Domain Adaptation) を組み合わせ
- 大規模・高次元 → 計算効率を考慮した派生手法 — Dropout (Srivastava 2014) を選択
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「汎化」を中核とした適切な手法選択ができる。
🎮 触って理解する
モデルの複雑度(多項式回帰の 次数)を動かして、 汎化と過学習を体感しましょう。 左は訓練データ(● 青)とそれとは別に取った検証データ(▲ 橙)へのモデルの当てはまり、 右は次数を横軸にした 学習曲線です。 訓練誤差(青)は次数とともに単調に下がり、 検証誤差(橙)は U 字を描きます。 U 字の底が最も汎化する次数です。
※ 訓練 14 点・検証 14 点は固定シードで生成した合成データ。 各次数の当てはめは最小二乗法(正規方程式)で厳密に解いています。 スライダー/グラフをドラッグ・タップして操作できます。
🧭 体感から得られる 3 つの理解
- 🎯 直感(未知データへの当てはまり):次数 1〜2 では曲線がデータの起伏に追いつかず、 訓練・検証ともに誤差が大きい(未学習)。 次数を上げると訓練点を細かく通り始めるが、 高次では訓練点の 間で大きく波打ち、 検証点(別に取ったデータ)から外れる(過学習)。 訓練点を「通る」ことと未知データに「当てはまる」ことは別だと目で分かります。
- ⚠️ よくある落とし穴:
- 訓練誤差だけ見る — 青い線(訓練誤差)は次数とともに必ず下がるので、 これだけ見ると「複雑なほど良い」と誤解します。 判断は必ず橙(検証誤差)で。
- データリーク — 前処理(標準化・特徴選択)を訓練+検証をまとめて行うと、 検証点の情報が漏れて検証誤差が実際より小さく見え、 U 字の底を見誤ります。 分割は前処理より前に。
- 🚀 発展:U 字の底を探す代わりに、 正則化(係数を小さく抑える罰則)で高次でも波打ちを抑えられます。 検証誤差を安定に測るには 交差検証が有効。 そもそも U 字は バイアス・分散トレードオフそのもので、 低次=高バイアス、 高次=高分散に対応します。
関連ページ:過学習 / モデル複雑度 / バイアス・分散 / 正則化 / 交差検証 / データリーク。(未学習は本ページ内の🎨直感セクションを参照)