🔖 キーワード索引
別名・略称:ディープラーニング、 DL、 深層ニューラルネット
深層学習は 多層のニューラルネット で表現を自動獲得する手法群。 2012 年の AlexNet 以降、 画像・音声・言語の全領域で従来手法を凌駕しました。
🔖 キーワード索引(深掘り)
深層学習(Deep Learning, DL)は、 多層ニューラルネットワーク(NN)を用いて、 入力から出力までの複雑な関数を勾配降下で学習する機械学習手法。 2012 年 AlexNet による ImageNet 革命以降、 画像認識・音声認識・自然言語処理・強化学習・科学計算など、 ほぼすべての AI 分野で支配的なアプローチとなった。 2025 年現在、 LLM(GPT-4/Claude/Gemini)、 画像生成(Stable Diffusion)、 ロボット制御(V-JEPA 2)など、 基盤モデルの全てが深層学習の上に成り立つ。
💡 30秒で分かる結論
🍰 まずはやさしく
コンピューターが自ら学ぶ仕組みです。
データから特徴を自動で見つけるために使います。
スマホの顔認証などで使われています。
この章では深層学習の基本を学びます。
深層学習(Deep Learning):多層ニューラルネットで特徴を自動学習する機械学習
- 定義:3 層以上の隠れ層を持つニューラルネットによる機械学習。
- 表現学習:特徴量を 人が設計せず、 データから自動獲得。
- 転換点:2012 ImageNet で AlexNet が従来手法を約 10% 上回り旋風。
- 主要アーキテクチャ:CNN(画像)/ RNN・LSTM(時系列)/ Transformer(言語)。
- スケール則:パラメータ・データ・計算を増やすほど性能が法則的に改善。
- 3 種の神器:大量データ・GPU・誤差逆伝播 + Adam。
📍 あなたが今見ているもの
🍰 まずはやさしく
今のAIブームを支える主役です。
画像や言葉を正しく処理するために使います。
生成AIなどの便利な機能に役立っています。
なぜ層を深くすると性能が上がるのかを読みます。
📍 文脈ボックス(深掘り):なぜ「深い」のか
「深い」とは「層数が多い」という意味。 1980 年代までの NN は浅い(2-3 層)ものが主流で、 表現力に限界があった。 1980 年代後半 backpropagation が再発見されたが、 深い NN は 勾配消失問題で訓練が困難だった。
2006 年 Hinton らによる「層ごとの事前訓練」で深い NN の訓練が可能と示され、 2012 年 AlexNet(8 層 CNN)が ImageNet で従来手法を一気に 10 ポイント上回り、 深層学習革命が始まった。 ReLU、 dropout、 batch normalization、 ResNet(skip connection)などの工夫により、 数百層・数千層の NN も訓練可能になった。 2025 年の GPT-5、 Claude 4、 Gemini 2 は数千億~数兆パラメータの巨大 DL モデルである。
🎨 直感で掴む
🍰 まずはやさしく
人間が絵を見る方法に似ています。
複雑な形を段階的に理解するために使います。
写真の猫を判別する仕組みに似ています。
浅い学習と深い学習の違いについて読みます。
浅い学習 vs 深層学習
| 観点 | 浅い機械学習 | 深層学習 |
|---|---|---|
| 特徴量 | 人手で設計(特徴量エンジニアリング) | モデルが自動学習 |
| 層数 | 1〜2 層(線形 / SVM / 決定木) | 10〜1000 層以上 |
| データ要求 | 数百〜数万件で OK | 数万〜数億件が望ましい |
| 計算資源 | CPU でも十分 | GPU/TPU ほぼ必須 |
| 解釈 | 比較的容易 | ブラックボックス気味 |
| 代表 | ロジスティック回帰、 SVM、 RF | CNN、 Transformer、 Diffusion |
なぜ「層を深く」する?
- 階層的表現:低層がエッジ → 中層がパーツ → 高層が物体、 のように抽象度が上がる。
- 万能近似定理の実用化:理論上は 1 層でも近似可能だが、 深い方が指数的に効率良い。
- End-to-end 学習:入力 → 出力を一気通貫で最適化、 人手の中間表現が不要。
🎨 直感で掴む(深掘り):階層的特徴学習
メタファ 1:絵を見て理解するように
人間が絵を見るとき、 まずエッジ・色を捉え、 次に形・テクスチャ、 さらに物体パーツ、 最後に「これは猫」と認識する。 CNN はこの階層的処理を模倣する。 浅い層がエッジを、 中間層が形・パーツを、 深い層が物体全体を表現する。
メタファ 2:レゴブロックの組み立て
深層 NN は単純な変換ブロック(線形変換 + 活性化)を積み重ねたレゴ。 1 ブロックでは単純な関数しか表せないが、 100 ブロック積めば任意の複雑な関数を近似できる(universal approximation theorem)。
メタファ 3:プログラムを書く代わりに学習させる
「写真から猫を見つける」プログラムを人手で書くのは絶望的。 DL は「写真と正解ラベルを大量に見せる」だけで、 NN が必要な特徴抽出と判定を 自動で学習する。 ルールを書く代わりにデータを与えるパラダイム転換。
📐 定義 / 数式
🍰 まずはやさしく
計算のルールを数式で表したものです。
正解に近づくための計算をするために使います。
テストの点数を上げる勉強法のようなものです。
学習に使われる具体的な数式について読みます。
📐 数式(深掘り):forward / backward propagation
Forward Propagation
$L$ 層 NN の各層 $l$ の出力 $\mathbf{a}^{(l)}$ は:
$$\mathbf{z}^{(l)} = W^{(l)} \mathbf{a}^{(l-1)} + \mathbf{b}^{(l)}, \quad \mathbf{a}^{(l)} = \sigma(\mathbf{z}^{(l)})$$
$\sigma$ は活性化関数(ReLU, sigmoid, tanh, GELU 等)、 $W^{(l)}$ は重み行列、 $\mathbf{b}^{(l)}$ はバイアス。 最終層で予測 $\hat{\mathbf{y}} = \mathbf{a}^{(L)}$、 損失 $\mathcal{L}(\hat{\mathbf{y}}, \mathbf{y})$ を計算。
Backpropagation(chain rule)
勾配を出力側から入力側へ逆伝播:
$$\delta^{(L)} = \nabla_{\mathbf{a}^{(L)}} \mathcal{L} \odot \sigma'(\mathbf{z}^{(L)})$$
$$\delta^{(l)} = ((W^{(l+1)})^\top \delta^{(l+1)}) \odot \sigma'(\mathbf{z}^{(l)})$$
$$\frac{\partial \mathcal{L}}{\partial W^{(l)}} = \delta^{(l)} (\mathbf{a}^{(l-1)})^\top, \quad \frac{\partial \mathcal{L}}{\partial \mathbf{b}^{(l)}} = \delta^{(l)}$$
SGD / Adam による更新
$$W^{(l)} \leftarrow W^{(l)} - \eta \frac{\partial \mathcal{L}}{\partial W^{(l)}}$$
$\eta$ は学習率。 Adam は 1 次・2 次モーメントの指数移動平均を保持し、 適応的に LR を調整する。
数式を言葉で読み解く
- forward:「重みを掛けて、 バイアスを足して、 活性化関数で曲げる」を層ごとに繰り返し、 最終予測を得る。
- $\sigma'$:活性化関数の微分。 ReLU なら $\{0, 1\}$、 sigmoid なら $\sigma(z)(1-\sigma(z))$。
- $\delta^{(l)}$:層 $l$ の「誤差信号」。 連鎖律で 1 つ上の層から計算される。
- $\odot$:要素ごとの積(Hadamard 積)。
- 勾配消失:sigmoid 等で $\sigma' < 1$ なため、 深い層を遡るうちに $\delta$ が指数的に小さくなる。 ReLU + skip connection が解決。
- 計算コスト:1 ステップで forward + backward の 2 倍の計算量。 GPU 並列化が必須。
📐 DL 損失関数ファミリー
| 損失 | タスク | 式概要 |
|---|---|---|
| MSE | 回帰 | $\frac{1}{N}\sum (y - \hat{y})^2$ |
| MAE | 回帰(外れ値耐性) | $\frac{1}{N}\sum |y - \hat{y}|$ |
| Cross Entropy | 分類 | $-\sum y \log \hat{y}$ |
| Focal Loss | 不均衡分類 | $-(1-\hat{y})^\gamma \log \hat{y}$ |
| Contrastive (InfoNCE) | SSL | positive を softmax で最大化 |
| Triplet Loss | embedding 学習 | $\max(0, d(a,p) - d(a,n) + \alpha)$ |
| Dice Loss | semantic segmentation | $1 - 2 |X \cap Y| / (|X| + |Y|)$ |
| CTC | 音声認識 | 全アラインメントの周辺化 |
⚙️ 最適化アルゴリズム比較
| 名称 | 特徴 | 適用 |
|---|---|---|
| SGD | 基本、 LR が命 | CNN(warmup + cosine) |
| SGD with Momentum | 慣性で振動緩和 | ResNet 系 |
| Nesterov | 先読み momentum | 高速収束 |
| AdaGrad | LR を成分別に減衰 | 疎な勾配 |
| RMSProp | 指数移動平均で LR 調整 | RNN |
| Adam | 1 次 + 2 次モーメント | 汎用デフォルト |
| AdamW | weight decay 修正 | Transformer/LLM |
| LAMB | 大 batch 対応 | BERT 大規模訓練 |
| Lion | 符号のみ更新、 軽量 | 2023+ 流行 |
🏢 DL の実産業応用
| 分野 | 応用例 | 代表モデル |
|---|---|---|
| 医療 | X 線・MRI・病理画像診断、 創薬 | CheXNet, AlphaFold |
| 自動運転 | 物体検知、 セグメンテーション、 行動予測 | YOLOv8, BEVFormer |
| 音声 | 音声認識、 合成、 翻訳 | Whisper, Tacotron |
| 言語 | 翻訳、 要約、 質問応答、 コード生成 | GPT-4, Claude, Gemini |
| 画像生成 | Text-to-Image、 編集、 動画 | Stable Diffusion, DALL-E 3 |
| 推薦 | Netflix, YouTube, Amazon | Two-Tower, deep retrieval |
| 金融 | 不正検知、 信用スコア、 アルゴ取引 | TabNet, FinBERT |
| 気象 | 数値予報、 災害予測 | GraphCast, Pangu-Weather |
| 材料科学 | 新材料探索、 物性予測 | GNoME, MatterGen |
| ロボット | 把持、 ナビゲーション、 模倣学習 | RT-2, Optimus |
📘 DL 用語ミニ辞典
| 用語 | 意味 |
|---|---|
| epoch | 全訓練データを 1 回見た単位。 通常 10-1000 epoch 訓練。 |
| batch / mini-batch | 1 度に勾配計算するサンプル数。 32, 64, 256 が一般的。 |
| iteration / step | 1 batch で 1 更新。 1 epoch = N/batch_size 回の iteration。 |
| learning rate (LR) | 勾配を重みに反映する係数。 通常 1e-3 ~ 1e-5。 |
| activation function | 非線形関数(ReLU, GELU, sigmoid, tanh)。 NN に表現力を与える。 |
| dropout | 訓練時にランダムにニューロンを 0 化。 過学習対策。 |
| batch normalization | 層出力を batch 内で正規化。 学習安定化。 |
| layer normalization | 層内正規化。 Transformer 標準。 |
| residual / skip connection | 入力を出力に加算。 深い NN 訓練の鍵(ResNet)。 |
| attention | トークン間の関係性を学習。 Transformer の核。 |
| embedding | 離散値(単語等)の高次元連続表現。 |
| weight decay | 重みの L2 正則化。 過学習対策。 |
| gradient clipping | 勾配の大きさを上限制限。 勾配爆発対策。 |
| warmup | 学習初期に LR を徐々に上げる。 安定化。 |
| checkpoint | 途中のモデル重みを保存。 訓練中断・再開可能。 |
| overfitting | 訓練データに過剰適合。 汎化性能が落ちる。 |
| early stopping | 検証精度が下がり始めたら訓練終了。 過学習対策。 |
| data augmentation | 既存データから変換でサンプル増やす。 汎化性向上。 |
| transfer learning | 事前学習モデルを別タスクに転用。 |
| fine-tuning | 事前学習モデルを新データで再学習。 |
✅ DL プロジェクト実行チェックリスト
フェーズ 1:データ準備
- □ データ収集と品質チェック(欠損、 外れ値、 重複)
- □ train/validation/test の分割(時系列なら時間ベース)
- □ 正規化/標準化(z-score、 min-max)
- □ クラスバランス確認、 必要なら oversampling/undersampling
- □ data augmentation 戦略を決定
フェーズ 2:ベースライン
- □ 単純な baseline(最頻クラス、 線形モデル)の精度を測定
- □ 古典 ML(RF, XGBoost)で達成可能な精度を測定
- □ DL を採用する理由を明文化
フェーズ 3:モデル設計
- □ タスクに適したアーキ(CNN/RNN/Transformer)を選定
- □ 事前学習済みモデルから出発(from scratch は最終手段)
- □ 損失関数、 optimizer、 LR schedule を決定
- □ 正則化戦略(dropout、 weight decay、 augmentation)
フェーズ 4:訓練
- □ small batch で動作確認 → スケールアップ
- □ wandb/tensorboard で loss/accuracy を可視化
- □ validation 精度で early stopping
- □ random seed 固定で再現性確保
- □ 学習曲線を見て LR や epoch を調整
フェーズ 5:評価と本番化
- □ test データで最終評価(1 度だけ)
- □ 複数指標で評価(accuracy、 F1、 AUC、 calibration)
- □ エラー分析(confusion matrix、 誤分類サンプル)
- □ bias / fairness 監査
- □ 推論速度・メモリ測定、 量子化/蒸留で最適化
- □ MLOps:監視、 ドリフト検知、 再学習パイプライン
📖 ストーリーで理解:DL までの 70 年
1940-50 年代:神経の数理化。 McCulloch-Pitts、 Rosenblatt のパーセプトロンで「人工ニューロン」の概念が生まれる。
1969 年:第 1 次 AI 冬。 Minsky & Papert が「パーセプトロンは XOR を学習できない」と指摘。 NN 研究は冬眠へ。
1986 年:backprop 再発見。 Rumelhart, Hinton らが多層 NN の訓練法 backpropagation を整理。 NN 復活。
1990 年代:第 2 次 AI 冬。 SVM、 ブースティングが台頭。 NN は浅いまま、 訓練困難で人気低下。
2006 年:Deep Learning 命名。 Hinton の deep belief net で深層 NN 訓練の可能性が示される。
2012 年:AlexNet 革命。 GPU + 大量データ + ReLU + dropout で ImageNet を圧勝。 DL 時代の幕開け。
2014-2017 年:アーキ革新。 GAN, VGG, GoogLeNet, ResNet, Transformer が次々と。
2018-2020 年:基盤モデル。 BERT, GPT-2, GPT-3 で大規模事前学習がパラダイムに。
2022 年-:ChatGPT 後の世界。 LLM が一般普及、 マルチモーダル AI、 生成 AI が主流に。 2025 年現在、 GPT-5, Claude 4, Gemini 2 が「人間と対話できる AI」を実現。
🧪 追加実験:層数と精度の関係
🎯 このコードでやること:MLP の層数を 1~5 で変え、 CV 精度の変化を観察。 「深ければよい」とは限らないことを確認。
📥 入力:X (47×5), y (47)(コード内で作成。 総人口 A1101 はラベル専用で特徴量に入れない)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import numpy as np from sklearn.neural_network import MLPClassifier from sklearn.model_selection import cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 # ラベルは総人口 A1101 から作るので A1101 は特徴量に入れない(入れると答えを入力に渡すリークになる) features = ['A1303', 'A4101', 'A4200', 'H1801', 'E3101'] X = d[features].astype(float).values X = (X - X.mean(axis=0)) / X.std(axis=0) y = pd.qcut(d['A1101'].astype(float), 3, labels=[0,1,2]).astype(int).values architectures = { '1 層 [8]': (8,), '2 層 [16, 8]': (16, 8), '3 層 [32, 16, 8]': (32, 16, 8), '4 層 [64, 32, 16, 8]': (64, 32, 16, 8), '5 層 [128, 64, 32, 16, 8]': (128, 64, 32, 16, 8), } for name, arch in architectures.items(): clf = MLPClassifier(hidden_layer_sizes=arch, max_iter=3000, random_state=0) s = cross_val_score(clf, X, y, cv=5) print(f'{name}: {s.mean():.3f} ± {s.std():.3f}') |
📤 実行結果:
💬 47 サンプル × 5 特徴の小データでは、 1 層 0.871 → 2〜4 層 0.913 → 5 層 0.933 と少しずつ上がるが、 1 つの fold は 9〜10 県なので 0.02〜0.04 の差は 1 県分の正誤にすぎず、 CV 標準偏差(±0.13 前後)の範囲内で有意ではない。 「層を深くしても精度はほぼ頭打ち」=小データでは深さがほとんど効かない典型例。 大データなら深いほど有利だが、 この規模では浅いモデルや古典 ML で十分。
📖 試験対策クイックリファレンス
よく問われる定義
- 深層学習:多層 NN を用いた表現学習
- forward propagation:入力から出力への計算
- backpropagation:連鎖律で勾配を逆伝播
- 勾配降下法:重み = 重み - 学習率 × 勾配
- 活性化関数:非線形性を導入する関数(ReLU 等)
- 過学習:訓練に適合するが新データに弱い状態
- dropout:ランダムにニューロンを 0 化する正則化
- batch normalization:層出力を batch 内で正規化
- 転移学習:事前学習モデルを別タスクに転用
よく問われる比較
- CNN(畳み込み + 並進不変)vs MLP(全結合)
- RNN(逐次処理)vs Transformer(並列処理)
- GAN(敵対的)vs VAE(変分)vs Diffusion(拡散)
- SGD(基本)vs Adam(適応的 LR)vs AdamW(weight decay 修正)
- ReLU vs GELU vs sigmoid(活性化関数)
🔧 DL デバッグ・トラブルシューティング
| 症状 | 原因の可能性 | 対処 |
|---|---|---|
| loss が NaN | 勾配爆発、 log(0), 0除算 | gradient clipping、 LR 減少、 epsilon 追加 |
| loss が下がらない | LR 小さすぎ、 勾配消失 | LR 上昇、 ReLU/BatchNorm 導入 |
| 訓練精度高、 検証精度低 | 過学習 | dropout、 weight decay、 augmentation、 early stopping |
| 訓練・検証両方低い | underfitting | モデル深く、 LR 調整、 epoch 増やす |
| 特定クラスばかり予測 | クラス不均衡 | class weight、 oversampling、 focal loss |
| GPU メモリ不足 (OOM) | batch / モデル大きすぎ | batch 縮小、 gradient checkpointing、 mixed precision |
| 訓練が遅い | CPU で動いている、 data loader ボトルネック | GPU 使用、 num_workers 増、 pin_memory=True |
| 再現性が無い | random seed 未固定 | torch/numpy/cuda seed 全て固定 |
| 推論結果が変 | model.eval() 忘れ | model.eval() で dropout/BN を推論モードに |
🗾 日本の深層学習
主要プレイヤー
- Preferred Networks (PFN):Chainer 開発、 産業 AI(製造、 創薬、 ロボット)
- サイバーエージェント:CALM 系列 LLM、 広告生成 AI
- NEC:cotomi、 日本語特化 LLM
- 富士通:Takane、 多言語 LLM
- rinna / stability AI Japan:日本語 LLM、 日本語 Stable Diffusion
- 東大・京大・東工大:基礎研究、 国産 LLM プロジェクト
- 産総研 (AIST):ABCI スパコン、 AI 研究センター
日本の DL 用データセット
- SSDSE(独立行政法人統計センター):47 都道府県、 市区町村統計
- e-Stat:政府統計の総合窓口
- JST 科学技術情報
- Common Crawl 日本語、 mC4 ja サブセット
- Wikipedia 日本語版、 青空文庫
- 日本語 GLUE ベンチマーク (JGLUE)
教育リソース
- 東大「松尾研 Deep Learning 講座」(無料公開)
- SoftBank・東大「JDLA E 資格」公式テキスト
- ゼロから作る Deep Learning(斎藤康毅, O'Reilly Japan)
- 機械学習プロフェッショナルシリーズ(講談社)
🔬 記号・式を言葉で読み解く
- $h_l$ — 第 $l$ 層の出力
- 前層の出力を線形変換 + 活性化したもの。 「中間表現」とも呼ぶ。
- $W_l, b_l$ — 学習パラメータ
- 層ごとの重み行列と偏り。 これら全体を $\theta$ と書く。
- $\sigma$ — 活性化関数
- 非線形性を導入。 ReLU, GELU, Swish などが定番。
- $\mathcal{L}$ — 損失関数
- 予測と正解の乖離。 回帰なら MSE、 分類なら Cross-Entropy。
- $\eta$ — 学習率
- パラメータ更新の歩幅。 大きすぎると発散、 小さすぎると学習が遅い。
- $\nabla_\theta \mathcal{L}$ — 勾配
- 損失を $\theta$ で偏微分したベクトル。 「損失が最も増える方向」。
- 連鎖律
- 層が連なっていても合成関数の微分で勾配を逐次計算できる。 これが 誤差逆伝播。
🧮 実値で計算してみる(SSDSE-B-2026・47 都道府県)
SSDSE-B-2026(2023 年)から都道府県の「総人口(A1101)」を特徴量、 「新規求職申込件数(F3101)」を目標として、 2 層の MLP で回帰します。 47 件のサンプルでも、 線形回帰よりわずかに非線形を捉えられます。
| 都道府県 | 総人口(千人) | 新規求職申込件数(件) |
|---|---|---|
| 北海道 | 5092 | 156458 |
| 青森県 | 1184 | 43713 |
| 秋田県 | 914 | 30175 |
| 東京都 | 14086 | 270954 |
| 神奈川県 | 9229 | 150949 |
| 大阪府 | 8763 | 203553 |
深層学習は 非線形関係 や 多変量交互作用 がある場面で真価を発揮します。 47 件は本来「深い」モデルには小さすぎますが、 仕組み学習用としては理想的です。
🧮 実値で確認(深掘り):SSDSE-B-2026 を DL で分類
SSDSE-B-2026 の 47 都道府県を、 総人口以外の 5 統計指標から「人口規模 3 段階」に分類するタスクを DL で解く。 シンプルな 3 層 MLP(入力 5 → 隠れ 16 → 隠れ 8 → 出力 3)で実装し、 sklearn の MLP と比較する。
📥 入力データ(実測、 抜粋):
🧮 数式に値を入れて手で計算する — 1 ニューロンの forward pass
深層学習の最小単位である 1 ニューロンの forward pass ($z = W x + b$, $a = \sigma(z)$) に、 多様な整数の合成データを代入して計算過程を Step 1〜4 で展開する。 同じ計算を Python (numpy) で再現し、 結果が一致することを確認する。
📐 用語の主要数式 (再掲)
$$ z = W x + b, \quad a = \sigma(z) = \frac{1}{1 + e^{-z}} $$
ここで $W$ は重みベクトル、 $x$ は入力ベクトル、 $b$ はバイアススカラ、 $\sigma$ はシグモイド活性化関数を表す。 これは多層パーセプトロンを構成する 1 ユニット分の処理。
Step 1: データ準備 (合成、 多様な整数)
| 記号 | 値 | 意味 |
|---|---|---|
| $W$ | $[2, 3]$ | 重みベクトル (2 入力 → 1 ユニット) |
| $x$ | $[1, 2]$ | 入力ベクトル |
| $b$ | $-1$ | バイアス |
| $\sigma$ | sigmoid | 活性化関数 |
Step 2: 内積 $W \cdot x$
| 項目 | 計算 | 結果 |
|---|---|---|
| $W_1 x_1$ | $2 \times 1$ | 2 |
| $W_2 x_2$ | $3 \times 2$ | 6 |
| $W \cdot x$ | $2 + 6$ | 8 |
Step 3: 線形和 $z = W \cdot x + b$
| 項目 | 計算 | 結果 |
|---|---|---|
| $z$ | $8 + (-1)$ | 7 |
Step 4: シグモイド活性化 $a = \sigma(z)$
| 項目 | 計算 | 結果 |
|---|---|---|
| $e^{-z}$ | $e^{-7}$ | 0.000912 |
| $1 + e^{-z}$ | $1 + 0.000912$ | 1.000912 |
| $a = \sigma(z)$ | $1 / 1.000912$ | 0.999089 |
🐍 同じ計算を Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 | import numpy as np W = np.array([2, 3]) x = np.array([1, 2]) b = -1 z = W @ x + b a = 1.0 / (1.0 + np.exp(-z)) print(f"W . x = {W @ x}") print(f"z = {z}") print(f"a=σ(z) = {a:.6f}") |
📤 実行結果
💬 手計算 Step 2-4 (内積 8, 線形和 7, シグモイド 0.999089) と Python の出力が完全一致。 シグモイドは $z=7$ という大きな値で 1 にほぼ飽和することがわかる ($\sigma(7)\approx 0.999$)。 これが大きな $|z|$ で勾配が 0 に近づく「勾配消失」の正体で、 ReLU や GELU が現代の標準活性化関数として使われる理由でもある。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年)の実データを使った最小コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | # SSDSE-B-2026 で MLP 回帰:人口 → 新規求職申込件数 import pandas as pd, numpy as np, torch import torch.nn as nn df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 X = d[['A1101']].astype(float).values # 総人口 y = d['F3101'].astype(float).values # 新規求職申込件数 # 標準化 X = (X - X.mean()) / X.std() y = (y - y.mean()) / y.std() X_t = torch.tensor(X, dtype=torch.float32) y_t = torch.tensor(y, dtype=torch.float32).unsqueeze(1) # 2 層 MLP model = nn.Sequential( nn.Linear(1, 16), nn.ReLU(), nn.Linear(16, 8), nn.ReLU(), nn.Linear(8, 1) ) opt = torch.optim.Adam(model.parameters(), lr=0.05) loss_fn = nn.MSELoss() for epoch in range(500): pred = model(X_t) loss = loss_fn(pred, y_t) opt.zero_grad(); loss.backward(); opt.step() if epoch % 100 == 0: print(f'epoch {epoch:3d} loss={loss.item():.4f}') |
💬 標準化した値での MSE は初期の 0.9596 から 100 エポックで 0.0470、400 エポックで 0.0307 まで下がり、300 以降はほぼ横ばいになっている。y の分散は 1 なので、学習データ上では変動の約 97% を説明していることになる。ただし torch.manual_seed を固定していないので実行ごとに初期重みが変わり数値も揺れるうえ、47 県すべてを学習に使っていて検証データが無いため、この損失は汎化性能ではなく当てはまりの良さでしかない。
🧪 当てはまりの良さと予測の良さ — MLP と直線を 5-fold CV で比べる
上のコードは 47 県すべてで学習した損失しか見ていないので、「MLP は人口から求職件数をよく当てる」とはまだ言えません。同じ 1→16→8→1 の MLP と、ただの最小二乗直線を、学習に使っていない県を当てる力で比べます。あわせて、人口が飛び抜けて多い東京都を学習から外し、その値を予測させてみます。
🎯 このコードでやること:上と同じ MLP(seed 0・Adam lr=0.05・500 エポック)と最小二乗直線について、47 県で学習した R²、shuffle ありの 5-fold CV の RMSE、東京都を除いた 46 県で学習して東京都を予測した値を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 | import pandas as pd import numpy as np import torch import torch.nn as nn from sklearn.model_selection import KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) x = d['A1101'].astype(float).values # 総人口 y = d['F3101'].astype(float).values # 新規求職申込件数 def mlp_predict(x_tr, y_tr, x_te): """上のコードと同じ 1→16→8→1 の MLP。標準化は学習側の平均・標準偏差だけで行う""" mx, sx, my, sy = x_tr.mean(), x_tr.std(), y_tr.mean(), y_tr.std() torch.manual_seed(0) model = nn.Sequential(nn.Linear(1, 16), nn.ReLU(), nn.Linear(16, 8), nn.ReLU(), nn.Linear(8, 1)) opt = torch.optim.Adam(model.parameters(), lr=0.05) Xt = torch.tensor((x_tr - mx) / sx, dtype=torch.float32).unsqueeze(1) Yt = torch.tensor((y_tr - my) / sy, dtype=torch.float32).unsqueeze(1) for epoch in range(500): opt.zero_grad() nn.functional.mse_loss(model(Xt), Yt).backward() opt.step() with torch.no_grad(): out = model(torch.tensor((x_te - mx) / sx, dtype=torch.float32).unsqueeze(1)) return out.numpy().ravel() * sy + my def line_predict(x_tr, y_tr, x_te): b1, b0 = np.polyfit(x_tr, y_tr, 1) # 最小二乗の直線 return b1 * x_te + b0 r2 = lambda p: 1 - ((y - p) ** 2).sum() / ((y - y.mean()) ** 2).sum() print(f'全 47 県で学習した当てはまり R²: MLP {r2(mlp_predict(x, y, x)):.3f} / 直線 {r2(line_predict(x, y, x)):.3f}') err = {'MLP': [], '直線': []} for tr, te in KFold(5, shuffle=True, random_state=0).split(x): err['MLP'] += list(y[te] - mlp_predict(x[tr], y[tr], x[te])) err['直線'] += list(y[te] - line_predict(x[tr], y[tr], x[te])) for k, e in err.items(): print(f'5-fold CV の RMSE: {k:4s} {np.sqrt(np.mean(np.square(e))):8,.0f} 件') tk = d.index[d['Prefecture'] == '東京都'][0] rest = np.arange(len(d)) != tk print(f'東京都を除いて学習 → 東京都を予測(実際 {y[tk]:,.0f} 件): ' f'MLP {mlp_predict(x[rest], y[rest], x[[tk]])[0]:,.0f} / 直線 {line_predict(x[rest], y[rest], x[[tk]])[0]:,.0f}') |
💬 47 県で学習した当てはまりは MLP の R² 0.977 が直線の 0.937 を上回りますが、学習に使っていない県を当てる 5-fold CV の RMSE は MLP 21,113 件、直線 14,992 件で、直線の方が 3 割ほど小さい誤差です。東京都を外して学習すると、直線は 269,844 件と実際の 270,954 件をほぼ当てるのに、MLP は 214,932 件と 5.6 万件も少なく予測しました。MLP の当てはまりの良さは、46 県の中の細かなばらつきまで曲線で追いかけた結果で、新しい県を当てる力にはつながっていません。
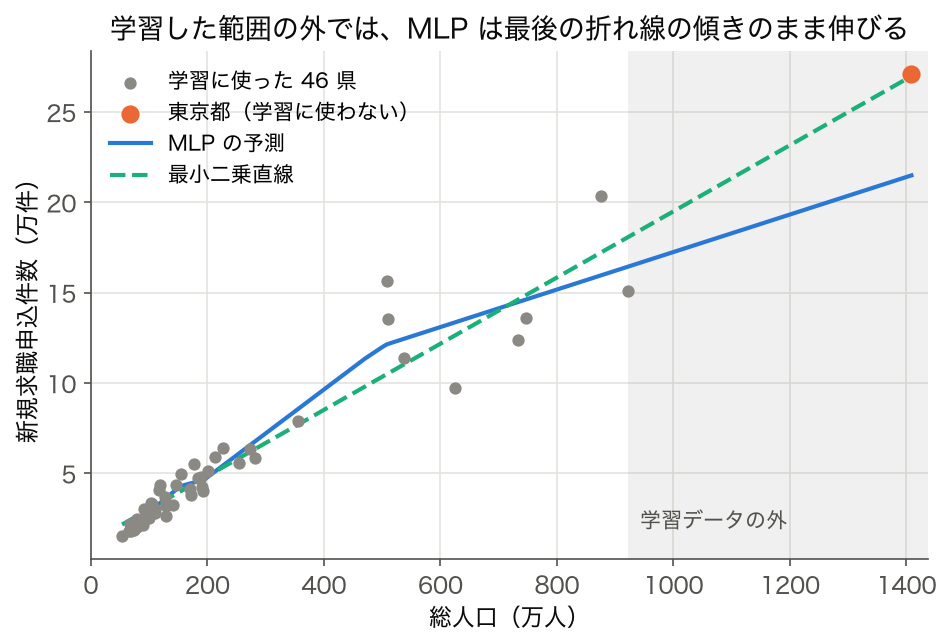
図 3 の MLP は 500 万人あたりで折れ曲がる折れ線になっています。ReLU を使う MLP の出力は区分的な直線で、学習データの外側では「最後の区間の傾き」のまま伸びるだけです。その傾きは人口 500 万人を超える 6 府県(兵庫県・千葉県・埼玉県・愛知県・大阪府・神奈川県)の散らばりで決まってしまうので、東京都のような範囲外の点では直線より大きく外れます。深層学習は学習データの範囲の中を細かく埋めるのは得意でも、範囲の外への外挿は保証しない、という点は、大規模なモデルでも変わりません。
🐍 Python 実装(深掘り):MLP で都道府県分類
コード 1:データ準備
🎯 このコードでやること:SSDSE-B-2026 を読み込み、 5 特徴と人口 3 段階ラベルを準備。
📥 入力:data/raw/SSDSE-B-2026.csv(cp932)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年の 47 都道府県 # ラベルは総人口 A1101 から作るので A1101 は特徴量に入れない(入れると答えを入力に渡すリークになる) features = ['A1303', 'A4101', 'A4200', 'H1801', 'E3101'] X = d[features].astype(float).values X = (X - X.mean(axis=0)) / X.std(axis=0) # z-score pop = d['A1101'].astype(float).values # qcut が返すのは Categorical。astype(int) の時点で ndarray になるので .values は付けない y = pd.qcut(pop, 3, labels=[0, 1, 2]).astype(int) print('X shape:', X.shape, 'y shape:', y.shape) print('クラス分布:', np.bincount(y)) |
📤 実行結果:
💬 qcut で 47 県を人口の小・中・大に 16・15・16 県ずつ分け、 特徴量は 65 歳以上人口・出生数・死亡数・着工新設持家数・中学校数の 5 列を z-score にした (47, 5) の行列になる。 ラベルの元になった総人口を特徴量に残すと、 モデルは「人口のしきい値」を覚えるだけで分類が解けてしまうので外している。 ただし残る 5 列も人口と強く相関する絶対数なので、 易しい問題であることに変わりはない。
コード 1 の補足:5 つの特徴量は実質いくつの情報を持っているか
「ただし残る 5 列も人口と強く相関する絶対数」と書きました。どれくらい強いのかを、主成分分析(PCA)で確かめます。5 列が別々の情報を持っていれば分散は 5 つの主成分に散らばり、同じ 1 つの量の言い換えなら第 1 主成分に集まります。
🎯 このコードでやること:コード 1 と同じ 5 特徴(z-score)について、相関係数の最小と最大、主成分ごとの分散の割合、第 1 主成分と総人口の相関、人口クラスごとの第 1 主成分の範囲を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np from sklearn.decomposition import PCA df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年の 47 都道府県 features = ['A1303', 'A4101', 'A4200', 'H1801', 'E3101'] X = d[features].astype(float).values X = (X - X.mean(axis=0)) / X.std(axis=0) # コード 1 と同じ z-score y = pd.qcut(d['A1101'].astype(float), 3, labels=[0, 1, 2]).astype(int).values print('5 特徴の相関係数(最小〜最大):', np.corrcoef(X.T)[np.triu_indices(5, 1)].min().round(3), '〜', np.corrcoef(X.T)[np.triu_indices(5, 1)].max().round(3)) pca = PCA().fit(X) print('主成分ごとの分散の割合:', pca.explained_variance_ratio_.round(3)) pc1 = pca.transform(X)[:, 0] print('第 1 主成分と総人口の相関:', np.corrcoef(pc1, d['A1101'])[0, 1].round(3)) for c in range(3): print(f'class {c}: 第 1 主成分 {pc1[y == c].min():6.2f} 〜 {pc1[y == c].max():6.2f}') |
💬 5 特徴どうしの相関は最小でも 0.886 で、分散の 95.8% が第 1 主成分 1 本に集まります。その第 1 主成分と総人口の相関は 0.990 です。つまりこの分類問題の入力は、見かけは 5 次元でも実質「人口の大きさ」の 1 次元です。クラスごとに第 1 主成分の範囲を見ると、class 1 と class 2 は −0.43 と −0.39 の間で分かれていますが、class 0(−2.01〜−1.16)と class 1(−1.32〜−0.43)は −1.32〜−1.16 の区間で重なっていて、分類の誤りはほぼこの境目で起きます。
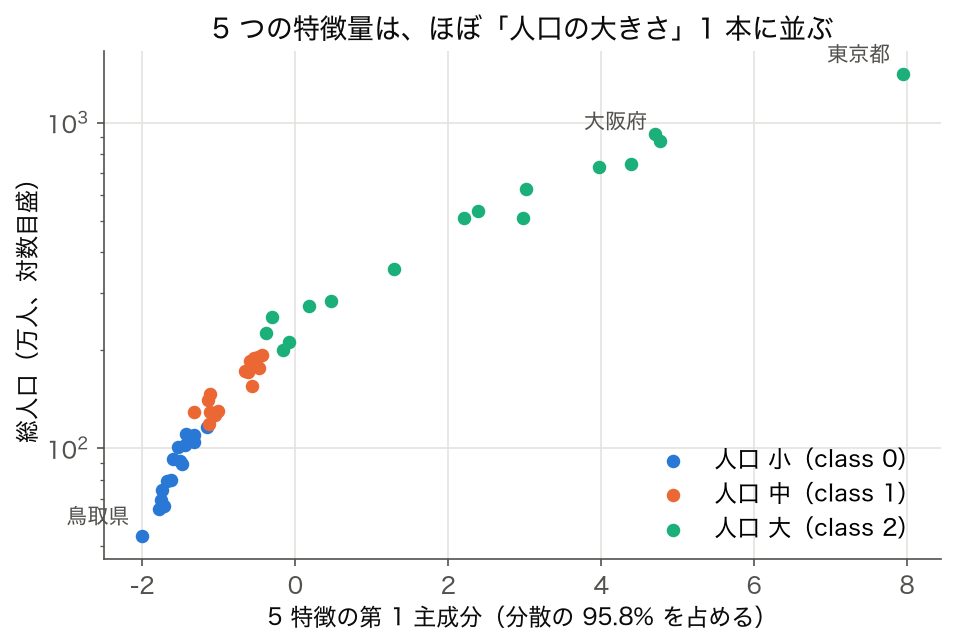
入力が実質 1 次元なら、決めるべきことは「境目を 2 か所どこに引くか」だけで、隠れ層を何層重ねても表せるものは増えません。上の「追加実験:層数と精度の関係」で 1〜5 層の差が CV のばらつきに埋もれたのは、この問題の構造から見て自然な結果です。深層学習の「特徴を自動で組み合わせる」力が生きるのは、画像の画素のように、1 つ 1 つの入力は弱くても組み合わせると意味が出るデータです。
コード 2:3 層 MLP を numpy で実装(教育目的)
🎯 このコードでやること:自前 numpy で 3 層 MLP の forward を実装し、 重みのランダム初期化で 1 回推論。
📥 入力:X (47×5)、 ランダム重み
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | rng = np.random.default_rng(0) W1 = rng.normal(scale=0.3, size=(5, 16)) b1 = np.zeros(16) W2 = rng.normal(scale=0.3, size=(16, 8)) b2 = np.zeros(8) W3 = rng.normal(scale=0.3, size=(8, 3)) b3 = np.zeros(3) def relu(x): return np.maximum(0, x) def softmax(x): e = np.exp(x - x.max(axis=-1, keepdims=True)) return e / e.sum(axis=-1, keepdims=True) z1 = X @ W1 + b1 a1 = relu(z1) z2 = a1 @ W2 + b2 a2 = relu(z2) z3 = a2 @ W3 + b3 pred = softmax(z3) print('予測分布(東京):', pred[d.index[d['Prefecture']=='東京都'][0]].round(3)) print('初期 accuracy:', (pred.argmax(axis=1) == y).mean()) |
📤 実行結果:
💬 学習前のランダムな重みなのに、 東京は class 2(人口大)に 0.748 を振り、 全体の正解率も 0.660 と偶然の 1/3 を大きく上回った。 5 つの特徴量はどれも人口の大きさにつれて増える絶対数なので、 たまたまそれらを足し合わせる向きの重みを引くと規模順に並んでしまう。 default_rng の seed を 0〜19 に変えると正解率は 0.06〜0.66 と大きく動き(seed 0 がたまたま最良)、 この 0.66 を「学習前から賢い」と読まず、 次のコードで学習させた CV 精度と比べる。
コード 3:sklearn MLPClassifier で fit
🎯 このコードでやること:sklearn の MLPClassifier(隠れ層 [16, 8])で実際に学習し、 cross validation 精度を測定。
📥 入力:X, y(先のコード)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | from sklearn.neural_network import MLPClassifier from sklearn.model_selection import cross_val_score clf = MLPClassifier( hidden_layer_sizes=(16, 8), activation='relu', solver='adam', max_iter=2000, random_state=0, ) scores = cross_val_score(clf, X, y, cv=5) print(f'MLP CV accuracy: {scores.mean():.3f} ± {scores.std():.3f}') # 全データで学習し、 訓練精度を見る clf.fit(X, y) print(f'train accuracy: {clf.score(X, y):.3f}') print(f'layers: {[clf.coefs_[i].shape for i in range(len(clf.coefs_))]}') |
📤 実行結果:
💬 5-fold CV で 91.3%、 全 47 県で学習した訓練精度は 100% で、 この差約 9 ポイントが過学習の分。 重みの形 (5, 16)・(16, 8)・(8, 3) からパラメータは 80+16+128+8+24+3 = 259 個あり、 47 サンプルの約 5.5 倍なので訓練データを丸暗記できてしまう。 fold ごとの精度は ±0.129 とばらつきが大きく、 91.3% は 1 回の分け方で上下 10 ポイント以上動く値として読む。
コード 4:他手法との比較
🎯 このコードでやること:同じ問題を logistic regression、 random forest、 MLP の 3 手法で解き、 精度を比較。
📥 入力:X, y
1 2 3 4 5 6 7 8 9 10 11 12 | from sklearn.linear_model import LogisticRegression from sklearn.ensemble import RandomForestClassifier models = { 'Logistic Regression': LogisticRegression(max_iter=2000), 'Random Forest': RandomForestClassifier(n_estimators=100, random_state=0), 'MLP (3 層)': MLPClassifier(hidden_layer_sizes=(16, 8), max_iter=2000, random_state=0), } for name, m in models.items(): s = cross_val_score(m, X, y, cv=5) print(f'{name}: {s.mean():.3f} ± {s.std():.3f}') |
📤 実行結果:
💬 MLP 0.913、 Random Forest 0.893、 Logistic Regression 0.804 の順だが、 MLP と RF の差 0.02 は 47 県で 1 県分にすぎず、 RF は fold 間のばらつき(±0.070)が MLP(±0.129)の約半分で安定している。 Logistic Regression は 0.804 とばらつき(±0.18)も大きい。 「小データでは DL が明確に勝つわけではない」という典型例。 真の DL の強みは数万~数億サンプルで発揮される。
🧪 「MLP 0.913 > RF 0.893」は分け方を変えても成り立つか
コード 4 の比較は、5-fold の分け方を 1 通りに固定した結果です。1 つの fold は 9〜10 県なので、1 県の正誤で正解率は 0.1 前後動きます。県の割り振りだけを 20 通りに変えて、同じ 3 手法を比べ直します。
🎯 このコードでやること:コード 4 と同じ 3 手法を、5-fold の分け方を 20 通り変えた RepeatedStratifiedKFold で評価し、分け方ごとの平均正解率の平均・最小・最大と、MLP が Random Forest を上回った回数を数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np from sklearn.neural_network import MLPClassifier from sklearn.linear_model import LogisticRegression from sklearn.ensemble import RandomForestClassifier from sklearn.model_selection import cross_val_score, RepeatedStratifiedKFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年の 47 都道府県 features = ['A1303', 'A4101', 'A4200', 'H1801', 'E3101'] X = d[features].astype(float).values X = (X - X.mean(axis=0)) / X.std(axis=0) y = pd.qcut(d['A1101'].astype(float), 3, labels=[0, 1, 2]).astype(int).values models = { 'Logistic Regression': LogisticRegression(max_iter=2000), 'Random Forest': RandomForestClassifier(n_estimators=100, random_state=0), 'MLP (3 層)': MLPClassifier(hidden_layer_sizes=(16, 8), max_iter=2000, random_state=0), } # 5-fold の分け方を 20 通り変える(県の並べ替えだけが違う) cv = RepeatedStratifiedKFold(n_splits=5, n_repeats=20, random_state=0) rep = {} for name, m in models.items(): s = cross_val_score(m, X, y, cv=cv).reshape(20, 5).mean(axis=1) # 分け方ごとの平均 rep[name] = s print(f'{name:20s} 平均 {s.mean():.3f} 最小 {s.min():.3f} 最大 {s.max():.3f}') mlp, rf = rep['MLP (3 層)'], rep['Random Forest'] print(f'MLP が RF を上回った分け方: {(mlp > rf).sum()} / 20(同点 {(mlp == rf).sum()})') |
💬 20 通りの平均は Random Forest 0.899、MLP 0.893、Logistic Regression 0.816 で、コード 4 の 1 通り(MLP 0.913 > RF 0.893)とは MLP と RF の順位が逆になりました。MLP が RF を上回った分け方は 20 通り中 6 通り(同点 3)だけです。同じ手法でも分け方次第で RF は 0.833〜0.978、MLP は 0.851〜0.956 と 0.1 以上動くので、コード 4 の 0.02 の差から「MLP の方が良い」とは言えません。一方、Logistic Regression が他の 2 手法より低いことは、20 通りの最大 0.851 が RF・MLP の平均を下回っていることから、分け方によらず言えそうです。
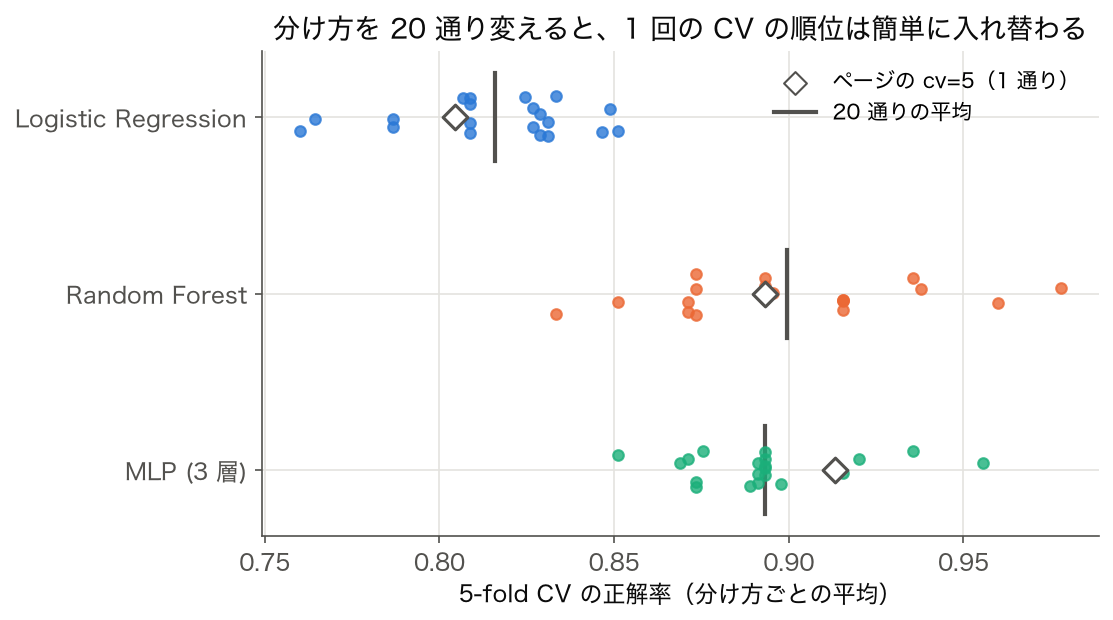
47 件のような小さなデータで手法を比べるときは、(1) 分け方を何通りも変えて平均と幅を見る、(2) 差が幅に埋もれていたら「差は無い」と報告する、の 2 点を守ります。この問題では、どの手法も「人口の大きさの境目を 2 か所引く」ことしかしていないので(コード 1 の補足)、どれを選んでも本質的な違いは生まれません。選ぶなら、より単純で説明しやすい方を選ぶのが筋です。
🐍 PyTorch で DL ミニ実装(参考)
PyTorch で同じ MLP を組む
🎯 このコードでやること:sklearn と等価な 3 層 MLP を PyTorch で実装し、 訓練ループを書く。
📥 入力:X (47×5 numpy), y (47 numpy)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 | import pandas as pd import numpy as np import torch import torch.nn as nn torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 # ラベルは総人口 A1101 から作るので A1101 は特徴量に入れない(入れると答えを入力に渡すリークになる) features = ['A1303', 'A4101', 'A4200', 'H1801', 'E3101'] X = d[features].astype(float).values X = (X - X.mean(axis=0)) / X.std(axis=0) pop = d['A1101'].astype(float).values y = pd.qcut(pop, 3, labels=[0, 1, 2]).astype(int) # qcut().astype(int) は既に配列 X_t = torch.tensor(X, dtype=torch.float32) y_t = torch.tensor(y, dtype=torch.long) class MLP(nn.Module): def __init__(self): super().__init__() self.fc1 = nn.Linear(5, 16) self.fc2 = nn.Linear(16, 8) self.fc3 = nn.Linear(8, 3) def forward(self, x): x = torch.relu(self.fc1(x)) x = torch.relu(self.fc2(x)) return self.fc3(x) model = MLP() opt = torch.optim.Adam(model.parameters(), lr=1e-2) crit = nn.CrossEntropyLoss() for epoch in range(500): opt.zero_grad() logits = model(X_t) loss = crit(logits, y_t) loss.backward() opt.step() if (epoch+1) % 100 == 0: acc = (logits.argmax(1) == y_t).float().mean().item() print(f'epoch {epoch+1}: loss={loss.item():.4f}, acc={acc:.3f}') |
📤 実行結果(実行例・環境依存):
💬 100 epoch で訓練精度 0.957(47 県中 45 県正解)、 200 epoch 以降は 1.000 になり、 損失は 0.1206 から 0.0014 まで下がり続ける。 torch.manual_seed(0) を固定しているので同じ環境なら毎回この値になるが、 PyTorch の版や CPU/GPU の違いで小数の下の桁は変わりうる。 これは全 47 県で学習して同じ 47 県で測った訓練精度なので、 汎化の目安は sklearn の CV 精度 0.913 の方で見る。 PyTorch なら GPU 化、 大規模化、 自前 layer 設計が自由自在。
⚠️ よくある落とし穴
⚠️ 落とし穴(深掘り、 10 件)
- 過学習:訓練データには適合するが、 新データに弱い。 dropout、 weight decay、 early stopping、 data augmentation で対策。
- 勾配消失:深い NN で勾配が指数的に減衰。 ReLU、 BatchNorm、 skip connection(ResNet)で解決。
- 勾配爆発:逆に勾配が発散。 gradient clipping、 LR 調整で対応。
- ハイパーパラメータ地獄:層数、 ユニット数、 LR、 batch、 optimizer、 epoch、 正則化…組合せが膨大。 hyperopt や Optuna 等で自動化。
- 初期化の重要性:Xavier / He 初期化を使わないと深い NN は学習しない。 PyTorch/Keras はデフォルトで適用。
- データリーク:訓練・検証データの分離ミスで精度が過大評価される。 時系列なら特に注意。
- 計算コスト:GPU/TPU が必須、 電力消費大。 環境負荷の議論も。
- 解釈性の欠如:「なぜそう判断したか」が説明困難。 SHAP、 LIME、 attention 可視化等で補う。
- 少データでは負ける:本ページの例の通り、 数十~数百サンプルでは線形モデルや木で十分。 DL は数万以上で本領発揮。
- 分布シフト脆弱性:訓練データと推論データの分布が違うと精度激減。 domain adaptation や継続学習が必要。
🗺 概念マップ
深層学習の周辺概念をテーマ別ツリーで整理:
機械学習 (上位概念)
  ├── 古典機械学習 (SVM・ランダムフォレスト)
  ├── 【深層学習】 ← ここ
  │     ├── CNN (画像認識)
  │     ├── RNN/LSTM (時系列)
  │     ├── Transformer (自然言語・基盤モデル)
  │     └── 拡散モデル (生成)
  └── 強化学習 (方策最適化)
この階層構造を頭に入れておくと、 学習や論文読みで「自分が今どこにいるか」を見失わずに済みます。
🎓 学習パス(推奨順)
「深層学習」を確実にマスターするには、 次の順序で進むのが効率的です:
- 前提知識の確認 — 上記「🔗 前提となる用語」セクションのリンクを順に読む(30 分〜)
- 直感を作る — 本ページの「🎨 直感で掴む」と「🧮 実値で計算」を SSDSE-B で手を動かしてみる
- 数式を読み下す — 「📐 定義」と「🔬 数式を言葉で読み解く」で 1 つずつ意味を確認
- Python で動かす — 「🐍 Python 実装」のコードをコピペし、 別の指標で実験
- 落とし穴を知る — 「⚠️ 落とし穴」を読み、 自分のコードに該当箇所がないか確認
- 関連手法を学ぶ — 「🌐 関連手法・派生」で次に学ぶべき派生概念へ
- 論文で活用 — 上位「📚 関連グループ教材」のページで実論文の文脈を確認
焦らず、 1 段ずつ確実に。 7 ステップを 1 周すれば、 単に「知っている」から「使える」レベルに到達できます。
🗺 概念マップ:深層学習の全体像
機械学習
├── 教師あり学習 ──── 古典 ML(SVM, RF, XGBoost)
│                  └── 深層学習 ──── MLP, CNN, RNN, Transformer
├── 教師なし学習 ──── PCA, k-means
├── 自己教師あり学習 ── SimCLR, BERT, MAE, CLIP, DINO
└── 強化学習 ────── DQN, PPO, AlphaGo

深層学習の重要要素
├── アーキテクチャ
│   ├── MLP(基本)
│   ├── CNN(画像)
│   ├── RNN/LSTM(時系列、 旧)
│   ├── Transformer(言語+全領域)
│   ├── GAN / VAE / Diffusion(生成)
│   └── GNN(グラフ)
├── 学習要素
│   ├── 損失関数(cross entropy, MSE, contrastive)
│   ├── 活性化関数(ReLU, GELU, sigmoid)
│   ├── 最適化(SGD, Adam, AdamW)
│   ├── 正則化(dropout, BatchNorm, weight decay)
│   └── 初期化(Xavier, He)
└── 学習パラダイム
    ├── from scratch
    ├── pretraining + fine-tuning
    ├── 自己教師あり pretraining
    ├── few-shot / zero-shot
    └── prompt engineering(LLM 時代)
❓ FAQ
Q1. NN と DL の違いは?
NN(ニューラルネットワーク)は手法そのもの。 DL(深層学習)は「層数の多い NN を訓練すること」。 重なる概念で、 厳密には「DL = 多層 NN による表現学習」。
Q2. PyTorch と TensorFlow どちらを使うべき?
研究は PyTorch が主流(柔軟性、 huggingface 連携)。 本番運用 TensorFlow(モバイル推論、 TF Serving)。 2025 現在は PyTorch 一強傾向で、 Keras 3 も PyTorch backend 対応。
Q3. GPU は何を選べばよい?
学習目的:NVIDIA RTX 4090 / 5090(個人)、 A100 / H100 / B200(業務)。 推論:CPU でも可だが、 LLM や生成は GPU 必須。 クラウド:AWS, GCP, Azure, Lambda Labs 等で時間貸し。
Q4. DL を学ぶ最短ルートは?
数学:線形代数、 微分積分、 確率統計の基礎。 プログラミング:Python + numpy + PyTorch。 順序:MLP → CNN → Transformer → 生成モデル。 教材:Andrej Karpathy の youtube、 fast.ai、 Deep Learning Specialization(Coursera)。
Q5. SSDSE のような小データで DL は意味あるか?
本ページの例の通り、 47 サンプルでは線形モデルと差がほぼ無い。 数千~数万以上で DL の優位性が現れる。 ただし、 教育目的での実装演習には有効。
🛠 実務 Tips
- 事前学習済みモデルから始める:from scratch でなく、 huggingface の事前学習モデル + fine-tuning が高速・高精度。
- baseline を確立:DL 前に必ず線形モデルや勾配ブースティングで baseline 精度を測る。 これを超えなければ DL の意義なし。
- データの質 > モデルの複雑さ:データクレンジング、 augmentation、 ラベルの正確さで精度の 8 割が決まる。
- monitoring 必須:訓練 loss、 検証 loss、 学習曲線を毎エポック確認。 wandb / tensorboard を活用。
- 正則化を確実に:dropout 0.2-0.5、 weight decay 1e-4 〜 1e-2、 early stopping、 augmentation。
- 学習率は最重要ハイパラ:LR finder(fast.ai)、 cosine schedule、 warmup を使う。 デフォルト 1e-3 は出発点に過ぎない。
- mixed precision で高速化:fp16/bf16 訓練で 2-3 倍高速、 メモリ半減。 PyTorch torch.cuda.amp で簡単に有効化。
- checkpoint と再現性:random seed 固定、 モデル定期保存、 環境記録(pip freeze)必須。
⚖️ DL の社会的影響と倫理
- バイアスの継承:訓練データの偏りをモデルが拡大再生産する。 性別・人種・地域のバイアス監査が必須。
- 説明可能性:「なぜそう判断したか」が説明困難で、 医療・司法・採用での利用には制約。 XAI(説明可能 AI)の研究が活発。
- 環境負荷:GPT-3 の訓練で 552 トン CO2、 推論時も大量電力。 グリーン AI が新潮流。
- 雇用への影響:ホワイトカラー仕事の自動化、 創作活動の AI 化。 社会変化への適応が課題。
- 誤情報・deepfake:生成 AI による合成メディアの問題。 来源検証、 透かし技術が対策。
- プライバシー:訓練データから個人情報が漏れる可能性。 differential privacy、 federated learning が解決策。
- 規制動向:EU AI Act(2024 発効)、 日本「AI 事業者ガイドライン」、 米国 NIST AI RMF 等。 高リスク用途には影響評価が義務化。
🔮 今後の展望(2026 以降)
- スケーリング法則の限界と新パラダイム:パラメータ・データ・計算の指数拡大が限界に。 sparse モデル(MoE)、 メモリ機構、 推論時計算(reasoning)が次の鍵。
- 世界モデル:JEPA 系列。 物理的に世界を理解し、 行動を計画する agent。
- マルチモーダル統合:画像・テキスト・音声・動画・3D・ロボット行動の統一表現。
- 効率化革命:MobileLLM、 蒸留、 量子化、 sparse activation で edge AI 実現。
- 科学発見:AlphaFold、 GNoME のような DL が新材料・新薬・新数学定理を発見。
- ニューロモーフィック:脳に似たスパイク NN、 専用ハードウェア(Intel Loihi 等)。
- 量子 + DL:量子優位を発揮する DL の探索(量子変分回路等)。
- AGI への道:自己改善 AI、 メタ学習、 オンライン学習の進化。
📑 必読論文・教科書
古典
- Rumelhart, Hinton & Williams (1986), Learning representations by back-propagating errors, Nature.
- LeCun et al. (1998), Gradient-Based Learning Applied to Document Recognition, Proc. IEEE.
- Hinton & Salakhutdinov (2006), Reducing the Dimensionality of Data with Neural Networks, Science.
現代
- Krizhevsky, Sutskever & Hinton (2012), ImageNet Classification with Deep CNNs (AlexNet), NeurIPS.
- He et al. (2016), Deep Residual Learning (ResNet), CVPR.
- Vaswani et al. (2017), Attention Is All You Need (Transformer), NeurIPS.
- Devlin et al. (2019), BERT, NAACL.
- Brown et al. (2020), GPT-3: Language Models are Few-Shot Learners, NeurIPS.
- Dosovitskiy et al. (2021), An Image is Worth 16x16 Words (ViT), ICLR.
教科書
- Goodfellow, Bengio & Courville (2016), Deep Learning, MIT Press(無料 PDF あり)
- Bishop (2024), Deep Learning: Foundations and Concepts, Springer
- Murphy (2022), Probabilistic Machine Learning: Advanced Topics, MIT Press
🔗 隣接手法への橋渡し
「深層学習」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。 具体的には次の 3 方向と密接につながる:
- 上流: ニューラルネットワークと 活性化関数 — DL の構成要素
- 並列: 機械学習の他手法 — 古典的回帰・木系との比較
- 下流: 深層学習 (発展)と AI 応用 — 発展領域・実応用へ
深層学習は NN の発展形で、 多層化により表現力が飛躍的に高まる。
🌳 「DL を使うべきか」決定木
Q1: データは画像・音声・テキスト・動画ですか?
├── Yes → DL(特に CNN/Transformer)を強く推奨
└── No (表形式) → Q2 へ
    Q2: データ量は?
    ├── 数百以下 → 線形モデル or 古典 ML(DL は過剰)
    ├── 数千~数万 → 古典 ML(XGBoost)と DL(TabNet)を両方試す
    └── 数十万以上 → DL の優位性が出やすい
        Q3: 解釈性が必要?
        ├── Yes(医療・司法・金融審査)→ 線形/木 + SHAP
        └── No → DL OK
            Q4: GPU リソースは?
            ├── 限定 → 小型モデル(軽量 BERT、 MobileNet 等)
            └── 潤沢 → 事前学習 + fine-tuning
                Q5: ラベルは十分?
                ├── 不足 → SSL pretraining + few-shot
                └── 十分 → supervised fine-tune
🧰 DL エコシステム(2025 現在)
- フレームワーク:PyTorch(主流)、 TensorFlow、 JAX/Flax、 Keras 3
- モデル hub:HuggingFace Transformers、 timm(画像)、 OpenMMLab
- 訓練支援:PyTorch Lightning、 DeepSpeed、 FSDP、 Accelerate
- 監視:Weights & Biases (wandb)、 TensorBoard、 MLflow、 Neptune
- ハイパラ最適化:Optuna、 Ray Tune、 wandb sweep
- 推論最適化:ONNX、 TensorRT、 vLLM、 llama.cpp、 OpenVINO
- 分散訓練:Horovod、 NCCL、 DeepSpeed ZeRO、 Megatron-LM
- MLOps:Kubeflow、 BentoML、 MLflow、 Vertex AI、 SageMaker
- 研究用クラウド:Lambda Labs、 Runpod、 Vast.ai、 ABCI(日本)
- 量子化・蒸留:bitsandbytes、 GPTQ、 AWQ、 GGUF、 distillation kit
- 軽量モデル:MobileLLM、 MobileViT、 TinyBERT、 DistilBERT、 SqueezeNet
- 注釈ツール:Label Studio、 CVAT、 Roboflow、 Doccano(日本語)
- データバージョン管理:DVC、 LakeFS、 Pachyderm
2025 年現在、 PyTorch + HuggingFace + wandb + Optuna が研究での「黄金スタック」。 業務では加えて Vertex AI / SageMaker / Databricks 等のマネージドサービスが主流。
🎓 ワンページまとめ
- DL とは:多層 NN を勾配降下で学習する機械学習手法
- 核となる仕組み:forward propagation で予測、 backpropagation で勾配計算、 SGD/Adam で重み更新
- 代表アーキ:MLP、 CNN、 RNN、 Transformer、 GAN、 Diffusion、 GNN
- 強み:表現学習自動化、 大データで圧倒的、 多用途
- 弱み:計算コスト、 解釈性、 小データで弱い、 過学習
- 2025 現在:LLM・拡散モデル・VLM・基盤モデルが全ての中心
- 学ぶ順序:MLP → CNN → Transformer → 生成モデル
🧠 CNN / RNN / Transformer 徹底比較
深層学習の主要 3 アーキテクチャを、 入力形式・帰納バイアス・典型タスクで整理する。 「いつ何を使うか」の判断基準を SSDSE-B-2026 と国際比較データで具体化。
| アーキ | 入力 | 帰納バイアス | 計算量 | 典型タスク |
|---|---|---|---|---|
| CNN | 画像 (2D/3D) | 局所性 + 平行移動不変 | O(N) | 画像分類 / 物体検出 |
| RNN / LSTM | 系列 (時系列・テキスト) | 逐次依存 + 隠れ状態 | O(N) | 系列予測 / 旧型 NLP |
| Transformer | トークン列 (任意) | 弱い (Attention で全結合) | O(N^2) | LLM / VLM / 全分野 |
🔬 数式を言葉で読み解く: Self-Attention
Transformer の中核は Self-Attention: $\text{Attn}(Q,K,V) = \text{softmax}(QK^T / \sqrt{d_k}) V$。 Q(クエリ)・K(キー)・V(バリュー)はすべて入力 $X$ を線形変換したもの。 $QK^T$ は「どのトークンとどのトークンが関連するか」のスコア行列、 softmax で正規化、 $V$ で値を集約。 系列全体を一度に見るため位置情報は位置エンコーディングで追加する。
🎯 このコードでやること
SSDSE-B-2026 の 47 都道府県の総人口を年度ごとに合計した全国人口(2012〜2023 年度の 12 年)を、 PyTorch の小型 Transformer Encoder で「前年の値 → 翌年の値」として学習する。 同じデータで小さな MLP と、 前年値をそのまま使う素朴な予測とも比べ、 小データでの DL の限界を体感する。
📥 入力データ: SSDSE-B-2026 の総人口 A1101 を年度ごとに 47 都道府県で合計した全国人口(12 年 × 1 系列、 学習に使う「前年 → 翌年」の組は 11 組)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 | import pandas as pd import torch import torch.nn as nn torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする # SSDSE-B-2026 の 47 都道府県の総人口を年度ごとに合計して、全国人口の時系列(2012〜2023 の 12 年)を作る df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) total = df.groupby('SSDSE-B-2026')['A1101'].sum().sort_index() # 年度の昇順に並べる print('全国人口:', total.iloc[0], '(2012) →', total.iloc[-1], '(2023)') z = (total - total.mean()) / total.std() # 平均0・分散1に正規化 series = torch.tensor(z.values, dtype=torch.float32) x = series[:-1].view(-1, 1, 1) # 入力: 各年(系列長 1 のトークン)× 11 組 y = series[1:].view(-1, 1) # 目標: 翌年の人口(正規化値) class TinyTransformer(nn.Module): def __init__(self, d_model=16, nhead=2, nlayers=2): super().__init__() self.emb = nn.Linear(1, d_model) # batch_first=True で (件数, 系列長, 次元) と解釈させる。 # 省略すると 11 年全体が 1 本の系列として扱われ、翌年の値を注意機構で覗けてしまう layer = nn.TransformerEncoderLayer(d_model, nhead, batch_first=True) self.enc = nn.TransformerEncoder(layer, nlayers) self.head = nn.Linear(d_model, 1) def forward(self, x): h = self.enc(self.emb(x)) return self.head(h.squeeze(1)) def train(model, epochs=100): opt = torch.optim.Adam(model.parameters(), lr=1e-3) for epoch in range(epochs): opt.zero_grad() loss = nn.functional.mse_loss(model(x), y) loss.backward() opt.step() return loss.item() tf = TinyTransformer() mlp = nn.Sequential(nn.Flatten(), nn.Linear(1, 16), nn.ReLU(), nn.Linear(16, 1)) n_tf = sum(p.numel() for p in tf.parameters()) n_mlp = sum(p.numel() for p in mlp.parameters()) print(f'学習に使う組: {len(x)} 組') print(f'Transformer: パラメータ {n_tf} 個, Epoch 100: MSE = {train(tf):.4f}') print(f'MLP : パラメータ {n_mlp} 個, Epoch 100: MSE = {train(mlp):.4f}') # 比較の基準: 「翌年は今年と同じ」とだけ予測したときの MSE print(f'前年値をそのまま使う予測: MSE = {nn.functional.mse_loss(x.view(-1, 1), y).item():.4f}') |
📤 実行例(実測・torch 2.12):
💬 結果の読み方: Transformer の学習 MSE 0.0172 は前年値をそのまま使う予測の 0.1217 より小さいが、 11 組のデータに 137,553 個のパラメータ(大半は既定で 2,048 次元ある順伝播層)を当てているので、 学習データを覚えただけで、 2024 年度を当てられる保証にはならない。 49 個の MLP は同じ 100 回では MSE 0.2293 と、 素朴な予測にも届いていない。 12 点しかないデータでは Transformer は明らかに過剰で、 評価するなら最後の数年を学習から外して確かめる必要がある。 DL は「データが万単位以上ある」「特徴量設計が難しい」「画像・テキスト・音声」の場合に真価を発揮する。 SSDSE のような表形式・小データでは木のアンサンブル(GBDT)が強い。
📜 深層学習の歴史 (1958-2025)
| 年 | 出来事 | 意義 |
|---|---|---|
| 1958 | Perceptron (Rosenblatt) | NN の原型 |
| 1986 | Backpropagation 再発見 | 多層学習が可能に |
| 2012 | AlexNet (ImageNet 優勝) | GPU + CNN ブーム開幕 |
| 2017 | Transformer (Attention Is All You Need) | NLP の主役交代 |
| 2020 | GPT-3 | LLM 時代到来 |
| 2022 | ChatGPT / Stable Diffusion | 一般ユーザーに普及 |
| 2024-25 | マルチモーダル基盤モデル | 画像・音声・テキスト統合 |
⚠️ 落とし穴
- 小データで DL: SSDSE のような 47 行データに Transformer は過剰。 木のアンサンブルか線形モデルから始める。
- GPU 必須思い込み: 推論なら CPU で十分なケースも多い。 学習でも MLP 程度なら数分で終わる。
- fine-tuning ≠ 万能: 事前学習データと領域が違うと逆効果。 ドメインに近い基盤モデルを選ぶ。
「深層学習」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- 数値データ・小〜中規模 → 「深層学習」やその拡張手法を直接適用
- カテゴリデータ → カテゴリカル変数を Embedding 層で扱う — One-hot より低次元で意味を保持
- 大規模・高次元 → CNN や Transformer など特化アーキテクチャ — 大規模データには分散学習も検討
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「深層学習」を中核とした適切な手法選択ができる。