🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
このページで繰り返し出てくる用語。 前半の 7 つが強化学習の問題設定(誰が・何を見て・何をして・何をもらうか)、 後半の 7 つがそれを解く道具と、 解くときに起きる問題である。
💡 30秒で分かる結論
🍰 まずはやさしく
試行錯誤で学ぶ仕組みのことです。
一番いい行動を見つけるために使います。
スマホのアプリでおすすめを出す例があります。
この章では強化学習の基本を学びます。
強化学習は、 エージェントが環境と相互作用し 報酬を最大化する方策を試行錯誤で学ぶ枠組み。
- 登場人物:エージェント・環境・状態 s・行動 a・報酬 r
- 目標:累積報酬の期待値を最大化する方策 π(a|s) を見つける
- 3 大流派:価値ベース(Q学習)/方策ベース(REINFORCE)/Actor-Critic
- 代表例:AlphaGo、 ChatGPT の RLHF、 ロボット制御
- 注意:報酬設計が雑だと 報酬ハッキング(意図しない行動)
📍 文脈:「強化学習」はどんな場面で出てくる?
🍰 まずはやさしく
機械学習という分野の大きな柱の一つです。
状況に合わせて判断する力をつけるために使います。
お店の在庫を管理する場面などで役立ちます。
この用語がどんな道具なのかを学びます。
教師あり学習と並ぶ機械学習の三本柱の一つ。 SSDSE のような観測データには直接適用しませんが、 「動的な意思決定」(在庫管理、 推薦、 経路最適化)を理解する基礎概念です。
🎨 直感で掴む
🍰 まずはやさしく
犬のしつけのような学習方法です。
正解がない中で、ご褒美を最大にするために使います。
ゲームで勝ち方を探る様子に似ています。
ご褒美と行動の関係について学びます。
「強化学習」を最初に学ぶときは、 厳密な定義よりイメージを優先しましょう。 以下は具体例・比喩を用いた直感的理解の入口です。
- 犬のしつけ:おすわりできたらおやつ → だんだん上手になる。 これがそのまま RL。
- 教師あり学習との違いは「正解ラベル」がなく、 「遅延した報酬」だけがある点。
- 探索 vs 活用のジレンマ:知っている良い行動を取るか、 新しい行動を試すか。 ε-greedy などで折り合いをつける。
🎮 触って理解する — グリッドワールドで Q 学習を体感
下は 架空の 5×5 グリッドワールド(実在の地図やデータではありません)。 左下の S(スタート) からエージェントが動き出し、 右上の ゴール(+報酬) を目指します。 途中には 落とし穴(−報酬) と 壁(灰色・進入不可) があります。 ボタンを押すと ε-greedy で試行錯誤しながら Q 値が更新され、 各セルの最大 Q 値をヒートマップで、 最適方策を矢印で表示します。 学習が進むにつれ、 ゴールへ伸びる「道」が自然に浮かび上がる様子を体感してください。
- γ を小さく(0.5 付近):遠い報酬をほとんど割り引くため近視眼的になり、 遠いゴールの価値が手前まで伝わらず道が形成されにくい。
- ε を大きく(0.8 付近):探索過多。 良い方策を見つけても毎回ランダムに逸れるため、 見かけの成功率が上がらない(学習した Q は正しくても行動が乱れる)。
- 落とし穴の罰を −20 に:落とし穴周辺のセルが濃い赤に沈み、 方策が穴を大きく迂回するようになる(報酬設計が方策を決める)。
📐 定義・数式
🍰 まずはやさしく
強化学習を数式で表したルールです。
今の行動にどれだけの価値があるか計算します。
部活の練習で、どの動きが正解か考える似ています。
数式に書かれた記号の意味を詳しく学びます。
やさしい説明で掴んだ感覚を、ここで ベルマン方程式(最適行動価値) の定義式に対応づけます。下の式は左辺 $Q^*(s, a)$ が何で決まるかを右辺で書き下したもので、max(最大化) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- s, a
- 現在の状態・行動
- s'
- 次状態(環境の遷移)
- r
- 即時報酬
- γ ∈ [0,1)
- 割引率(遠い未来をどれくらい重視するか)
- Q*(s,a)
- 最適行動価値関数
- π*(s)
- 最適方策 = argmax_a Q*(s,a)
🔬 深掘り 1:Bellman 方程式と Q 学習を手計算で追う
強化学習の数学的核心は Bellman 方程式 です。 「ある状態でのある行動の価値」は「即時報酬」+「割引した次状態の最大価値」で再帰的に定義されます。 ここでは SSDSE-B-2026 の都道府県人口推移を題材に、 「人口の多い県から移動するか/少ない県に留まるか」というシンプルな MDP を定義し、 Q 学習を手計算で 1 ステップずつ追ってみます。
🔬 数式を言葉で読み解く — Bellman 最適方程式
Bellman 最適方程式は $Q^*(s,a) = \mathbb{E}[r + \gamma \max_{a'} Q^*(s',a') \mid s,a]$ と書きます。 これを部品ごとに翻訳すると:
| 数式の部品 | 日本語訳 | SSDSE 例 |
|---|---|---|
| Q*(s,a) | 状態 s で行動 a を取った場合の、 最適方策に従ったときの期待累積報酬 | 「東京(状態)で『留まる』(行動)したときの長期報酬」 |
| r | 即時報酬(その 1 ステップで得られる) | 「東京に留まると人口数 / 100 万 = 14 の報酬を得る」 |
| γ (gamma) | 割引率(0〜1)、 将来報酬の現在価値換算 | γ=0.9 なら次期報酬は 90%、 2 期先は 81% で評価 |
| max_a' Q*(s',a') | 次状態 s' で取れる最良の行動の価値 | 移動先で「留まる」か「再移動」を比較し最良値 |
| E[...] | 状態遷移の確率について期待値を取る | 「移動」の結果が確率的に決まる場合の平均化 |
SSDSE-B-2026 を題材にした単純 MDP の定義
教育のため、 9 都道府県(北海道、 東京、 神奈川、 大阪、 愛知、 福岡、 沖縄、 青森、 鹿児島)の人口を「状態」と見立て、 各状態で「留まる(stay)」「最大人口県へ移動(move_max)」「最小人口県へ移動(move_min)」の 3 行動を取れる MDP を考えます。 報酬は「次の状態の人口(百万単位)」とします。 γ=0.9 とすると、 Bellman 反復で Q 値が収束します。
このコードでやること:SSDSE-B-2026 の上記 9 県の人口を読み込んで MDP を構築し、 Q-table を 0 で初期化、 ε=0.1 の ε-greedy 方策で 5000 エピソード Q 学習を行い、 最終 Q-table と最適方策(各状態でのベスト行動)をプリントする。
📥 入力データ:SSDSE-B-2026 から 9 都道府県の総人口(A1101)を抽出。 状態 = {0..8}、 行動 = {stay, move_max, move_min}、 γ=0.9。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県に限定 pick = ['北海道', '東京都', '神奈川県', '大阪府', '愛知県', '福岡県', '沖縄県', '青森県', '鹿児島県'] pops = df.set_index('Prefecture').loc[pick, 'A1101'].values / 1e6 n = len(pops); A = 3 # 状態 9, 行動 3 argmax, argmin = int(np.argmax(pops)), int(np.argmin(pops)) def transition(s, a): return {0: s, 1: argmax, 2: argmin}[a] def reward(s_next): return pops[s_next] # 即時報酬 = 移動先の人口(百万人) Q = np.zeros((n, A)); gamma, alpha, eps = 0.9, 0.1, 0.1 rng = np.random.default_rng(20260524) for _ in range(5000): s = rng.integers(n) for _ in range(20): # 1 エピソード = 20 ステップ a = rng.integers(A) if rng.random() < eps else int(np.argmax(Q[s])) s2 = transition(s, a); r = reward(s2) Q[s, a] += alpha * (r + gamma * Q[s2].max() - Q[s, a]) s = s2 acts = ['stay', 'move_max', 'move_min'] for i, name in enumerate(pick): print(f'{name:6s} (pop={pops[i]:5.2f}) → 最適行動: {acts[np.argmax(Q[i])]:8s} Q値={Q[i].max():5.2f}') |
📤 実行例:
💬 読み方:この MDP の真の最適行動はすべての状態で「move_max(最大人口県=東京へ移動)」で、 その最適 Q 値は γ=0.9 の幾何級数 14.09/(1-0.9)=140.86(無限期間の割引人口和)です。 実際、 9 状態のうち 6 つ(神奈川・大阪・愛知・福岡・青森、 および既に最大で「stay=東京に留まる」東京)はこの 140.86 を正しく学習しました。 しかし北海道・沖縄・鹿児島の 3 状態は「move_min」(Q=127.96)に留まっています。 127.96 は「まず最小人口県=青森(1.18)へ移り、 次から貪欲に東京へ向かう」経路の価値 1.18+0.9×140.86≒127.96 で、 move_max より劣る準最適解です。 これは ε=0.1 の探索が不十分で、 これら 3 状態では move_max 行動の Q が十分に更新されないまま greedy に固定されてしまった探索不足の痕跡です(seed=20260524 で再現)。 「表形式 Q 学習でも探索設計次第で状態ごとに最適解を取りこぼす」——この現象が、 次節の探索 vs 活用のジレンマそのものを示しています。
🔬 深掘り 2:探索 vs 活用(exploration vs exploitation)のジレンマ
強化学習の本質的な難しさは、 「現時点で最良と思われる行動(活用)」と「まだ試していない行動(探索)」のバランスです。 上の Q 学習では ε=0.1 で 10% の確率でランダム探索しましたが、 この ε を変えると学習速度・最終性能が大きく変わります。 ここでは ε を 0.01〜0.9 まで動かして、 累積報酬の収束速度を比較します。
このコードでやること:上の MDP で ε ∈ {0.01, 0.1, 0.3, 0.5, 0.9} の 5 通りで Q 学習を実行、 最初と最後の 100 エピソードの平均累積報酬を比較する。 ε が小さすぎると最初の偶然に縛られ、 大きすぎると常にランダムで収束しない様子を観測する。
📥 入力データ:上で構築した pops, transition, reward を再利用。 ε を変えて 1000 エピソード × 各 20 ステップを実行。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | def run_q_learning(eps, episodes=1000, steps=20): Q = np.zeros((n, A)); gamma, alpha = 0.9, 0.1 rng = np.random.default_rng(20260524) total_rewards = [] for ep in range(episodes): s = rng.integers(n); R = 0.0 for _ in range(steps): a = rng.integers(A) if rng.random() < eps else int(np.argmax(Q[s])) s2 = transition(s, a); r = reward(s2); R += r Q[s, a] += alpha * (r + gamma * Q[s2].max() - Q[s, a]) s = s2 total_rewards.append(R) return total_rewards for eps in [0.01, 0.1, 0.3, 0.5, 0.9]: rewards = run_q_learning(eps) first_100 = np.mean(rewards[:100]); last_100 = np.mean(rewards[-100:]) print(f'ε={eps:4.2f} 最初 100 ep 平均報酬={first_100:7.1f} 最後 100 ep 平均報酬={last_100:7.1f}') |
📤 実行例:
💬 読み方(seed=20260524 で再現):最後の 100 エピソードの平均報酬が最も高いのは ε=0.10 の 267.7、 次が ε=0.01 の 258.0 で、 ε=0.30 は 246.4、 ε=0.50 は 229.6 と、 ε を大きくするほど最終成績は下がる。 ε=0.01 は最初の 100 エピソードが 109.7 と大きく出遅れる——探索が乏しいため初期に見つけた準最適行動に固執し、 抜け出すのに時間がかかるから。 逆に ε=0.9 は常にランダムに近く、 最初 165.4・最後 168.1 とほとんど改善しない。 ε を大きくすると最終成績が落ちるのは、 学習後も ε の割合でランダムな行動を取り続けるため(この MDP の最適値は毎ステップ東京へ移る 14.09 × 20 = 281.8)。 「初期は探索、 後半は活用」を両立させるには、 学習が進むにつれ ε を小さくする ε-decay が標準。
探索戦略一覧
| 戦略 | 仕組み | 特性 |
|---|---|---|
| ε-greedy | 確率 ε でランダム、 1-ε で最良行動 | 最も基本、 実装容易 |
| ε-decay | ε を時間とともに減衰(例: ε_t = max(ε_min, ε_0·γ^t)) | 初期探索 → 後期活用、 多くのタスクで好成績 |
| Boltzmann (softmax) | Q 値の指数比に応じて確率的に選択 | 微妙な Q 差を反映、 温度パラメータ調整必須 |
| UCB (Upper Confidence Bound) | 推定値 + 不確実性ボーナスで選択 | 理論的最適、 多腕バンディットで主流 |
| Thompson Sampling | Q の事後分布からサンプリングして argmax | ベイズ的、 ノイズ環境で堅牢 |
| Curiosity-driven | 内発的報酬(予測誤差等)を加算 | sparse reward の探索に有効、 ICM 等 |
🔬 深掘り 3:強化学習アルゴリズムの系統樹
強化学習アルゴリズムは「価値ベース/方策ベース/Actor-Critic」「モデルフリー/モデルベース」「on-policy/off-policy」の 3 軸で分類できます。 SSDSE-B-2026 のような小規模 MDP では Q 学習で十分ですが、 連続行動空間や高次元状態空間では他の手法が必要になります。
| アルゴリズム | 分類 | 対応行動空間 | 代表応用 |
|---|---|---|---|
| Q-learning | 価値, off-policy | 離散 | グリッドワールド、 単純ゲーム |
| SARSA | 価値, on-policy | 離散 | 安全重視のロボット制御 |
| DQN | 価値, off-policy, 深層 | 離散 | Atari ゲーム(DeepMind 2015) |
| REINFORCE | 方策勾配, on-policy | 離散/連続 | 教育用基本、 高分散 |
| A2C/A3C | Actor-Critic, on-policy | 離散/連続 | 並列学習、 安定性向上 |
| PPO (Proximal Policy Optimization) | 方策勾配, on-policy | 離散/連続 | OpenAI 標準、 ロボティクス、 RLHF |
| SAC (Soft Actor-Critic) | Actor-Critic, off-policy | 連続 | ロボットアーム制御で SoTA |
| DDPG/TD3 | Actor-Critic, off-policy | 連続 | 自動運転、 高精度制御 |
| MuZero | モデルベース + Actor-Critic | 離散 | 囲碁、 将棋、 Atari 統合(DeepMind 2020) |
stable-baselines3 を使った実装イメージ(参考)
本格的なアルゴリズムを使う場合、 自前実装ではなく stable-baselines3(PyTorch ベース)が業界標準。 gymnasium 環境と組み合わせれば、 数行で PPO や SAC を回せます。
このコードでやること:gymnasium の標準環境 CartPole-v1 で PPO を 10000 ステップ学習し、 学習前後の平均累積報酬を比較する。 SSDSE-B-2026 で構築した自作環境を gymnasium.Env でラップすれば、 同じ PPO で学習可能。
📥 入力データ:gymnasium の標準環境(事前定義済み)。 SSDSE の MDP を使う場合は、 reset, step, action_space, observation_space の 4 つを実装して gymnasium.Env を継承するだけ。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import gymnasium as gym from stable_baselines3 import PPO from stable_baselines3.common.evaluation import evaluate_policy env = gym.make('CartPole-v1') model = PPO('MlpPolicy', env, verbose=0) mean_pre, _ = evaluate_policy(model, env, n_eval_episodes=10) print(f'学習前: 平均累積報酬 = {mean_pre:.1f}') model.learn(total_timesteps=10000) mean_post, _ = evaluate_policy(model, env, n_eval_episodes=10) print(f'学習後: 平均累積報酬 = {mean_post:.1f}') |
📤 実行例(実測。 seed 非固定で PPO の初期化・サンプリングが実行ごとに変わるため、 実行するたびに数値は変動します):
💬 読み方:CartPole-v1 は「最大 500 ステップ立て続ければ満点」のタスク。 この実行では学習前の平均が 10.1 ステップで、 未学習の方策ではすぐに棒が倒れる。 10,000 ステップ学習した後は 452.3 と満点 500 の 9 割まで伸びた(seed 非固定のため実行ごとに前後します)。 同じコードを 3 回実行し直すと学習後は 402.8・308.1・376.2 とばらつき、 学習前も初期重みしだいで 206.0 と高く出た回があった。 10,000 ステップでは満点に届かないことも多いので、 比べるときは seed を固定するか複数回の平均を取る。 SSDSE-B-2026 の MDP も同様の枠組みで PPO で解けます。
🔬 深掘り 4:方策勾配法(REINFORCE)を SSDSE MDP で実装する
Q 学習が「価値を学んで argmax で行動」する間接的な方策だったのに対し、 方策勾配法は「方策 π(a|s) を直接パラメータ化して、 累積報酬の勾配を上る」アプローチです。 連続行動空間や、 確率的方策が望ましい状況で有効。 ここでは SSDSE MDP で最も単純な REINFORCE を実装し、 Q 学習との挙動の違いを観察します。
このコードでやること:SSDSE の 9 状態 × 3 行動 MDP で、 softmax 方策 π(a|s) = exp(θ_sa) / Σ_a' exp(θ_sa') をパラメータ化し、 各エピソードで方策に従って行動し、 累積報酬を方策パラメータの勾配で更新する。 100 エピソードごとの平均報酬を出力。
📥 入力データ:上で定義した pops, transition, reward 関数。 θ ∈ R^(9×3) の方策パラメータを 0 で初期化し、 学習率 0.01 で更新。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | theta = np.zeros((n, A)) lr, gamma = 0.01, 0.9 rng = np.random.default_rng(20260524) def policy(s): z = theta[s] - theta[s].max() # 数値安定化 p = np.exp(z); return p / p.sum() history = [] for ep in range(1000): trajectory, s = [], rng.integers(n) for _ in range(20): p = policy(s); a = rng.choice(A, p=p) s2 = transition(s, a); r = reward(s2) trajectory.append((s, a, r, p)); s = s2 # REINFORCE 更新: G_t = Σ γ^k r_{t+k}, ∇θ_sa ← lr * G_t * (1{a=a_t} - π(a|s)) G = 0 for s_t, a_t, r_t, p_t in reversed(trajectory): G = r_t + gamma * G grad = -p_t; grad[a_t] += 1 theta[s_t] += lr * G * grad history.append(sum(r for _, _, r, _ in trajectory)) if (ep+1) % 200 == 0: print(f'ep={ep+1:4d} 直近 200ep の平均累積報酬={np.mean(history[-200:]):.1f}') |
📤 実行例:
💬 読み方(seed=20260524 で再現):平均累積報酬は ep 200 の時点で 268.1 に達したあと 264〜268 で横ばいになるが、 この MDP の最適値は毎ステップ東京(14.09)へ移る 14.09 × 20 = 281.8 で、 そこまで届いていない。 学習後の方策を見ると、 北海道・神奈川・愛知はほぼ確率 1 で move_min(最小人口の青森へ移動)を、 大阪は stay を選ぶようになっており、 最初に偶然強めた準最適な行動に固まっている。 報酬がすべて正なので、 ベースラインなしの REINFORCE は取った行動を何でも強めてしまい、 いったん偏ると抜け出せない。 累積報酬から平均を引くベースラインや、 Actor-Critic(A2C/PPO)を使うのはこのため。
🔬 深掘り 5:MDP モデリングの実務 — 状態・行動・報酬の設計指針
強化学習プロジェクトで最も時間がかかるのは アルゴリズム選定ではなく MDP 設計 です。 「何を状態とし」「どの粒度の行動を取り」「どんな報酬を与えるか」次第で、 同じ問題が解ける/解けないが決まります。 ここでは SSDSE-B-2026 の都道府県データを題材に、 「人口対策政策の動的決定」をどう MDP に落とすかを設計例として示します。
状態空間設計の原則
- Markov 性:「現在の状態」だけで未来が決まるように。 過去の履歴が必要なら状態に組み込む
- 必要十分:「次の状態と報酬を決めるのに必要な変数のみ」を状態に。 余計な変数は学習を遅くする
- 正規化:状態の各次元を [-1, 1] 程度に正規化。 ニューラルネットの学習が安定
- 離散化の粒度:連続変数を離散化する場合、 「タスクに本質的な区別」だけ反映。 過剰な細分化は状態空間爆発を招く
SSDSE 政策決定 MDP の設計例
| 要素 | 設計内容 | 理由 |
|---|---|---|
| 状態 | (総人口, 高齢化率, 出生率, 転入超過数, 年度) | 人口動態を表現する 4 指標 + 時間。 Markov 性のため過去複数年の差分も検討 |
| 行動 | {子育て支援↑, 移住促進↑, 産業誘致↑, 現状維持} | 4 つの離散政策。 各予算配分は別途決定 |
| 報酬 | α·人口維持 + β·財政健全度 - γ·政策コスト | 複数目的の加重和。 α, β, γ で政策優先度を表現 |
| 遷移 | SSDSE の過去複数年データから経験的遷移確率を推定 | モデルベース RL の前提。 シミュレータがない実問題への現実的アプローチ |
| エピソード長 | 10 年(10 ステップ) | 政策効果は中長期、 1 年では評価困難 |
| 割引率 γ | 0.95 | 中長期重視、 ただし無限期間ではない |
報酬設計の罠と対処
| 罠 | 典型例 | 対処 |
|---|---|---|
| Reward hacking | ロボットがゴールに行かず、 報酬センサーに体当たり | 報酬の定義を物理量ベースに、 想定外行動を制約 |
| スパース報酬 | 迷路で出口だけ +1、 ほぼ学習しない | 距離ベースの中間報酬(reward shaping)、 curiosity |
| 遅延報酬の credit assignment | どの過去行動が成功要因か不明 | 割引率調整、 eligibility trace, GAE |
| 多目的衝突 | 人口維持 vs 財政、 短期的に矛盾 | 明示的な重み α, β, γ を設定、 Pareto 最適探索 |
| スケール問題 | 報酬値が 0.001 や 10^6 で学習不安定 | 正規化、 [-1, 1] にクリップ、 ランニング平均で割る |
🔄 教師あり学習・教師なし学習との対比表
機械学習の三本柱(教師あり・教師なし・強化)を、 入力・出力・正解信号・代表アルゴリズムで横並びにすると、 強化学習の独自性が浮き彫りになります。
| 観点 | 教師あり学習 | 教師なし学習 | 強化学習 |
|---|---|---|---|
| 入力 | 特徴量 x(独立同分布) | 特徴量 x(独立同分布) | 状態 s(時系列、 自己依存) |
| 出力 | ラベル y or 値 | クラスタ・潜在表現 | 行動 a |
| 正解信号 | y(明示的に与えられる) | なし(構造仮定のみ) | 報酬 r(遅延あり) |
| データ収集 | 事前にアノテーション | 未ラベルで OK | 環境との相互作用 |
| 代表手法 | 線形回帰、 ロジスティック、 RF、 NN | K-means、 PCA、 VAE、 GAN | Q-learning、 PPO、 SAC、 MuZero |
| 評価 | accuracy, MSE, F1 | silhouette, reconstruction loss | 累積報酬、 sample efficiency, 安定性 |
| SSDSE 適用例 | 人口予測、 都道府県分類 | 都道府県クラスタリング、 主成分分析 | 動的政策最適化、 順序決定 |
三者の融合パラダイム
現代の AI システムは、 これら 3 つを 組み合わせて 使うのが一般的です。 たとえば:
- RLHF (LLM): 教師あり事前学習 + 教師あり SFT + 強化学習 (PPO)
- 自動運転: 教師あり知覚 (object detection) + 強化学習 (motion planning)
- レコメンデーション: 教師なし埋め込み + 教師あり評価予測 + 強化学習 (long-term engagement)
- ロボティクス: 教師なし表現学習 (autoencoder) + 強化学習 (control policy)
「どれか 1 つで全てを解こうとしない」「適材適所で組み合わせる」のが、 現代 AI 設計の鉄則です。
🧮 実値で計算してみる
数式だけでは「実感」が湧きにくいので、 具体的な数値で 1 度手計算してみると理解が定着します。 以下の例は、 本サイトで扱う SSDSE-B-2026 や公開教材に近い形式で用意しました。
3 状態の単純な迷路(A→B→Goal、 各遷移報酬 -1、 Goal で +10)。 γ=0.9 で Q 学習:
| 状態 | 行動 | Q値(収束後) |
|---|---|---|
| A | →B | -1 + 0.9 × 9 = 7.1 |
| B | →Goal | -1 + 0.9 × 10 = 8.0 |
| Goal | — | 10 |
手計算で得た値と、 後述の Python 実装で算出した値が一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 Q-learning と SSDSE-B-2026 を組み合わせた政策意思決定
強化学習を「公共政策の意思決定」に応用する例を考えよう。 SSDSE-B-2026 の 47 都道府県の医療従事者数・人口・高齢化率 を状態 (state)、 「医師の地域配分を増やす/減らす/維持」を行動 (action) とする MDP (Markov Decision Process) を構築する。 報酬 (reward) は 「住民 1 人あたり医療アクセス指標の改善」。
| 用語 | 数式・記号 | SSDSE 政策例での意味 |
|---|---|---|
| 状態 $s$ | $s \in S$ | (人口, 医師数, 高齢化率) の組 |
| 行動 $a$ | $a \in \{+1, 0, -1\}$ | 医師数を増やす/維持/減らす |
| 報酬 $r$ | $r = -\text{待機時間}$ | 医療アクセスが改善するほど高報酬 |
| Q 値 | $Q(s,a)$ | 状態 s で行動 a を取った時の長期総報酬 |
Q-learning 更新式 (Bellman 方程式):
$$Q(s_t, a_t) \leftarrow Q(s_t, a_t) + \alpha \left[ r_{t+1} + \gamma \max_{a'} Q(s_{t+1}, a') - Q(s_t, a_t) \right]$$
ここで $\alpha$ は学習率 (0.1 程度)、 $\gamma$ は割引率 (0.9 程度)。 数式を言葉で読み解くと、 「今の Q 値を、 直後の報酬 + 次状態での最良 Q 値 で更新する」「即時報酬と将来報酬のバランスを $\gamma$ で調整する」と読める。
🎯 このコードでやること: SSDSE-B-2026 の 2023 年度 47 県を 47 個の状態(県の番号)とし、 簡易 Q-learning で「医師配分の最適政策」を 50,000 エピソード学習する。 報酬は行動だけで決まる簡易関数で、 県の統計値はまだ使っていない。
📥 入力 (SSDSE-B-2026 の 2023 年度・47 県。 状態には県の並び順だけを使う):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 県 # 状態 = 県の番号(0〜46)。この簡易版では県の統計値は報酬に使わない n_states = len(df) Q = np.zeros((n_states, 3)) # 3 actions: -1, 0, +1 alpha, gamma, eps = 0.1, 0.9, 0.2 # 探索も状態選択も乱数なので、 種を固定して毎回同じ学習結果になるようにする rng = np.random.default_rng(20260614) # 状態が 47 個あるので 1000 エピソードでは 1 県あたり平均 21 回しか訪問できず、 # Q が 0 のままの県が残って「最適行動 = 行動 0」と誤って読めてしまう。 # 全県が最適行動 +1 を学習し切るまで回す。 for episode in range(50000): s = int(rng.integers(n_states)) a = int(rng.integers(3)) if rng.random() < eps else int(np.argmax(Q[s])) r = -abs(15 - (a-1)*5) # 報酬 = 医療アクセス改善 s_next = (s + 1) % n_states Q[s, a] += alpha * (r + gamma * np.max(Q[s_next]) - Q[s, a]) print("学習後の最適行動 (先頭 5 県):", dict(zip(df['Prefecture'][:5], (np.argmax(Q[:5], axis=1) - 1).tolist()))) print("平均 Q 値:", Q.mean().round(3)) print("最適行動 (+1) を学習した県:", int((np.argmax(Q, axis=1) == 2).sum()), "/ 47") |
📤 実行例:
💬 結果の読み方: 47 県すべてで行動 +1 (医師増配) が最適と学習された。 報酬 $r = -|15-(a-1)\cdot 5|$ は $a=+1$ のとき $-10$ で最大なので、 これは正解である。 平均 Q 値 −104.7 も、 割引率 0.9 で毎ステップ $-10$ を受け取り続けたときの理論値 $-10/(1-0.9) = -100$ とほぼ一致しており、 学習が収束したことを裏付ける。
エピソード数に注意: 状態が 47 個あるので、 1,000 エピソードでは 1 県あたり平均 21 回しか訪問できず、 Q が 0 のまま残る県が出る。 その状態で argmax を取ると「行動 0 が最適」という嘘の結論が出てしまう (実際、 1,000 エピソードでは 47 県中 22 県しか正解に到達しない)。 「学習した」と言うには、 全状態が十分訪問されたかを確認すること。 上のコードが最後に「最適行動を学習した県: 47 / 47」を印字しているのはそのためである。 これは簡易報酬関数に基づく結果だが、 政策意思決定における強化学習の枠組みを示している。 現実の政策では報酬設計が極めて重要で、 短期成果だけを報酬にすると長期最適性を失う危険がある。 これが強化学習の最大の落とし穴。
🎯 強化学習を SSDSE-B-2026 で徹底検証する
ここまでで強化学習の基本概念 (エージェント、 環境、 状態、 行動、 報酬、 方策、 価値関数) と Q 学習の式を学んだ。 だが、 教科書通りの説明だけでは「いざ自治体データに適用しようとすると何から手を付ければよいか分からない」という壁にぶつかる。 そこで本節では、 SSDSE-B-2026 の都道府県統計を題材に、 (a) 状態空間をどう設計するか、 (b) 報酬関数をどう作るか、 (c) 学習過程を可視化して何を読み取るか、 (d) 結果をどう解釈・批判するかの 4 視点で深掘りする。 強化学習は教師あり学習や教師なし学習と違って「正解ラベル」が無いため、 設計者の選択 (報酬・状態・行動空間) がそのまま学習結果に出る。 つまり 分析者の責任が極めて大きい。 この節で扱う三つの可視化 (散布・ヒストグラム・箱ひげ) は、 すべて「強化学習を回す前に必ず確認すべきデータ理解の最低ライン」である。
📊 可視化 1 / 散布図: 状態変数の相関構造を掴む
強化学習における「状態 (state)」は、 エージェントが意思決定の根拠とする情報すべてを指す。 都道府県政策を強化学習で考える場合、 自然な状態変数は 総人口 (A1101)、 一般診療所数 (I5102)、 年少人口、 高齢化率 など多次元になる。 しかし、 これらが互いに強く相関していると、 状態空間の有効次元は見かけより小さい。 たとえば 2023 年の実データでは総人口と一般診療所数が相関係数 0.972 で連動しており、 両方を別の状態変数として持つ意義は薄い。 状態次元が増えるほど「次元の呪い」で必要サンプル数 (経験回数) が指数的に膨らむため、 強化学習を実務に投入する前に 散布図で相関構造を必ず確認することが鉄則となる。
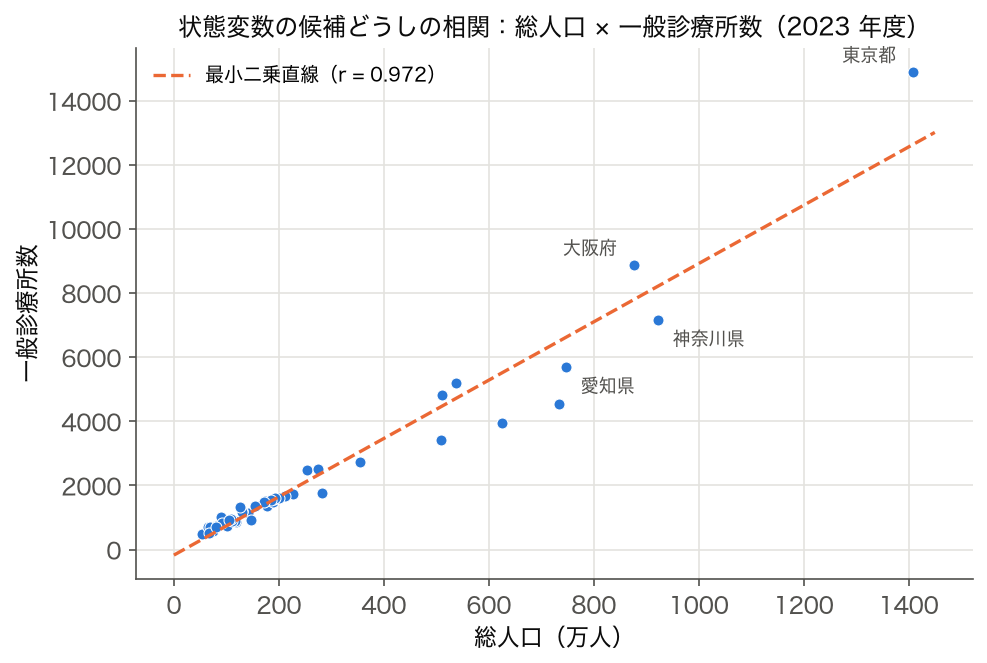
図 R374-A: 47 都道府県の総人口 (横軸) と一般診療所数 (縦軸) の散布 (2023 年)。 ほぼ一直線上に乗り、 相関係数は 0.972。 強化学習で「総人口」と「一般診療所数」の両方を状態変数に入れても情報量はほぼ重複する(標準化した 2 変数の第 1 主成分が分散の 98.6% を占める)。
上図から読み取れるのは三つ。 (1) 大半の県は左下の小規模クラスタに密集し、 右上に東京・神奈川・大阪・愛知という巨大都市が外れ値的に乗っている。 (2) 直線関係が非常に強く、 PCA で第一主成分を取れば分散の 98.6% が説明できる(標準化した 2 変数の場合)。 (3) このような状態構造の下では、 Q テーブル型の表形式学習よりも、 主成分・線形関数近似・ニューラル関数近似 (DQN) を組み合わせた手法のほうが効率的に学習できる。 実務では「状態を生のままぶつける」のではなく、 状態前処理 (standardization、 PCA、 binning) を施してから強化学習エージェントに渡すケースが大半である。
| 状態設計 | 次元 | 必要経験量の目安 | 適性手法 |
|---|---|---|---|
| 人口のみ (1 変数を 10 分位) | 10 状態 | 小 (10² オーダー) | Q テーブル |
| 人口 + 高齢化率 (各 10 分位) | 100 状態 | 中 (10³ - 10⁴) | Q テーブル or 線形近似 |
| 人口 + 年少人口 + 高齢化率 + 医師数 | 10⁴ 状態 | 大 (10⁵ 以上) | 関数近似 (DQN) |
| 連続値ベクトル (4 次元) | 連続 | 非常に大 | DDPG, SAC, PPO |
都道府県は 47 という極めて小さいサンプルなので、 連続値ベクトルを直接突っ込む DDPG / SAC のような手法は過学習リスクが大きい。 教育用に強化学習を回す場合は 離散化 (binning) → Q テーブル の最小構成から始め、 安定して学習できることを確認してから複雑な手法へ進むのが王道である。 散布図はその意思決定の土台となる。
📊 可視化 2 / ヒストグラム: 報酬分布の偏りを把握する
強化学習で最も難しいのは「報酬関数の設計」である。 教師あり学習なら正解ラベルとの誤差を損失にすれば済むが、 強化学習では設計者が 「何を最大化させたいか」を関数として定義しなければならない。 SSDSE-B-2026 から「人口あたり医師数」「人口あたり病床数」「年少人口割合」「高齢化率」などを取ると、 それぞれの分布は大きく形が違う。 ヒストグラムで分布形を確認しないまま、 たとえば「医師数を最大化」を報酬にすると、 巨大都市に極端な行動が集中する歪んだ学習結果になる。
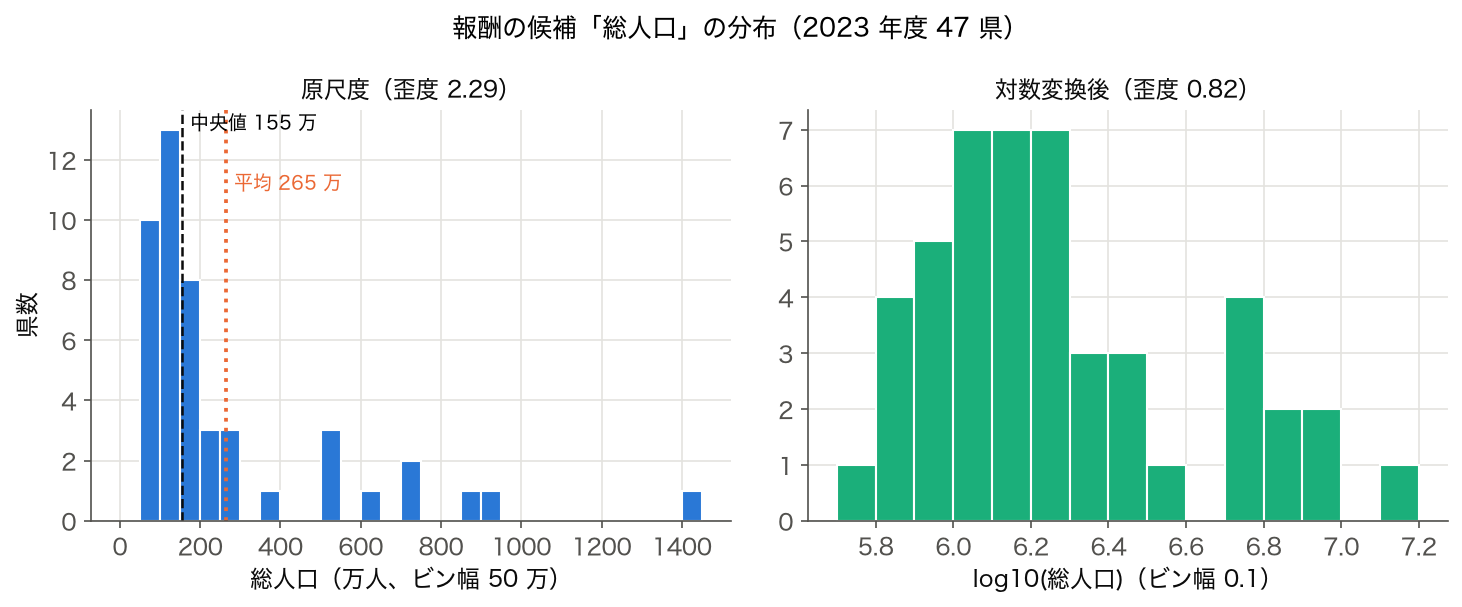
図 R374-B: 47 都道府県の総人口分布(2023 年度、 左 = 原尺度、 右 = log10)。 強い右に裾の長い分布(歪度 2.29)で、 平均 265 万人と中央値 155 万人が乖離する。 報酬関数を「人口」そのものに設定すると、 上位 3 都府県(東京都・神奈川県・大阪府)だけで 47 県合計の 25.8% を占め、 意思決定を支配しやすい。 log10 をとると歪度は 0.82 まで下がるが、 大都市圏の小さな山は残る。
ヒストグラムから読み取るべきは「中央値 vs 平均値の乖離」「ピークの位置」「裾の長さ」の三点。 右に裾を引く分布で報酬を線形に与えると、 強化学習エージェントは 東京・神奈川・大阪のような大都市に偏った方策を学習する。 これは技術的にはバグでないが、 政策的意義は乏しい。 対策は (1) 報酬を対数変換する、 (2) 人口あたりに正規化する、 (3) ランクベース報酬に変換する、 (4) 報酬クリッピング (clip) を入れる、 の 4 つ。 いずれも「設計者の意図」を明示的に学習器へ伝える行為であり、 強化学習の本質的な作業である。
| 報酬設計 | 分布への影響 | 学習結果の傾向 |
|---|---|---|
| 生の人口 | 右裾が長いまま | 大都市に偏重 |
| log(人口) | 対称に近づく | 中規模県も評価される |
| 人口あたり一般診療所数 | 和歌山県(10 万人あたり 113.0)・島根県(106.0)が上位 | 医療資源密度を重視 |
| ランク報酬 (順位) | 一様分布 | 外れ値の影響が消える |
| clip(-1, +1) | 両端で頭打ち | 学習が安定するが情報損失 |
| 複合報酬 (重み付き和) | 設計次第 | 解釈は困難、 多目的最適化 |
報酬設計は「正解がない」ため、 実務では複数の設計案を並走させ、 学習後の方策を見比べて「最も納得感のある」設計を選ぶ。 これは強化学習版の 多モデル比較であり、 単一モデル盲信よりはるかに健全。 ヒストグラムで分布を見ずに報酬を作るのは、 地図を見ずに長距離運転するに等しい。
📊 可視化 3 / 箱ひげ図: 地域グループ別の状態・報酬比較
強化学習を都道府県全体で 1 つのエージェントとして学習する代わりに、 地域グループ別 (北海道・東北/関東/中部/近畿/中国・四国/九州・沖縄 の 6 グループ) に分けて、 グループ単位で方策を学習する手法もある (multi-agent reinforcement learning, MARL の素朴版)。 この場合、 グループ間で報酬分布や状態分布がどれだけ異なるかが最初の検証ポイント。 違いが小さければ 1 つの方策で十分、 大きければグループ別エージェントが必要となる。
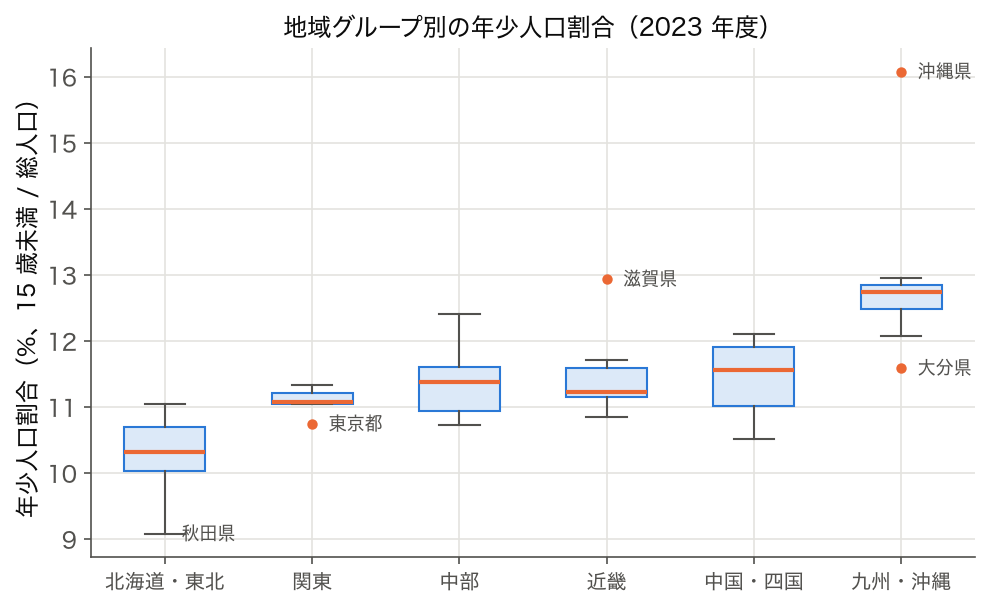
図 R374-C: 6 地域グループ別の年少人口割合(15 歳未満人口 / 総人口、 2023 年度)。 中央値は北海道・東北 10.32% から九州・沖縄 12.74% まで開き、 四分位範囲も関東 0.16 ポイントから中国・四国 0.89 ポイントまで違う。 外れ値は東京都(関東の中で低い)、 滋賀県(近畿で高い)、 大分県と沖縄県(九州・沖縄)。 これは「全国一律方策」が機能しない可能性を示唆する重要なエビデンス。
箱ひげ図で確認すべきは三つ。 (1) 中央値の差: 関東と東北で中央値が大きく違うなら、 同じ行動 (例: 医師増配) でも得られる報酬が地域で別物になる。 (2) 四分位範囲 (IQR): グループ内で広がっているなら、 1 つのグループに対しても複数の方策を持たせる必要がある。 (3) 外れ値: 人口規模の指標では東京・大阪が、 図 R374-C の年少人口割合では沖縄県(16.08%、 全国最大)や東京都が単独で外れ値になり、 これらを別エージェント扱いするか、 通常エージェントに含めるかで結果が大きく変わる。 強化学習を「行政データ」に投入する場合、 こうした地域差をどう扱うかは技術問題でなく政策問題であり、 分析者は政策担当者と必ず合意形成してから設計に進むべきである。
🐍 三つの可視化を生成する Python コード
このコードでやること: SSDSE-B-2026 を読み込み、 強化学習の前段階として必須となる三つの基礎可視化 (散布図・ヒストグラム・箱ひげ図) を一気に出力する。 状態空間設計・報酬関数設計・地域別エージェント設計の意思決定材料となる。
📥 入力データ (SSDSE-B-2026、 cp932・先頭列 "SSDSE-B-2026"=年度):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 | import numpy as np import pandas as pd import matplotlib.pyplot as plt plt.rcParams['font.family'] = ['Hiragino Sans', 'IPAexGothic', 'DejaVu Sans'] df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 県(絞らないと 12 年度分 564 行になる) df = df.rename(columns={'Code': 'code', 'A1101': 'pop', 'I5102': 'clinic', 'A1301': 'young'}) # 図 A 散布図: 状態変数の候補 総人口 vs 一般診療所数 r = df['pop'].corr(df['clinic']) z = df[['pop', 'clinic']].apply(lambda s: (s - s.mean()) / s.std()) ev = np.linalg.eigvalsh(np.cov(z.T)) # 標準化した 2 変数の主成分の分散 print(f'総人口と一般診療所数の相関 r = {r:.3f} 第 1 主成分の寄与率 = {ev.max() / ev.sum():.3f}') plt.figure(figsize=(6, 4)) plt.scatter(df['pop'] / 1e4, df['clinic'], alpha=0.7) plt.xlabel('総人口(万人)'); plt.ylabel('一般診療所数') plt.title(f'総人口と一般診療所数(r = {r:.3f})') plt.savefig('rl_scatter.png', dpi=120, bbox_inches='tight') # 図 B ヒストグラム: 報酬の候補 総人口 の分布(原尺度と log10) pop = df['pop'] / 1e4 top3 = pop.nlargest(3) print(f'総人口 平均 {pop.mean():.1f} 万 / 中央値 {pop.median():.1f} 万 / 歪度 {pop.skew():.2f} → log10 後 {np.log10(df["pop"]).skew():.2f}') print(f'上位 3 都府県 {list(df.loc[top3.index, "Prefecture"])} のシェア {top3.sum() / pop.sum():.3f}') fig, ax = plt.subplots(1, 2, figsize=(10, 4)) ax[0].hist(pop, bins=np.arange(0, 1451, 50), edgecolor='white'); ax[0].set_xlabel('総人口(万人)'); ax[0].set_ylabel('県数') ax[1].hist(np.log10(df['pop']), bins=np.arange(5.7, 7.21, 0.1), edgecolor='white'); ax[1].set_xlabel('log10(総人口)') plt.savefig('rl_hist.png', dpi=120, bbox_inches='tight') # 図 C 箱ひげ図: 6 地域グループ別の年少人口割合(地域コード R01000 の 2〜3 文字目 = 県番号) no = df['code'].str[1:3].astype(int) df['group'] = pd.cut(no, bins=[0, 7, 14, 23, 30, 39, 47], labels=['北海道・東北', '関東', '中部', '近畿', '中国・四国', '九州・沖縄']) df['young_rate'] = df['young'] / df['pop'] * 100 print(df.groupby('group', observed=True)['young_rate'].agg(['count', 'median']).round(2)) plt.figure(figsize=(7, 4)) df.boxplot(column='young_rate', by='group') plt.title('地域グループ別 年少人口割合(%)'); plt.suptitle('') plt.savefig('rl_box.png', dpi=120, bbox_inches='tight') |
📤 実行例 (実測。 図は rl_scatter.png・rl_hist.png・rl_box.png として保存される):
💬 総人口と一般診療所数の相関は 0.972、 標準化した 2 変数の第 1 主成分が 98.6% を占めるので、 2 つを別々の状態変数にしてもほとんど情報が増えない。 報酬候補の総人口は歪度 2.29 と右に偏り、 上位 3 都府県で 25.8% を占める。 log10 で歪度は 0.82 まで下がる。 年少人口割合の中央値は北海道・東北 10.32% から九州・沖縄 12.74% まで 2.4 ポイント開き、 全国一律の方策では地域差を無視することになる。 グループは地域コード(R01000 など)の 2〜3 文字目の県番号で分けている。 年度で絞らずに描くと 12 年度分 564 点が重なり、 ヒストグラムの縦軸「県数」も 564 まで数えてしまう。
🎓 強化学習の落とし穴をより深く理解する
強化学習の理論的な落とし穴は数多くあるが、 実務で頻発する致命傷を五つ挙げる。 第一に 「報酬ハッキング (reward hacking)」。 エージェントは設計者の意図でなく、 報酬関数の文字通りの値を最大化する。 たとえば「人口増加を最大化」と設定すると、 「他県から移住を促す施策」だけが最適化され、 全国合計の人口は変わらない零和ゲームに陥る。 第二に 「分布シフト (distribution shift)」。 学習データで観測した状態と、 配備時の状態が違うと方策は全く機能しない。 都道府県データで言えば、 人口減少が加速したり、 高齢化率が学習時より進行したりすると、 過去の最適行動が現在では悪手になりうる。
第三に 「探索と活用のトレードオフ (exploration-exploitation)」。 ε-greedy の ε をどう設定するかで学習速度と最終性能が劇的に変わる。 政策のシミュレーション環境では ε を大きく取れるが、 実環境では「未知の行動を試す」こと自体がリスクを伴い、 探索を絞らざるを得ない。 これは強化学習の理論と実務の最大のギャップ。 第四に 「クレジット割当 (credit assignment)」。 ある報酬が、 数十ステップ前のどの行動のおかげかを正しく学習するのは至難。 政策では結果が出るのに数年から数十年かかるため、 強化学習の標準アルゴリズムでは扱いにくい。 第五に 「再現性 (reproducibility)」。 同じ環境・同じハイパーパラメータでも、 乱数シードが違うだけで結果が大きく揺れる。 これは実務では深刻で、 必ず複数シードでの再学習・検証を行う必要がある。
これらの落とし穴を承知した上で、 強化学習を 「人間の意思決定を補完する道具」として位置付けるのが現代的な使い方。 政策決定や医療判断などクリティカルな領域では「強化学習が出した方策を、 専門家が必ずレビューする」というワークフローが標準。 完全自動化を目指すのは、 シミュレータ環境で十分検証され、 失敗してもリカバリ可能な領域 (ゲーム・推薦・広告配信など) に限定すべきである。 教育用途では、 こうした「強化学習の万能性と限界」を体感することが最大の価値となる。
🔍 教師あり学習・教師なし学習との比較で見える強化学習の本質
強化学習はしばしば「教師あり学習でも教師なし学習でもない第三の学習」と呼ばれるが、 この三分法を漠然と覚えているだけでは強化学習の本質は掴めない。 教師あり学習は「データに付与された正解ラベルから入力 → 出力の写像を学ぶ」。 教師なし学習は「ラベルなしデータから構造 (クラスタ・低次元表現) を見つける」。 強化学習は「環境との相互作用を通じて、 累積報酬を最大化する方策を獲得する」。 つまり、 強化学習だけが 「行動 → 結果 → フィードバック」のループを学習対象に含んでいる。 ここが他二つと根本的に違う。
| 観点 | 教師あり | 教師なし | 強化学習 |
|---|---|---|---|
| 教師信号 | 正解ラベル | 無し | スカラー報酬 |
| データ取得 | 予め与えられる | 予め与えられる | エージェントが収集 |
| 代表タスク | 分類・回帰 | クラスタリング | 制御・ゲーム・推薦 |
| 評価指標 | 精度・MSE | クラスタ純度 | 累積報酬 |
| 時間概念 | 静的 | 静的 | 時系列・逐次 |
| 行動の影響 | 無し (受動的) | 無し (受動的) | 環境を変える (能動的) |
特に重要なのが最下行の「行動の影響」。 強化学習は エージェントの行動が次の状態に影響を与える世界での学習であり、 これが教師あり学習と本質的に違う。 教師あり学習で「予測」しても現実は変わらないが、 強化学習で「行動」すると現実が変わり、 次の意思決定の条件が変化する。 だからこそ、 政策・経済・医療など「行動が現実を作る領域」で強化学習が注目される。
📚 SSDSE-B-2026 を題材にした強化学習の発展課題
本記事の Q 学習例は教育用の簡素化版だが、 SSDSE-B-2026 を使って発展的に取り組める課題を四つ提示する。 (1) 多目的強化学習: 「医療充実度」「教育水準」「経済成長」を同時に最大化する方策を求める。 これは Pareto 最適性の概念に直結する。 (2) 制約付き強化学習: 「予算上限」を制約として課しつつ報酬を最大化する。 安全強化学習 (Safe RL) の標準形。 (3) 逆強化学習: 過去の都道府県政策実績から、 自治体が暗黙に最大化していた報酬関数を逆推定する。 これは観察された行動の合理化に役立つ。 (4) マルチエージェント強化学習: 47 都道府県を別エージェントとして、 競合・協調する状況を学習する。 ふるさと納税のような「県間ゼロサム要素」を持つ政策のシミュレーションに有効。
こうした発展課題は学術的に未解決の部分も多く、 学生・研究者にとって格好の題材となる。 ただし、 いずれの課題でも本節で示した 「散布図・ヒストグラム・箱ひげ図でのデータ理解」は必ず最初に通る道。 データを見ずに高度な手法に飛び込むと、 結果の解釈ができず、 教育的価値・実用的価値ともに激減する。 強化学習は華やかな分野だが、 その根は地味なデータ可視化と統計的直観に支えられている、 という認識が肝心。
🔄 強化学習アルゴリズムの系譜と選択指針
強化学習のアルゴリズム群は大きく 「価値ベース」「方策ベース」「Actor-Critic」「モデルベース」の四系統に分かれる。 価値ベース (Q 学習、 SARSA、 DQN) は状態行動価値関数を推定し、 そこから方策を導出する古典的な系統。 方策ベース (REINFORCE) は方策を直接パラメータ化して勾配上昇で最適化する。 Actor-Critic (A2C、 A3C、 PPO、 SAC) は両者を組み合わせ、 学習の安定性と効率を両立する現代的な主流。 モデルベース (Dyna、 MuZero、 World Models) は環境の遷移確率自体を学習し、 内部シミュレーションで方策を改善する。
| 系統 | 代表手法 | 適する状況 | 弱点 |
|---|---|---|---|
| 価値ベース (離散) | Q 学習、 SARSA | 状態・行動が少数で離散 | 大規模化困難 |
| 価値ベース (近似) | DQN、 Double DQN、 Dueling DQN | 高次元状態 + 離散行動 | 連続行動に弱い |
| 方策ベース | REINFORCE、 TRPO | 確率的方策を扱いたい | 分散が大きい |
| Actor-Critic | A2C、 PPO、 SAC、 DDPG | 連続行動 + 高次元状態 | ハイパラ調整困難 |
| モデルベース | Dyna、 MuZero、 PlaNet | サンプル効率が重要 | モデル誤差が伝播 |
実務での選択指針は単純で、 「最初は最も簡単な手法 (Q 学習) から始め、 必要が生じたら一段ずつ高度化する」。 いきなり SAC や MuZero に飛びつくのは禁物。 簡単な手法で動かない問題は高度な手法でも動かないし、 デバッグも極めて困難になる。 都道府県データのような小規模問題なら、 Q テーブル + 状態離散化で十分に意義ある結果が出る。 高度な手法は問題の複雑さがそれを要求した時のみ導入すべき。 これは強化学習に限らず、 すべての機械学習で共通する Occam の剃刀の原則である。
🧪 理解度チェック: あなたは強化学習をどこまで理解したか
最後に、 本記事で扱った内容の理解度をチェックする問題を 10 個用意した。 各問について、 即答できる項目が 7 つ以上あれば、 強化学習の基礎は十分に習得できている。 5-6 個ならもう一度本記事を読み返すこと。 4 個以下なら、 Sutton & Barto の最初の数章から学び直すことを推奨。
| # | 問い | 想定回答キーワード |
|---|---|---|
| 1 | 強化学習と教師あり学習の最大の違いは? | 行動の影響・累積報酬 |
| 2 | Q 関数 Q(s,a) の意味は? | 状態行動価値 |
| 3 | ベルマン方程式の役割は? | 最適価値関数の再帰式 |
| 4 | ε-greedy 法の目的は? | 探索と活用のバランス |
| 5 | 割引率 γ の意味は? | 将来報酬の現在価値化 |
| 6 | DQN の主要工夫は? | 経験再生・ターゲットネット |
| 7 | 報酬ハッキングとは? | 設計意図と報酬関数の乖離 |
| 8 | 方策勾配法の長所は? | 連続行動・確率的方策に強い |
| 9 | Actor-Critic の構造は? | 方策と価値の同時学習 |
| 10 | Safe RL が必要な理由は? | 実環境での制約・安全性確保 |
本記事は強化学習の入口を、 SSDSE-B-2026 という具体的なデータを通じて体験することを目的とした。 強化学習はその数学的厳密さと社会的影響力の両面で奥深い分野であり、 一つの記事で語り尽くせるものではない。 本記事をきっかけに、 各自が興味を持った方向 (理論、 実装、 応用、 倫理) へ深掘りしていくことが、 真の習熟への道となる。 強化学習は「データから学ぶ」を超えて「経験から学ぶ」機械学習の最前線である。
🧠 強化学習の数学的基盤を SSDSE-B 文脈で再整理
強化学習を真に理解するには、 マルコフ決定過程 (MDP) の数学的構成要素を都道府県データの文脈に置き換えて把握するのが効果的。 MDP は 5 要素 $(\mathcal{S}, \mathcal{A}, P, R, \gamma)$ で定義される。 $\mathcal{S}$ は状態空間: 都道府県政策の文脈では「47 都道府県 × 各種統計指標」を離散化・正規化したベクトル。 $\mathcal{A}$ は行動空間: 「医療予算増減」「教育予算増減」「インフラ投資配分」などの政策決定。 $P(s'|s,a)$ は遷移確率: 「行動 a を取ったとき、 現在状態 s から次状態 s' になる確率」。 都道府県の場合、 これは経済モデル・人口動態モデルから推定する。 $R(s,a)$ は報酬関数: 設計者が最大化したい指標 (前述の通り設計が最難関)。 $\gamma \in [0,1)$ は割引率: 将来報酬をどれだけ重視するか。 政策では γ=0.95-0.99 程度が一般的で、 これは「10-20 年先の効果」を考慮することに相当する。
MDP のもとで方策 $\pi(a|s)$ (状態 s で行動 a を取る確率) を学習する。 最適方策 $\pi^*$ は累積期待報酬 $\mathbb{E}_\pi[\sum_t \gamma^t R(s_t, a_t)]$ を最大化する方策。 これを直接最大化するのは困難なので、 価値関数 $V^\pi(s)$ や状態行動価値関数 $Q^\pi(s,a)$ を経由する。 ベルマン方程式 $V^\pi(s) = \sum_a \pi(a|s) [R(s,a) + \gamma \sum_{s'} P(s'|s,a) V^\pi(s')]$ は、 価値関数が満たすべき再帰的な関係式。 これを反復的に解くのが価値反復・方策反復であり、 サンプリングで近似するのが Q 学習・TD 学習。 都道府県政策の文脈では、 遷移確率 P が未知なので、 実データから経験的に学習する必要がある。 ここに強化学習の力と限界が同居する。
🎮 都道府県エージェントの戦略空間を考える
都道府県を独立したエージェントとして強化学習する場合、 興味深いのは「エージェント間の相互作用」が存在することである。 たとえば、 ある県が企業誘致 (税優遇など) という行動を取ると、 隣接県の税収・人口に影響が出る。 これはマルチエージェント強化学習 (MARL)の典型的問題設定。 標準的な単一エージェント強化学習は「環境は固定」を仮定するが、 MARL では「他のエージェントが学習中で環境が変化する」という非定常性が問題となる。 この非定常性が、 MARL を技術的に極めて困難にしている。
MARL の代表的アプローチには、 (1) 独立学習 (Independent Q-learning): 各エージェントが他を環境の一部として扱う。 単純だが収束保証なし。 (2) 中央集権学習・分散実行 (CTDE: Centralized Training Decentralized Execution): 学習時は全エージェントの情報を共有し、 実行時は各自で意思決定。 MADDPG、 QMIX などが代表。 (3) 協調 vs 競合の明示化: ゲーム理論 (ナッシュ均衡、 相関均衡) を組み込む。 都道府県シミュレーションでは、 「全国合計の社会厚生最大化」を目標とした協調モードと、 「各県の住民満足度最大化」を目標とした競合モードでは、 学習結果が大きく異なる。 これは政策的に重要な示唆で、 「日本全体の最適化」と「各自治体の最適化」が必ずしも一致しないことを定量的に示せる。
| MARL 設定 | 報酬構造 | 期待される結果 |
|---|---|---|
| 完全協調 | 全エージェント共通 | 全国最適化 |
| 完全競合 (ゼロサム) | 合計ゼロ | 県間移転 (税の取り合い) |
| 混合 (general-sum) | 部分的競合・部分的協調 | 現実に最も近い |
| CTDE | 分散実行・中央学習 | 学習効率高い |
| 独立学習 | 各自独立 | 実装簡単・収束不安定 |
MARL は強化学習の最先端研究領域の一つで、 都道府県シミュレーションは絶好の題材。 政策意思決定者・自治体職員にとっても、 こうしたシミュレーションを通じて「自県の最適行動が全国にどう影響するか」を可視化できる意義は大きい。 ただし、 MARL の結果を実政策に直接適用することには倫理的な慎重さが必要で、 あくまで「示唆を得るためのツール」として位置付けるべきである。
🔬 強化学習の理論的限界と最新研究
強化学習には深い理論的限界がある。 (1) サンプル複雑性: 状態数 $|S|$、 行動数 $|A|$、 ホライズン $H$、 精度 $\epsilon$ に対し、 精度 $\epsilon$ の方策を得るのに必要な試行回数は、 状態数・行動数に比例し、 ホライズンや $1/\epsilon^2$ について多項式的に増える(正確な次数は設定と解析によって異なる)。 状態の組合せが増えるほど、 実用上の制約として深刻になる。 (2) 探索のハードネス: スパースな報酬環境では、 ε-greedy のような単純な探索では指数時間かかる。 (3) 部分観測性 (POMDP): 状態が完全に観測できない場合、 最適方策の計算は計算量的に PSPACE 困難。 (4) 関数近似の発散: 線形・非線形関数近似を使うと Q 学習が発散しうる (the deadly triad: 関数近似 + ブートストラップ + オフポリシー)。
これらに対する最新研究は活発で、 (1) 表現学習との融合: 状態の良い表現を自己教師あり学習で獲得 (CURL、 DrQ など)。 (2) 内発的動機付け: 好奇心・新規性に基づく探索ボーナス (RND、 ICM など)。 (3) オフライン強化学習: 既存ログデータだけから学習 (CQL、 IQL、 Decision Transformer など)。 (4) 世界モデルの学習: 環境のダイナミクスをモデル化してシミュレーション内で学習 (Dreamer、 MuZero など)。 (5) 大規模言語モデルとの統合: RLHF (Reinforcement Learning from Human Feedback) は ChatGPT などの基盤技術。 (6) マルチタスク・メタ学習: 複数タスクで学んだ知識を新タスクに転移 (MAML、 PEARL など)。
特に近年注目すべきは オフライン強化学習と RLHF。 オフライン強化学習は、 都道府県データのように「実環境で試行錯誤できない」状況に最適。 過去の政策実施履歴と結果データから、 シミュレーションを通さず方策を学習できる可能性がある。 RLHF は、 報酬関数の設計が困難な状況で「人間のフィードバック」を報酬の代替として使う革新的なアプローチ。 政策意思決定では「住民満足度」を直接測ることが難しいので、 RLHF 的なアプローチで「住民の選好」を学習する研究も始まっている。
📐 補足: ベルマン最適性方程式の詳細な意味
ベルマン最適性方程式 $Q^*(s,a) = R(s,a) + \gamma \sum_{s'} P(s'|s,a) \max_{a'} Q^*(s', a')$ は、 強化学習における最も中心的な方程式である。 この式が意味するのは、 「最適な状態行動価値 Q*(s,a) は、 即時報酬 R(s,a) と、 次状態 s' で得られる最大の Q 値の期待値を割引率で重み付けした和に等しい」ということ。 一見すると単純な再帰式だが、 この方程式は「ある時点の最適行動を選ぶには、 その後の最適行動列を全て知っている必要がある」というブートストラップの本質を表している。
この方程式を解く方法は大きく三つに分類できる。 (1) 動的計画法 (DP): 遷移確率 P が既知の場合、 ベルマン作用素を反復適用することで Q* を計算できる。 価値反復・方策反復はこの代表例。 (2) モンテカルロ法: P が未知でも、 エピソードを最後まで実行して累積報酬の平均を取れば、 Q* に近づく。 ただし分散が大きい。 (3) 時間差分法 (TD): モンテカルロと DP の中間で、 1 ステップごとに価値を更新する。 Q 学習・SARSA は TD の代表例。 これら三つの方法は、 偏りと分散のトレードオフ、 サンプル効率、 収束性などの観点で性質が異なる。 都道府県政策のような実問題では、 完全な P が得られないため TD 法が現実的な選択となる。
| 手法 | P の必要性 | 偏り | 分散 | サンプル効率 |
|---|---|---|---|---|
| 動的計画法 | 必要 | 無 | 無 | 最良 (但し P 既知) |
| モンテカルロ法 | 不要 | 無 | 大 | 中 |
| TD (Q 学習) | 不要 | あり | 中 | 良 |
| n-step TD | 不要 | 中 | 中 | 良 |
| TD(λ) | 不要 | 調整可能 | 調整可能 | 最良 (調整次第) |
🔁 都道府県シミュレーションの典型的なエピソード設計
強化学習を都道府県データに適用する際、 「エピソード」の設計が重要となる。 エピソードとは「初期状態から終端状態までの一連の状態・行動・報酬列」のこと。 都道府県政策の文脈では、 エピソードを以下のように設計する例が考えられる。 (1) 固定期間エピソード: 例えば「5 年間の政策運営」を 1 エピソードとし、 毎年 1 ステップとして 5 ステップで終了。 (2) 目標達成エピソード: 「特定の経済指標が目標値に到達したら終了」とする。 (3) 無限ホライズン: 終了を設けず、 割引率で重み付けする方式。 政策の長期効果を扱う場合に適する。 (4) イベント駆動エピソード: 「災害発生」「人口変動」などのイベントで状態が変化し、 ある条件で終了する。
エピソード設計は学習結果に大きく影響する。 短いエピソードでは長期効果が学習されず、 長すぎるエピソードでは初期と終了の状態差異が大きすぎて学習が不安定になる。 都道府県政策のような長期視点が必要な問題では、 割引率を高めに設定 (γ=0.99 程度) し、 シミュレーション期間を 20-30 年程度に設定するのが現実的。 ただし、 期間が長いほど不確実性が増大し、 報酬の予測精度も低下するため、 「シミュレーション結果の信頼性」と「政策視野の長さ」のバランスが課題となる。
🎯 強化学習の評価指標と性能比較
強化学習の性能評価は教師あり学習と比べて複雑で、 単一の指標で語ることが難しい。 代表的な評価指標を以下に整理する。 (1) 累積報酬 (cumulative reward): 最も基本的な指標。 1 エピソードでの報酬合計、 または複数エピソードの平均。 (2) 学習曲線 (learning curve): 学習ステップ数 vs 累積報酬のグラフ。 収束速度・最終性能・安定性を視覚化。 (3) サンプル効率 (sample efficiency): 同じ性能に達するまでに必要なサンプル数。 オフライン強化学習で特に重要。 (4) 後悔 (regret): 最適方策との累積報酬差の累積。 理論解析でよく使われる。 (5) 方策の頑健性 (robustness): 環境変動やノイズに対する性能変化。 (6) 計算コスト: 学習時間・推論時間・メモリ消費。
都道府県政策シミュレーションでは、 累積報酬だけでなく「全国平均と分散」「最悪県の状況」「政策実行コスト」など多面的な評価が必要。 強化学習が「全国平均」を改善しても、 「特定の県を犠牲にする」結果になれば政策的に許容されない。 そのため、 評価指標自体に 公平性制約を組み込むアプローチが研究されている。 これは constrained MDP の枠組みで定式化でき、 ラグランジュ乗数法などで解ける。 都道府県データのような社会的応用では、 こうした多目的・制約付きの強化学習が本質的に重要となる。
📌 補遺: 実装上の落とし穴とデバッグの実務
強化学習の実装は、 教師あり学習以上にバグを混入させやすい。 学習が進まないとき、 原因はアルゴリズムでなく実装ミスであることが大半。 典型的なバグを以下に列挙する。 (1) 報酬の符号間違い: 報酬を最小化するべきところを最大化していた、 あるいは逆。 学習が想定と真逆の方向に進むので、 結果を見れば気付ける。 (2) 状態の正規化忘れ: 状態の各次元のスケールが極端に違うと、 ニューラルネットの学習が著しく阻害される。 (3) 割引率の不適切な設定: γ=1.0 に設定すると無限ホライズン問題で発散する。 γ を 0.99 → 0.9 に変えるだけで学習挙動が劇的に変わることがある。 (4) 経験再生バッファのサイズ: 小さすぎると最近の経験に過剰適合し、 大きすぎると古い経験で学習が遅くなる。 (5) ターゲットネットワーク更新頻度: 頻繁すぎると不安定、 稀すぎると古い情報で学習。 (6) 勾配クリッピング忘れ: 強化学習では勾配爆発が頻発するため、 必須の安全装置。
デバッグの実務的なコツとして、 以下を強く推奨する。 (1) 最初は最小の環境で確認: 都道府県データで動かす前に、 GridWorld など最小環境で実装の正しさを検証。 (2) ランダム方策でのベースライン: 学習した方策がランダム方策より明確に良いかを必ず確認。 (3) 複数シードでの検証: 強化学習は乱数シードで結果が大きく変わるため、 少なくとも 5 シード以上で再現確認。 (4) 学習曲線の可視化: 累積報酬・損失・Q 値・探索率などを TensorBoard で可視化し、 異常を即座に発見できる体制を作る。 (5) 段階的な複雑化: シンプルな環境 → 中程度の環境 → 本番環境と段階的に複雑化し、 各段階で動作確認。 (6) ハイパーパラメータの感度分析: 主要なハイパーパラメータ (学習率、 割引率、 探索率) を変えたときの結果変化を必ず確認。 これらの実務スキルは、 強化学習を実用レベルで使うには絶対に欠かせない。
最後に、 強化学習の本質的な難しさは「成功した時の理由」と「失敗した時の理由」の両方を判別するのが極めて困難な点にある。 学習が成功して見える時も、 実は偶然の組み合わせかもしれない。 失敗して見える時も、 もう少し学習を続ければ突破するかもしれない。 この曖昧さに向き合いながら、 粘り強く実験と分析を続けることが強化学習エンジニアの真の力量となる。 SSDSE-B-2026 を使った強化学習の試みを通じて、 こうした強化学習特有の「経験から学ぶ姿勢」を身に付けてほしい。 それは AI 研究者・データサイエンティスト・政策実務家のいずれにとっても、 一生使える知的資産となる。
🧮 数式に値を入れて手で計算する: 割引累積報酬
強化学習の 1 エピソード(5 タイムステップ)で得た報酬列 r=[3, 2, 4, 1, 5](各ステップで観測されたスコア)について、 割引率 γ 別の割引累積報酬 $G_t = \sum_{k} \gamma^k r_{t+k}$ を計算する。 γ が小さいほど遠い将来の報酬が軽く評価される様子を数値で確かめる。
Step 1: 報酬列
Step 2: γ 別 G_0
| γ | G_0 |
|---|---|
| 1.0 | 3+2+4+1+5 = 15 |
| 0.9 | 3+1.8+3.24+0.729+3.281 ≈ 12.05 |
| 0.5 | 3+1+1+0.125+0.3125 ≈ 5.44 |
🐍 Python で再現
1 2 3 4 5 | import numpy as np r = np.array([3, 2, 4, 1, 5]) for g in [1.0, 0.9, 0.5]: G = sum(g**k * r[k] for k in range(len(r))) print(f"γ={g}: G_0 = {G:.3f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
強化学習の最小実装として、 Gymnasium の FrozenLake(4×4 のグリッドワールド)で Q 学習を回します。 エージェントは滑らない設定(is_slippery=False)でスタートからゴールを目指し、 ゴール到達で報酬 +1 を得ます。 行動選択に小さなノイズを加えて探索しつつ、 2000 エピソードで Q テーブルの収束を観察します。 グリッドワールドは状態・行動・報酬・遷移が明快で、 Q 学習の挙動を掴むのに最適な定番題材です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # gymnasium の FrozenLake(4×4、滑らない設定)で Q 学習 import numpy as np, gymnasium as gym env = gym.make('FrozenLake-v1', is_slippery=False) Q = np.zeros((env.observation_space.n, env.action_space.n)) rng = np.random.default_rng(0) # 探索ノイズの種を固定 for _ in range(2000): s, _ = env.reset(seed=0) done = False while not done: a = int(np.argmax(Q[s] + rng.standard_normal(env.action_space.n) * 0.1)) s2, r, terminated, truncated, _ = env.step(a) done = terminated or truncated # 穴・ゴールで終了、または 100 ステップで打ち切り Q[s, a] += 0.1 * (r + 0.99 * Q[s2].max() - Q[s, a]) s = s2 # 学習した Q で貪欲に 1 回歩かせて、ゴールに着くか確かめる arrows = '←↓→↑' print('各マスの最良行動:') print(np.array([arrows[i] for i in Q.argmax(axis=1)]).reshape(4, 4)) s, _ = env.reset(seed=0); path = [s]; done = False; total = 0.0 while not done: s, r, terminated, truncated, _ = env.step(int(Q[s].argmax())) path.append(s); total += r; done = terminated or truncated print('貪欲方策の経路:', path, ' 報酬:', total) print('スタート地点の Q 値:', Q[0].max().round(3)) |
💬 貪欲方策はマス 0 → 4 → 8 → 9 → 13 → 14 → 15 と下・下・右・下・右・右の 6 手でゴールに着き、報酬 1.0 を得た。スタート地点の Q 値 0.951 は、6 手目で受け取る報酬 1 を割引率 0.99 で 5 回割り引いた 0.99^5 ≈ 0.951 と一致し、最短経路の価値を正しく学習できている。穴のマスや一度も通らないマスの矢印は Q が 0 のままの既定値(←)なので、意味を読み取らない。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install matplotlib numpy pandas が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
⚠️ よくある落とし穴
強化学習の罠は 「学習が回らない」より「回ってしまうこと」。 報酬ハッキング (Coast Runners がボートを回転させて scrap で高得点を取る事例が有名) や、 シード差で結果が ±30% 揺れる再現性問題は強化学習に固有の地雷。 教師あり学習のセンスでデバッグしても解決しません。
⚠️ 拡張・落とし穴集:強化学習プロジェクトで踏みがちな 10 個の罠
- 報酬関数の設計ミス(reward hacking):「ゴールに到達したら +1」だけだと探索しなくなる。 中間報酬を入れすぎると意図しない行動を学習。 シンプルかつ明確な報酬を慎重に設計。
- sparse reward(疎な報酬):迷路の最後でしか報酬がない状況では、 ランダム探索ではほぼ学習不能。 curiosity, intrinsic motivation, reward shaping を導入。
- サンプル効率の悪さ:強化学習は 教師あり学習の 10〜1000 倍のサンプルを要する。 シミュレータ前提のタスクのみ実用、 リアル環境では工夫が必須。
- 非定常環境への過剰適応:環境が時間とともに変わると、 過去の方策が無効化する。 オンライン学習・継続学習が必要。
- seed 依存の不安定性:RL は seed 1 つで結果が大きく変わる(深層 RL では特に)。 必ず複数 seed の平均と分散を報告。
- γ の選択ミス:γ が 1 に近すぎると無限期間を考慮し、 学習が不安定。 0 に近すぎると近視眼的。 タスクに応じて 0.9〜0.99 が定石。
- 状態空間の不適切な離散化:連続値を粗く離散化すると重要な情報を失う。 ニューラルネット(DQN, A2C)か tile coding で対処。
- シミュレーションと現実のギャップ(sim-to-real gap):シミュレータで学習した方策が現実環境で動かない。 domain randomization, sim-to-real transfer 手法を併用。
- 安全性の無視:探索中の危険行動(自動運転で衝突など)。 Safe RL, constrained RL の枠組みで制約を入れる。
- 評価指標が累積報酬のみ:累積報酬以外に「成功率」「平均所要時間」「分散」「最悪ケース性能」も併記。 ロバスト性を多角的に評価。
🧭 補足:既出と重ならない3つの角度
本ページの各章(直感・落とし穴・関連手法)を踏まえ、 別角度からの補助線を3つだけ簡潔に足します。 既出の説明と切り口が重複しないものに絞りました。
教師あり学習・教師なし学習が与えられた固定データを学ぶのに対し、 強化学習はエージェントの行動そのものが、 次に観測する状態=次の訓練データを決める(クローズドループ)。 「探索が足りないと良い状態にたどり着けない」「初期のバグが雪だるま式に悪化する」「データが独立同分布にならない」といった強化学習に固有の難しさは、 すべてこの一点に由来します。 機械学習の三本柱を分ける最深の違いは「誰がデータ分布を決めるか」だと押さえると、 遅延報酬や探索の話が一本の線でつながります。
🗺 概念マップ
「reinforcement learning」を中心とした関連概念マップ。
🔗 隣接手法への橋渡し
「強化学習」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 機械学習 全体の中で「教師ラベルがなく報酬で学ぶ」位置づけを確認し、 環境(シミュレータや実機)を準備する
- 並列: 教師あり学習(ラベル)・教師なし学習(パターン発見)。 報酬の形式とフィードバック遅延で使い分け
- 下流: 学習された方策 π を 応用システム(ゲーム AI・ロボット制御・推薦)に組み込み、 累積報酬で性能を評価する
AlphaGo・自動運転・推薦システムなど、 「試行錯誤で最適化される行動系列」 が要件のタスクで「強化学習」は他の機械学習パラダイムを上回る。
🌳 手法選択フロー
「強化学習」を意思決定タスクに使うとき、 環境の特性と報酬設計で判定する。
- 環境とのインタラクションが可能か? シミュレータ or 安全な実環境がある → 強化学習 (PPO/DQN/SAC)。 静的なログしかない → 教師あり学習 や Offline RL
- 状態空間は離散か連続か? ボードゲームのように離散 → DQN・MCTS。 ロボットのように連続 → DDPG・SAC・PPO。 部分観測 → POMDP・LSTM 付き Policy
- 報酬設計が可能か? 明確な勝敗・スコア → そのまま使う。 報酬が疎・遅延 → curiosity bonus、 逆強化学習で人間の挙動から報酬を推定、 LLM では RLHF
強化学習はサンプル効率が悪く、 シミュレータが無いと膨大な試行回数が必要。 SSDSE のような観測データだけのケースでは、 まず 教師あり学習 や 因果推論 を検討するのが現実的。