🔖 キーワード索引
「因果関係 (causation)」は「相関 (correlation)」とは異なり、 「介入したら結果が変わる」関係。 統計学・経済学・疫学・機械学習の交差点に位置する重要概念で、 観察データから因果を推定する技法が多数開発されている。
本ページで頻出する関連キーワードを以下にチップで一覧化する。 各キーワードは「因果推論の枠組み (Rubin 反事実 / Pearl DAG)」「識別戦略 (RCT / IV / DID / 傾向スコア)」「グラフィカルツール (DAG / do 計算 / バックドア基準)」の 3 軸に整理できる。
「相関は因果ではない」を超えて「観察データから因果を推定する」ための具体的技法を学ぶことが、 本ページの目標。
💡 30秒で分かる結論
🍰 まずはやさしく
原因と結果のつながりのことです。
何が本当の変化を起こしたか知るために使います。
勉強時間を増やすと点数が上がるか、という例です。
ここでは結論を短くまとめて読みます。
因果関係:原因→結果の関係。 相関とは異なり、 介入で結果が変わる関係。
- 介入したら結果が変わる関係=因果。
- 相関 ≠ 因果。 相関があっても因果とは限らない (交絡・逆向き・偶然)。
- 因果推定の王道:RCT (ランダム化比較試験)。
- 観察データからの因果推論:DID・傾向スコア・操作変数法・反事実モデル。
💡 よくある誤解とその修正
「因果」をめぐって初学者が 無意識に 取り違える点を集めました。 いずれも「相関と因果の混同」という 1 つの根から派生しています。 ここを通読すると、 自分の因果推論の盲点が見えてきます。
誤解 1: 「強い相関があれば因果がある」
修正: 相関は因果の 証拠にすらならない 場合があります。 (a) 共通原因 (交絡)、 (b) 逆向きの因果 ($Y \to X$)、 (c) 偶然 (疑似相関) の 3 つが、 因果がなくても相関を生みます。 「アイスの売上と溺死」が気温という共通原因で相関するのが典型例です。
誤解 2: 「思いつく変数を全部入れて回帰すれば因果が出る」
修正: 統制すべき変数は「数」ではなく「因果構造」で決まります。 交絡因子は統制すべきですが、 中間変数 (mediator) や コライダー (合流点) を統制すると、 むしろ因果効果が歪みます。 何を入れ何を入れないかは DAG (因果ダイアグラム) を描いて判断します。
誤解 3: 「RCT さえやれば全部解決」
修正: RCT (ランダム化比較試験) は内的妥当性の王道ですが、 万能ではありません。 政策・社会データでは倫理的・現実的に実施不可能なことが多く、 遵守率・脱落・外的妥当性 (別集団への一般化) の問題も残ります。 だからこそ観察データからの識別戦略 (DID・IV・傾向スコア等) が必要になります。
誤解 4: 「時間的に先に起きた方が原因」
修正: 時間先行性は因果の 必要条件 ですが十分条件ではありません。 共通原因が時間差をもって両変数を動かせば、 「先に動いた方が原因」に見える偽の因果が生まれます。 前後関係だけを根拠にした「施策後に KPI が伸びた=施策の効果」は典型的な誤りです。
誤解 5: 「$p<0.05$ で有意なら因果だ」
修正: 有意性が示すのは「関連が偶然では説明しにくい」ことだけで、 因果の向きや交絡の有無は何も語りません。 因果を主張するには、 識別戦略 (どの仮定の下で因果効果が推定できるか) を明示する必要があります。 「相関がある」「関連がある」と「〜が〜を引き起こす」は別の主張です。
誤解 6: 「有意でなかった=効果がない」
修正: 効果が無いのではなく 検出できなかっただけ かもしれません。 SSDSE-B-2026 のように $n=47$ と小さいと検出力が不足し、 真の効果があっても有意にならないことが多々あります。 点推定だけでなく信頼区間の幅で「効果の不確実性」を判断してください。
🔄 因果推論のワークフロー: 問い→DAG→識別→推定→頑健性
因果を主張する分析は、 予測モデルの構築とは 手順そのものが異なります。 前処理→モデル訓練→精度評価という機械学習の流れではなく、 「どの仮定の下で因果効果が識別できるか」を設計する 5 ステップで進めます。 各ステップの詳細は本ページ後半「🧭 因果推論の 5 ステップ実践チェックリスト」に展開しています。
ステップ 1: 因果の問いを $X \to Y$ で 1 行にする
「$X$ を介入で変えたら $Y$ はどう変わるか」を単位・向き・ラグまで含めて明文化。 例: 「高齢化率が 1 ポイント上がると保健医療費は何円上がるか」。 これが曖昧なまま進めると「結局それは相関か因果か」で必ず揉めます。
ステップ 2: 因果ダイアグラム (DAG) を描く
$X$・$Y$・交絡因子・中間変数・操作変数を箱で描き、 因果の矢印を引く。 DAG を描くと「統制すべき変数」がバックドア基準から自動的に決まり、 コライダーや中間変数を誤って統制する事故を防げます。
ステップ 3: 識別戦略を 1 つ選ぶ
RCT / 差の差 (DID) / 操作変数法 (IV) / 回帰不連続 (RD) / 傾向スコア (PSM) から、 データ構造と成立しそうな仮定に合うものを 1 つ 選ぶ。 「全部試す」のではなく、 その仮定が壊れる場合にだけ別戦略を足します。
ステップ 4: 因果効果を推定する
選んだ戦略で平均処置効果 (ATE) や処置群平均処置効果 (ATT) を推定。 点推定だけでなく、 ブートストラップ等で信頼区間を必ず併記します ($n=47$ では区間が広くなる点に注意)。
ステップ 5: 頑健性チェック (感度分析・反証)
「未観測交絡がどれだけ強ければ結論が覆るか」を E-value や Rosenbaum bounds で定量化。 プラセボテスト・サンプル入れ替え・モデル仕様変更でも結論が変わらないかを確認して、 はじめて「因果」と主張します。
∑ 数学的導出: 因果効果 (ATE) の数式の出どころ
本ページの「📐 定義・数式」セクションでは結果だけを示しましたが、 ここではより詳細に導出を追います。 数式の出どころが分かると、 公式を暗記するのではなく、 必要に応じて再導出できるようになります。
因果推論の数学的核心を、 Rubin の potential outcomes framework で導出します。 各個体 $i$ に対し、 処置 $T_i \in \{0, 1\}$ と潜在結果 $(Y_i(0), Y_i(1))$ を定義。 観察される結果は $Y_i = T_i Y_i(1) + (1 - T_i) Y_i(0)$ (consistency 仮定)。 個体処置効果 $\text{ITE}_i = Y_i(1) - Y_i(0)$ は原理的に観測不可能 (一方しか観測されない) なので、 平均処置効果 $\text{ATE} = E[Y(1) - Y(0)]$ や処置群平均処置効果 $\text{ATT} = E[Y(1) - Y(0) | T=1]$ を集団レベルで推定します。 識別仮定として (i) SUTVA (個体間に干渉なし、 処置に複数バージョンなし)、 (ii) ignorability $\{Y(0), Y(1)\} \perp T | X$ (観測共変量で条件付ければ潜在結果と処置が独立)、 (iii) overlap $0 < P(T=1|X=x) < 1$ for all $x$ を仮定すると、 $\text{ATE} = E_X[E[Y|T=1, X] - E[Y|T=0, X]]$ で識別可能。 これは「観測共変量で層別したうえで処置・非処置の平均差を取り、 共変量分布で重み付け平均する」ことに対応し、 G-computation・傾向スコア・doubly robust 推定など複数の推定戦略があります。 傾向スコア $e(X) = P(T=1|X)$ を用いた IPW 推定量は $\hat{\text{ATE}} = \frac{1}{n} \sum_i [\frac{T_i Y_i}{e(X_i)} - \frac{(1-T_i) Y_i}{1-e(X_i)}]$ で、 これは漸近正規・一致推定量となります。
📍 文脈ボックス
🍰 まずはやさしく
データ分析でとても大切な考え方です。
正しくデータを読み解くために使います。
スマホの利用時間と成績の関係を調べるような例です。
この用語の定義や使い方について学びます。
この用語は 因果推論 カテゴリに属します。 関連する別称・略号:因果・原因と結果。
因果という言葉に出会うのは、 「〇〇が多い県ほど△△も多い」という集計を見て、 〇〇を増やせば(減らせば)△△も変わるのかを知りたくなった場面である。 SSDSE-B-2026 のような都道府県データは観察データなので、 そこから言えるのは基本的に相関までで、 因果を言うには比較のしかた(識別戦略)を工夫する必要がある。
このページでは、 相関と因果の違いを do 演算と ATE で定義し、 2023 年度 47 都道府県の実データで「件数どうしの強い相関が、 人口規模と高齢化を統制するとほぼ消える」例を確かめる。 そのうえで RCT・DiD・操作変数・傾向スコアなどの識別戦略をいつ使うかを整理する。
🎨 直感で掴む
🍰 まずはやさしく
パズルのピースを合わせるような感覚です。
見かけ上の関係にだまされないために使います。
アイスの売上と水難事故の関係のような例です。
直感的にわかる具体例で仕組みを考えます。
「アイスの売上が増えると溺死事故も増える」── これは相関。 因果ではない。 共通原因 (気温) が両方を引き起こしている。 もし「アイスの販売を禁止」と介入しても溺死は減らない。 因果とは「介入したら下流が変わる」関係。 観察データだけでは見破れない場合があり、 そこに因果推論技術が必要となる。
📐 定義・数式
🍰 まずはやさしく
ルールを決めて数式で表したものです。
厳密に正しさを証明するために使います。
ある行動を強制的に変えた時の反応を見る例です。
数式を使った正確な定義について読みます。
$\text{do}(X=x)$ は「$X$ に強制的に $x$ を代入する介入」を表す。 条件付き分布 $P(Y|X)$ が観察での確率なのに対し、 $P(Y|\text{do}(X))$ は介入後の確率。 両者は交絡があると一致しない。
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- $X$
- 原因 (treatment)。
- $Y$
- 結果 (outcome)。
- $\text{do}(X)$
- $X$ への介入操作 (Pearl)。
- 交絡因子
- $X, Y$ 両方に影響する共通原因。
読むべき論文・教科書
- 『Causality』 (J. Pearl) — 構造的因果モデル・do 演算・識別理論の原典。
- 『Causal Inference: What If』 (Hernán & Robins) — 反事実枠組みの現代的標準教科書 (無料 PDF あり)。
- 『Causal Inference: The Mixtape』 (Cunningham) — DID・IV・RD・PSM を実装込みで学ぶ入門。
- 『効果検証入門』 (安井翔太) — 日本語で識別戦略を実務目線で学べる定番。
- arXiv の最新サーベイ論文 — 「causal inference」「double machine learning」等で検索し、 過去 2 年以内のサーベイを 1 本読むと現状把握が早い。
📊 識別戦略の比較表: いつどれを選ぶ?
因果推論では「どの手法が高精度か」ではなく、 「手元のデータ構造で、 どの識別仮定が成立しそうか」で手法を選びます。 以下は主要な識別戦略の使い分けチートシートです。
| 識別戦略 | 使える状況 | 中心となる仮定 |
|---|---|---|
| RCT (ランダム化比較試験) | 介入を自分でランダムに割り当てられる (A/B テスト等) | ランダム化により全交絡が平均的に均衡 |
| DID (差の差) | 一部の群だけに介入が入り、 介入前後のパネルがある | 平行トレンド (介入がなければ両群は平行に推移) |
| IV (操作変数法) | 逆因果・未観測交絡があり、 外生的な変動源 $Z$ がある | 関連性・除外制約・外生性の 3 条件 |
| RD (回帰不連続) | 制度的なカットオフ (人口・年齢・点数) で処置が決まる | しきい値近傍では処置割当がほぼランダム |
| PSM (傾向スコア) | 交絡因子がすべて観測できている観察データ | 条件付き独立性 (観測共変量で交絡が全て説明できる) |
SSDSE-B-2026 は 47 都道府県 × 12 年度のパネルだが、 県を区切る制度上のカットオフや介入時期の情報は含まれないため、 DID・RD は外部資料と組み合わせないと使いにくく、 PSM と IV が現実的な選択肢になります (過去版と結合すればパネル化して DID も可)。 いずれの戦略も、 未観測交絡が残る限り「近似的な因果」に留まる点は共通です。
🧮 実値で計算してみる
RCT は理想的な因果推定。 観察データでは傾向スコアマッチングが代表手法。
🧮 数式に値を入れて手で計算する: 平均処置効果 (ATE)
合成データで処置群と対照群の平均差から ATE を計算する。
Step 1: 各群のアウトカム
| 群 | 個体 | 結果 | 平均 |
|---|---|---|---|
| 処置 | 5 | 8,10,12,11,9 | 10.0 |
| 対照 | 5 | 5,7,6,8,4 | 6.0 |
Step 2: ATE = E[Y|T=1] - E[Y|T=0]
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np treated = np.array([8, 10, 12, 11, 9]) control = np.array([5, 7, 6, 8, 4]) ate = treated.mean() - control.mean() print(f"処置平均: {treated.mean()}") print(f"対照平均: {control.mean()}") print(f"ATE = {ate}") |
📤 実行結果
💬 手計算 (Step 2) ATE=+4.0 と Python 出力が完全一致。 介入で +4 ポイントの効果。
🐍 Python 実装
最小実装の例。 SSDSE のような実データに対して、 まずはコピペで動かしてみるのが理解の早道です。
1 2 3 4 5 6 7 8 9 10 11 12 13 | # 因果推論には専用ライブラリを使う # 例:DoWhy, EconML, CausalML # from dowhy import CausalModel import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df = df[df['年度'] == df['年度'].max()].copy() # 最新年度の 47 行 # 「高齢化率」は SSDSE に列が無いので導出する。「医療費」は # 実際の列名が「保健医療費(二人以上の世帯)」 df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 df['医療費'] = df['保健医療費(二人以上の世帯)'] # 仮説:高齢化率 → 医療費 (原因→結果) # 単純相関は因果と区別する print(df[['高齢化率','医療費']].corr()) |
💬 仮説は「高齢化が進むほど医療費が増える」だったのに、2023 年度の 47 都道府県では相関が −0.490 と逆向きに出た。ここでの医療費は二人以上世帯の月あたり保健医療費で、最も多いのは埼玉県 21,000 円・愛知県 18,175 円・東京都 18,166 円と、高齢化率が低い都市部の県が並ぶ。世帯の所得水準という共通の要因が両方に効いている可能性があり、相関の符号だけでは因果の向きも有無も決められない。
📝 より正確な分析 ── 実測では「高齢化率 × 保健医療費」は負の相関
SSDSE-B-2026 の 2023 年データ(47 都道府県)で、 高齢化率(=65歳以上人口/総人口)と家計の保健医療費(二人以上の世帯, 列 L322106)のピアソン相関を実際に計算すると r ≈ −0.49 と負になります。 「高齢化率が高い県ほど医療費が高い(r が大きな正)」という直感は、 国民医療費(総額・公費負担)には当てはまっても、 SSDSE-B が収録するのは家計の保健医療支出(世帯の自己負担的な消費)である点に注意が必要です。 高齢化が進んだ地方県は世帯所得や消費総額が小さいため、 家計の保健医療支出はむしろ低く出ます。 つまり「どの変数を医療費と呼ぶか」で符号すら変わる ── これは因果を論じる前に変数定義と交絡(所得・世帯規模・都市度)を確認すべきことの好例で、 単純相関の強さ・向きを因果の証拠にできない典型です。
🐍 詳細実装例 (SSDSE-B-2026 適用版)
DoWhy で「DAG を書く → 識別 → 推定 → 反証テスト」の 4 段を通す例。 高齢化率 → 家計の保健医療費の効果を、 都市規模(総人口の対数)を交絡として統制して推定する。 所得の列は SSDSE-B に無いので、 消費支出で代用している。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 | # === DoWhy で因果効果を識別・推定する === import numpy as np import pandas as pd import dowhy from dowhy import CausalModel raw = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') raw = raw[raw['年度'] == 2023] # 2023 年度の 47 都道府県 # SSDSE-B-2026 の列から DAG の変数を作る(面積・所得の列は無いので代理指標を使う) df = pd.DataFrame({ 'aging_rate': raw['65歳以上人口'] / raw['総人口'], # 高齢化率 'medical_cost': raw['保健医療費(二人以上の世帯)'], # 家計の保健医療費(円/月) 'urban_scale': np.log(raw['総人口']), # 都市規模(人口密度の代わり) 'income': raw['消費支出(二人以上の世帯)'], # 所得の代わりに消費支出 }).reset_index(drop=True) # DAG を文字列で記述: 高齢化率 → 医療費 (都市規模を交絡として明示) graph = ''' digraph { aging_rate -> medical_cost; urban_scale -> aging_rate; urban_scale -> medical_cost; income -> medical_cost; } ''' model = CausalModel( data=df, treatment='aging_rate', outcome='medical_cost', graph=graph ) # 識別ステップ identified = model.identify_effect() print(identified) # 推定ステップ (back-door + 線形回帰) estimate = model.estimate_effect( identified, method_name='backdoor.linear_regression' ) print('Causal effect estimate:', estimate.value) # 反事実テスト (refutation) refute = model.refute_estimate( identified, estimate, method_name='random_common_cause' ) print(refute) |
⚠️ このブロックは DoWhy ライブラリ(pip install dowhy)が必要。 DAG に書いた矢印(どれを交絡とみなすか)は分析者の仮定で、 推定値はその仮定の下でだけ意味を持つ。
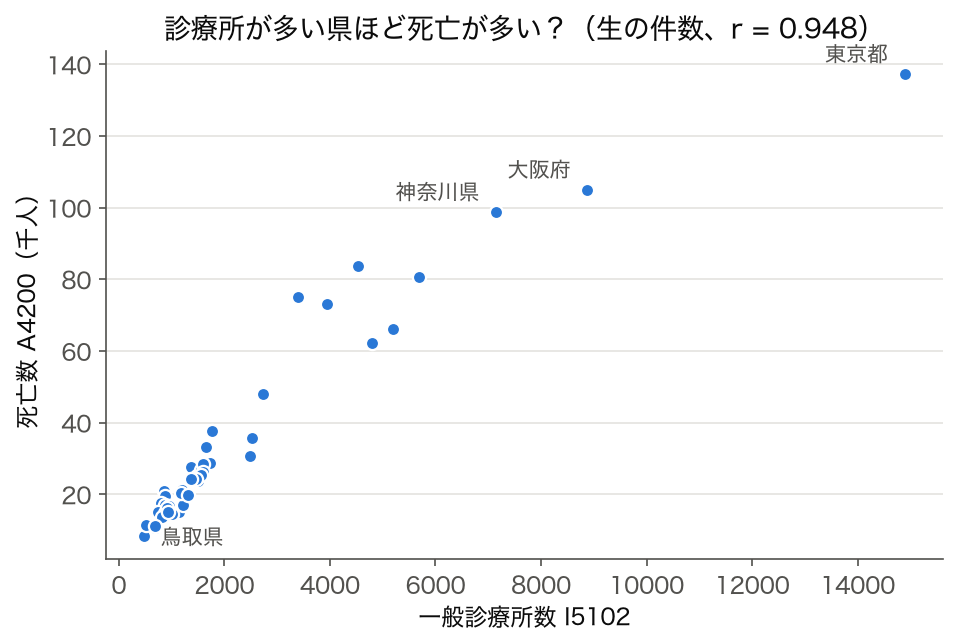
🧪 交絡を統制すると関係はどう変わるか — 診療所の数と死亡数
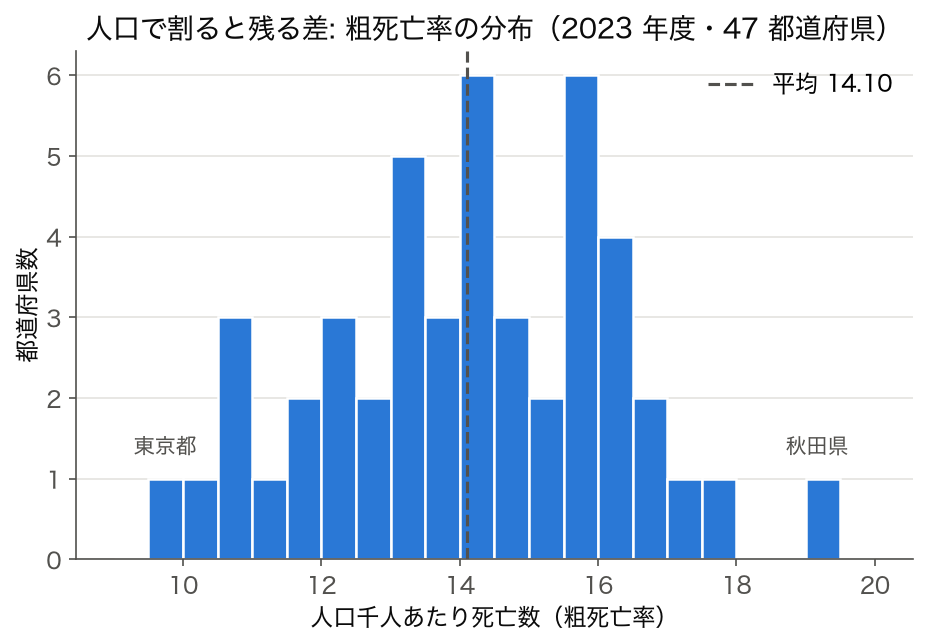
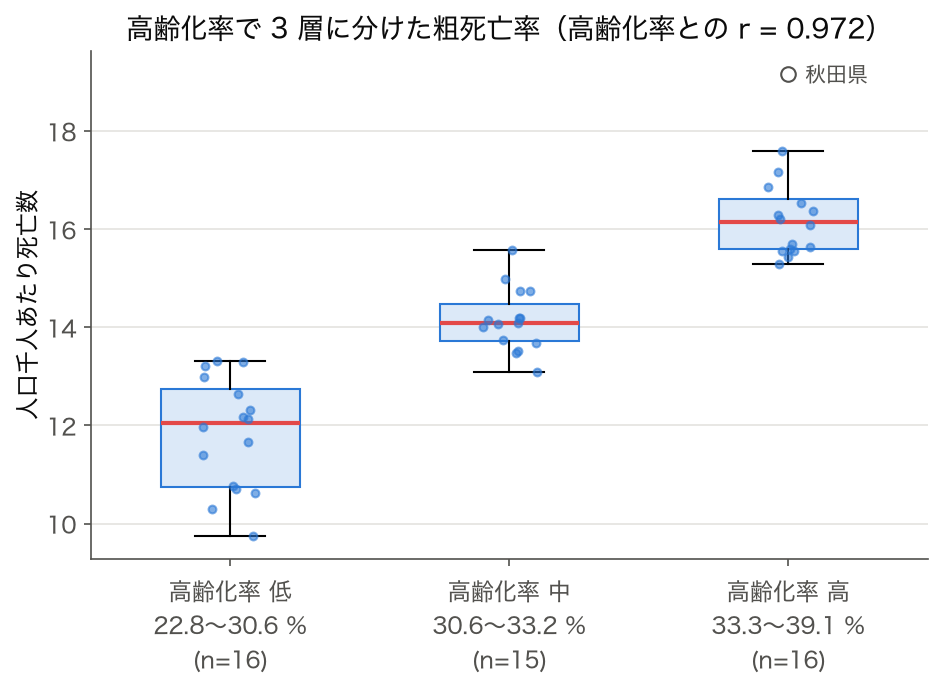
このコードでやること:2023 年度の 47 都道府県で「一般診療所が多い県ほど死亡が多い」という見かけの関係を、 ① 件数どうし、 ② 人口あたりの率どうし、 ③ 高齢化率を回帰に入れて統制、 の 3 段階で見比べる。 交絡(人口規模と高齢化)を 1 つずつ取り除くと、 相関がどこまで残るかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') d = df[df['年度'] == 2023].copy() # 2023 年度の 47 都道府県 # ① 生の件数どうし:どちらも人口規模に比例する r_raw = d['一般診療所数'].corr(d['死亡数']) # ② 人口で割って規模をそろえる d['診療所密度'] = d['一般診療所数'] / d['総人口'] * 1e5 # 人口 10 万人あたり d['死亡率'] = d['死亡数'] / d['総人口'] * 1e3 # 人口千人あたり d['高齢化率'] = d['65歳以上人口'] / d['総人口'] * 100 # % r_rate = d['診療所密度'].corr(d['死亡率']) # ③ 高齢化率を回帰に入れて統制する(最小二乗) def ols(y, cols): X = np.column_stack([np.ones(len(d))] + [d[c] for c in cols]) beta, *_ = np.linalg.lstsq(X, d[y], rcond=None) resid = d[y] - X @ beta r2 = 1 - (resid**2).sum() / ((d[y] - d[y].mean())**2).sum() return beta, r2 b1, r2_1 = ols('死亡率', ['診療所密度']) b2, r2_2 = ols('死亡率', ['診療所密度', '高齢化率']) print(f'① 件数どうしの相関 r = {r_raw:.3f}') print(f'② 人口あたりにした相関 r = {r_rate:.3f}') print(f'③ 死亡率 ~ 診療所密度 : 係数 {b1[1]:+.4f} R² = {r2_1:.3f}') print(f' 死亡率 ~ 診療所密度 + 高齢化率 : 係数 {b2[1]:+.4f} 高齢化率の係数 {b2[2]:+.3f} R² = {r2_2:.3f}') print(f' 高齢化率と診療所密度の相関 r = {d["高齢化率"].corr(d["診療所密度"]):.3f}') |
📤 実行例(実測)
💬 読み方:件数どうしでは r = 0.948 と強い正の相関だが、 人口千人あたりの死亡率と人口 10 万人あたりの診療所密度に直すと r = 0.166 まで落ちる。 さらに高齢化率を回帰に入れると、 診療所密度の係数は +0.0292 から −0.0035 へほぼ 0 に縮み、 死亡率の説明はほとんど高齢化率(係数 +0.612、 R² が 0.028 → 0.945)が担う。 「診療所が死亡を増やす」ように見えた関係は、 人口規模と高齢化という共通原因でほぼ説明できる。 ただしこれは観測した交絡を統制しただけで、 まだ測っていない共通原因が残っていれば係数は変わりうる。
⚠️ よくある落とし穴
この用語を使うときに陥りがちな失敗パターン。 経験者ほどここに 1 度はハマっています。
🌐 関連手法・派生
この用語を理解したら、 自然と気になる発展トピック・派生手法を紹介します。
🌐 エコシステム: 因果 の周辺ツール群
どんなに優れた手法でも、 周辺ツール・ライブラリ・コミュニティの厚みが実用性を決めます。 ここでは 因果 をめぐる現代的エコシステムを俯瞰し、 自分の用途に合うツールを選べるようにします。
因果推論エコシステムは、 Python では DoWhy (Microsoft、 DAG ベースの統合フレーム)・EconML (Microsoft、 機械学習ベース異質処置効果推定)・causalml (Uber、 因果機械学習)・linearmodels (パネルデータ・IV)・pyMC (ベイズ因果)・networkx (DAG 操作)。 R では MatchIt (マッチング)・twang (傾向スコア)・did (差分の差分)・rdrobust (回帰不連続)・plm (パネルデータ)・bnlearn (ベイジアンネットワーク)・dagitty (DAG 可視化)。 教科書では Pearl『Causality』、 Imbens & Rubin『Causal Inference for Statistics, Social, and Biomedical Sciences』、 Hernán & Robins『Causal Inference: What If』、 Cunningham『Causal Inference: The Mixtape』、 安井『効果検証入門』が定番。 実務応用は経済学 (政策評価)・疫学 (治療効果)・マーケティング (キャンペーン効果)・教育 (介入評価)・ソフトウェア開発 (A/B テスト) と幅広く、 SSDSE-B-2026 のような都道府県パネルデータは政策効果検証の典型題材となります。
🧭 因果推論の 5 ステップ実践チェックリスト ── 現場の「ふんわり結論」を構造化する
現場で「この施策が効いた」と判断する場面では、 多くの場合「施策後に KPI が伸びた」という時系列の前後関係だけが根拠になっている。 これは因果ではなく 単なる時間順序 に過ぎず、 同時期に発生していた季節要因・市場全体の伸び・別キャンペーンの効果・観測対象の自然成長といった候補を全て棄却して初めて「施策の効果」と言える。 ここでは因果推論を 5 つのステップに分解し、 それぞれで使う SSDSE-B-2026 都道府県データの確認方法と、 設計の段階で行う質問群を整理する。 47 都道府県データは「介入できない自然実験データ」の典型で、 この練習を踏むと、 後で企業内データに移行した時に「何を計測すべきだったか」が明瞭になる。
ステップ 1: 因果関係を主張したい「対象 (X→Y)」を 1 行で書き切る
最初に「X が増えると Y が増える / 減る」「X を実施すると Y が改善する」という主張を 1 行で文字にする。 これだけで議論が前進する。 SSDSE-B-2026 で言えば、 「医師数 (人口千人あたり)」が増えると「平均寿命」が伸びるか、 「大学卒業者割合」が増えると「県民所得」が伸びるか、 のように 2 列を選び X / Y を確定させる。 1 行に書けないまま分析を始めると、 結論段階で「結局何を言いたかったのか」が拡散し、 査読でも企画会議でも揉める。 教育現場では 必ず黒板の左上に「主張: ○○ → ○○ を引き上げる」と書き、 セッションが終わるまで消さない ルールを設けると良い。
- 悪い例: 「広告と売上の関係を分析する」── X / Y がどちらも曖昧で「相関を見る」のか「因果効果を測る」のかが不明。
- 良い例: 「TVCM 出稿量 (GRP) を 1,000 増やすと、 売上 (台) は 1 ヶ月後にいくつ増えるか」── 単位、 ラグ、 目的変数が確定している。
- SSDSE-B-2026 で書くなら: 「公共図書館数が 1 館増えると、 同一県の児童書貸出冊数は何冊増えるか」── 自治体予算の議論で使える形になる。
ステップ 2: 「交絡候補リスト」を 10 個書き出す ── ここで手を抜くと結論は崩れる
主張を書いたら、 次に X と Y の 両方 に影響する第三変数 (交絡因子) の候補を「少なくとも 10 個」書き出す。 10 個書く前に分析を始めてはいけない。 多くの現場では「思いついた 1〜2 個」を統制して終わるため、 残された交絡因子が結論を覆す。 SSDSE-B-2026 で「医師数 → 平均寿命」を分析するなら、 候補は「高齢化率」「県民所得」「就業者割合」「大学卒業者割合」「持ち家比率」「気温」「日照時間」「公共図書館数 (健康意識代理)」「世帯人員」「都市化度 (DID 人口比率)」など、 10 個以上は容易に挙げられる。 これらを後段の重回帰・傾向スコア・差の差分析でどう扱うかを設計段階で決めておく。
交絡候補を書き出す時のコツは「X に影響する候補」と「Y に影響する候補」の和集合を取ること。 X だけに影響する変数は 操作変数 として、 Y だけに影響する変数は 共変量 として扱う。 この区別を意識すると、 後で「どの変数を統制すべきか / 統制してはいけないか」の判断がブレない。 特に「介在変数 (mediator)」を交絡因子と誤解して統制すると、 X → Y の総合効果を過小評価するので注意が必要。 例えば「医師数 → 健康診断受診率 → 平均寿命」という鎖がある場合、 健康診断受診率は介在変数なので、 これを統制すると「医師数の純粋な効果」しか残らず、 政策判断としては誤った結論に繋がりうる。
ステップ 3: データ生成過程 (DGP) を矢印図で描く ── 1 枚の図が議論を救う
交絡候補をリストアップしたら、 それを 有向非巡回グラフ (DAG; Directed Acyclic Graph) として 1 枚にまとめる。 紙でもホワイトボードでも構わない。 X, Y, 交絡因子, 介在変数, 操作変数を箱で書き、 因果矢印を引く。 矢印が交差して読みにくくなったら、 それは「考えるべき変数が多すぎる」サインで、 分析範囲を絞るタイミング。 DAG を描くと「どの変数を統制すべきか」が自動的に決まる (バックドア基準と呼ばれる)。 これを共同研究者・上司・クライアントと共有することで、 「結局この分析は何を主張しているのか」が明確になり、 後段の議論が格段に短くなる。
| 変数の種類 | DAG での位置 | 統制すべきか | SSDSE-B-2026 での例 |
|---|---|---|---|
| 交絡因子 (confounder) | X と Y の両方に矢印を出す | 必ず統制 | 高齢化率 (医師数と寿命の両方に影響) |
| 介在変数 (mediator) | X → 介在 → Y の中継点 | 統制しない (総合効果を見る場合) | 健康診断受診率 |
| 操作変数 (instrument) | X にだけ矢印を出す | IV 法で活用 (統制ではない) | 医学部定員 (地域別の政策変数) |
| コライダー (collider) | X と Y から矢印を受ける | 絶対に統制しない | 入院率 (医師数・寿命の両方の結果) |
| 独立変数 | X / Y どちらにも矢印なし | 統制しても意味がない | 県の都道府県コード番号 |
ステップ 4: 識別戦略 (Identification Strategy) を 1 つに絞る
識別戦略とは「どの仮定の下で因果効果が推定できるか」を明示化した分析設計のこと。 主要な識別戦略は次の 5 つに集約される: (1) 無作為化比較試験 (RCT) ── 介入を完全にランダム化することで全ての交絡因子を平均的に均す。 (2) 傾向スコアマッチング / 重み付け ── 観察された交絡因子を多変量で同時に均す。 (3) 差の差 (Difference-in-Differences; DID) ── 処置前後 × 処置群対照群の 4 群比較で、 時間不変の交絡を消す。 (4) 操作変数法 (IV) ── X に影響するが Y には直接影響しない外生変数を使って、 内生性を回避する。 (5) 回帰不連続デザイン (RD) ── 制度的なカットオフ点付近の比較で、 局所的な因果効果を推定する。 SSDSE-B-2026 だけでは介入の時期やカットオフが分からないので DID と RD は外部資料なしでは使いにくく、 傾向スコアと IV が現実的な選択肢になる。 「これ全部やってみる」のではなく、 設計段階で 1 つ に絞り込み、 その仮定が壊れる場合にだけ別戦略を追加する。
ステップ 5: 感度分析と反証可能性の確保
分析が完成したら、 最後に「未観測の交絡因子がどの程度強ければ結論が覆るか」を計算する。 これを 感度分析 (sensitivity analysis) と呼ぶ。 Rosenbaum の Γ や E-value といった指標があり、 「観測されていない交絡因子が、 X とも Y とも 2 倍以上の関連を持っていれば結論が覆る」のように、 結論の頑健さを定量化できる。 SSDSE-B-2026 のような公的統計では未観測交絡は多数存在しうるため、 感度分析を省略すると「結論の脆弱性」が見えない。 また、 自分の仮説が反証されうる条件を事前に書き出しておくと、 「予想と違う結果が出た」場合の判断がブレない。 反証可能性を確保していない研究は、 結果がどうあれ「都合よく解釈」されるリスクが残る。
🧪 自然実験・準実験デザインの SSDSE-B-2026 への応用例 ── 都道府県データから因果を読む
SSDSE-B-2026 は介入できない自然実験データの宝庫である。 国や自治体が過去に実施した政策、 地理的・歴史的に偶然に生じた制度差、 経済成長や人口動態の地域的なばらつき ── これらを「あたかも実験」のように扱う準実験デザイン (quasi-experimental design) は、 因果効果を測る現実的な道具立てだ。 RCT が倫理的・予算的に不可能な公共政策の領域では、 これらの手法が事実上の標準になっている。 ここでは SSDSE-B-2026 の列を使って、 4 つの代表的な準実験デザインを具体例として示す。
応用例 1: 差の差 (Difference-in-Differences; DID) ── 介入の前後 × 群間比較
差の差分析は、 ある時点で 一部の地域・グループだけに介入が入った時に有効。 「介入群と対照群の 時間トレンド が平行だった (parallel trends assumption)」と仮定すると、 介入後の差から介入前の差を引いた差分が、 介入の純粋な効果として識別できる。 SSDSE-B-2026 は 47 都道府県 × 2012〜2023 年度のパネルなので、 県ごとの前後比較ができ、 DID の土台はそろっている(ただし介入の時期と対象は外部資料で特定する必要がある)。 例えば、 「介護保険制度改正 (特定の年度) 前後の、 改正を強く受けた県とそうでない県の高齢者就業率の動きの差」を比較すると、 制度改正の純粋な効果が推定できる。
DID の鍵は 平行トレンド仮定 (parallel trends assumption) の検証にある。 介入前の期間で、 介入群と対照群のトレンドが平行だったことを 図示で確認 し、 統計的にも検定する。 介入前のトレンドが既に乖離していた場合は、 「単に元から伸びていた地域が介入を受けた」だけの可能性があり、 DID の前提が壊れる。 平行トレンドが満たされない場合は、 イベントスタディ分析や合成統制法 (Synthetic Control Method) といった派生手法に切り替える。
応用例 2: 回帰不連続デザイン (RD Design) ── 制度上のカットオフを利用
回帰不連続デザインは、 制度上のしきい値の付近で「たまたま処置を受けた群と受けなかった群」が生じる状況で有効。 例えば、 「人口 10 万人未満の自治体には地方交付税の特例が適用される」「年齢 65 歳以上は医療費の自己負担割合が変わる」「点数 600 点以上は奨学金対象」のような制度的カットオフがある時、 そのしきい値の すぐ上 と すぐ下 のサンプルを比較する。 しきい値付近では「介入を受けるかどうかはほぼランダム」と見なせるため、 観測されない交絡因子も均衡していると仮定できる。
SSDSE-B-2026 では、 「人口規模に応じた地方交付税の傾斜配分」を利用して、 一定人口を境にした自治体間で公共サービスの違いを RD で測ることができる。 ただし、 47 都道府県という少ないサンプル数では、 しきい値付近のサンプルが極端に少なく、 推定が不安定になる。 RD を本格的に使うなら、 市区町村レベル (約 1,700 自治体) のデータに降りる必要がある。 RD の妥当性検証では「マニピュレーション検定 (McCrary 検定)」を必ず行う。 これは、 しきい値のすぐ上と下でサンプル分布に不自然な偏りがないか (= 制度の悪用や駆け込みがなかったか) を統計的に確認する手続き。
応用例 3: 操作変数法 (Instrumental Variable; IV) ── 内生性を回避する
操作変数法は、 「X が Y に影響するだけでなく、 Y も X に逆影響する (双方向の因果; 内生性)」場面で有効。 操作変数 Z は次の 3 条件を満たす必要がある: (1) Z は X に影響する (関連性条件)、 (2) Z は Y に直接影響しない (除外制約)、 (3) Z は X と Y の交絡因子と無相関 (外生性)。 古典的な例は「医師数 → 健康水準」の分析で、 過去に設置された医学部の地理的配置を Z として使うもの。 医学部の地理的配置は、 現在の健康水準には直接影響しないと仮定でき、 一方で現在の医師数 (X) には影響している。
SSDSE-B-2026 で IV を使う例として、 「県民所得 → 寿命」の分析が考えられる。 県民所得は寿命に影響するだろうが、 寿命が長い人が長く働けて所得が上がる逆方向の影響もあるため、 単純な回帰では因果が識別できない。 そこで、 「過去の主要産業の地理的配置 (例: 戦前の繊維業密度)」を Z として使うと、 現在の県民所得には影響するが、 現在の寿命には直接影響しないと考えられる。 ただし IV の除外制約は 検証不能な仮定 であり、 「本当に Z が Y に直接影響しないか」は分析者の主張に依存する。 そのため、 IV を使う論文では除外制約の妥当性を長文で正当化するのが普通。
応用例 4: 合成統制法 (Synthetic Control Method) ── 単一介入の効果測定
合成統制法は、 「たった 1 つの単位 (例: 1 つの県、 1 つの国) に介入が入った場合の効果」を測るために開発された。 介入を受けなかった他の単位の 加重平均 を作り、 介入を受けた単位の「もし介入がなかった場合の」反実仮想とする。 加重は、 介入前の期間で介入単位と最も似た動きをするように最適化する。 SSDSE-B-2026 で言えば、 「ある特定の県だけが先行して導入した政策 (例: 福井県の幼児教育無償化など) の効果」を、 他県の加重平均を使って測定できる。 元論文では「タバコ規制法案を導入したカリフォルニア州」「東西統一後の旧東ドイツ」「巨大震災後の神戸」などへの適用例が有名。
応用例 5: 傾向スコアマッチング (Propensity Score Matching; PSM) ── 観察データの近似 RCT
傾向スコアマッチングは、 「観察データから、 RCT のような群間バランスを再現する」ための手法。 介入を受ける確率 (傾向スコア) を共変量から推定し、 傾向スコアが近い介入群サンプルと対照群サンプルをペアリングする。 これにより、 観察された共変量の分布が介入群と対照群で揃い、 単純な平均比較で因果効果が推定できるようになる。 ただし、 「未観測の交絡因子は均衡しない」点に注意。 観測された変数だけで交絡を全て補正できると仮定する「条件付き独立性仮定 (Conditional Independence Assumption; CIA)」が成立しないと、 傾向スコアでも因果は識別できない。 SSDSE-B-2026 で傾向スコアを使うなら、 「ある政策を導入した県と導入しなかった県」を、 高齢化率・所得・人口密度などでマッチングし、 マッチング後の結果変数の差を「政策の効果」と解釈する。
📋 因果関係を主張する論文・レポートの査読チェックリスト 25 項目
論文・レポート・記事で「○○が△△を引き起こす」「○○の導入により△△が改善した」といった因果的な主張を見たら、 以下の 25 項目をチェックしよう。 1 つでも欠けていたら、 その主張は 因果ではなく相関、 あるいは 因果だが過大評価された可能性が高い。 これは査読者の視点であると同時に、 自分が因果を主張する側になった時の「自己点検リスト」でもある。 SSDSE-B-2026 を使った演習で「47 都道府県で相関を見ました」だけで終わらせず、 これらのチェックを潜らせる訓練を積むことで、 卒論・社内レポート・学会発表の質が一段上がる。
A. 研究設計レベルの 8 項目
| # | チェック項目 | なぜ重要か |
|---|---|---|
| 1 | X と Y の操作的定義が明示されているか | 「健康」「成功」「幸福度」などの抽象概念が、 どの観測変数で測定されているかが書かれていないと、 因果効果の解釈ができない。 |
| 2 | DAG または同等の因果図が示されているか | 図がない論文は、 「何を交絡因子と考えていたか」が言語的にしか書かれず、 統制変数の選択根拠が後から検証できない。 |
| 3 | 識別戦略 (RCT / DID / IV / RD / PSM 等) が明示されているか | 「重回帰しました」だけでは因果は識別できない。 どの仮定の下で因果効果が推定できているかの設計が必要。 |
| 4 | サンプルサイズと検出力 (power) が報告されているか | N が小さい研究では、 効果がないように見えても実は検出できなかっただけのことが多い。 |
| 5 | 事前登録 (pre-registration) されているか | 事後に結果を見てから仮説を作る HARKing を防ぐため、 主要な仮説と分析計画は事前登録が望ましい。 |
| 6 | 複数比較補正がされているか | 「20 個の変数を試したら 1 つだけ有意だった」は偶然の可能性が高い。 Bonferroni 補正・FDR 制御が必要。 |
| 7 | サンプリングフレームが明示されているか | 「誰を / 何を対象に分析したか」が曖昧だと、 結果の一般化可能性が判断できない。 |
| 8 | 選択バイアス (生存バイアス・自己選択) が議論されているか | 「成功した企業だけを分析した」など、 結果に基づいてサンプリングされている場合は因果効果が歪む。 |
B. 分析実行レベルの 9 項目
| # | チェック項目 | なぜ重要か |
|---|---|---|
| 9 | 記述統計と分布の確認が報告されているか | 外れ値の有無、 欠損のパターン、 変数の分布形状が分からないと、 後段の解析の妥当性が判断できない。 |
| 10 | 介入群と対照群のバランスチェックが報告されているか | RCT でも PSM でも、 群間のバランスが取れていることを確認しないと因果効果は識別できない。 |
| 11 | 統制変数の選択根拠が DAG と整合しているか | 介在変数を統制したり、 コライダーを統制したりすると、 因果効果の推定がむしろ歪む。 |
| 12 | 多重共線性が確認されているか | 説明変数同士が強く相関していると、 個々の係数の解釈が不安定になる。 VIF などで確認が必要。 |
| 13 | 頑健標準誤差・クラスタリングが適切か | パネルデータや階層データでは、 標準誤差を適切にクラスタリングしないと信頼区間が過小評価される。 |
| 14 | 効果量と信頼区間が報告されているか | p 値だけでは「効果がどれくらい大きいか」が分からない。 効果量の実用的な意味合いを議論できる必要がある。 |
| 15 | 頑健性テスト (robustness check) が実施されているか | サンプル除外・モデル仕様変更・外れ値処理を変えても結論が変わらないかの確認が必要。 |
| 16 | 感度分析 (sensitivity analysis) が実施されているか | 未観測の交絡因子がどの程度強ければ結論が覆るかを定量化することで、 結論の頑健性を示せる。 |
| 17 | プラセボテスト (placebo test) が実施されているか | 「効果がないはずの場面」で効果が検出されないことを確認することで、 主結果の信頼性を高められる。 |
C. 解釈・報告レベルの 8 項目
| # | チェック項目 | なぜ重要か |
|---|---|---|
| 18 | 「相関」と「因果」の用語が混同されていないか | 識別戦略が不十分なまま「○○が△△を引き起こす」と書くのは過剰主張。 「相関がある」「関連がある」が正確。 |
| 19 | 統計的有意性と実用的重要性が区別されているか | N が大きければ小さな効果でも p < 0.05 になる。 効果量の実用的意義の議論が必要。 |
| 20 | 外的妥当性 (一般化可能性) が議論されているか | 「米国の大学生 200 名を対象とした実験結果」が、 日本の労働者にそのまま適用できるかの議論が必要。 |
| 21 | 想定される反論 (alternative explanations) が網羅的に議論されているか | 「他に考えられる解釈」を全て検討した上で、 自分の主張がなぜ最も妥当かを論じる姿勢が必要。 |
| 22 | 研究の限界 (limitations) が誠実に列挙されているか | 「サンプルが小さい」「観察期間が短い」「特定の業界に限られる」など、 限界の自己開示が査読の信頼を高める。 |
| 23 | 利益相反 (conflict of interest) が開示されているか | 研究費の出資元や著者の所属が結論に影響する可能性がある場合、 開示が必要。 |
| 24 | データとコードの公開 (reproducibility) がされているか | 公開されていないと第三者が結果を検証できず、 査読プロセスが不完全になる。 |
| 25 | 先行研究との関係が明示されているか | 同じテーマで矛盾する結果がある先行研究にどう答えるか、 メタ分析の文脈での位置づけが必要。 |
使い方の補足 ── このチェックリストを「儀式」にしない
25 項目のチェックリストは、 ただ機械的にチェックを付けるためのものではない。 各項目について「本研究では何を / なぜそうしているか」を 1-3 行で記述させることで、 研究設計の質が一段上がる。 例えば項目 8 の「選択バイアス」については、 「本研究では○○の理由で○○のサンプリングを行ったため、 ○○のバイアスが残る可能性がある」と書くことで、 後段の解釈の限界が明示される。 これを「査読チェックリスト」として持ち、 自分が書く側の時にも、 自分が読む側の時にも、 機械的に潜らせる癖をつけるとよい。 関連用語として 疑似相関、 交絡変数、 DAG、 操作変数法、 差の差分析、 傾向スコア、 合成統制法、 回帰不連続デザイン、 無作為化比較試験 (RCT)、 選択バイアス、 介在変数、 コライダー、 バックドア基準、 条件付き独立性、 外的妥当性、 内的妥当性 を併せて確認することを推奨する。
補論: 因果推論の歴史的展開と学派 ── どの教科書から学べばよいか
因果推論は 20 世紀後半から急速に体系化が進んだ分野で、 大きく分けて 2 つの学派が並立している。 一つは ポテンシャル・アウトカム枠組み (Rubin の因果モデル)。 これは「もしも処置を受けていたら / 受けていなかったら」という反実仮想を出発点に、 平均処置効果 (ATE)、 処置群平均処置効果 (ATT)、 局所平均処置効果 (LATE) などの推定対象を厳密に定義する。 経済学・公衆衛生学・教育学で広く使われており、 ANGRIST and PISCHKE の Mostly Harmless Econometrics、 IMBENS and RUBIN の Causal Inference for Statistics, Social, and Biomedical Sciences が代表的な教科書。 もう一つは 構造的因果モデル (Pearl の SCM)。 こちらは有向グラフを使って因果関係を視覚化し、 do-演算子という独自の記法で介入の効果を表現する。 PEARL の Causality、 PEARL, GLYMOUR, JEWELL の Causal Inference in Statistics: A Primer が代表的。 両学派は本質的には同等の議論を異なる言語で行っていることが分かっており、 現代の因果推論論文では両方の道具を組み合わせて使うのが一般的。
日本語で因果推論を学ぶ場合、 「効果検証入門」 (安井翔太)、 「岩波データサイエンス Vol.3 因果推論」、 「計量経済学の第一歩」 (田中隆一)、 「統計的因果推論の理論と実装」 (高橋将宜)、 「データ分析の力 因果関係に迫る思考法」 (伊藤公一朗) あたりが入門書として優れている。 SSDSE-B-2026 を使った演習を続けながら、 これらの教科書で理論的背景を補強すると、 「相関と因果の違い」を体に染み込ませることができる。 さらに上を目指すなら、 国際的な学会 (American Causal Inference Conference、 Atlantic Causal Inference Conference) や、 Coursera / edX の MOOC (Hernán の Causal Diagrams、 Stanford の A Crash Course in Causality) が参考になる。 因果推論は急速に進化している分野なので、 最新の論文 (Journal of Causal Inference、 Econometrica、 American Economic Review、 American Journal of Epidemiology など) も定期的に追いかけることを推奨する。
補論: 機械学習時代の因果推論 ── 双対機械学習・因果フォレストの登場
近年は機械学習と因果推論の融合が進んでおり、 高次元データや非線形関係の中でも因果効果を推定できる手法群が登場している。 代表的なのが 双対機械学習 (Double / Debiased Machine Learning; DML)。 これは、 結果変数 Y を共変量 X で予測するモデルと、 処置変数 D を X で予測するモデルを別々に作り、 それぞれの残差で回帰することでバイアスを除去する手法。 Chernozhukov らが提案した。 もう一つが 因果フォレスト (Causal Forest)。 これはランダムフォレストを因果効果の推定に応用したもので、 「どのサンプル属性に対して効果が大きいか」を推定する 異質効果 (heterogeneous treatment effect) の分析に強い。 Wager と Athey が提案し、 EconML や grf という Python / R パッケージで利用可能。 これらの手法は SSDSE-B-2026 のような中規模データでも使え、 「47 都道府県の中で政策効果が大きかった県、 小さかった県の違い」を統計的に推定できる。
機械学習を因果推論に組み込む際の注意点は、 「予測の精度と因果の識別は別問題」という原則を忘れないこと。 機械学習モデルは予測精度を最大化するように訓練されるが、 そのまま因果効果の推定に使うと、 過剰適合や正則化バイアスの影響で効果が歪む。 そのため、 DML のように サンプル分割 (cross-fitting) や 残差化 (residualization) を組み合わせる工夫が必要。 また、 機械学習で「相関が強い」と判定された変数が、 必ずしも因果的に重要というわけではない。 機械学習の特徴量重要度は予測の文脈で意味を持つが、 因果効果の大きさとは別物。 この区別を曖昧にしたまま「ランダムフォレストで重要度上位の変数が因果的に重要」と主張するレポートは多いが、 これは典型的な誤用。 因果効果を主張するなら、 必ず識別戦略 (DAG、 DID、 IV、 RD、 PSM、 DML、 Causal Forest など) を明示すべき。
まとめ ── 因果関係を主張するための 3 つの心得
最後に、 因果関係を主張するための 3 つの心得を述べる。 (1) 「相関は因果ではない」を呪文のように繰り返さない。 これは正しいが、 「では何があれば因果と言えるか」の答えにはなっていない。 識別戦略を学び、 自分の分析でどの戦略を使っているかを明示する習慣を持つこと。 (2) DAG を描かずに因果を語らない。 言葉だけで議論すると、 必ずどこかで論理が飛ぶ。 DAG を 1 枚描けば、 自分が何を仮定しているかが他人にも自分にも見える。 (3) 自分の主張がどのような条件下で覆りうるかを言語化する。 反証可能性を確保していない研究は、 結果がどうあれ「都合よく解釈」される。 「未観測の交絡因子が○○以上強ければ結論は覆る」と感度分析で明示することで、 主張の信頼性が一段上がる。 この 3 つを守るだけで、 卒論・社内レポート・学会発表の質は大きく変わる。
🖼 視覚的理解 (3 図)
本概念を SSDSE-B-2026 都道府県データ(2023 年度・47 都道府県)で可視化する。 3 つの異なる切り口 (散布図・分布・群間比較) で、 「診療所が多い県ほど死亡が多い」という見かけの関係が、 どの交絡因子で説明されるのかを順にたどる。
🗺 拡張概念マップ:因果 の周辺地図
中心の「因果関係」から、 因果効果を定義する枠組み(反事実 / Rubin、 DAG / do 演算)と、 観察データから因果効果を取り出す識別戦略(RCT・DID・操作変数・傾向スコア)が伸びている。 上下左右の 6 つは「定義の言葉」と「推定の道具」の 2 種類に分かれ、 どの道具も定義側の仮定(交絡がすべて観測されている、 平行トレンド、 除外制約など)に頼っている。
🔭 上級トピック: 因果効果の識別:Back-door / Front-door / Do-calculus
Judea Pearl の因果推論フレームでは、 観測データから因果効果 $P(Y|do(X))$ を識別する 3 大ツールが back-door 基準、 front-door 基準、 do-calculus です。 Back-door 基準は、 DAG 上で $X$ から $Y$ への因果経路を阻害せず、 かつ全ての裏口 (X の祖先経由の経路) を遮断する変数集合 $Z$ を見つけたら、 $P(Y|do(X)) = \sum_z P(Y|X,Z)P(Z)$ で識別できるというものです。 これは交絡を $Z$ で層別すれば因果効果が回復できる、 という直感に対応します。 Front-door 基準は、 $X$ と $Y$ の間に介在する変数 $M$ (媒介変数) があり、 $X→M→Y$ のチェーンが交絡されていないとき、 $X→Y$ の直接交絡を観測せずとも因果効果を識別する強力なツール。 Do-calculus は Pearl が定式化した 3 つの推論規則 (rule 1: independence, rule 2: action/observation exchange, rule 3: insertion/deletion of actions) を組み合わせて、 観測分布と介入分布を相互変換する一般理論で、 これら 3 規則の繰り返し適用で全ての識別可能なケースを網羅できることが Shpitser & Pearl により証明されています。 実務では完全な DAG を書くこと自体が困難なため、 sensitivity analysis (E-value, Rosenbaum bounds) で「未観測交絡がどれくらいあれば結論が覆るか」を定量化する補完的アプローチも重要です。 SSDSE-B-2026 のような 47 都道府県データでは、 都道府県を unit としつつ年次でパネル化することで、 固定効果モデル・差分の差分法を併用し、 観察データの限界の中で最善の因果推論を試みます。
🔗 隣接手法への橋渡し
因果関係 (X→Y) は単なる相関を超えて「介入したら結果が変わるか」を問う、 統計学から因果推論への橋渡し概念。
- 上流: 実験計画 (RCT)と A/B テストでランダム化により交絡を排除、 観察データなら DAG (有向非巡回グラフ) で因果構造を仮定。
- 並列: 相関係数 (関連の強さだけ、 因果方向は不明)・回帰分析 (関連の関数形、 ただし交絡があれば因果ではない) — 「相関 ≠ 因果」が大原則。
- 下流: 因果推論 (Pearl の do-calculus, Rubin の potential outcomes)・交絡変数の制御 (傾向スコア、 IPW、 マッチング)・媒介分析・感度分析 (E-value)・反実仮想 (counterfactual) 推定。
SSDSE-B-2026 で「都道府県の出生率と保育所定員数の相関」を見ても、 因果は不明 (逆因果や交絡の可能性)。 真の因果効果を測るには、 政策変更の前後比較 (DID) や、 保育所拡充の自然実験を活用する設計が必要。
🌳 意思決定ツリー: 因果 を選ぶか
「因果 を使うべきか」を判断するためのフローチャート。 上から順番に Yes/No で答えていけば、 自分の問題に最適な手法選定にたどり着きます。
- 1. RCT (ランダム化実験) は可能か? Yes → 実施 (最強の因果証拠) / No → 2 へ。
- 2. パネルデータ (同一個体の時系列観測) があるか? Yes → 固定効果モデル・DID を検討 / No → 3 へ。
- 3. 自然実験 (準ランダムな介入変動) はあるか? Yes → 操作変数法・回帰不連続デザインを検討 / No → 4 へ。
- 4. 潜在的交絡変数を観測できるか? Yes → back-door 基準で識別、 傾向スコア法等で推定 / No → 5 へ。
- 5. 媒介変数があり、 front-door 基準を満たすか? Yes → front-door 識別 / No → 6 へ。
- 6. 感度分析で結論の頑健性を評価。 Tipping point (E-value) を計算し、 「未観測交絡がどれくらいあれば結論が覆るか」を定量化。
🎮 触って理解する
同じ「$X$ と $Y$ の散布図」でも、 背後の因果構造が違えば相関の意味はまるで変わります。 下のパネルで 3 つの構造を切り替え、 「$Z$ で条件付ける」と相関がどう動くかを自分の手で確かめてください。 大原則は 2 つ ── 交絡は条件付けで消え、 コライダーは条件付けで偽の相関が生まれる。 計算はすべて生成した点から実際にピアソン相関・偏相関を求めています。
🧠 直感:相関 ≠ 因果
散布図に右上がりの点の雲があっても、 それが「$X$ が $Y$ を引き起こす」ことを意味するとは限りません。 上のパネルの ② 交絡を選ぶと、 $X{\to}Y$ の矢印が一本も無いのに、 共通原因 $Z$ が両方を押し上げるだけで、 きれいな相関が現れます。 これがいわゆる疑似相関です。 逆に ① 直接因果では、 $Z$ を条件付けても相関がほぼ変わらず、 do(X) 介入でも残ります ── これが「本物の因果」の手触りです。
⚠️ よくある落とし穴:コライダーで「調整」してはいけない
「関係ありそうな変数はとりあえず全部入れて回帰する」は危険です。 パネルの ③ コライダーでは、 $X$ と $Y$ はもともと無相関($r\approx0$)なのに、 合流点 $Z$($X{\to}Z{\leftarrow}Y$)で条件付けた瞬間に偽の相関が湧き出します。 これがコライダーバイアス(合流点バイアス)です。 統制すべきは交絡因子であって、 コライダーや中間変数(mediator)を統制すると、 むしろ存在しない関係を作り出してしまいます。 「何を入れるか」は変数の数ではなく因果構造(DAG)で決めます。
🚀 発展:RCT・DAG・反事実
パネルの do(X) 介入ボタンは、 Pearl の $\text{do}$ 演算そのものです。 $X$ をランダムに割り当て、 $X$ に入ってくる矢印(交絡経路)を物理的に切断します。 交絡構造で do(X) を押すと見かけの相関が 0 に落ち ── これがランダム化比較試験(RCT)が交絡を消すメカニズムです。 観察データで RCT が使えないときは、 まず DAG(有向非巡回グラフ)を描いて「どの変数を条件付ければ交絡経路が塞がり、 かつコライダーを開かないか」(バックドア基準)を決め、 傾向スコア・操作変数法・DID などで因果効果を推定します。 究極的に因果が問うているのは反事実(counterfactual) ── 「もし介入していなかったら $Y$ はどうなっていたか」という、 観測できないもう一つの世界です。
🧠 解説深化 ① 直感 ── 「相関 ≠ 因果」を 3 条件と do 演算で言い切る
因果を一言でいえば「介入したら結果が変わる」関係です。 単に一緒に動く (相関) だけでは足りません。 判定の軸は 3 つ ── (1) 時間的先行: 原因は結果より先に起きる、 (2) 共変動: $X$ が動くと $Y$ も動く、 (3) 交絡の排除: 両者を同時に動かす第三の共通原因 (交絡) が無い。 この 3 条件を全て満たして初めて「$X$ が $Y$ の原因」と言えます。 (1)(2) だけなら 疑似相関 でも簡単に成立してしまいます。
Pearl の記法では、 観察で見える確率 $P(Y \mid X=x)$ と、 世界に手を突っ込んで $X$ を $x$ に強制したときの確率 $P(Y \mid \text{do}(X=x))$ を区別します。 交絡があると両者は一致しません。 「$X$ を観察したら $Y$ が高い」は、 「$X$ を上げたら $Y$ が上がる」を意味しないのです。 さらにその先に 反事実 (counterfactual) があります ── 「この県が実際には政策を導入したが、 もし導入していなかったら $Y$ はどうなっていたか」。 観測できないもう一つの世界との差こそが、 個体レベルの因果効果です。
📊 実データで見る「相関はあるが因果ではない」── SSDSE-B-2026 (2023 年, 47 都道府県)
「一般病院数 (I510120)」と「歯科診療所数 (I5103)」の県別ピアソン相関は r ≈ +0.90 と非常に強い正相関です。 だからといって「病院が増えると歯医者が増える」わけではありません。 両者を 総人口 (A1101) で統制した偏相関は r ≈ +0.16 まで落ちます (病院と人口は r ≈ 0.90、 歯科と人口は r ≈ 0.98)。 つまり見かけの強相関のほとんどは「人口という共通原因」が作った 交絡 です。 このように、 数を数えた変数どうしは人口規模で必ず相関します ── 相関係数の大きさは因果の証拠にならない、 という好例です。 ページ上部の 🎮 ウィジェットの「② 交絡」を選び「$Z$ で条件付ける」をオンにすると、 この現象を自分の手で再現できます。
⚠️ 解説深化 ② 落とし穴 ── 偽の因果を生む 7 つの罠
「相関を因果と混同」は入口に過ぎません。 現場で結論を覆すのは、 次の 7 パターンです。 特に太字の 3 つ (コライダー・媒介変数・シンプソン) は「変数を統制したこと自体が誤りを生む」ため、 統計に慣れた人ほど陥ります。
| 罠 | 何が起きるか | 対処 / 関連ページ |
|---|---|---|
| 交絡 (共通原因) | $X \leftarrow Z \rightarrow Y$。 共通原因 $Z$ が両方を動かし、 因果が無くても相関が出る。 | 交絡 を統制 (層別・回帰・傾向スコア) |
| 逆因果 | 向きが逆 ($Y \rightarrow X$)、 または双方向 (内生性)。 「医師が多い県は病人が多い」の類。 | 逆因果 / 内生性 / 同時性 |
| 選択バイアス | 標本の選ばれ方が結果に依存。 「成功例だけ」を集めると効果が歪む (生存バイアス)。 | 選択バイアス |
| コライダーで条件づけ | $X \rightarrow Z \leftarrow Y$。 合流点 $Z$ で層別・統制すると、 無相関だった $X,Y$ に偽の相関が湧く。 | コライダーは統制しない (DAG で判定) |
| 媒介変数の誤統制 | $X \rightarrow M \rightarrow Y$ の $M$ を統制すると、 $X$ の総合効果を過小評価する (過剰調整)。 | 総合効果を見たいなら媒介 $M$ は入れない |
| 生態学的誤謬 | 集団 (県) レベルの相関を、 個人レベルの因果に読み替える誤り。 集計の相関 ≠ 個人の関係。 | 分析単位と主張単位を一致させる |
| シンプソンのパラドックス | 全体の傾向と、 群別に見た傾向が逆転する。 どちらを見るべきかは因果構造で決まる。 | 下記の解説を参照 |
生態学的誤謬 (ecological fallacy) ── 都道府県データ特有の罠
SSDSE-B-2026 は 47 都道府県という集計 (集団) データです。 ここで得た相関を、 そのまま「個人」の因果に翻訳すると誤ります。 例えば「持ち家比率が高い県ほど平均寿命が長い」という県レベルの相関があっても、 「持ち家を買えば寿命が延びる」という個人の因果は導けません。 県内での個人差、 所得・地域医療などの交絡が集計で潰れているからです。 集計データで見えるのは県の特徴どうしの関係であって、 個人の介入効果ではない ── これを常に意識してください。 逆に、 個人データの関係を集団に当てはめる誤り (原子論的誤謬) もあります。
シンプソンのパラドックス ── 「全体」と「群別」で符号が逆転する
ある治療 $X$ と回復 $Y$ を全体で見ると「治療した方が回復率が低い」ように見えるのに、 重症度で群を分けると、 軽症群でも重症群でも「治療した方が回復率が高い」という逆転が起きることがあります。 これがシンプソンのパラドックスです。 鍵は「どちらの数字が正しいか」ではなく「重症度が交絡か媒介か」という因果構造 ── 重症度が治療選択と回復の両方に影響する交絡なら群別 (調整後) が正しく、 治療が重症度を経由して回復に効く媒介なら全体 (調整前) が正しいのです。 数字だけでは決まらず、 DAG が判定を与えます。
架空の数値例 (説明用に作った数字であり実データではありません)
| 群 | 治療あり 回復率 | 治療なし 回復率 |
|---|---|---|
| 軽症 | 93% (81/87) | 87% (234/270) |
| 重症 | 73% (192/263) | 69% (55/80) |
| 合算 | 78% (273/350) | 83% (289/350) |
群別ではどちらも治療が優位 (+6, +4 ポイント) なのに、 合算では治療が劣位 (−5 ポイント) に見えます。 重症患者ほど治療を受けやすい (重症度 → 治療) ため、 治療群に重症が偏り、 単純合算が歪みます。 重症度は交絡なので、 ここでは群別 (調整後) が正しい結論です。
🚀 解説深化 ③ 発展 ── DAG・潜在結果・識別戦略・因果の階層
DAG とバックドア基準 ── 「何を統制するか」を機械的に決める
DAG (有向非巡回グラフ) は変数を箱、 因果を矢印で描いた図です。 描くと、 統制すべき変数集合が バックドア基準 から自動的に決まります。 基準は「$X$ の子孫を含まず、 $X$ から $Y$ への裏口経路 (backdoor path) を全て塞ぐ集合 $Z$」。 その $Z$ で条件づければ $P(Y \mid \text{do}(X)) = \sum_z P(Y \mid X, Z{=}z)\,P(Z{=}z)$ で因果効果が識別できます。 逆に、 コライダーを $Z$ に入れると塞がっていた裏口が開いてしまう ── だから「関係ありそうな変数を全部入れる」は誤りなのです。 統制すべきは交絡、 入れてはいけないのはコライダーと媒介変数、 という判定を DAG が与えます。
反事実と潜在結果 (Rubin) ── 因果効果を数式で定義する
各個体 $i$ に、 処置を受けた場合の結果 $Y_i(1)$ と受けなかった場合の結果 $Y_i(0)$ という 2 つの潜在結果を考えます。 個体因果効果は $Y_i(1)-Y_i(0)$ ですが、 現実には片方しか観測できません (因果推論の根本問題)。 そこで集団平均 $\text{ATE}=E[Y(1)-Y(0)]$ を推定対象にします。 無視可能性 $\{Y(0),Y(1)\}\perp T \mid X$ と重なり (overlap) の仮定の下で、 観測データから $\text{ATE}=E_X\big[E[Y\mid T{=}1,X]-E[Y\mid T{=}0,X]\big]$ として識別できます。 Pearl の do 演算と Rubin の潜在結果は、 同じことを別の言語で述べた等価な枠組みです。
識別戦略の地図 ── RCT / 自然実験 / IV / DID / RDD
介入をランダムに割り当てられるなら RCT (ランダム化比較試験) が王道で、 交絡を平均的に均します。 それが不可能な観察データでは、 制度や偶然が作った「あたかも実験」= 自然実験 を使います。 主要な識別戦略は次の通りです。
- 操作変数法 (IV) ── $X$ に影響するが $Y$ には直接影響しない外生変数 $Z$ を使い、 内生性・逆因果を回避。 関連性・除外制約・外生性の 3 条件が要。
- 差の差 (DID) ── 一部の群だけに介入が入ったとき、 介入前後 × 群間の 4 象限比較で時間不変の交絡を消す。 平行トレンド仮定 が生命線。 パネルデータ・固定効果と併用する。
- 回帰不連続 (RDD) ── 制度的なカットオフ (人口・年齢・点数) の直上と直下を比較。 しきい値近傍では処置割当がほぼランダムと見なす。
- 傾向スコア (PSM/IPW) ── 観測共変量で処置確率を推定し、 群間バランスを揃えて近似 RCT を作る (未観測交絡は消えない点に注意)。
なお、 時系列における「予測に役立つか」を問う グレンジャー因果 は、 反事実的な意味での因果とは別物である点に注意してください (予測可能性 ≠ 介入効果)。 手法選択の詳細は本ページ上部「📊 識別戦略の比較表」も参照。 因果推論 (causal-inference) の体系全体を扱う独立ページは本用語集には未収録のため、 各識別戦略の個別ページを辿ってください。
Pearl の因果のはしご (Ladder of Causation) ── 関連・介入・反事実
Pearl は因果的な問いを 3 段のはしごに整理しました。 上の段は下の段の情報だけでは原理的に答えられないのが要点です。
| 段 | レベル | 典型的な問い | 記法 / 必要なもの |
|---|---|---|---|
| 第 1 段 | 関連 (Association) 見る | 「$X$ を観測したら $Y$ はどうなっている?」 | $P(Y\mid X)$ ── 観察データだけで済む |
| 第 2 段 | 介入 (Intervention) する | 「$X$ を変えたら $Y$ はどう変わる?」 | $P(Y\mid \text{do}(X))$ ── DAG + 識別戦略が要 |
| 第 3 段 | 反事実 (Counterfactual) 想像する | 「もしあのとき違えていたら $Y$ はどうだった?」 | $Y_x \mid X{=}x', Y{=}y'$ ── 構造モデルが要 |
相関分析は第 1 段、 RCT や DID は第 2 段、 「この患者にこの薬を投与していなかったら助かったか」といった問いは第 3 段です。 観察データ (第 1 段) からいきなり介入や反事実に登るには、 因果構造の仮定というはしごの横木が必要になります ── これが因果推論という営みの本質です。