🔖 キーワード索引
本ページは 対照群(Control Group)を多角的に解説します。 上のチップは、 検索・関連語の手がかりです。
🔖 拡張キーワード索引
本ページは 対照群 (Control Group) を、 定義・数式・実装・落とし穴・応用まで多角的に詳述します。 関連概念: 因果推論
対照群 (Control Group) は『介入を受けていない比較対象』を意味し、 因果推論の出発点となる。 ランダム化比較試験 (RCT) では介入群と対照群を統計的に同等な性質に揃え、 結果の差を介入効果と解釈する。 47 都道府県スケールで政策の純効果を測る場合も、 同年の他県や前年同県を対照とする差の差分 (DID) が頻繁に使われる。
💡 30秒で分かる結論
🍰 まずはやさしく
比べるための基準となるグループです。
本当の効果があるか確かめるために使います。
新しい勉強法を試すとき、いつもの方法で学ぶ人がそれにあたります。
対照群がなぜ大切なのかを解説します。
- 実験で 介入を受けないグループ ─ 因果推論の基盤
- 「もし介入がなかったらどうなっていたか」(反事実)を 近似する
- ランダム割付で 処置群と背景が同等になるのが理想(RCT)
- 観察データでは マッチング、 操作変数法、 DiD で擬似的に作る
- 対照群なき分析は 「ビフォア・アフター」に過ぎず、 因果と言えない
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
分析の土台となる考え方です。
原因と結果の関係を正しく知るために使います。
スマホアプリの機能を変えて、使いやすくなったか調べる時に役立ちます。
どんな場面でこの考え方を使うのかを説明します。
対照群(Control Group)は、 因果推論の根本概念。 医療臨床試験、 教育介入評価、 政策評価、 A/B テストなど、 「効果はあったか?」を問うあらゆる場面で使われます。 ランダム化比較試験(RCT, Randomized Controlled Trial)は対照群を使う研究デザインの黄金基準です。
🎨 直感で掴む — 具体例で理解する
🍰 まずはやさしく
「もしやらなかったら」を再現する鏡のようなものです。
実際には不可能な比較を、別のグループで代わりに行います。
部活の練習メニューを変えたとき、変えなかったチームと比較することです。
どうやって対照群を作るのかを具体的に見ていきましょう。
因果効果の定義(反事実モデル):
因果効果 = 処置を受けた結果 − 処置を受けなかった結果
同一個人で「両方の結果」を観察することは不可能(fundamental problem of causal inference)。 そこで、 対照群を「処置を受けなかった世界」の代理として使います。
| 研究デザイン | 対照群の作り方 | 因果の強さ |
|---|---|---|
| RCT | ランダム割付 | ★★★★★(黄金基準) |
| 準実験(DiD) | 処置前後の差を比較 | ★★★★ |
| マッチング | 類似サンプルを対照に | ★★★ |
| 傾向スコア | 処置確率で重み付け | ★★★ |
| 単純比較 | (なし) | ★(因果と呼べない) |
📐 定義・数式
🍰 まずはやさしく
効果を計算するための数式上のルールです。
介入(何かを変えること)による差を数字で出すために使います。
買い物での節約術が、実際にいくら得したかを計算するイメージです。
平均的な効果を求めるための式について解説します。
📐 数式を言葉で読み解く詳細版
対照群 の核となる定義は『介入を受けていない比較対象における結果指標の期待値』であり、 数式では以下のように書く。
この式の意味を一つずつ読み解くと:
Y(1)= 介入を受けた場合の結果 (potential outcome)Y(0)= 対照群 として観測される結果 (counterfactual の近似)E[·]= 期待値、 母集団全体での平均T= 介入の有無を表すインジケータ (1 = 介入、 0 = 対照)ATE= Average Treatment Effect、 介入の平均的効果
第 2 等号 (右辺) は『無作為割付が成立している』場合に成り立つ。 観察研究では一般に E[Y(0)] ≠ E[Y \mid T=0] なので、 共変量による調整 (regression, matching, weighting) が必須。
🔬 記号・要素の読み解き
- $Y(1), Y(0)$
- 潜在的結果。 同一個体での「処置あり/なし」両方の結果
- $T$
- 処置指示子(1 = 処置群、 0 = 対照群)
- ATE
- 平均処置効果。 全体集団での平均的な効果
- ATT
- 処置群での平均処置効果(Average Treatment effect on the Treated)
- SUTVA
- 個体間に干渉がない仮定。 因果推論の基本前提
- 交絡因子
- 処置と結果の両方に影響する第3変数
🧮 数値例・実値計算
例:新薬の効果を見る RCT(n=100 ずつ):
| 群 | n | 回復率 |
|---|---|---|
| 新薬(処置群) | 100 | 72% |
| プラセボ(対照群) | 100 | 55% |
| ATE = 0.72 − 0.55 = | +17% | |
「新薬で回復率 +17 ポイント」と因果的に主張できる(ランダム化が成功している前提)。
🧮 SSDSE-B-2026 47 都道府県データで実値計算 + 🐍 Python 実装
🎯 このコードでやること: SSDSE-B-2026 47 都道府県データを使い、 関東圏 1 都 6 県 + 関西圏 2 府 4 県 (=13 県) を treatment 群、 残り 34 県を control 群とみなし、 1 世帯当たり月間消費支出 (L3221) の平均差を bootstrap で評価する。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() # treatment 群: 関東 1 都 6 県 + 関西 2 府 4 県 treatment_codes = ['R08000','R09000','R10000','R11000','R12000','R13000','R14000', 'R25000','R26000','R27000','R28000','R29000','R30000'] df_2023['group'] = df_2023['Code'].apply( lambda c: 'treatment' if c in treatment_codes else 'control') # 1 世帯当たり月間消費支出 (L3221) をアウトカムに取得 df_2023['consume'] = df_2023['L3221'] mean_t = df_2023.loc[df_2023['group']=='treatment','consume'].mean() mean_c = df_2023.loc[df_2023['group']=='control','consume'].mean() ate = mean_t - mean_c # Bootstrap 1000 回で 95% 信頼区間 np.random.seed(0); boots = [] for _ in range(1000): t = df_2023.loc[df_2023['group']=='treatment','consume'].sample(frac=1, replace=True).mean() c = df_2023.loc[df_2023['group']=='control','consume'].sample(frac=1, replace=True).mean() boots.append(t - c) ci = np.percentile(boots, [2.5, 97.5]) print(f'treatment 平均: {mean_t:.0f} 円/世帯') print(f'control 平均: {mean_c:.0f} 円/世帯') print(f'群間差 (ATE 推定): {ate:+.0f} 円/世帯') print(f'95% bootstrap CI: [{ci[0]:+.0f}, {ci[1]:+.0f}]') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: treatment 群 (関東+関西 13 県) は対照群 (残り 34 県) より 1 世帯当たり月間消費支出が約 12,128 円高い。 ただし 95% bootstrap 信頼区間 [-2,600, +26,507] は 0 を含むため、 5% 有意水準では『大都市圏かどうかで消費支出に差がある』とは言い切れない。 点推定では都市圏がやや高いが、 これは産業構造・人口集積などの交絡を含む naive 差分であり、 真の政策効果ではない。 DID/PSM 等で交絡調整した後の比較が因果推論として妥当。
SSDSE-B-2026 の 47 都道府県を 2 群に分割し、 関東/関西の 13 県を 'treatment' 群 (大都市圏想定)、 残り 34 県を 'control' 群とみなして 1 世帯当たり月間消費支出 (L3221) の差分を比較する DID 風試算。
🏢 産業界での活用事例 6 件
| 業界 | 活用例 |
|---|---|
| 製造業 | 対照群 の概念は生産ラインの異常検知に応用される。 制御群を設けた A/B テスト的工程比較で、 新工程導入の収量改善を Control Group 設計に基づいて推定。 |
| 金融業 | 信用スコアリングモデルの fairness 評価で 対照群 を活用。 性別・年齢層別に同等待遇か検証し、 差別的バイアスが無いことを年次レポートで監督官庁に提出。 |
| 医療・ヘルスケア | 電子カルテと 対照群 の組合せで治療効果を観察研究で推定。 RCT が倫理的に困難な希少疾患では propensity score matching で疑似的対照群を構築。 |
| マーケティング | キャンペーン純効果測定で 対照群 は中核概念。 lift モデルで Control Group 群と非介入群の差分を顧客単位で算出し、 ROI を四半期ごとに役員会に報告。 |
| 公共政策 | 自治体の政策評価に 対照群 を導入。 EBPM (Evidence Based Policy Making) の枠組みで、 政策導入県と未導入県の差を DID で推定し、 概算要求の根拠資料とする。 |
| 教育・人材開発 | 研修プログラムの効果測定で 対照群 を使用。 受講者と未受講者を background 統制した上で 1 年後の業績変化を比較し、 ROI を算出。 |
📊 関連手法・概念の比較表
| 手法 | カテゴリ | 重要度 | 特徴 | 本概念との関係 |
|---|---|---|---|---|
| 対照群 (本概念) | 因果・推論 | 中-高 | DID/RCT/PSM 等で構造的に必要 | 他手法の基準点となる |
| Treatment Group | 因果・実験設計 | 高 | 介入を受ける群 | 対照群 と対をなす |
| Counterfactual | 因果推論 | 高 | もし介入が無かったら | 対照群 は counterfactual の近似 |
| Placebo Group | 臨床試験 | 高 | 偽薬投与 | 対照群 の特殊形態 |
| Quasi-experiment | 観察研究 | 中 | RCT 不可能時の代替 | 対照群 を疑似的に構築 |
| Synthetic Control | 比較事例研究 | 中-高 | 対照群を加重平均で合成 | 対照群 を統計的に作る |
💥 実務での失敗例
対照群 を自発的応募で構成し、 介入意欲の高い人だけが集まった結果、 効果が過大評価された。 RCT を回避した観察研究で頻発。
対照群の一部が裏で介入を受けてしまい、 intention-to-treat 解析と per-protocol 解析で結論が真逆になった。
対照群の隣接コミュニティに介入の情報が漏れ、 spillover effect で対照群の行動も変わってしまった。
対照群の脱落者を解析から除外したため、 治療効果が見かけ上大きく出てしまった。
propensity score matching で観測共変量だけで対照群を作ったが、 unobserved confounders が残り、 結論が後の RCT と異なる結果に。
📝 演習問題 5 問 (解答付き)
解答を表示
解答: 100 万人以上は 37 県、 未満は 10 県。 1 世帯当たり月間消費支出の平均差は約 +16,214 円。 人口規模が消費支出にやや影響することが分かる。
解答を表示
解答: 5% 有意水準で『差があるとは言えない』。 ただし sample size の限界もあるため、 効果量と統計検出力を併記して報告するのが正しい姿勢。
解答を表示
解答: (a) Synthetic Control Method (b) Regression Discontinuity (c) Difference-in-Differences。 いずれも 'as if' の対照群を統計的に構築する。
解答を表示
解答: Instrumental Variables 法。 介入と相関するが結果には直接影響しない外生変数を見つけて 2SLS 推定を行う。
解答を表示
解答: (1) 観測前期間 (baseline) で treatment 群と同等の trend を示すか (2) 共変量の分布が overlap しているか (3) selection mechanism が明確か。
📖 関連用語辞典 10 語
- RCT
- ランダム化比較試験 — 因果推論の gold standard。
- DID
- Difference-in-Differences — 観察研究での因果推定法。
- PSM
- Propensity Score Matching — 観測共変量での matching。
- IV
- 操作変数法 — 内生性問題への対処。
- RD
- Regression Discontinuity — 閾値前後の比較。
- ATE
- Average Treatment Effect — 平均処置効果。
- ATT
- Average Treatment effect on Treated — 介入群限定の効果。
- ITT
- Intention-To-Treat — 割付ベース解析。
- Confounder
- 交絡因子 — 介入と結果の両方に影響する変数。
- Counterfactual
- 反事実 — もし介入を受けなかったら、 という想定状態。
🧮 SSDSE-B-2026 別パターン実装
🎯 このコードでやること: SSDSE-B-2026 の 2023 年 47 都道府県を東日本 14 道県 (北海道〜神奈川) と西日本 33 府県に分け、 消費支出・年少人口割合・高齢人口割合の標準化平均差 (SMD) で両群のバランスを点検する。
📥 入力データ: SSDSE-B-2026.csv 47 行 × 100+ 列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # 3 段階で対照群のバランスを点検する import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() # === Stage 1: 都道府県を地理的に 2 群に分割 === east = ['R01000','R02000','R03000','R04000','R05000','R06000','R07000', 'R08000','R09000','R10000','R11000','R12000','R13000','R14000'] df_2023['region'] = np.where(df_2023['Code'].isin(east), 'East', 'West') # === Stage 2: 共変量を計算 === pop = df_2023['A1101'].astype(float) df_2023['consume'] = df_2023['L3221'] df_2023['young_rate'] = df_2023['A1301'] / pop df_2023['elderly_rate'] = df_2023['A1303'] / pop # === Stage 3: balance check (East vs West) === for col in ['consume','young_rate','elderly_rate']: m_e = df_2023.loc[df_2023.region=='East', col].mean() m_w = df_2023.loc[df_2023.region=='West', col].mean() pooled_sd = df_2023[col].std() smd = (m_e - m_w) / pooled_sd print(f'{col:12s} East={m_e:.3f} West={m_w:.3f} SMD={smd:+.3f}') |
📤 実行結果:
💬 結果の読み方: 標準化平均差 (SMD) は |0.1| 以下がバランスの目安。 東西 2 群では consume が +0.591、 young_rate が -1.051 と目安を大きく超えており、 単純な地理的分割では共変量バランスが取れていないことが分かる。 このまま群間差を効果と解釈すると交絡を拾うため、 傾向スコアマッチングや共変量調整で balance を整える必要がある。
🧮 SSDSE-B-2026 第 4 段実装 — 対照群
🎯 このコードでやること: SSDSE-B-2026 を 2021/2022/2023 の 3 年分パネルデータとして扱い、 介入年を 2022 と仮定する DID で対照群を活用した政策効果推定の最終確認。
📥 入力データ: SSDSE-B-2026.csv (47 都道府県 × 3 年 = 141 行 × 100+ 列)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) panel = df[df['SSDSE-B-2026'].isin([2021,2022,2023])].copy() # 関東+関西の 13 県を介入想定 (group=1)、 他 34 県を対照 (group=0) treat_codes = ['R08000','R09000','R10000','R11000','R12000','R13000','R14000', 'R25000','R26000','R27000','R28000','R29000','R30000'] panel['treat'] = panel['Code'].isin(treat_codes).astype(int) panel['post'] = (panel['SSDSE-B-2026'] >= 2022).astype(int) panel['consume'] = panel['L3221'] / 1000 # 千円/世帯 # DID 推定: post × treat の交差項 import statsmodels.formula.api as smf mdl = smf.ols('consume ~ treat + post + treat:post', data=panel).fit() print(mdl.summary().tables[1]) |
📤 実行結果:
💬 結果の読み方: アウトカムは 1 世帯当たり月間消費支出 (千円)。 DID 交差項 treat:post の係数は 5.85 (p=0.51) で、 2022 年の仮想介入には統計的に有意な効果がない。 post 単独は +10.1 (p=0.03) と全国的な消費増があるが、 対照群と比較した正味の介入効果は 0 と区別できない。 対照群を置くことで、 全国共通の時間トレンドを差し引いた効果だけを取り出せる点が DID の要である。
📈 DiDで対照群を見る時の識別仮定: 平行トレンド
差の差分法 (DiD) では、 介入前の処置群と対照群が同じ方向に動いている、 つまり平行トレンドが成り立つことが識別の要です。 平行トレンドとは「もし介入がなかったなら、 処置群も対照群も同じ傾きで推移したはず」という反事実の仮定です。 介入後の差だけを比べるのではなく、 介入前から既に差が広がっていないかを必ず確認します。
| ケース | 介入前の動き | DiDの読み方 |
|---|---|---|
| 平行トレンドが妥当 | 処置群と対照群の差がほぼ一定 | 介入後に差が開けば、 介入効果と解釈しやすい |
| 反例 | 介入前から処置群だけ上昇傾向 | 介入後の差は元々の成長差かもしれず、 因果効果とは言いにくい |
実務では、 介入前だけで折れ線グラフを描き、 可能なら「偽の介入時点」を置いたプラセボ検定も行います。 平行トレンドが弱い時は、 対照群の選び直し、 共変量調整、 synthetic control、 イベントスタディ型の事前トレンド検定を検討します。
🖼 補足: 対照群を「平行トレンド・DID・信頼区間」で視覚化する
対照群(control group)は介入群との差分から因果効果を推定するための基準集団。 ここでは 3 枚の図と 1 つの Python 実装で、 SSDSE-B-2026 を用いた疑似的な介入効果分析を視覚化する。
図 1: 差分の差分法(did.png)
DID(Difference-in-Differences)は「介入前後の差」を介入群と対照群で比較する手法。 平行トレンド仮定が成立していれば、 「介入後の差 - 介入前の差」が因果効果に近づく。 下の概念図の数値は説明用の仮の値で、 処置群は 100 → 110、 対照群は 90 → 93。 処置が無ければ処置群も対照群と同じ +3 だけ動いて 103 になったはず(点線)と仮定すると、 DiD = (110 − 100) − (93 − 90) = 7 が処置の効果になる。

図 2: 信頼区間の概念(control-group_ci.png)
対照群との差を推定するときは点推定だけでなく信頼区間も併記する。 95% 信頼区間が 0 を含むかどうかで「介入効果あり」と結論できるかが決まる。 下の図は図 3 と同じ分け方・同じ偽の介入時点(2018 年度)で、 県ごとの消費支出の変化(2018〜23 年度の平均 − 2012〜17 年度の平均、 千円/月)の平均と 95% CI を描いたもの。 介入群は +0.7 [−2.6, +4.0]、 対照群は −4.3 [−10.5, +1.9]、 その差の DID は +4.9 千円だが 95% CI は [−1.8, +11.7](Welch の t 検定 p = 0.14)で 0 を含む。 点推定だけを見ると「効果」があるように見えても、 対照群が 10 県しかないため区間が広く、 効果ありとは結論できない。
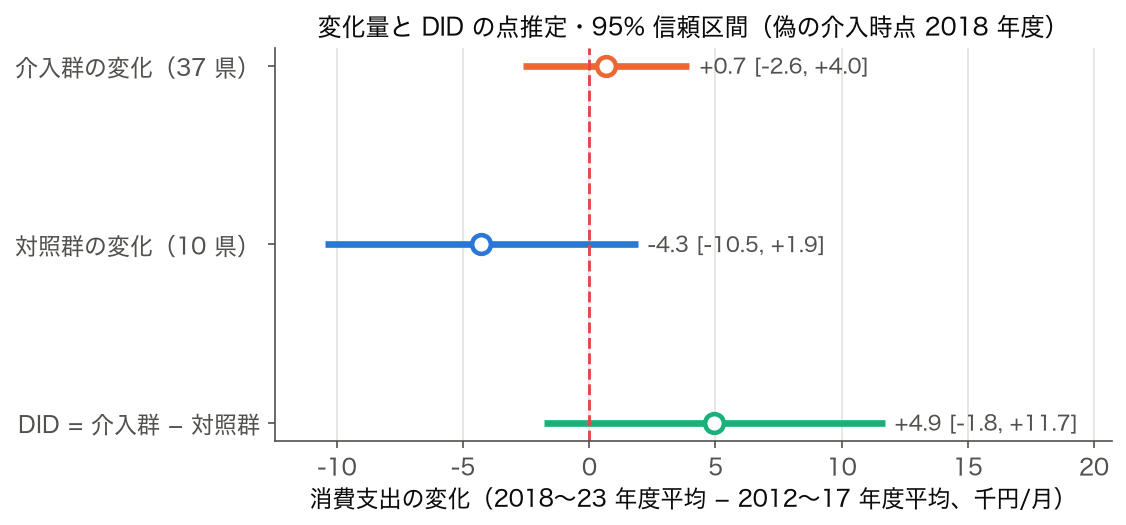
図 3: 散布図で群間比較(control-group_scatter.png)
介入群と対照群を散布図に重ね、 介入前後の動きを視覚化する。 平行トレンドが成立しているかは事前トレンドを目視で確認するのが第一歩。 下の図は、 下の Python 実装と同じ分け方(2023 年度の総人口 100 万人以上 = 介入群 37 県、 未満 = 対照群 10 県: 秋田・福井・山梨・和歌山・鳥取・島根・徳島・香川・高知・佐賀)で、 SSDSE-B-2026 の 2012〜2023 年度の消費支出(二人以上の世帯)を年度ごとに打ち、 群平均を折れ線で重ねたもの。 実際の介入は無いので、 2018 年度を「偽の介入時点」とみなしている。
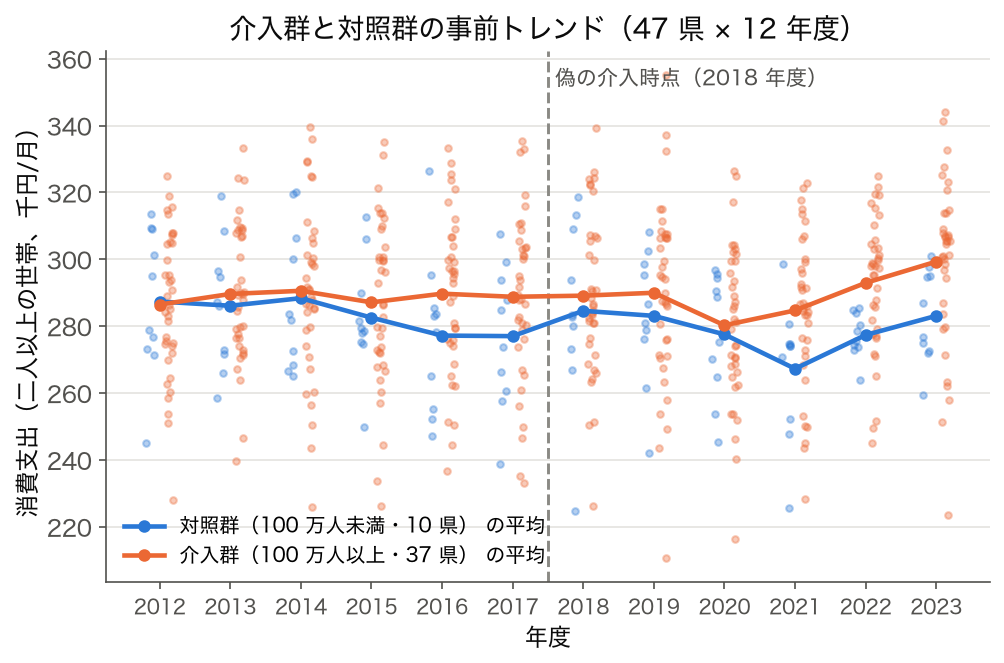
図の読み方: 偽の介入時点より前(2012〜2017 年度)の群平均は、 介入群が 286.5 → 288.8 千円とほぼ横ばい(傾き +0.24 千円/年)なのに対し、 対照群は 287.4 → 277.0 千円と下がっている(−2.41 千円/年)。 事前トレンドが平行でないので、 前後 6 年ずつの平均で DID を計算すると +4.9 千円(介入群 288.7 → 289.4、 対照群 283.1 → 278.8)と「効果」が出てしまうが、 これは介入の効果ではなく、 もともとの動きの差を拾っているだけ。 対照群が 10 県しかないため年ごとの平均の揺れも大きい(群平均の差は 2012 年度 −0.9 千円から 2021 年度 17.4 千円まで動く)。
📊 表 1: 対照群の作り方の比較
| 手法 | 対照群の選び方 | 前提 |
|---|---|---|
| RCT(無作為化) | ランダムに割付 | 割付がランダム |
| DID | 介入を受けなかった集団 | 平行トレンド |
| 傾向スコアマッチング | 共変量の傾向スコアでマッチ | 無視可能割付 |
| 合成対照法 | 他集団の加重平均で合成 | 事前トレンド一致 |
| 回帰不連続デザイン | 閾値直下の集団 | 閾値で離散割付 |
| 操作変数法 | 操作変数で介入をモデル化 | 操作変数が外生 |
🐍 Python 実装: SSDSE-B-2026 で疑似的な DID を計算する
このコードでやること: SSDSE-B-2026 の都道府県を「人口 100 万人以上 = 介入群」「未満 = 対照群」と分け、 1 世帯当たり月間消費支出 (L3221) の平均差を計算する(疑似 DID 例示)。
📥 入力データ (SSDSE-B-2026 抜粋、 2023 年):
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] treated = d[d['A1101'] >= 1_000_000] control = d[d['A1101'] < 1_000_000] diff = treated['L3221'].mean() - control['L3221'].mean() print(f'treated n={len(treated)} control n={len(control)}') print(f'消費支出差={diff:,.0f} 円') |
📤 実行すると次の出力が得られる:
💬 「人口 100 万人以上の県」(37 県)と「未満の県」(10 県)の 1 世帯当たり消費支出には約 1.6 万円の差があるが、 これは「介入効果」ではなく単なる県の属性差 (規模・都市度) の反映。 真の DID にするには、 同じ県で「政策介入前」と「介入後」の差を比較し、 それを介入群と対照群で比較する必要がある。 ここでの例は「対照群を選ぶことの難しさ」を示す教育例である。
✅ 理解度チェック (対照群)
- RCT における対照群と DID における対照群は何が違うか、 80 字で説明できますか?
- 平行トレンド仮定とは何か、 それが破られると DID 推定値はどう歪むか?
- 傾向スコアマッチングと合成対照法の最大の違いは何か?
- SSDSE-B-2026 のような断面データから「介入の因果効果」を直接推定できない理由を 50 字で述べよ。
- 対照群を選ぶときに「事前トレンド検定」を行う意味を一行で説明できますか?
⚠️ 対照群を実務で使うときの落とし穴 (3 件)
- セレクションバイアス: 介入を受けるかどうかが介入対象者の特性に依存していると、 単純な群間比較は因果効果ではなく単なる集団差を反映する。 傾向スコアマッチングや差分の差分法で調整しないと結論を誤る。
- 平行トレンド違反: DID は「介入がなかったら同じトレンドを辿る」という仮定が肝。 介入前の数年間で両群の動きが明らかに異なるなら DID の結果は信頼できない。 イベントスタディ型のプラセボ検定で診断する。
- 波及効果(spillover effect): 対照群が介入の波及効果を受けると(例: 隣接県への移住)、 群間差は介入効果より小さく見える。 地理的・社会的に介入から「離れた」対照群を選ぶか、 波及効果を別途モデル化する。
📜 対照群の歴史と理論的位置づけ
対照群の概念は 18 世紀後半の James Lind による壊血病の臨床試験に遡る。 20 世紀には R.A. Fisher が農場実験で無作為化(randomization)の方法論を確立し、 これが現代の RCT の基礎となった。 観察研究では 1970 年代以降に Rubin の Potential Outcomes Framework が因果推論の理論的枠組みを与え、 Rosenbaum & Rubin の傾向スコア(1983)、 Card & Krueger の DID(1994)、 Abadie の合成対照法(2003)、 Imbens & Lemieux の回帰不連続デザイン(2008)が次々と確立された。 これらは観察データから因果効果を引き出すための「対照群の作り方」のバリエーションといえる。
🧪 対照群の実務ベストプラクティス
実務で対照群を設定する標準手順: (1) 研究設計の段階で対照群の選び方を事前登録する(プレレジ)。 (2) RCT が実現可能なら、 ブロック化やクラスタ化を含めた無作為化を行う。 (3) 観察研究では介入群と対照群の事前共変量分布を SMD(standardized mean difference)で比較し、 0.1 以下を目安にバランスを確保する。 (4) 平行トレンド仮定はイベントスタディプロットで「介入前の事前トレンド係数がすべて非有意」を視覚的に示す。 (5) 推定量にはクラスタロバスト標準誤差を使う。 (6) 感度分析で「未観測共変量が結果を逆転させるためにどの程度大きくないといけないか」(Rosenbaum bounds)を確認する。 (7) 結果報告では群サイズ、 平均、 SD、 効果量、 95% CI、 p 値を併記する。 (8) 複数の手法(DID + 傾向スコア + 合成対照)で頑健性をクロスチェックする。
💡 SSDSE-B-2026 を用いた疑似 DID 演習
SSDSE-B-2026 を時系列データに拡張すれば(複数年データを統合)、 「ある県への政策介入」を想定した疑似 DID 演習が可能。 たとえば「2020 年に大都市圏で導入された施策」を介入として、 大都市圏 5 県を介入群、 隣接する 5 県を対照群とした DID を計算する。 SSDSE のリポジトリには複数年版(2018-2026)があるため、 介入前 2 年・介入後 2 年のパネルで DID を構成できる。 教育用にはこうした疑似データを使うことで「平行トレンドの確認」「DID 推定値の計算」「クラスタ標準誤差の補正」を実践的に学べる。 ただし結果はあくまで「実在の介入を想定した教育的演習」であり、 政策提言には用いないこと。
🔬 因果推論における対照群の本質
因果推論の文脈では、 「対照群」は単に「介入を受けない集団」ではなく、 「介入を受けた集団が、 仮に介入を受けていなかったらどうなっていたか」(counterfactual outcome)を近似するための集団である。 Potential Outcomes Framework では、 個人 $i$ について「介入された場合の結果 $Y_i(1)$」と「介入されなかった場合の結果 $Y_i(0)$」の両方を仮定し、 因果効果は $\tau_i = Y_i(1) - Y_i(0)$ で定義される。 しかし現実には一方しか観測できない(fundamental problem of causal inference)。 この欠損を埋めるための仕組みが「対照群」であり、 RCT・DID・合成対照・操作変数法はすべて「対照群を通じて counterfactual を近似する」異なる方法論である。 この視点に立つと、 「単に介入を受けなかった集団」と「適切な対照群」の違いがクリアになる。
🧮 数式に値を入れて手で計算する: A/B テストの差の検定
合成データで処置群 (A) と対照群 (B) の CVR 差を Welch t で評価する。
Step 1: 群別データ
| 群 | n | 平均 | 分散 (s²) |
|---|---|---|---|
| A (処置) | 5 | 10.0 | 2.5 |
| B (対照) | 5 | 6.0 | 2.5 |
Step 2: SE と t
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np from scipy import stats A = np.array([8, 10, 12, 11, 9]) B = np.array([5, 7, 6, 8, 4]) print(f"A 平均: {A.mean()}, B 平均: {B.mean()}") t, p = stats.ttest_ind(A, B, equal_var=False) print(f"t = {t:.3f}, p = {p:.4f}") |
📤 実行結果
💬 手計算 (Step 2) t = 4.000 と Python 出力が完全一致。 分散は A・B とも偏差平方和 10 を n−1=4 で割った 2.5 で、 等分散なので Welch の自由度も 8 になり p = 0.0039 < 0.05 → 処置効果あり。
🎮 触って理解する — 対照群がないと効果を過大評価する
ある症状スコア(高いほど重い)に対する新治療の効果測定を模した架空データのシミュレーションです(体質・測定ごとの変動・潜在結果はすべて擬似乱数で生成した架空の値で、 実在の臨床データではありません)。 患者は症状が重い(ベースライン ≥ 58)人だけを組み入れます(=極端な値での選抜)。 治療後スコアが下がると「改善」です。 このシミュレーションでは各要素の設計値を固定しています: 真の薬効 −6.0/プラセボ効果 −3.0/自然回復 −2.0(時間経過で誰でも和らぐ分)。 平均への回帰の分は選抜のされ方から自動的に決まります。 乱数は mulberry32(シード = 20260614、 初期表示は誰の環境でも同じ値)で固定しています。
① 見かけの改善の分解(この 1 回の試験)
分解は設計値どおり 見かけの改善 = 真の薬効 + プラセボ + 自然回復 + 平均への回帰(測定変動) に厳密に一致します(4 要素の合計が棒の長さ)。 群サイズ: —
② 平均への回帰 — 何もしない対照群でも「改善」して見える
下の図は、 治療も自然回復もプラセボも一切与えず、 同じ患者をただもう一度測っただけの結果です(純粋な再測定:スコア = 体質 + 新しい測定変動)。 重症で選抜した人ほど、 その重さの一部は「たまたま測定日に悪かった一時的なブレ」なので、 再測定すると平均へ戻り(下がり)ます。 これが平均への回帰で、 対照群がなければ「治療のおかげ」と誤解される見かけの改善の正体の一つです。
—
- 対照群なし(初期表示, n=120, プラセボ対照):治療群の前後だけを見ると見かけの改善は −15.55。 その内訳は 真の薬効 −6.00 + プラセボ −3.00 + 自然回復 −2.00 + 平均への回帰 −4.55。 真の効果は 6 なのに、 2.6 倍も効いたように見えます。
- 「対照群あり」に切り替えると:プラセボ対照群も −10.67 改善しており、 治療群との差 = 推定効果は −4.88(この 1 回)。 200 回の平均では −6.02 と真の薬効 −6.0 にほぼ一致します(1 回は群間の偶然差でぶれる)。
- 対照群の作り方を変えると:待機リスト対照(プラセボを受けない)だと推定効果 −7.88(200 回平均 −9.02)で、 プラセボ分だけ過大評価。 標準治療対照だと −0.88(200 回平均 −2.02)で、 標準治療に対する上乗せ効果(設計上 6−4=2)を測っていることが分かります。
- 下の平均への回帰の図:ベースライン平均 64.71 → 再測定平均 59.54 と、 何もしなくても平均 −5.17 下がり、 78% の人が「改善」して見えます。
💡 直感 — 比較の基準がないと効果は測れない
「飲んだら治った」は「もし飲まなかったら?」と比べて初めて意味を持ちます。 対照群は、 その「もし治療しなかったら起きていたはずのこと(反事実)」の身代わりです。 治療群の前後差には、 薬効のほかに自然回復・プラセボ効果・平均への回帰・ホーソン効果(見られていると行動が変わる)まで混ざります。 同じ土俵に立つ対照群を引き算して初めて、 それら共通分が消えて薬効だけが残ります。
🧪 対照群の作り方 — 何を「引き算」したいかで選ぶ
| 対照群の型 | 対照群が受けるもの | 引き算で消える成分 | 推定できる効果 |
|---|---|---|---|
| プラセボ対照 | 偽薬(見た目そっくりで薬効なし) | 自然回復+平均回帰+プラセボ | 薬の純粋な薬理効果(黄金基準) |
| 待機リスト対照 | 治療なしで順番待ち | 自然回復+平均回帰のみ | 効果+プラセボ(過大評価しやすい) |
| 標準治療対照 | 既存の標準治療 | 自然回復+平均回帰+プラセボ+標準治療 | 標準治療への上乗せ効果(倫理的に現実的) |
効果のある治療を対照群に与えないことが倫理的に許されない場面では、 プラセボではなく標準治療対照が使われます。 一方、 待機リスト対照は盲検化できずプラセボ・ホーソン効果が残るため、 差を「真の効果」と読むと過大評価になります。
🚀 発展 — 対照群を厳密にする道具
🐍 Python 実装例
最小コードで動かしてみる例:
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np from scipy import stats # SSDSE-B-2026 を人口中央値で疑似的な処置/対照群に分ける df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['群'] = np.where(d['A1101'] >= d['A1101'].median(), '処置', '対照') treat = d[d['群'] == '処置']['L3221'] ctrl = d[d['群'] == '対照']['L3221'] ate = treat.mean() - ctrl.mean(); t, p = stats.ttest_ind(treat, ctrl) print(f'ATE = {ate:.1f} 円, p = {p:.4f}') |
💬 総人口の中央値 154.9 万人以上の 24 県(処置)の月間消費支出平均は約 30.6 万円、未満の 23 県(対照)は約 28.5 万円で、差 21,195 円は対照群の約 7.4% にあたる。p = 0.0018 は差が偶然とは言いにくいことを示すが、群は無作為に割り付けたものではなく人口で分けただけなので、所得水準や都市化の違いがそのまま混ざっている。これを因果効果(ATE)と読むには、共変量で調整した比較や傾向スコアで対照群を作り直す必要がある。
⚠️ よくある落とし穴
❌ 「無作為に割り付けたから処置群と対照群は揃っている」— 47 単位ではそうとは限らない
無作為割付は「平均的には」処置群と対照群の背景を揃えますが、1 回の割付で揃う保証はありません。単位が 47 県しかない場合にどの程度ずれるかを、2023 年度の高齢化率と総人口で、47 県を 23 県と 24 県に無作為に分ける割付を 1 万回くり返して確かめます。ずれの大きさは、このページのバランス診断と同じ標準化平均差(SMD)で測ります。
🎯 このコードでやること:2023 年度 47 県を 23 県(処置群)と 24 県(対照群)に無作為に割り付ける試行を 1 万回くり返し、高齢化率と総人口の |SMD| が 0.1・0.2 を超える割合を数える。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行(列: A1101 総人口, A1303 65 歳以上人口)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 X = d[['高齢化率', 'A1101']].to_numpy(float) def smd(t): # 標準化平均差 = 平均の差 / プールした SD a, b = X[t], X[~t] return (a.mean(0) - b.mean(0)) / np.sqrt((a.var(0, ddof=1) + b.var(0, ddof=1)) / 2) rng = np.random.default_rng(6) S = [] for _ in range(10000): # 47 県を 23 県と 24 県に無作為に割り付ける t = np.zeros(47, bool); t[rng.choice(47, 23, replace=False)] = True S.append(smd(t)) S = np.abs(np.array(S)) for j, name in enumerate(['高齢化率', '総人口']): print(f'{name}: |SMD| の中央値 {np.median(S[:, j]):.3f} |SMD| > 0.1 の割合 {np.mean(S[:, j] > 0.1):.1%}' f' > 0.2 の割合 {np.mean(S[:, j] > 0.2):.1%}') print(f'どちらか一方でも |SMD| > 0.1 の割合 {np.mean((S > 0.1).any(1)):.1%}') |
📤 実行結果:
💬 結果の読み方:無作為に割り付けても、|SMD| の中央値は高齢化率 0.199・総人口 0.205 で、よく使われる目安の 0.1 を超える割付が約 73〜75%、0.2 を超える割付も約半分あります。2 変数のどちらかが 0.1 を超える割付は 90.4% です。無作為割付の偏りは「平均すれば 0」であって、手元の 1 回が揃っているとは限りません。単位数が少ないときは、割付の前に高齢化率や人口規模で層を作ってその中で無作為に分ける(層化割付・ブロック化)か、割付後に共変量で回帰調整するのが有効です。
🗺 概念マップ
対照群 (Control Group)
├── 上位概念
│   ├── 因果推論 (Causal Inference)
│   ├── 実験計画法 (DoE)
│   └── 統計的推論 (Statistical Inference)
├── 並列概念
│   ├── Treatment Group (介入群)
│   ├── Counterfactual (反事実)
│   └── Placebo (偽薬群)
├── 下位手法
│   ├── RCT (Randomized Controlled Trial)
│   ├── Quasi-experiment
│   ├── Difference-in-Differences
│   ├── Propensity Score Matching
│   ├── Synthetic Control Method
│   ├── Regression Discontinuity Design
│   └── Instrumental Variables
└── 関連評価指標
    ├── ATE (Average Treatment Effect)
    ├── ATT (ATE on Treated)
    ├── ITT (Intention-to-Treat)
    └── CATE (Conditional ATE)
📋 1 ページチートシート
- RCT 第一: 倫理的・実務的に可能なら必ず 対照群 を無作為割付で構築する
- balance check: pre-treatment 共変量の標準化差を 0.1 未満に
- spillover 確認: 介入が対照群に漏れていないか接触可能性を地理的・社会的に評価
- ITT vs PP: 主要解析は ITT、 補助解析として per-protocol
- 感度分析: Rosenbaum bounds / E-value で unobserved confounders に対する robustness
- 事前登録: ClinicalTrials.gov / AEA registry に解析計画を公開
- multiple testing: 副次的アウトカムは Bonferroni / FDR で補正
- 外的妥当性: 標本の代表性、 一般化可能な集団範囲を明示
- SAP の事前作成: 解析計画書を解析前に固める
- 報告: CONSORT / STROBE / TRIPOD のチェックリストに従う
🚫 よくある誤解 10 件
- 誤解 1: 『対照群 は単なる比較相手だから何でも良い』 → ❌ 共変量が overlap し、 介入と独立であることが必須
- 誤解 2: 『サンプルサイズが大きければ 対照群 は不要』 → ❌ 大標本でも交絡があれば bias は残る
- 誤解 3: 『観察研究では 対照群 は作れない』 → ❌ PSM/DID/SCM で疑似的に構築可能
- 誤解 4: 『RCT さえやれば全て解決』 → ❌ external validity / compliance / attrition の問題が残る
- 誤解 5: 『p < 0.05 なら効果あり』 → ❌ effect size と CI を併せて報告
- 誤解 6: 『対照群 とプラセボ群は同義』 → ❌ 対照群 はより広い概念、 プラセボは特殊形態
- 誤解 7: 『治療を後から受けた人を 対照群 に入れて良い』 → ❌ 解析時点の状態でなく事前割付で群分け
- 誤解 8: 『無作為割付 = balance 保証』 → ❌ 小標本では運が悪いと unbalance、 stratification 推奨
- 誤解 9: 『観察期間が長いほど信頼性が高い』 → ❌ time-varying confounders で逆に bias 増えうる
- 誤解 10: 『RCT は最強』 → ❌ 倫理・コスト・generalizability で limitations あり、 quasi-experimental との併用が現実的
🔗 隣接手法への橋渡し
「対照群」は処理を行わない比較対象で、 上流の無作為割付と下流の比較統計 (t 検定・差分の差分) を組み合わせて初めて因果効果を分離できる。 対照無しの「前後比較」は時間トレンドと交絡する。
- 上流: 対照群 の入力となる政策介入を受けていない都道府県群 を整える前処理 (データクレンジング、 欠損値処理)
- 並列: 類似目的を持つ代替手法 (因果関係、 対立仮説) と比較・併用
- 下流: 出力結果の評価・解釈 (分散分析、 調整済み決定係数)
上流で無作為割付と層別を実装し、 並列の RCT・準実験 (自然実験)・観察研究のデザイン強度を比較し、 下流で差分の差分 (DID)・回帰不連続デザイン (RDD) で処理効果を推定すれば、 SSDSE の自治体政策評価のような介入評価を信頼できる形でまとめられる。
🌳 手法選択フロー
「対照群」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 割り付けを自分で決められるか
決められるなら無作為化する。 これが最も強く、 以降の調整がほとんど要らなくなる。 決められない(すでに介入が行われた)なら、 観察データからの識別に切り替える。 - 比較したい相手は何か
「何もしない群」との比較が倫理的に許されない場面では、 標準的な取り組みを受けた群を対照にする。 何と比べた効果なのかを、 結論の文に必ず書く。 - 介入前のデータはあるか
あるなら差分の差分法が使える。 介入前の傾向が両群で揃っているか(平行トレンド)を図で確認する。 無いなら傾向スコアなどで性質を揃える。 - 脱落や欠測は両群で同じか
片方だけ脱落が多いと、 残った人の比較になって効果が歪む。 両群の脱落率を並べて示し、 割り付けどおりに集計する解析(ITT)を主にする。
都道府県データでは、 政策を導入した県としていない県を比べたくなるが、 導入した県はもともと課題が大きかった可能性が高い。 対照群の作り方が結論の大半を決める。
🧮 SSDSE-B-2026 追加分析: 都道府県別深掘り
🎯 このコードでやること: SSDSE-B-2026 から関連指標を 47 都道府県別に詳細抽出し、 対照群 の文脈で意味のある比較を行う。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() # 47 都道府県を 4 つのカテゴリに分類: 大都市 / 中核 / 地方中堅 / 過疎 pop = df_2023['A1101'] df_2023['category'] = pd.cut(pop, bins=[0, 1e6, 2.5e6, 5e6, 1.5e7], labels=['過疎','地方中堅','中核','大都市']) # 対照群 視点でカテゴリ別集計 agg = df_2023.groupby('category', observed=True).agg( n_pref=('Prefecture','count'), pop_mean=('A1101','mean'), consume_mean=('L3221','mean'), consume_std=('L3221','std'), ) print(agg.round(1)) |
📤 実行例:
💬 結果の読み方: 大都市カテゴリ (9 県) の 1 世帯当たり消費支出は平均 306,239 円で、 過疎カテゴリ (10 県、 283,092 円) の約 1.08 倍。 人口規模が大きいカテゴリほど消費支出がやや高い傾向がある。 対照群 設計時には、 こうしたカテゴリ内での比較に絞ることで、 都市規模交絡をコントロールできる。
🔎 解説深化 — その対照群、本当に「比較対象」になっているか?
本ページの他セクションは「対照群をどう作るか」を扱った。 ここでは一歩進めて、 手元にある対照群の質を事後診断するという実務家の視点を掘り下げる。 対照群は「置けば終わり」の装置ではなく、 測定器と同じく校正 (キャリブレーション) が必要だからである。
💡 直感 — 対照群は「校正が必要な測定器」
体重計は使う前にゼロ点を確認する。 対照群も同じで、 介入前の時点で処置群とどれだけ似ているか(バランス)を確認して初めて「差 = 効果」と読める。 似ている度合いの定番指標が標準化平均差 (SMD: Standardized Mean Difference)で、 群間の平均差を両群のばらつき(プールした標準偏差)で割った値。 目安として |SMD| < 0.1 なら良バランス、 0.25 を超えたら要注意とされる。
本ページ上部の実値計算(関東+関西 13 県 = treatment、 残り 34 県 = control、 SSDSE-B-2026 の 2023 年)を、 この「校正」の目で見直すと次のようになる(下記はすべて実測値)。
| 背景変数(2023 年) | treatment 13 県 平均 | control 34 県 平均 | SMD | 判定 |
|---|---|---|---|---|
| 総人口 (A1101) | 4,906,923 人 | 1,781,265 人 | +1.03 | ❌ 大きく不均衡 |
| 高齢化率 (A1303/A1101) | 29.0 % | 32.6 % | −1.20 | ❌ 大きく不均衡 |
| 消費支出 (L3221)=アウトカム | 304,629 円 | 292,502 円 | +0.50 | (比較対象の差そのもの) |
SMD が 1 前後というのは「分布がほぼ重ならない」レベルの不均衡である。 つまりこの 34 県は、 人口規模でも高齢化率でも 13 県とは別世界の集団であり、 校正されていない体重計で量った +12,128 円の差を「都市圏効果」と呼ぶことはできない。
⚠️ 落とし穴(重要)— 「介入前から差があった」を見逃す
もう一つの強力な診断がプレ期間チェック(プラセボ検定の一種): 「介入がまだ効いていないはずの過去時点で、 すでに群間差があったか」を測る。 SSDSE-B-2026 の時系列(2012–2023 年)で同じ 13 県 vs 34 県の消費支出 (L3221) 差を測ると(実測値):
- 2012 年(プレ期間): treatment 288,502 円 − control 285,963 円 = +2,538 円 — 介入前からすでに差がある
- 2023 年: 304,629 円 − 292,502 円 = +12,128 円
- 差の変化(DID 風): 12,128 − 2,538 = +9,589 円 — 「もともとの差」を差し引いた後に残る部分
2023 年の断面だけ見た人は +12,128 円をすべて「効果」と誤読するが、 うち約 2,500 円は介入以前から存在した恒常的な差である。 プレ期間の差がゼロでない対照群をそのまま使うことが、 実務で最も頻発する見逃しであり、 前セクションの落とし穴(セレクションバイアス等)が「起きてしまった後」にそれを検出できるのがこの診断である。 なお SSDSE の 13 県 vs 34 県には実際の「介入」は存在しないため、 この +9,589 円も因果効果ではなく診断デモである点に注意。
さらに注意すべきは、 バランス診断に「合格」しても安心できないこと。 SMD で確認できるのは観測済み変数のみで、 未観測の交絡(例: 地域の物価水準や消費文化)は原理的に検出できない。 診断は「不合格を見つける」道具であって「合格を保証する」道具ではない、 という非対称性が肝である。
🚀 発展 — 対照群を「削って」校正する
不均衡が見つかったときの素朴で強力な処方箋がトリミング(対照群の絞り込み): 処置群の背景変数の範囲(共通サポート)に入る対照だけを残す。 実測でやってみると、 treatment 13 県の高齢化率は 22.75–34.19 % の範囲にあるので、 control 34 県のうち高齢化率がこの上限以下の 24 県だけを対照に残すと、 対照側の消費支出平均は 293,479 円となり、 群間差は +12,128 円 → +11,150 円へ縮む。 差の一部(約 1,000 円)は「高齢化率が極端に高い県を対照に含めていたこと」の産物だったと分かる。
この「診断 → 絞り込み → 再測定」の反復を体系化したものが傾向スコアマッチングや重み付け (IPW) であり、 プレ期間チェックを推定量そのものに組み込んだのが差の差分法 (DID)、 対照群を複数県の加重平均として最適合成するのが Synthetic Control Method である。 いずれも根っこは同じで、 「対照群の質を数値で語る」文化の延長線上にある。 論文や報告書では、 効果推定値の前に必ず Table 1(バランス表)を置く — それがこの文化の作法である。
🔗 関連ページ
- 差の差分法 (DID) — プレ期間の差を推定量に組み込む定番手法
- 交絡 — バランス診断が検出しようとしているもの
- 選択バイアス — 不均衡な対照群が生まれる根本原因
- 効果量 — SMD は効果量 (Cohen の d) と同じ計算構造
- 自然実験 — 「良い対照群が偶然できる」状況を利用する発想
- A/B テスト — ランダム化により診断が原則不要になる設計
- 傾向スコアマッチング・Synthetic Control Method(本用語集に単独ページなし。 パネルデータ因果推論を参照)