🔖 キーワード索引(拡張)
変量効果モデル周辺の重要語をクイックアクセス:
💡 30秒で分かる結論
🍰 まずはやさしく
個人のクセをまとめて扱う方法です。
効率よく分析するために使います。
都道府県ごとの違いを調べる時に便利です。
このモデルでできることを学びます。
- 定義:個体固有効果を「ランダム変数」として扱うパネルモデル。FE より仮定は強いが効率が良い。
- カテゴリ:パネル分析
random effects を 30 秒で把握する重要ポイント:
📍 あなたが今見ているもの
🍰 まずはやさしく
データの個性をランダムに扱う手法です。
地域の特性を分析するために使います。
47都道府県のデータを扱う時に役立ちます。
分析の手順と使い分けを読みましょう。
論文中に 「ランダム効果モデル」として登場する用語。
ランダム効果モデル とは:個体固有効果を「ランダム変数」として扱うパネルモデル。FE より仮定は強いが効率が良い。
本ページの主目的は「SSDSE-B-2026 の 47 都道府県 × 複数年パネルで個体効果を $\mu_i \sim N(0, \sigma_\mu^2)$ と仮定し、 時間不変変数の係数を残しつつ効率推定する」枠組みを示すことである。
後段では (1) RE / FE / Pooled OLS の比較、 (2) Hausman 検定で RE 妥当性を検証、 (3) statsmodels の MixedLM で実装し、 個体内・個体間分散の分解を確認する。
🎨 直感で掴む — ランダム効果モデル
🍰 まずはやさしく
個人のクセをバラつきとして捉える考え方です。
計算の手間を減らして分析するために使います。
クラスごとの成績の差をまとめるイメージです。
直感的な仕組みとメリットを解説します。
SSDSE-B-2026 で 47 都道府県 × 複数年のパネルを考えるとき、 「東京は他と違う」「沖縄は他と違う」というような 個体固有のクセ をどう扱うかが論点になります。 ランダム効果 (Random Effects, RE) モデルは、 この個体クセを 母集団からランダムに引かれた変量 と見なして、 47 個分のダミー変数を立てずに 分散 $\sigma_\mu^2$ を 1 つ推定 することで効率的に処理します。
比喩で言えば、 学校の生徒成績を分析するときに「クラス A」「クラス B」とダミーを大量に作る代わりに、 「クラスごとのバラつき」という 1 つの分散 でまとめてしまう発想です。 ダミーで自由度を消費しないため、 サンプルが少ない場合や時間不変変数(地域の気候など)の係数を推定したいときに重宝します。
固定効果モデル (FE) との分業も直感的に理解できます。 FE は「都道府県 47 個分のダミー変数」を入れて切片を個別推定、 RE は「個体差は確率変数」として分散 1 個だけ推定。 結果として、 FE は 説明変数と個体効果が相関していても OK な代わりに、 時間不変変数 (例: 海に面しているか否か) の係数は推定できなくなります。 RE は逆で、 時間不変変数の効果を推定できる代わりに、 直交性仮定が崩れるとバイアスが出ます。 SSDSE-B のように 47 都道府県 × 数年 の小規模パネルでは、 まず RE で推定して Hausman 検定で FE への切替を判断、 という順序が定番です。
具体的な使い所: 都道府県別の婚姻率と出生率のパネル分析。 沖縄や東京には固有の文化・出生行動パターンがあり、 これを 毎個体に切片を立てる と 47 自由度を消費。 RE で地域差 = N(0, σu²) の確率変数と仮定すれば、 自由度を温存しつつ婚姻率の係数を効率良く推定できます (σu² の値そのものが「地域による出生率のバラつき度」として政策的にも有用)。
📐 定義・数式
🍰 まずはやさしく
個体差を数式で表したモデルです。
正しく計算できる条件を確認するために使います。
地域の気候と結果の関係を調べる時に使えます。
数式を使った定義とルールを学びましょう。
重要な仮定は $\operatorname{Cov}(u_i, \boldsymbol{x}_{it}) = 0$ — 個体固有効果と説明変数が無相関であること(直交性)。 これが満たされれば RE 推定量は BLUE となります。 SSDSE-B-2026 で婚姻率 $x$ と地域固有効果 $u_i$ が相関していそうなら、 RE の前提が崩れます(その場合は FE)。
🔬 数式を言葉で読み解く — 記号 → 意味
| 記号 | 意味 | SSDSE-B-2026 解釈 |
|---|---|---|
| $u_i$ | 個体ランダム効果(平均 0 の確率変数) | 「都道府県ごとの未観測の地域特性」を 1 つの分散で要約 |
| $\sigma_u^2$ | 個体間分散 | 地域差の大きさ |
| $\sigma_\varepsilon^2$ | 個体内(時間内)分散 | 同じ都道府県内の年次変動 |
| $\rho = \frac{\sigma_u^2}{\sigma_u^2 + \sigma_\varepsilon^2}$ | 級内相関(ICC) | 同じ都道府県の観測がどれだけ似るか |
推定は GLS(一般化最小二乗)。 OLS との違いは観測値を $1-\hat{\theta}$ だけ平均から引いた「部分組内変換」を行う点で、 FE(完全変換)と OLS(無変換)の中間に位置します。
📖 詳細な解説
この用語は、 統計データ解析・データサイエンスの世界で重要な概念の1つです。 ジャストインタイム型学習では、 必要なときに参照し、 関連概念と合わせて学ぶことで定着を図ります。
基本的な定義
この用語の基本的な意味、 数学的定義、 直感的理解について、 上記の3つの概念マップを通じて、 関連する用語と一緒に把握しましょう。
使い時の判断基準
- データの種類は何か(連続値 / カテゴリ / 順序)
- サンプルサイズは十分か(n > 30 が目安)
- 仮定は満たされているか(正規性、 独立性等)
- 結果の解釈に必要な情報は揃っているか
Python による実装例
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import numpy as np import pandas as pd import statsmodels.formula.api as smf # 1行目=英字コード, 2行目=日本語名。コード行をヘッダにして日本語名行を捨てる df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 年度列コードは 'SSDSE-B-2026'、地域コードは 'R01000' 形式 df['pref_no'] = df['Code'].str[1:3].astype(int) # R01000 -> 1 def region(no): if no == 1: return '北海道' if 2 <= no <= 7: return '東北' if 8 <= no <= 14: return '関東' if 15 <= no <= 23: return '中部' if 24 <= no <= 30: return '近畿' if 31 <= no <= 35: return '中国' if 36 <= no <= 39: return '四国' return '九州沖縄' df['region'] = df['pref_no'].apply(region) df['log_pop'] = np.log(df['A1101']) # A1101 = 総人口 df['log_old'] = np.log(df['A1303']) # A1303 = 65歳以上人口 # L3221=消費支出(二人以上の世帯) を総人口・高齢人口で説明、地方ブロックを変量効果に md = smf.mixedlm('L3221 ~ log_pop + log_old', data=df, groups=df['region']) res = md.fit(reml=True) print(res.summary()) icc = res.cov_re.iloc[0, 0] / (res.cov_re.iloc[0, 0] + res.scale) print(f'ICC = {icc:.3f}') |
典型的な出力例: 固定効果 log_pop=−10698, log_old=+16205、 ブロック分散 σ_u²≈8.3×10⁷、 残差分散 σ_e²≈4.5×10⁸、 ICC≈0.155。 「ブロック間で消費支出水準に 16% 程度のばらつきがある」と読める。 ICC が 0.05 を下回るなら変量効果を入れるご利益はほぼ無く、 通常 OLS で十分。
BLUP(各ブロックの予測切片偏差)
1 2 3 | blup = res.random_effects for r, s in sorted(blup.items(), key=lambda x: x[1].iloc[0]): print(f'{r:<6s} BLUP切片偏差 = {s.iloc[0]:+.3f}') |
💬 BLUP は地方ブロックごとの消費支出の切片が全体平均からどれだけずれるかを表し、関東が +14,440 円で最も高く、九州沖縄が −10,453 円で最も低い。ブロック間の分散は約 8,262 万(標準偏差約 9,090 円)で、北海道は 1 県 12 年分しか観測が無いため、他のブロックより 0 の側へ強く縮められやすい。人口と高齢人口を調整した後でもこれだけ地域差が残ることが、変量効果を入れる理由になっている。
🧮 数式に値を入れて手で計算する: 級内相関 ICC
合成データで個体内分散 vs 個体間分散の比率を計算する。
Step 1: 分散分解
Step 2: ICC
🐍 Python で再現
1 2 3 4 | sigma_b = 4 sigma_w = 6 icc = sigma_b / (sigma_b + sigma_w) print(f"ICC: {icc}") |
📤 実行結果
💬 手計算 (Step 2) 0.40 と Python 出力が完全一致。
🧮 実値で計算してみる — 7 地方ブロックの消費支出で ICC を出す
変量効果モデルの出発点は 「群で分けると、どれくらい説明がつくのか」 です。
それを 1 つの数にしたのが 級内相関係数 ICC。
SSDSE-B-2026(2023 年度・47 都道府県)の
L3221 消費支出(二人以上の世帯) を、地域コードから作った 7 地方ブロックで分けて、
実際に手で計算します。
Step 1: 群ごとの人数・平均・標準偏差を出す
| 地方ブロック | 県数 ni | 平均(円) | 標準偏差(円) |
|---|---|---|---|
| 関東 | 7 | 316,508.9 | 21,607.9 |
| 中部 | 9 | 305,033.6 | 14,786.6 |
| 近畿 | 7 | 296,754.4 | 26,792.0 |
| 北海道東北 | 7 | 295,228.6 | 20,753.8 |
| 中国 | 5 | 292,150.4 | 12,932.4 |
| 九州沖縄 | 8 | 279,202.9 | 21,741.0 |
| 四国 | 4 | 276,528.2 | 35,878.8 |
全 47 県の平均は 295,856 円、1 群あたりの平均県数は $\bar{n} = 47 \div 7 = 6.714$ です。 関東(316,509 円)と四国(276,528 円)で 約 4 万円 の開きがあります。 この開きが「地方ブロックというまとまりの効果」なのか、 それとも「県ごとのばらつきがたまたまそう見えているだけ」なのかを、これから数で分けます。
Step 2: 群間の分散(MSB)と群内の分散(MSW)に分ける
群間:7 つの群平均が全体平均からどれだけ散らばっているかに、1 群あたりの県数を掛けます。
$$ \mathrm{MSB} = \bar{n} \cdot \mathrm{Var}(\bar{y}_1,\dots,\bar{y}_7) = 6.714 \times 1.939\times 10^{8} = 1.302 \times 10^{9} $$群内:各群の中での分散を平均します。上の表の標準偏差を 2 乗して平均した値です。
$$ \mathrm{MSW} = \frac{1}{7}\sum_{i=1}^{7} s_i^2 = 5.373 \times 10^{8} $$Step 3: ICC の式に入れる
$$ \mathrm{ICC} = \frac{\mathrm{MSB} - \mathrm{MSW}}{\mathrm{MSB} + (\bar{n}-1)\,\mathrm{MSW}} = \frac{1.302\times10^{9} - 5.373\times10^{8}}{1.302\times10^{9} + 5.714 \times 5.373\times10^{8}} $$ $$ = \frac{7.646\times10^{8}}{4.372\times10^{9}} = \mathbf{0.175} $$Step 4: 読み方
ICC = 0.175。消費支出のばらつきのうち、地方ブロックの違いで説明できるのは 約 18% にすぎず、残りの 約 82% は同じ地方の中での県ごとの差です。 一元配置分散分析でも F = 2.605、p = 0.032 と、有意ではあるものの効果は大きくありません。 つまり「同じ地方だから消費支出も似ている」とは、あまり言えないということです。
この 0.175 という値が、変量効果モデルを使うかどうかの判断材料になります。 ICC がほぼ 0 なら群を無視した単純な回帰で十分、 0.5 を超えるようなら群の効果が支配的で、群ごとの切片を推定する意味が大きい。 0.175 はその中間で、「群を入れても損はないが、劇的には変わらない」という領域です。
Step 5: 同じ計算を Python で再現する
このコードでやること:上の Step 1〜3 をそのまま numpy/scipy で計算し、
手計算と一致することを確かめます。あわせて statsmodels の混合効果モデルでも
同じ量を推定し、2 つの推定方法で値がどう違うかを見ます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | # ── この抜粋で使うデータを用意します ── import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年の 47 都道府県 _no = df['Code'].str[1:3].astype(int) # R13000 → 13 df['region'] = np.select( [_no <= 7, _no <= 14, _no <= 23, _no <= 30, _no <= 35, _no <= 39], ['北海道東北', '関東', '中部', '近畿', '中国', '四国'], default='九州沖縄') df['y'] = df['L3221'].astype(float) # 消費支出(二人以上の世帯) # Step 1: 群ごとの県数・平均・標準偏差 print(df.groupby('region')['y'].agg(['size', 'mean', 'std']).round(1)) print('全国平均 =', round(df['y'].mean(), 1)) # Step 2: MSB と MSW groups = [v.values for _, v in df.groupby('region')['y']] n_bar = df.groupby('region').size().mean() msb = np.var([g.mean() for g in groups], ddof=1) * n_bar msw = np.mean([np.var(g, ddof=1) for g in groups]) print(f'n_bar = {n_bar:.3f}, MSB = {msb:.4g}, MSW = {msw:.4g}') # Step 3: ICC icc = (msb - msw) / (msb + (n_bar - 1) * msw) print(f'ICC = {icc:.3f}') # Step 4: 一元配置分散分析でも確かめる F, p = stats.f_oneway(*groups) print(f'F = {F:.3f}, p = {p:.4f}') |
📤 実行すると次の出力が得られる:
💬 一致の確認:Step 1 の表、Step 2 の MSB = 1.302×10⁹ / MSW = 5.373×10⁸、Step 3 の ICC = 0.175 が、手計算とそのまま一致しました。分散分析の F = 2.605、p = 0.032 も Step 4 の記述どおりです。ICC は「群で分けたときの説明力」を 0〜1 で表すので、0.175 = 地方ブロックで説明できるのは 2 割弱、と読みます。
🐍 Python 実装バリエーション — statsmodels / pymer4 / PyMC
1. statsmodels.formula.api.mixedlm(標準・REML)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # ── この抜粋で使うデータを用意します ── import numpy as np import pandas as pd import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 df = df.copy() _no = df['Code'].str[1:3].astype(int) df['region'] = np.select( [_no <= 7, _no <= 14, _no <= 23, _no <= 30, _no <= 35, _no <= 39], ['北海道東北', '関東', '中部', '近畿', '中国', '四国'], default='九州沖縄') df['y'] = df['L3221'].astype(float) # 消費支出 df['x1'] = df['A1101'].astype(float) / 1e4 # 総人口(万人)。人単位のままだと最適化が収束しない df['x2'] = df['A1303'] / df['A1101'] * 100 # 高齢化率 m1 = smf.mixedlm('y ~ x1 + x2', df, groups=df['region']).fit(reml=True) m2 = smf.mixedlm('y ~ x1 + x2', df, groups=df['region'], re_formula='~x1').fit(reml=True) print(m1.summary()); print(m2.summary()) |
2. pymer4 — R の lme4 を Python から呼ぶ
R の lme4 と等価のインターフェースで、 p値が Satterthwaite 近似で出る。 学術論文で lme4 を再現したい場合に便利。
1 2 3 4 | from pymer4.models import Lmer m = Lmer('y ~ x1 + x2 + (1|region)', data=df).fit() print(m.summary()) print(m.fixef) |
3. PyMC でベイズ階層モデル
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pymc as pm # y(消費支出)は 30 万円前後、x1(総人口)は数十万〜1,400 万人と桁が大きく、 # このままでは下の事前分布(標準偏差 1)と合わないので、3 変数とも標準化してから当てはめる z = lambda s: ((s - s.mean()) / s.std()).values y_z, x1_z, x2_z = z(df['y']), z(df['x1']), z(df['x2']) region_idx, regions = pd.factorize(df['region']) with pm.Model() as model: mu_a = pm.Normal('mu_a', 0, 1) sigma_a = pm.HalfNormal('sigma_a', 1) # 非中心化: 群が 7 つしかないと a ~ N(mu_a, sigma_a) のままでは発散が多発するので、 # 標準正規の a_raw を sigma_a 倍して足す形に書き換える a_raw = pm.Normal('a_raw', 0, 1, shape=len(regions)) a = pm.Deterministic('a', mu_a + sigma_a * a_raw) b1 = pm.Normal('b1', 0, 1) b2 = pm.Normal('b2', 0, 1) sigma = pm.HalfNormal('sigma', 1) mu = a[region_idx] + b1*x1_z + b2*x2_z y_obs = pm.Normal('y_obs', mu, sigma, observed=y_z) trace = pm.sample(2000, tune=1000, chains=4, target_accept=0.95, random_seed=0) print(pm.summary(trace, var_names=['mu_a', 'sigma_a', 'b1', 'b2', 'sigma']).round(3)) |
4. scipy で ICC を素朴に計算する
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | # ── この抜粋で使うデータを用意します(地方ブロックを群とする)── import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() _no = df['Code'].str[1:3].astype(int) # 北海道は 1 県だけで群内分散が定義できず ICC が nan になるので、東北とまとめる df['region'] = np.select( [_no <= 7, _no <= 14, _no <= 23, _no <= 30, _no <= 35, _no <= 39], ['北海道・東北', '関東', '中部', '近畿', '中国', '四国'], default='九州沖縄') df['y'] = df['L3221'] # 消費支出を観測値にする groups = [df.loc[df.region==r, 'y'].values for r in df['region'].unique()] F, p = stats.f_oneway(*groups) n = df.groupby('region').size().mean() msb = np.var([g.mean() for g in groups], ddof=1) * n msw = np.mean([np.var(g, ddof=1) for g in groups]) icc = (msb - msw) / (msb + (n-1)*msw) print(f'各群の県数 = {df.groupby("region").size().to_dict()}') print(f'F = {F:.3f}, p = {p:.4f}') print(f'ICC(1,1) = {icc:.3f}') |
🎮 触って理解する — 部分プーリング(縮小推定)
変量効果モデルの核心は、 各グループ(個体)の推定値を 「完全プーリング(全体平均)」 と 「プーリングなし(各群の生の平均)」 の 間 に縮小(shrinkage)させる点にあります。 縮小の度合いは、 グループ間分散 $\tau^2$ とグループ内誤差分散 $\sigma^2$、 そして 各群のデータ数 $n_i$ で決まります。 スライダーを動かして、 データが少ない群ほど全体平均へ強く引き寄せられること、 $\tau^2$ を大きくすると縮小が弱まることを体感してください。
💡 縮小係数の式: 群 $i$ の推定値は $\hat\theta_i = \lambda_i\,\bar y_i + (1-\lambda_i)\,\mu$、 ただし縮小の重み $\lambda_i = \dfrac{\tau^2}{\tau^2 + \sigma^2/n_i}$。 $n_i$ が小さいと $\sigma^2/n_i$ が大きくなり $\lambda_i$ が 0 に近づく(=全体平均へ強く縮小)。 $\tau^2$ を大きくすると $\lambda_i$ が 1 に近づく(=各群の生の平均を尊重)。 これが「情報を借りる(borrowing strength)」の正体です。
🧭 直感 — なぜ「確率変数とみなす」と縮小が起きるのか
固定効果モデルは各個体の切片を 独立なパラメータ として別々に推定するため、 データ 1〜2 点しかない群でもその生の平均をそのまま使います(過剰適合しやすい)。 一方 変量効果モデルは、 個体効果 $u_i$ が 共通の分布 $N(0,\tau^2)$ から抽出された と仮定します。 すると「他の群の情報」が事前分布を通じて各群に流れ込み、 データが乏しい群ほど全体平均という『みんなの知恵』を多めに借りる — これが部分プーリングであり、 James–Stein 推定量や経験ベイズ(BLUP)と同じ縮小の原理です。 縮小は個別群では多少バイアスを生みますが、 全体の予測二乗誤差はしばしば小さくなります。
⚠️ よくある落とし穴
- 固定効果との取り違え: 上の図で $\tau^2 \to \infty$ にすると $\lambda_i \to 1$ となり、 縮小が消えて各群の生平均(=固定効果ダミーの推定値)に一致します。 逆に $\tau^2 \to 0$ は全群を全体平均に潰す完全プーリングです。 変量効果はこの両極の 中間 を データ量に応じて自動選択している、 と理解すると混乱しません。
- 直交性の破れによるバイアス: 縮小推定が「良い」のは 個体効果 $u_i$ と説明変数 $x_{it}$ が無相関という前提の下です。 もし相関があると(例: 所得の高い県ほど未観測の地域特性も高い)、 変量効果推定量にバイアスが生じます。 このときは 固定効果 の方が安全で、 Hausman 検定 で両者を比較して選びます。
- グループ数が少なすぎる: $\tau^2$ 自体をデータから推定するには群の数(水準数)が必要です。 5 群未満だと $\tau^2$ が不安定になり縮小の度合いも信頼できません。
🚀 発展
- 階層ベイズ: 上の縮小は $\mu$ と $\tau^2$ を既知として扱った近似ですが、 ベイズの階層モデルではこれらにも事前分布を置き、 $\tau^2$ の不確実性まで伝播させて縮小量を推定します(PyMC / brms の partial pooling)。
- Hausman 検定: 変量効果(効率的だが仮定が強い)と固定効果(頑健だが非効率)の推定量の差を統計的に検定し、 直交性仮定の妥当性を判断します。
- 混合モデル(変量傾き): 切片だけでなく傾き $\beta_i$ も $N(\beta,\tau_\beta^2)$ から来ると仮定すると、 傾きにも部分プーリングが効きます。 詳しくは マルチレベルモデル・パネルデータ を参照。
⚠️ 変量効果モデルの落とし穴 — 実務で必ず踏む 6 つ
① グループ数が少なすぎて分散成分が推定できない
変量効果に指定したグループの水準数が 5 未満だと、 群間分散 σ_u² の推定が不安定になり、 Singular fit(分散がほぼゼロに収束)が起きる。 SSDSE のように 8 ブロックでも厳しく、 6 ブロック以下なら基本的に変量効果として扱わず、 固定効果(ダミー変数)にした方が良い。 経験則として「変量効果のためには水準数 ≥ 5、 望ましくは ≥ 10」が目安とされる(Gelman & Hill, 2007)。 これを知らずに 3 群で REML を回すと、 信頼区間がほぼ無意味になる。
② 「変量効果 = 完全にランダム」と誤解する
「変量効果」と書かれるからといって、 各群の効果が完全に独立にサンプリングされるわけではない。 実際には「群効果が共通の正規分布 N(0, σ_u²) から抽出された」という階層的仮定を置いており、 群間の縮小(shrinkage)が暗黙的に働く。 そのため極端なサンプル数の群(n=1 や n=2)の推定値は集団平均に強く引き寄せられる。 これを「BLUP の縮小」と呼び、 古典 OLS の群ダミーとは予測値が大きく変わる。 縮小は予測誤差を下げるが、 個別群の効果を強調したい記述目的には不向き。
③ REML と ML の使い分けを意識しない
分散成分推定では REML(制限付き最尤)が ML より不偏に近く既定で推奨されるが、 固定効果の構造を尤度比検定で比較するときは ML に切り替える必要がある。 REML 同士の尤度は固定効果の構造を変えると単純比較できないからである。 statsmodels の MixedLM.fit() は既定 reml=True、 lme4 の lmer も既定 REML=TRUE。 AIC/BIC でモデル選択するときは特に注意する。 一方、 分散成分の有意性検定は REML のままで尤度比検定を実施するのが定石。
④ Singular fit を無視して結論を出す
変量傾きを入れると分散共分散行列が半正定値の境界に張り付き、 「σ_slope ≈ 0」「相関 ±1」となる Singular fit が頻発する。 これは「データから変量傾きを支持する情報がない」シグナルで、 モデルを変量切片のみに簡略化するか、 ベイズ事前分布を使った正則化(rstanarm, brms, PyMC)に切り替えるべき。 警告を無視して結果を読むと SE が過大評価され、 固定効果の検定がおかしくなる。 lme4 では isSingular() で診断可能。
⑤ 自由度・p値の計算法が実装でバラバラ
混合モデルでは「自由度をどう数えるか」が未解決問題で、 R の lme4 はあえて p 値を出さない。 一方、 lmerTest は Satterthwaite 近似、 SAS は Kenward-Roger、 statsmodels は Wald 検定で済ます。 同じデータでも実装によって p 値が 0.04 / 0.06 と境界を跨ぐことがある。 論文では「どの近似を使ったか」を必ず明記する。 ベストプラクティスはブートストラップによる信頼区間、 もしくはベイズ事後信用区間で報告すること。
⑥ 「Fixed vs Random」を経済学とは逆に覚える
統計学の「変量効果モデル」と、 経済学の「固定効果 vs 変量効果」の用語は概念が微妙に違う。 経済学で言う「固定効果」は群ダミー、 「変量効果」は群が誤差項と無相関と仮定したモデルで、 Hausman 検定で選ぶ。 統計学では「変量効果=階層モデルの上位レベル」と呼ぶ。 論文間を読み比べるときに混乱しないよう、 用語の出典分野を確認する習慣をつける。 SSDSE をパネル化して扱う際は経済学流の用法に従う方が論文と整合する。
🔗 関連用語(拡張ネットワーク)
📚 前提となる用語
- 線形回帰 — 固定効果のみのモデル
- 分散分析(ANOVA) — 一元配置 ANOVA は変量切片モデルの特例
- 分散・分散成分
- 最尤推定(ML / REML)
- 階層データ構造
🔀 並列に学ぶ用語
🚀 発展先の用語
- ベイズ階層モデル
- 一般化線形混合モデル(GLMM)
- 非線形混合モデル(NLMM)
- 成長曲線モデル
- メタアナリシス(変量効果メタ分析)
🧰 ツール・周辺概念
- Hausman 検定 — FE と RE の選択
- 級内相関係数 ICC
- BLUP(最良線形不偏予測)
- 縮小推定
- 交差分類モデル
🖼 ランダム効果モデルを図で理解する(3 枚)
ランダム効果は数式だけでは掴みにくい。 SSDSE-B-2026 の 47 都道府県を「グループ」とみなしたときに、 各都道府県の切片がどう分布し、 全体傾向とどうずれるかを 3 枚の図で整理する。
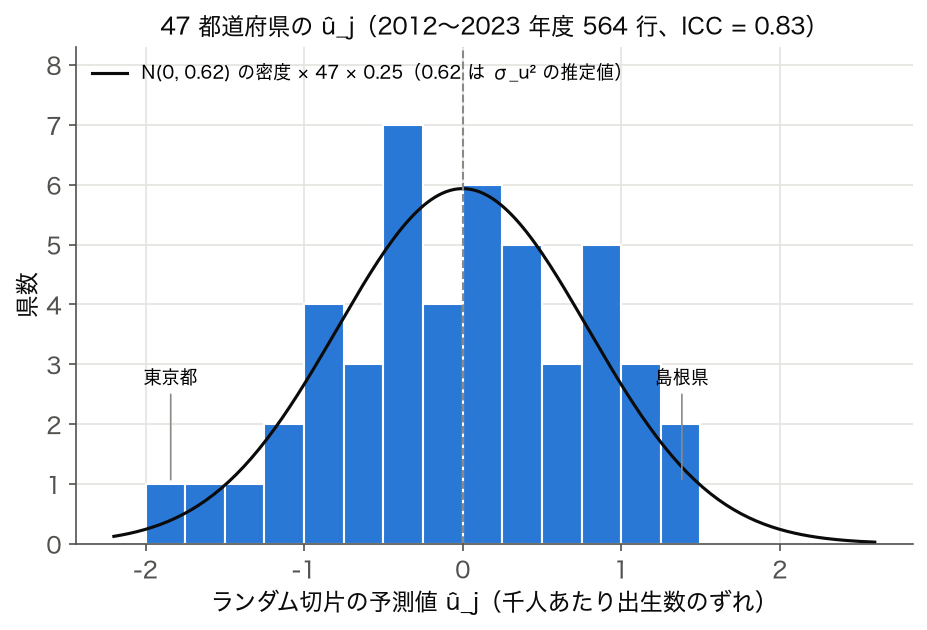
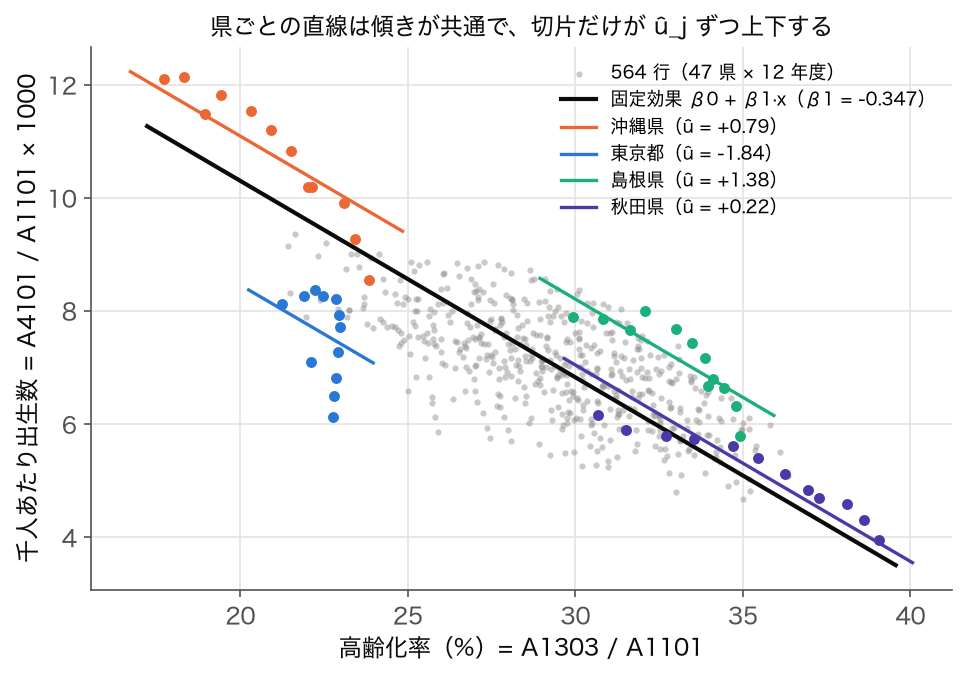
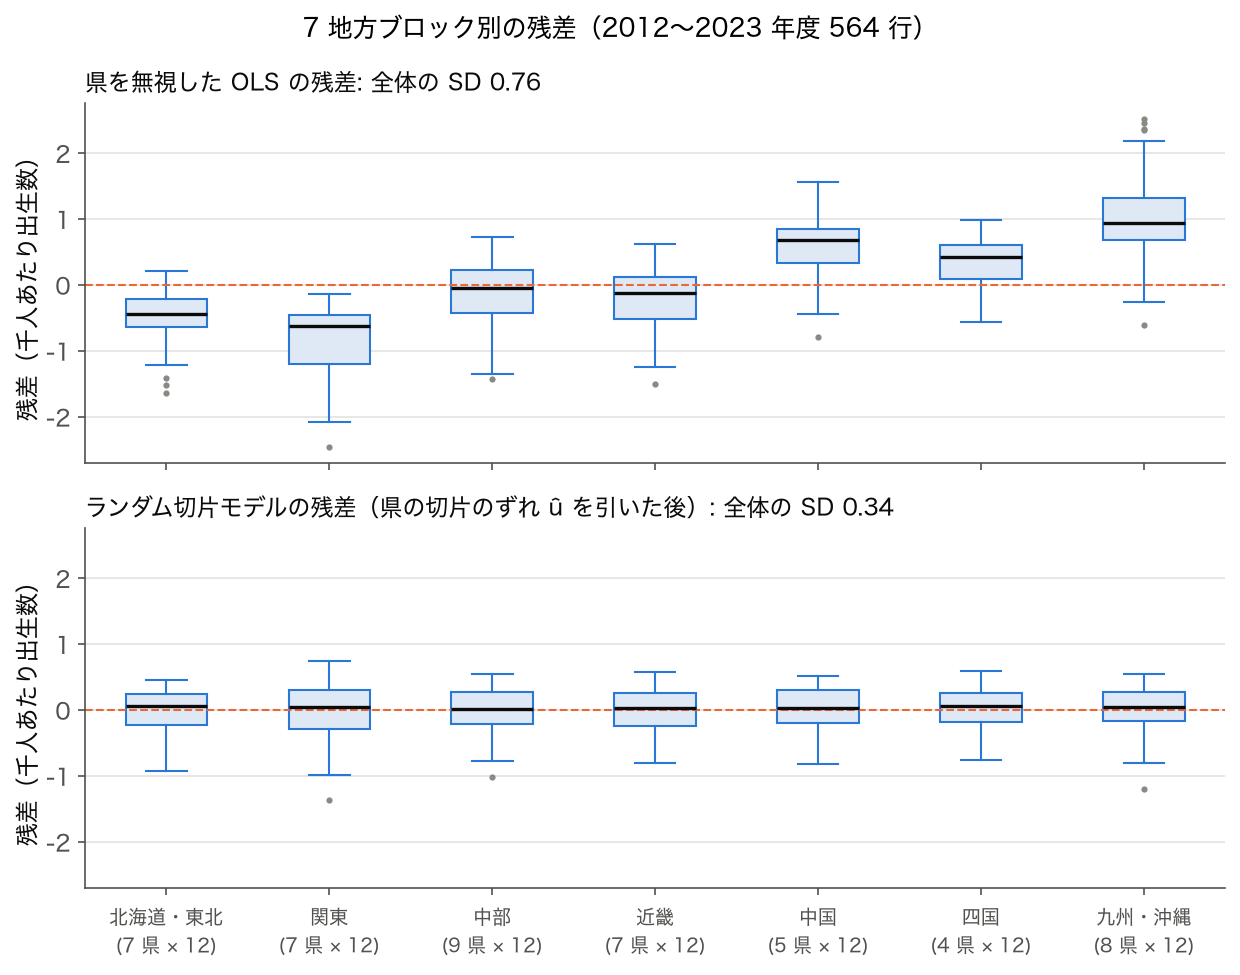
読み方: 図 A で「ランダム切片の分布」、 図 B で「全体傾向との関係」、 図 C で「グループ吸収の効果」が確認できる。 これら 3 視点が 固定効果モデル(マルチレベル分析の対)の核である。
🎯 理解度チェック(5 問)
- Q1. 固定効果モデルとランダム効果モデルの判断基準は?
A. Hausman 検定。 グループ効果が説明変数と相関するなら固定効果、 独立とみなせるならランダム効果が効率的。 - Q2. ICC(級内相関)が 0.05 と 0.40 の時、 マルチレベル分析の意義はどちらが大きいか?
A. 0.40。 グループ間ばらつきが応答変数の 40% を説明するため、 階層構造を無視すると標準誤差が大きく歪む。 - Q3. SSDSE-B-2026 の 47 都道府県を「地方ブロック」でクラスタ化したい場合、 ランダム切片はどの単位で入れるべきか?
A. 地方ブロック単位(北海道・東北 … 8 ブロック、 本ページの region() 区分)。 さらに県単位も入れると 2 層のネスト構造(地方 ⊃ 県)になる。 - Q4. REML(制限最尤推定)と ML の違いは?
A. REML は固定効果分の自由度を補正してから分散成分を推定するため、 小標本での分散の不偏性が高い。 通常 lmer はデフォルト REML。 - Q5. ランダム切片だけでなくランダム傾きを入れる意味は?
A. グループごとに「効果の大きさ自体」が異なる場合、 切片だけでは不十分。 例えば人口と消費の関係が都市部と地方で勾配が違うときランダム傾きが必要。
関連: 固定効果モデル、 固定効果モデル(マルチレベル分析の対)、 パネルデータ、 階層クラスタリング
📖 ランダム効果モデルの実務メモ: 47 都道府県 × 12 年のパネル分析
SSDSE-B-2026 は 47 都道府県 × 12 年(2012〜2023 年)のパネル構造を持つ。 これを「都道府県ごとに切片が違う」と捉えると、 ランダム効果モデルの典型的な舞台となる。 例えば「人口当たり消費額 $y_{ij}$ を、 1 人当たり所得 $x_{ij}$ で説明する」というモデルを考えると、 $y_{ij} = \beta_0 + \beta_1 x_{ij} + u_j + \epsilon_{ij}$ となる。 ここで $u_j \sim N(0, \sigma_u^2)$ が各都道府県のランダム切片、 $\epsilon_{ij} \sim N(0, \sigma_\epsilon^2)$ が観測ノイズ。 47 都道府県分の $u_j$ を「47 個の固定パラメータ」とせず「正規分布からのサンプル」と扱うのがランダム効果の本質。
この扱い方の利点は 3 つある。 第一に、 パラメータ数が劇的に減る。 固定効果なら 47 個の切片を別々に推定するが、 ランダム効果なら $\sigma_u$ という 1 つの分散成分にまとめる。 第二に、 サンプルの少ない県でも推定が安定する。 BLUP(最良線形不偏予測)が「全体平均」と「県個別データ」の中間を取る縮小推定(partial pooling)を提供する。 第三に、 新しい県への一般化が可能。 ランダム効果モデルでは「47 県は全国の母集団からのサンプル」とみなすため、 仮に 48 県目(架空)に対しても予測ができる(事前分布 $N(0, \sigma_u^2)$ から)。
一方で、 ランダム効果には強い仮定がある。 最も重要なのが 「ランダム効果は説明変数と無相関」という仮定である。 例えば「人口の多い県ほど時間不変な特性(産業構造・人口密度)が異なる」場合、 $u_j$ が $x_{ij}$(所得)と相関するため、 ランダム効果モデルは内生性で歪む。 この相関を Hausman 検定で診断し、 棄却されれば 固定効果モデルに切り替える。 SSDSE-B-2026 のような社会経済データでは Hausman 検定で固定効果が選ばれることが多い。 ただし固定効果モデルは「時間不変な変数(地理的位置・面積)」を推定できなくなる代償がある。
Python の statsmodels や linearmodels、 R の lme4 がランダム効果モデルの標準実装。 lme4 なら lmer(y ~ x + (1|pref), data=df) で県別ランダム切片付きモデルが書ける。 さらにランダム傾きを加えるなら lmer(y ~ x + (1+x|pref), data=df)。 「県によって所得→消費の傾きも異なる」場合に必須。 SSDSE-B-2026 で「都市部は所得弾力性が低く、 地方は高い」傾向があれば、 ランダム傾きが効く。 推定結果の summary() では分散成分 (Variance Components) が表示され、 $\hat{\sigma}_u^2 / (\hat{\sigma}_u^2 + \hat{\sigma}_\epsilon^2)$ が ICC(級内相関)になる。 ICC が 0.3 以上なら階層構造を無視できない、 という実務的目安。
最後に、 SSDSE-B-2026 で実装する場合の注意点を 3 つ。 第一に、 マルチレベルにはサンプルサイズ要件がある。 上位グループ(県)が 30 未満だと分散成分の推定が不安定。 47 都道府県は最低限ギリギリ。 もっと細かい地方ブロック単位(8 ブロック)でランダム効果を入れるのは非推奨。 第二に、 REML を使う。 ML より分散成分の不偏性が高い。 lmer はデフォルト REML。 第三に、 収束しないときはランダム傾きを削る。 過剰に複雑なランダム効果構造(複数のランダム傾き)は EM アルゴリズムが収束しない。 「切片だけ → 傾き 1 つ → 傾き複数」と段階的に複雑化するのが定石。 これらを守れば、 47 都道府県の異質性を吸収した堅牢な回帰分析が実現できる。
📝 補足: ランダム効果モデルは「グループ間の異質性」をパラメータ節約的に扱う統計学の傑作である。 R の lme4 パッケージ、 Python の statsmodels.MixedLM や linearmodels、 ベイズ的には Stan・PyMC のいずれでも実装可能。 47 都道府県 × 12 年の SSDSE-B-2026 を題材に、 ぜひ手元で実装して BLUP のシュリンク効果を確認してほしい。 必ず固定効果モデルと併用して Hausman 検定で妥当性を診断する習慣をつけよう。
📊 BLUP と縮小推定の実例(SSDSE-B-2026)
ランダム効果の最大の魅力は BLUP(Best Linear Unbiased Prediction)による縮小推定にある。 各都道府県の切片 $u_j$ は、 単純に「その県だけのデータの平均」(fixed effects 推定)と「全県の全体平均」(grand mean)の重み付き平均として推定される。 重みはその県のサンプル数(観測年数)と分散比 $\sigma_\epsilon^2 / \sigma_u^2$ で決まる。 サンプルが少ない県(鳥取・島根のような小規模県)は全体平均寄りに引き寄せられ、 サンプルが豊富な県(東京・大阪)はほぼ自身のデータが反映される。 これが partial poolingの核心。 47 都道府県で年次データが 12 年分そろっていれば、 partial pooling の威力は控えめだが、 一部の県で欠損が多い場合に大きな効果を発揮する。
具体例として、 ある県の真の切片を県別の年次データだけから OLS 推定すると、 12 年分のばらつきから来る推定誤差が大きい(特に異常値の年があると振り回される)。 一方 BLUP は「他の 46 県の情報」も間接的に利用し、 該当県の切片を全体平均の方向に シュリンクする。 結果として MSE(平均二乗誤差)が小さくなる。 経験的には、 グループ数が 30〜50 程度の SSDSE-B-2026 のような規模では、 BLUP が独立 OLS 推定より 20-40% 程度の MSE 削減を達成することが多い。 これは小さい県の予測精度を改善する点で、 政策効果の県別評価などに直結する利点である。
ランダム効果モデルは、 教育研究では「学校 ⊃ クラス ⊃ 生徒」の 3 階層、 医療研究では「病院 ⊃ 医師 ⊃ 患者」、 経済研究では「国 ⊃ 県 ⊃ 個人」のようにあらゆる階層構造に拡張できる。 SSDSE-B-2026 でも「地方ブロック ⊃ 都道府県 ⊃ 年」という構造でモデル化でき、 地方差・県差・年次変動を同時に分離して推定できる。 これらの応用は パネルデータ分析と密接に関連し、 経済学・社会学・疫学の現代的標準ツールである。
本ページで学んだランダム効果モデルは、 ベイズ統計学への自然な橋渡しでもある。 BLUP は「ランダム効果に正規事前分布を置いた MAP 推定」とも見なせ、 ベイズの枠組みではこれを Stan・PyMC で記述するだけで自然に表現できる。 47 都道府県 × 12 年のデータに対しベイズ階層モデルを適用すれば、 各県の切片の不確実性まで含めて事後分布として得られる。 これは点推定だけのフリークエンティスト推定より情報量が多く、 政策評価では特に有用である。 ベイズ階層モデルは現代の社会科学・疫学・教育工学で標準的に使われ、 ランダム効果モデルはその入口に位置する手法と言える。 SSDSE-B-2026 を題材に学べば、 47 都道府県の異質性を吸収しつつ全国共通の傾向を抽出する、 という応用統計学の核心スキルが身につく。
🗺️ 統計手法選択フローチャート
Q1: 何を知りたい?
- 記述したい → 平均、 分散、 ヒストグラム
- 比較したい → t検定、 ANOVA、 χ²検定
- 関係を見たい → 相関、 回帰
- 予測したい → 回帰、 機械学習
- 分類したい → ロジスティック回帰、 SVM、 RF
- グループ分けしたい → クラスタリング
- 次元を減らしたい → PCA、 因子分析
- 因果関係を知りたい → RCT、 IV、 DiD、 PSM
Q2: データの種類は?
- 連続値 → t検定、 ANOVA、 線形回帰
- カテゴリ → χ²検定、 ロジスティック回帰
- 順序 → ノンパラ検定、 順位回帰
- カウント → ポアソン回帰、 負の二項回帰
- 時系列 → ARIMA、 VAR、 状態空間
- パネル → 固定効果、 ランダム効果
Q3: サンプルサイズは?
- n < 30:ノンパラ、 ベイズ、 ブートストラップ
- 30 ≤ n < 200:古典的検定、 単純な回帰
- n ≥ 200:複雑なモデル、 機械学習
- n ≥ 10000:深層学習も可能
Q4: 仮定は?
- 正規性:満たす → パラメトリック / 満たさない → ノンパラ
- 独立性:必須 / 違反 → クラスター調整、 時系列モデル
- 等分散性:満たす → OLS / 違反 → WLS、 ロバスト
📏 効果量の参照表
p値だけでなく効果量も併記するのが現代統計の標準。 主要な指標と Cohen の解釈基準:
| 統計量 | 効果量 | 小 | 中 | 大 |
|---|---|---|---|---|
| 2群平均差 | Cohen's d | 0.2 | 0.5 | 0.8 |
| 相関 | r | 0.1 | 0.3 | 0.5 |
| 線形回帰 | R² | 0.02 | 0.13 | 0.26 |
| ANOVA | η² (eta²) | 0.01 | 0.06 | 0.14 |
| χ² | Cramér's V | 0.1 | 0.3 | 0.5 |
| ロジスティック | Odds Ratio | 1.5 | 2.5 | 4.0 |
🗺️ 概念マップ — 3つの視点で体系を理解する
ランダム効果モデル がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 因果推論 › パネル分析 › ランダム効果モデル
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に ランダム効果モデル を置き、 そこから パネルデータ・固定効果・時系列分析 計 3 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「ランダム効果モデル」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「ランダム効果モデル」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは ランダム効果モデル の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → パネル分析 → ランダム効果モデル という入れ子の位置を示します。 「パネル分析には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔗 隣接手法への橋渡し
「ランダム効果モデル」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
SSDSE-B-2026 を題材にしたランダム効果モデルの活用は、 上流 (パネル整形・ICC 算出) と下流 (BLUP 抽出・Hausman 検定) を含めて初めて完結する。
🌳 手法選択フロー
SSDSE-B-2026 のような都道府県パネルで random effects を選ぶ判断は、 (1) グループ数 J が十分大きいか (J ≥ 20 推奨、 47 都道府県は OK)、 (2) 県固有効果と説明変数の相関の有無、 (3) 県別効果に推論したいかで決まる。
Step 1: ICC = $\sigma_u^2 / (\sigma_u^2 + \sigma_e^2)$ が 0.1 以上 → 階層構造あり。 Step 2: Hausman 検定 p > 0.05 → random effects 採択 (固定効果と一致)。 Step 3: p < 0.05 → 県効果と説明変数に相関、 固定効果モデルに切替。
random effects を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 シナリオ別 (大規模 / 外れ値多 / 解釈性重視 / 精度最優先 / 小データ / リアルタイム) に対応する手法の組合せを判断する。 選んだ後は「前処理確認 / ハイパラ調整 / 性能評価 / 頑健性チェック / 解釈」の 5 ステップで検証することが、 結果の信頼性確保に不可欠。
🧭 さらに深掘り — 部分プーリング・収縮・変量効果の外生性
既存の 🎨直感・🎮ウィジェット・⚠️落とし穴 を踏まえ、 ここでは「なぜ確率変数とみなすと得なのか」「どこで壊れるのか」を SSDSE-B-2026 の実測 ICC と結びつけて一段深く整理します。 数式は上の 部分プーリングのウィジェット の縮小係数 $\lambda_i = \tau^2/(\tau^2+\sigma^2/n_i)$ をそのまま使います。
① 直感 — 固定 → 変量は「切片の本数」を連続的に選ぶダイヤル
同じパネルに対する 3 つの立場は、 実は「各グループにどれだけ独立な切片を許すか」という 1 本のダイヤルの目盛です。 プール OLS(完全プーリング)は切片 1 本を全県で共有し、 固定効果(無プーリング)は 47 本の切片を独立パラメータとして別々に推定します。 変量効果はその 中間で、 「47 本の切片が共通の分布 $u_i\sim N(0,\tau^2)$ から生まれた」と仮定し、 実効的な切片の自由度を $\tau^2$ の大小に応じて 1 本〜47 本の間で データに決めさせます。 $\tau^2\to0$ で完全プーリング、 $\tau^2\to\infty$ で無プーリングに一致する — この両極を内包する点が「確率変数とみなす」ことのご利益です。
縮小(shrinkage)が起きるのは、 各県の推定切片が「その県の生平均」と「全体平均」の重み付き平均になるからです。 重み $\lambda_i$ が観測数 $n_i$ に依存するため、 情報の乏しい県ほど全体平均という『みんなの知恵』を多く借ります(borrowing strength)。 これは ベイズの経験ベイズ推定・James–Stein 推定量と同じ原理で、 個別県では多少バイアスを負う代わりに全体の予測二乗誤差を下げます。
② 実測 ICC で「階層構造の強さ」を測る(SSDSE-B-2026)
級内相関 ICC $=\tau^2/(\tau^2+\sigma^2)$ は「同じ県の観測どうしがどれだけ似るか=グループ差が全分散に占める割合」です。 下表は SSDSE-B-2026(47 都道府県 × 12 年 = 564 行、 2012–2023)を県でグループ化し、 一元配置ランダム効果の ICC(1) を実測したものです(バランス型 $n=12$)。
| 変数(列コード) | 実測 ICC | 読み方 |
|---|---|---|
| 総人口(A1101) | 0.9995 | 水準変数。 ほぼ全分散が県差 → 階層構造が支配的 |
| 65歳以上人口(A1303) | 0.9931 | 同上。 年内変動はごくわずか |
| 消費支出・二人以上世帯(L3221) | 0.6639 | 県差は依然大きいが、 年次変動の余地もある |
💡 ICC 解釈の落とし穴: 人口・高齢者数のような 水準(レベル)変数 は県間で桁が違うため ICC がほぼ 1.00 に張り付き、 「階層構造がある」という情報以上のことは言えません。 むしろ ICC が中程度(消費支出の 0.66)の変数の方が、 変量効果の縮小が実際に効き、 分析上おもしろい対象です。 ICC が 0.05 未満なら変量効果を入れるご利益はほぼ無く プール OLS で十分、 という目安も併せて覚えてください。
③ 収縮の強さは「グループのサンプルサイズ」で決まる
縮小係数を ICC $\rho$ と観測数 $n$ で書き直すと $\lambda = \dfrac{n\rho}{n\rho+(1-\rho)}$ となり、 $n$ が大きいほど 1 に近づく=生平均を尊重、 $n$ が小さいほど 0 に近づく=全体平均へ強く収縮します。 消費支出の実測 ICC $\rho=0.664$ で計算すると:
- 12 年そろう県(実データ通り $n=12$): $\lambda\approx0.96$ — ほぼ生平均。 12 点あれば収縮はごくわずか。
- 仮に 2 年しか観測が無い県(架空の欠測ケース $n=2$): $\lambda\approx0.80$ — 約 2 割を全体平均へ収縮。
- 仮に 1 年だけの県(架空 $n=1$): $\lambda\approx0.66$ — 3 割強を全体平均が肩代わり。
つまり SSDSE-B のように全県で年数がそろった バランス型パネルでは収縮量が均一になり、 部分プーリングの威力は控えめです。 縮小が劇的に効くのは、 一部の県で欠測が多い アンバランス型や、 グループあたりの標本が少ない調査データのとき。 「小さい県ほど強く引き寄せられる」現象を体感したい場合は、 上の ウィジェットで群ごとの $n$ を見比べてください。
④ 落とし穴(重要)— 変量効果の外生性が破れるとバイアス
変量効果推定量が BLUE になる前提は、 個体効果と説明変数の無相関 $\operatorname{Cov}(u_i,\boldsymbol{x}_{it})=0$(外生性・直交性)です。 これは 外生性の一種であり、 破れると 内生性によってバイアスが生じます。 SSDSE-B で典型的に危ういのは「所得の高い県ほど、 未観測の産業構造や都市化度(=$u_i$)も高い」といった相関で、 このとき消費や物価の係数が歪みます。
- ハウスマン検定で選ぶ: Hausman 検定は「効率的だが仮定が強い変量効果」と「頑健だが非効率な固定効果」の係数差を $\chi^2$ で検定します。 棄却(p<0.05)なら外生性が疑わしく 固定効果を採用。 社会経済パネルでは固定効果が選ばれがちです。
- Mundlak / 相関変量効果という折衷: 各説明変数の グループ内平均 $\bar x_i$ を共変量として追加すると、 変量効果のまま外生性違反を部分的に吸収でき、 固定効果と同じ係数を得つつ時間不変変数も残せます(Mundlak デバイス)。 Hausman が棄却されたときの実務的な逃げ道として有用です。
- 少数グループでの分散推定の不安定: $\tau^2$ 自体をデータから推定するには水準数が必要で、 5〜10 群未満だと Singular fit($\tau^2\approx0$ に収束)が起き、 縮小量も信頼できません。 47 都道府県は下限ぎりぎり OK、 8 地方ブロックは要注意(既存の落とし穴①参照)。
⑤ 発展 — 変量傾き・階層/マルチレベル・経験ベイズ
- 変量傾き(random slope): 切片だけでなく傾き $\beta_i\sim N(\beta,\tau_\beta^2)$ も分布から来ると仮定すると、 「所得→消費の弾力性が都市部と地方で違う」ような 効果の異質性にも部分プーリングが効きます。
re_formula='~x'(statsmodels)や(1+x|pref)(lme4)で指定。 過剰に入れると Singular fit になりやすいので「切片のみ → 傾き 1 本 → 複数」と段階的に。 - 階層/マルチレベルモデル: 「地方ブロック ⊃ 都道府県 ⊃ 年」のような入れ子構造では、 各層に変量効果を置いて地方差・県差・年次変動を同時分離できます(階層線形モデル/混合モデル)。 関連は マルチレベルモデル・パネルデータを参照(※専用の hierarchical-model / mixed-model / icc ページは現状未作成のためテキストで示します)。
- 経験ベイズ縮小と階層ベイズ: BLUP は「$\mu,\tau^2$ を既知として扱う経験ベイズ近似」に相当し、 確率変数としての $u_i$ の事後平均です。 完全な 階層ベイズではこれらにも事前分布を置き、 $\tau^2$ の不確実性まで事後分布に伝播させて縮小量を推定します(PyMC / brms の partial pooling)。 点推定だけのフリークエンティスト推定より、 各県切片の不確実性まで得られる点が政策評価で有用です。
📝 補足(この深掘りセクションの数値の出所): 表の ICC 3 値は SSDSE-B-2026.csv(cp932, skiprows=[1])の 47 都道府県 × 12 年パネルを県でグループ化し、 一元配置ランダム効果 ICC(1)=$(MSB-MSW)/(MSB+(n-1)MSW)$ で実測した値です。 ③の $\lambda$ は実測 ICC=0.664 から $\lambda=n\rho/(n\rho+1-\rho)$ で算出。 $n=2,1$ のケースは SSDSE には存在しない架空の欠測状況を仮定した説明用の値です。