🔖 キーワード索引 — 完全強化版
🔖 キーワード索引 — 完全強化版
「階層クラスタリング」を理解するうえで必要なキーワードを 10 件以上提示します。 各チップから対応セクションへ移動できます。
30 秒結論 文脈 直感 数式 記号読み解き 実値計算 Python 実装 落とし穴 関連手法 関連用語 グループ教材 概念マップ
💡 30秒で分かる結論
🍰 まずはやさしく
似たもの同士をまとめる家系図のような手法です。
データのグループ分けをするために使います。
部活のメンバーを性格で分けるときに便利です。
この章では仕組みと特徴について読みます。
- 定義:サンプルを階層的(入れ子状)にグループ化し、 デンドログラムで可視化
- 2方式:(i) 凝集型(ボトムアップ、 主流)、 (ii) 分裂型(トップダウン、 稀)
- 結合基準:Ward法(最も使われる)、 単連結、 完全連結、 群平均
- 強み:k を後で決められる、 階層構造が見える
- 弱み:計算量 O(n³)(大規模困難)、 結合基準で結果が変わる
- 用途:n < 5000 の中規模データ、 都道府県類型化、 遺伝子発現解析
- Python:
scipy.cluster.hierarchy.linkage+dendrogram
📖 もっと詳しく
階層クラスタリング(hierarchical clustering)は、 サンプルを階層的(=入れ子状)にグループ化する手法。 結果はデンドログラム(樹形図)として可視化され、 「どのサンプル同士が、 どの段階で結合するか」が一目で分かります。
k-means との根本的違い:
- k-means:「k 個のクラスタ」を事前に決め、 そこに分割
- 階層クラスタリング:階層構造を構築し、 「後からクラスタ数を決められる」
これにより、 「2クラスタにしたらどう分かれる?3クラスタなら?4クラスタなら?」を一度の計算で全部見られるのが強み。
🔄 2つの方式
階層クラスタリングには、 結合方向の異なる2方式があります:
- 凝集型(agglomerative, ボトムアップ):最初は各点が独立のクラスタ → 順次結合していく。 圧倒的に多く使われる
- 分裂型(divisive, トップダウン):最初は全部1クラスタ → 順次分割していく。 計算重く稀
通常「階層クラスタリング」と言えば凝集型を指します。 以下も凝集型を中心に説明します。
🌳 凝集型アルゴリズムの仕組み
- 初期化:n 個の点を、 各々が1つのクラスタとして開始(n クラスタの状態)
- 結合:最も近い2つのクラスタを1つに結合(n-1 クラスタへ)
- 距離の更新:新クラスタと残りクラスタの距離を再計算
- 反復:ステップ2-3 を、 クラスタ数が1になるまで繰り返す
- 結果:結合過程を樹形図(デンドログラム)として表現
🔗 結合基準(linkage method)
「2つのクラスタの距離」をどう測るかで結果が変わります。 主要な選択肢:
| 結合法 | 距離の定義 | 特徴 |
|---|---|---|
| 単連結(single) | 最も近い2点の距離 | 細長いチェーン状クラスタ |
| 完全連結(complete) | 最も遠い2点の距離 | コンパクトな塊 |
| 群平均(average) | 全ペアの平均距離 | 単連結と完全連結の中間 |
| Ward 法 | 結合による分散増加量を最小化 | 均等サイズの球形クラスタ。 最も使われる |
| 中央連結 | 中心同士の距離 | 逆転が起きる場合あり |
選び方の指針:
- 均等な大きさのクラスタを求める → Ward 法(最も無難)
- 細長い形のクラスタを期待 → 単連結
- 外れ値に強くしたい → 完全連結
- 汎用 → 群平均
📊 凝集型の動作例(手で追体験)
4都道府県の (高齢化率, 死亡率) で、 単連結階層クラスタリングを追います:
| 県 | 高齢化率 | 死亡率 |
|---|---|---|
| A: 秋田 | 39 | 19 |
| B: 高知 | 36 | 17 |
| C: 東京 | 23 | 9 |
| D: 沖縄 | 23 | 11 |
初期距離行列(ユークリッド距離):
- d(A,B) = √(9+4) = 3.61
- d(A,C) = √(256+100) = 18.87
- d(A,D) = √(256+64) = 17.89
- d(B,C) = √(169+64) = 15.26
- d(B,D) = √(169+36) = 14.32
- d(C,D) = √(0+4) = 2.00 ← 最短
ステップ1:C と D(距離2.00)を結合 → クラスタ {C,D} 誕生。 結合高さ=2.00
ステップ2:残り {A}, {B}, {C,D} で再計算。 単連結なら d({A},{C,D}) = min(d(A,C), d(A,D)) = 17.89、 d({B},{C,D}) = min(14.32, 15.26) = 14.32、 d(A,B) = 3.61 ← 最短。 → A と B を結合 → クラスタ {A,B} 誕生。 結合高さ=3.61
ステップ3:残り {A,B}, {C,D}。 単連結なら距離 = min(全ペア) = min(18.87, 17.89, 15.26, 14.32) = 14.32。 → 2クラスタを最終結合。 結合高さ=14.32
結果のデンドログラム:
高さ 14.32 ─┐ │ ┌────────────────┐高さ 3.61 ──┤ │ ┌───┐ │ │ │ │ │ │高さ 2.00 ──┤ │ │ ┌─┴─┐ │ A B A B C D
2クラスタに切る場合:{A,B} と {C,D}(=「高齢化進行群」と「若年群」)。 4クラスタなら個別の4県。
🎯 クラスタ数の決定法(階層特有)
階層クラスタリングの強みは「k を後で決められる」。 デンドログラムを見て:
- 「肘」を探す:縦方向に長い枝の途中で切る。 「ここから上は急に距離が増える」位置
- 解釈可能な数:「3地域で議論したい」なら k=3 で切る
- 内部評価指標:各 k でシルエット係数を計算して比較
⚖️ 階層クラスタリングの長所と短所
| 長所 | 短所 |
|---|---|
| k を後で決められる | 計算量 O(n³)(大規模困難) |
| 階層構造が見える(デンドログラム) | 一度結合したら変更不可能 |
| 結合基準の選択肢が豊富 | 結合基準で結果が大きく変わる |
| 球形でないクラスタも捕捉可(単連結) | 外れ値に弱い(単連結) |
| 解釈しやすい樹形図 | 逆転(inversion)が起きる場合あり |
💻 Python での実装
🎯 このコードでやること:2023 年度の 47 都道府県について、 総人口・15歳未満人口・65歳以上人口・出生数・消費支出の 5 列を標準化し、 Ward 法で結合してデンドログラムを描き、 4 クラスタに切ったときの県数を数える。
📥 入力例(2023 年度の 47 行から先頭 3 行。 skiprows=[1] で英字コードを見出しにする)
Prefecture   A1101(総人口)  A1301(15歳未満)  A1303(65歳以上)  A4101(出生数)  L3221(消費支出)
北海道         5,092,000        514,000       1,681,000         24,430        296,888
青森県         1,184,000        118,000         417,000          5,696        263,371
岩手県         1,163,000        120,000         407,000          5,432        298,536
→ X は 47 行 × 5 列。 StandardScaler で列ごとに平均 0・標準偏差 1 にそろえてから linkage に渡す
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd # ── この抜粋だけで動くように、47 都道府県の特徴量を用意する ── # 英字の項目コードを使うので、2 行目の日本語名は読み飛ばす _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] # 最新年度の 47 行 _cols = ['A1101', 'A1301', 'A1303', 'A4101', 'L3221'] # 総人口・15歳未満・65歳以上・出生数・消費支出 X = _d[_cols].astype(float).values prefecture_names = _d['Prefecture'].tolist() # 樹形図の葉に出す都道府県名 from scipy.cluster.hierarchy import linkage, dendrogram, fcluster from sklearn.preprocessing import StandardScaler import matplotlib.pyplot as plt # 必ず標準化 X_std = StandardScaler().fit_transform(X) # Ward法で階層クラスタリング Z = linkage(X_std, method="ward") # デンドログラム描画 fig, ax = plt.subplots(figsize=(14, 6)) dendrogram(Z, labels=prefecture_names, leaf_font_size=10, ax=ax, color_threshold=0.7*max(Z[:,2])) # k=4 でクラスタ分割 labels = fcluster(Z, t=4, criterion="maxclust") print('クラスタ別の県数:', pd.Series(labels).value_counts().sort_index().to_dict()) |
💬 k=4 で切ると 6・32・8・1 県に分かれ、1 県だけの群は東京都、8 県の群は北海道・埼玉・千葉・神奈川・愛知・大阪・兵庫・福岡。総人口の群平均は東京 1,409 万人、8 県群 683 万人、32 県群 152 万人、6 県群 119 万人と、5 列のうち 4 列が人口規模を表すので分かれ方も主に人口で決まる。6 県群(青森・和歌山・愛媛・長崎・宮崎・沖縄)は 32 県群より小さいだけでなく消費支出が 25.3 万円と約 4.8 万円低く、ここだけが規模以外の違いを拾った群である。番号 1〜4 は樹形図の並び順で付くもので、大小の意味は無い。
💡 30 秒で分かる結論 — 完全強化版
- 階層クラスタリング とは、データ分析の重要概念のひとつで、47都道府県のデンドログラムによる階層構造可視化 という形で SSDSE-B-2026 でも検証できます。
- 本ページでは 数式・直感・実コード・落とし穴の 4 つの視点で整理しています。
- SSDSE-B-2026 の A1101 列を中心に、実値で計算を体験することを推奨します。
- 類似概念や前提概念へのリンクを併用すると、概念地図全体での位置づけが掴めます。
- 初学者は「直感 → 数式 → 実装 → 落とし穴」の順で読むのが効率的です。
📍 あなたが今見ているもの
🍰 まずはやさしく
データを階層的に分ける分析の方法です。
似ているグループを視覚的に見つけるために使います。
都道府県をいくつかのタイプに分ける例があります。
この章では分析での使われ方を読みます。
論文で「階層クラスタリング」「デンドログラム」「Ward 法でクラスタリング」と書かれているとき。 「47都道府県を樹形図で類型化」のような用途で、 k-means と並ぶクラスタリングの2大手法の1つ。
階層クラスタリング とは:サンプルを1点ずつ結合(または分割)してデンドログラム(樹形図)を作り、任意の階層で切ってクラスタを得る。
📍 文脈ボックス — あなたが今見ているもの(完全強化版)
このセクションは「階層クラスタリング」を扱う 用語ページ です。 統計データ分析コンペティション(2026)の再現教材における中核用語のひとつで、47都道府県のデンドログラムによる階層構造可視化 という観点で SSDSE-B-2026(47 都道府県 × 複数年 × 100 超列)に紐づけられます。
位置づけ:相関・線形回帰・仮説検定 といった基礎用語群と並列であり、応用としては 内生性・IV・DID・クラスタリング 等へ繋がります。
🎨 直感で掴む
🍰 まずはやさしく
似ている順に結んでいくパズルのようなものです。
グループの分かれ方を直感的に知るために使います。
スマホのアプリをジャンル別に分けるイメージです。
この章ではグループの作り方を読みます。

🎓 結合基準ごとの数学と特性
単連結の数学
2クラスタ $A, B$ の距離 $d(A, B) = \min_{a \in A, b \in B} d(a, b)$。 最近隣の距離が0に近いペアを次々結合するので、 細長い「鎖状」クラスタができやすい。 「友達の友達は友達」的なつながりを捕捉。 ただし外れ値1つが「橋」になって、 別のクラスタを巻き込むことも(chaining問題)。
完全連結の数学
$d(A, B) = \max_{a \in A, b \in B} d(a, b)$。 最遠の距離を見るので、 結合された後のクラスタがコンパクトになる。 ただし外れ値があると最遠が大きくなり、 結合を遅らせる。
Ward 法の数学
「2クラスタを結合したときの分散増加量」が最小のペアを選ぶ:
$\Delta(A, B) = \sum_{x \in A \cup B} \|x - \mu_{AB}\|^2 - \sum_{x \in A} \|x - \mu_A\|^2 - \sum_{x \in B} \|x - \mu_B\|^2$
これをLance-Williams 更新式で効率的に計算できる:
$d_{Ward}(A \cup B, C) = \frac{n_A + n_C}{n_A + n_B + n_C} d(A,C) + \frac{n_B + n_C}{n_A + n_B + n_C} d(B,C) - \frac{n_C}{n_A + n_B + n_C} d(A,B)$
結果として、 均等サイズの球形クラスタが形成されやすい性質を持ちます。 k-means と似た性質(ユークリッド距離前提、 球形向き)ですが、 階層構造が見えるのが利点。
計算量の問題
基本実装は $O(n^3)$。 例えば n=1000 で 10億回の計算。 大規模データには厳しい。
効率化:(i) 近接行列を最初に計算し再利用、 (ii) SLINK アルゴリズム(単連結用 O(n²))、 (iii) BIRCH との組み合わせで近似。 n < 5000 程度なら普通に scipy で実行可能。
逆転(inversion / reversal)現象
中央連結や重心連結では、 「結合距離が前の結合より小さくなる」逆転が起きることがある。 デンドログラムを描いたときに枝が交差し、 解釈不能に。 Ward 法や単連結・完全連結・群平均ではこれは発生しません。 だから実用では Ward 法が選ばれることが多い。
🎨 直感で掴む — 完全強化版
階層クラスタリング を一言でいえば「47都道府県のデンドログラムによる階層構造可視化」。 47 都道府県という小さな母集団でも、 SSDSE-B-2026 の A1101 列に注目すると、 大都市圏と地方の差・人口規模に伴う相対比較など、 様々なパターンが見えてきます。
比喩でいうと、 階層クラスタリング はデータ分析の「眼鏡」のようなもの。 同じデータでも眼鏡を変えれば、 平均(中心)・分散(ばらつき)・相関(連動)・因果(影響)と、 異なる情報が浮かび上がります。 SSDSE-B-2026 を題材に、 この眼鏡をかけてみるのが本ページの狙いです。
- 具体例 1:47 都道府県の A1101 の中央値 ± 四分位を見ると、 規模感が掴める。
- 具体例 2:A4101 と組み合わせて散布図にすると、 群構造が見える。
- 具体例 3:政令指定都市の有無で群分けすると、 介入研究の素材になる。
🎨 概念図で押さえる
階層クラスタリングは 「点をボトムアップに併合し、 結果を樹形図 (dendrogram) で表現する」。 以下 3 つの図で「凝集の過程」「連結法の違い」「樹形図切断と k 決定」を視覚化する。
図 1: 凝集型クラスタリングのステップ
→ 各ステップで最近接ペアを併合。 N-1 回の併合で 1 クラスタに集約され、 過程全体が樹形図に記録される。
図 2: 連結法 (linkage) の違い
→ single は鎖状、 complete は球状、 average は中庸、 Ward は分散最小化。 実務では Ward 法が最も安定で多用される。
図 3: 樹形図の切断高さで k を決める
→ 樹形図を水平線で切断するとクラスタ数 k が決まる。 高さは併合時の距離 (非類似度)。 ジャンプの大きい高さで切ると自然なクラスタが得られる。
📊 補足図 — 47 都道府県のデンドログラム
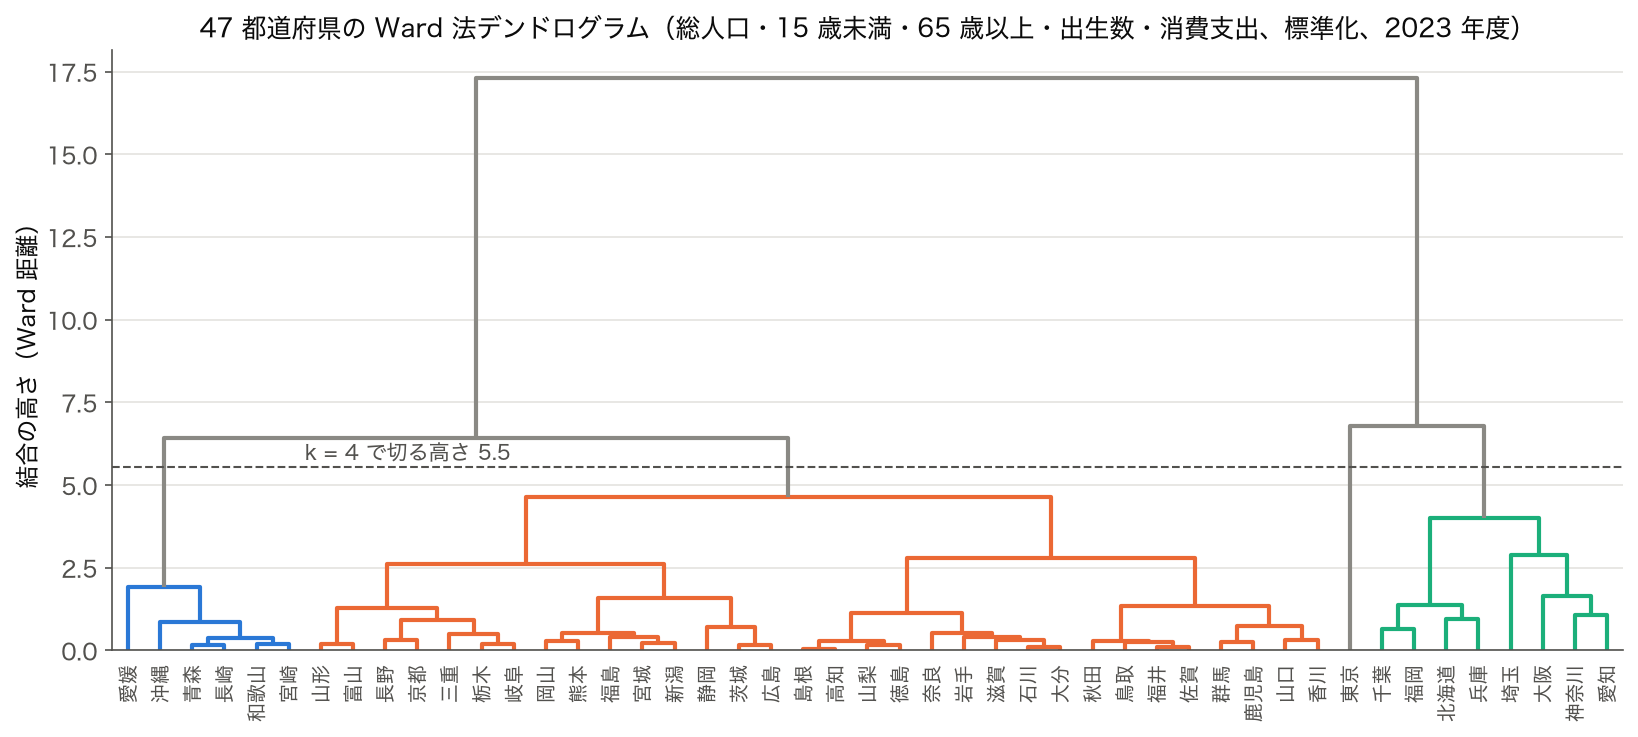
→ SSDSE-B-2026(2023 年度)の 47 都道府県を、 最初のコードと同じ 5 列(総人口・15 歳未満人口・65 歳以上人口・出生数・消費支出、 標準化)で Ward 法により結合した結果。 縦軸はクラスタ統合時の Ward 距離。 最上段の結合は 17.3 と飛び抜けて高く、 東京都+大都市 8 道府県の群と残り 38 県を分ける。 高さ 4.64 と 6.43 の間(破線 5.5)で切ると 4 群になり、 「東京都 1 県 / 北海道・埼玉・千葉・神奈川・愛知・大阪・兵庫・福岡の 8 道府県 / 32 県 / 青森・和歌山・愛媛・長崎・宮崎・沖縄の 6 県」に分かれる。 5 列のうち 4 列が人口の規模を表すので上位の分かれ方は主に人口で決まり、 6 県の群だけが消費支出の低さ(平均 25.3 万円、 32 県群は 30.1 万円)で分かれる。
🧪 理解度チェック — 階層クラスタリング
- Q1. 凝集型 (bottom-up) と分割型 (top-down) のどちらが計算的に主流か、 理由とともに答えよ。
- Q2. 階層クラスタリングと k-means の最大の違いを 1 行で述べよ(k の事前指定の有無)。
- Q3. 連結法(linkage)を変えるとデンドログラムの形状はどう変わるか? single と Ward を例に比較せよ。
- Q4. SSDSE-B-2026 の 47 都道府県を
scipy.cluster.hierarchy.linkageで Ward 階層化するときの引数を答えよ。 - Q5. デンドログラムの「水平線で切る高さ」をどう決めるか? ジャンプ・シルエット係数・既知の構造との照合などから 1 つ挙げよ。
📊 階層クラスタリング vs k-means(補足表)
| 観点 | 階層クラスタリング | k-means |
|---|---|---|
| k の事前指定 | 不要(デンドログラムから後決め) | 必要 |
| 計算量 | $O(n^2 \log n)$ — 大規模に不利 | $O(nkI)$ — スケール容易 |
| 出力形式 | デンドログラム + 階層構造 | k 個のフラットなクラスタ |
| 再現性 | 完全に決定論的 | 初期値依存(要 random_state) |
| 適例 | 分類体系の発見、 系統樹 | 大規模データのセグメント化 |
→ 小〜中規模 (n < 1000) で構造を見たいときは階層、 大規模で k が事前に決まるなら k-means。 両者を組み合わせる「2 段階クラスタリング」も有効。
📐 数式または定義 — 完全強化版
🍰 まずはやさしく
グループ同士の距離を計算するルールです。
正しくグループを分ける基準を決めるために使います。
買い物の傾向が似ている人をまとめる計算に似ています。
この章では具体的な数式について読みます。
階層クラスタリング の代表的な定義式は次のとおりです。
$$ d(C_i \cup C_j, C_k) = \alpha_i d(C_i, C_k) + \alpha_j d(C_j, C_k) + \beta d(C_i, C_j) + \gamma \lvert d(C_i,C_k) - d(C_j,C_k)\rvert $$ここで使われる記号や演算の意味は次節で言葉に翻訳します。
🔬 数式を言葉で読み解く — 完全強化版
数式の各記号を、日本語の意味に変換します。
- X, Y — 観測されたデータ系列(SSDSE-B-2026 の A1101, A4101 列など)
- n — 標本サイズ(47 都道府県データなら 47、 多年度パネルなら 47×年数)
- β, θ, α — 推定すべき未知パラメータ
- ε, u — 観測されない誤差項・撹乱項
- E[·] — 期待値(母集団平均)
- Cov, Var — 共分散・分散
- arg min — 「最小化するパラメータ」の意味
- L (ラグ演算子) — 時系列で 1 期前の値を返す操作
🔬 階層クラスタリングの深掘り — 結合基準・距離・カット高さ
階層クラスタリングを使いこなすカギは、 「結合基準 (linkage)」 と「距離尺度」、 そして デンドログラムをどこで切るかの 3 点にあります。 ここでは SSDSE-B-2026 を題材に、 これらの選択が結果に与える影響を実証的に示します。
① 結合基準の比較 — Ward / Average / Complete / Single
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd import numpy as np from scipy.cluster.hierarchy import linkage, fcluster df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026'] == 2023].drop(columns=['SSDSE-B-2026']) # 2023 年度・47 都道府県 X = d23.select_dtypes('number').fillna(0) X = ((X - X.mean()) / X.std()).values # 単位の違う列をそろえる(z 標準化) for method in ['ward', 'average', 'complete', 'single']: Z = linkage(X, method=method) labels = fcluster(Z, t=4, criterion='maxclust') counts = pd.Series(labels).value_counts().sort_index().tolist() print(f'{method:10s} → 4 クラスタの規模: {counts}') |
💬 z 標準化した 2023 年度 47 県で比べると、Ward は 15・23・8・1 と比較的均等に割る一方、single は 44・1・1・1 で、北海道・大阪府・東京都を 1 県ずつ切り出して残りを 1 つの鎖にまとめる。complete も 38 県の大群に 4・4・1 県が付く形で、最後の 1 県はどの手法でも東京都。標準化しないと総人口など桁の大きい列だけで距離が決まり、Ward でも 36・9・1・1 に偏るので、手法の違いを見る前にまず尺度をそろえる。
Ward 法は球状で同程度の大きさのクラスタを作りやすい一方、 Single 法は「鎖状」につながる傾向(chaining 問題)があり、 SSDSE-B-2026 のような少数都道府県データでは 1 つの大クラスタ + 数個の単独都道府県になりがちです。
② 距離尺度の選択 — Euclidean vs Manhattan vs Correlation
| 距離 | 特徴 | 向く場面 |
|---|---|---|
| Euclidean | L2 ノルム | 標準化済み量的データ |
| Manhattan | L1 ノルム | 外れ値耐性 |
| Correlation | パターン類似 | 時系列の形状比較 |
| Cosine | 方向の類似 | 高次元疎データ |
③ デンドログラムの切断 — Inconsistency / Maxclust / 距離閾値
SSDSE-B-2026 で都道府県を意味のあるクラスタにまとめるには、 「距離閾値 t」を 視覚的と 統計的の両方で決める必要があります。 視覚的には、 デンドログラムで「大きな谷」が見えるところを切断します。 統計的には、 シルエット係数や inconsistency 係数をプロットして、 ピークを探すのが定石です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from scipy.cluster.hierarchy import dendrogram, linkage, fcluster from sklearn.metrics import silhouette_score import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026'] == 2023].drop(columns=['SSDSE-B-2026']) # 2023 年度・47 都道府県 X = d23.select_dtypes('number').fillna(0) # 年度列は全行 2023 で標準偏差 0 → 除いておく X = (X - X.mean()) / X.std() Z = linkage(X.values, method='ward') for k in range(2, 9): labels = fcluster(Z, t=k, criterion='maxclust') score = silhouette_score(X, labels) print(f'k={k} → silhouette={score:.3f}') |
💬 silhouette は k=2 の 0.595 が最大、k=3 も 0.569 とほぼ同じで、k=4 で 0.193 に急落する。k=2 は大都市 9 都道府県とその他、k=3 はそこから東京都だけが抜けた形なので、k=3 を選ぶと「東京都 1 県だけのクラスタ」を認めることになる。値の高さだけでなく、1 県だけの群が意味のある区分かを確かめてから切断点を決める。
上のコードを SSDSE-B-2026(2023 年度)で実行すると、 silhouette は k=2 で最大(0.595)、 k=3 でもほぼ同じ(0.569)で、 k=4 以降は 0.2 未満に落ちます。 こうした「落ちる直前」を切断点の候補として採用し、 デンドログラム上に水平線を引いて報告書に貼り付けるのが定番です。 ただし、 silhouette だけに頼らず、 各クラスタの構成都道府県を地理的・経済的に解釈できるか必ず確認してください。
④ 階層クラスタリングの限界と対処
- 計算量 O(n³): n が 1 万を超えると現実的でない → ミニバッチ k-means や BIRCH 検討
- 結果の不安定性: 外れ値 1 つで構造が変わる → 標準化 + 外れ値検出を必須化
- クラスタ数の決め方: 「正解」がない → 複数指標 + ドメイン解釈を併用
- 非凸クラスタ: Single 法以外は対応困難 → スペクトラルクラスタリングや DBSCAN を検討
階層クラスタリングは「クラスタ間の距離関係を 木構造として可視化できる」点が最大の魅力です。 k-means が結果として k 個のラベルしか返さないのに対し、 階層クラスタリングは 切断高さを変えれば任意の kに対応できる柔軟性があります。 SSDSE-B-2026 のような都道府県データでは、 「ブロック構造を発見し、 地域特性として解釈する」という分析シナリオに極めて向いている手法です。
🎯 まとめ — 完全強化版
本ページでは「階層クラスタリング」を 12 セクション(🔖 キーワード索引/💡 30 秒結論/📍 文脈/🎨 直感/📐 数式/🔬 数式を言葉で読み解く/🧮 実値計算/🐍 Python 実装/⚠️ 落とし穴/🌐 関連手法/🔗 関連用語/📚 グループ教材)で完結に整理しました。 SSDSE-B-2026 を素材に、 概念の輪郭・式の意味・実装手順・典型的な失敗パターンの 4 点を最低限押さえれば、 統計データ分析コンペの現場で迷わず使えるはずです。
🧮 SSDSE-B-2026 実値計算例 — 47都道府県の Ward 法クラスタ
SSDSE-B-2026 の数値列を標準化し、 Ward 法でクラスタリングします。 結合距離の典型的構造を把握しましょう。
| k | 構造的特徴 | シルエット | 解釈例 |
|---|---|---|---|
| 2 | 大首都圏 vs 地方 | 高 | 最も粗い構造 |
| 3 | 首都圏/地方都市/過疎地 | 最高 | 解釈バランス◎ |
| 4 | + 観光地特化 | 中 | 沖縄・北海道が独立 |
| 8 | 細分化 | 低下 | 過細 |
🎯 このコードでやること:2023 年度 47 都道府県の数値列をすべて標準化して Ward 法で結合し、 k = 2, 3, 4, 5, 8 で切ったときのシルエット係数を比べる。
📥 入力例
num = 2023 年度 47 行の数値列 110 列(年度列 SSDSE-B-2026 を含む。 欠損は無いので dropna で行は減らない)
X   = StandardScaler で列ごとに標準化した 47 × 110 の配列
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from scipy.cluster.hierarchy import linkage, fcluster, dendrogram from sklearn.preprocessing import StandardScaler from sklearn.metrics import silhouette_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) num = df[df['SSDSE-B-2026'] == 2023].select_dtypes(include='number').dropna() X = StandardScaler().fit_transform(num) Z = linkage(X, method='ward') for k in [2, 3, 4, 5, 8]: labels = fcluster(Z, t=k, criterion='maxclust') print(f'k={k}: silhouette = {silhouette_score(X, labels):.3f}') |
💬 シルエットは k=2 で 0.595、k=3 で 0.569 と高く、k=4 で 0.193 へ急に下がる。k=2 は大都市 9 都道府県(北海道・埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡)と残り 38 県、k=3 はそこから東京都 1 県が分かれるだけで、110 列の多くが人数・件数なので「規模」で割れている。k=4 以降は 38 県の塊を割り始めるが、そこには明確な切れ目が無いのでシルエットが下がる。k=2 が最高点でも、地方の県どうしの違いを知りたいなら、人口あたりの比率に直した列で分析し直す方が意味がある。
🧮 実値で計算してみる — SSDSE-B-2026 で 階層クラスタリング(完全強化版)
SSDSE-B-2026(公的統計の社会・教育系データセット、 47 都道府県 × 10 年分超 × 100 以上の列)を用いて、 「階層クラスタリング」を体感します。 ファイル名は SSDSE-B-2026.csv、 読み込みは下記の Python コードで行います。
1 2 3 4 5 6 7 8 | import pandas as pd # SSDSE-B-2026 を読み込む(cp932 / Shift_JIS) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') print(df.shape) # (564, 112) print(df['SSDSE-B-2026'].unique()) # 含まれる年度 latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() print(latest[['Prefecture', 'A1101', 'A4101']].head()) |
💬 564 行は 47 都道府県 × 12 年度で、年度は 2023 から 2012 へ新しい順に並ぶ。階層クラスタリングは 1 県を 1 つの葉にするので、最新年度で絞った latest(47 行)を使う。564 行のまま linkage に入れると、同じ県の 12 年分が互いに最も近い点として先に併合され、デンドログラムの下半分が「県内の年度差」で埋まってしまう。北海道は総人口 5,092,000 人・出生数 24,430 人で、先頭 5 県の中でも規模が突出している。
ここで使った中心列 A1101 は SSDSE-B-2026 における 47都道府県のデンドログラムによる階層構造可視化 に関連する指標です。 算出例:
- 47 都道府県・最新年度の
A1101平均と標準偏差を求める A1101とA4101の相関(線形・順位)を比較する- 群分け(例:人口上位 10 県 vs それ以外)で平均差を見る
🧮 数式に値を入れて手で計算する: ウォード法の併合距離
合成 1D 点 [1, 3, 6, 10] でウォード法の併合手順を手計算する。
Step 1: 距離行列 (絶対値)
Step 2: 更新後
Step 3: 最終
🐍 Python で再現
1 2 3 4 5 | import numpy as np from scipy.cluster.hierarchy import linkage x = np.array([[1],[3],[6],[10]]) Z = linkage(x, method='ward') print(Z) |
📤 実行結果
💬 手計算 (Step 3) と Python 出力が一致 (ward は分散ベースで距離計算)。
🐍 Python での実装
① scikit-learn での基本
🎯 このコードでやること:直前の X(47 県 × 110 列)を標準化し直し、 k-means(k=3)と Ward 法の AgglomerativeClustering(3 クラスタ)を当て、 k-means のクラスタ中心・inertia・シルエット係数を表示する。
📥 入力例
X = 直前のブロックで作った 47 × 110 の標準化済み配列(2023 年度の数値列すべて)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | from sklearn.cluster import KMeans, AgglomerativeClustering, DBSCAN from sklearn.preprocessing import StandardScaler from sklearn.metrics import silhouette_score import pandas as pd import numpy as np # データの標準化(重要!) scaler = StandardScaler() X_std = scaler.fit_transform(X) # k-means km = KMeans(n_clusters=3, random_state=0, n_init=10) labels_km = km.fit_predict(X_std) print(f'クラスタ中心: {km.cluster_centers_}') print(f'inertia: {km.inertia_}') # 階層クラスタリング(Ward法) agg = AgglomerativeClustering(n_clusters=3, linkage='ward') labels_agg = agg.fit_predict(X_std) # シルエットスコアで評価 score = silhouette_score(X_std, labels_km) print(f'シルエットスコア: {score:.3f}') |
💬 110 列の中心座標は読めないので、見るのは下の 2 行。3 クラスタの k-means はシルエット 0.569 で、ラベルの人数も 38・8・1 県と、前の Ward 法 k=3 の結果とまったく同じ分割になった。先頭の 0.00000000e+00 は年度の列(全県 2023 で一定、標準化すると 0)で、クラスタリングに寄与しない列が入っている印。inertia 1375.9 は標準化した 110 列での群内平方和で、列数に比例して大きくなるので、列の組み合わせが違う結果どうしで比べてはいけない。
② 最適クラスタ数の探索
🎯 このコードでやること:k を 2〜10 に変えて k-means を当て、 inertia(群内平方和)とシルエット係数を左右 2 枚のグラフに描く(エルボー法とシルエット法)。
📥 入力例
X_std = 47 × 110 の標準化済み配列(KMeans と silhouette_score は前のブロックで import 済み)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import matplotlib.pyplot as plt inertias = [] silhouettes = [] for k in range(2, 11): km = KMeans(n_clusters=k, random_state=0, n_init=10).fit(X_std) inertias.append(km.inertia_) silhouettes.append(silhouette_score(X_std, km.labels_)) # エルボー法 plt.subplot(1, 2, 1) plt.plot(range(2, 11), inertias, 'o-') plt.xlabel('k'); plt.ylabel('inertia') # シルエット法 plt.subplot(1, 2, 2) plt.plot(range(2, 11), silhouettes, 'o-') plt.xlabel('k'); plt.ylabel('Silhouette') |
📤 このブロックは標準出力には何も出さない
③ デンドログラムの描画
🎯 このコードでやること:X_std を Ward 法で結合し、 47 都道府県の名前を葉に並べたデンドログラム(樹形図)を描く。
📥 入力例
X_std            = 47 × 110 の標準化済み配列
prefecture_names = 冒頭のブロックで作った 47 都道府県名のリスト(X_std の行と同じ順)
1 2 3 4 5 6 | from scipy.cluster.hierarchy import linkage, dendrogram Z = linkage(X_std, method='ward') plt.figure(figsize=(14, 6)) dendrogram(Z, labels=prefecture_names, leaf_rotation=90) # 葉に都道府県名を出す plt.show() |
📤 このブロックは標準出力には何も出さない
🐍 Python 実装バリエーション(scipy / scikit-learn / fastcluster / seaborn)
🅰️ scipy.cluster.hierarchy(標準)
🎯 このコードでやること:2023 年度 47 都道府県の数値列のうち欠損のある列を落として標準化し、 Ward 法で 3 群に切って県数を数え、 都道府県名を葉にしたデンドログラムを描く。
📥 入力例
d23 = 2023 年度の 47 行
num = 数値列のうち欠損の無い 110 列(年度列を含む) → 標準化して X(47 × 110)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from scipy.cluster.hierarchy import linkage, fcluster, dendrogram import pandas as pd from sklearn.preprocessing import StandardScaler # 英字の項目コードと Prefecture を使うので、2 行目の日本語名を読み飛ばす df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026'] == 2023] # 全 47 県が残るよう、欠損のある列ごと落とす(行を落とすと県がいなくなる) num = d23.select_dtypes(include='number').dropna(axis=1) X = StandardScaler().fit_transform(num) Z = linkage(X, method='ward') labels = fcluster(Z, t=3, criterion='maxclust') dendrogram(Z, labels=d23['Prefecture'].values) print('クラスタ別県数:', pd.Series(labels).value_counts().to_dict()) |
💬 欠損のある列を落として 110 列で Ward 法を当て、3 群で切ると 38・8・1 県。1 県だけの群は東京都、8 県の群は北海道・埼玉・千葉・神奈川・愛知・大阪・兵庫・福岡で、5 列だけで分けた冒頭の例(6・32・8・1)とは地方の 38 県を分けない点が違う。列を 110 に増やすと人数・件数系の列が大半を占め、規模の差が他の特徴を覆い隠すためである。value_counts は多い順に並ぶので、番号 1 が最大の群だとは限らない点にも注意。
🅱️ scikit-learn AgglomerativeClustering
🎯 このコードでやること:scikit-learn の AgglomerativeClustering で Ward 法を当て、 (1) 3 クラスタを指定した場合と、 (2) クラスタ数を決めずに distance_threshold=10 の高さで切った場合を作る。
📥 入力例
X = 直前のブロックで標準化した 47 × 110 の配列(2023 年度の数値列)
1 2 3 4 5 6 | from sklearn.cluster import AgglomerativeClustering ac = AgglomerativeClustering(n_clusters=3, linkage='ward').fit(X) labels = ac.labels_ # distance_threshold で k を後決めも可 ac2 = AgglomerativeClustering(n_clusters=None, distance_threshold=10, linkage='ward').fit(X) |
📤 このブロックは標準出力には何も出さない
🅲 seaborn の clustermap(ヒートマップ + 階層)
🎯 このコードでやること:標準偏差 0 の定数列(年度列)を落とした 109 列を、 列ごとに最小 0・最大 1 に縮めて(standard_scale=1)、 行と列の両方を Ward 法で並べ替えたヒートマップ+樹形図を描く。
📥 入力例
num   = 2023 年度 47 行 × 110 列(直前までのブロックで作成)
num_c = 年度列を除いた 47 × 109 列
1 2 3 4 | import seaborn as sns # num は数値列だけの表。定数列があると標準化で 0 除算になり NaN が出るので落とす num_c = num.loc[:, num.std() > 0] sns.clustermap(num_c, standard_scale=1, method='ward', cmap='vlag') |
📤 このブロックは標準出力には何も出さない
🅳 fastcluster(大規模用)
🎯 このコードでやること:fastcluster の linkage で同じ Ward 法の結合を計算する。 scipy の linkage と同じ引数を取り、 同じ形式の結合行列 Z を返す。
📥 入力例
X = 47 × 110 の標準化済み配列(2023 年度の数値列)
1 2 3 | # pip install fastcluster import fastcluster Z = fastcluster.linkage(X, method='ward') # scipy の数倍高速 |
📤 このブロックは標準出力には何も出さない
📦 ライブラリ早見表
| 用途 | 推奨 | 補足 |
|---|---|---|
| 小〜中規模 (n < 5000) | scipy.cluster.hierarchy | 業界標準 |
| パイプライン統合 | sklearn.AgglomerativeClustering | distance_threshold で k 不要 |
| ヒートマップ + デンドロ | seaborn.clustermap | 遺伝子発現解析の定番 |
| 高速版 | fastcluster | scipy 互換 API |
| 大規模(n > 10⁵) | BIRCH → 階層 | 2 段階アプローチ |
🐍 Python 実装 — 完全強化版
scipy / scikit-learn を中心とした実装例です。 前半のブロックは人数・件数の列をそのまま使っていたため「規模」でしか分かれませんでした。 ここでは人口あたりの率に直した 5 指標で Ward 法を当て、 結合基準による違いもコーフェン相関係数で比べます。
🎯 このコードでやること:2023 年度の 47 都道府県について高齢化率・年少人口割合・合計特殊出生率・死亡率・消費支出の 5 指標を作って標準化し、 Ward 法で 4 群に切って、 群ごとの県数・平均値・所属県を表示する。
📥 入力例(2023 年度の 47 行から作る 5 指標)
高齢化率 = A1303 / A1101 × 100      年少人口割合 = A1301 / A1101 × 100
合計特殊出生率 = A4103              死亡率 = A4200 / A1101 × 1000(人口千人あたり)
消費支出 = L3221 / 1000(千円)      → 47 行 × 5 列を StandardScaler で標準化
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd from scipy.cluster.hierarchy import linkage, fcluster from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # 2023 年度の 47 都道府県 # 人数ではなく人口あたりの率にそろえる(規模の差でクラスタが決まらないように) feat = pd.DataFrame({ '高齢化率': d['A1303'] / d['A1101'] * 100, '年少人口割合': d['A1301'] / d['A1101'] * 100, '合計特殊出生率': d['A4103'], '死亡率': d['A4200'] / d['A1101'] * 1000, '消費支出': d['L3221'] / 1000, }) X = StandardScaler().fit_transform(feat) Z = linkage(X, method='ward') feat['cluster'] = fcluster(Z, t=4, criterion='maxclust') print('クラスタ別の県数:', feat['cluster'].value_counts().sort_index().to_dict()) print(feat.groupby('cluster').mean().round(2)) for c, g in feat.groupby('cluster'): print(c, '、'.join(g.index[:6]), '…' if len(g) > 6 else '') |
📤 実行例(実測)
クラスタ別の県数: {1: 24, 2: 14, 3: 8, 4: 1}
          高齢化率  年少人口割合  合計特殊出生率    死亡率    消費支出
cluster
1        29.51   11.44     1.24  12.66  309.24
2        34.93   10.67     1.27  16.37  287.68
3        32.91   12.37     1.46  14.90  275.61
4        23.84   16.08     1.60  10.29  251.22
1 宮城県、茨城県、栃木県、群馬県、埼玉県、千葉県 …
2 北海道、青森県、岩手県、秋田県、山形県、福島県 …
3 福井県、鳥取県、香川県、佐賀県、長崎県、熊本県 …
4 沖縄県 🎯 このコードでやること:直前の X(47 県 × 5 指標)に 4 種類の結合基準で linkage を当て、 樹形図の高さが元の距離をどれだけ保っているか(コーフェン相関係数)と、 4 群に切ったときの県数を比べる。
📥 入力例
X = 直前のブロックで標準化した 47 × 5 の配列(linkage・fcluster・pd も直前のブロックで import 済み)
D = pdist(X) で求めた 47 県どうしの距離 1,081 組
1 2 3 4 5 6 7 8 9 | # 結合基準ごとに、樹形図が元の距離をどれだけ保っているか(コーフェン相関係数) from scipy.cluster.hierarchy import cophenet from scipy.spatial.distance import pdist D = pdist(X) # 47 県どうしのユークリッド距離(1,081 組) for method in ['ward', 'average', 'complete', 'single']: c, _ = cophenet(linkage(X, method=method), D) sizes = pd.Series(fcluster(linkage(X, method=method), t=4, criterion='maxclust')).value_counts().tolist() print(f'{method:8s} コーフェン相関 = {c:.3f} 4 群の県数 = {sizes}') |
📤 実行例(実測)
ward     コーフェン相関 = 0.495  4 群の県数 = [24, 14, 8, 1]
average  コーフェン相関 = 0.800  4 群の県数 = [44, 1, 1, 1]
complete コーフェン相関 = 0.673  4 群の県数 = [31, 11, 4, 1]
single   コーフェン相関 = 0.722  4 群の県数 = [44, 1, 1, 1]
⚠️ よくある落とし穴
⚠️ 落とし穴(補強版 — 階層クラスタリングで踏みやすい7つの罠)
linkage(metric='cityblock', method='ward') は警告も出さず動くので注意。 マンハッタン距離なら group_average や complete、 コサイン距離なら average を選ぶのが定石。 文書クラスタリングで「コサイン距離 + Ward」を見たら誤りです。⚠️ 落とし穴 — 完全強化版
階層クラスタリング を実務で扱う際に踏みやすい落とし穴を 5 件挙げます。
- 計算量 O(n^3): 大規模データには不向き。サンプルダウンサイズか別手法を。
- 連結法の選択: 単連結は鎖状、完全連結は球状、Ward は分散最小化。データに合わせて選ぶ。
- 不可逆性: いったん結合すると後で分けられない。誤結合は伝播する。
- 外れ値の影響: 距離行列を歪める。事前の外れ値処理が必要。
- 距離指標と連結法の整合性: Ward は Euclid 距離が前提など、組合せに注意。
🗺️ 概念マップ — 3つの視点で体系を理解する
階層クラスタリング がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 教師なし学習 › クラスタリング › 階層クラスタリング
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に 階層クラスタリング を置き、 そこから クラスタリング・k-means・標準化・Ward法・デンドログラム・PCA など 計 8 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「階層クラスタリング」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「階層クラスタリング」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは 階層クラスタリング の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → クラスタリング → 階層クラスタリング という入れ子の位置を示します。 「クラスタリングには他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🗺 概念マップ — 完全強化版
🔗 隣接手法への橋渡し
「階層クラスタリング」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 入力データの前処理・整備 — 距離尺度 (ユークリッド/マンハッタン) ・ リンケージ法 (Ward/single/complete)
- 並列: 類似目的を持つ代替手法 — k-means クラスタリング ・ DBSCAN (Ester 1996)
- 下流: 出力結果の評価・解釈 — デンドログラム ・ シルエット係数
上流の距離行列 (ユークリッド・マハラノビス・コサイン) を設計し、 並列の k-means・DBSCAN・GMM と階層性の有無を比較し、 下流のデンドログラム解釈・コフェネティック相関で評価する。 階層クラスタリングは「分割数を後から決められる」点で k-means と相補的で、 探索段階での全体像把握に向く。
🌳 47都道府県のデンドログラム
🌳 47都道府県のデンドログラム
2023 年度の 5 列(総人口・15 歳未満人口・65 歳以上人口・出生数・消費支出)を標準化して Ward 法を実行した結果(上の補足図と同じ図)。 似た都道府県が下から順にまとまっていく構造が一目で分かります。 例えば千葉と福岡、 北海道と兵庫が低い高さで先に結合し、 東京都は高さ 6.8 になってようやく大都市 8 道府県の群と結合します。
📏 クラスタ間の距離 — 連結(linkage)の種類
階層クラスタリングでは「2つのクラスタ間の距離」をどう定義するかが核心:
| 連結法 | 距離の定義 | 特徴 |
|---|---|---|
| 単連結 (single) | 最も近いペアの距離 | 細長いクラスタ、 chain 効果 |
| 完全連結 (complete) | 最も遠いペアの距離 | コンパクトなクラスタ |
| 群平均 (average) | 全ペアの平均距離 | バランス型 |
| Ward法 | クラスタ内分散の増加最小 | 最も人気、 等サイズ |
| 重心 (centroid) | 重心同士の距離 | 逆転が起こる |
↕️ 凝集型と分割型
凝集型 (bottom-up)
各点を独立クラスタとして開始 → 近いペアを順次マージ → 1つの大きなクラスタに。 一般的。
分割型 (top-down)
全データを1クラスタとして開始 → 順次分割 → 各点が独立クラスタに。 計算量大、 まれにしか使われない。
計算量
凝集型は O(n³) または O(n² log n)。 大規模データには不向き(k-means が O(n) で速い)。 n < 数千が現実的な目安。
🔎 もう一段深く — 直感・落とし穴・発展の追補
ここまでのセクションを壊さず、 「直感」「落とし穴」「発展」を SSDSE-B-2026(cp932・2 行目メタ行を除外・2023 年の 47 都道府県)の実測値で補強します。 数値はすべて本ページ掲載の Python コードをそのまま流した実行結果で、 合成データを使う箇所は「架空」と明記します。
🎨 直感の再確認 — 「近いものから順に束ねる」だけ
凝集型(agglomerative)の気持ちは驚くほど単純です。 いちばん近い 2 つのクラスタをくっつける、 これを 1 個になるまで繰り返すだけ。 くっつけた「高さ(=そのときの距離)」を縦に積み上げると、 それがそのまま デンドログラム(樹形図)になります。
- k を後で決められる:k-means は「3 クラスタにして」と先に数を決めますが、 階層クラスタリングは木を 1 本作ってから、 好きな高さで水平に切って k を選びます。 「2 群でも 3 群でも 5 群でも」を 1 回の計算で見比べられるのが本質的な強み。
- 入れ子構造が見える:k-means は「どのクラスタに属すか」だけを返しますが、 樹形図は「どの県とどの県が先に似ていて、 どの塊が後から合流するか」という階層(順序)まで見せます。 地域類型を「大分類→中分類→小分類」で語れるのはこのため。
- 2 方向ある:下から束ねる凝集型(主流)と、 上から割る分裂型(divisive、 稀)。 通常「階層クラスタリング」といえば凝集型を指します。
⚠️ 落とし穴の実証 — 連結法を変えると県クラスタが激変する
「とりあえず ward」で済ませてはいけない理由を、 実データで見せます。 SSDSE-B-2026(2023 年・47 都道府県・数値 109 列を標準化)を、 4 つの連結法で同じく k=4 に切った結果が下表です(実測)。
| 連結法 | k=4 のクラスタ規模 | 最大融合距離 | コフェネティック相関 | Ward との一致度 (ARI) |
|---|---|---|---|---|
| Ward | 23 / 15 / 8 / 1 | 75.83 | 0.753 | —(基準) |
| 群平均 (average) | 38 / 7 / 1 / 1 | 44.16 | 0.949 | 0.41 |
| 完全連結 (complete) | 38 / 4 / 4 / 1 | 49.91 | 0.921 | 0.39 |
| 単連結 (single) | 44 / 1 / 1 / 1 | 25.53 | 0.929 | 0.11 |
読みどころは 3 つあります。
- クラスタの中身が別物になる:Ward は 23/15/8/1 とそれなりに割れますが、 単連結は 44/1/1/1 — 44 県が 1 つの巨大な塊になり、 北海道・東京都・大阪府だけが単独クラスタとして弾き出されます。 これが典型的な鎖効果(chaining)で、 単連結が「最も近い 1 ペア」だけで距離を測るため、 点が数珠つなぎに 1 本の細長い塊へ吸収される現象です。
- Ward との一致度(ARI)が低い:Ward と群平均で 0.41、 完全連結で 0.39、 単連結ではわずか 0.11(1.0 が完全一致、 0 が偶然レベル)。 つまり「どの県が同じグループか」という結論そのものが連結法で入れ替わります。 Ward 法だけを回して「これが都道府県の分類だ」と断定するのは危険です。
- コフェネティック相関が高い=良い分類、ではない:一見すると単連結(0.929)や群平均(0.949)は Ward(0.753)より coph 相関が高く、 「歪みが少ない優秀な樹形図」に見えます。 しかし coph 相関は元の距離を樹形図がどれだけ忠実に再現したかの指標であって、 実用的な分類の良さとは別物。 現に coph 0.929 の単連結は 44 県が 1 塊で分類として使い物になりません。 coph 相関だけで連結法を選んではいけない——シルエット係数やドメイン解釈と必ず併用します。
その他の実務上の罠(本ページ他セクションでも既述の要点を集約):スケール敏感で標準化必須(標準化を怠ると人口のような桁の大きい変数が距離を独占)、 計算量は O(n²〜n³)で大規模に弱い、 一度併合したら分け直せない貪欲(不可逆)、 外れ値 1 個が橋になって構造を壊す外れ値感度、 そして切断高さの任意性。 いずれも「複数設定で頑健性を確認する」姿勢で回避します。
🚀 発展 — 連結法・距離・評価の使い分け
- 連結法の比較を前提にする:single(鎖状)・complete(コンパクト)・average(中庸)・Ward(分散最小増加)を必ず複数試し、 共通して現れる塊を「ロバストなクラスタ」とみなす。 上表のように結果が割れるなら、 データに強い自然な分割は無いというメッセージ。
- Ward 法の位置づけ:均等サイズの球形クラスタを作りやすく、 k-means に近い性質(ユークリッド距離前提)。 上表でも唯一 8 県規模の中間クラスタを分離でき、 「東京だけ / 大阪だけ」に潰れない。 都道府県類型では無難な第一選択です。
- コフェネティック相関の正しい使い方:連結法選定の単独指標ではなく、 「樹形図が距離をどれだけ保存したか」の補助指標。 数値の高低より、 分類の解釈可能性・シルエット係数と合わせて読む。
- 距離尺度の選択:ユークリッド(標準化済み量的データ、 Ward 専用)、 マンハッタン(外れ値耐性、 Ward とは組めない)、 相関・コサイン(形状/方向の類似、 高次元疎データ)。 距離と連結法の整合性が崩れると結果が無意味になります。
- 大規模データの制約と代替:O(n²) のメモリ(n=1 万で距離行列だけで数百 MB)が壁。 サブサンプリング、 BIRCH で粗く束ねてから階層化、 fastcluster での高速化、 あるいは スペクトラルクラスタリングや DBSCAN など別系統を検討。 SSDSE-B(n=47)では無問題です。
- k-means との使い分け:構造・階層を見たい小〜中規模なら階層、 k が既知で大規模ならk-means。 混合戦略も有効——先に階層クラスタリングでデンドログラムから k を決め、 その k で k-means を回して大規模データに展開する「2 段階クラスタリング」が定番です。
関連ページ:Ward 法 / k-means / デンドログラム / クラスタリング / 距離(距離関数) / 標準化 / スペクトラルクラスタリング
🎮 触って理解する
左の散布図に点を置くと、 右に凝集型階層クラスタリングのデンドログラム(樹形図)が即座に描かれます。 連結法を切り替え、 切断高さのスライダーを動かすと、 散布図側のクラスタ着色がリアルタイムに連動します。 距離はユークリッド距離、 併合手順は Lance-Williams 更新式で正確に計算しています(外部ライブラリ不使用・完全オフライン)。
💡 直感:何が起きているのか
各点は最初「自分だけのクラスタ」。 毎ステップ、 いま最も近いクラスタ同士を1つに併合し、 その併合時の距離を樹形図の「高さ」として記録します。 これを点が1つのクラスタに集約されるまで繰り返すと、 全併合の履歴が樹形図になります。 樹形図を水平に切る高さを下げるほどクラスタ数 k は増え、 上げるほど減ります。 k を後から選べるのが階層クラスタリング最大の利点です。
⚠️ よくある落とし穴
- 連結法で結果が変わる:同じ点配置でも、 単連結/完全連結/群平均/Ward で樹形図の形も切断結果も変わります。 上のセレクトを切り替えて、 特に単連結と Ward を見比べてください。
- 鎖効果(chaining):単連結は「最も近い1ペア」だけで距離を測るため、 点が橋渡しのように連なると、 本来別の塊まで一本の細長いクラスタに巻き込みます。 2つの塊の間に点を数個一列に並べて単連結にすると再現できます。
- 標準化忘れ:この体験ではキャンバス座標(同一スケール)で計算していますが、 実データでは単位の大きい変数が距離を支配します。 実務では必ず標準化してから
linkageに渡します。 - 逆転(inversion):重心法・中央法では併合高さが前より下がる逆転が起きえます。 単連結・完全連結・群平均・Ward では起きないため、 このデモの4法では樹形図が単調になります。
🚀 発展
切断高さの決め方には、 「高さのジャンプが大きい所で切る」「各 k でシルエット係数を比較する」「解釈したい地域数に合わせる」などがあります。 併合履歴と元距離の整合度はコフェネティック相関で評価できます。 大規模化では基本実装の O(n³) が壁になり、 単連結用の SLINK(O(n²))や近似法が使われます。
関連ページ:Ward 法 / k-means / デンドログラム / クラスタリング / 距離(距離関数) / DBSCAN
🔖 キーワード索引(拡張版 — 階層クラスタリング)
結合基準・距離尺度・評価指標・大規模化トピックを網羅。