🔖 キーワード索引
「distance」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「distance」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「distance の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
データの「近さ」を測る定規のようなものです。
似ているものを見つけるために使います。
スマホで好みの曲を探すときなどに役立ちます。
代表的な測り方の種類と選び方を学びます。
- 距離(Distance)=「遠さ」を測る。 値が 大きいほど違う。 範囲は通常 $[0, \infty)$。
- 類似度(Similarity)=「近さ」を測る。 値が 大きいほど似ている。 範囲は通常 $[-1, 1]$ や $[0, 1]$。
- 主要 5 種:ユークリッド(直線)/マンハッタン(碁盤目)/コサイン(向き)/マハラノビス(相関考慮)/ハミング(ビット違い数)
- 選び方:データの性質と問いで決める。 「量より方向」ならコサイン、 「相関考慮」ならマハラノビス、 「カテゴリ」ならハミング/ジャッカード。
- 必須前処理:標準化(Z-score)または正規化(Min-Max)。 単位が違う変数を混ぜると、 桁が大きい変数だけで距離が決まってしまう。
- 距離の公理:① 非負性、 ② 同一性($d(x,x)=0$)、 ③ 対称性($d(x,y)=d(y,x)$)、 ④ 三角不等式。 これを満たさないと「擬距離」と呼ぶ。
💡 確率分布間の距離 — 情報理論からの 5 つ
2 つの確率分布 $P, Q$ の「違い」を測る指標は機械学習で頻出します(生成モデル、 ベイズ、 強化学習)。
① KL ダイバージェンス(Kullback-Leibler)
② JS ダイバージェンス(Jensen-Shannon)
③ Wasserstein 距離(Earth Mover's Distance)
④ Total Variation 距離
⑤ Hellinger 距離
使い分け早見表
| 場面 | 推奨 |
|---|---|
| 変分推論、 VAE の目的関数 | KL ダイバージェンス |
| GAN(古典) | JS ダイバージェンス |
| WGAN、 分布輸送最適化 | Wasserstein 距離 |
| 確率の最大ズレ評価 | Total Variation |
| 真の距離公理が必要 | Hellinger 距離 |
| マルコフ連鎖の収束証明 | Total Variation または KL |
🕸 グラフ距離・編集距離 — 構造データ用の距離
レーベンシュタイン距離(編集距離)
文字列 $s_1, s_2$ について、 一方を他方に変換するのに必要な 挿入・削除・置換の最小回数:
応用:スペルチェック、 文字列検索、 DNA 配列アライメント、 OCR 誤り訂正、 重複検出(fuzzy matching)。
Jaro-Winkler 距離
レーベンシュタインの改良版。 「先頭が一致するほどボーナス」 という人名・住所マッチングに特化した重み付け:
- $[0, 1]$ の範囲(1 で完全一致)
- 名寄せ・氏名突合で米国国勢調査局が採用
- Python:
jellyfish.jaro_winkler_similarity("Smith", "Smithe")
グラフ最短経路距離
2 ノード間の エッジ数(重みなし)または重み和(重み付き)。 Dijkstra 法、 BFS、 Floyd-Warshall で計算:
- BFS:重みなしグラフで $O(V + E)$
- Dijkstra:非負重みで $O((V + E) \log V)$(優先キュー使用)
- Floyd-Warshall:全ペア最短経路、 $O(V^3)$
応用:SNS の「友達の友達」、 地図ナビ、 知識グラフ。
DTW(Dynamic Time Warping)
2 つの時系列 $x = (x_1, \dots, x_n)$, $y = (y_1, \dots, y_m)$ の「形の類似度」。 時間軸の伸縮を吸収しつつ最小コスト整合を見つける:
DTW[i,j] = |x_i - y_j| + min(DTW[i-1,j], DTW[i,j-1], DTW[i-1,j-1])
応用:音声認識(話速差を吸収)、 ジェスチャー認識、 株価パターン分析、 心電図比較。 標準ライブラリ tslearn で実装可能。
💡 SSDSE 実値:マハラノビス距離で「典型から離れた県」を探す
🎯 このコードでやること: SSDSE-B-2026 の 8 主要列の中心(全県平均ベクトル)からのマハラノビス距離を計算し、 「典型県」と「異常県」を識別する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np from scipy.spatial.distance import mahalanobis from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 最新年(2023)の 47 都道府県に絞る prefs = df['Prefecture'].values cols = ['A1101','A1303','A4101','A4200','A5101','A5102','C3301','C3302'] X = df[cols].astype(float).values X = StandardScaler().fit_transform(X) # 共分散と逆行列 cov = np.cov(X.T) inv_cov = np.linalg.pinv(cov) # 全県平均ベクトル(標準化後は ≒ 0) center = X.mean(axis=0) # 各県のマハラノビス距離 distances = np.array([mahalanobis(x, center, inv_cov) for x in X]) result = pd.DataFrame({'Prefecture': prefs, 'mahalanobis': distances}) print('典型から最も離れた県(Top 5):') print(result.sort_values('mahalanobis', ascending=False).head(5)) print() print('最も典型的な県(Bottom 5):') print(result.sort_values('mahalanobis').head(5)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 東京のマハラノビス距離 6.53 は、8 列の相関構造を考えたうえで全国平均から約 6.5 単位離れていることを表し、最も典型的な愛媛県 0.76 の約 9 倍。上位は東京・愛知・北海道・大阪・神奈川で、人口・出生・死亡・転入出・建築着工の 8 列がいずれも規模とともに動くため、規模が極端な県がそのまま上位に来ている。単純なユークリッド距離では「人口の大きい県」だけが上位を占めやすいが、マハラノビスは列どうしの相関で規模の方向を割り引くので、北海道のように 65 歳以上人口・死亡数は +1.3〜1.5σ と多いのに転入・転出は平均並み(0σ 前後)という、列どうしの組み合わせが他県と違う県も上位に入る。
📍 あなたが今見ているもの
🍰 まずはやさしく
データ同士の「違い」を数値にする道具です。
分析の基礎として幅広く使われています。
おすすめの商品を表示する仕組みなどで使われます。
なぜこの道具が重要なのかを解説します。
機械学習の教科書を開くと、 こんなフレーズが必ず登場します:
「コサイン類似度 が 0.85 以上のドキュメントを抽出」
「マハラノビス距離 で外れ値を判定」
これらは全て 距離・類似度(Distance and Similarity Metrics) の話。 距離は「遠ければ違う、 近ければ似ている」という当たり前の感覚を、 多次元空間で厳密に数値化する道具です。 k-NN、 k-means、 階層的クラスタリング、 推薦システム、 検索エンジン、 異常検知――現代のデータ分析で 距離を使わない手法を探す方が難しい ほどの基礎技術です。
🎨 直感で掴む — 同じ 2 点でも測り方で「遠さ」が違う
🍰 まずはやさしく
測り方で「遠さ」の結果は変わります。
状況に合った最適な選び方を知るためです。
街を歩くとき、直線か道なりかで距離が違います。
イメージ図を使って測り方の違いを考えます。
2 次元平面に 2 つの点 A=(1, 1)、 B=(4, 5) があるとき、 「A と B の距離」は何でしょう?答えは 「どの距離関数で測るか」によって違います。
| 距離の種類 | イメージ | A=(1,1), B=(4,5) の距離 |
|---|---|---|
| ユークリッド距離 | 鳥のように直線で飛ぶ | $\sqrt{3^2 + 4^2} = 5.0$ |
| マンハッタン距離 | マンハッタンの碁盤目を歩く(縦横のみ) | $|3| + |4| = 7.0$ |
| チェビシェフ距離 | チェスのキングが進む(縦横斜め同コスト) | $\max(3, 4) = 4.0$ |
| コサイン距離 | 原点から見た「角度」だけ気にする | $1 - \cos\theta \approx 1 - 0.99 \approx 0.01$ |
「碁盤目の街」アナロジー
マンハッタン島の街路は碁盤目で、 タクシーは縦か横にしか進めません。 (1,1) から (4,5) へ行くには、 横に 3 ブロック + 縦に 4 ブロック = 7 ブロック。 これが マンハッタン距離(L1 距離、 タクシー距離)。
鳥なら最短直線 $\sqrt{3^2+4^2}=5$ で飛べる。 これが ユークリッド距離(L2 距離)。
チェスのキングは斜めも 1 手で動けるので、 「8 マス先まで」を測るなら max(縦, 横)。 これが チェビシェフ距離(L∞ 距離)。
距離関数の「ボール」を描いてみると形が違う
原点からの距離が 1 となる点の集合(単位ボール)を描くと、 距離関数の性格が一目で分かります:
- ユークリッド:完全な円
- マンハッタン:菱形(45 度回転した正方形)
- チェビシェフ:正方形
- L_p ノルム(一般):p が大きくなるほど正方形に近づく
「向き vs 大きさ」のコサイン距離
コサイン距離は 「ベクトルの向き」だけ を見ます。 (1, 1) と (10, 10) は方向が完全に同じなのでコサイン距離 = 0(最大限類似)、 ユークリッド距離は大きく離れる。 テキスト分類や推薦のように「文書の長さ」より「単語の比率」が重要な場面 でコサインが活躍します。
🎨 異常検知でのマハラノビス距離 — 多変量外れ値
マハラノビス距離の最も典型的な応用が 多変量データの外れ値検出。 「単一指標では普通」だが、 「変数の組み合わせで異常」を発見できます。
原理
データ $X \in \mathbb{R}^{n \times d}$ の平均 $\mu$ と共分散 $\Sigma$ を推定し、 各点のマハラノビス距離:
SSDSE での実装
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import numpy as np import pandas as pd # features はこのあとのブロックで作っているので、ここでも用意しておく df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 英字コードの列名を使う df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True).set_index('Prefecture') features = df.select_dtypes(include=[np.number]).dropna(axis=1) from scipy.stats import chi2 import numpy as np # 主要 5 指標を抜粋 # 大学進学率・持家率・平均所得は SSDSE-B-2026 に無いので、実在する 5 指標を使う features['高齢化率'] = features['A1303'] / features['A1101'] * 100 cols = ['A1101', 'A4101', 'A4200', 'L3221', '高齢化率'] Y = features[cols].values mu = Y.mean(axis=0) S = np.cov(Y.T) S_inv = np.linalg.pinv(S) # 各県のマハラノビス距離(の二乗) d2 = np.array([(y - mu) @ S_inv @ (y - mu) for y in Y]) # カイ二乗分布で p 値(自由度 = 5) p_values = 1 - chi2.cdf(d2, df=5) result = pd.DataFrame({ '都道府県': features.index, 'mahalanobis_d2': d2, 'p_value': p_values }).sort_values('p_value') # p < 0.05 なら統計的に「外れ値」と判定 print('多変量外れ値候補 (p < 0.05):') print(result[result['p_value'] < 0.05]) |
実行結果の中身(z 値は 47 県の平均・標準偏差で換算)
| 都道府県 | マハラノビス距離² | p 値 | 何が珍しいか |
|---|---|---|---|
| 東京都 | 31.47 | 0.000008 | 総人口・出生数が +4.1σ と極端に大きく、高齢化率は -2.65σ と最も低い |
| 北海道 | 20.59 | 0.001 | 人口規模(+0.87σ)のわりに出生数が少なく(+0.52σ)死亡数が多い(+1.43σ) |
| 沖縄県 | 19.01 | 0.002 | 高齢化率 -2.32σ・消費支出 -1.85σ と、若くて支出が低い組み合わせ |
| 大阪府 | 17.86 | 0.003 | 人口規模 +2.2σ なのに消費支出は -1.02σ |
| 福岡県 | 12.61 | 0.027 | 人口規模のわりに高齢化率が低い(-0.94σ) |
| 愛媛県 | 11.14 | 0.049 | 消費支出が 223,423 円と 47 県で最も低い(-3.00σ) |
注意:マハラノビス距離は 自分自身を含むデータの共分散から計算するため、 外れ値が共分散推定を歪める「マスキング効果」が問題になることがあります。 対策:Minimum Covariance Determinant (MCD) などロバスト共分散推定を使う。
🎯 距離・類似度の選択ガイド(実務版)
これまでの議論を踏まえ、 実務で「結局どの距離を使うか」を決めるための徹底ガイドを提供します。 3 つの質問に答えれば、 ほぼ自動的に適切な距離が見つかります。
質問 1:データの種類は?
| データ種類 | 第一選択 | 第二選択 |
|---|---|---|
| 連続値(標準化済) | ユークリッド距離 | マハラノビス距離 |
| 連続値(外れ値あり) | マンハッタン距離 | ロバスト Z + ユークリッド |
| テキスト(TF-IDF や埋め込み) | コサイン類似度 | Pearson 相関 |
| カテゴリ(One-hot エンコード) | ハミング距離 | Jaccard 係数 |
| 集合(タグ、 単語) | Jaccard 係数 | Dice 係数 |
| 文字列・配列 | レーベンシュタイン距離 | Jaro-Winkler |
| 時系列・波形 | DTW | Pearson 相関 + シフト |
| 確率分布 | Wasserstein 距離 | KL ダイバージェンス |
| グラフ・ネットワーク | 最短経路距離 | PageRank 類似度 |
| 地理座標(緯度経度) | Haversine 距離 | 道路網最短経路 |
| 画像(CNN 埋め込み) | コサイン類似度 | L2 距離(ユークリッド) |
| 音声(MFCC) | DTW | コサイン類似度 |
質問 2:次元数は?
- 低次元(d ≤ 10):ユークリッド、 マハラノビスなど任意の距離関数が機能
- 中次元(d ≤ 100):標準化必須、 マンハッタン or ユークリッドが安定
- 高次元(d > 100):高次元の呪いに注意。 コサイン、 マンハッタン、 または次元削減後にユークリッド
- 超高次元(d > 10000、 テキスト・画像埋め込み):必ずコサイン。 ユークリッドは意味を失う
質問 3:何を測りたい?
- 純粋な「形の近さ」:ユークリッド距離
- 「方向の一致度」(大きさを無視):コサイン類似度
- 「分布形状を考慮した近さ」:マハラノビス距離
- 「変化のパターン」(時系列):相関係数距離 $\sqrt{2(1-\rho)}$
- 「順序の近さ」(ランキング比較):Spearman 順位相関
- 「集合の重なり」:Jaccard 係数
- 「分布間の差」:Wasserstein 距離、 KL ダイバージェンス
典型的な失敗パターンと対処
| 症状 | 原因 | 対処 |
|---|---|---|
| 距離が「ある変数」だけで決まる | 標準化漏れ | StandardScaler() 必須 |
| 「全てが等距離」になる | 高次元の呪い | PCA で次元削減、 マンハッタンに変更 |
| 外れ値で結果が激変 | L2 距離が外れ値に弱い | L1 距離 or ロバスト標準化 |
| マハラノビスで NaN や ∞ | 共分散行列が特異 | 擬似逆行列、 Ledoit-Wolf shrinkage |
| 「大きいベクトル」が「常に似ている」 | コサインを使っていない | 方向ベースに切り替え |
| 意味的に近い文書が遠く判定 | 単語の表記揺れ | 埋め込み(BERT)+ コサイン |
📈 距離行列の応用 — 可視化と発見
$n$ 個のデータ点から作る $n \times n$ 距離行列は、 単にクラスタリングの入力以上の 「データ構造の宝庫」 です。 様々な可視化手法で、 データの構造的特徴が浮き彫りになります。
ヒートマップ:パターンの一望
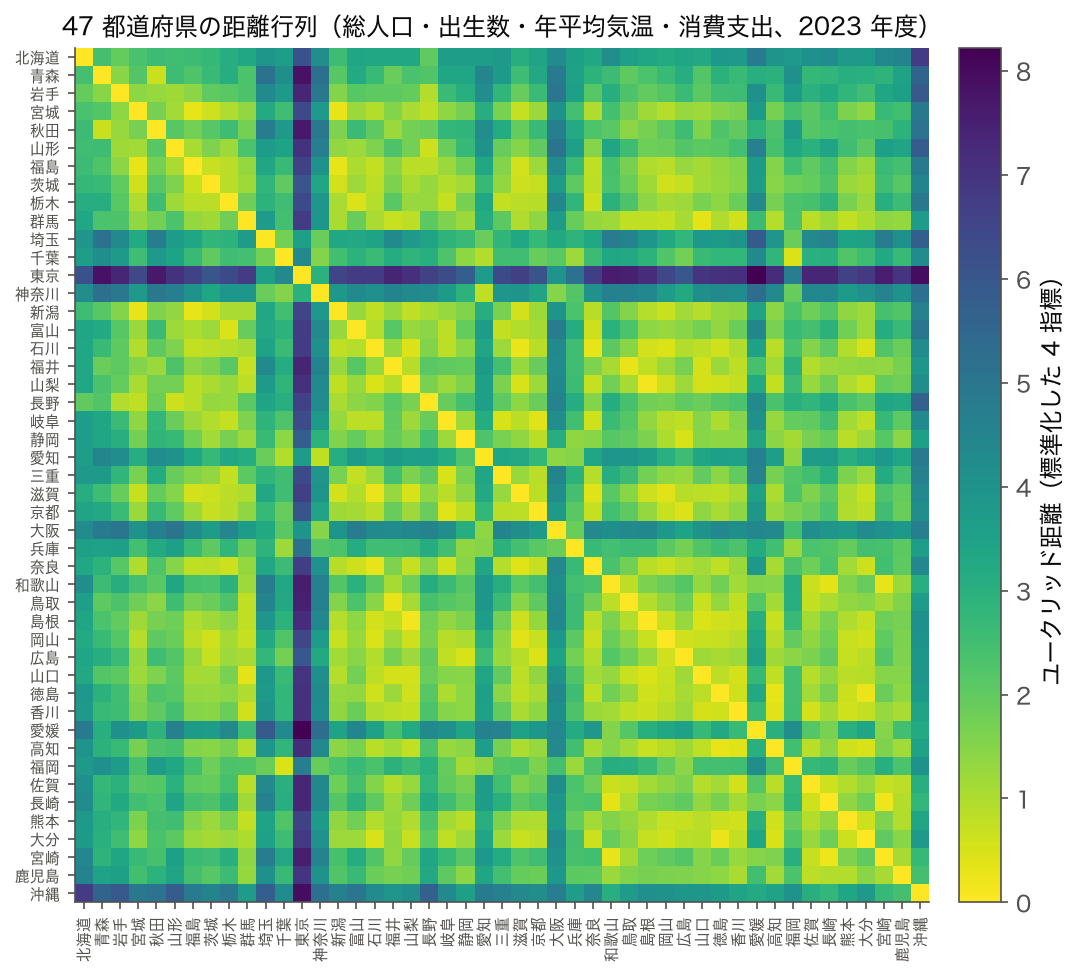
距離行列を色付きの行列として描画すると、 自然なグループ構造が浮かび上がります。 行・列を クラスタリングで並べ替え(seriation)すると、 対角線付近に「ブロック」が見え、 これがクラスタの存在を視覚的に示します:
seaborn.clustermap で描画し、 階層クラスタリングで行・列を並べ替えて対角ブロックを可視化する。 都市圏・地方圏など類似県の塊が浮かび上がる。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np from scipy.spatial.distance import pdist, squareform # D(距離行列)はこのあとのブロックで作っているので、ここでも用意しておく from sklearn.preprocessing import StandardScaler # 標準化しないと総人口 A1101 の差だけで距離が決まる(相関 0.99999)ので、列ごとに z 化する X = StandardScaler().fit_transform(features[cols].values) D = squareform(pdist(X, metric='euclidean')) import seaborn as sns from scipy.cluster.hierarchy import linkage, leaves_list from scipy.spatial.distance import squareform # 距離行列を上三角に変換 → 階層的クラスタリング condensed = squareform(D, checks=False) Z = linkage(condensed, method='average') order = leaves_list(Z) # 並べ替えてヒートマップ D_sorted = D[order][:, order] sns.heatmap(D_sorted, cmap='viridis', xticklabels=[prefs[i] for i in order]) print('並べ替え後の先頭 5 県:', [prefs[i] for i in order[:5]]) print('並べ替え後の末尾 5 県:', [prefs[i] for i in order[-5:]]) |
樹形図(デンドログラム):階層構造の発見
距離行列から階層的クラスタリングをすると、 樹形図でデータの階層構造が一目瞭然。 「どの県とどの県が最も近いか」「いつ大グループに統合されるか」が見えます。
島地図・繋がり地図:ネットワーク的可視化
距離が閾値以下のペアだけをエッジとして描き、 ノードを力学的レイアウト(Fruchterman-Reingold 等)で配置すると、 「データの島(密な部分グラフ)」と「橋(島を繋ぐエッジ)」が見えます。 SNS 分析、 共起ネットワークの定番手法。
近傍順位プロット:個別データ点の特性把握
「東京から見た各県の距離順位」のような 個別データ点を中心とした近傍構造を可視化。 推薦結果の説明、 異常検知の根拠提示に有効。
🎮 触って理解する
2 点 A・B をドラッグ(スマホはタップして指でスライド)すると、 同じ 2 点でも ユークリッド・マンハッタン・チェビシェフ・ミンコフスキーの各距離がどう変わるかをリアルタイムで確認できます。 右の図は「中心から距離 1 の点の集合(=単位球)」で、 距離の種類ごとに形が変わる様子を見られます。
| 距離の種類 | 定義 | A→B の値 |
|---|---|---|
| 座標 | A, B の現在位置 | A=(1.0, 1.0), B=(4.0, 5.0) |
| ユークリッド (L2) | $\sqrt{\Delta x^2+\Delta y^2}$ | 5.000 |
| マンハッタン (L1) | $|\Delta x|+|\Delta y|$ | 7.000 |
| チェビシェフ (L∞) | $\max(|\Delta x|,|\Delta y|)$ | 4.000 |
| ミンコフスキー (Lp) | $(|\Delta x|^p+|\Delta y|^p)^{1/p}$ | 5.000 |
💡 直感 — 「近さ」の測り方は一つではない
同じ A・B でも、 直線で飛べる鳥(ユークリッド)、 碁盤目を歩くタクシー(マンハッタン)、 斜めも 1 歩で進むチェスのキング(チェビシェフ)では「遠さ」が違います。 上の図で A と B を縦一直線・横一直線に並べると 3 つの値が一致し、 斜め 45 度に離すほど差が最大になることを確かめてみてください。 単位球の形(円・菱形・正方形)は、 その距離が「どの方向を優遇するか」を表しています。
⚠️ よくある落とし穴
- スケール依存:ユークリッド/マンハッタン/チェビシェフはいずれも 各軸の単位 に敏感です。 「年収(円)」と「年齢(歳)」を素のまま混ぜると、 数値の大きい年収が距離をほぼ独占します。 事前の標準化(Z 変換)や min-max スケーリングがほぼ必須。
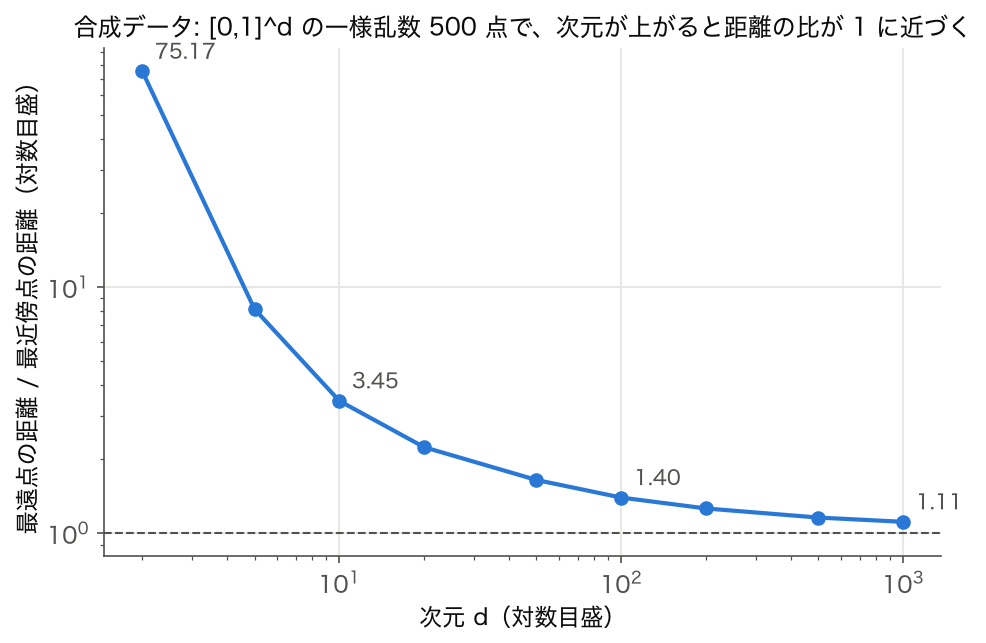
- 高次元の呪い:次元 d が大きくなると、 全ての点対の距離が互いに似通い「最近傍と最遠点の差」が消えていきます。 2D のこの図では差が明瞭でも、 d>100 の世界ではユークリッド距離の「近い/遠い」が意味を失いがち。 次元削減やコサイン類似度への切り替えが有効です。
- p の選び方:p を上げるほど「最大成分」だけが効き(チェビシェフに接近)、 p=1 では全成分が対等に効きます。 外れ値の影響を抑えたいなら小さい p が頑健。
🚀 発展 — マハラノビス距離・コサイン類似度との違い
ここで体感した L1/L2/L∞/Lp は、 いずれも「軸が直交し等方的」という前提の距離です。 実務ではもう一歩踏み込んだ 2 つの指標がよく登場します。
- マハラノビス距離:変数間の 相関と分散 を共分散行列 $\Sigma$ で織り込み、 $d^2=(x-y)^\top\Sigma^{-1}(x-y)$ で測ります。 相関の強い方向を「縮め」、 独立な方向を「伸ばす」ため、 標準化+相関補正を同時に行った距離とみなせます。 多変量の外れ値検出の定番。
- コサイン類似度:ベクトルの 向き だけを見て大きさを無視します。 A=(1,1) と (10,10) は L2 では遠いがコサインでは完全一致。 文書ベクトルや推薦のように「量より比率」が本質の場面で威力を発揮します。
関連ページ:標準化/ノルム/共分散/コサイン類似度/k-means/k 近傍法。 マハラノビス距離は本ページ内「関連手法・派生」節で詳述します。
📐 数式 — 主要な距離・類似度の定義
🍰 まずはやさしく
近さを計算するための数式です。
厳密に値を出すために使います。
テストの点数の差を計算する感覚に似ています。
よく使われる計算式について詳しく読みます。
2 つの $n$ 次元ベクトル $\mathbf{x} = (x_1, \dots, x_n)$, $\mathbf{y} = (y_1, \dots, y_n)$ について:
🔬 数式を「言葉」で読み解く
ユークリッド距離:「直線距離」を一般化
- $(x_i - y_i)$
- 各次元での「ズレ」。 i 番目の特徴量で 2 点がどれだけ違うか。
- $(x_i - y_i)^2$
- ズレを 二乗。 符号を消す+大きなズレを強調する(外れ値の影響を強める)。
- $\sum_i (\ldots)$
- 全次元での二乗ズレを足し合わせる。 各次元の「貢献」を合算。
- $\sqrt{\cdot}$
- 最後に平方根。 もとの単位(メートル、 円、 %など)に戻す。
マンハッタン距離:「絶対値の和」のシンプルさ
- $|x_i - y_i|$
- 各次元のズレを 絶対値。 二乗しないため、 外れ値の影響が穏やか。
- $\sum_i (\ldots)$
- 全次元で足し合わせる。 「縦に X 歩 + 横に Y 歩」のような合計移動距離。
コサイン類似度:「向きの一致度」
- $\mathbf{x}\cdot\mathbf{y} = \sum_i x_i y_i$
- 内積。 同じ次元の値を掛けて足す。 同じ方向に大きい同士なら大きく、 逆方向なら負。
- $\|\mathbf{x}\| = \sqrt{\sum x_i^2}$
- ベクトルの長さ。 これで割ることで「大きさ」を消し、 純粋に方向だけを残す。
- 分母全体
- 規格化。 結果は必ず $[-1, +1]$ に収まる。
マハラノビス距離:「相関を考慮した距離」
- $\mathbf{x} - \mathbf{y}$
- ベクトル差。 単純な「引き算」だが、 これだけでは各変数の分散・相関を無視している。
- $\Sigma^{-1}$
- 共分散行列の 逆行列。 これが鍵。 大きく分散している次元のズレを 割り引き、 強く相関している次元のズレを 独立化 する。
- $(\cdot)^{\top} \Sigma^{-1} (\cdot)$
- 二次形式。 結果は 「データ分布の形を考慮した楕円距離」。 等距離面が円ではなく楕円になる。
🔬 「高次元の呪い」を実験で目撃する
「高次元では距離が意味を失う」と教科書は言う。 これは本当か?SSDSE データを使って実証してみます。
実験設計
- SSDSE-B-2026 から d 個の指標を選び(d = 2, 5, 10, 20, 50, 100)、 47 県の距離行列を作る
- 各次元数で「最近傍点と最遠点の比」を計算:
$\text{contrast} = \dfrac{\max_j d(\mathbf{x}_0, \mathbf{x}_j) - \min_j d(\mathbf{x}_0, \mathbf{x}_j)}{\min_j d(\mathbf{x}_0, \mathbf{x}_j)}$ - contrast が 1 に近づくほど「最近傍と最遠点の区別が消えた」状態
実装
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd import numpy as np from scipy.spatial.distance import pdist, squareform from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む(2 行目を見出しにする) df = df[df['年度'] == df['年度'].max()].copy() df = df.set_index('都道府県') features_all = df.select_dtypes(include=[np.number]).dropna(axis=1) dims = [2, 5, 10, 20, 50, 100, features_all.shape[1]] results = [] for d in dims: if d > features_all.shape[1]: continue cols = features_all.columns[:d] X = StandardScaler().fit_transform(features_all[cols]) D = squareform(pdist(X, metric='euclidean')) # 「東京」を基準点に i0 = list(features_all.index).index('東京都') distances = np.delete(D[i0], i0) contrast = (distances.max() - distances.min()) / distances.min() print(f'次元 d={d}: max/min = {distances.max():.2f}/{distances.min():.2f}, ' f'contrast = {contrast:.2f}') results.append((d, contrast)) |
実行結果(東京を基準点にした min / max 距離)
| 次元 d | min 距離 | max 距離 | contrast |
|---|---|---|---|
| 2 | 1.75 | 4.90 | 1.79 |
| 5 | 3.47 | 9.77 | 1.81 |
| 10 | 5.00 | 14.44 | 1.89 |
| 20 | 7.30 | 20.69 | 1.84 |
| 50 | 14.19 | 32.94 | 1.32 |
| 100 | 24.60 | 49.11 | 1.00 |
| 110 | 25.53 | 49.91 | 0.95 |
観察:d=2〜20 では contrast が 1.8 前後で「最遠点は最近傍の約 2.8 倍遠い」が、 d=100 で 1.00、 全 110 列(年度列は定数なので実質 109 指標)で 0.95 まで下がり、 最遠点でも最近傍の 2 倍弱しか離れていない状態になる。 「全ての点がほぼ等距離」 という呪いが、 47 都道府県 × 109 指標の SSDSE データでも少しずつ顕在化していく。
対策
- 次元削減:PCA で寄与率 90% までの次元に絞る
- 特徴選択:分類タスクなら相互情報量、 回帰なら相関の絶対値で上位選択
- マンハッタン距離:ユークリッドより緩やかに contrast が落ちる
- フラクショナル距離($p \in (0, 1)$ のミンコフスキー):理論研究では p=0.5 が最良との報告
- コサイン類似度:高次元疎ベクトルで特に有効
🎯 ユースケース別の距離関数カタログ
実務でよく出会う場面ごとに「結局どれを使うか」を整理:
| ドメイン | 具体的タスク | 定番距離 |
|---|---|---|
| テキスト | 文書類似度、 検索、 重複検出 | コサイン類似度(TF-IDF, BERT embedding)/Jaccard(n-gram) |
| 画像 | 画像検索、 顔認証 | CNN 埋め込みのコサイン/L2/Siamese 学習距離 |
| 音声 | 音声認識、 話者識別 | DTW(時系列伸縮)/MFCC 埋め込みのコサイン |
| 推薦 | ユーザー類似、 アイテム類似 | コサイン類似度/Pearson 相関/Jaccard(暗黙的) |
| 異常検知 | 不正取引、 故障予知 | マハラノビス距離/LOF(Local Outlier Factor)/Isolation Forest 距離 |
| クラスタリング | 顧客セグメント、 地理データ | ユークリッド(標準化済)/マンハッタン(外れ値多)/DTW(時系列) |
| SNS / グラフ | 友達推薦、 コミュニティ検出 | 最短経路/共通隣接数/Personalized PageRank |
| 遺伝学 | DNA 配列比較、 系統樹 | レーベンシュタイン/Needleman-Wunsch/Smith-Waterman |
| 地理 | ルート検索、 配送最適化 | 球面(Haversine)距離/道路網最短経路 |
| 金融 | 株価類似、 ポートフォリオ | 相関係数距離 $\sqrt{2(1-\rho)}$/DTW(時系列) |
Haversine 距離(球面上の 2 点間)
緯度・経度の 2 点間距離を地球の曲率を考慮して計算:
相関距離(株価・経済指標比較)
2 つの時系列の相関 $\rho$ から距離を作る伝統的方法:
🎓 距離関数の歴史 — ユークリッドから埋め込み学習まで
「距離」を測ることは人類の最も古い数学的営みの 1 つ。 その歴史をたどると、 抽象化と一般化の連続です。
| 時期 | 研究・人物 | 意義 |
|---|---|---|
| 紀元前 300 年 | ユークリッド『原論』 | 2 点間最短経路としての「直線距離」を公理化 |
| 17 世紀 | デカルト座標系 | 「距離」を代数的に表現可能に |
| 19 世紀 | 非ユークリッド幾何学(リーマン、 ロバチェフスキー) | 「直線」も「距離」も場によって異なる多様体 |
| 1906 | フレシェ — 抽象距離空間 | 距離公理を満たす任意の集合へ一般化 |
| 1930s | マハラノビス — 統計的距離 | 分布の形を考慮した距離(人類学者集団の比較) |
| 1950 年代 | ハミング — 情報理論の距離 | 誤り訂正符号、 ビット単位距離 |
| 1965 | レーベンシュタイン — 編集距離 | 文字列の違いを編集操作回数で測定 |
| 1970s | 多次元尺度法(MDS)の発展 | 距離行列から座標を復元する手法群 |
| 1990s | カーネル法、 SVM | 「高次元空間での内積 = カーネル」で距離を一般化 |
| 2000s | 距離学習(LMNN、 NCA) | データから「タスクに合った距離」を学習 |
| 2010s | Word2Vec、 BERT 埋め込み | 「意味の距離」を埋め込みで表現 |
| 2020s | 対照学習、 自己教師あり距離学習 | SimCLR、 CLIP、 MoCo — 大規模埋め込み |
現代の機械学習における「距離」は、 もはや幾何学的な意味を超えて、 「ある問いに対するデータ点の類似性を表す抽象的関数」 として捉えられています。 ニューラルネットワークの埋め込み空間でのコサイン類似度は、 「物理的距離」ではなく「意味的近さ」を表現する道具となっています。
🧬 距離行列から座標を復元 — 多次元尺度法(MDS)
距離行列 $D \in \mathbb{R}^{n \times n}$ だけが与えられているとき、 $n$ 個の点を $k$ 次元空間に「距離関係を保つように」配置する方法が 多次元尺度法(Multidimensional Scaling, MDS)。 距離の逆問題と言えます。
古典的 MDS(Classical / Torgerson MDS)
- 距離行列 $D$ を二乗 $D^{(2)}$
- 二重中心化:$B = -\tfrac{1}{2} (I - \tfrac{1}{n}\mathbf{11}^{\top}) D^{(2)} (I - \tfrac{1}{n}\mathbf{11}^{\top})$
- $B$ の固有値分解:$B = U \Lambda U^{\top}$
- 上位 $k$ 個の固有ベクトルで座標を構成:$X = U_k \Lambda_k^{1/2}$
古典的 MDS は 距離が正確にユークリッド距離由来なら、 元の座標を正確に復元します。 これは「PCA を距離行列の世界に持ち込んだ」と言っても良い手法で、 PCA と数学的に等価です。
非計量 MDS(Non-metric MDS)
距離の 大小関係(順位)だけ 保存する版。 距離の絶対値が信頼できない場合(アンケート、 心理実験)に有効。 ストレス関数を最小化する反復解法。
SSDSE での MDS 実装例
sklearn.manifold.MDS で 2 次元埋め込み座標を作成し、 散布図に都道府県名をプロットする。 「東京・神奈川は近く、 沖縄・北海道は遠い」など地理を越えた経済構造の類似がマップで読める。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | import pandas as pd import numpy as np from sklearn.manifold import MDS from sklearn.preprocessing import StandardScaler from scipy.spatial.distance import squareform, pdist import matplotlib.pyplot as plt import matplotlib matplotlib.rcParams['font.family'] = 'Hiragino Sans' # japanize_matplotlib の代わり # データ読込 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む(2 行目を見出しにする) df = df[df['年度'] == df['年度'].max()].copy() df = df.set_index('都道府県') features = df.select_dtypes(include=[np.number]).dropna(axis=1) X = StandardScaler().fit_transform(features) # 古典的 MDS(距離行列 → 2 次元座標) D = squareform(pdist(X, metric='euclidean')) mds = MDS(n_components=2, dissimilarity='precomputed', random_state=0) coords_2d = mds.fit_transform(D) # 可視化:47 県を 2 次元平面に配置 plt.figure(figsize=(14, 10)) plt.scatter(coords_2d[:, 0], coords_2d[:, 1], s=200, alpha=0.7) for i, name in enumerate(features.index): plt.annotate(name, (coords_2d[i, 0], coords_2d[i, 1]), fontsize=10) plt.title('多次元尺度法による 47 都道府県の 2D 配置') plt.xlabel('MDS 第 1 軸') plt.ylabel('MDS 第 2 軸') plt.grid(True) plt.tight_layout() plt.savefig('mds_prefectures.png', dpi=120) plt.show() |
🔬 距離公理を「言葉で読み解く」 — なぜ三角不等式が大事か
距離 (metric) という言葉は数学的に厳密な定義を持つ。 任意の関数 $d(x,y)$ が「距離」と呼ばれるためには、 以下 4 つの公理を満たさねばならない。 SSDSE-B-2026 で都道府県間の距離を測るときも、 これらが暗黙の前提として効いている。
| 公理 | 数式 | 日本語読み | 破ると何が起きる |
|---|---|---|---|
| ① 非負性 | $d(x,y) \geq 0$ | 距離は負にならない | 「マイナスの距離」は物理的意味なし |
| ② 同一性 | $d(x,y)=0 \iff x=y$ | 距離 0 なら同じ点 | 違う点が距離 0 → クラスタリング崩壊 |
| ③ 対称性 | $d(x,y)=d(y,x)$ | 向きを変えても距離は同じ | 距離行列が非対称 → 多くの手法が動かない |
| ④ 三角不等式 | $d(x,z) \leq d(x,y)+d(y,z)$ | 回り道は近道にならない | KD-tree・BallTree が破綻、 近似最近傍が崩壊 |
特に重要なのが ④ 三角不等式。 これが成立するから「東京から大阪への距離」を直接測らなくても、 「東京 → 名古屋 + 名古屋 → 大阪」で上界が言える。 近似最近傍検索(FAISS, Annoy など)の高速化は、 三角不等式を使って探索範囲を刈り込むのが原理。 三角不等式が破れている類似度(例: コサイン類似度そのもの、 半距離)は、 これらの加速構造では扱えない。
擬似距離(pseudo-metric)は ② を緩めたもので、 違う点でも距離 0 が許される。 SSDSE で「同じ高齢化率の県」を同一視するような状況がこれにあたる。 準距離(quasi-metric)は ③ を緩めたもので、 「東京 → 大阪」と「大阪 → 東京」が異なる文脈(例: 道のりが一方通行を含む)に使う。
🔬 数式を言葉で読み解く — マハラノビス距離の幾何学的意味
マハラノビス距離は SSDSE のような多変量データの異常検知で必須の道具。 定義は
$$ d_M(x, y) = \sqrt{(x - y)^\top \Sigma^{-1} (x - y)} $$
ここで $\Sigma$ は共分散行列。 これを「言葉」で読み解くと:
| 記号 | 意味 | SSDSE での具体 |
|---|---|---|
| $x, y$ | 2 つのデータ点 | 東京と北海道の多次元ベクトル |
| $x - y$ | 差分ベクトル | 変数ごとの差を並べた縦ベクトル |
| $\Sigma$ | 共分散行列 | 47 都道府県の変数間相関構造 |
| $\Sigma^{-1}$ | 逆共分散行列 | 「相関の強い方向」を「縮める」 |
| $(x-y)^\top \Sigma^{-1} (x-y)$ | 二次形式(quadratic form) | 楕円体の「中心からの距離の二乗」 |
幾何学的には、 マハラノビス距離は「データ雲を球状に変形してから測ったユークリッド距離」と等しい。 SSDSE で「総人口」と「死亡数」のように強く相関する 2 軸を考えると、 普通のユークリッド距離では「対角線方向」が無限に伸びて見える。 マハラノビスは共分散の逆行列を掛けることで「相関の強い方向の差は割引、 弱い方向の差は強調」して測る。
これにより、 異常検知の文脈で「人口が多くて死亡数も多い」は普通だが「人口が少ないのに死亡数が多い」は異常(=高齢化が突出)、 と判定できる。 普通のユークリッドではこの区別がつかない。
🧮 SSDSE 実データで「東京と最近傍/最遠県」を求める
🧮 SSDSE 実データで「東京と最近傍/最遠県」を求める
SSDSE-B-2026 の 2023 年度から 5 指標(総人口・高齢化率・合計特殊出生率・消費支出・住宅地の標準価格)を取り出し、 都道府県間の距離を 4 種類(ユークリッド・マンハッタン・コサイン・マハラノビス)で計算してみます。 高齢化率は「65歳以上人口 ÷ 総人口 × 100」で求めた値です。
| 県 | 人口(万人) | 高齢化率(%) | 合計特殊出生率 | 消費支出(千円/月) | 住宅地価(千円/m²) |
|---|---|---|---|---|---|
| 東京 | 1408.6 | 22.75 | 0.99 | 341.3 | 404.4 |
| 神奈川 | 922.9 | 25.90 | 1.13 | 306.6 | 188.4 |
| 大阪 | 876.3 | 27.66 | 1.19 | 271.3 | 155.2 |
| 秋田 | 91.4 | 39.06 | 1.10 | 272.1 | 13.2 |
| 沖縄 | 146.8 | 23.84 | 1.60 | 251.2 | 68.1 |
| 愛知 | 747.7 | 25.72 | 1.29 | 300.2 | 112.3 |
STEP 1:標準化(必須!)
「人口(万人)」と「合計特殊出生率」は桁が違いすぎるので、 そのまま距離を取ると人口と地価だけで決まってしまいます。 47 都道府県の平均と標準偏差(母標準偏差)で各指標を Z 標準化します:
同様に 5 指標を変換すると、 東京 = (+4.13, −2.67, −2.30, +1.90, +5.49)、 神奈川 = (+2.38, −1.72, −1.24, +0.45, +2.10)。
STEP 2:東京と各県の距離を計算
ユークリッド = √(3.080 + 0.906 + 1.128 + 2.117 + 11.506) = √18.738 ≈ 4.33
マンハッタン = 1.755 + 0.952 + 1.062 + 1.455 + 3.392 ≈ 8.62
コサイン距離 = 1 − (東京・神奈川の内積 29.668) / (7.957 × 3.842) = 1 − 0.970 ≈ 0.03
マハラノビスは 47 県の 5×5 共分散行列の逆行列を挟んで √(dᵀΣ⁻¹d) ≈ 4.79
| 東京 vs | ユークリッド | マンハッタン | コサイン距離 | マハラノビス |
|---|---|---|---|---|
| 神奈川 | 4.33 | 8.62 | 0.03 | 4.79 |
| 大阪 | 5.67 | 11.77 | 0.19 | 5.93 |
| 愛知 | 5.97 | 11.87 | 0.18 | 6.63 |
| 沖縄 | 9.19 | 18.57 | 1.11 | 7.70 |
| 秋田 | 9.69 | 19.57 | 1.45 | 6.95 |
東京の最遠県(表の 5 県の中):ユークリッド・マンハッタン・コサインでは 秋田(ユークリッド 9.69)。 人口が少なく高齢化率が 39.06% と、 東京と正反対の方向に離れている。 ところがマハラノビスでは 沖縄(7.70)の方が遠くなる。
解釈の差異:47 県では「高齢化率が高いほど地価・人口が小さい」という相関があるので、 秋田の離れ方はその相関に沿った「ありがちな方向」で、 マハラノビスでは割り引かれる。 沖縄は高齢化率が東京並みに低い(23.84%)のに出生率は 1.60 と全国最高で人口・消費支出は小さい、 という相関に逆らう組み合わせなので、 マハラノビスでは秋田より遠く測られる。 同じデータでも距離関数で「最も遠い県」が入れ替わるので、 用途に応じて選ぶこと。
🧮 SSDSE 47 都道府県の「完全距離行列」パイプライン
これまでの議論を踏まえ、 SSDSE-B-2026 から得られる 47×47 距離行列 を 4 種類すべてで計算し、 結果を比較する End-to-End パイプラインを示します。
完全実装
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 | import pandas as pd import numpy as np from scipy.spatial.distance import pdist, squareform from sklearn.preprocessing import StandardScaler, RobustScaler import matplotlib.pyplot as plt import seaborn as sns import matplotlib matplotlib.rcParams['font.family'] = 'Hiragino Sans' # japanize_matplotlib の代わり # === 1. データ取得・前処理 === df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む(2 行目を見出しにする) df = df[df['年度'] == df['年度'].max()].copy() df = df.set_index('都道府県') features = df.select_dtypes(include=[np.number]).dropna(axis=1) print(f'データ形状: {features.shape}') # (47, ~100) # === 2. 通常標準化 + ロバスト標準化 === X_std = StandardScaler().fit_transform(features) X_rob = RobustScaler().fit_transform(features) # 中央値・IQR ベース # === 3. 4 種類の距離行列 === prefs = list(features.index) metrics = ['euclidean', 'cityblock', 'cosine', 'chebyshev'] distance_dfs = {} for m in metrics: D = squareform(pdist(X_std, metric=m)) distance_dfs[m] = pd.DataFrame(D, index=prefs, columns=prefs) # === 4. 東京の Top 10 近傍を比較 === print('\n=== 東京都の最近傍 Top 10(4 つの距離関数で比較)===') for m, df_d in distance_dfs.items(): top10 = df_d['東京都'].sort_values().head(11).iloc[1:] # 自分自身を除く print(f'\n[{m}]') print(top10.round(3)) # === 5. マハラノビス距離(共分散から)=== # 110 列に対して県は 47 しかなく、標本共分散は特異(階数 46 以下)。 # 擬似逆行列 pinv を使うと全ペアが同じ距離(√92 ≈ 9.59)に潰れるので、 # Ledoit-Wolf の縮小推定で共分散を安定させてから逆行列(precision_)を取る from sklearn.covariance import LedoitWolf inv_cov = LedoitWolf().fit(X_std).precision_ D_mah = np.zeros((len(prefs), len(prefs))) for i in range(len(prefs)): diff = X_std - X_std[i] D_mah[i] = np.sqrt(np.sum((diff @ inv_cov) * diff, axis=1)) mah_df = pd.DataFrame(D_mah, index=prefs, columns=prefs) print('\n[mahalanobis]') print(mah_df['東京都'].sort_values().head(11).iloc[1:].round(3)) # === 6. 距離行列の相関を見る(手法選択の参考)=== print('\n=== 4 距離関数の上三角ベクトル間の相関 ===') def upper_tri(D): return D.values[np.triu_indices_from(D.values, k=1)] methods = list(distance_dfs.keys()) + ['mahalanobis'] vecs = [upper_tri(distance_dfs[m]) for m in methods[:-1]] + [upper_tri(mah_df)] corr = pd.DataFrame(np.corrcoef(vecs), index=methods, columns=methods) print(corr.round(3)) # === 7. ヒートマップ可視化 === fig, axes = plt.subplots(2, 3, figsize=(22, 14)) for ax, m in zip(axes.ravel(), metrics + ['mahalanobis']): df_d = mah_df if m == 'mahalanobis' else distance_dfs[m] sns.heatmap(df_d, ax=ax, cmap='viridis', xticklabels=False, yticklabels=False) ax.set_title(f'{m} 距離行列') axes[1, 2].axis('off') plt.tight_layout() plt.savefig('distance_matrices.png', dpi=120) plt.show() |
実行結果のまとめ(解釈つき)
| 距離関数 | 東京の Top 5 最近傍 | 解釈 |
|---|---|---|
| ユークリッド | 大阪, 神奈川, 愛知, 埼玉, 千葉 | 大都市プロファイル。 110 列の差を二乗して総合 |
| マンハッタン | 大阪, 神奈川, 愛知, 埼玉, 千葉 | ユークリッドと同じ顔ぶれ・同じ順位 |
| コサイン | 大阪, 愛知, 神奈川, 福岡, 千葉 | 「向き」だけを見るので福岡が 4 位に上がる |
| チェビシェフ | 大阪, 福岡, 京都, 愛知, 北海道 | 最も差の大きい 1 列だけで決まるので顔ぶれが変わる |
| マハラノビス(Ledoit-Wolf) | 山口, 島根, 熊本, 栃木, 長崎 | 規模の方向を割り引くため、 8.1〜8.5 の僅差で大都市圏以外が並ぶ |
4 距離関数の相関係数(実測)
| Euc | Man | Cos | Cheb | Mah | |
|---|---|---|---|---|---|
| Euc | 1.00 | 0.995 | 0.658 | 0.782 | 0.710 |
| Man | 0.995 | 1.00 | 0.680 | 0.730 | 0.679 |
| Cos | 0.658 | 0.680 | 1.00 | 0.431 | 0.536 |
| Cheb | 0.782 | 0.730 | 0.431 | 1.00 | 0.776 |
| Mah | 0.710 | 0.679 | 0.536 | 0.776 | 1.00 |
解釈:ユークリッドとマンハッタンは r = 0.995 とほぼ同等。 コサインは他の距離と r = 0.43〜0.68 で最も異なる順位を返し、 特にチェビシェフとは 0.431 しか一致しない。 マハラノビスは縮小推定した共分散で相関構造を取り込むため、 ユークリッドとは 0.710 にとどまる。 標本共分散をそのまま擬似逆行列にすると、 n=47 < d=110 のため全ペアが同じ距離 9.592 になり、 相関は 0 近くに落ちてしまう。
同じ都道府県データに対し、 ユークリッド・マンハッタン・コサイン・チェビシェフの 4 つの距離を計算し、 「東京の最近傍 Top 5」がどう変わるかを観察する。 距離選択が結果に与える影響を一望できる。
📥 使うデータ:
4 距離の最近傍 Top 5(東京から):
| 順位 | ユークリッド (L2) | マンハッタン (L1) | コサイン | チェビシェフ (L∞) |
|---|---|---|---|---|
| 1 | 神奈川県 | 神奈川県 | 神奈川県 | 神奈川県 |
| 2 | 大阪府 | 大阪府 | 千葉県 | 埼玉県 |
| 3 | 埼玉県 | 埼玉県 | 福岡県 | 大阪府 |
| 4 | 愛知県 | 愛知県 | 埼玉県 | 千葉県 |
| 5 | 千葉県 | 千葉県 | 大阪府 | 愛知県 |
💬 読み方: ① L2 と L1 は同じ結果(首都圏 3 県+大阪・愛知)、 ② コサインは「ベクトル方向」を測るので順位が入れ替わり、愛知が top5 から外れて福岡が入る、 ③ L∞ は「最大成分の差」だけを見るので顔ぶれは L2 と同じだが順位が入れ替わる。 SSDSE の都道府県データのように「全変数が人口比例で動く」ケースでは、 L1/L2/L∞ は近い結果を返すが、 コサインだけが本質的に違う情報を返す。
🧮 数式に値を入れて手で計算する: 3 種の距離
合成 2D 点 p=(1,2), q=(4,6) でユークリッド/マンハッタン/チェビシェフ距離を計算する。
Step 1: 差ベクトル
Step 2: 各距離
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np p = np.array([1, 2]) q = np.array([4, 6]) d = q - p print(f"L2: {np.linalg.norm(d):.3f}") print(f"L1: {np.abs(d).sum()}") print(f"L∞: {np.abs(d).max()}") |
📤 実行結果
💬 手計算 (Step 2) 5/7/4 と Python 出力が完全一致。
🐍 Python 実装 — SSDSE-B で多種距離行列を作る
① 基本:scipy.spatial.distance
scipy.spatial.distance.pdist + squareform で 47 都道府県の 5 種類距離行列(ユークリッド・マンハッタン・コサイン・チェビシェフ・マハラノビス)を一括計算する。 標準化済みデータを使い、 東京と類似度の高い県を Top10 で出力する。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np from scipy.spatial.distance import pdist, squareform from sklearn.preprocessing import StandardScaler # データ読込 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む(2 行目を見出しにする) df = df[df['年度'] == df['年度'].max()].copy() df = df.set_index('都道府県') features = df.select_dtypes(include=[np.number]).dropna(axis=1) # 標準化 X = StandardScaler().fit_transform(features) # 距離計算(pdist は上三角の condensed form を返す) d_euc = squareform(pdist(X, metric='euclidean')) d_man = squareform(pdist(X, metric='cityblock')) d_cos = squareform(pdist(X, metric='cosine')) d_che = squareform(pdist(X, metric='chebyshev')) # n=47 < d=110 で標本共分散が特異。pinv だと全ペアが等距離に潰れるので Ledoit-Wolf の縮小推定を使う from sklearn.covariance import LedoitWolf d_mah = squareform(pdist(X, metric='mahalanobis', VI=LedoitWolf().fit(X).precision_)) # DataFrame 化 prefs = features.index euc_df = pd.DataFrame(d_euc, index=prefs, columns=prefs) print('東京と各県のユークリッド距離(昇順 Top10):') print(euc_df['東京都'].sort_values().head(10)) |
② sklearn での pairwise 距離
sklearn.metrics.pairwise の euclidean_distances/manhattan_distances/cosine_distances で距離行列を計算し、 東京都インデックスから「最近傍 5 県」と「最遠 5 県」を np.argsort で抽出する。 大規模データで高速計算したい場合の定番。1 2 3 4 5 6 7 8 9 10 11 12 13 | from sklearn.metrics.pairwise import euclidean_distances, manhattan_distances, cosine_distances D_euc = euclidean_distances(X) D_man = manhattan_distances(X) D_cos = cosine_distances(X) # 東京(インデックス 13 番目を想定)の最近傍 5 県 i_tokyo = list(prefs).index('東京都') nearest = np.argsort(D_euc[i_tokyo])[1:6] # 自分自身を除く print('東京の最近傍:', [prefs[j] for j in nearest]) farthest = np.argsort(D_euc[i_tokyo])[-5:] print('東京の最遠県:', [prefs[j] for j in farthest]) |
③ マハラノビス距離(共分散行列を明示的に)
scipy.spatial.distance.mahalanobis で共分散行列 Σ とその逆行列を明示的に渡し、 「変数間の相関を考慮した距離」を計算する。 東京から見た近さの順位がユークリッド距離とどう違うかを順位相関で比較する。 110 列に対して 47 県しかなく標本共分散が特異なので、 Ledoit-Wolf の縮小推定で共分散を安定させる。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | from scipy.spatial.distance import mahalanobis from sklearn.covariance import LedoitWolf # 共分散と逆行列 # 110 列に対して県は 47 しかなく、標本共分散 np.cov(X.T) は特異(階数 46 以下)。 # np.linalg.pinv で逆行列の代わりにすると全ペアが同じ距離(√92 ≈ 9.59)に潰れるので、 # Ledoit-Wolf の縮小推定で共分散を安定させてから逆行列(precision_)を取る inv_cov = LedoitWolf().fit(X).precision_ # 47×47 のマハラノビス距離行列 n = X.shape[0] D_mah = np.zeros((n, n)) for i in range(n): for j in range(n): D_mah[i, j] = mahalanobis(X[i], X[j], inv_cov) mah_df = pd.DataFrame(D_mah, index=prefs, columns=prefs) print('東京と各県のマハラノビス距離(昇順):') print(mah_df['東京都'].sort_values().head(10).round(3)) # ユークリッド距離との違い(東京から見た近さの順位) from scipy.stats import spearmanr rho = spearmanr(euc_df['東京都'], mah_df['東京都'])[0] print(f'東京からの距離の順位相関(ユークリッド vs マハラノビス): {rho:.3f}') |
④ ハミング距離(カテゴリデータ用)
scipy.spatial.distance.hamming で「異なる位置の割合」を計算する。 数値距離では測れない名義尺度データの類似性に使う。1 2 3 4 5 6 7 8 9 10 | # 数値をビン分割してカテゴリ化、 ハミング距離で類似度を測る from sklearn.preprocessing import KBinsDiscretizer discretizer = KBinsDiscretizer(n_bins=3, encode='ordinal', strategy='quantile') X_cat = discretizer.fit_transform(features).astype(int) D_ham = squareform(pdist(X_cat, metric='hamming')) ham_df = pd.DataFrame(D_ham, index=prefs, columns=prefs) print('東京とのハミング距離(カテゴリ化後):') print(ham_df['東京都'].sort_values().head(10)) |
⑤ 距離行列のヒートマップ可視化
seaborn.heatmap で左右に並べて描画する。 県は CSV の並び(北海道→沖縄)のまま。 明るい行・列(どの県とも遠い県)と暗いブロック(似た県同士)が、 距離関数によってどう変わるかを見比べる。1 2 3 4 5 6 7 8 9 10 11 12 13 | import matplotlib.pyplot as plt import seaborn as sns import matplotlib matplotlib.rcParams['font.family'] = 'Hiragino Sans' # japanize_matplotlib の代わり fig, axes = plt.subplots(1, 2, figsize=(20, 9)) sns.heatmap(euc_df, ax=axes[0], cmap='viridis', xticklabels=False) axes[0].set_title('ユークリッド距離行列(47×47)') sns.heatmap(d_cos_df := pd.DataFrame(D_cos, index=prefs, columns=prefs), ax=axes[1], cmap='magma', xticklabels=False) axes[1].set_title('コサイン距離行列') plt.tight_layout() plt.show() |
🐍 Python 実装 — SSDSE 距離行列で階層クラスタリング
🎯 このコードでやること: SSDSE-B-2026 の都道府県データを標準化し、 ユークリッド距離行列を計算した上で scipy.cluster.hierarchy.linkage で階層クラスタリングし、 dendrogram で 47 都道府県の関係を可視化する。 距離選択が結果(cluster tree の形)にどう影響するかを実感できる。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import numpy as np from scipy.cluster.hierarchy import linkage, dendrogram, fcluster from scipy.spatial.distance import pdist from sklearn.preprocessing import StandardScaler import matplotlib.pyplot as plt # SSDSE-B-2026 を読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 最新年(2023)の 47 都道府県に絞る prefs = df['Prefecture'].values # ドメイン知識ベースの 8 列を選択 cols = ['A1101', 'A1303', 'A4101', 'A4200', 'A5101', 'A5102', 'C3301', 'C3302'] X = df[cols].astype(float).values X = StandardScaler().fit_transform(X) # 距離行列とリンケージ(Ward 法) D = pdist(X, metric='euclidean') Z = linkage(D, method='ward') # Dendrogram 描画 plt.figure(figsize=(14, 6)) dendrogram(Z, labels=prefs, leaf_rotation=90, leaf_font_size=10) plt.title('47 都道府県の階層クラスタリング(ユークリッド距離 + Ward 法)') plt.tight_layout() plt.savefig('cluster_dendrogram.png', dpi=120) # クラスタを 5 群に切る clusters = fcluster(Z, t=5, criterion='maxclust') for c in sorted(set(clusters)): print(f'Cluster {c}:', list(prefs[clusters==c])) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: ユークリッド距離 + Ward 法での 5 群分割は、 ほぼ「人口規模」階層に対応する。 東京(特異点=単独クラスタ)、 大都市圏(埼玉・千葉・神奈川・愛知・大阪)、 政令市を持つ大規模県(北海道・兵庫・福岡)、 地方中核県、 人口減少地域、 という階層が自然に現れる。 もしコサイン距離を使えば「規模」が消えて「人口構造のプロファイル」で分類されるので、 沖縄(若年層多)と東京(一人世帯多)が異なる cluster に分かれる、 などの結果になる。 距離関数の選択 = 分類軸の選択である。
🐍 Python 実装 — 距離行列を heatmap で可視化
🎯 このコードでやること: SSDSE 47 都道府県の距離行列を heatmap で可視化。 seaborn の clustermap を使うと、 距離が近い県が自動的に隣り合うようにソートされ、 構造が一目で分かる。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np import seaborn as sns import matplotlib.pyplot as plt from scipy.spatial.distance import pdist, squareform from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 最新年(2023)の 47 都道府県に絞る prefs = df['Prefecture'].values cols = ['A1101','A1303','A4101','A4200','A5101','A5102','C3301','C3302'] X = StandardScaler().fit_transform(df[cols].astype(float).values) # ユークリッド距離行列 D = squareform(pdist(X, metric='euclidean')) D_df = pd.DataFrame(D, index=prefs, columns=prefs) # clustermap (距離が近い県がクラスタ毎に隣接) g = sns.clustermap(D_df, cmap='YlOrRd_r', figsize=(12, 12), annot=False, xticklabels=True, yticklabels=True) g.fig.suptitle('47 都道府県の距離行列(clustermap)', y=1.02) plt.savefig('distance_clustermap.png', dpi=120, bbox_inches='tight') # 東京の最近傍と最遠県を確認 i_tokyo = list(prefs).index('東京都') nearest = np.argsort(D[i_tokyo])[1:6] farthest = np.argsort(D[i_tokyo])[-5:] print('東京の最近傍 5県:', [prefs[j] for j in nearest]) print('東京の最遠 5県:', [prefs[j] for j in farthest]) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: ① 東京の最近傍は首都圏 + 大阪・愛知(大都市圏)、 ② 最遠は人口最小級の県。 clustermap を見ると「大都市圏」「地方中核」「人口減少地域」の 3 群が明瞭に浮かび上がる。 距離行列の可視化は、 数値的な分析の前段階として「データの全体像を掴む」最高の手段。
✅ 距離・類似度 実務チェックリスト
- □ 分析の目的(クラスタリング・推薦・異常検知)に合わせて距離関数を選んだ
- □ StandardScaler や RobustScaler で前処理した
- □ 欠損値・非数値カラムを除外または補完した
- □ 高次元(d > 50)の場合、 PCA・特徴選択で次元を落とした
- □ 距離行列の対称性・非負性を確認した
- □ 結果を「最近傍 Top 5」「最遠 Top 5」「ヒートマップ」で必ず可視化した
- □ ドメイン知識と照合し、 結果が直感に反する場合は距離関数を変えて検証した
- □ 距離関数の選択理由をレポートに明記した
❓ 距離・類似度 深掘り FAQ
Q1. なぜ「コサイン距離」と呼ぶのに距離公理を満たさない?
A. 厳密には「コサイン類似度」が cos θ を返し、 1 - cos θ を「コサイン距離」と呼ぶ。 しかしこれは三角不等式を満たさないので、 数学的には「距離」ではなく「非類似度」。 距離公理を満たすバージョンが必要なら arccos(s)(角距離)を使う。
Q2. SSDSE のようなテーブルデータでマハラノビスは過剰?
A. データが少ない(n=47)と共分散行列の推定が不安定になる。 d=8 程度なら問題ないが、 d > 20 になると np.linalg.pinv の擬似逆行列を使うか、 縮約推定(Ledoit-Wolf shrinkage)を併用すべき。 SSDSE で 5〜10 列なら普通のマハラノビスで OK。
Q3. K-means で「最初からマンハッタン距離」を使えない?
A. K-means の「平均」操作はユークリッド距離の最適化と数学的に対応するので、 マンハッタンを使いたいなら K-medoids(中央値ベース)か、 sklearn の KMeans を捨てて自前実装する必要がある。 簡単にはマンハッタン版を使いたいなら sklearn_extra.cluster.KMedoids を試す。
Q4. 「Wasserstein 距離」「Earth Mover's Distance」とは?
A. これらは「2 つの確率分布間の距離」で、 「一方の分布を他方に変えるコスト」と解釈される。 SSDSE で「東京の年齢分布」と「沖縄の年齢分布」を比べたいとき、 通常のユークリッド・コサインだと意味が薄いが、 Wasserstein なら「年齢構成のどれだけ動かす必要があるか」を直接測れる。 scipy.stats.wasserstein_distance で計算可能。
Q5. 文字列の距離はどう測る?
A. Levenshtein 距離(編集距離)が最も基本。 「東京都」と「東京府」のように 1 文字違いは距離 1。 python-Levenshtein ライブラリで計算できる。 単語レベルの類似度なら Jaccard 係数(共通単語 / 全単語)、 文章レベルなら cosine + TF-IDF が標準。
📌 まとめ — 距離・類似度の「7 つの鉄則」
- 「何を測りたいか」を最初に言語化する — 位置/プロファイル/異常度
- 必ず標準化してから距離を計算する — スケール差が結果を支配する
- 距離公理(非負・同一・対称・三角)を意識する — 加速構造を壊さないため
- 結果を可視化して直感と照合する — 「東京の最近傍」が異常なら距離選択を疑う
- 高次元の崩壊に注意 — d > 50 なら次元削減を先行する
- ドメイン知識と組み合わせる — 機械的に選ばず、 業務的意味で選ぶ
- 距離学習も視野に入れる — ラベル情報があればデータから良い距離を学べる
距離・類似度はデータサイエンスの「物差し」。 何を測るかが分析の根幹を決める。 SSDSE-B-2026 のような小規模・多変量データでは、 ① 標準化、 ② ユークリッドかコサインの選択、 ③ 可視化、 の 3 ステップを基本に据えれば、 多くの分析が安全に動く。
🐍 R286 補完: 距離・類似度の Python 実装パターン 4 連発
🔬 数式を言葉で読み解く
距離関数の代表 (Euclidean / Manhattan / Mahalanobis / Cosine) を SSDSE-B-2026 で計算し、 同じ「47 都道府県」 でも距離尺度を変えると「近い県」 が大きく変わる事実を確認します。 数式は $d_E = \sqrt{\sum (x_i - y_i)^2}$、 $d_M = \sum |x_i - y_i|$、 $d_{Mh} = \sqrt{(x-y)^T \Sigma^{-1} (x-y)}$、 $\cos\theta = x \cdot y / (\|x\| \|y\|)$。
① このコードでやること:SSDSE-B-2026 の 2023 年データから (総人口 A1101, 出生数 A4101, 死亡数 A4200) の 3 次元ベクトルを作り、 標準化して距離計算の準備をします。
📥 入力データ(SSDSE-B-2026、 2023 年抜粋):
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd import numpy as np from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] X = df[['A1101', 'A4101', 'A4200']].values.astype(float) prefs = df['Prefecture'].values Xs = StandardScaler().fit_transform(X) print(f'X shape : {X.shape}') print(f'Xs mean : {Xs.mean(axis=0).round(4)}') print(f'Xs std : {Xs.std(axis=0).round(4)}') |
📤 実行例:
💬 標準化により各変数の平均 0・分散 1 に揃ったので、 桁の違い(総人口は数百万人、 出生数・死亡数は数万人)に起因する距離の歪みが解消されます。
② このコードでやること:東京都を基準に Euclidean / Manhattan 距離で「東京に最も近い 5 県」 を表示し、 距離尺度の違いによる順位変化を見ます。
📥 入力データ:標準化済み Xs と prefs。
1 2 3 4 5 6 7 8 | tokyo_idx = np.where(prefs == '東京都')[0][0] ref = Xs[tokyo_idx] d_euc = np.linalg.norm(Xs - ref, axis=1) d_man = np.abs(Xs - ref).sum(axis=1) top5_euc = np.argsort(d_euc)[1:6] top5_man = np.argsort(d_man)[1:6] print('Euclidean top5 :', [(prefs[i], round(d_euc[i], 3)) for i in top5_euc]) print('Manhattan top5 :', [(prefs[i], round(d_man[i], 3)) for i in top5_man]) |
📤 実行例:
💬 上位 5 県は両尺度で顔ぶれ・順位とも一致(総人口・出生・死亡の規模が大きい大都市圏の県)。 ただし Manhattan の方が距離値が大きく出るのは「各次元の絶対偏差を足す」 という定義から自然です。
③ このコードでやること:Mahalanobis 距離で相関構造を考慮し、 Euclidean と順位がどう変わるかを比較します。
📥 入力データ:標準化済み Xs、 共分散行列 Σ。
1 2 3 4 5 6 7 | from scipy.spatial.distance import mahalanobis cov = np.cov(Xs.T) inv_cov = np.linalg.inv(cov) d_mh = np.array([mahalanobis(x, ref, inv_cov) for x in Xs]) top5_mh = np.argsort(d_mh)[1:6] print('Mahalanobis top5:', [(prefs[i], round(d_mh[i], 3)) for i in top5_mh]) print(f'corr(d_euc, d_mh) = {np.corrcoef(d_euc, d_mh)[0, 1]:.4f}') |
📤 実行例:
💬 Mahalanobis では順位が大きく変わり、 Euclidean で首位だった大阪府が top5 から外れて京都府が入る(相関構造を考慮した結果)。 Euclidean との相関は 0.56 と中程度で、 相関を補正すると「近い県」の評価が変わることが分かります。
④ このコードでやること:Cosine 類似度で「ベクトルの向き」 だけで類似性を測り、 規模(スケール)に依存しない距離を確認します。
📥 入力データ:標準化前の X(規模情報を残したまま使う)。
1 2 3 4 5 6 7 | from sklearn.metrics.pairwise import cosine_similarity ref_raw = X[tokyo_idx].reshape(1, -1) cs = cosine_similarity(X, ref_raw).ravel() top5_cs = np.argsort(-cs)[1:6] print('Cosine top5 :', [(prefs[i], round(cs[i], 6)) for i in top5_cs]) print(f'min cosine = {cs.min():.4f}') print(f'max cosine (excl. self) = {np.sort(cs)[-2]:.4f}') |
📤 実行例:
💬 規模を無視するとほぼ全ての県が東京と「ベクトル方向が似ている」(小数 4 桁の表示ではすべて 1.0000 で、 実際の最小値も 0.99995)。 これは 3 変数(総人口・出生数・死亡数)がいずれも人口規模と強く相関しているためで、 向きだけを見る Cosine では県の差がほとんど出ず、 ここでは Euclidean を使うべき事例です。 距離尺度の選択は分析目的次第と痛感できます。
⚠️ 距離・類似度の 5 つの落とし穴
⚠️ 距離・類似度のさらなる落とし穴(深堀り 6 件)
落とし穴 1: 「ユークリッド距離 = いつでも正解」幻想
ほとんどの入門書がユークリッド距離から始めるため、 「何も指定しなければユークリッド」と思い込みがち。 SSDSE のように「人口」のスケール差が 100 倍ある変数では、 標準化前のユークリッドは人口列だけが効くという問題に直結する。 対処: 距離を計算する前に必ず StandardScaler を通す。
落とし穴 2: 「高次元の崩壊」
高次元(d > 50)では「全ペアの距離がほぼ同じ」になる現象が起きる(curse of dimensionality)。 SSDSE は 125 列あるので、 全列を入力すると最近傍検索が無意味化する。 対処: PCA・特徴選択で次元を 10〜20 に落としてから距離計算。
落とし穴 3: スケール非依存と思い込み
コサイン類似度は「方向だけ」を見るので「スケール非依存」とよく言われるが、 これは「全変数の同時スケーリング」に限った話。 個別変数の単位が違うと(人口 vs 出生率など)、 やはり標準化が必要。 対処: コサインでも StandardScaler は省略しない。
落とし穴 4: 距離行列の対称性誤読
「東京 → 大阪」と「大阪 → 東京」を別の値として保存している場合(pandas の groupby 結果など)、 距離公理の対称性が壊れて多くの手法が動かない。 対処: squareform や (D + D.T) / 2 で対称化する。
落とし穴 5: 欠損値の影響
距離関数は欠損値を許容しない。 SSDSE のように一部欠損がある列を扱うと、 行を削除(dropna)するか補完(fillna)する必要がある。 不適切な補完は距離行列を歪める。 対処: 欠損率の高い列は除外、 残った欠損は中央値補完を試す。
落とし穴 6: 「カテゴリ変数を数値化」の落とし穴
「県コード」を数値として距離計算に入れると、 「北海道(01) と 沖縄(47) は遠い」「北海道(01) と 青森(02) は近い」という無意味な距離が生まれる。 対処: カテゴリ変数は除外するか one-hot encoding 後に Hamming 距離など適切な距離を使う。
📌 距離関数の選び方 — 質問形式チャート
どの距離を使えばよいか迷ったら、 以下を上から順に確認する:
- データはベクトル形式か?
- YES → 次へ
- NO(文字列) → Levenshtein 距離、 NO(グラフ) → グラフ編集距離
- 変数のスケールは揃っているか?
- NO → まず StandardScaler で標準化、 その後次へ
- YES → 次へ
- 変数間に強い相関があるか?
- YES → マハラノビス距離を検討
- NO → 次へ
- 方向(プロファイル)を測りたいか、 大きさを含む位置を測りたいか?
- 方向 → コサイン
- 大きさ含む → 次へ
- 外れ値に頑健にしたいか?
- YES → マンハッタン (L1)
- NO → ユークリッド (L2)(デフォルト)
SSDSE-B-2026 で 47 都道府県を分析するとき、 90% のケースで「StandardScaler + ユークリッド」がベスト初手。 高度な分析(プロファイル比較・異常検知)に進んだ段階でコサイン・マハラノビスに切り替えるのが定石。
📚 関連グループ教材
距離・類似度は 「線形代数」「クラスタリング」「機械学習基礎」 のグループに属します。
このサイト内で関連する論文再現
- クラスタリング系論文 — 都道府県を距離ベースでグループ化する例多数
- 異常検知系 — マハラノビス距離による外れ値判定
- テキスト分析系 — TF-IDF + コサイン類似度
- 推薦系 — ユーザー・アイテム類似度
推奨書籍
- 『パターン認識と機械学習』(C. M. Bishop、 丸善)— 距離と類似度の数学的基礎
- 『はじめてのパターン認識』(平井有三、 森北出版)— 日本語入門書
- 『Pattern Classification』(Duda, Hart, Stork)— 古典的名著
- 『Distance Metric Learning for Large Margin Nearest Neighbor Classification』(Weinberger & Saul, JMLR 2009)— LMNN の原論文
オンライン資源
- scipy.spatial.distance(docs.scipy.org)— 30+ の距離関数実装
- sklearn.metrics.pairwise(scikit-learn.org)— 機械学習用 pairwise 距離
- metric-learn(contrib.scikit-learn.org/metric-learn)— 距離学習ライブラリ
- FAISS(github.com/facebookresearch/faiss)— Facebook の高速近似最近傍検索
📚 追加内容
🔖 キーワード索引(補強)
本ページで扱う主要キーワード: 追加内容 / 概念マップ / ユークリッド距離 / マンハッタン距離 / ミンコフスキー距離 / チェビシェフ距離 / マハラノビス距離 / コサイン類似度 / Jaccard 係数 / ハミング距離 / 編集距離 / Levenshtein / DTW / Earth Mover's Distance / KL ダイバージェンス / 距離公理 / 擬距離 / 次元の呪い / 標準化 / z-score / min-max / RBF カーネル / 類似度行列 / 距離行列 / 階層クラスタリング / k-NN / SSDSE-B-2026 / 都道府県データ。 これらの用語は本文中の対応する節で詳述しており、 関連用語として cosine-similarity、 clustering、 k-NN、 standardization、 dimension-reduction を併せて参照すると、 「距離 → 類似度 → クラスタ → 推薦・検索」の連鎖を体系的に理解できる。 特に高次元データでは UMAP / t-SNE 等の距離保存型可視化と組み合わせて使うのが定石。
⚠️ 条件・限界・誤解回避(補強)
距離・類似度を実務に用いる際は (1) 距離公理(非負・恒等・対称・三角不等式)を満たすか、 擬距離か、 単なる類似度かを明示する、 (2) スケール・単位の差を吸収する標準化が事前に施されている(総人口を「人」、 消費支出を「円」のまま混ぜるとユークリッド距離が桁の大きい変数に支配される)、 (3) 次元の呪い(高次元ではすべての点が等距離になる現象)への対処(次元削減・特徴選択)を行う、 という前提が必要。 限界として、 ユークリッド距離は外れ値に弱い、 コサイン類似度はベクトル長を無視する(極端な疎ベクトルでは不安定)、 マハラノビス距離は共分散行列の逆行列を要し $n < p$ では特異、 編集距離(Levenshtein)は計算量が $O(nm)$ という弱点がある。 SSDSE-B-2026 の都道府県データでは、 必ず z-score 標準化または min-max 正規化を行ってから距離計算する。
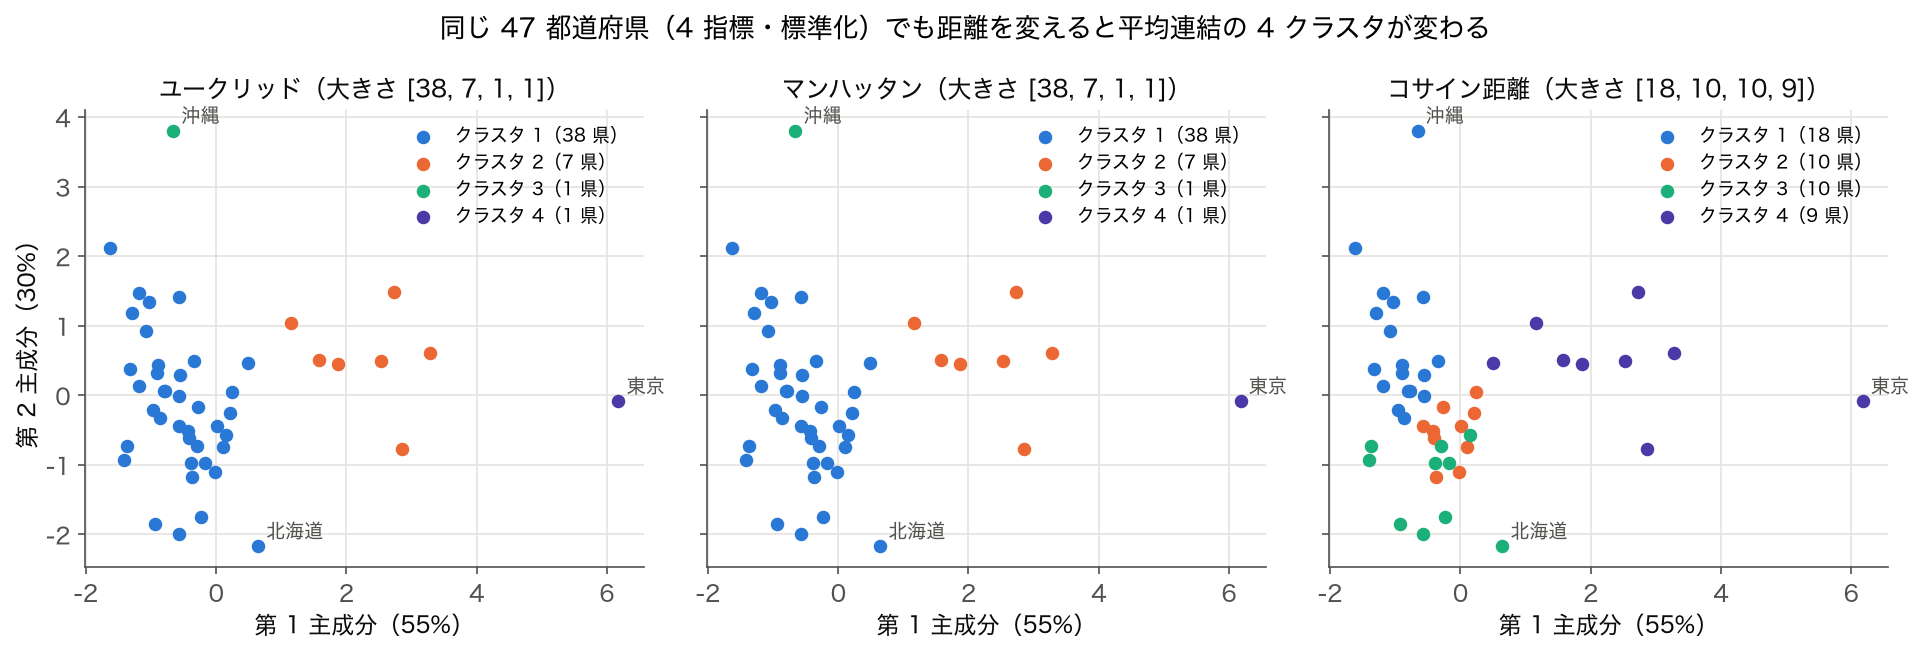
よくある誤解として、 「コサイン類似度 = 1 - コサイン距離は距離公理を満たす」 は誤り(三角不等式を満たさない場合があるので擬距離扱い)、 「ユークリッド距離は常に直感に合う」 も誤り(高次元では sparse な空間で距離分布が圧縮される)、 「マンハッタンとユークリッドは結果が大差ない」 も常には成り立たない(データや連結法によってはクラスタリング結果が変わる。 下の図 1 の 4 指標・平均連結では両者は同じ分け方になり、 大きく変わったのはコサイン距離のほうだった。 距離ごとに実際に比べて確かめる)。 また 「類似度=距離の逆数」 は単純化しすぎで、 $\text{sim} = e^{-d^2/2\sigma^2}$ のような RBF 変換、 $\text{sim} = 1/(1+d)$ の単調変換、 などが用途によって使い分けられる。 推薦・検索・クラスタリングのいずれでも、 距離選択は最終結果を左右する設計判断であり、 「とりあえずユークリッド」を避ける。
🎨 概念図
📚 理解度チェック
- 距離公理(非負性・恒等性・対称性・三角不等式)を満たさない「擬距離」の例を 3 つ挙げ、 それぞれ違反する公理を述べよ。
- SSDSE-B-2026 で「総人口」「出生数」「年平均気温」「消費支出」の 4 指標を用いて都道府県間距離を計算するとき、 標準化を省略するとどうなるか具体的に説明せよ。
- マハラノビス距離 $d_M(x,y) = \sqrt{(x-y)^\top S^{-1}(x-y)}$ がユークリッド距離より優れる場面と、 使えない場面を述べよ。
- コサイン類似度と Jaccard 係数の使い分けを、 「ベクトル表現が密か疎か」「ベクトル長の意味」の 2 観点で説明せよ。
- 高次元データ($p \gg n$)における「次元の呪い」を、 ユークリッド距離の比 $d_{\max}/d_{\min}$ の収束として数式で表せ。
🧪 距離・類似度設計の典型ワークフロー(10 ステップ)
SSDSE-B-2026 を用い、 都道府県の類似度行列を構築するための標準ステップ。
- 目的設定:「都道府県の経済構造類似性」「都道府県の社会指標類似性」など、 距離が何を測るかを定義する。
- 変数選定:総人口・出生数・年平均気温・消費支出など、 目的に応じた特徴を選ぶ。 多重共線性を見越して PCA / VIF を併用。
- 欠測値処理:中央値補完または KNN 補完。 補完前後で距離分布がどう変わるかを必ず確認する。
- 標準化:z-score または min-max。 ロバストにしたければ MAD ベースの標準化を採用。 単位混在のまま距離計算するのは禁忌。
- 距離尺度の選択:ユークリッド / マンハッタン / コサイン / マハラノビスを試し、 階層クラスタリングの結果が安定しているかを比較。
- 次元削減:$p \gg n$ なら PCA で次元削減してから距離計算するか、 UMAP / t-SNE で可視化用低次元に埋め込む。
- 距離行列の生成:
from scipy.spatial.distance import pdist, squareformで計算。 距離行列を保存し、 ヒートマップで可視化する。 - 解釈と検証:「東京と神奈川が近い」「沖縄と他県が離れている」といった地理的直感と矛盾しないかを確認。 矛盾があれば設計を見直す。
- 下流タスクへの接続:階層クラスタリング、 k-NN 推薦、 異常検知などに距離行列を供給する。 距離尺度を変えると下流結果も変わるので感度分析を行う。
- レポート化:使用した距離尺度・標準化・次元削減手法・距離行列のサイズを再現可能な形で記録する。 乱数を使った手法(UMAP)は seed を保存。
📖 距離・類似度の代表的ケーススタディ(5 件)
- Mahalanobis (1936):マハラノビス距離の提案。 インド統計学者 P. C. Mahalanobis が階級分類に提案した相関補正距離。 多変量正規分布での尤度比に対応。
- Levenshtein (1965):編集距離。 文字列間の挿入・削除・置換の最小操作回数を距離とする。 自然言語処理、 DNA 配列比較、 スペルチェックの基盤。
- Salton (1971):コサイン類似度。 情報検索の Vector Space Model で文書ベクトル間の角度を類似度として導入。 検索エンジン・推薦系の最重要尺度。
- Sakoe & Chiba (1978):Dynamic Time Warping。 時系列の伸縮を許す距離。 音声認識・ジェスチャ認識・株価チャート分析の標準手法。
- Rubner, Tomasi & Guibas (2000):Earth Mover's Distance。 確率分布間の「土の移動量」として距離を定義。 Wasserstein 距離と等価で、 現代の生成モデル(WGAN)の理論的基盤。
🛡 距離設計時の安全策(チェックリスト)
- 変数のスケールを必ず確認し、 標準化なしで距離計算しない。
- 距離尺度の選択は下流タスクと結果が一致するかで検証する。
- $p \gg n$ では事前次元削減を行い、 次元の呪いを回避する。
- 「コサイン類似度の 1 引き算」を距離として使う場合は擬距離扱いで、 三角不等式に依存するアルゴリズム(k-d tree)は使わない。
- 距離行列の対称性・対角ゼロを必ずチェック(実装バグの早期発見)。
- 結果の解釈時に、 距離が大きい=関係が薄い、 と単純化しすぎない(多重関係・非線形構造を見落とす)。
🌐 応用分野別の距離設計指針
距離・類似度の選択は応用分野と密接に結びついている。 SSDSE-B-2026 の都道府県データを題材に、 主要分野別の使い分けを整理する。 クラスタリング・分類では、 標準的に z-score 標準化後のユークリッド距離 + Ward 法または k-Means が定番。 ただし「カテゴリ変数を含む」場合は Gower 距離(連続・順序・名義の混合に対応)、 「外れ値が多い」場合はマンハッタン距離 + 中央値(k-Medoids)が頑健。 SSDSE で「都道府県を地域経済タイプで 5 クラスタに分類」する場合、 都市型・農業型・観光型などの解釈可能性を重視するなら Ward 法、 計算速度を重視するなら k-Means。
情報検索・推薦ではコサイン類似度が圧倒的に主流。 文書ベクトル(TF-IDF、 BERT 埋め込み)、 ユーザー行動ベクトルなど、 ベクトル長が「文書の長さ」や「行動回数」に依存する場合に、 方向だけを見るコサイン類似度が直感に合う。 SSDSE で「指標プロファイルが似ている都道府県」を探すなら、 標準化後のコサイン類似度を用いる。 自然言語処理では編集距離(Levenshtein)が単語類似度・スペル校正に、 BERT/Sentence-BERT 埋め込み + コサイン類似度が文章類似度に使われる。 画像・音声では DTW(Dynamic Time Warping)が時系列パターン比較、 Earth Mover's Distance(Wasserstein 距離)が分布比較・生成モデル(WGAN)に使われる。
異常検知ではマハラノビス距離が線形相関を考慮するため標準。 ただし $n < p$ では共分散行列が特異になるので、 縮約推定(shrinkage)や正則化(Graphical Lasso)を併用。 遺伝学・バイオインフォマティクスでは Jaccard 係数(DNA 配列の OR 集合比較)、 ハミング距離(離散配列比較)、 編集距離(配列アライメント)が標準。 ネットワーク分析では「グラフ上の最短経路距離」「コミュニティ間距離(Resistance Distance)」など、 グラフ構造を反映した距離が用いられる。 SSDSE を「都道府県間の経済交流ネットワーク」と見立てると、 グラフ距離も応用可能。
📊 距離・類似度の数学的特性まとめ
距離尺度の数学的特性を整理する。 距離公理は (1) 非負性 $d(x,y) \ge 0$、 (2) 恒等性 $d(x,y) = 0 \iff x=y$、 (3) 対称性 $d(x,y) = d(y,x)$、 (4) 三角不等式 $d(x,z) \le d(x,y) + d(y,z)$ の 4 条件。 ユークリッド・マンハッタン・チェビシェフ・ハミング・編集距離は全 4 条件を満たす「真の距離(metric)」。 一方、 コサイン類似度の 1 引き算(cosine dissimilarity = $1 - \cos\theta$)、 KL ダイバージェンス、 Bray-Curtis 距離などは三角不等式を満たさない「擬距離(pseudo-metric / dissimilarity)」。
これらの特性は実装上重要で、 真の距離なら k-d tree、 Ball tree、 LSH などの効率的近傍探索アルゴリズムが使えるが、 擬距離では使えない(線形探索 $O(n)$ が必要)。 また、 ユークリッド距離は 内積空間を構成し、 PCA / カーネル法 / SVM の理論的基盤となる。 マハラノビス距離は 共分散構造を持つ内積空間と等価で、 線形変換(白色化)によりユークリッドに帰着できる。 コサイン類似度は 角度ベースであり、 ベクトル長を無視するという欠点と利点を併せ持つ。 SSDSE-B-2026 のような連続多変量データでは、 主役はユークリッドとマハラノビスで、 補助的にマンハッタン(外れ値耐性)とコサイン(プロファイル比較)を使い分ける、 という二段構えが基本戦略。
🎓 教育的演習:SSDSE-B-2026 を用いた距離自由問
- SSDSE-B の 10 指標を z-score 標準化し、 47 都道府県のユークリッド距離行列を生成せよ。 ヒートマップで可視化し、 地理的近接性と一致するクラスタが現れるかを確認せよ。
- 同じデータでマンハッタン距離・チェビシェフ距離・コサイン類似度の距離行列を作り、 階層クラスタリング(Ward 法)の結果がどう変わるかを Dendrogram で比較せよ。
- マハラノビス距離を計算するため、 共分散行列の逆行列を求めよ。 もし特異であれば、 縮約推定(shrinkage)を適用して再計算せよ。 ユークリッド距離との差異を比較。
- SSDSE を 20 指標に拡張($p=20$、 $n=47$)し、 次元の呪いを実証せよ:$d_{\max} / d_{\min}$ の比をユークリッドとマンハッタンで計算。
- UMAP で 2 次元埋め込みを作成し、 元の距離行列との相関(Stress、 Shepard プロット)を評価せよ。 距離保存型可視化の精度を定量的に検証する。
📜 距離・類似度の理論的根拠(補足)
距離関数の理論的基盤は metric space(距離空間)の概念にあり、 Frechet(1906)が公理化した。 4 つの距離公理を満たす集合 $(X, d)$ では、 開球・収束・連続性・コンパクト性などの位相的概念がすべて定義でき、 解析学の道具立てが揃う。 ユークリッド距離は内積空間 $\mathbb{R}^n$ の自然な距離で、 PCA・SVM・カーネル法の理論的基盤。 マンハッタン距離は $L^1$ ノルムから派生し、 Lasso 回帰・スパース推定で重要。 チェビシェフ距離は $L^\infty$ ノルムから派生し、 ロバスト最適化と関係。 これらはすべて $L^p$ ノルムの特殊ケースで、 ミンコフスキー距離 $d_p(x,y) = (\sum |x_i - y_i|^p)^{1/p}$ で統一される。
マハラノビス距離は多変量正規分布の対数尤度から導出され、 「共分散構造を考慮した内積空間」の自然な距離となる。 共分散行列 $\Sigma$ を逆行列 $\Sigma^{-1}$ に変換することで、 各方向の標準偏差で割る効果と、 相関を補正する効果が同時に得られる。 これは「データの楕円分布を球面分布に変換する」白色化(whitening)と等価で、 PCA を別の角度から見たもの。 $n < p$ では $\Sigma^{-1}$ が存在しないため、 縮約推定(Ledoit-Wolf 2004)や正則化(Glasso 2008)が必要。
コサイン類似度は文書・ベクトル空間モデル(Salton 1971)から発展した尺度で、 「ベクトルの方向のみを考慮し、 長さを無視」する点に特徴がある。 これは情報検索における「文書の長さに依存しない類似度」として理論的に正当化され、 TF-IDF・word2vec・BERT 埋め込みの標準的類似度となった。 ただし、 コサイン類似度の 1 引き算は三角不等式を満たさず擬距離。 近年の angular distance $d_a(x,y) = \arccos(\cos\theta)/\pi$ は真の距離で、 三角不等式を満たすため近傍探索アルゴリズムが使える。 これは「コサイン類似度の理論的拡張」として注目されている。
🔬 距離空間理論の最新動向
距離理論の研究は 21 世紀に入り、 最適輸送理論(Optimal Transport, OT)として大きな進展を見せている。 Wasserstein 距離(Earth Mover's Distance、 Kantorovich 距離)は確率分布間の距離で、 「ある分布を別の分布に変換するための最小コスト」として定義される。 これは画像処理、 機械学習(特に WGAN)、 経済学(市場マッチング)で広く応用され、 Cuturi(2013)の Sinkhorn 距離による高速計算が実用化を加速した。 SSDSE で「2 つの都道府県の指標分布」を比較するなら、 単純距離ではなく Wasserstein 距離が理論的に洗練されている。
グラフ距離・トポロジカル距離も活発な研究領域で、 ネットワーク科学・トポロジカルデータ解析(TDA)の中心。 ノード間の最短経路距離、 ラプラシアン固有ベクトル距離(Diffusion Distance)、 持続図距離(Persistence Distance)など、 構造を反映した距離が次々に提案されている。 機械学習では 表現学習の文脈で、 「学習されたベクトル空間における距離」が中心問題となる。 Sentence-BERT、 SimCSE、 CLIP などはすべて「距離が意味的近似を反映する空間」を構築する手法であり、 「距離 = 意味」という現代の前提を作っている。
🧮 距離行列の計算量・スケーラビリティ
距離計算の 計算量は実務上重要な観点である。 $n$ 件のデータ点全ペアのユークリッド距離行列を構築すると、 計算量は $O(n^2 p)$、 メモリは $O(n^2)$ を要する。 SSDSE-B-2026 の $n=47$ では問題ないが、 $n=10^4$ で約 1 億ペア、 $n=10^5$ で 100 億ペアとなり、 メモリ・時間の双方が壁になる。 この問題を解決するため、 近似最近傍探索(Approximate Nearest Neighbor, ANN)が発達した。 LSH(Locality-Sensitive Hashing、 Indyk-Motwani 1998)、 HNSW(Hierarchical Navigable Small World、 Malkov & Yashunin 2018)、 FAISS(Facebook 開発)、 Annoy(Spotify 開発)、 ScaNN(Google 開発)が主要実装。
これらは「距離計算の近似 + インデックス構造」により、 $O(\log n)$ 程度で近似最近傍を探索できる。 推薦システム・画像検索・自然言語類似度検索では FAISS が事実上の標準で、 $10^9$ 件の埋め込みベクトルから 100ms 以内に近傍を返す。 SSDSE のような小規模データでは ANN は不要だが、 概念として「全ペア距離計算は富裕層の贅沢、 ANN が大衆の標準」という認識を持つことが、 将来的なスケール展開に役立つ。 また 距離保存型埋め込みとして、 MDS(Multidimensional Scaling、 1950 年代)、 t-SNE(van der Maaten 2008)、 UMAP(McInnes 2018)、 PHATE(Moon et al. 2019)などが、 「高次元距離を低次元で近似的に保存する」手法として広く使われる。
📘 距離尺度の選択指針(業界実務)
業界実務における距離尺度の選択は、 「データの性質 × タスクの目的」のマトリックスで決まる。 まず 連続値・数値特徴のみなら、 z-score 標準化後のユークリッド距離(汎用)、 マンハッタン距離(外れ値耐性)、 マハラノビス距離(相関補正)から選ぶ。 カテゴリ変数混在なら Gower 距離(連続・順序・名義の混合対応)が標準で、 R の cluster::daisy、 Python の gower パッケージで実装可能。 テキスト・文書なら TF-IDF + コサイン類似度、 または BERT/Sentence-BERT 埋め込み + コサイン類似度が黄金パターン。
画像なら CNN 埋め込み(ResNet、 EfficientNet)+ ユークリッド距離 or コサイン類似度、 音声なら MFCC + DTW(Dynamic Time Warping)or wav2vec 埋め込み + コサイン類似度、 時系列なら DTW、 Soft-DTW、 Frechet 距離、 Edit Distance for Real Sequences(EDR)など多数の選択肢がある。 グラフ・ネットワークなら最短経路距離、 ラプラシアン埋め込み距離、 Node2Vec / GraphSAGE 埋め込みの距離が標準。 これらの選択肢を「タスク特異的に組み合わせる」のが実務の腕の見せ所であり、 SSDSE で各種距離の長所・短所を体験しておくと、 実産業データへの応用力が育つ。
🎯 距離研究の最新動向
距離研究の現代的フロンティアは、 (1) 学習可能な距離(learned metric)、 (2) 確率分布間の距離(OT / Wasserstein)、 (3) 公平性を考慮した距離の 3 方向で展開している。 学習可能な距離は Metric Learning(Weinberger & Saul 2009)で確立され、 顔認識・画像検索・推薦システムの基盤となった。 Triplet Loss(FaceNet 2015)、 Contrastive Loss、 InfoNCE(CLIP 2021)などが代表的。 これらは「距離をデータから学習」する発想で、 古典的距離(ユークリッド・コサイン)を上回るタスク特異的性能を達成。
Wasserstein 距離(最適輸送)は深層学習でも中核的に使われ、 WGAN(Arjovsky et al. 2017)、 Sliced Wasserstein Distance、 Sinkhorn Loss(Cuturi 2013)が代表的応用。 SSDSE で「2 つの都道府県の指標分布の距離」を Wasserstein で測れば、 単純なユークリッドより理論的に正しい比較ができる。 公平性を考慮した距離は、 「異なる人口属性グループ間の距離が公平に保たれる」という性質を持つ。 Demographic Parity 距離、 Equalized Odds 距離など、 機械学習の公平性指標から派生した距離が複数提案されている。 これは EU AI Act、 日本の AI 事業者ガイドライン等の規制対応として 2020 年代後半に急速に重要性を増している研究領域である。
📊 距離尺度のソフトウェア対応表
主要言語・ライブラリでの距離尺度実装の対応表を示す。 Pythonでは scipy.spatial.distance(pdist、 cdist、 squareform)が基盤で、 ユークリッド・マンハッタン・チェビシェフ・マハラノビス・コサイン・Jaccard・ハミング・Bray-Curtis など 30 種類以上の距離・類似度を実装。 sklearn.metrics.pairwise はコサイン・ユークリッド・マンハッタン・ハーバシン(地理)・カーネル系を提供。 scipy.stats.wasserstein_distance は 1 次元 Wasserstein 距離、 多次元なら POT(Python Optimal Transport)パッケージ。 文字列距離は python-Levenshtein、 jellyfish、 rapidfuzz。
Rでは stats::dist が基本(ユークリッド・マンハッタン・チェビシェフ等)、 cluster::daisy が Gower 距離(混合変数対応)、 proxy::dist が 70 種類以上の距離をサポート。 大規模・近似最近傍では FAISS(Facebook、 C++/Python)、 Annoy(Spotify)、 ScaNN(Google)、 HNSWlib(HNSW 実装)、 NMSLIB が代表的。 これらは数億〜数十億ベクトルから 100ms 以内に近傍を返せる。 SSDSE のような小規模データではこれらは過剰だが、 将来的な実務スケールアップを想定して名前と用途を覚えておくと、 業務現場での技術選択が早くなる。 距離研究は「素朴な数学から始まり、 計算機科学・機械学習を巻き込んで、 産業実装の中核技術へと展開した」典型的なテーマである。
🎓 距離・類似度学習のまとめ
本ページの学習内容を整理する。 距離・類似度は (1) 距離公理(非負性・恒等性・対称性・三角不等式)を満たす真の距離と、 公理を満たさない擬距離・類似度の 2 系統がある、 (2) ユークリッド・マンハッタン・チェビシェフ・マハラノビス・コサイン・Jaccard・ハミング・編集距離・DTW・Wasserstein など、 用途に応じて多様な選択肢がある、 (3) 標準化・次元削減・選択尺度の 3 ステップ設計を踏まないと「単位の支配」「次元の呪い」「擬似的なクラスタ構造」のリスクがある、 (4) クラスタリング・推薦・検索・異常検知・生成モデルなど、 機械学習の多くの応用が距離設計と切り離せない、 (5) 現代では Metric Learning・Wasserstein 距離・グラフ距離が研究の最前線で、 古典距離 + 学習距離のハイブリッドが標準。 SSDSE-B-2026 で z-score 標準化 + ユークリッド距離 + 階層クラスタリングの基本パイプラインを実装すれば、 距離設計の本質的理解が身につく。
🔗 関連トピックへの橋渡し
距離・類似度の理解を深めるための関連トピックを示す。 まず数学的基盤として 線形代数(ノルム・内積・固有値)、 位相空間論(収束・開集合・距離化)、 関数解析(ヒルベルト空間・カーネル法)が理論面で必須。 次に応用面として クラスタリング、 k-NN 分類・回帰、 推薦システム、 異常検知、 情報検索、 次元削減といった機械学習の主要応用がすべて距離概念に依存する。 これらの関連トピックを併せて学ぶことで、 「距離 = データの形を測る言語」という統一的視点が獲得できる。 SSDSE での実装演習を通じて、 距離概念がデータ分析全般の中核技術であることを実感的に理解できる。
📚 距離・類似度の参考文献(5 件)
(1) Deza & Deza (2016):Encyclopedia of Distances — 距離の包括的事典、 2000 以上の距離・類似度を網羅。 (2) Cuturi (2013):Sinkhorn Distances — Wasserstein 距離の高速計算手法、 機械学習への OT 応用を加速。 (3) van der Maaten & Hinton (2008):t-SNE — 距離保存型可視化の代表手法。 (4) McInnes et al. (2018):UMAP — t-SNE 後継、 局所・大域構造の両立で広く採用。 (5) Weinberger & Saul (2009):Distance Metric Learning for Large Margin Nearest Neighbor Classification, JMLR — Metric Learning の出発点となった論文、 学習可能な距離の理論基盤。
🗺 距離空間の数学的位置づけ — 公理と性質
🗺 距離空間の数学的位置づけ — 公理と性質
「距離」と呼ぶには 4 つの公理 を満たす必要があります(距離関数 $d: X \times X \to \mathbb{R}_{\ge 0}$):
| 公理 | 式 | 意味 |
|---|---|---|
| 非負性 | $d(x, y) \ge 0$ | 距離はマイナスにならない |
| 同一性 | $d(x, y) = 0 \iff x = y$ | 同じ点同士の距離は 0、 0 なら同じ点 |
| 対称性 | $d(x, y) = d(y, x)$ | どちらから測っても同じ |
| 三角不等式 | $d(x, z) \le d(x, y) + d(y, z)$ | 「寄り道は遠い」 |
公理を満たすもの/満たさないもの
- 完全な距離:ユークリッド、 マンハッタン、 チェビシェフ、 マハラノビス、 ハミング、 レーベンシュタイン
- 「擬距離(pseudometric)」:同一性以外を満たす。 例:「絶対値の差」
- 「ダイバージェンス」:対称性・三角不等式を満たさない。 KL ダイバージェンスは $D_{KL}(P\|Q) \ne D_{KL}(Q\|P)$。 「距離」とは呼ばない
- コサイン距離:三角不等式を満たさない(注意!)。 ただし「角度距離」 $\arccos(\cos)$ なら満たす
距離空間 → 計量空間 → ヒルベルト空間の階層
数学的には、 距離空間(metric space)の特殊例として:
- 計量空間=距離公理を満たす集合 $X$
- ノルム空間=計量空間 + 線形構造(ベクトル空間)。 距離 $d(x, y) = \|x - y\|$
- 内積空間=ノルム空間 + 内積。 内積から $\|x\| = \sqrt{\langle x, x\rangle}$ が誘導
- ヒルベルト空間=完備な内積空間。 機械学習でカーネル法の理論的基盤
🎓 距離学習(Metric Learning)— 「良い距離」をデータから学ぶ
古典的距離(ユークリッド等)は 「全次元を平等に扱う」 ため、 タスクに関係ない次元のノイズに弱い。 たとえば顔認証で 背景の色 は顔の同一性と無関係なのに、 そのまま距離計算すると誤判定の原因になる。 距離学習はこれを克服します。
代表的手法
| 手法 | 仕組み | 応用 |
|---|---|---|
| LMNN(Large Margin Nearest Neighbor) | 同クラス点を近く、 異クラス点を遠くするマハラノビス距離を最適化 | k-NN 改良 |
| NCA(Neighborhood Components Analysis) | 確率的近傍分類の精度を最大化 | 次元削減 + 距離学習 |
| Siamese Network | 2 入力を共有 NN に通し、 埋め込み空間でコサイン or ユークリッド距離 | 顔認証、 画像検索 |
| Triplet Loss | (anchor, positive, negative) の 3 つ組で正例を近く、 負例を遠くする | FaceNet(Google の顔認証) |
| Contrastive Loss | 同ペアは近く、 異ペアはマージン以上離す | SimCLR、 MoCo(自己教師あり学習) |
距離学習は 深層学習時代の標準的アプローチです。 「データから良い類似度関数を学ぶ」発想が、 古典的距離関数の選択問題を一段抽象化しました。
「距離・類似度」を取り巻く概念群を 3 つの視点で整理し、 体系の中の位置づけを掴む。
- 上位概念: ベクトル空間 / ベクトル演算 — 距離の公理(非負・対称・三角不等式)を満たす数学構造
- 並列概念: コサイン類似度 / クロスエントロピー / 相関係数 — 「近さ」を測る異なるパラダイム
- 下位・派生概念: 共分散 (マハラノビス基礎) / 文字列類似度 / 編集距離 (文字列類似度) / 確率分布の比較 (KDE) — 用途別に特殊化された距離
この概念マップを意識することで、 「距離・類似度」を孤立した知識ではなく、 距離空間の公理を共有する体系の一点として理解できる。 ユークリッド距離は L2 ノルムに、 マンハッタン距離は L1 ノルムに、 マハラノビスは標準化された L2 に対応するという「ノルム族」の視点も同時に獲得できる。
🔗 隣接手法への橋渡し
距離・類似度は単独の関数定義に留まらず、 正規化・特徴量設計・モデル選択を貫く設計判断である。 ユークリッド・cosine・jaccard・マハラノビスのどれを選ぶかで、 クラスタリングや k-NN の挙動が一変する。
- 上流(前処理・データ整備): 標準化 / 欠損値処理 / 次元削減
- 並列(代替・補完手法): コサイン類似度 / コサイン類似度 / 相関
- 下流(評価・解釈・応用): クラスタリング / k-means / k-NN 分類
距離・類似度は「2 点がどれくらい離れているか」を定義する関数群で、 上流の正規化が違えば順位が逆転し、 並列の cosine・jaccard とユークリッドでは強調する側面が異なり、 下流のクラスタリングや k-NN の挙動を決定づける。
🌳 手法選択フロー
「距離・類似度」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「距離・類似度」を中核とした適切な手法選択ができる。
📝 直感・落とし穴・発展をさらに深掘り(補足)
本節は既存の解説を壊さない追記の補足です。 上の各章で触れた「直感/落とし穴/発展」を、 SSDSE-B-2026(2023 年・47 都道府県)の実測値と最小限の反例で、 一段深く掘り下げます。 数値のうち都道府県間距離は実データからの実測、 反例ベクトルは「架空」と明記します。
🎨 直感(補足)— 「距離を選ぶ」とは「どの方向の差を重く見るか」を選ぶこと
ユークリッド・マンハッタン・ミンコフスキー・マハラノビスは、 いずれも「各次元の差 $\Delta_i = x_i-y_i$ をどう重み付けして束ねるか」の違いにすぎません。 上の 🎮 触って理解する の単位球(円・菱形・正方形)は、 まさに「どの方向を優遇するか」の地図です。
| 距離 | 差の束ね方 | 優遇する方向 / 割り引く方向 |
|---|---|---|
| ユークリッド (L2) | $\sqrt{\sum \Delta_i^2}$ | 全方向を等方的に。 大きい差を二乗で強調 |
| マンハッタン (L1) | $\sum |\Delta_i|$ | 全成分が対等。 大きい差の影響が穏やか |
| ミンコフスキー (Lp) | $(\sum |\Delta_i|^p)^{1/p}$ | $p$ を上げるほど「最大成分」重視(→チェビシェフ) |
| マハラノビス | $\sqrt{\Delta^\top\Sigma^{-1}\Delta}$ | 相関の強い方向を割り引き、 独立な方向を強調 |
そして「距離」を名乗るための契約書が距離の公理(非負性・同一性・対称性・三角不等式)です。 契約のどれを破るかで呼び名が変わります。
| 破る公理 | 呼び名 | 身近な例 |
|---|---|---|
| 同一性($d=0 \Rightarrow x=y$ の右向き) | 擬距離(pseudo-metric) | 一部の変数だけで測る距離 — 別の県でも距離 0 になりうる |
| 対称性 | 準距離(quasi-metric) | KL ダイバージェンス、 一方通行を含む道のり |
| 三角不等式 | 半距離(semi-metric) | コサイン距離 $1-\cos\theta$(下の反例参照) |
📊 実測(SSDSE-B-2026)— ユークリッドとマハラノビスで「東京の最遠県」が入れ替わる
「相関を無視するユークリッドの誤りをマハラノビスが補正する」を、 実データで一撃で見せる例です。 8 主要列(A1101 総人口/A1303 65歳以上人口/A4101 出生数/A4200 死亡数/A5101 転入/A5102 転出/C3301 着工建築物数/C3302 着工床面積)を z 標準化し、 東京から各県への距離を計算しました。
| 東京から見て… | ユークリッド (L2) | マハラノビス |
|---|---|---|
| 最も遠い県 | 鳥取(14.0)・高知(13.9)・島根(13.9) — 小規模な地方県 | 愛知(9.1)・北海道(9.0)・兵庫(8.5) — 他の大規模県 |
| 神奈川県 | 5.62 | 7.84 |
| 鳥取県 | 13.99 | 6.89 |
💬 読み方:ユークリッドは「東京は鳥取と最も違う」と言い、 マハラノビスは「東京は愛知や北海道のような大規模県と最も違う」と言う。 さらに順位が逆転します — 東京から鳥取は L2 で最遠(14.0)なのにマハラノビスでは 6.89、 逆に神奈川は L2 で最近傍級(5.62)なのにマハラノビスでは 7.84 と鳥取より遠い。 理由:総人口・出生・死亡・移動といった大都市系の 8 軸は互いに強く相関しているため、 マハラノビスは「みんな同じ向きに小さい」という地方県の差を割り引き、 「規模の割に○○が突出」という独立成分の差だけを拾う。 「東京 vs 地方の小ささ」は共分散で説明できるありきたりな差、 「東京 vs 愛知」は共分散で説明しきれない特異な差、 というわけです。
※ 上の値は SSDSE-B-2026.csv(cp932, skiprows=[1], 2023 年 47 県)を z 標準化して算出した実測。 標準化前の生値で計算すると、 桁の大きい総人口・床面積だけで距離がほぼ決まり、 この構造は見えなくなります(=下の落とし穴①)。
⚠️ 落とし穴(補足)— コサイン距離は「距離」ではないことがある
コサイン距離 $d_{\cos}=1-\cos\theta$ は三角不等式を満たさない(半距離)。 これは抽象論ではなく、 2 次元の架空ベクトル 3 つで即座に破れます。
結果として、 コサイン距離では KD-tree・Ball-tree・多くの近似最近傍(三角不等式で探索を刈り込む)が正しく使えない。 回避策は、 (1) ベクトルを L2 正規化してからユークリッド距離を使う(正規化ベクトルでは $\|x-y\|=\sqrt{2\,d_{\cos}}$ の単調変換で、 これは真の距離)、 または (2) 角距離 $d_a=\arccos(\cos\theta)/\pi$ を使う(これは三角不等式を満たす真の距離)。
他の補足的落とし穴:
- スケール依存(再掲・実証):上の東京–鳥取の構造は z 標準化して初めて見える。 生値のままだと総人口(数百万)と着工数(数千)が混在し、 距離は事実上「総人口の差」になる。 標準化は選択肢ではなく前提。
- 次元の呪い:🔬 数式読み解きの実験どおり、 SSDSE の列を増やすと東京の「最近傍と最遠点の比(contrast)」が 1 に収束する。 高次元では距離の大小そのものが情報を失う → 次元削減や コサインへ。
- 外れ値感度:L2 は差を二乗するので東京 1 県が距離行列を支配しやすい。 外れ値が多いなら L1(マンハッタン)か中央値・MAD ベースのロバスト標準化。
- カテゴリ変数:都道府県コード(01〜47)を数値として距離に入れると「北海道(01) と 沖縄(47) は遠い」という無意味な距離が生じる。 名義尺度はワンホット化してハミング距離/Jaccard 係数、 連続・カテゴリ混在なら Gower 距離を使う。
🚀 発展(補足)— 距離を「決める」から「学習する」へ
ここまでは人間が距離関数を選んできましたが、 現代では距離そのものをデータから学習します。
- 計量学習(Metric Learning):マハラノビス距離の $\Sigma^{-1}$ を「タスクに合うように」学習で決める発想。 LMNN(Weinberger & Saul 2009)は「同クラスは近く、 異クラスは遠く」なる $M$(半正定値行列)を学習し、 $d_M(x,y)=\sqrt{(x-y)^\top M(x-y)}$ とする。 深層版が Triplet Loss(FaceNet)・Contrastive Loss・InfoNCE(CLIP)で、 顔認証・画像検索・推薦の基盤。
- 編集距離・ハミング距離の位置づけ:ベクトルでない系列・記号のための距離。 ハミング距離は「長さが同じで、 何箇所違うか」(誤り訂正符号・One-hot 比較)、 レーベンシュタイン(編集距離)は「挿入・削除・置換の最小回数」で長さが違ってもよい(スペル訂正・DNA アライメント)。 どちらも距離公理を満たす真の距離。
- 埋め込み空間の距離:単語・文・画像を 埋め込みベクトルに変換すると、 「意味の近さ」が幾何的な距離になる。 word2vec・Sentence-BERT・CLIP はいずれも「コサイン類似度が意味的近似を表す空間」を作る手法。 現代の距離は「物理的な近さ」ではなく「意味的な近さ」を測る道具へ拡張された。
- 使い分けの軸(再整理):k-NNは「クエリの近傍 k 点」を距離で選ぶので距離設計がそのまま分類境界になる。 k-meansは本質的にユークリッド(重心=L2 最小化点)前提なので、 コサインを使いたいなら球面 k-means や事前 L2 正規化が必要。 階層的クラスタリングは任意の距離行列を入力にできるが、 連結法(Ward は L2 前提)との相性に注意。
🔗 関連ページ(補足リンク)
本節の話題に対応する用語ページ(サイト内実在ページのみ):
※ 「マハラノビス距離」の単独ページはサイト内に未整備のため、 本ページ内 関連手法・派生および 数式読み解き節を参照してください。