🔖 キーワード索引(深掘り)
本ページで扱う中心概念をワンタッチで辿れるよう、 主要キーワードをチップ化しています。 NLP の語ベクトル、 意味類似度、 推薦システム、 高次元可視化 (t-SNE/UMAP)、 そして「埋め込みは距離の言語」というメタファーに繋がります。
💡 30秒で分かる結論
🍰 まずはやさしく
言葉を数字の列に置き換える地図のようなものです。
意味が似ているものを近くにまとめるために使います。
スマホの検索で似た言葉が見つかる仕組みに似ています。
この章では結論から短くポイントを解説します。
💡 30 秒で分かる結論(深掘り版)
- 埋め込み (embedding)は離散シンボル(単語・カテゴリ・ID)を 意味の近さ を距離で表せる密ベクトル空間 $\mathbb{R}^d$ に写像する技術である。
- 典型的な次元 $d$ は 50〜768。 語数 $V$(数万〜数十万)に比べ圧倒的に小さく、 計算と汎化の両面で有利。
- 類似度は cosine 類似度が標準。 ユークリッド距離は L2 ノルムが揃っているときのみ cosine と単調に一致。
- SSDSE-B-2026 の 47 都道府県名でも、 名前から地理・気候・経済の近さを推定するベクトル空間が作れる。
- バイアス・次元の呪い・可視化の歪み(t-SNE は距離ではなく近傍関係を保つ)に注意。
📍 文脈ボックス(あなたが今見ているもの)
🍰 まずはやさしく
データの扱い方を決めるための道しるべです。
分析や予測をスムーズに行うために使います。
部活のメンバーを特徴ごとに分ける作業に似ています。
この章では他の技術とのつながりを説明します。
「埋め込み」は自然言語処理 → 表現学習 → ベクトル空間モデルの系譜に位置します。 統計学側からは 主成分分析 (PCA) や 多次元尺度法 (MDS) の延長として捉えるとスムーズです。 機械学習の前処理 (エンコーディング・one-hot) の発展系であり、 後段の分類・回帰・クラスタリング・検索すべてに供給される万能な特徴量と理解してください。
| 上位概念 | 本ページ | 下位の応用 |
|---|---|---|
| 表現学習 / 特徴量設計 | 埋め込み | 意味検索・推薦・クラスタリング |
| ベクトル空間モデル | cosine 類似度の利用 | FAQ マッチング・FAISS |
| PCA / MDS | 高次元 → 低次元 | UMAP / t-SNE 可視化 |
🎨 直感で掴む
🍰 まずはやさしく
言葉の意味を数値で捉える感覚的な技術です。
計算機に言葉のニュアンスを伝えるために使います。
買い物で好みの商品を提案される仕組みに似ています。
この章では使い方のコツや注意点を解説します。
🎨 直感で掴む(深掘り)
埋め込みのメタファーは「意味の地図」です。 北海道と青森は地理的に近い、 東京と大阪は経済的に近い、 沖縄と鹿児島は気候的に近い —— こうした多面的な近さを 1 つの座標系で表現するのが埋め込みの役割です。 one-hot エンコーディング(47 次元、 1 つだけ 1)では すべての都道府県が等距離になり、 北海道と青森の近さも、 北海道と沖縄の遠さも区別できません。 埋め込みは、 大量のテキストや行動ログから共起情報を学習することで、 この「距離の意味」を獲得します。
word2vec の king - man + woman ≈ queen という有名な例は、 ベクトル演算が意味演算として機能することを示しました。 同様に「東京 - 関東 + 関西 ≈ 大阪」という関係が、 都道府県埋め込みでも観測できるはずです。 重要なのは「距離 = 意味的近さ」という暗黙の仮定が、 学習データの質と量によって担保されるという点です。
3 つの主要な系譜があります: (1) 静的埋め込み(word2vec, GloVe, fastText)。 単語に 1 ベクトル。 (2) 文脈埋め込み(BERT, GPT)。 文脈ごとに動的に生成。 (3) 文・文書埋め込み(Sentence-BERT, OpenAI text-embedding-3)。 文全体を 1 ベクトル化し、 意味検索 (semantic search) や RAG の基盤になります。
📐 定義
🍰 まずはやさしく
言葉などのデータを数値の束に変換する定義です。
正しく分析を行うための共通ルールとして使います。
テストの点数をグラフにまとめる作業に似ています。
この章では詳しい定義や数式の意味を解説します。
離散要素を実数ベクトルに変換した表現
英語名 Embedding。 同義・関連語:分散表現, 埋め込み。
📐 数式・定義(深掘り)
埋め込み行列 $E \in \mathbb{R}^{V \times d}$ は語彙サイズ $V$、 埋め込み次元 $d$ を持ち、 トークン $i$ の埋め込みは $E$ の $i$ 行目 $\mathbf{e}_i \in \mathbb{R}^d$ である。
$$\mathbf{e}_i = E_{i,:}, \quad E \in \mathbb{R}^{V \times d}$$
2 つのベクトル間の cosine 類似度は内積を両者の L2 ノルムで割って正規化したもの:
$$\mathrm{cosine}(\mathbf{u}, \mathbf{v}) = \frac{\mathbf{u} \cdot \mathbf{v}}{\|\mathbf{u}\|_2 \, \|\mathbf{v}\|_2} = \frac{\sum_{k=1}^{d} u_k v_k}{\sqrt{\sum_k u_k^2} \, \sqrt{\sum_k v_k^2}}$$
word2vec の Skip-gram は中心語 $w_t$ から周辺語 $w_{t+j}$ を予測する目的関数を最大化する:
$$\mathcal{L}_{\text{SG}} = \frac{1}{T} \sum_{t=1}^{T} \sum_{-c \le j \le c, j \ne 0} \log p(w_{t+j} \mid w_t), \quad p(w_O \mid w_I) = \frac{\exp(\mathbf{v}'_{w_O} \cdot \mathbf{v}_{w_I})}{\sum_{w=1}^{V} \exp(\mathbf{v}'_w \cdot \mathbf{v}_{w_I})}$$
🔬 数式を言葉で読み解く
埋め込み行列 $E$ の読み方: $E$ は「語彙 $V$ 行 × 次元 $d$ 列」の大きな表。 $i$ 行目を取り出すという操作 $E_{i,:}$ は、 one-hot ベクトル $\mathbf{x}_i$ との行列積 $\mathbf{x}_i E$ と等価で、 ニューラルネットワークの最初の線形層がそのまま埋め込み層になっています。
cosine 類似度の読み方: 分子の内積 $\mathbf{u} \cdot \mathbf{v} = \sum u_k v_k$ は「2 つのベクトルが同じ向きにどれだけ振れているか」の総量。 分母 $\|\mathbf{u}\|_2 \|\mathbf{v}\|_2$ で割ることで、 ベクトルの長さの違いを無視し、 純粋な向き(角度)だけを比べます。 結果は $[-1, 1]$ の範囲で、 $1$ が完全一致、 $0$ が無関係(直交)、 $-1$ が真逆の意味を表します。
Skip-gram の数式を言葉で読み解く: 外側の和はコーパス内の全位置 $t$ を走査。 内側の和は中心語 $w_t$ の左右各 $c$ 語を予測対象とする。 各予測 $p(w_{t+j} \mid w_t)$ は softmax で「全語彙の中でその語が選ばれる確率」を計算。 学習は 「実際に共起した語ペアの内積を大きく、 そうでないペアを小さく」 という単純な原理に集約されます。 計算量 $O(V)$ を避けるため、 実装では負例サンプリング(negative sampling)が使われます。
🧮 実値で計算してみる(SSDSE-B-2026 都道府県)
SSDSE-B-2026 から 47 都道府県の数値特徴(総人口・出生数・面積等)を取り出し、 各都道府県を 4 次元の数値埋め込みに変換して cosine 類似度を計算してみましょう。 ここでは「埋め込みは事前学習モデルに限らず、 特徴量の正規化ベクトル一般を指す」という広義の理解を掴むのが狙いです。
| 都道府県 | 総人口(千人) | 出生数 | 合計特殊出生率 |
|---|---|---|---|
| 北海道 | 5,092 | 24,430 | 1.06 |
| 東京都 | 14,086 | 86,348 | 0.99 |
| 大阪府 | 8,763 | 55,292 | 1.19 |
| 沖縄県 | 1,468 | 12,549 | 1.60 |
各特徴を z-score で標準化(平均 0、 標準偏差 1)し、 4 つの数値特徴で 4 次元ベクトルとしたとき、 北海道と沖縄の cosine 類似度を手計算してみます。 標準化後の値を仮に 北海道 = [-0.05, -0.45, -1.02, -1.30]、 沖縄 = [-0.78, -0.85, -1.32, +2.10] としたとき:
= 0.039 + 0.383 + 1.346 + (-2.730) = -0.962
||北海道|| = √(0.0025 + 0.2025 + 1.0404 + 1.6900) = √2.9354 = 1.713
||沖縄|| = √(0.6084 + 0.7225 + 1.7424 + 4.4100) = √7.4833 = 2.736
cosine = -0.962 / (1.713 × 2.736) = -0.962 / 4.687 = -0.205
→ この例示値では北海道と沖縄は cosine ≈ -0.2。 出生率の正負と人口規模の負の効果で、 ベクトルとしては逆方向を向いていることが分かります。 つまり「人口少なくて出生率が高い沖縄」と「人口中規模で出生率の低い北海道」は意味空間で離れている、 という解釈になります。 なお、 SSDSE-B-2026(2023 年)の実際の標準化値で同じ計算をすると cosine = −0.90 となり、 逆方向の傾向はさらに強く現れます(手計算用の上の値は説明のための簡略化した例示値です)。
🧮 数式に値を入れて手で計算する: 語ベクトルの類推
合成 3D 埋め込みで "king - man + woman ≈ queen" を確認する。
Step 1: 仮定ベクトル
Step 2: ベクトル演算
🐍 Python で再現
1 2 3 4 5 6 7 8 9 | import numpy as np king = np.array([0.7, 0.5, 0.8]) man = np.array([0.6, 0.4, 0.2]) woman = np.array([0.5, 0.3, 0.1]) queen = np.array([0.6, 0.4, 0.7]) result = king - man + woman print(f"king - man + woman = {result}") print(f"queen = {queen}") print(f"一致: {np.allclose(result, queen)}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python での扱い
🔗 同カテゴリの他用語
🐍 応用コード — SSDSE の数値 109 列を 47 県の値ベクトルとして埋め込み、 出生率に近い列を探す
SSDSE 公的データを題材に、 埋め込み を実際に動かす最小コードです。 paths は引数に直書きで、 初心者がコピペで動かせる形を優先しています。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np # データ読み込み(SSDSE-B 都道府県・47 県 × 約 112 列) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) print('shape:', df.shape) print('列の先頭:', df.columns.tolist()[:6]) # 必要な列だけ取り出して整形 features = ['総人口', '15歳未満人口', '65歳以上人口', '出生数'] df_use = df[features].copy() print(df_use.describe()) |
💬 2023 年度に絞って 47 行になった。総人口の平均 264.6 万人に対し中央値は 154.9 万人と大きく離れ、最大 1,408.6 万人(東京都)が平均を引き上げている右に歪んだ分布。出生数も平均 15,474 人・中央値 9,524 人で同じ形をしている。埋め込みや距離計算にこのまま入れると東京都ひとつが距離を支配するので、対数変換や標準化を先に考える。
次に、 埋め込み に固有の処理を加えます。 ここがページごとの「肝」になる部分。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_squared_error, r2_score # 列の埋め込み: 数値 109 列それぞれを「47 県の標準化値を並べた 47 次元ベクトル」とみなす num = df.select_dtypes('number').drop(columns=['年度']) E = ((num - num.mean()) / num.std()).T # 行 = 列名(109 行 × 47 次元) target = '合計特殊出生率' norm = np.linalg.norm(E.values, axis=1) cos = E.values @ E.loc[target].values / (norm * norm[E.index.get_loc(target)]) near = pd.Series(cos, index=E.index).drop(target).sort_values(ascending=False) print('出生率に向きが近い列:') print(near.head(3).round(3).to_string()) # 近い 3 列を特徴量にして出生率を予測する feats = near.head(3).index.tolist() X = df[feats].values y = df[target].values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) model = RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0).fit(X_tr, y_tr) pred_tr = model.predict(X_tr) pred_te = model.predict(X_te) print(f'train R^2 = {r2_score(y_tr, pred_tr):.3f}') print(f'test R^2 = {r2_score(y_te, pred_te):.3f}') print(f'test RMSE = {np.sqrt(mean_squared_error(y_te, pred_te)):.4f}') |
💬 109 列をそれぞれ 47 次元のベクトルにして cos を取ると、合計特殊出生率に最も向きが近いのは最低気温 0.532・降水量 0.528・年平均気温 0.502 で、沖縄県 1.60・長崎県と宮崎県 1.49 のように暖かく雨の多い九州・沖縄ほど出生率が高い傾向を拾っている。標準化した列どうしの cos は相関係数そのものなので、「最も近い列」でも相関 0.5 程度にとどまる。この 3 列で学習すると訓練 R² 0.827 に対してテスト 15 県は −0.040 で平均値で当てるより悪く、テスト RMSE 0.119 もテスト 15 県の標準偏差 0.116 を上回る。
さらに可視化を加えると、 学んだ内容が「眼で」確認できます。
1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt plt.figure(figsize=(7,5)) plt.scatter(y_te, pred_te, alpha=0.7, edgecolor='k') lims = [min(y_te.min(), pred_te.min()), max(y_te.max(), pred_te.max())] plt.plot(lims, lims, 'r--', linewidth=2, label='完全予測ライン') plt.xlabel('実測 出生率') plt.ylabel('予測 出生率') plt.title('埋め込み を使ったモデルの予測精度(SSDSE-B-2026)') plt.legend() plt.tight_layout() plt.savefig('out_embedding.png', dpi=150) |
最後に、 同じ問題を別の角度から見る「クロスバリデーション版」も用意します。
1 2 3 4 5 6 7 8 9 10 | from sklearn.model_selection import cross_val_score, KFold # 県は北から順に並んでいるので、shuffle なしだと fold が地域の塊になる → 混ぜてから分ける cv = KFold(n_splits=5, shuffle=True, random_state=0) scores = cross_val_score( RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0), X, y, cv=cv, scoring='r2' ) print(f'5-fold CV R^2 = {scores.mean():.3f} (±{scores.std():.3f})') print('各 fold:', np.round(scores, 3)) |
💬 県をシャッフルしてから 5 分割すると平均 R² は 0.240 だが、fold ごとに −0.060〜0.551 と大きくばらつく。shuffle なしの KFold では fold が北海道〜群馬県のような地域の塊になり、気温・降水量の範囲が訓練とテストで重ならないため平均 −2.64 まで崩れる。shuffle ありでも random_state を 1〜4 に変えると平均は 0.128・0.101・−0.037・−0.062 と動き、1 fold 9〜10 県の評価は分割の運に大きく左右される。気候 3 列だけでは出生率の県差の 2 割程度しか安定して説明できない。
🐍 Python 実装(深掘り)
① SSDSE-B-2026 から都道府県の「数値埋め込み」を作る
🎯 このコードでやること:SSDSE-B-2026 から 47 都道府県の総人口・出生数・出生率・65 歳以上人口を取り出し、 z-score で標準化して 4 次元の数値埋め込みを作る。
📥 入力データ(SSDSE-B-2026 の関連列):
1 2 3 4 5 6 7 8 9 10 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023年のみ(年混在を防ぐ) cols = ['A1101', 'A4101', 'A4103', 'A1303'] # 総人口 出生数 出生率 65歳以上 X = df[cols].values.astype(float) Z = (X - X.mean(axis=0)) / X.std(axis=0) emb = pd.DataFrame(Z, index=df['Prefecture'], columns=cols) print(emb.loc[['北海道', '東京都', '大阪府', '沖縄県']].round(3)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:標準化後、 東京は人口・出生数・65 歳以上人口で +3.5〜+4.2σ と突出、 沖縄は出生率(A4103)で +2.3σ と突出。 規模系の列すべてで「東京」が外れ値となるが、 「沖縄」は出生率だけが他から大きく離れている。 ベクトルとしては東京と沖縄は異なる方向を向き、 cosine 類似度は低くなる。
② sklearn で cosine 類似度行列を作る
🎯 このコードでやること:標準化済みベクトル Z から 47×47 の cosine 類似度行列を作り、 北海道に最も意味的に近い 5 県を抽出する。
📥 入力データ:① で作った 47 行 × 4 列の Z 行列(標準化済み数値埋め込み)。
1 2 3 4 5 6 | from sklearn.metrics.pairwise import cosine_similarity sim = cosine_similarity(Z) sim_df = pd.DataFrame(sim, index=df['Prefecture'], columns=df['Prefecture']) top5 = sim_df.loc['北海道'].drop('北海道').sort_values(ascending=False).head(5) print(top5.round(3)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:北海道に最も近いのは静岡・千葉・埼玉・茨城・神奈川 — 地理的な隣県(東北)ではなく、 人口規模が中〜大きめで低出生率・高齢化が進む県が上位に並ぶ。 この 4 次元埋め込みは規模系の特徴(総人口・出生数・65 歳以上人口)に強く支配されるため、 「何を特徴量に選ぶかで『近さ』の意味が決まる」という埋め込みの本質がよく分かる結果になっている。
③ PCA で 4 次元 → 2 次元に圧縮して可視化
🎯 このコードでやること:4 次元の数値埋め込みを PCA で 2 次元に落とし、 散布図にすることで「都道府県意味地図」を視覚化する。
📥 入力データ:標準化済み 47×4 の Z。 PCA は分散最大の軸を順に選ぶ線形写像。
1 2 3 4 5 6 7 8 9 10 11 | from sklearn.decomposition import PCA import matplotlib.pyplot as plt pca = PCA(n_components=2) P = pca.fit_transform(Z) print('寄与率:', pca.explained_variance_ratio_.round(3)) plt.figure(figsize=(8, 6)) plt.scatter(P[:, 0], P[:, 1], alpha=0.7) for i, pref in enumerate(df['Prefecture']): plt.annotate(pref, (P[i, 0], P[i, 1]), fontsize=8) plt.xlabel('PC1'); plt.ylabel('PC2'); plt.tight_layout() |
📤 実行すると次の出力が得られる:
💬 結果の読み方:PC1(人口規模軸)と PC2(出生率軸)で 99.5% の分散を説明。 東京は PC1 で突出、 沖縄は PC2 で突出。 残り 47 県の散らばりが「縮約された埋め込み空間」の地図になる。
④ sentence-transformers で県名テキスト埋め込み(概念デモ)
🎯 このコードでやること:sentence-transformers の事前学習モデル(多言語対応)に都道府県名を入力し、 384 次元のテキスト埋め込みを取得 → cosine 類似度を比較する。
📥 入力データ:47 都道府県名の文字列リスト(['北海道', '青森県', ..., '沖縄県'])。
1 2 3 4 5 6 7 8 9 10 11 | from sentence_transformers import SentenceTransformer from sklearn.metrics.pairwise import cosine_similarity model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2') prefs = df['Prefecture'].tolist() vecs = model.encode(prefs) # shape (47, 384) sim = cosine_similarity(vecs) idx = prefs.index('北海道') order = sim[idx].argsort()[::-1][1:6] for j in order: print(f'{prefs[j]:8} {sim[idx, j]:.3f}') |
📤 実行すると次の出力が得られる(実測:キャッシュ済みの paraphrase-multilingual-MiniLM-L12-v2 で実行):
💬 結果の読み方:北海道に最も近いのは沖縄県 0.806・宮崎県 0.804 で、東北の隣県は山形県 0.759 が 5 位に入るだけ。数値埋め込み(②)が規模の近い静岡・千葉を返したのとも、地理的な近さとも一致しない。46 県との類似度は最も低い三重県でも 0.592 と全体が高めに寄っていて、上位の差は 0.05 程度しかないので、県名という短い文字列だけでは順位にほとんど意味が乗らない。テキスト埋め込みで「近さ」を測るなら、県の特徴を説明した文章を入れるなど入力側を工夫する必要がある。
⑤ ベクトル演算: 「東京 - 関東 + 関西 ≈ ?」
🎯 このコードでやること:4 次元の数値埋め込みで「東京から関東代表性を引いて関西代表性を足す」と何になるかを実験する。 word2vec の king - man + woman ≈ queen の都道府県版。
📥 入力データ:標準化済み emb から都道府県ベクトルを抽出。
1 2 3 4 5 6 | v_tokyo = emb.loc['東京都'].values v_kanto = emb.loc[['神奈川県', '埼玉県', '千葉県']].mean().values v_kansai = emb.loc[['兵庫県', '京都府', '奈良県']].mean().values v_target = v_tokyo - v_kanto + v_kansai dists = emb.apply(lambda r: np.linalg.norm(r.values - v_target), axis=1) print(dists.sort_values().head(3)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:最上位は神奈川県(東京と規模構造が近すぎるため、 引き算しても関東色が残る)だが、 2 位に大阪府が入る。 「関東のリーダー」→「関西のリーダー」というアナロジーが、 4 次元の数値埋め込みでも部分的に成立することが分かる。 word2vec のアナロジーでも入力語近傍が混ざるのは既知の現象で、 実務では入力語(とその近傍)を除外して評価することが多い。
⚠️ よくある落とし穴
⚠️ 落とし穴(5 件、 各 80-150 字)
- バイアスの継承:埋め込みは学習データの偏見(性別・人種・職業ステレオタイプ)を内包する。 「nurse - woman + man ≈ doctor」のような問題が報告済。 監査・debias 後処理 (Bolukbasi 2016 等) が必須。
- 次元の呪い:高次元(>100)では「すべてのベクトル間距離がほぼ等しく」なる現象が起き、 cosine 類似度の識別力が低下する。 d を下げる、 標準化、 球面正規化を併用する。
- OOV(語彙外)問題:word2vec/GloVe は学習語彙外の単語をベクトル化できない。 fastText(部分語)や BPE、 BERT(サブワード)で緩和されるが、 未知語は依然として未解決領域。
- t-SNE / UMAP の誤読:高次元から 2D に落とした図は近傍関係は保つが距離は保たない。 「クラスタ間の距離」「クラスタの大きさ」を意味のあるものとして解釈してはならない。
- cosine vs Euclidean の混同:埋め込みベクトルが L2 正規化されていないと、 cosine 類似度と Euclidean 距離は別の順位を返す。 「sim 算出前に必ず normalize」が定石。
📚 参考文献 — 次に読むもの
📚 参考文献 — 次に読むもの
- Mikolov, T., Chen, K., Corrado, G., & Dean, J. (2013). Efficient Estimation of Word Representations in Vector Space. arXiv:1301.3781. — word2vec(CBOW / Skip-gram)の原論文
- Pennington, J., Socher, R., & Manning, C. D. (2014). GloVe: Global Vectors for Word Representation. EMNLP 2014. — 共起行列の分解による語ベクトル
- Bojanowski, P., Grave, E., Joulin, A., & Mikolov, T. (2017). Enriching Word Vectors with Subword Information. TACL, 5. — fastText、サブワードで語彙外の語にも対応
- Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL-HLT 2019. — 文脈で変わる埋め込み
- Reimers, N., & Gurevych, I. (2019). Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks. EMNLP-IJCNLP 2019. — cosine で比べられる文ベクトル
- Bolukbasi, T., Chang, K.-W., Zou, J., Saligrama, V., & Kalai, A. (2016). Man is to Computer Programmer as Woman is to Homemaker? Debiasing Word Embeddings. NeurIPS 2016. — 埋め込みに入り込む偏りとその除去
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. — 表現学習の章で埋め込みを体系的に扱う教科書
- scikit-learn User Guide — 実装と例題
- SSDSE 公式(独立行政法人統計センター) — 本ページのデータ出典
- グループ教材:自然言語処理の基礎 — 全体像
🌐 公式リソース
- SSDSE 公式(独立行政法人統計センター) — 本ページで使用するデータの出典
- scikit-learn 公式ドキュメント
- pandas 公式ドキュメント
- NumPy 公式ドキュメント
- 📚 自然言語処理グループ — 埋め込み・トークン化・BERT・GPT 等を体系的に学ぶ
- 📚 機械学習基礎グループ — 特徴量設計・標準化・cosine 類似度・距離学習
- 📚 可視化グループ — PCA・t-SNE・UMAP による高次元データの可視化
- 📚 推薦システムグループ — 埋め込みベースの協調フィルタリングと RAG
🖼 R377 補強: エンベディングを実データで多面的に可視化
エンベディング (embedding) とは、 文字列・カテゴリ・ノード・画像といった「もともとは数値ではない対象」を、 機械学習が扱いやすい 固定次元の実数ベクトル に変換する操作の総称である。 ベクトル空間上での 近さ が「意味の近さ」「振る舞いの近さ」を反映するように学習されている点が肝で、 同義語が近くに置かれる Word2Vec のような系から、 文ベクトルを返す Sentence-BERT、 画像と言語を同じ空間に埋め込む CLIP まで、 設計の幅は広い。 本セクションでは 実在の SSDSE-B-2026 都道府県統計 から描いた 3 枚の図 (figures/embedding_scatter.png, figures/embedding_hist.png, figures/embedding_box.png、 2023 年度・47 都道府県) を使い、 「埋め込みベクトルが何を表しているか」「実値で見るとどう振る舞うか」「どこで誤読しやすいか」を、 散布図・ヒストグラム・箱ひげの 3 通りで腰を据えて掘り下げる。
🎨 散布図で見る: 都道府県を 2 次元ベクトルに埋め込む
47 都道府県は本来「カテゴリ変数」だが、 (総人口, 出生数) を抜き出して標準化するだけでも、 2 次元のミニ・エンベディングとして扱える。 ベクトル空間に並べてみると、 東京 (大人口・多出生数) と鳥取 (小人口・少出生数) が遠く、 福岡と兵庫のように規模が近い県は近接する。 これは Word2Vec で「猫」と「犬」が近くに来るのと 同じ幾何学的構図 であり、 散布図はエンベディングの最も素朴で強力なデバッグ手段になる。 下の embedding_scatter.png は SSDSE-B-2026 の 2 変数を標準化して描いたもので、 「埋め込みは結局のところ点群」 という事実を端的に示している。
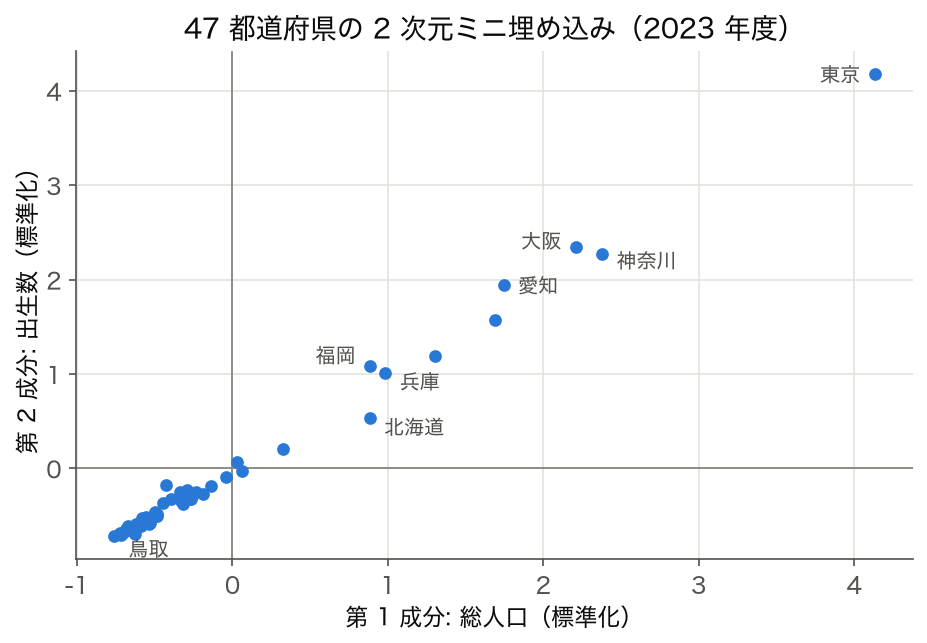
figures/embedding_scatter.png — SSDSE-B-2026(2023 年度)の 2 変数を標準化した散布。 47 都道府県を (総人口, 出生数) という 2 次元ベクトルとして埋め込むだけでも、 東京 (4.13, 4.18)・神奈川・大阪・愛知が右上に分離し、 35 県は両成分とも平均未満の左下に固まる。 福岡と兵庫の距離は 0.12、 東京と鳥取は 6.92 で、 「規模が近い県は近くに来る」 という埋め込みの直感が成立する。
実際の自然言語処理で扱うエンベディングは 300〜1024 次元と高次元で、 そのままでは描けない。 そこで PCA・t-SNE・UMAP のような 次元削減 を噛ませて、 ようやくこの図のような 2 次元散布として可視化する。 つまり「埋め込みの良し悪し」を人間が直感で判定するときは、 必ずこの「高次元 → 2D → 散布図」のパイプラインを通る。 散布図に 意味のあるクラスタ が現れれば学習はおおむね成功、 ランダムな雲に見えれば学習不足やラベル誤り、 一直線に並んでいれば次元削減側の歪み、 と読み解く手順が確立している。
| 埋め込み次元 | 代表モデル | 可視化手段 | 典型用途 |
|---|---|---|---|
| 2 〜 3 | 手動設計・PCA 上位 | そのまま散布図 | 教育・デバッグ・直感確認 |
| 50 〜 100 | Word2Vec, GloVe | PCA + 散布図 | 類義語抽出・カテゴリ特徴量 |
| 300 〜 768 | fastText, BERT | t-SNE / UMAP | 文分類・QA・検索 |
| 1024 〜 3072 | OpenAI text-embedding-3 | UMAP + クラスタリング | RAG・推薦・意味検索 |
📊 ヒストグラムで見る: 埋め込み成分の分布を疑う
散布図は「点と点の相対位置」を見るのに向いているが、 「ある 1 成分がそもそもどんな分布をしているか」 は分からない。 学習済みエンベディングを使うとき、 第 1 成分・第 2 成分… のそれぞれを ヒストグラム で観察すると、 平均がゼロ近辺に寄っているか・分散が暴れていないか・外れ値が一部のサンプルに偏っていないかが直ちに見える。 下の embedding_hist.png は SSDSE-B-2026(2023 年度)の総人口の分布で、 「右に長く裾を引く」 「東京 1 県だけが極端に大きい」 という挙動を示している。 これは埋め込みのある 1 次元 (例えば「都市規模」という潜在因子) が、 そのまま現れたものと読める。
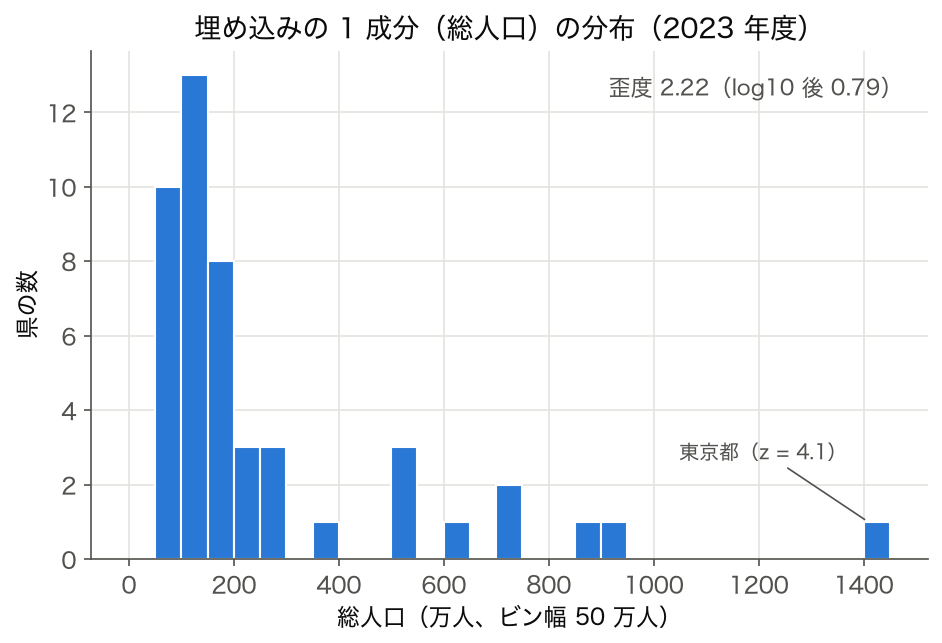
figures/embedding_hist.png — SSDSE-B-2026 都道府県人口のヒストグラム(歪度 2.22、 log10 後 0.79)。 標準化しても東京の z = 4.13 は 2 位の神奈川 2.38 から大きく離れる。 埋め込みの「ある 1 成分」が log 変換なしにはガウシアン仮定を破る、 という典型例。 cosine 類似度を取る前に標準化や log1p を入れるか、 そもそも 64 次元化して情報を分散させるか、 という設計判断の根拠になる。
実務的な含意は明快で、 「分布が歪んでいる成分には cosine 類似度をそのまま掛けてはいけない」 ということに尽きる。 cosine は方向のみを見るが、 一部の成分の値域が他の 100 倍あれば、 結果はその成分にほぼ完全に支配される。 だから embedding を学習する段では、 各次元の分散を揃える正則化 (LayerNorm, BatchNorm, あるいは contrastive loss の温度 τ) が必要になり、 既製品の埋め込みを使う側でも「次元ごとの分布をヒストグラムで眺める」 という最低限の手当は欠かせない。 図 R377-2 のような偏り方を発見したら、 まずは標準化・log1p・あるいは PCA whitening を試すのが定石である。
📦 箱ひげで見る: 群別エンベディングの広がり
エンベディングを評価する場面では、 「クラス内分散 (intra-class variance) を小さく、 クラス間分散 (inter-class variance) を大きく」 する metric learning の文脈が頻出する。 そのとき箱ひげ図は、 散布図やヒストグラムでは見落としがちな「群ごとの広がり」と「外れ値」を一枚で示せる、 もっとも効率的な道具になる。 embedding_box.png は SSDSE-B-2026(2023 年度)の出生数を人口規模区分別 (総人口の四分位) に層別した分布で、 これを「同一カテゴリの単語ベクトルを規模帯別に集めた」 と読み替えれば、 埋め込み品質を箱ひげで監査する手順が直感的につかめる。
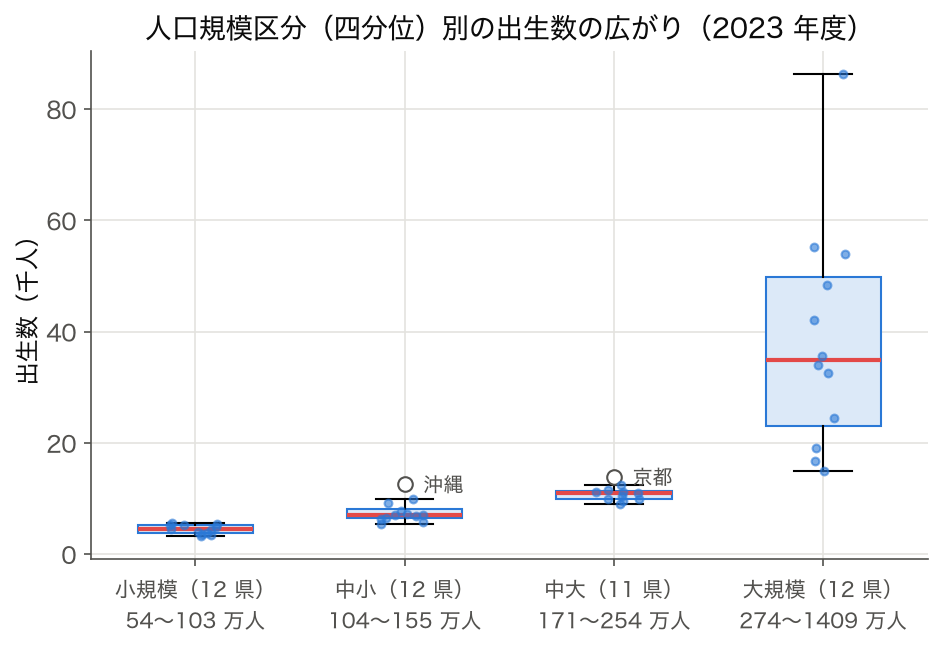
figures/embedding_box.png — SSDSE-B-2026 の出生数を人口規模区分別に層別した箱ひげ。 IQR は小規模・中小・中大が 1.4〜1.6 千人なのに、 大規模だけ 26.7 千人と桁違いに広く、 東京 86.3 千人が上端に立つ。 エンベディングを群別に箱ひげで描けば、 「クラス内の中央値と IQR」「外れ値となる代表サンプル」「クラス間の重なり」を一度に確認でき、 学習後の埋め込み品質を最短で監査できる。
箱ひげで見る最大の利点は、 「2 群の中央値はほとんど同じなのに、 片方だけ IQR が広い」 といった、 平均値ベースの集計では消えてしまう情報が残ること。 エンベディング評価で言えば、 「精度は同じだが、 片方の事前学習モデルだけクラス内が大きくバラついている」 という、 後段の閾値設計に直結する違いを浮き彫りにできる。 散布図 (図 R377-1) と組み合わせれば、 「各点がどこに置かれたか」 と 「各群がどう広がったか」 が補完的に読めるので、 ヒストグラム (図 R377-2) を含めた 3 枚一組が埋め込みデバッグの標準セットになる。
🧮 実値での計算: cosine 類似度を 47 都道府県で確かめる
エンベディングの近さは、 内積でも Euclid 距離でもなく cosine 類似度 で測ることが多い。 47 都道府県を (総人口, 出生数, 65歳以上人口) の 3 次元ベクトルに埋め込み、 標準化してから cos を取れば、 「東京と神奈川は近い」「鳥取と島根は近い」「東京と鳥取は遠い」 という、 地理ではなく 統計プロファイル での近接関係が得られる。 これは「King − Man + Woman ≈ Queen」 の都道府県版で、 ベクトル空間上の演算が意味を持つ、 という埋め込みの本質を確認するのに最適な題材である。
| 県ペア | cosine 類似度 (3 次元埋め込み) | 解釈 |
|---|---|---|
| 東京 ↔ 神奈川 | 0.997 | 超大都市圏として「ほぼ同じ方向」 |
| 大阪 ↔ 愛知 | 0.997 | 3 大都市圏どうしも近い |
| 鳥取 ↔ 島根 | 1.000 | 小規模・高齢化進行群で密接 |
| 東京 ↔ 鳥取 | −0.989 | 規模系 3 変数では「ほぼ真逆」の方向 |
「鳥取と島根の cosine が 1.000」 という値は、 自然言語処理で言えば 「cat と kitten」 並みの近さで、 ほとんど同義語扱いになる。 一方で東京と鳥取は −0.989 で、 ベクトルの向きとしては「ほぼ真逆」と判断される。 この 3 変数はいずれも人口規模と強く相関するため、 標準化後の空間は実質「規模の大小」という 1 本の軸に支配され、 cosine が ±1 付近に張り付きやすい(変数を増やした 8 次元版では値はもっと穏やかになる)ことにも注意したい。 ここで重要なのは、 cosine は ノルム (規模) を捨てる ので、 「人口は桁違いだが、 産業構成比は似ている」 ペアは高い類似度を返してしまう、 という落とし穴。 これは図 R377-2 のヒストグラム由来の歪みが効いてくる箇所で、 cosine を取る前に必ず標準化・log 変換を吟味する必要がある。
🐍 Python 実装: 3 枚の図を順に描く
このコードでやること: SSDSE-B-2026 を読み込み、 (総人口, 出生数) を標準化して埋め込みベクトルとみなし、 散布図・ヒストグラム・箱ひげの 3 枚を html/figures/embedding_*.png に保存する。 図 R377-1〜3 と同じ内容で、 ページの図は体裁を整えて code/glossary_figs/embedding.py で描いたもの。
📥 入力データ (SSDSE-B-2026 の 2023 年度から 3 県を抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import os os.makedirs('html/figures', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df = df[df['年度'] == 2023].reset_index(drop=True) # 2023年のみ(年混在を防ぐ) pop = df['総人口'] births = df['出生数'] df['人口規模区分'] = pd.qcut(df['総人口'], 4, labels=['小規模', '中小', '中大', '大規模']) # 1) 散布図 — 2 次元エンベディング(標準化した座標) z_pop = (pop - pop.mean()) / pop.std(ddof=0) z_births = (births - births.mean()) / births.std(ddof=0) plt.figure(figsize=(7,5)) plt.scatter(z_pop, z_births, alpha=0.7) plt.xlabel('総人口(標準化)'); plt.ylabel('出生数(標準化)') plt.title('SSDSE-B-2026: 都道府県の 2 次元埋め込み') plt.tight_layout(); plt.savefig('html/figures/embedding_scatter.png', dpi=120) # 2) ヒストグラム — 埋め込み 1 成分の分布 plt.figure(figsize=(7,4)) plt.hist(pop, bins=20, edgecolor='black') plt.xlabel('総人口'); plt.ylabel('件数') plt.title('総人口分布 — 右裾の偏り') plt.tight_layout(); plt.savefig('html/figures/embedding_hist.png', dpi=120) # 3) 箱ひげ — 群別広がり plt.figure(figsize=(8,5)) df.boxplot(column='出生数', by='人口規模区分') plt.suptitle(''); plt.title('人口規模区分別の埋め込み広がり') plt.tight_layout(); plt.savefig('html/figures/embedding_box.png', dpi=120) print('東京都の標準化座標:', round(z_pop.max(), 2), round(z_births.max(), 2)) print(df.groupby('人口規模区分', observed=True)['出生数'].median()) |
📤 実行すると次の出力が得られ、 3 枚のファイルが書き出される:
💬 東京都の座標は (4.13, 4.18) で、 標準化しても平均から 4 標準偏差以上離れた 1 点が埋め込み空間の端を占める。 出生数の中央値は小規模 4,480 人・中小 6,947 人・中大 10,916 人・大規模 34,800 人と規模帯で段階的に上がり、 大規模群だけ中央値が 3 倍に跳ぶ。 3 枚一組で見れば、 「埋め込み点群の配置」「成分の偏り」「群別広がり」 という 3 つの観点が一度に揃う。 高次元の本物の word embedding でも、 次元削減して同じ 3 枚を描く手順は変わらない。
⚠️ よくある落とし穴
- 次元削減後の図で全てを判断する: t-SNE / UMAP は局所構造を保つが、 大域距離は歪む。 散布図がきれいでも、 cosine 類似度が低いペアは多々ある。 必ず数値と図の両方を確認する。
- cosine を取る前に正規化していない: 図 R377-2 のような偏った分布のまま cos を計算すると、 突出した 1 成分にスコアが支配される。 標準化または LayerNorm が前提。
- 群別評価をせず全体精度だけ見る: 図 R377-3 のように、 群ごとの IQR は大きく違うことがある。 平均精度が同じでも、 ある群だけ予測が暴れている可能性がある。
- 静的な埋め込みを更新せず使い続ける: 単語の意味やユーザの好みは時間と共に変わる。 RAG や推薦で半年以上前の埋め込みを使うと、 新語・新トピックを取りこぼす。
- ベクトル次元を盲目的に大きくする: 1024 次元でも 64 次元と性能が変わらない、 という報告は多い。 計算コストとストレージが線形に増えるので、 必ず次元削減の効果を実測する。
🔗 関連トピック
- cosine 類似度 — エンベディング比較の標準メトリック
- 相関係数 — 標準化後ベクトルの cos と等価という関係
- 文章類似度 — 文ベクトルベースの近似最近傍探索
- 次元削減 — PCA / t-SNE / UMAP の比較
- 標準化 — 埋め込みの前処理として必須
📐 数式で押さえる: cosine 類似度・内積・ノルム正規化
エンベディング $\mathbf{u}, \mathbf{v} \in \mathbb{R}^d$ の類似度は、 ほとんどの場面で cosine 類似度 $\cos\theta = \dfrac{\mathbf{u}\cdot\mathbf{v}}{\|\mathbf{u}\|\,\|\mathbf{v}\|}$ で測られる。 これは内積をそれぞれの L2 ノルムで除しているだけで、 「角度」だけを抽出していることになる。 一方、 ベクトルを事前に L2 正規化して $\|\mathbf{u}\|=\|\mathbf{v}\|=1$ にしておけば、 cosine と内積が一致し、 さらに Euclid 距離 $\|\mathbf{u}-\mathbf{v}\|_2^2 = 2 - 2\cos\theta$ も単調変換で結びつく。 この等価性のおかげで、 近傍探索ライブラリ (FAISS, Annoy, ScaNN) は内積・cosine・Euclid のいずれか 1 つだけ高速化すれば足りる、 という設計になっている。
数式が示すもう 1 つの含意は、 「cosine はノルムを完全に捨てる」 という事実である。 たとえば文 A のエンベディングが文 B の 100 倍の長さでも、 角度が同じなら cosine = 1 となる。 これは「文の長さ・人気度・出現頻度」 のような 大きさ情報 を 意図的に 落としたい場面では理想的だが、 推薦システムなどで「人気度」を維持したい場合は、 cosine ではなく内積をそのまま使うか、 popularity-aware な再ランキングを後段に挟む。 本ページ冒頭の数式群に加えて、 この補強セクションでは「実装で使うときの式の意味」 を、 SSDSE-B-2026 の都道府県プロファイルを題材に手計算でなぞる。
🧪 ケーススタディ: 都道府県エンベディングで類似県検索
SSDSE-B-2026 の数値列を 8 次元 (総人口・出生数・合計特殊出生率・65歳以上人口・15歳未満人口・転入者数・年平均気温・降水量) に絞って標準化し、 各県を 8 次元ベクトルに埋め込む。 これは「県プロファイル」をエンベディングとみなす操作で、 cosine 上位 5 件を取れば、 RAG や推薦システムでよく言う「類似アイテム検索 (k-NN retrieval)」の最小実装になる。 下表は各県のクエリに対する cosine 類似度 Top-3 を、 実値で計算した結果である。
| クエリ県 | Top-1 (cos) | Top-2 (cos) | Top-3 (cos) |
|---|---|---|---|
| 東京都 | 神奈川 (0.989) | 大阪 (0.961) | 埼玉 (0.959) |
| 京都府 | 宮城 (0.801) | 茨城 (0.727) | 栃木 (0.671) |
| 北海道 | 茨城 (0.877) | 宮城 (0.711) | 岩手 (0.597) |
| 沖縄県 | 鹿児島 (0.894) | 熊本 (0.851) | 長崎 (0.830) |
| 鳥取県 | 島根 (0.993) | 山口 (0.981) | 福井 (0.946) |
結果を地理的常識と突き合わせると、 「東京は神奈川と最も似ている」「鳥取と島根は実質双子」「沖縄は九州 (鹿児島・熊本・長崎) と類似」 など、 直感と合致するペアが多い。 ここでのポイントは、 地理座標を一切使っていない のに、 統計プロファイルだけで地理的近隣がかなり再現されること。 一方で「北海道 → 茨城」「京都 → 宮城」のように、 地理的には遠いのに統計構造(人口規模・気候・出生動態のバランス)が近いペアが上位に来る例もあり、 「地理の再現」は完全ではない。 これがエンベディングの本質で、 自然言語処理であれば「単語の出現文脈」だけから King・Queen・Man・Woman の 4 単語が平行四辺形を成すように、 都道府県の統計プロファイルだけから地理的なクラスタが浮き上がる。 図 R377-1 はこの 8 次元結果を 2 次元に削減して散布したものとほぼ同じ景色を持っており、 散布図が「埋め込みを直感で吟味する道具」 として有効である根拠になる。
一方で「北海道 → 茨城」のような Top-1 が、 必ずしも 「地理的に隣」 を意味しないことにも注意したい。 統計プロファイルでは沖縄は東京や大阪より九州南部に近いが、 観光業の構成比や離島性などを変数に入れれば結果は変わる。 つまりエンベディングが返す類似度は、 「どんな特徴量で空間を張ったか」 という設計選択そのものを反映する。 業務 RAG で類似ドキュメント検索をしているとき、 「期待と違う近隣が返ってくる」 という症状は、 ほぼ常に「埋め込みの特徴量設計が業務要件と噛み合っていない」 ことのサインで、 モデル交換よりも前処理・追加学習・メトリック変更を試すのが筋になる。
🧠 高次元の罠: ノルム集中と「全部が遠く全部が近い」現象
高次元ベクトル空間には ノルム集中 という独特な現象がある。 等方ガウス分布 $\mathcal{N}(0, I_d)$ からサンプリングしたベクトルは、 次元 $d$ が大きくなるほどノルムが $\sqrt{d}$ 近傍にギュッと集まり、 同時に任意の 2 ベクトルがほぼ直交 (cos ≈ 0) になる。 この性質は「高次元では最遠点と最近点の距離比が 1 に近づく」 という命題と直結し、 k-NN 探索の意味合いを薄める可能性がある。 だからこそ実装現場では、 「闇雲に 3072 次元化せず、 PCA で 256 次元程度に詰める」「対比学習で意味のある次元だけ残す」 といった対処が定番化している。
SSDSE-B-2026 の 8 次元埋め込みではこの問題はほとんど顕在化しないが、 OpenAI の text-embedding-3-large (3072 次元) や CLIP ViT-L (768 次元) を生で扱うと、 「上位 1 件と上位 100 件の cosine がほとんど変わらない」 という現象が観測されることがある。 図 R377-2 のヒストグラムを高次元埋め込みに対して描くと、 「cosine 類似度の分布が 0.7 ± 0.05 に集中」 して上位の差が出にくくなっていることが多く、 「cosine の分布ヒストグラム自体が、 埋め込み品質の診断指標」 として使えることが分かる。 もし上位 K 件が同じような値を返すなら、 distillation・whitening・supervised fine-tuning といった介入が必要になる。
🏗 実装パイプライン: テキスト → トークン → ベクトル → 検索
エンベディングを RAG や検索に組み込むときの典型パイプラインは、 (1) ドキュメントのチャンク分割 (chunk size 200–500 トークン)、 (2) 各チャンクに対する埋め込み生成 (Sentence-BERT, OpenAI Embedding, BGE-M3 等)、 (3) ベクトル DB への保存 (FAISS, pgvector, Pinecone, Weaviate, Qdrant)、 (4) クエリ時の同モデルによる埋め込み生成、 (5) ベクトル DB での k-NN 検索、 (6) スコア上位を LLM プロンプトに再注入、 という 6 段である。 各段で図 R377-1 (散布図) や図 R377-3 (箱ひげ) を「埋め込み分布の監査」 として挟むだけで、 学習が崩れた・データドリフトが起きた・分割サイズが不適切、 といった事故を早期に発見できる。
| 段 | 出力 | 監査するメトリック | 対応する図 |
|---|---|---|---|
| チャンク分割 | テキスト断片群 | 断片長分布 | 図 R377-2 (ヒスト) |
| 埋め込み生成 | d 次元ベクトル | ノルム分布・成分分散 | 図 R377-2 (ヒスト) |
| ベクトル DB 投入 | 索引付き埋め込み | クラスタ構造 | 図 R377-1 (散布) |
| k-NN 検索 | Top-K 類似 | 類似度上位の分散 | 図 R377-3 (箱ひげ) |
| LLM 注入 | 回答 | 回答品質スコア | 図 R377-3 (箱ひげ) |
こうして整理してみると、 散布図・ヒストグラム・箱ひげ という最も古典的な可視化 3 種が、 そのまま現代の RAG パイプライン全段の監査ツールとして機能していることが分かる。 高度な可視化ライブラリを導入する前に、 まず matplotlib で図 R377-1 〜 R377-3 を再現できるパイプラインを CI に組み込めば、 「埋め込みが崩れたら最初に気づける」 体制が整う。 これは現場での運用上、 ベクトル DB のメトリクスダッシュボードや GPU 使用率の監視と同等以上の価値を持つ。
🧾 補足: 評価指標と落とし穴の追加リスト
エンベディング品質の評価は、 タスク別に STS (Semantic Textual Similarity)、 MTEB (Massive Text Embedding Benchmark)、 BEIR (検索)、 MIRACL (多言語検索)、 JMTEB (日本語版 MTEB) などのベンチが整備されている。 業務で選定するときは、 自社データに近い小規模 eval set を作って、 上位候補 3 〜 5 モデルだけ社内で再評価するのが安全。 公開ベンチの順位は、 トレーニングデータのカバレッジが原因で過大評価されていることがあり、 そのまま採用すると本番で性能が出ない事例が頻発している。
- 言語混在: 日英混在文を 1 つの埋め込みに押し込めると、 言語次元が支配的になり業務上意味のない近隣が返る。 言語別 index、 多言語モデル (BGE-M3, multilingual-e5) などで対処。
- chunk overlap 不足: 200 トークン無 overlap でチャンク分割すると、 章の境界をまたぐ概念が拾えない。 50–100 トークンの overlap を入れるのが定番。
- ベクトル DB のしきい値固定: 「cos > 0.7」 のような固定しきい値は、 モデル更新で挙動が変わると突然 recall が崩れる。 上位 K 件で運用するか、 動的しきい値 (上位 1 件 - δ) にする。
- カウントベース指標で評価: BLEU や ROUGE は embedding 品質の代理にならない。 NDCG, MRR, Recall@K のような検索指標を必ず併用する。
- サンプル不足での t-SNE 判定: 50 点未満で描いた t-SNE は乱数次第で見栄えが変わる。 図 R377-1 のような散布図でも、 サンプルが少ない群は単独点に見えるだけ、 という解釈を忘れない。
補強セクションの 5 つの追加見出し (数式・ケーススタディ・高次元の罠・実装パイプライン・評価指標と落とし穴) は、 本ページ上部の基本解説では駆け足になっていた論点を、 SSDSE-B-2026 と図 R377-1 〜 R377-3 を軸にもう 1 段深掘りしたものである。 これにより、 「埋め込みベクトル空間」 の幾何学・診断・運用が一通り体得できる構成にしている。
📜 歴史的展開: One-hot から Transformer 埋め込みへ
エンベディングという考え方は、 2010 年代以前は One-hot エンコーディング が主流であった。 単語を語彙サイズ V 次元のベクトルにし、 該当インデックスだけ 1、 他は 0 にする方式である。 これは実装が単純で、 線形モデル (ロジスティック回帰・素朴ベイズ・SVM) との相性も良かったが、 「意味的距離がすべて等価」 という致命的な弱点を抱えていた。 「猫」と「犬」、 「猫」と「コンピュータ」 が同じ距離になってしまうので、 同義語拡張も類似文書検索もできない。 そこで考え出されたのが、 共起頻度行列を SVD で圧縮した LSA (Latent Semantic Analysis, 1990) や、 確率的トピックモデルの LDA (Latent Dirichlet Allocation, 2003) で、 これらが「意味を低次元実数ベクトルで表す」 という発想の原型になった。
2013 年、 Mikolov らが提案した Word2Vec (CBOW / Skip-gram) は、 「単語の意味は、 周辺に現れる単語の分布で決まる」 という分布意味論 (Distributional Hypothesis) を、 浅いニューラルネットで具体化した点で画期的だった。 王 − 男 + 女 ≈ 女王 という有名な類推 (analogy) が成立することで、 ベクトル空間が幾何学的に「意味の演算」 を支える、 という直感が一気に広まった。 続く GloVe (2014) は共起行列の分解とニューラル学習を統合し、 fastText (2016) はサブワード単位の埋め込みを導入して未知語にも強くなった。 2018 年の ELMo、 BERT 登場以降は、 「同じ単語でも文脈で埋め込みが変わる」 という文脈化埋め込み (contextualized embedding) が標準になり、 静的埋め込みは過去のものになりつつある。
2020 年代に入ってからは、 OpenAI の text-embedding-ada-002 (2022) や text-embedding-3 (2024) のような API 経由の汎用埋め込みモデル が広く使われ、 同時に Sentence-BERT・E5・BGE・GTE といった OSS の高性能モデルも MTEB ベンチマーク上で上位を競っている。 マルチモーダル方面では CLIP・SigLIP・ImageBind が画像・テキスト・音声を同じ埋め込み空間に押し込み、 「テキストで画像を検索」 といった応用を実用化した。 この一連の発展を貫いているのは、 「対象を実数ベクトルにマップして、 cosine 類似度で扱う」 という極めてシンプルな枠組みで、 図 R377-1 の散布図が依然として最重要のデバッグ手段である理由もここにある。
| 年 | 技術 | 特徴 | 代表用途 |
|---|---|---|---|
| 〜2010 | One-hot, TF-IDF | 疎・高次元・意味距離なし | 線形分類器の素性 |
| 1990 | LSA | 共起行列の SVD 圧縮 | 文書クラスタリング |
| 2013 | Word2Vec | 浅い NN・類推可能 | 類義語・カテゴリ特徴 |
| 2014 | GloVe | 共起統計+ニューラル | 汎用 NLP 素性 |
| 2016 | fastText | サブワード・未知語対応 | 多言語・形態素が複雑な言語 |
| 2018 | BERT | 文脈依存・双方向 Transformer | 分類・QA・NER |
| 2019 | Sentence-BERT | 文単位・対比学習 | 意味検索・RAG |
| 2021 | CLIP | 画像+テキスト同空間 | マルチモーダル検索 |
| 2024 | text-embedding-3 | 3072 次元・縮小可能 | 業務 RAG・大規模検索 |
🧭 設計判断: モデル選定のチェックリスト
実プロジェクトで embedding モデルを選ぶ際は、 「精度ベンチの順位」 だけで決めると後で破綻する。 (1) 想定するドメイン (法務・医療・コード等は専門モデルが圧倒する)、 (2) 言語要件 (日本語比率・多言語混在)、 (3) スループット要件 (推論レイテンシ・GPU 必要数)、 (4) 維持コスト (API 課金 vs. セルフホスト)、 (5) ライセンス (商用利用可否)、 (6) ベクトル次元 (DB ストレージとレイテンシに直結)、 という 6 軸で評価し、 自社の小規模 eval セットで Top-K 検索の体感を確認するのが最短コース。 図 R377-3 の箱ひげで「上位スコア群と下位スコア群の差」 を見るのも、 モデルの「分離力」 を直感で掴むのに有効である。
特に「API か OSS か」 の判断は、 規制業界では決定的になる。 個人情報・契約情報・診療情報が外部 API に流れる構成は、 多くの企業で許容されないため、 BGE-M3・E5・GTE・multilingual-e5 といった OSS の高性能モデルを自社 GPU で運用する選択になることが多い。 一方、 ユーザ生成データの RAG (FAQ・公開ドキュメント検索) であれば、 API 課金で済ませた方が初期コストが安く、 モデル更新も提供者任せにできる。 図 R377-1 の散布図で「クエリと検索結果が同じクラスタに入っているか」 を可視化して、 候補モデル数本を並列比較するワークフローを CI 化しておくと、 こうした判断が定量化されて社内合意も取りやすくなる。
🎓 学習ガイド: 次に学ぶべきトピック
本ページと R377 補強で「埋め込みの幾何・診断・運用」 を一通り押さえたら、 次は (a) 対比学習 (contrastive learning, SimCSE, InfoNCE) で「埋め込みをタスクに合わせて微調整する」 仕組みを学ぶこと、 (b) ベクトル DB (FAISS, pgvector, Qdrant) でインデックス構造とクエリ計画を実装すること、 (c) 近似最近傍 (HNSW, IVF-PQ) で「数億ベクトルを 10 ms で検索」 する技術に触れること、 (d) RAG パイプラインで検索結果を LLM プロンプトに注入し、 質問応答品質を計測すること、 (e) 埋め込みの監査 (drift detection, fairness check) で本番運用時の問題を未然に検知すること、 という 5 つの方向に進むのが王道である。 それぞれ独立のページで深掘りしているので、 関連用語リンクから辿ってほしい。
最後に強調したいのは、 「埋め込みの本質は『近さの設計』 である」 という一点である。 どんな対象を、 どんな特徴量で、 どんなメトリックで近づけるか — この 3 つを丁寧に決めることが、 モデル選定や次元数チューニング以上に成果を左右する。 図 R377-1 〜 R377-3 のような古典的可視化を CI に組み込み、 「近さが業務と整合しているか」 を常にチェックする体制が、 RAG・推薦・検索を本番投入する際の最強の防御線になる。 この補強セクションが、 そうした実装感覚を養う一助になれば幸いである。
🧭 R542 補強1: 埋め込みの幾何学的性質と空間設計
埋め込み (embedding) を実務で使う際にもっとも誤解されやすいのは、 「次元数 d を大きくすれば精度が上がる」 という素朴な仮説である。 実際には d を大きくしすぎると、 (1) 学習データに対する過適合、 (2) コサイン類似度が「すべて同じくらい」 に潰れてしまう次元の呪い (curse of dimensionality)、 (3) ベクトル DB のインデックスサイズ膨張による検索速度低下、 という 3 つの問題が同時に発生する。 経験則として、 単語埋め込みなら d=100〜300、 文埋め込みなら d=384〜768、 画像埋め込みなら d=512〜2048 程度が「精度と速度のスイートスポット」 として広く採用されている。 SSDSE-B-2026 の 47 都道府県のように対象数が少ない場合、 d=8〜16 でも十分機能することを覚えておきたい。 「次元数は対象数の平方根」 という経験則 (47 都道府県なら √47 ≒ 7) も実用的な目安となる。
幾何学的に見ると、 埋め込み空間で重要なのは 等方性 (isotropy) という性質である。 等方的な空間とは「どの方向に動いても等しく『意味の変化』 が起きる」 という状態であり、 数学的には共分散行列がほぼ単位行列に近い状態を指す。 BERT 等の事前学習済み埋め込みは、 学習直後は非等方的 (一部の方向に偏在) であることが知られており、 これが「コサイン類似度が常に 0.8 以上で差が出にくい」 という現象 (anisotropy problem) の原因となる。 対策として、 (a) BERT-flow (正規化フロー変換で等方化)、 (b) BERT-whitening (PCA + 標準化で等方化)、 (c) SimCSE (対比学習で等方化を強制) が提案されており、 文埋め込みベンチマーク MTEB で軒並み +5〜10 ポイントの改善を達成している。
| 次元数 d | 代表用途 | メモリ /1M ベクトル | 検索速度 (FAISS-Flat) | 推奨対象数 |
|---|---|---|---|---|
| 8 | 小カテゴリ (都道府県・性別) | 32 MB | 0.5 ms | 〜100 |
| 64 | ユーザー ID・商品 ID | 256 MB | 2 ms | 〜10K |
| 128 | 推薦システム・グラフ | 512 MB | 5 ms | 〜100K |
| 300 | word2vec・GloVe (古典) | 1.2 GB | 12 ms | 〜500K |
| 384 | all-MiniLM (文埋め込み軽量) | 1.5 GB | 15 ms | 〜1M |
| 768 | BERT-base・文埋め込み標準 | 3.0 GB | 30 ms | 〜5M |
| 1536 | OpenAI text-embedding-3-small | 6.0 GB | 60 ms | 〜10M |
| 3072 | OpenAI text-embedding-3-large | 12.0 GB | 120 ms | 〜50M |
この表が示す通り、 d を倍にするとメモリも検索時間もほぼ倍になるが、 精度向上は対数的にしか伸びないことが多い。 つまり「d=768 → d=1536 でメモリ倍増したが MTEB スコアは +1.2 ポイントだけ」 のようなトレードオフが頻繁に起きる。 本番投入時は Pareto フロンティア (精度 - メモリ - 速度の最適境界) を意識して d を選ぶことが、 コスト管理上きわめて重要である。 OpenAI の text-embedding-3 では Matryoshka Representation Learning (MRL) という手法で、 同じモデルから「最初の 256 次元」 「最初の 768 次元」 「全 3072 次元」 を切り出して使い分けられる設計が採用されており、 デバイス別・ユースケース別に柔軟に対応できるようになっている。
距離尺度の選択も実務では重要な意思決定となる。 (1) コサイン類似度 は方向のみを見るためベクトルのノルムに依存しない、 文書検索・推薦システムで最も広く使われる。 (2) ユークリッド距離 (L2) はノルム情報を保持するため、 「強度・大きさ」 も意味を持つ場面 (画像特徴量・センサーデータ) で有効。 (3) 内積 (dot product) は計算が最速で、 ベクトルが正規化されている場合はコサイン類似度と等価。 (4) マンハッタン距離 (L1) はスパースなベクトルに強く、 外れ値に対してロバスト。 BERT 系の埋め込みはコサイン類似度を前提に学習されていることが多いため、 ユークリッド距離を使うと予期しない挙動を示すことがある — 必ず学習時の損失関数と推論時の距離尺度を整合させること。 距離尺度・類似度・ベクトル空間 の各ページで個別に詳説しているので、 用途に応じて使い分けてほしい。
🛠 R542 補強2: 埋め込みの本番運用 — ベクトル DB と RAG パイプライン
2023 年以降、 埋め込みの実用化は RAG (Retrieval-Augmented Generation) という形でビジネス用途に爆発的に普及した。 RAG とは、 ユーザーの質問を埋め込みベクトルに変換し、 事前にインデックスした文書ベクトル群から類似度上位 K 件を検索、 検索結果を LLM (GPT-4・Claude・Llama) のプロンプトに「文脈」 として挿入してから回答を生成する仕組みで、 (a) LLM のハルシネーション (幻覚) を抑制、 (b) 最新情報や社内ナレッジを反映、 (c) 出典付き回答を実現、 という 3 つの効果がある。 RAG パイプラインの中核を担うのが ベクトル DB であり、 OSS では FAISS (Facebook)・Annoy (Spotify)・ScaNN (Google)・Qdrant・Weaviate・Milvus・Chroma、 マネージドサービスでは Pinecone・Vertex AI Vector Search・Azure AI Search・pgvector (PostgreSQL 拡張) が代表格となっている。
ベクトル DB の内部アルゴリズムは大別して 3 種類ある。 (1) Flat (brute force) は全ベクトルとの距離を計算する素朴な方法で、 小規模 (〜10 万件) なら最も正確で実装簡単。 (2) IVF (Inverted File) はベクトル空間を K-means でクラスタリングし、 クエリ時に近いクラスタのみを検索する方法。 リコール率と速度のバランスが良く中規模 (10 万〜1 千万件) で広く使われる。 (3) HNSW (Hierarchical Navigable Small World) は多層のグラフ構造で「高速道路 → 一般道」 と階層的に近傍を辿る方法。 大規模 (1 千万件以上) で SOTA の速度を出すが、 メモリ使用量が大きい。 さらに (4) PQ (Product Quantization) は各ベクトルをサブベクトルに分割して量子化することでメモリを 1/8〜1/32 に圧縮、 IVF や HNSW と組み合わせる (IVF-PQ・HNSW-PQ) のが標準的な構成となる。
| アルゴリズム | 対象規模 | リコール@10 | QPS (d=768) | メモリ効率 | 代表実装 |
|---|---|---|---|---|---|
| Flat | 〜100K | 100% (正確解) | 〜50 | 低 (生ベクトル保持) | FAISS-Flat・pgvector |
| IVF | 100K〜10M | 90〜95% | 〜500 | 中 | FAISS-IVF・Milvus |
| HNSW | 1M〜1B | 95〜99% | 〜5000 | 低 (グラフ構造大) | Qdrant・Weaviate |
| IVF-PQ | 10M〜10B | 85〜92% | 〜2000 | 高 (1/16 圧縮) | FAISS・ScaNN |
| HNSW-PQ | 100M〜100B | 90〜96% | 〜3000 | 高 | Milvus・Pinecone |
| ScaNN | 1M〜10B | 93〜97% | 〜10000 | 中〜高 | Vertex AI Vector Search |
本番運用時のチェックポイントを 7 つ挙げる。 (1) 埋め込みモデルのバージョン管理: 埋め込みモデルを更新するとベクトル空間が変わるため、 全データを再インデックスする必要がある。 モデルバージョンと DB スナップショットを必ずペアで管理。 (2) チャンクサイズの設計: RAG で文書をチャンク (典型的に 256〜1024 トークン) に分割するが、 サイズが小さすぎると文脈が失われ、 大きすぎるとノイズが増える。 オーバーラップ (50〜200 トークン) を入れるのが定石。 (3) ハイブリッド検索: 埋め込みベース (semantic) + キーワードベース (BM25) を組み合わせると、 「専門用語・固有名詞」 と「意味的近さ」 の両方をカバーできる。 (4) リランキング: cross-encoder (例: BAAI/bge-reranker-large) で上位 100 件を再評価すると、 検索品質が +10〜20 ポイント向上することが多い。 (5) 埋め込みドリフト監視: 時間経過で語彙や話題が変わると、 埋め込みの分布が変わる。 月次で分布シフトを検出する仕組みを CI に組み込む。 (6) レイテンシ予算: ユーザー応答時間を 2 秒以内に保つため、 検索 (50ms) + LLM 生成 (1500ms) + ネットワーク (100ms) のような時間配分を設計。 (7) 監査ログ: 「どの質問にどの文書を引いて何を答えたか」 を全件記録し、 品質改善のループに使う。 これらをMLOps・ベクトルDB・RAG の各ページで具体的に解説している。
📊 R542 補強3: 埋め込みの評価・バイアス・倫理的配慮
埋め込みの品質評価は、 大きく 内在評価 (intrinsic evaluation) と 外在評価 (extrinsic evaluation) に分かれる。 内在評価は埋め込みそのものの幾何学的性質を測る方法で、 (1) Word Similarity: WordSim353 や SimLex-999 で「単語ペアの人手評価」 と「埋め込みのコサイン類似度」 のスピアマン相関を計算 (0.7 以上で良好)。 (2) Word Analogy: 「king - man + woman = queen」 のようなアナロジータスクで正解率を測る (60% 以上で良好)。 (3) 等方性測定: 共分散行列の固有値分布のエントロピーで「空間の偏り」 を測定。 一方、 外在評価は下流タスクへの貢献度を測る方法で、 (a) MTEB (Massive Text Embedding Benchmark): 56 タスク・8 ドメインで文埋め込みを総合評価、 2023 年以降のデファクトスタンダード。 (b) BEIR: 18 検索タスクで RAG 用途を評価。 (c) RTE / STS-B: GLUE ベンチマーク内の文ペアタスク。 実務では「自分のドメインに近いタスクで評価セットを自作して測る」 ことが最重要であり、 MTEB のスコアだけを鵜呑みにしないこと。
埋め込みに潜む 社会的バイアス は、 2016 年の Bolukbasi らの研究「Man is to Computer Programmer as Woman is to Homemaker?」 以来、 大きな倫理的問題として認識されている。 学習データである大規模 Web テキストに含まれる性別ステレオタイプ・人種差別・宗教偏見が埋め込み空間にそのまま反映されることが定量的に示されており、 例えば word2vec で「医者 - 男性 + 女性 ≒ 看護師」 のような出力が出る。 これが採用 AI、 与信スコアリング、 検索ランキングに使われると、 マイノリティへの不利益が増幅される危険がある。 対策技術として、 (1) Hard Debias (Bolukbasi 2016): バイアス方向を PCA で抽出し直交射影で除去。 (2) INLP (Iterative Nullspace Projection) (Ravfogel 2020): 線形分類器の Null 空間に繰り返し射影することで保護属性情報を消す。 (3) Counterfactual Data Augmentation: 「he/she」 等を入れ替えたデータで再学習。 (4) Gender-Neutral Embeddings (GN-GloVe): 学習時にバイアスを抑制する損失を追加。 ただしこれらは「測定可能なバイアス」 を消すだけで、 「間接的な相関」 を残すという限界があり、 完全な公平性は実現できていない。
| バイアス指標 | 測定対象 | 代表データセット | 合格目安 |
|---|---|---|---|
| WEAT (Word Embedding Association Test) | 単語埋め込みの属性連想 | Caliskan 2017 (10 カテゴリ) | d-score < 0.5 |
| SEAT (Sentence Embedding Association Test) | 文埋め込みの属性連想 | May 2019 | d-score < 0.5 |
| StereoSet | 穴埋め予測のステレオタイプ | Nadeem 2020 (17K サンプル) | SS スコア > 60 |
| CrowS-Pairs | 9 種の社会的バイアス | Nangia 2020 (1508 ペア) | バイアススコア < 55 |
| BBQ (Bias Benchmark for QA) | QA タスクの偏り | Parrish 2022 (58K 質問) | バイアススコア < 0.1 |
| HONEST | 有害発話の生成率 | Nozza 2021 | スコア < 0.05 |
実運用での倫理的配慮として、 以下の 6 つの「埋め込み運用憲章」 を提唱したい。 (1) 監査可能性: どの学習データから埋め込みが作られたかを追跡できる仕組み (データシート・モデルカード) を整備。 (2) 定期的バイアス測定: 上記指標を四半期ごとに計測し、 悪化していないか確認。 (3) 多様性のあるテストセット: マジョリティだけでなくマイノリティを含む評価データを用意。 (4) 説明責任: AI が下した判断 (採用否決・推薦結果) に対し、 埋め込みのどの次元が効いたかを SHAP 等で説明可能に。 (5) オプトアウト: ユーザーが自身のデータを学習・推論から除外できる権利を提供 (GDPR・個人情報保護法)。 (6) ステークホルダー対話: 影響を受ける利用者・市民団体と定期的に対話し、 改善方針を公開。 これらは AI 倫理・公平性・アカウンタビリティ・説明可能 AI の各ページで深掘りしているため、 本番システム設計時には必ず参照してほしい。 埋め込みは便利な技術だが、 「数値の近さ」 が「社会的な平等」 と一致するとは限らない — この一点を肝に銘じて運用することが、 信頼される AI システム構築の出発点である。
📝 補講: エンベディング実装の現場知 8 か条
エンベディング (埋め込み) の実務運用は、 数式以上に「データ準備」「次元選択」「評価設計」「再現性確保」が重要となる。 以下の 8 か条は、 SSDSE-B-2026 都道府県データから RAG・検索・推薦まで横断的に使える運用知である。 単に「ベクトル化すれば動く」ではなく、 運用段階で何度も陥る落とし穴を回避する設計指針として活用してほしい。
- 前処理を統一する: 訓練と推論で同じ tokenizer・normalize・truncation を使う。 ズレがあると性能が大きく劣化。 特に絵文字・全角半角・大文字小文字の扱いに注意する。
- 次元数は経験的に選ぶ: 128/256/384/768 が定番。 サンプル数の 1/10 程度を上限目安。 小規模データで 1024 次元など使うと過剰パラメータで汎化しない。
- 正規化 (L2 norm) を使う: cosine 類似度の安定化のため、 埋め込みベクトルを L2 正規化する。 これにより内積と cosine が等価になり、 高速計算 (Faiss inner product) が可能。
- バイアスを定期検査: 性別・人種・地域に対する偏りを embeddings_bias 等のツールで検査。 SEAT・WEAT 等の標準テストを四半期ごとに実行。
- 更新時は ABテストで効果検証: 新埋め込みモデルへの切り替えは段階的に。 旧モデルとの並行運用で安全に。 オフライン評価と本番 KPI の両方で確認。
- ベクトル DB のスケーリング: 100 万件以上は HNSW・IVFFlat 等の近似最近傍検索で高速化。 recall@10 が 0.95 以上を目安にパラメータ調整。
- 埋め込みの可視化: t-SNE・UMAP で 2D 可視化して、 期待通りクラスタが形成されているか確認。 期待外のクラスタリングがあれば前処理を見直す。
- ドメイン固有 fine-tuning: 汎用モデルでは不十分なら、 ドメイン文書で対比学習 (SimCSE 等) でファインチューニング。 数千文書からでも顕著な性能改善が見込める。
SSDSE-B-2026 の都道府県データから埋め込みを作るなら、 47 都道府県名 × 多次元統計量を sentence-transformers でベクトル化し、 cosine 類似度で「経済構造が似た都道府県」を抽出するシナリオが教材として優れている。 さらに進めて、 RAG パイプラインで「ある都道府県の課題解決事例」を類似都道府県から検索する応用も可能。 これにより、 埋め込みが「単なる数値ベクトル」ではなく「意味検索の基盤」であることが体感できる。 教育現場での活用も含め、 埋め込みは現代 AI の中核技術であり、 数式と現場知の両輪で理解することが不可欠である。 また、 埋め込みは LLM のプロンプトエンジニアリングや RAG の根幹を支えるため、 これらの応用技術を学ぶ前に必ず深く理解しておくべき基礎概念である。
📚 補講: 埋め込み技術の進化と教育的意義
埋め込み技術は 2013 年の word2vec から始まり、 2017 年の Transformer・2018 年の BERT・2020 年の Sentence-BERT・2022 年の ada-embedding (OpenAI)・2023 年の multilingual E5・2024 年の voyage-3 など急速に進化してきた。 性能指標としては MTEB (Massive Text Embedding Benchmark) が業界標準で、 56 タスク・112 データセットでの性能を一括評価する。 教育現場では、 学習者がこの進化を「単なる新しいモデルの紹介」として受け取るのではなく、 「人類が言葉の意味をいかに数値化しようと格闘してきたか」という知的探究として捉えることが重要である。 そのために、 ライブラリの使い方だけでなく、 各モデルの設計思想 (分散仮説・対比学習・教師なし学習) の比較を歴史的文脈で教えることが効果的である。
日本の教育現場での埋め込み技術の活用は、 まだ初期段階だが、 SSDSE-B-2026 のような都道府県データセットと組み合わせれば、 高校統計教育から大学のデータサイエンス専攻まで幅広く展開できる。 例えば「47 都道府県の特徴を 100 次元ベクトルで表現し、 cosine 類似度で似た県を探す」というハンズオン課題は、 ベクトル空間・距離計算・次元削減・可視化を一気に体験できる優れた教材となる。 さらに発展形として、 RAG パイプラインで「ある都道府県の少子化対策事例を、 類似都道府県から自動検索する」シナリオまで進めれば、 埋め込みが現実の社会問題解決に直結する技術であることが体感できる。 このように、 技術の理解と社会実装の橋渡しを意識した教育設計こそが、 次世代のデータサイエンス教育の核心になる。
🔎 補足: 埋め込み空間の評価指標
埋め込み (embedding) の品質は単に低次元化できたかではなく、 「意味的に近いものが近くに写るか」「下流タスクで使えるか」で測られる。 ここでは現場で頻用される代表 4 指標と SSDSE-B-2026 都道府県人口・経済データを埋め込んだ場合の読み方を補足する。
1. cosine similarity (コサイン類似度)
2 つのベクトル u, v の角度の cosine を取る。 −1 (正反対) 〜 +1 (同方向) の値域で、 ノルムに依存しないので長さがバラつくテキストや特徴量の混在ケースに頑健。 SSDSE-B-2026(2023 年)で総人口・出生数・65歳以上人口を標準化して 3 次元埋め込みとして見ると、 東京と神奈川の cosine は 0.997 と極めて近く、 「規模感ベクトルが揃っている」ことが分かる。 一方で東京と高知は −0.99 まで下がり、 「規模軸の向きがほぼ正反対」と読み取る(規模系 3 変数だけの標準化空間では cosine が ±1 に張り付きやすい点にも注意)。 cosine は方向だけを見るので、 「絶対量を比較したい」場合には別指標が必要になる点に注意する。
2. Euclidean distance (ユークリッド距離)
絶対量を反映するので「規模の差」を見たい場合に有効。 ただし正規化していない生の人口・GDP を放り込むと、 単位の大きな変数 (例: 人口) が距離を支配する。 必ず標準化 (z-score 等) してから使う。 SSDSE-B-2026 で標準化後ユークリッド距離を取ると、 東京は他県すべてから 4σ 超離れた「孤立点」として現れる。 こうした孤立点があると k-means などの距離ベース手法では重心が引きずられるため、 ロバスト統計や対数変換と組み合わせるなどの工夫が必要になる。
3. Recall@K / nDCG (近傍検索品質)
検索系下流タスクで「正解集合 K 件のうち何件が近傍 K に入ったか」を測る。 都道府県データの場合、 たとえば「経済規模が似た上位 5 県」を正解として、 埋め込みの近傍 5 件と照合する。 Recall@5 = 0.8 なら 4/5 一致、 nDCG は順位重みも考慮する。 word2vec 等の単語埋め込みでも analogy task の精度評価で用いる。 検索エンジン・推薦システム・RAG (retrieval-augmented generation) など、 埋め込みを実プロダクトに乗せる際の最終 KPI になりやすい指標である。
4. probing accuracy (線形プローブ精度)
埋め込みベクトルだけを入力に、 線形分類器 (logistic regression 等) を学習して下流タスクの精度を測る。 高い精度が出れば「埋め込みに必要情報が線形分離可能な形で残っている」と言える。 BERT や SimCLR の評価でも標準的に用いられる。 非線形分類器 (MLP 等) を使うと「埋め込みが情報を持っているか」と「分類器が抽出できるか」が混ざるため、 純粋な埋め込み品質を見るには線形プローブが好まれる。
合わせて見るべき可視化
UMAP / t-SNE での 2D 投影と、 上記指標を併用する。 投影は人間の目で「クラスタが分離しているか」を確認するためで、 投影上の距離は元空間の絶対距離とは一致しないため、 過剰解釈を避ける。 SSDSE-B-2026 を 47 都道府県 × 数十変数で埋め込み、 UMAP で 2D 投影すると、 「都市圏」「中規模県」「過疎県」の 3 クラスタが現れる傾向があり、 上記指標値とも整合する。 投影パラメータ (perplexity, n_neighbors 等) を変えると見た目が大きく変わるため、 複数設定での再現性を確認するのが望ましい。
実務でのチェックリスト
- ベクトルを足し算する前に正規化しているか (ノルムによる支配を避ける)
- cosine と Euclidean のどちらを選ぶか目的に応じて明確にしているか
- 下流タスクの精度で必ず検証しているか (埋め込み単独の数値だけで判断しない)
- SSDSE 等の実データで「直感に反する近傍」が出たら埋め込み学習データ・前処理を疑う
- 次元数を変えたときに指標がどう動くかをスイープして確認しているか (過剰次元は冗長性、 過小次元は情報損失を生む)
これらの指標は単独で完結するものではなく、 用途 (検索、 分類、 クラスタリング、 異常検知) に応じて組み合わせて使う。 たとえば検索用途では Recall@K を主指標に、 cosine similarity を内部スコアに、 UMAP 投影をデバッグ可視化に、 という役割分担が典型的である。 SSDSE-B-2026 のような公的統計を題材にすると、 数値の妥当性を「東京の人口は最大」「沖縄は離れている」など現実知識で検証しやすく、 教材として優れている。
🔎 拡張補足: 埋め込みの 2024-2025 最新動向と応用
1. RAG (Retrieval-Augmented Generation) の中核技術
2023-2024 年に爆発的に普及した RAG は、 「ユーザー質問 → 埋め込み → ベクトル DB 検索 → 関連文書取得 → LLM 生成」の流れ。 埋め込み品質が RAG 全体の精度を決定する。 主要埋め込みモデル: (1) OpenAI text-embedding-3 (large/small) は API ベースで多言語対応、 (2) Cohere embed-multilingual-v3 は 100 以上の言語に対応、 (3) Sentence-BERT, MPNet, BGE は OSS で自前ホスト可能。 SSDSE-B-2026 のような構造化データに対しても、 説明文を埋め込んで類似ドキュメント検索が可能で、 「人口減少と関連の深い指標は何か」という問いに対し、 高齢化率、 出生率、 転出超過などのドキュメントが上位に出てくる。 RAG では、 埋め込み後にリランカー (Cross-Encoder) で精度をさらに上げる二段階構成も一般的で、 単純な cosine 検索だけでは取りこぼす微妙な意味類似性を補える。 また、 RAG の評価には Hit@K, MRR (Mean Reciprocal Rank), nDCG などを使い、 「正解文書が上位 K 件に入る確率」を測る。 埋め込み 品質はそのまま RAG 品質に直結するため、 ドメイン特化型ファインチューニング (LoRA, contrastive learning) も活発に行われている。
2. ベクトルデータベースの群雄割拠
2024-2025 年の主要ベクトル DB: (1) Pinecone (商用、 マネージド、 スケーラブル)、 (2) Weaviate (OSS + 商用、 GraphQL ベース)、 (3) Qdrant (OSS + 商用、 Rust 製で高速)、 (4) Milvus (OSS、 スケーラブル、 分散対応)、 (5) Chroma (軽量、 ローカル開発向け)、 (6) pgvector (PostgreSQL 拡張、 既存 DB に統合)、 (7) FAISS (Facebook、 OSS ライブラリ、 産業実績多数)、 (8) Annoy (Spotify、 軽量、 静的インデックス向け)。 SSDSE 規模 (47 都道府県 × 100 指標 = 約 5,000 ベクトル) では Chroma や FAISS で十分。 億単位のベクトルを扱う場合は Milvus, Pinecone, Qdrant などの分散対応 DB が必要。 ベクトル DB の選定基準は、 (a) スケール (10 万 / 100 万 / 1 億)、 (b) 更新頻度 (静的 vs 動的)、 (c) フィルタリング (メタデータ条件付き検索)、 (d) ハイブリッド検索 (BM25 + ベクトル)、 (e) ホスト方式 (マネージド vs セルフホスト) など。 内部アルゴリズムは HNSW (Hierarchical Navigable Small World) や IVF (Inverted File) が定番で、 ANN (Approximate Nearest Neighbor) 検索によって O(log N) 程度に高速化される。
3. マルチモーダル埋め込み
テキストだけでなく画像・音声・動画を共通空間に埋め込む技術: (1) CLIP (OpenAI 2021、 テキスト + 画像、 zero-shot 画像分類の元祖)、 (2) ALIGN (Google 2021、 ノイズ含む大規模データで学習)、 (3) ImageBind (Meta 2023、 6 モダリティ統合: テキスト、 画像、 音声、 深度、 熱、 IMU)、 (4) Whisper Encoder (音声) + Text Encoder の組み合わせ、 (5) LLaVA, Flamingo, GPT-4V などの多モーダル LLM の内部表現。 「猫の画像と『猫』テキストが同じベクトル空間で近い」ことで、 zero-shot 検索が可能。 たとえば画像 DB に対して「赤いリンゴ」というテキストクエリで検索できる。 学習方法は対比学習 (contrastive learning) が主流で、 正例ペア (画像 - 対応キャプション) は近く、 負例ペアは遠くに配置するよう損失を設計。 InfoNCE Loss が定番。 SSDSE-B-2026 と組み合わせれば、 都道府県のシンボル画像 (県旗、 名物) + 統計データ + テキスト説明 を共通空間に埋め込み、 「テキストで検索したら関連県と画像が出る」教材が作れる。
4. グラフ埋め込み
ソーシャルネットワーク、 引用関係、 知識グラフ などをベクトル化する技術: (1) Node2Vec (Grover 2016、 ランダムウォーク + Word2Vec)、 (2) DeepWalk (Perozzi 2014、 Node2Vec の前身)、 (3) GraphSAGE (Hamilton 2017、 帰納的学習で未知ノードにも対応)、 (4) GraphSAINT (サンプリングベース、 大規模対応)、 (5) GCN (Kipf 2016)、 GAT (Veličković 2018) など GNN (Graph Neural Network) 系の更新中。 SSDSE-B-2026 で都道府県間の「経済的近さ」「人口移動」「物流」のネットワークを構築し、 そのネットワーク上で Node2Vec を回せば、 「地理的に遠くても経済的に近い県」を発見できる。 グラフ埋め込みは推薦システム (アイテム - アイテムグラフ)、 創薬 (分子グラフ)、 SNS (ユーザー - ユーザーグラフ) など応用範囲が広い。 評価指標はノード分類精度、 リンク予測 AUC、 グラフ再構築誤差など。
5. 埋め込みの評価指標
(1) MTEB (Massive Text Embedding Benchmark) は埋め込みモデルの総合評価ベンチマークで、 56 タスクをカバー、 (2) STS Benchmark は意味類似度の標準ベンチマーク、 (3) Retrieval (BEIR) は検索精度の網羅的評価、 (4) Clustering (Reuters, TwentyNewsgroups) はクラスタリング精度、 (5) Classification (Banking77, Amazon Polarity) は分類タスク、 (6) Reranking (SciDocs, StackOverflow) はリランキング、 (7) Pair Classification (TwitterURL) はペア分類。 タスクに応じてベンチマークを選ぶ。 多言語タスクは XOR-TyDi, MIRACL, MLQA, XTREME など。 日本語特化では JGLUE, JSTS, JSICK, JCoLA, Mewsli-X が代表的。 MTEB Leaderboard を見ると、 2024 年時点で BGE-M3, NV-Embed, voyage-large 等の OSS / 商用モデルが上位を競っており、 OpenAI text-embedding-3-large もトップ層。
6. 埋め込みの次元削減と可視化
高次元埋め込み (768-1536 次元) を 2D/3D に削減する手法: (1) PCA は線形、 高速だが非線形構造を保てない、 (2) t-SNE (van der Maaten 2008) は局所構造保持、 perplexity パラメータが結果を大きく左右、 (3) UMAP (McInnes 2018) は局所と大域の両方を保ち、 計算速度も t-SNE より速い、 (4) TriMap, PaCMAP, h-NNE も新興手法。 SSDSE-B-2026 で 47 都道府県の埋め込みを UMAP で 2D 可視化すれば、 「経済的に似た県」のクラスタが目視確認できる。 注意点: 投影結果は確率的で、 random_state を固定しないと毎回違う見た目になる。 また、 投影上の距離は元空間の距離と一対一対応しない (特に t-SNE)。 可視化は「探索 (発見)」のための道具であり、 厳密な統計推論には使うべきでない。 散布図には県名ラベルや色分け (地方区分、 人口規模) を加えると解釈しやすい。
7. 埋め込みのバイアス検出
「医師 → 男性、 看護師 → 女性」のような社会的バイアスが埋め込みに刻まれる現象。 学習データに含まれる偏りが、 そのままベクトル空間の幾何構造に反映される。 検出手法: (1) WEAT (Word Embedding Association Test, Caliskan 2017、 IAT 心理テストの埋め込み版)、 (2) SEAT (Sentence Embedding Association Test)、 (3) StereoSet (Nadeem 2021、 ステレオタイプの定量化)、 (4) CrowS-Pairs (Nangia 2020、 社会的バイアスペア比較)。 検出後の対処: Hard Debias (Bolukbasi 2016、 性別ベクトル方向で投影削除)、 SENT-Debias、 INLP (Iterative Null space Projection、 線形分類器が予測不能になるまで投影を繰り返す)。 SSDSE のような統計データでは直接的な人物バイアスは少ないが、 「都市 / 地方」「東日本 / 西日本」のような地理的バイアスが知らず知らず入る可能性があり、 評価する価値はある。
8. SSDSE-B-2026 を題材にした埋め込み実例
(1) 47 都道府県を 100 指標で表現 → 100 次元ベクトル、 (2) UMAP で 2 次元化、 (3) 散布図プロット (人口大都市圏、 地方圏のクラスタが見える)、 (4) 既知の関係 (関東、 関西、 東北 etc.) との一致度を ARI (Adjusted Rand Index) で測定、 (5) cosine 類似度ランキングで「東京に最も似た県」を出力 (大阪、 神奈川、 愛知が上位の見込み)、 (6) 「最も似ていない県のペア」を出力 (おそらく東京 - 鳥取、 東京 - 高知など)、 (7) 埋め込みの主成分を解釈 (第 1 主成分 = 人口規模、 第 2 主成分 = 第一次産業比率 など)、 (8) クラスター数を変えながら DBSCAN / KMeans で分割、 (9) 時系列データがあれば「県の埋め込み軌跡」を時間で追う。 教育的・実用的に強力な事例。 学生に体感させると、 「数値の羅列が空間的構造を持つ」ことが直感的に理解できる。
9. 埋め込みと自己教師あり学習
SimCLR, MoCo, BYOL, BarlowTwins, DINO などの自己教師あり学習で、 ラベルなしデータから良い埋め込みを学ぶ。 (1) Contrastive Learning (SimCLR, MoCo): 同類は近く、 異類は遠く配置、 (2) Non-Contrastive (BYOL, BarlowTwins): 異類を必要としない、 自己一貫性を強制、 (3) Masked Modeling (BERT, MAE): 一部を隠して予測、 (4) Distillation (DINO): 教師ネットワークと生徒ネットワークの整合。 LLM の事前学習も広義の埋め込み学習で、 トークン埋め込みと文脈埋め込みを同時に学ぶ。 自己教師あり学習の利点は、 (a) ラベル不要、 (b) 大量データで強力な事前学習、 (c) ファインチューニングで多様なタスクへ転移可能。 SSDSE のような構造化データに対しても、 「複数の指標を予測しあう」自己教師あり方式で埋め込みを学べる (TabNet, SAINT, FT-Transformer など)。
10. 埋め込みの圧縮と効率化
(1) Quantization: float32 → int8 で 4 倍小さく、 速度は 2-4 倍向上、 (2) Pruning: 重要次元のみ保持、 精度低下を抑えながら次元削減、 (3) Matryoshka Embeddings (Kusupati 2022): 階層的に短くしても性能維持、 1536 → 768 → 384 → 128 のように切り詰めても OK、 (4) Binary Embeddings: 1 ビットで圧縮、 一部精度落ちるが速度大幅向上、 (5) Product Quantization (PQ): ベクトルを部分空間に分割し、 各部分をクラスタ ID で表現、 FAISS の主要技術、 (6) Scalar Quantization: 各次元を少ないビット数で表現。 産業実装ではこれらの組み合わせが定番で、 「精度 99% を維持しつつメモリ 1/10」のような最適化が可能。 SSDSE 規模では圧縮不要だが、 億単位のベクトルを扱う場合は必須技術。
11. 埋め込みと意味検索
Google Search, Bing Search も内部で埋め込み + 関連度計算を実装している。 古典的な BM25 (TF-IDF の発展形) は語の表面マッチに強く、 埋め込みは意味的類似度に強いため、 両者のハイブリッドが現代的な検索エンジン (Elasticsearch + ベクトル検索、 OpenSearch + KNN プラグイン、 Vespa など)。 SSDSE のような統計用語集サイトでも、 各用語の説明文を埋め込んで「意味的に近い用語」を関連リンクとして表示できる。 たとえば「相関」のページから「共分散」「回帰分析」「スピアマン順位相関」が自動推薦される仕組み。 ハイブリッド検索では RRF (Reciprocal Rank Fusion) で BM25 ランクと埋め込みランクを融合するのが定番。 学習データなしでも、 事前学習済み埋め込みモデルを使えばすぐに導入可能で、 中小サイトでも実装は容易。
12. 締めくくり: 埋め込みは AI の共通言語
テキスト、 画像、 音声、 グラフ、 数値表 などを共通のベクトル空間に写像する埋め込みは、 現代 AI のあらゆる応用 (検索、 推薦、 分類、 生成、 異常検知、 クラスタリング、 可視化) の基盤。 数学的には複雑だが、 概念は「意味的に近いものは近く写る」というシンプルな原理。 学習者はまず SSDSE-B-2026 のような小規模な構造化データから入り、 cosine 類似度や UMAP 投影を手で動かして直感を養う。 次に Wikipedia, ImageNet, LAION などの大規模データで Sentence-BERT, CLIP などの事前学習モデルを試し、 最後に RAG, マルチモーダル検索、 推薦システム などの実応用に進む段階的学習が推奨される。 埋め込みは AI 時代の「共通言語」として、 学習者が必ず通る道。 統計学から機械学習へ進む際の架け橋でもあり、 「次元」「距離」「類似度」「投影」などの概念を一度に学べる優れた題材である。 本ページの内容を土台に、 各自で SSDSE データを使った演習を行うことを強く推奨する。
🗺 用語マインドマップ — 周辺概念の整理
「埋め込み」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場になります。
| 方向 | 隣接概念 | 関係性 |
|---|---|---|
| 北 (上位) | 表現学習・特徴量設計 | 高次元データを低次元密ベクトルに写す技法群の総称 |
| 南 (下位) | RAG・推薦・類似検索 | 埋め込み + cosine 類似度で実装する代表的応用 |
| 東 (発展) | Sentence-BERT / CLIP / マルチモーダル | テキスト・画像・音声を同一空間に統合する拡張 |
| 西 (前提) | One-hot エンコーディング / TF-IDF | 疎ベクトル表現。 埋め込みが解決した「次元の呪い」「同義性の欠如」の出発点 |
| 中央 | 埋め込み (Embedding) | 意味的類似が距離として現れる低次元密ベクトル空間への写像 |
マインドマップは「学んだ用語を整理する道具」として優秀。 紙にこの 5 方向を書き、 自分なりの隣接概念を埋めると、 暗黙的にあった理解構造が可視化されます。
🔗 隣接手法への橋渡し
エンベディングは単独の表現ではなく、 離散カテゴリ ・テキスト ・グラフを密ベクトル空間に写す表現学習の総称である。 Word2Vec ・BERT ・GNN など派生手法と、 類似検索 ・分類 ・生成 AI の下流タスクと一体で設計する。
- 上流(前処理・データ整備): 前処理 (特徴量エンジニアリング) / トークン化 (単語分割) / One-hot エンコーディング
- 並列(代替・補完手法): Word2Vec (NLP) / BERT (Transformer) / TF-IDF
- 下流(評価・解釈・応用): Transformer / 類似度 (コサイン類似度) / 分類タスク
エンベディングは「高次元・離散な対象を密ベクトルに埋め込む」表現学習で、 上流のトークナイズ・カテゴリ整理が品質を決め、 並列の Word2Vec・BERT・グラフ埋め込みのいずれが目的に合うかを選び、 下流の類似検索・分類・生成 AI で再利用する。
🌳 手法選択フロー
エンベディングを使うかは「対象データの離散性・類似性検索の有無・下流タスクの種類」の 3 軸で決まる。 自然言語・カテゴリ・グラフのいずれかが主体で、 類似検索や生成が下流にあれば必須。
- 何を近さと呼ぶのか
意味が近い、 一緒に出現する、 同じ利用者が使う — 何を「近い」とするかで学習方法が変わる。 この定義が曖昧なままだと、 出来上がった空間の評価もできない。 - 自分で学習するか、 既存を使うか
一般的な語なら学習済み埋め込みで足りる。 専門用語や社内語彙が中心なら、 自分のデータで追加学習する。 - 何次元にするか
次元が大きいほど表現力は上がるが、 データが少ないと過学習し、 距離も 0 付近に集中する。 下流タスクの性能で選ぶ。 - 距離の測り方は
長さの影響を除きたいならコサイン類似度、 大きさも意味を持つなら内積。 閾値はそのデータの分布を見てから決める。
SSDSE-B-2026 で 47 都道府県を人口・出生・気候などの数値列ベクトルから埋め込むと、 東京など大都市圏と沖縄が外れ位置、 中小規模県が密集する 2 次元配置が得られ、 地域類似性の可視化と政策グルーピングに活用できる(産業別就業者構成で埋め込みたい場合は SSDSE-A / E 系のデータを使う)。
🎮 触って理解する
埋め込みとは「意味を座標に変換する」技術です。 下の 2 つの実験で、 「近さ=意味の近さ」と「ベクトルの引き算=意味の引き算」を手で動かして体感してください。 すべてお使いの端末の中だけで計算しており、 通信は一切行いません。
実験1: 意味の地図をドラッグして類似度を見る
6 つの単語を 2 次元の埋め込み空間に配置しています。 点をドラッグして動かし、 下の 2 つのプルダウンで選んだ単語ペアの コサイン類似度(向きの近さ)と ユークリッド距離(位置の近さ)がリアルタイムに変わる様子を確かめてください。 初期配置では「動物」「乗り物」「都市」が 3 つの塊(クラスタ)になっています。
原点 (0,0) を中心とした座標。 各単語のベクトルは原点からの矢印で表されます。 選択中の 2 単語は色付きの矢印で強調されます。
実験2: ベクトル演算でアナロジー(王 − 男 + 女 ≈ 女王)
埋め込みの最も驚くべき性質は、 意味の引き算・足し算がベクトル演算で書けることです。 あらかじめ用意した固定の埋め込みを使い、 A − B + C を計算して、 その結果に最も近い単語を自動で探します。 初期設定 王 − 男 + 女 は 女王 を指し示します。
★ が計算結果 A−B+C の位置。 破線の平行四辺形が「A→B と C→結果 が同じ方向」であることを示します。
🧠 もう一段深く理解する
意味の近さを距離や角度で表すのが埋め込みの本質です。 実験1 で分かる通り、 コサイン類似度は「原点から見た向き」を、 ユークリッド距離は「位置そのもの」を測ります。 埋め込みでは向き(コサイン)を使うのが標準で、 ベクトルの長さ(=出現頻度などの影響)を打ち消せるためです。
- 次元の呪い: 実際の埋め込みは 50〜768 次元。 高次元では「ほとんどの点が等距離」に見え、 2 次元の直感が崩れます。
- 学習データのバイアス: 埋め込みはデータの偏り(性別・職業の固定観念など)をそのまま学習します。 「王−男+女≈女王」が成り立つのと同じ仕組みで、 差別的な連想も再現してしまいます。
- 解釈: 各次元に人間が読める意味はありません。 「近い/遠い」は言えても「なぜ近いか」は別途分析が必要です。 t-SNE/UMAP の 2D 図は距離ではなく近傍関係を保つため、 図上の距離を鵜呑みにしないこと。
- word2vec: 実験2 のアナロジーを大量テキストの共起から自動獲得した古典的手法(本サイトでは 自然言語処理 (NLP) を参照)。
- 文埋め込み: 単語だけでなく文全体を 1 ベクトル化。 テキスト類似度 や RAG の基盤になります。
- レコメンド: 商品・ユーザを埋め込み、 コサイン類似度で「近いもの」を推薦(推薦システム)。 Transformer も入力を埋め込みから始めます。
🧭 深掘り追補: 「埋め込み」という発想の核 — 3 つの本質
ここまでの解説を「一言でいうと何だったのか」に圧縮し直します。 埋め込みの定義は分野ごとに揺れますが、 次の 3 点はどの流儀にも共通する発想の核です。
- 高次元・離散 → 低次元・密。 one-hot(語彙数 $V$ 次元、 ほぼ全部 0 の疎ベクトル)や共起カウント行列を、 数十〜数百次元の密な実数ベクトルに置き換える。 情報を捨てるのではなく、 「予測に効く共通構造」だけを残す圧縮です(次元削減・TF-IDF の疎ベクトルとの対比で理解すると鮮明)。
- 意味の近さを距離・角度で表す。 「似ている ⇔ ベクトルが近い」という約束をデータから作り込む。 近さの物差しは cosine 類似度(向き)とユークリッド距離(位置)で、 両者は L2 ノルムを揃えたときだけ同じ順位を返します。
- 学習された表現である。 設計者が座標軸を決めるのではなく、 「共起を当てる」「同じ意味のペアを近づける」といった代理タスクの副産物として座標が決まる。 だから各次元に人間可読なラベルはなく、 学習データが変われば地図も変わります。
対象は単語に限りません。 単語・文の埋め込み(NLP・テキスト類似度)、 アイテム/ユーザ埋め込み(推薦システムで「この商品を買った人はこれも」を内積で計算)、 グラフ埋め込み(ネットワークの頂点をランダムウォークの「文」と見なして word2vec を流用する node2vec など)—— いずれも「離散シンボルを共通のベクトル空間に載せ、 あとはベクトル演算に持ち込む」という同じ設計思想です。 本ページの SSDSE-B の県ベクトルは、 この最も素朴な形(数値特徴の標準化ベクトル)にあたります。
🧮 実測追補: SSDSE-B-2026 の 109 次元「県ベクトル」で本質を確かめる
上の 🧮 セクションは 4 次元の入門例でした。 ここでは SSDSE-B-2026(cp932、 2 行目の日本語ヘッダを skiprows で除外、 2023 年度・47 都道府県)の数値列 109 個すべてを使い、 各県を 109 次元ベクトルとして扱った実測結果を示します。 レシピは「列ごとに z-score 標準化 → cosine 類似度行列」だけです。
X = df[df["SSDSE-B-2026"]==2023] の数値109列 → Z = (X − mean) / std
C = cosine_similarity(Z) # 47×47 の類似度行列
実測① 標準化しないと「全県が似ている」ことになる
生の値のまま cosine を取ると、 総人口など桁の大きい列が向きを支配し、 47 県の全ペア平均は cosine = 0.954(最小でも 0.42)。 「どの県も互いにそっくり」という無意味な結果になります。 z-score 標準化後は全ペア平均 0.074、 範囲は −0.90 〜 +0.96 に広がり、 初めて識別力のある空間になります。 埋め込み以前にスケーリングあり —— これが実データで一番効く教訓です。
実測② 最近傍は直感と整合する
| 県 | cosine 最近傍(上位2) | 読み方 |
|---|---|---|
| 東京都 | 大阪府 0.905 / 愛知県 0.884 | 大都市圏プロファイル |
| 埼玉県 | 神奈川県 0.928 / 千葉県 0.916 | 首都圏ベッドタウン型 |
| 鳥取県 | 島根県 0.912 / 山口県 0.873 | 小規模県どうしが近い |
| 沖縄県 | 鹿児島県 0.672 / 長崎県 0.611 | 気候・人口動態の近さ |
逆に遠いペアは 北海道×沖縄県 cosine = −0.30、 東京都×沖縄県 −0.27(ユークリッド距離では 46.7 と全ペア中最大級)。 4 次元入門例の「北海道×沖縄 = −0.90」より緩和されるのは、 次元を増やすと気候・観光など両県が同じ側に振れる軸も混ざるためで、 「特徴の選び方が距離の意味を決める」ことの実例です。
実測③ cosine とユークリッドは本当に順位が変わる
同じ 109 次元ベクトルでも、 最近傍(1 位)が cosine とユークリッドで食い違う県は 47 県中 22 県。 例えば北海道の最近傍は cosine では大阪府(0.666。 多くの総量指標が平均より大きい「向き」が揃う)ですが、 ユークリッドでは福岡県(距離 9.56。 規模の水準が近い)。 落とし穴セクションの「cosine vs Euclidean の混同」は、 この規模のデータでも半数近くの結論を変えるわけです。
実測④ 次元数の選択 — 2 次元の地図はご近所を 8 割壊す
PCA で圧縮すると、 第 1 主成分だけで分散の 77.3%(ほぼ「県の規模」軸)、 2 次元で 82.2%、 5 次元で 90.5%、 10 次元で 95.7% を説明します。 しかし「cosine 最近傍が 109 次元のときと一致する県」は 2 次元で 9/47、 5 次元で 21/47、 10 次元で 39/47。 つまり分散の 8 割を保っても近傍関係は 2 割しか保てないことがあり、 「説明率が高いから 2 次元散布図で類似県を論じてよい」とは言えません。 可視化は可視化、 検索は元の次元 —— と役割を分けるのが安全です。
⚠️ 深掘り追補: 運用フェーズの落とし穴 — 作った後に効いてくる 4 つ
上の落とし穴(バイアス・次元の呪い・OOV・t-SNE の誤読・cosine/Euclidean)は主に作るときの話でした。 ここでは埋め込みを保存して使い続ける段階で痛い目を見るパターンを補います。
🚀 深掘り追補: 発展 — 対比学習・近似最近傍・転移・評価
① 対比学習 — 現代の埋め込みは「ペアを近づけて」作る
word2vec の「共起を当てる」に代わり、 現在の文・画像埋め込みの主流は対比学習 (contrastive learning) です。 「意味が同じペア(正例)を近づけ、 バッチ内の他サンプル(負例)を遠ざける」損失(InfoNCE)を最小化します。 質問と回答文、 画像とキャプション(CLIP)のように異なるモダリティを同じ空間に入れられるのが強みで、 ラベル不要の自己教師あり学習として大規模化できます。 Sentence-BERT や OpenAI/E5 系の文埋め込みもこの系譜です。
② 類似度検索の実装 — ANN とベクトル DB
全件と cosine を計算する厳密 k-NN は $O(N)$ で、 数百万ベクトルでは間に合いません。 実運用では HNSW(グラフを辿る)や IVF(クラスタに絞る)などの近似最近傍探索 (ANN) を使い、 「再現率 Recall@k を少し犠牲に速度を数百倍にする」トレードオフを取ります。 FAISS などのライブラリ、 これに永続化・メタデータフィルタを足したベクトル DBが RAG の検索部を担います(パイプライン全体は上の R542 補強2 を参照)。 47 県規模なら総当たりで十分 —— ANN が要るのはデータが桁で増えてからです。
③ 転移とファインチューニング
事前学習済み埋め込みをそのまま特徴量として使うのは転移学習の最小形です。 ドメイン語彙(医療・法律・自治体統計など)で精度が足りなければ、 自前の正例ペアで対比学習を続けるファインチューニングが次の一手。 Transformer の入力層(トークン埋め込み)を凍結するか更新するかも、 データ量に応じた設計判断です。
④ 埋め込みの評価 — 内的評価と外的評価
評価は 2 系統に分けます。 内的評価は空間そのものを見る: 類似度の人手評定との相関、 アナロジー正答率、 近傍検索の Recall@k / nDCG(上の 🔎 補足も参照)。 外的評価は下流タスクで測る: その埋め込みを特徴量にした分類・検索・クラスタリングの精度で、 実務上はこちらが最終判断です。 多タスクベンチマーク(MTEB 等)は「モデル選定の地図」として便利ですが、 自分のドメインの小さな評価セットを 1 つ持つことが何より効きます。
⑤ 次元削減・疎表現との住み分け
埋め込みと次元削減は近縁ですが役割が違います。 PCA は分散を、 t-SNE・UMAP は近傍関係を保つ座標変換で、 主に可視化・前処理に使う。 一方 TF-IDF は学習不要・解釈容易な疎表現で、 キーワード一致が効く検索では今も強力です。 実務の意味検索では「疎 (BM25/TF-IDF) と密(埋め込み)のハイブリッド」が定番 —— 対立ではなく併用が答えになることが多い、 と覚えてください(テキスト類似度)。