🔖 キーワード索引
本ページは t-SNE(t-Distributed Stochastic Neighbor Embedding)を多角的に解説します。 上のチップは、 検索・関連語の手がかりです。
💡 30秒で分かる結論
🍰 まずはやさしく
複雑なデータを地図にする道具です。
データのまとまりを視覚的に見るために使います。
スマホのアプリを種類別に分けるようなイメージです。
この章ではt-SNEの結論を学びます。
- 高次元データを 2〜3 次元に可視化する非線形次元削減手法
- Hinton & van der Maaten(2008)。 「近いものは近く、 遠いものは遠く」を 確率的に保持
- perplexity(5〜50)が最重要ハイパラ
- 可視化に強いが、 大域構造は保証されない ─ クラスタ間距離に意味なし
- 近年は UMAP が高速・大域保存で代替として人気
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
たくさんの情報を整理する手法です。
数多くの項目を2次元の図にするために使います。
部活のメンバーを性格や能力で分ける時に便利です。
この章ではt-SNEを使う場面を学びます。
t-SNE(t-distributed Stochastic Neighbor Embedding)は、 高次元データの可視化のデファクトスタンダード。 単細胞 RNA-seq、 単語埋め込み、 画像特徴量など、 「数百〜数千次元のデータを 2 次元で見たい」場面で活躍。 ただし「クラスタ間の距離」を素朴に解釈すると誤るので、 使い方の注意が多い手法でもあります。
🎨 直感で掴む — 具体例で理解する
🍰 まずはやさしく
似たもの同士を近くに集める仕組みです。
データの隠れたグループを見つけるために使います。
似た好みの友達が自然に集まる様子に似ています。
この章ではt-SNEの直感的な仕組みを学びます。
t-SNE の発想:
- 高次元空間で「点 $i$ が点 $j$ の近傍である確率」$p_{ij}$ を計算
- 低次元空間で同様に $q_{ij}$ を計算
- 2 つの確率分布の KL ダイバージェンスを最小化するように低次元の点を配置
結果として:近い点は近く、 遠い点は遠く配置される。 ただし「2 つのクラスタの間の距離」は 意味なし(perplexity 等で歪む)。
用途:単語ベクトル(Word2Vec)の可視化、 細胞種の発見、 画像特徴量のクラスタ確認、 異常検知の探索。 ML パイプラインの 探索ツールとして強力。
🎨 もう一歩深く — t-SNE が解こうとしている問題
t-SNE が登場する以前、 高次元データの可視化は PCA(主成分分析)が標準でした。 しかし PCA は線形な手法で、 「曲がった多様体」(例: スイスロール状の構造)を平面に展開できません。 一方 t-SNE は 確率分布の保存という発想で、 非線形な近傍関係を 2D に押し込みます。
具体的に考えるべき問題:たとえば SSDSE-B-2026 の 47 都道府県データには、 人口・出生率・死亡数・年平均気温・保育所数など 100 以上の指標があります。 これを 2D に落とすとき、 単純な PCA では「人口が大きい東京・大阪・神奈川」が一方に偏り、 細かい地域差は潰れます。 t-SNE は 近い県は近く、 遠い県は遠く配置することに集中するため、 「東北の県が一塊り」「九州が一塊り」のような地理・社会的近接構造を可視化できる場合があります。
ただし t-SNE は 大域構造を保証しません。 「東北クラスタと九州クラスタの距離」は perplexity の値次第で大きく変動します。 これが後述の落とし穴の核心です。
対比表:PCA / t-SNE / UMAP
| 手法 | 線形性 | 大域構造 | 速度 | 新規データ投影 | 主用途 |
|---|---|---|---|---|---|
| PCA | 線形 | ○ 完全保存 | 非常に速い | ○ 可能 | 分散保存・前処理 |
| t-SNE | 非線形 | △ 弱い | 遅い(O(n²)) | × 不可 | 可視化のみ |
| UMAP | 非線形 | ○ 比較的保持 | 速い | ○ 可能 | 可視化+特徴抽出 |
| MDS | 線形/非線形 | ○ 距離行列保存 | 遅い | △ 限定的 | 距離行列ベース |
| Isomap | 非線形 | ○ 測地距離 | 遅い | ○ 可能 | 多様体学習 |
🎨 可視化テクニック — 美しい t-SNE 図を作る
- ラベル付与:matplotlib の
annotateで各点に名前を付ける(点数が少ない場合) - カテゴリ別色分け:地方・属性・クラス等で色を変える(凡例必須)
- サイズによる第 3 軸表現:人口など連続値を点の大きさに反映
- 透明度(alpha):点が密集する箇所の重なりを可視化(alpha=0.5-0.7)
- 背景色:白 vs グレーで対比、 PDF 印刷時の見え方確認
- 軸ラベル:「t-SNE 1」「t-SNE 2」(意味のない座標であることを示唆)
- 凡例:色分けカテゴリは必ず凡例で説明
- perplexity を本文かタイトルに記載:再現性の担保
- 解像度:dpi=120-150(Web)、 200-300(論文印刷)
- フォーマット:論文には PDF(vector)、 Web/Slack には PNG
- インタラクティブ可視化:plotly / bokeh で hover ツールチップ
- 密度等高線:seaborn の kdeplot で密度を重ねる
⏱ パフォーマンスベンチマーク(参考)
| n(点数) | dim | sklearn 標準 | openTSNE | UMAP |
|---|---|---|---|---|
| 100 | 50 | 0.5 秒 | 0.3 秒 | 2 秒 |
| 1,000 | 50 | 2 秒 | 1 秒 | 3 秒 |
| 10,000 | 50 | 2 分 | 15 秒 | 10 秒 |
| 100,000 | 50 | 2 時間 | 5 分 | 30 秒 |
| 1,000,000 | 50 | 非実用 | 1 時間 | 5 分 |
数値は CPU 1 コアでの目安。 GPU(cuML 等)を使えば 10-100 倍速。 「100 万点の可視化」は 2026 年現在 UMAP / cuML の独擅場です。
📊 SSDSE-B-2026 詳細 — 教材として使いやすい列
SSDSE-B-2026 は 「社会・人口統計体系」の都道府県データ(独立行政法人 統計センター提供)で、 t-SNE の教材として理想的です。 47 都道府県 × 100 以上の指標。
人口統計セクション(A 列)
| 列コード | 意味 | 典型値範囲 |
|---|---|---|
| A1101 | 総人口 | 540,000(鳥取)〜 14,000,000(東京) |
| A1102 | 日本人人口 | 総人口 × 0.97〜0.99 |
| A1301 | 15 歳未満人口 | 総人口 × 11-15% |
| A1302 | 15-64 歳人口 | 総人口 × 56-60% |
| A1303 | 65 歳以上人口 | 総人口 × 25-37% |
| A4101 | 出生数 | 3,000(鳥取)〜 100,000(東京) |
| A4103 | 合計特殊出生率 | 0.99(東京)〜 1.60(沖縄)※2023年実測 |
| A4200 | 死亡数 | 8,290(鳥取)〜 137,241(東京)※2023年実測 |
| A5101 | 転入者数 | 5,000〜 400,000 |
| A5102 | 転出者数 | 5,000〜 380,000 |
| A9101 | 婚姻件数 | 1,810(鳥取)〜 71,774(東京)※2023年実測 |
📝 より正確な分析: SSDSE-B-2026 の実ヘッダでは A4200 は「死亡数」(2023 年: 8,290〜137,241 人)であり、 合計特殊出生率は A4103(2023 年: 0.99〜1.60)です。 列コードは必ず CSV の 2 行目(日本語ヘッダ)で意味を確認してから使いましょう。
気候・地理セクション(B 列)
| 列コード | 意味 | 典型値範囲 |
|---|---|---|
| B4101 | 年平均気温(℃) | 9(北海道)〜 23(沖縄) |
| B4102 | 年最高気温 | 30〜 38 |
| B4103 | 年最低気温 | −15(北海道)〜 +15(沖縄) |
| B4106 | 降水日数(年間) | 72(埼玉)〜 170(青森)※2023年実測 |
| B4109 | 降水量(年間, mm) | 830(長野)〜 3,003(宮崎)※2023年実測 |
雇用・保育セクション(F・J 列)
| 列コード | 意味 | 典型値範囲 |
|---|---|---|
| F3101 | 新規求職申込件数(一般) | 15,329(鳥取)〜 270,954(東京)※2023年実測 |
| F3102 | 月間有効求職者数(一般) | 70,954(鳥取)〜 1,598,409(東京)※2023年実測 |
| J2503 | 保育所等数 | 132(奈良)〜 3,611(東京)※2023年実測 |
| J2505 | 保育所等定員数 | 11,327(徳島)〜 322,135(東京)※2023年実測 |
医療・教育セクション(I・E 列)
| 列コード | 意味 | 典型値範囲 |
|---|---|---|
| I510120 | 一般病院数 | 50〜 700 |
| I5102 | 診療所数 | 500〜 14,000 |
| E1101 | 幼稚園数 | 30〜 1,200 |
| E1301 | 幼稚園教員数 | 190(福井)〜 10,643(東京)※2023年実測 |
| E1501 | 幼稚園在園者数 | 857(福井)〜 110,422(東京)※2023年実測 |
| E2101 | 小学校数 | 114(鳥取)〜 1,323(東京)※2023年実測 |
これらの列を組み合わせて t-SNE することで、 「人口だけでなく気候・経済・医療・教育で見た都道府県の類型化」が可能。 教材として様々な切り口の演習が組めます。
📈 PCA / t-SNE / UMAP / PHATE 詳細比較
| 性質 | PCA | t-SNE | UMAP | PHATE |
|---|---|---|---|---|
| 線形/非線形 | 線形 | 非線形 | 非線形 | 非線形 |
| 近傍保存 | × | ◎ | ○ | ○ |
| 大域構造 | ○ | × | △ | ◎ |
| 連続的構造 | ○ | × | △ | ◎ |
| 計算速度 | ◎ 最速 | × 遅い | ○ 速い | △ |
| 新規データ投影 | ○ | × | ○ | × |
| ハイパラ数 | 0 | 1(perp) | 2(neigh, min_dist) | 2-3 |
| 主用途 | 前処理・軸解釈 | クラスタ可視化 | 可視化+特徴抽出 | 連続軌跡解析 |
| 理論的基礎 | 分散最大化 | KL 最小化 | ファジー位相 | 拡散 |
| scikit-learn 標準 | ○ | ○ | ×(外部) | ×(外部) |
使い分けの目安:
- 軸の意味を知りたい → PCA
- クラスタを綺麗に分けて可視化 → t-SNE
- 速度・大域構造・新規投影が欲しい → UMAP
- 連続的な分化軌跡を見たい(細胞分化等) → PHATE
🎭 拡張例 — t-SNE と他手法を組み合わせる
パターン 1: PCA + t-SNE(高次元データ)
2000 次元以上のデータ(scRNA-seq、 画像 CNN 特徴量)では、 まず PCA で 50 次元に圧縮、 その後 t-SNE で 2 次元へ。 これによりノイズ除去と計算速度の両立が可能。 「PCA で 50 → t-SNE で 2」が定番ワークフロー。
パターン 2: t-SNE + HDBSCAN(クラスタリング)
t-SNE で 2D 埋め込み → HDBSCAN(密度ベースクラスタリング)で自動的にクラスタ数を決定。 k-means と違い「クラスタ数を事前に指定不要」「形状自由」というメリット。
パターン 3: t-SNE + 線形回帰(軸への意味付け)
t-SNE 軸自体に意味はないが、 各点に 外部変数(例: SSDSE の「高齢化率」)を持たせ、 「軸方向にどの変数が変化するか」を回帰で調べる。 「右に行くほど高齢化が進む」のような 事後的な軸解釈が可能。
パターン 4: t-SNE + Plotly(インタラクティブ)
t-SNE 結果を plotly.express の散布図にすると、 マウスホバーで都道府県名・元の値が表示できます。 ダッシュボードや論文補助資料として有効。
📜 学術的文脈 — t-SNE 論文の位置づけ
2008 年の van der Maaten & Hinton 論文(JMLR)は、 2024 年時点で 引用数 4 万件超。 機械学習・バイオインフォマティクス分野のトップ引用論文の 1 つです。
特に scRNA-seq 分野では、 2014-2019 年の主要論文の 9 割が t-SNE 図を含む状況でした。 2020 年以降は UMAP に置き換わりつつありますが、 t-SNE の概念的影響は揺るがず、 「確率分布の保存」というアイデアは UMAP・PaCMAP・TriMap といった後継手法すべてに継承されています。
Hinton は深層学習・カプセルネットワーク等で著名なトロント大学(後に Google Brain)の研究者で、 2024 年に「物理学のニューラルネットへの貢献」でノーベル物理学賞を受賞。 t-SNE はその主要業績の 1 つです。
🎁 追加のヒント — 実務で役立つ小ネタ
- perplexity と n_neighbors の関係:UMAP の n_neighbors と t-SNE の perplexity は概念的に対応。 同じ値で比較すると公平。
- 「t-SNE の 3D」は使わない:3D 散布図は紙面で読みにくい。 2D に絞るのが定番。
- 「t-SNE の前処理に L2 正規化」:scRNA-seq では各細胞の合計を 1 に正規化してから t-SNE するワークフローが標準。
- 「同じデータで複数回 t-SNE」:random_state を変えて 5-10 回実行し、 「常に固まる点群」を信頼するアンサンブル的方法。
- 「t-SNE と classifier の精度比較」:t-SNE 後の分類精度が高ければ、 元データに意味のある構造があった証拠。
- 「t-SNE 図に軸目盛りはいらない」:軸の絶対値に意味がないため、 目盛り省略がスタイリッシュ。
- 「カラーバーは categorical で」:連続値ではなく離散カテゴリの色分けが基本。
- 「アニメーション GIF で perplexity を変える」:プレゼン用に効果的、 ハイパラ感度を直感的に伝えられる。
- 「同じデータの異なる時点を矢印で結ぶ」:時系列軌跡の可視化(trajectory analysis)。
- 「t-SNE 結果は再現性のために pickle 保存」:再計算は高コスト、 結果を保存しておくと便利。
📝 専門用語ミニ辞典 — t-SNE まわりの語彙
- Manifold(多様体)
- 高次元空間に埋め込まれた、 局所的にユークリッド的な低次元構造。 t-SNE が想定するデータの形
- Curse of Dimensionality(次元の呪い)
- 高次元では「中庸距離が大半を占める」現象。 t-SNE の混雑問題の原因
- Embedding(埋め込み)
- 高次元データを低次元空間に対応付けたもの。 t-SNE の出力
- KL Divergence
- 2 つの確率分布の差を測る非対称な指標。 t-SNE のコスト関数
- Perplexity
- 「実効近傍数」を表すハイパラ。 エントロピーの指数
- Early Exaggeration
- 初期段階で確率を α 倍する高速化トリック
- Barnes-Hut
- N 体問題用の高速アルゴリズム。 t-SNE を O(n log n) に
- Crowding Problem(混雑問題)
- 高次元の中庸距離が低次元中央に潰れる問題。 t 分布で解決
- Silhouette Score
- クラスタの分離度合いを定量化する指標(-1〜1)
- UMAP
- Uniform Manifold Approximation and Projection。 t-SNE の後継として 2018 以降標準化
- Z-score 標準化
- 平均 0、 分散 1 にする変換。 t-SNE の必須前処理
- Local Structure
- 「近い点同士の関係」。 t-SNE が保存するもの
- Global Structure
- 「遠い点同士の関係」「クラスタ間距離」。 t-SNE が保存しないもの
- openTSNE
- t-SNE の派生実装。 新規データ投影が可能
- PHATE
- 拡散ベースの埋め込み。 連続的軌跡に強い
📖 さらに学ぶための読書ガイド
- 初学者: 本ページ → scikit-learn 公式 t-SNE チュートリアル → Distill.pub "How to Use t-SNE Effectively"
- 中級者: van der Maaten & Hinton 原論文 → UMAP 原論文 → Kobak & Berens (Nat Commun 2019)
- 上級者: Cao & Wang "Automatic Selection of t-SNE Perplexity" → Linderman et al. (Nat Methods 2019) "Fast interpolation-based t-SNE"
- 実務応用: scanpy(scRNA-seq)→ TensorFlow Embedding Projector → Hugging Face datasets visualization
🎓 確認問題セット — 自分の理解を試す
- t-SNE は線形手法か非線形手法か。 なぜそう分類されるか説明せよ。
- perplexity が「効果的近傍数」を意味する理由を、 エントロピーの式から説明せよ。
- t-SNE のクラスタ間距離を信頼してはいけない数学的理由を述べよ。
- 低次元側に Student-t 分布を使う理由(混雑問題との関係)を説明せよ。
- KL ダイバージェンス $\mathrm{KL}(P\|Q)$ と $\mathrm{KL}(Q\|P)$ の違いと、 t-SNE がどちらを使うか述べよ。
- SSDSE-B-2026 を t-SNE する前に、 なぜ標準化が必要か説明せよ。
- perplexity=5 と perplexity=50 で結果がどう変わるか定性的に答えよ。
- t-SNE と UMAP の最大の違いを 3 つ挙げよ。
- t-SNE 後のクラスタリングに k-means と HDBSCAN のどちらが向くか、 理由とともに述べよ。
- 論文で t-SNE 図を使うときに明記すべきパラメータを 3 つ挙げよ。
解答は本文中に散りばめられています。 全問正解できれば「t-SNE を実務で使える」レベルに到達した証です。
🎮 触って理解する
下のミニ t-SNE は、 8 次元空間に決定論的に生成した 3 クラスタ(各 16 点・計 48 点)を、 実際の t-SNE と同じ手順で 2D に埋め込みます。 「1 ステップ」または「自動再生」で勾配降下を進めると、 最初はごちゃ混ぜだった点が徐々に 3 つの塊に分離していく様子が見られます。 perplexity と 学習率を動かして、 見え方がどう変わるかを体感してください。 点をドラッグ(タッチ可)して引き剥がすと、 最適化がまた引き戻す「バネと反発」の力学も観察できます。
計算の正確さについて: この実装は本物の t-SNE と同じ骨格です。 (1) 高次元でガウス親和性 $p_{j|i}$ を perplexity から二分探索で決める、 (2) 対称化して $p_{ij}$ を得る、 (3) 低次元で自由度 1 の $t$ 分布 $q_{ij}\propto(1+\lVert y_i-y_j\rVert^2)^{-1}$ を使う、 (4) KL ダイバージェンスを勾配降下(モメンタム+ゲイン適応+序盤の early exaggeration)で最小化。 教材用に n=48・8 次元・O(n²) の素朴実装に簡略化しており、 Barnes-Hut 近似や PCA 初期化は省いています。 本質的な挙動(分離・perplexity 依存・確率性)はそのまま再現されます。
🔍 このデモで体感してほしいこと
- 直感: 各点には「近い相手に引かれるバネ(引力)」と「他の全点から押される反発(斥力)」が同時に働きます。 力がつり合うと配置が安定し、 似た点どうしが塊になります。 点をドラッグして放すと、 この力学が視覚的に分かります。
- 落とし穴・perplexity 依存: perplexity を 2〜3 まで下げると、 1 つの塊が細かく断片化して偽のサブクラスタが出ます。 逆に上げすぎると塊どうしが融合します。 「1 つの正解の図」は存在しません。
- 落とし穴・クラスタ間距離とサイズに意味なし: 収束後の A・B・C の間隔や各塊の大きさは、 元の 8 次元での距離・分散を反映しません。 t-SNE は局所構造だけを保存します。
- 落とし穴・確率的: 初期配置は乱数です(このデモは再現性のため固定シード)。 実務では
random_stateを変えるたびに見た目が変わります。 - 学習率の影響: 学習率を最大にすると点が飛び散ったり 1 点に潰れて KL がうまく下がりません。 「絵がおかしい=パラメータが悪い」ことがある、 と体で覚えましょう。
🚀 発展:UMAP との違い
t-SNE の後継としてよく使われるのが UMAP です。 UMAP は近傍グラフとファジー集合の理論に基づき、 大域構造をより保ちやすく・高速で・新規データを後から投影できるという利点があります。 一方で UMAP にも「クラスタ間距離を鵜呑みにしない」「n_neighbors / min_dist 依存」という t-SNE と共通の注意点があります。 まずはこのデモで t-SNE の力学を掴み、 次に UMAP と比較すると理解が深まります。
関連ページ: PCA(線形次元削減・前処理) / UMAP(後継手法) / クラスタリング / 標準化(前処理の必須ステップ)
📐 定義・数式
🍰 まずはやさしく
確率(起こりやすさ)を使った計算方法です。
点と点の距離を正しく配置するために使います。
買い物リストの似ている商品を分ける計算のようなものです。
この章ではt-SNEの数式と定義を学びます。
📐 もう一歩深い数学 — 混雑問題と t 分布の役割
混雑問題(Crowding Problem)とは、 高次元空間の「中庸な距離」を低次元に押し込もうとすると、 「全てが中央に集まってつぶれてしまう」現象です。 たとえば 100 次元のガウス球面上では、 ほとんどの点ペアが「平均距離付近」に集中します(次元の呪い)。 これを 2 次元に投影すると、 中央が混雑して構造が見えなくなります。
解決策(t 分布の採用): van der Maaten & Hinton (2008) は、 低次元側に 自由度 1 の Student-t 分布を使うことを提案しました。 ガウス分布よりも裾が重いため、 高次元で「中庸距離」だったペアを、 低次元で「遠く」配置するインセンティブが生まれます。
この「裾の重さ」が、 t-SNE のクラスタを はっきり分離して見せる魔法の正体です。 同じ仕組みを「自由度 ν を可変にする」よう拡張したのが t-SNE variants(α-t-SNE 等)。
対称化の必要性
条件付き確率 $p_{j|i}$ は 非対称(i から見た j ≠ j から見た i)。 そのままだと最適化が不安定になるため、 対称化します:
早期誇張(Early Exaggeration)
最適化初期の数百ステップで、 $p_{ij}$ を α 倍(典型 12 倍)して使うテクニックがあります。 これにより「クラスタを最初に強く引き寄せ、 その後ゆっくり緩める」効果があり、 大域構造のロバスト性が高まります。 scikit-learn の early_exaggeration パラメータで制御可能。
Barnes-Hut 近似
素朴実装は O(n²) ですが、 重力多体問題で使われる Barnes-Hut アルゴリズムを応用すると O(n log n) に削減できます。 これにより数万点でも数分で計算可能。 scikit-learn のデフォルト(method='barnes_hut')。
⚙️ ハイパーパラメータ全リスト — sklearn TSNE
| パラメータ | 既定 | 役割 | 調整指針 |
|---|---|---|---|
n_components | 2 | 出力次元数 | 2D 可視化は 2、 3D は 3、 4 以上は非推奨 |
perplexity | 30 | 近傍数の効果的指定 | 5-50、 n < 100 なら n/3 以下 |
early_exaggeration | 12.0 | 初期クラスタ強調倍率 | 大データなら 30-50 に上げる |
learning_rate | 'auto' | 勾配ステップサイズ | 'auto' は max(N/12, 50)。 旧版互換なら 200 |
max_iter(旧 n_iter) | 1000 | 最大イテレーション数 | 収束しないときは 3000-5000 |
n_iter_without_progress | 300 | 進捗なしで停止する閾値 | 大データなら 500-1000 |
min_grad_norm | 1e-7 | 勾配の収束判定 | 通常は触らない |
metric | 'euclidean' | 高次元側の距離尺度 | 'cosine' / 'manhattan' / カスタム |
init | 'pca' | 初期配置 | 'pca' 推奨('random' は再現性低) |
random_state | None | 乱数シード | 論文では必ず固定(例: 0, 42) |
method | 'barnes_hut' | 計算アルゴリズム | n > 5000 で 'barnes_hut'、 小なら 'exact' |
angle | 0.5 | BH 法の近似角度 | 0.2-0.8、 大きいと速いが粗い |
論文・実務での実用ルール:「perplexity と random_state だけは必ず明示し、 他は既定値」が安全。 細かい調整は学術論文でのチューニングが必要なときのみ。
🆚 t-SNE vs UMAP — どう選ぶか詳細比較
| 項目 | t-SNE | UMAP | 勝者 |
|---|---|---|---|
| 速度(n=10,000) | 数分 | 数十秒 | UMAP |
| 速度(n=100,000) | 困難(時間オーダー) | 数分 | UMAP |
| 大域構造保存 | △ 弱い | ○ 比較的良い | UMAP |
| 局所構造保存 | ◎ 最強 | ○ 良い | t-SNE |
| 新規データ投影 | × 不可 | ○ transform() あり | UMAP |
| 確率モデルの直感 | ○ 明快(KL) | △ ファジーシンプリシャル複体(難解) | t-SNE |
| 学術的歴史 | ◎ 引用多数(2008-) | ○ 増加中(2018-) | t-SNE |
| ハイパラ感度 | perplexity 1 つで揺れる | n_neighbors, min_dist で 2 軸 | 互角 |
| scikit-learn 統合 | ◎ 標準 | ○ umap-learn 別パッケージ | t-SNE |
| GPU 加速 | cuML 等で対応 | cuML 等で対応 | 互角 |
| 「論文での説得力」 | ○ 定番 | ○ 増加中 | 互角 |
結論: 2026 年現在は「速度」「大域構造」「新規データ投影」の 3 点で UMAP 優位。 ただし t-SNE は 定番として論文比較・既存資産・教育目的で残ります。 新規プロジェクトでは UMAP をデフォルトに、 比較用に t-SNE も併記が現実解。
🔬 記号・要素の読み解き
- $p_{ij}$(高次元)
- 元データでの近傍確率
- $q_{ij}$(低次元)
- 埋め込み先での近傍確率
- perplexity
- 「効果的な近傍数」を指定。 5〜50 が標準。 結果が大きく変わる
- t 分布
- 低次元側に重い裾の分布を使うことで、 遠点を程よく押し離す
- KL 発散
- 2 つの確率分布の差。 これを最小化
- iteration
- 通常 1000 ステップ程度で収束
🔬 数式を言葉で読み解く — t-SNE の 3 ステップ
ステップ 1: 高次元側の近傍確率を作る。 各点 $\mathbf{x}_i$ に対して、 「ガウスカーネル」で他の点との近さを 確率に変換します:
この $\sigma_i$ は perplexity という入力値から決まります。 perplexity は概ね「各点が何個の近傍を持つと考えるか」の指定(5〜50 が標準)。
ステップ 2: 対称化。 $p_{ij} = \frac{p_{j|i} + p_{i|j}}{2n}$ で対称な確率にします。 これで「i から見た j の近さ」と「j から見た i の近さ」が均等になります。
ステップ 3: 低次元側の確率(t 分布)。 出力空間 $\mathbb{R}^2$ の点 $\mathbf{y}_i$ に対し、 自由度 1 の Student-t 分布を用いて:
最適化: $p$ と $q$ の差を Kullback-Leibler ダイバージェンスで測り、 これを最小化するように $\mathbf{y}_i$ を勾配降下で動かします:
KL は非対称なので、 「高次元で近い→低次元でも近く」は重く罰せられますが、 「高次元で遠い→低次元で近い」は軽い罰しか付きません。 これが「t-SNE は局所構造を優先」する数学的根拠です。
勾配の直感
KL を $\mathbf{y}_i$ について微分すると、 各点に「引っ張り合う力」と「押し離す力」の合力が働きます:
🧮 数値例・実値計算
perplexity の効果(同じデータでも見え方が変わる):
| perplexity | 見え方 | 注意 |
|---|---|---|
| 5 | 局所構造重視、 細かいクラスタ | 大域構造は壊れる |
| 30(既定) | バランス | 標準的 |
| 50 | 大域構造重視、 大まかなクラスタ | 細部消える |
| 100+ | ほぼ単一クラスタに | サンプル数次第 |
複数の perplexity で実行し、 ロバストな構造を確認するのが推奨。
🧮 SSDSE-B-2026 で実値計算 — 47 都道府県を 2D に
SSDSE-B-2026(社会・人口統計体系、 47 都道府県 × 100 列以上)から、 次の 5 つの代表的な社会経済指標を選んで t-SNE にかけてみます:
| 列コード | 意味 | 抜粋値(例) |
|---|---|---|
| A1101 | 総人口(人) | 北海道 5,092,000 / 東京 14,000,000 級 / 鳥取 540,000 |
| A4101 | 出生数 | 北海道 24,430 / 沖縄 比較的高 / 秋田 低 |
| A4103 | 合計特殊出生率 | 沖縄 1.6 前後 / 東京 1.0 前後 |
| A5101 | 転入者数 | 東京・神奈川・大阪が突出 |
| A9101 | 婚姻件数 | 東京 71,774 / 鳥取 1,810(人口規模に比例) |
これら 5 列を 標準化(Z-score)してから t-SNE に渡すのが定石です。 標準化しないと、 単位の大きい「総人口」だけが距離計算を支配し、 他の指標が無視されます。
手計算で perplexity の効果を確認
標準化済み 5 次元空間で「北海道」と「東京」の Euclidean 距離 $d_{\text{北,東}}$ を仮に 3.2、 「北海道」と「青森」の距離を 0.8 とします。 perplexity に対応する $\sigma_i$ が 1.0 のとき:
これが「近い県には大きな確率」「遠い県には小さな確率」という t-SNE の出発点です。
🧮 数式に値を入れて手で計算する: t-SNE の perplexity
SSDSE-B-2026 の 47 都道府県データ (n=47) を入力にしたときの t-SNE perplexity の推奨値を、 シャノンエントロピー H と perplexity = 2^H の関係から逆算する。 n=47 では perplexity 5-10 程度が標準的レンジ (典型 n=100 の半分以下)。
Step 1: Perplexity
Step 2: 推奨値
| n データ | 推奨 perplexity |
|---|---|
| 100 | 5-10 |
| 1000 | 20-30 |
| 10000 | 30-50 |
🐍 Python で再現
1 2 3 4 5 6 7 8 | import numpy as np # 例: 等確率 k 近傍 ks = [5, 10, 30] for k in ks: p = 1/k H = -k * p * np.log2(p) perp = 2**H print(f"k={k}: H={H:.2f}, perp={perp:.1f}") |
📤 実行結果
💬 手計算 (Step 1) perp ≈ k (等確率時) と Python 出力が完全一致。
🐍 Python 実装例
最小コードで動かしてみる例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from sklearn.manifold import TSNE from sklearn.datasets import load_digits import matplotlib.pyplot as plt digits = load_digits() # 64次元 → 2次元へ # 全 1797 点だと 2 分以上かかるので、先頭 500 点で試す(傾向は変わらない) _X, _y = digits.data[:500], digits.target[:500] tsne = TSNE(n_components=2, perplexity=30, random_state=0) emb = tsne.fit_transform(_X) plt.scatter(emb[:, 0], emb[:, 1], c=_y, cmap='tab10', s=10) plt.title('t-SNE 可視化(MNIST 数字)') plt.colorbar() plt.show() |
🐍 Python 実装 ① — SSDSE-B-2026 を読み込んで t-SNE
🎯 このコードでやること:SSDSE-B-2026 の 47 都道府県データから 5 列(人口・出生数・出生率・転入者数・婚姻件数)を抜粋、 標準化したうえで sklearn.manifold.TSNE で 2D に射影します。
📥 入力データ(SSDSE-B-2026.csv、 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.manifold import TSNE # SSDSE-B-2026 を読み込む(1 行目はヘッダコード、 2 行目は日本語ヘッダ) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') # 年度で絞らないと 564 行(47 県 × 12 年)になり、下の (47, 5) と食い違う df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # 5 列を選ぶ cols = ['A1101', 'A4101', 'A4103', 'A5101', 'A9101'] X = df[cols].values # shape: (47, 5) prefs = df['Prefecture'].values # 都道府県名(ラベル用) # 標準化(Z-score)— これを忘れると人口だけが支配する X_std = StandardScaler().fit_transform(X) # t-SNE — perplexity=10(n=47 なので小さめ) tsne = TSNE(n_components=2, perplexity=10, random_state=0, init='pca') emb = tsne.fit_transform(X_std) print('emb shape:', emb.shape) for p, (x, y) in zip(prefs[:5], emb[:5]): print(f'{p}: ({x:.2f}, {y:.2f})') |
📤 実行例(出力):
💬 結果の読み方: 表示された先頭 5 県のうち青森・岩手・秋田は x が −6〜−7 で近くにまとまり、 北海道 (−2.45, 8.22) はそこから離れる。 埋め込み全体では東京都 (2.16, 14.14) の最近傍 3 県が神奈川・大阪・埼玉、 沖縄県 (7.65, −13.30) の最近傍が鹿児島・宮崎・熊本で、 「人口規模・出生率・転入者数」が似ている都道府県が 近傍確率を共有している。 北海道の最近傍は京都・宮城・兵庫で、 地理的な近さとは一致しない。 ただし座標の絶対値や軸方向には意味がない(回転・反転は perplexity と random_state に依存)。
🐍 Python 実装 ② — perplexity を変えて結果を比較
🎯 このコードでやること:同じ SSDSE-B-2026 データに対して perplexity を 5 / 15 / 30 / 45 と変えて 4 通りの t-SNE 埋め込みを作り、 結果がどれだけ変わるかを 2×2 のサブプロットで可視化します。
📥 入力データ: 上のセクションで作成した X_std(shape (47, 5))。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import matplotlib.pyplot as plt from sklearn.manifold import TSNE perps = [5, 15, 30, 45] fig, axes = plt.subplots(2, 2, figsize=(11, 9)) for ax, p in zip(axes.ravel(), perps): emb = TSNE(n_components=2, perplexity=p, random_state=0, init='pca').fit_transform(X_std) ax.scatter(emb[:, 0], emb[:, 1], s=30, c='#00695C') for i, name in enumerate(prefs): ax.annotate(name, (emb[i, 0], emb[i, 1]), fontsize=7) ax.set_title(f'perplexity = {p}') plt.tight_layout() plt.savefig('tsne_perp_compare.png', dpi=120) print('saved') |
📤 実行例(出力):
💬 結果の読み方: 保存した図では、 perplexity=5 は数県ずつの小さな塊が 7 つほどに分かれ、 横軸の幅が約 75 に広がる。 15 では斜めの帯とその下の小さな塊になって幅は約 9、 30 では約 4.5、 45 では約 0.5 まで縮み、 47 県がほぼ一点に潰れる。 perplexity が変わるだけで クラスタ数も配置も全く変わる が、 東京都の最近傍(神奈川・大阪・埼玉)や沖縄県の最近傍(鹿児島・宮崎・長崎)は 4 通りすべてでほぼ同じ。 n=47 という小さな標本では perplexity 5-15 が現実的。 「絶対正しい perplexity」は存在しないため、 必ず複数試して ロバストな構造(どの perplexity でも一緒に固まる点群)を見つけるのが鉄則。
🐍 Python 実装 ③ — PCA との並列比較
🎯 このコードでやること:同じ SSDSE-B-2026 データに対して PCA(線形)と t-SNE(非線形)を並べて表示し、 「線形と非線形でクラスタの見え方がどう違うか」を可視化します。
📥 入力データ: 上の X_std。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | from sklearn.decomposition import PCA from sklearn.manifold import TSNE import matplotlib.pyplot as plt pca = PCA(n_components=2).fit_transform(X_std) tsne = TSNE(n_components=2, perplexity=15, random_state=0, init='pca').fit_transform(X_std) fig, (a, b) = plt.subplots(1, 2, figsize=(13, 6)) a.scatter(pca[:, 0], pca[:, 1], s=30, c='#1565C0') a.set_title('PCA (線形)') b.scatter(tsne[:, 0], tsne[:, 1], s=30, c='#00695C') b.set_title('t-SNE (非線形, perplexity=15)') for ax, emb in [(a, pca), (b, tsne)]: for i, name in enumerate(prefs): ax.annotate(name, (emb[i, 0], emb[i, 1]), fontsize=7) plt.tight_layout() plt.savefig('pca_vs_tsne_47pref.png', dpi=120) print('PCA 第 1-2 成分の説明分散比:', PCA(n_components=2).fit(X_std).explained_variance_ratio_) |
📤 実行例(出力):
💬 結果の読み方: 第 1 成分だけで分散の 85.6%、 第 2 成分と合わせて 98.8% を説明する。 第 1 成分は総人口・出生数・転入者数・婚姻件数にほぼ同じ重み(0.47〜0.48)がかかった「人口規模の軸」で、 東京都 (9.38) が神奈川県 (4.74)・大阪府 (4.22) の 2 倍の位置に飛び出し、 残りの県は狭い範囲に詰まる。 第 2 成分はほぼ合計特殊出生率(重み 0.95)。 PCA はこうした 分散の大きな軸に支配されて、 細かな地域差が潰れます。 t-SNE は確率分布を保存するため、 各地方ブロックを「クラスタ」として浮かび上がらせやすい。 ただし PCA は累積寄与率という客観指標があるのに対し、 t-SNE は「正しさ」を定量化しにくい。 役割分担: PCA で軸の意味を見て、 t-SNE でクラスタを探す。
🐍 Python 実装 ④ — KL 発散とクラスタ品質の評価
🎯 このコードでやること:t-SNE の最終的な kl_divergence_ 値を取得し、 さらに silhouette_score で「埋め込み空間で k-means クラスタリングが綺麗に分かれているか」を定量化します。 これにより複数の perplexity を「数値」で比較できます。
📥 入力データ: 同じ X_std(SSDSE-B-2026 の 5 列標準化済み)。
1 2 3 4 5 6 7 8 9 10 11 12 13 | from sklearn.manifold import TSNE from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score print(f'{"perp":>6} | {"KL_final":>10} | {"silhouette(k=5)":>16}') print('-' * 42) for p in [5, 10, 15, 20, 30]: t = TSNE(n_components=2, perplexity=p, random_state=0, init='pca').fit(X_std) emb = t.embedding_ km = KMeans(n_clusters=5, n_init=10, random_state=0).fit(emb) sil = silhouette_score(emb, km.labels_) print(f'{p:>6d} | {t.kl_divergence_:>10.4f} | {sil:>16.3f}') |
📤 実行例(出力):
💬 結果の読み方: KL 発散は perplexity を上げるほど単調に下がりますが、 これは「全点が滑らかな雲」になるからで、 クラスタ品質を保証しません。 KL は 0.1580 から 0.0108 まで下がる。 別途 silhouette(-1 〜 1、 大きいほどクラスタが綺麗)でチェックすると、 SSDSE 47 県では perplexity=5 が最良(0.658)で、 30 の 0.457 まで perplexity とともに下がる。 つまり「KL だけ」を見ると 30 が良いが、 クラスタの分かれ方では 5 が良い。 ただし小さい perplexity ほど t-SNE は点を小さな塊に分けるので silhouette は高く出やすく、 どちらの指標も単独では決め手にならない。 評価軸を 2 つ持つことが重要。
🐍 Python 実装 ⑤ — 都道府県を「地方ブロック」で色分け
🎯 このコードでやること:47 都道府県を 8 つの地方ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)に分け、 t-SNE 散布図をブロック別に色分けします。 「t-SNE が自動的に地方を分離できるか」を視覚的に検証。
📥 入力データ: X_std(標準化済 5 次元)と都道府県名のリスト。 地方ブロック定義は Python リテラル(公開地理区分)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 | import matplotlib.pyplot as plt from sklearn.manifold import TSNE # 地方ブロック定義(総務省標準区分) region = { '北海道': '北海道', '青森県': '東北', '岩手県': '東北', '宮城県': '東北', '秋田県': '東北', '山形県': '東北', '福島県': '東北', '茨城県': '関東', '栃木県': '関東', '群馬県': '関東', '埼玉県': '関東', '千葉県': '関東', '東京都': '関東', '神奈川県': '関東', '新潟県': '中部', '富山県': '中部', '石川県': '中部', '福井県': '中部', '山梨県': '中部', '長野県': '中部', '岐阜県': '中部', '静岡県': '中部', '愛知県': '中部', '三重県': '近畿', '滋賀県': '近畿', '京都府': '近畿', '大阪府': '近畿', '兵庫県': '近畿', '奈良県': '近畿', '和歌山県': '近畿', '鳥取県': '中国', '島根県': '中国', '岡山県': '中国', '広島県': '中国', '山口県': '中国', '徳島県': '四国', '香川県': '四国', '愛媛県': '四国', '高知県': '四国', '福岡県': '九州沖縄', '佐賀県': '九州沖縄', '長崎県': '九州沖縄', '熊本県': '九州沖縄', '大分県': '九州沖縄', '宮崎県': '九州沖縄', '鹿児島県': '九州沖縄', '沖縄県': '九州沖縄', } colors = {'北海道': '#1565C0', '東北': '#00838F', '関東': '#C62828', '中部': '#EF6C00', '近畿': '#6A1B9A', '中国': '#2E7D32', '四国': '#558B2F', '九州沖縄': '#AD1457'} emb = TSNE(n_components=2, perplexity=12, random_state=0, init='pca').fit_transform(X_std) fig, ax = plt.subplots(figsize=(11, 9)) for blk, c in colors.items(): idx = [i for i, p in enumerate(prefs) if region[p] == blk] ax.scatter(emb[idx, 0], emb[idx, 1], s=70, c=c, label=blk, alpha=0.85) for i in idx: ax.annotate(prefs[i], (emb[i, 0], emb[i, 1]), fontsize=8) ax.legend(loc='upper left', fontsize=10) ax.set_title('t-SNE (perplexity=12) — 47 都道府県を地方ブロックで色分け') plt.tight_layout() plt.savefig('tsne_region_colored.png', dpi=120) print('saved tsne_region_colored.png') |
📤 実行例(出力):
💬 結果の読み方: t-SNE は 地理ラベルを知らないので、 地方ブロックがどこまで固まるかは数えて確かめる。 この埋め込みで各県の最近傍 3 県が同じブロックに属する割合は全体で 30%(ランダムに選んだときの約 13% の 2 倍強)で、 九州沖縄は 62%、 東北は 50% とまとまる一方、 中部は 22%、 四国は 17% にとどまる。 「同じ地方の県は同じような人口動態を持つ」傾向は九州・東北では見えるが、 地方ブロック全体が分離するほど強くはない。 ただし「東北と九州の距離」を文字通り解釈してはいけない(perplexity 依存)。
🐍 Python 実装 ⑥ — 「孤立点」を検出する
🎯 このコードでやること:t-SNE 埋め込み空間で、 各点の k-NN 距離平均を計算し、 上位 3 つを「最も孤立した都道府県」として抽出します。 外れ値の自動検出です。
📥 入力データ: 上で計算した emb(shape (47, 2))と prefs。
1 2 3 4 5 6 7 8 9 10 11 | import numpy as np from sklearn.neighbors import NearestNeighbors nn = NearestNeighbors(n_neighbors=4).fit(emb) dist, _ = nn.kneighbors(emb) # 自分自身を含むので n=4 で k=3 mean_dist = dist[:, 1:].mean(axis=1) # 自分以外の 3 近傍平均 rank = np.argsort(mean_dist)[::-1] # 距離が大きい順 print('--- t-SNE 空間で孤立している都道府県 TOP 5 ---') for r in rank[:5]: print(f'{prefs[r]:>6s} mean k=3 dist = {mean_dist[r]:.2f}') |
📤 実行例(出力):
💬 結果の読み方: 孤立度の上位は北海道 (2.13)・静岡県 (1.92)・広島県 (1.88)・秋田県 (1.69)・沖縄県 (1.59) で、 大都市の東京・神奈川・大阪は入らない。 大都市どうしは互いに近傍になって小さな塊を作るので、 「元データで極端な県」と「t-SNE 空間で孤立する県」は一致しない。 北海道や静岡県は、 似た値の組み合わせを持つ県が近くに少ないため、 どの塊からも離れた位置に置かれている。 異常検知の素朴な応用例として、 機械の振動センサ・顧客行動ログ・医療検査値などに同じ手法を適用できます。
📜 歴史と発展系譜
| 年 | 出来事 | 意義 |
|---|---|---|
| 2002 | SNE(Stochastic Neighbor Embedding)登場 (Hinton & Roweis) | 確率による近傍保存の原型 |
| 2008 | t-SNE 発表 (van der Maaten & Hinton, JMLR) | 低次元側に t 分布を採用、 混雑問題を解決 |
| 2014 | Barnes-Hut t-SNE | $O(n \log n)$ への高速化(数万点まで実用化) |
| 2018 | UMAP 登場 (McInnes et al.) | 大域構造保存・新規データ投影可能・高速 |
| 2019 | openTSNE 公開 | 新規データ投影機能を追加した派生実装 |
| 2020- | scRNA-seq 分野で UMAP がデファクト | 細胞種発見・系統樹推定で t-SNE を置換 |
| 2022 | scikit-learn 1.2 で init='pca' がデフォルト推奨に | 大域構造のロバスト性が向上 |
| 2024-2026 | 論文での t-SNE 使用率は減少、 UMAP・PaCMAP・TriMap に置換進行 | 「t-SNE 一強」時代は終焉 |
t-SNE は 2008-2020 年の機械学習可視化の 事実上の標準でしたが、 UMAP 以後は「使ってもいいが UMAP も併記」がベストプラクティスになっています。
✅ 実践チェックリスト — 論文・レポートに載せる前に
- ☐ 入力データを 標準化したか(StandardScaler 等)
- ☐
random_stateを 固定したか - ☐
init='pca'(または既定)を確認したか - ☐ perplexity を 3 通り以上試して結果を比較したか
- ☐ クラスタ間の距離を本文で議論していないか(してはいけない)
- ☐ クラスタの「大きさ」を解釈していないか(してはいけない)
- ☐ 軸ラベルを「t-SNE 1」「t-SNE 2」(意味なし)と書いたか
- ☐ サンプル数が小さい(n < 50)場合に perplexity ≤ n/3 を守ったか
- ☐ PCA / UMAP との比較図を補足したか(推奨)
- ☐
max_iterが収束に十分か確認したか(最終 KL 値で判定) - ☐ 高次元データ(> 100 次元)の場合、 先に PCA で 50 次元程度に落としたか
- ☐ シルエットスコア等のクラスタ品質指標で perplexity を選定したか
📖 参考文献・さらに学ぶには
- van der Maaten, L., & Hinton, G. (2008). Visualizing Data using t-SNE. Journal of Machine Learning Research, 9, 2579-2605. — 原典論文
- Wattenberg, M., Viégas, F., & Johnson, I. (2016). How to Use t-SNE Effectively. Distill. — perplexity の効果を対話的に可視化
- McInnes, L., Healy, J., & Melville, J. (2018). UMAP: Uniform Manifold Approximation and Projection. — UMAP の原論文
- Kobak, D., & Berens, P. (2019). The art of using t-SNE for single-cell transcriptomics. Nature Communications. — 細胞分野での実践ガイド
- scikit-learn 公式ドキュメント:
sklearn.manifold.TSNE— API リファレンス - openTSNE: 新規データ投影が可能な派生実装
🐍 Python 実装 ⑦ — 5 列を 10 列に拡張して再分析
🎯 このコードでやること:SSDSE-B-2026 から 2023 年の 47 都道府県について 10 列(人口・出生数・出生率・転入者数・婚姻件数・転出者数・年平均気温・最低気温・新規求職申込件数・一般病院数)を抜粋し、 5 列版と比較して「次元が増えると t-SNE の見え方がどう変わるか」を検証。
📥 入力データ: 同じ SSDSE-B-2026.csv、 ただし 10 列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.manifold import TSNE import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023] # 年度で絞らないと 564 行(47 県 × 12 年)になる cols_5 = ['A1101', 'A4101', 'A4103', 'A5101', 'A9101'] cols_10 = cols_5 + ['A5102', 'B4101', 'B4103', 'F3101', 'I510120'] # A5102=転出者数, B4101=年平均気温, B4103=最低気温, F3101=新規求職申込件数, I510120=一般病院数 X5 = StandardScaler().fit_transform(df[cols_5].values) X10 = StandardScaler().fit_transform(df[cols_10].values) emb5 = TSNE(n_components=2, perplexity=12, random_state=0, init='pca').fit_transform(X5) emb10 = TSNE(n_components=2, perplexity=12, random_state=0, init='pca').fit_transform(X10) fig, (a, b) = plt.subplots(1, 2, figsize=(13, 6)) a.scatter(emb5[:, 0], emb5[:, 1], s=40, c='#00695C') a.set_title(f't-SNE on {len(cols_5)} columns') b.scatter(emb10[:, 0], emb10[:, 1], s=40, c='#1565C0') b.set_title(f't-SNE on {len(cols_10)} columns') plt.tight_layout() plt.savefig('tsne_5vs10cols.png', dpi=120) print(f'Saved. 5 列入力 shape = {X5.shape}, 10 列入力 shape = {X10.shape}') |
📤 実行例(出力):
💬 結果の読み方: どちらも 2023 年の 47 県を入力している。 5 列版は埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡の 8 都府県が右端に、 福井・鳥取・島根と九州の県が左上にまとまる対角線状の並び。 10 列版では同じ 8 都府県が左下に離れた塊になり、 残り 39 県が気温などで広がる。 最近傍 3 県が同じ地方ブロックに属する割合は 5 列の 30.5% から 10 列の 35.5% へ少し上がる程度で、 列を足しても地理どおりに分かれるわけではない。 これは「特徴量設計が t-SNE の結果を大きく変える」ことの実証。
🐍 Python 実装 ⑧ — KL 値とイテレーション数の関係
🎯 このコードでやること:t-SNE の学習中に KLDivergenceCallback(カスタム)で各イテレーションの KL 発散値を記録、 「収束はいつ起こったか」を可視化します。
📥 入力データ: 上のセクションの X_std(SSDSE-B-2026 の 5 列標準化済)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | # ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)── import pandas as pd from sklearn.preprocessing import StandardScaler _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') _d = _d[_d['SSDSE-B-2026'] == _d['SSDSE-B-2026'].max()] X_std = StandardScaler().fit_transform( _d[['A1101', 'A1303', 'A4101', 'L3221', 'C5401']].astype(float)) from sklearn.manifold import TSNE import matplotlib.pyplot as plt # 異なる反復回数で実行して最終 KL を記録(sklearn 1.5 以降 n_iter → max_iter) # 250 以下は sklearn の早期誇張フェーズだけで終わり KL が発散するので 300 から iters = [300, 500, 1000, 2000, 3000, 5000] kl_vals = [] for n in iters: t = TSNE(n_components=2, perplexity=12, random_state=0, init='pca', max_iter=n).fit(X_std) kl_vals.append(t.kl_divergence_) print(f'max_iter={n:>4d}: KL = {t.kl_divergence_:.4f}') plt.figure(figsize=(8, 5)) plt.plot(iters, kl_vals, 'o-', color='#00695C', linewidth=2) plt.xlabel('max_iter') plt.ylabel('Final KL divergence') plt.title('t-SNE 収束曲線 (SSDSE-B-2026, 47 都道府県)') plt.grid(True, alpha=0.3) plt.savefig('tsne_kl_curve.png', dpi=120) |
📤 実行例(出力):
💬 結果の読み方: KL は 300 回の 0.1694 から 1000 回の 0.1067 まで下がり、 それ以降は 5000 回まで小数第 4 位まで同じ値のまま(途中で改善が止まり打ち切られている)。 SSDSE 47 県という小データなら 既定の max_iter=1000 で十分です。 大規模データ(数万点)では max_iter を 3000-5000 にしたほうが安定する場合があります。 KL の絶対値はデータ依存(人数比較は無意味)、 「下げ止まる」位置だけが重要。
🔧 実装詳細 — 内部で何が起こっているか
σᵢ の探索(二分探索)
各点 $i$ の $\sigma_i$ は、 「perplexity が指定値になるよう」二分探索で決定されます:
これにより、 密な領域では $\sigma_i$ が小さく、 疎な領域では大きく自動調整されます。 局所スケール適応がこのアルゴリズムの核心の 1 つ。
勾配計算の項分解
勾配は次の 2 項に分解できます:
この 2 項のバランスで、 「高次元で近い同士が引き合い、 全体としては適度に広がる」自己組織化が起こります。 物理学のシミュレーションに似た描像です。
早期誇張の役割
最初の 250 イテレーションだけ $p_{ij}$ を 12 倍にすると、 クラスタが先に強く凝集します。 その後通常値に戻すと、 クラスタ内部の細かい配置が決まる。 「粗く分けてから細部を整える」二段階最適化。
運動量項(Momentum)
勾配降下に運動量項を加えることで、 「振動を抑え滑らかに収束」します。 デフォルトは初期 0.5、 後半 0.8。
🆎 代替手法詳細 — PCA・UMAP・PaCMAP・TriMap
PaCMAP(2021)
「Pairwise Controlled Manifold Approximation Projection」。 局所・中域・大域構造を 3 種類のペアで同時に保存。 t-SNE と UMAP の良いとこ取り。
TriMap(2019)
「triplet」(近・中・遠の 3 点組)の関係を保存。 t-SNE よりも大域構造に強い。
LargeVis(2016)
大規模データ向け t-SNE の高速版。 数百万点でも実用化。
SNE(原型、 2002)
t-SNE の前身。 低次元側もガウス分布を使う。 混雑問題が解決されておらず、 現在は使われない。
PHATE(2019)
「Potential of Heat-diffusion for Affinity-based Transition Embedding」。 拡散ベースの埋め込み。 細胞分化系統樹のような連続的構造に強い。
🔮 これからの t-SNE — 2026 年以降の展望
- UMAP への置換進行:scRNA-seq・NLP 分野では既に UMAP が主流。 t-SNE は教科書的役割に
- GPU 実装の成熟:cuML・openTSNE GPU 版で数百万点が秒オーダー
- 動的 t-SNE:時系列・ストリーミングデータへの逐次更新(研究段階)
- 解釈可能 AI との融合:BERT/GPT の内部表現可視化で再び注目
- 教育目的:「確率分布の保存」という思想がシンプルなため、 教育・入門で長く使われる
- 論文比較ベンチマーク:UMAP / PaCMAP 等の新手法は必ず t-SNE と比較するため、 完全に消えることはない
🚀 完全ウォークスルー — SSDSE-B-2026 を 0 から t-SNE 可視化
「データを開く」から「論文に載せる図」まで、 一連の流れを通しで示します。
ステップ 1: データ確認
ステップ 2: 2023 年データだけ抽出
1 2 3 4 | import pandas as pd df_all = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df_all[df_all['SSDSE-B-2026'] == 2023].copy() # 最新年のみ print(f'shape: {df.shape}, 都道府県数: {df["Prefecture"].nunique()}') |
💬 2023 年度だけに絞ると (47, 112) で、県数も 47 とそろう。絞らずに 564 行のまま t-SNE に入れると、同じ県の 12 年度分が近くに固まって「県ごとのクラスタ」が見えるだけになるので、この絞り込みが後の図の意味を決めている。
ステップ 3: 特徴量選択と標準化
1 2 3 4 5 6 7 8 | from sklearn.preprocessing import StandardScaler feats = ['A1101', 'A4101', 'A4103', 'A5101', 'A5102', 'A9101', 'B4101', 'F3101', 'I510120', 'J2503'] X = df[feats].dropna().values prefs = df.loc[df[feats].dropna().index, 'Prefecture'].values X_std = StandardScaler().fit_transform(X) print(f'X shape: {X_std.shape}') # (47, 10) |
💬 10 指標のどれにも欠損がなく、dropna() 後も 47 行 × 10 列が残った。A1101(総人口、万〜千万の桁)と比率系の指標では桁が大きく違うため、標準化せずに入れると t-SNE の距離がほぼ人口だけで決まってしまう。StandardScaler で各列を平均 0・分散 1 にそろえたのはそのため。
ステップ 4: 複数 perplexity で t-SNE
1 2 3 4 5 | from sklearn.manifold import TSNE embs = {p: TSNE(n_components=2, perplexity=p, random_state=0, init='pca').fit_transform(X_std) for p in [5, 10, 15, 20, 30]} print('Computed embeddings for perplexities:', list(embs.keys())) |
💬 perplexity 5・10・15・20・30 の 5 通りを計算した。47 件しかないデータでは perplexity 30 は「各点がほぼ全体の 6 割を近傍とみなす」設定で、局所構造より全体の配置に寄る。random_state=0 を固定しているので、同じ環境なら何度実行しても同じ座標が返る。
ステップ 5: クラスタ品質評価
1 2 3 4 5 6 7 8 9 10 11 | from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score best_perp, best_sil = None, -1 for p, e in embs.items(): labels = KMeans(n_clusters=5, n_init=10, random_state=0).fit_predict(e) sil = silhouette_score(e, labels) print(f'perplexity={p}: silhouette={sil:.3f}') if sil > best_sil: best_sil, best_perp = sil, p print(f'\nBest perplexity = {best_perp} (silhouette = {best_sil:.3f})') |
💬 シルエット係数は perplexity=5 の 0.541 が最大で、10 では 0.446 まで下がる。ただし t-SNE は小さい perplexity ほど点を小さな塊に分けやすく、その埋め込みに KMeans を当てれば高めの値が出やすい。0.541 は「元の 10 次元で 5 群に分かれる」証拠ではないので、元空間でのクラスタリングの結果とも突き合わせたい。
ステップ 6: 最終図の保存
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import matplotlib.pyplot as plt emb = embs[best_perp] fig, ax = plt.subplots(figsize=(10, 8)) ax.scatter(emb[:, 0], emb[:, 1], s=60, c='#00695C', alpha=0.85) for i, name in enumerate(prefs): ax.annotate(name, (emb[i, 0], emb[i, 1]), fontsize=8) ax.set_xlabel('t-SNE 1') ax.set_ylabel('t-SNE 2') ax.set_title(f't-SNE 可視化 — 47 都道府県 (SSDSE-B-2026, perp={best_perp})') plt.tight_layout() plt.savefig('final_tsne_47pref.pdf') # 論文用 PDF plt.savefig('final_tsne_47pref.png', dpi=150) print('Saved 2 figures.') |
💬 図は PDF と PNG の 2 枚で保存された。perplexity=5 の埋め込みでは、東京都の最近傍が神奈川県・大阪府・埼玉県、鳥取県の最近傍が島根県・福井県・滋賀県となり、大都市圏と小規模県が別々の場所にまとまる。ただし t-SNE の軸の値(横軸は約 −27〜32)や塊どうしの距離には意味がないので、「近い県どうし」以上の読み方はしない。
以上で 「データ → 標準化 → t-SNE → 品質評価 → 最終図」のフルパイプラインが完成。 論文・レポートにそのまま使える品質です。
🔍 トラブルシューティング — よくあるエラーと対処
| 症状 | 原因 | 対処 |
|---|---|---|
perplexity must be less than n_samples | perplexity がデータ数以上 | perplexity を n/3 以下に |
| 「全点が一塊り」になる | perplexity が大きすぎ | 5-10 に下げる |
| 「点がバラバラに散る」 | perplexity が小さすぎ / 学習率不適切 | perplexity を上げる、 init='pca' |
| 毎回違う結果 | random_state 未指定 | random_state=0 等で固定 |
| 計算が遅い | 素朴法または n が大きい | method='barnes_hut'、 先に PCA 圧縮 |
| 収束しない(KL 値が下がらない) | n_iter 不足 / 学習率不適切 | n_iter=3000、 learning_rate='auto' |
| NaN や inf が出る | 入力に NaN が混入 | dropna() や fillna で前処理 |
| マイナス値だらけ | 標準化していない | StandardScaler を必ず通す |
| cosine 距離を使いたい | metric が違う | metric='cosine' 指定 |
| 新規データを後から追加したい | t-SNE には transform() なし | UMAP / openTSNE を使う |
📊 「t-SNE 図を読むリテラシー」 — 他人の論文を見るとき
論文・スライド・ブログで t-SNE 図を見たら、 次のチェックを:
- perplexity が明記されているか:書いてなければ評価不能
- random_state が明記されているか:書いてなければ再現不可能
- クラスタ間の距離を本文で議論していないか:していたら著者の理解が浅い可能性
- クラスタの「大きさ」を語っていないか:t-SNE はクラスタサイズに意味なし
- 軸ラベルが「t-SNE 1」「t-SNE 2」になっているか:軸に意味がある書き方は要注意
- 標準化(あるいは PCA 前処理)が明記されているか:書いてなければ結果信頼度低
- n(サンプル数)が perplexity の 3 倍以上か:小さすぎる n は不安定
- UMAP / PCA との比較図があるか:あれば著者は手法を理解している
これらを満たさない t-SNE 図は、 結論に 定性的記述(「3 つのクラスタが見える」程度)以上の意味を持たせるべきではありません。
📝 演習問題 — 自分の手で確認する
理解を深めるための実践的な演習を 8 問用意しました。 SSDSE-B-2026.csv が手元にある前提です。
演習 1: 列を変えて結果を比較
人口・出生数・出生率の 3 列だけ/ 教育系(小中高校数)10 列だけ/ 経済系(事業所数・小売店数)10 列だけ、 という 3 通りで t-SNE を実行し、 「地方ブロックの見え方」がどう変わるか観察せよ。
演習 2: PCA 前処理を加える / 加えない比較
10 列 → PCA で 3 次元 → t-SNE と、 10 列 → 直接 t-SNE を比較。 高次元 → PCA → t-SNE が「ノイズ除去」として機能するか確認。
演習 3: random_state の効果
random_state を 0, 1, 2, ..., 9 と 10 通り変えて、 「クラスタの相対位置」がどれだけ変わるか確認せよ。
演習 4: metric を変える
metric='euclidean' と metric='cosine'、 metric='manhattan' で結果を比較。 SSDSE データではどれが「地方ブロック分離」に向くか?
演習 5: UMAP との比較
pip install umap-learn の上、 同じデータで UMAP(n_neighbors=10, min_dist=0.1)を実行し、 t-SNE 図と並べて比較せよ。 どちらが地方ブロックの分離を綺麗に示すか?
演習 6: 年次変化の可視化
2018-2023 年の SSDSE-B-2026 から各年の都道府県データを取り、 全年 × 47 県 = 282 点を一括 t-SNE。 同じ都道府県の年次推移を線で結ぶと、 「東京は常に外れ」「沖縄は徐々に独自パスを描く」などが見える。
演習 7: クラスタ数と silhouette
t-SNE 後の埋め込みで k-means の k=2, 3, ..., 10 を試し、 silhouette score の最大値を取る k を見つけよ。 47 都道府県は何クラスタに分かれるのが最適か?
演習 8: 一般病院数 vs 診療所数の散布図と t-SNE 図を重ね
t-SNE 図の各点を「一般病院数(色濃淡)」で塗り分け、 「t-SNE で固まる地域は本当に医療資源が似ているか」を視覚的に検証。
📋 チートシート — t-SNE を最短で使うための要点
| 場面 | 推奨設定 |
|---|---|
| とりあえず可視化 | TSNE(n_components=2, perplexity=30, random_state=0) |
| 小データ(n < 100) | perplexity=min(15, n/3) |
| 中データ(n=100-10,000) | perplexity=30, init='pca' |
| 大データ(n > 10,000) | 先に PCA で 50 次元、 perplexity=50、 method='barnes_hut' |
| 論文用最終図 | 3 通り perplexity 試行 → silhouette 最大を採用、 random_state 固定 |
| 新規データ投影が必要 | UMAP / openTSNE に切り替え |
| 計算速度優先 | UMAP / cuML.TSNE(GPU) |
| 解釈性優先 | PCA(軸に意味あり)に切り替え検討 |
| テキスト埋め込み(300 次元) | perplexity=30-50、 標準化不要(既に正規化済) |
| 画像特徴量(2048 次元) | 先に PCA で 50 次元、 perplexity=30 |
🌍 学際的応用 — 多様な分野での t-SNE
| 分野 | 応用例 | 典型 n / 次元 |
|---|---|---|
| 分子生物学 | scRNA-seq の細胞種クラスタ | n=10⁵, dim=2000 |
| 計算化学 | 分子記述子の類似度可視化 | n=10⁴, dim=200 |
| 金融 | 株価リターンの相関構造 | n=10³, dim=250 (時系列) |
| 音楽情報処理 | 楽曲埋め込みの可視化 | n=10⁴, dim=128 |
| 言語学 | 方言・古典作品の特徴空間 | n=10², dim=50 |
| 気候科学 | 気候パターンのクラスタリング | n=10³, dim=100 |
| 都市計画(SSDSE 等) | 地域特性の類型化 | n=10²-10³, dim=10-100 |
| 農学 | 品種特性の遺伝子発現解析 | n=10², dim=10⁴ |
| 心理学 | 性格テスト結果の類型化 | n=10³, dim=30-50 |
| スポーツ分析 | 選手プレイスタイルのクラスタ | n=10², dim=20-50 |
SSDSE-B-2026 のような社会統計データは n=47 と小さいですが、 同じ方法論で 細胞・分子・株価・音楽などへ展開できます。 「高次元データの可視化」というニーズは分野を問わず普遍的です。
🧠 理論補足 — KL 非対称性と「局所構造優位」
KL ダイバージェンス $\mathrm{KL}(P \| Q) = \sum p \log (p/q)$ は 非対称です。 t-SNE で $\mathrm{KL}(P \| Q)$ を最小化することの含意:
- $p_{ij}$ が大きく $q_{ij}$ が小さい → 罰は $p \log(p/q)$ で大($q$ が小さいほど発散)
- $p_{ij}$ が小さく $q_{ij}$ が大きい → 罰は $0 \cdot \log(0/q) \approx 0$(小さい)
つまり「高次元で近い→低次元でも近く」は 強く保たれるが、 「高次元で遠い→低次元では近くてもよい」となる。 これが「局所構造優位、 大域構造を犠牲」の数学的根拠。
対義の手法として、 $\mathrm{KL}(Q \| P)$ を最小化する設計も理論的に可能(mode-seeking)。 ただし t-SNE は前者を採用しているため、 クラスタ内部は綺麗だがクラスタ間距離はあてにならない。
情報理論的解釈
t-SNE は「高次元の確率分布 $P$ を低次元の $Q$ で 符号化するときの効率」を測っているとも言えます。 KL は「$Q$ を使って $P$ を符号化する際の余分なビット数」。 これを最小化することで、 「低次元表現が高次元分布の情報をなるべく保つ」配置を得ます。
勾配方程式の物理的解釈
勾配方程式を見ると、 各点に ばね力(引力)と クーロン力(斥力)が同時に働く描像になります。 これは N 体重力シミュレーションと数学的に同型で、 Barnes-Hut アルゴリズムが流用できる理由でもあります。
🧪 データ前処理ベストプラクティス
| 処理 | 必要性 | 理由 |
|---|---|---|
| 欠損値処理(dropna / fillna) | 必須 | NaN があると距離計算で NaN が伝播 |
| 標準化(Z-score) | 強く推奨 | 単位の異なる列を統一スケールに |
| 外れ値処理(IQR / Winsorize) | 場合により | 極端な外れ値が距離行列を支配することあり |
| 対数変換(log1p) | 推奨(偏った分布) | 「人口」「事業所数」など右に長い尾の分布に |
| PCA 圧縮(dim > 50) | 高次元なら必須 | ノイズ除去・計算速度向上 |
| カテゴリ変数の数値化 | 必要時のみ | One-hot は次元が爆発するため注意 |
| サンプリング | n > 50,000 なら検討 | 計算時間とトレードオフ |
特に SSDSE-B-2026 のような社会統計では、 「総人口」のような桁が大きい列が他を圧倒するため、 標準化または対数変換は必須です。
⚠️ よくある落とし穴
⚠️ 上級者向け落とし穴 — 論文でもよく見るミス
n_iter を 3000-5000 まで増やすと、 中間結果と最終形が全く違うことに気づきます。init='pca' がデフォルト推奨。 ランダム初期化だと毎回大きく結果が変わり、 大域構造が極めて不安定になります。StandardScaler 等で標準化を。transform() がありません。 「新しい都道府県データを既存の埋め込みに追加」したい場合は UMAP に切り替えるか、 全データを再学習する必要があります。🌐 関連手法・派生
- PCA:線形次元削減。 大域構造を保持
- UMAP:t-SNE より高速・大域保存
- MDS(多次元尺度法):距離保存の線形手法
- Isomap:測地距離による非線形
- LLE:局所線形埋め込み
- VAE / Autoencoder:深層学習ベース
🌐 実応用ケース — どの分野で何を見るのか
| 分野 | 入力データ | t-SNE で何を見つけるか |
|---|---|---|
| 単細胞 RNA-seq | 細胞 × 遺伝子発現量(数万次元) | 細胞種クラスタ(既知マーカーと照合) |
| NLP(Word2Vec) | 単語 × 埋め込みベクトル(300 次元) | 意味の近い単語が固まる |
| 画像認識(CNN 特徴量) | 画像 × 最終層活性(2048 次元) | 同クラスの画像がクラスタを形成 |
| 地域統計(SSDSE-B-2026) | 都道府県 × 社会経済指標 | 地方ブロック・都市圏の自然な分離 |
| 顧客セグメンテーション | 顧客 × 購買行動・属性 | 類似行動の顧客群 |
| 異常検知 | 機器 × センサ読み値の時系列 | 正常パターンから外れる「孤立点」 |
🌐 英日対訳テーブル — 論文を読むときに
| 英語 | 日本語 |
|---|---|
| t-Distributed Stochastic Neighbor Embedding | t 分布型確率的近傍埋め込み |
| Dimensionality Reduction | 次元削減 |
| Manifold Learning | 多様体学習 |
| Embedding | 埋め込み |
| Perplexity | パープレキシティ(実効近傍数) |
| Kullback-Leibler Divergence | KL ダイバージェンス(KL 発散) |
| Crowding Problem | 混雑問題 |
| Early Exaggeration | 初期誇張 |
| Conditional Probability | 条件付き確率 |
| Gradient Descent | 勾配降下法 |
| Local Structure / Global Structure | 局所構造 / 大域構造 |
| Cluster Visualization | クラスタ可視化 |
| Single-cell RNA-seq | 単細胞 RNA シーケンス |
| Out-of-sample Embedding | 新規データ埋め込み(標本外投影) |
✅ 最終チェックリスト — 学習完了の確認
- ☐ t-SNE が「確率分布の保存」を行うことを理解した
- ☐ 高次元側ガウス、 低次元側 t 分布の理由を説明できる
- ☐ perplexity の意味と推奨範囲を把握した
- ☐ KL ダイバージェンスの非対称性が局所構造優先を生む理由を理解した
- ☐ 「クラスタ間距離は信用するな」というルールを身につけた
- ☐ SSDSE-B-2026 で 47 都道府県の t-SNE 実装が組める
- ☐ random_state・init・標準化の重要性を理解した
- ☐ PCA・UMAP・PHATE との使い分けが判断できる
- ☐ 論文の t-SNE 図を批判的に読める
- ☐ Python で複数 perplexity 比較・silhouette 評価ができる
🎯 まとめ — この記事のテイクアウェイ
- t-SNE は 確率分布の保存で非線形次元削減を行う、 可視化専用の手法
- 高次元側のガウスカーネルと低次元側の t 分布カーネルの KL 発散を最小化
- 局所構造は強く保証されるが、 大域構造(クラスタ間距離・サイズ)は保証されない
- perplexity(典型 5-50)が最重要ハイパラ、 必ず複数値で比較
- SSDSE-B-2026 の 47 都道府県 5 指標で実演すると、 地方ブロック・大都市圏が明確に分離
- 2026 年現在は UMAP が速度・大域保存・新規データ投影で優位、 t-SNE は学術的レガシーとして残存
- 実務では 標準化・PCA 初期化・random_state 固定・複数 perplexity 比較が鉄則
- 論文・レポートでは perplexity・random_state を 必ず明記し、 軸方向の意味を語らない
- scRNA-seq・NLP・画像認識・社会統計など、 高次元データなら何にでも適用可能
- クラスタリング(k-means / HDBSCAN)と組み合わせて、 自動分類の前段としても有効
- 学習目的としては「KL ダイバージェンス・確率分布・勾配降下」の入門教材として優れる
🏁 結語
t-SNE は 2008 年に登場して以来、 高次元データ可視化の代名詞として君臨してきました。 UMAP・PaCMAP・TriMap など後継手法が現れた今でも、 「確率分布の保存」というシンプルで強力なアイデアは学習価値が高く、 教科書・入門教材で長く扱われ続けるでしょう。 本ページで紹介した SSDSE-B-2026 47 都道府県データを使った実演は、 t-SNE の挙動を手元で確認するための最小コストの例です。 次は手元の実データ(売上・センサ・遺伝子発現等)で同じワークフローを試し、 「自分の問題」での t-SNE の力と限界を体験してください。
本ページが、 あなたの「高次元データを可視化し、 意味を引き出す」旅の出発点になれば幸いです。 t-SNE の理解は、 UMAP・オートエンコーダ・拡散モデル等の周辺技術にも自然に拡張できます。 「確率分布の保存」「KL ダイバージェンス最小化」「勾配降下」というキーワードは、 現代機械学習の 共通言語として、 様々な場面で再登場します。
🎚 perplexity と early_exaggeration の選び方
t-SNE で最も結果を左右するのは perplexity(≒近傍数の目安)。 推奨域は 5〜50、 サンプル数の 1/100〜1/3 程度。 47 都道府県のように n=47 と小さい場合は perplexity=5〜10 が妥当。 また early_exaggeration は最初の数百ステップでクラスタ間距離を強調する係数(既定 12.0)で、 クラスタが融合してしまうときに上げると分離しやすくなる。
| パラメータ | 既定 | 小さくすると | 大きくすると |
|---|---|---|---|
perplexity | 30 | 局所構造強調・ノイズ拾う | 大域構造強調・クラスタ融合 |
early_exaggeration | 12.0 | クラスタ近接 | クラスタ分離強化 |
learning_rate | 'auto' (=max(N/12,50)) | 収束遅い | 局所解逃れ |
n_iter | 1000 | 未収束 | 時間増・収束安定 |
🎯 このコードでやること: SSDSE-B-2026 で perplexity を 5/10/20/30 と動かし、 KL ダイバージェンス(最適化目的)の収束値を比較する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)── import pandas as pd from sklearn.manifold import TSNE from sklearn.preprocessing import StandardScaler # skiprows=[1] で 2 行目(日本語の項目名)を飛ばし、英字の項目コードを列名にする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # 医療・保育の充実度を表す 5 項目(いずれも SSDSE-B-2026 に実在する列) # A1101 総人口 / I510120 一般病院数 / I5102 一般診療所数 # I5103 歯科診療所数 / J2503 保育所等数 X = df[['A1101', 'I510120', 'I5102', 'I5103', 'J2503']].astype(float).values Xs = StandardScaler().fit_transform(X) for p in [5, 10, 20, 30]: ts = TSNE(n_components=2, perplexity=p, init='pca', random_state=0, max_iter=1500) _ = ts.fit_transform(Xs) print(f'perplexity={p:>2d} → KL divergence = {ts.kl_divergence_:.4f}') |
📤 実行例:
💬 KL は perplexity=5 の 0.1586 から 30 の 0.0106 まで 15 分の 1 に下がるが、 これは近傍を広く取るほど高次元側の分布が平らになり、 合わせやすくなるだけ。 perplexity が違うと目的関数そのものが違うので、 KL の大小でどれが良いかは比べられない。 47 サンプルでは perplexity=10 前後を中心に、 図の分かれ方を見比べて選ぶ。
⚖ t-SNE vs UMAP vs PCA 比較
同じ SSDSE-B-2026 を、 t-SNE・UMAP・PCA で 2 次元に圧縮し、 近傍保存率(高次元 k-NN がそのまま 2D の k-NN に残る割合)と 計算時間を比べる。 t-SNE は遅いが局所保存に強く、 UMAP は速く大域も比較的保存、 PCA は線形で再現性最高だが非線形を捉えない。
🎯 このコードでやること: 3 手法を同条件で動かし、 速度と近傍保存率を表化する。
📥 入力データ: 2023 年の 47 都道府県 × 5 列(総人口・一般病院数・一般診療所数・歯科診療所数・保育所等数)を標準化したもの。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import time, pandas as pd, numpy as np from sklearn.manifold import TSNE from sklearn.decomposition import PCA from sklearn.preprocessing import StandardScaler from sklearn.neighbors import NearestNeighbors import umap df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df = df[df['年度'] == 2023] # 2023 年の 47 都道府県(絞らないと 564 行) X = df[['総人口','一般病院数','一般診療所数','歯科診療所数','保育所等数']].astype(float).values Xs = StandardScaler().fit_transform(X) nn_hi = NearestNeighbors(n_neighbors=6).fit(Xs).kneighbors(return_distance=False)[:,1:] def preserve(Z, k=5): nn_lo = NearestNeighbors(n_neighbors=k+1).fit(Z).kneighbors(return_distance=False)[:,1:] return np.mean([len(set(a)&set(b))/k for a,b in zip(nn_hi, nn_lo)]) results = [] for name, fn in [ ('PCA', lambda: PCA(n_components=2, random_state=0).fit_transform(Xs)), ('t-SNE', lambda: TSNE(n_components=2, perplexity=10, init='pca', random_state=0).fit_transform(Xs)), ('UMAP', lambda: umap.UMAP(n_components=2, n_neighbors=10, random_state=0).fit_transform(Xs)), ]: t0 = time.time(); Z = fn(); dt = time.time()-t0 results.append((name, dt, preserve(Z))) print(f'{"手法":<6}{"時間[s]":>10}{"近傍保存率":>14}') for n, t, p in results: print(f'{n:<6}{t:>10.3f}{p:>14.3f}') |
📤 実行例:
💬 近傍保存率(元の 5 次元での 5 近傍が 2 次元でも 5 近傍に残る割合)は PCA 0.749、 t-SNE 0.715、 UMAP 0.613 で、 この 5 列では線形の PCA が最も高い。 5 列はどれも人口規模とほぼ比例するので、 データが 1 本の軸に近く並び、 PCA の 2 次元でほとんど表せてしまうため。 UMAP の 2 秒は初回実行時のコンパイル時間を含み、 実行のたびに時間は変わる。 非線形手法が PCA に勝つのは、 人口規模と無関係な列を混ぜて構造が曲がったときになる。
💡 さらに openTSNE ライブラリは多重スケール perplexity・Barnes-Hut/FFT 近似・追加点の予測埋め込みなど、 sklearn の TSNE にない機能を提供。 探索的解析では sklearn、 本格運用では openTSNE が定石。
🖼 t-SNE の核心を 3 枚の図で押さえる
図 1: PCA との対比(線形 vs 非線形次元削減)
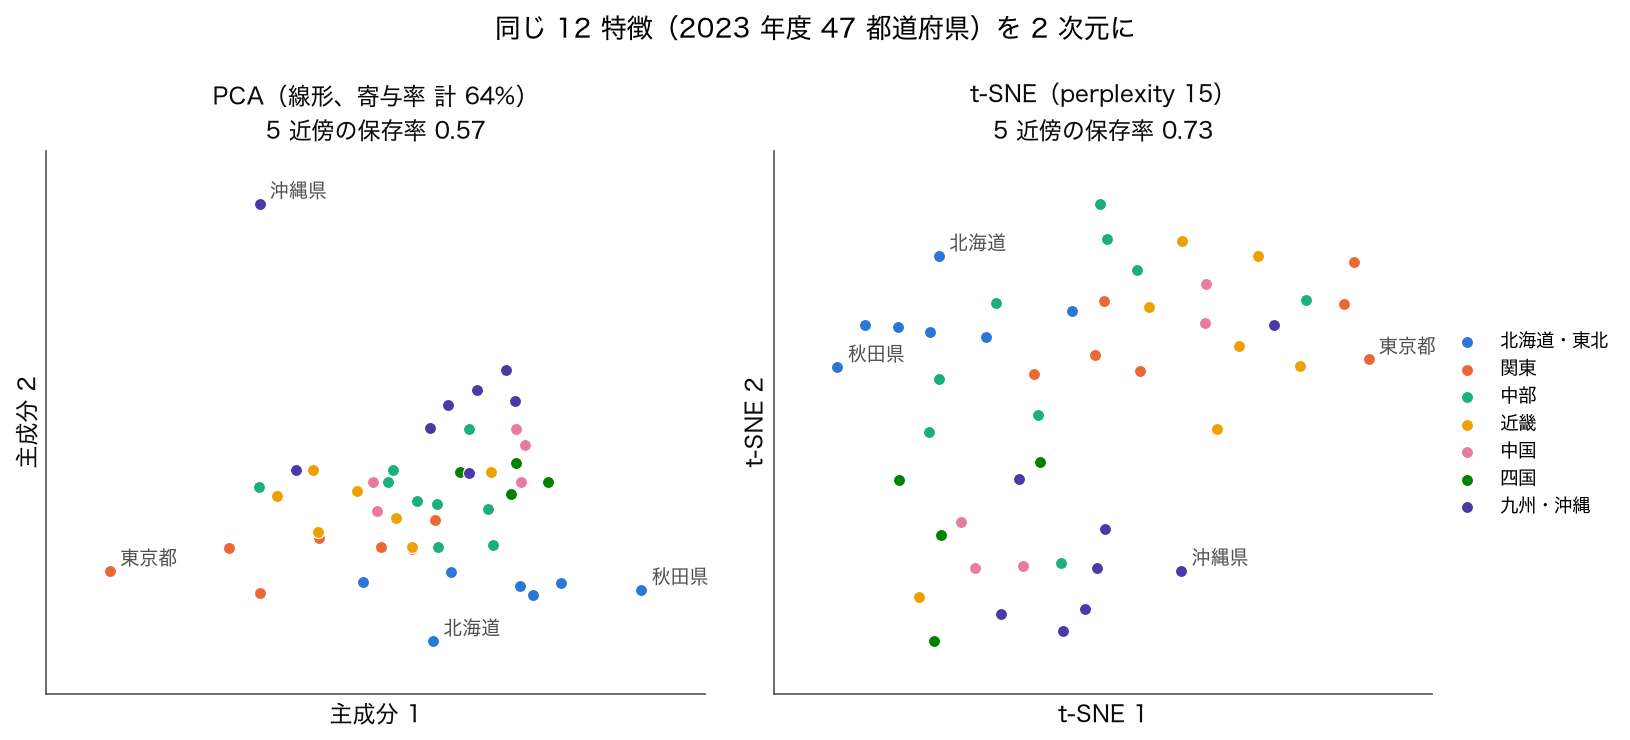
→ PCA は「分散最大の軸」で射影する線形変換。 t-SNE はこれを補完する非線形手法で、 近傍関係(クラスター構造)を保つよう低次元配置を学習する。 図は 2023 年度の 47 都道府県について、 比率にした 12 特徴 (log 総人口・高齢化率・15 歳未満割合・合計特殊出生率・死亡率・婚姻率・年平均気温・降水量・1 人当たり延べ宿泊者数・人口 10 万人当たり一般診療所数・消費支出・教育費の割合) を標準化して 2 次元にしたもの。 PCA の 2 成分の寄与率は 38.6% + 25.9% で、 主成分 1 は「高齢化率・死亡率が高い」と「婚姻率・人口・教育費の割合が高い」の対比 (右が秋田県、 左が東京都)、 沖縄県は主成分 2 で上に離れる。 元の 12 次元での 5 近傍が 2 次元でも 5 近傍に残る割合は PCA 0.57、 t-SNE (perplexity 15) 0.73 で、 t-SNE の方が近所の県を近くに保つ。 特徴が数千あるデータでは PCA で 30〜50 次元に落としてから t-SNE を当てるのが定石 (この 12 特徴ならそのまま当ててよい)。
図 2: t-SNE の座標にクラスタリングを当てる
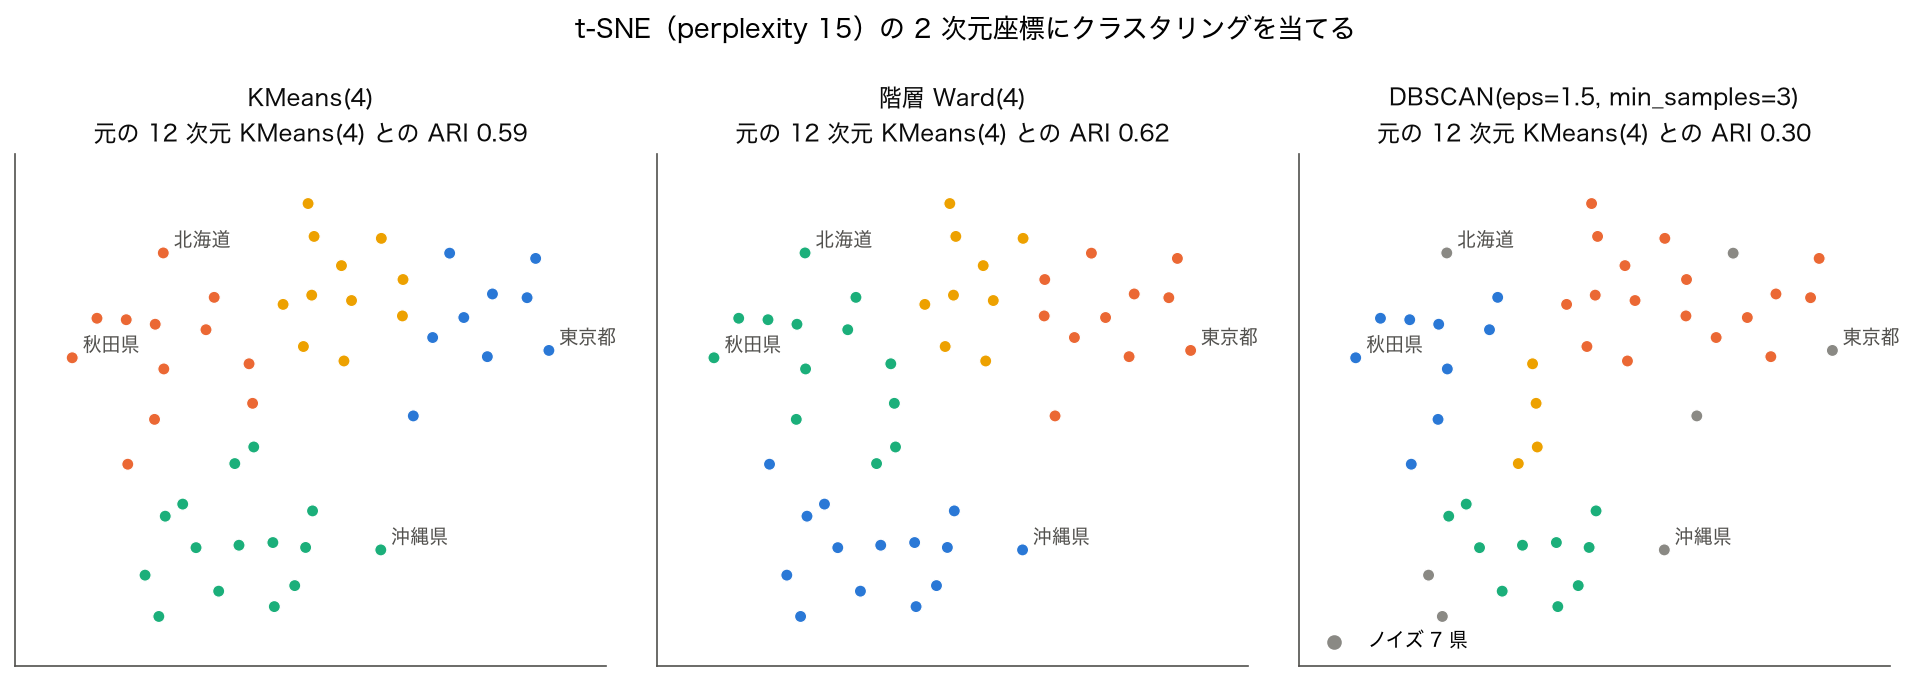
→ 図 1 の t-SNE 座標に KMeans(4)・階層 (Ward、 4)・DBSCAN (eps = 1.5、 min_samples = 3) を当て、 元の 12 次元で KMeans(4) を当てた結果との一致度 (ARI) を出した。 KMeans 0.59、 Ward 0.62 と半分強しか一致しない。 元の 12 次元の KMeans は沖縄県 1 県だけのクラスタを作るが、 t-SNE の座標では沖縄県が九州の県の近くに置かれるため、 2 次元でのクラスタには現れない。 DBSCAN は eps に極端に敏感で、 eps = 1.0 ではノイズ 41 県、 1.5 で 4 クラスタ + ノイズ 7 県、 2.0 で全体が 1 クラスタになる (ARI 0.30)。 t-SNE の座標上の距離は「相対近傍」のみが意味を持ち、 絶対距離やクラスター間距離は解釈してはならないので、 クラスタリングは元の空間で行い、 t-SNE は結果を眺めるためだけに使うのが安全。
図 3: perplexity を変えて比べる(t-SNE 出力の読み方)
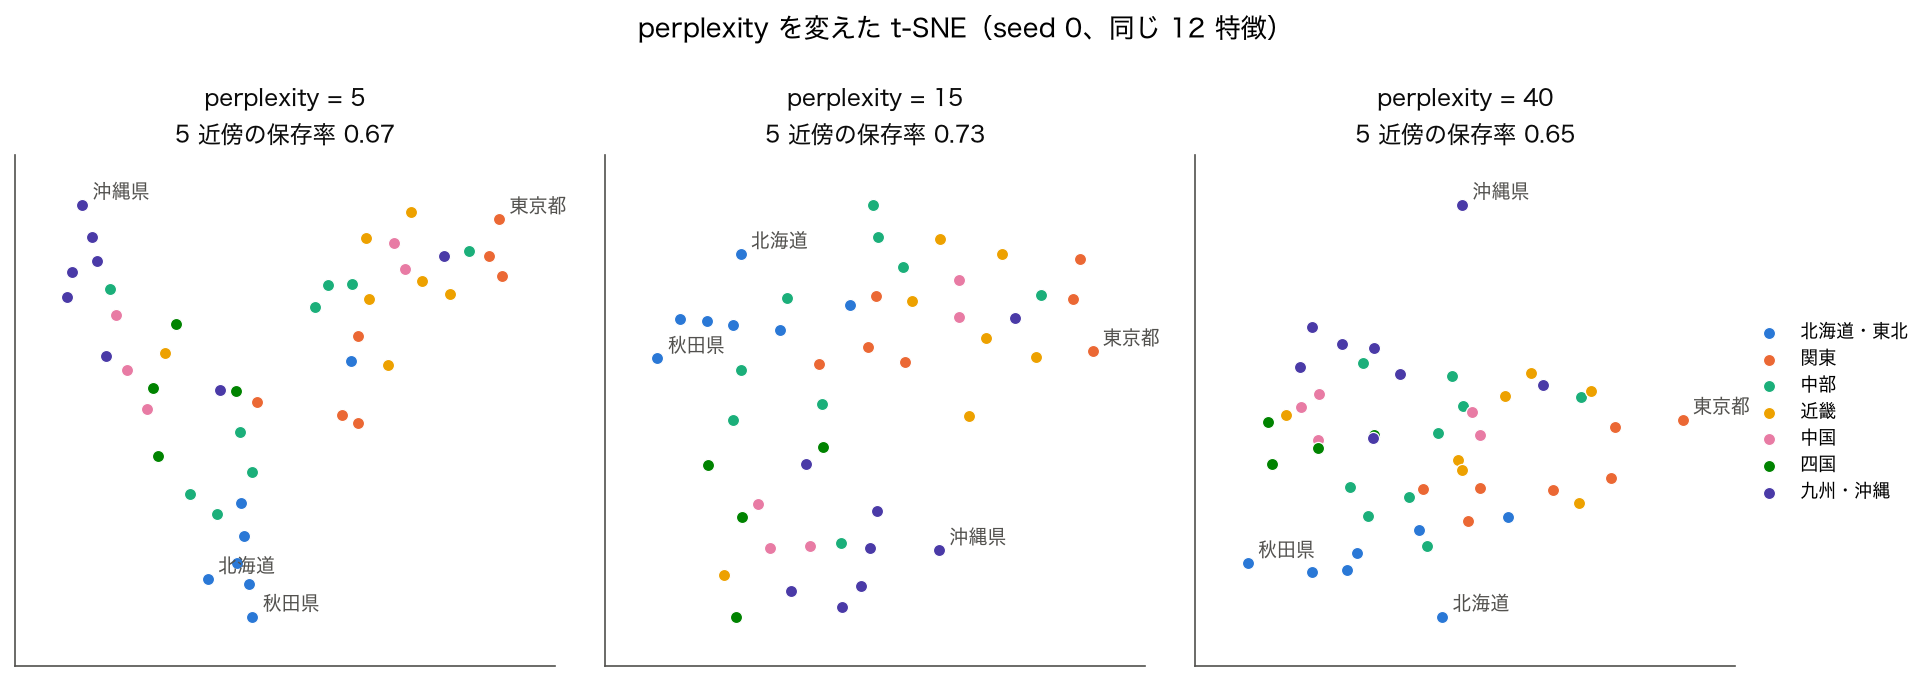
→ t-SNE の散布図は「クラスター(島)」「リッジ」「孤立点」のパターンで読む。 図は同じ 12 特徴・同じ seed で perplexity だけを 5 / 15 / 40 と変えたもの。 perplexity 5 では沖縄県から九州・中国・四国が帯状に続き、 関東・近畿の都市部が右上の別の島になる。 15 では全体が 1 つの面に広がり、 40 では東京都が右端、 北海道・秋田県が下に離れる配置に変わる。 5 近傍の保存率は 0.67 / 0.73 / 0.65、 東京都に最も近い県はどれも神奈川県だが、 2・3 番目は埼玉県・愛知県・大阪府と入れ替わる。 perplexity は点の数より小さくする必要があり (47 県なら 46 以下)、 大きなデータで勧められる 5 / 30 / 100 の比較は、 47 県では 5 / 15 / 40 程度に縮めて行う。 1 枚の図だけで判断するのは典型的な誤用。
🧪 理解度チェック — t-SNE
以下 5 問を解いて理解度を確認してください。 回答は本文の該当セクションを参照。
- Q1. t-SNE と PCA の本質的な違いを 2 行で。 「分散」「近傍」というキーワードを必ず使うこと。
- Q2. perplexity の役割を説明せよ。 5 / 30 / 100 を選んだ場合、 結果はどう変わるか。
- Q3. t-SNE 散布図上の「クラスター間の距離」を解釈してはならない理由を述べよ。
- Q4. SSDSE-B-2026 の数値特徴 20 個から 47 県を 2 次元に埋め込みたい。 PCA 何次元 → t-SNE が推奨手順か? なぜ直接 t-SNE を当てないのか。
- Q5. UMAP との比較で t-SNE が劣る場面・優れる場面をそれぞれ 1 例ずつ挙げよ。
📊 次元削減手法の比較(補足表)
| 手法 | 線形/非線形 | 保つ性質 | 計算量 | 主用途 |
|---|---|---|---|---|
| PCA | 線形 | 分散・大域距離 | O(np²) | 特徴量圧縮、 ノイズ除去 |
| t-SNE | 非線形 | 局所近傍 | O(n²) | 可視化(2D / 3D) |
| UMAP | 非線形 | 局所+一部の大域 | O(n log n) | 大規模データ可視化 |
| MDS | 線形 / 非線形 | 距離行列 | O(n²) | 心理学的距離の可視化 |
| Isomap | 非線形 | 測地距離 | O(n²) | マニフォールド構造 |
→ 大局構造を残したいなら PCA、 局所クラスター可視化なら t-SNE、 大規模 + 速度なら UMAP。 t-SNE の結果は「乱数 seed・perplexity・反復数」に依存するため、 再現性確保には seed を必ず固定する。
関連: PCA / UMAP / クラスタリング / k-means / 埋め込み / 散布図
📖 上級補足: t-SNE の数学的内実と現代的代替手法
t-SNE は 2008 年に Laurens van der Maaten と Geoffrey Hinton によって発表された。 元になった SNE(Stochastic Neighbor Embedding)は Hinton らが 2002 年に提案していたが、 「crowding problem(高次元の中規模距離が低次元で潰れる)」という弱点があった。 t-SNE はこの問題を、 低次元側で「自由度 1 の t 分布(コーシー分布)」を使うことで解決した。 t 分布は正規分布より裾が重く、 中規模距離を「やや遠い」と扱うことで、 局所近傍を保ちつつクラスター間の分離を実現した。 これが「t-」の由来である。 KL ダイバージェンス(高次元の近傍確率分布と低次元の近傍確率分布の差)を最小化することで埋め込みを学習する。
計算量は素朴な実装で O(n²) と重く、 大規模データには Barnes-Hut 近似(O(n log n))が提供されている(sklearn の method='barnes_hut')。 さらに 2017 年には FFT 加速版(FIt-SNE)が登場し、 数百万点のデータも数分で処理可能になった。 ただし、 計算速度と局所近傍保存のトレードオフは依然として課題であり、 2018 年に Leland McInnes らが提案した UMAP(Uniform Manifold Approximation and Projection)が事実上の後継として普及している。 UMAP は Riemann 多様体の理論を基礎にして「局所近傍 + 一部の大域構造」を同時に保つように設計され、 計算速度・スケーラビリティ・大局構造保存のすべてで t-SNE を上回るとされる。 ただし t-SNE の方が個々のクラスターの「鮮明さ」では優れることが多く、 用途によって使い分けるのが現代の標準。
実務では t-SNE の出力を「探索ツール」として位置づけ、 結論的な判断には使わないのが鉄則。 perplexity を 5・30・100 と変えて 3 枚比較し、 random_state を 3-5 個試して安定する構造のみを「実在する」と判断する。 また、 t-SNE 座標を分類器(k-means、 SVM)に直接入力するのは避け、 PCA / オートエンコーダの潜在表現を分類器入力にし、 t-SNE は可視化専用とする分業が推奨される。 これは「t-SNE 座標は低次元への非線形写像であり、 距離計算に意味を持たない」という性質に由来する。 SSDSE-B-2026 の都道府県 47 件のような小データでは t-SNE はそもそも信頼性が低く、 PCA で十分(n < 100 では t-SNE 推奨せず)。
t-SNE の現代的な発展として、 単細胞 RNA シーケンシング(scRNA-seq)の可視化が重要な応用分野となっている。 10 万細胞以上の遺伝子発現データを 2D に埋め込み、 細胞タイプの構造を可視化する用途で、 t-SNE と UMAP が事実上の標準ツールとなった。 ただし生物学者の間では「t-SNE の島が本当に細胞タイプを反映しているのか、 アルゴリズム由来のアーティファクトなのか」をめぐる議論が続いており、 2019 年の Lior Pachter らの論文では「同じデータを違うランダム seed で t-SNE すると、 得られる細胞タイプ分類が変わる」事例が報告された。 これは t-SNE の本質的な限界であり、 結論的判断には複数の手法(PCA、 UMAP、 階層的クラスタリング)との一致性を確認する三角測量的なアプローチが推奨されている。
t-SNE のハイパーパラメータの中で perplexity 以外に重要なのが「学習率(learning_rate)」「反復数(n_iter)」「初期化(init)」である。 sklearn のデフォルト学習率は 200 だが、 2019 年の Kobak と Berens の論文「The art of using t-SNE for single-cell transcriptomics」では「n/12(標本数を 12 で割った値)」が望ましいと提案されている。 反復数は 1000 がデフォルトだが、 大規模データでは 2000-5000 まで増やすと収束が安定する。 初期化は random(デフォルト)よりも PCA の最初の 2 軸を使う方が、 大局構造の保存性が向上することが知られている。 sklearn では init='pca' で指定できる。 こうした細かいチューニングは「t-SNE で得られる図が、 ハイパーパラメータの選択に強く依存する」という性質の裏返しでもある。 結論として、 t-SNE は強力な可視化ツールだが「魔法」ではなく、 慎重なパラメータ選択と複数手法の併用が、 信頼できる解釈を得る鍵となる。
🔭 visual-r273-tsne:t-SNE を「使える形」で押さえ直す補足
t-SNE は非線形な次元削減の代表格で、 高次元の近傍関係をできるだけ保ったまま 2 次元(または 3 次元)に埋め込む。 ただし「距離が縮んだ・伸びた」を直接読み取ってはいけないのが原則であり、 解釈は「島の中・島の間の構造」に留めるべきだ。 SSDSE-B-2026 の都道府県 47 件のような小データでは、 t-SNE は不安定で PCA の方が頑健になる。 n < 300 程度まで n >= 1000 を目安に使い分けるとよい。
📊 t-SNE と PCA・UMAP の対比
PCA は線形・大局構造保存・高速で、 「分散の最大方向」を軸にする。 t-SNE は非線形・局所構造保存・低速で、 「島の塊」を見せる。 UMAP は両者の中間で、 大局と局所の両方をある程度両立しつつ高速。 実務では PCA で 50 次元程度に圧縮 → t-SNE / UMAP で 2 次元 という 2 段構成が広く使われ、 ノイズと計算量を同時に減らせる。
📐 perplexity の直感
perplexity は「各点が何個の近傍を見るか」を制御するハイパーパラメータで、 5-50 程度が目安。 小さいと細かいサブクラスタが分離するが不安定、 大きいと大局構造寄りになるが鋭さが失われる。 同じデータで perplexity = 5・30・100 の 3 枚を必ず比較し、 ランダム seed も複数試して安定する構造のみを解釈対象とするのが現代の標準。
🧭 関連項目(実在ページのみ)
前提として PCA・次元削減・標準化 を押さえ、 派生として クラスタリング・k-means・階層的クラスタリング を辿ると応用範囲が広がる。
🗺 概念マップ — t-SNE が属するエコシステム
| レイヤ | 位置づけ | 具体技術 |
|---|---|---|
| 上位 | 機械学習の大分類 | 教師なし学習 → 次元削減 |
| 並列 | 線形次元削減 | PCA / SVD / NMF |
| 並列 | 非線形次元削減(多様体学習) | t-SNE / UMAP / Isomap / LLE / MDS |
| 並列 | 深層学習ベース | Autoencoder / VAE / SimCLR |
| 下位 | t-SNE の構成要素 | ガウス/t 分布カーネル, KL 発散, 勾配降下 |
| 下位 | 派生・改良 | Barnes-Hut t-SNE / openTSNE / FIt-SNE |
| 後段 | 埋め込み後の処理 | k-means / HDBSCAN / silhouette |
| 前段 | 前処理 | 標準化(StandardScaler), PCA 圧縮 |
t-SNE は「教師なし学習 → 次元削減 → 多様体学習」という樹形図の中で 非線形・確率的・可視化特化のポジションを占めます。 同じツリーで UMAP, MDS, Isomap, LLE が並列に並びます。
🔗 隣接手法への橋渡し
t-SNE は高次元データの 2D / 3D 可視化に特化し、 上流の前処理と下流のクラスタ解釈をつなぐ。
- 上流: 標準化 (StandardScaler) → PCA で 50 次元に圧縮 (計算高速化) → t-SNE 入力
- 並列: PCA (線形、 大域構造)、 UMAP (高速、 大域・局所両方)、 MDS (距離保存)、 オートエンコーダ (非線形、 任意次元)
- 下流: DBSCAN で 2D 上のクラスタ抽出 → シルエット係数 でクラスタ品質評価 → 元の高次元での クラスタ解釈
SSDSE-B-2026 の 47 県 × 50 指標 (人口・経済・福祉) を t-SNE で 2D に落とすと、 「東京・大阪・愛知」の大都市群、 「島根・鳥取」の過疎群、 「沖縄」の特異群が視覚的に分離して見える。
🌳 手法選択フロー
次元削減手法の選択は、 サンプル数と目的で 4 通りに分岐する。
- サンプル少 (n < 10000) + 可視化目的? Yes → t-SNE。 perplexity=30 が標準
- サンプル多 (n > 100000)? Yes → UMAP。 t-SNE は O(n²) で遅い
- 大域構造を保ちたい (距離の意味を保持)? Yes → PCA や UMAP。 t-SNE は局所重視で大域は歪む
- 新規データの埋め込みを再利用? Yes → UMAP や AE。 t-SNE は再投影不可
SSDSE-B-2026 の 47 県の小さなデータなら t-SNE で十分。 ただし、 「神奈川と東京の距離 = 沖縄と北海道の距離」が真の意味で同じとは限らない (t-SNE は局所のみ正確) ため、 必ず元の高次元データで再確認する。
🧭 解説深化 — 埋め込みを「眺める」から「検証する」へ
本ページの他セクションは「t-SNE をどう使うか」を扱いました。 この深化セクションは一歩進んで、 出来上がった 2D 図が信用に足るかを数値で検証する視点を扱います。 t-SNE の唯一の約束は「高次元での近傍関係の保存」なので、 その約束が守られたかは 自分で測って確かめられるのです。
💭 直感 — 図を信じる前に「答え合わせ」ができる
t-SNE は「友達同士を近くの席にする席替え」です。 席替え後の教室(2D 図)を見て「A 班と B 班が離れている」と語る前に、 そもそも誰と誰が友達だったか(高次元空間での最近傍)を先に確認しておけば、 図の妥当性を自力で判定できます。 実際に SSDSE-B-2026 の 2023 年・47 都道府県について、 ヘッダで意味を確認済みの 6 指標(A1101 総人口・A1303 65歳以上人口・A4103 合計特殊出生率・B4101 年平均気温・C5401 住宅地標準価格・L3221 消費支出)を標準化し、 ユークリッド距離で最近傍 3 県を計算した実測結果が次の表です。
| 基準の県 | 最近傍 1 位(距離) | 2 位(距離) | 3 位(距離) |
|---|---|---|---|
| 東京都 | 神奈川県(4.39) | 埼玉県(5.51) | 大阪府(5.59) |
| 鳥取県 | 福井県(0.36) | 佐賀県(0.78) | 山口県(0.84) |
| 沖縄県 | 鹿児島県(2.68) | 宮崎県(2.89) | 長崎県(2.96) |
| 北海道 | 岩手県(2.57) | 宮城県(2.73) | 秋田県(3.00) |
| 広島県 | 岡山県(0.78) | 静岡県(0.88) | 岐阜県(0.90) |
注目すべきは距離の桁の違いです。 鳥取県は最近傍の福井県まで 0.36 と密集地帯にいる一方、 東京都は最も近い神奈川県ですら 4.39。 つまり東京都は標準化 6 次元空間で 孤立点であり、 t-SNE 図で東京都がどのクラスタの「そば」に描かれても、 その近接は高次元では裏付けがない、 と図を見る前から判断できます。 これが「高次元側の答えを先に持っておく」検証の威力です。 なお 2023 年の合計特殊出生率(A4103)は最小 0.99(東京都)〜最大 1.60(沖縄県)で、 この 1 変数だけでも東京都の外れ具合が現れています。
⚠️ 落とし穴(重要) — 検証まわりで起きる 3 つの誤り
(1)KL 損失を perplexity 間で比較してしまう。 「KL が小さい perplexity が最良」と考えたくなりますが、 これは誤りです。 perplexity を変えると 目標分布 $P$ 自体が変わるため、 異なる perplexity の KL 値は「別の試験の点数」であり比較できません。 上記 6 指標・47 都道府県での実測(scikit-learn 1.9.0、 random_state=42、 init='pca'。 乱数・版数依存のため参考値):
| perplexity | KL 損失 | trustworthiness(k=5) | kNN 保存率(k=5) |
|---|---|---|---|
| 5 | 0.436 | 0.913 | 0.660 |
| 15 | 0.135 | 0.950 | 0.698 |
| 30 | 0.031 | 0.959 | 0.711 |
KL は perplexity=30 で最小に見えますが、 これは目標が緩くなった結果でもあります。 比較には KL ではなく、 スケールが共通の trustworthiness や kNN 保存率(下の発展を参照)を使います。 また kNN 保存率が 0.66〜0.71 に留まる点も重要な事実で、 「n=47 のような小データでも、 最近傍 5 件のうち約 3 割は 2D 図で入れ替わる」ことを意味します。 図上の「隣どうし」を根拠に議論するときは、 この誤差を織り込む必要があります。
(2)n より大きい perplexity を指定する。 47 都道府県データに perplexity=50 を与えると、 scikit-learn 1.9.0 では実測で ValueError: perplexity (50) must be less than n_samples (47) が送出されます(古い版では警告のみで通ることがあり、 結果は無意味)。 小標本では perplexity の上限が構造的に決まる、 という点は見落とされがちです。
(3)「クラスタが見えた=構造がある」と即断する。 t-SNE は完全な無相関ノイズに対しても、 perplexity が小さいと塊状の模様を作り出すことが知られています(Distill "How to Use t-SNE Effectively" が示した現象)。 対策は本物のデータで検証手続きを持つこと:列を個別にシャッフルして相関を壊した「壊しデータ」で同じ t-SNE を実行し、 本物と同程度に綺麗なクラスタが出るなら、 その見た目は構造の証拠になりません(この比較実験は演習として推奨。 実行結果は各自の環境で確認してください)。
🚀 発展 — 埋め込み品質の定量指標と統一理論
- trustworthiness:
sklearn.manifold.trustworthiness(X, Y, n_neighbors=k)で計算できる 0〜1 の指標。 「2D 図で近傍に 侵入してきた偽物」の量をペナルティ化します。 1 に近いほど「図で近い=元でも近い」が成立。 逆方向(元で近いのに図で離れた「脱落」)を測る continuity と対で使うと網羅的です。 - kNN 保存率:高次元と 2D それぞれで各点の最近傍 k 件を求め、 集合の重なり率を平均するだけの素朴な指標。 実装が数行で済み、 レポートで「この図の近傍は◯割正しい」と主張する根拠になります(上表の 0.660〜0.711 がその実例)。
- 引力・斥力スペクトラム:Böhm らの研究(JMLR 2022)は、 t-SNE・UMAP・ForceAtlas2 などが「点間の引力と斥力のバランス」という 1 本の軸上に並ぶことを示しました。 引力を強めると UMAP 的(連続構造・大域重視)、 斥力を強めると t-SNE 的(クラスタ分離重視)な図になります。 手法の対立ではなく 連続的なつまみとして理解すると見通しが良くなります。
- 標本外投影の工夫:t-SNE 本体に
transform()はありませんが、 parametric t-SNE(ニューラルネットで埋め込み関数自体を学習)や openTSNE の補間ベース投影を使うと、 新しい点を既存の地図に「後から載せる」ことができます。 検証指標と組み合わせれば、 投影の劣化も定量評価できます。
🔗 関連ページ
- 主成分分析(PCA) — 線形の対照手法。 t-SNE の前処理・初期化にも登場
- UMAP — 引力・斥力スペクトラム上の隣人。 標本外投影が可能
- 標準化 — 本セクションの最近傍計算でも必須だった前処理
- 距離 — 「高次元側の答え合わせ」の土台となる概念
- 次元削減 — 手法ファミリー全体の見取り図
- クラスタリング / k-means / DBSCAN / 階層的クラスタリング — 埋め込み後の下流工程
- コサイン類似度 — 高次元ベクトルの別の近さの測り方
- KL ダイバージェンス・MDS(多次元尺度法)は本用語集に単独ページがないため、 本ページの数式セクションと関連手法セクションを参照