🔖 キーワード索引
このページに登場する主要キーワード。 クリックで該当セクションへ。
💡 30秒で分かる結論
🍰 まずはやさしく
曲がったデータを平らに広げる道具です。
データの本当の距離を保つために使います。
都道府県ごとの特徴を地図にする例があります。
この章では計算の手順と注意点を読みます。
Isomap は、高次元データが乗っている「曲がった多様体」の上の測地距離(曲面に沿った最短距離)を保ったまま低次元に落とす、非線形の次元削減法。
- 3 ステップ:① k 近傍グラフを作る → ② グラフ上の最短経路で測地距離行列を求める → ③ その距離行列に古典 MDS を掛けて 2〜3 次元へ埋め込む。
- 分野:次元削減・多様体学習 — 📚 次元削減 / 📚 多様体学習
- PCA との違い:PCA は直線距離(ユークリッド距離)で射影するため S 字や螺旋状の曲面を潰す。Isomap は曲面に沿った距離を使うので「平らに展開」できる。
- 評価:
reconstruction_error(小さいほど良い)とtrustworthiness(1.0 が最良)。損失は測地距離と埋め込み距離のずれ(stress)。 - 注意:最重要パラメータは近傍数 $k$。小さすぎるとグラフが分断、大きすぎると多様体を跨ぐ「近道(short-circuit)」が入り PCA に退化する。
本記事は SSDSE-B-2026(教育用標準データセット、独立行政法人統計センター提供)の 47 都道府県データを題材に、10 の社会指標から Isomap で 2 次元埋め込みを作り、大都市/北日本/南日本が滑らかに並ぶ様子を再現する。
📍 文脈ボックス — あなたが今見ているもの
🍰 まずはやさしく
データの次元を減らす手法の解説ページです。
複雑なデータの形を正しく捉えるために使います。
47都道府県の統計データを使って学びます。
このページでは3つの学習プランを提示します。
あなたは Isomap(Isometric Mapping) の用語ページを読んでいる。 これは「次元削減 / 多様体学習」カテゴリに属し、 PCA の次に学ぶ非線形次元削減の入口となる手法である。 本ページは 3 つの読み方を提供する:
- 15 分で全体像:「30 秒結論」→「直感で掴む」→「定義」だけを通読する。
- 60 分で実装まで:「Python 実装」を写経し、 SSDSE-B-2026 で手元の埋め込みを再現する。
- じっくり理解:「落とし穴」「関連手法」「実務メモ」で t-SNE / UMAP との使い分けまで押さえる。
本記事の計算は data/raw/SSDSE-B-2026.csv(cp932、2 行目に単位行、564 行 × 112 列 = 2012〜2023 年の 12 年分 × 47 都道府県)を用い、 2023 年断面の 47 行に絞って行う。 合成データ・乱数生成は使わない(KMeans の初期化のみ random_state 固定)。
🎨 直感で掴む
🍰 まずはやさしく
丸まった紙をシワなく広げるイメージです。
表面に沿った正しい距離を測るために使います。
ロールケーキの上をアリが歩く例で考えます。
この章では距離の測り方の違いを読みます。
Isomap のイメージは 「丸めた紙をシワを保ったまま広げる」。 高次元空間で曲がって配置されたデータを、 曲面に沿った距離(測地距離)を壊さずに平らな低次元へ広げ直す。
🎨 3 つの比喩
もう一歩深い直感 — 測地距離とユークリッド距離
同じ 2 点でも「距離の測り方」で位置関係が変わる。 これが Isomap と PCA の分かれ道である。
| 測り方 | 意味 | SSDSE-B-2026 での例 |
|---|---|---|
| ユークリッド距離(PCA) | 空間を直線で貫く最短距離 | 東京と沖縄を「指標の差の二乗和」で直接測る |
| 測地距離(Isomap) | 近傍グラフを伝ったときの道のり | 東京→(神奈川→愛知→大阪→…)→沖縄と、 似た県を経由して測る |
データが「都市規模の連続体」のような 1 本の曲がった帯の上に乗っているとき、 測地距離はその帯に沿って伸び、 PCA が潰す構造を Isomap は保てる。
📐 定義
🍰 まずはやさしく
曲面上の距離を保つ計算方法のことです。
直線では測れないデータの構造を知るために使います。
スマホのデータなど複雑な数値に活用できます。
この章では使う条件や仕組みについて読みます。
Isomap(Isometric Mapping、等長写像)は、 データが低次元の多様体(曲面)上に乗っているという多様体仮説のもとで、 多様体上の測地距離をできるだけ保つように低次元へ埋め込む非線形次元削減法。 2000 年に Tenenbaum・de Silva・Langford が Science 誌で発表した。
🎯 いつ・どこで使うか
- データが曲がった多様体(スイスロール、S 字曲面、球面など)に乗っていて、 PCA では構造が潰れるとき。
- 距離関係を保ったまま可視化したい、 あるいは埋め込み座標を下流の クラスタリング・回帰の特徴量にしたいとき。
- サンプル数がおおむね 100〜10,000 程度のとき(全点対最短経路の計算量が $O(n^2\log n)$ 〜 $O(n^3)$ のため)。
📋 前提条件・適用範囲
- スケール統一:指標ごとに桁が違うと距離が特定指標に支配される。 事前の標準化(平均0・分散1)がほぼ必須。
- グラフの連結性:k 近傍グラフが連結していないと、 一部の点で測地距離が無限大になり MDS が破綻する。
- 近傍数 $k$:小さすぎると分断、 大きすぎると多様体を跨ぐ近道(short-circuit)が入る。 $n$ が小さいほど $k$ も小さめに。
- ノイズ・外れ値:外れ値が近傍グラフに混じると最短経路が歪む。 事前の外れ値処理を検討する。
📐 アルゴリズムと数式
入力を $n$ 個の高次元点 $\{x_1,\dots,x_n\}$、 $x_i\in\mathbb{R}^D$ とする。 Isomap は次の 3 ステップで低次元座標 $\{y_1,\dots,y_n\}$、 $y_i\in\mathbb{R}^d$(通常 $d=2,3$)を求める。
ステップ1:近傍グラフ構築。 各点 $x_i$ について最も近い $k$ 個の点を辺で結び、 辺の重みをユークリッド距離 $\lVert x_i-x_j\rVert$ とする重み付きグラフ $G$ を作る。
ステップ2:測地距離の推定。 グラフ $G$ 上の最短経路長 $d_G(i,j)$ を Dijkstra 法または Floyd-Warshall 法で全点対に計算する。 これが多様体上の測地距離の近似となる:
$$D_{ij} = d_G(i,j) = \min_{\text{path }i\to j}\ \sum_{(u,v)\in\text{path}} \lVert x_u - x_v\rVert$$
ステップ3:古典的 MDS。 測地距離行列 $D$(各要素は二乗して用いる)を二重中心化した行列 $B=-\tfrac{1}{2}HD^{(2)}H$($H=I-\tfrac{1}{n}\mathbf{1}\mathbf{1}^\top$ は中心化行列)を固有分解し、 上位 $d$ 個の固有値・固有ベクトルから低次元座標を得る。 これは次の応力(stress)を最小化することに相当する:
$$\min_{y_1,\dots,y_n}\ \sum_{i<j}\bigl(D_{ij} - \lVert y_i - y_j\rVert\bigr)^2$$
つまり「高次元での測地距離 $D_{ij}$ を、 低次元でのユークリッド距離 $\lVert y_i-y_j\rVert$ でできるだけ再現する」座標を探す。 PCA が距離行列にユークリッド距離を使うのに対し、 Isomap はそこだけを測地距離に差し替えた——これが「線形 MDS を非線形に拡張した」と言われる理由である。
📜 Isomap をめぐる系譜
| 年 | 出来事 | Isomap との関係 |
|---|---|---|
| 1952 | Torgerson: 古典的 MDS | 距離行列から座標を復元する土台。 Isomap のステップ3そのもの |
| 1962 | Shepard / Kruskal: 非計量 MDS | 「距離を保つ埋め込み」という発想の源流 |
| 1998 | Schölkopf ら: Kernel PCA | 非線形次元削減の別系統(カーネルで高次元化) |
| 2000 | Tenenbaum・de Silva・Langford: Isomap | MDS に「測地距離」を持ち込み多様体学習を創始 |
| 2000 | Roweis・Saul: LLE | 同年発表。 局所線形性を保つ姉妹手法 |
| 2003 | Belkin・Niyogi: Laplacian Eigenmaps | グラフラプラシアンで局所構造を保存 |
| 2008 | van der Maaten・Hinton: t-SNE | 可視化で事実上の標準に。 局所構造を強調 |
| 2018 | McInnes・Healy: UMAP | 大域構造の保持と速度を改善、 大規模データ向け |
🔬 数式を言葉で読み解く(3 ステップ・ナレーション)
🎬 ナレーション 1:近傍グラフ $G$ の意味
最初に作る $k$ 近傍グラフは「どの県とどの県が直接似ているか」の地図だ。 各県から最も近い $k$ 県へ線を引く。 このとき遠い県どうしには直接の線を引かないのがポイント。 東京と沖縄の間には線がなく、 東京→神奈川→…→鹿児島→沖縄のように、 似た県を伝わないと辿り着けない。 この「伝い歩き」の構造こそ多様体の形を写している。
🎬 ナレーション 2:測地距離 $D_{ij}$ と最短経路
$D_{ij}=d_G(i,j)$ は「グラフ上を石伝いに歩いた最短の道のり」。 直線で測れば近く見える 2 点でも、 多様体が曲がっていれば道のりは長くなる。 SSDSE-B-2026 では、 東京と沖縄はユークリッド距離でも遠いが、 測地距離ではさらに「大都市の連続体をぐるっと回る」ぶん相対的に伸びる。 この伸びが後の 2 次元配置で「東京と沖縄をより遠くに置く」効果を生む。
🎬 ナレーション 3:古典 MDS と応力最小化
最後に $\min_{y}\sum_{i<j}(D_{ij}-\lVert y_i-y_j\rVert)^2$ を解く。 これは「測地距離 $D_{ij}$ をものさしにして、 その間隔を保つように 47 個の点を 2 次元平面へ配置し直す」作業だ。 実際には距離行列を二重中心化して固有分解するので、 反復なしの一発(閉形式)で解ける。 得られる第 1 軸・第 2 軸が、 データを最もよく説明する「曲面に沿った座標」になる。 reconstruction_error はこの応力の残差に対応し、 小さいほど測地距離をよく再現できている。
🧮 実値で計算してみる(SSDSE-B-2026 2023 年 47 都道府県)
data/raw/SSDSE-B-2026.csv を 2023 年の 47 行に絞り、 主要指標を眺めてから、 測地距離の計算を手で追う。
STEP 1: データを眺める(2023 年の抜粋・実値)
STEP 2: 基本統計(実測)
| 列 | 意味 | min | median | max | std |
|---|---|---|---|---|---|
| A1101 | 総人口 | 537,000 (鳥取) | 1,549,000 | 14,086,000 (東京) | 2.80e6 |
| A1303 | 65歳以上人口 | 179,000 (鳥取) | 524,000 | 3,205,000 (東京) | 6.94e5 |
| A4200 | 死亡数 | 8,290 (鳥取) | 23,744 | 137,241 (東京) | 2.91e4 |
| A9101 | 婚姻件数 | 1,810 (鳥取) | 5,599 | 71,774 (東京) | 1.31e4 |
| B4101 | 年平均気温(℃) | 11.0 (北海道) | 17.4 | 23.8 (沖縄) | 2.05 |
STEP 3: 主要指標間の相関(Isomap 前の多重共線性チェック)
| ペア | Pearson r | 解釈 |
|---|---|---|
| A1101 vs A9101 | 0.989 | 総人口と婚姻件数はほぼ完全相関 → 規模の軸に強く支配される |
| A1101 vs A1303 | 0.991 | 総人口と高齢者数もほぼ完全相関 |
| A1101 vs A4200 | 0.989 | 総人口と死亡数もほぼ完全相関 |
| B4101 vs A1303 | 0.084 | 気温と高齢者数はほぼ無相関 → 規模とは独立な軸 |
人口系の指標は強く相関し「規模」という 1 本の軸を作る。 気温はそれと独立。 標準化後に Isomap を掛けると、 この「規模の軸」と「気候(南北)の軸」が第 1・第 2 軸として現れやすい。
🧮 手で追う: 測地距離(グラフ最短経路)
4 点だけの小さな近傍グラフで、 測地距離が直線距離と食い違う様子を確認する。
Step A: 隣接(辺の重み)
Step B: Floyd 後(全点対最短経路)
🐍 Python で再現
①目的:上の手計算($d(1,4)=3$)を scipy の最短経路で確かめる。 ②橋渡し:隣接行列を渡し Floyd-Warshall を回すだけ。
1 2 3 4 5 6 7 8 9 10 11 12 | import numpy as np from scipy.sparse.csgraph import shortest_path # 4点の近傍グラフ(辺の重み=つないだ点の間のユークリッド距離) adj = np.array([ [0, 1, 0, 5], [1, 0, 1, 0], [0, 1, 0, 1], [5, 0, 1, 0] ], dtype=float) # Floyd-Warshall で全点対の最短経路(=測地距離)を求める dist = shortest_path(adj, method='FW', directed=False) print(dist) |
📤 実行結果
💬 読み取り:$d(1,4)=3$ と手計算が完全一致。 直線の辺重み 5 ではなく、 グラフを伝った 3 が採用されている。 Isomap はこの測地距離行列を MDS に渡す。
🎮 触って理解する — 測地線距離 vs ユークリッド距離(合成デモ)
下の渦巻きは合成デモ用データ(2 次元スパイラル上の 60 点、SSDSE-B-2026 とは無関係の人工データ)。 点をタップまたはドラッグすると、 近いほうの端点 A/B がその位置の点に移動する。 2 点間のユークリッド距離(赤破線)と、 k 近傍グラフ上を Dijkstra 法で辿った最短経路=測地線距離の近似(青折れ線)が同時に表示される。 スライダーで近傍数 $k$ を動かし、 グラフの形と 2 つの距離がどう変わるかを見てほしい。
1 次元への展開(unrolling):下の帯は、 渦巻きの内端の点からの測地線距離を横軸にして全点を 1 直線上に並べ直したもの。 1 本の曲線ではこれが古典 MDS の 1 次元解と一致する(弧長座標=等長な展開)。 $k=3$〜$5$ では色(渦巻き上の順番)が左から右へ滑らかに並び、 スパイラルが 1 本の直線に伸びる。 $k$ を上げてショートカットが入ると順番が崩れて折り畳まれ、 $k$ を下げてグラフが切れると置けない点(灰色)が現れる。
初期状態($k=4$、 A=内端付近・B=外端付近)の代表値(本デモの実装で検証済み・単位は画面座標 px):
| k | グラフ | ユークリッド距離 A–B | 測地線距離 A–B(Dijkstra) | 読み取り |
|---|---|---|---|---|
| 1〜2 | 非連結 | 217.0 | ∞(経路なし) | k が小さすぎて渦巻きの途中でグラフが切れる |
| 4 | 連結 | 217.0 | 995.4(27 ホップ、直線の約 4.6 倍) | 渦に沿って歩く「正しい」測地線 |
| 6 | 連結 | 217.0 | 328.1(6 ホップ) | 腕をまたぐショートカット辺が入り測地線が崩壊 |
| 12 | 連結 | 217.0 | 246.6(3 ホップ) | ほぼ直線距離に退化= Isomap が PCA 化する |
💡 デモから学ぶ直感 — 多様体の上を「歩く」
渦巻きの上のアリは紙面から離れられない。 A から B へ「空中を直線で飛ぶ」のがユークリッド距離、 「渦に沿って歩く」のが測地線距離である。 このデモでは直線 217 px に対し道のりは 995 px——データが曲がった多様体に乗っているとき、 2 つの距離は何倍も食い違う。 Isomap の本質は、 この「歩く距離」を k 近傍グラフの最短経路で近似し(内端から外端まで全長約 1,060 px)、 それを保ったまま低次元に置き直すことに尽きる。 下の帯がまさにその結果で、 巻かれていた 1 次元構造が直線として取り出される。
⚠️ デモが示す落とし穴 — k の 3 つの顔
スライダーを往復すると、 $k$ には「小さすぎ・ちょうど良い・大きすぎ」の 3 状態しかないことが体感できる。 (1) 小さすぎ(k=1〜2):点がまばらな区間でグラフが非連結になり、 測地線距離が定義できず Isomap は破綻する(本デモは渦の中腹に意図的に隙間を入れてある)。 (2) ちょうど良い(k=3〜5):辺が渦に沿ってのみ張られ、 最短経路が本当の「巻きに沿った道のり」をなぞる。 (3) 大きすぎ(k≥6):内側の腕と外側の腕を直接つなぐショートカット辺(short-circuit)が混入し、 測地線が 995→328→247 px と一気に潰れて直線距離側へ退化する。 さらに実データでは、 密度が場所によって違うため同じ $k$ でも領域ごとに (1) と (3) が同時に起きうること、 多様体に穴や凹み(非凸性)があると測地線がそれを迂回して距離が歪むこと、 そして学習後に新しい点を追加できない(近傍グラフと最短経路の再計算が必要で out-of-sample 埋め込みが苦手)ことも押さえておきたい。
🌐 発展 — MDS との関係、LLE / t-SNE / UMAP との違い
このデモの「測地線距離行列」に古典 MDS(距離行列の二重中心化+固有分解)を掛けたものが Isomap の全てである。 つまり Isomap = MDS の距離だけを測地線距離に差し替えた手法で、 下の 1 次元展開はその最小構成(曲線なら弧長座標がそのまま MDS 解になる)。 一方 LLE は最短経路を計算せず「各点を近傍の線形結合で再構成する重み」を保ち、 t-SNE や UMAP は距離そのものではなく「近傍である確率・位相」を保つ。 このため t-SNE/UMAP はデモのような大域の道のり(A–B が直線の 4.6 倍遠い、 という情報)を再現する保証がなく、 逆に Isomap はショートカット 1 本で大域構造が壊れる敏感さを持つ。 全体像は 多様体学習、 線形側の対照は PCA を参照。
🐍 Python での実装
まず SSDSE-B-2026 の読み込み定型を確認する。 ①目的:cp932・単位行スキップ・年フィルタを正しく行う。
1 2 3 4 5 6 7 8 | import pandas as pd # SSDSE-B-2026 は cp932、2行目が日本語の列名行なので skiprows=[1] で外す df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) # (564, 112) = 12年 x 47県 print(df['SSDSE-B-2026'].unique()) # [2023 ... 2012](CSV は新しい年度から並ぶ) # 分析はある年の断面(47行)を取り出して行う df_2023 = df[df['SSDSE-B-2026']==2023].copy() print(df_2023.shape) # (47, 112) |
💬 564 行は 12 年度 × 47 県で、unique() が 2023 から 2012 の降順で並ぶのは CSV が各県の新しい年度から記録されているため。2023 年度で絞った df_2023 は 47 行 × 112 列になるが、この中には年度・地域コード・都道府県名の 3 列も残っている。Isomap の近傍グラフは数値の距離で作るので、この 3 列を落とし、総人口のような桁の大きい列が距離を支配しないよう標準化してから fit_transform に渡す。
実装 1: 47 都道府県を Isomap で 2 次元に埋め込む
①目的:10 指標から Isomap の 2 次元座標を作り、 各県がどこに並ぶかと再構成誤差を見る。 ②橋渡し:標準化 → Isomap(n_neighbors=5, n_components=2) を fit_transform するだけ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd from sklearn.manifold import Isomap from sklearn.preprocessing import StandardScaler # cp932(=shift_jis)・2行目(日本語の単位行)を skiprows=[1] で除外 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True) # 10 指標: 総人口/65歳以上/死亡数/婚姻件数/気温/降水日数/幼小中学校数/消費支出 feats = ['A1101','A1303','A4200','A9101','B4101','B4106','E1101','E2101','E3101','L3221'] X = df_2023[feats].fillna(df_2023[feats].median()).values Xs = StandardScaler().fit_transform(X) # 桁の違う指標を平均0・分散1に揃える(必須) iso = Isomap(n_neighbors=5, n_components=2) emb = iso.fit_transform(Xs) df_2023['iso1'], df_2023['iso2'] = emb[:,0], emb[:,1] print("47 都道府県を Isomap 2D に埋め込み (先頭10県):") print(df_2023[['Prefecture','iso1','iso2']].head(10).to_string(index=False)) print(f"\nreconstruction_error = {iso.reconstruction_error():.3f}") |
📤 実行結果:
💬 読み取り:第 1 軸 iso1 は概ね「規模(大都市 ↔ 地方)」を表し、 表示した先頭 10 県では総人口・婚姻件数の大きい北海道が 6.90 と正に突出し、 人口の小さい青森県 −4.46・秋田県 −4.55 が負の側に並ぶ(47 県全体の右端は東京都 11.52 で、 北海道は大阪府 6.98 に次ぐ 3 番目)。 iso1 と総人口の相関は r = 0.93。 第 2 軸 iso2 は年平均気温との相関が r = 0.75 で南北・気候に対応し、 青森県が −3.47、 沖縄県が +4.82 と両端に来る。 reconstruction_error=1.592 は k=5 のときの測地距離の再現残差で、 単独では良否を判断せず、 次の実装 3 で $k$ を振って相対比較する。
実装 2: Isomap(測地距離)と PCA(直線距離)を比べる
①目的:同じデータに Isomap と PCA を掛け、 「測地距離を使うと距離がどう伸びるか」を数値で見る。 ②橋渡し:実装 1 の埋め込みに PCA を並べ、 最も離れた東京-沖縄の距離を比較する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | # Isomap(測地距離) vs PCA(直線距離) を同じデータの 2D 埋め込みで比較 import pandas as pd import numpy as np from sklearn.manifold import Isomap from sklearn.decomposition import PCA from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True) feats = ['A1101','A1303','A4200','A9101','B4101','B4106','E1101','E2101','E3101','L3221'] X = StandardScaler().fit_transform(df_2023[feats].fillna(df_2023[feats].median()).values) iso_emb = Isomap(n_neighbors=5, n_components=2).fit_transform(X) pca_emb = PCA(n_components=2).fit_transform(X) print(f"Isomap 第1軸 分散: {iso_emb[:,0].var():.3f}") print(f"PCA 第1軸 分散: {pca_emb[:,0].var():.3f}") # 東京と沖縄(社会構造が最も離れた2県)の 2D 上の距離 tk = df_2023.index[df_2023['Prefecture']=='東京都'][0] ok = df_2023.index[df_2023['Prefecture']=='沖縄県'][0] print(f"\n東京-沖縄 Isomap 距離: {np.linalg.norm(iso_emb[tk]-iso_emb[ok]):.3f}") print(f"東京-沖縄 PCA 距離: {np.linalg.norm(pca_emb[tk]-pca_emb[ok]):.3f}") |
📤 実行結果:
💬 読み取り:Isomap は「多様体上の道のり」を保つため、 第 1 軸の分散も、 東京-沖縄の距離も PCA より大きくなる。 東京と沖縄は人口・気候・経済が大きく違い、 多様体上を似た県伝いに遠回りする必要があるので、 Isomap ではより遠くに配置される。 これが線形の PCA では出せない非線形の効き方である。
実装 3: 近傍数 $k$ の影響(再構成誤差と trustworthiness)
①目的:Isomap の最重要パラメータ $k$ を 3〜15 で振り、 埋め込み品質がどう動くかを測る。 ②橋渡し:ループで $k$ を変え、 reconstruction_error と trustworthiness を並べて出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # 近傍数 k を変えて再構成誤差と trustworthiness を観察する import pandas as pd from sklearn.manifold import Isomap, trustworthiness from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True) feats = ['A1101','A1303','A4200','A9101','B4101','B4106','E1101','E2101','E3101','L3221'] X = StandardScaler().fit_transform(df_2023[feats].fillna(df_2023[feats].median()).values) print(" k | reconstruction_error | trustworthiness") for k in [3, 5, 7, 10, 15]: iso = Isomap(n_neighbors=k, n_components=2) emb = iso.fit_transform(X) err = iso.reconstruction_error() tw = trustworthiness(X, emb, n_neighbors=5) print(f" {k:2d} | {err:.3f} | {tw:.3f}") |
📤 実行結果:
💬 読み取り:reconstruction_error は $k$ を増やすほど単調に下がるが、 これは近傍が密になり測地距離がユークリッド距離に近づく(=多様体を跨ぐ近道が増え PCA に退化していく)ためで、 「小さいほど良い」と鵜呑みにできない。 一方 trustworthiness(高次元の近傍関係の保存度、 1.0 が最良)は $k=5$ で最大 0.964。 $n=47$ と小さい本データでは $k=5$〜7 が「グラフが連結し、 かつ近道が入りすぎない」バランス点。 誤差の絶対値ではなく trustworthiness と合わせて $k$ を選ぶ。
実装 4: Isomap → KMeans で 47 県を 4 グループに分ける
①目的:Isomap で 3 次元に圧縮してからクラスタリングし、 直接 10 次元で KMeans した場合と分離度を比べる。 ②橋渡し:Isomap(n_components=3) → KMeans(4) と、 素の 10 次元 KMeans の Silhouette を比較する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # Isomap で 3D に圧縮 → KMeans、直接 KMeans(10D) と比較 import pandas as pd from sklearn.manifold import Isomap from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler from sklearn.metrics import silhouette_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True) feats = ['A1101','A1303','A4200','A9101','B4101','B4106','E1101','E2101','E3101','L3221'] X = StandardScaler().fit_transform(df_2023[feats].fillna(df_2023[feats].median()).values) emb3 = Isomap(n_neighbors=7, n_components=3).fit_transform(X) # 10D -> 3D km_10 = KMeans(n_clusters=4, random_state=42, n_init=10).fit(X) km_3 = KMeans(n_clusters=4, random_state=42, n_init=10).fit(emb3) print(f"直接 KMeans (10D) Silhouette = {silhouette_score(X, km_10.labels_):.3f}") print(f"Isomap->KMeans (3D) Silhouette = {silhouette_score(emb3, km_3.labels_):.3f}") df_2023['c'] = km_3.labels_ print("\nIsomap+KMeans の 4 クラスタ:") for k in range(4): mem = df_2023[df_2023['c']==k]['Prefecture'].tolist() print(f" c{k} ({(df_2023['c']==k).sum()}件): {mem[:6]}") |
📤 実行結果:
💬 読み取り:Isomap で 3 次元に圧縮してから KMeans を掛けると Silhouette が 0.327→0.423 に改善。 「次元削減でクラスタが見えやすくなる」典型例である。 得られた 4 群は c2=大都市圏、 c3=北日本の県、 c0=西日本・四国、 c1=中規模のその他、 と地理・規模で解釈できる。
実装 5: 件数の列ばかりだと、Isomap は「人口の物差し」を 1 本引くだけになる
①目的:実装 1〜4 の 10 指標のうち 7 列(総人口・65 歳以上人口・死亡数・婚姻件数・幼稚園数・小学校数・中学校数)は、どれも「県が大きいほど大きい」件数です。これらを標準化しても、ほぼ同じ情報を 7 回数えていることに変わりはありません。実装 1 の「iso1 は規模」という読み取りが、多様体の発見ではなく列の選び方の結果ではないかを確かめます。②橋渡し:件数を人口あたり・子ども人口あたりの率に直した 10 指標で同じ Isomap を作り、軸の意味がどう変わるかを比べます。
🎯 このコードでやること:2023 年度の 47 都道府県で、①件数 7 列どうしの相関、②実装 1 と同じ 10 指標の Isomap 第 1 軸と総人口の相関、③件数を率に直した 10 指標(高齢化率・死亡率・婚姻率・学校数 ÷ 15 歳未満人口・総人口の対数など)の Isomap 各軸と最も相関の強い指標、を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import numpy as np import pandas as pd from sklearn.manifold import Isomap, trustworthiness from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) size = ['A1101', 'A1303', 'A4200', 'A9101', 'E1101', 'E2101', 'E3101'] c = d[size].corr().values[np.triu_indices(7, 1)] print(f'① 件数 7 列の相関: 平均 {c.mean():.3f}, 最小 {c.min():.3f}') feats = ['A1101','A1303','A4200','A9101','B4101','B4106','E1101','E2101','E3101','L3221'] X = StandardScaler().fit_transform(d[feats]) emb = Isomap(n_neighbors=5, n_components=2).fit_transform(X) print(f'② 件数のまま: iso1 と総人口の相関 {np.corrcoef(emb[:, 0], d["A1101"])[0, 1]:.3f}, ' f'trustworthiness {trustworthiness(X, emb, n_neighbors=5):.3f}') R = pd.DataFrame({ '高齢化率': d['A1303'] / d['A1101'], '死亡率': d['A4200'] / d['A1101'], '婚姻率': d['A9101'] / d['A1101'], '年平均気温': d['B4101'], '降水日数': d['B4106'], '幼稚園/15歳未満': d['E1101'] / d['A1301'], '小学校/15歳未満': d['E2101'] / d['A1301'], '中学校/15歳未満': d['E3101'] / d['A1301'], '消費支出': d['L3221'], '総人口(対数)': np.log(d['A1101'])}) Xr = StandardScaler().fit_transform(R) er = Isomap(n_neighbors=5, n_components=2).fit_transform(Xr) print(f'③ 率に直す: trustworthiness {trustworthiness(Xr, er, n_neighbors=5):.3f}') for j in range(2): r = R.apply(lambda col: np.corrcoef(er[:, j], col)[0, 1]) top = r.reindex(r.abs().sort_values(ascending=False).index)[:3] ends = d['Prefecture'].values[np.argsort(er[:, j])] print(f' iso{j+1}: ' + ', '.join(f'{k} {v:+.3f}' for k, v in top.items()) + f' / 両端 {list(ends[:2])} … {list(ends[-2:])}') |
💬 件数 7 列の相関は平均 0.966(最も低い組でも 0.926)で、7 列は実質 1 本の「規模」の物差しです。そのため件数のままの Isomap の第 1 軸は総人口と r = 0.933 で、実装 1 の「iso1 は規模」はこの列の選び方からほぼ自動的に出てきます。率に直すと第 1 軸は死亡率(−0.927)・高齢化率(−0.916)・子ども 1 人あたりの小学校数(−0.892)と相関する「高齢化・少子化の軸」に変わり、端には高知県・青森県と沖縄県・東京都が来ます。第 2 軸は幼稚園の多さ(−0.713)・気温(−0.559)・降水日数(+0.531)の軸で、山口県・徳島県と新潟県・山形県が両端です。trustworthiness は 0.964 から 0.930 に下がりますが、これは「規模 1 本で説明できていた」データから、互いに相関の弱い指標の多いデータに変わったためで、埋め込みが悪くなったとは限りません。Isomap に何を渡すかで、見える「多様体」は別物になります。
実務での判断: 都道府県データでは、件数の列を何本入れるかで第 1 軸が決まってしまうことがよくあります。Isomap(に限らず PCA・t-SNE・UMAP でも)に渡す前に、件数は人口などの分母で割るか、規模の列を 1 本(総人口の対数など)に絞っておくと、「規模以外に県を分けているものは何か」が見えるようになります。
実装 6: どの 2 県の間で「遠回り」が大きいか — 測地距離 ÷ 直線距離
①目的:Isomap の核心は、近傍グラフの上を「似た県伝いに歩いた道のり」(測地距離)で距離を測り直すことでした。実装 2 では東京-沖縄だけを見ましたが、47 × 46 ÷ 2 = 1,081 組すべてで、測地距離が直線(ユークリッド)距離の何倍になっているかを調べます。倍率が大きい組ほど、Isomap が「直線で近く見えても、実は間にデータが無い」と判断した組です。
🎯 このコードでやること:実装 1 と同じ標準化した 10 指標で k = 5 の近傍グラフ(無向)を作り、全 1,081 組の測地距離(グラフ最短経路)と直線距離を計算して、比の大きい上位 5 組・比の中央値・東京-沖縄の値を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | from scipy.sparse.csgraph import shortest_path, connected_components from scipy.spatial.distance import pdist, squareform from sklearn.neighbors import kneighbors_graph G = kneighbors_graph(X, n_neighbors=5, mode='distance') G = G.maximum(G.T) # どちらかの 5 近傍なら辺を張る D_geo = shortest_path(G, directed=False) # 測地距離(Dijkstra) D_euc = squareform(pdist(X)) # 直線距離 iu = np.triu_indices(len(X), 1) ratio = D_geo[iu] / D_euc[iu] P = d['Prefecture'].values print(f'組の数 {len(ratio)}, 比の中央値 {np.median(ratio):.3f}, 比が 1 の組 {np.sum(np.isclose(ratio, 1))}') for t in np.argsort(-ratio)[:5]: i, j = iu[0][t], iu[1][t] print(f'{P[i]}-{P[j]}: 直線 {D_euc[i, j]:.2f} 測地 {D_geo[i, j]:.2f} 比 {ratio[t]:.2f}') tk, ok = np.where(P == '東京都')[0][0], np.where(P == '沖縄県')[0][0] print(f'東京都-沖縄県: 直線 {D_euc[tk, ok]:.2f} 測地 {D_geo[tk, ok]:.2f} 比 {D_geo[tk, ok] / D_euc[tk, ok]:.2f}') for k in [2, 3]: Gk = kneighbors_graph(X, n_neighbors=k); Gk = Gk.maximum(Gk.T) n, lab = connected_components(Gk, directed=False) small = P[lab == np.argmin(np.bincount(lab))] if n > 1 else [] print(f'k={k}: 連結成分 {n} 個', f'小さい方 {list(small)}' if n > 1 else '') |
💬 1,081 組の比の中央値は 1.239 で、159 組(互いに直接の近傍の組など)は比が 1 です。遠回りが最も大きいのは北海道と東北・北陸の県の組で、北海道-新潟県は直線では 4.75 と近いのに、グラフ上では 11.90(2.51 倍)も歩かされます。北海道は気温・降水日数では東北・北陸に近い一方、総人口・死亡数など件数の列では大都市圏の県に近く、その「両方の性質を持つ」位置のせいで、5 近傍が大都市圏側に張られて東北側とは直接つながらないためです。東京都-沖縄県は比 1.29 で中央値とあまり変わらず、実装 2 の「Isomap で遠くなる」の大部分は、もともと直線でも遠い(12.66)ことによります。k を 2 にすると、グラフは北海道・埼玉県・千葉県・東京都・神奈川県・愛知県・大阪府・兵庫県・福岡県の 9 都道府県と残り 38 県の 2 つに切れ、両者の間の測地距離は定義できなくなります(k = 3 で連結)。
読み方の注意: 比が大きい組は「Isomap がデータの形を見抜いた」とも「近傍グラフの作り方の都合で遠回りさせられた」とも読めます。北海道-新潟県の 2.51 倍は、実装 5 で見た「件数 7 列が規模を 7 回数える」ことと無関係ではありません。k = 2 で切れた 9 都道府県が総人口の上位 9 都道府県(すべて 500 万人以上、10 位の静岡県は 356 万人)とぴったり重なることも、近傍グラフが規模の列に強く引っ張られていることを示しています。測地距離を解釈に使うときは、①どの列で近傍を決めたか、②k を 1〜2 変えても大きな比の組が入れ替わらないか、の 2 点を必ず確かめます。
北海道の近傍を実際に書き出すと、この事情がはっきりします。標準化した 10 指標で北海道に近い順に並べると、愛知県 3.79・兵庫県 4.08・福岡県 4.17・千葉県 4.23・埼玉県 4.57 と、5 近傍はすべて人口 500 万人以上の県で、気候の近い青森県(5.63)や新潟県(4.75)は入りません。しかも、北海道を自分の 5 近傍に含む県は 1 つもありません(北海道は「一方的に大都市圏を近傍と見ている」点)。新潟県の 5 近傍は石川県 1.72・滋賀県 1.88・島根県 2.03・富山県 2.08・福井県 2.15 と中規模の県で固まっているので、北海道から新潟県へ行くには、大都市圏の県を経由して中規模の県の集まりへ降りていく遠回りが必要になり、これが 2.51 倍の正体です。率に直した実装 5 の指標で同じ計算をすると北海道の近傍が変わるので、比の大きな組も入れ替わります。「測地距離」はデータに内在する性質というより、「どの列で、何近傍で、グラフを張ったか」に対する答えだと考えるのが安全です。
🎯 このコードでやること:実装 5 の「率に直した 10 指標」(標準化済みの Xr)で k = 5 の近傍グラフを張り直し、北海道の 5 近傍と、測地距離 ÷ 直線距離の上位 5 組・中央値を出して、件数のままの結果と比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | G = kneighbors_graph(Xr, n_neighbors=5, mode='distance') G = G.maximum(G.T) D_geo = shortest_path(G, directed=False) D_euc = squareform(pdist(Xr)) h = np.where(P == '北海道')[0][0] near = np.argsort(D_euc[h])[1:6] print('北海道の 5 近傍:', ', '.join(f'{P[j]} {D_euc[h, j]:.2f}' for j in near)) iu = np.triu_indices(len(Xr), 1) ratio = D_geo[iu] / D_euc[iu] print(f'比の中央値 {np.median(ratio):.3f}') for t in np.argsort(-ratio)[:5]: i, j = iu[0][t], iu[1][t] print(f'{P[i]}-{P[j]}: 直線 {D_euc[i, j]:.2f} 測地 {D_geo[i, j]:.2f} 比 {ratio[t]:.2f}') n = np.where(P == '新潟県')[0][0] print(f'北海道-新潟県: 直線 {D_euc[h, n]:.2f} 測地 {D_geo[h, n]:.2f} 比 {D_geo[h, n] / D_euc[h, n]:.2f}') |
💬 率に直すと北海道の 5 近傍は長野県 2.75・岩手県 2.80・山形県 3.29・新潟県 3.37・宮城県 3.47 と、気候や高齢化の進み方の近い県に入れ替わり、北海道-新潟県は直接の近傍になって比は 1.00 です。比の上位は香川県-宮崎県(2.72)・山形県-山口県(2.63)・岩手県-福島県(2.50)などまったく別の組に変わり、中央値も 1.239 から 1.362 に上がりました。件数のままでは「規模」という 1 本の太い道があって多くの組がそこを通れたのに対し、率の指標では県がより多くの方向にばらけ、遠回りの組が増えたと読めます。同じ 47 県でも、列の選び方で「誰と誰が遠回りか」がこれだけ変わります。
理解度チェック(実装 5・6 の数字で)
- 件数のままの 10 指標で作った Isomap の第 1 軸が総人口と r = 0.933 になるのはなぜか。
答え: 10 列のうち 7 列が「県が大きいほど大きい」件数で、互いの相関が平均 0.966 もある。標準化しても規模の情報が 7 回数えられ、距離の大部分を規模が占める。 - 率に直した Isomap の第 1 軸の一方の端に東京都と沖縄県が並ぶ。この軸は何を表していると読めるか。
答え: 死亡率(r = −0.927)・高齢化率(−0.916)と強く相関するので「若さ(高齢化・少子化の進み方の逆)」の軸。東京都と沖縄県は高齢化率が 47 県で最も低い 2 都県(22.8%・23.8%)。 - 北海道-新潟県の測地距離が直線距離の 2.51 倍になった。これだけで「北海道と新潟県は本当は似ていない」と言ってよいか。
答え: 言えない。近傍の張り方(k、使う列)しだいで変わる量で、件数の列が北海道を大都市圏側の近傍に引き寄せている可能性がある。k や列を変えても比が大きいままかを確かめてから解釈する。
⚠️ よくある落とし穴と誤解
sklearn.manifold.Isomap は Disconnected graph 警告を出し埋め込みが破綻するので、 $k$ を 5〜10 に増やすか連結成分を確認する。StandardScaler で平均0・分散1に揃えてから Isomap を掛ける。sklearn の transform() は近似(学習点への距離から補間)であり厳密な再学習ではない。 逐次データや本番推論で埋め込みを使うなら、 transform が高速で一貫する UMAP やパラメトリックな手法を検討する。🧠 さらに深掘り — 幾何・近似の正しさ・次元の呪い
ここまでの「30秒結論〜落とし穴」を踏まえ、 「なぜ測地距離でなければ展開できないのか」「グラフ最短経路は本当に測地距離なのか」「次元の呪いとどう関係するのか」という 3 つの問いを掘り下げる。 PCA との対照、 多様体学習全体の中での位置づけを意識して読み進めてほしい。
🎨 直感の深化 — 内在次元と「折り畳み」の幾何
Isomap の前提である多様体仮説は「$D$ 次元空間に散らばって見えるデータが、 実は $d\ll D$ 次元の曲がった面(多様体)の上にほぼ乗っている」というもの。 この $d$ を内在次元(intrinsic dimension)と呼ぶ。 合成例(架空・合成データ)のスイスロールは、 3 次元空間に置かれているが本質は 2 次元シート(内在次元 $d=2$)を丸めただけである。 PCA は「空間を貫く直線」しか引けないため、 丸まって重なったシートの表と裏を同一視して潰す——これが「線形手法は折り畳みに弱い」ことの正体だ。
📐 グラフ最短経路は本当に測地距離か — 近似の収束保証
「k 近傍グラフの最短経路 $d_G$」はあくまで真の測地距離 $d_M$ の近似である。 では、 どんな条件でこの近似は正しくなるのか。 Isomap の原著と同時期の理論(Bernstein・de Silva・Langford・Tenenbaum, 2000, "Graph approximations to geodesics on embedded manifolds")は、 標本数 $n\to\infty$ かつ近傍半径を適切に縮めていけば、 $d_G$ が真の測地距離 $d_M$ に(任意の精度で)収束することを示した。 つまり Isomap は「データが十分密なら測地距離を正しく復元できる」という漸近的な保証を持つ、 数学的に裏付けられた手法である。
この保証が破れるのが落とし穴の温床になる。 (1) 標本が疎だと継ぎ足しの刻みが粗く、 経路が真の曲面から浮いて距離が過大になる。 (2) 近傍が広すぎると局所でも曲がりを無視できず、 多様体を貫く弦(chord)で距離が過小になる——これが 🎮 デモで見た short-circuit の数理的な説明だ。 $k$ の調整とは、 この「疎による過大」と「広すぎによる過小」の綱引きの最適点を探す作業に他ならない。 有限標本の実データ($n=47$ の SSDSE-B-2026 など)では収束の前提が満たされないため、 trustworthiness のような別指標での検証(上の実装 3)が欠かせない。
⚠️ 落とし穴の深層 — ノイズ・穴・密度・計算コスト
上の「⚠️ よくある落とし穴」を、 発生機序まで踏み込んで整理する。
| 落とし穴 | 何が起きるか | 機序(なぜ) | 対処 |
|---|---|---|---|
| ノイズ感度 | 多様体から浮いた点が最短経路を歪める | 測地距離は最小を取るため、 外れ値が作った「近道の橋」を経路が選んでしまう(min 演算はノイズに対し非対称に効く) | 事前の外れ値除去、 C-Isomap、 頑健な近傍選択 |
| 穴あき・非凸多様体 | 距離が引き伸ばされ埋め込みが歪む | 収束保証は多様体が凸領域を等長に曲げたものである前提。 穴があると経路が迂回し内在距離より長くなる | 多様体の「形」を先に確認、 局所を保つ LLE 系を併用 |
| 密度の不均一 | 同じ $k$ でも領域ごとに分断と近道が同時発生 | 密な領域では近傍が近すぎ、 疎な領域では届かない。 固定 $k$ は密度を仮定している | 密度で辺重みを再スケールする C-Isomap、 半径固定の $\varepsilon$-近傍 |
| 計算コスト | $n$ が大きいと急激に遅い・メモリを食う | 全点対最短経路が $O(n^2\log n)$〜$O(n^3)$、 距離行列 $D$ が $O(n^2)$ メモリ。 固有分解も $O(n^3)$ | Landmark Isomap、 近似最近傍、 $n{>}10^4$ なら UMAP |
とくにノイズと穴は「距離を min で測る」という Isomap の設計に由来する構造的弱点で、 パラメータ調整だけでは消えない。 データが本当に滑らかな低次元多様体に乗っているかどうかの吟味が、 $k$ の微調整より先に来る。
🌐 発展 — 測地距離の近似手法とスケール対策
標準 Isomap の $O(n^3)$ を緩める、 あるいは弱点を補う派生が複数ある。 いずれも「ステップ 2・3 をどう軽く/頑健にするか」の工夫である。
| 派生 | 変えた点 | 効果 |
|---|---|---|
| Landmark Isomap (L-Isomap) | 少数の代表点(landmark)だけで測地距離を計算し Landmark MDS で埋め込む | 計算量を $O(n^3)$ から概ね $O(mnk)$($m$=landmark 数)へ削減。 大規模化の定石 |
| C-Isomap(Conformal) | 各辺の重みを局所密度で割って再スケール | 密度が場所で変わる多様体(等角写像)に対応。 密度不均一の落とし穴を緩和 |
| Kernel Isomap | 測地距離行列に定数シフトを加え半正定値(PSD)を保証 | 固有値が負になる破綻を防ぎ、 新規点の out-of-sample 埋め込みを与える |
なお sklearn.manifold.Isomap は path_method='auto' で規模に応じ Floyd-Warshall(小)/Dijkstra(大)を切り替え、 近傍探索も neighbors_algorithm で ball_tree/kd_tree を選べる。 SSDSE-B-2026 の 47 行なら標準実装で一瞬だが、 市区町村(約 1,700)へ広げると landmark 化や近似が現実的になる。
🔬 発展 — LLE / t-SNE / UMAP との「数理的な分かれ道」
関連手法の表(下の「🌐 関連手法・派生」)を、 「何を保存し、 何を最小化するか」という数理の芯で対比する。 Isomap が大域の測地距離を保つのに対し、 他手法は「保存する量」自体を差し替えている。
| 手法 | 保存する量 | 最小化する目的関数 | Isomap との決定的な差 |
|---|---|---|---|
| Isomap | 大域の測地距離 $d_G$ | 応力 $\sum_{i<j}(D_{ij}-\lVert y_i-y_j\rVert)^2$(閉形式) | —(基準) |
| LLE | 局所の線形再構成重み $W$ | $\sum_i\lVert y_i-\sum_j W_{ij}y_j\rVert^2$(疎な固有問題) | 距離を一切使わず局所線形性のみ。 最短経路計算が不要でスケールしやすい |
| t-SNE | 近傍である確率(高次元 Gauss/低次元 Student-t) | KL ダイバージェンス(勾配降下) | 大域距離を保証しない。 重い裾で「詰め込み問題」を回避し局所を強調 |
| UMAP | ファジィな位相(近傍グラフの構造) | 交差エントロピー(確率的最適化) | 局所+中間の大域を両立、 高速で transform も速い |
要点は 2 つ。 第一に、 LLE は Isomap の「測地距離+MDS」を「局所重み+疎固有分解」に置き換えたもので、 大域距離を捨てる代わりに計算を軽くしている。 第二に、 t-SNE / UMAP は距離そのものではなく「近傍らしさ(確率・位相)」を保つため、 「東京-沖縄が直線の何倍遠いか」といった大域の量は原理的に再現しない。 逆に Isomap はショートカット 1 本で大域が崩れる敏感さを持つ。 次元削減の目的が「距離を下流に渡す」なら Isomap、 「クラスタを目で見る」なら t-SNE/UMAP、 という使い分けはこの数理の差から必然的に導かれる。
🌀 発展 — 次元の呪いと多様体仮説
Isomap のステップ 1(k 近傍グラフ構築)は、 高次元での次元の呪い(curse of dimensionality)と正面から向き合う。 次元 $D$ が上がると、 ランダムな点どうしのユークリッド距離は互いに似通っていく(距離集中)——最近傍と最遠点の距離の比が 1 に近づき、 「近い/遠い」の区別が曖昧になる。 距離に基づく最近傍探索が土台の Isomap にとって、 これは足元を崩す現象である。
それでも Isomap(や多様体学習全般)が機能しうるのは、 多様体仮説が次元の呪いへの「逃げ道」を与えるから。 データが内在次元 $d\ll D$ の多様体に乗っているなら、 距離集中が効くのは無関係な $D-d$ 方向のノイズであって、 多様体に沿った局所の近傍構造は保たれる。 だからこそ Isomap は「局所だけユークリッド距離を信じる」設計にしている。 裏を返すと、 多様体から浮いた高次元ノイズが大きいほど、 近傍グラフが誤り、 次元の呪いが表面化する——これが「ノイズ感度」の落とし穴の根っこでもある。 SSDSE-B-2026 は 47 サンプル×約 110 列という「サンプル数 < 次元」の極端な高次元小標本で、 事前の標準化と、 相関の高い人口系指標が作る低い内在次元(上の実値計算 STEP 3 参照)が、 Isomap を成立させている前提条件になっている。
🔗 関連用語 — 前提・並列・発展
前提となる用語
並列に位置する用語
発展先の用語
🖼 Isomap を図で理解する(3 枚)
Isomap は「多様体上の測地距離を保つ次元削減」である。 普通の PCA が直線距離(ユークリッド距離)で射影するのに対し、 Isomap はデータが乗っている曲面に沿った距離を使う。 3 枚の図で違いを整理する。
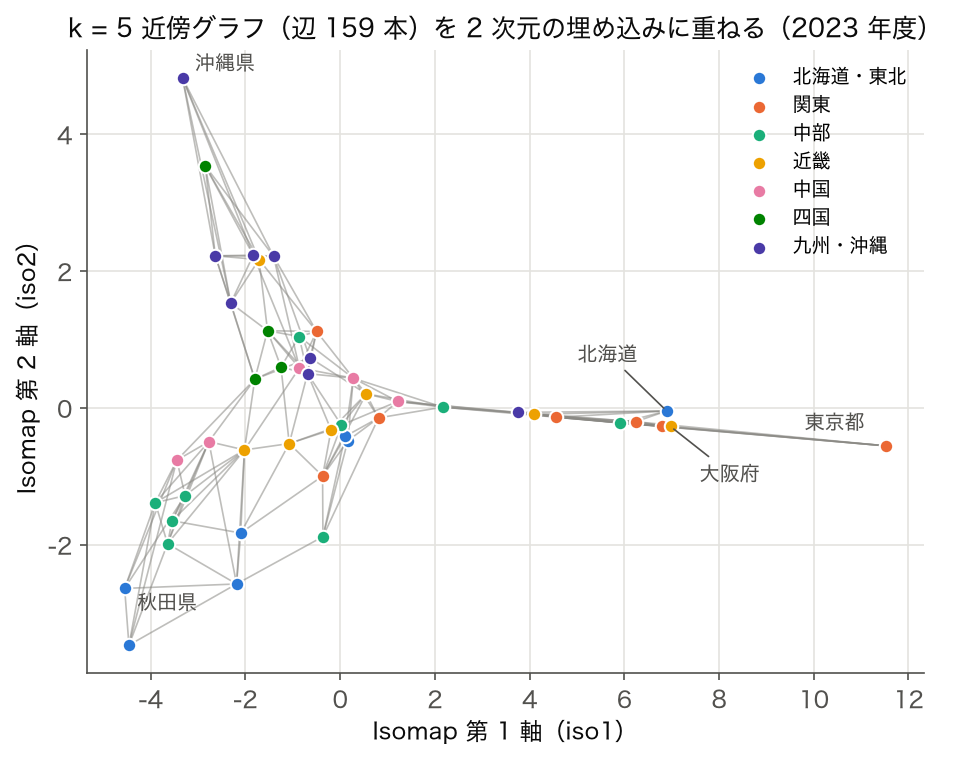
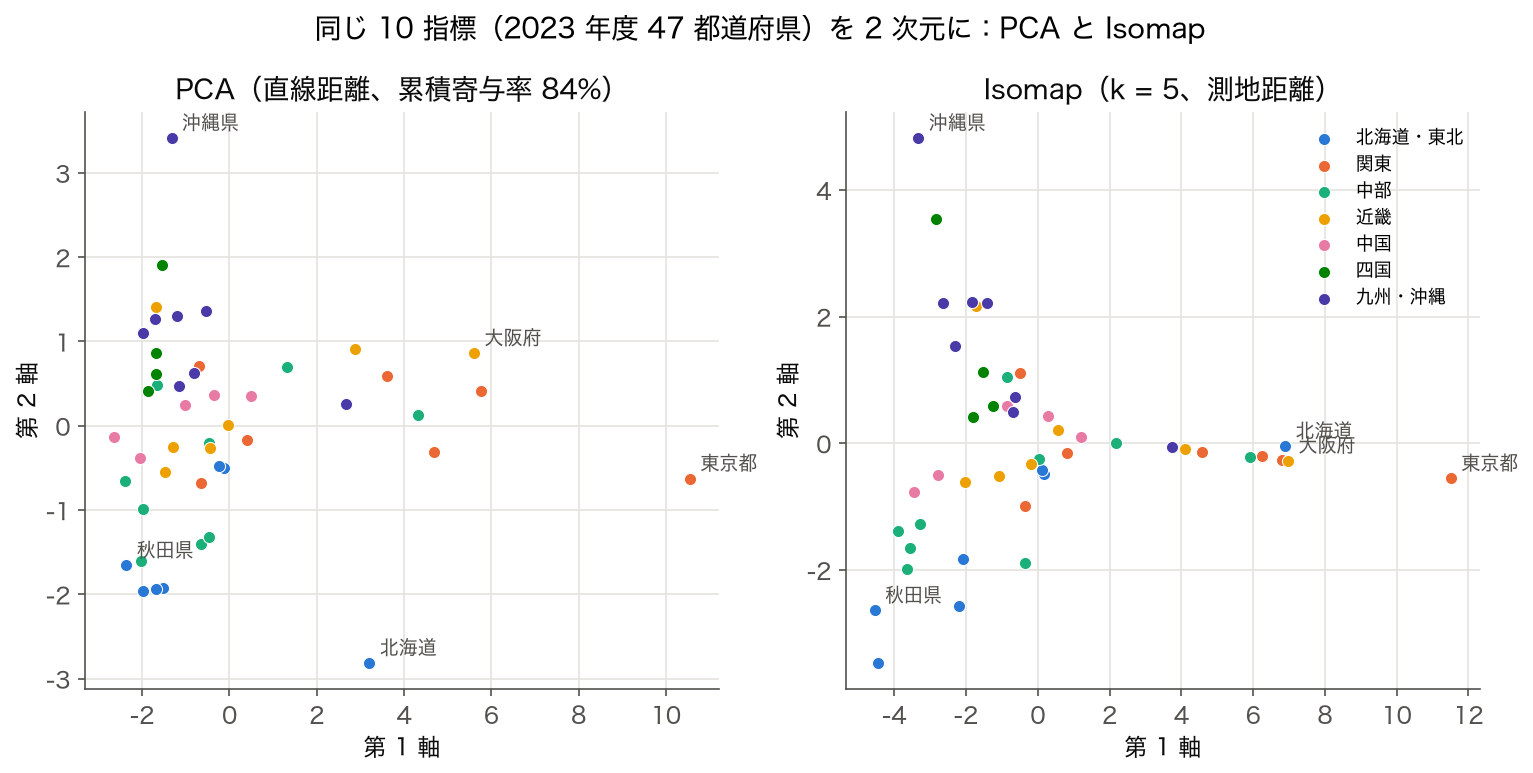
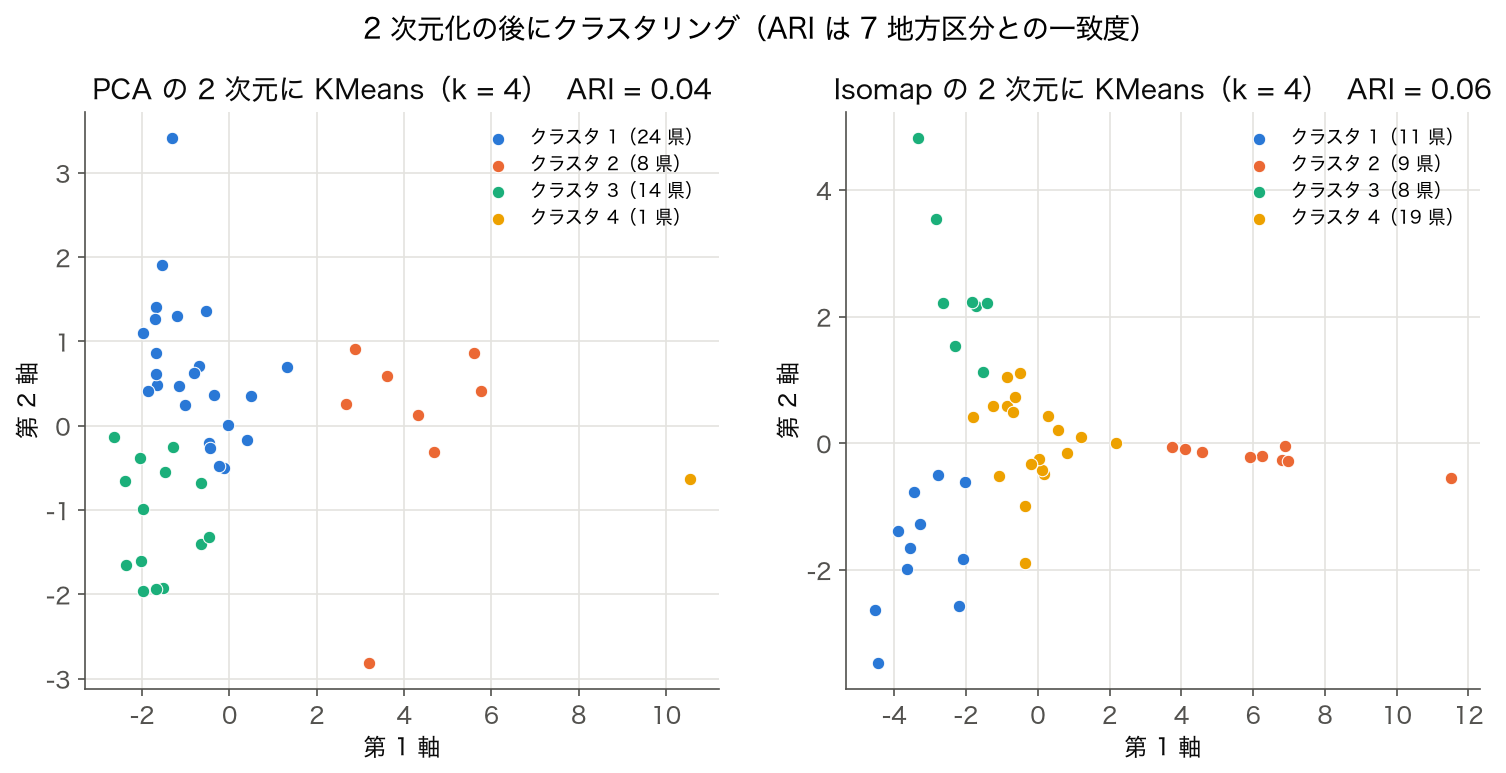
読み方: 図 A で「近傍グラフ構築」、 図 B で「測地距離保存」、 図 C で「下流タスク(クラスタリング)への影響」が確認できる。 Isomap は線形手法では拾えない構造を取り出すための強力な前処理。
🎯 理解度チェック(5 問)
- Q1. Isomap の 3 ステップを順に挙げよ。
A. (1) k 近傍グラフを作る、 (2) Dijkstra/Floyd で全対最短経路(測地距離)を計算、 (3) その距離行列に古典的 MDS を適用して低次元埋め込みを得る。 - Q2. Isomap が PCA より優れる典型場面は?
A. データが曲がった多様体(Swiss roll、 S 字、 球面など)上に乗っている場合。 線形手法では潰れる構造を保てる。 - Q3. 近傍数 $k$ を大きくしすぎるとどうなるか?
A. 「short-circuit」現象。 多様体を跨いだショートカットがグラフに混入し、 測地距離がユークリッド距離に退化する。 結果として PCA とほぼ同じ射影になる。 - Q4. SSDSE-B-2026 の 47 都道府県 × 110 列に Isomap を当てるとき、 k はいくつが妥当か?
A. n=47 では k=5〜8 程度が無難。 k=15 だと近傍が密になり全体が連結してしまい、 多様体構造が見えにくい。 - Q5. Isomap と t-SNE / UMAP の使い分けは?
A. Isomap は大域構造(全体の距離関係)を保つ。 t-SNE や UMAP は局所構造(近隣関係)を保つ。 可視化のみなら t-SNE/UMAP、 距離情報を下流で使うなら Isomap。
関連: PCA、 t-SNE、 次元削減、 k-means、 階層クラスタリング
📖 Isomap の実務メモ: 多様体仮説と SSDSE-B-2026 への適用
Isomap は 「高次元データは低次元の多様体(曲面)上に乗っている」という多様体仮説に基づく次元削減手法である。 SSDSE-B-2026 の 47 都道府県 × 約 110 列を考えてみよう。 都道府県は経済・社会の様々な軸を持つが、 実際には「人口規模」「産業構造」「都市度」のような数本の隠れた軸でほぼ説明できる。 これらの軸は線形ではない場合が多く、 例えば「都市規模が大きくなるにつれて第三次産業比率が S 字状に上がる」といった関係が普通である。 PCA は線形射影しかできないためこの S 字構造を潰してしまうが、 Isomap は多様体上の測地距離を保ったまま射影するため、 構造を保てる。
アルゴリズムは 3 ステップ。 第一ステップは k 近傍グラフ構築。 各点について k 個の最も近い点を辺で結ぶ。 SSDSE-B-2026 の 47 都道府県に対しては k=5〜8 が標準。 第二ステップは 測地距離の計算。 グラフ上の最短経路を Dijkstra 法または Floyd-Warshall 法で全対間に求める。 これが「多様体上の距離」の近似となる。 第三ステップは 古典 MDS (multidimensional scaling)。 測地距離行列を中心化し、 その固有分解の上位 d 個の固有ベクトルから低次元埋め込みを得る。 通常 d=2 で可視化、 d=3〜5 で下流タスク用の特徴量化に使う。
Isomap の最大の落とし穴は 「short-circuit 問題」である。 近傍数 $k$ を大きくしすぎると、 本来離れている多様体上の 2 点が「ショートカット辺」で結ばれてしまい、 測地距離が真のユークリッド距離に退化する。 Swiss roll(巻物状の多様体)で最も顕著で、 巻物の表側と裏側を直接結ぶ辺が混入した瞬間に、 Isomap は PCA と同等の射影になってしまう。 SSDSE-B-2026 の場合、 47 都道府県は密に近隣を持つため、 k=15 だと一気にショートカットが入る。 k=5〜8 が「過剰連結なく、 かつグラフが連結する」ちょうど良い範囲。
Isomap・t-SNE・UMAP は混同されがちだが、 設計思想が異なる。 Isomap は 大域構造(全体の距離関係)を保つ。 つまり 47 都道府県のうち「東京と沖縄が遠い」「青森と秋田が近い」という距離情報を保持する。 これに対し t-SNE は 局所構造(近隣関係)を保つ。 「東京の近隣 5 県は神奈川・千葉・埼玉・茨城・栃木」といった近隣リストの保存に強いが、 東京と沖縄の距離は信用できない。 UMAP は両者の中間。 用途で言えば、 可視化なら t-SNE / UMAP、 下流の機械学習に距離を渡すなら Isomap、 というのが定石。 SSDSE-B-2026 で「東京は外れ値」と主張したいなら Isomap、 「地方ブロックのクラスタを描きたい」なら t-SNE が向く。
Python 実装は sklearn.manifold.Isomap で 3 行で書ける: from sklearn.manifold import Isomap; iso = Isomap(n_neighbors=5, n_components=2); Z = iso.fit_transform(X)。 ただし大規模データ(n > 10,000)では Dijkstra が遅くなる。 sklearn は path_method='auto' で n に応じて Floyd-Warshall(小規模)か Dijkstra(大規模)を切り替える。 さらに高速化が必要なら Landmark Isomap(一部の点を landmark として測地距離を計算)を使う。 SSDSE-B-2026 の 47 都道府県スケールなら標準 Isomap で十分。 また、 reconstruction error(iso.reconstruction_error())が「Isomap がどれだけよく多様体を表現できているか」の指標になる。 値が小さいほど良いが、 絶対値より「k を変えたときの相対変化」を見るのが実務的。
📝 補足: Isomap は多様体学習という分野の出発点であり、 PCA から進んで非線形次元削減を学ぶ最初の手法として最適である。 SSDSE-B-2026 のような 47 サンプル × 110 次元という小規模高次元データでは、 線形手法だけでは構造を見落とす可能性が高い。 Isomap を組み合わせることで、 都道府県間の地理・経済構造を視覚化できる。 多様体学習・距離学習・グラフベース手法は近年の表現学習(特にグラフニューラルネットワーク)にも繋がる重要な土台である。
📜 Isomap の理論的位置づけと拡張
Isomap は 2000 年に Tenenbaum・de Silva・Langford がサイエンス誌で発表した手法で、 LLE(Locally Linear Embedding)と並んで「多様体学習」というサブ分野を立ち上げた。 それ以前は MDS や PCA など線形手法が主流だったが、 「データは線形空間ではなく低次元の曲がった多様体上にある」という洞察を計算可能な形で具現化したのが Isomap である。 古典 MDS(線形手法)に「グラフ最短経路で距離を測る」という非線形要素を 1 つ足しただけのシンプルな拡張だが、 これだけで Swiss roll のような曲面を平らに展開できる。
後継として LLE(2000)、 Laplacian Eigenmaps(2003)、 Hessian Eigenmaps(2003)、 LTSA(2004)が次々と提案された。 2008 年に t-SNE が登場し可視化の世界では事実上の標準になり、 2018 年に UMAP が登場して t-SNE の弱点(大域構造の保持)を改善した。 現在は「Isomap=大域距離保持」「t-SNE=局所近隣保持」「UMAP=両者の中間」という棲み分けが定着している。 SSDSE-B-2026 のような小規模で構造的なデータでは Isomap の利点(解釈可能な距離)が活きるが、 数万行の埋め込み行列を可視化するなら UMAP が無難。 用途と規模に応じて使い分けるのが実務の流儀である。
Isomap の理論的限界も理解しておく必要がある。 第一に、 連結性の仮定。 k 近傍グラフが連結(すべての点が繋がる)でないと、 一部の点に対して測地距離が無限大になり MDS が破綻する。 SSDSE-B-2026 で k=3 だと連結しない可能性があるため、 k=5〜8 を選ぶか、 グラフが連結するまで k を徐々に増やす実装が必要。 第二に、 計算量。 全対最短経路の計算は $O(n^2 \log n)$ で、 n が大きいと急激に遅くなる。 Landmark Isomap や近似手法で対処する。 第三に、 外挿の困難さ。 学習時に存在しなかった新しい点を埋め込むには iso.transform(X_new) が必要だが、 これは k 近傍探索を再実行する必要があり、 オンライン学習には不向き。 UMAP は fit 後の transform が高速で、 この点では UMAP に軍配が上がる。
それでも Isomap は「データ構造を理解する」目的では非常に有効である。 SSDSE-B-2026 を 110 次元から 2 次元に Isomap で射影し、 各都道府県のラベルを付けてプロットすると、 北日本クラスタ・関東圏クラスタ・関西圏クラスタが視覚的に浮かび上がる。 さらに「東京と神奈川の距離」「北海道と沖縄の距離」が大域的に保持されるため、 経済地理学的な解釈ができる。 これは PCA や t-SNE では難しい。 多様体学習を学ぶ最初の一歩として Isomap は理論的・実装的に最もシンプルで、 学習価値が高い手法と言える。
最後に、 Isomap が教えてくれる重要な教訓を一つ。 「データの構造はユークリッド距離だけでは見えない」ということである。 47 都道府県の経済データはユークリッド距離で見ると東京がほぼ常に外れ値だが、 測地距離で見れば「東京に至る経路」上に大阪・名古屋・横浜などの大都市が並ぶ「都市規模の連続体」として理解できる。 こうした視点の転換が、 多様体学習の核心的価値である。 Isomap を学ぶことは、 単に新しい手法を覚えるだけでなく、 「距離とは何か」「データはどう繋がっているか」という問いを深める知的体験でもある。 PCA や t-SNE と組み合わせて多角的にデータを見ることで、 SSDSE-B-2026 のような複雑な社会経済データから新しい洞察を引き出せるようになる。 Isomap の理論を理解し、 sklearn で実装し、 図で確認するという 3 ステップを反復することで、 多様体学習が「ブラックボックス」から「使いこなせる道具」に変わる。 ぜひ実データで試してほしい。 SSDSE-B-2026 の 47 都道府県データから始めて、 もっと大きなデータセット(市区町村レベル、 海外の地域データ)へと拡張していけば、 多様体学習の威力と限界が体感できる。 これは現代のデータサイエンスにおいて、 線形手法だけでは到達できない深いデータ理解への扉となる。 Isomap は古典的だが、 多様体仮説に基づくデータ理解の出発点として今なお重要な手法である。 統計データ分析コンペでは、 PCA や t-SNE と並んで Isomap を組み合わせることで、 データのもつ多面的な構造を視覚化できる。 これは特徴量エンジニアリングや解釈可能性の向上に直結し、 上位入賞を狙う際の差別化要素となるだろう。 Isomap を学んだ後は、 LLE、 Laplacian Eigenmaps、 UMAP、 そして近年の表現学習 (Self-Supervised Learning) へと進める。 多様体仮説という基本思想は、 現代の深層学習にも貫かれている重要な視点である。
🗺 概念マップ(Isomap の位置づけ)
Isomap は「線形の PCA / MDS」から「非線形の多様体学習」への橋渡しに位置する。 中心に Isomap を置くと、 周辺に測地距離・k 近傍グラフ・MDS・t-SNE / UMAP・発表者 Tenenbaum(2000) が並ぶ。
🔗 隣接手法への橋渡し
Isomap (Isometric Mapping) は非線形次元削減手法。 高次元データの「多様体構造 (manifold)」を測地距離で保ったまま低次元に埋め込む。 PCA や t-SNE と並ぶ次元削減の主要手法。
- 上流: 欠損値処理 ・ 標準化 (各次元のスケール統一) ・ k 近傍グラフ構築 — Isomap の入力前処理
- 並列: PCA (線形次元削減) ・ UMAP (高速 + クラスタ保持) ・ t-SNE (局所構造強調) ・ LLE (Locally Linear Embedding)
- 下流: クラスタリング ・ k-means ・ 可視化 (2-3 次元プロット) ・ 異常検知 (多様体から外れた点)
Isomap の強みは「測地距離 (manifold 上の最短経路)」を保つこと。 例: スイスロール状のデータで PCA は内側と外側を混同するが、 Isomap は巻きをほどいて 2 次元に展開できる。 弱点は k 近傍グラフが疎すぎる/密すぎると埋め込みが破綻する点。
🌳 手法選択フロー
次元削減手法を、 データ性質と目的で 3 段階で判定する。
- 線形構造で十分か? Yes → PCA (高速・解釈容易)、 No (曲がった多様体) → 非線形手法 (Isomap / UMAP / t-SNE) へ
- 目的は? 可視化のみ → t-SNE / UMAP (クラスタが目立つ)、 距離保持で下流分析 → Isomap (測地距離保持)、 速度重視 → UMAP (Isomap より 10 倍速い)
- データ規模は? n < 1000 → Isomap で OK、 n = 1000-10000 → 近似 Isomap or UMAP、 n > 10000 → UMAP / PCA + UMAP の 2 段階
scikit-learn の sklearn.manifold.Isomap(n_neighbors=10, n_components=2) から始めるのが定石。 n_neighbors はデータの「滑らかさ」に依存し、 5-20 で試行錯誤する。