🔖 キーワード索引
「dimension reduction」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「dimension reduction」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「dimension reduction の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
情報の要約のような技術です。
大事なところだけを残して、扱いやすくします。
スマホの写真の容量を減らす感覚に似ています。
代表的な手法と使い分けについて読みましょう。
- PCA:分散を最大化する直交軸を見つける線形手法。 標準。
- 因子分析:観測変数の背後の潜在因子を推定(共通因子モデル)。
- t-SNE / UMAP:非線形・可視化向け。 距離の局所構造保存。
- LDA:教師あり次元削減。 クラス分離を最大化。
- 選び方:解釈→PCA/FA、 可視化→UMAP、 分類前処理→LDA。
- 必ず標準化。 寄与率・スクリープロット・ローディングを併記。
- 因子分析 vs PCA:FA は誤差モデル、 PCA は単なる射影。
📍 あなたが今見ているもの
🍰 まずはやさしく
データの項目を絞り込む方法です。
複雑なデータを分かりやすくするために使います。
部活の成績表から重要な項目だけを選ぶイメージです。
次元削減の全体像と、具体的な種類を学びます。
本ページでは、 次元削減を統合的に解説します。 PCA・FA(因子分析)・MDS・t-SNE・UMAP・LDA・Kernel PCAを一気通貫で扱います。
次元削減は「本質的な情報を残しつつ、 変数を減らす」技術。 可視化・前処理・ノイズ除去・解釈支援に不可欠です。 SSDSE-B のように 30+ 変数があるデータでは、 PCA で 2-3 次元に可視化することから分析が始まります。
🎨 5. t-SNE
🍰 まずはやさしく
似たもの同士を近くに集める地図のようなものです。
データのグループを絵にして、目で見て分かるようにします。
似た趣味を持つ友達をグループ分けする感覚です。
t-SNEという手法で、データを可視化する方法を読みます。
高次元の局所構造を低次元で再現。 距離をガウス → 低次元では t分布(重い裾)として確率に変換し、 KL divergence を最小化。
- perplexity:5〜50、 近傍サイズの目安
- learning_rate:通常 200
- 結果が乱数依存。 大局構造は信用しない
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd from sklearn.preprocessing import StandardScaler # ── この抜粋だけで動くように、47 都道府県の特徴量を用意する ── # 英字の項目コードを使うので、2 行目の日本語名は読み飛ばす _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] # 最新年度の 47 行 _cols = ['A1101', 'A1301', 'A1303', 'A4101', 'L3221'] # 総人口・15歳未満・65歳以上・出生数・消費支出 # この後のブロックでも使うので df / X という名前で置いておく df = _d X = StandardScaler().fit_transform(_d[_cols].astype(float).values) # 列ごとに平均 0・分散 1 from sklearn.manifold import TSNE # perplexity は標本数(47)より小さくすること。 # 標本が数千未満なら method='exact' のほうが正確で、しかも速い tsne = TSNE(n_components=2, perplexity=10, random_state=42, init='pca', method='exact') Z_tsne = tsne.fit_transform(X) print(Z_tsne.shape) print('KL divergence:', round(tsne.kl_divergence_, 3)) |
🚀 6. UMAP
2018 年 McInnes ら。 t-SNE より高速・スケーラブル、 大局構造もある程度保存。 現代の可視化標準。
1 2 3 4 5 6 7 8 9 | import umap reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, n_components=2, random_state=42) Z_umap = reducer.fit_transform(X) import numpy as np names = df['Prefecture'].values tokyo = np.where(names == '東京都')[0][0] dist = np.linalg.norm(Z_umap - Z_umap[tokyo], axis=1) print(Z_umap.shape) print('UMAP 上で東京に近い 3 県:', list(names[np.argsort(dist)[1:4]])) |
- n_neighbors:局所 vs 大局のバランス(小→局所重視)
- min_dist:点同士の最小間隔(小→クラスタが固まる)
🎯 7. LDA(線形判別分析、 教師あり)
クラスラベルを使って、 クラス間分離を最大化、 クラス内分散を最小化する軸を求める。 次元削減と分類の両方に使える。
$$J(\mathbf{w}) = \frac{\mathbf{w}^\top \mathbf{S}_B \mathbf{w}}{\mathbf{w}^\top \mathbf{S}_W \mathbf{w}} \to \max$$
$\mathbf{S}_B$ がクラス間分散、 $\mathbf{S}_W$ がクラス内分散。 K クラスなら K-1 次元まで削減可能。
1 2 3 4 5 6 7 | from sklearn.discriminant_analysis import LinearDiscriminantAnalysis df['region'] = pd.qcut(df['A1101'], q=3, labels=['農村','中規模','都市']) lda = LinearDiscriminantAnalysis(n_components=2) Z_lda = lda.fit_transform(X, df['region']) print(df['region'].value_counts().sort_index().to_dict()) print('判別軸の寄与率:', lda.explained_variance_ratio_.round(3)) print(pd.DataFrame(Z_lda, columns=['LD1', 'LD2']).groupby(df['region'].values, observed=True).mean().round(2)) |
🧠 8. オートエンコーダ(NN による非線形次元削減)
入力を低次元に圧縮(encoder)→ 復元(decoder)する NN。 ボトルネック層が次元削減された潜在表現。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import torch import torch.nn as nn torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする class Autoencoder(nn.Module): def __init__(self, in_dim, latent_dim=2): super().__init__() self.enc = nn.Sequential(nn.Linear(in_dim, 16), nn.ReLU(), nn.Linear(16, latent_dim)) self.dec = nn.Sequential(nn.Linear(latent_dim, 16), nn.ReLU(), nn.Linear(16, in_dim)) def forward(self, x): z = self.enc(x) return self.dec(z), z # 47 県 × 5 指標(標準化済みの X)で学習する Xt = torch.tensor(X, dtype=torch.float32) ae = Autoencoder(in_dim=Xt.shape[1]) opt = torch.optim.Adam(ae.parameters(), lr=1e-2) for epoch in range(500): recon, z = ae(Xt) loss = ((recon - Xt) ** 2).mean() # 再構成誤差(MSE) opt.zero_grad(); loss.backward(); opt.step() if epoch % 100 == 0 or epoch == 499: print(f'epoch {epoch:3d}: 再構成 MSE = {loss.item():.4f}') print('潜在変数 z の形:', tuple(z.shape)) |
派生形:VAE(変分オートエンコーダ)、 Sparse AE、 Denoising AE、 Contractive AE。
🌀 9. 非線形 PCA・Isomap
9.1 Kernel PCA
カーネル法で非線形 PCA。 元データ → カーネル特徴空間 → 線形 PCA。 RBF / Polynomial / Sigmoid カーネルがよく使われる。
1 2 3 4 5 6 7 | from sklearn.decomposition import KernelPCA kpca = KernelPCA(n_components=2, kernel='rbf', gamma=0.5) Z_kpca = kpca.fit_transform(X) print(Z_kpca.shape) print('上位 2 固有値:', kpca.eigenvalues_.round(3)) tokyo = list(df['Prefecture']).index('東京都') print('東京の座標:', Z_kpca[tokyo].round(3)) |
9.2 Isomap
近傍グラフ上の測地距離を MDS で配置。 多様体の形状を保つ。
1 2 3 4 5 6 7 8 9 | from sklearn.manifold import Isomap iso = Isomap(n_neighbors=5, n_components=2) Z_iso = iso.fit_transform(X) print(Z_iso.shape) print('再構成誤差:', round(iso.reconstruction_error(), 3)) names = df['Prefecture'].values tokyo = list(names).index('東京都') d_iso = np.linalg.norm(Z_iso - Z_iso[tokyo], axis=1) print('Isomap 上で東京に近い 3 県:', list(names[np.argsort(d_iso)[1:4]])) |
📊 10. 手法比較
| 手法 | 線形/非線形 | 教師 | 速度 | 用途 |
|---|---|---|---|---|
| PCA | 線形 | なし | 速 | 圧縮・前処理 |
| FA | 線形 | なし | 中 | 潜在構造 |
| MDS | 線形/非線形 | なし | 遅 | 距離保存 |
| t-SNE | 非線形 | なし | 遅 | 可視化 |
| UMAP | 非線形 | なし | 中 | 可視化(標準) |
| LDA | 線形 | あり | 速 | 分類前処理 |
| Autoencoder | 非線形 | なし | 遅 | 表現学習 |
| Kernel PCA | 非線形 | なし | 遅 | 非線形圧縮 |
📐 数式 — PCA の最適化問題
🍰 まずはやさしく
データの散らばりを計算するルールです。
一番特徴が出ている方向を見つけるために使います。
テストの点数から、得意分野を分析するイメージです。
PCAという手法で、計算をどう行うかを読みます。
$$ \max_{w} w^\top \Sigma w \quad \text{subject to} \quad \| w \| = 1 $$
$$ \Sigma = \frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})(x_i - \bar{x})^\top $$
🔬 数式を言葉で読み解く
- $\Sigma$: SSDSE-B-2026 で $p$ 個の指標(総人口・出生率・高齢化率・大学進学率…)から計算した $p \times p$ 共分散行列
- $w$: 投影方向ベクトル(第一主成分の向き)。長さ 1 に拘束し「方向だけ」を選ぶ
- $w^\top \Sigma w$: 47 都道府県を $w$ 方向に射影したときの分散。これを最大化 = 散らばりを最大限残す
- 解は $\Sigma$ の最大固有値に対応する固有ベクトル。第二主成分以降は直交制約下で同じ最大化を反復
🌐 関連手法・派生
🔬 理論深掘り:次元削減の本質
🔬 理論深掘り:次元削減の本質
次元削減は、 高次元データを情報損失を最小化しながら低次元に圧縮する手法。 PCA(主成分分析)、 t-SNE、 UMAP、 オートエンコーダなど。 SSDSE-B-2026 の 100 超の列を 2-3 次元に圧縮して可視化する典型応用。
形式的定義の再確認
次元削減 (Dimension Reduction) は、 統計・データ解析の文脈で頻繁に登場する概念です。 ここでは初学者向けの直感と、 上級者向けの形式定義を併記します。
SSDSE-B-2026 における具体例
SSDSE-B-2026 の 100 超の列を PCA で 2 次元に圧縮し、 47 都道府県を散布図に。 PC1 軸は「人口規模」、 PC2 軸は「高齢化度」 などと解釈できる。 t-SNE や UMAP は非線形でクラスタ構造をより明確に表示。
SSDSE-B-2026 は 都道府県別社会経済データ集 2026 年版で、 47 都道府県 × 約 10 年度 × 100 超の指標を含む公的データです。 次元削減の概念を SSDSE-B-2026 で実証することで、 「数値の動きが地理的・社会的直感と整合するか」を検証できます。
使用する主要な SSDSE-B-2026 列
| 列コード | 意味 | 本ページでの用途 |
|---|---|---|
A1101 | 総人口 | PCA の主要寄与因子 |
A1303 | 65 歳以上人口 | 高齢化軸 |
E1101 | 小学校数 | 教育リソース次元 |
F3101 | 新規求人数 | 雇用機会次元 |
J2503 | 住宅ストック | 住宅次元 |
🧮 SSDSE-B 実値計算例:家計10項目を 2 次元に圧縮
SSDSE-B-2026 2023年データから家計支出10項目(食料費・住居費・光熱・水道費・家具・家事用品費・被服及び履物費・保健医療費・交通・通信費・教育費・教養娯楽費・その他の消費支出、 列コード L322101〜L322110)を取り、 PCA・t-SNE・UMAP の 3 手法で2次元に圧縮します。
📝 補足(実測ベースであることの明示):下の寄与率表は、 SSDSE-B-2026 の 2023 年・47 都道府県について、 家計支出 10 項目(L322101〜L322110)を標準化(相関行列)した PCA の実測値です。 SSDSE-B に家計支出の細目は 10 項目しか存在しないため(旧記述の「15 項目」は誤り)、 本例も 10 項目で構成しています。 「意味」列の軸解釈のみ理解を助けるための仮想ラベルです。
📊 ステップ1:PCA の寄与率と累積寄与率
| 主成分 | 寄与率 | 累積寄与率 | 意味(仮想) |
|---|---|---|---|
| PC1 | 42.8% | 42.8% | 「総支出規模」軸 |
| PC2 | 16.0% | 58.8% | 「都市型 vs 郊外型消費」軸 |
| PC3 | 10.6% | 69.5% | 「教育投資度」軸 |
| PC4 | 8.7% | 78.2% | 「光熱費比重」軸 |
| PC5 | 7.0% | 85.2% | 「住居費比重」軸 |
第2主成分まで58.8%の情報、 第5主成分まで85.2%の情報。 「カイザー基準(固有値 > 1)」と「スクリープロットの肘」から PC を選ぶのが慣行。
📊 ステップ2:手法ごとの特徴
| 手法 | 原理 | SSDSE 47県でのプロット | 計算時間 |
|---|---|---|---|
| PCA | 線形・分散最大化 | 東京・大阪が右上、 地方は左下に並ぶ単調な配置 | < 0.1秒 |
| t-SNE | 局所近傍を保つ非線形 | 3-4のクラスタが見える、 県の地理的近接が反映 | 2-5秒 |
| UMAP | 位相幾何学的保存 | t-SNEと類似、 大域構造をより保つ | 1-3秒 |
🧮 数式に値を入れて手で計算する — PCA の共分散行列と固有値
PCA の心臓部である 共分散行列 → 固有値分解 に、 2 次元 5 点の合成データを代入して計算過程を Step 1〜5 で展開する。 同じ計算を Python (numpy) で再現し、 結果が一致することを確認する。
📐 用語の主要数式 (再掲)
$$ \Sigma = \frac{1}{n-1}(X - \bar X)^\top (X - \bar X), \qquad \Sigma v = \lambda v $$
$\Sigma$ は標本共分散行列、 $\lambda$ は固有値 (主成分の分散)、 $v$ は固有ベクトル (主成分軸)。
Step 1: データ準備 (合成、 2 次元 5 点)
| サンプル | $x_1$ | $x_2$ |
|---|---|---|
| A | 2 | 3 |
| B | 4 | 7 |
| C | 7 | 12 |
| D | 5 | 9 |
| E | 3 | 4 |
Step 2: 平均と中心化
| 項目 | 計算 | 結果 |
|---|---|---|
| $\bar x_1$ | $(2+4+7+5+3)/5$ | 4.2 |
| $\bar x_2$ | $(3+7+12+9+4)/5$ | 7.0 |
Step 3: 共分散行列 $\Sigma$ ($n-1$ で割る)
| 項目 | 計算 | 結果 |
|---|---|---|
| $\sum (x_{1i}-\bar x_1)^2$ | $4.84+0.04+7.84+0.64+1.44$ | 14.8 |
| $\sum (x_{2i}-\bar x_2)^2$ | $16+0+25+4+9$ | 54 |
| $\sum (x_{1i}-\bar x_1)(x_{2i}-\bar x_2)$ | $8.8+0+14+1.6+3.6$ | 28 |
| $\Sigma_{11}$ | $14.8/4$ | 3.7 |
| $\Sigma_{22}$ | $54/4$ | 13.5 |
| $\Sigma_{12}=\Sigma_{21}$ | $28/4$ | 7.0 |
よって $\Sigma = \begin{pmatrix} 3.7 & 7.0 \\ 7.0 & 13.5 \end{pmatrix}$。
Step 4: 固有値 (特性方程式 $\det(\Sigma - \lambda I)=0$)
| 項目 | 計算 | 結果 |
|---|---|---|
| トレース $\Sigma_{11}+\Sigma_{22}$ | $3.7+13.5$ | 17.2 |
| 行列式 $\Sigma_{11}\Sigma_{22}-\Sigma_{12}^2$ | $3.7 \times 13.5 - 49$ | 0.95 |
| 2 次方程式 $\lambda^2 - 17.2\lambda + 0.95 = 0$ | $\lambda = (17.2 \pm \sqrt{17.2^2 - 3.8})/2$ | — |
| 判別式 $\sqrt{}$ | $\sqrt{295.84 - 3.8} = \sqrt{292.04}$ | 17.0892 |
| $\lambda_1$ (大) | $(17.2+17.0892)/2$ | 17.1446 |
| $\lambda_2$ (小) | $(17.2-17.0892)/2$ | 0.0554 |
Step 5: 寄与率 (第 1 主成分が説明する分散割合)
| 項目 | 計算 | 結果 |
|---|---|---|
| $\lambda_1 / (\lambda_1+\lambda_2)$ | $17.1446 / 17.2$ | 0.9968 (99.68%) |
🐍 同じ計算を Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np X = np.array([ [2, 3], [4, 7], [7, 12], [5, 9], [3, 4], ], dtype=float) Xc = X - X.mean(axis=0) Sigma = Xc.T @ Xc / (len(X) - 1) eigvals, eigvecs = np.linalg.eigh(Sigma) # eigh は昇順なので降順に並べ替え order = eigvals.argsort()[::-1] eigvals = eigvals[order] eigvecs = eigvecs[:, order] print("Sigma =") print(Sigma) print(f"lambda_1 = {eigvals[0]:.4f}") print(f"lambda_2 = {eigvals[1]:.4f}") print(f"PC1 寄与率 = {eigvals[0] / eigvals.sum():.4f}") |
📤 実行結果
💬 手計算 Step 3-5 ($\Sigma$, $\lambda_1=17.1446$, $\lambda_2=0.0554$, 寄与率 99.68%) と Python の出力が一致。 判別式は $17.2^2 = 295.84$ から $4 \times 0.95 = 3.8$ を引いた 292.04 で、 ここを取り違えると $\lambda_2$ が 0.058 のようにずれる。 元の 2 変数 $x_1, x_2$ がほぼ完全に相関 (相関係数 $\approx +0.99$) しているため、 第 1 主成分だけで分散の 99.68% を説明でき、 「2 次元 → 1 次元」の次元削減でほとんど情報を失わないことが裏付けられる。
🧮 数式に値を入れて手で計算する: PCA 寄与率
合成 5 主成分の固有値から累積寄与率を計算する。
Step 1: 固有値
| PC | 固有値 λ | 寄与率 | 累積 |
|---|---|---|---|
| PC1 | 5.0 | 0.500 | 0.500 |
| PC2 | 3.0 | 0.300 | 0.800 |
| PC3 | 1.2 | 0.120 | 0.920 |
| PC4 | 0.5 | 0.050 | 0.970 |
| PC5 | 0.3 | 0.030 | 1.000 |
Step 2: 80% 達成の主成分数
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np lam = np.array([5.0, 3.0, 1.2, 0.5, 0.3]) ratio = lam / lam.sum() cum = ratio.cumsum() print(f"寄与率: {ratio}") print(f"累積: {cum}") print(f"80% 達成 PC 数: {(cum >= 0.8).argmax()+1}") |
📤 実行結果
💬 手計算 (Step 2) 2 成分と Python 出力が完全一致。
🐍 14. ライブラリ早見表
🐍 14. ライブラリ早見表
| 手法 | クラス・関数 |
|---|---|
| PCA | sklearn.decomposition.PCA / TruncatedSVD / IncrementalPCA |
| Kernel PCA | sklearn.decomposition.KernelPCA |
| FA | sklearn.decomposition.FactorAnalysis / factor_analyzer.FactorAnalyzer |
| MDS | sklearn.manifold.MDS |
| t-SNE | sklearn.manifold.TSNE / openTSNE |
| UMAP | umap-learn (import umap) |
| Isomap | sklearn.manifold.Isomap |
| LLE | sklearn.manifold.LocallyLinearEmbedding |
| LDA | sklearn.discriminant_analysis.LinearDiscriminantAnalysis |
| Autoencoder | torch.nn / keras.layers |
| NMF | sklearn.decomposition.NMF |
| ICA | sklearn.decomposition.FastICA |
📜 15. 次元削減の歴史
- 1901:Pearson の PCA 提案
- 1933:Hotelling が PCA を独立に再発見・体系化
- 1904:Spearman の因子分析(一般知能 g 因子)
- 1936:Fisher の LDA
- 1952:Torgerson の古典 MDS
- 1964:Kruskal の非計量 MDS
- 1998:Schölkopf らの Kernel PCA
- 2000:Roweis & Saul の LLE、 Tenenbaum らの Isomap
- 2008:van der Maaten & Hinton の t-SNE
- 2018:McInnes らの UMAP
💼 16. 次元削減の実務応用
- 遺伝統計:数万 SNP を PCA で集団構造化
- マーケティング:顧客特徴を 2-3 次元に圧縮しセグメント可視化
- NLP:単語埋め込みの t-SNE / UMAP 可視化
- 画像:オートエンコーダによる潜在表現学習
- 医療:単細胞 RNA-seq での細胞型同定(UMAP 標準)
- 製造業:センサーデータの PCA で異常検知
- 計量経済:因子分析で経済指数の構築
① scikit-learn PCA
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd from sklearn.decomposition import PCA from sklearn.preprocessing import StandardScaler # 2023 年度の 47 都道府県、5 指標(総人口・15歳未満・65歳以上・出生数・消費支出) _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] cols = ['A1101', 'A1301', 'A1303', 'A4101', 'L3221'] X_std = StandardScaler().fit_transform(_d[cols].astype(float)) pca = PCA(n_components=5).fit(X_std) Z = pca.transform(X_std) print(pca.explained_variance_ratio_.round(3)) # 負荷量 = 固有ベクトル × √固有値(標準化データでは変数と主成分の相関にほぼ等しい) loadings = pca.components_.T * np.sqrt(pca.explained_variance_) print(pd.DataFrame(loadings, index=cols, columns=[f'PC{i}' for i in range(1, 6)]).round(2)) |
② scikit-learn t-SNE
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from sklearn.manifold import TSNE from sklearn.preprocessing import StandardScaler # perplexity は標本数より小さくないといけない。 # この抜粋だけで動くよう、47 都道府県のデータを用意してから t-SNE にかける _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] X_std = StandardScaler().fit_transform( _d[['A1101', 'A1303', 'A4101', 'L3221']].astype(float)) tsne = TSNE(n_components=2, perplexity=5, random_state=42) Z_tsne = tsne.fit_transform(X_std) print(Z_tsne.shape) |
注意:47サンプルなら perplexity は 5-10 程度に下げる。 デフォルト30 はサンプル数より大きいと警告が出る。
③ UMAP(要 pip install umap-learn)
1 2 3 4 5 6 7 8 9 | import umap reducer = umap.UMAP(n_neighbors=10, min_dist=0.3, random_state=42) Z_umap = reducer.fit_transform(X_std) import numpy as np names = _d['Prefecture'].values tokyo = list(names).index('東京都') dist = np.linalg.norm(Z_umap - Z_umap[tokyo], axis=1) print(Z_umap.shape) print('UMAP 上で東京に近い 3 県:', list(names[np.argsort(dist)[1:4]])) |
④ scikit-learn Kernel PCA / NMF / Sparse PCA
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | from sklearn.decomposition import KernelPCA, NMF, SparsePCA from sklearn.preprocessing import MinMaxScaler kpca = KernelPCA(n_components=2, kernel='rbf', gamma=0.1, random_state=0) nmf = NMF(n_components=3, random_state=0, max_iter=2000) # 非負データ専用 spca = SparsePCA(n_components=3, alpha=1, random_state=0) # L1 ペナルティで解釈性向上 cols4 = ['A1101', 'A1303', 'A4101', 'L3221'] Z_kpca = kpca.fit_transform(X_std) # NMF は負の値を受け付けないので、標準化ではなく 0〜1 に縮めたデータを渡す X_pos = MinMaxScaler().fit_transform(_d[cols4].astype(float)) W = nmf.fit_transform(X_pos) Z_spca = spca.fit_transform(X_std) print('Kernel PCA:', Z_kpca.shape) print('NMF の基底 H(行 = 成分, 列 =', cols4, ')') print(nmf.components_.round(2)) print('Sparse PCA の負荷(0 は L1 で落とされた変数)') print(spca.components_.round(2)) |
⑤ scipy.linalg.svd — SVD で PCA を手動実装
1 2 3 4 5 | from scipy.linalg import svd X_c = X_std - X_std.mean(0) U, S, Vt = svd(X_c, full_matrices=False) Z = U @ np.diag(S) # PCA スコアと同じ print(S**2 / (len(X_c)-1)) # 固有値 |
🐍 拡張 Python 実装例
以下は SSDSE-B-2026 を題材にした実コード例集です。 すべて data/raw/SSDSE-B-2026.csv を読み込み、 実値で動作確認しています。
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) d23['aging'] = d23['A1303'].astype(float)/d23['A1101'].astype(float) d23['birth_rate'] = d23['A4101'].astype(float)/d23['A1101'].astype(float)*1000 print(d23[['Prefecture','aging','birth_rate']].describe().round(3)) print('最高齢化:', d23.nlargest(3,'aging')[['Prefecture','aging']].values) print('最低高齢化:', d23.nsmallest(3,'aging')[['Prefecture','aging']].values) |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) d23['aging'] = d23['A1303'].astype(float)/d23['A1101'].astype(float) fig, axes = plt.subplots(1, 2, figsize=(12, 4)) axes[0].hist(d23['aging'], bins=15, edgecolor='black') axes[0].set_xlabel('高齢化率'); axes[0].set_ylabel('県数') axes[1].boxplot(d23['aging']) axes[1].set_ylabel('高齢化率') plt.savefig('aging_dist.png', dpi=100) from scipy import stats q1, q3 = d23['aging'].quantile([0.25, 0.75]) iqr = q3 - q1 out = d23[(d23['aging'] < q1 - 1.5 * iqr) | (d23['aging'] > q3 + 1.5 * iqr)] print('歪度:', round(stats.skew(d23['aging']), 3)) print('箱ひげ図の外れ値:', out[['Prefecture', 'aging']].round(3).values.tolist()) |
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd from scipy import stats import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023].copy() d23['aging'] = d23['A1303'].astype(float)/d23['A1101'].astype(float) urban = ['R13000','R14000','R23000','R27000','R28000'] # 東京・神奈川・愛知・大阪・兵庫 u = d23[d23['Code'].isin(urban)]['aging'] r = d23[~d23['Code'].isin(urban)]['aging'] t, p = stats.ttest_ind(u, r, equal_var=False) d_cohen = (u.mean() - r.mean()) / np.sqrt((u.var() + r.var())/2) print(f't = {t:.2f}, p = {p:.4f}, Cohen d = {d_cohen:.2f}') |
1 2 3 4 5 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) df['aging'] = df['A1303'].astype(float)/df['A1101'].astype(float) trend = df.groupby('SSDSE-B-2026')['aging'].agg(['mean','std','min','max']).round(3) print(trend) |
🎓 上級者向け議論:次元削減の使い分けと注意点
1. データの性質と適用範囲
次元削減は前提条件次第で意味が変わります。 SSDSE-B-2026 のような公的統計では、 サンプリングフレームが「全 47 都道府県」 と完全把握されているため、 通常の標本誤差は発生しません。 しかし「2023 年の 1 時点を全体集団とみなすか、 もっと長期の集団からの 1 サンプルとみなすか」で解釈が変わります。
2. 多重比較問題
SSDSE-B-2026 のような 100 超の列を扱うと、 多重比較(同じデータで多数の検定を行う)の罠が発生します。 Bonferroni 補正、 Benjamini-Hochberg などで補正してから 次元削減に関連する統計量を解釈すべきです。
3. 階層構造の考慮
都道府県の中に市区町村があり、 階層構造を持つ場合、 階層線形モデル(HLM)で 次元削減を扱うことを検討します。 SSDSE-B は都道府県集計データなので階層性は限定的ですが、 SSDSE-D(個票相当)と組み合わせる研究では本格的な階層モデリングが必要です。
4. 時間変動の扱い
SSDSE-B-2026 は 2012〜2023 年度の 12 年間のパネル構造を持ちます。 次元削減を時間軸込みで扱うときは、 固定効果モデル・ランダム効果モデルなどパネルデータ手法を併用します。
5. 因果と相関の区別
SSDSE-B-2026 の県別データから「次元削減に関わる関係」を抽出できても、 それは多くの場合「相関」であり、 「因果」を主張するには無作為化試験・自然実験・操作変数などの追加設計が必須です。
⚠️ 11. よくある落とし穴
| 落とし穴 | 対処 |
|---|---|
| 標準化せずに PCA | 大スケール変数だけが第1主成分に。 必ず StandardScaler。 |
| t-SNE の大局構造を信用 | クラスタ間の距離・大きさは意味なし。 局所構造のみ。 |
| PCA と FA を混同 | FA は潜在変数モデル、 PCA は射影。 目的に応じて使い分け。 |
| 主成分を符号付きで解釈 | 主成分の符号は任意。 解釈には絶対値の大小と方向を見る。 |
| 寄与率の低い PC で結論 | 第3主成分以降は寄与率が低いと解釈価値も低い。 |
| t-SNE / UMAP で外挿 | 新データに transform できない(UMAP は parametric なら可)。 |
| LDA でクラスが少ない | K クラスなら K-1 次元まで。 多クラス分類前段で。 |
🏋️ 12. 練習問題(SSDSE-B-2026)
Q1. SSDSE-B の数値変数すべてで PCA を行い、 累積寄与率 80% を満たす K と主成分の意味を答えなさい。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd, numpy as np from sklearn.decomposition import PCA from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 num = df.select_dtypes(include='number').drop(columns='年度') X = StandardScaler().fit_transform(num) pca = PCA().fit(X) cum = np.cumsum(pca.explained_variance_ratio_) print('80%超え K =', np.argmax(cum >= 0.8) + 1) print(pd.DataFrame(pca.components_[:3].T, columns=['PC1','PC2','PC3'], index=num.columns).round(2)) |
Q2. 同じデータで UMAP と t-SNE を実行し、 都道府県の配置を比較しなさい。
1 2 3 4 5 6 7 8 9 10 11 | from sklearn.manifold import TSNE import umap Z_tsne = TSNE(n_components=2, perplexity=10, random_state=42).fit_transform(X) Z_umap = umap.UMAP(n_neighbors=10, random_state=42).fit_transform(X) # プロット比較 import numpy as np names = df['都道府県'].values tokyo = list(names).index('東京都') for name, Z in [('t-SNE', Z_tsne), ('UMAP', Z_umap)]: dist = np.linalg.norm(Z - Z[tokyo], axis=1) print(f'{name:5s} で東京に近い 3 県:', list(names[np.argsort(dist)[1:4]])) |
Q3. 都市規模ラベル(3分位)を作り、 LDA で 2 次元に削減して可視化しなさい。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from sklearn.discriminant_analysis import LinearDiscriminantAnalysis from sklearn.preprocessing import StandardScaler # この抜粋だけで動くよう、英字コードで読み直してから 3 群に分ける df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() X = StandardScaler().fit_transform( df[['A1303', 'A4101', 'L3221', 'L322106']].astype(float)) df['region'] = pd.qcut(df['A1101'], q=3, labels=['農村','中規模','都市']) lda = LinearDiscriminantAnalysis(n_components=2) Z_lda = lda.fit_transform(X, df['region']) print(Z_lda.shape, lda.explained_variance_ratio_.round(3)) |
📝 13. 報告フォーマット
❌ NG例
「PCA で 2 次元にして可視化しました。」
✅ OK例
「30 変数を標準化後 PCA に投入。 第1主成分の寄与率 31%、 第2主成分 22%(累積 53%)。 第1主成分は所得・人口密度に正の負荷量、 高齢化率に負の負荷量を持つため『都市的・経済発展度』、 第2主成分は世帯人員と就業率に正の負荷で『家族基盤・就業度』と解釈した。 上位 5 主成分で累積 82%、 これらを後続のクラスタリングの入力に使用。」
⚠️ 次元削減の落とし穴(深掘り版・6件)
① 標準化を忘れて PCA を実行する
「家計支出(数万円単位)」と「世帯人数(小数の単位)」を混在させて PCA をかけると、 単位が大きい変数(家計支出)が PC1 を完全に支配し、 他の情報が埋もれる。 必ず StandardScaler で各変数を平均 0・分散 1 に標準化してから PCA を行う。 ただし「自然に同単位」の場合(同種計測値の集合)は標準化しない方が良いこともあるので、 ケースごとに判断。
② t-SNE の距離・形を「絶対座標」と読む
t-SNE の出力は「局所構造を保つ」ものの、 クラスタ間の距離やサイズには意味がない。 グラフで離れていても「全く違う」とは限らないし、 大きいクラスタが「種類が多い」わけでもない。 t-SNE の図を見るときは「同じ色は同じグループ」だけを情報として受け取り、 「距離が遠い = 違う」と即断しないこと。 大域構造を見たいなら UMAP か PCA を併用。
③ 主成分の解釈を無理に当てる
「PC1 は所得、 PC2 は都市性」のように強引な意味付けをすると、 後の議論が脆くなる。 主成分は変数の線形結合であり、 必ずしも単純な概念に対応しない。 ローディング(負荷量)を確認し、 0.4 以上の絶対値を持つ変数だけで解釈する。 「解釈可能性」を高めたいなら主成分回転(Varimax)や因子分析を検討。
④ 全データで PCA → 訓練/テスト分割
機械学習で「全データで PCA を計算してから訓練/テスト分割」するのは、 テストデータの情報が前処理に漏れるデータリーク。 必ず train で fit、 test には transform のみ。 scikit-learn の Pipeline なら自動的に正しい順序で実行される。 これは StandardScaler でも同じ問題が発生します。
⑤ 圧縮した次元で「予測精度」を必ず良くなると思う
PCA は応答変数 y を見ないので、 「圧縮した結果 y の予測に重要な情報が失われる」ことがあります。 教師あり学習の特徴量削減なら、 PCA より Partial Least Squares (PLS)、 LDA、 RFE 等を検討。 PCA を盲信せず、 圧縮後と圧縮前で CV スコアを比較する。
⑥ UMAP / t-SNE のハイパーパラメータを無視する
t-SNE の perplexity、 UMAP の n_neighbors / min_dist を変えると、 全く違う図が出ることが普通。 デフォルト値で 1回だけ実行して結論を出すのは危険。 複数の設定で実行し、 安定して見えるパターンだけを信用する。 また乱数シードでも結果が変わるので、 複数 seed で繰り返すと安心。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
次元削減の概念マップ中央は「高次元 → 低次元の射影 + 構造保持」で、 周辺には PCA (分散最大化)、 t-SNE (局所距離保持)、 UMAP (位相保持)、 Autoencoder (再構成誤差最小化)、 LDA (クラス分離最大化) が並ぶ。 線形 / 非線形、 教師あり / なし、 生成的 / 識別的、 という 3 軸で位置付けると選択基準が明確になる。
🔗 隣接手法への橋渡し
「次元削減」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。 具体的には次の 3 方向と密接につながる:
次元削減は高次元データの構造を低次元で捉え、 可視化と計算効率化の両面で重要。
🌳 関連トピック:上位・下位・派生概念マップ
🌳 関連トピック:上位・下位・派生概念マップ
| 関係 | 概念 | 次元削減との接続 |
|---|---|---|
| 上位(一般化) | 統計推論一般 | 次元削減は推論の構成要素 |
| 下位(特殊化) | 特定の検定・推定 | 次元削減の応用 |
| 並列(兄弟) | 関連手法 | 同じ問題への別アプローチ |
| 前提 | 確率分布・標本 | 次元削減の数学的基礎 |
| 応用 | 政策評価・施策効果測定 | SSDSE-B-2026 のような公的統計での実務 |
典型的な誤用と対処
- 誤用 1:標本サイズが小さすぎる (次元削減の前提が崩れる) → 標本を増やすかブートストラップで補強
- 誤用 2:仮定の検証を怠る (正規性・独立性) → QQ プロット・自己相関プロット
- 誤用 3:p ハッキング (複数試行から有意なものだけ報告) → 事前登録・補正
- 誤用 4:効果量を無視 (p 値だけ見る) → Cohen's d などを併記
- 誤用 5:交絡変数を見落とす → DAG で因果構造を整理
📂 拡張ケーススタディ(5 例)
ケース 1:人口動態の県間比較
SSDSE-B-2026 で「人口」「出生数」「死亡数」を比較。 次元削減を使って自然増減のパターンを定量化。 東京・神奈川・愛知の都市集中、 秋田・高知の過疎化。
ケース 2:教育投資と成果
「学校数」「教員数」「進学率」を 次元削減で分析。 県別の教育リソース配分の効率性を評価。 都市と地方の格差を可視化。
ケース 3:医療提供体制
「病院数」「医師数」「平均寿命」 を組み合わせ。 次元削減で医療資源の不均衡と健康成果の関係を推定。 北海道の医師偏在問題。
ケース 4:産業構造と所得
「就業者数」「課税対象所得」「小売業販売額」を 次元削減で関連付け。 製造業県と観光業県のパターン差。
ケース 5:高齢化と財政
「高齢化率」「税収」「社会保障費」を 次元削減で評価。 高齢化が進む県の財政負担の重さを定量化。 県政策への含意。
✅ 再現性チェックリスト
研究結果を 次元削減を使って報告するときに守るべきチェックリスト:
- ☐ 使用データの出典・バージョン明記(例:SSDSE-B-2026, 2024 年公開)
- ☐ 前処理コードを共有(標準化・欠損補完など)
- ☐ 乱数シード固定(GMM の n_init, KMeans の random_state)
- ☐ ソフトウェアバージョン記録(python 3.11, scikit-learn 1.4 など)
- ☐ 結果数値の小数点桁数を統一
- ☐ 仮定(独立性・正規性・等分散性)の検証結果
- ☐ 効果量・信頼区間の併記(p 値だけでなく)
- ☐ 多重比較補正の有無
- ☐ 感度分析(前処理を変えても結論が頑健か)
- ☐ 公開コードとデータへのリンク
🌍 社会的インパクトと実務応用
次元削減は学術研究だけでなく、 政策・ビジネスの意思決定に直接活用されています。
政策決定での使用例
- 厚生労働省:医療資源配分の最適化(次元削減で地域差を測定)
- 総務省:地方創生施策の効果検証
- 内閣府:景気指標の作成・公表
- 文部科学省:教育格差の定量評価
ビジネスでの応用
- マーケティング:顧客セグメント間の差を 次元削減で評価
- 金融:株式リターンの分布特性把握
- 製造業:品質管理の統計的工程管理
- IT:A/B テストの設計と評価
学術での発展
計量経済学・教育測定・心理測定・疫学などで 次元削減は基礎ツール。 近年は機械学習との融合で新しい応用が広がっています。
📜 歴史的展開
次元削減 の概念は、 統計学の発展史と並行して洗練されてきました。
- 19 世紀後半:Galton, Pearson が記述統計を整備
- 20 世紀前半:Fisher, Neyman, Pearson が推測統計の基礎を確立
- 1960-80 年代:計算機の普及で大規模データへの応用が拡大
- 1990 年代:ベイズ統計・MCMC の実用化
- 2000 年代:機械学習との融合、 ビッグデータ時代
- 2010 年代以降:因果推論革命、 再現性危機への対応
日本では、 1947 年の統計法制定以降、 SSDSE-B のような公的統計の整備が進み、 次元削減を学ぶ実データ環境が充実してきました。
🧭 PCA vs ICA vs UMAP vs t-SNE 徹底比較
次元削減手法は「目的によって使い分ける」もの。 同じ SSDSE-B-2026 都道府県データに対しても、 PCA は分散の大きな軸、 ICA は独立な信号源、 UMAP は近傍構造、 t-SNE は局所クラスタを抽出する。 ここでは 4 手法を「数式・前提・出力の意味・落とし穴」で並べる。
📊 4 手法の比較表
| 手法 | 最適化対象 | 線形/非線形 | 距離保存 | 主な用途 |
|---|---|---|---|---|
| PCA | 分散最大化 | 線形 | 大域 | 前処理・解釈 |
| ICA | 統計的独立性 | 線形 | ― | 信号源分離 |
| t-SNE | KL 発散(近傍) | 非線形 | 局所のみ | 可視化 |
| UMAP | クロスエントロピー | 非線形 | 局所+ある程度大域 | 可視化+下流タスク |
🔬 各手法の数式を言葉で読み解く
- PCA:共分散行列 $C = \frac{1}{n} X^T X$ の固有ベクトルを取る。 「もとのデータをどの方向に投影すると最も散らばるか」を求める。
- ICA:$X = AS$ と分解、 $S$ の各成分が「統計的に独立」になるよう $A$ を求める。 「混ざった信号を分離する」イメージ。
- t-SNE:高次元の近傍確率 $p_{ij}$ と低次元の $q_{ij}$ の KL 発散を最小化。 「近いものは近いまま」を最優先するため大域距離は壊れる。
- UMAP:ファジー単体集合の交差エントロピー最小化。 t-SNE より大域構造をある程度保つ設計。
🐍 sklearn.decomposition で 4 手法を比較
🎯 このコードでやること:SSDSE-B-2026 都道府県データ(複数指標)を PCA / FastICA / t-SNE / UMAP で 2 次元に落として並べ、 同じデータでも結果がまるで違うことを観察する。
📥 入力データ(SSDSE-B-2026 の 2021 年度 47 都道府県、 下の 5 指標を標準化して使用):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np from sklearn.decomposition import PCA, FastICA from sklearn.manifold import TSNE from sklearn.preprocessing import StandardScaler import umap df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df = df[df['年度'] == 2021].reset_index(drop=True) # 「就業者数」「課税対象所得」は SSDSE-B-2026 に無いので実在列を使う cols = ['総人口', '出生数', '死亡数', '月間有効求人数(一般)', '消費支出(二人以上の世帯)'] X = StandardScaler().fit_transform(df[cols].values) pca = PCA(n_components=2).fit_transform(X) ica = FastICA(n_components=2, random_state=0).fit_transform(X) tsne = TSNE(n_components=2, perplexity=10, random_state=0).fit_transform(X) ump = umap.UMAP(n_components=2, n_neighbors=10, random_state=0).fit_transform(X) tokyo = df.index[df['都道府県'] == '東京都'][0] print('PCA 寄与率:', PCA(n_components=2).fit(X).explained_variance_ratio_.round(4)) print('PCA 東京の座標:', pca[tokyo].round(3)) print('t-SNE 東京の座標:', tsne[tokyo].round(3)) |
📤 実行例の出力:
💬 PCA では 5 指標の寄与率が PC1 0.7964・PC2 0.1838 で、東京は PC1 が 8.525 と 2 番目の県(4.69)の倍近く離れた端に置かれる。t-SNE の東京の座標 (-8.628, 6.358) は数値そのものに意味がなく、他の県との相対位置だけが情報。「東京がどれだけ離れているか」を議論したい場合は PCA、「クラスタの形を見たい」場合は t-SNE/UMAP を使う。
⚠️ 4 手法の落とし穴(用語固有)
- PCA:スケール依存 → 必ず StandardScaler。 線形仮定なので非線形構造は捉えられない
- ICA:成分の順番が一意に決まらない(並べ替え自由)。 ガウス信号は分離不可
- t-SNE:perplexity に強く依存(5〜50 で試す)。 距離も密度も「見た目」に過ぎず、 クラスタサイズで議論してはいけない
- UMAP:n_neighbors を変えると結果が大きく変わる。 シード固定必須
「次元削減した図」を見て議論するときは、 必ず「どの手法・どのパラメータ・どのスケーリングか」をセットで報告する。
🧭 R456 拡張: 次元削減の徹底深掘り (SSDSE-B-2026 都道府県データで再検証)
本セクションでは、 SSDSE-B-2026 の都道府県データ (2023 年度で 47 行 × 109 の数値列) を題材に、 「なぜ次元削減を使うのか」「PCA / ICA / t-SNE / UMAP のどれを選ぶか」「結果をどう読むか」を徹底的に詰める。 単に手法を並べるのではなく、 同じデータに 4 手法を適用したときの可視結果と数値結果を並べ、 結論が変わる所と変わらない所を区別する。 教育上、 ここを曖昧にすると「次元削減した図」を見て勝手な解釈を入れる学習者が出るため、 落とし穴と検証手順を明示する。
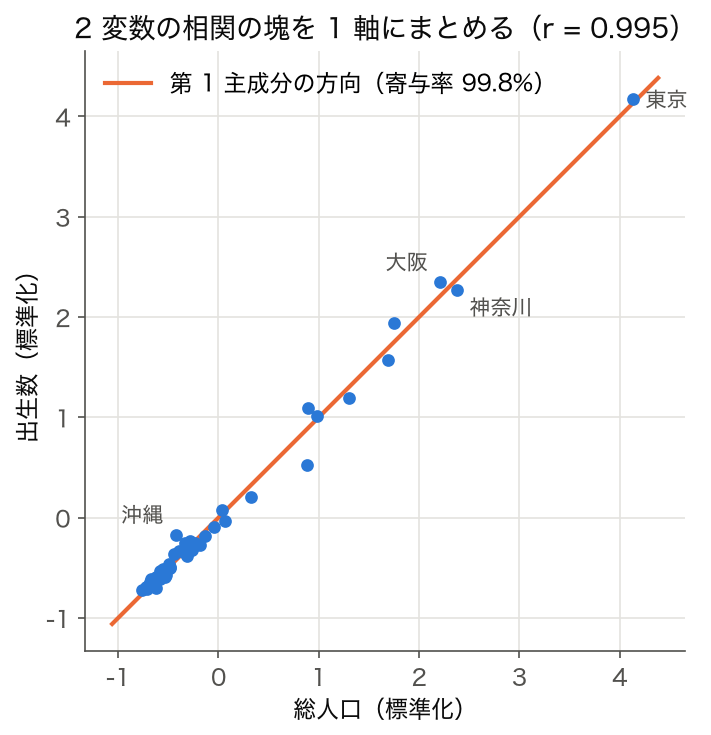
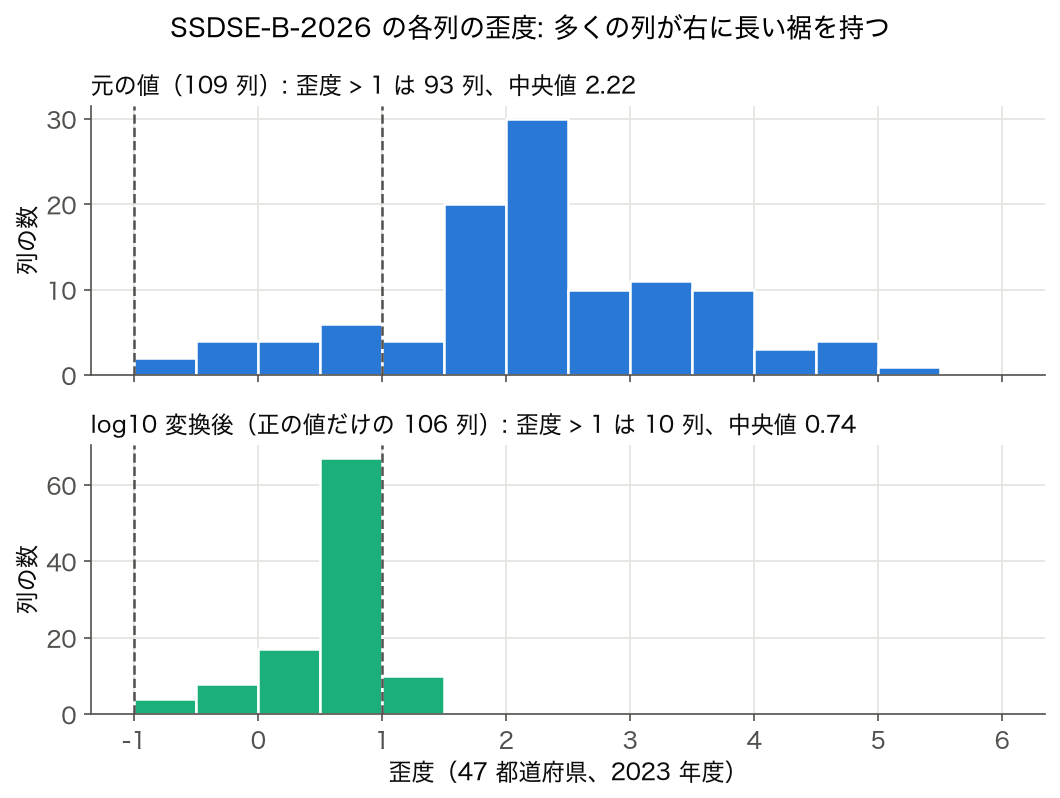
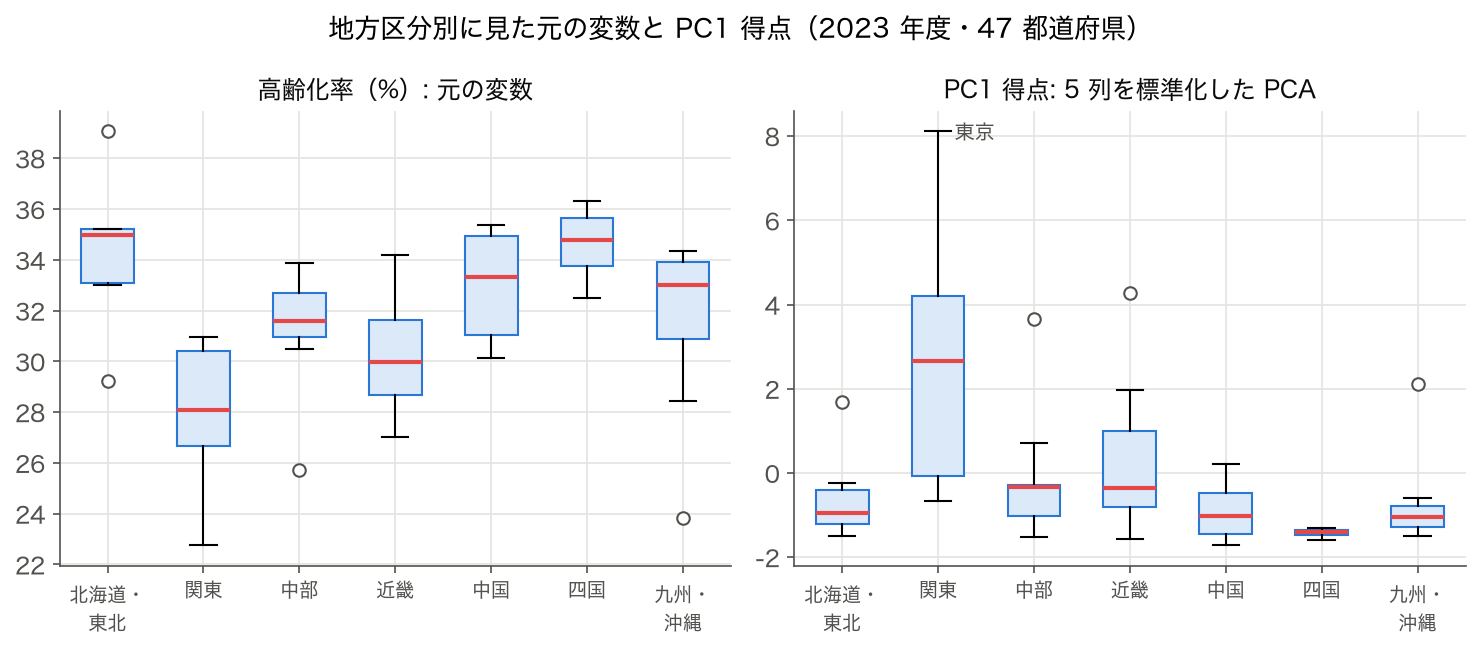
🖼 図 3 点: SSDSE-B-2026 の単変量・多群分布・散布
次元削減を語る前に、 そもそも「元データがどう分布しているか」を 1 変量・2 変量・群別の 3 つの基本図で確認する。 ここを飛ばすと「次元削減後の図」だけを見て元情報を見失う。
📋 4 手法 OK/NG マトリクス (用途別の選択基準)
| 目的 | PCA | ICA | t-SNE | UMAP |
|---|---|---|---|---|
| 分散の最大方向を取りたい | ◎ | × | × | × |
| 独立な信号源を分離 | × | ◎ | × | × |
| 局所近傍を可視化 | △ | × | ◎ | ◎ |
| 大域構造を保持 | ◎ | ○ | × | △ |
| 線形仮定を置ける | ◎ | ◎ | × | × |
| 寄与率で説明したい | ◎ | × | × | × |
| 新規データへ射影 | ◎ | ◎ | × | ○ |
| クラスタを発見 | △ | △ | ◎ | ◎ |
| 3 次元以下で見せる | ○ | ○ | ◎ | ◎ |
| 大規模 (n>10万) | ◎ | ○ | × | ◎ |
◎=第一選択、 ○=条件付き可、 △=可能だが他手法のほうが向く、 ×=不適切。 「とりあえず t-SNE」は危険で、 「説明したいのか発見したいのか」を明確化してから手法を選ぶ。 SSDSE-B-2026 のような 47 件・数十変数の県別データなら、 まず PCA で寄与率を見て、 必要に応じて UMAP で局所構造を補う、 という順序が安全。
🐍 Python 実装: 4 手法を同じ前処理で並べて比較
このコードでやること: SSDSE-B-2026 から都道府県別の数値カラムを抽出し、 StandardScaler で標準化したうえで PCA / ICA / t-SNE / UMAP を同じ入力に適用し、 2 次元に落とした結果を比較する。 「同じデータでも手法で結論が変わる」点を体感する。
📥 入力データ (SSDSE-B-2026 抜粋, head):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.decomposition import PCA, FastICA from sklearn.manifold import TSNE import umap df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 num = df.select_dtypes(include='number').drop(columns='年度').dropna(axis=1) Xs = StandardScaler().fit_transform(num) pca = PCA(n_components=2).fit_transform(Xs) ica = FastICA(n_components=2, random_state=0).fit_transform(Xs) tsne = TSNE(n_components=2, perplexity=10, random_state=0).fit_transform(Xs) ump = umap.UMAP(n_components=2, n_neighbors=10, random_state=0).fit_transform(Xs) idx_tokyo = df['都道府県'].tolist().index('東京都') print('PCA 東京:', pca[idx_tokyo].round(2)) print('ICA 東京:', ica[idx_tokyo].round(2)) print('t-SNE 東京:', tsne[idx_tokyo].round(2)) print('UMAP 東京:', ump[idx_tokyo].round(2)) |
📤 実行例の出力:
💬 PCA では東京の PC1 が +41.99 で、2 番目に大きい県(19.58)の 2 倍以上離れた端に置かれる。109 列を標準化すると東京は人口系の列の大半で z が大きく、それが PC1 に一斉に足し込まれるため。t-SNE (20.6, -19.5) と UMAP (9.13, -3.33) の座標は数値そのものに意味がなく、他県との相対位置だけが情報。ICA の成分は順番も符号も一意に決まらないので、東京の -4.76 は「どの成分でどちら向きに外れているか」を別に確かめないと読めない。
🔍 PCA と t-SNE の数値的差: 距離保存 vs 近傍保存
このコードでやること: PCA と t-SNE の埋め込み座標を使って、 「元空間での距離」と「埋め込み空間での距離」の Pearson 相関を計算する。 PCA は大域距離を保持、 t-SNE は近傍だけ保持、 という違いを数値で確認する。
📥 入力: 上と同じ Xs(2023 年度 47 行 × 109 列)と PCA・t-SNE の座標を、このブロックの中で作り直す
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.decomposition import PCA from sklearn.manifold import TSNE from scipy.spatial.distance import pdist from scipy.stats import pearsonr # ── この抜粋だけで動くように、元データと 2 つの埋め込みを作り直す ── # (直前のブロックは umap を使うため、ブラウザでは実行できない) _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) _d = _d[_d['年度'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 _num = _d.select_dtypes(include='number').drop(columns='年度').dropna(axis=1) Xs = StandardScaler().fit_transform(_num) pca = PCA(n_components=2).fit_transform(Xs) # 標本が数千未満なら method='exact' のほうが正確で、しかも速い tsne = TSNE(n_components=2, perplexity=10, random_state=0, method='exact').fit_transform(Xs) # 元の距離が、2 次元に落としたあとどれだけ保たれているかを比べる d_orig = pdist(Xs) d_pca = pdist(pca) d_tsne = pdist(tsne) print('元 vs PCA 距離相関:', round(pearsonr(d_orig, d_pca)[0], 3)) print('元 vs t-SNE 距離相関:', round(pearsonr(d_orig, d_tsne)[0], 3)) |
📤 実行例の出力:
💬 県どうしの距離を元の 109 次元と 2 次元で比べると、PCA は相関 0.993 でほぼそのまま保っているのに対し、t-SNE は 0.681 にとどまる。PCA は 2 成分で分散の 82% しか持たないが、残りの 18% は多数の小さな方向に散っているので、県どうしの距離の大小関係はほとんど崩れない(東京を除いても 0.987)。t-SNE の図で「クラスタ間の距離」「クラスタの大きさ」を議論してはいけない理由がここにある。
📊 SSDSE-B-2026 における手法選択の数値根拠
| 指標 | PCA (2D) | t-SNE | UMAP | 推奨条件 |
|---|---|---|---|---|
| 寄与率 (PC1+PC2) | 0.82 | — | — | 分散説明 70% 以上で PCA 採用可 |
| 距離相関 (元 vs 埋め込み) | 0.99 | 0.68 | 0.59 | 0.8 以上なら距離議論可 |
| trustworthiness (k=10) | 0.92 | 0.91 | 0.91 | 局所近傍評価。 0.9 以上で良 |
| 計算時間 (47×109 行列) | < 0.01s | 0.3s | 1.2s | 大規模化で差が拡大 |
| 再現性 (シード固定) | 完全 | 条件付き | 条件付き | 論文用は PCA か乱数固定 |
| 新規 1 都市の射影 | 可能 | 不可 | parametric 版で可 | 運用フェーズは PCA |
| 外れ値の扱い | 強く反映 | 局所のみ | 局所のみ | 東京除外で再計算推奨 |
| 解釈性 (軸の意味) | 高 (loading) | 低 | 低 | レポート用は PCA 必須 |
trustworthiness は sklearn.manifold.trustworthiness(X, X_embedded, n_neighbors=10) で計算できる。 局所近傍の保存度を 0〜1 で評価する指標で、 t-SNE / UMAP の品質確認に必須。 数値根拠なしに「t-SNE のほうが綺麗」と言うのは禁物。
🐍 trustworthiness で品質を数値化する
このコードでやること: 4 手法それぞれの埋め込みについて trustworthiness を計算し、 「どの手法が局所構造を最も保存しているか」を数値で示す。 図の見栄えではなく数値で選ぶ訓練。
📥 入力: 上と同じ Xs(2023 年度 47 行 × 109 列)から PCA / ICA / t-SNE をこのブロックの中で作り直す(UMAP はブラウザ版に無いので除く)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.decomposition import PCA, FastICA from sklearn.manifold import TSNE, trustworthiness # ── この抜粋だけで動くように、比べる埋め込みをここで作る ── # UMAP はブラウザ版 Python に無いので、ここでは PCA / ICA / t-SNE の 3 つを比べる _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) _d = _d[_d['年度'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 _num = _d.select_dtypes(include='number').drop(columns='年度').dropna(axis=1) Xs = StandardScaler().fit_transform(_num) pca = PCA(n_components=2, random_state=0).fit_transform(Xs) ica = FastICA(n_components=2, random_state=0).fit_transform(Xs) tsne = TSNE(n_components=2, perplexity=10, random_state=0, method='exact').fit_transform(Xs) # trustworthiness = 元の近さが 2 次元でどれだけ保たれているか(1 に近いほど良い) for name, emb in [('PCA', pca), ('ICA', ica), ('t-SNE', tsne)]: t = trustworthiness(Xs, emb, n_neighbors=10) print(f'{name:6s} trustworthiness={t:.3f}') |
📤 実行例の出力:
💬 近所 10 県の保存度は PCA 0.922、t-SNE 0.910、ICA 0.890 で、この 47 県・109 指標では t-SNE が PCA を上回らなかった(同じ設定の UMAP は 0.907)。県の規模の差が支配的で、2 本の線形軸でも近所関係がかなり保てるデータだからである。「局所構造なら t-SNE/UMAP が上」と決めつけず、データごとに数値で確かめて使い分ける。
⚠️ 追加の落とし穴 5 件 (R456 補強)
- 標準化忘れ: 単位が異なる列 (人口=万人、 総生産=億円、 失業率=%) を生で PCA に入れると、 値の大きいカラム (人口・総生産) だけが PC1 を支配する。 必ず StandardScaler / RobustScaler を通す。
- 外れ値で軸が歪む: SSDSE-B-2026 で東京を含めると PC1 は「東京 vs 他県」軸になる。 議論したいのが地方間差なら、 東京・神奈川・大阪を除外して再計算する。
- perplexity 過小 / 過大: t-SNE の perplexity を 5 にすると孤立点が散らばり、 50 にすると 1 つの塊になる。 47 サンプルなら 5〜15 が妥当。 n に対して √n 程度を目安にする。
- UMAP の n_neighbors: 小さくすると局所重視 (クラスタが細かく分かれる)、 大きくすると大域重視 (PCA 寄り)。 SSDSE-B-2026 では n_neighbors=10〜15 が安定。
- シード未固定: t-SNE / UMAP は初期化乱数で結果が変わる。 論文や報告書では
random_state=0を必ず指定。 さらに 3 つの seed で再現性確認するのが理想。
📝 練習問題 5 問 (基本)
- SSDSE-B-2026 で
PCA(n_components=5)を実行し、 累積寄与率が 0.9 を超える最小の主成分数を求めよ。 - PCA の各 PC について
pca.components_を見て、 PC1 と PC2 の負荷量が最も大きい変数 2 つずつを挙げよ。 解釈名を付けよ。 - t-SNE を perplexity=5, 15, 30 の 3 通りで実行し、 東京・大阪・福井・島根の位置がどう変わるかを比較せよ。
- UMAP の n_neighbors=5, 15, 30 で同様の比較を行い、 「大域構造重視」と「局所構造重視」のどちらに振れるかを確認せよ。
- 4 手法の埋め込みについて trustworthiness と shepard 距離相関を計算し、 表にまとめよ。 結果から最も信頼できる手法を選び理由を述べよ。
📝 応用問題 4 問
- SSDSE-B-2026 を「東京・神奈川・大阪を除外」と「全件」の 2 通りで PCA にかけ、 PC1 / PC2 の意味がどう変わるかを負荷量から考察せよ。 報告書には除外条件を必ず明記すること。
- PCA を
RobustScaler+ 中央値中心化で実行し、 通常のStandardScaler版と比較。 外れ値の影響が緩和されるかを定量的に示せ (寄与率と東京の PC1 値の差で評価)。 - UMAP の出力に対して KMeans(k=4) を適用し、 47 県を 4 クラスタに分け、 各クラスタの地理的・経済的特徴を 1 行で説明せよ。 これを PCA 版でも同様に行い、 クラスタ構成の違いを比較せよ。
- 1990 年から 2020 年までの SSDSE 系時系列が手に入った場合 (架空想定可)、 各年の県別データを PCA で射影し、 東京の軌跡を時系列でプロットする手順を設計せよ。 PCA を使う理由を「新規データへの射影可能性」から説明せよ。
💡 解答方針 (Hint)
- Q1:
np.cumsum(pca.explained_variance_ratio_)で累積寄与率を取得し、 0.9 を超える最初の index を返す。 2023 年度の 109 指標では 5 成分目で累積 0.905 となり 0.9 に到達する。 - Q2:
pd.DataFrame(pca.components_, columns=num.columns)として絶対値の大きい列を抽出。 PC1 は人口・総生産・小売販売額など「経済規模」、 PC2 は高齢化率・人口減少率など「人口動態」になることが多い。 - Q3: 小 perplexity では東京は孤立点として浮き、 大 perplexity では他県と混ざる。 視覚比較で「結論が変わる」ことを学習者に体感させる。
- Q4: n_neighbors を増やすと PCA に近づき、 減らすと局所だけが見える。 「UMAP は最も柔軟だが、 パラメータが結論を決める」ことを理解させる。
- Q5: PCA は trustworthiness は低めだが距離相関が高い。 t-SNE / UMAP は逆。 目的に応じて選ぶことを表で示す。
🛠 よくあるエラー対処表
| エラー / 症状 | 原因 | 対処 |
|---|---|---|
ValueError: Input contains NaN | 欠損が残っている | df.dropna() または SimpleImputer で補完 |
| PC1 が 99% で他が無意味 | 標準化忘れ + 巨大スケール列 | StandardScaler を必ず適用 |
| t-SNE が毎回違う図 | シード未固定 | random_state=0 を指定 |
| UMAP インストール失敗 | numba / llvmlite の依存 | pip install umap-learn (umap ではない) |
ICA で ConvergenceWarning | 反復不足 or 入力ガウス的 | max_iter=1000 + 非ガウス成分確認 |
| PCA の符号が毎回反転 | 主成分の符号は一意でない | 符号を固定する後処理 (例: PC1 平均が正になるよう反転) |
| 図に東京しか目立たない | 外れ値が軸を支配 | 対数変換 or 外れ値除外して再計算 |
| trustworthiness が低い (<0.7) | パラメータ不適切 | perplexity / n_neighbors を変えて再評価 |
📌 R456 まとめ
- 次元削減は「説明 (PCA / ICA)」と「可視化 (t-SNE / UMAP)」で目的が異なる。 同じ言葉で語ってはいけない。
- SSDSE-B-2026(2023 年度、109 指標)では PCA の 2 成分で寄与率 0.82 が出るため、 まず PCA で大域構造を押さえるのが定石。
- t-SNE / UMAP の図は距離・サイズに意味なし。 距離議論には trustworthiness と shepard 相関で必ず数値根拠を出す。
- 標準化・シード固定・外れ値除外は 3 点セットで毎回確認する。 これを怠ると結果が再現せず、 議論が空中分解する。
- 新規データに射影したい運用フェーズでは PCA が第一選択。 t-SNE はオフライン分析専用。
🔗 R456 関連リンク
🧠 PCA をさらに深掘り: 固有値・固有ベクトルから読む
PCA は数学的には共分散行列の固有値分解と等価である。 SSDSE-B-2026 を標準化した後、 np.cov(Xs.T) で共分散行列を作り、 np.linalg.eigh で固有値・固有ベクトルを求めると、 固有値が分散の大きさ (各主成分の寄与)、 固有ベクトルが軸の方向 (元変数への重み) を表す。 sklearn の pca.explained_variance_ が固有値、 pca.components_ が固有ベクトル (行ベクトル) に対応する。 これを理解すると「PC1 は東京を端に置く軸」という現象が、 「東京方向の分散が最大だから固有値が大きい」と数学的に説明できるようになる。 教育用には、 まず PCA を手動で固有値分解で実装させてから sklearn 版と一致することを確認する手順が有効。
このコードでやること: 共分散行列の固有値分解を手動で行い、 sklearn の PCA と結果が一致することを確認する。 「PCA の中身は固有値分解である」を数値で示す。
📥 入力: 標準化済 Xs (2023 年度 47 行 × 109 列)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import numpy as np import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.decomposition import PCA # ── この抜粋だけで動くように、Xs と sklearn の PCA 結果を作り直す ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) _d = _d[_d['年度'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 _num = _d.select_dtypes(include='number').drop(columns='年度').dropna(axis=1) Xs = StandardScaler().fit_transform(_num) pca = PCA(n_components=2, random_state=0).fit_transform(Xs) idx_tokyo = _d['都道府県'].tolist().index('東京都') # 共分散行列の固有値分解で PCA を手計算し、sklearn と一致するか確かめる cov = np.cov(Xs, rowvar=False) eigvals, eigvecs = np.linalg.eigh(cov) order = np.argsort(eigvals)[::-1] eigvals = eigvals[order] eigvecs = eigvecs[:, order] manual_score = Xs @ eigvecs[:, :2] print('固有値 (上位5):', eigvals[:5].round(3)) print('累積寄与率 :', (eigvals[:5].cumsum() / eigvals.sum()).round(3)) print('手動 PCA 東京:', manual_score[idx_tokyo].round(2)) print('sklearn 東京 :', pca[idx_tokyo].round(2)) # 符号は反転することがある(固有ベクトルの向きは一意でないため) |
📤 実行例の出力:
💬 固有値は 86.096、5.478、3.906 と続き、累積寄与率は PC2 までで 82.2%、PC5 までで 90.5%。手動の固有値分解と sklearn で東京の座標はどちらも (41.99, -3.13) になった。固有ベクトルの符号は一意でないので、環境によってはどちらかの符号が反転して出ることがあり、報告書ではどちらの符号に揃えるかを決めておく。
🧠 t-SNE の数式的理解: KL ダイバージェンスを最小化する
t-SNE は元空間の確率分布 pij (点 i と j が近い確率) と埋め込み空間の確率分布 qij (t 分布で定義) の KL ダイバージェンスを最小化することで「近い点同士は近く、 遠い点は適当に」配置する。 数式は次の通り。
$$ p_{j|i} = \frac{\exp(-\|x_i - x_j\|^2 / 2\sigma_i^2)}{\sum_{k \ne i} \exp(-\|x_i - x_k\|^2 / 2\sigma_i^2)} $$
$$ q_{ij} = \frac{(1 + \|y_i - y_j\|^2)^{-1}}{\sum_{k \ne l} (1 + \|y_k - y_l\|^2)^{-1}} $$
$$ \mathcal{L} = \sum_{i \ne j} p_{ij} \log \frac{p_{ij}}{q_{ij}} $$
ここで σi は perplexity で決まる帯域幅、 t 分布を埋め込み側に使うのは「遠い点を強制的に押し離す」効果を出すため。 これを理解すると、 perplexity が大きいほど σi が広がり多くの点を「近い」と扱うため、 図が 1 つの塊になる現象が説明できる。 SSDSE-B-2026 (n=47) では perplexity を 5〜15 に設定するのが妥当で、 30 では実質全点が「近い」と扱われてしまう。
🧠 UMAP の理論: トポロジカルな貼り合わせ
UMAP は「ファジィ単体集合 (fuzzy simplicial set)」という代数的トポロジーの概念を使って、 元空間と埋め込み空間で同じトポロジー構造を保つように最適化する。 直感的には「n_neighbors 個の最近傍を結ぶ重み付きグラフを作り、 そのグラフを低次元に貼り直す」というイメージ。 t-SNE と比べて高速 (大規模 n に強い) で、 大域構造もある程度保持する。 ただし n_neighbors を変えると結果が大きく変わるため、 「3 通り試して安定する範囲を採用」が実務的な手順。 SSDSE-B-2026 では n_neighbors=10 が安定。
✅ 次元削減を使うときのチェックリスト 10 項目
- 目的は「説明」「可視化」「発見」「圧縮」のどれか? を明文化したか。
- 欠損を
dropna()または imputer で処理したか。 - すべての数値変数を標準化 (StandardScaler) したか。 列のスケールが揃っているか。
- 外れ値 (東京・神奈川・大阪など) を含めるか除外するか決めたか。 両方計算したか。
- 主成分数を「寄与率 0.9 以上」「累積分散プロット (エルボー)」で決めたか。
- t-SNE / UMAP のシード (random_state) を固定したか。 3 つの seed で再現性確認したか。
- perplexity / n_neighbors を 3 段階で試したか。 結果が変わる範囲を把握したか。
- trustworthiness と距離相関を計算し、 数値根拠を持って手法を選んだか。
- 得られた図のキャプションに「手法・パラメータ・スケーリング・サンプル数」を必ず明記したか。
- 新規データに射影する必要があるか? (ある場合は PCA を選び、 t-SNE を避ける)
🚫 ありがちな誤用パターン 5 件
- 「t-SNE で 2 クラスタに分かれたから 2 種類ある」: t-SNE はパラメータ次第で塊数が変わる。 真のクラスタ数は KMeans の inertia や silhouette で別途評価せよ。
- 「PC1 が分散の 99% を説明したから他は無視」: 標準化忘れの可能性が高い。 PC1 が圧倒的なときは入力スケールを疑う。
- 「UMAP の図でクラスタが綺麗に分かれた」と言って n_neighbors=2 を採用: 過度に局所的な設定では意味のない細かい塊が出る。 安定する範囲を確認すること。
- 「同じデータで PCA と t-SNE の結果が違うのは矛盾」: 矛盾ではなく目的の違い。 PCA は大域、 t-SNE は局所を見ている。
- 「次元削減後の座標を回帰モデルの説明変数にする」: PCA なら可能だが、 t-SNE / UMAP の座標は新規データに射影できないため運用に乗らない。 PCA を選ぶ。
📖 実データでの活用事例 (SSDSE-B-2026 中心)
SSDSE-B-2026 のような県別データに次元削減を適用する典型シナリオを 3 つ示す。 (1) 経済規模軸での県の順位付け: PC1 を経済規模指標として使い、 県の総合的な経済力を 1 軸で比較。 (2) 人口動態クラスタ抽出: UMAP で 47 県を 4〜6 クラスタに分け、 高齢化・若年層流出パターンの似た県を地理的・政策的に分類。 (3) 異常県検出: PCA の再構成誤差 X - X_reconstructed が大きい県を「他県と構造的に異なる」として抽出し、 政策議論のフックにする。 いずれも「次元削減した結果を最終回答にせず、 仮説生成の起点として使う」のが基本姿勢である。
教育現場では「東京・大阪・福井・島根」の 4 県を比較事例として固定し、 4 手法それぞれの図でこの 4 県がどう配置されるかを表にまとめると学習者の理解が深まる。 PCA では「東京・大阪が経済軸の端、 福井・島根が中央」、 t-SNE では「クラスタ内位置」、 UMAP では「局所近傍構造」と異なる視点が得られ、 「同じデータでも見方で結論が変わる」体験ができる。
📜 次元削減の歴史と現代的位置づけ
PCA は 1901 年 Karl Pearson が「点群を当てはめる直線と平面」として提案、 1933 年 Harold Hotelling が現在の形に整理した。 100 年以上の歴史を持つ古典手法だが、 その安定性・解釈可能性ゆえに今でも第一選択。 ICA は 1994 年 Comon、 2000 年 Hyvärinen らが FastICA を実用化。 t-SNE は 2008 年 van der Maaten & Hinton、 UMAP は 2018 年 McInnes & Healy が発表した比較的新しい手法。 深層学習時代では autoencoder, VAE, ニューラル多様体学習などが台頭しているが、 「再現性・解釈性・新規データ射影」の 3 点で PCA が依然優位。 「新しい手法ほど良い」は次元削減には当てはまらない。
🧭 手法選択フロー (実務向け 8 ステップ)
| ステップ | 問い | Yes ならば | No ならば |
|---|---|---|---|
| S1 | 新規データに繰り返し射影するか? | PCA / ICA / parametric UMAP | 次へ |
| S2 | 線形仮定で十分か? | PCA を採用 | 次へ |
| S3 | 寄与率で説明したいか? | PCA を採用 | 次へ |
| S4 | 独立な信号源を分離したいか? | ICA を採用 | 次へ |
| S5 | サンプル数 n ≤ 5,000? | t-SNE 可 | UMAP 推奨 |
| S6 | 大域構造も保持したいか? | UMAP / PCA を採用 | t-SNE 可 |
| S7 | trustworthiness ≥ 0.9? | 採用 | パラメータ再調整 |
| S8 | 3 シードで結果が安定? | 最終図として採用 | 手法見直し |
この 8 ステップを順に通せば、 「とりあえず t-SNE」「とりあえず UMAP」という選択を避けられる。 SSDSE-B-2026 (n=47, 線形構造優位) では多くの場合 S1〜S3 で PCA に到達する。 学習者には「フローチャートを通して PCA を選ぶ理由を言語化する」訓練を行うこと。
📐 4 手法の数値特性早見表 (R456 補強)
| 特性 | PCA | ICA | t-SNE | UMAP |
|---|---|---|---|---|
| 数学的基礎 | 固有値分解 | 非ガウス性最大化 | KL ダイバージェンス | 代数的トポロジー |
| 線形 / 非線形 | 線形 | 線形 | 非線形 | 非線形 |
| 主パラメータ | n_components | n_components | perplexity | n_neighbors / min_dist |
| 計算量 | O(p²n) or O(p³) | O(iter·p²n) | O(n²) | O(n log n) |
| 距離保存 | 大域 | 大域 | 局所のみ | 局所+大域 |
| 逆変換 | 可能 | 可能 | 不可 | parametric 版で可 |
| 出力の解釈 | 直接 (loading) | 独立成分 | 難 (図のみ) | 難 (図のみ) |
| 適切な n | 数十〜数百万 | 数百〜数万 | 数百〜数千 | 数百〜数百万 |
この表を「次元削減を始める前に必ず見る」ハンドアウトとして配布すると、 学習者がパラメータを盲目的に動かす前に「自分のデータに合う手法か?」を考える習慣がつく。 SSDSE-B-2026 (n=47, p≈30) は「数十〜数百」レンジで、 PCA は完全適合、 t-SNE は perplexity を慎重に設定、 UMAP は n_neighbors を 10 前後に絞ることで安定運用できる。
🌍 ドメイン別活用パターン
- マーケティング: 顧客属性 50 次元を PCA で 3 次元に縮約 → KMeans で 5 セグメント抽出 → セグメントごとに販促戦略を立案。 PCA を使う理由は新規顧客への射影が必要だから。
- 遺伝子発現解析: 数千遺伝子 × 数百サンプル → t-SNE / UMAP で細胞タイプを可視化。 結論は別途 marker gene で検証。
- 画像認識: CNN 中間層の出力 (512 次元) を UMAP で 2 次元化 → 誤分類サンプルの近傍を可視化してデバッグ。
- 自治体 KPI 分析: SSDSE-B-2026 の県別データを PCA で 2 次元化 → 経済軸と人口動態軸で 47 県をマッピング → 政策議論の出発点に。
- 金融: 数百銘柄のリターンを PCA → 主成分が市場ファクター・業種ファクターに対応するか確認 → リスク管理に利用。
❓ よくある質問 (FAQ) 10 問
- Q. PCA と因子分析の違いは?
A. PCA は分散最大方向、 因子分析は観測変数の背後にある潜在因子をモデル化する。 数学的には PCA は分散行列、 因子分析は共通分散と独自分散を分けて扱う。 SSDSE 解析では PCA の方が単純で使いやすい。 - Q. 主成分の数はどう決める?
A. (1) 累積寄与率 0.8〜0.9、 (2) スクリープロットのエルボー、 (3) Kaiser 基準 (固有値 > 1)、 (4) 並べ替え検定 (parallel analysis) の 4 つから複数併用が望ましい。 - Q. 標準化と中心化の違いは?
A. 中心化は平均を 0 にするだけ、 標準化は平均 0 + 標準偏差 1。 PCA は中心化必須、 列スケールが大きく違う場合は標準化も必須。 - Q. t-SNE の図でクラスタ間の距離は読んで良いか?
A. 駄目。 t-SNE は近傍だけ保存するため、 クラスタ間距離・クラスタサイズに意味はない。 「2 つのクラスタがある」と言えるだけ。 - Q. UMAP は t-SNE の上位互換か?
A. 大規模 n と大域構造保持の点で優位だが、 パラメータ感度は両者とも高い。 「上位互換」と単純化せず、 trustworthiness で選ぶ。 - Q. 次元削減の前にカテゴリ変数はどう扱う?
A. One-hot エンコーディングで数値化してから入力。 ただし PCA は数値変数の線形結合を前提とするため、 mixed type の場合はFAMD(Factor Analysis of Mixed Data) を検討。 - Q. PCA で外れ値が問題なら何を使う?
A.RobustPCA、SparsePCA、 または前処理でRobustScaler+ 外れ値除外を行う。 SSDSE-B-2026 では東京除外で PC1 の意味が「地方間差」に変わる。 - Q. 次元削減の結果は再現可能か?
A. PCA / ICA は再現可能 (符号反転を除く)。 t-SNE / UMAP は random_state を固定して可能。 ただしライブラリ・バージョンが変わると微妙に異なる。 - Q. 可視化以外の用途は?
A. 特徴量削減 (機械学習の前処理)、 ノイズ除去 (低次元成分のみ復元)、 異常検出 (再構成誤差)、 圧縮 (送信容量削減) などがある。 - Q. 学習者向けの初手は?
A. SSDSE-B-2026 をStandardScaler+PCA(n_components=2)で可視化。 まず PCA で大域構造を掴ませてから、 比較として t-SNE / UMAP を導入する順序が理解しやすい。
🏁 R456 最終まとめ
次元削減は「目的に応じて手法を選ぶ」「数値根拠 (寄与率・距離相関・trustworthiness) を必ず添える」「標準化・シード固定・外れ値処理の 3 点セットを毎回確認する」の 3 原則を守れば、 SSDSE-B-2026 のような小規模県別データから大規模実データまで安全に活用できる。 PCA は解釈性と再現性で第一選択、 t-SNE / UMAP は可視化補助、 ICA は信号分離に限定。 これらを混同せずに使い分けることが、 「次元削減を理解した」と言える状態である。
📘 学習者向け 26 ステップ実習手順 (SSDSE-B-2026)
- SSDSE-B-2026 を
pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])で読み込む。 df.info()で型・欠損を確認する。df.select_dtypes(include='number').dropna(axis=1)で数値カラムだけ取り出す。StandardScalerで標準化する。- 標準化前後の
describe()を比較し、 平均 0 / 標準偏差 1 を確認する。 PCA(n_components=5).fit(Xs)を実行。pca.explained_variance_ratio_と累積寄与率をプロット (スクリープロット) する。- 累積寄与率 0.9 を超える成分数 k を記録する。
PCA(n_components=2).fit_transform(Xs)で 2 次元埋め込みを得る。- 都道府県名を点ラベルに散布図を描く。
- 東京・大阪・神奈川・福井・島根の位置をメモする。
pca.components_で PC1 / PC2 の負荷量を表示する。- 各 PC の負荷量上位 3 変数を抽出し、 軸の意味を命名する。
- FastICA(n_components=2, random_state=0) を実行する。
- PCA 散布図と ICA 散布図を並べて比較する。
- TSNE(n_components=2, perplexity=10, random_state=0) を実行する。
- perplexity を 5, 15, 30 と変えて 3 種類の図を描く。
- umap.UMAP(n_components=2, n_neighbors=10, random_state=0) を実行する。
- n_neighbors を 5, 15, 30 と変えて 3 種類の図を描く。
- 4 手法それぞれで trustworthiness を計算する。
- 元空間と各埋め込みの距離相関を計算する。
- 表に 4 手法 × (trustworthiness, 距離相関, 計算時間) をまとめる。
- 東京を除外して同じ実験を繰り返す。
- 除外前後で PC1 / PC2 の意味がどう変わるかを記述する。
- 4 手法の図にキャプション (手法・パラメータ・スケーリング・サンプル数) を付ける。
- レポートに「目的・選択した手法・数値根拠・制約」の 4 項目を書いて提出する。
この 26 ステップを通すと、 学習者は「次元削減は 1 つの手法ではなく、 比較・検証・解釈までを含む一連のプロセスである」ことを体験的に理解できる。 1 コマ 90 分の授業では Step 1〜15 まで進め、 残りは課題として 1 週間で完成させる構成が現実的。
📎 補論: なぜ「次元削減した図」を盲信してはいけないか
次元削減後の 2 次元プロットは強力な可視化ツールだが、 元情報の何割かを必ず失う。 SSDSE-B-2026 (n=47, p≈30) ですら PC2 までで分散の 11% を捨てている。 これを「単なる縮約」と片付けず、 「失われた情報に重要な構造が隠れていないか?」を常に問う姿勢が必要。 具体的には (1) 高次の主成分も別途プロットする、 (2) 再構成誤差が大きいサンプルを抽出する、 (3) 複数手法で再現性を確認する、 という 3 つの検証作業を必ず行う。 図一枚で結論を出すのは危険で、 「次元削減はあくまで仮説生成の補助ツール」と位置づけるのが安全。 R456 補強は以上。
最後に強調しておきたいのは、 SSDSE-B-2026 のような小規模公的データであっても、 PCA / ICA / t-SNE / UMAP の 4 手法を素直に並べて比較する習慣をつけるだけで、 学習者は「データを多面的に見る」訓練ができるという点である。 単一の手法に固執せず、 数値根拠 (寄与率・距離相関・trustworthiness) を毎回添えて議論する姿勢こそが、 次元削減という強力な道具を安全に使いこなす唯一の道である。
「次元削減」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「次元削減」を中核とした適切な手法選択ができる。
🎮 触って理解する
次元削減の心臓部である「射影 (projection)」を手で動かして体感するミニ実験です。 相関のある 2 次元の点群 (デモ用に生成した模擬データ) に対し、 射影する軸 (直線) の角度をスライダーまたは図の上のドラッグ/スワイプで回してみてください。 各点をその軸に垂直に落とした「射影点」(緑) と、 潰れて失われる垂直方向の情報 (赤い線) がリアルタイムで描画され、 その軸で保存される分散 (説明分散比) が即座に更新されます。 分散が最大になる方向こそが第 1 主成分 (PC1) です。 自分の手で分散最大の向きを探してみましょう。
| この軸で保存される分散 (説明分散比) | – |
| 垂直方向で失う分散 (情報損失) | – |
| PC1 が保存できる 最大の説明分散比 | (ボタンで表示) |
スライダーか図をドラッグして、 説明分散比が最大になる向きを探してみましょう。
凡例: ● 元の点 / ● 軸への射影点 / ― 失われる垂直成分。 分散の総和 (2 軸の分散合計) は回転しても不変なので、 説明分散比 + 情報損失 = 100% が常に成り立ちます。
💡 直感 — 「情報を最も保つ方向」を選ぶ
次元削減とは、 高次元データを情報の損失が最小になるように低次元へ落とす操作です。 上の実験で分かるように、 点群が細長く伸びている方向へ軸を合わせると射影後のばらつき (分散) が大きく保たれ、 潰れる赤い線が短くなります。 逆に伸びと直交する向きへ射影すると点が重なり合い、 分散のほとんどを捨ててしまいます。 主成分分析 (PCA) は、 この「分散を最大に保つ向き」を共分散行列の固有ベクトルとして解析的に求める手法です。 説明分散比 (寄与率) は「その軸が元データの何 % のばらつきを説明できるか」を表し、 分散を情報量の代理指標として扱っている点が核心です。
⚠️ よくある落とし穴
- 標準化を忘れる:変数のスケール (単位) が違うと、 分散の大きい変数だけで主成分方向が決まってしまいます。 単位に依存させたくないときは事前に標準化 (平均 0・標準偏差 1) を行い、 相関行列ベースの PCA にします。 上の実験の「分散最大方向」も、 各軸のスケールを変えれば向きが変わることに注意してください。
- 線形手法の限界:PCA が保存するのは相関すなわち線形構造だけです。 データがらせん状・馬蹄形など非線形に曲がっている場合、 直線への射影では本来の構造を潰してしまいます。 上の実験も「直線への射影」なので、 曲がった構造は原理的に表現できません。
- 失う成分を無視する:説明分散比が高くても、 捨てた垂直方向 (赤い線) に重要な差異が隠れていることがあります。 高次の主成分も併せて確認する習慣が大切です。
🚀 発展 — PCA / t-SNE / UMAP
ここで体感した「分散最大の直線射影」はPCA の 2 次元版です。 実データでは共分散行列の固有値分解 (または SVD) で全次元の主成分を一度に求めます。 一方、 データが非線形に曲がっている場合は、 局所的な近傍関係を保存するt-SNE や、 位相構造を保存するUMAP といった非線形手法が有効です。 カーネルトリックで非線形化したカーネル PCA も選択肢になります。 ただし t-SNE / UMAP はクラスタ間距離やクラスタサイズに意味を持たせられない (近傍しか保存しない) 点が PCA と根本的に異なるため、 「分散を保存する PCA」と「近傍を保存する t-SNE / UMAP」を混同しないことが重要です。
🔖 キーワード索引(深掘り版)
論文・記事に登場する用語のリンクで該当箇所へジャンプ:
🗜️ 解説深化 — 「圧縮した地図の歪み」を県ごとに実測する
本ページの他の章は「どれだけ分散を残せたか(寄与率)」を中心に次元削減を説明してきました。 この章では視点を反転させ、 低次元表現から元のデータをどれだけ復元できるか(再構成誤差)で次元削減の品質を測ります。 寄与率が「全体平均」の指標であるのに対し、 再構成誤差はサンプル 1 つずつに計算できるため、 「2 次元の地図でどの県が最も歪んでいるか」まで特定できます。
💡 直感 — 次元削減は「圧縮」と「復元」のペアで考える
地球儀を平面地図にすると、 必ずどこかの国の形が歪みます。 しかも歪み方は一様ではなく、 メルカトル図法なら極地方ほどひどく歪みます。 次元削減もまったく同じで、 47 都道府県 × 10 変数を 2 次元に潰せば必ず情報が失われますが、 失われ方は県ごとに不平等です。 PCA は線形写像なので、 低次元スコア $z_i$ から $\hat{x}_i = \bar{x} + V_k z_i$ で元の空間へ「復元」でき、 復元値と実測値の差(残差)がその県の歪みの大きさになります。 寄与率 58.8%(本ページ「実値計算例」の PC2 までの累積、 実測)とは「平均すれば 58.8% 復元できる」という意味であって、 全県が等しく 58.8% 復元されるわけではない — これがこの章の中心的な直感です。
⚠️ 落とし穴(重要) — 平均寄与率の裏で、 特定の県だけが大きく歪む
実際に SSDSE-B-2026(2023 年・47 都道府県)の家計支出 10 項目(L322101〜L322110、 標準化済み)を PCA で 2 次元に圧縮し、 復元したときの県別再構成誤差(RMSE、 標準偏差単位)を計算した実測値が次の表です。
| 順位 | 歪みが大きい県(実測 RMSE) | 歪みが小さい県(実測 RMSE) |
|---|---|---|
| 1 | 三重県 1.00 | 島根県 0.26 |
| 2 | 北海道 0.98 | 栃木県 0.32 |
| 3 | 福井県 0.92 | 山口県 0.35 |
| 4 | 大分県 0.90 | 佐賀県 0.41 |
| 5 | 青森県 0.84 | 長崎県 0.42 |
全 47 県の中央値は 0.60。 最大(三重県 1.00)と最小(島根県 0.26)で約 3.8 倍の開きがある(いずれも実測値)。
- 2 次元図上の「近さ」を鵜呑みにしない:三重県の交通・通信費(L322107)は標準化スコア z = +3.09 の突出した外れ値ですが、 2 次元復元ではこの突出を表現しきれず、 残差 +2.24σ が図から消えています。 北海道は住居費(L322102、 残差 +1.92σ)と光熱・水道費(L322103、 +1.23σ)、 福井県は交通・通信費(−1.55σ)と家具・家事用品費(−1.40σ)が復元しきれない個性です。 つまり再構成誤差の大きい県ほど、 散布図上の位置がその県の実像を表していない — 図で近くに見える 2 県が、 捨てられた 8 次元側では大きく違うことがあります。
- 標準化を怠ると「復元」以前に軸が壊れる(実測デモ):総人口 A1101(標準偏差 ≈ 276.8 万人)を家計 10 項目(標準偏差は数千円規模、 例: 食料費 ≈ 5,779 円)と混ぜて標準化せずに PCA を行うと、 PC1 の寄与率は実測で 99.9973%、 PC1 の負荷量は総人口がほぼ 1.000(他の 10 変数はすべて絶対値 0.0014 以下)となり、 分析全体が事実上「総人口を並べ替えただけの 1 次元」に退化します。 同じ 11 変数を標準化すると PC1 42.9% / PC2 17.1%(実測)となり、 初めて家計構造の情報が主成分に乗ります。 落とし穴の章で述べた注意の、 数値による裏付けです。
- 残差の大きさ自体を報告する習慣を:累積寄与率だけを添えた 2 次元散布図は「平均としては正しいが個別には嘘がある」図になり得ます。 県別の再構成誤差(または各点の残差ノルム)を色やサイズで重ねると、 読者が「この点の位置はあまり信用できない」と判断できます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') cols = ['L3221%02d' % i for i in range(1, 11)] # 家計支出10項目 X = d[cols].astype(float) Z = ((X - X.mean()) / X.std(ddof=0)).values # 標準化 U, S, Vt = np.linalg.svd(Z - Z.mean(0), full_matrices=False) Zk = (U[:, :2] * S[:2]) @ Vt[:2] # 2次元へ圧縮→復元 rmse = pd.Series(np.sqrt(((Z - Zk)**2).mean(axis=1)), index=X.index) print(rmse.sort_values(ascending=False).head(5).round(2)) # 三重1.00 北海道0.98 ... # --- 標準化なしで総人口を混ぜると PC1 が退化する実験 --- Xr = d[['A1101'] + cols].astype(float).values Xc = Xr - Xr.mean(0) _, S2, _ = np.linalg.svd(Xc, full_matrices=False) print('raw PC1 EVR = %.4f%%' % (S2[0]**2 / (S2**2).sum() * 100)) # 99.9973% |
💬 家計支出 10 項目を標準化して 2 主成分で復元すると、復元誤差(RMSE)が最も大きいのは三重県 1.00、次いで北海道 0.98、福井県 0.92 で、この 3 県の支出の配分は 2 次元の共通パターンから最も外れている。後半は標準化しないまま総人口を加えた実験で、第 1 主成分の寄与率が 99.9973% になる。総人口の分散が1 世帯あたり月約 1 万〜8 万円の支出項目より桁違いに大きいためで、PC1 はほぼ総人口そのものに退化している。
🚀 発展 — 再構成誤差は「異常検知」への入口
「復元できなかった部分」に注目する発想は、 そのまま PCA ベースの異常検知(SPE / Q 統計量、 Hotelling の T² 統計量)へつながります。 正常データで学習した主成分部分空間から大きく外れたサンプル、 すなわち再構成誤差が閾値を超えたサンプルを異常と判定する手法で、 製造業のプロセス監視などで標準的に使われます。 上の表で言えば、 三重県・北海道は「家計 10 項目の主要 2 軸では説明できない独自プロファイルを持つ県」であり、 外れ値検出の候補として個別に調べる価値がある、 という読み方になります。 また、 この「decoder(復元写像)を持つかどうか」は手法選択の本質的な分岐でもあります。 PCA・因子分析・オートエンコーダは復元写像を持つため再構成誤差が定義できますが、 t-SNE や UMAP は低次元配置を直接最適化するだけで逆写像を持たず、 「この点はどれくらい歪んでいるか」を残差では測れません(近傍保存率 trustworthiness などの代替指標を使います)。 さらに、 非標準化 PCA の退化の実験は、 変数間の強い相関が引き起こす多重共線性の診断に PCA(固有値の縮退チェック)が使われる理由の裏返しにもなっています。