🔖 キーワード索引
🔖 キーワード索引(拡張)
「k-means」は SSE (クラスタ内二乗距離和) を目的関数とする非階層クラスタリング手法。 本ページの中核キーワードを以下に整理する。
これらのキーワードは「assignment step → update step → 収束判定」と「k 選択 → 初期化 → 形状判定」の 2 軸で k-means 実務を構成する。
💡 30秒で分かる結論
🍰 まずはやさしく
似たもの同士を分けるグループ分けです。
データを自動でいくつかの集団にまとめます。
スマホのアプリで好みの人を分けるようなものです。
この手法の結論を短くまとめます。
- 目的:n 個のサンプルを、 k 個のクラスタに自動分類
- 原理:各クラスタ中心からの距離の二乗和(SSE)を最小化
- 反復:「割り当て」と「中心更新」を収束まで繰り返す(通常 10-30 回)
- k は事前に決める:エルボー法・シルエット係数で決定
- 標準化必須:単位の違う変数を入れる前に StandardScaler
- 限界:球形クラスタ専用、 外れ値に弱い、 局所最適に陥る
- Python:
sklearn.cluster.KMeans(n_clusters=k, n_init="auto")
📖 もっと詳しく
k-means は機械学習の教師なし学習の代表手法。 「事前に決めた k 個のグループに、 似ているサンプル同士を集める」反復アルゴリズム。 1957年に Lloyd が提案し、 1967年に MacQueen が "k-means" と命名。 シンプルかつ高速で、 現在も クラスタリング手法の標準。
「means(平均)」が名前の由来:各クラスタの「中心(centroid)」を、 そのクラスタに属するサンプルの平均位置で表すから。 「k 個の中心」を探すアルゴリズム、 と言えます。
k-means は探索的データ分析の万能ツール。 顧客セグメンテーション、 地域類型化、 異常検知、 画像圧縮(色のクラスタリング)まで幅広く使われます。
📍 あなたが今見ているもの
🍰 まずはやさしく
データを分けるための定番の道具です。
似ているグループを自動で作るために使います。
都道府県を特徴で分けるときに便利です。
この手法がどこで使われるかを紹介します。
論文で「k-means クラスタリング」「k=4 でクラスタリングした」「エルボー法で k を決定」のように登場する手法。 47都道府県を「似ている県のグループ」に自動分類するときの定番ツール。
k-means法 とは:事前に決めた k 個のクラスタ中心からの距離が最小になるように、反復的にクラスタを更新するアルゴリズム。
🎨 直感で掴む
🍰 まずはやさしく
点と中心の距離で分けるイメージです。
自然なグループ構造を見つけるために使います。
部活のメンバーを能力で分けるような感覚です。
仕組みを直感的に理解するための例を見ます。
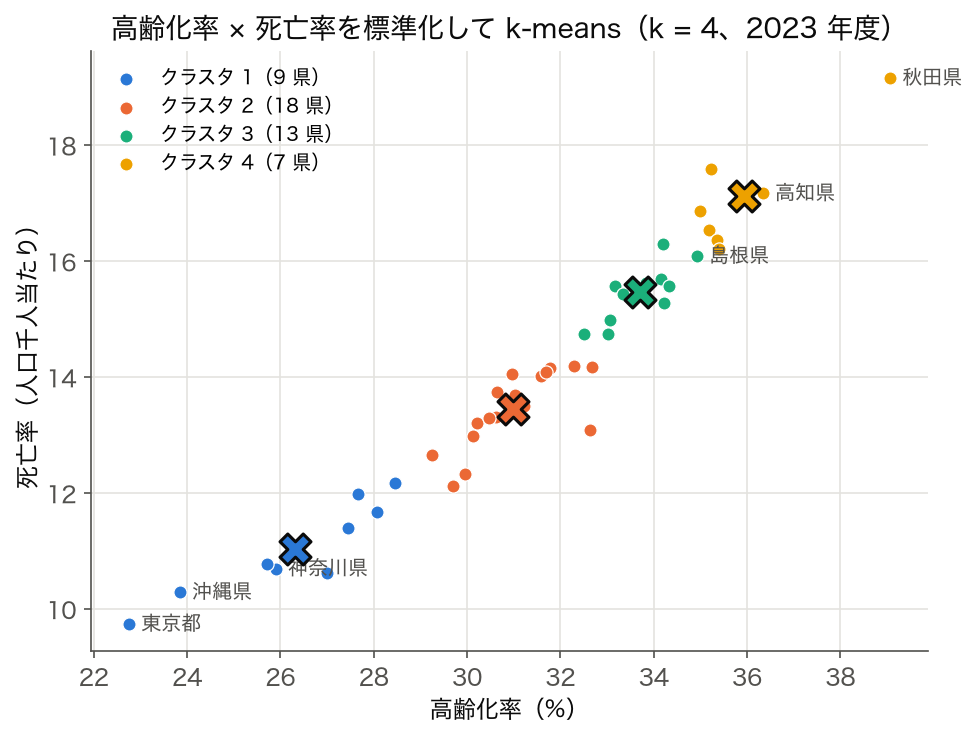
図を見ると、 4色の点群(クラスタ)と各クラスタの × 印(中心)が見えます。 k-meansは「各点が、 自分が属するクラスタ中心に最も近い」状態に収束した結果。
右上の黄のクラスタ 4(7 県、 中心は高齢化率 35.9%・死亡率 17.1)は「高齢化進行・死亡率高」(秋田・高知・青森・岩手・山形・山口・徳島)、 左下の青のクラスタ 1(9 都府県、 中心 26.3%・11.0)は「若年層多・死亡率低」(東京・神奈川・沖縄・埼玉・千葉・愛知・滋賀・大阪・福岡)と、 高齢化率の順に 4 段に分かれています(島根県は 1 段下のクラスタ 3 の端)。 2 つの指標がほぼ一直線に並ぶので、 群のあいだに隙間があるわけではなく「連続した帯をどこで切るか」を k-means が決めている点には注意。 それでも解釈可能な構造に分かれています。 「データに自然なグループ構造があれば、 k-means はそれを発見してくれる」ことが体感できる。
反復のイメージ — 「中心 → 割り当て」を交互に:(1) ランダムに k 個の中心を置く、 (2) 各点を「最も近い中心」に割り当てる、 (3) 各クラスタ内の点の平均位置に中心を移動、 (4) 中心が動かなくなるまで (2)-(3) を繰り返す。 これは E ステップ(割り当て)と M ステップ(中心更新)を交互に行う EM 法の一種で、 必ず単調に SSE が減少して収束します。 ただし初期値依存のため、 異なる初期値で 10 回走らせて最良の解を採用する n_init=10 が sklearn の標準動作です。
「平均」が中心の名前の由来:k-means の「means」は文字通り mean = 平均。 各クラスタの中心は所属点の 算術平均 です。 中央値(メドイド)を使う k-medoids、 確率分布で割り当てる GMM、 階層構造を作る 階層クラスタリング など、 「中心の定義」と「割り当て方」を変えることで様々な派生手法が生まれます。
🎮 点を置いてクラスタリング(触って理解する k-means)
下のキャンバスをクリックして点を配置し、 スライダーで k(クラスタ数)を決めて、 「▶ 1ステップ」で 割り当て(assignment)→ 重心更新(update) を1手ずつ、 「⏩ 自動収束」で最後まで動かせます。 各点が所属クラスタの色に塗られ、 ✕ 印の重心が平均位置へ移動していく様子を観察できます。 「🎲 初期値ランダム」を何度も押すと、 同じ点配置でも初期重心しだいで結果が変わる(初期値依存)ことが体感できます。 右上の WCSS(=SSE, クラスタ内二乗和)が反復のたびに単調に減るのがエルボー法の直感です。
✕ = 重心(centroid, 所属点の平均座標)/ ● = データ点(所属クラスタ色)。 割り当て手番では点の色が、 更新手番では ✕ の位置が変わります。
- 収束の仕組み:割り当て→更新を繰り返すと WCSS が必ず単調減少し、 割り当てが変わらなくなった時点で収束(Lloyd アルゴリズム)。
- 初期値依存:「🎲 初期値ランダム」で同じ点配置を何度も走らせると、 収束後の WCSS や色分けが変わることがある → 局所最適。 だから実務では
n_init≥10で複数初期値を試す(k-means++ は離れた点を初期重心に選んでこれを緩和)。 - k とエルボー:k を増やすと WCSS は必ず下がるが、 下がり方が鈍る「肘」が最適 k の目安。
- 球状仮定の限界:三日月・細長い形の点群を置くと、 k-means はうまく分割できない。 そうした形状は DBSCAN(密度ベース)や 階層クラスタリング が向く。
📐 数式
🍰 まずはやさしく
中心からの距離を計算する数式です。
グループ内のズレを最小にするために使います。
買い物で予算に近い商品を選ぶ計算に似ています。
計算のルールを数式を使って詳しく説明します。
📐 k-means の数学
損失関数
$$ J = \sum_{i=1}^{n} \sum_{j=1}^{k} z_{ij} \| x_i - \mu_j \|^2 $$
z_ij ∈ {0, 1}:i番目点がクラスタjに属するかどうか。 μ_j:クラスタjの中心。
アルゴリズム(Lloyd's algorithm)
- 初期中心をランダムに k個選ぶ
- 各点を最寄りの中心に割り当てる(assignment step)
- 各クラスタの中心を再計算(update step)
- 収束するまで 2-3 を繰り返す
計算量は O(n × k × d × iter)。 大規模データでは k-means++ や Mini-Batch k-means を使用。
k-means++ の初期化
「離れた点を初期中心に選ぶ」工夫。 通常のランダム初期化より速く・確実に良い解に収束。 sklearn のデフォルト。
🔬 数式を言葉で読み解く
- $k$
- クラスタ数:事前に決める。 通常 2〜10。 エルボー法・シルエット係数で決定
- $S_i$
- $i$ 番目のクラスタ(サンプルの集合)
- $\mu_i$
- $S_i$ の中心(centroid):$\mu_i = \frac{1}{|S_i|} \sum_{x \in S_i} x$(クラスタ内サンプルの平均)
- $\|x - \mu_i\|$
- サンプル $x$ から中心 $\mu_i$ までのユークリッド距離
- $\|x - \mu_i\|^2$
- 二乗することで「遠いほど強くペナルティ」
🔬 k-means を実データで多角的に確認する(R283 補強)
k-means は 4 行のコードで動くが、 「標準化」「k の選択」「初期化のランダム性」「形状の前提」を理解せずに使うと無意味なクラスタが出る。 SSDSE-B-2026 で 4 角度から検証する。
① 標準化前後の SSE 比較 — 単位の影響
このコードでやること: SSDSE-B-2026 から「総人口 A1101」「年平均気温 B4101」を取り出し、 標準化なし/ありで k-means を実行、 各クラスタの内訳を比較する。
📥 入力: SSDSE-B-2026.csv。 総人口 A1101(百万単位)、 年平均気温 B4101(十数℃)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 最新2023年・47都道府県 X_raw = df[['A1101', 'B4101']].fillna(df[['A1101', 'B4101']].mean()).values # 標準化なし(総人口 A1101 は百万単位、年平均気温 B4101 は十数℃) km_raw = KMeans(n_clusters=3, n_init=10, random_state=42).fit(X_raw) # 標準化あり X_std = StandardScaler().fit_transform(X_raw) km_std = KMeans(n_clusters=3, n_init=10, random_state=42).fit(X_std) vc = lambda km: pd.Series(km.labels_).value_counts().sort_index().to_dict() print('標準化なし: クラスタ別件数', vc(km_raw)) print('標準化あり: クラスタ別件数', vc(km_std)) |
📤 実行例:
💬 結果の読み方: 標準化なしでは「クラスタ 2 が東京 1 件だけ」になる(人口の桁が大きく、 距離計算が人口だけで決まる)。 標準化後は 30/8/9 に分かれ、 総人口の桁に潰されていた気温の情報も距離に効くようになる → 意味のあるクラスタリング。
② エルボー法で最適な k を決定
このコードでやること: k=1〜8 まで k-means を実行し、 SSE(inertia_)の推移から肘を探す。
📥 入力: ①の df から実在6列 A1101・A1303・A4101・B4101・L3221・C5401 を取り、 標準化した X_std。
1 2 3 4 5 6 7 8 9 10 11 12 13 | from sklearn.cluster import KMeans cols = ['A1101', 'A1303', 'A4101', 'B4101', 'L3221', 'C5401'] X = df[cols].fillna(df[cols].mean()).values X_std = StandardScaler().fit_transform(X) sse = [] for k in range(1, 9): km = KMeans(n_clusters=k, n_init=10, random_state=42).fit(X_std) sse.append(km.inertia_) for k, s in zip(range(1, 9), sse): print(f'k={k}: SSE={s:.2f} 減少={sse[k-2]-s if k>1 else 0:.2f}') |
📤 実行例:
💬 結果の読み方: k=1→2 で 137 と大きく落ち、 k=2→3 は 32、 k=3→4 は 34、 k=4→5 で 20 と鈍りはじめる → 肘は k=4 前後。 SSE の減少幅が明確に小さくなる位置を目安に k=4 を採る。
③ シルエット係数で k を再検証
このコードでやること: k=2〜7 でシルエット係数を計算し、 エルボー法の結果と整合するか確認する。
📥 入力: ②の X_std。
1 2 3 4 5 6 7 | from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score for k in range(2, 8): km = KMeans(n_clusters=k, n_init=10, random_state=42).fit(X_std) sil = silhouette_score(X_std, km.labels_) print(f'k={k}: silhouette={sil:.3f}') |
📤 実行例:
💬 結果の読み方: シルエット係数は k=2 が最大(0.555)→「大きく 2 群(大都市圏 vs その他)に分かれている」。 一方エルボーは k=4 前後を推奨。 基準が食い違う場合は分析目的で決める。 「2 群でざっくり」なら k=2、「地域類型を細かく」なら k=4。
④ 初期化のランダム性 — n_init による結果の安定性
このコードでやること: n_init=1 と n_init=20 で k-means を 5 回実行し、 SSE のばらつきを比較。 局所最適に陥るリスクを定量化する。
📥 入力: ②の X_std。 random_state は変化させる。
1 2 3 4 5 6 7 8 | from sklearn.cluster import KMeans for n_init in [1, 20]: sse_list = [] for rs in range(5): km = KMeans(n_clusters=4, n_init=n_init, random_state=rs).fit(X_std) sse_list.append(km.inertia_) print(f'n_init={n_init:2d}: SSE = {[round(s, 2) for s in sse_list]} 最大-最小 = {max(sse_list)-min(sse_list):.2f}') |
📤 実行例:
💬 結果の読み方: n_init=1 では SSE が 78〜95 と大きくばらつく(初期値次第で局所最適に陥る試行がある)。 n_init=20 では毎回ほぼ 78.8 に収束し安定 → 大域最適に到達できている。 実務では必ず n_init≥10 を指定する。
k-means 4 つの実験のまとめ
- ① 標準化なしの k-means は単位の大きい変数で支配される — 必ず StandardScaler
- ② エルボー法は SSE の減少量で k を決定(減少が半減する位置)
- ③ シルエット係数とエルボーの結果は食い違うことあり — 分析目的で選ぶ
- ④ n_init=1 だと SSE が試行ごとに変動 — 必ず n_init≥10
🧮 計算してみる
6都道府県のデータ(高齢化率と死亡率)で、 k=2 の k-means が実際にどう動くか、 反復計算を追ってみます。
| 都道府県 | 高齢化率 x | 死亡率 y |
|---|---|---|
| 秋田 | 39 | 19 |
| 高知 | 36 | 17 |
| 大阪 | 28 | 13 |
| 神奈川 | 26 | 11 |
| 東京 | 23 | 9 |
| 沖縄 | 23 | 11 |
初期中心をランダムに:C1 = (40, 20)、 C2 = (20, 10)(k-means++ では確率的に選びますが、 簡単のためここでは固定)
各点から両中心までのユークリッド距離を計算:
| 点 | d(C1) | d(C2) | 割当 |
|---|---|---|---|
| 秋田 (39,19) | √(1+1) = 1.4 | √(361+81) = 21.0 | C1 |
| 高知 (36,17) | √(16+9) = 5.0 | √(256+49) = 17.5 | C1 |
| 大阪 (28,13) | √(144+49) = 13.9 | √(64+9) = 8.5 | C2 |
| 神奈川 (26,11) | √(196+81) = 16.6 | √(36+1) = 6.1 | C2 |
| 東京 (23,9) | √(289+121) = 20.2 | √(9+1) = 3.2 | C2 |
| 沖縄 (23,11) | √(289+81) = 19.2 | √(9+1) = 3.2 | C2 |
C1 クラスタ:秋田、高知(2点)/C2 クラスタ:大阪、神奈川、東京、沖縄(4点)
各クラスタの平均を新しい中心とする:
- 新 C1 = (平均(39,36), 平均(19,17)) = (37.5, 18.0)
- 新 C2 = (平均(28,26,23,23), 平均(13,11,9,11)) = (25.0, 11.0)
中心が大きく動きました:C1 は (40,20) → (37.5, 18)、 C2 は (20,10) → (25, 11)
新しい中心で再度距離計算:
| 点 | d(新C1) | d(新C2) | 割当 |
|---|---|---|---|
| 秋田 (39,19) | 1.80 | 16.1 | C1(変化なし) |
| 高知 (36,17) | 1.80 | 12.5 | C1(変化なし) |
| 大阪 (28,13) | 10.7 | 3.6 | C2(変化なし) |
| 神奈川 (26,11) | 13.5 | 1.0 | C2(変化なし) |
| 東京 (23,9) | 17.1 | 2.8 | C2(変化なし) |
| 沖縄 (23,11) | 16.1 | 2.0 | C2(変化なし) |
すべての点の割当が前回と同じ!中心も動かない。 収束完了。 たった2イテレーションで終了しました。
最終結果:
- クラスタ1(高齢化進行群):秋田、 高知。 中心 (37.5, 18.0)。 「高齢化率約37.5%、 死亡率約18‰の県」
- クラスタ2(中・低齢化群):大阪、 神奈川、 東京、 沖縄。 中心 (25.0, 11.0)。 「高齢化率約25%、 死亡率約11‰の県」
SSE(残差二乗和) = (秋田からC1の距離²) + (高知からC1の距離²) + ... = 1.80² + 1.80² + 3.61² + 1.00² + 2.83² + 2.00² = 3.25 + 3.25 + 13 + 1 + 8 + 4 = 32.5。 これより小さい分割は存在しません(この初期値からは)。
k=3 にしたら?大阪・神奈川を1群、 東京・沖縄を別群、 秋田・高知を1群、 のように細分化されます。 SSEはさらに小さく。 でもどこかで「k を増やしても効率が悪い」境界(=エルボー)が来ます。
🎓 k-means の設計判断 — k の決定・初期化・距離
1. k(クラスタ数)の決め方
「いくつのクラスタに分けるか」は分析者が決める。 客観的指標の選択肢:
- エルボー法:k = 1, 2, ..., 10 と変えて SSE をプロット。 「肘」のように折れる位置が最適 k。 直感的だが主観も入る
- シルエット係数:各点で「自クラスタ内の距離」と「最近隣クラスタへの距離」の比。 -1〜+1 で、 高いほど良い。 k で平均値が最大の値を選ぶ
- Calinski-Harabasz 指数:群間分散 / 群内分散。 大きいほど良い
- ギャップ統計量:ランダムデータと比較。 統計的に裏付けられた指標
- 事前理論:「6地域に分けたい」など実用的制約
2. 初期化:k-means++
ランダム初期化は局所最適に陥りやすい。 k-means++ は次の手順で賢く初期化:
- 1つ目の中心はランダム選択
- 2つ目以降は、 「既選択中心から遠い」サンプルほど高確率で選ぶ(距離の二乗に比例する確率)
- k 個の中心が分散して配置される
scikit-learn の KMeans はデフォルトで k-means++。 さらに n_init 回試行して最良の SSE を採用。
3. 距離の選択
標準はユークリッド距離。 ただし他の選択肢もあります:
- マンハッタン距離:軸方向の距離の和。 外れ値に強い → k-medians
- コサイン距離:方向の類似度(テキスト分析で多用)
- マハラノビス距離:相関構造を考慮
ただしユークリッド以外を使うと「平均」が幾何的に意味を失うので、 厳密には k-medoids(中心を実在サンプルに)が適切。
4. 計算量と収束性
計算量:$O(n \cdot k \cdot d \cdot \text{iter})$。 通常 iter は数十回。 n=100万 でも数秒で完了するのが強み。
収束性:k-means は必ず収束しますが、 大域最適解への収束は保証されません。 SSE は反復のたびに必ず減少(または同じ)となりますが、 局所最適に陥る可能性があります。 これが「複数回試行」が必要な理由。
NP困難性:k-means の大域最適解を求める問題は NP困難(k≥2 で)。 だから「最適解の近似」を反復で求めるしかない。
🧮 SSDSE-B-2026 で k-means を即実行
最新の SSDSE-B-2026 を使い、 47 都道府県を 4 クラスタに分けるコード。 教材標準パスを直書きしています。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 最新2023年・47都道府県 X = df[['A1101', 'A1303', 'A4101', 'B4101', 'L3221', 'C5401']].dropna() X_scaled = StandardScaler().fit_transform(X) km = KMeans(n_clusters=4, n_init=10, random_state=42).fit(X_scaled) print(km.labels_) # 各都道府県のクラスタ番号 print(km.inertia_) # SSE(小さいほど締まりが良い) |
💬 4 つのクラスタは、東京都だけの 1 県(ラベル 2)、埼玉・千葉・神奈川・愛知・大阪・兵庫・福岡の 7 府県(ラベル 3)、残りを 24 県と 15 県に分けた 2 群になった。6 変数とも規模に引きずられる量なので、実質は「人口の大きさ」で輪切りにした結果に近い。inertia 79.18 は標準化後の全平方和 282(47 県 × 6 変数)の約 28% が残った値で、ラベル番号 0〜3 そのものには順序の意味はない。
出力のとおり、 東京都は 1 県だけのクラスタ、 大阪・神奈川・愛知など 7 府県が大都市圏クラスタにまとまり、 秋田・高知や沖縄はいずれも残り 2 群のどちらかに入ります(単独クラスタにはならない)。 SSDSE-B-2026 の最新値で確かめられます。
🎯 理解度チェック — k-means 法
読み終えたら、 以下の練習問題で「自分で説明できるか」を確認しよう。 答えが詰まった箇所は対応する節に戻る。
- Q1. k-means の目的関数(クラスタ内 SSE)はどのように書ける? また、 なぜ 距離の二乗を使うのか 1 行で説明せよ。
- Q2. 初期セントロイドの選び方が結果に与える影響を述べ、 k-means++ がそれをどう緩和するか 2 行で説明せよ。
- Q3. SSDSE-B-2026 の「総人口 A1101(百万人)」と「年平均気温 B4101(十数℃)」を 標準化せずに k-means に投入すると何が起きるか。 標準化後と比べてクラスタ構成がどう変わるか 1 行で予想せよ。
- Q4. エルボー法とシルエット係数で最適 k を選ぶとき、 どちらがより信頼できるかとその理由を述べよ。
- Q5. k-means が 球形クラスタを前提とする理由を、 目的関数の形から説明せよ。 細長い・密度が異なるクラスタには何を使うべきか。
🛠 自分で手を動かす(5 分課題):
SSDSE-B-2026.csvから「総人口 A1101」「65歳以上人口 A1303」「年平均気温 B4101」の 3 変数を抽出し、StandardScalerで標準化。KMeans(n_clusters=k)を k=2〜8 で回し、inertia_の推移をプロットしてエルボーを目視する。- 選んだ k で再度フィットし、
silhouette_scoreを計算してエルボーの選択と一致するか確認する。 - 各クラスタに属する都道府県名を
printで出し、 「クラスタが何を意味するか」を 1 行で言語化する。
🧮 数式に値を入れて手で計算する: K-means 1 反復
合成 4 点 1D データで K=2 の 1 反復を手計算する。
Step 1: データと初期重心
Step 2: 割当 (最近傍)
Step 3: 重心更新
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np from sklearn.cluster import KMeans X = np.array([[1],[2],[8],[10]]) km = KMeans(n_clusters=2, init=np.array([[1],[10]]), n_init=1, random_state=0).fit(X) print(f"重心: {km.cluster_centers_.flatten()}") print(f"ラベル: {km.labels_}") |
📤 実行結果
💬 手計算 (Step 3) [1.5, 9.0] と Python 出力が完全一致。
🐍 Python での実装
① scikit-learn での基本
🎯 このコードでやること:SSDSE-B-2026 の 2023 年度・47 都道府県 × 6 変数を標準化し、 k=3 の k-means と Ward 法の階層クラスタリングを当てて、 中心・inertia・両者の一致度・シルエットを出します。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | from sklearn.cluster import KMeans, AgglomerativeClustering, DBSCAN from sklearn.preprocessing import StandardScaler from sklearn.metrics import silhouette_score, adjusted_rand_score import pandas as pd import numpy as np # SSDSE-B-2026 を読み込み、2023 年度の 47 都道府県 × 実在 6 変数を取り出す d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = d[d['SSDSE-B-2026'] == 2023] cols = ['A1101', 'A1303', 'A4101', 'B4101', 'L3221', 'C5401'] X = d[cols].astype(float).values # データの標準化(重要!) scaler = StandardScaler() X_std = scaler.fit_transform(X) # k-means km = KMeans(n_clusters=3, random_state=0, n_init=10) labels_km = km.fit_predict(X_std) print('クラスタ中心(標準化後):') print(pd.DataFrame(km.cluster_centers_, columns=cols).round(2)) print(f'inertia: {km.inertia_:.2f}') print('クラスタ別件数:', np.bincount(labels_km).tolist()) # 階層クラスタリング(Ward法) agg = AgglomerativeClustering(n_clusters=3, linkage='ward') labels_agg = agg.fit_predict(X_std) print(f'k-means と Ward の一致度 (ARI): {adjusted_rand_score(labels_km, labels_agg):.3f}') # シルエットスコアで評価 score = silhouette_score(X_std, labels_km) print(f'シルエットスコア: {score:.3f}') |
② 最適クラスタ数の探索
🎯 このコードでやること:総人口・出生数・死亡数・婚姻件数の 4 指標を標準化し、 k=2〜10 の inertia とシルエット係数を並べて図に描きます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 | # ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df = df[df['年度'] == df['年度'].max()] for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 # 見本でよく使われる仮の列名を、実データから作っておく df['income'] = df['消費支出(二人以上の世帯)'] df['population'] = df['総人口'] _region = {'北海道': '北海道', '青森県': '東北', '岩手県': '東北', '宮城県': '東北', '秋田県': '東北', '山形県': '東北', '福島県': '東北', '茨城県': '関東', '栃木県': '関東', '群馬県': '関東', '埼玉県': '関東', '千葉県': '関東', '東京都': '関東', '神奈川県': '関東'} df['region'] = df['都道府県'].map(_region).fillna('その他') df['地域'] = df['region'] _feats = ['総人口', '出生数', '死亡数', '婚姻件数'] df = df.dropna(subset=_feats + ['消費支出(二人以上の世帯)']) X = df[_feats].to_numpy(dtype=float) y = df['消費支出(二人以上の世帯)'].to_numpy(dtype=float) x = df['総人口'].to_numpy(dtype=float) from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score from sklearn.preprocessing import StandardScaler import matplotlib.pyplot as plt # この抜粋の X_std は 47 都道府県 × 4 指標(上で作った X を標準化) X_std = StandardScaler().fit_transform(X) inertias = [] silhouettes = [] for k in range(2, 11): km = KMeans(n_clusters=k, random_state=0, n_init=10).fit(X_std) inertias.append(km.inertia_) silhouettes.append(silhouette_score(X_std, km.labels_)) print(f'k={k:2d}: inertia={km.inertia_:6.2f} silhouette={silhouettes[-1]:.3f}') # エルボー法 plt.subplot(1, 2, 1) plt.plot(range(2, 11), inertias, 'o-') plt.xlabel('k'); plt.ylabel('inertia') # シルエット法 plt.subplot(1, 2, 2) plt.plot(range(2, 11), silhouettes, 'o-') plt.xlabel('k'); plt.ylabel('Silhouette') |
③ デンドログラムの描画
🎯 このコードでやること:総人口・15 歳未満人口・65 歳以上人口・出生数・消費支出の 5 指標を標準化し、 Ward 法で 47 都道府県を結合していく樹形図(デンドログラム)を描きます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd # ── この抜粋だけで動くように、47 都道府県・最新年度を読み込む ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] import matplotlib.pyplot as plt from sklearn.preprocessing import StandardScaler from scipy.cluster.hierarchy import linkage, dendrogram # ── この抜粋だけで動くように、標準化した行列と葉のラベルを用意する ── X_std = StandardScaler().fit_transform( _d[['A1101', 'A1301', 'A1303', 'A4101', 'L3221']].astype(float).values) labels = _d['Prefecture'].tolist() Z = linkage(X_std, method='ward') plt.figure(figsize=(14, 6)) dendrogram(Z, labels=labels, leaf_rotation=90) plt.show() |
🐍 実装バリエーション — scikit-learn / scipy / faiss
(A) scikit-learn KMeans — 標準
🎯 このコードでやること:上の ② で作った 4 指標を標準化してから、 k-means++ 初期化・k=4 の KMeans を当て、 ラベル・中心・SSE を出します。
1 2 3 4 5 6 7 8 9 10 11 12 | from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler import numpy as np # X は上の ② で作った 47 都道府県 × 4 指標(総人口・出生数・死亡数・婚姻件数)の生の値。 # 桁が違うので標準化してから渡す Xs = StandardScaler().fit_transform(X) km = KMeans(n_clusters=4, init='k-means++', n_init='auto', max_iter=300, random_state=42).fit(Xs) print(km.labels_) # 各サンプルのクラスタ番号 print(np.round(km.cluster_centers_, 2)) # 中心(標準化後の単位) print(round(km.inertia_, 2)) # SSE |
(B) scikit-learn MiniBatchKMeans — 大規模データ向け
🎯 このコードでやること:10 万件 × 4 次元の合成データに、 100 件ずつのミニバッチで中心を更新する MiniBatchKMeans を当てます。
1 2 3 4 5 6 7 8 9 10 11 | import numpy as np from sklearn.cluster import MiniBatchKMeans # ── この抜粋だけで動くように、大きめのデータを作る ── # MiniBatchKMeans は「1 度に全件を見ない」ので大規模でも速い、という例 rng = np.random.default_rng(0) X_large = rng.normal(size=(100_000, 4)) # 10 万件 × 4 次元(合成データ) mbk = MiniBatchKMeans(n_clusters=4, batch_size=100, n_init=10, random_state=42) mbk.fit(X_large) # 件数が増えても数秒 print('クラスタ中心の形:', mbk.cluster_centers_.shape) |
(C) scipy.cluster.vq — 低レベル
🎯 このコードでやること:同じ 4 指標を scipy の whiten で列ごとに尺度をそろえ、 scipy.cluster.vq の kmeans と vq で 4 クラスタに分けます。
1 2 3 4 5 6 7 8 9 10 | from scipy.cluster.vq import kmeans, vq, whiten import numpy as np # whiten で各列を標準偏差 1 に揃える(scipy の kmeans は自分では揃えない) Xw = whiten(X) centroids, distortion = kmeans(Xw, 4, seed=0) clusters, _ = vq(Xw, centroids) print('クラスタ別件数:', np.bincount(clusters).tolist()) print(f'distortion(中心までの平均距離): {distortion:.3f}') # シンプルだが n_init などのオプションが少ない |
(D) k-medoids (PAM) — ロバスト代替
🎯 このコードでやること:4 指標を標準化し、 中心を実在の県に限る k-medoids(マンハッタン距離)で 4 クラスタに分けます。
1 2 3 4 5 6 | from sklearn_extra.cluster import KMedoids from sklearn.preprocessing import StandardScaler Xs = StandardScaler().fit_transform(X) # 桁をそろえてから距離を測る kmed = KMedoids(n_clusters=4, metric='manhattan', random_state=42).fit(Xs) # 中心が「実在サンプル」になる。 外れ値に強い |
(E) Gaussian Mixture — 確率的拡張
🎯 このコードでやること:4 指標を標準化し、 共分散を自由に取る GMM(4 成分)で各県の所属確率を出します。
1 2 3 4 5 6 7 8 9 10 | import numpy as np from sklearn.mixture import GaussianMixture from sklearn.preprocessing import StandardScaler Xs = StandardScaler().fit_transform(X) # 4 指標の桁をそろえる gmm = GaussianMixture(n_components=4, covariance_type='full', random_state=42).fit(Xs) proba = gmm.predict_proba(Xs) # 各クラスタへの所属確率 print('クラスタ別件数:', np.bincount(proba.argmax(axis=1), minlength=4).tolist()) print('最大所属確率が 0.9 未満の県数:', int((proba.max(axis=1) < 0.9).sum())) # 楕円体クラスタOK、 ソフトクラスタリング |
(F) FAISS — 数億規模の超高速
🎯 このコードでやること:4 指標を標準化して float32 に直し、 faiss の Kmeans で 4 クラスタの中心を学習して各県を最も近い中心に割り当てます。
1 2 3 4 5 6 7 8 | import faiss from sklearn.preprocessing import StandardScaler Xs = StandardScaler().fit_transform(X).astype('float32') # faiss は float32 を要求 kmeans_faiss = faiss.Kmeans(d=Xs.shape[1], k=4, niter=20, verbose=False, seed=42) kmeans_faiss.train(Xs) _, labels = kmeans_faiss.index.search(Xs, 1) # GPU 対応、 大規模ベクトル検索(埋め込み)に必須 |
⚠️ よくある落とし穴
StandardScaler で平均0・分散1に揃えてから。 具体例:人口100万人の差は、 失業率5%の差より桁が6つ違う。 ユークリッド距離はほぼ「人口の差」になり、 失業率の情報がほぼ消える。
KMeans(n_init=10) は10回試行して最良を返す("auto" なら自動調整)。 学術論文では random_state を固定し再現可能にする。判定方法:PCA で2次元プロットして、 クラスタの形状を視覚的に確認。
📊 SSDSE実データでの応用
2023 年度 47 都道府県の家計 5 項目(二人以上の世帯の食料費・住居費・光熱・水道費・教育費・教養娯楽費)を標準化して k-means (k=3) を適用しました:
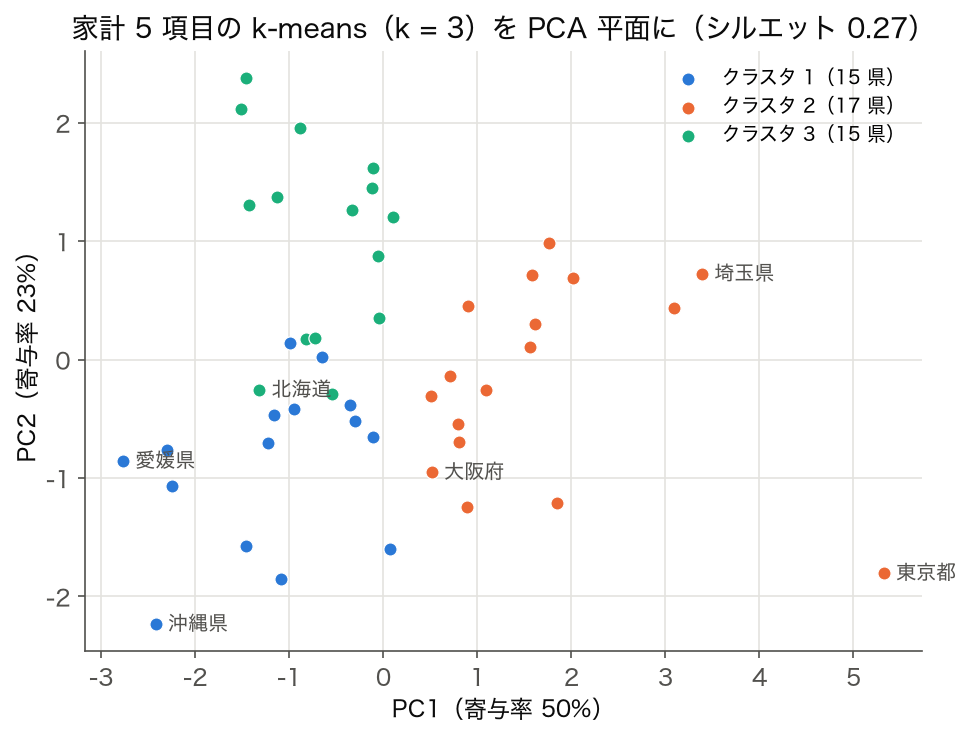
PC1(寄与率 50%、 食料費・教育費・教養娯楽費が大きいほど右)と PC2(23%、 光熱・水道費が大きく住居費が小さいほど上)の散布図上で、 3 つのクラスタはおおむね別の場所に集まりますが、 境目では接していて「綺麗に分離」とまでは言えません(シルエット係数 0.27)。 各クラスタの平均を見ると「家計タイプ」として解釈できます:クラスタ 2(17 都府県:東京・埼玉・神奈川・大阪・愛知など)は食料費 86.3・教育費 13.7・教養娯楽費 31.4 千円と支出が大きい都市型、 クラスタ 3(15 道県:北海道・東北・北陸・山陰など)は光熱・水道費 27.8 千円が突出した寒冷地型、 クラスタ 1(15 県:四国・九州・沖縄など)は食料費 76.2・教育費 7.4 千円と全体に支出が小さい型です。
🎯 k の選び方
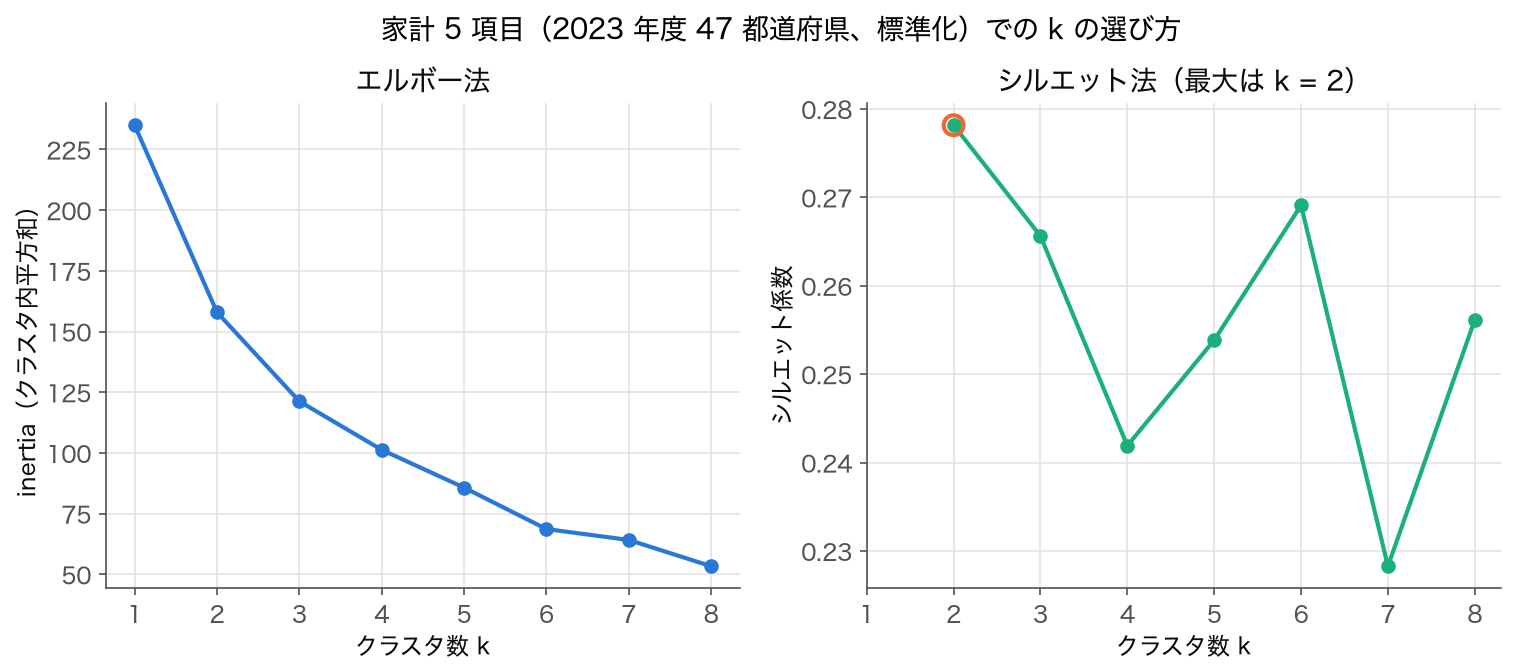
エルボー法とシルエット法で最適な k を探します。
- エルボー法:inertia の折れ目を見る。 上の家計 5 項目では 235.0(k=1)→ 157.9(k=2)→ 121.3(k=3)→ 101.3(k=4)と k=2〜3 までの下がり方が大きく、 その後はなだらか。 ここでは k=2 〜 3 が候補
- シルエット法:スコアが最大の k を選ぶ。 ここでは k=2 が最大 0.278 だが、 k=3 は 0.266、 k=6 は 0.269 と僅差で、 どれも 0.3 未満(分離は弱い)。 数値だけで決めず、 クラスタの解釈しやすさと合わせて選ぶ
⚠️ k-means の限界
- クラスタの形を「球状」と仮定。 長細い形には不向き
- クラスタサイズが均一を前提
- 密度が均一を前提
- k を事前に決める必要がある
- 初期化に依存(n_init を増やすか k-means++ で対処)
- 外れ値に弱い
これらの限界を超えるには、 GMM、 DBSCAN、 スペクトラルクラスタリングなどを検討。
⚠️ 追加の落とし穴 — k-means の実務(既存に追加)
random_state を固定しないと毎回違う結果になる。 学術論文・本番運用では必ず random_state=42 等を明示。 また n_init(複数初期化試行回数)の指定も再現性に影響する。 さらに、 ハイパーパラメータ・前処理 (標準化方法) も全て記録し、 完全な再現性確保が責任。📝 補足解説(直感・落とし穴・発展の深掘り)
既存の各節を壊さずに、 k-means の「なぜ動くか(直感)」「どこで壊れるか(落とし穴)」「どう拡張するか(発展)」を一枚に凝縮した追記ノート。 数値はいずれも SSDSE-B-2026(2023年・47都道府県、 標準化済み6変数)の実測。
🎨 直感の芯 — Lloyd 法は「割当」と「平均」の往復
k-means の反復(Lloyd 法)は 2 手番の往復に尽きる。 (1) 割当ステップ:各点を最も近い重心に割り当てる(=空間を重心ごとのボロノイ領域に分割)。 (2) 更新ステップ:各クラスタの重心を、 所属点の平均座標へ動かす。 これを重心が動かなくなるまで繰り返す。
なぜ必ず収束するのか:目的関数は「クラスタ内平方和(inertia=慣性)」=各点から自分の重心までの二乗距離の総和。 割当ステップは「より近い重心へ移す」ので inertia を増やさない。 更新ステップも inertia を増やさない — なぜなら「二乗距離の和を最小にする点」は、 その集合の平均そのものだから。 平均に動かすこと自体が SSE を必ず下げる。 両ステップとも単調に inertia を減らす(または不変)ので、 取りうる割当が有限である以上、 有限回で収束する。 これが「means(平均)」が中心の定義に選ばれた数学的理由でもある。
※ 単調収束するのは「ある局所最適へ」であって、 大域最適とは限らない(後述)。 これが初期値依存と n_init の伏線になる。
⚠️ 落とし穴チェックリスト(要点の凝縮)
- k を事前に決める必要:エルボー法(inertia の減少が鈍る「肘」)とシルエット係数(クラスタ内凝集と分離のバランス、 -1〜+1 で高いほど良い)で客観化。 両者は食い違うことがあり、 最終的には分析目的で決める(本ページ ③ 参照)。
- 初期値依存・局所最適:初期重心しだいで収束先が変わる。
k-means++(離れた点を確率的に初期重心へ)+n_init≥10で緩和。 大域最適を求める問題自体は NP 困難なので、 反復は「良い近似」を狙う手段。 - 球状・等分散・等サイズの暗黙仮定:目的関数が等方的なユークリッド二乗距離なので、 三日月・細長い・密度差・大小不均衡なクラスタでは破綻。 形状を疑うなら密度ベースやグラフベース、 確率モデルへ。
- スケール敏感:距離計算が桁の大きい変数に支配される。 標準化(平均0・分散1)は事実上必須(本ページ ① で単位差の影響を実測)。
- 外れ値に弱い:重心=平均なので極端値 1 点で中心が引きずられる。 中央値/実在点を中心にする k-medians・k-medoids が頑健。
- 空クラスタ:どの点も割り当たらない重心が出ることがある。 scikit-learn は最遠点などで自動的に再配置するが、 k が過大なサインでもある。
🚀 発展① k-means++ 対 random 初期化(SSDSE-B-2026 実測)
このコードでやること:単一初期化(n_init=1)を 30 通りの乱数で走らせ、 k-means++ と素朴な random(Forgy)で inertia の平均・最良を比較。 初期化の賢さが「良い解に届く確率」に効くことを定量化する。
📥 入力: 本ページ ② の X_std(実在6変数 A1101・A1303・A4101・B4101・L3221・C5401、 標準化済み、 47都道府県)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np import pandas as pd from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler # 本ページ ② と同じ X_std(2023 年・47 都道府県 × 実在 6 変数、標準化済み)を作り直す d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = d[d['SSDSE-B-2026'] == 2023] cols = ['A1101', 'A1303', 'A4101', 'B4101', 'L3221', 'C5401'] X_std = StandardScaler().fit_transform(d[cols].fillna(d[cols].mean()).values) def stat(init): v = [KMeans(4, init=init, n_init=1, random_state=rs).fit(X_std).inertia_ for rs in range(30)] return round(float(np.mean(v)), 2), round(float(np.min(v)), 2) print('k-means++ (平均, 最良):', stat('k-means++')) print('random (平均, 最良):', stat('random')) |
📤 実行例:
💬 結果の読み方: 1 回きりの初期化だと、 k-means++ は平均 inertia 87.59・最良 78.88 に届きやすいのに対し、 random は平均 96.41 と局所最適に留まりがち。 k-means++ が「離れた点を初期重心に選ぶ」ぶん良い解へ寄る。 それでも 1 回では最良に届かない試行があるため、 実務では n_init≥10 の複数初期化が保険になる(本ページ ④ の安定性検証と対応)。
🚀 発展② GMM のソフト割当と k-means のハード割当の対比(実測)
このコードでやること:同じ X_std に GMM(ガウス混合モデル)を当て、 各県の「所属確率」を出す。 k-means が全県を 1 クラスタにハード割当するのに対し、 GMM は確率でソフト割当し、 境界にいる県を数値で炙り出せる。
📥 入力: 本ページ ② の X_std と df(Prefecture 列)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.mixture import GaussianMixture # 途中のブロックで df を日本語列名で読み直しているので、ここで英字コード版に読み直す df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年の 47 都道府県 X_std = StandardScaler().fit_transform( df[['A1101', 'A1303', 'A4101', 'B4101', 'L3221', 'C5401']].astype(float)) gmm = GaussianMixture(n_components=4, covariance_type='full', random_state=42).fit(X_std) proba = gmm.predict_proba(X_std) # 各県 × 各クラスタの所属確率 maxp = proba.max(axis=1) # 最も確からしいクラスタの確率 i = maxp.argmin() # 最も「迷っている」県 print('境界県:', df['Prefecture'].values[i], round(float(maxp[i]), 3)) print('確率:', [round(float(p), 2) for p in proba[i]]) print('確率0.9未満の県数:', int((maxp < 0.9).sum()), '/ 47') |
📤 実行例:
💬 結果の読み方: 富山県は 2 つのクラスタに 0.84 対 0.16 でまたがる「境界県」。 k-means のハード割当ではこの曖昧さは 0/1 に潰れて見えないが、 GMM のソフト割当なら数値化できる。 残る 46 県も最大確率は石川県の 0.93 が最低で、 ほかは 0.96 以上とほぼ迷いなく割り当たっている。 「割当の硬さ」と「楕円体クラスタ(共分散)を許すか」が k-means と GMM の設計差。
🔗 関連ページ(相対リンク・実在ファイルのみ)
※ 「シルエット係数」「エルボー法」「k-means++」「k-medoids」は本用語集に単独ページが未整備のため、 リンクにせず本文(本ページ ③④、 数式節、 落とし穴節)内の解説を参照。
🗺️ 概念マップ — 3つの視点で体系を理解する
k-means法 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 教師なし学習 › クラスタリング › k-means
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に k-means法 を置き、 そこから クラスタリング・階層クラスタリング・標準化・平均・分散・Ward法 など 計 13 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「k-means法」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「k-means法」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは k-means の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → クラスタリング → k-means という入れ子の位置を示します。 「クラスタリングには他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔗 隣接手法への橋渡し
k-means 法は中心点更新 → 割り当て更新の反復で動作し、 単独で意味を成すには上流の標準化と下流の k 選定・解釈が不可欠である。
- 上流: クラスタリング前処理 (距離計算が妥当になるためのスケール統一) (標準化、 距離尺度)
- 並列: 別系統のクラスタリング手法 (階層クラスタリング、 DBSCAN) と比較・併用
- 下流: 得られたクラスタの可視化・業務適用 (PCA可視化、 セグメント別推薦)
上流の標準化が距離計算の前提となり、 並列の階層クラスタリング/DBSCAN で形状仮定 (球状) の妥当性を逆検証し、 下流の PCA 可視化と組み合わせて初めて「k-means が見つけたクラスタ」が解釈可能になる。
🌳 手法選択フロー
クラスタリング手法は「クラスタ形状の前提」「k を事前に決められるか」「データ規模」「外れ値の多さ」で選び分ける。 以下の判断フローで k-means が適切かを確認する。
- Step 1 (k は決められるか): 業務要件や事前知識で k が決まっている → k-means / k-means++ が第一候補。 k が不明 → DBSCAN・階層クラスタリングを優先。
- Step 2 (クラスタ形状): 球状・等サイズに見える → k-means OK。 細長い・三日月型・ノイズ多 → DBSCAN / spectral clustering。
- Step 3 (データ規模): 数万件超え・高次元 → mini-batch k-means。 数百件で精度優先 → 標準 k-means + n_init=10〜50。
- Step 4 (外れ値): 外れ値が無視できないほど多い → k-medoids (中央値ベース)。 少ない → 事前除去 + k-means で十分。
- Step 5 (検証): 標準化済か / シルエット係数 0.3 以上か / エルボー曲線で k が妥当か / 異なる random_state で再現するか、 を必ず確認する。
「とりあえず k=3」ではなく、 上記 5 ステップを経た選択であれば、 結果のクラスタを業務判断や次工程 (顧客セグメント別施策、 都道府県分類など) に渡せる根拠が立つ。