🔖 キーワード索引
物体検出(Object Detection)を深く理解するために、 本ページで扱う主要キーワードを並べます。 クリックで該当セクションへジャンプ:
💡 30秒で分かる結論
🍰 まずはやさしく
画像の中の物を探す技術です。
物の場所と名前を同時に知るために使います。
スマホで写真の人物を囲む機能に似ています。
この章では仕組みと評価の方法を学びます。
- 物体検出とは、 画像 1 枚から「どこに(座標)」「何が(クラス)」「どれくらい確信して(信頼度)」あるかを同時に出力するタスク。
- 出力は bounding box(矩形, x_min, y_min, x_max, y_max) + クラスラベル + 信頼度スコア の三つ組。
- 性能評価の中心指標は IoU(Intersection over Union) と mAP(mean Average Precision)。 IoU≥0.5 を正解と見なすのが mAP@0.5。
- 代表モデル: Faster R-CNN(2 段階, 高精度), YOLO 系(1 段階, 高速), DETR(Transformer ベース)。
- 分類(classification)との違いは「位置情報の出力」、 セグメンテーションとの違いは「ピクセル単位ではなく矩形」。
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
画像認識という分野の主要な技術です。
どこに何があるかを正確に答えるために使います。
自動運転で歩行者を見つける時に役立ちます。
他の似た技術との違いについて解説します。
物体検出(Object Detection)は、 画像認識の中核タスクの 1 つ。 単純な「画像分類」(猫か犬か)より一段難しく、 「画像のどこに何があるか」を答えます。 自動運転(周辺車両・歩行者)、 監視カメラ、 製造業の品質検査など 産業応用が極めて多い領域です。
📍 文脈ボックス:あなたが今見ているもの
あなたは今、 コンピュータビジョン(CV)の中核タスクの一つである「物体検出」のページにいます。 CV のタスクは以下の階層で整理できます:
- 画像分類(Image Classification): 画像 1 枚 → 1 ラベル(例: 「猫」)。位置情報なし。
- 物体検出(Object Detection): 画像 1 枚 → 複数の (矩形, ラベル, スコア)。← 今ここ
- セマンティックセグメンテーション: 画像 1 枚 → ピクセル単位のクラスマップ。 個体は区別しない。
- インスタンスセグメンテーション: 画像 1 枚 → ピクセル単位 + 個体区別(Mask R-CNN 等)。
- パノプティックセグメンテーション: 上記の統合(モノとモノでないものを区別)。
物体検出は自動運転(人・車・標識検知)、 監視カメラ、 医療画像(病変検出)、 小売(棚卸し)、 農業(果実検出)など実応用の多くで採用されています。
🎨 直感で掴む — 具体例で理解する
🍰 まずはやさしく
写真に付箋を貼るような作業です。
物の種類と自信の強さを記録するために使います。
部活の集合写真から友達を探す感覚です。
機械にとってなぜ難しいのかを考えます。
画像認識タスクの階層:
| タスク | 出力 | 例 |
|---|---|---|
| 画像分類 | 1 つのラベル | 「この画像は猫」 |
| 物体検出 | 複数のボックス + ラベル | 「(100,50,200,150) に猫、 (300,100,400,300) に犬」 |
| セマンティックセグメンテーション | ピクセル単位のラベル | 「このピクセル群が猫」 |
| インスタンスセグメンテーション | ピクセル + 個体ID | 「猫1、 猫2 を区別」 |
物体検出は「いくつあるか分からない物体を検出」する必要があり、 アルゴリズム設計が複雑。 主流は 1 段階検出器(YOLO, SSD)と 2 段階検出器(Faster R-CNN)に分かれます。
🎨 直感で掴む
物体検出を「画像にラベル付き付箋を貼る作業」と考えてみましょう。 写真の中の犬・人・自転車それぞれに長方形の付箋を貼り、 「犬 92%」「人 88%」「自転車 76%」と書き込みます。 これがまさに物体検出器の出力です。
人間は瞬時にこれを行えますが、 機械にとっては難題です。 なぜなら:
- 位置の探索空間が膨大: 1024×768 画像なら矩形候補は 10 億通り超。
- スケール変化: 同じ「人」でも手前は 500 px、 遠景は 20 px。
- オクルージョン: 物体同士が重なり、 一部しか見えない。
- クラス間の曖昧さ: 子犬と狼、 自転車とバイク等。
そこで近年のモデルは「① 候補矩形を多数生成 → ② 各候補をクラス分類 + 矩形微調整 → ③ 重複矩形を間引く(NMS)」という流れで処理します。 これを 1 段階で同時にやるのが YOLO、 2 段階に分けるのが Faster R-CNN です。
| モデル系 | 代表 | 特徴 | 速度 | 精度 |
|---|---|---|---|---|
| 2 段階検出 | Faster R-CNN, Mask R-CNN | 候補抽出 → 分類の二段構え | 中 | 高 |
| 1 段階検出 | YOLO v3-v10, SSD, RetinaNet | grid + anchor で一発推論 | 高 | 中〜高 |
| Transformer 系 | DETR, Deformable DETR | NMS 不要・end-to-end | 中 | 高 |
| Anchor-free | FCOS, CenterNet | アンカー不要、 中心点予測 | 高 | 中〜高 |
📐 定義・数式
🍰 まずはやさしく
正解との重なり具合を測るルールです。
AIの予測がどれくらい正しいか判定するために使います。
買い物で欲しい物を正確に見つける感覚です。
計算に使う重要な指標について説明します。
📐 数式または定義
物体検出を支える 4 つの中核数式を順に示します。
(1) IoU(Intersection over Union): 予測矩形 A と正解矩形 B の重なり度合いを 0〜1 で測る指標。
$$\mathrm{IoU}(A, B) = \frac{\mathrm{Area}(A \cap B)}{\mathrm{Area}(A \cup B)} = \frac{|A \cap B|}{|A| + |B| - |A \cap B|}$$(2) Precision / Recall: 検出された矩形のうち IoU≥τ の割合が Precision、 正解矩形のうち拾えたものの割合が Recall。
$$\mathrm{Precision} = \frac{TP}{TP + FP}, \quad \mathrm{Recall} = \frac{TP}{TP + FN}$$(3) Average Precision(AP): 信頼度スコアの閾値を変えて描いた PR 曲線の下面積。
$$\mathrm{AP} = \int_0^1 P(r)\,dr \approx \sum_{i=1}^{N} (r_i - r_{i-1}) \cdot P_i$$(4) mean Average Precision(mAP): 全クラスの AP の平均。
$$\mathrm{mAP} = \frac{1}{C} \sum_{c=1}^{C} \mathrm{AP}_c$$(5) Non-Maximum Suppression(NMS): 重複矩形を間引くアルゴリズム。 同クラス内で IoU が閾値(例 0.5)以上の矩形のうち最高スコア以外を捨てる。
$$\mathrm{Keep}(b_i) \iff \forall j: s_j > s_i \Rightarrow \mathrm{IoU}(b_i, b_j) < \tau_{\mathrm{nms}}$$🔬 記号・要素の読み解き
- バウンディングボックス
- (x, y, w, h) または (x1, y1, x2, y2) で物体を矩形で囲む
- クラス
- 物体のカテゴリ(人、 車、 犬 など)
- 信頼度(confidence)
- 「この検出が正しい確率」
- IoU
- 重なり率。 マッチング判定に使う
- NMS(Non-Max Suppression)
- 重複検出を 1 つに統合する後処理
- mAP
- 全クラスの総合精度
🔬 数式を言葉で読み解く
「数式を言葉で読み解く」ことは、 数学アレルギーを乗り越える最良の方法です。 各記号の意味を日本語で並べ直します:
| 記号 | 意味 | 物体検出での実体 |
|---|---|---|
| A, B | 2 つの矩形(集合) | 予測 box と正解 box |
| A ∩ B | 共通部分(重なり領域) | 交差矩形の面積 |
| A ∪ B | 和集合(合体領域) | 予測と正解の総面積 |
| IoU=1 | 完全一致 | 予測 = 正解 |
| IoU=0 | 重なりゼロ | 完全外れ |
| TP, FP, FN | 真陽性 / 偽陽性 / 偽陰性 | IoU≥0.5 で正解 → TP、 過検出 → FP、 見落とし → FN |
| P(r) | Recall=r での Precision | PR 曲線の高さ |
| C | クラス数 | COCO なら 80, PASCAL VOC なら 20 |
| τ_nms | NMS の IoU 閾値 | 通常 0.45〜0.5 |
読み下し例: 「IoU = (重なりの面積) ÷ (合体の面積)。 IoU が 0.5 以上なら『当たり』とみなし、 PR 曲線を作って積分すると AP、 それをクラス平均すると mAP」。
🧮 数値例・実値計算
YOLOv5 等の代表モデルの性能比較(COCO データセット):
| モデル | mAP | 速度 (FPS) | パラメータ数 |
|---|---|---|---|
| YOLOv5s | 37.4 | 140 | 7.2M |
| YOLOv5x | 50.7 | 32 | 87M |
| Faster R-CNN | 42.0 | 5 | 41M |
| DETR | 44.9 | 10 | 41M |
| YOLOv8x | 53.9 | 40 | 68M |
速度と精度はトレードオフ。 リアルタイム用途(自動運転)は YOLO 系、 精度重視は R-CNN 系。
🧮 数式に値を入れて手で計算する: mAP の計算
合成データでクラス別 AP と平均 (mAP) を計算する。
Step 1: クラス別 AP
| クラス | AP |
|---|---|
| person | 0.85 |
| car | 0.78 |
| dog | 0.92 |
| cat | 0.65 |
Step 2: mAP
🐍 Python で再現
1 2 3 | import numpy as np ap = np.array([0.85, 0.78, 0.92, 0.65]) print(f"mAP: {ap.mean():.3f}") |
📤 実行結果
💬 手計算 (Step 2) 0.80 と Python 出力が完全一致。
🧮 IoU を手で計算する — 「重なって見えるのに不正解」になる例
上の mAP の計算はクラス別 AP が与えられた後の「平均をとる」部分だけでした。ここからは、その AP がどこから来るのかを 仮想の箱の座標(画像や実在のデータセットではなく、計算の仕組みを見るための合成データ)で 1 段ずつ手計算し、Python で同じ値になることを確かめます。まずは全ての出発点になる IoU です。
正解の箱 $A = (x_1, y_1, x_2, y_2) = (50, 40, 150, 120)$、予測の箱 $B = (70, 50, 170, 140)$ とします(単位はピクセル、左上と右下の座標)。
| Step | 計算 | 値 |
|---|---|---|
| 1. 面積 | $|A| = (150-50)(120-40) = 100 \times 80$、$|B| = (170-70)(140-50) = 100 \times 90$ | 8,000 と 9,000 |
| 2. 重なりの幅・高さ | 幅 $\min(150,170) - \max(50,70) = 150-70$、高さ $\min(120,140) - \max(40,50) = 120-50$ | 80 と 70 |
| 3. 重なりと和集合 | $|A \cap B| = 80 \times 70$、$|A \cup B| = 8000 + 9000 - 5600$ | 5,600 と 11,400 |
| 4. IoU | $5600 / 11400$ | 0.4912 |
予測は正解の箱の 70% を覆っている(5,600 ÷ 8,000)のに、IoU は 0.4912 で閾値 0.5 にわずかに届きません。mAP@0.5 ではこの予測は FP(過検出)になり、同時に正解 A は誰にも当てられなかったので FN(見逃し)にも数えられます。「1 つの惜しい予測が FP と FN の 2 回分の失点になる」のが IoU 閾値で判定する評価の特徴です。
🎯 このコードでやること:上の Step 1〜4 を関数にして同じ箱で IoU を計算し、さらに「右に 8 ピクセル・下に 8 ピクセルずれた予測」の IoU を物体の一辺 16〜256 ピクセルで比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np def iou(a, b): """a, b = (x1, y1, x2, y2)。左上と右下の座標(ピクセル)""" iw = max(0, min(a[2], b[2]) - max(a[0], b[0])) # 重なりの幅 ih = max(0, min(a[3], b[3]) - max(a[1], b[1])) # 重なりの高さ inter = iw * ih area_a = (a[2] - a[0]) * (a[3] - a[1]) area_b = (b[2] - b[0]) * (b[3] - b[1]) return inter, area_a + area_b - inter, inter / (area_a + area_b - inter) gt, pred = (50, 40, 150, 120), (70, 50, 170, 140) inter, union, v = iou(gt, pred) print(f'重なり {inter} 和集合 {union} IoU = {v:.4f} → 閾値 0.5 で', 'TP' if v >= 0.5 else 'FP') # 同じ 8 ピクセルのずれ(右に 8・下に 8)が、物体の大きさでどう効くか print('一辺 s IoU(8 px ずれ)') for s in [16, 32, 64, 128, 256]: g = (0, 0, s, s) p = (8, 8, s + 8, s + 8) print(f'{s:>6} {iou(g, p)[2]:.3f}') |
💬 IoU は手計算の 5,600 ÷ 11,400 = 0.4912 と一致し、閾値 0.5 で FP と判定されます。後半の表が物体検出の評価でいちばん誤解されやすい点で、同じ 8 ピクセルのずれでも、一辺 256 ピクセルの物体なら IoU 0.884 で余裕の TP、64 ピクセルなら 0.620 で mAP@0.5 は TP でも mAP@0.75 では FP、32 ピクセルで 0.391、16 ピクセルでは 0.143 と完全な外れ扱いになります。COCO の「小物体(面積 32² 未満)の AP が大物体よりずっと低い」という傾向の一部はモデルの力不足ではなく、この IoU の物差しが小さい物体ほど厳しいことから来ています。小物体が主役の用途(遠方の歩行者、ドローン画像の果実など)では、サイズ別に AP を分けて報告し、閾値の意味をそろえて比べる必要があります。
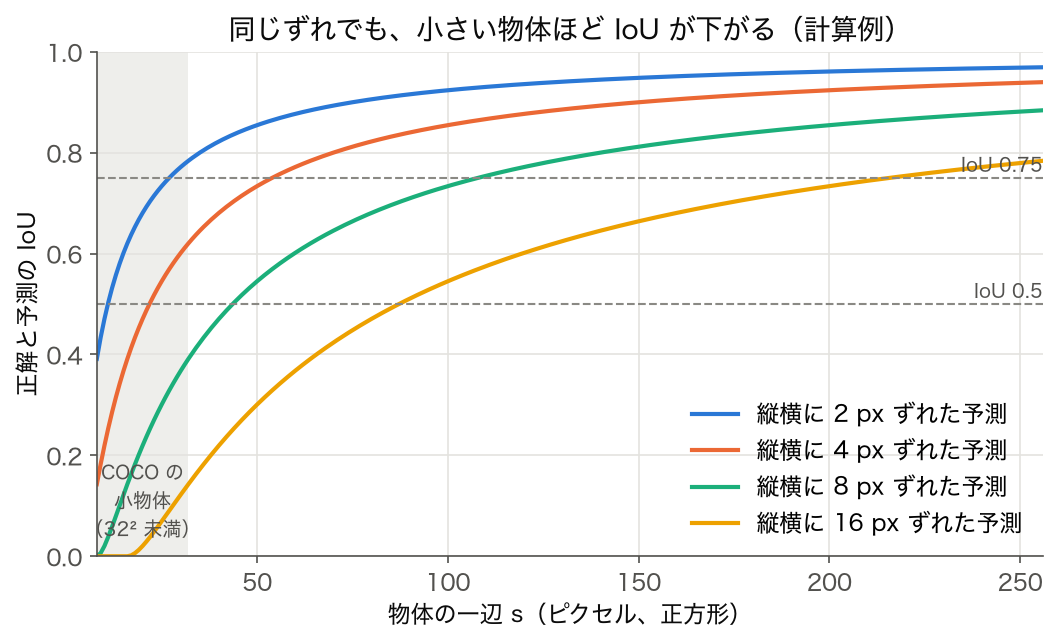
図の読み方: 上のコードの計算を、ずれ δ = 2・4・8・16 ピクセルについて一辺 8〜256 ピクセルで連続に描いたもの(IoU = (s−δ)² ÷ (2s² − (s−δ)²)、乱数なしの計算例)。8 ピクセルのずれで IoU 0.5 を超えるには一辺 44 ピクセル以上、0.75 を超えるには 108 ピクセル以上が必要です。わずか 2 ピクセルのずれでも、一辺 11 ピクセル未満では IoU 0.5 に届きません。灰色の帯は COCO が「小物体」と呼ぶ面積 32² 未満の範囲で、ここでは 4 ピクセルずれるだけで IoU が 0.620 以下になり、mAP@[0.5:0.95] の高い閾値ではほぼ FP として数えられます。画像を縮小して入力すると物体の一辺も同じ割合で縮むので、入力解像度を下げたときに小物体の AP が真っ先に落ちるのもこの曲線の左側に移るためです。図の作成スクリプトは code/glossary_figs/object-detection.py。
🧮 NMS を手で回す — 閾値 τ を下げすぎると隣の物体まで消える
検出器は 1 つの物体のまわりに少しずつずれた箱を何本も出すので、NMS(Non-Maximum Suppression)で「信頼度の最も高い箱を残し、それと IoU が τ を超える箱を消す」を繰り返して 1 本にまとめます。隣り合って立つ 2 人の人物を想定した仮想の候補箱 5 本で、手順を追います。
| 箱 | 座標 (x1, y1, x2, y2) | 信頼度 | 想定 |
|---|---|---|---|
| a | (100, 100, 200, 300) | 0.95 | 人物 1 |
| b | (110, 105, 210, 305) | 0.90 | 人物 1 の重複 |
| c | (180, 100, 280, 300) | 0.85 | 人物 2(人物 1 と 20 px 重なる) |
| d | (185, 110, 285, 310) | 0.60 | 人物 2 の重複 |
| e | (400, 400, 450, 450) | 0.30 | 離れた小さい箱 |
| Step | 計算(τ = 0.5) | 結果 |
|---|---|---|
| 1. 最高信頼度を残す | a(0.95)を確定 | 残り b, c, d, e |
| 2. a との IoU | b: 重なり 90 × 195 = 17,550、和集合 20,000 + 20,000 − 17,550 = 22,450 → 0.782 c: 重なり 20 × 200 = 4,000、和集合 36,000 → 0.111 d: 重なり 15 × 190 = 2,850、和集合 37,150 → 0.077 e: 重なり 0 → 0 | 0.782 > 0.5 の b だけ削除 |
| 3. 残りの最高を残す | c(0.85)を確定 | 残り d, e |
| 4. c との IoU | d: 重なり 95 × 190 = 18,050、和集合 40,000 − 18,050 = 21,950 → 0.822 | d を削除 |
| 5. 最後 | e を確定 | 残るのは a, c, e |
🎯 このコードでやること:手計算と同じ 5 本の候補箱に、IoU 閾値 τ = 0.5 と τ = 0.1 で NMS を実行し、どの箱がどの箱に消されたかを表示する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | import numpy as np boxes = np.array([[100, 100, 200, 300], # a: 人物 1 [110, 105, 210, 305], # b: 人物 1 の重複 [180, 100, 280, 300], # c: 人物 2(人物 1 と隣り合う) [185, 110, 285, 310], # d: 人物 2 の重複 [400, 400, 450, 450]]) # e: 離れた小さい箱 scores = np.array([0.95, 0.90, 0.85, 0.60, 0.30]) names = np.array(list('abcde')) def iou_1_to_n(box, others): iw = np.clip(np.minimum(box[2], others[:, 2]) - np.maximum(box[0], others[:, 0]), 0, None) ih = np.clip(np.minimum(box[3], others[:, 3]) - np.maximum(box[1], others[:, 1]), 0, None) inter = iw * ih area = lambda b: (b[..., 2] - b[..., 0]) * (b[..., 3] - b[..., 1]) return inter / (area(box) + area(others) - inter) def nms(boxes, scores, tau): order = np.argsort(-scores) keep = [] while order.size: i = order[0] keep.append(i) rest = order[1:] ious = iou_1_to_n(boxes[i], boxes[rest]) for j, v in zip(rest, ious): if v > tau: print(f' {names[i]} を残す → {names[j]} は IoU {v:.3f} > {tau} で削除') order = rest[ious <= tau] return keep for tau in [0.5, 0.1]: print(f'τ = {tau}') print(' 残った箱:', ', '.join(names[nms(boxes, scores, tau)])) |
💬 τ = 0.5 では手計算どおり b(a との IoU 0.782)と d(c との IoU 0.822)が消え、a・c・e の 3 本が残ります。人物 1 と人物 2 はそれぞれ 1 本ずつになり、NMS が意図どおりに働いています。τ = 0.1 に下げると、人物 2 の本命の箱 c が a との IoU 0.111 で消されてしまいます。この例では偶然 d(a との IoU 0.077)が生き残るので人物 2 はかろうじて検出されますが、残るのは信頼度 0.60 の、正解からずれた箱です。τ を下げるほど重複は確実に消えますが、混み合った場面(群衆、商品棚、隣接する車)では別の物体まで消すことになり、再現率が落ちます。逆に τ を上げすぎると重複が残って FP が増えるので、τ は検証データで AP を見ながら決め、混雑が本質的な用途では Soft-NMS(消さずに信頼度を下げる)を検討します。
🧮 AP を検出の順位表から手で計算する — 全点補間と 11 点補間
AP は「信頼度の高い順に検出を並べ、1 件ずつ TP/FP を判定しながら適合率と再現率を更新し、その曲線の下の面積を求めたもの」です。正解が 6 個ある 1 クラスの画像群に対して、検出器が 10 件の箱を出したとします(仮想の結果)。各検出には「最もよく重なる正解の番号」と「その IoU」が付いています。
| 順位 | 信頼度 | 重なる正解 | IoU | IoU 0.5 での判定 |
|---|---|---|---|---|
| 1 | 0.98 | g1 | 0.88 | TP |
| 2 | 0.95 | g2 | 0.81 | TP |
| 3 | 0.91 | g1 | 0.62 | FP(g1 は順位 1 で当てられ済み=重複) |
| 4 | 0.87 | g3 | 0.72 | TP |
| 5 | 0.80 | なし | — | FP(背景を検出) |
| 6 | 0.74 | g4 | 0.55 | TP |
| 7 | 0.66 | g5 | 0.47 | FP(IoU 不足) |
| 8 | 0.58 | なし | — | FP |
| 9 | 0.45 | g6 | 0.79 | TP |
| 10 | 0.30 | g5 | 0.53 | TP(g5 はまだ誰にも当てられていない) |
| Step | 計算 | 値 |
|---|---|---|
| 1. 累積の TP と FP | 順位 k までの TP 数・FP 数を数える(例: 順位 5 で TP 3・FP 2) | 下の出力の表 |
| 2. 適合率と再現率 | 適合率 = 累積 TP ÷ k、再現率 = 累積 TP ÷ 6(例: 順位 5 で 3/5 = 0.600、3/6 = 0.500) | 下の出力の表 |
| 3. 包絡線 | 各再現率で「それ以上の再現率での最大の適合率」に置き換える。再現率 0.167, 0.333, 0.500, 0.667, 0.833, 1.000 で 1.000, 1.000, 0.750, 0.667, 0.600, 0.600 | ギザギザを除いた階段 |
| 4. 全点補間の AP | 再現率は 1/6 ずつ増えるので $\tfrac{1}{6}(1.000 + 1.000 + 0.750 + 0.667 + 0.600 + 0.600) = \tfrac{4.617}{6}$ | 0.7694 |
| 5. 11 点補間の AP | 再現率 0, 0.1, …, 1.0 の 11 点で包絡線を読む: 1, 1, 1, 1, 0.75, 0.75, 0.667, 0.6, 0.6, 0.6, 0.6 の平均 $= 8.567 / 11$ | 0.7788 |
🎯 このコードでやること:手計算と同じ 10 件の検出を信頼度順に TP/FP 判定し、累積の適合率・再現率の表と、全点補間・11 点補間の AP を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import numpy as np # 仮想の検出結果 10 件(1 クラス、正解の箱は 6 個)。 # gt = 一番よく重なる正解の番号(無ければ -1)、iou = その正解との IoU det = [(0.98, 1, 0.88), (0.95, 2, 0.81), (0.91, 1, 0.62), (0.87, 3, 0.72), (0.80, -1, 0.0), (0.74, 4, 0.55), (0.66, 5, 0.47), (0.58, -1, 0.0), (0.45, 6, 0.79), (0.30, 5, 0.53)] N_GT = 6 def ap_at(thr, verbose=False): det_s = sorted(det, key=lambda d: -d[0]) # 信頼度の高い順 used, tp = set(), [] for s, g, v in det_s: ok = g != -1 and v >= thr and g not in used # 同じ正解への 2 回目は FP if ok: used.add(g) tp.append(int(ok)) tp = np.array(tp) ctp, cfp = np.cumsum(tp), np.cumsum(1 - tp) prec, rec = ctp / (ctp + cfp), ctp / N_GT if verbose: print(' 順位 信頼度 判定 累積TP 累積FP 適合率 再現率') for k in range(len(tp)): print(f'{k+1:>4} {det_s[k][0]:.2f} {"TP" if tp[k] else "FP"} {ctp[k]:>5} {cfp[k]:>5} {prec[k]:.3f} {rec[k]:.3f}') # 全点補間(COCO・VOC2010 以降): 右側の最大の適合率で包絡線をとって面積を足す r = np.concatenate([[0], rec, [1]]); p = np.concatenate([[1], prec, [0]]) for i in range(len(p) - 2, -1, -1): p[i] = max(p[i], p[i + 1]) idx = np.flatnonzero(r[1:] != r[:-1]) ap_all = float(np.sum((r[idx + 1] - r[idx]) * p[idx + 1])) # 11 点補間(VOC2007): 再現率 0, 0.1, ..., 1.0 で「それ以上の再現率での最大適合率」を平均 ap11 = float(np.mean([prec[rec >= t].max() if (rec >= t).any() else 0 for t in np.linspace(0, 1, 11)])) return tp, ap_all, ap11 tp, a, a11 = ap_at(0.5, verbose=True) print(f'IoU 0.5: AP(全点補間) = {a:.4f} AP(11 点補間) = {a11:.4f}') |
💬 表の適合率・再現率は Step 1〜2 の手計算と一致し、全点補間の AP 0.7694、11 点補間の AP 0.7788 も Step 4・5 と一致します。同じ検出結果でも補間の仕方で AP が 0.0094 違うので、論文や記事の AP を比べるときは「VOC2007 の 11 点」か「全点(VOC2010 以降・COCO は 101 点)」かをそろえる必要があります。表を見ると、適合率は順位 3(重複の FP)と順位 5・7・8 で下がり、順位 9・10 の TP で少し戻ります。包絡線をとるのはこのギザギザを消して「その再現率を達成できる最良の適合率」で評価するためです。なお順位 10 の検出は信頼度 0.30 と低いのに TP で、これがあるから再現率 1.000 に届いています。後処理で信頼度 0.5 未満を捨てていれば、この 1 件と順位 9 の TP を失い、AP の計算に入る再現率の上限は 0.667 で止まります。
🧮 IoU 閾値を 0.5 から 0.95 まで動かす — mAP@0.5 と mAP@[0.5:0.95] が大きく違う理由
同じ 10 件の検出でも、TP と認める IoU の閾値を上げると TP は減っていきます。COCO の主指標 mAP@[0.5:0.95] は閾値 0.50, 0.55, …, 0.95 の 10 段階で AP を計算して平均したものです。あわせて、sklearn.metrics.average_precision_score に TP/FP の列を渡して「AP」を計算してしまう、よくある間違いも並べます。
🎯 このコードでやること:IoU 閾値 0.50〜0.95 の 10 段階それぞれで TP 数・再現率の上限・全点補間の AP を計算し、mAP@[0.5:0.95] を出す。同じ TP/FP の列を sklearn の average_precision_score に渡した値と比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import numpy as np from sklearn.metrics import average_precision_score # 上のブロックと同じ仮想の検出 10 件(信頼度, 正解の番号, IoU)と正解 6 個 det = [(0.98, 1, 0.88), (0.95, 2, 0.81), (0.91, 1, 0.62), (0.87, 3, 0.72), (0.80, -1, 0.0), (0.74, 4, 0.55), (0.66, 5, 0.47), (0.58, -1, 0.0), (0.45, 6, 0.79), (0.30, 5, 0.53)] N_GT = 6 scores = np.array([d[0] for d in det]) # すでに信頼度の高い順 def tp_flags(thr): used, tp = set(), [] for s, g, v in det: ok = g != -1 and v >= thr - 1e-12 and g not in used used |= {g} if ok else set() tp.append(int(ok)) return np.array(tp) def ap_all_point(tp): ctp = np.cumsum(tp) prec, rec = ctp / np.arange(1, len(tp) + 1), ctp / N_GT r = np.r_[0, rec, 1]; p = np.r_[1, prec, 0] p = np.maximum.accumulate(p[::-1])[::-1] # 右側の最大値で包絡線 i = np.flatnonzero(r[1:] != r[:-1]) return float(np.sum((r[i + 1] - r[i]) * p[i + 1])) aps = [] print(' IoU閾値 TP数 再現率の上限 AP sklearn の AP') for t in np.round(np.arange(0.50, 0.96, 0.05), 2): tp = tp_flags(t) a = ap_all_point(tp); aps.append(a) sk = average_precision_score(tp, scores) if tp.sum() else float('nan') print(f' {t:.2f} {tp.sum()} {tp.sum() / N_GT:.3f} {a:.4f} {sk:.4f}') print(f'AP@0.5 = {aps[0]:.4f} AP@0.75 = {aps[5]:.4f} AP@[0.5:0.95] = {np.mean(aps):.4f}') |
💬 IoU 0.5 では 6 個の正解すべてに TP があり AP 0.7694 ですが、0.55 で順位 10(IoU 0.53)、0.60 で順位 6(0.55)が FP に変わり、0.75 では TP 3 個・AP 0.3889 と半分になります。0.90 以上ではどの検出も届かず AP 0 です。10 段階の平均 mAP@[0.5:0.95] = 0.3918 は AP@0.5 の約半分で、COCO の表で mAP@[0.5:0.95] が mAP@0.5 より大きく低いのは、この「箱の位置の精密さ」まで点数に入れているからです。右端の列が落とし穴で、sklearn の average_precision_score は渡された検出の中だけで再現率を計算するので、一度も検出されなかった正解(FN)を知りません。IoU 0.80 では正解 6 個のうち 2 個しか当たっていない(再現率の上限 0.333)のに 1.0000 を返し、0.75 でも 0.7778 と正しい AP 0.3889 の 2 倍になります。0.5 でも補間をしないため 0.7620 と少しずれます。物体検出の AP は pycocotools や torchmetrics の MeanAveragePrecision など、正解の総数を分母にする実装で計算します。
🧮 件数が合っても検出が合っているとは限らない — 数える用途の落とし穴
果実の数や来店者数のように「検出した箱の数」をそのまま件数として使う用途では、信頼度の下限(これ未満の箱を捨てる値)の選び方で件数が変わります。同じ 10 件の検出で、下限を 4 通りに変えて件数の誤差と中身(TP・FP・FN)を並べます。
🎯 このコードでやること:信頼度の下限を 0.9 / 0.7 / 0.5 / 0.3 に変えたときの検出数・TP・FP・FN・件数の誤差(検出数 − 正解数)・適合率・再現率を表にする(IoU 閾値は 0.5)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np # 上のブロックと同じ仮想の検出 10 件(信頼度, 正解の番号, IoU)と正解 6 個。IoU 閾値は 0.5 det = [(0.98, 1, 0.88), (0.95, 2, 0.81), (0.91, 1, 0.62), (0.87, 3, 0.72), (0.80, -1, 0.0), (0.74, 4, 0.55), (0.66, 5, 0.47), (0.58, -1, 0.0), (0.45, 6, 0.79), (0.30, 5, 0.53)] N_GT = 6 print('信頼度の下限 検出数 TP FP FN 件数の誤差 適合率 再現率') for cut in [0.9, 0.7, 0.5, 0.3]: kept = [d for d in det if d[0] >= cut] used, tp = set(), 0 for s, g, v in kept: if g != -1 and v >= 0.5 and g not in used: used.add(g); tp += 1 fp, fn = len(kept) - tp, N_GT - tp print(f' {cut:.1f} {len(kept):>2} {tp} {fp} {fn} {len(kept) - N_GT:+d}({(len(kept) - N_GT) / N_GT:+.0%})' f' {tp / len(kept):.3f} {tp / N_GT:.3f}') |
💬 下限 0.7 では検出が 6 件で、正解の 6 個と件数の誤差は 0 です。しかし中身は TP 4・FP 2・FN 2 で、見逃し 2 件と背景・重複の誤検出 2 件が打ち消し合って件数だけが合っている状態です。下限を 0.5 にすると FP が 4 に増えて +33%、0.3 では見逃しは 0 になるものの +67% の過大計上になり、0.9 では −50% の過小計上です。検証データで件数の誤差だけを見て下限を決めると、別の画像では FP と FN の釣り合いが崩れて誤差が一気に出ることがあります。数える用途でも、適合率と再現率を別々に確認し、必要なら「検出数 ÷ 適合率 × 再現率」の形で件数を補正するか、密度推定型の数え方と比べるのが安全です。
🧮 mAP は「クラスの単純平均」 — 少ないクラスの AP が同じ重みで効く
冒頭の手計算で mAP = (0.85 + 0.78 + 0.92 + 0.65) ÷ 4 = 0.80 としたように、mAP はクラスごとの AP を同じ重みで平均します(マクロ平均)。評価セットの正解箱が person 500 個・car 300 個・dog 40 個・cat 20 個だったと仮定して、箱の数で重みづけした平均と比べます。
| Step | 計算 | 値 |
|---|---|---|
| 1. mAP(単純平均) | (0.85 + 0.78 + 0.92 + 0.65) ÷ 4 = 3.20 ÷ 4 | 0.8000 |
| 2. 箱数で重みづけ | (0.85×500 + 0.78×300 + 0.92×40 + 0.65×20) ÷ 860 = (425 + 234 + 36.8 + 13) ÷ 860 = 708.8 ÷ 860 | 0.8242 |
| 3. cat が 0.30 に下がると | mAP = 2.85 ÷ 4、重みづけ = (425 + 234 + 36.8 + 6) ÷ 860 = 701.8 ÷ 860 | 0.7125 と 0.8160 |
🎯 このコードでやること:手計算と同じクラス別 AP と、仮定した正解箱の数で、mAP(単純平均)と箱数で重みづけした平均を計算し、cat の AP だけが下がった場合と比べる。
1 2 3 4 5 6 7 8 9 10 | import numpy as np cls = ['person', 'car', 'dog', 'cat'] ap = np.array([0.85, 0.78, 0.92, 0.65]) # 上の手計算のクラス別 AP n_gt = np.array([500, 300, 40, 20]) # 仮定: 評価セットの正解箱の数 for label, a in [('元の AP', ap), ('cat だけ 0.30 に下がった', np.array([0.85, 0.78, 0.92, 0.30]))]: macro = a.mean() # mAP(クラスを同じ重みで平均) weighted = (a * n_gt).sum() / n_gt.sum() # 正解箱の数で重みづけ print(f'{label:<16} mAP = {macro:.4f} 箱数で重みづけ = {weighted:.4f}') |
💬 mAP 0.8000 と重みづけ 0.8242、cat が下がった場合の 0.7125 と 0.8160 は Step 1〜3 と一致します。正解箱が全体の 2.3%(20 ÷ 860)しかない cat の AP が 0.65 → 0.30 に落ちると、mAP は 0.0875 下がるのに、箱数で重みづけした平均は 0.0082 しか動きません。mAP は「どのクラスも同じくらい大事」という立場の指標なので、珍しいクラスの失敗がはっきり表に出ます。逆に、件数の多いクラスだけが大事な用途では mAP が実感より悪く見えることもあるので、mAP 1 つで判断せず、クラス別 AP の表を一緒に見るのが基本です。
🧪 理解度チェック — 手計算の数値で確かめる
| 問題 | 解答 |
|---|---|
| Q1. 正解の箱 (0, 0, 100, 100) と予測 (20, 0, 120, 100) の IoU は? mAP@0.75 で TP になるか。 | 重なり 80 × 100 = 8,000、和集合 10,000 + 10,000 − 8,000 = 12,000、IoU = 0.667。0.75 未満なので FP(mAP@0.5 なら TP)。 |
| Q2. 一辺 16 ピクセルの物体に対して、予測が右に 4 ピクセルだけずれた(縦のずれ 0)。IoU は? | 重なり 12 × 16 = 192、和集合 256 + 256 − 192 = 320、IoU = 0.600。4 ピクセルでも小物体では 0.75 の閾値を満たさない。 |
| Q3. 上の順位表で、順位 3 の検出(g1 に IoU 0.62)が無かったら AP@0.5(全点補間)はいくつか。 | 検出は 9 件になり、適合率は順位順に 1, 1, 1, 0.75, 0.8, 0.667, 0.571, 0.625, 0.667。包絡線は再現率 1/6〜3/6 で 1.0、4/6 で 0.8、5/6 と 6/6 で 0.667。AP = (1 + 1 + 1 + 0.8 + 0.667 + 0.667) ÷ 6 = 0.856。重複を 1 本消すだけで 0.769 から上がるので、NMS の τ が AP に効くことが分かる。 |
| Q4. NMS の例で τ = 0.15 にすると、残る箱は? | a を残すと b(0.782)が消え、c(0.111)は 0.15 以下なので残る。c を残すと d(0.822)が消える。残るのは a, c, e で τ = 0.5 と同じ。τ = 0.1 との違いは、a と c の IoU 0.111 を境にしている。 |
| Q5. 「AP@0.5 = 0.77、AP@[0.5:0.95] = 0.39」のモデルについて言えることは? | 物体の有無と大まかな位置はよく当てているが、箱の位置は正解から少しずれていることが多い(IoU 0.75 を超える TP が半分しかない)。箱の精密さが要る用途(計測・ロボットの把持など)では位置回帰の改善が必要。 |
| Q6. 上の mAP の重みづけの例で、dog(正解箱 40 個)の AP が 0.92 → 0.50 に下がったら、mAP と箱数で重みづけした平均はいくつになるか。 | mAP = (0.85 + 0.78 + 0.50 + 0.65) ÷ 4 = 2.78 ÷ 4 = 0.695。重みづけ = (425 + 234 + 0.50×40 + 13) ÷ 860 = 692 ÷ 860 = 0.805。mAP は 0.105 下がるが、重みづけは 0.020 しか下がらない。 |
| Q7. 数える用途の例で、信頼度の下限 0.7 は件数の誤差 0 だった。この下限を「最適」と言ってよいか。 | 言えない。TP 4・FP 2・FN 2 で、見逃しと誤検出が打ち消し合っているだけ。画像の条件が変わって FP と FN の釣り合いが崩れれば誤差が出るので、適合率 0.667・再現率 0.667 を別々に報告し、別の検証データでも件数の誤差を確かめる。 |
🐍 Python 実装例
最小コードで動かしてみる例:
1 2 3 4 5 6 7 8 9 10 11 12 13 | from ultralytics import YOLO # 事前学習済み YOLOv8 で物体検出 model = YOLO('yolov8n.pt') # 画像で推論 results = model('image.jpg') # 検出結果(バウンディングボックス + クラス + 信頼度) for r in results: print(r.boxes.xyxy) # 座標 print(r.boxes.cls) # クラスID print(r.boxes.conf) # 信頼度 |
⚠️ よくある落とし穴
⚠️ 落とし穴 - 拡張版
上記の基本的な落とし穴に加え、 現場で実際に遭遇する 10 個の追加注意点を解説。
- train/val リーク: 同じシーンの連続フレームを train と val に分けると擬似的に val 精度が高くなる。 シーン単位で分割すべし。
- 長尾分布の罠: COCO でも少数の頻出クラス(特に person)にインスタンスが大きく偏る。 LVIS では極端な long-tail のため class-balanced sampling 必須。
- アノテーション仕様の揺れ: 「自動車」を「車体のみ」とするか「窓・ミラー含む」とするかで box が変わる。 ガイドライン文書化が必須。
- 重複物体カウントエラー: 群衆検出で 1 人を 2 つに数える / 2 人を 1 つに数えるエラー。 Soft-NMS や Crowd-NMS で改善。
- 動的シーンへの過適合: 学習データが特定の街路パターンに偏ると未知シーンで一気に精度低下。 ドメイン多様性を確保。
- ラベルノイズ: アノテーターのミスで 5-10% のラベルが誤っているのは珍しくない。 Label cleaning, co-teaching 等で対応。
- 計算リソース過大評価: 「YOLO は 200 FPS」とあるが入力サイズ・バッチ・前処理を含めると実 30 FPS のことも。 自前環境での測定必須。
- 動画の時間整合性問題: 単フレーム検出を動画に適用すると、 同じ物体の box が小刻みにブレる。 時間平滑化 / トラッキング統合で対策。
- カラー空間問題: BGR / RGB の取り違えで精度激減。 OpenCV と PIL の違いに注意。
- 適切なライセンス確認: YOLOv5/v8 は GPL-3.0、 商用利用には別途ライセンス購入が必要。 プロジェクト初期に確認。
📚 関連グループ教材
この用語の全体像を学ぶには、 まず横断的な教材で文脈を掴むのが効率的です:
- 📚 画像認識 — CV の中核タスク
📚 主要参考文献
- Ren, S. et al. (2015). "Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks." NeurIPS.
- Redmon, J. et al. (2016). "You Only Look Once: Unified, Real-Time Object Detection." CVPR.
- Liu, W. et al. (2016). "SSD: Single Shot MultiBox Detector." ECCV.
- Lin, T.-Y. et al. (2017). "Focal Loss for Dense Object Detection." ICCV.
- Lin, T.-Y. et al. (2017). "Feature Pyramid Networks for Object Detection." CVPR.
- He, K. et al. (2017). "Mask R-CNN." ICCV.
- Tian, Z. et al. (2019). "FCOS: Fully Convolutional One-Stage Object Detection." ICCV.
- Carion, N. et al. (2020). "End-to-End Object Detection with Transformers." ECCV.
- Zhu, X. et al. (2021). "Deformable DETR." ICLR.
- Zhang, H. et al. (2023). "DINO: DETR with Improved DeNoising Anchor Boxes." ICLR.
- Liu, S. et al. (2024). "Grounding DINO: Open-Set Object Detection." ECCV.
- Wang, A. et al. (2024). "YOLOv10: Real-Time End-to-End Object Detection." arXiv.
🧠 セルフチェッククイズ
理解度を確認する 10 問。 答えは下にあります。
- Q1. IoU=0.6 の場合、 mAP@0.5 では TP / FP どちらに分類されるか?
- Q2. 1 段階検出と 2 段階検出の最大の違いを 1 行で説明せよ。
- Q3. Focal Loss の γ パラメータを大きくする効果は?
- Q4. NMS の τ_nms 閾値を下げると検出数はどう変化するか?
- Q5. COCO の mAP@[0.5:0.95] は何段階の IoU 閾値で平均しているか?
- Q6. DETR の特徴を Faster R-CNN との対比で 2 つ挙げよ。
- Q7. Anchor-free 検出のメリットを 1 つ説明せよ。
- Q8. Mosaic データ拡張の利点を 1 行で説明せよ。
- Q9. Open-vocabulary 検出が従来手法と異なる点は?
- Q10. 小物体検出が一般に難しい理由を 1 つ挙げよ。
▶ 解答を表示
- A1: TP(IoU≥0.5 を満たすため)
- A2: 1 段階は候補抽出と分類を同時に、 2 段階は候補抽出 → 分類の二段構えで行う
- A3: 簡単サンプルの loss 寄与をより強く抑制する
- A4: 検出数が減少(同物体の重複削減が強くなる)
- A5: 10 段階(0.5, 0.55, 0.6, ..., 0.95)
- A6: ① NMS 不要 ② end-to-end 学習可能(アンカー設計不要も可)
- A7: アンカーのハイパーパラメータ調整が不要で設計が簡潔
- A8: 4 枚の画像をモザイク状に合成し、 1 度に多様な物体を学習できる
- A9: テキストプロンプトで任意のクラスを検出可能(事前定義クラスに縛られない)
- A10: 特徴マップ解像度不足で物体が消える / アンカーサイズが大きすぎ覆えない 等
📋 補足: 用語の追加深掘り
物体検出に関連する重要概念をさらに 8 つ補足解説します。
▶ ROI Align(vs ROI Pooling)
Faster R-CNN の ROI Pooling は座標を整数化するため精度損失が生じる。 Mask R-CNN で提案された ROI Alignは bilinear interpolation で連続座標を保ち、 セグメンテーション精度を大きく改善。 現代の検出器も RoIAlign が標準。
▶ Feature Pyramid Network(FPN)
CNN の浅い層(高解像度・低意味性)と深い層(低解像度・高意味性)を融合し、 各解像度で検出可能にする仕組み。 小物体検出には浅い層、 大物体には深い層を使う。 FPN 以前は単一解像度で検出していたため小物体に弱かった。
▶ PANet(Path Aggregation Network)
FPN は top-down のみだが、 PANet は bottom-up パスを追加して情報を双方向に流す。 YOLOv4+ の neck で標準採用。 小物体検出を更に改善。
▶ Soft-NMS
通常の NMS は重複矩形を捨てるが、 Soft-NMS はスコアを「IoU に応じて減衰」させて残す。 これにより密集物体(群衆)でも個別物体を区別しやすくなる。
▶ Distribution Focal Loss(DFL)
回帰値を「単一値」でなく「離散分布」として予測する手法。 GFL / PP-YOLOE で採用。 box 境界の曖昧性を表現でき、 精度向上に寄与。
▶ Knowledge Distillation
大型 teacher モデルから小型 student モデルへ知識を移す手法。 物体検出では teacher の予測 box / 分類確率を soft target として student に学ばせる。 エッジ展開時に必須。
▶ Test-Time Augmentation(TTA)
推論時に画像を複数回フリップ・リサイズ・回転して結果を平均する手法。 mAP を 1-3 pt 改善することがあるが推論時間は数倍。 コンペでは定番。
▶ Hard Negative Mining
背景クラスのうち「分類が難しい」サンプルだけを選んで学習する手法。 背景の大部分は簡単に分類できるため、 全てを学習に使うと簡単サンプルが loss を支配。 SSD / RetinaNet で活用。
📚 関連グループ教材(補足)
物体検出の理解を深めるには、 周辺の用語ページもセットで読むのが効果的です:
- 📖 畳み込みニューラルネット(CNN) — 検出器のバックボーンの基礎
- 📖 Vision Transformer — DETR 系の基礎
- 📖 画像分類 — 検出と並ぶ CV 基本タスク
- 📖 混同行列 — TP/FP/FN/TN の起源
- 📖 適合率・再現率 — mAP の構成要素
- 📖 データ拡張 — 検出器学習で必須
🧪 物体検出パイプライン徹底解剖(YOLO / R-CNN / DETR の核を比較)
物体検出は単一の手法ではなく、領域提案・特徴抽出・分類・回帰の 4 工程をどう組み合わせるかで系統が分かれる。 ここでは代表 3 系統 (YOLO / Faster R-CNN / DETR) を一段深く掘り下げ、 実務でアーキ選定するときの判断軸を示す。
🔬 数式を言葉で読み解く:IoU と mAP の本質
IoU (Intersection over Union) は 2 つの矩形の重なり比率で、
$$\mathrm{IoU} = \frac{|B_{\text{pred}} \cap B_{\text{gt}}|}{|B_{\text{pred}} \cup B_{\text{gt}}|}$$
分子は予測矩形と正解矩形の 共通面積、 分母は 合計面積。 0.5 を超えれば「ほぼ当たり」、 0.75 以上で「精密」と評価する慣行。 mAP は IoU 閾値ごとに Precision-Recall 曲線を描き、 その平均面積をクラスごとに取りさらに平均した量。 COCO ベンチでは mAP@[.5:.95] のように 10 段階を平均する。
🎯 系統別の判断基準テーブル
| 系統 | 速度 | 精度 | 小物体 | 向く用途 |
|---|---|---|---|---|
| YOLOv8 | ◎ (60 FPS+) | ○ | △ | リアルタイム監視、 ロボティクス |
| Faster R-CNN | △ (10 FPS) | ◎ | ○ | 医療画像、 衛星画像 |
| DETR | △ | ○ | △ | post-process 不要な end-to-end 系 |
🖼 物体検出の核心を 3 枚の図で押さえる
図 1: 候補箱から NMS で検出結果を絞る(仮想データ)
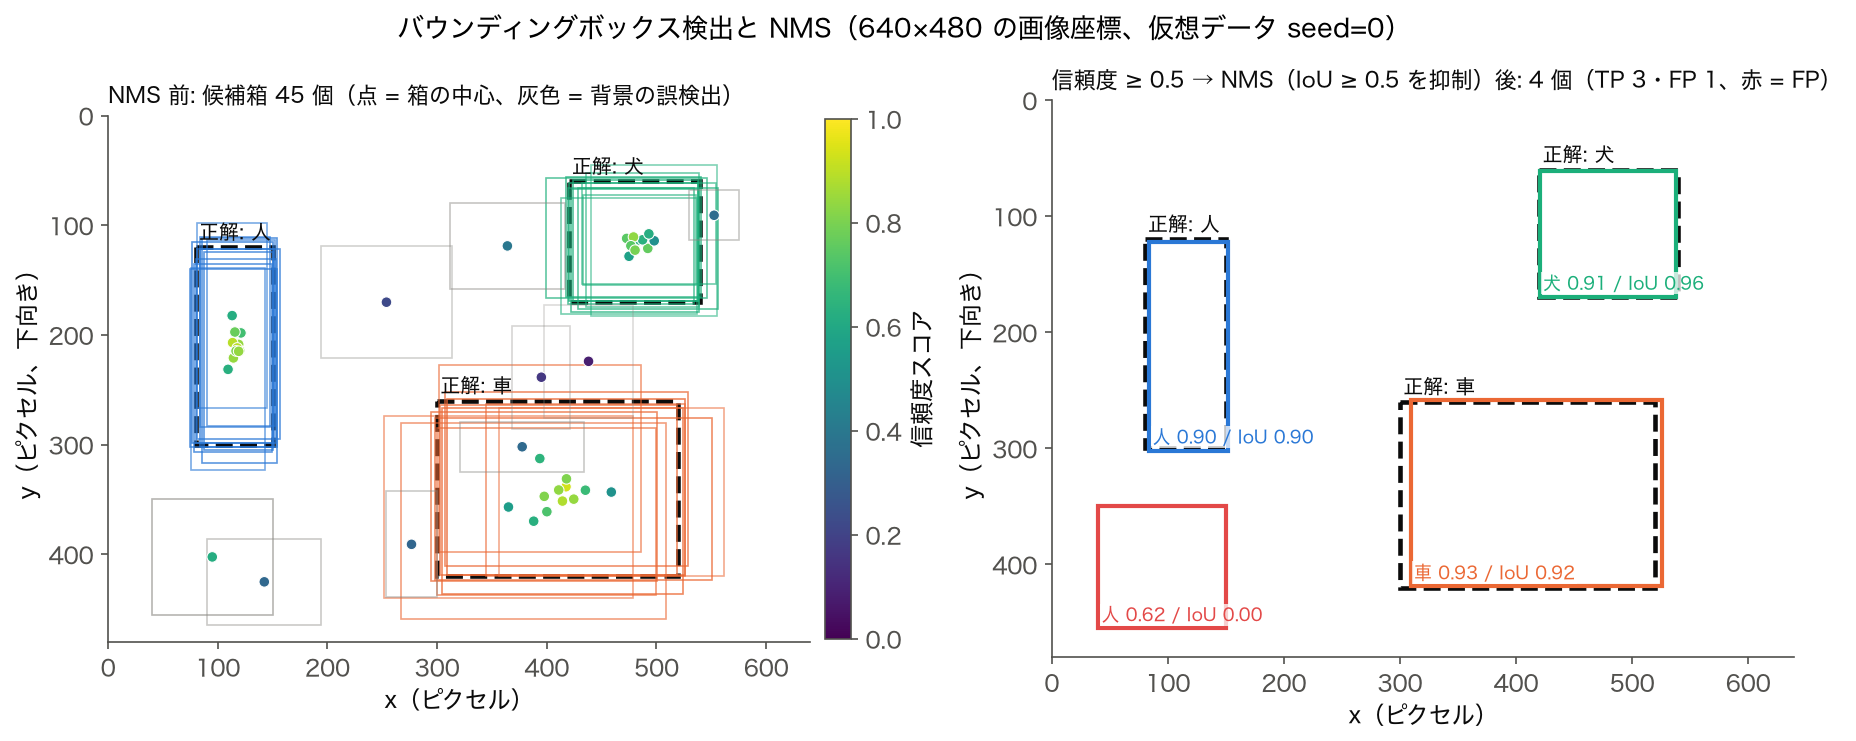
→ 物体検出は「クラス分類 + 位置回帰」を同時に行うタスク。 この図は画像を使わず、 640×480 の座標上に正解箱 3 つ(人・車・犬、 破線)を置き、 検出器が出したことにする候補箱を乱数で作った仮想データ(seed = 0)。 左は NMS 前の候補 45 個で、 点が箱の中心、 色が信頼度スコア。 1 つの物体のまわりに位置と大きさが少しずつ違う箱が 12 個ずつ重なり、 背景にも誤検出が 9 個出ている。 右は信頼度 0.5 未満を捨て(36 個が残る)、 クラスごとに IoU ≥ 0.5 で重なる箱を NMS で抑制した結果で、 各物体に 1 箱ずつ(IoU 0.90・0.92・0.96 の TP 3 個)が残る。 一方、 背景を信頼度 0.62 で「人」と判定した箱はどの箱とも重ならないので NMS では消えず、 FP として残る。 検出結果は (x, y, w, h, class, score) の組として出力され、 IoU で正解箱と照合して TP / FP を数え、 mAP で総合評価する。
図 2: Precision-Recall 曲線と AP(仮想データ)
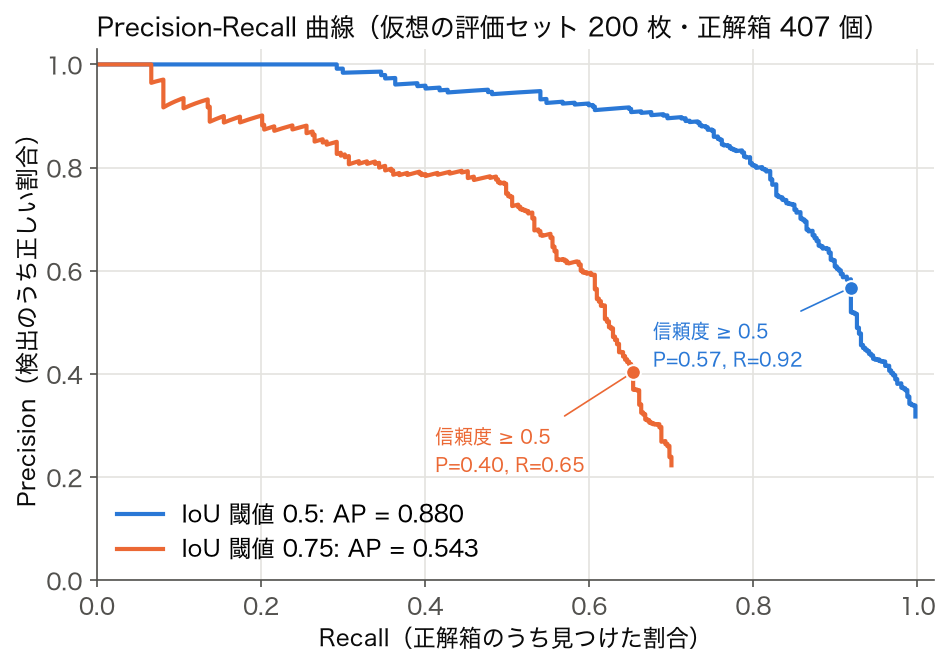
→ 図 1 と同じ作り方で、 画像 200 枚(正解箱 1〜3 個ずつ、 計 407 個)の仮想の評価セットに検出器 A の候補箱を作り、 NMS 後の検出を信頼度の高い順に並べて、 1 つずつ採用するたびの Precision と Recall を結んだのが Precision-Recall 曲線。 曲線の下の面積(右側の最大値で包んだ全点補間)が AP で、 IoU 閾値 0.5 なら AP = 0.880、 位置合わせを厳しくした 0.75 では同じ検出でも AP = 0.543 まで下がる。 点は信頼度閾値 0.5 の位置で、 IoU 0.5 基準なら Precision 0.57・Recall 0.92。 閾値を上げると左上(取りこぼし増・誤検出減)へ、 下げると右下へ動く。 物体検出では TN(「何も無い」と正しく言えた箱)が数えられないため ROC ではなくこの曲線を使い、 クラスごとの AP を平均したものが mAP になる。
図 3: ブートストラップで AP の不確実性を見る(仮想データ)
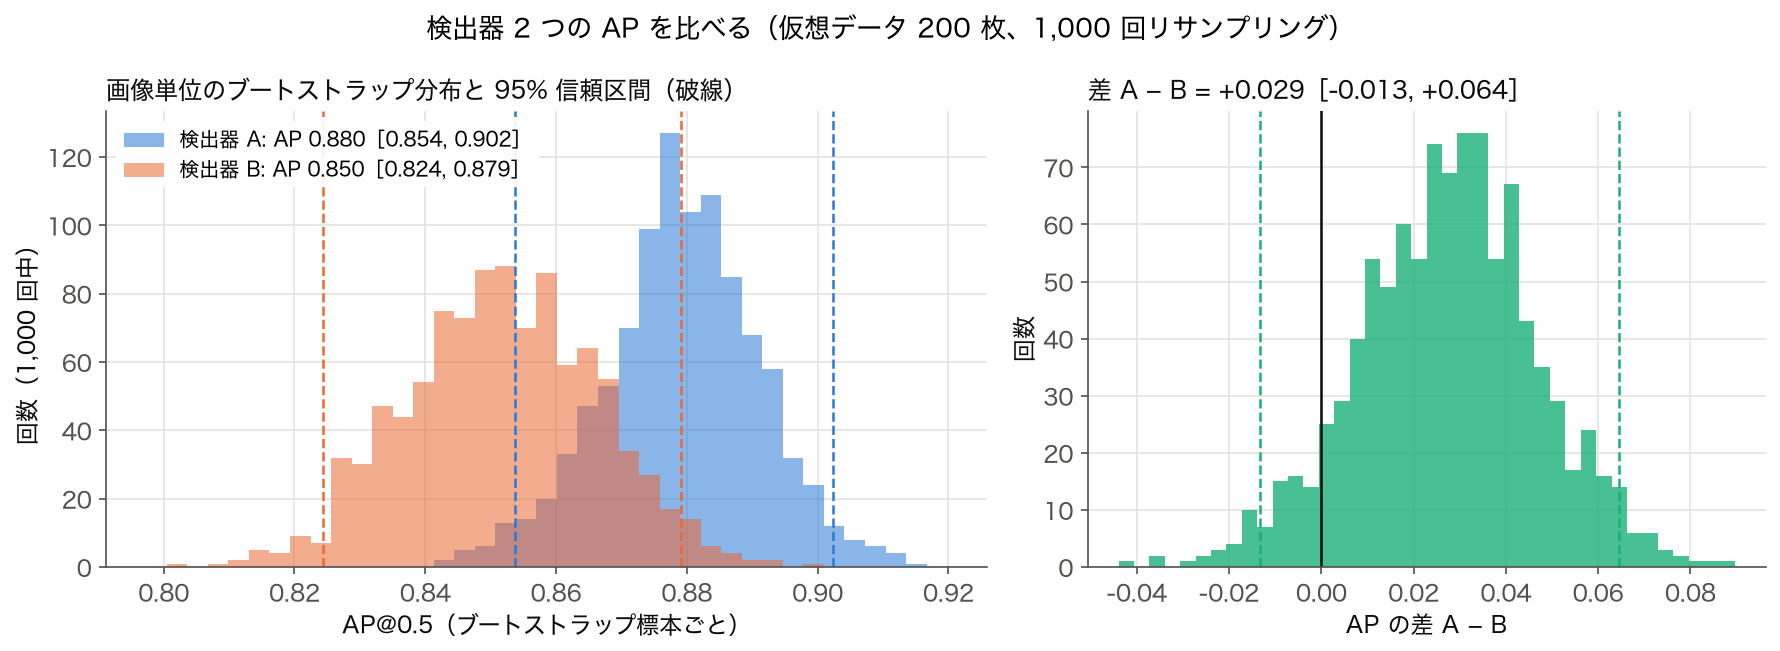
→ AP の点推定だけでなく、 評価画像を復元抽出し直すブートストラップで信頼区間を出す。 同じ 200 枚に、 位置ずれがやや大きい検出器 B も当てて 1,000 回リサンプリングすると、 AP@0.5 は A が 0.880(95% 区間 0.854〜0.902)、 B が 0.850(0.824〜0.879)。 同じリサンプル内で差を取った A − B は +0.029 で、 95% 区間は −0.013〜+0.064 と 0 をまたぐ(B が上回る標本が 7.8%)。 つまり「A が 3 ポイント上」はこの枚数では誤差の範囲で、 有意差ありとは言えない。 2 つのモデルの区間を別々に見るのではなく、 同じ画像の組で差の分布を見るのが要点。
🧪 理解度チェック — 物体検出
以下 5 問を解いて理解度を確認してください。 回答は本文の該当セクションを参照。
- Q1. 物体検出と画像分類の違いを 1 行で。 出力形式(次元数)の違いも併記すること。
- Q2. IoU(Intersection over Union)の定義を式で示し、 IoU=0.5 と 0.75 のどちらが「より厳しい」評価か説明せよ。
- Q3. NMS(Non-Maximum Suppression)が必要な理由と、 IoU 閾値を 0.3 にすると 0.7 と何が変わるか。
- Q4. YOLO(1 段階)と Faster R-CNN(2 段階)の違いを「速度」「精度」「小物体」の 3 軸で比較せよ。
- Q5. COCO 流の mAP@[.5:.95] と PASCAL VOC の mAP@0.5 の差を述べよ。 同じモデルで通常どちらが小さくなるか。
📊 主要検出モデルの比較(補足表)
| モデル | 段階 | 速度 (FPS) | COCO mAP | 主用途 |
|---|---|---|---|---|
| Faster R-CNN | 2 段階 | 5-10 | 36-42 | 高精度・研究ベンチ |
| YOLOv5/v8 | 1 段階 | 100-300 | 37-53 | リアルタイム・エッジ |
| SSD | 1 段階 | 30-50 | 25-30 | モバイル |
| DETR | Transformer | 15-25 | 42-49 | NMS 不要・密集物体 |
| RetinaNet | 1 段階 | 10-30 | 36-40 | Focal Loss 提案元 |
→ リアルタイム要件 ≥30 FPS なら YOLO、 研究で精度上限を狙うなら DETR / Faster R-CNN。 物体検出は事前学習済みモデル(COCO 80 class)を fine-tuning するのが定石で、 ゼロから学習するケースはほぼない。
関連: 画像分類 / CNN / 画像認識 / アノテーション / 分類 / ディープラーニング
📖 上級補足: 物体検出の歴史と評価指標の深掘り
物体検出の系譜は 2001 年の Viola-Jones(Haar 特徴量 + AdaBoost)に遡る。 デジタルカメラの顔検出として広く使われたこの手法は、 計算量の小ささ・実時間性で画期的だった。 2012 年の AlexNet で画像分類が DL に置き換わると、 物体検出も急速に DL 化が進み、 2013 年の R-CNN、 2014 年の SPP-Net、 2015 年の Fast R-CNN・Faster R-CNN と「2 段階検出器」が発展した。 一方、 2016 年に Redmon が発表した YOLO(You Only Look Once)は「画像をグリッドに分け、 各セルでクラスとボックスを同時推定」する 1 段階方式を導入し、 リアルタイム検出の時代を切り開いた。 SSD(2016)も同時期に登場し、 モバイル展開の標準となった。
評価指標 mAP(mean Average Precision)は PASCAL VOC(2007-2012)で標準化された。 PASCAL VOC では IoU ≥ 0.5 を「正解」とし、 各クラスの Precision-Recall 曲線下面積(AP)を計算、 全クラスで平均する。 一方、 COCO(2014 以降)はより厳しく、 IoU 閾値を 0.5 から 0.95 まで 0.05 刻みで 10 段階評価し、 各 AP を平均する mAP@[.5:.95] を採用した。 これにより「ボックスが正解にぴったり一致する」性能を測れるようになった。 また、 小物体(< 32×32 px)・中物体・大物体での性能を AP_S / AP_M / AP_L として分けて評価することで、 検出器の弱点(多くが小物体検出に弱い)を明らかにする設計となっている。
2020 年代に入り、 Facebook AI Research が提案した DETR(DEtection TRansformer)は、 Transformer の Self-Attention 機構を物体検出に応用し、 NMS(Non-Maximum Suppression)を不要にした画期的なアーキテクチャである。 集合予測(set prediction)として物体検出を定式化し、 Hungarian Matching で予測ボックスと正解ボックスを 1 対 1 対応させる。 ただし学習が遅い(500 epoch 以上)という弱点があり、 Deformable DETR・DINO などの改良版が次々登場している。 産業応用では「精度・速度・モデルサイズ」のトリレンマがあり、 例えば自動運転は速度優先で YOLO 系、 医療画像は精度優先で DETR 系、 エッジデバイスはサイズ優先で MobileNet-SSD という棲み分けが見られる。 SSDSE-B-2026 のような統計データでは物体検出は使われないが、 衛星画像から農地・建物を検出して都道府県別の集計に変換する応用は実際に進んでいる。
🔭 visual-r273-objdet:物体検出を「使える形」で押さえ直す補足
物体検出は「画像分類」と「位置推定(バウンディングボックス回帰)」を同時に行うタスクである。 ここでは、 前段で説明した YOLO・SSD・Faster R-CNN・DETR の差を、 SSDSE-B-2026 のような統計データを扱う側の視点から整理する。 物体検出は SSDSE には直接含まれないが、 衛星画像(農林水産業の作付け面積把握)・店舗カメラ(来店者数集計)・ドローン映像(インフラ点検)を「都道府県別の数値」に変換する前処理として産業で広く使われている。
📊 1 段階 vs 2 段階:選び方の基準
2 段階検出器(Faster R-CNN 系)は 領域提案 → 分類 の 2 段構成で精度が高い反面、 1 枚あたり数百ミリ秒かかる。 1 段階検出器(YOLO・SSD 系)は 1 回の forward で全候補を同時推定するため 30 FPS 以上の実時間処理が可能だが、 小物体・重なる物体に弱い傾向がある。 自動運転は「人命に関わる即時性」が必須なので 1 段階、 医療画像の腫瘍検出は「見逃しゼロが至上命題」なので 2 段階、 と棲み分けるのが原則である。
📐 IoU と mAP の落とし穴
IoU(Intersection over Union)は 重なり面積 ÷ 和集合面積で、 0.5 が伝統的な「合格点」だが、 自動運転のように「数 cm のずれで衝突回避を誤る」用途では IoU ≥ 0.75 や 0.9 を要求することもある。 mAP は IoU 閾値に依存するため、 「PASCAL VOC の mAP=0.85 と COCO の mAP=0.45」を直接比較してはいけない。 報告書を読むときは 必ず IoU 閾値・テストセット・クラス数を確認すること。
🧭 関連項目(実在ページのみ)
前提として 画像認識・CNN を押さえ、 評価系列として AUC・混同行列・評価指標、 派生として 画像認識(セグメンテーションを含む上位概念)・CNN(特徴抽出の基幹) を順に辿るとよい。
🗺 概念マップ:物体検出を取り巻く知識マップ
物体検出を中心にした関連概念のツリーマップ:
├── 入力
│ ├── 静止画 (RGB / RGB-D / グレースケール / マルチスペクトル)
│ ├── 動画 (連続フレーム)
│ └── 点群 (LiDAR / ステレオ / RGB-D 深度)
├── アーキテクチャ
│ ├── 2 段階 (Faster R-CNN, Mask R-CNN, Cascade R-CNN)
│ ├── 1 段階 anchor-based (SSD, RetinaNet, YOLO v1-v5)
│ ├── 1 段階 anchor-free (FCOS, CenterNet, YOLOX, YOLOv8)
│ ├── Transformer (DETR, Deformable DETR, DINO, Co-DETR)
│ └── Open-vocab (OWL-ViT, Grounding DINO, GLIP)
├── 構成要素
│ ├── Backbone (ResNet, EfficientNet, Swin, ViT)
│ ├── Neck (FPN, PAN, BiFPN)
│ ├── Head (classification + regression)
│ └── Post-processing (NMS, Soft-NMS, score thresholding)
├── 学習
│ ├── 損失 (CE, Focal, Smooth L1, GIoU, CIoU)
│ ├── 対応付け (Max-IoU, ATSS, OTA, TAL)
│ ├── データ拡張 (Mosaic, MixUp, Copy-Paste, RandAugment)
│ └── 事前学習 (COCO pretrain, self-supervised)
├── 評価
│ ├── IoU / GIoU / DIoU / CIoU
│ ├── Precision / Recall / F1
│ ├── AP (11-point / 101-point / continuous)
│ └── mAP (@0.5, @0.75, @[0.5:0.95], AP_S/M/L)
├── デプロイ
│ ├── クラウド (GPU/TPU)
│ ├── エッジ (Jetson, Coral, Hailo)
│ ├── モバイル (CoreML, TFLite, ONNX Runtime Mobile)
│ └── 最適化 (TensorRT, INT8 量子化, pruning, distillation)
└── 応用
├── 自動運転 (人・車・標識・信号)
├── 監視 (侵入・異常行動)
├── 医療 (病変・組織)
├── 小売 (商品・客)
├── 農業 (果実・雑草)
├── スポーツ (選手・ボール)
├── 製造 (欠陥・部品)
└── 環境 (野生動物・植生)
🎯 まとめ
物体検出(Object Detection)は CV の中核タスクであり、 画像 1 枚から複数の (矩形, クラス, 信頼度) を出力する。 評価は IoU と mAP が中心で、 代表モデルは Faster R-CNN(2 段階)、 YOLO(1 段階)、 DETR(Transformer)の 3 系統。 予測ボックスと正解ボックスの IoU が 0.5 を超えれば正解 (TP) と判定され、 位置ずれが大きくなるほど mAP は急激に低下する。 実応用では精度と速度のトレードオフ、 アノテーションコスト、 ドメインギャップに注意。 産業導入では自動運転・医療・小売・農業・スポーツなど幅広い分野で実用化されている。
📑 クイックリファレンス(チートシート)
現場で素早く参照できる物体検出チートシート:
| 状況 | 推奨モデル | 理由 |
|---|---|---|
| リアルタイム必須 (60+ FPS) | YOLOv8n/s, YOLOv10n | 軽量・高速 |
| 精度最優先 | DINO-Swin-L, Co-DETR | COCO mAP 60+ |
| バランス重視 | YOLOv8m/l, Faster R-CNN-FPN | 速度・精度両立 |
| 少データ (1 クラス<100 枚) | 転移学習 + 強力なデータ拡張 | pre-trained 重要 |
| 小物体多数 | FPN/PAN 付きモデル, 高解像度入力 | multi-scale が鍵 |
| クラス不均衡 | Focal Loss + class-balanced sampling | long-tail 対策 |
| 未知クラス検出 | Grounding DINO, OWL-ViT | open-vocab |
| エッジ展開 | YOLOv8n + INT8 量子化 | 省メモリ・低遅延 |
| 医療画像 | Faster R-CNN + Focal Loss | recall 重視 |
| 産業欠陥検査 | 独自学習 YOLOv5 + ハードネガ採掘 | false alarm 削減 |
▶ よく使うコマンド・スニペット
yolo detect predict model=yolov8n.pt source='path/to/image.jpg'
# YOLOv8 学習
yolo detect train data=dataset.yaml model=yolov8n.pt epochs=100 imgsz=640
# YOLOv8 検証
yolo detect val model=runs/detect/train/weights/best.pt data=dataset.yaml
# YOLOv8 → ONNX 変換
yolo export model=best.pt format=onnx
# TensorRT 変換
trtexec --onnx=best.onnx --saveEngine=best.engine --fp16
# Detectron2 (Faster R-CNN) 推論例
python demo/demo.py --config-file configs/COCO-Detection/faster_rcnn_R_50_FPN_3x.yaml \\
--input image.jpg --output output.jpg \\
--opts MODEL.WEIGHTS detectron2://COCO-Detection/faster_rcnn_R_50_FPN_3x/137849458/model_final_280758.pkl
🔗 隣接手法への橋渡し
「物体検出」は単独で完結せず、 前後の手法と組み合わさって価値が発揮される。 入力データの準備 (上流)・同目的の代替手法との比較 (並列)・結果の活用 (下流) という 3 軸で隣接領域を整理する。
- 上流 (入力の準備): 画像データ の収集、 アノテーション (バウンディングボックス付与)、 データ拡張
- 並列 (同目的の代替): 画像分類 (画像全体のラベル)、 セマンティックセグメンテーション (画素単位)、 インスタンスセグメンテーション が並列タスク
- 下流 (結果の活用): IoU・mAP での評価、 NMS による重複除去、 トラッキング・行動認識への接続
この上流・並列・下流の対応を地図化することで、 「物体検出」を中核に据えた分析パイプライン (データ準備 → 手法選択 → 結果の検証と展開) の全体像が見えてくる。
🌳 手法選択フロー
「物体検出」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 位置まで要るのか、 有無だけでよいか
「写っているか」だけなら画像分類で足りる。 「どこに、 いくつ」が要るときに初めて物体検出を使う。 検出は学習データの作成コストが桁違いに高い。 - アノテーションを用意できるか
矩形を 1 つずつ描く作業が要る。 数千枚なら数百時間規模。 用意できないなら、 学習済みモデルで検出できる一般物体に問題を寄せられないか検討する。 - 速さと精度のどちらが要るか
映像をリアルタイムで処理するなら 1 段階検出(YOLO 系)。 精度を優先し 1 枚ずつ処理してよいなら 2 段階検出。 - 評価をどう定義したか
検出は「どれくらい重なれば正解か」(IoU の閾値)で数値が大きく変わる。 閾値を明記しないと mAP は比較できない。
物体検出は分類より一段コストが高い。 「位置が本当に必要か」を最初に確かめると、 分類で済んで工数が数分の一になることがある。