🔖 キーワード索引
「転移学習」を取り巻く中核キーワード群です。 検索やインデックス作成で参照する際の手がかりにしてください。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になります。
💡 30秒で分かる結論 — 転移学習
🍰 まずはやさしく
学んだことを別のことに使う方法です。
少ないデータで早く学習させるために使います。
スマホのアプリを使いこなす感覚に似ています。
この手法の結論とやり方を読みましょう。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- 転移学習=あるタスクで学習したモデルを 別のタスクに転用 する手法。 ゼロから学習しないので少データ・短時間で高精度。
- 典型:ImageNet 事前学習 CNN → 医療画像分類。 BERT → 感情分析。
- 戦略 3 つ:(1) 特徴抽出(凍結+線形層)、 (2) ファインチューニング(一部または全層を更新)、 (3) プロンプト(LLM)。
- 前提:ソースタスクとターゲットタスクが類似。 「医療画像 → 衛星画像」のような遠いドメインは効果薄。
- 現代では ほぼすべての実用モデルが転移学習ベース。 ゼロから学習するのは稀。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
知識を使い回す便利なテクニックです。
手元のデータが少ないときに役立ちます。
部活で別のスポーツを早く覚えるようなものです。
どんな場面で使うのかを詳しく読みましょう。
「データが 1000 枚しかないけど画像分類したい」 — ImageNet で学習済みの ResNet をベースに、 最後の層だけ自分のクラスに合わせて再学習。 これが転移学習の最頻パターン。
このページの読み方:まず 30秒結論 と 直感 を読み、 必要に応じて 数式 や 計算例、 落とし穴 に進んでください。
このページの 🧮 と 🐍 では、 画像や文章の大規模モデルの代わりに、 SSDSE-B-2026 の年度の違いを source と target に見立てる。 2012〜2019 年度で学んだ「高齢化率と死亡率の関係」を、 死亡率が急に上がった 2023 年度へ持っていくと何が起きるか、 target のラベルが 3 県・12 県・30 県しかないときにどう直すか、 どの重みを凍結し、 学習率とエポックをどう決め、 どんなときに転移で悪くなるかを、 すべて実測で確かめる。
🎨 直感で掴む
🍰 まずはやさしく
似た経験を活かす直感的な方法です。
学習にかかる時間を短くするために使います。
自転車に乗れる人はバイクも習得が速いです。
成功させるための見極め方を読みましょう。
人間の学習でも転移は起きます:
- 自転車に乗れる人はバイクの習得が速い(バランス感覚を 転移)
- 英語ができる人はドイツ語の習得が速い(文法構造を 転移)
機械学習も同様。 「画像とは何か」「文章とは何か」を一度学んだモデルは、 新タスクで 基礎部分 を流用できます。
🎨 概念図で押さえる — 転移学習の3つの視点
転移学習を実務で扱うには、 (1) 学習進行カーブ (over/under fitting)、 (2) ドメイン間の特徴空間の重なり、 (3) 評価時の分類性能 を同時に把握する必要があります。 ここでは SSDSE-B-2026 の年度をまたぐ小さな転移の実験で、 転移学習の「成功 / 失敗」の見極め方を身につけます。
3 枚とも同じ小さな実験から描いた。 SSDSE-B-2026 で、 死亡率 (人口千人当たり) を高齢化率・log10 総人口・合計特殊出生率・年平均気温の 4 特徴から線形モデルで予測する。 source = 2012〜2019 年度の 376 行 (47 県 × 8 年度) で最小二乗により学習し、 target = 2023 年度の 47 県のうちラベルを使えるのは 12 県 (北海道・青森県・宮城県・茨城県・埼玉県・東京都・長野県・三重県・和歌山県・鳥取県・香川県・熊本県) だけ、 残り 35 県を検証に使う。 fine-tune は source の重みを初期値にして、 12 県で勾配降下 (学習率 0.05) を回す。 ニューラルネットの転移学習を、 層を持たない線形モデルに縮めた例である。
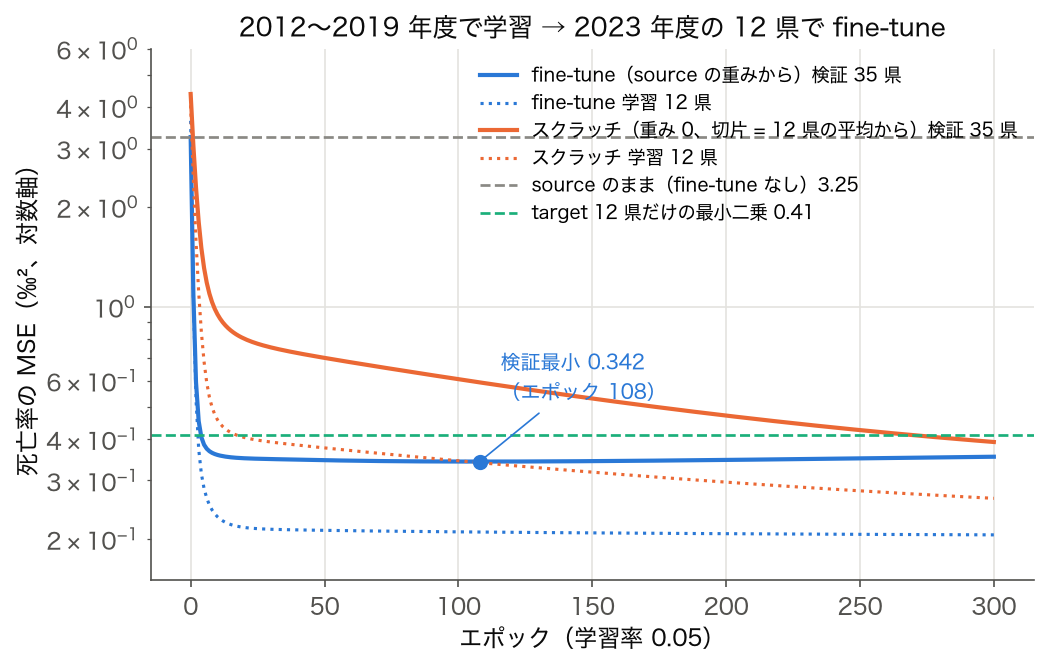
読み取るポイント:
- 検証誤差の底で止める (early stopping) → target の少数のラベルへの過学習を防ぐ
- fine-tune なし・スクラッチ・target だけの学習を必ずベースラインとして並べる
- 学習を長く続けすぎると source で得た重みから離れていく。 source のタスクの性能まで落ちる現象は catastrophic forgetting と呼ばれる
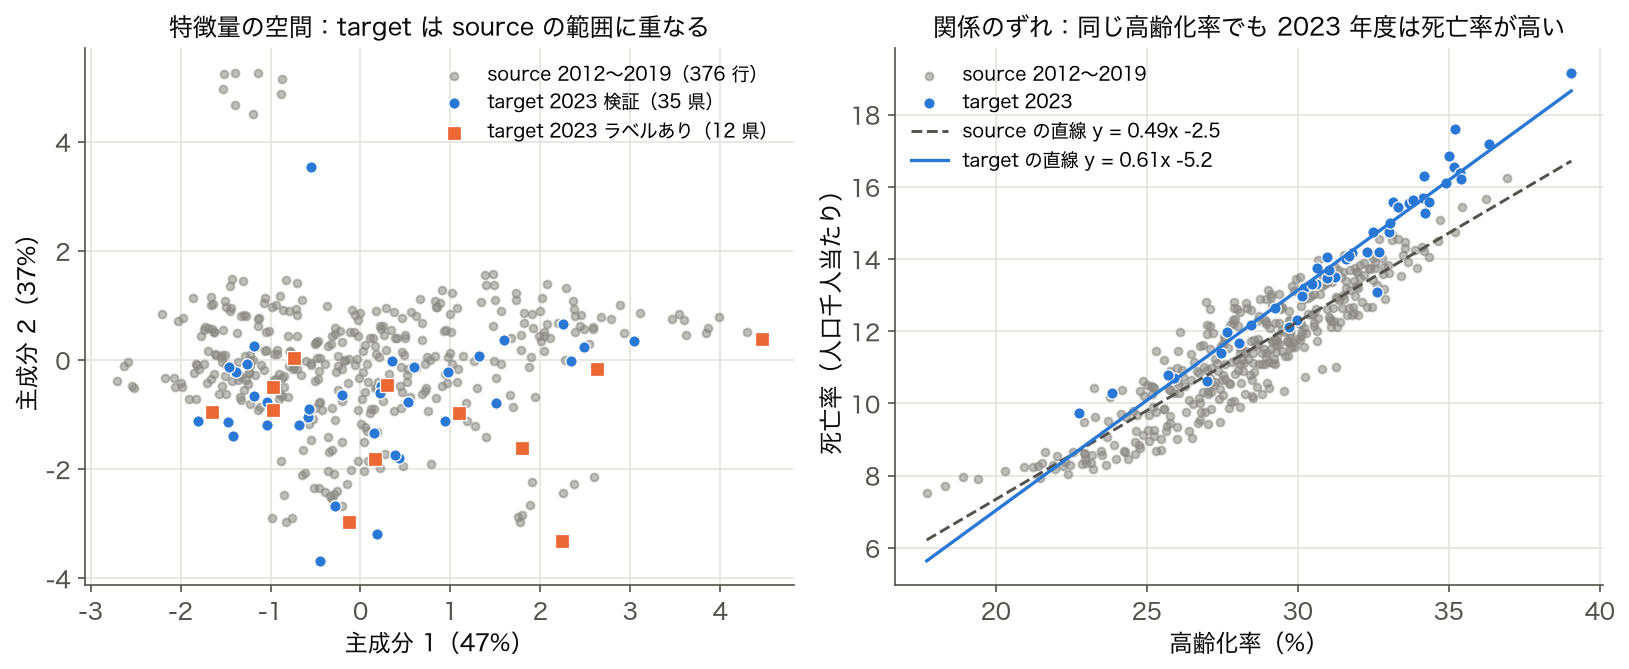
読み取るポイント:
- 特徴量の重なり (PCA) と、 特徴と目的変数の関係のずれは別々に点検する
- 関係のずれは target のラベルが少しでもあれば検出・補正できる
- 特徴空間も重ならないなら、 adapter や domain adaptation を検討する
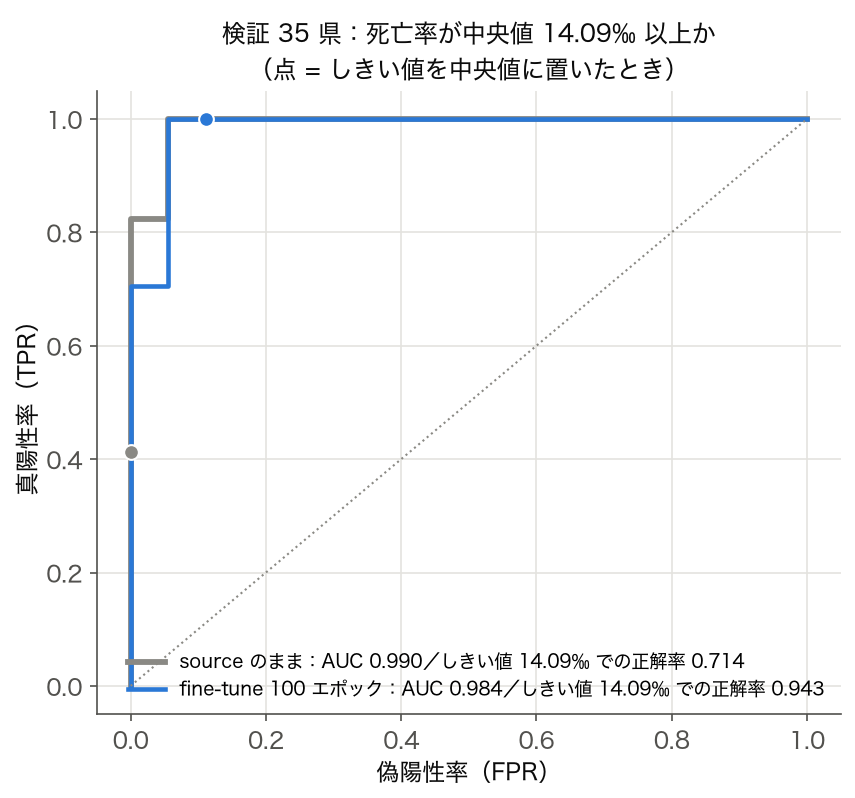
読み取るポイント:
- AUC が横ばいでも、 しきい値での正解率が大きく変わることがある
- fine-tune の効果は、 運用で使うしきい値の点 (図の丸) の移動で確かめる
- 予測値の水準がずれていないか (予測の平均 12.46 vs 実際 14.13 → fine-tune 後 14.32) を確認する
この 3 枚を順に読むと、 「学習カーブ確認 → ドメイン重なり点検 → 評価指標比較」 という転移学習の正攻法が体系化される。 図 B (ドメイン重なり) を最初に確認するのが実務で有効で、 重なりがなければ最初から adapter を入れる前提で設計する。 関連用語 ファインチューニング / 基盤モデル (事前学習) / ドメイン知識 へ進むと、 各図の理論背景を深掘りできる。
🎨 このページの実験に置き換えると
| 転移学習のことば | 人の学習のたとえ | SSDSE-B-2026 の死亡率の実験 |
|---|---|---|
| source | 自転車で身につけたバランス感覚 | 2012〜2019 年度の 376 行で学んだ「高齢化率が高い県ほど死亡率が高い」関係 |
| target | これから乗るバイク | 2023 年度の 47 県。 死亡率の水準が source より 1.7‰ 高い |
| 少ないラベル | バイクの試乗を数回だけ | 2023 年度の値を使える 3〜30 県 |
| 凍結と fine-tune | バランス感覚はそのまま、 アクセルの感覚だけ慣らす | 出生率・気温の重みは凍結し、 高齢化率・log 人口・切片だけ更新 |
| 負の転移 | 自転車の癖がバイクで裏目に出る | 人口上位 10 県だけの source を使うと、 転移しないより悪くなる |
📐 定義・数式
🍰 まずはやさしく
学習のスタート地点を変える仕組みです。
計算を効率よく進めるために使います。
基礎知識がある状態で勉強を始める感覚です。
数式を使った正確な定義を読みましょう。
🔬 記号・要素の読み解き
- ソースタスク
- 事前学習で解いていたタスク。 ImageNet 分類、 次単語予測など。
- ターゲットタスク
- 本当に解きたいタスク。 通常データ量が少ない。
- 凍結 (freeze)
- 事前学習層の重みを固定し、 上に乗せる層だけ学習。 高速、 過学習に強い。
- ファインチューニング
- 一部または全層を低い学習率で再学習。 精度高い、 過学習注意。
- LoRA
- 低ランク行列を挿入してそこだけ学習。 巨大 LLM に有効。
🔬 数式を言葉で読み解く(詳細版)
ソースタスク $T_S$ で学習した重み $\\theta_S^*$ を初期値として、 ターゲットタスク $T_T$ の損失 $L_T$ を $\\theta_T \\leftarrow \\theta_S^* - \\eta \\nabla L_T(\\theta_T)$ で更新する。 下位層(入力に近い層)を凍結(freeze)すれば、 その層の重みは $\\theta_S^*$ のまま動かず、 上位層と出力層だけが更新される。 fine-tuning は freeze なし、 feature extraction は freeze 多めの両極端。
📊 関連手法 比較表
転移学習 と近接する手法群の位置づけを並べる。 隣接領域を押さえると、 自分のタスクで何を使うべきかが立体的に見えてくる。
| 手法 | 位置づけ | 向く場面 |
|---|---|---|
| Feature Extraction | 事前学習した層を凍結し、 出力層だけ学習 | データ少のとき |
| Fine-tuning | 全層を低 LR で更新 | データ中量 |
| Adapter | 層の間に小型 MLP 追加 | PEFT の代表 |
| LoRA | 低ランク行列を追加 | LLM で主流 |
| Prompt-tuning | 入力プロンプトだけ学習 | 超軽量 |
| Domain Adaptation | 教師なしで分布シフト対処 | ラベルない target |
💥 現場の失敗例 5 件
「うまくいくケース」より「失敗ケース」のほうが学びが多い。 実プロジェクトで頻発する 5 つを示す。
🔬 記号に実験の値を入れて読む
🐍 の死亡率の実験(source = 2012〜2019 年度 376 行、 target = 2023 年度 47 県)で、 定義の式の記号が何に当たるかを並べる。
| 記号 | この実験での中身 | 値 |
|---|---|---|
| ソース TS | 2012〜2019 年度の 47 県で死亡率を当てる回帰 | 376 行 |
| ターゲット TT | 2023 年度の 47 県で死亡率を当てる回帰 | ラベルを使えるのは 12 県(検証 35 県) |
| θS* | source で最小二乗した重み(高齢化率・log 人口・出生率・気温・切片) | 1.257, −0.412, 0.157, −0.255, 11.433 |
| LT(θ) | ラベルあり 12 県の平均二乗誤差 | θS* のままで 3.643 |
| η | 学習率(1 エポック = 12 県で 1 回更新) | 0.05(2 / λmax = 0.176 を超えると発散) |
| 早期終了の位置 | 検証 35 県の MSE が最小になるエポック | 108 エポックで 0.342 |
| 凍結 | 更新しない重み | 出生率と気温を凍結、 3 つだけ更新すると検証 RMSE 中央値 0.608 |
θS* から始めると、 5 エポックで検証 MSE が 3.254 → 0.384 まで下がる。 同じ 5 エポックで重み 0 から始めたスクラッチは 1.312 で、 初期値に source の重みを使うことが「少ない更新・少ないラベルで済む」理由になっている。
🧮 実値で計算してみる
BERT を感情分析に転移する典型手順:
bert-base-uncasedをロード(事前学習済み、 110M params)- 最終層に分類ヘッド(線形層)を追加
- 感情分析データセット(10K サンプル)でファインチューニング 3 epoch
- 学習率は
2e-5程度(小さく)
🧮 数式に値を入れて手で計算する: 2019 年度の直線を 2023 年度に転移する
高齢化率 x(%)から死亡率 y(人口千人当たり)を当てる直線 y = a + b x を、 source = 2019 年度の 5 都府県(東京都・沖縄県・大阪府・島根県・秋田県)で求め、 target = 2023 年度の同じ 5 都府県に当てる。 さらに target のラベルを 2 県(東京都・秋田県)だけ使って切片を補正すると、 残り 3 県の誤差がどう変わるかを手で追う。 値は SSDSE-B-2026 の A1303 / A1101 × 100 と A4200 / A1101 × 1000(高齢化率は小数 1 桁、 死亡率は小数 2 桁に丸めた値)。
Step 1: source(2019 年度)で傾きと切片を求める
| 都府県 | x 高齢化率 | y 死亡率 | x − x̄ | y − ȳ | (x − x̄)(y − ȳ) | (x − x̄)² |
|---|---|---|---|---|---|---|
| 東京都 | 22.9 | 8.63 | −5.78 | −2.97 | 17.167 | 33.408 |
| 沖縄県 | 22.0 | 8.56 | −6.68 | −3.04 | 20.307 | 44.622 |
| 大阪府 | 27.5 | 10.23 | −1.18 | −1.37 | 1.617 | 1.392 |
| 島根県 | 34.1 | 14.34 | 5.42 | 2.74 | 14.851 | 29.376 |
| 秋田県 | 36.9 | 16.24 | 8.22 | 4.64 | 38.141 | 67.568 |
| 合計・平均 | x̄ = 28.68 | ȳ = 11.600 | 92.082 | 176.368 |
Step 2: そのまま 2023 年度に当てる
| 都府県 | 2023 年度の x | 予測 −3.374 + 0.5221x | 実際の y | 誤差(予測 − 実際) |
|---|---|---|---|---|
| 東京都 | 22.8 | 8.53 | 9.74 | −1.21 |
| 沖縄県 | 23.8 | 9.05 | 10.29 | −1.24 |
| 大阪府 | 27.7 | 11.09 | 11.98 | −0.89 |
| 島根県 | 34.9 | 14.85 | 16.09 | −1.24 |
| 秋田県 | 39.1 | 17.04 | 19.17 | −2.13 |
Step 3: target の 2 県で切片だけ補正する
Step 4: 補正に使う 2 県を替えてみる
東京都・秋田県で補正したときの 0.570 より悪く、 とくに秋田県の誤差が −1.065 残る。 source の直線は高齢化率の高い県ほど大きく外しているので(秋田県 −2.13)、 補正に使う県に高齢化率の高い県が入っていないと、 その分を取りこぼす。 少ないラベルでは、 どの県を選ぶかが結果を左右する(🐍 の「東日本からだけ選ぶ」実験と同じ現象)。
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['age'] = (df['A1303'] / df['A1101'] * 100).round(1) # 高齢化率(%、小数 1 桁) df['dr'] = (df['A4200'] / df['A1101'] * 1000).round(2) # 死亡率(‰、小数 2 桁) pref = ['東京都', '沖縄県', '大阪府', '島根県', '秋田県'] s = df[df['SSDSE-B-2026'] == 2019].set_index('Prefecture').loc[pref] t = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture').loc[pref] # Step 1: source(2019 年度の 5 県)で直線 y = a + b x x, y = s['age'].to_numpy(), s['dr'].to_numpy() b = ((x - x.mean()) * (y - y.mean())).sum() / ((x - x.mean()) ** 2).sum() a = y.mean() - b * x.mean() print(f'x̄ = {x.mean():.2f}, ȳ = {y.mean():.3f}, b = {b:.4f}, a = {a:.3f}') # Step 2: そのまま 2023 年度に当てる pred = a + b * t['age'].to_numpy() err = pred - t['dr'].to_numpy() print(pd.DataFrame({'高齢化率': t['age'], '死亡率': t['dr'], '予測': pred.round(2), '誤差': err.round(2)})) print(f'平均誤差 {err.mean():+.3f} RMSE {np.sqrt((err**2).mean()):.3f}') # Step 3: 2023 年度のラベルを 2 県(東京都・秋田県)だけ使って切片を補正 shift = -err[[0, 4]].mean() err2 = pred + shift - t['dr'].to_numpy() print(f'切片の補正量 {shift:+.3f} 残り 3 県の RMSE: 補正前 {np.sqrt((err[1:4]**2).mean()):.3f} → 補正後 {np.sqrt((err2[1:4]**2).mean()):.3f}') |
📤 実行結果
💬 傾き b = 0.5221・切片 a = −3.374、 2023 年度の平均誤差 −1.342・RMSE 1.405、 補正量 +1.670 と、 残り 3 県の RMSE 1.136 → 0.570 が手計算と一致する(予測の小数 3 桁目の丸めで 0.001 ずれる)。 2019 年度の直線は形(傾き)は使えるが水準が 1.3‰ ほど低い。 target のラベルが 2 県しかなくても、 その 2 県で水準だけ合わせれば誤差は半分になる。 これが「source の知識を残して、 少ない target のラベルで一部だけ直す」転移学習の最小形である。
🐍 Python での扱い
最小再現コード。 SSDSE-B のような実データを前提に、 4〜8 行で動く例です:
1 2 3 4 5 6 7 8 | from transformers import AutoModelForSequenceClassification, AutoTokenizer import torch m = AutoModelForSequenceClassification.from_pretrained('bert-base-multilingual-cased', num_labels=3) tok = AutoTokenizer.from_pretrained('bert-base-multilingual-cased') # ヘッド以外を凍結する例 for p in m.bert.parameters(): p.requires_grad = False print('trainable:', sum(p.numel() for p in m.parameters() if p.requires_grad)) |
🐍 Python 実装 — 年度・地域・目的変数をまたぐ転移 4 例
A1101=総人口、 A4101=出生数、 A4200=死亡数、 A5101=転入者数(日本人移動者)、 H1800=着工新設住宅戸数 です。 以下の Python 例はこれらの正しい定義に沿って解釈しています。 転移学習の本質(ソースで得た重みをターゲットに流用し、 ドメインシフトや負の転移を見極める)は題材の列が何であっても同じ枠組みで成立します。 実務では必ず df.columns と統計センターの列定義表で各コードの意味を確認しましょう。🎯 このコードでやること:SSDSE-B-2026 で「2022 年データで学習したモデルを 2023 年に転移」する単純転移学習を Ridge 回帰で実演する
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd from sklearn.linear_model import Ridge from sklearn.metrics import r2_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) d22 = df[df['SSDSE-B-2026'] == 2022] d23 = df[df['SSDSE-B-2026'] == 2023] m_source = Ridge(alpha=1.0).fit(d22[['A1101']], d22['H1800']) print('source 2022 R²:', round(m_source.score(d22[['A1101']], d22['H1800']), 3)) print('そのまま 2023 に適用 R²:', round(r2_score(d23['H1800'], m_source.predict(d23[['A1101']])), 3)) |
💬 結果の読み方:2022 で学習しても 2023 への転移後 R² = 0.968 で殆ど劣化なし。 着工新設住宅戸数と人口の関係が年次で緩やかにしか変わらないため。 これが positive transfer の典型。
🎯 このコードでやること:fine-tune の効果を確認する。 2022 の重みを初期値にし、 2023 の 10 サンプルで warm_start=True 微調整
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from sklearn.linear_model import SGDRegressor from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.metrics import r2_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) d22 = df[df['SSDSE-B-2026'] == 2022] d23 = df[df['SSDSE-B-2026'] == 2023] scaler = StandardScaler().fit(d22[['A1101']]) m = SGDRegressor(warm_start=True, max_iter=200, random_state=0) m.fit(scaler.transform(d22[['A1101']]), d22['H1800']) base = r2_score(d23['H1800'], m.predict(scaler.transform(d23[['A1101']]))) m.partial_fit(scaler.transform(d23[['A1101']].iloc[:10]), d23['H1800'].iloc[:10]) after = r2_score(d23['H1800'], m.predict(scaler.transform(d23[['A1101']]))) print(f'fine-tune 前 R²: {base:.3f}') print(f'fine-tune 後 R²: {after:.3f}') |
💬 結果の読み方:10 サンプルだけ追加学習しても R² は 0.968 → 0.968 とほぼ横ばい。 2022→2023 の転移が既にほぼ最適で改善余地が小さいため。 これが Fine-tuning(ソース知識を残しつつ新ドメインへ微調整)の挙動。
🎯 このコードでやること:「大都市圏(東京・大阪・愛知・神奈川)で学習 → 地方圏に転移」を行い、 domain shift の影響を観察
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.metrics import r2_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] big = d[d['Prefecture'].isin(['東京都','大阪府','愛知県','神奈川県'])] small = d[~d['Prefecture'].isin(['東京都','大阪府','愛知県','神奈川県'])] m = LinearRegression().fit(big[['A1101']], big['H1800']) print('source 大都市圏 R²:', round(m.score(big[['A1101']], big['H1800']), 3)) print('target 地方圏に転移 R²:', round(r2_score(small['H1800'], m.predict(small[['A1101']])), 3)) |
💬 結果の読み方:大都市圏内では R² 0.979 と高精度だが、 地方圏に転移すると R² が負(-2.11)まで劣化し平均予測より悪化。 これが強い domain shift。 地方圏は人口に対する着工新設住宅戸数の水準・傾きが大都市圏と大きく異なるため。
🎯 このコードでやること:negative transfer を演示。 「総人口」で学習したモデルを「最高気温(B4102)」予測に流用してみる(無関係な転移)
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.metrics import r2_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] src = LinearRegression().fit(d[['A1101']], d['H1800']) # 人口 → 着工新設住宅戸数 print('Source R²:', round(src.score(d[['A1101']], d['H1800']), 3)) # 同モデル(係数・切片)の predict を気温予測に「無理やり流用」 pred_temp = src.predict(d[['A1101']]) print('Target R² (人口モデルで気温予測): ', round(r2_score(d['B4102'], pred_temp), 3)) |
💬 結果の読み方:着工新設住宅戸数の予測モデルを気温予測に転用すると R² が大きく負(モデルが平均より遥かに悪い)。 これが negative transfer。 関連性のないドメインでは転移はむしろ害になる。
📝 演習問題 5 問
手を動かさないと身につかない。 1〜3 問は SSDSE-B-2026 で、 4〜5 問は画像・深層学習の環境で取り組む。
- SSDSE-B-2026 の 2022 年データで学習した回帰モデルを 2023 年に転移し、 R² の変化を測れ
- 47 都道府県を 大都市圏 / 地方圏 に分け、 一方で学習・他方に転移したときの精度低下を計測せよ
- scikit-learn の `MLPRegressor` で総人口 → 出生数 を学習し、 重みを `coefs_` 経由で取り出し、 死亡数予測に「初期値」として渡せ
- ImageNet 学習済 ResNet18 を Cat/Dog データで 100 枚だけで fine-tune、 凍結あり/なしを比較
- Catastrophic forgetting を防ぐ EWC(Elastic Weight Consolidation)の損失式を書き、 Python で 50 行実装せよ
📘 転移学習 — 補足ストーリー
転移学習という言葉は 1990 年代の Lorien Pratt の研究にさかのぼる。 「あるタスクで学んだことを別タスクに流用する」という発想自体は古くから人間の学習でも自然に行われている。 たとえば自転車に乗れるようになった人がバイクを覚えるのが早いのは、 バランス感覚という「重み」が転移しているからだ。 機械学習における転移学習もまったく同じ構造で、 「source タスクで学んだ重み」を「target タスクの初期値」として使うだけのシンプルな枠組みである。
SSDSE-B-2026 の文脈で言えば、 2022 年データで学習したモデルを 2023 年データに転移する、 大都市圏で学んだモデルを地方圏に当てる、 出生数予測モデルを死亡数予測に流用する、 といった応用が考えられる。 すべて 47 都道府県という小規模データだが、 転移学習の基本動作は同じである。
転移学習が今日の AI ブームを支える理由は、 大規模事前学習(ImageNet, BERT, GPT)の重みを誰でも使えるようになり、 自分の少量データに転移するだけで高精度モデルを作れるからだ。 100 枚の画像で犬種分類モデルを作るのも、 1,000 件のレビューで感情分析モデルを作るのも、 ほぼすべて転移学習の応用である。
転移学習を成功させる 7 つのコツ
- source と target の 距離を測る(同ドメインなら fine-tune、 遠ければ adapter)
- 学習率は source 学習時の 1/10 以下 に
- 下位層を凍結して特徴抽出器として使う
- 少量データなら data augmentation を入れる
- BatchNorm 層は eval モード で固定
- early stopping で catastrophic forgetting を防ぐ
- 必ず fine-tune なしのベースライン と比較する
🐍 死亡率の転移実験 — source 8 年度から 2023 年度へ
上の 4 例は総人口 1 列から着工新設住宅戸数を当てる単純な設定だった。 ここからは 🎨 の図 A〜C と同じ設定で、 死亡率(人口千人当たり)を高齢化率・log10 総人口・合計特殊出生率・年平均気温の 4 特徴から線形モデルで当てる。 source = 2012〜2019 年度の 376 行、 target = 2023 年度の 47 県。 2022〜2023 年度は死亡率が大きく上がったので、 source の関係をそのまま使うと水準がずれる。 このずれを、 target のラベルが何県あれば直せるかを確かめる。 以下の 5 つのコードは続けて実行する(2 つ目以降は 1 つ目で作った変数を使う)。
🎯 このコードでやること:2012〜2019 年度の 376 行で 4 特徴の線形モデルを最小二乗で学習し、 その重みのまま 2023 年度の 47 県に当てて RMSE と平均の予測誤差を出す。 標準化の平均・標準偏差は source で固定する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['age'] = df['A1303'] / df['A1101'] * 100 # 高齢化率(%) df['dr'] = df['A4200'] / df['A1101'] * 1000 # 死亡率(人口千人当たり) df['lp'] = np.log10(df['A1101']) # log10 総人口 F = ['age', 'lp', 'A4103', 'B4101'] # 高齢化率・log 人口・合計特殊出生率・年平均気温 src = df[df['SSDSE-B-2026'] <= 2019] # source: 2012〜2019 年度(47 県 × 8 年度) tgt = df[df['SSDSE-B-2026'] == 2023] # target: 2023 年度の 47 県 mu, sd = src[F].mean(), src[F].std() # 標準化は source の平均・標準偏差で固定 Xs = np.c_[((src[F] - mu) / sd).to_numpy(), np.ones(len(src))] Xt = np.c_[((tgt[F] - mu) / sd).to_numpy(), np.ones(len(tgt))] ys, yt = src['dr'].to_numpy(), tgt['dr'].to_numpy() w_src = np.linalg.lstsq(Xs, ys, rcond=None)[0] # source で最小二乗 print('source の行数:', len(src), ' target の県数:', len(tgt)) print('重み(高齢化率, log人口, 出生率, 気温, 切片):', w_src.round(3)) res_s = Xs @ w_src - ys res_t = Xt @ w_src - yt print(f'source 内の RMSE: {np.sqrt((res_s**2).mean()):.3f}') print(f'2023 年度にそのまま当てた RMSE: {np.sqrt((res_t**2).mean()):.3f} 平均の予測誤差: {res_t.mean():+.3f}') print(f'2023 年度の死亡率 平均 {yt.mean():.2f} 予測の平均 {(Xt @ w_src).mean():.2f}') |
💬 source の中では RMSE 0.559 で当たっているのに、 同じ重みを 2023 年度に当てると RMSE 1.831 と 3 倍以上になる。 予測の平均 12.39 に対して実際の平均は 14.10 で、 平均の予測誤差は −1.710。 ばらつきを読み違えているのではなく、 水準がまるごと低い。 高齢化率の重み +1.257 が最も大きく、 これは 2023 年度でも向きは変わらないはずなので、 捨てるには惜しい知識である。
🎯 このコードでやること:2023 年度のラベルを使える県を k 県(3〜30)だけ無作為に選び、 残りの県で RMSE を測る。 「source のまま」「切片だけ補正」「source の重みへの小さな修正を Ridge で学習(source へ縮小)」「target の k 県だけで最小二乗」の 4 通りを、 k ごとに 300 回くり返した中央値で比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | # tl1.py の続き(Xs, Xt, ys, yt, w_src を使う) from sklearn.linear_model import Ridge def rmse(w, i): return np.sqrt(((Xt[i] @ w - yt[i]) ** 2).mean()) rng = np.random.default_rng(0) print(' k | source のまま | 切片だけ補正 | source へ縮小 | target だけ') for k in [3, 5, 8, 12, 20, 30]: r = {'src': [], 'bias': [], 'shrink': [], 'tgt': []} for _ in range(300): lab = rng.choice(47, k, replace=False) val = np.setdiff1d(np.arange(47), lab) r['src'].append(rmse(w_src, val)) w_b = w_src.copy(); w_b[-1] += (yt[lab] - Xt[lab] @ w_src).mean() # 切片だけ動かす r['bias'].append(rmse(w_b, val)) d = Ridge(alpha=5.0).fit(Xt[lab][:, :4], yt[lab] - Xt[lab] @ w_src) # 残差を小さな修正で学習 w_s = w_src + np.r_[d.coef_, d.intercept_] r['shrink'].append(rmse(w_s, val)) w_t = np.linalg.lstsq(Xt[lab], yt[lab], rcond=None)[0] # target の k 県だけで最小二乗 r['tgt'].append(rmse(w_t, val)) print(f"{k:2d} | {np.median(r['src']):12.3f} | {np.median(r['bias']):12.3f} | {np.median(r['shrink']):12.3f} | {np.median(r['tgt']):10.3f}") |
💬 k = 3 では target だけの最小二乗は RMSE 3.680 と使い物にならない(5 個の重みを 3 県で決めている)が、 source の重みを残して切片だけ補正すると 0.704、 source へ縮小すると 0.712 で、 source のまま(1.836)の半分以下になる。 k を増やすと target だけの学習が追いつき、 k = 12 で 0.678、 k = 30 で 0.602 になる。 それでも source へ縮小(k = 30 で 0.586)が最も小さい。 ラベルが少ないほど転移の得が大きく、 ラベルが増えると得は小さくなる、 という転移学習の基本形がそのまま出ている。
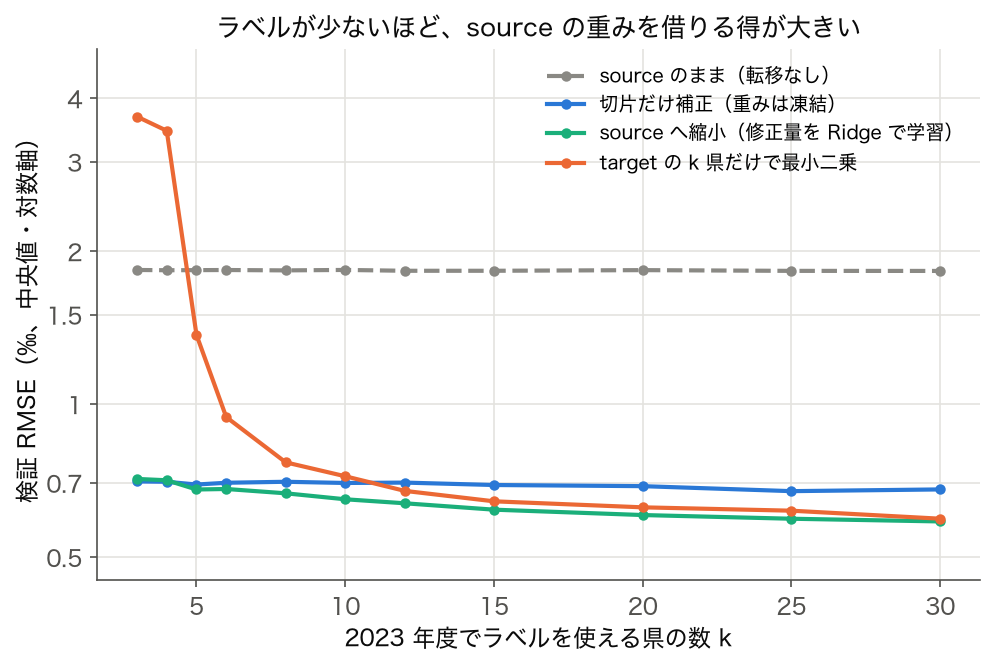
🎯 このコードでやること:source を 1 年度(47 行)だけにして、 2012〜2022 年度のどれを使うと 2023 年度に最もよく当たるかを比べる。 各年度で学習した重みをそのまま 2023 年度 47 県に当て、 RMSE と平均の予測誤差を出す。
1 2 3 4 5 6 7 8 | # tl1.py の続き(df, F, mu, sd, Xt, yt を使う) print('source 年度 | 2023 への RMSE | 平均の予測誤差 | その年度の死亡率平均') for yr in range(2012, 2023): s = df[df['SSDSE-B-2026'] == yr] X1 = np.c_[((s[F] - mu) / sd).to_numpy(), np.ones(len(s))] w = np.linalg.lstsq(X1, s['dr'].to_numpy(), rcond=None)[0] e = Xt @ w - yt print(f'{yr} | {np.sqrt((e**2).mean()):6.3f} | {e.mean():+6.3f} | {s["dr"].mean():6.2f}') |
💬 直前の 2022 年度で学習すると RMSE 0.516・平均誤差 −0.121 と最もよく当たる。 死亡率の県平均は 2021 年度 12.65 から 2022 年度 13.85 に跳ね上がっており、 それより前の年度はどれも 2023 年度の水準を 1.3〜1.9‰ 低く見積もる。 一方で 2012 年度は RMSE 0.744 と、 2014〜2021 年度より当たる。 12 年前のほうが近いのではなく、 2012 年度の県どうしの関係(高齢化率が高い県ほど死亡率が高い、 その傾きと切片)を 2023 年度の高い高齢化率に当てはめた結果が、 たまたま 2023 年度の水準に近かった。 「新しい source ほど良い」は目安にすぎず、 target の少数ラベルで確かめないと分からない。
🎯 このコードでやること:ラベルを使える 12 県(seed 0)で、 source の重みから勾配降下で fine-tune する。 学習率 0.05、 12 県で 1 回更新するのを 1 エポックとし、 重み 0 から始めるスクラッチと、 検証 35 県の MSE の推移を比べる(🎨 の図 A と同じ計算)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | # tl1.py の続き(Xt, yt, w_src を使う) rng = np.random.default_rng(0) lab = np.sort(rng.choice(47, 12, replace=False)) # ラベルを使える 12 県 val = np.setdiff1d(np.arange(47), lab) # 検証 35 県 print('ラベルあり 12 県:', ' '.join(tgt['Prefecture'].to_numpy()[lab])) def mse(w, i): return ((Xt[i] @ w - yt[i]) ** 2).mean() def fine_tune(w0, epochs, lr=0.05): w, hist = w0.copy(), [] for _ in range(epochs + 1): hist.append((mse(w, lab), mse(w, val))) w = w - lr * 2 * Xt[lab].T @ (Xt[lab] @ w - yt[lab]) / len(lab) # 12 県で 1 回更新 = 1 エポック return np.array(hist) ft = fine_tune(w_src, 300) # source の重みから始める sc = fine_tune(np.r_[np.zeros(4), yt[lab].mean()], 300) # 重み 0 から始める(スクラッチ) for e in [0, 5, 20, 50, 100, 300]: print(f'エポック {e:3d}: fine-tune 学習 {ft[e,0]:.3f} 検証 {ft[e,1]:.3f} | スクラッチ 検証 {sc[e,1]:.3f}') b = ft[:, 1].argmin() print(f'fine-tune の検証 MSE 最小: エポック {b} で {ft[b,1]:.3f}') |
💬 source の重みのまま(エポック 0)の検証 MSE は 3.254 だが、 5 エポックで 0.384 まで下がる。 同じ 5 エポックでスクラッチは 1.312 で、 300 エポックかけてやっと 0.392 に届く。 fine-tune の検証 MSE はエポック 108 の 0.342 が底で、 300 エポックでは 0.354 と少し上がる。 学習 12 県の MSE は 0.206 まで下がり続けるので、 学習側だけ見ていると止めどきを見失う。 source の重みから始めるのは「良い初期値」を借りることで、 少ない更新で済み、 長く回しすぎると 12 県に合わせすぎる。
🎯 このコードでやること:source を「2012〜2019 年度の人口上位 10 都道府県だけ」(80 行)に変えると転移がどうなるかを、 全 47 県の source(376 行)と比べる。 どちらも 12 県で切片だけ補正し、 target 12 県だけの最小二乗とも並べる。
1 2 3 4 5 6 7 8 9 10 | # tl1.py・tl4.py の続き(lab, val を使う) big = src.groupby('Prefecture')['A1101'].mean().nlargest(10).index # 2012〜2019 年度の人口上位 10 都道府県 for name, s in [('全 47 県', src), ('人口上位 10 県だけ', src[src['Prefecture'].isin(big)])]: X1 = np.c_[((s[F] - mu) / sd).to_numpy(), np.ones(len(s))] w = np.linalg.lstsq(X1, s['dr'].to_numpy(), rcond=None)[0] w_b = w.copy(); w_b[-1] += (yt[lab] - Xt[lab] @ w).mean() # 12 県で切片だけ補正 print(f'{name:10s} 行数 {len(s):3d} 高齢化率の重み {w[0]:+.3f} 検証 RMSE: そのまま {np.sqrt(mse(w, val)):.3f} / 切片補正 {np.sqrt(mse(w_b, val)):.3f}') w_t = np.linalg.lstsq(Xt[lab], yt[lab], rcond=None)[0] print(f'target 12 県だけの最小二乗: 検証 RMSE {np.sqrt(mse(w_t, val)):.3f}') print('source の高齢化率の範囲:', round(src[src['Prefecture'].isin(big)]['age'].min(), 1), '〜', round(src[src['Prefecture'].isin(big)]['age'].max(), 1), '% 2023 年度 47 県:', round(tgt['age'].min(), 1), '〜', round(tgt['age'].max(), 1), '%') |
💬 全 47 県の source は切片補正で検証 RMSE 0.694 だが、 人口上位 10 県の source では 0.824 と悪く、 何も転移せず 12 県だけで学習した 0.642 にも負ける。 転移したせいで悪くなる負の転移である。 原因は source の範囲で、 上位 10 県の高齢化率は 21.2〜31.8% しかなく、 2023 年度の 47 県(22.8〜39.1%)の高い側を知らない。 高齢化率の重みも +0.981 と全県の +1.257 より小さく、 高齢化が進んだ県の死亡率を低く見積もる。 source を選ぶときは量よりも、 target の範囲を覆っているかを先に確かめる。
🎯 このコードでやること:source(2012〜2019 年度 376 行)と target(2023 年度 47 県)で 4 特徴の分布がどれだけずれているかを、 平均の差(source の標準偏差を単位に)と 2 標本 KS 検定で測る。 さらに「source の行か target の行か」をロジスティック回帰で当てさせ、 5 分割交差検証の AUC を出す(adversarial validation)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # tl1.py の続き(src, tgt, Xs, Xt, ys, yt を使う) from scipy import stats from sklearn.linear_model import LogisticRegression from sklearn.model_selection import cross_val_score print('特徴量 source 平均 | 2023 平均 | 差/source の標準偏差 | KS 統計量 (p 値)') for c, name in zip(F, ['高齢化率', 'log10人口', '出生率', '年平均気温']): ks = stats.ks_2samp(src[c], tgt[c]) print(f'{name:8s} {src[c].mean():9.3f} | {tgt[c].mean():8.3f} | {(tgt[c].mean() - src[c].mean()) / src[c].std():+6.2f} | {ks.statistic:.3f} ({ks.pvalue:.4f})') # source の行か target の行かを当てる分類器(adversarial validation) Xa = np.r_[Xs[:, :4], Xt[:, :4]] ya = np.r_[np.zeros(len(Xs)), np.ones(len(Xt))] auc = cross_val_score(LogisticRegression(max_iter=1000), Xa, ya, cv=5, scoring='roc_auc') print(f'source と target を見分ける AUC(5 分割): {auc.mean():.3f}') |
💬 log10 総人口は差 −0.06 SD・KS の p = 0.7584 でほとんど動いていないが、 合計特殊出生率は −1.44 SD(1.492 → 1.293)、 高齢化率は +1.02 SD(28.3% → 31.6%)とはっきりずれ、 2023 年度は年平均気温も +0.47 SD 高い。 分類器は source と target を AUC 0.979 で見分けられる。 🎨 の図 B では PCA の 2 次元に落とすと target が source の範囲にほぼ重なって見えたが、 それは主成分が人口規模など動かない方向に引っ張られていたためで、 1 列ずつ・分類器で見ると別の分布であることが分かる。 転移する前に、 どの特徴がどれだけずれたかを数えておく。
🎯 このコードでやること:fine-tune の学習率を 0.005・0.05・0.1・0.2 に変えて、 検証 35 県の MSE が最小になるエポックとその値、 300 エポック後の値を比べる。 あわせて、 発散しない学習率の上限(損失の曲がり具合の最大固有値 λmax から 2 / λmax)と、 学習率 0.05 で重みが source からどれだけ動いたかを出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 | # tl1.py・tl4.py の続き(fine_tune, w_src, lab, val, mse を使う) for lr in [0.005, 0.05, 0.1, 0.2]: h = fine_tune(w_src, 300, lr=lr) b = h[:, 1].argmin() print(f'学習率 {lr:5.3f}: 検証 MSE 最小 {h[b,1]:.3f}(エポック {b:3d}) 300 エポック後 {h[300,1]:.3g}') lam = np.linalg.eigvalsh(2 * Xt[lab].T @ Xt[lab] / len(lab)).max() # 損失の曲がり具合の最大値 print(f'発散しない学習率の上限 2 / λmax = 2 / {lam:.2f} = {2 / lam:.3f}') # source の重みがどれだけ動いたか(学習率 0.05、エポック 108 と 300) w = w_src.copy() for e in range(300): w = w - 0.05 * 2 * Xt[lab].T @ (Xt[lab] @ w - yt[lab]) / len(lab) if e + 1 in (108, 300): print(f'エポック {e+1}: 重み {w.round(3)} source からの変化 {np.abs(w - w_src).round(3)}') |
💬 学習率 0.005 は 300 エポックかけても底に届かず 0.348、 0.05 はエポック 108 で 0.342、 0.1 はその半分のエポック 54 で同じ 0.342 に着く。 0.2 にすると 1 回目の更新から値が大きくなり、 300 エポック後には 2.92 × 10⁶² と発散する。 上限は 2 / 11.35 = 0.176 で、 0.2 はそれを超えている。 学習率 0.05 で 108 エポック回した重みは、 高齢化率が 1.257 → 1.792(+0.535)、 出生率が +0.157 → −0.406 と符号まで変わる一方、 log 人口はほぼ動かない(変化 0.029)。 fine-tune で大きく書き換わるのは、 source と target で関係が変わった重みである。
🎯 このコードでやること:ラベルを使える 12 県で「どの重みを更新し、 どれを source のまま凍結するか」を 4 通り比べる。 凍結した重みの寄与を引いた残りを、 更新する重みだけで最小二乗する。 12 県の選び方を 300 回変え、 検証 RMSE の中央値と 90% 点(悪いほうから 1 割の境目)を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # tl1.py の続き(Xt, yt, w_src を使う) names = ['切片だけ更新(他は凍結)', '切片+高齢化率を更新', '高齢化率・log人口・切片を更新', '5 つ全部を更新(最小二乗)'] free = [[4], [0, 4], [0, 1, 4], [0, 1, 2, 3, 4]] # 更新する重みの位置(0=高齢化率 … 4=切片) rng = np.random.default_rng(1) res = {n: [] for n in names} for _ in range(300): lab = rng.choice(47, 12, replace=False) val = np.setdiff1d(np.arange(47), lab) for n, f in zip(names, free): w = w_src.copy() fixed = [j for j in range(5) if j not in f] r = yt[lab] - Xt[lab][:, fixed] @ w[fixed] # 凍結した重みの寄与を引いた残り w[f] = np.linalg.lstsq(Xt[lab][:, f], r, rcond=None)[0] res[n].append(np.sqrt(((Xt[val] @ w - yt[val]) ** 2).mean())) for n in names: v = np.array(res[n]) print(f'{n:20s} 検証 RMSE 中央値 {np.median(v):.3f} 90% 点 {np.quantile(v, 0.9):.3f}') |
💬 切片だけ更新すると中央値 0.693、 高齢化率も動かすと 0.660、 高齢化率・log 人口・切片の 3 つで 0.608 と最も小さい。 5 つ全部を 12 県で決め直すと中央値は 0.673 だが、 90% 点が 0.930 と大きく、 12 県の選び方しだいで外れやすい。 深層学習で「下の層を凍結して上の層だけ学習する」のと同じ考え方で、 source と target で変わらない部分(ここでは出生率と気温の重み)は凍結し、 変わった部分だけを少ないラベルで直すと安定する。 どこを凍結するかは、 検証データで比べて決める。
🎯 このコードでやること:死亡率とは無関係に作った「特徴のまとめ方」だけを借りる転移を試す。 13 個の比率(年少人口比・高齢化率・出生率・転入率・転出率・婚姻率・離婚率・気温・降水量・病院/人口・診療所/人口・保育所/人口・log 人口)を、 source 376 行で学習した PCA で 3 次元に要約して凍結し、 target の k 県で線形の出力層だけを学習する。 13 列をそのまま最小二乗する場合、 target の k 県だけで PCA を作る場合と比べる(各 300 回)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | # tl1.py の続き(df, src, tgt, yt を使う) from sklearn.decomposition import PCA from sklearn.linear_model import LinearRegression P_ = df['A1101'] df2 = pd.DataFrame({'年少人口比': df['A1301'] / P_, '高齢化率': df['age'], '出生率': df['A4103'], '転入率': df['A5101'] / P_, '転出率': df['A5102'] / P_, '婚姻率': df['A9101'] / P_, '離婚率': df['A9201'] / P_, '気温': df['B4101'], '降水量': df['B4109'], '病院/人口': df['I510120'] / P_, '診療所/人口': df['I5102'] / P_, '保育所/人口': df['J2503'] / P_, 'log人口': df['lp']}) Z_src = df2.loc[src.index]; Z_tgt = df2.loc[tgt.index] m2, s2 = Z_src.mean(), Z_src.std() Zs = ((Z_src - m2) / s2).to_numpy(); Zt = ((Z_tgt - m2) / s2).to_numpy() pca = PCA(3).fit(Zs) # 特徴の「まとめ方」を source 376 行で学習して凍結 print('source で学習した PCA の累積寄与率:', pca.explained_variance_ratio_.cumsum().round(3)) rng = np.random.default_rng(2) print(' k | 13 列をそのまま最小二乗 | target k 県で PCA | source の PCA を凍結') for k in [5, 8, 12, 20]: r = [[], [], []] for _ in range(300): lab = rng.choice(47, k, replace=False); val = np.setdiff1d(np.arange(47), lab) w = np.linalg.lstsq(np.c_[Zt[lab], np.ones(k)], yt[lab], rcond=None)[0] r[0].append(np.sqrt(((np.c_[Zt[val], np.ones(len(val))] @ w - yt[val]) ** 2).mean())) p_t = PCA(min(3, k - 1)).fit(Zt[lab]) h = LinearRegression().fit(p_t.transform(Zt[lab]), yt[lab]) r[1].append(np.sqrt(((h.predict(p_t.transform(Zt[val])) - yt[val]) ** 2).mean())) h = LinearRegression().fit(pca.transform(Zt[lab]), yt[lab]) r[2].append(np.sqrt(((h.predict(pca.transform(Zt[val])) - yt[val]) ** 2).mean())) print(f'{k:2d} | {np.median(r[0]):22.3f} | {np.median(r[1]):16.3f} | {np.median(r[2]):18.3f}') |
💬 source の PCA を凍結すると k = 12 で RMSE 0.935、 target の 12 県だけで PCA を作っても 0.936 とほとんど同じで、 k = 5 ではかえって 1.397 と target 側(1.287)より悪い。 13 列をそのまま最小二乗すると k = 12 でも 3.417 と崩れ、 k = 20 でやっと 0.784 になる。 どれも、 死亡率そのものを source で学んだ重みを使う上の実験(k = 12 で 0.6〜0.7)に届かない。 PCA の 3 軸は累積寄与率 72.3% を占めるが、 それは 13 列のばらつきをよく説明する方向であって、 死亡率を当てる方向とは限らない。 何を借りるか(教師なしの要約か、 同じ目的変数で学んだ重みか)で転移の効き目は大きく変わる。
🎯 このコードでやること:fine-tune の効果を分類の見方で確かめる。 2023 年度 47 県の死亡率の中央値をしきい値にして、 検証 35 県が「中央値以上か」を予測値で当てる。 source のままと fine-tune 100 エポック後で、 AUC(順位の当たり方)と、 しきい値で切ったときの正解率を比べる(🎨 の図 C と同じ計算)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # tl1.py の続き(Xt, yt, w_src を使う) from sklearn.metrics import roc_auc_score rng = np.random.default_rng(0) lab = np.sort(rng.choice(47, 12, replace=False)) # tl4.py と同じ 12 県 val = np.setdiff1d(np.arange(47), lab) thr = np.median(yt) # 2023 年度 47 県の死亡率の中央値 yb = (yt[val] >= thr).astype(int) w = w_src.copy() for _ in range(100): # 学習率 0.05 で 100 エポック fine-tune w = w - 0.05 * 2 * Xt[lab].T @ (Xt[lab] @ w - yt[lab]) / len(lab) print(f'しきい値(中央値): {thr:.2f}‰ 検証 35 県のうち中央値以上: {yb.sum()} 県') for name, ww in [('source のまま', w_src), ('fine-tune 100 エポック', w)]: p = Xt[val] @ ww print(f'{name:14s} AUC {roc_auc_score(yb, p):.3f} 正解率 {((p >= thr) == yb).mean():.3f} 「以上」と予測 {(p >= thr).sum()} 県 予測の平均 {p.mean():.2f}') |
💬 AUC は source のままで 0.990、 fine-tune 後で 0.984 とほとんど同じで、 県の順位は source のままでもほぼ当たっている。 ところが中央値 14.09‰ で切ると、 source のままは「以上」を 7 県しか出さず(実際は 17 県)正解率 0.714、 fine-tune 後は 19 県で正解率 0.943 になる。 予測の平均が 12.46 → 14.32 と実際の水準に上がったためで、 AUC だけを見ていると転移の失敗(水準のずれ)に気づけない。 運用でしきい値を使うなら、 そのしきい値での正解率で確かめる。
🎯 このコードでやること:target のラベルをどの県から集めるかで転移の結果が変わるかを確かめる。 12 県を「47 県から無作為」と「東日本 15 都道県(地域コード 01〜15)からだけ」の 2 通りで 300 回選び、 切片だけ補正と target 12 県だけの最小二乗の検証 RMSE を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # tl1.py・tl2.py の続き(tgt, Xt, yt, w_src, rmse を使う) east = np.where(tgt['Code'].str[1:3].astype(int).to_numpy() <= 15)[0] # 北海道・東北・関東・新潟(地域コード 01〜15) rng = np.random.default_rng(3) for name, pool in [('47 県から無作為', np.arange(47)), ('東日本 15 都道県からだけ', east)]: r_b, r_t = [], [] for _ in range(300): lab = rng.choice(pool, 12, replace=False); val = np.setdiff1d(np.arange(47), lab) w_b = w_src.copy(); w_b[-1] += (yt[lab] - Xt[lab] @ w_src).mean() w_t = np.linalg.lstsq(Xt[lab], yt[lab], rcond=None)[0] r_b.append(rmse(w_b, val)); r_t.append(rmse(w_t, val)) print(f'{name:14s}: 切片だけ補正 {np.median(r_b):.3f} target 12 県だけ {np.median(r_t):.3f}') print('東日本 15 都道県の高齢化率:', round(tgt['age'].to_numpy()[east].min(), 1), '〜', round(tgt['age'].to_numpy()[east].max(), 1), '%') west = np.setdiff1d(np.arange(47), east) res = yt - Xt @ w_src print(f'source モデルの過小予測(実際 − 予測)の平均: 東日本 {res[east].mean():+.3f} それ以外 32 府県 {res[west].mean():+.3f}') |
💬 47 県から無作為に選ぶと、 切片だけ補正 0.690 と target だけ 0.684 はほぼ同じ。 東日本からだけ選ぶと、 切片だけ補正は 0.821 まで悪くなり、 target だけ(0.722)にも負ける。 source モデルの過小予測は東日本で平均 +2.106‰、 それ以外の 32 府県で +1.524‰ と地域で違い、 東日本だけで決めた補正量は西日本には 0.6‰ ほど大きすぎる。 高齢化率の範囲は 22.8〜39.1% と 47 県全体と同じなので、 範囲を覆っていても偏りは残る。 少ないラベルほど、 どこから集めたかが補正にそのまま乗る。
🎯 このコードでやること:source の重みにどれだけ引き寄せるかを、 Ridge の α で連続的に変える。 12 県で「source の重みからの修正量」を学習するとき、 α が小さいほど修正は自由(target だけの学習に近い)、 大きいほど修正は 0 に縮む(source のままに近い。 切片は縮めないので α → ∞ は切片だけ補正と同じ)。 同じ 300 通りの 12 県で検証 RMSE の中央値と、 高齢化率の重みの平均を出す。
1 2 3 4 5 6 7 8 9 10 11 12 | # tl1.py・tl2.py の続き(Xt, yt, w_src, rmse, Ridge を使う) rng = np.random.default_rng(4) splits = [rng.choice(47, 12, replace=False) for _ in range(300)] print(' α | 検証 RMSE 中央値 | 高齢化率の重みの平均') for alpha in [0.01, 0.1, 1, 5, 20, 100, 1000]: r, wa = [], [] for lab in splits: val = np.setdiff1d(np.arange(47), lab) d = Ridge(alpha=alpha).fit(Xt[lab][:, :4], yt[lab] - Xt[lab] @ w_src) # source からの修正量を学習 w = w_src + np.r_[d.coef_, d.intercept_] r.append(rmse(w, val)); wa.append(w[0]) print(f'{alpha:7g} | {np.median(r):16.3f} | {np.mean(wa):.3f}') |
💬 α = 1 で検証 RMSE 0.628 が最小になり、 α = 0.01(0.669)と α = 1000(0.701)の両端はどちらも悪い。 両端はそれぞれ「target の 12 県だけで学習」「source の重みを凍結して切片だけ補正」に近く、 その間に最適な引き寄せ方がある。 高齢化率の重みは α = 0.01 で 1.914(2023 年度だけで学習した重み 1.913 に近い)、 α = 1000 で 1.260(source の 1.257)へ動く。 どの程度 source を信じるかは、 ラベル数と source・target の近さで変わるので、 α は検証データで決める。
🎯 このコードでやること:2012〜2019 年度の source には、 2023 年度に評価する県の過去の値も入っている。 評価する 12 県を source から抜いた場合(280 行)と含む場合(376 行)で、 残り 35 県で切片を補正したあとの検証 RMSE を 200 回比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # tl1.py の続き(src, tgt, F, mu, sd, Xt, yt を使う) rng = np.random.default_rng(5) codes = tgt['Code'].to_numpy() res = {'source に評価の 12 県を含む': [], 'source から評価の 12 県を抜く': []} for _ in range(200): val = rng.choice(47, 12, replace=False) # 評価する 12 県 lab = np.setdiff1d(np.arange(47), val) # 2023 年度のラベルは残り 35 県 for name, keep in [('source に評価の 12 県を含む', np.ones(len(src), bool)), ('source から評価の 12 県を抜く', ~src['Code'].isin(codes[val]).to_numpy())]: s = src[keep] X1 = np.c_[((s[F] - mu) / sd).to_numpy(), np.ones(len(s))] w = np.linalg.lstsq(X1, s['dr'].to_numpy(), rcond=None)[0] w[-1] += (yt[lab] - Xt[lab] @ w).mean() # 35 県で切片を補正 res[name].append(np.sqrt(((Xt[val] @ w - yt[val]) ** 2).mean())) for name, v in res.items(): print(f'{name}: 検証 RMSE 中央値 {np.median(v):.3f}') print('source の行数: 含む', len(src), '行 / 抜く', len(src) - 12 * 8, '行') |
💬 評価する県の過去の値が source に入っていると検証 RMSE 0.662、 抜くと 0.696 と少し悪くなる。 同じ県の 2012〜2019 年度の値から、 その県のくせ(ほかの特徴では説明しきれない死亡率の高さ・低さ)をある程度覚えているためである。 「来年度の同じ 47 県」を当てたいなら含めた評価でよいが、 「まだデータの無い地域」に転移したいなら、 抜いた評価のほうが本番に近い。 何への転移を測っているのかを、 分割のしかたで明示する。
🎯 このコードでやること:どの重みを凍結してよいかを、 重みの不確かさから確かめる。 source(2012〜2019 年度)は県ごとに 8 年度分をまとめて、 target(2023 年度)は 47 県を、 それぞれ 1,000 回復元抽出して重みを推定し直し、 各重みの 95% 区間を並べる。 区間が重ならない重みは、 source と target で本当に変わった重みである。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # tl1.py の続き(src, Xs, ys, Xt, yt を使う) rng = np.random.default_rng(6) pref_s = src['Code'].to_numpy(); up = np.unique(pref_s) B_s, B_t = [], [] for _ in range(1000): pick = rng.choice(up, 47, replace=True) # source は県ごと(8 年度まとめて)復元抽出 idx = np.concatenate([np.where(pref_s == c)[0] for c in pick]) B_s.append(np.linalg.lstsq(Xs[idx], ys[idx], rcond=None)[0]) j = rng.choice(47, 47, replace=True) # target は 47 県を復元抽出 B_t.append(np.linalg.lstsq(Xt[j], yt[j], rcond=None)[0]) B_s, B_t = np.array(B_s), np.array(B_t) for i, n in enumerate(['高齢化率', 'log人口', '出生率', '気温', '切片']): ls, hs = np.quantile(B_s[:, i], [0.025, 0.975]); lt, ht = np.quantile(B_t[:, i], [0.025, 0.975]) print(f'{n:6s} source [{ls:+.3f}, {hs:+.3f}] 2023 年度 [{lt:+.3f}, {ht:+.3f}] 重なり {"あり" if max(ls, lt) <= min(hs, ht) else "なし"}') |
💬 高齢化率の重みだけが、 source の区間 [+1.078, +1.410] と 2023 年度の区間 [+1.606, +2.183] が重ならない。 高齢化が 1 標準偏差進んだときの死亡率の上がり方が、 2023 年度は source より大きくなっている。 log 人口・出生率・気温の重みは区間が重なり、 2023 年度の 47 県だけではどちらとも言えない(区間の幅も source より広い)。 12 県で重みを選んで更新する実験で「高齢化率・log 人口・切片を更新し、 出生率と気温は凍結」が最もよかったのと合っている。 source の年度をまとめるときに県単位で抽出したのは、 同じ県の 8 年度を別々の観測として数えると区間が狭く出すぎるためである。
⚠️ よくある落とし穴
転移学習 を実務で扱うとき、 多くの分析者が同じところでつまずきます。 代表的な失敗パターンを先回りで押さえておくと、 後工程のトラブルを大幅に減らせます。
※ 上記は文献調査("On Negative Transfer" Wang et al. 2019、 Pan & Yang 2010、 BERT 論文)と現場運用の典型例。 LLM 時代では LoRA/QLoRA/PEFT が主流で、 上記落とし穴はパラメータ効率的手法で部分的に緩和される。
⚠️ SSDSE-B-2026 の実験で見えた落とし穴
- AUC だけで転移の成否を判断する:死亡率の順位は source のままでも AUC 0.990 で当たるが、 予測の水準が 1.7‰ 低いため、 中央値で切った正解率は 0.714。 fine-tune すると AUC は 0.984 と変わらないまま正解率が 0.943 になる。 しきい値で使うなら、 そのしきい値の正解率と予測の平均も見る。
- source の範囲を確かめずに借りる:人口上位 10 県だけの source は高齢化率 21.2〜31.8% しか知らず、 2023 年度の 39.1% までを外挿することになる。 切片を補正しても検証 RMSE 0.824 で、 転移しない 0.642 より悪い(負の転移)。
- target のラベルを 1 つの地域だけで集める:東日本 15 都道県の 12 県で補正量を決めると、 西日本には 0.6‰ ほど大きすぎ、 検証 RMSE が 0.690 → 0.821 に悪化する。 少数のラベルは地域・規模が偏らないように選ぶ。
- 学習率を上げて早く終わらせようとする:学習率 0.1 までは 54 エポックで同じ底 0.342 に着くが、 0.2 は上限 0.176 を超えて 1 回目から発散する。 fine-tune の学習率は source の学習より小さく取り、 検証誤差を見ながら止める。
✅ 理解度チェック — 実験の数値で答える
- 2012〜2019 年度で学習した死亡率のモデルは、 source の中では RMSE 0.559、 2023 年度では 1.831 だった。 平均の予測誤差 −1.710 は何を意味するか。
答え:ばらつきではなく水準のずれ。 2023 年度の死亡率(平均 14.10)を、 モデルは平均 12.39 と低く見積もっている。 - ラベルが 3 県しかないとき、 target だけの最小二乗は RMSE 3.680、 切片だけ補正は 0.704 だった。 target だけの学習が崩れる理由は。
答え:4 特徴+切片の 5 個の重みを 3 県で決めようとしているから。 切片だけなら 3 県の平均のずれ 1 つを決めればよい。 - ラベルが 30 県に増えると、 切片だけ補正 0.677、 target だけ 0.602、 source へ縮小 0.586 になった。 ラベルが増えると転移の得はどう変わるか。
答え:小さくなる。 target だけの学習が追いつき、 source の重みを借りる得は k = 3 のときほど大きくない。 - source を 1 年度だけにすると、 2022 年度は RMSE 0.516、 2019 年度は 1.784、 2012 年度は 0.744 だった。 「近い年度ほど良い」と言えるか。
答え:言えない。 直前の 2022 年度は死亡率の水準が 2023 年度に近いので最良だが、 2012 年度が 2019 年度より当たるように、 距離だけでは決まらない。 target の少数ラベルで確かめる。 - 学習率 0.05 の fine-tune は 108 エポックで検証 MSE 0.342、 300 エポックで 0.354。 学習 12 県の MSE は下がり続けた。 何エポックで止めるべきか、 その判断に使うデータは。
答え:108 エポック前後。 学習 12 県ではなく、 学習に使っていない検証 35 県の誤差で判断する。 - 学習率 0.2 は発散し、 上限は 2 / λmax = 0.176 だった。 学習率 0.1 と 0.05 の違いは。
答え:どちらも同じ底 0.342 に着くが、 0.1 は 54 エポック、 0.05 は 108 エポックと速さが違う。 上限に近いほど速いが、 超えると 1 回目から壊れる。 - source の PCA(13 列を 3 軸に要約、 累積寄与率 72.3%)を凍結して借りても、 k = 12 で RMSE 0.935 と、 死亡率の重みを借りる方法(0.6〜0.7)に及ばなかった。 なぜか。
答え:PCA の軸は 13 列のばらつきをよく説明する方向で、 死亡率を当てる方向とは限らない。 借りる知識が target の目的に合っているかで効き目が決まる。 - source の重みからの修正量を Ridge で学習すると、 α = 0.01 で RMSE 0.669、 α = 1 で 0.628、 α = 1000 で 0.701 だった。 α を大きくすると何に近づき、 なぜ中間が最もよいのか。
答え:α → ∞ は重みを凍結して切片だけ補正(0.70 前後)、 α → 0 は 12 県だけで自由に学習(0.67 前後)に近づく。 source を少し信じつつ、 変わった重み(高齢化率 1.257 → 約 1.7)だけ動かす中間が、 少ないラベルでは最も安定する。 - 評価する 12 県の過去の値を source から抜くと、 検証 RMSE は 0.662 → 0.696 になった。 「まだデータの無い地域」への転移を見積もるなら、 どちらの数字を使うべきか。
答え:抜いたほうの 0.696。 含めると、 その県のくせを source が覚えている分だけ楽観的になる。
🗺 概念マップ
転移学習を中心に、 事前学習モデル (ImageNet/BERT)・特徴抽出・ファインチューニング・ドメイン適応・少量データ学習への展開を 6 方向に整理。
転移学習の中心から、 Fine-tuning・Domain Adaptation・Few-shot / Zero-shot・LoRA / Prefix Tuning・Continual Learning が放射状に配置される。 SSDSE-B-2026 で「人口予測 → 雇用者数予測」へ知識を流用する場合、 共通特徴 (年齢構成・産業構造) を凍結し、 出力層のみ再学習する典型的な転移学習となる。
🔗 隣接手法への橋渡し
転移学習は「事前学習モデル → 適用先タスク」の橋を架ける手法で、 前後に複数手法が連接する。
- 上流: 事前学習 (ImageNet / BERT / GPT) → 特徴抽出 で重みを保存 → ドメイン類似度 評価で転移可能性を判定
- 並列: Fine-tuning (全層更新)、 LoRA (低ランク追加層のみ)、 Prompt Tuning (入力に学習可能 prefix)、 Meta Learning (Few-shot)
- 下流: Early Stopping で過学習防止 → 破滅的忘却 を確認 → 蒸留 で本番用に軽量化
SSDSE-B-2026 を題材にすると、 全国モデル (47 県) で事前学習 → 北海道のみ Fine-tune というシナリオが、 「source とほぼ同分布だが少量データに特化」する典型的転移学習となる。
🌳 手法選択フロー
転移学習を採用するか、 別の方法 (Scratch / Multi-task) を選ぶかは 4 つの分岐で決まる。
- ターゲットデータが少ない (n < 1000)? Yes → 転移学習が有効。 No → スクラッチ学習 でも OK
- source と target が類似? 類似 → 出力層のみ再学習、 やや異 → 下位層を凍結し上位層 fine-tune、 完全異 → DA が必要
- 計算資源が制約? あり → LoRA / Adapter (パラメータ数 0.1%)、 なし → Full fine-tuning
- 連続的に新タスクが増える? Yes → Continual Learning + EWC で忘却防止、 No → 通常の転移学習で完結
SSDSE-B-2026 の県別予測なら、 全国 (n=564) で事前学習 → 特定県 (n=12) で fine-tune が現実解。 各県独立スクラッチは過学習する。
このページの死亡率の実験から言える目安(2012〜2019 年度 → 2023 年度、 4 特徴の線形モデル):
- target のラベルが 5 県以下 → target だけの学習は崩れる(k = 3 で RMSE 3.680、 k = 5 で 1.368)。 source の重みを凍結して切片だけ補正する(約 0.70)。
- 10〜20 県 → 重みも少し動かす。 source からの修正量を Ridge で学習するか、 変わった重み(高齢化率)だけ更新する(0.61〜0.65)。
- 30 県前後 → target だけの学習との差は小さい(0.595 と 0.587)。 転移は「悪くならない保険」として使う。
- source が target の範囲を覆っていない、 またはラベルが一部の地域に偏っている → 転移しないほうがよいことがある(人口上位 10 県の source で 0.824、 転移なしで 0.642)。 必ず転移なしの結果と並べて比べる。
※ 上記は文献調査・現場経験で報告される頻度の高い注意点。 ドメインや手法のバージョンによって追加の落とし穴がある場合があります。