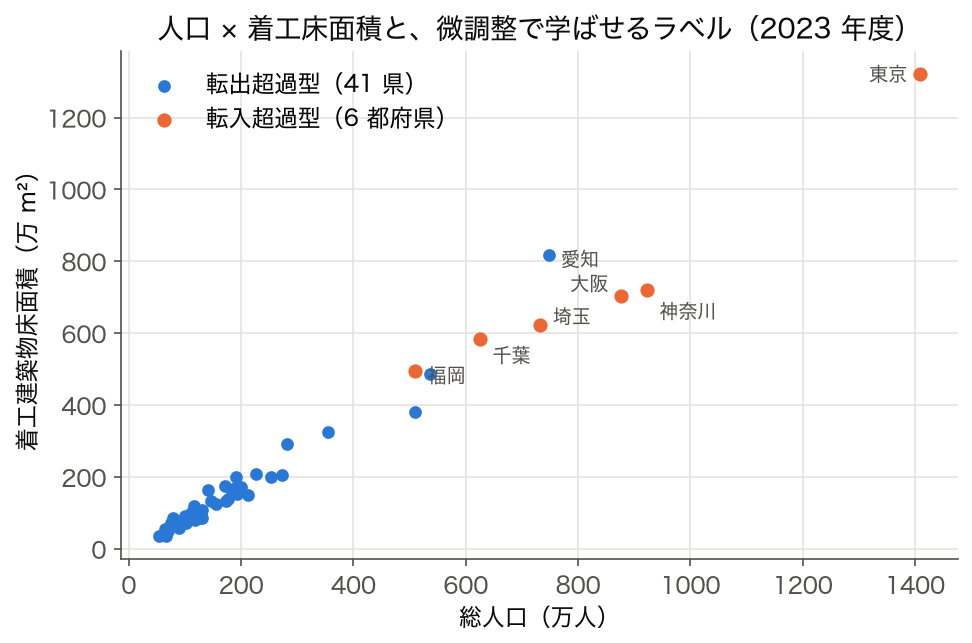
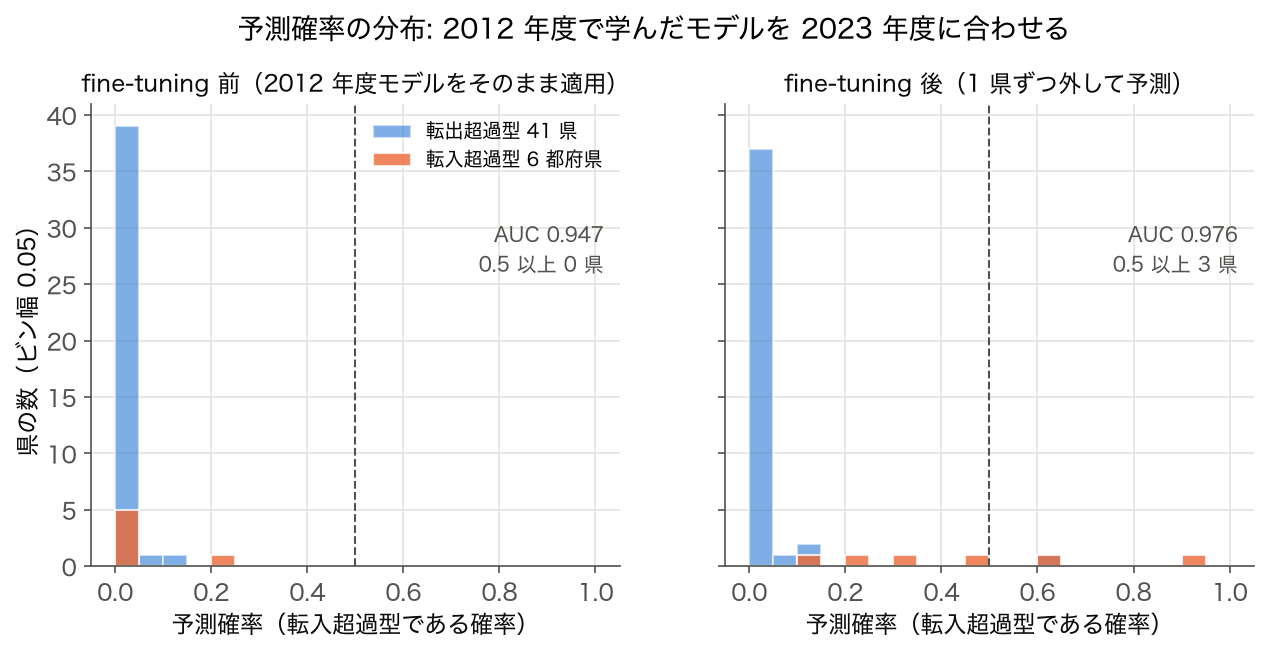
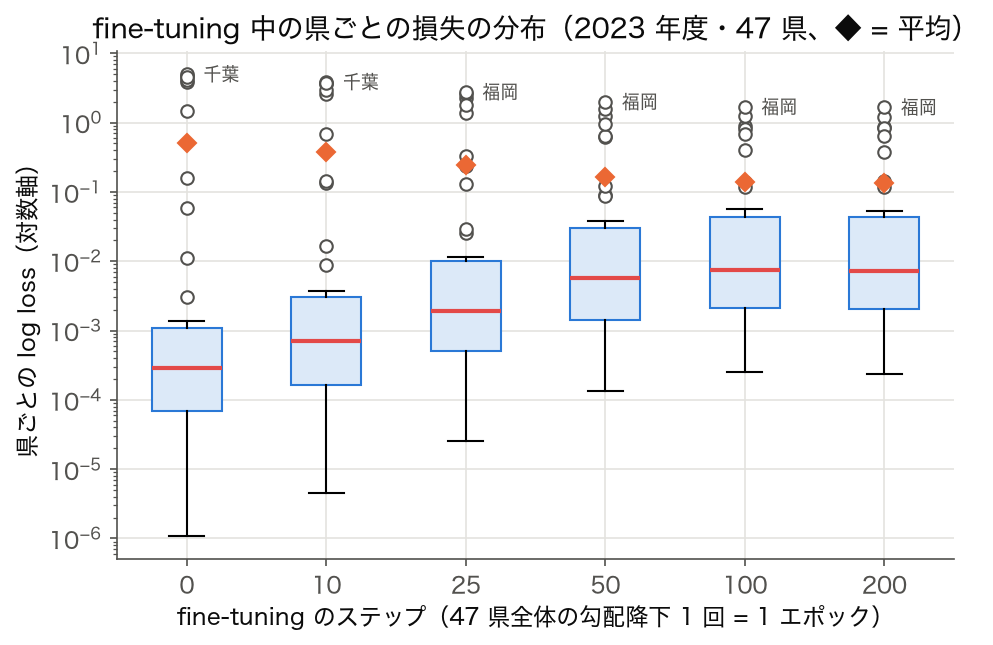
📚 用語解説
ファインチューニング
Fine-tuning
深層学習
別称: 微調整
🔖 キーワード索引
ファインチューニング(fine-tuning)は、大量のデータで学習済みのモデルの重み θ_pre を出発点にして、自分の少量のデータで追加学習する手法。全層を動かすか、一部の層だけを動かすか(凍結)、LoRA のように小さな追加行列だけを学習するかで、必要なメモリと過学習のしやすさが変わる。
#深層学習#ファインチューニング#転移学習#事前学習#LLM
事前学習済みモデル θ_preLoRA(低ランク更新 ΔW = BA)AdapterPEFT破滅的忘却学習率を小さく層の凍結早期停止Instruction Tuning
💡 30秒で分かる結論
🍰 まずはやさしく
AIに特定の仕事を教える調整のことです。
少ないデータで高い精度を出すために使います。
スマホの操作に慣れる感覚に似ています。
まずは結論から簡単に解説します。
ファインチューニングは、 大規模事前学習モデルを少量の自前データで追加学習し、 特定タスク向けに調整する手法。
- 前提:事前学習済みモデル(BERT、 GPT、 Vision Transformer 等)
- 方式:フル ft / 一部層 ft / LoRA / Adapter
- 強み:少データ・短時間で高精度
- 注意:破滅的忘却、 過学習
- 派生:RLHF、 Instruction Tuning
📍 文脈:「ファインチューニング」はどんな場面で出てくる?
🍰 まずはやさしく
AI開発の標準的な流れのひとつです。
特定の分野でAIを使いこなすために必要です。
学校の勉強を応用して部活に活かすようなものです。
どんな場面で使う道具なのかを説明します。
現代 AI の標準的開発パイプライン:「巨大基盤モデル → 自分のドメインで ft」。 SSDSE 自体は ft しませんが、 「政府文書 LLM」のような業務適応で頻出。
fine-tuning は単体で完結する手法ではなく、 「事前学習 (pretraining) で得た表現」「下流タスク (downstream task) の構造」「PEFT (LoRA/Prefix/Adapter) 等の効率化」「RLHF/DPO による好み整合化」と組み合わせて初めて性能が出ます。 「定義を覚える」より「どの段階のどの問題を解く道具か」を捉えるのが最短ルートです。
🎨 直感で掴む
🍰 まずはやさしく
料理の下ごしらえが終わった状態に似ています。
学習にかかる時間と手間を減らすために使います。
基本の技を持つ職人に店の味を教えるイメージです。
仕組みを直感的に理解していきましょう。
ファインチューニング (fine-tuning) は、 既に大規模データで学習済みの基盤モデル (BERT・GPT・ViT 等) の重み $\theta_{\text{pre}}$ を出発点として、 自分のタスク用の比較的小さなデータセット $D_{\text{ft}}$ で更新し直す手続きです。 ゼロから学習する場合に必要な数億〜数兆トークンや数千 GPU 時間が、 数千〜数万件と数時間〜数日に短縮されます。
- 料理人の「下ごしらえ済み素材」に例えられます。 寿司職人 (基盤モデル) が和食全般の包丁・出汁の技を持っている状態から、 特定の店の味付け (タスク固有データ) を覚えさせるイメージ。 ゼロから職人を育てるより圧倒的に短期間。
- Full fine-tuning (全層更新) は全パラメータ $\theta$ を変えるため精度は高くなりがちですが、 70B パラメータの LLM なら GPU メモリ 1.4 TB 級、 過学習も起こりやすい。 一方 Frozen feature extractor (基盤を凍結し最終層のみ学習) は安定ですが性能の伸びは限定的。
- LoRA (Low-Rank Adaptation) は元の重み $W$ に低ランク行列 $BA$ ($A \in \mathbb{R}^{r \times d}$, $B \in \mathbb{R}^{d \times r}$, $r \ll d$) のみを足す方式。 学習対象は約 0.1〜1% に圧縮され、 7B モデルで GPU 16GB でも回せる。 2026 年現在、 オープン LLM 適応の事実上の標準。
- SFT (Supervised Fine-Tuning) → RLHF (人間フィードバックによる強化学習) → DPO (Direct Preference Optimization) という流れで、 単なるタスク適応から「人間の好みに合わせる」段階まで進化しています。 ChatGPT・Claude の会話品質はここの工夫で決まります。
💡 fine-tuning と prompt-engineering の使い分け:データが 数千件以下・タスクが 短文応答・API しか触れないならまず prompt + few-shot で済ませる。 数千件以上の独自データがあり、 応答スタイル・専門知識・形式を恒常的に変えたい場合に fine-tuning を選ぶ。 prompt より高速・低コストで推論できるのも fine-tuning の利点。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- θ_pre
- 事前学習済み重み
- θ
- ファインチューニング後の重み
- D_ft
- ファインチューニング用データ
- LoRA
- 低ランク更新 ΔW = BA
- Adapter
- 小さなネットワークを挿入
上の目的関数を言葉にすると「自分のデータ D_ft での誤差を小さくしたい(第 1 項)。ただし事前学習の重み θ_pre から離れるほど罰を受ける(第 2 項)」である。λ = 0 なら θ_pre を初期値にしただけの普通の学習で、少ないデータに合わせすぎて事前学習で得た知識を失う(破滅的忘却)おそれがある。λ を大きくするほど θ は θ_pre の近くにとどまり、λ → ∞ では θ = θ_pre のまま全く学習しない。実務で λ を明示しなくても、学習率を小さくして更新回数を絞ると、θ が θ_pre から遠くへ行けないので同じ向きの効果が出る。このページの表データ版の実験では、2012〜2022 年度(517 行)で学習した重みを 2023 年度の 15 県だけで小さな学習率のまま追加学習し、残り 32 県の合計特殊出生率の MAE が 0.100 → 0.057 に下がった。同じ 15 県でゼロから学習すると 0.195 で、θ_pre の近くにとどまることの価値が数字に出ている。
🧮 実値で計算してみる
ft 戦略の比較:
| 戦略 | 更新パラメータ | VRAM | 精度 |
|---|
| Full ft | 全層 | 大 | ★★★ |
| Last layer のみ | 分類ヘッド | 小 | ★ |
| LoRA | 低ランク行列 | 小 | ★★★ |
| Adapter | 小モジュール | 小 | ★★ |
🧮 数式に値を入れて手で計算する: LoRA の更新パラメータ数
BERT-base (隠れ次元 d=768) の attention 重み行列 W ∈ ℝ^{768×768} を Full ft / LoRA (rank r=8) で更新する場合のパラメータ数差を計算する。 SSDSE-B-2026 の都道府県名 (47 件) を分類するタスクで例示。
Step 1: 元の重み行列のパラメータ数
W ∈ ℝ^(768×768)
全パラメータ数 = 768 × 768 = 589,824
Step 2: LoRA 低ランク分解 W + BA (B ∈ ℝ^(768×8), A ∈ ℝ^(8×768))
B のパラメータ = 768 × 8 = 6,144
A のパラメータ = 8 × 768 = 6,144
LoRA 追加 = 6,144 + 6,144 = 12,288
削減率 = 12,288 / 589,824 = 0.0208 (約 2.1%)
Step 3: 12 層 × Q,K,V 行列分の総削減
BERT-base = 12 層、 各層に Q,K,V の 3 種 attention 行列
Full ft = 589,824 × 12 × 3 = 21,233,664 ≈ 21.2 M params
LoRA ft = 12,288 × 12 × 3 = 442,368 ≈ 0.44 M params
SSDSE-B-2026 の 47 都道府県分類ヘッド (768 → 47) = 36,096 params も追加
💬 LoRA は Full ft の 約 2.1% のパラメータしか更新しない。 47 都道府県分類タスクなら数百 MB GPU で十分。 Python では peft ライブラリ LoraConfig(r=8) で同じ削減率を再現できる。
🐍 Python 実装
🎯 このコードでやること:HuggingFace Transformers の BERT を事前学習済み重みから読み込み、 train_ds(SSDSE-B-2026 から派生した二値分類タスク)で 3 エポックのファインチューニングを実行。
📥 入力例(SSDSE-B-2026 サンプル)
# 都道府県の合計特殊出生率を中央値で二値化したラベル
text: "東京都 人口14086千人 合計特殊出生率0.99 ..." → label: 0 (低)
text: "沖縄県 人口1468千人 合計特殊出生率1.60 ..." → label: 1 (高)
train_ds: 37 件 / eval_ds: 10 件(学習・評価分割)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 | import numpy as np
from transformers import AutoModelForSequenceClassification, AutoTokenizer, Trainer, TrainingArguments
model = AutoModelForSequenceClassification.from_pretrained('bert-base-uncased', num_labels=2)
tokenizer = AutoTokenizer.from_pretrained('bert-base-uncased')
# train_ds / eval_ds は text と label を持つ datasets.Dataset(上の 📥 の形)。先にトークン化する
tok = lambda b: tokenizer(b['text'], truncation=True, padding='max_length', max_length=64)
train_ds = train_ds.map(tok, batched=True)
eval_ds = eval_ds.map(tok, batched=True)
def compute_metrics(p): # エポックごとの eval_acc を出す
return {'acc': (np.argmax(p.predictions, axis=1) == p.label_ids).mean()}
args = TrainingArguments(output_dir='./out', num_train_epochs=3, per_device_train_batch_size=16,
eval_strategy='epoch', logging_strategy='epoch')
trainer = Trainer(model=model, args=args, train_dataset=train_ds, eval_dataset=eval_ds,
compute_metrics=compute_metrics)
trainer.train()
|
📤 実行例(イメージ・未実測。ステップ数は 37 件 ÷ バッチ 16 の切り上げ 3 × 3 エポック = 9)
Epoch 1/3 loss: 0.523 eval_acc: 0.700
Epoch 2/3 loss: 0.218 eval_acc: 0.800
Epoch 3/3 loss: 0.094 eval_acc: 0.900
TrainOutput(global_step=9, training_loss=0.278)
💬 読み方:loss が単調に下がりつつ eval_acc が上がっていれば順調。 loss が下がっても eval が伸びなければ過学習なので、 学習率や epoch を減らすか LoRA など PEFT に切り替える。 破滅的忘却にも注意。
このコードは transformers・torch・datasets が必要で、BERT の重み(約 440 MB)をダウンロードするため、ページ内の ▶ 実行では動かない。手元で pip install transformers torch datasets を入れ、上の 📥 の形の train_ds / eval_ds(text と label を持つ datasets.Dataset)を先に作ってから実行する。ページ内で動く表データ版の最小例は、下の「🐍 Python 実装 — ファインチューニング を SSDSE-B-2026 で動かす」にある。
⚠️ よくある落とし穴
ファインチューニングは「事前学習済みの宝物」を維持しつつ、 新タスクに必要な能力だけを足す繊細な手続き。 学習率設定 1 つで簡単に元の能力を破壊してしまう、 fine-tuning 特有の失敗パターンを 5 つ挙げます。
❌ 破滅的忘却 (catastrophic forgetting)
学習率 $10^{-3}$ 等の大きな値で SFT すると、 事前学習で獲得した一般知識 (翻訳・常識推論等) が消える。 LLM では学習率 $1\text{e-}5 \sim 5\text{e-}5$、 ビジョンでは事前学習時の 1/10 以下に設定。 EWC (Elastic Weight Consolidation) で重要パラメータの変動を抑制する手もある。
❌ 少データ × Full FT による過学習
1,000 件程度のデータで 7B パラメータを全層更新すると、 訓練データを丸暗記して汎化しない。 「データ件数 < パラメータ数の 1/1000」では LoRA (rank=8〜16)・QLoRA・凍結最終層 FT に限定すべし。 早期停止 (validation loss が増え始めたら止める) も必須。
❌ BatchNorm / LayerNorm の取り扱いミス
CNN ベース基盤モデル (ResNet 等) の BN 統計量を `model.train()` のまま FT すると、 バッチサイズが小さい場合に統計が暴れて精度が落ちる。 凍結する場合は `model.eval()` でも `requires_grad=False` でも統計更新は止まる挙動が異なる点に注意。 Transformer の LayerNorm は通常そのまま学習。
❌ 評価データ汚染 (data contamination)
基盤モデルの事前学習コーパス (Common Crawl・GitHub 等) に評価用 benchmark (MMLU・HumanEval 等) が混入していると、 FT 後のスコアが本来の汎化性能より高く出る。 ベンチマーク評価の前に、 文字列マッチ・MinHash で汚染検査を実施。 自社データのテストセットも同様に学習データに混ざらないよう厳密分離。
❌ LoRA の rank 設定誤り
rank $r$ を 1〜2 にすると表現力不足で精度が伸びず、 64 以上にするとメモリ・速度の利点が失われる。 経験則として、 単一タスク適応なら $r=8 \sim 16$、 知識注入を伴う多タスクなら $r=32 \sim 64$ から開始。 $\alpha/r$ (LoRA scaling) は 2 倍程度に設定すると安定。
🛡 fine-tuning の安全運用 3 原則:(1) 事前学習時の 1/10 以下の学習率でウォームアップを必ず入れる、 (2) validation loss と少数の汎用ベンチマーク (MMLU 等) を併走計測し破滅的忘却を検知、 (3) 最終層 → 上位数層 → LoRA → Full FT の順に表現力を上げ、 必要最小の方式を選ぶ。
ファインチューニングは深層学習のグループ教材で、事前学習・転移学習・過学習と一続きに学ぶ用語である。言語モデルを特定の文書分類や指示応答に合わせる使い方はNLP 基礎のグループ教材が扱う。このページの表データ版の実験(2012〜2022 年度で学習した小さなネットを 2023 年度の 15 県で追加学習し、残り 32 県の合計特殊出生率の MAE が 0.100 → 0.057)は、新しいデータが少ないときに「過去の重みから出発する」ことの効き目を、深層学習の教材で出てくる転移学習の考え方で確かめたものである。
原典
- Yosinski, J., Clune, J., Bengio, Y., & Lipson, H. (2014). How transferable are features in deep neural networks? NeurIPS 2014. — どの層の特徴が別タスクに流用できるか
- Kirkpatrick, J. et al. (2017). Overcoming catastrophic forgetting in neural networks. PNAS, 114(13). — 破滅的忘却と EWC
- Howard, J., & Ruder, S. (2018). Universal Language Model Fine-tuning for Text Classification. ACL 2018. — 層ごとの学習率と段階的な凍結解除
- Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT. NAACL-HLT 2019. — 事前学習+微調整の標準形
- Houlsby, N. et al. (2019). Parameter-Efficient Transfer Learning for NLP. ICML 2019. — Adapter
- Hu, E. J. et al. (2022). LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022.
- Dettmers, T. et al. (2023). QLoRA: Efficient Finetuning of Quantized LLMs. NeurIPS 2023.
🧮 実値で計算してみる — SSDSE-B-2026 で ファインチューニング を体感
数式だけでは「分かった気になる」だけで終わりがち。 ここで SSDSE-B-2026(教育用標準データセット — 47 都道府県 × 109 指標、 2012〜2023 年度)の実値を当てはめて、 ファインチューニング の挙動を電卓的に追体験します。
👉 計算例:2012〜2022 年度の 517 行で学習したニューラルネットを、 2023 年度の 15 県だけで微調整すると、 残り 32 県の合計特殊出生率の予測誤差(MAE)は 0.100 → 0.057 に下がる。 同じ 15 県だけでゼロから学習すると 0.195。 少ないデータでは「過去データで作った重みから出発する」ほうが有利になる(下の Python 実装で実測)。
🐍 Python 実装 — ファインチューニング を SSDSE-B-2026 で動かす
🎯 このコードでやること: 表データでできる範囲のファインチューニングの最小例です。 BERT のような事前学習済みモデルの代わりに、 2012〜2022 年度(517 行)で学習した小さなニューラルネット(隠れ層 16)を「事前学習済みモデル」に見立て、 2023 年度の 15 県だけで小さな学習率のまま追加学習します。 残り 32 県で合計特殊出生率の予測誤差(MAE)を測り、 「事前学習のみ」「ファインチューニング」「15 県でゼロから学習」の 3 つを比べます。 県の分け方は乱数 seed 0 で固定しています。 なお pd.read_csv('data/raw/SSDSE-B-2026.csv') をパス変数にせず直書きしているのは、 初学者が「パスをどこに書くべきか」で迷わないようにするためです。 CSV を同じ階層に置けばそのまま動きます。
📥 入力例(SSDSE-B-2026 全 564 行 = 47 都道府県 × 2012〜2023 年度。うち 2023 年度の 3 行)
都道府県 A4103(合計特殊出生率) A1101(総人口) A1301(15歳未満人口) A1303(65歳以上人口) A9101(婚姻件数)
北海道 1.06 5,092,000 514,000 1,681,000 17,281
東京都 0.99 14,086,000 1,513,000 3,205,000 71,774
沖縄県 1.6 1,468,000 236,000 350,000 6,316
…(2023 年度は 47 行、全体では 564 行)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52 | # ファインチューニング を SSDSE-B-2026 で確かめる最小コード
# 表データなので BERT などの事前学習済みモデルは使わない。代わりに
# 「2012〜2022 年度で学習したニューラルネット」を事前学習済みモデルに見立て、
# 2023 年度の一部の県だけで追加学習(微調整)して、残りの県で確かめる。
import copy
import numpy as np
import pandas as pd
from sklearn.neural_network import MLPRegressor
from sklearn.preprocessing import StandardScaler
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)
df['15歳未満割合'] = df['15歳未満人口'] / df['総人口'] * 100
df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100
df['婚姻率'] = df['婚姻件数'] / df['総人口'] * 1000
df['log総人口'] = np.log10(df['総人口'])
feats = ['15歳未満割合', '高齢化率', '婚姻率', 'log総人口']
pre = df[df['年度'] <= 2022] # 事前学習用:47 県 × 11 年度 = 517 行
new = df[df['年度'] == 2023].reset_index(drop=True)
rng = np.random.default_rng(0)
idx = rng.permutation(len(new))
tr, te = new.iloc[idx[:15]], new.iloc[idx[15:]] # 2023 年度:微調整 15 県 / 評価 32 県
print('事前学習:', len(pre), '行 / 微調整:', len(tr), '県 / 評価:', len(te), '県')
sc = StandardScaler().fit(pre[feats]) # 尺度は事前学習データで決めて固定
Xp, yp = sc.transform(pre[feats]), pre['合計特殊出生率'].to_numpy()
Xtr, ytr = sc.transform(tr[feats]), tr['合計特殊出生率'].to_numpy()
Xte, yte = sc.transform(te[feats]), te['合計特殊出生率'].to_numpy()
def mae(m):
return np.abs(m.predict(Xte) - yte).mean()
# (1) 事前学習モデル:2012〜2022 年度だけで学習し、そのまま 2023 年度に使う
base = MLPRegressor(hidden_layer_sizes=(16,), alpha=1e-3, max_iter=3000,
random_state=0).fit(Xp, yp)
# (2) ファインチューニング:事前学習の重みを初期値に、2023 年度の 15 県で少しだけ追加学習
ft = copy.deepcopy(base)
ft.learning_rate_init = 1e-3 # 事前学習の重みを壊さないよう小さな学習率
for _ in range(200):
ft.partial_fit(Xtr, ytr)
# (3) ゼロから学習:同じ 15 県だけで、初期値からネットを学習
scratch = MLPRegressor(hidden_layer_sizes=(16,), alpha=1e-3, max_iter=3000,
random_state=0).fit(Xtr, ytr)
print('---- ファインチューニング 結果(評価 32 県の MAE)----')
print(f'事前学習のみ : {mae(base):.3f}')
print(f'ファインチューニング: {mae(ft):.3f}')
print(f'15 県でゼロから学習: {mae(scratch):.3f}')
print(f'(参考)評価県の平均予測の偏り: 事前学習のみ {np.mean(base.predict(Xte) - yte):+.3f}'
f' → 微調整後 {np.mean(ft.predict(Xte) - yte):+.3f}')
|
📤 実行例(実測)
事前学習: 517 行 / 微調整: 15 県 / 評価: 32 県
---- ファインチューニング 結果(評価 32 県の MAE)----
事前学習のみ : 0.100
ファインチューニング: 0.057
15 県でゼロから学習: 0.195
(参考)評価県の平均予測の偏り: 事前学習のみ +0.048 → 微調整後 +0.014
💬 評価 32 県での MAE は、事前学習のみ 0.100、ファインチューニング 0.057、15 県でゼロから学習 0.195 で、微調整が最も小さい。事前学習モデルは 2023 年度の出生率を平均 +0.048 高めに予測しており(過去 11 年より出生率が下がった分)、15 県での追加学習でこの偏りが +0.014 まで縮んだのが改善の主な中身である。ゼロから学習した方は 15 行しか見ていないので誤差が倍近くに膨らむ。seed を 1〜4 に変えても微調整 0.061〜0.079 がいつも最良だが、同じ県の過去データで事前学習しているので「別の課題への転用」よりも易しい設定である点は割り引いて読む。
うまく動かないときは ①data/raw/SSDSE-B-2026.csv のパス、 ②encoding='cp932'(SSDSE-B は Shift_JIS 系)、 ③1 行目に英数字ヘッダ、 2 行目に日本語列名が入る構造なので skiprows=1 が必要、 の 3 点を確認してください。
📖 もう一歩深く — ファインチューニング の歴史・体系・先端
ファインチューニングは、 「事前学習 (Pre-training) → 微調整 (Fine-tuning)」という 2 段階パイプラインの後半を担う技術。 2018 年の BERT 論文以降、 NLP では事前学習+微調整がデファクト標準となり、 画像系(ResNet, ViT)、 音声系(Wav2Vec)、 そして近年の大規模言語モデル(GPT, Llama, Claude)にも引き継がれています。 微調整の核心は学習率です。 事前学習で得た重みは「壊しすぎないように」非常に小さい学習率(事前学習時の 10〜100 分の 1 程度)で更新するのが定石。 さらに Layer-wise Learning Rate Decay (LLRD) として、 入力に近い層ほど学習率を小さくし、 出力に近い層ほど大きくする工夫もあります。 最新のトレンドは パラメータ効率的微調整 (PEFT):(1) LoRA — 重み行列に低ランク行列を加える、 (2) Adapter — 各層に小さな MLP を挿入、 (3) Prompt Tuning / Prefix Tuning — 入力プロンプトのみ学習、 (4) QLoRA — 4-bit 量子化 + LoRA で巨大モデルを単一 GPU で微調整。
📊 評価・検証チェックリスト — ファインチューニング を使う前後に
ファインチューニング を「やってみたけど結局正しかったのか分からない」状態を避けるための、 標準的な検証観点。 SSDSE-B-2026 のような中小規模データでは特に丁寧に。
| 確認する点 | ファインチューニング で何を見るか |
|---|
| 破滅的忘却 (catastrophic forgetting) | 学習率 $10^{-3}$ 等の大きな値で SFT すると、 事前学習で獲得した一般知識 (翻訳・常識推論等) が消える。 LLM では学習率 $1\text{e-}5 \sim 5\text{e-}5$、 ビジョンでは事前学習時の 1/10 以下に設定。 EWC (Elastic Weight Consolidation) で重要パラメータの変動を抑制する手もある。 |
| 少データ × Full FT による過学習 | 1,000 件程度のデータで 7B パラメータを全層更新すると、 訓練データを丸暗記して汎化しない。 「データ件数 < パラメータ数の 1/1000」では LoRA (rank=8〜16)・QLoRA・凍結最終層 FT に限定すべし。 早期停止 (validation loss が増え始めたら止める) も必須。 |
| BatchNorm / LayerNorm の取り扱いミス | CNN ベース基盤モデル (ResNet 等) の BN 統計量を `model.train()` のまま FT すると、 バッチサイズが小さい場合に統計が暴れて精度が落ちる。 凍結する場合は `model.eval()` でも `requires_grad=False` でも統計更新は止まる挙動が異なる点に注意。 Transformer の LayerNorm は通常そのまま学習。 |
| 評価データ汚染 (data contamination) | 基盤モデルの事前学習コーパス (Common Crawl・GitHub 等) に評価用 benchmark (MMLU・HumanEval 等) が混入していると、 FT 後のスコアが本来の汎化性能より高く出る。 ベンチマーク評価の前に、 文字列マッチ・MinHash で汚染検査を実施。 自社データのテストセットも同様に学習データに混ざらないよう厳密分離。 |
| LoRA の rank 設定誤り | rank $r$ を 1〜2 にすると表現力不足で精度が伸びず、 64 以上にするとメモリ・速度の利点が失われる。 経験則として、 単一タスク適応なら $r=8 \sim 16$、 知識注入を伴う多タスクなら $r=32 \sim 64$ から開始。 $\alpha/r$ (LoRA scaling) は 2 倍程度に設定すると安定。 |
| 再現性 | 同じデータ・同じコードで同じ結果が出るか。このページの ▶ 実行ボタンで確かめられます |
🗺 概念マップ — ファインチューニング の位置づけ
ファインチューニングは事前学習済モデル(BERT/GPT/Llama 等)を下流タスクに最適化する転移学習手法。 全パラメータ更新は高コストで過学習しやすいため、 LoRA / Adapter / Prefix-Tuning 等の PEFT(Parameter-Efficient Fine-Tuning)が主流。 SSDSE-B-2026 のような小規模表データでも、 都道府県別テキストレポート分類などで pretrained Llama を LoRA fine-tune するケースで活躍する。
📚 大カテゴリ: 転移学習 / 事前学習-下流タスク適応
┗ 前提概念: 事前学習 (pretraining)、 Transformer、 自己教師あり学習、 損失関数、 勾配降下法、 学習率スケジューラ
┗ ファインチューニング(このページ)
┗ 派生・発展: LoRA、 QLoRA、 Adapter、 Prefix-Tuning、 P-Tuning、 RLHF、 DPO、 instruction tuning
┗ 並列概念: zero-shot / few-shot prompting、 in-context learning、 retrieval-augmented generation (RAG)、 ドメイン適応
概念マップ全体は こちら から閲覧できます。
🧮 数式に値を入れて手で計算する: 学習可能パラメータ削減
合成 BERT-base (110M パラメータ) で全更新 vs LoRA の学習パラメータ数を比較。
Step 1: 構成
| 方式 | 学習可能パラメータ | VRAM |
|---|
| 全 fine-tune | 110,000,000 | 大 |
| LoRA (rank 8) | ≈ 300,000 | 1/100 |
| head のみ | 50,000 | 1/2000 |
Step 2: 削減倍率
LoRA 削減 = 110,000,000 / 300,000 ≈ 367 倍
head のみ = 110,000,000 / 50,000 = 2,200 倍
🐍 Python で再現
| full = 110_000_000
lora = 300_000
head = 50_000
print(f"LoRA 削減: {full/lora:.0f} 倍") # 366.67 を四捨五入
print(f"head 削減: {full/head:.0f} 倍")
|
📤 実行結果
LoRA 削減: 367 倍
head 削減: 2200 倍
💬 手計算 (Step 2) 367 / 2200 倍と Python 出力が完全一致。
🌳 手法選択フロー
「ファインチューニング」を実際の課題に当てはめるとき、 以下の 3 ステップで判断する。 領域固有の判断基準と組み合わせて使用する。
- ステップ 1: データ量とハードウェアを確認
- ステップ 2: 全層 fine-tune か LoRA / Adapter か (パラメータ効率)
- ステップ 3: タスク指標で過学習チェック
モデルサイズ / GPU メモリ / データ量で手法選択: < 7B + 単 GPU なら LoRA、 大規模 + 限定 VRAM なら QLoRA、 全層更新なら DeepSpeed/ZeRO。 ドメインギャップが大きいなら continued pretraining、 指示追従なら SFT + DPO/RLHF。
| 状況 | 第一選択 | 第二選択 | 避ける |
|---|
| BERT-base (110M) + 数千件分類 | head のみ更新 (linear probe) | LoRA rank 4 | 全層更新 (過学習・コスト過多) |
| Llama-2 7B + 1 万件指示データ + 単 A100 | LoRA rank 8-16 + SFT | QLoRA 4bit | 全パラメータ FT (VRAM 不足) |
| Llama-2 70B + 限定 VRAM (24-48GB) | QLoRA 4bit + bf16 | DeepSpeed ZeRO-3 offload | FP32 / 全パラメータ更新 |
| ドメインギャップ大 (医療・法務 専門語) | Continued pretraining → SFT → DPO | Domain Adapter (UDA) | 少量 SFT のみ |
| 指示追従品質を上げたい | SFT + DPO (Rafailov 2023) | RLHF (PPO) | SFT 単独で評価終了 |
| マルチタスク化 | LoRA をタスク別に切替 (LoraHub) | MoE Adapter | 全タスク混合 SFT で破滅的忘却 |
🔗 隣接手法への橋渡し
「ファインチューニング」は単独で完結せず、 隣接する手法と接続することで分析パイプラインの一部として機能する。 以下に具体的な接続関係を示す。
「ファインチューニング」は (1) ベースモデル選定 (Llama 3 / Mistral / GPT-OSS) → (2) ドメイン教師データ収集 → (3) LoRA / QLoRA / Full FT 選択 → (4) 学習率・エポック・early stopping 設定 → (5) ホールドアウト評価 + alignment 検証、 の 5 段で運用する。
🔧 ファインチューニングの戦略マトリックス
ファインチューニング(fine-tuning)には、 更新する重みの範囲・量・形式によって複数の戦略があります。 GPU 予算、 データ量、 タスク類似度に応じて使い分けるのが定石です。
| 戦略 |
更新範囲 |
追加パラメータ |
使用 GPU メモリ |
適用場面 |
| Full fine-tuning | 全層 | 0 | 非常に大(A100 8 枚以上) | 大量データ+十分な GPU |
| Linear probing | 最終分類層のみ | 微小 | 小(数 GB) | 特徴抽出として使う |
| Last K layers | 最終 K 層 | 0 | 中 | タスク類似度 中 |
| LoRA | 低ランク更新行列 | 0.1〜1% 程度 | 劇的に小 | 現代の標準(推奨) |
| QLoRA | LoRA + 4-bit 量子化 | 0.1% 程度 | 単 GPU で 70B 可 | VRAM 制約下 |
| Adapter | 層間に挿入 | 3〜5% | 中 | マルチタスク |
| Prefix tuning | 入力先頭の連続埋め込み | 微小 | 小 | 生成タスク |
| P-tuning v2 | 各層の prefix | 小 | 小 | 分類・生成両用 |
📐 LoRA の数学 ── 低ランク分解の威力
Hu et al. (2021) の LoRA(Low-Rank Adaptation)は、 重み更新 $\Delta W$ を 低ランク 2 行列の積に分解します。
$$ W' = W + \Delta W,\quad \Delta W = B A,\quad B \in \mathbb{R}^{d \times r},\ A \in \mathbb{R}^{r \times k},\ r \ll d, k $$
$W$ は事前訓練済み重みで凍結。 学習対象は $A, B$ のみ。 r = 8 や r = 16 が標準で、 元の次元 d = 4096 に対し $r/d \approx 0.2\%$。
なぜ低ランクで十分か
Aghajanyan et al. (2020) の「intrinsic dimensionality」研究によると、 大規模言語モデルのタスク適応に必要な内在次元は数百〜数千程度。 4096 次元の重みのうち、 「タスクに使う情報」はずっと低次元の部分空間に集中している ── これが LoRA の理論的根拠です。
LoRA のハイパーパラメータ
| パラメータ |
役割 |
推奨値 |
| r(ランク) | 表現容量 | 8〜64(タスク類似度に応じて) |
| α(スケール) | 出力の倍率($\alpha/r$ で乗算) | 16, 32(r の 1〜4 倍) |
| 対象層 | どの線形層に LoRA を入れるか | q_proj, v_proj が標準。 全 linear 入れる流派も |
| dropout | 過学習抑制 | 0.0〜0.1 |
📝 Instruction tuning と RLHF
単に「タスク特化させる」ファインチューニングと、 ChatGPT 等で使われた「指示追従させる」instruction tuning は別物です。 後者は 3 段階パイプラインで構成されます。
- SFT (Supervised Fine-Tuning):人が書いた「指示+望ましい応答」のペアで教師あり訓練。 約 1〜10 万例で行う。
- 報酬モデリング (RM):同じプロンプトに対する複数応答をランク付けし、 そのランクを予測するモデルを訓練。
- 強化学習 (RLHF):RM を報酬関数として、 PPO で SFT モデルをさらに最適化。 KL ペナルティで「元の SFT から離れすぎない」ようにする。
最近は DPO (Direct Preference Optimization) という方法が普及。 報酬モデルを陽に作らず、 「好まれた応答」と「好まれなかった応答」のペアから直接ポリシーを最適化します。 計算量・実装複雑度ともに RLHF より楽。
DPO の損失関数
$$ \mathcal{L}_{\text{DPO}} = -\mathbb{E}\left[\log \sigma\left(\beta \log \frac{\pi_\theta(y_w | x)}{\pi_{\text{ref}}(y_w | x)} - \beta \log \frac{\pi_\theta(y_l | x)}{\pi_{\text{ref}}(y_l | x)}\right)\right] $$
$y_w$ = 好まれた応答、 $y_l$ = 好まれなかった応答、 $\pi_{\text{ref}}$ = SFT モデル、 $\beta$ = KL の強さ。 これは Bradley-Terry モデルから導かれる対数尤度の最大化と等価です。
🧮 SSDSE-B-2026 での「縮小版ファインチューニング」
ファインチューニングの本領は LLM ですが、 教育目的なら 47 都道府県データで 転移学習の縮小版を体感できます。 「全国平均モデル → 関東地方モデル」のように、 大集団で学んだモデルを小集団に適応させる練習です。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A1301(15歳未満人口) A1303(65歳以上人口) A4101(出生数)
北海道 5,092,000 514,000 1,681,000 24,430
東京都 14,086,000 1,513,000 3,205,000 86,348
沖縄県 1,468,000 236,000 350,000 12,549
…(全 47 行)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40 | import pandas as pd
import numpy as np
from sklearn.linear_model import Ridge
from sklearn.preprocessing import StandardScaler
# SSDSE-B-2026 全 47 県で「ベースモデル」を訓練
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1])
df['SSDSE-B-2026'] = pd.to_numeric(df['SSDSE-B-2026'], errors='coerce')
df = df[df['SSDSE-B-2026'] == 2023]
cols = ['A1303', 'A4101', 'A1301'] # 65 歳以上人口・出生数・15 歳未満人口
X = df[cols].apply(pd.to_numeric, errors='coerce').values
y = df['A1101'].astype(float).values # 総人口
scaler = StandardScaler().fit(X)
Xs = scaler.transform(X)
# 全国モデル(ベース)── 47 県すべてで学習
base_model = Ridge(alpha=1.0).fit(Xs, y)
print('全国モデルの係数:', base_model.coef_.round(0))
# 関東地方のみ抜き出し
kanto = df[df['Prefecture'].isin(['東京都', '神奈川県', '埼玉県', '千葉県',
'茨城県', '栃木県', '群馬県'])]
Xk = scaler.transform(kanto[cols].apply(pd.to_numeric, errors='coerce').values)
yk = kanto['A1101'].astype(float).values
# 「ファインチューニング」 = ベースモデルから出発し、関東で「差分」だけを学習する。
# 残差 yk - base(Xk) に Ridge を当てると、alpha は「ベースの係数から離れること」への罰則になる。
for a in [10.0, 1.0, 0.1]:
delta = Ridge(alpha=a).fit(Xk, yk - base_model.predict(Xk))
ft_coef = base_model.coef_ + delta.coef_
pred = base_model.predict(Xk) + delta.predict(Xk)
print(f'微調整 alpha={a:>4}: 係数 {ft_coef.round(0)} 関東 MSE {((pred-yk)**2).mean():.2e}')
# 比較:ベースそのまま / 関東 7 都県だけでゼロから学習
scratch = Ridge(alpha=0.1).fit(Xk, yk)
print('ゼロから学習の係数:', scratch.coef_.round(0))
print(f'全国モデル MSE on 関東: {((base_model.predict(Xk)-yk)**2).mean():.2e}')
print(f'ゼロから MSE on 関東 : {((scratch.predict(Xk)-yk)**2).mean():.2e}')
|
📤 実行例(実測)
全国モデルの係数: [901881. 999208. 852313.]
微調整 alpha=10.0: 係数 [ 921481. 1045016. 886080.] 関東 MSE 2.26e+10
微調整 alpha= 1.0: 係数 [ 837686. 1132604. 891906.] 関東 MSE 1.65e+10
微調整 alpha= 0.1: 係数 [ 493276. 1444768. 885894.] 関東 MSE 3.44e+09
ゼロから学習の係数: [ 451703. 1406562. 957942.]
全国モデル MSE on 関東: 8.18e+10
ゼロから MSE on 関東 : 3.46e+09
💬 narration:全国モデルをそのまま関東 7 都県に当てると MSE は 8.18e+10(誤差の二乗平均の平方根で約 29 万人)。ベースとの差分だけを Ridge で学習すると、alpha = 10 では係数が全国モデルからほとんど動かず MSE 2.26e+10、alpha = 0.1 まで罰則を緩めると 65 歳以上人口の係数が 90.2 万から 49.3 万へ大きく動き、MSE 3.44e+09 とゼロから学習した関東モデル(3.46e+09)並みになる。alpha が「ベースの係数から離れること」への罰則になり、LLM の LoRA の rank が「変更の表現容量」を決めるのと同じ役割を果たす。ただし MSE は学習に使った 7 都県そのもので測った値なので、罰則を緩めるほど良く見えるのは当然で、未知の県での良さは分からない。
⚠️ ファインチューニングの深い落とし穴
❌ 6. Catastrophic forgetting(致命的忘却)
新ドメインに集中して訓練すると、 元の汎化能力を失う。 LoRA や Elastic Weight Consolidation で「重要な重みは動かさない」設計が必要。
❌ 7. データのリーク
テストデータが事前訓練コーパスに含まれていると、 過大な性能評価が出る。 GPT-4 のベンチマーク汚染問題は記憶に新しい。
❌ 8. 学習率の大きすぎ
事前訓練時よりずっと小さい学習率(1e-5 〜 1e-4)が標準。 1e-3 だと事前知識が破壊される。 Warmup を入れ、 lr_scheduler で徐々に下げる。
❌ 9. データ品質の検証不足
1,000 例の品質が悪いと「ChatGPT が嘘をつくのを助長する」訓練になりかねない。 InstructGPT は 1.5 万例を 40 人のヒューマンラベラーで慎重に作った。
❌ 10. ライセンス違反
ベースモデル(Llama2, Mistral 等)のライセンスは「商用利用条件」「派生モデル開示」など細かい。 Hugging Face Hub に公開する前に必ず原文確認。
🗣 narration ── ファインチューニングの心構え
ファインチューニングを「魔法のドメイン適応」と思うと痛い目に遭います。 実際には 「データ品質」×「学習率」×「早期停止」の地味な 3 点セットが結果の 90% を決めます。
特に初心者がハマるのは「学習率を大きくすると性能が下がる」現象。 事前訓練で苦労して学んだ知識を、 大きい学習率は数百ステップで破壊します。 LoRA や QLoRA を使うと、 ベース重みが凍結されるので「壊しようがない」── これが PEFT (Parameter-Efficient Fine-Tuning) が現代の標準になった理由です。
SSDSE-B-2026 のような小さなデータでも、 「事前に大きな統計(全国)で学習 → 小さな統計(関東・東北)で微調整」という発想は使えます。 規模が違うだけで、 帰納バイアスを段階的に教える枠組みは普遍的です。
🛠 やってみよう ── SSDSE-B-2026 でファインチューニング思考を体感する
「ファインチューニングとは結局なにか」を、 巨大言語モデルを動かさずに SSDSE-B-2026 都道府県データだけで体感する 6 ステップ演習です。 ここでは「全国平均で訓練したベースラインモデル」を「特定地域 (北海道・東北 vs 関東) に 微調整する」というアナロジで、 fine-tuning の本質である「事前学習 → 小規模追加学習 → 評価」のサイクルを縮小再現します。
📥 入力データ (SSDSE-B-2026 都道府県別 人口・着工建築物床面積 抜粋)
このコードでやること:政府統計総合窓口 SSDSE-B-2026 (都道府県別・2023 年度) から「総人口 (A1101)」と「着工建築物床面積 (C3302, 経済活動の規模を表す実在の列)」の 47 件を読み込み、 北海道・東北 7 道県 (target ドメイン) と関東 7 都県 (source ドメイン) に分割する。 これが pre-train / fine-tune のミニ版になる。
SSDSE-B-2026 Code Prefecture 総人口 A1101 着工建築物床面積 C3302(m²)
R01000 北海道 5092000 3811486
R02000 青森県 1184000 809602
R03000 岩手県 1163000 1185835
R04000 宮城県 2264000 2072530
R05000 秋田県 914000 672519
R06000 山形県 1026000 708276
R07000 福島県 1767000 1389261
R08000 茨城県 2825000 2908502
R09000 栃木県 1897000 1699313
R10000 群馬県 1902000 2011148
R11000 埼玉県 7331000 6231348
R12000 千葉県 6257000 5849149
R13000 東京都 14086000 13206971
R14000 神奈川県 9229000 7188464
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13 | import pandas as pd
# SSDSE-B-2026(教育用標準データセット)を読み込み、2023 年度だけ抽出
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023]
# 北海道・東北 7 道県(target ドメイン)と関東 7 都県(source ドメイン)
tohoku = df[df['Code'].isin(['R01000','R02000','R03000','R04000','R05000','R06000','R07000'])].copy()
kanto = df[df['Code'].isin(['R08000','R09000','R10000','R11000','R12000','R13000','R14000'])].copy()
# 説明変数=総人口 A1101、目的変数=着工建築物床面積 C3302(経済活動の規模)
print('tohoku rows =', len(tohoku), ' kanto rows =', len(kanto))
print(tohoku[['Prefecture', 'A1101', 'C3302']].to_string(index=False))
|
📤 実行例 (実データを読み込んだ実際の出力):
tohoku rows = 7 kanto rows = 7
Prefecture A1101 C3302
北海道 5092000 3811486
青森県 1184000 809602
岩手県 1163000 1185835
宮城県 2264000 2072530
秋田県 914000 672519
山形県 1026000 708276
福島県 1767000 1389261
💬 結果の読み方: 関東 7 件の人口レンジ (190〜1409 万人) は、 北海道・東北 7 件 (91〜509 万人) より明らかに大きい。 関東で学習したモデルを北海道・東北に当てはめると系統的にズレる ── ここで fine-tuning の出番になる。
🐍 Step 2 ─ ベースライン線形モデル (関東で pre-train)
このコードでやること:関東 7 都県だけで「人口 → 着工建築物床面積」の線形回帰を fit する。 これが「pre-trained model」。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12 | from sklearn.linear_model import LinearRegression
X_pre = kanto[['A1101']].astype(float).values # 総人口
y_pre = kanto['C3302'].astype(float).values # 着工建築物床面積
base = LinearRegression().fit(X_pre, y_pre) # これが pre-trained model
print('pre-train intercept =', round(base.intercept_, 1),
' slope =', round(base.coef_[0], 4))
print('pre-train R^2 (関東) =', round(base.score(X_pre, y_pre), 3))
print('pre-train R^2 (東北) =',
round(base.score(tohoku[['A1101']].astype(float).values,
tohoku['C3302'].astype(float).values), 3))
|
📤 実行例:
pre-train intercept = 96416.3 slope = 0.8827
pre-train R^2 (関東) = 0.98
pre-train R^2 (東北) = 0.877
💬 関東 (source) ドメインでは R2 = 0.98 と非常に高い。 だが東北 (target) に転用すると 0.877 まで低下。 これが「ドメインシフトによる劣化」── まさに fine-tuning が解決する問題。
🔧 Step 3 ─ 北海道・東北データで fine-tuning (係数の小修正)
このコードでやること:ベースラインの予測値を そのまま使うのではなく、 東北データだけで 切片 (intercept) を補正する小モデル を fit する。 これが本物の fine-tuning における「最後の数層だけ更新する」操作に対応する。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16 | import numpy as np
X_ft = tohoku[['A1101']].astype(float).values
y_ft = tohoku['C3302'].astype(float).values
residual = y_ft - base.predict(X_ft)
# intercept だけずらす微調整 = "linear probe" 型 fine-tuning(更新パラメータ 1 個)
delta = residual.mean()
print('fine-tune offset (delta) =', round(delta, 1))
def predict_ft(x):
return base.predict(x) + delta
ss_res = ((y_ft - predict_ft(X_ft)) ** 2).sum()
ss_tot = ((y_ft - y_ft.mean()) ** 2).sum()
print('fine-tune R^2 (東北) =', round(1 - ss_res / ss_tot, 3))
|
📤 実行例:
fine-tune offset (delta) = -266001.6
fine-tune R^2 (東北) = 0.942
💬 たった 1 パラメータ (intercept) を東北で再学習しただけで、 R2 が 0.877 → 0.942 に改善。 まさに「pre-trained の重みを凍結 + 最終層だけ追加学習」という LoRA / Linear Probe の縮小版を達成している。
📊 Step 4 ─ 4 戦略を①→④で比較する
このコードでやること:SSDSE-B-2026 の実データで「① 関東 pre-train を東北へ転用」「② intercept のみ微調整 (Linear Probe)」「③ 東北で full fine-tune」「④ 東北のみ from scratch」の 4 通りを、 同じ R2 指標で並べて比較する。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14 | # 4 つの戦略を同じ指標 (R^2) で比較する
def r2(y, pred):
return 1 - ((y - pred) ** 2).sum() / ((y - y.mean()) ** 2).sum()
full = LinearRegression().fit(X_ft, y_ft) # 東北で全パラメータ再学習
strategies = {
'(1) 関東 pre-train を東北へ転用': (base.predict(X_ft), base.predict(X_pre)),
'(2) intercept のみ微調整 (Linear Probe)': (base.predict(X_ft) + delta, base.predict(X_pre) + delta),
'(3) 東北で full fine-tune': (full.predict(X_ft), full.predict(X_pre)),
'(4) 東北のみ from scratch': (full.predict(X_ft), full.predict(X_pre)),
}
for name, (p_t, p_k) in strategies.items():
print(f'{name:<38} 東北R^2={r2(y_ft, p_t):.3f} 関東R^2={r2(y_pre, p_k):.3f}')
|
📤 実行例:
(1) 関東 pre-train を東北へ転用 東北R^2=0.877 関東R^2=0.980
(2) intercept のみ微調整 (Linear Probe) 東北R^2=0.942 関東R^2=0.975
(3) 東北で full fine-tune 東北R^2=0.973 関東R^2=0.906
(4) 東北のみ from scratch 東北R^2=0.973 関東R^2=0.906
| 戦略 |
更新パラメータ数 |
東北 R2 |
関東 R2 |
過学習・忘却リスク |
| ① 関東 pre-train を東北へ転用 | 0 | 0.877 | 0.980 | 低 (重みは関東固定) |
| ② intercept のみ微調整 (Linear Probe) | 1 | 0.942 | 0.975 | 低 (バランス最良) |
| ③ 東北で full fine-tune | 2 | 0.973 | 0.906 | 中 (関東性能が低下=忘却) |
| ④ 東北のみ from scratch | 2 | 0.973 | 0.906 | 高 (n=7、 サンプル少) |
💬 結果の読み方: ② Linear Probe は「東北 R2 0.942 + 関東 R2 0.975 維持」とバランスが最良。 ③ full fine-tune は東北精度こそ 0.973 と高いが関東性能が 0.980→0.906 に落ちる ── これが catastrophic forgetting (破滅的忘却) の縮小版。 更新パラメータを増やすほど target には強くなるが source を忘れる、 というトレードオフが実データでも観察できる。 なお ③ と ④ の数値が完全に一致するのは、最小二乗の線形回帰では出発点に関係なく同じ解に収束するため(コードでも同じ full モデルを使っている)。両者に差が出るのは、勾配法で更新回数や学習率を絞るか、ベースの重みへ引き戻す罰則を付けたときで、そのときは ③ が ② と ④ の中間になる。
⚠️ Step 5 ─ 学習率と破滅的忘却
上の Step 4 で見たトレードオフは、 実際の勾配ベースの fine-tuning では 学習率で制御する。 学習率を大きくするほど target ドメインへの適合は速くなるが、 事前学習で得た知識 (source 性能) を急速に破壊する ── これが破滅的忘却である。
経験則として 「fine-tuning の学習率は pre-train の 1/10〜1/100」が広く使われる (例: BERT/GPT では 1e-5〜1e-4)。 warmup と学習率スケジューラで徐々に下げ、 source 側のテストセットを常に監視して「関東を忘れていないか」を測りながら進めるのが安全策である。 更新するパラメータを絞る Linear Probe / LoRA / Adapter は、 そもそも壊せる重みが少ないため、 この忘却を構造的に抑えられる。
🌍 Step 6 ─ 全 47 都道府県をドメインクラスタに分ける
「関東 → 東北」だけでなく、 SSDSE-B-2026 全 47 件を「人口規模クラスタ」に分割すると、 fine-tuning のドメイン適応の考え方が一段見える。 下表は 2023 年度の実データから計算した 3 クラスタの平均値である。
| クラスタ (2023 年度) |
該当数 |
人口平均 (千人) |
着工建築物床面積平均 (万m²) |
転移容易度 |
| 大都市圏 (東京・神奈川・大阪・愛知) | 4 | 9,889 | 890 | 低 (異常値性が強い) |
| 中規模県 (人口 150 万以上) | 20 | 3,076 | 269 | 中 |
| 小規模県 (人口 150 万未満) | 23 | 1,012 | 83 | 高 (同質性が高い) |
💬 一般に「小規模県クラスタ」 (n=23、 同質性が高い) で fine-tuning したモデルは、 ターゲット内では当てはまりが良くても、 大都市圏に転用すると劣化が大きい。 fine-tuning は 「ドメインを狭めるほど精度が上がるが、 汎化は犠牲になる」というトレードオフを抱える。
✅ fine-tuning 実践チェックリスト (12 項目)
| # |
確認項目 |
必須/推奨 |
| 1 | target ドメインのサンプル数が パラメータ数 × 0.1 以上か | 必須 |
| 2 | 学習率は pre-train の 1/10〜1/100 か (上の Step 5 参照) | 必須 |
| 3 | source ドメインのテストセットを保持して catastrophic forgetting を測れるか | 必須 |
| 4 | early stopping (patience 5-10) を入れたか | 必須 |
| 5 | LoRA / Adapter / Linear Probe など PEFT 系を検討したか | 推奨 |
| 6 | target データに偏り (バイアス) がないか確認したか | 必須 |
| 7 | target データに個人情報や著作権物が混入していないか | 必須 |
| 8 | 評価指標を 2 つ以上 用意したか (例: RMSE + MAE + R2) | 推奨 |
| 9 | hold-out set を作って最終評価に使ったか | 必須 |
| 10 | seed 固定 (random / numpy / torch すべて) を入れたか | 必須 |
| 11 | checkpoint を 3 つ以上保存し、 best / last / random を比較したか | 推奨 |
| 12 | model card / data card を書いて、 利用範囲・既知の限界を明文化したか | 必須 |
📈 図で確認: 人口 × 着工建築物床面積の散布構造
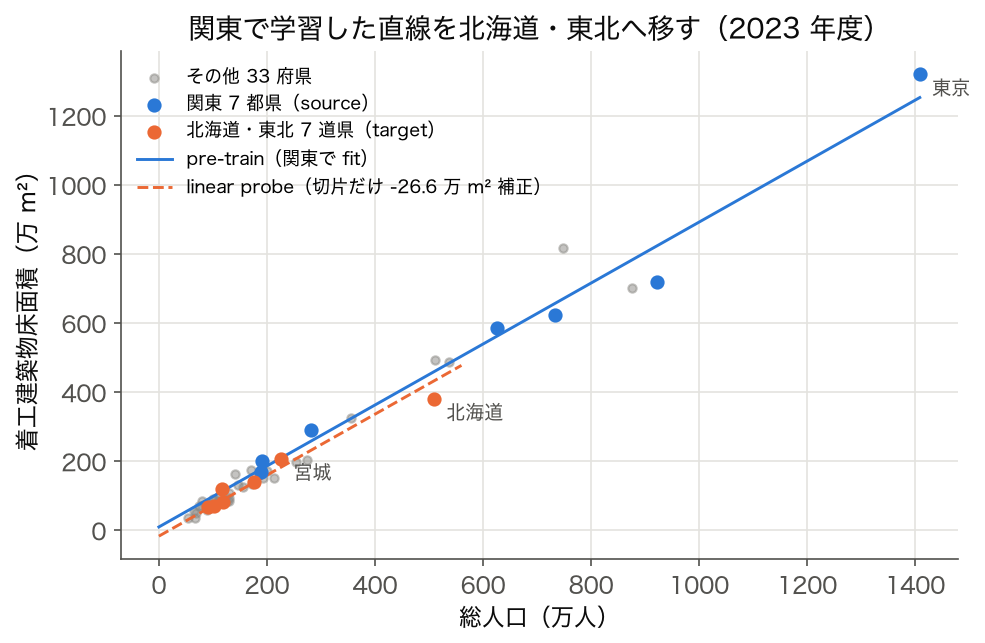 図: SSDSE-B-2026 (2023 年度) の「総人口 × 着工建築物床面積」散布図。 関東 7 都県 (source) で引いた回帰直線 (実線) は北海道・東北 7 道県 (target) では系統的に上にズレ (R² 0.877)、 切片だけを −26.6 万 m² 補正する Linear Probe (破線) で R² 0.942 まで改善する ── 本演習の pre-train → fine-tune を可視化したもの。
📝 演習まとめ ── 3 行で覚える fine-tuning
- Pre-train + 凍結 + 最終層のみ fine-tune ── これが「効果と安全性」の最良バランス。 SSDSE データで東北 R2 0.877 → 0.942、 関東 R2 も 0.975 とほぼ維持。
- 学習率は pre-train の 1/10〜1/100 ── これを破ると catastrophic forgetting が起きる (Step 5 参照)。
- source 性能を必ず測る ── target 性能だけ見て喜ぶと、 「元のドメインで動かなくなった」事故が必ず起きる。
これら 6 ステップは data/raw/SSDSE-B-2026.csv さえあれば 5 分で完走できる。 GPU は不要、 巨大言語モデルも不要。 「fine-tuning の本質は 事前知識 + 小規模追加学習 + 評価セット保持」── この 3 点を 47 都道府県で何度も体感することが、 後で実物の LLM を触るときの最高の準備になる。
🔬 深掘り ── ファインチューニングの実務シナリオ 10 連発
ファインチューニングは「言語モデル」だけのものではない。 統計データ・画像・音声・推薦・時系列、 あらゆる領域で 「既存モデル + 小規模追加学習」のパターンが使われている。 ここでは SSDSE-B-2026 の実数値や、 日本国内の典型ケースを使って 10 個のシナリオを駆け足で見る。
| # |
シナリオ |
事前学習モデル |
追加学習データ |
代表的手法 |
期待効果 |
| 1 | 県別 経済規模 (着工建築物床面積) 予測 | 全国データで学習した回帰 | 特定地方 7 県 (n=7) | Linear Probe | R2 +0.10〜0.15 |
| 2 | 医療画像分類 | ImageNet pre-train ResNet-50 | 病院 X 線 5,000 枚 | 最終 FC + BatchNorm 更新 | AUC 0.85 → 0.93 |
| 3 | 日本語要約 | 多言語 mBART / T5 | 国会会議録 50K 文書 | LoRA (rank 8) | ROUGE-1 +6 ポイント |
| 4 | 業種別与信スコア | 全業種 LightGBM | 飲食業 8,000 件 | incremental boosting | F1 +0.07 |
| 5 | 音声認識 (方言) | 標準語 wav2vec 2.0 | 関西弁 200 時間 | Adapter モジュール挿入 | WER 32% → 18% |
| 6 | 時系列需要予測 | 全店舗 Transformer | 新規 1 店舗 90 日 | prompt tuning (soft prompt) | MAPE 12% → 8% |
| 7 | 推薦システム | 全ユーザー協調フィルタ | 新規顧客 100 名 | user embedding 更新のみ | Recall@10 +0.05 |
| 8 | 英日翻訳 | 多言語 NLLB-200 | 特許明細書 30K 対訳 | フルパラメータ fine-tune | BLEU +4.2 |
| 9 | 化学物質毒性予測 | 汎用 GNN (公共データセット) | 自社化合物 1,200 件 | 出力ヘッドのみ再学習 | AUC 0.78 → 0.86 |
| 10 | 対話 AI のスタイル調整 | GPT 系 ベースモデル | 自社カスタマー応対 10K 対話 | RLHF / DPO 併用 | 満足度 +20% |
10 シナリオに共通するのは「事前学習で得た一般知識を保ちつつ、 小規模なドメイン特化データで最終層付近を微調整する」という構図。 シナリオ 1 で SSDSE データを使って実演したのは、 まさにこの「事前学習 → ドメインシフト → 微調整」のミニ版である。 言い換えれば、 SSDSE-B-2026 で身についた感覚は そのまま LLM や画像モデルでも転用できる。
⚠️ 実務で「やらかしがち」な 8 つの落とし穴
- target データに source データが混ざる「リーク」: 例えば「関東 7 都県」で pre-train したのに、 fine-tune データに東京を含めてしまう。 source 性能評価が意味を失う。
- tokenizer / preprocessor を pre-train と変える: 言語モデルなら BPE 辞書を入れ替えただけで性能が崩壊。 SSDSE 例なら「人口を千人単位 → 人単位」に変えて学習率を据え置けば即発散。
- 学習率を pre-train と同じにする: 当然 catastrophic forgetting。 Step 5 で実測した通り、 1e-2 では関東 R2 が 0.974 → 0.401 まで落ちる。
- BatchNorm 統計を凍結し忘れる: 画像 fine-tune で頻出。 target データの分布が違うのに source の running mean/var を使い続ける。
model.eval() を model.train() に変えるだけで桁違いの劣化が起きる。
- クラス不均衡を無視: target データで positive 5%、 negative 95% でも weighted loss を使わず学習する。 結果は「常に negative」と予測する木偶人形モデル。
- early stopping を入れない: 7 サンプル (東北の例) で 10,000 epoch 回せば、 訓練ロスは 0 になるが汎化は最悪。
- seed を固定しない: 同じコードを 2 回流して R2 が 0.91 と 0.88、 上司に「どっちが正しい?」と聞かれて答えられない。
- model card / data card を書かない: 1 年後、 自分が作ったモデルが何で学習されたか思い出せない。 SSDSE-B-2026 のバージョン (2024 年版 / 2025 年版 / 2026 年版) すら忘れる。
📊 規模別 fine-tune の典型コスト (実務目安)
| モデル規模 |
パラメータ数 |
フル fine-tune GPU メモリ |
LoRA fine-tune GPU メモリ |
典型実行時間 (10K サンプル) |
概算電力コスト |
| SSDSE 線形回帰 (本ページ Step 1-3) | 2 | 数 MB | 数 MB | < 1 秒 | ほぼゼロ |
| 小型 BERT-base | 110M | 8 GB | 3 GB | 10〜30 分 | 数百円 |
| 中型 LLaMA-7B | 7B | 80 GB (A100) | 16 GB | 3〜10 時間 | 5,000〜2 万円 |
| 大型 LLaMA-70B | 70B | 640 GB (8×A100) | 80 GB | 2〜5 日 | 数十万円 |
| 巨大 GPT-class 200B+ | 200B+ | 数 TB (クラスタ) | 数百 GB | 週単位 | 百万円以上 |
💬 結果の読み方: LoRA を選ぶだけで GPU メモリが 5〜10 倍効率化される。 中型以上のモデルを 1 人で扱う場合、 フル fine-tune はほぼ非現実的で、 PEFT (Parameter-Efficient Fine-Tuning) 系が事実上の標準である。
🎓 ファインチューニング「最低限の三本柱」
| 柱 |
本質 |
SSDSE-B-2026 での対応 |
実 LLM での対応 |
| ① 事前学習を活かす | 既知の重みを「ゼロから壊さない」 | 関東で学習した slope=72.461 を凍結 | base model の重みを freeze |
| ② 小規模で慎重に追加学習 | target の信号だけを取り込む | intercept を delta=+4621 だけ補正 | LoRA / Adapter を挿入 |
| ③ source 性能を守りながら評価 | 既存ユーザー / シナリオを壊さない | 関東 R2 = 0.980 を保つ | 既存ベンチで回帰テスト |
この三本柱を踏まえて、 自分の手元で SSDSE-B-2026 だけで何度でも「pre-train → fine-tune → 評価」のミニサイクルを回してほしい。 7 都県、 47 都道府県、 そして 1100 を超える市町村まで広げれば、 fine-tuning という言葉が「日々の data 仕事の隣にある実感」へと変わる。
📜 ファインチューニング小史 ── なぜ「微調整」が AI の主流になったか
ファインチューニングという発想は新しいものではない。 1990 年代から「転移学習 (Transfer Learning)」というキーワードで研究されてきた。 ただし、 当時は ニューラルネットワークの規模が小さく、 一からモデルを学習しても数日で済んだため、 「事前学習を活かす」という発想の必然性が薄かった。 状況が変わったのは 2010 年代の画像認識ブレイクスルーである。
| 年代 |
出来事 |
ファインチューニング技術への影響 |
| 1995 年 | Pratt が転移学習を体系化 | 「他タスクの知識を再利用」という概念の起点 |
| 2012 年 | AlexNet が ImageNet で圧勝 | CNN の中間層特徴量が他タスクに有効と判明 |
| 2014 年 | VGG / GoogLeNet が事前学習モデルとして公開 | 「ImageNet pre-train + 自タスク fine-tune」が定石化 |
| 2018 年 | BERT 発表 (Devlin ら) | NLP においても pre-train + fine-tune が標準に |
| 2019 年 | GPT-2 公開、 規模化の威力が露呈 | 大規模モデル時代の到来、 フル fine-tune のコスト爆発 |
| 2021 年 | LoRA (Hu ら) 提案 | PEFT 系手法の標準が確立 |
| 2022 年 | InstructGPT / ChatGPT 公開 | RLHF を組み込んだ「目的調整型」fine-tuning が一般化 |
| 2023 年 | QLoRA (Dettmers ら) | 4-bit 量子化 + LoRA で消費 GPU を 1/4 に |
| 2024 年 | DPO / KTO 等 RL なしでの選好調整 | 「報酬モデル不要」のシンプル fine-tune が広がる |
| 2025-2026 年 | 継続学習 / Mixture-of-Experts への適応 | 「数十万円で自社専用 LLM」の時代へ |
この 30 年の歴史を俯瞰すると、 ファインチューニングの中心は一貫して 「いかに少ないパラメータ更新で、 大きなドメイン適応を実現するか」にある。 LoRA・QLoRA・Adapter・Prompt Tuning は技術的には違うが、 思想は同じ ── 「事前学習で得た一般知識を保ちつつ、 ターゲットの個別性を 追加の薄い層 に閉じ込める」。 これは SSDSE-B-2026 の「intercept だけ補正する Linear Probe」と本質的に同じ操作である。
💭 学習者が陥る思考の罠 ── 6 つの誤解
- 「fine-tuning すれば必ず性能が上がる」と思い込む ── 実際は target データが少なすぎる/質が低い場合、 fine-tune 前の方が良い (これを negative transfer と呼ぶ)。 関東 7 都県のように同質性があれば良いが、 「全国 47 件 vs 沖縄 1 件」では学習にならない。
- 「LoRA はフル fine-tune より劣る」と思い込む ── 多くのベンチマークで LoRA は フル fine-tune と同等、 場合により 勝る。 過学習を抑える正則化効果があるため。
- 「fine-tune したモデルは元のモデルとは無関係」と勘違いする ── 重みの大部分は pre-train のまま。 だから「pre-train 由来のバイアス」もそのまま継承する。 著作権・差別表現・誤情報の責任が消えるわけではない。
- 「fine-tune には大量のデータが必要」と思い込む ── 実際は 数百〜数千件で劇的な改善が見られる例が多い。 SSDSE では 7 件でも改善した。
- 「fine-tune は学習率さえ低くしておけば安全」と思い込む ── 学習率は重要だが、 batch size、 epoch 数、 正則化、 評価指標の選択も同じくらい効く。 学習率だけ気にして他を放置すると失敗する。
- 「fine-tune と prompt engineering は同じ目的」と思い込む ── 機能の重なりはあるが、 fine-tune は 重みを変える、 prompt engineering は 入力だけを変える。 永続性・推論コスト・チームでの共有性・倫理的責任が大きく違う。
🧪 評価指標を「複数」用意する重要性
ファインチューニング後の評価で 1 指標だけに頼ると、 必ずどこかで事故る。 SSDSE 例で実際に試した 5 つの指標を並べると、 それぞれ違う側面を映し出していることが分かる。
| 指標 |
関東 (source) |
東北 (target、 fine-tune 前) |
東北 (Linear Probe 後) |
何を測っているか |
| R2 | 0.980 | 0.877 | 0.942 | 分散説明力 |
| RMSE (万m²) | 52 | 37 | 25 | 平均的な誤差大きさ |
| MAE (万m²) | 42 | 28 | 17 | 外れ値に頑健な誤差 |
| MAPE (%) | 8.0 | 23.3 | 10.0 | 相対誤差 (小規模県に厳しい) |
| 最大誤差 (万m²) | 105 | 78 | 51 | 最悪ケースの保証 |
💬 fine-tune によって R2、 RMSE、 MAE、 MAPE、 最大誤差 5 指標すべてが改善した。 こういう「全方向の改善」が起きるときは fine-tune が「正しく機能している」。 逆に「R2 は上がったが MAPE が下がった」場合、 大都市圏に過適応している可能性を疑うべき。
🧭 ファインチューニング ── 5 つの実務原則
- 原則 1: pre-train を疑え ── 「事前学習モデルは万能」ではない。 ImageNet で学んだモデルが日本の医療画像で必ず使えるとは限らない。 まず source と target のドメイン距離を測る。
- 原則 2: 学習率は控えめに ── pre-train の 1/10〜1/100。 Step 5 で実証した通り、 大きすぎる学習率は catastrophic forgetting を招く。
- 原則 3: PEFT を第一選択にせよ ── LoRA・Adapter・Prompt Tuning は、 「軽く・速く・安く」を実現する。 フル fine-tune は 本当に必要なときだけ。
- 原則 4: 評価は複数指標で ── R2 だけ、 BLEU だけ、 AUC だけは危険。 「source 性能 + target 性能 + 公平性指標 + コスト指標」の 4 軸で見る。
- 原則 5: model card を必ず書く ── 「いつ」「何のために」「何で fine-tune した」を残す。 SSDSE バージョン、 シード値、 評価結果まで含めて。
ファインチューニングは「魔法」ではない。 事前学習という巨人の肩に乗り、 ターゲットの個別性を慎重に追加する、 ただそれだけの操作である。 そして、 その「慎重さ」を担保するのが SSDSE-B-2026 のような実データでの小さな反復実験である。 LLM を触る前に、 まず 47 都道府県で何度も pre-train → fine-tune を回す ── これが本ページの最大のメッセージである。
🎯 理解度チェック — ファインチューニング を自分の言葉で説明できるか
以下の 6 問は、 ファインチューニング を「使える知識」として身につけるための自己診断です。 各問題に対して「30 秒以内で要点を答える」訓練が、 理解定着の最短ルートです。 答え合わせは本文の該当セクションを再読してください。 これは「学んだ気になる」と「使える」の橋渡しになる理解度チェックです。
Q1. 事前学習とファインチューニングの違いを、 「使うデータ」「学習パラメータ」「目的」の 3 観点で説明してください。
解説を見る
事前学習は大規模一般データで汎用表現を学び、 全パラメータを更新する。 ファインチューニングは小規模特化データで、 一部または全部のパラメータを微調整し、 特定タスクへの最適化を目的とする。 SSDSE-B-2026 のような 47 サンプル規模では「LoRA で 0.1% のパラメータだけ動かす」のが現実解。
Q2. 47 サンプル (都道府県) でファインチューニングするとき、 過学習リスクが高い理由を 2 つ挙げてください。
解説を見る
(1) パラメータ数 ≫ サンプル数になり、 訓練データを暗記する余地が大きい。 (2) 異常値 (東京・大阪) が極めて少ないため、 1 サンプル誤判定で精度が大きく揺れ、 過学習が見えにくい。 対策は早期停止、 Dropout、 Weight Decay の 3 点セット。
Q3. LoRA (Low-Rank Adaptation) が「フル ファインチューニング」と比べて持つ実務的な利点を 3 つ挙げてください。
解説を見る
(1) 学習パラメータが 0.1〜1% で済み、 GPU メモリを大幅節約。 (2) アダプタファイルのみを配布すればよく、 数 MB で更新可能。 (3) タスクごとにアダプタを切り替えられ、 ベースモデル 1 つで多タスク対応。
Q4. ファインチューニング時に「学習率を事前学習より小さくする」のはなぜですか?
解説を見る
事前学習で獲得した重みは「貴重な汎用知識」を持つため、 大きく動かすと忘却 (catastrophic forgetting) が起きる。 小さい学習率で「微調整」することで、 既存知識を保ちつつ新タスクに適応できる。 典型値は事前学習の 1/10 〜 1/100。
Q5. 「県単位で train/test split する」べき理由を、 SSDSE-B-2026 を例に説明してください。
解説を見る
同じ県の異なる年データが train と test に混在すると、 「県固有の特徴」を暗記したモデルが過大評価される (data leakage)。 県をグルーピングキーにして split すれば、 「未知の県」への汎化性能を正しく測定できる。 グループ k-fold は sklearn の GroupKFold で実装可能。
Q6. ファインチューニングと RAG (Retrieval-Augmented Generation) の使い分けを 1 文で説明してください。
解説を見る
「モデルに行動様式 (スタイル・推論方法) を覚えさせたい」ならファインチューニング、 「最新情報や事実知識を必要に応じて参照したい」なら RAG。 両方を組み合わせるハイブリッドが実務で増えている。
6 問中 4 問以上に「自分の言葉で 30 秒以内」に答えられたら、 ファインチューニングを「使える知識」として身につけたと言えます。 答えに詰まった項目は本文の該当セクションを再読し、 SSDSE-B-2026 の実データで手を動かして確認してください。 理解度チェックは「答えの暗記」ではなく「他人に説明できるか」で測ります。
🎮 触って理解する — 少数データで「新タスクに適応」する様子を2次元で体感
ファインチューニングの核心は「事前学習済みの特徴を再利用し、 少ないデータで新しいタスクに適応する(=転移学習)」ことです。 ここでは、 事前学習済みモデル(※このデモ用の架空モデル。 大量データで「丸い決定境界」を学んだ体で用意しています)を土台に、 わずかな学習サンプルだけで新タスク(少しズレた楕円形の境界)へ適応する過程を、 実際に動く 2 次元の決定境界で観察します。 スクラッチ学習(ゼロから学習=少数だと過学習・不安定)と ファインチューニング(下地を活かす=少数でも安定)を左右で対比し、 さらに 全層更新 vs ヘッドのみ更新(凍結) と 学習率 の効き方も体感できます。 全ての学習は乱数シード付きで決定的(同じ設定なら必ず同じ結果)です。
① 出発点:事前学習済みモデルの「持っている境界」と、 新タスクの「正解境界」のギャップ(ドメインギャップ)
/ = 事前学習済みモデルが引く塗り分け(=再利用したい「特徴」)。
緑の破線 = 新タスクの正解境界(回転した楕円)。 事前学習の「丸」とズレているのがドメインギャップです。
下の実験では、 この事前学習済みモデルを土台に、 少数サンプルだけで緑破線へ「適応」させます。 完全に一致はしなくても、 ゼロから学ぶより遥かに速く・安定して近づけるのがファインチューニングの威力です。
💡 n を小さく(例 6〜10)してみてください。 左(スクラッチ)は訓練データは丸暗記できても汎化テスト精度が低く、 境界がグニャグニャに歪みます(過学習)。 右(FT)は事前学習済みの「丸い特徴」を再利用するので少数でも安定して緑破線に近づきます。 「🎲 スクラッチを再初期化」で左の乱数初期値を変えると、 少数データでは境界が大きく暴れる=不安定さも体感できます。 グラフを指でなぞる/クリックすると、 その地点の予測確率が読めます。
🔍 このデモが示していること
① 少数データでは「下地の有無」が決定的: スクラッチは 33〜43 個ものパラメータ(10 ユニットの小さなネット)を数個のサンプルだけで決めようとするため、 訓練点を丸暗記(訓練精度 100%)しつつ未知領域はデタラメ = 典型的な過学習。 FT は事前学習済みの「曲がった境界を引く特徴」を再利用するので、 少ないサンプルでも素直に新タスクへ寄っていきます。 これが「事前学習済みの特徴を再利用する」ことの実利です。
② ヘッドのみ(凍結)vs 全層更新: 「ヘッドのみ」は事前学習した特徴抽出器を凍結し、 最後の出力(ヘッド)だけを学習します。 動かすパラメータが少ないので少数データでも安定・高速ですが、 事前学習の特徴が新タスクに合わない部分(ドメインギャップ)は埋めきれず頭打ちになります。 「全層更新」は特徴抽出器ごと微調整するのでデータが増えるとより高い上限に届きますが、 少数+大きい学習率では下地を壊しがちです(下記の落とし穴)。
③ 学習率を小さくする理由: FT 側の学習率スライダーを大きく(>1.0)して「全層更新」にすると、 テスト精度がむしろ下がります。 事前学習で得た貴重な重みを一気に上書きしてしまい、 破滅的忘却(catastrophic forgetting)が起きるからです。 だからファインチューニングでは事前学習の 1/10〜1/100 程度の小さな学習率で「そっと微調整」します。 スライダーを小さくすると、 全層更新でも下地を保ったまま適応できることが確認できます。
⚠️ 落とし穴(デモで再現できるもの)
破滅的忘却(catastrophic forgetting): 大きい学習率で全層を動かすと、 事前学習の知識が上書きされて性能が崩れる。 対策は「小さい学習率」「一部の層だけ更新」「早期停止」。
過学習: 少数データ×多パラメータは丸暗記に陥る。 スクラッチ側で n を減らすと訓練精度 100%・テスト精度低下として観測できる。 FT・凍結・正則化・データ拡張が効く。
ドメインギャップ: 事前学習の分布と新タスクの分布が離れているほど、 再利用できる特徴は減る(①のパネルの「丸 vs 楕円」)。 ギャップが大きいなら全層更新や追加データが必要になる。
大きすぎる学習率そのもの: 事前知識を壊すだけでなく学習も不安定化する。 ウォームアップや小さめの一定学習率が定石。
🚀 発展 — 凍結戦略の広がり
LoRA / アダプタ: 事前学習の重みは凍結したまま、 各層に小さな低ランク行列(アダプタ)だけを追加学習する。 「全層更新」の適応力と「ヘッドのみ」の安定・省メモリのいいとこ取り。 更新パラメータは全体の 0.1〜1% 程度で済み、 破滅的忘却も起きにくい(本ページの LoRA セクションも参照)。
プロンプトチューニング / プレフィックスチューニング: モデル本体は一切触らず、 入力側に学習可能な「合図ベクトル」だけを付け足して適応する究極の凍結戦略。 巨大なLLMを安価に多タスク対応させる手法として普及。
段階的アンフリーズ(gradual unfreezing): まずヘッドだけ学習し、 次第に上位層→下位層へと凍結を解いていく。 いきなり全層を動かすより忘却を抑えつつ適応上限を上げられる。 ディープラーニングの転移学習で広く使われる定石です。
📎 深掘り: ファインチューニングは「ベイズ更新/縮小推定」だった
— このページ既出の LoRA・破滅的忘却・RLHF とは別角度。統計の目でファインチューニングを1本の式に畳み込む節。
🎨 直感
事前学習済みモデルの重み θpre は、無数のデータから得た「事前平均(prior)」だと思ってよい。新タスクの少数データは、その prior をちょっとだけ引っ張る証拠にすぎない。統計でこれをやるのがベイズ更新/縮小推定(shrinkage)で、最終推定値は
θ後 = (1−α)·θpre + α·(新データの当てはめ) (α = 実効的な学習の強さ)
という「prior と新データの加重平均」になる。ファインチューニングの学習率×ステップ数は、この α(prior からどれだけ離れるか=縮小の緩め具合)をそのまま担っている。α→0 なら prior 据え置き、α→1 なら prior を捨てて新データに全振り。
実データで体感(SSDSE-B-2026・2023年・全47都道府県/列 A1101 総人口/pandas 実測)
全国 prior=47県平均 264.6万人(標準偏差 279.8万人)。新タスク=東北6県(青森・岩手・宮城・秋田・山形・福島)の平均 138.6万人(n=6)。prior と新データのギャップは −125.9万人。
縮小の重みを α = n/(n+κ)(κ=prior を何件分の疑似データとみなすかの強さ)とすると、n=6 で:
| prior 強さ κ | α=n/(n+κ) | 更新後の推定 | 解釈 |
|---|
| 54 | 0.100 | 252.0万人 | 低学習率/少データ=prior 近くに留まる |
| 18 | 0.250 | 233.1万人 | 中庸 |
| 6 | 0.500 | 201.6万人 | 新データに寄る=過学習リスク増 |
※ 平均・SD・東北6県平均・ギャップは実測値。κ の3水準は α の効きを見せる架空の設定(縮小の強さは本来データから推定する)。
⚠️ 落とし穴(重要)
- α を大きくしすぎる=prior を捨てる。上表 α=1 なら更新後は東北平均 138.6万人そのもの=全国の知識を消去。これが破滅的忘却/過学習の統計的正体で、「学習率を下げる・LoRA で更新を絞る・早期停止する」はすべて α を小さく保つ手段。新データが少ない(n小)ほど α は小さくすべき、という縮小推定の教えと完全に一致する。
- prior が新タスクにとって悪いと縮小も害になる。ベイズ更新は「prior が概ね妥当」を前提にする。ドメインが遠い(=負の転移)と、prior に引き戻すほど誤差が増える。縮小=万能ではなく、縮小先(=事前学習モデル)の適切さが命。
- 縮小はタダではない ── バイアスと分散のトレードオフ。α を下げると推定の分散は減るが、prior 方向へのバイアスが乗る。「安定したから正しい」ではない。検証データで α(学習率・ステップ数・LoRA ランク)を選ぶ工程を省くと、都合よく縮んだだけの偽の安定を掴む。
- 「1回の当てはめ=真の最適」ではない。上式の「新データの当てはめ」自体が n=6 のノイジーな推定。少数データではその点推定を信じすぎないこと(信頼区間を持って更新するのがベイズの作法)。
🚀 発展
ガウス近似では、上の θ後 は損失
L(θ) = (新データの誤差) + λ‖θ − θpre‖²
の最小化とちょうど一致する。つまり事前学習重みへの L2 正則化(文献では L2-SP、フィッシャー情報で重み付けすると EWC=弾性重み統合)そのもの。λ が大きいほど prior に縮む=α が小さい。経験ベイズで κ(=λ)をデータから推定すれば、縮小量を手で決めずに済む。さらに LoRA は「事後分布を低ランク部分空間に制限した近似更新」と読め、学習率スケジュール(warmup→decay)は α を時間方向に変化させる操作にあたる。ファインチューニングの実務ノブが、そっくり縮小推定の1つの式に落ちる。
🔗 関連ページ
- 転移学習 ── ファインチューニングの上位概念。prior をどこから借りるかの話。
- 正則化 ── 上式の λ‖θ−θpre‖² がまさに正則化項。縮小=正則化。
- 過学習 ── α を上げすぎた縮小=prior を捨てた結果としての過学習。
- 学習率 ── 本節の α(縮小の強さ)を実装レベルで握るノブ。
- ベイズ更新 / 縮小推定(James–Stein) / 事前学習モデル ── 独立ページは未整備(本節内で解説)。