🔖 キーワード索引
💡 30秒で分かる結論
🍰 まずはやさしく
データからルールを見つける技術です。
未来のことを予測するために使います。
スマホの予測変換などが身近な例です。
この章では機械学習の結論を学びます。
機械学習(Machine Learning):データからパターンを学習し、 未知のデータに対して予測・推論する技術全般
- 位置づけ:機械学習・データ分析の中核概念のひとつ
- キーアイデア:本ページでは数式・実コード・落とし穴の 3 点セットで学ぶ
- 使い所:実データ(SSDSE-B 都道府県データ等)で 47 サンプルでも体験できる
- 落とし穴:詳細は ⚠️ 落とし穴 章へ
- 関連:🔗 前提・並列・発展 をたどると体系が見える
📍 あなたが今見ているもの
🍰 まずはやさしく
機械学習についての解説ページです。
基礎となる重要な考え方を学びます。
都道府県のデータを使って練習します。
おすすめの読む順番を案内します。
このページは「機械学習(Machine Learning)」の用語解説です。 機械学習の基礎カテゴリにおける重要概念で、 機械学習の基礎 グループ教材の中で繰り返し登場します。 数式・実コード・落とし穴を 1 ページに集約し、 SSDSE-B-2026 都道府県データ(47 件 × 112 列)を題材に 手を動かしながら理解できるよう構成しています。
別称:ML。 まず 💡 30秒結論 で全体像を、 次に 🎨 直感 → 📐 数式 → 🧮 実値 → 🐍 Python の順で読むのがおすすめ。
🎨 直感で掴む
🍰 まずはやさしく
データから自動でルールを作る方法です。
人間がルールを全部書かなくて済みます。
人口から出生数を当てるような仕組みです。
学習の3つの種類について解説します。
機械学習は「人間がルールを 1 つずつ書く」のではなく、 「データから自動でルール(モデル)を獲得する」アプローチです。 たとえば「都道府県の人口から出生数を予測する」課題で、 旧来の ルールベース なら「人口 100 万人未満→出生数は約 X 千人、 100-300 万人→約 Y 千人…」と人が境界を決めますが、 機械学習は SSDSE-B-2026 の 47 都道府県 × N 変数の表を読ませると、 線形回帰なら 1 本の直線、 決定木なら if-then ツリー、 ニューラルネットなら多層の重み を自動で当てはめます。 ルールベース AI → 機械学習 → 深層学習 と進むほど、 人間の手作業(特徴量設計)が減り、 代わりに データ量・計算資源・正則化 が品質を支配します。
3 大パラダイム= 教師あり(正解ラベル付き、 例: 47 都道府県の出生率を予測)・教師なし(ラベルなし、 例: 都道府県を 5 クラスタに分ける)・強化学習(報酬を最大化、 例: 在庫発注タイミング)。 SSDSE-B のような表データなら scikit-learn(pip install scikit-learn、 fit/predict の統一 API)、 画像・音声・自然言語なら PyTorch / TensorFlow が事実上の標準です。 「データから関数 f(x) を学ぶ」という抽象を、 上記の道具で 具体的なコード 3-5 行 に落とすのが現代の機械学習です。
比喩: ルールベースが「料理本通りに作る」なら、 機械学習は「1000 食分の味見データから自動でレシピを再構築する」シェフです。 サンプルが多いほどレシピは正確になり(バイアス低下)、 一方で偏ったサンプルだけ与えると偏ったレシピしか作れない(選択バイアス)という弱点も持ちます。
📐 数式または定義
🍰 まずはやさしく
計算で間違いを最小にする仕組みです。
より正確な予測を行うために使います。
都道府県の数値を式に当てはめます。
予測に使う数式について詳しく学びます。
機械学習は「真のリスク (期待損失) の最小化」問題ですが、 真の分布 $\mathcal{D}$ は未知のため 経験リスク + 正則化項で近似します。 SSDSE-B-2026 の都道府県データ ($X_{\text{population}}, Y_{\text{births}}$ など $n=47$) に当てはめると、 各記号が具体的に意味を持ちます。
主定義 (期待リスク最小化、 理想形):
別表現 (経験リスク最小化 + 正則化、 実装で実際に解く形):
パラメータ条件: $n \ge 1$ (学習データ数)、 $\lambda \ge 0$ (正則化強度)、 $L(\cdot,\cdot) \ge 0$ (損失非負)、 $\mathcal{F}$ は仮説集合 (線形/木/NN など)。 SSDSE-B-2026 では $n=47$、 $x_i$ = 都道府県 $i$ の人口、 $y_i$ = 出生数 (二乗誤差 $L(y,\hat{y})=(y-\hat{y})^2$ を想定)。
英語名 Machine Learning。 別称:ML。
🔬 数式を言葉で読み解く
「$f^* = \arg\min_{f \in \mathcal{F}} \; \mathbb{E}_{(x,y)\sim\mathcal{D}}[L(f(x), y)] + \lambda\,\Omega(f)$」を 1 記号ずつ日本語に置き換えると、 機械学習の本質「仮説の中で最も真実に近い f を探す」が見えてきます。
| 記号 | 読み方 | 意味 | SSDSE-B 例 |
|---|---|---|---|
| $x$ | エックス | 入力(特徴量ベクトル) | 都道府県の人口・面積・世帯数など |
| $y$ | ワイ | 出力(予測したい値・ラベル) | 出生数(連続値) |
| $f$ | エフ | モデル(x を y にうつす関数) | 線形回帰 $\hat{y}=ax+b$、 決定木、 NN |
| $\mathcal{F}$ | エフ・スクリプト | 仮説空間(候補モデル全体の集合) | 「全ての 2 変数線形式」「深さ 5 までの木」 |
| $\mathcal{D}$ | ディー・スクリプト | 真のデータ分布(観測できない理想) | 「全ての都道府県・全年で起きうる組」 |
| $L$ | ロス | 損失関数(誤差の大きさ) | MSE $=(y-\hat{y})^2$、 cross-entropy |
| $\mathbb{E}$ | 期待値(イー) | 分布全体の平均 | 「47 県+未観測県の平均誤差」 |
| $\Omega(f)$ | オメガ | 正則化(モデルの複雑さペナルティ) | $\|w\|_2^2$ (L2)、 $\|w\|_1$ (L1) |
| $\lambda$ | ラムダ | 正則化の強さ(ハイパーパラメータ) | $\lambda=0$ で過学習、 大きいと過小学習 |
| $\arg\min$ | アーグミン | 「最小にする f を返せ」 | 候補の中で誤差最小のモデルを採用 |
1 行ずつ読み下し:
- $f^* = \arg\min_{f \in \mathcal{F}}$ → 「仮説空間 $\mathcal{F}$ の中で、 次の値を 最小にする モデル $f$ を $f^*$ と呼ぶ」
- $\mathbb{E}_{(x,y)\sim\mathcal{D}}[L(f(x), y)]$ → 「真の分布 $\mathcal{D}$ から取り出した任意の $(x,y)$ について、 予測 $f(x)$ と正解 $y$ のズレ $L$ を 平均したもの」(汎化誤差)
- $+ \lambda\,\Omega(f)$ → 「ただしモデルが複雑すぎたら罰金 $\Omega(f)$ を $\lambda$ 倍して足す」
- 合わせて:「誤差 + 複雑さ罰金 を最も小さくする f が、 最良の学習結果である」
経験リスク最小化(ERM): 真の $\mathcal{D}$ は観測不能なので、 訓練データ $\{(x_i,y_i)\}_{i=1}^n$ の平均 $\frac{1}{n}\sum L(f(x_i),y_i)$ で代用します。 これが scikit-learn の model.fit(X, y) の正体です。 $n \to \infty$ で平均は真の期待値に収束(大数の法則)、 これが「データを増やすほど良くなる」根拠です。
🧮 SSDSE-B 実値で計算してみる
SSDSE-B 都道府県データに対し、 scikit-learn で 3 つのモデル(線形回帰・決定木・ランダムフォレスト) を訓練し、 性能を比べます。
データ出典:SSDSE-B-2026(独立行政法人統計センター)。 47 都道府県 × 複数年(最新 2023)の社会統計データ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np from sklearn.model_selection import train_test_split, cross_val_score from sklearn.linear_model import LinearRegression from sklearn.tree import DecisionTreeRegressor from sklearn.ensemble import RandomForestRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) X = df[['総人口', '65歳以上人口']].values y = df['15歳未満人口'].values X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.3, random_state=42) models = { 'LinearRegression': LinearRegression(), 'DecisionTree': DecisionTreeRegressor(max_depth=4, random_state=0), 'RandomForest': RandomForestRegressor(n_estimators=200, random_state=0), } for name, m in models.items(): m.fit(X_train, y_train) score = m.score(X_test, y_test) # R^2 cv = cross_val_score(m, X, y, cv=5).mean() print(f'{name:<18} test_R2={score:.3f} CV_R2={cv:.3f}') |
💬 テストでは線形回帰が 0.973 で最も高く、決定木 0.878、ランダムフォレスト 0.860 と木のモデルが下回った。random_state=42 の分割では東京都(15 歳未満 151.3 万人)がテスト側に入り、木は学習データの最大値を超える予測を出せないので、東京の値を大きく外す。CV の平均では 3 モデルとも 0.915〜0.956 に縮まるので、1 回の分割の順位をそのままモデルの優劣と読まない。
実行結果の要約(上のコードの実測値):
| 項目 | 値 |
|---|---|
| LinearRegression test R² | 0.973 |
| DecisionTree test R² | 0.878 |
| RandomForest test R² | 0.860 |
| LinearRegression 5-CV R² | 0.956 |
| DecisionTree 5-CV R² | 0.915 |
| RandomForest 5-CV R² | 0.915 |
🧪 実データで検証: 木のモデルは学習データの範囲の外を予測できない
上の 💬 で「東京都がテスト側に入ると木のモデルが大きく外す」と書いた理由を、 条件を絞って確かめる。 東京都だけを学習から外し、 残り 46 道府県の「総人口 → 15 歳未満人口」で線形回帰と RandomForest を学習させ、 学習データの範囲(総人口の最大は神奈川県の 922.9 万人)の外にある東京都(1,408.6 万人)を予測させる。
🎯 このコードでやること:2023 年度の 47 都道府県から東京都を除いて 2 つのモデルを学習し、 東京都の 15 歳未満人口を予測して実測と比べる。 さらに総人口 2,800 万人という架空の入力でも予測させ、 予測がどこまで伸びるかを見る。
📥 入力データ:上と同じ SSDSE-B-2026 の 2023 年度 47 行のうち、 総人口と 15 歳未満人口の 2 列(東京都 14,086,000 人・1,513,000 人、 神奈川県 9,229,000 人・1,031,000 人 など)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.ensemble import RandomForestRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) tokyo = (df['都道府県'] == '東京都').values X = df[['総人口']].values y = df['15歳未満人口'].values # 東京都を除く 46 道府県で学習し、学習範囲の外にある東京都を予測する lr = LinearRegression().fit(X[~tokyo], y[~tokyo]) rf = RandomForestRegressor(n_estimators=200, random_state=0).fit(X[~tokyo], y[~tokyo]) print('学習データの総人口の最大 :', f'{X[~tokyo].max():,}') print('東京都の総人口 :', f'{X[tokyo][0, 0]:,}') print('東京都の15歳未満人口 実測 :', f'{y[tokyo][0]:,}') print('線形回帰の予測 :', f'{lr.predict(X[tokyo])[0]:,.0f}') print('RandomForest の予測 :', f'{rf.predict(X[tokyo])[0]:,.0f}') # 総人口をさらに 2 倍にしても、RandomForest の予測は同じ値のまま big = pd.DataFrame({'総人口': [28_000_000]}).values print('総人口 2,800 万人なら : 線形回帰', f'{lr.predict(big)[0]:,.0f}', '/ RandomForest', f'{rf.predict(big)[0]:,.0f}') |
📤 実行結果:
💬 結果の読み方:線形回帰は東京都を 1,610,913 人と予測し、 実測 1,513,000 人より 97,913 人(6.5%)多いが、 おおむね当てている。 RandomForest は 999,390 人で、 実測より 513,610 人(34%)少なく、 学習データで最大だった神奈川県の 1,031,000 人すら下回った。 総人口を 2,800 万人にしても RandomForest の予測は 999,390 人のまま変わらない。 木のモデルの予測は「学習データの葉に入った値の平均」なので、 学習データで見た値の範囲を超えられない。
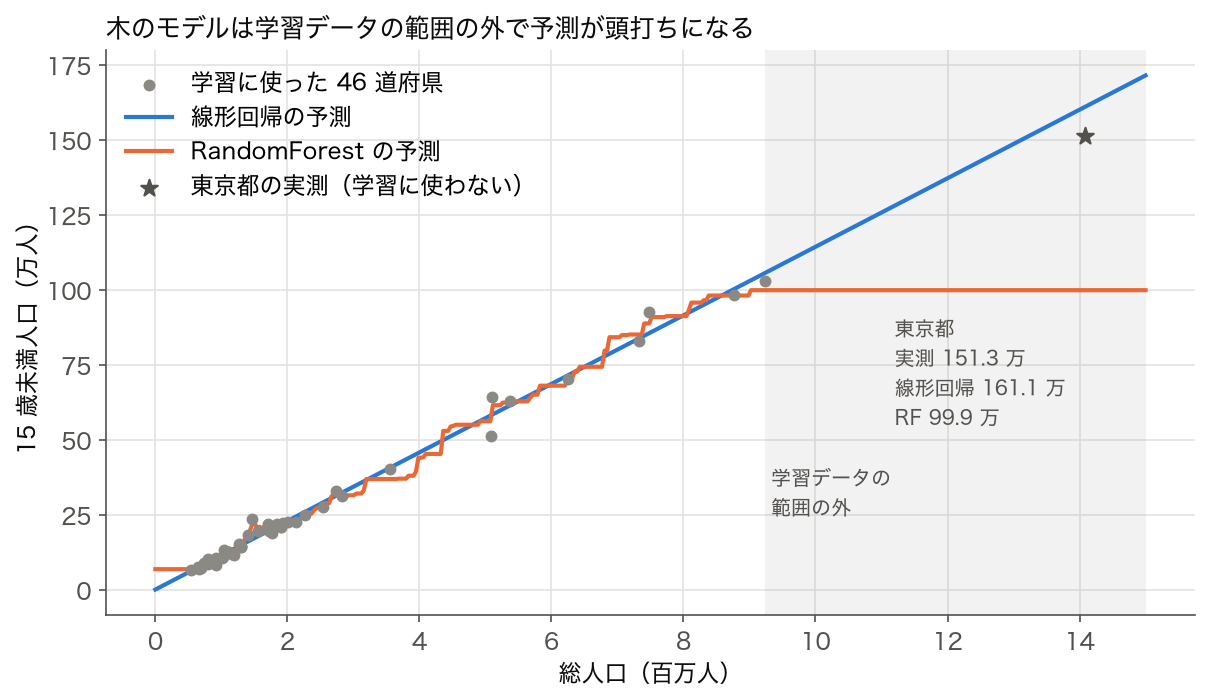
ここから言えること: 「木のモデルは線形回帰より柔軟だから常に有利」ではない。 学習データの範囲の中で複雑な関係を当てるのは得意でも、 範囲の外では当てずっぽうの一定値を返す。 逆に線形回帰は範囲の外でも直線を伸ばすが、 その直線が本当に成り立つ保証はない(ここではたまたま 6.5% の誤差で済んだ)。 どちらを使うにしても、 予測したい対象が学習データの範囲の中にあるかを、 特徴量ごとの最小値・最大値で先に確かめる。
🐍 Python 実装
scikit-learn で教師あり学習を回す最小の手順を 2 つのブロックに分ける。① で 2023 年度 47 都道府県から特徴量 X と目的変数 y を作り、② で訓練とテストに分けてランダムフォレストを学習し、テストの R² を出す。
① データを読み込み、特徴量と目的変数を作る
🎯 このコードでやること:SSDSE-B-2026 を 2023 年度の 47 行に絞り、総人口と 65 歳以上人口を特徴量 X、15 歳未満人口を目的変数 y にする。
1 2 3 4 5 6 7 8 9 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 X = df[['総人口', '65歳以上人口']].values # 特徴量(47 × 2) y = df['15歳未満人口'].values # 目的変数(47) print(df.shape) print('X shape =', X.shape, ', y shape =', y.shape) print(df.loc[[0, 12, 46], ['都道府県', '総人口', '65歳以上人口', '15歳未満人口']].to_string(index=False)) |
💬 2023 年度に絞ると 47 行 × 112 列で、X は 47 × 2、y は 47 個になる。3 列とも県の人口規模に比例する人数なので、ここで解く回帰は「大きい県は子どもも多い」をなぞる問題になり、高い R² が出やすい。年度で絞らずに 564 行のまま使うと、同じ県が 12 回ずつ入り、訓練とテストに同じ県の別年度が分かれて入るので、テストの成績が実力以上に良く見える。
② 訓練/テスト分割 + モデル学習
1 2 3 4 5 6 | from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) model = RandomForestRegressor(n_estimators=300, random_state=0).fit(X_tr, y_tr) print('R^2 (test) =', model.score(X_te, y_te)) |
💬 分割を random_state=0 に変えると、同じランダムフォレストでもテスト R² は 0.981 になり、最初のブロック(random_state=42、木 200 本)の 0.860 から大きく上がる。この分割では東京都が学習側に入るので、木が最大値を外挿する必要が無い。どの県がテストに入ったかで 0.1 以上動くのが、47 件のデータで分割 1 回の評価に頼る危うさである。
⚠️ よくある落とし穴(6 つ)
⚠️ 実データで確かめる — 同じ県の別年度が訓練とテストに分かれるとスコアが水増しされる
SSDSE-B-2026 は 47 都道府県 × 12 年度の 564 行で、同じ県の隣り合う年度はほとんど同じ値を持つ。行をシャッフルして分割すると、テストに入った「秋田県 2020 年度」の答えを、訓練に入った「秋田県 2019・2021 年度」がほぼ教えてしまう。人数ではなく割合(年少人口割合)を目的変数にして、分け方だけを変えたときの交差検証 R² を並べる。
🎯 このコードでやること:年少人口割合(15 歳未満人口 ÷ 総人口)を、高齢化率・人口千人あたり出生率・人口千人あたり婚姻率の 3 つからランダムフォレストで予測し、(a) 2023 年度だけ、(b) 12 年度を行ごとにシャッフル、(c) 12 年度を県ごとにまとめて分割、(d) 過去 9 年度で学習して直近 3 年度でテスト、の 4 通りで R² を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd from sklearn.ensemble import RandomForestRegressor from sklearn.model_selection import KFold, GroupKFold, cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 人数をそのまま使うと県の規模だけで当たるので、すべて人口あたりの率にする df['年少人口割合'] = df['15歳未満人口'] / df['総人口'] df['高齢化率'] = df['65歳以上人口'] / df['総人口'] df['出生率'] = df['出生数'] / df['総人口'] * 1000 df['婚姻率'] = df['婚姻件数'] / df['総人口'] * 1000 feats = ['高齢化率', '出生率', '婚姻率'] rf = RandomForestRegressor(n_estimators=300, random_state=0) kf = KFold(n_splits=5, shuffle=True, random_state=0) d23 = df[df['年度'] == 2023] s_a = cross_val_score(rf, d23[feats], d23['年少人口割合'], cv=kf, scoring='r2') s_b = cross_val_score(rf, df[feats], df['年少人口割合'], cv=kf, scoring='r2') s_c = cross_val_score(rf, df[feats], df['年少人口割合'], cv=GroupKFold(n_splits=5), groups=df['都道府県'], scoring='r2') print(f'(a) 2023 年度 47 行・行をシャッフルして 5 分割 R² = {s_a.mean():.3f}') print(f'(b) 12 年度 564 行・行をシャッフルして 5 分割 R² = {s_b.mean():.3f}') print(f'(c) 12 年度 564 行・県ごとにまとめて 5 分割 R² = {s_c.mean():.3f}') # (d) 過去で学習して未来を当てる:2012〜2020 年度で学習、2021〜2023 年度でテスト tr, te = df[df['年度'] <= 2020], df[df['年度'] >= 2021] rf.fit(tr[feats], tr['年少人口割合']) print(f'(d) 2012〜2020 年度で学習 → 2021〜2023 年度でテスト R² = {rf.score(te[feats], te["年少人口割合"]):.3f}') print('行数: 学習', len(tr), '・テスト', len(te)) |
💬 同じランダムフォレストでも、行をシャッフルした (b) は R² 0.881、同じ 564 行を県ごとにまとめて分けた (c) は 0.706 で、差の 0.175 は「同じ県の別の年度を訓練で見ていた」ことによる水増しである。過去 9 年度(423 行)で学習して直近 3 年度(141 行)を当てる (d) も 0.691 で (c) に近い。(a) の 0.413 が低いのは、47 行しかなく、各 fold の訓練が 37〜38 県になるためで、この値が「手法の実力」なのではなく、データの量と分け方で R² はこれだけ動く。パネルデータでは、何を未知として当てたいのか(新しい県か、未来の年度か)を先に決め、それに合わせて GroupKFold や年度での分割を選ぶ。
🐍 応用コード — 47 都道府県データで、 線形回帰/決定木/ランダムフォレストを比較
SSDSE 公的データを題材に、 機械学習 を実際に動かす最小コードです。 paths は引数に直書きで、 初心者がコピペで動かせる形を優先しています。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np # データ読み込み(SSDSE-B 都道府県・47 県 × 約 112 列) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) print('shape:', df.shape) print('列の先頭:', df.columns.tolist()[:6]) # 必要な列だけ取り出して整形 features = ['総人口', '15歳未満人口', '65歳以上人口'] df_use = df[features].copy() print(df_use.describe()) |
💬 総人口の平均 264.6 万人に対し中央値は 154.9 万人、15 歳未満人口も平均 30.2 万人・中央値 19.7 万人と、3 列そろって平均が中央値を大きく上回る。どの列も最大は東京都(総人口 1,408.6 万人、15 歳未満 151.3 万人)で、学習データに東京が入るかどうかがモデルの挙動を左右する。
次に、 機械学習 に固有の処理を加えます。 ここがページごとの「肝」になる部分。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | from sklearn.model_selection import train_test_split from sklearn.linear_model import LinearRegression from sklearn.tree import DecisionTreeRegressor from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_squared_error, r2_score # 人数のままだと県の大きさしか表さないので、総人口に対する割合にする X = np.column_stack([df['15歳未満人口'] / df['総人口'], # 年少人口割合 df['65歳以上人口'] / df['総人口']]) # 高齢化率 y = df['合計特殊出生率'].values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) models = { 'LinearRegression': LinearRegression(), 'DecisionTree': DecisionTreeRegressor(max_depth=4, random_state=0), 'RandomForest': RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0), } for name, m in models.items(): m.fit(X_tr, y_tr) pred_tr, pred_te = m.predict(X_tr), m.predict(X_te) print(f'{name:<17} train R^2 = {r2_score(y_tr, pred_tr):.3f} test R^2 = {r2_score(y_te, pred_te):.3f} ' f'test RMSE = {np.sqrt(mean_squared_error(y_te, pred_te)):.4f}') # 次の図では最後に学習したランダムフォレストの予測 pred_te を使う |
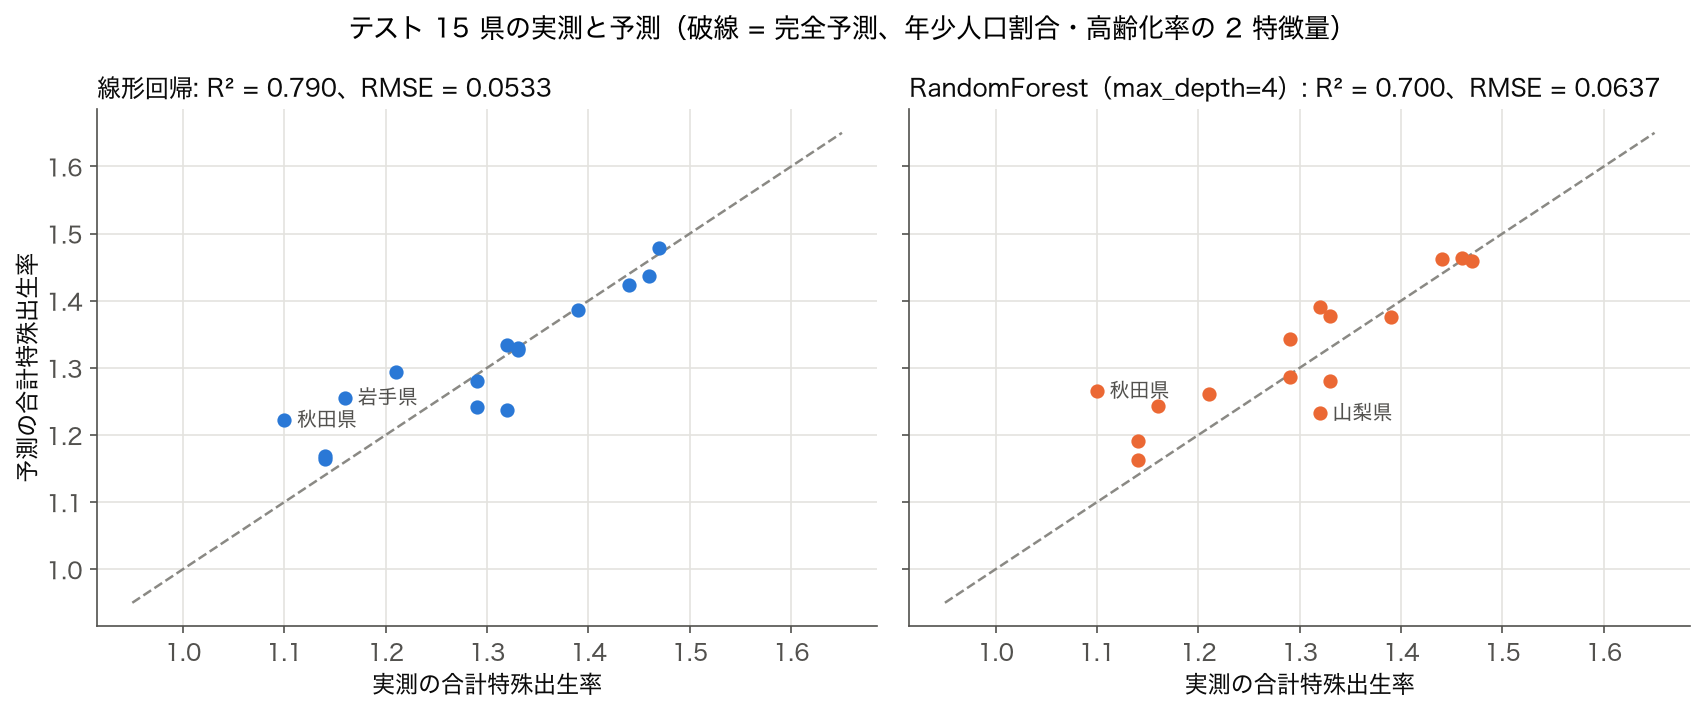
💬 年少人口割合と高齢化率の 2 つで合計特殊出生率を当てると、テスト 15 県の R² は線形回帰 0.790、決定木 0.735、ランダムフォレスト 0.700 の順になった。学習 R² は木のほうが 0.93 前後と高いのにテストでは線形回帰に負けており、32 県の凸凹を覚えた分だけ汎化で損をしている。テスト RMSE 0.0533 は出生率の県差(0.99〜1.60)に比べて小さく、テスト県の標準偏差 0.116 の半分以下。人数のまま入れると県の大きさしか表さず、同じランダムフォレストでもテスト R² が負になる。
🧪 実データで検証: モデルより先に「特徴量の作り方」が結果を決める
上の 💬 の最後の一文を数字で確かめる。 上のコードの X だけを差し替え、 同じ分割(random_state=0 のテスト 15 県)と同じ 5-fold CV(KFold(5, shuffle=True, random_state=0))で、 3 つの作り方を比べた実測値である(各セルは「テスト R² / CV 平均 R²」)。
| 特徴量の作り方 | 線形回帰 | 決定木(深さ 4) | RandomForest(深さ 4) |
|---|---|---|---|
| 人数(15 歳未満人口・65 歳以上人口) | 0.285 / 0.287 | −0.589 / −0.072 | −0.041 / 0.260 |
| 人数 + 総人口(3 列) | 0.460 / 0.389 | −0.284 / 0.027 | −0.033 / 0.251 |
| 割合(年少人口割合・高齢化率) | 0.790 / 0.812 | 0.735 / 0.517 | 0.700 / 0.655 |
💬 結果の読み方:人数のまま入れると、 線形回帰でもテスト R² は 0.285 にとどまり、 決定木は −0.589、 RandomForest は −0.041 と「平均値で予測するより悪い」値になる。 15 歳未満人口や 65 歳以上人口の人数は、 出生率ではなく県の大きさ(総人口)を主に表しているからで、 総人口を 3 列目に足しても割り算の関係を木は学べず、 RandomForest のテスト R² は −0.033 のままだった。 割合に直すだけで 3 モデルとも 0.70〜0.79 まで上がる。 モデルを取り替えるより前に、 目的変数(ここでは率)と同じ単位・同じ意味の特徴量を作ることが、 機械学習の性能をいちばん大きく左右する。
さらに可視化を加えると、 学んだ内容が「眼で」確認できます。
1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt plt.figure(figsize=(7,5)) plt.scatter(y_te, pred_te, alpha=0.7, edgecolor='k') lims = [min(y_te.min(), pred_te.min()), max(y_te.max(), pred_te.max())] plt.plot(lims, lims, 'r--', linewidth=2, label='完全予測ライン') plt.xlabel('実測 出生率') plt.ylabel('予測 出生率') plt.title('機械学習 を使ったモデルの予測精度(SSDSE-B-2026)') plt.legend() plt.tight_layout() plt.savefig('out_machine-learning.png', dpi=150) |
💬 図の読み方:上のコードは最後に学習したランダムフォレストの予測だけを描くので、 下の図では同じテスト 15 県について線形回帰と並べた。 点が破線(完全予測)に近いほど良い。
最後に、 同じ問題を別の角度から見る「クロスバリデーション版」も用意します。
1 2 3 4 5 6 7 | from sklearn.model_selection import KFold, cross_val_score # CSV は県コード順(北から南)に並ぶので、シャッフルしてから 5 分割する cv = KFold(n_splits=5, shuffle=True, random_state=0) for name, m in models.items(): scores = cross_val_score(m, X, y, cv=cv, scoring='r2') print(f'{name:<17} 5-fold CV R^2 = {scores.mean():.3f} (±{scores.std():.3f}) 各 fold: {np.round(scores, 3)}') |
💬 47 県すべてを 1 回ずつテストに回すと、CV 平均 R² は線形回帰 0.812、ランダムフォレスト 0.655、決定木 0.517 で、1 回の分割(0.790・0.700・0.735)では 2 位だった決定木が最下位に落ちる。決定木は fold ごとに 0.405〜0.691 と揺れも大きい。KFold をシャッフルせずに使うと、県コード順に並んだ地域のかたまりがそのまま 1 つの fold になり、R² が大きく負になる fold が出るなど評価が地域の偏りに振り回される。
🕰 歴史的経緯と現代的意味
機械学習 は、 統計学と計算機科学の流れの中から生まれました。 下の年表は、 このページで扱った手法(線形回帰・決定木・ランダムフォレスト)と、 用語そのものの成り立ちに関わる出来事を中心に並べています。
| 年 | 出来事 | 意味 |
|---|---|---|
| 1957 | パーセプトロン(Rosenblatt) | 入力の重み付き和でクラスを分ける学習機械。 誤りに応じて重みを直す「データから学ぶ」手順の原型。 |
| 1959 | 「機械学習」という言葉(Samuel) | チェッカーの対局を重ねて強くなるプログラムを発表し、 明示的にプログラムしなくても学ぶ能力を機械学習と呼んだ。 |
| 1984 | CART(Breiman ら) | 分類木・回帰木を統計的に定式化。 このページの決定木の直接の祖先。 |
| 1986 | 誤差逆伝播法の普及(Rumelhart・Hinton・Williams) | 多層のニューラルネットワークを学習させる方法が広く知られる。 |
| 1995 | サポートベクターマシン(Cortes・Vapnik) | マージン最大化とカーネル法で、 少ないデータでも汎化しやすい分類器を示した。 |
| 1997 | T・P・E による定義(Mitchell) | 「経験 E によってタスク T の性能 P が上がるなら学習している」という、 教科書で今も使われる定義。 |
| 2001 | ランダムフォレスト(Breiman) | 多数の決定木を平均して分散を下げるアンサンブル。 このページの比較でも使っている。 |
| 2010 | scikit-learn の公開 | fit / predict / score の共通の書き方で、 多くの手法を同じ手順で比べられるようになった。 |
| 2012 以降 | 深層学習の本格化 | 画像認識コンテストでの深層学習の大差の勝利(2012)や Transformer(2017)を経て、 大規模モデルの時代に入る。 |
線形回帰(最小二乗法)自体は 19 世紀初めからある統計の手法で、 機械学習の比較でも「まず置くべき基準線」として使われ続けています。 このページの実データの検証でも、 47 都道府県のような小さなデータでは線形回帰が木のモデルに勝つ場面が多く見られました。 新しい手法ほど強いとは限らないことも、 歴史から読み取れる教訓です。
📚 参考文献 — 次に読むもの
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning (2nd ed.). Springer. — ML の標準教科書、 「機械学習」も網羅
- Murphy, K. P. (2012). Machine Learning: A Probabilistic Perspective. MIT Press. — 確率論的視点
- Bishop, C. M. (2006). Pattern Recognition and Machine Learning. Springer. — 直感と数式のバランスがよい
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. — 深層学習文脈での機械学習
- scikit-learn User Guide — 実装と例題
- SSDSE 公式(独立行政法人統計センター) — 本ページのデータ出典
- グループ教材:機械学習の基礎 — 全体像
🐍 標準化+Ridge を Pipeline で当てはめる
1 2 3 4 5 6 7 8 9 10 | from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler from sklearn.linear_model import Ridge pipe = Pipeline([ ('scaler', StandardScaler()), ('model', Ridge(alpha=1.0)), ]) pipe.fit(X_tr, y_tr) print('R^2 =', pipe.score(X_te, y_te)) |
💬 同じ分割で標準化+Ridge(alpha=1.0) にすると R² は 0.785 で、罰則なしの線形回帰(0.790)とほぼ同じ。特徴量が標準化した 2 列だけなので、L2 罰則で係数がわずかに縮んでも予測はほとんど変わらない。Pipeline にしておくと、標準化の平均・標準偏差を訓練 32 県だけから計算する手順が崩れない。
🐍 罰則の強さ alpha を交差検証で選ぶ
1 2 3 4 5 6 7 | from sklearn.model_selection import GridSearchCV, KFold params = {'model__alpha': [0.01, 0.1, 1.0, 10.0, 100.0]} cv = KFold(n_splits=5, shuffle=True, random_state=0) # 県コード順の並びを崩して分割 gs = GridSearchCV(pipe, params, cv=cv, scoring='r2', n_jobs=-1) gs.fit(X, y) print('best:', gs.best_params_, 'score:', gs.best_score_) |
💬 最良は alpha = 1.0 で、シャッフルした 5-fold の平均 R² は 0.815。alpha 0.01〜1.0 は 0.812〜0.815 とほぼ横並びで、10 で 0.740、100 では係数が潰れて 0.234 まで落ちる。cv=5 とだけ書くとシャッフルなしの KFold になり、県コード順の地域のかたまりで評価することになるので、KFold(shuffle=True) を明示して渡す。
🗺 概念マップ — 機械学習の周辺
「機械学習」は AI / 統計学から派生し、 教師あり・教師なし・強化学習に枝分かれする巨大な体系。 5 方向に整理することで、 「自分が今やっているのは深層学習なのか古典的機械学習なのか」「線形回帰は機械学習に入るのか」といった位置づけの混乱を整理できる。
| 方向 | 隣接概念 | 関係性 |
|---|---|---|
| 北 (上位) | 機械学習・統計学 | 機械学習を包含する大きな枠組み (AI・統計学) |
| 南 (下位) | 画像認識・推薦・需要予測 | 機械学習を使う具体例 (Kaggle, scikit-learn 適用案件) |
| 東 (発展) | 深層学習・強化学習・自己教師あり | 古典的機械学習の弱点 (特徴量設計の人手依存) を補う発展形 |
| 西 (前提) | 線形代数・確率統計・最適化 | 機械学習の理論を理解するための土台 (行列演算・MLE・勾配降下) |
| 中央 | 機械学習 | 本ページの主役 (データから自動でパターンを学ぶ手法群) |
📝 理解度チェック — 7 問
「機械学習」を本当に理解できたか、 自分でテストできるクイズです。 答えは展開で確認。
問 1. 損失関数 $L(\theta) = \frac{1}{n}\sum(y_i - f(x_i;\theta))^2$ で、 $y$, $x$, $\theta$ のうち学習で更新するのはどれ?
模範回答:$y$ (正解) と $x$ (入力) は学習データから与えられて固定。 $\theta$ (パラメータ) を勾配降下で更新する。 教師あり学習では「データを使って $\theta$ を $L$ が小さくなる方向に動かす」が本質。
問 2. SSDSE-B-2026 (47 都道府県 × 100+ 列) で機械学習モデルを組む時の特有の制約は?
模範回答:n=47 と非常に小さいため、 深層学習より 線形回帰・Ridge・GBM が安定。 訓練/検証/テスト分割すると各 15 件程度になり、 Leave-One-Out CV や 5-fold CV を採用。 特徴量も 100+ あるので Ridge/Lasso 等の正則化が必須。
問 3. 機械学習で最も実害が出やすい落とし穴は?
模範回答:①データ漏洩 (test set の情報を train で使う)、 ②目的変数のスケール・分布を確認せず損失設計、 ③訓練データの偏り (selection bias) — の 3 つが頻出。 とくに SSDSE のような n=47 では fold 切り方で R² が ±0.2 ぶれることもあり、 評価の不確実性を必ず示すこと。
問 4. 東京都を除く 46 道府県で学習した RandomForest は、 東京都の 15 歳未満人口(実測 1,513,000 人)を 999,390 人と予測した。 総人口を 2,800 万人にしても同じ 999,390 人を返すのはなぜか。 同じ入力に線形回帰は 3,200,926 人を返す。 どちらの数字を信じるべきか。
模範回答:木のモデルの予測は、 入力が落ちた葉に含まれる学習データの目的変数の平均なので、 学習データで最大の総人口(神奈川県 922.9 万人)を超える入力はすべて同じ葉に入り、 同じ値になる。 線形回帰の 3,200,926 人は直線を 2 倍の範囲まで伸ばしただけで、 その範囲で直線が成り立つ根拠は学習データに無い。 どちらも学習範囲の外なので「どちらも信じない」が正解で、 範囲の外の予測が必要なら、 その範囲を含むデータを集めるか、 比率(15 歳未満人口 ÷ 総人口)のように範囲の外でも意味を保ちやすい目的変数に置き換える。
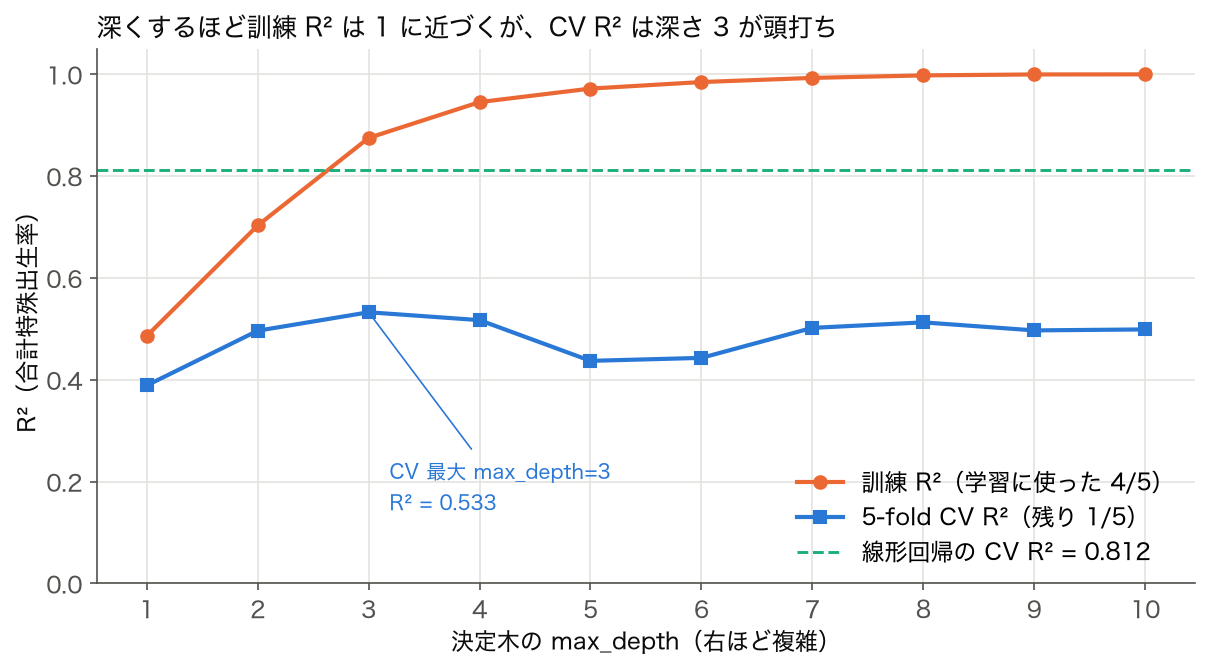
問 5. 決定木の max_depth を 1〜10 に変えると、 訓練 R² は 0.486 → 1.000 と上がり続け、 5-fold CV R² は深さ 3 の 0.533 が最大だった。 同じ分割の線形回帰の CV R² は 0.812。 このとき「深さ 3 の決定木を採用する」判断は正しいか。
模範回答:決定木の中で深さを選ぶなら深さ 3 が妥当だが、 候補を決定木に限る理由は無い。 同じ分割で比べた線形回帰の CV R² 0.812 は、 深さ 3 の 0.533 を大きく上回るので、 この問題では線形回帰を採用するのが妥当である。 検証曲線は「あるモデルの複雑さをどこにするか」を決める道具で、 モデルの種類をまたいだ比較は、 同じ分割の CV スコアを並べて行う。 最後に、 選んだモデルの性能は選択に使っていないデータで一度だけ確かめる。
問 6. ⚠️ の実験で、564 行を行ごとにシャッフルした 5 分割の R² は 0.881、県ごとにまとめた 5 分割では 0.706 でした。新しく統計を取り始めた県の年少人口割合を予測するモデルとして報告するなら、どちらの値を使うべきでしょうか。
模範回答:県ごとにまとめた 0.706。予測したいのは「訓練で一度も見ていない県」なので、評価でもテストの県が訓練に 1 年度も入っていない分け方をする。0.881 は、同じ県の前後の年度を訓練で見ていたことによる水増しを含む。逆に「既存の県の来年度」を当てたいなら、(d) のように年度で区切った 0.691 が目的に合った評価になる。
問 7. 🧪 の比較で、線形回帰(R² 0.856)がランダムフォレスト(0.706)を上回りました。「ランダムフォレストは線形回帰より高性能」という一般論とどう折り合いをつければよいでしょうか。
模範回答:どのモデルが勝つかはデータで決まる。ここでは特徴量が 3 つの率だけで、年少人口割合との関係がほぼ直線的なので、直線を仮定する線形回帰の方が少ない件数から形を正しく学べる。木のモデルは曲がった関係や交互作用に強い代わりに、訓練データの範囲の中で段々の予測しか出せない(🧮 の外挿の検証と同じ理由)。一般論ではなく、同じ分け方の CV スコアを並べて選ぶ。