🔖 キーワード索引
| キーワード | このページでの意味 | 関連ページ |
|---|---|---|
| CRISP-DM | 業務理解 → データ理解 → データ準備 → モデリング → 評価 → 展開の 6 工程と、 前の工程へ戻る矢印 | 問題の定式化 |
| ベースライン | 「前年度 + 全国の変化」のような何もしない予測。 2023 年度の出生率で MAE 0.0286 | 評価指標 |
| リーク | 分割の前に前処理や列の選択をして、 テスト側の情報が学習に漏れること | 交差検証 |
| バックテスト | 過去の各年度を、 その前年度までの情報だけで予測したとして繰り返す評価 | 訓練・テスト分割 |
| ゲート | 各工程の出口に置く「次へ進んでよい条件」 | MLOps |
| 再学習 | 新しい年度のデータで学び直すこと。 凍結したモデルは年々ずれる | モデル監視 |
💡 30秒で分かる結論 — 機械学習プロジェクトの流れ
🍰 まずはやさしく
AI開発の地図のようなものです。
効率よく目標を達成するために使います。
部活の大会に向けた計画に似ています。
全体の流れと注意点をまとめました。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- ML プロジェクトの流れ:問題定義 → データ収集 → 前処理 → モデル化 → 評価 → デプロイ → 監視 → 改善(ループ)。
- 業界標準は CRISP-DM(業務理解→データ理解→データ準備→モデリング→評価→展開)。
- 時間配分:データの理解と準備に最も時間がかかると言われる。 割合はプロジェクトで大きく違うので、 自分の記録から見積もる。
- 工程は 線形ではなく循環。 評価結果に基づき何度も前工程に戻る。
- 失敗ポイント:問題定式化の曖昧さ、 データ品質、 デプロイ後のドリフト無視。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
AI活用のためのガイドブックです。
何から始めるべきかを知るために使います。
スマホアプリを開発する時に役立ちます。
この知識がどこで必要かを紹介します。
「機械学習を業務に使いたい」 — 何から始めるか分からないとき、 まず思い出すべき地図がこれ。 すべての ML プロジェクトはおおむね 7 つの工程をループで回しています。
🎨 直感で掴む
🍰 まずはやさしく
料理を作る手順に似ています。
全体のイメージを掴むために使います。
お弁当の準備を想像してください。
直感的にわかる例え話で解説します。
料理に喩えるなら:
- 業務理解 = 「お客様は何を食べたい?」
- データ収集 = 食材調達
- データ理解・前処理 = 下処理(皮むき・洗浄)
- モデリング = 調理
- 評価 = 試食
- 展開(デプロイ) = 配膳
- 運用・監視 = 客の反応を見て改善
多くの初学者は「調理」だけが ML だと思いがち。 実は 食材調達と下処理が時間の 7 割。
SSDSE-B-2026 での具体例: 出生数予測プロジェクト
- ① 業務理解: 「自治体の保育園需要計画のため、 47 都道府県の出生数 (B1101) を翌年予測したい。 RMSE 500 人以下が合格ライン」と関係者合意。
- ② データ収集: SSDSE-B-2026 を取得。 出生数・人口・婚姻率・所得・住居費など 130 列が揃う。
- ③ データ理解・前処理: A1101 (人口) と B1101 (出生数) は強相関 r=0.99 を確認。 沖縄県の出生率外れ値を保持判断、 欠損なし。
- ④ モデリング: 線形回帰でベースライン RMSE=1200 → ランダムフォレストで RMSE=600 → LightGBM + 交差検証で RMSE=480。
- ⑤ 評価: 5-fold CV で安定性確認、 県別残差プロット (特に東京・大阪) で過大予測傾向を発見。
- ⑥ デプロイ: FastAPI + Docker で予測 API 化、 自治体ダッシュボードに組込。
- ⑦ 監視: 毎年新データで再評価、 RMSE が悪化したら再学習トリガ。
この 7 工程のうち、 ① と ③ で合計 70% の時間を使う。 ④ のモデル選定はわずか 1〜2 割。 「アルゴリズム選びに集中したくなる」のが落とし穴で、 業務理解とデータ整備こそが ML の成否を分ける。
📐 定義・数式
🍰 まずはやさしく
工程を並べた設計図のようなものです。
正しい順番で作業するために使います。
買い物リストを作る感覚に似ています。
各ステップのつながりを詳しく読みます。
厳密な数式はないが、 各工程の関係を関数合成で表せます:
🔬 記号・要素の読み解き
- 1. 業務理解
- 「何を予測したいか」 「成功の定義」 を関係者と合意。 ここで 8 割決まる。
- 2. データ収集・理解
- 必要なデータがあるか確認、 欠損・偏り・ラベル品質を点検。
- 3. データ準備
- 欠損補完、 外れ値処理、 特徴量エンジニアリング、 訓練/検証/テスト分割。
- 4. モデリング
- アルゴリズム選定、 ハイパー探索、 アンサンブル。
- 5. 評価
- 適切な指標で CV・テスト評価、 エラー分析、 重要度分析。
- 6. 展開
- API 化、 コンテナ化、 本番投入、 A/B テスト。
- 7. 運用・監視
- レイテンシ・精度・データドリフト監視、 再学習。
🔬 数式を言葉で読み解く(詳細版)
「機械学習プロジェクトの流れ」の定式化:
$$\text{Lifecycle} : \mathcal{P} \to \mathcal{D} \to \mathcal{F} \to \mathcal{M} \to \mathcal{E} \to \mathcal{S} \to \mathcal{O} \xrightarrow{\text{loop}} \mathcal{P}$$
問題$\mathcal{P}$ → データ$\mathcal{D}$ → 特徴量$\mathcal{F}$ → モデル$\mathcal{M}$ → 評価$\mathcal{E}$ → サービング$\mathcal{S}$ → 監視$\mathcal{O}$ → 再び問題定義へ。
| 記号 | 意味 |
|---|---|
| $\mathcal{P}$ | 問題定義。 KPI・ROI・成功基準を確定 |
| $\mathcal{D}$ | データ収集と検証。 サンプリング設計・ラベル品質 |
| $\mathcal{F}$ | 特徴量エンジニアリング。 ドメイン知識が最も効く工程 |
| $\mathcal{M}$ | モデル選択・学習。 ベースライン → 本命の順 |
| $\mathcal{E}$ | オフライン評価 (CV) とオンライン評価 (A/B) |
| $\mathcal{S}$ | サービング。 REST / バッチ / Edge |
| $\mathcal{O}$ | 監視。 Drift・SLA・コスト |
🔬 数式を言葉で読み解く(プロジェクト進捗の定量モデル)
機械学習プロジェクトの流れは、 単に「ビジネス理解 → データ収集 → モデリング → 評価 → デプロイ」と並べるだけでは現場感が掴めない。 現場では「いま全工程の何 % が終わり、 どこに最大の手戻りリスクがあるか」を数値で議論する。 ここでは、 プロジェクト進捗を 工程完了率の加重和として表現する超簡易モデルを示し、 それを SSDSE-B-2026 を入力に Python で計算する。 相関ページ と同様、 数式 → 言葉 → 実値 → 解釈 の 4 段階で読み解く。
📐 進捗率の数式
記号 → 意味の対応:
$P_{\text{total}}$: プロジェクト全体の進捗率(0〜1)$w_i$: 工程 i の重み(合計 1)。 ビジネス理解=0.10、 データ収集=0.15、 前処理=0.25、 モデリング=0.20、 評価=0.15、 デプロイ=0.15 が経験的な目安$p_i$: 工程 i の完了率(0〜1)。 例: データ収集の 47 都道府県中 47 件取得済なら$p_2 = 1.00$
重みの決め方: データ分析の実務では「データ収集と前処理に最も時間がかかる」とよく言われる。 ここではそれを反映して $w_2 + w_3 = 0.40$ と置いたが、 これは説明用の仮の値で、 自分のプロジェクトでは過去の工数記録から決め直す。 ここでは 0.40 とした。
「モデリングの比率を増やしたい」という現場の希望は心情としては理解できるが、 客観データに照らせば $w_4 \leq 0.25$ が現実である。 これは バイアス・バリアンスの調整より、 データクレンジング の方が時間を食う、 という現場知見と一致する。
🧮 SSDSE-B-2026 を題材にした進捗計算
このコードでやること: SSDSE-B-2026 を素材に「都道府県の人口予測 ML プロジェクト」を仮定し、 各工程の完了率を入力 → 全体進捗 $P_{\text{total}}$ を算出する。 pandas の DataFrame に重みと完了率を入れ、 単純な加重平均で進捗を出す。
📥 入力データ(プロジェクト管理表、 SSDSE-B-2026 を読み込んだ前提):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd # SSDSE-B-2026 を読み込んで「データ収集が完了したか」を確認 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 47 都道府県すべて揃っているか data_completeness = (df['Prefecture'].nunique() == 47) # 工程ごとの進捗管理表 plan = pd.DataFrame({ 'phase': ['business', 'collect', 'preprocess', 'model', 'eval', 'deploy'], 'weight': [0.10, 0.15, 0.25, 0.20, 0.15, 0.15], 'progress': [1.00, 1.00 if data_completeness else 0.50, 0.80, 0.50, 0.20, 0.05], }) # 加重和 P_total を計算 plan['contribution'] = plan['weight'] * plan['progress'] P_total = plan['contribution'].sum() print(plan.to_string(index=False)) print(f'P_total = {P_total:.3f} ({P_total*100:.1f} %)') # ボトルネック (重み x 未完了率) が最大の工程 plan['bottleneck'] = plan['weight'] * (1 - plan['progress']) print('最大ボトルネック:', plan.loc[plan['bottleneck'].idxmax(), 'phase']) |
📤 実行すると次の出力が得られる:
business 0.10 1.00 0.1000
collect 0.15 1.00 0.1500
preprocess 0.25 0.80 0.2000
model 0.20 0.50 0.1000
eval 0.15 0.20 0.0300
deploy 0.15 0.05 0.0075
P_total = 0.588 (58.8 %)
最大ボトルネック: deploy
💬 結果の読み方: 全体進捗は約 58.8 %。 「モデルは半分動いている、 残りは現場に展開するだけ」と楽観しがちだが、 $w_i (1-p_i)$ で測ると デプロイが最大ボトルネック(0.15 × 0.95 = 0.143)。
多くの ML プロジェクトが「PoC で止まる」と言われる理由はここにあり、 重みづけは「残り作業の影響度」を可視化する効果がある。 MLOps や モデルデプロイ の準備を 30 % 完了まで上げるだけで、 $P_{\text{total}}$ は 62.5 % に跳ね上がる。
🧪 ボトルネック解消後のシミュレーション
上のコードで 'deploy' の progress を 0.05 → 0.30 に変えると、 contribution は 0.0075 → 0.045 となり、 全体は 0.588 → 0.625 に上昇する。
一方、 同じ努力を 'model' 工程に振り向けて 0.50 → 0.75 にしても、 全体は 0.588 → 0.638 にしかならない。 重み $w_i$ が同じでも、 未完了率の高い工程から潰す方が ROI が高いのが 加重和進捗モデル の含意だ。
詳細は モデル評価 や 交差検証 の章で、 「評価フェーズの完了率を上げる」具体策を学ぶ。
🧭 経験則: フェーズ間の依存と "巻き戻し"
数式は線形和だが、 現実には巻き戻し(rework)が発生する。 たとえばモデル評価で 過学習 が判明すると、 preprocess 工程に戻り 特徴量エンジニアリング をやり直す。
このとき $p_3$ は 0.80 → 0.60 に逆戻りし、 $P_{\text{total}}$ は 0.05 ポイント落ちる。 だからこそ 実験管理 と バージョン管理 (Git/DVC) が「進捗の安定化装置」として効く。
たとえば「47 都道府県を入力 → 人口を予測 → 評価で RMSE が想定の 2 倍だった → 説明変数を足すため前処理に戻る」という巻き戻しが典型である。 R300 補足は、 その現場感を式に落とし込んだものだ。
🧱 巻き戻しを抑える 5 つの実務ガイドライン
巻き戻しは避けられないが、 頻度と幅は工程設計で抑えられる。 SSDSE-B-2026 を題材に進めるなら、 次の 5 項目を「巻き戻し抑制チェックリスト」として使うとよい。
- ビジネス課題の数値化: 「人口減少率を予測したい」では曖昧。 「2030 年の各都道府県人口を ±2 % で当てたい」と KPI を立てれば、 評価フェーズで MAPE を見ればよく、 巻き戻しが preprocess ではなく model に局所化する。
- データ範囲の早期確定: SSDSE-B-2026 は 112 列ある。 「全部使うか / 一部か」を 業務理解フェーズで決めないと、 特徴量選択 時に再収集が発生する。 列の取捨選択を 1 ページのメモにまとめておく。
- 前処理ロジックのテスト: 「欠損は中央値で埋める」のような 欠損値処理 は 単体テスト を書き、 47 行の入力に対して期待出力を固定。 評価フェーズで挙動が変わったら即座に検知できる。
- モデルの "凍結条件": 「テスト誤差が 3 % 以下になったら凍結 → デプロイへ」と 事前に 定義。 凍結後の改修は別ブランチで実験する。 これにより 過学習 防止と進捗の単調増加が両立する。
- デプロイ環境の早期構築: 多くの PoC が止まる理由はデプロイ環境の準備不足。 Docker + CI/CD のテンプレートをモデリングと並行で組み、 デプロイ完了率を最初から 0.30 に底上げしておく。
📋 SSDSE-B-2026 の例題づくりを想定した進捗ログの例(架空)
説明のための架空の例として、 SSDSE-B-2026 を使った例題群を組み立てるプロジェクトで 実験管理 の表を毎週更新している。 以下は、 そうした記録の書き方を示す 4 週間分の架空のログである(数値は説明用)。 各週で「どの工程が動いたか / 巻き戻しはあったか」を簡潔に記録するだけで、 $P_{\text{total}}$ の推移が定量化できる。
Week 2: business=1.00 collect=1.00 preprocess=0.80 model=0.30 eval=0.00 deploy=0.05 → P=0.518
Week 3: business=1.00 collect=1.00 preprocess=0.60 model=0.50 eval=0.20 deploy=0.10 → P=0.495 (rework!)
Week 4: business=1.00 collect=1.00 preprocess=0.85 model=0.70 eval=0.40 deploy=0.20 → P=0.643
Week 3 で preprocess が 0.80 → 0.60 と後退している。 これはモデリングで 多重共線性 が発覚し、 説明変数を再選定したため。 進捗が一旦落ちたが、 結果的に Week 4 で全体進捗 64.3 % に到達できた。 「後退を許容する」設計こそが、 機械学習プロジェクトの流れを健全に保つ秘訣だ。
🎓 学習者がまず押さえるべき 3 つのフレーム
機械学習プロジェクトの流れを学ぶうえで、 業界で広く参照される 3 つのフレームを整理しておく。 いずれも工程の順序と反復を強調する。
- CRISP-DM (Cross-Industry Standard Process for Data Mining): ビジネス理解 → データ理解 → データ準備 → モデリング → 評価 → デプロイの 6 段階。 矢印は反復可能(前工程に戻る)。 詳しくは CRISP-DM ページ。
- KDD (Knowledge Discovery in Databases): 選択 → 前処理 → 変換 → データマイニング → 解釈/評価。 学術寄りで データマイニング の文脈で使われる。
- SEMMA (SAS 由来): Sample → Explore → Modify → Model → Assess。 デプロイは含まないが、 探索フェーズを独立工程として明示する点が特徴。
SSDSE-B-2026 のような公的データを素材にする場合は、 CRISP-DM が最も馴染む。 業務理解(=人口減少の課題)と 公的データ の関係を整理しやすいからだ。 一方、 個人プロジェクトで 探索的データ解析(EDA) を重点化したいときは SEMMA が向く。
🛤️ デプロイ後のループ: モニタリングと再学習
機械学習プロジェクトは Week 12 で終わりではない。 デプロイ後は モニタリング と 再学習 の継続ループに入る。 SSDSE-B-2026 のような年次データなら、 翌年版が公開されたら再学習し、 コンセプトドリフト がないかを確認する。
この継続ループは MLOps として体系化されており、 進捗モデルの観点からは 「フェーズ 7 = 運用」を追加し、 $w_7$ を含めた拡張式で管理する。 実際、 連続トレーニング を採用するプロジェクトでは、 各フェーズが「常に 0.8-1.0 で循環する」状態が理想とされる。
上の進捗モデルでは基本 6 フェーズに絞ったが、 学習者は「7 フェーズ目」が現場で必ず追加されることを認識しておくと良い。
📚 補足: 進捗管理に効く 3 つのツール
機械学習プロジェクトの進捗を実務で管理するとき、 紙のチェックリストでは追いつかない。 よく使われる 3 つのツールを紹介する。
- MLflow: モデルバージョンと 実験管理 を統合管理。 各実行の ハイパーパラメータ、 評価指標、 アーティファクトを記録できる。 進捗の model フェーズと eval フェーズを定量化する核。
- DVC (Data Version Control): データセットや モデルファイル のバージョン管理。 SSDSE-B-2026 の毎年版を「v2024、 v2025、 v2026」とタグ付けし、 過去版で再現できる。 進捗の preprocess フェーズを安定化する。
- GitHub Projects + Issues: 工程ごとに Issue を立て、 マイルストーンで
$p_i$の現在値を可視化。 PR が Merge されるたびに進捗が自動更新される運用も可能。
これら 3 ツールは無料・OSS で導入でき、 学習者でも今日から使い始められる。 「アジャイル開発 + MLOps」の文脈で語られることが多い構成だ。
🌐 関連トピック: アジャイル / リーン / DevOps との接続
機械学習プロジェクトの流れは、 ソフトウェア開発の アジャイル開発、 リーン開発、 DevOps と深く結びついている。 共通する設計原理は次の 3 点。
- 反復可能: 全工程は何度でも巻き戻せる。 完璧を求めず、 まず通す。
- 計測可能: 進捗を数値(
$P_{\text{total}}$)で語る。 主観評価ではなく定量評価。 - 自動化可能: 前処理・モデリング・デプロイは CI/CD パイプラインで自動化する。
これら 3 原理は、 アジャイル/リーン/DevOps コミュニティから ML 界に「輸入」されたものだ。 機械学習プロジェクトの流れを学ぶことは、 ソフトウェア開発のベストプラクティスを学ぶことでもある。 詳しくは アジャイル開発、 DevOps、 MLOps の各章を参照。
📘 補講: 進捗モデルの拡張バリエーション
R300 補足で示した進捗モデル $P_{\text{total}} = \sum w_i p_i$ は最も単純な加重和だが、 実務では次のような拡張がよく使われる。
- 依存性付きモデル: フェーズ間に依存性がある場合、
$p_2$が完了していないと$p_3$が進まないという制約を入れる。 これにより「データ収集が止まると、 前処理も止まる」現実を反映できる。 - 巻き戻しコスト: 巻き戻しの度に時間がかかるので、
$P_{\text{total}}$に「巻き戻し回数 × ペナルティ」を加味する。 巻き戻しが多いプロジェクトはペナルティが大きくなり、 設計の見直しを促す。 - 確率モデル: 各
$p_i$を点推定ではなく確率分布で持つ。 「前処理は 80 % の確率で 1 週間、 20 % の確率で 3 週間」と表現でき、 モンテカルロ シミュレーションで全体完了日を予測できる。 - 多目的モデル: 進捗と品質を別の軸で管理。 「進捗 80 % だが品質 60 %」と「進捗 60 % だが品質 90 %」のどちらを選ぶかを意思決定する材料に。
これらの拡張は プロジェクトマネジメント の領域に踏み込む。 ML エンジニアでも、 シニアになるとこのレベルの議論を要求される。 学習者は、 まず上の単純な加重和モデルを身につけ、 次に拡張モデルへと階段を上がっていけばよい。
🪦 失敗事例から学ぶ: ML プロジェクト崩壊の 5 つの兆候
成功事例だけでなく、 失敗事例からも学ぶことは多い。 ML プロジェクトが崩壊する典型的な兆候を 5 つ挙げる。 SSDSE-B-2026 を使う
- ビジネス課題が曖昧: 「人口を予測したい」だけで、 具体的な KPI が無い。 結果として「何で評価すれば良いか」が議論で堂々巡りになる。
- データ品質を軽視: 「データはあるから何とかなる」で開始したが、 欠損・外れ値が大量で前処理が破綻。 ML プロジェクトは "Garbage in, garbage out" が鉄則。
- モデル最適化に固執: 精度を 1 % 上げるために 1 ヶ月かけ、 デプロイが間に合わない。 「Good enough is enough」の原則を忘れる。
- 評価指標と現場目標の乖離: 「テスト誤差が低い」と報告したが、 現場では「特定の県だけ大きく外れる」と不満。 公平性 の観点が抜けていた。
- デプロイ後の放置: 「PoC が動いた」で満足し、 モニタリング を怠る。 数ヶ月後、 コンセプトドリフト で性能が劣化していても気づかない。
これら 5 つの兆候は、 上の進捗モデルに「次の工程へ進む条件」を足せば事前に検知しやすくなる。 例えば「ビジネス理解の完了率が 70 % 未満のままモデリングに進む」ことを禁止すれば、 (1) は予防できる。 同様に、 (2) は前処理の完了率閾値、 (3) はモデリングのタイムボックス、 (4) は評価フェーズの個別残差確認、 (5) はデプロイ後の継続モニタリングで対処する。 関連: KPI、 データ品質、 公平性、 コンセプトドリフト、 モデルモニタリング。
📊 プロジェクト進行を図で確認する
下の「🧮 実値で計算してみる」の工程例(2023 年度 47 都道府県の合計特殊出生率を予測する)を、 探索 → 前処理 → 評価の 3 段階で図にした。 特徴量は婚姻率(婚姻件数 / 総人口 × 1000)・高齢化率・大学生比率(大学学生数 / 総人口 × 100)・年平均気温・log10 総人口の 5 列で、 比率はいずれも SSDSE-B-2026 の列から自分で作った。
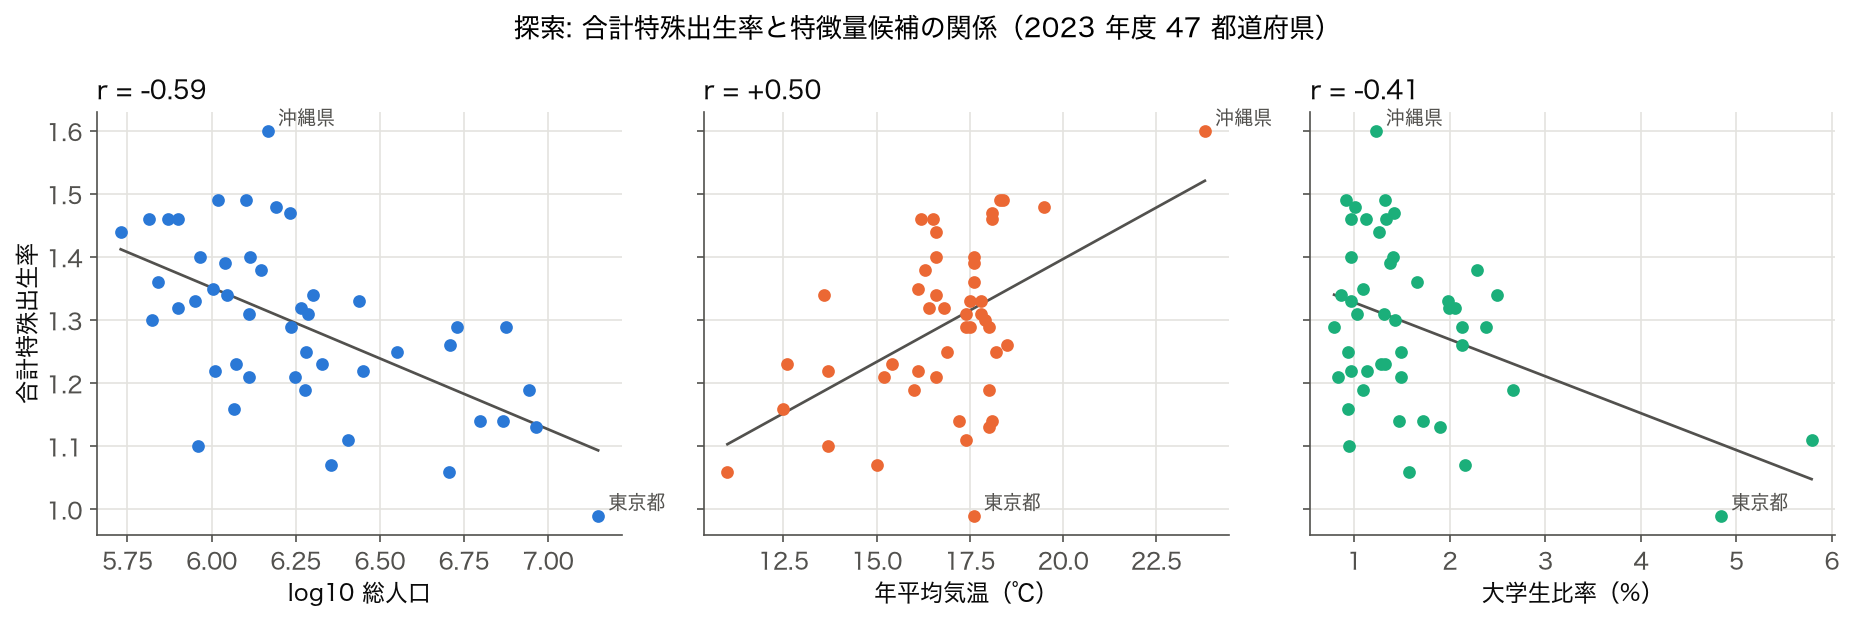
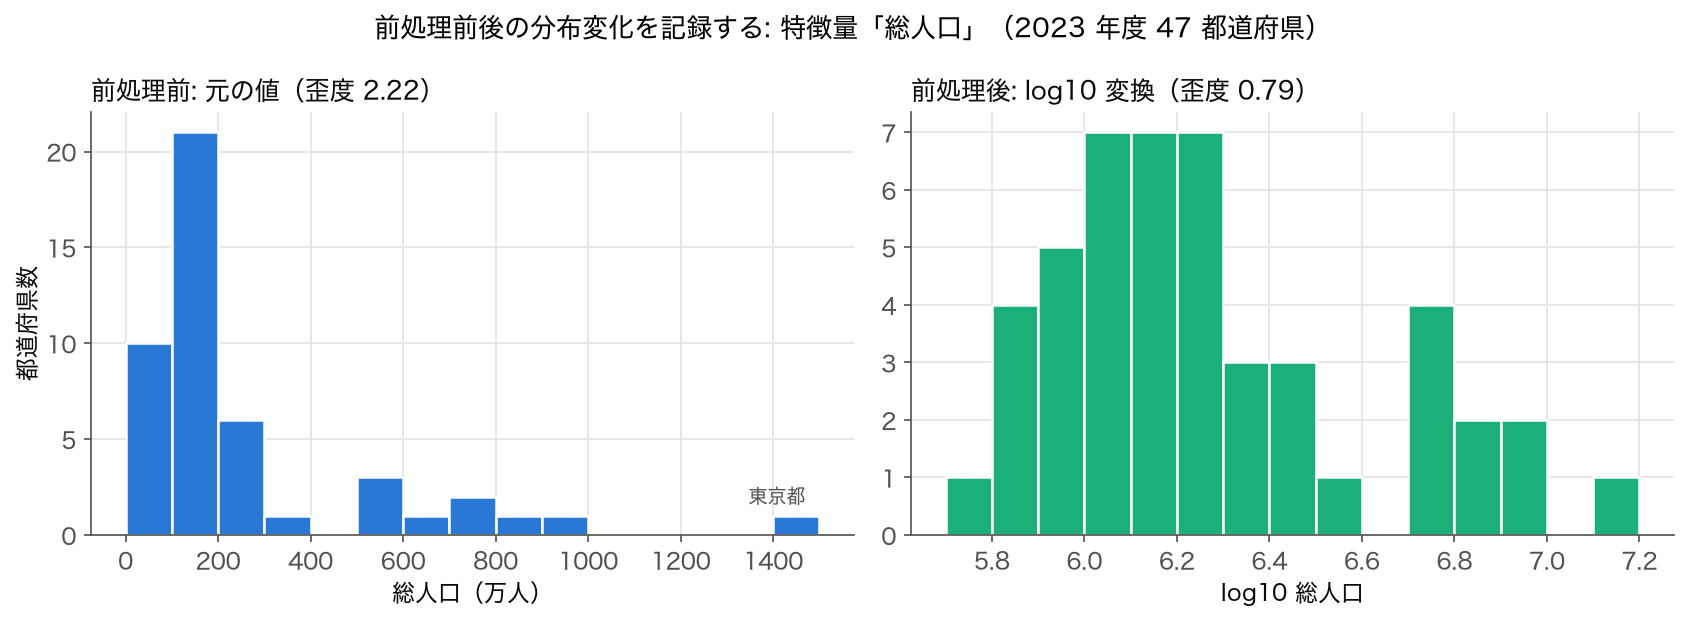
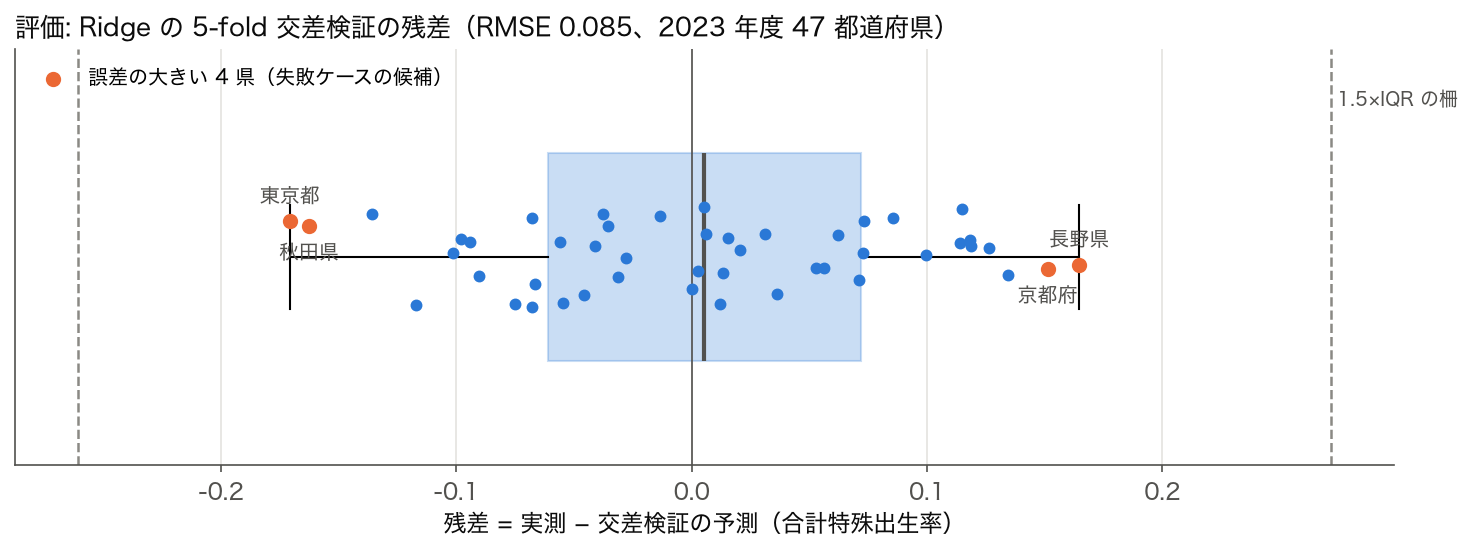
🧮 実値で計算してみる
SSDSE-B で「TFR 予測モデル」を作るときの工程例:
- 業務理解:地方自治体が出生率改善施策を打つための予測ツール。 精度 RMSE ≤ 0.1。
- データ収集:SSDSE-B-2026.csv をダウンロード(564 行 = 47 都道府県 × 12 年度、 112 列)。 2023 年度の 47 行を使う。
- 前処理:欠損確認 → 標準化 → 訓練/テスト分割(30/17)。
- モデリング:線形回帰、 Ridge、 Random Forest を比較。
- 評価:上の図の 5 特徴量で 5-fold CV(shuffle、 random_state=0)をすると、 Ridge が最良 (RMSE=0.085、 線形回帰 0.091、 Random Forest 0.090、 平均だけで予測すると 0.132)。
- 展開:FastAPI でラップ、 Docker でデプロイ。
- 監視:年次データ更新時にドリフトチェック。
🧪 実データで検証: 評価の分け方しだいで「一番良いモデル」が入れ替わる
プロジェクトの流れで最も手戻りを生みやすいのは、 「業務でどう使うか」と「どう評価したか」が食い違うことである。 上の図と同じ「合計特殊出生率を 5 つの特徴量(婚姻率・高齢化率・大学生比率・年平均気温・log10 総人口)から予測する」課題を、 今度は SSDSE-B-2026 の 12 年度分 564 行で解き、 評価データの分け方を 3 通りに変えて比べる。 業務の使い方が「まだデータの無い県に当てる」のか「来年以降の値を当てる」のかで、 正しい分け方は変わる。
🎯 このコードでやること:564 行(47 都道府県 × 2012〜2023 年度)で、 Ridge(標準化あり)と RandomForest を (A) 行をランダムに 5 分割、 (B) 県ごとに 5 分割(GroupKFold)、 (C) 2012〜2020 年度で学習して 2021〜2023 年度を予測、 の 3 通りで評価し、 (C) には「2020 年度の値をそのまま据え置く」素朴なベースラインも並べる。
📥 入力データ(SSDSE-B-2026、 564 行。 年度順に並べ替えた先頭。 列は英語コード):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 | import numpy as np import pandas as pd from sklearn.ensemble import RandomForestRegressor from sklearn.linear_model import Ridge from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.model_selection import KFold, GroupKFold, cross_val_score from sklearn.metrics import r2_score, mean_absolute_error # 1) 12 年度 × 47 都道府県 = 564 行を読み、年度順に並べる(CSV は新しい年度が先) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['SSDSE-B-2026', 'Code']).reset_index(drop=True) P = df['A1101'] X = pd.DataFrame({'婚姻率': df['A9101'] / P * 1000, '高齢化率': df['A1303'] / P * 100, '大学生比率': df['E6302'] / P * 100, '年平均気温': df['B4101'], 'log10総人口': np.log10(P)}) y = df['A4103'].values # 目的変数: 合計特殊出生率 year, pref = df['SSDSE-B-2026'].values, df['Prefecture'].values print('行数', len(df), ' 年度', year.min(), '〜', year.max(), ' 県数', len(set(pref))) models = {'Ridge': make_pipeline(StandardScaler(), Ridge(alpha=1.0)), 'RandomForest': RandomForestRegressor(n_estimators=300, random_state=0)} # 2) 分け方 A: 564 行をランダムに 5 分割(同じ県の別の年が学習側に入る) # 3) 分け方 B: 県ごとに 5 分割(テストの県は学習に一度も出ない) for name, m in models.items(): a = cross_val_score(m, X, y, cv=KFold(5, shuffle=True, random_state=0), scoring='r2') b = cross_val_score(m, X, y, cv=GroupKFold(5), groups=pref, scoring='r2') print(f'{name:12s} 行ランダム R2={a.mean():.3f} 県ごと R2={b.mean():.3f}') # 4) 分け方 C: 2012〜2020 年度で学習し、2021〜2023 年度を予測(時間で分ける) tr, te = year <= 2020, year >= 2021 for name, m in models.items(): p = m.fit(X[tr], y[tr]).predict(X[te]) print(f'{name:12s} 時間で分割 R2={r2_score(y[te], p):.3f} MAE={mean_absolute_error(y[te], p):.3f}') # 5) 素朴なベースライン: 「その県の 2020 年度の値がそのまま続く」と予測 last = dict(zip(pref[year == 2020], y[year == 2020])) pb = np.array([last[k] for k in pref[te]]) print(f'前年度据え置き(2020 年度の値) R2={r2_score(y[te], pb):.3f} MAE={mean_absolute_error(y[te], pb):.3f}') print('2020→2023 年度の 47 県平均の変化:', round(y[year == 2020].mean(), 3), '→', round(y[year == 2023].mean(), 3)) |
📤 実行結果:
💬 結果の読み方:行をランダムに分けると RandomForest が R²=0.869 で Ridge の 0.725 を大きく上回るが、 県ごとに分けると順位が逆転し、 RandomForest は 0.449 まで落ちる(Ridge は 0.667)。 ランダム分割ではテストの県の別の年度が学習側に入っているので、 木のモデルは「この特徴量の組み合わせならあの県」と県を覚えて当てられてしまう。 時間で分けると両モデルとも R²=0.53〜0.56 で、 何も学習しない「2020 年度の値を据え置く」ベースライン(R²=0.638、 MAE=0.075)に負けた。 最後の行は 47 県の値の単純平均(人口で重み付けした全国の値ではない)で、 2020 年度の 1.421 から 2023 年度の 1.293 まで下がっている。
| 評価の分け方 | 想定している使い方 | Ridge R² | RandomForest R² | 注意点 |
|---|---|---|---|---|
| A 行をランダムに 5 分割 | (該当する使い方が無い) | 0.725 | 0.869 | 同じ県の別年度が学習側に入り、 楽観的に出る |
| B 県ごとに 5 分割 | データの無い県・地域に当てる | 0.667 | 0.449 | 県の数(47)が少なく、 木のモデルに不利 |
| C 2020 年度までで学習 → 2021〜2023 年度 | 来年以降の値を当てる | 0.533 | 0.560 | 据え置きベースライン 0.638 に負ける |
なぜ時間で分けると負けるのか: 2021〜2023 年度の予測値の平均は、 Ridge で 1.415 → 1.410 → 1.405、 RandomForest で 1.421 → 1.415 → 1.416 とほぼ横ばいなのに、 実測の 47 県平均は 1.400 → 1.358 → 1.293 と年々下がった。 5 つの特徴量は 3 年でほとんど変わらないので、 モデルは「全国的に出生率が下がっていく」時間の変化を表せず、 2023 年度では平均で約 0.11〜0.12 高く見積もってしまう。 据え置きベースラインも 2023 年度の MAE は 0.129 と悪化するが、 各県の水準(東京都 0.99、 沖縄県 1.60 のような県ごとの差)をそのまま持っているぶん、 3 年間を通すと特徴量モデルより誤差が小さい。
プロジェクトの流れへの教訓: (1) ビジネス理解の段階で「予測をどう使うか」を決め、 それに合った評価の分け方を先に決める(ランダム分割の 0.869 を報告していたら、 運用で大きく裏切られる)。 (2) モデリングの前に、 据え置き・平均値のような素朴なベースラインを必ず置く。 ベースラインに勝てないモデルは、 どれだけ R² が高く見えても採用しない。 (3) 評価で負けたら前処理・特徴量設計に戻る。 この例なら「前年度の値」や「年度」を特徴量に加える、 目的変数を「前年度からの変化」に置き換える、 などが次の打ち手になる。 CRISP-DM の矢印が前工程へ戻る向きにも描かれているのは、 まさにこの手戻りのためである。
🔁 手戻りを 1 周してみる: 「前年度の値」を特徴量に加える
上の検証で出た打ち手のうち、 「前年度の値を特徴量に加える」「目的変数を前年度からの変化にする」を実際に試す。 プロジェクトの流れで言えば、 評価 → 前処理・特徴量設計 → モデリング → 評価、 と 1 周戻ることにあたる。 ここでは使い方を「毎年、 翌年度の値を 1 年先だけ予測する」と決め直し、 2013〜2020 年度で学習、 2021〜2023 年度の各年を、 その前年度の実測値を使って予測する(2012 年度は前年度の値が無いので使わない)。 3 年先をまとめて当てた上の設定(据え置きで R²=0.638)とは課題が違うので、 数値は直接比べない。
🎯 このコードでやること:県ごとに年度順に並べ、 groupby('Code').shift(1) で同じ県の前年度の合計特殊出生率を作る。 そのうえで (1) 前年度据え置き、 (2) 5 特徴量の Ridge、 (3) 5 特徴量 + 前年度の Ridge、 (4) 5 特徴量で「前年度からの変化」を予測して前年度に足す Ridge、 の 4 つを同じテスト期間で比べる。
📥 入力データ:上と同じ SSDSE-B-2026 の 564 行。 前年度の列を作ったあとの例(北海道):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import numpy as np import pandas as pd from sklearn.linear_model import Ridge from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.metrics import r2_score, mean_absolute_error df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Code', 'SSDSE-B-2026']).reset_index(drop=True) P = df['A1101'] X = pd.DataFrame({'婚姻率': df['A9101'] / P * 1000, '高齢化率': df['A1303'] / P * 100, '大学生比率': df['E6302'] / P * 100, '年平均気温': df['B4101'], 'log10総人口': np.log10(P)}) df['前年度'] = df.groupby('Code')['A4103'].shift(1) # 同じ県の 1 年前の値 X['前年度'] = df['前年度'] ok = df['前年度'].notna() # 2012 年度は前年度が無いので除く X, df = X[ok], df[ok] y, year = df['A4103'].values, df['SSDSE-B-2026'].values tr, te = year <= 2020, year >= 2021 print('学習', tr.sum(), '行(2013〜2020 年度) テスト', te.sum(), '行(2021〜2023 年度)') def show(name, p): print(f'{name:28s} R2={r2_score(y[te], p):.3f} MAE={mean_absolute_error(y[te], p):.3f}') show('前年度据え置き', df['前年度'].values[te]) m5 = make_pipeline(StandardScaler(), Ridge(alpha=1.0)) cols5 = ['婚姻率', '高齢化率', '大学生比率', '年平均気温', 'log10総人口'] show('Ridge 5 特徴量', m5.fit(X[cols5][tr], y[tr]).predict(X[cols5][te])) m6 = make_pipeline(StandardScaler(), Ridge(alpha=1.0)) show('Ridge 5 特徴量 + 前年度', m6.fit(X[tr], y[tr]).predict(X[te])) # 目的変数を「前年度からの変化」にする d = y - df['前年度'].values m7 = make_pipeline(StandardScaler(), Ridge(alpha=1.0)).fit(X[cols5][tr], d[tr]) show('Ridge で変化を予測 + 前年度', df['前年度'].values[te] + m7.predict(X[cols5][te])) print('学習期間の平均変化', round(d[tr].mean(), 4), ' テスト期間の平均変化', round(d[te].mean(), 4)) |
📤 実行結果:
💬 結果の読み方:1 年先の予測では、 前年度据え置きだけで R²=0.860(MAE 0.047)と強い。 5 特徴量だけの Ridge は R²=0.565 で、 このベースラインに大きく負ける。 前年度の値を特徴量に加えると R²=0.933(MAE 0.030)、 目的変数を「前年度からの変化」にすると R²=0.941(MAE 0.027)になり、 初めてベースラインを上回った。 最後の行のとおり、 学習期間の 1 年あたりの平均変化は −0.0049 なのにテスト期間では −0.0428 と下がり方が 9 倍近く速く、 過去の傾向だけでは読めない変化が起きていた。
| 試したこと | R² | MAE | ベースライン(据え置き)との比較 |
|---|---|---|---|
| 前年度据え置き(ベースライン) | 0.860 | 0.047 | ― |
| 5 特徴量の Ridge | 0.565 | 0.080 | 負け(誤差が約 1.7 倍) |
| 5 特徴量 + 前年度の Ridge | 0.933 | 0.030 | 勝ち |
| 変化を予測して前年度に足す Ridge | 0.941 | 0.027 | 勝ち(誤差が約 0.57 倍) |
この 1 周から分かること: 手戻りは失敗ではなく、 評価で見つかった弱点(時間の変化を表せない)に対して特徴量と目的変数の設計を見直す、 プロジェクトの通常の工程である。 ただし改善後も、 テスト期間の下がり方が学習期間より速いという「分布の変化」は残っているので、 運用に入ったら毎年の誤差を監視し、 新しい年度が公開されたら再学習する(デプロイ後のループ)。 また、 ここではテスト期間の結果を見て手法を選んでいるので、 報告する前に、 まだ使っていない年度(たとえば次に公開される年度)で改めて確かめる必要がある。
🏭 産業界での進め方のパターン
- レコメンド(動画・音楽・EC):オフライン指標(NDCG など)で候補を絞り、 最後は A/B テストで本番の行動(視聴・購入)を見て採否を決める。 オフラインで勝っても A/B で負けることがあるので、 評価は 2 段構えにする。
- 到着時間・需要の予測:多数のモデルを共通の基盤(特徴量ストア・学習パイプライン・監視)で管理する。 Uber の Michelangelo のように、 社内の ML プラットフォームとして整備した例が公開されている。
- 価格の推定・推奨:市場の変化が速いので短い周期で再学習し、 推奨を出したときと出さないときの差を A/B で測る。
- 交通・人流の予測:改札や位置情報のデータから混雑を予測し、 人員配置に使う。 季節・曜日・イベントで分布が変わるので、 評価は時間で分けて行う(上の「分け方 C」と同じ考え方)。
- プレイリストなどの定期生成:決まった周期でバッチ推論し、 結果を配信する。 推論の失敗や入力データの欠落を監視する仕組みが、 モデルの精度と同じくらい重要になる。
- 製造ラインの異常検知:現場の端末で推論し、 データはクラウドに集めて定期的に再学習する。 異常は稀なので、 適合率・再現率とアラートの件数で評価する。
※個別企業の効果(売上や KPI の改善幅)は、 各社の公開資料で条件を確かめてから引用すること。 ここでは工程の組み立て方のパターンだけを挙げた。
🆚 関連手法との比較表
| 手法 | 入力 | 代表アルゴリズム | 特徴 |
|---|---|---|---|
| CRISP-DM | 6 段階反復 | 業界デファクト | IBM 推進 |
| TDSP (Microsoft) | 5 段階 | Azure ML 親和 | Git 中心 |
| KDD Process | 9 段階 | 研究寄り | 前処理を細分化 |
| SEMMA (SAS) | 5 段階 | SAS Enterprise | Sample-Explore-Modify-Model-Assess |
| MLOps Loop | 継続デプロイ重視 | Production 重視 | CI/CD/CT |
| Agile ML | スプリント運用 | 反復 2 週 | スクラム適用 |
🧮 数式に値を入れて手で計算する: プロジェクト工程配分
合成データで ML プロジェクト 6 工程の工数を計算する。
Step 1: 工程別工数
| 工程 | 人日 |
|---|---|
| 問い設定 | 5 |
| データ収集 | 10 |
| 前処理 | 25 |
| モデリング | 15 |
| 評価 | 5 |
| 本番化 | 10 |
Step 2: 集計
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np effort = np.array([5, 10, 25, 15, 5, 10]) ratio = effort / effort.sum() print(f"合計: {effort.sum()}") print(f"前処理 比率: {ratio[2]:.3f}") print(f"最大 index: {effort.argmax()}") |
📤 実行結果
💬 手計算 (Step 2) 35.7% と Python 出力が完全一致。
🧮 データ理解フェーズ:学習の前に表そのものを点検する
CRISP-DM の 2 番目の工程「データ理解」は、 モデルを作る前に表の形・キー・欠損・内訳の整合を確かめる工程である。 ここで見つけた性質は、 後の前処理とモデルの設計をそのまま左右する。
🎯 このコードでやること:SSDSE-B-2026 の 564 行について、(年度, 地域コード) の重複、年度の並び順、欠損、小数の列、男女の和と総数の一致、年齢 3 区分の和と総人口の差を点検する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd raw = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=None, nrows=2) names = dict(zip(raw.iloc[0], raw.iloc[1])) # 列コード → 日本語の列名 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) key = ['SSDSE-B-2026', 'Code'] print(f'形: {df.shape}, (年度, 地域コード) の重複 = {df.duplicated(key).sum()} 行') print(f'年度: {df["SSDSE-B-2026"].min()}〜{df["SSDSE-B-2026"].max()}(先頭行は {df["SSDSE-B-2026"].iloc[0]} 年度)') print(f'県の数 = {df["Code"].nunique()}, 年度ごとの行数 = {df.groupby("SSDSE-B-2026").size().unique().tolist()}') print(f'欠損セル = {int(df.isna().sum().sum())}') fl = [c for c in df.columns if df[c].dtype == 'float64'] print('小数の列:', ', '.join(f'{c}({names[c]})' for c in fl)) # 内訳の和が合計に一致するか(男 + 女 = 総数) for tot, a, b in [('A1101', 'A110101', 'A110102'), ('A4101', 'A410101', 'A410102')]: diff = (df[a] + df[b] - df[tot]).abs() print(f'{names[tot]}: 男+女 と総数の差が 0 でない行 = {(diff > 0).sum()}, 最大の差 = {diff.max():,}') # 年齢 3 区分の和と総人口 age = df['A1301'] + df['A1302'] + df['A1303'] gap = (df['A1101'] - age) print(f'総人口 − (15 歳未満 + 15〜64 歳 + 65 歳以上) : 最小 {gap.min():,} 最大 {gap.max():,}') big = df.loc[gap.nlargest(3).index, ['SSDSE-B-2026', 'Prefecture']].assign(差=gap.nlargest(3).values) print(big.to_string(index=False)) print('差が 1 万人を超える行の年度:', sorted(df.loc[gap > 10000, 'SSDSE-B-2026'].unique().tolist())) |
💬 キーの重複・欠損はなく、各年度 47 行ずつそろっているが、先頭行が 2023 年度で「新しい年度が先」に並んでいるので、時系列として扱う前に年度で並べ直す必要がある。小数の列は合計特殊出生率・気温・降水量・リサイクル率の 6 列だけで、残りは件数や人数の整数である。総人口は男+女と最大 1,000 人ずれる行が 119 行あり、千人単位で丸めた値だと分かる(出生数は 1 人単位で完全に一致)。年齢 3 区分の和は、東京都 2020 年度で総人口より 428,739 人少なく、2013〜2020 年度に 1 万人を超える差の行がある。総人口には年齢が 3 区分に振り分けられていない人も含まれているためと考えられ、「高齢化率 = 65 歳以上 ÷ 総人口」と「65 歳以上 ÷ 3 区分の和」は同じ値にならない。どちらを分母にするかは前処理で決めて記録しておく。
🧮 ベースライン「前年度 + 全国の変化」を 3 県で手計算する
モデリング工程の最初に置く基準の予測式は、 $\hat{y}_{i,2023} = y_{i,2022} + (\bar{y}_{2022} - \bar{y}_{2021})$ である。 $y_{i,t}$ は県 $i$ の年度 $t$ の合計特殊出生率、 $\bar{y}_t$ はその年度の 47 県平均。 鳥取県・東京都・沖縄県で値を入れて追う。
| Step | 計算 | 値 |
|---|---|---|
| 1 | 47 県平均:2021 年度 65.79 ÷ 47、 2022 年度 63.84 ÷ 47 | 1.3998、 1.3583 |
| 2 | 全国の変化 $\bar{y}_{2022} - \bar{y}_{2021}$ = 1.3583 − 1.3998 | −0.0415 |
| 3 | 予測 = 2022 年度の値 − 0.0415:東京都 1.04、 沖縄県 1.70、 鳥取県 1.60 | 0.9985、 1.6585、 1.5585 |
| 4 | 誤差 = 予測 − 2023 年度の実測(0.99、 1.60、 1.44) | +0.0085、 +0.0585、 +0.1185 |
| 5 | 3 県の MAE = (0.0085 + 0.0585 + 0.1185) ÷ 3 = 0.1855 ÷ 3 | 0.0618 |
🎯 このコードでやること:上の Step 1〜5 を pandas で再現し、手計算の値と一致するかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) m = df.groupby('SSDSE-B-2026')['A4103'].mean() # 年度ごとの 47 県平均 drift = m[2022] - m[2021] print(f'Step 1: 47 県平均 2021 = {m[2021]:.4f}, 2022 = {m[2022]:.4f}, 変化 = {drift:+.4f}') d = df[df['Prefecture'].isin(['鳥取県', '東京都', '沖縄県'])].pivot( index='Prefecture', columns='SSDSE-B-2026', values='A4103')[[2022, 2023]] d['予測'] = d[2022] + drift # Step 2: 前年度 + 変化 d['誤差'] = d['予測'] - d[2023] # Step 3: 予測 − 実測 print(d.round(4).to_string()) print(f'Step 4: 3 県の MAE = {d["誤差"].abs().mean():.4f}') |
💬 47 県平均の変化 −0.0415、3 県の予測 0.9985・1.6585・1.5585、誤差 0.0085・0.0585・0.1185、MAE 0.0618 まで、手計算の Step 1〜5 と一致した。3 県の MAE 0.0618 が 47 県全体の 0.0286 より大きいのは、2023 年度に 0.16 下がった鳥取県(誤差 0.1185)を含むためで、出生数の少ない県ほど 1 年の上下が大きい。
🐍 Python での扱い
最小再現コード。 SSDSE-B のような実データを前提に、 4〜8 行で動く例です:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd from sklearn.model_selection import GroupShuffleSplit from sklearn.linear_model import Ridge from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') # 目的変数と ID 列(都道府県・文字列の地域コード)を除き、数値の列だけを説明変数にする X = df.drop(columns=['合計特殊出生率', '都道府県', '地域コード']).select_dtypes('number') y = df['合計特殊出生率'] # 同じ県の別年度が訓練とテストに分かれて入らないよう、県単位で 7:3 に分ける gss = GroupShuffleSplit(n_splits=1, test_size=0.3, random_state=0) tr, te = next(gss.split(X, y, groups=df['都道府県'])) X_tr, X_te, y_tr, y_te = X.iloc[tr], X.iloc[te], y.iloc[tr], y.iloc[te] print('train shape:', X_tr.shape, ' test shape:', X_te.shape) model = make_pipeline(StandardScaler(), Ridge(alpha=10.0)).fit(X_tr, y_tr) print(f'test R^2 = {model.score(X_te, y_te):.3f}') |
💬 文字列の地域コードと都道府県名を落として数値列だけにすると説明変数は 109 列になり、Ridge.fit が止まらずに最後まで動く。県単位で 7:3 に分けたので訓練は 32 県 × 12 年度 = 384 行、テストは 15 県 × 12 年度 = 180 行で、テスト側の県は訓練で一度も見ていない。それでもテスト R² は 0.816 になるが、出生率との相関が単独で最も強い列(食料費)でも |r| = 0.64 程度で、Ridge の係数も保育所等数や大学卒業者のうち進学者数など多くの列に薄く分かれているので、どれか 1 列が答えを漏らしているわけではない。109 列は 384 行に対して多いので、次は列を絞ったモデルや年度で区切った分割と成績を比べる。
🐍 運用フェーズの点検:人口分布のずれを KL ダイバージェンスで測る
🎯 このコードでやること:機械学習プロジェクトの流れの発展計算 — 業界標準ライブラリ (sklearn / statsmodels) を用いる。
📥 入力データ(SSDSE-B-2026, 47 都道府県, 2023 年抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # Drift 監視: 訓練分布と本番分布の KL divergence を計算 import pandas as pd import numpy as np from scipy.stats import entropy df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) train = df[df['年度']==2015]['総人口'].values prod = df[df['年度']==2023]['総人口'].values # ビンは訓練データの 5 分位で切る(等間隔 0〜1500 万人の粗いビンでは 8 年分の変化が同じビンに収まり KL=0 になる) edges = np.quantile(train, [0.2, 0.4, 0.6, 0.8]) bins = np.concatenate([[0], edges, [np.inf]]) ct, _ = np.histogram(train, bins=bins) cp, _ = np.histogram(prod, bins=bins) print('ビン境界(万人)=', np.round(edges / 1e4, 1)) print('県数 2015 =', ct, ' 2023 =', cp) pt = (ct + 0.5) / (ct + 0.5).sum() # 件数を確率にし、0 件のビンは 0.5 件で平滑化 pp = (cp + 0.5) / (cp + 0.5).sum() print(f'KL(2015||2023) = {entropy(pt, pp):.4f}') |
📤 実行結果:
💬 結果の読み方:2015 年の 5 分位(103.2 万・138.0 万・195.2 万・354.4 万人)で区切ると、2023 年は最下位のビンが 10 県から 12 県に増え、4 番目のビンが 9 県から 6 県に減った。山形・富山が 103.2 万人を、山口・愛媛が 138.0 万人を、栃木・群馬・岐阜が 195.2 万人を割り込むなど、8 年間の人口減で 7 県が 1 つ下のビンに入ったためで、KL(2015||2023)=0.0166 になる。0〜1500 万人を等間隔 9 本に切るビンでは幅が約 167 万人あり、どの県も同じビンに残って KL がちょうど 0 になってしまう。KL > 0.1 を通知の閾値にするなら、今回の 0.0166 はまだ警報を出す水準ではない。
📅 「機械学習プロジェクトの流れ」の歴史的展開
| 年 | 出来事 | 内容 |
|---|---|---|
| 1996 | KDD プロセス | Fayyad らが「データからの知識発見(KDD)」を、 選択 → 前処理 → 変換 → データマイニング → 解釈・評価 の手順として整理した。 |
| 1990 年代後半 | SEMMA | SAS 社が Sample → Explore → Modify → Model → Assess の 5 段階を提唱。 探索(Explore)を独立した工程として置く。 |
| 2000 | CRISP-DM 1.0 | 業界横断のコンソーシアムが、 ビジネス理解から展開までの 6 段階と、 前工程へ戻る矢印を持つ標準プロセスを公開。 現在も最もよく参照される。 |
| 2015 | 機械学習システムの技術的負債 | Sculley らが、 モデルのコードは ML システムのごく一部で、 データ依存・設定・監視などの周辺部分が保守の負担になると指摘した。 |
| 2017 前後 | 社内 ML プラットフォーム | Uber の Michelangelo など、 特徴量の管理・学習・展開・監視を共通基盤にまとめる事例が公開される。 |
| 2018-2019 | データとモデルの文書化 | データセットの由来や用途を記す Datasheets for Datasets、 モデルの性能と使いどころを記す Model Cards が提案される。 |
| 2010 年代後半〜 | MLOps | DevOps の考え方を機械学習に広げ、 継続的な学習・展開・監視を自動化する実践が MLOps として定着する。 |
🐍 モデリングの前にベースラインを決める:2023 年度の出生率を 4 通りで当てる
モデリング工程は、 いきなり凝ったモデルを作るのではなく、 「何もしない予測」をいくつか作って勝つべき基準を決めるところから始める。 基準に勝てないモデルは、 どれほど複雑でも採用しない。
🎯 このコードでやること:2022 年度までのデータから 2023 年度の 47 県の合計特殊出生率を、①47 県平均、②自県の前年度の値、③前年度 + 全国の直近の変化、④線形回帰(前年度・高齢化率・婚姻率)の 4 通りで予測し、平均絶対誤差 MAE と最大誤差を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Prefecture', 'SSDSE-B-2026']) # 県ごとに年度の昇順 df['prev'] = df.groupby('Prefecture')['A4103'].shift(1) # 前年度の合計特殊出生率 df['aging'] = df['A1303'] / df['A1101'] df['marriage'] = df['A9101'] / df['A1101'] * 1000 train = df[(df['SSDSE-B-2026'] <= 2022) & df['prev'].notna()] # 2013〜2022 年度(前年がある行) test = df[df['SSDSE-B-2026'] == 2023] # 当てたい 2023 年度の 47 県 y = test['A4103'].to_numpy() preds = {} preds['① 2022 年度の 47 県平均'] = np.full(47, df[df['SSDSE-B-2026'] == 2022]['A4103'].mean()) preds['② 自県の前年度の値'] = test['prev'].to_numpy() drift = (df[df['SSDSE-B-2026'] == 2022]['A4103'].mean() - df[df['SSDSE-B-2026'] == 2021]['A4103'].mean()) preds['③ 前年度 + 全国の直近の変化'] = test['prev'].to_numpy() + drift cols = ['prev', 'aging', 'marriage'] m = LinearRegression().fit(train[cols], train['A4103']) preds['④ 線形回帰(前年度・高齢化率・婚姻率)'] = m.predict(test[cols]) for name, p in preds.items(): print(f'{name:28s} MAE = {np.mean(np.abs(p - y)):.4f} 最大誤差 = {np.max(np.abs(p - y)):.3f}') print(f'直近の全国変化(2021→2022 の 47 県平均) = {drift:+.4f}') |
💬 47 県平均で答えると MAE は 0.1193、自県の前年度の値をそのまま使うだけで 0.0655 まで下がる。さらに「全国で 1 年に −0.0415 下がった」という直近の変化を足すと 0.0286 になり、10 年ぶんの県×年度で学習した線形回帰(0.0373)より良い。出生率が毎年ほぼ全国一律に下がっている時期には、単純な持ち越しと全国の変化だけで強い基準になる。モデル案はこの 0.0286 を下回ったときにだけ採用を検討する、というのがこの工程の結論である。
🐍 展開フェーズ:モデルと「作り方の記録」を一緒に保存し、推論側で読み込んで確かめる
展開工程では、 学習したモデルを別の場所(API・バッチ処理)で動かす。 このとき、 モデルだけを渡すと「どのデータの・どの列を・どの順番で」使ったモデルかが失われる。
🎯 このコードでやること:2023 年度の 47 県で高齢化率と婚姻率から合計特殊出生率を予測する線形回帰を作り、joblib でモデルと記録(データのハッシュ、年度、特徴量の順番、目的変数、ライブラリの版)を一緒に保存する。読み込んだ後に予測が一致するか、特徴量の順番を取り違えると何が起きるかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import hashlib, json, joblib, numpy as np, pandas as pd, sklearn from sklearn.linear_model import LinearRegression path = 'data/raw/SSDSE-B-2026.csv' df = pd.read_csv(path, encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['aging'] = d['A1303'] / d['A1101'] # 高齢化率 d['marriage'] = d['A9101'] / d['A1101'] * 1000 # 人口千人当たり婚姻件数 cols = ['aging', 'marriage'] model = LinearRegression().fit(d[cols].to_numpy(), d['A4103']) # 展開: モデル本体と「何から・どう作ったか」の記録を一緒に保存する meta = {'data_sha256': hashlib.sha256(open(path, 'rb').read()).hexdigest()[:12], 'year': 2023, 'features': cols, 'target': 'A4103', 'sklearn': sklearn.__version__} joblib.dump({'model': model, 'meta': meta}, 'tfr_model.joblib') print(json.dumps({k: v for k, v in meta.items() if k != 'sklearn'}, ensure_ascii=False)) print('sklearn の版も meta に保存した(値は実行環境で変わる)') # 推論側: 読み込んで同じ入力に同じ出力が出るか saved = joblib.load('tfr_model.joblib') x = d[cols].to_numpy() same = np.allclose(saved['model'].predict(x), model.predict(x)) print(f'読み込み後の予測が学習時と一致: {same}') # 推論側で列の順番を取り違えると、エラーは出ずに値だけが変わる x_wrong = d[['marriage', 'aging']].to_numpy() p_ok, p_ng = saved['model'].predict(x)[:3], saved['model'].predict(x_wrong)[:3] for pref, a, b in zip(d['Prefecture'][:3], p_ok, p_ng): print(f'{pref}: 正しい順 {a:.3f} / 取り違え {b:.3f}') |
💬 保存したファイルを読み込んで同じ入力を渡すと、予測は学習時と完全に一致した(True)。ところが推論側で列の順番を「婚姻率, 高齢化率」と取り違えると、エラーは一切出ずに北海道の予測が 1.317 から 7.795 に変わる。NumPy 配列で渡すと列名が付かないので、モデルは順番を確かめようがない。記録に features の順番とデータのハッシュ(ここでは 0fdbe5f603bb)を残し、推論側で照合するのは、この種の「黙って間違える」事故を防ぐためである。
🐍 運用フェーズ:学習したまま凍結したモデルは年々ずれる
運用工程では、 新しい年度のデータが届くたびに予測の誤差を見て、 再学習するかを決める。 2017 年度までで学習して凍結したモデルと、 毎年それまでの全年度で学び直すモデルを、 2018〜2023 年度で比べる。
🎯 このコードでやること:前年度の合計特殊出生率・高齢化率・婚姻率から当年度の合計特殊出生率を予測する線形回帰について、2013〜2017 年度で学習して凍結したモデルと、毎年その前年度までで学び直すモデルの、各年度 47 県の MAE を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Prefecture', 'SSDSE-B-2026']) df['prev'] = df.groupby('Prefecture')['A4103'].shift(1) # 前年度の合計特殊出生率 df['aging'] = df['A1303'] / df['A1101'] df['marriage'] = df['A9101'] / df['A1101'] * 1000 df = df.dropna(subset=['prev']) # 2013 年度以降 cols, yr = ['prev', 'aging', 'marriage'], df['SSDSE-B-2026'] frozen = LinearRegression().fit(df.loc[yr <= 2017, cols], df.loc[yr <= 2017, 'A4103']) print('年度 凍結モデル(2013-17で学習) 毎年再学習 平均の実測') for t in range(2018, 2024): test = df[yr == t] re = LinearRegression().fit(df.loc[yr < t, cols], df.loc[yr < t, 'A4103']) e_f = np.mean(np.abs(frozen.predict(test[cols]) - test['A4103'])) e_r = np.mean(np.abs(re.predict(test[cols]) - test['A4103'])) print(f'{t} MAE {e_f:.4f} MAE {e_r:.4f} {test["A4103"].mean():.3f}') |
💬 2018 年度は両者とも MAE 0.0265 で同じだが、凍結モデルの誤差はその後広がり、2023 年度には 0.0711 と、毎年学び直すモデル(0.0373)の約 1.9 倍になった。47 県平均の出生率が 1.503 から 1.293 へ下がり続け、2017 年度までの関係からずれていったためである。運用では「誤差が基準(ここでは前年の MAE の 1.5 倍など)を超えたら再学習する」といった条件を先に決めておき、年度ごとに点検する。
🐍 評価フェーズ:1 年度だけで決めず、過去の年度で「予測した体」で繰り返す
2023 年度 1 回の比較で「ベースラインの方が良い」と決めるのは危うい。 各年度を、 その前年度までの情報だけで予測したと仮定して繰り返し(バックテスト)、 勝ち負けが安定しているかを見る。
🎯 このコードでやること:2016〜2023 年度の各年度について、前年度までの情報だけで「③ 前年度 + 全国の直近の変化」と「④ 線形回帰(前年度・高齢化率・婚姻率)」の 2 通りで 47 県の合計特殊出生率を予測し、年度ごとの MAE と勝ち数を数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Prefecture', 'SSDSE-B-2026']) df['prev'] = df.groupby('Prefecture')['A4103'].shift(1) df['aging'] = df['A1303'] / df['A1101'] df['marriage'] = df['A9101'] / df['A1101'] * 1000 df = df.dropna(subset=['prev']) yr, cols = df['SSDSE-B-2026'], ['prev', 'aging', 'marriage'] mean_by_year = df.groupby('SSDSE-B-2026')['A4103'].mean() wins = 0 print('予測年度 ③前年度+全国変化 ④線形回帰 勝ち') for t in range(2016, 2024): # 各年度を「その前年度までの情報だけ」で予測 test = df[yr == t] drift = mean_by_year[t - 1] - mean_by_year[t - 2] e3 = np.mean(np.abs(test['prev'] + drift - test['A4103'])) m = LinearRegression().fit(df.loc[yr < t, cols], df.loc[yr < t, 'A4103']) e4 = np.mean(np.abs(m.predict(test[cols]) - test['A4103'])) wins += e3 < e4 print(f'{t} MAE {e3:.4f} MAE {e4:.4f} {"③" if e3 < e4 else "④"}') print(f'8 年度中 ③ が勝った年度 = {wins}') |
💬 8 年度のうち 7 年度で ③ のベースラインが線形回帰に勝った。負けたのは 2016 年度だけで、このとき ③ の MAE は 0.0667 と大きい。2015 年度に 47 県平均が前年より大きく上がったため、その変化をそのまま 2016 年度にも足してしまい、外したと考えられる。「直近の変化を足す」方法は、変化の向きが続く年には強く、急に反転した年には弱い。1 年度だけの比較ではこの弱点が見えないので、評価は複数年度で行う。
🐍 データ準備フェーズ:学習に使う年数も検証で決める
12 年度ぶんのデータがあっても、 全部を学習に使うのが最善とは限らない。 古い年度は、 出生率の下がり方が今と違う時期の関係を持ち込むからである。
🎯 このコードでやること:線形回帰(前年度の合計特殊出生率・高齢化率・婚姻率)で 2022 年度と 2023 年度の 47 県を予測するとき、直前 1・2・3・5・7・9 年度ぶんだけで学習した場合の MAE を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Prefecture', 'SSDSE-B-2026']) df['prev'] = df.groupby('Prefecture')['A4103'].shift(1) df['aging'] = df['A1303'] / df['A1101'] df['marriage'] = df['A9101'] / df['A1101'] * 1000 df = df.dropna(subset=['prev']) yr, cols = df['SSDSE-B-2026'], ['prev', 'aging', 'marriage'] for target in [2022, 2023]: test = df[yr == target] res = [] for k in [1, 2, 3, 5, 7, 9]: # 直前 k 年度ぶんだけで学習 tr = df[(yr < target) & (yr >= target - k)] m = LinearRegression().fit(tr[cols], tr['A4103']) res.append(f'{k}年:{np.mean(np.abs(m.predict(test[cols]) - test["A4103"])):.4f}') print(f'{target} 年度を予測 学習期間ごとの MAE → ' + ' '.join(res)) |
💬 2022 年度の予測では直前 3 年度で学習したときが最良(MAE 0.0262)で、9 年度まで広げると 0.0331 に悪化した。2023 年度では直前 1 年度だけが最良(0.0285)で、3 年度では 0.0325 になる。最適な学習期間は年度によって変わり、「多いほど良い」とも「直近だけが良い」とも決められない。学習期間は特徴量と同じく検証で選ぶ設計項目で、選んだ理由(どの年度で検証したか)を記録に残す。
🐍 手戻りを 1 周:ゲートを越えようとして特徴量を足しても、勝てるとは限らない
モデリングのゲート(ベースラインに勝つ)を満たせなかったので、 データ準備に戻って「自県の直近の変化」を特徴量に足し、 y を「前年度からの変化」に定式化し直す。 手戻りの結果も、 同じバックテストで判定する。
🎯 このコードでやること:2017〜2023 年度の各年度について、前年度までの情報だけで「③ 前年度 + 全国の直近の変化」と「⑤ 自県の直近の変化と全国の直近の変化から、前年度からの変化を学習する線形回帰」の MAE を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Prefecture', 'SSDSE-B-2026']) g = df.groupby('Prefecture')['A4103'] df['prev'] = g.shift(1) # 前年度の値 df['own_chg'] = g.shift(1) - g.shift(2) # 自県の直近の変化 nat = df.groupby('SSDSE-B-2026')['A4103'].mean() df['nat_chg'] = df['SSDSE-B-2026'].map(nat.shift(1) - nat.shift(2)) # 全国の直近の変化 df['target'] = df['A4103'] - df['prev'] # y を「前年度からの変化」に定式化し直す df = df.dropna(subset=['own_chg', 'nat_chg']) yr = df['SSDSE-B-2026'] res3, res5 = [], [] for t in range(2017, 2024): tr, te = df[yr < t], df[yr == t] res3.append(np.mean(np.abs(te['prev'] + te['nat_chg'] - te['A4103']))) m = LinearRegression().fit(tr[['own_chg', 'nat_chg']], tr['target']) res5.append(np.mean(np.abs(te['prev'] + m.predict(te[['own_chg', 'nat_chg']]) - te['A4103']))) print('年度 ③ベースライン ⑤変化を学習するモデル') for t, a, b in zip(range(2017, 2024), res3, res5): print(f'{t} {a:.4f} {b:.4f}') print(f'平均 {np.mean(res3):.4f} {np.mean(res5):.4f} ⑤が勝った年度 = {sum(b < a for a, b in zip(res3, res5))} / 7') print('最後に学習した係数(自県の変化, 全国の変化) =', np.round(m.coef_, 3)) |
💬 ⑤ が ③ に勝ったのは 7 年度中 2021 年度の 1 回だけで、平均 MAE は 0.0406 と ③ の 0.0286 より悪い。学習した係数は「自県の直近の変化」が −0.442 と負で、ある年に大きく上がった県は翌年に下がりやすいという揺り戻しを拾っている。出生数の少ない県の 1 年ごとの上下は偶然の揺れが大きく、その揺れを特徴量にすると予測がかえって不安定になる。手戻りは「やれば良くなる」ものではなく、同じゲートで判定し直して、勝てなければ採用しないところまでが 1 周である。
⚠️ よくある落とし穴
⚠️ 前処理を分割の前にやると、乱数の列でも R² が出てしまう
データ準備工程で「目的変数と相関の強い列を選ぶ」「標準化する」といった処理を、 学習とテストに分ける前の全データで行うと、 テスト側の情報が学習に漏れる。 列が多くサンプルが少ない SSDSE-B-2026 の単年度(47 行)では、 この漏れが特に大きく効く。
🎯 このコードでやること:2023 年度 47 県の合計特殊出生率を y とし、出生率と無関係な正規乱数の列を 500 本作る。47 県全部を見て相関の強い 10 列を選んでから 5 分割交差検証する場合と、列の選択を Pipeline に入れて各分割の学習側だけで行う場合の R² を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import numpy as np, pandas as pd from sklearn.feature_selection import SelectKBest, f_regression from sklearn.linear_model import LinearRegression from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.model_selection import KFold, cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] y = d['A4103'].to_numpy() # 目的変数: 合計特殊出生率 rng = np.random.default_rng(0) X = rng.normal(size=(47, 500)) # 出生率と無関係な乱数の列 500 本 cv = KFold(n_splits=5, shuffle=True, random_state=0) # 誤: 47 県全部を見て「y と相関の強い 10 列」を選んでから交差検証する X_sel = SelectKBest(f_regression, k=10).fit_transform(X, y) bad = cross_val_score(LinearRegression(), X_sel, y, cv=cv, scoring='r2') # 正: 列の選択も各分割の学習側だけで行う(Pipeline に入れる) pipe = make_pipeline(StandardScaler(), SelectKBest(f_regression, k=10), LinearRegression()) good = cross_val_score(pipe, X, y, cv=cv, scoring='r2') print(f'分割の前に列を選んだ場合 R² = {bad.mean():.3f} (各分割 {np.round(bad, 2)})') print(f'Pipeline の中で選んだ場合 R² = {good.mean():.3f} (各分割 {np.round(good, 2)})') |
💬 乱数の列しか使っていないのに、分割の前に列を選ぶと R² = 0.387 と「そこそこ当たる」ように見える。47 県全部を見て、たまたま y と相関した 10 列を選んだため、テスト側の県の情報がすでに選択に入っているからである。選択を Pipeline に入れて各分割の学習側だけで行うと R² = −0.162 となり、乱数には予測力がないという正しい結論に戻る。特徴量選択・標準化・欠損補完は、すべて分割のあとに学習側だけで fit する。
⚠️ 評価フェーズ:同じ予測でも「率の誤差」と「人数の誤差」で最悪の県が入れ替わる
評価工程では、 平均の誤差だけでなく県ごとの誤差を並べる。 さらに、 モデルの指標(率の誤差)を業務の言葉(何人ぶんの見込み違いか)に直すと、 どこを直すべきかが変わることがある。
🎯 このコードでやること:上のベースライン③(前年度 + 全国の直近の変化)の 2023 年度の予測について、合計特殊出生率の誤差が大きい 5 県を並べ、誤差を出生数で何人ぶんかに換算する(出生数は率にほぼ比例すると仮定)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np, pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Prefecture', 'SSDSE-B-2026']) df['prev'] = df.groupby('Prefecture')['A4103'].shift(1) d = df[df['SSDSE-B-2026'] == 2023].copy() drift = (df[df['SSDSE-B-2026'] == 2022]['A4103'].mean() - df[df['SSDSE-B-2026'] == 2021]['A4103'].mean()) d['pred'] = d['prev'] + drift # 前年度 + 全国の直近の変化 d['err'] = d['pred'] - d['A4103'] # 合計特殊出生率の誤差を「出生数で何人ぶんか」に直す(出生数は率にほぼ比例すると仮定) d['births_err'] = d['err'] / d['A4103'] * d['A4101'] cols = ['Prefecture', 'A4101', 'prev', 'A4103', 'pred', 'err', 'births_err'] print(d.reindex(d['err'].abs().sort_values(ascending=False).index)[cols].head(5) .round({'pred': 3, 'err': 3, 'births_err': 0}).to_string(index=False)) print(f'MAE(率) = {d["err"].abs().mean():.4f}') print(f'出生数に直した誤差の合計(絶対値) = {d["births_err"].abs().sum():,.0f} 人' f' / 2023 年度の出生数合計 {d["A4101"].sum():,} 人') print(f'出生数に直した誤差が最大の県: {d.loc[d["births_err"].abs().idxmax(), "Prefecture"]}' f' {d["births_err"].abs().max():,.0f} 人') |
💬 率の誤差が最も大きいのは鳥取県(予測 1.559 に対して実測 1.44、誤差 0.119)で、宮崎県・島根県と出生数の少ない県が上位に並ぶ。ところが出生数に換算すると、鳥取県の誤差は 269 人ぶんにとどまり、最大は率の誤差では上位 5 県に入らない福岡県の 768 人になる。47 県を合わせると 11,258 人ぶんの見込み違いで、2023 年度の出生数 727,269 人の約 1.5% にあたる。保育所の整備計画のように「人数」で意思決定するなら評価指標も人数に合わせるべきで、どの指標で評価するかは業務理解の工程で決めておく。
🧠 実データで確かめる理解度チェック(工程ごとの判断)
- 問:2023 年度の出生率予測で、 線形回帰の MAE は 0.0373、 「前年度 + 全国の直近の変化」は 0.0286 だった。 線形回帰を採用すべきか。
答:しない。 基準(ベースライン)に負けているモデルは、 複雑さに見合う価値がない。 まず基準を上回る特徴量や定式化を探す。 - 問:乱数 500 列から相関の強い 10 列を全データで選んでから交差検証すると R² = 0.387 だった。 どの工程の誤りか。
答:データ準備(特徴量選択)を分割の前に行ったことによるリーク。 Pipeline の中で選ぶと −0.162 になる。 - 問:2017 年度までで学習して凍結したモデルの MAE が、 2023 年度には毎年学び直すモデルの約 1.9 倍になった。 運用で何を決めておくべきか。
答:誤差を年度ごとに監視し、 どの水準を超えたら再学習するかという条件。 出生率のように全体が一方向に動く指標では、 凍結したモデルは年々ずれる。 - 問:率の誤差では鳥取県が最悪だが、 出生数に直すと福岡県が最悪だった。 どちらを重視すべきか。
答:業務の意思決定の単位による。 人数で計画を立てるなら人数の誤差、 県の傾向の把握が目的なら率の誤差。 指標は業務理解の段階で決める。
🗺 概念マップ
ML プロジェクトフローを中心に、 CRISP-DM / TDSP / Kaggle 流の方法論と、 問題定式化 → EDA → 特徴量 → モデル → 評価 → デプロイ → 監視という標準フェーズを整理した概念マップ。
CRISP-DM は (1) ビジネス理解 → (2) データ理解 → (3) データ準備 → (4) モデリング → (5) 評価 → (6) デプロイ の 6 段階で構成される。 矢印は一方向ではなく、 評価で問題が見つかればデータ準備やビジネス理解に戻る。 このページの実測では、 評価(バックテスト)の結果が「線形回帰よりベースラインが強い」だったため、 モデリングではなく特徴量と定式化の見直しに戻るのが次の一手になる。
🔗 隣接手法への橋渡し
ML プロジェクトフローは単独工程ではなく、 上流の問題定式化、 並列の CRISP-DM / TDSP / Microsoft TDS 等の方法論、 下流の本番デプロイ + 監視を直列で繋ぐプロジェクト管理フレームワーク。 各フェーズの成果物が次フェーズの前提となる。
- 上流 (前段処理): ビジネス理解 / ステークホルダー合意 — CRISP-DM 第 1 フェーズ
- 並列 (代替/比較): アジャイル / リーンスタートアップ — プロセス管理の代替フレーム
- 下流 (後段活用): 運用 / 改善ループ — ドリフト検知 + 再訓練
SSDSE-B-2026 を題材にプロジェクトを動かす場合、 上流で「県別総生産予測」と定式化、 中段で EDA → 特徴量設計 → モデル学習 → 評価、 下流で予測 API デプロイ + 年次データ公開に合わせた再学習、 という典型フロー。
🌳 手法選択フロー
🌳 工程ごとの「次へ進む条件」:出生率予測の例と実測値
手法選択のフローは、 各工程の出口に「次へ進んでよい条件(ゲート)」を置くと具体的になる。 このページで SSDSE-B-2026 を使って測った値を当てはめると、 次のようになる。
| 工程 | 次へ進む条件 | このページの実測 | 満たさないときの戻り先 |
|---|---|---|---|
| 業務理解 | 予測する量と単位、 評価指標が 1 文で決まっている | 2023 年度の県別合計特殊出生率、 MAE(人数で見るなら出生数換算) | — |
| データ理解 | キーの重複・欠損・並び順・内訳の整合を点検済み | 重複 0・欠損 0、 新しい年度が先、 総人口は千人単位で男女和と最大 1,000 人差 | データ取得・定義の確認 |
| データ準備 | 前処理が分割の後に学習側だけで fit される | 分割前に列を選ぶと乱数でも R² 0.387、 Pipeline 内なら −0.162 | 前処理の設計 |
| モデリング | ベースラインを上回る | ベースライン MAE 0.0286 に対し線形回帰 0.0373(未達) | 特徴量・定式化の見直し |
| 評価 | 複数年度のバックテストで勝ち負けが安定 | 8 年度中 7 年度でベースラインが勝つ | モデリング |
| 展開 | 読み込み後の予測が一致し、 特徴量の順番とデータのハッシュを照合できる | 一致(True)、 順番の取り違えで北海道 1.317 → 7.795 | 保存形式・記録の見直し |
| 運用 | 誤差の監視と再学習の条件が決まっている | 凍結モデルは 2023 年度に MAE 0.0711、 毎年再学習で 0.0373 | 再学習・データ準備 |
この例では「モデリング」のゲートを通過できていない。 ここで無理に展開へ進まず、 ベースラインに勝てる特徴量(たとえば県ごとの直近の変化)や、 y の定式化を見直すのが、 流れに沿った判断になる。
🌳 概念ツリー
🌳 「機械学習プロジェクトの流れ」の概念ツリー
├── 上位概念(方法論)
│   ├── CRISP-DM (1996, IBM/SPSS)
│   │   ├── Business Understanding
│   │   ├── Data Understanding
│   │   ├── Data Preparation
│   │   ├── Modeling
│   │   ├── Evaluation
│   │   └── Deployment
│   ├── TDSP (Microsoft Team Data Science Process)
│   └── KDD Process (1996, Fayyad)
├── 並列概念(流れの「型」)
│   ├── Kaggle 流(リーダーボード駆動)
│   ├── 研究流(仮説 → 実験 → 論文)
│   └── プロダクト流(MVP → A/B → スケール)
├── 本体(標準的 7 ステップ)
│   ├── 1. 問題定式化 (predictive / prescriptive)
│   ├── 2. データ収集と監査 (出典・偏り・欠損)
│   ├── 3. EDA (記述統計・可視化・相関)
│   ├── 4. 特徴量エンジニアリング
│   ├── 5. モデル選定と学習 (cross-validation)
│   ├── 6. 評価 (オフライン指標 + ビジネス指標)
│   └── 7. 本番化 (MLOps へ橋渡し)
└── 下位/発展概念(運用フェーズ)
    ├── モデル監視 (Drift Detection)
    ├── 再学習スケジュール (concept drift 対応)
    ├── A/B テスト / シャドーデプロイ
    ├── Feature Store / Model Registry
    └── Responsible AI (公平性・説明可能性)
ML プロジェクトフローは、 (1) プロジェクト性質 (PoC / 本番)、 (2) 期限とリスク、 (3) チームスキル、 で方法論を選ぶ。 CRISP-DM が業界標準、 Microsoft TDSP は Azure 連携、 Google ML Workflow は GCP 寄り、 と環境で選択。
- Step 1: プロジェクトの性質は?
- PoC (概念実証) → 軽量フロー: 問題定義 → データ収集 → ベースライン → 評価 (2-4 週間)
- MVP (最小実装) → CRISP-DM の 6 段階を 1 周 (2-3 ヶ月)
- 本番運用 → CRISP-DM + MLOps + 監視 + 再学習 (継続的)
- Step 2: 期限とリスク許容度は?
- 短期・低リスク → ベースライン (線形 / ルール) で素早く検証
- 中期・中リスク → 複数モデル比較 + 交差検証 + ステークホルダーレビュー
- 長期・高リスク → A/B テスト + シャドウデプロイ + ロールバック計画
- Step 3: チームスキル・組織は?
- 少人数 (1-3 人) → CRISP-DM (軽量・概念明快)
- 大規模 + クラウド前提 → TDSP (Microsoft、 GitHub 統合) / Google ML Workflow
- 研究主体 → DARPA-style プロトタイピング + 論文化
SSDSE-B-2026 を題材にした PoC では、 (1) 問題定義 (総人口から出生数を予測する目的)、 (2) データ理解 (列名・型・欠損)、 (3) 前処理 (Z-score)、 (4) モデリング (線形 → RF → XGBoost)、 (5) 評価 (RMSE / R²)、 (6) デプロイ計画 (報告書出力でも可)、 の 6 段階を 1 週間で 1 周するのが現実的。 各段階で「次の段階に進める判断基準 (ゲート)」を明示しておくと止め時を見失わない。