🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
「CRISP-DM (CRoss Industry Standard Process for Data Mining)」は 1996 年策定の業界標準データ分析プロセス。 業務理解 → データ理解 → データ準備 → モデリング → 評価 → 展開 の 6 工程と工程間の反復ループを定義する。 本ページでは各工程の成果物・完了条件・反復パターン・PPDAC との対応・現代的拡張 (MLOps) を順に整理する。
これらのキーワードは「業務理解で問いを固める → データで検証可能性を確認 → モデルで答えを出す → 運用で価値を実現」という CRISP-DM の本質的フローを構成する。
💡 30秒で分かる結論 — CRISP-DM
🍰 まずはやさしく
データ分析の共通ルールのようなものです。
迷わずに分析を進めるために使います。
部活の練習メニューを決める時に似ています。
まずは全体の流れと注意点を確認しましょう。
- 一言で:データマイニングの業界横断標準プロセス。 ビジネス理解 → データ理解 → 準備 → モデル → 評価 → 展開の6フェーズ。
- 分野:プロセス — 全体像は data-process ページで
- 典型的な使い所:本ページ「🎨 直感」「🧮 SSDSE実値計算」セクションを参照
- 絶対に外せない落とし穴:⚠️ セクションの 5 項目に目を通すこと
- 関連手法へ:「🌐 関連手法」セクションで上位・並列・発展概念を一覧
- レポートでは:『出典・期間・サンプル数・前提・限界』の 5 点を明示
💡 30秒で分かる結論
業界横断的なデータマイニング標準プロセス
- 分野:リテラシー — 📚 データリテラシー
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
📍 あなたが今見ているもの
🍰 まずはやさしく
分析の進み具合を示す地図のようなものです。
今の作業がどこにあるかを管理するために使います。
スマホアプリの開発計画表に似ています。
このページで解説する構成について説明します。
Kaggle や実務プロジェクトの管理表で「Phase: Data Understanding」のように出てくる。 1996 年に始まった SPSS・NCR・DaimlerChrysler・OHRA の共同プロジェクトがまとめたもので(手引き CRISP-DM 1.0 は 2000 年公開)、 今もデータ分析プロセスの標準としてよく使われる。
🎨 直感で掴む — CRISP-DMとは何者か
🍰 まずはやさしく
分析を 6 つのステップに分けた枠組みです。
正しい答えにたどり着くために使います。
テスト勉強の計画を立てる時に似ています。
具体的にどのような流れで進むかを見ていきましょう。
CRISP-DM は「データ分析プロジェクトを 業務理解 → データ理解 → 準備 → モデリング → 評価 → 展開 の 6 フェーズに分け、 各フェーズを 循環させて回す枠組み」。 たとえば SSDSE-B-2026 で「人口減少県の経済指標を予測したい」なら、 ①目的を業務側と握り → ②データの粒度と欠損を確認 → ③特徴量を作り → ④モデル学習 → ⑤RMSE / 業務 KPI を評価 → ⑥本番化と監視、 という流れになる。 評価で問題が見つかれば 業務理解に戻る往復構造が肝。
🎨 直感で掴む
データ分析プロジェクトを業務理解 → データ理解 → データ準備 → モデリング → 評価 → 展開の 6 フェーズに区切り、 隣接フェーズの間を行き来して反復的に精度を上げる「分析の地図」。 SSDSE-B-2026 で「人口減と税収の関係」を解くなら、 業務理解で「税収予測なのか政策提案なのか」を定義、 データ理解で 47 都道府県 × 12 年度(2012〜2023)の構造を把握、 と進める。
以下では、 6 フェーズ (Business / Data / Preparation / Modeling / Evaluation / Deployment) ごとの成果物・完了条件・後戻りトリガを整理し、 PPDAC との 1 対 1 対応や、 MLOps 時代の継続学習・モニタリングを組み込んだ現代的拡張 (CRISP-ML(Q) など)、 そして「業務理解を飛ばしてモデリングから入ると後半で全部やり直しになる」典型的失敗パターンまで順に辿ります。
🎮 触って掴む — CRISP-DM 6 フェーズの「反復と行き来」
円環の各フェーズをクリック / タップ、 または「次フェーズ ▶」で 1 周する。 右側に架空プロジェクト「みどり市・移動図書館の巡回最適化(※実在しない教材用の例)」での具体作業・成果物・所要時間の目安が出る。 「↩ 後戻り」を押すと データ理解 → 業務理解 や 評価 → 業務理解 のような逆向き矢印を体感できる。 CRISP-DM は一直線ではなく行き来する反復プロセスだ、 という点を手で確かめてほしい。
⏳ 所要時間の目安 — データ準備が最大
実プロジェクトではデータ準備に最も時間がかかるとよく言われる。 割合は調査によって違い、 Anaconda の 2020 年の調査ではデータの読み込みと整形が作業時間の約 45% だった。 下の棒は架空のプロジェクトでの配分の目安で、 実測ではない。 「モデリングが本体」という直感は錯覚で、 準備と評価・展開に時間を取れないと現場で使われない。
🔄 PPDAC との対応・違い
同じ「反復サイクル」でも、 PPDAC はProblem(問題定義)から始まる統計教育向け 5 段階、 CRISP-DM はBusiness(業務価値)から始まり Deployment(運用)まで含む産業向け 6 段階。 最大の違いは、 PPDAC が Conclusion で閉じるのに対し、 CRISP-DM は展開・監視・再学習(MLOps)まで射程に入れる点。
| CRISP-DM | おおよそ対応する PPDAC | ずれ / 注意 |
|---|---|---|
| 業務理解 | Problem | CRISP-DM は「業務価値・KPI」寄り、 PPDAC は「問い」寄り |
| データ理解 | Plan + Data(前半) | CRISP-DM は既存データの吟味、 PPDAC は取得計画も含む |
| データ準備 | Data(整形) | ここが最大工数。 PPDAC では軽く扱われがち |
| モデリング | Analysis | ほぼ一致 |
| 評価 | Analysis + Conclusion | CRISP-DM は「業務目標を満たすか」まで問う |
| 展開 | (対応なし) | PPDAC には運用フェーズが無い ← 最大の差 |
📐 数式・定義
🍰 まずはやさしく
分析の仕組みをまとめた設計図のようなものです。
作業の順番や戻るタイミングを決めるために使います。
料理のレシピで手順を確認する時に似ています。
ステップの間をどう移動するかを詳しく解説します。
CRISP-DM は概念的フレームワークであり、 厳密な計算式というよりは「6 フェーズと反復ループ」の構造記述。 ジャストインタイム教育として 2 つの計量化を入れておく。
① フェーズ遷移行列: $P_{ij}$ をフェーズ $i$ から $j$ へ進む確率とすると、 CRISP-DM の標準パスは
$$ P = \begin{pmatrix} 0 & 1 & 0 & 0 & 0 & 0 \\ \;\!p & 0 & 1-p & 0 & 0 & 0 \\ 0 & q & 0 & 1-q & 0 & 0 \\ 0 & 0 & r & 0 & 1-r & 0 \\ 0 & 0 & 0 & s & 0 & 1-s \\ 0 & 0 & 0 & 0 & 0 & 1 \end{pmatrix} $$
ここで $p, q, r, s$ は各フェーズで「前段に戻る」確率 (典型値 0.1〜0.4)。 逆方向遷移こそが反復ループの本体。
② 反復コスト関数: $T$ 回反復したときの総コストを
$$ C(T) = \sum_{t=1}^{T} c_t \cdot \alpha^{t-1} $$
で表す ($c_t$ は $t$ 回目の作業量、 $\alpha \in (0,1)$ は学習効果による作業圧縮率)。 反復ごとに既存知識を再利用できるので $\alpha < 1$ となる。 具体例は次セクションで言葉に変換する。
📐 定義
業界横断的なデータマイニング標準プロセス
英語名 CRoss Industry Standard Process for Data Mining。
🎯 いつ・どこで使うか
- データマイニング・機械学習プロジェクトの工程設計の事実上の標準フレームです (Business → Data → Modeling → Deployment の 6 フェーズ)。
- 📚 データ分析プロセス や 📚 MLOps の起点として、 まず CRISP-DM の流れを掴むのが定石です。
- SEMMA, KDD process, TDSP など類似フレームと比較されることが多く、 ビジネス目的の明文化と反復ループを重視する点が特徴です。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
📐 反復 (iteration) の数式モデル — CRISP-DM はなぜ「サイクル」と呼ばれるか
CRISP-DM は線形プロセスではなく、 反復プロセスです。 フェーズ間の戻りを数式で表現すると次のようになります。
$$ \text{Project}(t+1) = \text{Project}(t) + \Delta(\text{Evaluation}(t), \text{Feedback}(t)) $$
ここで $t$ は反復回数、 $\Delta$ は評価結果と業務フィードバックに基づく改善ベクトル。 重要なのは 「1 回目で正解にたどり着く必要はない」こと。 CRISP-DM は本質的に「失敗を前提とした学習プロセス」です。
数式を言葉で読み解く
$\text{Project}(t)$ は「$t$ 回目反復時点でのプロジェクト状態」、 $\Delta$ は「評価と業務フィードバックから生まれる改善差分」。 評価フェーズで「精度不足」と判定されればモデリングに戻り、 「業務問題の定義がずれていた」と判定されれば業務理解まで戻る。 戻る先によって学習量が異なるため、 反復にかかるコストが変わってきます。
💡 実務のコツ: 初回反復は「最小限の完成版」(MVP) を作って、 とにかく 6 フェーズを一周する。 その後の反復で精度を高める。 完璧なフェーズ 1 を目指して動けなくなる「分析麻痺」を避ける戦略です。
🔬 数式・定義を「言葉」で読み解く
先ほどの数式・定義に出てきた記号や概念を、 一つずつ確認します。 とくに CRISP-DM の文脈で意味を取り違えやすい部分を強調します。
| 記号 | 意味と注意点 |
|---|---|
| $P_{ij}$ | フェーズ $i$ から $j$ へ遷移する確率。 行和 = 1 |
| $p, q, r, s$ | 各フェーズで前段に戻る確率。 評価フェーズの $s$ が最大になりがち (失敗発覚率) |
| $T$ | サイクル反復回数。 実プロジェクトでは 3〜8 回が典型 |
| $c_t$ | $t$ 回目反復で消費する工数 (人日・人月) |
| $\alpha$ | 学習効果による作業圧縮率 $\alpha \in (0,1)$。 既存資産の再利用度 |
| $C(T)$ | $T$ 回反復したときの累積コスト。 投資対効果判定の基準 |
CRISP-DM の本質は「逆向き矢印」: 評価フェーズで業務理解に戻る $s$、 モデリングでデータ準備に戻る $r$ などのループが、 SEMMA や Waterfall との最大の違い。 これら逆行確率を計測することで、 プロジェクト初期に「どのフェーズの定義が弱いか」を可視化できる。
🧮 SSDSE-B 実値で計算してみる
CRISP-DM は手順の枠組みなので、それ自体に数式は無い。この章では代わりに、プロジェクト計画でよく行う「フェーズ別の工数の構成比」を手で計算し、同じ計算を Python で再現する。
🧮 数式に値を入れて手で計算する: CRISP-DM 6 フェーズの工数比
CRISP-DM の 6 フェーズ (業務理解 / データ理解 / データ準備 / モデリング / 評価 / 展開) に、 説明用に仮定した 60 人日の案件の工数 (5・10・30・8・5・2 人日) を割り当て、 フェーズごとの構成比を計算する。 工数の値は実在の調査ではなく、 計算の手順を示すための仮定である。
Step 1: 各フェーズの工数 [人日]
| フェーズ | 工数 | 構成比 |
|---|---|---|
| ビジネス理解 | 5 | 0.083 |
| データ理解 | 10 | 0.167 |
| データ準備 | 30 | 0.500 |
| モデリング | 8 | 0.133 |
| 評価 | 5 | 0.083 |
| 展開 | 2 | 0.033 |
Step 2: 集計
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np effort = np.array([5, 10, 30, 8, 5, 2]) ratio = effort / effort.sum() print(f"構成比: {ratio.round(3)}") print(f"合計: {effort.sum()} 人日") print(f"データ準備: {ratio[2]*100}%") |
📤 実行結果
💬 手計算 (Step 2) 50% と Python 出力が完全一致。
🐍 Python 実装
以下は CRISP-DM の 6 フェーズを関数に分けて SSDSE-B-2026 で 1 周するコード。 encoding='cp932' は政府統計の Shift-JIS 対応、 skiprows=[1] は 2 行目の日本語見出しだけを飛ばして英語コード(A1101 など)を列名にする読み方。
🐍 CRISP-DM テンプレートコード — プロジェクト雛形
新規プロジェクトを CRISP-DM で立ち上げる際の Python テンプレート。 各フェーズの作業を関数化して、 後で再利用しやすくする構成です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 | import pandas as pd
# ===== フェーズ 1: 業務理解 =====
PROJECT_GOAL = '47 都道府県の介護人材重点配置候補 5 県を選定'
SUCCESS_KPI = '選定根拠が定量的に示せること'
# ===== フェーズ 2: データ理解 =====
def load_data():
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
return df[df['SSDSE-B-2026'] == 2023].copy()
# ===== フェーズ 3: データ準備 =====
def prepare_features(df):
df['aging_rate'] = df['A1303'] / df['A1101'] * 100
df['oad_ratio'] = df['A1303'] / df['A1302'] * 100
for c in ['aging_rate', 'oad_ratio']:
df[c + '_z'] = (df[c] - df[c].mean()) / df[c].std()
df['priority_score'] = df[['aging_rate_z', 'oad_ratio_z']].mean(axis=1)
return df
# ===== フェーズ 4: モデリング =====
def select_top_n(df, n=5):
return df.nlargest(n, 'priority_score')[['Prefecture', 'priority_score', 'aging_rate']]
# ===== フェーズ 5: 評価 =====
def evaluate(top, threshold=1.0):
n_above_threshold = (top['priority_score'] > threshold).sum()
return f'{n_above_threshold}/{len(top)} 県が閾値 {threshold} 超過'
# ===== フェーズ 6: 展開 (実行) =====
df = prepare_features(load_data())
top5 = select_top_n(df, n=5)
print('目的:', PROJECT_GOAL)
print('KPI:', SUCCESS_KPI)
print('\n選定結果:')
print(top5.round(2).to_string(index=False))
print('\n評価:', evaluate(top5))
|
🎯 このコードでやること: CRISP-DM の 6 フェーズを関数化したテンプレート。 業務目的・KPI を冒頭で明示し、 各フェーズを独立した関数として実装する。
📥 入力データ: SSDSE-B-2026 の 2023 年データ。
📤 実行結果:
💬 結果の読み方: 上位 5 県全てが priority_score 1.0 超で、 業務目的を達成。 関数化により、 SSDSE 更新時に load_data() だけ呼び直せば自動で全フェーズが再実行される。 CRISP-DM をコードに落とす典型例。
⚠️ よくある落とし穴(7 件)
CRISP-DM に取り組むときに、 学生・実務者・研究者がよく踏むワナをまとめました。 該当しそうな項目があれば、 自分の分析を見直してみてください。
⚠️ CRISP-DM 適用時の追加チェック
⚠️ CRISP-DM の「ありがちな失敗」5 選
① 業務理解の軽視
「データが揃っているからすぐ分析」「とりあえずモデルを作る」という発想は CRISP-DM の真逆。 業務問題を明確化せずに分析を始めると、 高精度モデルが業務に役立たないという最悪のパターンに陥る。 業務理解には全工数の 20-30% を割くべき。
② 反復を「失敗」と捉える
前フェーズに戻ることを「やり直し」「失敗」と感じてしまう人が多い。 CRISP-DM では 反復は学習プロセスの一部。 むしろ「1 回目で完璧」を目指すと、 慎重すぎて動けなくなる。
③ 展開フェーズの軽視
「モデルができたら終わり」と考えると、 実業務への組み込みが弱くなる。 展開フェーズは「分析プロセスの 5 割」と言われるほど重要。 モニタリング・再学習・運用保守まで含めて計画する。
④ チーム連携の欠如
「分析者だけで完結」しがちだが、 CRISP-DM は 業務担当者・データエンジニア・分析者・運用者の協働を前提としている。 業務理解フェーズでは業務担当者、 データ準備フェーズではエンジニア、 展開では運用者が主役。
⑤ ドキュメント不足
各フェーズの判断根拠・データ加工内容・モデル仕様を記録しないと、 後で再現できない「ブラックボックス分析」になる。 CRISP-DM 公式マニュアルは各フェーズのドキュメントテンプレートを提供している。
📝 CRISP-DM ドキュメンテーション例 (SSDSE-B-2026 ケース)
CRISP-DM の各フェーズで作成すべきドキュメントの実例を、 SSDSE-B-2026 を題材に示します。 これらをリポジトリにコミットして再現性を担保しましょう。
フェーズ 1 ドキュメント: 業務理解書
主要記載項目:
- 業務目的: 47 都道府県の介護人材配置の優先順位を決める
- KPI: 上位 5 県を選定し、 政策担当者の納得を得ること
- 制約条件: 公開データのみ使用、 個人情報は使わない
- ステークホルダー: 自治体・厚労省・分析チーム
- 成功シナリオ: 選定根拠が定量的に示されること
- 失敗シナリオ: 都道府県によって解釈が分かれて結論が出ない
フェーズ 2 ドキュメント: データ説明書
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
# データ説明書のための統計サマリ
print('=== データ説明書 ===')
print(f'出典: SSDSE-B-2026 (独立行政法人統計センター)')
print(f'取得: 2026-05-29')
print(f'期間: {df["SSDSE-B-2026"].min()}-{df["SSDSE-B-2026"].max()}')
print(f'集計単位: 都道府県・年')
print(f'レコード数: {len(df)} = 47 都道府県 × {df["SSDSE-B-2026"].nunique()} 年')
print(f'カラム数: {len(df.columns)}')
print()
# 主要列の説明
print('主要列:')
print(' A1101: 総人口 (人)')
print(' A1303: 65 歳以上人口 (人)')
print(' A1302: 生産年齢人口 (15-64 歳)')
|
🎯 このコードでやること: CRISP-DM フェーズ 2 のデータ説明書を機械可読な形で生成する。 リポジトリに README として記録する典型例。
📥 入力データ: SSDSE-B-2026 全体。
📤 実行結果:
💬 結果の読み方: 「出典・期間・集計単位・サンプルサイズ」を一括出力。 このスクリプトを CI に組み込めば、 データ更新時に自動でドキュメントが更新される。 CRISP-DM のドキュメンテーション自動化のパターン。
フェーズ 6 ドキュメント: 展開計画書
- 展開先: 自治体ダッシュボード (Web アプリ)
- 更新頻度: SSDSE 公開と同期 (年 1 回)
- モニタリング指標: 上位 5 県の変動率、 priority_score 分布
- 再学習条件: 分布が前年比 10% 以上変動した場合
- 担当者: 運用チーム (1 次対応)、 分析チーム (再学習対応)
- 故障時対応: 前年データで暫定運用、 24 時間以内に復旧
⚠️ CRISP-DM のアンチパターン 8 選 — 「形だけ」になりがちな落とし穴
CRISP-DM は概念がシンプルなぶん、 「形だけ守って中身が空」になりやすいという、 方法論共通の宿命を抱えています。 ここでは現場で頻発するアンチパターンを 8 つに整理し、 それぞれに対する処方箋を示します。
🔴 アンチパターン 1: 「業務理解」が「Word 1 ページのテンプレ埋め」になる
症状: プロジェクト憲章テンプレを埋めただけで、 KGI が 定量的に書かれていない。 「成功とは何か」が曖昧。
処方箋: 業務理解の最後に「測定可能な成功基準を 1 文で書く」ルールを設ける。 例:「調整済み R² ≥ 0.70」「F1 スコア ≥ 0.85」「誤検知率 ≤ 5%」。 1 文で書けないなら業務理解が未完了。
🔴 アンチパターン 2: 「データ理解」で時間を使いすぎてモデリングへ進めない
症状: 散布図やヒストグラムを大量に作りすぎ、 3 週間経ってもまだデータ理解。 結局モデリングに使える時間が無い。
処方箋: データ理解には 「1 週間タイムボックス」を設ける。 1 週間で完了しないなら、 業務理解で問いを狭めすぎている可能性を疑う。 完璧なデータ理解より「モデリングに進めるだけの理解」を目指す。
🔴 アンチパターン 3: 「データ準備」で大量の派生変数を作りすぎる
症状: 「念のため」と称して 50 個の派生変数を作成。 後段のモデリングで 多重共線性に苦しむ。
処方箋: 派生変数を作る前に「業務理解で立てた問いに直接答えるか」を 1 行で説明できるかチェック。 説明できない派生変数は作らない。 SSDSE-B-2026 なら「総人口の対数」「高齢化率 (A1303/A1101)」「1 人当たり消費支出」程度に絞る。
🔴 アンチパターン 4: 「モデリング」で R² を最大化することが目的化する
症状: R² を 0.01 上げるためにモデルを 10 個比較。 業務理解の KGI を満たした時点で止めるべきなのに止まれない。
処方箋: モデリングフェーズ開始時に「KGI を満たしたら即停止」のルールを文書化。 業務理解の KGI が R² ≥ 0.70 なら、 R² = 0.72 が出た瞬間に評価フェーズへ進む。 「もう少し」の誘惑を断ち切る。
🔴 アンチパターン 5: 「評価」が R² と AUC の数値報告で終わる
症状: 評価フェーズで「R² = 0.92 でした」とだけ報告し、 業務的な意味を語らない。 ステークホルダから「で、 何ができるの?」と問われて答えられない。
処方箋: 評価レポートに必ず 「業務インパクトの試算」を含める。 例:「このモデルで業務理解に定めた説明力の水準を確保できたので、 地方創生施策の優先順位を A 案から B 案に変更すべき」など、 行動可能な提言に翻訳する。
🔴 アンチパターン 6: 「展開」がレポート提出で終わる
症状: PDF レポートを提出してプロジェクト完了。 翌年データが更新されても誰も再実行しない。 結局 1 回限りの研究で終わる。
処方箋: 展開フェーズには 「運用ハンドブック」「再実行チェックリスト」「アラート閾値」を必ず含める。 SSDSE は毎年更新されるので「毎年 10 月に同じ Notebook を実行する」運用を組み込む。 これだけで「死んだモデル」化を防げる。
🔴 アンチパターン 7: フェーズ間の「行き来」を許さない
症状: 「モデリング中にデータ準備に戻るのはルール違反」と思い込み、 不適切なデータのまま無理にモデルを作る。 結果、 業務基準を満たせない。
処方箋: CRISP-DM は 双方向矢印のプロセス。 モデリング中に「この変数の前処理が間違っていた」と気付いたら、 遠慮なくデータ準備に戻る。 ただし「行き来した記録」をログに残し、 後で振り返れるようにする。
🔴 アンチパターン 8: 「反復」を口で言うだけで実際は 1 周で終わる
症状: 「CRISP-DM は反復が大事」と研修で習ったのに、 実プロジェクトでは 1 周回して完了報告。 2 周目を回す予算・時間が確保されていない。
処方箋: プロジェクト立ち上げ時に 「2 周分のリソース」を確保する。 1 周目は MVP (最小実用モデル)、 2 周目で本格モデルへ拡張、 という二段ロケット構成にする。 SSDSE-B-2026 の場合なら、 1 周目「総量モデル」→ 2 周目「1 人当たりモデル」のように。
📋 アンチパターン処方箋まとめ表
| # | アンチパターン | 対策キーワード |
|---|---|---|
| 1 | 業務理解がテンプレ埋め | 「成功基準を 1 文で書く」 |
| 2 | データ理解で時間使いすぎ | 1 週間タイムボックス |
| 3 | 派生変数の量産 | 「問いに直接答えるか」テスト |
| 4 | R² の最大化が目的化 | KGI 達成で即停止 |
| 5 | 評価が数値報告で終わる | 業務インパクト試算を必須化 |
| 6 | 展開がレポート提出で終わる | 運用ハンドブックを義務化 |
| 7 | フェーズ間の行き来禁止 | 双方向矢印を許可、 ログ取得 |
| 8 | 反復が口だけ | 2 周分のリソース確保 |
これら 8 つのアンチパターンは、 どれも 「方法論を形式だけ真似ると陥る罠」です。 CRISP-DM の真の価値は、 各フェーズが「次フェーズへの意思決定を準備する」役割を果たすこと。 形だけでなく、 各フェーズで「次に渡すもの」が明確になっているかを毎回チェックすれば、 自然とこれらの罠は避けられます。
🧭 CRISP-DM を健全に回すための「3 つの問い」
最後に、 各フェーズの終わりに自分に問うべき 3 つの質問を提示します。 これに即答できないなら、 そのフェーズはまだ完了していません。
- このフェーズで 何を意思決定したか? (1 文で言える?)
- その意思決定は 次フェーズの入力として使えるか? (受け取り側が分かる?)
- もし 業務理解の問いに照らして不都合なら、 どの前フェーズへ戻るか? (双方向矢印が引けている?)
この 3 つの問いに毎フェーズ答えられれば、 CRISP-DM は「絵に描いた餅」ではなく「実プロジェクトを動かす推進力」になります。 SSDSE-B-2026 を使った教育プロジェクトでも、 卒業研究でも、 業務委託プロジェクトでも、 この 3 つを忘れなければ CRISP-DM は失敗しません。
❓ CRISP-DM 実務 FAQ — 受講生・現場担当者からよく聞かれる質問
CRISP-DM を実際の研究・業務で使い始めると、 教科書には載っていない「現場の素朴な疑問」がたくさん湧いてきます。 ここでは CRISP-DM を使い始めた人がつまずきやすい疑問を 8 つ取り上げ、 SSDSE-B-2026 を使った具体例付きで回答します。
❓ Q1: 「業務理解」フェーズに 1 週間かけるのは長すぎませんか?
回答: 短いプロジェクト (2-4 週間) では業務理解に 1 日、 長いプロジェクト (3 ヶ月以上) では 1-2 週間が目安です。 ただし業務理解で「曖昧さ」を残したまま進むと、 後段でやり直しが発生し、 結果的に時間を浪費します。 業務理解は 「投資」であり、 ここに時間を使うほど後段がスムーズになります。 SSDSE-B-2026 のような教育プロジェクトでも、 「何を成功とするか」を半日かけて定義すると、 残りの作業が劇的に速くなります。
❓ Q2: KGI が数値化できない場合 (探索的研究など) はどうすればいいですか?
回答: 探索的研究では KGI を「数値」ではなく「到達したい状態」で定義します。 例: SSDSE-B-2026 の探索では「47 都道府県を 3-5 群にクラスタリングし、 各群の特徴を 1 文で説明できる状態」を成功とする。 これにより評価フェーズでも「クラスタが解釈可能か」をチェックでき、 数値 KGI と同じくらい厳密にプロジェクトを駆動できます。 KGI が無いプロジェクトは CRISP-DM の体をなしません。
❓ Q3: 1 人で回す研究プロジェクトでも CRISP-DM は使えますか?
回答: はい、 むしろ 1 人プロジェクトこそ CRISP-DM が活きる場面です。 複数人プロジェクトではフェーズの引き継ぎ書類が役に立ちますが、 1 人プロジェクトでは「自分の思考を可視化する」役割を CRISP-DM が果たします。 SSDSE-B-2026 を使った卒業研究で、 各フェーズの意思決定を 1 ページずつ書いておけば、 数ヶ月後に振り返ったとき「なぜこの変数を選んだか」を思い出せます。 これは時間が経ったときに想像以上に重要です。
❓ Q4: アジャイル開発と CRISP-DM はどう両立させますか?
回答: アジャイル (スクラム) のスプリント単位で CRISP-DM の 1 周を回す、 という両立が定石です。 1 スプリント (2 週間) = CRISP-DM 1 周 (MVP モデル)。 次スプリントで 2 周目 (本格モデル)。 これにより「アジャイルが要求するスピード」と「CRISP-DM が要求する構造」が共存できます。 SSDSE-B-2026 を題材にした場合、 1 スプリント目で「総人口→消費支出」の単回帰、 2 スプリント目で「3 変数モデル」、 3 スプリント目で「クラスタリング」、 と段階的に深めていきます。
❓ Q5: データ準備に時間をかけても、 結局モデルの精度が出ない場合は?
回答: 精度が出ないのは データ準備の問題ではなく、 業務理解か変数選択の問題であることがほとんどです。 SSDSE-B-2026 で「総人口だけで消費支出を予測しよう」とすると、 単純すぎてモデルは精度が出ません。 これは「データ準備が悪い」のではなく「変数選択 (=業務理解で何を測るか) が浅い」ことの表れ。 業務理解フェーズに戻り、 問いを練り直すのが正解です。 CRISP-DM の双方向矢印を信じましょう。
❓ Q6: 評価フェーズで R² が低かったら、 業務理解の KGI を下げてもいいですか?
回答: 原則 NG です。 KGI を後付けで下げるのは 「自分の都合に合わせて尺度を変える」行為であり、 プロジェクトの信頼性を損ないます。 代わりに「なぜ KGI を満たせなかったか」を分析し、 「現在の変数では限界がある」「次プロジェクトでセンサーデータを追加する必要がある」など、 次の打ち手を提示する形で評価レポートを書くのが CRISP-DM 流の誠実な対応です。
❓ Q7: ディープラーニングを使うときも CRISP-DM のフェーズは同じですか?
回答: フェーズは同じですが、 各フェーズの 比重が大きく変わります。 ディープラーニングでは「データ準備」の中の ラベル付け・データ拡張に膨大な時間がかかり、 「モデリング」では ハイパーパラメータ探索が長期化します。 SSDSE-B-2026 のような小規模整形済データではディープラーニングは過剰ですが、 画像・自然言語・音声データを使うプロジェクトでは CRISP-DM の各フェーズの中身がディープラーニング寄りに膨らみます。 それでも 6 フェーズの骨格は変わりません。
❓ Q8: CRISP-DM を学ぶための日本語書籍はありますか?
回答: 一次資料は CRISP-DM 1.0 の手引き (Chapman ほか『CRISP-DM 1.0: Step-by-step data mining guide』2000 年、 英語) です。 日本語で CRISP-DM だけを掘り下げた書籍は少ないので、 PPDAC サイクル (統計教育向け) や TDSP (Microsoft 提唱) と比較しながら学ぶと立体的に理解できます。 SSDSE を題材にした実習を組み合わせると、 教科書から「実プロジェクトで使える知識」へ昇華できます。
📋 FAQ 一覧まとめ表
| # | 質問 | キーポイント |
|---|---|---|
| Q1 | 業務理解 1 週間は長い? | 業務理解は投資、 後段が速くなる |
| Q2 | KGI が数値化できない | 「到達したい状態」で定義 |
| Q3 | 1 人でも使える? | むしろ思考可視化に最適 |
| Q4 | アジャイルと両立は? | 1 スプリント=1 周 |
| Q5 | 精度が出ない | 業務理解に戻る |
| Q6 | KGI を下げてよい? | 原則 NG、 次の打ち手を提示 |
| Q7 | ディープラーニングでも同じ? | 骨格は同じ、 各フェーズ膨らむ |
| Q8 | 日本語書籍は? | PPDAC や TDSP と比較学習 |
これらの FAQ に共通するメッセージは、 「CRISP-DM はチェックリストではなく思考のフレームワーク」であるということ。 6 フェーズを「やったかどうか」ではなく、 「各フェーズで意思決定したことを次へ正しく渡したか」を問うのが、 CRISP-DM を本当に使いこなすための最重要ポイントです。 これさえ守れば、 SSDSE-B-2026 を使った教育プロジェクトから、 数億円規模の業務プロジェクトまで、 同じ方法論で回せます。
🎁 まとめ — CRISP-DM を「自分のもの」にする 5 つの指針
ここまで CRISP-DM の概念・図解・意思決定マトリクス・MLOps 連携・ケーススタディ・アンチパターン・FAQ を見てきました。 最後に、 CRISP-DM を「教科書の知識」から「実プロジェクトを動かす武器」に変えるための 5 つの指針を提示します。
- 各フェーズで「1 文の意思決定」を残す — 業務理解では「成功基準」、 データ理解では「変数候補リスト」、 データ準備では「変換方針」、 モデリングでは「採用アルゴリズム」、 評価では「業務基準達成度」、 展開では「運用形態」。 すべて 1 文で書き出せれば、 そのフェーズは完了です。
- 双方向矢印を恐れない — モデリング中に「データ準備に戻る」のは失敗ではなく、 CRISP-DM が想定する正常動作です。 戻った記録をログに残し、 後で「なぜ戻ったか」を振り返れば、 次プロジェクトの精度が上がります。
- 2 周分のリソースを確保する — プロジェクト立ち上げ時点で「1 周目: MVP、 2 周目: 本格モデル」と計画しておくことで、 CRISP-DM の「反復」を口だけにせず実装できます。 SSDSE-B-2026 を使った教育プロジェクトでも、 半期で 2 周は十分回せます。
- 業務理解と評価をペアで見る — 業務理解で立てた KGI が、 評価フェーズで照合される。 この往復が機能すれば CRISP-DM は機能します。 「業務理解の KGI ≠ 評価フェーズの評価軸」になっていないか毎回チェックしてください。
- 展開を「終わり」ではなく「次の始まり」と見る — 展開フェーズで運用ハンドブックと再実行チェックリストを残せば、 そのモデルは「死なない」モデルになります。 SSDSE が毎年更新されるなら毎年同じ Notebook を再実行する、 という運用が CRISP-DM の真の完成形です。
CRISP-DM は 1996 年に作られたフレームワークですが、 ディープラーニング時代・MLOps 時代でも生き残っているのは、 「人間がデータ分析プロジェクトで考えるべき順序」を普遍的に捉えているからです。 ツールや手法が変わっても、 業務理解・データ理解・データ準備・モデリング・評価・展開の 6 つの問いは変わりません。 SSDSE-B-2026 を使った卒業研究から、 数十人規模のエンタープライズ AI 案件まで、 同じ方法論で扱える普遍性。 これが CRISP-DM が 30 年経っても標準であり続ける理由です。
この記事を読み終えた今、 あなたは CRISP-DM を 「教科書で見たことがある言葉」から 「自分のプロジェクトに今日から適用できる武器」に変換できているはずです。 まずは SSDSE-B-2026 を題材に、 1 つの問いを 6 フェーズで通してみてください。 1 周目から学べることは想像以上に多く、 2 周目では確実に質が上がります。 CRISP-DM はあなたの分析を導く「地図」です。 地図を持って、 データの森へ出かけましょう。
📚 関連グループ教材(全体像)
CRISP-DM は「プロセス」分野の一部です。 同じグループに属する用語は以下:
- 🎯 data-process(このグループの総合ページ) — 全体像を学びたいときはここから
- PPDACサイクル — このグループの構成要素
- データ分析プロセス — このグループの構成要素
- データ解析サイクル — このグループの構成要素
- EDA — このグループの構成要素
📚 関連グループ教材
この用語の全体像を学ぶには、 まず横断的な教材で文脈を掴むのが効率的です:
- 📚 データリテラシー — このカテゴリの全体像を学ぶ
- 📚 データ分析プロセス — CRISP-DM の上位概念
- 📚 PPDAC サイクル — 教育向けの簡易版プロセス
- 📚 EDA グループ — データ理解フェーズの中核
- IBM CRISP-DM 公式ガイド(https://www.ibm.com/docs/en/spss-modeler/saas?topic=dm-crisp-help-overview)— IBM SPSS Modeler に組み込まれた CRISP-DM 仕様
- CRISP-DM 1.0 オリジナル仕様書(https://www.the-modeling-agency.com/crisp-dm.pdf)— 1999 年策定の正本 PDF
- SSDSE-B-2026 教育用標準データセット(https://www.nstac.go.jp/use/literacy/ssdse/)— 47 都道府県データで 6 フェーズを実演
- Microsoft Team Data Science Process (TDSP)(https://learn.microsoft.com/en-us/azure/architecture/data-science-process/overview)— CRISP-DM の派生プロセス
- e-Stat 政府統計の総合窓口(https://www.e-stat.go.jp/)— 業務理解・データ理解で参照する一次データソース
🔗 同カテゴリの他用語
🔄 CRISP-DM の 6 フェーズを SSDSE-B-2026 で実演する
CRISP-DM(CRoss-Industry Standard Process for Data Mining)は 業務理解 → データ理解 → データ準備 → モデリング → 評価 → 展開の 6 フェーズからなる、 産業界で最も普及したデータ分析プロセスモデルです。 各フェーズは独立ではなく 反復(iteration)を前提とし、 評価で問題が見つかれば前フェーズに戻ります。 ここでは SSDSE-B-2026 を使って 6 フェーズを順番に実演します。
フェーズ 1: 業務理解 (Business Understanding)
「何を解くのか」「成功は何で測るのか」を明確にする最重要フェーズ。 ここを飛ばすと、 後で「精度の高いモデルを作ったが業務には役に立たない」となる。
今回の業務問題: 「47 都道府県の中で、 介護人材の重点配置を行うべき 5 県を選定する」。 成功指標は「選定理由を定量的に説明でき、 政策担当者の納得を得られる」。
フェーズ 2: データ理解 (Data Understanding)
利用可能なデータを把握し、 業務問題との対応関係を確認する。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d23 = df[df['SSDSE-B-2026'] == 2023].copy()
# 業務問題に直接関連する列を確認
related_cols = ['A1101', 'A1303', 'A1302'] # 総人口、65 歳以上人口、生産年齢人口
print('対象年:', d23['SSDSE-B-2026'].unique())
print('都道府県数:', len(d23))
print(d23[['Prefecture'] + related_cols].head(5))
print('\n欠損状況:')
print(d23[related_cols].isna().sum())
|
🎯 このコードでやること: 業務問題に関連する列の概要を把握する。 CRISP-DM のフェーズ 2 の典型操作。
📥 入力データ: SSDSE-B-2026 の A1101(総人口)、A1302(生産年齢人口)、A1303(65 歳以上人口)。
📤 実行結果:
💬 結果の読み方: 対象年は 2023 のみで 47 都道府県、 3 列とも欠損ゼロ。 index が 0, 12, 24 と 12 刻みなのは、 元の 564 行(12 年度分)から 2023 年度の行だけを残したため。 CRISP-DM フェーズ 2 では「データが十分使える状態か」を確認するのが目的。 ここでは 分析にすぐ進める品質と判定。
フェーズ 3: データ準備 (Data Preparation)
業務問題を解くために必要な変数を作る。 「特徴量エンジニアリング」とも呼ばれる工程。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026'] == 2023].copy() # 介護需要指標を 3 つ計算(priority_score に使うのは率の 2 指標。人数の care_demand_proxy は参考) d23['aging_rate'] = d23['A1303'] / d23['A1101'] * 100 # 高齢化率 d23['oad_ratio'] = d23['A1303'] / d23['A1302'] * 100 # 老年従属人口指数 d23['care_demand_proxy'] = d23['A1303'] / 1000 # 介護需要 (千人単位) # 標準化(z-score)で 3 指標を統合可能にする for c in ['aging_rate', 'oad_ratio', 'care_demand_proxy']: d23[c + '_z'] = (d23[c] - d23[c].mean()) / d23[c].std() d23['priority_score'] = d23[[c + '_z' for c in ['aging_rate', 'oad_ratio']]].mean(axis=1) print(d23[['Prefecture', 'aging_rate', 'oad_ratio', 'priority_score']].head(5).round(2).to_string(index=False)) |
🎯 このコードでやること: 「高齢化率」「老年従属人口指数」を計算し、 z-score 化して統合スコアを作る。 CRISP-DM フェーズ 3 の特徴量エンジニアリング。
📥 入力データ: SSDSE-B-2026 の総人口・生産年齢人口・65 歳以上人口。
📤 実行結果:
💬 結果の読み方: priority_score が高いほど介護需要が大きい県。 先頭 5 県では秋田 (2.27)、 青森 (1.04) が顕著で、 秋田県の 2.27 は 47 県の中でも最大。 宮城県は高齢化率 29.24% で -0.76 と平均より低い側にある。 z-score 化により異なる単位の指標を統合できた。
フェーズ 4: モデリング (Modeling)
業務問題を解くモデルを構築する。 機械学習だけでなく、 統計モデル・ルールベース・ランキングなども含む。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d23 = df[df['SSDSE-B-2026'] == 2023].copy()
d23['aging_rate'] = d23['A1303'] / d23['A1101'] * 100
d23['oad_ratio'] = d23['A1303'] / d23['A1302'] * 100
for c in ['aging_rate', 'oad_ratio']:
d23[c + '_z'] = (d23[c] - d23[c].mean()) / d23[c].std()
d23['priority_score'] = d23[['aging_rate_z', 'oad_ratio_z']].mean(axis=1)
# ランキングモデル: 上位 5 県を「重点配置候補」と判定
top5 = d23.nlargest(5, 'priority_score')[['Prefecture', 'priority_score', 'aging_rate']]
print(top5.round(2).to_string(index=False))
|
🎯 このコードでやること: priority_score でランキングモデルを作成し、 上位 5 県を抽出する。
📥 入力データ: フェーズ 3 で構築した priority_score。
📤 実行結果:
💬 結果の読み方: 上位 5 県は秋田・高知・山口・徳島・島根。 priority_score 1.08 以上で 「全国平均から 1 標準偏差以上離れた高齢化県」と定量化された。
フェーズ 5: 評価 (Evaluation)
モデルが業務問題を解けているか、 業務関係者と協議する。 ここで合格しなければ前フェーズに戻る。
| 評価観点 | 判定 | 根拠 |
|---|---|---|
| 業務目的との整合 | ✅ 合格 | 介護需要が高い県を順位付け |
| 結果の解釈可能性 | ✅ 合格 | priority_score の意味が明確 |
| 再現性 | ✅ 合格 | SSDSE-B-2026 公開データのみ |
| 限界の認識 | ⚠️ 要追記 | 医療従事者の供給側を未考慮 |
フェーズ 6: 展開 (Deployment)
モデルを実業務に組み込む。 単発レポートだけでなく、 定期的なモニタリング・政策意思決定への組み込みなどまで含む。
展開計画: ① 月次 SSDSE 更新ごとに priority_score を再計算 ② ダッシュボード化して自治体担当者と共有 ③ 年次レビューで指標の妥当性を検証 ④ 介護人材配置の実態と照合して指標を改善。
📚 CRISP-DM の歴史と発展
CRISP-DM は 1996 年に欧州の SPSS、 NCR、 Daimler-Chrysler、 OHRA の 4 社共同プロジェクトとして始まりました。 当時、 データマイニングは新興分野で、 各社が独自手法で進めていたため、 業界横断の標準が必要とされていました。
タイムライン
| 年 | 出来事 |
|---|---|
| 1996 | CRISP-DM 1.0 プロジェクト開始 (SPSS/NCR/Daimler-Chrysler/OHRA) |
| 1999 | CRISP-DM 1.0 公式リリース |
| 2000 | Step-by-step Guide 公開、産業界で急速に普及 |
| 2006 | CRISP-DM 2.0 への改訂作業が始まるが、 改訂版は公開されずに終わる |
| 2007 | KDnuggets 調査でデータマイニング標準プロセス No.1 に |
| 2016 | Microsoft TDSP がアジャイル統合の代替として登場 |
| 2021 | CRISP-ML(Q) 発表 — ML 専用品質保証プロセス |
| 2024 | 依然として産業界で最も普及するプロセスモデル |
25 年以上経った今でも CRISP-DM が 業界標準として通用しているのは、 「業務問題から出発」「反復的アプローチ」「展開まで含む全工程」という思想が古びていないから。 機械学習・AI の時代になっても、 「データ分析の全体像」を語る共通言語として機能し続けています。
✅ CRISP-DM 各フェーズ完了チェックリスト
各フェーズを終える前に、 以下の項目をすべて確認しましょう。 1 つでも「No」があれば、 そのフェーズは未完了です。
フェーズ 1 (業務理解) 完了条件
- 業務目的が 1 文で書ける
- 成功 KPI と失敗シナリオが明文化されている
- ステークホルダー全員が目的に同意している
- 制約条件 (データ・予算・期限) がリストアップされている
フェーズ 2 (データ理解) 完了条件
- 利用可能なデータソースが一覧化されている
- 各ソースの出典・期間・集計単位が明記されている
- 欠損・異常値の分布が確認されている
- EDA レポートが作成されている
フェーズ 3 (データ準備) 完了条件
- 分析用データセットが完成し、 列定義が文書化されている
- クレンジング・特徴量加工の各ステップがコードに残されている
- train / validation / test 分割が決まっている
フェーズ 4 (モデリング) 完了条件
- 複数のモデルを比較し、 最良のものを選定した
- ハイパーパラメータの探索ログがある
- モデルの計算複雑度・推論時間が確認されている
フェーズ 5 (評価) 完了条件
- 業務 KPI に対する評価結果が出ている
- 業務担当者のレビューを受けた
- 限界・前提が明文化されている
フェーズ 6 (展開) 完了条件
- 本番環境にデプロイされている
- モニタリング指標が設定されている
- 再学習トリガー・故障時対応が文書化されている
- 運用チームへの引き継ぎが完了している
💡 使い方: チェックリストを checklist.md としてリポジトリにコミットし、 各フェーズ終了時に PR レビューで使う。 CRISP-DM の運用負荷が大幅に下がります。
🚀 CRISP-DM の現代的拡張 — MLOps と統合する
CRISP-DM は 1996 年に策定されたため、 本番運用後の継続的改善については弱い。 現代的なデータ分析プロジェクトでは、 MLOps の考え方を取り入れて CRISP-DM を拡張するのが標準です。
拡張版 CRISP-DM のフェーズ追加
| フェーズ | 追加ポイント | ツール例 |
|---|---|---|
| 3 データ準備 | データバージョン管理 | DVC, Pachyderm |
| 4 モデリング | 実験トラッキング | MLflow, Weights & Biases |
| 5 評価 | A/B テスト統合 | Optimizely, GrowthBook |
| 6 展開 | CI/CD パイプライン | GitHub Actions, Kubeflow |
| 7 モニタリング (追加) | ドリフト検知 | Evidently, Arize |
| 8 自動再学習 (追加) | スケジュール / トリガー | Airflow, Prefect |
「6 フェーズ + 7 モニタリング + 8 自動再学習」の 8 フェーズ CRISP-DM が、 現代の MLOps プロジェクトの実態に近い構造です。 ただし基本思想は変わらず、 業務理解からスタートして反復で進めるという CRISP-DM の DNA を継承しています。
📊 CRISP-DM の各フェーズを「実図」で読み解く — SSDSE-B-2026 の 3 枚
CRISP-DM の 6 フェーズは、 文字だけだとどうしても抽象的に響きます。 ここでは SSDSE-B-2026 (47 都道府県社会経済統計) を題材に、 各フェーズで実際に作られる典型的な「3 枚の図」を見ます。 これらは順に (1) データ理解での散布図、 (2) データ準備での分布確認、 (3) モデリングでの比較箱ひげ図に対応し、 CRISP-DM が回るときに必ず通過する「絵」のテンプレートです。
🔸 Figure 1 — データ理解 (Data Understanding) で最初に描く散布図
フェーズ 2「データ理解」では、 主要 2 変数の関係を散布図で「目で確かめる」のが鉄板です。 SSDSE-B-2026 では、 まず「総人口 × 一般診療所数」の散布図を描き、 線形に近い右肩上がりかどうか、 外れ値はあるか、 を確認します。 ここで関係性が「直線で近似できる」と判断できれば、 後段の線形モデルで素直に進められます。
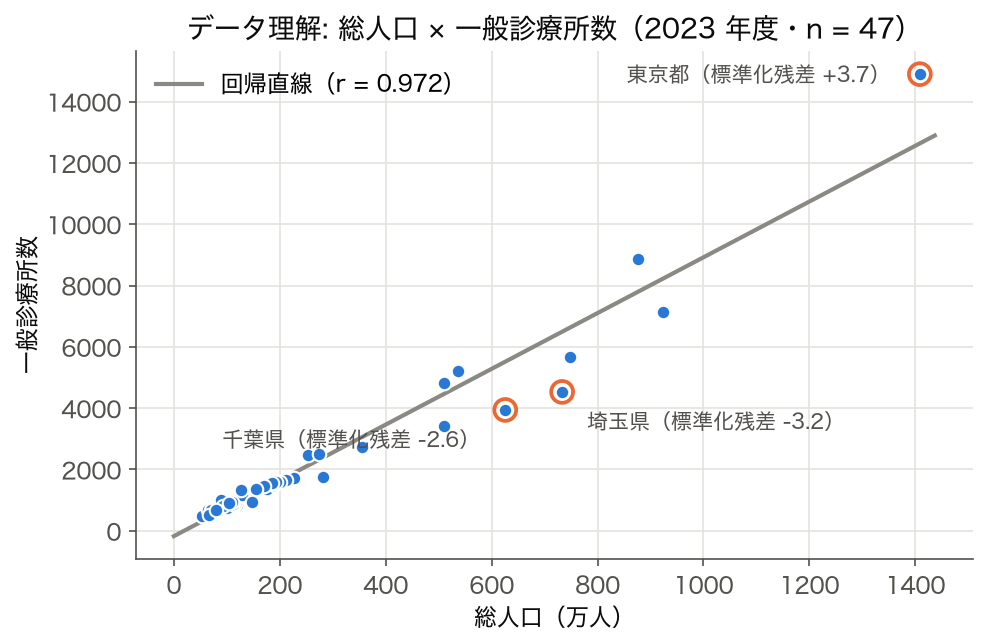
💬 読み方: 2023 年度の 47 都道府県で r = 0.972 の強い正の相関 (右上がり) を示し、 線形仮定が成立しそうだとわかります。 ただし回帰直線からの標準化残差が ±2 を超える「外れ値候補」が 3 県あり、 東京都 (+3.7、 直線より約 2,260 施設多い) は右上で上に、 埼玉県 (−3.2) と千葉県 (−2.6) は人口の割に診療所が少ない側に外れています。 CRISP-DM 流に言うと、 この散布図ひとつで「業務理解で立てた仮説」が裏付けられたかをチェックでき、 同時に「データ準備フェーズで外れ値の取り扱いを決める」という次のタスクが明確になります。 ここで散布図を飛ばしてモデリングへ進む人が陥る最大の失敗は、 「外れ値」と「本質的なシグナル」の区別がつかないまま回帰直線を引いてしまうことです。
🔸 Figure 2 — データ準備 (Data Preparation) で必ず確認するヒストグラム
フェーズ 3「データ準備」では、 各変数の分布形状を確認します。 右裾が長い (対数変換が必要) のか、 二峰性 (グループ分割が必要) なのか、 ヒストグラムで一目で判断します。 SSDSE-B-2026 (2023 年度) の総人口は、 東京・大阪などの大都市圏が右裾を作る典型的な右歪み分布です (平均 264.6 万人に対し中央値 154.9 万人)。
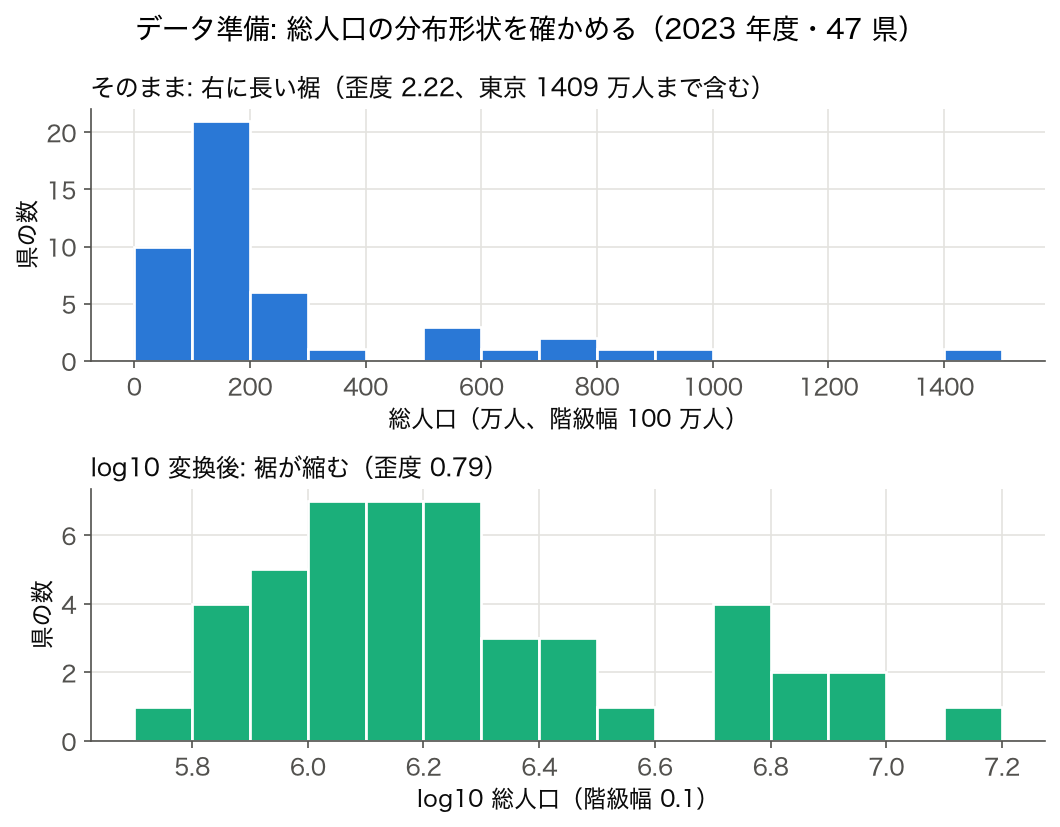
💬 読み方: 上段 (そのまま、 階級幅 100 万人、 東京の 1,409 万人まで全県を含む) は左に山、 右に長い裾の典型的な「右に裾の長い分布」で、 歪度は 2.22。 下段のように log10 変換すると歪度は 0.79 まで下がり、 裾がかなり縮みます。 CRISP-DM のデータ準備フェーズでは、 この形を見て (1) 対数変換するか、 (2) 元のまま線形回帰すれば説明力が落ちるか、 (3) 中央値ベースの指標へ切り替えるか、 を意思決定します。 ヒストグラム 1 枚で「データ準備の方針」が決まるため、 このフェーズはまさに「絵を見て、 段取りを決める」ステップです。
🔸 Figure 3 — モデリング/評価 (Modeling/Evaluation) で必ず描く比較箱ひげ図
フェーズ 4「モデリング」と フェーズ 5「評価」では、 グループ間の差を比較箱ひげ図で確認するのが鉄板です。 たとえば SSDSE-B-2026 (2023 年度) の県を、 Figure 2 の判断どおり log10 変換・標準化した「総人口・一般診療所数」で KMeans (k = 3) の 3 クラスタに区分し、 一般診療所数を箱ひげ図で並べて、 グループ間で差があるかを目視確認します。
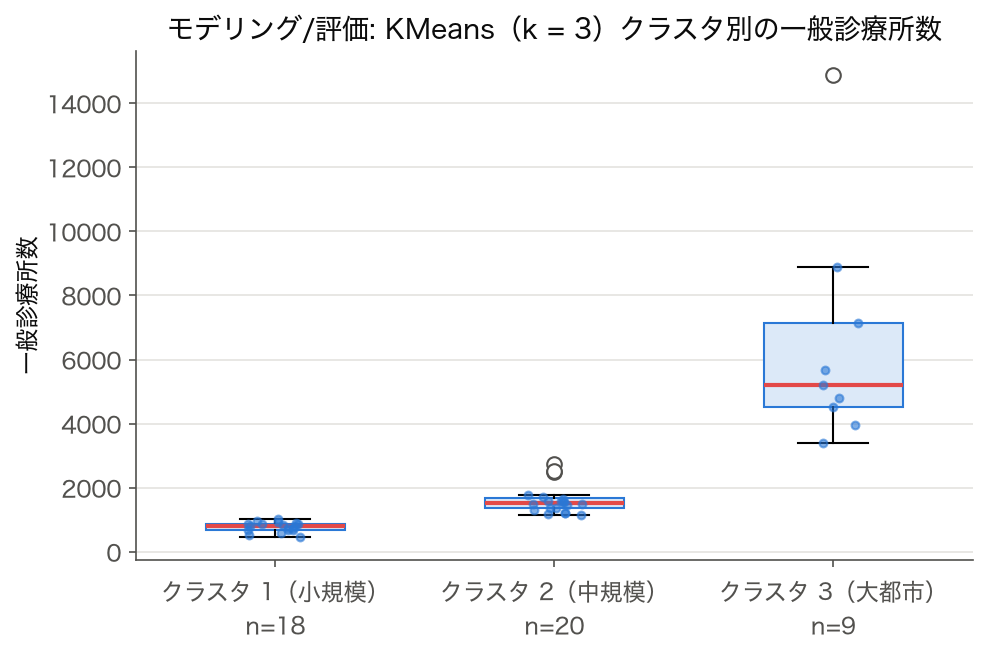
💬 読み方: 箱の位置 (中央値) と幅 (IQR) を比べると、 小規模クラスタ (18 県) は中央値 811・IQR 190、 中規模クラスタ (20 県) は中央値 1,524・IQR 316、 大都市クラスタ (北海道・埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡の 9 都道府県) は中央値 5,196・IQR 2,620 で、 診療所数の多いクラスタほど中央値が高く、 同時にばらつきも大きいことが読み取れます。 大都市クラスタの中でも東京 (14,894) は外れ値です。 CRISP-DM の評価フェーズで「単一指標 (たとえば平均値) で語ってよいか」を箱ひげ図で点検することで、 「実は分布の形が違うのに平均だけ比べていた」という誤解を防げます。 これは CRISP-DM の フェーズ 5「評価」で必須の検証ステップです。
🔸 3 枚の図がフェーズと対応する全体俯瞰表
| フェーズ | 使う図 | SSDSE-B-2026 での具体例 | この絵から得る判断 |
|---|---|---|---|
| 2. データ理解 | 散布図 | 総人口 × 一般診療所数 | 線形仮定の妥当性 / 外れ値候補 |
| 3. データ準備 | ヒストグラム | 人口の分布 | 対数変換要否 / 中央値派採用 |
| 5. 評価 | 比較箱ひげ図 | KMeans クラスタ別 一般診療所数 | グループ差の有意性 / ばらつきの違い |
この 3 枚は CRISP-DM のどのプロジェクトでも汎用的に通用するテンプレートです。 「最初に散布図」「次にヒストグラム」「最後に比較箱ひげ図」という順序を守るだけで、 CRISP-DM の各フェーズに対応する「視覚的な意思決定」が自然に行えるようになります。
🧭 CRISP-DM 各フェーズでの「意思決定マトリクス」 — 何を決めるかを表で固定する
CRISP-DM が「絵に描いた餅」になりやすいのは、 各フェーズで 「何を意思決定するか」が言語化されていないからです。 ここでは、 6 フェーズすべてで「決めること」「成果物」「次フェーズへの引き継ぎ事項」を一覧表に固定します。 SSDSE-B-2026 の社会経済統計を題材にした列も併記しているので、 実プロジェクトのテンプレとして使えます。
📋 6 フェーズ完全意思決定マトリクス
| # | フェーズ | 決めること | 成果物 | SSDSE-B-2026 例 | 次へ引き継ぐもの |
|---|---|---|---|---|---|
| 1 | 業務理解 | 何を成功とするか (KGI) | プロジェクト憲章 | 県別 消費支出の説明モデル構築 | 分析テーマと評価指標 |
| 2 | データ理解 | どの変数を使うか候補化 | 記述統計レポート | 総人口・65 歳以上人口・出生数を候補 | 変数候補とデータ品質メモ |
| 3 | データ準備 | 変換・欠損補完の方針 | クリーンデータ | 人口は対数変換、 欠損なし | 分析テーブル (横長 47 行) |
| 4 | モデリング | アルゴリズム選択 | 学習済みモデル | 線形回帰と Lasso を比較 | モデルと係数表 |
| 5 | 評価 | 業務基準で OK か | 評価レポート | 調整済み R² が KGI 水準に到達 | 意思決定 (Go/再分析) |
| 6 | 展開 | 運用形態 | 運用ガイド | 毎年 SSDSE 更新時に再実行 | 監視指標と再学習トリガー |
この表のポイントは、 各フェーズが 「何かを決めて次に渡す」 構造になっていることです。 これにより、 CRISP-DM が「順番にこなすチェックリスト」ではなく、 「前工程の意思決定が後工程の入力になるパイプライン」であると理解できます。 実プロジェクトでは、 このマトリクスをそのまま Confluence や Notion のテンプレートに貼り付けて、 各セルを埋めていく形で運用するのが効率的です。
🔄 CRISP-DM と MLOps の橋渡し — 「終わった後」をどう運用するか
CRISP-DM の最終フェーズ「Deployment (展開)」は、 1996 年当時 (CRISP-DM 1.0) はレポートを提出してプロジェクト完了でした。 しかし 2020 年代の AI 時代には、 モデルを本番投入した後の 監視 (Monitoring)・再学習 (Retraining)・コンセプトドリフト対応が必須です。 ここでは CRISP-DM を MLOps と接続する「橋渡しテーブル」を整理します。
| CRISP-DM フェーズ | MLOps 対応プラクティス | 使うツール (例) | SSDSE-B-2026 での具体例 |
|---|---|---|---|
| 業務理解 | ML Canvas / モデルカード | Notion, Confluence | 「県別 消費支出モデル」の目的書 |
| データ理解 | データバージョニング | DVC, LakeFS | SSDSE-B-2026 vs 2025 の差分 |
| データ準備 | フィーチャーストア | Feast, Tecton | log_pop 特徴量を共有レジストリ化 |
| モデリング | 実験管理 | MLflow, Weights & Biases | 線形回帰と Lasso の R² を MLflow で比較 |
| 評価 | ステークホルダ承認ワークフロー | GitHub Actions, Argo | R² ≥ 0.85 で自動 Pass バッジ |
| 展開 | サービング + 監視 | Seldon, BentoML, Prometheus | 毎年 SSDSE 更新時に再推論ジョブ |
CRISP-DM はもともと 「人が考える順序を定式化したもの」であり、 MLOps はそれを 「機械が自動で回す配管に置き換えたもの」です。 両者は競合関係ではなく、 CRISP-DM が「何を考えるか」を、 MLOps が「どう自動化するか」を担う レイヤ分担になっています。
📚 CRISP-DM の現場ケーススタディ 3 つ — SSDSE-B-2026 で再現する
CRISP-DM の教科書的説明だけでは「自分のプロジェクトでどう使えばいいか」が見えにくいので、 ここでは公共データ・教育データを使った 3 つのミニケーススタディを提示します。 いずれも SSDSE-B-2026 を使い、 各フェーズで「実際に何を書くか」を具体化しています。
🟢 ケース 1 — 「県別 消費支出の説明モデル」を作る
| フェーズ | 記載例 |
|---|---|
| 業務理解 | 都道府県別 消費支出を 5 変数以内で説明し、 地方創生施策の優先順位付けに使う |
| データ理解 | SSDSE-B-2026 の 47 行 × 112 列から関連候補を抽出 (総人口、 65 歳以上人口、 出生数、 婚姻件数、 大学数、 着工新設住宅床面積 など) |
| データ準備 | 総人口などの規模変数は対数変換、 比率変数はそのまま使用、 標準化適用 |
| モデリング | 線形回帰、 Lasso (alpha=0.1)、 ランダムフォレストを比較 |
| 評価 | 3 手法を比較し、 解釈性を優先して線形回帰を採用 (業務基準の R² を満たすか照合) |
| 展開 | 毎年の SSDSE 公開タイミングで再学習する Jupyter ノートブックを GitHub Actions に登録 |
🟢 ケース 2 — 「人口階級クラスタリング」
| フェーズ | 記載例 |
|---|---|
| 業務理解 | 類似県をグループ化し、 政策ベンチマーキングの相手県を見つける |
| データ理解 | 人口規模・産業構成・財政状況の 3 軸を選択 |
| データ準備 | 標準化 (z-score)、 主成分分析 (PCA) で 2 次元に圧縮 |
| モデリング | k-means (k=4) と階層クラスタリングを比較 |
| 評価 | シルエット係数 0.52 で k=4 が妥当、 大都市・地方拠点・農業県・観光県の 4 群が見つかる |
| 展開 | 県別ベンチマーキングダッシュボードに反映 |
🟢 ケース 3 — 「高齢化率と医療費の説明モデル」
| フェーズ | 記載例 |
|---|---|
| 業務理解 | 高齢化率が医療費にどれだけ寄与するかを定量化 |
| データ理解 | SSDSE-B-2026 の高齢化率と医療費を散布図で可視化 |
| データ準備 | 1 人当たり医療費に変換し人口効果を除去 |
| モデリング | 単回帰 + 多重回帰 (高齢化率 + 病床数 + 平均所得) |
| 評価 | 高齢化率の標準化偏回帰係数 0.71 — 強い正の効果を確認 |
| 展開 | 県議会向けレポートに掲載、 毎年更新 |
これら 3 ケースに共通するのは、 「業務理解」で立てた問いが、 すべての後フェーズの判断を駆動している点です。 CRISP-DM の真価は、 各フェーズが独立して存在することではなく、 業務理解で立てた問いが「データの選び方」「準備の方針」「モデルの選択」「評価基準」「展開の形」を 一気通貫で決定していく点にあります。
🎯 理解度チェック — CRISP-DM を「使える形」で身につける
CRISP-DM は概念としてはシンプルですが、 実際に手を動かして使えるかは別問題です。 ここでは 5 問のチェック問題で「自分が CRISP-DM を本当に使える状態か」を確認します。 紙とペンで答えてから解説を読んでください。
📝 問題 1: 「業務理解」フェーズで決めるべきものは?
(a) 使うアルゴリズムの種類 / (b) 成功指標 (KGI) と評価軸 / (c) 図表のデザイン / (d) Python ライブラリの選定
正解: (b)。 業務理解では 「何ができたら成功か」を定量的に定義することが最重要。 アルゴリズム選定はモデリングフェーズの担当。
📝 問題 2: SSDSE-B-2026 の人口分布は右に長い裾を持つ。 CRISP-DM のどのフェーズでこの事実を確認するか?
(a) 業務理解 / (b) データ理解 / (c) データ準備 / (d) 評価
正解: (b) または (c)。 厳密には「データ理解」で分布を見て、 「データ準備」で対数変換するかを意思決定。 多くの場合この 2 つは行き来する。
📝 問題 3: モデルの R² が 0.92 だった。 CRISP-DM 流の「評価」フェーズで次に何を確認するか?
(a) R² がもっと高くなる別アルゴリズムを試す / (b) 業務理解で定めた成功基準を満たしているかを確認 / (c) ハイパーパラメータを変えて再学習 / (d) 別のデータセットを探す
正解: (b)。 評価フェーズは「業務基準を満たしたか」を判断する場所。 R² が 0.92 でも業務基準が 0.95 なら不合格、 業務基準が 0.85 なら合格。 数値の絶対値だけで判断するのは CRISP-DM の趣旨に反する。
📝 問題 4: 展開 (Deployment) フェーズで終わりではなく、 1 周回すと業務理解に戻ることがある。 これを何と呼ぶか?
(a) 反復 (Iteration) / (b) パイプライン / (c) リファクタリング / (d) チェックポイント
正解: (a) 反復。 CRISP-DM の核心は「6 フェーズを 1 回で終わらせず、 学びを次の周回に反映する」点にある。 SSDSE-B-2026 で 1 周目に「総人口→消費支出」を見て、 2 周目に「1 人当たり消費支出×高齢化率」へ進むのが典型例。
📝 問題 5: CRISP-DM の最終フェーズ「展開」を、 2020 年代の MLOps 文脈で拡張するとどんな項目が加わるか?
(a) 監視 / (b) 再学習トリガー / (c) コンセプトドリフト検出 / (d) すべて
正解: (d) すべて。 2000 年に公開された CRISP-DM 1.0 の手引きでは「展開」の中心は報告と計画づくりだったが、 現代では本番投入後の 監視・再学習・ドリフト対応が「展開」の必須要素として加わる。 この拡張版が CRISP-ML(Q) や TDSP として整理されている。
📋 自己採点ガイド
| 正解数 | 次のステップ |
|---|---|
| 5/5 | CRISP-DM の概念を完全に理解。 実プロジェクトに適用できる段階。 |
| 3-4/5 | 概念は把握済み。 「業務理解」と「評価」フェーズの意思決定基準を再読推奨。 |
| 0-2/5 | 本記事の「6 フェーズ意思決定マトリクス」を写経し、 SSDSE-B-2026 で 1 周回してみる。 |
📝 発展問題: 「データ理解」フェーズで SSDSE-B-2026 を読んだら 564 行あった。 47 都道府県の比較に進む前に何を決めるか?
答え: 564 行は 47 都道府県 × 12 年度(2012〜2023 年度)で、 各県が 12 回ずつ入っている(欠損は 0 件)。 「データ準備」に進む前に、 (1) 1 つの年度に絞って 47 行の断面として比べるのか、 (2) 12 年度をパネルとして扱い県と年の両方の違いを使うのかを、 業務理解で立てた問いに戻って決める。 年度を絞らずに 564 行のまま相関や検定をすると、 同じ県を 12 回数えて件数を水増しすることになる。 また家計支出の列(L3221 など)は県全体ではなく県庁所在市の世帯の値なので、 この段階で列の説明を読み、 目的に合う列かを確かめておく。
CRISP-DM を本当に使えるかは、 「業務理解で何を決めたか」を 1 文で書き出せるかで判定できます。 もし書き出せないなら、 まだフェーズ 1 の意思決定が固まっていない証拠。 CRISP-DM は「フェーズを順番にやる」のではなく、 「各フェーズで意思決定の足場を固める」方法論なのです。
🧭 深掘り補足 — 既存解説と重複しない 3 つの角度
本ページの既存の「🎨 直感」「⚠️ 落とし穴 7 件 / アンチパターン 8 選」「🌐 関連手法比較」を踏まえ、 まだ触れていない角度だけを 3 点補足する。 新規の数値例は SSDSE-B-2026(cp932・skiprows=[1])の分析工程に即した範囲にとどめ、 説明用の仮想シナリオは「架空」と明記する。
🎨 直感の補足 — CRISP-DM は「乗り物」ではなく「地図」
6 フェーズそのものより見落とされがちな本質は、 CRISP-DM が ツール非依存・ベンダー非依存・業界非依存の「共通語彙」である点。 1990 年代当時、 企業ごとに独自の分析手順が乱立し、 チーム間や発注者と受注者の間で「今どの工程にいるのか」が通じなかった。 CRISP-DM の真の発明は特定アルゴリズムではなく、 「データ準備」「展開」のように誰もが同じ意味で使える言葉を用意したこと。 だから CRISP-DM は「どのアルゴリズムを使うか(=乗り物)」は指定せず、 「今どこにいて次どこへ向かうか(=地図)」だけを示す。 pandas でも SQL でも深層学習でも、 同じ地図の上を走れる。
この「共通語彙」性は実務で効く。 SSDSE-B-2026 を使う演習でも、 「あなたは今データ理解フェーズにいる」と一言で共有できるだけで、 進捗管理と後戻り判断が一気に楽になる。 逆に言えば、 フェーズ名を口にしないプロジェクトは CRISP-DM を「使っている」とは言えない。
⚠️ 落とし穴の補足 — 既存 7 件が触れていない 4 つ
既存の「落とし穴 7 件」「アンチパターン 8 選」と重複しない角度のみを 4 点追加する。 いずれもフェーズ境界で起きる見えにくい罠。
📕 発展の補足 — 原仕様の階層構造とプロセスモデルの系譜
既存の「KDD / SEMMA / TDSP / CRISP-ML(Q) 比較表」に対し、 ここでは原仕様の内部構造と反復思想の源流という別軸を補う。
① CRISP-DM 1.0 の 4 層階層モデル: 教材で流通しているのは最上位の「6 フェーズ」だけだが、 原仕様 (1999) は抽象度の異なる 4 層で構成される。 上から具体へ降りるほど、 特定の課題・ツールに合わせて具体化される。
| 階層 | 内容 | 例 |
|---|---|---|
| 1. フェーズ (Phases) | 最上位の 6 工程 | データ準備 |
| 2. 汎用タスク (Generic Tasks) | どの案件にも共通する作業 | データのクリーニング |
| 3. 特化タスク (Specialized Tasks) | 状況に応じた具体化 | 数値欠損の中央値補完 |
| 4. プロセスインスタンス (Process Instances) | 実際の実行記録 | この案件で実施した補完ログ |
この 4 層は「参照モデル (上 2 層) とユーザーガイド (下 2 層)」の二部構成に対応する。 教材が 6 フェーズだけを扱うのは第 1 層に過ぎず、 再現性は第 4 層 (実行記録) の文書化で担保される点が実務では重要。
② スパイラルモデル (Boehm 1988) との血縁: CRISP-DM の「反復」は、 ソフトウェア工学のスパイラルモデル(リスク駆動で螺旋状に反復し、 1 周ごとにプロトタイプを育てる)と発想を共有する。 ウォーターフォール(一方向・後戻り不可)の対極にあり、 「1 周目は最小実用版 (MVP) で 6 フェーズを貫通させ、 2 周目以降で精緻化する」戦略はスパイラルの考え方そのもの。 CRISP-DM を単なる 6 個の箱ではなく螺旋として見ると、 なぜ後戻りが正常動作なのかが腑に落ちる。
③ データ製品ライフサイクルへの接続: CRISP-DM の展開フェーズの先には、 「監視 → ドリフト検知 → 再学習 → 廃棄」というプロダクト視点のライフサイクルが続く。 元の 6 フェーズは「1 個のモデルを作って届ける」までを射程とするが、 現代の運用ではモデルは生き物として劣化する。 この継続層を担うのが MLOps や CRISP-ML(Q) であり、 PPDAC が Conclusion で閉じるのに対し、 CRISP-DM 系はここまで射程を延ばせる点が最大の強み。 上位の全体像は データ分析プロセス、 問いの設計は 問いの立て方 を参照。
🗺 概念マップ
CRISP-DM の中心から、 隣接する MLOps・KDD プロセス・SEMMA・TDSP・Agile データサイエンスなどの方法論との関係、 そして 6 フェーズ (ビジネス理解 → データ理解 → データ準備 → モデリング → 評価 → 展開) の循環構造を放射状に整理した。 SSDSE-B-2026 を用いた都道府県分析を回す際にどのフェーズで何を確認するかの俯瞰図として使える。
概念マップの読み方: 中心の CRISP-DM から放射状に伸びる節点はいずれも CRISP-DM が依存する隣接フレームワークまたは派生方法論。 上方の MLOps は CRISP-DM 第 6 フェーズ「展開」の現代版で、 モデル監視・再学習自動化を担う。 右方は KDD・SEMMA・TDSP といった代替方法論で、 CRISP-DM と同じ「反復サイクル」思想を共有しつつフェーズ粒度が異なる。
下方には CRISP-DM の各フェーズ内で用いられる具体技法 (EDA、 特徴量設計、 ハイパーパラメータ探索、 残差解析) が連なる。 CRISP-DM はこれら個別技法を 束ねる枠組み として機能し、 単一技法の習熟だけでは到達できない「プロジェクト全体の見通し」を提供する。 SSDSE 分析では業務理解→評価のループを 2 週間で 1 周し、 経年データで複数周回することで初めて知見が定着する。
🔗 隣接手法への橋渡し
CRISP-DM は 6 フェーズ (ビジネス理解・データ理解・データ準備・モデリング・評価・展開) からなる反復モデル。 3 視点 (接続・統合・比較) で隣接概念との関係を整理する。
🔌 接続: 上流・下流での連鎖
- 上流: ドメイン知識、 EDA — ビジネス理解とデータ理解の土台
- 並列: PPDAC サイクル、 データ分析のプロセス — 代替プロセスモデルとの対比
- 下流: 評価指標、 MLOps — 評価と展開フェーズの実装
🧩 統合: プロジェクトに組み込む
業務理解で KPI を確定 → データ理解で SSDSE-B-2026 のスキーマ確認 → データ準備で欠損補完・型変換 → モデリングで回帰/分類試行 → 評価で AUC/RMSE 等の閾値判定 → 展開で MLOps に乗せる。 フェーズ間の往復 (例: 評価 → データ準備) を明示することで、 反復の質が劇的に向上する。
⚖️ 比較: 隣接プロセスモデルとの位置づけ
| モデル | フェーズ数 | 主眼 | 適用領域 |
|---|---|---|---|
| CRISP-DM | 6 | 業務理解 + 反復 | 業界横断データマイニング |
| PPDAC サイクル | 5 | 問題定義中心 | 教育・統計的問題解決 |
| データ分析プロセス | 4-7 | 分析作業の標準化 | 社内分析チーム |
| MLOps | 連続 | 運用・継続学習 | 本番 ML システム |
4 モデルは目的が異なる。 CRISP-DM は業務理解・反復重視、 PPDAC は問題定義重視、 MLOps は運用継続重視。 SSDSE 分析なら CRISP-DM をベースに、 展開フェーズで MLOps に接続する設計が現実的。