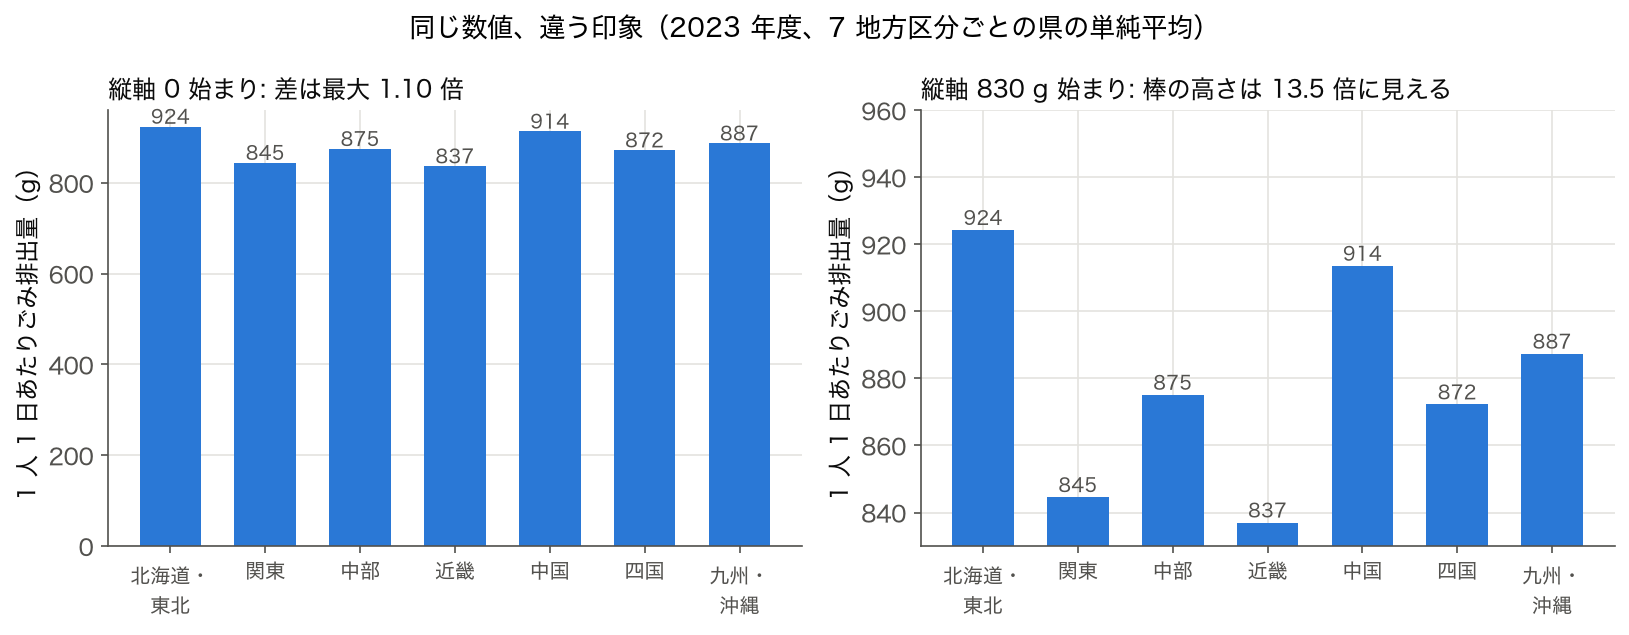
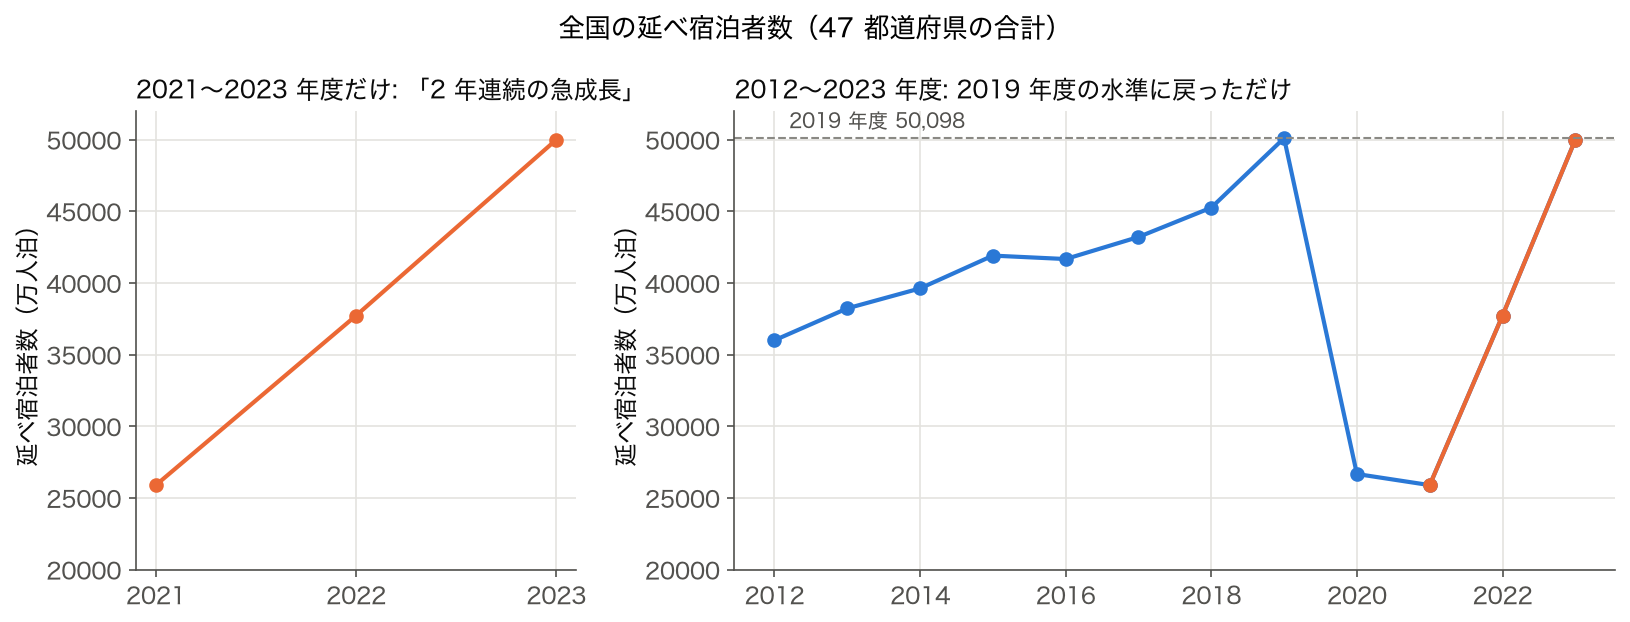
📍 あなたが今見ているもの
🍰 まずはやさしく
データ分析の全体像をまとめた地図です。
分析の質を高めるために使います。
部活の記録をまとめる時に役立ちます。
分析の流れや準備の手順について読みます。
本ページでは、 データリテラシー を統合的に解説します。 PPDAC サイクル ・CRISP-DM ・問いの設計 ・EDA ・変数の尺度 ・批判的読解 を一気通貫で扱います。
「どの手法を使うか」よりその前段 のリテラシーが、 分析の質を決定します。 数理・データサイエンス・AI モデルカリキュラム(MDASH)でも導入科目として位置づけられています。
🧮 SSDSE-B-2026 で実値計算 — データリテラシー演習
「データを正しく見る」基本動作を SSDSE-B-2026 の都道府県データで実行します。
例1:要約統計量を一括で得る
🎯 解説: SSDSE-B-2026(47都道府県データ)でデータリテラシーの基本確認動作を行う。 まずはデータを読み込み、 構造・型・欠損・代表値を「見る」ことが分析の出発点。 ファイルパスは自分の環境に合わせて変更すること。
📥 入力例: data/raw/SSDSE-B-2026.csv(2023年・47都道府県横断)
  年度  地域コード  都道府県  A1101(総人口)  A1303(65歳以上)  ...
  2023  R01000    北海道    5092000        1681000
  2023  R13000    東京都    14086000       3205000
  2023  R47000    沖縄県    1468000        350000
📋 コピー import pandas as pd
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
df = df [ df [ '年度' ] == 2023 ] # 2023 年の 47 都道府県に絞る(12 年度分を混ぜない)
print ( 'shape:' , df . shape )
print ( df . drop ( columns = '年度' ) . describe () . T . head ( 5 )) # count / mean / std / min / 25% / 50% / 75% / max
print ( '---' )
print ( df . dtypes . value_counts ()) # 各データ型の列数
print ( '欠損数:' , df . isna () . sum () . sum ())
📤 実行例(実測)
shape: (47, 112)
count mean std ... 50% 75% max
総人口 47.0 2.645809e+06 2.797551e+06 ... 1549000.0 2636500.0 14086000.0
総人口(男) 47.0 1.287085e+06 1.373649e+06 ... 732000.0 1269500.0 6914000.0
総人口(女) 47.0 1.358723e+06 1.424664e+06 ... 817000.0 1367000.0 7172000.0
日本人人口 47.0 2.578617e+06 2.691343e+06 ... 1533000.0 2573500.0 13448000.0
日本人人口(男) 47.0 1.253234e+06 1.320011e+06 ... 725000.0 1236500.0 6594000.0
[5 rows x 8 columns]
---
int64 104
float64 6
object 2
Name: count, dtype: int64
欠損数: 0
💬 2023 年度に絞ると shape は (47, 112) で、欠損は 0。型は int64 が 104 列、float64 が 6 列、object が 2 列(地域コード・都道府県)。総人口の平均 264.6 万人に対して中央値は 154.9 万人と 1.7 倍の開きがあり、最大の東京都 1,408.6 万人が平均を押し上げている。平均だけで「典型的な県」を語らず、中央値と並べて読む。
例2:分布と外れ値の確認(IQR ルール)
📥 入力例: data/raw/SSDSE-B-2026.csv(2023年・47都道府県横断)
  年度  地域コード  都道府県  A1101(総人口)  A1303(65歳以上)  ...
  2023  R01000    北海道    5092000        1681000
  2023  R13000    東京都    14086000       3205000
  2023  R47000    沖縄県    1468000        350000
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 import pandas as pd
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
# 47 都道府県・最新年度に絞る(絞らないと最初の数値列が「年度」になり、外れ値が 0 件になる)
df = df [ df [ '地域コード' ] . astype ( str ) . str . match ( r '^R\d {5} $' , na = False )] . copy ()
df [ '年度' ] = pd . to_numeric ( df [ '年度' ], errors = 'coerce' )
df = df [ df [ '年度' ] == df [ '年度' ] . max ()]
col = '総人口'
df [ col ] = pd . to_numeric ( df [ col ], errors = 'coerce' )
q1 , q3 = df [ col ] . quantile ([ 0.25 , 0.75 ])
iqr = q3 - q1
lo , hi = q1 - 1.5 * iqr , q3 + 1.5 * iqr
outliers = df [( df [ col ] < lo ) | ( df [ col ] > hi )]
print ( f ' { col } の外れ値 (n= { len ( outliers ) } ): 下限 { lo : ,.0f } / 上限 { hi : ,.0f } ' )
print ( outliers [[ '都道府県' , col ]] . to_string ( index = False ))
📤 実行例(実測)
総人口 の外れ値 (n=9): 下限 -1,369,750 / 上限 5,040,250
都道府県 総人口
北海道 5092000
埼玉県 7331000
千葉県 6257000
東京都 14086000
神奈川県 9229000
愛知県 7477000
大阪府 8763000
兵庫県 5370000
福岡県 5103000
💬 2023 年度 47 都道府県の総人口は IQR が 160.25 万人で、上限 504.0 万人を超える 9 都道府県が外れ値になった。北海道 509.2 万人・福岡県 510.3 万人は上限をわずかに超えただけで、東京都 1,408.6 万人とは外れ方の桁が違う。下限は −137.0 万人と負になるので、右に歪んだこの分布では下側の外れ値は出ようがない。規模の列は外れ値として除くより、人口当たりに直すか対数をとってから見る。
例3:層別集計(地域ブロック別)
📥 入力例: data/raw/SSDSE-B-2026.csv(2023年・47都道府県横断)
  年度  地域コード  都道府県  A1101(総人口)  A1303(65歳以上)  ...
  2023  R01000    北海道    5092000        1681000
  2023  R13000    東京都    14086000       3205000
  2023  R47000    沖縄県    1468000        350000
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import pandas as pd
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
df = df [ df [ '年度' ] == 2023 ] # 2023 年の 47 都道府県に絞る(12 年度分を混ぜない)
block_map = {
'北海道' : '北海道' , '青森県' : '東北' , '岩手県' : '東北' , '宮城県' : '東北' ,
'秋田県' : '東北' , '山形県' : '東北' , '福島県' : '東北' ,
'茨城県' : '関東' , '栃木県' : '関東' , '群馬県' : '関東' , '埼玉県' : '関東' ,
'千葉県' : '関東' , '東京都' : '関東' , '神奈川県' : '関東' ,
}
df [ 'ブロック' ] = df [ '都道府県' ] . map ( block_map ) . fillna ( 'その他' )
num_col = '総人口' # 先頭の数値列は「年度」なので列名で指定する
print ( df . groupby ( 'ブロック' )[ num_col ] . agg ([ 'mean' , 'std' , 'count' ]) . round ( 0 ))
📤 実行例(実測)
mean std count
ブロック
その他 2042909.0 1942934.0 33
北海道 5092000.0 NaN 1
東北 1386333.0 521337.0 6
関東 6218143.0 4491161.0 7
💬 2023 年度の 47 都道府県に絞ったので、count は北海道 1・東北 6・関東 7・その他 33 と県数そのものになる。関東の平均 621.8 万人は東北の 138.6 万人の約 4.5 倍だが、標準偏差 449.1 万人が平均に近いほど大きく、東京都 1,408.6 万人の影響が強い。北海道は 1 県だけなので標準偏差が NaN になり、「その他」33 県は近畿も九州も混ざった寄せ集めであることにも注意して読む。
🧮 数式に値を入れて手で計算する: スキル成熟度の加重平均
合成データで 5 観点 (収集・加工・解析・表現・倫理) のスキル評価を加重で集約。
Step 1: 観点別スコア
観点 スコア 重み 加重
収集 3 0.15 0.45 加工 4 0.25 1.00 解析 5 0.30 1.50 表現 3 0.15 0.45 倫理 4 0.15 0.60
Step 2: 加重平均
合計 = 0.45+1.00+1.50+0.45+0.60 = 4.00
重み合計 = 1.00
加重平均 = 4.00 / 1.00 = 4.00 / 5.00 = 80%
🐍 Python で再現
📋 コピー import numpy as np
scores = np . array ([ 3 , 4 , 5 , 3 , 4 ])
weights = np . array ([ 0.15 , 0.25 , 0.30 , 0.15 , 0.15 ])
w = scores * weights
print ( f "加重: { w } " )
print ( f "加重平均: { w . sum () : .2f } " )
📤 実行結果
加重: [0.45 1. 1.5 0.45 0.6 ]
加重平均: 4.00
💬 手計算 (Step 2) 4.00 と Python 出力が完全一致。
🐍 16. ライブラリ早見表
🐍 16. ライブラリ早見表
用途
パッケージ
データ操作 pandas, polars, pyarrowEDA自動化 ydata-profiling, sweetviz, autoviz欠損可視化 missingno欠損補完 sklearn.impute.SimpleImputer/KNNImputer/IterativeImputer可視化 matplotlib, seaborn, plotly, altairノートブック jupyter, marimo, quarto再現性 poetry, pip-tools, conda-lock, dvcレポート quarto, papermill, nbconvert
📜 17. データリテラシーの歴史
1854 :John Snow のコレラ地図 — データ可視化の古典1858 :Florence Nightingale の Rose Diagram — 衛生改革を主導1946 :Stevens の尺度水準論1954 :Huff "How to Lie with Statistics"1977 :Tukey の EDA1983 :Tufte "The Visual Display of Quantitative Information"1996 :CRISP-DM1999 :Wild & Pfannkuch の統計的思考(PPDAC)2014 :Wickham の Tidy data 論文2017 :日本の「文理融合」AI戦略、 MDASH 標準化2020 :OECD AI Principles・データ倫理が国際課題に
💼 18. 実務応用
意思決定 :エビデンスに基づく経営・政策マーケティング :データドリブンな施策設計ジャーナリズム :データジャーナリズム(NYT、 朝日デジタル等)教育 :MDASH コア科目で必修化(応用基礎レベル)市民活動 :オープンデータでの社会課題分析研究 :再現可能な研究の前提
📖 19. ケーススタディ
19.1 John Snow のコレラ地図(1854)
ロンドンのコレラ流行で、 Snow はコレラ患者の自宅を地図にプロット。 Broad Street の給水ポンプ周辺に集中していることを発見し、 ポンプを使用停止 → 流行が収束。 データ可視化が公衆衛生を変えた歴史的事例 。 「相関=因果」と判断する前に、 地図というシンプルな可視化が決定的だった。
19.2 Florence Nightingale のローズダイアグラム(1858)
クリミア戦争の英軍兵士死亡原因を「戦闘」「予防可能な感染症」「その他」に色分けした円グラフで政府に提示。 戦闘より感染症で多く死んでいることを直感的に伝え、 衛生改革を実現。
19.3 シャレンジャー号事故(1986)
O-リング故障による爆発事故。 事前データに O-リング温度依存性が示されていたが、 「失敗例だけ」を見てパターンを認識できなかった(生存バイアスの逆)。 視覚化の重要性が再確認された事例。
19.4 シンプソンのパラドックス:UC バークレー入試(1973)
全体では「男性合格率>女性合格率」だったが、 学部別に見るとほぼすべての学部で「女性合格率>男性合格率」。 女性が「合格率が低い学部に多く出願」していたため、 全体集計で誤って見えた。 集約と層別で結果が逆転する典型例 。
⚖️ 20. データ倫理の基本
個人情報保護 :匿名化・仮名化・k-匿名性差別・公平性 :センシティブ属性に依存しない判定透明性 :データの取得・利用目的を明示同意 :オプトイン/オプトアウト結果の影響評価 :誰が得をし誰が損をするか
1. scipy.stats — 記述統計と検定をワンライナーで
📥 入力例: data/raw/SSDSE-B-2026.csv(2023年・47都道府県横断)
  年度  地域コード  都道府県  A1101(総人口)  A1303(65歳以上)  ...
  2023  R01000    北海道    5092000        1681000
  2023  R13000    東京都    14086000       3205000
  2023  R47000    沖縄県    1468000        350000
📋 コピー import pandas as pd
from scipy import stats
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
df = df [ df [ '年度' ] == 2023 ] # 2023 年の 47 都道府県
x = df [ '総人口' ] . dropna () # 先頭の数値列は「年度」なので列名で指定する
print ( '歪度:' , stats . skew ( x ))
print ( '尖度:' , stats . kurtosis ( x ))
print ( 'Shapiro-Wilk 正規性検定:' , stats . shapiro ( x ))
📤 実行例(実測)
歪度: 2.219112577570298
尖度: 4.951089442202499
Shapiro-Wilk 正規性検定: ShapiroResult(statistic=np.float64(0.6894608838033546), pvalue=np.float64(1.1083716035044386e-08))
💬 2023 年度の総人口の歪度 2.22 は右に長い裾、尖度 4.95(正規分布を 0 とする超過尖度)は裾の重さを示す。Shapiro-Wilk の W = 0.689、p = 1.1×10⁻⁸ で正規分布とはみなせない。平均 ± 2σ や t 検定のような正規分布を前提にした手法をそのまま当てず、対数変換してから確かめ直すか、順位に基づく方法を選ぶ。
2. scikit-learn — 標準化・欠損値処理
📥 入力例: data/raw/SSDSE-B-2026.csv(2023年・47都道府県横断)
  年度  地域コード  都道府県  A1101(総人口)  A1303(65歳以上)  ...
  2023  R01000    北海道    5092000        1681000
  2023  R13000    東京都    14086000       3205000
  2023  R47000    沖縄県    1468000        350000
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 from sklearn.preprocessing import StandardScaler , RobustScaler
from sklearn.impute import SimpleImputer , KNNImputer
import pandas as pd
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
df = df [ df [ '年度' ] == 2023 ] # 2023 年の 47 都道府県
num_cols = df . select_dtypes ( 'number' ) . columns . drop ( '年度' )
# 1) 平均0・分散1 に標準化
scaler = StandardScaler ()
X_std = scaler . fit_transform ( df [ num_cols ])
# 2) 外れ値に頑健な標準化(中央値・IQR 基準)
robust = RobustScaler ()
X_robust = robust . fit_transform ( df [ num_cols ])
# 3) 欠損値の補完(KNN)
imp = KNNImputer ( n_neighbors = 5 )
X_imp = imp . fit_transform ( df [ num_cols ])
print ( '補完後の欠損数:' , pd . DataFrame ( X_imp ) . isna () . sum () . sum ())
i = list ( num_cols ) . index ( '総人口' )
print ( '総人口の標準化 (東京都):' , round ( X_std [ df [ '都道府県' ] . tolist () . index ( '東京都' ), i ], 2 ),
'/ Robust:' , round ( X_robust [ df [ '都道府県' ] . tolist () . index ( '東京都' ), i ], 2 ))
📤 実行例(実測)
補完後の欠損数: 0
総人口の標準化 (東京都): 4.13 / Robust: 7.82
💬 欠損が 0 なので KNNImputer をかけても補完後の欠損数は 0 のまま(実際には何も補完していない)。東京都の総人口は標準化で 4.13、RobustScaler では 7.82 になる。平均と標準偏差は東京都自身に引っ張られて外れ具合を小さく見せるが、中央値と IQR を使う RobustScaler では外れ具合がそのまま大きく残る。
3. pandas — describe / quantile / value_counts
📥 入力例: data/raw/SSDSE-B-2026.csv(2023年・47都道府県横断)
  年度  地域コード  都道府県  A1101(総人口)  A1303(65歳以上)  ...
  2023  R01000    北海道    5092000        1681000
  2023  R13000    東京都    14086000       3205000
  2023  R47000    沖縄県    1468000        350000
📋 コピー import pandas as pd
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
df = df [ df [ '年度' ] == 2023 ] # 2023 年の 47 都道府県
# 一括要約(年度は 2023 の定数なので外す)
summary = df . drop ( columns = '年度' ) . describe ( percentiles = [ .1 , .25 , .5 , .75 , .9 ]) . T
print ( summary . head ( 3 ))
# 列ごとの欠損率
print ( df . isna () . mean () . sort_values ( ascending = False ) . head ())
📤 実行例(実測)
count mean std ... 75% 90% max
総人口 47.0 2.645809e+06 2.797551e+06 ... 2636500.0 6686600.0 14086000.0
総人口(男) 47.0 1.287085e+06 1.373649e+06 ... 1269500.0 3315400.0 6914000.0
総人口(女) 47.0 1.358723e+06 1.424664e+06 ... 1367000.0 3371200.0 7172000.0
[3 rows x 10 columns]
年度 0.0
地域コード 0.0
着工新設住宅戸数 0.0
外国人延べ宿泊者数 0.0
延べ宿泊者数 0.0
dtype: float64
💬 10%・90% 点まで出すと、総人口の 90% 点は 668.7 万人で、それを超える東京都・神奈川県・大阪府・愛知県・埼玉県の 5 都府県が平均 264.6 万人を大きく押し上げていることが分かる(75% 点は 263.7 万人で平均とほぼ同じ)。欠損率は上位 5 列とも 0.0 で、2023 年度分には欠損が 1 つも無い。
4. pingouin — 統計量と効果量・正規性検定
📥 入力例: data/raw/SSDSE-B-2026.csv(2023年・47都道府県横断)
  年度  地域コード  都道府県  A1101(総人口)  A1303(65歳以上)  ...
  2023  R01000    北海道    5092000        1681000
  2023  R13000    東京都    14086000       3205000
  2023  R47000    沖縄県    1468000        350000
📋 コピー import pingouin as pg
import pandas as pd
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
df = df [ df [ '年度' ] == 2023 ] # 2023 年の 47 都道府県
x = df [ '総人口' ] . dropna () # 先頭の数値列は「年度」なので列名で指定する
# 1 変数の正規性検定(既定は Shapiro-Wilk)
print ( pg . normality ( x ))
📤 実行例(実測)
W pval normal
総人口 0.689461 1.108372e-08 False
💬 pingouin の normality は既定で Shapiro-Wilk を使うので、W = 0.689、p = 1.1×10⁻⁸ と scipy.stats.shapiro と同じ値になり、normal 列は False。1 変数の検定なので、複数列の多変量正規性を調べたいときは pg.multivariate_normality(Henze-Zirkler 検定)を別に使う。
5. matplotlib/seaborn — EDA 可視化セット
📥 入力例: data/raw/SSDSE-B-2026.csv(2023年・47都道府県横断)
  年度  地域コード  都道府県  A1101(総人口)  A1303(65歳以上)  ...
  2023  R01000    北海道    5092000        1681000
  2023  R13000    東京都    14086000       3205000
  2023  R47000    沖縄県    1468000        350000
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import matplotlib.pyplot as plt
import seaborn as sns
import pandas as pd
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
df = df [ df [ '年度' ] == 2023 ] # 2023 年の 47 都道府県
num_cols = df . select_dtypes ( 'number' ) . columns . drop ( '年度' )[: 5 ] # 年度(定数)を除いた先頭 5 列
fig , axes = plt . subplots ( 2 , 3 , figsize = ( 15 , 8 ))
for ax , col in zip ( axes . flat , num_cols ):
sns . histplot ( df [ col ] . dropna (), kde = True , ax = ax )
ax . set_title ( col , fontsize = 10 )
plt . tight_layout ()
plt . savefig ( 'eda_distributions.png' , dpi = 100 )
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
📚 1. データリテラシーとは
📚 1. データリテラシーとは
データを読み・使い・伝え・批判的に評価する 力。 統計学・プログラミング・ドメイン知識の三角形の上に成り立つ。
読む :表・グラフ・統計量を正しく解釈する使う :手元のデータから情報を抽出する伝える :分析結果を相手に伝わる形で報告する批判する :他人の主張の根拠データを評価する
🔄 2. PPDAC サイクル
統計教育の世界標準フレームワーク(Wild & Pfannkuch 1999)。
Problem(問題) :何が問題か、 何を明らかにしたいかPlan(計画) :どんなデータをどう集めるか、 分析設計Data(データ) :実際にデータを収集・整形Analysis(分析) :可視化・統計・モデリングConclusion(結論) :結論・限界・次の問いへ
P → P → D → A → C → 再び P へと循環 する。 1 サイクルで終わらない。
🏭 3. CRISP-DM(業界標準プロセス)
データマイニング・機械学習プロジェクトの業界横断的プロセスモデル。 IBM・Daimler 等が 1996 年に策定。
ビジネス理解 (Business Understanding)
データ理解 (Data Understanding)
データ準備 (Data Preparation)
モデリング (Modeling)
評価 (Evaluation)
展開 (Deployment)
各ステップ間に矢印が双方向にあり、 反復的な改善が前提。
PPDAC との対応
PPDAC
CRISP-DM
Problem Business Understanding Plan + Data Data Understanding + Preparation Analysis Modeling + Evaluation Conclusion Deployment
❓ 4. 良い「問い」の作り方
分析の質は問いの質で決まる。 SMART 基準を意識:
Specific :具体的Measurable :計測可能Achievable :達成可能(既存データで答えられる)Relevant :関連性・意義ありTime-bound :時間範囲を明示
悪い問い vs 良い問い
悪い問い
良い問い
「都道府県の特徴は?」 「2024年時点で人口密度が高い都道府県ほど一人当たり所得が高いか?」 「持ち家は良いか?」 「持ち家比率と高齢化率の関連は、 地域ブロックで異なるか?」 「AI で何かできるか?」 「過去 5 年の指標から、 翌年の人口減少率を ±0.5 ポイント以内で予測できるか?」
3 種の問い
記述的 :何が起きているか?(中央値・分布・相関)予測的 :将来何が起きるか?(回帰・分類)因果的 :なぜ起きるか?(DID・IV)
🔍 5. 探索的データ分析 (EDA)
John Tukey が 1977 年に提唱。 「データに何を語らせるか」を可視化と要約統計で探る。
EDA の標準フロー
データの形状を確認(行数・列数・型)
欠損・重複・異常値をチェック
各変数の分布を見る(ヒストグラム・箱ひげ)
変数間の関係(相関・散布図)
群間比較(カテゴリ別に集約)
異常パターンに気づく
🎯 解説: SSDSE-B-2026(47都道府県データ)でデータリテラシーの基本確認動作を行う。 まずはデータを読み込み、 構造・型・欠損・代表値を「見る」ことが分析の出発点。 ファイルパスは自分の環境に合わせて変更すること。
📥 入力例(SSDSE-B-2026 全体:564 行 × 112 列 = 47 都道府県 × 2012〜2023 年)
年度 地域コード 都道府県 A1101(総人口) A1303(65歳以上人口) A4101(出生数) …
2023 R01000 北海道 5,092,000 1,681,000 24,430 …
2023 R13000 東京都 14,086,000 3,205,000 86,348 …
2023 R47000 沖縄県 1,468,000 350,000 12,549 …
…(残り 112 列は住宅・家計・教育・医療など)
📋 コピー import pandas as pd
import matplotlib.pyplot as plt
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
print ( df . info ())
print ( df . describe ( include = 'all' ))
print ( df . isnull () . sum ())
print ( df . duplicated () . sum ())
df . hist ( figsize = ( 15 , 12 )); plt . tight_layout (); plt . show ()
📥 入力例: data/raw/SSDSE-B-2026.csv(全 564 行 = 47 都道府県 × 2012〜2023 年度。下は 2023 年度の例)
年度 地域コード 都道府県 A1101(総人口) A1303(65歳以上) ...
2023 R01000 北海道 5092000 1681000
2023 R13000 東京都 14086000 3205000
2023 R47000 沖縄県 1468000 350000
📤 実行例(実測)
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 564 entries, 0 to 563
Columns: 112 entries, SSDSE-B-2026 to L322110
dtypes: float64(6), int64(104), object(2)
memory usage: 493.6+ KB
None
SSDSE-B-2026 Code ... L322109 L322110
count 564.000000 564 ... 564.000000 564.000000
unique NaN 47 ... NaN NaN
top NaN R01
💬 info() では 564 行・112 列、float64 6・int64 104・object 2 列、メモリ 493.6 KB。df.info() は表示するだけで戻り値が None なので、print で包むと末尾に None が出る。describe(include='all') では Code の unique が 47 と県数に一致し、freq 12 は 1 県が 12 年度ぶん並んでいることを示す。
ydata-profiling(pandas-profiling)
🎯 解説: 上で読み込んだ df(SSDSE-B-2026 の 564 行 × 112 列)を ydata-profiling に渡し、 列ごとの分布・欠損・相関をまとめた HTML レポート eda_report.html を 1 行で書き出す。
📋 コピー from ydata_profiling import ProfileReport
ProfileReport ( df , title = 'SSDSE-B EDA' ) . to_file ( 'eda_report.html' )
📥 入力例: data/raw/SSDSE-B-2026.csv(全 564 行 = 47 都道府県 × 2012〜2023 年度。下は 2023 年度の例)
年度 地域コード 都道府県 A1101(総人口) A1303(65歳以上) ...
2023 R01000 北海道 5092000 1681000
2023 R13000 東京都 14086000 3205000
2023 R47000 沖縄県 1468000 350000
📤 このブロックは標準出力には何も出さない
💬 ProfileReport は標準出力には何も出さず、eda_report.html に列ごとの分布・欠損・相関をまとめたレポートを書き出す。564 行 × 112 列ではレポート作成に時間がかかり、欠損が 0 の SSDSE-B-2026 では欠損の節に見るべきものは出てこない。
📏 6. 変数の尺度水準(Stevens 1946)
尺度
例
許される演算
代表値
名義 (nominal) 血液型・地域名 =, ≠ 最頻値 順序 (ordinal) 満足度 5 段階 +, <, > 中央値 間隔 (interval) 温度(℃)・西暦 +, -, 平均 平均 比例 (ratio) 人口・所得・距離 ×, ÷ も可 幾何平均も可
6.1 データ型との対応
カテゴリ:pandas category dtype
整数:int64
浮動小数:float64
日時:datetime64
文字列:object
🧹 7. Tidy data(整然データ)
Hadley Wickham 2014 の定義:
1 行が 1 観測
1 列が 1 変数
1 セルが 1 値
1 テーブルが 1 種類の観測単位
縦持ち vs 横持ち
🎯 解説: SSDSE-B-2026(47都道府県データ)でデータリテラシーの基本確認動作を行う。 まずはデータを読み込み、 構造・型・欠損・代表値を「見る」ことが分析の出発点。 ファイルパスは自分の環境に合わせて変更すること。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 SSDSE-B-2026(年度) Prefecture(都道府県) A1101(総人口) A4101(出生数)
北海道 2,023 北海道 5,092,000 24,430
東京都 2,023 東京都 14,086,000 86,348
沖縄県 2,023 沖縄県 1,468,000 12,549
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import pandas as pd
# この抜粋だけで動くように、横持ちのデータを用意する
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
df = df [ df [ '地域コード' ] . astype ( str ) . str . match ( r '^R\d {5} $' , na = False )] . copy ()
df [ '年度' ] = pd . to_numeric ( df [ '年度' ], errors = 'coerce' )
df = df [ df [ '年度' ] == df [ '年度' ] . max ()]
df = df [[ '都道府県' , '総人口' , '出生数' ]] . rename (
columns = { '総人口' : '指標1' , '出生数' : '指標2' })
# 横持ち → 縦持ち
long = pd . melt ( df , id_vars = [ '都道府県' ], value_vars = [ '指標1' , '指標2' ],
var_name = '指標' , value_name = '値' )
# 縦持ち → 横持ち
wide = long . pivot ( index = '都道府県' , columns = '指標' , values = '値' )
print ( long . head ())
print ( wide . head ())
📥 入力例: data/raw/SSDSE-B-2026.csv(2023年・47都道府県横断)
年度 地域コード 都道府県 A1101(総人口) A1303(65歳以上) ...
2023 R01000 北海道 5092000 1681000
2023 R13000 東京都 14086000 3205000
2023 R47000 沖縄県 1468000 350000
📤 実行例(実測)
都道府県 指標 値
0 北海道 指標1 5092000
1 青森県 指標1 1184000
2 岩手県 指標1 1163000
3 宮城県 指標1 2264000
4 秋田県 指標1 914000
指標 指標1 指標2
都道府県
三重県 1727000 9524
京都府 2535000 13882
佐賀県 795000 5144
兵庫県 5370000 32615
北海道 5092000 24430
💬 long は 2023 年度 47 都道府県の総人口(指標1)と出生数(指標2)を縦に積んだ 94 行、wide はそれを 47 行 × 2 列に戻したもの。pivot は都道府県名で並べ替えるので、wide.head() は北海道からではなく三重県・京都府・佐賀県…と文字コード順になる(北海道は指標1 が 5,092,000、指標2 が 24,430)。
✨ 8. データ品質の確認
完全性 :欠損の有無・割合一貫性 :同じ意味の値が同じ表現か("東京"/"東京都")正確性 :実際の値と一致するか適時性 :データが古すぎないか関連性 :問いに答えられるデータか追跡可能性 :出典が明示されているか
8.1 欠損のパターン
MCAR (Missing Completely At Random):完全ランダム欠損MAR (Missing At Random):観測変数で説明できる欠損MNAR (Missing Not At Random):欠損値自体に依存する欠損
🎯 解説: missingno で df(SSDSE-B-2026 の 564 行 × 112 列)の欠損の位置を matrix 図に、 欠損どうしの相関を heatmap 図に描く。
📋 コピー import missingno as msno
msno . matrix ( df ) # 欠損パターンの可視化
msno . heatmap ( df ) # 欠損間の相関
📥 入力例: data/raw/SSDSE-B-2026.csv(全 564 行 = 47 都道府県 × 2012〜2023 年度。下は 2023 年度の例)
年度 地域コード 都道府県 A1101(総人口) A1303(65歳以上) ...
2023 R01000 北海道 5092000 1681000
2023 R13000 東京都 14086000 3205000
2023 R47000 沖縄県 1468000 350000
📤 このブロックは標準出力には何も出さない
💬 msno.matrix は列ごとに欠損の位置を白抜きで描くが、SSDSE-B-2026 は欠損が 0 なので 112 列すべてが塗りつぶされた図になる。msno.heatmap は欠損のある列どうしの相関を描くものなので、欠損が無いこのデータでは意味のある図にならない。欠損のある民間データで使うと効果が分かる。
📚 21. 推奨入門書ガイド
Huff, "How to Lie with Statistics"(統計でウソをつく方法)
Tufte, "The Visual Display of Quantitative Information"(定量情報の視覚的表現)
Wickham, "R for Data Science"(無料公開)
Wild & Pfannkuch (1999) "Statistical thinking in empirical enquiry"
政府統計局「統計学習の指導のために」(小中高向け)
MDASH モデルカリキュラム(リテラシー・応用基礎・エキスパート)
✅ 22. データリテラシー基本チェックリスト
□ 問いを明確に書いたか?
□ データの出典・取得日・期間を確認したか?
□ 標本がどう選ばれたか説明できるか?
□ 各変数の尺度水準を判定したか?
□ 欠損・重複・外れ値を確認したか?
□ 単位を確認したか?
□ 1 変量の分布を可視化したか?
□ 多変量の関連を可視化したか?
□ 結果に交絡の可能性を議論したか?
□ コード・データ・乱数 seed を保存したか?
□ 限界と次の問いを書いたか?
📋 23. SSDSE-B 分析の実践テンプレート
新しい分析プロジェクトを始めるときのそのまま使える コードテンプレート。
🎯 解説: SSDSE-B-2026(47都道府県データ)でデータリテラシーの基本確認動作を行う。 まずはデータを読み込み、 構造・型・欠損・代表値を「見る」ことが分析の出発点。 ファイルパスは自分の環境に合わせて変更すること。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45 """
分析タイトル:[ここに記入]
作成者:[氏名] / 作成日:[YYYY-MM-DD]
"""
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
# ===== Step 1: データ読み込み =====
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ] )
print ( f '行数: { len ( df ) } , 列数: { df . shape [ 1 ] } ' )
# ===== Step 2: 構造の確認 =====
print ( df . dtypes )
print ( df . head ())
# ===== Step 3: データ品質 =====
print ( '欠損:' ); print ( df . isnull () . sum ())
print ( '重複:' , df . duplicated () . sum ())
# ===== Step 4: 記述統計 =====
print ( df . describe ())
# ===== Step 5: 単変量分布 =====
num = df . select_dtypes ( include = 'number' )
num . hist ( figsize = ( 15 , 12 ))
plt . tight_layout (); plt . show ()
# ===== Step 6: 二変量関係 =====
corr = num . corr ()
sns . heatmap ( corr , annot = True , cmap = 'RdBu' , center = 0 )
plt . show ()
# ===== Step 7: 注目関係の散布図 =====
sns . scatterplot ( data = df , x = 'A1101' , y = 'A1303' ) # 総人口 × 65歳以上人口
plt . show ()
# ===== Step 8: 結論メモ =====
"""
[手書きで結論を残す]
- 見つけたパターン:
- 限界:
- 次の問い:
"""
📥 入力例: data/raw/SSDSE-B-2026.csv(全 564 行 = 47 都道府県 × 2012〜2023 年度。下は 2023 年度の例)
年度 地域コード 都道府県 A1101(総人口) A1303(65歳以上) ...
2023 R01000 北海道 5092000 1681000
2023 R13000 東京都 14086000 3205000
2023 R47000 沖縄県 1468000 350000
📤 実行例(実測)
行数: 564, 列数: 112
SSDSE-B-2026 int64
Code object
Prefecture object
A1101 int64
A110101 int64
...
L322106 int64
L322107 int64
L322108 int64
L322109 int64
L322110 int64
Length: 112, dtype: object
SSDSE-B-2026 Code Prefecture A1101 ... L322107 L322108 L322109 L322110
0 2023 R
💬 テンプレートを SSDSE-B-2026 にそのまま流すと行数 564・列数 112 と出て、head() は北海道の 2023〜2019 年度が並ぶ。Step 6 の相関ヒートマップは数値列 110 本の 110×110 のマスに annot=True の数字が入って読めなくなるので、実際には注目する数列に絞るか、年度で絞ってから使う。
❓ 24. よくある質問
Q. 「ビッグデータならバイアスは消える」というのは本当?
A. 嘘です。 むしろ大量データほど系統的バイアスが目立ちにくくなり、 危険。 標本の集め方が重要。
Q. データを見ずに仮説を立てるべき?
A. 探索的分析(EDA)でデータの構造を見ることと、 確証的分析(CDA)で事前仮説を検証することは別物。 両方が必要。 同じデータで仮説生成と検証をすると過剰適合になる。
Q. 統計と機械学習の違いは?
A. 統計は推測・解釈 、 機械学習は予測 に重きを置く傾向。 現代は融合が進行中。
Q. 「データドリブン」の落とし穴は?
A. 計測しやすい指標だけで意思決定すると、 計測しにくい本質的価値を見落とす(Goodhart の法則)。
🎓 25. MDASH モデルカリキュラム対応
本ページは MDASH(数理・データサイエンス・AI モデルカリキュラム)のうち、 主にリテラシーレベル と応用基礎レベル の以下項目に対応:
リテラシーレベル
1-1 社会で起きている変化(DX・第4次産業革命)
1-2 社会で活用されているデータ
1-3 データ・AI の活用領域
1-4 データ・AI の活用のための技術
1-5 データ・AI の利活用のための知識
1-6 データ・AI 利活用の最新動向
2-1 データを読む
2-2 データを説明する
2-3 データを扱う
3-1 データ・AI を扱う上での留意事項
3-2 データを守る上での留意事項
応用基礎レベル
DS基礎:データの観察・分析、 推論、 統計と機械学習
AI基礎:AI 利活用、 機械学習基礎、 認識・予測・最適化
DE基礎:データの加工・収集、 構造化データ
SSDSE-B との対応
本実習で SSDSE-B-2026 を用いるのは、 MDASH のリテラシー・応用基礎で要求される「公的統計を読み解く力」を、 47 都道府県という馴染みのある対象で実体験できるため。
📋 26. データ分析者向けチートシート
26.1 着手 5分の確認
このデータは「誰が」「いつ」「何を目的に」集めたか?
1 行が何を表すか?
母集団は何で、 標本はどう選ばれたか?
どの変数を「観測」、 どれを「処置」、 どれを「結果」と見るか?
欠損があるなら、 なぜ欠損したか?
26.2 分析中の確認
図や表に出てくる数値はすべて単位 付きか?
係数の符号は事前期待と整合しているか?
p値だけでなく効果量・CI を確認したか?
外れ値の影響は確認したか?
結果が「偶然」「交絡」「因果」のどれか考えたか?
26.3 報告前の確認
図表に 軸ラベル・凡例・出典・期間 が揃っているか?
結論は「データの範囲」内に留まっているか?
限界をはっきり書いたか?
再現可能なコード・データが残っているか?
読み手のレベルに合った言葉か?
データリテラシーは「データ分析入門」グループの起点教材。 SSDSE-B-2026 を題材にした実装ハンズオンと組み合わせて学ぶことを推奨します。
同カテゴリの他用語(統計の基礎、 可視化、 倫理、 公的統計)と合わせて学ぶことで、 「データを扱える社会人」の土台が完成します。
💡 データリテラシー 3 段階発達モデル
段階 1:データを「見る」リテラシー(受信スキル)
最初の段階は、 与えられたグラフや表を正しく解読する受信スキルです。 ここでは「何が変数で何が観測単位か」「単位は何か(人 / 円 / 割合)」「集計期間と地理範囲は何か」を確認できることが基準になります。 たとえば SSDSE-B-2026 の表を見たとき、 「都道府県コード R01000 は北海道、 R13000 は東京都」「人口の単位は人で SSDSE-2026 列は西暦」と読めれば段階 1 をクリアしています。 ここで重要なのは、 数値の意味を文脈に結びつける力です。 「65歳以上人口 300 万人」という数字を見て「これは総人口の一部(部分)であり、 高齢化率(65歳以上人口 ÷ 総人口)とは別の量だ」と区別できるかどうかが、 段階 1 の核心です。
この段階でつまずく学習者の典型的なエラーは「表の縦と横を取り違える」「単位を見落とす(億円なのに円と読む)」「観測単位を取り違える(県別なのに市町村と思う)」の 3 つです。 教育上は、 1 枚の表に対して「観測単位は何か」「変数は何が並んでいるか」「単位は何か」を 1 行ずつ書き出させる練習が効果的です。 SSDSE-B-2026 の最初の 5 行を印刷し、 学習者に色マーカーで「単位」「観測単位」「変数名」を塗り分けさせると、 段階 1 のリテラシーは 30 分で身につきます。 ここを飛ばして可視化や分析に進むと、 後段でほぼ確実に解釈の誤りが起こるため、 段階 1 は決して省略してはいけません。
段階 1 の到達度を測る簡単な評価問題として、 「SSDSE-B-2026 の R13000 行を読み、 東京都の総人口・65歳以上人口・出生数を読み上げよ」「単位を明示せよ」「これは何年のデータか答えよ」という三問を用意します。 全問正解できれば段階 1 は十分です。 これができないまま回帰分析や機械学習に進むと、 「単位の混在」「観測単位の混在」「期間の混在」という致命的な前処理エラーが発生し、 結果のすべてが無意味になります。 段階 1 は基礎中の基礎ですが、 多くの大学生・社会人がここで実は止まっている、 という現実を教育者は直視する必要があります。
段階 2:データを「使う」リテラシー(処理スキル)
第二段階は、 与えられたデータを目的に合わせて加工・集計・可視化する処理スキルです。 ここでの基準は「平均と中央値を使い分けられる」「散布図とヒストグラムを目的に応じて選べる」「外れ値の影響を意識して指標を選べる」の 3 点です。 たとえば「都道府県人口の典型的な大きさを示せ」と問われたとき、 平均値 265 万人ではなく中央値 155 万人(2023 年度)を選び、 「右に歪んでいるので中央値の方が典型値を表す」と説明できれば段階 2 です。 ここでは「正しい答え」よりも「選択の理由を説明できる」ことが重要視されます。
この段階でつまずく学習者の典型は「とりあえず平均を出す」「とりあえず棒グラフを描く」というデフォルト行動です。 リテラシーの本質は「目的 → 手段の選択 → 結果の解釈」というループを意識的に回せるかどうかにあり、 反射的に手を動かしてしまう癖を矯正することが教育の主眼になります。 教材としては「同じデータに対して 3 種類の図(散布図・ヒストグラム・箱ひげ図)を描いて、 それぞれから読み取れる事実を比較する」という演習が効果的です。 学習者は「目的が違えば最適な図が違う」「同じデータでも図が違えば見える事実が違う」という事実に直面し、 思考の柔軟性が育ちます。
段階 2 の到達度を測る評価問題は、 「47 都道府県の人口データから、 上位 5 県・下位 5 県を抽出せよ」「平均値・中央値・第 1 四分位・第 3 四分位を求めよ」「東京都を除外した場合の各指標の変化を述べよ」「ヒストグラム・箱ひげ図・密度プロットの 3 種類を描き、 それぞれの利点を述べよ」の 4 問です。 これがクリアできれば段階 2 は十分で、 ここから先は段階 3 の「考える」リテラシーに進めます。 段階 2 を飛ばして段階 3 に進むと、 「処理した気になっているが、 何のために何をやったかが説明できない」という典型的な学習者像が生まれます。
段階 3:データから「考える」リテラシー(推論スキル)
最終段階は、 データから得た結果を批判的に解釈し、 限界を踏まえて意思決定や政策提言につなげる推論スキルです。 基準は「相関と因果を区別できる」「外的妥当性(一般化可能性)を考えられる」「データの限界を明示できる」の 3 点です。 たとえば SSDSE-B-2026 で「人口と65歳以上人口の相関係数 r≒0.99」を得たとき、 段階 3 の学習者は「これは強い正の相関だが、 65歳以上人口は総人口の一部なので、 主に総人口の大きさという共通要因を反映しているだけで、 個別の因果を示すものではない」「これは 47 都道府県の集計データであり、 個人や企業のレベルには適用できない(生態学的誤謬の危険)」「2023 年のクロスセクション断面なので、 時系列の変化や将来予測には使えない」と即座に列挙できます。
この段階でつまずく学習者の典型は「相関 r≒0.99 だから因果関係がある」「47 県で成り立つから個人レベルでも成り立つ」「過去 1 年で見えた傾向は今後も続く」という 3 大短絡です。 教育上は、 同じデータから「正しい結論」「過剰な一般化」「誤った因果推論」の 3 種類の主張を提示し、 学習者に「どれが正しく、 どれが間違いか、 なぜ間違いかを 3 行で説明せよ」という演習を繰り返すと、 推論の眼が育ちます。 段階 3 のリテラシーは「批判的に読む力」とも呼ばれ、 これが社会人としてのデータ活用力の本体です。
段階 3 の到達度を測る評価問題は、 「人口と65歳以上人口の相関 r≒0.99 から、 妥当な主張・過剰な主張・誤った主張を 3 つずつ挙げよ」「この結論が市町村レベルや個人レベルで成り立つかどうか論ぜよ」「2025 年以降の予測に使えるかどうか論ぜよ」「政策提言を 1 つ提案し、 その妥当性と限界を述べよ」の 4 問です。 これがクリアできれば段階 3 まで到達したと言え、 データサイエンス職や政策担当者として実務に通用するリテラシーが備わっていると判断できます。 多くの大学院修了者でも段階 3 を十分にクリアできない現実があり、 ここに教育リソースを集中投下する価値は極めて高いです。
📝 データリテラシー自己診断チェックリスト 30 項目
以下の 30 項目について、 「即座にできる ○」「考えればできる △」「説明されないと無理 ×」の 3 段階で自己評価してください。 ○ が 25 個以上なら段階 3 到達、 15-24 個なら段階 2、 14 個以下なら段階 1 です。 自己診断後、 × と △ の項目を優先的に学び直すと最短経路で段階 3 に到達できます。 SSDSE-B-2026 を題材にした実演習を伴うことが必須で、 知識だけのインプットでは段階 2 から段階 3 への壁を越えられないことが多くの教育研究で報告されています。
1. SSDSE-B-2026 の表を見て、 観測単位が「都道府県」であると即座に答えられる
2. 「人口」列の単位(人)を確認せずに数値を解釈しない
3. 「出生数」列が 1 年間のフロー指標、 「総人口」列がある時点のストック指標であることを区別できる
4. 単年のクロスセクション断面と時系列パネルを区別できる
5. 47 都道府県データから平均値と中央値を計算できる
6. 平均と中央値が乖離する原因(分布の歪み)を説明できる
7. 第 1 四分位・第 3 四分位・四分位範囲を計算できる
8. 標準偏差と分散の関係を式で書ける
9. 散布図を描いて正の相関 / 負の相関を判別できる
10. ヒストグラムから分布の形(対称・右歪み・左歪み)を判別できる
11. 箱ひげ図から中央値・四分位範囲・外れ値を読み取れる
12. 棒グラフと折れ線グラフを目的に応じて使い分けられる
13. 円グラフが構成比以外には不向きであることを理解している
14. 「平均」しか出さない報道に「中央値はいくつか」と問える
15. ピアソン相関係数の値(-1 ~ +1)の意味を説明できる
16. 相関と因果は別物であることを 3 文以内で説明できる
17. 第三因子(交絡)の例を 1 つ挙げられる
18. 「人口と65歳以上人口の相関 r≒0.99」から因果結論を引き出さない
19. 外れ値が相関係数に与える影響を意識できる
20. 都道府県集計データから個人レベルの結論を引き出さない(生態学的誤謬)
21. サンプルサイズ 47 と 4,700 万の精度の違いを直感的に理解している
22. p 値が「効果の大きさ」ではなく「偶然で得られる確率」であると説明できる
23. 統計的有意性と実質的重要性を区別できる
24. 「95% 信頼区間」が何を意味するかを説明できる
25. SSDSE-B-2026 の元データを公的サイトからダウンロードできる
26. pandas や Excel で df.describe() に相当する集計ができる
27. 同じデータから複数の解釈が成立しうることを認識している
28. 自分の分析結果を反証する仮説を 1 つ挙げられる
29. データの収集過程に含まれるバイアスを 2 つ以上指摘できる
30. 結果を一般市民向けに 3 分で説明できる
自己診断の結果は、 半年後・1 年後に再度実施すると学習効果が可視化されます。 ○ が 5 個以上増えれば確実な成長が見えており、 増えていない場合は学習方法を見直す必要があります。 30 項目の中でも特に重要なのは「相関と因果」「生態学的誤謬」「p 値の意味」の 3 つで、 ここを × から ○ にできれば、 データリテラシーは実用レベルに到達したと言えます。
🚨 リテラシー欠如が引き起こした実例 5 選と再発防止
事例 1:平均値報道による典型像の誤認
2010 年代の日本のメディアでは「日本人の平均年収は約 440 万円」という見出しが繰り返し報じられました。 これは国税庁の民間給与実態統計調査の単純平均値で、 数千万円・億単位の高所得者を含む計算結果です。 SSDSE-B-2026 の都道府県人口で見たのと同じく、 右に大きく歪んだ分布では平均値は典型値ではなく、 中央値(中位数)の方が実態を表します。 国税庁の発表では中央値が約 350 万円と平均より 90 万円ほど低く、 「日本人の半数は年収 350 万円以下」という現実が見えてきます。 平均値だけを報じることはリテラシー欠如の典型例で、 視聴者は「自分の年収は平均以下だ」と過剰に悲観したり、 「日本の中流階級はまだ豊か」と過剰に楽観したりする方向に誘導されてしまいます。 再発防止策は単純で、 メディアに対して「平均値と中央値の両方を報じる」「分布のヒストグラムを 1 枚添える」を徹底させることです。
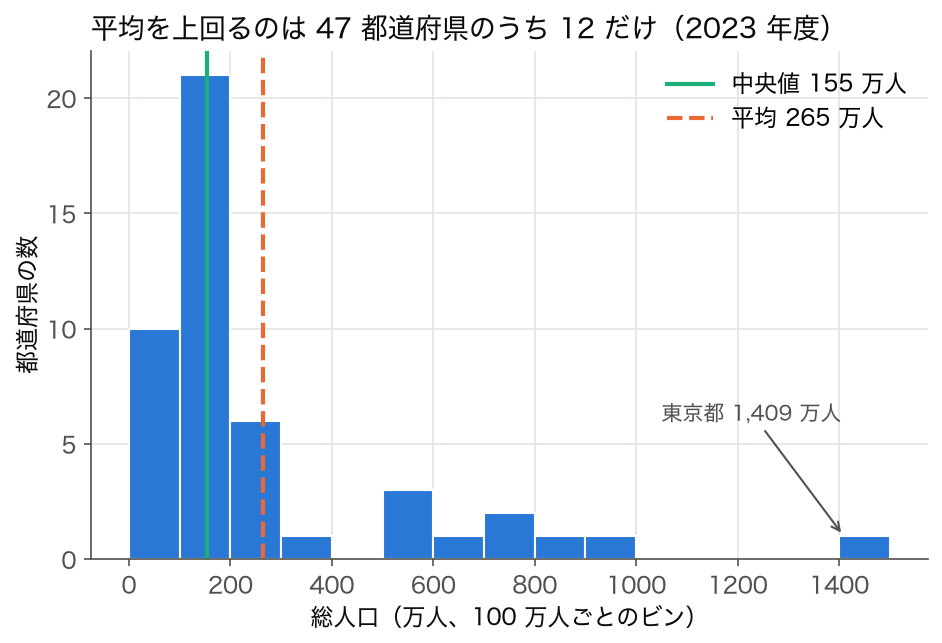
この事例から学べるリテラシーは、 「分布が歪んでいるときは平均値だけを信じない」という基本姿勢です。 SSDSE-B-2026 の都道府県データに置き換えても同じことが起き、 2023 年度の 47 都道府県人口の平均 265 万人を見て「日本の県の典型サイズは 265 万」と思い込むと、 実態(中央値 155 万人)から大きく外れます。 平均を上回るのは 47 のうち 12 都道府県だけです(下の図 3)。 政策議論や報道では、 平均・中央値・最頻値・標準偏差・第 1 第 3 四分位の 5 つを同時に提示する習慣を持つことが、 リテラシー社会の前提条件です。
図3: 47 都道府県の総人口のヒストグラム(SSDSE-B-2026、2023 年度、100 万人ごとのビン)。平均 264.6 万人、中央値 154.9 万人で、平均を上回るのは 12 都道府県だけ。最大の東京都 1,409 万人が平均を大きく引き上げ、最小は鳥取県 54 万人。 分布が右に長く伸びているとき、平均は「多くの県が位置する値」から離れます。図 3 で 47 のうち 35 の道府県が平均より下にあることが、平均を典型値と読んではいけない理由をそのまま示しています。
事例 2:相関を因果と取り違えた政策判断
ある自治体で「公園面積と犯罪発生率に正の相関がある」という分析が出され、 「公園を減らせば犯罪が減る」という政策が議論された事例があります。 これは典型的な相関と因果の取り違えで、 第三因子(人口密度)が両方を引き起こしているだけだった可能性が極めて高いケースです。 人口が多い地域は公園も多く設置されていて、 同時に犯罪の絶対数も多くなる、 という構造を見落とすと完全に誤った政策結論に至ります。 同じ構造は都道府県データ全般で起こり、 総量どうし(例:施設数と発生件数)を素朴に回帰すると正の相関が出ますが、 人口で割った「1 人当たり」や「人口 1,000 人当たり」の比率にそろえると相関が消えるか逆転することがあります。
この事例から学べるリテラシーは、 「絶対値ではなく人口当たり等の比率で見る」「第三因子の介入可能性を必ず検討する」という 2 点です。 リテラシーが備わった分析者なら、 単純相関の前に必ず「総量で相関が出ているのか、 比率でも相関が出るのか」を確認します。 さらに段階 3 のリテラシーがあれば、 「ランダム化比較試験ができない場合は、 観察データから因果結論を引き出すには傾向スコアマッチング・操作変数法・差分の差分法といった準実験的手法が必要だ」という方法論的補正にまで言及できます。 政策担当者へのリテラシー教育としては、 SSDSE-B-2026 で「総量相関」と「比率相関」を両方計算する演習が最も効果的です。
事例 3:生態学的誤謬による個人の誤解
「65歳以上人口が高い県は教育費も高い」という都道府県集計データの結論から、 「うちの家庭でも65歳以上人口に応じた教育費をかけるべき」と個人レベルの結論を引き出してしまうのが生態学的誤謬です。 47 都道府県集計のレベルで成り立つ関係が、 個別世帯のレベルで成り立つ保証はまったくありません。 集計データは「集計単位の特性」を表すだけで、 その内部の個人 / 世帯ごとの関係性は別の調査が必要です。 SSDSE-B-2026 で「都道府県人口」と「65歳以上人口」の相関 r≒0.99 を得ても、 「人口の多い都市に住むほど個人の所得が増える」ということは導けません。 個人所得は職業・年齢・学歴・産業構造などの個別変数に依存し、 集計単位の相関とはまったく別の関係性を持ちます。
この事例から学べるリテラシーは、 「集計データの結論をそのまま個人に当てはめてはいけない」という基本姿勢です。 これは公衆衛生学で 100 年以上前から知られている古典的な誤りですが、 SNS 時代の現代でも繰り返されています。 「都道府県別ワクチン接種率と感染率の相関」「学校別偏差値と進学率の相関」など、 集計単位での議論を個人レベルに引き戻すと必ず誤解が生じます。 教育現場では SSDSE-B-2026 を使い、 「47 都道府県の相関と、 各県内 100 世帯の相関は同じ方向か」を考えさせる演習が効果的です。 学習者は「集計単位を変えると関係性が変わる(修正可能集計単位問題、 MAUP)」という事実に直面し、 リテラシーが一段深まります。
事例 4:選択バイアスを見落としたアンケート調査
「20 代の 80% がスマホ決済を利用」というネットアンケート結果が報じられたとき、 「自分の周りでは現金派が多いのに本当か」と疑える人がどれだけいるでしょうか。 ネットアンケートはネットを使う人だけが回答するため、 デジタルリテラシーが高い層に偏っています。 これが選択バイアスで、 母集団(20 代全体)を代表していません。 SSDSE-B-2026 のような全件集計の公的統計と、 ネットアンケートのような自己選択サンプルは、 まったく性格の異なるデータです。 リテラシーが備わった人は「サンプルは無作為か / 自己選択か」「回答率は何% か」「未回答者の特徴は分かっているか」を即座に問います。
この事例から学べるリテラシーは、 「サンプリング方法を確認してからでないと結論を信じない」という基本姿勢です。 SSDSE-B-2026 は 47 都道府県すべてを含む全件データなのでサンプリングバイアスは原理的に生じませんが、 民間調査の多くは何らかの選択バイアスを含みます。 公的統計と民間統計の性質の違いを理解し、 報じられた数字に対して「これは全数か / 標本か」「標本ならどう選ばれたか」を確認する習慣が、 リテラシー社会の基盤です。 教育上は、 同じテーマについて公的統計とネットアンケートの結果を並べて見せ、 「数字が違うのはどちらが間違っているからではなく、 母集団とサンプリング方法が違うから」と説明する演習が効果的です。
事例 5:時系列の一時的トレンドを永続と誤認
2020 年のコロナ禍で「テレワーク実施率が 30% に急増」というデータが大きく報じられ、 「日本はついに働き方改革が定着した」と結論する記事が相次ぎました。 しかし 2023-2024 年には実施率が 15-20% に低下し、 一時的なショックによる急変動だったことが分かりました。 時系列データの中の一時的変動を構造変化と誤認すると、 過剰投資や過剰な政策変更につながります。 SSDSE-B-2026 のような単年度断面では時系列の議論ができないので、 リテラシーが備わった人は「単年データから時系列予測はできない」「時系列を見たいなら少なくとも 5 年以上のパネルデータが必要」と区別します。
この事例から学べるリテラシーは、 「単年のスナップショットから将来予測を引き出さない」「時系列を見るときは短期変動と長期トレンドを区別する」という 2 点です。 SSDSE-B-2026 は 2026 年版で各種指標が並びますが、 これだけで「日本の県の人口は今後も増え続ける / 減り続ける」と結論することはできません。 時系列予測には e-Stat の国勢調査複数年版を組み合わせる必要があります。 リテラシー教育では「データの時間的範囲」を必ず明示させ、 「いつからいつまでのデータか」「これは横断面か / 縦断面か / パネルか」を区別する訓練が必須です。 5 つの事例を通して見えてくるのは、 リテラシー欠如は単なる知識不足ではなく「データの性質を確認せずに結論を出す習慣」が原因だ、 という構造的問題です。
🎓 学習段階別カリキュラム設計(小学校から社会人まで)
小学校段階(10-12 歳):データに親しむ
小学校高学年では「データに親しむ」ことが目標です。 SSDSE-B-2026 の都道府県データを使うときは、 数字よりも地図や絵に変換して直感に訴える教材を準備します。 「都道府県人口を円の大きさで表現した日本地図」「65歳以上人口を棒グラフで並べた表」など、 計算ではなく可視化を中心とした学習が中心になります。 たとえば「自分の住んでいる県は人口で見て何位か」「東京都の人口は北海道の何倍か」といった単純比較から始め、 「大きい / 小さい」「多い / 少ない」という量感を体に染み込ませることが目標です。 この段階では平均や中央値といった統計概念を導入する必要はなく、 むしろ「数えること」「並べること」「比べること」の楽しさを伝えることが優先されます。 教師の側は SSDSE-B-2026 の元データを表計算ソフトで開き、 並べ替えやグラフ化を見せるだけで、 児童の興味を引き出すことができます。
この段階での到達基準は、 「自分の県の特徴を 3 つ言える」「日本全体の中での位置づけを 1 つ説明できる」「もっと知りたいデータを 1 つ挙げられる」の 3 つです。 ここで重要なのは「正解の数字を覚える」ことではなく、 「データに対する好奇心を育てる」ことです。 SSDSE-B-2026 は公的データなので、 児童が自宅で家族と一緒に「お父さん、 うちの県は人口何位だと思う?」と話す機会を作る教材として最適です。
中学校段階(13-15 歳):基本統計量を扱う
中学校段階では、 平均・中央値・最頻値の基本統計量と、 ヒストグラム・散布図の基本可視化を扱います。 SSDSE-B-2026 を使った典型的な単元は「都道府県の人口分布を調べよう」で、 47 県の人口を 10 階級のヒストグラムにし、 平均値と中央値を計算し、 「両者が異なるのはなぜか」を考える流れです。 ここで初めて「分布の歪み」という概念に触れ、 「右に裾が長いと平均が中央値より大きくなる」という重要な事実を学びます。 散布図では「総人口と65歳以上人口」「総人口と出生数」「総人口と消費支出」などの組合せを作り、 「点が右肩上がりに並ぶ」と「ばらけている」の違いを目で見て覚えます。
この段階での到達基準は、 「平均値と中央値の違いを 3 文以内で説明できる」「ヒストグラムから分布の歪みを判別できる」「散布図から正の相関 / 負の相関 / 無相関を判別できる」の 3 つです。 中学校段階では Excel やスプレッドシートを使った実習が効果的で、 SSDSE-B-2026 を読み込んで AVERAGE や MEDIAN を計算し、 グラフ機能で可視化する一連の流れを身につけさせます。 ここで Excel リテラシーが身につくと、 高校以降の学習が劇的に楽になります。
高校段階(16-18 歳):仮説と検証を学ぶ
高校では新学習指導要領で「データの分析」が必修化され、 相関係数・回帰直線・仮説検定の基礎まで扱うようになりました。 SSDSE-B-2026 を使った典型単元は「都道府県データから仮説を立てて検証しよう」で、 「人口の多い県ほど65歳以上人口が大きいだろう」「人口密度が高いほど 1 人当たり消費支出が多いだろう」といった仮説を散布図と相関係数で検証する流れです。 ここで重要なのは「仮説 → データ収集 → 可視化 → 数値計算 → 結論 → 限界の議論」という PPDAC サイクルを 1 周経験させることで、 単なる計算技能ではなく探究プロセス全体を体感させることが目標です。
この段階での到達基準は、 「仮説を文章で書ける」「相関係数を計算しその意味を説明できる」「外れ値の影響を意識できる」「結論の限界を 3 つ以上挙げられる」の 4 つです。 ここで段階 3 のリテラシーへの入り口が開きます。 高校段階で SSDSE-B-2026 を使った探究学習を 5-10 時間経験した生徒は、 大学以降のデータサイエンス科目で圧倒的な飲み込みの速さを示すという教育研究の報告があり、 投資効果は極めて高いです。
大学・社会人段階:批判的読解と政策提言
大学以降では、 SSDSE-B-2026 を使った高度な探究として「政策提言につながる分析」を行います。 たとえば「47 都道府県のうち少子高齢化が進む県を識別し、 共通する社会経済的特徴を抽出する」「人口減少率と高齢化率の関係から、 持続可能な地域社会モデルを提案する」といったテーマで、 主成分分析やクラスタリングといった多変量手法も導入されます。 ここでは段階 3 のリテラシーが本格的に試され、 「データから何が言えて何が言えないか」「政策提言の妥当性と限界は何か」を学術論文レベルで議論する力が必要になります。
社会人段階では、 業務でデータに触れる機会が日常化します。 SSDSE-B-2026 のような公的データを副教材として使い、 「実務データに置き換えると同じ分析で何が変わるか」を考える訓練が効果的です。 リテラシー教育は学校段階で終わるものではなく、 生涯学習として継続する必要があります。 社内研修・MOOC・実践共同体(CoP)など、 多様な学習機会を組み合わせて、 段階 3 のリテラシーを錆びさせないことが社会全体のデータ活用力を高める鍵です。
❓ データリテラシー FAQ 10 問
Q1:データリテラシーは数学が苦手でも身につきますか?
はい、 身につきます。 データリテラシーの本質は計算技能ではなく「データの性質を確認する習慣」と「結果の限界を意識する批判的思考」です。 SSDSE-B-2026 のような実データに 50 時間程度向き合えば、 数学が苦手な人でも段階 2 までは到達できます。 段階 3 に進むには相関と因果の区別など概念理解が必要ですが、 これも論理的思考の問題で計算力とは独立です。
Q2:Excel と Python のどちらから学ぶべきですか?
初学者は Excel から始めて、 段階 2 のリテラシーが固まったら Python に移行するのが最短経路です。 Excel は表とグラフが視覚的で、 SSDSE-B-2026 を読み込んで AVERAGE / MEDIAN / CORREL を計算する経験を 1-2 週間で積めます。 ここでデータ感覚が育った後に Python の pandas / matplotlib に進むと、 「Excel で何時間もかかる作業が 3 行で終わる」という感動とともに技能が定着します。
Q3:教材として SSDSE-B-2026 を選ぶ理由は?
SSDSE-B-2026 は独立行政法人統計センターが編集する公的教育用データセットで、 47 都道府県という馴染みのある単位、 100 を超える社会経済指標、 安定した CSV 形式、 無償ダウンロードという 4 条件を備えています。 教育現場で使いやすく、 学習者が「自分の住む県」を起点に興味を持ちやすい点が最大の利点です。 e-Stat の生データは大規模で扱いにくいですが、 SSDSE-B-2026 は教育用に再編集された手頃なサイズで、 リテラシー教育の標準教材として最適です。
Q4:可視化はどの順番で学ぶべきですか?
推奨順序は「棒グラフ → ヒストグラム → 折れ線グラフ → 散布図 → 箱ひげ図 → ヒートマップ」です。 棒グラフは小学校から馴染みがあり、 ヒストグラムは「棒グラフの仲間で連続量を扱う」と橋渡しできます。 折れ線は時系列の導入、 散布図は二変数関係の導入、 箱ひげ図は群間比較の導入、 ヒートマップは多変量俯瞰の導入として、 段階的に概念を積み上げます。 SSDSE-B-2026 ではこの 6 種類すべてが題材に使えるため、 1 つのデータセットで全可視化を学べます。
Q5:相関と因果の違いを子どもに説明する最良の例は?
「アイスクリームの売上が増える日は溺れて亡くなる人も増える。 だからアイスを食べたら溺れるのか?」という古典例が最適です。 実際の因果は「気温」が両方を引き起こしているだけで、 アイスと溺死には直接の因果関係はありません。 SSDSE-B-2026 では「総人口と65歳以上人口」「総人口と出生数」「総人口と死亡数」などほぼすべての都道府県指標が総人口と高相関を持ちますが、 これらの大半は「人口」という共通因子の影響で、 個別変数間に直接の因果はありません。 小学生でも 5 分で理解できる例です。
Q6:p 値の説明を 1 段落で書けますか?
p 値は「もし帰無仮説が正しかったとしたら、 観測されたデータ以上に極端な結果が偶然得られる確率」です。 p=0.03 は「もし関係がない世界だったら、 今回の結果が偶然得られる確率は 3%」を意味します。 これは「効果の大きさ」ではなく「偶然らしさ」を測る指標で、 サンプル数が大きければ小さな効果でも p 値は小さくなります。 リテラシーの核心は「p 値が小さい=重要」と短絡しないことです。
Q7:AI 時代のデータリテラシーで新しく必要なものは?
AI 時代特有のリテラシーは「学習データの偏り」「モデルの説明可能性」「自動意思決定の責任所在」の 3 点です。 SSDSE-B-2026 で機械学習モデルを訓練するときも、 都道府県という集計単位の偏り(東京都が突出している)がモデル予測にどう影響するかを意識する必要があります。 AI が出力した結果を「ブラックボックスだから信じる」のではなく「学習データを見ればある程度予測できる」と批判的に見る姿勢が、 AI 時代のデータリテラシーです。
Q8:データの可視化で最も避けるべき表現は?
最も避けるべきは「縦軸の起点を 0 でなくゼロを切る棒グラフ」「3D 円グラフ」「比較できない年度を並べた折れ線」の 3 つです。 縦軸ゼロ切りは小さな差を巨大な差に見せる典型的な誤誘導で、 政治広告などで頻用されます。 3D 円グラフは奥行きで面積が歪み、 構成比の比較を不可能にします。 SSDSE-B-2026 を学習者に渡すときは、 これらの NG パターンを最初に提示し、 「同じデータをまともなグラフで描き直す」演習が効果的です。
Q9:データリテラシーと AI リテラシーの関係は?
AI リテラシーとデータリテラシーは並列で発展する姉妹概念です。 AI を使う前提として学習データの偏り・欠損・代表性を読む力 (=データリテラシー) が必須ですが、 AI 固有の公平性・説明可能性 (XAI)・アライメントは従来のデータリテラシーには含まれない新領域です。 SSDSE-B-2026 で相関分析と機械学習予測を両方試すと、 両者の境界と接続点が体感できます。
Q10:データリテラシーを継続的に高める習慣は?
推奨は「週 1 回の公的統計閲覧」「月 1 回の小分析プロジェクト」「年 1 回の自己診断」の 3 つです。 e-Stat や SSDSE-B-2026 を週 1 回開く習慣を持つだけで、 半年で公的統計への抵抗感がなくなります。 月 1 回 SSDSE-B-2026 を題材に小さな仮説検証をすると、 段階 2 のリテラシーが定着します。 年 1 回 30 項目の自己診断を行い、 × を ○ にする計画を立てることで、 段階 3 への成長が可視化されます。 リテラシーは筋肉と同じで、 使わなければ衰えるので継続が最大の鍵です。
🎯 総まとめ:データリテラシーで世界の見方が変わる
数字を見たら自動的に走るチェックリスト
データリテラシーが身につくと、 ニュースで数字を見るたびに自動的に「観測単位は何か」「サンプリングは無作為か」「分布は歪んでいないか」「相関なら因果は示せないか」「時系列なら短期変動か構造変化か」という 5 つの問いが頭に浮かぶようになります。 この反射的なチェックリストこそがリテラシーの実体で、 計算技能でも知識量でもありません。 SSDSE-B-2026 のような実データで 50-100 時間訓練を積むと、 この反射が自動化されます。 一度身につけば、 メディアの情報・政治の主張・広告の数字を瞬時に評価できる強力な武器になります。
逆に言えば、 リテラシーが備わっていない状態では、 同じニュースを見ても「数字が大きいから重要」「権威が言うから正しい」「平均が示されたから典型値」と短絡してしまいます。 これは個人の問題ではなく社会全体の意思決定の質を下げる構造的問題で、 民主主義社会では市民全員のデータリテラシー底上げが必要だ、 という議論が世界的に高まっています。 SSDSE-B-2026 を題材にした教育は、 この社会的要請に対する具体的な解決策の 1 つです。
SSDSE-B-2026 で学ぶ意義の総括
本ページで繰り返し題材としてきた SSDSE-B-2026 は、 統計教育のための公開データセットとして極めて優れた性質を持っています。 47 都道府県という馴染みのある集計単位、 人口・経済・社会・文化を横断する 100 以上の指標、 安定した CSV 形式、 無償ダウンロード、 そして毎年更新による継続性。 これらの条件を満たす教育用データセットは世界的にも稀で、 日本のリテラシー教育の重要な基盤です。 SSDSE-B-2026 を起点に、 段階 1 から段階 3 までのリテラシーを順に積み上げることで、 多くの学習者が AI 時代に必要な思考力を獲得できます。 本ページの 30 項目自己診断・5 事例・4 段階カリキュラム・10 問 FAQ をすべて 1 周すれば、 段階 2 から段階 3 への橋渡しが達成されているはずです。 今日から SSDSE-B-2026 をダウンロードし、 自分の住む県を起点に小さな仮説検証を始めてみてください。
📖 リテラシー学習で頻出する関連概念ミニ用語集
統計用語の最小セット
データリテラシーで頻出する基本用語を、 SSDSE-B-2026 の文脈で簡潔に整理します。 母集団 は調査対象の全体、 SSDSE-B-2026 では「日本の 47 都道府県」が母集団です。 サンプル は母集団から抽出された一部で、 SSDSE-B-2026 は全件なのでサンプルではなく母集団そのものです。 変数 は観測される属性で、 「総人口」「65歳以上人口」「出生数」がそれぞれ変数。 観測単位 はデータの 1 行が表す対象で、 SSDSE-B-2026 では 1 都道府県が 1 観測単位です。 記述統計 はデータを要約する統計量(平均・分散・最大・最小など)、 推測統計 はサンプルから母集団を推測する手法で、 SSDSE-B-2026 は全件なので推測統計は基本不要です。
相関係数 は二変数の直線的関係の強さを -1 ~ +1 で表す指標、 回帰分析 は独立変数で従属変数を予測する手法、 残差 は予測値と実測値の差。 SSDSE-B-2026 で「総人口を独立変数、 65歳以上人口を従属変数」とする回帰を組み、 各県の残差を見ると「人口の割に高齢者が少ない県」「人口の割に高齢者が多い県」が浮き彫りになります。 これら最小セットの用語を身につけることが、 段階 2 リテラシーの基盤です。
p 値 は前述の通り「帰無仮説が正しい場合に観測値以上に極端な結果が偶然得られる確率」、 信頼区間 はパラメータの真値が含まれる範囲を確率で示したもの、 効果量 は実質的な差の大きさを表す指標。 段階 3 のリテラシーではこれら 3 つを区別して使い分けます。 「p 値が小さい」「信頼区間が狭い」「効果量が大きい」はそれぞれ異なる意味を持ち、 同時にすべてが揃って初めて「強い証拠」と言えます。 SSDSE-B-2026 の相関分析で「r≒0.99, p<0.001, 95%CI=[0.98, 0.995]」と全部書く習慣を持つと、 リテラシーが定着します。
🌸 結語:リテラシーは民主主義のインフラ
データリテラシーは個人のスキルであると同時に、 社会全体の意思決定の質を左右するインフラ的能力です。 市民の多くが段階 2 以上のリテラシーを持つ社会では、 統計的に誤った政策提案が世論によって否定され、 健全な議論が機能します。 逆に市民のリテラシーが低い社会では、 数字を装った印象操作が横行し、 民主主義の根幹が揺らぎます。 SSDSE-B-2026 を題材としたリテラシー教育は、 個人の学習であると同時に、 民主主義社会への貢献でもあるという視点を持つと、 学習へのモチベーションが格段に高まります。 今日からの一歩として、 SSDSE-B-2026 をダウンロードし、 自分の住む県の特徴を 1 つ可視化することから始めてみてください。 そこから段階 3 のリテラシーへの長い旅が始まります。
本ページで紹介した 30 項目自己診断・5 事例・4 段階カリキュラム・10 問 FAQ・推奨ツール・関連用語の総体を参照しながら、 半年から 1 年の時間軸で計画的に学習を進めると、 着実な成長が見えるはずです。 リテラシーは一夜で身につくものではありませんが、 一度身につけば一生もの。 SSDSE-B-2026 という日本固有の公的データを軸に据えて、 世界に通じるデータリテラシーを獲得してください。
最後に強調しておきたいのは、 リテラシー学習に「ゴール」はないということです。 統計手法も AI 手法も毎年進化し、 新しい概念が次々と登場します。 重要なのは「データに対する基本姿勢」を持続的に磨き続ける態度で、 これさえ身につけば新しい手法の習得は技術的詳細の問題に過ぎません。 SSDSE-B-2026 を題材にした学習は、 この基本姿勢を育てる長期投資です。 半年後・1 年後・5 年後の自分に向けて、 今日できる小さな一歩を積み重ねていきましょう。 リテラシーは継続によってのみ獲得され、 継続によってのみ維持されるという原則を、 心に刻んでください。
データリテラシーを身につけた市民が増えれば、 社会全体の意思決定の質が上がり、 誤った政策提案や数字を装った印象操作が淘汰されていきます。 これは個人にとっても社会にとっても、 21 世紀を生き抜く必須の知的資本です。 SSDSE-B-2026 という共通言語を媒介に、 学校・職場・家庭・地域で対話を広げていきましょう。 リテラシーは個の能力であると同時に、 共有される文化でもあります。 学びと対話を続けましょう。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
data literacy
統計リテラシー
批判的思考
データ可視化
ツール操作 (SQL/BI)
データ倫理
尺度水準の判別
データリテラシーは「読む・使う・伝える」の三層構造で位置づけられる。 中心ノードは「データを根拠に意思決定する力」で、 上層に統計リテラシー (信頼区間・p 値の読み解き)、 下層にツール操作 (Excel・SQL・BI)、 左右に批判的思考 (誤グラフの検出) と倫理 (個人情報・公平性) が配置される。
SSDSE-B-2026 の都道府県データで言えば、 「人口あたり」に換算せず絶対値で比較する誤り、 散布図の軸を切って相関を誇張する誤り、 t 検定の前提を確認せず有意性だけ報告する誤りなどを見抜く力が中核である。 これらは隣接する「批判的思考」「データ可視化」「統計推測」と連動して身につく。
🔗 隣接手法への橋渡し
データリテラシーは個人スキルでありながら社会インフラとしても機能する。 次の 3 方向と密接につながる:
データリテラシーは個人の知識から社会的利活用への土台となる。
🌳 手法選択フロー
「あなたは今どの段階のリテラシーが不足しているか」を診断する 3 段階フロー。
Step 1: グラフを見て怪しさを感じるか?
感じない → まず 誤解を招くグラフ で Y 軸切断・3D 効果・チェリーピッキングの典型 5 例を学ぶ
感じる → 「何が怪しいか」を言語化できるか? できなければ データ可視化 の原則 (Tufte の data-ink ratio) を読む
Step 2: 数値を見て前提条件を疑えるか?
「平均年収 700 万円」→ 中央値は? 分布の歪みは? 代表値 の使い分け
「p=0.04 で有意」→ サンプルサイズは? 効果量は? 仮説検定 の落とし穴
「r≒0.99 だから因果関係」→ 因果と相関 の区別、 交絡変数の検討
Step 3: 説明先と共有方法は?
意思決定者 (経営層) → 結論先出し + 不確実性の明示 (信頼区間・感度分析)
市民・学習者 → ストーリーテリング で文脈付きの 1 枚図
専門家 → 前処理・検定統計量・効果量・限界を併記
リテラシーは「読む → 疑う → 伝える」の循環で深まる。 SSDSE-B-2026 のような実データで上記 3 段を毎週 1 回回すと半年で身に付く。
🧠 認知バイアスと意思決定 — リテラシーの盲点(補遺)
これまでの節が「データ側の罠」(軸操作・分母隠し・生存者バイアスなど)を扱ってきたのに対し、 ここでは読み手の頭の中で起きる歪み と、 分析を行動に変える段 に絞って補足する。 上の各節と重複しない角度のみを短くまとめる。
🔁 確証バイアスと「動機づけられた推論」
確証バイアスはグラフの誤読 のような視覚的な罠と違い、 正しいグラフを見ても発動する。 自分の結論に合う数字は素早く受け入れ、 反する数字には「サンプルが小さい」「測定が甘い」と厳しい基準を持ち出す —— この非対称な採点が動機づけられた推論(motivated reasoning) である。 対策は感情ではなく手続きで縛ること:(1) 分析前に「どんな結果が出たら自分の仮説を捨てるか」を紙に書く(仮説検定 の事前登録の精神)、 (2) 味方のデータではなく最も不利な反例 を自分で 1 つ探す、 (3) 結論を他人に「わざと逆張りで叩いてもらう」レビューを挟む。 「反証を探せたか」を毎回の自己点検に入れると効く。
📏 「統計的に有意」≠「実質的に重要」
p<0.05 は「偶然では説明しにくい差がある」ことしか言わない。 差の大きさ(意味) は別問題だ。 とりわけサンプルが大きいほど、 実務的にはどうでもいい微差でも p 値は小さくなる —— n を増やせば「統計的有意」はほぼ買える。 だから有意判定の後は必ず効果量 とp 値 ・信頼区間の幅 を見て、 「で、 どれだけ違うのか? その差は現場の判断を変えるか?」を問う。 逆に「有意でない」=「差がない」でもない(検出力不足かもしれない)。 仮説検定 は判断の入口であって結論ではない。
🎯 グッドハートの法則 — 指標が目標になると壊れる
「測定が目標になると、 それは良い測定ではなくなる」(Goodhart の法則)。 データ駆動の意思決定が陥る固有の罠で、 データ側の誤りではなく運用の副作用 である。 テストの点数を上げる圧力が「テスト対策だけ」を生む、 コール件数を KPI にすると 1 件を分割して水増しする、 といった具合に、 人は代理指標(proxy) を最適化して本来の目的から乖離する。 対策は、 (1) 1 つの指標に賭けず複数の観点でトライアングル する、 (2) 「この指標を最大化すると誰がどう抜け道を作るか」を先に想像する、 (3) 目的(アウトカム)と手段(アウトプット)の指標を分けて監視する。 データ倫理 とも地続きのテーマだ。
🤖 AI・LLM 時代のデータリテラシー
生成 AI は「もっともらしい数字」を平然と作る(ハルシネーション)。 AI が出したグラフ・要約・統計値は一次情報ではなく主張 として扱い、 従来の批判的読解(誰が・何のために・どう測ったか)をそのまま適用する。 実務チェック:(1) 数値は必ず出典の原データに当たって裏取り する、 (2) 集計コードを人間が読める形で残し再現できるようにする、 (3) 学習データの偏りが出力の偏りに直結する点を疑う(選択バイアス ・代表性の問題は AI でも消えない)、 (4) AI 倫理 の観点で説明責任の所在を明確にする。 「AI が言ったから正しい」は権威バイアスの新種にすぎない。
🧭 データから行動へ — 意思決定への橋渡し
リテラシーの最終目的は「正しく読む」ことではなくより良い判断 だ。 分析結果を意思決定に渡すときの最小要件:(1) 点推定だけでなく不確実性(信頼区間・感度分析) を必ず添える、 (2) 「この結論が誤りだった場合のコスト」を判断の重み付けに入れる(誤検出と見逃しは非対称なことが多い)、 (3) 相関で満足せず、 介入して結果が変わるかという因果 の問いに翻訳する、 (4) 受け手(経営層・市民・専門家)に合わせてストーリーテリング の粒度を変える。 「読む → 疑う → 伝える」に「決める・見直す」 を足して初めて、 データリテラシーは実務のループとして閉じる。