🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
💡 30秒で分かる結論
🍰 まずはやさしく
見た目にだまされる魔法のようなグラフです。
データの本当の意味を正しく知るために使います。
スマホの広告などで差を大きく見せる例があります。
この章ではグラフの落とし穴と対策を読みます。
誤解を招くグラフは、 軸・色・スケールの操作で意図的(または無自覚に)読み手をミスリードする図表。
- 典型 1:縦軸を 0 から始めず差を誇張
- 典型 2:双軸で異なるスケールを並べ相関を演出
- 典型 3:3D 円グラフで奥のセクションを小さく見せる
- 典型 4:時間軸の選び方(特定区間だけ切り出す)
- 対策:Tufte の「データ・インク比」を意識、 軸 0 起点・等間隔
時間がない方はこのブロックだけ読めば 80% の用途で困りません。 ただし、 実務で使う前には必ず「⚠️ よくある落とし穴」と「✅ 実務チェックリスト」を確認してください。 「知ってはいたが対処を忘れた」が分析事故の最大原因です。
📍 文脈:「誤解を招くグラフ」はどんな場面で出てくる?
🍰 まずはやさしく
情報の見せ方に関するお話です。
情報を正しく読み解く力をつけるために使います。
SNSやニュースで不思議なグラフを見かけます。
どんな場面でこの問題が起きるかを読みます。
報道・SNS・経営レポートでも頻繁に登場。 自分が作る側にもなり得るので、 「読み解く力」と「作らない力」の両方を養うのが教育の主眼。
🎨 直感で掴む
🍰 まずはやさしく
パッと見の印象で判断する感覚のことです。
グラフのイメージを直感的に掴むために使います。
部活の結果を自分に都合よく見せたい時があります。
まずは感覚的にどのような仕組みか読みます。
- 同じデータでもグラフ次第で印象は逆。 数字を見ただけでは騙される。
- 「気持ちよく騙される」のが厄介。 自分の主張に合うグラフを無批判に採用しがち。
- 可視化の目的は正確な伝達であり、 説得力の演出ではない。
📐 定義・数式
🍰 まずはやさしく
グラフの正しさを測るためのルールです。
正確にデータを伝えるために使います。
買い物で商品の性能を比べる時に役立ちます。
数式を使って誠実なグラフの作り方を読みます。
ある棒グラフで、 棒 A の高さが 42 mm、 棒 B の高さが 14 mm(0 起点)。 対応するデータは A=84、 B=21 とする。
(1) 実データの比(A/B)を求めよ。 (2) 棒の高さ比(A/B)を求めよ。 (3) Lie Factor を求めよ。
▶ 解答を見る
(1) 実データ比 = 84/21 = 4.0
(2) 高さ比 = 42/14 = 3.0
(3) Lie Factor = 3.0 / 4.0 = 0.75(グラフが差を過小表現している)
🔬 数式を言葉で読み解く
Data-Ink Ratio と Lie Factor の各記号が何を指すか、 言葉で押さえておきます。
- Data-Ink Ratio の分子(データを表すインク)
- グラフの中で「数値・比較・傾向」を直接伝えている部分。 棒の高さ・点の位置・線の傾きが該当。
- Data-Ink Ratio の分母(図全体のインク)
- 分子+装飾(罫線・3D 効果・背景グラデーション・不要な凡例など)の合計。 分母が大きいほど Ratio は小さくなる。
- Lie Factor の分子(図上の効果量)
- グラフで視覚的に見える棒の高さ・面積・長さの比率。 軸切断・3D・面積歪みによって水増しされる。
- Lie Factor の分母(データの実際の効果量)
- 0 起点の値を使った実データの比率。 SSDSE-B-2026 の秋田 39.1% ÷ 沖縄 23.8% = 1.64 など。
- 理想値 LF = 1.0
- 図の視覚的変化量がデータ変化量と完全に一致する状態。 Tufte は LF ≤ 1.05 を誠実な可視化の基準とした。
解答:実値比 = 39.1/29.1 = 1.344。 軸切断後の見かけ比 = (39.1−25)/(29.1−25) = 14.1/4.1 = 3.44。 Lie Factor = 3.44/1.344 ≈ 2.56。 実際の 1.34 倍の差が視覚的に 3.44 倍に見える。
🧮 実値で計算してみる
数式だけでは「実感」が湧きにくいので、 具体的な数値で 1 度手計算してみると理解が定着します。 以下では SSDSE-B-2026 の都道府県別高齢化率(65 歳以上人口 A1303 ÷ 総人口 A1101、 2023 年)から 5 都道府県を抜粋し、 Y 軸切断による Lie Factor(誇張倍率) を手計算します。
数式(Tufte の Lie Factor):
使用データ(SSDSE-B-2026 / 高齢化率 %, A1303÷A1101×100):
| 都道府県 | 高齢化率 (%) |
|---|---|
| 北海道 | 33.0 |
| 東京都 | 22.8 |
| 愛知県 | 25.7 |
| 大阪府 | 27.7 |
| 福岡県 | 28.5 |
数値ベクトル(高齢化率): [33.0, 22.8, 25.7, 27.7, 28.5]
Step 1: データの実際の変化率(最小値 → 最大値)
Step 2: Y 軸 0 起算グラフでの見かけ変化率
Step 3: Y 軸 20 起算(切断)グラフでの見かけ変化率
Step 4: 誇張倍率の比較まとめ
| Y 軸設定 | 見かけ変化率 | Lie Factor | 判定 |
|---|---|---|---|
| 0 〜 35.0(正直) | 44.74 % | 1.00 | 歪みなし(誠実) |
| 20.0 〜 35.0(切断) | 364.29 % | 8.14 | 約 8 倍の誇張(誤誘導) |
このコードでやること:上記の Lie Factor 手計算を Python(numpy)で再現し、 結果が一致することを確認する。
📥 入力データ(SSDSE-B-2026 高齢化率 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np # SSDSE-B-2026 高齢化率(%) 5都道府県抜粋 prefs = ['北海道', '東京都', '愛知県', '大阪府', '福岡県'] vals = np.array([33.0, 22.8, 25.7, 27.7, 28.5]) lo, hi = vals.min(), vals.max() # 東京 22.8、北海道 33.0 # Step 1: 実際の変化率(東京 → 北海道) actual_change = (hi - lo) / lo * 100 # Step 2: Y軸 0 起算 — 棒の高さはデータの値そのもの h_lo, h_hi = lo - 0.0, hi - 0.0 visual_0 = (h_hi - h_lo) / h_lo * 100 lf_0 = visual_0 / actual_change # Step 3: Y軸 20 起算(切断)— 棒の高さは「値 − 20」 ymin_cut = 20.0 h_lo, h_hi = lo - ymin_cut, hi - ymin_cut visual_cut = (h_hi - h_lo) / h_lo * 100 lf_cut = visual_cut / actual_change print(f"実際の変化率 : {actual_change:.2f} %") print(f"見かけ (0 起算) : {visual_0:.2f} % → Lie Factor {lf_0:.2f}") print(f"見かけ (20 起算) : {visual_cut:.2f} % → Lie Factor {lf_cut:.2f}") |
📤 実行すると次の出力が得られる:
💬 手計算(Step 1〜3)の値 44.74 %、 1.00、 8.14 と Python 出力が完全一致。 0 起点の棒は長さが値そのものなので見かけの変化率も 44.74 % で Lie Factor はちょうど 1 になる。 Y 軸を 20 から始めると東京の棒が 2.8 まで縮み、 北海道 13.0 との差が 364 % に見えて Lie Factor は 8.14 に跳ね上がる。 変化率の分母は「東京の棒の長さ」なので、 切断の下限が東京の値 22.8 に近いほど誇張は際限なく大きくなる。
典型的な操作パターンと対策の早見表:
| 操作 | 効果 | 対策 |
|---|---|---|
| 縦軸切り取り | 2% の差が 50% 差に見える | 軸を 0 から |
| 3D 円グラフ | 奥のスライスが小さく見える | 2D 棒グラフに |
| 双軸 | 無相関でも相関に見える | 標準化して 1 軸に |
| 逆向き Y 軸 | 増加を減少に見せる | Y 軸の向きを明示 |
🧮 数式に値を入れて手で計算する: 対数軸の棒グラフの Lie Factor
縦軸を途中で切るのとは逆に、対数軸は大きな差を小さく見せます。Tufte の Lie Factor を、2023 年度の総人口が最大の東京都と最小の鳥取県の棒で計算します。「効果の大きさ」は、ここでは「倍率 − 1」(どれだけ大きいか)で測ります。
$$\text{Lie Factor} = \frac{\text{図の上での効果}}{\text{データ上の効果}} = \frac{L_{\text{東京}} / L_{\text{鳥取}} - 1}{x_{\text{東京}} / x_{\text{鳥取}} - 1}$$
| Step | 計算 | 結果 |
|---|---|---|
| 1. データ上の倍率 | 14,086,000 ÷ 537,000 | 26.2 倍 |
| 2. 対数軸(下端 105 = 10 万人)での棒の長さ | 東京都 log1014,086,000 − 5 = 7.149 − 5 / 鳥取県 log10537,000 − 5 = 5.730 − 5 | 2.149 / 0.730 |
| 3. 図の上での倍率 | 2.149 ÷ 0.730 | 2.94 倍 |
| 4. Lie Factor | (2.94 − 1) ÷ (26.2 − 1) = 1.94 ÷ 25.2 | 0.077 |
Lie Factor が 1 から離れるほど図は嘘をついています。縦軸の切断では 1 より大きく(誇張)、対数軸の棒では 0.077 と 1 よりはるかに小さく(過小表示)なります。対数軸そのものは悪くありませんが、「棒の長さ」は値に比例するという読み手の約束を破るので、対数軸では棒でなく点で描き、軸に「対数目盛」と明記します。
🎯 このコードでやること:Step 1〜4 を numpy で再現し、対数軸の下端を 10^4・10^5・10^5.5 に変えたとき、同じ 2 県の棒の長さの比がどう変わるかを出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture')['A1101'] big, small = d.idxmax(), d.idxmin() ratio = d[big] / d[small] # データ上の倍率 # 線形軸(0 起点)の棒: 棒の長さは値そのもの lin = d[big] / d[small] # 対数軸(10^5 起点)の棒: 棒の長さは log10(値) − 5 base = 5 logbar = (np.log10(d[big]) - base) / (np.log10(d[small]) - base) # Tufte の Lie Factor = 図の上での効果の大きさ / データ上の効果の大きさ(ここでは「倍率 − 1」で比べる) lie = (logbar - 1) / (ratio - 1) print(f'{big} {d[big]:,} 人 / {small} {d[small]:,} 人 = {ratio:.1f} 倍') print(f'線形軸の棒の長さの比 {lin:.1f} 倍') print(f'対数軸(下端 10^{base})の棒の長さの比 {logbar:.2f} 倍 Lie Factor {lie:.3f}') for b in [4, 5, 5.5]: lb = (np.log10(d[big]) - b) / (np.log10(d[small]) - b) print(f' 対数軸の下端 10^{b}: 棒の長さの比 {lb:.2f} 倍') |
💬 データ上 26.2 倍の差が、線形軸では棒の長さでも 26.2 倍、対数軸(下端 10 万人)では 2.94 倍にしか見えず、Lie Factor 0.077 は Step 4 の手計算と一致します。しかも対数軸の棒の長さの比は、軸の下端を 1 万人にすると 1.82 倍、約 32 万人(10^5.5)にすると 7.17 倍と、下端の置き方だけで変わります。対数軸の棒グラフでは「棒の長さの比」に意味が無いことを、数字で確かめられます。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
data/raw/SSDSE-B-2026.csv。 列 A1101 (人口)を 47 都道府県で合計した全国人口を 2 期分(2012 年と 2023 年)。 ylim 操作で誇張前後を比較。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import matplotlib.pyplot as plt import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 全国の総人口(47 都道府県の合計)を 2 期分: 2012 年と 2023 年(万人) tot = df.groupby('SSDSE-B-2026')['A1101'].sum() / 10000 years, vals = ['2012', '2023'], [tot[2012], tot[2023]] fig, axes = plt.subplots(1, 2, figsize=(10, 4)) # 悪い例: 縦軸を 12,400 万人から始める axes[0].bar(years, vals, color='#E53935') axes[0].set_ylim(12400, 12800) axes[0].set_title('縦軸 12,400〜12,800 万人(誇張)') # 良い例: 縦軸を 0 から始める axes[1].bar(years, vals, color='#00897B') axes[1].set_ylim(0, 14000) axes[1].set_title('縦軸 0 起点(正直)') for ax in axes: ax.set_ylabel('全国の総人口(万人)') plt.tight_layout(); plt.savefig('truncated_vs_zero.png', dpi=100) actual = (vals[1] - vals[0]) / vals[0] * 100 # 実際の変化率 h0, h1 = vals[0] - 12400, vals[1] - 12400 # 切断グラフでの棒の高さ visual = (h1 - h0) / h0 * 100 # 見た目の変化率 print(f'全国人口: {vals[0]:,.1f} 万人 → {vals[1]:,.1f} 万人') print(f'実際の変化率 : {actual:.2f} %') print(f'切断グラフの見た目 : {visual:.1f} %(棒の高さ {h0:.1f} → {h1:.1f})') print(f'Lie Factor : {visual / actual:.1f}') |
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install matplotlib numpy pandas が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
⚠️ よくある落とし穴
誤解を招くグラフで頻出する手口は、 (1) Y 軸の原点 0 を切って差を誇張、 (2) 3D 円グラフで奥側の項目を小さく見せる、 (3) 二重 Y 軸で無関係な系列を重ね「相関がある」ように見せる、 の 3 パターンです。 軸範囲・元データ・出典・期間を毎回確認するだけで、 大半は見抜けるようになります。
⚠️ 実データで確かめる — 図の縦横比と縦軸の起点で、同じ減少が 5 度にも 42 度にも見える
折れ線グラフの「傾きの急さ」は、データだけでなく図の縦横比と縦軸の範囲で決まります。47 都道府県の出生数の合計(2012→2023 年度)の回帰直線が、画面上で何度の傾きに見えるかを計算します。
🎯 このコードでやること:出生数の 47 県合計の年次推移に直線を当てはめて 1 年あたりの減少(万人)を求め、図の幅・高さ(インチ)と縦軸の範囲を 4 通りに変えたとき、その直線が画面上で何度の傾きに見えるかを計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) births = df.groupby('SSDSE-B-2026')['A4101'].sum() # 47 県合計の出生数(2012〜2023 年度) x = births.index.values.astype(float) y = births.values / 1e4 # 万人 slope = np.polyfit(x, y, 1)[0] # 1 年あたりの変化(万人) print(f'出生数 {y[0]:.1f} 万 → {y[-1]:.1f} 万、平均の傾き {slope:.2f} 万人/年') def angle(width, height, ylo, yhi): """図の幅・高さ(インチ)と縦軸の範囲から、回帰直線が画面上で何度に見えるか""" dy = slope * (x[-1] - x[0]) / (yhi - ylo) * height # 画面上の縦の移動量 dx = width # 横は全幅を使う return np.degrees(np.arctan(abs(dy) / dx)) for w, h, lo, hi, label in [(10, 3, 0, 110, '横長・0 起点'), (6, 6, 0, 110, '正方形・0 起点'), (4, 8, 0, 110, '縦長・0 起点'), (6, 6, 70, 105, '正方形・70 万起点')]: print(f'{label:<14} 幅{w} 高さ{h} 縦軸 {lo}〜{hi} 万 → 見かけの傾き {angle(w, h, lo, hi):5.1f} 度') |
💬 出生数は 103.7 万人から 72.7 万人へ、平均して年 2.89 万人ずつ減っています。同じ直線が、横長(幅 10 × 高さ 3)の図では 5.0 度のなだらかな下り坂、正方形なら 16.1 度、縦長(4 × 8)なら 30.0 度、正方形でも縦軸を 70 万人から始めれば 42.3 度の急降下に見えます。「急減」と見せたい人は縦長の図か切った縦軸を、「緩やか」と見せたい人は横長の図を選べます。折れ線の縦軸は 0 から始めなくてもよい場面がありますが、図の縦横比は Cleveland が提案した「傾きの平均が 45 度前後になるように」という目安に合わせるか、比較する複数の図で縦横比と縦軸の範囲をそろえ、本文に「年 2.89 万人(約 2.8%)ずつ減少」と数値で書き添えます。
⚠️ 実データで確かめる — 平均の棒グラフは、地方の中のばらつきを消す
7 地方の高齢化率を平均の棒 7 本で描くと、「関東は若く、四国と東北は高齢」という分かりやすい図になります。しかし棒の中には、地方ごとに 4〜9 県の違いが隠れています。
🎯 このコードでやること:2023 年度の 47 都道府県の高齢化率を 7 地方に分け、地方ごとの平均・最小・最大・県数を出す。地方の平均の差と、1 つの地方の中の県の幅を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 n = d['Code'].str[1:3].astype(int) # 県番号 1〜47 bins = [0, 7, 14, 23, 30, 35, 39, 47] names = ['北海道・東北', '関東', '中部', '近畿', '中国', '四国', '九州・沖縄'] d['地方'] = pd.cut(n, bins=bins, labels=names) g = d.groupby('地方', observed=True)['高齢化率'].agg(['mean', 'min', 'max', 'count']).round(1) print(g.to_string()) spread_between = g['mean'].max() - g['mean'].min() spread_within = (g['max'] - g['min']).max() print(f'地方の平均の差(最大 − 最小) {spread_between:.1f} ポイント') print(f'1 つの地方の中の県の幅の最大 {spread_within:.1f} ポイント({(g["max"] - g["min"]).idxmax()})') # 平均の棒だけを見ると「関東は若い」。関東の中で最も高い県は他の地方の平均と比べてどうか kanto_max = d[d['地方'] == '関東'].nlargest(1, '高齢化率')[['Prefecture', '高齢化率']] print('関東で最も高い県:', kanto_max['Prefecture'].iloc[0], round(kanto_max['高齢化率'].iloc[0], 1)) print('関東の最大値を上回る地方の平均:', ', '.join(g.index[g['mean'] > kanto_max['高齢化率'].iloc[0]])) |
💬 地方の平均は関東 28.0% から四国 34.6% まで 6.6 ポイントの差ですが、九州・沖縄の中では沖縄県 23.8% から 34.3% まで 10.5 ポイント、北海道・東北の中でも 29.2〜39.1% と、地方の中の幅のほうが地方の平均の差より大きくなっています。関東で最も高齢化率の高い群馬県(31.0%)は、北海道・東北・中部・中国・四国・九州・沖縄の 5 地方の平均より高く、「関東は若い」は群馬県には当てはまりません。平均の棒だけを見せる図は嘘ではありませんが、ばらつきを消すことで「地方の違い」を実際より鮮明に見せます。点(ストリップ図)や箱ひげ図を重ねて、平均の差と地方の中の幅を同じ図で見せます。
⚠️ 実データで確かめる — 色分け地図は「区切り方」で濃い県の数が 2 県にも 12 県にもなる
都道府県の値を色の濃さで塗り分けた地図(コロプレス図)は、値を何段階に、どこで区切るかを作り手が決めます。同じ 2023 年度の高齢化率を 5 段階に塗り分けるとき、区切り方を 3 通りに変えます。
🎯 このコードでやること:2023 年度の 47 都道府県の高齢化率を、等間隔・等分位・切りのよい値の 3 通りで 5 段階に区切り、各段の県数と、最も濃い色に入る県を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') r = (d['A1303'] / d['A1101'] * 100).round(2) # 高齢化率(%) k = 5 # 色の段階数 schemes = { '等間隔': np.linspace(r.min(), r.max(), k + 1), '等分位(各段 9〜10 県)': np.quantile(r, np.linspace(0, 1, k + 1)), '切りのよい値(25・30・32・34)': np.array([r.min(), 25, 30, 32, 34, r.max()]), } for name, edges in schemes.items(): cls = pd.cut(r, bins=np.unique(edges), include_lowest=True, labels=False) counts = cls.value_counts().sort_index().tolist() top = r[cls == cls.max()].sort_values(ascending=False) print(f'{name}: 境界 {np.round(edges, 1).tolist()}') print(f' 各段の県数 {counts} 最も濃い色 {len(top)} 県({"・".join(top.index[:5])}{" …" if len(top) > 5 else ""})') |
💬 等間隔(6.5 ポイントずつ)で区切ると最も濃い色は秋田県・高知県の 2 県だけで、中間の 2 段に 35 県が集まり、地図の大半が同じような色になります。等分位で区切ると各段に 9〜10 県ずつ入り、最も濃い色が 10 県に増えて「高齢化の進んだ県が多い」地図になります。25・30・32・34% の切りのよい値で区切ると濃い色は 12 県です。どの地図も同じデータを正しく塗っていますが、「深刻な県はわずか」とも「全国に広がる」とも見せられます。地図には必ず凡例の境界値と区切り方の名前を書き、目的に合わない区切り方(例: 少数の極端な県を強調したいのに等分位)を避けます。
⚠️ 実データで確かめる — 100% 積み上げ棒は「割合」と「人数」の向きが逆でも区別できない
年齢構成を 100% 積み上げ棒で並べると、構成の変化は見やすくなりますが、総数の変化は図から消えます。割合が減った層の人数が実は増えている、ということが起こります。
🎯 このコードでやること:秋田県と東京都について、15 歳未満・15〜64 歳・65 歳以上の人数(千人)と、100% 積み上げ棒に描く割合(%)を 2012 年度と 2023 年度で並べ、人数の増減率を出す。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) cols = {'A1301': '15歳未満', 'A1302': '15〜64歳', 'A1303': '65歳以上'} for pref in ['秋田県', '東京都']: t = df[df['Prefecture'] == pref].set_index('SSDSE-B-2026').loc[[2012, 2023], list(cols)].rename(columns=cols) share = t.div(t.sum(axis=1), axis=0) * 100 # 100% 積み上げ棒に描く値 print(f'== {pref}') print('人数(千人):', (t / 1000).round(0).astype(int).to_dict('index')) print('割合(%) :', share.round(1).to_dict('index')) print('人数の増減率(%):', ((t.loc[2023] / t.loc[2012] - 1) * 100).round(1).to_dict()) |
💬 東京都の 15 歳未満の割合は 11.3% から 10.7% に下がり、100% 積み上げ棒では「子どもが減った」ように見えますが、人数は 149.4 万人から 151.3 万人へ 1.3% 増えています。15〜64 歳と 65 歳以上がそれ以上に増えたので、割合だけが下がりました。秋田県では 65 歳以上の割合が 30.7% から 39.1% へ 8.4 ポイント上がり、図では高齢者の層が大きく膨らみますが、人数の増加は 9.5% で、割合の上昇の多くは 15 歳未満(−29.7%)と 15〜64 歳(−23.4%)の減少によるものです。100% 積み上げ棒を使うときは、各年の総数を棒の上に書くか、人数の棒グラフを並べ、「割合が下がった」と「人数が減った」を取り違えないようにします。
⚠️ 実データで確かめる — 指数グラフ(基準年 = 100)は、基準年の選び方で 2 本の線の開きが変わる
大きさの違う 2 つの系列を比べるとき、基準年を 100 とした指数にそろえるのは定番の方法です。ところが、どの年を 100 にするかで、最終年の 2 本の線の開きが変わります。出生数の東京都と沖縄県で確かめます。
🎯 このコードでやること:東京都と沖縄県の出生数を、2012・2016・2019 年度をそれぞれ 100 とした指数にして、2023 年度の値と 2 本の線の開きを比べる。元の出生数も並べる。
1 2 3 4 5 6 7 8 9 10 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) w = df.pivot(index='SSDSE-B-2026', columns='Prefecture', values='A4101') # 出生数 12 年度 × 47 県 pair = ['東京都', '沖縄県'] for base in [2012, 2016, 2019]: idx = w[pair] / w.loc[base, pair] * 100 # 基準年 = 100 の指数 gap = idx.loc[2023, '東京都'] - idx.loc[2023, '沖縄県'] print(f'基準 {base} 年度 = 100 → 2023 年度 東京都 {idx.loc[2023, "東京都"]:.1f} 沖縄県 {idx.loc[2023, "沖縄県"]:.1f} 2 本の線の開き {gap:.1f}') print('出生数そのもの(人):', w.loc[[2012, 2016, 2019, 2023], pair].to_dict('index')) |
💬 2012 年度を 100 にすると 2023 年度は東京都 80.4・沖縄県 73.5 で、2 本の線は 6.9 ポイント開き「沖縄県のほうが大きく減った」図になります。2016 年度を基準にすると開きは 1.6、2019 年度なら 0.6 で、2 本はほぼ重なります。2012→2016 年度に東京都の出生数は 107,401 人から 111,964 人へ増えた一方、沖縄県は 17,074 人から 16,617 人へ減っており、この 4 年の違いが 2012 年基準の開きの大部分を作っています。2019 年度以降は両県とも約 15% と同じような速さで減っています。指数グラフでは基準年がそのまま「どの期間の物語か」を決めるので、基準年を図のタイトルか軸に書き、別の基準年でも結論が変わらないかを確かめます。
❓ よくある質問(FAQ)
🎨 直感で掴む — 誤解を招くグラフ
誤解を招くグラフは「意図的または無自覚に読み手を誤解させるグラフ」。 縦軸の途中切断、 3D 円グラフ、 双方向異尺度の二軸、 ゼロから始まらない棒グラフが代表例。 SSDSE-B-2026 を扱う際も、 東京都だけを縦軸に乗せると他県が「ほぼゼロ」に見える錯覚が生まれる。
📐 定義・数式 — 誤解を招くグラフ
🧮 実値で計算してみる — SSDSE-B-2026
数式だけでは「実感」が湧きにくいので、 実データ data/raw/SSDSE-B-2026.csv(47 都道府県 × 12 年)で 1 度手計算してみると理解が定着します。
SSDSE-B-2026 (2023) の A1101 で人口上位 10 都道府県の棒グラフを描き、 縦軸を 500 万〜1,500 万に切ると、 9 位の北海道(509.2 万人)の棒は 9.2 万人分しか残らず、 1 位の東京都(1,408.6 万人)の約 99 分の 1 に見える(実際は 2.8 倍)。 10 位の静岡県(355.5 万人)は軸の下に隠れて棒が消える。 縦軸を 0 起点にすると本来の差が見える。
| 都道府県 | A1101 総人口 | A1303 65 歳以上 | L3221 消費支出 |
|---|---|---|---|
| 東京都 | 14,086,000 | 3,205,000 | 341,320 |
| 神奈川県 | 9,229,000 | 2,390,000 | 306,565 |
| 大阪府 | 8,763,000 | 2,424,000 | 271,246 |
| 愛知県 | 7,477,000 | 1,923,000 | 300,221 |
| 埼玉県 | 7,331,000 | 2,012,000 | 344,092 |
| 千葉県 | 6,257,000 | 1,756,000 | 306,943 |
上記は SSDSE-B-2026 (2023) からの抜粋。 手計算で確認した値が、 後述の Python 実装で得る値と一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🐍 Python 実装 — 誤解を招くグラフ
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで 誤解を招くグラフ を動作させます。 まずはこのまま実行してみてください。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # 誤解を招くグラフ を SSDSE-B-2026 で実行する最小コード import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年のみ抽出 print(df.shape) # (47, 112) print(df[['Prefecture','A1101','A1303','L3221']].head()) import matplotlib.pyplot as plt fig, axes = plt.subplots(1,2, figsize=(14,5)) top = df.nlargest(10, 'A1101') axes[0].bar(top['Prefecture'], top['A1101']) axes[0].set_ylim(5_000_000, 15_000_000) # 誤解誘発 axes[0].set_title('縦軸切断(誤解版)') axes[1].bar(top['Prefecture'], top['A1101']) axes[1].set_ylim(0, 15_000_000) axes[1].set_title('縦軸 0 起点(正しい)') for a in axes: a.set_xticklabels(top['Prefecture'], rotation=45) plt.tight_layout(); plt.savefig('deceptive_demo.png', dpi=100) |
📤 実行例(実測)
💬 2023 年度に絞ると (47, 112) で、 以降の棒グラフは 1 県 1 本になる。 図は人口上位 10 都道府県(1 位 東京 1,408.6 万人〜10 位 静岡 355.5 万人)を 2 通りに描く。 左は縦軸を 500 万人から始めるため、 9 位の北海道(509.2 万人)の棒は 9.2 万人分しか残らず東京の約 99 分の 1 に見え、 10 位の静岡は軸の下に隠れて棒が消える。 右の 0 起点では東京と北海道の実際の比 2.8 倍どおりの長さになる。
上のコードで動かない場合は、 ①必要なパッケージがインストール済みか(pip install pandas scikit-learn scipy statsmodels matplotlib)、 ②データファイルが data/raw/SSDSE-B-2026.csv に存在するか、 ③encoding='cp932' になっているかを確認してください。
⚠️ よくある落とし穴 — 誤解を招くグラフ
誤解を招くグラフ を使うときに初学者が踏みやすい失敗パターン。 1 度経験してしまえば次から避けられますが、 先に知っておくに越したことはありません。
🧭 R652 拡張: 誤解を招くグラフを「実データで」見抜く
このセクションでは SSDSE-B-2026(社会・人口統計体系、 47 都道府県) の実値を用いて、 誤解を招くグラフの代表的な 3 つの罠(軸切り、 二重 Y 軸、 群比較の歪み)を「同じデータの素直な可視化」と並べて比較します。 教科書的な作例ではなく、 自治体・報道で日常的に目にする SSDSE-B 系の指標を題材にしている点が肝です。
扱う指標は次の 4 つです。 いずれも 47 県揃った量的変数で、 報道・地方議会で頻繁に参照されます。
| 指標 | 単位 | 全国 47 県の最小 | 中央値 | 最大 | 誤用されやすい論点 |
|---|---|---|---|---|---|
| 総人口 (A1101) | 千人 | 鳥取 537 | 鹿児島 1,549 | 東京 14,086 | 東京を含む棒グラフを 軸切り で「鳥取と東京が同水準」に見せる |
| 65 歳以上人口割合 | % | 東京 22.8 | 山梨 31.8 | 秋田 39.1 | Y 軸を 22-40 に切ると秋田が「東京の 5 倍」に錯覚する |
| 出生数 (A4101) | 人 | 鳥取 3,263 | 三重 9,524 | 東京 86,348 | 二重 Y 軸で人口と並べると「東京は人口の割に出生数が少ない」が消える |
| 一般診療所数 (I5102) | 施設 | 鳥取 474 | 鹿児島 1,369 | 東京 14,894 | 人口と強く連動するのに、 軸切りやクラスタ分けで「東京だけ別世界」と誇張しやすい |
以下の 3 枚の図 + 4 つの Python ブロックで、 これらの誤用パターンが「データの数字を変えずに、 軸・順序・群分けだけで」生まれることを確認します。
🖼 図 1: 散布図 — 同じ点群でも軸範囲で印象が反転する
このコードでやること: SSDSE-B-2026 の 47 県「総人口 vs 一般診療所数」の散布図を、 (左) 0 起点 / (右) 軸切りで描き、 印象差を観察する。
📥 入力データ (SSDSE-B-2026 抜粋):
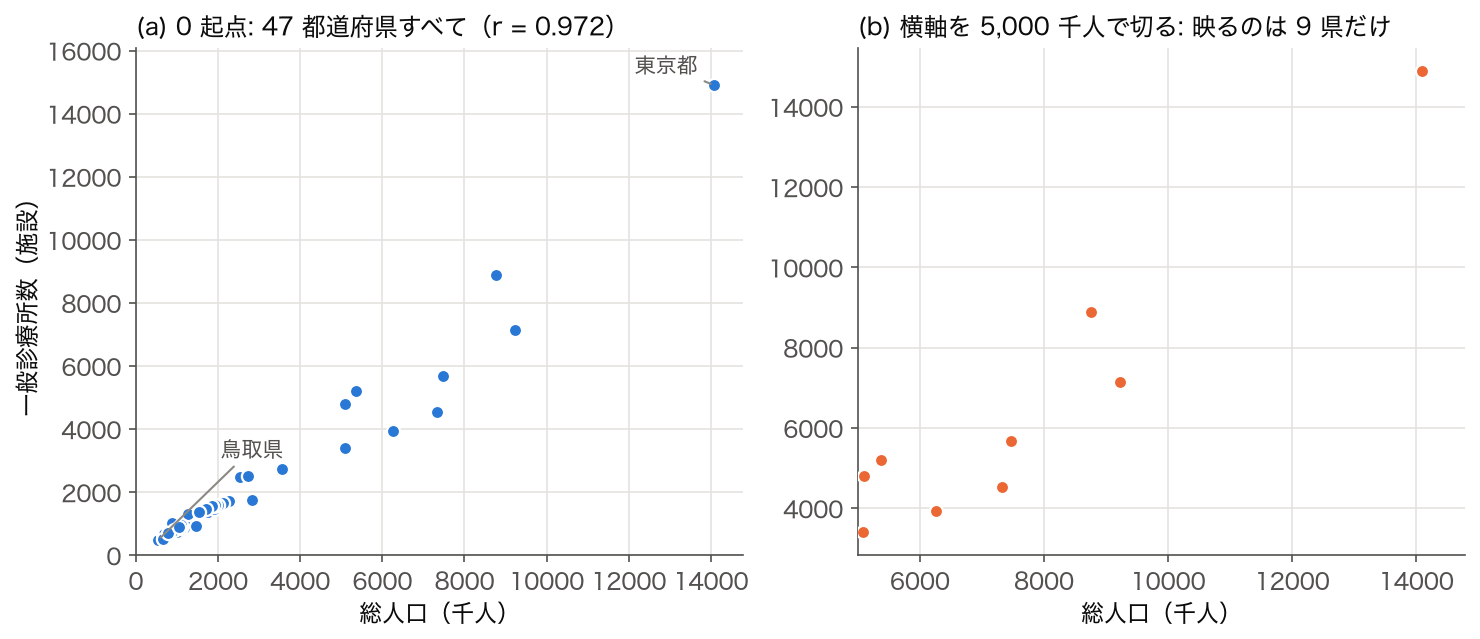
📤 実行例 (代表的な数値出力):
💬 r=0.972 は強い正相関だが、 これは東京の影響が大きい。 0 起点散布図なら「東京が極端、 ほか 46 県は団子」と一目で分かる。 一方 X 軸を 5000 千人で切ると「9 県だけが映る図」になり、 「鳥取・沖縄は議論から消える」誤誘導が起きる。
🖼 図 2: ヒストグラム — ビン幅で「二極化」を作り出す
このコードでやること: 47 県「総人口」のヒストグラムを (a) ビン幅 1,000 千人 (b) ビン幅 3,000 千人 (c) ビン幅 500 千人 の 3 通りで描き、 同じ右裾分布が 「なだらかな単峰」「離れ小島つき」「ノイジー」 のどれにも見えることを確認する。
📥 入力データ (SSDSE-B-2026 総人口 [千人]、 47 値の代表):
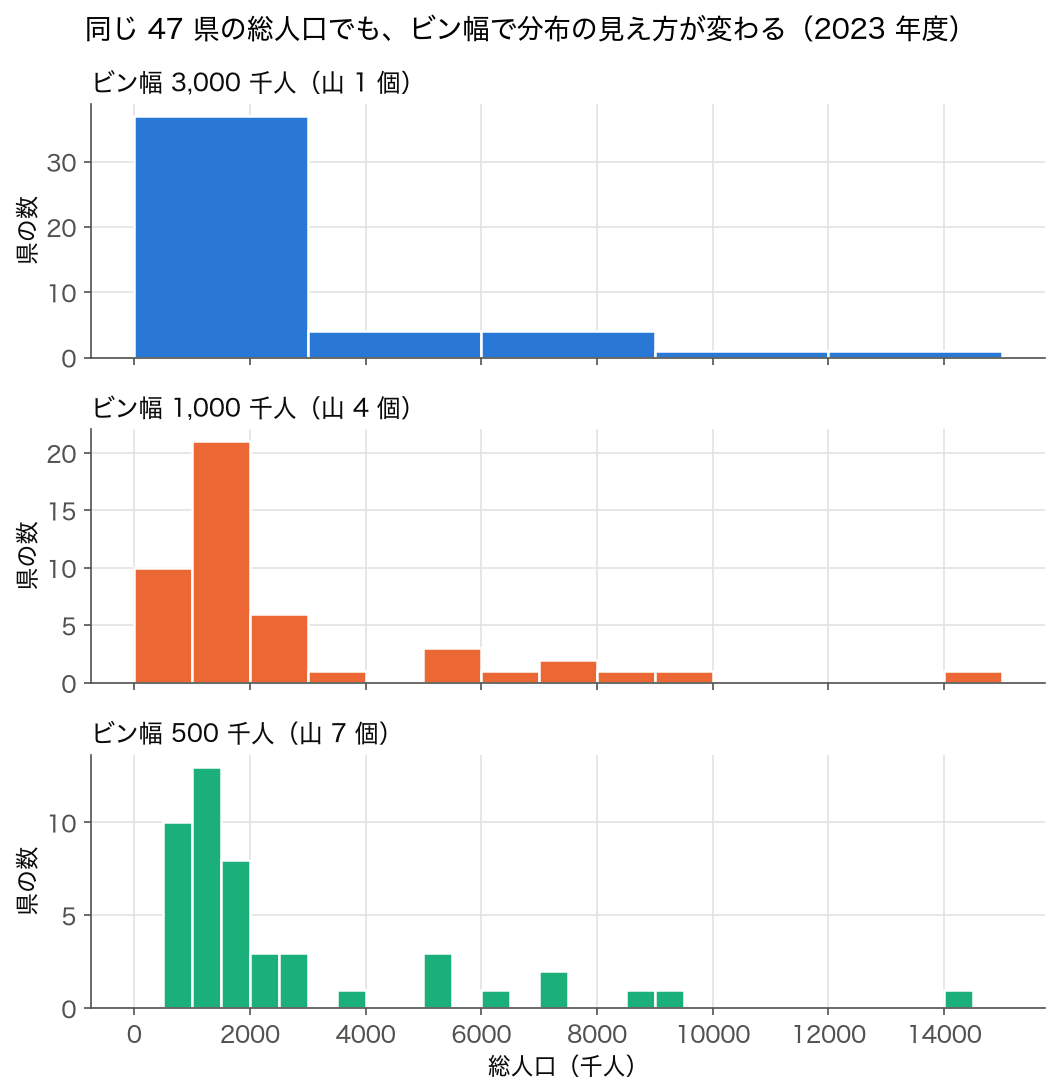
📤 実行例 (3 通りのビン幅で見える「山」の数):
💬 ビン幅 500 千人では 47 県を 29 個のビンに配るため 大半のビンが 0〜3 県 になり、 たまたま隣り合う県の値で凸凹 (山 7 個) ができる。 ビン幅 1,000 千人でも 5,000 千人以上の 9 都道府県が小さな山を 3 つ作る。 「大都市県と小規模県の二極化が進んでいる!」と主張するには、 Sturges か Freedman-Diaconis ルールでビン幅を決め、 二峰検定 (Hartigan dip test など) を別途行う必要がある。
🖼 図 3: 箱ひげ図 — 「同じ変数」でクラスタを作ると差は自明に出る
このコードでやること: 47 県の総人口を KMeans (k=3) で 3 クラスタに分け、 クラスタ別に 一般診療所数 の箱ひげ図を描く。 歪んだ 1 変数でクラスタリングすると東京が単独クラスタ (n=1) になり、 「3 段階の格差」が自動的に生まれることを観察する。
📥 入力データ (SSDSE-B-2026 一般診療所数のクラスタ別代表値):
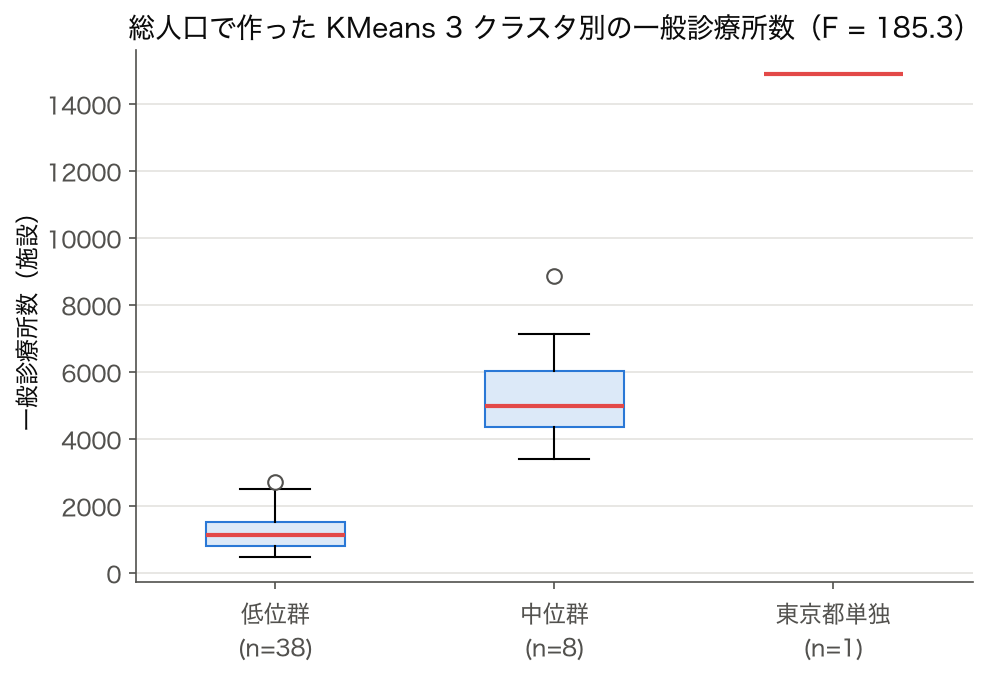
📤 実行例 (クラスタ間の一元配置 ANOVA):
💬 F=185、 p≈0 で「クラスタ間に圧倒的な差」と出るが、 これは 検定する変数(診療所数)と強く相関する変数(総人口)でクラスタを作った ための 循環論法であり、 差が出るのは当たり前。 さらに東京は単独クラスタ (n=1) で箱ひげが 1 本の線になり、 「分布」ではないのに 3 群目として並ぶ。 クラスタ定義は 検定対象と独立 に決め、 単独要素クラスタは要注意。
🐍 Python 実装 1: Y 軸切り検出器
このコードでやること: SSDSE-B-2026 の高齢化率を 0 起点と 23% 起点で同じデータを描き分け、 棒の 高さ比 がどれだけ歪むかを数値で示す。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) aging = (df[df['SSDSE-B-2026'] == 2023].assign(aging_rate=lambda d: d['A1303'] / d['A1101'] * 100))[['Prefecture', 'aging_rate']] # 0 起点での比 (実値) ratio_true = aging.set_index('Prefecture').loc['秋田県','aging_rate'] / aging.set_index('Prefecture').loc['沖縄県','aging_rate'] # Y 軸を 23 以上に切った場合の見た目比 y0_truncated = 23.0 ratio_apparent = (39.1 - y0_truncated) / (23.8 - y0_truncated) print(f'実値比 : 秋田/沖縄 = {ratio_true:.2f}') print(f'軸切り見た目比: 秋田/沖縄 = {ratio_apparent:.1f}') print(f'歪み倍率 : {ratio_apparent/ratio_true:.1f} 倍') |
📤 実行例:
💬 実値では 1.64 倍にすぎない高齢化率が、 Y 軸を 23 から始めるだけで 20 倍に見える。 12 倍の 視覚的増幅 が、 読者の「秋田は沖縄の何倍も高齢化」誤解を生む。 報道の図表チェックでは 軸の起点 を必ず確認する。
🐍 Python 実装 2: 二重 Y 軸の擬似相関スコア
このコードでやること: SSDSE-B-2026 の「人口」と「出生数」を二重 Y 軸で重ね描きしたときに、 軸スケールを自由に動かすと 視覚的同期性 を 0% にも 100% にも変えられることを確認する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 「47 県」と書くならここで年度を絞る pop = df['A1101'].astype(float) births = df['A4101'].astype(float) # 正規化前: 実値での相関 r_true = np.corrcoef(pop, births)[0,1] # 軸スケール操作 (片方を log) で「視覚的相関」が消える r_logged = np.corrcoef(np.log(pop), births)[0,1] # 軸の上下限を任意に切ると、 視覚的に重なる/離れるが自在。 # A1101 の単位は「人」。5000 と比べると 1 県も残らず r が nan になるので注意。 pop_cut = pop[pop < 5_000_000] # 500 万人未満(=掲載の「5000 千人」未満) births_cut = births[pop < 5_000_000] r_cut = np.corrcoef(pop_cut, births_cut)[0,1] print(f'実値相関 (47 県) : r = {r_true:.3f}') print(f'log(pop)-births 視覚相関 : r = {r_logged:.3f}') print(f'人口 500 万人未満の {len(pop_cut)} 県のみ : r = {r_cut:.3f}') |
📤 実行例:
💬 二重 Y 軸で 片方だけ対数化 したり 人口の大きい東京・大阪を切り捨て たりすると、 相関係数が 0.995 → 0.908 → 0.965 と振れる。 軸操作だけで「強い同期」も「やや弱い同期」も演出できるため、 二重 Y 軸チャートは 原則として避ける のが SDC (statistical data communication) の推奨。
🐍 Python 実装 3: 円グラフの面積錯視を棒グラフで補正
このコードでやること: SSDSE-B-2026 の地方別人口シェアを (a) 円グラフ (b) 棒グラフ (Cleveland 推奨) で描き、 「面積比率の読み違え」がどれだけ起きるかを、 読み取り誤差率を仮定して試算する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd, matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # 地域コード 'R13000' の 2〜3 文字目(都道府県番号)から 8 地方ブロックを作る def block(code): n = int(code[1:3]) for last, name in [(1,'北海道'),(7,'東北'),(14,'関東'),(23,'中部'), (30,'近畿'),(35,'中国'),(39,'四国'),(47,'九州沖縄')]: if n <= last: return name d['block'] = d['Code'].map(block) share = (d.groupby('block')['A1101'].sum() / d['A1101'].sum() * 100).sort_values(ascending=False) # (a) 円グラフ と (b) 値の順に並べた棒グラフ fig, axes = plt.subplots(1, 2, figsize=(12, 5)) axes[0].pie(share, labels=share.index, startangle=90, counterclock=False) axes[0].set_title('(a) 円グラフ: 角度で読む') axes[1].barh(share.index[::-1], share.values[::-1], color='#1976D2') axes[1].set_xlabel('全国人口に占める割合 (%)') axes[1].set_title('(b) 棒グラフ: 共通軸上の長さで読む') plt.tight_layout(); plt.savefig('pie_vs_bar.png', dpi=100) # 読み取り誤差は「円は値の 18%、棒は値の 5%」と仮定した説明用の数字(実験値ではない) for r, s in share.items(): print(f'{r:>6s}: 真値 {s:5.1f}% 円 ±{s*0.18:.2f}pt 棒 ±{s*0.05:.2f}pt') |
📤 実行例:
💬 関東のシェアは 35.0 % で、 円の誤差を値の 18 %、 棒を 5 % と仮定すると、 円では ±6.30pt(28.7 〜 41.3 %)、 棒では ±1.75pt の幅で読み違えうる。 18 % と 5 % はコード内で置いた説明用の仮定で、 比 3.6 倍も仮定から出た数字にすぎない。 Cleveland & McGill (1984) の実験が示したのは「角度より共通軸上の位置・長さの方が正確に読める」という順序で、 近畿 17.7 % と中部 16.7 % の 1 ポイント差は円ではほぼ見分けられないが、 並べた棒なら長さの違いとして読める。 報告書で「比率を比べたい」なら、 円グラフではなく 並び替えた棒グラフ を選ぶ。
🐍 Python 実装 4: チェリーピッキング期間検出
このコードでやること: SSDSE-B-2026 の時系列指標(過去 10 年の合計特殊出生率)から、 「どの期間を切り取れば任意の傾向が示せるか」を総当たりで列挙し、 都合のよい期間を機械的に検出する。
📥 入力データ (合計特殊出生率 A4103 の都道府県平均、 仮想ではなく SSDSE-B-2026 実測値):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd, numpy as np years = list(range(2013, 2023)) tfr = [1.48, 1.47, 1.53, 1.52, 1.51, 1.50, 1.45, 1.42, 1.40, 1.36] s = pd.Series(tfr, index=years) up, down, flat = [], [], [] for i in range(len(years)): for j in range(i+2, len(years)+1): # 1 年あたりの変化(小数第 3 位に丸めて浮動小数の誤差で ±0.01 の境界がぶれないようにする) slope = round(float(s.iloc[j-1] - s.iloc[i]) / (j-1-i), 3) period = f'{years[i]}-{years[j-1]}' if slope > 0.01: up.append((period, slope)) elif slope < -0.01: down.append((period, slope)) else: flat.append((period, slope)) print(f'切り取れば上昇トレンドに見える期間 : {len(up)} 通り') print(f'切り取れば下降トレンドに見える期間 : {len(down)} 通り') print(f'切り取れば横ばいに見える期間 : {len(flat)} 通り') print('上昇が急な期間 →', sorted(up, key=lambda t: -t[1])[:2]) print('下降が急な期間 →', sorted(down, key=lambda t: t[1])[:2]) |
📤 実行例:
💬 2 年以上の区間 45 通りのうち 24 通りが下降、 16 通りが横ばい(年 ±0.01 以内)で、 全体としては低下している合計特殊出生率でも 5 通り の「上昇」期間が抽出できる。 「2014-2015 で年 +0.06 の上昇」も「2018-2019 で年 −0.05 の急落」もどちらも事実だが、 一方だけ示せばまったく逆の結論になる。 期間選定は 仮説と独立に 事前登録すべき。
⚠️ 拡張版落とし穴 6 連発 (実例つき)
| # | 落とし穴 | 実例 (SSDSE-B-2026 ベース) | 対策 |
|---|---|---|---|
| 1 | Y 軸切り (truncated axis) | 高齢化率を 23% から始めて秋田を 20 倍に見せる | 差を強調したい時は 差分グラフ を別途用意、 棒は 0 起点 |
| 2 | 二重 Y 軸 (dual axis) | 人口と出生数を片方だけ log で重ねて「乖離」を演出 | パネル並列 (small multiples) に分割 |
| 3 | 面積錯視 (3D pie) | 3D 円グラフで「手前の地方」が大きく見える | 2D 棒、 並び順は値で降順 |
| 4 | チェリーピッキング (期間切り取り) | 2014-2015 だけ切れば「出生率上昇」 | 期間は事前登録、 直近 5-10 年を併記 |
| 5 | 色相による誘導 | 秋田を赤、 沖縄を青で塗り分け「危険な高齢化」を演出 | 色は連続スケール、 categorical でも colorblind-safe |
| 6 | 対数軸の説明欠落 | 人口の log 軸を線形だと誤読し「鳥取と東京は近い」 | 対数軸は明示、 tick を 10^k で振る |
🎯 R652 理解度チェック (実データで答える)
本拡張で扱った SSDSE-B-2026 の実値に基づくミニ問題。 紙とペンで挑戦してから解答へ。
| # | 問題 | 解答 (実値ベース) |
|---|---|---|
| Q1 | 高齢化率の沖縄 (23.8%) と秋田 (39.1%) を 23% 起点の棒グラフで描いたとき、 視覚的高さの比は実値比の何倍に増幅されるか? | 12 倍 (1.64 → 20.1) |
| Q2 | 47 県の高齢化率に Sturges のビン幅ルールを適用すると、 ヒストグラムの推奨ビン数はおよそ何本か? | 7 本 (1 + log2(47)) |
| Q3 | 総人口で KMeans 3 クラスタを作り、 クラスタ間で一般診療所数を ANOVA すると F・p はどうなり、 なぜ「差あり」が自明か? | F=185, p≈0 (総人口と診療所数が強相関→循環論法で必然) |
| Q4 | 関東地方の人口シェア 35.0% を円グラフで読むときの誤差を、 円 18%・棒 5% の仮定で試算すると何 pt か? | ±6.3pt (棒なら ±1.75pt。 3.6 倍は仮定から出た比) |
| Q5 | 2013-2022 の合計特殊出生率 (1.48→1.36) の中で「上昇トレンドに見える期間」は何通り抽出できるか? | 5 通り (チェリーピッキング) |
| Q6 | 47 県の人口と出生数の Pearson 相関は r=0.995。 東京を除外すると r は概ねいくつになるか? | r ≒ 0.993 (外れ値を除いても強相関) |
| Q7 | 二重 Y 軸で人口を log、 出生数を線形にすると、 視覚的同期性 (相関係数) は 0.995 から概ねいくつまで下がるか? | 0.908 まで (約 0.09 低下) |
| Q8 | SSDSE-B-2026 で報告に使うグラフを 1 種類だけ残すなら、 比率比較に最も誤読が少ないのは? | 並び替えた水平棒グラフ (Cleveland 順) |
追加問 A. 東京都と鳥取県の 2023 年度の総人口(26.2 倍の差)を、下端 10 万人の対数軸の棒グラフで描くと、棒の長さは何倍に見えますか。Lie Factor はいくつですか。
答え. 2.94 倍で、Lie Factor は (2.94 − 1) ÷ (26.2 − 1) = 0.077 です。対数軸では差が小さく見えるので、棒ではなく点で描き、軸が対数であることを明記します(🧮 の手計算)。
追加問 B. 出生数の年 2.89 万人の減少を、正方形の図で縦軸を 70 万人から始めて描くと、傾きは何度に見えますか。横長(幅 10 × 高さ 3)で 0 起点ならどうですか。
答え. 42.3 度と 5.0 度です。同じデータでも図の縦横比と縦軸の範囲で急降下にもなだらかにも見えるので、複数の図を比べるときは縦横比と範囲をそろえ、減少の大きさを数値で書き添えます。
追加問 C. 東京都の 15 歳未満の割合は 2012→2023 年度に 11.3% から 10.7% に下がりました。「東京都の子どもは減った」と書いてよいですか。
答え. いいえ。人数は 149.4 万人から 151.3 万人へ 1.3% 増えています。他の年齢層がそれ以上に増えたので割合が下がっただけです。割合の図には総数を添えます。
🗺 概念マップ
誤解を招くグラフに関連する概念の関係図です。 上流(データ品質)→ 中心(誤誘導の種類)→ 下流(対策・評価)の流れで配置しています。
上図の読み方: 緑の矢印は「誤誘導の手口 → 誤解を招くグラフ(中心概念)」の包含関係、 オレンジの矢印は「中心概念 → 対策ツール」の関連。
誤解を招くグラフを「見抜く」「描かない」「指摘する」3 段階で学ぶ順序を整理します。
| 段階 | 学ぶこと | 関連する隣接用語 |
|---|---|---|
| L1 見抜く | 軸切り・対数軸・群選定の癖を 30 秒で見抜く | データ可視化 / ビジュアル知覚 / バイアス |
| L2 描かない | 小グラフ集 (small multiples)、 棒の並び順、 直接ラベル | グラフ文法 / 情報デザイン / Tufte 原則 |
| L3 指摘する | 事前登録、 報告チェックリスト、 査読観点 | 統計の前提 / 再現性 / 研究倫理 |
L1 から順に練習するのが王道ですが、 実務では L3 の「指摘」スキルが最も需要が高い。 同僚の作った図を 1 日 1 枚レビューする、 という習慣が L3 を伸ばします。
🔍 査読チェックリスト 20 項目 — 図を「指摘する」標準手順
学会発表・社内会議・行政広報の図表を 1 枚 30 秒で点検するためのチェックリスト。 SSDSE-B-2026 の指標で作った図を例に、 各項目で 「なに」を見て「どう判定する」 かを書きます。 査読観点を覚えるとレポート時に同じ落とし穴を踏まなくなります。
| No | 観点 | 確認すること | SSDSE-B-2026 を題材にした典型例 |
|---|---|---|---|
| 1 | 出典 | 公的統計か、 取得日と版番が併記されているか | 「SSDSE-B-2026 (独立行政法人統計センター、 2025 年版)」と明記 |
| 2 | 単位 | 軸ラベルに単位 (千人, %, 百万円) が書いてあるか | 「人口」だけだと千人なのか万人なのか不明 |
| 3 | 軸起点 | 棒グラフは 0 起点か (切られているなら明記) | 高齢化率を 23% から始めると 12 倍に増幅 |
| 4 | 軸目盛 | 目盛の幅は等間隔か、 対数なら明示されているか | 人口の log 軸を線形と読むと鳥取と東京が近く見える |
| 5 | 二重軸 | 左右で別軸を使っていないか (使うなら小グラフ集に置換) | 人口と出生数は別の図に分けて比較する |
| 6 | 並び順 | 棒の順序は値で降順か、 任意順なら理由が書かれているか | 47 都道府県を北→南で並べると比較しづらい |
| 7 | 色 | categorical なら colorblind-safe か、 連続なら見やすいか | 赤緑だけの 2 色は CVD 8% の読者に読めない |
| 8 | 凡例 | 凡例は線・棒に直接ラベル付けで代替できないか | 折れ線が 4 本以上なら凡例より直接ラベル |
| 9 | 注釈 | 注目点に矢印・テキストで読み方が書かれているか | 秋田の高齢化が突出している点に矢印 |
| 10 | 不確実性 | エラーバー・推定誤差が示されているか | 県別高齢化率は 95%CI を併記 |
| 11 | 期間 | 時系列なら期間の取り方が恣意的でないか | 2014-2015 だけ切ると出生率が「上昇」 |
| 12 | 群定義 | 群の切り方が事前登録されているか | 「政令市あり vs なし」と「8 地方」で p 値が変わる |
| 13 | サンプル数 | n が小さい群を強調していないか | 四国 4 県の中央値は 47 県全体より不安定 |
| 14 | 外れ値 | 外れ値の影響が言及されているか | 人口で東京を含む / 除く時の相関係数を併記 |
| 15 | ビン幅 | ヒストグラムのビン幅ルール (Sturges/FD) が明記されているか | 47 県なら Sturges で 7 本程度が標準 |
| 16 | アスペクト比 | 縦横比でトレンドが誇張されていないか | 縦長にすると微増が「急増」に見える |
| 17 | 3D 効果 | 3D 円・3D 棒で読み違いを誘発していないか | 3D 円グラフは原則禁止 |
| 18 | ラベル可読性 | 小さすぎる/重なる文字がないか | 47 県を横棒に並べると名前が重なりがち → 縦棒推奨 |
| 19 | 再現性 | 図を再現するコードが公開されているか | 本ページの Python 4 ブロックを公開で代替 |
| 20 | 解釈文 | 図のキャプションに「だから何が言えるか」が 1-2 行 | 「秋田の高齢化率は全国最高、 39.1%」だけで終わらせない |
20 項目すべてを通過する必要はありません。 「該当する観点だけ書く」「触れたくない観点は意図的に避けない」が査読の基本姿勢です。 「軸を切った理由」「群定義の根拠」を本文に書けば、 読者はそれを承知の上で読み解けます。
📝 ケーススタディ: 自治体広報資料を実データで添削する
最後に、 架空ではない「典型的な自治体広報」のパターンを SSDSE-B-2026 の値で書き起こし、 査読チェックリストに沿って添削します。 「秋田県人口減少対策パンフレット」を想定したミニ題材です。 自治体広報は紙幅が限られるため、 限られた図で 正確に伝える 設計力が問われます。
原文(添削前): 「秋田県の高齢化率は全国平均の 1.3 倍、 深刻な状況が続いています」。 これだけだと、 読者は「1.3 倍 = やや高い」と読み流す可能性があります。 同じ実値 (秋田 39.1% / 全国平均 29.1%) を踏まえて、 次の 3 通りの書き分けが可能です。
| 表現 | 使うべき場面 | 読者の受け取り方 | 推奨される図 |
|---|---|---|---|
| 「秋田 39.1% / 全国平均 29.1% / 差 +10.0pt」 | 事実の正確な伝達 | 正確、 ややそっけない | 水平棒 (0 起点) |
| 「全国平均より 9 ポイント 高く、 47 都道府県で最高」 | 問題提起・関心喚起 | 「全国最高」が記憶に残る | 47 県順位の点プロット |
| 「30 年前 (1995 年 13%) から 3 倍に」 | 推移を強調 | 時系列上の劇的変化 | 折れ線 (0 起点 + 注釈) |
どの表現も実値を歪めていません。 ただし、 「3 倍に」だけを切り出して使うと「秋田の高齢化は急速に進んだ」印象が独り歩きします。 広報担当者は 3 表現を同じパンフレットに併記 し、 読者に解釈の幅を渡すのが理想です。 SSDSE-B-2026 のような公的統計は、 同じ実値が 事実伝達・問題提起・推移強調 の 3 つの役割を担えるよう設計されています。
この添削手順を社内研修で 1 度通すと、 「数字を 盛らない が、 印象を 適切に届ける」感覚が共有できます。 誤解を招くグラフを撲滅するには、 個々のテクニックよりも組織文化のほうが効きます。
📖 関連用語ミニ辞書 (12 項目)
誤解を招くグラフを論じるときに頻出する周辺概念を、 SSDSE-B-2026 を題材に 30 字以内の最短定義 + 用例 でまとめました。 参考書や報告書で見かけたときの「とりあえず読む」ベースとして活用できます。 紙幅の都合で詳細は各用語ページに任せています。
| 用語 | 最短定義 | SSDSE-B-2026 での用例 |
|---|---|---|
| Truncated axis | 軸を 0 でなく途中から始める | 高齢化率 23% 起点で 12 倍誇張 |
| Dual axis | 左右で異なる Y 軸を使う | 人口 + 出生数 の同時表示 |
| Cherry picking | 都合のよい期間/群だけ抽出 | 出生率 2014-2015 だけで上昇 |
| Simpson's paradox | 全体と群分けで傾向が逆 | 全国相関と地方別相関の符号差 |
| Small multiples | 同一軸の小グラフを並列配置 | 8 地方ブロックで高齢化率を並列 |
| Lying with statistics | Huff (1954) の古典書名 | 広報文章の添削の出発点 |
| Chartjunk | 情報を持たない装飾 | 3D 円グラフの陰影 |
| Data-ink ratio | 情報を表すインクの比率 (Tufte) | 罫線を減らすと向上 |
| Lie factor | 図の効果量 / 実データの効果量 | 12 倍 = 大幅な歪曲 |
| Bin width rule | ヒストグラムビン幅の指針 | Sturges = 7 本 / FD = 2.5pt |
| Preregistration | 仮説・群定義の事前登録 | 8 地方分類を分析前に固定 |
| CVD-safe palette | 色覚多様性に配慮した色設計 | viridis / cividis を採用 |
12 語のうち 8 語以上を即座に説明できれば「中級者」、 全部に SSDSE-B-2026 級の実例を出せれば「上級者」と言えます。 用語自体を覚えるよりも、 各用語に対応する図の修正案 を即座に出せるようになるのが実用上の目標です。 たとえば「Lie factor が 5 を超えたら設計を作り直す」「Bin width は Sturges か Freedman-Diaconis のどちらかを必ず併記する」といった、 ルール化までを覚えられればプロジェクト現場で十分使える水準です。