📍 あなたが今見ているもの
🍰 まずはやさしく
分析のスタート地点となる道具です。
データの全体像を正しく掴むために使います。
スマホの利用時間をみんなで比べる時に役立ちます。
分析の基本となる可視化の手法を読みましょう。
論文・記事に 「ヒストグラム」「箱ひげ図」「KDE」「バイオリンプロット」「ECDF」「QQプロット」 として登場する 1変量データの可視化手法群。 すべての分析の出発点となる探索的データ解析 (EDA) の中核ツール。
🔖 キーワード索引
論文記事から各用語のリンクをクリックすると、 該当箇所が開きます:
💡 30秒で分かる結論
🍰 まずはやさしく
データの形を絵にする方法です。
データの偏りや特徴を知るために使います。
テストの点数の散らばりを調べる時に便利です。
代表的な6つのグラフについて学びます。
🗂️ 章俯瞰 — 6つの 1変量可視化
1変量データを見ることは、 あらゆる分析の出発点。 数値要約(平均、 分散)だけでは見えない分布の形・歪み・多峰性・外れ値を確認できます。
| 手法 | 分かること | 適性 n |
|---|---|---|
| ヒストグラム | 分布の形、 ピーク、 歪み | 30〜数万 |
| 箱ひげ図 | 5数要約、 外れ値、 群比較 | 10〜大量 |
| KDE | 滑らかな密度、 多峰性 | 50〜数千 |
| バイオリン | 箱ひげ + 密度形状 | 50〜数千 |
| ECDF | 累積比率、 2分布比較 | 任意 |
| QQプロット | 理論分布との一致 | 任意 |
📊 ヒストグラム(Histogram)
連続値データを階級(ビン)に分け、 各階級の度数を棒の高さで表現。 分布の全体像を最も直感的に見せる可視化。
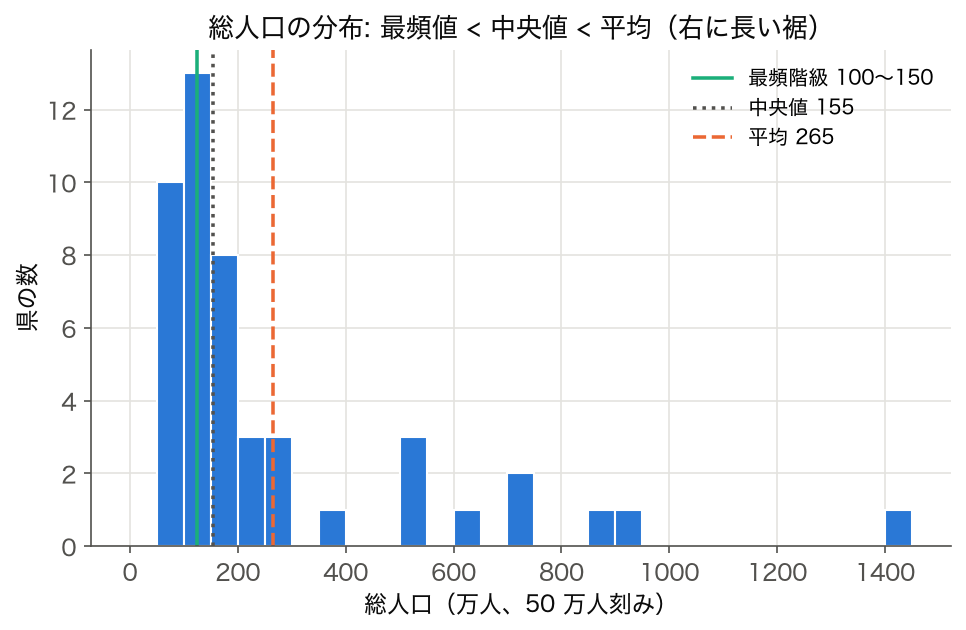
上の図は SSDSE-B-2026(2023 年度)の 47 都道府県の総人口を 50 万人刻みで描いたもの。 最頻階級は 100〜150 万人(13 県)、 中央値 155 万人、 平均 265 万人と「最頻値 < 中央値 < 平均」の順に並び、 右端に東京都(1,409 万人)が離れて立つ右に長い裾の分布(歪度 2.22)であることが一目で分かる。
📏 ビン数の決め方
ヒストグラムはビン数で見え方が大きく変わる。 主要なルール:
- Sturges: $k = \lceil \log_2 n + 1 \rceil$(小〜中サンプル)
- Scott: $h = 3.5 \sigma / n^{1/3}$(ビン幅、 正規分布前提)
- Freedman-Diaconis: $h = 2 \cdot \mathrm{IQR} / n^{1/3}$(外れ値に強い、 推奨)
- √n ルール: $k = \sqrt{n}$(簡便)
$n = 47$(47都道府県)なら、 Sturges で約 7 ビン、 √n で約 7 ビン。 実務では複数のビン数を試して「分布の本質」を見るのが安全。
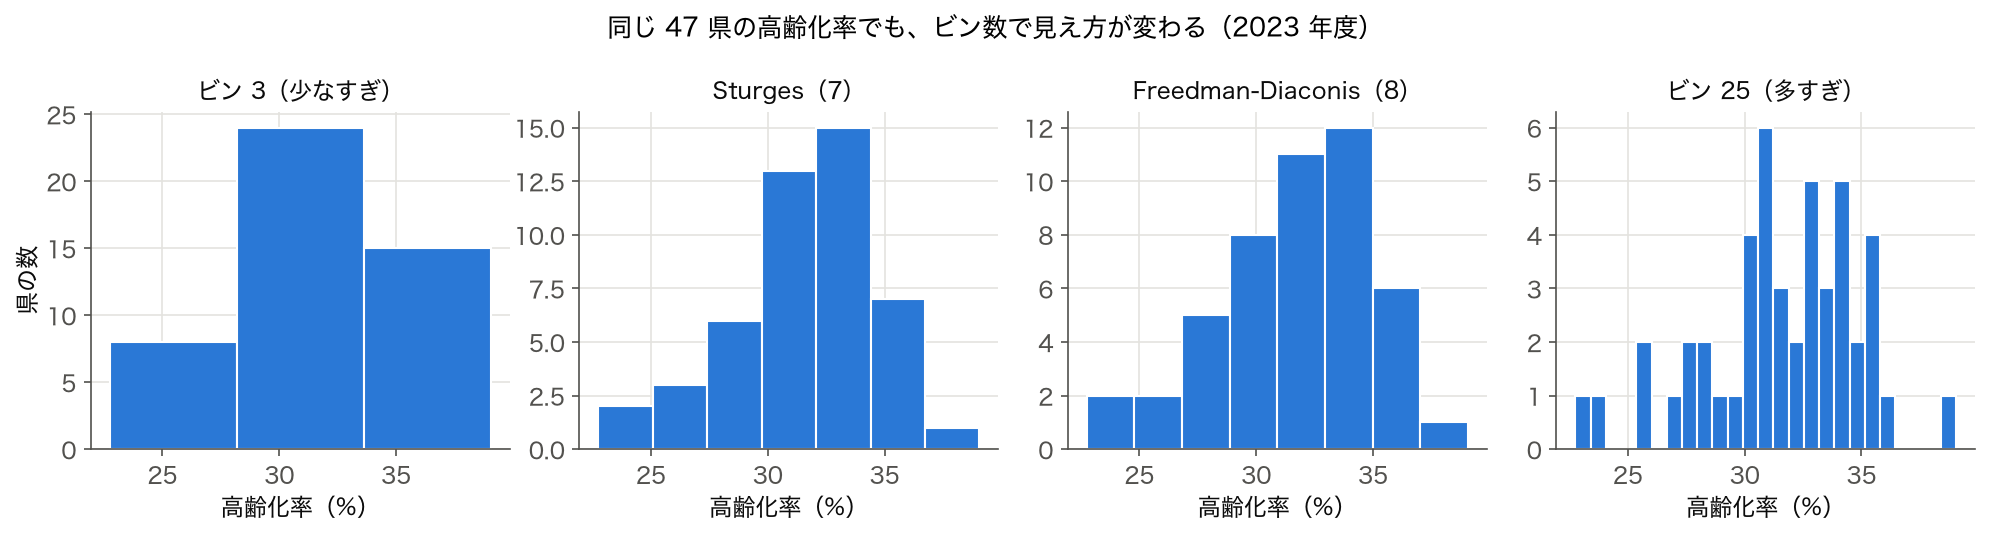
2023 年度 47 都道府県の高齢化率 (22.75〜39.06%) で試すと、 Sturges は ⌈log₂47 + 1⌉ = ⌈6.55⌉ = 7 ビン、 Freedman-Diaconis はビン幅 2 × IQR 3.97 / 47^(1/3) = 2.20 ポイントで 8 ビン。 どちらも 30〜35% に山があり、 左 (低い側) に裾が伸びる形が読める。 3 ビンでは山の位置しか分からず、 25 ビンでは度数 0〜6 の棒がばらついて形が崩れ、 東京都 (22.75%) や秋田県 (39.06%) の孤立した棒がノイズと区別しにくい。
🎯 ヒストグラムから読み取れる分布の形
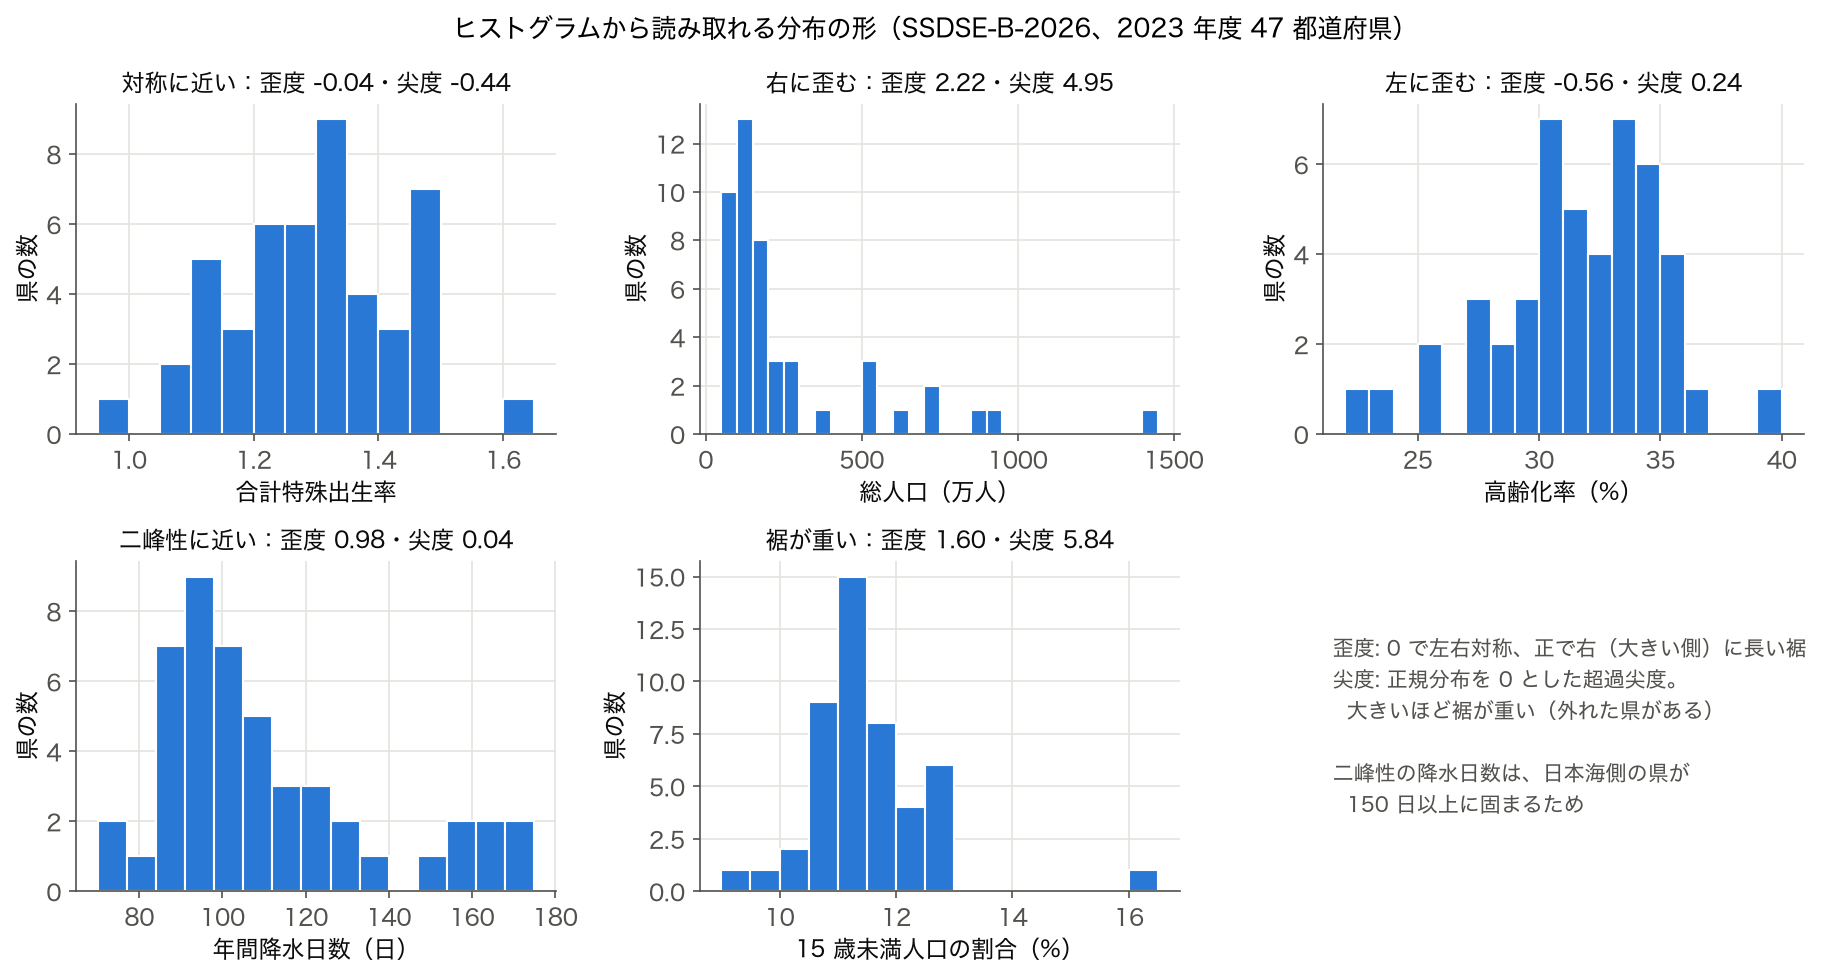
上の図は 2023 年度 47 都道府県の実データ。 合計特殊出生率は歪度 −0.04 でほぼ対称、 総人口は歪度 2.22 で右に長い裾、 高齢化率は歪度 −0.56 で左 (低い側) に裾を引く (東京都・沖縄県・愛知県など)、 年間降水日数は 90〜110 日の山と、 青森県 170 日・秋田県 169 日など日本海側の 150 日以上の小さな山に分かれ、 15 歳未満人口の割合は沖縄県 16.1% 1 県が離れて超過尖度 5.84 と裾が重い。
- 対称(正規):左右が鏡像
- 右に歪む:所得・株価・都市人口の典型
- 左に歪む:満点に張り付くテスト点数など
- 二峰性:2 つの集団が混在している可能性
- 裾の重さ:尖度(kurtosis)で数値化
🐍 Python での描画
data/raw/SSDSE-B-2026.csv (CP932、 47 都道府県 × 2023 年度)。 列 A1101 (総人口)を 1 万人単位に変換して使用。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import matplotlib.pyplot as plt import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023] pop = df['A1101'] / 10000 ## 万人単位 fig, axes = plt.subplots(2, 2, figsize=(12, 8)) ## 左上:ヒストグラム(Sturges 公式) axes[0, 0].hist(pop, bins='sturges', edgecolor='white', color='#1976D2') axes[0, 0].set_title('ヒストグラム(線形軸)') ## 右上:対数ヒストグラム axes[0, 1].hist(np.log1p(pop), bins=15, edgecolor='white', color='#388E3C') axes[0, 1].set_title('log1p 後(正規に近づく)') ## 左下:箱ひげ図 + ストリップ axes[1, 0].boxplot(pop, vert=False, widths=0.5) axes[1, 0].scatter(pop, np.ones_like(pop) + np.random.uniform(-0.1, 0.1, len(pop)), alpha=0.5) axes[1, 0].set_title('箱ひげ + 生データ点') ## 右下:ECDF sorted_pop = np.sort(pop) ecdf = np.arange(1, len(sorted_pop)+1) / len(sorted_pop) axes[1, 1].step(sorted_pop, ecdf, where='post') axes[1, 1].set_title('ECDF(経験的累積分布)') plt.tight_layout() |
② seaborn — 統計可視化の高レベル API
data/raw/SSDSE-B-2026.csv。 列 A4101 (出生数・ 人)。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import seaborn as sns ## displot — KDE + ヒストグラム + rug の三位一体 sns.displot(data=df, x='A4101', kde=True, rug=True, height=5) ## バイオリンプロット — 分布形状を保持 sns.violinplot(data=df, y='A4101', inner='box') ## boxenplot — 大規模データ向けの分位点版 sns.boxenplot(data=df, y='A4101') ## stripplot + boxplot の重ね描き(raincloud 風) fig, ax = plt.subplots(figsize=(8, 5)) sns.boxplot(data=df, y='A4101', ax=ax, width=0.3) sns.stripplot(data=df, y='A4101', ax=ax, color='red', alpha=0.5, jitter=0.1) |
③ scipy.stats — 統計量と分布検定
data/raw/SSDSE-B-2026.csv。 列 A1101 (総人口) と log1p 変換後の値。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | from scipy import stats x = df['A1101'].values ## 記述統計量 print(f'平均 : {np.mean(x):.0f}') print(f'中央値 : {np.median(x):.0f}') print(f'最頻値 : {stats.mode(x, keepdims=False).mode}') print(f'歪度 : {stats.skew(x):.3f}') print(f'尖度 : {stats.kurtosis(x):.3f}') print(f'IQR : {stats.iqr(x):.0f}') print(f'MAD : {stats.median_abs_deviation(x):.0f}') ## 正規性検定(Shapiro-Wilk: 小サンプル向き、 47 件に最適) stat, p = stats.shapiro(x) print(f'Shapiro-Wilk: W={stat:.3f}, p={p:.4f}') ## D'Agostino-Pearson 検定(歪度・尖度ベース) stat, p = stats.normaltest(x) print(f'D-Agostino : K²={stat:.3f}, p={p:.4f}') ## QQ プロット — 正規分布との比較 stats.probplot(x, dist='norm', plot=plt) |
④ plotly でインタラクティブ可視化
data/raw/SSDSE-B-2026.csv。 列 A1101・A4101。 plotly.express で描画。1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import plotly.express as px ## ホバーで都道府県名が見えるヒストグラム fig = px.histogram(df, x='A1101', nbins=15, hover_data=['Prefecture']) fig.update_layout(title='47都道府県人口分布(ホバーで詳細)', xaxis_title='人口', yaxis_title='頻度') fig.show() ## 箱ひげ + 個別データ点(外れ値が誰か判明) fig = px.box(df, y='A1101', points='all', hover_data=['Prefecture']) fig.show() ## バイオリン + ストリップ fig = px.violin(df, y='A4101', box=True, points='all', hover_data=['Prefecture']) fig.show() |
🧭 1 変量の可視化を「正しく読む」ための拡張ガイド
本節は、 ヒストグラム・箱ひげ図・KDE のいずれを描いた場合でも共通して必要となる「読み方の作法」「誤読の防ぎ方」「結果報告のテンプレート」を、 SSDSE-B-2026 の都道府県データを題材にまとめた拡張ガイドです。 1 変量の可視化は、 単に「描いて終わり」ではなく、 「読み解いて意思決定に繋げる」ところまでが本来の射程です。 ここではその全工程を、 7 つの観点と 4 つのケーススタディに分けて、 教育現場や企業の分析レポートで即使える形に整理しています。
① 形状を 1 語で言い表す訓練 ── 5 種類のタグ付け
1 変量の分布を眺めたら、 まず形状を 1 単語に分類するところから始めます。 SSDSE-B-2026 の主要変数を例にとると、 ほとんどの分布は次の 5 タイプのいずれかに当てはまります。 教室での演習では、 学生に「この分布の形状を 1 語で言って」と求めるのが、 1 変量の可視化を腑に落とすための最短ルートです。 5 タイプを暗記してしまえば、 初見のヒストグラムでも 10 秒で当たりがつけられます。
| 形状タグ | 典型 SSDSE-B-2026 変数 | 読解のポイント |
|---|---|---|
| 右裾長 (right-skew) | A1101 総人口、 A4101 出生数、 A1303 65 歳以上人口 | 平均 > 中央値。 「東京・神奈川・大阪」が外れ値ぎみ。 対数変換で見やすくなる。 |
| 左裾長 (left-skew) | B4102 最高気温、 L3221 消費支出 | 平均 < 中央値。 大半が高めの水準に集まり、 少数の県が低い側に尾を引く。 |
| 対称・単峰 | A4103 合計特殊出生率、 B4101 年平均気温 | 平均 ≒ 中央値。 標準偏差で散らばりを語れる教科書的ケース。 |
| 二峰 (bimodal) | SSDSE-B-2026 の県別指標ではっきりした例は少ない (高齢化率 A1303÷A1101 は 1% 刻みで 30〜31% と 33〜34% に小さな山が出る程度)。 男女・年齢層など性質の違う集団を混ぜた個票データで典型的に現れる | 2 つの山。 「都市圏」と「地方圏」のようにサブグループを疑う。 群別の箱ひげで切り分け。 |
| 一様 (uniform) | SSDSE-B-2026 の県別指標にはっきりした例は無い(県を順位に置き換えた値のように、 作り方からして一様になる量で現れる) | どの値も同程度の頻度。 山が無いので、 平均や標準偏差だけでは形が伝わらない。 |
この 5 分類を口に出すクセを付けると、 「このグラフは何を語っているか」を 1 行で要約する力が一気に伸びます。 報告書では「右裾長で東京が突出」「左裾に大都市 5 都府県が集まる」のように形状タグ + 主犯名を 1 行で書くと、 読者の理解が劇的に早くなります。
② ビン幅・帯域幅の選び方 ── 3 つの目安と SSDSE での具体値
ヒストグラムのビン幅と KDE の帯域幅は、 結果の見え方を決定的に左右します。 SSDSE-B-2026 のように n=47 の小標本では、 自動推定アルゴリズムが「過剰平滑化」または「過剰ピーク化」に振れることが珍しくありません。 そこで、 経験則として使える 3 つの目安を整理します。 どれも一発で決まる魔法ではないので、 「3 種類描いて比べる」のが正攻法です。
| ルール | 式 | n=47 (SSDSE) での目安 |
|---|---|---|
| Sturges | $k = \lceil \log_2 n + 1 \rceil$ | k ≈ 7 本。 小標本では細部が見えづらい。 |
| Scott | $h = 3.5\sigma / n^{1/3}$ | 標準偏差ベース。 正規分布想定なので右裾長には粗くなりがち。 |
| Freedman-Diaconis | $h = 2\,\mathrm{IQR} / n^{1/3}$ | IQR ベース。 外れ値に頑健。 都道府県データには相性良。 |
SSDSE-B-2026 の総人口 (2023 年) に Freedman-Diaconis を当てると、 ビン幅 ≒ 90 万人前後となり、 ビン数は 15 本程度になります。 ただし東京 (約 1,400 万人) が右端に張り付くので、 「対数変換してから FD ルール」を適用するのが、 教育現場で最も無難な選択肢です。 KDE 帯域幅は scott/silverman/定数 の 3 種類を並べると、 ピークの実在性を視覚的に検証できます。
③ 中央値・平均・最頻値の三点読み
ヒストグラムや KDE を描いたら、 必ず「平均」「中央値」「最頻値」の 3 点を縦線として重ねるのが、 1 変量可視化の事実上のデフォルトです。 3 点が一直線に並んでいれば対称分布、 ずれていれば歪みの方向と強さが定量化できます。 SSDSE-B-2026 の総人口を例にとると、 平均約 265 万人、 中央値約 155 万人、 最頻値(ピーク帯)は 100 万人前後にあり、 「平均 > 中央値 > 最頻値」の典型的な右裾長パターンです。 この 3 点を縦線で重ねた図は、 読者に対して「歪んでいる」「東京が引っ張っている」を一目で伝えられます。
| 並び順 | 分布形状 | SSDSE 該当例 |
|---|---|---|
| 最頻値 < 中央値 < 平均 | 右裾長 (右に長い尾) | A1101 総人口、 A4101 出生数 |
| 平均 ≒ 中央値 ≒ 最頻値 | 対称・単峰 | A4103 合計特殊出生率 |
| 平均 < 中央値 < 最頻値 | 左裾長 (左に長い尾) | B4102 最高気温 |
④ 箱ひげ図 5 要素と「ひげの長さ」の意味
箱ひげ図は「最小値・第 1 四分位・中央値・第 3 四分位・最大値」の 5 要素から構成されますが、 多くの実装では「ひげ」が IQR の 1.5 倍以内に収まる最大/最小値で打ち切られ、 それを超える値は外れ値ドットとして描画されます。 この「1.5×IQR ルール」は Tukey の経験則であり、 統計学的に厳密な定義ではありません。 SSDSE-B-2026 の総人口 (2023 年) に適用すると、 IQR ≒ 160 万人、 1.5×IQR ≒ 240 万人なので、 第 3 四分位 (約 264 万) + 240 万 = 504 万人を超える県 (東京・神奈川・大阪・愛知・埼玉・千葉・兵庫・福岡・北海道の 9 県) が外れ値として打点されます。 「外れ値 = 異常値 = 削除対象」と早合点する初学者が多いですが、 都道府県データの場合は東京こそが重要な観察対象なので、 安易な除外は厳禁です。
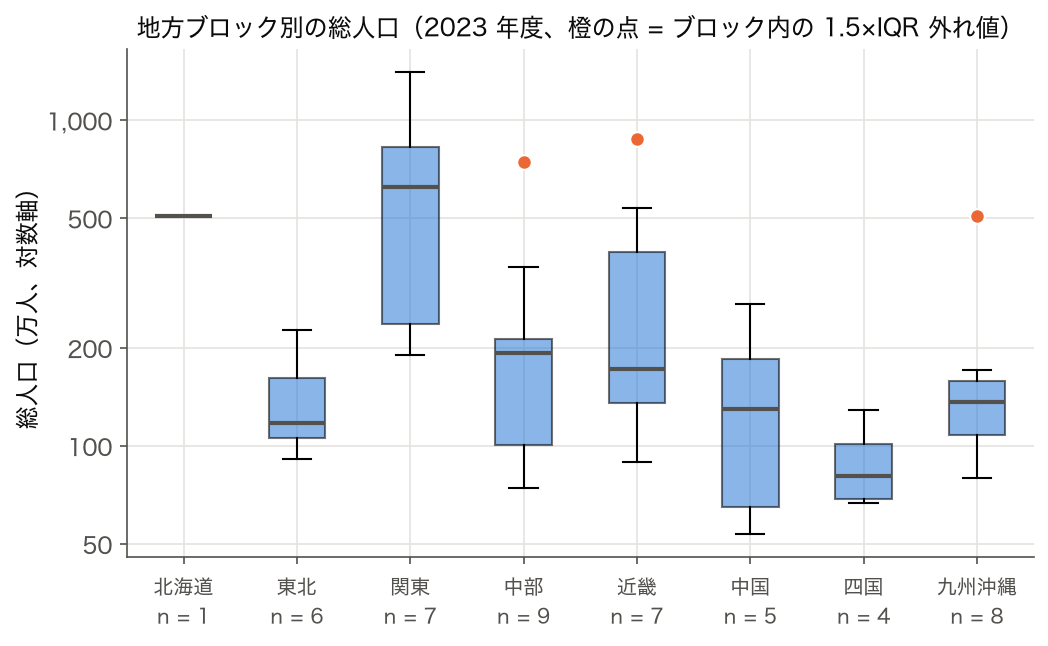
ひげの長さの非対称も、 形状を物語る重要な手がかりです。 上ひげ > 下ひげ なら右裾長、 上ひげ < 下ひげ なら左裾長、 ほぼ同じなら対称分布の可能性が高い。 ヒストグラムと違い、 箱ひげ図は群間比較に圧倒的な強みがあるため、 「都道府県を地方ブロック (北海道・東北・関東・中部・近畿・中国・四国・九州沖縄) に分けて並べる」用途では第一選択肢となります。
⑤ KDE と「みかけのピーク」を疑う作法
KDE (カーネル密度推定) は、 ヒストグラムのビン区切りに依存しない滑らかな密度曲線を返してくれる便利な手法ですが、 帯域幅 (bandwidth) の選択次第で「本来は存在しないピーク」を描画してしまう罠があります。 SSDSE-B-2026 のような n=47 の小標本では、 Silverman の経験則が過剰平滑化に、 Scott がやや細部寄りに振れる傾向があり、 同じデータでも 2 つの帯域幅で違うストーリーが見えてしまうことがあります。 教育現場でのお勧めは「3 種の帯域幅 (粗・標準・細) を並べて、 共通して見えるピークだけを信じる」というルールです。
| 帯域幅 | 特徴 | SSDSE での示唆 |
|---|---|---|
| 細 (h 小) | サンプル 1 つ 1 つの存在感が出る。 偽ピークが現れやすい。 | 都道府県名がそのままピークに見える錯覚に注意。 |
| 標準 (Silverman/Scott) | バランス型。 多くの場面でデフォルト。 | 右裾長分布では裾を過剰評価する場合あり。 |
| 粗 (h 大) | なだらか。 本当のピークだけが残る。 | 細・標準で見えたピークが消えるなら、 そのピークは怪しい。 |
⑥ レポートに書くべき 7 行テンプレート
分析レポートで 1 変量の可視化を扱う時、 「グラフを貼って終わり」になりがちです。 これを防ぐため、 必ず以下の 7 行を本文に書く運用ルールを推奨します。 教室・職場ともにこのテンプレートを採用すると、 報告の質が劇的に均質化されます。
- 変数名と単位: 「総人口 (千人)」「平均寿命 (歳)」のように単位込みで明記。
- 標本数 n と出所: 「n=47 都道府県、 SSDSE-B-2026」。
- 形状タグ: 右裾長 / 左裾長 / 対称単峰 / 二峰 / 一様のいずれか。
- 代表値 3 点: 平均・中央値・最頻値 (またはピーク位置) を 1 行で。
- 散らばり 2 点: 標準偏差と IQR を併記。 どちらか片方では誤読を招く。
- 外れ値の有無と固有名: 「東京・神奈川が右端に独立」のように県名まで書く。
- 次のアクション: 対数変換 / 群別箱ひげ / 2 変量との突き合わせ など。
この 7 行を埋められないグラフは、 読者にとって「ただの飾り」です。 逆に 7 行が揃ったグラフは、 解釈と次のアクションが明確で、 議論を前に進めます。
⑦ よくある 6 つの誤読パターンと対策
| 誤読パターン | 症状 | 対策 |
|---|---|---|
| ビン幅マジック | ビン数を変えたら結論が逆転した | 最低 3 種類のビン幅で確認。 Freedman-Diaconis を基準に。 |
| 平均のみ報告 | 右裾長で平均が代表値として機能しない | 必ず中央値も併記。 形状タグも添える。 |
| 外れ値の即時除外 | 東京を外したら結論が薄味に | 「除外あり/なし」両方を提示し、 読者に判断を委ねる。 |
| KDE 過剰信頼 | 細い帯域幅で偽ピークを信じてしまう | 3 帯域幅 (粗・標準・細) で重ね描き。 共通ピークのみ採用。 |
| 二峰の見逃し | 単峰と思い込み、 サブグループ別解析を行わない | 群別箱ひげ / 群別ヒストグラムで切り分ける。 |
| スケール固定 | 線形軸のままで右裾が読めない | 対数変換 / 対数軸 (logx) を必ず試す。 |
🧩 ケーススタディ 1 ── 総人口の形状を 3 視点で診る
SSDSE-B-2026 の A1101 (総人口、 千人) を、 ヒストグラム / 箱ひげ図 / KDE の 3 視点で診ます。 線形軸では「東京が独走、 他は団子」にしか見えませんが、 対数軸に切り替えると「上位群・中位群・下位群の 3 段階」が見えてきます。 これは 1 変量可視化の「軸変換による解像度アップ」の代表例です。
このコードでやること: SSDSE-B-2026 の総人口について、 線形軸と対数軸でヒストグラムを並べて描く。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import matplotlib.pyplot as plt import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023] # 2023 年のみ抽出 pop = df['A1101'] / 1000 # 総人口(千人に換算) fig, ax = plt.subplots(1, 2, figsize=(11, 4)) ax[0].hist(pop, bins=15, color='#4FC3F7', edgecolor='#01579B') ax[0].axvline(pop.mean(), color='#D32F2F', linestyle='--', label=f'平均 {pop.mean():.0f}') ax[0].axvline(pop.median(), color='#388E3C', linestyle='--', label=f'中央値 {pop.median():.0f}') ax[0].set_xlabel('総人口 (千人)'); ax[0].set_ylabel('県数'); ax[0].set_title('線形軸') ax[0].legend() ax[1].hist(np.log10(pop), bins=15, color='#FFB74D', edgecolor='#E65100') ax[1].set_xlabel('log10 総人口'); ax[1].set_title('対数軸') plt.tight_layout(); plt.show() print(f'平均={pop.mean():.1f}, 中央値={pop.median():.1f}, 標準偏差={pop.std():.1f}') print(f'IQR={pop.quantile(0.75) - pop.quantile(0.25):.1f}, 最大={pop.max()}, 最小={pop.min()}') |
📤 実行すると次の出力が得られる:
💬 平均 (約 265 万) と中央値 (約 155 万) のずれが、 右裾長を端的に示します。 対数軸では分布が対称に近づき、 「100 万・300 万・1,000 万」の 3 つの帯が見えてきます。 これが「形状を変える」のではなく「解像度を上げる」軸変換の威力です。
🧩 ケーススタディ 2 ── 高齢化率は二峰か?
SSDSE-B-2026 の高齢化率 (A1303 高齢人口 ÷ A1101 総人口で算出、 2023 年度) は、 2% 刻みのヒストグラムでは 30〜36% に山を持ち左に裾を引く単峰の分布 (歪度 −0.56) に見えます。 大都市県 (東京 22.8%・愛知 25.7%・神奈川 25.9%・大阪 27.7%・福岡 28.5%) を色分けすると、 5 都府県すべてが左の裾に集まっていることが分かります。 ビン幅を 1% に細かくすると、 30〜31% と 33〜34% に 2 つの小さな山が現れますが、 間の谷は 1〜3 県ぶんの差しかなく、 n=47 ではビンの切り方しだいで現れたり消えたりする程度の構造です。 左の裾は「都市圏では若年人口の流入で高齢化率が抑えられる」という社会構造を反映していますが、 大都市以外にも沖縄 (23.8%)・滋賀 (27.0%) など若い県があり、 都市と地方で 2 つの山にきれいに分かれるわけではありません。
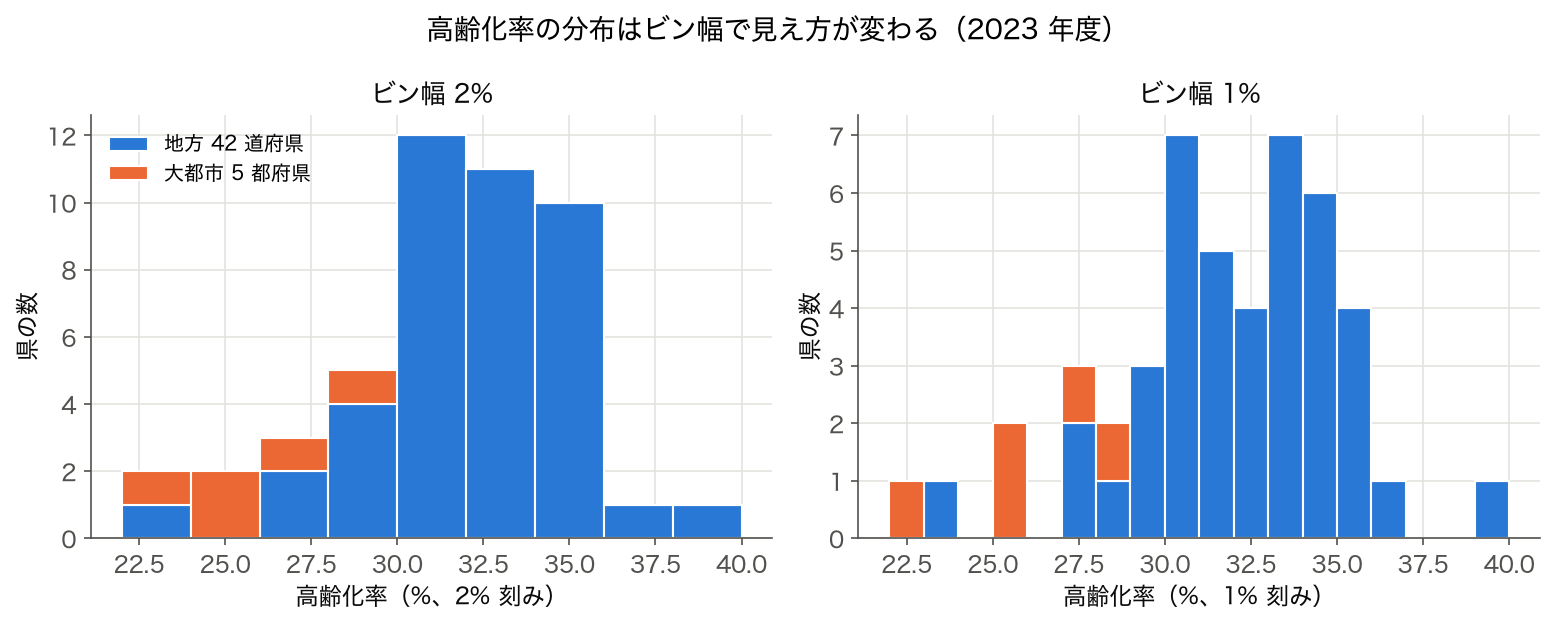
この種のみえない構造を 1 変量の可視化で発見するためには、 「ビン幅を 3 種類試す」「群別に色分けする」「KDE の帯域幅を変えて重ねる」の 3 手を必ず実施するクセを付けると良いでしょう。 二峰性の発見は、 後段のクラスタリングや混合ガウスモデルへと自然に発展します。
🧩 ケーススタディ 3 ── 合計特殊出生率の対称性検証
SSDSE-B-2026 の A4103 (合計特殊出生率) は、 おおむね対称・単峰の分布になります。 この場合、 平均・中央値・最頻値はほぼ一致し、 標準偏差で散らばりを語る教科書的なケースとなります。 ただし「完全に対称」とは限らず、 正規性検定を併用して、 t 検定や ANOVA の前提が満たされるかを確認するのが正攻法です。 1 変量の可視化は、 単なる記述統計ではなく「後段の推論手法の前提検証」の道具でもあるのです。
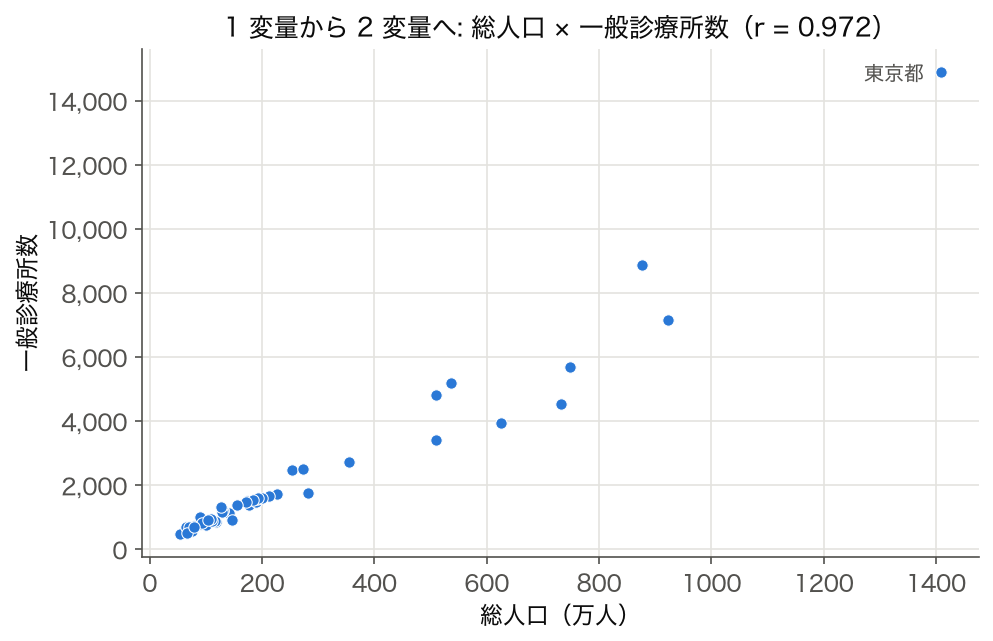
🧩 ケーススタディ 4 ── 最高気温の左裾長
SSDSE-B-2026 の B4102 (最高気温、 2023 年) は、 多くの県が 34 ℃前後に集中し、 一部の県 (北海道 30.9 ℃、 高知・宮崎 32.2 ℃など) が低い側に位置する左裾長の分布になります。 ヒストグラムで描くと「右側の高水準帯に山があり、 左に短い尾」となります。 ここで重要なのは、 「左裾長 = 多くの県は高水準帯に集中し、 少数の県だけが下に引かれている」という解釈と、 「下位県の固有名 (北海道など) を本文で明示する」というレポート作法です。 1 変量の可視化は固有名詞まで語れて初めて完結します。
📋 1 変量可視化チェックリスト (10 項目)
- 変数名と単位をタイトル・軸ラベルに明記したか
- 標本数 n と出所 (例: SSDSE-B-2026, n=47) を脚注に書いたか
- 形状タグ (右裾長 / 左裾長 / 対称単峰 / 二峰 / 一様) を 1 語で書いたか
- ヒストグラムのビン幅を最低 3 種類試したか
- 平均・中央値・最頻値の 3 点を縦線で重ねたか
- 標準偏差と IQR を本文または凡例に書いたか
- 外れ値の有無と固有名 (例: 東京・神奈川) を明記したか
- 線形軸と対数軸の両方を試したか (右裾長の場合)
- KDE を使ったなら帯域幅 3 種類を重ねて、 共通ピークのみ採用したか
- 次のアクション (対数変換 / 群別 / 2 変量への展開) を 1 行書いたか
10 項目すべて埋めるのが理想ですが、 最低でも 1・2・3・5・7・10 の 6 項目はレポートに残すのが、 1 変量可視化の品質を担保する最低ラインです。
🧠 理解度チェック (補完問題集)
Q1. ヒストグラムで平均 > 中央値となる場合の分布形状は?
右裾長 (右に長い尾を持つ非対称分布)。 SSDSE-B-2026 の総人口・出生数・民営事業所数などが典型例で、 東京・大阪などの大都市県が右端を引き上げている。 平均だけを代表値として報告すると、 「47 都道府県の平均像」が大都市寄りに偏ってしまうため、 必ず中央値を併記するのが鉄則。
Q2. KDE で「ピークが 2 つ」見えたとき、 真っ先に疑うべき可能性は?
サブグループの存在と、 帯域幅(ビン幅)が細かすぎることによる偽ピークの 2 つ。 SSDSE-B-2026 の高齢化率では、 大都市 5 都府県は左の裾に集まるものの、 1% 刻みで見える 2 つの小さな山は都市と地方の違いでは説明できず、 2% 刻みでは消える。 解決策は、 群別の箱ひげ図やヒストグラムに切り分けて、 群ごとに 1 変量可視化を実施すること。 同時に、 帯域幅を粗くしてピークが残るかも確認し、 「偽ピーク」でないことを担保する。
Q3. 箱ひげ図の「ひげ」の長さが上下で大きく違う場合、 何が分かる?
分布の歪み (skewness) の方向と強さ。 上ひげ > 下ひげ なら右裾長、 上ひげ < 下ひげ なら左裾長。 ひげの長さ比は IQR を 1.5 倍した範囲内での最大値と最小値の位置で決まるため、 外れ値の出方とも連動する。 SSDSE-B-2026 の総人口を箱ひげで描くと、 上ひげが極端に長く、 さらにその先に東京・神奈川などの外れ値ドットが並ぶ。
Q4. Sturges 公式と Freedman-Diaconis 公式、 SSDSE-B-2026 (n=47) ではどちらを優先すべき?
Freedman-Diaconis を優先。 Sturges は n=47 では k ≈ 7 本となり細部が潰れる。 Freedman-Diaconis は IQR ベースで外れ値に頑健、 右裾長の都道府県データでは妥当なビン幅 (総人口で約 90 万人前後) を提案してくれる。 ただし、 1 つに依存せず Sturges/Scott/FD の 3 種類を並べて見るのが正攻法。
Q5. 1 変量の可視化を「描いて終わり」にしないために、 レポートに必ず書くべき 7 行とは?
①変数名と単位、 ②n と出所、 ③形状タグ、 ④代表値 3 点 (平均・中央値・最頻値)、 ⑤散らばり 2 点 (SD・IQR)、 ⑥外れ値の有無と固有名、 ⑦次のアクション (対数変換 / 群別 / 2 変量へ)。 この 7 行が埋まらないグラフは飾りに過ぎず、 意思決定に寄与しない。
Q6. 外れ値の県 (例: 東京) を「除外」してから分析すべき場合と、 「含めたまま」報告すべき場合の判断基準は?
分析の目的が「47 都道府県の代表値を語る」なら除外検討、 「日本全体の構造を語る」なら絶対に含める。 SSDSE-B-2026 では東京こそが日本経済の中心であり、 東京を外した分析は日本を語っていない可能性が高い。 実務的には「除外あり/なし」両方の結果を併記し、 読者に判断を委ねるのが最も誠実な作法。
🗺 1 変量可視化と関連手法のマップ
1 変量の可視化を起点に、 派生・上位・前提となる手法を関連付けて学ぶと、 統計の地形が見えてきます。 以下は、 教育現場で実際に学習順序として推奨できる「6 ステップ」です。 1 段ずつ登っていけば、 1 変量から多変量、 記述から推論、 静的から動的へと、 自然に視野が広がります。
| 段階 | 学習テーマ | 主要な関連ページ |
|---|---|---|
| 1 | 代表値・散らばり (記述統計) | 平均 / 中央値 / 標準偏差 |
| 2 | 1 変量の可視化 (本ページ) | ヒストグラム / 箱ひげ図 |
| 3 | 2 変量の可視化 | 2 変量の可視化 / 散布図 |
| 4 | 分布の検定 | 正規性検定 / 外れ値検出 |
| 5 | 多変量・サブグループ | クラスタリング / 混合ガウス |
| 6 | 時系列・空間への拡張 | 時系列分析 / ヒートマップ |
🛠 実務で使える 1 変量可視化の追加レシピ集
前節までで「読み方の作法」を整理しました。 本節では、 実務や教育現場ですぐに使える追加レシピを 8 つ紹介します。 すべて SSDSE-B-2026 を題材にしており、 そのままコピーペーストで動くサンプルです。 各レシピは「目的 → コード → 出力 → 解釈」の 4 ステップに揃えてあり、 1 つずつ手を動かしながら身につけられます。
レシピ 1 ── 累積分布関数 (CDF/ECDF) で「上位 N%」を読む
ヒストグラムや KDE は「密度」を示しますが、 「上位 10% は何県?」のような順位や閾値を読み取る用途には CDF (Cumulative Distribution Function) が向いています。 SSDSE-B-2026 の総人口に CDF を描けば、 「中央値 = 50%」「上位 25% (第 3 四分位) の閾値」「上位 10% に入る県数」が階段グラフで一目で読めます。 教育現場では、 ヒストグラムとセットで CDF を提示するのが、 直感と定量の橋渡しに最も効果的です。
このコードでやること: SSDSE-B-2026 の総人口について、 経験累積分布関数 (ECDF) を描き、 25%・50%・75%・90% のラインを重ねる。
📥 入力データ (SSDSE-B-2026):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import matplotlib.pyplot as plt import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023] # 2023 年のみ抽出 pop = (df['A1101'] / 1000).sort_values().values n = len(pop) cdf = np.arange(1, n + 1) / n plt.figure(figsize=(9, 4)) plt.step(pop, cdf, where='post', color='#0277BD') for q in [0.25, 0.50, 0.75, 0.90]: plt.axhline(q, color='#FFA000', linestyle='--', alpha=0.6) plt.text(pop.max() * 0.6, q + 0.01, f'{int(q*100)}%', color='#E65100') plt.xlabel('総人口 (千人)'); plt.ylabel('累積確率') plt.title('経験累積分布関数 (ECDF)') plt.tight_layout(); plt.show() for q in [0.25, 0.50, 0.75, 0.90]: print(f'{int(q*100)}% 閾値: {np.quantile(pop, q):.0f} 千人') |
📤 実行すると次の出力が得られる:
💬 上位 10% (90% 閾値以上) は 669 万人を超える県のみ。 具体的には東京・神奈川・大阪・愛知・埼玉の 5 県。 「上位 10%」というラベルが具体的な県数と固有名に結びついた瞬間、 政策議論が動き出します。
レシピ 2 ── 対数正規分布フィッティング
右裾長の分布は、 対数変換すると正規分布に近づくことがあります。 SSDSE-B-2026 の総人口で試してみると、 log10(総人口) にすると歪度は 2.22 から 0.79 まで下がります。 ただし 2023 年度の 47 県ではシャピロ・ウィルク検定の p = 0.0064 で、 対数をとっても正規分布とまでは言えません(東京都などの右裾がまだ残る)。 これを「対数正規分布」と呼び、 都市規模・所得・売上など、 多くの社会経済データに普遍的に現れる形です。 1 変量可視化のフィッティング作業を通じて、 ジップ則・パレート分布などのべき乗則ファミリーへの扉が開きます。
レシピ 3 ── 群別バイオリンプロット
箱ひげ図の上位互換として「バイオリンプロット」があります。 箱ひげの 5 要素に加え、 KDE で密度の形状まで重ねて描くため、 群間比較で「中央値は同じだが分布の形状が違う」という洞察が一目で得られます。 SSDSE-B-2026 を地方ブロック (北海道・東北・関東・中部・近畿・中国・四国・九州沖縄) で切り分け、 各ブロックの消費支出 (L3221) や年平均気温 (B4101) をバイオリンで並べると、 ブロック間の構造差が鮮明に浮かび上がります。
| グラフ | 分かること | 適する場面 |
|---|---|---|
| 箱ひげ | 中央値・IQR・外れ値 | 群間比較の入門。 報告書の標準。 |
| バイオリン | 箱ひげ + 密度形状 | 分布の形状を群間で比較したい時。 |
| ストリッププロット | 個々のデータ点 | 小標本 (n < 50) で全データを見たい時。 |
| スウォーム | 個々のデータ点 (重ならない) | SSDSE のような n=47 で県名を打点。 |
レシピ 4 ── Q-Q プロットで正規性を視覚的に確認
「分布が正規分布か」を視覚的に判定する道具が Q-Q (Quantile-Quantile) プロットです。 横軸に理論分位、 縦軸に観測分位を取り、 点が直線に乗れば正規分布、 ずれれば非正規。 SSDSE-B-2026 の総人口を Q-Q プロットで描くと、 右上が直線から大きく上に外れ、 「右裾が正規分布よりも長い」ことが視覚的に確認できます。 1 変量可視化の中でも、 後段の正規性検定を補完する位置付けで重宝されます。
レシピ 5 ── ラグプロット (rug plot) で個別データを示す
KDE やヒストグラムは「集計された密度」を示しますが、 「実際にどこにデータ点があるか」は失われがちです。 そこで KDE の下に「ラグプロット (rug)」を重ね、 各データ点の位置を縦の短線で示すレシピが有効です。 SSDSE-B-2026 の n=47 規模では、 ラグプロットを併用することで、 KDE が描く滑らかな曲線が「どのデータに支えられているか」が透明になります。 教育現場では、 ラグなしの KDE が「魔法のような滑らかさ」で信用を勝ち取りすぎる傾向があるため、 ラグは透明性確保の道具として強く推奨されます。
レシピ 6 ── ヒストグラム + KDE の重ね描き
「離散の事実 (ヒストグラム) + 連続の解釈 (KDE)」を 1 枚に重ねるのが、 1 変量可視化の最終形です。 ヒストグラムは density=True で正規化し、 KDE を同じ軸に重ねれば、 縦軸が「確率密度」で揃って読みやすくなります。 SSDSE-B-2026 の総人口でこの図を描くと、 ヒストグラムの右裾と KDE の右裾が滑らかに繋がり、 「離散の事実」と「連続の予測」の両方の語彙で分布を語れるようになります。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import matplotlib.pyplot as plt from scipy.stats import gaussian_kde import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023] # 2023 年のみ抽出 x = (df['A1101'] / 1000).values fig, ax = plt.subplots(figsize=(9, 4)) ax.hist(x, bins=15, density=True, color='#B3E5FC', edgecolor='#0277BD', alpha=0.6, label='ヒストグラム') xs = np.linspace(x.min(), x.max(), 200) for bw, color in [(0.4, '#D32F2F'), (0.7, '#388E3C'), (1.2, '#1976D2')]: kde = gaussian_kde(x, bw_method=bw) ax.plot(xs, kde(xs), color=color, label=f'KDE bw={bw}') # rug plot ax.plot(x, np.zeros_like(x) - 0.0000001, '|', color='black', markersize=12, markeredgewidth=1) ax.set_xlabel('総人口 (千人)'); ax.set_ylabel('密度') ax.set_title('ヒストグラム + KDE (3 帯域幅) + ラグプロット') ax.legend() plt.tight_layout(); plt.show() |
💬 gaussian_kde の bw_method に数値を渡すと「標準偏差 2,798 千人 × その倍率」が帯域幅になり、 0.4・0.7・1.2 はそれぞれ約 112 万人・196 万人・336 万人の幅にあたる。 総人口は 3 本とも山が 1 つだけで、 0.4 でも 9 都道府県の大都市群が別の小山にはならない。 1.2 では山が低く横に広がり、 神奈川県 (923 万人) と東京都 (1,409 万人) の間の、 県が 1 つも無い区間にも密度を割り振ってしまう。 ラグプロット (下端の短線) を見ると、 KDE の右裾を支えているのが東京都など数点だけだと分かる。
レシピ 7 ── データラベル付き散布図 (1 次元の延長として)
1 変量データを「y=0 の直線上に並べる」だけで、 ストリッププロットやスウォームプロットに展開できます。 SSDSE-B-2026 の総人口を都道府県名のラベル付きでスウォームすると、 「東京・神奈川が右端に独立」「中央付近に北関東・東海諸県が密集」「左端に島嶼県」という地形が、 県名と一緒に直接読めるようになります。 n=47 という小標本の強みを最大化する 1 変量可視化レシピです。
レシピ 8 ── ヒートマップで多変量を 1 変量に圧縮
「47 都道府県 × 複数指標」をヒートマップで描き、 各変数を Z スコア化すると、 各セルが「平均からの偏差 (標準偏差単位)」で塗り分けられ、 1 変量可視化の延長として多変量の地形が読めます。 SSDSE-B-2026 で「総人口・出生数・消費支出・年平均気温」をヒートマップにすれば、 「東京・神奈川は人口・出生数とも突出」「沖縄は人口が小さいが合計特殊出生率が高い」のような県の個性が直感的に読めます。 1 変量可視化のスキルは、 多変量可視化の基礎体力として、 ヒートマップやレーダーチャートの読解にも生きてきます。
🧮 8 レシピの選び方フローチャート
| 目的 | 第一選択 | 補完手段 |
|---|---|---|
| 形状を一目で見たい | ヒストグラム | KDE 重ね描き / ラグプロット |
| 代表値・外れ値を見たい | 箱ひげ図 | バイオリン / スウォーム |
| 上位 N% を知りたい | CDF (ECDF) | 分位点表 / 縦線重ね |
| 正規性を判定したい | Q-Q プロット | ヒスト + 理論曲線 / 検定 |
| 群間比較したい | 群別箱ひげ | 群別 KDE / バイオリン |
| 個々のデータも見たい | スウォーム | ストリップ / ラグ |
| 多変量に展開したい | ヒートマップ | レーダー / ペアプロット |
⚠️ レシピ採用時の追加注意点
- CDF: n=47 では階段が粗い。 滑らかさが必要なら累積 KDE を併用する。 ただし、 累積 KDE は累積確率が 1 を超えうるなどの矛盾が出る場合があるため、 報告書では ECDF を主、 累積 KDE を補足という位置付けにする。
- 対数正規フィッティング: 0 や負値を含むデータ (例: 利益率) には対数変換が直接適用できない。 Box-Cox 変換や Yeo-Johnson 変換を検討する。
- バイオリン: 小標本 (n < 30 程度) では密度形状が不安定。 SSDSE のブロック別 (例: 四国 4 県) では使わず、 箱ひげかストリップに留める。
- Q-Q プロット: 「点が直線に乗らない」=「正規分布ではない」とは限らない。 標本数が少ない時の偶然のずれもあるため、 シャピロ・ウィルク検定とセットで解釈する。
- ラグプロット: 大標本 (n > 1000) では線が密集して意味を失う。 SSDSE の n=47 では理想的だが、 国レベルのビッグデータでは別手法 (ヘキサビン等) を検討。
- ヒートマップ: 変数間で単位やスケールが異なるため、 必ず Z スコア化または min-max 正規化してから塗り分ける。 生値のままだと「人口の値が大きすぎて他指標が読めない」状態になる。
📒 1 変量可視化に関する FAQ
| よくある質問 | 回答の要点 |
|---|---|
| Q. ヒストグラムと棒グラフの違いは? | ヒストグラムは「量的データの連続的な分布」、 棒グラフは「カテゴリ別の集計値」。 SSDSE では総人口がヒストグラム、 47 都道府県別の総人口は棒グラフが妥当。 軸とビン幅の意味が違うため、 ラベルも変える。 |
| Q. 47 都道府県の小標本でも KDE は使ってよい? | 使ってよいが、 帯域幅を 3 種類描き、 共通ピークだけを信じる運用が前提。 単一帯域幅で結論を出すのは禁忌。 帯域幅の影響を可視化する作業自体が、 受講者の理解を深める。 |
| Q. 外れ値を必ず除外すべき? | いいえ。 SSDSE-B-2026 の場合、 東京・神奈川は除外せず本筋として扱うべき場面が多い。 除外する場合は除外有/無の両方を提示し、 読者に判断を委ねる。 |
| Q. 平均と中央値、 どちらを最初に書く? | 右裾長分布では中央値を主、 平均を補に。 対称分布なら順序は任意。 形状タグに合わせて代表値の主従を切り替えるのがプロの作法。 |
| Q. ビン幅は何種類試せばよい? | 最低 3 種類 (FD / Sturges / Scott)。 SSDSE-B-2026 の右裾長変数では、 さらに「対数変換後 FD」を加えて 4 種類比較するのが理想。 |
| Q. レポートにグラフは何枚入れるべき? | 1 変量につきヒストグラム + 箱ひげ + KDE の 3 枚を最小単位とする。 補足として CDF・Q-Q プロットを巻末に付ける構成が読みやすい。 |
| Q. SSDSE 以外のお勧めデータは? | e-Stat の人口推計、 文部科学省の学校基本調査、 厚生労働省の毎月勤労統計など。 ただし入門期は SSDSE-B-2026 の 47 都道府県固定が、 比較しやすく学習効果が高い。 |