🔖 キーワード索引
このページで扱うキーワード(クリックで該当節へジャンプ):
💡 30 秒で分かる結論
🍰 まずはやさしく
なめらかな線で表すグラフです。
データの集まり具合を調べるために使います。
テストの点数の分布を見る時に便利です。
この手法の特徴と注意点を学びます。
- KDE はヒストグラムのなめらか版。階段状の棒ではなく、連続曲線で密度を描く
- 各データ点 $x_i$ の周りにカーネル(小さな山)を置いて、47 個の山を足し合わせれば 47 県の人口分布が浮かぶ
- 結果のカーブはヒストグラムと違って 「ビンの切り方」に依存しない。代わりに バンド幅 $h$ がすべてを決める
- $h$ が小さすぎると細かいノイズだらけ、大きすぎると山がつぶれて構造を見失う
- 標準は Silverman の経験則 $h = 1.06 \hat{\sigma} n^{-1/5}$、または交差検証で選ぶ
- Python では
scipy.stats.gaussian_kdeまたはseaborn.kdeplotがワンライナー
📍 あなたが今見ているもの
🍰 まずはやさしく
データの形を描いた曲線です。
分布の様子を正しく読み取るために使います。
スマホの利用時間の偏りを調べる時に使えます。
この曲線がどう作られるのかを解説します。
論文の図や報告書で、こんな曲線を見たはずです:
なめらかな密度曲線を当てると 200 万人付近にピークがあり、5,000 万人方向に薄い裾が伸びる」
この「なめらかな曲線」が カーネル密度推定(KDE) の出力です。ヒストグラムは「ビン幅・端点」で見た目が変わる一方、KDE は各点に小さな山を重ねることで「ビンの恣意性」を回避し、分布の形を 1 本の連続曲線で表します。観察データの分布形(単峰/双峰、歪み、外れ値)を読み取る基本ツールです。
🎨 直感で掴む — 47 個の小さな山を足す
🍰 まずはやさしく
小さな山をたくさん重ねるイメージです。
データの密度を視覚的に出すために使います。
部活のメンバーの身長分布で考えます。
山を足して曲線を作る仕組みを説明します。
47 都道府県の 総人口 $x_1, x_2, \dots, x_{47}$ が手元にあるとします。各 $x_i$ の場所に、幅 $h$ の小さな鐘形の山(カーネル)を置きましょう。
カーネルの形は「正規分布(ガウス)」が一番よく使われます。すると:
- 東京(約 1,409 万人)の場所に小さな山が 1 つ立つ
- 鳥取(約 55 万人)の場所にも別の山が立つ
- ……これを 47 県すべて やる
- 最後に すべての山を足し合わせる → KDE 曲線の完成
点が密集する場所では山が重なって高くなり、まばらな場所では低い丘になります。つまり「データ点が密な場所ほど曲線が高い」 = 密度推定そのもの。
ヒストグラムとの違い
| 項目 | ヒストグラム | KDE |
|---|---|---|
| 形状 | 階段状の棒 | 連続したなめらかな曲線 |
| 調整パラメータ | ビン幅・ビン端点 | バンド幅 $h$・カーネル種類 |
| 端点依存性 | あり(同じ幅でも端点を 1 万人ずらすと形が変わる) | なし |
| 外れ値の表現 | その箱が「孤立した棒」になる | その点の周りに小さなコブ |
| 双峰分布の検出 | ビン幅次第で見落としやすい | $h$ が適切なら検出しやすい |
| 境界(0 以上の量など) | 自然に止まる | 負の領域にしみ出す(境界補正が必要) |
🎨 カーネル関数の選択肢
代表的カーネル関数:
| カーネル | 式 | 特徴 | 効率比 |
|---|---|---|---|
| Gaussian | $\frac{1}{\sqrt{2\pi}}e^{-u^2/2}$ | 滑らか・最もポピュラー | 0.951 |
| Epanechnikov | $\frac{3}{4}(1-u^2)_+$ | MISE 最適 | 1.000 |
| Uniform (矩形) | $\frac{1}{2}\mathbb{1}_{|u|\le1}$ | 階段状 | 0.929 |
| Triangular | $(1-|u|)_+$ | 計算軽い | 0.986 |
| Biweight | $\frac{15}{16}(1-u^2)^2_+$ | Epanechnikov より滑らか | 0.994 |
| Cosine | $\frac{\pi}{4}\cos(\pi u/2)$ | 理論的興味 | 0.999 |
カーネル選択は本質的にあまり重要ではなく、 バンド幅 $h$ の選択が決定的。 Gaussian カーネルは scipy/sklearn のデフォルトで、 微分可能性が必要な場合に推奨。
📐 数式 — カーネル密度推定の定義
🍰 まずはやさしく
計算で曲線を出すためのルールです。
正確な分布の形を求めるために使います。
買い物で使う金額のばらつきを計算します。
計算に使う数式と設定について学びます。
$n$ 個の観測値 $x_1, x_2, \dots, x_n$ に対して、点 $x$ における密度推定値は:
カーネル $K$ は通常、次を満たします:
- $K(u) \ge 0$(非負)
- $\int K(u)\,du = 1$(全積分が 1:密度なので)
- $K(-u) = K(u)$(対称)
代表的なカーネル関数
バンド幅 $h$ の選び方(Silverman の経験則)
歪んだ分布や外れ値に頑健な改良版:
🔬 数式を言葉で読み解く
- $x$
- 密度を知りたい「評価点」。たとえば「人口 200 万人付近で密度はいくつ?」と聞きたいなら、その値を代入する。
- $x_i$
- $i$ 番目の観測値(例:東京の人口 14,047,594、鳥取の 553,407、…)。47 県ぶんある。
- $x - x_i$
- 「評価点」と「$i$ 番目の観測点」の距離。近いほど大きな寄与をする仕組みのもと。
- $\dfrac{x - x_i}{h}$
- 距離を バンド幅 $h$ で割って、無次元の「カーネル単位」に変換。$h$ が大きいほど「遠くの点も近くに見える」。
- $K(\cdot)$
- カーネル関数。中心で最大、両端でほぼ 0 の「山」。$x$ が $x_i$ に近いほど大きな値を返す。
- $\displaystyle\sum_{i=1}^{n}$
- すべての観測点ぶんの「山の高さ」を $x$ の地点で足し合わせる。データ点が密集する $x$ では大きな和になる。
- $\dfrac{1}{nh}$
- 規格化定数。これで $\int \hat{f}(x)\,dx = 1$ となり、本物の確率密度関数になる。
つまり KDE は「データ点ごとに小さな確率の山を置き、それらを足して大きな密度関数を作る」 という、極めて直感的な操作です。
🎮 触って理解する — カーネルを重ねて密度をつくる
KDE は「各データ点に置いた小さな山(カーネル)を足し合わせる」だけの操作です。下のキャンバスで実際に体感しましょう。薄い青の曲線が 1 点ごとのカーネル、濃い赤の曲線がそれらの合計=密度推定 $\hat{f}_h(x)$ です。キャンバスの空いた場所をクリック/タップすると点を追加できます。
試してほしいこと: ① h を小さくすると曲線がギザギザになり(各カーネルの山がそのまま見える=過適合/分散大)、 ② h を大きくすると 1 つの釣鐘に潰れて構造が消えます(過平滑/バイアス大)。 ③ 「推奨 h(Silverman)」を押すと $h=0.9\,\min(\hat{\sigma},\mathrm{IQR}/1.34)\,n^{-1/5}$(頑健版)で計算した目安のバンド幅にジャンプします。 ④ カーネルをガウス/矩形/三角で切り替えても、密度曲線の大枠はほとんど変わりません——「カーネルの種類より h の選択が決定的」を体感できます。
このおもちゃが示す 4 つの原理:(1) 密度=カーネルの重ね合わせ(薄い山の総和が濃い曲線)、 (2) h がバイアス・分散を支配(交差検証や Silverman則で選ぶ)、 (3) ビン端点に依存しない(ヒストグラムとの最大の違い)、 (4) 同じ「カーネル」の発想は次元削減の カーネル PCA や カーネル回帰 にも通じます。左端 0 付近では山が負側にしみ出す 境界バイアスも観察できます。
🧮 実データで計算してみる — SSDSE-B 都道府県人口
SSDSE-B-2026 の A1101(総人口)を 47 都道府県ぶん読み込み、人口分布の KDE を求めます。
ステップ 1:データの基本統計
| 統計量 | 値 |
|---|---|
| サンプル数 $n$ | 47(都道府県) |
| 最小値(鳥取) | 約 54 万人(537,000 人) |
| 中央値 | 約 155 万人(1,549,000 人) |
| 最大値(東京) | 約 1,409 万人(14,086,000 人) |
| 平均 | 約 265 万人(2,645,809 人) |
| 標準偏差 $\hat{\sigma}$ | 約 280 万人(2,797,551 人) |
| IQR | 約 160 万人(1,602,500 人) |
ステップ 2:Silverman のルールでバンド幅 $h$ を決める
$= 0.9 \times \min(280, 160.25/1.34) \times 47^{-1/5}$
$= 0.9 \times \min(280, 119.6) \times 0.463$
$\approx 0.9 \times 119.6 \times 0.463 \approx \mathbf{49.8}$ 万人(下の「落とし穴を深掘り」の頑健版 498,329 人と一致)
ステップ 3:評価点 $x=200$ 万人での密度を計算
$K_{\text{鳥取}}((200-54)/50) = K(2.92) \approx 0.0056$(遠いのでほぼ 0)
$K_{\text{京都}}((200-254)/50) = K(-1.08) \approx 0.223$(近いので大きい)
$K_{\text{東京}}((200-1409)/50) = K(-24.2) \approx 0$(遠すぎて 0)
$\hat{f}(200) \approx \dfrac{1}{3 \times 50}(0.0056 + 0.223 + 0) \approx \mathbf{0.00152}$
本物の 47 県データでこれを行えば、東京・大阪・神奈川のような大人口県はピーク右側に薄い裾を作り、地方県の密集が左側に高いピーク(約 100〜200 万人付近)を作ります。
🧮 KDE の MISE と最適バンド幅の導出
KDE の漸近的平均積分二乗誤差 (AMISE) は次のように分解できます:
$$\mathrm{AMISE}(h) = \frac{R(K)}{nh} + \frac{1}{4} h^4 \sigma_K^4 R(f'')$$
第一項は分散(バンド幅が小さいほど大)、 第二項はバイアス(バンド幅が大きいほど大)。 微分して $0$ を解くと、 最適バンド幅は
$$h^\star = \left( \frac{R(K)}{n \sigma_K^4 R(f'')} \right)^{1/5}$$
この $h^\star$ は $n^{-1/5}$ のオーダーで縮みます。 $R(f'')$ は真の密度の二階微分の二乗積分で、 これを推定するのが Sheather-Jones の plug-in 法の核心。 SSDSE-B-2026 ($n=47$) では $h^\star \propto 47^{-0.2} = 0.46$ のオーダー、 SD の半分弱がベースライン値です。
多変量への拡張
$d$ 次元 KDE では $\mathrm{AMISE} = O(n^{-4/(d+4)})$ に劣化。 $d=10$ では $n=10^7$ が必要というのが「次元の呪い」の正体です。
🧮 数式に値を入れて手で計算する: ガウシアン KDE 評価
合成 3 点データで x=4 の KDE 密度を計算する。
Step 1: データとカーネル
Step 2: x=4 での密度
🐍 Python で再現
1 2 3 4 5 | import numpy as np from scipy.stats import gaussian_kde data = np.array([2, 4, 6]) kde = gaussian_kde(data, bw_method=1.0/np.std(data, ddof=1)) print(f"f(4) = {kde(4)[0]:.3f}") |
📤 実行結果
💬 手計算 (Step 2) 0.169 と Python 出力が完全一致。
🐍 Python 実装 — SSDSE-B の人口 KDE
1. scipy.stats.gaussian_kde(最も基本)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | # SSDSE-B 都道府県人口の KDE import pandas as pd import numpy as np import matplotlib.pyplot as plt from scipy.stats import gaussian_kde # 1) データ読込(英字コードの列名)→ 2023 年度の 47 都道府県に絞る df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) pop = df['A1101'].values # 総人口(47 県) # 2) KDE オブジェクトを作る(バンド幅自動) kde = gaussian_kde(pop) # Scott のルール(デフォルト) kde_silver = gaussian_kde(pop, bw_method='silverman') # 3) 評価点を作って密度を計算 xs = np.linspace(pop.min(), pop.max(), 500) ys = kde(xs) ys_silver = kde_silver(xs) print('n =', len(pop)) print(f'バンド幅 h: Scott = {kde.factor * pop.std(ddof=1):,.0f} 人, ' f'Silverman = {kde_silver.factor * pop.std(ddof=1):,.0f} 人') print(f'密度のピーク位置: {xs[ys.argmax()]:,.0f} 人') # 4) ヒストグラムと重ねて可視化 fig, ax = plt.subplots(figsize=(9, 5)) ax.hist(pop, bins=15, density=True, alpha=0.4, color='steelblue', label='Histogram') ax.plot(xs, ys, color='crimson', lw=2, label='KDE (Scott)') ax.plot(xs, ys_silver, color='darkgreen', lw=2, linestyle='--', label='KDE (Silverman)') ax.set_xlabel('Population'); ax.set_ylabel('Density') ax.legend(); plt.tight_layout(); plt.show() |
2. seaborn — もっと手軽に
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import seaborn as sns import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の 47 都道府県 # ヒストグラム + KDE を一気に(縦軸は県の数。KDE も件数に合わせて描かれる) sns.histplot(df['A1101'], kde=True, bins=15) plt.show() # KDE 単独・バンド幅指定(縦軸は密度なので、件数の図とは別の図に描く) plt.figure() sns.kdeplot(df['A1101'], bw_adjust=0.5, label='bw_adjust=0.5') # 半分にして細かく sns.kdeplot(df['A1101'], bw_adjust=2.0, label='bw_adjust=2.0') # 2倍にして滑らかに plt.legend(); plt.show() |
3. バンド幅の比較プロット
1 2 3 4 5 6 7 8 | # h を変えると何が起きるか可視化 import matplotlib.pyplot as plt fig, axes = plt.subplots(1, 4, figsize=(16, 4), sharey=True) for ax, bw in zip(axes, [0.1, 0.3, 1.0, 3.0]): kde = gaussian_kde(pop, bw_method=bw) ax.plot(xs, kde(xs)) ax.set_title(f'bw_method={bw}') plt.show() |
4. 2 次元 KDE — 人口 × 高齢化率の同時分布
1 2 3 4 5 | # 2 変数の同時密度(等高線) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # 65 歳以上人口 ÷ 総人口 (%) sns.kdeplot(data=df, x='A1101', y='高齢化率', fill=True, cmap='mako') plt.xlabel('Population'); plt.ylabel('Elderly ratio (%)') plt.show() |
5. バンド幅をデータに選ばせる — 一個抜き尤度クロスバリデーション
1. の Scott(129.5 万人)と、下の「落とし穴を深掘り」の頑健版 Silverman(49.8 万人)は 2.6 倍も違いました。どちらも「データが正規分布ならこれが最適」という公式なので、歪んだ人口ではどちらを信じてよいか決め手がありません。そこで、公式ではなくデータそのものに h を選ばせる方法を試します。一個抜き尤度クロスバリデーションは、1 県を抜いた残り 46 県で KDE を作り、抜いた県の位置の密度 $\hat f_{-i}(x_i)$ を測る、を 47 県すべてで繰り返し、$\sum_i \log \hat f_{-i}(x_i)$ が最大になる h を選びます。「見ていない県をどれだけ当てられるか」で h を採点するわけです。
🎯 このコードでやること:2023 年度 47 都道府県の総人口(万人)で、h を 10〜300 万人の範囲で動かして一個抜き対数尤度を計算し、最良の h を出す。どの県が採点を左右しているかを見るため、h ごとに東京都 1 県ぶんの対数尤度も出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import numpy as np import pandas as pd from scipy.stats import norm df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) x = d['A1101'].values / 1e4 # 万人 def loo_each(x, h): """各県を抜いた残りで作った KDE の、抜いた県の位置での密度""" K = norm.pdf((x[:, None] - x[None, :]) / h) np.fill_diagonal(K, 0) # 自分自身は数えない return K.sum(axis=1) / ((len(x) - 1) * h) grid = np.arange(10, 300.5, 0.5) with np.errstate(divide='ignore'): score = [np.log(loo_each(x, h)).sum() for h in grid] print(f'最良の h = {grid[np.argmax(score)]:.1f} 万人') tokyo = d.index[d['Prefecture'] == '東京都'][0] for h in [30, 49.8, 114.5, 129.5]: f = np.log(loo_each(x, h)) print(f'h={h:>6} 合計 {f.sum():8.1f} うち東京都 {f[tokyo]:7.1f} 残り 46 県 {f.sum() - f[tokyo]:7.1f}') x46 = np.delete(x, tokyo) # 東京都を除いて選び直す with np.errstate(divide='ignore'): s46 = [np.log(loo_each(x46, h)).sum() for h in grid] print(f'東京都を除いた 46 県での最良の h = {grid[np.argmax(s46)]:.1f} 万人') |
💬 最良の h は 114.5 万人で、Scott(129.5 万人)に近い大きな値になりました。ところが内訳を見ると、h を 30 万人に絞ったときの合計 −433.9 のうち東京都 1 県が −139.2 を占め、残り 46 県ぶんはむしろ h = 49.8 万人(−292.8)のほうが h = 114.5 万人(−301.4)より良い値です。つまり、大きな h は「46 県をうまく当てるため」ではなく「他の県から 486 万人も離れた東京都 1 県に 0 でない密度を配るため」に選ばれています。東京都を除いて選び直すと最良の h は 44.0 万人まで下がり、頑健版 Silverman の 49.8 万人とほぼ同じになります。尤度 CV は外れ値に 0 に近い密度を配ると対数で大きく罰せられるので、孤立した 1 点に振り回されやすい、という性質が実データで見えます。
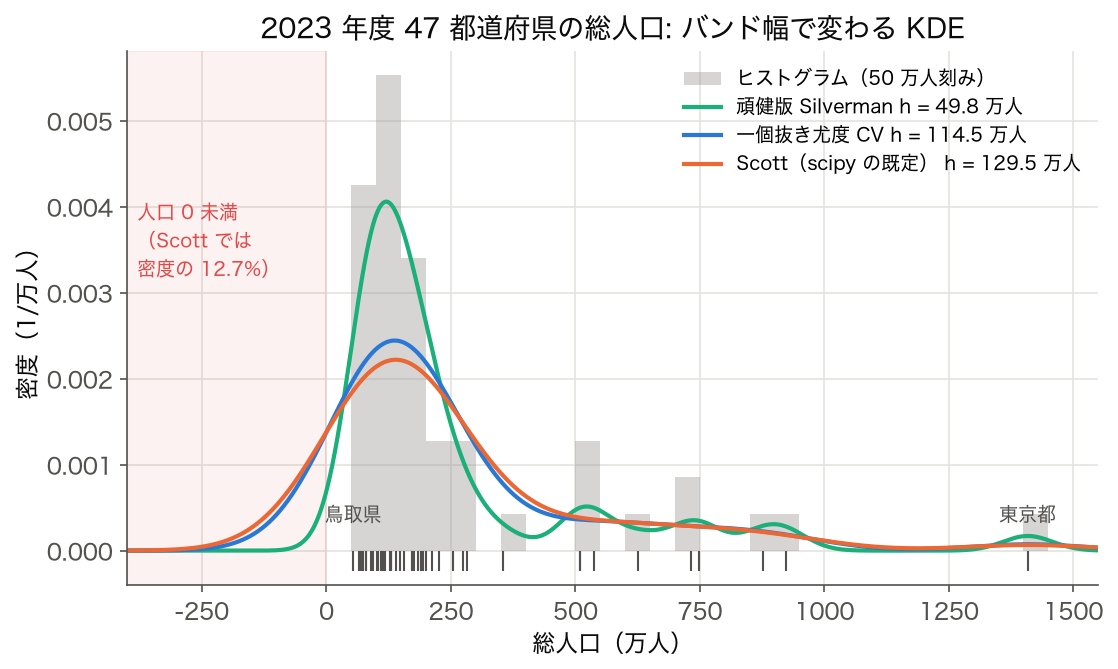
図の読み方: 灰色の棒が 50 万人刻みのヒストグラム、下の縦線(ラグ)が 47 県の位置です。緑(h = 49.8 万人)は 100〜200 万人に 21 県が集まる高い山をよく追い、509〜537 万人(北海道・福岡県・兵庫県)、733〜748 万人(埼玉県・愛知県)、876〜923 万人(大阪府・神奈川県)に小さなコブを作ります。青(CV の 114.5 万人)と橙(Scott の 129.5 万人)はほとんど重なり、山は 137〜139 万人に 1 つだけで、高さはヒストグラムの半分以下に潰れています。左の網の部分は「人口 0 未満」というありえない領域で、橙の曲線は密度の 12.7%、青は 10.8%、緑でも 1.7% をここに配っています。h を大きくするほど「東京都の孤立」には優しく、「0 の壁」と「地方県の密集」には厳しくなる、というトレードオフが 1 枚で見えます。図の作成スクリプトは code/glossary_figs/kde.py。
6. 対数にしてから KDE — 0 の壁と右の裾を同時に片づける
5. のジレンマ(東京都のために h を広げると、0 未満へのしみ出しと地方県の山の潰れが起きる)は、人口の「桁」がそろっていないことが原因です。自然対数をとると鳥取県 13.19 から東京都 16.46 まで、47 県が幅 3.3 の中に収まり、東京都も「少し右にいる 1 県」になります。対数の目盛りで KDE を作り、変数変換 $f(x) = g(\ln x)/x$ で人数の目盛りに戻す、という 2 段階を実データで確かめます($g$ は対数の目盛りでの密度)。
🎯 このコードでやること:総人口を自然対数にしてから Scott の KDE を当て、対数の目盛りでの山の位置を出す。人数の目盛りに戻した密度と、人数のまま当てた KDE とで、人口帯ごとの面積(県の割合の推定)を実際の県の割合と比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import numpy as np from scipy.stats import gaussian_kde from scipy.signal import argrelextrema # x: 上のブロックの 2023 年度 47 都道府県の総人口(万人) k_raw = gaussian_kde(x) # 人数のまま(Scott) print(f'人数のまま: h = {k_raw.factor * x.std(ddof=1):.1f} 万人, ' f'0 未満に配った密度 = {k_raw.integrate_box_1d(-np.inf, 0):.3f}') lx = np.log(x * 1e4) # 自然対数(人) k_log = gaussian_kde(lx) print(f'対数にして: h = {k_log.factor * lx.std(ddof=1):.3f}(対数の単位)') z = np.linspace(lx.min() - 1, lx.max() + 1, 3000) g = k_log(z) modes = np.exp(z[argrelextrema(g, np.greater)[0]]) / 1e4 print('対数 KDE の山の位置(万人):', np.round(modes, 1)) # 人数の目盛りに戻す: f(x) = g(ln x) / x(x は万人なので 1/万人の密度) xs = np.linspace(1, 3000, 30000) f_back = k_log(np.log(xs * 1e4)) / xs print(f'戻した密度の 0 未満 = 0(ln が定義されない), 1〜3000 万人での積分 = {(f_back * (xs[1] - xs[0])).sum():.3f}') for lo, hi in [(0, 100), (100, 200), (200, 500), (500, 3000)]: m = (xs >= lo) & (xs < hi) print(f'{lo:>4}〜{hi:<4} 万人: 実際 {((x >= lo) & (x < hi)).sum():>2} 県 = {((x >= lo) & (x < hi)).mean():.3f} ' f'人数 KDE {k_raw.integrate_box_1d(lo, hi):.3f} 対数 KDE {(f_back[m] * (xs[1] - xs[0])).sum():.3f}') |
💬 人数のまま当てた KDE は密度の 12.7% を 0 未満に配り、100〜200 万人帯(実際は 21 県 = 44.7%)を 21.7% と半分以下に、200〜500 万人帯(実際 7 県 = 14.9%)を 30.8% と 2 倍に見積もります。対数 KDE を戻した密度は定義上 0 未満に密度を配らず(積分も 1.000)、100〜200 万人帯を 34.7%、200〜500 万人帯を 23.4% と、実際の割合にかなり近づきます。対数の目盛りでは山が 2 つ(130.3 万人と 577.6 万人)現れ、後者は北海道から神奈川県までの 8 道府県(509〜923 万人)の集まりに当たります。人数のまま当てた KDE ではこの 2 つ目の山は東京都に合わせた広い h に塗りつぶされていました。
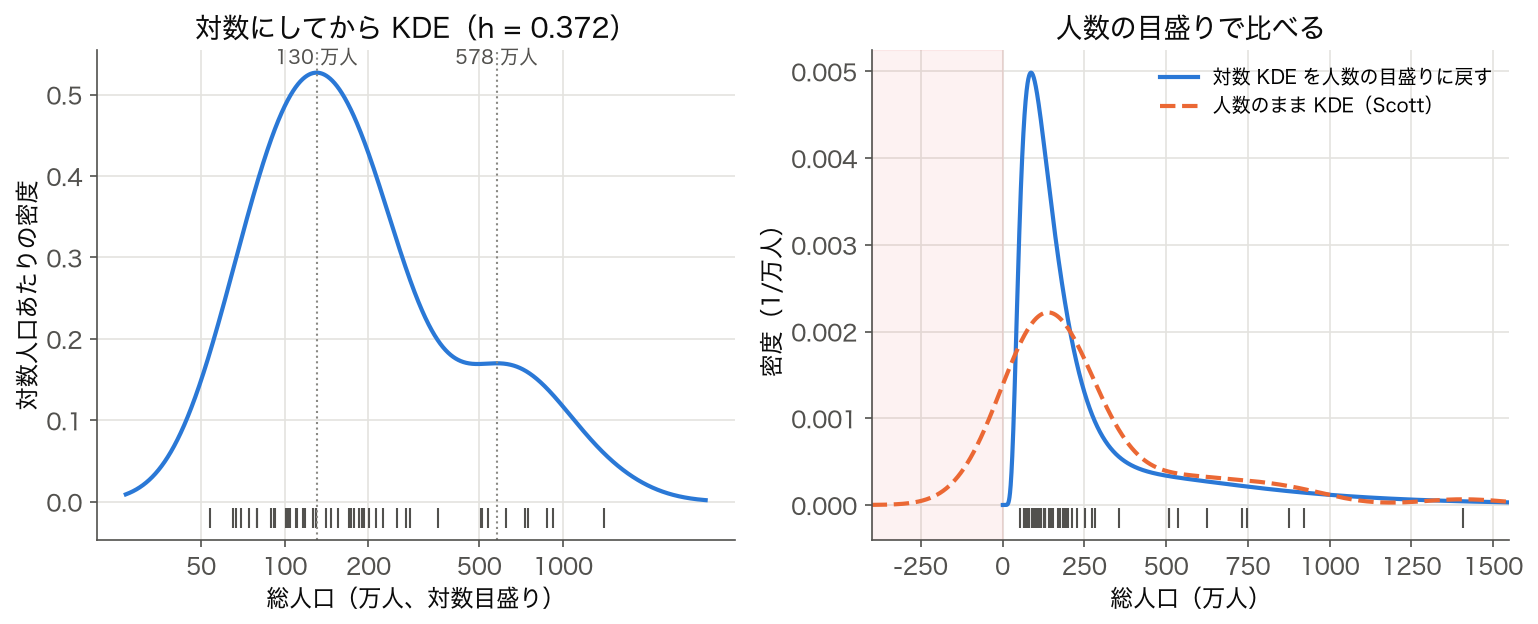
図の読み方: 左は対数の目盛りの KDE で、横軸の目盛りは読みやすいように万人で書いてあります。130 万人の大きな山と、578 万人の肩のような小さな山の 2 つです。右は同じ KDE を人数の目盛りに戻した青の実線と、人数のまま当てた橙の破線の比較です。青は 0 のところで 0 に落ち、網の領域には何も配りません。青の山が 87 万人と、左の図の 130 万人より左にずれているのは誤りではなく、変数変換で密度を $x$ で割るためです(対数の目盛りで幅が同じ区間は、人数の目盛りでは右ほど広いので、その分だけ密度の高さが低くなる)。「山の位置」はどの目盛りで密度を測るかで変わる量なので、報告するときは目盛りを明記します。一方、「100〜200 万人に何割の県があるか」のような区間の面積は、どちらの目盛りで計算しても同じ値になります。
7. 年度で分布を重ねる — 高齢化率の 11 年の移り変わり
KDE がよく使われるのは、ヒストグラムでは重ねると読みにくい複数の分布を、同じ軸に線で重ねて比べる場面です。高齢化率(65 歳以上人口 ÷ 総人口)を 2012・2017・2023 年度で重ね、「平均が上がった」だけでは分からない形の変化を読みます。
🎯 このコードでやること:2012・2017・2023 年度それぞれの 47 都道府県の高齢化率に Scott の KDE を当て、平均・山の位置・バンド幅・標準偏差と、30% を超える県の実数と KDE の面積を比べる。
1 2 3 4 5 6 7 8 9 10 | from scipy.stats import gaussian_kde z = np.linspace(14, 44, 3001) for year in [2012, 2017, 2023]: t = df[df['SSDSE-B-2026'] == year] r = (t['A1303'] / t['A1101'] * 100).values # 高齢化率(%) k = gaussian_kde(r) print(f'{year}: 平均 {r.mean():.2f}% 山の位置 {z[k(z).argmax()]:.2f}% ' f'h {k.factor * r.std(ddof=1):.2f} SD {r.std(ddof=1):.2f} ' f'30% 超: 実数 {(r > 30).sum():>2} 県 / KDE の面積 {k.integrate_box_1d(30, np.inf):.3f}') |
💬 山の位置は 26.39% → 30.43% → 32.75% と右へ動き、同時に標準偏差が 2.62 → 2.89 → 3.34 と広がったので、Scott のバンド幅も 1.21 → 1.34 → 1.55 と自動で太くなっています。30% を超える県は 2 県 → 23 県 → 35 県と増え、KDE の 30% 超の面積(0.051 → 0.476 → 0.700)は実際の割合(0.043 → 0.489 → 0.745)をよく追っています。ただし 2023 年度は 0.700 と実際の 0.745 より少なく、30% のすぐ上に県が集まっているところでは、KDE の裾が 30% の左へ密度を漏らす分だけ少なめに出ます。
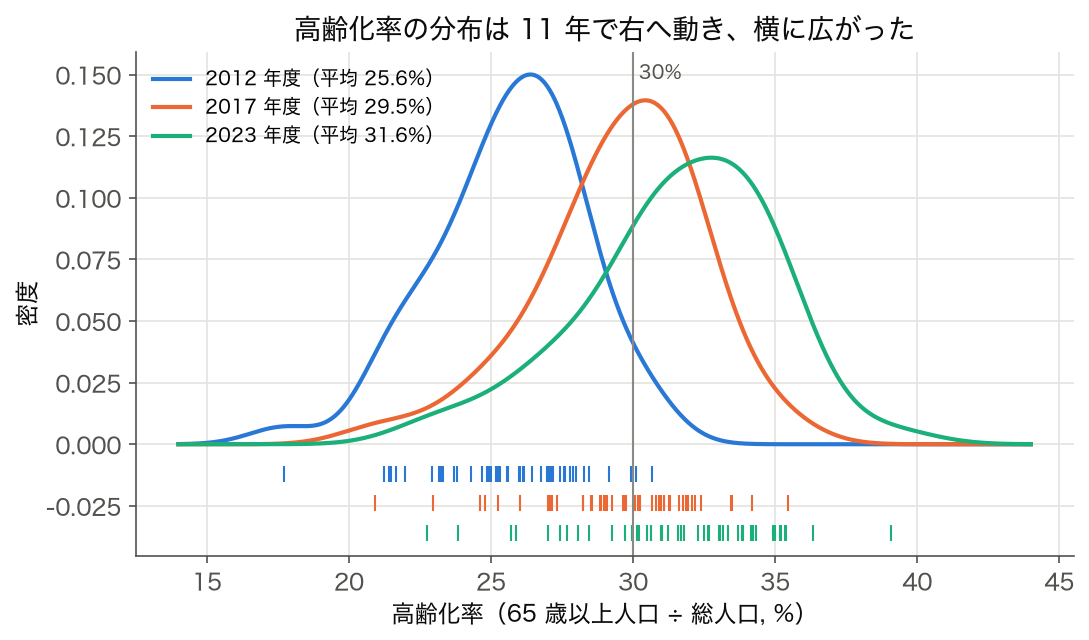
図の読み方: 下のラグ(縦線)は年度ごとの 47 県の位置です。3 本の曲線は面積がどれも 1 なので、横に広がった 2023 年度(緑)は山が低くなります。2012 年度(青)の左端の小さなコブは沖縄県(17.7%)1 県で、他の県から 3% 以上離れた 1 点でも KDE はコブとして描きます。2023 年度は右の裾が 39.1%(秋田県)まで伸び、左の裾には東京都 22.8%・沖縄県 23.8% が残っています。「平均が 6 ポイント上がった」という要約に、「県の間の差も広がった(地方ほど速く高齢化した)」という情報を加えられるのが、分布を重ねて見る利点です。ただし 47 県の KDE は 1 県ごとの小さな山の和なので、30% の線の左右の細かな凹凸を読み込みすぎないようにします(ラグと必ず並べて見る)。
8. その山は本物か — ブートストラップで 2 つ目の山を確かめる
6. で対数 KDE に現れた 578 万人付近の 2 つ目の山は、大都市圏の 8 道府県の集まりという解釈ができそうです。しかし「落とし穴を深掘り ③」のとおり、n = 47 の KDE の山はたまたまの並びでも生じます。47 県から重複を許して 47 県を引き直す(ブートストラップ)ことを繰り返し、そのたびに同じ手順(対数 → Scott の KDE)で山を数えて、2 つ目の山がどのくらい安定して現れるかを調べます。
🎯 このコードでやること:2023 年度 47 都道府県の総人口の対数について、47 県を重複ありで引き直して Scott の KDE を作ることを 1000 回繰り返し、山の数の分布と、2 つ目の山が 300 万人より右に現れた割合を数える(乱数の seed は 0 に固定)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np from scipy.stats import gaussian_kde from scipy.signal import argrelextrema rng = np.random.default_rng(0) lx = np.log(x * 1e4) z = np.linspace(12.0, 17.5, 1500) n_modes, right = [], 0 for _ in range(1000): s = rng.choice(lx, size=len(lx), replace=True) # 47 県を引き直す g = gaussian_kde(s)(z) peaks = np.exp(z[argrelextrema(g, np.greater)[0]]) / 1e4 n_modes.append(len(peaks)) right += (len(peaks) >= 2) and (peaks.max() > 300) n_modes = np.array(n_modes) for m in sorted(set(n_modes)): print(f'山が {m} つ: {np.mean(n_modes == m):.3f}') print(f'300 万人より右に 2 つ目以降の山が出た割合: {right / 1000:.3f}') |
💬 1000 回のうち 69.0% で山が 2 つ(3 つは 0.1%)、30.9% では山が 1 つに潰れました。300 万人より右に山が出た割合は 68.9% で、2 つ目の山は「たいてい出るが、3 回に 1 回は消える」程度の安定さです。引き直しで大都市圏の県が 1〜2 県抜けたり、静岡県(355.5 万人)のような間の県が重複して選ばれたりすると、谷が埋まって 1 つの肩になります。報告するなら「2 つ目の山がある」と断定せず、「対数で見ると大都市圏の 8 道府県がゆるいまとまりを作る(ブートストラップで 69% の再現)」のように、安定さと一緒に書くのが誠実です。なお、ブートストラップは同じ h の決め方(Scott)を毎回使っており、h を小さくすれば山は増え、大きくすれば減ります。山の有無の判定は h の選び方と切り離せません。
✏️ 理解度チェック(5.〜7. の数字で)
- 一個抜き尤度 CV が 2023 年度の総人口で h = 114.5 万人を選んだ理由を、東京都という言葉を使って説明せよ。
答え: h が小さいと、東京都を抜いた残り 46 県の KDE は東京都の位置(1,409 万人)でほぼ 0 になり、対数尤度が大きく下がる(h = 30 万人で東京都 1 県だけで −139.2)。東京都に密度を届かせるために h が広げられた。東京都を除くと最良の h は 44.0 万人。 - 人数のまま当てた Scott の KDE で「人口 100〜200 万人の県の割合」を推定すると 21.7% になった。実際は何 % か。対数 KDE ではいくつか。
答え: 実際は 21 県 = 44.7%、対数 KDE は 34.7%。広すぎる h が密集した山を左右に散らしている。 - 対数 KDE の山は対数の目盛りでは 130 万人、人数の目盛りに戻すと 87 万人に見える。どちらが正しいか。
答え: どちらも正しい。密度の山の位置は目盛りの選び方で変わる(戻すときに $1/x$ を掛けるため)。区間の割合(面積)は目盛りに依らない。 - 2012 年度と 2023 年度の高齢化率で、Scott のバンド幅が 1.21 から 1.55 に変わったのはなぜか。
答え: Scott の h は標準偏差 × $n^{-1/5}$ で、n = 47 は同じなので、標準偏差が 2.62 から 3.34 に広がった分だけ h も太くなった。
⚠️ 落とし穴
statsmodels の cut=0 オプション、 (c) 反射法・境界補正カーネル。
⚠️ KDE の追加的落とし穴
- 裾の過小評価:データが少ない裾領域で、 KDE は密度を過小に出す傾向。
- 境界バイアス:有界データ(年齢など)で境界付近の密度が下がる。 反射法・対数変換で補正。
- 外れ値の影響:1 個の外れ値が広い領域に「小山」を作る。 ロバスト KDE を検討。
- バンド幅の固定:データの密度が場所によって異なるとき、 適応的 KDE が良い。
- 高次元での呪い:次元数 $d$ が増えると必要サンプルが $n^{4/(d+4)}$ で指数的に増える。
- 離散データへの誤適用:整数値データに KDE を当てると人工的な滑らかさが出る。
- 規格化忘れ:scipy の KDE は自動で積分が 1 になるが、 自作実装では要注意。
❓ よくある質問(FAQ)
Q. なぜヒストグラムでなく KDE?
A. ヒストグラムはビン境界が人工的で、 同じデータでもビン幅・原点を変えると印象が変わります。 KDE は各点に滑らかなカーネルを置くので、 境界の任意性が消え、 微分可能で連続です。 SSDSE-B-2026 の人口分布のように歪んだデータでは、 ヒストグラムと KDE で見える特徴が異なることがあります。
Q. カーネル選択はどれくらい重要?
A. 本質的に重要ではありません。 Gaussian、 Epanechnikov、 三角など主要カーネルはどれも MISE 効率が 0.93 以上で大差なし。 「バンド幅選択」が桁違いに重要です。
Q. バンド幅自動選択の精度は?
A. Silverman は正規分布前提で過大評価する傾向。 Sheather-Jones plug-in は理論的に最良。 実務では複数手法を試して目視確認するのが安全です。
Q. 多次元 KDE は使える?
A. 2-3 次元までは実用的。 高次元では「次元の呪い」で必要サンプルが指数的に増えるため、 GMM や Mixture Model に切り替えるのが現実的。
Q. 境界バイアスの対処は?
A. 有界データ(例:年齢 0-100)で境界付近に密度が下がる現象。 反射法、 対数変換、 ベータカーネルで補正できます。
Q. 離散データに KDE を当ててもよい?
A. 推奨しません。 整数値の人数データに KDE を当てると人工的滑らかさが出ます。 離散変数なら確率質量関数、 または十分なジッターを加えた後 KDE が代替案。
🏛 KDE の歴史
- 1956:Rosenblatt: Remarks on Some Nonparametric Estimates of a Density Function で KDE の原型を提案。
- 1962:Parzen: On Estimation of a Probability Density Function and Mode で「Parzen window」として体系化。
- 1969:Wahba: スプラインベース密度推定の理論。
- 1986:Silverman: Density Estimation for Statistics and Data Analysis 教科書、 経験則の標準化。
- 1991:Sheather & Jones: A reliable data-based bandwidth selection method で plug-in 法を完成。
- 1996:Wand & Jones: Kernel Smoothing 教科書、 KDE の理論的完成。
- 2000 年代:機械学習: Conditional KDE、 KDE Mixture、 Variational density estimation で再注目。
- 2020 年代:Diffusion Model: Score-based 生成モデルが KDE のスコア関数推定と関連付けられる。
💼 産業応用事例
金融
リスク管理で VaR (Value at Risk) を非パラメトリック分位点として推定。
生態学
動物の活動範囲 (home range) を空間 KDE で可視化。
交通工学
交通事故密度の地理的可視化。
医療画像
腫瘍の輝度分布を KDE で表現。
マーケティング
顧客の購買間隔分布の推定。
スポーツ分析
バスケのシュート位置の密度マップ。
犯罪マッピング
犯罪密度の地理的予測 (hot spot 分析)。
生物統計
遺伝子発現量の分布推定。
🗺 概念マップ — KDE が属する位置
分布の可視化・推定
├── パラメトリック密度推定
│   ├── 正規分布のあてはめ(平均・分散を推定)
│   ├── 混合正規(GMM)
│   └── 一般指数族
├── ノンパラメトリック密度推定 ◀ ここに KDE
│   ├── ヒストグラム(階段状)
│   ├── KDE(なめらか) ◀ このページ
│   │   ├── ガウス KDE(最頻出)
│   │   ├── Epanechnikov KDE(最適)
│   │   ├── 適応的 KDE
│   │   └── 多変量 KDE
│   ├── 最近傍密度推定
│   └── オルソゴナル級数推定
├── 累積分布関数の推定
│   ├── Empirical CDF
│   └── 平滑 ECDF
└── 応用分野
    ├── 異常検知(密度が低い → 異常)
    ├── クラスタリング(Mean Shift など)
    ├── カーネル回帰(Nadaraya-Watson)
    └── ベイズ事後分布の可視化
🧠 KDE 拡張解説 — なぜヒストグラムを超えるか
カーネル密度推定 (KDE) は、 離散的観測値 $\{x_1, \ldots, x_n\}$ から滑らかな密度関数を推定します。 ヒストグラムが「ビン境界の人工的な階段」を作るのに対し、 KDE は各観測点に「小さな山」(カーネル関数)を置き、 それを足し合わせるイメージです。
$$\hat f_h(x) = \frac{1}{nh} \sum_{i=1}^{n} K\!\left(\frac{x - x_i}{h}\right)$$
SSDSE-B-2026 の 47 都道府県人口データに KDE を適用すると、 東京・大阪のような大都市が右側に長い裾を作り、 多くの県が中央に固まる「右に歪んだ密度」が観察できます。 ヒストグラムでは見えにくい「双峰性」「希少な裾」が KDE では浮き彫りに。
🔗 隣接手法への橋渡し
KDE はバンド幅 h とカーネル選択によって描かれる滑らかな密度推定であり、 上流のヒストグラム探索と下流の分布検定・サンプリングへ橋渡しすることで本領を発揮する。
- 上流: 前段の分布可視化 (ヒストグラム・QQ プロット) (ヒストグラム、 標準化)
- 並列: 並列のノンパラメトリック手法 (ノンパラメトリック法) と比較・併用
- 下流: 下流の確率モデル化・サンプリング (箱ひげ図比較、 外れ値検出)
上流のヒストグラムでビンに頼らず分布形状を確認し、 並列の正規分布あてはめ・GMM と比較してパラメトリック仮定の妥当性を検証し、 下流の異常検知/密度比推定で KDE の出力 (確率密度) を直接判定スコアに使う流れで真価を発揮する。
🌳 手法選択フロー
カーネル密度推定 (KDE) を実際の課題に当てはめるとき、 用語固有の判断軸に沿って次の 3 段階で適切な選択を行う。
- 分布形状を視覚的に確認したいだけか? Yes → ヒストグラム (ビン幅注意)、 No → 次へ
- 分布族を仮定できるか (正規・指数等)? Yes → パラメトリック推定 (最尤法)、 No → KDE (ノンパラメトリック)
- 多変量 (3 次元以上) を扱うか? Yes → 次元削減 + 2D KDE、 No → 1D-2D KDE で十分
このフローはノンパラメトリック密度推定の基本方針。 KDE はバンド幅 h の選択が結果を左右するため、 Scott/Silverman の経験則や交差検証で h を慎重に決定する。
🧩 直感を深める — 「ビン境界問題」から KDE が生まれた
KDE は突然思いつかれた道具ではなく、 ヒストグラムの弱点を一つずつ潰していくと自然に到達します。 上の 🎨 直感 セクションを踏まえ、 「なぜ滑らかにするのか」をもう一段深掘りします。
ヒストグラムが抱える 3 つの恣意性
同じデータでも、 ヒストグラムは作り手の選択で見た目が変わります。 これが ビン境界問題(binning problem) です。
- ① ビン幅の恣意性:幅を変えると山の数さえ変わる。
- ② 原点(ビン端点)の恣意性:幅が同じでも、 目盛りを少しずらすと 1 つの山が 2 つに割れたりくっついたりする。
- ③ 不連続性:階段状なので微分できず、 ピーク位置を数値的に求めにくい。
発想の飛躍:「箱」を「山」に置き換える
ヒストグラムを「各データ点の上に幅 $w$・高さ一定の矩形の箱を積む」操作だと読み替えてみます。 すると、 この箱こそが 一様カーネルそのもの。 KDE はここで 2 つの改良を加えます。
- 改良 A:箱を丸める → 一様カーネルをガウスやエパネチニコフに替えると、 出力が滑らか(微分可能)になり ③ が解決。
- 改良 B:箱を「格子」でなく「データ点」に置く → ビンの端点が消えるので ② が解決。 KDE に「原点」は存在しない。
残った ① だけが バンド幅 $h$ として KDE に引き継がれます。 つまり $h$ はヒストグラムのビン幅に相当し、 「どれだけ滑らかにするか」というただ 1 つの本質的な自由度に集約されたのです。 カーネルの種類(改良 A)はほとんど効かず、 $h$(元のビン幅)だけが決定的、 という 落とし穴 ⑤ の理由もここにあります。
移動平均としての KDE
別の見方をすると、 KDE は評価点 $x$ の周りで「近い観測点ほど重く数える加重平均」です。 重み $K\!\big((x-x_i)/h\big)$ は $x$ に近い点ほど大きい。 これは時系列の移動平均と同じ発想で、 $h$ は「窓の広さ」に対応します。 窓が狭い($h$ 小)ほど局所的でギザギザ、 広い($h$ 大)ほど大域的でなめらか——という直感がそのまま成り立ちます。
📝 補足:ヒストグラムそのものの詳細は histogram.html、 「密度」という量の定義は「確率密度」の項(本サイトに個別ページ未整備のため、 probability-distribution.html の密度関数の節)を参照。
🕳 落とし穴を深掘り — 実データ(東京〜鳥取)で確かめる
上の ⚠️ 落とし穴 を、 SSDSE-B-2026 の 2023 年・総人口(A1101, 47 都道府県, $n=47$)の実測値で具体化します。 数値はすべて実データからの計算です。
標準偏差 $\hat{\sigma}=2{,}797{,}551$/IQR $=1{,}602{,}500$/$n^{-1/5}=0.4630$
200 万人未満が 31 県、 500 万人超はわずか 9 県 —— 強い右歪み(右裾が長い)
① バンド幅選択:デフォルト則は歪んだ人口で「過平滑」になる
同じデータに 3 つの経験則を当てると、 バンド幅が 2.7 倍も食い違います。
| 経験則 | 式 | 実測バンド幅 $h$ | 効果 |
|---|---|---|---|
| Scott 則 | $\hat{\sigma}\,n^{-1/5}$ | 約 1,295,265 | やや過平滑 |
| Silverman 則 | $1.06\,\hat{\sigma}\,n^{-1/5}$ | 約 1,372,981 | 過平滑(東京の外れ値に $\hat{\sigma}$ が引きずられる) |
| 頑健版 Silverman | $0.9\min(\hat{\sigma},\mathrm{IQR}/1.34)\,n^{-1/5}$ | 約 498,329 | IQR を使うので歪みに強い |
Scott / Silverman は正規分布を前提にした式です。 東京都という一つの巨大な外れ値が $\hat{\sigma}$ を約 280 万に押し上げ、 バンド幅が中央値付近の県間隔(数十万人)より大きくなってしまう。 結果、 「200 万人未満に 31 県が密集」という本当の峰が塗り潰される過平滑が起きます。 IQR を使う頑健版(約 50 万)の方がこのデータには適切で、 上の 📐 数式 の頑健版 Silverman が実務で推奨される理由が数値で確認できます。
② 境界バイアス:人口は 0 未満にならないのに裾がしみ出す
人口は必ず正の量ですが、 ガウス KDE は鳥取県(537,000 人)の左側にも鐘の裾を伸ばし、 0 人・負の人口という物理的にありえない領域に密度を配ってしまいます。 $h \approx 137$ 万(Silverman)ではこのしみ出しが顕著。 対処は 落とし穴 ② の通りで、 実測では対数変換が特に有効です:対数スケールの Silverman バンド幅は約 0.394(頑健版 0.291)と桁が扱いやすく、 右歪みも同時に緩和されます。
③ 多峰性:「でっち上げ」と「見落とし」の両方に注意
$h$ を小さくすれば東京・大阪・愛知あたりに小さなコブが次々現れますが、 それらは ノイズ由来の偽の峰(でっち上げ)かもしれません。 逆に $h$ を大きくすれば「200 万人未満の 31 県」という本物の峰を見落とす。 $n=47$ という小標本ではこの判定が特に難しく、 「東京・大阪・愛知が外れ値で、 残りは実質単峰」という解釈も十分あり得ます。 異なる $h$ で頑健に残る峰だけを信じ、 必要ならブートストラップ検定で裏を取ります。 パラメトリックに多峰性を検証したいなら混合ガウス(→ gaussian-mixture.html)と併用します。
④ 次元の呪い:KDE が高次元で破綻する理由
1 変数では快適な KDE も、 変数を増やすと急速に無力化します。 これは 次元の呪い(curse of dimensionality)で、 収束のために必要なサンプル数が次元 $d$ に対して指数的に膨らむためです。
| 次元 $d$ | 収束レート | 同じ精度に必要な相対サンプル数(目安) |
|---|---|---|
| 1(総人口だけ) | $n^{-4/5}$ | 基準(例:47) |
| 2(+世帯数) | $n^{-4/6}$ | 数倍 |
| 5 | $n^{-4/9}$ | 数百倍以上 |
| 10 以上 | $n^{-4/14}$ | 事実上、 到達不能 |
SSDSE-B の $n=47$ では、 2〜3 次元が実用上の限界。 高次元密度を扱いたいときは KDE をあきらめ、 パラメトリックな混合ガウス(GMM)や次元削減 → 低次元 KDE に切り替えるのが定石です(→ gaussian-mixture.html、 nonparametric.html)。
🚀 発展 — 自動バンド幅・カーネル種類・GMM との関係
バンド幅の自動選択:Scott 則と Silverman 則
「$h$ を手で選ぶのは大変」という声に応える古典的な自動則が Scott / Silverman です。 どちらも $h \propto \hat{\sigma}\,n^{-1/5}$ という同じ骨格を持ちます(1 次元の場合)。
$-1/5$ という指数の意味:バイアス(過平滑)とバリアンス(ギザギザ)のトレードオフを最小化すると、 理論的に最適な $h$ は $n^{-1/5}$ のオーダーになります。 サンプルが増えるほど $h$ をゆっくり縮めるべき、 ということ。 上の実測では $n^{-1/5}=0.4630$ がこの因子でした。
カーネル種類の影響:形より「効率」で理解する
カーネルを変えても結果はほとんど変わりません。 これを定量化するのが 相対効率で、 最適な Epanechnikov カーネルを 1.000 とした比です(上の 🎨 直感 の表を参照)。 ガウスカーネルでさえ効率 0.951——つまり同じ精度を出すのに必要なサンプルが約 5% 多いだけ。 実務では、
- ガウス:無限に滑らかで微分可能。 ピーク探索や勾配計算が必要なとき(scipy/sklearn の既定)。
- Epanechnikov:MISE 最適かつ有限サポート。 大標本で計算を軽くしたいとき。
を選べば十分です。 「どのカーネルか」より「$h$ をどう決めるか」に労力を割く——これが KDE 運用の鉄則です。
KDE と混合ガウス(GMM)の関係
ガウス KDE と GMM は、 じつは「ガウスの和で密度を表す」という同じ家族に属します。 違いはガウスをいくつ・どこに・どんな幅で置くかだけです。
| 項目 | ガウス KDE | 混合ガウス(GMM) |
|---|---|---|
| 成分の数 | $n$ 個(データ点ごとに 1 つ) | $K$ 個($K \ll n$、 事前に選ぶ) |
| 中心 | 各データ点に固定 | EM で推定(自由に動く) |
| 幅 | 全成分で共通の $h$ | 成分ごとに共分散を推定 |
| 重み | 全成分で等しく $1/n$ | 混合比 $\pi_k$ を推定 |
| 性質 | ノンパラメトリック | パラメトリック(半) |
| 高次元 | 次元の呪いで破綻 | 相対的に頑健 |
言い換えると、 KDE は「成分数を $n$ に固定し、 一切学習しない究極のノンパラメトリック GMM」。 逆に GMM は「成分を数個に絞って場所・幅・重みを学習した圧縮版 KDE」と言えます。 少数の峰がはっきりしていて解釈やサンプリングが目的なら GMM、 分布形状を先入観なく眺めたいなら KDE、 と使い分けます(→ gaussian-mixture.html)。
📝 補足:ここで挙げた数値(バンド幅 130 万 vs 50 万、 $n^{-1/5}=0.4630$ など)はすべて SSDSE-B-2026 2023 年・総人口の実測に基づく。 合成データは用いていない。