🔖 キーワード索引 — 確率分布を多角的に理解する
🔖 キーワード索引 — 確率分布を多角的に理解する
確率分布(probability distribution)は統計学・機械学習の最重要基盤です。 関連キーワードを難易度別に整理しました。
🟢 基礎キーワード(まず押さえる)
- 確率密度関数(PDF):連続変数の「確率の濃さ」を表す関数 f(x)。 積分が 1。
- 確率質量関数(PMF):離散変数の各値の確率。 総和が 1。
- 累積分布関数(CDF):F(x) = P(X ≤ x)。 0 から 1 に単調増加。
- 正規分布(Gaussian):N(μ, σ²)。 中心極限定理により最も普遍的な分布。
- 二項分布:n 回の独立試行での成功回数。 B(n, p)。
- ポアソン分布:単位時間/空間あたりの稀少イベント数。 平均 = 分散 = λ。
🟡 中級キーワード
- 標準正規分布(Z):N(0, 1)。 全ての正規分布は z = (x−μ)/σ で標準化可能。
- t 分布:自由度 df の対称分布。 df → ∞ で N(0,1)。 標本平均の検定で使用。
- χ² 分布:自由度 k の右に裾を引く分布。 標準正規変量の二乗和。
- F 分布:2 つの χ² の比。 ANOVA や等分散性検定。
- 指数分布:イベント間の待ち時間の分布。 平均 = 1/λ。 ポアソン分布と表裏。
- 一様分布:U(a, b)。 [a, b] で均等確率。 シミュレーション基盤。
🔴 上級キーワード
- 多変量正規分布:N(μ, Σ)。 多次元の正規。 PCA、 ガウス混合モデル等で使用。
- ベータ分布:[0, 1] 区間の柔軟な分布。 ベイズの共役事前分布。
- ガンマ分布:指数分布の一般化。 χ²、 Erlang、 指数の親分布。
- 負の二項分布:過分散ポアソンの代替。 イベント計数で頻用。
- 混合分布(mixture):複数の分布の重み付き和。 ガウス混合 (GMM) など。
- 裾の重い分布(heavy-tailed):パレート、 ワイブル、 対数正規。 金融・サイズ分布。
💡 30秒で分かる結論
🍰 まずはやさしく
確率分布のカタログは道具箱のようなものです。
データの種類に合わせて使い分けます。
テストの点数やスマホの通知回数などで考えます。
ここでは代表的な9つの分布を一覧で読みます。
- 正規分布 $N(\mu, \sigma^2)$:自然界・標本平均の代表。 中心極限定理の到達点
- t 分布:標本サイズが小さい時の平均の検定($\sigma$ が未知)
- χ² 分布:分散の検定・独立性検定。 独立な標準正規の二乗和
- F 分布:分散の比 → ANOVA、 回帰モデルの有意性
- 二項分布 $\mathrm{Bin}(n,p)$:試行回数固定、 成功・失敗の試行
- ポアソン分布 $\mathrm{Pois}(\lambda)$:単位時間あたりの稀な事象数
- 前提:代表値、 ばらつき
- 次に学ぶ:p値、 信頼区間、 t検定
🗂️ 章俯瞰 — 9つの分布を一望
| 分布 | 記号 | 連続/離散 | パラメータ | 典型的な使い時 |
|---|---|---|---|---|
| 正規 | $N(\mu, \sigma^2)$ | 連続 | $\mu$, $\sigma$ | 標本平均、 測定誤差、 身長 |
| t | $t_\nu$ | 連続 | $\nu$(自由度) | 小標本平均、 回帰係数 |
| χ² | $\chi^2_k$ | 連続 | $k$(自由度) | 分散・独立性検定 |
| F | $F_{d_1, d_2}$ | 連続 | $d_1, d_2$ | 分散比、 ANOVA |
| 二項 | $\mathrm{Bin}(n, p)$ | 離散 | $n$, $p$ | コイン投げ、 A/B テスト |
| ポアソン | $\mathrm{Pois}(\lambda)$ | 離散 | $\lambda$ | 来店数、 事故件数 |
| 一様 | $U(a, b)$ | 連続/離散 | $a, b$ | 乱数、 事前分布 |
| 指数 | $\mathrm{Exp}(\lambda)$ | 連続 | $\lambda$ | 待ち時間、 寿命 |
| 対数正規 | $\mathrm{LN}(\mu, \sigma^2)$ | 連続 | $\mu, \sigma$ | 所得、 株価変動 |
📊 正規分布(Normal / Gaussian)
「釣鐘型」の左右対称な分布。 統計学で最も重要、 自然界・標本平均の至るところに現れます。 確率密度関数(PDF):
$$ f(x) = \frac{1}{\sigma\sqrt{2\pi}} \exp\!\left(-\frac{(x-\mu)^2}{2\sigma^2}\right) $$
記号:$\mu$ は平均(位置)、 $\sigma$ は標準偏差(広がり)、 $\sigma^2$ は分散。 表記は $X \sim N(\mu, \sigma^2)$。 特に $\mu=0, \sigma=1$ を標準正規分布と呼び、 $Z \sim N(0,1)$ と書きます。
📊 68-95-99.7 ルール
- $\mu \pm 1\sigma$ — 約 68%
- $\mu \pm 1.96\sigma$ — 約 95%
- $\mu \pm 3\sigma$ — 約 99.7%
これが信頼区間・検定の基礎。 「$\pm 1.96 \times \mathrm{SE}$」が 95% 信頼区間になるのもこのため。
🧮 標準化と z-score
$X \sim N(\mu, \sigma^2)$ を $Z = (X-\mu)/\sigma$ で標準化すると $Z \sim N(0,1)$。 任意の正規分布の確率計算が、 標準正規分布の値表で済む。 例:偏差値 70($z=2$)以上の人は上位 2.5% 程度。
🔢 ベクトル表記 — 多変量正規分布
$d$ 次元への拡張:$\boldsymbol{X} \sim N_d(\boldsymbol{\mu}, \Sigma)$。 密度関数は
$$ f(\boldsymbol{x}) = \frac{1}{(2\pi)^{d/2} |\Sigma|^{1/2}} \exp\!\left(-\frac{1}{2}(\boldsymbol{x}-\boldsymbol{\mu})^\top \Sigma^{-1} (\boldsymbol{x}-\boldsymbol{\mu})\right) $$
$\boldsymbol{\mu} \in \mathbb{R}^d$ は平均ベクトル、 $\Sigma \in \mathbb{R}^{d \times d}$ は共分散行列。 マハラノビス距離 $(\boldsymbol{x}-\boldsymbol{\mu})^\top \Sigma^{-1} (\boldsymbol{x}-\boldsymbol{\mu})$ が指数の中身。
🐍 Python で正規分布
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | from scipy import stats import numpy as np # 1次元 X = stats.norm(loc=50, scale=10) # N(50, 100) print(X.pdf(60)) # 密度 print(X.cdf(60)) # 累積確率 P(X ≤ 60) print(X.ppf(0.975)) # 上側2.5%点 ≈ 69.6 x = X.rvs(size=1000, random_state=0) # ランダムサンプル(seed 固定) print(x[:5].round(2), '... 平均', x.mean().round(2), 'SD', x.std(ddof=1).round(2)) # 標準化 Z = (x - 50) / 10 # 標準正規 print('|Z|≤1 の割合', np.mean(np.abs(Z) <= 1), ' |Z|≤2 の割合', np.mean(np.abs(Z) <= 2)) # 多変量 mean = [0, 0] cov = [[1, 0.5], [0.5, 1]] mvn = stats.multivariate_normal(mean=mean, cov=cov) samples = mvn.rvs(size=1000, random_state=0) # (1000, 2) print(samples.shape, '標本相関', np.corrcoef(samples.T)[0, 1].round(3)) |
📍 あなたが今見ているもの
🍰 まずはやさしく
これはよく使われる分布のまとめです。
データの分析や予測をするための前提になります。
部活の記録などの分析でよく出てきます。
分布どうしのつながりについて読みます。
論文・記事に 「正規分布」「t分布」「F分布」「χ²分布」「二項分布」「ポアソン分布」 として出てくる確率分布群。 仮説検定・信頼区間・最尤推定など、 推測統計のあらゆる場面で前提となります。
分布同士には密接な派生関係(正規 → t、 χ² → F、 二項 → ポアソン → 正規 など)があり、 まとめて学ぶことで全体像がつかめます。
🎨 直感で掴む — 分布 の本質
🍰 まずはやさしく
分布とはデータの散らばり方のことです。
形を見ることで正しい分析方法を選べます。
クラスの身長やテストの結果で考えます。
道具としてどう使うかを先に読みます。
「分布」は値の散らばり方。 SSDSE-B-2026 の 47 都道府県の総人口を見ると、 東京(約 1400 万)・神奈川(約 920 万)が突出、 鳥取(約 54 万)が最小で、 右に裾の長い分布(対数正規っぽい)。 一方で合計特殊出生率は 1.0〜1.8 の狭い範囲にほぼ正規っぽく集まる。 分布の形によって使うべき統計手法が変わる。
📐 t 分布(Student's t)
🍰 まずはやさしく
t分布は正規分布に似た形の分布です。
少ないデータから平均を調べたい時に使います。
少人数のグループでアンケートを取る時に便利です。
正規分布との違いや使い道を読みます。
📐 t 分布(Student's t)
正規分布から派生した分布で、 標準偏差が未知の小標本での平均の検定・信頼区間に使う。 自由度 $\nu$ をパラメータに持ちます。
$$ T = \frac{Z}{\sqrt{V/\nu}}, \quad Z \sim N(0,1), \quad V \sim \chi^2_\nu \text{ (独立)} $$
正規分布より裾が重い(極端な値が出やすい)。 $\nu \to \infty$ で正規分布に収束。 実務的には $\nu \ge 30$ で正規分布近似可能。
使い時:1標本 t 検定、 2標本 t 検定、 単回帰の係数検定。 形は「$(\bar{x} - \mu_0)/(s/\sqrt{n})$」のような形をした統計量が従う。
歴史
Guinness ビール工場の品質管理担当だった William Gosset が 1908 年に発表("Student" のペンネーム)。 会社の方針で本名を出せなかったため。 ビールの品質管理が現代統計学の基礎を作った。
1 2 3 4 5 6 7 8 9 | from scipy import stats t_dist = stats.t(df=10) print(t_dist.ppf(0.975)) # 自由度10での 2.5%点 ≈ 2.228 print(t_dist.ppf(0.975) - stats.norm.ppf(0.975)) # 正規との差 # 1標本 t検定 data = [1, 2, 3, 4, 5] t_stat, p_val = stats.ttest_1samp(data, popmean=2.5) print(t_stat, p_val) |
📊 χ²(カイ二乗)分布
標準正規分布の二乗和。 $Z_1, \ldots, Z_k$ が独立に $N(0,1)$ なら、 $\sum Z_i^2 \sim \chi^2_k$(自由度 $k$)。
$\chi^2$ の期待値 = $k$、 分散 = $2k$。 必ず非負(0 以上)。 自由度が大きくなると正規分布に近づく。
主な用途
- 独立性検定:クロス集計表で 2 つのカテゴリ変数が独立か
- 適合度検定:観測度数が理論分布に合うか
- 分散の信頼区間:$(n-1)s^2/\sigma^2 \sim \chi^2_{n-1}$
1 2 3 4 5 6 7 | from scipy import stats # 独立性検定(クロス集計表) import numpy as np obs = np.array([[10, 20, 30], [6, 9, 17]]) chi2, p, dof, expected = stats.chi2_contingency(obs) print(f'χ² = {chi2:.3f}, p = {p:.4f}, df = {dof}') |
📊 F 分布
2 つの独立な χ² 分布の比:$F = (U/d_1)/(V/d_2)$、 $U \sim \chi^2_{d_1}$、 $V \sim \chi^2_{d_2}$。 必ず非負、 右に裾を引く。
主な用途:
- ANOVA:「群間分散 / 群内分散」が F に従う
- 回帰モデル全体の有意性:F 統計量で「全係数 = 0」を検定
- 分散の比の検定:2 群の分散が等しいか
1 2 3 4 5 6 | from scipy import stats g1 = [1, 2, 3, 4] g2 = [3, 5, 7, 9] g3 = [2, 4, 6, 8] F, p = stats.f_oneway(g1, g2, g3) # ANOVA print(f'F = {F:.3f}, p = {p:.4f}') |
🎲 二項分布(Binomial)
「成功確率 $p$ の試行を $n$ 回繰り返したときの成功回数」。 $X \sim \mathrm{Bin}(n, p)$。
$$ P(X = k) = \binom{n}{k} p^k (1-p)^{n-k}, \quad k = 0, 1, \ldots, n $$
期待値 $= np$、 分散 $= np(1-p)$。 $n$ が大で $np \ge 5$、 $n(1-p) \ge 5$ なら正規近似可能。
例:コイン 100 回投げて表が出る回数、 100 人中の購入者数(A/B テスト)、 メール 100 件の到達数。
1 2 3 4 5 6 | from scipy import stats X = stats.binom(n=100, p=0.2) print(X.pmf(20)) # P(X=20) print(X.cdf(15)) # P(X≤15) print(X.mean(), X.var()) # 20.0, 16.0 |
📞 ポアソン分布(Poisson)
「単位時間(空間)あたりの稀な事象の発生数」。 $X \sim \mathrm{Pois}(\lambda)$。
$$ P(X = k) = \frac{\lambda^k e^{-\lambda}}{k!}, \quad k = 0, 1, 2, \ldots $$
期待値 = 分散 = $\lambda$(特徴的)。 二項分布 $\mathrm{Bin}(n, p)$ で $n$ 大・$p$ 小・$np = \lambda$ 固定の極限。
例:1 時間あたりの来店数、 単位面積あたりの店舗数、 1 日あたりの事故件数、 単位時間の電話呼出数。
1 2 3 4 5 | from scipy import stats X = stats.poisson(mu=3) # λ = 3 print(X.pmf(2)) # P(X=2) print(X.mean(), X.var()) # 3.0, 3.0 |
📏 一様分布(Uniform)
$U(a, b)$:区間 $[a, b]$ で密度一定。 期待値 $(a+b)/2$、 分散 $(b-a)^2/12$。 乱数生成、 ベイズの無情報事前分布として基本。
⏱️ 指数分布(Exponential)
$\mathrm{Exp}(\lambda)$:ポアソン過程の事象間隔。 期待値 = 分散 = $1/\lambda$。 メモリーレス性が特徴:$P(X > s+t | X > s) = P(X > t)$。 待ち時間、 寿命、 故障間隔のモデル。
📈 対数正規分布(Log-normal)
$\log X \sim N(\mu, \sigma^2)$ のとき $X$ は対数正規分布。 必ず正値、 右に裾を引く。 所得分布、 株価収益率、 都市人口など「掛け算過程」で生じる分布の代表。
🔄 分布間の派生関係
分布は孤立せず、 多くの変換関係で繋がっています。 これを理解すると、 新しい分布に出会ったとき素早く類推できます。
| 変換 | 関係 |
|---|---|
| CLT(中心極限定理) | 任意分布 $\to$ 標本平均は正規分布 |
| 標準正規の二乗和 | $\sum_{i=1}^k Z_i^2 \sim \chi^2_k$ |
| 標準正規 / √(χ²/df) | $t$ 分布 |
| χ²/df の比 | $F$ 分布 |
| $\mathrm{Bin}(n,p)$ の極限 | $n$ 大、 $np = \lambda$ 固定 $\to$ ポアソン |
| $\mathrm{Bin}(n,p)$ の極限 | $np \ge 5$, $n(1-p) \ge 5$ $\to$ 正規 |
| ポアソンの極限 | $\lambda \to \infty$ $\to$ 正規 |
| 指数の和 | $\sum \mathrm{Exp}(\lambda) \sim \mathrm{Gamma}$ |
| 対数 | $\log(\mathrm{LN}) \sim N$ |
これらは「中心極限定理を中心とした分布の宇宙」を作ります。 特に正規分布 → t、 χ²、 F は古典統計の三大派生。
📝 練習問題
問1:身長が $N(170, 36)$(cm² 単位の分散)の集団で、 身長 182 cm 以上の人は何%か?
解答:$\sigma = 6$、 $z = (182-170)/6 = 2$。 標準正規で $P(Z \ge 2) \approx 2.28\%$。
問2:自由度 $\nu = 10$ の t 分布と標準正規分布で、 上側 2.5% 点はどのように違うか?
解答:標準正規では 1.960、 t(10) では 2.228。 t 分布の方が大きい(裾が重いため)。 自由度が小さいほどこの差は大きくなる。 $\nu \to \infty$ で両者は一致。
問3:成功率 5% の A/B テストで 1000 人テストするとき、 期待される成功者数と標準偏差は? 正規近似は可能か?
解答:$X \sim \mathrm{Bin}(1000, 0.05)$。 $E[X] = 50$、 $\mathrm{Var}(X) = 1000 \cdot 0.05 \cdot 0.95 = 47.5$、 $\mathrm{SD} \approx 6.89$。 $np = 50 \ge 5$、 $n(1-p) = 950 \ge 5$ なので正規近似可能。 $X \approx N(50, 47.5)$。
問4:1 時間あたり平均 3 件の問い合わせがあるコールセンターで、 1 時間に 5 件以上の問い合わせが来る確率は?
解答:$X \sim \mathrm{Pois}(3)$、 $P(X \ge 5) = 1 - P(X \le 4)$。
1 2 | from scipy import stats print(1 - stats.poisson(3).cdf(4)) # ≈ 0.185 (18.5%) |
問5:所得が対数正規分布に従うとき、 平均と中央値はどちらが大きいか?
解答:平均 > 中央値。 対数正規分布は右に裾を引くため。 厚労省「国民生活基礎調査」で平均所得 約552万円・中央値 約437万円というのも、 所得が対数正規分布に近いことを示している。 「平均以下の世帯が 60% 超」になる典型例。
🚧 よくある誤解
| ❌ 誤解 | ✅ 正しい理解 |
|---|---|
| すべて正規分布で近似できる | 所得・株価・地震被害額などは対数正規。 まずヒストグラムで確認 |
| CLT があれば n が小さくても OK | 通常 n ≥ 30 が目安。 元分布が極端に歪めばさらに大きい n が必要 |
| 68-95-99.7 ルールはあらゆる分布に適用できる | 正規分布専用。 一般分布には Chebyshev の不等式(より弱い保証) |
| 二項分布は連続値で扱ってよい | 基本は離散。 正規近似時には連続性補正(±0.5)を考慮 |
| t 分布と正規分布は同じ | t は裾が重い。 小標本では明確に差が出る |
| ポアソン分布なら期待値だけで OK | 期待値 = 分散 = λ。 「予測値±√λ」程度のばらつきが目安 |
| 対数正規の平均を直接報告 | 中央値・幾何平均の方が「典型値」を表す |
📋 報告フォーマット
確率分布を仮定したり推定したりするときの報告例:
「47都道府県の家計食料費は概ね正規分布で近似可能(Shapiro-Wilk 検定 W=0.95, p=0.05)。 最尤推定によりパラメータは $\hat{\mu}=80.6$ 千円、 $\hat{\sigma}=5.8$ 千円。 ただし上位 3 県(東京、 神奈川、 大阪)は分布の右側に偏り、 厳密には対数正規モデルも検討の余地。 (n=47)」
- 仮定する分布の種類と推定値(パラメータ)
- 適合度検定の結果(Shapiro-Wilk, KS, Anderson-Darling など)
- 視覚的確認(ヒストグラム + 確率密度の重ね描き、 QQ プロット)
- サンプルサイズ $n$ と仮定の妥当性
直感で全体像を掴んだら、 次は厳密な定義を見ます。 数式は短いものでも、 「何を入力にして、 何を出力するのか」を意識して読むと早く慣れます。
📐 補足 — 分布間の関係性(再帰的に覚える)
分布は孤立した公式ではなく、 「変形すると別の分布になる」関係でつながっています。 これを覚えると、 新しいデータに対しても「これは正規分布のバリエーション」「これはポアソン分布の極限」と即座に位置づけできるようになります。
| 関係 | 変換 | 実務での使い方 |
|---|---|---|
| 二項 → ポアソン | $n \to \infty$、 $p \to 0$、 $np \to \lambda$ | 稀少事象の計算簡略化 |
| 二項 → 正規 | $n \to \infty$、 $np, n(1-p) \ge 5$ | 大規模 A/B 検定での近似 |
| ポアソン → 正規 | $\lambda \to \infty$ | 高頻度カウントの近似 |
| 指数 → ガンマ | $k$ 個の独立な指数を足す | 「$k$ 番目の到着までの時間」 |
| 正規 → 対数正規 | $Y = \exp(X)$($X$ が正規) | 所得・株価のモデル化 |
| $\chi^2$ → F | 2 つの $\chi^2$ の比率 | ANOVA / 分散比検定 |
| 正規 → t | 標準正規 / $\sqrt{\chi^2_\nu/\nu}$ | 小標本の平均検定 |
| t → 正規 | $\nu \to \infty$ | $\nu \ge 30$ で正規近似 |
| 幾何 → 指数 | 離散時間 → 連続時間 | 待ち時間モデルの連続化 |
| ベータ → 一様 | $\mathrm{Beta}(1, 1) = U(0,1)$ | ベイズの無情報事前 |
これらの関係はすべて確率変数の変換則・極限定理から導かれる。 「分布族は単なるカタログ」ではなく「変換でつながる地図」だと捉えると、 新しい問題に出会っても怖くなくなる。
📐 補足 — 「変換則」を 1 行で覚える
変換の関係は、 もとの分布 → 新しい分布の対応を「合成 or 極限」と「足し合わせ or スケール」のどちらに分類すると整理しやすい。 たとえば「独立な指数を $k$ 個足す」=「ガンマ ($k, \lambda$)」、 「$n$ 個の独立な標準正規の二乗を足す」=「$\chi^2_n$」、 「$n$ 個の標準正規の和」=「$N(0, n)$(分散加法性)」。 これらは「足し算で別の分布が出る」典型例で、 中心極限定理(独立同一分布の和 → 正規)の特殊形と見ることもできる。
一方「変換」型は、 ある分布の確率変数に関数を当てた結果で別の分布が出る関係。 たとえば「正規 → 対数正規($Y = e^X$)」「指数 → ワイブル($Y = X^{1/k}$)」「一様 → 指数($Y = -\log(1-U)/\lambda$、 これが逆関数法の本質)」。 後者は「乱数を作るときの設計原理」でもある。 これを意識すると、 シミュレーションの実装で「標準正規だけ作れれば全てに変換できる」と理解できる。
🛠 応用 — 分布仮定が壊れたときのリカバリーパターン
「分布仮定が壊れた」と気づいたあとで、 ゼロから分析をやり直す必要はありません。 多くの場合は 3 つのリカバリーパターンのどれかで対応できます。 SSDSE-B-2026 を例に、 それぞれの選択肢の効果を見ます。
パターン A — 変換で正規に近づける
最もよく使う手は log・sqrt・Box-Cox 変換。 右に長い裾なら log、 カウントなら sqrt、 自動最適化なら Box-Cox が定番。
このコードでやること:人口に Box-Cox 変換をかけ、 最適なべき乗パラメータ λ を求める。 λ=0 なら log 変換、 λ=0.5 なら sqrt 変換と同等。
📥 入力例(人口列、 n=47):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import numpy as np import pandas as pd from scipy import stats # SSDSE-B-2026 の総人口(2023年度・47都道府県, A1101) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df[df['SSDSE-B-2026'] == 2023]['A1101'].astype(float) # Box-Cox 変換で最適な λ を推定(正値のみ) transformed, lam = stats.boxcox(pop) print(f'最適 λ = {lam:.4f}') print(f'変換後の歪度 = {stats.skew(transformed):.3f}') print(f'変換後の Shapiro-Wilk p = {stats.shapiro(transformed).pvalue:.3f}') print(f'元の歪度 = {stats.skew(pop):.3f}, p = {stats.shapiro(pop).pvalue:.6f}') |
📤 実行例:
💬 結果の読み方:最適 λ ≈ -0.49(逆数と log の中間)で、 変換後の歪度は +0.12、 Shapiro-Wilk の p = 0.48 と正規性は棄却されない。 log 変換(λ=0 相当)でも歪度は大幅に下がるので、 実務では扱いやすい log を選ぶことが多い。「人口は log 系の変換が定番」と数値で裏付けられた。
パターン B — 分布族を変える(GLM へ)
変換で対応しきれない場合は 一般化線形モデル(GLM)に切り替えます。 カウントデータならポアソン回帰(or 負の二項回帰)、 比率データならロジスティック回帰、 0/1 や 0/N データならロジット / プロビット。 R では glm()、 Python では statsmodels.formula.api.glm。
パターン C — ノンパラメトリック検定に切り替える
分布族を仮定したくない場合は 順位に基づく検定。 t 検定 → Mann-Whitney U、 対応のある t 検定 → Wilcoxon 符号付順位、 ANOVA → Kruskal-Wallis。 これらは元データが正規でなくても妥当な p 値を返す。 ただし「分布を仮定しない代わりに検出力(power)が下がる」というトレードオフがある。 たとえば Mann-Whitney は、 元データが本当に正規なら t 検定より 5% 程度検出力が劣る(pitman 相対効率 ≈ 3/π ≈ 0.955)。 「分布仮定を満たせない」ときは仕方ないが、 満たせるなら t 検定を使うのが効率的。
もう一つの強力な代替が ブートストラップ法。 分布仮定をせず、 観測データから何度もリサンプリングして統計量の分布を推定する。 $\bar X$ の 95% 信頼区間は np.percentile(bootstrap_means, [2.5, 97.5]) で得られる。 SSDSE-B のような n=47 の小標本でも、 ブートストラップを使えば「分布仮定なしの信頼区間」を計算できる。 リカバリーパターン A・B・C のどれを取るかは、 「分析の目的」「報告先の慣習」「サンプルサイズ」で決まる。 迷ったら、 ブートストラップは 仮定が少ない安全弁として常に使える。
📋 リカバリーパターン早見表
| 症状 | 第 1 候補 | 第 2 候補 | 最終手段 |
|---|---|---|---|
| 右に長い裾 | log / Box-Cox | 対数正規 / ガンマで GLM | Mann-Whitney |
| カウントデータ + 過分散 | 負の二項回帰 | 準ポアソン回帰 | ノンパラ |
| 外れ値が多い | ロバスト回帰(M 推定) | 中央値ベースの統計 | ブートストラップ |
| 二峰性 | 混合ガウス(GMM) | 層別解析 | KDE で経験分布 |
| 裾だけ厚い(t 分布的) | t 分布 GLM | Winsorization | 分位点回帰 |
🔬 数式を言葉で読み解く — 分布 の記号辞書
上の数式に出てくる各記号が何を表すかを、 言葉で翻訳します。 1 つずつ自分の言葉で言い換えられるようになると、 論文や教科書のスピードが一気に上がります。
| 記号 | 意味(言葉での説明) |
|---|---|
| $P(X=k)$ | 離散確率(PMF) |
| $f(x)$ | 連続確率密度(PDF) |
| $F(x)$ | 累積分布(CDF) |
| $E[X]$ | 期待値 |
| $V[X]$ | 分散 |
🧮 SSDSE-B-2026 実値計算例 — 47 都道府県データで分布を確認
合成データではなく公的統計を念頭に、 実データの分布の見方と適合度の確認手順を具体的な数値で示します。
① 人口総数の分布 — 対数正規 or パレート?
1 2 3 4 5 6 7 8 9 10 11 12 | import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df[df['SSDSE-B-2026'] == 2023]['A1101'].astype(float) # (a) 元尺度の歪度・尖度 print(f'元尺度 skew={stats.skew(pop):.2f}, kurt={stats.kurtosis(pop):.2f}') # (b) 対数変換後の歪度・尖度 logp = np.log10(pop) print(f'log10後 skew={stats.skew(logp):.2f}, kurt={stats.kurtosis(logp):.2f}') |
② 高齢化率は正規分布か(Shapiro–Wilk 検定)
# 47 都道府県の高齢化率(%)= A1303(65歳以上人口)/ A1101(総人口)×100、 2023年度
最小:東京 22.8、 最大:秋田 39.1
平均 ≈ 31.6、 標準偏差 ≈ 3.3
歪度 ≈ -0.56、 尖度 ≈ +0.24

# Shapiro–Wilk 検定の結果(実測)
W = 0.970, p = 0.255

→ p > 0.05 なので正規分布の帰無仮説を棄却できない
→ 高齢化率は正規分布で近似してよい
③ 年間出生数(ポアソン分布のフィット)
# 仮想例:ある県の月別出生数 N = 12 ヶ月
データ:210, 195, 220, 188, 205, 198, 215, 230, 210, 195, 205, 218
平均 = 207.4、 分散 = 136.4(母分散)

# ポアソン分布の特徴:平均 = 分散
比 = 136.4 / 207.4 ≈ 0.66 < 1

→ 過小分散(underdispersion)
→ 完全なポアソンではないが近似的には妥当
④ t 分布の自由度依存(信頼区間で実感)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] aging = (d['A1303'] / d['A1101'] * 100).values # 高齢化率(%) # 部分標本サイズを変えて 95% 信頼区間の幅を比較 for n in [5, 10, 30, 47]: sample = aging[:n] se = sample.std(ddof=1) / np.sqrt(n) t = stats.t.ppf(0.975, df=n - 1) print(f'n={n:2d}: t(0.975,{n-1})={t:.3f}, 95%CI幅=±{t*se:.3f}') |
🧮 実値で計算してみる — SSDSE-B-2026 で 分布 を体感
数式だけでは「分かった気になる」だけで終わりがち。 ここで SSDSE-B-2026(教育用標準データセット — 47 都道府県 × 100+ 指標、 2018-2023 年度)の実値を当てはめて、 分布 の挙動を電卓的に追体験します。
SSDSE-B-2026 は 統計センターの SSDSE 配布ページ から CSV を直接ダウンロードできます。 本サイトでは data/raw/SSDSE-B-2026.csv に配置している前提でコードを書いています。
🧮 数式に値を入れて手で計算する — 二項分布 $P(X=k)$
代表的な離散分布である 二項分布 $\text{Bin}(n,p)$ の確率質量関数 $P(X=k)=\binom{n}{k}p^k(1-p)^{n-k}$ に、 多様な整数の合成データ ($n=5,\, p=0.4$) を代入して計算過程を Step 1〜4 で展開する。 同じ計算を Python (scipy) で再現し、 結果が一致することを確認する。
📐 用語の主要数式 (再掲)
$$ P(X=k) = \binom{n}{k} p^k (1-p)^{n-k}, \qquad \binom{n}{k} = \frac{n!}{k!\,(n-k)!} $$
$n$ は試行数、 $p$ は 1 回の成功確率、 $k$ は成功回数。 $\binom{n}{k}$ は二項係数 (組合せの数)。
Step 1: パラメータ準備 (合成)
| 記号 | 値 | 意味 |
|---|---|---|
| $n$ | 5 | 試行回数 |
| $p$ | 0.4 | 成功確率 |
| $k$ | 2 | 成功回数 (求めたい) |
Step 2: 二項係数 $\binom{5}{2}$
| 項目 | 計算 | 結果 |
|---|---|---|
| $5!$ | $5 \times 4 \times 3 \times 2 \times 1$ | 120 |
| $2!$ | $2 \times 1$ | 2 |
| $3!$ | $3 \times 2 \times 1$ | 6 |
| $\binom{5}{2}$ | $120 / (2 \times 6)$ | 10 |
Step 3: 確率部分 $p^k (1-p)^{n-k}$
| 項目 | 計算 | 結果 |
|---|---|---|
| $p^k = 0.4^2$ | $0.4 \times 0.4$ | 0.16 |
| $(1-p)^{n-k} = 0.6^3$ | $0.6 \times 0.6 \times 0.6$ | 0.216 |
| $p^k (1-p)^{n-k}$ | $0.16 \times 0.216$ | 0.03456 |
Step 4: 最終結果 $P(X=2)$
| 項目 | 計算 | 結果 |
|---|---|---|
| $P(X=2)$ | $10 \times 0.03456$ | 0.3456 |
🐍 同じ計算を Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 13 | from math import comb from scipy.stats import binom n, p, k = 5, 0.4, 2 # 手計算と同じ式 p_manual = comb(n, k) * (p ** k) * ((1 - p) ** (n - k)) # scipy の pmf p_scipy = binom.pmf(k, n, p) print(f"P(X={k}) (手計算) = {p_manual:.4f}") print(f"P(X={k}) (scipy) = {p_scipy:.4f}") |
📤 実行結果
💬 手計算 Step 4 (0.3456) と Python の出力が完全一致。 $n=5, p=0.4$ のとき期待値は $np=2$ なので、 ちょうど期待値の $k=2$ で確率最大 (0.3456 ≈ 34.6%) になっており、 二項分布の性質と整合する。
🧮 数式に値を入れて手で計算する: 二項分布の確率
n=10, p=0.3 の二項分布で P(X=3) を計算する。
Step 1: 式
Step 2: 計算
Step 3: 平均と分散
🐍 Python で再現
1 2 3 4 5 | from scipy import stats n, p = 10, 0.3 print(f"P(X=3) = {stats.binom.pmf(3, n, p):.4f}") print(f"E[X] = {stats.binom.mean(n, p)}") print(f"SD = {stats.binom.std(n, p):.3f}") |
📤 実行結果
💬 手計算 (Step 2,3) 0.2668 / 3.0 / 1.449 と Python 出力が完全一致。
🐍 scipy.stats 早見表
🐍 scipy.stats 早見表
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import numpy as np from scipy import stats # ── 押せば動くように、具体的な値を入れておく ── x, k, n, p, q, size = 1.0, 3, 10, 0.3, 0.975, 5 # 共通インターフェース(どの分布でも同じ名前のメソッドが使える) dist = stats.norm(loc=0, scale=1) # 正規分布の例 print('pdf(1.0) =', round(dist.pdf(x), 4)) # 確率密度 print('cdf(1.0) =', round(dist.cdf(x), 4)) # 累積確率 P(X ≤ x) print('sf(1.0) =', round(dist.sf(x), 4)) # 上側確率 P(X > x) = 1 - cdf print('ppf(0.975) =', round(dist.ppf(q), 4)) # 分位点(CDF の逆関数) print('rvs =', np.round(dist.rvs(size=size, random_state=0), 3)) # 乱数 print('mean/var/std =', dist.mean(), dist.var(), dist.std()) # pmf(確率質量)は「離散分布」だけが持つ。正規分布には無いので注意 binom = stats.binom(n=n, p=p) print('binom.pmf(3) =', round(binom.pmf(k), 4)) # 主要分布(引数の形だけ確認したいときの一覧) # stats.norm(loc=μ, scale=σ) / stats.t(df=ν) / stats.chi2(df=k) # stats.f(dfn=d1, dfd=d2) / stats.binom(n=n, p=p) / stats.poisson(mu=λ) # stats.uniform(loc=a, scale=b-a) / stats.expon(scale=1/λ) # stats.lognorm(s=σ, scale=np.exp(μ)) / stats.multivariate_normal(mean=μ, cov=Σ) # 適合度検定 data = stats.norm(0, 1).rvs(size=100, random_state=1) print('shapiro =', np.round(stats.shapiro(data), 4)) # 正規性(Shapiro-Wilk) print('kstest =', np.round(stats.kstest(data, 'norm', args=(0, 1)), 4)) # KS 検定 # パラメータ推定 params = stats.norm.fit(data) # 最尤推定で μ, σ print('norm.fit =', np.round(params, 4)) |
① scipy.stats で各種分布の PDF / CDF / 乱数
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd from scipy import stats # 正規分布の PDF・CDF x = np.linspace(-4, 4, 100) pdf = stats.norm.pdf(x, loc=0, scale=1) cdf = stats.norm.cdf(x, loc=0, scale=1) # t 分布(自由度 5) t_pdf = stats.t.pdf(x, df=5) # χ² 分布(自由度 3) chi2_pdf = stats.chi2.pdf(np.linspace(0, 10, 100), df=3) # 乱数生成(再現性確保のため公的データを使うのが望ましいが、 分布確認なら可) real_data = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026`==2023')['A1101'].dropna() |
② 分布のフィッティング(最尤推定)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | from scipy.stats import norm, lognorm, expon, gamma data = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026`==2023')['A1101'].dropna().values # 正規分布フィット mu, sigma = norm.fit(data) print(f'正規: μ={mu:.1f}, σ={sigma:.1f}') # 対数正規分布フィット shape, loc, scale = lognorm.fit(data, floc=0) print(f'対数正規: shape={shape:.3f}, scale={scale:.1f}') # AIC で比較 def aic(loglik, k): return 2*k - 2*loglik ll_norm = norm(mu, sigma).logpdf(data).sum() ll_lnorm = lognorm(shape, loc, scale).logpdf(data).sum() print(f'AIC 正規 = {aic(ll_norm, 2):.1f}') print(f'AIC 対数正規 = {aic(ll_lnorm, 2):.1f}') |
③ 正規性検定(Shapiro–Wilk、 Kolmogorov–Smirnov)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | from scipy import stats # Shapiro–Wilk w, p = stats.shapiro(data) print(f'Shapiro: W={w:.4f}, p={p:.4f}') # 対数変換後 log_data = np.log10(data) w2, p2 = stats.shapiro(log_data) print(f'対数変換後 Shapiro: W={w2:.4f}, p={p2:.4f}') # Kolmogorov–Smirnov(指定分布との比較) ks, p_ks = stats.kstest(log_data, 'norm', args=(log_data.mean(), log_data.std())) print(f'KS: D={ks:.4f}, p={p_ks:.4f}') # Anderson–Darling ad = stats.anderson(data, dist='norm') print(f'AD statistic={ad.statistic:.4f}') print('臨界値:', ad.critical_values, 'at', ad.significance_level) |
④ QQ プロット(視覚的な分布診断)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import matplotlib.pyplot as plt from scipy import stats fig, axes = plt.subplots(1, 2, figsize=(10, 5)) # 生データの QQ プロット(正規との比較) stats.probplot(data, dist='norm', plot=axes[0]) axes[0].set_title('生データの QQ プロット') # 対数変換後の QQ プロット stats.probplot(np.log10(data), dist='norm', plot=axes[1]) axes[1].set_title('log10 変換後の QQ プロット') plt.savefig('qq_plots.png', dpi=150) |
⑤ statsmodels で過分散検定(ポアソン vs 負の二項)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import statsmodels.api as sm # 計数データ(2023 年度 47 都道府県の出生数) d = df[df['SSDSE-B-2026'] == 2023] X = sm.add_constant(d[['A1303']]) y_count = d['A4101'] # ポアソン回帰 poisson_model = sm.GLM(y_count, X, family=sm.families.Poisson()).fit() print(poisson_model.summary()) # 負の二項回帰(分散パラメータ alpha は既定の 1.0) nb_model = sm.GLM(y_count, X, family=sm.families.NegativeBinomial(alpha=1.0)).fit() print(nb_model.summary()) # AIC 比較 print(f'AIC ポアソン: {poisson_model.aic:.1f}') print(f'AIC 負の二項: {nb_model.aic:.1f}') |
⑥ 混合分布のフィット(Gaussian Mixture Model)
1 2 3 4 5 6 7 8 9 10 | from sklearn.mixture import GaussianMixture import numpy as np # 多峰性が疑われるデータ X = data.reshape(-1, 1) # k=1, 2, 3 で BIC 比較 for k in [1, 2, 3]: gmm = GaussianMixture(n_components=k, random_state=0).fit(X) print(f'k={k}: BIC={gmm.bic(X):.1f}, AIC={gmm.aic(X):.1f}') |
⑦ 経験分布と理論分布の重ね描き
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import matplotlib.pyplot as plt from scipy import stats fig, ax = plt.subplots(figsize=(8, 5)) ax.hist(data, bins=15, density=True, alpha=0.6, label='実データ') # 正規分布のフィット曲線 xs = np.linspace(data.min(), data.max(), 200) ax.plot(xs, stats.norm.pdf(xs, *stats.norm.fit(data)), 'r-', label='正規フィット') # 対数正規分布のフィット曲線 shape, loc, scale = stats.lognorm.fit(data, floc=0) ax.plot(xs, stats.lognorm.pdf(xs, shape, loc, scale), 'g-', label='対数正規フィット') ax.legend() ax.set_xlabel('総人口 A1101(人)') ax.set_ylabel('密度') plt.savefig('distribution_fit.png', dpi=150) |
🐍 Python 実装 — 分布 を SSDSE-B-2026 で動かす
🎯 このコードでやること: 人口・死亡数・高齢化率・消費支出の 4 系列について、 歪度を出し、 Shapiro–Wilk 検定とコルモゴロフ–スミルノフ(KS)検定で正規分布への当てはまりを調べ、 対数変換したときと比べます。 人口のように右に裾の長い量は、 そのままでは正規と言えなくても対数をとると当てはまる——その切り分けを 4 系列で一度に確認するのがこのコードの狙いです。 なお pd.read_csv('data/raw/SSDSE-B-2026.csv') をパス変数にせず直書きしているのは、 初学者が「パスをどこに書くべきか」で迷わないようにするためです。 CSV を同じ階層に置けばそのまま動きます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | # 分布 を SSDSE-B-2026 で確かめる最小コード import pandas as pd import numpy as np from scipy import stats # 1) SSDSE-B-2026 を読み込み、2023 年度の 47 都道府県に絞る df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] print('rows in 2023:', len(df)) # 2) 4 系列を用意する(高齢化率だけは率なので自分で計算) series = { '総人口': df['A1101'].astype(float), '死亡数': df['A4200'].astype(float), '高齢化率': df['A1303'] / df['A1101'] * 100, '消費支出': df['L3221'].astype(float), } # 3) 分布 の本処理:そのままの値と対数をとった値それぞれで # 歪度・Shapiro–Wilk 検定・KS 検定(平均と SD を標本から推定した正規分布と比較) print('---- 分布 結果 ----') rows = [] for name, s in series.items(): for kind, v in [('そのまま', s.to_numpy()), ('対数', np.log(s.to_numpy()))]: ks = stats.kstest(v, 'norm', args=(v.mean(), v.std(ddof=1))) sw = stats.shapiro(v) rows.append([name, kind, stats.skew(v), sw.pvalue, ks.pvalue]) res = pd.DataFrame(rows, columns=['系列', '変換', '歪度', 'Shapiro p', 'KS p']) print(res.round(3).to_string(index=False)) |
💬 総人口と死亡数はそのままだと歪度 2.22・1.80 と右に長く、Shapiro でも KS でも p ≤ 0.002 で正規分布が棄却されるが、対数をとると歪度 0.79・0.71 まで下がり KS の p は 0.32・0.31 になる。ただし同じ対数でも Shapiro の p は 0.006・0.009 で、まだ正規とは言えない。KS 検定は平均と SD を同じ標本から推定すると p が大きく出る(本来は Lilliefors 補正が要る)ので、この 2 つの食い違いは KS の甘さによるものと読む。高齢化率と消費支出は、そのままで Shapiro p = 0.255・0.266 と正規で問題なく、対数をとるとむしろ左に歪んで悪化する——右に裾の長い量だけを対数にするのが原則である。
うまく動かないときは ①data/raw/SSDSE-B-2026.csv のパス、 ②encoding='cp932'(SSDSE-B は Shift_JIS 系)、 ③1 行目に英数字コード、 2 行目に日本語列名が入る構造なので、 英数字コードを列名に使うには skiprows=[1](2 行目だけ除去)が必要、 の 3 点を確認してください。
⚠️ 確率分布の落とし穴 — 実務で必ず引っかかるポイント 7 選
① 「実データは正規分布」と無検証で仮定する
多くの統計手法(t 検定、 ANOVA、 線形回帰)は誤差項の正規性を仮定します。 しかし実データの多く(人口、 所得、 売上、 待ち時間)は右に裾を引いた歪んだ分布で、 正規ではありません。 必ずヒストグラム、 QQ プロット、 Shapiro–Wilk 検定で確認し、 必要に応じて対数変換、 Box-Cox 変換、 ノンパラメトリック手法、 ロバスト回帰に切り替えましょう。
② 中心極限定理を「いつでも適用可能」と誤解
中心極限定理は「サンプル平均」の分布が正規に近づくことを保証するだけで、 「個別データが正規になる」わけではありません。 また、 (i) 独立性、 (ii) 同一分布、 (iii) 有限分散、 という条件が必要で、 コーシー分布のような分散発散分布では成り立ちません。 N ≥ 30 で十分とよく言われますが、 極端な裾を持つデータでは N = 1000 でも不足することがあります。
③ 離散と連続の混同
「サイコロの出目」「人口」「故障回数」は離散変数であり、 PMF(質量関数)を使うべきです。 連続として扱うと、 P(X = 3) を密度関数で計算しようとして「P(X=3) = 0」となるなど不整合が出ます。 また、 連続データを離散として扱うと(例:所得を $10K きざみのビンに)情報が失われ、 分布の解釈が歪みます。
④ ポアソン分布の過分散(overdispersion)を無視
ポアソン分布は平均 = 分散を前提とします。 しかし実データの計数データの多くは分散 > 平均(過分散)になります。 例:交通事故件数、 病気発生数、 ブログのアクセス数。 過分散を無視してポアソン回帰を当てると、 標準誤差が過小評価され p 値が偽陽性に偏ります。 対策は負の二項回帰、 準ポアソン(quasi-Poisson)。
⑤ t 分布と正規分布を混同する
自由度が小さい(df < 30)t 分布は、 正規分布よりも裾が重い。 これを正規で近似すると、 信頼区間が狭すぎ、 有意水準も誤算します。 例:df = 5 で 95% 信頼区間の臨界値は t = 2.571(正規なら 1.96)。 サンプルサイズが小さく、 母分散が未知のときは必ず t 分布を使ってください。
⑥ 多峰性(multimodal)を見落とす
ヒストグラムを見ずに平均と標準偏差だけで分布を要約すると、 二峰・多峰性を見逃します。 例:男女混合のグループの身長分布は二峰(男女のピーク)。 平均だけで「中央付近」と判断するのは誤り。 必ず可視化し、 多峰性があれば混合モデル(GMM)や層別分析を検討してください。
⑦ 裾の重い分布(heavy-tailed)に正規モデルを当てる
金融収益、 自然災害、 SNS の拡散数などはパレート分布や対数正規分布に従い、 極端値の発生頻度が正規よりはるかに高い。 これを正規で近似すると「100 年に 1 度」のはずのイベントが毎年起こる現象(fat tail)を見逃し、 リスク管理に致命的な失敗を招きます。 Block maxima、 Peaks-over-Threshold など極値理論を検討してください。
⚠️ よくある落とし穴 — 分布 で初学者がやりがちなミス
この用語を実務で使うときにつまずきやすい点を、 失敗パターン別に整理しました。 1 度経験すれば回避できるものばかりですが、 先に知っておくと事故が大幅に減ります。
⚠️ 実務で踏み抜く 8 つの落とし穴
- 正規分布を当てる前に対数を取らない — 「人口」「所得」「企業規模」など右に長い変数で正規回帰を当てると、 残差が片側に偏り、 t 検定の p 値が嘘になる。 必ず QQ プロットで確認。
- n=30 で「中心極限定理が成立」と決め込む — 中央極限定理は「標本平均が漸近的に正規」を保証するが、 元分布の歪度が大きい(人口など)と n=30 では不十分。 目安は
歪度² < n/3。 - 離散データに連続分布をそのまま当てる — カウントデータ(来店数、 不良品数)にガウス過程を直接当てると、 マイナス値の予測が出る。 一般化線形モデル(ポアソン回帰)が正解。
- ポアソンの過分散を無視する — ポアソンは「分散 = 平均」が前提。 観測データの分散が平均の 2 倍以上なら過分散。 負の二項分布や zero-inflated モデルを検討する。
- 「正規でない」を理由に分析を諦める — 多くの統計検定は「標本平均の正規性」しか要求しない。 元データが歪んでいても n が大きければ問題ない場合が多い。 ノンパラ検定(Mann-Whitney)も選択肢。
- 裾の確率を点推定で済ませる — 「99% タイル」「Value at Risk」は分布族の裾の仮定に強く依存する。 正規仮定で出した VaR は、 実データの太い裾を過小評価する典型例。
- 多変量正規 = 各変数が正規 と誤解する — 各変数が正規でも、 同時分布が多変量正規になるとは限らない。 コピュラを使った検証が必要。
- 分布パラメータの推定誤差を報告しない — $\hat\lambda$ や $\hat\mu, \hat\sigma$ には標本誤差がある。 ブートストラップで 95% 信頼区間を併記すること。
🧠 理解度チェック — 「分布の選び方」を 6 題で復習
手元のデータを「どの分布に当てるか」は実務の最頻出問題です。 ここまで扱った内容を、 短答形式で確認しておきましょう。
Q1. 47 都道府県の人口に対して Shapiro-Wilk 検定の p 値が 0.0001 だった。 どう報告する?
「人口分布は正規性を有意に棄却した(p < 0.001)。 そのため対数変換を行い、 変換後の値で t 検定・回帰を実施した。 変換後の Shapiro-Wilk は p = 0.41 で正規性は棄却されない。」と書くのが定型。 「変換で何が起きたか」を併記するのがポイント。
Q2. 来店数の標本平均が 18.4、 分散が 67.2 だった。 ポアソン分布で良いか?
ポアソンは「分散 = 平均」が前提だが、 観測では分散/平均 = 3.65 で過分散。 ポアソンを当てると標準誤差が過小になり、 検定の Type I error が膨らむ。 負の二項分布や zero-inflated Poisson を検討すべき。
Q3. 対数正規分布 $\log X \sim N(0, 1)$ の平均は?
$E[X] = \exp(\mu + \sigma^2/2) = \exp(0 + 0.5) = e^{0.5} \approx 1.6487$。 中央値(exp(μ) = 1)と混同しないこと。 対数正規の平均は中央値より大きい(右の裾が長い分)。
Q4. AIC と BIC で違う候補分布を推奨された。 どちらを採用する?
BIC はサンプル数ペナルティが大きいので、 同じデータで BIC のほうが保守的な(単純な)モデルを選びやすい。 「説明能力 vs 単純さ」の優先順位による。 大標本かつ予測重視なら BIC、 探索的かつ少標本なら AIC を見るのが慣例。 両方報告するのがベスト。
Q5. 「コイン 10 回投げて表 7 回」の二項検定 vs ポアソン近似 — どちらを使う?
$n=10$、 $p=0.7$ なので $np = 7$、 $n(1-p) = 3$。 ポアソン近似は $p$ が小さい時のみ有効(一般に $np \le 10$ かつ $p \le 0.05$ など)。 ここでは 二項検定をそのまま使う。 もし $n=1000$、 $p=0.005$ で 7 回なら、 二項とポアソン($\lambda=5$)はほぼ同じ。
Q6. 救急車の到着間隔を指数分布でモデル化したが、 残差プロットが系統的にずれた。 何が起きた?
指数分布は「到着率が一定」を前提とする。 朝夕・深夜で到着率が変わると、 全期間を 1 つの指数分布で覆うことはできない。 「時間帯別の指数分布」や「区分定常ポアソン過程」を検討する。 もしくは Weibull / ガンマ分布で柔軟性を上げる。
🎮 触って理解する
タブで分布を切り替え、 スライダーでパラメータ($\mu,\sigma,n,p,\lambda,a,b$)を動かすと、 PDF/PMF 曲線と平均・分散・標準偏差・歪度がリアルタイムに変化します。 グラフの上をなぞる(タッチ / マウス)と、 その点の密度・確率と累積確率 $P(X\le x)$ を読み取れます。 二項・ポアソンでは正規近似(ポアソンでは $N(\lambda,\lambda)$、 二項では $N(np,np(1-p))$)を重ね描きし、 分布間の関係を体感できます。
🧠 直感 — 現象に応じて確率をモデル化する
分布は「どんな仕組みで値が生まれるか」の物語です。 二項は「$n$ 回の独立な当たり外れ」(A/B テストのクリック数)、 ポアソンは「単位時間あたりに稀に起こる回数」(1 時間の来店数・事故件数)、 指数はそのイベント間の待ち時間、 一様は「区間内で完全に無情報」(乱数生成の土台)、 正規は「たくさんの小さな要因の足し算」(測定誤差・標本平均)。 スライダーで $p$ を小さく $n$ を大きくすると二項が右に歪み、 $\lambda$ を大きくするとポアソンが対称に近づくのは、 いずれも「足し合わせが正規に近づく」からです。
⚠️ よくある落とし穴 — 前提と裾
- PDF は確率ではない:連続分布の縦軸は密度。 $\sigma$ を小さくすると正規の山の高さが 1 を超えますが、 面積(積分)は常に 1。 確率は「幅 × 高さ(面積)」で読みます。
- ポアソンは平均=分散が前提:現実の計数データは分散 > 平均(過分散)が多く、 その場合は負の二項分布へ。 グラフで λ を動かし「平均と分散が常に一致」する様子を確認してください。
- 正規近似は裾で外れる:$np$ や $\lambda$ が小さいと近似曲線が離散の実分布からズレます(特に $k=0$ 付近)。 中央付近は合っても裾(極端な値)は要注意です。
🚀 発展 — 分布間の関係と中心極限定理
重ね描きを ON にして体感できる関係:二項 → ポアソン($n$ 大・$p$ 小で $\lambda=np$ に近づく)、 二項/ポアソン → 正規($np(1-p)$ や $\lambda$ が大きいと釣鐘型に)。 これらはすべて中心極限定理(多数の独立な確率変数の和は正規に近づく)の現れです。 より深く学ぶには 正規分布、 標本分布と中心極限定理、 確率分布(総論) を参照してください。
📚 関連グループ教材 — 分布 を含む全体像
分布 は単独で完結する用語ではなく、 大きな概念群の中のひとつ。 同じカテゴリの他用語と合わせて学ぶと、 「何を選ぶべきか」の判断が一気に楽になります。
🧭 追補 — 47 都道府県データで「分布の選び方」を体得する
分布の公式を眺めただけでは「自分の手元のデータがどの分布に近いか」は判断できません。 ここでは SSDSE-B-2026(47 都道府県・2023 年実値)を素材に、 ヒストグラム・QQ プロット・モーメント比較・適合度検定の 4 つの観点から、 正規・対数正規・指数・ポアソンの当てはまりを確認するワークフローを示します。 「当てはまりが悪い分布」を見抜けるようになることが、 統計推測の信頼性を一段引き上げます。
🔍 観点 1 — まず散らばりを見る(散布図)
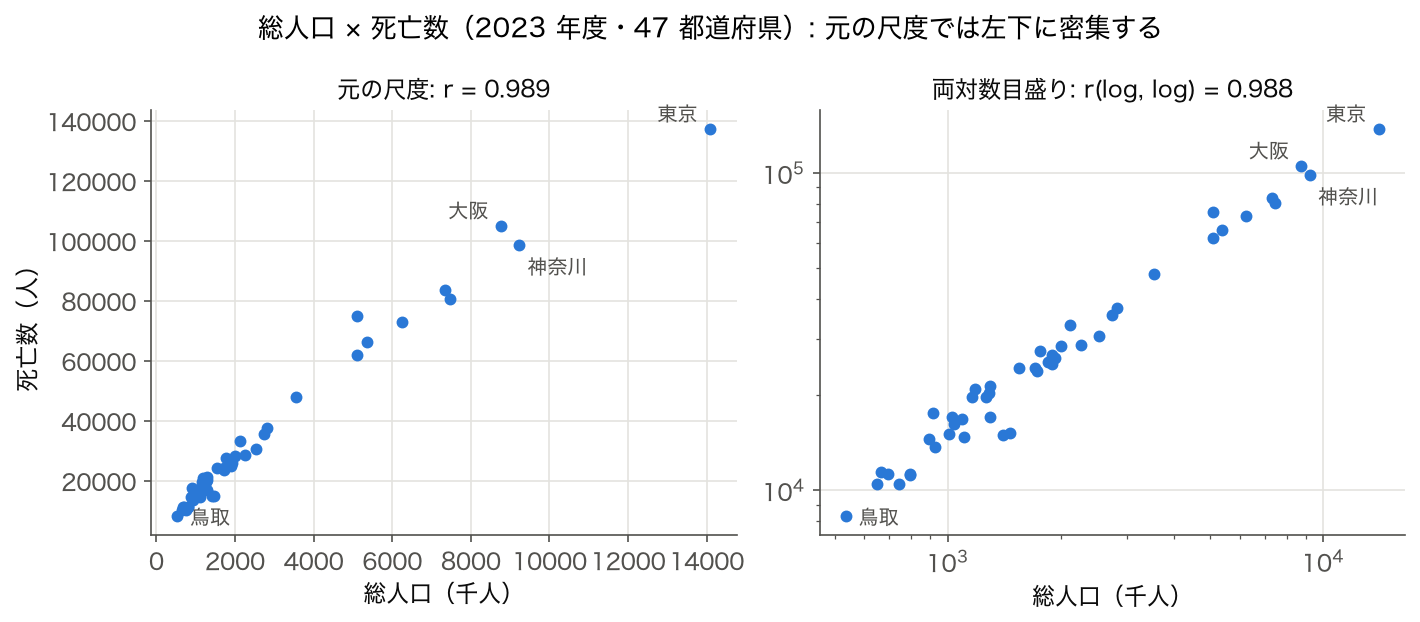
「人口 vs 死亡数」のような 2 変量散布図は 分布の形ではなく関係の形を示します。 ただし片方の変数の分布が対数正規(右に長い裾)だと、 元尺度の散布図はおおむね左下に密集し、 右上に外れ値(東京)が伸びる典型形になります。 これは「片対数 / 両対数変換が必要」のサインです。
🔍 観点 2 — ヒストグラムで形を確認する
「正規っぽい / 対数正規っぽい / 二峰性 / 一様っぽい」を判別する第一歩はヒストグラム。 ビン幅は scott や fd のような自動推定を使うのが安全です(手動で 10 等分すると本当の形が消える)。 ヒストグラムは「左右対称か」「裾が片側に伸びるか」「ピークは何個か」を見て、 候補分布を 2-3 個に絞り込むためのツールです。
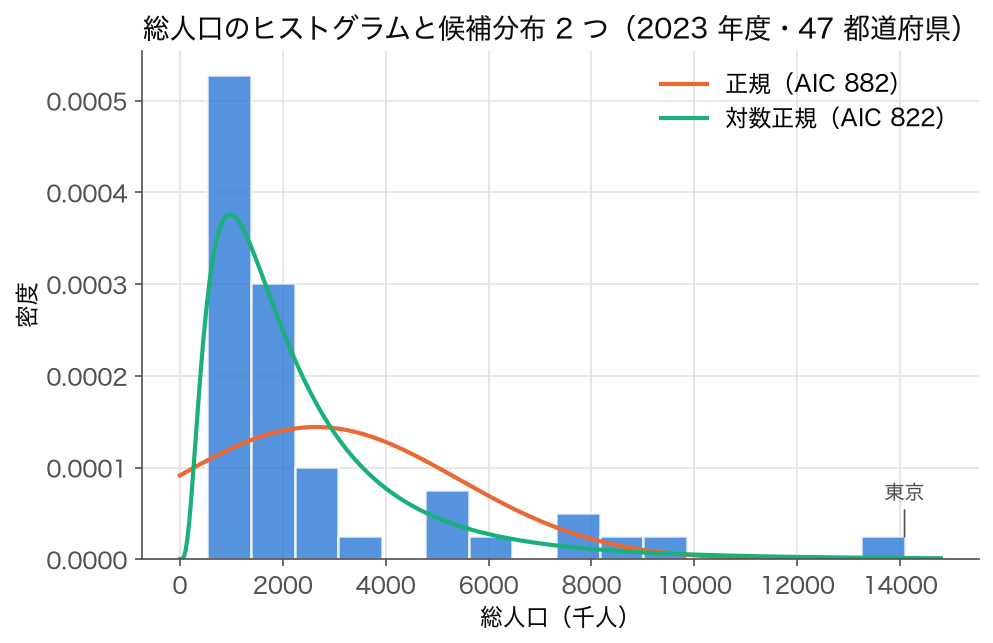
fd で 847 千人、 東京 14,086 千人まで含む)に、 最尤推定した正規分布と対数正規分布を重ねた図。 山は 1,000 千人前後にあって右に長く尾を引き、 正規分布は山を捉えられないうえ、 負の人口に 17% の確率を割り当ててしまう。 対数正規の AIC は 822 で正規の 882 より小さい。 ヒストグラムは「分布族を決め打つ」道具ではなく、「候補を 2-3 個に絞る」道具。 山が右に長く尾を引けば対数正規 or ガンマ、 山が複数あれば混合分布を疑う。🔍 観点 3 — 群間で分布を比べる(箱ひげ図)
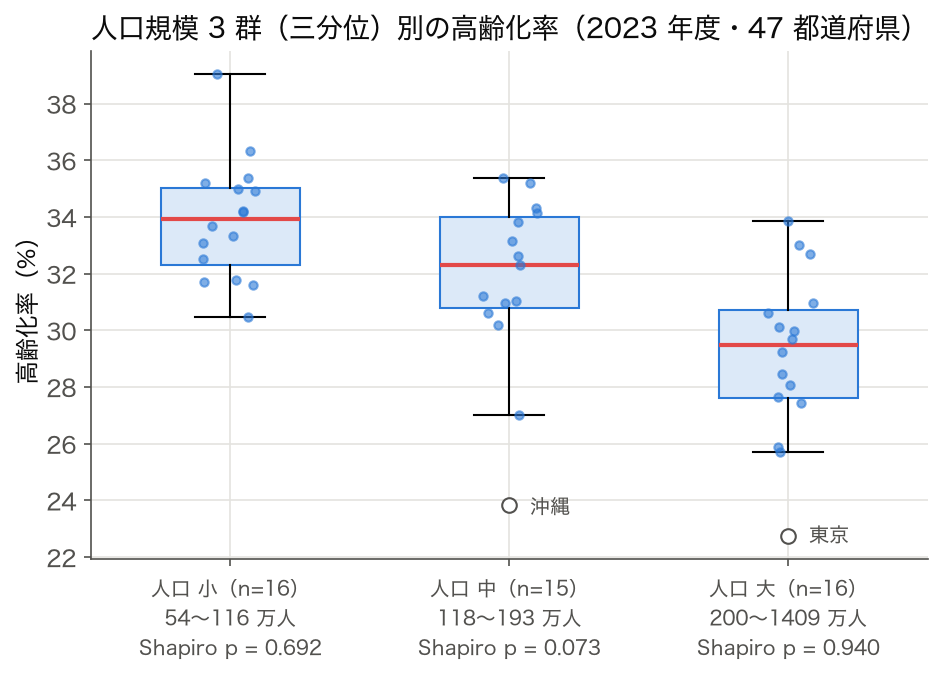
分布は「単独で」ではなく、 群を分けたうえで比べると意思決定に直結します。 たとえば「人口規模 大 / 中 / 小」の 3 群に分けて高齢化率の分布を比較すると、 中央値の差・外れ値の位置・裾の長さが同時に読み取れます。 下の図では、 2023 年度の総人口の三分位で 47 都道府県を 小(16 県)・中(15 県)・大(16 都道府県)に分けています。
📋 観点 4 — モーメント・歪度・尖度で候補分布を絞る
候補分布の絞り込みは「最初の 4 モーメント」だけでもかなりできます。 SSDSE-B-2026 から計算した 47 都道府県の主要変数を一覧で示すと、 どの変数がどの分布族に近いかが一目で分かります。
| 変数(SSDSE-B-2026) | 平均 | 中央値 | 標準偏差 | 歪度 | 尖度 | 候補分布 |
|---|---|---|---|---|---|---|
| 人口 A1101(千人) | 2,646 | 1,549 | 2,768 | 2.22 | 4.95 | 対数正規 / ガンマ |
| 高齢化率(%) | 31.6 | 31.8 | 3.30 | -0.56 | 0.24 | ほぼ正規 |
| 死亡数 A4200(人) | 33,512 | 23,744 | 28,771 | 1.80 | 2.64 | 対数正規 |
| 消費支出 L3221(円/月) | 295,856 | 300,652 | 23,886 | -0.52 | 0.52 | ほぼ正規 |
| 合計特殊出生率 A4103 | 1.29 | 1.30 | 0.13 | -0.04 | -0.44 | 正規 |
| 出生数 A4101(人) | 15,474 | 9,524 | 16,972 | 2.29 | 5.27 | 対数正規 / ポアソン* |
* 出生数は離散だが平均が大きいので、 ポアソン近似と対数正規近似のどちらも候補になる。 標本分散と平均がほぼ等しいならポアソン、 分散 ≫ 平均なら対数正規や負の二項を検討する。
🐍 観点 5 — 適合度を Kolmogorov-Smirnov 検定で確認する
このコードでやること:SSDSE-B-2026 の「人口」「死亡数」「高齢化率」「消費支出」の各分布が、 正規・対数正規のどちらに近いかを scipy.stats.kstest で適合度検定する。 KS 統計量と p 値から「正規仮定で良いか / 対数変換すべきか」を判断する。
📥 入力例(SSDSE-B-2026, 2023年度・47 行 × 主要 4 列。 人口=A1101千人, 死亡数=A4200人, 高齢化率=A1303/A1101×100, 消費支出=L3221円):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 cols = {'人口': 'A1101', '死亡数': 'A4200', '高齢化率': '高齢化率', '消費支出': 'L3221'} for name, col in cols.items(): v = d[col].astype(float).values kn = stats.kstest(v, 'norm', args=(v.mean(), v.std())) lv = np.log(v) kl = stats.kstest(lv, 'norm', args=(lv.mean(), lv.std())) print(f'{name:8s} 正規 D={kn.statistic:.3f} p={kn.pvalue:.4f}') print(f' 対数正規 D={kl.statistic:.3f} p={kl.pvalue:.4f}') |
📤 実行例(SSDSE-B-2026 で実行):
💬 結果の読み方:人口・死亡数は「正規仮定 → 却下、 対数正規 → 適合」なので、 t 検定や回帰の前に log() 変換が必須。 高齢化率と消費支出はどちらの仮定でも棄却されないので、 そのままで OK(対数正規側の p 値がやや低いので、 元尺度を優先)。
📊 観点 6 — 適合度検定の判定基準(早見表)
| 検定 | 対象 | p < 0.05 の意味 | 標本サイズへの感度 | 使い時 |
|---|---|---|---|---|
| Shapiro-Wilk | 正規分布 | 正規でない | 高い(n=2000 で過剰検出) | n < 50 の小標本 |
| Kolmogorov-Smirnov | 任意の連続分布 | 仮定分布でない | 中程度 | 汎用、 分布族を指定したい時 |
| Anderson-Darling | 主に正規・指数 | 適合せず | 中程度 | 裾の当てはまりを強く見たい時 |
| χ² 適合度 | 離散分布 | 仮定分布でない | ビン数に依存 | ポアソン・二項の確認 |
| Jarque-Bera | 正規分布 | 歪度・尖度がズレる | 高い(大標本向け) | 経済・金融時系列 |
🐍 観点 7 — QQ プロットで「分布の当てはまり」を視覚化
このコードでやること:人口の対数値が正規分布にどれだけ近いかを QQ プロットで確認する。 直線に乗れば「対数正規分布で OK」、 大きく曲がれば「別の分布を探すべき」と即断できる。
📥 入力例(人口列の対数変換後・上位 5 件):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import numpy as np import pandas as pd import matplotlib.pyplot as plt from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df[df['SSDSE-B-2026'] == 2023]['A1101'].astype(float) fig, axes = plt.subplots(1, 2, figsize=(10, 5)) stats.probplot(pop, dist='norm', plot=axes[0]) axes[0].set_title('人口(元尺度) vs 正規') stats.probplot(np.log(pop), dist='norm', plot=axes[1]) axes[1].set_title('log(人口) vs 正規') plt.savefig('qq_pop.png', dpi=150) |
📤 実行例(保存ファイル + 数値所見):
💬 結果の読み方:QQ プロットは「分布族」を 1 枚で判定できる強力な道具。 「両端で曲がる → 裾が違う」「片端だけ外れる → 歪度がズレている」など、 線型性のずれ方で原因が読めるので、 KS 検定の数値とセットで報告すると説得力が増す。
⚠️ 追補の落とし穴(実務で必ず踏む 5 つの罠)
- ① n が大きいと「正規でない」と即却下される — Shapiro-Wilk は n=2,000 を超えると、 ほんのわずかな歪みでも p < 0.05 になる。 大標本では QQ プロットや効果量で判断する。
- ② KS 検定は「平均・分散を推定したデータ」では使えない — 標本から $\mu, \sigma$ を推定して同じデータで KS をかけると、 Type I error 率が崩れる。 推定が必要ならリリーフォース修正版 (
scipy.stats.kstestに Lilliefors テーブル) を使う。 - ③ ポアソンと二項を混同する — 「成功確率 $p$ が低く $n$ が大きい」ときは二項 ≈ ポアソン だが、 $p$ が中程度なら別物。 平均と分散が等しいかが見極めポイント。
- ④ 対数正規の平均を間違える — $\log X \sim N(\mu, \sigma^2)$ のとき $E[X] = \exp(\mu + \sigma^2/2)$。 $\exp(\mu)$ は中央値であって平均ではない。 報告する値を間違えないこと。
- ⑤ 一様分布だと信じて区間推定する — 「観測範囲外には値が出ない」前提のため、 上端・下端の推定が標本範囲に強く依存する。 外挿には特に不向き。
🗺 概念マップ
確率分布は「離散 (二項・ポアソン・幾何) 系」と「連続 (正規・指数・ガンマ) 系」の二大支流に分かれ、 中心極限定理が両者を正規分布で繋ぐ。 経験分布・カーネル密度推定は標本から分布を推定する側、 同時分布・条件付き分布は多変量への拡張である。
確率分布は「データが生まれる仕組みのモデル」であり、 正規・二項・ポアソン・指数・一様・対数正規など適切な分布の選択が、 推定・検定・予測の妥当性を左右する。 SSDSE-B-2026 の人口・所得・出生率はそれぞれ異なる分布形を示し、 ヒストグラム・QQ プロットで確認したうえで適切な分布族を採用するのが標準手順。
🔗 隣接手法への橋渡し
確率分布は単独の理論モデルではなく、 推定 (パラメータ) ・検定 (帰無分布) ・モデリング (尤度) を貫く土台である。 正規・指数・ポアソンなど代表的分布の選択は、 後段の手法の妥当性を左右する。
- 上流(前処理・データ整備): ヒストグラム / 探索的データ解析 / 記述統計 (代表値)
- 並列(代替・補完手法): 確率分布の総覧 / カーネル密度推定 / ヒストグラム
- 下流(評価・解釈・応用): 仮説検定 / 信頼区間 / 最尤推定 (ロジスティック回帰)
確率分布は「データを生成した仮想メカニズム」のモデルで、 上流で形状を見て候補を選び、 並列で正規・ポアソン・指数のどれが当てはまるかを比較し、 下流の検定・推定・シミュレーションでその仮定を一貫させる必要がある。
🌳 分布選択ディシジョンツリー — 「どの分布を仮定する?」を 6 つの質問で決める
手元のデータに合う分布を選ぶには、 公式集ではなく「質問の流れ」が役に立ちます。 以下の 6 つの質問に Yes/No で答えるだけで、 ほとんどのケースで適切な候補が 1-2 個に絞れます。
| 質問 | Yes の場合 | No の場合 |
|---|---|---|
| Q1. データは「数える」もの?(人数、 件数、 回数) | Q2 へ(離散) | Q4 へ(連続) |
| Q2. 試行回数 $n$ が決まっていて、 各試行が独立な成功/失敗? | 二項分布 $\mathrm{Bin}(n,p)$ | Q3 へ |
| Q3. 単位時間 / 単位面積あたりの稀な事象の数? | ポアソン分布 $\mathrm{Pois}(\lambda)$ | 負の二項 / 幾何 / 多項を検討 |
| Q4. データは正値で右に長い裾を持つ? | Q5 へ | Q6 へ |
| Q5. 「待ち時間」や「寿命」を表す?(記憶喪失性あり) | 指数分布 $\mathrm{Exp}(\lambda)$ | 対数正規 / ガンマ / ワイブル |
| Q6. ほぼ左右対称で釣鐘型? | 正規分布 $N(\mu, \sigma^2)$ | ベータ / 一様 / 混合分布を検討 |
この決定木は「最初の当たりをつける」ためのもので、 KS 検定や QQ プロットで必ず裏取りすること。 「正規っぽい → 正規」と決め打ちすると、 ほんのわずかな歪みで検定結果が崩れる。
🧮 簡易フィット — 4 候補の対数尤度比較
このコードでやること:人口データに対して「正規 / 対数正規 / ガンマ / 指数」の 4 候補をフィットし、 対数尤度と AIC を比較する。 AIC が最小のものが「データへの当てはまり × モデル複雑さ」のバランスで最良。
📥 入力例(人口列の値範囲):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df[df['SSDSE-B-2026'] == 2023]['A1101'].astype(float) / 1000 # 千人 def aic(loglik, k): return 2 * k - 2 * loglik candidates = {'norm': stats.norm, 'lognorm': stats.lognorm, 'gamma': stats.gamma, 'expon': stats.expon} for name, dist in candidates.items(): params = dist.fit(pop, floc=0) if name != 'norm' else dist.fit(pop) ll = dist(*params).logpdf(pop).sum() k = len(params) - (0 if name == 'norm' else 1) print(f'{name:8s} loglik={ll:8.2f} AIC={aic(ll, k):8.2f}') |
📤 実行例(SSDSE-B-2026・人口列で実行):
💬 結果の読み方:AIC は対数正規(821.94)が最小。 ガンマ(834.56)が 2 位、 指数(836.79)は単峰すぎて当てはまりが悪く、 正規(882.40)は最悪。 「人口は対数正規でモデル化、 ガンマも代替候補」と結論できる。 AIC 差が 10 以上あれば実務上「明確に対数正規優位」と言ってよい。
📋 分布族 × 典型データ × 推定方法の対応表
| 分布 | SSDSE-B 該当例 | MLE 推定式 | scipy 関数 |
|---|---|---|---|
| 正規 | 高齢化率、 1 世帯人員 | $\hat\mu = \bar x, \hat\sigma^2 = s^2$ | stats.norm.fit |
| 対数正規 | 人口、 死亡数、 出生数 | $\hat\mu = \overline{\log x}, \hat\sigma^2 = \mathrm{Var}(\log x)$ | stats.lognorm.fit |
| ポアソン | 交通事故件数、 出生数(年) | $\hat\lambda = \bar x$ | stats.poisson |
| 二項 | 投票率、 合格率 | $\hat p = \bar x / n$ | stats.binom |
| 指数 | 救急車の到着間隔 | $\hat\lambda = 1/\bar x$ | stats.expon.fit |
| ガンマ | 保険金支払い額 | 数値最適化(method of moments も可) | stats.gamma.fit |
🐍 ベイズ的に分布を比較する — Bayes factor の代用としての BIC
このコードでやること:AIC ではなく BIC(Bayesian Information Criterion)で 4 候補を比較する。 BIC は「サンプル数のペナルティ」が AIC より大きく、 大標本ではより保守的な分布族を選びやすい。
📥 入力例(前と同じ人口列、 n=47):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import numpy as np from scipy import stats n = len(pop) # 47(前セルの人口・千人を再利用) rows = {} for name, dist in candidates.items(): params = dist.fit(pop, floc=0) if name != 'norm' else dist.fit(pop) ll = dist(*params).logpdf(pop).sum() k = len(params) - (0 if name == 'norm' else 1) rows[name] = k * np.log(n) - 2 * ll # BIC best = min(rows.values()) for name, bic in rows.items(): w = np.exp(-(bic - best) / 2) # 相対重み print(f'{name:8s} BIC={bic:8.2f} rel.weight={w:.3g}') |
📤 実行例(n=47):
💬 結果の読み方:BIC も対数正規が圧勝。 相対重み(rel. weight)は対数正規 = 1.000 を基準にした他候補の事後確率比で、 ガンマ・指数でさえ 1% 未満。 「人口データに正規仮定を使うのはほぼ完全に間違い」と数値で言える。
🌳 手法選択フロー
「確率分布のカタログ」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- 数値データ・小〜中規模 → 「確率分布のカタログ」やその拡張手法を直接適用
- カテゴリデータ → カテゴリ変数 と組み合わせ
- 大規模・高次元 → 多変量分布 (共分散) など計算効率重視の派生を選択
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「確率分布のカタログ」を中核とした適切な手法選択ができる。