🔖 キーワード索引
ベイズの定理に関する用語を 登場人物・式の部品・使い道・対立する立場 別に索引化します。「原因から結果」ではなく「結果から原因」に向かう向きを意識すると、記号が何を指しているか迷わなくなります。
| カテゴリ | キーワード(日本語) | キーワード(英語) |
|---|---|---|
| 式の登場人物 | 事前確率、 尤度、 事後確率、 周辺尤度(証拠)、 正規化定数 | prior, likelihood, posterior, marginal likelihood / evidence, normalizing constant |
| 確率の基礎 | 条件付き確率、 同時確率、 周辺確率、 独立、 全確率の定理 | conditional / joint / marginal probability, independence, law of total probability |
| 診断の文脈 | 感度(真陽性率)、 特異度、 陽性的中率、 陰性的中率、 有病率 | sensitivity, specificity, PPV, NPV, prevalence |
| 更新の考え方 | 逐次更新、 ベイズ更新、 共役事前分布、 事後平均、 信用区間 | sequential update, Bayesian updating, conjugate prior, posterior mean, credible interval |
| 代表的な応用 | ナイーブベイズ、 スパム判定、 ベイズ推定、 A/B テスト、 異常検知 | naive Bayes, spam filtering, Bayesian inference, A/B testing, anomaly detection |
| 立場の違い | ベイズ統計 vs 頻度論、 信用区間 vs 信頼区間、 主観確率、 無情報事前分布 | Bayesian vs frequentist, credible vs confidence interval, subjective probability, uninformative prior |
| よくある誤り | 基準率の無視、 検察官の誤謬、 逆確率の取り違え、 事前分布の恣意性 | base rate fallacy, prosecutor fallacy, inverse fallacy, prior sensitivity |
💡 30秒で分かる結論
🍰 まずはやさしく
予想を書き換えるための道具です。
新しいデータで正解率を上げるために使います。
迷惑メールを自動で分ける仕組みに似ています。
結論となる数式と使い道を学びます。
ベイズの定理 ── 事前確率と尤度から事後確率を求める定理
- 新しいデータで信念を更新する数式。 「事前確率 × 尤度 ∝ 事後確率」
- 式:
P(H|D) = P(D|H) × P(H) / P(D) - 使い道:迷惑メール判定、 医療診断、 A/Bテスト、 因果推論、 機械学習一般
- 頻度主義(古典統計)と対立。 主観確率を許容するか/しないか
- 事前分布を意識的に選ぶ/更新の反復計算(ベイズ更新)が要諦
📍 文脈 ── どこで出会うか
🍰 まずはやさしく
情報を集めて考えを深める枠組みです。
データから正しい答えを導くために使います。
都道府県のデータを分析する時に役立ちます。
定義から実装までの流れを順番に読みます。
ベイズは「データを見るたびに信念を更新する」枠組み。 確率を「データを増やしながら精製する泥」と捉える、 直感に合う考え方です。 機械学習・統計の幅広い基礎理論でもあります。
本ページでは「bayes theorem」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「bayes theorem」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
経験で予想を更新する感覚のことです。
ある出来事が起きた理由を考えるために使います。
メールの単語から迷惑メールかを判断します。
具体例を使って直感的に理解しましょう。
迷惑メール判定:
- 事前確率:受信メールが迷惑である確率 P(spam) ≈ 0.5
- 尤度:単語「無料」が迷惑メールに出る確率 P(無料|spam) = 0.8
- 尤度:「無料」が通常メールに出る確率 P(無料|ham) = 0.1
- あるメールに「無料」がある場合:P(spam|無料) = 0.8 × 0.5 / (0.8×0.5 + 0.1×0.5) ≈ 0.89
事前 0.5 → 事後 0.89 と更新された。 これが Naive Bayes 分類器の原理。
📐 定義/数式
🍰 まずはやさしく
確率の計算ルールをまとめた式です。
もともとの予想を正しく修正するために使います。
スマホの予測変換などの仕組みに関わります。
記号の意味と計算の方法について読みます。
🔬 数式を言葉で読み解く
- P(H)
- 事前確率(prior)。 データを見る前の信念
- P(D|H)
- 尤度(likelihood)。 仮説の下でデータが出る確率
- P(H|D)
- 事後確率(posterior)。 データ反映後の信念
- P(D)
- 周辺尤度(evidence)。 正規化定数
- MAP推定
- 事後を最大化する仮説を選ぶ
🔬 さらに深掘り:ベイズの定理を SSDSE 都道府県データで実践
🔖 拡張キーワード索引
💡 30秒で分かる結論(拡張版)
- ベイズの定理は 事前の信念 × 観測の尤度 ÷ 全観測の確率 で事後の信念を計算する。
- 「99% の精度の検査で陽性 → 99% の確率で病気」は嘘。 有病率(事前確率)を無視するから。
- SSDSE 都道府県データなら「人口 100 万人未満」「合計特殊出生率 1.5 以上」のような分類問題に直接適用できる。
- 事前分布にベータ分布、 尤度に二項分布を組み合わせると 共役性で事後も解析的にベータ分布になる(電卓で計算可能)。
📍 文脈ボックス
あなたが今見ているのは ベイズの定理 の「拡張節」です。 上の節で「数式と医療診断の例」を学んだので、 ここでは SSDSE-B-2026 の都道府県データを使った「合計特殊出生率の地域分類」を実演します。 「ある地域が出生率 1.5 以上である事後確率は何%か?」をベイズで計算します。 これは Naive Bayes 分類器の最も素朴な形です。
🎨 直感で掴む(拡張)
SSDSE-B-2026 の 2023 年データに登場する 47 都道府県のうち、 合計特殊出生率 1.40 以上は 11 県(沖縄・宮崎・島根など)です。 「ある県が 九州地方(福岡・佐賀・長崎・熊本・大分・宮崎・鹿児島) である」という情報を観測したとき、 その県の出生率が 1.5 以上である事後確率はいくつになるか? ── これが「新情報で信念を更新する」ベイズの実演です。
- 事前(prior):47 県のうち出生率≥1.5 は 9 県 → P(高出生) ≈ 9/47 ≈ 0.19
- 尤度(likelihood):高出生 9 県のうち九州にあるのは 5 県 → P(九州 | 高出生) ≈ 5/9 ≈ 0.56
- 尤度(負):低出生 38 県のうち九州にあるのは 2 県 → P(九州 | 低出生) ≈ 2/38 ≈ 0.053
- 事後(posterior):P(高出生 | 九州) = (0.56 × 0.19) / (0.56×0.19 + 0.053×0.81) ≈ 0.71
事前 19% から事後 71% へジャンプ。 「九州」という観測が信念を大幅に更新した、 ということです。
📐 数式または定義(拡張)
2 クラス分類(仮説 $H_1$ vs $H_0$)の事後オッズは尤度比 × 事前オッズ:
$$ \frac{P(H_1 \mid D)}{P(H_0 \mid D)} = \underbrace{\frac{P(D \mid H_1)}{P(D \mid H_0)}}_{\text{尤度比}} \cdot \underbrace{\frac{P(H_1)}{P(H_0)}}_{\text{事前オッズ}} $$
対数を取ると線形:
$$ \log \frac{P(H_1 \mid D)}{P(H_0 \mid D)} = \log \frac{P(D \mid H_1)}{P(D \mid H_0)} + \log \frac{P(H_1)}{P(H_0)} $$
ベルヌーイ試行(成功確率 $\theta$)に対する ベータ–二項モデルの共役更新は:
$$ \theta \sim \text{Beta}(\alpha, \beta) \to \theta \mid (s \text{ 成功}, f \text{ 失敗}) \sim \text{Beta}(\alpha + s, \beta + f) $$
🔬 数式を言葉で読み解く(拡張)
- 尤度比 LR
- 「データ $D$ が仮説 $H_1$ の下でどれだけ起きやすいか/$H_0$ の下でどれだけ起きやすいか」の比。 LR > 1 なら $H_1$ 寄りに更新、 LR < 1 なら $H_0$ 寄り。
- 事前オッズ
- データを見る前の「$H_1$ がもっともらしい度合い ÷ $H_0$ がもっともらしい度合い」。 ベースレート(基準率)の表現。
- 事後オッズ
- データを見たあとの信念の比。 「事前 × 尤度比」という掛け算(対数なら足し算)。
- Beta(α,β) の更新
- α は「過去の成功擬似カウント」、 β は「過去の失敗擬似カウント」と解釈できる。 新しく s 回成功・f 回失敗を観測したら、 α と β にそのまま足し算で更新できる(数式不要!)。
🧮 実値で計算してみる(SSDSE-B-2026・合計特殊出生率)
SSDSE-B-2026 の 2023 年 47 都道府県データから「合計特殊出生率 ≥ 1.40 を 高出生」「九州地方の県」を観測として、 事後確率を手計算します。
| 区分 | 該当県数 | うち九州 7 県 | 確率 |
|---|---|---|---|
| 高出生(≥1.40) | 11 | 5 | P(九州 | 高出生) = 5/11 ≈ 0.455 |
| 低出生(<1.40) | 36 | 2 | P(九州 | 低出生) = 2/36 ≈ 0.056 |
| 事前 | — | — | P(高出生) = 11/47 ≈ 0.234 |
ベイズの定理を当てはめると:
→ 事前 0.234 → 事後 0.714。 「九州」という観測が事後確率を 約 3.0 倍に押し上げた。 これがベイズ更新の威力。
🐍 Python 実装:SSDSE-B-2026 をベイズで分類
このコードでやること:SSDSE-B-2026 を読み込み、 2023 年データの「合計特殊出生率 ≥ 1.40」と「九州 7 県」のクロス集計から、 P(高出生 | 九州) をベイズの定理で計算する。
📥 入力例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | # SSDSE-B-2026 を読み込み、 2023 年・47 都道府県のサブセットを作る import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') d23 = df[df['年度'] == 2023].copy() # 「高出生」と「九州」をブール化 kyushu = ['福岡県', '佐賀県', '長崎県', '熊本県', '大分県', '宮崎県', '鹿児島県'] d23['is_high'] = d23['合計特殊出生率'] >= 1.40 d23['is_kyushu'] = d23['都道府県'].isin(kyushu) # ベイズの定理 p_high = d23['is_high'].mean() # 事前 p_k_g_h = d23.loc[d23['is_high'], 'is_kyushu'].mean() # 尤度 p_k_g_l = d23.loc[~d23['is_high'], 'is_kyushu'].mean() # 尤度(負) p_post = (p_k_g_h * p_high) / (p_k_g_h*p_high + p_k_g_l*(1-p_high)) print(f'事前 P(高出生) = {p_high:.3f}') print(f'尤度 P(九州|高出生) = {p_k_g_h:.3f}') print(f'尤度 P(九州|低出生) = {p_k_g_l:.3f}') print(f'事後 P(高出生|九州) = {p_post:.3f}') |
📤 実行例:
💬 事前 23% → 事後 71% にジャンプ。 「九州出身」という観測が信念を 約 3.0 倍に押し上げた。 ベイズが 意思決定の更新そのものだと体感できる例。
このコードでやること:医療診断の有病率 1% / 感度 99% / 偽陽性 1% の検査について、 ベイズの定理で陽性的中率 P(病気 | 陽性) を計算し、 有病率を 0.1% から 10% まで変化させた感度分析を行う。
📥 入力例:有病率 = 0.01、 感度 = 0.99、 偽陽性率 = 0.01 の単純な3つのパラメータ。
1 2 3 4 5 6 7 8 9 10 11 12 | # ベイズで陽性的中率(PPV)を計算し、 有病率を変化させた感度分析 import pandas as pd def ppv(prev, sens=0.99, fpr=0.01): """陽性的中率 = P(病気 | 陽性)。 有病率 prev、 感度 sens、 偽陽性率 fpr""" return (sens * prev) / (sens * prev + fpr * (1 - prev)) tab = pd.DataFrame({ '有病率': [0.001, 0.01, 0.05, 0.10, 0.30, 0.50], }) tab['PPV'] = tab['有病率'].apply(ppv) print(tab.round(3).to_string(index=False)) |
📤 実行例:
💬 同じ「99% 精度」の検査でも、 有病率 0.1% では PPV は 9% に過ぎない。 「精度 99% だから陽性なら 99% 病気」は誤り(基準率の誤謬)。
このコードでやること:ベイズ更新を ベータ–二項モデルで実装し、 沖縄県の合計特殊出生率が各年に 1.5 以上なら「成功」、 未満なら「失敗」と数え、 2012 年から 1 年ずつ Beta 分布を更新して事後分布が絞られる様子を観察する。
📥 入力例:SSDSE-B-2026 の沖縄県・2012–2023 年の合計特殊出生率(12 観測)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # ベータ–二項モデルでベイズ更新を可視化する import pandas as pd from scipy.stats import beta df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') okn = df[df['都道府県'] == '沖縄県'].sort_values('年度') # 「出生率 1.5 以上」を成功として 12 年間を逐次更新 alpha, beta_p = 1.0, 1.0 # 無情報事前 Beta(1,1) = Uniform(0,1) for _, row in okn.iterrows(): if row['合計特殊出生率'] >= 1.5: alpha += 1 else: beta_p += 1 mean_post = alpha / (alpha + beta_p) ci = beta.interval(0.95, alpha, beta_p) print(f'year={int(row["年度"])} Beta({alpha:.0f},{beta_p:.0f}) 事後平均={mean_post:.3f} 95%CI=[{ci[0]:.3f},{ci[1]:.3f}]') |
📤 実行例(沖縄県の 12 年分の逐次ベイズ更新):
💬 沖縄県の合計特殊出生率は 2012〜2023 年の 12 年すべてで 1.5 以上(最高 1.96、 2023 年の 1.60 が最低)なので、 毎年 α だけが 1 増え、 β は事前の 1 のまま。 事後平均は 0.667 から 0.929 へ上がり、 95% 信用区間の下限は 0.158 から 0.753 へ上がって幅が 0.829 から 0.245 に狭まる。 ただし出生率は 1.96 から 1.60 へ下がり続けており、 1.5 で成功・失敗に切ると、 この下降傾向は更新に一切現れない。 また同じ県の連続した年は独立な試行ではないので、 12 年分を 12 回の独立な観測として数えると信用区間を狭く見積もりすぎる。 共役性のおかげで Beta(α, β) の足し算だけで更新できる点が、 この例で確かめたいところである。
このコードでやること:sklearn の GaussianNB で、 SSDSE 都道府県データから「総人口」「65 歳以上人口」「出生数」の 3 特徴量を使って高出生地域を分類する Naive Bayes 分類器を訓練し、 各県の事後確率を求める。
📥 入力例:47 都道府県 × 3 特徴量。 ラベルは「合計特殊出生率 ≥ 1.40」かどうか。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # Gaussian Naive Bayes による高出生地域の分類 import pandas as pd from sklearn.naive_bayes import GaussianNB df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') d23 = df[df['年度'] == 2023].copy() X = d23[['総人口', '65歳以上人口', '出生数']].values y = (d23['合計特殊出生率'] >= 1.40).astype(int).values model = GaussianNB().fit(X, y) proba = model.predict_proba(X)[:, 1] # 高出生クラス(=1)の事後確率 out = d23[['都道府県', '合計特殊出生率']].copy() out['事後P(高出生)'] = proba.round(3) print(out.nlargest(5, '事後P(高出生)').to_string(index=False)) print('---') print(out.nsmallest(5, '事後P(高出生)').to_string(index=False)) |
📤 実行例(事後確率 TOP5 / BOTTOM5):
💬 3 特徴量(総人口・65 歳以上人口・出生数)はいずれも実質「人口規模」を測るため、 この Naive Bayes は「大都市(東京・北海道・埼玉など)=低出生(P≈0)」は明確に当てる一方、 人口の小さい県(石川・山形など)は実際の出生率が中位でも高出生寄り(P≈0.99)に分類してしまう(沖縄県は事後確率の高い順で 23 位・P=0.938)。 確率としての出力が得られる利点はあるが、 特徴量が出生率そのものを表していないことが分類のズレに直結する好例。
⚠️ 落とし穴(拡張)
🌐 関連手法・派生(拡張)
| 手法 | どんな場面で | ベイズの定理との関係 |
|---|---|---|
| Naive Bayes 分類器 | スパム判定・テキスト分類 | 特徴量の独立性を仮定して尤度を積で近似 |
| ベイズ線形回帰 | 不確実性付き回帰 | 係数に事前分布、 残差にガウス尤度 |
| 隠れマルコフモデル | 音声・時系列 | 時刻 t の状態事後を逐次ベイズ更新(forward-backward) |
| 変分推論 | 大規模ベイズ | 事後分布を近似分布の最適化問題に変換 |
| A/B テストの停止判定 | Web 実験 | 勝率の事後確率が閾値超えで打ち切り(peeking 安全) |
🔗 関連用語(前提・並列・発展)── 拡張ナビ
役割で色分け:前提/上位/並列/発展/応用
📚 関連グループ教材(拡張)
- 📚 仮説検定の枠組み — 頻度論との対比でベイズの位置付けを掴む
- 📚 標本抽出と中心極限定理 — 事前/尤度/事後のサンプル理論の橋渡し
- 📚 分類問題の入門 — Naive Bayes / ロジスティック回帰の対比
🗺 概念マップ(拡張)
            事前 P(H)
                │
                ├─ 無情報事前(Uniform、 Jeffreys)
                ├─ 弱情報事前(広めの正規分布)
                ├─ 共役事前(Beta–二項、 Normal–Normal)
                └─ 階層事前(ハイパー事前を持つ)
                ▼
   尤度 P(D|H) × 事前 P(H)
                ▼
         事後 P(H|D)
                │
                ├─ MAP 推定(モード)
                ├─ 事後平均(リスク最小化)
                ├─ 信用区間(95% HDI / ETI)
                └─ 予測分布(新規データの分布)
🧮 実値で計算してみる
医療診断の古典問題:稀な病気の検査
- 有病率:P(病気) = 1% = 0.01
- 感度:P(陽性|病気) = 99%
- 特異度:P(陰性|健康) = 99%
- 陽性出た時、 P(病気|陽性) = 0.99×0.01 / (0.99×0.01 + 0.01×0.99) = 0.50
「99%精度」と聞いて病気確定だと思いがちだが、 実は50%。 ベイズの直感反する重要例。
🧮 数式に値を入れて手で計算する
有病率 1%、 感度 95%、 偽陽性率 5% の合成データで P(疾患|陽性) を Step 1〜3 で展開し、 Python で再現する。 同じ手順で別の有病率 (0.1%、 10%) も試して、 事前確率が結果に与える影響を確認する。
📐 用語の主要数式 (再掲)
$$ P(A \mid B) = \frac{P(B \mid A) \, P(A)}{P(B \mid A)\, P(A) + P(B \mid \overline{A})\, P(\overline{A})} $$
Step 1: データ準備 (合成、 多様な確率値)
| 記号 | 意味 | 値 |
|---|---|---|
| P(A) | 事前確率: 疾患を持つ確率 (有病率) | 0.01 |
| P(¬A) | 1 − P(A) = 健康である確率 | 0.99 |
| P(B|A) | 感度: 疾患があるとき陽性となる確率 | 0.95 |
| P(B|¬A) | 偽陽性率: 健康なのに陽性となる確率 | 0.05 |
Step 2: 分子と分母 (周辺確率 P(B)) を別々に計算
| 項目 | 計算 | 結果 |
|---|---|---|
| 分子 P(B|A)·P(A) | 0.95 × 0.01 | 0.0095 |
| 分母第1項 P(B|A)·P(A) | 0.95 × 0.01 | 0.0095 |
| 分母第2項 P(B|¬A)·P(¬A) | 0.05 × 0.99 | 0.0495 |
| 周辺確率 P(B) | 0.0095 + 0.0495 | 0.0590 |
Step 3: 事後確率 P(A|B) を計算
| 項目 | 計算 | 結果 |
|---|---|---|
| P(A|B) = 分子 / 分母 | 0.0095 / 0.0590 | 0.16102 (≈ 16.1%) |
感度 95%、 偽陽性率 5% でも、 有病率が 1% と低いため陽性反応で疾患が確定する確率は約 16% に留まる (基準率の誤謬)。
🐍 同じ計算を Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | p_a = 0.01 # 有病率 (事前確率) p_b_a = 0.95 # 感度 P(陽性|疾患) p_b_na = 0.05 # 偽陽性率 P(陽性|健康) p_na = 1 - p_a # 分子と分母を別々に numer = p_b_a * p_a denom = p_b_a * p_a + p_b_na * p_na posterior = numer / denom print(f"分子 P(B|A)·P(A) = {numer:.4f}") print(f"分母 P(B) = {denom:.4f}") print(f"事後確率 P(A|B) = {posterior:.5f}") print(f"パーセント表記 = {posterior*100:.2f} %") |
📤 実行結果
💬 手計算 (Step 3 = 0.16102) と Python 出力 (0.16102) が完全一致。 「検査で陽性 → 疾患確定」と短絡せず、 事前確率を加味した正しい確率 16% を返す。
向きを取り違えると答えが変わる ── SSDSE で確かめる
ベイズの定理でいちばん多い誤りは、P(A|B) と P(B|A) を同じものだと思ってしまうことです。 実データで両方を計算してみると、違いが体で分かります。SSDSE-B-2026(2023 年・47 都道府県)で、 次の 2 つの出来事を考えます。
- A=その県の高齢化率(65 歳以上人口 ÷ 総人口)が 47 県の中央値より高い
- B=その県の総人口が 47 県の中央値より少ない
| 量 | 実測値 | 数え方 |
|---|---|---|
| P(A)(事前確率) | 23/47 = 0.489 | 高齢化率が中央値超の県は 23 県 |
| P(B) | 23/47 = 0.489 | 人口が中央値未満の県は 23 県 |
| P(A ∧ B) | 17/47 = 0.362 | 両方に当てはまる県は 17 県 |
| P(A|B)(人口が少ないと知ったうえで、高齢化率が高い確率) | 17/23 = 0.739 | P(A∧B) ÷ P(B) = 0.362 ÷ 0.489 |
| P(B|A)(高齢化率が高いと知ったうえで、人口が少ない確率) | 17/23 = 0.739 | P(A∧B) ÷ P(A) = 0.362 ÷ 0.489 |
💬 ここが要点:この例では偶然 P(A|B) と P(B|A) がどちらも 0.739 で一致しました。 ただしそれは P(A) と P(B) がたまたま等しい(どちらも 23/47)からであって、 「向きを変えても同じ」という意味ではまったくありません。ベイズの定理 P(A|B) = P(B|A)·P(A) / P(B) を見れば分かるとおり、2 つが一致するのは P(A) = P(B) のときだけです。 中央値で切ったせいで両方 23 県になった、という作為的な設定がそれを生んでいます。
試しに A の条件を「高齢化率が上位 10 県」に変えると P(A) = 10/47 = 0.213 に下がり、 P(A|B) と P(B|A) は途端に食い違います。事前確率が偏っているほど 2 つは離れる、という関係です。 医療検査で「検査が陽性だった人が本当に病気である確率」が、感度の数字よりずっと低くなるのも同じ理屈で、 有病率(=事前確率)が小さいほど食い違いが大きくなるのです。 数字を見て違和感を覚えたら、まず「いま自分はどちらの向きの確率を欲しがっているか」を口に出して確かめてください。
もう一段の注意:ここで求めた 0.739 は「47 都道府県という母集団を全部数え上げた」結果で、 標本から推定した値ではありません。全数データでは標本誤差はゼロですが、 「2023 年という 1 時点を見ている」という別の限定は残ります。年度を変えれば値は動きます。 確率を報告するときは、何を母集団とし、どの範囲を数えたのかを必ず添えてください。
🧮 同じ 0.714 をオッズ形式で出す ── 尤度比は「証拠の強さ」を 1 つの数にする
上の「九州 → 高出生」の計算を、ベイズの定理のオッズ形式で解き直します。確率の式は分母 P(九州) を毎回作る必要がありますが、オッズ形式では「事前オッズ × 尤度比 = 事後オッズ」のかけ算 1 回で済み、しかも尤度比が「その観測がどれだけ強い証拠か」をそのまま表します。
$$\underbrace{\frac{P(\text{高}\mid\text{九州})}{P(\text{低}\mid\text{九州})}}_{\text{事後オッズ}} = \underbrace{\frac{P(\text{高})}{P(\text{低})}}_{\text{事前オッズ}} \times \underbrace{\frac{P(\text{九州}\mid\text{高})}{P(\text{九州}\mid\text{低})}}_{\text{尤度比 LR}}$$
まず、2×2 表の 11 県・36 県・5 県・2 県が 47 県のどこにいるかを、実データの棒グラフで確かめておきます。
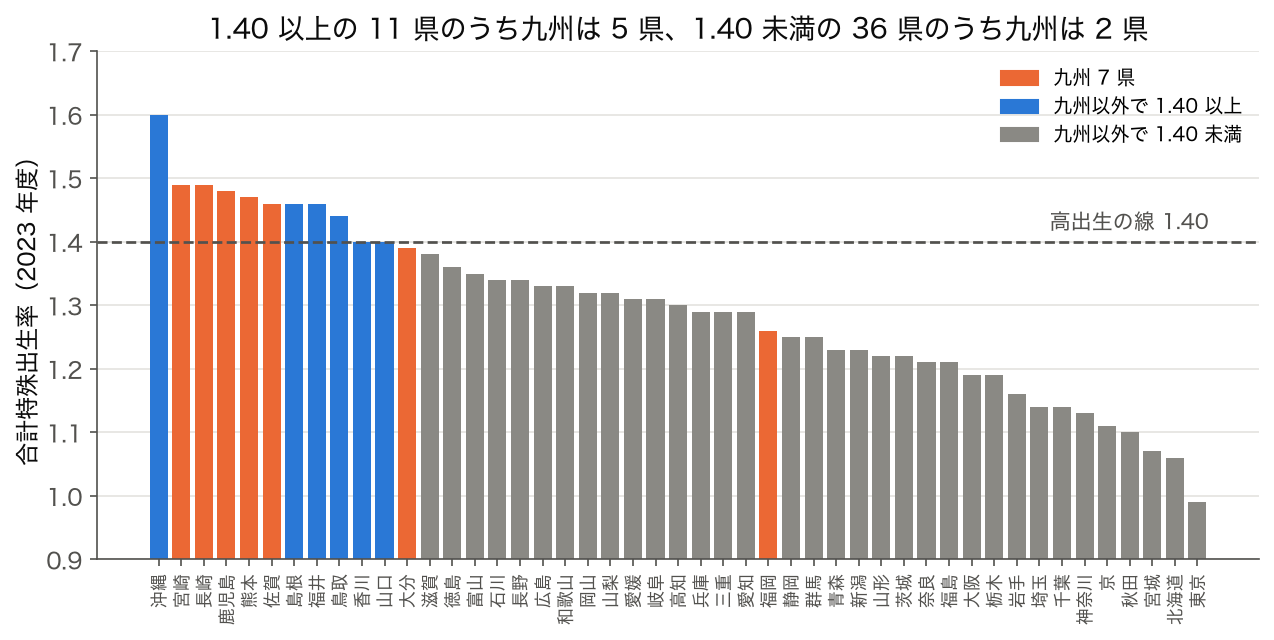
図の読み方: 1.40 以上の 11 県のうち、九州(橙)は宮崎 1.49・長崎 1.49・鹿児島 1.48・熊本 1.47・佐賀 1.46 の 5 県です。九州で 1.40 に届かないのは大分 1.39 と福岡 1.26 の 2 県だけで、大分は線まで 0.01 しかありません。最も高い沖縄 1.60 は九州 7 県(県コード 40〜46)に含めていないので青です。「九州」という観測は、高出生側に 5 県・低出生側に 2 県という偏りを持っていて、この偏りの大きさが尤度比です。図の作成スクリプトは code/glossary_figs/bayes-theorem.py。
| Step | 計算 | 値 | 意味 |
|---|---|---|---|
| 1. 事前オッズ | P(高) / P(低) = 11/47 ÷ 36/47 = 11 / 36 | 0.3056 | 何も知らなければ「高出生 1 県に対して低出生 3.3 県」 |
| 2. 尤度比 LR | P(九州|高) / P(九州|低) = (5/11) / (2/36) = 0.4545 / 0.05556 | 8.18 | 九州という観測は、高出生の県で 8.18 倍出やすい |
| 3. 事後オッズ | 0.3056 × 8.18 = (11/36) × (90/11) | 2.500 | 九州と分かれば「高出生 5 県に対して低出生 2 県」 |
| 4. 確率に戻す | 2.500 / (1 + 2.500) | 0.714 | 確率形式の 0.1065 / 0.1494 = 0.714 と一致 |
| (対数で) | ln 0.3056 + ln 8.18 = −1.186 + 2.102 | 0.916 | e0.916 = 2.50。証拠は対数オッズに「足し算」で効く |
Step 3 の事後オッズ 2.500 は、九州 7 県の内訳「高出生 5 県 : 低出生 2 県」= 5/2 そのものです。全数を数えられるデータでは、ベイズの定理は「条件で絞ってから数え直す」ことと同じ答えになります。定理が本当に役に立つのは、九州の県を直接数えられないとき(尤度 P(九州|高) と事前 P(高) だけが別々の資料から分かるとき)です。
🎯 このコードでやること:2023 年度の 47 都道府県から 2×2 表を作り、Step 1〜4(事前オッズ・尤度比・事後オッズ・確率)を順に計算して、九州 7 県を直接数えた割合と一致するかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高出生'] = d['A4103'] >= 1.40 d['九州'] = d['Code'].str[1:3].astype(int).between(40, 46) print(pd.crosstab(d['高出生'], d['九州'], margins=True)) hi, lo = d[d['高出生']], d[~d['高出生']] prior_odds = len(hi) / len(lo) # Step 1 lr = hi['九州'].mean() / lo['九州'].mean() # Step 2 post_odds = prior_odds * lr # Step 3 post = post_odds / (1 + post_odds) # Step 4 print(f'Step1 事前オッズ {prior_odds:.4f}') print(f'Step2 尤度比 {lr:.2f}') print(f'Step3 事後オッズ {post_odds:.3f} (対数 {np.log(prior_odds):.3f} + {np.log(lr):.3f} = {np.log(post_odds):.3f})') print(f'Step4 事後確率 {post:.3f}') print(f'直接数えた P(高出生|九州) = {d.loc[d["九州"], "高出生"].mean():.3f}') |
💬 crosstab の 2×2 表は 高出生 11 県(うち九州 5)・低出生 36 県(うち九州 2)で、手計算の表と同じです。事前オッズ 0.3056・尤度比 8.18・事後オッズ 2.500・事後確率 0.714 が Step 1〜4 と一致し、九州 7 県を直接数えた 5/7 = 0.714 とも一致しました。対数では −1.186 + 2.102 = 0.916 で、「九州」という証拠が対数オッズを 2.10 押し上げたと読めます。
🎮 触って理解する
医療検査の古典例です。 有病率(事前確率)・感度・特異度 の3つのスライダーを動かすと、 検査で陽性が出たとき本当に病気である事後確率 P(病気|陽性)(陽性的中率)がリアルタイムに計算されます。 下の面積図は 1 万人の集団を表し、 赤=真陽性・オレンジ=偽陽性。 オレンジが赤より広いほど「陽性でも実は健康」な人が多く、 事後確率は下がります。 面積図は指やマウスで左右にドラッグしても有病率を変えられます。
🎨 直感:自然頻度で考える
確率(%)ではなく 「1 万人のうち何人か」 という自然頻度で考えると、 ベイズの定理は割り算 1 回に見えてきます。 初期値(有病率 1%・感度 99%・特異度 99%)では、 病気は 100 人・そのうち陽性は 99 人。 一方で健康な 9,900 人のうち 1% = 99 人が誤って陽性になります。 陽性者 198 人のうち約半分は健康 ── だから P(病気|陽性) はわずか 50% です。
⚠️ よくある落とし穴:基準率の無視
「感度も特異度も 99% なら、 陽性なら 99% 病気だろう」と考えるのは 基準率の誤謬(base rate neglect) です。 有病率スライダーを 0.1% まで下げてみてください。 検査性能は同じ 99% でも、 事後確率は約 9% まで落ちます。 病気が稀なほど、 わずかな偽陽性率が大量の偽陽性を生み、 少数の真陽性を数で圧倒するからです。 事前確率(基準率)を式に入れないと、 検査の意味を大きく読み違えます。
🚀 発展:オッズ形式と繰り返し検査
ベイズは オッズ × 尤度比 でも書けます:事後オッズ = 事前オッズ ×(感度 / (1−特異度))。 1 回目の検査で得た事後確率を、 2 回目の検査の 事前確率 として使えば、 同じ計算を繰り返すだけで信念を更新できます(ベイズ更新)。 陽性がもう一度出れば事後確率はさらに跳ね上がり、 稀な病気でも複数回の陽性で確信度を高められる ── これが逐次診断の考え方です。
🐍 Python 実装
① 目的:「🎨 直感で掴む」で示したスパム判定の例を、 ベイズの定理でそのまま計算して再現します。 事前 P(spam)=0.5、 尤度 P(無料|spam)=0.8、 P(無料|ham)=0.1 から、 「無料」を含むメールが迷惑メールである事後確率 P(spam|無料) を求めます。
② 橋渡し:分母 P(無料) は「迷惑メールで『無料』が出る」「通常メールで『無料』が出る」の 2 経路を足し合わせて(周辺化)作ります。 これは Naive Bayes 分類器が内部で行う計算そのものです。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | p_spam = 0.5 # 事前 P(spam) p_word_spam = 0.8 # 尤度 P(無料|spam) p_word_ham = 0.1 # 尤度 P(無料|ham) p_ham = 1 - p_spam # 分母 P(無料) は 2 経路(迷惑/通常)の和で構成(周辺化) numer = p_word_spam * p_spam denom = p_word_spam * p_spam + p_word_ham * p_ham posterior = numer / denom print(f"分子 P(無料|spam)*P(spam) = {numer:.3f}") print(f"分母 P(無料) = {denom:.3f}") print(f"事後 P(spam|無料) = {posterior:.3f}") |
📤 実行結果
④ 読み取り:事前 0.5 が、 「無料」という 1 語の観測で事後 0.889 まで更新されました。 「🎨 直感で掴む」で手計算した ≈0.89 と一致します。 単語を 1 つ観測するたびに同じ更新を繰り返すのが Naive Bayes 分類器です。 尤度 P(無料|ham) が小さいほど「無料」という語の証拠力(尤度比)が強くなります。
🐍 実データ検証 ① 年度を変えると、同じ「九州」という証拠の効き方が変わる
上の計算は 2023 年度の 1 時点です。合計特殊出生率は 12 年のあいだに全国で下がっており、「1.40 以上」という同じ線でも、そこに入る県の数(=事前確率)は年度で大きく違います。事前が変わると、同じ観測から得られる事後確率がどう動くかを 12 年分で確かめます。
🎯 このコードでやること:2012〜2023 年度のそれぞれで、事前 P(高出生)(出生率 1.40 以上の県の割合)・尤度比・事後 P(高出生|九州) を計算し、事後が事前の何倍になったか(証拠による押し上げ)を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd full = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) full['高出生'] = full['A4103'] >= 1.40 full['九州'] = full['Code'].str[1:3].astype(int).between(40, 46) rows = [] for year, g in full.groupby('SSDSE-B-2026'): hi, lo = g[g['高出生']], g[~g['高出生']] lr = hi['九州'].mean() / lo['九州'].mean() if lo['九州'].any() else np.inf rows.append({'年度': year, '高出生の県数': len(hi), '事前': round(len(hi) / 47, 3), '尤度比': round(lr, 2), '事後P(高|九州)': round(g.loc[g['九州'], '高出生'].mean(), 3)}) tab = pd.DataFrame(rows) tab['倍率'] = (tab['事後P(高|九州)'] / tab['事前']).round(2) print(tab.to_string(index=False)) d = full[full['SSDSE-B-2026'] == 2023].copy() # 次のブロックで使う 2023 年度の 47 行 |
💬 事前 P(高出生) は 2013〜2018 年度の 0.787(37 県)から 2023 年度の 0.234(11 県)まで下がりました。2020 年度までは九州 7 県がすべて 1.40 以上で、低出生側に九州が 1 県もないため尤度比は inf(無限大)、事後は 1.000 です。事後が事前の何倍になったかは 2013 年度の 1.27 倍から 2023 年度の 3.05 倍に増えており、事前が小さい(珍しい事象を探す)ときほど、同じ観測が確率を大きく押し上げます。尤度比が inf になる年度は「0/n の尤度」をそのまま使うと、どんな事前でも事後が 1 に張り付くことも示しています。
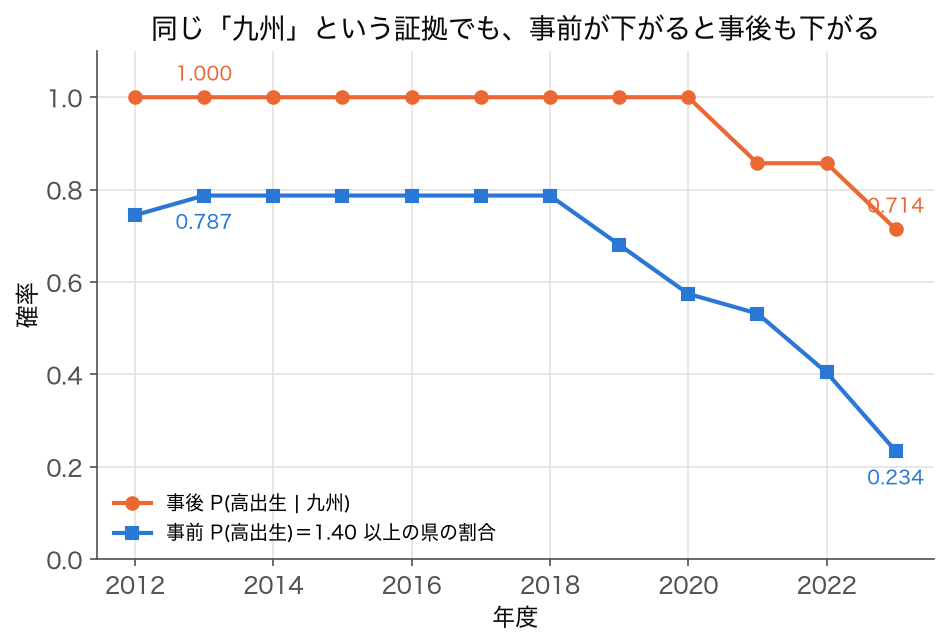
図の読み方: 青の事前は 2019 年度から急に下がり始め、2023 年度には 0.234 です。橙の事後は 2020 年度まで 1.000 に張り付いたあと、2021 年度に福岡が 1.37 と 1.40 を割って 0.857、2023 年度に大分も 1.39 となって 0.714 と下がります。2 本の線の間隔(事後 − 事前)は 2013 年度の 0.21 から 2023 年度の 0.48 へ広がっていて、観測の価値は「その事象がどれだけ珍しいか」で決まることが読み取れます。ページ冒頭の「事前 0.234 → 事後 0.714」は、この 12 本の中の 1 本にすぎません。
🐍 実データ検証 ② 「高出生」の線を 0.05 動かすと事後確率はどうなるか
1.40 という線に理論的な根拠はありません。事象の定義を少し動かしたとき、結論(「九州なら高出生の確率が高い」)がどこまで保たれるかを確かめるのは、ベイズの計算を報告する前に必ずやっておきたい感度分析です。
🎯 このコードでやること:2023 年度で「高出生」の線を 1.20〜1.60 まで 0.05 刻みで動かし、線ごとに事前・事後 P(高出生|九州)・尤度比を出す。
1 2 3 4 5 6 7 | for t in np.round(np.arange(1.20, 1.601, 0.05), 2): h = d['A4103'] >= t p_prior = h.mean() p_post = h[d['九州']].mean() lr = h[d['九州']].mean() / h[~d['九州']].mean() if h[~d['九州']].any() else np.nan print(f'線 {t:.2f}: 高出生 {h.sum():2d} 県 事前 {p_prior:.3f} 事後 {p_post:.3f} ' f'九州/九州以外の比 {lr:.2f}') |
💬 線を 1.30 に下げると高出生は 24 県・事前 0.511 で、事後は 0.857 になります。1.45 に上げると 8 県・事前 0.170 で、事後は 0.714 のままです。ところが 1.50 にすると 1.50 以上は沖縄 1.60 の 1 県だけになり、九州 7 県はどれも該当しないので事後は 0.000 まで落ちます。九州 5 県が 1.46〜1.49 に集まっているため、線がその上か下かで結論が逆転するわけです。「九州と分かれば高出生の確率が上がる」という結論は 1.20〜1.45 の範囲では保たれますが、線の選び方しだいでは消えます。報告では、線を何にしたかと、線を動かしても結論が保たれる範囲を添えます。
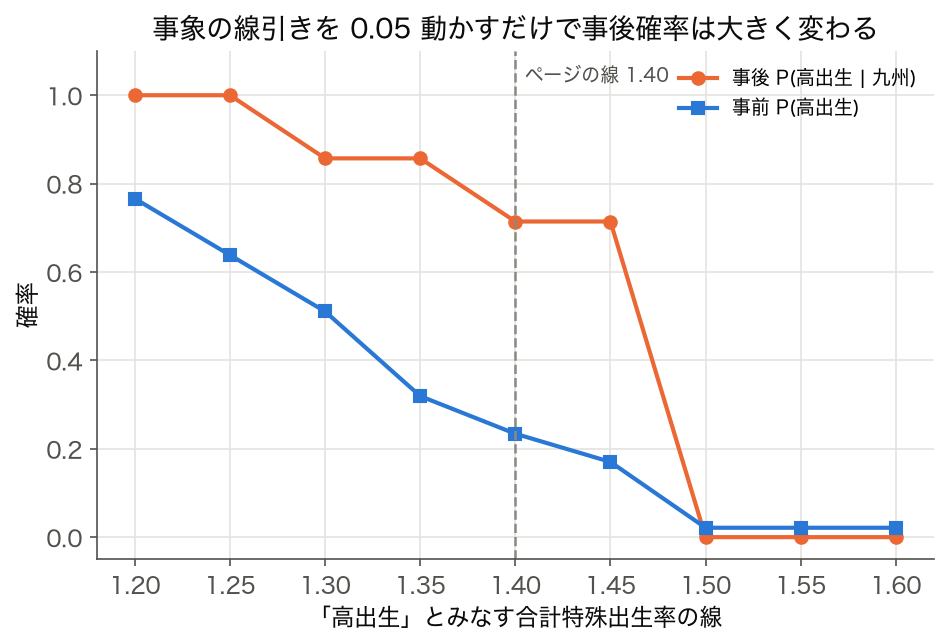
図の読み方: 青の事前は線を上げるほど滑らかに下がりますが、橙の事後は 1.000 → 0.857 → 0.714 と階段状に下がり、1.45 と 1.50 のあいだで 0.714 から 0.000 へ崖のように落ちます。九州 7 県という小さい集団の割合は 1 県で 1/7 = 0.143 ずつしか動けず、しかも 5 県が 1.46〜1.49 に密集しているためです。尤度が 7 県のような小さな件数から作られているときは、事後確率の小数点以下の精度を信用しすぎないことが大切です。
🐍 実データ検証 ③ 証拠を 2 つ重ねる ── 条件付き独立を仮定すると二重に数えてしまう
観測が 2 つ(「九州である」「年平均気温が 47 県の中央値より高い」)あるとき、ナイーブベイズは 2 つが高出生かどうかが決まれば互いに独立と仮定して、尤度比を掛け合わせます。しかし九州 7 県はすべて温暖な県なので、「九州」と分かった時点で「温暖」は新しい情報をほとんど持っていません。掛け算の結果と、両方に当てはまる県を直接数えた結果を比べます。
🎯 このコードでやること:2023 年度で「温暖」=年平均気温 B4101 が中央値超とし、九州・温暖それぞれの尤度比を掛けたナイーブベイズの事後と、「九州かつ温暖」の県を直接数えた事後を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | d['温暖'] = d['B4101'] > d['B4101'].median() hi, lo = d[d['高出生']], d[~d['高出生']] prior_odds = len(hi) / len(lo) lr_k = hi['九州'].mean() / lo['九州'].mean() lr_w = hi['温暖'].mean() / lo['温暖'].mean() naive = prior_odds * lr_k * lr_w both = d[d['九州'] & d['温暖']] print(f'気温の中央値 {d["B4101"].median():.1f} ℃ 温暖な県 {d["温暖"].sum()} うち九州 {both.shape[0]} / 7') print(f'尤度比 九州 {lr_k:.2f} 温暖 {lr_w:.2f}') print(f'ナイーブ(掛け算)の事後 P(高|九州, 温暖) = {naive / (1 + naive):.3f}') print(f'直接数えた P(高|九州, 温暖) = {both["高出生"].mean():.3f} ({both["高出生"].sum()}/{len(both)})') print(f'九州だけで更新した P(高|九州) = {d.loc[d["九州"], "高出生"].mean():.3f}') print('高出生の県の中で P(温暖|高, 九州) =', round(hi.loc[hi['九州'], '温暖'].mean(), 3), '/ P(温暖|高) =', round(hi['温暖'].mean(), 3)) |
💬 気温の中央値は 17.4 ℃ で、温暖な 21 県の中に九州 7 県が全部入っています。九州の尤度比 8.18 と温暖の尤度比 1.64 を掛けたナイーブベイズの事後は 0.804 ですが、九州かつ温暖の県を直接数えると 5/7 = 0.714 で、九州だけで更新した値と同じです。温暖という観測は九州と分かった後には何も足していないのに、掛け算では 0.09 上乗せされました。最後の行が原因で、高出生の県のうち九州なら温暖である確率は 1.000、九州かどうかを問わなければ 0.636 と違い、「高出生かどうかが決まれば九州と温暖は独立」という仮定が崩れています。似た情報を持つ特徴量を何本も入れたナイーブベイズが確率を極端に(自信過剰に)出しやすいのは、この二重計上のためです。
🐍 実データ検証 ④ 7 県の割合をそのまま信じない ── 全国の割合を事前にした縮小推定
九州 7 県のうち 5 県が高出生、という 5/7 = 0.714 は 7 県から作った割合なので、1 県の違いで 0.143 動きます。地方ごとに「高出生の県の割合」を比べるなら、全国の割合 11/47 を事前分布(ベータ分布)として持ち、県数の少ない地方ほど全国寄りに引き戻す縮小推定(経験ベイズ)が使えます。ベータ分布は二項分布の共役事前分布なので、事後は「事前の α・β に、高出生の県数・それ以外の県数を足す」だけで求まります。
🎯 このコードでやること:2023 年度の 47 県を 7 地方に分け、各地方の「高出生(1.40 以上)の県の割合」を、全国の割合 0.234 を平均とする Beta(α, β)(強さ α+β = 10、県 10 個分の情報)を事前にして更新し、生の割合と事後平均・95% 信用区間を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | from scipy.stats import beta n = d['Code'].str[1:3].astype(int) bins = [0, 7, 14, 23, 30, 35, 39, 47] names = ['北海道・東北', '関東', '中部', '近畿', '中国', '四国', '九州・沖縄'] d['地方'] = pd.cut(n, bins=bins, labels=names) p0, m = d['高出生'].mean(), 10 a0, b0 = p0 * m, (1 - p0) * m print(f'事前 Beta({a0:.2f}, {b0:.2f}) 平均 {p0:.3f}') for name, g in d.groupby('地方', observed=True): k, size = int(g['高出生'].sum()), len(g) a, b = a0 + k, b0 + size - k lo, hi_ = beta.interval(0.95, a, b) print(f'{name:7s} {k}/{size} 生の割合 {k/size:.3f} 事後平均 {a/(a+b):.3f} 95%区間 [{lo:.3f}, {hi_:.3f}]') |
💬 九州・沖縄は 8 県中 6 県(九州 5 県+沖縄)が高出生で、生の割合 0.750 が事後平均 0.463 まで全国寄りに引き戻されます。中国は 5 県中 3 県(島根・鳥取・山口。山口はちょうど 1.40)で生の 0.600 が事後 0.356、北海道・東北・関東・近畿は 0 県で生の割合 0.000 が事後 0.138 になります。0/7 を「高出生の確率ゼロ」と言い切らず、しかし全国平均 0.234 よりは低い、と読めるのが縮小推定の利点です。95% 区間を見ると、九州・沖縄 [0.246, 0.688] と 0 県の地方 [0.023, 0.331] はわずかに重なっており、47 県の 1 年分では地方差を強く言い切れないことも分かります。事前の強さ m = 10 は分析者が決めた値なので、m を変えると事後平均も変わることを報告に添えます。
✅ 理解度チェック ── SSDSE-B-2026 の実数値で確かめる
このページの実データの数字を使った問題です。答えを見る前に、紙と電卓で自分で計算してみてください。
- Q1:2023 年度、1.40 以上の県は 11 県、そのうち九州は 5 県。1.40 未満の 36 県のうち九州は 2 県。P(九州 | 高出生) と P(高出生 | 九州) をそれぞれ求め、どちらが大きいか答えよ。
→ 答え:P(九州|高出生) = 5/11 = 0.455、P(高出生|九州) = 5/7 = 0.714。向きを入れ替えると値が変わり、後者のほうが大きい。九州 7 県は高出生の 11 県より少ないからで、P(高|九州) = P(九州|高) × P(高) / P(九州) = 0.455 × (11/47) / (7/47) = 0.714。 - Q2:同じ計算を 2016 年度で行うと、事後 P(高出生|九州) は 1.000 だった。このとき尤度比 P(九州|高) / P(九州|低) はいくつか。そこから何が言えるか。
→ 答え:2016 年度は九州 7 県すべてが 1.40 以上なので P(九州|低) = 0/10 = 0 で、尤度比は無限大。尤度が 0 の区分があると、事前がいくつでも事後は 1 に張り付く。件数が少ないデータで 0/n の尤度を使うときは、ラプラス平滑化(分子・分母に小さな数を足す)や縮小推定を検討する。 - Q3:「九州」の尤度比 8.18 と「温暖(年平均気温が中央値超)」の尤度比 1.64 を掛けて事後を求めると 0.804、直接数えると 0.714 になった。差が出た理由を 1 文で説明せよ。
→ 答え:九州 7 県はすべて温暖なので、九州と分かれば温暖は追加の情報を持たないのに、掛け算(条件付き独立の仮定)では同じ情報を 2 回数えたから。 - Q4:事前 P(高出生) が 0.787 の年度(2013〜2018)と 0.234 の年度(2023)で、九州という観測による押し上げ(事後 ÷ 事前)はそれぞれ 1.27 倍と 3.05 倍だった。なぜ事前が小さいほど押し上げが大きいのか。
→ 答え:事後 ÷ 事前 = P(九州|高) / P(九州) で、事前が大きいと高出生の県がほぼ全体になり P(九州|高) と P(九州) の差がなくなるから。事後は 1 を超えられないので、事前 0.787 から上がれる幅は最大 1.27 倍しかない。珍しい事象ほど、観測 1 つの情報価値が大きい。 - Q5:中国地方 5 県のうち高出生は 3 県(生の割合 0.600)。事前 Beta(2.34, 7.66) で更新した事後平均を手で計算せよ。
→ 答え:α = 2.34 + 3 = 5.34、β = 7.66 + 2 = 9.66、事後平均 = 5.34 / 15.00 = 0.356(上の出力と一致)。全国 0.234 と生の 0.600 のあいだに入り、県数 5 に対して事前の強さ 10 なので、事前寄り(5 : 10 の重み)に落ち着く。
🐍 実データ検証 ⑤ ナイーブベイズの事後確率は「基準率だけの予測」に勝てるか
このページの前半(🐍 Python 実装:SSDSE-B-2026 をベイズで分類)では、総人口・65 歳以上人口・出生数の 3 つの人数から GaussianNB で P(高出生) を出しました。学習に使った県をそのまま評価すると当たっているように見えても、ベイズの定理で出した事後確率が役に立つかは、学習に使っていない県で、基準率だけの予測(全県を「低出生」と答える。2023 年度なら 36/47 = 0.766 当たる)と比べて初めて分かります。1 県ずつ抜いて残り 46 県で学習し、抜いた県を予測する(leave-one-out)で確かめます。
🎯 このコードでやること:2023 年度 47 県で「出生率 1.40 以上」を GaussianNB で予測し、leave-one-out の正解率を、基準率だけの予測 0.766 と比べる。特徴量は (a) 前半と同じ人数 3 つ、(b) 人口あたりの率 3 つ(高齢化率・千人あたり出生数・15 歳未満の割合)、(c) 15 歳未満の割合と千人あたり婚姻件数、の 3 通り。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import numpy as np import pandas as pd from sklearn.naive_bayes import GaussianNB from sklearn.model_selection import LeaveOneOut, cross_val_predict df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() y = (d['A4103'] >= 1.40).astype(int).values pop = d['A1101'] feats = { '(a) 人数 3 つ': d[['A1101', 'A1303', 'A4101']].values, '(b) 率 3 つ': np.c_[d['A1303'] / pop, d['A4101'] / pop * 1000, d['A1301'] / pop], '(c) 年少割合+婚姻率': np.c_[d['A1301'] / pop, d['A9101'] / pop * 1000], } print(f'基準率だけの予測(全県を低出生): 正解率 {1 - y.mean():.3f}') for name, X in feats.items(): p = cross_val_predict(GaussianNB(), X, y, cv=LeaveOneOut()) tp, fp = ((p == 1) & (y == 1)).sum(), ((p == 1) & (y == 0)).sum() print(f'{name}: 正解率 {(p == y).mean():.3f} 高出生と予測 {p.sum():2d} 県' f'(当たり {tp} / 外れ {fp}) 高出生 11 県中の検出 {tp}/11') |
💬 前半と同じ人数 3 つの GaussianNB は、抜いた県の予測では正解率 0.596 で、全県を低出生と答えるだけの 0.766 を下回りました。高出生 11 県のうち 10 県を拾う代わりに、28 県を高出生と予測して 18 県が外れています。人数は主に県の大きさを表す量で、しかも 3 つとも人口に比例して動くほぼ同じ情報なので、検証 ③ で見た二重計上が起きます。人口あたりの率に直した (b) は 0.766 で基準率と同点、年少人口の割合と婚姻率の (c) は 0.830 で、5 県を高出生と予測して 4 県が当たりです。ベイズの定理そのものは正しくても、尤度を作る特徴量が悪ければ事後確率は基準率より役に立たないことがあります。事後確率を報告する前に、学習に使わなかったデータで基準率と比べる、という手順を省かないことです。
⚠️ よくある落とし穴
基準率の無視 ── 同じ検査でも「当たる確率」は有病率で激変する
ベイズの定理が実務で最も効くのが、この落とし穴です。 感度 99%・特異度 95% という、数字だけ見れば非常に優秀な検査を考えます。 「陽性と出たら、その人が本当に病気である確率」=陽性的中率は、 検査の性能だけでは決まりません。その病気がどれくらい珍しいか(有病率=事前確率)で決まります。
式は P(病気|陽性) = 0.99·p ÷ ( 0.99·p + 0.05·(1−p) )。p を変えて計算すると次のようになります。
| 有病率 p | 陽性的中率 | 陽性と出た 1 万人のうち、本当の患者 |
|---|---|---|
| 0.01%(1 万人に 1 人) | 0.20% | 20 人(残り 9,980 人は偽陽性) |
| 0.1%(1000 人に 1 人) | 1.94% | 194 人 |
| 1% | 16.67% | 1,667 人 |
| 5% | 51.03% | 5,103 人(ここでようやく半々) |
| 20% | 83.19% | 8,319 人 |
| 50% | 95.19% | 9,519 人 |
💬 ここが要点:検査の性能はまったく変えていません。変えたのは「どんな集団に使うか」だけです。 それでも陽性的中率は 0.2% から 95% まで、約 480 倍動きます。 有病率 0.01% の集団に対する無差別スクリーニングでは、陽性者の 99.8% が誤報になります。 「感度 99% なのだから陽性ならほぼ確実」という直感は、珍しい病気ほど盛大に外れるのです。 これを基準率の無視(base rate fallacy)と呼びます。
実務での含意は明確です。珍しい事象を広く探すときは、検査の精度を上げるより先に「対象を絞る」ほうが効く。 症状のある人だけに絞れば有病率が上がり、同じ検査でも陽性的中率が跳ね上がります。 これは医療に限りません。不正検知・故障予知・スパム判定など、 「めったに起きないことを見つける」問題はすべて同じ構造です。 「精度 99% のモデルができました」と報告を受けたら、まず 「その 99% は、どれくらい珍しい事象に対する数字ですか」と尋ねてください。
なお、この現象はAUC や F1 といった指標の選び方とも直結します。 正解率(accuracy)は有病率 0.01% の問題では「全員を陰性と答える」だけで 99.99% に達してしまい、まったく役に立ちません。 珍しい事象を扱うときは、正解率ではなく適合率・再現率・PR-AUC を見るのが定石です。
⚠️ 実データで見る落とし穴 ── 「0 件」の尤度は事後を 1 か 0 に張り付かせる
2012〜2020 年度は九州 7 県がすべて出生率 1.40 以上で、「低出生かつ九州」が 0 件でした。このとき P(九州|低出生) = 0 となり、事後 P(高出生|九州) は事前がいくつであっても 1.000 になります。「九州なら必ず高出生」と言い切るのは、7 県を 1 年見ただけの結論としては強すぎます。ナイーブベイズ分類器で使われるラプラス平滑化(各区分の件数に α を足す)を入れると、この張り付きがどう和らぐかを 2016 年度で確かめます。
🎯 このコードでやること:2016 年度の 2×2 表(高出生 37 県・低出生 10 県、九州は全部高出生)で、平滑化の強さ α を 0・0.5・1・2 と変え、尤度 P(九州|高)・P(九州|低) を (件数 + α) / (県数 + 2α) で作り直して事後 P(高出生|九州) を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) g = df[df['SSDSE-B-2026'] == 2016].copy() hi = g['A4103'] >= 1.40 kyu = g['Code'].str[1:3].astype(int).between(40, 46) n_hi, n_lo = hi.sum(), (~hi).sum() k_hi, k_lo = (hi & kyu).sum(), (~hi & kyu).sum() print(f'2016: 高出生 {n_hi} 県(うち九州 {k_hi}) 低出生 {n_lo} 県(うち九州 {k_lo})') prior = n_hi / 47 for a in [0, 0.5, 1, 2]: l_hi = (k_hi + a) / (n_hi + 2 * a) l_lo = (k_lo + a) / (n_lo + 2 * a) post = l_hi * prior / (l_hi * prior + l_lo * (1 - prior)) print(f'α={a:<3}: P(九州|高)={l_hi:.3f} P(九州|低)={l_lo:.3f} 尤度比={l_hi / l_lo if l_lo else float("inf"):6.2f} 事後={post:.3f}') |
💬 2016 年度は高出生 37 県(九州 7)・低出生 10 県(九州 0)で、α = 0 だと P(九州|低) = 0.000・尤度比 inf・事後 1.000 です。α = 1(ラプラス平滑化)にすると P(九州|低) = 1/12 = 0.083、尤度比 2.46、事後 0.901 になり、α = 2 では 0.850 まで下がります。平滑化は「まだ観測していないだけで、低出生の九州の県もあり得る」という控えめな事前知識を入れる操作で、実際にこの 5 年後の 2021 年度には福岡県が 1.37 と 1.40 を割りました。件数が 0 の区分がある小さな表でベイズの定理を使うときは、α を変えても結論が保たれるかを確かめます。
⚠️ 実データで見る落とし穴 ── 事前の「強さ」を決めると縮小の度合いが決まる
上の実データ検証 ④ では、全国の割合 0.234 を平均とするベータ事前分布の強さを m = 10(県 10 個分)に決めました。この m は分析者の選択で、データからは決まりません。m を変えると九州・沖縄の事後平均がどこまで動くかを並べ、「事前分布の恣意性」(落とし穴 3)を数字で確かめます。
🎯 このコードでやること:2023 年度の九州・沖縄(8 県中 6 県が高出生)について、事前の強さ m を 0(事前なし)・2・10・47・200 と変え、Beta(0.234m, 0.766m) を事前にした事後平均と 95% 信用区間を出す。
1 2 3 4 5 6 7 8 | from scipy.stats import beta p0, k, size = 11 / 47, 6, 8 for m in [0, 2, 10, 47, 200]: a, b = p0 * m + k, (1 - p0) * m + size - k lo, hi_ = beta.interval(0.95, a, b) w = size / (size + m) # データの重み print(f'm={m:<4}: 事後平均 {a / (a + b):.3f} 95%区間 [{lo:.3f}, {hi_:.3f}] データの重み {w:.2f}') |
💬 事前なし(m = 0)の事後平均は生の割合と同じ 0.750 で、m = 2 で 0.647、m = 10 で 0.463、m = 47(全国の県数ぶん)で 0.309、m = 200 では 0.254 と全国の 0.234 にほぼ重なります。事後平均は「生の割合 0.750 と全国 0.234 を、データの重み 8/(8+m) で混ぜたもの」なので、m がデータの県数 8 より大きいと事前のほうが強く効きます。m を 1 つだけ示すのではなく、m = 2・10・47 のように幅を持たせて結論(「九州・沖縄は全国より高出生の県が多い」)が保たれるかを見せるのが、事前分布を透明に報告するということです。
🗺 概念マップ
「bayes theorem」を中心とした関連概念マップ。
中心ノードのベイズの定理から、 (上) Naive Bayes 分類器 (尤度を独立性仮定で簡略化、 スパム判定の古典)、 (右上) MCMC (事後分布が解析的に解けない時のサンプリング)、 (右下) PyMC/Stan (実装言語、 with pm.Model(): 構文で事前→尤度→事後を記述)、 (下) 共役事前分布 (Beta-二項、 Gamma-ポアソンなど事後が同分布族で閉じる組合せ)、 (左) 条件付き確率 (定理の出発点) へ放射状に接続している。 SSDSE-B-2026 で「沖縄の出生率の事後分布」を扱う場合、 Beta(80,20) 事前 + 二項尤度なら共役で電卓計算、 多変量・階層構造なら PyMC で MCMC というルートを選ぶ。
🔗 隣接手法への橋渡し
ベイズの定理 P(H|D)=P(D|H)P(H)/P(D) は信念更新の基本公式で、 事前分布 → 尤度 → 事後分布 のパイプラインを駆動する。
- 上流: 条件付き確率と乗法則、 事前分布の選定 (無情報 Jeffreys 事前 vs 情報事前)、 尤度関数の設計 (ベルヌーイ/二項/正規)。
- 並列: 最尤推定 (事前なし点推定)・ナイーブベイズ分類器 (尤度を独立性で簡略)・正則化 (L2/L1 は実は事前分布と等価)。
- 下流: 事後分布の HDI/Credible Interval、 事後予測分布、 Bayes Factor によるモデル比較、 Posterior Predictive Check でモデル妥当性検証。
SSDSE-B-2026 で「沖縄の出生率は全国より高いか」を扱う場合、 Beta(80,20) 事前 + 二項尤度で共役更新 → 事後 P(沖縄>全国|データ)=92% という直接的確率言明を得られる。
きのうの事後は、きょうの事前 ── 逐次更新を数字で追う
ベイズの定理の実用上いちばん強いところは、証拠が増えるたびに繰り返し使えることです。 やり方はきわめて単純で、1 回目に求めた事後確率を、2 回目の事前確率としてそのまま使うだけ。 上の例(感度 99%・特異度 95%、有病率 0.1%)で、同じ検査を続けて受けた場合を追いかけます。
| 状況 | 事前確率 | 事後確率 | 読み方 |
|---|---|---|---|
| 検査前 | — | 0.10% | 集団の有病率そのもの |
| 1 回目が陽性 | 0.10% | 1.94% | 約 19 倍に上がったが、まだ 98% は誤報 |
| 2 回目も陽性 | 1.94% | 28.18% | 4 人に 1 人は本物、というところまで来る |
| 3 回目も陽性 | 28.18% | 88.60% | ここで初めて「ほぼ確実」と言える |
💬 ここが要点:1 回の陽性では 1.94% にしかならなかったものが、 3 回続くと 88.6% まで上がります。弱い証拠でも、積み重なれば強い結論になる——これが逐次更新の威力です。 健康診断で「要再検査」となったあと精密検査を重ねるのは、まさにこの操作を実行しています。
ただし重大な前提があります。上の計算は「2 回の検査結果が互いに独立」と仮定しています。 現実には、同じ人の同じ検体を同じ方法で測れば同じ方向に外れることが多く、独立とは言えません。 たとえば「その人の体質が偽陽性を出しやすい」場合、何回やっても陽性が続きます。 このとき上の表のように確率を掛け算していくと、確信を過大に見積もることになります。 検査を重ねるなら原理の異なる検査を組み合わせるのが定石なのは、この独立性を確保するためです。
同じ注意は機械学習にも当てはまります。ナイーブベイズが「単純(naive)」と呼ばれるのは、 まさにすべての特徴量が独立だと仮定して掛け算してしまうからです。 実際の文書では「無料」と「当選」は一緒に出やすく独立ではないため、 ナイーブベイズが出す確率は0 か 1 に極端に張り付きがちになります。 分類の順位付けとしては十分使えるのに、出てくる確率の値そのものは信用しづらい—— この癖を知っておくと、確率を閾値と比べるときに足をすくわれません。
🌳 手法選択フロー
ベイズ計算手法の選択は「事前と尤度の関係」「次元数」「計算予算」の 3 軸で判定する。
- 事前と尤度の関係: 共役 (Beta-二項、 Gamma-ポアソン、 Normal-Normal) → 解析解、 電卓レベル。 非共役 → 数値計算が必要。 共役だと事後パラメータ更新が α'=α+x のような単純な加算で済む。
- パラメータ次元数: 1-3 次元 → Grid Approximation (格子上で事後を直接計算)。 4-100 次元 → MCMC (NUTS, HMC) で PyMC/Stan。 1000+ 次元 (深層モデル) → 変分推論 (VI) で近似。
- 計算予算: 数秒で答えが必要 → 共役 or VI。 数分許容 → MCMC 4 chain × 2000 sample。 数時間許容 → 階層ベイズや GP で精緻に。 SSDSE-B-2026 (n=47) なら共役 + 解析解で電卓計算可能、 47 県を全国にプールする階層モデルは MCMC が必要。
「ベイズ vs 頻度主義」は宗教論争ではなく、 不確実性を確率分布で表現したいか点推定で良いかの用途別選択。 事前情報がある (専門家知識、 過去研究) ならベイズ、 大規模データで事前の影響が無視可能なら頻度主義どちらでも収束する。
🧠 直感を深める ── 事前→尤度→事後の「更新」を体で覚える
ベイズの定理は「新しい証拠を見るたびに、 手持ちの信念を少しずつ書き換える手続き」です。 3 つの登場人物を、 順番に押さえておきましょう。
- 事前確率 P(H) ── 証拠を見る前の「もっともらしさ」。 いわゆる基準率(ベースレート)。 例:ある病気の有病率、 メールが迷惑である割合。
- 尤度 P(D|H) ── 「もし仮説 H が正しいなら、 この証拠 D はどれくらい出やすいか」。 検査の感度や、 単語の出現率がこれにあたります。
- 事後確率 P(H|D) ── 証拠を織り込んだ後の更新された信念。 これが次の観測では新しい「事前」になります(後述の逐次更新)。
キモは 「事後 ∝ 尤度 × 事前」。 尤度が強くても事前が極端に小さければ、 事後はさほど大きくなりません。 逆に事前が高ければ、 弱い証拠でも十分な確信に届きます。 証拠と基準率の綱引き、 それがベイズです。
🔢 基準率の誤謬を「自然頻度」で潰す(架空の検診例)
「確率(%)」のまま考えると直感が狂います。 「10 万人のうち何人か」という自然頻度に翻訳すると、 ベイズは割り算 1 回に化けます。 次は架空(合成)の検診シナリオです(有病率 0.5%・感度 90%・特異度 95%)。
| 10 万人を分けると | 人数 | 内訳 |
|---|---|---|
| 病気(0.5%) | 500 人 | 感度90% → 真陽性 450 人/偽陰性 50 人 |
| 健康(99.5%) | 99,500 人 | 特異度95%(偽陽性率5%)→ 偽陽性 4,975 人/真陰性 94,525 人 |
| 陽性者 合計 | 5,425 人 | うち本当に病気は 450 人だけ |
感度も特異度も高いのに、 陽性でも病気の確率はわずか 約 8%。 病気が稀(事前が小さい)だと、 わずかな偽陽性率が圧倒的多数の健康な人に掛かり、 偽陽性の絶対数が真陽性を数で押し流すからです。 「陽性=罹患」ではありません。 これが 基準率の誤謬(base rate fallacy)。 ページ上部の 🎮 触って理解する で有病率スライダーを下げると、 同じ現象を面積図で確認できます。
💡 実データの手触り:SSDSE-B-2026 の 2023 年 47 都道府県では、 合計特殊出生率が全国平均(約 1.29)を超える県は少数派で、 ≥1.40 は 11 県(最小は東京 0.99、 最大は沖縄 1.60)。 「高出生県」という事前が小さいクラスを当てにいくと、 やはり基準率が効いてきます(このページ上部の SSDSE 実践節を参照)。
⚠️ 落とし穴を掘り下げる ── なぜ間違えるのか
🚀 発展 ── 逐次更新・ナイーブベイズ・事前分布の選び方
① ベイズ更新の逐次適用(きのうの事後は、 きょうの事前)
ベイズの真骨頂は逐次性です。 1 つ目の証拠で得た事後を、 2 つ目の証拠の事前として再投入すれば、 同じ式を回すだけで信念が育ちます。 オッズ×尤度比の形にすると掛け算 1 回で済みます:
$$ \text{事後オッズ} = \text{事前オッズ} \times \text{LR}_1 \times \text{LR}_2 \times \cdots $$
上の架空検診(有病率0.5%・感度90%・特異度95%)で、 陽性が2 回連続で出た場合を追ってみます。 陽性の尤度比は LR⁺ = 感度 / (1−特異度) = 0.90 / 0.05 = 18。
1 回目では 8% でも、 独立な 2 回目の陽性で 62% まで跳ね上がる。 稀な事象でも証拠を積めば確信に届く ── これが逐次診断・オンライン学習・カルマンフィルタ・A/B テストの逐次停止に共通する骨格です(2 回の検査が独立という仮定が崩れると過大評価になる点は注意)。
② ナイーブベイズ分類器への橋渡し
特徴量が複数 $D = (x_1, x_2, \ldots, x_k)$ あるとき、 厳密な尤度 $P(x_1,\ldots,x_k \mid H)$ は組合せ爆発を起こします。 そこで 「クラスが決まれば各特徴は条件付き独立」と割り切って(naive)、 尤度を積に分解するのがナイーブベイズ分類器です:
$$ P(H \mid x_1,\ldots,x_k) \;\propto\; P(H)\prod_{j=1}^{k} P(x_j \mid H) $$
このページ上部のスパム判定(「無料」という 1 語で 0.5→0.889)は、 特徴が 1 個のナイーブベイズそのもの。 語を増やすたびに $P(\text{語}_j \mid \text{spam})$ を掛けていくだけです。 独立仮定は現実にはほぼ成り立ちませんが(例:SSDSE の「総人口」と「65歳以上人口」は強相関)、 それでも決定境界の推定は驚くほど頑健で、 高次元テキスト分類の定番であり続けています。 独立性が疑わしい場合は ロジスティック回帰 が安全な代替です。 分類器全般の位置づけは 分類/分類の基礎 を参照(本用語集にナイーブベイズの単独ページはまだありません)。
③ 事前分布の選び方 ── 無情報・弱情報・共役
事前分布は「データを見る前の知識」を数式にしたもの。 目的別に選びます。
| タイプ | 中身 | 使いどころ・注意 |
|---|---|---|
| 無情報事前 | 一様分布、 Jeffreys 事前 | 先入観を最小化したいとき。 ただし「平ら=無情報」は座標系依存(確率で平らでも対数オッズでは偏る)。 Jeffreys 事前は変数変換に対して不変。 |
| 弱情報事前 | 広めの正規分布など | 極端な値だけ穏やかに抑えたいとき。 少数データでの暴れを防ぐ実務的な既定値。 |
| 共役事前 | Beta–二項、 Gamma–ポアソン、 Normal–Normal | 尤度と組めば事後が同じ分布族で閉じ、 解析解(電卓レベル)で更新できる。 |
| 情報事前 | 専門家知識・過去研究で中心と分散を指定 | 根拠のある事前を積極的に使う。 選び方は必ず透明に報告する。 |
共役性の威力は、 上部「ベータ–二項モデル」節が実演しています。 $\theta \sim \text{Beta}(\alpha,\beta)$ に $s$ 回成功・$f$ 回失敗を観測すると、 事後は $\text{Beta}(\alpha+s,\ \beta+f)$。 更新は足し算だけ。 なお Beta(1,1) は Uniform(0,1)(無情報事前の一例)であり、 「無情報」と「共役」は排他ではありません。 事前をデータから決め直して同じデータで事後を出す(経験ベイズの乱用)と循環になるため、 手順の透明性が必須です。
🔗 あわせて読む(このページから直接たどれる関連用語)
ベイズの定理の理解を、 前提・並列・発展の順に深めるための本用語集内の実在ページです。
- 前提:確率 / 条件付き確率(定理の出発点 P(A|B)=P(A∩B)/P(B)) / 確率分布 / 代表的な分布
- 検査・分類の指標:偽陽性 / 偽陰性 / 特異度 / 評価指標
- 並列(頻度主義との対比):仮説検定 / p 値 / 信頼区間 / オッズ比
- 発展・応用:分類 / 分類の基礎 / ロジスティック回帰 / 正則化(L1/L2 は事前分布と等価) / 交差エントロピー / A/B テスト / 機械学習
※ 「ナイーブベイズ」の単独ページは本用語集に未作成のため、 テキスト表記に留めています(内容は 分類 ページを参照)。