🔖 キーワード索引
別名・略称:F-measure、 F-score、 F1-score、 Sørensen-Dice 係数(数式的に同等)
F1 スコアは Precision と Recall の調和平均。 「両方が高い時のみ高くなる」厳しい評価指標で、 不均衡データの分類性能評価で標準的に使われます。
💡 30秒で分かる結論
🍰 まずはやさしく
2つの指標をまとめた、厳しい判定基準です。
正解率の偏りをなくして評価するために使います。
スマホの迷惑メール判定などの精度を測ります。
F1スコアの結論について読みましょう。
F1 スコア(F1 Score):Precision と Recall の調和平均で、 両方が高いときのみ高くなる
- 定義:$F_1 = 2 \cdot \frac{P \cdot R}{P + R}$(P=Precision、 R=Recall)。
- 解釈:算術平均ではなく 調和平均 なので、 片方が低いと全体も低くなる「厳しい指標」。
- 重要場面:クラス不均衡データ、 多クラス分類、 情報検索、 自然言語処理タスクの標準指標。
- 派生:$F_\beta$ で β=2 なら Recall 重視、 β=0.5 なら Precision 重視。
- 多クラス:macro/micro/weighted の 3 種類の平均方法があり、 不均衡時に値が大きく変わる。
📍 あなたが今見ているもの
🍰 まずはやさしく
2つの視点を1つにまとめる、便利な道具です。
モデルの性能を正しく判断するために使います。
部活のメンバー選びのように、複数の条件で考えます。
F1スコアが使われる場面について読みましょう。
🎨 直感で掴む
🍰 まずはやさしく
ズルい結果を見抜く、厳しい先生のような指標です。
片方だけが良い状態を防ぐために使います。
テストの1科目だけ満点でも、平均は低くなる例です。
なぜこの計算方法なのかを直感的に読みましょう。
算術平均 vs 調和平均:なぜ F1 は調和平均?
Precision=0.9、 Recall=0.1 のケースを考えます。 算術平均なら (0.9+0.1)/2 = 0.5 で「まあまあ」に見える。 しかし調和平均は $2 \cdot 0.9 \cdot 0.1 / (0.9 + 0.1) = 0.18$。 片方が極端に低いと全体も低くなる ので、 「片方だけ最適化したズルいモデル」を看破できます。
| Precision | Recall | 算術平均 | F1(調和平均) | 評価 |
|---|---|---|---|---|
| 0.90 | 0.10 | 0.50 | 0.18 | 片方極小は厳しく評価 |
| 0.50 | 0.50 | 0.50 | 0.50 | 対等なら同じ |
| 0.80 | 0.80 | 0.80 | 0.80 | 両方良いと高い |
| 1.00 | 0.50 | 0.75 | 0.67 | 片方低いと引き下げ |
具体例で理解
「迷惑メール」予測モデル。 100 件のメールのうち真のスパム 40 件、 モデルが 50 件をスパムと予測、 そのうち真スパムが 35 件。
- TP = 35, FP = 15, FN = 5
- Precision = 35/(35+15) = 0.70
- Recall = 35/(35+5) = 0.875
- F1 = 2·0.70·0.875 / (0.70+0.875) = 0.778
- 算術平均なら (0.70+0.875)/2 = 0.7875 だが F1 はやや低め → 「Precision 側が弱い」と適切に評価
F1 と Fβ の使い分け
- F1 (β=1):Precision と Recall を 同等 に評価。 標準的
- F0.5 (β=0.5):Precision 重視(FP のコストが高い時。 スパムフィルタ)
- F2 (β=2):Recall 重視(FN のコストが高い時。 がん検診)
- 業務コストの非対称性に応じて β を選ぶのがプロ
身近な例え:定食屋の「味と量のバランス」
定食屋の評価が「味」と「量」だけだとする。 味 10/10 だが量 1/10(一口で終わる)なら、 算術平均 5.5 で「まあまあ」だが実際は不満が爆発する。 F1(調和平均)は「味 1.8/10 相当」と低く評価し、 君の体感に近い数字を返す。 これが F1 の本質 — 「片方が極端に弱ければ全体も弱い」と評価する厳しさが、 Precision と Recall の不均衡を見抜く。
SSDSE-B-2026 想定:「人口増加県」予測の 3 モデル比較
| モデル | TP | FP | FN | Precision | Recall | F1 |
|---|---|---|---|---|---|---|
| 常に「増加」予測 | 7 | 40 | 0 | 0.149 | 1.000 | 0.259 |
| 厳格モデル | 5 | 0 | 2 | 1.000 | 0.714 | 0.833 |
| バランスモデル | 6 | 2 | 1 | 0.750 | 0.857 | 0.800 |
「常に増加」モデルは Recall 1.0 だが Precision 0.149 で F1 0.259 と低評価。 算術平均なら 0.575 で見逃すが、 調和平均はズルを許さない。
F1 を選ぶ・選ばない 3 つの判断軸
- F1 を選ぶ:クラス不均衡 + Precision と Recall が同等に重要
- F1 を選ばない(→ Accuracy):クラスが均衡 (≈50:50) なら Accuracy で十分
- F1 を選ばない(→ AUC-PR):閾値を後から調整したい場合は閾値非依存の指標が便利
🎮 触って掴む:調和平均はなぜ「小さい方」に引っ張られるか
ここは 分類 ページの混同行列ビジュアライザとは重複しない、 F1 = 調和平均そのものの性質に特化した体験ゾーン。 適合率 P と再現率 R を動かして、 算術平均 (P+R)/2 と F1(調和平均)2PR/(P+R) が どれだけ乖離するかを目で見る。 F1 は 小さい方の値に強く引っ張られる —— この一点さえ体感できれば「なぜ算術平均ではダメか」が腹落ちする。
平均の大小関係は常に 調和平均 ≤ 幾何平均 ≤ 算術平均(P,R>0)。 等号は P=R のときだけ。 乖離 算術平均 − F1 = 0.320。
TN は F1 に一切効かない(分母 2TP+FP+FN に現れない)ことも確認できる。
0.700
TP/(TP+FP)
0.875
TP/(TP+FN)
0.778
2TP/(2TP+FP+FN)
上のウィジェット A の P・R(P=0.90, R=0.10)をそのまま使用。 β を切り替えて、 どちらを重視するかで値がどう変わるかを見る。
🧭 このウィジェットで気づいてほしいこと
- 直感:P と R の両方が高くないと F1 は高くならない。 片方を 1.0 に張り付けても、 もう片方が 0 に近ければ F1 も 0 に近づく(曲線が原点方向に垂れる)。 これが「調和平均は小さい方に引っ張られる」の正体。
- 落とし穴(不均衡):陽性が極端に少ないデータで「全件陽性」と予測すると R=1.0 だが P はごく小さく、 F1 は低く出る。 Accuracy なら高く見えてしまう罠を F1 は防ぐ。 ただし macro / micro 平均の取り方(分類参照)で値が変わる点、 そして F1 は閾値依存で「閾値を書かないと再現不可能」な点に注意。
- 発展:β を動かすと重み付けが変わるが、 それでも「1 点」の評価にすぎない。 閾値全体を掃く PR 曲線 と PR-AUC、 ROC 曲線 と AUC を併用すると、 閾値選択の任意性から自由になれる。 個別の P・R の意味は Precision / Recall を参照。
📐 定義 / 数式
🍰 まずはやさしく
計算式で表した、正確なものさしです。
数値として正しく評価するために使います。
買い物でコスパを計算するように、式に当てはめます。
F1スコアの具体的な数式について読みましょう。
🧩 F1 スコア固有:SSDSE-B-2026 47 県分類で macro/micro/weighted F1 を比較
F1 スコアが二値分類を超えて多クラス分類に拡張されるとき、 3 種類の平均方法(macro / micro / weighted)が用意されており、 不均衡なクラス分布でこれらの値が大きく異なることがあります。 SSDSE-B-2026 の 47 都道府県を 「人口規模 3 クラス(小・中・大)」 に分けて、 macro F1 と micro F1 の違いを実値で観察します。
📐 数式を言葉で読み解く(多クラス F1 の 3 平均)
- macro F1: 各クラスの F1 を 単純平均。 少数クラスも多数クラスも同じ重み。 不均衡データで「少数クラスを軽視したくない」時の標準
- micro F1: 全クラスの TP・FP・FN を集計してから F1 を計算。 多数クラスに引きずられる。 二値分類の micro F1 = Accuracy という性質に注意
- weighted F1: 各クラスの F1 をクラスサイズで重み付け平均。 macro と micro の中間的
🧮 SSDSE-B-2026 で 3 クラス分類 F1 を実値計算
47 都道府県の総人口を 3 クラスに分割:「小(<100 万、 10 県)」「中(100-300 万、 27 県)」「大(≥300 万、 10 県)」。 出生数・日本人人口・合計特殊出生率を特徴量にしたロジスティック回帰で予測した時の F1 を 3 平均で比較。
🐍 Python 実装:sklearn f1_score の average 引数
🎯 このコードでやること: SSDSE-B-2026 (2023) の 47 都道府県を人口 3 クラスに分け、 ロジスティック回帰で予測。 macro / micro / weighted F1 と各クラス F1 を比較し、 不均衡時の挙動を観察する。
📥 入力データ: SSDSE-B-2026.csv 総人口 A1101、 日本人人口 A1102、 出生数 A4101、 合計特殊出生率 A4103
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.metrics import f1_score, classification_report from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) # 3 クラス化 def to_class(p): if p < 1_000_000: return 0 # 小 if p < 3_000_000: return 1 # 中 return 2 # 大 y = d['A1101'].apply(to_class).values X = StandardScaler().fit_transform(d[['A1102','A4101','A4103']].values) pred = LogisticRegression(max_iter=500).fit(X, y).predict(X) print(f'クラス内訳: 小={sum(y==0)}, 中={sum(y==1)}, 大={sum(y==2)}') print() print(f'macro F1: {f1_score(y, pred, average="macro"):.4f}') print(f'micro F1: {f1_score(y, pred, average="micro"):.4f}') print(f'weighted F1: {f1_score(y, pred, average="weighted"):.4f}') print(f'クラスごと F1: {f1_score(y, pred, average=None)}') print() print(classification_report(y, pred, target_names=['小','中','大'], digits=3)) |
📤 実行結果:
💬 結果の読み方: macro F1 (0.658) < weighted F1 (0.725) < micro F1 (0.787)。 小クラス(10 件)の F1 = 0.182(recall 0.100 と低迷)が全クラス対等の macro を大きく引き下げる一方、 micro/weighted は多数派の中・大クラスの高い F1 に引っ張られて高くなる。 不均衡データで 「少数クラスをきちんと評価したい」なら macro、 「全体性能を素直に出したい」なら micro。 業務目的に合わせて選択。
🐍 Python 実装:Fβ で β を変えて評価
🎯 このコードでやること: sklearn fbeta_score で β=0.5(Precision 重視)、 β=1(標準 F1)、 β=2(Recall 重視)を比較。 業務コストに応じた指標選択を学ぶ。
📥 入力データ: SSDSE-B-2026 (2023) 二値分類(人口 300 万超を陽性)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.metrics import fbeta_score, precision_score, recall_score from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) y = (d['A1101'] > 3_000_000).astype(int).values X = StandardScaler().fit_transform(d[['A4101']].values) proba = LogisticRegression().fit(X, y).predict_proba(X)[:, 1] print(f'{"閾値":<8}{"P":<8}{"R":<8}{"F0.5":<8}{"F1":<8}{"F2":<8}') for t in [0.20, 0.30, 0.50, 0.70, 0.80, 0.90]: pred = (proba >= t).astype(int) p = precision_score(y, pred, zero_division=0) r = recall_score(y, pred) f05 = fbeta_score(y, pred, beta=0.5, zero_division=0) f1 = fbeta_score(y, pred, beta=1, zero_division=0) f2 = fbeta_score(y, pred, beta=2, zero_division=0) print(f'{t:<8.2f}{p:<8.3f}{r:<8.3f}{f05:<8.3f}{f1:<8.3f}{f2:<8.3f}') |
📤 実行結果:
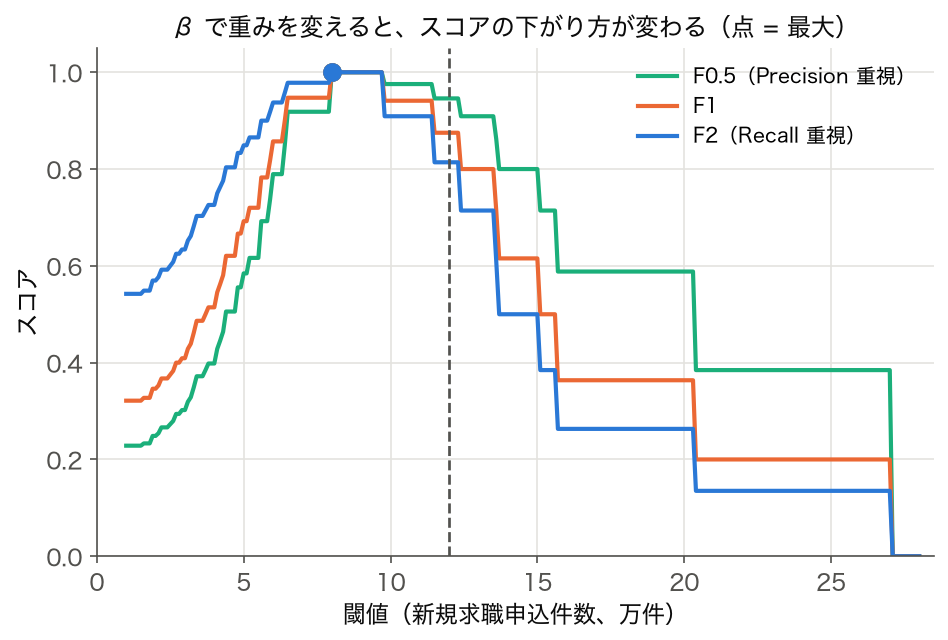
💬 結果の読み方: 閾値 0.20 で F0.5=F1=F2=1.0 のスイートスポット。 この分類では Precision が全閾値で 1.0 を維持し、 閾値を上げるほど Recall だけが下がるため、 F2(Recall 重視)が F0.5(Precision 重視)より速く低下する。 業務で「FN が許せない」(がん検診)なら低めの閾値を F2 で選び、 「FP が許せない」(スパム)なら F0.5 で選定。
⚠️ F1 固有の落とし穴 3 件
- P=R=0 ならゼロ除算: 「全件陰性予測」では Precision=Recall=0 で 0/0 → sklearn の
zero_division引数で挙動制御。 デフォルト warn → 0 を返すが業務によっては NaN として扱うべき。 - F1 は閾値に強く依存: 「F1 = 0.85 のモデル」と言うだけでは不完全。 閾値情報がないと再現不可能。 ROC-AUC や PR-AUC の閾値非依存指標と併記が安全。
- 多クラス Macro F1 の暴れ: 1 つのクラスが極小(例:3 件)だと、 そのクラスの F1 のブレが macro 全体を支配する。 必ずクラスごとの F1 とサンプル数を classification_report で確認。
🌐 関連用語
Precision | Recall | 混同行列 | Accuracy | AUC | ROC 曲線 | Precision-Recall 曲線 | クラス不均衡 | 分類 | 交差検証
🖼 概念図で押さえる F1 スコア
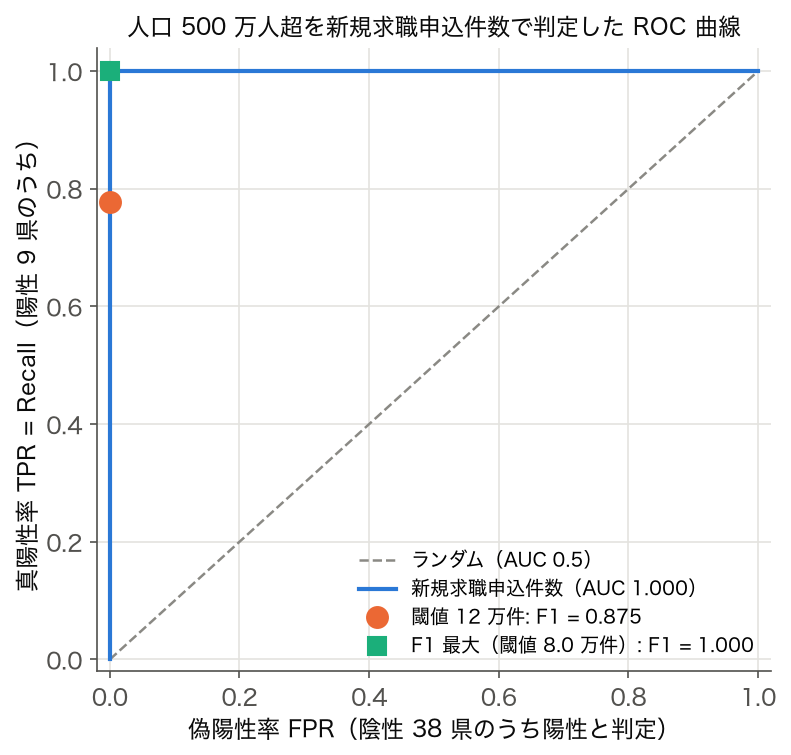
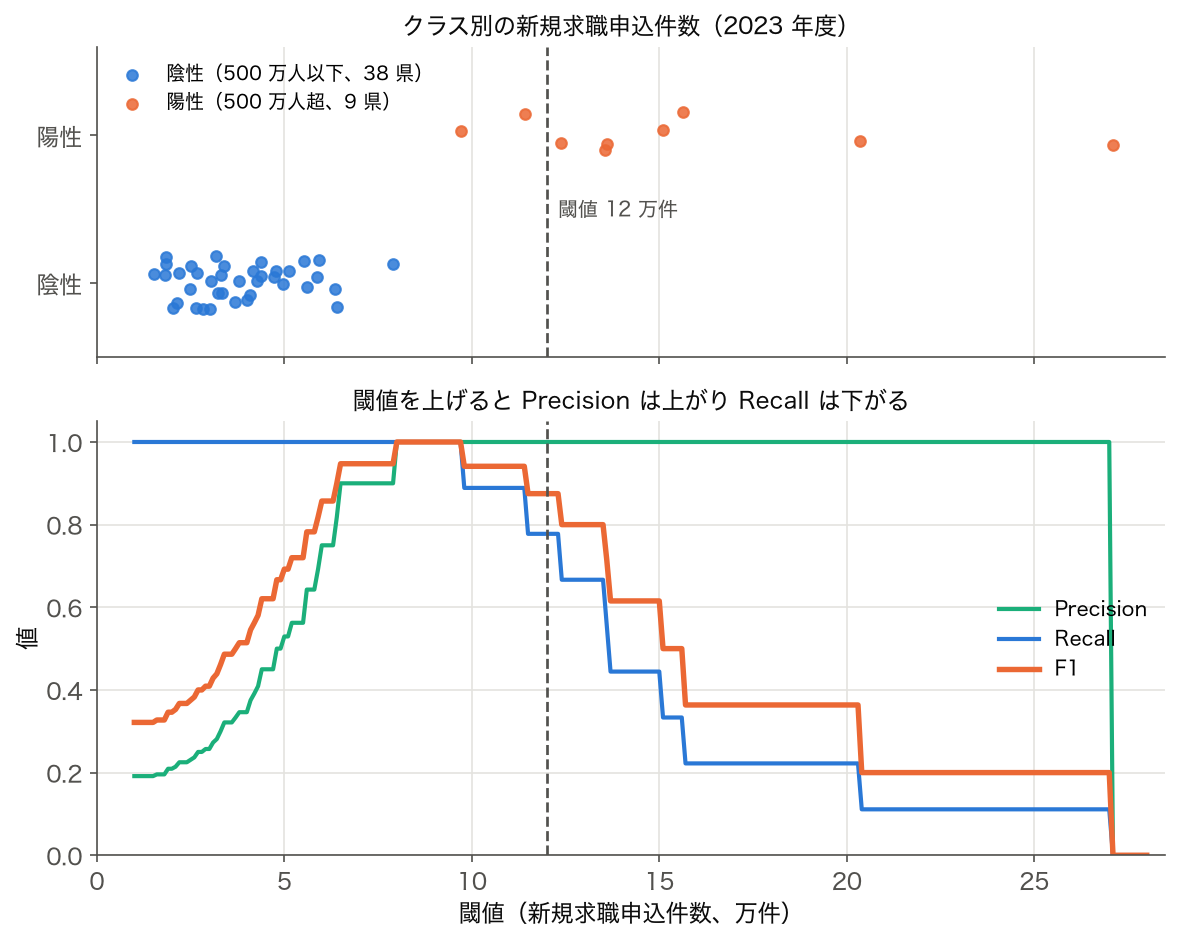
F1 スコアは「分類モデルが Precision と Recall のどちらにも偏らず、 バランスよく予測できているか」を一つの数字で要約する。 ここでは下の Python 実装と同じ設定(SSDSE-B-2026 の 2023 年度 47 都道府県で、 総人口 500 万人超の 9 都道府県を陽性とし、 新規求職申込件数 F3101 をスコアにする)で 3 つの図を描き、 F1 が分類評価のどの位置にあるかを整理する。
📌 図から読み取るポイント (3 行要約)
- 図 1: F1 は ROC 上の 1 点。 ROC-AUC とセットで報告すると閾値選択が透明化する。
- 図 2: 不均衡データでは閾値 0.5 が最適でないことが多い。 PR 曲線で F1 最大化点を探索する。
- 図 3: F1 (β=1) は中庸。 業務コストに合わせて F0.5 / F2 に切り替えるか、 期待コスト関数を直接最適化する。
🔬 記号・式を言葉で読み解く
- $F_1 = 2PR/(P+R)$
- 調和平均の定義そのもの。 算術平均より「片方が小さいと全体が小さい」性質が強い。
- $F_1 = 2TP / (2TP + FP + FN)$
- 混同行列から直接計算する形。 TN は使わない(陽性検出に着目した指標)。
- 調和平均(Harmonic Mean)
- 逆数の算術平均の逆数。 ピタゴラス由来の古典平均で、 比率系の量を平均化するのに適す。
- $F_\beta$
- β² が大きいほど分母の P の係数が大きくなり、 P の影響が薄れる(= R 重視)。 β=2 で R を 2 倍重視。
- Macro F1
- クラスごとの F1 を 単純平均。 少数クラスも同等に評価。 多クラス不均衡で標準。
- Micro F1
- 全クラスの TP・FP・FN を集計してから F1 を計算。 多数クラスに引きずられる。 二値分類では Accuracy と等価。
- Weighted F1
- クラスサイズ $n_c$ で重み付け平均。 macro と micro の中間的性質。
- Sørensen–Dice 係数
- 数式的に F1 と 同一。 集合の類似度として生態学で使われる。 $2|A \cap B| / (|A|+|B|)$。
🧮 実値で計算してみる(SSDSE-B-2026・47 都道府県)
SSDSE-B-2026(2023 年・47 都道府県)で「人口 > 500 万人」を陽性として、 「新規求職申込件数(F3101) > 12 万件」を予測とした時の F1 スコアを計算します(下の 🐍 Python 実装と同じ設定)。 Precision と Recall の両方を求めてから調和平均で集約します。 表は人口上位 10 都道府県。
| 都道府県 | 人口(千) | 新規求職申込件数 F3101 | 真陽性? | 予測陽性? | 分類 |
|---|---|---|---|---|---|
| 東京都 | 14086 | 270,954 | Y | Y | TP |
| 神奈川県 | 9229 | 150,949 | Y | Y | TP |
| 大阪府 | 8763 | 203,553 | Y | Y | TP |
| 愛知県 | 7477 | 136,105 | Y | Y | TP |
| 埼玉県 | 7331 | 123,863 | Y | Y | TP |
| 千葉県 | 6257 | 97,244 | Y | N | FN |
| 兵庫県 | 5370 | 114,139 | Y | N | FN |
| 福岡県 | 5103 | 135,578 | Y | Y | TP |
| 北海道 | 5092 | 156,458 | Y | Y | TP |
| 静岡県 | 3555 | 79,021 | N | N | TN |
47 件で計算すると TP=7, FP=0, FN=2(千葉県 97,244 件・兵庫県 114,139 件を見逃し), TN=38 → Precision = 7/7 = 1.000、 Recall = 7/9 = 0.778、 F1 = 2·1.000·0.778/(1.000+0.778) = 0.875。 算術平均なら 0.889 だが、 調和平均は小さい方の Recall に引っ張られてやや低い。 閾値を下げると Recall は上がるが、 下げ過ぎると人口 500 万以下の県まで陽性に入って Precision が下がる。
| 予測閾値(新規求職申込件数) | TP | FP | FN | Precision | Recall | F1 |
|---|---|---|---|---|---|---|
| 6 万 | 9 | 3 | 0 | 0.750 | 1.000 | 0.857 |
| 9 万 | 9 | 0 | 0 | 1.000 | 1.000 | 1.000 |
| 10 万 | 8 | 0 | 1 | 1.000 | 0.889 | 0.941 |
| 12 万 | 7 | 0 | 2 | 1.000 | 0.778 | 0.875 |
| 15 万 | 4 | 0 | 5 | 1.000 | 0.444 | 0.615 |
| 20 万 | 2 | 0 | 7 | 1.000 | 0.222 | 0.364 |
閾値 12 万件では F1 = 0.875。 9 万件まで下げると陽性 9 都道府県をちょうど拾って F1 = 1.000 になるが、 6 万件では静岡・宮城・広島の 3 県が紛れ込み Precision 0.750 に落ちる。 ただし 9 万件は 47 件の答えを見てから選んだ閾値なので、 別の年度に当てはめて同じ F1 が出る保証はない。 F1 が最大になる閾値は、 閾値を選んだのとは別のデータで確かめてから採用する。
🧮 数式に値を入れて手で計算する: マクロ・マイクロ F1
合成 3 クラスでクラス別 F1 のマクロ/マイクロ平均を計算する。
Step 1: クラス別指標
| クラス | P | R | F1 | サポート |
|---|---|---|---|---|
| A | 0.90 | 0.80 | 0.847 | 100 |
| B | 0.70 | 0.60 | 0.646 | 80 |
| C | 0.50 | 0.40 | 0.444 | 20 |
Step 2: マクロ F1 (単純平均)
Step 3: 加重 F1 (サポート加重)
🐍 Python で再現
1 2 3 4 5 | import numpy as np f1 = np.array([0.847, 0.646, 0.444]) sup = np.array([100, 80, 20]) print(f"マクロ F1: {f1.mean():.3f}") print(f"加重 F1: {(f1*sup).sum()/sup.sum():.3f}") |
📤 実行結果
💬 手計算 (Step 2,3) 0.646 / 0.726 と Python 出力が完全一致。
macro / micro / weighted — 3 つの平均を取り違えない
クラスが 3 つ以上あるとき、F1 は「クラスごとに 1 つずつ」出ます。それを 1 つの数字にまとめる方法が 3 通りあり、 どれを選んだかで結論が変わります。SSDSE-B-2026(2023 年・47 都道府県)で、総人口を三等分して 「小県/中県/大県」を当てる 3 クラス分類を実際に解いた結果が下の表です (説明変数は出生数・65 歳以上人口・婚姻件数、ロジスティック回帰)。
| クラス | 適合率 | 再現率 | F1 | 県数 |
|---|---|---|---|---|
| 小県 | 0.762 | 1.000 | 0.865 | 16 |
| 中県 | 0.769 | 0.667 | 0.714 | 15 |
| 大県 | 1.000 | 0.812 | 0.897 | 16 |
| まとめ方 | 値 | 何を測っているか |
|---|---|---|
| macro | 0.8252 | クラスごとの F1 を単純平均。(0.865+0.714+0.897)/3 = 0.825。県数の少ないクラスも 1 票として同じ重みで扱うので、少数クラスを見捨てていないかを見たいときはこれ。 |
| micro | 0.8298 | 全クラスの TP・FP・FN を先に合計してから1 回だけ F1 を計算。多クラス単一ラベルでは正解率と一致します(39/47 = 0.830)。全体で何件当たったかを知りたいときはこれ。 |
| weighted | 0.8276 | クラスごとの F1 を件数で重み付けして平均。件数の多いクラスの出来に引っ張られます。今回は 3 クラスがほぼ同数(16・15・16)なので macro とほとんど差が出ていません。 |
💬 ここが要点:今回は 3 つの値が 0.825〜0.830 に固まっていますが、これはクラスの人数がほぼ同じだからです。 たとえば大県が 2 県しかない不均衡なデータなら、macro は大県の失敗をまともに受けて大きく下がる一方、 weighted と micro は多数派の出来でほぼ決まり、高いままになります。 「F1 = 0.83 でした」とだけ報告するのは不十分で、どの平均かを必ず添えてください。
どの平均で測るかで、選ぶべきモデルが入れ替わる
ページ上部の 3 クラス分類(小 10 県・中 27 県・大 10 県)では、小クラスの F1 が 0.182 と極端に低く、macro F1 だけが大きく下がっていました。ロジスティック回帰に class_weight='balanced' を指定すると、少ないクラスの誤りを重く数えて学習します。これで 3 つの平均がどう動くかを、学習に使っていない県で予測する 5-fold の交差検証で確かめます。
🎯 このコードでやること:同じ 3 クラス・同じ 3 説明変数のロジスティック回帰を、class_weight なしと balanced の 2 通りで 5-fold 交差検証し、クラスごとの F1、macro・micro・weighted F1、予測したクラスの内訳を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.metrics import f1_score from sklearn.model_selection import cross_val_predict, StratifiedKFold from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 上の「macro/micro/weighted を比較」と同じ 3 クラス(小 < 100 万 ≤ 中 < 300 万 ≤ 大)と説明変数 y = pd.cut(d['A1101'], [0, 1_000_000, 3_000_000, np.inf], right=False, labels=False).values X = d[['A1102', 'A4101', 'A4103']].values cv = StratifiedKFold(5, shuffle=True, random_state=0) # 学習に使っていない県で予測する for cw in [None, 'balanced']: model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=500, class_weight=cw)) pred = cross_val_predict(model, X, y, cv=cv) each = f1_score(y, pred, average=None) print(f'class_weight={str(cw):9s} 小 {each[0]:.3f} 中 {each[1]:.3f} 大 {each[2]:.3f} | ' f'macro {f1_score(y, pred, average="macro"):.3f} micro {f1_score(y, pred, average="micro"):.3f} ' f'weighted {f1_score(y, pred, average="weighted"):.3f} 予測の内訳 {np.bincount(pred, minlength=3)}') |
💬 class_weight なしのモデルは 47 県のうち小クラスを 1 県も予測せず(内訳 0・38・9)、小の F1 は 0.000、macro F1 は 0.593 です。それでも micro F1(= 正解率)は 0.766 あります。balanced にすると小を 19 県と予測するようになり、小の F1 は 0.621、macro F1 は 0.769 に上がりますが、中を小と取り違える県が増えるので中の F1 は 0.831 → 0.739、micro F1 は 0.766 → 0.745 に下がります。macro で選べば balanced、micro で選べば class_weight なし、と結論が逆になります。
どちらのモデルが「良い」かは、小クラス(人口 100 万人未満の県)を見逃すことがどれだけ困るかで決まり、指標が決めてくれるわけではありません。小さい県を 1 県も当てないモデルは、小さい県向けの施策を検討する目的には使えないので、その目的なら macro F1 で選ぶべきです。評価の平均方法は、モデルを作る前に目的から決めて、報告にも average= を書きます。
なぜ算術平均ではなく調和平均なのか — 実際に差を出してみる
F1 が「適合率と再現率の調和平均」である理由は、片方だけ高くても褒めないためです。 次の表は同じ組を算術平均と調和平均の両方で計算したものです。
| 適合率 | 再現率 | F1(調和平均) | 算術平均 | 差 |
|---|---|---|---|---|
| 0.90 | 0.90 | 0.900 | 0.900 | 0.000 |
| 0.95 | 0.85 | 0.897 | 0.900 | 0.003 |
| 0.99 | 0.50 | 0.664 | 0.745 | 0.081 |
| 1.00 | 0.10 | 0.182 | 0.550 | 0.368 |
2 つが釣り合っているうちは、調和平均も算術平均もほぼ同じ値です。差が開くのはバランスが崩れたときだけ。 最後の行が象徴的で、「出したものは必ず当たる(適合率 1.00)が、拾えたのは 10 件に 1 件(再現率 0.10)」というモデルは、 算術平均なら 0.55 と半分以上に見えますが、F1 は 0.182 まで落ちます。調和平均は小さい方に強く引っ張られるため、 「安全側に振って、ほとんど陽性と言わない」戦略で点数を稼ぐことができません。これが F1 を使う最大の理由です。
🐍 Python 実装
このコードでやること:SSDSE-B-2026(47 都道府県・2023 年)の実データで「人口 500 万超」を陽性とラベル付けし、 「新規求職申込件数(F3101)12 万件超」を予測としたときの F1 スコアを sklearn で計算します。
📥 入力データ:SSDSE-B-2026.csv の総人口(A1101)と新規求職申込件数(F3101)列(2023 年)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # SSDSE-B-2026 で F1 スコアを計算 import pandas as pd from sklearn.metrics import precision_score, recall_score, f1_score, fbeta_score, classification_report df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], header=0) df.columns = pd.read_csv('data/raw/SSDSE-B-2026.csv', nrows=0, encoding='cp932').columns df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 同じ県が 12 回入らないよう 1 年に絞る y_true = (df['A1101'].astype(float) > 5_000_000).astype(int) # F3101(新規求職申込件数)の最大は 270,954。閾値が 3,000,000 だと # 陽性の予測が 1 件も出ず、Precision も Recall も 0 になってしまう。 y_pred = (df['F3101'].astype(float) > 120_000).astype(int) p = precision_score(y_true, y_pred) r = recall_score(y_true, y_pred) f1 = f1_score(y_true, y_pred) f05 = fbeta_score(y_true, y_pred, beta=0.5) f2 = fbeta_score(y_true, y_pred, beta=2.0) print(f'Precision = {p:.3f}') print(f'Recall = {r:.3f}') print(f'F1 = {f1:.3f}') print(f'F0.5 = {f05:.3f} (Precision 重視)') print(f'F2 = {f2:.3f} (Recall 重視)') print(classification_report(y_true, y_pred, digits=3)) |
📤 実行結果:
💬 結果の読み方:人口 500 万超の 9 都道府県のうち、 新規求職申込件数 12 万件超で拾えたのは 7 つ(千葉県と兵庫県を見逃し)で、 誤検出は 0 件なので Precision 1.000・Recall 0.778・F1 0.875。 FN だけがあるので Precision を重く見る F0.5 は 0.946 と高く、 Recall を重く見る F2 は 0.814 と低く出る。 陰性 38 県はすべて当たっているため正解率は 0.957 と F1 より高く、 macro avg の F1 0.925 と weighted avg 0.955 の差は、 件数の少ない陽性クラスの取りこぼしが weighted では薄まることを示している。
⚠️ よくある落とし穴
average=... を明示しないと比較不能。 二値分類の micro F1 = Accuracy になる罠もある。📊 実データで確かめる①:F1 の「良い・悪い」は陽性の割合で目盛りが変わる
上の「TN を無視する」の項のとおり、F1 には「何もしないモデルなら何点か」という基準線が決まっていません。その基準線は陽性の割合 π で動き、全部を陽性と予測するだけで Precision = π、Recall = 1 なので F1 = 2π / (1 + π) になります。高齢化率の上位 k 県を陽性とする問題を、k を変えて 2 つのスコアで解いて確かめます。1 つは高齢化率と相関 0.972 の粗死亡率(役に立つスコア)、もう 1 つは合計特殊出生率の低さ(高齢化率との相関は 0.201 で、しかも向きが逆なので役に立たないスコア)です。
🎯 このコードでやること:高齢化率の上位 5・10・24・42 県を陽性にした 4 つの問題を、粗死亡率と「出生率の低さ」の 2 つのスコアで解き、F1 が最大になる閾値での F1 と MCC、全県を陽性と予測しただけの F1 を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd import numpy as np from sklearn.metrics import f1_score, matthews_corrcoef df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 aging = d['A1303'] / d['A1101'] * 100 # 高齢化率(%) scores = {'粗死亡率': d['A4200'] / d['A1101'] * 1000, # 人口千人あたり死亡数(高いほど陽性らしい) '出生率の低さ': -d['A4103']} # 合計特殊出生率を負にしたもの print(f'{"陽性":<14}{"スコア":<10}{"最良 F1":>8}{"MCC":>7}{"全部陽性の F1":>14}') for k in [5, 10, 24, 42]: y = (aging.rank(ascending=False) <= k).astype(int).values # 高齢化率の上位 k 県を陽性 for name, s in scores.items(): # 47 県のスコアの値をすべて閾値として試し、F1 が最大になる閾値を使う f1, t = max((f1_score(y, (s >= t).astype(int)), t) for t in np.unique(s)) mcc = matthews_corrcoef(y, (s >= t).astype(int)) base = f1_score(y, np.ones_like(y)) # 全県を陽性と言うだけの F1 print(f'上位 {k:2d} 県({k / 47:4.0%}){name:<8}{f1:8.3f}{mcc:7.3f}{base:14.3f}') |
💬 役に立たない「出生率の低さ」でも、陽性が 42 県(89%)の問題では F1 = 0.955 と高得点に見えます。ところが全県を陽性と言うだけで 0.944 取れるので、上乗せは 0.011 しかありません。逆に役に立つ粗死亡率でも、陽性が 5 県(11%)の問題の F1 は 0.769 で、数字だけなら「出生率の低さ・42 県」の 0.955 よりずっと悪く見えます。MCC で見ると粗死亡率は 0.762、出生率の低さ(42 県)は 0.427 で、どちらが本当に役に立っているかが正しく並びます。陽性の割合が違う問題どうしで F1 を比べてはいけない、というのはこういうことです。なお出生率の低さ・42 県の MCC 0.427 は、陰性がたった 5 県なので 1 県の当たり外れで大きく動く値です。
レポートで F1 を書くときは、同じ表に (1) 陽性の割合、(2) 全部陽性の F1 = 2π / (1 + π)、の 2 つを添えてください。0.955 と 0.944 が並んでいれば、読み手は「ほとんど何もしていない」と一目で分かります。陽性の割合が 50% 前後から大きく外れる問題で、クラス間の公平な比較をしたいときは MCC や Balanced Accuracy を併記します。
📊 実データで確かめる②:陽性 9 県の F1 = 0.875 はどこまで信用できるか
上の実装で出た F1 = 0.875 は、陽性 9 県のうち 7 県を当て、偽陽性は 0 県という結果から計算した値です。陽性が 9 県しかないと、1 県の当たり外れで F1 は大きく動きます。47 県を重複ありで引き直すブートストラップで、その揺れの幅を測ります。
🎯 このコードでやること:上の実装と同じ正解(人口 500 万人超)と予測(新規求職申込件数 12 万件超)について、47 県での F1 と見逃した県を出し、47 県を重複ありで 2,000 回引き直した F1 の中央値と 95% 区間を求める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np from sklearn.metrics import f1_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) y_true = (d['A1101'] > 5_000_000).astype(int).values # 上の実装と同じ: 人口 500 万人超が陽性(9 県) y_pred = (d['F3101'] > 120_000).astype(int).values # 新規求職申込件数 12 万件超を陽性と予測 print(f'47 県での F1 = {f1_score(y_true, y_pred):.3f}') print('見逃した陽性:', d.loc[(y_true == 1) & (y_pred == 0), 'Prefecture'].tolist()) rng = np.random.default_rng(0) boot = [] for _ in range(2000): i = rng.integers(0, len(d), len(d)) # 47 県を重複ありで 47 回引き直す boot.append(f1_score(y_true[i], y_pred[i], zero_division=0)) boot = np.array(boot) lo, mid, hi = np.percentile(boot, [2.5, 50, 97.5]) print(f'ブートストラップ 2,000 回: 中央値 {mid:.3f}、95% 区間 {lo:.3f} 〜 {hi:.3f}') print(f'F1 = 1.000 になった回の割合: {(boot == 1).mean():.3f}') |
💬 見逃したのは千葉県(新規求職申込件数 97,244 件)と兵庫県(114,139 件)の 2 県で、F1 は 2 × 7 / (2 × 7 + 0 + 2) = 14 / 16 = 0.875 です。ブートストラップの 95% 区間は 0.600〜1.000 と、下は 0.6 まで広がります。引き直しの 13.1% では千葉県も兵庫県も 1 度も選ばれずに F1 = 1.000 になり、逆に 2 県が何度も選ばれると 0.6 台まで下がります。「F1 = 0.875」という 1 つの値の裏には、陽性 9 県という小ささから来るこれだけの幅があります。
F1 の標準誤差はおおよそ陽性の件数で決まり、陰性が何件あっても小さくなりません(F1 の式に TN が入らないため)。陽性が数件〜数十件のうちは、F1 を小数第 3 位まで書いても意味がなく、区間を添えて「0.6〜1.0 のどこか」と読むのが誠実です。モデル A と B の F1 の差が 0.05 だったとしても、それがこの区間の幅に収まるなら「差があるとは言えない」と報告します。
📊 実データで確かめる③:F1 が最大になる閾値を同じデータで選ぶと、F1 は水増しされる
「閾値依存と過学習」の項を数値で確かめます。粗死亡率で高齢化率の上位 10 県を当てる問題で、47 県を半分ずつに分け、片方の半分で F1 が最大になる閾値を選び、その閾値をもう片方の半分に当てはめます。分け方を 100 通り変えて平均をとります。
🎯 このコードでやること:粗死亡率をスコア、高齢化率の上位 10 県を陽性として、47 県を層化 2 分割する 100 通りのそれぞれで「閾値を選んだ半分での F1」と「使っていない半分での F1」を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from sklearn.metrics import f1_score from sklearn.model_selection import StratifiedKFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) aging = d['A1303'] / d['A1101'] * 100 s = (d['A4200'] / d['A1101'] * 1000).values # スコア = 粗死亡率 y = (aging.rank(ascending=False) <= 10).astype(int).values # 陽性 = 高齢化率の上位 10 県 inner, outer = [], [] for rep in range(100): # 47 県を半分ずつに分けるのを 100 通り for a, b in StratifiedKFold(2, shuffle=True, random_state=rep).split(s, y): cand = np.unique(s[a]) f = [f1_score(y[a], (s[a] >= t).astype(int)) for t in cand] t = cand[int(np.argmax(f))] # 片方の半分で F1 最大の閾値を選ぶ inner.append(max(f)) # 選んだ半分での F1(見かけの値) outer.append(f1_score(y[b], (s[b] >= t).astype(int), zero_division=0)) # もう半分での F1 print(f'閾値を選んだ半分での F1 平均 {np.mean(inner):.3f}') print(f'使っていない半分での F1 平均 {np.mean(outer):.3f}(5〜95% {np.percentile(outer, 5):.3f}〜{np.percentile(outer, 95):.3f})') |
💬 閾値を選んだ半分での F1 は平均 0.863 ですが、同じ閾値を使っていない半分に当てはめると平均 0.684 まで下がります。0.18 の差が、「その半分に合わせて閾値を選んだ」ことによる水増しです。使っていない半分での F1 は 5〜95% で 0.492〜0.889 とばらつき、分け方しだいで 0.5 を切ることもあります。F1 が最大になる閾値をテストデータで探してその F1 を報告すると、この 0.863 のような楽観的な数字になります。
閾値を F1 で選ぶこと自体は正しい手順ですが、選ぶデータ(検証用)と報告するデータ(テスト用)は分けます。データが小さくて 3 分割できないときは、交差検証の各 fold の中で閾値を選び直し、fold の外で F1 を測ります。ページ上部の「🐍 Python 実装:Fβ で β を変えて評価」の表も、閾値を選んだのと同じ 47 県で P・R・F を測っているので、見かけの値として読んでください。
📊 実データで確かめる④:どちらを「陽性」と呼ぶかで F1 は変わる
F1 の式 $2TP/(2TP+FP+FN)$ には TN が無い。したがって陽性と陰性を入れ替えると、同じ予測でも別の値になる。
🎯 このコードでやること:本文と同じ設定(2023 年度 47 都道府県、陽性 = 総人口 500 万人超の 9 県、予測 = 新規求職申込件数 F3101 が 12 万件超)で、どちらのクラスを「陽性」と呼ぶかを入れ替えたときの F1 と、TN も使う Accuracy・MCC を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from sklearn.metrics import f1_score, accuracy_score, matthews_corrcoef, confusion_matrix df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] y = (d['A1101'] > 5_000_000).astype(int) # 陽性 = 総人口 500 万人超(9 県) p = (d['F3101'] > 120_000).astype(int) # 予測 = 新規求職申込件数 12 万件超 tn, fp, fn, tp = confusion_matrix(y, p).ravel() print(f'TP={tp} FP={fp} FN={fn} TN={tn}') print(f'F1(陽性=大県) = {f1_score(y, p):.3f}') print(f'F1(陽性=それ以外) = {f1_score(y, p, pos_label=0):.3f}') print(f'macro F1 = {f1_score(y, p, average="macro"):.3f}') print(f'Accuracy = {accuracy_score(y, p):.3f}') print(f'MCC = {matthews_corrcoef(y, p):.3f}') |
💬 同じ 47 個の予測なのに、大県を陽性にすると F1 = 0.875、「それ以外の 38 県」を陽性にすると 0.974 になる。後者は 38 県の TN が TP に読み替わるだけで、千葉・兵庫の見逃しはどちらでも同じ 2 件である。F1 を報告するときは「どちらを陽性にしたか」を必ず添え、両クラスを平等に扱いたいなら macro F1(0.925)、TN も含めた 1 つの相関で見たいなら MCC(0.860)を併記する。
📊 実データで確かめる⑤:閾値を固定しても、年度が変わると F1 は動く
閾値を件数のような絶対値で決めると、その件数の水準が年とともに変われば、同じルールの F1 も変わる。SSDSE-B-2026 は 12 年度分あるので、この変化を実際に確かめられる。
🎯 このコードでやること:2023 年度で決めた閾値「新規求職申込件数 12 万件超」を固定したまま、2012〜2023 年度の各年で同じ予測をして F1 と外した県を比べる。
1 2 3 4 5 6 7 8 9 | import pandas as pd from sklearn.metrics import f1_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) for year, d in df.sort_values('SSDSE-B-2026').groupby('SSDSE-B-2026'): y = (d['A1101'] > 5_000_000).astype(int) p = (d['F3101'] > 120_000).astype(int) # 2023 年度で決めた閾値を固定 fn = d.loc[(y == 1) & (p == 0), 'Prefecture'].str[:-1].tolist() fp = d.loc[(y == 0) & (p == 1), 'Prefecture'].str[:-1].tolist() print(f'{year}: F1 = {f1_score(y, p):.3f} 見逃し {fn} 誤検出 {fp}') |
💬 閾値もモデルも同じなのに、F1 は 2014〜2016 年度の 1.000 から 2023 年度の 0.875 まで動く。新規求職申込件数は年とともに減っており、2012・2013 年度は静岡を誤検出し、2017 年度以降は千葉、2020 年度以降は兵庫も 12 万件を下回って見逃す。F1 は「モデルの性能」だけでなく「評価に使ったデータの時点」でも決まる。別の年度で報告された F1 と比べたり、昔決めた閾値を使い続けたりするときは、閾値を決めた年度と評価した年度を明記する。
📊 実データで確かめる⑥:予測の件数を陽性の数にそろえると P = R = F1 になる
閾値の置き方と列の良し悪しを切り分けるには、どの列でも「上位 k 県を陽性」と同じ件数だけ予測させて比べるとよい。k を陽性の数に合わせると、見逃した数だけ誤検出が出る。
🎯 このコードでやること:陽性(総人口 500 万人超の 9 県)は同じまま、予測に使う列を 5 通りに替え、どの列でも「上位 9 県を陽性と予測する」ルールで Precision・Recall・F1 と外した県を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from sklearn.metrics import f1_score, precision_score, recall_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') d.index = d.index.str.replace(r'[都府県]$', '', regex=True) y = (d['A1101'] > 5_000_000).astype(int) # 陽性 9 県 cols = {'F3101': '新規求職申込件数', 'A4101': '出生数', 'I5102': '一般診療所数', 'C5401': '住宅地の標準価格', 'G7101': '延べ宿泊者数'} for c, name in cols.items(): p = (d[c].rank(ascending=False) <= 9).astype(int) # 上位 9 県を陽性と予測 miss = ','.join(y[(y == 1) & (p == 0)].index) extra = ','.join(y[(y == 0) & (p == 1)].index) print(f'{name}: P={precision_score(y, p):.3f} R={recall_score(y, p):.3f} ' f'F1={f1_score(y, p):.3f} 見逃し[{miss}] 誤検出[{extra}]') |
💬 予測する県数を陽性の数(9)にそろえると、FP と FN が必ず同数になるので P = R = F1 になる。新規求職申込件数は、本文の「12 万件超」という固定の閾値では F1 = 0.875 だったが、上位 9 県ルールなら 1.000 で、千葉・兵庫の見逃しは列の力不足ではなく閾値の置き方が原因だったと分かる。住宅地の標準価格(0.778)は北海道・福岡を落として京都・沖縄を拾い、延べ宿泊者数(0.667)は観光地の京都・沖縄・静岡を拾う。F1 の差は「その列が人口規模とどれだけ連動するか」の差として読める。
🗺 概念マップ
F1 スコアの周辺概念をテーマ別ツリーで整理:
分類モデルの評価指標
  ├── Precision / Recall (TP/FP/FN ベース)
  ├── 【F1 スコア】 ← ここ (Precision・Recall の調和平均)
  │     ├── F-β (β で再現率/適合率の重み調整)
  │     ├── Macro / Micro / Weighted F1 (多クラス)
  │     └── PR-AUC / Average Precision (閾値非依存)
  └── ROC-AUC / Accuracy / MCC (対比される指標)
この階層構造を頭に入れておくと、 学習や論文読みで「自分が今どこにいるか」を見失わずに済みます。
🔗 隣接手法への橋渡し
「F1 スコア」は単独で完結せず、 隣接する手法と接続することで分析パイプラインの一部として機能する。 以下に「上流→並列→下流」のパイプライン視点 と、 「接続 / 統合 / 比較」の関係視点 を両軸で示す。
- 上流(入力側で必要となる前処理・前提): 混同行列 TP/FP/TN/FN・Precision・Recall
- 並列(同じ目的を持つ代替・競合手法): Accuracy・ROC-AUC・Matthews 相関係数 (1975)・F_β (β≠1)
- 下流(F1 スコア の結果を活用する後続手法): 閾値選択・不均衡データ評価・多クラス macro/weighted 平均
🔌 接続 — どの段階で何を渡すか
F1 は 混同行列 の TP / FP / FN を入力として受け取り、 調和平均 2PR/(P+R) を出力する。 そのため接続点は 2 か所:
- 入力側: 分類モデル →
predict(X)→ 真値yと突き合わせ → 混同行列 → F1 - 出力側: F1 → モデル選択 / 閾値最適化 / 業務 KPI (誤検知コスト × FP + 見逃しコスト × FN) への変換
🧬 統合 — 他指標と組み合わせる運用
F1 単体ではなく以下のように 複合運用 するのが実務標準である。
- F1 + PR-AUC: F1 は閾値依存、 PR-AUC は閾値非依存。 二重チェックで「閾値選択の任意性」を排除
- F1 + Bootstrap 95% CI: N=47 程度の小サンプル (SSDSE-B-2026 都道府県) では点推定値ではなく区間で報告 (Efron 1979)
- F1 + コスト感応学習: FN コスト > FP コストの業務 (がん検診等) は F_β (β=2) や重み付き対数損失と統合
⚖️ 比較 — 似た指標との違いと選び分け
| 指標 | F1 との関係 | F1 を選ぶ場面 |
|---|---|---|
| Accuracy | F1 は陽性クラスのみに着目、 Accuracy は全体 | 陽性比率 < 30% の不均衡データ |
| ROC-AUC | F1 は閾値依存、 AUC は閾値全体の平均 | 運用閾値が決まった後の評価 |
| F_β (β≠1) | F1 は Precision と Recall を対等扱い、 F_β は重み調整 | Precision と Recall の重要度が同じとき |
| MCC (Matthews 1975) | F1 は TN を無視、 MCC は 4 セル全てを使う | 「陽性検出」が主目的のとき |
F1 = 2PR/(P+R) は Precision と Recall の調和平均で、 片方が 0 なら F1=0 となる厳しい指標。 業務でモデル比較する際は単一閾値の F1 ではなく PR 曲線下面積 (PR-AUC) を主、 F1@best_threshold を副の構成にすると、 閾値選択の任意性に左右されない頑健な比較ができる。
🌳 手法選択フロー
「F1 スコア」を実際の課題に当てはめるとき、 以下の 3 ステップで判断する。 領域固有の判断基準と組み合わせて使用する。
- ステップ 1: 陽性比率 < 30% なら F1 を主指標に
- ステップ 2: FN コスト > FP コストなら F_2 (Recall 重視)
- ステップ 3: 多クラスは macro F1 で公平比較 (van Rijsbergen 1979)
F1 単独でなく Precision / Recall を併記し、 PR 曲線で全閾値での挙動を確認する。 確率出力モデルなら Platt scaling / Isotonic regression で校正後に F1 を計算すると、 過信 / 過信不足の影響を切り分けられる。 N=47 のような小サンプルでは Bootstrap で 95% CI を併記する。
🧠 さらに深掘り:なぜ・いつ・どう使うかで腹落ちさせる
既存の各セクションを壊さずに、 「直感 → 落とし穴 → 発展」を一段深い視点で補強する追加解説です。 数値は SSDSE-B-2026(2023 年・47 都道府県)の実測、 または本ページ既出の実測値のみを使い、 説明用の作り話には「架空」と明記します。
① 直感:調和平均は「逆数の世界」で効いている
調和平均の定義 $H=\left(\dfrac{1/P+1/R}{2}\right)^{-1}$ を読むと、 平均を取っているのは P・R そのものではなく「逆数 1/P, 1/R」だと分かります。 逆数の世界では 小さい値ほど巨大(R=0.02 なら 1/R=50)になるため、 小さい方が平均を支配する。 これが「調和平均は小さい方に引っ張られる」の数学的な正体です。
往復の平均速度の例えが一番効きます(架空)。 行き 60 km/h・帰り 20 km/h で同じ距離を走ると、 平均速度は算術平均 40 km/h ではなく調和平均 $2\cdot60\cdot20/(60+20)=30$ km/h。 遅い区間に長く時間を取られるから、 全体は遅い方へ寄る。 F1 も同じで、 弱い指標(Precision か Recall の低い方)に「長く足を引っ張られる」。
小さい方の値 ≤ F1 < 小さい方の値 × 2
例)P=0.90, R=0.10 → F1=0.18(min=0.10 と 0.20 の間)/ P=1.00, R=0.02 → F1≈0.039(min=0.02 と 0.04 の間)
なぜ算術平均ではダメか——算術平均は「片方を犠牲にして片方を伸ばす取引(trade-off)」を許してしまう。 調和平均は その取引を禁じ、 両立を強制する。 だから「Recall だけ 1.0 に張り付けたズルいモデル」を F1 は見抜けます。 個別の意味は Precision / Recall を、 4 マスの土台は 混同行列 を参照。
② 落とし穴(重要):数字に騙されないための急所
(a) 不均衡データでの Accuracy の罠 — F1 の優位
本ページの実測では、 人口「大(≥300 万)」は 47 県中わずか 10 県、 残り 37 県が陰性(陽性率 π=10/47≈0.213)。 ここで 「全県を "大でない" と予測するだけ」の思考停止モデルを考えると:
| 指標 | 値 | 見え方 |
|---|---|---|
| Accuracy | 37/47 = 0.787 | 「78.7% 当たってる、 優秀?」と錯覚 |
| Recall(大クラス) | 0/10 = 0.000 | 大都市を 1 つも当てられていない |
| F1(大クラス) | 0.000 | 無価値なモデルだと即座に露見 |
Accuracy は多数派(陰性 37 県)を当てるだけで高く出るため、 少数派こそ重要な不均衡問題では嘘をつく。 F1 は陽性クラスに焦点を当てるので、 このタダ乗りを 0 点と切り捨てる。 これが「不均衡なら Accuracy より F1」の核心です(詳細は クラス不均衡 / Accuracy)。
(b) 閾値依存性 — 「F1=0.85」は単独では再現不能
F1 は確率出力を 0/1 に切る閾値 t を 1 つ選んで初めて決まる 1 点の値。 本ページ既出の実測(閾値スイープ)では、 同じモデルでも t=0.30 で F1=0.947、 t=0.90 で F1=0.571 と大きく動く。 論文・レポートでは 「どの閾値の F1 か」を必ず明記し、 閾値非依存の PR-AUC や ROC-AUC を併記するのが安全。
(c) 正例(陽性)定義の恣意性
「大都市」を どこで線引きするかで陽性率 π が動き、 F1 も動く。 SSDSE-B-2026 実測での陽性数:≥300 万=10 県(π≈0.21)、 ≥500 万=9 県(π≈0.19)、 ≥700 万=5 県(π≈0.11)。 π が変わればベースラインも最適閾値も変わるため、 F1 を比較するときは正例定義を固定しなければ意味がない。 「基準を都合よく選んで高い F1 を出す」のは典型的なチェリーピッキング。
(d) F1 は真陰性(TN)を完全に無視する
$F_1=2TP/(2TP+FP+FN)$ に TN は現れない(ウィジェット B で体感可)。 「陽性を当てる」問題では長所だが、 TN の正しさも評価したい場面(両クラス対等に扱いたい等)では不適。 その場合は TN を含む Balanced Accuracy、 特異度(Specificity)、 あるいは 4 マス全てを使う Matthews 相関係数(MCC) を併用する。
(e) マクロ / マイクロ / 加重 F1 は別物 — 明示しないと比較不能
本ページの 3 クラス実測が典型例で、 同じ予測でも macro 0.658 < weighted 0.725 < micro 0.787 と割れる。 使い分けの原則:
- macro:各クラスの F1 を単純平均。 少数クラスを軽視したくないときの第一選択。 小クラス 1 個の暴れが全体を支配しやすい点に注意。
- micro:全クラスの TP/FP/FN を合算してから F1。 多数派に引きずられる。 二値分類の micro F1 = Accuracy という落とし穴つき。
- weighted:クラスサイズで重み付け。 macro と micro の中間。 全体性能を素直に出したいとき。
報告時は必ず average= を書く。 3 値が割れたら、 それ自体が「クラス不均衡が効いている」というシグナルです。
③ 発展:PR 曲線・Fβ・多クラス・最適閾値
(a) PR 曲線と F1 の幾何学的関係
Precision-Recall 平面で「F1 が一定の点」を結ぶと、 等 F1 線(iso-F1 曲線)は双曲線を描く($F_1=c$ を解くと $R=\dfrac{cP}{2P-c}$)。 右上ほど大きい F1 の等高線。 F1 を最大化する閾値とは、 PR 曲線がいちばん右上の等 F1 双曲線に接する点のこと。 だから PR 曲線を描けば、 最適閾値と到達可能な最大 F1 が一目で分かります。 曲線全体を要約する PR-AUC(Average Precision)は閾値非依存で、 F1(1 点)と補完的。
(b) Fβ:重視度をβで連続的に動かす
$F_\beta=(1+\beta^2)\dfrac{PR}{\beta^2 P+R}$ は「Recall を Precision の β 倍重視する」意味を持つ。 β=2 なら分母が $4P+R$ となり Recall 重視(FN が致命的=がん検診など)、 β=0.5 なら Precision 重視(FP が致命的=スパム判定など)。 F1 は β=1 の特例にすぎず、 業務コストの非対称性に合わせて β を選ぶのがプロの判断(ウィジェット C で体感可)。
(c) 多クラスでの平均法の選び方(実務フロー)
- 少数クラスの検出力を公平に見たい → macro(+クラス別 F1 とサポート数を必ず併記)
- 全体の当たり具合を素直に出したい → micro / weighted
- まず
classification_report(digits=3)でクラス別 F1・support を出し、 どの平均が何に引っ張られているかを確認してから 1 つを主指標に選ぶ
(d) F1 最適閾値の正しい選び方
やること:validation データで $t^\*=\arg\max_t F_1(t)$ を探し、 その $t^\*$ を固定して test データで最終評価する。 sklearn.metrics.precision_recall_curve が各閾値の P・R を返すので、 そこから F1 を計算して最大点を取ればよい。 絶対にやってはいけないのは test データで閾値を選ぶこと(交差検証 や validation で選定し、 test はあくまで最終確認)。 これを守らないと F1 が楽観的に膨らむ過学習になります。
🔗 関連ページ(実在ページのみ)
土台:混同行列 / Precision / Recall 対比:Accuracy / 特異度 閾値非依存:PR 曲線 / ROC 曲線 / AUC 文脈:クラス不均衡 / 評価指標 / 交差検証。 (※ Matthews 相関係数 MCC は専用ページ未整備のためテキストのみ。)