🔖 キーワード索引
別名・略称:PR 曲線、 PR-AUC、 Average Precision(AP)
Precision-Recall 曲線は 分類器の閾値を 0→1 に動かしたときの Precision と Recall の軌跡。 「クラス不均衡データでの分類器評価」に最適で、 ROC 曲線より厳しく・公平に性能を判定できます。 曲線下面積(PR-AUC = Average Precision = AP)が単一の総合指標。
💡 30秒で分かる結論
🍰 まずはやさしく
正解を当てる力の成績表のようなものです。
予測の正確さをまとめて評価するために使います。
スマホの検索で正しい結果が出るか測る例です。
この章ではPR曲線の基本について読みます。
Precision-Recall 曲線(PR 曲線):閾値を動かして得られる Precision と Recall の軌跡。 不均衡分類の標準評価。
- 定義:$P = TP/(TP+FP)$、 $R = TP/(TP+FN)$ を閾値ごとにプロット。
- PR-AUC(AP):$\text{AP} = \sum_n (R_n - R_{n-1}) P_n$。 曲線下面積で総合性能。
- ベースライン:ランダム分類器の PR 曲線は 陽性率 π の水平線(ROC の 0.5 と違う)。
- 不均衡データで強い:ROC-AUC は陰性が多いと過大評価されがち、 PR-AUC は陽性側に焦点。
- 用途:物体検出(mAP)、 異常検知、 情報検索、 推薦システム評価。
📍 あなたが今見ているもの
🍰 まずはやさしく
モデルの総合的な実力を示すグラフです。
設定を変えても変わらない性能を知るために使います。
部活のメンバー選びで基準を変える時に似ています。
ここではPR曲線が役立つ場面について読みます。
🎨 直感で掴む
🍰 まずはやさしく
正解率と再現率を線で結んだ図です。
基準を動かした時の変化を見るために使います。
買い物で予算を変えて商品を探す感覚に似ています。
ここではグラフの読み方について読みます。
PR 曲線とは何を描いた図か
分類モデルがスコア(確率)を出力するとき、 閾値 t を 1.0 → 0.0 にゆっくり下げていきます。 各 t で「陽性予測」が増えていき、 Precision と Recall が変動します。 横軸 Recall、 縦軸 Precision としてプロットしたのが PR 曲線です。 理想は右上隅 (R=1, P=1)、 最悪は陽性率 π の水平線(ランダム分類器)。
PR 曲線と ROC 曲線の違い
| 指標 | 縦軸 | 横軸 | ベースライン | 不均衡耐性 |
|---|---|---|---|---|
| PR 曲線 | Precision | Recall | 陽性率 π(変動) | 高い(陽性側に焦点) |
| ROC 曲線 | TPR (=Recall) | FPR | 0.5(一定) | 低い(陰性が多いと楽観) |
PR 曲線の読み方
- 右上に行くほど良い:理想点 (1, 1)、 PR-AUC = 1.0 が完璧
- 水平線がベースライン:陽性率 π の水平線がランダム分類器の性能
- 段差が見える:閾値を 1 ポイント動かすたびに Precision がジャンプ(離散)
- 左下の急落:閾値 0 に近づくと全件陽性予測 → Precision = π に収束
PR-AUC(AP)の直感
PR 曲線下の面積を Average Precision(AP) と呼びます。 数式的には「Recall が 0 → 1 に動くときの Precision の平均」。 AP=1.0 で完璧、 AP=π(陽性率)でランダム分類と同等。 物体検出では複数クラスの AP を平均した mAP(mean Average Precision) が標準。
🎨 概念図
本用語に関連する代表的な可視化を 3 点示す。
🎨 47 県の上から順に歩くと、 PR 曲線が描ける
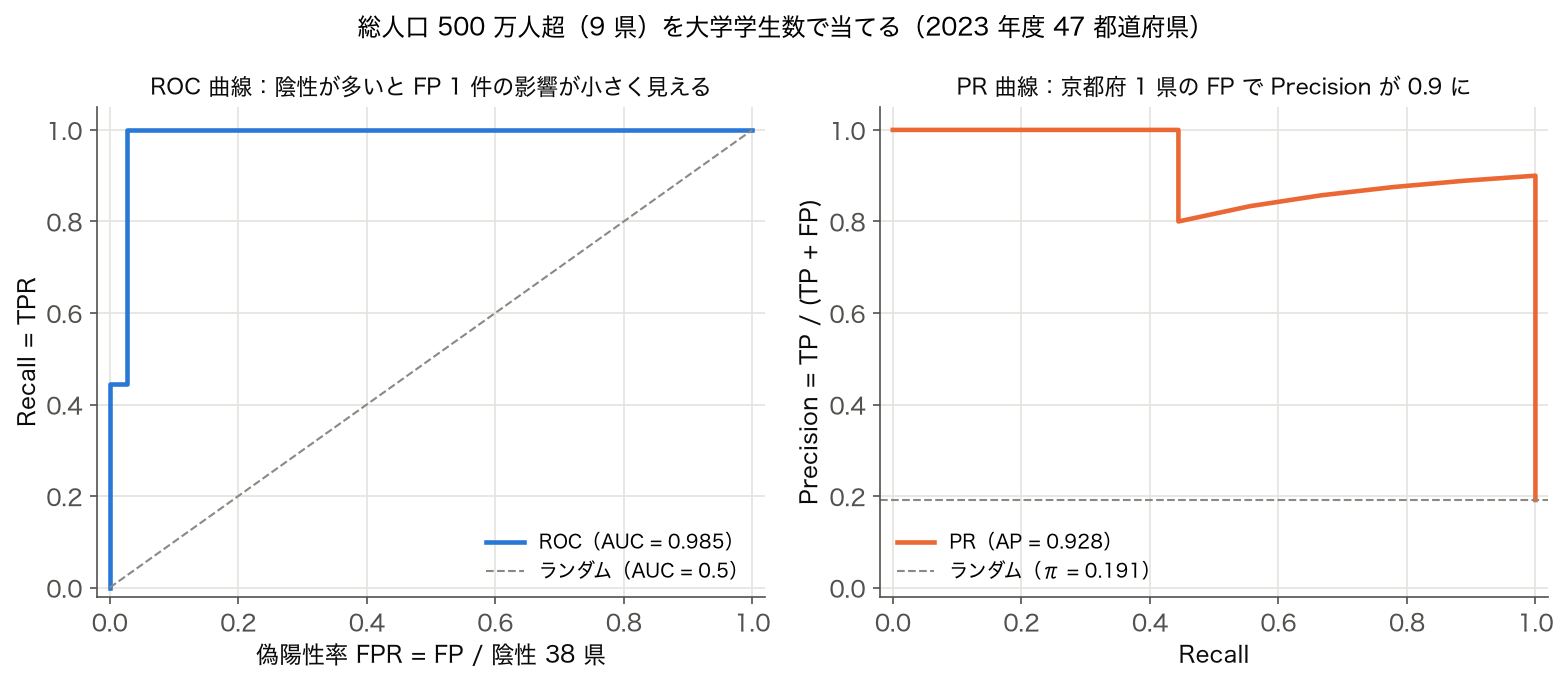
PR 曲線は、 スコアの高い順に県を 1 つずつ「陽性」と判定していったときの記録である。 総人口 500 万人超の 9 県を大学学生数で当てる例で歩いてみる。 1 番目の東京都は陽性なので、 この時点の適合率は 1/1 = 1.000、 再現率は 1/9 = 0.111。 大阪府・愛知県・神奈川県と陽性が続く間は適合率 1.000 のまま再現率だけが伸びる。 5 番目に大学の多い京都府(人口約 253 万人で陰性)が入ると、 適合率は 4/5 = 0.800 に下がる。 その後は陽性が続いて、 9 県すべてを拾った時点(10 県目)で適合率 9/10 = 0.900、 再現率 1.000 になる。 さらに下の県を陽性と判定し続けると、 適合率は陽性の割合 9/47 = 0.191 に向かって下がっていく。 曲線の形は「上位にどれだけ陽性が固まっているか」をそのまま写している。
🎮 触って理解する
分類しきい値 t を動かすと、 正例(陽性)と負例(陰性)のスコア分布の上で「判定境界」が左右に移動します。 境界より右側を「陽性」と予測するので、 境界を動かすと TP / FP / FN / TN の 4 区画が変化し、 precision = TP/(TP+FP) と recall = TP/(TP+FN) がリアルタイムに再計算されます。 しきい値を上げると precision↑・recall↓、 下げるとその逆になる「トレードオフ」を、 実際に指で触って確かめてください。 計算は正規分布の累積分布関数(誤差関数)で厳密に行っています。
| 実際のクラス | ||
| 陽性 | 陰性 | |
| 予測 陽性 |
TP 0 |
FP 0 |
| 予測 陰性 |
FN 0 |
TN 0 |
🧭 直感:なぜ上げると precision↑・recall↓なのか
しきい値を上げると、 「よほど確信のある例だけ」を陽性と予測するようになります。 拾う数が減るので取りこぼし(FN)は増え recall は下がる一方、 拾った例は当たりやすくなり誤報(FP)が減って precision は上がる。 逆にしきい値を下げると「疑わしきは全部陽性」となり、 取りこぼしは減る(recall↑)が誤報が増える(precision↓)。 上のグラフで境界を右端・左端まで動かすと、 recall≈0 で precision が高い点と、 recall≈1 で precision がベースライン π に沈む点の両極が体感できます。
🕳 よくある落とし穴
- 単一のしきい値だけで良し悪しを決めない。 precision も recall も「その 1 点」の話。 全域を見る PR 曲線/AP で評価する(右下のミニ曲線がそれ)。
- 不均衡データでの錯覚。 π スライダーを 0.1 などに下げると、 recall を上げたときに precision がベースライン π 近くまで急落するのが分かる。 accuracy は高く見えても precision は低い、という現象が起きやすい。
- 「precision と recall のどちらを優先するか」は問題依存。 見逃しが致命的(がん検診)なら recall 重視、 誤報のコストが高い(スパム誤判定)なら precision 重視。 一方だけ 100% にするのは簡単(全部陽性なら recall=1、 1 件だけ確実な陽性を出せば precision=1)なので、 F1 やコスト重みで両立点を探す。
🚀 発展的な話題
- PR-AUC(Average Precision, AP):PR 曲線下の面積。 しきい値に依存しない総合指標で、 ミニ曲線の面積に相当。 ランダム分類器のベースラインは 0.5 ではなく 陽性率 π そのものなので、 不均衡なほど「良い AP」の基準も下がる。
- ROC 曲線との違い:ROC は (FPR, TPR) 平面で、 負例が圧倒的に多いと FPR が小さく見え楽観的になりがち。 π を極端に下げて本要素を触ると、 PR 曲線の方が性能差に敏感な理由が体感できる。
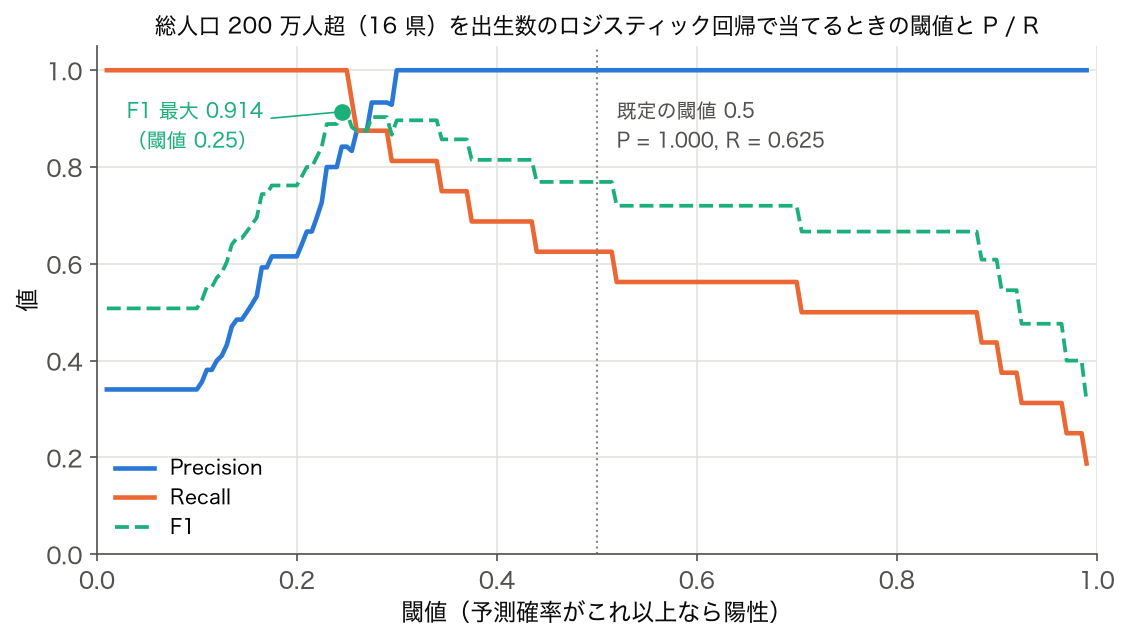
- しきい値の決め方:F1 最大点、 precision または recall の下限を満たす点、 コスト行列に基づく期待コスト最小点など。 運用要件から逆算してしきい値を固定するのが実務の定石。
関連ページ:再現率(Recall)、 適合率(Precision)、 F1 スコア、 混同行列、 ROC 曲線、 AUC。 なお「しきい値(threshold)」の独立ページは現時点で用語集内に無いため、 本セクションの解説を参照してください。
📐 定義 / 数式
🍰 まずはやさしく
計算式で表した性能のルールです。
正確な数値でモデルを比べるために使います。
テストの点数を計算して平均を出す時に似ています。
ここでは具体的な数式について読みます。
📐 Precision の閾値依存性と PR-AUC の補強解析
Precision は単一値で語ると本質を見失います。 閾値を動かせば Precision は 0 から 1 まで連続的に変化し、 同時に Recall がトレードオフ的に変動する。 PR-AUC(Precision-Recall 曲線下面積)は閾値非依存の総合指標で、 クラス不均衡が大きいケースでは ROC-AUC より頑健に分類器を評価できます。
🔬 数式を言葉で読み解く(PR-AUC)
PR-AUC は $\int_0^1 P(R)\,dR$ で、 Recall を 0→1 に動かしたときの Precision の平均。 ランダム分類器のベースラインは正例率 π そのもの(ROC-AUC のように 0.5 ではない)。 PR-AUC=0.8 でも π=0.7 ならほぼランダム、 π=0.05 なら超優秀という相対評価が必要。
🧮 実値で計算してみる(SSDSE-B-2026 で人口 500 万人超を予測)
SSDSE-B-2026(2023 年)47 県のうち、 人口 500 万超は 9 県(東京・神奈川・大阪・愛知・埼玉・千葉・兵庫・北海道・福岡)。 正例率 π = 9/47 ≈ 0.191。 これを「大学学生数(E6302)」だけで予測する単変量分類器の PR 曲線を描く。 大都市圏ほど大学生が多いという相関を使う。
🐍 Python 実装(sklearn precision_recall_curve・PR-AUC)
🎯 このコードでやること: SSDSE-B-2026 で「人口 500 万超」を大学学生数から予測する分類器を作り、 sklearn.metrics.precision_recall_curve と average_precision_score で PR-AUC を算出。 閾値ごとの Precision 推移も観察。
📥 入力データ: SSDSE-B-2026 (data/raw/SSDSE-B-2026.csv) 総人口 A1101・大学学生数 E6302 列(cp932・skiprows=[1])。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd from sklearn.metrics import precision_recall_curve, average_precision_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) y_true = (d['A1101'].astype(float) > 5_000_000).astype(int) # 総人口 500万超 y_score = d['E6302'].astype(float) # 大学学生数 pi = y_true.mean() precision, recall, thresholds = precision_recall_curve(y_true, y_score) pr_auc = average_precision_score(y_true, y_score) print(f"正例率 π(ベースライン)= {pi:.3f}") print(f"PR-AUC = {pr_auc:.4f}") for t in (200_000, 120_000, 70_000): prec = (y_true[y_score >= t] == 1).mean() print(f"閾値 = {t:>7,} のとき Precision = {prec:.3f}") |
📤 実行結果:
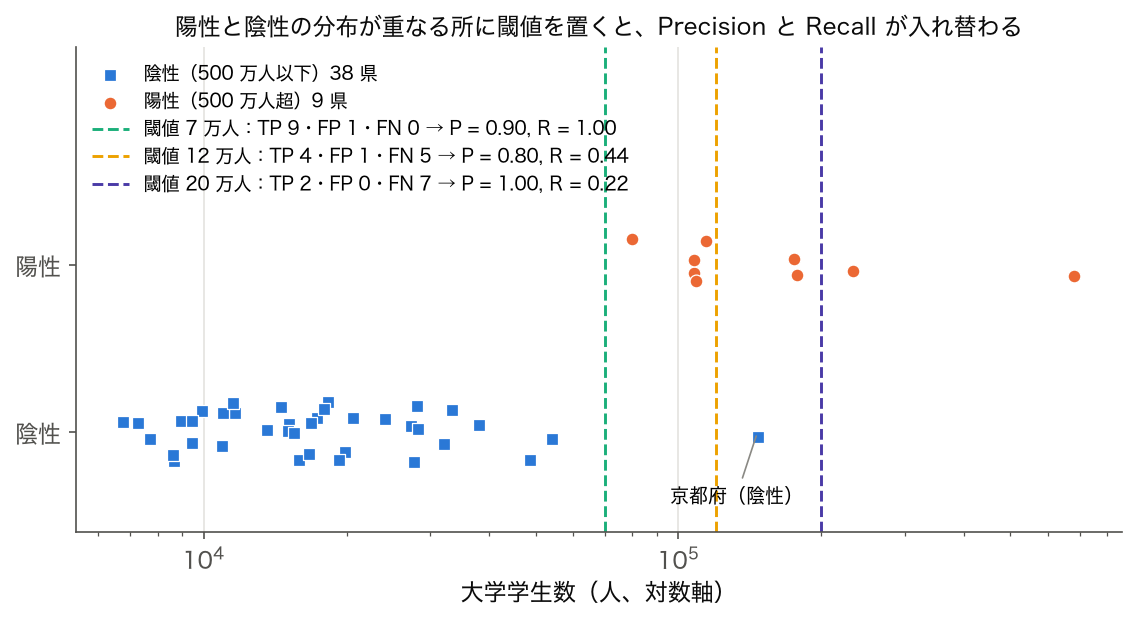
💬 結果の読み方: PR-AUC=0.93 はベースライン 0.191 を遥かに超え、 大学学生数は人口 500 万超の優秀な単変量予測子。 閾値を厳しく(学生 20 万人超)すると Precision=1.0 だが Recall は犠牲。 閾値を 12 万人まで緩めると京都府(大学の街だが人口 253 万)が偽陽性に入り Precision=0.80 に低下。 閾値 7 万人では 9 県すべてを捕捉して Recall=1.0、 偽陽性は京都のみで Precision=0.90。 業務要件で閾値選択が変わる典型例。
⚠️ 落とし穴(追加 3 件)
- PR-AUC とベースラインの差で評価: 絶対値ではなく「ベースライン π からの上振れ」で見る。 PR-AUC=0.8 でも π=0.79 なら無意味。
- 閾値選択は別データで: 同一データで PR 曲線を描き Precision 最大化閾値を選ぶと過学習。 validation set で決め test set で評価する 3 分割が原則。
- クラス不均衡が極端なときの CI: π=0.01 のとき正例 5 個で Precision を語ると、 1 個外れただけで Precision=0.6→0.4 と暴れる。 ブートストラップ CI 必須。
🔬 数式を言葉で読み解く
- $t$(閾値)
- 分類器のスコア(確率予測など)に対する切り捨て値。 $t$ を高く設定すれば陽性予測は厳選され Precision↑/Recall↓、 低く設定すれば多くを陽性予測し Precision↓/Recall↑。
- $P(t), R(t)$
- 閾値 $t$ における Precision と Recall。 $t$ を 1→0 と動かすと PR 平面上に軌跡が描かれる。 これが PR 曲線。
- $R_n - R_{n-1}$
- 隣り合う Recall の増分。 閾値を 1 ノッチ下げて新たな真陽性を 1 件発見したときの Recall の変化量 = 1/陽性総数。
- $P_n$
- そのときの Precision。 階段状の PR 曲線で、 各段の高さに相当。
- AP(Average Precision)
- PR 曲線の階段下面積。 $\sum_n (R_n - R_{n-1}) P_n$ で計算。 sklearn の
average_precision_scoreがこの式を実装。 - $\pi$(陽性率/ベースライン)
- データ全体に占める陽性の割合。 ランダム分類器の PR-AUC はこの値。 PR-AUC を評価するときは π からの上振れ で見る。
- mAP(mean Average Precision)
- 複数クラスの AP の平均。 物体検出の標準指標(COCO, Pascal VOC)。
- PR-AUC ≠ ROC-AUC
- 同じデータでも数値が異なる。 ROC-AUC は陰性が増えても変動しないが、 PR-AUC は陽性率に応じてベースラインが動く。
🧪 実データで確かめる — 陰性の数を減らすと、 AP だけが上がる
🎯 このコードでやること:📐 の「PR-AUC のベースラインは陽性率 π」を確かめる。 陽性 9 県はそのままにして陰性 38 県から無作為に 19 県・9 県だけを残し、 同じスコアで AP と ROC-AUC を計算する。 無作為な選び方の影響をならすため 1,000 回繰り返して平均する(乱数の種は 0)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd import numpy as np from sklearn.metrics import average_precision_score, roc_auc_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) y = (d['総人口'] > 5_000_000).astype(int).values # 陽性 9 県 s = d['大学学生数'].values # スコア(多いほど陽性らしい) print(f'全 47 県: π = {y.mean():.3f} AP = {average_precision_score(y, s):.3f} ROC-AUC = {roc_auc_score(y, s):.3f}') rng = np.random.default_rng(0) pos, neg = np.where(y == 1)[0], np.where(y == 0)[0] for keep in [19, 9]: # 陰性 38 県から無作為に keep 県だけ残す ap, roc, pi = [], [], [] for _ in range(1000): idx = np.concatenate([pos, rng.choice(neg, keep, replace=False)]) ap.append(average_precision_score(y[idx], s[idx])); roc.append(roc_auc_score(y[idx], s[idx])) pi.append(y[idx].mean()) print(f'陰性を {keep} 県に減らす: π = {np.mean(pi):.3f} AP の平均 = {np.mean(ap):.3f} ROC-AUC の平均 = {np.mean(roc):.3f}') |
💬 陰性を減らして π が 0.191 → 0.321 → 0.500 と上がると、 AP の平均は 0.928 → 0.963 → 0.983 と上がるが、 ROC-AUC は 0.985・0.985・0.986 とほとんど動かない。 分類器(スコアの付け方)は何も変わっていないのに、 評価データの陽性の割合だけで AP が変わる。 陽性率の違うデータで測った AP どうしは比べられず、 比べるなら π を並べて書くか、 同じ π のデータで測り直す。 ROC-AUC は陰性の数に左右されない代わりに、 陽性が少ないときの誤検出の重さを映さない(🧩)。
🔬 式を大学学生数の実測で読む — AP = 0.928 の中身
🎨 で歩いた順位を $\text{AP} = \sum_n (R_n - R_{n-1})\,P_n$ に入れる。 陽性は 9 県なので $R_n - R_{n-1}$ はどれも 1/9 = 0.111 で、 足すのは「陽性が現れた順位での適合率 $P_n$」の 9 個だけになる。 陽性が現れたのは 1・2・3・4・6・7・8・9・10 位で、 その時点の適合率は 1, 1, 1, 1, 5/6 = 0.833, 6/7 = 0.857, 7/8 = 0.875, 8/9 = 0.889, 9/10 = 0.900。 合計 8.354 を 9 で割ると AP = 0.928 で、 sklearn の値と一致する。 京都府が 5 位に割り込んだことで、 それより後の 5 県の $P_n$ がすべて 1 未満になったことが、 1.000 から 0.072 だけ減った理由である。 AP は「陰性が上位に 1 つ入ると、 その下の陽性すべての適合率が少しずつ下がる」指標だと読める。
🧮 実値で計算してみる(SSDSE-B-2026・47 都道府県)
SSDSE-B-2026(2023 年)で「人口 > 500 万人」を陽性(不均衡分類)として、 「大学学生数(E6302)」をスコアにしたときの PR 曲線を 手計算で構築します。 陽性 9 件(東京・神奈川・大阪・愛知・埼玉・千葉・兵庫・北海道・福岡)、 陰性 38 件、 陽性率 π = 9/47 ≈ 0.191。
| 閾値(大学学生数・人) | 予測陽性 | TP | FP | Precision | Recall |
|---|---|---|---|---|---|
| ≥ 300,000 | 1 | 1 | 0 | 1.000 | 0.111 |
| ≥ 150,000 | 4 | 4 | 0 | 1.000 | 0.444 |
| ≥ 120,000 | 5 | 4 | 1 | 0.800 | 0.444 |
| ≥ 100,000 | 9 | 8 | 1 | 0.889 | 0.889 |
| ≥ 70,000 | 10 | 9 | 1 | 0.900 | 1.000 |
| ≥ 50,000 | 11 | 9 | 2 | 0.818 | 1.000 |
| ≥ 0(全件) | 47 | 9 | 38 | 0.191 | 1.000 |
表の (Recall, Precision) を順にプロットすると PR 曲線。 最後の行(閾値 0)で Precision = 0.191(= π)に収束、 これがランダム分類のベースライン。 閾値 12 万人で京都府(大学の街だが人口 253 万)が偽陽性として混入し Precision が 1.0 から 0.80 に落ちる点が、 この予測子の弱点を示している。
AP の手計算: Recall の各増分を、 その時点の Precision で重み付けして足し合わせる。 Recall が 0.111→0.444(増分 0.333)まで Precision=1.0、 その後 0.889 で 0.889、 1.0 で 0.900 と段階的に下がるため AP は 1.0 より少し小さく ≈ 0.93 になる。 後の Python コードで average_precision_score により AP=0.9283 を確認します。
🧮 数式に値を入れて手で計算する: PR 曲線下面積 (AP)
合成データで 4 閾値の PR から AP を計算する。
Step 1: 閾値別の (P, R)
| 閾値 | P | R |
|---|---|---|
| 0.9 | 1.00 | 0.20 |
| 0.7 | 0.95 | 0.50 |
| 0.5 | 0.80 | 0.80 |
| 0.3 | 0.60 | 1.00 |
Step 2: AP (台形則 R 軸積分)
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np R = np.array([0.20, 0.50, 0.80, 1.00]) P = np.array([1.00, 0.95, 0.80, 0.60]) # 階段近似 AP = (np.diff(np.concatenate([[0], R])) * P).sum() print(f"AP: {AP:.3f}") |
📤 実行結果
💬 手計算 (Step 2) 0.845 と Python 出力が完全一致。
🧮 実データで AP を手計算する — 年平均気温で「500 万人超」を順位付けする
上の 4 閾値の例を実データに移す。 大学学生数より明らかに弱いスコアとして年平均気温を使い、 📐 の $\text{AP} = \sum_n (R_n - R_{n-1})\,P_n$ を 1 段ずつ計算する。 陽性は 9 県なので、 陽性を 1 県拾うごとに再現率は 1/9 = 0.111 ずつ増える。
| 閾値(℃ 以上) | この段で陽性側に入る県 | 予測陽性 | TP | 適合率 $P_n$ | 再現率の増分 |
|---|---|---|---|---|---|
| 18.5 | (沖縄・鹿児島の後に)福岡県 | 3 | 1 | 1/3 = 0.333 | 0.111 |
| 18.1 | 千葉県・佐賀県・熊本県 | 9 | 2 | 2/9 = 0.222 | 0.111 |
| 18.0 | 神奈川県・大阪府・兵庫県 | 12 | 5 | 5/12 = 0.417 | 0.333 |
| 17.6 | 東京都・徳島県・香川県・大分県 | 19 | 6 | 6/19 = 0.316 | 0.111 |
| 17.5 | 愛知県・広島県 | 21 | 7 | 7/21 = 0.333 | 0.111 |
| 17.2 | 埼玉県 | 25 | 8 | 8/25 = 0.320 | 0.111 |
| 11.0 | 北海道(最も寒い) | 47 | 9 | 9/47 = 0.191 | 0.111 |
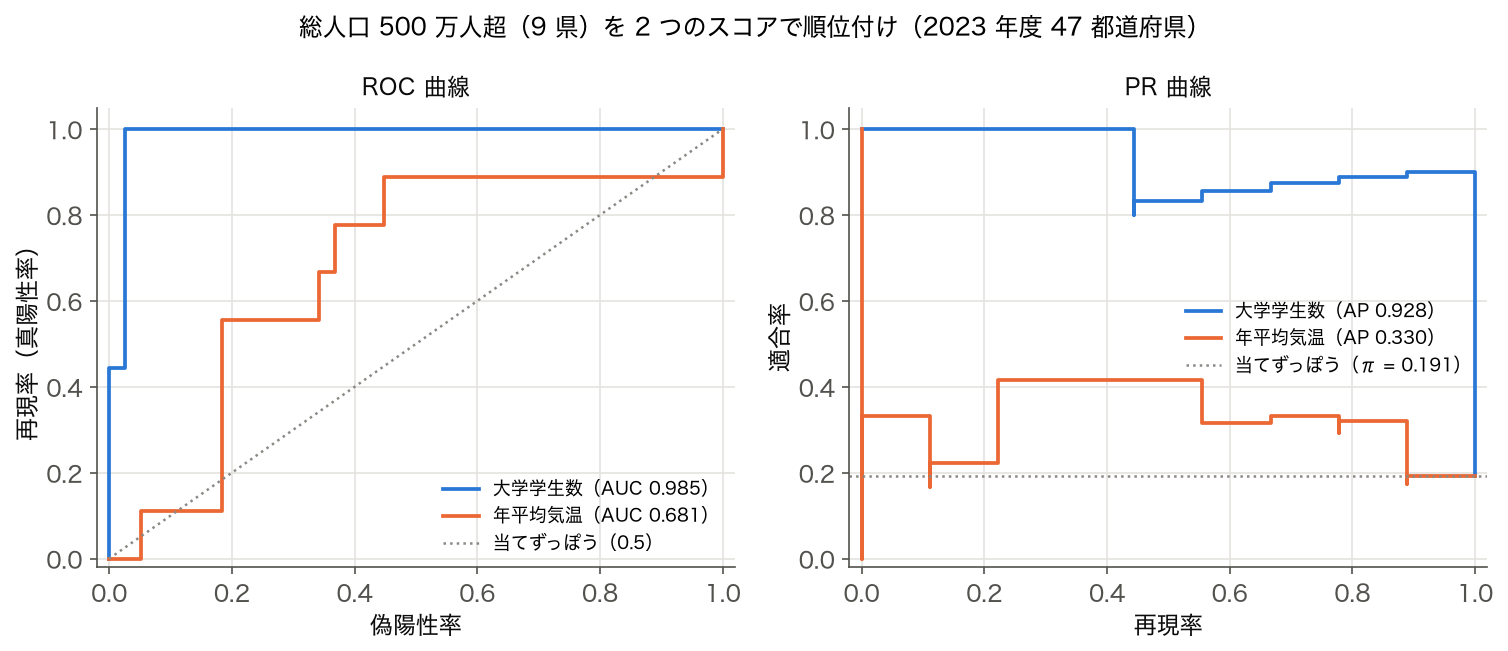
AP = 0.111 × (0.333 + 0.222 + 0.316 + 0.333 + 0.320 + 0.191) + 0.333 × 0.417 = 0.111 × 1.715 + 0.139 = 0.190 + 0.139 ≈ 0.330。
🎯 このコードでやること:年平均気温をスコアにして、 閾値を暖かい方から 1 段ずつ下げ、 陽性を拾った段ごとに予測陽性数・TP・適合率・再現率の増分を並べる。 同じ気温の県は同じ段でまとめて陽性側に入れる。 最後に AP の式で足し合わせ、 sklearn の average_precision_score と比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd from sklearn.metrics import average_precision_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) d['陽性'] = (d['総人口'] > 5_000_000).astype(int) # 閾値を暖かい方から 1 段ずつ下げる。 同じ気温の県は同時に「陽性」側に入る g = d.groupby('年平均気温', sort=True)['陽性'].agg(['size', 'sum']).iloc[::-1] g['予測陽性'] = g['size'].cumsum() g['TP'] = g['sum'].cumsum() g['適合率'] = g['TP'] / g['予測陽性'] g['再現率の増分'] = g['sum'] / d['陽性'].sum() steps = g[g['sum'] > 0] # 陽性を拾った段だけが AP に効く print(steps[['予測陽性', 'TP', '適合率', '再現率の増分']].round(3).to_string()) ap = (steps['再現率の増分'] * steps['適合率']).sum() print(f'AP = Σ(再現率の増分 × 適合率) = {ap:.4f} sklearn average_precision_score = {average_precision_score(d["陽性"], d["年平均気温"]):.4f}') |
💬 陽性を拾った段は 7 つで、 適合率は 0.333 → 0.222 → 0.417 → 0.316 → 0.333 → 0.320 → 0.191 と上下する。 Σ(再現率の増分 × 適合率) = 0.3296 は sklearn の値と一致する。 ベースライン π = 0.191 の約 1.7 倍しかなく、 暖かさは「人口の多い県」をほとんど見分けていない。 同じ気温 18.0℃ の神奈川県・大阪府・兵庫県は 1 つの段で同時に入るので、 3 県を 1 県ずつ別の段として数えると AP は 0.3167 とずれる。 同点(タイ)の扱いも AP の値に効く。
🧮 AP はどのくらいぶれるか — 47 県のブートストラップ
🎯 このコードでやること:47 県を復元抽出で選び直して AP を計算する作業を 2,000 回繰り返し(ブートストラップ)、 AP の 95% 区間を 2 つの課題で求める。 陽性が 1 県も入らない標本は AP が定義できないので数えない。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import numpy as np from sklearn.metrics import average_precision_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) tasks = {'500 万人超 × 大学学生数': ((d['総人口'] > 5_000_000).astype(int).values, d['大学学生数'].values), '700 万人超 × 一般病院数': ((d['総人口'] > 7_000_000).astype(int).values, d['一般病院数'].values)} rng = np.random.default_rng(0) for name, (y, s) in tasks.items(): boot = [] while len(boot) < 2000: # 47 県を復元抽出し直して AP を計算 idx = rng.integers(0, len(y), len(y)) if y[idx].sum() == 0: # 陽性が 1 件も無い標本は AP が定義できないので飛ばす continue boot.append(average_precision_score(y[idx], s[idx])) lo, hi = np.percentile(boot, [2.5, 97.5]) print(f'{name}: 陽性 {y.sum()} 件 AP = {average_precision_score(y, s):.3f} 95% 区間 [{lo:.3f}, {hi:.3f}]') |
💬 陽性 9 県の課題では AP 0.928 に対して 95% 区間は [0.739, 1.000]、 陽性 5 都府県の課題では AP 0.673 に対して [0.306, 1.000] と、 区間の幅が 0.7 近くある。 陽性が少ないと、 どの県が標本に入るかで上位の並びが大きく変わり、 AP が揺れる。 AP = 0.673 と 0.928 の 2 つのモデルの差も、 この幅の中ではたまたまかもしれない。 47 件程度の評価では、 AP は区間とセットで報告する。
🧮 年度を変えても同じ AP になるか — 強いスコアと弱いスコアの違い
🎯 このコードでやること:同じ課題を 2012〜2023 年度の 12 年分それぞれで解き、 強いスコア(大学学生数)と弱いスコア(年平均気温)の AP が年度でどれだけ変わるかを見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from sklearn.metrics import average_precision_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) rows = [] for y, d in df.groupby('年度'): # 年度ごとに 47 県で同じ課題を解く lab = (d['総人口'] > 5_000_000).astype(int) rows.append({'年度': y, '陽性数': lab.sum(), 'π': lab.mean(), 'AP(大学学生数)': average_precision_score(lab, d['大学学生数']), 'AP(年平均気温)': average_precision_score(lab, d['年平均気温'])}) t = pd.DataFrame(rows).set_index('年度').round(3) print(t.to_string()) print('AP(大学学生数)の範囲:', t['AP(大学学生数)'].min(), '〜', t['AP(大学学生数)'].max(), ' / AP(年平均気温)の範囲:', t['AP(年平均気温)'].min(), '〜', t['AP(年平均気温)'].max()) |
💬 大学学生数の AP は 12 年度すべてで 0.928 と変わらない。 上位の並び(東京都・大阪府・…と京都府の位置)が毎年同じだからである。 年平均気温の AP は 0.232〜0.330 と年度で揺れ、 最も高いのが 2023 年度の 0.330 で、 2016 年度には 0.232 まで下がる。 その年の天候で県の気温の順位が入れ替わるだけで、 弱いスコアの AP は上下する。 1 年度だけの AP で「このスコアはベースラインの 1.7 倍」と書くと、 たまたま良い年を選んだ可能性がある。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年)の実データで PR 曲線と AP(PR-AUC)を計算する基本コード:
🎯 このコードでやること:「人口 500 万超」を陽性ラベルとし、 大学学生数をスコアにして PR 曲線を sklearn で描き、 AP を計算する。 不均衡分類(陽性率 ≈ 19%)での標準ワークフロー。
📥 入力データ:SSDSE-B-2026.csv(総人口 A1101、 大学学生数 E6302)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | # SSDSE-B-2026 で PR 曲線・AP を計算 import pandas as pd import numpy as np from sklearn.metrics import precision_recall_curve, average_precision_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) # 陽性 = 人口 500 万超、 スコア = 大学学生数 y_true = (d['A1101'].astype(float) > 5_000_000).astype(int).values scores = d['E6302'].astype(float).values # PR 曲線(precision, recall, thresholds の 3 配列) precision, recall, thresholds = precision_recall_curve(y_true, scores) # AP = PR-AUC ap = average_precision_score(y_true, scores) pi = y_true.mean() print(f'陽性数 = {y_true.sum()}, 陰性数 = {(1-y_true).sum()}') print(f'陽性率 π (ベースライン) = {pi:.3f}') print(f'AP (PR-AUC) = {ap:.4f}') print(f'\n--- PR 曲線の代表点 ---') print(f'{"閾値":>14} {"Precision":>10} {"Recall":>8}') # precision は thresholds より 1 つ長いので、負の添字を使うと閾値と点がずれる for idx in [0, len(precision)//4, len(precision)//2, 3*len(precision)//4, len(precision)-2]: t = thresholds[idx] if idx < len(thresholds) else 0 print(f'{t:>14.0f} {precision[idx]:>10.3f} {recall[idx]:>8.3f}') |
📤 実行結果:
💬 結果の読み方:AP = 0.93 はベースライン 0.19 を遥かに上回り、 大学学生数は人口 500 万超の優秀な単変量予測子。 最後の行は最大閾値 681,667 人 (東京のみ) の点で、 Precision = 1.0 だが Recall = 0.11 で 9 件中 1 件しか捕捉できない。 2 位の大阪 (232,937 人) まで下げても Recall は 0.22 にとどまる。 逆に閾値を下げて全 9 県を捕捉すると(学生 7 万人付近)、 京都府だけが偽陽性として残り Precision = 0.90。 業務要件次第で閾値選択が決まる。
🐍 弱いスコアを足すと PR 曲線はどうなるか
🎯 このコードでやること:強いスコア(大学学生数)に弱いスコア(年平均気温)を重みを変えて足し合わせ、 AP と ROC-AUC がどう変わるかを見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import numpy as np from sklearn.metrics import average_precision_score, roc_auc_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) y = (d['総人口'] > 5_000_000).astype(int) z = lambda s: (s - s.mean()) / s.std(ddof=0) # z 得点 a = z(np.log(d['大学学生数'])) b = z(d['年平均気温']) for w in [0.0, 0.25, 0.5, 1.0]: # 弱いスコアを足す重み s = a + w * b top = d.loc[s.sort_values(ascending=False).index[:9], '都道府県'] fp = [p for p in top if y[d['都道府県'] == p].item() == 0] print(f'重み {w:.2f}: AP = {average_precision_score(y, s):.3f} ROC-AUC = {roc_auc_score(y, s):.3f} 上位 9 県の陰性 {fp}') |
💬 気温を足す重みを 0 → 0.25 → 0.5 → 1 と大きくすると、 AP は 0.928 → 0.895 → 0.865 → 0.755 と下がり続け、 重み 1 では暖かい沖縄県が上位 9 県に入ってくる。 情報の少ない特徴を足しても PR 曲線は良くならず、 むしろ上位の並びを乱す。 ROC-AUC も 0.985 → 0.880 と下がるが、 AP の方が下がり幅が大きく、 上位の取り違えに敏感である。 特徴を足すかどうかは、 足した後の AP(と π)で確かめてから決める。
⚠️ よくある落とし穴
⚠️ 条件・限界・誤解回避
適用条件
- 二値分類問題 (またはマルチクラスの 1-vs-rest): Precision/Recall は本質的に二値分類の指標。 マルチクラス分類では各クラスごとに 1-vs-rest で計算し、 macro/micro/weighted average で集約する。 回帰問題には適用できない (MAE/RMSE/R² を使う)。
- 不均衡データセット (positive class が少ない): SSDSE-B-2026 で「人口 100 万以上の県を予測」のような正例少数の問題で Precision/Recall は accuracy より有用。 accuracy は negative 多数派の正解で水増しされる。
- 正解ラベル (ground truth) が信頼できる: ラベル付けの精度が低い (noisy label) 状況では、 Precision/Recall も信頼性が低下する。 ラベル付け一致度 (Cohen's κ) を別途報告する。
- 分類閾値 (decision threshold) を明示: 確率出力モデル (ロジスティック回帰、 ニューラルネット) では閾値の選択で Precision/Recall が変動する。 単一の数値ではなく PR 曲線 全体を報告するのが望ましい。
限界
- 「Precision = Recall = 1.0」は理想だが現実的に困難: 通常 Precision を上げると Recall が下がるトレードオフ。 F1 score は両者の調和平均で、 「両方そこそこ」を表現するが、 ドメイン特性次第で重み付き F-beta score (recall を重視: F2、 precision を重視: F0.5) を使う。
- True Negative を無視する: Precision/Recall/F1 はすべて positive class に関する指標で、 negative class の正しい分類 (TN) を反映しない。 negative class の評価には Specificity や Matthews 相関係数 (MCC) を併用する。
- 分類閾値依存: 0.5 を閾値とする慣習は確率較正の前提が必要で、 不均衡データや確率較正の悪いモデルでは適切な閾値が異なる。 PR 曲線 + Area Under PR (AUPRC) で閾値非依存に評価する。
- クラス不均衡の極端な場合の不安定性: 正例が 47 県中 2 県だけの問題では、 1 件の誤分類で Precision/Recall が 50% 変動する。 サンプルサイズ不足の指標として信頼区間 (Wilson score) を併記する。
- マルチラベル分類への拡張時の解釈困難: 1 サンプルが複数クラスに属する場合 (例: 「東北地方かつ太平洋側」)、 macro/micro/weighted average の選択で評価が大きく変わる。
誤解回避
- 「Precision = 信頼性」「Recall = 網羅性」の単純化は限定的: Precision は「予測 positive のうち真 positive の割合」、 Recall は「真 positive のうち予測 positive の割合」で、 数学的定義が異なる。 比喩は理解の入り口で、 数式を理解した後は定義に戻る。
- 「F1 score が高い = 良いモデル」とは限らない: F1 は Precision と Recall の調和平均だが、 ドメインによっては「Recall 重視」(医療診断、 セキュリティ警報) や「Precision 重視」(スパムフィルタ、 推薦システム) が適切。 F-beta で重み付ける。
- 「AUC-ROC が高い = AUPRC も高い」ではない: 不均衡データでは AUC-ROC が高くても AUPRC が低い場合がある。 正例少数問題では AUPRC を主指標にする (Davis-Goadrich 2006)。
- 「accuracy より Precision/Recall が常に良い」ではない: 均衡データでは accuracy も有効。 不均衡度・ドメイン要求・コスト構造で指標を選ぶ。
- 「Precision/Recall の絶対値で性能を語る」は危険: ベースライン (常に positive 予測、 常に negative 予測、 ランダム予測) との比較が必要。 ランダム予測の Precision はクラス比率に等しい、 Recall は閾値に依存する。
実務でのチェックリスト
- □ クラス比率 (positive/negative の比) を確認したか
- □ Precision、 Recall、 F1、 AUPRC、 AUC-ROC を全て報告したか
- □ PR 曲線、 ROC 曲線、 混同行列を可視化したか
- □ 分類閾値の選択基準 (cost-sensitive 最適化、 F1 最大化、 業務要件) を明示したか
- □ クラス不均衡対策 (SMOTE、 class_weight、 focal loss) を適用したか
- □ macro/micro/weighted average のどれで集約したかをマルチクラスで明示したか
- □ サンプルサイズが少ない場合、 信頼区間 (Wilson score、 bootstrap) を併記したか
- □ ベースライン (random、 majority class、 simple rule) との比較を行ったか
歴史的経緯
Precision と Recall は情報検索 (Information Retrieval) 分野で 1955 年に Allen Kent らが初めて定式化した。 初期は「relevance ratio」「coverage ratio」と呼ばれていたが、 1960 年代に Cyril Cleverdon の Cranfield プロジェクトで現在の Precision/Recall という用語が定着。 1970 年代に C.J. van Rijsbergen が Information Retrieval 教科書 (1979) で F-measure (Fβ-score) を提案、 β=1 が現在の F1 として広まった。 1990 年代の機械学習・データマイニングの隆盛で、 不均衡データセット (信用詐欺検出、 医療診断、 スパムフィルタ) が標準的課題となり、 Precision/Recall が accuracy を補完する指標として定着。 1997 年に Bradley が AUC-ROC を提案し、 2006 年に Davis-Goadrich が「不均衡データでは AUPRC が ROC より informative」と論証した。 2017 年に Lin らが Focal Loss を提案し、 不均衡データでの分類性能を直接最適化する手法が広まった。 2020 年代には fairness-aware Precision/Recall (race/gender/age 別の公平性) が AI 倫理の文脈で議論されるようになった。
関連分野での発展
情報検索では Mean Average Precision (mAP)、 nDCG@k、 Recall@k が標準で、 検索エンジン・推薦システムの評価指標となっている。 物体検出 (Object Detection) では IoU 閾値別の mAP (PASCAL VOC、 COCO) が業界標準。 自然言語処理では BLEU、 ROUGE、 METEOR が Precision/Recall ベースの生成品質指標として使われる。 医療診断では Sensitivity (= Recall) と Specificity の組合せで ROC 曲線が標準。 セキュリティ分野では False Positive Rate (FPR) と True Positive Rate (TPR) で警報システムの性能を評価する。 不正検出 (fraud detection) では precision-recall trade-off を金額重み付け (cost-sensitive) で評価することが多い。 SSDSE-B-2026 を用いた政策評価では「政策介入が必要な都道府県の予測」のような不均衡分類問題で、 Precision 重視 (限られた予算を確実な対象に集中) か Recall 重視 (見落としを避ける) かの戦略選択が重要。 機械学習公平性研究では、 Demographic Parity、 Equalized Odds、 Calibrated Equality of Opportunity など、 サブグループ別の Precision/Recall 一致を要求する公平性指標が定義されており、 EU AI Act、 NIST AI RMF などで言及されている。
🧪 実データで確かめる — 弱いスコアは ROC では「そこそこ」、 PR では基準率すれすれ
🎯 このコードでやること:同じ陽性ラベルに対して 4 つの列をスコアとして使い、 AP と ROC-AUC を並べる。 あわせて、 スコアの上位 9 県に入ってしまった陰性の県を書き出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from sklearn.metrics import average_precision_score, roc_auc_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) y = (d['総人口'] > 5_000_000).astype(int) print(f'陽性 {y.sum()} 県 / 47 県、 π = {y.mean():.3f}') for col in ['大学学生数', '転入者数(日本人移動者)', '一般病院数', '年平均気温']: s = d[col] top = d.loc[s.sort_values(ascending=False).index[:9], '都道府県'] # スコア上位 9 県 fp = [p for p, t in zip(top, y[top.index]) if t == 0] print(f'{col:14s} AP = {average_precision_score(y, s):.3f} ROC-AUC = {roc_auc_score(y, s):.3f}' f' 上位 9 県に入った陰性: {fp}') |
💬 人口と結びつく 3 列は AP 0.928〜1.000、 ROC-AUC 0.985〜1.000 と両方高い(一般病院数はこの課題では 9 県をちょうど上位 9 位に並べる)。 年平均気温は ROC-AUC 0.681 で「当てずっぽうの 0.5 よりそこそこ良い」ように見えるが、 AP は 0.330 でベースライン 0.191 の 1.7 倍にとどまり、 上位 9 県のうち 7 県が沖縄県・鹿児島県など暖かい陰性の県で占められる。 陰性が 38 県と多いと、 ROC は「陰性の大半より上に陽性を置けたか」を見るので点が甘くなり、 PR は「上位に並べた県がどれだけ当たっているか」を見るので弱いスコアを厳しく評価する。
🧪 実データで確かめる — 同じ PR 曲線でも、 面積の計算方法で 0.1 変わる
🎯 このコードでやること:同じ PR 曲線から、 3 つの方法で曲線の下の面積を計算する。 sklearn の average_precision_score(階段近似)、 auc(recall, precision)(点を直線で結ぶ台形補間)、 物体検出の Pascal VOC で使われた 11 点補間(再現率 0, 0.1, …, 1.0 で「その再現率以上での最大の適合率」を平均)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import numpy as np from sklearn.metrics import precision_recall_curve, average_precision_score, auc df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) y = (d['総人口'] > 7_000_000).astype(int).values # 陽性 5 都府県(🧩 と同じ課題) s = d['一般病院数'].values prec, rec, _ = precision_recall_curve(y, s) ap_step = average_precision_score(y, s) # 階段近似(sklearn の AP) ap_trap = auc(rec, prec) # 台形補間 # 11 点補間: 再現率 0, 0.1, …, 1.0 で「その再現率以上での最大の適合率」を平均 ap_11 = np.mean([prec[rec >= r].max() for r in np.linspace(0, 1, 11)]) print(f'AP(階段近似) = {ap_step:.4f}') print(f'台形補間の面積 = {ap_trap:.4f}') print(f'11 点補間の AP = {ap_11:.4f}') |
💬 同じ順位付け・同じ PR 曲線なのに、 階段近似 0.6726、 台形補間 0.6335、 11 点補間 0.7348 と、 最大で約 0.10 違う。 陽性が 5 件しかないと曲線の点が少なく、 点のあいだをどう埋めるかの差がそのまま面積に出る。 11 点補間は「その先の最大値」で穴を埋めるので高めに、 台形補間は PR 空間では正しくない直線補間をするので低めに出やすい。 論文やコンペの AP と比べるときは、 どの計算方法かを必ずそろえる。
🧪 実データで確かめる — 選んだ閾値は、 別の年度では同じ成績を出さない
🎯 このコードでやること:「閾値は評価に使うデータとは別のデータで選ぶ」を、 年度をずらして確かめる。 2012 年度のデータだけで F1 が最大になる一般病院数の閾値を選び、 それを 2023 年度に当てはめて適合率と再現率がどう変わるかを見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) def pr(year, thr): d = df[df['年度'] == year] y = d['総人口'] > 7_000_000 p = d['一般病院数'] >= thr tp = (p & y).sum(); fp = (p & ~y).sum(); fn = (~p & y).sum() return tp / max(tp + fp, 1), tp / (tp + fn), tp, fp, fn # 2012 年度のデータだけで F1 が最大になる閾値を選ぶ d12 = df[df['年度'] == 2012] cands = np.sort(d12['一般病院数'].unique()) f1 = [] for t in cands: P, R, *_ = pr(2012, t); f1.append(0 if P + R == 0 else 2 * P * R / (P + R)) best = cands[int(np.argmax(f1))] print(f'2012 年度で選んだ閾値: 一般病院数 ≥ {best}') for y in [2012, 2023]: P, R, tp, fp, fn = pr(y, best) print(f'{y} 年度に当てはめる: 適合率 {P:.3f} 再現率 {R:.3f} (TP {tp}, FP {fp}, FN {fn})') |
💬 2012 年度で選んだ閾値(病院数 287 以上)は、 2012 年度では適合率 0.625・再現率 1.000 だが、 2023 年度に当てはめると適合率 0.571・再現率 0.800 に下がり、 陽性の 1 都府県を取りこぼす。 11 年のあいだに病院数そのものが減り、 選んだ閾値が新しいデータの分布に合わなくなったためである。 選んだデータの上で測った適合率・再現率は、 閾値をそのデータに合わせた分だけ楽観的になる。 閾値は検証用のデータで選び、 評価は別のデータで行い、 運用中も定期的に選び直す。
🗺 概念マップ
Precision-Recall 曲線の周辺概念をテーマ別ツリーで整理:
分類モデル評価指標
  ├── ROC 曲線・ROC-AUC (対比: 不均衡データに弱い)
  ├── 【Precision-Recall 曲線】 ← ここ
  │     ├── Average Precision (AP) / 曲線下面積 (PR-AUC)
  │     ├── F1 / F-β スコア (PR の調和平均)
  │     └── mAP (mean Average Precision) / Precision@k / R-Precision
  └── 混同行列 / Recall@k / MCC / Cohen's κ
PR 曲線は閾値を動かしたときの(再現率, 適合率)の軌跡で、 その 1 点を 1 つの数にしたものが F1・F-β、 曲線全体を 1 つの数にしたものが AP(PR-AUC)になる。 対になる ROC 曲線は横軸を偽陽性率にしたもので、 陰性の数が多いと差が見えにくい。
🔗 隣接手法への橋渡し
適合率-再現率は不均衡分類の評価指標で、 F1・PR 曲線・ROC・AUC と一体で運用される。
- 上流: 混同行列 — 混同行列の TP/FP/FN/TN から精度 = TP/(TP+FP)、 再現率 = TP/(TP+FN) を計算。 不均衡データで accuracy より重要。
- 並列: ROC-AUC — ROC-AUC は全閾値での FPR-TPR、 PR-AUC は精度-再現率の AUC。 不均衡時は PR-AUC の方が情報量大。
- 下流: F1 スコア — F1 は精度と再現率の調和平均で、 両者のバランスを 1 指標に集約。 マクロ F1 / マイクロ F1 でクラス別と全体を分離。
- 応用: 医療診断 (再現率重視: 見落とし回避)・スパム判定 (精度重視: 誤検知回避) で重点が変わる。 SSDSE で都道府県分類タスクなら F1 で総合評価。
SSDSE-B-2026 を用いた演習では、 「適合率-再現率」 を中核に据えて上記の上流・並列・下流の手法を実データで連結する経験を積むと、 単独の手法暗記より実務的応用力が身につく。
🌳 手法選択フロー
「適合率と再現率」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- どちらの誤りが高くつくか
見逃しが致命的(病気の検査、 不正検知)なら再現率を優先。 誤検出が高くつく(重要メールを迷惑扱い)なら適合率を優先。 ここを決めないと閾値は決まらない。 - 閾値をどこに置くか
PR 曲線を描き、 目標を満たす点を検証データで選ぶ。 0.5 は既定値であって最適値ではない。 選んだ閾値は必ず報告に書く。 - 1 つの数字にまとめる必要があるか
F1 は両者の調和平均で、 どちらも極端に低いと下がる。 重みを変えたいなら $F_\beta$。 ただし 1 つに丸めると、 どちらを犠牲にしたのかが見えなくなる。 - 陰性が大多数か
そうなら ROC は楽観的に見える。 陰性の数に影響されない PR 曲線とその下面積(AP)で評価する。
適合率と再現率は閾値を動かすと逆方向に動く。 片方だけを報告するのは、 都合の良い点を選んだのと同じになる。
🧩 さらに深掘り:同じモデルでも「PR で見るか ROC で見るか」で評価が激変する
姉妹ページ(precision / recall / roc-curve / f1-score)とは切り口を変え、 ここでは PR-AUC(AP)と ROC-AUC を同一タスク・同一ランキングで並べて比較し、 不均衡データで両者がどれだけ食い違うかを実データで検証します。 すべて SSDSE-B-2026(2023 年・47 都道府県)の実測値です。
🎨 直感:PR 曲線の「合格ライン」はタスクごとに動く
ROC 曲線のベースライン(当てずっぽう)は 常に AUC=0.5 で固定です。 一方 PR 曲線のベースラインは 陽性率 π そのもので、 タスクによって上下します。 つまり「PR-AUC=0.5」という同じ数字でも、 π=0.5 のタスクなら「当てずっぽうと同じ」、 π=0.1 のタスクなら「ベースラインの 5 倍」で意味が真逆になります。 PR-AUC は絶対値だけ見ても評価できず、 必ず π と並べて読む——これが ROC との最大の違いです。
🕳 落とし穴(重要):ROC-AUC=0.95 で安心 → PR-AUC=0.67 という現実
「総人口 > 700 万人」を陽性(陽性 5 件=埼玉・東京・神奈川・愛知・大阪、 陰性 42 件、 π=0.106)とし、 「一般病院数(I510120)」をスコアにして順位付けした場合の実測 AUC:
なぜ同じランキングでこれほど差が出るのか。 病院数で上位から並べると:
| 順位 | 県(病院数) | 正解 | Precision | Recall |
|---|---|---|---|---|
| 1 | 東京都(588) | 陽性 | 1.000 | 0.20 |
| 2 | 北海道(464) | 陰性(FP) | 0.500 | 0.20 |
| 3 | 大阪府(463) | 陽性 | 0.667 | 0.40 |
| 4 | 福岡県(390) | 陰性(FP) | 0.500 | 0.40 |
| 5 | 兵庫県(312) | 陰性(FP) | 0.400 | 0.40 |
| 6 | 埼玉県(296) | 陽性 | 0.500 | 0.60 |
| 7 | 神奈川県(289) | 陽性 | 0.571 | 0.80 |
| 8 | 愛知県(278) | 陽性 | 0.625 | 1.00 |
北海道(病院 464=全国 2 位だが人口 509 万で陰性)、 福岡・兵庫(人口 500 万台で 700 万に届かず陰性)が上位に食い込み、 再現率がまだ低い序盤で Precision を 0.5 前後まで削り取ります。 病院数は「面積・医療体制」を色濃く反映し「人口規模」とはズレるためです。 ROC-AUC はこの誤りを 42 件の真陰性(TN)の多さで薄めて 0.95 と楽観的に見せますが、 PR は TN を一切見ないため、 少数の陽性を取り違えるコストがそのまま数字に出て 0.67 に落ちます。 AP を階段近似で手計算しても
0.2×1.000 + 0.2×0.667 + 0.2×0.500 + 0.2×0.571 + 0.2×0.625 = 0.6726
と sklearn の average_precision_score に一致します。 教訓:不均衡タスクで「ROC-AUC が高い=良いモデル」と早合点すると危険。 少数派の検出品質は PR-AUC でしか正しく見えない。
📝 補足:同じ陽性ラベルでも「大学学生数(E6302)」をスコアにすると ROC-AUC=0.9810 / PR-AUC=0.9111(差 0.07)、 「出生数(A4101)」なら両方 1.0000。 スコアの良し悪しによって PR-ROC の乖離幅そのものが変わる点も、 実データで確認できます(いずれも 2023 年実測)。
🚀 発展:π が動くと PR 曲線ごと動く/閾値はコスト比で選ぶ
- PR 曲線は陽性率 π に依存する:ダウンサンプリングやオーバーサンプリングで学習データの π を変えると、 同じモデルでも PR 曲線・AP が変化します。 ROC 曲線は π に不変なので、 「サンプリング後のモデルを AP で比較する」ときは元の π に戻す(校正する)必要があります。
- PR-Gain 曲線:ベースライン π の影響を除いて曲線を線形補間可能にした Precision-Recall-Gain(Flach & Kull, 2015)という改良版があり、 AP の代わりに AUPRG を使うと不均衡タスク間の比較が公平になります。
- 閾値は指標ではなくコスト比で決める:上の表で「Precision 重視なら順位 1〜3、 Recall 重視なら順位 8 まで」のように、 見逃し(FN)と誤検出(FP)のコスト比 c=Cost(FN)/Cost(FP) を決めてから運用点を選びます。 曲線 1 本の面積(AP)はモデル比較用、 実運用の閾値選定は別問題という切り分けが重要です。
- AP と台形 PR-AUC は別物:sklearn の
average_precision_score(階段近似)とauc(recall, precision)(台形補間)は、 特にプロット点が少ない場合に値がずれます。 論文報告では AP を使うのが標準です。
🔗 関連ページ
- precision(適合率):PR 曲線の縦軸。 FP をどれだけ抑えられているか。
- recall(再現率):PR 曲線の横軸。 陽性の取りこぼし=FN の少なさ。
- roc-curve(ROC 曲線):本セクションで対比した「もう一方の物差し」。 π 不変・ベースライン 0.5。
- f1-score(F1 スコア):PR 曲線上の 1 点(特定閾値)での P と R の調和平均。