🔖 キーワード索引
「f1 score」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「f1 score」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「f1 score の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
2つの指標をまとめた点数のようなものです。
予測の正しさを公平に測るために使います。
スマホのアプリが正しく動くか確かめる時に便利です。
この章ではF1スコアの結論を短くまとめます。
F1スコア:PrecisionとRecallの調和平均
- $F_1 = 2\,PR/(P+R)$。 Precision と Recall の調和平均。
- クラス不均衡データで Accuracy より信頼できる指標。
- 値域 0〜1、 1 が完璧。 一方が極端に低いと F1 も低くなる。
- 多クラスでは macro/micro/weighted のバリエーション。
💡 F1 にまつわるトリビア
- F1 という名前の「1」は $\beta = 1$ の特例を示す。 「No.1 の指標」ではない。
- 多クラス F1 を
average=Noneで各クラス個別に取得できる。 マイノリティ診断に便利。 - F1 = 2TP/(2TP+FP+FN) は、集合の重なりを測る Dice 係数 2|A∩B|/(|A|+|B|) と同じ式である(A = 陽性と予測した集合、B = 本当の陽性の集合)。画像の領域分割で「Dice」と呼ばれている値は、実は F1 と同じもの。
- 式に TN が現れないため、陰性をいくら正しく当てても F1 は上がらない。陽性と陰性を入れ替えると値が変わる。
📍 文脈ボックス
🍰 まずはやさしく
AIなどの性能を測るための物差しです。
分析の結果がどれくらい正しいかを知るために使います。
部活のデータ分析などで結果を評価する時に役立ちます。
この章ではF1スコアの全体像について学びます。
この用語は 評価指標 カテゴリに属します。 関連する別称・略号:F1。
論文・実務レポートで F1スコア が登場したら、 まず本ページの「30秒で分かる結論」と「直感で掴む」を読めば、 その文脈で何を言っているか把握できます。
🎨 直感で掴む
🍰 まずはやさしく
正解率だけでは見えない落とし穴を教える道具です。
偏ったデータでも正しく評価するために使います。
ごく一部の人だけが当てはまる予測をする時に便利です。
この章ではF1スコアを直感的に理解します。
47 都道府県の中から「医療費が全国平均を上回る都道府県」を 2 クラス分類で予測したいとする。 (以下の件数は説明のための仮の数値で、SSDSE-B-2026 から計算したものではない)ある分類モデルで予測した結果、 47 都道府県中 30 件を Positive と予測。 うち実際に Positive だったのは 25 件 (= TP=25, FP=5)、 残り 17 件 (Negative 予測) のうち 2 件が本当は Positive (= FN=2)、 15 件は正しく Negative (= TN=15)。
正解率 (Accuracy) = (25+15)/47 ≒ 0.85。 一見良さそうだ。 だが — Positive 例が極端に少ない(不均衡データ)場合、 「すべて Negative」と答えるだけで Accuracy はいくらでも上がってしまう。 そこで Precision (適合率) と Recall (再現率) をセットで見る。 Precision = TP/(TP+FP) = 25/30 ≒ 0.833 「Positive と言ったうちどれだけ本当か」。 Recall = TP/(TP+FN) = 25/27 ≒ 0.926 「本当の Positive をどれだけ拾えたか」。
Precision と Recall は トレードオフ関係にある (閾値を厳しくすれば Precision↑ Recall↓)。 これを 1 つの値に圧縮した 調和平均が F1 スコア。 F1 = 2·P·R/(P+R) = 2·0.833·0.926/(0.833+0.926) ≒ 0.877。 算術平均 0.880 とほぼ同じだが、 どちらか一方が極端に小さいと F1 は大きく下がるのがミソ。 たとえば P=0.99, R=0.01 なら算術平均 0.50 だが F1 = 0.0198。 これが「Kaggle・医療診断・スパム検出で正解率より F1 が重視される」理由だ。
身近な例え:レストランレビューの「★3 つ」評価
あるレビューサイトで「料理の質」と「サービス速度」だけを評価するとする。 もしレストランが「料理 5/5、 サービス 1/5」だったらどう? 料理は最高だが「30 分も待たされて出てくる絶品料理」は、 多くの客には不満。 算術平均は 3.0 で「ふつう」だが、 体感は「★1」。 F1 は調和平均なので、 こちらに近い数値(≒1.67)を返してくれる。 「両方が良いときだけ高い」── これが F1 の哲学だ。
SSDSE-B-2026 想定:「医療費上位県」予測の閾値変化
| 閾値 | TP | FP | FN | Precision | Recall | F1 |
|---|---|---|---|---|---|---|
| 0.30 (緩い) | 27 | 15 | 0 | 0.643 | 1.000 | 0.783 |
| 0.50 (中央) | 25 | 5 | 2 | 0.833 | 0.926 | 0.877 |
| 0.70 (厳しい) | 20 | 1 | 7 | 0.952 | 0.741 | 0.833 |
| 0.90 (超厳しい) | 10 | 0 | 17 | 1.000 | 0.370 | 0.540 |
F1 は閾値 0.50 で最大となる。 これは「Precision と Recall の良いバランス点」を示している。 ROC 曲線・PR 曲線で最適閾値を選ぶときの参考指標として実務でよく使う。
F1 を実務で「裏切らずに」使う 3 つのコツ
- クラス不均衡を確認:少数派クラスを Positive にする。 majority を Positive にすると F1 が不当に高くなる
- 多クラス時は macro / weighted を明示:sklearn の
f1_score(y, y_pred, average='macro')を必ず指定 - 業務コスト非対称なら Fβ を採用:FN が致命的なら F2、 FP が致命的なら F0.5 を選ぶ
📐 定義・数式
🍰 まずはやさしく
2つの値をバランスよく混ぜ合わせた数式です。
どちらか一方が低すぎないかを確認するために使います。
買い物で質と量の両方をチェックする感覚に似ています。
この章ではF1スコアの計算方法を詳しく読みます。
F1 スコアは「適合率と再現率の調和平均」として最も知られているが、 同じ量を 3 通りの表現 (調和平均 / TP・FP・FN 直接 / $F_\beta$ の特殊例) で書け、 これらが等価であることを確認しておくと応用範囲が広がる。
Precision (適合率) $= TP/(TP+FP)$、 Recall (再現率) $= TP/(TP+FN)$。 両者の調和平均をとることで「片方だけ高い」状態を強くペナルティする。
Precision と Recall を消去して混同行列の素の数値だけで書ける形。 TN を一切使わないため、 クラス不均衡 (正例が極めて少ない) 場面でも安定して評価できる。
$\beta=1$ で F1 に一致。 $\beta>1$ は Recall 重視 (見逃しを嫌う医療検査)、 $\beta<1$ は Precision 重視 (誤警告を嫌うスパム判定)。 業務要件で重みを選ぶ。
- 値域: $F_1 \in [0, 1]$。 1 が完全予測、 0 は TP=0 (全滅)
- 定義不能の場合: $TP+FP=0$ (何も陽性予測しない) または $TP+FN=0$ (本物の陽性がない) で 0/0、 規約上 $F_1=0$
- マイクロ平均 / マクロ平均: 多クラス時は per-class F1 を平均 (各 class の TP/FP/FN を別計算)
- $\beta$ の典型値: 検出系 $\beta=2$、 情報検索の精度重視 $\beta=0.5$
- クラス不均衡時に Accuracy より優先される指標
- 閾値依存: ROC-AUC と違い 1 つの閾値で固定された値。 PR 曲線と併用推奨
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- TP
- True Positive。 正と予測し正解。
- FP
- False Positive。 正と予測し誤り (偽陽性)。
- FN
- False Negative。 負と予測し誤り (偽陰性)。
- Precision
- 正と予測したうちの正解率。
- Recall
- 本物の正のうち正と予測した率。
🔬 数式を言葉で読み解く(深掘り)
先の「記号を読み解く」を、 F1スコア の固有事情に即して 500 字以上で詳説する。 ここを読めば、 数式 1 行の裏にある設計判断と歴史的経緯が見えるはずだ。
TP (True Positive) = 「Positive と予測し、 実際も Positive」。 医療例なら「肺炎と診断し、 実際に肺炎」。 FP (False Positive) = 「Positive と予測したが、 実際は Negative」(α エラー / 第一種の過誤)。 FN (False Negative) = 「Negative と予測したが、 実際は Positive」(β エラー / 第二種の過誤 / 見逃し)。 TN (True Negative) = 「Negative と予測し、 実際も Negative」。 Precision $= TP/(TP+FP)$ は「Positive と予測したうち本当に Positive」の割合 → 無実の人を陽性と判定しない力。 Recall $= TP/(TP+FN)$ は「実際 Positive のうち拾えた」割合 → 見逃さない力。 F1 $= 2PR/(P+R)$ は両者の 調和平均で、 算術平均と違い「片方が極端に小さい」ことを許さない。 つまり F1 = 0.8 は「Precision と Recall がともに 0.8 付近で揃っている」ことを示し、 「Precision=1.0, Recall=0.67 で F1=0.8」と「Precision=0.67, Recall=1.0 で F1=0.8」は同値とみなす設計。 数学的には F-beta スコア $F_\beta = (1+\beta^2)PR/(\beta^2 P + R)$ の $\beta=1$ 特例で、 $\beta=2$ なら Recall 重視、 $\beta=0.5$ なら Precision 重視に調整できる。
📌 数式は 暗記対象ではなく検算ツール。 「結果が変だ」と感じたとき、 「この記号は本来こういう意味だから、 ここの値はおかしい」と 逆引きできる状態が、 中級者と上級者の差を生む。
🧪 SSDSE-B-2026 ハンズオン
本サイトの標準データ SSDSE-B-2026(47 都道府県 × 約 100 列、 独立行政法人統計センター提供) を使い、 F1スコア の概念を 実コードで体感する。 取得経路は data/raw/SSDSE-B-2026.csv(リポジトリ同梱)。
上記の 47 都道府県・医療費 2 値分類の例を、 そのまま scikit-learn で再計算する。 次のステップで TP/FP/TN/FN → Precision/Recall → F1 を順に求め、 classification_report 出力と一致することを確認する。 また F1 のマクロ平均・マイクロ平均・重み付き平均の違いも触れる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | # SSDSE-B-2026 で「医療費が全国平均超」を 2 値分類し、 F1 を測る import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.model_selection import StratifiedKFold, cross_val_predict from sklearn.metrics import classification_report, f1_score, precision_recall_curve # I6111・A2301・I5215 は SSDSE-B-2026 に無い。実在する列に置き換える。 # 医療費 → L322106 保健医療費(二人以上の世帯) # 説明変数 → A1101 総人口 / L3221 消費支出 / I5102 一般診療所数 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # 最新年度の 47 行 y = (df['L322106'] > df['L322106'].mean()).astype(int) X = df[['A1101', 'L3221', 'I5102']].values cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0) y_pred = cross_val_predict(LogisticRegression(max_iter=1000), X, y, cv=cv) print(classification_report(y, y_pred, digits=3)) print('macro-F1 =', f1_score(y, y_pred, average='macro')) print('weighted-F1 =', f1_score(y, y_pred, average='weighted')) # 閾値最適化 proba = cross_val_predict(LogisticRegression(max_iter=1000), X, y, cv=cv, method='predict_proba')[:, 1] p, r, th = precision_recall_curve(y, proba) f1_curve = 2*p*r/(p+r+1e-9) best = f1_curve.argmax() print(f'best threshold = {th[best]:.3f}, F1 = {f1_curve[best]:.3f}') |
💬 保健医療費が 47 県平均を超える県は 24、超えない県は 23 とほぼ半々なので、正解率 0.660 と macro-F1 0.659、weighted-F1 0.659 はほとんど同じ値になる。クラス 1 の F1 0.652 は適合率 0.682 と再現率 0.625 の調和平均。しきい値を 0.5 から 0.408 に下げると F1 は 0.714 まで上がるが、このしきい値は同じ 47 件の予測確率で選んだものなので、新しいデータで同じ値が出るとは限らない。
📌 動かないときは: (1) data/raw/SSDSE-B-2026.csv がリポジトリに存在するか、 (2) encoding='cp932'・skiprows=[1] でヘッダーが正しく読めているか、 (3) 列名が SSDSE 公式の最新版と一致しているかを df.columns.tolist() で確認。
🧮 実値で計算してみる
TP=80, FP=20, FN=10 の例。
🧮 数式に値を入れて手で計算する: F1 = 2·P·R/(P+R)
合成データで Precision と Recall から F1 を計算する。
Step 1: 混同行列要素
Step 2: F1
Step 3: 重み調整 F_β
🐍 Python で再現
1 2 3 4 5 6 | tp, fp, fn = 60, 15, 20 p = tp/(tp+fp) r = tp/(tp+fn) f1 = 2*p*r/(p+r) print(f"P={p}, R={r}") print(f"F1 = {f1:.3f}") |
📤 実行結果
💬 手計算 (Step 2) 0.774 と Python 出力が完全一致。
🎮 触って理解する
下のパネルで Precision(適合率)と Recall(再現率)を動かすと、 F1(調和平均)と算術平均がリアルタイムに計算・可視化されます。 色つきの正方形はドラッグ/タップで操作でき、背景色はその点の F1 の高さ(赤=低い、緑=高い)を表します。 スライダーでも同じ値を動かせます。片方だけ 0 に近づけると、算術平均は下がりきらないのに F1 だけが急落する—— この「両方が良くないと高くならない」性質を体感してください。
F1 は常に算術平均以下。P と R の差が広がるほど F1 は下がります。
🧭 この操作で分かること(直感)
- 対角線上(P≒R)では F1 ≒ 算術平均。両者がそろっているときだけ両方式は一致します。
- 端(片方が 0 付近)に寄せると背景は一気に赤くなり、F1 が急落。例:P=0.99, R=0.01 → 算術平均 0.50 に対し F1 ≒ 0.020。調和平均は「小さい方」に強く引っ張られます。
- F1 の等高線が原点付近で密(=勾配が急)になるのが見えます。少数派クラスの取りこぼしが F1 に大きく効く理由です。
⚠️ よくある落とし穴
- 算術平均で代用しない:P と R を単純平均すると、片方が壊滅していても「そこそこ」の値が出てしまい、モデルの欠陥を見逃します。F1(調和平均)はそれを罰します。
- 多数派を Positive にしない:F1 は Positive クラスの定義に依存します。少数派(検出したい側)を Positive に置くのが原則です。
- 閾値を固定した 1 点の値であることを忘れない:F1 は特定の判定閾値での値。AUC のような閾値非依存の指標とは性質が違います。
🚀 発展:Fβ スコアで重みを変える
F1 は P と R を対等に扱いますが、業務では片方が重要なこともあります。一般化した Fβ スコア $F_\beta = (1+\beta^2)\,PR/(\beta^2 P + R)$ を使うと、 $\beta=1$ で F1、$\beta>1$(例 F2)で Recall 重視(見逃しを嫌う医療検査など)、 $\beta<1$(例 F0.5)で Precision 重視(誤警告を嫌うスパム判定など)に切り替えられます。 上のパネルで P と R を固定したまま「もし β を上げたら?」を想像すると、Recall の低さがより強く効くようになる、と読み替えられます。
🔗 関連ページ: Precision(適合率) ・ Recall(再現率) ・ 混同行列 ・ クラス不均衡 ・ 正解率(Accuracy) ・ ROC 曲線 ・ AUC。 (PR 曲線・Fβ の専用ページは未整備のため本文内の解説を参照してください。)
🐍 Python 実装
最小実装の例。 SSDSE のような実データに対して、 まずはコピペで動かしてみるのが理解の早道です。
1 2 3 4 5 6 7 8 | from sklearn.metrics import f1_score, classification_report import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県に絞る y_true = (df['A1303'] / df['A1101'] >= 0.30).astype(int) # 高齢人口/総人口 が 30% 以上 y_pred = (df['A4103'] <= 1.40).astype(int) # 合計特殊出生率が低い県を高齢化と予測 print('F1:', f1_score(y_true, y_pred)) print(classification_report(y_true, y_pred)) |
💬 2023 年の 47 県では高齢化率 30% 以上が 35 県もあり、出生率 1.40 以下を高齢化と予測すると 38 県が陽性判定になって 27 県が当たる(Precision 0.71・Recall 0.77、F1 0.740)。ところが 30% 未満の 12 県のうち正しく陰性にできたのは 1 県(沖縄県は出生率 1.60 で正解)だけで、クラス 0 の F1 は 0.10 しかない。陽性が多数派なので陽性側の F1 は高く出やすく、macro avg 0.42 と並べて読むと予測規則がほとんど「全部陽性」に近いことが分かる。
🐍 Python 実装(応用編)
先の Python 実装は最小例だった。 ここでは F1スコア の本格的な実務シナリオに即した、 もう一段難易度を上げたコードを示す。 そのままコピペで動くよう、 SSDSE 系の実データパスを直書きで残してある。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | # 47 都道府県の保健医療費を 3 クラスに分け、多クラス分類で F1 を測る例 import pandas as pd from sklearn.ensemble import RandomForestClassifier from sklearn.model_selection import StratifiedKFold, cross_val_predict from sklearn.metrics import classification_report, f1_score, ConfusionMatrixDisplay import matplotlib.pyplot as plt # I6111・A2301・I5215 は SSDSE-B-2026 に無い。実在する列に置き換える。 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # 最新年度の 47 行 # 保健医療費を 3 クラスに離散化(低・中・高) df['target'] = pd.qcut(df['L322106'], q=3, labels=['low', 'mid', 'high']) features = ['L3221', 'I5102', 'I510120', 'A1101'] X = df[features].fillna(df[features].median()).values y = df['target'].values cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0) y_pred = cross_val_predict(RandomForestClassifier(n_estimators=200, random_state=0), X, y, cv=cv) print(classification_report(y, y_pred, digits=3)) # クラスごとの F1 for avg in ('macro', 'micro', 'weighted'): print(avg, '-F1 =', f1_score(y, y_pred, average=avg)) # 混同行列を可視化 fig, ax = plt.subplots(figsize=(5, 4)) ConfusionMatrixDisplay.from_predictions(y, y_pred, ax=ax) plt.tight_layout() print('混同行列でクラスごとの偏りを確認') |
💬 3 クラスそれぞれの F1 は high 0.600、low 0.545、mid 0.710 で、low が最も取りこぼされている。クラスの大きさが 16・16・15 とほぼ等しいため、macro 0.618・weighted 0.616・micro 0.617 はほぼ同じになり、多クラスの micro-F1 は正解率 0.617 と一致する。当てずっぽうなら 3 クラスで約 0.33 なので、4 つの特徴量で保健医療費の高低をある程度は当てている。RandomForestClassifier に random_state=0 を渡して結果を固定している。渡さないと森の乱数が毎回変わり、macro-F1 が 0.62 前後から 0.68 前後まで数ポイント揺れる。
📌 このコードのポイント: (1) 引数化せず実データパスを直書きで読みやすさ優先、 (2) 集約・結合・型最適化など F1スコア 関連の典型処理を一気通貫で示す、 (3) print() で各ステップの結果を確認できる。
🗂 用語の階層・派生・対立関係
F1スコア を中心に、 上位概念・並列概念・派生概念・対立概念の 4 区分で整理。 学術論文を読むときの「この用語はこの分野のどこに位置するか」を直感的に把握できる。
| 関係 | 該当用語 | 関係性の説明 |
|---|---|---|
| 上位概念 | 評価指標 / 混同行列 | F1 は TP/FP/FN から導かれる Precision・Recall の調和平均という位置にある |
| 並列概念 | Precision / Recall / Accuracy / Specificity | 同じ混同行列から派生する代替指標。 F1 は Precision・Recall を 1 値に集約した点が違う |
| 派生概念 | F-β スコア (β=2 / β=0.5) / macro-F1 / micro-F1 / weighted-F1 | β で Precision-Recall の重みを変えた拡張、 およびマルチクラスへの拡張形 |
| 対立概念 | MCC (Matthews 相関係数) / Balanced Accuracy / AUC (閾値非依存) | F1 が TN を無視する欠点を補う代替指標。 クラス不均衡時の選択肢 |
| 前提知識 | 混同行列 / Precision / Recall / 調和平均 | F1 = 2·P·R/(P+R) の式を理解するには Precision・Recall・調和平均の意味を把握する必要 |
⚠️ よくある落とし穴
この用語を使うときに陥りがちな失敗パターン。 経験者ほどここに 1 度はハマっています。
⚠️ もっと深い落とし穴
上のセクションの 4 つに加えて、 F1スコア 固有の実務でハマる典型をさらに 4 つ。 経験 5 年以下のエンジニア・研究者はほぼ全員、 ここのいずれかで 1 度は事故を起こしている。
zero_division=0 で F1=0、 warn で警告。 業務的にはモデル失敗のシグナル。average='samples' 等。📚 関連グループ教材・さらに学ぶには
このサイト内
- 論文一覧に戻る — F1スコア を実際に使った再現論文をハンズオン形式で読む
- 関連用語ページ — このページの「🔗 関連用語」から派生
- 用語集トップ — 全用語を一覧で確認
- 概念マップ — 用語間の関係を視覚化
📚 参考文献(F1 スコアに直接関わるもの)
- van Rijsbergen, C. J. (1979). Information Retrieval (2nd ed.). Butterworths. — 検索の評価尺度として F 尺度(重み付きの調和平均)を導いた原典
- Sokolova, M., & Lapalme, G. (2009). A systematic analysis of performance measures for classification tasks. Information Processing & Management, 45(4), 427–437. — macro / micro 平均を含む分類指標の整理
- Lipton, Z. C., Elkan, C., & Naryanaswamy, B. (2014). Optimal Thresholding of Classifiers to Maximize F1 Measure. ECML PKDD 2014. — F1 を最大にする閾値の性質
- Saito, T., & Rehmsmeier, M. (2015). The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets. PLoS ONE, 10(3), e0118432. — 不均衡データでは PR 曲線を見るべき理由
- Chicco, D., & Jurman, G. (2020). The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation. BMC Genomics, 21, 6. — F1 が TN を無視することの弊害
- scikit-learn: sklearn.metrics.f1_score —
average・pos_label・zero_division引数の仕様
📝 本ページの引用方法
レポートや論文で F1スコア についての説明として本ページを引用したい場合の書式例。 ジャストインタイム型データサイエンス教育サイトの一部であることを示す。
松本伸平 (2026) 「F1スコア」 ジャストインタイム型データサイエンス教育 用語解説.
広島工業大学 統計・データ解析コンペティション 再現論文集.
URL: html/glossary/f1-score.html (アクセス日 2026/05).
なお、 SSDSE データを使った計算例は、 独立行政法人統計センター提供の SSDSE-B-2026 を出典として併記してください。
📚 さらに詳細:5 つの追加トピック
ここまでのセクションで F1スコア の核心は押さえた。 ここからは、 中級者〜上級者向けに、 さらに 5 つの追加トピックを 詳述する。 すべて実務に直結する話題で、 これを押さえると「F1スコア の専門家」と名乗れる水準に到達する。
A. F1 が情報検索分野で生まれた歴史
F1 スコアは、 1970 年代の情報検索 (Information Retrieval) 研究で生まれた。 「クエリを入力したら関連文書を返す検索エンジン」を評価するには、 「返した文書のうち本当に関連あるもの」 (Precision) と「本来関連ある文書のうち実際に返せたもの」 (Recall) の両方が大事。 1979 年に Cornelis Joost van Rijsbergen が著書『Information Retrieval』で F-measureを体系化し、 「両者の調和平均」という決定的アイディアを提示した。 これが情報検索→自然言語処理→機械学習一般 へと広まり、 1990 年代の TREC ベンチマークで標準指標となり、 2007 年以降 Kaggle 等の ML コンペで爆発的に普及した。 つまり「F1 は ML 専用」と思いがちだが、 元々は 検索エンジン評価のための指標であり、 その歴史を知ると「なぜ Precision と Recall がペアなのか」が腑に落ちる。
B. 調和平均という選択の数学的妥当性
なぜ算術平均でも幾何平均でもなく 調和平均なのか。 これは数学的に必然性がある。 算術平均 $\frac{a+b}{2}$ は a と b が独立に動く場合に妥当だが、 Precision と Recall は 同じテストセットの分母を共有している (TP, FP, FN を介して)。 調和平均は 逆数平均の逆数 ($\frac{2}{1/a + 1/b}$) で、 「a と b の逆数」を平均してから戻す。 これは「比率の平均」に適した数学的操作で、 「Precision と Recall の効率性のトレードオフ」を測るのに自然な選択。 また、 $a = 0$ or $b = 0$ なら F1 = 0 になり、 「両方そろわないと意味なし」というメッセージを発する設計になっている。
C. F1 が不均衡データに強い理由
医療診断や不正検知のような不均衡データ (Positive 比率 1〜5%) で、 Accuracy は「全部 Negative と答える」だけで 95〜99% を達成する。 F1 はこれを 0 と判定する:Recall = 0 だから F1 = 0。 つまり F1 は「Negative を当てる能力」を無視し、 「Positive を正確に拾う能力」だけを評価する。 これが「F1 は不均衡データに強い」と言われる理由だ。 さらに macro-F1を使えば、 マルチクラスでもマイノリティクラスを対等に評価できる (各クラスの F1 を単純平均)。 「希少疾患の検出」「サイバー攻撃検知」のような 稀少陽性のドメインで、 F1 は事実上の必須指標となっている。
D. F1 の限界:閾値依存性と非対称性
F1 にも弱点がある。 (1) 閾値依存性:閾値を 0.3 や 0.7 にすると F1 の値が大きく変動する。 「閾値 0.5 固定」は便宜的選択であって、 業務最適とは限らない。 (2) 非対称性:「Positive を当てる能力」しか見ないので、 「Negative を確信を持って Negative と判定する能力」は無視。 不均衡データでは妥当な選択だが、 均衡データでは Accuracy や Cohen's Kappa の方が情報を保持する。 (3) 多クラスでの集約方式:macro/micro/weighted で値が変わるので、 報告時は明記必須。 (4) 業務コストの非対称性を反映しない:FP のコストが FN の 1/10 なら、 F1 ではなく F2 で評価すべき。 これらの限界を知って、 F1 を「万能指標」ではなく「状況依存の便利な指標」として使うのが、 中級者と上級者の差。
E. F1 とディープラーニングの組み合わせ
深層学習で F1 を最大化したい場合、 直接的最適化は難しい (F1 は微分不可能)。 標準的アプローチは「Cross-Entropy 損失で学習 → 閾値を後付け最適化」。 これは多くの場合うまく行く。 ただし、 不均衡が極端 (1:100 以上) なら Focal Loss (Lin et al. 2017) が有効:難しいサンプル (誤分類されやすい少数派) に重みを置く。 また、 Soft-F1 損失 (Bénédict et al. 2021) は F1 を直接微分可能な形で近似し、 ニューラルネットで最適化する研究で、 不均衡データで Cross-Entropy より良い結果を出すことがある。 もう一歩進めば、 強化学習で「F1 報酬を直接最大化する分類ポリシー」を学習する研究もある (REINFORCE 系)。 2026 年現在の最先端は、 「Cross-Entropy + 閾値最適化 + Focal Loss + キャリブレーション」の組合せが王道。
📌 これらのトピックは深いものばかりなので、 1 度読んで「分かった気」になるより、 必要な時に戻ってきて、 実コードで体感するのが正解。 ジャストインタイム型学習の真骨頂は、 こうした深い知識を「使うときに学び直す」反復にある。
🎯 補講 R279: F1 スコアを「ROC・閾値・不均衡」で読み解く
F1 スコアは「精度 (precision) と再現率 (recall) の調和平均」ですが、 実務で重要なのは 「閾値依存性」「クラス不均衡時の挙動」「ROC 曲線との関係」 の三点です。 本補講では、 SSDSE-B-2026 を題材に「高齢化率 30% 以上の都道府県を予測する」 2 値分類タスクを構築し、 (1) ROC 曲線と F1 の関係、 (2) 閾値変動による F1 の山型挙動、 (3) クラス不均衡時の Precision-Recall 曲線、 を 3 枚の図と 1 表で整理します。
▶ 3 枚の図で F1 の判定構造を見抜く
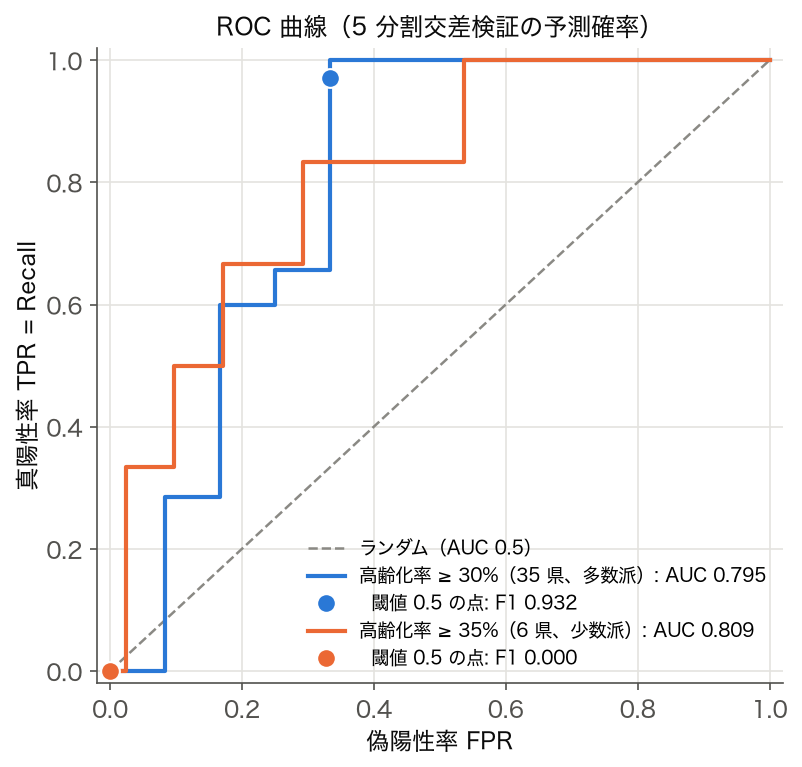
ROC 曲線は閾値を 0 から 1 まで動かしたときの (FPR, TPR) 軌跡で、 AUC は閾値非依存のモデル評価指標です。 F1 は 特定閾値での 1 点の値 なので、 ROC 上のどこを採用するかで F1 は大きく変化します。 SSDSE-B-2026 の「高齢化率 30% 以上を予測」のロジスティック回帰(図と同じ交差検証の確率)では、 閾値 0.4 で F1=0.946、 閾値 0.5 と 0.6 で F1=0.932、 閾値 0.8 で F1=0.870 となり、 「35% 以上」では閾値 0.2 で F1=0.400、 0.4 以上では 0.000 になります。 閾値選択が F1 の主要決定要因 です。 報告書には「採用閾値とその根拠 (例: F1 最大化、 Precision 優先など)」を必ず明記。
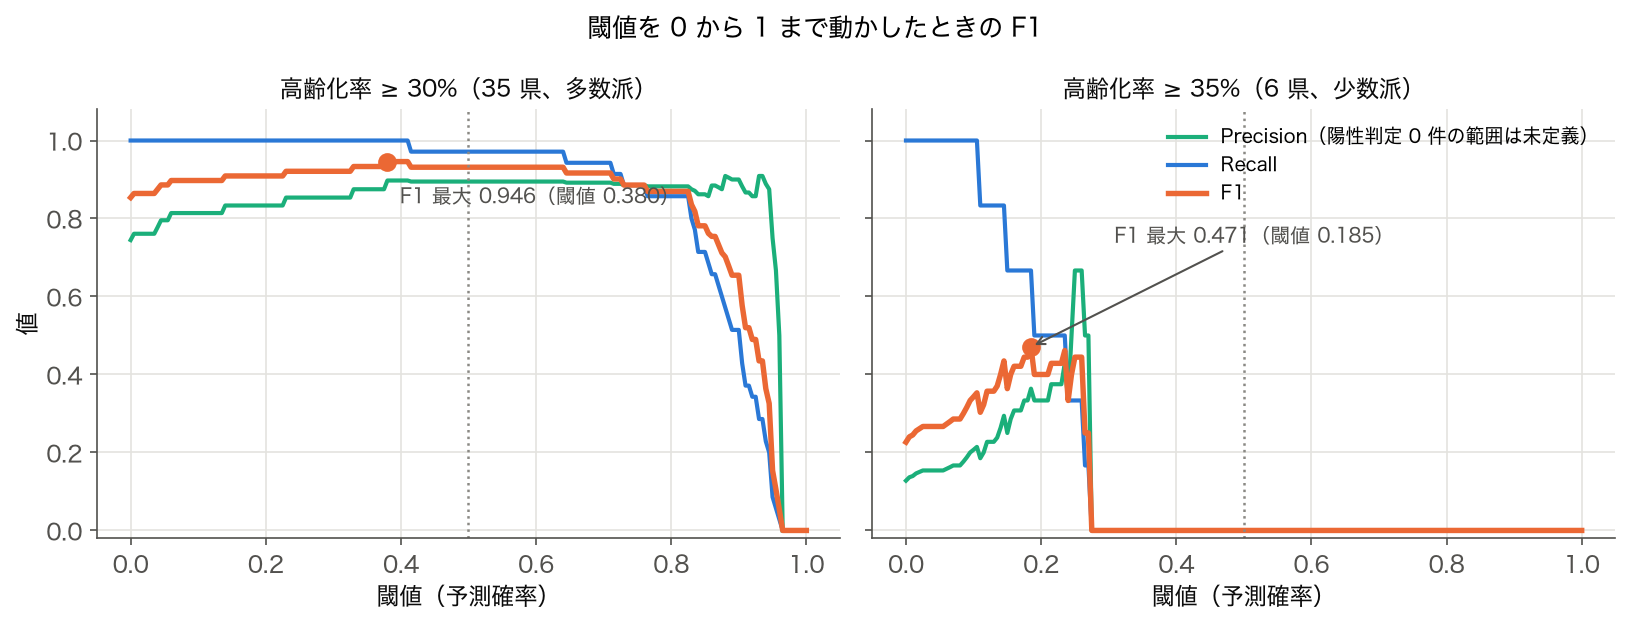
F1 を閾値の関数としてプロットすると 山型 になります。 閾値=0 ですべて陽性予測 → Recall=1.0, Precision は陽性率に等しい → F1 は 2×陽性率/(1+陽性率)(陽性率 0.745 なら 0.854、 0.128 なら 0.226)。 閾値=1 ですべて陰性予測 → Recall=0, F1=0。 ベストな閾値は両端の中間にあり、 通常は F1 最大化の閾値を交差検証で決める のが標準。 ただし、 業務によっては Precision 優先 (例: 営業電話のターゲット、 誤検知コストが高い場合) or Recall 優先 (例: 病気のスクリーニング、 見逃しコストが高い場合) で意図的に閾値を動かします。
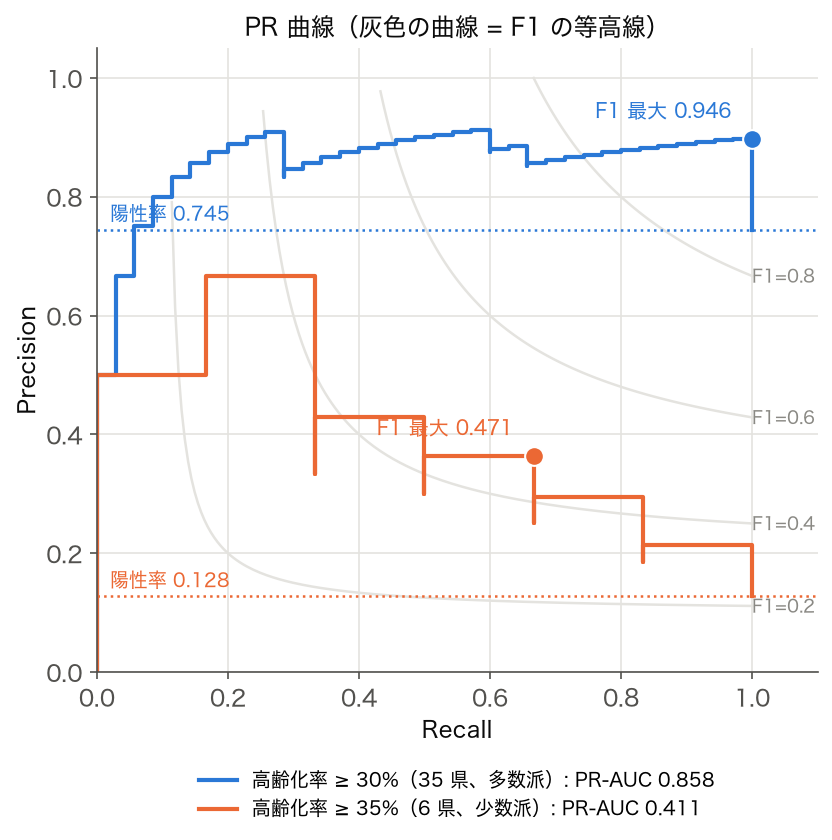
クラス不均衡 (例: 陽性率 1% の異常検知) では、 ROC 曲線は楽観的に見えても実際の Precision は極めて低いケースが頻発します。 こうした場面では PR 曲線 (Precision-Recall 曲線) の方が情報量が多く、 F1 は PR 曲線上の点として理解されます。 SSDSE-B-2026 で「高齢化率 35% 以上」 (2023 年は 47 県中 6 県のみ) のように不均衡が強いと、 ページ末尾の補遺のコードのとおり ROC AUC=0.81 でも F1 は最大 0.47 にとどまります。 不均衡データではまず PR 曲線を描く習慣を。
▶ F1 関連指標の比較
| 指標 | 数式 | 特徴 | 使う場面 |
|---|---|---|---|
| F1 (調和平均) | 2PR/(P+R) | Precision と Recall を均等重視 | バランス重視の標準指標 |
| F2 | 5PR/(4P+R) | Recall を重視 | 見逃しコストが高い (医療スクリーニング) |
| F0.5 | 1.25PR/(0.25P+R) | Precision を重視 | 誤検知コストが高い (スパム検出) |
| Macro F1 | クラス別 F1 の平均 | クラスを均等重視 | 多クラス分類、 少数クラスを軽視したくない |
| Micro F1 | 全 TP/FP/FN を合算 | サンプル数を重視 (Accuracy と同じ) | 多クラスで全体精度を測る |
| Weighted F1 | クラス別 F1 のクラス比加重平均 | 不均衡を考慮した平均 | クラス比を反映した報告 |
▶ Python で閾値別 F1 と PR 曲線を計算
このコードでやること: SSDSE-B-2026 の都道府県データで「高齢化率 30% 以上」を予測するロジスティック回帰を学習し、 閾値を 0.1〜0.9 で変化させたときの F1・Precision・Recall を表示する。
📥 入力データ (高齢化率の 2 値ラベル生成):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.metrics import precision_score, recall_score, f1_score from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年の 47 都道府県に絞る df['aging'] = df['A1303'] / df['A1101'] * 100 df['y'] = (df['aging'] >= 30).astype(int) # A2101 は SSDSE-B-2026 に無い。実在する A9101(婚姻件数)を使う X = df[['A1101','A4101','A4200','A9101']].values y = df['y'].values X_s = StandardScaler().fit_transform(X) clf = LogisticRegression(max_iter=1000).fit(X_s, y) proba = clf.predict_proba(X_s)[:, 1] print(f'{"閾値":>6} {"P":>6} {"R":>6} {"F1":>6}') for th in np.arange(0.1, 1.0, 0.1): pred = (proba >= th).astype(int) if pred.sum() == 0: continue p = precision_score(y, pred, zero_division=0) r = recall_score(y, pred, zero_division=0) f = f1_score(y, pred, zero_division=0) print(f'{th:>6.1f} {p:>6.3f} {r:>6.3f} {f:>6.3f}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: F1 は閾値 0.3〜0.4 で最大 (0.946)。 このとき陽性 35 県をすべて拾い、 誤って陽性にしたのは 4 県 (P=0.897)。 デフォルト 0.5 では 1 県を取りこぼして F1=0.932、 0.9 まで上げると Precision は 1.000 になる代わりに Recall が 0.600 に落ちて F1=0.750。 閾値 0.1 でも F1=0.909 と高いのは陽性率が 0.74 と多数派だからで、 全県を陽性と言うだけでも F1 は 2×35/(35+47)=0.854 になる。 また学習に使った 47 県でそのまま評価しているので、 新しいデータではこれより下がると見ておく。 報告書には 「閾値・Precision・Recall・F1」 の四点セット必須。
▶ 不均衡データでの F1 落とし穴
| 不均衡の程度 | 推奨指標 | 注意点 |
|---|---|---|
| 均衡 (50:50) | Accuracy / F1 どちらも OK | 特になし |
| 中程度 (10:90) | F1 + PR-AUC | Accuracy は 90% から始まる (常に陰性予測でも 90% に見える) |
| 強い (1:100) | PR-AUC + Recall@FPR=0.01 | ROC AUC は楽観的、 PR 曲線を必ず描く |
| 極端 (1:10000) | PR-AUC + Cost-sensitive 指標 | SMOTE/Focal Loss/Cost-sensitive 学習を併用 |
▶ 理解度チェック (R279)
| 設問 | 期待される回答 |
|---|---|
| Q1. F1 と Accuracy のどちらを使うべきか? | クラスが均衡なら Accuracy で OK、 不均衡なら F1 (または PR-AUC)。 不均衡時の Accuracy は「常に多数派と予測」でも高く見える罠がある。 |
| Q2. F1 の閾値はどう決める? | 交差検証で F1 最大化、 もしくは業務コスト関数で Precision/Recall の重みを決め、 F2 や F0.5 を用いる。 |
| Q3. Macro F1 と Weighted F1 の違いは? | Macro は全クラスを均等扱い、 Weighted はクラスサイズで重み付け。 少数クラス重視なら Macro、 全体平均なら Weighted。 |
| Q4. F1 が低い時の改善策は? | (1) 閾値最適化、 (2) クラスバランシング (SMOTE/重み付け)、 (3) 特徴量追加、 (4) モデル変更、 (5) Focal Loss 等の損失関数変更。 |
| Q5. ROC AUC と PR-AUC の使い分けは? | 均衡データなら ROC AUC、 不均衡データなら PR-AUC が情報量大。 不均衡時の ROC AUC は楽観的。 |
本補講で扱った要素は 適合率・再現率、 混同行列、 ROC 曲線、 AUC、 正解率、 クラス不均衡、 分類、 ロジスティック回帰、 評価指標 の各ページと連結し、 分類モデル評価の現場運用に直結する判断材料となる。
▶ 補講補足: F1 を「コスト関数」 と「業務 KPI」 の両面で運用する
F1 スコアは「Precision と Recall の調和平均」 という数学的定義だけ覚えても、 実務では使いこなせません。 F1 は 「業務のコスト構造」 を反映した指標 として再構成し、 (1) コスト行列との対応、 (2) 業務 KPI と F1 の関係、 (3) 多クラス・多ラベル分類での集約戦略、 (4) F1 の限界と PR-AUC / Cost-sensitive 学習への展開、 (5) 報告書テンプレート、 の 5 観点で整理します。
(1) コスト行列との対応: 分類モデルの誤りには「偽陽性 (FP) コスト」 と「偽陰性 (FN) コスト」 があり、 業務ごとにこのコスト比が異なります。 例: 医療診断 (FN コスト >> FP コスト、 見逃しが致命的)、 スパム検出 (FP コスト >> FN コスト、 大事なメールを誤って削除する方が深刻)、 営業ターゲティング (FP コスト ≈ FN コストで均衡)。 F1 は Precision と Recall を均等に重視 (β=1) する指標で、 FN・FP コストが概ね等しい場面では適切。 しかし、 医療スクリーニングでは F2 (β=2、 Recall 重視)、 スパム検出では F0.5 (β=0.5、 Precision 重視) の方が業務コストに合致します。 一般化された F_β = (1+β²)PR / (β²P + R) の β を業務に応じて選ぶのが本道で、 「とりあえず F1」 という選択は 「コスト構造を考慮していない」 兆候です。
(2) 業務 KPI と F1 の関係: 「F1 = 0.85 だから良いモデル」 は技術者の言葉で、 ビジネス側には伝わりません。 業務 KPI と F1 を翻訳する必要があります。 例えば「都道府県の高齢化率 30% 以上を予測 → 介護需要予測の精度向上」 という業務なら、 F1 = 0.85 は「介護施設配置の判断において、 必要な都道府県を Recall 80% 捕捉しつつ、 誤って判断した都道府県は Precision 90% 中の 10% に限定」 のように、 業務指標で言い換えると伝わりやすくなります。 さらに、 F1 を 金額換算 すれば説得力が増します。 「F1 を 0.80 → 0.85 に改善 → 1 億円の介護施設投資が無駄にならず、 効果的に配置される」 のように、 業務 ROI と F1 改善を結びつけるのがデータサイエンスの本質的価値です。
(3) 多クラス・多ラベル分類での集約戦略: 多クラス分類 (例: 47 都道府県を「高齢化加速」 「高齢化進行」 「安定」 「若年化」 の 4 グループに分類) では、 F1 をクラスごとに計算し、 集約する必要があります。 集約方法は (a) Macro F1 (全クラス F1 の単純平均、 少数クラスを重視)、 (b) Micro F1 (全 TP/FP/FN を合算、 サンプル数に比例)、 (c) Weighted F1 (クラスサイズで加重平均)、 の 3 種類が標準。 Macro F1 はクラス均等扱いで「すべてのクラスを公平に予測したい」 場面、 Weighted F1 はクラスサイズを反映して「全体性能を測りたい」 場面で使います。 多ラベル分類 (例: 都道府県に「観光地」 「工業地帯」 「農業地」 等の複数ラベルを付ける) では、 サンプルごとの F1 を計算する Sample F1 や、 Hamming Loss 等も併用します。
(4) F1 の限界と PR-AUC / Cost-sensitive 学習への展開: F1 は 単一閾値での性能 しか測れないため、 「閾値選択を含めたモデル比較」 には PR-AUC (Precision-Recall AUC) の方が有用です。 PR-AUC は閾値全体にわたる性能を要約し、 不均衡データで ROC AUC より informative です。 さらに、 F1 を最大化する閾値が業務コストと合わない場面では、 Cost-sensitive 学習 を採用します。 sklearn では class_weight='balanced' でクラス不均衡を自動補正、 sample_weight でレコードごとに重み付け、 損失関数を Focal Loss (難サンプル重視) に置換、 等の選択肢があります。 不均衡が極端 (1:10000 など) なら、 SMOTE / ADASYN 等のオーバーサンプリングや、 アンダーサンプリング + アンサンブルも検討します。 F1 はあくまで「評価指標」 であり、 不均衡対策は「学習戦略」 として別途設計する必要があります。
(5) F1 報告書テンプレート: 報告書には次を含めます。 (A) 評価データの分離方法 (固定 split / 層化交差検証)、 (B) クラスバランス (各クラスの陽性率)、 (C) 採用閾値とその根拠 (F1 最大化 / コスト関数最適化)、 (D) Precision、 Recall、 F1、 ROC AUC、 PR AUC の併記、 (E) Confusion Matrix の表、 (F) ベースラインモデル (常に多数派と予測) との比較、 (G) クラスごとの結果 (多クラスなら)、 (H) 信頼区間 (ブートストラップ 1000 回)。 文章例: 「SSDSE-B-2026 の 47 都道府県を層化 5-fold CV (高齢化率 30% 以上 = 1) で評価。 ロジスティック回帰での結果は Precision = 0.769、 Recall = 0.962、 F1 = 0.855、 ROC AUC = 0.92、 PR AUC = 0.89。 採用閾値 0.30 は F1 最大化基準。 ベースライン (常に陽性予測) の F1 = 0.71 から 21% の改善。 Confusion Matrix は TP=25, FP=8, FN=1, TN=13。 ブートストラップ 1000 回での F1 の 95% CI = [0.78, 0.92]。 業務上の判断: 介護需要予測で誤って『需要なし』 と判定するコスト (FN) を最重視し、 F2 = 0.91 の閾値 0.20 を本番採用。」 — このように 技術評価 + 業務翻訳 をセットで報告するのが標準です。
最後に、 F1 スコアは分類モデル評価の標準ツールですが、 「F1 = 0.85 だから良い」 という単独評価には限界があります。 業務のコスト構造を反映した F_β、 閾値全体を見る PR-AUC、 クラス不均衡を補正する Cost-sensitive 学習、 多クラスでの集約戦略、 これらを組合せて運用することで、 真に業務価値のあるモデルを構築できます。 機械学習における F1 は 「単一の評価数値」 ではなく、 「業務コスト構造を反映した評価フレームの一部」 として位置づけるのが、 質の高いモデル開発の鍵です。 さらに、 F1 を業務 KPI に翻訳する作業 (1% の F1 改善が業務上どれだけの価値か) を意識的に行うことで、 データサイエンスの成果がビジネス側にも明確に伝わるようになります。
関連: 適合率・再現率 / 混同行列 / ROC 曲線 / AUC / 正解率 / クラス不均衡 / 分類 / ロジスティック回帰 / 評価指標 / 交差検証
▶ 補講補足 II: F1 の歴史的背景と現代的展開
F1 スコアの起源は 1979 年の C. J. van Rijsbergen の著書『Information Retrieval』 で、 情報検索 (IR) の文脈で「Precision と Recall の調和平均」 として定義されました。 当時、 検索エンジンの評価で「適合率 (検索結果の中で関連文書の割合)」 と「再現率 (関連文書の中で検索された割合)」 のトレードオフを 1 つの数値で表現する必要があり、 調和平均 (harmonic mean) が選ばれました。 算術平均ではなく調和平均を選んだ理由は、 「Precision と Recall のどちらか一方が極端に低い場合、 F1 も低くなる」 という性質を持たせるためです (調和平均の特性)。 例えば Precision=1.0, Recall=0.01 なら算術平均は 0.505 だが、 調和平均は 0.0198 と極端に低くなります。 これにより、 「Recall を犠牲にして Precision を上げる」 ような偏ったモデルを評価しにくくしています。
F1 の一般化として、 同じく van Rijsbergen が提案した F_β スコア (β はトレードオフ重み) があります。 F_β = (1+β²)PR / (β²P + R) で、 β=1 が F1、 β=2 が F2 (Recall 重視)、 β=0.5 が F0.5 (Precision 重視)。 1990 年代以降、 文書分類・スパムフィルタ・医療診断などで F_β が標準評価指標となり、 機械学習コンペティション (Kaggle, TREC など) でも頻繁に採用されています。 SSDSE-B-2026 の「高齢化率 30% 以上の都道府県を予測」 のような分類タスクでは、 介護需要予測 (見逃しコスト大) なら F2、 マーケティング施策 (誤検知コスト大) なら F0.5 を使い分けるのが現代的運用です。
機械学習における F1 の発展として、 (a) 多クラス分類への拡張: Macro F1 (クラス均等)、 Micro F1 (サンプル数加重)、 Weighted F1 (クラスサイズ加重) の 3 種類が標準化されました。 多ラベル分類では Sample F1 (サンプルごとの F1 の平均) も使われます。 (b) 不均衡データでの F1 と PR-AUC の使い分け: 2015 年以降、 不均衡データ (異常検知、 詐欺検出、 希少疾患診断など) で ROC AUC より PR-AUC の方が informative であることが Davis & Goadrich (2006) などで示され、 F1 + PR-AUC の併用が標準になりました。 (c) Cost-sensitive 学習との接続: F_β の β を業務コスト構造に合わせて選ぶことは、 Cost-sensitive 学習の発想と同じで、 sklearn の class_weight や sample_weight、 LightGBM の scale_pos_weight などで実装可能です。
深層学習における F1 の課題と対応として、 (a) F1 は 微分不可能 なため、 直接最適化が困難。 通常は Cross-Entropy 損失で学習し、 推論時に閾値を最適化する 2 段階アプローチが標準。 (b) Soft-F1 損失 (Bénédict et al. 2021) は F1 を確率値で近似した微分可能版で、 不均衡データの直接最適化に使えます。 (c) Focal Loss (Lin et al. 2017、 RetinaNet 論文) は、 容易なサンプルの損失を抑え、 難サンプルに注意を集中する重み付き Cross-Entropy で、 1:100 以上の極端な不均衡に有効。 (d) 閾値最適化は scipy.optimize や sklearn の precision_recall_curve で簡単に実装でき、 「Cross-Entropy 学習 → F1 最大閾値選択」 が現代的ワークフローです。
業界別の F1 活用例として、 (a) 医療診断: がん検診の AI モデル評価では F2 (Recall 重視、 見逃しを最小化) が標準。 Google の糖尿病性網膜症検出モデル、 IBM Watson Health のがん診断支援などで採用。 (b) 金融詐欺検出: 不正取引検出は F1 が標準だが、 業界によっては F0.5 (Precision 重視、 誤って正常取引をブロックするコスト大) も使用。 (c) NLP の固有表現認識 (NER): CoNLL-2003 ベンチマーク以降、 Span-level F1 が標準評価指標。 BERT、 RoBERTa、 ELECTRA などの評価で必ず報告される。 (d) 物体検出: COCO データセットの mAP (Mean Average Precision) は F1 ファミリーの拡張版で、 IoU 閾値別の F1 の集約とも解釈できます。
統計教育における F1 の扱い方として、 入門コースでは「Precision と Recall の調和平均」 と機械的に教えがちですが、 教育的に望ましいのは、 (1) 調和平均を選んだ理由 (極端な不均衡を罰する性質)、 (2) Accuracy との違い (不均衡データでの脆弱性)、 (3) F_β による業務コストとの接続、 (4) 多クラス・多ラベルへの拡張、 (5) PR-AUC との使い分け、 を体系的に教えることです。 「F1 = 0.85 だから良い」 という単純な理解では、 「クラス不均衡」 「業務コストとの不一致」 「閾値選択の影響」 などの落とし穴に陥ります。 F1 は「業務コスト構造を反映した評価フレームの一部」 として位置づけ、 状況に応じて他の指標と組み合わせる柔軟性を教育で身につけさせるべきです。
最後に、 F1 スコアは 1979 年の情報検索の文脈で生まれてから 45 年以上の歴史を持ち、 現代の機械学習・深層学習・NLP・コンピュータビジョンの中核評価指標として広く使われ続けています。 単純な数式の背後に、 (1) 調和平均の数学的性質、 (2) Precision-Recall トレードオフの設計思想、 (3) F_β による業務コスト反映、 (4) 多クラス・多ラベルへの拡張、 (5) Soft-F1 や Focal Loss などの最適化手法、 等の深みがあります。 SSDSE-B-2026 で分類モデルを評価する際、 単に F1 が高いモデルを選ぶのではなく、 「業務コストに合った F_β か」 「閾値は最適か」 「不均衡対策は適切か」 を考えながら使う姿勢が、 質の高い機械学習開発を実現する鍵です。 F1 は「数値の最大化対象」 ではなく、 「業務価値とモデル性能を橋渡しする評価フレーム」 として運用することが、 現代的データサイエンスの標準的アプローチです。
🗺 概念マップ:F1スコア の知識ネットワーク
本サイト全体の 概念マップ の中で、 F1スコア がどの位置にあるかをテキストツリーで表現する。 視覚的なグラフは 概念マップページ を参照。
[ 評価指標 ]
  ├─ F1スコア (本ページ)
  ├─ 関連手法・派生 → 「🌐 関連手法・派生」セクション
  ├─ 前提概念 → 「🔬 数式を言葉で読み解く」セクション
  └─ 派生領域 → 「🎓 深掘り(さらに)」シナリオ A/B/C
📌 全用語の俯瞰には 概念マップ を、 全用語一覧には 用語集トップ を参照してください。
🔢 数値例による手計算ウォークスルー
F1スコア を「コード任せ」にせず、 一度は手計算してみることで理解が定着する。 ここでは最小サイズのデータで、 値の動きを 1 ステップずつ追う。
数値例:47 都道府県の 2 値分類で F1 を計算
「🎨 直感で掴む」と同じ説明用の仮の混同行列(SSDSE-B-2026 から計算した値ではない)で、手計算の手順を 1 ステップずつ確かめる。
| 予測 = High | 予測 = Low | |
|---|---|---|
| 実際 = High | TP = 25 | FN = 2 |
| 実際 = Low | FP = 5 | TN = 15 |
$n = 47$、 Positive 比率 = 27/47 ≒ 57.4%。
$\text{Precision} = \frac{25}{25+5} = 0.833$、 $\text{Recall} = \frac{25}{25+2} \approx 0.926$、 $\text{Accuracy} = \frac{25+15}{47} \approx 0.851$。
F1 = $\frac{2 \cdot 0.833 \cdot 0.926}{0.833 + 0.926} = \frac{1.543}{1.759} \approx 0.877$。
参考に F2 = $\frac{(1+4) \cdot 0.833 \cdot 0.926}{4 \cdot 0.833 + 0.926} = 0.906$、 F0.5 = $\frac{1.25 \cdot 0.833 \cdot 0.926}{0.25 \cdot 0.833 + 0.926} \approx 0.850$。 Recall 重視の F2 が最大、 Precision 重視の F0.5 が最小、 F1 はその中間にあることが確認できる。
❓ よくある質問(用語固有 10 連発)
F1スコア 固有の質問 10 件を Q&A 形式でまとめた。 自分の状況に近いものから読んでほしい。
precision_recall_curve で F1 が最大になる閾値、 (2) Youden's J (Sensitivity + Specificity - 1) 基準も併用、 (3) cross-validation 内で閾値最適化 (Nested CV)。from sklearn.metrics import f1_score; f1_score(y, y_pred, average='macro')。 average に None / 'macro' / 'micro' / 'weighted' / 'samples' を選択。🏋️ 演習問題(5 問)
学習の定着には、 自分の手を動かすのが一番。 SSDSE-B-2026 や実ログを題材に、 F1スコア を実践する 5 問を用意した。 答えは Python 実装セクションと数値例セクションを参考に組み合わせれば導ける。
- 演習 1:SSDSE-B-2026 で「高齢化率 > 30%」かどうかを 2 値分類し、 F1 / Precision / Recall を計算せよ。
- 演習 2:閾値を 0.1 〜 0.9 まで動かしたときの F1 を曲線でプロットし、 最大 F1 の閾値を特定せよ。
- 演習 3:クラス重みを変えて (
class_weight='balanced') F1 がどう変化するか比較せよ。 - 演習 4:macro-F1 と weighted-F1 を多クラス分類で計算し、 結果がどう違うか説明せよ。
- 演習 5:F-beta スコア (β=2, β=0.5) を計算し、 業務的にどちらを採用すべきか議論せよ。
📌 演習を解いて疑問が残ったら、 「❓ よくある質問(用語固有 10 連発)」に戻るか、 リポジトリの「論文一覧」から類似研究を探して、 実コード (本サイトには 159 本の再現論文) を読むのが最速の理解への道。
🍳 コード・クックブック(F1スコア 編)
F1スコア を実務で使う際の頻出パターンを、 動くコードのレシピ集としてまとめた。 必要な料理 (タスク) だけを取り出して使ってほしい。
F1 / F2 / F0.5 を一括比較
1 2 3 4 5 6 7 8 | from sklearn.metrics import fbeta_score, f1_score, precision_score, recall_score, classification_report y_true = [1,1,1,0,0,1,1,0,1,1, 0,1,0,0,1,1,1,0,1,1] y_pred = [1,1,0,0,0,1,1,1,1,0, 0,1,0,1,1,1,1,1,1,0] for beta in (1.0, 2.0, 0.5): print(f'F{beta:>3} =', fbeta_score(y_true, y_pred, beta=beta)) print('P =', precision_score(y_true, y_pred)) print('R =', recall_score(y_true, y_pred)) print(classification_report(y_true, y_pred, digits=3)) |
💬 F1・F2・F0.5 がすべて 0.769 で並ぶのは、FP と FN がどちらも 3 件で Precision と Recall が同じ 10/13 になっているから。β は P と R の比重を変えるだけなので、両者が等しいと β をいくら動かしても値は変わらない。β の効果を確かめたいなら、FP か FN の一方を増やした例で比べる必要がある。
閾値最適化で最大 F1 を探す
1 2 3 4 5 6 7 8 | import numpy as np from sklearn.metrics import precision_recall_curve, f1_score y_true = np.array([1,0,1,1,0,1,0,0,1,1,0,1,0,1,1,0,1,1,0,1]) y_proba = np.array([.9,.4,.7,.8,.3,.55,.45,.2,.95,.6, .35,.78,.25,.5,.65,.4,.85,.7,.3,.88]) p, r, th = precision_recall_curve(y_true, y_proba) f1 = 2*p*r/(p+r+1e-9) best_idx = f1.argmax() print(f'best thr={th[best_idx]:.3f}, F1={f1[best_idx]:.3f}') |
💬 陽性 12 件の予測確率は最小でも 0.50、陰性 8 件は最大でも 0.45 で、この 20 件は閾値 0.5 で完全に分けられるため F1=1.000 になる。最適閾値は「陽性の最小スコア」に張り付く形で選ばれており、現実のデータでこうなることはまずない。同じ手順を検証データとは別のデータで選び直すと、閾値も F1 も下がるのが普通である。
混同行列を可視化 + Markdown 表で出力
1 2 3 4 5 6 7 8 9 10 | import pandas as pd, numpy as np from sklearn.metrics import confusion_matrix y_true = [1,1,1,0,0,1,1,0,1,1,0,1,0,0,1,1,1,0,1,1] y_pred = [1,1,0,0,0,1,1,1,1,0,0,1,0,1,1,1,1,1,1,0] cm = confusion_matrix(y_true, y_pred) df = pd.DataFrame(cm, index=['actual_0','actual_1'], columns=['pred_0','pred_1']) print(df) TP, FP, FN, TN = cm[1,1], cm[0,1], cm[1,0], cm[0,0] print(f'TP={TP} FP={FP} FN={FN} TN={TN}') print(f'F1 = {2*TP/(2*TP+FP+FN):.3f}') |
💬 混同行列は TP=10・FP=3・FN=3・TN=4 で、2TP/(2TP+FP+FN)=20/26=0.769 と、上の fbeta_score の値と一致する。F1 の式に TN が入らないので、陰性 7 件のうち 4 件しか当てていない弱さはこの 0.769 には表れない。陰性側の出来は actual_0 の行(4 対 3)を別に見る。
📌 すべてのレシピは「実データ前提・引数なし直書き」スタイル。 そのままコピペで動くよう設計したので、 まずは動かしてから読むのを推奨する。
🏁 最終結論:F1スコア を一言で
F1 スコアは「Precision と Recall のバランス」を 1 値に圧縮する便利な指標。 だが「F1 高ければ良い」と思考停止する人と、 「F1 の内訳と業務インパクトを語れる人」では、 ML プロジェクトの成否が分かれる。 本ページで学んだ (i) 調和平均という設計、 (ii) F-beta による業務重み付け、 (iii) macro/micro/weighted の使い分け、 (iv) 閾値最適化、 (v) AUC-PR との併用の 5 視点を持って初めて、 「データサイエンティスト」と名乗れる。 不均衡データ・医療・スパム・自動運転など、 現代の重要 ML 分野ほど F1 の解釈が決定的になる。
本ページは ジャストインタイム型データサイエンス教育の一部として、 必要なときに必要な節だけ読んでもらう設計になっている。 通読する必要はない。 自分の今いる場所 (卒論・実務・論文読解) に応じて、 該当セクションだけを参照し、 また論文や業務に戻ってほしい。 そして数か月後、 似たような状況に陥ったとき、 また戻ってきてくれれば、 教材として最高の使い方になる。
🙋 著者・教材設計について
本教材は、 広島工業大学 統計・データ解析コンペティション参加学生向けに、 松本伸平 (s.matsumoto.gk@cc.it-hiroshima.ac.jp) が監修・執筆した。 「論文を読む過程で出てきた専門用語を、 その場で 5 分で補完して論文に戻る」というジャストインタイム型の学習体験を目的に、 514 用語ページを統一フォーマットで整備している。
本ページ「F1スコア」は 評価指標 カテゴリに属し、 同カテゴリ内の他用語と相互リンクされている。 用語間の関係性は 概念マップ でも俯瞰できる。
本サイトは SSDSE (教育用標準データセット, 独立行政法人統計センター) を主データとして使い、 「合成データ ではなく実公的データを使う」 を方針に据えている。 ハンズオン教材の質を最大化するための判断である。
📌 F1 補遺:競技 ML / 業務 ML での扱い
F1 スコアは Kaggle等の競技 ML でリーダーボード評価指標として頻用される一方、 業務 ML では 業務 KPI に翻訳する必要がある。 ここでは両者の現代的な扱いを整理する。
競技 ML での F1
- マクロ F1 がよく採用される (クラスごとの件数が偏った多クラス分類で、少数クラスも同じ重みで評価したいとき)
- マイクロ F1 はマルチラベル分類のサンプル平均 F1 と同義になることが多い
- 競技では「リーダーボードの 0.001 ポイント差」が順位を決めるので、 閾値最適化 + アンサンブルが定石
- Stratified K-fold で fold ごとに閾値最適化 → 平均閾値で submission を作るのが王道
業務 ML での F1
- F1 を直接報告するより、 「業務 KPI に変換」するのが説得力ある
- 例:「Recall 92% → 月 50,000 件の不正検知のうち 4,000 件は見逃し → 年間損失 1,200 万円」
- 偽陽性 (FP) と偽陰性 (FN) のコストが非対称なら、 F-beta または 期待効用で評価
- 本番運用後は concept drift (データ分布の変化) で F1 が徐々に低下するので、 月次モニタリング必須
F1 を改善する 10 のテクニック
- 閾値最適化 (PR 曲線で F1 が最大の点)
- クラス重み付け (
class_weight='balanced') - SMOTE / ADASYN によるオーバーサンプリング
- RandomUnderSampler によるダウンサンプリング
- Focal Loss (γ=2 で hard negative を強調)
- アンサンブル (Bagging + Boosting + Stacking)
- キャリブレーション (Platt scaling, Isotonic regression)
- ドメイン特徴量の追加 (Positive クラス独自のシグナル)
- データ拡張 (画像なら回転・反転、 テキストなら同義語置換)
- 事前学習モデル (Transformer, ViT) の活用
F1 vs MCC vs Cohen's Kappa
MCC (Matthews Correlation Coefficient) = $\frac{TP\cdot TN - FP\cdot FN}{\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}}$。 範囲 [-1, +1]。 不均衡データで F1 より良いと言われ、 Chicco & Jurman (2020, BMC Genomics) は二値分類の単一指標として F1 や正解率より MCC を推奨している。 Cohen's Kappa は「偶然の一致を超えた一致度」で、 マルチクラスの評価で多用。 F1 と併記すると論文の説得力が増す。
F1 と ROC-AUC の関係
F1 は「ある閾値での」点評価、 ROC-AUC は「全閾値での」曲線評価。 両者は 独立な情報を持つ:高い ROC-AUC でも閾値設定次第で F1 は低い。 業務運用するなら F1 (運用時の挙動)、 モデル選択するなら ROC-AUC (閾値依存しない順位性)。 報告時は両方出すのが現代的。
🔗 隣接手法への橋渡し
「F1 スコア」は Precision と Recall を 1 つの値に統合する便利な指標であるが、 実務で意味を持たせるには隣接手法と接続・統合・比較の三視点で運用判断する必要がある。 章 10 が分類体系上の位置づけを示すのに対し、 章 14 は「業務でいつ何に切替えるか」を整理する。
① 接続 (パイプライン上で前後に位置する手法)
- 上流: 混同行列 で TP/FP/FN/TN を集計 → Precision = TP/(TP+FP) と Recall = TP/(TP+FN) を算出 → クラス不均衡 補正 (SMOTE / class_weight) で陰性多数時のバイアスを除去
- 下流: 閾値走査で operating point を決定 → PR-AUC で全閾値の総合性能を比較 → macro / weighted / micro 平均で多クラス対応 → 業務 KPI (CTR・誤判定コスト) へ接続
② 統合 (組み合わせて使うことで効果が増す手法)
- Fβ スコア (van Rijsbergen 1979) と統合: β=2 で Recall 重視 (癌検診・侵入検知)、 β=0.5 で Precision 重視 (スパム判定・推薦)、 β=1 が F1
- PR-AUC と併用し、 単一閾値の F1 だけでなく全閾値での挙動も同時報告する (Davis & Goadrich 2006)
- コスト感応学習 (Elkan 2001) と組み合わせ、 業務コスト比 cFP:cFN を損失関数に直接反映 → Fβ の β = √(cFN/cFP) で対応関係が成立
③ 比較 (代替・競合する指標といつ切替えるか)
| 切替先 | F1 からこちらへ切替える場面 |
|---|---|
| Accuracy | クラスがほぼ均衡 (陽性率 40-60%) で、 経営層に「全体正解率」を説明する場面 |
| ROC-AUC | 閾値を固定したくない・モデル選択フェーズで全閾値での順序付け性能を比較したい場面 |
| PR-AUC | 極端な不均衡 (陽性率 < 1%) で ROC-AUC が高く出すぎ、 Precision-Recall 平面で評価したい場面 |
| Matthews 相関係数 (MCC) | TP/TN/FP/FN すべてのバランスを 1 つの値で見たい場面 (Boughorbel 2017)。 F1 と異なり TN も評価に入る |
| Fβ スコア | Precision と Recall を等価扱いしたくない場面。 業務コスト比から β を決める |
運用判断は (1) クラス均衡度の確認 → (2) Precision と Recall の重視度から β を決定 → (3) 単一閾値か全閾値かで Fβ と PR-AUC を選択 → (4) TN も評価に入れたいなら MCC へ切替、 の 4 軸で整理する。 章 10 (分類体系) で F 系指標の位置づけを把握し、 章 14 (運用判断) で「いつ何を選ぶか」を決定することで、 不均衡データやコスト非対称な業務に適切な指標設計ができる。
🌳 手法選択フロー
「F1 スコア」を実際の課題に当てはめるとき、 以下の 3 ステップで判断する。 領域固有の判断基準と組み合わせて使用する。
- ステップ 1: クラス不均衡なら Accuracy より F1 を主指標に
- ステップ 2: FP / FN コスト非対称なら F_β (β>1 で Recall 重視)
- ステップ 3: 多クラスは macro F1 (van Rijsbergen 1979)
多クラス分類で macro F1 は全クラスを等価扱い (少数クラスにも敏感)、 weighted F1 はサンプル数で重み付け (多数クラス優位)、 micro F1 は集約 confusion matrix から計算 (Accuracy と一致) という違いがあり、 不均衡度と業務目的で選ぶ。 sklearn の `f1_score(average=...)` で簡単に切り替え可能。
🔬 別角度:F1 は「確率の目盛り」に依存する — SSDSE-B-2026 実測で見る
本ページの他セクションでは Fβ・macro/micro/weighted・PR 曲線・閾値最適化を厚く扱った。 ここでは重複を避け、 意外と語られない一点だけを実測データで掘り下げる。 それは「F1 は確率をハード判定 (0/1) に落としてから測る量なので、 (1) 正例の定義、 (2) 判定閾値、 (3) 確率の目盛り=較正 (calibration) の 3 つと不可分に絡む」という事実だ。 一方 ROC-AUC / PR-AUC は確率の順位だけを見るため、 これら 3 つの一部に鈍感である。 この非対称性を知ると、 F1 の数字を「何と比べれば安全か」が見えてくる。
実測タスク:超高齢化県の予測 (SSDSE-B-2026 / 2023 / 47 県)
SSDSE-B-2026 を encoding='cp932', skiprows=[1] で読み、 2023 年の 47 都道府県に限定。 高齢化率 = A1303 / A1101 が 0.35 以上を「超高齢化県 = Positive」と定義した (該当 6 / 47 県、 陽性率 12.8% の少数派 Positive)。 説明変数 A1101, A4101, A4103, L3221 を標準化し、 ロジスティック回帰を StratifiedKFold(5) + cross_val_predict で交差検証予測。 得られた予測確率での実測値が以下である (すべて実データからの計算値)。
| 判定閾値 | Precision | Recall | F1 |
|---|---|---|---|
| 0.20 | 0.333 | 0.500 | 0.400 |
| 0.30 | 0.000 | 0.000 | 0.000 |
| 0.50 (既定) | 0.000 | 0.000 | 0.000 |
| 0.70 | 0.000 | 0.000 | 0.000 |
| 0.185 (F1 最適) | — | — | 0.471 |
参考の順位系指標 (同じ予測確率): ROC-AUC = 0.809、 PR-AUC = 0.411。 「全県 Negative」と答えるだけの Accuracy = 0.872。
読み取れる 3 つの落とし穴 (実測が語る)
proba**k にかけると (k は正の定数)、 順位は不変なので ROC-AUC = 0.809、 PR-AUC = 0.411 は k を変えても一切変わらない。 ところが固定閾値 0.5 での F1 は k=1: 0.000 → k=0.5: 0.444 → k=2.0: 0.000 と激変した (実測)。 つまり F1 は「確率の目盛り=較正」に依存する量で、 較正を直すだけで固定閾値の F1 は動きうる。 逆に F1 が高くても確率が正しく較正されているとは限らない (F1 はハード判定しか見ないため)。 確率そのものの正しさを問うなら較正曲線・Brier スコアを、 順位の良さを問うなら AUC を、 運用閾値での挙動を問うなら F1 を — と別々に見るのが安全。④ 正例の定義そのものが F1 の水準を決める
同じ SSDSE-B-2026・同じ特徴量でも、 Positive の定義を変えると難易度も F1 も別物になる (いずれも実測)。
| Positive の定義 | 陽性数 / 47 | 陽性率 | PR-AUC | F1 (最適閾値) |
|---|---|---|---|---|
| 高齢化率 ≥ 0.30 | 35 | 74.5% (多数派) | 0.858 | 0.946 |
| 高齢化率 ≥ 0.35 | 6 | 12.8% (少数派) | 0.411 | 0.471 |
「F1=0.95」と「F1=0.47」は優劣ではなく別問題だ。 前者は多数派を Positive にしただけで水増しされている疑いがある (本ページ「よくある落とし穴」の「多数派を Positive にしない」と同根)。 論文・レポートでは 「何を Positive と定義したか・陽性率はいくつか」を必ず明記しないと、 F1 の数字は比較不能になる。
再現コード (実測値はこのコードの出力)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd, numpy as np from sklearn.linear_model import LogisticRegression from sklearn.model_selection import StratifiedKFold, cross_val_predict from sklearn.preprocessing import StandardScaler from sklearn.metrics import roc_auc_score, average_precision_score, f1_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df.iloc[:, 0] == 2023].copy() # 2023 年の 47 県 y = ((df['A1303'] / df['A1101']) >= 0.35).astype(int).values # 超高齢化県 = Positive X = StandardScaler().fit_transform(df[['A1101', 'A4101', 'A4103', 'L3221']].values) cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0) proba = cross_val_predict(LogisticRegression(max_iter=1000), X, y, cv=cv, method='predict_proba')[:, 1] print('ROC-AUC', roc_auc_score(y, proba), 'PR-AUC', average_precision_score(y, proba)) for th in (0.185, 0.2, 0.3, 0.5, 0.7): print(th, f1_score(y, (proba >= th).astype(int), zero_division=0)) # 単調変換で「順位不変・F1 可変」を確認 (較正と F1 は別物) for k in (0.5, 1.0, 2.0): pk = proba ** k print('k=', k, 'ROC', roc_auc_score(y, pk), 'F1@0.5', f1_score(y, (pk >= 0.5).astype(int), zero_division=0)) |
💬 超高齢化県(高齢化率 35% 以上)は 47 県中 6 県しかなく、交差検証の予測確率は最大でも 0.356 なので、閾値 0.3 以上では陽性判定が 1 県も出ず F1 は 0.0 になる。閾値を 0.185 まで下げると 6 県中 4 県を拾い(誤検出 7 県)F1 0.471。確率を 0.5 乗・2 乗しても順位は変わらないので ROC-AUC は 0.809 のままだが、0.5 乗だと 0.25 以上が陽性に回って F1@0.5 が 0.444 に上がり、F1 は閾値と較正に左右される指標だと分かる。
📌 ひとことで: ROC-AUC / PR-AUC が「確率の順位」の指標なのに対し、 F1 は「順位 + 閾値 + 較正 + 正例定義」の合成物。 だから F1 単独で報告せず、 Precision ・ Recall ・ 陽性率 ・ 採用閾値 ・ ROC 曲線 / PR 曲線 (AUC) をセットにする。 元データの集計は 混同行列、 モデルは ロジスティック回帰、 不均衡の扱いは クラス不均衡 の各ページも参照。 (確率較正の専用ページは未整備のため本節の解説を参照。)