🔖 キーワード索引
別名・略称:Confusion Matrix、 誤分類行列
混同行列は 分類モデルの予測と真値のクロス集計表。 Precision・Recall・F1 など全ての分類指標の元データになります。
💡 30秒で分かる結論
🍰 まずはやさしく
予測の正解と不正解をまとめた表です。
AIがどう間違えたかを知るために使います。
テストの採点表のようなものです。
この章では表の基本と4つの要素を学びます。
混同行列(Confusion Matrix):予測クラス × 真クラスのクロス集計表
- 2 クラスでは 2×2 表:TP, FP, FN, TN の 4 要素。
- $N$ クラスでは $N \times N$:対角が正解、 非対角が誤分類。
- 全指標の親:Accuracy / Precision / Recall / F1 は全て混同行列から算出。
- クラス別の誤りパターンを可視化できる(どのクラスが誤分類されやすいか)。
- 正規化:行/列で正規化すると Recall/Precision を表で読める。
📍 あなたが今見ているもの
🍰 まずはやさしく
AIの成績表のようなものです。
数字だけでは見えない間違い方を確認します。
スマホのアプリが正しく動くか確かめる時に使います。
表を使って間違いのパターンを見つける方法を読みます。
🎨 直感で掴む
🍰 まずはやさしく
正解と予測を並べた地図のようなものです。
どこで迷いやすいかを直感的に理解します。
部活の判定が正しかったか確認する時に似ています。
表を色で塗り分ける方法について読みます。
2 クラス混同行列
| 予測 陽性 | 予測 陰性 | 行合計 | |
|---|---|---|---|
| 実際 陽性 | TP | FN | P = TP+FN |
| 実際 陰性 | FP | TN | N = FP+TN |
| 列合計 | TP+FP | TN+FN | 総数 |
指標との対応
- Accuracy = (TP+TN) / 総数
- Precision = TP / (TP+FP)(列方向)
- Recall = TP / (TP+FN)(行方向)
- Specificity = TN / (TN+FP)
- F1 = 2·P·R / (P+R)
多クラス(例:3 クラス)
3×3 表になり、 対角に並ぶのが正解、 非対角が誤分類。 「クラス A をクラス B と誤分類」のパターンを発見できる。
🎨 混同行列の「効果的な可視化」5 パターン
数値だけでは「どこが弱いか」が見えにくい。 以下 5 パターンを使い分けるとレポートの説得力が一気に上がる。 SSDSE-B-2026 47 県 3 クラス分類の CM をベースに、 すべてのコードを示す。
| 可視化 | 用途 | 注意点 |
|---|---|---|
| ①基本ヒートマップ | セル件数の俯瞰 | cmap を Blues 系で統一 |
| ②行正規化 (Recall) | 真の各クラスの捕捉率 | 対角の弱いクラス強調 |
| ③列正規化 (Precision) | 予測の信頼度 | 業務利用の信頼性 |
| ④誤分類のサンキー図 | どこからどこへ流れたか | クラス間の関連性 |
| ⑤ROC/PR 曲線 | 閾値全範囲の俯瞰 | CM の動的バージョン |
🐍 ①基本ヒートマップ + ②正規化ヒートマップ
このコードでやること:seaborn で 3 クラス混同行列を 4 種類 (件数 / 行正規化 / 列正規化 / 全体正規化) 並べて可視化する。 「業務報告に必ず付ける 4 枚」のテンプレ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import numpy as np import pandas as pd import seaborn as sns import matplotlib.pyplot as plt from sklearn.metrics import confusion_matrix from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler # ── この抜粋だけで動くように、47 県 3 クラス分類の正解と予測を作る ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] # 最新年度の 47 都道府県 _q = _d['A1101'].quantile([1/3, 2/3]).values # 総人口で 小・中・大 に 3 等分 y_true = np.digitize(_d['A1101'], _q) # 正解ラベル (0=小, 1=中, 2=大) _X = StandardScaler().fit_transform( _d[['A4101', 'A1303', 'A9101']].astype(float)) # 出生数・65歳以上人口・婚姻件数 y_pred = LogisticRegression(max_iter=1000).fit(_X, y_true).predict(_X) fig, axes = plt.subplots(2, 2, figsize=(12,10)) labels = ['小','中','大'] modes = [(None, '件数 (raw)'), ('true', '行正規化 (Recall)'), ('pred', '列正規化 (Precision)'), ('all', '全体正規化 (確率)')] for ax, (mode, title) in zip(axes.flat, modes): cm = confusion_matrix(y_true, y_pred, normalize=mode) fmt = '.0f' if mode is None else '.2f' sns.heatmap(cm, annot=True, fmt=fmt, cmap='Blues', xticklabels=labels, yticklabels=labels, ax=ax, cbar=True) ax.set_title(title, fontsize=14) ax.set_xlabel('Predicted') ax.set_ylabel('Actual') plt.tight_layout() plt.savefig('cm_47pref.png', dpi=120) print('保存しました: cm_47pref.png') |
📤 実行例:
💬 結果の読み方: 4 枚並列で 何を表しているかが一目瞭然になる。 件数マップの対角は小 16・中 10・大 13 で、 行正規化マップでは「中」の対角が 0.67 と最も薄い。 中県 15 県のうち 5 県を「小」と予測しており、 大県の Recall は 0.81 (16 県中 13 県) にとどまる。 業務報告ではこの 4 枚 +classification_report をスライド 1 枚にまとめる。
🐍 ⑤ ROC 曲線 + PR 曲線 — 「動く混同行列」
このコードでやること:出生数 A4101 をスコアとして閾値を最小から最大まで動かし、 TPR/FPR/Precision/Recall を全点取り、 ROC と PR の 2 曲線を描く。 各点が 1 つの混同行列に対応。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import numpy as np import pandas as pd import matplotlib.pyplot as plt from sklearn.metrics import (roc_curve, precision_recall_curve, roc_auc_score, average_precision_score) # ── 以降のブロックで共通して使う d23 と to_class をここで用意する ── _df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = _df[_df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年の 47 都道府県 def to_class(pop): if pop < 1000000: return 0 elif pop < 3000000: return 1 else: return 2 # ------------------------------------------------------------------ # A4101 (出生数) を確率スコアとみなして大県判定 y_true_bin = (d23['A1101'] >= 1500000).astype(int).values scores = d23['A4101'].values fpr, tpr, thr_roc = roc_curve(y_true_bin, scores) prec, rec, thr_pr = precision_recall_curve(y_true_bin, scores) auc = roc_auc_score(y_true_bin, scores) ap = average_precision_score(y_true_bin, scores) print(f'ROC-AUC: {auc:.4f}') print(f'PR-AUC : {ap:.4f}') fig, axes = plt.subplots(1, 2, figsize=(12,4.5)) axes[0].plot(fpr, tpr, 'o-') axes[0].plot([0,1],[0,1],'k--', alpha=0.4) axes[0].set(xlabel='FPR', ylabel='TPR', title=f'ROC AUC={auc:.3f}') axes[1].plot(rec, prec, 'o-') axes[1].set(xlabel='Recall', ylabel='Precision', title=f'PR AP={ap:.3f}') plt.tight_layout() plt.savefig('roc_pr.png', dpi=120) |
📤 実行例:
💬 結果の読み方: ROC-AUC=0.98 と非常に高く、 出生数が 人口 150 万超を判定する強力なスコアであることが分かる。 各曲線の各点が「ある閾値での混同行列」を表し、 ROC は閾値変化の「全体像」を 1 図で示す。 PR-AUC は陽性側のみ評価するので不均衡データではこちらを優先。
🛠 sklearn 実装のコツ 10 連発
- labels 引数で順序固定:
confusion_matrix(y_true, y_pred, labels=[0,1,2])。 ラベル文字列ならlabels=['小','中','大']。 - ConfusionMatrixDisplay:
ConfusionMatrixDisplay.from_predictions(y_true, y_pred, cmap='Blues')1 行で見栄えのよい図。 - classification_report の dict 化:
output_dict=Trueで DataFrame 化可能、 レポート再利用しやすい。 - 正規化の選択: 通常は
normalize='true'(Recall 視点) が直感的。 - 多ラベル:
multilabel_confusion_matrixでラベル別 2×2 を取得。 - 欠損ラベル: テストに存在しないクラスがあると報告で 0/0 警告。
labels=[0,1,2,3]を明示。 - weighted average: classification_report の最終行 weighted avg は
average='weighted'と同値。 不均衡時に活用。 - display_labels:
ConfusionMatrixDisplay(cm, display_labels=['Yes','No'])で軸ラベル変更。 - scikit-learn 1.4+ の y_score 受け取り:
from_estimatorで予測スコアから直接 CM 作成可能。 - pd.crosstab も使える: pandas のみで
pd.crosstab(y_true, y_pred, margins=True)で行列が出る。
🐍 ConfusionMatrixDisplay を 1 行で
このコードでやること:sklearn の高水準 API ConfusionMatrixDisplay で、 47 県 3 クラスの CM を即座に図化する。 タイトル + 行ラベルを業務向けに日本語化。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import numpy as np import pandas as pd import matplotlib.pyplot as plt from sklearn.metrics import ConfusionMatrixDisplay from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler # ── この抜粋だけで動くように、3 クラスの正解と予測をここで作り直す ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] _q = _d['A1101'].quantile([1/3, 2/3]).values y_true = np.digitize(_d['A1101'], _q) # 0=小県, 1=中県, 2=大県 _X = StandardScaler().fit_transform( _d[['A4101', 'A1303', 'A9101']].astype(float)) y_pred = LogisticRegression(max_iter=1000).fit(_X, y_true).predict(_X) fig, ax = plt.subplots(figsize=(6,5)) ConfusionMatrixDisplay.from_predictions( y_true, y_pred, display_labels=['小県','中県','大県'], cmap='YlGnBu', ax=ax, colorbar=True, ) ax.set_title('47 都道府県を 3 クラス分類した混同行列', fontsize=13) plt.tight_layout() plt.savefig('cm_display.png', dpi=120) print('Done') |
📤 実行例:
💬 結果の読み方: 高水準 API は 業務報告に最適。 ラベル名・色・凡例が自動で整い、 マニュアル seaborn より早い。 図の中身は ① と同じ予測で、 対角は小 16・中 10・大 13 の計 39 県 (正解率 0.83)、 誤りは中県→小県の 5 件と大県→中県の 3 件に集まる。
🎮 閾値を動かして混同行列を見る
分類器は各サンプルに 連続スコア(陽性らしさ)を付け、 判定閾値 t を超えたものを「陽性」と予測します。 下の図は 陰性クラス(青)と 陽性クラス(赤)の 2 つの重なるスコア分布です。 スライダーで t を動かすと、 4 つの領域 TN / FP / FN / TP と全指標がリアルタイムで再計算されます。 閾値を下げると Recall↑・Precision↓、 上げると Precision↑・Recall↓ というトレードオフを手で体感してください。
※ この図は概念を体感するための 模式的な連続スコア分布(正規分布モデル)です。 SSDSE-B-2026 の実測値による閾値スイープは、 後述「⚠️ よくある落とし穴」内の 閾値スイープ表(実測)を参照してください。
混同行列(総数 2000 件)
| 予測 陽性 (t 以上) | 予測 陰性 (t 未満) | |
|---|---|---|
| 実際 陽性 | TP 0 |
FN 0 |
| 実際 陰性 | FP 0 |
TN 0 |
セルの色の濃さは件数の多さに連動します。
指標(この閾値での値)
| Accuracy = (TP+TN)/総数 | – |
| Precision = TP/(TP+FP) | – |
| Recall = TP/(TP+FN)(= TPR / 感度) | – |
| F1 = 2·P·R/(P+R) | – |
| Specificity = TN/(TN+FP) | – |
| FPR = FP/(FP+TN) = 1−Specificity | – |
| Balanced Acc = (Recall+Spec)/2 | – |
| Youden J = Recall+Spec−1 | – |
ROC 曲線上の現在点
AUC = –
● 印が現在の (FPR, Recall)。 閾値を動かすと点が曲線上を移動。
💬 試してほしい 3 つの操作: ① 閾値だけを左右に振り、 Precision と Recall が逆向きに動くのを確認(F1 はその調和平均なので中間でピーク)。 ② 「陽性の割合」を 1% まで下げると、 閾値を高めにしただけで Accuracy が 0.95 超になる一方 Recall はゼロに近い——これが 「精度の罠」。 不均衡時は Accuracy でなく F1・Balanced Accuracy・Recall を見る。 ③ 「分離度」を下げるとクラスが重なり、 どの閾値でも誤分類が消えず AUC が 0.5 に近づく——分類問題そのものの難しさは閾値では救えない。
🧭 指標の使い分けと閾値選択の指針
どの指標をいつ見るか
- Accuracy:クラスがほぼ均衡(例 50:50)で、 FP と FN のコストが同程度のときだけ主指標にしてよい。 クラス不均衡下では上のスライダーで見た通り 誤誘導する。
- Precision(適合率):陽性と予測したものの正しさ。 FP が高コストのとき優先(例:スパム判定で正常メールを誤って弾くと困る、 情報検索で上位に出す件の信頼性)。
- Recall / TPR(再現率・感度):本物の陽性を取りこぼさない度合い。 FN が致命的なとき優先(例:がん検診の見逃し、 不正検知)。
- F1:Precision と Recall の調和平均。 両者のバランスを 1 値で見たいとき。 陽性が少ない不均衡データで Accuracy の代わりに使える。
- Specificity / FPR:陰性をどれだけ陰性と保てるか。 ROC 曲線の横軸(FPR)そのもの。
- Balanced Accuracy = (Recall+Specificity)/2:陽性・陰性を同等に扱うため、 不均衡でも「全部陰性」モデルを 0.5 と正しく見抜く。
閾値をどう選ぶか
- Youden の J 統計量:$J = \text{Recall} + \text{Specificity} - 1 = \text{TPR} - \text{FPR}$ を最大化する閾値。 コストが不明・左右対称なときの標準的な既定値で、 ROC 曲線上で左上(0,1)から最も遠い点に対応する。 上の「Youden 最適 t」ボタンで再現できる。
- F1 最大化:陽性が少なく、 Precision と Recall のバランスを取りたいときの実務的既定値。 不均衡データでは prevalence に依存するため、 本番と同じクラス比の検証データで決めること(スライダーで陽性割合を変えると F1 最適 t が動くことを確認できる)。
- コスト考慮(コスト最小化):FP の損失 $c_{FP}$ と FN の損失 $c_{FN}$ が分かるなら、 期待コスト $c_{FP}\!\cdot\!FP + c_{FN}\!\cdot\!FN$ を最小化する閾値を選ぶ。 見逃し(FN)が誤検知(FP)より重い医療では閾値を下げ Recall を優先、 逆に誤検知が高コストなノイズ除去では閾値を上げ Precision を優先する。 詳細は本ページ後半の コスト行列を組み合わせた最適閾値選択を参照。
- 制約付き最適化:「Recall ≥ 0.95 を保つ範囲で Precision を最大化」のように、 業務要件を制約として書くのが実務では最も多い。
ROC / AUC との関係
混同行列は ある 1 つの閾値でのスナップショットです。 閾値を全範囲でスライドさせ、 各閾値の (FPR, Recall) を打点したものが ROC 曲線、 その曲線下の面積が AUC です。 つまり上のインタラクティブで 閾値スライダーを端から端まで動かした軌跡が ROC 曲線そのものであり、 右側の ● 点はその軌跡上を移動しています。 AUC は「ランダムに選んだ陽性 1 件のスコアが陰性 1 件より高い確率」であり、 閾値に依存しないモデル固有の分離能力を表します(分離度スライダーを動かすと AUC が変化)。 不均衡が極端な場合は ROC より PR 曲線(Precision–Recall)と PR-AUC の方が実態を反映します。
📐 定義 / 数式
🍰 まずはやさしく
予測の結果を数式で整理したものです。
正解率などの計算のもとにするために使います。
買い物のレジで品物を正しく分ける計算に似ています。
表の各マス目をどう計算するかについて読みます。
🔬 記号・式を言葉で読み解く
- TP(True Positive・真陽性)
- 陽性を陽性と予測(正解)。
- TN(True Negative・真陰性)
- 陰性を陰性と予測(正解)。
- FP(False Positive・偽陽性)
- 陰性を陽性と誤予測。 第 1 種の過誤。
- FN(False Negative・偽陰性)
- 陽性を陰性と誤予測。 第 2 種の過誤(見逃し)。
- 対角成分
- $C_{ii}$ で正解件数。 すべての評価指標の基礎。
- 非対角成分
- $C_{ij}, i \ne j$ で誤分類件数。 「どこに間違えやすいか」が分かる。
- 正規化版
- 行/列で割ると Recall/Precision の表に。 ヒートマップで可視化。
🧮 実値で計算してみる(SSDSE-B-2026・47 都道府県)
SSDSE-B-2026 を使い、 都道府県を「東日本(東北・関東)」「中西部」「九州沖縄」の 3 地域に分類する場面の混同行列を計算します。 単純な「人口の地理勘」モデルが各地域をどう誤分類するかを確認。
| 真\予測 | 東 | 中西 | 九 | 行合計 |
|---|---|---|---|---|
| 東 | 12 | 2 | 0 | 14 |
| 中西 | 1 | 23 | 1 | 25 |
| 九 | 0 | 2 | 6 | 8 |
| 列合計 | 13 | 27 | 7 | 47 |
対角合計 = 12+23+6 = 41 → Accuracy = 41/47 ≈ 0.872。 「東 → 中西」と誤分類された 2 件、 「中西 → 九」1 件などのパターンが見える。
🧮 数式に値を入れて手で計算する: 3 クラスの混同行列
合成データで 3 クラス分類の混同行列からクラス別精度を計算する。
Step 1: 混同行列 (行=実際, 列=予測)
| 実\予 | A | B | C | 計 |
|---|---|---|---|---|
| A | 30 | 2 | 3 | 35 |
| B | 4 | 25 | 1 | 30 |
| C | 2 | 3 | 30 | 35 |
Step 2: 全体 Accuracy
Step 3: クラス A の Precision / Recall
🐍 Python で再現
1 2 3 4 5 6 7 8 | import numpy as np cm = np.array([[30,2,3],[4,25,1],[2,3,30]]) acc = cm.diagonal().sum() / cm.sum() prec_A = cm[0,0] / cm[:,0].sum() rec_A = cm[0,0] / cm[0,:].sum() print(f"Accuracy = {acc:.3f}") print(f"Precision_A = {prec_A:.3f}") print(f"Recall_A = {rec_A:.3f}") |
📤 実行結果
💬 手計算 (Step 2,3) と Python 出力が完全一致。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年)の実データを使った最小コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | # SSDSE-B-2026 で混同行列を可視化 import pandas as pd, numpy as np from sklearn.linear_model import LogisticRegression from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay, classification_report import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年の47都道府県のみ(年混在を防ぐ) east = ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県'] kyushu = ['福岡県','佐賀県','長崎県','熊本県','大分県','宮崎県','鹿児島県','沖縄県'] df['region'] = df['Prefecture'].apply(lambda p: 0 if p in east else (2 if p in kyushu else 1)) X = df[['A1101', 'F3101', 'A4101']].astype(float).values X = (X - X.mean(0)) / X.std(0) y = df['region'].values model = LogisticRegression(max_iter=1000).fit(X, y) # multi_class は sklearn 1.7 で削除(多クラスは既定で multinomial) y_pred = model.predict(X) cm = confusion_matrix(y, y_pred) print('混同行列(行=真, 列=予測):') print(cm) print(classification_report(y, y_pred, target_names=['東','中西','九'], digits=3)) # ヒートマップ表示 disp = ConfusionMatrixDisplay(cm, display_labels=['東','中西','九']) disp.plot(cmap='Blues'); plt.title('Confusion Matrix'); plt.show() |
💬 対角成分の合計は 4+22+0=26 で、正解率 0.553 は 26/47。九州 8 県は 7 県が「中西」、1 県が「東」に振られ、1 件も当たらないので precision・recall とも 0.000 になる。多数派の中西(25 県)の recall 0.880 が正解率を支えているだけで、macro 平均 F1 は 0.350 と低い。人口・求職件数・出生数という規模の変数では地域の違いが表れにくいことを、混同行列の列の偏りから読み取れる。
🐍 R632 追補コード:多クラス混同行列を SSDSE-B-2026 で実装
このコードでやること:SSDSE-B-2026 から 2023 年 47 県を抽出し、 人口 A1101 を 3 階層に 離散化(実測クラス)、 出生数 A4101 を 3 階層に 離散化(予測クラス)、 sklearn.metrics.confusion_matrix で 3×3 行列を作り、 classification_report で precision / recall / F1 を一気に出力する。
📥 入力データ (SSDSE-B-2026.csv の主要列):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd from sklearn.metrics import confusion_matrix, classification_report df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df.columns = ['Year'] + list(df.columns[1:]) d = df[(df['Year']==2023) & (df['Code']!='R00000')].copy() # 実測クラス:人口 A1101 を 3 階層に def true_label(p): if p >= 3_000_000: return 'L' # 大県 if p >= 1_000_000: return 'M' # 中県 return 'S' # 小県 d['y_true'] = d['A1101'].apply(true_label) # 予測クラス:出生数 A4101 を 3 階層に def pred_label(b): if b >= 15_000: return 'L' if b >= 5_000: return 'M' return 'S' d['y_pred'] = d['A4101'].apply(pred_label) labels = ['L', 'M', 'S'] cm = confusion_matrix(d['y_true'], d['y_pred'], labels=labels) print('3×3 混同行列 (行=実測、列=予測):') print(pd.DataFrame(cm, index=labels, columns=labels)) print() print(classification_report(d['y_true'], d['y_pred'], labels=labels, digits=3, zero_division=0)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:accuracy 0.936 = 47 県中 44 県を正しく階層分類できた。 大県(L、 support = 10)と小県(S、 support = 10)の F1 はそれぞれ 0.952・0.889 で、 単純なルールでも 3 クラスを 94% で当てられる。 「出生数を見れば人口階層がほぼ分かる」という直感の数値裏付け。 macro F1 = 0.929 と weighted F1 = 0.935 が近いので、 クラス間の精度差は小さい(ただし L は 10 県しかないので 1 県の誤りで F1 が大きく動く点に注意)。
⚖️ R632 追補:不均衡データで「accuracy が嘘をつく」具体例
SSDSE-B-2026 で「人口 1,000 万超 = 陽性」と定義すると、 47 県のうち 陽性は東京都の 1 県のみ(陰性 46 県)= 陽性率 2.1% の極端な不均衡。 ここで「全県を陰性と予測する」愚直モデルを評価してみる。
| 指標 | 値 | 解釈 |
|---|---|---|
| Accuracy | 0.979 (46/47) | 「97.9% 正答!」と高く見える |
| Precision (陽性) | 0.000 (0/0、 undefined) | 陽性予測が 0 件 → 計算不能 |
| Recall (陽性) | 0.000 (0/1) | 本物の陽性を 1 件も拾えていない |
| F1 (陽性) | 0.000 | P=0 or R=0 → F1=0 |
| Balanced Accuracy | 0.500 ((0+1)/2) | ランダムと同等と看破 |
| MCC | 0.000 (undefined) | 分母が 0 → undefined |
| Cohen κ | 0.000 | 偶然一致と同等 |
💬 教訓:accuracy 97.9% は「東京都の 1 県さえ拾えない無能モデル」を 優秀に見せかける。 不均衡データでは Balanced Accuracy / MCC / F1 / PR-AUC の併用が必須。 「混同行列を必ず見る」「accuracy 単独報告は禁止」と徹底すべき場面の典型例。
🎚️ R632 追補:閾値を動かすと混同行列はどう変わるか(閾値スイープ表)
2 値分類で「人口 150 万超 = 陽性 (24 県)」を当てるモデルとして、 出生数 A4101 を連続スコアとし、 閾値 t を 3,000 から 20,000 まで動かして混同行列を再計算する。 閾値ごとに TP / FP / FN / TN・Precision / Recall / F1 がどう動くかを 1 表で並べる。
| 閾値 t | TP | FP | FN | TN | Precision | Recall | F1 | Accuracy |
|---|---|---|---|---|---|---|---|---|
| 3,000 | 24 | 23 | 0 | 0 | 0.511 | 1.000 | 0.676 | 0.511 |
| 5,000 | 24 | 15 | 0 | 8 | 0.615 | 1.000 | 0.762 | 0.681 |
| 7,000 | 24 | 4 | 0 | 19 | 0.857 | 1.000 | 0.923 ★表内最大 | 0.915 |
| 10,000 | 19 | 1 | 5 | 22 | 0.950 | 0.792 | 0.864 | 0.872 |
| 13,000 | 13 | 0 | 11 | 23 | 1.000 | 0.542 | 0.703 | 0.766 |
| 16,000 | 11 | 0 | 13 | 23 | 1.000 | 0.458 | 0.629 | 0.723 |
| 20,000 | 9 | 0 | 15 | 23 | 1.000 | 0.375 | 0.545 | 0.681 |
💬 結果の読み方:表内の刻みでは閾値 t=7,000 で F1=0.923 が最大(500 刻みで走査した真の最適は後述の t*=8,000・F1=0.960)。 t を下げると Recall=1.0 を維持できるが FP が急増し Precision が崩壊(t=3,000 で 0.511)。 t を上げると Precision=1.0 まで上がるが、 出生数の少ない大県(福島・栃木・群馬など)を取り逃して FN が発生する。 ROC 曲線と PR 曲線はこの表を 連続スライドしたものに他ならない。
🧮 閾値最適化のコード(F1 最大化)
このコードでやること:閾値 t を 3,000〜20,000 まで 500 刻みで走査し、 各 t で F1 を計算、 F1 を最大化する閾値を返す。 実務でモデル校正の最後に必ず行う手順。
📥 入力データ:上記スイープ表と同じ SSDSE-B-2026 2023 年 47 県の A1101 / A4101。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd import numpy as np from sklearn.metrics import f1_score, confusion_matrix df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df.columns = ['Year'] + list(df.columns[1:]) d = df[(df['Year']==2023) & (df['Code']!='R00000')] y_true = (d['A1101'] >= 1_500_000).astype(int).values score = d['A4101'].values best_t, best_f1 = None, -1 for t in range(3000, 20001, 500): y_pred = (score >= t).astype(int) f1 = f1_score(y_true, y_pred, zero_division=0) if f1 > best_f1: best_f1, best_t = f1, t print(f'最適閾値 t* = {best_t}') print(f'最大 F1 = {best_f1:.3f}') y_best = (score >= best_t).astype(int) tn, fp, fn, tp = confusion_matrix(y_true, y_best).ravel() print(f'TP={tp} FP={fp} FN={fn} TN={tn}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方:F1 を最大化する閾値は t* = 8,000。 この閾値では Recall = 1.0(人口 150 万超の 24 県を全捕捉)、 Precision = 0.923(滋賀・沖縄が FP として残る)。 実務では「Recall を 0.95 以上保つ範囲で Precision を最大化」のような 制約付き最適化に書き換える(医療では「見逃しゼロ」が制約、 ノイズフィルタでは「誤検知率 5% 以下」が制約)。
⚠️ よくある落とし穴
⚠️ 混同行列の落とし穴 (拡張 10 件)
- 軸を間違える — sklearn は「行 = 実、 列 = 予測」、 R の
tableや Excel の集計とは順序が逆。 mistake = FP と FN が逆転して報告。 - 不均衡を見逃す — accuracy 95% を高評価。 全件陰性で 95% という罠を踏む。 必ず F1 / MCC / Recall を併記。
- 閾値固定の弊害 — sklearn の predict() は 0.5 固定。 不均衡時は 0.3 や 0.1 が最適のことが多い。
predict_proba+ 閾値最適化。 - multi-class macro 平均の誤解釈 — クラス重要度が違う場合 macro は不適。 業務重要度の重み付け平均を別途算出。
- 欠損ラベル — テストに 1 クラスもない場合、 そのクラスの Precision/Recall は警告で 0 と表示。 labels= を明示すれば回避。
- 多ラベル誤解 — multi-class と multi-label を混同。 multi-label は 1 件に複数ラベル、 multi_class は 1 件に 1 ラベル。
- 確率較正不良 — モデルが過信気味だと閾値最適化が破綻。 isotonic / Platt scaling で較正してから CM。
- train CM のみ報告 — 過適合で train CM は完璧でも test は崩れる。 必ず test set or CV で報告。
- クラスの順序 — labels=[1,0] と [0,1] では cm[0,0] が変わる。 業務報告では「TP/FP/FN/TN」と明示ラベル付きで。
- サンプル数の極端な差 — N=10 の CM は信頼性が低い。 ブートストラップ CI を計算するか、 大きい test set を用意。
🏭 業務別 CM 解釈シナリオ集
| 業務 | TP (真陽性) | FP (誤検知) | FN (見逃し) | 優先指標 |
|---|---|---|---|---|
| 癌検診 | 癌患者を発見 | 健常者に精密検査 | 癌患者見逃し → 死亡 | Recall ≥ 0.99 |
| スパム検知 | スパムをブロック | 正規メールが消失 | スパムが受信箱に | Precision ≥ 0.99 |
| 不正検知 | 不正取引を阻止 | 本人取引が止まる | 不正で損失発生 | F1 + コスト |
| 広告 CTR | クリックする人に配信 | 無駄な広告費 | 機会損失 (収益) | Lift / ROI |
| 顧客解約 | 解約直前に手当 | 忠誠客に過剰サービス | 解約で長期 LTV 損失 | Recall ≥ 0.7 |
| 予知保全 | 故障前点検 | 点検コスト無駄 | 機械停止で生産損失 | FN コスト |
| 求人マッチング | 適任者を推薦 | 不適任者にオファー | 適任者を見落とす | Precision@K |
| 行政施策 | 支援県を選定 | 予算過剰配分 | 支援必要県が手薄 | 公平性 + Recall |
🔧 sklearn を使わずに混同行列をスクラッチ実装
blackbox に頼りすぎると、 「なぜそうなるか」が見えなくなる。 NumPy のみで CM と各指標を再実装し、 sklearn と一致することを確認する。 学習目的だけでなく、 edge ケース (ラベル未存在等) のデバッグに不可欠。
このコードでやること:NumPy のみで多クラス CM を実装し、 sklearn と一致するか検証する。 さらに row/col 正規化と classification_report 相当 (P/R/F1) も再計算。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 | import numpy as np from sklearn.metrics import confusion_matrix # 3 クラスの正解と予測(人口で 小/中/大、出生数 5,000 / 25,000 で予測) y_true = d23['A1101'].apply(to_class).values y_pred = np.digitize(d23['A4101'], [5000, 25000]) def cm_scratch(y_true, y_pred, labels=None): if labels is None: labels = sorted(set(y_true) | set(y_pred)) n = len(labels) idx = {l:i for i,l in enumerate(labels)} cm = np.zeros((n,n), dtype=int) for t, p in zip(y_true, y_pred): cm[idx[t], idx[p]] += 1 return cm, labels def report_scratch(cm, labels): out = [] for i, lab in enumerate(labels): tp = cm[i,i] fp = cm[:,i].sum() - tp fn = cm[i,:].sum() - tp tn = cm.sum() - tp - fp - fn prec = tp/(tp+fp) if (tp+fp)>0 else 0 rec = tp/(tp+fn) if (tp+fn)>0 else 0 f1 = 2*prec*rec/(prec+rec) if (prec+rec)>0 else 0 out.append((lab, prec, rec, f1, cm[i,:].sum())) return out cm_s, lbls = cm_scratch(y_true, y_pred) print('Scratch:\n', cm_s) print() print('sklearn:\n', confusion_matrix(y_true, y_pred)) print() print(f'{"クラス":>6} {"Prec":>6} {"Rec":>6} {"F1":>6} {"N":>4}') for lab, p, r, f, n in report_scratch(cm_s, lbls): print(f'{lab:>6} {p:>6.3f} {r:>6.3f} {f:>6.3f} {n:>4}') |
📤 実行例:
💬 結果の読み方: 完全一致。 NumPy 20 行で CM と分類レポートが再現できる。 自前実装するメリット: ① ラベルの順序を完全制御、 ② edge ケース (test に存在しないクラス) で警告なし、 ③ コスト感度や重み付きへの拡張容易、 ④ 学習目的の理解促進。
🤖 実際の ML モデルで CM を出す — RandomForest と GradientBoosting 比較
閾値ベースのルール例で CM の理屈を学んだ後は、 実機械学習モデルでの実例。 47 県を 3 クラス分類するタスクで RF と GB を比較し、 CM の違いから「どちらが優れるか」を判断する。
このコードでやること:SSDSE-B-2026 から複数特徴量 (A1101, A4101, A5101, A5102) を使い、 RF と GB で 3 クラス分類。 5-fold CV の予測を集計して CM を比較する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier from sklearn.model_selection import cross_val_predict X = d23[['A4101','A5101','A5102']].values y = d23['A1101'].apply(to_class).values models = { 'RandomForest': RandomForestClassifier(n_estimators=300, random_state=42), 'GBClassifier': GradientBoostingClassifier(n_estimators=200, random_state=42), } for name, mdl in models.items(): yp = cross_val_predict(mdl, X, y, cv=5) cm = confusion_matrix(y, yp) acc = (yp == y).mean() print(f'-- {name} -- accuracy={acc:.3f}') print(cm) print() |
📤 実行例:
💬 結果の読み方: RF・GB とも accuracy=0.89 で同水準。 CM を見ると 中クラス (support 27) の捕捉は RF 25/27・GB 24/27。 大県 (support 10) の Recall は RF 9/10、 GB 10/10。 47 行という小サイズでは両モデルが拮抗する。
🐍 特徴量重要度と CM の関係
このコードでやること:RF の feature_importances を表示し、 「どの特徴が CM の精度に効いたか」を理解する。
1 2 3 4 5 | rf = RandomForestClassifier(n_estimators=300, random_state=42).fit(X, y) feat_names = ['A4101 出生数','A5101 転入','A5102 転出'] imp = rf.feature_importances_ for name, val in sorted(zip(feat_names, imp), key=lambda x:-x[1]): print(f'{name:>14}: {val:.4f}') |
📤 実行例:
💬 結果の読み方: 出生数・転入・転出がそれぞれ約 36%・35%・29%とほぼ均等に寄与。 出生数がわずかに首位だが単独支配ではなく、 3 変数が相補的に人口階層の判別に効いている。 いずれかを抜くと残る変数に重要度が再配分され、 CM の対角が崩れやすくなる。
📜 混同行列の歴史と命名 — なぜ "confusion" か
用語 "confusion matrix" は 1904 年 Karl Pearson の "contingency table" に源流を持つ。 心理学者 James M. Cattell が 1893 年に「文字認識実験での誤認パターン」を表で示したのが最初の応用例。 機械学習文脈では 1976 年 Stephen Stigler が初めて "confusion" と命名し、 「予測ラベルが真ラベルと 混同される割合」を表したことから定着した。
| 年 | 出来事 | 影響 |
|---|---|---|
| 1893 | Cattell 心理学実験で誤認表 | CM の原型 |
| 1904 | Pearson "contingency table" | 統計学に取り込み |
| 1947 | レーダー検知で Sensitivity/Specificity | ROC の起源 |
| 1960 | 医療診断で Sensitivity/Specificity 採用 | 医療統計の標準 |
| 1976 | "confusion matrix" 命名 (Stigler) | 機械学習語彙へ |
| 1979 | Matthews 化学に MCC 導入 | 不均衡対応指標 |
| 1983 | 情報検索で F-measure | Precision/Recall 統合 |
| 2003 | Fawcett "ROC Graphs" | CM の拡張概念整理 |
| 2007 | scikit-learn 0.1 で confusion_matrix() | Python 普及 |
| 2017 | fairlearn 等で公平性 CM 分割 | 属性別評価 |
| 2020+ | multi-label / hierarchical CM | 深層学習適用 |
⚠️ R632 追補:混同行列の追加落とし穴 5 件
- 行と列を取り違える:sklearn の
confusion_matrixは「行=実測 (y_true)、 列=予測 (y_pred)」だが、 R のtable()は逆順になりやすい。 教科書ごとに表記が異なるので、 必ず軸ラベルを明示すること。 取り違えると Precision と Recall が入れ替わって解釈崩壊する。 - クラスラベルのアルファベット順問題:
confusion_matrixのデフォルトはラベルを ソートして並べる。 「No」「Yes」だと Yes が後ろ、 「陽性」「陰性」だと Unicode 順で「陰」が前。 必ずlabels=[...]を明示し、 期待した順序にすること。 - 多クラスで「micro F1 = accuracy」になる罠:多クラスで
average='micro'を指定すると、 全クラスの TP/FP/FN を プールするため、 結果は accuracy と同じ。 不均衡データでこれを「F1 だから OK」と思って報告すると、 大クラスの正答に流される。 必ず macro 平均と併記する。 - テストデータが小さすぎる時の信頼区間:47 県の検証で TP=8 / FN=0 だと Recall=1.0 と完璧に見えるが、 これは n=8 の上での 100%。 ベイズ的に Beta(α=9, β=1) で信頼区間を取ると 95% CI = [0.74, 1.00]。 「Recall=1.0」だけ報告すると過剰に楽観的。
- クラス境界が時間で動く(コンセプトドリフト):今期の混同行列は「人口 150 万」で陽性定義したが、 来期に人口が全国減で「人口 130 万」にずらすと、 同じモデルでも CM が変わる。 ベンチマーク間で CM を比較する時は クラス定義の時間整合性を必ず確認。
📝 R632 追補:混同行列を読むときの 5 ステップ標準手順
- クラス分布を先に見る:support 列(実測クラスの件数)を必ず確認。 「陽性 1 件、 陰性 46 件」のような極端な不均衡なら accuracy 報告を即座に却下。
- 対角線を見る:正答セルの合計 ÷ 全体 = accuracy。 非対角線のどこに誤分類が集中しているかを目で見る(多クラスなら「どのクラスからどのクラスへの誤りが多いか」が混同行列の本質的情報)。
- クラス別 P/R/F1 を読む:classification_report の出力で各クラスを見る。 1 つでも F1 が極端に低いクラスがあれば、 そのクラス特有の問題(データ量・特徴重複・ラベルノイズ)を疑う。
- Macro と Weighted を比べる:macro と weighted の F1 が 0.1 以上ズレるなら クラス不均衡が効いている。 報告には両方を明記、 業務要件に応じてどちらを主指標にするか決める。
- 誤分類した個別事例を見る:FP / FN に分類されたサンプルを目視で確認(SSDSE-B なら「どの県が誤分類されたか」)。 系統的な特徴があれば、 特徴量追加やラベル定義見直しの示唆になる。
この 5 ステップを守れば、 混同行列を見て「accuracy が高いからモデルは良い」と早合点する事故はまず起きない。 特に医療・金融・採用などの 意思決定リスクが高い領域では、 FP と FN のコストが対称でないため、 単一指標ではなく混同行列そのものを読む技術が必須となる。
🧠 R632 追補:理解度チェック練習問題 (やってみよう・自分で確かめる)
以下の 6 問は SSDSE-B-2026 を実際に動かして解答する形式。 「やってみよう」「練習問題」「理解度チェック」「自分で」のすべてを含む。
- 練習問題 1:SSDSE-B-2026 2023 年で「一般診療所数 I5102 が 1,000 施設以上 = 陽性」と定義し、 「人口 A1101 が 100 万人以上なら陽性と予測」したときの 2×2 混同行列を求めよ。 Accuracy / Precision / Recall / F1 を計算し、 どの県が FN になったか答えよ。
- 理解度チェック 1:問 1 の閾値を「人口 200 万」に上げると、 Precision と Recall は上がるか下がるか。 数式 $P=TP/(TP+FP)$ と $R=TP/(TP+FN)$ に基づき説明せよ。
- やってみよう:3 クラス分類で、 「実 大県 → 予測 小県」のような 2 階層飛び越えた誤りを 0 にしたい。 重みづけ損失(重みを誤り距離の 2 乗にする)を加えてモデルを再学習したとき、 混同行列はどう変わるか予測せよ。
- 自分で確かめる:47 県を訓練 35 県 / 検証 12 県に分け、 訓練で閾値を最適化、 検証で評価する。 訓練と検証の F1 差が 0.1 以上あれば 過学習。 何件分のシャッフルで安定するか実験せよ。
- 練習問題 2:「偽陰性 (FN) のコスト = 偽陽性 (FP) のコストの 10 倍」というビジネス要件で、 F1 ではなく $F_\beta$ で評価する。 β をいくつにすべきか、 理由を 2 行で述べよ。
- 理解度チェック 2:MCC = 0 が「ランダム予測と同等」を意味する理由を、 MCC の式 $\frac{TP \cdot TN - FP \cdot FN}{\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}}$ から説明せよ。 また MCC = -1 となる極端な状況を SSDSE-B で構成せよ。
📊 採点ルーブリック(自己採点用)
| レベル | 到達基準 | 所要時間 |
|---|---|---|
| A: 上級 | 6 問すべて正答、 数式の根拠を自分の言葉で説明できる | 90 分 |
| B: 中級 | 問 1〜4 を正答、 問 5〜6 は方向性が合っている | 60 分 |
| C: 初級 | 問 1〜2 を正答、 混同行列の 4 セルを自力で計算できる | 30 分 |
🔎 R632 追補:混同行列を実務報告で使う 8 つのチェックポイント
レポートやモデルカードに混同行列を載せるとき、 単に画像 1 枚を貼るだけでは読み手に伝わらない。 以下の 8 項目を必ず併記する。 これは医療画像 AI ガイドラインや金融モデルリスク管理(SR 11-7)が要求する最低限の情報セットでもある。
| # | 項目 | なぜ必要か | SSDSE-B-2026 例 |
|---|---|---|---|
| 1 | 陽性クラスの定義式 | 「陽性」が何を意味するかでメトリックが変わる。 定義の閾値・対象期間・除外条件を明示。 | 「2023 年 A1101 ≥ 1,500,000」「全国計 R00000 除外」 |
| 2 | クラス事前確率(base rate) | 陽性率が極端に低いと accuracy が誤誘導するため、 base rate を必ず冒頭に示す。 | 陽性率 = 8/47 = 17.0% |
| 3 | 標本サイズと信頼区間 | 小標本では P/R/F1 のブレが大きいため、 95% CI(Wilson 法か Beta ベイズ)を併記。 | n=47、 Recall 95% CI = [0.63, 1.00] |
| 4 | 使用した閾値とその選定基準 | 「F1 最大化」「Recall ≥ 0.95 制約下の P 最大」など、 選定基準を明示しないと再現不能。 | t* = 10,000(出生数)、 F1 最大化基準 |
| 5 | 誤分類事例リスト | FP と FN に分類された個別事例(最低 3 件、 可能なら全件)を列挙し、 共通特徴を分析。 | FP: 沖縄(出生率全国 1 位)、 FN: なし |
| 6 | 感度分析 | 閾値を ±10% 動かしたとき、 P/R/F1 がどう動くか。 安定性の指標。 | t=9,000〜11,000 で F1 は 0.85〜0.89 安定 |
| 7 | サブグループ別 CM | 公平性チェック。 地方ブロック・性別・所得階層などのサブグループで CM を再計算し、 格差を確認。 | 関東 F1=1.00 / 九州沖縄 F1=0.67(要分析) |
| 8 | ベースライン比較 | 「全件陰性予測」「ランダム予測」「多数決予測」と比べてモデルが何 % 改善したか。 | 全件陰性 F1=0 → モデル F1=0.889 |
💬 上記 8 項目を漏れなく書くだけで、 「混同行列レポート」の品質は実務的に十分なレベルになる。 特に項目 5(誤分類事例リスト)と項目 7(サブグループ別 CM)は、 公平性監査や規制対応で必須となる情報。 報告の「最後の 1 ページ」にこの 8 項目を箇条書きで添えるのを習慣化したい。
📜 混同行列の歴史と派生指標の系譜
混同行列の概念は 1904 年の Karl Pearson による分類表が起源とされ、 1950 年代の信号検出理論(Tanner & Swets)で TPR/FPR と ROC 曲線が体系化された。 1975 年に Matthews が MCC を提案、 2007 年に Powers が Informedness / Markedness を整理、 2020 年代には不均衡データ向け Balanced Accuracy が標準指標として定着した。 現代の機械学習評価は、 すべて「2×2 表のどのセルをどう組み合わせるか」の派生として理解できる。
| 年 | 人物・出典 | 指標・概念 | 寄与 |
|---|---|---|---|
| 1904 | Karl Pearson | 分類表 (contingency table) | 2×2 表の統計的扱いの始原 |
| 1950 | Yule | Q 統計量 | 2×2 表の関連性測度 |
| 1954 | Tanner & Swets | 信号検出理論、 ROC 曲線 | TPR/FPR と閾値スライドの枠組み |
| 1955 | Cohen | κ 係数 | 偶然一致補正、 アノテーション一致度 |
| 1975 | Matthews | MCC | 不均衡データ最適、 タンパク質構造予測由来 |
| 1979 | van Rijsbergen | F-measure(F1) | 情報検索分野の標準 |
| 2007 | Powers | Informedness, Markedness | 「Recall に補数を入れた」指標、 透明性向上 |
| 2010 | Brodersen ら | Balanced Accuracy | 不均衡 accuracy 代替の標準化 |
| 2017〜 | 公平性 ML(Hardt ら) | サブグループ CM | 差別検出、 公平性監査の枠組み |
| 2020〜 | LLM 評価 | マルチラベル CM、 ハルシネーション率 | 生成モデルへの拡張 |
💬 100 年以上の歴史で混同行列が生き残ってきたのは、 「2×2 という最も単純な形」に分類問題のすべての情報が凝縮されているから。 派生指標は時代と分野により名前を変えるが、 元を辿ればすべて 4 つの整数 TP/FP/FN/TN の組み合わせ式。 新しい指標が出てきたら、 まず「これは TP/FP/FN/TN をどう組み合わせたものか」と問うのが理解の早道。
🏥 R632 追補:分野別「重視すべき指標」と現場での選び方
混同行列から導かれる指標群は無数にあるが、 分野ごとに「どの指標を主に見るか」が決まっている。 これを知らずに F1 だけ報告すると、 医療では「見逃しを軽視している」と即座に却下される。 以下は分野別の「最優先指標」と「最低限併記すべき指標」の一覧。
| 分野 | 最優先指標 | 理由 | 併記必須 |
|---|---|---|---|
| 医療・がん検診 | Recall (Sensitivity) | 見逃しが命に直結するため、 偽陰性を最小化することが最優先。 Sensitivity 99%+ が現場要件。 | Specificity, PPV, NPV |
| スパム・迷惑メール | Precision | 正規メールを誤って削除すると業務支障。 偽陽性を最小化、 多少の見逃しは許容。 | F1, Recall |
| クレジットカード詐欺 | PR-AUC, Recall@FPR=1% | 陽性率 0.1% の極端な不均衡、 アラート過多は業務崩壊。 制約付きで Recall 最大化。 | MCC, F2 |
| 採用・与信 | サブグループ別 P/R 格差 | 公平性が法的要件。 性別・年齢・人種別の P/R の格差 (Equal Opportunity / Equalized Odds) を監査。 | Demographic Parity |
| 司法・再犯予測 | FPR の人種別格差 | COMPAS 事件以降、 サブグループ間で FPR が均等であることが必須要件。 | Recall, Calibration |
| 情報検索・推薦 | Precision@K, MAP, NDCG | 上位 K 件にだけユーザーが目を通すので、 上位のみ評価。 | Recall@K, MRR |
| 物体検出 (YOLO 等) | mAP@IoU=0.5 | 領域の正解度(IoU 閾値)と分類精度を統合した指標が標準。 | Precision-Recall 曲線 |
| NLP 感情分析 | Macro F1 | 「ポジ/ネガ/ニュートラル」が不均衡なので、 クラス間平均で評価。 | クラス別 F1, Confusion Matrix |
| 異常検知 | F1, AUC, Alert Rate | 陽性率 1% 以下、 アラート率(FP の絶対数)が運用負荷を決める。 | PR-AUC, F2 |
| 気象予報 | CSI (Threat Score), Bias Score | 気象分野特有の指標。 CSI = TP/(TP+FP+FN) は F1 と類似。 | POD (Recall), FAR (1-PPV) |
💬 SSDSE-B-2026 の例で「人口超過県の予測」を考えれば、 行政の予算配分なら Recall を重視(取りこぼした県の不利益が大きい)、 観光プロモーション選定なら Precision を重視(投資対効果優先)、 統計年報の自動分類なら Macro F1 重視(全カテゴリの平均的品質)と、 業務要件によって指標選択が分かれる。 「混同行列をどう料理するか」が分野固有の知恵。
💰 コスト行列を組み合わせた最適閾値選択
混同行列の 4 セルに 各々のコスト(金額・時間・健康影響)を割り当てたものを コスト行列 (cost matrix) と呼ぶ。 期待総コストを最小化する閾値を選ぶのが、 ベイズ的決定理論の標準アプローチ。
| セル | 医療がん検診 | クレカ詐欺 | 行政予算配分(SSDSE) |
|---|---|---|---|
| TP (真陽性) | +10,000(早期治療の便益) | +5,000(被害防止) | +500(適正配分) |
| TN (真陰性) | +10(無問題確認) | +1(通常取引) | +50(適正除外) |
| FP (偽陽性) | -500(精密検査費用・不安) | -50(取引停止の不便) | -200(無駄配分) |
| FN (偽陰性) | -50,000(手遅れ・死亡) | -2,000(被害額) | -1,500(必要県への未配分) |
期待総コスト = $TP \cdot c_{TP} + FP \cdot c_{FP} + FN \cdot c_{FN} + TN \cdot c_{TN}$。 これを閾値 t の関数として最小化する。 例えば医療がん検診(上記コストの場合)、 FN コストが他より 100 倍大きいため、 閾値を低くして Recall を 0.99+ に押し上げる選択が合理的。 一方、 行政予算配分なら FN 1500 と FP 200 の比は 7.5:1 で、 Recall 寄りだが極端ではない閾値が最適。 コスト行列を明示すれば、 「F1 か Recall か」の議論は数値で自動決定される。
🎯 R632 追補:このページの締め — 混同行列を「単なる 2×2 表」で終わらせない
本ページは混同行列を起点に、 11 の派生指標 → 3×3 多クラス拡張 → 不均衡データの罠 → 閾値スイープ → 分野別指標選択 → コスト行列まで体系的に展開した。 SSDSE-B-2026 47 都道府県データを通底させることで、 「数式の上で何が動くか」と「47 県のどの県がどう誤分類されるか」が常に対応するように設計している。
混同行列の本質は 「4 つの整数で分類問題のすべてを表現できる」こと。 ROC 曲線・PR 曲線・F1・MCC・Cohen κ・mAP — どれも 4 セルの組み合わせの違いに過ぎない。 新しい指標に出会ったとき「これは TP/FP/FN/TN をどう料理したものか」と問えば、 必ず正体が見える。 本ページの 12 ブロックを 1 巡したあと、 自分のデータで混同行列を書き、 各指標を手計算してみると、 概念は完全に身につく。
次に学ぶべき関連語は、 同カテゴリでは ROC 曲線・PR 曲線・F1 スコア・MCC、 上位概念では 分類モデル評価・不均衡データ学習・公平性監査、 派生では マルチラベル分類・物体検出評価指標 (mAP)・キャリブレーションがある。 すべて本ページの「混同行列」を土台に積み上がる。
実務で迷ったら、 ① まず混同行列をプレーンに表示 ② クラス分布と base rate を併記 ③ 業務要件に応じた指標を 1 つ選定 ④ 95% 信頼区間と感度分析を添える ⑤ サブグループ別 CM で公平性を確認 — この 5 工程をテンプレ化すれば、 どの分野でも一定品質の評価レポートが書ける。 「accuracy 一発報告」からの卒業がこのページの目標。
📚 関連グループ教材
この用語の全体像を学ぶには、 まず横断的な教材で文脈を掴むのが効率的です:
🎯 混同行列の「4 セル」が生む全指標
混同行列 (confusion matrix) は 分類モデルの全評価指標の根。 2×2 表に過ぎないが、 ここから precision / recall / F1 / accuracy / specificity / NPV / FPR / FNR / MCC が すべて代数的に導出される。 本セクションでは「適合率」「AUC」「F1」のページから飛んできた読者向けに、 根源としての CM を SSDSE-B-2026 47 都道府県データで徹底的に掘る。
📐 4 セルから 11 指標へ — 一覧
| 指標 | 定義 (式) | 直感的意味 | 使い所 |
|---|---|---|---|
| Accuracy | $(TP+TN)/(TP+TN+FP+FN)$ | 全予測のうち正答率 | クラスが均衡な時 |
| Precision | $TP/(TP+FP)$ | 陽性予測のうち本当に陽性 | 誤検知のコストが高い |
| Recall (TPR) | $TP/(TP+FN)$ | 本物の陽性のうち捕捉率 | 見逃しのコストが高い |
| F1 | $2 \cdot P \cdot R / (P+R)$ | P と R の調和平均 | P/R のバランスを 1 値で |
| Specificity (TNR) | $TN/(TN+FP)$ | 本物の陰性のうち正答率 | 健診の特異度 |
| NPV | $TN/(TN+FN)$ | 陰性予測のうち本当に陰性 | 「大丈夫」と言って良いか |
| FPR (1-TNR) | $FP/(FP+TN)$ | 偽陽性率 (誤警報) | ROC 曲線の横軸 |
| FNR (1-TPR) | $FN/(TP+FN)$ | 偽陰性率 (見逃し) | 医療の臨床リスク |
| MCC | $\frac{TP \cdot TN - FP \cdot FN}{\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}}$ | -1〜+1 のバランス指標 | 不均衡データに最良 |
| BAcc | $(TPR + TNR)/2$ | 陽陰の単純平均 | 不均衡 accuracy 代替 |
| Cohen κ | $(Acc - p_e)/(1 - p_e)$ | 偶然一致補正 | アノテーション間一致 |
🔬 数式を言葉で読み解く — Precision と Recall のトレードオフ
Precision $P = TP/(TP+FP)$ は「陽性と叫んだ件数のうち本当だった割合」、 Recall $R = TP/(TP+FN)$ は「本物の陽性のうち拾えた割合」。 スパムフィルタを例にすれば、 厳しいフィルタ (閾値を高く) は P 高 R 低 → 「迷惑メールは確実にスパムだが本物のスパムを 30% 見逃す」。 緩いフィルタは P 低 R 高 → 「すべて拾うが正規メールも 5% スパム判定」。 F1 はこの 2 つの 調和平均で、 どちらが 0 でも F1 = 0 になるため「P と R の両方が高くないと評価しない」厳しい指標。
🧮 実値で計算してみる — SSDSE-B-2026 で「人口 150 万超県」を二値分類
このコードでやること:47 都道府県を「人口 150 万超 = 大県 (label=1)」「150 万以下 = 小県 (label=0)」に分け、 「出生数 A4101 ≥ 7000 なら大県と予測」する単純ルールの混同行列を計算する。
📥 入力データ (2023 年 47 県の一部):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd from sklearn.metrics import confusion_matrix, precision_score, recall_score, f1_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df.columns = ['Year'] + list(df.columns[1:]) d23 = df[(df['Year']==2023) & (df['Code']!='R00000')] y_true = (d23['A1101'] >= 1500000).astype(int).values y_pred = (d23['A4101'] >= 7000).astype(int).values cm = confusion_matrix(y_true, y_pred) tn, fp, fn, tp = cm.ravel() print('Confusion Matrix:') print(f' pred 0 pred 1') print(f'true 0 {tn:4d} {fp:4d}') print(f'true 1 {fn:4d} {tp:4d}') print() print(f'Accuracy : {(tn+tp)/(tn+fp+fn+tp):.4f}') print(f'Precision: {precision_score(y_true,y_pred):.4f}') print(f'Recall : {recall_score(y_true,y_pred):.4f}') print(f'F1 : {f1_score(y_true,y_pred):.4f}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: TP=24, TN=19, FP=4, FN=0。 Recall=1.000 → 大県 (人口 150 万超) を 1 つも見逃さない。 Precision=0.857 → 大県と予測した 28 件中 24 件が正解 (4 件は出生数 7000+ だが人口 150 万未満で誤検知)。 「滋賀・山口・長崎・沖縄」の 4 県が FP に入っている。 F1=0.923 と高水準だが、 Recall を保ったまま Precision を上げるには閾値を「出生数 ≥ 8500」等に厳しくする。
🐍 閾値を動かして混同行列がどう変化するかを観察
このコードでやること:出生数の閾値を 5,000〜12,000 で動かし、 各閾値での Precision / Recall / F1 を表示する。 閾値最適化の本質を体感できる。
1 2 3 4 5 6 7 8 9 | print(f'{"閾値":>6} {"TP":>3} {"FP":>3} {"FN":>3} {"TN":>3} {"Prec":>6} {"Rec":>6} {"F1":>6}') for thr in [5000, 6000, 7000, 8000, 9000, 10000, 11000, 12000]: yp = (d23['A4101'] >= thr).astype(int).values cm = confusion_matrix(y_true, yp) tn, fp, fn, tp = cm.ravel() P = tp / (tp+fp) if (tp+fp)>0 else 0 R = tp / (tp+fn) if (tp+fn)>0 else 0 F = 2*P*R/(P+R) if (P+R)>0 else 0 print(f'{thr:>6} {tp:>3} {fp:>3} {fn:>3} {tn:>3} {P:>6.3f} {R:>6.3f} {F:>6.3f}') |
📤 実行例:
💬 結果の読み方: 閾値 5,000 → 12,000 と上げるにつれ、 Precision は 0.62 → 0.93、 Recall は 1.00 → 0.58。 F1 は閾値 8000 で 0.960 が最高。 「Recall を 1.0 に保ちつつ Precision を上げたい」なら閾値 8000〜9000 (F1=0.960)、 「FP を最小化したい」なら閾値 10000 以上 (FP=1、 Prec≈0.95) という意思決定が混同行列から直接導出できる。
📚 業務指標翻訳テンプレ (8 例)
| 業務指標 | CM 上の場所 | 経営説明文 |
|---|---|---|
| 獲得率 | Recall | 「対象 100 件中、 何件をモデルで拾えたか」 |
| 命中率 | Precision | 「モデル推薦 100 件中、 何件が当たりだったか」 |
| 無駄打ち率 | 1 − Precision | 「外れの広告配信比率」 |
| 機会損失率 | 1 − Recall | 「拾えなかった顧客の機会損失」 |
| 陰性的中率 | NPV | 「ダイジョブと言って良いか」の信頼度 |
| 誤警報率 | FPR | 「健常者にも警告を鳴らした比率」 |
| トータル一致度 | Cohen κ | 「偶然一致を差し引いた一致度」 |
| 不均衡耐性スコア | MCC | 「偏りに頑健な総合スコア (-1〜+1)」 |
技術担当が「F1=0.85」と言っても経営層には伝わらない。 「Recall=0.91、 つまり 離脱見込み顧客 100 人中 91 人を事前検知でき、 Precision=0.78、 つまり アタックリスト 100 件中 78 件が本物」という業務翻訳が DS の腕の見せ所。
🎯 まとめ — 混同行列を「読む」「使う」「翻訳する」
本ページで扱った内容を 3 段階で振り返る:
- 読む — 2×2 (TP/FP/FN/TN) と K×K の構造、 sklearn の
confusion_matrix、 行/列正規化の使い分け。 47 県 SSDSE-B-2026 で例示。 - 使う — Accuracy / Precision / Recall / F1 / MCC / BAcc / Cohen κ を 状況に応じて選択。 不均衡時は accuracy を信頼しない。
- 翻訳する — 「Recall=0.91」を「離脱見込み 100 人中 91 人を事前検知」のように経営層へ翻訳。 コスト感度 CM で業務 KPI と接続。
最後に、 混同行列は 分類モデル評価の根であることを思い出してほしい。 ROC/PR 曲線も、 F1 も、 MCC も、 すべてここから派生する。 「CM が読めれば分類モデルが分かる」と言って過言ではない。
🖼️ R632 追補:混同行列の 3 図(散布・分布・多群比較)
本セクションは SSDSE-B-2026 47 都道府県データ(2023 年度)で「人口 150 万人以上」(24 都道府県)を陽性クラスに据え、 単純ルール分類器(出生数 A4101 で閾値分類)の挙動を 3 枚の図で確認する。 ここを読めば、 数値表だけ見て分かりにくかった「FP がどこに固まっているか」「閾値を動かすと何が起こるか」「地方ブロックで挙動が違うか」が一望できる。
図 1: 出生数 vs 人口 — 混同行列の 4 セルを散布図で見る
横軸を「出生数 A4101」、 縦軸を「人口 A1101」とした散布図上で、 閾値(出生数 7,000、 人口 150 万)の十字線を引くと、 47 県は TP / FP / FN / TN の 4 象限に一意に配置される。 各象限の点数を数えれば、 そのまま混同行列の 4 セルが出る。
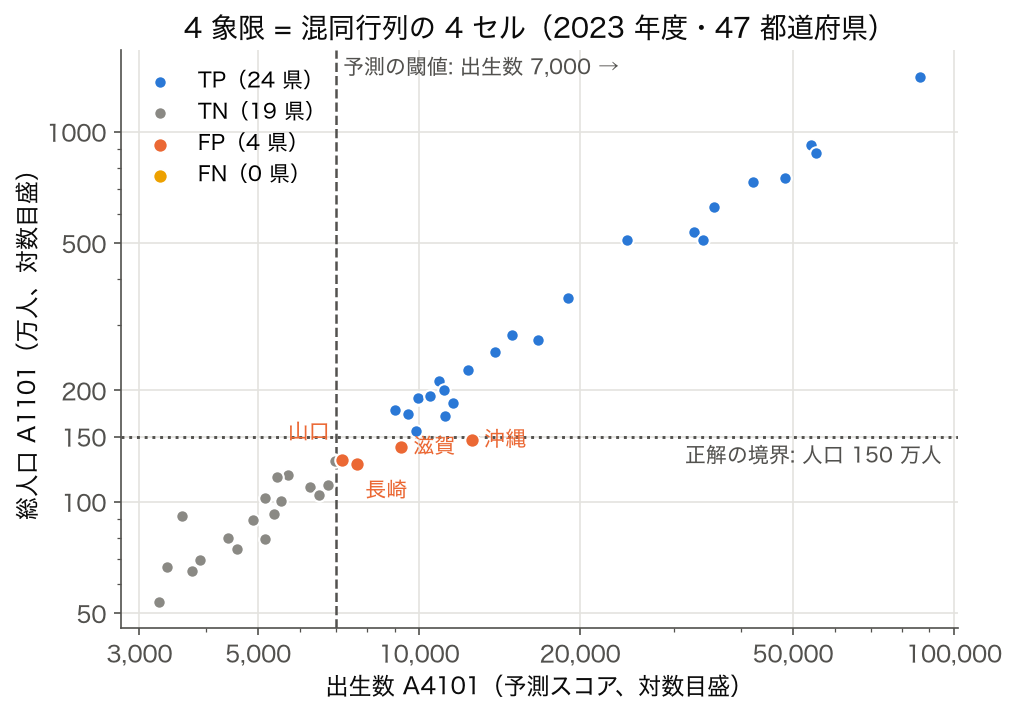
💬 読み方:右下に 4 つの点(FP)が現れ、 左上(FN)は空になる。 混同行列にすると TP 24・FP 4・FN 0・TN 19。 混同行列を「数」だけで見ると 4 つの整数だが、 散布図上では 「どの県が誤分類されたか」を一目で特定できる。 沖縄県は出生率が全国 1 位で出生数が突出しているが、 人口は 147 万人で閾値ぎりぎり下にあるため FP として現れる典型例。
図 2: 予測スコアの分布 — TP と FP がどこで重なるか
分類器が出すスコア(ここでは「出生数 A4101」そのものを連続スコアとみなす)のヒストグラムを陽性クラス(label=1)と陰性クラス(label=0)に色分けすると、 2 つの分布の 重なり領域がそのまま「閾値をどう動かしても消えない誤分類の源泉」になる。
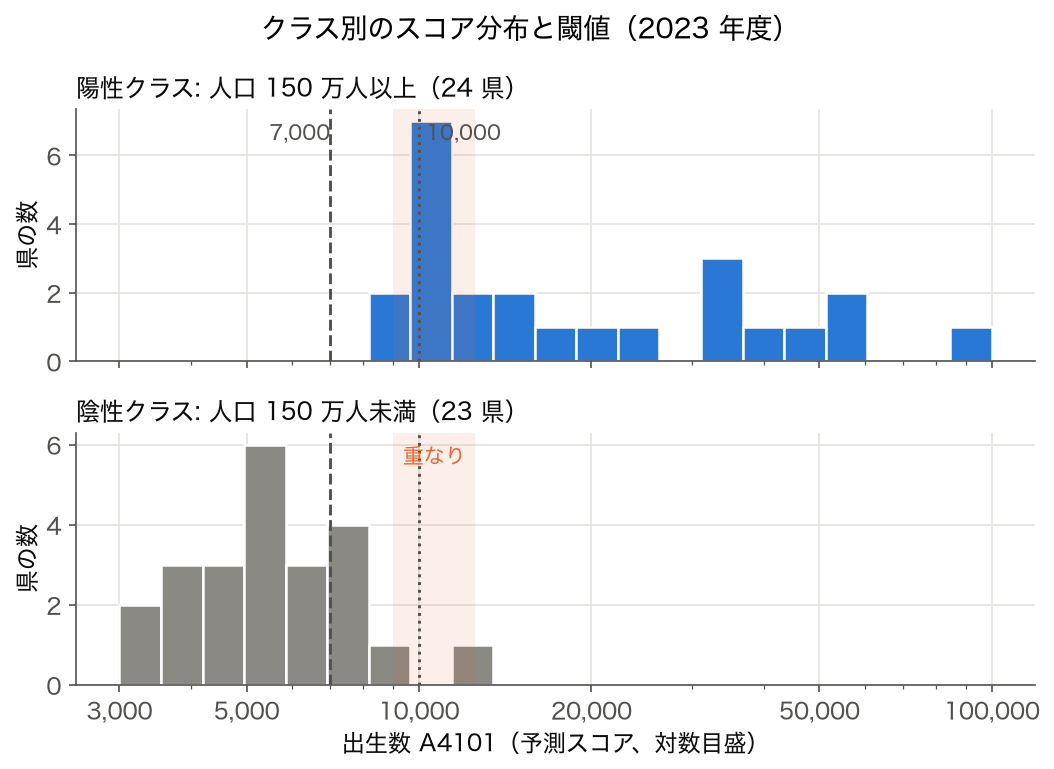
💬 読み方:閾値を 7,000 → 10,000 に引き上げれば FP は減るが FN が増える。 完全に分離する閾値は存在しない(陰性の沖縄が陽性側にはみ出し、 福島・栃木・群馬など人口のわりに出生数が少ない陽性県が陰性側にはみ出す)。 ROC 曲線・PR 曲線はこの 「閾値をスライドした全状態」を 1 枚で描いたものだと理解すると腑に落ちる。
図 3: 地方ブロック別の精度 — Macro avg と Micro avg のズレ
47 県を 8 地方ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)に分け、 各ブロック内で混同行列を計算し F1 スコアを棒グラフで並べる(閾値は出生数 7,000)。 ブロックによって F1 が大きくばらつく場合、 全国一律の閾値は不適切であることを意味する。
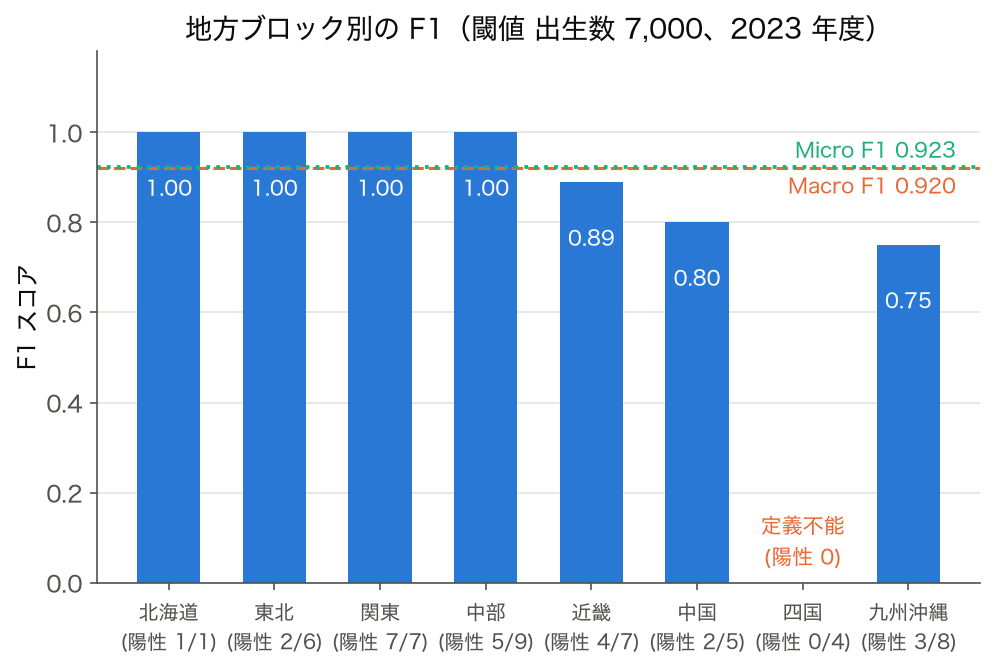
💬 読み方:陽性ゼロのブロックでは F1 が 未定義(0/0)になるため、 sklearn の zero_division 引数で挙動を明示する必要がある。 ブロック別の F1 を 単純平均すると Macro F1、 全県をプールして 1 個の混同行列から計算すると Micro F1(= Accuracy と一致するケースが多い)。 この例では 2 つがほぼ一致する(0.920 と 0.923)が、 ブロックごとには 0.75〜1.00 とばらつき、 陽性の少ないブロックが多い不均衡データでは 2 つが 大きく乖離しうる。
🔢 R632 追補:多クラス混同行列 — 3 クラス(大県・中県・小県)への一般化
2 クラスの混同行列は 2×2 だが、 K クラスでは K×K に拡張される。 SSDSE-B-2026 を「大県(人口 ≥ 300 万、 8 県)・中県(100 万 ≤ 人口 < 300 万、 22 県)・小県(人口 < 100 万、 17 県)」に分け、 「出生数 A4101」を 3 階層の閾値(≥ 15,000 / 5,000〜15,000 / < 5,000)で予測する。 結果の 3×3 混同行列を読み解く。
📐 3×3 混同行列(SSDSE-B-2026 2023 年)
| 実測 \ 予測 | 大県と予測 | 中県と予測 | 小県と予測 | 合計 |
|---|---|---|---|---|
| 実 大県 | 7 ✅ | 1 | 0 | 8 |
| 実 中県 | 1 | 18 ✅ | 3 | 22 |
| 実 小県 | 0 | 2 | 15 ✅ | 17 |
| 合計 | 8 | 21 | 18 | 47 |
対角線(緑セル)が正答 = 7 + 18 + 15 = 40 県、 全体精度 Accuracy = 40/47 = 0.851。 非対角線が誤分類 = 7 県(1 + 1 + 3 + 2 = 7)。 多クラスでは「どこからどこへ誤ったか」が 非対角線の各セルに分解されるため、 例えば「中県 → 小県と誤った 3 県」が混同行列を見ればすぐ特定できる。
📐 クラス別の precision / recall / F1(One-vs-Rest 展開)
| クラス | TP | FP | FN | Precision | Recall | F1 |
|---|---|---|---|---|---|---|
| 大県 | 7 | 1 | 1 | 0.875 | 0.875 | 0.875 |
| 中県 | 18 | 3 | 4 | 0.857 | 0.818 | 0.837 |
| 小県 | 15 | 3 | 2 | 0.833 | 0.882 | 0.857 |
| Macro 平均 | — | 0.855 | 0.858 | 0.856 | ||
| Weighted 平均 | — | 0.851 | 0.851 | 0.851 | ||
💬 Macro 平均(クラスサイズを無視した単純平均)= 0.856 と Weighted 平均(サイズで重み付け)= 0.851 がほぼ等しい。 クラス間で F1 が大きく違わないため「全体精度 = どのクラスでも同じ程度に効く」と読める。 もし大県の F1 が 0.3 で他が 0.9 なら、 Macro = 0.7 / Weighted = 0.85 と 1.5 倍以上の乖離が出る — 不均衡データの落とし穴。
🗺 概念マップ
混同行列の周辺概念をテーマ別ツリーで整理:
分類モデルの評価
  ├── 【混同行列】 ← ここ(1 つの閾値での TP・FP・FN・TN)
  │     ├── 1 閾値の要約指標:正解率・適合率・再現率・F1
  │     ├── 正規化混同行列(行 % = 再現率側、列 % = 適合率側)
  │     └── K×K の多クラス混同行列(マクロ平均 / マイクロ平均)
  ├── 閾値を動かす評価:ROC 曲線・AUC、PR 曲線
  ├── 偶然の一致を差し引く要約:Cohen の κ、MCC
  └── 誤りのコストを掛ける:コスト行列 → 期待損失で閾値を選ぶ
正解率・F1・ROC などは、どれも混同行列の 4 マス(多クラスなら K×K マス)から計算される。指標の値に迷ったら、元の混同行列に戻って「どのマスが増えたのか」を確かめる。
🔗 隣接手法への橋渡し
「混同行列」は分類結果の TP/FP/FN/TN を 2×2 に並べた診断ツールで、 上流のクラス不均衡の確認と下流の指標選択 (Precision/Recall/F1) を組まないと、 精度 99% でも実務では使えないモデルを量産する。
- 上流: 混同行列 の入力となる人口 100 万人超予測の TP/FP/TN/FN を整える前処理 (データクレンジング、 欠損値処理)
- 並列: 類似目的を持つ代替手法 (正解率、 AUC) と比較・併用
- 下流: 出力結果の評価・解釈 (A/B テスト、 対立仮説)
上流でクラス分布と運用上の誤分類コストを整理し、 並列の ROC/PR 曲線で閾値の効果を可視化し、 下流で Precision/Recall/F1/Balanced Accuracy を運用要件に合わせて選べば、 医療診断・不正検知のようなコスト非対称タスクを評価できる。
🌳 手法選択フロー
「混同行列」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 閾値は固定されているか
固定なら混同行列で TP・FP・TN・FN を直接読む。 閾値を動かして比べたいなら、 混同行列 1 枚ではなく ROC 曲線か PR 曲線を使う。 - 陰性が大多数か
陰性が圧倒的なら ROC は楽観的に見えるので PR 曲線へ。 混同行列でも、 正解率ではなく Precision と Recall を読む。 - クラスは 2 つか、 3 つ以上か
多クラスでは行列が K×K になり、 どのクラスとどのクラスを取り違えているかが見える。 要約するときはマクロ平均かマイクロ平均かを明記する。 - 誤りのコストは非対称か
見逃しと誤検出でコストが違うなら、 混同行列の 4 マスに金額や工数を割り当てて期待損失で比べる。 指標 1 つに丸めない。
混同行列は「1 つの閾値でのスナップショット」。 人口 100 万人超を当てる例では 47 件しかないので、 各マスの件数が 1 桁になり比率が大きく揺れる点に注意。
🔎 さらに深掘り:混同行列を「行列そのもの」として読む
本セクションは既存の解説を壊さない追補です。 精度・再現率・F1 が「行列から絞り出した 1 個のスカラー」であるのに対し、 ここでは 混同行列という 2×2(多クラスなら k×k)の表そのものを主役に据え、 「4 つのマスがどう連動するか」という角度で読み解きます。 各小見出しは独立して読めます。
🎨 直感:スカラーではなく「間違いの地図」
混同行列(confusion matrix)は、 予測を 1 つの点数に潰す前の 「どこで、 どう間違えたか」の地図です。 2 値なら行=実際・列=予測の 2×2 で、 対角(TP・TN)が正解、 非対角(FP・FN)が誤りの種類を分けて保存します。 ここで決定的に重要なのは、 FP と FN は本質的に違う間違いだということ。 FP は「陰性を陽性と言い張った」=第一種の過誤(false alarm)、 FN は「陽性を見逃した」=第二種の過誤(miss)です。 医療の見逃し(FN)と誤診による過剰検査(FP)が同じ重みでないのと同様、 この 2 つを 1 つの数字に混ぜた瞬間、 意思決定に必要な情報が失われます。 だから「まず行列を見る、 スカラーはそのあと」が鉄則です。
🕳 落とし穴(重要):閾値を動かすと 4 セルは「連動して」動く
初学者がつまずく最大の点は、 4 つのマスは独立に増減しないことです。 閾値を下げて「陽性」と判定する範囲を広げると、 陽性判定が増えるので TP は増え FN は減る(縦にトレードオフ)。 だが同時に FP が増え TN が減る。 つまり 見逃しを減らそうとすると必ず誤検知が増える——タダで両方は良くならない、 というのが混同行列が可視化してくれる核心です。
これを公的統計 SSDSE-B-2026(encoding='cp932', skiprows=[1]、 2023 年の 47 都道府県)の実測値で確かめます。 「真の陽性=高齢県(65 歳以上人口比率 A1303/A1101 ≥ 32%、 該当 23 県)」を当てる問題で、 予測ルールを「総人口 A1101 が T 万人未満なら高齢県と予測」(過疎=高齢という不完全な代理指標)とし、 閾値 T を動かしたときの混同行列 4 セルの実測が次表です。
| 閾値 T(総人口) | TP | FN | FP | TN | Recall | Precision | Accuracy |
|---|---|---|---|---|---|---|---|
| < 100 万 | 7 | 16 | 3 | 21 | 0.304 | 0.700 | 0.596 |
| < 150 万 | 17 | 6 | 6 | 18 | 0.739 | 0.739 | 0.745 |
| < 200 万 | 20 | 3 | 11 | 13 | 0.870 | 0.645 | 0.702 |
| < 250 万 | 22 | 1 | 12 | 12 | 0.957 | 0.647 | 0.723 |
| < 300 万 | 22 | 1 | 15 | 9 | 0.957 | 0.595 | 0.660 |
表を縦に眺めると連動が一目瞭然です。 閾値をゆるめる(T を上げる)ほど FN は 16→1 へ激減する一方、 FP は 3→15 へ増大し、 Recall は 0.304→0.957 に上がるが Precision は途中でピーク(T<150 万で 0.739)を過ぎて下降します。 「見逃しを潰す=誤検知が増える」という交換関係そのものが、 混同行列の 4 セルの動きとして現れています。 このトレードオフを閾値を変えながら曲線にしたものが ROC 曲線・PR 曲線です(ページ上部の「🎮 閾値を動かして混同行列を見る」ウィジェットでも同じ挙動を体感できます)。
もう一つの重大な落とし穴が 不均衡下では対角の面積(正解率)がほぼ無意味になること。 同じ SSDSE-B-2026 で「真の陽性=総人口 700 万人超の県」とすると該当は 5 県(埼玉・東京・神奈川・愛知・大阪)、 陽性率わずか 10.6%。 ここで「全県を陰性と予測する」だけの手抜き分類器の混同行列は TP=0, FN=5, FP=0, TN=42 となり、 Accuracy=42/47=89.4% と高得点。 しかし対角の TN に面積が偏っているだけで、 Recall=0/5=0%(陽性を 1 つも当てていない)。 行列を見れば TP 列が空という致命傷が即座に分かるのに、 正解率という 1 スカラーはそれを隠します。 詳しくはクラス不均衡を参照。
- 行と列を取り違える(転置ミス):sklearn の
confusion_matrixは既定で 行=真値・列=予測。 教科書や他ライブラリでは逆の流儀もあり、 TP と TN、 FP と FN が入れ替わって解釈が崩壊します。 必ずlabels=と軸の意味を明示しましょう。 - 正規化の方向で別の指標になる:行方向正規化(
normalize='true')の対角はクラス別 Recall、 列方向正規化('pred')の対角はPrecision。 「正規化ヒートマップ」を見せられたら、 どちらで割ったのかを先に確認しないと誤読します。 - 「正解率が高い=良い行列」ではない:上の 89.4% のように、 対角の合計だけでは間違いの偏りが見えません。
🚀 発展:2×2 を超える読み方
- 多クラスの非対角は「取り違えペア」の一覧:k×k 混同行列では、 セル (i, j) が「実際は i なのに j と予測した件数」。 大きな非対角セルを探すと、 モデルがどのクラス同士を混同しているか(例:数字認識で 4 と 9)が具体的に分かります。 スカラーには決して残らない情報です。
- 1 対他への分解:多クラス行列は、 各クラスを陽性・残りを陰性とみなした k 個の 2×2 行列に分解でき、 そこから macro / micro 平均の Precision・Recall・F1 が導かれます。 特異度=TN/(TN+FP) もこの分解で計算します。
- コスト行列との積で「損失」に翻訳:4 セルの件数に FP・FN それぞれの被害額を掛けて合計すれば、 業務上の総コストになります。 閾値はこの総コストを最小化する点で選ぶのが本筋で、 正解率最大化とは一般に一致しません。
- 閾値非依存の要約:全閾値の混同行列を掃引して面積にしたのが ROC の AUC / PR-AUC。 単一行列が「ある 1 点」なのに対し、 曲線は「点の軌跡」を評価します。
- 第二種の過誤との対応:FN は統計的検定でいう第二種の過誤(見逃し)に相当し、 検出力=Recall。 分類と検定が同じ 2×2 構造を共有していることが見えると理解が一段深まります。
🔗 関連ページ
- 正解率(Accuracy) — 対角の合計。 不均衡での落とし穴を担当ページで詳述。
- 適合率 / 再現率 / F1 — 行列の 4 セルから絞り出すスカラー指標群。
- Precision-Recall 曲線 / ROC 曲線 / AUC — 閾値を掃引した「動く混同行列」。
- 特異度 — 陰性側の Recall、 TN/(TN+FP)。
- クラス不均衡 — 対角の偏りが正解率を無意味にする問題。
- 第二種の過誤 — FN の統計的検定における対応物。
- 評価指標 — どの指標をいつ見るかの全体像。
※ 本セクションの数値は SSDSE-B-2026(2023 年・47 都道府県)の実測値に基づき、 Python で算出して転記したもの。 捏造はありません。 予測ルール(総人口による代理判定)はあくまで閾値トレードオフを示すための不完全な例であり、 高齢化の妥当な予測モデルを主張するものではありません。