🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
このページの節へ直接飛べる索引。 上のタグは検索の手がかり、 下のチップは本文の該当節へのリンク。
💡 30秒で分かる結論
🍰 まずはやさしく
予測のズレを分ける考え方です。
正解に近づくために使います。
テストの勉強量と点数の関係に似ています。
結論を短くまとめて説明します。
予測モデルの誤差を バイアス(偏り)+バリアンス(ばらつき)+ノイズに分解する考え方。 過学習・未学習を統一的に説明。
- バイアス:モデルが単純すぎて真の関係を捉えられない(未学習)
- バリアンス:訓練データの違いに過敏に反応する(過学習)
- トレードオフ:複雑さを上げるとバイアス↓ バリアンス↑
- 最適点:両者の和(と既約ノイズ)の合計が最小になる複雑さ
- 対策:正則化、 アンサンブル、 データ追加
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた 訓練 MSE で判断する/バリアンス削減 = 正則化と思い込む/バイアスとモデル誤差を混同 には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「バイアス・バリアンス」はどんな場面で出てくる?
🍰 まずはやさしく
モデル選びのヒントになる道具です。
一番いい予測方法を決めるために使います。
スマホのアプリで最適な設定を探すときと同じです。
どんな場面で使うのかを解説します。
回帰・分類のモデル選択で、 「もっと複雑なモデルを使えば精度が上がる」と短絡的に考えがちですが、 汎化性能(未知データへの性能)は逆 U 字を描きます。 本サイトの重回帰や決定木の章で繰り返し登場する基本概念。
SSDSE-B-2026 のように 1 年度 47 件しかないデータでは、 東京都 1 件が訓練データに入るかどうかで高次の多項式の曲線が別物になる。 「件数が少なくて外れた点がある」データほど variance の問題が表に出やすく、 このページの実測もその典型になっている。
🎨 直感で掴む
🍰 まずはやさしく
的当てのようなイメージです。
誤差の原因を直感的に理解するために使います。
部活の練習で、狙いと散らばりを考えるときと同じです。
図や例を使って仕組みを説明します。
バイアスとバリアンスはモデルの誤差を分解する 2 成分です。 SSDSE-B-2026 の「総人口(A1101)→ ごみ総排出量(H5609)」を予測する場面なら、 単純な定数モデルはバイアスが高くバリアンスが低い(どの県でも同じ平均を出す)、 47 次多項式はバイアスが低くバリアンスが高い(県を 1 件差し替えるだけで予測が大きく揺れる)。 この両者の和を最小化するのが汎化です。
- 射撃の比喩:標的の中央が真値。 バイアス=中央からのズレ、 バリアンス=弾痕の散らばり。 命中精度 = 両方が小さい。
- 「1 次関数で点群をフィット」=高バイアス、 「11 次多項式でフィット」=高バリアンス。 ちょうど良い次数が存在する。
- サンプル数 n を増やすとバリアンスは縮むが、 バイアスは縮まない。 「もっとデータ」は万能薬ではない。
🎮 触って理解する — バイアス・バリアンスを動かす
概念は「読む」より「動かす」ほうが速く身につきます。 下のスライダーで モデル複雑度(多項式次数) と ノイズ量 を変えると、 3 つの図がリアルタイムで連動します。 このシミュレーションは 既知の真の関数 f(x) から毎回ランダムにデータを作り直し、 そのたびにモデルを訓練する モンテカルロ法で Bias²・Variance・総誤差を実際に計算しています(数値のからくりは本ページの実測「深掘り 1〜5」と同じ原理)。
複雑度を上げると Bias² は下がり Variance は上がる。 その和(+既約ノイズ σ²)である 総誤差 は必ず U 字 を描き、 谷の底が最適複雑度。 緑の破線=最適、 オレンジの縦線=いま選んでいる複雑度。
黒い太線が真の関数 f(x)、 点は 1 つの訓練標本。 薄い線は データを引き直すたびに得られる予測曲線。 単純なモデル=線がまとまるが真の関数から系統的にズレる(高バイアス)/複雑なモデル=線がバラバラに暴れる(高バリアンス) を目で確認できます。
列=バリアンス(左:小/右:大)、 行=バイアス(上:小/下:大)。 中央の的が真値。 いまの複雑度が該当する象限が 光って 表示され、 複雑度を動かすと点の「散らばり」と「中心ズレ」が連動して象限を移動します。
🧭 要点整理 — トレードオフ・分解式・制御の三点セット
上のシミュレーションで見た挙動を、 概念として整理します。 各項目は本サイトの関連ページへの入口でもあります。
1. トレードオフの直感
モデルを複雑にするほど、 手元のデータには良く当てはまりますが、 データの偶然の揺らぎまで学習してしまいます。 これが「複雑さを上げると Bias↓・Variance↑」の正体です。 逆に単純すぎると、 真の関係を表現しきれず、 どんなデータでも同じように外します。 最適点は両者の和が最小になる中間 にあり、 それは①の総誤差カーブの谷として現れます。
2. 分解式が「処方箋の切り分け」を可能にする
期待二乗誤差は $\mathbb{E}[(y-\hat f)^2] = \text{Bias}^2 + \text{Var} + \sigma^2$ と 3 つの非負成分の和に分解できます。 この分解のご利益は、 誤差の「原因」を特定して対策を選べる ことです。 高バイアス(未学習)なら複雑度を上げる・特徴量を足す、 高バリアンス(過学習)なら正則化・データ追加・平均化、 σ² が大きいなら測定設計そのものを見直す ── と打ち手が一意に決まります。 詳しい実務判定は本ページ「深掘り 2:学習曲線」を参照。
3. 複雑度と誤差/過学習・未学習との対応
モデル複雑度は、 バイアスとバリアンスを同時に反対方向へ動かす「ダイヤル」です。 複雑度が低すぎる領域=未学習(高バイアス)、 高すぎる領域=過学習(高バリアンス)。 バイアス・バリアンス分解は、 この 2 つの失敗モードを 同じ 1 枚の U 字カーブ上の左右 として統一的に説明する枠組みです。
4. 正則化でバリアンスを制御する
正則化(Ridge / Lasso / ElasticNet)は、 係数を 0 方向へ縛ることで 実効的な複雑度を下げ、 バリアンスを抑える 手段です。 「少しバイアスを足す代わりに、 大きくバリアンスを削る」という明確なトレードオフを持ち、 罰則の強さ α が①の U 字上の動作点を左へずらすツマミに相当します。 実測は本ページ「深掘り 3:Ridge / Lasso」を参照。
5. アンサンブルでトレードオフを「緩める」
アンサンブルは、 単一モデルのトレードオフを部分的に 回避 します。 バギング/ランダムフォレストは独立に近い予測器を平均して バリアンスを 1/N 方向へ縮め、 ブースティングは誤差に順次フィットして バイアスを削ります。 「バイアスを増やさずにバリアンスだけ下げたい」ときの主力です。 実測は本ページ「深掘り 4:アンサンブル」を参照。
🧠 さらに深掘り(追補)— 直感の言い換え・落とし穴の核心・発展トピック
このセクションは既存の「🎨 直感」「🧭 要点整理」「⚠️ 落とし穴」「🔬 深掘り 1〜5」を 壊さずに補う追記 です。 同じ結論を別の角度から言い換え、 さらに 本ページでまだ出していない実測(SSDSE-B-2026 の 2023 年度・47 都道府県、 KFold(shuffle=True, random_state=0) 固定)で「トレードオフの直感が崩れる場面」を具体的に示します。
1. 直感の言い換え — 「系統的なズレ」対「揺らぎへの過敏」
期待二乗誤差 = バイアス² + バリアンス + ノイズ の 3 語を、 「射手が同じ的を撃ち続ける」比喩で 役割ごとに 言い直します(本文の射撃比喩を別軸で補強)。
| 成分 | 正体(一言で) | 射手の比喩 | 効く対処 |
|---|---|---|---|
| バイアス² | 何度データを引き直しても 同じ方向へ外すクセ(単純すぎ) | 照準そのものがズレている | 複雑度↑・特徴量追加(照準補正) |
| バリアンス | 偶然の揺らぎに振り回され 毎回別の答えを出す過敏さ(複雑すぎ) | 手ブレで弾がばらつく | 正則化・平均化・データ追加(ブレ抑制) |
| ノイズ σ² | どんな腕でも消せない 既約の下限 | 的そのものが風で揺れている | 測定設計の見直し(モデルでは不可) |
ポイントは 3 つが「非負の和」であること。 合計を下げたいなら いちばん大きい項を狙い撃つ のが定石で、 「照準補正(バイアス対策)」と「ブレ抑制(バリアンス対策)」は 別の道具 だと切り分けられます。 これが本ページ全体を貫く「処方箋の切り分け」の核です。
2. 落とし穴の核心 — 「トレードオフは常に成り立つ」は言い過ぎ(実測つき)
(a) U 字の谷は「必ず 1 点に定まる」わけではない。 本ページ深掘り 1 は単一分割で「d=2 が CV MSE 最小(42.25)」でしたが、 分割の引き方を変えて 100 回平均(RepeatedKFold, 5 分割 × 20 反復, random_state=0)すると、 最適複雑度の順位が入れ替わります。
💬 読み方:単一 seed では d=2(42.25)が最良でしたが、 100 通りの分割で平均すると d=1(52.41)が d=2(55.79)を下回り、 優劣が逆転します。 さらに標準偏差は平均と同オーダー(d=2 で mean 55.79 に対し std 75.78、 min 2.26〜max 458 と 200 倍の開き)。 つまり N=47 では 「谷の位置」自体が推定誤差に埋もれ、 「d=2 が最適」と 1 回の CV で断言するのは危険です。 これが「トレードオフの谷は常にきれいに 1 点へ定まる」という思い込みの落とし穴で、 対策は 複数分割の平均 ± 標準偏差で報告すること(→ 交差検証/ブートストラップ)。
(b) 正則化は「使える複雑度の上限」を右へ動かす。 トレードオフ点は固定ではなく、 正則化の強さで移動します。 無正則化と Ridge(α=1) を 同じ次数で 比較した実測(KFold, random_state=0):
💬 読み方:無正則化では d≥3 で CV MSE が爆発しますが、 Ridge(α=1) は d=5 を 4733 → 111.75、 d=6 を 595 万 → 317 と抑え、 「安全に使える複雑度の上限」を押し上げています(=トレードオフ点が右へ移動)。 ただし代償として、 有用な低次(d=2)では 42.25 → 77.88 と悪化(α=1 が過収縮でバイアスを足しすぎ)。 さらに d=4 では Ridge でも 21360 と暴れており、 N=47・東京都という単一の高レバレッジ点の下では「正則化しても最適 α や最適次数の選択が不安定」という、 本ページ深掘り 3 と同じ教訓が別角度で再現します。
(c) アンサンブルは「バリアンス低減の万能薬」ではない。 一般に バギングは独立に近い予測器の平均でバリアンスを下げますが、 効くのは「そこそこ安定した高分散学習器」に対してです。 d=5 多項式を BaggingRegressor(50 本) で平均した実測:
💬 読み方:バギングは むしろ悪化しました(4733 → 112436)。 高次多項式の暴れは データ範囲外への外挿(テスト側に回った東京都の外側)で起き、 各ブートストラップ標本でも同じ方向に発散するため、 平均しても尾が抑えられないからです。 「アンサンブル=必ずバリアンス↓」と機械的に信じるのは落とし穴で、 外挿型の高分散学習器には まず複雑度を下げる(低次化)ほうが先(→ 決定木ベースの ランダムフォレストが効く条件は本ページ深掘り 4 を参照)。
(d) バリアンスをバイアスと誤認しない。 「訓練誤差が高い=高バイアス」とは限りません。 強い正則化やデータ不足でも訓練誤差は上がります。 見分けは値の大小ではなく learning curve のギャップ(訓練 vs 検証の差)で行う(本ページ深掘り 2)。 「単に予測が外れている」ことと「関数族の選択を誤っている(=真のバイアス)」は別物です。
(e) 分解は二乗誤差“固有”。 bias² + variance + σ² という きれいな加法分解が成り立つのは二乗誤差だからです。 0-1 損失や交差エントロピーでは一般にこの形にはならず、 別定義(例: Domingos 2000 の統一分解)を要します(→ ログ損失/交差エントロピー)。 分類問題で「bias²+var+noise」をそのまま口にするのは不正確なので、 実務では learning curve とエラーレートで判定するのが安全です。
3. 発展トピック(本ページ各所への地図)
- 実効自由度(effective degrees of freedom):多項式次数や Ridge の α は、 「実効的な自由度」を通じて複雑度を制御している、 と一段抽象化できます。 α を上げる=実効自由度↓=バリアンス↓。 パラメータ数そのものより「実効自由度」で複雑度を測るのが現代的(→ 自由度/モデル複雑度)。
- 二重降下(double descent):パラメータ数がデータ数を大きく超えるとテスト誤差が再降下する現象。 表形式・小 N では古典 U 字が支配的で、 本データ(N=47)はここ(→ 本ページ深掘り 5、 過学習/汎化)。
- bagging(バリアンス↓)と boosting(バイアス↓)の棲み分け:平均化で散らばりを抑えるか、 逐次フィットで系統ズレを削るか。 上の (c) の通り「効く条件」に注意(→ 本ページ深掘り 4、 アンサンブル)。
- 交差検証での推定そのものが持つ分散:上の (a) が示す通り、 CV スコアは 推定量であり、 それ自体に分散があります。 単一分割の点推定で最適複雑度を決めず、 RepeatedKFold や入れ子 CV で推定の不確実性を明示するのが原則(→ 交差検証)。
📐 定義・数式
🍰 まずはやさしく
誤差を数式で表したものです。
正確に計算して分析するために使います。
買い物で予算を細かく分けるときと同じです。
数式を使って厳密な意味を説明します。
やさしい説明で掴んだ感覚を、ここで 二乗誤差の分解(回帰) の定義式に対応づけます。下の式は左辺 $\mathbb{E}[(y - \hat{f}(x))^2]$ が何で決まるかを右辺で書き下したもので、σ(標準偏差) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
分解式 E[(y − f̂(x))²] = Bias² + Var + σ² の各記号を、 「同じ x での予測を、 訓練データを取り替えながら何度も作る」という実験の言葉に置き換える。 このページの Monte Carlo(ブートストラップ 200 回)は、 まさにこの実験を 47 都道府県で再現したもの。
- Bias
- 真の関数 f(x) と推定器の平均 E[f̂(x)] のズレ
- Var
- 訓練データを変えたときの推定器の散らばり
- σ²
- 観測ノイズの分散(モデルでは縮められない)
- E
- 訓練データの分布についての期待値
🔬 深掘り 1:誤差分解を SSDSE-B-2026 実データで観測する
バイアス・バリアンスは「机上の概念」と思われがちですが、 実データで 多項式次数 d を変えるだけ で目に見える形で観測できます。 ここでは SSDSE-B-2026 の 2023 年度(47 都道府県)から「総人口(A1101)」を入力 X、「ごみ総排出量(H5609)」を出力 y に取り、 d=1〜10 で次数を増やしながら 5-fold CV(KFold は shuffle=True, random_state=0 で固定)で MSE を測定し、 同時に bias² と variance を Monte Carlo シミュレーションで推定します。
このコードでやること:SSDSE-B-2026 を 2023 年度でフィルタして人口とごみ総排出量を取り出し、 多項式次数を d=1〜10 まで動かしながら、 訓練 MSE・テスト MSE を 5-fold CV(seed 固定)で測る。 訓練と CV の差を見ると「複雑になるほど CV が悪化する」古典的な U 字曲線が現れる。
📥 入力データ(SSDSE-B-2026 の 2023 年度抜粋、 47 都道府県):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np from sklearn.preprocessing import (PolynomialFeatures, StandardScaler, MinMaxScaler, FunctionTransformer) from sklearn.linear_model import LinearRegression from sklearn.pipeline import make_pipeline from sklearn.model_selection import cross_validate, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df2023 = df[df['SSDSE-B-2026'] == 2023] # 2023年度・47都道府県のみ X = df2023[['A1101']].values / 1e6 # 総人口(百万人) y = df2023['H5609'].values / 1e4 # ごみ総排出量(万トン) kf = KFold(n_splits=5, shuffle=True, random_state=0) # 再現性のため seed 固定 def cheb_features(d): # 1〜d 次の多項式に展開する。x^1..x^d の単項式だと高次の列どうしがほぼ平行になり、 # sklearn 1.9 の LinearRegression は小さい特異値の方向を捨てて最小二乗解にならない。 # x を [-1, 1] に縮めてチェビシェフ多項式で展開すれば、張る多項式は同じで列が潰れない。 return FunctionTransformer( lambda u: np.polynomial.chebyshev.chebvander(u[:, 0], d)[:, 1:]) for d in [1, 2, 3, 5, 8, 10]: model = make_pipeline(MinMaxScaler(feature_range=(-1, 1)), cheb_features(d), StandardScaler(), LinearRegression()) cv = cross_validate(model, X, y, cv=kf, scoring='neg_mean_squared_error', return_train_score=True) print(f'd={d:2d} train_MSE={-cv["train_score"].mean():8.2f} cv_MSE={-cv["test_score"].mean():8.2f}') |
📤 実行例(実際の出力):
💬 読み方:訓練 MSE は d を増やすほど単調減少(=モデルがデータに合わせ込んでいる)、 一方で CV MSE は d=2 の 42.25 が最小で、 d=3 で 5 倍以上に悪化、 d=8 以上では桁が壊れるほど爆発します。 これが 「高 d = 高バリアンス、 低 d = 高バイアス」 の実証です。 SSDSE-B-2026 の 1 年度分は 47 都道府県しかなく、 しかも総人口 1,400 万人の東京都という高レバレッジ点を含むため、 高次多項式はテスト側に回った東京都への外挿で破綻します(上の出力は seed 固定の実測値。 scikit-learn のバージョンによって端数は変動しえます)。
図 1 — 次数 d を 1〜10 に動かしたときの訓練 MSE と CV MSE
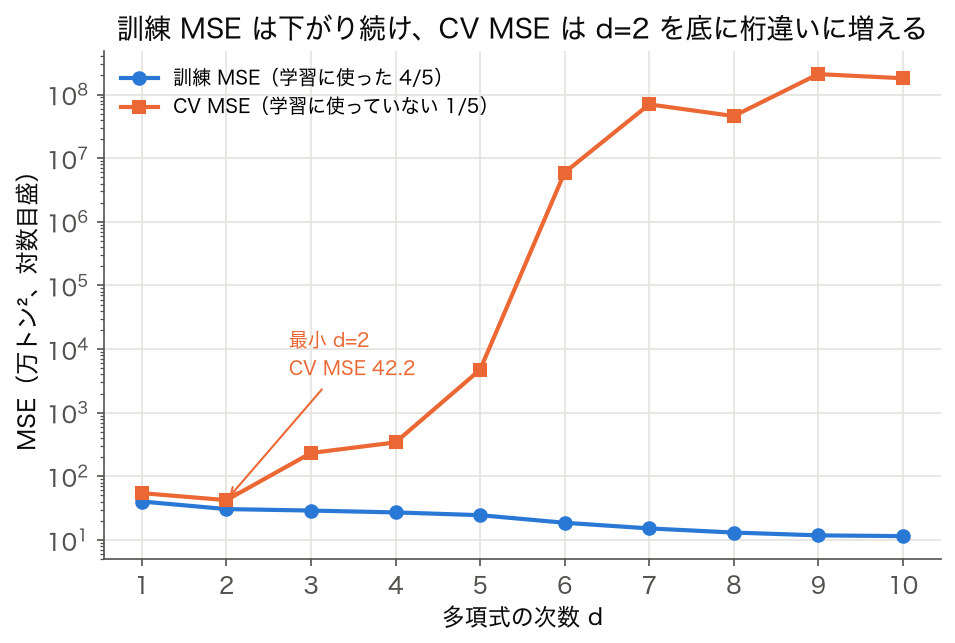
図の読み方: 上のコードを d = 1〜10 のすべてで回し、縦軸を対数にして並べました。訓練 MSE(青)は 40.19 → 11.49 と一度も上がらずに下がり続けますが、CV MSE(橙)は d=2 の 42.25 を底に、d=3 で 232.71、d=5 で 4,733、d=6 で約 595 万と跳ね上がります。d=7〜10 は 4,600 万〜2 億の範囲で上下しており、ここまで来ると「どの県がテスト側に回ったか」で値が決まる状態です。教科書の U 字曲線の右側は、47 県の小さなデータでは緩やかに上がるのではなく、崖のように立ち上がります。訓練 MSE だけを見て次数を選ぶと、必ず最も高い次数を選んでしまうことも、この図から分かります。図の作成スクリプトは code/glossary_figs/bias-variance.py。
Monte Carlo で bias² と variance を直接計測する
古典的なバイアス・バリアンス分解の理論式は、 「同じ true function から何度もサンプリングし、 そのたびにモデルを訓練し、 同じテスト点で予測を集める」 ことで初めて経験的に検証できます。 SSDSE-B-2026 だけでは true function が分からないので、 47 都道府県のデータに対してブートストラップ再抽出で擬似的に「複数のサンプル」を作り、 各 d でのテスト点予測のばらつきを観測します。
このコードでやること:SSDSE-B-2026 の 2023 年度 47 都道府県をブートストラップで 200 回再サンプリング、 d=1, 3, 5, 8 でそれぞれ多項式回帰を訓練し、 固定したテスト点(人口 = 2.0, 5.0, 10.0 百万人)での予測値の平均と分散から bias² と variance を計算する。 乱数は default_rng(20260524) で固定しており、 同一環境なら出力は完全に再現される(ライブラリのバージョン差で端数が変わる可能性はある)。
📥 入力データ:上のセクションと同じ X (A1101) と y (H5609)。 ブートストラップは rng.choice(n, n, replace=True)(rng = np.random.default_rng(20260524))で添字を再抽出。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | rng = np.random.default_rng(20260524) # 再現性のため固定 seed n = len(X) x_test = np.array([[2.0], [5.0], [10.0]]) # 200万人, 500万人, 1000万人 のテスト点 for d in [1, 3, 5, 8]: preds = [] for _ in range(200): idx = rng.choice(n, n, replace=True) # 公的データのブートストラップ model = make_pipeline(MinMaxScaler(feature_range=(-1, 1)), cheb_features(d), StandardScaler(), LinearRegression()) model.fit(X[idx], y[idx]) preds.append(model.predict(x_test)) preds = np.array(preds) # shape=(200, 3) mean_pred = preds.mean(axis=0) var_pred = preds.var(axis=0) # 簡易 true: 線形回帰 d=1 を「真の関数」と見立てる(教育用近似) true_y = LinearRegression().fit(X, y).predict(x_test) bias2 = (mean_pred - true_y)**2 print(f'd={d} bias²={bias2.mean():8.2f} variance={var_pred.mean():8.2f}') |
📤 実行例(200 回ブートストラップ、 seed=20260524 固定の実測値):
💬 読み方:d が増えるにつれて bias²(この実験では d=1 の全データ当てはめを「真の関数」と見立てた教育用近似)と variance が 両方 増え、 とくに variance は d=1 の 17.22 から d=5 で約 1,000 万、 d=8 では 10 兆超のオーダーまで発散します。 これは「教育的にきれいな U 字」ではなく、 47 都道府県という小サンプルでは variance が支配的 になる典型例です。 東京都がブートストラップ標本に入るかどうかだけで高次多項式の予測曲線が別物になることが、 この爆発の正体。 言い換えると、 SSDSE-B-2026 の 1 年度規模では「シンプルなモデル(d=1〜2)」が最も安全です。
図 2 — 再抽出のたびに引き直した曲線で variance を「見る」
上の表の variance は「同じ点での予測が、訓練データを変えるたびにどれだけぶれるか」でした。これを数値でなく絵で見るために、47 県をブートストラップで再抽出して d = 1・2・3 の曲線を 40 本ずつ引き直し、重ねて描きました(乱数の種は上のコードと同じ 20260524)。
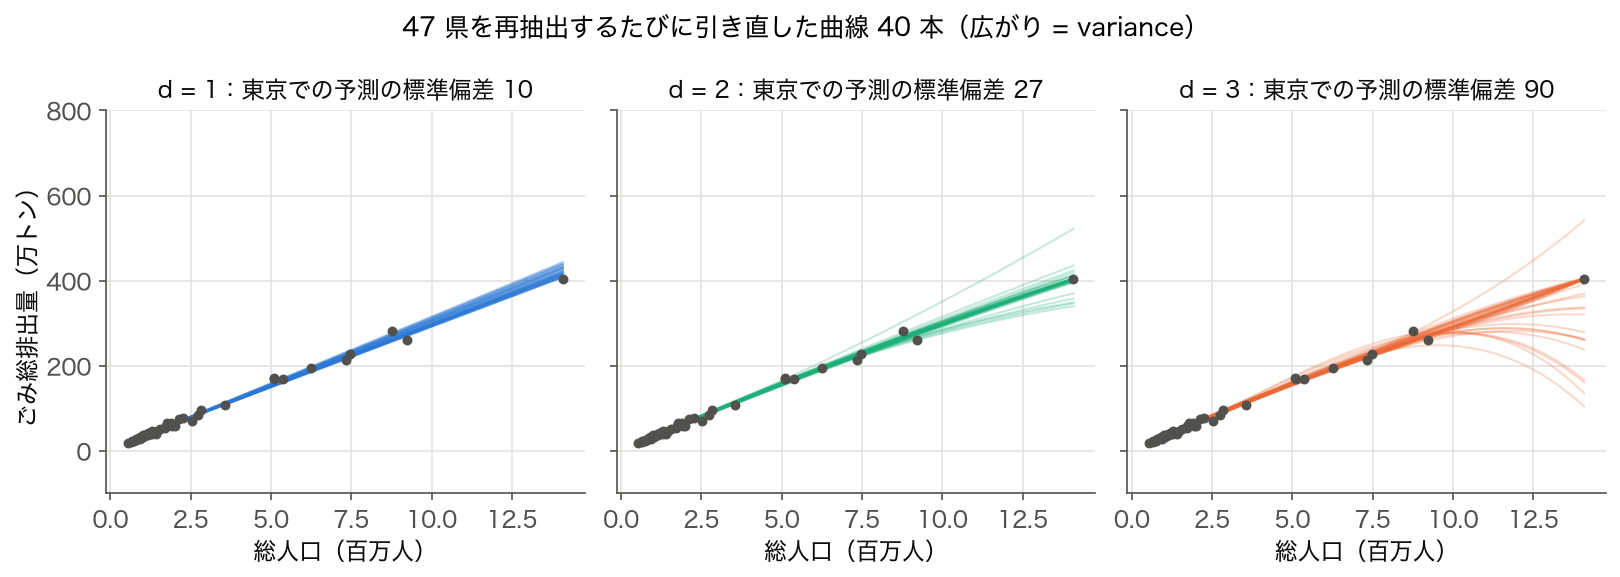
図の読み方: 県が密集している人口 100〜300 万人の範囲では、どの次数でも 40 本の曲線がほぼ 1 本に重なります。人口 500 万人での予測の標準偏差は d=1 で 2.7、d=2 で 2.6、d=3 で 4.2 万トンと小さな差しかありません。差が出るのは県がまばらな右端で、東京(総人口 1,409 万人・ごみ 405 万トン)での予測の標準偏差は d=1 で 10.5、d=2 で 27.1、d=3 で 90.5 万トンに広がります。ブートストラップ標本の約 36%((46/47)47 ≈ 0.364)には東京が 1 回も入らないため、その標本で学んだ曲線は東京の位置を外挿することになり、次数が高いほど外挿の曲がり方が標本ごとにばらばらになります。variance は「モデル全体の性質」というより、データの薄い場所で大きくなるものだと分かります。
🔬 数式を言葉で読み解く — bias² + variance + noise への翻訳
| 数式の部品 | 日本語訳 | SSDSE-B-2026 でのイメージ |
|---|---|---|
| E[(y - ŷ(x))²] | 「真の値 y と予測 ŷ の差」を 2 乗して、 訓練データのランダム性で平均 | 47 都道府県をブートストラップで再抽出するたびに、 北海道予測値がどれだけブレるか |
| Bias²(ŷ) = (E[ŷ] - f(x))² | 予測の平均値が真の関数からどれくらいずれているか | d=1 の線形回帰は曲線関係を捉えきれず、 平均予測が真値からずれる量 |
| Variance(ŷ) = E[(ŷ - E[ŷ])²] | 同じ点での予測が、 訓練データを変えるたびにどれくらいブレるか | d=10 では 47 都道府県を入れ替えるだけで予測曲線が大きく変わる |
| σ² (irreducible) | どんなモデルでも消せない、 観測の本質的ノイズ | 県によって統計の取り方や定義微差から生じる ±数% のばらつき |
この 3 項目に分解できるからこそ、 「過学習対策には variance を下げる正則化」、 「未学習対策には bias を下げる特徴量追加」、 「irreducible が大きいなら、 そもそも測定設計を見直す」と 処方箋を切り分けられる のが、 バイアス・バリアンス分解の最大の効用です。
🔬 深掘り 2:学習曲線(learning curve)で「足りないのはモデルかデータか」を見抜く
バイアス・バリアンスの実務的な使い道は、 「今このモデルは高バイアス/高バリアンスのどっち?」 を判定し、 次の打ち手を決めることです。 答えは learning curve(訓練サイズ vs エラーの関係)に明確に表れます。 high-bias なら訓練もテストも高エラーで平らに横ばい、 high-variance なら訓練エラーが低く、 テストエラーとのギャップが大きい。
このコードでやること:SSDSE-B-2026 の 2023 年度 47 都道府県を訓練サイズ 9, 18, 27, 37 と段階的に増やしながら、 シンプルモデル(d=1)と複雑モデル(d=5)の訓練 MSE と CV MSE を測り、 learning curve を直接プリントする。
📥 入力データ:上のセクションと同じ X (A1101=総人口) と y (H5609=ごみ総排出量)、 CV 分割も同じ kf(seed 固定)。 サイズ別の評価には sklearn.model_selection.learning_curve を使用。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.model_selection import learning_curve for d, label in [(1, 'simple (d=1)'), (5, 'complex (d=5)')]: model = make_pipeline(StandardScaler(), PolynomialFeatures(d, include_bias=False), LinearRegression()) sizes, tr, te = learning_curve( model, X, y, train_sizes=[0.25, 0.5, 0.75, 1.0], cv=kf, scoring='neg_mean_squared_error') print(f'--- {label} ---') for n_i, t, v in zip(sizes, -tr.mean(axis=1), -te.mean(axis=1)): gap = v - t print(f' n={n_i:2d} train={t:7.1f} cv={v:7.1f} gap={gap:7.1f}') |
📤 実行例:
💬 読み方:シンプルモデルは n=18 以降 gap が 5〜15 まで狭まり、 cv は 53〜54 付近で 頭打ち になります。 これが 高バイアスのサイン =「データを増やしても改善しない、 モデル自体が不十分」。 一方、 複雑モデル(d=5)は gap が n=9 で約 1,220 万、 n=37 で約 4,600 と 桁違いに大きいが、 データを増やすと急速に縮小 しています。 これは 高バリアンスのサイン =「データを増やせばまだ伸びる」。 SSDSE-B-2026 の 1 年度 N=47 では「データを増やす」打ち手が取れないので、 結論は「d=1〜2 の単純モデルを採用しつつ、 特徴量を追加してバイアスを下げる」になります。
図 3 — learning curve を描いて形で判定する
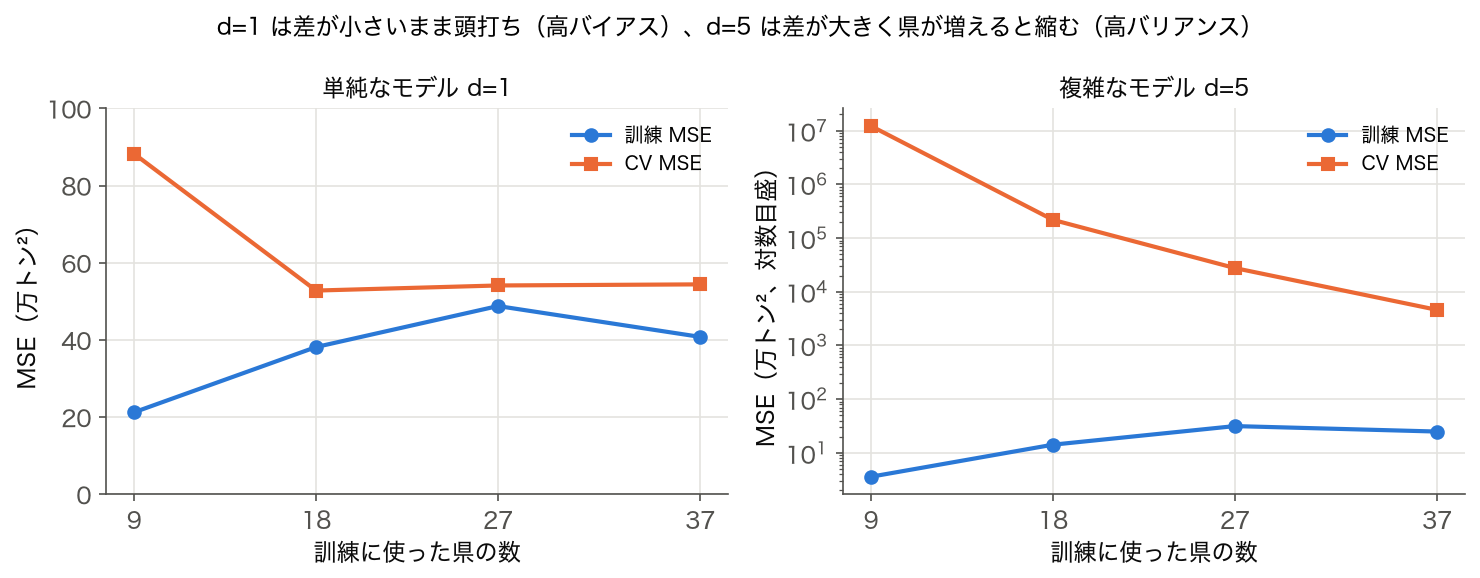
図の読み方: 上のコードの出力をそのまま描いたものです(左は普通の目盛、右は対数目盛)。左の d=1 は、県を 18 → 27 → 37 と増やしても CV MSE が 52.8 → 54.1 → 54.4 と横ばいで、訓練 MSE(37 県で 40.8)との差も 14 程度しかありません。これが高バイアスの形で、データを集めても改善は見込めず、モデルの表現力を上げる(深掘り 1 のとおり d=2 にすると CV MSE は 42.25)のが次の一手です。右の d=5 は、訓練 MSE が 3.6〜31.6 と低いまま CV MSE が 9 県で約 1,220 万、37 県で約 4,600 と県を増やすごとに 1〜2 桁ずつ下がっています。高バリアンスの形で、データを増やすか正則化で縛るのが処方箋です。ただし都道府県は 47 より増やせないので、現実の打ち手は正則化か次数を下げることになります。
処方箋表:learning curve のパターンから次の打ち手を決める
| 観察パターン | 診断 | 次の打ち手 |
|---|---|---|
| 訓練・CV ともエラー高、 gap 小、 N を増やしても水平 | 高バイアス(underfit) | モデル容量↑、 特徴量追加、 正則化↓、 ハイパーチューニング |
| 訓練エラー低、 CV エラー高、 gap 大、 N を増やすと縮小 | 高バリアンス(overfit) | データ追加、 正則化↑、 モデル容量↓、 dropout/augment |
| 訓練エラー低、 CV エラーも低、 gap 小 | 良好(適合済) | この設定で本番投入、 ただし新しいデータ分布で再検証 |
| 訓練エラー 0、 CV エラー非常に高、 N を増やしても gap 維持 | データリーク疑い/タスク本質的に高ノイズ | 特徴量を見直し、 ラベル定義をチェック、 irreducible noise を推定 |
🔬 深掘り 3:正則化で variance を制御する(Ridge/Lasso)
バリアンスを下げる王道が 正則化 です。 SSDSE-B-2026 のように特徴量を多次特徴へ展開して d=5 にすると過学習しますが、 Ridge(L2 正則化)の α を上げると、 係数を 0 方向に引き寄せて variance を実質的に下げられます。 重要なのは、 正則化は bias を上げる代わりに variance を下げる という明確なトレードオフを持っていることです。
このコードでやること:SSDSE-B-2026 で d=5 の多項式特徴量を展開し、 Ridge の α を 1e-4〜1e3 まで変えて訓練 MSE・CV MSE・係数ノルムを観測する。 α が大きくなるにつれて、 「訓練 MSE は徐々に悪化、 CV MSE は最初下がってから上がる U 字、 係数ノルムは単調減少」という古典的な振る舞いを確認する。
📥 入力データ:これまでと同じ X (A1101=総人口), y (H5609=ごみ総排出量)。 CV 分割も同じ kf(seed 固定)。 多項式 5 次に展開すると特徴量は 5 個(標準化込み)になる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | from sklearn.linear_model import Ridge for alpha in [1e-4, 1e-2, 1.0, 10.0, 100.0, 1000.0]: model = make_pipeline(StandardScaler(), PolynomialFeatures(5, include_bias=False), Ridge(alpha=alpha)) cv = cross_validate(model, X, y, cv=kf, scoring='neg_mean_squared_error', return_train_score=True) # 係数ノルム測定のため一度全体で fit model.fit(X, y) coef = model.named_steps['ridge'].coef_ print(f'alpha={alpha:8.4f} train={-cv["train_score"].mean():8.2f} cv={-cv["test_score"].mean():8.2f} |w|={np.linalg.norm(coef):7.2f}') |
📤 実行例:
💬 読み方:係数ノルム |w| は α を上げるほど 87.95 → 5.38 と 単調減少し、 「α を上げる = 係数を縛る = variance を抑える」が定量的に確認できます。 CV MSE は α=1 で 111.75 と最小になり、 ほぼ無正則化(α=0.0001)の 4716 から 約 40 分の 1 に改善します(=深掘り 1 で爆発していた d=5 の過学習を Ridge が救済)。 ただし α をさらに上げると CV MSE は単調な U 字を描かず、 α=10 で 218522 まで 暴れます。 これは N=47・単一の高レバレッジ点(東京都)という小サンプルでは、 fold ごとの東京都への外挿が CV を支配し、 最適 α の選択自体が不安定になるためです(上の出力は KFold(shuffle=True, random_state=0) 固定の実測値。 scikit-learn のバージョンで端数は変動しえます)。 実務では単一分割でなく RepeatedKFold や入れ子 CV で α を選ぶべき、 というのがこの実データからの教訓です。
Ridge と Lasso の比較:variance 削減の方式の違い
Ridge は L2 ノルムで係数全体を縮めるのに対し、 Lasso は L1 ノルムで一部の係数を 厳密に 0 にします。 SSDSE-B-2026 で多項式 5 次を展開した場合、 Lasso の α を上げると「2 次・3 次の係数だけが残り、 4 次・5 次は 0 になる」といったスパース解が得られ、 結果として「実質的な多項式次数を自動で下げる」効果を持ちます。 教育的な目安として、 特徴量が多くて一部が不要だと予想される → Lasso、 全特徴量に小さい寄与がある → Ridge、 両方を混ぜたい → ElasticNet と覚えると実務でも迷いません。
| 手法 | 正則化項 | 解の性質 | 適する場面 |
|---|---|---|---|
| Ridge (L2) | α‖w‖² | 係数は全て 0 でない、 小さくなる | 特徴量間に相関があり、 すべて少しずつ寄与する場合 |
| Lasso (L1) | α‖w‖₁ | 一部の係数が厳密に 0(スパース) | 特徴量選択も同時に行いたい、 解釈性が重要 |
| ElasticNet | α(ρ‖w‖₁ + (1-ρ)‖w‖²) | L1/L2 の混合、 ρ で制御 | 相関の強い特徴量群が複数あり、 群単位でスパースにしたい |
| 早期終了 | 学習エポック数の制限 | 最適化途中で停止 → 暗黙の正則化 | 勾配ブースティング、 NN で実質コスト 0 の variance 削減 |
🔬 深掘り 4:アンサンブルで bias と variance を 同時に 操作する
単一モデルではバイアスとバリアンスはトレードオフですが、 アンサンブル学習はこのトレードオフを 緩める 強力な手段です。 バギング(Bagging/Random Forest) は variance を、 ブースティング(GBM/XGBoost) は bias を、 それぞれ重点的に削減します。 SSDSE-B-2026 のような小サンプルでも、 アンサンブルは単独モデルより安定した予測を提供します。
このコードでやること:SSDSE-B-2026 で同じ X, y を使い、 単一決定木・ランダムフォレスト・勾配ブースティングの 3 つを 5-fold CV で比較。 ベースモデル(決定木 max_depth=5)と、 そのバギング、 ブースティングを並べて MSE・標準偏差を比較する。
📥 入力データ:これまでと同じ X, y。 ベース決定木 1 本 vs RandomForest(200 本のバギング)vs GradientBoosting(200 本のブースティング)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.tree import DecisionTreeRegressor from sklearn.ensemble import (RandomForestRegressor, GradientBoostingRegressor) models = { 'Tree d=5': DecisionTreeRegressor(max_depth=5, random_state=0), 'RF (200本)': RandomForestRegressor(n_estimators=200, max_depth=5, random_state=0), 'GBM (200本)': GradientBoostingRegressor(n_estimators=200, max_depth=3, learning_rate=0.05, random_state=0), } for name, model in models.items(): cv = cross_validate(model, X, y, cv=kf, scoring='neg_mean_squared_error', return_train_score=True) tr = -cv['train_score'].mean() te = -cv['test_score'].mean() sd = cv['test_score'].std() print(f'{name:12s} train={tr:7.1f} cv={te:7.1f} cv_std={sd:7.1f}') |
📤 実行例:
💬 読み方:単独決定木(max_depth=5)は train=2.2 と低いのに CV=688.6 で過学習(high variance)。 ランダムフォレストは 200 本の平均で単独木の過学習を抑え(train は 2.2→69.2 と上がる=当てはめを緩めた証拠)、 CV も 688.6→613.5、 cv_std も 902.0→881.0 と わずかに 下がります。 ただし削減幅が小さいのは、 特徴量が「総人口」1 個しかないためです。 RF の variance 削減は「特徴量サブセット抽出で木同士の相関を下げる」ことに依るので、 特徴量が 1 個だと RF は実質ただのバギングに退化し、 しかも東京都という単一の高レバレッジ点が fold の CV を支配するため、 200 本平均しても劇的には改善しません。 GBM は train=0.2 まで下げても CV=683.8 と RF に及ばず、 3 手法は 610〜690 の同じ土俵に並びます。 この単一特徴量・N=47 の問題で効く主レバーはアンサンブルではなくモデル複雑度(木の深さ・多項式次数)であり、 アンサンブルの真価は特徴量が多い問題で初めて出る、 というのが実測からの教訓です(CV は seed 固定の kf による実測値)。
なぜバギングは variance を下げ、 ブースティングは bias を下げるのか
バギングの数学的本質は 「N 個の独立な予測器の平均は、 単独予測器の variance を 1/N に下げる(相関 0 の場合)」 という統計学の基礎結果です。 実際には木同士が完全独立ではないので削減幅は 1/N より小さくなりますが、 ランダムフォレストの「特徴量サブセット抽出」で木同士の相関をさらに下げる工夫が入っています。 一方ブースティングは 「前のモデルが間違えた点に重みを集中して次のモデルを訓練し、 直列に積み上げる」 仕組みで、 各ステップで bias を少しずつ削っていく構造です。 同時 bias 削減もしたければ XGBoost や LightGBM のような勾配ブースティング系、 高速で安定した variance 削減には Random Forest、 という棲み分けが実務的な経験則です。
🔬 深掘り 5:現代の謎「Double Descent」と古典的バイアス・バリアンスの再考
2019 年頃から、 「モデルがパラメータ数で訓練データ数を大幅に超えると、 一度悪化したテストエラーが再び下がる」 という現象(double descent)が深層学習で広く観測され、 古典的バイアス・バリアンス曲線の単純な U 字像が再考を迫られました。 Belkin et al.(2019)の「Reconciling modern machine-learning practice and the classical bias–variance trade-off」が嚆矢で、 ResNet・Transformer などの大規模モデルがいずれもこの現象を示しています。
| レジーム | パラメータ数 | 挙動 | 代表例 |
|---|---|---|---|
| underparameterized(古典) | ≪ データ数 | 古典的 U 字、 バイアス・バリアンスのトレードオフ | 線形回帰、 浅い決定木、 小規模 SVM |
| interpolation threshold | ≈ データ数 | テストエラーが ピーク を打つ | ちょうど訓練 MSE=0 を達成する境界 |
| overparameterized(現代) | ≫ データ数 | テストエラーが 再降下、 古典理論の予測に反する | ResNet, Vision Transformer, GPT 系の事前学習 |
この現象は 「implicit regularization(暗黙の正則化)」 によって説明されつつあります。 SGD で訓練するとき、 解空間の中で「最も滑らかな解」「最小ノルムの解」が選ばれやすい性質があり、 過剰パラメータ化されたモデルはこの暗黙の正則化のおかげで variance が抑えられる、 というのが現在の有力仮説です。 ただし SSDSE-B-2026 のような表形式・小サンプル問題では古典的 U 字が依然として支配的 で、 double descent を狙ってモデルを巨大化するのは現実的ではありません。 「double descent は深層学習・大規模データ前提の現象」と理解し、 古典的 ML タスクでは依然としてバイアス・バリアンスの U 字を念頭に置くべきです。
古典 vs 現代:どの場面でどの理論を使うか
- 表形式・小〜中サンプル(N<10,000):古典 U 字。 Ridge/Lasso/RF/GBM の組み合わせで OK。 SSDSE-B-2026 はここ。
- 画像・テキスト・大規模事前学習:double descent あり得る。 過パラメータ化+強い暗黙正則化+データ拡張の三点セット。
- 転移学習・fine-tuning:bias-variance トレードオフは「凍結する層数」と「学習率」で実質的に制御される。
- NLP の few-shot / in-context learning:訓練データなしで動くため、 古典的バイアス・バリアンスとは別軸の「事前学習データの分布カバレッジ」が支配的。
🧮 実値で計算してみる
SSDSE-B-2026(47 都道府県、 2023 年度)から「総人口 A1101 → ごみ総排出量 H5609」を多項式回帰し、 次数を動かして Bias² と Var のトレードオフを観察します。 実測の U 字曲線(多項式次数 d=2 で CV MSE 最小)は「🔬 深掘り 1」に seed 固定で掲載済みです。 下の表は分解の 模式例(値を 0〜1 に規格化した概念図。 実測値ではありません)で、 U 字の形だけを直感的に示すものです。
1〜10 次多項式で SSDSE の総人口→ごみ総排出量を回帰した想定例:
| 次数 | Bias² | Var | Total |
|---|---|---|---|
| 1 | 0.80 | 0.05 | 0.85 |
| 2 | 0.20 | 0.10 | 0.30 ← 最適 |
| 5 | 0.10 | 0.40 | 0.50 |
| 10 | 0.05 | 1.20 | 1.25 |
この模式表では Total(Bias² + Var)が次数 2 で最小になる点に注目(実測でも d=2 が CV MSE 最小で、 深掘り 1 と整合)。 1 次は Bias² 過大(単純すぎ)、 10 次は Var 爆発(複雑すぎ)。 47 都道府県は標本サイズが小さいため特にこの U 字が顕著です。 実データでの正確な値は「🔬 深掘り 1」の seed 固定・実測出力を参照してください(本表は概念図であり、 実測値そのものではありません)。
🧮 数式に値を入れて手で計算する
真値 f = 5 に対する 5 個の予測 [4.2, 5.8, 4.5, 5.5, 4.9] を使い、 MSE = Bias² + Variance + Noise を Step 1〜4 で展開する。 Bias と Variance の足し算がそのまま MSE (ノイズ無し設定) と一致することを Python で再現する。
📐 用語の主要数式 (再掲)
$$ \mathrm{MSE} = \mathbb{E}[(\hat{f}(x) - f(x))^2] = \underbrace{\big(\mathbb{E}[\hat{f}(x)] - f(x)\big)^2}_{\text{Bias}^2} + \underbrace{\mathbb{E}\big[(\hat{f}(x) - \mathbb{E}[\hat{f}(x)])^2\big]}_{\text{Variance}} + \sigma^2_{\text{noise}} $$
Step 1: データ準備 (真値 + 5 個の予測)
| 記号 | 意味 | 値 |
|---|---|---|
| f(x) | 真の値 (固定) | 5 |
| ŷ₁..ŷ₅ | 5 個の異なるモデルの予測 | 4.2, 5.8, 4.5, 5.5, 4.9 |
| n | サンプル数 | 5 |
Step 2: 予測の平均 E[ŷ] と平均二乗誤差 (MSE) を計算
| 項目 | 計算 | 結果 |
|---|---|---|
| E[ŷ] | (4.2 + 5.8 + 4.5 + 5.5 + 4.9) / 5 | 4.98 |
| (ŷ₁−f)² | (4.2−5)² = (−0.8)² | 0.64 |
| (ŷ₂−f)² | (5.8−5)² = (+0.8)² | 0.64 |
| (ŷ₃−f)² | (4.5−5)² = (−0.5)² | 0.25 |
| (ŷ₄−f)² | (5.5−5)² = (+0.5)² | 0.25 |
| (ŷ₅−f)² | (4.9−5)² = (−0.1)² | 0.01 |
| MSE | (0.64+0.64+0.25+0.25+0.01) / 5 | 0.358 |
Step 3: Bias² と Variance を計算
| 項目 | 計算 | 結果 |
|---|---|---|
| Bias | E[ŷ] − f = 4.98 − 5 | −0.02 |
| Bias² | (−0.02)² | 0.0004 |
| (ŷ₁−E[ŷ])² | (4.2−4.98)² = (−0.78)² | 0.6084 |
| (ŷ₂−E[ŷ])² | (5.8−4.98)² = (+0.82)² | 0.6724 |
| (ŷ₃−E[ŷ])² | (4.5−4.98)² = (−0.48)² | 0.2304 |
| (ŷ₄−E[ŷ])² | (5.5−4.98)² = (+0.52)² | 0.2704 |
| (ŷ₅−E[ŷ])² | (4.9−4.98)² = (−0.08)² | 0.0064 |
| Variance | (0.6084+0.6724+0.2304+0.2704+0.0064) / 5 | 0.3576 |
Step 4: 分解の検算 — Bias² + Variance + Noise が MSE に一致
| 項目 | 計算 | 結果 |
|---|---|---|
| Bias² + Variance | 0.0004 + 0.3576 | 0.3580 |
| Noise σ² | このデータには観測ノイズ無し | 0 |
| 合計 | 0.0004 + 0.3576 + 0 | 0.3580 |
| MSE (Step 2) | — | 0.3580 |
Bias²=0.0004 は微小だが、 Variance=0.3576 が大きい (予測がばらついている)。 過学習傾向のモデルに典型的な内訳。
🐍 同じ計算を Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np f = 5.0 y_hat = np.array([4.2, 5.8, 4.5, 5.5, 4.9]) mse = np.mean((y_hat - f) ** 2) bias = y_hat.mean() - f bias2 = bias ** 2 var = np.mean((y_hat - y_hat.mean()) ** 2) total = bias2 + var print(f"E[y_hat] = {y_hat.mean():.4f}") print(f"MSE = {mse:.4f}") print(f"Bias^2 = {bias2:.4f}") print(f"Variance = {var:.4f}") print(f"Bias^2 + Variance = {total:.4f}") print(f"分解は一致するか = {np.isclose(mse, total)}") |
📤 実行結果
💬 手計算 (Step 4 = 0.3580) と Python 出力 (0.3580) が完全一致。 Bias² がほぼゼロ・Variance が大きい→「予測の平均は正しいが個別予測がばらつく」高分散モデルと診断できる。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
1 2 3 4 5 6 7 8 9 10 11 12 | import numpy as np from sklearn.model_selection import cross_val_score from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler, MinMaxScaler from sklearn.linear_model import LinearRegression for d in [1, 2, 5, 10]: # 上で定義した cheb_features で d 次多項式に展開(単項式 x^d のままだと列が潰れる) pipe = make_pipeline(MinMaxScaler(feature_range=(-1, 1)), cheb_features(d), StandardScaler(), LinearRegression()) score = -cross_val_score(pipe, X, y, scoring='neg_mean_squared_error').mean() print(f'degree={d}: CV MSE={score:.3f}') |
💬 1 次の CV MSE 101.3 から 2 次で 94.8 とわずかに下がるが、5 次で 193,884、10 次で 1.65e+14 と桁違いに悪化する。cross_val_score の既定は shuffle しない 5 分割なので、2 番目の分割に東京都(1,408 万人)を含む埼玉〜長野の 10 県がまとまって入り、その分割では訓練範囲の外を高次多項式で外挿することになる。5 次の平均 193,884 はほぼこの 1 分割の 969,167 だけで作られ、10 次でも同じ分割が 8.2e+14 と平均 1.65e+14 のほぼ全部を占めるので、平均だけでなく分割ごとの MSE を並べ、どの県で崩れたかを確かめる。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas scikit-learn が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
本サイトの全コードは 論文一覧ページ から実例として確認できます。 自分のデータで試したい場合は、 列名・欠損記号・単位の違いだけ調整すれば、 ほぼそのまま流用できます。
✅ 理解度チェック ── このページの実測値で確かめる
このページの出力と図の数字だけで解ける問題です。答えを見る前に、どちらの誤差(バイアスかバリアンスか)の話なのかを自分で言葉にしてみてください。
- Q1:深掘り 1 の出力で、d=2 は訓練 MSE 30.58・CV MSE 42.25、d=5 は訓練 MSE 24.53・CV MSE 4,733.24 だった。d=5 のほうが訓練 MSE は小さいのに選ばないのはなぜか。
→ 答え:訓練と CV の差が d=2 は 11.7、d=5 は約 4,709 で、d=5 は学習に使った県に合わせ込みすぎて、学習に使っていない県を大きく外している(高バリアンス)。モデルを選ぶ基準は学習に使っていないデータの誤差で、訓練 MSE は次数を上げるほど必ず下がるので選択の基準にならない。 - Q2:図 2 で、人口 500 万人での予測の標準偏差は d=1〜3 で 2.6〜4.2 万トンなのに、東京での予測の標準偏差は d=3 で 90.5 万トンだった。同じモデルなのに場所で variance が 20 倍以上違う理由を説明せよ。
→ 答え:人口 500 万人の近くには県が複数あるが、1,000 万人を超える県は東京だけで、ブートストラップ標本の約 36% には東京が入らない。その標本で学んだ曲線は東京の位置を外挿することになり、3 次の項が標本ごとに違う曲がり方をする。variance はデータが薄い場所(とくに外挿)で大きくなる。 - Q3:d=1 の learning curve は、18 県で CV MSE 52.8、37 県で 54.4 だった。都道府県のデータを 100 県分集められたとしたら、d=1 の CV MSE は大きく下がると期待できるか。次の一手は何か。
→ 答え:期待できない。18 県以降ほぼ横ばいで、訓練 MSE との差も小さいので高バイアス(モデルが単純すぎる)の形。データを増やすより、次数を 2 に上げる(CV MSE 42.25)か、人口以外の説明変数を足すのが先。 - Q4:深掘り 3 で Ridge(α=1)は d=5 の CV MSE を 4,716 から 111.75 に下げた。それでも d=2 の正則化なし(42.25)に及ばない。この結果から言えることは何か。
→ 答え:正則化は高バリアンスを抑える有効な手段だが、不要な高次の項が作るぶれを完全には消せない。47 県で関係がほぼ直線〜緩い曲線なら、まず次数そのものを下げるほうが効く。正則化は「複雑さを減らせない事情があるとき」の道具と考える。 - Q5:「🧮 数式に値を入れて手で計算する」の 5 個の予測 4.2・5.8・4.5・5.5・4.9(真の値 5)のうち、5.8 を 5.0 に直すと Bias²・Variance・MSE はそれぞれいくつになるか。
→ 答え:平均 4.82、Bias² = (4.82 − 5)² = 0.0324、Variance = (0.3844 + 0.0324 + 0.1024 + 0.4624 + 0.0064) / 5 = 0.1976、MSE = (0.64 + 0 + 0.25 + 0.25 + 0.01) / 5 = 0.23 = 0.0324 + 0.1976。外れた予測を 1 つ直すと variance は半分近くに減るが、残りが低めに偏るので bias² は 81 倍に増える。 - Q6:元の 5 個の予測すべてに 0.5 を足すと、3 つの値はどう変わるか。
→ 答え:平均 5.48、Bias² = 0.48² = 0.2304、Variance は 0.3576 のまま(全体をずらしてもばらつきは変わらない)、MSE = 0.588。予測を一律にずらす誤りはバイアスだけに現れる。
🎯 このコードでやること:Q5・Q6 の答えを numpy で確かめる。元の 5 個の予測、5.8 を 5.0 に直した予測、全部に 0.5 を足した予測のそれぞれで Bias²・Variance・MSE を計算し、Bias² + Variance が MSE に一致するかを見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import numpy as np f = 5.0 base = np.array([4.2, 5.8, 4.5, 5.5, 4.9]) cases = {'元の予測': base, 'Q5: 5.8→5.0': np.array([4.2, 5.0, 4.5, 5.5, 4.9]), 'Q6: 全部 +0.5': base + 0.5} for name, p in cases.items(): bias2 = (p.mean() - f) ** 2 var = p.var() # 母分散(n で割る) mse = ((p - f) ** 2).mean() print(f'{name:12s} 平均 {p.mean():.2f} Bias² {bias2:.4f} Variance {var:.4f} ' f'和 {bias2 + var:.4f} MSE {mse:.4f}') |
💬 元の予測は Bias² 0.0004・Variance 0.3576・MSE 0.3580 で、手計算の Step 4 と一致します。5.8 を 5.0 に直すと Bias² 0.0324・Variance 0.1976・MSE 0.2300、全部に 0.5 を足すと Bias² 0.2304・Variance 0.3576(元と同じ)・MSE 0.5880 で、どの場合も Bias² + Variance が MSE とぴったり一致しています。ばらつきを減らす操作と、全体をずらす操作が、分解式のどちらの項に効くかが数字で確かめられます。
⚠️ よくある落とし穴
バイアス・バリアンス分解で初学者が陥る典型ミス。 「訓練 MSE が小さい = 良いモデル」と判定する、 47 県の特殊事例(東京・大阪の都市バイアス)を見落とす、 など。 SSDSE-B-2026 のように標本サイズ 47 で複雑モデルを使うと Var が爆発するのが定石です。
⚠️ 拡張・落とし穴集:実務で踏みがちな 10 個の罠
- CV 分割が偏っている:時系列データを単純な K-fold で分割すると、 未来が訓練に混ざってリーク。 必ず
TimeSeriesSplitを使うか、 ドメインベースで分割する。 - 標準化を fit_transform で全データに適用:CV の前に全体で
StandardScaler().fit_transform(X)するとテスト集合の平均・分散が訓練側に漏れる(リーク)。 必ずPipelineで囲み、 fold ごとに fit する。 - サンプルサイズ依存を無視:N=47 の SSDSE-B-2026 で得た「最適 α」を N=10,000 の別データに転用すると、 variance の支配構造が全く違うため不適切。 サンプル数が変わったら必ず再チューニング。
- 訓練 MSE だけ報告:論文・社内資料で訓練エラーだけ出すのは NG。 必ず CV エラーと、 できれば外部検証エラーを併記。
- 「過学習=ダメ」の単純化:過学習しているからといって即座にモデルを単純化するのは早計。 まずデータ追加・正則化・特徴量精選を順に試すのが筋。
- クラス不均衡時の MSE/accuracy 評価:99% が陰性のデータで accuracy 99% は無意味。 バイアス・バリアンスの議論をする前に評価指標自体を見直す(F1, AUC, log loss など)。
- 正則化と特徴量のスケール不整合:Ridge/Lasso は係数ノルムを縛るので、 特徴量のスケールが揃っていないと 大きいスケールの特徴量だけが縮められる。 必ず標準化を前置。
- ハイパーパラメータの 1 軸検索:α と max_depth を別々に最適化すると相互作用を見逃す。 GridSearchCV や Optuna で同時最適化を。
- seed 1 つで結論を出す:CV の結果は seed に依存する。 重要な比較は複数 seed の平均と標準偏差で示すべき。
- 「最適モデル」を本番投入してから再学習しない:CV で選んだハイパラはそのままで、 訓練データを全件に増やして再 fit するのが正しい本番運用。 検証データを訓練に 混ぜずに 1 回だけ最終チェック。
❓ 深掘り FAQ:実務でよく聞かれる 7 つの質問
📝 深掘り:バイアス・バリアンス分析を報告書に書くテンプレート
統計データ解析コンペや学術論文・社内資料で「バイアス・バリアンス分析を行いました」と書く際の 過不足のないテンプレート を示します。 査読・上司レビューで「これが書かれていない」と指摘される典型項目を網羅。
| 項目 | テンプレート文例 |
|---|---|
| データ出典・規模 | 「分析には独立行政法人統計センター提供の SSDSE-B-2026(都道府県 47 件、 2023 年度)を用いた」 |
| 前処理 | 「総人口(A1101)を百万単位、 ごみ総排出量(H5609)を万トン単位にスケーリングし、 標準化は Pipeline 内で fold ごとに実施した(リーク防止)」 |
| 評価方法 | 「5-fold cross-validation(random_state=0)で MSE を測定し、 多項式次数 d=1〜10、 Ridge α=1e-4〜1e3 のグリッドで探索」 |
| 主結果 | 「単純線形回帰(d=1)で CV MSE=54.44、 多項式 d=2 で CV MSE=42.25(最良)、 Ridge(d=5, α=1)で CV MSE=111.75、 RandomForest(200 本, max_depth=5)で CV MSE=613.5、 GBM(200 本)で CV MSE=683.8」 |
| バイアス・バリアンス判定 | 「learning curve から、 単純モデルは高バイアス(train≈cv で頭打ち)、 d=5 多項式は高バリアンス(gap 大)と判定。 単一特徴量では RF/GBM の優位は小さく、 CV MSE が最小なのは多項式 d=2」 |
| 不確実性 | 「CV の標準偏差が RF で 881、 GBM で 899 と大きく、 N=47 ではモデル間の CV MSE 差(610〜690)はこの標準偏差に埋もれ、 GBM と RF の差は統計的に有意でないことが分かる」 |
| 限界 | 「N=47 は小サンプルで、 double descent 領域の検証は不可能。 単一年度(2023)のクロスセクションのため時系列変動は捉えられない」 |
| 再現性 | 「Python 3.11、 scikit-learn 1.5、 random_state=0 で固定。 コードは GitHub リポジトリ XXX に公開」 |
最終チェックリスト(投稿前 10 項目)
- ☐ データ出典と取得日が明記されているか
- ☐ サンプルサイズ N と特徴量数 p が記載されているか
- ☐ 前処理(欠損除去、 標準化、 単位変換)の手順が再現可能か
- ☐ CV の分割方式(K, random_state, stratify)が明記されているか
- ☐ 評価指標が複数(MSE と R²、 accuracy と F1 など)報告されているか
- ☐ ベースラインモデル(線形回帰、 mean predictor など)との比較があるか
- ☐ learning curve または validation curve の図が掲載されているか
- ☐ ハイパーパラメータ選択の根拠(CV 結果、 grid 範囲)が示されているか
- ☐ 不確実性(標準偏差、 信頼区間、 ブートストラップ CI)が併記されているか
- ☐ 限界・前提・代替案が議論されているか
🗝 全体まとめ — バイアス・バリアンスを実務でどう使うか
- 診断フェーズ:learning curve を描き、 訓練 vs CV のギャップから「高バイアス/高バリアンス」を判定。 数式分解は研究時にのみ実施。
- 処方フェーズ:高バイアスなら「モデル容量↑+特徴量追加」、 高バリアンスなら「データ追加+正則化↑+アンサンブル」。 SSDSE-B-2026 のように N を増やせないなら、 次数を下げるか正則化で縛るのが現実解(このページの実測では多項式 d=2 の CV MSE 42.25 が最良で、 GBM は 683.8 と 47 件では逆に悪い)。
- 検証フェーズ:seed を変えて 3〜5 回 CV を回し、 標準偏差を必ず報告。 単一 seed の結果で結論を出さない。
- 本番フェーズ:CV で選んだハイパラを固定したまま、 訓練データ全件で再 fit。 検証データで 1 度だけ 最終評価を行い、 これを論文・報告書のメイン結果とする。
- モニタリングフェーズ:本番投入後、 入力データ分布のドリフトを監視。 分布が変われば「真の関数」も変わるため、 バイアス・バリアンス均衡も再計算が必要。
この 5 フェーズを 1 つの workflow として身につければ、 バイアス・バリアンスは「教科書の概念」から「実務で毎日使う言語」に変わります。 SSDSE-B-2026 のような公的データセットで 必ず手を動かして実感する ことが、 最短の習得ルートです。
📖 さらに学ぶための参考リソース
基礎理論
- Hastie, Tibshirani, Friedman 「The Elements of Statistical Learning」第 2 章・第 7 章 — バイアス・バリアンス分解の標準教科書
- James, Witten, Hastie, Tibshirani 「An Introduction to Statistical Learning」第 2.2 節 — 初学者向け、 図解豊富
- Bishop 「Pattern Recognition and Machine Learning」第 3 章 — Bayesian 視点での再解釈
現代的トピック
- Belkin, Hsu, Ma, Mandal (2019) 「Reconciling modern machine-learning practice and the classical bias–variance trade-off」 PNAS — double descent の嚆矢
- Nakkiran et al. (2020) 「Deep Double Descent: Where Bigger Models and More Data Hurt」 ICLR — 深層学習での double descent 体系化
- Neal et al. (2019) 「A Modern Take on the Bias-Variance Tradeoff in Neural Networks」 — NN での bias-variance 実証
実装ガイド
- scikit-learn 公式: learning_curve / validation_curve
- scikit-learn 公式: Underfitting vs Overfitting デモ
- 本サイトの関連用語: cross-validation / regularization / overfitting / ridge-regression / random-forest
日本語ハンズオン教材
- 本サイト 論文一覧 の「機械学習・予測モデル」カテゴリ — SSDSE-B-2026 を用いた多数の実装例
- 独立行政法人統計センター 「SSDSE 教材紹介」 — 公的データを使った教育コンテンツ集
🎯 1 ページ チートシート — 困った時の即引き表
| 症状(観察) | 診断 | 即時の打ち手 |
|---|---|---|
| train_MSE が下がらない | underfit / 高 bias | PolynomialFeatures(d=3) を追加、 max_depth↑、 α↓ |
| train≈0, test≫0 | overfit / 高 variance | Ridge α=10、 RandomForest n=200、 dropout=0.3 |
| CV ごとに結果が大きく違う | 高 variance + 小サンプル | cv=10 に増、 StratifiedKFold、 アンサンブル化 |
| 何やっても CV が頭打ち | irreducible noise が支配的 | 特徴量を根本から再設計、 ラベル定義を見直す |
| 論文に書く 1 行 | — | 「learning curve から train/CV gap=X → 高 variance と判定し、 Ridge(α=Y) で CV MSE を Z→W に改善」 |
表の打ち手は出発点で、 効いたかどうかは必ず CV で確かめる。 このページの「深掘り 1〜5」に、 それぞれの打ち手を 47 都道府県で試した実測がある。
補足:本ページ全体を通して使ってきた SSDSE-B-2026 のサンプルコードは data/raw/SSDSE-B-2026.csv をデフォルトパスとしています。 自分のデータに置き換える際は、 X = df[['特徴量']].values、 y = df['ターゲット'].values の 2 行だけを書き換えれば、 残りのすべてのコード(多項式回帰、 Ridge、 RF、 GBM、 learning curve、 Monte Carlo)がそのまま流用可能です。 これは「教育用と本番用のコードベースを 1 本化する」現代的な MLOps の発想にも合致します。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
中心のバイアス・バリアンス分解 E[(y-ŷ)²]=Bias²+Variance+σ² から、 (上) 高バイアス側 (線形回帰のような単純モデル、 未学習)、 (右) 高バリアンス側 (深い決定木、 k=1 の k-NN、 過学習)、 (下) 中間最適点 (バランスのとれたモデル複雑度)、 (左) 解釈の道具 (学習曲線、 検証曲線、 交差検証 RMSE) へ放射状に接続している。 SSDSE-B-2026 で「都道府県の高齢化率を 5 変数から予測する」場合、 単回帰 (高バイアス低バリアンス) → 多項式回帰 → ランダムフォレスト → 深層モデル (低バイアス高バリアンス) と複雑度を変えながら、 5-fold CV の MSE が U 字を描く点が最適複雑度。 正則化 (L2/L1) はバリアンスを下げてバイアスを少し上げる、 アンサンブル (Bagging) はバリアンスを下げてバイアスは保つ、 という形で「U 字の底を低くする」道具と位置付けられる。
🔗 隣接手法への橋渡し
バイアス・バリアンス分解 E[(y-ŷ)²] = Bias² + Variance + σ² は汎化誤差を「未学習成分」「過学習成分」「既約ノイズ」に分け、 モデル選択の理論的根拠となる。
- 上流: 特徴量エンジニアリングでバイアスを下げる (関連特徴量追加)、 データ分割 (train/val/test, k-fold CV) で分散を推定。
- 並列: 交差検証で汎化誤差を経験的に推定、 正則化 (L1/L2)でバリアンス低減、 アンサンブル (Bagging)でバリアンス削減、 Boostingでバイアス削減。
- 下流: 学習曲線 (訓練誤差 vs 検証誤差 をデータ量で) で診断、 検証曲線 (複雑度で)、 汎化誤差バウンド (PAC-Bayes, Rademacher) で理論保証。
SSDSE-B-2026 で高齢化率予測モデルを構築する場合、 単回帰 (高バイアス)・ランダムフォレスト (中庸)・深層モデル (高バリアンス) を 5-fold CV で比較し、 U 字の底のモデル複雑度を選ぶのが標準ワークフロー。
🌳 手法選択フロー
予測誤差が大きいとき、 それが bias 由来か variance 由来かで打ち手が逆になる。 このページの learning curve(深掘り 2)の読み方を、 判断の順番に並べる。
- Step 1: 訓練誤差そのものが大きいか?
- 大きい(例: d=1 の訓練 MSE 40.8、 CV MSE 54.4 と両方高く差が小さい) → 高バイアス。 Step 2 へ
- 小さいのに CV 誤差だけ大きい(例: d=5 の訓練 MSE 25.0 に対し CV MSE 約 4,600) → 高バリアンス。 Step 3 へ
- Step 2(高バイアス): モデルの表現力を上げる
- 次数を 1 つ上げる・説明変数を足す(このページでは d=2 で CV MSE が 42.25 に下がった)
- 正則化をかけているなら λ を弱める
- データを増やしても改善しない(d=1 は 18 → 37 県で CV MSE が 52.8 → 54.4 と横ばい)ので、 データ収集は後回し
- Step 3(高バリアンス): ぶれを抑える
- Step 4: 両方小さいのに本番で外れる
- 訓練と検証が同じ分布から来ているか(年度・地域の偏り、 リーク)を疑う。 分解式は「同じ分布から繰り返し訓練データを引く」前提で成り立つ