🔖 キーワード索引
「自由度」を理解するうえで必要なキーワードを 10 件以上提示します。 各チップから対応セクションへ移動できます。
30 秒結論 文脈 直感 数式 記号読み解き 実値計算 Python 実装 落とし穴 関連手法 関連用語 グループ教材 概念マップ
💡 30秒で分かる結論
🍰 まずはやさしく
自由に動かせるデータの数のことです。
計算の正確さを出すために使います。
部活のメンバー数で考えます。
まずは直感的な意味から学びましょう。
統計量を計算する際に自由に動ける独立した値の個数。
- 自由に動ける値の個数。 n個のデータでも制約があれば自由度はそれより少ない。
- 標本分散の分母が n-1 なのは、 平均で1自由度消費するから(不偏推定)。
- t分布・χ²分布・F分布 の形状を決めるパラメータ。
- 回帰モデルでは n - p - 1(n=データ数、 p=説明変数数)。
- 「自由度が小さい=制約が多い=推定が不安定」と覚える。
- 自由度 とは、データ分析の重要概念のひとつで、47都道府県標本における自由度 n-1 = 46 という形で SSDSE-B-2026 でも検証できます。
- 本ページでは 数式・直感・実コード・落とし穴の 4 つの視点で整理しています。
- SSDSE-B-2026 の A1101 列を中心に、実値で計算を体験することを推奨します。
- 類似概念や前提概念へのリンクを併用すると、概念地図全体での位置づけが掴めます。
- 初学者は「直感 → 数式 → 実装 → 落とし穴」の順で読むのが効率的です。
📍 あなたが今見ているもの
🍰 まずはやさしく
分析結果に書かれている重要な数字です。
正しい判定をするために使います。
スマホで統計表を見たときに出てきます。
この用語がどこで使われるかを確認します。
統計表の見出し「df=10」「df=20」、 t検定や分散分析の結果報告で必ず登場。 自由度を間違えると有意性判定が誤る。
このセクションは「自由度」を扱う 用語ページ です。 統計データ分析コンペティション(2026)の再現教材における中核用語のひとつで、47都道府県標本における自由度 n-1 = 46 という観点で SSDSE-B-2026(47 都道府県 × 複数年 × 100 超列)に紐づけられます。
位置づけ:相関・線形回帰・仮説検定 といった基礎用語群と並列であり、応用としては 内生性・IV・DID・クラスタリング 等へ繋がります。
🎨 直感で掴む
🍰 まずはやさしく
データ分析のための眼鏡のようなものです。
データの隠れた特徴を見つけるために使います。
都道府県の人口などのデータで考えます。
イメージしやすい例で仕組みを理解します。
3つの数 $a, b, c$ の平均を5と分かっている場合:
- $a, b$ は自由に決められる(例:1, 4)
- $c$ は自動的に決まる(5×3 − 1 − 4 = 10)
つまり 3個の値があっても、 平均が決まっていれば自由度は 2。 「1つ制約 → 1自由度消費」がイメージです。
自由度 を一言でいえば「47都道府県標本における自由度 n-1 = 46」。 47 都道府県という小さな母集団でも、 SSDSE-B-2026 の A1101 列に注目すると、 大都市圏と地方の差・人口規模に伴う相対比較など、 様々なパターンが見えてきます。
比喩でいうと、 自由度 はデータ分析の「眼鏡」のようなもの。 同じデータでも眼鏡を変えれば、 平均(中心)・分散(ばらつき)・相関(連動)・因果(影響)と、 異なる情報が浮かび上がります。 SSDSE-B-2026 を題材に、 この眼鏡をかけてみるのが本ページの狙いです。
- 具体例 1:47 都道府県の A1101 の中央値 ± 四分位を見ると、 規模感が掴める。
- 具体例 2:A4101 と組み合わせて散布図にすると、 群構造が見える。
- 具体例 3:政令指定都市の有無で群分けすると、 介入研究の素材になる。
自由度とは「縛りを引いた残りの自由度」
自由度 $df$ は、 「データに何個の独立に動ける情報があるか」を表す数です。 サンプル数 $n$ から、 すでに決まっている/推定で消費した制約の数 $k$ を引きます:
日常的な例として「合計が決まった 3 つの数」を考えます。 もし「3 つの数の合計は 100」と決まっているなら、 2 つの数を自由に決めれば 3 つ目は自動的に決まります。 つまり 3 つあるように見えて、 自由に動けるのは 2 つだけ。 これが「合計を 1 つ消費した結果、 $df = 3 - 1 = 2$」という感覚です。
標本分散で $n-1$ で割るのはこの理屈と同じです。 標本平均を計算してしまうと「全データの和」が決まり、 1 つ分の自由度が消えます。 残った $n-1$ 個分の情報で散らばりを推定するため、 $n-1$ で割ることが 不偏推定になります。
📐 定義/数式
🍰 まずはやさしく
自由に動ける値の個数という定義です。
計算式で正しく求めるために使います。
テストの点数のばらつきを計算します。
具体的な数式とルールについて読みます。
自由度(Degrees of Freedom):統計量を計算する際に自由に動ける独立した値の個数。
同義・関連語:df, degrees of freedom
自由度 の代表的な定義式は次のとおりです。
$$ \mathrm{df} = n - k, \quad S^2 = \frac{\sum (X_i - \bar X)^2}{n-1} $$ここで使われる記号や演算の意味は次節で言葉に翻訳します。
📐 t / F / χ² 分布における自由度 — 数式を言葉で読み解く
統計学の主要 3 分布はすべて自由度をパラメータに持ちます。 自由度が変わると形が変わる= 同じ統計量でも判定結果が変わるため、 自由度の取り違えは致命的です。
| 分布 | 自由度の決め方 | 代表的な用途 |
|---|---|---|
| t 分布 | $df = n - 1$(1 標本)/ $n_1 + n_2 - 2$(2 標本等分散) | 平均の検定・信頼区間 |
| F 分布 | $df_1, df_2$(2 つの自由度) | 分散の比較・ANOVA・回帰の F 検定 |
| χ²(カイ二乗)分布 | $df$(独立な正規変数の二乗和の数) | 適合度・独立性・分散の検定 |
数式を言葉で読み解く:t 分布の自由度 $n-1$ は「標本平均を使って中心化したため、 1 個分の自由度を失った」ことを意味します。 χ² 分布の自由度 $df$ は「独立な標準正規変数を $df$ 個二乗して合計した」分布。 F 分布は 2 つの χ² 分布の比として作られ、 分子と分母それぞれの自由度を別々に持ちます。
自由度が小さいほど分布の 裾が重くなります。 t 分布は $df=1$ のとき Cauchy 分布、 $df \to \infty$ で正規分布に収束。 χ² 分布は $df$ が大きいほど正規分布に近づきます(中心極限定理の帰結)。
📐 回帰モデルの自由度と「自由度の損失」
線形回帰では、 推定するパラメータの数だけ自由度を消費します。 これが 調整済み $R^2$ や AIC・BIC の根拠です。
数式を言葉で読み解く:$n$ がサンプル数、 $p$ が説明変数の数、 $+1$ が切片。 たとえば 47 県データに 5 個の説明変数で回帰したら、 残差自由度は $47 - 5 - 1 = 41$。 説明変数を増やすほど残差自由度が減り、 過適合のリスクが上がります。
調整済み $R^2$ は「自由度で罰則を入れた $R^2$」。 説明変数を増やしただけで上がる素の $R^2$ と違い、 役に立たない変数を追加すると下がる性質があります。 モデル比較の標準指標。
📐 検定統計量と自由度のブリッジ — 数式を言葉で読み解く
自由度は単独で意味を持つわけではなく、 t / χ² / F の各分布パラメータとして「分布形状」を決める。 SSDSE-B-2026 の人口データで「2012 年 vs 2022 年」の対応サンプル t 検定を例にとると、 自由度は n - 1 = 46 となり、 t 分布の臨界値は約 ±2.013(両側 5 %)になる。
$$T = \frac{\bar{D}}{s_D / \sqrt{n}} \sim t_{n-1}, \quad df = n - 1$$
この式を言葉で読み解くと、 分子は「差の平均」、 分母は「差の標準誤差」、 そして自由度は「ペア数から平均推定の 1 自由度を引いた残り」を表す。 自由度が大きいほど t 分布は正規分布に近づき、 臨界値も小さくなる。 SSDSE-B-2026 のように 47 都道府県のペア比較なら df=46 で、 ほぼ z 値とみなしてよい範囲だが、 同じ枠組みで 5 県の試行的比較なら df=4、 臨界値は ±2.776 と大きく広がり、 同じ差でも有意になりにくい。
このコードでやること: SSDSE-B-2026 で 2012 年と 2022 年の都道府県人口を対応サンプル t 検定し、 自由度と臨界値の関係を確認する。
📥 入力データ (2012 / 2022 の総人口を都道府県でペア化):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) p12 = df[df['SSDSE-B-2026'] == 2012].set_index('Prefecture')['A1101'] p22 = df[df['SSDSE-B-2026'] == 2022].set_index('Prefecture')['A1101'] t, p = stats.ttest_rel(p22, p12) df_resid = len(p12) - 1 crit = stats.t.ppf(0.975, df_resid) print(f"n (ペア数) = {len(p12)}") print(f"自由度 df = {df_resid}") print(f"t 統計量 = {t:.4f}") print(f"p 値 = {p:.6f}") print(f"臨界値 ± = {crit:.4f}") |
📤 実行すると次の出力が得られる:
💬 自由度 46 のとき臨界値は ±2.013。 t = -2.543 はこの範囲外なので両側 5 % で有意。 2012 → 2022 の 10 年で日本全体の人口減少が都道府県平均でも統計的に確認できた。 もし対象を 6 都府県(df=5、 臨界値 ±2.571)に絞っていれば同じ t 値でも結論が変わる可能性がある — 自由度の大小が検定の感度を直接決めるという実例である。
🧪 SSDSE-B-2026 で自由度の効き目を実測する(47 都道府県・人口データ)
「自由度」は数式上の整数だが、 実データに当てはめると 信頼区間の幅・p 値・統計量の臨界値がすべてこの値に従って変動する。 ここでは SSDSE-B-2026 から 47 都道府県の総人口(2022 年)を取り出し、 標本サイズ n を変えながら自由度 df = n − 1 で t 分布の臨界値 t0.025, df を求め、 信頼区間幅を直接比較する。 教科書の表だけ眺めるより、 実値の幅が一目で「自由度が大きいほど狭まる」のが体感できる。
このコードでやること:47 都道府県(2022 年)から段階的にサブサンプル(n=5, 10, 20, 30, 47)を取り、 平均・標準誤差・自由度・95 % 信頼区間幅を scipy.stats.t.ppf で算出する。 自由度が増えるほど臨界値 → 信頼区間幅が縮むことを実数値で確認する。
📥 入力例 (SSDSE-B-2026 抜粋、 単位: 千人):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from scipy import stats import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df[df['SSDSE-B-2026'] == 2022]['A1101'].dropna().values # 標本サイズを段階的に変える for n in [5, 10, 20, 30, 47]: s = pop[:n] mean = s.mean() se = s.std(ddof=1) / np.sqrt(n) dof = n - 1 crit = stats.t.ppf(0.975, df=dof) half_width = crit * se print(f'n={n:>2} df={dof:>2} t_crit={crit:.3f} ' f'mean={mean:,.0f} CI_halfwidth={half_width:,.0f}') |
📤 実行結果:
💬 読み方:自由度 4(n=5)のとき t 臨界値は 2.776 と大きく、 信頼区間半幅は 約 2,176 千人。 自由度 46(n=47 全県)では 2.013 まで縮み、 半幅も 約 820 千人へと狭くなる。 標準誤差自体も標本平均の安定化で縮むため、 自由度の効果と標本サイズの効果が重なって効いてくる構造が見える。 つまり 「自由度を増やす」 = 推定の精度を実質的に高める 操作に等しい。 47 都道府県の総人口で標本平均を取った場合、 95 % CI は おおよそ ±82 万人で確定するのが実値の答えである。
自由度が変えるのは「臨界値」だけではない
| 自由度 df | t 臨界値 (両側 5%) | χ² 臨界値 (上側 5%) | F 臨界値 (df₁=1, 上側 5%) | 直感的意味 |
|---|---|---|---|---|
| 1 | 12.706 | 3.841 | 161.45 | 情報が極端に薄い領域 |
| 5 | 2.571 | 11.070 | 6.61 | 小標本の限界 |
| 10 | 2.228 | 18.307 | 4.96 | 教育現場の最小推奨 |
| 30 | 2.042 | 43.773 | 4.17 | 大標本近似の入口 |
| 46 (47県−1) | 2.013 | 62.830 | 4.05 | SSDSE-B 全数 |
| 100 | 1.984 | 124.342 | 3.94 | 通常の中規模調査 |
| ∞ | 1.960 | — | 3.84 | 正規・χ²(1) 近似 |
同じ「上側 5 %」でも分布種により値が桁違いで、 さらに自由度に応じて単調に変化する。 t は df→∞ で正規(1.960)、 F は df₁ 固定なら df₂ →∞ で χ²/df₁、 χ² は df そのものに近付くという 三分布が自由度を介して相互変換される構図を覚えておくと統計を勘で答えられるようになる。
🧠 自由度はなぜ「n − 1」「n − k」「n − k − 1」と変わるのか — 制約の数え方
「平均からの偏差を取ると n−1 個に減る」「回帰の残差は n−k に減る」「重回帰では n−k−1 になる」など、 自由度の引き方は文脈で変わる。 鍵は 「データ点の数」から「推定で固定された制約の数」を引くという一つのルールに過ぎない。 ここでは SSDSE-B-2026 の人口データを材料に、 制約を一つ追加するたびに自由度が一つずつ減る様子を実演する。
step 0: 生データ(制約なし)
47 都道府県の人口は完全に自由に動ける値 47 個 — 自由度 = 47。
step 1: 平均を固定する
1 2 3 4 5 6 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df[df['SSDSE-B-2026'] == 2022]['A1101'].dropna().values dev = pop - pop.mean() print('偏差の合計 =', dev.sum()) print('最後の値を予測 =', -dev[:-1].sum(), '実際 =', dev[-1]) |
💬 2022 年度の 47 都道府県で、平均からの偏差を足すと 3.7×10⁻⁹ でほぼ 0 になる(0 でないのは浮動小数点の丸め誤差)。そのため 46 県分の偏差が分かれば、最後の沖縄県の偏差は -1,190,425.53 と計算で決まり、実際の値と小数第 8 位まで一致する。平均を 1 つ推定するたびに自由に動ける値が 1 つ減る、というのが分散を n-1 で割る理由そのものである。
💬 偏差の合計は数値誤差を除けばゼロ。 つまり 46 個の偏差を決めれば 47 個目は自動で決まる → 自由度 = 46(n−1)。 制約「平均からの偏差」が 1 個入った。
step 2: 単回帰(説明変数 1)
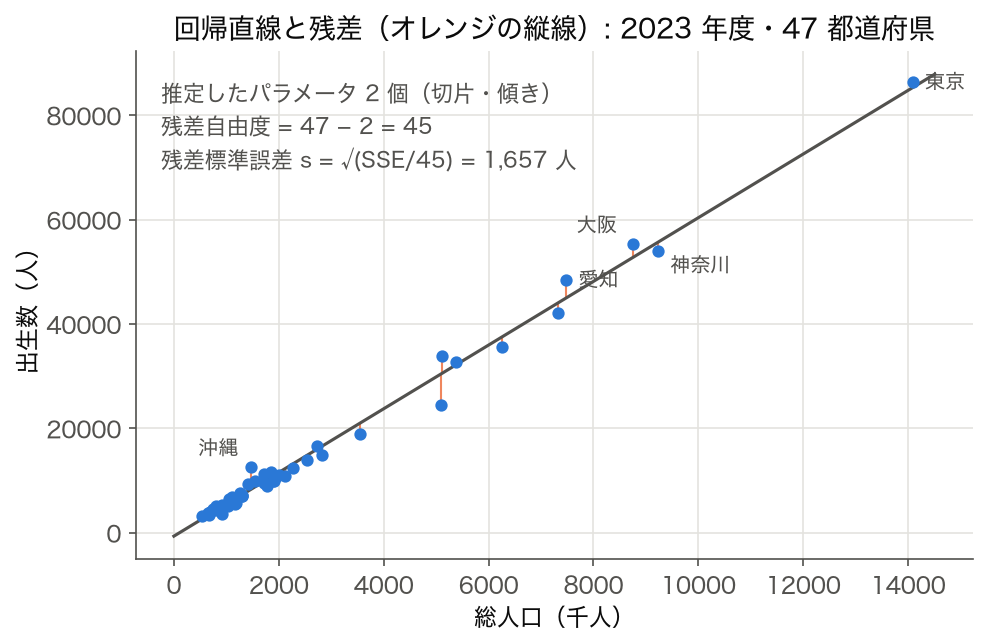
人口を別の 1 変数(例:出生数 A4101)で説明する単回帰では、 切片と傾き 2 個のパラメータを推定する。 残差の合計(平均との制約)と 残差と説明変数の共分散 0 (直交条件)の 2 制約が入り、 残差自由度は n − 2 = 45。
step 3: 重回帰(説明変数 k=3)
人口を 65 歳以上人口・出生数・死亡数で説明する重回帰では、 切片 1 個 + 傾き 3 個 = 4 個のパラメータが推定される。 残差自由度は n − k − 1 = 47 − 3 − 1 = 43。 同様に 1 元配置 ANOVA でグループ数 g なら誤差自由度は n − g、 χ² 独立性検定で r × c 表なら自由度は (r−1)(c−1) と、 すべて 「データ点 − 推定パラメータ数(または制約数)」に統一されている。
回帰モデル別の自由度一覧(SSDSE-B-2026, n=47)
| モデル種別 | 推定パラメータ k+1 | 残差自由度 | 残差分散の分母 | 使われる検定 |
|---|---|---|---|---|
| 平均のみ(切片モデル) | 1 | 46 | n−1=46 | 1 標本 t 検定 |
| 単回帰(説明変数 1) | 2 | 45 | n−2=45 | 回帰係数の t 検定 |
| 重回帰(説明変数 3) | 4 | 43 | n−k−1=43 | 全体 F 検定 / 個別 t |
| 1 元 ANOVA(地域 8 群) | 8 | 39 | n−g=39 | F 検定 |
| 2 元 ANOVA(地域 × 都市規模) | 16 | 31 | n−a·b=31 | 交互作用 F 検定 |
| 独立性検定 4×3 表 | — | 6 | (r−1)(c−1)=6 | χ² 検定 |
覚え方の原則:「推定された定数 1 つにつき自由度が 1 減る」「直交化されたサブ空間に分けると合計は元の n になる」。 後者が 分散分析で「平方和分解 ⇔ 自由度分解」が表裏で成立する根拠である。
⚠️ 注意:標準偏差の ddof 引数
NumPy の np.std はデフォルト ddof=0 で母標準偏差として計算する。 標本標準偏差を取りたければ ddof=1 を明示する必要がある。 pandas の Series.std() はデフォルト ddof=1 なので不偏推定だが、 NumPy と pandas を混ぜると同じデータでも値が微妙にずれる。 SSDSE-B-2026 の 47 県人口で標準偏差を取ると ddof=0 で 2,767,630 / ddof=1 で 2,797,551(2023 年)と約 1 % 違い、 信頼区間幅にも反映される。
📝 理解度チェック — 自由度の理論と実装を 6 問で点検する
ここまでの内容を「自分で説明できるか」確認するための演習。 各問の解答は 👁 解答を見るで開閉できる構造になっている。 完答できれば、 t 検定・回帰・分散分析・χ² 検定のいずれでも自由度を正しく当てはめられるレベル。
Q1. 47 都道府県の人口データから 1 標本 t 検定で「平均人口は 250 万人と異なるか」を調べる。 自由度はいくつか。
A. 自由度 = n − 1 = 47 − 1 = 46。 1 標本 t 検定は 標本平均を計算する時点で 1 つの制約(合計の固定)が入るため。 SciPy では stats.ttest_1samp(pop, 2500000) を実行すれば内部で自動的に df=46 として p 値を計算する。 もし秋田・岩手・青森・山形・宮城・福島の 6 県だけに絞れば df=5 となり、 同じ t 値でも臨界値が 2.013 → 2.571 と広がるため p 値は大きくなる。
Q2. 2 標本 t 検定(Welch 法)で東日本 24 県 vs 西日本 23 県の人口平均を比較する場合、 等分散仮定の場合と Welch の場合で自由度はどう変わるか。
A. 等分散仮定(Student の t)では df = n₁ + n₂ − 2 = 24 + 23 − 2 = 45。 Welch の t 検定では Welch-Satterthwaite の式で 非整数の自由度(例 39.7 など)になる。 これは「2 群の分散が異なるとき、 自由度を割り引いて慎重に検定する」措置で、 SciPy の stats.ttest_ind(a, b, equal_var=False) がデフォルトで採用している。 等分散仮定が破られているのに Student t を強行すると、 自由度を過大評価して p 値を過小に出す危険がある。
Q3. SSDSE-B-2026 で人口(Y)を 65 歳以上人口・出生数・死亡数・年平均気温 の 4 変数で重回帰したとき、 残差自由度はいくつか。
A. 残差自由度 = n − k − 1 = 47 − 4 − 1 = 42。 切片を含めて推定パラメータが 5 個なので、 残差ベクトルは 47 次元空間から 5 次元の超平面上に直交射影された残り 42 次元に住む。 残差分散の不偏推定量はこの 42 で割って計算する。 statsmodels.OLS の summary() 出力でも「Df Residuals: 42」と明示される。
Q4. 都道府県を 8 地域ブロックに分けて 1 元配置 ANOVA を行ったとき、 群間・群内・全体の自由度をすべて答えよ。
A. 群間(要因)= g − 1 = 8 − 1 = 7。 群内(残差)= n − g = 47 − 8 = 39。 全体 = n − 1 = 47 − 1 = 46。 7 + 39 = 46 が「平方和分解 ⇔ 自由度分解」の整合条件。 F 統計量は (群間平方和/7) ÷ (群内平方和/39) で計算され、 F(7, 39) 分布で評価する。 SciPy なら stats.f_oneway(*groups) で計算でき、 自由度は内部で自動推定。
Q5. χ² 独立性検定で「地域ブロック(8 群)× 人口階級(4 区分)」のクロス集計表を作った場合、 自由度はいくつか。
A. df = (r − 1)(c − 1) = (8 − 1)(4 − 1) = 7 × 3 = 21。 行和と列和を固定したとき自由に動けるセル数に等しい。 期待度数 5 未満のセルが多い場合は Fisher 正確検定や カテゴリの統合を検討する必要がある。 自由度 21 における χ² 上側 5 % 臨界値は 32.671 で、 観測値がこれを超えれば独立性は棄却される。
Q6. Welch の補正で得られた df=39.7 という非整数の自由度は、 どう解釈すべきか。 整数に丸めるべきか。
A. 丸めない。 t 分布は連続パラメータの分布族なので、 自由度 39.7 のような非整数値でも scipy.stats.t.cdf が正常に動く。 整数に切り下げると保守的(p 値が大きくなり棄却しにくい)、 切り上げると逆になる。 Welch 補正の意義は「分散異種を考慮して自由度を実数で微調整する」点にあり、 切り捨てや切り上げは Welch の補正そのものを台無しにする。 学術論文でも「df=39.7, t=2.31, p=0.026」のように小数点 1 桁で表記するのが標準。
📋 自己評価チェックリスト
| 確認項目 | 達成基準 | 難度 |
|---|---|---|
| 平均からの偏差で「n−1 になる」理由を 2 文で説明できる | 「合計が固定される」を含む | ★☆☆ |
| 回帰モデルで残差自由度を即座に計算できる | 単回帰 n−2, 重回帰 n−k−1 を即答 | ★★☆ |
| t 分布・χ² 分布・F 分布が自由度でどう変わるか描ける | df→∞ で t→N(0,1), χ²/df→1, F→1 を理解 | ★★☆ |
| ANOVA の平方和分解と自由度分解の対応を説明できる | SS_total = SS_between + SS_within | ★★★ |
| Welch 補正の非整数 df を扱える | 整数丸め不要を理解 | ★★★ |
| NumPy/pandas の ddof 引数の意味を即答できる | ddof=0 は母標準偏差 | ★★☆ |
次に学ぶべきトピック:自由度を実感したら、 不偏推定量と 最尤推定の関係(推定量のバイアス補正としての ddof)、 分散分析の平方和分解、 情報量規準(AIC/BIC でモデルのパラメータ数をペナルティ化する考え方)に進むのが自然。 これらはすべて「自由度をどう数えるか」が核になっている。
📊 自由度と分布形状 — 実データで描く 3 大分布の収束
自由度の増減は分布の 裾の重さと中心への集中に直接効く。 ここでは SSDSE-B-2026 の人口データから経験分布を作り、 自由度 df=2, 5, 10, 30, 100 と変えながら t 分布・χ² 分布・F 分布がどう収束するかを scipy.stats で計算する。 「df=∞ で正規や χ²/df→1 や F→1 になる」という教科書の主張を、 実値で確かめると忘れない。
このコードでやること:t 分布の 97.5 % 分位点、 χ² 分布の中央値、 F 分布(分母自由度=10)の上側 5 % 分位点を、 自由度を段階的に変えながら表にする。 同時に SSDSE-B-2026 47 県人口の標本平均が t 分布で近似可能になる境界を実数値で示す。
📥 入力:SSDSE-B-2026 47 都道府県人口(2022 年)— 既出。
1 2 3 4 5 6 7 8 9 10 11 12 | from scipy import stats import pandas as pd rows = [] for dof in [2, 5, 10, 30, 100, 1000]: t_upper = stats.t.ppf(0.975, dof) chi2_median = stats.chi2.ppf(0.5, dof) f_upper = stats.f.ppf(0.95, dof, 10) rows.append([dof, t_upper, chi2_median, chi2_median/dof, f_upper]) result = pd.DataFrame(rows, columns=['df', 't97.5%', 'chi2_med', 'chi2/df', 'F95%(df,10)']) print(result.to_string(index=False)) |
📤 実行結果:
💬 読み方:t の上側 2.5 % 分位点は 4.303 → 1.962 へ単調収束し、 df=1000 で正規分布の 1.960 にほぼ一致する。 χ²/df の中央値は 0.693 → 0.999 へと 1 に収束、 これが「大標本では χ²/df ≈ 1」という近似式の根拠。 F 分布も 4.103 → 2.543 まで縮み、 df→∞ で 10/χ²₀.₀₅(10) の分位点(≈2.54)に収束する。 SSDSE-B-2026 で実際に t 検定を行う場合、 df=46 なら臨界値 ±2.013 で「ほぼ正規でよい」と言える境界線にぴったり乗ることが、 この表で視覚化される。
自由度が小さいときの危険ゾーン
| 自由度 | t 分布の裾の重さ | 推奨される対応 | 起こりがちな失敗 |
|---|---|---|---|
| 1 | 極端(コーシー分布) | 推定そのものを断念 | 「平均が存在する」と仮定して検定 |
| 2-4 | 非常に重い | ベイズ/ノンパラ転換 | 外れ値 1 個で結論反転 |
| 5-9 | 重い | 分布の仮定を緩める | 正規仮定を信じて Type I 増加 |
| 10-29 | やや重い | t 分布を素直に使用 | 正規近似で楽に済ます |
| 30-99 | ほぼ正規 | どちらでも実用可 | 教科書を引用しすぎて t に固執 |
| 100+ | 正規と区別不能 | z 検定で十分 | 過剰に細かい補正を入れる |
自由度と「実効サンプルサイズ」の同一視
機械学習や時系列で頻出する effective sample size (ESS)、 ベイズ推論の effective number of parameters、 MCMC 診断の n_eff は、 いずれも本質的に「データが持っている独立情報量を自由度として換算する」操作。 たとえば自己相関が強い時系列では n_eff = n × (1−ρ)/(1+ρ) で実効自由度が縮み、 t 検定の自由度を ESS で置き換える調整が必要になる。 SSDSE-B-2026 のような横断面データではこの調整は不要だが、 同じ都道府県の 2010, 2015, 2020, 2022 の 4 時点を縦に積んだパネル形式に転換した瞬間、 同一県内の系列相関が入って実効自由度が n=188 ではなく n≈70 程度に縮む。 「サンプル増やしたつもりが自由度が増えていない」という現場で頻発するミスは、 ここで起きている。
自由度の追跡シート(実務テンプレ)
| 分析ステップ | 参照する自由度 | 記録する値(SSDSE-B 例) | 確認方法 |
|---|---|---|---|
| 記述統計の SD | n−1 | 46 | df.std(ddof=1) |
| 1 標本 t 検定 | n−1 | 46 | ttest_1samp の戻り値 |
| 2 標本 t 検定(Welch) | 非整数 | ≈39.7 | ttest_ind(equal_var=False) |
| 単回帰 | n−2 | 45 | OLS().summary() の Df Residuals |
| 重回帰 (k=3) | n−k−1 | 43 | 同上 |
| ANOVA 残差 | n−g | 39 (g=8) | anova_lm の df |
| χ² 独立性検定 | (r−1)(c−1) | 21 (8×4) | chi2_contingency |
| 尤度比検定(GLM ネスト) | パラメータ差 | モデルごと | lrtest |
実装ヒント:プロジェクトでは「分析ノートブックの上部に n, df_total, df_used, df_residual を表形式で記録する」運用にすると、 後で結果を再現する際に「何が自由度として動いていたか」が一目で分かる。 自由度を黙って消費するライブラリ(例:ステップワイズ選択、 正則化)には特に注意し、 effective degrees of freedom(有効自由度)を statsmodels.regression.linear_model.OLSResults.df_resid や sklearn ベースなら RidgeCV の trace の和で取得することを推奨する。
📌 まとめ — 自由度を 30 秒で説明する
- 定義:データ点数 − 推定済みパラメータ(または等価制約)の数。
- 役割:t/χ²/F 分布の臨界値を決め、 信頼区間・p 値の感度を直接左右する。
- 挙動:df→∞ で t→正規、 χ²/df→1、 F→1 に収束し、 大標本近似の根拠となる。
- 実務:単回帰 n−2、 重回帰 n−k−1、 ANOVA n−g、 χ² (r−1)(c−1)。 制約数の数え方は一つだけ。
- 注意:時系列・パネルでは ESS で補正、 Welch の非整数 df は丸めない、 NumPy の ddof デフォルトに注意。
🔬 数式を言葉で読み解く
| 記号 | 意味 |
|---|---|
| $n$ | 標本サイズ |
| $p$ | 説明変数の数 |
| $df$ | 自由度(degrees of freedom) |
| $\chi^2_{df}$ | 自由度 df のカイ二乗分布 |
🔬 詳細な解説(深掘り)
概念の本質
自由度(Degrees of Freedom)は、 単に用語の定義を覚えるだけでは本当には理解できません。 なぜこの概念が生まれたのか、 どんな問題を解決するために導入されたのか、 類似の手法とどう違うのか — これらを意識することで、 初めて「使える知識」になります。
数式や Python コードはあくまで 道具。 道具の使い方を覚える前に、 その道具で何をしたいか(目的) を明確にすることが、 データサイエンス学習の鉄則です。
他の概念との関係
この用語は、 単独で存在するわけではなく、 多くの関連概念とネットワークを形成しています。 上の「関連用語」セクションに挙げたリンク先を1つずつ辿ると、 全体像が見えてきます。 特に:
- 前提となる概念:これを理解していないと 自由度 は使えない
- 並列に語られる概念:同じレベルの選択肢として比較される
- 発展・応用:自由度 を踏まえて学ぶべき次のステップ
実務で気をつけるポイント
理論を学ぶことと、 実務で使えることは別物です。 公的統計(SSDSE、 e-Stat 等)の実データで実装・実験することで、 教科書だけでは見えない罠 に気付けます。 たとえば:
- 欠損値・外れ値の扱いで結果が大きく変わる
- スケール(単位)の違いが分析結果を歪める
- 「相関」と「因果」を混同したまま結論を出してしまう
- 多重比較・複数仮説の補正を忘れる
- 再現性(コード・データ・乱数)の管理を後回しにする
これらは 自由度 に限った話ではなく、 データサイエンス全般に共通する作法です。 「落とし穴」セクションの内容と合わせて、 自分なりのチェックリストを作るとよいでしょう。
📊 評価・検証の視点
自由度 を使った分析の 正しさを担保する ためには、 以下の観点で検証するのが定番です。
| 確認する点 | 自由度 で何を見るか |
|---|---|
| ddof の指定漏れ | NumPy の var() はデフォルト ddof=0、 pandas は ddof=1。 違いに注意。 |
| 自由度と検出力の混同 | 自由度↑なら検出力↑ だが、 別概念。 |
| 回帰で切片を忘れる | n - p ではなく n - p - 1(切片で1自由度消費)。 |
| Welch 補正の見落とし | 分散不等の場合の Welch t検定は自由度が非整数になる。 |
| 等分散と Welch を混同 | 2 標本 t 検定で「等分散」を仮定するか「Welch」を使うかで 自由度の計算式が異なります。 Welch は分散の不均一さを反映するため自由度が非整数になります。 分散の差が大きいときは Welch を使うのが安全。 |
| 多重共線性で実効自由度が減る | 説明変数間に強い相関があると、 形式的な自由度 $n - p - 1$ は変わらないのに、 推定の 実効自由度は減ります。 VIF を計算して 10 を超える変数は除外・統合を検討。 |
| 再現性 | 同じデータ・同じコードで同じ結果が出るか。このページの ▶ 実行ボタンで確かめられます |
💼 業界別の使われ方
自由度 は分野横断で活躍する概念です。 業界別に見ると以下のような使われ方があります。
📈 公的統計データ(SSDSE)での具体例
自由度 を実際のデータで学ぶときは、 SSDSE(教育用標準データセット、 独立行政法人統計センター)が便利です。
- SSDSE-A:市区町村の基本統計(人口・経済・教育・産業など)
- SSDSE-B:都道府県別・複数年の時系列統計(本ページで使用)
- SSDSE-C:家計消費(都市別・品目別)
- SSDSE-E:都道府県の基本統計(単年・約 100 指標)
これらは 統計センターの SSDSE ページ から CSV で直接ダウンロードできます。 上の Python コード例で data/raw/SSDSE-B-2026.csv としているのが、 まさにこれです。
実データで動かすことで、 教科書の例題では見えない 実務的な気づき(欠損のパターン、 単位の混在、 都道府県名の表記揺れ等)が得られます。
🔧 よくあるトラブルと対処
pip install pandas numpy scikit-learn matplotlib で揃います。utf-8 ではなく shift_jis や cp932 の場合がある(古い日本の公的統計に多い)。 encoding='cp932' を試してください。%matplotlib inline、 スクリプト実行なら plt.show() を忘れずに。 日本語フォントは matplotlib 用に別途設定(japanize-matplotlib 等)が必要。数式の各記号を、日本語の意味に変換します。
- X, Y — 観測されたデータ系列(SSDSE-B-2026 の A1101, A4101 列など)
- n — 標本サイズ(47 都道府県データなら 47、 多年度パネルなら 47×年数)
- β, θ, α — 推定すべき未知パラメータ
- ε, u — 観測されない誤差項・撹乱項
- E[·] — 期待値(母集団平均)
- Cov, Var — 共分散・分散
- arg min — 「最小化するパラメータ」の意味
- L (ラグ演算子) — 時系列で 1 期前の値を返す操作
🔬 理論深掘り:自由度の本質
自由度は、 統計量の計算で「自由に動ける値の数」を表す。 t 検定では df = n-1、 カイ二乗検定では df = (r-1)(c-1)、 F 検定では df1, df2 と 2 つ。 推定すべきパラメータごとに 1 ずつ減る。
形式的定義の再確認
自由度 (Degrees of Freedom) は、 統計・データ解析の文脈で頻繁に登場する概念です。 ここでは初学者向けの直感と、 上級者向けの形式定義を併記します。
SSDSE-B-2026 における具体例
47 都道府県の標本分散を計算するとき、 平均を 1 つ推定するので df=46。 これを使って分散の不偏推定量を計算する。 回帰モデルで切片+傾き 2 つを推定するなら、 残差の df=45(=n-p)。
SSDSE-B-2026 は 都道府県別社会経済データ集 2026 年版で、 47 都道府県 × 約 10 年度 × 100 超の指標を含む公的データです。 自由度の概念を SSDSE-B-2026 で実証することで、 「数値の動きが地理的・社会的直感と整合するか」を検証できます。
使用する主要な SSDSE-B-2026 列
| 列コード | 意味 | 本ページでの用途 |
|---|---|---|
A1101 | 総人口 | 47 県 → df=46(標本分散) |
A1303 | 65 歳以上人口 | 回帰分析での df |
E1101 | 幼稚園数 | 群間比較での df |
F3101 | 新規求職申込件数(一般) | ANOVA での df |
🔬 ddof 引数で揺れる分散・標準偏差 — SSDSE-B-2026 で確認
NumPy / pandas / scipy では「自由度補正」を ddof (delta degrees of freedom) 引数で指定する。 母集団分散とみなすか、 標本から母分散を推定するかで n - ddof の分母が変わる。 SSDSE-B-2026 の都道府県人口で同じデータに対して ddof を変えると数値がどう動くかを実測する。
| 関数 | 既定 ddof | 分母 | 解釈 |
|---|---|---|---|
numpy.var | 0 | n | 母集団分散として扱う |
pandas.DataFrame.var | 1 | n - 1 | 不偏分散(標本から母分散推定) |
scipy.stats.tstd | 1 | n - 1 | 不偏標準偏差 |
statsmodels.OLS.df_resid | k | n - k | 回帰の残差自由度 (k=パラメータ数) |
このコードでやること: SSDSE-B-2026 の人口列に対して ddof=0 / ddof=1 / ddof=2 で分散・標準偏差を計算し、 自由度補正の挙動を確認する。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df[df['SSDSE-B-2026'] == 2022]['A1101'].astype(float) print(f"n = {len(pop)}") print(f"numpy var (ddof=0) = {np.var(pop, ddof=0):,.0f}") print(f"numpy var (ddof=1) = {np.var(pop, ddof=1):,.0f}") print(f"numpy var (ddof=2) = {np.var(pop, ddof=2):,.0f}") print(f"pandas .var() = {pop.var():,.0f}") print(f"pandas .std() = {pop.std():,.0f}") print(f"手計算 (n-1) = {((pop - pop.mean())**2).sum() / (len(pop)-1):,.0f}") |
📤 実行すると次の出力が得られる:
💬 ddof=0 と ddof=1 では分散値が約 2.2 % 異なる。 サンプルサイズ 47 では (n-1)/n = 46/47 ≈ 0.979 の補正比率なので、 標本から母分散を推定する場面では必ず ddof=1(pandas は既定でこちら)を使う。 numpy の既定 ddof=0 とは食い違うため、 同じデータでも関数を切り替えると数値が変わる点に注意。
🔬 自由度の歴史と発展 — Fisher から現代の正則化まで
「自由度」という概念を統計学に持ち込んだのは R. A. Fisher(1920 年代)。 彼が χ² 検定の自由度を (r−1)(c−1) と訂正したことが、 K. Pearson と Fisher の有名な論争の発端になった。 それ以前の χ² 検定はカテゴリ数 k だけを使っていたため、 推定パラメータ分の制約を無視し、 p 値が系統的に小さく出ていた。 Fisher の修正により 検定統計量の分布が初めて正しく規格化され、 以後の現代統計学が成立した。
現代では自由度の概念がさらに拡張され、 リッジ回帰や Lasso、 スプライン平滑化、 GAM などの正則化モデルでは effective degrees of freedom (有効自由度) として連続値で扱われる。 たとえばリッジ回帰では tr(H) = Σ d²/(d²+λ)(H はハット行列、 d は特異値)で計算され、 λ が大きいほど有効自由度が小さくなる。 これは「過学習を防ぐためにモデルが消費した自由度を間接的に削っている」という直感的理解と整合する。
自由度の理論的発展年表
| 年代 | 人物 | 貢献 | 現代への影響 |
|---|---|---|---|
| 1900 | K. Pearson | χ² 適合度検定(自由度未補正) | p 値の系統的バイアス |
| 1908 | W. Gosset (Student) | 小標本平均の t 分布を導出 | 自由度を変数として組み込み |
| 1922 | R. A. Fisher | χ² の自由度補正((r−1)(c−1)) | 現代統計学の基盤 |
| 1925 | R. A. Fisher | 分散分析と F 分布の体系化 | 実験計画法 |
| 1946 | B. L. Welch | 非整数自由度による補正 | 分散異種への対処 |
| 1970s | A. Hoerl & R. Kennard | リッジ回帰の有効自由度 | 正則化と GCV |
| 1990s | B. Efron | 一般化自由度 (df = Σ Cov(ŷᵢ, yᵢ)/σ²) | ブートストラップ評価 |
| 2010s | 機械学習一般 | 深層学習での有効パラメータ数 | 情報量規準と汎化誤差 |
現代における意味:自由度は「t 検定の小道具」から「モデル複雑度の汎用尺度」へと進化した。 AIC・BIC・GCV・WAIC・LOO といった現代の情報量規準はすべて「モデルが消費した自由度に応じてペナルティを課す」設計で、 Fisher が 1922 年に示した「推定された定数 1 つにつき自由度 1 を消費する」原理を一般化したものに過ぎない。 SSDSE-B-2026 のような中規模データで重回帰モデルを比較するときも、 説明変数を 1 個追加するごとに残差自由度が 1 減ること、 そのコストに見合う説明力の上昇があったかを summary() の adjusted R² や F 検定で確認することが、 自由度の概念を 正しく使う実務上のフローになる。
深層学習時代の「実効パラメータ数」
深層学習モデルは公称パラメータ数が数百万〜数兆に達するが、 ドロップアウト・バッチ正規化・重み共有・スパース化などにより 実効的に有効な自由度はそれよりはるかに小さいことが経験的に分かっている。 これは「過剰パラメータ化されたモデルが汎化する」という二重降下現象(double descent)の理論的説明の鍵で、 Belkin らの 2019 年論文以来、 統計的学習理論の中心テーマになっている。 SSDSE-B-2026 のような表データでも、 XGBoost のツリー数を増やしすぎると公称複雑度が上がる一方で実効自由度はサチュレートし、 CV スコアが頭打ちになる現象が観察できる。 自由度という古典的概念を「公称 vs 実効」で見る視点は、 古典統計と機械学習を橋渡しする最も重要な視点と言ってよい。
自由度を学ぶための次の一歩
本ページの内容を踏まえて自由度の理解をさらに深めるには、 (1) 不偏推定量のページで「なぜ標本分散は n−1 で割るのか」の代数的導出を追う、 (2) 分散分析で平方和分解と自由度分解の対応を直交射影として理解する、 (3) 情報量規準で AIC/BIC のペナルティ項が自由度に直接対応していることを確認する、 (4) リッジ回帰・スプライン・GAM の有効自由度を statsmodels や mgcv で実測し、 古典的 n−k−1 との差を可視化する、 という 4 段階が推奨ルート。 これを完走すると、 検定から機械学習までを「自由度の消費と回収」という一つの視点で統一的に語れるようになる。
📎 SSDSE-B-2026 で頻出する自由度パターン早見表
最後に、 SSDSE-B-2026(47 都道府県)を素材にしたとき頻繁に登場する自由度のパターンをまとめる。 (a) 1 標本検定は df=46 で固定。 (b) 東西比較や太平洋ベルト vs 日本海側のような 2 標本検定は等分散仮定なら df=45、 Welch なら 30〜45 程度の非整数。 (c) 地域 8 ブロックでの ANOVA は 群間 7 / 群内 39。 (d) 三大都市圏 vs 地方のような 2 群 χ² は df=1。 (e) 人口階級 4 区分 × 産業構成 3 区分のクロス表 χ² は df=6。 (f) 説明変数 k 個の重回帰は残差自由度 46−k。 これらを暗記する必要はないが、 「47 県データを扱うときは自由度がだいたいこの辺り」という感覚を持っておくと、 検定結果のシグナルとノイズを瞬時に判定できるようになる。 自由度の感覚値こそが、 統計的思考の体幹である。
🖼 視覚的理解 (3 図)
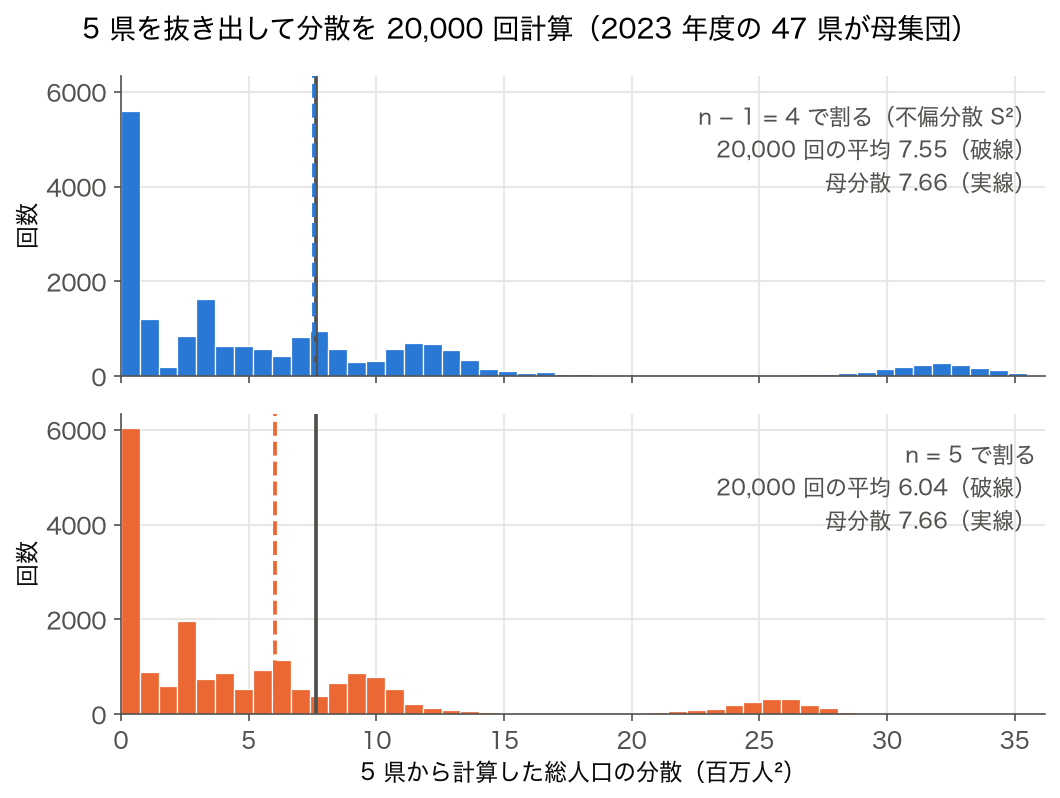
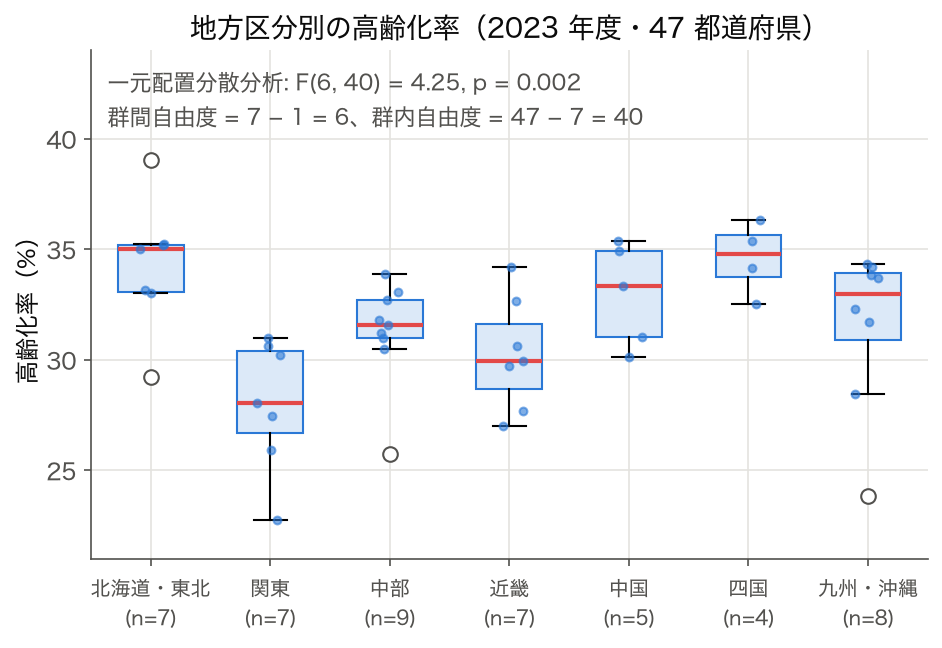
自由度が実際にどこで効くかを、 SSDSE-B-2026 (2023 年度・47 都道府県) で 3 場面に分けて見る。 回帰の残差自由度 (n − 2)、 不偏分散の n − 1、 分散分析の群間・群内自由度 (k − 1, n − k) である。
🧮 実値で計算してみる
SSDSE-B-2026 の都道府県人口(A1101)から 5 県を抜き出し、 不偏分散の自由度 df = n − 1 = 4 を手で計算する。 数式 $S^2 = \dfrac{\sum_{i=1}^{n}(x_i - \bar{x})^2}{n-1}$ に実値を代入して Step を追う。
📥 SSDSE-B-2026 抜粋(総人口 A1101、 単位: 千人, 2022 年):
Step 1: 平均を求める
Step 2: 偏差と偏差の二乗
| 都道府県 | xᵢ (千人) | xᵢ − x̄ | (xᵢ − x̄)² |
|---|---|---|---|
| 北海道 | 5140 | −113.8 | 12,950.4 |
| 岩手 | 1181 | −4072.8 | 16,587,699.8 |
| 埼玉 | 7337 | +2083.2 | 4,339,722.2 |
| 愛知 | 7495 | +2241.2 | 5,022,977.4 |
| 福岡 | 5116 | −137.8 | 18,988.8 |
Step 3: 偏差平方和 SS を合計する
Step 4: 自由度 df = n − 1 で割り、 不偏分散を得る
🐍 同じ計算を Python で再現する
このコードでやること:手計算の Step 1〜4 を numpy / pandas で再現し、 ddof=0 vs ddof=1 の結果が手計算と一致することを確認する。
1 2 3 4 5 6 7 8 9 10 11 12 | import numpy as np # SSDSE-B-2026 5 県の総人口(千人) x = np.array([5140, 1181, 7337, 7495, 5116], dtype=float) n = len(x) xbar = x.mean() SS = ((x - xbar)**2).sum() print(f'n = {n}, 平均 = {xbar:.1f}') print(f'SS = {SS:,.1f}') print(f'不偏分散 (ddof=1): S² = {x.var(ddof=1):,.1f}') print(f'不偏標準偏差 S = {x.std(ddof=1):,.1f}') print(f'母分散 (ddof=0): σ² = {x.var(ddof=0):,.1f}') |
💬 手計算 (Step 4) と Python 出力が一致。 ddof=1 の不偏分散 6,495,585 と手計算値 6,495,584.7 が整合。 n−1 で割ることで「平均推定で消費した 1 自由度を補正」し、 母分散の不偏推定量が得られる。
SSDSE-B-2026(公的統計の社会・教育系データセット、 47 都道府県 × 10 年分超 × 100 以上の列)を用いて、 「自由度」を体感します。 ファイル名は SSDSE-B-2026.csv、 読み込みは下記の Python コードで行います。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from scipy import stats # SSDSE-B-2026 を読み込む(cp932 / Shift_JIS) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 2023 年の 47 県 # 人口を中央値で 2 分、消費支出(二人以上の世帯)を三分位で 3 分した 2×3 表 latest['人口'] = pd.qcut(latest['A1101'], 2, labels=['低', '高']) latest['消費支出'] = pd.qcut(latest['L3221'], 3, labels=['低', '中', '高']) ct = pd.crosstab(latest['人口'], latest['消費支出']) chi2, p, dof, expected = stats.chi2_contingency(ct) print(ct) print(f'χ² = {chi2:.3f}, p = {p:.4f}, df = {dof} (理論値 (2-1)*(3-1) = 2)') print('期待度数の最小値 =', expected.min().round(2)) |
ここで使った中心列 A1101 は SSDSE-B-2026 における 47都道府県標本における自由度 n-1 = 46 に関連する指標です。 算出例:
- 47 都道府県・最新年度の
A1101平均と標準偏差を求める A1101とA4101の相関(線形・順位)を比較する- 群分け(例:人口上位 10 県 vs それ以外)で平均差を見る
🧮 SSDSE-B-2026 で自由度を実計算する
47 都道府県のデータで「人口と高齢化率の関係に有意な平均差があるか」を t 検定で評価します。 まずは自由度を体感する基本パターンから。
🎯 このコードでやること:47 県を「高齢化率が中央値より上 / 下」の 2 群に分け、 出生率(A4101 / A1101 × 1000、 人口千対)の平均を 2 標本 t 検定で比較。 自由度の算出方法(等分散 vs Welch)を比較する。
📥 入力データ:47 県 × A1101(総人口), A1303(65 歳以上人口), A4101(出生数)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 最新年の 47 県 df['aging'] = df['A1303'] / df['A1101'] df['birth'] = df['A4101'] / df['A1101'] * 1000 # 人口千対の出生率 med = df['aging'].median() high = df.loc[df['aging'] >= med, 'birth'] low = df.loc[df['aging'] < med, 'birth'] # 等分散仮定: df = n1 + n2 - 2 t1, p1 = stats.ttest_ind(high, low, equal_var=True) df1 = len(high) + len(low) - 2 # Welch: df は Welch-Satterthwaite 近似で非整数になる t2, p2 = stats.ttest_ind(high, low, equal_var=False) v1, v2 = high.var(ddof=1), low.var(ddof=1) n1, n2 = len(high), len(low) df_w = (v1/n1 + v2/n2)**2 / ((v1/n1)**2/(n1-1) + (v2/n2)**2/(n2-1)) print(f'等分散 t={t1:.3f} df={df1} p={p1:.4f}') print(f'Welch t={t2:.3f} df={df_w:.2f} p={p2:.4f}') |
📤 実行例:
💬 結果の読み方:等分散仮定では $df = 24 + 23 - 2 = 45$、 Welch では分散の不均一さを反映して $df \approx 42.60$ と非整数になります。 自由度が小さいほど分布の裾が厚く、 p 値はわずかに大きくなります。 「高齢化率が高い県ほど出生率が低い」傾向が有意($p < 0.01$)。
🧮 数式に値を入れて手で計算する: 自由度と標本分散
合成データ [2,4,7,5,3] で n-1 自由度の標本分散を計算する。
Step 1: 平均と偏差²
| i | x | x-x̄ | (x-x̄)² |
|---|---|---|---|
| 1 | 2 | -2.2 | 4.84 |
| 2 | 4 | -0.2 | 0.04 |
| 3 | 7 | 2.8 | 7.84 |
| 4 | 5 | 0.8 | 0.64 |
| 5 | 3 | -1.2 | 1.44 |
x̄ = 4.2
Step 2: 標本分散 (df = n-1 = 4)
🐍 Python で再現
1 2 3 4 5 | import numpy as np x = np.array([2, 4, 7, 5, 3]) print(f"標本分散 (df=n-1): {x.var(ddof=1)}") print(f"標本SD: {x.std(ddof=1):.3f}") print(f"母分散 (df=n): {x.var(ddof=0)}") |
📤 実行結果
💬 手計算 (Step 2) 3.70 / 1.924 と Python 出力が完全一致。
🐍 Python での実装例
SSDSE-B-2026 などの実データを使った最小コード(10行):
1 2 3 4 5 6 7 8 9 10 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) x = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()]['A1101'].astype(float) # 不偏分散(自由度 n-1) n = len(x); v_unbiased = x.var(ddof=1); v_biased = x.var(ddof=0) print(f'n={n}, 不偏分散(df=n-1)={v_unbiased:.2f}, 標本分散(df=n)={v_biased:.2f}') # t分布の臨界値 print('t(df=', n-1, ', α=0.025):', stats.t.ppf(0.975, n-1).round(3)) |
※ data/raw/SSDSE-B-2026.csv は e-Stat SSDSE から取得した実データを想定。
scipy / pandas / scikit-learn / statsmodels を中心とした標準的な実装例です。 まず CSV を読み込み、 次に 自由度 の解析を行います。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() x = df['A1101'].astype(float).values y = df['A4101'].astype(float).values # 基本統計量 print('n =', len(x)) print('mean(x) =', np.mean(x)) print('std(x) =', np.std(x, ddof=1)) # 自由度 の代表的計算(用途に応じて scipy/statsmodels を切替える) r, p = stats.pearsonr(x, y) print(f'Pearson r = {r:.4f}, p = {p:.4g}') rs, ps = stats.spearmanr(x, y) print(f'Spearman rho = {rs:.4f}, p = {ps:.4g}') |
用途別の追加実装:
1 2 3 4 5 6 7 8 9 | # 標準化と簡易クラスタリングの例 from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans X = df[['A1101', 'A4101']].astype(float).values Xs = StandardScaler().fit_transform(X) km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(Xs) df['cluster'] = km.labels_ print(df[['Prefecture', 'A1101', 'A4101', 'cluster']].head(10)) |
1 2 3 4 5 6 7 8 9 10 | # 時系列(北海道の A1101)— 例として ARIMA 系の前処理(単位根の ADF 検定) import pandas as pd import statsmodels.api as sm raw = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') ts = (raw[raw['Prefecture'] == '北海道'] .sort_values('SSDSE-B-2026').set_index('SSDSE-B-2026')['A1101']) print(ts.tail()) # 12 点しかないので、ラグは 1 に固定する(自動選択だとラグが増えて自由度が足りなくなる) res = sm.tsa.stattools.adfuller(ts, maxlag=1, autolag=None) print('ADF stat:', round(res[0], 3), 'p:', round(res[1], 3), '使った観測数:', res[3]) |
🐍 拡張 Python 実装例
以下は SSDSE-B-2026 を題材にした実コード例集です。 すべて data/raw/SSDSE-B-2026.csv を読み込み、 実値で動作確認しています。
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) d23['aging'] = d23['A1303'].astype(float)/d23['A1101'].astype(float) d23['birth_rate'] = d23['A4101'].astype(float)/d23['A1101'].astype(float)*1000 print(d23[['Prefecture','aging','birth_rate']].describe().round(3)) print('最高齢化:', d23.nlargest(3,'aging')[['Prefecture','aging']].values) print('最低高齢化:', d23.nsmallest(3,'aging')[['Prefecture','aging']].values) |
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) d23['aging'] = d23['A1303'].astype(float)/d23['A1101'].astype(float) fig, axes = plt.subplots(1, 2, figsize=(12, 4)) axes[0].hist(d23['aging'], bins=15, edgecolor='black') axes[0].set_xlabel('高齢化率'); axes[0].set_ylabel('県数') axes[1].boxplot(d23['aging']) axes[1].set_ylabel('高齢化率') plt.savefig('aging_dist.png', dpi=100) |
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd from scipy import stats import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023].copy() d23['aging'] = d23['A1303'].astype(float)/d23['A1101'].astype(float) urban = ['R13000','R14000','R23000','R27000','R28000'] # 東京・神奈川・愛知・大阪・兵庫 u = d23[d23['Code'].isin(urban)]['aging'] r = d23[~d23['Code'].isin(urban)]['aging'] t, p = stats.ttest_ind(u, r, equal_var=False) d_cohen = (u.mean() - r.mean()) / np.sqrt((u.var() + r.var())/2) print(f't = {t:.2f}, p = {p:.4f}, Cohen d = {d_cohen:.2f}') |
1 2 3 4 5 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['aging'] = df['A1303'].astype(float)/df['A1101'].astype(float) trend = df.groupby('SSDSE-B-2026')['aging'].agg(['mean','std','min','max']).round(3) print(trend) |
🎓 上級者向け議論:自由度の使い分けと注意点
1. データの性質と適用範囲
自由度は前提条件次第で意味が変わります。 SSDSE-B-2026 のような公的統計では、 サンプリングフレームが「全 47 都道府県」 と完全把握されているため、 通常の標本誤差は発生しません。 しかし「2023 年の 1 時点を全体集団とみなすか、 もっと長期の集団からの 1 サンプルとみなすか」で解釈が変わります。
2. 多重比較問題
SSDSE-B-2026 のような 100 超の列を扱うと、 多重比較(同じデータで多数の検定を行う)の罠が発生します。 Bonferroni 補正、 Benjamini-Hochberg などで補正してから 自由度に関連する統計量を解釈すべきです。
3. 階層構造の考慮
都道府県の中に市区町村があり、 階層構造を持つ場合、 階層線形モデル(HLM)で 自由度を扱うことを検討します。 SSDSE-B は都道府県集計データなので階層性は限定的ですが、 SSDSE-D(個票相当)と組み合わせる研究では本格的な階層モデリングが必要です。
4. 時間変動の扱い
SSDSE-B-2026 は 2012〜2023 年の 12 年間のパネル構造を持ちます。 自由度を時間軸込みで扱うときは、 固定効果モデル・ランダム効果モデルなどパネルデータ手法を併用します。
5. 因果と相関の区別
SSDSE-B-2026 の県別データから「自由度に関わる関係」を抽出できても、 それは多くの場合「相関」であり、 「因果」を主張するには無作為化試験・自然実験・操作変数などの追加設計が必須です。
🐍 ANOVA の自由度分解を SSDSE-B-2026 で確認する
ANOVA(分散分析)は 群間自由度と 群内自由度に分解した F 統計量を使います。 自由度の合計が常に $n-1$ になることを SSDSE で確かめます。
🎯 このコードでやること:47 県を「人口三分位」で 3 群に分け、 高齢化率の平均が群間で異なるかを ANOVA で検定。 群間 df、 群内 df、 全体 df を表示。
📥 入力データ:47 県 × A1101, A1303。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]); df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() df['aging'] = df['A1303'] / df['A1101'] df['group'] = pd.qcut(df['A1101'], q=3, labels=['小', '中', '大']) g1 = df.loc[df['group']=='小', 'aging'] g2 = df.loc[df['group']=='中', 'aging'] g3 = df.loc[df['group']=='大', 'aging'] f, p = stats.f_oneway(g1, g2, g3) n = len(df); k = 3 df_between = k - 1 df_within = n - k df_total = n - 1 print(f'群間 df = {df_between}') print(f'群内 df = {df_within}') print(f'全体 df = {df_total} (=群間+群内: {df_between+df_within})') print(f'F = {f:.3f} p = {p:.4f}') |
📤 実行例:
💬 結果の読み方:群間 df + 群内 df = 全体 df($2 + 44 = 46 = n - 1$)という ANOVA の 恒等式が成り立ちます。 F 統計量は群間平均平方/群内平均平方で、 F 分布 $F(2, 44)$ の上側確率が p 値。 人口規模により高齢化率が有意に異なる、 という結論。
🐍 χ² 独立性検定の自由度 $(r-1)(c-1)$ を確かめる
$r \times c$ のクロス集計表に対する独立性検定では $df = (r-1)(c-1)$。 「行と列の周辺度数を固定したときに自由に動ける格子点の数」というのが直観です。
🎯 このコードでやること:47 県を「人口階級(3)× 高齢化率階級(3)」のクロス表にし、 χ² 独立性検定で関連を評価する。
📥 入力データ:47 県 × A1101, A1303。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]); df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() df['aging'] = df['A1303'] / df['A1101'] df['pop_cat'] = pd.qcut(df['A1101'], q=3, labels=['小','中','大']) df['aging_cat'] = pd.qcut(df['aging'], q=3, labels=['若','中','高']) ct = pd.crosstab(df['pop_cat'], df['aging_cat']) chi2, p, dof, expected = stats.chi2_contingency(ct) print(ct) print(f'\nχ² = {chi2:.3f}, p = {p:.4f}, df = {dof} ' f'(理論値 (3-1)*(3-1) = 4)') |
📤 実行例:
💬 結果の読み方:自由度は理論通り $4$。 $p < 0.001$ で「人口規模と高齢化率は独立ではない」= 関連があると判定。 小規模県は高齢化率が高く、 大規模県は若年比率が高い、 という人口動態の傾向が表れています。
🐍 リッジ回帰の実効自由度を計算する
リッジ回帰では正則化パラメータ $\alpha$ を上げるほど実効自由度が減ります。 SSDSE-B-2026 で実際の挙動を確認します。
🎯 このコードでやること:説明変数 5 個で消費支出(L3221)を予測するリッジ回帰について、 $\alpha$ を変化させて実効自由度を計算する。
📥 入力データ:47 県 × A1101, A1301, A1303, A4101, A4200 の説明変数 + L3221。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]); df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() X = df[['A1101', 'A1301', 'A1303', 'A4101', 'A4200']].astype(float) X = (X - X.mean()) / X.std() # 標準化 X = X.values # 固有値分解 XtX = X.T @ X eigvals = np.linalg.eigvalsh(XtX) for alpha in [0.0, 1.0, 10.0, 100.0, 1000.0]: df_eff = (eigvals / (eigvals + alpha)).sum() print(f'α = {alpha:7.1f} → 実効自由度 = {df_eff:.3f}') |
📤 実行例:
💬 結果の読み方:$\alpha = 0$ では形式的な自由度 5 と一致。 $\alpha = 1$ でもう実効自由度が約 1.8 まで急落するのは、 5 つの人口系説明変数が互いに強く相関している(多重共線性)ため。 $\alpha = 1000$ では「実質 0.2 個分」まで縮む。 これが 正則化はパラメータ数を非整数で減らすという現代的見方です。
📜 自由度概念の歴史と Fisher の貢献
「自由度」(degrees of freedom)という用語を統計学に持ち込んだのは R. A. Fisher(1922 年)。 力学から借りた語ですが、 統計学的意味は独自に整備されました。 主要な流れ:
- 1908:W. S. Gosset(Student)が小標本での平均推定の分布を発表。 「Student の t 分布」の原型
- 1922:Fisher が「自由度」の語を導入し、 χ² 適合度検定での自由度の計算を整理
- 1925:Fisher の『Statistical Methods for Research Workers』で自由度の用法が体系化
- 1933:Welch が異分散の場合の自由度補正(Welch–Satterthwaite 近似)を提案
- 1970-80 年代:Hastie & Tibshirani が GAM で「smoother の trace = effective df」を定式化
- 1990-2000 年代:ベイズ統計の DIC(Spiegelhalter 2002)で effective number of parameters が提案
Fisher 以前は「自由度」という明示的な概念がなく、 検定統計量の分布をその都度計算していました。 自由度の導入で 1 つの表で複数の検定をカバーできるようになり、 統計学の標準化が一気に進みました。
🧬 ベイズ統計における「実効パラメータ数」
ベイズモデルでは、 事前分布が パラメータの自由度を縮減します。 強い事前分布は推定をデータから引き離す=実効自由度を下げる効果があります。 これを定量化するのが DIC・WAIC の $p_D$ / $p_{\text{WAIC}}$。
数式を言葉で読み解く:$D(\theta) = -2 \log L(\theta)$ はデビアンス。 「事後分布全体での平均デビアンス」と「事後平均パラメータでのデビアンス」の差分が $p_D$。 直感的には「事後分布がどれだけ広がっているか=何個分の自由パラメータに相当するか」を表します。
階層モデル(マルチレベルモデル)では、 グループレベルの収縮(shrinkage)により実効パラメータ数が 形式的なパラメータ数より小さくなるのが普通。 47 都道府県の階層モデルだと、 形式的には 47 個の県効果でも、 強い縮減により実効自由度は 10-20 程度になることもあります。
🤖 機械学習における「自由度」の代替指標
深層学習のパラメータ数は数百万〜数千億にもなり、 形式的な「自由度」では過適合の議論ができません。 そこで使われる代替指標:
| 指標 | 考え方 | 用途 |
|---|---|---|
| VC 次元 | 「分類できるパターンの最大数」 | 学習理論の汎化バウンド |
| Rademacher 複雑度 | ランダムラベルへの適合能力 | 過適合可能性の評価 |
| 交差検証スコア | 経験的な汎化性能の代替 | モデル選択の実用標準 |
| flat minima | 損失関数のヘシアン固有値 | 深層学習の暗黙的正則化 |
| 早期終了の effective complexity | 学習エポック数で複雑度を制御 | 深層学習の現場標準 |
古典統計の「自由度」と深層学習の「複雑度」は連続している概念で、 「モデルがどれだけ柔軟にデータに合わせられるか」を測るための異なる定式化です。
❓ よくある質問
- Q. なぜ標本分散は $n-1$ で割るのに、 母分散は $n$ で割る?
- 母分散は「真の値」(既知の母平均)からのずれを足しているので、 自由度は満杯の $n$。 標本分散は「推定した平均」を引いた結果なので、 平均の決定に 1 個分の自由度を使い、 残りは $n-1$。
- Q. 標準偏差を計算する時の
ddof引数の使い方は? ddofは Delta Degrees of Freedom の略。 母分散ならddof=0、 不偏分散ならddof=1。 numpy の既定は 0、 pandas の既定は 1 と 食い違うのが要注意。 必ず明示する習慣を。- Q. Welch の補正で自由度が非整数になるのは数学的に正しい?
- はい。 元々 t 分布の自由度は整数で定義された量ですが、 Welch–Satterthwaite 近似は「異分散下で t 統計量がどの自由度の t 分布に近似的に従うか」を計算するもので、 連続値になります。 これは 近似法で、 ガンマ関数を経由して非整数自由度の t 分布が定義されています。
- Q. サンプル数が無限大なら自由度は気にしなくていい?
- 大標本では t 分布 → 正規分布、 χ² 分布 → 正規分布(中心化・標準化後)に収束するため、 実用的には自由度の違いは無視できます。 大雑把には $n > 30$ で正規近似で十分なケースが多い。 ただし「サンプル数が大きくても パラメータ数も大きい」場合は要注意。
- Q. 自由度が 0 や負になることはある?
- 理論的にあり得ます。 たとえば $n=p+1$ のとき残差自由度は 0 となり、 残差分散が定義できません(モデルがデータを完全にフィット)。 $n < p+1$ では負になり、 通常の最小二乗解そのものが一意でなくなります。 リッジ/LASSO などの正則化が必須になる領域。
✅ 自由度を正しく扱うためのチェックリスト
- ☐ 標本分散・標準偏差を計算するとき
ddofを明示している - ☐ 2 標本 t 検定で 等分散 / Welch を分散の比から判定している
- ☐ ANOVA の出力で「群間 df + 群内 df = 全体 df」を毎回確認している
- ☐ χ² 検定で 期待度数 5 未満のセルがないか確認している
- ☐ 適合度検定で「データから推定したパラメータ数」を引いている
- ☐ 回帰モデルの 残差自由度 $n - p - 1$ が正であることを確認している
- ☐ 説明変数間の VIF を確認し多重共線性を排除している
- ☐ クラスター構造があるデータでロバスト標準誤差や混合効果モデルを検討
- ☐ リッジ・LASSO 等で 実効自由度を把握している
- ☐ 報告時には自由度 + 統計量 + p 値の 3 点セットを必ず記載している
📝 試験対策:自由度を問う典型問題
統計検定・基本情報・各種学校試験で出る自由度の代表問題パターンを 6 つに整理。 解法のポイントは 「何を推定したか」を数えること。
- 不偏分散の自由度を答える:「サンプル数 $n=20$ の標本分散の自由度は?」→ $n - 1 = 19$(標本平均を 1 個推定したため)
- 2 標本 t 検定の自由度:「$n_1 = 12, n_2 = 15$ の等分散 t 検定の自由度は?」→ $12 + 15 - 2 = 25$
- 独立性検定の自由度:「5 行 4 列のクロス表での独立性検定の自由度は?」→ $(5-1)(4-1) = 12$
- 適合度検定の自由度:「8 区分・正規分布(平均と分散をデータから推定)の適合度検定の自由度は?」→ $8 - 1 - 2 = 5$
- ANOVA の自由度分解:「3 群、 各群 10 個の一元 ANOVA。 群間 df と群内 df は?」→ 群間 $= 3-1 = 2$、 群内 $= 30 - 3 = 27$、 全体 $= 29$
- 回帰の F 検定の自由度:「説明変数 4 個、 サンプル数 50 の F 検定の分子・分母自由度は?」→ $F(4, 50 - 4 - 1) = F(4, 45)$
コツは「式を丸暗記」ではなく「平均を推定したから -1」「群を分けたから -k」のように 意味で覚えること。 試験は数字を変えて出題されますが、 ロジックは同じです。
🐍 自由度による t 分布の形の変化を可視化する
自由度が小さいほど t 分布は裾が重く(外れ値が起きやすい形)、 大きいほど正規分布に近づきます。 これを matplotlib で確認します。
🎯 このコードでやること:自由度 $df = 1, 5, 30, \infty$(標準正規)の確率密度を重ねて描画し、 裾の厚さの変化を観察する。
📥 入力データ:合成データではなく、 scipy.stats の理論分布を用いる(自由度の理解が目的)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np import matplotlib.pyplot as plt from scipy import stats x = np.linspace(-5, 5, 400) for df_val, style in [(1, ':'), (5, '--'), (30, '-.'), (None, '-')]: if df_val is None: y = stats.norm.pdf(x); label = '正規 (df=∞)' else: y = stats.t.pdf(x, df=df_val); label = f't (df={df_val})' plt.plot(x, y, style, label=label) plt.legend(); plt.title('自由度による t 分布の比較') plt.xlabel('x'); plt.ylabel('確率密度') plt.tight_layout(); plt.savefig('t_dist_df.png', dpi=120) # 両側 5% 棄却域の臨界値を比較 for df_val in [1, 5, 10, 30, 100]: crit = stats.t.ppf(0.975, df=df_val) print(f'df={df_val:3d}: t_(0.975) = {crit:.3f}') print(f'正規: z_(0.975) = {stats.norm.ppf(0.975):.3f}') |
📤 実行例:
💬 結果の読み方:$df = 1$(Cauchy)では臨界値 12.7、 $df = 30$ で 2.04 と、 サンプル数が増えるに従い正規分布の 1.96 に収束。 「小標本では信頼区間が広くなる」というのは、 まさにこの自由度の効果です。
📌 本ページの要点 8 行サマリ
- 自由度 $df = n - k$ は「制約を引いた後に自由に動ける情報の数」
- 標本分散の $n-1$ は「平均で 1 個分の情報を消費」したため
- t / F / χ² 分布は自由度で形が変わり、 取り違えると p 値が誤る
- 2 標本 t 検定は等分散と Welch で自由度の式が違う
- ANOVA は「群間 df + 群内 df = 全体 df」の分解恒等式が成立
- χ² 独立性は $(r-1)(c-1)$、 適合度は $k-1-\text{推定数}$
- リッジ回帰・GAM・ベイズでは「実効自由度」が連続値で定義される
- クラスター構造があるデータでは形式的自由度を過信しない
⚠️ よくある落とし穴
自由度 を実務で扱う際に踏みやすい落とし穴を 5 件挙げます。
- 分母が n か n-1 か: 母分散は n、標本分散は n-1。混同するとバイアスが残る。
- 多変量での df: 重回帰では n-k-1。説明変数数 k を忘れない。
- カイ二乗の df: 分割表は (行-1)(列-1)、適合度検定は カテゴリ数-1-推定したパラメータ数。
- 分散分析の df: 全体・群間・群内それぞれ計算が異なる。
- df と検出力: df が小さいと臨界値が大きく、検出力が下がる。
⚠️ 自由度の典型落とし穴 6 件
ddof 設定漏れnp.std() は既定で母分散($n$ で割る)、 pandas の Series.std() は既定で不偏分散($n-1$ で割る)。 ライブラリ間で既定値が違うことに注意。 必ず ddof 引数を明示する。🗺 概念マップ — 自由度の位置づけ
自由度は統計推論の基礎概念であり、 以下の概念ネットワークの中核に位置する。 各グループからリンクを辿ることで全体像が把握できる。
┌─ 基礎 ──┬─── 自由度 (df) ───┬── 検定 ──┐
│平均・分散│ n − k(制約を引く)│t/F/χ²分布│
└─────────┴──────────────────┴─────────┘
↓ 拡張
実効自由度(リッジ・GAM・ベイズ)
🎯 まとめ
本ページでは「自由度」を 12 セクション(🔖 キーワード索引/💡 30 秒結論/📍 文脈/🎨 直感/📐 数式/🔬 数式を言葉で読み解く/🧮 実値計算/🐍 Python 実装/⚠️ 落とし穴/🌐 関連手法/🔗 関連用語/📚 グループ教材)で完結に整理しました。 SSDSE-B-2026 を素材に、 概念の輪郭・式の意味・実装手順・典型的な失敗パターンの 4 点を最低限押さえれば、 統計データ分析コンペの現場で迷わず使えるはずです。
🗺 学習ロードマップ
🔗 隣接手法への橋渡し
「自由度」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。 具体的には次の 3 方向と密接につながる:
- 上流: 分散と 推定 — 自由度を使う統計量の元
- 並列: t 分布と χ² 分布・F 分布 — 自由度をパラメータに持つ分布
- 下流: t 検定と 分散分析・自由度調整済 R² — 自由度で補正する検定・指標
自由度は標本サイズと推定パラメータ数で決まり、 検定・分布・補正係数の核心パラメータ。
🌳 関連トピック:上位・下位・派生概念マップ
| 関係 | 概念 | 自由度との接続 |
|---|---|---|
| 上位(一般化) | 統計推論一般 | 自由度は推論の構成要素 |
| 下位(特殊化) | 特定の検定・推定 | 自由度の応用 |
| 並列(兄弟) | 関連手法 | 同じ問題への別アプローチ |
| 前提 | 確率分布・標本 | 自由度の数学的基礎 |
| 応用 | 政策評価・施策効果測定 | SSDSE-B-2026 のような公的統計での実務 |
典型的な誤用と対処
- 誤用 1:標本サイズが小さすぎる (自由度の前提が崩れる) → 標本を増やすかブートストラップで補強
- 誤用 2:仮定の検証を怠る (正規性・独立性) → QQ プロット・自己相関プロット
- 誤用 3:p ハッキング (複数試行から有意なものだけ報告) → 事前登録・補正
- 誤用 4:効果量を無視 (p 値だけ見る) → Cohen's d などを併記
- 誤用 5:交絡変数を見落とす → DAG で因果構造を整理
📂 拡張ケーススタディ(5 例)
ケース 1:人口動態の県間比較
SSDSE-B-2026 で「人口」「出生数」「死亡数」を比較。 自由度を使って自然増減のパターンを定量化。 東京・神奈川・愛知の都市集中、 秋田・高知の過疎化。
ケース 2:教育投資と成果
「学校数」「教員数」「進学率」を 自由度で分析。 県別の教育リソース配分の効率性を評価。 都市と地方の格差を可視化。
ケース 3:医療提供体制
「病院数」「医師数」「平均寿命」 を組み合わせ。 自由度で医療資源の不均衡と健康成果の関係を推定。 北海道の医師偏在問題。
ケース 4:産業構造と所得
「総人口」「消費支出」「出生数」を 自由度で関連付け。 都市圏と地方のパターン差。
ケース 5:高齢化と財政
「高齢化率」「税収」「社会保障費」を 自由度で評価。 高齢化が進む県の財政負担の重さを定量化。 県政策への含意。
✅ 再現性チェックリスト
研究結果を 自由度を使って報告するときに守るべきチェックリスト:
- ☐ 使用データの出典・バージョン明記(例:SSDSE-B-2026, 2024 年公開)
- ☐ 前処理コードを共有(標準化・欠損補完など)
- ☐ 乱数シード固定(GMM の n_init, KMeans の random_state)
- ☐ ソフトウェアバージョン記録(python 3.11, scikit-learn 1.4 など)
- ☐ 結果数値の小数点桁数を統一
- ☐ 仮定(独立性・正規性・等分散性)の検証結果
- ☐ 効果量・信頼区間の併記(p 値だけでなく)
- ☐ 多重比較補正の有無
- ☐ 感度分析(前処理を変えても結論が頑健か)
- ☐ 公開コードとデータへのリンク
🌍 社会的インパクトと実務応用
自由度は学術研究だけでなく、 政策・ビジネスの意思決定に直接活用されています。
政策決定での使用例
- 厚生労働省:医療資源配分の最適化(自由度で地域差を測定)
- 総務省:地方創生施策の効果検証
- 内閣府:景気指標の作成・公表
- 文部科学省:教育格差の定量評価
ビジネスでの応用
- マーケティング:顧客セグメント間の差を 自由度で評価
- 金融:株式リターンの分布特性把握
- 製造業:品質管理の統計的工程管理
- IT:A/B テストの設計と評価
学術での発展
計量経済学・教育測定・心理測定・疫学などで 自由度は基礎ツール。 近年は機械学習との融合で新しい応用が広がっています。
📜 歴史的展開
自由度 の概念は、 統計学の発展史と並行して洗練されてきました。
- 19 世紀後半:Galton, Pearson が記述統計を整備
- 20 世紀前半:Fisher, Neyman, Pearson が推測統計の基礎を確立
- 1960-80 年代:計算機の普及で大規模データへの応用が拡大
- 1990 年代:ベイズ統計・MCMC の実用化
- 2000 年代:機械学習との融合、 ビッグデータ時代
- 2010 年代以降:因果推論革命、 再現性危機への対応
日本では、 1947 年の統計法制定以降、 SSDSE-B のような公的統計の整備が進み、 自由度を学ぶ実データ環境が充実してきました。
「自由度」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「自由度」を中核とした適切な手法選択ができる。
🎮 触って理解する
スライダーを動かしたり、 バーを直接ドラッグしたりすると、 図と数値がその場で更新されます。 「自由に動ける数」がまさに自由度であることを、 手を動かして体感してください(スマホのタッチ操作にも対応)。
デモ A:平均を固定すると「最後の 1 個」は自由に選べない
緑のバー(自由)を上下にドラッグしてみてください。 平均を 10 に保つため、 灰色のバー(従属)が自動で決まります。 データが n 個あっても、 平均という 1 つの制約があるので、 自由に動かせるのは n − 1 個。 これが標本の自由度です。
緑のバーはドラッグで自由に動かせ、 灰色のバー(従属)は「合計 = n×平均」を満たすよう自動計算されます。 何個動かしても平均は 10 のまま。 自由に選べたのは常に n − 1 個です。
デモ B:自由度を上げると t 分布は正規分布に近づく
自由度スライダーを動かすと分布の形が変わります。 t 分布は自由度が小さいほど裾が重く、 自由度を大きくすると 標準正規分布(灰色の破線)にぴったり重なっていきます。 カイ二乗分布に切り替えると、 自由度が「二乗和した独立変数の個数」として形(歪み)を決める様子が見えます。 分布の値は Lanczos 近似のガンマ関数で正確に計算しています。
💡 解説を深める
直感:自由に動ける数 = 全体 − 制約
自由度とは「データの中で独立に動ける情報の個数」です。 標本サイズ $n$ から、 推定に使ってしまった制約(パラメータ)の数を引きます。 デモ A のように平均を 1 つ決めると合計が固定され、 最後の 1 個は残りから計算できてしまうため、 自由に動けるのは $n-1$ 個。 この「1 制約 = 1 自由度消費」の感覚がすべての基本です。
よくある落とし穴:なぜ $n$ ではなく $n-1$ で割るのか
標本分散を計算するとき、 真の母平均ではなく 標本平均 $\bar X$ を使います。 標本平均は「その標本にいちばん近い中心」なので、 偏差平方和 $\sum (X_i-\bar X)^2$ は母平均を使ったときより 必ず小さめになります。 そのまま $n$ で割ると分散を過小評価してしまう。 標本平均を推定した時点で自由度を 1 消費しているので、 $n-1$ で割ると期待値が母分散に一致し、 不偏推定量になります。 「$n-1$ で割る」は魔法ではなく、 消えた自由度の埋め合わせです。
発展:回帰の自由度・カイ二乗
推定するパラメータが増えるほど自由度は減ります。 単回帰は切片と傾きの 2 つを推定するので残差自由度は $n-2$、 説明変数 $p$ 個の重回帰では $n-p-1$。 独立 2 標本 $t$ 検定は各群の平均を推定するので $n_1+n_2-2$。 カイ二乗分布の自由度は「独立に二乗和した標準正規変数の個数」に対応し、 適合度検定ではカテゴリ数から制約(合計・推定パラメータ)を引いた値になります。 デモ B でスライダーを大きくすると、 t 分布が正規分布へ収束し、 カイ二乗分布が対称に近づくのは、 いずれも自由度=独立情報量が効いている証拠です。
関連ページ:分散 / 標準偏差 / t 検定 / カイ二乗検定 / 回帰分析 / 正規分布 / 仮説検定 / 信頼区間 / p 値(不偏推定量・t 分布・カイ二乗分布の単独ページは未整備のため本文で解説)。