🔖 キーワード索引
「time series」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「time series」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「time series の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
時間順に並んだデータを分析する方法です。
未来の動きを予測するために使います。
スマホで見る毎日の気温の変化などが例です。
この章では分析の基本と代表的なモデルを読みます。
- 定義:時間順に並んだデータを分析する手法群。自己相関や周期性、トレンドが特徴。
- カテゴリ:時系列
- 基本構成要素:トレンド・季節性・周期性・残差(STL 分解)。
- 定常性:平均・分散が時間に依存しない性質。 ADF/KPSS で検定。
- 代表モデル:ARIMA, SARIMA, ETS, Prophet, 状態空間モデル, LSTM。
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
🎯 このコードでやること:時系列を扱う基本の型。SSDSE-B-2026 から東京都の「食料費(二人以上の世帯)」を取り出し、年度の古い順に並べて 12 年分の系列にし、前年差の平均を出して折れ線で描く。
📥 入力例(SSDSE-B-2026、東京都の 12 行から 3 行)
都道府県  年度  食料費(二人以上の世帯)
東京都    2012   79991
東京都    2020   92079
東京都    2023   97776
…(CSV 上は 2023 → 2012 の降順に並んでいる)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # 基本パターン:1 つの県・1 つの指標を年度順に並べて時系列にする import pandas as pd import matplotlib.pyplot as plt # データ読み込み(header=1 で 2 行目の日本語列名を見出しにする) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # CSV は新しい年度が先(2023 → 2012)に並ぶので、年度で並べ替えてから使う tk = df[df['都道府県'] == '東京都'].sort_values('年度').set_index('年度') s = tk['食料費(二人以上の世帯)'] print(s.to_string()) print('前年差の平均:', round(s.diff().mean(), 1)) # 可視化:横軸を年度にした折れ線 s.plot(marker='o') plt.ylabel('食料費(円/月)') plt.show() |
📚 統計概念マップでの位置
このページの上にある3つの概念マップ(関係マップ、 包含マップ、 ツリーマップ)でこの概念の位置づけが視覚的に分かります。 関連手法を辿って学習を進めましょう。
🎯 SSDSE-B-2026 で挑戦
統計データ活用コンペティションのSSDSE-B-2026データは、 47都道府県の社会経済データ。 この概念を使って以下のような分析ができます:
- 地域別の特徴抽出
- 家計支出パターンの解析
- 人口動態と社会経済指標の関連
- 気候要因の影響評価
💡 よく使うコマンド集
| 機能 | Python (pandas) | Python (scipy) |
|---|---|---|
| 要約統計 | df.describe() | stats.describe() |
| 平均 | df.mean() | np.mean() |
| 標準偏差 | df.std() | np.std() |
| 相関 | df.corr() | stats.pearsonr() |
| t検定 | — | stats.ttest_ind() |
| 回帰 | — | stats.linregress() |
| 分布フィッティング | — | stats.norm.fit() |
🚧 一般的な落とし穴と対策
- 外れ値の影響:散布図・ 箱ひげ図で確認、 ロバスト手法も検討
- サンプルサイズ不足:power analysis で事前に確認
- 仮定の違反:正規性、 独立性、 等分散性をチェック
- 多重比較問題:補正(Bonferroni、 FDR)を適用
- p-hacking:事前登録(pre-registration)で防ぐ
- 因果と相関の混同:観察データから因果結論を出さない
📊 結果報告の標準フォーマット
- 点推定:得られた値
- 不確実性:信頼区間または標準誤差
- サンプルサイズ:n を明記
- 効果量:実質的な意義
- p値:統計的有意性
- 仮定の確認:診断プロット
🌐 関連分野での応用
- マーケティング:A/Bテスト、 顧客分析
- 医療:臨床試験、 疫学研究
- 金融:リスク管理、 ポートフォリオ
- 製造:品質管理、 工程最適化
- 公共政策:効果評価、 計画立案
- 研究:仮説検証、 探索的解析
🎓 さらに学ぶための文献
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression"
- VanderPlas "Python Data Science Handbook"
🔗 統計用語ネットワーク
この概念は、 他の多くの統計概念と密接に関連しています。 ジャストインタイム型学習では、 必要に応じて関連用語へジャンプしながら全体像を構築します。
主要な関連概念のグループ
| グループ | 主要概念 |
|---|---|
| 記述統計 | 平均、 中央値、 最頻値、 分散、 標準偏差、 共分散、 相関係数 |
| 可視化 | ヒストグラム、 散布図、 箱ひげ図、 ヒートマップ |
| 推測統計 | 標本平均、 標準誤差、 信頼区間、 p値、 有意水準 |
| 確率分布 | 正規分布、 t分布、 χ²分布、 F分布、 二項分布 |
| 仮説検定 | t検定、 F検定、 χ²検定、 ノンパラ検定 |
| 回帰 | 単回帰、 重回帰、 OLS、 Ridge、 LASSO |
| 分類 | ロジスティック回帰、 決定木、 SVM、 k-NN |
| 教師なし学習 | クラスタリング、 PCA、 因子分析 |
| 時系列 | ARIMA、 VAR、 指数平滑法、 自己相関 |
| 因果推論 | DiD、 IV、 傾向スコア、 交絡変数 |
| 前処理 | 標準化、 正規化、 欠損値処理、 多重共線性対策 |
| 評価 | R²、 残差、 CV、 RMSE、 効果量 |
学習順序の推奨
- 記述統計(平均、 分散、 標準偏差)
- 可視化(ヒストグラム、 散布図)
- 確率分布(正規分布)
- 推測統計(標準誤差、 信頼区間、 p値)
- 仮説検定(t検定、 χ²検定)
- 相関と回帰(単回帰、 重回帰)
- 多変量解析(PCA、 クラスタリング)
- 機械学習(決定木、 RF、 NN)
- 時系列・因果推論(応用)
📝 実践練習 — SSDSE-B-2026 で挑戦
初級課題
- 東北6県の家計食料費の基本統計量を計算
- 食料費のヒストグラムを描く
- 食料費と教育費の散布図を描く
- 都道府県を「東日本/西日本」に分け、 平均を比較
中級課題
- 家計支出 5項目で相関行列を作成、 ヒートマップ可視化
- 食料費 → 教育費の単回帰を実行、 残差分析
- 家計5項目で PCA を実施、 バイプロット表示
- k-means (k=3) で都道府県をクラスタリング、 解釈
上級課題
- 地域別の家計パターンに有意差があるか ANOVA で検定
- 重回帰で教育費を予測、 多重共線性を VIF で確認
- Ridge/LASSO で正則化、 CV で α を最適化
- 階層クラスタリングと Ward 法で都道府県を分類、 デンドログラム作成
📍 あなたが今見ているもの
🍰 まずはやさしく
時間の流れに沿ったデータの分析手法です。
データサイエンスの重要な考え方を学ぶために使います。
都道府県ごとの所得の変化などを分析します。
定義から実装までを6つの視点で読み解きます。
論文中に 「時系列分析」として登場する用語。
時系列分析 とは:時間順に並んだデータを分析する手法群。自己相関や周期性、トレンドが特徴。
本ページでは「time series」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「time series」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む — 時系列 の本質
🍰 まずはやさしく
過去のデータが未来のヒントになる考え方です。
データの傾向や周期性を掴むために使います。
婚姻数や出生数の年ごとの変化が例です。
時間的なつながりがどう影響するかを読みます。
時系列(time series)は「同じ対象を時間順に観測したデータ」。 一般のデータが 行と行が独立と仮定するのに対し、 時系列は 時間的な依存関係(自己相関)が本質。 「昨日の気温が分かれば今日の気温も予測しやすい」ように、 過去が未来に情報を持つ。
SSDSE-B-2026 で取れる時系列の例:
- 全国の婚姻件数: 2014 年 64.4 万件 → 2018 年 58.7 万件 → 2020 年 52.5 万件(コロナ) → 2023 年 47.4 万件。 10 年で 17 万件減(−26%)のトレンド。
- 全国の出生数: 2014 年 100.4 万人 → 2018 年 91.8 万人 → 2023 年 72.7 万人。 10 年で 28 万人減(−28%)。 婚姻減と出生減はラグ 1-2 年で連動。
- 都道府県別 65 歳以上人口: 北海道 2014 = 152 万人 → 2023 = 168 万人。 一方で
15歳未満人口は 62 万人 → 51 万人と減少。 人口ピラミッドの非対称な動き。 - 東京都の総人口: 2014 年 1,339 万人 → 2023 年 1,409 万人と 10 年で +70 万人。 一方、 秋田県は 104 万人 → 91 万人 (−12 万人) と対照的。
時系列の 4 つの構成要素(古典的分解): $y_t = T_t + S_t + C_t + I_t$。 トレンド(長期的傾向)、 季節成分(年内周期)、 循環成分(数年周期)、 不規則成分(残差)に分けて理解する。 SSDSE-B-2026 の出生数は 下降トレンドに コロナの一時急減(不規則)が重なった構造。 月次データなら 3 月卒業 → 結婚増 → 翌年出生増という季節性も見える。
時系列が「ふつうのデータ」と決定的に違う 3 点:
- (1) 順序が意味を持つ: ランダムにシャッフルしてはいけない。 訓練/テスト分割も 時間順でないとリーク。
- (2) 自己相関 → 独立性の仮定が崩れる: 標本平均の SE は単純な $\sigma/\sqrt{n}$ ではなく、 自己相関を考慮した有効サンプルサイズで割り増し。
- (3) 定常性が前提: AR/MA/ARIMA など多くのモデルは 平均・分散が時間で変わらないと仮定。 違反すれば差分や対数変換で定常化。
主な分析タスク: トレンド抽出(移動平均、 LOESS)、 季節調整(X-12-ARIMA、 STL 分解)、 予測(ARIMA、 Prophet、 LSTM)、 異常検知(Z-score、 STL 残差)、 因果推論(Granger 因果、 介入研究)。 SSDSE-B-2026 の都道府県 × 年度パネルでは パネル時系列(固定効果モデル、 動学パネル GMM)が定番。
📐 数式または定義 — 時系列 の形式的表現
🍰 まずはやさしく
時系列を数式で表したルールのようなものです。
今の値を過去の値から計算するために使います。
昨日のテストの点数で今日の点数を予想する例です。
数式の中にある記号の意味を一つずつ読みます。
直感で全体像を掴んだら、 次は厳密な定義を見ます。 数式は短いものでも、 「何を入力にして、 何を出力するのか」を意識して読むと早く慣れます。
🔬 数式を言葉で読み解く — 時系列 の記号辞書
上の数式に出てくる各記号が何を表すかを、 言葉で翻訳します。 1 つずつ自分の言葉で言い換えられるようになると、 論文や教科書のスピードが一気に上がります。
| 記号 | 意味(言葉での説明) |
|---|---|
| $y_t$ | 時刻 $t$ の値 |
| $c$ | 切片(長期平均に関係) |
| $\phi_i$ | $i$ 期前の自己回帰係数 |
| $\varepsilon_t$ | 誤差項(ホワイトノイズを仮定) |
| $p$ | モデルの「次数」=何期前まで使うか |
🧮 SSDSE-B-2026 実値計算 — 出生数の ARIMA 予測
「全国出生数」の年次データ(SSDSE-B-2026 の 47 都道府県を年度ごとに合計した 12 点)に ARIMA(1,1,1) を当てはめ、 5 年先まで予測します。 年次データなので季節項は付けません(コードの seasonal_order=(0,0,0,0) がそれに対応)。
🎯 このコードでやること:SSDSE-B-2026 から全国の出生数(47 都道府県の合計)を年度ごとに作り、ADF 検定で定常性を確かめたうえで ARIMA(1,1,1) を当てはめ、2024〜2028 年度の 5 年先を予測する。
📥 入力例(SSDSE-B-2026 を header=1 で読み、年度ごとに出生数を合計した 12 点)
年度   出生数(全国)
2012  1,037,165
2018    918,361
2023    727,269
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import statsmodels.api as sm # SSDSE-A は市区町村単位で見出しが 3 行あり、年次の系列にならない。 # 年度の入っている SSDSE-B から全国の出生数の推移(2012〜2023 年)を作る df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df['出生数'] = pd.to_numeric(df['出生数'], errors='coerce') ts = df.groupby('年度')['出生数'].sum().sort_index() print(ts) # ADF 検定(定常性確認) adf = sm.tsa.adfuller(ts) print(f'ADF p-value = {adf[1]:.4f}') # > 0.05 なら非定常 # ARIMA(1,1,1)(季節項なし) mod = sm.tsa.statespace.SARIMAX(ts, order=(1,1,1), seasonal_order=(0,0,0,0)).fit(disp=False) print(mod.summary()) forecast = mod.get_forecast(steps=5) print(forecast.predicted_mean.round(0)) print(forecast.conf_int().round(0)) |
STL 分解で構成要素を可視化
🎯 このコードでやること:全国出生数の 12 点を STL で「トレンド+周期 5 の成分+残差」に分けて図にする。年次データに決まった周期は無いので、period=5 は仮に置いた値。
📥 入力例: 上のコードで作った ts(全国出生数、2012〜2023 年度の 12 点)。
1 2 3 | from statsmodels.tsa.seasonal import STL stl = STL(ts, period=5).fit() # 5 年周期と仮定 stl.plot() |
予測結果(上の ARIMA(1,1,1) の実測値)
| 年度 | 実測(万人) | ARIMA(1,1,1) 予測(万人) | 95% 予測区間(万人) |
|---|---|---|---|
| 2023 | 72.7 | — | — |
| 2024 | — | 71.4 | [67.7, 75.1] |
| 2025 | — | 70.2 | [65.0, 75.3] |
| 2026 | — | 69.0 | [62.8, 75.2] |
| 2027 | — | 67.9 | [60.9, 74.9] |
| 2028 | — | 66.9 | [59.1, 74.6] |
🧮 実値で計算してみる — SSDSE-B-2026 で 時系列 を体感
数式だけでは「分かった気になる」だけで終わりがち。 ここで SSDSE-B-2026(教育用標準データセット — 47 都道府県 × 100+ 指標、 2012-2023 年度)の実値を当てはめて、 時系列 の挙動を電卓的に追体験します。
SSDSE-B-2026 は 統計センターの SSDSE 配布ページ から CSV を直接ダウンロードできます。 本サイトでは data/raw/SSDSE-B-2026.csv に配置している前提でコードを書いています。
🧮 数式に値を入れて手で計算する: 時系列の分解
合成 12 月データから トレンド・季節・残差を分解する。
Step 1: 元データ
Step 2: トレンド (3 期移動平均)
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np x = np.array([100, 95, 110, 130, 140, 145, 150, 145, 130, 115, 100, 95]) trend = x.mean() ma3 = np.convolve(x, np.ones(3)/3, mode='valid') print(f"全体平均: {trend}") print(f"3 期 MA 範囲: {ma3.min():.1f} - {ma3.max():.1f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装バリエーション
A. statsmodels.tsa(標準ライブラリ)
🎯 このコードでやること:statsmodels の SARIMAX で、全国出生数(年次 12 点)に季節項なしの ARIMA(1,1,1) を当てはめ、推定結果の要約を出す。
📥 入力例: 上で作った ts(全国出生数、2012〜2023 年度の 12 点)。
1 2 3 4 5 6 7 | import statsmodels.api as sm # ts は年度ごとの全国出生数(12 時点)。年次データに「12 か月周期」は無いので、 # seasonal_order=(1,1,1,12) を付けると季節差分でデータが尽き、標準誤差が非数になる。 # 月次データを扱うときだけ季節項を入れること。 mod = sm.tsa.statespace.SARIMAX(ts, order=(1,1,1), seasonal_order=(0,0,0,0)) res = mod.fit(disp=False) print(res.summary()) |
B. pmdarima(auto_arima で自動次数決定)
🎯 このコードでやること:pmdarima の auto_arima で、全国出生数(年次 12 点)に合う ARIMA の次数を AIC 最小で自動探索する。年次データなので季節項は探さない(seasonal=False)。
📥 入力例: 上で作った ts(全国出生数、12 点)。
1 2 3 4 5 | import pmdarima as pm # ts は年次データ(12 点)なので季節項は探さない(m=12 は月次データ用) auto = pm.auto_arima(ts, seasonal=False, stepwise=True, information_criterion='aic') print(auto.summary()) |
C. prophet(ビジネス向け・休日効果対応)
🎯 このコードでやること:Prophet で全国出生数(年次 12 点)の 2024〜2028 年を予測し、予測値と不確実性区間を表に出す。
📥 入力例: ds = 2012〜2023 年の各 1 月 1 日、y = 全国出生数(上で作った ts)。
1 2 3 4 5 6 7 8 9 10 | from prophet import Prophet d = pd.DataFrame({'ds': pd.to_datetime(ts.index, format='%Y'), 'y': ts.values}) # 年次データは 1 年に 1 点しか無いので、年周期(yearly_seasonality)は推定できない m = Prophet(yearly_seasonality=False, weekly_seasonality=False, daily_seasonality=False).fit(d) # ds は各年の 1 月 1 日なので、未来も年初('YS')で 5 年分つくる future = m.make_future_dataframe(periods=5, freq='YS') fcst = m.predict(future) print(fcst[['ds', 'yhat', 'yhat_lower', 'yhat_upper']].tail(5).round(0)) m.plot(fcst) |
D. sktime(パイプライン・CV を sklearn 風に)
🎯 このコードでやること:sktime の ARIMA(1,1,1) で、全国出生数の最後の 5 年(2019〜2023 年度)を検証用に取り分け、残り 7 年で学習して 5 期先を予測する。
📥 入力例: 上で作った ts(全国出生数、12 点)。temporal_train_test_split で学習 7 点(2012〜2018 年度)・検証 5 点に分ける。
1 2 3 4 5 6 | from sktime.forecasting.arima import ARIMA from sktime.split import temporal_train_test_split y_train, y_test = temporal_train_test_split(ts, test_size=5) forecaster = ARIMA(order=(1,1,1), suppress_warnings=True).fit(y_train) y_pred = forecaster.predict(fh=list(range(1, 6))) print(y_pred) |
E. scipy.signal による周期検出
🎯 このコードでやること:scipy.signal.periodogram で全国出生数(12 点)のパワースペクトルを計算し、周波数ごとの強さを片対数グラフに描く。
📥 入力例: 上で作った ts(全国出生数、12 点)。fs=1 なので周波数の単位は「1 年あたりの回数」。
1 2 3 4 | from scipy.signal import periodogram f, Pxx = periodogram(ts.values, fs=1) import matplotlib.pyplot as plt plt.semilogy(f, Pxx); plt.xlabel('frequency'); plt.ylabel('PSD') |
🐍 Python 実装 — 時系列 を SSDSE-B-2026 で動かす
🎯 このコードでやること:SSDSE-B-2026 から東京都の 12 年度分を取り出して古い順に並べ、合計特殊出生率の前年差・3 年移動平均・lag-1 自己相関・直線トレンドと、総人口との相関(水準どうし・前年差どうし)を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | # 時系列 を SSDSE-B-2026 で確かめる最小コード import pandas as pd import numpy as np # 1) SSDSE-B-2026(教育用標準データセット)を読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print('shape:', df.shape) # (564, 112) — 47 都道府県 × 12 年度 print('cols head:', list(df.columns[:8])) # 2) 時系列にするので年度は絞らず、1 つの県(東京都)の 12 年度分を古い順に並べる tk = df[df['都道府県'] == '東京都'].sort_values('年度').set_index('年度') print('rows for 東京都:', len(tk), '/ 年度:', tk.index.min(), '〜', tk.index.max()) # 3) 時系列 を動かすために必要な列だけ取り出す y = tk['合計特殊出生率'].astype(float) x = tk['総人口'].astype(float) # 4) 時系列 の本処理(このページの主題): 前年差・移動平均・自己相関・トレンド print('---- 時系列 結果 ----') out = pd.DataFrame({'出生率': y, '前年差': y.diff().round(2), '3年移動平均': y.rolling(3).mean().round(3), '総人口(万人)': (x / 1e4).round(0)}) print(out.to_string()) print('lag-1 自己相関 (出生率):', round(y.autocorr(lag=1), 3)) slope = np.polyfit(y.index, y.values, 1)[0] print('出生率の直線トレンド (1 年あたり):', round(slope, 4)) print('corr(x, y) 12 年度:', round(y.corr(x), 3)) print('corr(前年差どうし):', round(y.diff().corr(x.diff()), 3)) |
💬 東京都の合計特殊出生率は 2012 年度の 1.09 から 2015〜2016 年度の 1.24 まで上がり、そこから 7 年続けて下がって 2023 年度に 0.99 になった。直線トレンドの −0.0115/年は、この「上がってから下がる」形を 1 本の傾きにならしたもので、2017 年度以降の年 −0.03〜−0.05 という実際の落ち方より緩く見える。lag-1 自己相関 0.84 は前年の値が翌年をよく言い当てることを示し、12 点の時系列では独立な観測として数えられない。総人口との相関は水準どうしで −0.354、前年差どうしで +0.382 と符号が逆になるので、トレンドを持つ系列どうしの相関は差分を取ってから確かめる。
うまく動かないときは ①data/raw/SSDSE-B-2026.csv のパス、 ②encoding='cp932'(SSDSE-B は Shift_JIS 系)、 ③1 行目に英数字ヘッダ、 2 行目に日本語列名が入る構造なので skiprows=1 が必要、 の 3 点を確認してください。
⚠️ 時系列分析の落とし穴 7 連発
1. 定常性を検定せずに ARMA を当てはめる。単位根(unit root)を持つ系列に ARMA を当てると、 係数推定が不一致になり予測が暴走します。 ADF・KPSS・Phillips-Perron などを併用し、 必要なら 1 階差分(d=1)or 季節差分(D=1)を取った系列で再検定するのが正攻法です。
2. 過剰差分(over-differencing)に注意しない。「定常化のために」と差分を 2 回も 3 回も取ると、 MA 係数が −1 に張り付くなど不安定な推定が起きます。 KPSS で「定常」と出る最小回数を採用し、 残差の ACF/PACF を必ず目視確認しましょう。
3. 通常の CV(ランダム分割)でモデル選択する。未来から過去へのリークが起き、 評価指標が過剰に良く見えます。 必ず TimeSeriesSplit または expanding/sliding window で「過去→未来」順の評価を行い、 ホールドアウトも時系列末尾に取りましょう。
4. 季節性周期を間違える。月次データは m=12、 週次は m=52、 日次なら m=7(曜日)や m=365(年)。 SSDSE の年次データは原則季節性なしですが、 景気循環など長周期の隠れた季節性に注意。 STL 分解と periodogram の併用で確認しましょう。
5. 外れ値・構造変化を無視する。2008 リーマンショックや 2020 コロナ禍のような外的ショックは、 通常の AR/MA で吸収しきれません。 介入変数(dummy)として明示的に投入、 もしくは状態空間モデルで「構造変化」を扱う必要があります。
6. 信頼区間ではなく予測区間(PI)で報告すべきところを CI で報告。係数の CI は「真のパラメータ」の不確実性、 PI は「次の観測値」の不確実性で、 後者の方が広いのが正しい。 政策・経営判断には PI を必ず付け、 「点予測のみ」報告は厳禁です。
7. Prophet を万能と信じる。Prophet は柔軟で扱いやすい反面、 観測値が少ない系列・強い自己相関・複雑な季節性では SARIMA や状態空間モデルに劣ることが多いです。 必ず ARIMA 系・ETS・ナイーブ予測との水平比較を行いましょう。
⚠️ よくある落とし穴 — 時系列 で初学者がやりがちなミス
この用語を実務で使うときにつまずきやすい点を、 失敗パターン別に整理しました。 1 度経験すれば回避できるものばかりですが、 先に知っておくと事故が大幅に減ります。
📚 統計学習の総合ガイド
🎯 学習目標
このページの概念をマスターすることで、 以下のスキルが身につきます:
- 定義と公式を正確に理解
- 適切な使用場面を判断
- Python で実装し、 結果を可視化
- 仮定の確認と診断
- 結果の解釈と報告
- 限界と注意点の理解
- 関連手法との使い分け
📊 SSDSE-B-2026 データの構造
このコンペの主要データセット(SSDSE-B-2026)の構造:
- 47都道府県 × 過去複数年(パネル形式)
- 112列の社会経済指標
- 人口、 出生、 死亡、 婚姻、 経済、 教育、 環境、 家計など多次元
- 政府統計を統合した信頼性の高いデータ
🔍 主要な変数群
| カテゴリ | 変数例 |
|---|---|
| 人口 | 総人口、 年齢別人口、 性別人口 |
| 人口動態 | 出生数、 死亡数、 合計特殊出生率、 婚姻数 |
| 気候 | 気温、 降水量、 降水日数 |
| 教育 | 幼小中高校数、 教員数、 生徒数、 大学進学率 |
| 経済 | 求職件数、 求人件数、 旅館数 |
| 医療 | 病院数、 診療所数、 歯科診療所 |
| 家計 | 消費支出、 食料費、 住居費、 教育費等の項目別 |
💡 ジャストインタイム型学習
このガイドは「必要なときに必要な知識」を提供する設計:
- 論文中の用語をクリック → 該当の用語解説へジャンプ(ポップアップ)
- 概念マップで関連用語を辿る
- 包含マップで体系を把握
- ツリーマップで全体を俯瞰
- Python コードをコピーして実行
- SSDSE データで実際に試す
🛠️ Python データサイエンス環境
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | # 事前に(ターミナルで 1 回だけ): pip install pandas numpy scipy statsmodels scikit-learn matplotlib seaborn # 標準的なインポート import pandas as pd import numpy as np import matplotlib.pyplot as plt import seaborn as sns from scipy import stats from sklearn.preprocessing import StandardScaler from sklearn.model_selection import train_test_split from sklearn.metrics import r2_score, mean_squared_error # 日本語表示の設定(matplotlib) plt.rcParams['font.family'] = 'Hiragino Sans' plt.rcParams['axes.unicode_minus'] = False # データ読み込み(SSDSE-B は cp932。skiprows=1 で 1 行目の英字コードを飛ばし、2 行目の日本語の項目名を列名にする) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print(df.shape) # 47 都道府県 × 12 年度(2012〜2023) # 時系列にする: 全国の出生数を年度ごとに合計する(groupby で年度が昇順に並ぶ) births = df.groupby('年度')['出生数'].sum() print(births.to_string()) |
💬 全国の出生数は 2012 年度の 1,037,165 人から 2023 年度の 727,269 人まで約 30% 減り、前年より増えたのは 2015 年度(+2,124 人)だけだった。年ごとの減り幅は 2019 年度の −53,149 人が最大で、2022・2023 年度も 4 万人台の減少が続く。平均と分散が時間とともに動く非定常な系列なので、ARIMA などに当てる前に差分を取ってから定常性を確かめる。
🌟 効果的なEDAテンプレート
🎯 このコードでやること:探索的データ分析(EDA)をひとまとめにした関数 quick_eda を定義する。形・型・欠損・要約統計を表示し、数値列のヒストグラムと相関ヒートマップ(target を渡せば散布図行列も)を描く。
📥 入力例: 任意の DataFrame(例:SSDSE-B-2026 を skiprows=1 で読んだ 564 行 × 112 列)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import numpy as np import matplotlib.pyplot as plt import seaborn as sns def quick_eda(df, target=None): """探索的データ分析の基本テンプレート""" print(f"Shape: {df.shape}") print(f"\nColumn types:\n{df.dtypes}") print(f"\nMissing values:\n{df.isnull().sum()}") print(f"\nBasic stats:\n{df.describe()}") # 数値列の可視化 numeric_cols = df.select_dtypes(include=[np.number]).columns df[numeric_cols].hist(bins=20, figsize=(15, 10)) plt.tight_layout() plt.show() # 相関ヒートマップ if len(numeric_cols) > 1: plt.figure(figsize=(12, 10)) sns.heatmap(df[numeric_cols].corr(), annot=True, fmt='.2f', cmap='RdBu_r', center=0) plt.show() # ターゲットがあれば散布図行列 if target and target in df.columns: cols = list(numeric_cols[:5]) if df[target].dtype == 'O': # 文字列の列なら色分け(hue)に使う。hue の列も渡す sns.pairplot(df[cols + [target]], hue=target) else: sns.pairplot(df[cols]) plt.show() |
📈 報告書テンプレート
分析結果を報告する際の標準的な構成:
- 背景・目的:なぜこの分析が必要か
- データ:出所、 サンプルサイズ、 期間
- 方法:使用した統計手法、 仮定
- 結果:図表、 統計量、 検定結果
- 解釈:結果が何を意味するか
- 限界:分析の制約
- 結論:要点まとめ、 今後の課題
時系列 は単独で完結する用語ではなく、 大きな概念群の中のひとつ。 同じカテゴリの他用語と合わせて学ぶと、 「何を選ぶべきか」の判断が一気に楽になります。
🖼 補足: 時系列分析の 3 つの視覚化と分解
時系列分析の第一歩は「データの形を見る」こと。 ここではトレンド・季節性・自己相関の 3 つの視点から、 SSDSE-B-2026 を題材に時系列を視覚化する流れを示す。
図 1: トレンドと移動平均(time-series_trend.png)
時系列は「トレンド + 季節成分 + 残差」に分解できる。 STL 分解や移動平均で平滑化することで、 短期変動に埋もれた長期トレンドを抽出できる。 SSDSE の都道府県時系列(2012-2023 年度の 12 点)は年次データなので季節成分は無く、 左図のように総人口 (2012 年度 = 100 の指数) は 47 県中 40 県で減少のトレンドがはっきり見える。 2023 年度の指数は秋田県 86.0 (−14.0%)・青森県 87.7・高知県 88.7 が低く、 増えたのは東京都 106.4・沖縄県 104.0 など 7 都県だけ。 右図の全国 (47 県の合計) は 12,759 万人 → 12,435 万人 (−2.54%) で、 前年度差は 2019 年度まで −5〜−19 万人だったのが 2020 年度 −41 万人、 2021 年度 −65 万人と大きくなる。 中心化 3 年移動平均はこのトレンドをなぞり、 実測との差は最大でも 7.9 万人 (2020 年度) と小さい。 2015・2020 年度は国勢調査の確定値、 それ以外は推計値なので、 年度間の差にはこの切り替えの影響も入りうる。 周期成分を取り出すには点数が足りない。
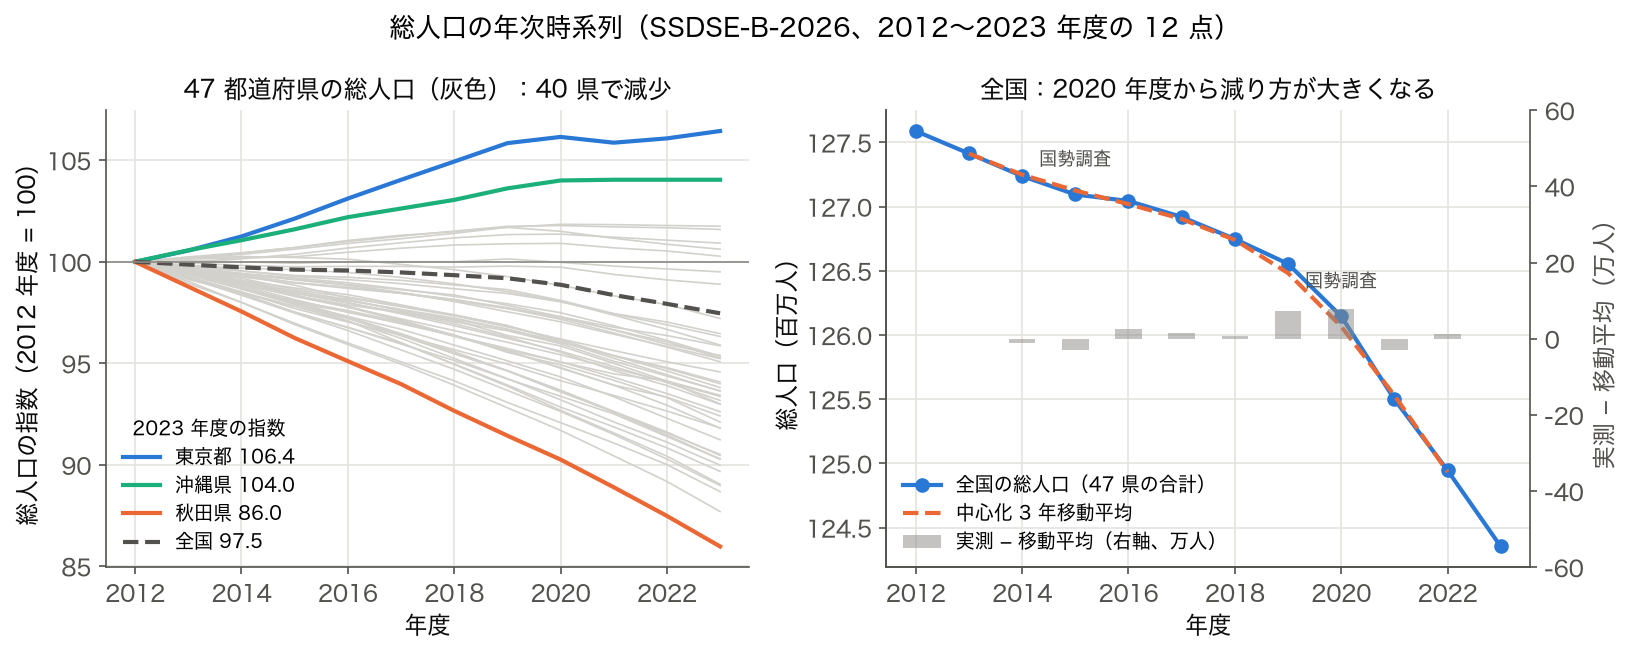
図 2: 自己相関関数(time-series_acf.png)
時系列は同じ系列の過去値と相関を持つ「自己相関」が本質。 ACF(自己相関関数)と PACF(偏自己相関関数)の形から AR / MA / ARMA のモデル次数を判別する。 ACF が指数減衰なら AR、 ある lag で切れるなら MA、 両者の組み合わせなら ARMA を示唆する。 図は秋田県の総人口 (12 点) で、 水準の ACF はラグ 1 の 0.74 から 0.50、 0.27、 0.07 とゆっくり減衰し、 PACF はラグ 1 が 0.74、 ラグ 2 以降は −0.11〜−0.13 と小さい。 AR(1) の形に見えるが、 これは毎年ほぼ同じ量 (−1.2〜−1.6 万人) 減り続けるトレンドが作る見かけの自己相関で、 前年度差 (11 点) をとると ACF はラグ 1 でも 0.34 に下がる。 12 点では 95% 区間 (青い帯) が ±0.57 前後と広く、 水準の ACF・PACF のラグ 1 以外はどれも区間の中に入るので、 次数の判別はほとんどできない。
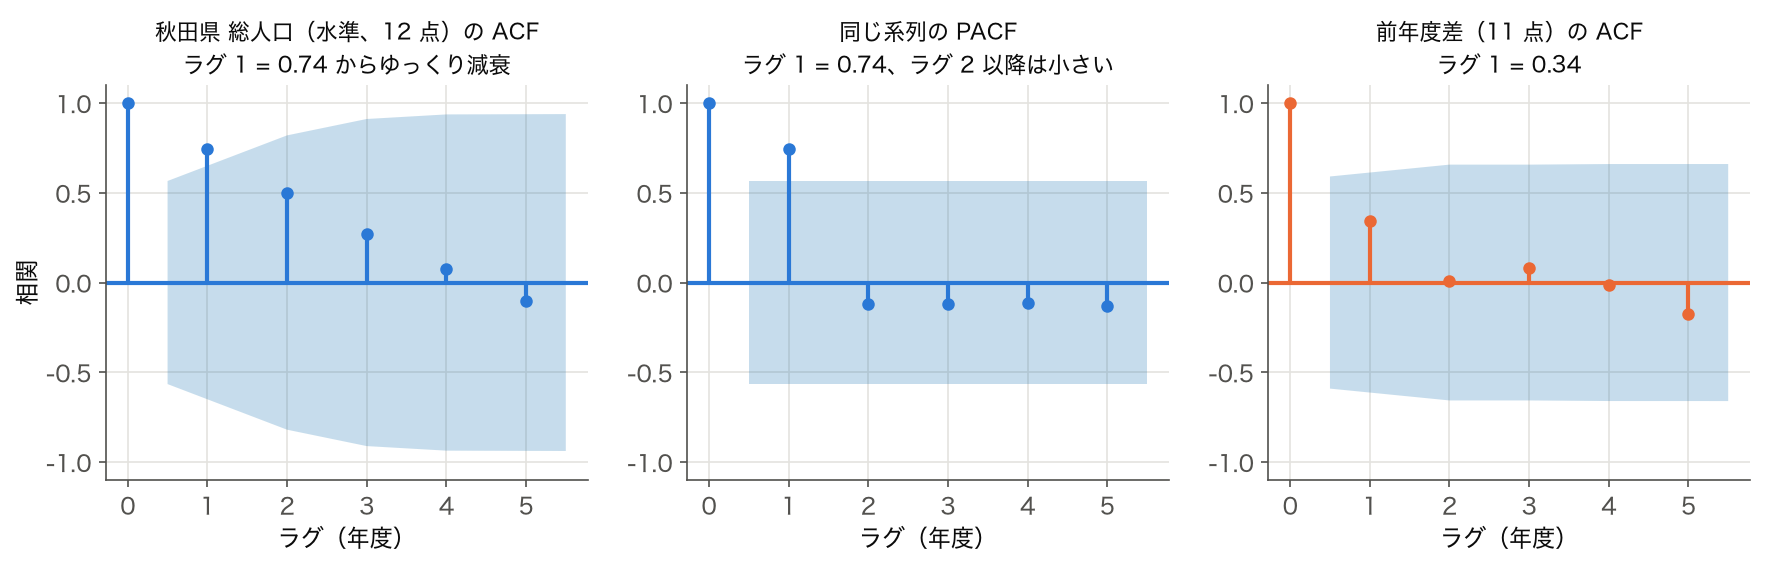
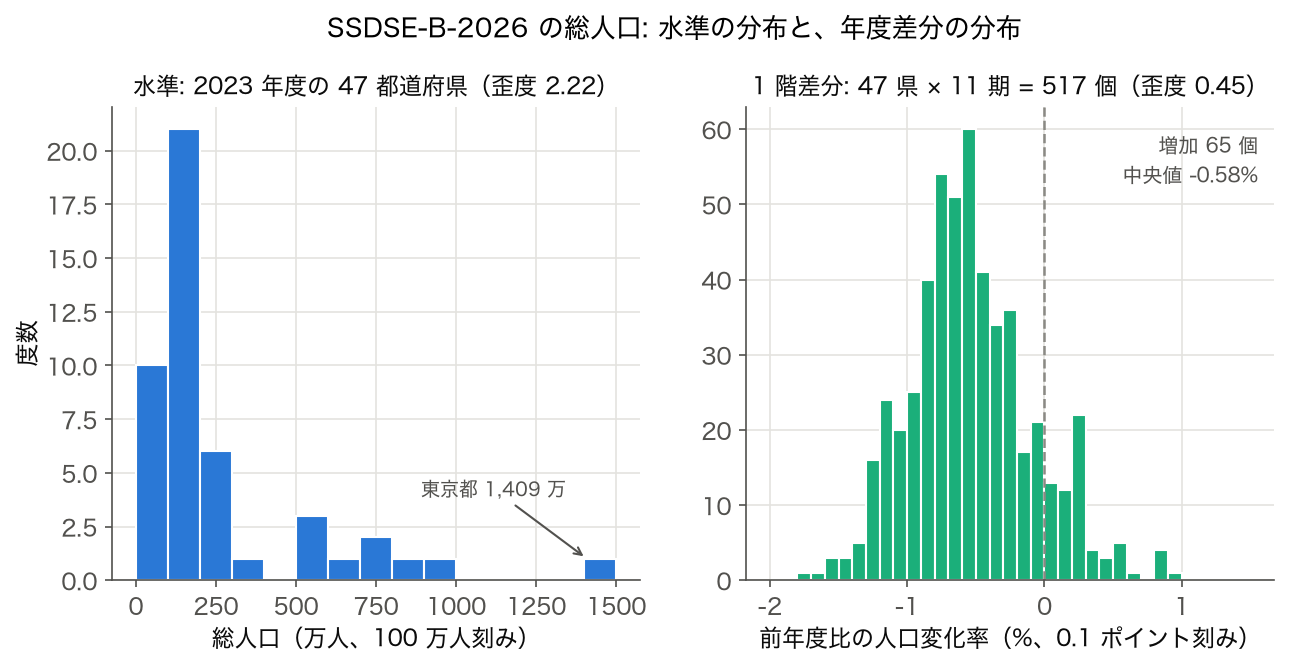
図 3: 総人口の分布と、年度差分の分布(time-series_hist.png)
SSDSE-B-2026 の 2023 年度の総人口をヒストグラムにすると(左)、 少数の大都市圏が右裾を作る右歪の分布になる(歪度 2.22、 東京都 1,409 万人)。 一方、 各県の総人口を年度の古い順に並べて前年度比の変化率をとる(1 階差分に相当)と(右)、 47 県 × 11 期 = 517 個は中央値 −0.58% を中心にした山になり、 歪度は 0.45 まで小さくなる。 増加は 517 個中 65 個で、 東京都・神奈川県・埼玉県・千葉県・愛知県・大阪府・福岡県・沖縄県・滋賀県・宮城県の 10 都府県に限られる。 最も大きく減ったのは秋田県の 2023 年度 (−1.72%)。 県を問わない年度別の中央値も 2013 年度 −0.47% から 2023 年度 −0.81% へと減少幅が広がっており、 差分をとっても平均が一定とは言い切れない。 時系列分析でもデータや残差の分布形をヒストグラムで確認する習慣が重要で、 正規性からのズレや裾の重さを把握することが予測区間の妥当性評価につながる(ARIMA や状態空間モデルは「残差が正規ホワイトノイズ」を仮定する)。
📊 表 1: 時系列モデルの選び方
| モデル | 適する場面 | 特徴 |
|---|---|---|
| AR(p) | 過去値で説明できる | PACF が p で切れる |
| MA(q) | 過去誤差で説明できる | ACF が q で切れる |
| ARMA(p,q) | 定常時系列 | ACF/PACF 両方が減衰 |
| ARIMA(p,d,q) | トレンドあり非定常 | d 階差で定常化 |
| SARIMA | 季節性あり | 季節差分 + ARIMA |
| 状態空間 / Prophet | 複雑な構造変化 | 柔軟・実務的 |
🐍 Python 実装: SSDSE-B-2026 の人口時系列で ACF を描く
このコードでやること: SSDSE-B-2026 から東京都の総人口(2012〜2023 年度の 12 点)を取り出して年度の古い順に並べ、自己相関関数(ACF)のラグ 1〜5 を出力する。
📥 入力データ (SSDSE-B-2026 の東京都 12 行から抜粋):
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd from statsmodels.tsa.stattools import acf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 1 つの県を取り出し、年度の古い順に並べてから ACF を取る # (CSV のまま総人口の列を使うと、47 県の系列が 2023→2012 の逆順でつながった列になる) tk = df[df['都道府県'] == '東京都'].sort_values('年度') x = tk['総人口'].values # 2012〜2023 年度の 12 点 r = acf(x, nlags=5) for k, v in enumerate(r): print(f'lag {k}: r={v:.3f}') |
📤 実行すると次の出力が得られる:
💬 東京都の総人口の自己相関は lag 1 で 0.783、lag 2 で 0.542 と下がり、lag 4 で 0.035、lag 5 で −0.189 になる。2020 年度まで増えてその後は横ばいという 12 点なので、離れた年どうしほど水準の似方が弱まる。CSV の総人口の列を 564 行のまま ACF にかけると lag 1 が 0.958 と出るが、これは 47 県の系列が 2023→2012 の逆順でつながった列の隣どうしを比べただけで、時系列の自己相関ではない(2023 年度の 47 県を並べた横断面でも lag 1 は 0.498 になる)。
✅ 理解度チェック (時系列分析)
- ACF と PACF の違いを 30 字以内で説明できますか?
- 非定常な時系列を ARIMA で扱うには何階差分すればよいか? Augmented Dickey-Fuller 検定はどう使う?
- SARIMA の S は何を表すか? 月次データなら通常どの値を選ぶ?
- SSDSE-B-2026 の都道府県データを「時系列」として扱うのが不適切な理由を述べてみよう。
- Prophet と ARIMA の違いを「自動性」「解釈性」「外生変数」の 3 つの観点で比較できますか?
⚠️ 時系列分析を実務で使うときの落とし穴 (3 件)
- 非定常を放置して相関させると spurious regression(見せかけの回帰): トレンドのある 2 つの非定常時系列を OLS 回帰すると、 因果関係がなくても高い R² が出る(Granger and Newbold 1974)。 「どちらも右肩上がり」というだけで相関は高く出るため、 時系列同士の相関は因果の証拠にならない(Granger 因果でさえ「予測に役立つ」以上の意味は持たない)。 まず ADF 検定や KPSS 検定で定常性を確認し、 非定常なら差分や共和分検定を経由する。
- 季節性を見逃すと予測区間が崩壊: 月次データでは年次の季節性、 日次データでは週次の季節性を考慮する必要がある。 STL 分解か SARIMA で季節成分を分離し、 残差を見る。
- サンプル数が少ないと過学習しやすい+検出力も不足する: ARIMA(p,d,q) の (p,q) を AIC で最小化すると、 短い系列では複雑なモデルを選びすぎる。 一定の上限(p+q≤5)を設けるか、 時系列 CV で実際の予測精度を確認する。 また上の手計算例のような n=12 程度の短い系列では、 ACF の 95% 信頼帯(約 ±2/√n)が非常に広く、 真の自己相関や季節性があっても統計的には「有意でない」と出やすい(検出力不足)。 「有意でない=構造がない」ではない点に注意。
📜 時系列分析の歴史
時系列分析の基礎は 1920 年代の Yule の AR モデル、 1930 年代の Slutsky の MA モデルに遡る。 1970 年に Box & Jenkins が「時系列分析—予測と制御」を出版し、 ARIMA の体系的方法論が確立した。 1980 年代以降は Engle の ARCH/GARCH(ボラティリティ分析)、 Granger の共和分理論(マクロ経済時系列)、 状態空間モデル(Kalman filter)が発展。 近年は Facebook Prophet(2017)や深層学習ベースの N-BEATS/Transformer 時系列モデルが普及し、 ビジネス時系列予測の標準ツールになりつつある。
🧪 時系列分析の実務ベストプラクティス
実務で時系列予測を行う標準手順は以下のとおり。 (1) データを時系列順にソートし、 欠損値・外れ値・タイムスタンプの重複を確認する。 (2) プロットで全体像を眺め、 トレンド・季節性・構造変化点の有無を目視する。 (3) STL 分解または X-13 ARIMA-SEATS で「トレンド + 季節 + 残差」に分解する。 (4) 残差プロットで定常性と自己相関を確認する。 (5) ADF / KPSS 検定で定常性を確認する。 (6) 必要なら差分・対数変換で定常化する。 (7) ACF / PACF からモデル候補を絞る。 (8) AIC/BIC でモデル選択する。 (9) 時系列クロスバリデーション(rolling origin、 expanding window)で予測精度を評価する。 (10) 予測区間(95%)を併記し、 不確実性を伝える。 (11) Backtesting で過去データに対するパフォーマンスを確認する。 (12) 本番運用ではモデルドリフト監視を組み込む。 これらを怠ると「短期的には当たっているように見えるモデル」を本番投入してしまい、 構造変化のたびに大きく外す事故につながる。 特に COVID-19 のような構造変化が起きるとほとんどのモデルが破綻するため、 異常検知と再学習のしくみをセットで設計するのが望ましい。
💡 時系列予測の評価指標
時系列予測の評価には RMSE / MAE / MAPE / SMAPE / MASE などが使われる。 RMSE は大きな誤差を強調、 MAE は等価値、 MAPE はパーセント表示で直感的だが分母が小さいと不安定、 SMAPE は対称的、 MASE は単純な「ナイーブ予測(前期間値そのまま)」に対する相対誤差で複数系列の比較に向く。 SSDSE-B-2026 のような断面データには時系列予測指標は適用しないが、 時系列拡張版(複数年の都道府県データ)では MASE が解釈しやすい。 ベイズ予測区間や Quantile loss も近年は標準で、 単点予測ではなく予測分布を出すアプローチが業界標準になりつつある。 特に小売需要予測・電力需要予測の分野では、 quantile regression forest や DeepAR のような分布予測モデルが事実上のデファクトスタンダードとなった。
🔮 時系列の構造変化を検出する
時系列に構造変化(structural break)があると単一モデルでは捉えきれない。 Chow 検定・CUSUM 検定・Bai-Perron 検定で破断点を検出するのが古典的アプローチ。 近年は changepoint パッケージ (R) や ruptures (Python) で複数破断点の自動検出が可能。 たとえば COVID-19 前後で消費パターンが大きく変化した小売データは、 破断点を検出して期間別にモデルを切り替えるか、 状態空間モデルでパラメータを時変にする等の対応が必要である。
🗺️ 統計手法選択フローチャート
Q1: 何を知りたい?
- 記述したい → 平均、 分散、 ヒストグラム
- 比較したい → t検定、 ANOVA、 χ²検定
- 関係を見たい → 相関、 回帰
- 予測したい → 回帰、 機械学習
- 分類したい → ロジスティック回帰、 SVM、 RF
- グループ分けしたい → クラスタリング
- 次元を減らしたい → PCA、 因子分析
- 因果関係を知りたい → RCT、 IV、 DiD、 PSM
Q2: データの種類は?
- 連続値 → t検定、 ANOVA、 線形回帰
- カテゴリ → χ²検定、 ロジスティック回帰
- 順序 → ノンパラ検定、 順位回帰
- カウント → ポアソン回帰、 負の二項回帰
- 時系列 → ARIMA、 VAR、 状態空間
- パネル → 固定効果、 ランダム効果
Q3: サンプルサイズは?
- n < 30:ノンパラ、 ベイズ、 ブートストラップ
- 30 ≤ n < 200:古典的検定、 単純な回帰
- n ≥ 200:複雑なモデル、 機械学習
- n ≥ 10000:深層学習も可能
Q4: 仮定は?
- 正規性:満たす → パラメトリック / 満たさない → ノンパラ
- 独立性:必須 / 違反 → クラスター調整、 時系列モデル
- 等分散性:満たす → OLS / 違反 → WLS、 ロバスト
📏 効果量の参照表
p値だけでなく効果量も併記するのが現代統計の標準。 主要な指標と Cohen の解釈基準:
| 統計量 | 効果量 | 小 | 中 | 大 |
|---|---|---|---|---|
| 2群平均差 | Cohen's d | 0.2 | 0.5 | 0.8 |
| 相関 | r | 0.1 | 0.3 | 0.5 |
| 線形回帰 | R² | 0.02 | 0.13 | 0.26 |
| ANOVA | η² (eta²) | 0.01 | 0.06 | 0.14 |
| χ² | Cramér's V | 0.1 | 0.3 | 0.5 |
| ロジスティック | Odds Ratio | 1.5 | 2.5 | 4.0 |
🚀 実務応用の深掘り
典型的なプロジェクトの流れ
- 問題理解:ステークホルダーとの対話、 KGI/KPI 設定
- データ収集:内部DB、 公的データ(SSDSE等)、 API
- EDA:データの全体像把握、 異常検出
- 仮説立案:ドメイン知識からの仮説
- モデリング:シンプルから複雑へ段階的に
- 検証:CV、 ホールドアウト、 A/Bテスト
- 解釈:可視化、 SHAP、 部分依存プロット
- 展開:本番デプロイ、 監視
ベストプラクティス
- シンプルなモデルから始める(線形回帰、 単純ルール)
- 必ずベースラインと比較
- 過学習を防ぐ(CV、 正則化、 早期停止)
- 解釈可能性を重視
- 再現可能なコード・ノートブック
- バージョン管理(Git)と環境管理(venv, conda)
- ドキュメント化を怠らない
論文・コンペでよく使う言い回し
| 日本語 | 英語 |
|---|---|
| 統計的に有意 | statistically significant |
| 効果量 | effect size |
| 95%信頼区間 | 95% confidence interval (CI) |
| 標本サイズ | sample size |
| 検出力 | statistical power |
| 第1種の誤り | Type I error / false positive |
| 第2種の誤り | Type II error / false negative |
| 多重比較問題 | multiple comparisons problem |
| 過学習 | overfitting |
| 汎化性能 | generalization |
| 交差検証 | cross-validation (CV) |
統計データ活用コンペでのコツ
- SSDSE データの構造を理解し、 適切なテーブルを選ぶ
- 地域別・年度別の比較で時空間的視点を入れる
- 1つの分析で多角的に切り口を変える
- 仮説と発見の両方を持つ
- ストーリーラインを明確に
- 図表を1枚1枚作り込む
- 政策提言や実務的意義に繋げる
🗺️ 概念マップ — 3つの視点で体系を理解する
時系列分析 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 時系列 › 基礎 › 時系列分析(時間順に並んだデータ全般)
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に 時系列分析 を置き、 そこから ARIMA・VAR・指数平滑法 計 3 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「時系列分析」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「時系列分析」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは 時系列分析 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 基礎 → 時系列分析 という入れ子の位置を示します。 「基礎には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔗 隣接手法への橋渡し
時系列分析は独立した一手法ではなく、 前処理 → モデル選択 → 評価 → 予測の連鎖でひとつの分析パイプラインを構成する。
- 上流 (前処理): 欠損補完 (時間順序を考慮した interpolate) → 定常性 の確認 (ADF / KPSS 検定) → 必要なら差分や Box-Cox 変換 → 自己相関 (ACF/PACF) でモデル次数選定。 SSDSE-B-2026 の年次データ (47 都道府県 × 数年分) を
pd.to_datetime+set_indexで時系列形式に整形。 - 並列 (モデル選択): ARIMA / SARIMA (古典的・解釈性高い)、 状態空間モデル (Kalman フィルタ・水準と傾きを分離)、 Prophet (季節性と祝日対応に強い)、 LSTM / Transformer (長期依存・多変量対応)、 指数平滑法 (実装軽量・短期予測向き)。 データ量と季節性の有無で選択。
- 下流 (予測・評価): 訓練/テスト分割は時系列順 (シャッフル禁止) →
TimeSeriesSplitでクロスバリデーション → MAE / RMSE / MAPE で評価 → 残差の自己相関を Ljung-Box 検定で確認 → 予測区間を残差分散から構築 → BI ツール で可視化、 政策・経営判断に活用。
時系列を クロスセクション や パネルデータ と組み合わせると、 さらに「時間×地域」「時間×個体」の二次元構造を捉えられる。 SSDSE-B-2026 の都道府県年次データはまさにパネル形式で、 固定効果モデルや動学的パネル分析と接続する自然な拡張先。
🌳 手法選択フロー
「time series」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| データが大規模 (n が多い、 高次元) | 計算コスト / メモリ / 並列化が必要 | ARIMA 等 |
| 外れ値が多い / ノイズあり | 頑健性 / 外れ値除去 / 中央値ベース | SARIMA 等 |
| 解釈性を重視する | 線形 / 木構造 / ルールベース | 指数平滑法 等 |
| 予測精度を最優先する | アンサンブル / ハイパラ調整 / 交差検証 | Prophet 等 |
| データが少ない | 正則化 / ベイズ / 転移学習 / 簡素なモデル | LSTM 等 |
| リアルタイム/オンライン処理 | ストリーミング / 軽量モデル / 逐次更新 | 状態空間モデル 等 |
選んだ後の検証ステップ
- 前処理確認: 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切か
- ハイパラ調整: 交差検証で安定する値を選ぶ
- 性能評価: タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用
- 頑健性チェック: 別手法 / 別シードで結果が大きく違わないか確認
- 解釈: 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討
🎨 直感をさらに深める — 「順序」がすべてを変える
時系列の核心は「観測が時間順に並び、 隣り合う値が情報を共有している」点にある。 ふつうの表データ(クロスセクション)は行を入れ替えても意味が変わらないが、 時系列は並べ替えた瞬間に情報が壊れる。 これが i.i.d.(独立同分布)の仮定を捨てるということ。
4 成分への分解でイメージする:観測 $y_t$ を「長期の向き(トレンド $T_t$)+ 年内の繰り返し(季節性 $S_t$)+ 数年周期のうねり(循環 $C_t$)+ 説明のつかない揺れ(ノイズ $I_t$)」に分けて眺める。 「今どの成分を見ているのか」を意識するだけで、 グラフの読み方が一段深くなる。
自己相関=「過去が未来を予測する」を実データで体感。 SSDSE-B-2026[cp932, skiprows=[1]]で東京都の総人口(列 A1101)2012–2023 年の 12 時点を取り出すと、 13,234,000 人 → 14,086,000 人へと +852,000 人(+6.4%)のトレンド。 この系列のラグ 1 自己相関は r = 0.783で、 「昨年の人口が分かれば今年もほぼ分かる」高い persistence を示す。 秋田県(同 A1101)は逆に 1,063,000 → 914,000 人(−149,000 人、 −14.0%)の下降トレンドだが、 やはり r = 0.742と自己相関は高い。 上がる県も下がる県も「前年の値を強く引きずる」のが人口時系列の性質。
⚠️ 落とし穴を深掘り — 時系列で「うっかり」やる致命傷
① 見せかけの回帰(spurious regression)— 実データで再現
非定常な系列どうしを回帰すると、 因果がなくても高い相関が出る(Granger & Newbold 1974)。 SSDSE-B-2026 で東京都の総人口と秋田県の総人口(2012–2023)の相関を取ると r = −0.958。 東京は増え秋田は減るので強い負相関に見えるが、 両者に直接の因果はなく、 単に「別方向のトレンドを持つ」だけ。 実際、 1 階差分(前年差)を取ってから相関を計算すると r = +0.537 まで落ちる。 レベル(原系列)での相関はトレンドが作った蜃気楼だったわけだ。 時系列どうしの相関は、 まず定常性を確認してから解釈する(→ 見せかけの相関)。
② 定常性の確認(単位根)を飛ばさない
上の東京都人口は r(ラグ1)=0.783 と強い自己相関=単位根(unit root)が疑われる非定常系列。 ADF 検定(帰無仮説「単位根あり=非定常」)と KPSS 検定(帰無仮説「定常」)を併用し、 非定常なら 1 階差分を取る。 実際に差分を取ると東京で r(ラグ1)=0.656、 秋田で 0.742 → 0.343 と自己相関が下がり、 定常に近づく(これらも SSDSE-B-2026 の実測値)。
③ 時系列 CV で「未来漏れ」を絶対に起こさない
通常のランダム分割 CV は未来の情報で過去を予測するリークを生み、 評価が過剰に良く出る。 必ず TimeSeriesSplit や expanding / sliding window で「過去 → 未来」の順に評価し、 ホールドアウトは系列の末尾に置く。 標準化・欠損補完・特徴量作成も訓練区間の情報だけで行う(テスト期間の平均を使った標準化は典型的リーク)。
④ その他の頻出トラップ
- 季節調整の誤り:周期 $m$ の設定ミス(月次=12, 週次=52, 曜日=7)。 誤った $m$ で季節成分を引くと逆に構造を壊す。
- 外挿の危険:モデルは観測範囲の外を保証しない。 直線トレンドをそのまま延ばすと、 秋田県人口が数十年で負になるような非現実的予測を生む。
- 欠測の補間バイアス:時系列の欠測を前後平均や線形補間で埋めると、 自己相関を人工的に強め、 分散を過小評価する。 欠損処理は時間順序を保つ手法(forward-fill, Kalman 平滑)を選ぶ。
- リサンプリング / 集計粒度:日次 → 月次のように粒度を粗くすると季節性やノイズが平均化されて消える。 逆に細かくすると欠測・ゼロが増える。 分析目的に合う粒度を先に決める。
🚀 発展 — 定常化からモデリング、 予測区間まで
定常化の道具箱
- 階差(differencing):$\nabla y_t = y_t - y_{t-1}$ でトレンドを除去。 季節差分 $\nabla_m y_t = y_t - y_{t-m}$ で季節性を除去。 取りすぎ(over-differencing)は MA 係数を −1 に張り付かせるので、 KPSS で「定常」と出る最小回数に留める。
- 対数・Box-Cox 変換:分散が水準に比例して増える(乗法的)系列を加法的に均す。 人口や売上のように「% で動く」量に有効。
代表的モデル群
- ARIMA / SARIMA:AR+差分+MA の古典。 季節版が SARIMA。 解釈性が高く少数データでも安定。
- 状態空間モデル(Kalman フィルタ):水準・傾き・季節を潜在状態として分離し、 時変パラメータや欠測に強い。
- 指数平滑法(ETS):直近を重く加重。 Holt-Winters で trend+季節に対応。 実装軽量。
- STL 分解:LOESS ベースでトレンド・季節・残差にロバストに分解し、 外れ値の影響を受けにくい。
- Prophet:トレンド+季節+祝日を加法的に組む実務向け。 ただし短系列・強自己相関では ARIMA 系に劣ることも多く、 必ずナイーブ予測と水平比較する。
- LSTM / RNN / Transformer:長期依存・多変量・非線形を捉える深層系。 データ量が多いときの選択肢。
診断と予測区間
- 自己相関 ACF / 偏自己相関 PACF:次数 $(p,q)$ の目安。 ACF が指数減衰なら AR、 ラグ $q$ で切れれば MA。
- 残差の白色性:Ljung-Box 検定で残差に自己相関が残らないか確認。 残るなら次数を見直す。
- モデル選択:AIC / BIC を最小化しつつ、 時系列 CV の実測予測精度で最終判断。
- 予測区間(PI):係数の信頼区間(CI)ではなく「次の観測値」の不確実性を表す PI を必ず併記。 PI は CI より広いのが正しい。 分位点回帰や DeepAR のような分布予測も近年の標準。
多変量・因果への展開:VAR / VECM(複数系列の相互依存・共和分)、 Granger 因果(「予測に役立つか」で定義される時系列の因果)。 SSDSE-B-2026 の都道府県×年度はパネルデータなので、 固定効果や動学パネルへ自然に接続する。
🔗 関連ページへ — この概念の前後左右
サイト内に個別ページがある用語はリンク、 未整備の用語は太字テキストで示す。
📘 前提
- 定常性 (stationarity) — 多くのモデルの大前提。 単位根の確認。
- 自己相関 (autocorrelation) — 過去が未来を予測する量。 次数決定の判断材料。
- ラグ変数 (lag) — 「k 期前の値」。 AR モデルの基本語彙。
- トレンド / 季節性 (trend / seasonality)、 移動平均 (moving average) — 個別ページは未整備(時系列グループにまとめ掲載)。
⚖️ 並列・比較
- ARIMA / SARIMA、 指数平滑法 (ETS) — 古典予測モデル。
- クロスセクション、 パネルデータ — 時間軸の有無で対比。
- 状態空間モデル (state space)、 Prophet、 SARIMA — 個別ページ未整備。
🚀 発展・応用
- VAR / VECM、 Granger 因果 — 多変量・因果。
- LSTM / RNN — 深層時系列。
- 見せかけの相関・回帰 — 非定常系列の落とし穴。
- 交差検証(時系列版)、 AIC / BIC — モデル評価。
- 欠損値処理 — 時間順序を壊さない補間。
🎮 触って理解する — 時系列の分解(トレンド+季節性+残差)
時系列は「トレンド + 季節性 + ノイズ」の重ね合わせ(加法モデル $y_t = T_t + S_t + I_t$)として捉えるのが第一歩。 下のスライダーで 3 成分を自由に合成すると、 その合成系列だけを入力にした古典的分解(① 中心化移動平均でトレンド $\hat T_t$ を抽出 → ② 残り $y_t - \hat T_t$ を周期位置ごとに平均して季節成分 $\hat S_t$ を推定 → ③ 残差 $\hat R_t = y_t - \hat T_t - \hat S_t$)が即座に走り、 合成 ⇄ 分解の往復をリアルタイムで確認できる。 灰色の破線が「合成に使った真の成分」、 色付きの実線が「分解で推定した成分」。 両者が重なれば分解成功。
🧭 まず試すこと — 合成 ⇄ 分解の往復を体感
- 成分を 1 つずつゼロに:「トレンド=0」を押すと系列は水平の波+ノイズだけに、「季節性=0」で右肩上がりのギザギザ直線に、「ノイズ=0」で滑らかな理想形になる。 観測系列は本当に 3 成分の足し算だと分かる。
- ノイズ=0 で分解の正確さを確認:真の周期と分解周期が一致していれば、 推定トレンド・推定季節性は真値(灰破線)にほぼ完全に重なり、 残差はゼロに張り付く。 古典的分解は「合成の逆演算」になっている。
- 周期をわざと間違える:「自動追従」を外して m̂ を真の周期 m からずらすと、 季節成分の推定が崩れ、 拾い損ねた波が残差に漏れる(残差 SD がノイズ SD より大きくなる)。 下の黄色ボックスの警告と数値で確認。
- ノイズを強くする:σ を上げると残差パネルが暴れ、 分散シェアの「残差」が増える。 それでも移動平均トレンドの推定傾きは真の傾きに近い値を保つ — 平均化がノイズを打ち消すため。
💡 直感 — 時系列 = 成分の重ね合わせ
出生数・婚姻件数・県内総生産のような実データは、 一見ランダムに揺れて見えても「長期的な傾向(トレンド)」「決まったリズム(季節性)」「説明できない揺らぎ(残差)」の重ね合わせで近似できることが多い。 分解の価値はそれぞれの成分に別の物語があること — トレンドは構造変化(少子化・都市集中)、 季節性は制度と暦(3 月卒業・年度末)、 残差は突発イベント(コロナの婚姻急減)を語る。 移動平均がトレンドを抽出できるのは、 窓幅を周期 m にそろえると季節成分が 1 周期分で足し合わされてゼロになるから(このシミュレーションでは m が偶数のとき端に重み 1/2 を置く中心化 2×m 移動平均を使用)。
⚠️ よくある落とし穴
- 加法 vs 乗法の取り違え:ここで扱ったのは加法モデル $y_t = T_t + S_t + I_t$。 しかし売上高のように「水準が上がると季節の振れ幅も比例して大きくなる」データは乗法モデル $y_t = T_t \times S_t \times I_t$ が適切。 見分け方は簡単で、 系列の振幅がトレンドとともに拡大していれば乗法(対数を取れば加法に変換できる: $\log y_t = \log T_t + \log S_t + \log I_t$)。
- 周期の誤設定:上の実験のとおり、 m̂ を間違えると季節成分が残差に漏れて「ノイズが多いデータ」に見えてしまう。 月次なら 12、 四半期なら 4 が普通だが、 週次データ(≈52.18)や日次データ(週+年の複合周期)は要注意。 自己相関(ACF)のピーク位置で周期を確認してから分解するのが定石。
- 移動平均の端点問題:中心化移動平均は系列の最初と最後の m/2 点でトレンドを計算できない(上のパネル②で橙線が端で途切れているのがそれ)。 直近の動向こそ知りたい実務では致命的になり得るため、 端点も推定できる LOESS ベースの STL 分解などが好まれる。
- 分解結果でそのまま検定しない:分解後の残差は構成上自己相関を持ち得る。 「残差が白色雑音か」は Ljung-Box 検定で確認し、 相関が残るなら ARIMA 系モデルで残差構造まで組み込む。
🚀 発展 — STL・SARIMA・予測へ
ここで体感した古典的分解(moving average + 季節平均)は 1920 年代からある最も基本的な方法。 現代の実務では、 STL 分解(Seasonal-Trend decomposition using LOESS)が標準 — 局所回帰でトレンドを推定するため端点も計算でき、 季節成分が年々変化することも許容し、 外れ値に頑健なオプションを持つ(Python では statsmodels.tsa.seasonal.STL、 本ページ上部の実値計算セクションで使用済み)。 分解を「理解」から「予測」へ進めるなら、 季節差分と通常差分を組み込んだ SARIMA(ARIMA の季節拡張)、 トレンド・季節をそれぞれ平滑化パラメータで追跡する 指数平滑法(Holt-Winters)が二大古典。 いずれも適用前に定常性の確認が前提となる。 「分解 → 各成分を個別に予測 → 再合成」という戦略も実務では有効で、 M4/M5 予測コンペの上位解法にも組み込まれている。