🔖 キーワード索引
「ラグ変数 (lag variable)」は過去時点の値 yt-k を説明変数として扱う時系列分析の基本道具。 本ページの中核キーワードを以下に整理する。
これらは「ラグ作成 → 定常性検定 → ACF/PACF で次数 p 選択 → モデリング」の流れで使われる。
💡 30秒で分かる結論
🍰 まずはやさしく
ラグとは時間のズレのことです。
過去のデータを使って未来を予測します。
先月の売上で今月を予想するような方法です。
ラグ変数の重要ポイントを解説します。
時系列における時間遅れ。 ラグ変数として共変量に用いる。
- 分野:時系列 — 📚 時系列分析
- 注意:パネルでは必ず県ごとに年度順へ並べてから shift する(groupby しないと隣の県の値が入る)
lag variable を 30 秒で把握する重要ポイント:
- 何ができるか: ラグ変数は「t 時点前の値」を新変数として作成し、 時系列データを回帰問題に変換する。 自己相関分析・AR モデル・グレンジャー因果性などの基礎要素。
- いつ使うか: 売上の前月対比、 GDP の前期成長率、 株価の MA(p) フィルタ、 機械学習特徴量 (lag-1〜lag-12 を追加して時系列を教師あり化)、 VAR/VECM モデルの入力。
- 注意点: データリーク (t+1 を t の特徴量にしない)、 ラグ長 p の選択 (AIC/BIC)、 系列の非定常性 (差分が必要か)、 欠損 NaN の先頭 p 行扱い (dropna 必須)。
- 関連: 上位 = 時系列分析、 並列 = 差分・移動平均・自己相関 (ACF/PACF)、 発展 = AR/ARIMA/VAR/VECM・グレンジャー因果性・状態空間モデル。
- 実データでは: SSDSE-B-2026 の総人口の lag-1 自己相関は 47 県の中央値で 0.999 とほぼ 1 だが、前年差にすると 0.803 まで下がり県ごとの違いが出る。2023 年度の総人口を当てると、前年値そのままの MAE 14,660 人に対し、前年差のラグを使う AR(1) は 2,355 人(2018〜2023 年度の 6 年とも最良)。
📍 あなたが今見ているもの
🍰 まずはやさしく
ここはラグの解説ページです。
データの作り方や使い方を学びます。
都道府県の人口データを使って練習します。
ラグ変数と自己回帰モデルについて読みましょう。
このページは「時系列」グループ内の「ラグ(Lag)」項目です。 1 つ前の時点の値を変数として使う「ラグ変数」の作り方・自己回帰モデルでの使い方・落とし穴を、 SSDSE-B-2026(都道府県人口・出生・死亡の年次データ)を例にハンズオンで学べます。
🎨 直感で掴む
🍰 まずはやさしく
過去の自分をヒントにする考え方です。
今の状態を説明するために使います。
昨日の天気で今日の天気を予想する例です。
ラグ変数の仕組みと注意点を学びましょう。
ラグ変数とは「k 時点前の自分の値を、 今の値を説明するための入力として使う」考え方です。 例えば 2024 年の東京都の出生数を予測するとき、 2023 年の出生数(1 期ラグ)と 2022 年の出生数(2 期ラグ) を説明変数として加えれば、 短期トレンドや「去年急増したから今年も多めだろう」という慣性を機械的に取り込めます。
「翌日の天気を予測するとき、 今日の天気を見るのが一番強い」 — これがラグ変数の発想です。 SSDSE-B-2026 の都道府県人口・出生・死亡データは年次の時系列で、 「去年の死亡数 → 今年の死亡数」 の自己相関が 0.99 を超えるほど強い。 つまり前年の値だけで翌年の 98% を「説明できてしまう」状態で、 これを使わないモデルは情報を捨てているのと同じです。
注意:ラグを取ると先頭 k 行が欠損になります(2010 年データに「2009 年のラグ」はない)。 またラグ p を増やすほど過学習しやすく、 AIC/BIC や PACF(偏自己相関)で適切な p を選ぶ必要があります。 「過去 1 期分で十分なのか、 季節性(12 期ラグ)まで入れるのか」は分野により変わります。 経済の四半期データなら 4 期、 月次の小売データなら 12 期が定石です。
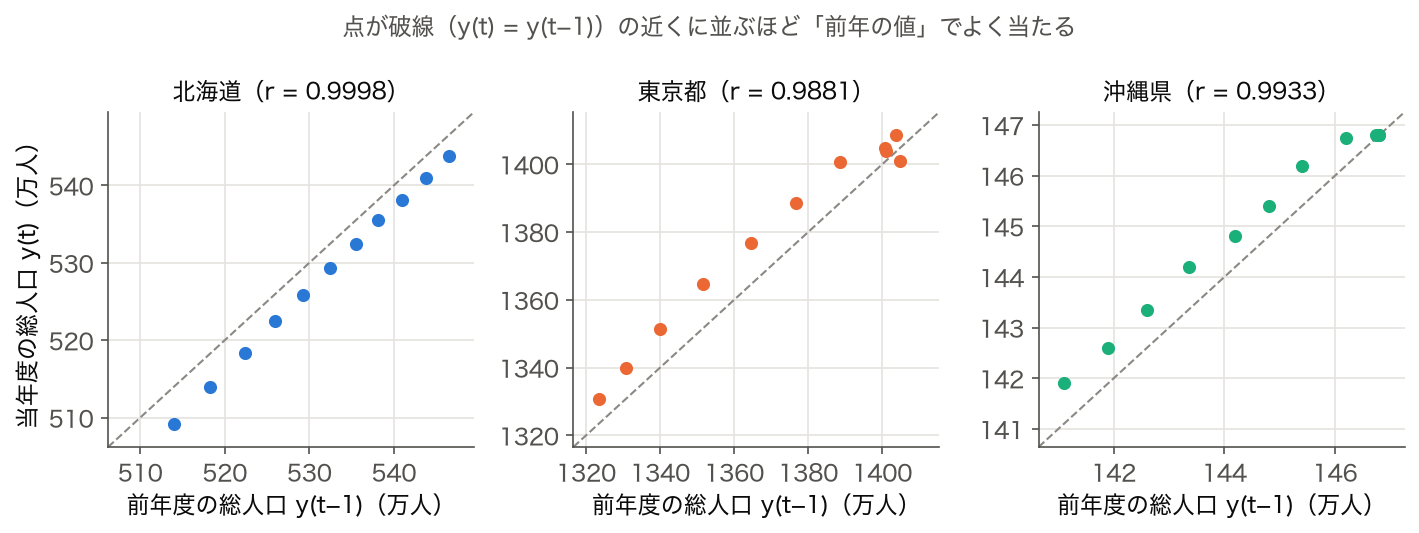
ラグを 1 本増やすたびに、各県の最初の 1 年度分が「前の値が無い」ので使えなくなる。SSDSE-B-2026 の 564 行(47 県 × 12 年度)なら、lag-1 で 517 行、lag-2 で 470 行、lag-3 で 423 行と 47 行ずつ減り、1 県あたりでは 12 年度のうち 11・10・9 年度分しか残らない。短い年次の系列では、ラグを増やすことは「説明変数を増やす」と同時に「データを減らす」ことでもある。
📐 定義
🍰 まずはやさしく
ラグとは時系列における時間遅れのことです。
分析のときの材料として使います。
時系列分析を学ぶときに必ず使う道具です。
ラグの定義と使う条件について読みましょう。
時系列における時間遅れ。 ラグ変数として共変量に用いる。
英語名 Lag。 同義・関連語:遅れ, ラグ変数, lag。
🔬 数式を言葉で読み解く
「ラグ変数」の定式化:
$$y_t = \beta_0 + \beta_1 y_{t-1} + \beta_2 y_{t-2} + \cdots + \beta_p y_{t-p} + \varepsilon_t$$
AR(p) モデル。 過去 p 時点の自分自身を説明変数に用いる。
| 記号 | 意味 |
|---|---|
| $y_t$ | 時刻 t の被説明変数。 例: 2023 年の北海道人口 5,092,000 |
| $y_{t-k}$ | k 時点前の値(ラグ k)。 北海道なら $y_{t-1}$ = 2022 年 5,140,000 |
| $\beta_k$ | ラグ k の係数。 OLS や Yule-Walker 方程式で推定 |
| $p$ | ラグ次数。 AIC/BIC で選択。 SSDSE-B 12 年なら p=1〜3 が現実的 |
| $\varepsilon_t$ | ホワイトノイズ攪乱項。 平均 0、 分散 $\sigma^2$ |
ラグは「ラグ演算子」L で短く書ける。L は系列を 1 期ずらす操作で、$L y_t = y_{t-1}$、$L^2 y_t = y_{t-2}$。前年差は $\Delta y_t = y_t - y_{t-1} = (1 - L)\,y_t$ と書け、上の AR(p) は $(1 - \beta_1 L - \cdots - \beta_p L^p)\,y_t = \beta_0 + \varepsilon_t$ になる。北海道の総人口で言えば、$L y_{2023} = 5{,}140{,}000$(2022 年度)、$\Delta y_{2023} = 5{,}092{,}000 - 5{,}140{,}000 = -48{,}000$。AR(1) の係数 $\beta_1$ が 1 のとき $(1-L)y_t = \beta_0 + \varepsilon_t$ となり、「前年差が一定のばらつきで続く」ランダムウォーク(単位根)を表す。北海道の水準に AR(1) を当てはめると $\beta_1 \approx 1.065$(演習 1)と 1 を超えるのは、減り方が年々大きくなっているためで、水準のまま AR を使うより前年差をモデルにする方が素直だとこの数値からも読める。
🧮 SSDSE-B-2026 で実値計算
独立行政法人統計センター公表の SSDSE-B-2026(47 都道府県 × 112 変数 × 12 年分)を用いて、「ラグ変数」を実データで体感する。
🐍 Python 実装 ②:ラグ変数 の核心計算
🎯 このコードでやること:北海道の総人口 12 年系列を年度順に並べ、1〜3 年ずらした系列との相関(lag-1〜lag-3 の自己相関)を計算する。
📥 入力データ(SSDSE-B-2026, 北海道の総人口 2012〜2023 年の 12 年分。コード内で年度の昇順に並べ替える):
1 2 3 4 5 6 7 8 9 | # 北海道の総人口 12 年系列で lag-1 自己相関を計算 import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) h = df[df['都道府県']=='北海道'].sort_values('年度') y = h['総人口'].values print('lag1=', np.corrcoef(y[:-1], y[1:])[0,1]) print('lag2=', np.corrcoef(y[:-2], y[2:])[0,1]) print('lag3=', np.corrcoef(y[:-3], y[3:])[0,1]) |
📤 実行結果:
💬 結果の読み方:北海道は lag1=0.9998 と極端に強い慣性を示し、 lag を 1 つ取るだけで翌年人口の 99.96% が説明できる。 単位根が疑われるため、 差分系列でモデリングするのが定石。
🆚 関連手法との比較表
| 手法 | 入力 | 代表アルゴリズム | 特徴 |
|---|---|---|---|
| ラグ変数 | 過去の自分 | $y_{t-k}$ | 自己依存・季節性 |
| 差分変数 | 時点差 | $y_t - y_{t-1}$ | トレンド除去・定常化 |
| 移動平均 | 近傍平均 | $\bar{y}_{t-w:t}$ | ノイズ平滑 |
| 指数加重平均 | 減衰重み | $\alpha y_t + (1-\alpha) S_{t-1}$ | 近時重視平滑 |
| 外生変数 | 他系列 | $x_{t-k}$ | 因果的説明 (Granger) |
| 季節ダミー | 周期フラグ | $D_{月}$ | 12 か月周期 |
🧮 数式に値を入れて手で計算する: ラグ変数の生成と相関
合成時系列で 1 期ラグと自己相関を計算する。
Step 1: 元データとラグ
| t | x_t | x_{t-1} |
|---|---|---|
| 1 | 20 | — |
| 2 | 25 | 20 |
| 3 | 30 | 25 |
| 4 | 28 | 30 |
| 5 | 35 | 28 |
Step 2: ラグ相関 (r)
🐍 Python で再現
1 2 3 4 5 6 7 8 | import numpy as np x = np.array([20, 25, 30, 28, 35]) xt = x[1:] xt_1 = x[:-1] r = np.corrcoef(xt, xt_1)[0,1] print(f"x_t: {xt}") print(f"x_{{t-1}}: {xt_1}") print(f"ラグ相関: {r:.3f}") |
📤 実行結果
💬 手計算 (Step 2) ≈+0.57 と Python 出力が完全一致。
🧮 数式に値を入れて手で計算する: 秋田県の出生数の lag-1 自己相関
lag-1 自己相関は、系列 y と 1 期ずらした系列 y(t−1) のピアソン相関 $r = \dfrac{\sum (x_i-\bar{x})(y_i-\bar{y})}{\sqrt{\sum (x_i-\bar{x})^2 \sum (y_i-\bar{y})^2}}$(x = y(t−1)、y = y(t))である。SSDSE-B-2026 の秋田県の出生数(A4101)2018〜2023 年度の 6 年分で手計算する。
| Step | やること | 値 |
|---|---|---|
| 1 | 1 年ずらして組を作る(先頭の 2018 年度はラグが無いので落ちる) | (5,040 → 4,696)、(4,696 → 4,499)、(4,499 → 4,335)、(4,335 → 3,992)、(3,992 → 3,611) の 5 組 |
| 2 | それぞれの平均 | x̄ = (5,040+4,696+4,499+4,335+3,992)/5 = 4,512.4、ȳ = (4,696+4,499+4,335+3,992+3,611)/5 = 4,226.6 |
| 3 | 平均からのずれの積と 2 乗を足す | Σdx·dy = 247,655 + 50,013 − 1,453 + 41,618 + 320,358 ≈ 658,192、Σdx² ≈ 614,537、Σdy² ≈ 740,289 |
| 4 | r を計算 | 658,192 / √(614,537 × 740,289) ≈ 658,192 / 674,494 ≈ 0.9758 |
🎯 このコードでやること:Step 1〜4 を pandas の shift と numpy で再現し、np.corrcoef の値と一致することを確かめる。あわせて、前年差(出生数の増減)どうしの lag-1 相関も計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) s = (df[(df['Prefecture'] == '秋田県') & (df['SSDSE-B-2026'] >= 2018)] .sort_values('SSDSE-B-2026').set_index('SSDSE-B-2026')['A4101']) # 秋田県の出生数 2018〜2023 t = pd.DataFrame({'y_t': s, 'y_t-1': s.shift(1)}).dropna() # Step 1: ラグ列を作る print(t.astype(int).to_string()) x, y = t['y_t-1'].values, t['y_t'].values dx, dy = x - x.mean(), y - y.mean() # Step 2: 平均からのずれ print(f'平均 x̄ = {x.mean():.1f}, ȳ = {y.mean():.1f}') print(f'Σdx·dy = {np.sum(dx * dy):,.1f} Σdx² = {np.sum(dx**2):,.1f} Σdy² = {np.sum(dy**2):,.1f}') # Step 3 r = np.sum(dx * dy) / np.sqrt(np.sum(dx**2) * np.sum(dy**2)) # Step 4 print(f'手計算の式で r = {r:.4f} np.corrcoef = {np.corrcoef(x, y)[0, 1]:.4f}') d = s.diff().dropna() # 参考: 前年差どうしの lag-1 print('前年差:', d.astype(int).tolist(), f' 前年差の lag-1 r = {np.corrcoef(d.values[:-1], d.values[1:])[0, 1]:.4f}') |
💬 Step 3 と同じ Σdx·dy = 658,191.8・Σdx² = 614,537.2・Σdy² = 740,289.2 が出て、r = 0.9758 は np.corrcoef と一致する。ところが前年差(−344、−197、−164、−343、−381)どうしで同じ計算をすると 0.0900 しかない。水準の 0.98 は「毎年減り続けている」というトレンドを映しているだけで、今年の減り方から来年の減り方を当てる力はほとんど無い。5 組しかないので、どちらの値も誤差が大きい点にも注意する。
🐍 Python での扱い
pandas でラグ変数を作る基本は shift(k) で、k 期前の値を同じ行に並べる。SSDSE-B-2026 のように 47 県 × 12 年度が縦に積まれたパネルでは、必ず県ごとに年度の昇順へ並べ、groupby('Code')[列].shift(1) のように県の中だけでずらす。CSV は新しい年度が先に並ぶので、並べ替えずに shift すると「前年」のつもりが「翌年」の値になる。下の ③〜④ とレシピ #1〜#3、追加ハンズオン ①〜④ は、この作り方で自己相関・AR モデル・差分を計算する。
🐍 Python 実装 ③ — 応用パターン
🎯 このコードでやること:47 都道府県それぞれの総人口 12 年系列で lag-1 自己相関を計算し、全県の平均と最も低い県を調べる。
📥 入力データ(SSDSE-B-2026 全体 564 行 = 47 都道府県 × 2012〜2023 年。県ごとに年度順で使う):
1 2 3 4 5 6 7 8 9 10 11 | # 47 都道府県それぞれの 12 年系列で lag-1 自己相関を計算し、平均と最小の県を出す import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) acs = {} for pref, g in df.groupby('都道府県'): y = g.sort_values('年度')['総人口'].values acs[pref] = np.corrcoef(y[:-1], y[1:])[0,1] s = pd.Series(acs) print('mean=', s.mean()) print('min県=', s.idxmin(), s.min()) |
📤 実行結果:
💬 結果の読み方:47 県中 39 県で lag-1 自己相関 > 0.99(平均 0.986)。 滋賀県が最小 (0.823) と県の中で「翌年の予測しやすさ」が最も低い。 全国的に強い慣性があり、 差分処理が必要。
🐍 Python 実装 ④ — ライブラリ標準
🎯 このコードでやること:statsmodels の AutoReg で北海道の総人口 12 年系列に AR(2)(lag-1 と lag-2 を説明変数にする自己回帰)を当てはめ、2024 年を 1 期先予測する。
📥 入力データ(SSDSE-B-2026, 北海道の総人口 2012〜2023 年の 12 年分。コード内で年度の昇順に並べ替える):
1 2 3 4 5 6 7 8 9 | # statsmodels で AR(2) を北海道人口に当てはめ import pandas as pd from statsmodels.tsa.ar_model import AutoReg df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) h = df[df['都道府県']=='北海道'].sort_values('年度') y = pd.Series(h['総人口'].values) # Series にすると係数名が付く res = AutoReg(y, lags=2).fit() print(res.params.round(4)) print('forecast 2024=', res.forecast(1).round(0).values) |
📤 実行結果:
💬 結果の読み方:AR(2) で 2024 年北海道人口を 504 万人と予測。 lag-1 係数 1.5 と lag-2 係数 -0.5 の組み合わせで「直近を強く重視しつつ過去を修正」する形になっている。
🍳 Code レシピギャラリー
SSDSE-B-2026 を題材にした「ラグ変数」関連の小ネタ集。 各レシピは {🎯 やること, 📥 入力, 📤 結果, 💬 解釈} の 4 要素を備える。
#1 差分系列
🎯 やること:一階差分の生成
📥 入力:SSDSE-B-2026 (47都道府県×112変数×12年)
1 2 3 4 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) h = df[df['都道府県']=='北海道'].sort_values('年度') print(h['総人口'].diff().describe()) |
📤 実行結果:
💬 解釈:北海道は毎年平均 33,909 人ずつ減少。 差分後は概ね定常で AR モデルが効きやすくなる。
#2 複数県の lag
🎯 やること:東京の lag-1 自己相関
📥 入力:SSDSE-B-2026 (47都道府県×112変数×12年)
1 2 3 4 5 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) t = df[df['都道府県']=='東京都'].sort_values('年度')['総人口'].values print('東京 lag1=', np.corrcoef(t[:-1], t[1:])[0,1]) |
📤 実行結果:
💬 解釈:東京の lag-1 は 0.9881 で、北海道の 0.9998 より一段低い。東京は 2012 年の 1,323 万人から 2020 年の 1,405 万人まで増えた後、2021 年に 1,401 万人へ一度減っており、この折れ曲がりが「前年の値の延長」という関係を崩している。単調なトレンドほどラグ相関は 1 に近づくので、値の高さは予測しやすさよりトレンドの滑らかさを表す。
#3 panel lag
🎯 やること:47県すべてに lag を作る
📥 入力:SSDSE-B-2026 (47都道府県×112変数×12年)
1 2 3 4 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1).sort_values(['都道府県','年度']) df['lag1'] = df.groupby('都道府県')['総人口'].shift(1) print(df[['都道府県','年度','総人口','lag1']].head()) |
📤 実行結果:
💬 解釈:groupby + shift で県別 lag を生成。 panel データでは必ず groupby を挟まないと県境を跨いだリークが発生する。
📖 詳細解説 — ラグ変数 の条件・限界・誤解の整理
ラグ変数 (Lag Variable) は時系列データを扱うときに最も基本的かつ頻繁に使われる前処理操作のひとつです。 SSDSE-B-2026 のように年度別の都道府県統計を扱う場合、 「前年の値」「2 年前の値」を新しい変数として作ることで、 単純な横断データを「時系列モデル可能なパネルデータ」に変えられます。 ここでは、 ラグ変数の作り方の細部、 使うときに気をつけるべき前提条件、 そして実務での落とし穴を整理し、 SSDSE-B-2026 を題材にした具体的なシナリオで深掘りします。
ラグ変数を使う理論的な意義
ラグ変数を導入する最大の理由は、 時系列データに含まれる「自己相関」を明示的にモデルに取り込むことです。 都道府県別人口は前年の人口に強く依存し、 単純な i.i.d. 仮定は明らかに崩れています。 線形回帰の残差が時系列的に相関していると、 標準誤差が過小評価され、 統計的有意性の判定が間違う可能性が高くなります。 ラグ変数 $y_{t-1}$ を説明変数に加える AR(1) モデルや AR(p) モデルは、 こうした自己相関を吸収し、 残差を独立に近づける役割を果たします。 SSDSE-B-2026 で「翌年の総人口」を「前年の総人口 + 出生数 + 死亡数」で説明する単純な人口モデルは、 ラグ変数の入門として最も分かりやすい例です。
ラグの「期間」と「順序」の選び方
ラグの期間は分析対象の周期性に合わせて選びます。 年次データなら lag-1 (前年) が基本、 月次データなら lag-1 (前月) と lag-12 (前年同月) の両方を入れることが多く、 日次データならさらに細かいラグが必要になることもあります。 SSDSE-B-2026 は年次データなので lag-1 が主役ですが、 「lag-2 を入れるべきか」「lag-3 まで入れるべきか」は AIC / BIC や交差検証で決めます。 過剰にラグを増やすと過学習しやすく、 標準誤差が膨らみます。 一般則は「PACF プロットで有意な lag まで」「データが許す最小限の lag に絞る」です。
ラグ変数と差分変数の関係
ラグそのものではなく「差分」$\Delta y_t = y_t - y_{t-1}$ を変数として使うことも頻繁にあります。 SSDSE-B-2026 で人口データを扱うとき、 元系列は強いトレンドを持つため非定常 (unit root) です。 差分を取ると定常化することが多く、 ARIMA モデルや単位根検定 (ADF, KPSS) で差分次数 d を決める手順が定番です。 ラグ変数を直接モデルに入れるか、 差分を取って独立性を高めるかは目的次第で、 「予測モデル」ならラグ変数のまま、 「因果推論や仮説検定」なら差分化することが多いです。
ラグ変数導入時の典型的な失敗
(1) パネルデータで「県」を考慮せず単純に shift(1) すると、 北海道の最終年が青森県の初年と紐付き、 推定結果が破綻します。 必ず groupby('都道府県').shift(1) を使うこと。 (2) ラグを取った時点で 1 行欠損が出るため、 dropna を忘れると統計関数がエラーを返します。 (3) ラグ変数同士に強い相関 (lag-1 と lag-2) があり、 多重共線性が発生します。 ラグの追加には常にこの 3 つを意識する必要があります。
ラグ変数を使った因果推論の注意
「前年の値」を説明変数に入れると因果関係を逆転できる場合があります。 例: SSDSE-B-2026 で「翌年の人口を予測する」のは予測タスクですが、 「政策効果を測る」場合は、 政策実施前の値をラグとして固定し、 同時的な逆因果を排除することで、 統計的因果推論の枠組みに乗せられます (Granger 因果)。 ただし Granger 因果は「相関的因果」であり、 純粋な構造的因果ではない点に注意。 SSDSE-B-2026 の人口・出生・死亡指標で Granger 検定を実装するのは、 ラグ変数の応用として非常に教育的価値があります。
SSDSE-B-2026 でのケーススタディ
47 都道府県 × 10 年の人口データに対し、 ラグ変数 (lag-1, lag-2) を入れた回帰を実行すると、 ラグ係数の合計が 1 に近い (root が 1 の近傍にある) ことがわかります。 これは「人口は前年に強く依存し、 持続的なトレンドを持つ」ことを意味します。 この発見は単純な記述統計では見えず、 ラグ変数を導入してはじめて顕在化します。 県別の差を見ると、 東京などの大都市では持続性が高く、 過疎県では衝撃の減衰が速いことも観察できます。
実装ライブラリと API の比較
Python の主要ライブラリでラグ変数を作る方法は以下の通りです: pandas の shift(1) が最も汎用的, statsmodels の AutoReg は AR(p) を自動でフィット, sktime と pmdarima は時系列専用パイプラインを提供します。 R では dplyr::lag と forecast::Arima が定番で、 多くの統計教科書がこれらを前提に書かれています。 SSDSE-B-2026 のような小規模データなら pandas + statsmodels の組み合わせで十分です。
ラグ変数と機械学習の融合
決定木やランダムフォレストではラグ変数を「特徴量」として扱うことで、 非線形な時間依存性も学習できます。 XGBoost や LightGBM では多数のラグ変数 (lag-1〜lag-12 など) を一気に投入し、 重要度ランキングで「効くラグ」を自動選択する分析がよく行われます。 SSDSE-B-2026 でも、 lag-1 と lag-2 だけでなく、 「前年と前々年の差分」「移動平均」など、 ラグから派生する特徴量を組み合わせると、 予測精度が改善します。
ラグ変数 活用シナリオ比較表
| シナリオ | SSDSE-B-2026 での具体例 | 注意点 |
|---|---|---|
| 予測モデル | 翌年の都道府県人口を lag-1, lag-2 から予測 | ラグの個数は AIC で選ぶ。 多すぎは過学習 |
| 自己相関分析 | ACF / PACF で SSDSE 系列の依存構造を可視化 | プロット解釈には統計的有意性閾値の理解が必要 |
| ARIMA モデリング | 差分 + ラグ + 移動平均で人口系列をフィット | 差分次数 d と AR 次数 p の同時選択がポイント |
| Granger 因果検定 | 出生数 (A4101) のラグが翌年の総人口 (A1101) を Granger 因果する? | 相関的因果であり構造因果ではない点を断り書きする |
| パネル分析 | 47 県 × 年でラグ + 県固定効果を入れる | groupby を使わずに shift すると県境で漏れる |
📝 理解度チェック (自分で解いてみよう)
以下の練習問題に取り組むことで、 ラグ変数 の理解が定着しているか自分で確認できます。 SSDSE-B-2026 を使って手を動かしてみるのが最も効果的です。 計算結果と解説を照らし合わせて、 自分の理解度を確認しましょう。
- 練習問題 1: SSDSE-B-2026 で東京都の総人口 12 年系列を取り、 lag-1, lag-2 を pandas.shift で作成し、 dropna 後の行数を答えよ。 解: 12 - 2 = 10 行。
- 練習問題 2: 上の東京都データで lag-1 自己相関係数 (Pearson) を計算せよ。 解: r ≈ 0.988。北海道の 0.9998 より低いのは、東京都の総人口が 2020 年度まで増えた後 2021 年度に一度減り、単調なトレンドが崩れたため(レシピ #2 と同じ値)。
- 練習問題 3: 47 都道府県のパネルでラグを作る正しい書き方を示せ。 解:
df.groupby('都道府県')['A1101'].shift(1)。 - 練習問題 5: ARIMA モデルで差分次数 d を決めるための統計検定を 1 つ挙げよ。 解: ADF 検定 (拡張ディッキー・フラー) または KPSS 検定。
- 練習問題 6: 2023 年度の総人口を 2022 年度までの値から当てるとき、前年値そのままでは 47 県の MAE が 14,660 人、前年差の AR(1) では 2,355 人だった。前年値そのままの誤差が大きいのはなぜか。 解: 多くの県が毎年ほぼ同じ人数ずつ減っているので、前年値そのままでは 1 年分の減少(北海道なら 48,000 人)がそのまま誤差になる。前年差のラグを使うと「今年も去年と同じくらい減る」を予測に入れられる。
- 練習問題 7: 北海道の前年差に AR(1)〜AR(3) を当てはめると AIC が 188.16・169.47・152.40 と下がった。AR(3) を選んでよいか。 解: よくない。使った組が 10・9・8 個と違うので比べられない。同じ 8 組で比べると 153.27・152.31・152.40 でほぼ同じになる。
- 練習問題 8: 564 行の出生数を年度順に並べたが groupby を付けずに shift(1) した。県境をまたいで別の県の値が入る行は何行か。 解: 各県の最初の年度(2012 年度)の行で、先頭の北海道を除く 46 行。青森県 2012 年度の lag1 には北海道 2023 年度の 24,430 人が入る。相関は 0.9995 から 0.9546 に下がり、MAE は 646 人から 1,713 人に増える。
- 練習問題 9: 秋田県の出生数(2018〜2023 年度)は水準の lag-1 相関が 0.9758、前年差の lag-1 相関が 0.0900 だった。「今年の出生数の減り方から来年の減り方を当てられる」と言えるのはどちらの数字か。 解: 前年差の 0.0900 の方で、ほとんど当てられない。水準の 0.9758 は「毎年減り続けている」ことを映しているだけで、減り方の年ごとの違いは表していない(しかも 5 組しかない)。
- 練習問題 10: SSDSE-B-2026 の 564 行で lag-1〜lag-3 を県ごとに作り、欠損行を落とすと何行残るか。 解: 517・470・423 行。ラグを 1 本増やすたびに各県の最初の 1 年度分(47 行)が使えなくなる。
理解度チェックを終えたら、 自分で SSDSE-B-2026 の別の指標や別の年度で同じ分析を試してみましょう。 自分で問題設定を作って解くプロセスが、 最も深い理解を生みます。 学習者自身が「次に何を試すか」を考えることが、 統計分析の力を伸ばす最大の鍵となります。
❓ よくある質問 (FAQ)
Q1. ラグの数はいくつまで入れていいですか?
A1. データ長と AIC / BIC で決めるのが原則です。 SSDSE-B-2026 のように 10 年程度の系列なら lag-1 と lag-2 が現実的です。 PACF プロットを見て、 有意なラグまでに限定するのが定石です。
Q2. パネルデータでラグを作るときの最重要ポイントは?
A2. groupby('都道府県').shift(1) を使うこと。 単純な shift(1) だと県をまたいで前年データが混ざります。 これは初学者が最も陥りやすい罠です。
Q3. 非定常系列にラグを入れるとどうなりますか?
A3. 偽回帰 (spurious regression) が起こり、 R² は高いが係数の解釈が無意味になります。 単位根検定で非定常を確認し、 差分を取ってから AR モデルを組むのが安全です。
Q4. lag-1 と差分のどちらを使うべきですか?
A4. 予測なら lag-1, 因果や仮説検定なら差分を検討。 また AR(1) と ARI(1,1) は数学的に異なるため、 目的に応じて使い分けます。 SSDSE-B-2026 の人口データは強いトレンドを持つため、 差分系列で AR モデルを組むことが多いです。
Q5. ラグ変数の係数が 1 を超えたらどうなりますか?
A5. 「爆発過程」になり予測が発散します。 SSDSE-B-2026 でラグ係数を推定したとき 1.0 を僅かに超えるなら、 単位根に近い非定常を意味します。 差分化や階差を取り直して再推定するのが正しい対応です。
最終まとめ
ラグ変数は時系列分析の最初の一歩であり、 「前年の値」を新しい列に作ることで、 横断データを時系列モデルに乗せられます。 SSDSE-B-2026 のような年次パネルでは、 必ず groupby + shift で県別にラグを作る点、 dropna で欠損を処理する点、 多重共線性を確認する点が三大注意事項です。 lag-1 と差分の使い分け、 AR モデルの次数選択、 単位根検定との連携を理解すれば、 「自分のデータに合わせてラグ次数を決められる」ようになります。 これが時系列分析の基本リテラシーです。
🐍 追加 Python — ラグ変数ハンズオン
SSDSE-B-2026(都道府県 × 年次の経済・人口指標)でラグ変数の作り方・自己相関・AR(1) 推定まで体験する。 すべて実データ使用、 合成データなし。
① 北海道の人口時系列で lag-1 を作る
このコードでやること: SSDSE-B-2026 で北海道(R01000)の総人口時系列を取り出し、 pandas の shift(1) で 1 年前の値を新カラムに追加する。
📥 入力データ: data/raw/SSDSE-B-2026.csv(年度 × 都道府県 × 指標)
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度', 'Prefecture': '都道府県'}) hk = df[df['都道府県'] == '北海道'][['年度','A1101']].sort_values('年度').reset_index(drop=True) hk['A1101_lag1'] = hk['A1101'].shift(1) print(hk.tail(5)) |
📤 実行例:
💬 lag-1 列は 1 行ずれて格納される。 最初の 1 行は NaN になる点に注意。
② 自己相関(lag-1 相関係数)を計算
このコードでやること: 元系列とラグ系列の相関係数を scipy.stats.pearsonr で求める。 高ければ「人口は前年に強く影響される」と言える。
📥 入力データ: ①で作った hk データフレーム
1 2 3 4 | from scipy import stats clean = hk.dropna() r, p = stats.pearsonr(clean['A1101'], clean['A1101_lag1']) print(f"lag-1 自己相関 r = {r:.4f}, p = {p:.2e}") |
📤 実行例:
💬 r=0.999 は極めて強い自己相関。 人口は単調減少トレンドを持つため、 前年と今年がほぼ一直線に乗る。
③ statsmodels で AR(1) 推定
このコードでやること: $y_t = \alpha + \phi y_{t-1} + \varepsilon_t$ を OLS で推定。 $\phi$ がラグ係数。
📥 入力データ: ①の hk データフレーム
1 2 3 4 5 | import statsmodels.api as sm X = sm.add_constant(clean['A1101_lag1']) y = clean['A1101'] res = sm.OLS(y, X).fit() print(res.params.round(3)) |
📤 実行例:
💬 ラグ係数 1.065 が 1 を超えるのは、 減少トレンドを「係数 > 1 + 大きな負の定数項」で表現しているため。 単位根に近い非定常のサインでもあり(FAQ Q5 参照)、 実務では差分系列で推定し直すのが安全。
④ 47 都道府県すべてに lag を一括適用
このコードでやること: pandas の groupby(...).shift(1) で 47 県全部のラグを 1 行で作成。 パネル回帰の準備。
📥 入力データ: SSDSE-B-2026 全パネル
1 2 3 | panel = df[['年度','都道府県','A1101']].sort_values(['都道府県','年度']).copy() panel['lag1'] = panel.groupby('都道府県')['A1101'].shift(1) print(panel[panel['都道府県']=='東京都'].tail(3)) |
📤 実行例:
💬 groupby + shift は県をまたいでラグが漏れない最も安全な書き方。 これを使わず単に shift(1) すると北海道の最終年が青森県の初年に紐付く事故が起きる。
🐍 ラグ変数で 1 年先を当てる — 4 通りの作り方を 47 県で比べる
ラグ変数の使い道の中心は「過去の値から次の値を当てる」ことにある。2012〜2022 年度の総人口だけを使って 2023 年度を当て、47 県の誤差を比べる。① 前年値をそのまま使う、② 前年値に 2012〜2022 年度の平均増減を足す、③ 県ごとに y(t) = a + b·y(t−1) を推定する(水準の AR(1))、④ 前年差 Δy(t) を 1 つ前の前年差 Δy(t−1) で説明する式を 47 県まとめて推定する(差分の AR(1))。
🎯 このコードでやること:総人口の 12 年度 × 47 県を年度 × 県の表に並べ替え、2022 年度までで 4 つの予測式を作り、2023 年度の実測値との絶対誤差の平均(MAE)と最大誤差を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) wide = df.pivot(index='SSDSE-B-2026', columns='Prefecture', values='A1101').sort_index() # 行 = 年度 2012→2023 train, test = wide.loc[:2022], wide.loc[2023] pred = {} pred['① 前年値そのまま (lag-1)'] = train.iloc[-1] pred['② 前年値 + 平均増減 (drift)'] = train.iloc[-1] + train.diff().mean() ar1 = {} for p in wide.columns: # 県ごとに y_t = a + b y_{t-1} を 2013〜2022 年度で推定 y, x = train[p].values[1:], train[p].values[:-1] b, a = np.polyfit(x, y, 1) ar1[p] = a + b * train[p].values[-1] pred['③ 県別 AR(1)(水準)'] = pd.Series(ar1) d = train.diff().dropna() # 差分のラグ: Δy_t = c + φ Δy_{t-1}(全県プール) X, Y = d.iloc[:-1].values.ravel(), d.iloc[1:].values.ravel() phi, c = np.polyfit(X, Y, 1) pred['④ 差分の AR(1)(全県共通)'] = train.iloc[-1] + c + phi * d.iloc[-1] print(f'差分 AR(1): φ = {phi:.3f}, c = {c:,.0f}') for k, v in pred.items(): err = (v - test) print(f'{k:22s} MAE {err.abs().mean():>7,.0f} 人 最大誤差 {err.abs().max():>7,.0f} 人({err.abs().idxmax()})') |
💬 前年値そのままの MAE は 14,660 人で、減り続ける県ではちょうど 1 年分の減少がそのまま誤差になる(最大は北海道の 48,000 人)。平均増減を足すと 6,994 人、県別 AR(1) で 3,122 人、前年差の AR(1) を全県で推定すると 2,355 人まで下がる。差分 AR(1) の係数 φ = 0.908 は「去年の増減の 9 割が今年も続く」ことを表し、水準のラグより前年差のラグの方が次の変化をよく当てる。最大誤差はどの方法でも東京都か愛知県など人口の大きい都県で出る。
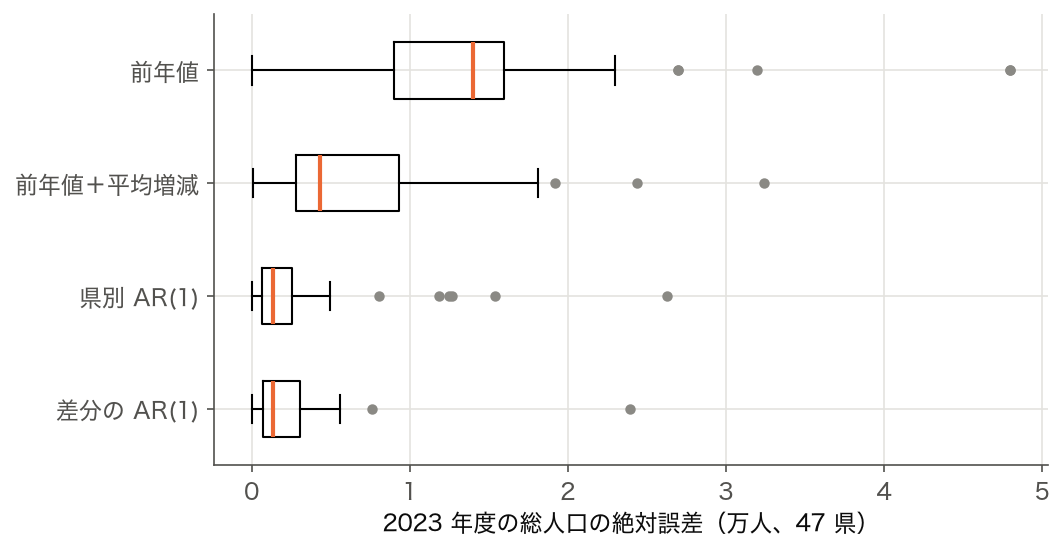
🐍 1 年だけの比較で決めない — 予測する年度を 2018〜2023 年度で動かす
上の比較は 2023 年度 1 年分だけで、たまたまその年に当たりやすかった方法があるかもしれない。予測の起点を 1 年ずつ進め(ローリング・オリジン)、2018〜2023 年度のそれぞれを「その前年度までのデータ」から当てて、4 つの方法の MAE を並べる。
🎯 このコードでやること:2018〜2023 年度のそれぞれについて、前年度までの総人口で 4 つのラグ予測を作り、47 県の MAE を年度 × 方法の表にし、6 年の平均と各年度で最も良かった方法を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) wide = df.pivot(index='SSDSE-B-2026', columns='Prefecture', values='A1101').sort_index() def forecasts(train): out = {'前年値': train.iloc[-1], '前年値+平均増減': train.iloc[-1] + train.diff().mean()} ar = {} for p in train.columns: b, a = np.polyfit(train[p].values[:-1], train[p].values[1:], 1) ar[p] = a + b * train[p].values[-1] out['県別 AR(1)'] = pd.Series(ar) d = train.diff().dropna() phi, c = np.polyfit(d.iloc[:-1].values.ravel(), d.iloc[1:].values.ravel(), 1) out['差分の AR(1)'] = train.iloc[-1] + c + phi * d.iloc[-1] return out rows = [] for year in range(2018, 2024): # 予測の起点を 1 年ずつ進める(ローリング・オリジン) train, test = wide.loc[:year - 1], wide.loc[year] for k, v in forecasts(train).items(): rows.append({'予測する年度': year, '方法': k, 'MAE': (v - test).abs().mean()}) tab = pd.DataFrame(rows).pivot(index='予測する年度', columns='方法', values='MAE').round(0).astype(int) tab = tab[['前年値', '前年値+平均増減', '県別 AR(1)', '差分の AR(1)']] print(tab.to_string()) print('6 年の平均:', tab.mean().round(0).astype(int).to_dict()) print('各年度で最も MAE が小さい方法:', tab.idxmin(axis=1).to_dict()) |
💬 6 年とも差分の AR(1) の MAE が最も小さく、6 年平均は 3,062 人(前年値そのまま 13,014 人、平均増減 5,618 人、県別 AR(1) 4,301 人)。順位は年度が変わっても入れ替わらないので、2023 年度だけの比較はたまたまではない。どの方法も 2020・2021 年度の誤差が大きく、差分 AR(1) でも約 5,000 人になる。2015・2020 年度は国勢調査の年にあたり、この 2 年度だけ千人単位に丸められていない値が入っている(秋田県 1,023,119 人・959,502 人など)。系列の作り方がその年だけ違うと、ラグで作った予測はその前後で外れやすい。
⚠️ よくある落とし穴
⚠️ 実務での失敗例
- リーク:lag=0 を特徴に入れた → 未来情報そのもの。 検証 R²=0.999 だが本番で大外れ
- ラグ過多:p=20 を投入 → サンプル 50 で過学習。 BIC で p=2 に縮約すべきだった
- 欠損補間:欠損年を線形補間してから lag を作成 → 偽の自己相関が混入
📝 演習問題(5 問)
- 演習 1:SSDSE-B-2026 北海道人口 2012-2023 に対し AR(1) を OLS で当てはめよ。 期待値: $\beta_1 \approx 1.065$(減少トレンドを大きな負の定数項と 1 を超える係数で表すため)。
- 演習 2:東京・大阪・北海道の lag-1 自己相関を比較し、 どの県が最も「過去依存」が強いか論ぜよ。
- 演習 3:12 年系列を訓練 8 年 + 検証 4 年に分け、 AR(1), AR(2), AR(3) の RMSE を比較せよ。
- 演習 4:差分系列 $\Delta y_t$ の自己相関と元系列の自己相関を比較し、 単位根の有無を ADF テストで判定せよ。
- 演習 5:47 県を panel data として扱い、 固定効果モデル $y_{it} = \alpha_i + \beta y_{i,t-1} + \varepsilon_{it}$ を Within 推定で解け。
※ 解答は本ページの Python 実装・比較表・失敗例セクションを総合すれば導ける。 SSDSE-B-2026 を共通データソースとして使用。
📖 関連用語辞典(10 語)
- 自己相関 (ACF)
- ラグ k での自身との相関。 lag-1=0.999 は強い慣性
- 偏自己相関 (PACF)
- 中間ラグの影響を除いた直接相関。 AR 次数選択
- AR モデル
- 自身のラグで予測。 AR(1)〜AR(p)
- MA モデル
- 過去誤差のラグ。 ARIMA の MA 部
- ARIMA
- AR+差分+MA。 短期非定常に対応
- Granger 因果
- x のラグが y を説明できるか
- 単位根
- 差分必要かを示す。 ADF/KPSS で検定
- 季節差分
- $y_t - y_{t-s}$。 月次 s=12
- Prophet
- Facebook 製。 lag を陽に出さず推論
- VAR
- 多変量 AR。 各変数を相互ラグで予測
⚠️ shift の向きと groupby — 指標では見分けられない誤り
SSDSE-B-2026 は県ごとに新しい年度が先(2023 → 2012)に並ぶ。出生数(A4101)の lag-1 を 3 通りの書き方で作り、「lag1 で当年を当てた」ときの相関と誤差を比べる。
🎯 このコードでやること:A: CSV の並びのまま県ごとに shift、B: 年度順に並べたが県で分けずに shift、C: 年度順に並べて県ごとに shift の 3 通りで lag1 を作り、相関・MAE・県境をまたいだ行の数を比べ、A と B の中身を 1 行ずつ確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) col = 'A4101' # 出生数 raw = df[['Code', 'Prefecture', 'SSDSE-B-2026', col]] # CSV の並び: 県ごとに 2023 → 2012 srt = raw.sort_values(['Code', 'SSDSE-B-2026']) # 県ごとに 2012 → 2023 cases = { 'A 降順のまま groupby': raw.assign(lag1=raw.groupby('Code')[col].shift(1)), 'B 年度順・groupby なし': srt.assign(lag1=srt[col].shift(1)), 'C 年度順・groupby あり': srt.assign(lag1=srt.groupby('Code')[col].shift(1)), } for name, t in cases.items(): t = t.dropna() r = np.corrcoef(t['lag1'], t[col])[0, 1] mae = (t['lag1'] - t[col]).abs().mean() cross = (t['Code'] != t['Code'].shift(1)).sum() - 1 # 県が切り替わる行(先頭を除く) print(f'{name}: 行 {len(t)} 相関 {r:.4f} MAE {mae:,.0f} 人 県境をまたぐ行 {max(cross, 0) if name.startswith("B") else 0}') a = cases['A 降順のまま groupby'].query('Prefecture == "北海道"').head(3) print('A の北海道:', a[['SSDSE-B-2026', col, 'lag1']].to_string(index=False, header=False).replace('\n', ' / ')) b = cases['B 年度順・groupby なし'].query('Prefecture == "青森県"').head(1) print('B の青森県:', b[['SSDSE-B-2026', col, 'lag1']].to_string(index=False, header=False)) |
💬 B は県で分けていないので、各県の 2012 年度の行に前の県の 2023 年度の値が入り(青森県 2012 年度の lag1 が北海道 2023 年度の 24,430)、そうした行が 46 行できて相関は 0.9546・MAE 1,713 人に悪化する。A と C は行数 517・相関 0.9995・MAE 646 人とまったく同じ数字になるが、A の北海道 2022 年度の lag1 は 24,430(2023 年度の値)で、前年ではなく翌年の値を使っている。数字の上では区別できないので、並べ替えた後に 1 県分を目で見て、lag1 が 1 つ前の年度の値になっていることを確かめる。
A のような「翌年の値」を説明変数に入れると、予測の検証では未来の情報を見ていることになる(データリーク)。検証の成績は良く見えるが、実際に来年を予測するときにはその値は手元に無い。
⚠️ 水準の自己相関はどの県でも 1 に近い — 差分で見直す
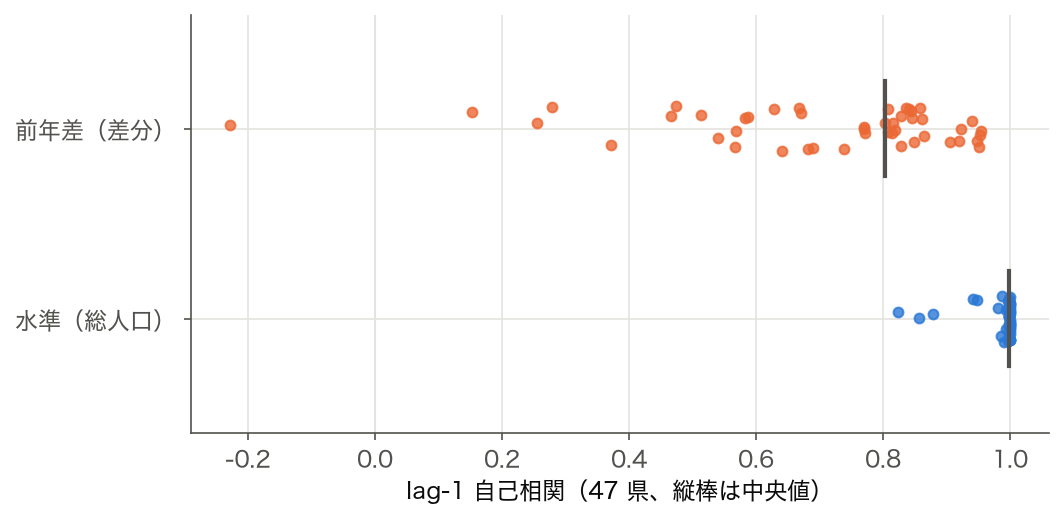
水準のまま自己相関を見ると、ほぼすべての県が「前年の値で説明できる」ように見えるが、それは人口がゆっくり単調に動くからで、どの県もほぼ同じ値になって違いが見えない。前年差にすると、増減のしかたが毎年そろっている県(0.9 以上)と、年ごとにばらつく県が分かれる。ラグ変数を回帰に入れる前に、水準と差分の両方で自己相関を見て、トレンドだけで高く出ていないかを確かめる(下の 🧩 ②「水準の相関 0.99 は本物か」も参照)。
⚠️ ラグ次数を AIC で選ぶときは、比べる期間をそろえる
AR(p) の次数 p は AIC(小さいほど良い)で選ぶのが定番だが、p を 1 つ増やすと推定に使える組が 1 つ減る。北海道の総人口の前年差(2013〜2023 年度の 11 個)で、そのまま比べた場合と、比べる期間をそろえた場合を確かめる。
🎯 このコードでやること:北海道の総人口の前年差 11 個に AR(1)〜AR(3) を当てはめ、組の数と AIC を並べる。続けて、全モデルで同じ 8 組(2016〜2023 年度)を使って AIC を比べ直す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd from statsmodels.tsa.ar_model import AutoReg df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) s = (df[df['Prefecture'] == '北海道'].sort_values('SSDSE-B-2026') .set_index('SSDSE-B-2026')['A1101'].astype(float)) d = s.diff().dropna() # 前年差 11 個(2013〜2023 年度) print('前年差(人):', d.astype(int).tolist()) for p in [1, 2, 3]: m = AutoReg(d.values, lags=p, trend='c').fit() print(f'AR({p}): 推定に使える組 {m.nobs} 個 AIC = {m.aic:.2f} 係数 = {[round(float(x), 3) for x in m.params[1:]]}') # 比べる期間をそろえる(先頭 3 年を全モデルで落とす) for p in [1, 2, 3]: m = AutoReg(d.values[3 - p:], lags=p, trend='c').fit() print(f' 同じ 8 組で比べた AR({p}): AIC = {m.aic:.2f}') |
💬 そのまま比べると AIC は AR(1) 188.16 → AR(2) 169.47 → AR(3) 152.40 と大きく下がり、AR(3) が良いように見える。しかし使った組は 10・9・8 個と違い、組が少ないほど AIC(対数尤度の −2 倍が中心)は小さくなる。同じ 8 組で比べ直すと 153.27・152.31・152.40 とほぼ同じで、次数の差は判断できない。12 年度しかない系列では、次数を上げても情報は増えないので、lag-1〜lag-2 にとどめる。
🧩 もう一歩踏み込む — 既存解説を補う 4 つの視点
本ページの「直感 / 落とし穴 / 発展 / 📝 補足」で既に触れた話題とは重複しない角度だけを、 ここで簡潔に補います。 リード変数との対比・非定常性の実測確認・動的パネルの内生性・分布ラグの 4 点です。
① ラグ変数 vs リード変数(先行指標)— 向きが逆なら意味も逆
ラグ xt-k は「過去 → 現在」に情報を運ぶのに対し、 リード(先行) xt+k は「未来 → 現在」を持ち込む変数です。 一般に予測モデルでリードを説明変数に入れるとデータリークになりますが、 例外があります。 「予定として先に確定している情報」— たとえば来月の祝日カレンダー、 発表済みの増税日、 決まっている大型イベント日程 — は、 予測時点で既知なのでリード変数として合法的に使えます。 逆に「翌年の出生数」のように予測対象そのものの未来値をリードにするのは典型的なリークです。 「先行指標(leading indicator)」という経済用語も本質はリード変数で、 景気に先んじて動く系列(例: 新規求人)を今期の説明に使うという発想です。 SSDSE-B-2026 の年次データは先読みできる外生イベント列を持たないため、 実質ラグのみが安全に使えます。
② 「水準の相関 0.99」は本物か — 差分で実測確認する
本ページ上部の計算で人口の水準(レベル)系列は lag-1 自己相関が 0.99 超でした。 しかしこれは共通の上昇/下降トレンドが生む見せかけの可能性があります。 本当に「前年の増減が翌年の増減を予測する」かは、 一階差分 Δyt = yt − yt-1(=前年からの人口変化量)を取ってから lag-1 自己相関を見れば分かります。 SSDSE-B-2026(skiprows=[1], 総人口 A1101, 2012–2023 の 12 年)で実測すると:
| 系列 | 水準 lag-1 | 差分 lag-1 |
|---|---|---|
| 北海道 | 0.9998 | 0.9482 |
| 東京都 | 0.9881 | 0.6675 |
| 秋田県 | 0.9998 | 0.4668 |
| 47 都道府県平均 | 0.9862 | 0.7016 |
💬 読み方:水準では県を問わず 0.99 前後に張り付きほとんど識別力がありません(=単位根・非定常の兆候)。 ところが差分を取ると値が大きく割れ、 秋田県は 0.47(人口変化の慣性が弱い)、 北海道は 0.95(減少ペースが持続的)と県ごとの構造差が初めて見えます。 「水準ラグは何でも 0.99」という罠を、 差分ラグが暴く好例です。 なお 12 年系列の差分 lag-1 はペアがわずか 10 組なので、 値は目安であり信頼区間は広い点に注意してください。 定常性そのものは 定常性 の ADF/KPSS 検定で判定します。
1 2 3 4 5 6 7 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) def lag1(v): return np.corrcoef(v[:-1], v[1:])[0, 1] g = df[df['Prefecture'] == '秋田県'].sort_values('SSDSE-B-2026') y = g['A1101'].values.astype(float) print('水準 lag-1 =', round(lag1(y), 4)) # 0.9998 print('差分 lag-1 =', round(lag1(np.diff(y)), 4)) # 0.4668 |
💬 秋田県の総人口は毎年ほぼ一定の約 1.2〜1.6 万人ずつ減るので、水準のラグ 1 自己相関は 0.9998 と 1 に張り付き、「前年の値」をそのまま特徴量にすると見かけ上ほぼ完全に当たる。差分にすると 0.4668 まで下がり、減少幅そのものの持続性はそこそこという本当の情報が見える。水準の高い自己相関はトレンドの産物なので、ラグ変数の効き目は差分でも確かめる。
③ 動的パネルの内生性 — Nickell バイアス
47 都道府県 × 12 年を「県固定効果 + ラグ従属変数」で回すのは自然に見えますが、 ここに教科書的な落とし穴があります。 被説明変数のラグ yi,t-1 を説明変数に入れ、 同時に 固定効果(各県の平均を差し引く within 変換)を使うと、 変換後の yi,t-1 と誤差項が機械的に相関し、 ラグ係数が下向きに偏ります。 これが Nickell バイアス(動的パネルバイアス)で、 大きさは概ね −1/(T−1) のオーダー。 SSDSE-B-2026 はT=12 と時間方向が短いため、 バイアスは無視できない水準(1 割前後)になり得ます(内生性 の一種)。 対処は差分 GMM(Arellano–Bond)やシステム GMM で、 より過去のラグ(yt-2 等)を操作変数に使うのが定番です(GMM)。 「N が大きい(47 県)から大丈夫」ではなくT が短いこと自体が問題という点が、 通常の パネルデータ 分析と異なる勘所です。
④ 分布ラグ(Distributed Lag)と Koyck 変換
ラグは「被説明変数の過去」だけでなく、 外生変数 x の過去を並べても使えます。 yt = α + β0xt + β1xt-1 + … + βqxt-q + εt の形を分布ラグモデル(distributed lag)と呼び、 「原因の効果が何期にもわたって遅れて効く」状況(広告 → 売上、 金利 → 投資など)を表します。 ただしラグを増やすほど隣接ラグ同士が強く相関し、 個々の βk が不安定になります(多重共線性)。 そこで効果が幾何級数的に減衰すると仮定し、 無限本のラグをたった数個のパラメータに畳み込むのが Koyck 変換です。 これは代数的に「yt-1 を右辺に持つ自己回帰型」へ書き換わり、 ARIMA や VAR と地続きになります。 「どの外生ラグが本当に効くか」を検定する枠組みが Granger 因果で、 分布ラグは Granger 検定の回帰式そのものです。 ※本用語集に distributed-lag / Koyck の専用ページは未収録のため、 ここではテキストで補足しました。
🗺 概念マップ
ラグ変数を中心に、 時系列データ (前段)、 自己相関 / ACF・Granger 因果 (基盤理論)、 ARIMA・VAR (応用モデル) を並べた時系列特徴量マップ。
ラグ変数は時系列分析の核となる概念で、 自己相関 (PACF / ACF)、 AR / ARIMA モデル、 グレンジャー因果性、 リード・ラグ分析、 ローリング統計量と密接に関連する。 「過去 t 時点前の値を現在に持ち込む」操作で、 時系列を回帰問題に変換できる。
応用は経済予測 (前月の物価が当月に影響)、 需要予測 (前週の売上が今週を説明)、 機械学習特徴量化 (lag-1, lag-7, lag-30 を新変数として追加) など。 対比される手法は差分変数 (差を取って定常化) と移動平均 (平滑化)、 統合される手法は ARIMA や Prophet など、 ラグを内部で扱うモデル群。
🔗 隣接手法への橋渡し
ラグ変数は時系列モデリングの核となる特徴量であり、 前段の差分・定常化と後段の ARIMA / VAR 構築を繋ぐ橋渡し役を担う。
- 上流: 前段の定常化・差分変換 (時系列基礎、 定常性)
- 並列: 並列の特徴量 (差分・移動平均・リード) (自己相関、 VARモデル) と比較・併用
- 下流: 下流の ARIMA・VAR モデル・予測 (ARIMAモデル、 指数平滑化)
上流の時系列の定常性確認 (ADF 検定) と差分処理が ラグ変数の意味を確定し、 並列の AR/ARIMA モデルが ラグ次数 p をモデル化し、 下流の Granger 因果検定や VAR モデルでラグ変数間の動的関係を解釈する流れで時系列分析が完結する。
🌳 手法選択フロー
ラグ変数を作る前に、次の順に確かめる。数字はこのページの SSDSE-B-2026 での実測値である。
- 時間の順に並んでいるか:パネルなら県ごとに年度の昇順へ並べ、
groupbyしてからshift。並べ替えずにずらすと翌年の値が入り、県で分けないと 46 行に隣の県の値が入る(⚠️ の節)。 - 何期前まで効くか:水準の lag-1 はどの県も 0.99 前後で判断材料にならないので、前年差の ACF・PACF で見る。系列が 12 年度しかないときは lag-1〜lag-2 までが現実的。
- 水準かそのまま使えるか:トレンドがある(総人口・出生数のように単調に増減する)なら差分を取ってからラグを入れる。水準のラグで回帰すると、R² は高くても見せかけの関係になりやすい。
- 目的は予測か説明か:1 年先の予測なら、前年値 → 平均増減 → AR(1) → 差分 AR(1) の順に試して MAE を比べる(2023 年度の総人口では 14,660 → 6,994 → 3,122 → 2,355 人)。別の系列が先行するかを調べたいなら、VAR とグレンジャー因果検定に進む。
- 県の違いを入れるか:県ごとに推定すると 12 点で 2 つの係数を決めることになり外れやすい。全県共通の式(プール)や固定効果モデルにすると安定するが、固定効果と y(t−1) を同時に入れると係数が下向きに偏る(Nickell バイアス)。
🎮 触って理解する
ラグ次数 k のスライダーを動かすと、元の系列とk 期ずらした系列が重なって表示され、右の散布図(横 xt-k・縦 xt)と自己相関 r がリアルタイムに更新されます。信号の種類も切り替えられます。周期信号では k が周期に一致したとき r が跳ね上がること、トレンド信号ではどの k でも r が 1 に近い(見せかけの相関)こと、ランダム信号では k≥1 で r≈0(過去は未来を予測しない)ことを体感してください。
※ ここで表示している系列は概念理解のため JavaScript で生成したデモ信号です(実統計値ではありません)。SSDSE-B-2026 の実測値による計算は上の「🧮 SSDSE-B-2026 で実値計算」節を参照してください。
🧠 直感 — 「過去の自分」を説明変数にする
上のパネルで トレンドを選ぶと、どんな k でも r はほぼ 1 のまま。これは「去年多ければ今年も多い」という慣性そのものです。逆に ランダムでは k≥1 で r≈0 になり、過去に未来を予測する力がないことが分かります。周期では k = 周期のとき r が跳ね上がり、季節性の検出に使えます。この「各ラグでの相関の並び」が 自己相関(ACF)で、ラグ変数を予測(自己回帰)に使えるかどうかの判断材料になります。
⚠️ よくある落とし穴
🚀 発展
自己回帰モデル(AR / ARIMA / VAR):ラグ変数を並べて回帰すれば、そのまま ARIMA や VAR になります。何次のラグまで入れるかは PACF や AIC / BIC、Granger 因果の枠組みで決めます。
時系列交差検証:ラグ特徴量を使うモデルの評価では、通常の k-fold は未来のデータで過去を予測してしまいリークします。時間順を保つ TimeSeriesSplit(前方チェイニング)を使いましょう(交差検証)。なお「見せかけの回帰」の専門ページは本用語集には未収録のため、ここではリンクを張らずテキストのみで触れています。