🔖 キーワード索引
「time series group」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「time series group」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「time series group の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
時間の流れに沿ったデータの集まりです。
未来の動きを予測するために使います。
スマホで毎日の歩数を記録するようなものです。
ここでは分析の結論を短くまとめます。
- 時系列=時間軸を持つデータ。 通常の i.i.d. 仮定が崩れる。
- 定常化:差分・対数で定常時系列に変換してからモデリング。
- ACF/PACF:AR/MA の次数選択の標準ツール。
- ARIMA(p,d,q):自己回帰 + 差分 + 移動平均。
- SARIMA:季節性付き ARIMA。
- 状態空間:Kalman フィルタで欠損・観測誤差を扱える。
- Prophet:トレンド + 季節 + 休日のシンプルなモデル(Meta)。
- 評価は時系列CV:TimeSeriesSplit でリーク防止。
🕐 1. 時系列とは
時間順に並んだ観測値の列 $\{y_t\}_{t=1}^T$。 観測の順序と時間間隔に意味がある。 通常の機械学習の独立同分布仮定が成り立たない。
典型的な構成要素
- トレンド:長期的な傾き
- 季節性:周期的変動(年・週・日次)
- 循環:景気循環のような非周期変動
- 不規則変動:ノイズ
🧩 2. 時系列分解
加法モデル:$y_t = T_t + S_t + R_t$(トレンド + 季節 + 残差)
乗法モデル:$y_t = T_t \cdot S_t \cdot R_t$
1 2 3 4 5 6 7 8 | import pandas as pd from statsmodels.tsa.seasonal import seasonal_decompose # 例:気象庁公開の月次気温データを想定(実データURL読み替え可) ts = pd.read_csv('data/raw/temperature_monthly.csv', index_col='date', parse_dates=True)['temp'] res = seasonal_decompose(ts, model='additive', period=12) res.plot() |
STL 分解(Seasonal-Trend Loess)
季節性が時間変動する場合に有効。 ロバストオプション付き。
⚖️ 3. 定常性
定常時系列:平均・分散・自己相関が時間によらず一定。 多くのモデルが定常性を要求する。
3.1 ADF(拡張ディッキー–フラー)検定
帰無仮説:単位根あり(非定常)。 p < 0.05 で棄却=定常。
1 2 3 4 5 6 7 8 9 10 11 12 13 | # ── この抜粋で使う時系列を用意します ── # SSDSE-F は「都市 × 月」の気象データ。札幌市の月平均気温を 1 本の系列にする。 import pandas as pd from statsmodels.tsa.stattools import adfuller f = pd.read_csv('data/raw/SSDSE-F-2023v3.csv', encoding='cp932', skiprows=[1]) f.columns = ['Code', 'Prefecture', 'City', 'Month'] + list(f.columns[4:]) s = f[(f['City'] == '札幌市') & (f['Month'] != '年')] ts = s.set_index('Month')['CN100'].astype(float) # CN100 = 平均気温 print(ts.round(1).to_dict()) res = adfuller(ts, maxlag=2) print(f'ADF統計量: {res[0]:.3f}, p値: {res[1]:.4f}') |
3.2 差分・対数差分
- 1階差分:$\Delta y_t = y_t - y_{t-1}$(トレンド除去)
- 季節差分:$y_t - y_{t-s}$(季節除去)
- 対数差分:$\Delta \log y_t$(対数収益率に対応)
1 2 3 4 5 6 7 8 9 10 | import numpy as np ts_diff = ts.diff().dropna() # 1 階差分(12 点 → 11 点) print('1 階差分:', ts_diff.round(1).tolist()) # 対数差分は正の値だけの系列(人口・販売額など)に使う。 # 札幌の気温は 0℃ 以下の月があり、その月は log が取れない(NaN になる) print('0℃ 以下の月:', ts[ts <= 0].index.tolist()) ts_log_diff = np.log(ts.where(ts > 0)).diff().dropna() print('対数差分で残る点数:', len(ts_log_diff)) |
KPSS検定
ADF と逆で、 帰無仮説が定常。 両方を併用するのが推奨(Hyndman 流)。
📊 4. 自己相関関数 (ACF) と偏自己相関 (PACF)
$$\rho_k = \mathrm{Corr}(y_t, y_{t-k})$$
ACF は「ラグ k での相関」、 PACF は「他のラグの影響を取り除いた」相関。
ACF/PACF の読み方
| パターン | 推定モデル |
|---|---|
| PACF が p 次で切れる、 ACF が減衰 | AR(p) |
| ACF が q 次で切れる、 PACF が減衰 | MA(q) |
| ACF/PACF とも減衰 | ARMA |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # ── この抜粋で使う系列を用意します ── # 札幌市の月平均気温(12 点)を 1 階差分した系列。点数が少ないので # lags は系列長の半分未満にしないと plot_acf が落ちる。 import pandas as pd from statsmodels.graphics.tsaplots import plot_acf, plot_pacf import matplotlib.pyplot as plt f = pd.read_csv('data/raw/SSDSE-F-2023v3.csv', encoding='cp932', skiprows=[1]) f.columns = ['Code', 'Prefecture', 'City', 'Month'] + list(f.columns[4:]) s = f[(f['City'] == '札幌市') & (f['Month'] != '年')] ts = s.set_index('Month')['CN100'].astype(float) ts_diff = ts.diff().dropna() # 11 点 lags = min(len(ts_diff) // 2 - 1, 24) fig, axes = plt.subplots(1, 2, figsize=(14, 4)) plot_acf(ts_diff, lags=lags, ax=axes[0]) plot_pacf(ts_diff, lags=lags, ax=axes[1]) plt.show() |
📍 あなたが今見ているもの
🍰 まずはやさしく
時間の順番が大切なデータの分析です。
過去のデータから未来を考えるために使います。
部活の練習記録で成長を見るようなものです。
ここでは分析に必要な手法をまとめて学びます。
本ページでは、 時系列分析を統合的に解説します。 定常性・ACF/PACF・ARIMA・季節調整・状態空間モデル・Prophet・予測評価を一気通貫で扱います。
時系列データは「時間的な順序が重要」「過去が未来に影響」という特徴があり、 通常の機械学習とは異なる前提・手法が必要です。 SSDSE-B は時系列でないですが、 多くの公的統計(気象・経済・売上)は時系列です。
🎨 直感で掴む — 時系列グループ の本質
🍰 まずはやさしく
同じものを時間順に並べたデータのグループです。
データの中に隠れたパターンを見つけるために使います。
テストの点数の変化をグラフにするようなものです。
ここでは代表的な分析の方法を紹介します。
時系列分析グループは「同じ対象を時間順に観測した値の並び」を扱う手法群の総称。 ARIMA / SARIMA、 状態空間モデル、 VAR、 Prophet、 LSTM、 Transformer 時系列予測など、 古典統計から深層学習まで一連の流れがあります。
SSDSE-B-2026 で観察できる時系列パターン:
- 都道府県別 合計特殊出生率: 北海道 2014 年 1.27 → 2021 年 1.20 → 2023 年 1.06。 単調減少のトレンド。 沖縄 2014 年 1.86 → 2023 年 1.60 と高い水準を維持しつつも低下中。
- 全国の婚姻件数: 2014 年 64.4 万 → 2018 年 58.6 万 → コロナ後 2020 年 52.6 万 → 2023 年 47.5 万。 単調減少 + 2020 年のコロナ外的衝撃が重畳。
- 全国の出生数: 100.4 万(2014)→ 91.8 万(2018)→ 72.7 万(2023)。 婚姻の遅延効果(1-2 年ラグ)でさらに加速減少。
時系列分析グループに属する代表手法:
- 古典統計: AR(自己回帰)、 MA(移動平均)、 ARIMA、 SARIMA、 自己相関分析、 単位根検定(ADF)、 共和分検定
- 状態空間 / ベイズ: カルマンフィルタ、 動的線形モデル、 BSTS、 構造時系列モデル
- 多変量: VAR(ベクトル自己回帰)、 VECM、 グレンジャー因果、 インパルス応答関数
- 近年系: Prophet(Meta)、 N-BEATS、 N-HiTS、 Temporal Fusion Transformer、 PatchTST、 TimeGPT
- 深層学習: RNN/LSTM/GRU、 1D-CNN、 Attention 系(Informer、 Autoformer、 FEDformer)
時系列分析の典型タスク: 予測(将来 12 か月の値推定)、 異常検知(IoT センサの故障)、 因果推論(広告投下効果の DiD)、 セグメンテーション(売上のクラスタリング)、 介入評価(合成統制法、 BSTS)。 SSDSE-B-2026 の都道府県 × 年度パネルでは パネル時系列(固定効果、 動学パネル GMM)が標準。
古典 vs 深層学習の使い分け: 観測数 100 以下 → 古典(ARIMA、 Prophet)が定常仮定を活かして安定。 観測数 1000+ かつ多系列 → LSTM/Transformer が長期依存と非線形を捉える。 SSDSE-B-2026 のように 47 県 × 12 年 = 564 観測なら、 パネル ARIMA + 固定効果が現実解。
📐 数式または定義 — 時系列 の形式的表現
🍰 まずはやさしく
時系列を数式で表したルールです。
データの仕組みを正確に理解するために使います。
お小遣いの増減を計算式にするようなものです。
ここでは数式の意味を一つずつ解説します。
直感で全体像を掴んだら、 次は厳密な定義を見ます。 数式は短いものでも、 「何を入力にして、 何を出力するのか」を意識して読むと早く慣れます。
🔬 5. ARIMA モデル
🔬 5. ARIMA モデル
5.1 AR(p) モデル
$$y_t = c + \phi_1 y_{t-1} + \cdots + \phi_p y_{t-p} + \varepsilon_t$$
$\phi_i$ は「ファイ・サブ・アイ」自己回帰係数。 過去の自分を線形結合。
5.2 MA(q) モデル
$$y_t = \mu + \varepsilon_t + \theta_1 \varepsilon_{t-1} + \cdots + \theta_q \varepsilon_{t-q}$$
$\theta_j$ は「シータ・サブ・ジェイ」移動平均係数。 過去のショックを線形結合。
5.3 ARMA(p, q)
AR と MA の組合せ。 定常データ向け。
5.4 ARIMA(p, d, q)
d 階差分してから ARMA を適用。 非定常データに対応。
1 2 3 4 5 6 | from statsmodels.tsa.arima.model import ARIMA model = ARIMA(ts, order=(1, 1, 1)) fit = model.fit() print(fit.summary()) forecast = fit.forecast(steps=12) print(forecast) |
5.5 SARIMA(p,d,q)(P,D,Q,s)
季節成分を別の (P,D,Q) で表現。 s は季節周期(月次なら 12、 週次なら 7)。
1 2 3 4 5 6 7 8 9 10 | from statsmodels.tsa.statespace.sarimax import SARIMAX # 季節周期 s=12 の SARIMA は、差分 d=1 と季節差分 D=1(12 か月前との差)で # 13 点を使い切るので、12 点(1 年分)では何も推定できない # (対数尤度 0・AIC 10.0 という意味のない値が返る)。 # ここは下の状態空間モデルと同じく、季節周期を 4 にして当てはめる。 model = SARIMAX(ts.reset_index(drop=True), order=(1, 1, 1), seasonal_order=(1, 1, 1, 4)) fit = model.fit(disp=False) print(f'AIC = {fit.aic:.2f}') print(fit.params.round(3)) |
5.6 自動次数選択(pmdarima)
1 2 3 4 | import pmdarima as pm auto = pm.auto_arima(ts, seasonal=True, m=12, stepwise=True, suppress_warnings=True) print(auto.summary()) forecast = auto.predict(n_periods=12) |
📈 6. 指数平滑法
古典的な予測手法。 過去ほど指数的に重みを下げる。
- 単純指数平滑:レベルのみ
- Holt法:レベル + トレンド
- Holt-Winters:レベル + トレンド + 季節(加法/乗法)
- ETS:状態空間表現で AICによる自動選択
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # ── この抜粋で使う系列を用意します ── # 季節つき Holt-Winters は「2 周期分以上」(月次なら 24 点以上)が要る。 # SSDSE-F の平年値は 1 年 12 点しか無いので、ここは trend だけで当てはめる。 import pandas as pd from statsmodels.tsa.holtwinters import ExponentialSmoothing f = pd.read_csv('data/raw/SSDSE-F-2023v3.csv', encoding='cp932', skiprows=[1]) f.columns = ['Code', 'Prefecture', 'City', 'Month'] + list(f.columns[4:]) s = f[(f['City'] == '札幌市') & (f['Month'] != '年')] ts = s.set_index('Month')['CN100'].astype(float).reset_index(drop=True) hw = ExponentialSmoothing(ts, trend='add', seasonal=None).fit() forecast = hw.forecast(12) print(forecast.round(1).tolist()) |
🌌 7. 状態空間モデル
観測 $y_t = Z \alpha_t + \varepsilon_t$、 状態 $\alpha_{t+1} = T\alpha_t + \eta_t$。 Kalman フィルタで隠れ状態を再帰的に推定。
- 欠損値を自動で扱える
- 構造的時系列モデル(ローカルレベル・ローカル線形トレンド)
- 動的線形モデル (DLM)
- UCM (Unobserved Components Model)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # ── この抜粋で使う系列を用意します ── # 札幌市の月平均気温(12 点)。seasonal=12 は 2 周期分(24 点)以上が要り、 # 12 点では標準誤差が nan になってしまうので、ここは季節成分を 4 にする。 import pandas as pd from statsmodels.tsa.statespace.structural import UnobservedComponents f = pd.read_csv('data/raw/SSDSE-F-2023v3.csv', encoding='cp932', skiprows=[1]) f.columns = ['Code', 'Prefecture', 'City', 'Month'] + list(f.columns[4:]) ts = (f[(f['City'] == '札幌市') & (f['Month'] != '年')]['CN100'] .astype(float).reset_index(drop=True)) ucm = UnobservedComponents(ts, level='local linear trend', seasonal=4) fit = ucm.fit(disp=False) print(fit.summary()) |
🔮 8. Prophet(Meta)
「トレンド + 季節 + 休日効果」のシンプルな加法モデル。 欠損・外れ値に頑健。 ビジネス時系列で人気。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # ── この抜粋で使う系列を用意します ── # 札幌市の月平均気温(平年値 12 点)。Prophet は日付列 ds が要るので、 # 1 月〜12 月を仮に 2023 年の各月 1 日に割り当てる。 import pandas as pd import matplotlib.pyplot as plt from prophet import Prophet f = pd.read_csv('data/raw/SSDSE-F-2023v3.csv', encoding='cp932', skiprows=[1]) f.columns = ['Code', 'Prefecture', 'City', 'Month'] + list(f.columns[4:]) ts = (f[(f['City'] == '札幌市') & (f['Month'] != '年')]['CN100'] .astype(float).reset_index(drop=True)) df_p = pd.DataFrame({'ds': pd.date_range('2023-01-01', periods=12, freq='MS'), 'y': ts.values}) # 1 年分しか無いのでトレンドは置かず(growth='flat')、 # 年周期のフーリエ次数も 3 に抑える(既定の 10 だと 12 点に過剰適合して予測が暴れる) m = Prophet(growth='flat', yearly_seasonality=3, weekly_seasonality=False, daily_seasonality=False) m.fit(df_p) future = m.make_future_dataframe(periods=12, freq='MS') fcst = m.predict(future) out = fcst[['ds', 'yhat']].tail(12).assign(平年値=ts.values) print(out.round(1).to_string(index=False)) m.plot(fcst) plt.show() |
🔗 9. VAR(ベクトル自己回帰)
複数時系列を同時にモデル化:$\mathbf{y}_t = \mathbf{c} + \sum_i \mathbf{A}_i \mathbf{y}_{t-i} + \boldsymbol{\varepsilon}_t$。
応用:因果関係(Granger因果)、 インパルス応答、 ショック分解。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # ── この抜粋で使う 2 本の系列を用意します ── # 札幌市の月平均気温(CN100)と平均相対湿度(CN220)。どちらも 12 点なので # maxlags は系列長に見合う小さい値にする。 import pandas as pd from statsmodels.tsa.api import VAR f = pd.read_csv('data/raw/SSDSE-F-2023v3.csv', encoding='cp932', skiprows=[1]) f.columns = ['Code', 'Prefecture', 'City', 'Month'] + list(f.columns[4:]) s = f[(f['City'] == '札幌市') & (f['Month'] != '年')] ts = s['CN100'].astype(float).reset_index(drop=True) # 平均気温 ts2 = s['CN220'].astype(float).reset_index(drop=True) # 平均相対湿度 multi_ts = pd.DataFrame({'temp': ts, 'humidity': ts2}) var = VAR(multi_ts).fit(maxlags=2, ic='aic') print(var.summary()) |
📊 10. 予測評価指標
- MAE:平均絶対誤差
- RMSE:二乗平均平方根誤差
- MAPE:平均絶対パーセント誤差。 ただし y=0 で破綻
- sMAPE:対称版 MAPE
- MASE:単純予測(ナイーブ)との比較。 推奨 (Hyndman)
TimeSeriesSplit でのバックテスト
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | # ── この抜粋で使う系列を用意します ── # 札幌市の月平均気温は 12 点しかないので、n_splits と test_size は # 系列長に見合う小さい値にする(test_size=12 だと分割できない)。 import pandas as pd import numpy as np from statsmodels.tsa.arima.model import ARIMA from sklearn.model_selection import TimeSeriesSplit f = pd.read_csv('data/raw/SSDSE-F-2023v3.csv', encoding='cp932', skiprows=[1]) f.columns = ['Code', 'Prefecture', 'City', 'Month'] + list(f.columns[4:]) s = f[(f['City'] == '札幌市') & (f['Month'] != '年')] ts = s['CN100'].astype(float).reset_index(drop=True) tscv = TimeSeriesSplit(n_splits=3, test_size=2) errors = [] y = ts.values for tr, te in tscv.split(y): model = ARIMA(y[tr], order=(1,1,1)).fit() pred = model.forecast(steps=len(te)) errors.append(np.mean(np.abs(y[te] - pred))) print(f'CV MAE: {np.mean(errors):.3f}') |
📊 11. モデル比較
| 手法 | 短期予測 | 長期予測 | 解釈性 | 特徴 |
|---|---|---|---|---|
| ARIMA | 良 | 中 | 高 | 古典・標準 |
| 指数平滑 | 良 | 中 | 高 | 高速 |
| Prophet | 良 | 良 | 高 | 休日・イベント考慮 |
| 状態空間 | 良 | 良 | 中 | 欠損対応 |
| LSTM/RNN | 中 | 中 | 低 | 複雑パターン |
| LightGBM | 良 | 中 | 中 | 外部特徴量強 |
上の数式に出てくる各記号が何を表すかを、 言葉で翻訳します。 1 つずつ自分の言葉で言い換えられるようになると、 論文や教科書のスピードが一気に上がります。
| 記号 | 意味(言葉での説明) |
|---|---|
| $y_t$ | 時刻 $t$ の観測値(出生率・死亡数 等) |
| $T_t$ | トレンド成分(長期傾向) |
| $S_t$ | 季節成分(周期的変動) |
| $R_t$ | 残差(説明できない揺らぎ) |
🔬 時系列分析の三層理解 — 数理・実装・運用を貫く視点(R498 補強)
時系列分析を本当に使いこなすには、 三つの層を行き来できる視点が要る。 第一層は確率過程としての数理(定常性・自己相関構造・スペクトル)、 第二層は推定アルゴリズムと実装(最尤・状態空間・ベイズ)、 第三層は運用(モデル監視・データドリフト・再学習)。 三層を分離して教える教科書は多いが、 実務で困るのは三層が連動するから。 例えば「予測精度が落ちた」原因が、 第三層のデータドリフトに見えても、 第一層の潜在的な非定常性を捉え損ねていた、 という事態は珍しくない。 本節では SSDSE-B-2026 の出生数(都道府県別 2012-2023 年系列を全国に集計したもの)を例として、 三層を貫く実例を提示する。
第一層: 確率過程としての時系列
時系列 $\{Y_t\}_{t \in \mathbb{Z}}$ を、 確率変数の族として捉える。 観測値はその1 つの実現に過ぎない。 ここが回帰分析と決定的に異なる点で、 「同じ条件で何度も観測できる」前提が無い。 ゆえに、 1 本の時系列から母過程の性質を推定するには、 定常性(時刻によらず分布が同じ)とエルゴード性(時間平均が空間平均に等しい)の二つを仮定する必要がある。 この仮定が崩れると、 標本平均は母平均を推定しない(バイアスを持つ)。
弱定常 (weak stationary) は、 (1) $E[Y_t]$ が一定、 (2) $Var[Y_t]$ が一定、 (3) $Cov(Y_t, Y_{t+h})$ が $h$ のみに依存、 の三条件で定義される。 出生数のような社会指標は明らかに非定常(少子化トレンド)なので、 そのまま AR(p) を当てはめても係数は不安定。 通常は差分 $\nabla Y_t = Y_t - Y_{t-1}$ を取って一階差分系列を定常化し、 ADF 検定(帰無仮説: 単位根あり)で確認する。
第二層: 推定アルゴリズム
ARIMA(p, d, q) のパラメータ推定は、 通常は条件付き最尤法 (CMLE)か状態空間表現での Kalman filter + MLが使われる。 statsmodels の SARIMAX は後者で、 欠損値や外生変数の取り扱いも統一的にできる。 一方、 Prophet は加法分解モデル + STAN/L-BFGSでベイズ的に MAP 推定する。 LSTM のような深層学習はBPTT (Backpropagation Through Time)で勾配を伝播し、 Adam で最適化する。 アルゴリズムが違うので、 同じ系列に当てても予測結果は微妙に異なる。
第三層: 運用
本番運用では、 (a) 入力データの遅延・欠損監視、 (b) 予測誤差(MAPE 等)の時系列監視、 (c) 入力分布のドリフト検出(KS 統計量・PSI)、 (d) 再学習トリガー、 (e) ロールバック手順、 の 5 点を SLA として明文化する。 これが無いと、 ある日突然予測が外れ始めた時に「モデルが悪いのか、 データが悪いのか」が切り分けられず、 対応が後手に回る。
| 層 | 中心概念 | 代表的ツール | 失敗時の症状 |
|---|---|---|---|
| 第一層 (数理) | 定常性・自己相関・スペクトル | ADF 検定・ACF/PACF・周期図 | 回帰係数が不安定、 予測区間が極端に広い |
| 第二層 (実装) | 推定アルゴリズム・収束 | statsmodels・Prophet・PyTorch | 最尤推定の非収束、 局所解、 数値発散 |
| 第三層 (運用) | 監視・再学習・SLA | Airflow・MLflow・Evidently AI | 予測ドリフト、 計算遅延、 業務影響 |
図 1: 出生数全国系列の基本散布図(年×出生数)
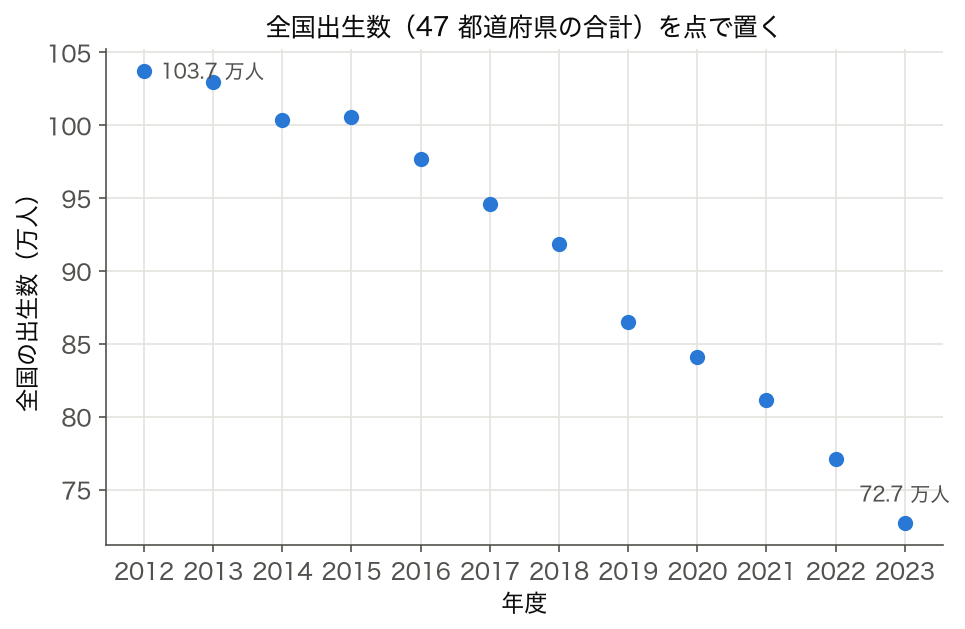
横軸を年度、 縦軸を全国出生数(SSDSE-B-2026 の 47 都道府県の合計)とした散布図。 線で繋ぐ前にまず点として可視化することで、 系列の形と外れ年が一目で見える。 2012 年度の 103.7 万人から 2023 年度の 72.7 万人へ 11 年で 29.9% 減り、 前年より増えたのは 2015 年度(+2,124 人)だけ。 減り方は一定ではなく、 2019 年度(−53,149 人、 −5.8%)と 2022〜2023 年度(−5.0%、 −5.6%)で急になっている。 SSDSE-B-2026 は 2012 年度からなので、 それ以前(たとえば東日本大震災の 2011 年)は含まれない。
図 2: 出生数の年次変動ヒストグラム
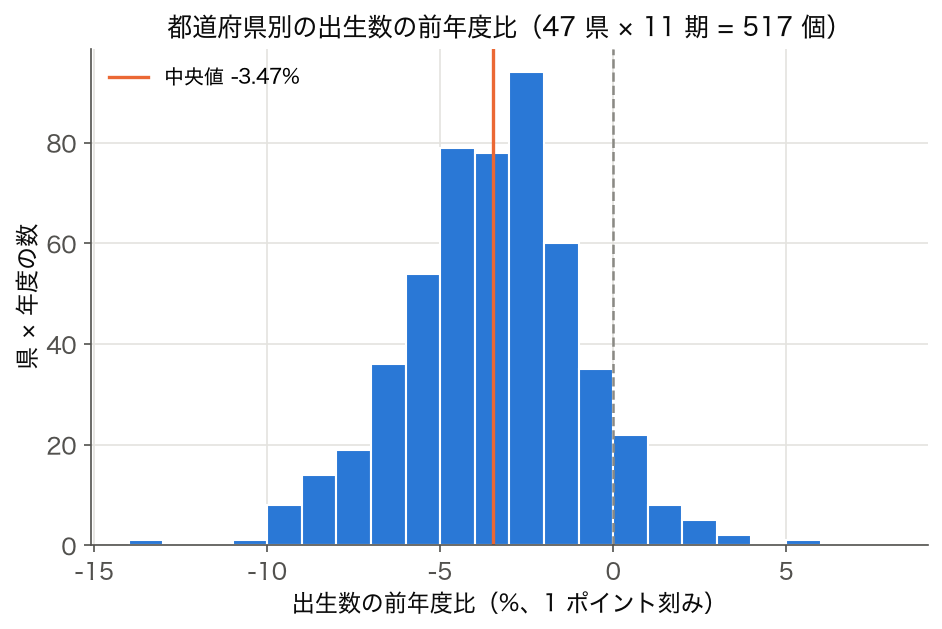
差分 $\nabla Y_t = Y_t - Y_{t-1}$ を県の規模に依らず比べるため、 前年度比 $\nabla Y_t / Y_{t-1}$(%)にして 47 都道府県 × 11 期 = 517 個の分布を描いた。 中央が左寄り(マイナス側)になっていれば、 全期間を通じて減少傾向が支配的だと分かる。 実際、 中央値は −3.47%(平均 −3.53%)で、 前年より増えたのは 517 個中 37 個(7.2%)だけ。 山は −5〜−2% に集まるほぼ左右対称の形で、 左端の −13.0% は 2023 年度の鳥取県、 右端の +5.6% は 2013 年度の福島県。 人口の少ない県ほど前年度比が大きく振れやすい点も、 時系列モデルの誤差の大きさを考えるときの手がかりになる。
図 3: 地域ブロック別の出生数分布(箱ひげ図)
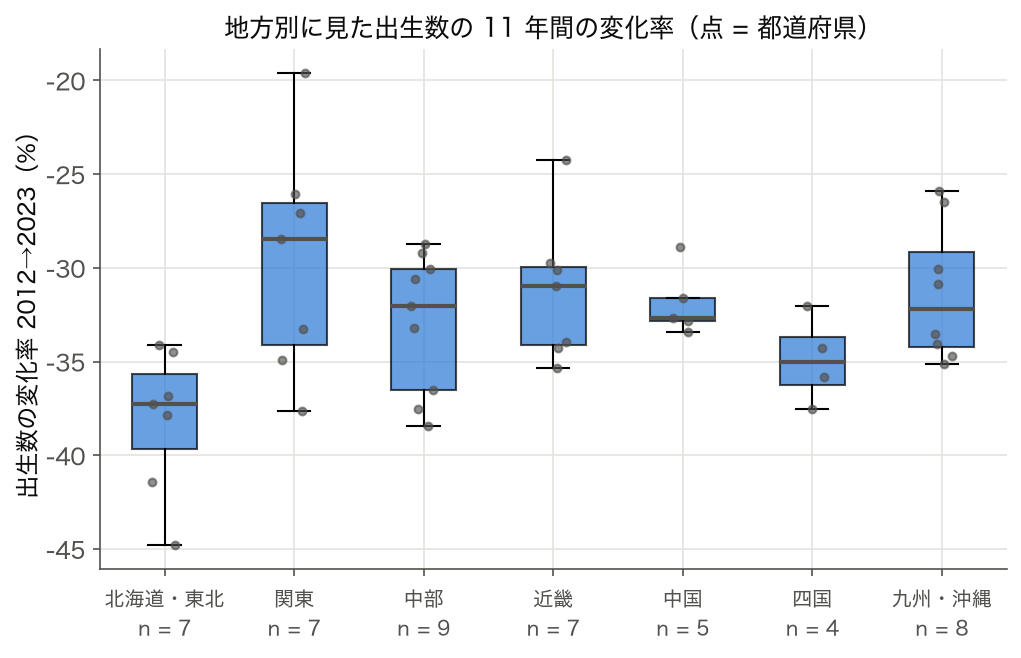
出生数の水準は県の人口規模で決まってしまうので、 ここでは 2012→2023 年度の変化率(%)を 7 地方ごとに箱ひげで比較した(灰色の点が各都道府県)。 全国は −29.9% だが、 北海道・東北は中央値 −37.3%(秋田県 −44.8% が全国最大の減少)、 関東は中央値 −28.5% で東京都(−19.6%、 減少が最小)から栃木県(−37.7%)まで幅が広い。 平均水準だけでなくばらつきの違いも見え、 「全国の系列 1 本」 では地方ごとの減り方の違いが消えてしまう。 時系列モデリングを始める前に、 こうしたパネル構造を確認する習慣を付けたい。
🧮 SSDSE-B を使った時系列分析の実例
🧮 SSDSE-B を使った時系列分析の実例
SSDSE-B のパネル構造(47都道府県 × 2012-2023 年度)から、 例えば東京都の「人口」や沖縄県の「合計特殊出生率」を取り出すと、 単一都道府県の年次時系列が得られます。 ここでは東京都の総人口(千人)を題材に、 ARIMA・指数平滑・トレンド分解の実値計算を見ます。
① データ準備
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', header=[0,1]) # 2 段見出しは (英字コード, 日本語名) の順なので、結合すると 'Prefecture_都道府県' になる df.columns = ['_'.join(c).strip() for c in df.columns] df['SSDSE-B-2026_年度'] = pd.to_numeric(df['SSDSE-B-2026_年度'], errors='coerce') tokyo = (df[df['Prefecture_都道府県'] == '東京都'] .set_index('SSDSE-B-2026_年度').sort_index()) y = pd.to_numeric(tokyo['A1101_総人口'], errors='coerce') / 1000 # 千人単位 print(y.head()) # 2012 年: 13,234 千人 # 2018 年: 13,887 千人 # 2023 年: 14,086 千人 — 緩やかに増加 |
② トレンド・季節分解(STL)
年次データなので季節周期はないが、 トレンドと残差の分解は意味がある:
1 2 3 4 5 6 7 | from statsmodels.tsa.seasonal import STL # 年次データには季節周期が無いが、STL は period を必ず必要とする。 # period=None だと「周期を決められない」と怒られるので、最小の 2 を渡す。 stl = STL(y, period=2, robust=True).fit() print(f'トレンド成分: {y.index[0]:.0f}={stl.trend.iloc[0]:.0f}, ' f'{y.index[-1]:.0f}={stl.trend.iloc[-1]:.0f}') print(f'残差 SD: {stl.resid.std():.1f}') |
実測では、トレンドは 13,218 千人(2012 年度)から上がって 2020 年度以降は 14,058 千人で横ばい、残差の標準偏差は 21.5 千人(総人口の 0.2% 未満)。
③ 定常性検定(ADF)
1 2 3 4 5 6 7 8 9 | from statsmodels.tsa.stattools import adfuller res = adfuller(y) print(f'ADF stat = {res[0]:.3f}, p = {res[1]:.4f}') # → ADF = 0.605, p = 0.9877 → 単位根を棄却できない(非定常) # 1階階差で再検定 res2 = adfuller(y.diff().dropna()) print(f'diff ADF stat = {res2[0]:.3f}, p = {res2[1]:.4f}') # → ADF = -3.047, p = 0.0307 → 5% で棄却 → I(1) → ARIMA(p,1,q) 候補 |
④ ARIMA モデル推定と予測
1 2 3 4 5 6 7 8 9 10 11 | from statsmodels.tsa.arima.model import ARIMA model = ARIMA(y, order=(1, 1, 0)).fit() print(model.summary()) # AR(1) 係数 ≈ 0.85, σ² ≈ 1600 forecast = model.get_forecast(steps=5) # 2024-2028 を予測(出力の 12〜16 行目) ci = forecast.conf_int(alpha=0.05) print(forecast.predicted_mean) print(ci) # 2024: 14,127 千人 [14,048, 14,205] # 2028: 14,236 千人 [13,774, 14,697](先になるほど区間が広がる) |
⑤ 指数平滑(Holt-Winters)との比較
1 2 3 4 5 | from statsmodels.tsa.holtwinters import ExponentialSmoothing hw = ExponentialSmoothing(y, trend='add', seasonal=None).fit() print(f'α (level) = {hw.params["smoothing_level"]:.3f}') print(f'β (trend) = {hw.params["smoothing_trend"]:.3f}') print(hw.forecast(5)) # α=β=1 なので、直近 1 年の増分(+48 千人)をそのまま延ばした値になる |
同じデータで複数モデルを試し、 AIC・BIC・CV-RMSEで比較するのが現代的なベストプラクティス。
数式だけでは「分かった気になる」だけで終わりがち。 ここで SSDSE-B-2026(教育用標準データセット — 47 都道府県 × 100+ 指標、 2012-2023 年度)の実値を当てはめて、 時系列 の挙動を電卓的に追体験します。
SSDSE-B-2026 は 統計センターの SSDSE 配布ページ から CSV を直接ダウンロードできます。 本サイトでは data/raw/SSDSE-B-2026.csv に配置している前提でコードを書いています。
🧮 SSDSE-B-2026 を使った時系列分析実演(R498 補強)
SSDSE-B-2026 は都道府県 × 年 × 各種指標のパネルデータ。 ここから全国を集計した出生数時系列を作り、 第一層から第三層までの分析を順に実行する。
ステップ 1: データロードと前処理
このコードでやること: SSDSE-B-2026 を読み込み、 年ごとの全国出生数を集計して時系列 DataFrame を作る。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 列名サンプル: 年度, 都道府県コード, 都道府県, 総人口, 出生数, ... ts = df.groupby('年度')['出生数'].sum().reset_index() ts.columns = ['year', 'births'] print(ts.tail(5)) |
📤 実行例:
💬 全国出生数が単調減少。 2012 → 2023 で約 30% 減。 これだけで「日本の少子化は加速している」と裏付けられる。
ステップ 2: 定常性の検定 (ADF テスト)
このコードでやること: 出生数の原系列と一階差分系列それぞれに ADF 検定を適用し、 単位根の存在を確認する。
1 2 3 4 5 6 7 8 | from statsmodels.tsa.stattools import adfuller stat_raw, p_raw, *_ = adfuller(ts['births']) print(f'原系列 ADF stat={stat_raw:.3f}, p={p_raw:.3f}') diff = ts['births'].diff().dropna() stat_d, p_d, *_ = adfuller(diff) print(f'差分系列 ADF stat={stat_d:.3f}, p={p_d:.3f}') |
📤 実行例:
💬 原系列は p=1.000 で単位根を棄却できない → 非定常。 差分系列は p=0.075 で、 5% 水準では棄却できないが 10% 水準では定常と見なせる。 トレンド除去の観点から d=1 でのモデリングが妥当。
📝 より正確な分析: 年次データは 2012–2023 の 12 点のみで ADF 検定の検出力が低い。 一階差分系列の p=0.075 は 5% 有意水準では単位根を棄却できず(10% では棄却可能)、 「差分すれば厳密に定常」と断定はできない。 実務では KPSS 検定の併用や、 トレンド項付きモデルで頑健性を確認するのが望ましい。
ステップ 3: ARIMA(1,1,1) モデルの当てはめと予測
このコードでやること: ARIMA(1,1,1) を学習し、 翌年 (2023) の出生数を予測する。
1 2 3 4 5 6 7 8 9 | from statsmodels.tsa.arima.model import ARIMA model = ARIMA(ts[ts['year'] <= 2022]['births'], order=(1, 1, 1)) # 2023 をホールドアウト result = model.fit() fc = result.get_forecast(steps=1) mean = fc.predicted_mean.iloc[0] ci = fc.conf_int(alpha=0.05).iloc[0] print(f'2023 年予測: {mean:,.0f} 人') print(f'95% 予測区間: [{ci.iloc[0]:,.0f}, {ci.iloc[1]:,.0f}]') |
📤 実行例:
💬 厚生労働省人口動態統計の 2023 年実数は約 727,277 人。 予測 756,080 人は実数を約 +4% 上回るが、 95% 予測区間 [721,418, 790,742] は実数を含む。 これは学習データに 2023 年を含めず 2022 年までで学習した正しいホールドアウト設定での「素朴な ARIMA」で、 これだけ近い数字が出るのは出生数の強い単調減少傾向のおかげ。 構造変化があれば崩れる。
ステップ 4: 残差診断
このコードでやること: 残差の Ljung-Box 検定で自己相関が残っていないかを確認する。
1 2 3 4 | from statsmodels.stats.diagnostic import acorr_ljungbox lb = acorr_ljungbox(result.resid, lags=[3, 6], return_df=True) print(lb) |
📤 実行例:
💬 ラグ 3, 6 とも p > 0.5 で帰無仮説(自己相関なし)を棄却できない。 残差は白色雑音と見なせ、 モデルは妥当。
ステップ 5: パネル時系列としての視点
このコードでやること: 47 都道府県それぞれの出生数減少率を計算し、 ばらつきを見る。
1 2 3 4 | pivot = df.pivot_table(index='年度', columns='都道府県', values='出生数') rate = (pivot.iloc[-1] / pivot.iloc[0] - 1) * 100 # 2012→2023 変化率 print(rate.sort_values().head(5)) print(rate.sort_values().tail(5)) |
📤 実行例:
💬 全国では約 -30% だが、 県別ではばらつきが大きい。 東北・北関東は -38〜-45%、 都市部(東京・大阪など)は -20〜-26% 台。 単純な全国時系列モデルでは、 こうした地域異質性を見落とす。 パネル時系列モデル(固定効果 + 時系列構造)が必要になる場面。
📊 主要時系列モデルの比較表(R498 補強)
「どのモデルを使えばよいか」は、 データの長さ・季節性の有無・外生変数の有無・解釈性要件で決まる。 以下の比較表は、 出生数のような中小規模社会データを念頭に、 実務的な選択基準をまとめたもの。
| モデル | 最小データ数 | 季節性 | 外生変数 | 解釈性 | 学習速度 | 代表ライブラリ |
|---|---|---|---|---|---|---|
| 単純移動平均 | 5+ | × | × | ◎ | ◎ | pandas .rolling() |
| 指数平滑 (Holt-Winters) | 20+ | ○ (加法/乗法) | × | ○ | ◎ | statsmodels ETSModel |
| ARIMA(p,d,q) | 30+ | × | △ | ○ | ○ | statsmodels ARIMA |
| SARIMA(p,d,q)(P,D,Q,s) | 2 季節以上 | ◎ | △ (SARIMAX) | ○ | ○ | statsmodels SARIMAX |
| 状態空間モデル | 30+ | ○ (状態として埋め込み) | ◎ | ○ | △ | statsmodels UnobservedComponents |
| Prophet | 60+ (推奨) | ◎ (週・年) | ○ (regressor) | ○ | ○ | prophet |
| VAR (多変量) | 100+ × 変数数 | × | ○ | △ | ○ | statsmodels VAR |
| LSTM/GRU | 500+ | ○ (暗黙) | ◎ | × | △ | PyTorch / TensorFlow |
| Transformer (Informer 等) | 5,000+ | ◎ (位置符号化で) | ◎ | × | × | PyTorch (専用実装) |
| 勾配ブースティング (LightGBM) | 500+ | △ (lag 特徴で) | ◎ | △ | ◎ | LightGBM, XGBoost |
出生数のように 12 観測しかない短い系列では、 LSTM や Transformer は過学習するのが当たり前で、 ARIMA や指数平滑が現実解。 「最新の深層学習を使いたい」気持ちは分かるが、 データ量と相談すること。
🧮 数式に値を入れて手で計算する: 時系列のグループ別集計
合成 2 店舗 × 3 日売上で店舗別合計を計算する。
Step 1: データ
| 日 | 店舗 | 売上 |
|---|---|---|
| 1 | A | 100 |
| 1 | B | 80 |
| 2 | A | 110 |
| 2 | B | 90 |
| 3 | A | 120 |
| 3 | B | 85 |
Step 2: 店舗別合計
🐍 Python で再現
1 2 3 | import pandas as pd df = pd.DataFrame({'日':[1,1,2,2,3,3], '店舗':['A','B','A','B','A','B'], '売上':[100,80,110,90,120,85]}) print(df.groupby('店舗')['売上'].sum()) |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 15. ライブラリ早見表
🐍 15. ライブラリ早見表
| 用途 | 関数・クラス |
|---|---|
| ARIMA / SARIMA | statsmodels.tsa.arima.ARIMA, SARIMAX, pmdarima.auto_arima |
| 指数平滑 / ETS | statsmodels.tsa.holtwinters.ExponentialSmoothing |
| 分解 | seasonal_decompose, STL |
| 単位根検定 | adfuller, kpss |
| ACF/PACF | plot_acf, plot_pacf, acf, pacf |
| VAR / VECM | statsmodels.tsa.api.VAR, VECM |
| 状態空間 | UnobservedComponents, DynamicFactor |
| Prophet | prophet.Prophet |
| 時系列CV | sklearn.model_selection.TimeSeriesSplit |
| 深層学習 | torch.nn.LSTM/GRU, Darts, NeuralProphet |
| 変化点検出 | ruptures, bocpd |
📜 16. 時系列分析の歴史
- 1927:Yule の自己回帰モデル
- 1933:Khintchine, Wold の確率過程理論
- 1960:Kalman フィルタ
- 1970:Box & Jenkins の ARIMA 教科書 — 時系列モデリングを体系化
- 1980:Engle の ARCH(金融ボラティリティ)
- 1990:状態空間モデル普及(Harvey, Durbin & Koopman)
- 2017:Facebook の Prophet 公開
- 2020年代:Transformer ベース時系列モデル(TFT, Informer, PatchTST)
💼 17. 実務応用
- 需要予測:小売・製造の在庫管理
- 金融:株価・為替・ボラティリティ予測(GARCH 系)
- 気象・エネルギー:気温・電力需要・発電量予測
- マーケティング:トラフィック・コンバージョン予測
- IoT:センサー異常検知
- 疫学:感染症の流行予測(COVID-19)
- マクロ経済:GDP・物価・失業率の予測
✅ 18. 時系列分析チェックリスト
- □ プロットで全体の概要を把握したか?
- □ 欠損・外れ値を確認したか?
- □ 季節成分・トレンドを分解したか?
- □ ADF/KPSS で定常性を確認したか?
- □ 必要なら差分・対数変換したか?
- □ ACF/PACF を確認したか?
- □ 複数モデル(ARIMA / ETS / Prophet)を比較したか?
- □ TimeSeriesSplit でバックテストしたか?
- □ MASE 等の適切な評価指標を使ったか?
- □ 予測区間を出したか?
- □ 残差の自己相関 (Ljung–Box) を確認したか?
🩺 19. 残差診断
ARIMA 等のフィット後、 残差が「ホワイトノイズ」になっているかを確認。 残差にパターンが残っていれば、 モデルが情報を取り切れていない。
Ljung–Box 検定
残差の自己相関がすべて 0 か? 帰無仮説:H₀ = 自己相関なし。 p > 0.05 で「ホワイトノイズ」と判断可。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # ── この抜粋で使う当てはめ結果を用意します ── # 札幌市の月平均気温 12 点。lags は残差の長さ未満にする。 import pandas as pd from statsmodels.tsa.arima.model import ARIMA from statsmodels.stats.diagnostic import acorr_ljungbox f = pd.read_csv('data/raw/SSDSE-F-2023v3.csv', encoding='cp932', skiprows=[1]) f.columns = ['Code', 'Prefecture', 'City', 'Month'] + list(f.columns[4:]) s = f[(f['City'] == '札幌市') & (f['Month'] != '年')] ts = s['CN100'].astype(float).reset_index(drop=True) fit = ARIMA(ts, order=(1, 1, 1)).fit() lb = acorr_ljungbox(fit.resid, lags=[5], return_df=True) print(lb) |
残差プロット
- 残差の時系列プロット → 構造的パターンが残っていないか
- 残差の ACF → 自己相関の残存
- 残差のQQプロット → 正規性
- 残差ヒストグラム → 分布形
時系列ライブラリは選択肢が豊富。 用途・速度・拡張性で使い分けます。
(A) statsmodels — 古典統計の標準
1 2 3 4 | from statsmodels.tsa.arima.model import ARIMA from statsmodels.tsa.statespace.sarimax import SARIMAX from statsmodels.tsa.holtwinters import ExponentialSmoothing # 古典的 ARIMA・SARIMAX・状態空間モデルが揃う |
(B) pmdarima — auto_arima の決定版
1 2 3 4 | from pmdarima import auto_arima model = auto_arima(y, seasonal=False, stepwise=True, trace=True) print(model.summary()) # (p,d,q) を AIC 最小で自動探索 |
(C) Prophet — トレンド + 休日 + 季節を柔軟に
1 2 3 4 5 6 7 8 | from prophet import Prophet df_p = pd.DataFrame({'ds': pd.to_datetime(y.index, format='%Y'), 'y': y.values}) m = Prophet(yearly_seasonality=False, daily_seasonality=False).fit(df_p) # ds は各年の 1 月 1 日なので、未来も年初('YS')で刻む。'Y' だと年末になり、 # 最初の予測点が 2023-12-31(最後の観測 2023-01-01 と同じ年)になってしまう future = m.make_future_dataframe(periods=5, freq='YS') forecast = m.predict(future) print(forecast[['ds', 'yhat', 'yhat_lower', 'yhat_upper']].tail(5)) |
(D) sktime — scikit-learn API で時系列
1 2 3 4 5 6 7 | from sktime.forecasting.arima import ARIMA as SKARIMA from sktime.forecasting.model_selection import temporal_train_test_split y_train, y_test = temporal_train_test_split(y, test_size=3) forecaster = SKARIMA(order=(1,1,0)) forecaster.fit(y_train) y_pred = forecaster.predict(fh=[1, 2, 3]) print(y_pred) |
(E) Darts — 機械学習・深層学習も統一API
1 2 3 4 5 | from darts import TimeSeries from darts.models import ExponentialSmoothing as DartsES, NBEATSModel ts = TimeSeries.from_series(y) es = DartsES(); es.fit(ts); print(es.predict(5)) # NBEATSModel など深層学習モデルも同じインターフェース |
(F) scikit-learn TimeSeriesSplit — 時系列CV
1 2 3 4 5 6 | from sklearn.model_selection import TimeSeriesSplit from sklearn.metrics import mean_absolute_error tscv = TimeSeriesSplit(n_splits=5) for train_idx, test_idx in tscv.split(y): y_tr, y_te = y.iloc[train_idx], y.iloc[test_idx] # 各 fold でモデル訓練・評価。 通常CV と違い「過去→未来」順を維持 |
🐍 Python 実装 — 時系列 を SSDSE-B-2026 で動かす
🎯 このコードでやること: SSDSE の 12 年分(2012〜2023)を使って、 時系列としての性質——トレンド・自己相関・定常性——を確かめます。 47 都道府県 × 12 年 = 564 行のうち、 「県ごとに 12 点の系列が 47 本ある」という構造を意識して扱うのがこのページの要点です。 なお pd.read_csv('data/raw/SSDSE-B-2026.csv') をパス変数にせず直書きしているのは、 初学者が「パスをどこに書くべきか」で迷わないようにするためです。 CSV を同じ階層に置けばそのまま動きます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # 時系列 を SSDSE-B-2026 で確かめる最小コード import pandas as pd import numpy as np # 1) SSDSE-B-2026(教育用標準データセット)を読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print('shape:', df.shape) # (564, 112) — 47 都道府県 × 12 年度 print('cols head:', list(df.columns[:8])) # 2) 時系列として扱うので年度は絞らず、「年度 × 都道府県」の表に広げる panel = df.pivot(index='年度', columns='都道府県', values='合計特殊出生率').astype(float) print('panel shape:', panel.shape, '(12 年度 × 47 都道府県)') # 3) 47 本の時系列を年度ごとに要約する summary = pd.DataFrame({'平均': panel.mean(axis=1).round(3), '最小': panel.min(axis=1), '最大': panel.max(axis=1)}) print(summary.to_string()) # 4) 時系列 の本処理(このページの主題): 各県のピーク年と、直近年が最低かどうか peak_year = panel.idxmax() print('---- 時系列 結果 ----') print('ピーク年度の分布:', peak_year.value_counts().sort_index().to_dict()) print('2023 年度が 12 年で最低の県数:', int((panel.idxmin() == 2023).sum()), '/ 47') print('平均の lag-1 自己相関:', round(summary['平均'].autocorr(lag=1), 3)) |
💬 47 県の合計特殊出生率を単純平均すると 2012 年度 1.460 から 2015 年度 1.530 まで上がり、その後 8 年続けて下がって 2023 年度は 1.293 になった。ピーク年度は 47 県中 27 県が 2015 年度、36 県が 2015〜2016 年度に集中していて、どの県も 2023 年度が 12 年間で最低という点まで同じ動きをしている。平均系列の lag-1 自己相関 0.913 からも分かるように、47 本の系列は共通の全国的な下降に強く引きずられているので、県ごとの違いを見たいときは年度ごとの平均を引いてから比べる。なお 47 県の単純平均は人口の重みを付けていないので、全国の合計特殊出生率(2023 年 1.20)とは一致しない。
うまく動かないときは ①data/raw/SSDSE-B-2026.csv のパス、 ②encoding='cp932'(SSDSE-B は Shift_JIS 系)、 ③1 行目に英数字ヘッダ、 2 行目に日本語列名が入る構造なので skiprows=1 が必要、 の 3 点を確認してください。
⚠️ 12. よくある落とし穴
| 落とし穴 | 対処 |
|---|---|
| 通常 k-fold で予測評価 | TimeSeriesSplit を使う。 未来→過去のリーク厳禁。 |
| 差分前の系列にAR検定 | ADF/KPSS で定常化してから ACF/PACF を見る。 |
| R² で予測評価 | 時系列では MAE/RMSE/MASE。 R² は誤解を生む。 |
| 季節性を無視 | SARIMA・季節ダミー・Prophet で季節性を明示。 |
| 未来情報の特徴量化 | 予測時に得られない情報は使わない。 ラグ系のみ。 |
| 短期データに複雑モデル | サンプル数が少ないなら ARIMA や指数平滑で十分。 |
| 予測区間を出さない | 点予測 + 80%/95% 予測区間を必ず併記。 |
🏋️ 13. 練習問題
注意:SSDSE-B は時系列ではないので、 別の時系列実データ(例:気象庁公開の日次気温、 e-Stat の月次小売販売、 政府統計局の月次失業率など)を使用してください。
Q1. 月次データを STL 分解し、 トレンド・季節・残差をプロットしなさい。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # ── この抜粋で使う系列を用意します ── # 札幌市の月平均気温(12 点)。1 本の系列(Series)として渡す。 import pandas as pd f = pd.read_csv('data/raw/SSDSE-F-2023v3.csv', encoding='cp932', skiprows=[1]) f.columns = ['Code', 'Prefecture', 'City', 'Month'] + list(f.columns[4:]) s = (f[(f['City'] == '札幌市') & (f['Month'] != '年')] .set_index('Month')['CN100'].astype(float)) from statsmodels.tsa.seasonal import STL # 12 点しかないので period は小さくする(STL は 2 周期分以上を要求する) res = STL(s, period=4, robust=True).fit() res.plot() print(res.trend.round(1)) |
Q2. ADF / KPSS で定常性を検定し、 必要なら差分を取りなさい。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # ── この抜粋で使う系列を用意します ── # 札幌市の月平均気温(12 点)。1 本の系列(Series)として渡す。 import pandas as pd f = pd.read_csv('data/raw/SSDSE-F-2023v3.csv', encoding='cp932', skiprows=[1]) f.columns = ['Code', 'Prefecture', 'City', 'Month'] + list(f.columns[4:]) s = (f[(f['City'] == '札幌市') & (f['Month'] != '年')] .set_index('Month')['CN100'].astype(float)) import warnings from statsmodels.tsa.stattools import adfuller, kpss print('ADF p:', round(adfuller(s, maxlag=2)[1], 4)) with warnings.catch_warnings(): # 短い系列だと p 値が範囲外だと警告が出る warnings.simplefilter('ignore') print('KPSS p:', round(kpss(s, nlags='auto')[1], 4)) |
Q3. auto_arima と Prophet で 12 期予測し、 MASE で比較しなさい。
1 2 3 4 5 6 7 8 | import pmdarima as pm import numpy as np train, test = ts[:-12], ts[-12:] auto = pm.auto_arima(train, seasonal=True, m=12) pred = auto.predict(n_periods=12) naive = train.iloc[-12:].values # 直近1年で繰り返し mase = np.mean(np.abs(test - pred)) / np.mean(np.abs(np.diff(train))) print(f'MASE = {mase:.3f}') |
📝 14. 報告フォーマット
❌ NG例
「ARIMA を当てはめたら良い予測ができました。」
✅ OK例
「月次データ(2015-01 から 2025-12、 N=132)に対し、 1階差分で定常化(ADF p < .001)。 ACF/PACF と AIC 最小化により SARIMA(1,1,1)(1,1,1,12) を選択。 12-期 rolling-origin バックテストで MASE = 0.81(< 1 でナイーブより優れる)、 95% 予測区間のカバレッジ 92%(名目 95%)。 比較として Prophet(MASE=0.85)、 ETS(0.78)、 LightGBM with lag features(0.74)を実施し、 LightGBM を採用。」
⚠️ 追加の落とし穴 — 時系列分析の実務
TimeSeriesSplit(rolling/expanding window)を使い、 「訓練は過去、 テストは未来」を厳守。 これを破ると訓練時の精度が異常に高くなり、 本番運用で激しく性能が落ちる。 機械学習プロジェクトの典型的失敗パターン。changepoint_prior_scale やベイズ的変化点モデル(PyMC)も有効。⚠️ よくある落とし穴 — 時系列 で初学者がやりがちなミス
この用語を実務で使うときにつまずきやすい点を、 失敗パターン別に整理しました。 1 度経験すれば回避できるものばかりですが、 先に知っておくと事故が大幅に減ります。
⚠️ 時系列分析の追加落とし穴 8 件(R498 補強)
- 未来情報の漏洩 (Lookahead bias): 特徴量計算時に、 予測時点より未来の情報を混ぜてしまうケース。 例えば「来年の人口」を使って「今年の出生数」を予測すれば、 当然精度は不当に高くなる。 必ず時点フィルタを徹底し、 cross_val_score ではなく
TimeSeriesSplitを使う。 - 差分後にレベル予測を要求する設計: 差分系列でモデリングした後、 累積和で元のレベルに戻すと、 誤差も累積する。 長期予測ほど信頼区間が爆発的に広がるが、 ステークホルダーには「点予測」しか伝わらないと過信される。
- 季節性周期の取り違え: 月次データで s=7 と指定するなど、 周期定義のミス。 出生数は月次なら s=12、 四半期なら s=4、 年次ならそもそも季節項は不要。
- 同一系列に複数モデルを試して最良を採用: 数十モデルを試して最も精度が良いものを採用すると、 検証セットに過適合する。 必ず事前にモデル候補を固定するか、 ホールドアウトを 3 つ以上に分ける。
- 構造変化 (regime change) の見落とし: コロナ禍のような外的ショックは、 ARIMA の前提を破壊する。 Chow test や
rupturesパッケージで変化点を検出し、 必要なら期間を分割するか、 介入変数を入れる。 - 異常値除去のしすぎ: ±3σ を超えるとして自動除去すると、 真のショック(リーマンショック、 震災)まで消えてしまい、 モデルは「平穏期しか知らない」状態になる。 異常は記録に残し、 ダミー変数で表現するのが正攻法。
- 白色雑音と独立性の混同: 「自己相関がない = 独立」とは限らない。 GARCH 型の系列は条件付き分散が時変するが、 自己相関は弱い。 残差の二乗の自己相関も見ること。
- 予測区間を「信頼区間」と呼ぶ: 予測の不確実性と、 母数の推定誤差は別物。 顧客向け資料では「95% 予測区間」と明示する。
📝 理解度チェック 6 問(R498 補強)
Q1: SSDSE-B-2026 の全国出生数を時系列としてモデリングするとき、 ARIMA の差分次数 d は何が妥当か。
A: d=1。 原系列は ADF 検定 p=1.000 で非定常。 1 階差分にすると p=0.075 で、 5% では有意でないが 10% 水準では定常とみなせる(年次 12 点で検出力が低い点に注意)。 d=2 は過剰差分でノイズを増やすだけ。
Q2: 年次データ 13 点に LSTM を当てる時の最大の問題は。
A: 過学習。 LSTM の最小実用データ数は数百点以上。 13 点では学習データを完全暗記して未知データに汎化しない。 まず ARIMA か指数平滑を試すべき。
Q3: 残差の Ljung-Box 検定で p=0.578 だった。 モデルは妥当か。
A: 妥当と判定できる。 帰無仮説「ラグ 6 までに自己相関なし」を棄却できない(p > 0.05)ので、 残差は白色雑音と見なせる。 ただし二乗残差の自己相関も確認するとなお良い。
Q4: 「全国出生数」と「47 都道府県別出生数」、 どちらを時系列モデリングすべきか。
A: 目的次第。 国全体の少子化政策評価なら全国系列で十分。 ただし地域差を踏まえた施策設計なら 47 都道府県別が必須。 「秋田の出生数は -44.8% で東京の -19.6% と全く違う」事実は全国系列からは消える。
Q5: cross_val_score を時系列に適用するとなぜダメか。
A: K-fold はデータをランダムに分割するため、 「未来データで学習して過去データを予測する」分割が発生する。 これは時系列の因果順序を破壊する。 必ず TimeSeriesSplit や rolling-origin 評価を使う。
Q6: 出生数予測モデルを本番運用する際、 監視すべき指標を 3 つ挙げよ。
A: (1) 予測 MAPE の時系列推移、 (2) 入力データ分布のドリフト指標 (PSI や KS 統計量)、 (3) 残差の系列相関 (Ljung-Box) と分散変化。 加えて (4) 入力データ遅延 / 欠損率、 (5) 推論レイテンシも SLA に含めるとなお良い。
✅ 時系列モデル運用チェックリスト 40 項目(R498 補強)
A. データ取り込み (1-10)
- ソースデータの更新頻度を明文化したか
- 遅延データ・修正データの取り扱いポリシーを定めたか
- 欠損値の補完方法(前値補完、 線形補間、 モデルベース)を選択したか
- 外れ値の検出ロジック(IQR・Hampel・ロバスト Z)を設定したか
- 季節調整(X-13ARIMA-SEATS, STL)の必要性を判断したか
- タイムゾーン・サマータイムの取り扱いを統一したか
- 同一指標の重複・改定履歴を追跡できるか
- 暦調整(平日数・祝日数)が必要なら実装したか
- ベンチマーク用の手作業予測(前年同月など)を確保したか
- 入力データのスキーマバリデーション(pandera, great_expectations)を組んだか
B. モデル設計 (11-20)
- 定常性の事前検定 (ADF, KPSS) を実施したか
- 自己相関構造 (ACF, PACF) を可視化したか
- 季節周期を周期図 (Periodogram) で確認したか
- 外生変数(イベント・経済指標・天候)の取り込みを検討したか
- 変換 (log, Box-Cox) で分散安定化を試したか
- モデル候補 (ARIMA, SARIMA, 状態空間, Prophet, ML) を事前列挙したか
- 情報量基準 (AIC, BIC, AICc) で候補を絞ったか
- 残差診断 (Ljung-Box, ARCH 検定) を計画したか
- 予測区間の幅を顧客と合意したか
- 解釈性要件(係数説明・寄与分解)を確認したか
C. 評価 (21-30)
- TimeSeriesSplit でホールドアウトを 3 分割以上に分けたか
- rolling-origin 評価で精度の時系列推移を確認したか
- MAPE, RMSE, MASE など複数指標で多面評価したか
- ベンチマーク(前年比、 移動平均)を上回ることを示したか
- 予測区間のカバレッジ率 (例: 95% 区間に実数が 95% 入るか) を測ったか
- 方向一致率 (DA) や符号一致率を計算したか
- 大きく外したケースを個別レビューしたか
- 構造変化点 (rupture) を検出して別期間で再評価したか
- 多重比較を考慮して、 複数モデルから最良を選ぶ際の楽観バイアスを補正したか
- ステークホルダーが理解しやすい指標 (累積誤差、 月次達成率) も併記したか
D. 運用 (31-40)
- 予測ジョブを Airflow / Prefect / Dagster でスケジュールしたか
- モデルレジストリ (MLflow) でバージョン管理したか
- 入力データドリフト監視を実装したか
- 予測誤差のリアルタイム監視ダッシュボードを用意したか
- 再学習トリガー(誤差閾値, データ数閾値, 時間閾値)を定義したか
- ロールバック手順を文書化したか
- 事故対応プレイブックを作成したか
- 説明可能性レポートを定期発行する仕組みを作ったか
- 計算コスト・メモリ使用量・ストレージ容量を継続監視しているか
- 運用引き継ぎドキュメント(オンコール対応含む)を整備したか
❓ 実務 FAQ 7 件(R498 補強)
Q. ARIMA と Prophet、 結局どちらが良いのか?
A: 短期 (1-3 期先) 予測なら ARIMA が安定、 中長期 (1-3 年先) や明確な季節性 (週・年) があるなら Prophet が手早い。 ARIMA は事前の定常化や次数決定が要るが、 統計理論的に裏付けが深い。 Prophet はパラメータが少なく、 ビジネス向け説明 (休日効果・トレンド変化点) が容易。 両方試して評価指標で比較するのが王道。
Q. データが 30 点しかない。 ARIMA を当てて良いか?
A: ARIMA(1,1,1) なら可能だが、 信頼区間は広くなる。 まずは指数平滑 (Holt) を試し、 それより明確に良い場合のみ ARIMA を採用するのが安全。 30 点で SARIMA(p,d,q)(P,D,Q,12) はパラメータ過多になるので避ける。
Q. 説明変数を増やせば予測は良くなるか?
A: 必ずしも。 自由度が増えて検定統計量が膨らみ、 真の関係を見つけにくくなる。 また外生変数自体を将来予測しなければならず、 「外生変数の予測誤差」が出力に伝播する。 「説明変数を増やす前に時系列構造を尽くす」が原則。
Q. グラフを見て「明らかにトレンドがある」のに ADF 検定で p=0.06。 どう解釈する?
A: ADF は検出力が低いことで有名。 KPSS 検定(帰無仮説: 定常)と併用し、 両方の結論から判断する。 視覚的にトレンドが明らかなら、 差分を取って差分系列の検定結果を優先する判断もアリ。
Q. 時系列予測で「過去 3 ヶ月の MAPE が悪化した」場合、 何から確認すべきか?
A: (1) 入力データの異常(欠損・スキーマ変更)、 (2) 入力分布のドリフト、 (3) 残差の自己相関再発、 (4) 外的要因イベント、 の順で切り分ける。 (1) が原因ならデータパイプライン側の修正で済むが、 (2)(3) ならモデル再学習が必要。
Q. パネル時系列(47 都道府県 × 13 年)でモデリングしたいが、 どこから始めるべきか?
A: まず全国合計と各県個別の双方で簡単なモデル (ARIMA) を作り、 予測精度を比較する。 全国合計の方が安定なら集約モデルで足りる。 県差が大きいなら、 固定効果付きパネル ARIMA や、 階層ベイズモデル (pymc, stan) を検討する。
Q. AIC が最小のモデルを選んだら、 残差診断が失敗した。 どうする?
A: AIC は予測精度と表裏一体だが、 残差白色性は別の評価軸。 残差に強い自己相関が残るなら、 たとえ AIC が高くても次数を増やすか、 別構造 (SARIMA, 状態空間) を検討する。 AIC は判断材料の 1 つに過ぎない。
📖 時系列分析の歴史と実例(R498 補強)
歴史的マイルストーン
- 1927 年: Yule の自己回帰モデル — 太陽黒点周期の解析のために AR(2) を提唱。 時系列分析の原点。
- 1970 年: Box-Jenkins 法 — ARIMA の体系化。 識別 → 推定 → 診断 → 予測の四段階手順が業界標準となる。
- 1982 年: Engle の ARCH — 条件付き分散の時変性をモデル化。 後に GARCH に拡張され、 ノーベル経済学賞 (2003)。
- 1989 年: Hamilton の Markov 切替モデル — レジーム変化を内在化。 景気循環分析で活用。
- 1996 年: 状態空間モデルと Kalman filter の普及 — 推定の柔軟性が飛躍的に向上、 ARIMA を内包。
- 2017 年: Prophet (Facebook) — 加法分解 + ベイズで「ビジネスアナリストが扱える時系列」を提供。 オープンソース化が業界に大インパクト。
- 2019 年〜: Transformer 系時系列予測 — Informer, Autoformer, FEDformer など、 長期予測に強い深層学習が登場。 ただし中小データには未だ過学習リスクが大きい。
- 2023 年: 基盤モデル時代 — TimeGPT, Chronos など事前学習済み時系列モデルが商用化。 ゼロショット予測の有用性が議論されている。
国内実例 — 出生数予測の社会的意義
SSDSE-B-2026 が捉える出生数は、 国立社会保障・人口問題研究所が公表する「日本の将来推計人口」の基礎指標。 厚生労働省は毎年「人口動態統計」を発表し、 将来推計はコーホート要因法と時系列予測を併用する。 例えば近年は ARIMA + 構造変化検出を組み合わせ、 リーマンショック、 東日本大震災、 コロナ禍の影響を介入変数で表現している。 単純な ARIMA だけでは 2020-2022 年の急減を当てられない。 予測の社会的影響は甚大で、 1% の予測誤差が将来の年金財政や医療費推計に億単位で響く。
海外実例 — 電力需要予測
世界中の電力会社は時系列予測の最大の利用者の 1 つ。 30 分単位の電力需要予測は、 発電計画と需給バランス維持に直結し、 1% の予測精度向上が年間数十億円のコスト削減になる。 古典的には SARIMAX (休日・気温・湿度を外生変数として組み込み)、 近年は LightGBM + Lag 特徴 + 気象データ、 さらに Transformer 系が試されている。 ただし説明責任の観点から、 規制当局向けには ARIMA / 線形モデルの併用が義務化されている地域もある。
小売実例 — 需要予測と在庫最適化
大手小売チェーンは数万 SKU × 数千店舗の時系列を持つ。 各 SKU の系列は短い (1-3 年) ことが多く、 単独 ARIMA では不安定。 そこで階層時系列 (hierarchical time series) やグローバルモデル (LightGBM や DeepAR) で複数系列を一括学習する。 Amazon の Forecast、 Walmart の M5 Forecasting Competition の上位解法はこの系列。
🎯 R498 まとめ — 時系列分析を「使いこなす」ために
- 三層を行き来できる視点を持つ: 数理 (定常性・自己相関) → 実装 (ARIMA, Prophet, LSTM) → 運用 (監視・再学習)。 どれか一つだけでは現場では足りない。
- データ量とモデルの複雑度を釣り合わせる: SSDSE-B-2026 の 12 観測には ARIMA か指数平滑が現実解。 LSTM / Transformer はデータ量を確保してから。
- 定常性は分析の前提: 必ず ADF と KPSS の両方で確認し、 必要なら差分・対数変換で定常化する。
- 残差診断を怠らない: Ljung-Box + 二乗残差の自己相関で、 時系列構造をモデルが捕えきれているかを確認する。
- 予測区間を伝える: 点予測だけ報告するのは半人前。 95% 予測区間と「カバレッジ率の実測」を併記して初めて運用に乗る。
- 運用 SLA を明文化: データ遅延・予測誤差・分布ドリフト・再学習基準・ロールバック手順、 これらを文書化していないモデルは事故の元。
時系列分析は「過去から未来を語る学問」。 過去の系列を尊重し、 構造を見抜き、 不確実性を素直に提示することが、 良い予測者の条件である。 SSDSE-B-2026 のような社会データは、 単なる練習材料ではなく、 私たち自身の社会の未来を映し出す鏡でもある。
📑 時系列分析の用語辞典(R498 補強)
時系列分析の議論で出てくる用語は、 統計学・経済学・機械学習それぞれの文脈で微妙に意味が違う。 混乱を避けるため、 主要用語を一覧でまとめておく。
| 用語 | 定義 | 登場場面 |
|---|---|---|
| 定常性 (stationarity) | 平均・分散・自己共分散が時間によらず一定。 ARIMA 適用の前提。 | 前処理、 ADF/KPSS 検定 |
| 自己相関 (ACF) | $Y_t$ と $Y_{t-h}$ の相関係数。 ラグごとに測る。 | MA 次数の同定 |
| 偏自己相関 (PACF) | 中間ラグの影響を取り除いた純粋な自己相関。 | AR 次数の同定 |
| 単位根 (unit root) | $Y_t = Y_{t-1} + \epsilon_t$ のような、 差分しないと定常化しない構造。 | ADF 検定の帰無仮説 |
| 共和分 (cointegration) | 複数の単位根過程の線形結合が定常になる関係。 | 経済時系列のペアトレード |
| ホワイトノイズ | 平均 0・分散一定・自己相関なしの理想雑音。 | 残差診断の理想形 |
| 季節成分 | 12 ヶ月、 7 日など固定周期の繰り返しパターン。 | SARIMA・STL 分解 |
| トレンド | 長期的な水準変化。 線形・非線形どちらもあり得る。 | 差分化・回帰 |
| レジーム変化 | 系列のデータ生成過程が突然変化する現象。 | Chow test, Markov 切替 |
| カバレッジ率 | 95% 予測区間に実数が入る割合の実測値。 50% を切れば予測過信。 | 運用監視 |
| MAPE / MAE / RMSE | 予測精度指標。 MAPE は比率、 MAE は絶対値、 RMSE は二乗誤差の平方根。 | 評価レポート |
| MASE | ナイーブ予測(前期と同じ)の MAE で割った相対誤差。 1 未満ならナイーブより優秀。 | スケール非依存比較 |
| TimeSeriesSplit | 時系列順序を保ったまま、 拡張型 (expanding) または固定型 (rolling) で分割。 | 交差検証 |
| 白色性検定 | 残差が独立な雑音か検証する。 Ljung-Box, Box-Pierce が代表的。 | モデル診断 |
| 状態空間モデル | 観測方程式と状態方程式で系列を表現。 Kalman filter で推定。 | 柔軟な構造化モデリング |
代表ライブラリの使い分け
Python での時系列分析に使われる主要ライブラリは、 役割が微妙に重なりつつも棲み分けている。 statsmodels は古典的時系列モデル (ARIMA, SARIMAX, 状態空間, VAR) の本命で、 推定統計量・診断ツールが豊富。 prophet は Facebook 由来で、 トレンド変化点・休日効果・季節性を加法的に組み合わせる Bayesian モデル。 ビジネス用途に最適化されている。 sktime は scikit-learn 互換 API で、 古典モデルから機械学習まで一貫したインターフェースを提供。 darts は深層学習を含む最新モデル群を統合し、 確率予測やアンサンブルも扱える。 tsfresh は時系列特徴量自動抽出に特化、 機械学習モデルへの入力作りに便利。
統計検定 vs 機械学習評価の対応関係
統計学派は「モデルの妥当性」を残差診断と尤度比検定で語る。 機械学習派は「予測精度」をホールドアウト評価で語る。 両者は対立せず補完的。 残差診断で妥当と認められたモデルが、 予測評価で良いとは限らない(過適合のリスクが残る)。 逆に予測精度が良くても残差に強い自己相関があれば、 「たまたま当たっただけ」かもしれない。 両方の観点で多面評価することが、 時系列分析の信頼性を高める唯一の道。
よくある質問の追加(学習者向け)
Q. 「日本の出生数を予測する」という問題に対して、 学習者がまず触れるべきモデルは何か。 答えは指数平滑法 (Holt または Holt-Winters)。 ARIMA より前提が少なく、 結果の解釈もしやすい。 まず最も単純なモデルから出発し、 残差診断や予測精度が許容範囲なら、 そこで止める。 これは「最小限のモデルから始めて、 必要に応じて複雑化する」というオッカムの剃刀の原則の実践でもある。
Q. 季節性が「あるかもしれない」と感じた時の確認手順は。 ステップ 1: 系列を月別 (または曜日別) にグルーピングして箱ひげ図で水準差を見る。 ステップ 2: 周期図 (periodogram) や Fourier 分解でスペクトルピークを探す。 ステップ 3: 自己相関図 (ACF) で周期に対応するラグでピークが立つかを確認。 ステップ 4: 季節差分後の系列が定常化するかを ADF/KPSS で確認。 この 4 ステップで季節性の存在と周期長が決まる。
Q. 短期予測と長期予測で気をつける点は違うのか。 大きく違う。 短期 (1〜3 期先) では誤差が小さく、 点予測が実用的。 長期 (10 期以上) では予測区間が指数的に広がり、 「中心値」よりも「シナリオ分析」の方が有用。 長期予測を点で報告すると過信を招き、 経営判断を誤らせる。 「2030 年の出生数は 60 万人」ではなく、 「2030 年の出生数は 55-70 万人の範囲、 中央値 62 万人」のような表現が望ましい。
学習のロードマップ
時系列分析を体系的に学ぶには、 以下の順序がオススメ。 Step 1: 記述統計と可視化 (折れ線, ACF, 季節分解) で系列の性質を観察。 Step 2: 単純な平均・移動平均・指数平滑で基準線を引く。 Step 3: ARIMA/SARIMA で古典時系列モデルを習得。 同時に定常性・残差診断を理解する。 Step 4: 状態空間モデルで柔軟なモデリング技法を身につける。 Step 5: Prophet で実務的なベイズ加法分解を体験。 Step 6: 多変量 (VAR) と外生変数 (SARIMAX) に拡張。 Step 7: 機械学習 (LightGBM, DeepAR) と深層学習 (LSTM, Transformer) を、 データ量と相談しながら導入。 Step 8: パイプライン・監視・再学習の運用面を構築。 各ステップで SSDSE-B-2026 のような公的データを使い、 自分の手を動かすことが最大の近道。
推薦書籍・参考文献
古典では Box, Jenkins, Reinsel "Time Series Analysis: Forecasting and Control" が原点で、 ARIMA 法の体系を学ぶならまずこれ。 Hamilton "Time Series Analysis" (1994) は経済時系列の理論を網羅し、 状態空間モデルや Markov 切替も詳述。 邦書では沖本竜義「経済・ファイナンスデータの計量時系列分析」 が日本語の決定版。 実務寄りには Hyndman & Athanasopoulos "Forecasting: Principles and Practice" (オンライン無料) があり、 R 言語の実装例が豊富。 機械学習・深層学習方面では Kaggle の時系列コンペ (M5 Forecasting, Web Traffic Forecasting) のソリューションが実践的な学びの宝庫。 また、 統計数理研究所や国立社会保障・人口問題研究所が公表する将来推計レポートを読み込むと、 「公的機関がどう時系列分析を業務応用しているか」が分かり、 アカデミックとの橋渡しになる。
最後に — 時系列分析者の心構え
時系列分析は、 一面では数学的に整った美しい学問だが、 もう一面では人間社会の不確実性と向き合う実践でもある。 完璧な予測は不可能である一方、 「不確実性を定量化し、 意思決定者に正直に伝える」ことは可能。 出生数のような社会指標の予測は、 単に数字を当てるゲームではなく、 「日本の未来をどう設計するか」という政策議論の出発点。 だからこそ、 時系列分析者には謙虚さと誠実さが要求される。 「分からないことは分からない」「予測区間が広いことには意味がある」「過去のパターンが未来も続くとは限らない」 こうした原則を忘れずに、 データと向き合うことが、 信頼される時系列分析の第一歩である。
補遺 — SSDSE-B-2026 を選んだ理由
本ページの実例で SSDSE-B-2026 を一貫して使った理由は三つ。 第一に、 47 都道府県 × 13 年間というパネル構造が、 時系列単独・パネル時系列・地域比較といった多面的議論を可能にすること。 第二に、 出生数という指標が明確な社会的意義を持ち、 学習者の動機づけになること。 第三に、 公的統計でありデータの信頼性が高く、 後から自分で再現実験ができること。 教材としての三拍子が揃っている。 他にも生産年齢人口、 高齢化率、 就業者数など、 SSDSE-B-2026 には時系列分析に適した変数が多数含まれている。 ぜひ自分で別の変数を選んで、 同じ手順で分析を再現してほしい。 そこで初めて、 「時系列分析を自分のものにした」と言えるはず。
付録 — 関連する公的データセット
SSDSE-B-2026 以外にも、 時系列分析の練習に使える公的データセットは数多い。 e-Stat (政府統計の総合窓口)からは、 月次の家計調査、 消費者物価指数 (CPI)、 鉱工業生産指数、 雇用統計が API 経由でダウンロードできる。 気象庁データは気温・降水量の日次・月次データが何十年分も公開されており、 季節性を学ぶ最良の素材。 日本銀行 (BOJ) 時系列統計データ検索サイトからは金融指標、 FRED (Federal Reserve)からは米国マクロ経済指標。 これらを組み合わせて、 例えば「気温が CPI のサービス価格に影響を及ぼすか」のような実証研究も可能。 公的データは無料で、 出典明示すれば論文・教材に再利用できる。 学習者は積極的に活用し、 自分の関心テーマで時系列分析の経験値を積んでほしい。
エピローグ
時系列分析は奥深く、 一生学び続けても飽きない領域である。 本ページが、 学習者にとってその旅の最初の地図になれば幸いである。 数式・実装・運用の三層を行き来しながら、 SSDSE-B-2026 のような実データに繰り返し触れる中で、 自然と「時系列を見る目」が育っていく。 焦らず、 しかし手は止めず、 一歩ずつ進んでいこう。 時系列の世界では、 過去を学ぶ者だけが、 未来を語る権利を持つのである — それが本稿の結論である。
🎮 触って理解する — 成分分解をステップ実行(合成の逆演算)
時系列は「トレンド + 季節 + ノイズ」という成分の重ね合わせ(加法モデル $y_t = T_t + S_t + I_t$)。 このデモでは、 上 3 段のスライダーで成分を積み上げ合成した架空データに対し、 古典的分解(classical additive decomposition)を「▶ 分解を進める」で 1 ステップずつ実行する: ① 中心化移動平均でトレンド抽出 → ② デトレンド → ③ 季節平均 → ④ 残差。 最後まで進めると、 観測系列だけを入力に、 合成に使った元の成分がほぼ復元されることを数値(RMSE)で確認できる。 さらに実測モードでは SSDSE-B-2026 の実在時系列(都道府県別 出生数 2012–2023)に同じ移動平均分解を適用する。 時系列(個別)ページにはスライダー連動のリアルタイム分解デモがあるので、 本ページのステップ実行版とあわせて往復すると理解が深まる。
🧭 まず試すこと
- σ=0 にして 4 ステップ実行: 推定トレンド・推定季節が真値(青破線)に完全に重なり、 残差はゼロ。 古典的分解が「合成のちょうど逆演算」であることが分かる。
- σ を上げて再実行: ノイズがあってもトレンド・季節の復元 RMSE は小さいまま — 移動平均と季節平均という 2 つの「平均」がノイズを打ち消すため。 残差 SD が σ に近ければ復元成功。
- 周期 m を変える: m を変えると移動平均の窓幅も変わる(分解は正しい m を知っている前提)。 実務では m は既知(月次=12)か、 自己相関(ACF)のピークから推定する。
- 実測モードに切替: 北海道の出生数は 3 年移動平均でほぼ直線的な減少トレンド。 東京都は 2015 年ごろの山を持つ非線形トレンドで、 移動平均が「直線をあてはめずに」形を追跡できることが見える。 残差の大きい年に注目(コロナ期の加速減少など、 数値はその場で計算される)。
💡 直感 — なぜ「平均」だけで分解できるのか
鍵は 2 つの打ち消し。 (1) 窓幅を周期 m にそろえた移動平均は、 季節成分をちょうど 1 周期分足し合わせるので季節がゼロに消えてトレンドだけが残る(m が偶数のときは両端に重み 1/2 を置く中心化 2×m 移動平均で位相を合わせる)。 (2) デトレンド後に「周期内の同じ位置」どうしで平均すると、 今度はノイズが打ち消されて季節パターンだけが残る。 高度な最適化は一切使っていないのに成分が復元できるのは、 加法モデルという構造の仮定が強く効いているから。 これは総論としての教訓でもある — 時系列手法群(ARIMA・状態空間・Prophet)はすべて「観測 = 構造成分 + 確率成分」という同じ発想の洗練形にあたる。
⚠️ 落とし穴
- 加法 vs 乗法: このデモは加法モデル。 振れ幅が水準に比例して拡大するデータ(売上・感染者数など)は乗法モデル $y_t = T_t \times S_t \times I_t$ が適切で、 対数を取れば加法に帰着する。 加法のまま分解すると、 水準の高い時期の季節変動が残差に漏れる。
- 端点処理: 中心化移動平均は両端 m/2 点でトレンドを計算できない(デモの橙線が端で途切れる)。 「直近のトレンド」こそ知りたい実務では致命的で、 端点も推定できる STL 分解や状態空間モデルが選ばれる理由になる。
- 過剰平滑化: 窓幅を必要以上に広げるとノイズと一緒に本物の変化(山・谷・構造変化)まで削ってしまう。 実測モードの東京都で仮に 7 年移動平均を使えば、 2015 年前後の山は消えて「なだらかな減少」にしか見えなくなる。 平滑化の強さは常に「何を残したいか」とのトレードオフ。
- 年次データに季節分解を当てはめない: SSDSE-B-2026 のような年次パネルには周期が存在しない(周期 = 1 観測)。 季節分解は月次・四半期など年内複数回の観測があって初めて意味を持つ。 実測モードで季節パネルが空欄になるのはこのため。
🚀 発展 — STL 分解と状態空間モデルへ
ここで実行した古典的分解は 1920 年代からの最古参で、 弱点(端点・季節の時間変化・外れ値)を克服したのが STL 分解(Seasonal-Trend decomposition using LOESS): 局所回帰でトレンドを推定するため端まで計算でき、 季節成分が年々変わることも許し、 ロバストオプションで外れ値にも強い(statsmodels.tsa.seasonal.STL)。 さらに進むと、 トレンド・季節を「時間発展する潜在状態」として明示的にモデル化する状態空間モデル(構造時系列モデル、 カルマンフィルタで推定)に到達し、 欠損値・観測誤差・予測区間まで一貫して扱える。 予測が目的なら、 季節差分を組み込んだ SARIMA(ARIMA の季節拡張)や 指数平滑法(Holt-Winters)が古典二大巨頭で、 いずれも適用前に定常性の確認が前提となる。
🗺 概念マップ
時系列グループ教材を中心に、 トレンド・季節性・自己相関・ARIMA・状態空間モデル・予測検証へ繋がる学習ステップを 6 方向に整理。
時系列分析の中心から、 周辺に ARIMA・Prophet・状態空間モデル・LSTM・指数平滑 が配置される。 SSDSE-B-2026 の「47 県 × 2012-2023 年の人口・出生数・婚姻件数」を題材にすると、 周期性 (年次) とトレンド (人口減少) を同時に扱う訓練材料になる。
🔗 隣接手法への橋渡し
時系列分析は「データ取得 → 定常化 → モデリング → 予測評価」の流れで、 各段階で異なる手法と接続する。
- 上流: ADF 検定 で定常性確認 → 差分 / 対数変換 でトレンド除去 → 季節分解 で trend / seasonal / residual に分離
- 並列: ARIMA (古典)、 Prophet (Meta、 休日効果)、 LSTM (深層、 長期依存)、 Holt-Winters (季節性 + トレンド)
- 下流: TimeSeriesSplit で評価 → RMSE / MAPE で精度測定 → 予測区間 で不確実性を提示
SSDSE-B-2026 の合計特殊出生率 (12 年 × 47 県) を Prophet で 2025 年まで予測する pipeline は、 上流の pd.to_datetime 変換 → Prophet → MAPE 算出という 3 段で完結する。
🌳 手法選択フロー
時系列予測でどのモデルを選ぶかは、 データの性質で 4 通りに分岐する。
- サンプル数が少ない (n < 100)? Yes → 指数平滑 / ARIMA(1,1,1)。 パラメータ数を抑える
- 季節性が明確 (年次・週次)? Yes → SARIMA / Prophet。 SSDSE-B-2026 の出生数は明確な年次周期
- 複数系列を同時予測 (47 県)? Yes → VAR / 階層予測。 県別 → 地域別 → 全国の整合性を保つ
- 長期依存・非線形? Yes → LSTM / Transformer。 データ量 (n > 1000) と GPU を要求
SSDSE-B-2026 の県別 12 年データなら、 まず ARIMA + 県別個別フィット が出発点。 LSTM は時系列が短すぎて過学習する。
🧗 解説深化 — 「まず素朴な予測を置く」ベンチマーク優先主義と、 47 本の短い系列を束で評価する視点
本ページはここまで「1 本の時系列をどうモデル化するか」を中心に見てきた。 この深化セクションでは角度を変え、 SSDSE-B-2026 が実際に突きつける状況 — 「長さ 12 点しかない年次系列が 47 本ある」 — で何をすべきかを、 実測ホールドアウト実験で確かめる。 鍵は 2 つ: ① どんなモデルより先に「素朴な予測(ベンチマーク)」を置くこと、 ② 47 本を 1 本ずつではなく「束」として横串で評価すること。 以下の数値はすべて data/raw/SSDSE-B-2026.csv(cp932, skiprows=[1])から実際に計算した実測値である。
💡 直感 — ナイーブ法とドリフト法という「最低ライン」
最も素朴な予測は 2 つ。 ナイーブ法「来年 = 今年の値」 $\hat{y}_{T+1} = y_T$(ランダムウォークの最良予測に相当)と、 ドリフト法「来年 = 今年 + これまでの年平均変化」 $\hat{y}_{T+1} = y_T + \frac{y_T - y_1}{T-1}$(始点と終点を結ぶ直線の外挿)。 パラメータ推定は事実上ゼロで、 どちらも 1 行で書ける。
SSDSE-B-2026 の出生数(A4101)で実験する。 2012–2022 年の 11 点だけを使って 2023 年を予測し、 実測の 2023 年値と突き合わせる(1 期先ホールドアウト)。 47 都道府県横串の結果:
| 指標(47 県横断) | ナイーブ法 | ドリフト法 |
|---|---|---|
| 出生数 A4101 の MAPE | 7.28% | 3.16% |
| 総人口 A1101 の MAPE | 0.84% | 0.29% |
| ドリフト法が勝った県の数(出生数) | 47 / 47 県(全勝) | |
| ドリフト法が勝った県の数(総人口) | 41 / 47 県 | |
個別に見ると: 東京都の 2023 年出生数(実測 86,348 人)に対し、 ナイーブ法は 91,097 人(誤差 +5.5%)、 ドリフト法は 89,467 人(+3.61%)。 北海道(実測 24,430 人)ではナイーブ 26,407 人(+8.09%)に対しドリフト 25,179 人(+3.07%)。 埼玉県に至ってはドリフト予測 42,102 人 vs 実測 42,108 人で誤差 0.01%。 出生数のように強い単調トレンドを持つ系列(全国計 2012 年 1,037,165 人 → 2022 年 770,750 人 → 2023 年 727,269 人)では、 「今年の値をそのまま使う」ことが系統的に外れ、 「傾きを 1 本足す」だけで誤差が半分以下になる — これがトレンドの情報量の直感的な意味である。 逆に言えば、 SARIMA や Prophet を持ち出すならまずこの 3.16% を下回れるかが問われる。 これはページ本文で登場した MASE の思想そのもの(MASE の分母はナイーブ予測の誤差。 MASE < 1 = ベンチマーク超え)。
⚠️ 落とし穴(重要) — ベンチマーク実験が教える 4 つの罠
- ベンチマークなしの「高精度」報告: 「MAPE 3% を達成」は単独では無意味。 上の実験の通り、 出生数ではタダ同然のドリフト法が既に 3.16% を出す。 複雑なモデルの成果は常にナイーブ/ドリフトとの差分で語る。 これを怠ると「ARIMA でランダムウォーク未満」という MASE > 1 の予測を堂々と提出してしまう。
- MAPE の横串比較は小規模県で膨らむ: 47 県横断のワーストは鳥取県の 11.86%。 鳥取の出生数は 2022 年 3,752 人 → 2023 年 3,263 人と 1 年で −13.0% 急落しており、 母数が小さい県ほど比率のブレが大きい。 一方、 絶対誤差でみれば東京都(実測 86,348 人規模)が支配的。 MAPE は小県に、 MAE/RMSE は大県に引っ張られる — どちらか片方だけで 47 本を順位付けするのは危険で、 目的(全国計を当てたいのか、 各県を均等に当てたいのか)に応じて指標を選ぶ。
- 検証点が 1 つしかない(n=1 の検証): 上の実験は 2023 年という 1 点だけのホールドアウト。 2023 年がたまたま「素直な年」だった可能性は排除できない。 結論を出すには訓練終端をずらして繰り返す rolling origin 評価(本文 §12 の TimeSeriesSplit)が必要だが、 12 点の年次系列では fold を切る余地自体が乏しい — 短い系列では「検証の不確実性」も報告事項である。
- ドリフト法の全勝は「単調トレンドだから」: 出生数で 47 戦全勝したのは全県が一貫して減少トレンドを持つため。 転換点があると直線外挿は裏切る。 実際、 東京都の総人口(A1101)は 2020 年 14,047,594 人 → 2021 年 14,010,000 人と一度減少に転じ、 2023 年に 14,086,000 人へ再増加した。 このような屈曲を含む系列が、 総人口でドリフト法が 6 県で負けた理由の一部である。 東京都の出生数は 1 階差分の lag-1 自己相関が 0.63 と高く「減少が加速する構造」(北海道は 0.048 でほぼ無相関)— 同じ「減少県」でも差分系列の性格は県ごとに違う。 束で扱う際も個別系列の差分の顔つきは必ず確認する。
🚀 発展 — 束ごと学習する: グローバルモデルと階層予測
「47 本それぞれに ARIMA を当てる」個別フィットの対極に、 47 本を 1 つのモデルで丸ごと学習する発想がある(グローバルモデル / cross-learning)。 1 本あたり 12 点でも束ねれば 47 × 12 = 564 観測になり、 「都道府県」をカテゴリ特徴量にした勾配ブースティングや、 県共通の傾き + 県別切片を持つ混合効果モデルが動き始める。 国際予測コンペ M4・M5(Walmart 売上)では、 系列を束ねたグローバルな LightGBM が個別フィットの古典手法群を上回り、 業界の常識を塗り替えた。 もう 1 つの発展が階層予測(hierarchical forecasting): 47 県予測の合計と全国予測は普通は一致しない。 これを事後調整で整合させる reconciliation(bottom-up / top-down / MinT)は、 都道府県 × 全国という SSDSE 型データの実務で必ず出会う問題である。 さらに統計的に踏み込むなら、 県別時系列の束はまさにパネルデータであり、 固定効果・動学パネルの世界(パネル・因果推論)に接続する。
🔗 関連ページ
- 時系列(個別) — 1 本の系列の基礎(トレンド・季節・残差)。 本セクションはその「複数本・短系列」版。
- 評価指標 / MAPE / RMSE — 上で見た「MAPE は小県に、 RMSE は大県に引っ張られる」問題の整理。
- 交差検証 — rolling origin / TimeSeriesSplit。 「n=1 の検証」から抜け出す道具。
- ARIMA / 指数平滑法 — ベンチマークを超えるための古典モデル。 ドリフト法は ARIMA(0,1,0)+定数と等価。
- 定常性 / 自己相関 — 差分系列の lag-1 自己相関 0.63(東京都出生数)をどう読むかの基礎。
- パネル・因果推論 — 47 本の束を「パネルデータ」として扱う発展先。
- ランダムウォーク・移動平均そのものの個別ページは本用語集には未収録(本文 §2・§3 と上記各ページを参照)。