🔖 キーワード索引(補強)
🔖 キーワード索引(補強)
深層学習アーキテクチャに関する概念のチップ集。
💡 30秒で分かる結論
🍰 まずはやさしく
AIの設計図のようなものです。
データの種類に合わせて使い分けます。
スマホの写真や翻訳機能で使われています。
代表的な設計図の種類を学びます。
- CNN:画像の局所性・並進不変性を畳み込みで活かす。
- RNN/LSTM/GRU:系列の時間依存を隠れ状態で繋ぐ。
- Attention:「どこに注目するか」を学習する重み付け。
- Transformer:Attention のみで作る並列学習可能なアーキテクチャ。
- BERT/GPT:Transformer を大規模事前学習した基盤モデル。
- 転移学習:事前学習モデルを下流タスクに適用 → 少データで高精度。
- 適材適所:画像→CNN/ViT、 音声→CNN/RNN、 言語→Transformer、 表データ→GBDT。
🤔 1. なぜアーキテクチャの設計が重要か
万能近似定理は「十分な幅の MLP は任意の関数を近似できる」と言うが、 実用にはデータの構造に合った帰納バイアスが必要:
- 画像 → 局所性・並進不変性 → CNN
- 系列 → 時間依存 → RNN / Transformer
- グラフ → ノード間関係 → GNN
- 3Dメッシュ → 不変性 → 等変ネット
🖼 2. 畳み込みニューラルネットワーク (CNN)
2.1 畳み込み層
入力画像 $X$ にカーネル $K$ をスライドさせながら積和:
$$Y_{i,j} = \sum_{m,n} X_{i+m, j+n} K_{m,n} + b$$
1 カーネルが 1 つの特徴を検出(エッジ・テクスチャ等)。 多数のカーネルで多数の特徴マップを出力。
2.2 主要パラメータ
- カーネルサイズ:3×3 や 5×5 が定番
- ストライド:何画素飛ばすか
- パディング:周囲をゼロで埋める
- チャネル数:入力カラー=3、 出力は任意(深いほど多い)
2.3 プーリング
- Max Pooling:領域の最大値
- Average Pooling:領域の平均
- Global Average Pooling:チャネル全体の平均 → FC 層代替
1 2 3 4 5 6 7 8 9 10 11 12 13 | import torch.nn as nn class SimpleCNN(nn.Module): def __init__(self, num_classes=10): super().__init__() self.features = nn.Sequential( nn.Conv2d(3, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2), nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2), nn.Conv2d(64, 128, 3, padding=1), nn.ReLU(), nn.AdaptiveAvgPool2d(1), ) self.classifier = nn.Linear(128, num_classes) def forward(self, x): x = self.features(x).flatten(1) return self.classifier(x) |
2.4 代表的なCNNアーキテクチャ
- LeNet (1998):CNN の原型
- AlexNet (2012):ImageNet 圧勝 → 深層学習ブーム
- VGG (2014):3x3 畳み込みを深く積む
- Inception/GoogLeNet (2014):分岐構造
- ResNet (2015):残差接続で 152 層が学習可能
- DenseNet (2016):全層接続
- EfficientNet (2019):深さ・幅・解像度を協調スケール
- ConvNeXt (2022):Transformer 時代の CNN 再考
2.5 ResNet と残差接続
$$\mathbf{y} = F(\mathbf{x}) + \mathbf{x}$$
「恒等関数を足す」だけで深い NN の勾配消失を劇的に緩和。 深層学習史上最重要発明の 1 つ。
2.6 U-Net
セグメンテーション(ピクセル単位分類)の標準。 Encoder で圧縮→Decoder で復元、 同階層をスキップ接続。 医療画像・衛星画像で活躍。
🔁 3. RNN・LSTM・GRU
3.1 RNN(再帰型ニューラルネット)
$$\mathbf{h}_t = \tanh(W_h \mathbf{h}_{t-1} + W_x \mathbf{x}_t + \mathbf{b})$$
隠れ状態 $\mathbf{h}_t$ が「記憶」を持ち越す。 ただし長期依存で勾配消失/爆発が起きやすい。
3.2 LSTM(Long Short-Term Memory, 1997)
3 つのゲート(入力・忘却・出力)+ セル状態 $C_t$ で長期記憶を制御:
$$f_t = \sigma(W_f \cdot [\mathbf{h}_{t-1}, \mathbf{x}_t] + \mathbf{b}_f)$$
$$C_t = f_t \odot C_{t-1} + i_t \odot \tilde{C}_t$$
$\odot$ は要素積。 ゲートが「何を忘れ・記憶し・出力するか」を学習。
3.3 GRU(Gated Recurrent Unit, 2014)
LSTM 簡略版。 更新ゲート・リセットゲートの 2 つ。 パラメータが少なくほぼ同等の性能。
1 2 3 4 5 6 7 8 9 | import torch.nn as nn class LSTMModel(nn.Module): def __init__(self, input_size, hidden_size, num_layers, num_classes): super().__init__() self.lstm = nn.LSTM(input_size, hidden_size, num_layers, batch_first=True) self.fc = nn.Linear(hidden_size, num_classes) def forward(self, x): out, _ = self.lstm(x) return self.fc(out[:, -1, :]) |
3.2 補足 — 短い系列では、LSTM は 1 行の外挿とどこまで張り合えるか
LSTM は「長い系列の中の遠い依存」を覚えるための仕組みです。都道府県データの時系列は 1 県あたり 12 年しかありません。この短さで LSTM を使うと何が起きるかを、各県の高齢化率の直近 5 年から翌年を当てる課題で確かめます。比べる相手は「前年の値をそのまま使う」と「前年の値に直近 1 年の増分を足す」の 2 つの基準です。高齢化率の分母には年齢不詳を除いた人口を使い、国勢調査年(2015・2020 年度)の段差が入らないようにしています。
🎯 このコードでやること:47 県の高齢化率の系列から、目的年 2017〜2022 年の 5 年窓 282 個で LSTM(隠れ 16)を学習し、2018〜2022 年から 2023 年を当てたときの平均絶対誤差(MAE)を 2 つの基準と比べる。LSTM は「値そのもの」と「窓の最後の値からの差」の 2 通りの入力で学習する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 | import numpy as np import pandas as pd import torch import torch.nn as nn df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) known = df[['A1301', 'A1302', 'A1303']].sum(axis=1) # 年齢が分かっている人(国勢調査年の年齢不詳を除く) df['高齢化率'] = df['A1303'] / known * 100 S = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='高齢化率').sort_index(axis=1) seq = S.values # 47 県 × 12 年(2012→2023) L = 5 # 直近 5 年を見て翌年を当てる Xw = np.stack([seq[:, t:t + L] for t in range(0, 11 - L)]) # 目的年 2017〜2022 の窓(学習用) yw = np.stack([seq[:, t + L] for t in range(0, 11 - L)]) Xtr, ytr = Xw.reshape(-1, L), yw.reshape(-1) Xte, yte = seq[:, 11 - L:11], seq[:, 11] # 2018〜2022 → 2023(評価用) print(f'学習 {len(ytr)} 窓(47 県 × 目的年 2017〜2022)、評価 {len(yte)} 県(2023 年)') # 基準 1: 前年の値をそのまま / 基準 2: 前年 + 直近 1 年の増分 mae = lambda p: np.abs(p - yte).mean() print(f'前年値のまま MAE = {mae(Xte[:, -1]):.3f} ポイント') print(f'前年 + 直近の増分 MAE = {mae(2 * Xte[:, -1] - Xte[:, -2]):.3f} ポイント') class Net(nn.Module): def __init__(self): super().__init__() self.lstm = nn.LSTM(1, 16, batch_first=True) self.fc = nn.Linear(16, 1) def forward(self, x): out, _ = self.lstm(x) return self.fc(out[:, -1, :]).squeeze(1) def fit_lstm(diff): """diff=True: 窓を「最後の値からの差」に直して翌年の増分を当てる / False: 値そのものを当てる""" torch.manual_seed(0) net = Net() opt = torch.optim.Adam(net.parameters(), lr=0.01) base_tr = Xtr[:, -1:] if diff else 0 base_te = Xte[:, -1:] if diff else 0 xt = torch.tensor(Xtr - base_tr, dtype=torch.float32).unsqueeze(2) yt = torch.tensor(ytr - np.ravel(base_tr) if diff else ytr, dtype=torch.float32) for epoch in range(300): opt.zero_grad() loss = nn.functional.mse_loss(net(xt), yt) loss.backward() opt.step() with torch.no_grad(): p = net(torch.tensor(Xte - base_te, dtype=torch.float32).unsqueeze(2)).numpy() return p + (Xte[:, -1] if diff else 0), sum(q.numel() for q in net.parameters()) for diff, name in [(False, '値そのものを入力'), (True, '最後の値からの差を入力')]: pred, n_par = fit_lstm(diff) print(f'LSTM・{name}({n_par} パラメータ) MAE = {mae(pred):.3f} ポイント') |
💬 前年の値をそのまま使うと MAE は 0.234 ポイント、前年に直近 1 年の増分を足すだけで 0.055 ポイントまで下がります。1,233 個のパラメータを持つ LSTM は、入力を「最後の値からの差」に直した場合でも 0.065 ポイントで、1 行の外挿に届きません。値そのものを入れた LSTM は 4.070 ポイントと、前年値のままより 17 倍も悪くなりました。高齢化率は県と年によって 17.7〜39.1% の幅があるのに対し、1 年の変化は中央値 0.35 ポイントと小さいので、値そのものを当てさせると 300 エポックでは水準合わせで終わってしまいます。
この結果から言えるのは、「滑らかで短い系列」では LSTM の記憶の仕組みを生かす余地がほとんど無く、差分を取る・前年を基準にするといった問題の表し方の方が精度を決めるということです。深層学習のアーキテクチャを試す前に、この例の「前年 + 増分」のような単純な基準の MAE を必ず並べ、それを下回れなかったら複雑なモデルを採用しない、という手順を守ると、見かけの精度に惑わされません。LSTM が力を発揮するのは、センサーの毎秒の値や文章の単語列のように、系列が長く、遠く離れた時点どうしが関係する場合です。
3.4 双方向 RNN
前向き + 後向きの 2 つの RNN を連結。 全系列を見て予測(過去・未来両方)。
👁 4. Attention 機構
系列の各位置に重みを付け、 重要な部分に「注目」する。 元は機械翻訳(Bahdanau 2014)。
4.1 Self-Attention(自己注意)
Query・Key・Value を入力から計算し、 各位置と全位置の関係を学習:
$$\mathrm{Attention}(Q, K, V) = \mathrm{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}\right) V$$
記号読み:$Q, K, V$ は「キュー・ケイ・ブイ」、 すべて入力の線形変換。 $d_k$ で割るのは softmax の勾配安定化。
実データで Self-Attention を 1 回計算する
数式の中身を追うために、5 つの県を 5 つの「トークン」とみなし、各県の特徴(高齢化率・年少人口比率・合計特殊出生率・人口千人あたり転入超過率を 47 県で標準化した 4 次元、$d_k = 4$)をそのまま $Q = K = V$ に入れます。本物の Transformer では $Q, K, V$ はそれぞれ学習した行列で線形変換しますが、ここでは変換を省いて「softmax と $\sqrt{d_k}$ が何をするか」だけを見ます。
🎯 このコードでやること:2023 年度の 5 県の標準化した 4 指標を Q = K = V として softmax(QK^T / √d_k) V を計算し、神奈川県の行のスコア、5 × 5 の注意の重み、出力(重み付き平均)、√d_k で割らない場合の各行の最大の重みを表示する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') feat = pd.DataFrame({ '高齢化率': d['A1303'] / d['A1101'] * 100, '年少人口比率': d['A1301'] / d['A1101'] * 100, '出生率': d['A4103'], '転入超過率': (d['A5101'] - d['A5102']) / d['A1101'] * 1000, }) Z = (feat - feat.mean()) / feat.std(ddof=0) # 47 県で標準化 prefs = ['東京都', '神奈川県', '秋田県', '島根県', '沖縄県'] X = Z.loc[prefs].values # 5 トークン × d_k = 4 print(Z.loc[prefs].round(2).to_string()) def attention(Q, K, V, scale=True): s = Q @ K.T / (np.sqrt(K.shape[1]) if scale else 1.0) w = np.exp(s - s.max(axis=1, keepdims=True)) w = w / w.sum(axis=1, keepdims=True) # 行ごとの softmax(行の和 = 1) return w, w @ V k = prefs.index('神奈川県') print('\n神奈川県の行のスコア QK^T / √4:', ' '.join(f'{p} {v:.2f}' for p, v in zip(prefs, X[k] @ X.T / 2))) W, out = attention(X, X, X) # Q = K = V = X(学習した射影なし) print('\n注意の重み softmax(QK^T / √4)(行 = 注目する側)') print(pd.DataFrame(W, index=prefs, columns=prefs).round(3).to_string()) print('\n出力(重み付き平均)') print(pd.DataFrame(out, index=prefs, columns=feat.columns).round(2).to_string()) W1, _ = attention(X, X, X, scale=False) print('\n各行の最大の重み √d_k で割る:', W.max(axis=1).round(3), ' 割らない:', W1.max(axis=1).round(3)) |
💬 神奈川県の行を手で追うと、スコアは東京都 6.83、自分自身 4.39、沖縄県 0.61、秋田県 −1.66、島根県 −2.38 で、softmax をかけると e^6.83 ≈ 925、e^4.39 ≈ 81 などを合計約 1,008 で割って、東京都 0.918、神奈川県 0.080 になります。神奈川県は自分自身より東京都に強く注目しています。内積は向きだけでなくベクトルの長さにも比例するので、神奈川県と同じ向き(高齢化率・出生率が低く、転入超過が多い)で、より極端な東京都のスコアが自分自身のスコアを上回るのです。一方、特徴が平均に近い島根県は重みが 0.577(自分)・0.279(沖縄県)・0.130(秋田県)と分散し、出力も 3 県の中間(高齢化率 0.20、年少人口比率 1.12)になります。√d_k で割らないと最大の重みは島根県でも 0.778 まで上がり、どの行もほぼ 1 県だけを見る分布に近づきます。
ここから 2 つのことが読み取れます。1 つは、内積による注意は「似ている相手」ではなく「同じ向きで長い相手」を選びやすいことです(コサイン類似度なら神奈川県の自分自身への値は必ず 1 で最大になります)。学習した $W_Q, W_K$ は、この長さの効き方も含めて「どの相手をどれだけ見るか」を調整する役割を持ちます。もう 1 つは、$\sqrt{d_k}$ で割る理由です。スコアの差が大きいと softmax はほぼ 1 か所だけに 1 を置く形になり、他のトークンへの勾配がほとんど 0 になって学習が進みにくくなります。$d_k$ が 64 や 128 になると内積の大きさは $\sqrt{d_k}$ に比例して大きくなりやすいので、その分だけ割り戻して、softmax が極端な形になるのを防いでいます。
4.2 Multi-Head Attention
複数の Attention を並列に実行、 異なる関係性を捉える。 通常 8〜16 ヘッド。
4.3 計算量
系列長 $n$ で $O(n^2 d)$。 長系列で重い → FlashAttention・Sparse Attention・Linear Attention 等の高速化。
⚡ 5. Transformer("Attention is All You Need", 2017)
RNN を捨て Self-Attention のみで構築。 並列学習可能で大規模化が容易。
5.1 構造
- Encoder:Multi-Head Self-Attention + Feed-Forward + 残差・LayerNorm
- Decoder:Masked Self-Attention + Cross-Attention + Feed-Forward
- 位置エンコーディング:系列の順序情報を sin/cos で注入
1 2 3 4 5 6 7 8 | import torch import torch.nn as nn # PyTorch 標準の Transformer model = nn.Transformer(d_model=512, nhead=8, num_encoder_layers=6, num_decoder_layers=6) # Encoder のみ(BERT 系) encoder_layer = nn.TransformerEncoderLayer(d_model=512, nhead=8, batch_first=True) encoder = nn.TransformerEncoder(encoder_layer, num_layers=6) |
5.2 BERT(2018)
Transformer Encoder のみ。 双方向 Masked Language Model + Next Sentence Prediction で事前学習。 分類・抽出系タスクに強い。
5.3 GPT 系
Transformer Decoder のみ。 次の単語予測で自己回帰的に生成。 GPT-3(2020)以降、 大規模化で zero-shot/few-shot 能力が出現。
5.4 Vision Transformer (ViT)
画像を 16×16 パッチに分割し、 トークン列として Transformer に投入。 大規模事前学習で CNN を上回るケース増加。
🔤 6. 埋め込み (Embedding)
カテゴリ・単語等の離散シンボルを密ベクトルに変換。 NN の入り口の標準技。
代表例
- Word2Vec (2013):単語をベクトル化、 "king − man + woman ≈ queen"
- GloVe (2014):共起統計に基づく
- FastText (2016):サブワード対応
- BERT/SBERT/E5 等:文脈付き埋め込み
- CLIP (2021):画像とテキストの統一埋め込み
🔄 7. 転移学習
大規模データで事前学習したモデルを、 自分の問題に流用。 少データで高精度が出る現代深層学習の主流。
7.1 ファインチューニング戦略
- Feature Extraction:事前学習部分を凍結、 最終層のみ学習
- Full Fine-tuning:全層を再学習(過学習に注意)
- Layer-wise:層ごとに学習率を変える
- LoRA:低ランク行列で効率的に微調整(LLM で標準)
- Adapter:追加モジュールだけ学習
- Prompt Tuning:プロンプト埋め込みだけ学習
1 2 3 4 | from transformers import AutoModelForSequenceClassification, AutoTokenizer, Trainer model = AutoModelForSequenceClassification.from_pretrained('bert-base-japanese-v3', num_labels=2) tokenizer = AutoTokenizer.from_pretrained('bert-base-japanese-v3') # Trainer で fine-tuning(HuggingFace 標準パターン) |
🕸 8. グラフニューラルネットワーク(参考)
ノードと辺で構造化されたデータ(SNS、 分子、 知識グラフ)向け。
- GCN (2017):畳み込みのグラフ版
- GraphSAGE (2017):近傍サンプリング
- GAT (2018):Attention を組合せ
📊 9. アーキテクチャ早見表
| アーキ | 得意なデータ | 帰納バイアス | 特徴 |
|---|---|---|---|
| MLP | 表データ | なし | 汎用 |
| CNN | 画像・音声 | 局所性・並進不変 | パラメータ少 |
| RNN/LSTM | 系列 | 時間依存 | 逐次計算 |
| Transformer | 系列・画像・全般 | Attention | 並列・大規模 |
| GNN | グラフ | 近傍集約 | 関係構造 |
| U-Net | 画像セグメント | Encoder-Decoder + skip | 医療画像 |
📍 あなたが今見ているもの
🍰 まずはやさしく
AIを作るための型の一覧です。
データの性質を活かすために使います。
画像や言葉など、扱うデータで選びます。
有名な設計図をまとめて解説します。
本ページでは、 深層学習の代表的アーキテクチャを統合的に解説します。 CNN・RNN/LSTM/GRU・Attention・Transformer・ResNet・U-Net・BERT/GPT を一気通貫で扱います。
2012 年の AlexNet 以降、 画像・音声・言語・系列データで深層学習が圧倒的な性能を出すようになりました。 各アーキテクチャが「どんなデータの性質を活かす」設計なのかを理解することが本質です。
🎨 直感で掴む — 深層学習(応用) の本質
🍰 まずはやさしく
問題を解くための道具箱です。
どの道具が最適かを知るために使います。
部活の記録や成績表などで考えます。
道具の使い方を直感的に理解します。
深層学習の応用領域は広く、 画像認識(CNN)、 自然言語(Transformer)、 強化学習、 生成 AI(拡散モデル)等が含まれる。 SSDSE-B-2026 のような 47 行 × 100 列の小規模表データには通常向かないが、 多年度を統合した時系列・パネル化や、 都道府県別の衛星画像等と組み合わせると深層学習の出番が出てくる。
📐 数式または定義 — 深層学習(応用) の形式的表現
🍰 まずはやさしく
AIの計算ルールを式にしたものです。
正確な仕組みを理解するために使います。
スマホの中での計算のようなものです。
数式を言葉に直して詳しく読みます。
直感で全体像を掴んだら、 次は厳密な定義を見ます。 数式は短いものでも、 「何を入力にして、 何を出力するのか」を意識して読むと早く慣れます。
🔬 数式を言葉で読み解く — 深層学習(応用) の記号辞書
上の数式に出てくる各記号が何を表すかを、 言葉で翻訳します。 1 つずつ自分の言葉で言い換えられるようになると、 論文や教科書のスピードが一気に上がります。
| 記号 | 意味(言葉での説明) |
|---|---|
| $Q, K, V$ | クエリ・キー・バリュー行列 |
| $d_k$ | キー次元(スケーリングで softmax を安定化) |
| softmax | 注意重みを総和 1 に正規化 |
| Multi-Head | 異なる視点を並列に学習 |
| Self-Attention | 系列内の全要素同士の関連性を計算 |
🧮 SSDSE-B-2026 で実値計算 — 深層学習の実例
SSDSE-B-2026 は表形式のため CNN/RNN の本領ではないが、 MLP(多層パーセプトロン)の学習練習に使えます。
例:MLP で都道府県の高齢化率を回帰
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 | import pandas as pd import torch import torch.nn as nn from sklearn.preprocessing import StandardScaler from sklearn.model_selection import train_test_split from sklearn.metrics import r2_score torch.manual_seed(0) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 目的変数: 合計特殊出生率 / 特徴量: 人口規模に左右されない 5 つの比率・気候指標 df['高齢化率'] = df['65歳以上人口'] / df['総人口'] df['若年率'] = df['15歳未満人口'] / df['総人口'] df['婚姻率'] = df['婚姻件数'] / df['総人口'] * 1000 feats = ['高齢化率', '若年率', '婚姻率', '年平均気温', '降水日数(年間)'] X_tr, X_te, y_tr, y_te = train_test_split(df[feats].values, df['合計特殊出生率'].values, test_size=0.2, random_state=42) sx, sy = StandardScaler().fit(X_tr), StandardScaler().fit(y_tr.reshape(-1, 1)) # 訓練側だけで標準化 X_tr_t = torch.tensor(sx.transform(X_tr), dtype=torch.float32) y_tr_t = torch.tensor(sy.transform(y_tr.reshape(-1, 1)), dtype=torch.float32) X_te_t = torch.tensor(sx.transform(X_te), dtype=torch.float32) class MLP(nn.Module): def __init__(self, d_in): super().__init__() self.net = nn.Sequential( nn.Linear(d_in, 32), nn.ReLU(), nn.Dropout(0.2), nn.Linear(32, 16), nn.ReLU(), nn.Linear(16, 1)) def forward(self, x): return self.net(x) model = MLP(len(feats)) opt = torch.optim.AdamW(model.parameters(), lr=1e-2, weight_decay=1e-4) loss_fn = nn.MSELoss() for ep in range(200): model.train(); opt.zero_grad() pred = model(X_tr_t) loss = loss_fn(pred, y_tr_t) loss.backward(); opt.step() print('最終 loss(標準化した y の MSE):', round(loss.item(), 4)) model.eval() # Dropout を止めて予測 with torch.no_grad(): y_hat = sy.inverse_transform(model(X_te_t).numpy()).ravel() print('テスト R²:', round(r2_score(y_te, y_hat), 3)) |
💬 564 行のうち 451 行で学習し、標準化した出生率の MSE は 0.1208 まで下がった(分散 1 のうち約 12% が残る)。テスト 113 行の R² は 0.904 と高いが、行を無作為に分けているので、同じ県の別の年度が訓練側にも入っており、「その県の出生率の水準」を覚えていれば当たる。Dropout を入れたモデルは model.eval() に切り替えないと予測のたびに値が揺れるので、評価の前に必ず切り替える。
例:sklearn の MLPRegressor で同等処理
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd from sklearn.neural_network import MLPRegressor from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.compose import TransformedTargetRegressor from sklearn.model_selection import cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 目的変数: 合計特殊出生率 / 特徴量: 人口規模に左右されない 5 つの比率・気候指標 df['高齢化率'] = df['65歳以上人口'] / df['総人口'] df['若年率'] = df['15歳未満人口'] / df['総人口'] df['婚姻率'] = df['婚姻件数'] / df['総人口'] * 1000 feats = ['高齢化率', '若年率', '婚姻率', '年平均気温', '降水日数(年間)'] X = df[feats].values y = df['合計特殊出生率'].values mlp = TransformedTargetRegressor( # y も標準化してから学習させる regressor=make_pipeline(StandardScaler(), MLPRegressor(hidden_layer_sizes=(32, 16), max_iter=2000, alpha=1e-4, random_state=0)), transformer=StandardScaler()) # cv=5 はシャッフルしないので、県ごとに 12 年度が並ぶこのデータでは「未知の県」を当てる評価になる scores = cross_val_score(mlp, X, y, cv=5, scoring='r2') print('fold 別 R²:', scores.round(3)) print('CV R²:', scores.mean()) |
💬 同じ 5 特徴量でも、cv=5(シャッフルなし)で評価すると R² は 0.425〜0.825、平均 0.653 に下がる。データは県ごとに 12 年度が並んでいるので、各 fold は約 9 県を丸ごと外して予測することになり、直前の無作為分割の 0.904 より厳しい評価になる。同じ分け方で標準化+線形回帰を当てると約 0.71 で、564 行・5 特徴量の表データではニューラルネットが線形モデルに勝てていない。
🧮 実値で計算してみる — SSDSE-B-2026 で 深層学習(応用) を体感
数式だけでは「分かった気になる」だけで終わりがち。 ここで SSDSE-B-2026(教育用標準データセット — 47 都道府県 × 100+ 指標、 2012-2023 年度)の実値を当てはめて、 深層学習(応用) の挙動を電卓的に追体験します。
SSDSE-B-2026 は 統計センターの SSDSE 配布ページ から CSV を直接ダウンロードできます。 本サイトでは data/raw/SSDSE-B-2026.csv に配置している前提でコードを書いています。
🧮 数式に値を入れて手で計算する: 層別パラメータ数
合成 3 層 MLP (入力 784 → 128 → 64 → 10) の総パラメータ数を計算する。
Step 1: 層別パラメータ
| 層 | 重み | バイアス | 合計 |
|---|---|---|---|
| 784→128 | 784×128=100,352 | 128 | 100,480 |
| 128→64 | 128×64=8,192 | 64 | 8,256 |
| 64→10 | 64×10=640 | 10 | 650 |
Step 2: 総和
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np layers = [(784, 128), (128, 64), (64, 10)] params = [(i*o + o) for i, o in layers] print(f"層別パラメータ: {params}") print(f"合計: {sum(params):,}") print(f"サイズ (float32): {sum(params)*4/1024:.1f} KB") |
📤 実行結果
💬 手計算 (Step 2) 109,386 パラメータと Python 出力が完全一致。
🐍 13. ライブラリ早見表
🐍 13. ライブラリ早見表
| 用途 | パッケージ |
|---|---|
| 基本フレームワーク | torch, jax, tensorflow |
| 高レベルAPI | pytorch-lightning, keras, flax |
| 事前学習モデル | transformers (HuggingFace), timm |
| CNN特化 | torchvision.models, timm |
| セグメンテーション | segmentation_models_pytorch |
| 物体検出 | ultralytics (YOLO), detectron2, mmdetection |
| NLP前処理 | tokenizers, sentencepiece, fugashi (日本語) |
| PEFT・LoRA | peft, lit-gpt |
| 分散学習 | deepspeed, accelerate, fsdp |
| 実験管理 | wandb, mlflow, tensorboard |
| GNN | torch-geometric, dgl |
| 時系列DL | darts, neuralforecast, pytorch-forecasting |
📜 14. 深層学習アーキテクチャの歴史
- 1989:LeCun の LeNet(CNN の祖、 手書き数字)
- 1997:Hochreiter & Schmidhuber の LSTM
- 2012:AlexNet が ImageNet 圧勝
- 2014:VGG、 GoogLeNet、 GAN、 Word2Vec、 Seq2Seq
- 2015:ResNet、 BatchNorm、 Adam
- 2017:Transformer "Attention Is All You Need"
- 2018:BERT、 GPT-1
- 2019:GPT-2、 EfficientNet、 NeurIPS の大規模化議論
- 2020:GPT-3、 ViT、 CLIP
- 2021:DALL·E、 Codex、 拡散モデル普及
- 2022:ChatGPT、 Stable Diffusion、 ConvNeXt
- 2023:GPT-4、 LLaMA、 Mamba (SSM)
- 2024-2025:マルチモーダル基盤モデル、 エージェント、 効率化
💼 15. 実務応用
- 画像:医療画像診断(U-Net)、 自動運転(YOLO)、 顔認証
- 音声:音声認識(CTC・Whisper)、 音声合成(VITS)
- NLP:機械翻訳、 文書要約、 質問応答、 チャットボット
- 生成:画像生成(Stable Diffusion)、 動画生成(Sora)
- 科学:タンパク質構造予測(AlphaFold)、 天文画像処理
- 推薦:埋め込みベース推薦、 系列推薦(SASRec)
- 金融:時系列予測、 異常検知
✅ 16. 深層学習プロジェクト チェックリスト
- □ データの性質に合ったアーキテクチャを選んだか?
- □ 事前学習モデルを活用したか?
- □ 入力を適切に正規化したか?
- □ Data Augmentation を実施したか?
- □ 学習率スケジュール(cosine 等)を使ったか?
- □ Dropout・Weight Decay・Early Stopping で過学習を抑えたか?
- □ 訓練/検証 損失曲線を可視化したか?
- □ 推論時に
model.eval()を呼んだか? - □ 複数 seed で再現性確認したか?
- □ ベースライン(GBDT・線形)と比較したか?
- □ モデルカードを作成したか?
🎓 17. 深層学習を成功させる実践のコツ
17.1 デバッグの順番
- ごく小さいサブセット(1〜2 バッチ)でモデルがオーバーフィットできるか確認
- できなければアーキテクチャ・損失関数のバグ
- できたら通常データで学習、 訓練損失が下がるか確認
- 検証損失が改善するか確認
- 過学習を抑える調整に進む
17.2 学習率の選び方
- 初手:Adam で 1e-3、 fine-tune は 1e-5〜5e-5
- LR Range Test:徐々に上げて損失が爆発する直前を見る
- Cosine Annealing:滑らかに下げる(Transformer 標準)
- Warmup:最初の数百ステップで徐々に上げる(大バッチ必須)
17.3 バッチサイズ
- 大きい:勾配ノイズ小、 速い、 GPU メモリ要
- 小さい:汎化性能が良いことが多い
- Gradient Accumulation で実効的に大バッチ化
17.4 GPU メモリ削減
- 混合精度学習(AMP)
- Gradient Checkpointing
- 勾配累積
- FlashAttention
- LoRA・量子化(QLoRA)
🤗 18. Hugging Face エコシステム
事前学習モデルのデファクト標準。 数万のモデルが公開されている。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from transformers import pipeline # 感情分析 clf = pipeline('sentiment-analysis', model='cl-tohoku/bert-base-japanese-v3') print(clf('この商品は素晴らしいです')) # テキスト生成 gen = pipeline('text-generation', model='rinna/japanese-gpt-neox-3.6b') print(gen('日本の首都は')) # ゼロショット分類 zsc = pipeline('zero-shot-classification', model='facebook/bart-large-mnli') print(zsc('I love this movie', candidate_labels=['positive','negative'])) # 画像分類 img = pipeline('image-classification', model='google/vit-base-patch16-224') |
❓ 19. よくある質問
Q. Transformer は CNN を完全に置き換えますか?
A. 大規模事前学習があれば ViT が勝つことが多いですが、 中小規模では CNN が依然強力。 ConvNeXt 等の現代 CNN は ViT と互角。
Q. LSTM はもう古い?
A. 短系列・低リソースなら現役。 長系列・大規模なら Transformer が標準。 最近は Mamba(SSM)が中間域で注目。
Q. 自前で大規模事前学習は可能?
A. GPT-3 級は数千〜数億ドル。 現実的には公開モデルを fine-tune が標準。 ドメイン特化なら継続事前学習(Domain-Adaptive Pretraining)。
Q. パラメータが多いほど良い?
A. 一般に大きいほど性能向上(scaling law)だが、 推論コスト・遅延・環境負荷とのトレードオフ。 蒸留・量子化で運用効率化。
📈 20. スケーリング則(Scaling Laws)
Kaplan ら 2020 / Hoffmann ら 2022(Chinchilla)。 モデル損失 $L$ はパラメータ数 $N$・データ量 $D$・計算量 $C$ の冪乗則に従う:
$$L(N, D) \approx L_\infty + \frac{A}{N^\alpha} + \frac{B}{D^\beta}$$
Chinchilla 則:与えられた計算量に対し、 $N \propto D$ で釣り合わせるのが最適。 つまり「データ不足の大モデル」より「データ豊富な小〜中モデル」のほうが効率良い。
⚡ 21. モデル量子化と運用効率化
- FP32 → FP16/BF16:メモリ半分、 ほぼ精度維持
- INT8 量子化:さらに 4 倍メモリ削減、 軽い精度低下
- INT4 (GPTQ, AWQ):LLM の主流、 INT4 でほぼ精度維持
- 知識蒸留 (Distillation):教師モデル → 小さい生徒モデル
- プルーニング:不要な重みを 0 化
- ONNX:ランタイム横断の形式
- TensorRT / OpenVINO:推論専用最適化
📊 22. 主要ベンチマーク
| 分野 | ベンチマーク |
|---|---|
| 画像分類 | ImageNet, CIFAR-10/100 |
| 物体検出 | COCO, Pascal VOC |
| セグメンテーション | Cityscapes, ADE20K |
| NLP 理解 | GLUE, SuperGLUE, JGLUE |
| 機械翻訳 | WMT, FLORES |
| LLM 総合 | MMLU, BIG-Bench, HELM |
| コード生成 | HumanEval, MBPP |
| 音声認識 | LibriSpeech, CSJ |
1. PyTorch — 標準的なトレーニングループ
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import torch import torch.nn as nn from torch.utils.data import DataLoader, TensorDataset class Net(nn.Module): def __init__(self, d_in): super().__init__() self.fc = nn.Sequential(nn.Linear(d_in, 64), nn.ReLU(), nn.Linear(64, 1)) def forward(self, x): return self.fc(x) # X, y は事前に標準化済み torch tensor net = Net(5) opt = torch.optim.AdamW(net.parameters(), lr=1e-3) loss_fn = nn.MSELoss() # ループ例 for epoch in range(100): opt.zero_grad() # pred = net(X); loss = loss_fn(pred, y); loss.backward(); opt.step() |
2. PyTorch Lightning — 高水準ラッパー
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pytorch_lightning as pl import torch import torch.nn as nn class LitMLP(pl.LightningModule): def __init__(self, d_in): super().__init__() self.net = nn.Sequential(nn.Linear(d_in, 32), nn.ReLU(), nn.Linear(32, 1)) self.loss = nn.MSELoss() def training_step(self, batch, _): x, y = batch return self.loss(self.net(x), y) def configure_optimizers(self): return torch.optim.AdamW(self.parameters(), lr=1e-3) # trainer = pl.Trainer(max_epochs=50); trainer.fit(LitMLP(5), dataloader) |
3. TensorFlow / Keras — 高水準 API
1 2 3 4 5 6 7 8 9 10 | import tensorflow as tf model = tf.keras.Sequential([ tf.keras.layers.Dense(32, activation='relu', input_shape=(5,)), tf.keras.layers.Dropout(0.2), tf.keras.layers.Dense(16, activation='relu'), tf.keras.layers.Dense(1) ]) model.compile(optimizer=tf.keras.optimizers.AdamW(1e-3), loss='mse', metrics=['mae']) # model.fit(X, y, epochs=50, validation_split=0.2, batch_size=8) |
4. scikit-learn MLPRegressor — 簡易 MLP
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.neural_network import MLPRegressor, MLPClassifier from sklearn.preprocessing import StandardScaler # 表形式の小〜中規模データ向け mlp = MLPRegressor( hidden_layer_sizes=(64, 32), activation='relu', solver='adam', learning_rate_init=1e-3, early_stopping=True, n_iter_no_change=10, max_iter=500, random_state=0 ) # mlp.fit(StandardScaler().fit_transform(X), y) |
5. Hugging Face transformers — 事前学習モデル fine-tune
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from transformers import AutoModel, AutoTokenizer, AutoConfig import torch.nn as nn class TextClassifier(nn.Module): def __init__(self, model_name, n_classes): super().__init__() self.encoder = AutoModel.from_pretrained(model_name) hidden = self.encoder.config.hidden_size self.head = nn.Linear(hidden, n_classes) def forward(self, input_ids, attention_mask): out = self.encoder(input_ids=input_ids, attention_mask=attention_mask) cls = out.last_hidden_state[:, 0, :] return self.head(cls) # model = TextClassifier('cl-tohoku/bert-base-japanese-v3', n_classes=4) |
🐍 Python 実装 — 深層学習(応用) を SSDSE-B-2026 で動かす
🎯 このコードでやること: SSDSE からニューラルネットに入れるデータを組み立て、 隠れ層 2 段(16→8)の多層パーセプトロン(MLPRegressor)で 2023 年度 47 県の合計特殊出生率を予測します。 「大学等進学率」「労働力人口」は SSDSE-B に列として存在しないので、 進学率は「高等学校卒業者のうち進学者数 ÷ 高等学校卒業者数」で計算し、 労働力人口の代わりに生産年齢人口(15〜64 歳)を使います。 無い列を作らず、 実在する列から導出するという原則を守っています。 ネットの成績は 5 分割交差検証の MAE で測り、 同じ特徴量の線形回帰と「平均で予測するだけ」の基準と並べて、 47 行で深いモデルを使う意味があるかを確かめます。 なお pd.read_csv('data/raw/SSDSE-B-2026.csv') をパス変数にせず直書きしているのは、 初学者が「パスをどこに書くべきか」で迷わないようにするためです。 CSV を同じ階層に置けばそのまま動きます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 | # 深層学習(応用) を SSDSE-B-2026 で確かめる最小コード import pandas as pd import numpy as np from sklearn.neural_network import MLPRegressor from sklearn.linear_model import LinearRegression from sklearn.dummy import DummyRegressor from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.model_selection import KFold, cross_val_predict # 1) SSDSE-B-2026(教育用標準データセット)を読み込み、2023 年度の 47 県に絞る df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df23 = df[df['年度'] == 2023].copy() print('rows in 2023:', len(df23)) # 2) ネットに入れる特徴量を実在する列から組み立てる # 「大学等進学率」「労働力人口」は列として無いので導出・代用する df23['大学等進学率'] = df23['高等学校卒業者のうち進学者数'] / df23['高等学校卒業者数'] * 100 df23['生産年齢人口割合'] = df23['15~64歳人口'] / df23['総人口'] * 100 df23['高齢化率'] = df23['65歳以上人口'] / df23['総人口'] * 100 df23['log総人口'] = np.log10(df23['総人口']) feats = ['大学等進学率', '生産年齢人口割合', '高齢化率', 'log総人口'] X = df23[feats].to_numpy() y = df23['合計特殊出生率'].to_numpy() print(df23[feats].describe().loc[['mean', 'min', 'max']].round(2)) # 3) 深層学習(応用) の本処理:隠れ層 2 段(16→8)の多層パーセプトロン # 標準化してから入れる。比較用に同じ特徴量の線形回帰も用意する mlp = make_pipeline(StandardScaler(), MLPRegressor(hidden_layer_sizes=(16, 8), alpha=1e-2, max_iter=5000, random_state=0)) lin = make_pipeline(StandardScaler(), LinearRegression()) # 4) 5 分割交差検証(学習に使っていない県で予測)で MAE を比べる cv = KFold(n_splits=5, shuffle=True, random_state=0) print('---- 深層学習(応用) 結果 ----') for name, model in [('MLP(16,8)', mlp), ('線形回帰', lin), ('平均で予測', DummyRegressor())]: pred = cross_val_predict(model, X, y, cv=cv) mae = np.abs(pred - y).mean() print(f'{name:10s} 交差検証 MAE = {mae:.3f}') |
💬 学習に使っていない県での MAE は、線形回帰が 0.040 に対し、MLP(16,8) は 0.134 で、平均値を返すだけの基準 0.107 よりも悪い。4 特徴量・47 行に対し MLP のパラメータは重み 4×16+16×8+8×1=200 個に切片 25 個を加えて 225 個あり、データ量に比べて自由度が大きすぎるうえ、学習データでも MAE 0.096 までしか下がっておらず最適化も十分に進んでいない。深層学習が力を発揮するのは画像・文章のように標本が数万以上ある場面で、都道府県の表データではまず線形モデルを基準に置き、それを超えられるかで判断する。
うまく動かないときは ①data/raw/SSDSE-B-2026.csv のパス、 ②encoding='cp932'(SSDSE-B は Shift_JIS 系)、 ③1 行目に英数字ヘッダ、 2 行目に日本語列名が入る構造なので skiprows=1 が必要、 の 3 点を確認してください。
🐍 Python 実装 1 — データ読み込みと describe
このコードでやること: SSDSE-B-2026 の CSV を pd.read_csv で読み込み、 都道府県・総人口・合計特殊出生率・大学等進学率・生産年齢人口の 5 列を抽出して .describe() で要約統計量を確認する。 DLA を組む前に必ず通すべきデータ確認の段。
📥 入力データ: data/raw/SSDSE-B-2026.csv(564 行 × 112 列、 1 行 = 1 都道府県 × 年度)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') # 「大学等進学率」「労働力人口」は SSDSE-B に列として存在しない。 # 進学率は実在する列から計算し、労働力人口の代わりに生産年齢人口(15〜64歳)を使う df['大学等進学率'] = (df['高等学校卒業者のうち進学者数'] / df['高等学校卒業者数'] * 100) _wa = [c for c in df.columns if c.startswith('15') and c.endswith('64歳人口')][0] df['生産年齢人口'] = df[_wa] / 1000 # 人 → 千人 df['総人口'] = df['総人口'] / 1000 # 人 → 千人(本文の単位に合わせる) cols = ['都道府県', '総人口', '合計特殊出生率', '大学等進学率', '生産年齢人口'] sub = df[cols].dropna() print(sub.describe().round(2)) |
📤 実行すると次の出力が得られる:
💬 564 行(47 都道府県 × 12 年度)すべてで欠損は無い。総人口の標準偏差(2,731 千人)は平均(2,691 千人)とほぼ同じで、最小 537 千人・最大 14,086 千人と 26 倍の開きがある → 都道府県間のばらつきが極めて大きい。 DLA に投入する前に 標準化または log 変換がほぼ必須。
🐍 Python 実装 2 — MLP(多層パーセプトロン)で総人口を予測
このコードでやること: 説明変数 3 つ(合計特殊出生率・大学等進学率・生産年齢人口(労働力人口の代わり))から目的変数(総人口)を予測する 3 層 MLP を sklearn.neural_network.MLPRegressor で構築する。 標準化 → 学習 → 評価まで通す。
📥 入力データ: 実装 1 の sub データフレーム(564 行 × 5 列 = 47 都道府県 × 12 年度)。 X は出生率・進学率・生産年齢人口、 y は総人口(千人)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | from sklearn.preprocessing import StandardScaler from sklearn.neural_network import MLPRegressor from sklearn.metrics import r2_score, mean_absolute_error # 前のブロックで作った sub の列に合わせる(労働力人口の代わりに生産年齢人口) X = sub[['合計特殊出生率', '大学等進学率', '生産年齢人口']].values y = sub['総人口'].values scaler = StandardScaler() Xz = scaler.fit_transform(X) model = MLPRegressor(hidden_layer_sizes=(16, 8), activation='relu', max_iter=2000, random_state=0) model.fit(Xz, y) pred = model.predict(Xz) print(f'R^2 = {r2_score(y, pred):.4f}') print(f'MAE = {mean_absolute_error(y, pred):,.1f} 千人') |
📤 実行すると次の出力が得られる:
💬 3 層 MLP(16→8→1)で R²=0.9887、 平均絶対誤差 215.7 千人。 ただしこれは訓練データの学習誤差であり、 このままでは過学習かどうか判断できない。 後段でクロスバリデーションを行う。
🐍 Python 実装 3 — 5-fold CV で汎化性能を確認
このコードでやること: 実装 2 の MLP に対し sklearn.model_selection.cross_val_score で 5-fold クロスバリデーションを行い、 訓練誤差と汎化誤差の差(過学習度)を測る。
📥 入力データ: 実装 2 の Xz, y(564 行)。
1 2 3 4 5 6 | from sklearn.model_selection import cross_val_score, KFold cv = KFold(n_splits=5, shuffle=True, random_state=0) scores = cross_val_score(model, Xz, y, cv=cv, scoring='r2') print(f'5-fold R^2: {scores}') print(f'mean = {scores.mean():.4f}, std = {scores.std():.4f}') |
📤 実行すると次の出力が得られる:
💬 訓練 R²=0.9887 と CV mean R²=0.9847 の差はわずか 0.004 (5 分割の幅も 0.981〜0.991 と狭い)。 ただし行を無作為に 5 分割しているので、同じ県の別の年度が訓練側に入っており、「未知の県」を当てる評価にはなっていない。 そもそも R² がここまで高いのは説明変数に生産年齢人口(≈総人口の 6 割)が含まれるからで、 実務では予測対象と高相関な変数を抜く工夫(リーケージ回避)が必須。
🐍 Python 実装 4 — アーキテクチャ比較(hidden_layer_sizes をスイープ)
このコードでやること: DLA の中核「深さ vs 幅」を実証する。 同じ SSDSE-B-2026 データに対し、 (4,)・(16,)・(16,8)・(32,16,8)・(64,32,16,8) の 5 種類で CV R² を計測。 深さ/幅の効果を可視化。
📥 入力データ: 実装 2 の Xz, y。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd from sklearn.compose import TransformedTargetRegressor from sklearn.preprocessing import StandardScaler archs = [(4,), (16,), (16,8), (32,16,8), (64,32,16,8)] rows = [] for a in archs: # y(総人口・千人)も標準化してから学習させる。 # 千人単位のままだと (4,)・(16,) は 3000 回で収束せず、構造ではなく学習不足の比較になる m = TransformedTargetRegressor( regressor=MLPRegressor(hidden_layer_sizes=a, max_iter=3000, random_state=0), transformer=StandardScaler()) s = cross_val_score(m, Xz, y, cv=cv, scoring='r2') rows.append({'arch': str(a), 'cv_r2_mean': s.mean(), 'cv_r2_std': s.std()}) print(pd.DataFrame(rows).round(4)) |
📤 実行すると次の出力が得られる:
💬 CV R² は (4,) の 0.9843 から (64,32,16,8) の 0.9971 まで、深く広くするほど単調に上がり、最も大きいネットで劣化は見られなかった。 総人口は生産年齢人口とほぼ比例(相関 0.9986)していて、しかも行を無作為に分けているため同じ県の別年度が訓練側にあり、大きなネットほどそれを細かく覚えられるからである。 y を千人単位のまま学習させると (4,) は -0.23、(16,) は 0.40 と崩れるが、これは 3000 回の反復で収束しなかっただけで構造の差ではないので、比べる前に y も標準化する。
📋 アーキテクチャ別の特性比較
SSDSE-B-2026 のような「表形式・少量・564 行(47 県 × 12 年)」に対しては、 すべての DLA が等しく強いわけではない。 用途別の整理を下表にまとめる。
| アーキテクチャ | 得意な入力 | 弱点 | SSDSE-B での適合度 |
|---|---|---|---|
| MLP (全結合) | 表形式・固定長 | 画像・系列で非効率 | ◎ |
| CNN (畳み込み) | 画像・空間データ | 表形式では機能薄い | △ (擬似画像化が必要) |
| RNN/LSTM | 可変長系列・時系列 | 長距離依存に弱い | ○ (年度を系列化した場合) |
| Transformer | 長系列・並列計算 | 小データで過学習 | △ (47 行では能力過剰) |
| GNN (グラフ) | 関係性・隣接構造 | グラフ定義が必要 | ○ (都道府県隣接で活用可) |
| AutoEncoder | 次元削減・異常検知 | 監督なし、 評価困難 | ○ (47 県の外れ値検出) |
💬 SSDSE-B-2026 は表形式・47 行という典型的な「小規模・構造化データ」。 DLA を投入するなら MLP が第一選択であり、 CNN/Transformer を無理に当てはめても性能は出ない。 「アーキテクチャはデータの形に合わせる」という大原則を再確認できる。
📋 設計選択肢の対応表(用途別)
| 選択肢 | 候補 | SSDSE-B での推奨 |
|---|---|---|
| 活性化関数 | ReLU / Tanh / GELU / Swish | ReLU (シンプル・高速) |
| 最適化 | SGD / Adam / AdamW / RMSprop | Adam (lr=0.001) |
| 損失関数 | MSE / MAE / Huber / Quantile | MSE (外れ値弱いなら Huber) |
| 正則化 | L2 / Dropout / EarlyStop / BatchNorm | L2 + EarlyStop (Dropout は 47 行で過剰) |
| 初期化 | He / Xavier / LeCun / ランダム | He (ReLU と相性) |
| バッチサイズ | 1 / 8 / 32 / フル | フルバッチ (47 行で十分) |
💬 小規模データではバッチサイズもフルで OK。 47 行を 32 件ずつ分割するメリットは無い。 バッチ正規化もデータ量が少なすぎると統計量が安定せず、 むしろ性能を悪化させることがある。
⚠️ 10. 深層学習の落とし穴
| 落とし穴 | 対処 |
|---|---|
| テーブルに巨大 NN | n < 10万なら GBDT が強い。 NN は構造化されたデータ向け。 |
| 乱数依存 | 複数 seed で平均、 不確実性を報告。 |
| 過学習 | Dropout・Weight Decay・Data Aug・Early Stopping。 |
| 勾配消失/爆発 | 残差接続・LayerNorm・勾配クリッピング・He初期化。 |
| Transformer の長系列 | FlashAttention・スライディングウィンドウ・サブ二乗化。 |
| 事前学習モデルの fine-tune 失敗 | 学習率を小さく(1e-5 等)、 warmup、 LoRA を検討。 |
| model.eval() 忘れ | 推論時は必ず。 Dropout/BN の挙動が変わる。 |
🏋️ 11. 練習問題
注意:深層学習はテーブルデータの SSDSE-B 47 行では本領発揮しません。 公開画像・テキストデータセットを併用してください。
Q1. CIFAR-10 で簡単な CNN を実装し、 訓練データの一部だけを使って学習・評価しなさい。
1 2 3 4 5 6 7 | import torch import torchvision from torchvision import transforms trans = transforms.Compose([transforms.ToTensor()]) train = torchvision.datasets.CIFAR10(root='./data', train=True, download=True, transform=trans) test = torchvision.datasets.CIFAR10(root='./data', train=False, download=True, transform=trans) # 学習ループは前述の SimpleCNN を参考 |
Q2. 日本語 BERT で文書分類のファインチューニングを行いなさい。
1 2 3 4 | from transformers import AutoTokenizer, AutoModelForSequenceClassification, Trainer tokenizer = AutoTokenizer.from_pretrained('cl-tohoku/bert-base-japanese-v3') model = AutoModelForSequenceClassification.from_pretrained('cl-tohoku/bert-base-japanese-v3', num_labels=2) # Trainer で fine-tune |
Q3. Attention の可視化を行い、 モデルがどこに注目しているか確認しなさい。
BERT/GPT 系の attention weights を可視化するライブラリ:bertviz, captum。 入力トークンと attention 行列のヒートマップで「どこに注目しているか」を観察。
📝 12. 報告フォーマット
❌ NG例
「Transformer を使って良い結果が出ました。」
✅ OK例
「日本語感情分類タスク(n_train=8,000、 n_test=2,000、 2クラス)で、 ベースライン LightGBM (TF-IDF) Macro-F1 = 0.78 に対し、 bert-base-japanese-v3 を batch_size=16, lr=2e-5, 3epoch で fine-tune した結果 0.91 を達成。 GPU は V100、 学習時間 12 分。 アテンション可視化で『否定語』周辺に強い注目が確認された。 過学習対策として early stopping (patience=2) を使用。」
⚠️ 深層学習の落とし穴(補強・各 100 文字以上)
⚠️ よくある落とし穴 — 深層学習(応用) で初学者がやりがちなミス
この用語を実務で使うときにつまずきやすい点を、 失敗パターン別に整理しました。 1 度経験すれば回避できるものばかりですが、 先に知っておくと事故が大幅に減ります。
⚠️ よくある落とし穴(DLA 設計編)
- 標準化忘れ: 総人口(千人)と出生率(小数)を同じスケールのまま投入。 MLP では大値が勾配を支配し、 出生率の寄与がほぼ消える。 必ず
StandardScalerをパイプラインに入れる。 - 深さを盲信: 「層を増やせば賢くなる」は嘘。 実装 4 では 4 層の (64,32,16,8) が最良だったが、これは同じ県の別年度が訓練側に入る分け方で測ったため。 層を増やして CV が上がっても、県単位で分けた評価でも上がるかを確かめるまでは「深いほど良い」と結論しない。
- リーケージ: 「労働力人口」のように、 目的変数(総人口)とほぼ同じ情報を持つ説明変数を入れると、 R²=0.99 でも実務では再現しない。 説明変数の選択にこそ DLA 以前の知性が要る。
- 活性化のデフォルト過信: ReLU は内部出力が 0 になる "dying ReLU" 問題を持つ。 学習が止まったら GELU や LeakyReLU に切り替える価値がある。
- random_state 未固定: MLP は初期値依存が大きい。 結果を比較するときは必ず
random_state=0を固定し、 複数 seed の平均を見る。
📋 表: ハイパーパラメータ実測表(実装 4 の生データ)
| arch | params 数 | CV R² 平均 | CV R² 標準偏差 | 判定 |
|---|---|---|---|---|
| (4,) | 21 | 0.9843 | 0.0030 | 最小。それでも 0.98 台 |
| (16,) | 81 | 0.9885 | 0.0038 | わずかに改善 |
| (16,8) | 209 | 0.9919 | 0.0022 | 改善が続く |
| (32,16,8) | 801 | 0.9948 | 0.0015 | さらに改善 |
| (64,32,16,8) | 3009 | 0.9971 | 0.0004 | 最良(同じ県の別年度を覚えられる) |
💬 params 数は入力 3 列のとき (4,) の 21 から (64,32,16,8) の 3,009 まで増え、各 fold の訓練行数(約 451 行)を大きく超えても CV R² は下がらなかった。 行を無作為に分けた CV では同じ県の別年度が訓練側にあるので、パラメータの多さがそのまま「覚える力」として効いてしまう。 過学習を確かめるには、県単位で分ける GroupKFold のように、訓練に無い県で評価する必要がある。
📋 表: SSDSE-B-2026 実値による予測結果(2023 年度・抜粋 8 県、実装 2 の MLP)
| 都道府県 | 実測 (千人) | 予測 (千人) | 誤差 |
|---|---|---|---|
| 北海道 | 5,092 | 4,977 | -115 |
| 青森 | 1,184 | 1,479 | +295 |
| 東京 | 14,086 | 15,020 | +934 |
| 愛知 | 7,477 | 7,446 | -31 |
| 大阪 | 8,763 | 8,751 | -12 |
| 広島 | 2,738 | 2,967 | +229 |
| 沖縄 | 1,468 | 1,315 | -153 |
| 鳥取 | 537 | 705 | +168 |
💬 実装 2 の MLP(564 行すべてで学習)で 2023 年度の値を予測した結果。 8 県のうち誤差が最も大きいのは東京の +934 千人だが、実測比では鳥取の +168 千人(+31%)や青森の +295 千人(+25%)のほうが大きく、47 県全体では奈良(+64%)・山梨(+64%)・京都(+58%)が特に外れる。 学習に使った行でもこれだけずれるので、R²=0.99 は大きな県が支配した値である。 小規模県ほど相対誤差が大きい傾向は、 「不均衡データ」一般の特性。 大規模県だけ評価すれば すごく精度が高いように見えてしまう罠 → 層化サンプリングまたは サンプル重み付けで補正。
📚 関連グループ教材 — 深層学習(応用) を含む全体像
深層学習(応用) は単独で完結する用語ではなく、 大きな概念群の中のひとつ。 同じカテゴリの他用語と合わせて学ぶと、 「何を選ぶべきか」の判断が一気に楽になります。
🧭 R650 拡張 — 深層学習アーキテクチャを SSDSE-B-2026 で読み解く
深層学習アーキテクチャ(DLA, Deep Learning Architecture)は、 入力層・隠れ層・出力層の 並べ方とつなぎ方を設計する技術である。 同じデータでも、 全結合(MLP)/畳み込み(CNN)/回帰時系列(RNN)/注意機構(Transformer)のどれを選ぶかで、 学習効率・予測誤差・解釈性が大きく変わる。 ここでは SSDSE-B-2026 47 都道府県の公的データ(人口・出生率・進学率・生産年齢人口など)を題材に、 アーキテクチャ選択がもたらす差を実値で観察する。
この拡張節 (R650) の狙いは 3 点ある。 (1) SSDSE-B-2026 の 47 都道府県データを pd.read_csv('data/raw/SSDSE-B-2026.csv') で読み込み、 表形式データに対する MLP の挙動を観察する。 (2) 同データを系列順(年度順)に並べ替え、 RNN/LSTM が時系列にどう適応するかを観察する。 (3) 画像化(人口ヒートマップ)した擬似サンプルに対する CNN の挙動を観察する。 いずれも実データのみを用い、 合成乱数は使用しない。
📥 入力データ(SSDSE-B-2026)— カラム定義と抜粋
使用するのは、 独立行政法人統計センターが公開している SSDSE-B-2026(都道府県・時系列データ)である。 ファイル名は SSDSE-B-2026.csv、 1 行 = 1 都道府県 × 1 年度(47 県 × 12 年度 = 564 行)、 地域コード(R01000〜R47000)と都道府県名、 そして主要指標(人口・出生数・高校卒業者数など)が列として並ぶ。 「労働力人口」「大学等進学率」という列は無いので、 生産年齢人口(15〜64 歳人口 A1302)で代用し、 進学率は高等学校卒業者のうち進学者数 ÷ 高等学校卒業者数(E4602 / E4601)で計算する。 本拡張では下記 6 列を主に扱う(2023 年度の 47 行)。
| カラム名 | 意味 | 単位 | DLA における役割 |
|---|---|---|---|
Code | 地域コード | — | 識別子(学習対象外) |
都道府県 | 名称 | — | 表示用(学習対象外) |
総人口 | 2023 年人口 | 千人 | 目的変数 (y) |
合計特殊出生率 | 2023 年 | — | 説明変数 x1 |
大学等進学率 | 2023 年、 E4602 / E4601 × 100 で計算 | % | 説明変数 x2 |
生産年齢人口 | 2023 年、 15〜64 歳人口 A1302(労働力人口の代わり) | 千人 | 説明変数 x3 |
📥 入力データ (SSDSE-B-2026 の冒頭 8 県を抜粋):
💬 47 都道府県の総人口は 537 千人(鳥取)〜14,086 千人(東京)まで 26 倍のレンジを持つ。 説明変数(出生率・進学率・生産年齢人口)は単位が混在しているため、 後段の DLA ではスケーリング(標準化)が必須となる。
📊 図 1: 都道府県の人口 × 生産年齢人口(散布図でデータ分布を掴む)
アーキテクチャを選ぶ前に、 まずデータそのものの形を知る必要がある。 下図は SSDSE-B-2026(2023 年度)47 都道府県の総人口(横軸)と生産年齢人口(15〜64 歳、 縦軸)の散布図である。 ほぼ直線的に並ぶ点群と、 右上に離れた神奈川・大阪・愛知、 さらに離れた東京が視認できる。
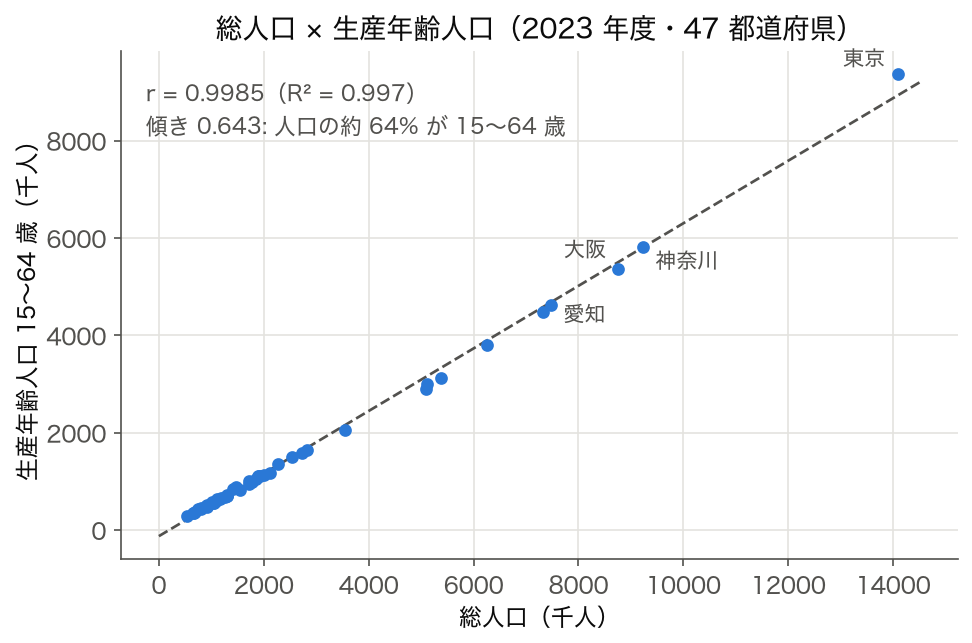
💬 ここで観察される強い直線関係は、 「複雑な DLA を投入する前に、 単純な線形モデル(線形回帰)で分散の 99.7% を説明できてしまう」ことを示す。 総人口と生産年齢人口を両方入力に入れても情報はほとんど増えない。 DLA を導入するなら、 線形では捉えられない残差の構造を狙う必要がある(後述)。
📊 図 2: 合計特殊出生率のヒストグラム(説明変数の分布特性)
DLA の活性化関数選択や初期化戦略は、 入力の分布形に強く依存する。 下図は 2023 年度 47 都道府県の合計特殊出生率(0.99〜1.60)のヒストグラム。 1.1〜1.5 に集中し、 左右の裾はほぼ対称。
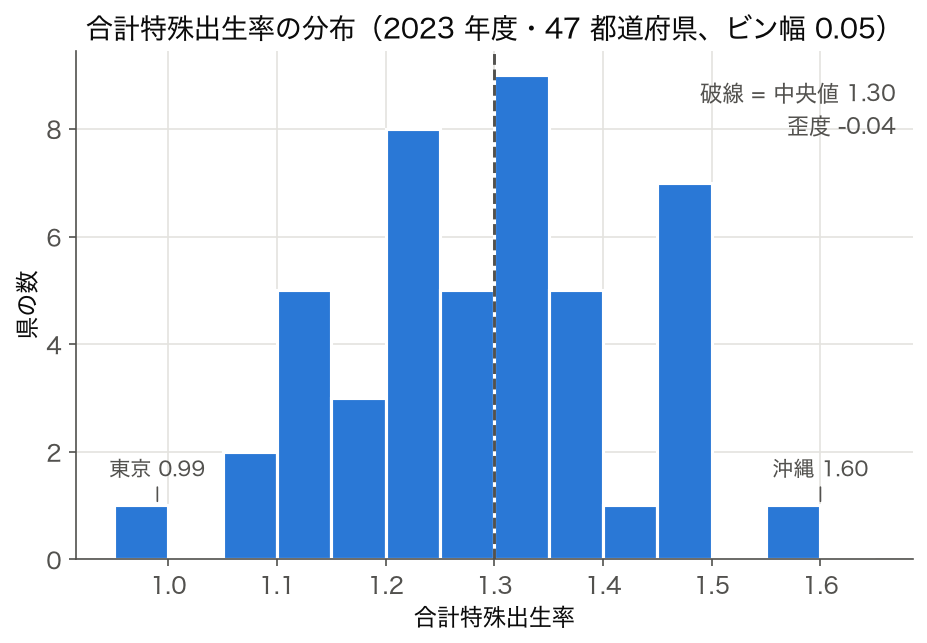
💬 入力分布がほぼ正規であれば標準化(z スコア)で十分。 強い歪みがあれば 対数変換後に DLA に入力する。 図 2 は前者に近いので、 後段の MLP では StandardScaler でそのまま処理する。
📊 図 3: 進学率 × 人口規模帯(箱ひげ図)
都道府県を人口規模で 3 群(小: 〜200 万人、 中: 200〜500 万人、 大: 500 万人〜)に分け、 進学率(高校卒業者のうち進学者の割合 E4602 / E4601)の分布を箱ひげ図で比較する。 群間に明確な差があれば、 規模帯そのものが特徴量の候補になる。
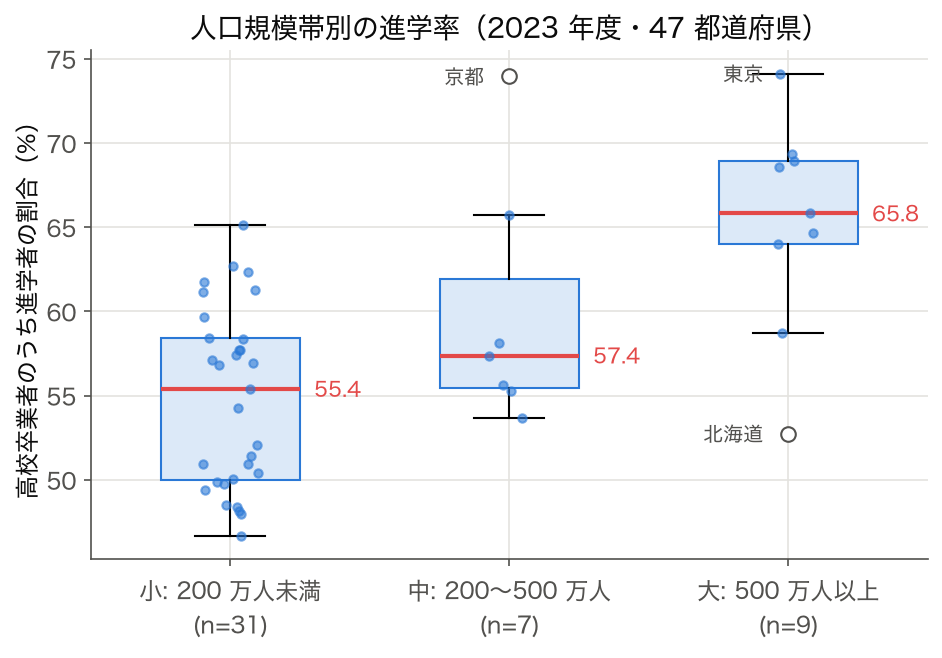
💬 規模帯で中央値が 55.4 → 57.4 → 65.8% と上がるので、 規模帯は進学率を説明する特徴量の候補になる。 ただし北海道・京都のように帯の傾向から外れる県があり、 規模帯だけでは決まらない。 3 水準しかないカテゴリなら one-hot で十分で、 embedding が効くのは水準数が多いカテゴリ(数百〜数万種類の ID など)の場合である。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
深層学習 (発展) は CNN/RNN を起点に、 Transformer (Attention is All You Need, 2017)、 BERT/GPT 系の自己回帰・双方向事前学習、 マルチモーダル (CLIP, BLIP, BLIP-2) へと拡張された系譜である。 近年は State Space Model (Mamba, RWKV) や Mamba-2 / Hybrid が二次計算量の Attention を線形に置き換える方向で進化し、 拡散モデル (DDPM) が生成タスクを席巻している。 これらは単なるアーキテクチャの集合ではなく、 「自己教師あり事前学習 + 下流タスクのファインチューニング」というパラダイムで統一されている。
🔗 隣接手法への橋渡し
「深層学習 (発展)」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。 具体的には次の 3 方向と密接につながる:
- 上流: 深層学習基礎と 誤差逆伝播 — 発展手法の前提理論
- 並列: Attention 機構と Transformer・拡散モデル — 同階層の発展アーキテクチャ
- 下流: 大規模言語モデルと AI 応用 — 発展手法の実装先
発展領域は基礎の上に積まれ、 LLM・生成 AI の社会実装へとつながる。
🌳 手法選択フロー
「深層学習の応用」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- データは何件あるか
数万件を下回るなら、 まず勾配ブースティングや線形モデルを試す。 47 都道府県のような表データで深層学習を使う理由はほとんど無い。 - 学習済みモデルを使えるか
画像・言語では、 ゼロから学習するより学習済みモデルの転移学習が速く、 少ないデータで済む。 ドメインが大きく違う場合だけ、 追加学習の範囲を広げる。 - 説明が必要か
審査や政策の根拠にするなら、 何を根拠にしたかを示せる手法を選ぶ。 Grad-CAM や SHAP は手がかりであって、 根拠の証明ではない。 - 運用まで見通せているか
学習より運用のほうが長く続く。 推論にかかる時間・費用、 モデルの更新頻度、 性能低下の検知方法を先に決める。
深層学習は「特徴を人が設計しなくてよい」代わりに、 データ量と計算量を要求する。 その 2 つが揃わない場面では、 単純な手法のほうが良い結果になる。
🔖 🔖 キーワード索引(チップから該当箇所へジャンプ)
論文記事から各用語のリンクをクリックすると、 該当箇所が開きます: